
L’histoire de la pensée scientifique moderne s’est construite sur une méfiance salutaire à l’égard des évidences empiriques immédiates. Parmi les canons méthodologiques les plus vigoureusement enseignés dans les départements de psychologie, d’épidémiologie et de statistique figure l’adage fondamental selon lequel la corrélation n’implique pas la causalité. Cette mise en garde épistémologique protège le chercheur contre les illusions d’optique intellectuelles engendrées par le biais de confusion, les coïncidences fortuites et les relations fallacieuses issues de variables masquées. Toutefois, par un curieux effet de symétrie mentale non questionné, un postulat implicite s’est enraciné dans l’inconscient collectif méthodologique : si la corrélation ne prouve pas la causalité, la causalité, elle, devrait obligatoirement engendrer une corrélation mesurable. En vertu de cette intuition partagée, l’absence de covariation linéaire entre deux phénomènes est fréquemment interprétée comme le verdict irréfutable de l’inexistence d’un lien de dépendance causale.
Cette conviction symétrique repose sur une incompréhension radicale des fondements mathématiques de l’analyse bivariée et de la nature ontologique des processus générateurs de données. L’assertion « la causalité implique la corrélation » est formellement fausse. Dans une multitude d’architectures dynamiques réelles — qu’il s’agisse des équilibres homéostatiques du système nerveux, des interactions comportementales régulées par rétroaction ou des structures à voies causales opposées —, une cause puissante, directe et déterministe peut s’exercer sans laisser la moindre trace dans une matrice de corrélation linéaire standard. Pire encore, la métrique canonique introduite par Karl Pearson peut afficher une valeur strictement nulle en présence d’un déterminisme parfait reliant deux variables observables.
Le présent article propose une déconstruction systématique de ce dogme implicite à travers une exploration transversale alliant formalisation statistique, épistémologie des sciences du comportement et psychologie expérimentale. En nous appuyant sur les cadres modernes de l’inférence causale — notamment la théorie contrefactuelle des résultats potentiels développée par Donald Rubin et les modèles graphiques causaux théorisés par Judea Pearl —, nous démontrerons mathématiquement et conceptuellement pourquoi l’empreinte statistique d’un lien causal peut s’évanouir dans l’espace métrique. À l’aide de trois archétypes fondamentaux (les relations non linéaires symétriques, les mécanismes de contrôle cybernétique à rétroaction négative et les médiations à interférence destructive), nous établirons les conditions précises sous lesquelles la réalité ontologique d’une cause devient totalement aveugle aux outils classiques de l’analyse linéaire.
1. Introduction épistémologique : Le paradigme classique de la corrélation et de la causalité
1.1 La maxime traditionnelle et son asymétrie logique
Le principe voulant que la corrélation n’implique pas la causalité constitue un impératif catégorique de l’investigation empirique moderne. Dès les travaux pionniers de David Hume sur la contingence de la liaison causale, la philosophie des sciences a souligné l’impossibilité d’extraire la certitude d’une connexion nécessaire à partir de la seule contiguïté spatio-temporelle ou de la répétition d’une conjonction constante. L’esprit humain possède une disposition neurocognitive innée à inférer des scénarios explicatifs déterministes dès lors qu’il perçoit deux événements survenant conjointement. Cette tendance à la projection projective — que les psychologues cognitifs associent à l’heuristique de représentativité et au biais d’hyperactive agency detection — pousse spontanément le sujet à transformer une covariation fortuite en une relation d’ascendance et de descendance nomologique.
Dans l’arsenal méthodologique contemporain, cette leçon a été institutionnalisée au point d’en devenir un automatisme discursif. Dès le premier cycle universitaire, les étudiants apprennent à repérer les tiers facteurs d’influence, les corrélations absurdes — telles que la célèbre corrélation entre les ventes de glaces et les attaques de requins — et les phénomènes de confusion résiduelle. Or, cet apprentissage rigoureux masque une asymétrie logique pernicieuse. En logique formelle, la proposition « P implique Q » n’est nullement équivalente à sa réciproque « Q implique P », ni à sa négation partielle. Transposée au domaine métrologique : affirmer que « la corrélation n’implique pas la causalité » ne dit absolument rien sur la validité de l’énoncé « la causalité implique la corrélation ».
L’interrogation réciproque — la présence d’une cause génère-t-elle nécessairement une corrélation mesurable à l’aide de nos estimateurs conventionnels ? — est étonnamment négligée dans l’enseignement méthodologique standard. La déconstruction des évidences intuitives est pourtant le moteur essentiel du progrès scientifique dans les disciplines du comportement. Présupposer qu’une force causale doit nécessairement se trahir par une association métrique proportionnelle revient à commettre une erreur épistémologique tout aussi dommageable que celle consistant à confondre concomitance et causalité. Cette négligence aveugle le chercheur face à des dynamiques réelles complexes dont la signature statistique apparente s’apparente à une absence totale de signal.
1.2 L’illusion d’une réciprocité causale automatique
L’ancrage de cette fausse croyance découle d’un glissement logique bien connu sous le nom de sophisme de l’affirmation du conséquent, appliqué insidieusement aux protocoles d’analyse bivariée. La déduction erronée s’articule comme suit : « Si deux variables entretiennent un lien de cause à effet direct et non perturbé, alors elles devraient co-varier (si X augmente, Y doit changer). Or, l’analyse empirique révèle que le coefficient de corrélation linéaire entre X et Y est nul (r = 0, p > 0,05). Par conséquent, il n’existe aucun lien causal entre X et Y. » Ce raisonnement syllogistique défaillant repose sur une prémisse majeure fondamentalement incomplète qui méconnaît la géométrie des fonctions mathématiques et la topologie des systèmes dynamiques.
Dans la pratique courante des laboratoires, cette inférence fallacieuse entraîne des conséquences théoriques considérables. Combien de pistes de recherche en neuropsychologie, en psychopathologie ou en psychologie sociale ont-elles été prématurément abandonnées au stade de l’analyse exploratoire sous prétexte que les matrices de corrélation initiales ne mettaient en évidence aucune dépendance bivariée significative ? Lorsqu’un chercheur observe un coefficient de Pearson voisin de zéro, son réflexe conditionné consiste à accepter l’hypothèse nulle et à reléguer la variable manipulée ou observée au rang de bruit stochastique dénué de pertinence clinique ou expérimentale. Cet angle mort produit une hécatombe méthodologique silencieuse : des causes thérapeutiques réelles, des facteurs de vulnérabilité majeurs ou des mécanismes de régulation cérébrale cruciaux sont rejetés comme inexistants, non pas en raison de leur inefficacité ontologique, mais du fait de l’incapacité de l’estimateur statistique à capter leur mode d’expression métrique.
L’objectif central de cet article est de prouver rigoureusement pourquoi la causalité n’implique pas la corrélation. À travers un cadre analytique unifié, nous montrerons que l’absence de corrélation linéaire n’est ni une condition suffisante ni même une condition nécessaire pour disqualifier l’existence d’une relation causale invariante. En analysant trois cas d’école morphologiquement distincts, nous doterons le chercheur et le praticien d’une grille de lecture robuste permettant d’éviter l’écueil de la cécité métrique.
1.3 La distinction entre causalité ontologique et mesure statistique
Pour aborder ce paradoxe sans ambiguïté conceptuelle, il s’avère indispensable d’opérer une scission nette entre la réalité ontologique des mécanismes générateurs et les propriétés formelles des métriques d’observation empirique. La causalité appartient au domaine ontique : elle caractérise le mode de fonctionnement intrinsèque de la réalité, la trame nomologique régissant la manière dont les états du monde sont engendrés par des états antérieurs ou concomitants. En psychologie cognitive ou en neurobiologie, un mécanisme causal désigne un processus neurophysiologique ou computationnel réel : l’activation d’un faisceau synaptique, la libération d’un neurotransmetteur, la saturation d’un tampon de mémoire de travail ou l’engagement conscient d’une stratégie de réévaluation émotionnelle. Ces processus se déploient dans l’espace et le temps selon des lois physiques et physiologiques invariantes.
À l’inverse, la corrélation appartient exclusivement au domaine épistémique et métrologique. Elle n’est rien d’autre qu’un calcul algébrique appliqué à un échantillon fini de mesures numériques, un estimateur statistique conçu pour évaluer le degré auquel deux variables aléatoires se conforment à une trajectoire affine partagée dans un espace bidimensionnel. L’estimateur de Pearson, en particulier, est un instrument réducteur par essence : il projette la complexité multivariée et non linéaire d’un processus biologique ou comportemental sur une droite vectorielle unique. Confondre l’absence de projection linéaire avec l’absence de mécanisme générateur revient à commettre une erreur de catégorie au sens du philosophe Gilbert Ryle, en prêtant à la réalité des propriétés qui n’appartiennent qu’au scalpel utilisé pour la découper.
Avant d’examiner en détail les situations de découplage total entre cause et covariation, il est indispensable de poser avec exactitude la définition mathématique de la corrélation au sens classique et de la confronter aux formalismes contemporains de la causalité probabiliste et interventionniste. Cette clarification épistémologique préalable permettra de comprendre pourquoi l’inadéquation entre la structure des lois de la nature et les contraintes mathématiques de l’estimateur de Pearson est non pas une exception aberrante, mais une issue théorique inévitable dès lors que la complexité des systèmes vivants entre en jeu.
2. Définitions fondamentales : Causalité ontologique versus corrélation statistique
2.1 Définition rigoureuse de la corrélation au sens de Pearson
La formalisation mathématique moderne de la corrélation trouve son expression la plus célèbre dans le coefficient de corrélation produit-moment développé par Karl Pearson à la fin du XIXe siècle. Pour deux variables aléatoires réelles $X$ et $Y$, dont les espérances mathématiques respectives sont notées $E[X]$ et $E[Y]$, et les écarts-types $\sigma_X$ et $\sigma_Y$, le coefficient de corrélation linéaire de Pearson, usuellement désigné par $\rho_{X,Y}$, est défini comme le rapport de leur covariance sur le produit de leurs écarts-types :
$$\rho_{X,Y} = \frac{\mathrm{Cov}(X, Y)}{\sigma_X \sigma_Y} = \frac{E[(X – E[X])(Y – E[Y])]}{\sqrt{E[(X – E[X])^2]} \sqrt{E[(Y – E[Y])^2]}}$$
Ce coefficient est une quantité adimensionnelle bornée sur l’intervalle $[-1, 1]$. Sa signification géométrique est extrêmement circonscrite : il quantifie la proximité de la distribution conjointe de $X$ et $Y$ par rapport à une relation linéaire parfaite définie par une équation affine de type $Y = \beta_0 + \beta_1 X$. La valeur $rho = 1$ indique une colinéarité parfaite de pente positive, $rho = -1$ une colinéarité parfaite de pente négative, et $rho = 0$ signale une absence complète d’association linéaire. Ce formalisme repose sur des hypothèses sous-jacentes exigeantes, notamment la normalité bivariée des distributions marginales et l’homoscédasticité des variances conditionnelles, conditions rarement remplies dans les sciences humaines et de la santé.
Il est capital de souligner la sensibilité sélective du coefficient de Pearson : il est exclusivement sensible aux relations monotones rectilignes. Dès l’instant où l’association fonctionnelle liant les deux variables s’écarte de la trajectoire droite, le pouvoir informatif de $rho$ s’effondre. La covariance normalisée n’est que le reflet d’une dispersion directionnelle conjointe le long d’une ligne. Si une dépendance déterministe rigoureuse s’organise selon une courbure spatiale particulière ou s’annule par compensation symétrique autour d’un barycentre, le numérateur de Pearson s’évanouit mathématiquement, réduisant l’indice à zéro sans que les variables ne cessent d’être intimement et inévitablement interconnectées.
2.2 Théories modernes de la causalité en psychologie et statistiques
Face aux limites des approches associatives, la statistique théorique contemporaine a dû élaborer des formalismes sémantiques distincts pour traiter de la causalité. Deux cadres de référence dominent aujourd’hui les méthodologies quantitatives avancées. Le premier est le modèle des résultats potentiels (Rubin Causal Model), popularisé par Donald Rubin. Dans cette perspective contrefactuelle, une variable $X$ exerce un effet causal sur une variable $Y$ pour une unité individuelle $i$ si la valeur que prendrait $Y$ lorsque l’unité est soumise au traitement $X = x$ diffère de la valeur que prendrait $Y$ si cette même unité était soumise à la condition de contrôle $X = x’$ :
$$\tau_i = Y_i(x) – Y_i(x’)$$
L’effet causal individuel réside dans la comparaison entre ce qui s’est produit et ce qui se serait produit, toutes choses égales par ailleurs, dans un monde contrefactuel hypothétique. Comme il est impossible d’observer simultanément les deux états pour un même individu (le « problème fondamental de l’inférence causale »), la recherche s’intéresse à l’effet causal moyen au niveau de la population, défini par l’espérance $ATE = E[Y(x) – Y(x’)]$.
Le second cadre, développé de manière monumentale par Judea Pearl, repose sur les graphes orientés acycliques (DAG pour Directed Acyclic Graphs) et l’algèbre interventionniste régie par l’opérateur $do(\cdot)$. Dans ce modèle, affirmer que $X$ est une cause directe de $Y$ signifie qu’une modification délibérée de l’état de $X$ induite par une intervention extérieure forcée — notée $do(X = x)$ — modifie la distribution de probabilité de $Y$, brisant ainsi les dépendances passives générées par les ancêtres communs :
$$P(Y mid do(X = x)) \neq P(Y mid do(X = x’))$$
Ces théories partagent un postulat épistémologique crucial : un mécanisme causal se définit par son invariance structurelle face à une manipulation contrefactuelle ou active, et non par la forme de la distribution jointe des variables observées passivement. L’existence d’une cause est une propriété intrinsèque de l’architecture génératrice du monde, totalement indépendante de la question de savoir si cette intervention produit une covariation linéaire mesurable dans un échantillon observationnel donné.
2.3 Le décalage structurel entre mécanisme causal et dépendance linéaire
Ce bref rappel terminologique met en exergue le fossé conceptuel infranchissable qui sépare la causalité de la corrélation linéaire. D’un point de vue de théorie des probabilités pure, la dépendance statistique est un concept bien plus vaste que la corrélation. Deux variables aléatoires $X$ et $Y$ sont dites statistiquement indépendantes si et seulement si leur densité de probabilité conjointe est égale au produit de leurs densités marginales pour toutes les valeurs possibles de leur domaine de définition :
$$f_{X,Y}(x, y) = f_X(x) \cdot f_Y(y) \quad \forall (x, y)$$
L’indépendance statistique entraîne rigoureusement une corrélation nulle ($\rho_{X,Y} = 0$). Cependant, la réciproque est dramatiquement fausse : une corrélation nulle n’implique absolument pas l’indépendance statistique. Deux variables peuvent être unies par une dépendance stochastique ou déterministe intégrale tout en affichant une corrélation de Pearson strictement égale à zéro. La corrélation n’est qu’un test de dépendance linéaire du premier ordre, aveugle à tous les moments statistiques d’ordre supérieur et aux topologies non rectilignes.
Dès lors, lorsqu’une théorie psychologique ou biologique postule qu’un facteur $X$ cause un comportement $Y$, cette assertion signifie qu’il existe une chaîne de transformations énergétiques, biochimiques ou computationnelles reliant les variations de $X$ aux réponses de $Y$. Rien dans les lois de la physique ni dans les principes de l’évolution biologique ne contraint ces transformations à adopter la forme géométrique d’une droite affine. Le produit des variances croisées peut parfaitement s’annuler le long du continuum de mesure. Utiliser la corrélation de Pearson comme critère d’arbitrage pour valider ou rejeter une hypothèse causale relève donc d’un aveuglement méthodologique caractérisé.
3. Pourquoi l’assertion inverse échoue : Les fondements mathématiques et conceptuels
3.1 L’annulation géométrique de la covariance
Le premier mécanisme fondamental expliquant l’échec de la réciproque repose sur les propriétés algébriques de l’opérateur d’espérance mathématique dans le calcul de la covariance. Rappelons que la covariance peut s’exprimer sous la forme développée :
$$\mathrm{Cov}(X, Y) = E[XY] – E[X]E[Y]$$
Supposons une situation où la variable dépendante $Y$ est entièrement déterminée par la variable causale $X$ à travers une fonction déterministe $f$, telle que $Y = f(X)$. Dans un tel univers, il n’existe aucun aléa, aucun bruit de mesure, aucun tiers facteur perturbateur : connaître $X$ équivaut à connaître $Y$ avec une précision absolue de 100 %. La causalité est ici non seulement présente, mais totale et indiscutable. Pourtant, la condition nécessaire pour que la corrélation linéaire s’annule réside simplement dans l’égalité géométrique :
$$E[X \cdot f(X)] = E[X] \cdot E[f(X)]$$
Cette égalité est trivialement satisfaite dès lors que la fonction $f$ présente une symétrie spatiale paire (c’est-à-dire $f(-x) = f(x)$) et que la distribution marginale de la variable causale $X$ est symétrique autour de son espérance nulle ($E[X] = 0$). Dans ce scénario, les contributions positives au produit croisé $X \cdot Y$ situées dans le demi-plan où $X > 0$ sont rigoureusement et symétriquement compensées par les contributions négatives de même magnitude situées dans le demi-plan où $X < 0$. Dans le formalisme hilbertien des espaces de variables aléatoires de variance finie muni du produit scalaire défini par la covariance, $X$ et $Y$ deviennent fonctionnellement orthogonales.
Cette orthogonalité fonctionnelle démontre que l’estimateur de Pearson ne mesure pas l’intensité de la détermination nomologique, mais simplement l’asymétrie directionnelle de l’association. Deux grandeurs physiques ou psychiques peuvent être indissolublement enchaînées par une loi causale universelle tout en demeurant parfaitement orthogonales dans l’espace euclidien des produits scalaires statistiques ordinaires.
3.2 Les systèmes dynamiques et contraintes d’équilibre
Le deuxième fondement conceptuel invalidant l’implication causale directe provient de la science des systèmes cybernétiques et de la dynamique non linéaire des organismes vivants. Les sciences statistiques traditionnelles sont nées dans un paradigme passif d’échantillonnage agronomique ou démographique, où les variables sont observées sans rétroaction immédiate du système sur lui-même. Or, les entités psychologiques, neurologiques et sociales ne sont pas des réceptacles passifs subissant des stimuli extérieurs ; ce sont des systèmes adaptatifs complexes régis par le principe d’équifinalité et la recherche active d’états d’équilibre stables.
Lorsqu’un système dynamique intègre une boucle de rétroaction négative (negative feedback loop), l’intervention d’une force causale perturbatrice $X$ déclenche instantanément une réponse compensatoire interne proportionnelle dont la finalité exacte est de neutraliser la variance de la variable cible $Y$. Plus le mécanisme causal régulateur est puissant, précis et rapide dans son exécution, moins la variable finale $Y$ manifestera de fluctuations observables. À l’extrême limite de l’efficacité fonctionnelle, la variance de $Y$ tend vers zéro ($\sigma_Y^2 to 0$). Or, dans l’équation du coefficient de Pearson, si la variance du terme cible s’annule, la covariance s’effondre également, et le coefficient devient mathématiquement indéfini ou empiriquement nul :
$$\lim_{\sigma_Y to 0} \frac{\mathrm{Cov}(X, Y)}{\sigma_X \sigma_Y} = 0$$
On aboutit ainsi à un paradoxe cybernétique majeur : le succès absolu d’une causalité adaptative produit la disparition intégrale de la corrélation entre la perturbation causale initiale et l’état terminal du système. La dynamique d’équilibration masque l’infrastructure causale sous-jacente aux yeux de l’analyste statique, créant l’illusion d’une imperméabilité totale du phénomène aux contraintes environnementales.
3.3 L’interférence structurelle et les voies compensatoires
Le troisième principe statistique responsable de l’occultation d’un lien causal concerne la géométrie des graphes multivariés et les phénomènes d’extinction algébrique par compensation de chemins causaux opposés. Dans la réalité biopsychosociale, une cause primaire n’opère presque jamais isolément à travers un conduit unique. Un événement générateur majeur $X$ projette généralement son influence à travers une pluralité de branches causales divergentes qui finissent par converger à nouveau vers la variable d’intérêt $Y$.
Dans un modèle d’équations structurelles classique, l’effet total exercé par une variable $X$ sur une variable $Y$ correspond à la sommation algébrique de son effet direct et de l’ensemble de ses effets indirects médiés par des variables tierces :
$$\beta_{\mathrm{total}} = c = c’ + \sum_k (a_k \cdot b_k)$$
Si la cause $X$ engendre simultanément un effet direct de signe positif ($c’ > 0$) et active parallèlement un médiateur inhibiteur dont le produit des coefficients indirects est de signe négatif ($a \cdot b < 0$), ces deux voies de transmission s’affrontent au niveau de la variable de convergence. Si la magnitude de ces forces antagonistes s’avère équivalente ($c’ = – a \cdot b$), l’effet marginal agrégé s’annule précisément ($\beta_{\mathrm{total}} = 0$). Il en résulte une interférence destructive absolue, rigoureusement comparable à celle observée en physique ondulatoire lorsque deux ondes de même fréquence et d’amplitudes opposées s’annihilent au point d’observation.
Dans cette configuration d’extinction structurelle, la corrélation bivariée mesurée entre $X$ et $Y$ sera rigoureusement nulle, alors même que $X$ détermine deux forces titanesques qui modèlent la réponse interne du sujet. L’absence d’association visible n’est pas le reflet d’une absence d’impact, mais la signature d’une tension structurelle dynamique dissimulée par une agrégation naïve. Nous allons à présent examiner concrètement ces trois archétypes à travers des situations empiriques emblématiques issues des sciences psychologiques.
4. Exemple 1 : Les relations fonctionnelles symétriques (Le cas non linéaire quadratique)
4.1 Modélisation déterministe quadratique : Y = X²
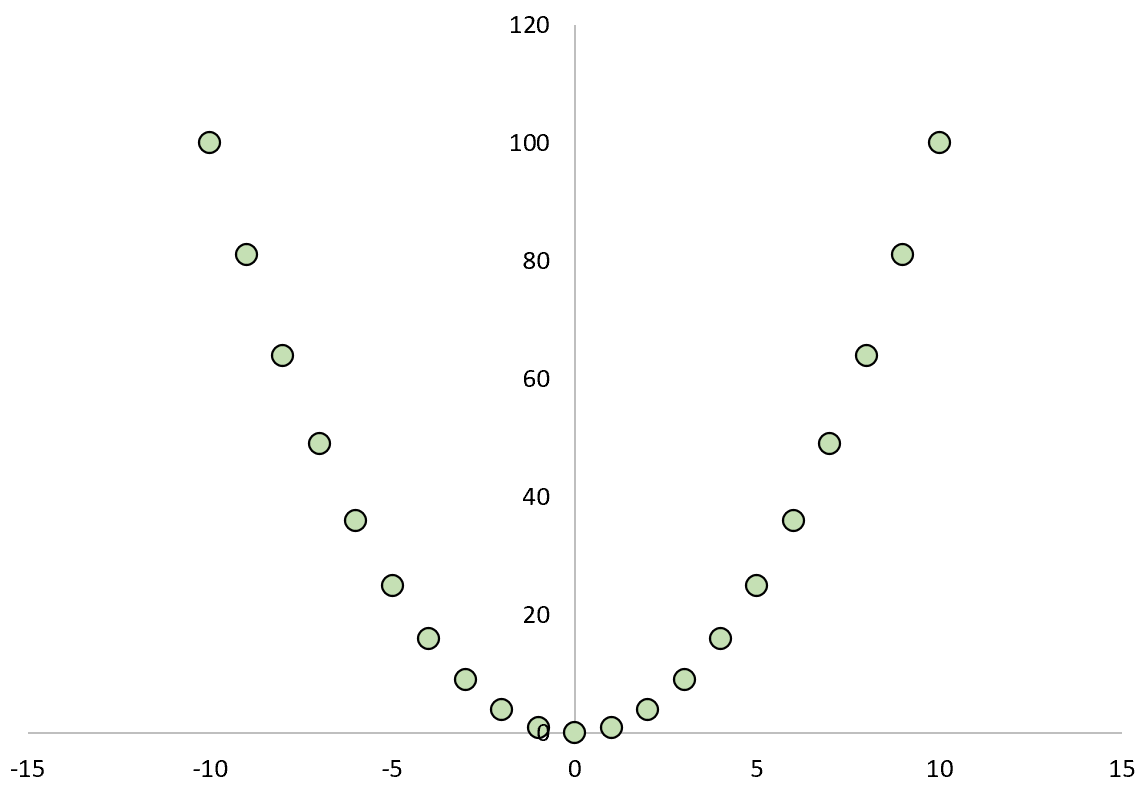
Pour illustrer de manière irréfutable la cécité de l’outil statistique de base, considérons le cas le plus élémentaire et le plus pur : une relation fonctionnelle quadratique parfaite reliant une variable explicative $X$ à une variable dépendante $Y$. Définissons un système formel dans lequel la variable $Y$ est rigoureusement égale au carré de $X$ :
$$Y = X^2$$
Supposons que la variable causale indépendante $X$ suive une loi de probabilité continue uniforme sur l’intervalle symétrique $[-a, a]$, où $a > 0$. La densité de probabilité de cette variable est donnée par $f_X(x) = \frac{1}{2a}$ pour tout $x in [-a, a]$, et $0$ en dehors. Par construction, l’espérance mathématique de cette variable est rigoureusement nulle en raison de sa symétrie centrale :
$$E[X] = \int_{-a}^{a} x \frac{1}{2a} , dx = \left[ \frac{x^2}{4a} \right]_{-a}^{a} = \frac{a^2 – a^2}{4a} = 0$$
Calculons à présent l’espérance de la variable dépendante $Y$ sous ce régime déterministe :
$$E[Y] = E[X^2] = \int_{-a}^{a} x^2 \frac{1}{2a} , dx = \left[ \frac{x^3}{6a} \right]_{-a}^{a} = \frac{a^3 – (-a^3)}{6a} = \frac{2a^3}{6a} = \frac{a^2}{3}$$
Pour déterminer le coefficient de corrélation linéaire de Pearson, nous devons évaluer la covariance entre $X$ et $Y$, ce qui nécessite le calcul préalable de l’espérance de leur produit croisé $E[XY]$ :
$$E[XY] = E[X \cdot X^2] = E[X^3] = \int_{-a}^{a} x^3 \frac{1}{2a} , dx = \left[ \frac{x^4}{8a} \right]_{-a}^{a} = \frac{a^4 – a^4}{8a} = 0$$
En injectant ces grandeurs dans la formule analytique de la covariance, le verdict mathématique est immédiat et incontestable :
$$\mathrm{Cov}(X, Y) = E[XY] – E[X]E[Y] = 0 – (0 \cdot \frac{a^2}{3}) = 0$$
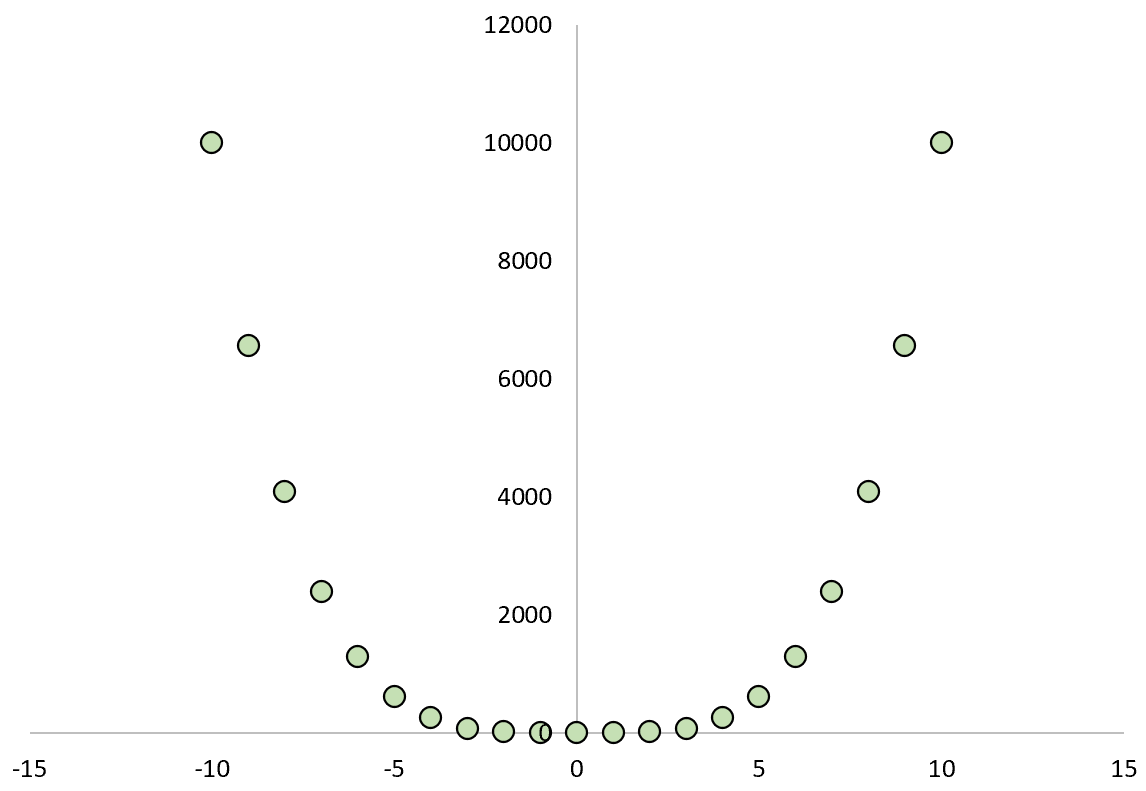
Le numérateur du coefficient de corrélation de Pearson étant rigoureusement nul, il s’ensuit inéluctablement que $\rho_{X,Y} = 0$. Face à cet ensemble de données, un logiciel de traitement statistique conventionnel imprimera un coefficient $r = 0,000$ et une valeur de probabilité $p = 1,000$. Un observateur appliquant aveuglément la grille d’interprétation naïve conclura qu’« il n’existe aucune relation entre X et Y ». Pourtant, la réalité sous-jacente est une dépendance fonctionnelle déterministe absolue : si l’on connaît la valeur de $X$, la valeur de $Y$ est prédite avec une marge d’erreur nulle. La cause engendre l’effet sans la moindre fluctuation stochastique, mais l’empreinte de cette causalité totale est une parabole parfaite, dont la courbure symétrique neutralise intégralement le scalpel linéaire de Pearson.
4.2 Application psychologique : La loi de Yerkes-Dodson
Loin d’être une simple curiosité algébrique confinée aux manuels d’analyse mathématique, cette structure symétrique quadratique constitue l’une des régularités les plus documentées de l’histoire de la psychologie expérimentale et des neurosciences comportementales : la loi de Yerkes-Dodson. Énoncée initialement en 1908 par Robert Yerkes et John Dillingham Dodson, cette loi décrit la relation fondamentale qui unit le niveau d’éveil physiologique ou d’activation corticale (l’arousal ou le stress perçu) et l’efficience des performances cognitives ou motrices.
Cette relation adopte une morphologie canonique en « U inversé ». À un niveau d’activation physiologique très bas (état de somnolence, apathie, sous-stimulation sensorielle), l’organisme ne parvient pas à mobiliser les ressources attentionnelles nécessaires pour traiter efficacement les informations environnementales ; la performance cognitive est médiocre. À mesure que le niveau de stress ou de vigilance s’élève vers un point médian optimal, l’allocation des capacités de la mémoire de travail s’améliore, la vitesse de traitement perceptif s’accélère et la focalisation exécutive atteint son pic de rendement maximal. En revanche, lorsque le stress dépasse ce seuil critique pour atteindre des niveaux d’anxiété aiguë ou de panique végétative, le système cognitif subit une désorganisation massive : l’hyper-focalisation sur les stimuli de menace induit une saturation de l’espace de travail conscient, l’inhibition motrice se dérègle et la performance s’effondre de façon dramatique.
Considérons à présent une étude observationnelle ou quasi-expérimentale contemporaine s’intéressant à cette dynamique au sein d’une cohorte hétérogène comprenant à la fois des individus profondément apathiques, des sujets idéalement stimulés et des participants souffrant d’anxiété sévère. Si le chercheur tente d’estimer l’effet de l’activation physiologique sur la réussite à une tâche cognitive complexe en calculant une simple corrélation bivariée linéaire de Pearson, l’inclinaison ascendante de la courbe chez les individus sous-activés sera exactement contrebalancée par la trajectoire descendante observée chez les individus sur-stimulés. La droite de régression des moindres carrés demeurera désespérément horizontale ($r \approx 0$).
L’erreur d’interprétation qui découle de ce résultat nul constitue une tragédie méthodologique et clinique. Le chercheur non averti publiera un article concluant que « le niveau de stress n’exerce aucune influence sur la performance intellectuelle ». Sur la base de ce postulat erroné, un intervenant en milieu scolaire ou en ergonomie cognitive pourrait juger inutile d’adapter les exigences de l’environnement, ignorant qu’en réalité, le stress est le moteur primordial structurant le rendement intellectuel des individus. La relation causale est majeure, universelle et robuste, mais son organisation spatiale non monotone la rend invisible au regard de l’analyse linéaire standard.
4.3 Déclinaisons psychologiques de l’effet en U inversé
L’effet en U inversé ne se cantonne pas au domaine restreint de la vigilance ; il traverse l’ensemble de la nosologie et de la psychologie fonctionnelle. Prenons le cas de l’estime de soi dans ses rapports avec l’adaptation sociale et relationnelle. Une estime de soi effondrée induit un déficit chronique d’affirmation, une hyper-vulnérabilité au sentiment d’infériorité, un retrait dépressif et une incompétence relationnelle marquée. À l’opposé du spectre, un niveau d’estime de soi démesuré, confinant à la grandiosité narcissique pathologique, génère des comportements d’arrogance, une incapacité d’empathie, de l’agressivité face à la moindre contestation et un isolement relationnel tout aussi toxique. L’adaptation interpersonnelle optimale se situe précisément dans une zone médiane équilibrée. Un échantillon intégrant l’intégralité de cette distribution révélera une covariance linéaire nulle entre le niveau d’estime de soi global et des indicateurs de qualité des liens sociaux.
Un phénomène similaire est abondamment documenté en psychologie du sport et du contrôle moteur sous le concept de choking under pressure ou d’interférence attentionnelle sur les compétences automatisées. Lorsqu’un athlète d’élite exécute un geste hautement complexe (tel qu’un lancer franc au basket-ball ou un swing de golf), un déficit total de conscience ou d’attention de sa part entraîne une dégradation du timing. Inversement, une hyper-focalisation consciente sur les composantes kinesthésiques du mouvement détruit la fluidité des automatismes procéduraux corticaux et paralyse l’exécution motrice. Là encore, le lien causal liant le degré de contrôle attentionnel conscient à l’efficacité motrice suit une courbure en cloche parfaite dont le sommet représente l’optimum fonctionnel et dont les extrémités symbolisent deux modes d’échec complémentaires.
Enfin, en neuropharmacologie et en psychiatrie biologique, la quasi-totalité des molécules actives ciblant les systèmes monoaminergiques (comme les agonistes dopaminergiques prescrits dans le déficit de l’attention ou la maladie de Parkinson) répond à des courbes d’efficacité biphasiques de type hormétique. Une dose infra-thérapeutique demeure inefficace, une dose modérée restaure l’efficience synaptique préfrontale, tandis qu’une dose excessive déclenche une désensibilisation des récepteurs membranaires, de l’agitation ou des symptômes psychotiques. Dans chacune de ces sphères fondamentales de l’existence humaine, la causalité est le moteur exclusif du phénomène, mais l’analyse corrélationnelle simple de Pearson est frappée d’une cécité épistémologique congénitale.
5. Analyse statistique de l’Exemple 1 : L’aveuglement du coefficient de Pearson
5.1 Démonstration formelle de la nullité de r
Pour appréhender la mécanique profonde de cette invisibilité, examinons formellement les conditions de décomposition des moments statistiques d’ordre supérieur. Soit $X$ une variable aléatoire continue régie par une fonction de densité de probabilité $f_X(x)$ définie sur $\mathbb{R}$. La condition formelle de symétrie d’une distribution autour de son espérance $E[X] = \mu$ s’écrit mathématiquement :
$$f_X(\mu + t) = f_X(\mu – t) \quad \forall t in \mathbb{R}$$
Sans perte de généralité, centrons la variable causale de manière à fixer $\mu = 0$. Il est une propriété canonique du calcul intégral que pour toute fonction impaire $g(x)$ (vérifiant $g(-x) = -g(x)$), l’intégrale sur un domaine symétrique autour de zéro est strictement nulle. Considérons à présent le moment centré d’ordre trois $E[X^3]$ :
$$E[X^3] = \int_{-\infty}^{+\infty} x^3 f_X(x) , dx$$
Puisque la fonction de densité $f_X(x)$ est paire par hypothèse et que l’opérateur monôme $x^3$ est une fonction impaire, le produit d’une fonction paire par une fonction impaire est une fonction impaire :
$$g(x) = x^3 f_X(x) implies g(-x) = (-x)^3 f_X(-x) = -x^3 f_X(x) = -g(x)$$
Par conséquent, l’intégrale définissant le moment d’ordre trois s’annule identiquement : $E[X^3] = 0$. Revenons à l’expression de la covariance entre $X$ et une transformation polynomiale paire quelconque $Y = g_{\mathrm{pair}}(X)$, dont le cas quadratique $Y = X^2$ est le représentant canonique :
$$\mathrm{Cov}(X, X^2) = E[X \cdot X^2] – E[X] E[X^2] = E[X^3] – 0 \cdot E[X^2] = 0 – 0 = 0$$
Cette démonstration prouve avec une élégance absolue que dès lors que la variable indépendante présente une distribution symétrique (comme c’est typiquement le cas des distributions gaussiennes idéalisées régissant les traits psychométriques ou les mesures physiologiques), la covariance avec toute transformation quadratique, quartique ou polynomiale paire s’annule par nécessité géométrique intégrale. L’indice de corrélation linéaire est incapable par essence de distinguer ce lien causal déterministe absolu d’un bruit blanc purement indépendant produit par un générateur de nombres aléatoires. Il existe une dissociation ontologique radicale entre la prévisibilité algorithmique (qui ici est maximale, le coefficient de détermination non linéaire $R^2_{\mathrm{généralisé}} = 1$) et la corrélation métrique de Pearson qui affiche impunément $0$.
5.2 Pièges dans l’analyse de régression standard
Cette incapacité de Pearson contamine en cascade l’ensemble des modélisations fondées sur la régression linéaire ordinaire par les moindres carrés (OLS pour Ordinary Least Squares). Lorsqu’un chercheur spécifie un modèle linéaire standard sous la forme canonique :
$$Y_i = \beta_0 + \beta_1 X_i + \varepsilon_i$$
L’estimateur de la pente $\hat{\beta}_1$ dépend directement de la covariance empirique échantillonnale :
$$\hat{\beta}_1 = \frac{\sum_{i=1}^n (X_i – \bar{X})(Y_i – \bar{Y})}{\sum_{i=1}^n (X_i – \bar{X})^2} = \frac{\widehat{\mathrm{Cov}}(X, Y)}{\hat{\sigma}_X^2}$$
Lorsque la vraie structure génératrice des données est quadratique et symétrique, l’estimateur de la pente converge presque sûrement vers zéro : $\hat{\beta}_1 x\rightarrow{p} 0$. Le test d’hypothèse de Student appliqué au coefficient de régression produira une statistique $t$ voisine de zéro et une p-valeur très supérieure au seuil canonique de $0,05$. L’erreur consisterait à ériger ce résultat numérique en décret de stérilité causale. Si le statisticien n’inspecte pas préalablement les diagrammes de dispersion bivariés (scatterplots) ou l’analyse graphique de la distribution des résidus de régression par rapport aux valeurs prédites (diagnostic des résidus), cette structure restera totalement indétectée.
Dans un tel contexte, les résidus du modèle linéaire standard ne présenteront pas une répartition homoscédastique aléatoire autour de l’axe zéro, mais afficheront une forme parabolique résiduelle flagrante, violant de plein fouet l’hypothèse de Gauss-Markov d’indépendance des erreurs conditionnelles ($E[\varepsilon mid X] \neq 0$). Le modèle sous-jacent est radicalement faux, et le coefficient $\beta$ non significatif n’est pas le reflet de l’impuissance de la cause $X$, mais la sanction de la stupidité de l’observateur qui tente d’enfermer une parabole vivante dans un corset rectiligne.
5.3 Solutions méthodologiques alternatives
Face à cet aveuglement de l’analyse linéaire, la statistique mathématique a développé au fil des décennies des métriques alternatives capables d’identifier la dépendance stochastique et fonctionnelle sous n’importe quelle géométrie spatiale. La première avancée majeure réside dans la corrélation de distance (distance correlation, notée $\mathrm{dCor}$), théorisée par Gábor Székely et ses collaborateurs en 2007. Fondée sur la transformée de Fourier et la distance euclidienne entre fonctions caractéristiques conjointes et marginales, la corrélation de distance possède la propriété fondamentale suivante :
$$\mathrm{dCor}(X, Y) = 0 iff X \text{ et } Y \text{ sont rigoureusement et mutuellement indépendantes}$$
Contrairement au coefficient de Pearson, si $Y = X^2$ sur un domaine symétrique, la corrélation de distance ne sera jamais nulle ; elle renverra une valeur strictement positive (typiquement $\approx 0,49$ pour une distribution uniforme symétrique), alertant immédiatement le chercheur sur l’existence d’une dépendance structurelle majeure. Une deuxième approche issue de la théorie de l’information de Claude Shannon repose sur le coefficient d’information mutuelle (Mutual Information, noté $I(X; Y)$) :
$$I(X; Y) = \iint f_{X,Y}(x, y) \log \left( \frac{f_{X,Y}(x, y)}{f_X(x) f_Y(y)} \right) , dx , dy$$
L’information mutuelle quantifie la réduction de l’incertitude (ou de l’entropie) sur la variable $Y$ que procure la connaissance de la variable $X$. Dans le cas d’une relation déterministe $Y = X^2$, l’information mutuelle tend vers l’entropie intrinsèque du système et ne s’annule jamais, capturant la causalité déterministe avec une acuité maximale. Enfin, dans le cadre de la modélisation statistique paramétrique, l’intégration systématique de termes polynomiaux d’ordre supérieur ($Y = \beta_0 + \beta_1 X + \beta_2 X^2 + \varepsilon$) ou le recours aux splines de régression pénalisée au sein de modèles additifs généralisés (GAM) permet de transcender la linéarité restrictive et de restituer à la causalité son expression métrique légitime.
6. Exemple 2 : Les systèmes homéostatiques et boucles de rétroaction négative
6.1 Le principe cybernétique du contrôle et de l’équilibration
Le deuxième grand scénario dans lequel une causalité incontestable dissout intégralement sa propre corrélation statistique appartient au domaine de la cybernétique et de la théorie générale des systèmes initiée par Norbert Wiener et Ludwig von Bertalanffy. Ce principe régit l’organisation des systèmes vivants : l’homéostasie. Un système cybernétique à rétroaction négative (closed-loop negative feedback control) se caractérise par la présence d’un capteur évaluant en continu l’état réel d’une variable vitale, d’un point de consigne (setpoint) fixant l’état idéal à préserver, d’un comparateur générant un signal d’erreur, et d’un actionneur mobilisant des ressources correctives proportionnelles pour compenser les perturbations environnementales exogènes.
L’archétype mécanique le plus intuitif est le régulateur de vitesse (cruise control) d’un véhicule automobile contemporain naviguant sur une autoroute vallonnée. Considérons la pente de la route ($X$) comme la variable causale perturbatrice exogène, et la vitesse réelle du véhicule ($Y$) comme la variable dépendante d’intérêt. La force gravitationnelle induite par une montée abrupte est une cause physique irréfutable de ralentissement cinétique : en vertu de la deuxième loi de Newton ($F = m \cdot a$), une élévation de la pente exerce une force mécanique rétrograde qui a pour effet immédiat et inévitable de freiner la masse de l’automobile.
Or, quelle observation statistique recueille-t-on si le régulateur électronique de vitesse fonctionne avec une perfection technique absolue ? Dès que le capteur décèle une baisse infinitésimale de la vitesse, le calculateur injecte instantanément un surplus de carburant dans les cylindres du moteur. L’accroissement de la force motrice annule rigoureusement la résistance gravitationnelle. La vitesse réelle ($Y$) demeure strictement constante, par exemple fixée immuablement à 110 kilomètres par heure, quelle que soit la sévérité des montées ou des descentes ($X$). Si l’on compile les données télémétriques de cette course sur un graphique croisant la pente du terrain ($X$) et la vitesse du véhicule ($Y$), on observe une droite parfaitement horizontale, dénuée de la moindre dispersion de variance. Le coefficient de corrélation linéaire de Pearson entre la déclivité de la route et la vitesse du véhicule est strictement nul ($\rho_{X,Y} = 0$). Conclure que la gravité n’exerce aucun effet causal sur la vitesse de l’automobile serait une aberration physique grossière.
6.2 Application psychologique : L’effort compensatoire face à la charge cognitive
Ce paradoxe cybernétique trouve une transposition directe et universelle en psychologie cognitive et en ergonomie comportementale à travers le modèle de l’effort compensatoire et de l’allocation des ressources attentionnelles, conceptualisé originellement par des théoriciens comme Daniel Kahneman et développé par Robert Hockey dans sa théorie de la régulation de l’effort compensatoire (Compensatory Control Model).
Imaginons un protocole expérimental dans lequel des opérateurs humains — tels que des contrôleurs aériens ou des étudiants engagés dans des épreuves d’arithmétique mentale complexe — sont soumis à des tâches dont la difficulté intrinsèque ou la charge cognitive externe ($X$) est manipulée expérimentalement le long d’un gradient croissant allant de conditions aisées à des conditions de surcharge sévère. Parallèlement, nous enregistrons leur performance finale ($Y$), mesurée par l’exactitude des décisions ou le taux d’erreur globale. La cause $X$ (la saturation de la mémoire de travail imposée par la tâche) possède un potentiel délétère incontestable sur les fonctions exécutives : elle impose une consommation massive de ressources computationnelles cérébrales.
Toutefois, l’être humain n’est pas un automate passif. Face à l’augmentation de la difficulté ($X$), le sujet mobilise un mécanisme de régulation homéostatique : l’effort mental conscient et compensatoire. L’individu s’investit davantage, élève sa concentration volontaire, engage des stratégies métacognitives plus coûteuses sur le plan métabolique et mobilise l’activité de son cortex préfrontal dorsolatéral. Tant que le système n’atteint pas son seuil absolu de rupture ou d’épuisement total, cette allocation d’effort neutralise l’impact de la complexité de la tâche. La performance finale ($Y$) demeure d’une constance remarquable, oscillant autour de 95 % de réussite sur l’ensemble des conditions expérimentales.
Si l’analyste se contente de corréler passivement la difficulté de la tâche ($X$) et la précision de la performance ($Y$), il observera une absence quasi-totale d’association linéaire ($r \approx 0$). L’interprétation positiviste naïve conduirait à déclarer que « la complexité de la tâche n’a aucun impact sur les capacités cognitives des participants ». En omettant de mesurer la consommation des ressources physiologiques internes (comme la variabilité de la fréquence cardiaque, la dilatation pupillaire ou le métabolisme du glucose cérébral), le chercheur rate l’intégralité de la réalité causale. La difficulté de la tâche a provoqué une cascade causale intense qui s’est heurtée à une réponse de résistance homéostatique réussie, dissolvant l’empreinte de la perturbation dans l’invariance du résultat final.
6.3 Régulation émotionnelle et homéostasie psychologique
Cette dynamique d’annulation s’observe avec une acuité plus saisissante encore dans la recherche clinique consacrée au stress, à la régulation émotionnelle et aux processus de résilience psychologique. Considérons la relation entre l’intensité objective des événements de vie stressants ($X$) — tels que des conflits organisationnels, des contraintes financières ou des pressions académiques — et le bien-être subjectif ou le niveau d’affect positif ($Y$).
Le paradigme transactionnel du stress développé par Richard Lazarus et Susan Folkman enseigne que l’impact causal d’un agent stresseur est médié et tamponné par les processus d’évaluation cognitive (appraisal) et les stratégies de coping. Lorsqu’un individu doté de solides compétences d’autorégulation émotionnelle est exposé à un accroissement brutal de la menace environnementale ($X$), il active immédiatement des mécanismes de réévaluation positive, de soutien social ciblé ou de résolution de problèmes pragmatique. Cette réaction adaptative neutralise la détresse émotionnelle potentielle. Le bien-être affectif ressenti ($Y$) peut demeurer stable et inchangé malgré la tempête contextuelle.
Dans un protocole épidémiologique transversal (cross-sectional) reposant sur un recueil de données par auto-questionnaires à un instant $t$, la corrélation bivariée calculée entre l’exposition aux facteurs de stress et la santé mentale globale sera fréquemment décevante, voire statistiquement non significative chez les individus hautement adaptatifs. Conclure sur cette base que les stresseurs environnementaux n’ont aucune nocivité causale propre constitue une bévue méthodologique majeure. L’absence de corrélation observable est précisément l’indicateur du triomphe fonctionnel de la résilience humaine. La cause stresseuse agit avec force, mais son retentissement psychopathologique est maintenu à zéro par l’action continue du bouclier homéostatique.
7. Analyse dynamique de l’Exemple 2 : Pourquoi le contrôle actif dissout la corrélation
7.1 Mathématiques du contrôle en boucle fermée
Pour formaliser rigoureusement la destruction de la corrélation statistique par l’homéostasie, il est nécessaire de recourir aux équations différentielles de la théorie du contrôle linéaire en boucle fermée. Dans sa contribution historique de 1986, le psychologue Wayne A. Hershberger a formulé ce que la littérature nomme aujourd’hui le « paradoxe de Hershberger » ou le paradoxe du contrôle cybernétique.
Soit un système où l’état d’une variable régulée $Y(t)$ à chaque instant dépend de la somme d’une perturbation externe $X(t)$ et de l’action compensatoire $C(t)$ déployée par l’organisme :
$$Y(t) = X(t) + C(t)$$
Le contrôleur cybernétique observe l’écart entre la variable régulée $Y(t)$ et son point de consigne de référence $Y^*$ (que nous poserons égal à zéro par souci de simplification : $Y^* = 0$). Le signal d’erreur est donc $e(t) = 0 – Y(t) = -Y(t)$. L’organisme génère une action corrective $C(t)$ régie par une fonction de transfert de gain proportionnel $K > 0$ :
$$C(t) = K \cdot e(t) = -K \cdot Y(t)$$
Substituons cette équation d’action dans l’équation d’état initiale du système :
$$Y(t) = X(t) – K \cdot Y(t) implies Y(t)(1 + K) = X(t) implies Y(t) = \frac{1}{1 + K} X(t)$$
Calculons à présent la variance théorique de la variable de sortie régulée $\sigma_Y^2$, ainsi que sa covariance avec la cause perturbatrice $\mathrm{Cov}(X, Y)$, en supposant que la perturbation $X$ présente une variance $\sigma_X^2 > 0$ :
$$\sigma_Y^2 = \mathrm{Var}\left( \frac{1}{1 + K} X \right) = \left( \frac{1}{1 + K} \right)^2 \sigma_X^2$$
$$\mathrm{Cov}(X, Y) = \mathrm{Cov}\left( X, \frac{1}{1 + K} X \right) = \frac{1}{1 + K} \sigma_X^2$$
Analysons le comportement asymptotique de ces grandeurs lorsque l’efficacité du mécanisme régulateur devient optimale, c’est-à-dire lorsque le gain de contrôle tend vers l’infini ($K to \infty$) :
$$\lim_{K to \infty} \sigma_Y^2 = 0 \quad \text{et} \quad \lim_{K to \infty} \mathrm{Cov}(X, Y) = 0$$
Dans un système régulateur hautement performant ($K$ très élevé), la variance empirique de $Y$ devient indiscernable du bruit de mesure infinitésimal. Plus fascinant encore : calculons la corrélation qui se noue entre la perturbation externe $X(t)$ et l’effort correctif compensatoire de l’organisme $C(t)$ :
$$C(t) = -K \cdot Y(t) = -\frac{K}{1 + K} X(t)$$
Le coefficient de corrélation linéaire entre la cause perturbatrice $X$ et l’action adaptative $C$ est donné par :
$$\rho_{X, C} = \frac{\mathrm{Cov}(X, C)}{\sigma_X \sigma_C} = \frac{-\frac{K}{1+K}\sigma_X^2}{\sigma_X \left( \frac{K}{1+K}\sigma_X \right)} = -1$$
Cette dérivation formelle livre une leçon épistémologique magistrale : dans un système adaptatif, l’influence causale maximale de $X$ ne se reflète pas dans la variable dépendante $Y$ (où la corrélation s’éteint totalement, $\rho_{X,Y} \approx 0$), mais se réfugie intégralement dans la corrélation négative parfaite qui lie la perturbation à l’effort compensatoire ($\rho_{X,C} = -1$). L’analyste qui ne mesure que la variable de résultat $Y$ est condamné à décréter l’absence d’effet d’une cause qui, en réalité, mobilise l’ensemble de la machinerie homéostatique du sujet.
7.2 Le piège de la modélisation statique transversale
Cette démonstration algébrique permet de diagnostiquer l’un des vices méthodologiques les plus destructeurs en sciences humaines : l’illusion de stationnarité dans les études transversales à coupe unique (cross-sectional studies). Lorsque des données sont recueillies via un questionnaire distribué à un échantillon à un moment temporel figé, le statisticien agrège sans distinction des systèmes adaptatifs qui se trouvent à des phases différentes de leur boucle de régulation dynamique.
L’agrégation temporelle de processus dynamiques rapides produit une neutralisation complète des gradients de causalité. Dans un organisme biologique ou mental, le couple perturbation-réponse opère à des échelles de temps micro-temporelles (quelques secondes à quelques heures). En capturant une photographie macroscopique statique, l’enquêteur observe le résultat consolidé de la régulation — c’est-à-dire l’état d’équilibre final $Y \approx \text{constant}$ — et en déduit fallacieusement l’absence de lien fonctionnel. Cette approche est incapable de distinguer la passivité ontologique d’un système qui ne subit aucun effet de la réactivité parfaite d’un système qui absorbe activement toutes les contraintes.
7.3 L’apport des designs longitudinaux et de l’analyse en séries temporelles
Pour briser ce mur d’invisibilité statistique, la recherche doit abandonner les modélisations statiques au profit d’architectures d’évaluation dynamiques et longitudinales à haute résolution temporelle. La méthode par excellence réside dans le protocole d’évaluation écologique momentanée (EMA pour Ecological Momentary Assessment) ou d’échantillonnage de l’expérience vécue (Experience Sampling Method).
En sollicitant les participants plusieurs fois par jour via des dispositifs mobiles connectés, le chercheur enregistre les fluctuations micro-temporelles des variables d’exposition ($X_t$), des mécanismes de régulation ($C_t$) et des états émotionnels terminaux ($Y_t$). Ces séries temporelles multivariées peuvent ensuite être modélisées à l’aide de modèles vectoriels autorégressifs à retards échelonnés (VAR pour Vector Autoregressive Models) :
$$Y_t = \alpha + \sum_{p=1}^P \phi_p Y_{t-p} + \sum_{q=1}^Q \beta_q X_{t-q} + \varepsilon_t$$
Dans ce formalisme temporel, la causalité au sens de Clive Granger redevient éclatante. Même si la corrélation contemporaine instantanée entre $X_t$ et $Y_t$ est nulle en raison de l’adaptation rapide du sujet, le coefficient d’influence retardé $\beta_{t-1}$ mettra en évidence l’impact déstabilisateur temporaire causé par la perturbation avant que l’action compensatoire ne vienne restaurer la consigne homéostatique. Seule la temporalité fine permet d’écarter le voile sous lequel l’équilibre cybernétique dissout l’empreinte de la cause.
8. Exemple 3 : Les voies causales multiples et effets de suppression (Concurrence de chemins)
8.1 Le modèle à chemins causaux antagonistes de Judea Pearl
Le troisième scénario emblématique d’invisibilité corrélationnelle se déploie lorsque la structure topologique du système génère des chemins causaux antagonistes qui se neutralisent mutuellement. Dans le formalisme des graphes orientés acycliques (DAG) développé par Judea Pearl, une variable indépendante $X$ peut influencer une variable de résultat $Y$ à la fois directement et par l’intermédiaire d’une variable médiatrice $M$.
Considérons le diagramme causal suivant, où les arêtes fléchées représentent des liens de causalité structurelle non ambiguë :
- Une flèche directe relie $X$ à $Y$, caractérisée par un coefficient d’effet direct $c’$.
- Une flèche relie $X$ au médiateur $M$, caractérisée par un coefficient d’effet $a$.
- Une flèche relie le médiateur $M$ à la variable de résultat $Y$, caractérisée par un coefficient d’effet $b$.
Dans une telle architecture graphique, l’effet causal de $X$ sur $Y$ s’écoule simultanément à travers deux canaux de transmission structurels distincts : le canal direct ($X to Y$) et le canal indirect ($X to M to Y$). Rien dans la physique des causalités n’impose à ces deux canaux d’opérer dans la même direction vectorielle. Que se produit-il lorsque le canal direct exerce un effet amplificateur ou destructeur, tandis que le canal médié propage un effet exactement opposé ?
8.2 Application psychologique : Anxiété d’évaluation, préparation et performance
Pour incarner cette structure mathématique dans une réalité psychologique concrète, examinons l’un des phénomènes les plus étudiés en psychologie de l’éducation : l’impact de l’anxiété d’évaluation ou du stress de performance ($X$) sur la note finale obtenue à un examen académique complexe ($Y$).
D’un côté, il existe un mécanisme neurocognitif direct hautement documenté par la théorie du contrôle attentionnel d’Eysenck et Derakshan. Le jour de l’examen, l’état d’anxiété aiguë ressentie par le candidat induit une libération massive de cortisol et de catécholamines, déclenchant des pensées intrusives et des ruminations d’échec dans la mémoire de travail phonologique. Ces pensées parasites saturent la bande passante exécutive nécessaire au raisonnement formel et bloquent la récupération des informations encodées dans la mémoire à long terme. Ce chemin causal direct ($X to Y$) est incontestablement néfaste et affiche un signe négatif marqué ($c’ < 0$).
D’un autre côté, en amont de l’épreuve, l’anxiété de trait face à l’évaluation opère comme un puissant signal motivationnel d’aversion au risque. L’angoisse d’échouer incite l’étudiant à déployer des comportements d’anticipation protecteurs : il planifie des séances d’étude approfondies, passe des heures supplémentaires à réviser ses manuels et s’astreint à un travail préparatoire assidu ($M$). Ce premier segment médié est positif ($a > 0$ : l’anxiété favorise l’effort de préparation). À son tour, le temps de révision intensif et la rigueur de la préparation exercent un impact causal hautement bénéfique sur la maîtrise conceptuelle des contenus évalués le jour de l’examen, ce qui se traduit par une amélioration substantielle de la note ($b > 0$ : la préparation augmente la note). Par la règle de composition des chemins, l’effet indirect global de l’anxiété, médié par le travail préparatoire, est le produit de ces deux coefficients positifs : $a \cdot b > 0$.
Nous sommes face à une situation où l’anxiété agit simultanément comme un poison cognitif aigu le jour J ($c’ < 0$) et comme un moteur de travail salutaire durant les semaines précédant l’examen ($a \cdot b > 0$). Que se passe-t-il si l’on calcule la simple corrélation bivariée entre le trait d’anxiété ($X$) et la note d’examen ($Y$) sur un large échantillon d’étudiants ? L’effet direct négatif et l’effet indirect positif entrent en collision frontale. S’ils sont de force comparable, le coefficient de corrélation de Pearson s’effondrera à zéro ($r \approx 0$). L’observateur naïf affirmera : « L’anxiété n’a aucun rapport avec la réussite scolaire. » Cette conclusion est fondamentalement erronée : l’anxiété possède deux impacts causaux gigantesques mais de dynamiques opposées, qui se neutralisent mutuellement dans la moyenne marginale.
8.3 Autres cas psychologiques d’interférence destructive
Cette configuration de suppression antagoniste se retrouve dans de multiples pans de la recherche psychologique. Prenons le cas de la personnalité extravertie ($X$) et de la longévité des relations amoureuses ($Y$). L’extraversion favorise les aptitudes à la communication ouverte, la bonne humeur partagée et l’expressivité émotionnelle, qui sont d’incontestables facteurs d’attachement et de pérennité du couple ($c’ > 0$). Mais parallèlement, une extraversion très élevée augmente l’exposition à un large réseau social externe et l’attrait pour de nouvelles expériences stimulantes ($M$), multipliant ainsi mathématiquement les opportunités de tentation infidèle et d’instabilité conjugale ($b < 0$). L’impact direct stabilisateur est annulé par le coût indirect de la recherche de variété, générant une corrélation brute nulle entre extraversion et durée des unions affectives.
Un autre exemple saisissant provient de la psychothérapie d’exposition pour les troubles anxieux ou les états de stress post-traumatique (ESPT). L’exposition prolongée aux stimuli phobogènes ($X$) active transitoirement une détresse émotionnelle viscérale intolérable à court terme ($c’ < 0$ sur le sentiment d’apaisement immédiat). Pourtant, cette même activation émotionnelle est la condition physiologique sine qua non pour déclencher les cascades moléculaires d’extinction de la peur et la reconsolidation mnésique inhibitrice au niveau de l’amygdale cérébrale ($M to Y$), qui aboutissent à la guérison durable à moyen et long terme ($a \cdot b > 0$). Une évaluation transversale mal synchronisée ne révélera aucune corrélation entre thérapie d’exposition et bien-être global.
Dans les sciences organisationnelles, le perfectionnisme adaptatif ($X$) engendre un engagement remarquable et une minutie de production qui améliorent les performances professionnelles ($c’ > 0$), mais il induit simultanément une sur-fatigue chronique et un refus de déléguer ($M$) qui précipitent le syndrome d’épuisement professionnel (burnout), dégradant in fine le rendement global ($a \cdot b < 0$). La corrélation marginale nulle n’est alors que l’épitaphe statistique d’une lutte d’influences internes invisibles au microscope bivarié.
9. Analyse conceptuelle de l’Exemple 3 : Médiation antagoniste et paradoxe d’invisibilité
9.1 Décomposition algébrique de l’effet total
Pour appréhender formellement les mathématiques sous-jacentes à ce troisième archétype, il convient de rappeler la célèbre décomposition des effets causaux théorisée par Baron et Kenny et raffinée par Judea Pearl. Dans un système à trois variables satisfaisant aux équations de régression linéaire récursives :
$$M = i_1 + a X + \varepsilon_1$$
$$Y = i_2 + c’ X + b M + \varepsilon_2$$
L’effet total non conditionnel exercé par $X$ sur $Y$, traditionnellement noté $c$, s’obtient en substituant l’équation de $M$ dans l’équation de $Y$ :
$$Y = i_2 + c’ X + b(i_1 + a X + \varepsilon_1) + \varepsilon_2 = (i_2 + b i_1) + (c’ + a b)X + (b \varepsilon_1 + \varepsilon_2)$$
L’effet total correspond rigoureusement à l’égalité fondamentale :
$$c = c’ + a \cdot b$$
Dans cette équation, le coefficient de corrélation marginale empirique $r_{X,Y}$ est une fonction directe de l’effet total $c$ :
$$r_{X,Y} = c \cdot \frac{\sigma_X}{\sigma_Y}$$
Le paradoxe d’invisibilité surgit avec une clarté limpide dès lors que les deux voies de transmission s’équilibrent parfaitement en valeur absolue mais s’opposent en signe :
$$c’ = – (a \cdot b) implies c = c’ + a \cdot b = 0 implies r_{X,Y} = 0$$
Il est impératif de distinguer ce phénomène de celui d’une variable de confusion classique (confounder). Un facteur de confusion est une cause commune à $X$ et $Y$ qui introduit une fausse corrélation sans ancrage causal. Dans le cas présent, le médiateur $M$ est une véritable variable suppressive (suppressor variable) : il ne crée pas une fausse liaison, il en annule une authentique au niveau agrégé. L’omission de cette variable dans le protocole d’analyse condamne le chercheur à ignorer un système causal pourtant d’une violence extrême dans ses composantes directes et indirectes.
9.2 Le paradoxe de Simpson comme extension multi-niveaux
Cette dynamique d’interférence structurelle trouve un prolongement multi-niveaux spectaculaire dans le paradoxe de Simpson (ou paradoxe de Yule-Simpson). Dans cette configuration, une corrélation causale réelle et constante peut non seulement s’annuler, mais même inverser son signe lors du passage de sous-groupes stratifiés à une agrégation macroscopique globale.
Supposons que la population d’étude soit segmentée par une variable dispositionnelle latente $Z$ (par exemple, la capacité de réserve cognitive ou un trait génétique de résilience). Au sein du sous-groupe $Z = 1$, la cause $X$ exerce un impact positif net sur $Y$ ($r_{X,Y mid Z=1} > 0$). Au sein du sous-groupe $Z = 0$, la cause $X$ exerce également un impact positif net de même intensité sur $Y$ ($r_{X,Y mid Z=0} > 0$). La causalité est donc indubitablement positive pour l’ensemble des individus de l’univers considéré.
Toutefois, si la variable $Z$ est distribuée de telle manière que les individus présentant des valeurs élevées de $X$ sont massivement concentrés dans le sous-groupe ayant des valeurs de base de $Y$ structurellement très faibles, l’agrégation aveugle de tous les participants dans un nuage de points unique créera un déplacement des barycentres capable d’aplatir intégralement la pente globale de régression. Le chercheur qui analyse la population sans stratifier par $Z$ constatera une corrélation globale rigoureusement égale à zéro ($r_{\mathrm{global}} = 0$). Ce constat illustre à quel point la conditionnement stratifié et l’analyse contrefactuelle multi-niveaux sont indispensables pour dissiper les mirages statistiques nés de l’hétérogénéité des cohortes.
9.3 Méthodes de détection structurelle des médiations masquées
Pour surmonter le piège de la médiation antagoniste, les sciences du comportement doivent bannir le recours aux filtres préalables fondés sur la signification de la corrélation bivariée. Dans l’ancienne méthodologie de Baron et Kenny (1986), l’une des étapes prérequises pour tester une médiation imposait que la relation globale entre $X$ et $Y$ soit préalablement significative ($c \neq 0$). Ce critère obsolète a fait des ravages : il interdit précisément de détecter les cas d’interférence destructive où $c = 0$ précisément parce que la médiation opère avec une efficacité absolue.
La méthodologie contemporaine préconise l’utilisation de la modélisation par équations structurelles (SEM pour Structural Equation Modeling) et l’estimation directe des effets indirects par rééchantillonnage non paramétrique (bootstrapping), telle que popularisée par Andrew Hayes dans les macros PROCESS. En générant des milliers de sous-échantillons avec remise, le statisticien construit des intervalles de confiance robustes pour le produit croisé $a \cdot b$, indépendamment de la nullité de l’effet total non conditionnel $c$ :
$$\mathrm{IC}_{95%} = \left[ (a \cdot b)_{\text{\inf}}, (a \cdot b)_{\text{\sup}} \right]$$
Si l’intervalle de confiance du produit indirect ne contient pas la valeur zéro, la chaîne de transmission causale est rigoureusement confirmée, même si la corrélation brute $r_{X,Y}$ est de 0,001. Cependant, cette avancée analytique exige un prérequis non négociable : la possession d’une théorie psychologique forte. Aucun algorithme statistique inductif ne peut deviner l’existence d’un chemin compensatoire s’il n’a pas été théorisé, mesuré et inclus dans le graphe causal initial par l’esprit critique du chercheur.
10. Biais cognitifs et psychologie de l’inférence causale erronée
10.1 L’heuristique de représentativité et l’attente de linéarité
L’attachement viscéral des chercheurs et des cliniciens au postulat selon lequel la causalité doit impliquer la corrélation ne relève pas d’une simple carence de formation technique ; il plonge ses racines dans l’architecture cognitive de l’esprit humain. Comme l’ont démontré les travaux fondateurs d’Amos Tversky et Daniel Kahneman, nos jugements probabilistes sous incertitude sont massivement influencés par des raccourcis mentaux, au premier rang desquels figure l’heuristique de représentativité.
L’être humain possède un modèle mental du monde fondamentalement linéaire, continu et proportionnel : l’attente intuitive est qu’une grande cause doive produire un grand effet visible, et que toute variation quantitative de l’intrant (l’effort, la dose, le stresseur) doive se traduire par une variation de gradient monotone de l’extrant (le résultat, la réponse clinique, la performance). Une relation fonctionnelle qui adopte une géométrie parabolique en cloche (Exemple 1), qui stabilise un état final par régulation dynamique adaptative (Exemple 2) ou qui s’annule par division de vecteurs opposés (Exemple 3) viole les attentes de simplicité cognitive. Parce qu’elle ne « ressemble » pas à l’archétype mental de l’action physique directe (une boule de billard heurtant une autre en ligne droite), la relation causale non corrélée est intuitivement rejetée comme impossible ou non crédible.
10.2 Le biais de confirmation face aux statistiques nulles
Ce biais de linéarité s’articule à une seconde distorsion cognitive majeure : le biais de confirmation renforcé par l’illusion de preuve négative. Dans la culture académique du Null Hypothesis Significance Testing (NHST), la p-valeur supérieure à 0,05 associée à un test de corrélation de Pearson est quasi universellement perçue par les praticiens comme la « preuve » de l’absence de relation, confondant de manière impardonnable l’absence de preuve d’une association avec la preuve de l’absence d’un lien fonctionnel.
Lorsqu’un chercheur observe un coefficient $r \approx 0$ accompagné d’un $p = 0,42$, le biais de confirmation l’incite à considérer l’affaire comme classée. Il rationalise ce chiffre nul comme la confirmation empirique que son intuition théorique était fausse, plutôt que d’interroger la validité conceptuelle de son estimateur. Cette méprise engendre un gaspillage colossal de ressources scientifiques : des projets de recherche hautement prometteurs portant sur des thérapies innovantes ou des biomarqueurs précoces sont abandonnés au fond des tiroirs (le fameux file drawer problem) simplement parce que la réalité causale étudiée fonctionnait selon une logique homéostatique ou non linéaire que le test de Student bivarié n’était pas armé pour percevoir.
10.3 La quête de récits causaux simplificateurs
À un niveau sociologique et épistémologique plus vaste, la recherche effrénée de corrélations linéaires simples répond à un besoin fondamental de réduction de l’incertitude dans la communication scientifique et la prise de décision politique. Les médias généralistes, les décideurs de santé publique et le grand public réclament des narratifs causaux univoques et digestes : « Le composé chimique X augmente de 20 % le risque de maladie », « Le trait de personnalité Y prédit le salaire d’adulte ». Ces messages reposent tous sur la transposition discursive directe d’un coefficient de corrélation linéaire.
Admettre que la causalité est une propriété systémique, émergente, capable de s’exercer dans le secret d’une covariance nulle, exige un saut épistémologique inconfortable. Cela impose d’accepter que la réalité biologique et psychologique est un tissu de boucles de rétroaction cybernétiques et d’équilibres antagonistes instables, réfractaire aux slogans simplificateurs. Cette complexité conceptuelle explique pourquoi les approches corrélationnelles bivariées naïves continuent de dominer la littérature empirique, malgré leurs défaillances fondamentales lorsqu’il s’agit de révéler l’architecture profonde du réel.
11. Implications méthodologiques pour la recherche en psychologie et neurosciences
11.1 L’impératif de l’interventionnisme expérimental
Pour s’affranchir définitivement des pièges de la corrélation nulle, les sciences du comportement doivent réaffirmer la primauté épistémologique de l’interventionnisme expérimental sur l’observation passive. Dans le formalisme révolutionnaire de Judea Pearl, la seule manière d’établir sans équivoque une dépendance causale consiste à appliquer l’opérateur $do(\cdot)$ au sein d’un essai randomisé contrôlé (RCT).
L’immense vertu de la manipulation expérimentale forcée — lorsqu’elle est correctement exécutée — est qu’elle brise artificiellement et délibérément les boucles de rétroaction naturelle et les mécanismes de régulation homéostatique du sujet. Dans l’exemple du régulateur de vitesse, si un expérimentateur intervient pour déconnecter physiquement l’injection automatique de carburant ($do(\text{injection} = \text{constante})$), la pente de la route ($X$) provoquera instantanément une chute spectaculaire et mesurable de la vitesse du véhicule ($Y$), faisant resurgir la corrélation physique avec éclat. De même, en psychologie, forcer un protocole en empêchant les sujets de mobiliser leur temps de révision ou leurs stratégies d’effort compensatoire permet de démasquer l’impact néfaste brut de la charge cognitive ou de l’anxiété.
11.2 Le dépassement du modèle linéaire général
Au niveau de la modélisation statistique computationnelle, le paradigme du XXIe siècle doit être celui du dépassement résolu du Modèle Linéaire Généralisé (GLM) classique. Les départements de psychologie et de psychiatrie computationnelle doivent intégrer en routine des estimateurs flexibles capables de découvrir des topologies arbitraires sans contraindre les données à une trajectoire rectiligne a priori.
Parmi ces méthodes d’avant-garde, les Modèles Additifs Généralisés (GAM pour Generalized Additive Models), développés par Trevor Hastie et Robert Tibshirani, constituent une réponse d’une puissance exceptionnelle :
$$g(E[Y]) = \beta_0 + f_1(X_1) + f_2(X_2) + dots + f_k(X_k)$$
Dans un GAM, les relations entre prédicteurs et variables cibles ne sont plus contraintes par des paramètres constants de pente ($\beta X$), mais sont estimées de manière non paramétrique via des fonctions de lissage lisses (smooth functions de type splines pénalisées). Si une causalité en U inversé existe entre le stress et la cognition, le modèle GAM ajustera automatiquement une courbe parabolique et testera formellement la significativité de la fonction non linéaire $f(X)$, là où la régression linéaire ordinaire décrétait un néant statistique.
Parallèlement, le recours aux algorithmes d’apprentissage automatique (tels que les forêts aléatoires de Breiman ou les réseaux de neurones profonds) combinés aux analyses d’interprétabilité globale par valeurs de SHAP (SHapley Additive exPlanations) permet d’isoler l’importance structurelle de variables causales non monotones qui échappent aux seuils de significativité des tests d’indépendance de Pearson. Enfin, la modélisation de la dynamique non linéaire par reconstruction de l’espace des phases (méthodes d’attracteurs étranges de Takens) offre aux neurosciences la capacité d’appréhender les causalités chaotiques décorrélées qui gouvernent l’excitabilité des réseaux neuronaux.
11.3 La conception de protocoles fins et multidimensionnels
L’ultime rempart contre la cécité métrique réside dans la finesse de conception des protocoles empiriques eux-mêmes. Il est impératif que les investigateurs renoncent aux conceptions mono-dimensionnelles mesurant un intrant et un extrant isolés au sein de systèmes dynamiques vivants.
Tout d’abord, la temporalité de l’observation doit impérativement s’aligner sur la constante de temps du phénomène étudié : capturer un processus adaptatif exige une cadence d’échantillonnage supérieure à la fréquence de régulation de la boucle homéostatique. Deuxièmement, les protocoles doivent intégrer délibérément la mesure des variables de médiation compensatoire potentielles. Si l’on étudie l’impact d’une exposition toxique ou d’une contrainte psychique, il est criminel de ne pas mesurer simultanément les mécanismes de défense, l’effort métabolique, ou les stratégies de contournement déployées par l’organisme pour y résister. Ce n’est qu’en mesurant le coût de la régulation ($C$) que l’on parvient à quantifier l’intensité de la cause ($X$) lorsque la variable de résultat ($Y$) demeure imperturbablement stable.
12. Synthèse épistémologique : Repenser l’expérimentation et l’analyse des données
12.1 Récapitulation des trois barrières mathématiques
Au terme de cette exploration transversale, le tableau suivant récapitule les trois grands mécanismes structurels par lesquels la causalité ontologique se découple intégralement de la corrélation linéaire métrique :
- La barrière géométrique (Exemple 1) : La non-monotonie et la symétrie fonctionnelle. Dès lors qu’une chaîne causale déterministe présente une géométrie spatiale symétrique (telle que la loi quadratique de Yerkes-Dodson en U inversé), les composantes vectorielles positives et négatives de la covariance s’annihilent mathématiquement dans le moment centré d’ordre trois ($E[X^3] = 0$). Le déterminisme est total, mais le coefficient de corrélation linéaire de Pearson s’annule rigoureusement ($rho = 0$).
- La barrière cybernétique (Exemple 2) : L’homéostasie dynamique et la rétroaction négative. Dès lors qu’un système adaptatif déploie une force compensatoire proportionnelle à la perturbation externe pour maintenir son équilibre interne, la variance de la variable terminale est activement réduite à zéro. Par le paradoxe de Hershberger, plus l’efficacité causale de la régulation est parfaite, plus la corrélation mesurée entre la perturbation et l’état final s’évapore ($\lim_{K to \infty} \rho_{X,Y} = 0$).
- La barrière structurelle (Exemple 3) : L’opposition de chemins causaux et l’interférence destructive. Dès lors qu’un facteur déclencheur génère simultanément un impact direct et un impact indirect médié de polarités algébriques inverses (comme l’anxiété d’évaluation qui nuit à la cognition le jour J mais dope le temps de révision en amont), les effets s’annulent dans la sommation marginale de l’effet total ($c’ = – a \cdot b$). La corrélation bivariée globale tombe à zéro sans que le facteur causal ne perde son pouvoir structurant.
12.2 Guide pratique pour le chercheur et le clinicien
Face à une matrice statistique affichant une absence de corrélation linéaire ($r \approx 0, p > 0,05$), le chercheur ou le clinicien ne doit plus jamais céder au réflexe paresseux d’en conclure à l’inexistence du phénomène. Il doit au contraire soumettre ses données à une grille d’audit épistémologique et méthodologique rigoureuse :
- Audit de forme : Ai-je examiné visuellement les diagrammes de dispersion bivariés et les résidus de mon modèle ? La distribution des données trahit-elle une relation non linéaire, un point d’inflexion, une dynamique biphasique ou un seuil critique d’activation ? Si oui, remplacer l’estimateur de Pearson par la corrélation de distance de Székely, l’information mutuelle ou un modèle GAM.
- Audit d’équilibre systémique : La variable cible appartient-elle à un organisme vivant doté d’une régulation homéostatique ou de mécanismes de compensation adaptative ? Ai-je mesuré le coût biologique, cognitif ou comportemental déployé par le sujet pour maintenir cet équilibre ? Si non, abandonner le protocole statique transversal et mettre en place une analyse dynamique longitudinale à retards échelonnés (VAR/EMA) pour capturer les micro-ruptures transitoires précédant la régulation.
- Audit d’architecture causale : Existe-t-il des chemins de transmission multiples par lesquels la cause peut agir de manière divergente ? Ai-je spécifié et mesuré des médiateurs antagonistes susceptibles d’exercer un effet de suppression ? Si oui, modéliser le système à l’aide d’équations structurelles (SEM) et procéder à une décomposition formelle des effets directs et indirects par bootstrapping.
12.3 Vers une science psychologique post-linéaire
La déconstruction de la symétrie causale n’est pas une simple querelle d’experts en méthodologie statistique ; elle conditionne l’avenir même des sciences de l’esprit et du vivant. Depuis plus d’un siècle, la psychologie et la psychiatrie ont largement modélisé l’appareil psychique à l’aide d’outils statistiques linéaires empruntés à l’agronomie du XIXe siècle, présupposant que l’univers fonctionnait selon des gradients constants de causes et d’effets observables.
Ce paradigme réducteur a épuisé sa fécondité épistémologique. L’esprit humain, le cerveau et les sociétés sont des systèmes complexes adaptatifs auto-organisés, fonctionnant au bord du chaos, régis par la multi-finalité, la récursivité et l’invariance active. Les lois les plus fondamentales qui gouvernent notre pensée, notre adaptation émotionnelle et nos équilibres nosologiques se nichent précisément dans la zone aveugle de l’estimateur de Pearson. Reconnaître que la causalité est une dynamique ontologique du réel tandis que la corrélation n’en est qu’un reflet géométrique contingent et souvent trompeur constitue le pas décisif vers une véritable science psychologique post-linéaire, capable d’appréhender la plénitude de la complexité humaine dans toute sa rigueur structurelle.
Références
- Baron, R. M., & Kenny, D. A. (1986). The moderator-mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Granger, C. W. J. (1969). Investigating causal relations by econometric models and cross-spectral methods. Econometrica, 37(3), 424–438. https://doi.org/10.2307/1912791
- Hastie, T. J., & Tibshirani, R. J. (1990). Generalized Additive Models. Chapman and Hall/CRC.
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). The Guilford Press.
- Hershberger, W. A. (1986). An approach through the looking-glass: An investigation of the relationship between tracking error and cursor movement. Journal of Experimental Psychology: Human Perception and Performance, 12(4), 443–456. https://doi.org/10.1037/0096-1523.12.4.443
- Hockey, G. R. J. (1997). Compensatory control in the regulation of human performance under stress and high workload: A cognitive-energetical framework. Biological Psychology, 45(1-3), 73–93. https://doi.org/10.1016/S0301-0511(96)05223-4
- Kahneman, D. (1973). Attention and effort. Prentice-Hall.
- Lazarus, R. S., & Folkman, S. (1984). Stress, appraisal, and coping. Springer Publishing Company.
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Pearl, J., & Mackenzie, D. (2018). The book of why: The new science of cause and effect. Basic Books.
- Pearson, K. (1895). Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242.
- Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688–701. https://doi.org/10.1037/h0037350
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- Székely, G. J., Rizzo, M. L., & Bakirov, N. K. (2007). Measuring and testing dependence by correlation of distances. The Annals of Statistics, 35(6), 2769–2794. https://doi.org/10.1214/009053607000000505
- Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124
- Wiener, N. (1948). Cybernetics: Or control and communication in the animal and the machine. John Wiley & Sons.
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503