
Dans le domaine de l’inférence statistique et de l’épidémiologie contemporaine, la quête d’une estimation sans biais constitue la pierre angulaire de toute démarche scientifique rigoureuse. Lorsqu’un chercheur ou un analyste tente d’extrapoler les caractéristiques d’une population globale à partir de l’observation minutieuse d’une fraction restreinte de celle-ci, la validité interne et externe des conclusions repose entièrement sur la qualité structurelle du processus d’échantillonnage. Or, l’un des écueils méthodologiques les plus insidieux et dévastateurs réside dans le phénomène de sous-couverture, une faille qui s’insinue dès la conception même du cadre d’investigation, bien avant que le premier questionnaire ne soit administré ou que la première mesure ne soit enregistrée.
Le biais de sous-couverture ne relève pas d’une simple imprécision technique imputable aux fluctuations aléatoires inhérentes au tirage au sort ; il traduit une exclusion systématique, prédéterminée par les limites intrinsèques des instruments de recensement utilisés pour définir la population joignable. Qu’il s’agisse des sondages d’opinion préélectoraux excluant les ménages non inscrits sur les listes électorales, des cohortes biomédicales omettant les populations sans domicile fixe, ou des enquêtes numériques ignorant les franges déconnectées de la société, ce biais altère la trajectoire des résultats statistiques et produit une image déformée du réel. Cette distorsion produit des conséquences éthiques, sociétales et scientifiques d’une gravité souvent sous-estimée par les décideurs institutionnels.
Cet article propose une exploration approfondie, exhaustive et didactique du biais de sous-couverture. En articulant formalisation mathématique, perspectives historiques fondamentales, analyses sociologiques et protocoles statistiques de remédiation, nous disséquerons les rouages de cette asymétrie de représentation. De l’échec paradigmatique du Literary Digest en 1936 aux dérives algorithmiques du forage de mégadonnées modernes, en passant par le syndrome WEIRD qui frappe la psychologie académique, ce guide complet vise à équiper les chercheurs, statisticiens et praticiens des outils conceptuels indispensables pour diagnostiquer, prévenir et neutraliser cette menace méthodologique persistante.
1. Introduction fondamentale au concept de biais de sous-couverture
1.1 Définition théorique et opérationnelle
Dans le cadre de la théorie classique de l’échantillonnage probabiliste, conceptualisée notamment par des pionniers tels que Jerzy Neyman, la validité d’une inférence repose sur l’attribution à chaque unité élémentaire de la population d’une probabilité d’inclusion non nulle et parfaitement calculable. Le biais de sous-couverture (souvent désigné en anglais par le terme undercoverage bias) survient dès lors qu’une fraction non négligeable de la population cible se voit assigner, de facto ou de jure, une probabilité d’inclusion rigoureusement égale à zéro lors de la constitution du protocole de recueil de données. Cette exclusion systématique crée une scission insurmontable entre la population d’intérêt théorique et la réalité empirique couverte par l’instrument d’investigation.
Pour appréhender ce mécanisme avec une précision opérationnelle sans faille, il convient d’établir une distinction formelle entre trois entités fondamentales : la population cible, la base de sondage et l’échantillon observé. La population cible, notée conventionnellement $U$, représente l’ensemble universel exhaustif des unités statistiques sur lesquelles porte l’interrogation scientifique (par exemple, l’ensemble des résidents adultes d’un territoire donné). La base de sondage, notée $U_F$, constitue quant à elle la liste physique, le registre administratif ou le dispositif technique à partir duquel les unités sont concrètement sélectionnées (tel qu’un annuaire téléphonique, un registre électoral ou une base de données de sécurité sociale). Enfin, l’échantillon observé, noté $s$, est le sous-ensemble extrait de $U_F$ qui participe effectivement à la collecte. La sous-couverture survient avec certitude dès que $U_F \subset U$, signifiant que la base de sondage est un sous-ensemble strict de la population cible, laissant une fraction $U_M = U setminus U_F$ totalement hors de portée de l’expérimentateur.
D’un point de vue mathématique élémentaire, la déviation induite par ce défaut de couverture peut être formulée analytiquement. Soit $Y$ la variable d’intérêt dont on cherche à estimer la moyenne populationnelle $\bar{Y}$. Si l’on scinde la population cible $U$ en deux strates exclusives — la strate couverte par la base de sondage ($C$) et la strate non couverte ou manquante ($M$) —, la véritable moyenne s’exprime comme une moyenne pondérée :
$$\bar{Y} = W_C \bar{Y}_C + W_M \bar{Y}_M$$
où $W_C = N_C / N$ représente la proportion de la population couverte, $W_M = N_M / N$ la proportion de la population exclue, $\bar{Y}_C$ la moyenne de la caractéristique chez les individus couverts, et $\bar{Y}_M$ la moyenne chez les individus exclus. Lorsqu’un estimateur non biaisé $\hat{\bar{Y}}_C$ est calculé à partir de la base de sondage disponible pour approcher la moyenne globale $\bar{Y}$, son espérance mathématique correspond uniquement à $\bar{Y}_C$. Le biais de sous-couverture, noté $B(\hat{\bar{Y}})$, se définit alors formellement par :
$$B(\hat{\bar{Y}}) = E(\hat{\bar{Y}}_C) – \bar{Y} = \bar{Y}_C – (W_C \bar{Y}_C + W_M \bar{Y}_M) = W_M (\bar{Y}_C – \bar{Y}_M)$$
Cette formalisation met en lumière deux enseignements fondamentaux : l’ampleur du biais est directement proportionnelle au taux de non-couverture de la base ($W_M$) ainsi qu’à la disparité substantive existant entre les individus couverts et les individus exclus quant au phénomène mesuré ($(\bar{Y}_C – \bar{Y}_M)$). Si les exclus présentent un comportement ou un état rigoureusement identique aux individus couverts, le biais s’annule en dépit d’une couverture incomplète ; inversement, même une faible omission structurelle peut engendrer un biais massif si la frange exclue présente des particularités extrêmes par rapport au reste de la population.
1.2 Origine historique et émergence épistémologique
L’histoire de la statistique appliquée est jalonnée de désillusions méthodologiques qui ont façonné l’évolution des protocoles de collecte. Au tournant du vingtième siècle, les sondages fonctionnaient largement selon une logique intuitive et empirique : les praticiens présumaient qu’accumuler un nombre massif d’observations suffisait à garantir la véracité des résultats, ignorant délibérément la structure interne de leurs échantillons. Les premiers instituts d’opinion publique et revues d’analyse politique fondaient leurs prédictions sur des envois postaux géants ou des coupons-réponses insérés dans la presse écrite, sans s’interroger sur l’asymétrie sociale des récipiendaires de ces imprimés.
La rupture épistémologique s’opère dans les années 1930 et 1940, sous l’impulsion théorique de statisticiens fondateurs tels que Jerzy Neyman et William Gemmell Cochran. À travers la formalisation de l’échantillonnage aléatoire stratifié et du plan de sondage probabiliste, ces auteurs ont démontré que la précision d’une estimation ne dépend pas de la taille absolue de l’échantillon, mais de l’assignation contrôlée des probabilités d’inclusion. Cette période a été marquée par la prise de conscience brutale des limites intrinsèques des cadres d’échantillonnage administratifs : annuaires des téléphones, répertoires d’immatriculation automobile ou listes d’abonnés de revues bourgeoises ne constituaient nullement des reflets neutres de la société, mais bien des filtres de sélection de classe.
Parallèlement, le développement de la psychométrie et des sciences du comportement a mis en évidence l’impact dévastateur des erreurs non dues à l’échantillonnage (non-sampling errors). Les chercheurs ont progressivement compris que l’erreur d’échantillonnage pure — celle mesurée par la variance de l’estimateur — ne représentait que la partie émergée de l’iceberg méthodologique. Les distorsions d’omission, longtemps qualifiées d’anomalies résiduelles, ont été reconnues comme des biais systématiques capables d’annihiler totalement la validité des modèles d’évaluation psychologique et des théories du développement cognitif, forçant la communauté scientifique à repenser la standardisation de ses outils d’inclusion.
1.3 Enjeux de représentativité dans la recherche scientifique
Au cœur de la démarche empirique moderne se trouve le paradigme du microcosme : l’échantillon sélectionné par l’expérimentateur est supposé agir comme une réduction homothétique, miniature et fidèle de la population macroscopique qu’il entend incarner. Pour que ce principe d’homothétie opère, chaque strate, chaque spécificité socioculturelle et chaque variance biologique doivent se retrouver dans l’échantillon dans des proportions conformes aux paramètres réels de la population. Dès lors que la base de sondage initiale occulte systématiquement certaines strates, le modèle du microcosme s’effondre, transformant l’échantillon en un reflet déformant incapable de soutenir une inférence légitime.
Cette altération compromet sévèrement la validité écologique des résultats de recherche. En psychologie, en médecine ou en sociologie, la validité écologique désigne la mesure dans laquelle les relations observées en laboratoire ou au sein d’un échantillon s’appliquent fidèlement aux conditions de vie ordinaires des populations. Si une intervention clinique n’est testée que sur des patients bénéficiant d’une insertion sociale stable et d’une couverture médicale optimale, il est fallacieux de supposer que son efficacité sera équivalente au sein de populations précarisées vivant dans des contextes de privation matérielle et d’instabilité constante.
Le chercheur se retrouve alors confronté à un dilemme permanent entre contrainte budgétaire et impératif d’exhaustivité. Concevoir un cadre d’échantillonnage parfait, qui identifierait chaque membre de la population cible jusqu’au plus marginalisé, impose des coûts logistiques, financiers et temporels souvent exorbitants. La tentation de recourir à des bases de sondage préexistantes, numérisées, standardisées et peu onéreuses est forte. Cependant, l’arbitrage en faveur de l’économie de moyens se paie au prix fort : celui de la généralisation abusive, une faute épistémologique majeure par laquelle un praticien attribue imprudemment à l’ensemble de l’humanité les caractéristiques d’une sous-population hyper-spécifique issue d’une base de sondage tronquée.
2. Fondements méthodologiques et cadres d’échantillonnage
2.1 Analyse structurelle de la base de sondage
La base de sondage matérialise l’interface opérationnelle entre le monde théorique des concepts abstraits et le monde empirique de la collecte de données. Sa confection requiert une rigueur documentaire absolue, soumise à des critères d’adéquation, de complétude et d’actualisation temporelle. Une base de sondage idéale doit présenter une bijection parfaite avec la population cible : à chaque unité de la population doit correspondre exactement un identifiant dans la liste, sans omission, sans ajout indu et sans redondance. En pratique, cette adéquation parfaite n’est qu’une fiction méthodologique que l’ingénierie des enquêtes s’efforce d’approcher.
Les sources de dysfonctionnement des bases de sondage sont multiples et souvent insidieuses. L’incomplétude structurelle découle fréquemment de l’obsolescence des registres administratifs : les bases de données démographiques perdent leur précision au fil des déménagements, des décès non enregistrés et des flux migratoires non comptabilisés. Les listes basées sur l’inscription volontaire (comme les plateformes d’associations de consommateurs ou les répertoires de volontaires en ligne) souffrent d’une déficience rédhibitoire en excluant par définition l’ensemble des individus réfractaires à ces démarches d’enregistrement public. De surcroît, les découpages administratifs conduisent fréquemment à des exclusions géographiques arbitraires, négligeant les territoires périphériques, les habitats non cadastrés ou les zones d’accès complexe.
Il est crucial de dissocier analytiquement la sous-couverture des phénomènes adjacents que sont la sur-couverture et la duplication :
- La sous-couverture : Absence physique ou administrative de membres de la population cible dans le fichier d’échantillonnage, rendant leur sélection strictement impossible.
- La sur-couverture : Inclusion accidentelle d’éléments n’appartenant pas à la population d’intérêt (par exemple, des résidents temporaires étrangers ou des entreprises incluses dans un registre de particuliers).
- La duplication : Présence répétée d’un même individu sous des identifiants distincts, attribuant artificiellement à cette personne une probabilité de tirage double ou triple par rapport aux autres.
Tandis que la sur-couverture et la duplication introduisent des inefficiences et augmentent la variance des estimateurs — erreurs qui peuvent être partiellement purgées lors de la phase de filtrage —, la sous-couverture génère un biais indétectable par la simple manipulation interne de l’échantillon, car l’analyste ignore tout de ce qu’il ne peut pas observer.
2.2 Échantillonnage probabiliste versus non probabiliste
L’édifice mathématique de l’échantillonnage probabiliste repose sur le théorème selon lequel un estimateur linéaire (tel que l’estimateur d’Horvitz-Thompson) est rigoureusement non biaisé si et seulement si les probabilités d’inclusion $\pi_i$ de chaque unité $i$ de la population sont strictement positives ($\pi_i > 0$) et connues avec certitude. Dans ce cadre théorique pur, la sous-couverture est neutralisée dès lors que le processus de randomisation embrasse l’intégralité du domaine d’étude. Chaque individu possède une chance théorique d’être tiré, ce qui autorise l’usage des lois limites centrales et la construction d’intervalles de confiance rigoureux.
À l’opposé, les plans d’échantillonnage non probabilistes — qu’il s’agisse de la méthode des quotas, des échantillons de volontaires ou des collectes ciblées par réseaux sociaux — constituent le terreau par excellence du biais de sous-couverture. En s’affranchissant du tirage aléatoire sur une liste exhaustive, l’expérimentateur s’en remet à des mécanismes de sélection dépendants du comportement des sujets ou de la commodité des enquêteurs. Dès lors, des segments entiers de la population cible voient leur probabilité d’inclusion s’effondrer à zéro, sans qu’aucun modèle probabiliste formel ne puisse modéliser cette absence.
Face à ces faiblesses, un sophisme méthodologique fréquent consiste à invoquer la taille colossale de l’échantillon pour affirmer la validité des résultats. Cette croyance, qualifiée d’« illusion de la taille de l’échantillon » (big data paradox formalisé par Xiao-Li Meng), est mathématiquement fausse. Réunir un million d’individus à travers un dispositif non probabiliste souffrant d’une sous-couverture structurelle ne fait que concentrer et rigidifier l’erreur systématique : la variance de l’estimateur décroît vers zéro, resserrant les intervalles de confiance autour d’une valeur radicalement erronée. Un petit échantillon probabiliste bien couvert de mille individus surpassera toujours en justesse et en représentativité un ensemble de données gigantesque issu d’une base tronquée.
2.3 Modélisation de l’erreur totale d’enquête
Pour conceptualiser l’impact global des imperfections de recueil, les statisticiens d’enquête ont développé le cadre unificateur de l’Erreur Totale d’Enquête (Total Survey Error ou TSE). Ce modèle méthodologique sépare l’incertitude finale pesant sur un estimateur en deux grandes dimensions fondamentales : les erreurs de mesure (ce qui est effectivement capté par l’instrument) et les erreurs de représentation (qui est effectivement interrogé par le dispositif). Le biais de sous-couverture s’inscrit au premier rang des erreurs de représentation, précédant l’erreur d’échantillonnage aléatoire et le biais de non-réponse.
Ce positionnement analytique exige de dissocier scrupuleusement l’erreur d’échantillonnage de la sous-couverture. L’erreur d’échantillonnage découle de la variance d’échantillonnage intrinsèque à la variabilité biologique ou comportementale entre les individus tirés aléatoirement ; elle diminue inexorablement à mesure que la taille de l’échantillon $n$ tend vers la taille de la population $N$. En revanche, le biais de sous-couverture est invariant face à la taille de l’échantillon : il persiste inchangé même si l’expérimentateur interroge cent pour cent des individus inscrits sur une base de sondage déficiente.
Dans l’évaluation de la qualité des données, la performance globale d’un estimateur se mesure à travers l’Erreur Quadratique Moyenne (EQM, ou Mean Squared Error – MSE), définie par la relation :
$$EQM(\hat{\theta}) = Var(\hat{\theta}) + [B(\hat{\theta})]^2$$
où $Var(\hat{\theta})$ représente la variance d’échantillonnage et $B(\hat{\theta})$ le biais total agrégé, au sein duquel le terme de sous-couverture occupe une place déterminante. Dans les protocoles affectés par une sous-couverture structurelle, le terme $[B(\hat{\theta})]^2$ domine massivement la variance, rendant toute tentative d’optimisation de la taille de l’échantillon totalement superflue tant que le problème d’inclusion originel demeure non résolu.
3. Mécanismes d’émergence : échantillonnage de convenance et participation volontaire
3.1 La mécanique pernicieuse de l’échantillonnage de convenance
L’échantillonnage de convenance représente l’une des voies les plus directes et fréquentes menant à l’établissement d’une sous-couverture sévère. Ce mode de recrutement se caractérise par la sélection d’unités d’observation guidée principalement par des motifs d’accessibilité immédiate, de proximité physique, de coût marginal nul et de commodité temporelle pour l’investigateur. Qu’il s’agisse de recruter des passants sur le parvis d’une université, d’interroger les clients d’un centre commercial un mardi matin ou de solliciter ses propres relations professionnelles, cette démarche subordonne les impératifs de rigueur statistique à des opportunités contextuelles contingentes.
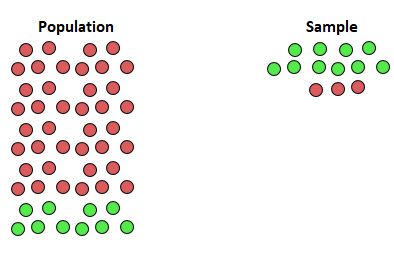
Ce protocole entraîne l’exclusion implicite de pans massifs de la société. Les individus souffrant de handicaps sévères, les personnes hospitalisées ou en perte d’autonomie, les travailleurs postés exerçant selon des horaires décalés, ou encore les populations rurales isolées géographiquement sont irrémédiablement évincés des cadres de convenance urbains ou institutionnels. Le point de recrutement physique ou spatial agit comme un filtre de sélection radical : un échantillon constitué au cœur d’une technopole tertiaire ne croisera jamais la réalité matérielle des zones industrielles en déclin ou des banlieues précarisées.
Un corollaire direct de cette sélection par capillarité immédiate réside dans la sous-estimation dramatique de la variance réelle des variables étudiées. Les individus partageant un même espace-temps physique ou institutionnel ont tendance à présenter des caractéristiques sociologiques, idéologiques et comportementales homogènes en vertu des principes d’homophilie spatiale. L’échantillon qui en découle donne aux chercheurs une fausse impression de cohésion et de précision, alors qu’il n’a fait que capturer une micro-culture locale au détriment de l’hétérogénéité véritable de la population parente.
3.2 L’effet d’auto-sélection et les réponses volontaires
L’auto-sélection constitue un mécanisme psychologique et comportemental qui amplifie les déficiences structurelles des bases d’échantillonnage ouvertes. Lorsque l’inclusion dans une étude repose sur l’initiative spontanée des individus — comme c’est le cas dans les sondages en ligne ouverts, les lignes téléphoniques d’émissions de télévision ou les consultations citoyennes non régulées —, le processus d’échantillonnage n’est plus contrôlé par le statisticien, mais par la motivation intrinsèque des participants potentiels.
La recherche en psychologie sociale démontre avec constance que la propension à participer spontanément à une enquête est fortement corrélée à la polarisation affective, idéologique ou émotionnelle vis-à-vis du sujet traité. Les individus affichant des opinions modérées, ambivalentes ou désabusées ont une probabilité d’engagement quasi nulle, laissant le champ libre aux militants, aux personnes outrées ou aux usagers hyper-investis. De surcroît, les volontaires systématiques partagent des profils psychométriques atypiques par rapport à la moyenne : ils manifestent des scores significativement plus élevés d’extraversion, de curiosité intellectuelle, d’altruisme perçu et de besoin d’expression sociale.
Ce filtrage spontané introduit ce que les épidémiologistes qualifient de corrélations artefactuelles. En omettant silencieusement les larges segments de la population apathiques, méfiants envers les institutions académiques ou dépourvus d’intérêt personnel dans le thème de l’étude, l’échantillon obtenu relie artificiellement des traits qui, dans la population globale, sont totalement déconnectés. Les relations causales postulées à partir de telles données reflètent alors moins la structure du comportement humain que les idiosyncrasies propres à la sous-population des individus disposés à s’exprimer gratuitement dans l’espace public.
3.3 L’impact des barrières d’accès et d’infrastructure
Au-delà des aspects psychologiques, la sous-couverture découle souvent de barrières matérielles, linguistiques et technologiques concrètes qui empêchent des franges entières de citoyens de figurer au sein des bases d’échantillonnage. Dans une société numérisée, l’obligation implicite de posséder un équipement informatique récent, un abonnement Internet haut débit et un navigateur compatible exclut d’emblée les populations en situation d’illectronisme, les résidents des zones blanches et les ménages confrontés à la précarité énergétique ou financière.
Les obstacles linguistiques et cognitifs constituent un autre facteur d’éviction structurelle particulièrement insidieux. La majorité des questionnaires standardisés sont rédigés dans la langue nationale officielle, selon des tournures syntaxiques empruntées aux conventions administratives et académiques. Les personnes allophones, les populations immigrées récentes ne maîtrisant pas les subtilités de la langue d’accueil, ainsi que les individus souffrant de troubles neurocognitifs ou d’analphabétisme fonctionnel se trouvent de facto exclus des fichiers d’enquête, faute de dispositifs d’adaptation ou de traduction en langue maternelle.
Enfin, la dimension temporelle et socio-économique joue le rôle d’un impitoyable censeur de représentativité. Participer à une étude d’une heure nécessite un capital temporel disponible dont sont privés les travailleurs précaires cumulant plusieurs emplois, les familles monoparentales subissant une lourde charge mentale et les aidants familiaux. Si l’on ajoute à cela les phénomènes d’itinérance, de mal-logement, de domiciliation temporaire chez des tiers ou d’incarcération, on réalise qu’une multitude d’individus n’existent tout simplement pas sur les registres postaux ou municipaux, constituant une sous-population invisible aux yeux des méthodologies d’échantillonnage conventionnelles.
4. Exemples classiques et contemporains dans les sciences sociales et les sondages
4.1 L’archétype historique : le sondage du Literary Digest de 1936
Aucun cas d’école n’illustre avec autant de force le pouvoir destructeur de la sous-couverture que le désastre prédictif de l’élection présidentielle américaine de 1936 impliquant le magazine The Literary Digest. Cette revue hebdomadaire influente jouissait d’un prestige méthodologique immense, ayant prédit avec succès les résultats des scrutins présidentiels de 1920, 1924, 1928 et 1932. Pour l’élection de 1936, opposant le président démocrate sortant Franklin D. Roosevelt au candidat républicain Alf Landon, la publication mit en œuvre un protocole d’une envergure industrielle sans précédent, postant plus de dix millions de bulletins de vote fictifs à travers les États-Unis.
Le magazine parvint à recueillir plus de 2,3 millions de réponses effectives — un échantillon titanesque devant lequel tout statisticien moderne s’inclinerait en termes de puissance statistique pure. Sur la base de ce dépouillement colossal, le Literary Digest proclama avec une assurance péremptoire que Landon écraserait Roosevelt avec 57 % des suffrages contre 43 %. Le résultat final du scrutin réel constitua l’un des plus grands raz-de-marée de l’histoire électorale américaine, mais en sens inverse : Roosevelt fut réélu triomphalement avec 60,8 % du vote populaire, reléguant Landon à 36,5 %. L’écart entre la prédiction et la réalité dépassait les 24 points de pourcentage, ruinant définitivement la crédibilité de la revue, qui fit faillite peu de temps après.
L’autopsie méthodologique de cette catastrophe identifia la sous-couverture de la base de sondage comme la cause fondamentale du désastre. Pour constituer son fichier d’adresses de dix millions d’individus, la rédaction s’était appuyée sur trois sources maîtresses : les annuaires téléphoniques, les registres d’immatriculation des véhicules automobiles et les listes d’abonnés de revues haut de gamme (y compris la leur). Or, en 1936, les États-Unis subissaient encore les séquelles économiques profondes de la Grande Dépression. Seules les classes supérieures et moyennes aisées pouvaient s’offrir le luxe d’une ligne téléphonique, d’une automobile privée ou d’abonnements de presse. Les classes ouvrières, les chômeurs, les métayers et les millions de bénéficiaires des programmes sociaux du New Deal — qui votaient massivement pour Roosevelt — étaient purement et simplement absents de ces registres sélectifs.
Par contraste, un jeune statisticien encore peu connu à l’époque, George Gallup, comprit intuitivement la faille de ce dispositif. En utilisant un échantillon probabiliste par quotas de seulement cinquante mille personnes, mais rigoureusement stratifié pour inclure toutes les couches socio-économiques de la nation, Gallup prédit non seulement la victoire de Roosevelt, mais anticipa également avec exactitude l’effondrement de la prédiction du Literary Digest avant même que le scrutin n’ait lieu. Cet événement marqua l’avènement des sondages scientifiques et l’enterrement définitif de la croyance aveugle dans la taille brute des échantillons.
4.2 Les enquêtes téléphoniques fixes et la transition mobile
Pendant la seconde moitié du vingtième siècle, les enquêtes par composition aléatoire de numéros (Random Digit Dialing ou RDD) basées sur le réseau téléphonique filaire ont constitué le mètre-étalon des sondages sociologiques et politiques dans le monde occidental. Cette méthodologie reposait sur l’hypothèse solide selon laquelle l’écrasante majorité des foyers disposait d’une ligne fixe raccordée au réseau national. La sélection aléatoire de préfixes géographiques assurait une couverture satisfaisante de l’ensemble du territoire et des groupes démographiques.
Toutefois, la révolution technologique des années 2000 a vu s’opérer une mutation comportementale rapide : l’abandon massif du téléphone fixe par les ménages au profit exclusif de la téléphonie mobile (phénomène des cell-phone-only households). Ce phénomène a introduit une sous-couverture générationnelle et socio-économique d’une ampleur inédite. Les premières cohortes à couper leur ligne fixe étaient composées d’étudiants, de jeunes professionnels célibataires, de locataires changeant fréquemment de domicile et de ménages à faibles revenus cherchant à réduire leurs charges de télécommunication. Les instituts de sondage qui ont persisté à n’échantillonner que des lignes fixes ont soudainement mesuré l’opinion d’une population vieillissante, propriétaire de son logement et sociologiquement conservatrice.
Pour rétablir la couverture, les méthodologistes ont été contraints de développer des plans d’échantillonnage à double base (dual-frame surveys), combinant simultanément des tirages sur lignes fixes et sur numéros de téléphones portables. Cette transition a toutefois engendré une immense complexité technique :
- Difficulté de géolocaliser précisément les téléphones portables en raison de la portabilité des numéros entre régions.
- Problème des probabilités d’inclusion multiples pour les individus disposant à la fois d’une ligne fixe et d’un ou plusieurs mobiles professionnels et personnels.
- Déploiement généralisé des systèmes de filtrage d’appels, des répondeurs automatiques et du refus des appels émanant de numéros inconnus, transformant la sous-couverture technique en une barrière d’accès quasi infranchissable.
4.3 Sondages électoraux récents et disparités géographiques
Les scrutins démocratiques de la dernière décennie ont mis en lumière une résurgence critique de la sous-couverture géographique et culturelle. Qu’il s’agisse de l’élection présidentielle américaine de 2016, du référendum sur le Brexit au Royaume-Uni la même année, ou de plusieurs consultations référendaires en Colombie et en Europe, les prévisions des principaux instituts de sondage ont systématiquement sous-estimé l’ampleur des votes populistes, souverainistes ou contestataires.
L’analyse post-électorale a révélé que les bases d’échantillonnage conventionnelles peinent structurellement à couvrir les zones rurales reculées, les bassins industriels déclassés et les franges périurbaines éloignées des grands centres métropolitains. Dans ces territoires, le tissu institutionnel est distendu : la participation associative est faible, le scepticisme envers les médias et les centres de recherche universitaires est à son paroxysme, et la connectivité aux plateformes numériques d’enquête est dégradée. Les personnes résidant dans ces espaces périphériques échappent aux radars statistiques habituels.
Cette sous-couverture territoriale engendre un biais systémique, car le lieu d’habitation est devenu l’un des prédicteurs les plus discriminants du comportement politique contemporain. Les habitants des métropoles globalisées, sur-représentés dans les bases de sondage numériques ou téléphoniques rapides, partagent des valeurs cosmopolites, progressistes et optimistes vis-à-vis de la mondialisation qui diffèrent radicalement des visions portées par les populations des zones périphériques. Dès lors que la base de sondage omet une partie des électeurs ruraux ou périurbains, le modèle électoral prédit immanquablement un score bien trop élevé pour les options politiques soutenues par les élites urbaines.
5. Manifestations du biais de sous-couverture dans la recherche psychologique
5.1 Le syndrome WEIRD en psychologie académique
Dans un article retentissant publié en 2010 dans la revue Behavioral and Brain Sciences, les anthropologues et psychologues Joseph Henrich, Steven Heine et Ara Norenzayan ont mis au jour une crise épistémologique profonde affectant les sciences du comportement : le biais WEIRD. Cet acronyme désigne les populations issues de sociétés occidentales, éduquées, industrialisées, riches et démocratiques (Western, Educated, Industrialized, Rich, and Democratic). Les auteurs ont révélé que près de 96 % des sujets participant aux études expérimentales de psychologie étaient issus de pays occidentaux, lesquels ne représentent qu’environ 12 % de la population planétaire.
Cette sous-couverture globale de l’humanité a des conséquences désastreuses sur la validité théorique des modèles psychologiques. Historiquement, la psychologie académique s’est construite sur le postulat implicite de l’universalité de ses lois : les processus fondamentaux touchant la perception visuelle, le raisonnement logique, la prise de décision, la cognition spatiale, la mémoire de travail et la dynamique des émotions ont été modélisés à partir d’échantillons WEIRD, présumés être des prototypes représentatifs de l’espèce humaine (Homo sapiens).
Or, les recherches transculturelles démontrent que les sujets WEIRD constituent en réalité des valeurs aberrantes (outliers) statistiques extrêmes à l’échelle du globe sur un vaste éventail de dimensions psychologiques. Par exemple, la sensibilité à l’illusion visuelle de Müller-Lyer — longtemps considérée comme une propriété biologique invariable du système visuel humain — s’avère quasi absente chez les populations de chasseurs-cueilleurs San du désert du Kalahari, démontrant que cette perception est conditionnée par l’environnement architectural fait d’angles droits typique des sociétés industrialisées. En omettant de couvrir plus de 85 % de la variabilité culturelle et socio-économique mondiale, la psychologie générale a confondu les normes cognitives d’une élite géographique avec la nature humaine universelle.
5.2 Le recours massif aux cohortes d’étudiants de premier cycle
Au sein même de cette sous-couverture globale, un second filtre de sélection encore plus réducteur gangrène la recherche psychologique expérimentale : l’utilisation quasi exclusive d’étudiants de premier cycle en psychologie comme participants aux études empiriques. Pour des raisons de faisabilité logistique, de faiblesse des budgets de recherche et de proximité physique immédiate, les laboratoires universitaires ont mis en place des bourses d’étudiants ou des systèmes d’attribution de crédits académiques récompensant la participation à des protocoles de laboratoire.
Ce sous-ensemble de la population présente des propriétés sociodémographiques, cognitives et affectives profondément singulières qui interdisent toute extrapolation à la population adulte générale :
- Une homogénéité d’âge extrême, généralement comprise entre 18 et 22 ans, période de développement neurobiologique marqué par une maturation incomplète du cortex préfrontal et des capacités de régulation émotionnelle.
- Des capacités d’abstraction verbale, de fluidité intellectuelle et de littératie numérique largement supérieures à la médiane de la population nationale.
- Une situation socio-économique temporaire caractérisée par l’absence d’engagements familiaux et financiers de long terme, façonnant des attitudes morales, politiques et sociétales particulièrement flexibles.
Cette sous-couverture structurelle des individus non scolarisés dans l’enseignement supérieur, des ouvriers, des artisans, ainsi que des personnes d’âge mûr et des personnes âgées porte un coup fatal à la réplicabilité des sciences cognitives. Lorsqu’un protocole explorant la mémoire prospective ou la résolution de conflits relationnels est calibré sur des cohortes de jeunes étudiants brillants et motivés par l’obtention de notes universitaires, sa transposition au sein de la population générale travaillant en entreprise ou vivant en maison de retraite échoue presque systématiquement.
5.3 Biais d’échantillonnage dans la recherche clinique et psychiatrique
Dans le domaine de la psychiatrie et de la psychologie clinique, le biais de sous-couverture génère des risques sanitaires directs. Lors de la conception d’essais cliniques randomisés (ECR) destinés à évaluer l’efficacité de nouvelles psychothérapies ou de molécules pharmacologiques, les comités de recherche déploient des critères d’exclusion d’une sévérité extrême. Les protocoles écartent fréquemment les patients présentant des comorbidités multiples (telles que la coexistence d’une dépression majeure et d’une addiction à l’alcool), les individus ayant manifesté des idéations suicidaires récentes, ainsi que les patients sous poly-médication.
Si ces critères restrictifs répondent à une exigence de standardisation de la validité interne, ils provoquent une sous-couverture complète de la psychiatrie réelle. En pratique clinique ambulatoire ou hospitalière, le patient présentant un trouble isolé sans comorbidité ni facteur aggravant constitue une exception rarissime. Les cohortes cliniques recrutées au sein d’environnements universitaires aseptisés sur-représentent des patients stables, disposant d’un solide réseau de soutien familial, motivés par le suivi médical et bénéficiant d’un niveau d’éducation facilitant l’alliance thérapeutique.
Les patients marginalisés, les sans-abri souffrant de schizophrénie, les détenus en milieu carcéral et les personnes en détresse psychosociale aiguë sont ainsi systématiquement évincés des essais thérapeutiques. En conséquence, les taux d’efficacité des antidépresseurs ou des thérapies cognitivo-comportementales rapportés dans les publications les plus prestigieuses s’avèrent considérablement gonflés par rapport aux résultats obtenus sur le terrain, où les praticiens font face à des populations non couvertes par la littérature fondamentale, chez qui les traitements conventionnels rencontrent une résistance massive.
6. La sous-couverture à l’ère numérique : plateformes en ligne et mégadonnées
6.1 La fracture numérique et les enquêtes par formulaire web
L’essor fulgurant d’Internet et des technologies mobiles a suscité chez nombre de chercheurs et d’instituts d’études le fantasme d’un accès instantané, universel et démocratisé à l’ensemble du corps social. Les formulaires d’enquête distribués par courrier électronique, par notifications d’applications ou via des bannières publicitaires en ligne sont devenus le vecteur dominant de la collecte de données, promettant d’agréger des dizaines de milliers de répondants à une fraction dérisoire du coût d’un enquêteur en face-à-face.
Cette approche occulte les réalités sociologiques de la fracture numérique, laquelle ne se résume pas à une question d’infrastructure matérielle, mais englobe des inégalités de compétences et d’usages (fracture de second degré). Même dans les sociétés occidentales hautement connectées, l’accès assidu et aisé aux questionnaires en ligne est fortement biaisé en faveur des individus jeunes, diplômés du supérieur et exerçant des professions tertiaires assises devant un écran d’ordinateur. Les personnes âgées dépendantes, les travailleurs manuels effectuant des tâches physiques soutenues et les fractions les plus défavorisées de la société utilisent Internet presque exclusivement sur smartphone pour des besoins de messagerie instantanée ou de visionnage vidéo, mais n’ouvrent jamais de longs formulaires d’enquête austères.
De plus, l’ergonomie des interfaces web introduit un filtre cognitif discriminant. La vitesse de chargement des pages, la réactivité des serveurs, la complexité des échelles de réponse matricielles et l’exigence d’une concentration visuelle soutenue conduisent à des abandons massifs chez les usagers dotés d’une faible littératie numérique. L’échantillon final de répondants web ne représente donc pas la population des citoyens d’un pays, mais le segment spécifique des internautes les plus agiles, instruits et disponibles technologiquement.
6.2 Les panels rétribués en ligne et le crowdsourcing scientifique
Pour répondre à la nécessité d’obtenir rapidement des données empiriques, les sciences sociales ont recours à des panels de consommateurs rétribués en ligne et à des plateformes de micro-travail participatif (crowdsourcing) telles qu’Amazon Mechanical Turk (MTurk), Prolific ou CloudResearch. Ces plateformes mettent en relation des expérimentateurs avec des cohortes de centaines de milliers d’individus acceptant de remplir des questionnaires expérimentaux en échange de rétributions financières modestes, souvent de quelques dizaines de centimes d’euro par tâche.
Ce mode de collecte engendre une forme singulière et toxique de sous-couverture. En premier lieu, la structure démographique des travailleurs de ces plateformes est aberrante : sur MTurk, par exemple, on observe une sur-représentation massive de jeunes célibataires sans enfants, athées, politiquement très orientés à gauche et présentant des niveaux d’anxiété sociale et de solitude significativement supérieurs à la moyenne nationale. Les catégories socioprofessionnelles supérieures, les cadres dirigeants, les artisans, les agriculteurs et les retraités aisés ne participent pas à ces plateformes, le rendement financier horaire étant dérisoire au regard de la valeur de leur temps disponible.
En second lieu, ce système a favorisé l’émergence d’une catégorie de répondants ultra-professionnalisés (super-workers). Une poignée d’individus remplit des dizaines d’enquêtes quotidiennes pour maximiser ses revenus, développant une accoutumance aux paradigmes expérimentaux standards (comme le dilemme du tramway ou les échelles de personnalité de Likert). Cette professionnalisation désensibilise les sujets aux stimuli d’expérimentation et anéantit la spontanéité comportementale. Enfin, l’invasion contemporaine de ces plateformes par des robots conversationnels automatisés (bots) exploitant des modèles de langage pour collecter les récompenses dégrade la pureté biologique de ces échantillons, substituant à la voix humaine des générations de texte artificielles.
6.3 Les mégadonnées et réseaux sociaux : le mirage de l’exhaustivité
Le développement spectaculaire des mégadonnées (Big Data) issues du traçage continu sur les réseaux sociaux (X, Facebook, Instagram, TikTok) a conduit certains analystes à proclamer prématurément « la fin de l’échantillonnage ». Selon cette vision réductionniste, dès lors que l’on aspire l’intégralité des flux de publications publiques d’un réseau social (approche $N = \text{tout}$), la question de la représentativité et de la couverture deviendrait caduque, la masse des données se substituant aux méthodes de sondage traditionnelles.
Il s’agit d’une erreur d’analyse conceptuelle. Confondre l’exhaustivité d’une plateforme numérique avec l’exhaustivité d’une population humaine relève de l’aveuglement méthodologique. Les utilisateurs actifs de plateformes comme X (anciennement Twitter) ne constituent en aucun cas une coupe transversale de la société : ils sont plus jeunes, plus masculins, plus urbains et affichent une politisation conflictuelle disproportionnée par rapport à la population générale. En outre, une minorité infime d’utilisateurs (moins de 10 %) produit plus de 80 % du volume total des messages, ce qui signifie que l’aspiration des flux ne capture que les pulsions d’un noyau hyper-vocal.
À cette asymétrie humaine s’ajoute une sous-couverture algorithmique insidieuse. Les algorithmes de modération de contenu, de détection de pourriels (spam), de priorisation du fil d’actualité et de suspension de comptes invisibilisent des pans entiers de discours ou de profils sans la moindre transparence scientifique. Une analyse de sentiment sociétale opérée exclusivement sur les réseaux sociaux ne mesure pas le moral d’une nation, mais l’état émotionnel filtré d’une sous-population hyper-connectée soumise aux incitations marchandes des plateformes de diffusion de flux.
7. Conséquences épistémologiques, éthiques et statistiques de la sous-couverture
7.1 Distorsion des paramètres d’intérêt et inférences invalides
L’impact statistique premier de la sous-couverture réside dans le déplacement systématique des estimateurs fondamentaux par rapport à leur véritable valeur paramétrique. Les moyennes, proportions, médianes et quartiles calculés à partir d’un échantillon vicié à sa source présentent une erreur systématique non réductible par l’accumulation d’observations. Ce déplacement est mathématiquement incompressible tant que la base d’échantillonnage ne fait l’objet d’aucune correction exogène.
Dans le champ de l’analyse multivariée et de la modélisation économétrique ou psychométrique, les conséquences s’avèrent plus déstabilisatrices encore. L’omission d’une fraction spécifique de la population altère la structure de covariance des données : les coefficients de régression linéaire ou logistique subissent des atténuations artificielles ou, au contraire, des surévaluations catastrophiques. Ce phénomène, apparenté au biais de sélection de Heckman, détruit l’orthogonalité des résidus et fausse les tests d’hypothèses, gonflant dramatiquement les taux d’erreurs de type I (rejet à tort de l’hypothèse nulle d’absence d’effet) et d’erreurs de type II (incapacité à détecter un effet pourtant bien réel).
La validité interne et externe des conclusions théoriques s’en trouve ruinée :
- Validité interne menacée : L’effet mesuré peut être le sous-produit accidentel de l’absence des populations non couvertes, chez lesquelles la relation causale s’avère inexistante ou inversée.
- Validité externe anéantie : Le chercheur ne possède aucune base mathématique légitime pour extrapoler ses coefficients au-delà du sous-groupe couvert par son instrument d’investigation.
7.2 Invisibilisation sociologique et implications éthiques
Au-delà de la stricte métrologie mathématique, la sous-couverture constitue un acte involontaire mais puissant d’invisibilisation sociale et politique. Dans un monde où l’action publique et l’attribution des budgets de l’État reposent de plus en plus sur des « politiques fondées sur les données probantes » (evidence-based policy), n’apparaître dans aucune base de sondage équivaut politiquement à ne pas exister. Les minorités ethniques isolées, les populations sans-papiers, les résidents de bidonvilles, les personnes transgenres précaires ou les itinérants, étant systématiquement évincés des recensements et registres d’enquêtes, voient leurs besoins, leurs souffrances et leurs demandes écartés des priorités gouvernementales.
Cette carence méthodologique conduit à l’élaboration de politiques publiques contre-productives, calibrées sur les besoins exclusifs des segments les plus stables et visibles de la population. Les programmes de santé préventive, les réformes éducatives ou l’aménagement des transports urbains sont alors pensés par et pour une population couverte, créant des dispositifs inadaptés et excluants pour les populations omises.
Il existe ici une responsabilité déontologique de premier ordre incombant au statisticien et au chercheur en sciences humaines. Revendiquer l’universalité de conclusions scientifiques obtenues par l’omission structurelle des plus vulnérables s’apparente à une injustice épistémique. Le silence des bases de sondage renforce les asymétries de pouvoir matérielles, conférant à des données tronquées la caution de la rigueur et de la neutralité académiques.
7.3 Effets pervers sur la prise de décision managériale et médicale
Dans l’univers des organisations et des entreprises, le biais de sous-couverture conduit à des défaillances stratégiques coûteuses. Les études de marché reposant sur des panels numériques de consommateurs rémunérés ignorent les populations à fort pouvoir d’achat mais réfractaires à l’exploitation de leurs données, ou à l’inverse les segments populaires dépourvus d’équipements récents. Les lancements de produits ou services conçus d’après ces études se heurtent alors au mur de la réalité commerciale, les attentes des consommateurs réels n’ayant rien de commun avec celles de l’échantillon sollicité.
En médecine translationnelle et en pharmacologie, le préjudice est plus grave encore. La sous-couverture de certains sous-groupes démographiques dans les cohortes cliniques de phase III — notamment les femmes enceintes, les enfants, les individus âgés de plus de 75 ans et les personnes d’ascendance africaine ou asiatique — a conduit à des drames sanitaires majeurs. Les posologies médicamenteuses et les profils de tolérance hépatique ou cardiaque calqués exclusivement sur des profils types d’hommes caucasiens de corpulence moyenne se révèlent inadaptés aux métabolismes féminins ou aux particularismes enzymatiques d’autres populations.
Lorsque ces traitements standardisés sont déployés à grande échelle, des réactions indésirables sévères et des inefficacités thérapeutiques se manifestent au sein des groupes exclus des essais préliminaires. Ces échecs prévisibles minent durablement la confiance des citoyens et des institutions envers l’expertise médicale et scientifique, nourrissant des réticences légitimes face aux recommandations vaccinales ou médicamenteuses.
8. Distinctions conceptuelles : sous-couverture versus autres biais méthodologiques
8.1 Biais de sous-couverture versus biais de non-réponse
Il règne souvent une confusion entre le biais de sous-couverture et le biais de non-réponse, tous deux étant des composantes de l’erreur totale de représentation. La frontière théorique et temporelle qui les sépare est pourtant limpide : elle dépend de l’étape du processus d’échantillonnage où s’opère l’exclusion.
La sous-couverture est un problème structural amont : elle affecte la constitution de la base de sondage elle-même ($U_F \subset U$). Les personnes non couvertes n’ont jamais été sélectionnées, ne recevront jamais la moindre sollicitation et ne savent même pas qu’une étude est en cours de réalisation. Leur probabilité de contact est strictement égale à zéro en raison de défaillances cadastrales ou administratives. À l’opposé, le biais de non-réponse est un problème comportemental aval : il affecte la phase de collecte au sein des individus correctement inscrits sur la base et effectivement sélectionnés par le tirage probabiliste. Ces personnes sont contactées, mais refusent activement de répondre, sont temporairement indisponibles ou ne finalisent pas l’entretien.
Bien que ces deux phénomènes se traduisent tous deux par une déperdition d’information et un biais potentiel sur les estimateurs, les protocoles statistiques de traitement sont fondamentalement distincts :
- La non-réponse peut être documentée grâce aux métadonnées des tentatives d’appels, aux profils de refus ou à des enquêtes spécifiques auprès des réticents (non-response follow-up).
- La sous-couverture est aveugle : l’expérimentateur ne possède aucune information empirique interne sur les personnes absentes de son cadre de référence, rendant sa remédiation dépendante de sources de données purement externes.
8.2 Biais de sous-couverture versus biais d’attrition
La distinction entre biais de sous-couverture et biais d’attrition s’articule autour de la dimension temporelle de l’axe de recherche. La sous-couverture s’exprime de manière instantanée, transversale et inaugurale dès l’instant initial $T_0$ de la mise en place de la base de sondage. Elle fige les limites de ce qui est observable avant même l’administration du protocole.
Le biais d’attrition, quant à lui, est une pathologie exclusive des études longitudinales et des cohortes de suivi temporel. Il intervient entre le point initial $T_0$ et les points ultérieurs de mesure ($T_1, T_2, dots, T_n$), lorsque des participants régulièrement inclus à l’origine quittent l’étude en cours de route pour cause de décès, de déménagement, de perte de contact ou de lassitude cognitive. L’attrition devient un biais d’échantillonnage dès lors que le désengagement des participants n’est pas aléatoire (Missing Completely At Random – MCAR), mais corrélé à la variable dépendante ou à des variables pronostiques (par exemple, les patients dont la santé se détériore sont ceux qui abandonnent le protocole clinique).
Ces deux distorsions se superposent fréquemment selon un mécanisme délétère cumulatif. Une cohorte épidémiologique affectée dès le départ par une sous-couverture des populations à statut précaire subit presque systématiquement une attrition sélective au détriment de ces mêmes fractions marginales au fil des années. L’échantillon résiduel à dix ans d’intervalle ne reflète plus qu’une sous-population ultra-résiliente et socialement intégrée, faussant tout calcul de taux de survie ou de trajectoire de vieillissement cognitif.
8.3 Biais de sous-couverture versus biais de volontariat et de survie
Le biais de volontariat s’articule comme une forme particulière de participation active où l’individu décide de lui-même de franchir la frontière de l’observation. Tandis que la sous-couverture passive résulte d’une omission subie de l’extérieur par l’outil de l’enquêteur, le volontariat implique une action motrice délibérée du répondant. L’interaction entre ces deux mécanismes est évidente : la présence d’une barrière d’accès élimine d’emblée les populations fragiles (sous-couverture), tandis que l’appel public aux candidatures sélectionne uniquement les plus engagés au sein du résidu joignable (biais de volontariat).
Le biais de survie (survivorship bias) constitue une forme spécifique de sous-couverture rétrospective conditionnée par le temps ou un processus de sélection séquentiel. Ce biais se manifeste avec acuité lorsque l’analyste n’observe que les unités statistiques qui ont franchi un processus éliminatoire rigoureux, sans tenir compte de la cohorte d’origine qui a péri ou disparu en chemin. L’exemple paradigmatique développé par le statisticien Abraham Wald durant la Seconde Guerre mondiale — portant sur le renforcement du blindage des bombardiers revenus de mission — montre que mesurer les impacts de balles sur les avions survivants induit une sous-couverture absolue des appareils abattus, dont les zones touchées étaient fatales.
Dans les enquêtes organisationnelles sur le bien-être au travail, la confusion entre ces concepts est fréquente. Un questionnaire portant sur le syndrome d’épuisement professionnel (burnout) distribué au sein d’une grande entreprise souffre d’un double filtre : une sous-couverture structurelle des employés en arrêt de travail de longue durée ou ayant démissionné sous le poids de la souffrance éthique (biais de survie), doublée d’un biais d’auto-sélection parmi les salariés présents incitant les plus épuisés à ignorer le questionnaire pour préserver leur énergie restante.
9. Mécanismes de diagnostic et de détection quantitative du biais
9.1 Comparaison avec les données de recensement et les étalons externes
La première démarche opérationnelle permettant de diagnostiquer l’existence et l’amplitude d’un biais de sous-couverture réside dans la confrontation méthodique de la structure interne de l’échantillon observé avec des étalons de référence démographiques externes, typiquement issus des recensements généraux conduits par les instituts statistiques nationaux (tels que l’INSEE en France ou le Census Bureau aux États-Unis).
Cette approche consiste à évaluer l’écart distributionnel marginal sur des covariables sociodémographiques réputées invariantes et stables, telles que la répartition par tranche d’âge, le sexe à la naissance, le plus haut niveau de diplôme certifié, la catégorie socio-professionnelle (CSP) et le lieu de résidence selon le découpage territorial. Si la base de sondage ou l’échantillon obtenu présente une proportion d’individus sans diplôme de 10 %, alors que le recensement national atteste que cette fraction représente 30 % de la population cible, le diagnostic de sous-couverture pour cette strate s’impose comme une évidence mathématique.
Sur le plan inférentiel, ces disparités structurelles peuvent être formellement confirmées par des tests d’adéquation statistique, au premier rang desquels figure le test de conformité du Khi-deux de Pearson ($\chi^2$) :
$$\chi^2 = \sum_{k=1}^{K} \frac{(O_k – E_k)^2}{E_k}$$
où $O_k$ représente l’effectif observé au sein de la modalité $k$ de l’échantillon, et $E_k$ l’effectif théorique attendu selon la distribution du recensement national. Bien que précieux, ce diagnostic présente une limite fondamentale : il ne garantit la justesse de l’échantillon que sur les variables observables auditées. Rien ne certifie que l’absence de divergence sur le sexe et l’âge immunise la mesure contre une sous-couverture masquée portant sur la variable d’intérêt clinique ou comportementale si celle-ci n’est pas corrélée aux variables du recensement.
9.2 Études de cadrage et enquêtes de suivi sur les exclus
Lorsqu’un doute persiste quant à la complétude d’un registre de sondage, le déploiement d’études de cadrage indépendantes permet d’évaluer quantitativement le volume et le profil des individus omis. L’une des approches les plus puissantes découle de l’adaptation des techniques de capture-recapture issues de la biologie des populations vers les sciences sociales.
La méthode de capture-recapture consiste à croiser deux ou plusieurs bases d’échantillonnage indépendantes couvrant la même population cible théorique au même instant. En notant $N_{A}$ le nombre d’individus identifiés dans la base $A$, $N_{B}$ le nombre d’individus répertoriés dans la base $B$, et $m$ le nombre de sujets communs retrouvés simultanément dans les deux fichiers, l’estimateur de Lincoln-Petersen permet d’approcher la taille totale véritable de la population $N$ par l’équation :
$$\hat{N} = \frac{N_A \times N_B}{m}$$
La fraction totale non couverte par aucune des deux bases se déduit par simple soustraction : $\hat{N}_{exclus} = \hat{N} – (N_A + N_B – m)$.
Parallèlement, les méthodologistes recourent aux analyses de sensibilité basées sur les « bornes de Manski » (Manski bounds). Formalisée par l’économètre Charles Manski, cette méthode renonce à formuler des hypothèses invérifiables sur les caractéristiques des non-couverts. Elle consiste à calculer les valeurs extrêmes que pourrait mathématiquement prendre l’estimateur d’intérêt global dans le pire des scénarios possibles (par exemple, en postulant arbitrairement que 100 % des individus non couverts possèdent le trait étudié, puis que 0 % ne le possèdent). Si l’intervalle d’incertitude ainsi délimité entre la borne inférieure et la borne supérieure demeure suffisamment restreint pour maintenir les orientations décisionnelles, les conclusions de l’enquête sont jugées robustes au biais de sous-couverture.
9.3 Audit des bases de données et cartographie des lacunes
Un diagnostic préventif approfondi exige un examen clinique du processus de génération des données administratives qui composent la base de sondage. Les listes d’échantillonnage ne sont jamais des entités passives ; elles résultent de flux continus d’entrées, de mises à jour et de radiations régies par des règles juridiques ou techniques rigides.
L’audit de la base implique de reconstituer la généalogie des enregistrements :
- Quels sont les délais moyens entre un changement d’adresse d’un citoyen et sa transcription effective dans le fichier d’échantillonnage ?
- Existe-t-il des seuils financiers ou légaux d’inscription qui écartent systématiquement les foyers les plus modestes ?
- Y a-t-il des « zones grises » administratives, comme les cités universitaires, les campings permanents ou les résidences secondaires, exclues des découpages cadastraux standards ?
Pour mesurer quantitativement ces déficiences, les statisticiens calculent le ratio ou taux de couverture brut $R_c$, défini par :
$$R_c = \frac{N_{\text{base}}}{N_{\text{population réelle}}}$$
Ce ratio est complété par des indices de disparité structurelle mesurant les écarts relatifs strate par strate. La cartographie spatiale par Système d’Information Géographique (SIG) permet ensuite de localiser précisément les poches territoriales où le taux de couverture s’effondre en deçà des seuils de tolérance, orientant ainsi les efforts d’investigation complémentaire de terrain.
10. Stratégies préventives dans la conception des protocoles de recherche
10.1 Optimisation et diversification des bases de sondage
La parade méthodologique la plus élégante face au biais de sous-couverture consiste à agir de manière proactive lors de la conception du protocole en neutralisant le problème à sa source. Lorsque aucune base de sondage existante ne parvient à embrasser la diversité de la population cible, la mise en œuvre d’approches multi-bases (multi-frame sampling) s’impose comme une nécessité technique.
Ce protocole, formalisé théoriquement par Hartley, repose sur la combinaison synergique de deux ou plusieurs bases de sondage complémentaires conçues pour compenser mutuellement leurs lacunes respectives. À titre d’exemple, une enquête nationale sur la consommation peut croiser une base d’abonnés de réseaux de communication fixes (offrant une couverture optimale des populations âgées et sédentaires) avec une base d’abonnements de services mobiles géolocalisés (captant les jeunes ménages nomades). L’enjeu statistique de cette démarche réside dans l’élimination des doublons créés par l’intersection des deux listes et l’ajustement méticuleux des probabilités d’inclusion jointes pour préserver la non-divergence des estimateurs.
Lorsque les registres nominatifs ou téléphoniques s’avèrent inexistants ou trop obsolètes, le recours au sondage aréolaire (area frame sampling) demeure l’étalon-or des instituts de statistique publique. Plutôt que de tirer des individus sur une liste, les statisticiens tirent au sort des portions géographiques parfaitement cartographiées (carreaux de population, îlots cadastraux). Des enquêteurs se rendent ensuite physiquement dans les zones sélectionnées pour dresser la liste exhaustive de chaque habitation avant de procéder au tirage aléatoire des ménages. Ce procédé contourne totalement les lacunes des registres administratifs préexistants.
10.2 Approches d’échantillonnage probabiliste avancées
Pour immuniser un protocole de recherche contre la sous-représentation de fractions marginales mais substantielles de la population, l’utilisation de l’échantillonnage stratifié disproportionné constitue un outil préventif puissant. Contrairement à la stratification proportionnelle, qui reproduit fidèlement les pourcentages démographiques dans l’échantillon, cette méthode sur-échantillonne délibérément les strates minoritaires ou difficiles d’accès (par exemple, les ménages monoparentaux vivant sous le seuil de pauvreté).
En augmentant massivement l’effectif interrogé au sein de ces sous-populations d’intérêt, le statisticien s’assure d’obtenir une puissance statistique suffisante pour estimer précisément les paramètres internes de cette strate sans que la variance n’explose. Lors du calcul de l’estimateur global de la population, la structure initiale est rétablie par l’attribution de pondérations inverses aux probabilités de sélection (estimateur de Horvitz-Thompson).
Pour les populations dites « cachées » ou sans cadre d’enregistrement légal (comme les usagers de drogues intraveineuses, les travailleurs du sexe ou les migrants sans titre de séjour), les méthodes d’échantillonnage par la chaîne de référence conventionnelle échouent à garantir la représentativité. C’est ici qu’intervient l’échantillonnage piloté par les répondants (Respondent-Driven Sampling ou RDS). Ce protocole probabiliste complexe associe le recrutement par réseau de pairs (boule de neige) à un modèle mathématique fondé sur les chaînes de Markov et la théorie des réseaux sociaux. En suivant mathématiquement les transitions de sélection d’un individu à l’autre et en pondérant les observations par la taille du réseau social déclaré de chaque répondant, le RDS permet d’atteindre un état asymptotique stationnaire indépendant des caractéristiques des individus initiateurs (« graines » initiales), éliminant ainsi le biais de sous-couverture inhérent à ces terrains complexes.
10.3 Collecte multimode et flexibilité des formats d’accès
L’utilisation exclusive d’un canal unique d’administration des enquêtes (qu’il soit purement numérique, téléphonique ou postal) constitue la garantie certaine de générer une sous-couverture systémique en raison des disparités d’équipement et d’alphabétisation évoquées précédemment. Pour parer à cette défaillance, l’ingénierie contemporaine des sondages préconise les protocoles de collecte multimode séquentiels ou simultanés.
Un protocole multimode séquentiel déploie les instruments par vagues successives et complémentaires :
- Lancement d’une invitation initiale à remplir un formulaire en ligne par courriel ou SMS (canal le plus économique pour toucher la majorité numériquement agile).
- Envoi postal d’un questionnaire papier auto-administré accompagné d’une enveloppe de retour préaffranchie aux ménages n’ayant pas répondu après plusieurs relances (captant ainsi les populations âgées ou déconnectées).
- Déplacement physique d’enquêteurs de terrain au domicile des ménages récalcitrants pour une interview en face-à-face assistée par ordinateur (CAPI) ou déploiement d’appels téléphoniques ciblés (CATI).
Cette diversification des modes d’administration doit impérativement s’accompagner d’une flexibilité des formats linguistiques et physiques. Les questionnaires doivent être traduits et validés culturellement dans les langues des principales communautés minoritaires du territoire investigué. De même, les protocoles doivent offrir des interfaces adaptées aux personnes en situation de handicap visuel (synthèse vocale, braille, contrastes élevés) et proposer des plages horaires de sollicitation extrêmement étendues (tôt le matin, tard le soir, week-ends) pour inclure les travailleurs à horaires décalés.
11. Méthodes statistiques de correction et d’ajustement post-collecte
11.1 Techniques de redressement et post-stratification
Lorsque la phase de collecte est close et que l’échantillon final manifeste des écarts structurels résiduels imputables à des défauts de couverture partiels, le recours aux techniques d’ajustement post-enquête constitue la première ligne de défense de l’analyste. La plus fondamentale de ces techniques est la post-stratification directe.
Le principe repose sur la stratification a posteriori de l’échantillon en $H$ cellules basées sur des variables sociodémographiques dont la distribution au sein de la population cible est connue par des sources censitaires fiables. Si la cellule $h$ représente une fraction $W_h = N_h / N$ de la population globale, mais ne pèse que $w_h = n_h / n$ au sein de l’échantillon observé, chaque unité appartenant à cette cellule reçoit un coefficient de pondération correctif individuel $d_h$ calculé par le ratio :
$$d_h = \frac{W_h}{w_h} = \frac{N_h / N}{n_h / n}$$
Dans les configurations d’enquêtes complexes où les effectifs croisés au sein de cellules multidimensionnelles deviennent trop réduits (risque de cellules vides), l’algorithme de calage sur marges (connu internationalement sous le nom de méthode du Raking Ratio ou méthode itérative des quotients, popularisée par Deville et Särndal) permet de caler l’échantillon sur les distributions marginales unidimensionnelles successives sans nécessiter de connaître les croisements intimes des variables.
L’attribution de ces pondérations n’est toutefois pas une panacée sans risque. La post-stratification repose sur une hypothèse statistique fondamentale : le mécanisme d’omission doit être homogène au sein de chaque cellule de redressement (hypothèse d’absence de biais résiduel intra-cellule). De plus, l’inflation de pondérations extrêmes attribuées à des profils rares entraîne inéluctablement une augmentation sensible de la variance des estimateurs (effet de plan de pondération). Enfin, la post-stratification présente une incapacité théorique absolue : elle ne peut en aucun cas corriger une sous-couverture totale, c’est-à-dire le cas où une fraction de la population a une probabilité de présence nulle dans l’échantillon ($n_h = 0$).
11.2 Modélisation par scores de propension et appariement
Pour traiter les déformations de sélection plus complexes, notamment lors de l’intégration de panels web non probabilistes aux côtés d’enquêtes probabilistes de référence, la modélisation par score de propension (développée originellement par Rosenbaum et Rubin dans le cadre de l’inférence causale) s’avère un instrument méthodologique central.
Dans ce contexte méthodologique, le score de propension d’un individu représente sa probabilité conditionnelle $P(S=1 | X)$ d’appartenir à la base d’échantillonnage ou de participer à l’enquête, sachant un vecteur $X$ de caractéristiques multidimensionnelles préexistantes. Cette probabilité est généralement estimée par le biais d’un modèle de régression logistique multivariée ou par des algorithmes d’apprentissage automatique supervisé (arbres de décision, forêts aléatoires), en regroupant artificiellement l’échantillon non probabiliste et un échantillon probabiliste étalon réputé parfaitement représentatif de la population cible.
Une fois ces scores de propension calculés, deux voies de redressement statistique s’ouvrent au modélisateur :
- La pondération par l’inverse de la propension : (Inverse Probability Weighting – IPW), où chaque sujet de l’enquête est pondéré par l’inverse de sa probabilité d’avoir été inclus ($w_i = 1 / \hat{e}(X_i)$), ce qui a pour effet mathématique de recréer une pseudo-population équilibrée.
- L’appariement statistique : (Propensity Score Matching), consistant à n’extraire de l’échantillon biaisé que les individus dont le profil sociologique et comportemental s’aligne fidèlement sur celui de sujets étalons observés dans l’échantillon de référence de haute qualité.
L’efficacité de ces démarches demeure toutefois tributaire de l’hypothèse de « sélection sur les observables » : si la variable responsable de l’omission n’est pas mesurée dans le vecteur $X$, le biais persiste insidieusement dans les données redressées.
11.3 Méthodes d’imputation multiple et analyses de robustesse
Une approche conceptuelle alternative consiste à reformuler le problème de la sous-couverture comme une pathologie extrême de données manquantes au niveau de l’unité (unit nonresponse). Les individus exclus de la base de sondage peuvent être modélisés comme des observations fantômes dont on connaît la proportion globale grâce aux statistiques démographiques macroscopiques, mais dont les valeurs sur la variable d’intérêt $Y$ sont intégralement manquantes.
Dans ce cadre analytique, les procédures d’imputation multiple par équations chaînées (MICE) ou par modélisation conjointe permettent de générer stochastiquement plusieurs jeux de données complets en attribuant aux non-observés des valeurs simulées fondées sur les distributions conditionnelles estimées. Contrairement à une imputation par la moyenne, l’imputation multiple injecte une incertitude aléatoire qui permet de préserver la variance réelle des données et de calculer des intervalles de confiance honnêtes intégrant le déficit d’information induit par la couverture imparfaite.
Lorsque l’omission relève d’un mécanisme non ignorable (Missing Not At Random – MNAR) — situation où la raison même de l’exclusion dépend directement de la valeur de la variable d’intérêt inobservée —, l’analyste doit impérativement exécuter des simulations de Monte Carlo et des analyses de sensibilité poussées. En faisant varier systématiquement les paramètres d’exclusion dans des dizaines de milliers de scénarios synthétiques, le statisticien évalue la stabilité de ses conclusions empiriques face à des ruptures majeures de l’hypothèse d’inclusion, documentant ainsi le niveau de fragilité intrinsèque des résultats publiés.
12. Synthèse critique et recommandations pour la pratique de recherche
12.1 L’exigence de transparence méthodologique
La lutte contre le biais de sous-couverture commence par une réforme des pratiques d’écriture et de publication au sein des revues scientifiques internationales. Trop longtemps, les sections méthodologiques des articles académiques ont relégué la description des bases de sondage à des mentions laconiques, masquant les limitations d’accès derrière une technicité de surface. La transparence méthodologique intégrale doit s’imposer comme un impératif éthique et déontologique non négociable.
Tout rapport de recherche ou article empirique devrait impérativement inclure une « déclaration formelle de couverture », documentant sans complaisance :
- La définition exhaustive de la population cible théorique versus les limites réelles de la base de sondage opérationnelle mobilisée.
- L’estimation quantitative rigoureuse du taux de couverture initial ($R_c$) et l’énumération explicite des sous-populations qui ont été sciemment ou involontairement exclues du protocole.
- Le compte-rendu exhaustif des canaux d’accès utilisés, des barrières matérielles identifiées et des motifs de rejet d’autres modes d’investigation.
- La publication en accès ouvert (Open Data et Open Code) des protocoles de pondération, des équations de calage et des scripts statistiques utilisés pour redresser l’échantillon.
De plus, les comités de rédaction et les pairs évaluateurs doivent faire preuve d’une intransigeance absolue face aux extrapolations lexicales abusives. L’usage de termes globalisants tels que « les humains », « les citoyens » ou « les consommateurs » doit être proscrit dès lors que l’échantillon investigué n’est issu que d’un sous-segment restreint et numériquement sur-équipé de la population.
12.2 Développer une réflexivité épistémologique chez le chercheur
L’éradication du biais de sous-couverture exige une transformation de la posture intellectuelle des chercheurs eux-mêmes. Trop souvent conditionnés par la contrainte de la rentabilité académique immédiate (« publier ou périr »), les investigateurs ont tendance à reproduire des schémas d’échantillonnage de convenance sans interroger les angles morts sociologiques qu’ils perpétuent. Développer une réflexivité épistémologique consiste à poser systématiquement la question critique fondamentale : « Qui est absent de mes données ? »
Cette démarche réflexive impose de reconnaître l’encastrement social du chercheur. Les hypothèses de recherche, les méthodes de sollicitation et les outils de recueil sont inévitablement façonnés par la culture, la classe sociale et le statut intellectuel de ceux qui les conçoivent. Ce que le chercheur considère comme une démarche neutre (remplir un formulaire en ligne, se déplacer dans un laboratoire universitaire) représente pour une large fraction de la société une épreuve anxiogène, stigmatisante ou physiquement inaccessible.
Pour démanteler ces biais de conception, la collaboration précoce avec les acteurs associatifs, les travailleurs sociaux, les collectifs de patients et les organisations communautaires de terrain s’avère indispensable. Ces acteurs possèdent une connaissance intime des personnes invisibilisées et des barrières symboliques qui les tiennent éloignées des protocoles académiques. Les intégrer dès la phase de rédaction des projets de recherche permet de co-construire des protocoles d’accès inclusifs, respectueux et adaptés aux réalités de vie de ceux que la science ignore trop fréquemment.
12.3 Vers une recherche plus inclusive et représentative
Considérer la représentativité statistique non pas comme une contrainte technique accessoire, mais comme une condition d’exercice de la justice épistémique représente l’horizon éthique de la recherche contemporaine. Une science qui n’étudie que les privilégiés pour prétendre légiférer sur l’ensemble de l’humanité participe à la reproduction des inégalités structurelles de nos sociétés.
L’avenir de la recherche quantitative repose sur l’intégration harmonieuse d’approches méthodologiques mixtes. L’analyse statistique gagne en puissance et en justesse lorsqu’elle s’appuie sur des investigations qualitatives approfondies (entretiens semi-directifs, observations ethnographiques de terrain). Ces approches de proximité permettent d’explorer la vie intérieure et les conditions réelles des populations exclues des bases d’échantillonnage de masse, apportant l’épaisseur humaine et la précision contextuelle que les chiffres ne peuvent capturer.
Enfin, les développements technologiques émergents, tels que l’intelligence artificielle appliquée à l’échantillonnage adaptatif et la modélisation bayésienne des populations éparses, offrent des opportunités méthodologiques prometteuses. En combinant la puissance prédictive de ces outils avec un engagement humaniste en faveur de l’inclusion démographique, la communauté scientifique peut désormais s’affranchir des erreurs du passé et bâtir une connaissance véritablement universelle, représentative de la diversité de l’expérience humaine.
Références
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons.
- Deville, J.-C., & Särndal, C.-E. (1992). Calibration estimators in survey sampling. Journal of the American Statistical Association, 87(418), 376–382. https://doi.org/10.1080/01621459.1992.10475217
- Groves, R. M., Fowler, F. J., Couper, M. P., Lepkowski, J. M., Singer, E., & Tourangeau, R. (2009). Survey methodology (2nd ed.). John Wiley & Sons.
- Hartley, H. O. (1962). Multiple frame surveys. Proceedings of the Social Statistics Section, American Statistical Association, 203–206.
- Heckman, J. J. (1979). Sample selection bias as a specification error. Econometrica, 47(1), 153–161. https://doi.org/10.2307/1912352
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/S0140525X0999152X
- Horvitz, D. G., & Thompson, D. J. (1952). A generalization of sampling without replacement from a finite universe. Journal of the American Statistical Association, 47(260), 663–685. https://doi.org/10.1080/01621459.1952.10483446
- Kish, L. (1965). Survey sampling. John Wiley & Sons.
- Manski, C. F. (2003). Partial identification of probability distributions. Springer-Verlag. https://doi.org/10.1007/b97478
- Meng, X.-L. (2018). Statistical paradises and paradoxes in big data (I): Law of large populations, big data paradox, and the 2016 US presidential election. The Annals of Applied Statistics, 12(2), 685–726. https://doi.org/10.1214/18-AOAS1161SF
- Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558–625. https://doi.org/10.2307/2342192
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41
- Särndal, C.-E., Swensson, B., & Wretman, J. (1992). Model assisted survey sampling. Springer-Verlag. https://doi.org/10.1007/978-1-4612-4378-6
- Squire, P. (1988). Why the 1936 Literary Digest poll failed. Public Opinion Quarterly, 52(1), 125–133. https://doi.org/10.1086/269085
- Tourangeau, R., Conrad, F. G., & Couper, M. P. (2013). The science of web surveys. Oxford University Press. https://doi.org/10.1093/acprof:oso/9780199747047.001.0001