
Dans le champ de l’analyse quantitative, de la modélisation statistique et des sciences sociales, la tentation d’extrapoler le comportement des individus à partir des propriétés observées au niveau des groupes constitue l’un des écueils méthodologiques les plus insidieux et les plus destructeurs de validité. Cette faille inférentielle, connue sous le nom générique de biais d’agrégation, survient dès lors qu’un chercheur ou un analyste postule que les relations mathématiques, les corrélations ou les tendances mesurées sur des données agrégées (des moyennes régionales, des pourcentages nationaux ou des indices départementaux) s’appliquent fidèlement et de manière symétrique aux entités individuelles qui composent ces mêmes collectifs.
Loin d’être un artefact mathématique trivial ou une simple anomalie de laboratoire, ce phénomène met en péril l’intégrité même des politiques publiques, des diagnostics cliniques, des investissements économiques et des modèles d’apprentissage automatique contemporains. En condensant l’information brute dans des métriques de synthèse telles que la moyenne ou la médiane, le processus d’agrégation efface irrémédiablement la variance intra-groupe, créant des mirages statistiques d’une cohérence visuelle parfois spectaculaire, mais totalement déconnectés des mécanismes sous-jacents qui gouvernent la vie réelle des unités observées. L’histoire des sciences empiriques regorge ainsi d’erreurs d’interprétation tragiques où des interventions ciblées ont produit des effets strictement opposés aux prévisions, précisément parce que la modélisation sous-jacente reposait sur l’illusion d’une continuité parfaite entre le macrocosme et le microcosme.
Comprendre en profondeur la genèse, la mécanique mathématique et les ramifications pratiques du biais d’agrégation exige une déconstruction rigoureuse des paradigmes de mesure. Il ne suffit pas d’affirmer que « corrélation n’est pas causalité » ; il convient de démontrer avec exactitude comment et pourquoi le simple fait de regrouper des points dans l’espace ou dans des catégories administratives altère fondamentalement la covariance, transforme les signes des pentes de régression et produit des coefficients artificiellement gonflés. À travers cet article exhaustif, nous explorerons les fondements théoriques, les équations sous-jacentes, les illustrations empiriques concrètes et les architectures analytiques de pointe qui permettent de conjurer ce piège méthodologique et d’appréhender la réalité humaine dans toute sa complexité multi-échelle.
1. Introduction et définition fondamentale du biais d’agrégation
### 1.1 Définition conceptuelle et théorique
Le biais d’agrégation désigne l’altération systématique, l’inversion ou la distorsion des estimations de paramètres statistiques qui survient lorsque des données sont regroupées, combinées ou observées à une échelle macroscopique, alors que la question de recherche ou la cible d’inférence concerne des unités élémentaires désagrégées. Au cœur de cette pathologie méthodologique se trouve le postulat erroné selon lequel les tendances observées à l’échelle d’un groupe s’appliquent fidèlement à chaque individu qui le compose. Ce transfert illégitime de propriétés d’un niveau d’organisation vers un niveau inférieur trahit une incompréhension radicale des systèmes dynamiques et de la structure mathématique de la variance.
Il existe en effet une distinction primordiale et épistémologiquement incontournable entre les propriétés émergentes d’une population et les caractéristiques intrinsèques des unités sous-jacentes. Une collectivité territoriale peut présenter un taux de criminalité moyen élevé et un niveau moyen de scolarisation supérieur sans qu’il soit permis de conclure que les personnes les plus éduquées de ce territoire commettent davantage d’infractions. Les propriétés émergentes traduisent souvent des configurations écologiques, des interactions entre sous-groupes, des effets de ségrégation spatiale ou des dynamiques d’opportunité économique qui ne résident nullement dans la psychologie ou la moralité des citoyens pris individuellement. L’amalgame entre ces deux dimensions engendre une confusion délétère entre le comportement d’un ensemble et les actions de ses composants.
D’un point de vue historique, l’émergence formelle de ce concept au sein de la méthodologie statistique remonte au milieu du vingtième siècle, bien que des intuitions précurseurs apparaissent dès les travaux fondateurs d’Émile Durkheim sur le suicide ou les réflexions de sociologues électoraux des années 1930. Les sciences du comportement ont progressivement dû admettre que les relations psychologiques ne pouvaient pas être simplement extrapolées à partir d’indicateurs démographiques nationaux. Ce débat a marqué le passage d’une sociologie purement holiste à des approches intégrant l’individualisme méthodologique et la modélisation contextuelle, soulignant la nécessité vitale d’aligner l’unité d’analyse théorique avec l’unité d’observation empirique.
L’importance de la granularité dans l’interprétation des modèles explicatifs apparaît dès lors comme une condition absolue de validité scientifique. Travailler sur des données fortement agrégées donne souvent au chercheur un faux sentiment de puissance explicative, matérialisé par des ajustements de régression immaculés et des p-valeurs séduisantes. Néanmoins, dès lors que l’échelle de mesure ne respecte pas l’échelle du mécanisme causal sous-jacent, le modèle théorique ne décrit pas la réalité des processus étudiés ; il ne fait que modéliser un artefact d’échantillonnage produit par le découpage administratif ou catégoriel des données originales.
### 1.2 La rupture épistémologique entre macro-analyse et micro-analyse
La tension méthodologique entre macro-analyse et micro-analyse ne constitue pas un simple désaccord de degré technique, mais une véritable rupture épistémologique. D’un côté, la macro-analyse opère sur des données regroupées, des moyennes géographiques, des totaux sectoriels et des séries chronologiques institutionnelles ; de l’autre, la micro-analyse ausculte les trajectoires individuelles, les réponses subjectives, les choix budgétaires des ménages et les marqueurs biométriques. Confondre ces deux approches revient à supposer que la société ou tout autre système complexe n’est qu’une juxtaposition mécanique d’unités isotropes, ignorant délibérément les phénomènes d’hétérogénéité, de rétroaction et d’interaction locale.
Les pièges de l’extrapolation descendante dans la recherche empirique se manifestent avec une acuité particulière lorsque des décideurs tentent d’importer des régularités macroéconomiques directement dans la régulation des comportements individuels. Par exemple, observer au niveau national qu’une augmentation des dépenses publiques de santé s’accompagne d’un allongement de l’espérance de vie ne garantit nullement que chaque citoyen bénéficiant d’une subvention publique verra sa longévité s’accroître de façon proportionnelle. L’extrapolation descendante ignore les mécanismes de redistribution interne, l’élasticité différentielle des demandes individuelles et les goulets d’étranglement structurels qui s’annulent ou se compensent dans les bilans agrégés.
Ce problème touche au cœur de ce que l’épidémiologiste et méthodologue Donald T. Campbell définissait comme la validité interne d’une inférence. L’impact de l’échelle d’observation sur cette validité est direct : lorsqu’un chercheur change d’échelle d’analyse, il modifie tacitement la définition opérationnelle de ses variables. Une variable telle que « le revenu moyen de la commune de résidence » ne mesure pas le pouvoir d’achat d’un sujet d’étude spécifique, mais l’environnement socio-économique, la qualité relative des infrastructures municipales et la valeur foncière de l’espace de vie. Tenter d’estimer un paramètre causal individuel à travers une métrique contextuelle vicie la modélisation à sa racine, rendant toute inférence strictement caduque.
2. Les fondements mathématiques et statistiques du biais d’agrégation
### 2.1 Compression de la variance et amplification artificielle des corrélations
Pour comprendre la nature pernicieuse du biais d’agrégation, il est indispensable de disséquer ses ressorts formels dans la théorie de l’échantillonnage et de l’analyse de régression. Le premier mécanisme opératoire réside dans l’élimination systématique de la variance intra-groupe par le calcul des moyennes de sous-groupes. Considérons une population totale découpée en $K$ groupes, où chaque individu $i$ appartenant au groupe $k$ possède des valeurs pour deux variables continues $X_{ik}$ et $Y_{ik}$. La variance totale d’une variable se décompose selon le théorème classique de la décomposition de la variance en deux termes orthogonaux :
$$\text{Var}_{\text{totale}}(X) = \text{Var}_{\text{inter-groupes}}(\bar{X}_k) + \text{E}[\text{Var}_{\text{intra-groupe}}(X_k)]$$
Lorsque l’analyste remplace les observations élémentaires $(X_{ik}, Y_{ik})$ par les moyennes de chaque sous-groupe $(\bar{X}_k, \bar{Y}_k)$, le terme correspondant à l’espérance de la variance intra-groupe est purement et simplement retranché de l’espace d’analyse. En faisant disparaître le bruit statistique individuel, les déviations idiosyncratiques et les fluctuations locales, les moyennes de groupe deviennent des grandeurs particulièrement stables, lisses et artificiellement alignées.
Il en résulte un gonflement mathématique spectaculaire du coefficient de détermination ($R^2$) et du coefficient de corrélation linéaire de Pearson à mesure que le niveau d’agrégation s’élève. Si l’on regroupe des millions de citoyens en quelques dizaines de régions géographiques, les résidus individuels s’annulent mutuellement en vertu de la loi des grands nombres. Les points représentant les moyennes régionales se rapprochent considérablement d’une droite idéale, conférant à la régression une robustesse factice. Une corrélation qui stagnerait péniblement à $r = 0,20$ à l’échelle des individus peut aisément bondir à $r = 0,85$ ou $r = 0,95$ lorsque le calcul porte sur les moyennes des circonscriptions électorales ou des cantons.
À cette compression linéaire s’ajoutent les conséquences redoutables de l’inégalité de Jensen et des relations non-linéaires sur les distributions agrégées. Si le mécanisme causal sous-jacent entre $X$ et $Y$ n’est pas strictement linéaire, mais obéit par exemple à une fonction convexe $f(X)$ (telle qu’une fonction exponentielle ou une fonction puissance), alors la moyenne des images ne correspond pas à l’image de la moyenne :
$$\text{E}[f(X)] ge f(\text{E}[X])$$
Par conséquent, ajuster un modèle linéaire sur des moyennes $(\bar{X}, \bar{Y})$ introduit un biais d’estimation structurel qui fausse non seulement la force de la relation, mais également les dérivées marginales et l’élasticité du phénomène étudié. L’agrégation de distributions asymétriques produit des décalages d’asymétrie (skewness) et d’aplatissement (kurtosis) qui annihilent l’hypothèse de normalité des résidus indispensables aux tests d’inférence standards (tests de Student, de Fisher).
### 2.2 Glissement de covariance et effets de composition
L’illusion d’une forte relation entre deux variables agrégées ne découle pas seulement de la compression de la variance, mais aussi d’une distorsion géométrique connue sous le nom de glissement de covariance. Tout comme la variance, la covariance totale entre deux grandeurs $X$ et $Y$ se décompose rigoureusement en la somme de la covariance moyenne intra-groupe et de la covariance inter-groupes :
$$\text{Cov}_{\text{totale}}(X, Y) = \text{Cov}(\bar{X}_k, \bar{Y}_k) + \text{E}[\text{Cov}_{\text{intra-groupe}}(X_k, Y_k)]$$
Le coefficient de régression calculé au niveau agrégé estime exclusivement la pente liée à la composante inter-groupes, soit :
$$\beta_{\text{agrégé}} = \frac{\text{Cov}(\bar{X}_k, \bar{Y}_k)}{\text{Var}(\bar{X}_k)}$$
Or, la pente d’intérêt pour comprendre l’impact d’une variation individuelle de $X$ sur $Y$ est la pente moyenne intra-groupe :
$$\beta_{\text{individuel}} = \text{E}\left[\frac{\text{Cov}_{\text{intra}}(X_k, Y_k)}{\text{Var}_{\text{intra}}(X_k)}\right]$$
Il n’existe aucune garantie mathématique, ni aucune raison théorique a priori, pour que $\beta_{\text{agrégé}}$ soit égal à $\beta_{\text{individuel}}$. Pire encore, la différence entre ces deux quantités dépend directement de la corrélation existant entre le niveau moyen du groupe $\bar{X}_k$ et les caractéristiques inobservées ou les effets fixes propres à ce même groupe. Dès que l’agrégation intervient, des variables de confusion non mesurées s’infiltrent massivement dans la covariance inter-groupes. Des éléments contextuels tels que les régulations locales, les disparités climatiques, les traditions institutionnelles ou la composition démographique agissent simultanément sur $\bar{X}_k$ et $\bar{Y}_k$, sans impacter nécessairement les relations individuelles.
La modélisation de l’erreur d’estimation résultant d’un modèle univarié sur données macroscopiques montre ainsi que le biais d’agrégation $B$ s’exprime comme suit :
$$B = \beta_{\text{agrégé}} – \beta_{\text{individuel}} = \gamma \cdot \frac{\text{Cov}(\bar{X}_k, Z_k)}{\text{Var}(\bar{X}_k)}$$
Où $Z_k$ représente l’ensemble des variables de confusion écologiques omitted au niveau agrégé et $\gamma$ le véritable impact de ces facteurs sur la variable dépendante. Dès lors que la répartition des individus au sein des groupes n’est pas le fruit d’un tirage aléatoire parfait mais procède d’un tri spatial ou social spontané (phénomènes de ségrégation résidentielle, de clustering sectoriel ou d’appariement sélectif), la covariance $\text{Cov}(\bar{X}_k, Z_k)$ devient substantielle. Ce tri crée des effets de composition majeurs qui gonflent artificiellement ou inversent le signe de la relation macroscopique, rendant la pente agrégée totalement impropre à guider des décisions microéconomiques ou cliniques.
3. Étude de cas détaillée : Le lien entre éducation et revenu des ménages
### 3.1 L’observation macroscopique : Une corrélation presque parfaite
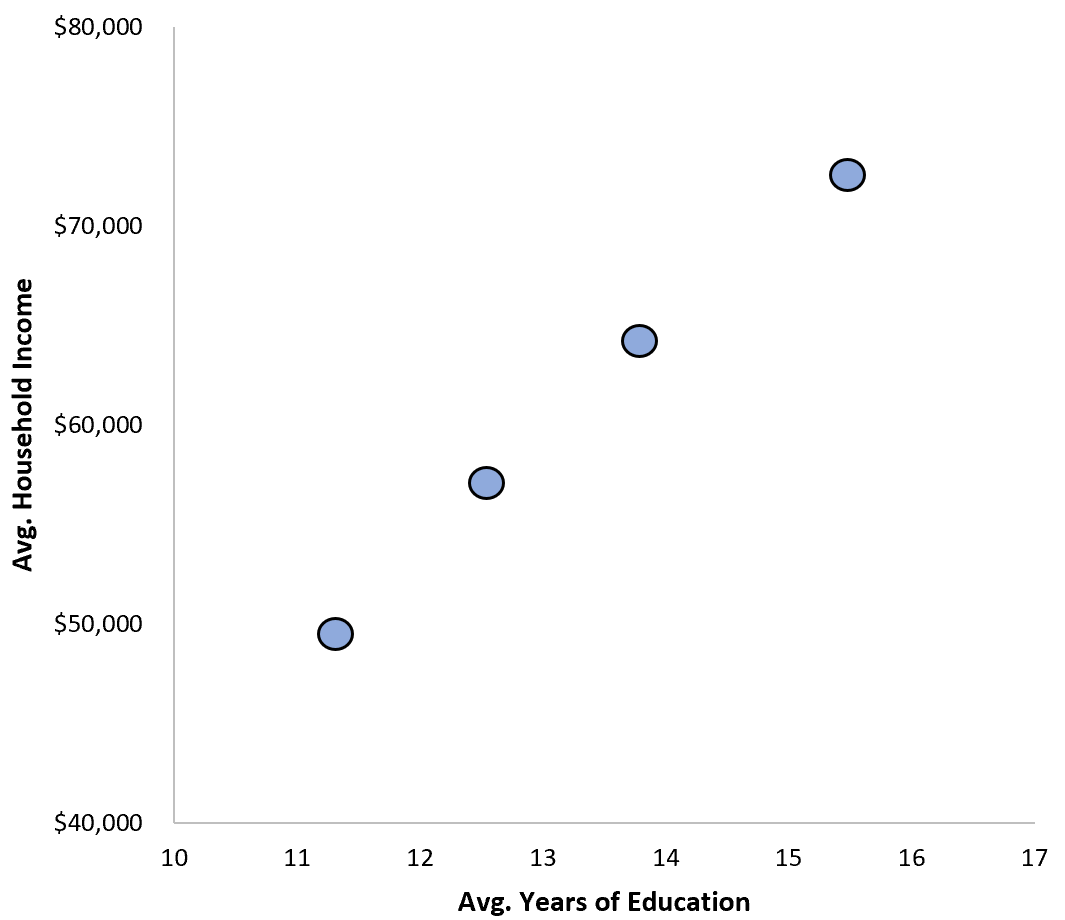
Pour ancrer cette démonstration théorique dans la réalité de l’analyse de données, examinons une étude empirique portant sur la relation entre le niveau d’instruction et la rémunération financière. Imaginons une recherche menée sur quatre agglomérations urbaines distinctes (Ville Alpha, Ville Bêta, Ville Gamma et Ville Delta) situées au sein d’un même grand État fédéré ou d’une région administrative. Un analyste macroéconomique, disposant uniquement des bases de données de recensement municipal, extrait deux indicateurs fondamentaux : le nombre moyen d’années de scolarité accomplies par les chefs de ménage et le revenu annuel moyen des ménages de chaque agglomération.
Les calculs statistiques menés à l’échelle de ces quatre municipalités génèrent les données synthétiques suivantes :
– **Ville Alpha** : 11,2 années d’études en moyenne ; revenu moyen de 32 000 euros par an.
– **Ville Bêta** : 12,8 années d’études en moyenne ; revenu moyen de 44 000 euros par an.
– **Ville Gamma** : 14,1 années d’études en moyenne ; revenu moyen de 58 000 euros par an.
– **Ville Delta** : 15,9 années d’études en moyenne ; revenu moyen de 76 000 euros par an.
Lorsque l’on trace le diagramme de dispersion associé à ces quatre points géographiques et que l’on procède à l’ajustement d’un modèle de régression linéaire par la méthode des moindres carrés ordinaires, le résultat obtenu paraît indiscutable. L’analyste observe un alignement quasi parfait des quatre municipalités sur la droite de régression. L’évaluation mathématique de l’association met en évidence un coefficient de corrélation linéaire de Pearson spectaculaire de **r = 0,9632** (soit un $R^2$ dépassant 0,92).
À la lecture de ce résultat, la conclusion semble d’une clarté lumineuse pour les décideurs politiques : chaque année supplémentaire de scolarité moyenne s’accompagne d’une progression quasi déterministe et massive du niveau de revenu. L’interprétation séduisante de ce diagramme de dispersion conduit immédiatement les planificateurs à recommander des politiques éducatives indifférenciées, convaincus que l’allongement de la durée des études constitue un levier omnipotent qui générera mécaniquement, au profit de n’importe quel citoyen pris isolément, une hausse drastique de son niveau de vie monétaire.
### 3.2 L’analyse désagrégée : La réalité au niveau individuel
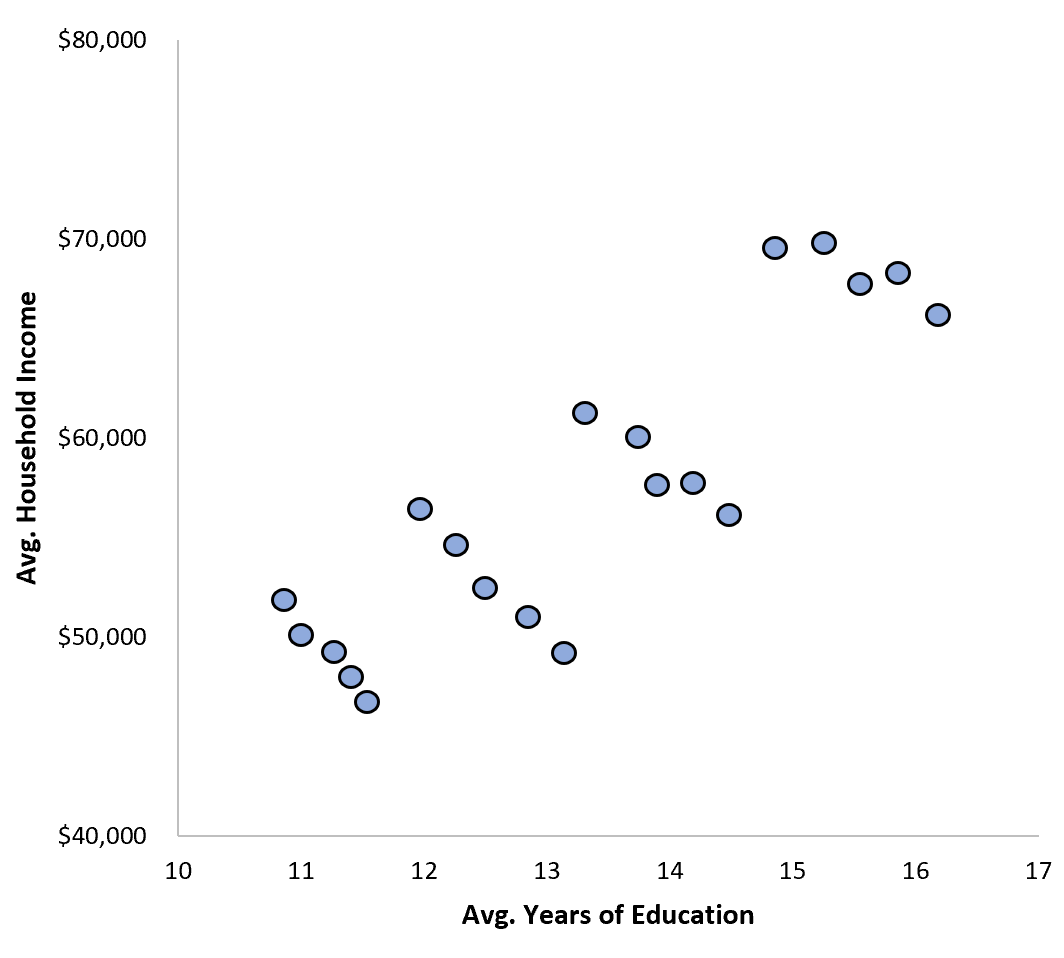
Toutefois, cette certitude s’effondre de manière spectaculaire dès lors que l’on a accès aux données individuelles exhaustives et que l’on cartographie les observations au niveau de chaque ménage au sein de chacune des quatre municipalités. En collectant un échantillon représentatif de 2 000 ménages (500 par agglomération), la structure interne de la relation émerge enfin de la gangue des agrégats territoriaux.
Au sein de chaque ville considérée isolément, la dispersion des revenus pour un niveau d’études donné est colossale. On observe de nombreux ménages ayant suivi des études supérieures mais occupant des emplois précaires dans le secteur des arts, de l’enseignement ou de l’économie sociale, tandis que des artisans, entrepreneurs de travaux publics ou techniciens spécialisés sans diplôme universitaire génèrent des flux de revenus substantiels. En calculant le coefficient de corrélation linéaire de Pearson sur l’ensemble des 2 000 couples de données individuelles brutes $(X_i, Y_i)$, la relation s’effondre drastiquement pour atteindre un modeste **r = 0,1788** (soit un $R^2$ résiduel d’environ 0,032).
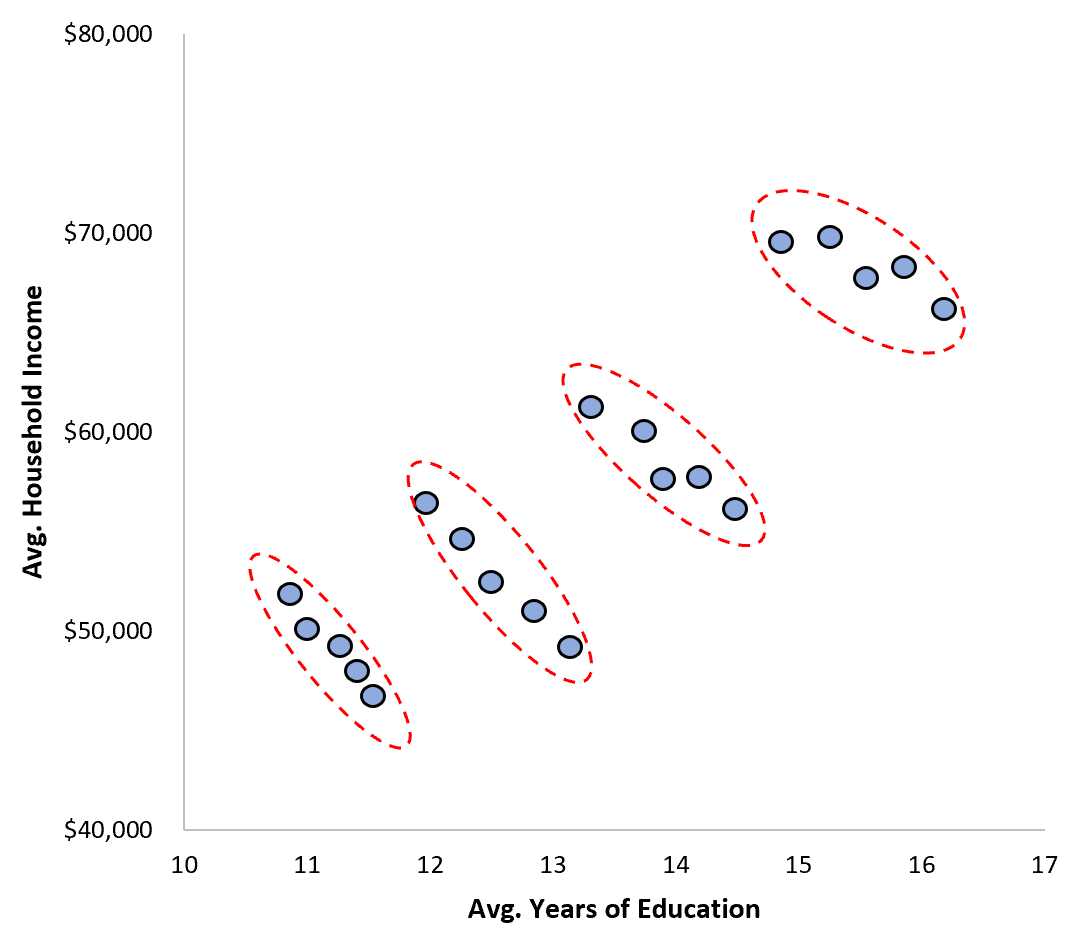
La visualisation du nuage de points réel révèle le subterfuge statistique opéré par les moyennes municipales. Au lieu d’une trajectoire univoque et puissante, le graphique désagrégé montre quatre nébuleuses de points largement étalées verticalement et horizontalement. La pente intra-ville est extrêmement faible, traduisant le fait qu’au niveau micro-économique immédiat, le rendement direct d’une année d’étude supplémentaire sur le revenu courant du ménage est modeste et grevé d’une immense incertitude individuelle.
Quelle dynamique a donc produit la corrélation illusoire de $r = 0,9632$ à l’échelle macroscopique ? La réponse réside dans l’existence de facteurs structurels urbains et de variables de confusion environnementales non mesurées au niveau communal. La Ville Delta, par exemple, héberge un pôle technologique d’envergure internationale, un siège boursier et un tissu d’entreprises à très haute valeur ajoutée, tirant à la hausse le coût de l’immobilier, le coût de la vie et le niveau global de tous les salaires locaux, indépendamment du niveau de diplôme. À l’inverse, la Ville Alpha subit une désindustrialisation lourde où l’ensemble du marché de l’emploi est déprimé. Le regroupement des données a tout simplement capté la richesse territoriale globale et l’attractivité économique de l’écosystème urbain — qui attire et concentre mécaniquement les ménages diplômés tout en rémunérant mieux l’ensemble des actifs — pour l’imputer faussement à une relation causale universelle entre la durée des études et le salaire d’un travailleur individuel.
4. Distinction conceptuelle : Biais d’agrégation, sophisme écologique et paradoxe de Robinson
### 4.1 Le sophisme écologique et les travaux fondateurs de William S. Robinson
Bien que les expressions soient parfois utilisées de manière interchangeable dans la littérature profane, il convient de distinguer formellement le biais d’agrégation, le sophisme écologique (ecological fallacy) et le paradoxe de Robinson, afin de maintenir une rigueur conceptuelle irréprochable. L’acte de naissance officiel de cette prise de conscience au sein des sciences quantitatives modernes est scellé par l’article séminal publié en 1950 par le statisticien et sociologue William S. Robinson dans l’American Sociological Review, intitulé « Ecological Correlations and the Behavior of Individuals ».
Dans cette recherche historique, Robinson s’attelait à mesurer la relation entre le statut d’immigrant (la part de personnes nées à l’étranger) et le taux d’alphabétisation aux États-Unis à partir des données exhaustives du recensement de 1930. En analysant les données consolidées à l’échelle des 48 États composant le pays à cette époque, Robinson calcule une corrélation écologique positive remarquable : le coefficient de corrélation linéaire entre le pourcentage de résidents nés à l’étranger et le taux d’alphabétisation s’élève à **r = 0,53**. Un lecteur naïf examinant ce résultat macroscopique conclurait immédiatement que les immigrants sont globalement plus alphabétisés en langue anglaise que les personnes nées sur le sol américain.
Or, lorsque Robinson descend d’un échelon pour calculer la corrélation au niveau des neuf grandes divisions géographiques régionales, le coefficient grimpe à **r = 0,77**. Mais lorsqu’il traite enfin la matrice des données individuelles portant sur l’intégralité des 97 millions de citoyens répertoriés dans le recensement, le coefficient de corrélation bascule et s’effondre pour devenir strictement négatif : **r = -0,11**. À l’échelle des individus, les personnes nées à l’étranger étaient en réalité statistiquement moins susceptibles de maîtriser la lecture et l’écriture de l’anglais que les natifs américains.
Ce paradoxe s’explique par un effet de composition spatiale : les immigrés ne s’installaient pas de manière aléatoire sur le territoire fédéral. Ils convergeaient massivement vers les États industrialisés du Nord-Est et du Midwest, régions qui disposaient déjà des systèmes scolaires publics les plus avancés et des populations autochtones les plus alphabétisées. En agrégeant les données au niveau des États, Robinson avait mesuré la politique d’instruction publique des États d’accueil et non l’alphabétisation réelle des populations immigrées. Robinson a ainsi formellement prouvé que la corrélation écologique ne constitue en aucun cas une approximation de la corrélation individuelle, jetant les bases de la théorisation du sophisme écologique comme erreur logique consistant à déduire la nature d’un individu à partir des statistiques du groupe auquel il appartient.
### 4.2 Biais d’agrégation versus sophisme atomiste
Si le sophisme écologique matérialise l’erreur d’attribution allant du haut vers le bas (du macro vers le micro), il possède un jumeau symétrique souvent négligé mais tout aussi destructeur sur le plan analytique : le sophisme atomiste, également qualifié de sophisme individualiste. Ce dernier survient lorsqu’un chercheur observe une régularité empirique ou un mécanisme psychologique valide à l’échelle de l’individu isolé, et postule unilatéralement que cette propriété s’applique telle quelle à la société, à l’organisation ou au système tout entier, sans tenir compte des interactions, des rétroactions et des contraintes contextuelles globales.
Le biais d’agrégation, au sens technique et méthodologique le plus strict, constitue la déformation fonctionnelle et mathématique qui sous-tend ces deux erreurs d’inférence. Le sophisme écologique et le sophisme atomiste représentent les défaillances de raisonnement logique opérées par le chercheur, tandis que le biais d’agrégation désigne la distorsion numérique quantitative (l’écart vectoriel) qui sépare l’estimateur calculé sur des données groupées de celui calculé sur des données granulaires.
Pour structurer la pensée méthodologique, on peut dresser une typologie des erreurs d’échelle dans les sciences modernes :
– **Le sophisme écologique (ou d’agrégation)** : Inférence illégitime sur des unités individuelles déduite d’observations écologiques globales.
– **Le sophisme atomiste (ou de désagrégation)** : Inférence illégitime sur les propriétés d’un système complexe déduite de mesures menées sur ses parties isolées.
– **L’effet contextuel réel** : Situation valide où le contexte environnemental (macro) exerce une influence causale authentique sur l’individu (micro), mesurable uniquement si les deux niveaux sont inclus conjointement dans l’architecture économétrique.
– **Le problème de l’unité spatiale modifiable (MAUP – Modifiable Areal Unit Problem)** : Sensibilité extrême des résultats statistiques à la manière dont les frontières spatiales ou les découpages administratifs des agrégats sont arbitrairement dessinés.
Reconnaître ces nuances permet aux scientifiques d’éviter de jeter le doute sur toute recherche macroscopique tout en interdisant formellement l’usage de données écologiques pour tirer des conclusions sur les trajectoires humaines singulières.
5. Le paradoxe de Simpson : Une manifestation extrême du biais d’agrégation
### 5.1 Mécanisme d’inversion des directions d’association
Le paradoxe de Simpson, décrit initialement par Edward H. Simpson en 1951 (et anticipé par Karl Pearson dès 1899 et Udny Yule en 1903), représente sans conteste la manifestation la plus contre-intuitive et la plus spectaculaire du biais d’agrégation. Il décrit une configuration géométrique et statistique dans laquelle une tendance ou une corrélation observée dans plusieurs sous-groupes distincts s’inverse totalement lorsque ces sous-groupes sont réunis pour former une cohorte unique.
Sur le plan géométrique et vectoriel, ce basculement des pentes de régression s’explique de manière lumineuse. Imaginons deux sous-populations distinctes, $A$ et $B$. Au sein du groupe $A$, l’augmentation de la variable prédictive $X$ entraîne une diminution linéaire constante de la variable cible $Y$ ; la pente de régression $\beta_A$ est donc strictement négative. De même, au sein du groupe $B$, la pente de régression $\beta_B$ est tout aussi négative. Intuitivement, l’esprit humain s’attend à ce que l’agrégation de l’ensemble des points produise une pente globale négative. Pourtant, si le groupe $B$ présente à la fois des valeurs moyennes de $X$ bien plus élevées que le groupe $A$, et des valeurs moyennes de $Y$ également beaucoup plus élevées, le barycentre du groupe $B$ se trouve positionné en haut à droite du repère cartésien par rapport au barycentre du groupe $A$.
En traçant la droite de régression des moindres carrés sur l’ensemble consolidé sans stratifier par groupe, la droite est forcée de relier le centre de gravité du nuage $A$ à celui du nuage $B$. Cette exigence mathématique fait pivoter brutalement la pente : l’association globale devient vigoureusement positive. Ce phénomène met en lumière le rôle déterminant d’une troisième variable modératrice ou confondante, souvent inobservée ou ignorée, dont la distribution asymétrique au sein des sous-populations distord la trajectoire globale. L’agrégation transforme une relation intrinsèquement inhibitrice au niveau local en une fausse relation promotrice au niveau macroscopique.
### 5.2 Exemples canoniques dans la littérature scientifique
L’affaire historique des admissions à l’Université de Californie à Berkeley en 1973 constitue l’illustration la plus célèbre et la plus étudiée du paradoxe de Simpson appliqué aux sciences sociales. À l’automne 1973, les statistiques agrégées d’admission aux cycles supérieurs de l’université révèlent un écart saisissant : environ 44 % des candidats masculins avaient été admis, contre seulement 35 % des candidates féminines. Face à un différentiel de neuf points de pourcentage, l’université fut menacée de poursuites judiciaires pour discrimination sexiste systémique.
La direction de l’université fit alors appel au statisticien Peter Bickel pour identifier la source exacte de ce biais d’embauche au niveau des départements. En désagrégeant les données département par département, les chercheurs découvrirent avec stupéfaction que, dans la quasi-totalité des départements académiques majeurs, le taux d’admission des femmes était soit égal, soit statistiquement supérieur à celui des hommes. Aucune discrimination masculine n’existait au niveau local ; dans certains cursus, un biais favorable aux femmes était même mesurable.
L’inversion paradoxale des données globales s’expliquait par une variable de confusion majeure : le choix du département de candidature. Les femmes postulaient en masse dans des filières des sciences humaines, des arts et de la littérature, départements sous-financés où le nombre de places était extrêmement contingenté et où le taux d’admission global était par conséquent très faible pour tous les candidats (autour de 10 à 20 %). À l’inverse, les hommes postulaient majoritairement dans les départements d’ingénierie, de chimie et de sciences dures, qui bénéficiaient de capacités d’accueil monumentales et affichaient des taux d’admission très élevés (60 à 80 %). L’agrégation des candidatures avait occulté ce choix différentiel de cursus, transformant une disparité structurelle entre disciplines en une fausse accusation de discrimination individuelle au guichet d’admission.
Des mécanismes similaires polluent régulièrement les essais cliniques et les interventions thérapeutiques. Supposons qu’un nouveau médicament expérimental soit testé pour réduire la mortalité liée à une pathologie cardiaque. Si les praticiens administrent préférentiellement ce traitement de pointe aux patients dont le pronostic initial est désespéré (patients âgés et polypathologiques), tandis que le traitement placebo standard est alloué aux patients présentant des formes bénignes, l’analyse agrégée brute montrera que les sujets traités décèdent davantage que les non-traités. Conclure à la toxicité du médicament sur la base de ce chiffre agrégé serait catastrophique, car au sein de chaque strate de gravité clinique (légère, modérée, sévère), le traitement expérimental aura effectivement sauvé des vies. L’omission de la variable de gravité engendre un biais d’agrégation d’une gravité létale.
6. Les mécanismes cognitifs et psychologiques sous-jacents
### 6.1 L’heuristique de représentativité et l’illusion d’homogénéité de l’endogroupe
L’omniprésence du biais d’agrégation dans le discours public, les médias et les cercles académiques ne s’explique pas uniquement par des limites techniques ; elle trouve ses racines dans le fonctionnement même de la cognition humaine. Notre cerveau, soumis à un bombardement sensoriel et informationnel continu, utilise des heuristiques de jugement pour simplifier le traitement du réel et économiser des ressources attentionnelles. Parmi ces raccourcis mentaux, l’heuristique de représentativité, brillamment modélisée par Amos Tversky et Daniel Kahneman dans leurs travaux fondateurs des années 1970, joue un rôle moteur dans l’adhésion instinctive aux erreurs d’agrégation.
L’esprit humain tend spontanément à considérer les groupes, les classes sociales ou les populations géographiques comme des entités homogènes et monomorphes. Lorsqu’un individu apprend qu’une nation possède un revenu par habitant exceptionnellement élevé, l’heuristique de représentativité le pousse à inférer inconsciemment que n’importe quel citoyen croisé au hasard dans la rue de cette nation incarne personnellement cette richesse. Nous projetons sur l’élément isolé les attributs saillants du collectif auquel il est rattaché. Ce biais est encore démultiplié par ce que la psychologie sociale appelle l’effet d’homogénéité de l’exogroupe : les observateurs ont une propension structurelle à percevoir les membres d’un groupe auquel ils n’appartiennent pas comme étant « tous identiques » sur le plan de leurs attitudes, de leurs croyances et de leurs compétences.
Cette réduction de la charge cognitive par l’adhésion aux tendances macroscopiques simplifiées procure un confort intellectuel immédiat. Les moyennes agrégées gomment le vacarme assourdissant de la variance locale, des exceptions aberrantes et des distributions multimodales. Pour un cerveau avide de prévisibilité, une droite de régression univariée tirée sur quatre pays est infiniment plus intelligible, rassurante et facile à mémoriser qu’un nuage de dix mille points désordonnés et contradictoires. L’abstraction statistique est ainsi traitée par nos réseaux neuronaux comme une entité physique réelle, conférant à la moyenne un statut ontologique immérité au détriment des trajectoires réelles des individus.
### 6.2 Le biais de confirmation et la quête de récits séduisants
À cette faille de représentativité s’articule le biais de confirmation, qui transforme le chercheur ou l’analyste en un auditeur complaisant de ses propres théories préconçues. Les données agrégées ont la particularité perverse d’offrir une flexibilité narrative bien supérieure aux données individuelles. En ajustant le niveau d’agrégation (par ville, par département, par région ou par décennie), un analyste peut aisément faire émerger des corrélations macroscopiques spectaculaires qui s’alignent miraculeusement avec le récit sociologique, économique ou idéologique qu’il cherche à démontrer.
Les corrélations agrégées s’intègrent admirablement dans des architectures narratives épurées. Dire que « les pays les plus consommateurs de chocolat par habitant comptent le plus de prix Nobel » constitue une anecdote séduisante, immédiatement virale et intellectuellement stimulante (bien qu’il s’agisse d’un exemple célèbre de corrélation écologique fallacieuse publiée par Franz Messerli en 2012). À l’inverse, expliquer laborieusement que la consommation individuelle de théobromine n’exerce aucune influence prouvée sur les performances cognitives des lauréats scientifiques, et que cette relation macroscopique reflète simplement l’histoire du développement économique, de la puissance des institutions universitaires et des climats tempérés d’Europe occidentale, exige un effort de déconstruction cognitive bien plus exigeant.
Il existe de surcroît une véritable résistance psychologique des chercheurs face à la complexité des données brutes. Les principes fondamentaux de la psychologie de la Gestalt appliqués à la perception visuelle des données (les graphiques de données ou data visualization) démontrent que notre système optique est génétiquement conçu pour détecter des alignements, des clusters et des symétries. Sur un graphique en nuage de points agrégé, l’œil humain fusionne les quelques barycentres observés pour y lire immédiatement une flèche causale univoque. Rompre cette illusion nécessite de reprogrammer activement son appareil critique pour apprendre à se méfier viscéralement de la beauté formelle des tendances macroscopiques trop élégantes pour être vraies.
7. Conséquences méthodologiques en psychologie et psychométrie
### 7.1 Divergence entre processus intra-individuels et structures inter-individuelles
Le domaine de la psychologie scientifique et de la psychométrie contemporaine subit de plein fouet les ravages conceptuels du biais d’agrégation, particulièrement lorsqu’il s’agit de transposer des modèles factoriels de personnalité ou d’intelligence à l’étude du comportement dynamique d’une personne dans le temps. Dans un article révolutionnaire publié en 2004, le méthodologue Peter Molenaar a sonné l’alarme en introduisant le concept d’ergodicité au sein de la psychologie comportementale : une population n’est dite ergodique que si les régularités statistiques calculées à l’échelle du groupe (structures inter-individuelles) sont strictement identiques aux dynamiques observées au fil du temps pour un individu singulier (processus intra-individuels).
Or, Molenaar a mathématiquement démontré que les êtres humains ne constituent presque jamais des systèmes ergodiques. La modélisation canonique des traits de personnalité selon le modèle des Big Five (Ouverture, Conscience, Extraversion, Agréabilité, Névrosisme) en offre un exemple frappant. Lorsque des chercheurs font passer des questionnaires de personnalité à un million d’individus à un instant $T$, ils constatent que ces cinq facteurs émergent de manière orthogonale et robuste à travers les analyses factorielles inter-individuelles. Cependant, si l’on suit un seul individu en mesurant ses états psychologiques toutes les trois heures pendant deux ans, la structure factorielle intra-individuelle de cette personne ne ressemble en rien aux Big Five : deux traits distincts au niveau populationnel peuvent être intimement intriqués et covarier vigoureusement chez cette personne (par exemple, le névrosisme et l’extraversion peuvent fusionner sous forme d’une réactivité émotionnelle singulière).
Les échelles de mesure psychométriques standardisées, lorsqu’elles sont calibrées et agrégées au niveau populationnel, créent ainsi des normes diagnostiques qui échouent lamentablement à caractériser la trajectoire dynamique des individus réels. Une personne peut présenter un score d’anxiété générale de 50/100, qui ne correspond à aucun de ses états réels mais n’est que la moyenne mathématique stérile entre des crises de panique aiguës nocturnes (90/100) et des phases d’apathie diurne absolue (10/100). L’agrégation inter-individuelle efface le caractère oscillatoire, non-linéaire et chaotique des processus psychiques vivants.
### 7.2 L’apport des méthodes d’échantillonnage de l’expérience vécue
Pour contourner l’impasse du biais d’agrégation, la psychologie et la psychiatrie clinique ont été contraintes d’opérer une révolution méthodologique majeure grâce aux protocoles de recueil écologique momentané (Ecological Momentary Assessment ou EMA) et aux méthodes d’échantillonnage de l’expérience vécue (Experience Sampling Methodology ou ESM). Ces dispositifs capturent, par l’intermédiaire d’applications mobiles ou de capteurs physiologiques connectés, les fluctuations réelles des états émotionnels, des cognitions et des symptômes en temps réel, dans l’environnement naturel des sujets et sur des centaines de points temporels successifs.
La comparaison des covariations d’états affectifs au niveau quotidien versus au niveau global a mis en lumière des divergences stupéfiantes. Au niveau inter-individuel agrégé, la littérature montre traditionnellement une corrélation modérée et stable entre le sentiment de stress perçu et la productivité au travail. Mais au niveau écologique intra-individuel, cette relation se décompose en dynamiques totalement hétérogènes selon les personnes : chez certains individus hautement résilients, le stress agit comme un amplificateur immédiat de la concentration (relation positive non-linéaire), tandis que chez d’autres, le moindre pic de cortisol paralyse instantanément le système exécutif (relation négative abrupte). Moyenniser ces profils diamétralement opposés dans une méta-analyse agrégée produit un coefficient résiduel proche de zéro, masquant des lois psychologiques vitales et opérationnelles.
Les dangers cliniques de ce biais sont considérables : prescrire une thérapie comportementale, un protocole de gestion du stress ou un traitement psychotrope à un patient sur la seule foi de données d’efficacité agrégées issues de méta-analyses aveugles aux sous-types dynamiques expose le praticien à aggraver son état. Une intervention thérapeutique qui fonctionne « en moyenne sur un échantillon d’un millier de patients » peut s’avérer profondément iatrogène et déstabilisatrice pour un individu singulier dont les boucles de rétroaction psychologiques s’écartent de la médiane statistique.
8. Répercussions sur les politiques publiques et la sociologie appliquée
### 8.1 Erreurs d’allocation budgétaire et de planification territoriale
Dans le domaine de l’action publique et de l’ingénierie sociale, le biais d’agrégation cesse d’être une préoccupation académique abstraite pour devenir une machine à gaspiller les deniers publics et à amplifier les injustices territoriales. Les gouvernements et les administrations décentralisées sont structurellement contraints de prendre des décisions budgétaires à partir de tableaux de bord macroscopiques synthétisant les données par districts scolaires, par départements ou par bassins d’emploi. Cette centralisation métrique engendre des erreurs d’allocation colossales.
L’affectation des ressources scolaires et des budgets d’éducation prioritaire fournit un exemple tragique de ces défaillances. Lorsqu’une administration évalue le niveau de précarité sociale à l’échelle d’un district scolaire tout entier, le calcul du revenu moyen par ménage opère comme un rideau de fumée. Si un district regroupe à la fois des zones résidentielles ultra-huppées et des cités d’habitat social marginalisées, la moyenne générale du district sera confortablement située dans la médiane nationale. En conséquence, les écoles primaires de ce district ne recevront aucune dotation de soutien renforcé ni d’effectifs allégés, bien qu’elles accueillent des enfants issus de poches de grande précarité extrême. La variance intra-district ayant été masquée par l’agrégation territoriale, les enfants les plus vulnérables sont privés de soutien pédagogique précisément parce qu’ils cohabitent statistiquement avec des ménages favorisés au sein d’une même découpe administrative.
Il en va de même pour les politiques de redynamisation économique et d’aménagement urbain. Le découpage de « zones franches urbaines » ou de périmètres de revitalisation rurale basés sur des indicateurs communaux globaux échoue régulièrement à enrayer la pauvreté. De vastes poches de détresse sociale subsistent au cœur des municipalités réputées riches (les angles morts de l’agrégation), tandis que des subventions publiques substantielles sont captées par des acteurs économiques prospères fortuitement situés dans des zones classées prioritaires sur la foi de moyennes territoriales désuètes.
### 8.2 Politiques de santé publique et épidémiologie sociale
L’épidémiologie sociale et la santé publique constituent un autre théâtre d’affrontement majeur où le biais d’agrégation peut conduire à l’élaboration de directives nutritionnelles ou médicales désastreuses. L’histoire médicale est jalonnée de corrélations écologiques fallacieuses établies entre les habitudes alimentaires moyennes des nations et leur taux d’incidence de maladies chroniques ou cardiovasculaires.
Le cas célèbre du « paradoxe français » illustre magnifiquement cette problématique. Dans les années 1980 et 1990, des études épidémiologiques macroscopiques ont comparé les données agrégées de consommation de graisses saturées, de vin rouge et la mortalité par cardiopathie ischémique à travers plusieurs pays occidentaux. Les données montraient qu’à niveau équivalent de consommation de lipides, la France présentait un taux de mortalité cardiovasculaire nettement inférieur à celui des États-Unis ou de la Grande-Bretagne. Très rapidement, des chercheurs et des relais d’opinion ont attribué ce bénéfice à la consommation modérée de vin rouge (via le resvératrol), érigeant une habitude culturelle moyenne en panacée thérapeutique individuelle.
Cependant, les études prospectives de cohortes individuelles menées avec un contrôle rigoureux des facteurs de confusion ont révélé une tout autre réalité : la consommation d’alcool, y compris à dose modérée, augmente le risque oncologique individuel et n’explique nullement la supposée immunité cardiovasculaire des Français. L’écart macroscopique résultait en réalité d’un décalage chronologique dans l’adoption du régime alimentaire industriel moderne par les différentes populations, de différences profondes dans la codification des causes de décès sur les certificats médicaux, ainsi que du rôle de l’activité physique et de la consommation globale de fruits et légumes frais non mesurée dans les modèles écologiques univariés. Fonder des campagnes de santé publique sur des moyennes nationales sans validation micro-analytique rigoureuse risque d’induire des comportements nocifs à l’échelle des individus.
9. Le biais d’agrégation en psychologie organisationnelle et du travail
### 9.1 Performances d’équipe versus compétences individuelles
Le management contemporain, friand de tableaux de bord d’entreprise et d’indicateurs de performance clés (KPI), est structurellement vulnérable au biais d’agrégation dès qu’il tente de piloter le capital humain à l’aide de métriques consolidées. L’un des pièges les plus répandus consiste à confondre le climat relationnel ou l’efficacité globale d’une équipe opérationnelle avec l’état de satisfaction, d’engagement et de compétence de chaque collaborateur pris isolément.
Une équipe de développement technologique peut afficher une productivité agrégée exceptionnelle, mesurée par le nombre de fonctionnalités livrées dans les délais impartis, sans que cela ne reflète une excellence partagée. Dans la réalité des flux de travail, cette performance collective apparente peut n’être portée que par deux experts exceptionnellement talentueux et hyper-impliqués qui compensent silencieusement les lacunes, le désengagement ou l’incompétence de leurs six collègues. En s’en tenant à la métrique macroscopique de l’équipe, la direction d’entreprise commet deux erreurs critiques : elle surestime la valeur professionnelle des éléments passifs et, surtout, elle ignore la charge mentale écrasante qui pèse sur les porteurs réels du projet, jusqu’à ce que ces derniers s’effondrent brutalement dans un épuisement professionnel foudroyant.
Ce décalage alimente des dynamiques perverses d’effet Pygmalion et de biais d’attribution managériale. Les dirigeants attribuent les succès ou les échecs globaux à des « cultures d’équipe » ou à un « esprit de corps » mythifié, sans ausculter les architectures réelles de coopération, de dépendance et de friction individuelle. L’agrégation des scores de performance crée une illusion de fluidité collective qui occulte l’iniquité interne de la contribution au bien commun de l’entreprise.
### 9.2 Diagnostic organisationnel et baromètres sociaux
La pratique courante des enquêtes de satisfaction interne, des questionnaires de climat social et des baromètres QVT (Qualité de Vie au Travail) constitue un foyer permanent de biais d’agrégation au sein des directions des ressources humaines. Chaque année, les grandes firmes multinationales déploient des sondages standardisés pour publier avec fierté un indice synthétique de bien-être au travail, souvent de l’ordre de « 78 % de salariés épanouis dans l’entreprise ».
Ces chiffres synthétiques agissent comme de redoutables anesthésiants organisationnels. La moyenne générale est mécaniquement tirée vers le haut par les départements tertiaires non soumis à la pénibilité physique, les états-majors administratifs ou les fonctions supports protégées. En revanche, elle dissimule complètement la détresse aiguë, les dynamiques de harcèlement moral ou le surmenage explosif qui frappent spécifiquement des micro-services sous-représentés en volume, tels que les équipes logistiques de nuit, les centres d’appels ou les services informatiques de maintenance critique.
Pour conjurer ce piège, les départements de ressources humaines doivent abandonner l’illusion des baromètres globaux monolithiques au profit de stratégies d’analyse granulaire. Cela implique de décomposer systématiquement les données par grappes organisationnelles fines, d’étudier avec acuité la distribution des écarts-types plutôt que les seules moyennes arithmétiques, et de traquer la bimodalité des réponses. Un service où la moitié des agents attribue la note de 10/10 et l’autre moitié la note de 0/10 présente une moyenne rassurante de 5/10, mais se trouve en réalité au bord de l’implosion sociale. L’agrégation masque l’incendie jusqu’à ce que la crise devienne irrémédiable.
10. Outils statistiques et méthodologies pour détecter le biais d’agrégation
### 10.1 La modélisation multiniveau et les modèles mixtes hiérarchiques
Pour dépasser les apories du biais d’agrégation sans pour autant renoncer à analyser l’impact des contextes collectifs sur les individus, la statistique moderne a développé un ensemble d’architectures paramétriques d’une puissance remarquable : les modèles linéaires hiérarchiques (Hierarchical Linear Models ou HLM) et la modélisation multiniveau (Multilevel Modeling). Popularisées notamment par Stephen Raudenbush, Anthony Bryk et Harvey Goldstein, ces méthodes permettent de désagréger explicitement la variabilité d’un phénomène selon les différents niveaux structurels de son recueil.
Au lieu de forcer les données à s’écraser sur une régression univariée simple ou sur un modèle par moyennes de groupes, la modélisation multiniveau formalise simultanément les équations au niveau individuel (Niveau 1) et au niveau du contexte (Niveau 2). Supposons que nous souhaitions évaluer la performance scolaire ($Y_{ij}$) d’un élève $i$ scolarisé dans un établissement $j$, en fonction de son niveau socio-économique individuel ($X_{ij}$) et du budget global de l’établissement ($W_j$) :
$$\text{Niveau 1 : } Y_{ij} = \beta_{0j} + \beta_{1j} X_{ij} + \epsilon_{ij}$$
$$\text{Niveau 2 : } \beta_{0j} = \gamma_{00} + \gamma_{01} W_j + u_{0j}$$
$$\text{Niveau 2 : } \beta_{1j} = \gamma_{10} + \gamma_{11} W_j + u_{1j}$$
Dans cette architecture, les paramètres de régression du niveau individuel (l’ordonnée à l’origine $\beta_{0j}$ et la pente de régression $\beta_{1j}$) ne sont plus considérés comme des constantes universelles, mais deviennent eux-mêmes des variables aléatoires modélisées au niveau macroscopique par des covariables contextuelles ($W_j$) et des résidus de groupe ($u_{0j}, u_{1j}$).
Le point d’ancrage fondamental de toute analyse multiniveau réside dans l’estimation de la variance intra-classe et inter-classes à travers le calcul du **Coefficient de Corrélation Intraclasse (ICC)**, déduit d’un modèle sans prédicteur (le modèle nul) :
$$\text{ICC} = \rho = \frac{\tau_{00}}{\tau_{00} + \sigma^2}$$
Où $\tau_{00}$ représente la variance de l’ordonnée à l’origine entre les groupes (variance inter-groupes) et $\sigma^2$ la variance résiduelle des individus au sein des groupes (variance intra-groupe). L’ICC quantifie avec une précision mathématique rigoureuse la proportion de la variance totale du phénomène qui est imputable à la structure de regroupement. Si l’ICC est proche de zéro, le regroupement n’exerce aucune influence et l’analyse individuelle standard est valide ; si l’ICC est élevé (par exemple, supérieur à 0,10 ou 0,15), ignorer le niveau de regroupement garantit l’apparition d’un biais d’agrégation substantiel et l’effondrement des erreurs-types, conduisant à des faux positifs massifs (inflation de l’erreur de type I).
### 10.2 Techniques de centrage et décomposition des effets
L’usage des modèles multiniveaux ne protège pas automatiquement le chercheur du biais d’agrégation si les prédicteurs du niveau 1 ne font pas l’objet d’une opération méthodologique cruciale : le centrage des variables. Dans les modélisations complexes, le choix entre le centrage sur la moyenne générale (Grand Mean Centering ou GMC) et le centrage sur la moyenne du groupe (Centering Within Cluster ou CWC) conditionne entièrement la signification substantielle des coefficients estimés.
Si un analyste applique un centrage sur la moyenne générale ($X_{ij} – \bar{X}_{..}$), le paramètre estimé pour la pente individuelle demeure un hybride mathématique non décomposé, mélangeant indistinctement l’effet individuel pur et l’effet contextuel agrégé. À l’inverse, l’application rigoureuse du centrage sur la moyenne du groupe ($X_{ij} – \bar{X}_{.j}$) permet d’épurer totalement la variable individuelle de toute composante écologique. En réintroduisant parallèlement la moyenne du groupe $\bar{X}_{.j}$ au niveau 2 de l’équation, le chercheur isole mathématiquement deux grandeurs parfaitement orthogonales :
1. **L’effet individuel pur** ($\beta_{\text{individuel}}$) : l’impact d’une augmentation de $X$ pour un individu par rapport à ses pairs au sein de son propre groupe.
2. **L’effet contextuel distinct** ($\beta_{\text{contexte}} = \gamma_{\text{macro}} – \beta_{\text{individuel}}$) : le gain ou la perte incrémentale imputable exclusivement au fait d’appartenir à un groupe dont la moyenne globale est élevée, à statut individuel strictement identique.
Cette technique de décomposition d’effets fournit un test empirique de spécification implacable pour identifier le biais d’agrégation. Si un test d’hypothèse révèle que $\beta_{\text{contexte}}$ est statistiquement différent de zéro, cela signifie de facto qu’un biais d’agrégation massif aurait frappé toute régression linéaire univariée ignorant cette séparation d’échelles. De tels protocoles de modélisation constituent aujourd’hui le standard d’or (gold standard) de la recherche empirique dans les sciences comportementales et économiques.
11. Stratégies préventives et bonnes pratiques pour les chercheurs
### 11.1 Conception de protocoles de recherche multi-échelles
Pour immuniser durablement les protocoles scientifiques contre le biais d’agrégation, la prévention doit intervenir dès la phase de conception théorique et d’échantillonnage, bien avant les premières saisies de données ou l’exécution des scripts de traitement statistique. La règle directrice fondamentale consiste à concevoir des protocoles de recherche multi-échelles qui imposent la collecte systématique de données au niveau le plus désagrégé possible. Il est trivial d’agréger ultérieurement des données granulaires si la théorie le requiert, alors qu’il est rigoureusement impossible de reconstituer la variance individuelle perdue à partir de données reçues sous forme de moyennes de groupes.
Cela exige la mise en œuvre d’architectures d’échantillonnage stratifié et en grappes conçues de manière à garantir une puissance statistique adéquate à chaque niveau de la hiérarchie. Trop souvent, des études empiriques échantillonnent un grand nombre de groupes (par exemple, 100 municipalités) mais n’interrogent que trois ou quatre personnes par grappe, ou inversement, interrogent des milliers d’individus concentrés dans seulement trois entités administratives. Dans les deux cas, la puissance statistique s’effondre pour estimer les paramètres d’un niveau spécifique, poussant l’analyste à des agrégations de secours méthodologiquement toxiques. Une bonne pratique impose de calculer la puissance statistique requise conjointement pour le niveau micro et le niveau macro à l’aide de formules de correction d’effet de plan (design effect).
Lorsque les chercheurs sont contraints de travailler sur des données secondaires groupées — par exemple des bases statistiques patrimoniales ou des registres institutionnels où l’anonymisation a imposé la suppression des identifiants individuels — la déontologie scientifique la plus stricte commande d’expliciter sans ambiguïté les limites intrinsèques de ces données. Il est formellement prohibé d’utiliser des verbes d’action individuelle (« les électeurs éduqués ont choisi ce candidat », « les patients précaires refusent les soins ») lorsque le modèle sous-jacent repose sur des unités spatiales (« les circonscriptions à fort diplôme ont voté pour ce candidat », « les quartiers défavorisés enregistrent un moindre recours aux consultations »). L’alignement sémantique sur la nature réelle de la donnée constitue la première ligne de défense contre le glissement vers le sophisme écologique.
### 11.2 Visualisation et communication transparente des données
La restitution visuelle et la communication des résultats jouent un rôle déterminant dans la propagation ou l’éradication des biais d’interprétation. Les représentations graphiques traditionnelles qui se contentent de tracer une droite de régression reliant des points de moyennes régionales sans restituer l’incertitude sous-jacente doivent être impitoyablement proscrites des publications scientifiques et des rapports de conseil. Elles agissent sur le système visuel des décideurs comme une invitation irrépressible à l’inférence écologique abusive.
Une pratique recommandée consiste à adopter des visualisations graphiques superposant simultanément les trajectoires individuelles et les tendances collectives. L’usage de nuages de points désagrégés intégraux enrichis d’un codage couleur par groupe permet d’afficher en arrière-plan la formidable dispersion des données brutes, tout en superposant en premier plan les droites de régression spécifiques à chaque sous-groupe ainsi que la droite agrégée générale. Cette approche graphique rend visuellement évidente toute manifestation d’un paradoxe de Simpson ou d’un glissement de pente : le lecteur identifie immédiatement si la direction générale est cohérente avec les dynamiques locales ou si elle n’est qu’un artefact d’orientation inter-classes.
Enfin, les comités de rédaction des revues scientifiques, les évaluateurs pairs (reviewers) et les directeurs de programmes de recherche doivent être activement sensibilisés et formés à la détection de ces failles. Toute publication soumettant des affirmations comportementales individuelles adossées exclusivement à des régressions sur agrégats macroéconomiques devrait faire l’objet d’un refus de publication immédiat pour défaut rédhibitoire de validité interne, ou être renvoyée aux auteurs avec l’exigence formelle d’un recadrage complet de l’argumentation à l’échelle écologique stricte.
12. Synthèse épistémologique et perspectives à l’ère du Big Data et de l’IA
### 12.1 Le Big Data et l’illusion d’exhaustivité
L’avènement contemporain du Big Data, des entrepôts de données massives et de l’intelligence artificielle générative n’a nullement relégué le biais d’agrégation au rang de curiosité historique ; il en a au contraire démultiplié la puissance de nuisance et la subtilité technique. Une illusion technologique largement répandue postule que le volume colossal de données disponibles — des téraoctets de données de géolocalisation, de transactions bancaires ou de métadonnées de navigation internet — suffirait à neutraliser les erreurs d’inférence statistique. Rien n’est plus faux : accumuler des milliards d’observations regroupées ne modifie d’aucune manière l’écart formel entre la covariance macroscopique et la covariance microscopique. Si le niveau d’agrégation est méthodologiquement erroné, la taille spectaculaire de l’échantillon ne fait que conférer une certitude numérique totale à une déduction fondamentalement fausse.
Le danger s’amplifie considérablement lorsque des modèles complexes d’apprentissage automatique (machine learning) et des réseaux de neurones profonds sont entraînés sur des données hybrides combinant des indicateurs individuels et des prédicteurs agrégés par zone de résidence (géomarketing, scores de risque de quartier). En cherchant à maximiser leur fonction de perte et à minimiser l’erreur prédictive globale, les algorithmes prédictifs exploitent avidement les corrélations agrégées artificiellement gonflées.
Il en résulte des phénomènes massifs de discrimination algorithmique indirecte et de profilage prédictif déviant. Par exemple, dans les systèmes d’octroi automatisé de crédit bancaire ou de tarification des polices d’assurance-maladie, un algorithme peut attribuer un score de risque de défaillance rédhibitoire à un jeune entrepreneur solvable, simplement parce qu’il réside dans un quartier administratif dont le taux moyen de défaut de paiement est élevé. L’algorithme réitère de manière automatisée, opaque et à une échelle industrielle le sophisme écologique traditionnel : il prive un individu d’une opportunité économique légitime en lui imputant péremptoirement les propriétés globales de son collectif géographique d’appartenance.
### 12.2 Considérations éthiques et vision intégrative pour la science
Face à ces dérives technologiques et méthodologiques, la responsabilité éthique et déontologique du scientifique des données, de l’économiste et du chercheur en sciences sociales se trouve directement engagée. Diffuser auprès du grand public ou des centres décisionnels politiques des conclusions causales inférées à partir de données mal calibrées n’est pas une simple maladresse de laboratoire ; c’est une faute morale aux conséquences sociétales directes. Les discours stigmatisants envers certaines catégories de population, les ségrégations territoriales amplifiées par les politiques de zonage et les interventions médicales inadaptées trouvent trop souvent leur genèse dans une lecture béotienne de corrélations agrégées non déconstruites.
L’avenir de la démarche scientifique exige ainsi l’adoption résolue d’une vision intégrative et d’une approche écologique authentique, capable de respecter la complexité dynamique de l’individu sans nier la puissance structurante des contextes environnementaux dans lesquels il s’inscrit. L’individu n’est ni un atome isolé insensible aux lois macroéconomiques qui l’entourent, ni une réplique miniaturisée et passive de son groupe d’appartenance. Les dynamiques humaines émergent d’un dialogue permanent, non-linéaire et interactif entre la biologie, la subjectivité individuelle et les contraintes structurelles collectives.
Seule une triangulation méthodique constante articulant intimement les observations micro-analytiques granulaires (études longitudinales, échantillonnage de l’expérience vécue, protocoles expérimentaux) et les modélisations macro-analytiques avancées (modèles hiérarchiques multiniveaux, décompositions de variance, modèles d’équations structurelles) permet de réconcilier ces échelles d’observation. En apprenant à traquer le biais d’agrégation jusque dans les replis les plus dissimulés de nos équations et de nos visualisations graphiques, la communauté scientifique se dote des outils indispensables pour bâtir un savoir à la fois empiriquement solide, humainement juste et épistémologiquement émancipateur.
Références
- Bickel, P. J., Hammel, E. A., & O’Connell, J. W. (1975). Sex bias in graduate admissions: Data from Berkeley. Science, 187(4175), 398-404. https://doi.org/10.1126/science.187.4175.398
- Bryk, A. S., & Raudenbush, S. W. (1992). Hierarchical linear models: Applications and data analysis methods. Sage Publications.
- Goldstein, H. (2011). Multilevel statistical models (4th ed.). John Wiley & Sons. https://doi.org/10.1002/9780470973394
- Kahneman, D., & Tversky, A. (1972). Subjective probability: A judgment of representativeness. Cognitive Psychology, 3(3), 430-454. https://doi.org/10.1016/0010-0285(72)90016-3
- Messerli, F. H. (2012). Chocolate consumption, cognitive function, and Nobel laureates. New England Journal of Medicine, 367(16), 1562-1564. https://doi.org/10.1056/NEJMon1211064
- Molenaar, P. C. (2004). A manifesto on psychology as idiographic science: Bringing the person back into scientific psychology, this time forever. Measurement: Interdisciplinary Research and Perspectives, 2(4), 201-218. https://doi.org/10.1207/s15366359mea0204_1
- Openshaw, S. (1984). The modifiable areal unit problem. Geo Books.
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). Sage Publications.
- Robinson, W. S. (1950). Ecological correlations and the behavior of individuals. American Sociological Review, 15(3), 351-357. https://doi.org/10.2307/2087176
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238-241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- Subramanian, S. V., Jones, K., Kaddour, A., & Krieger, N. (2009). Revisiting Robinson: The perils of individualistic and ecologic fallacy. International Journal of Epidemiology, 38(2), 342-360. https://doi.org/10.1093/ije/dyn359
- Yule, G. U. (1903). Notes on the theory of association of attributes in statistics. Biometrika, 2(2), 121-134. https://doi.org/10.1093/biomet/2.2.121