
L’analyse discriminante linéaire (souvent abrégée LDA, d’après l’anglais Linear Discriminant Analysis) constitue l’un des piliers méthodologiques fondamentaux de la statistique multivariée et de l’apprentissage automatique supervisé. Conçue initialement par le statisticien et biologiste britannique Ronald Aylmer Fisher en 1936 pour résoudre des problématiques taxonomiques liées à la classification morphologique de spécimens botaniques, cette méthode s’est progressivement muée en un paradigme central du traitement de données multidimensionnelles. Combinant les vertus d’un classifieur linéaire probabiliste et d’un opérateur de projection sous-spatiale optimale, la LDA répond à une double exigence : séparer distinctement des populations pré-identifiées tout en réduisant l’espace des variables sans diluer l’information discriminante sous-jacente.
Dans le paysage contemporain de la science des données, où prolifèrent des algorithmes non linéaires d’une complexité computationnelle substantielle tels que les forêts aléatoires, les machines à vecteurs de support à noyaux ou les réseaux de neurones profonds, la LDA préserve une pertinence heuristique et opérationnelle singulière. Sa nature paramétrique et générative lui confère une transparence mathématique absolue, garantissant une interprétabilité analytique rigoureuse que les modèles dits de « boîte noire » ne peuvent offrir. De surcroît, sa parcimonie algorithmique en fait une approche particulièrement résiliente face au surapprentissage dans les scénarios où la taille des échantillons demeure modeste par rapport à la dimension de l’espace des prédicteurs, à la condition expresse que ses postulats distributionnels sous-jacents soient scrupuleusement respectés.
Ce guide exhaustif a pour vocation de déconstruire, d’analyser et d’implémenter l’analyse discriminante linéaire à travers le langage de programmation Python, en articulant de manière continue rigueur axiomatique et mise en œuvre technique. Du fondement géométrique du critère de séparation de Fisher à la formulation bayésienne des fonctions discriminantes, nous explorerons les mécanismes intimes de cet algorithme. Nous aborderons ensuite l’évaluation scrupuleuse de ses hypothèses de validité (normalité multivariée, homoscédasticité, absence de colinéarité critique) avant de déployer un protocole d’implémentation industrielle étape par étape utilisant l’écosystème scientifique standard composé de NumPy, SciPy, Pandas, Matplotlib, Seaborn et Scikit-Learn.
1. Fondements théoriques et mathématiques de l’analyse discriminante linéaire
1.1 Principe de maximisation de la variance inter-classes et intra-classes
L’intuition géométrique originelle formulée par Ronald Fisher repose sur une idée d’une grande élégance : trouver une direction de projection sous-spatiale, définie par un vecteur de projection unidimensionnel ou multidimensionnel, le long de laquelle les centres de gravité des différentes classes sont aussi éloignés que possible les uns des autres, tandis que la dispersion des observations autour de leur centre respectif est minimale. Autrement dit, l’analyse cherche à maximiser le rapport entre la variabilité externe (inter-classes) et la variabilité interne (intra-classes). Pour formaliser ce critère mathématique de façon analytique, il est nécessaire d’introduire les deux matrices fondamentales qui structurent la géométrie des données : la matrice de dispersion intra-classe et la matrice de dispersion inter-classe.
Soit un ensemble d’apprentissage constitué de $n$ observations réparties au sein de $K$ classes mutuellement exclusives, notées $C_1, C_2, dots, C_K$. Chaque observation $x_i$ est un vecteur colonne de dimension $p$. La matrice de dispersion intra-classe, couramment désignée par la notation $S_W$ (pour Within-class scatter matrix), quantifie la somme des carrés des écarts des individus par rapport au barycentre de leur classe respective. Elle est définie par la relation matricielle suivante :
$$S_W = \sum_{k=1}^{K} \sum_{x in C_k} (x – \mu_k)(x – \mu_k)^T$$
où $\mu_k$ représente le vecteur moyen empirique de la classe $C_k$, calculé sur les $n_k$ individus composant ce groupe. Cette matrice $S_W$, de dimensions $p \times p$, est proportionnelle à la matrice de covariance combinée (ou pooled covariance matrix). Elle traduit l’incertitude et le bruit résiduel interne à chaque groupe qui ne dépendent pas des différences structurelles inter-groupes.
Inversement, la matrice de dispersion inter-classe, désignée sous le symbole $S_B$ (pour Between-class scatter matrix), capture la dispersion relative des différents centres de gravité $\mu_k$ autour du barycentre global de la population totale, noté $\mu$. Elle est formalisée selon l’expression :
$$S_B = \sum_{k=1}^{K} n_k (\mu_k – \mu)(\mu_k – \mu)^T$$
Dans l’optique de projeter les observations $x$ sur un axe unidimensionnel dirigé par un vecteur unitaire $w$, la projection scalaire d’une observation devient $y = w^T x$. Dans cet espace projeté, la variance inter-classes s’exprime par le terme quadratique $w^T S_B w$, tandis que la variance intra-classes s’écrit $w^T S_W w$. Le problème d’optimisation de Fisher revient alors à identifier le vecteur optimal $w$ maximisant le quotient scalaire, universellement connu sous le nom de ratio de Rayleigh généralisé :
$$J(w) = \frac{w^T S_B w}{w^T S_W w}$$
Pour déterminer le vecteur $w$ qui maximise cette fonction objective, nous dérivons $J(w)$ par rapport à $w$ et annulons le gradient résultant. En exploitant les propriétés du calcul matriciel différentiel, cette maximisation équivaut à résoudre un problème aux valeurs propres généralisé :
$$S_W^{-1} S_B w = \lambda w$$
Sous réserve que la matrice $S_W$ soit non singulière et donc strictement inversible, les directions discriminantes optimales correspondent aux vecteurs propres de l’opérateur linéaire $S_W^{-1} S_B$, associés aux plus grandes valeurs propres réelles $lambda$. Ces valeurs propres quantifient directement le pouvoir de séparation accordé par chaque composante discriminante respective.
1.2 Différenciation entre LDA pour la classification et LDA pour la réduction de dimensionnalité
L’analyse discriminante linéaire s’articule autour d’une dualité fonctionnelle qu’il convient de distinguer rigoureusement : d’une part, elle opère comme une technique supervisée de réduction de dimensionnalité géométrique ; d’autre part, elle agit comme un classifieur probabiliste Bayes-optimal. Cette distinction conceptuelle conditionne la manière dont les praticiens exploitent l’espace latent produit par les projections matricielles.
Lorsqu’elle est mobilisée à des fins de réduction de dimensionnalité, la LDA opère une transformation linéaire projective de l’espace initial de dimension $p$ vers un sous-espace de dimension $d$, où $d ll p$. Toutefois, une contrainte algébrique stricte s’impose quant à la dimensionnalité maximale atteignable par ce sous-espace. La matrice de dispersion inter-classes $S_B$ est construite à partir de la somme de $K$ vecteurs de rang 1 formés par les écarts $(\mu_k – \mu)$. Comme le barycentre global $\mu$ est lui-même une combinaison linéaire des moyennes locales $\mu_k$, seuls $K-1$ de ces vecteurs sont linéairement indépendants. Par conséquent, le rang algébrique de $S_B$ est au plus égal à $K-1$. Il en découle que le produit matriciel $S_W^{-1} S_B$ possède au maximum $K-1$ valeurs propres non nulles. Dès lors, le nombre maximal de composantes discriminantes linéaires orthogonales extractibles ne peut excéder la limite structurelle de $C – 1$, où $C$ (ou $K$) correspond au nombre total de classes distinctes présentes dans le problème considéré.
À l’opposé, lorsque la LDA est employée comme classifieur, son objectif premier n’est pas uniquement de compresser l’espace des données, mais d’assigner formellement chaque nouvelle observation à la classe la plus plausible. Pour ce faire, elle segmente l’espace vectoriel d’origine à l’aide d’hyperplans de décision linéaires. Dans cette modalité, le rôle des probabilités a priori $\pi_k = P(Y = C_k)$ devient prépondérant. Ces probabilités agissent directement sur la position de l’hyperplan de coupure dans l’espace en déplaçant le seuil décisionnel au profit des classes statistiquement majoritaires au sein de la population. D’un point de vue géométrique, la frontière de décision linéaire sépare les régions d’assignation en découpant le domaine en polyèdres convexes.
La divergence entre la projection supervisée propre à la LDA et les techniques non supervisées réside fondamentalement dans la prise en compte explicite de l’étiquette de classe. Alors qu’une projection aveugle recherche les axes d’étirement global de la distribution, la LDA impose une contrainte morphologique orientée qui force l’alignement des axes factoriels sur les contrastes d’intérêt expérimental, prévenant activement la confusion entre la variabilité aléatoire d’échantillonnage et la structure de groupe discriminante.
1.3 Formulation probabiliste et règle de décision bayésienne
L’analyse discriminante linéaire gagne une dimension théorique fondamentale lorsqu’elle est abordée sous l’angle de la théorie bayésienne de la décision. Dans ce cadre génératif, nous cherchons à évaluer la probabilité a posteriori qu’une observation spécifique $x$ appartienne à une classe déterminée $C_k$, notée $P(Y = C_k mid X = x)$. En appliquant de manière formelle le théorème de Bayes, cette quantité s’exprime selon la relation :
$$P(Y = C_k mid X = x) = \frac{f_k(x) \pi_k}{\sum_{j=1}^{K} f_j(x) \pi_j}$$
où $\pi_k$ désigne la probabilité a priori d’occurrence de la classe $C_k$, et $f_k(x) = f(x mid Y = C_k)$ correspond à la fonction de densité conditionnelle de probabilité décrivant la distribution des prédicteurs $X$ au sein de cette même modalité $C_k$.
Le postulat paramétrique fondamental de la LDA réside dans l’hypothèse selon laquelle chaque classe suit une loi normale multivariée (ou distribution gaussienne multidimensionnelle). La densité de probabilité s’écrit alors analytiquement :
$$f_k(x) = \frac{1}{(2\pi)^{p/2} |\Sigma_k|^{1/2}} \exp\left( -\frac{1}{2} (x – \mu_k)^T \Sigma_k^{-1} (x – \mu_k) \right)$$
L’hypothèse d’homoscédasticité propre à la LDA stipule que toutes les classes partagent rigoureusement la même matrice de covariance, soit $\Sigma_k = \Sigma$ pour tout $k in {1, dots, K}$. En injectant cette matrice commune $\Sigma$ dans l’expression de la densité conditionnelle, la probabilité a posteriori se simplifie de façon remarquable. En vertu de la règle de décision du Maximum a posteriori (MAP), une observation $x$ est attribuée à la classe $C_k$ qui maximise la quantité $P(Y = C_k mid X = x)$. Comme le dénominateur de la formule de Bayes est invariant par rapport à $k$, maximiser la probabilité a posteriori revient à maximiser le numérateur $f_k(x) \pi_k$.
Puisque la fonction logarithme népérien est strictement croissante, cette optimisation est équivalente à la maximisation du logarithme de l’expression conjointe. En développant formellement cette transformation logarithmique, les termes quadratiques en $x^T \Sigma^{-1} x$ s’annulent mutuellement lors de la comparaison de deux classes, ce qui fait disparaître toute courbure des surfaces de séparation :
$$\delta_k(x) = \ln(f_k(x)\pi_k) = -\frac{1}{2} ln|Sigma| – \frac{p}{2}\ln(2\pi) – \frac{1}{2}(x – \mu_k)^T \Sigma^{-1} (x – \mu_k) + \ln(\pi_k)$$
En éliminant les constantes additives indépendantes de l’indice de classe $k$, nous obtenons l’expression épurée de la fonction discriminante linéaire $\delta_k(x)$ :
$$\delta_k(x) = x^T \Sigma^{-1} \mu_k – \frac{1}{2} \mu_k^T \Sigma^{-1} \mu_k + \ln(\pi_k)$$
Cette fonction $\delta_k(x)$ est une transformation strictement affine de l’observation $x$. L’équation délimitant la frontière de décision entre deux classes arbitraires $C_j$ et $C_k$ s’obtient en égalisant $\delta_j(x) = \delta_k(x)$, ce qui définit un hyperplan linéaire dans $\mathbb{R}^p$. Cette formulation bayésienne démontre rigoureusement pourquoi et comment le modèle produit des frontières linéaires optimales au sens de la minimisation de l’espérance de perte de classification sous l’empire des postulats gaussiens.
2. Comparaison conceptuelle : LDA, ACP et régression logistique
2.1 Analyse comparative entre LDA et Analyse en Composantes Principales (ACP)
L’Analyse discriminante linéaire et l’Analyse en composantes principales (ACP) sont deux approches de transformation linéaire d’espace fréquemment juxtaposées dans la littérature en science des données. Bien qu’elles partagent des similitudes méthodologiques évidentes — notamment l’usage de diagonalisations spectrales de matrices carrées symétriques pour extraire des axes factoriels orthogonaux —, leurs objectifs mathématiques et leurs domaines d’application divergent profondément.
L’ACP est une méthode descriptive non supervisée. Son postulat téléologique consiste à maximiser la variance globale de l’échantillon projeté, sans prêter la moindre attention à d’éventuelles étiquettes ou partitions préexistantes. Géométriquement, l’ACP cherche les axes d’allongement maximal du nuage de points global dans l’espace euclidien. Cette posture agnostique présente un risque méthodologique majeur lors d’une phase de modélisation prédictive : l’axe portant la variance globale la plus élevée ne coïncide pas nécessairement avec l’axe le long duquel les groupes se séparent. Si la variabilité interne aux classes prédomine sur la variabilité inter-classes (par exemple en présence de facteurs de confusion ou de bruit expérimental massif), l’ACP retiendra ces variations indésirables en priorité, conduisant inévitablement à un écrasement destructeur des frontières de classe sur les premières composantes principales.
À l’inverse, la LDA est une méthode intrinsèquement supervisée. Guidée par le critère de Fisher, elle calibre ses axes factoriels précisément pour maximiser la séparabilité inter-classes tout en étouffant la dispersion interne. Là où l’ACP s’intéresse à la variance totale, la LDA décompose cette dernière en deux entités sous-jacentes orthogonales afin d’isoler le signal discriminant. Néanmoins, ces deux techniques s’avèrent hautement complémentaires. Dans les contextes de très haute dimension (le problème du « fléau de la dimensionnalité », typique des études génomiques ou du traitement d’images où $p gg n$), la matrice de dispersion intra-classe $S_W$ devient irrémédiablement singulière et non inversible. Dans cette situation, un protocole séquentiel classique, désigné sous l’appellation ACP-LDA, consiste à appliquer préalablement une ACP pour réduire la dimension de l’espace à une dimension inférieure à $n$, rendant ainsi $S_W$ strictement inversible et permettant à la LDA de déployer sa puissance discriminante sans instabilité matricielle.
2.2 LDA versus régression logistique multinominale
La distinction épistémologique entre l’analyse discriminante linéaire et la régression logistique multinominale relève de la dichotomie classique entre classifieurs génératifs et classifieurs discriminatifs. Bien que ces deux méthodologies produisent des frontières de décision formellement identiques — à savoir des hyperplans de décision affines —, la trajectoire analytique par laquelle elles estiment ces paramètres diffère radicalement.
La LDA se positionne en classifieur génératif. Elle vise à modéliser la distribution de probabilité conjointe $P(X, Y) = P(X mid Y) P(Y)$ en imposant une structure distributionnelle paramétrique gaussienne sur les prédicteurs conditionnellement à chaque classe. Les paramètres $\mu_k$ et $\Sigma$ sont estimés directement par la méthode des moments ou par le maximum de vraisemblance conjointe. La régression logistique, quant à elle, s’inscrit dans une démarche strictement discriminative. Elle ne formule aucun postulat quant à la distribution empirique des prédicteurs $X$ et modélise directement la probabilité conditionnelle a posteriori $P(Y mid X)$ via une fonction logistique (ou softmax dans sa version multinominale), optimisant sa fonction de log-vraisemblance conditionnelle par descente de gradient ou algorithme de Newton-Raphson.
Cette divergence architecturale dicte leur robustesse relative face aux caractéristiques du jeu de données :
- Efficacité asymptotique : Sous réserve que les postulats de normalité multivariée et d’homoscédasticité soient scrupuleusement vérifiés, la LDA est asymptotiquement plus efficiente que la régression logistique. Cela signifie qu’elle atteint une erreur d’estimation plus faible et converge plus rapidement vers la frontière optimale avec des volumes d’échantillons nettement plus restreints.
- Séparation parfaite des données : Lorsque les classes sont parfaitement scindées dans l’espace des descripteurs, la régression logistique subit une instabilité numérique sévère connue sous le nom de phénomène de quasi-séparation complète, provoquant la divergence de ses coefficients vers l’infini. La LDA ne souffre aucunement de ce problème, ses paramètres étant estimés de façon fermée et déterministe via les centroïdes et la covariance.
- Robustesse aux déviations : Si les prédicteurs comportent des variables qualitatives discrètes, présentent des queues de distribution lourdes ou violent ouvertement l’hypothèse de normalité, la régression logistique surpasse systématiquement la LDA, son approche non paramétrique la protégeant contre les biais de spécification distributionnelle.
3. Hypothèses statistiques préalables et diagnostics de validité
3.1 Normalité multivariée au sein de chaque modalité
L’assise formelle de l’analyse discriminante linéaire repose sur l’hypothèse canonique selon laquelle les vecteurs de caractéristiques conditionnés par la classe $k$ se conforment rigoureusement à une loi normale multivariée $\mathcal{N}_p(\mu_k, \Sigma)$. Cette présupposition implique non seulement que chaque descripteur pris individuellement doive présenter une distribution univariée en cloche, symétrique et sans aplatissement excessif, mais également que toute combinaison linéaire quelconque de ces prédicteurs suive également une loi normale univariée.
Dans la pratique statistique, les déviations modérées par rapport à cette hypothèse de normalité multivariée n’annihilent pas nécessairement l’efficacité de la LDA. L’algorithme fait preuve d’une certaine résilience empirique, notamment grâce aux propriétés asymptotiques induites par le théorème central limite lorsque la taille de chaque sous-échantillon $n_k$ est substantielle (typiquement supérieure à quelques dizaines d’individus par modalité). Néanmoins, la présence d’une asymétrie marquée (skewness prononcée) ou de queues de distribution particulièrement épaisses (kurtosis élevée) altère significativement l’estimation des centroïdes empiriques et de la matrice de covariance combinée, induisant un décalage biaisé de l’hyperplan séparateur optimal.
Face à des non-normalités substantielles, les statisticiens recourent fréquemment à des transformations de variables stabilisatrices de variance et symétrisantes. L’application d’opérateurs mathématiques tels que la transformation logarithmique, la racine carrée ou, de façon plus systématique, la transformation paramétrique de Box-Cox ou de Yeo-Johnson, permet de contraindre les distributions asymétriques à se rapprocher d’un comportement quasi-gaussien, rétablissant ainsi l’intégrité fonctionnelle des déductions probabilistes bayésiennes de la LDA.
3.2 Homoscédasticité et égalité des matrices de covariance
La seconde hypothèse structurelle, et sans doute la plus critique pour la LDA, est celle de l’homogénéité des matrices de variance-covariance entre l’ensemble des classes sous examen, formellement désignée par le terme d’homoscédasticité. Mathématiquement, ce postulat s’énonce :
$$\Sigma_1 = \Sigma_2 = dots = \Sigma_K = \Sigma$$
C’est précisément cette égalité structurelle qui autorise l’annulation des composantes quadratiques lors de l’établissement du ratio de vraisemblance logarithmique dans la règle du maximum a posteriori, forçant ainsi l’équation de la frontière de décision à demeurer strictement linéaire.
Lorsque cette présomption d’équivalence est violée — une situation couramment qualifiée d’hétéroscédasticité —, les variances et covariances propres à chaque groupe divergent sensiblement les unes des autres. L’application aveugle d’une LDA sous de telles conditions engendre une instabilité majeure : la matrice combinée $S_W$ ne reflète plus fidèlement la courbure locale des différentes sous-populations, ce qui conduit à une sous-estimation systématique du taux d’erreur dans les classes à forte variance et à des frontières linéaires incapables d’envelopper correctement les nuages de points d’extensions divergentes.
Sur le plan théorique, la réponse naturelle à l’hétéroscédasticité réside dans l’adoption de l’analyse discriminante quadratique (QDA, pour Quadratic Discriminant Analysis). La QDA préserve la matrice de covariance singulière $\Sigma_k$ de chaque groupe, ce qui génère des frontières de décision modélisées par des formes quadratiques (ellipses, paraboles, hyperboles). Toutefois, cette flexibilité accrue a un coût computationnel et paramétrique élevé : la QDA requiert l’estimation de $K$ matrices de covariance distinctes, multipliant le nombre de paramètres libres à ajuster par un facteur proportionnel à $K p^2$, augmentant de ce fait le risque de surapprentissage sur de petits échantillons.
3.3 Absence de multicollinéarité parfaite et indépendance des observations
Le fonctionnement algébrique intrinsèque de la LDA exige impérativement que la matrice de dispersion intra-classe $S_W$, ou de manière analogue la matrice de covariance combinée $\Sigma$, soit strictement inversible. L’inversibilité d’une matrice carrée de taille $p \times p$ requiert qu’elle soit de plein rang, c’est-à-dire que son déterminant soit strictement non nul : $det(S_W) \neq 0$. Cette condition formelle impose deux prérequis statistiques stricts :
- Absence de multicollinéarité stricte : Aucun prédicteur ne doit être une combinaison linéaire parfaite d’autres prédicteurs. Une colinéarité critique entre variables explicatives produit une matrice de covariance quasi-singulière, se traduisant par des valeurs propres infinitésimales et un nombre de conditionnement matriciel extrêmement élevé, ce qui provoque une explosion de la variance des coefficients discriminants estimés.
- Rapport taille d’échantillon / dimension : Le nombre total d’observations doit impérativement excéder le nombre de variables explicatives minoré du nombre de classes, soit structurellement $n – K > p$. Lorsque $p > n$, $S_W$ devient mathématiquement dégénérée (de rang au maximum $n – K$), interdisant toute inversion directe par les algorithmes conventionnels.
Parallèlement, la théorie d’échantillonnage sous-tendant la LDA postule l’indépendance statistique absolue des observations constituant l’échantillon d’apprentissage. Toute présence d’autocorrélation temporelle, spatiale ou de structures hiérarchiques emboîtées sans modélisation adéquate biaise les variances résiduelles et conduit à des estimations de significativité excessivement optimistes.
4. Étape 1 : Configuration de l’environnement Python et importation des modules
4.1 Mise en place de l’écosystème scientifique
La concrétisation informatique d’une analyse discriminante linéaire rigoureuse requiert un environnement de calcul scientifique moderne. L’écosystème Python propose une suite de bibliothèques éprouvées garantissant une efficacité algorithmique adossée à des routines compilées de bas niveau (telles que BLAS et LAPACK). Pour conduire l’intégralité du pipeline méthodologique — de la vérification diagnostique des hypothèses théoriques jusqu’à l’ajustement du modèle et sa visualisation géométrique —, l’ingestion d’un ensemble ciblé de bibliothèques est indispensable.
L’environnement repose sur les fondations matricielles et tabulaires fournies respectivement par NumPy pour l’algèbre linéaire haute performance et Pandas pour la manipulation structurelle des données. La couche d’analyse statistique inférentielle et de vérification d’hypothèses sollicite les modules spécialisés de SciPy (notamment la composante scipy.stats) complétés par des routines de Statsmodels pour l’évaluation de la colinéarité. L’infrastructure d’apprentissage automatique est prise en charge de manière unifiée par Scikit-Learn, dont la classe LinearDiscriminantAnalysis forme le cœur fonctionnel de notre démarche. Enfin, la restitution visuelle de la cartographie multidimensionnelle et des frontières de décision s’appuie sur la synergie entre Matplotlib et Seaborn.
Une précaution méthodologique élémentaire mais impérative réside dans la gestion de la reproductibilité scientifique. La plupart des opérations subséquentes, telles que les fractionnements d’échantillons ou les validations croisées itératives, intègrent des composantes stochastiques d’échantillonnage aléatoire. La fixation rigoureuse d’une graine aléatoire globale (random seed) au sein des différents modules constitue le garant d’une reproductibilité exacte des métriques et des trajectoires de projection obtenues.
4.2 Inspection des dépendances et de l’architecture logicielle
Au-delà de la simple disponibilité des bibliothèques au sein de l’interpréteur Python, il convient d’attacher une importance critique à l’intégrité structurelle des structures de données allouées en mémoire vive. L’analyse discriminante linéaire impliquant de fréquentes opérations d’inversion matricielle, de factorisation de Cholesky ou de décomposition en valeurs singulières, l’adéquation des types de données (privilégiant les structures continues en mémoire de type float64) permet de prévenir les phénomènes pernicieux d’instabilité numérique ou de débordement de mémoire.
L’ordonnancement de l’architecture logicielle du pipeline de modélisation doit impérativement respecter les recommandations formulées par la spécification de style PEP 8. La séparation hermétique entre la phase d’ingestion des données, la phase de validation diagnostique exploratoire, le cycle d’entraînement paramétrique et la couche d’évaluation des performances garantit une maintenabilité optimale du code et élimine le risque majeur de fuite de données (data leakage) au sein des routines prédictives.
Il est également recommandé d’examiner attentivement la compatibilité des versions installées dans l’interpréteur d’exécution, la bibliothèque Scikit-Learn ayant fait évoluer au fil de ses versions majeures l’ordonnancement interne de ses solveurs discriminants et les signatures d’appels de ses métriques de performance visuelle.
5. Étape 2 : Chargement, exploration et préparation structurée des données
5.1 Acquisition et conversion du jeu de données en DataFrame
Afin d’illustrer de manière limpide la mécanique opérationnelle de l’analyse discriminante linéaire, le recours à un jeu de données morphologiques canonique ou psychométrique s’impose. Le jeu de données classique des Iris de Fisher, collecté initialement par le botaniste Edgar Anderson et popularisé mondialement par Fisher en 1936, incarne le cas d’étude paradigmatique pour la LDA. Composé de 150 observations réparties équitablement entre trois espèces florales (Iris setosa, Iris versicolor et Iris virginica), il comprend quatre prédicteurs continus décrivant la longueur et la largeur des sépales et des pétales.
L’extraction programmatique s’effectue directement via les chargeurs intégrés de Scikit-Learn (load_iris) ou depuis des dépôts structurés. Pour garantir une traçabilité expérimentale absolue, les données matricielles brutes doivent être converties en une structure tabulaire unifiée de type DataFrame Pandas. Lors de cette conversion, les prédicteurs morphologiques sont explicitement renommés (par exemple sepal_length, sepal_width, petal_length, petal_width), tandis que le vecteur des cibles catégorielles est converti en une série typée formellement pour expliciter la sémantique des classes d’appartenance.
Cette rigueur de typage est cruciale : elle garantit que les descripteurs numériques soient instanciés sous forme de scalaires réels continus, interdisant toute conversion accidentelle en variables ordinales ou catégorielles qui viendrait corrompre la validité des calculs de barycentres et de matrices de dispersion.
5.2 Analyse exploratoire et caractérisation descriptive des groupes
Avant d’engager tout processus d’estimation paramétrique, une caractérisation statistique granulaire des sous-populations s’avère indispensable. L’évaluation de la distribution marginale de chaque variable explicative doit être opérée de manière conditionnelle à chaque classe. Cette démarche descriptive implique l’extraction des moments statistiques fondamentaux : la moyenne arithmétique empirique, qui localise le centre de gravité unidimensionnel de la classe, l’écart-type, qui en jauge la dispersion locale, ainsi que les quantiles permettant d’appréhender la présence potentielle d’asymétrie ou de valeurs aberrantes.
L’exploration multivariée se déploie à travers l’observation de diagrammes de dispersion croisés (pairplots). Ces visualisations bidimensionnelles croisées permettent de matérialiser les degrés relatifs de chevauchement entre les différentes modalités :
- Dans le cas spécifique des Iris, les représentations bivariées révèlent immédiatement que la classe Iris setosa s’isole de manière quasi absolue du reste de l’échantillon, suggérant une séparabilité linéaire triviale le long de dimensions individuelles telles que la longueur du pétale.
- En revanche, les distributions d’Iris versicolor et d’Iris virginica exhibent une zone de contiguïté et de recouvrement partiel substantielle, positionnant l’optimisation géométrique de Fisher comme un instrument analytique nécessaire pour résoudre l’ambiguïté morphologique entre ces deux taxons.
Cette phase exploratoire vérifie également l’équilibre marginal des classes. L’égalité exacte des effectifs au sein des trois modalités ($n_k = 50$) confère à notre échantillon une structure homosymétrique, ce qui simplifie l’influence des probabilités a priori $\pi_k = 1/3$ sur la translation spatiale des frontières de décision.
6. Étape 3 : Tests d’adéquation statistique des hypothèses en Python
6.1 Évaluation numérique de la normalité univariée et multivariée
La validité des inférences probabilistes bayésiennes dérivées de la LDA repose sur la conformité de chaque sous-groupe à une distribution normale multivariée. Pour auditer cette exigence sur le plan empirique, une double démarche — analytique et graphique — doit être mise en œuvre de façon scrupuleuse pour chaque classe considérée isolément.
Dans un premier temps, la normalité univariée de chaque variable au sein de chaque groupe est interrogée à l’aide du test de Shapiro-Wilk, implémenté via la fonction scipy.stats.shapiro. Ce test statistique calcule une statistique d’adéquation $W$ comparant les écarts empiriques ordonnés aux quantiles théoriques d’une loi gaussienne. Une valeur $p$ inférieure au seuil alpha conventionnel (communément fixé à 0,05) conduit au rejet de l’hypothèse nulle de normalité. Cette vérification numérique gagne à être systématiquement enrichie par la génération de tracés quantile-quantile univariés (Q-Q plots via statsmodels.graphics.gofplots.qqplot), qui permettent d’identifier directement la morphologie des déviations : concavité traduisant une asymétrie, ou écarts marqués sur les extrémités signifiant un phénomène d’épaississement des queues de distribution.
Toutefois, la juxtaposition de distributions marginales univariées normales ne constitue en rien une condition suffisante pour attester de la normalité conjointe multivariée. Il est dès lors impératif de recourir à des tests d’adéquation multivariée, tels que le test de Mardia (fondé sur les coefficients multivariés d’asymétrie et d’aplatissement) ou le test robuste d’Henze-Zirkler. Ces tests évaluent globalement si la distance de Mahalanobis des individus par rapport au centroïde de leur classe se conforme rigoureusement à une loi théorique du chi-deux à $p$ degrés de liberté, garantissant ainsi l’intégrité de la modélisation générative.
6.2 Contrôle de l’homogénéité des matrices de covariance
L’hypothèse d’homoscédasticité — prérequis absolu pour assurer la stricte linéarité des frontières discriminantes — requiert une procédure diagnostique rigoureuse destinée à éprouver l’invariance de la matrice de covariance à travers les différents groupes.
À l’échelle univariée, l’homogénéité des variances pour chaque descripteur isolé peut être examinée par le biais du test de Levene (scipy.stats.levene), qui présente l’avantage remarquable d’être nettement moins sensible aux déviations de normalité que le test classique de Bartlett. Si la valeur $p$ associée s’avère non significative, l’hypothèse de constance des variances marginales peut être provisoirement retenue.
Cependant, à l’instar de la normalité, l’égalité des variances marginales ne garantit nullement l’égalité des covariances croisées. L’évaluation formelle de l’homoscédasticité multivariée exige la mise en œuvre du test M de Box. La statistique de Box repose sur une comparaison log-vraisemblance entre le déterminant de la matrice de covariance combinée $S_W$ et la somme pondérée des logarithmes des déterminants des matrices de covariance empiriques individuelles $S_k$ :
$$M = (n – K) ln|S_W| – \sum_{k=1}^K (n_k – 1) ln|S_k|$$
Le test M de Box est notoirement conservateur et extrêmement sensible aux légères entorses à la normalité gaussienne, rejetant souvent l’hypothèse nulle à tort dans les grands échantillons. En pratique, les analystes complètent ce test par une inspection visuelle directe des matrices de corrélation par classe au moyen de cartes thermiques (heatmaps Seaborn), évaluant si les structures de dépendance bivariée présentent des disparités morphologiques excessives justifiant un arbitrage méthodologique vers la QDA.
6.3 Détection de la multicolinéarité et conditionnement
L’inversibilité mathématique et la stabilité computationnelle de la matrice de dispersion intra-classe $S_W$ dépendent étroitement de l’absence de redondance linéaire critique entre les prédicteurs. Lorsque deux descripteurs ou davantage capturent une information informationnellement redondante, la matrice tend vers la singularité, provoquant une instabilité stochastique majeure des coefficients de projection.
Le diagnostic de cette pathologie s’effectue couramment par l’extraction du facteur d’inflation de la variance (VIF, pour Variance Inflation Factor) pour chaque variable explicative. Le VIF mesure l’ampleur selon laquelle la variance d’un coefficient de régression estimé est gonflée en raison de la colinéarité de cette variable avec l’ensemble des autres descripteurs du modèle. Il est calculé selon la relation :
$$\text{VIF}_j = \frac{1}{1 – R_j^2}$$
où $R_j^2$ représente le coefficient de détermination issu de la régression de la $j$-ème variable sur toutes les autres variables prédictives disponibles. Une valeur de VIF excédant le seuil empirique de 5 ou 10 signale une colinéarité sévère nécessitant une intervention structurelle : élimination sélective de la variable redondante, synthèse par projection en amont ou incorporation d’un facteur de régularisation matricielle.
Parallèlement au VIF, l’examen spectral de la matrice de covariance par l’évaluation de son nombre de conditionnement — défini par le ratio entre la plus grande et la plus petite valeur propre de la matrice — permet de jauger la sensibilité numérique du système d’équations linéaires. Un indice de conditionnement disproportionné prévient l’analyste de l’imminence d’erreurs d’arrondi numérique délétères lors de l’étape d’inversion.
7. Étape 4 : Partitionnement des données et protocole de validation croisée
7.1 Division stratifiée de l’échantillon d’entraînement et de test
Afin de mesurer de manière impartiale la capacité de généralisation statistique de l’analyse discriminante linéaire sur des observations non observées lors de l’ajustement, l’échantillon global doit être fractionné hermétiquement en un sous-ensemble d’apprentissage (training set) et un sous-ensemble de test indépendant (test set).
Ce partitionnement ne saurait être opéré par un tirage aléatoire uniforme simple. En présence de classes multiples, un tirage non contrôlé risque d’induire des distorsions préjudiciables dans les proportions relatives des groupes, voire de sous-représenter dramatiquement une modalité minoritaire au sein de la cohorte de validation. Il est par conséquent impératif de recourir à un fractionnement stratifié, implémenté dans Scikit-Learn via train_test_split en activant le paramètre stratify=y. Ce procédé contraint l’algorithme d’échantillonnage à répliquer rigoureusement la distribution marginale originale des classes au sein de chaque compartiment.
D’un point de vue méthodologique, l’arbitrage du ratio d’allocation s’établit généralement selon les proportions canoniques 70/30 ou 80/20, garantissant un volume d’observations suffisant au sein du bloc d’entraînement pour permettre une convergence asymptotique robuste des estimateurs des centroïdes $\mu_k$ et de la covariance combinée $\Sigma$, tout en conservant une taille de test représentative pour calculer des intervalles de confiance étroits autour des métriques d’exactitude.
7.2 Standardisation conditionnelle des prédicteurs
L’impact de la mise à l’échelle des descripteurs sur l’analyse discriminante linéaire soulève des débats théoriques d’une grande subtilité. D’un point de vue strictement analytique, la formulation mathématique classique de la LDA est invariante face à toute transformation affine inversible appliquée aux variables. Puisque l’opérateur de Mahalanobis intègre l’inverse de la matrice de covariance $\Sigma^{-1}$, tout facteur d’échelle constant multipliant un prédicteur est mathématiquement neutralisé par la mise à l’échelle inverse de la variance correspondante au dénominateur.
Toutefois, sur le plan de la stabilité informatique et de l’implémentation algorithmique, la standardisation préalable des variables (centrage pour obtenir une moyenne nulle et réduction pour fixer la variance unitaire via StandardScaler) offre des bénéfices substantiels :
- Elle atténue considérablement les risques de dépassement de capacité (overflow ou underflow numérique) lors du traitement de jeux de données comportant des échelles disparates s’étendant sur plusieurs ordres de grandeur.
- Elle stabilise les solveurs matriciels reposant sur la décomposition en valeurs singulières ou la régularisation pénalisée.
- Elle confère une lisibilité immédiate aux coefficients discriminants extraits a posteriori, permettant de déduire l’importance prédictive relative de chaque variable sans artefact d’unité de mesure.
Une précaution méthodologique stricte doit être respectée : le transformateur StandardScaler doit être calibré exclusivement sur le jeu d’apprentissage à l’aide de la méthode fit_transform, puis appliqué sur les données de test au moyen exclusif de la méthode transform. Cette précaution prévient toute fuite d’information statistique entre les deux sous-ensembles.
7.3 Schéma de validation croisée stratifiée répétée
Bien que le simple fractionnement entraînement/test fournisse une première estimation des capacités de généralisation, il demeure tributaire de la variance d’échantillonnage inhérente au découpage initial, particulièrement sur des jeux de données d’envergure modeste comme celui des Iris de Fisher. Pour obtenir une évaluation exempte de biais de partitionnement, l’implémentation d’une validation croisée stratifiée répétée (Repeated Stratified K-Fold) s’impose comme le standard méthodologique de référence.
Cette approche consiste à diviser les données d’entraînement en $K$ plis (généralement 5 ou 10) tout en préservant scrupuleusement la représentativité proportionnelle de chaque classe. L’algorithme est successivement ajusté sur $K-1$ plis et évalué sur le pli résiduel, le processus étant itéré de façon cyclique jusqu’à ce que chaque segment ait opéré en tant qu’ensemble de validation. La répétition de ce processus sur plusieurs tirages aléatoires distincts (par exemple 10 répétitions d’un 5-fold) permet d’obtenir une distribution empirique des scores de performance, autorisant ainsi le calcul de moyennes robustes et la dérivation d’intervalles de dispersion statistique quantifiant avec précision la stabilité structurelle du modèle.
8. Étape 5 : Entraînement et ajustement du modèle LDA avec Scikit-Learn
8.1 Instanciation de la classe LinearDiscriminantAnalysis
L’implémentation de la LDA dans la bibliothèque Scikit-Learn s’effectue à travers la classe unifiée sklearn.discriminant_analysis.LinearDiscriminantAnalysis. Cette classe encapsule l’ensemble des mécanismes d’estimation paramétrique et de projection sous-spatiale. Son instanciation judicieuse requiert néanmoins un arbitrage rigoureux concernant le paramètre central désigné par l’argument solver, qui détermine la nature du moteur d’algèbre linéaire mobilisé pour exécuter la discrimination :
solver='svd'(Singular Value Decomposition) : Il s’agit du solveur configuré par défaut. Il calcule directement la décomposition en valeurs singulières de la matrice des données centrées sans former explicitement la matrice de covariance combinée $S_W$. Cette approche confère au solveur une supériorité numérique considérable, éliminant les pertes de précision liées au produit matriciel $X^T X$. Il est particulièrement recommandé pour les matrices denses conventionnelles, bien qu’il interdise l’application de techniques de rétrécissement de covariance (shrinkage).solver='lsqr'(Least Squares QR) : Ce solveur résout le système d’équations en exploitant les moindres carrés régularisés. Il présente l’immense avantage théorique d’autoriser l’activation du paramètreshrinkage, ce qui le rend idéal lorsque le nombre de prédicteurs est substantiel ou que la matrice approche la singularité.solver='eigen'(Eigenvalue Decomposition) : Ce solveur applique la diagonalisation classique sur le ratio de Rayleigh $S_W^{-1} S_B$. Bien qu’il autorise également le rétrécissement de variance, il peut se révéler moins stable numériquement en présence d’un fort conditionnement matriciel.
L’argument priors permet d’injecter manuellement des probabilités d’appartenance a priori personnalisées. En l’absence de spécification explicite, la classe calcule automatiquement la fréquence empirique relative de chaque classe au sein du sous-ensemble d’apprentissage ($\pi_k = n_k / n$). Dès lors, l’exécution de la méthode fit(X_train, y_train) engage la calibration fermée des centroïdes vectoriels et des opérateurs de projection.
8.2 Analyse des paramètres estimés par l’algorithme
Une fois le cycle d’ajustement complété, le modèle LDA instancié stocke au sein de ses attributs internes l’ensemble des grandeurs géométriques et statistiques estimées. L’inspection de ces paramètres fournit un éclairage précieux sur l’organisation spatiale des groupes identifiés par l’algorithme.
L’attribut means_ renferme les coordonnées exactes des vecteurs centroïdes $\mu_k$ pour chacune des classes analysées dans l’espace des descripteurs standardisés. L’examen des écarts euclidiens entre ces moyennes multivariées préfigure l’axe le long duquel s’exercera la discrimination maximale. L’attribut priors_ consigne les probabilités a priori effectivement retenues lors du calcul des fonctions discriminantes bayésiennes.
Un paramètre d’une importance analytique fondamentale est matérialisé par l’attribut explained_variance_ratio_. À l’instar de l’analyse en composantes principales, ce vecteur contient la proportion relative du pouvoir de séparation inter-classes capturée par chaque fonction discriminante linéaire successive. Chaque valeur scalaire correspond au ratio entre la valeur propre $\lambda_i$ associée au $i$-ème axe discriminant et la somme totale des valeurs propres extraites de l’opérateur $S_W^{-1} S_B$ :
$$\text{Ratio}_i = \frac{\lambda_i}{\sum_{j=1}^{\min(K-1, p)} \lambda_j}$$
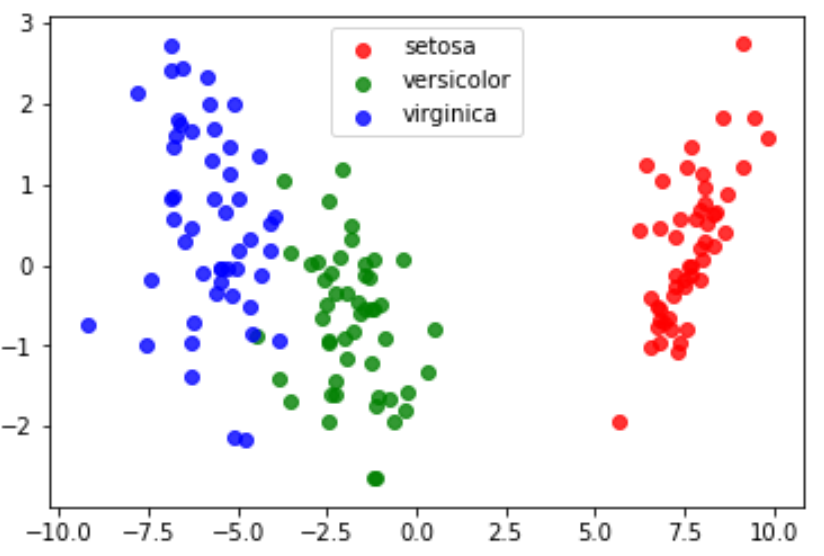
Dans l’analyse morphologique des Iris de Fisher, la première composante discriminante linéaire (LD1) capte généralement plus de 99 % de la séparabilité inter-classes totale. Cette concentration massive démontre qu’une unique dimension de projection linéaire suffit à discriminer l’essentiel de la variance morphologique entre les trois espèces florales.
9. Étape 6 : Réduction de dimensionnalité et projection géométrique
9.1 Transformation des données dans l’espace sous-jacent
Au-delà de son statut de classifieur bayésien, l’analyse discriminante linéaire déploie toute sa pertinence analytique lors de l’application de sa méthode transform. Cette opération applique formellement la matrice de projection $W$, composée des vecteurs propres discriminants normalisés, sur la matrice initiale des descripteurs $X$, réalisant ainsi le changement de base vectoriel :
$$Z = X W$$
Les nouvelles colonnes générées au sein de la matrice projetée $Z$, classiquement désignées sous les vocables de composantes discriminantes linéaires (notées LD1, LD2, etc.), constituent des combinaisons linéaires optimales des caractéristiques d’origine. Chaque individu est désormais repéré par ses coordonnées factorielles au sein de ce sous-espace de dimension réduite à son strict minimum informatif ($K-1$).
Cette transformation doit être opérée de façon symétrique sur la matrice d’apprentissage standardisée et sur la matrice de test indépendante. L’analyse descriptive de ces scores discriminants projetés permet d’évaluer immédiatement la puissance de compression de la LDA : sur le premier axe discriminant, les barycentres des différentes classes se trouvent écartés à leur distance de Mahalanobis maximale, tandis que l’étalement interne de chaque classe est réduit à l’isotropie sphérique.
Il est important de noter une différence géométrique majeure avec l’ACP : bien que les vecteurs de projection dérivés de l’opérateur $S_W^{-1} S_B$ soient linéairement indépendants, ils ne sont pas mutuellement orthogonaux au sens du produit scalaire euclidien usuel. Ils satisfont en revanche à une condition d’orthogonalité généralisée pondérée par la matrice de covariance intra-classe, vérifiant l’égalité matricielle formelle $W^T S_W W = I$, où $I$ représente la matrice identité.
9.2 Visualisation bidimensionnelle des projections et des frontières
L’exploitation graphique de l’espace latent sous-jacent culmine avec la construction d’un diagramme de dispersion bidimensionnel projetant les individus selon les axes factoriels LD1 et LD2. Cette visualisation permet d’appréhender intuitivement la structure topologique de la séparation des classes.
Pour enrichir la rigueur diagnostique de cette représentation visuelle, la superposition d’ellipses de confiance paramétriques (à un seuil conventionnel de 95 %) autour des centroïdes de chaque groupe s’avère particulièrement instructive. Ces ellipses, tracées à partir des sous-matrices de covariance projetées, permettent de matérialiser visuellement la dispersion locale de chaque modalité. La quasi-circularité et l’égalité de volume de ces ellipses constituent un indicateur empirique d’un parfait respect de l’homoscédasticité et de l’isotropie recherchées par l’opérateur de projection.
Enfin, la cartographie exhaustive des frontières de décision linéaire peut être dressée en instanciant un maillage bidimensionnel dense (meshgrid) sur l’étendue des axes LD1 et LD2. En assignant chaque nœud de cette grille à sa classe prédite par la LDA bayésienne, des surfaces de couleur distinctes segmentent le plan. Cette approche graphique rend directement perceptibles la rectitude absolue des frontières de coupure, la disposition angulaire des hyperplans séparateurs ainsi que l’identification immédiate d’éventuelles observations marginales localisées dans des zones d’ambiguïté frontalière ou formellement mal classées.
10. Étape 7 : Évaluation rigoureuse des performances et métriques de classification
10.1 Matrice de confusion et analyse granulaire des erreurs
L’évaluation quantitative des performances de classification de l’analyse discriminante linéaire s’articule initialement autour de l’extraction de la matrice de confusion sur le jeu de données de test, visualisée préférentiellement via la classe ConfusionMatrixDisplay de Scikit-Learn. Cette matrice carrée $K \times K$ juxtapose de manière exhaustive les étiquettes réelles observées (lignes) et les assignations prédites par le modèle bayésien (colonnes).
L’analyse de cette matrice ne doit pas se limiter à la simple lecture du taux de précision global (overall accuracy), lequel peut masquer des disparités diagnostiques majeures. Une décomposition granulaire des taux d’erreur implique le calcul de métriques sectorielles ciblées :
- La précision (precision) : Elle mesure la fiabilité prédictive du modèle lorsqu’il affirme l’appartenance à une classe donnée, quantifiant la proportion d’individus effectivement pertinents parmi l’ensemble des prédictions positives d’une modalité.
- Le rappel (recall ou sensibilité) : Il mesure l’exhaustivité de la détection, quantifiant la capacité intrinsèque du modèle à identifier l’intégralité des membres réels d’une sous-population sans omission.
- Le score F1 (F1-score) : Il fournit la moyenne harmonique équilibrée entre précision et rappel, offrant un indicateur synthétique résilient.
Dans un contexte multiclasse, ces métriques doivent être consolidées selon des schémas d’agrégation macro (accordant un poids rigoureusement identique à chaque modalité indépendamment de son effectif) et pondéré (pondéré par le support réel de chaque classe). L’examen attentif des confusions asymétriques — par exemple le transfert erroné d’individus d’Iris versicolor vers la modalité Iris virginica — permet de sonder avec précision la localisation topologique du déficit d’étanchéité des frontières linéaires.
10.2 Probabilités d’appartenance et courbes ROC multiclasses
L’un des atouts prééminents de la LDA en tant que modèle probabiliste génératif réside dans sa capacité à délivrer, au-delà d’une simple affectation discrète, une estimation vectorielle continue des probabilités a posteriori d’appartenance via l’invocation de sa méthode predict_proba. Chaque observation se voit ainsi associer un vecteur de probabilités $\left(P(Y = C_1 mid x), dots, P(Y = C_K mid x)\right)$ contraint sur le simplexe standard de probabilité.
Cette granularité probabiliste permet d’évaluer la sensibilité de la séparation par l’établissement des courbes ROC (Receiver Operating Characteristic) multiclasses. La stratégie préconisée repose sur l’approche dite « un contre tous » (One-vs-Rest ou OvR), qui décompose le problème à $K$ classes en $K$ problématiques binaires indépendantes. Pour chaque classe prise individuellement comme classe positive face à l’agrégation de toutes les autres :
- La courbe ROC est tracée en faisant varier continûment le seuil d’acceptation probabiliste de 0 à 1, confrontant le taux de vrais positifs au taux de faux positifs.
- L’aire sous la courbe (AUC, pour Area Under the Curve) est intégrée pour fournir une mesure quantitative absolue de la séparabilité probabiliste, invariante face au déséquilibre des effectifs.
- Des moyennes consolidées, micro-moyennées (agrégeant les contributions globales) et macro-moyennées (moyennant simplement les AUC individuelles), synthétisent le niveau de discrimination global du modèle.
De surcroît, la fiabilité de ces probabilités peut être interrogée par des courbes de calibration (diagrammes de fiabilité), vérifiant si une assignation à un indice de confiance de 80 % correspond empiriquement à une fréquence réelle de succès avoisinant 80 %.
10.3 Validation de la stabilité par cross_val_score
Pour parachever l’évaluation des capacités de généralisation sans dépendre de la chance d’un tirage singulier du jeu de test, la fonction cross_val_score de Scikit-Learn est sollicitée pour conduire une validation croisée automatisée sur l’intégralité du jeu d’échantillons initial. Cette procédure itérative soumet le pipeline complet (englobant la standardisation et l’ajustement du modèle) à une série rigoureuse d’épreuves de réplication.
L’exploitation statistique des résultats obtenus transcende la simple présentation d’un score d’exactitude moyen. L’écart-type des performances d’exactitude ou de F1-score à travers l’ensemble des plis constitue l’indicateur par excellence de la stabilité structurelle du modèle : un écart-type particulièrement bas démontre l’insensibilité du classifieur aux fluctuations de l’échantillonnage expérimental, tandis qu’une dispersion notable trahit une sensibilité pathologique aux variations locales des données.
En s’appuyant sur cette distribution des scores de validation croisée, l’analyste formule un intervalle de confiance empirique (généralement à un niveau de confiance de 95 %) encadrant la performance moyenne de généralisation attendue lors du déploiement futur de la solution sur de nouvelles observations issues de la même population statistique.
11. Étape 8 : Interprétation analytique des coefficients discriminants
11.1 Interprétation des coefficients bruts et standardisés
L’un des avantages comparatifs les plus remarquables de l’analyse discriminante linéaire vis-à-vis des méthodes d’apprentissage automatique contemporaines réside dans sa complète transparence explicative. Les paramètres constitutifs de l’hyperplan de décision sont directement accessibles au sein des attributs coef_ et intercept_ de l’objet Scikit-Learn une fois le modèle ajusté.
L’attribut coef_ renferme une matrice dont les lignes correspondent aux équations linéaires associées à chaque classe (ou à chaque frontière binaire). Chaque coefficient scalaire $\beta_{kj}$ traduit la sensibilité de la fonction discriminante de la classe $k$ face à une variation marginale de la $j$-ème variable explicative. Cependant, lorsque les variables d’origine sont exprimées dans leurs unités physiques hétérogènes (par exemple en millimètres, années ou grammes), ces coefficients bruts ne peuvent être comparés directement pour hiérarchiser l’impact des prédicteurs.
Pour contourner ce biais dimensionnel, il est nécessaire de calculer et d’interpréter les coefficients discriminants standardisés. Si le modèle a été ajusté sur des variables préalablement centrées et réduites par StandardScaler, les coefficients issus de coef_ sont d’emblée affranchis de l’effet d’échelle. Dans le cas contraire, la standardisation s’opère a posteriori en multipliant chaque coefficient brut par l’écart-type intra-classe empirique de la variable correspondante :
$$\beta_{kj}^* = \beta_{kj} \times s_{W, j}$$
L’examen des magnitudes absolues $|\beta_{kj}^*|$ met en lumière la hiérarchie d’importance des prédicteurs. Une variable dotée d’un coefficient standardisé de forte amplitude et de signe positif concourt de manière prépondérante à orienter l’assignation vers la classe considérée, tandis qu’une valeur proche de zéro atteste de l’inutilité relative de ce descripteur au sein du processus de séparation linéaire conjointe.
Le terme constant (intercept_), quant à lui, intègre simultanément le terme de pénalité quadratique issu des moyennes de groupes et l’ajustement logarithmique lié aux probabilités a priori ($\ln \pi_k$), opérant la translation rigoureuse de l’hyperplan dans l’espace afin d’optimiser le compromis d’erreur global.
11.2 Corrélations canoniques et saturations factorielles
Bien que l’analyse des coefficients discriminants standardisés fournisse une vue synthétique de l’impact individuel de chaque prédicteur, elle peut être trompeuse en présence de corrélations inter-variables modérées, les coefficients reflétant l’apport partiel d’une variable conditionnellement à la présence de toutes les autres au sein de l’équation.
Pour contourner cette limite, les statisticiens recourent à l’analyse des corrélations structurelles (souvent désignées sous le vocable de saturations factorielles ou structure loadings). Une saturation factorielle correspond au coefficient de corrélation linéaire de Pearson mesuré entre les valeurs prises par une variable originale spécifique et les coordonnées factorielles projetées (les scores LD) des observations sur un axe discriminant donné :
$$r_{j, m} = \text{Corr}(X_j, \text{LD}_m)$$
Ce calcul débouche sur la matrice des saturations discriminantes. Contrairement aux coefficients de régression multivariés, ces corrélations structurelles bivariées ne sont pas perturbées par la colinéarité résiduelle existant entre les prédicteurs. Elles reflètent la véritable affinité substantielle existant entre chaque descripteur physique et la dimension conceptuelle abstraite capturée par la fonction discriminante :
- Une saturation s’élevant au-delà de 0,5 ou 0,6 en valeur absolue signale que la variable d’origine est intrinsèquement liée à l’axe factoriel considéré.
- Dans l’exemple canonique des Iris, les variables morphologiques liées aux pétales (longueur et largeur du pétale) affichent des corrélations structurelles quasi unitaires avec la première composante discriminante (LD1), confirmant sans ambiguïté que la première dimension de Fisher s’assimile à un méta-descripteur synthétique de la taille du pétale.
La synthèse graphique conjointe de ces saturations factorielles sous la forme de cercles de corrélations structurelles permet de clôturer la démarche analytique par une interprétation thématique et opérationnelle exhaustive des axes sous-tendant la classification.
12. Diagnostics avancés, limites méthodologiques et alternatives
12.1 Gestion des violations d’hypothèses et alternatives non linéaires
Lorsque les vérifications diagnostiques conduites en amont révèlent des déviations patentes par rapport aux postulats fondateurs de l’analyse discriminante linéaire, le maintien d’une formulation linéaire stricte peut dégrader la validité des résultats prédictifs. Plusieurs extensions mathématiques permettent de surmonter ces impasses méthodologiques.
En présence d’une violation formelle du postulat d’homoscédasticité (écart statistiquement significatif au test M de Box et dispersions géométriques asymétriques), l’alternative méthodologique directe réside dans l’analyse discriminante quadratique (QDA). En renonçant à la contrainte d’une matrice de covariance commune $\Sigma$, la QDA autorise chaque classe à modéliser sa propre géométrie interne via $\Sigma_k$. Les surfaces séparatrices adoptent alors des courbures paraboliques, hyperboliques ou elliptiques capables d’envelopper adéquatement des sous-populations aux dispersions dissemblables, sous réserve toutefois de disposer d’un effectif suffisant pour estimer le surplus de paramètres de covariance sans induire de surapprentissage.
Lorsque les données souffrent à la fois d’hétéroscédasticité et d’une taille d’échantillon restreinte, une voie médiane réside dans l’analyse discriminante régularisée (RDA, pour Regularized Discriminant Analysis). Conçue par Jerome Friedman en 1989, la RDA introduit deux hyperparamètres continus $\alpha$ et $\gamma$ réalisant un double compromis : un rétrécissement de la matrice propre de chaque classe $\Sigma_k$ vers la matrice combinée $\Sigma$ d’une part, et une régularisation de type Ridge contractant la matrice résultante vers un multiple de la matrice identité d’autre part :
$$\hat{\Sigma}_k(\alpha, \gamma) = (1 – \gamma) \left[ (1 – \alpha)\Sigma_k + \alpha \Sigma \right] + \gamma \frac{\text{Tr}\left[(1 – \alpha)\Sigma_k + \alpha \Sigma\right]}{p} I$$
Cette double régularisation stabilise de façon spectaculaire les conditionnements matriciels défaillants tout en adaptant dynamiquement la courbure des frontières.
Enfin, face à des distributions dont la géométrie séparatrice est intrinsèquement non linéaire (enroulements spatiaux, anneaux concentriques), la LDA linéaire échoue structurellement. L’alternative repose alors sur l’analyse discriminante à noyaux (Kernel LDA). En exploitant l’astuce du noyau (kernel trick) à l’aide de fonctions de base radiale gaussienne (RBF) ou polynomiale, la Kernel LDA projette implicitement les observations au sein d’un espace de Hilbert de dimension infinie dans lequel une séparation linéaire conventionnelle redevient possible.
12.2 Problématique de la grande dimensionnalité et sélection de caractéristiques
L’un des défis contemporains majeurs imposés à l’analyse discriminante linéaire réside dans son comportement pathologique face aux données de très haute dimensionnalité, couramment désigné sous le terme de problème $p gg n$. Lorsque le nombre de caractéristiques physiques analysées excède la taille de la cohorte d’apprentissage, la matrice empirique de dispersion intra-classe $S_W$ subit une singularité absolue : son rang ne peut excéder $n – K$, rendant son inversion strictement impossible et provoquant l’effondrement mathématique de l’opérateur de Fisher.
Pour parer à ce fléau de la dimensionnalité, trois stratégies complémentaires peuvent être déployées :
- Le rétrécissement bayésien de la covariance (Covariance Shrinkage) : Dans Scikit-Learn, l’activation des solveurs
lsqroueigenconjuguée au paramètreshrinkage='auto'met en œuvre l’estimateur analytique optimal développé par Ledoit et Wolf (2004). Cette approche remplace la matrice empirique $S_W$ par une combinaison linéaire convexe entre la matrice non inversible et une matrice cible bien conditionnée (la matrice identité mise à l’échelle), garantissant une inversibilité stricte et une régularisation optimale du spectre des valeurs propres. - La sélection de caractéristiques univariée ou récursive en amont : Avant d’engager la LDA, l’espace des variables peut être filtré à l’aide de tests d’ANOVA unidimensionnels (
SelectKBestavec le scoref_classif) ou par des approches d’élimination récursive de caractéristiques (RFE, pour Recursive Feature Elimination), élaguant les descripteurs informativement redondants ou dominés par le bruit statistique. - L’analyse discriminante parcimonieuse (Sparse LDA) : Cette variante incorpore des pénalités normatives de type $L_1$ (Lasso) directement au sein du problème de maximisation du ratio de Rayleigh. Cette contrainte force un nombre substantiel de coefficients de projection discriminants à s’annuler exactement, opérant simultanément une réduction de dimensionnalité, une sélection automatique de prédicteurs pertinents et une simplification notable de l’interprétabilité du modèle final.
L’ensemble de ces protocoles avancés, couplé à une structuration méthodique du code sous forme de pipelines d’inférence Scikit-Learn encapsulant mise à l’échelle, régularisation et validation croisée, garantit une robustesse opérationnelle maximale et pérennise le déploiement de l’analyse discriminante linéaire en tant qu’instrument statistique de premier ordre dans les architectures prédictives industrielles contemporaines.
Références
- Anderson, E. (1936). The species problem in Iris. Annals of the Missouri Botanical Garden, 23(3), 457–509. https://doi.org/10.2307/2394164
- Box, G. E. P. (1949). A general distribution theory for a class of likelihood criteria. Biometrika, 36(3/4), 317–346. https://doi.org/10.1093/biomet/36.3-4.317
- Fisher, R. A. (1936). The use of multiple measurements in taxonomic problems. Annals of Eugenics, 7(2), 179–188. https://doi.org/10.1111/j.1469-1809.1936.tb02137.x
- Friedman, J. H. (1989). Regularized discriminant analysis. Journal of the American Statistical Association, 84(405), 165–175. https://doi.org/10.1080/01621459.1989.10478752
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Ledoit, O., & Wolf, M. (2004). A well-conditioned estimator for large-dimensional covariance matrices. Journal of Multivariate Analysis, 88(2), 365–411. https://doi.org/10.1016/j.jmva.2004.02.004
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Édouard, D. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.org/papers/v12/pedregosa11a.html
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709