
Dans l’écosystème contemporain du traitement de données sur tableur, l’application Google Sheets s’est imposée comme une plateforme collaborative incontournable, rivalisant avec les outils traditionnels d’ingénierie bureautique grâce à son intégration native au cloud et à son interopérabilité étendue. Au cœur de cette puissance computationnelle réside une fonction matricielle d’une singulière élégance : la fonction QUERY. Conçue pour interfacer les capacités analytiques du langage d’interrogation structuré avec la flexibilité d’une grille matricielle bidimensionnelle, cette instruction permet d’effectuer des opérations complexes de projection, de sélection, d’agrégation et de pivotement au sein d’une unique formule condensée.
Cependant, la restitution des données extraites ou transformées pose un défi ergonomique et sémantique permanent. Par défaut, le moteur de calcul projette des descripteurs de colonnes bruts issus de la source ou, pire encore, génère des étiquettes calculées hautement impersonnelles telles que des concaténations d’opérateurs arithmétiques et d’identifiants de champs. Cette friction informationnelle altère la lisibilité des rapports décisionnels, contraint l’utilisateur à des manipulations annexes fastidieuses et nuit à la clarté cognitive indispensable à l’analyse experte. C’est précisément pour remédier à cette césure entre la logique de la base de données et l’exigence de restitution visuelle que la clause LABEL a été introduite au sein de la grammaire formelle du langage de requête de l’interface de programmation de visualisation de Google.
Le présent traité constitue une monographie exhaustive dédiée à la maîtrise absolue de la clause LABEL dans les requêtes Google Sheets. À travers une analyse multidimensionnelle combinant théorie de l’information, rigueur syntaxique, diagnostics d’erreurs d’exécution et cas d’usage avancés issus des secteurs de la finance et de la psychométrie, nous explorerons les mécanismes fondamentaux qui permettent de transfigurer des flux tabulaires bruts en artéfacts analytiques sophistiqués, auto-documentés et pérennes.
1. Fondements et rôle sémantique de la fonction QUERY dans Google Sheets
1.1 Architecture du langage de requête Google Visualization API
La fonction QUERY ne déploie pas un interpréteur SQL conventionnel, mais s’appuie rigoureusement sur le langage de requête défini par l’API de visualisation de Google (Google Visualization API Query Language). Cette spécification formelle emprunte les paradigmes déclaratifs du standard SQL tout en adaptant son comportement aux particularités des structures matricielles de données en mémoire. L’interpréteur évalue la chaîne d’instructions transmise au second paramètre de la fonction afin de compiler un plan d’exécution optimisé, capable de filtrer, trier et regrouper les enregistrements sans altérer l’intégrité de la table source.
Contrairement aux fonctions matricielles traditionnelles de Google Sheets, telles que FILTER, SORT ou l’association canonique INDEX/MATCH, le moteur de QUERY traite l’intégralité de la matrice comme une relation relationnelle unifiée. Les mécanismes de transformation opèrent à travers un flux computationnel où la mémoire tampon analyse les types de données dominants de chaque colonne pour forcer une homogénéité stricte. Cette architecture confère une vitesse d’exécution supérieure sur des jeux de données volumineux, mais impose en contrepartie le respect scrupuleux d’une grammaire normalisée au sein de laquelle chaque composant syntaxique joue un rôle déterministe.
L’avantage opérationnel déterminant de cette approche réside dans la modularité conceptuelle offerte à l’analyste de données. Au lieu de chaîner ou d’imbriquer des formules matricielles complexes risquant d’induire une dette technique et une opacité fonctionnelle, une unique expression QUERY centralise l’ensemble des règles de gestion applicables à l’extraction. C’est dans ce cadre déclaratif que s’inscrivent les clauses de mise en forme et de structuration, transformant une simple projection de coordonnées cellulaires en une vue analytique hautement qualifiée.
1.2 Mécanique de restitution des en-têtes de colonnes par défaut
Lorsqu’une instruction d’extraction est exécutée sans directives de renommage explicites, le moteur d’exécution applique un algorithme heuristique d’inférence pour déterminer la composition de la première ligne de sortie. Si la matrice d’origine contient des valeurs textuelles sur sa première ligne et que le troisième argument optionnel de la fonction est configuré pour reconnaître un en-tête, ces libellés originaux sont systématiquement projetés tels quels au sommet de la plage réceptrice. Toutefois, dès lors que l’instruction procède à des regroupements dimensionnels ou à des transformations mathématiques, cette mécanique prévisible se dégrade.
L’application d’opérateurs d’agrégation engendre l’apparition d’étiquettes machinées composées du nom de la fonction et de la désignation de la colonne cible, formant des chaînes telles que le total cumulé d’une colonne de ventes ou la moyenne arithmétique d’une métrique de performance. Ces intitulés bruts sont totalement inadaptés à une diffusion professionnelle. Par ailleurs, dans l’éventualité où la plage source est dénuée d’en-tête formel ou lorsqu’une sous-matrice anonyme construite par le biais de littéraux de tableaux est interrogée, le système génère des descripteurs génériques qui dénaturent la hiérarchie visuelle du document final.
L’écrasement ou l’inadéquation de ces libellés par défaut ne représente pas uniquement un désagrément esthétique ; il constitue un facteur direct d’erreur humaine dans l’interprétation des tableaux de bord. L’absence d’explicitation contextuelle oblige les parties prenantes à inspecter le code source de la cellule pour déduire la signification opérationnelle d’une métrique, annihilant ainsi le principe fondamental de lisibilité immédiate qui régit la modélisation sous tableur.
1.3 Définition et utilité formelle de la clause LABEL
La clause LABEL se définit formellement comme une directive post-analytique non destructrice au sein de la grammaire du langage de visualisation de Google. Son rôle sémantique exclusif consiste à réassigner arbitrairement la chaîne de caractères assignée au descripteur d’en-tête de n’importe quelle colonne projetée, qu’il s’agisse d’un champ source brut, d’une dimension transformée ou du résultat d’un calcul agrégé. Elle s’interpose entre la couche de calcul logique et la couche de sérialisation visuelle renvoyée dans les cellules de la feuille de calcul.
Cette clause confère à l’analyste un contrôle absolu sur le contrat d’interface des données restituées. Elle assure la contextualisation précise des métriques en autorisant l’introduction d’unités de mesure, de précisions temporelles ou d’adaptations linguistiques directement au sein de la définition de la vue. Par cette médiation, l’utilisateur final n’est plus confronté à des abréviations cryptiques issues de systèmes d’information tiers, mais accède directement à une nomenclature métier normalisée.
Il convient de souligner que cette personnalisation s’effectue dans le respect total de l’intégrité de la table source. Aucune modification structurelle n’est requise sur les données primaires, ce qui préserve les liaisons en amont et garantit la réutilisabilité des données brutes par d’autres processus automatisés. La clause LABEL matérialise ainsi une séparation étanche entre le stockage des données et leur représentation contextuelle.
2. Syntaxe fondamentale et grammaire formelle de la clause LABEL
2.1 Emplacement syntaxique au sein de la chaîne de requête
La grammaire du moteur de visualisation impose un ordre séquentiel strict pour les différentes clauses composant une instruction. Contrairement à certains dialectes SQL permissifs qui autorisent des variations structurales, l’interpréteur de Google Sheets requiert une ordonnance rigide des mots-clés. La clause LABEL occupe obligatoirement l’avant-dernière ou la dernière position dans l’arbre syntaxique, ne pouvant être suivie que par la clause FORMAT, si cette dernière est sollicitée.
L’agencement conventionnel de la chaîne d’instruction doit scrupuleusement respecter la hiérarchie suivante : la projection initiale SELECT, les prédicats de filtrage WHERE, les critères d’agrégation GROUP BY, la redistribution bidimensionnelle PIVOT, l’agencement séquentiel ORDER BY, la troncature quantitative LIMIT, le décalage de lecture OFFSET, la réassignation des en-têtes LABEL, et enfin l’assignation des patrons d’affichage FORMAT. L’insertion prématurée de la clause LABEL avant un filtre ou une clause de regroupement interrompt le processus d’analyse lexicale du compilateur interne, provoquant instantanément une rupture d’évaluation matérialisée par une erreur d’exécution.
Cette disposition terminale répond à une logique fonctionnelle limpide : le moteur de requête doit d’abord résoudre l’ensemble des transformations matricielles, des jointures virtuelles et des calculs d’agrégation avant de décorer le schéma de sortie avec des libellés textuels personnalisés. Ainsi, la clause LABEL s’applique exclusivement aux colonnes validées dans le sous-espace dimensionnel défini par l’instruction globale.
2.2 Règles de délimitation typographique et gestion des guillemets
L’incorporation de la clause LABEL exige une discipline typographique rigoureuse relative à l’usage des délimiteurs de chaînes. La formule complète de la fonction QUERY est elle-même encapsulée entre des guillemets doubles droits conformément aux exigences syntaxiques de Google Sheets pour la définition de chaînes littérales. Par conséquent, les libellés assignés au sein de la clause LABEL doivent impérativement être délimités par des apostrophes simples droites afin d’éviter la fermeture anticipée de la chaîne globale.
Une complexité particulière survient lorsqu’un libellé personnalisé contient intrinsèquement une apostrophe, comme cela est fréquent dans la langue française (par exemple dans l’expression du chiffre d’affaires). Dans cette configuration, l’omission d’une stratégie d’échappement induit une rupture de lecture au niveau de l’interpréteur, qui considère l’apostrophe interne comme la fin de la déclaration du libellé. Pour pallier cette contrainte sans déstabiliser la syntaxe, l’analyste doit doubler l’apostrophe interne ou employer des mécanismes de substitution textuelle via la concaténation de caractères codifiés.
Les conséquences d’une mauvaise imbrication des délimiteurs ne se limitent pas à l’invalidation locale de l’étiquette : elles entraînent l’échec global de l’évaluation matricielle de la cellule. Le moteur d’analyse lexicale rejette la totalité de la formule, empêchant la projection du jeu de données et affichant une notification d’erreur de syntaxe générique, d’où la nécessité absolue de valider l’intégrité de chaque paire de guillemets avant le déploiement en production.
2.3 Typage implicite et conservation de l’intégrité des données
L’exécution de la clause LABEL n’exerce aucune influence sur le typage structurel des données contenues dans les colonnes sous-jacentes. Qu’une colonne contienne des entiers signés, des valeurs à virgule flottante, des horodatages ou des valeurs booléennes, l’application d’un nouveau descripteur textuel au sommet de la série matricielle ne modifie en rien la nature binaire des enregistrements sous-jacents.
Cette étanchéité fondamentale garantit que les opérations mathématiques, statistiques ou logiques effectuées ultérieurement par d’autres formules pointant vers la plage générée continuent de fonctionner sans friction de conversion de type. Par exemple, si une colonne de montants monétaires est renommée pour inclure des mentions textuelles explicites, les fonctions périphériques telles que VLOOKUP ou des calculs de déviation standard traiteront les cellules de données avec leur précision numérique native, ignorant le changement purement cosmétique de l’en-tête.
Il convient également de préciser que la clause LABEL n’induit aucun effet de bord lors de la transmission des résultats matriciels vers des outils de visualisation externes, tels que Looker Studio ou les bibliothèques d’affichage graphique de Google. La métadonnée d’en-tête est mise à jour dans le dictionnaire de schéma virtuel, permettant aux composants de restitution visuelle d’adopter immédiatement la nouvelle désignation sans nécessiter de recalcul ou de reformatage structurel.
3. Renommage d’une colonne unique : Méthodologie et cas élémentaires
3.1 Déclaration unitaire d’un libellé personnalisé
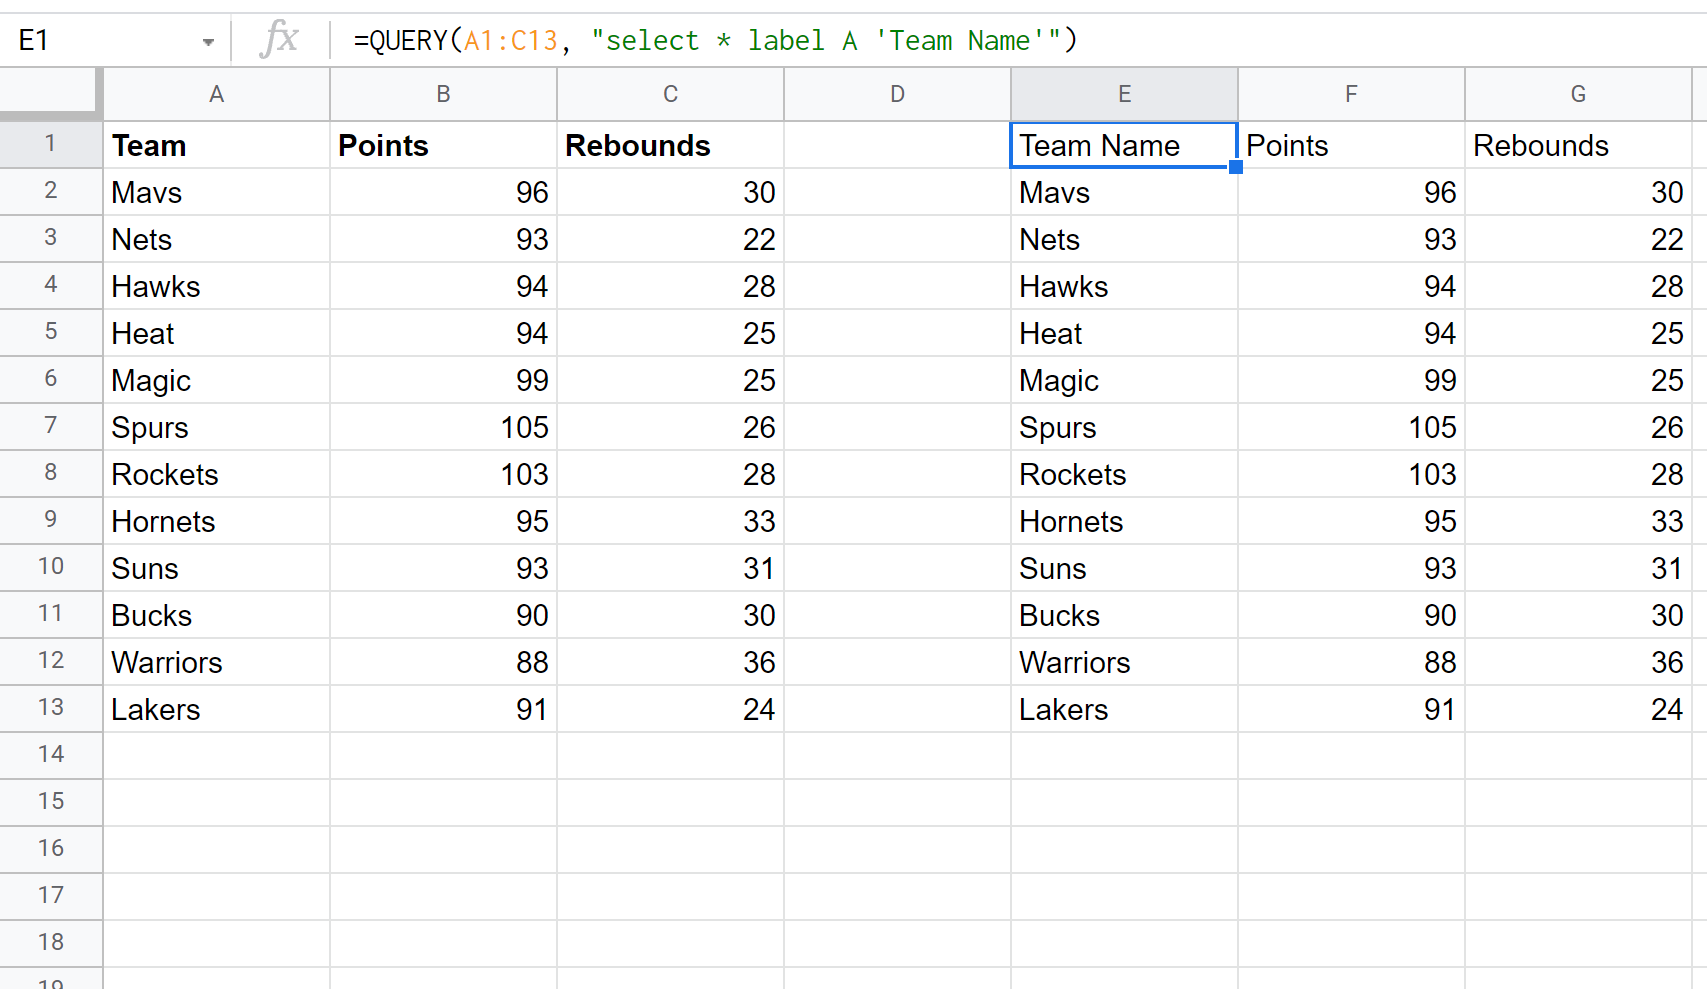
La mise en œuvre unitaire de la clause LABEL constitue le cas d’usage fondamental à partir duquel s’articulent toutes les applications avancées. La structure canonique de cette instruction se formalise par l’adjonction, à la fin de la requête textuelle, du mot-clé label suivi de l’identifiant technique de la colonne visée, puis de la chaîne de substitution délimitée par des apostrophes simples. Dans le cas d’une référence directe à une plage de cellules, l’identifiant technique correspond rigoureusement à la lettre de la colonne telle qu’elle apparaît dans la feuille source.
Considérons une extraction simple où seule la première colonne d’une table doit être projetée avec une désignation modifiée. La requête s’articule par l’instruction de sélection suivie immédiatement de la directive de renommage désignant la lettre de la colonne concernée et le texte souhaité. Le moteur évalue cette séquence en isolant le vecteur de données correspondant, puis en remplaçant la première ligne par le texte littéral spécifié dans la clause.
La validation empirique de cette projection s’observe directement sur la grille de calcul réceptrice : la cellule hébergeant la formule matricielle affiche immédiatement le nouveau libellé, tandis que les cellules adjacentes et inférieures reçoivent le flux de données correspondant sans le moindre décalage d’indexation. L’opération s’exécute de manière synchrone, attestant de l’efficacité computationnelle du moteur interne lors d’une altération de métadonnée unitaire.
3.2 Analyse de cas pratique : Renommage d’attributs qualitatifs
Afin d’illustrer la pertinence de cette opération dans un environnement professionnel, examinons la gestion d’un registre de ressources humaines ou d’équipes opérationnelles. Les bases sources exportées d’outils de gestion de la relation client ou de progiciels de gestion intégrés comportent fréquemment des descripteurs techniques concis, par exemple le terme brut désignant une unité organisationnelle. La restitution d’un tel tableau à un comité de direction nécessite un rehaussement immédiat du registre de langage.
En formulant une requête ciblant les attributs qualificatifs d’une entité et en modifiant la désignation sommaire pour lui attribuer une appellation complète et soignée, l’analyste transforme instantanément la perception du document. Alors que la colonne ciblée adopte une désignation conforme aux normes institutionnelles de l’entreprise, les colonnes périphériques qui ne font l’objet d’aucune clause de renommage conservent strictement leurs en-têtes préexistants, attestant de la sélectivité absolue de l’opérateur.
Cette sélectivité garantit une économie d’effort substantielle : l’analyste n’est nullement tenu de redéclarer l’ensemble des descripteurs de la matrice s’il ne souhaite en modifier qu’un seul. L’amélioration cognitive qui en découle est immédiate pour le lecteur final, qui appréhende la taxonomie du tableau sans avoir à déduire le sens des acronymes ou des termes tronqués issus de l’extraction technique initiale.
3.3 Impact sur l’indexation et la disposition des données extraites
L’adjonction d’une clause LABEL n’exerce aucune force rétroactive ou collatérale sur l’ordre géométrique des colonnes au sein du résultat restitué. L’arrangement spatial des vecteurs de données est exclusivement gouverné par la clause de projection SELECT. Si une formule projette successivement les colonnes identifiées par les lettres B, A puis C, la clause de renommage n’a pas le pouvoir de transposer ces vecteurs, même si la déclaration des libellés s’effectue dans un ordre différent.
Cette dissociation totale entre l’ordre de présentation des colonnes et la déclaration de leurs attributs sémantiques constitue une force architecturale majeure. Elle prévient les régressions visuelles accidentelles lors de la refonte des libellés. La clause LABEL délègue l’intégralité de la logique de projection spatiale aux opérateurs situés en amont pour se consacrer exclusivement à la couche d’habillage nominal des métadonnées de surface.
Sur le plan de l’interopérabilité, la présence d’un libellé personnalisé ne modifie en rien le comportement des formules matricielles situées en aval dans le flux de calcul. Les fonctions de recherche indicées qui scrutent la zone de restitution continuent de faire référence aux coordonnées physiques des cellules générées, garantissant qu’aucune rupture de référence matricielle ne découle d’un changement d’intitulé dans la clause d’étiquetage.
4. Attribution simultanée d’étiquettes à colonnes multiples
4.1 Syntaxe de séparation par virgules et enchaînement d’instructions
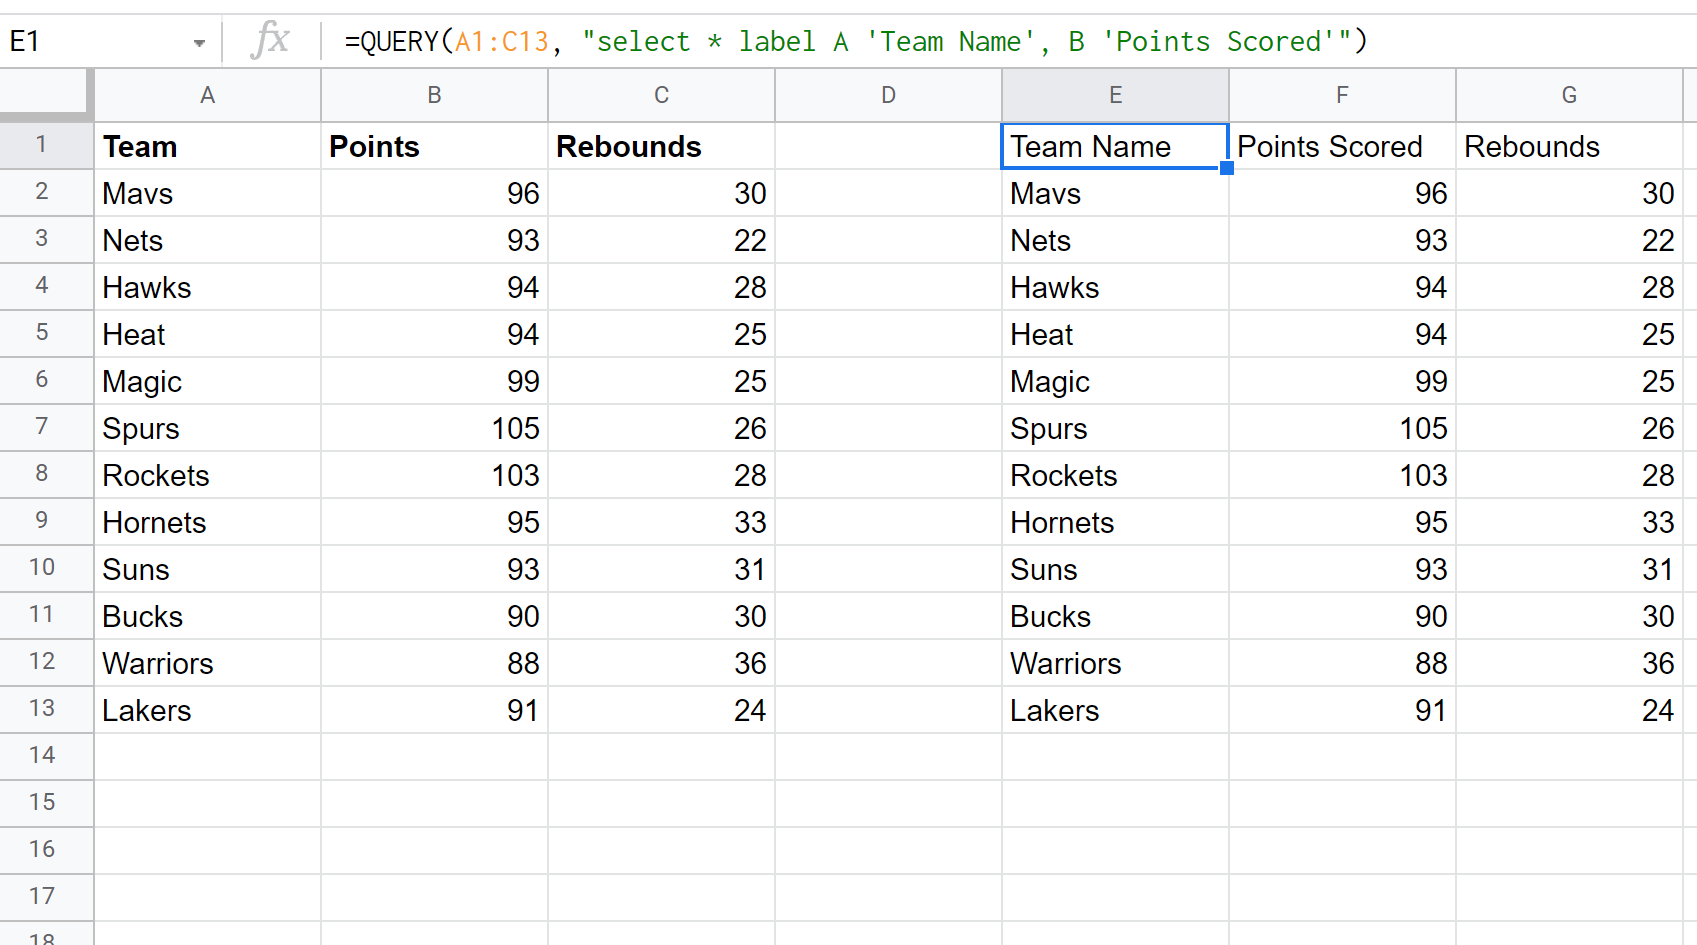
La montée en complexité des tableaux de bord analytiques impose fréquemment de renommer simultanément une multiplicité d’attributs au sein d’une unique extraction de données. Pour satisfaire à cette exigence sans alourdir la requête par des déclarations redondantes, la grammaire de l’API de visualisation prévoit un opérateur de liaison séquentiel : la virgule. Après la déclaration initiale du mot-clé label, les différentes assignations sont chaînées les unes après les autres en étant rigoureusement séparées par ce signe de ponctuation.
Le formalisme syntaxique se structure de la façon suivante : le mot-clé d’amorce est renseigné une seule fois, puis l’analyste spécifie le premier identifiant de colonne suivi de son libellé entre apostrophes simples, adjoint une virgule d’espacement, puis déclare le second identifiant avec son libellé respectif, et ainsi de suite jusqu’à épuisement des attributs ciblés. Il est impératif de ne pas répéter le mot-clé label entre chaque assignation, sous peine de déclencher une exception de compilation pour redondance lexicale imprévue.
Sur le plan des capacités computationnelles, l’interpréteur de Google Sheets fait preuve d’une robustesse remarquable, tolérant le traitement conjoint de dizaines d’assignations au sein de la même clause. Toutefois, la maintenance de requêtes excessivement denses nécessite une attention scrupuleuse à l’équilibre des délimiteurs, l’omission d’une simple virgule intercalaire suffisant à paralyser l’intégralité du traitement matriciel.
4.2 Exemple comparatif : Traitement conjoint d’attributs nominatifs et métriques
Pour mesurer l’efficacité de cette syntaxe sur un ensemble hétérogène, analysons le traitement conjoint d’une série comprenant une dimension textuelle nominative et une mesure quantitative issue d’une évaluation périodique. Dans une configuration brute, l’extraction de deux colonnes représentant par exemple l’identité d’un collaborateur et son volume d’heures de formation délivre des intitulés souvent hachés ou purement informatiques.
L’introduction d’une clause unifiée permet d’attribuer simultanément un libellé qualitatif au premier attribut et une désignation métrique précisant l’unité de mesure au second. Le tableau comparatif entre le rendu par défaut et le rendu formaté via la requête met immédiatement en lumière l’éradication de toute ambiguïté terminologique. Le décideur n’a plus sous les yeux des descripteurs sibyllins, mais un document achevé qui juxtapose harmonieusement des notions qualitatives et des indicateurs quantitatifs standardisés.
Cette harmonisation globale améliore la valeur communicationnelle du rapport financier ou opérationnel. En une seule intervention déclarative, la feuille de calcul s’émancipe de son statut de simple réceptacle de données brutes pour accéder au rang de livrable institutionnel directement exploitable lors des revues de gestion.
4.3 Gestion des conflits d’ordonnancement et d’homonymie
Une caractéristique fondamentale du parseur de requêtes de Google Sheets réside dans son indépendance totale vis-à-vis de l’ordonnancement des déclarations au sein de la clause LABEL. Il n’existe aucune exigence de faire correspondre l’ordre des assignations de libellés à l’ordre d’énumération des colonnes stipulé dans la projection initiale. L’analyste peut librement définir le libellé d’une colonne située en fin de sélection avant de déclarer celui de la première colonne sans induire la moindre perturbation dans la restitution finale.
Un cas particulier requiert une vigilance théorique accrue : celui de l’homonymie intentionnelle ou accidentelle d’étiquettes de colonnes. Le moteur autorise formellement l’attribution d’un libellé strictement identique à deux colonnes de nature totalement divergente. Par exemple, deux indicateurs temporels distincts peuvent tous deux recevoir la mention textuelle de date. Si cette permissivité syntaxique offre une flexibilité dans certains contextes graphiques très spécifiques, elle introduit un risque majeur d’ambiguïté pour les formules ou scripts analytiques exploitant les en-têtes en aval.
Pour prévenir toute confusion cognitive ou technique, il est fermement recommandé d’adopter des règles de nommage univoques même en présence de métriques conceptuellement proches. L’incorporation de qualificatifs différentiels dans les libellés permet d’éviter les méprises lors de l’exploitation automatisée des plages de résultats par des modules de script ou des extensions d’analyse prédictive.
5. Suppression des en-têtes de colonnes via la clause LABEL
5.1 Mécanisme de l’étiquette vide (chaîne blanche)
L’une des fonctionnalités les plus ingénieuses et pourtant sous-estimées de la clause LABEL réside dans sa capacité à supprimer purement et simplement la ligne d’en-tête générée par une requête. Ce comportement s’obtient au moyen d’un idiome syntaxique précis : l’assignation d’une chaîne de caractères vide, matérialisée par deux apostrophes simples consécutives et jointes, sans aucun espace intercalaire, pour chaque colonne projetée dans la sélection.
Lorsque l’interpréteur de l’API de visualisation détecte que l’ensemble des colonnes résultantes sont associées à une chaîne vide au sein de la clause de labellisation, il prend la décision structurelle d’élider totalement la dimension d’en-tête de la matrice de sortie. La première ligne du résultat projeté dans la grille correspond alors directement au premier enregistrement factuel de la série de données. Ce processus ne masque pas simplement le texte : il élimine la cellule supérieure elle-même, décalant l’ensemble de la restitution d’un rang vers le haut.
Cette technique s’avère infiniment plus élégante et prévisible que les méthodes archaïques consistant à masquer manuellement la ligne de la feuille ou à intercaler des décalages d’indices par des formules matricielles de tronquage. Elle permet à la logique d’extraction d’assumer intrinsèquement la décision architecturale de ne fournir qu’un flux de valeurs pures.
5.2 Applications aux flux d’intégration de données continues
La neutralisation des en-têtes trouve son application reine dans l’architecture des flux d’intégration continue de données au sein de classeurs volumineux. Lorsque plusieurs requêtes d’extraction sont combinées verticalement au sein d’un littéral de tableau pour consolider des données distribuées sur différentes feuilles thématiques, la récurrence involontaire d’en-têtes intermédiaires viendrait corrompre la continuité séquentielle de la matrice consolidée.
En assignant des étiquettes vides aux requêtes subordonnées, l’analyste peut empiler plusieurs instructions de manière fluide et transparente, seule la première requête conservant la responsabilité de porter les descripteurs de colonnes maîtres. Il en résulte une série continue, parfaitement alignée et immédiatement exploitable par des algorithmes d’apprentissage automatique ou des modules de modélisation statistique.
De surcroît, cette approche optimise drastiquement la création de plages de validation de données destinées à alimenter des menus déroulants interactifs. L’incorporation parasite d’un en-tête dans une liste de sélection constitue une anomalie ergonomique récurrente ; l’oblitération formelle de l’en-tête via la clause LABEL garantit que la liste proposée à l’utilisateur ne comporte rigoureusement que des valeurs d’options valides.
5.3 Comparaison avec l’argument d’en-tête natif de QUERY
Une confusion fréquente chez les praticiens de Google Sheets concerne la distinction entre l’usage de chaînes vides dans la clause LABEL et l’ajustement du troisième argument de la fonction QUERY, dédié au nombre d’en-têtes de la plage source. Cet argument numérique indique à l’interpréteur combien de lignes au sommet de la plage d’origine doivent être considérées comme des métadonnées d’identification plutôt que comme des enregistrements d’échantillon.
La configuration de ce troisième argument à zéro ne garantit absolument pas la suppression systématique des en-têtes dans la projection de sortie. Si la requête procède à des agrégations ou si le moteur identifie des singularités typologiques sur la première ligne, il recréera de manière unilatérale des en-têtes techniques pour héberger les résultats. En revanche, l’application d’une chaîne vide par la clause LABEL constitue une directive prescriptive absolue à laquelle le moteur ne peut déroger, assurant ainsi un contrôle déterministe sur le rendu physique final.
Par conséquent, les règles de gouvernance des développements sur tableur recommandent de maintenir une définition sémantiquement rigoureuse du troisième paramètre pour refléter la réalité de la source, tout en déléguant l’éradication des en-têtes de sortie à la clause LABEL, assurant ainsi une parfaite prévisibilité du schéma de restitution.
6. Interaction entre la clause LABEL et les fonctions d’agrégation
6.1 Renommage des colonnes calculées (SUM, AVG, COUNT, MAX, MIN)
L’utilisation de la fonction QUERY prend toute son ampleur lors de l’élaboration d’indicateurs de synthèse par le biais des opérateurs mathématiques conventionnels que sont la somme cumulée, la moyenne pondérée, le dénombrement d’occurrences ou l’identification des bornes extrêmes. Toutefois, par construction, le moteur de calcul préfixe systématiquement les colonnes résultantes par le nom de l’opérateur employé, aboutissant à des descripteurs hautement inesthétiques au sein d’une restitution formelle.
Pour rebaptiser une colonne calculée, la clause LABEL exige une formulation qui cible non pas la lettre brute de la colonne source, mais l’intégralité de l’expression mathématique telle qu’elle a été rédigée au sein de la projection SELECT. Si l’instruction initiale agrège une métrique sous la forme d’une somme, le mot-clé de labellisation doit invoquer explicitement cette même syntaxe fonctionnelle avant de lui associer sa désignation définitive.
Le respect de cette concordance stricte est la condition sine qua non de la réussite du traitement. L’analyste doit veiller à répliquer fidèlement la casse typographique et les arguments de la fonction d’agrégation dans la clause terminale. Dès lors que cette correspondance est assurée, le titre technique est instamment remplacé par un intitulé d’une totale limpidité métier, permettant d’intégrer directement le tableau de synthèse au sein d’un rapport exécutif sans aucune manipulation post-requête.
6.2 Gestion des en-têtes générés automatiquement par l’API
L’interprétation automatique des fonctions statistiques par l’API de visualisation génère une dette ergonomique substantielle en imposant des dénominations préformatées qui perturbent la cohérence lexicale des feuilles de calcul. Dans le cas d’analyses multiniveaux, ces préfixes automatiques peuvent s’allonger démesurément et provoquer des tronquages de colonnes particulièrement néfastes à la lisibilité sur des terminaux d’affichage aux dimensions contraintes.
La substitution systématique de ces descripteurs mécaniques par des concepts fonctionnels relève d’une saine pratique d’ingénierie des données. La substitution terminologique permet d’éliminer la terminologie logicielle pour recentrer l’attention sur la signification informationnelle des séries observées. Par exemple, au lieu de laisser subsister un en-tête automatisé signalant le décompte d’une variable d’inventaire, l’analyste le remplacera judicieusement par une désignation professionnelle explicite reflétant la taille de l’échantillon ou le volume d’actifs audités.
Il importe également de souligner le comportement de la clause LABEL face aux opérations arithmétiques combinées. Lorsque la projection résulte de calculs scalaires complexes associant des agrégations et des facteurs de pondération constants, c’est l’expression algébrique complète qui doit être déclarée dans la clause de labellisation, offrant ainsi un moyen infaillible d’attribuer un nom vernaculaire à des formules hautement abstraites.
6.3 Synergie avec la clause GROUP BY et lisibilité analytique
L’orchestration conjointe des clauses GROUP BY et LABEL permet de concevoir de véritables tableaux croisés synthétiques sans devoir recourir aux outils d’interface graphique parfois rigides de Google Sheets. Dans ce schéma opérationnel, la clause de regroupement segmente l’espace vectoriel selon des axes dimensionnels tandis que la clause de labellisation harmonise conjointement les descripteurs des dimensions d’analyse et les étiquettes des indicateurs d’agrégation calculés.
Cette synergie structurelle élève considérablement la densité informationnelle des restitutions. Par exemple, lors de la génération d’un récapitulatif par centre de coûts opérationnels, l’analyste peut harmoniser simultanément l’en-tête de la colonne des départements et celui de la métrique financière agrégée au sein d’une unique ligne de code. L’ordonnancement rigoureux des données s’accompagne d’une hiérarchisation visuelle parfaite, facilitant la lecture transversale par les auditeurs ou analystes financiers.
Sur le plan de l’architecture logicielle au sein du classeur, cette combinatoire transforme une formule élémentaire en un composant analytique modulaire d’une rare élégance. Le résultat produit est auto-porteur : il intègre sa propre structure matricielle, ses règles d’agrégation mathématique et son habillage ergonomique complet, limitant ainsi la prolifération de cellules d’en-têtes statiques dont la désynchronisation guette en permanence les modèles financiers vivants.
7. Interaction de la clause LABEL avec PIVOT, ORDER BY et WHERE
7.1 Comportement syntaxique de LABEL en contexte de pivotement (PIVOT)
L’intégration de la clause PIVOT au sein d’une instruction QUERY représente sans conteste l’un des mécanismes les plus sophistiqués du langage, mais elle introduit également une contrainte structurelle majeure concernant la clause LABEL. Le pivotement redistribue les modalités uniques d’une colonne sous forme de nouveaux axes de colonnes horizontaux, induisant une génération dynamique d’en-têtes matriciels dont le nombre et les libellés dépendent des valeurs effectivement présentes dans le jeu de données d’entrée.
Face à cette dynamique matricielle bidimensionnelle, la clause LABEL subit une limitation formelle stricte : elle est structurellement incapable d’intercepter et de renommer les colonnes dynamiquement générées par la clause PIVOT. Le système d’interrogation n’admet la redéfinition des étiquettes que sur les dimensions conservées en ordonnée ou sur les métriques globales, mais rejette toute tentative de manipulation des en-têtes issus de la transposition croisée.
Pour surmonter cette restriction inhérente au moteur de visualisation, les praticiens doivent recourir à des architectures de contournement matricielles. L’une des approches les plus robustes consiste à supprimer les en-têtes de la requête pivotée au moyen de techniques d’oblitération ou d’indices, puis à reconstruire la ligne de titre supérieure en superposant une formule dynamique secondaire faisant appel à TRANSPOSE et UNIQUE, préservant ainsi la réactivité de l’affichage face aux mutations des données sources.
7.2 Respect de l’ordre d’évaluation des clauses de requête
La stabilité d’exécution d’une formule matricielle repose sur le respect inconditionnel de l’ordonnancement séquentiel des clauses au sein du compilateur. Le moteur de traitement de Google Sheets n’opère pas une interprétation probabiliste ou permissive de la chaîne textuelle transmise : il applique un analyseur prédictif descendant qui attend chaque composant grammatical à une position relative immuable.
L’analyste doit mémoriser l’ordre de priorité canonique qui régit impérativement la grammaire : les prédicats de filtrage conditionnel WHERE précèdent obligatoirement les déclarations d’agrégation GROUP BY, lesquelles doivent impérativement s’effacer devant la clause de pivotement PIVOT. Les instructions d’ordonnancement ORDER BY prennent place en aval des opérations matricielles, immédiatement suivies par les clauses quantitatives LIMIT et OFFSET. Ce n’est qu’à l’issue de cet enchaînement transformationnel complet que la clause LABEL peut être légitimement invoquée pour habiller les résultats.
Toute tentative d’intervertir cet agencement, par exemple en positionnant une directive de renommage avant une condition d’exclusion ou avant une limitation du volume de lignes, entraîne l’interruption immédiate de l’analyse syntaxique. Le compilateur émet une exception formelle de parsing, signifiant qu’un élément inattendu a corrompu la séquence logique de la chaîne de traitement.
7.3 Débogage des interférences avec les clauses de filtrage WHERE
D’un point de vue conceptuel, il n’existe aucune interaction fonctionnelle directe entre les conditions d’exclusion formulées dans la clause WHERE et la redéfinition des libellés orchestrée par la clause LABEL. Le filtrage conditionnel sélectionne les lignes admissibles au sein de l’espace vectoriel avant toute considération esthétique, tandis que la labellisation ne traite que des colonnes projetées dans la phase finale du pipeline.
Cependant, des interférences indirectes surviennent fréquemment lors de l’assemblage de requêtes complexes comportant des prédicats logiques multiples et des déclarations de renommage étendues. L’erreur la plus répandue réside dans l’injection erronée du nouveau libellé au sein même des conditions de filtrage. L’analyste doit impérativement garder à l’esprit que la clause WHERE ne peut faire référence qu’aux identifiants techniques initiaux de la base de données source, et jamais aux alias textuels attribués ultérieurement par la clause LABEL.
Lors de sessions de débogage sur des formules défaillantes, la méthodologie préconisée consiste à tronquer temporairement la chaîne d’instruction pour isoler le segment logique du segment déclaratif. En validant d’abord la viabilité mathématique du couple filtrage-projection, puis en réinjectant progressivement la clause LABEL en terminaison de chaîne, le modélisateur identifie instantanément l’origine précise de l’anomalie d’interprétation.
8. Utilisation dynamique de la clause LABEL avec concaténation textuelle
8.1 Injection de variables dynamiques issues d’autres cellules
La rigidité d’un tableau de bord décisionnel réside souvent dans le caractère statique de ses en-têtes, qui peinent à refléter l’évolution des paramètres de pilotage sélectionnés par les utilisateurs. La force distinctive de la fonction QUERY dans Google Sheets réside dans sa capacité à fusionner la rigueur de sa grammaire interne avec la plasticité des mécanismes de manipulation textuelle propres aux tableurs, autorisant ainsi l’injection dynamique de libellés contextualisés.
Ce principe architectural repose sur le paramétrage interactif des formules : une cellule de contrôle, matérialisée par exemple par un menu déroulant de sélection temporelle ou géographique, est directement interrogée pour nourrir la clause de labellisation. Dès lors que l’utilisateur modifie la valeur de cette cellule référente, la chaîne d’instruction de la requête se recompile instantanément en mémoire, mettant à jour de façon synchrone le libellé de la colonne sans exiger la moindre intervention sur le code source de la fonction.
Cette approche dynamique confère une valeur ajoutée substantielle aux rapports financiers et opérationnels. Un en-tête peut ainsi automatiquement mentionner la devise de référence sélectionnée, l’exercice budgétaire actif ou le palier de tolérance statistique retenu, supprimant tout risque de quiproquo lors de la consultation des synthèses chiffrées par des interlocuteurs non spécialistes.
8.2 Concaténation par l’opérateur perluète (&) et gestion des apostrophes
La mise en œuvre technique de cette interactivité requiert une maîtrise sans faille de l’opérateur de concaténation typographique, communément désigné sous le nom de perluète (&). L’objectif consiste à scinder la chaîne de caractères statique de la requête pour y intercaler la référence de la cellule source, tout en maintenant avec une précision millimétrique les délimiteurs d’apostrophes simples indispensables à la reconnaissance syntaxique de la clause LABEL.
Le patron d’assemblage standardisé impose d’ouvrir la séquence par un guillemet double, d’inscrire le mot-clé de renommage et l’identifiant de la colonne cible, d’insérer une apostrophe simple d’ouverture, puis de clore temporairement le guillemet double. L’opérateur de liaison textuelle est ensuite appelé pour adjoindre la coordonnée de la cellule dynamique, suivi d’une seconde perluète réintroduisant un segment textuel encadré par des guillemets doubles et contenant l’apostrophe simple de fermeture.
La moindre approximation dans cet agencement méticuleux conduit inéluctablement à une rupture d’analyse lexicale. Il est fréquent que des praticiens omettent de refermer l’apostrophe interne ou égarent un guillemet de délimitation de chaîne, engendrant une erreur d’évaluation immédiate. L’utilisation subsidiaire de fonctions d’encapsulation telles que CONCATENATE ou la conversion préalable via la fonction TEXT permet de sécuriser l’opération lorsque les variables injectées possèdent des formats numériques ou temporels particuliers.
8.3 Sécurisation des entrées pour éviter les erreurs syntaxiques
L’injection de paramètres dynamiques au sein d’une chaîne de commande logicielle n’est jamais exempte de risques structurels. Dans le cadre de Google Sheets, l’introduction impromptue de certains caractères typographiques au sein de la cellule de commande référencée peut altérer involontairement l’intégrité de la grammaire de l’API de visualisation. Ce phénomène s’apparente, sur le plan conceptuel, aux mécanismes d’injection de code rencontrés dans les environnements de bases de données relationnelles classiques.
Le vecteur de vulnérabilité le plus critique demeure l’apostrophe simple présente au sein de la variable textuelle injectée. Si la cellule cible contient un terme contracté, cette apostrophe textuelle sera interprétée par le compilateur de requêtes comme la balise de clôture prématurée du libellé, désarticulant la fin de l’instruction et générant un échec critique. Pour juguler ce risque, il incombe à l’analyste de purifier systématiquement les entrées variables au moyen de fonctions d’échappement ou de substitution préventive, à l’image de SUBSTITUTE, configurée pour doubler les apostrophes indésirables avant leur incorporation.
Par ailleurs, la modélisation doit intégrer une gestion rigoureuse des valeurs résiduelles nulles ou des dépassements quantitatifs de longueur de chaîne. L’application de règles de validation de données en amont sur les cellules de contrôle constitue le rempart le plus efficace pour garantir qu’aucune donnée anormale ne vienne compromettre la pérennité structurelle de la requête dynamique.
9. Diagnostics, erreurs fréquentes et dépannage syntaxique
9.1 Analyse de l’erreur #VALUE! et mauvaise utilisation des guillemets
Dans l’écosystème d’ingénierie de Google Sheets, la survenue de l’indicateur d’erreur #VALUE! lors de l’évaluation d’une fonction QUERY signale presque universellement une divergence insurmontable entre la chaîne syntaxique soumise et les attentes grammaticales du compilateur interne de l’API de visualisation. L’interpréteur, incapable de construire un graphe d’exécution valide, interrompt la transformation et consigne une exception au niveau de la cellule.
L’étiologie dominante de ce dysfonctionnement réside dans la manipulation asymétrique ou lacunaire des guillemets doubles et des apostrophes simples. Lorsqu’un analyste omet de fermer un libellé ou insère un guillemet double à la place d’une apostrophe simple à l’intérieur de la requête, le parseur lexical de Google Sheets entre en conflit avec le compilateur sous-jacent. Le survol de la cellule marquée de l’indicateur rouge révèle généralement un diagnostic formulé en des termes techniques indiquant l’impossibilité d’analyser la chaîne d’interrogation.
Le protocole d’investigation méthodique face à cette pathologie repose sur la technique de décomposition progressive. Il convient d’extraire la chaîne de commande de la fonction QUERY pour l’isoler dans une cellule tierce sous forme de texte brut afin d’inspecter visuellement l’intégrité de chaque délimiteur. Une fois l’anomalie typographique localisée et rectifiée, l’instruction consolidée peut être réinjectée en toute sécurité au sein de la matrice opérationnelle.
9.2 Conflits entre identifiants de colonnes (Lettres vs Col1, Col2)
L’une des singularités architecturales les plus déroutantes de la fonction QUERY réside dans la coexistence de deux systèmes référentiels mutuellement exclusifs pour identifier les colonnes au sein des clauses de calcul et de labellisation. La sélection du référentiel adéquat dépend exclusivement de la forme sous laquelle la matrice de données source est fournie au premier argument de la formule.
Lorsque la source est stipulée sous la forme d’une référence directe à une plage continue native, le moteur exige impérativement l’emploi des lettres physiques des colonnes. Inversement, dès lors que la plage est encapsulée au sein d’un tableau d’accolades littérales ou qu’elle découle de l’évaluation préalable d’une fonction intermédiaire telle que IMPORTRANGE ou ARRAYFORMULA, la matrice source devient anonyme. Dans cette seconde configuration, le compilateur rejette formellement toute référence alphabétique et impose l’utilisation exclusive de descripteurs indicés selon la nomenclature formelle stricte faisant débuter l’indexation au chiffre un.
L’erreur fatale consiste à déclarer une clause de renommage en utilisant la notation indicée sur une plage native, ou réciproquement d’invoquer une lettre de colonne sur un flux anonymisé. Le moteur de traitement ne réalise aucune translation implicite entre ces deux modes référentiels : l’inadéquation spatiale produit une interruption immédiate du processus analytique, accompagnée d’un message signalant l’inexistence de la colonne ciblée dans le schéma actif.
9.3 Échecs d’analyse lexicale liés aux caractères réservés
Le langage de requête de l’API de visualisation de Google intègre un dictionnaire de termes techniques et de symboles réservés dont la présence fortuite au sein de la chaîne d’instruction peut induire des collisions lexicales destructrices. Si un libellé personnalisé contient des vocables appartenant à la grammaire de l’interpréteur ou intègre des signes de ponctuation mathématique sans encadrement adéquat, le système risque d’interpréter ces segments comme des directives fonctionnelles dévoyées.
Les difficultés s’accentuent lorsque les libellés intègrent des caractères monétaires, des symboles de pourcentage ou des opérateurs relationnels destinés à clarifier le tableau final. Par exemple, l’inclusion non sécurisée d’un chevron de comparaison au cœur d’une étiquette textuelle peut induire l’analyseur en erreur si la délimitation de la chaîne est compromise par un problème d’apostrophe. L’interpréteur tente alors de raccorder ce signe à une condition de filtrage absente, entraînant l’effondrement logique de la requête.
Pour immuniser les formules contre ces écueils lexicaux, il convient d’observer une discipline typographique rigoureuse en proscrivant les caractères de contrôle non standards dans les libellés dynamiques et en veillant à ce que toute chaîne textuelle soit intégralement et strictement isolée entre ses délimiteurs légitimes, sans la moindre ambiguïté pour le compilateur.
10. Optimisation cognitive et ergonomie des tableaux de bord analytiques
10.1 Réduction de la charge cognitive par des libellés standardisés
L’exploitation efficiente des données quantitatives en contexte managérial est largement tributaire des principes fondamentaux de l’ergonomie cognitive. Selon la théorie de la charge cognitive formulée par les sciences de l’éducation et de la communication visuelle, la capacité de traitement de l’esprit humain est drastiquement entravée lorsqu’un individu est contraint d’allouer des ressources intellectuelles à la clarification d’un environnement informationnel mal conçu ou ambigu.
Dans un tableur, la présence d’en-têtes bruts, d’identifiants techniques ou de concaténations logicielles automatiques génère un bruit visuel délétère qui parasite la lecture instantanée des données. Le lecteur doit mentalement traduire chaque intitulé technique en son équivalent opérationnel avant même de pouvoir entamer l’analyse critique des grandeurs numériques présentées. Cette friction inutile ralentit la prise de décision et démultiplie le risque d’erreur d’interprétation lors des phases de revue critique.
Le recours délibéré et méthodique à la clause LABEL permet d’éradiquer ce bruit informationnel à la source. En fournissant des nomenclatures standardisées, épurées et signifiantes, l’analyste libère la bande passante cognitive des décideurs, facilitant une assimilation rapide, fluide et sans distorsion des indicateurs de performance clés projetés au sein du document.
10.2 Alignement terminologique avec les référentiels métiers
L’ingénierie des données moderne impose une passerelle constante entre les schémas de persistance des bases de données d’entreprise et les cadres de référence lexicaux adoptés par les différentes branches opérationnelles. Les bases de données relationnelles privilégient fréquemment une nomenclature normalisée concise, optimisée pour l’indexation machine mais dépourvue de toute résonance intuitive pour les métiers de terrain.
La clause LABEL opère précisément la médiation indispensable entre ces deux univers hermétiques. Elle permet de transposer les identifiants techniques de la base source dans le langage vernaculaire propre aux départements financiers, marketing ou logistiques destinataires du livrable. Cette acculturation terminologique renforce substantiellement l’appropriation des outils de pilotage par les utilisateurs finaux, qui reconnaissent immédiatement leurs concepts de gestion quotidiens sans avoir à subir l’opacité des conventions informatiques.
Cet alignement lexical contribue également à l’élimination des silos organisationnels. Lorsque les analystes techniques et les décideurs exécutifs partagent un lexique parfaitement synchronisé au sein de leurs interfaces analytiques partagées, la communication s’en trouve fluidifiée et les débats peuvent porter exclusivement sur les orientations stratégiques dictées par les chiffres plutôt que sur la signification contestée des termes employés.
10.3 Principes de psychologie cognitive appliqués à la datavisualisation
L’intégration de la clause LABEL participe directement au respect des lois canoniques de la psychologie de la perception visuelle, notamment les lois de la Gestalt qui régissent la manière dont l’œil humain structure spontanément les ensembles sémiotiques complexes. Un tableau de données ne constitue pas une simple grille passive : il s’agit d’une interface cognitive dynamique où chaque choix typographique oriente la trajectoire oculaire de l’observateur.
La clarté et l’homogénéité des descripteurs de colonnes réduisent l’impact pernicieux du biais d’ancrage et préviennent les interprétations biaisées en contexte d’incertitude. L’introduction systématique des unités de mesure au sein de l’étiquette permet de contextualiser immédiatement les ordres de grandeur, interdisant toute confusion entre des devises monétaires divergentes ou entre des pourcentages bruts et des valeurs relatives normalisées.
En soignant la formulation textuelle via des règles de concision rigoureuses, l’analyste évite la saturation visuelle induite par des intitulés excessivement verbeux tout en garantissant un niveau de précision suffisant pour guider sans ambiguïté l’attention du lecteur vers les signaux faibles et les ruptures de tendance matérialisés par les données chiffrées.
11. Cas d’études empiriques et implémentations sectorielles avancées
11.1 Traitement de données biométriques et psychométriques
Le champ de la recherche empirique en psychologie quantitative et en sciences biométriques illustre avec une acuité particulière l’utilité formelle de la clause LABEL. Les inventaires de personnalité standardisés, tels que le modèle à cinq facteurs mesuré par des questionnaires de type NEO-PI-R, génèrent des jeux de données d’évaluation caractérisés par des acronymes méthodologiques compacts représentant des dimensions latentes complexes telles que le névrosisme, l’extraversion, l’ouverture, l’agréabilité et le caractère consciencieux.
La restitution de ces scores statistiques à des cliniciens, des éducateurs ou des participants profanes exige une reformulation descriptive immédiate sous peine d’induire des diagnostics erronés. Par le truchement d’une requête combinant la normalisation z-score d’un échantillon expérimental et l’application d’une clause LABEL exhaustive, l’analyste transcende les acronymes abstraits pour déployer des descripteurs psychologiques exhaustifs accompagnés des intervalles de confiance correspondants.
L’élégance de cette solution réside dans sa robustesse méthodologique : la base de données brute conserve intactes ses variables d’indexation conformes aux standards psychométriques internationaux, tandis que la couche de restitution génère de façon dynamique une synthèse clinique prête à la soutenance académique, respectant scrupuleusement les exigences de clarté documentaire dictées par les sociétés savantes.
11.2 Consolidation de rapports financiers et indicateurs de performance
Dans le domaine de l’ingénierie financière et de la comptabilité analytique, la consolidation périodique des grands livres comptables confronte régulièrement les directions du contrôle de gestion à des nomenclatures hétérogènes. Les extractions de balances de vérification associent des numérotations de comptes normées à des libellés d’écritures disparates, impropres à la communication d’un compte de résultat synthétique devant un conseil d’administration.
L’élaboration d’une requête articulée autour d’agrégations catégorielles via GROUP BY permet d’agréger massivement les écritures de débit et de crédit, tandis que la clause LABEL intervient pour substituer aux numéros de comptes normalisés les appellations conventionnelles du reporting financier international. Les colonnes d’agrégation mathématique se voient instantanément attribuer des intitulés audités tels que le résultat d’exploitation brut ou la marge contributive consolidée.
Cette méthodologie garantit une traçabilité intégrale indispensable lors des revues d’audit légal. À tout moment, le contrôleur de gestion peut valider la chaîne de calcul liant l’écriture unitaire au tableau de bord exécutif, tout en assurant une actualisation automatique des montants lors de l’intégration de nouvelles saisies comptables dans le journal source.
11.3 Structuration de jeux de données multi-sources interconnectés
L’émergence des architectures de travail distribuées conduit fréquemment à agréger des flux d’information distants au sein d’un tableau de bord de pilotage central. Google Sheets offre à cet effet la fonction IMPORTRANGE, permettant d’extraire dynamiquement des plages localisées sur des classeurs tiers appartenant à des filiales opérationnelles géographiquement fragmentées.
L’imbrication d’une requête QUERY enrichie de la clause LABEL autour d’une collection d’instructions d’importation permet de réaliser une véritable normalisation sémantique à la volée. Bien que les systèmes sources décentralisés utilisent des dénominations de colonnes fluctuantes dictées par des habitudes locales, la requête centrale harmonise l’ensemble des flux entrants sous un référentiel lexical universel au moyen de la syntaxe indicée.
Il en résulte une fédération de données hautement résiliente : l’hétérogénéité structurelle des sources périphériques est instantanément absorbée et corrigée par le filtre déclaratif de la requête centrale. Les gestionnaires du siège accèdent ainsi à un entrepôt de données matriciel homogène, auto-documenté et libéré des disparités terminologiques inhérentes aux organisations décentralisées.
12. Synthèse méthodologique, bonnes pratiques et limites intrinsèques
12.1 Synthèse comparative des approches de titrage dans Google Sheets
La gestion des en-têtes de colonnes au sein de Google Sheets peut être abordée selon trois paradigmes méthodologiques distincts : le titrage manuel statique sur une ligne dédiée, l’injection dynamique d’en-têtes via des formules de manipulation matricielle comme VSTACK ou les littéraux de tableaux, et enfin l’attribution interne par la clause LABEL au sein de la fonction QUERY. L’évaluation comparative de ces approches met en exergue des compromis substantiels en matière de maintenabilité, de robustesse et de complexité architecturale.
Le titrage manuel, bien que d’une accessibilité immédiate pour les utilisateurs novices, présente une fragilité systémique rédhibitoire : toute modification structurelle de la requête sous-jacente entraîne un décalage spatial des colonnes sans que les en-têtes statiques ne se réalignent, induisant des erreurs d’interprétation critiques. L’assemblage matriciel externe offre une plasticité certaine mais alourdit la structure du classeur par la prolifération de formules gigognes complexes à auditer.
La clause LABEL s’impose comme la méthodologie supérieure en encapsulant dans un périmètre syntaxique unifié la logique de transformation des données et leur définition sémantique. Elle assure un couplage parfait entre l’indicateur calculé et sa désignation de surface, conférant aux modèles une résilience maximale face aux évolutions dimensionnelles des bases de données sources.
12.2 Matrice des règles de gouvernance pour les formules complexes
Le déploiement industriel de requêtes hautement sophistiquées au sein de classeurs partagés requiert l’instauration d’un cadre de gouvernance documentaire rigoureux afin de prévenir l’entropie logicielle. Une requête QUERY étirée sur plusieurs centaines de caractères sans organisation visuelle devient rapidement indéchiffrable pour un tiers chargé d’assurer la maintenance applicative du modèle.
Il est expressément recommandé d’appliquer une convention d’espacement et d’indentation au sein même de la chaîne de requête en exploitant les sauts de ligne matérialisés par la combinaison de touches dédiée au sein de la barre de formule. La clause LABEL gagne à être isolée sur une ligne distincte, avec une énumération ordonnée des assignations facilitant l’inspection visuelle des apostrophes de délimitation et la vérification de la couverture complète des colonnes déclarées.
De surcroît, les règles d’ingénierie préconisent de consigner systématiquement une documentation d’architecture dans un onglet dédié du classeur, répertoriant les correspondances entre les identifiants techniques des sources et les libellés adoptés. Cette traçabilité formelle immunise l’organisation contre la perte de connaissances lors des rotations de personnel et simplifie substantiellement les procédures périodiques d’audit qualité.
12.3 Perspectives d’automatisation et alternatives par Apps Script
En dépit de sa puissance expressive et de son élégance conceptuelle, la clause LABEL de la fonction QUERY se heurte à des limites architecturales incontournables. Dès lors qu’un projet requiert une adaptation dynamique des en-têtes reposant sur des algorithmes prédictifs non linéaires, des règles de récursivité avancées ou une interaction directe avec des interfaces de programmation tierces via le protocole REST, l’interpréteur de visualisation atteint le seuil de ses capacités natives.
Dans ces configurations hautement complexes, le basculement vers l’environnement de développement Google Apps Script devient une nécessité méthodologique. Le recours à des scripts personnalisés en langage JavaScript permet de manipuler directement le modèle d’objets du document, autorisant la création de fonctions personnalisées hautement modulaires capables d’ajuster dynamiquement les schémas d’en-têtes en réponse à des déclencheurs événementiels ou temporels complexes.
Néanmoins, cette ouverture vers la programmation impérative ne disqualifie nullement la pertinence de la clause LABEL pour l’immense majorité des applications analytiques du quotidien. La vision prospective de l’évolution de Google Sheets suggère plutôt une hybridation accrue, où la rapidité d’exécution déclarative de la fonction QUERY continuera d’assurer la structuration de base des données, tandis que les scripts programmatiques se concentreront sur les mécanismes d’automatisation périphérique et l’intégration continue au sein du cloud d’entreprise.
Références
- Google Cloud. (2024). Google Visualization API Query Language Reference. Google Developers. https://developers.google.com/chart/interactive/docs/querylanguage
- Google Workspace. (2024). Fonction QUERY : Aide Google Sheets. Centre d’aide Google. https://support.google.com/docs/answer/3093343
- Sweller, J. (2011). Cognitive Load Theory. In J. P. Mestre & B. H. Ross (Eds.), The Psychology of Learning and Motivation (Vol. 55, pp. 37–76). Academic Press.
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23.