
L’estimation statistique contemporaine au sein des sciences quantitatives, de l’économétrie et de la psychométrie appliquée se heurte de manière récurrente aux limites structurelles du modèle linéaire classique estimé par la méthode des moindres carrés ordinaires. Alors que la modélisation statistique moderne tend vers l’intégration d’un nombre toujours plus massif de covariables explicatives, souvent issues de batteries d’évaluations complexes, de capteurs physiologiques ou de registres longitudinaux, l’hypothèse fondamentale d’indépendance linéaire des prédicteurs se trouve systématiquement violée. Cette redondance informationnelle, désignée sous le terme de multicolinéarité, altère l’estimation des paramètres, gonflant démesurément leur instabilité numérique et détruisant toute capacité de généralisation prédictive hors échantillon.
Face à l’effondrement de la précision des estimateurs non biaisés en présence de matrices de covariance mal conditionnées, la régularisation mathématique s’impose non pas comme un simple artifice calculatoire, mais comme une révision épistémologique profonde du compromis entre le biais et la variance. La régression Ridge, conceptualisée initialement par Hoerl et Kennard au début des années 1970 sous l’appellation d’estimation par crête, introduit une pénalisation quadratique de type L2 sur les coefficients de régression. En renonçant délibérément au dogme de l’absence stricte de biais théorique, cette approche permet de contracter de manière contrôlée les estimateurs vers l’origine, stabilisant l’inversion matricielle et réduisant l’erreur quadratique moyenne globale à des niveaux inaccessibles pour l’estimation classique.
Cet article propose une exploration intégrale, rigoureuse et étape par étape de la régression Ridge dans l’environnement statistique R. De la dérivation analytique de la fonction de coût pénalisée à l’optimisation algorithmique fine de l’hyperparamètre de régularisation par validation croisée à k-blocs, ce guide détaille l’ensemble du pipeline méthodologique. En s’appuyant sur des bibliothèques logicielles de référence telles que glmnet et les outils modernes de manipulation de données, nous fournissons aux chercheurs, psychométriciens et analystes de données les compétences théoriques et pratiques nécessaires pour maîtriser ce pilier de l’apprentissage statistique supervisé.
1. Introduction et fondements théoriques de la régression Ridge
1.1 Le problème de la multicolinéarité dans les modèles linéaires classiques
Dans le cadre du modèle de régression linéaire gaussien multivarié, le vecteur de réponse continu s’exprime sous la forme matricielle canonique reliant les prédicteurs au terme d’erreur stochastique. L’estimation des moindres carrés ordinaires (MCO) repose sur la minimisation de la distance euclidienne entre les observations empiriques et le sous-espace vectoriel engendré par les colonnes de la matrice d’expérience. Lorsque ces colonnes présentent une indépendance linéaire parfaite, le produit matriciel de la transposée de la matrice d’expérience par elle-même constitue une matrice semi-définie positive inversible, garantissant l’unicité mathématique du vecteur de coefficients. Toutefois, la réalité empirique des jeux de données complexes confronte presque toujours l’analyste à des configurations de multicolinéarité stricte ou approchée.
La multicolinéarité stricte survient lorsqu’il existe une combinaison linéaire exacte entre deux ou plusieurs prédicteurs, ce qui entraîne une réduction du rang effectif de la matrice d’expérience en deçà de son nombre de colonnes. Dans cette situation pathologique, le déterminant de la matrice de dispersion s’annule rigoureusement, rendant son inversion impossible et privant le système d’équations normales de toute solution unique. Bien que cette situation d’interdépendance absolue soit généralement identifiable et imputable à des erreurs d’encodage redondant, la multicolinéarité approchée s’avère infiniment plus pernicieuse. Elle se manifeste dès lors que deux prédicteurs ou sous-ensembles de covariables exhibent un degré de corrélation bivariée ou multivariée particulièrement élevé, sans pour autant former une relation linéaire déterministe parfaite.
Sur le plan géométrique et matriciel, la quasi-colinéarité induit un mauvais conditionnement structurel de la matrice de produit scalaire. Les valeurs propres de cette matrice se dispersent de façon asymétrique, la plus petite d’entre elles devenant infinitésimale et asymptotiquement proche de zéro. Lors de l’inversion analytique nécessaire au calcul des estimateurs non biaisés, l’inversion de ces valeurs propres minuscules agit comme un amplificateur d’erreur gigantesque. Il en résulte une explosion de la trace de la matrice de variance-covariance des estimateurs. Les termes diagonaux de cette matrice, qui représentent la variance d’échantillonnage de chaque paramètre partiel, augmentent de manière exponentielle, sapant la robustesse du modèle.
Les conséquences opérationnelles de cette instabilité matricielle sont dévastatrices pour l’analyste de données. D’un point de vue inférentiel, les erreurs-types des estimateurs deviennent excessives, ce qui entraîne une chute dramatique des statistiques de test de Student associées. Des prédicteurs exerçant pourtant une influence théorique et empirique majeure sur la variable réponse se voient attribuer des valeurs de p très supérieures aux seuils de significativité conventionnels. En outre, le modèle devient hypersensible aux moindres perturbations stochastiques : la modification mineure d’une poignée d’observations ou l’ajout d’une variable bruitée peut provoquer un basculement complet du signe des coefficients de régression, conduisant à des interprétations paradoxales contraires aux connaissances établies du domaine d’application.
1.2 Le compromis biais-variance dans l’estimation statistique
Pour appréhender la justification méthodologique de la régression Ridge, il convient de replacer l’estimation de paramètres dans le cadre fondamental de la théorie de la décision statistique et de la décomposition analytique de l’erreur de généralisation. Considérons un modèle supervisé visant à prédire une réponse continue sur la base d’un vecteur d’attributs. L’erreur quadratique moyenne de prédiction (MSE pour Mean Squared Error), évaluée sur un point arbitraire hors de l’échantillon d’apprentissage, se décompose de manière canonique en trois composantes additives distinctes : le carré du biais statistique de l’estimateur, la variance propre de cet estimateur induite par l’échantillonnage aléatoire, et la variance du terme d’erreur incompressible, intrinsèque à la nature stochastique du phénomène modélisé.
Le prestigieux théorème de Gauss-Markov stipule que, sous les conditions classiques d’exogénéité, d’homoscédasticité et d’absence d’autocorrélation résiduelle, l’estimateur des moindres carrés ordinaires est le meilleur estimateur linéaire non biaisé, souvent désigné par l’acronyme BLUE (Best Linear Unbiased Estimator). Cette optimalité signifie qu’au sein de la classe restreinte des estimateurs affines et strictement impartiaux, dont l’espérance mathématique converge parfaitement vers la véritable valeur du paramètre de population, les MCO possèdent la variance minimale. Néanmoins, cette propriété théorique élégante dissimule une limitation pratique majeure : la restriction exclusive aux estimateurs sans biais s’avère fréquemment sous-optimale lorsque l’objectif ultime réside dans la réduction globale de l’erreur de prédiction quadratique totale.
En présence de prédicteurs corrélés, bien que le biais des MCO soit rigoureusement nul, la composante de variance de la décomposition MSE prend des proportions démesurées. Le principe épistémologique de la régularisation consiste à s’affranchir de l’exigence d’absence de biais. En acceptant d’injecter une quantité modérée et délibérément calibrée de biais systématique dans l’estimation des paramètres, il devient possible de réduire de façon spectaculaire la variance de l’échantillonneur. Dès lors que la diminution de variance surpasse le carré du biais additionnel généré, l’erreur quadratique moyenne globale décroît substantiellement, assurant un gain de précision prédictive net sur des données non observées.
Cette optimisation empirique de la généralisation présente un intérêt capital lors du déploiement de modèles prédictifs sur des cohortes expérimentales indépendantes. Dans les protocoles d’investigation où les données d’entraînement ne constituent qu’une instanciation stochastique d’une population sous-jacente plus vaste, un estimateur non biaisé à variance extrême s’ajuste excessivement aux bruits idiosyncratiques de l’échantillon disponible, un phénomène connu sous le vocable de surajustement (overfitting). La régularisation agit comme un mécanisme de stabilisation mathématique contraignant les paramètres dans des limites plausibles, garantissant que les inférences et prédictions futures demeureront fiables, reproductibles et immunisées contre les fluctuations mineures de collecte.
1.3 Pertinence méthodologique en sciences quantitatives et psychologie empirique
L’application de la régression Ridge s’avère particulièrement féconde dans les disciplines caractérisées par la collecte systématique de mesures multidimensionnelles corrélées, à l’image de la psychologie empirique, de la psychométrie, de la psychiatrie observationnelle et des sciences cognitives. Dans ces champs d’investigation, l’architecture des protocoles repose massivement sur des batteries d’instruments composites, tels que des inventaires d’auto-évaluation, des échelles de personnalité de type Likert ou des épreuves neuropsychologiques chronométrées, conçus précisément pour saturer un spectre commun de construits psychologiques latents.
Lorsque des chercheurs s’attachent à modéliser un critère clinique ou comportemental à partir des facettes d’un inventaire de personnalité structuré, tel que le modèle à cinq facteurs (Big Five), les prédicteurs inclus dans l’équation présentent par conception une proximité théorique et sémantique étroite. Les différentes sous-échelles mesurant par exemple l’anxiété, la dépression, la vulnérabilité émotionnelle et l’impulsivité tendent à covarier de façon substantielle au sein des populations évaluées. L’intégration simultanée de ces dimensions au sein d’une régression classique engendre invariablement des conflits d’estimation : certains items voient leur contribution neutralisée ou leur coefficient inversé arbitrairement, masquant la structure étiologique sous-jacente au profit d’artefacts d’optimisation numérique.
Par ailleurs, les designs expérimentaux contemporains en neuroimagerie comportementale ou en génétique quantitative sont fréquemment confrontés au problème structurel où le nombre de covariables enregistrées approche, voire dépasse, la taille de l’échantillon d’individus recrutés. Si le cadre extrême où le nombre de paramètres surpasse le nombre d’observations interdit mathématiquement le calcul des MCO conventionnels, les scénarios intermédiaires souffrent d’une dégradation précoce de la puissance statistique. La régression pénalisée Ridge permet d’intégrer l’ensemble des dimensions mesurées sans requérir d’élagage théoriquement injustifié, garantissant l’estimation robuste de profils comportementaux complets tout en circonscrivant l’inflation du risque d’erreur de type I induit par la colinéarité résiduelle.
2. Formulation mathématique de la pénalisation L2
2.1 La fonction de perte sous contrainte quadratique
D’un point de vue analytique, la régression linéaire standard cherche à déterminer le vecteur de paramètres qui minimise la somme des carrés des résidus (RSS pour Residual Sum of Squares). En notant la matrice d’expérience de dimension n lignes et p colonnes et le vecteur des observations cibles, la fonction objectif empirique s’écrit comme la norme euclidienne au carré de la différence entre les observations réelles et le vecteur des projections linéaires. L’annulation du gradient de cette fonction par rapport aux coefficients conduit directement aux équations normales classiques, dont la résolution matricielle repose entièrement sur l’inversibilité du produit croisé des variables explicatives.
La formulation théorique de la régression Ridge modifie cette fonction de coût en lui adjoignant un terme de régularisation pénalisant l’amplitude excessive des paramètres estimés. Mathématiquement, cette pénalité correspond à la norme euclidienne au carré du vecteur des coefficients, classiquement appelée norme L2, pondérée par un scalaire positif ou nul désigné par la lettre grecque lambda. La nouvelle fonction objectif à minimiser se structure ainsi comme la somme de la perte d’ajustement empirique et de la contrainte quadratique sur les poids du modèle :
Fonction de perte Ridge = || y – X beta ||^2 + lambda * || beta ||^2
Cette minimisation sans contrainte explicite admet une formalisation duale équivalente dans le cadre de l’optimisation sous contraintes d’inégalité de Karush-Kuhn-Tucker. Le problème se reformule alors comme la minimisation de la somme des carrés des résidus conditionnellement au fait que la somme des carrés des coefficients de régression demeure inférieure ou égale à un plafond budgétaire constant s. Sur le plan de la géométrie différentielle, cette formulation contrainte met en présence deux structures géométriques au sein de l’espace des paramètres : les ellipsoïdes de niveau constant de la somme des résidus quadratiques, centrés sur la solution non contrainte des MCO, et une sphère ou hypersphère centrée sur l’origine des coordonnées, définie par la contrainte quadratique L2.
Le point d’équilibre minimisant la fonction pénalisée correspond au point de tangence géométrique exact entre la surface ellipsoïdale de la fonction d’ajustement et la surface de l’hypersphère de contrainte. Puisque la surface de cette hypersphère L2 est lisse, continue et dépourvue de singularités géométriques ou de sommets orientés le long des axes de coordonnées, le point de tangence optimal ne s’établit pas de façon préférentielle sur les plans orthogonaux formés par les axes. En conséquence directe, les coefficients de régression se trouvent tous uniformément contractés vers l’origine sans jamais atteindre exactement la valeur zéro pour une pénalité finie, ce qui constitue une propriété centrale distinguant la régularisation Ridge d’autres formulations pénalisées.
La dérivation matricielle formelle de la fonction de perte Ridge met en évidence l’existence d’une solution analytique fermée. En différentiant l’expression vectorielle par rapport au vecteur de paramètres et en égalant le gradient résultant au vecteur nul, nous obtenons l’équation matricielle fondamentale suivante :
beta_ridge = (X’ X + lambda * I_p)^(-1) X’ y
Dans cette formulation élégante, la matrice I_p désigne la matrice identité d’ordre p. L’adjonction du terme scalaire lambda multiplié par la matrice identité sur la diagonale principale de la matrice de produit croisé constitue l’essence mathématique de l’estimation par crête (ridge). Ce décalage diagonal garantit de manière absolue que la matrice combinée demeure symétrique et strictement définie positive, et ce, quelle que soit la sévérité de la multicolinéarité initiale régnant au sein des colonnes de la matrice d’expérience.
2.2 Le rôle du paramètre de régularisation lambda
L’hyperparamètre lambda gouverne l’intensité relative accordée à la pénalité de contraction vis-à-vis de l’ajustement strict aux données d’observation. L’analyse des régimes asymptotiques de cette grandeur scalaire permet d’en élucider les propriétés de contrôle mathématique. Lorsque le paramètre de régularisation converge vers la limite inférieure zéro, le terme de pénalisation s’annule rigoureusement. L’expression de l’estimateur Ridge se réduit alors à la résolution classique des moindres carrés ordinaires, sous réserve que la matrice d’expérience soit de plein rang. Le modèle recouvre son comportement non biaisé, mais s’expose à nouveau à l’instabilité induite par la colinéarité.
À l’inverse, lorsque la valeur de lambda croît de manière monotone vers l’infini, la contribution de la somme des carrés des résidus devient négligeable devant l’ampleur mathématique du terme de régularisation au sein de la fonction de coût. Pour éviter une explosion de la pénalité quadratique, l’algorithme d’optimisation se voit contraint de comprimer de façon continue l’ensemble des coefficients de régression vers une limite asymptotique nulle. Dans cette configuration de pénalisation absolue, l’influence de l’intégralité des covariables s’efface totalement, et la prédiction du modèle se réduit à une droite horizontale constante matérialisée par l’estimation de l’interception, laquelle équivaut simplement à la moyenne empirique de la variable réponse.
Entre ces deux polarités théoriques extrêmes, l’introduction du terme scalaire lambda fois l’identité transforme radicalement le conditionnement matriciel du problème numérique. Le nombre de conditionnement d’une matrice symétrique définie positive s’évalue traditionnellement par le ratio entre sa plus grande et sa plus petite valeur propre. En ajoutant le paramètre lambda à chaque valeur propre intrinsèque de la matrice de dispersion initiale, la plus faible des valeurs propres se trouve relevée à une valeur minimale strictement bornée par lambda. En conséquence, le rapport entre les valeurs propres extrêmes se contracte drastiquement, conférant à la matrice inversée une insensibilité exemplaire aux imprécisions computationnelles et aux micro-fluctuations d’échantillonnage.
2.3 Distinction fondamentale entre régression Ridge, Lasso et Elastic Net
L’étude approfondie de la régression régularisée exige d’établir une démarcation nette entre la régression Ridge et les deux autres grandes méthodologies pénalisées que sont le Lasso et l’Elastic Net. Le Lasso (Least Absolute Shrinkage and Selection Operator), théorisé par Robert Tibshirani en 1996, substitue à la pénalité quadratique L2 une pénalisation fondée sur la norme L1, c’est-à-dire sur la somme des valeurs absolues des coefficients de régression. Bien que cette modification paraisse mineure sur le plan de l’écriture algébrique, ses répercussions géométriques et fonctionnelles sont fondamentales.
L’espace de contrainte généré par la norme L1 se matérialise sous la forme d’un polytope convexe présentant des arêtes vives et des sommets positionnés exactement sur les axes orthogonaux du repère de coordonnées. Lorsque les contours elliptiques de la fonction de perte résiduelle rencontrent cette surface polygonale, le point de tangence s’établit de manière privilégiée sur l’un de ces angles saillants. Par conséquent, le Lasso possède la propriété mathématique intrinsèque d’annuler rigoureusement un sous-ensemble de coefficients, effectuant ainsi une sélection automatique de variables. Cette sparsité est absente de la régression Ridge, qui préserve impérativement l’ensemble des prédicteurs au sein de l’équation finale par un rétrécissement proportionnel et graduel.
Cependant, en situation de multicolinéarité extrême, le Lasso exhibe un comportement heuristique problématique : confronté à un faisceau de variables fortement interdépendantes, l’algorithme a tendance à sélectionner arbitrairement une unique covariable dans le groupe pour annuler brutalement toutes les autres, sans considération théorique pour leur rôle sous-jacent. La régression Ridge, au contraire, adopte une stratégie d’agrégation coopérative : elle rétrécit simultanément l’ensemble des coefficients associés à ces variables colinéaires, distribuant le poids prédictif de manière homogène et stable entre les éléments du bloc redondant.
L’Elastic Net, développé par Zou et Hastie en 2005, réalise la synthèse programmée de ces deux approches en combinant linéairement les pénalités L1 et L2 au moyen d’un paramètre de mélange convexe traditionnellement noté alpha. Cette formulation hybride permet de bénéficier de la capacité de sélection parcimonieuse du Lasso tout en conservant l’effet de regroupement (grouping effect) et la stabilité numérique offerts par la pénalité Ridge. Le tableau conceptuel suivant formalise les divergences structurelles majeures séparant ces trois architectures de modélisation régularisée :
- Régression Ridge (Norme L2) : Pénalité proportionnelle au carré des coefficients. Rétrécissement asymptotique continu sans annulation stricte. Conservation de l’ensemble des covariables dans le modèle. Excellente gestion des blocs de colinéarité corrélés. Existence d’une solution analytique exacte sous forme matricielle fermée.
- Régression Lasso (Norme L1) : Pénalité proportionnelle à la valeur absolue des coefficients. Rétrécissement discontinu induisant une sparsité structurelle par annulation exacte de paramètres. Sélection automatique d’attributs. Comportement instable face aux groupes de variables hautement corrélées. Résolution par optimisation convexe non dérivable (descente par coordonnées).
- Régression Elastic Net (Norme Hybride L1 + L2) : Combinaison convexe régie par le scalaire alpha compris entre 0 et 1. Sélection simultanée de variables et stabilisation des coefficients groupés. Idéal lorsque le nombre de variables hautement corrélées dépasse la taille d’échantillon. Coût calculatoire supérieur requérant l’optimisation bidimensionnelle conjointe de deux hyperparamètres.
3. Configuration de l’environnement de développement R
3.1 Sélection et installation des bibliothèques nécessaires
L’implémentation opérationnelle de la régression Ridge sous l’interpréteur statistique R s’articule autour d’un écosystème de bibliothèques spécialisées garantissant une efficacité computationnelle optimale et une ergonomie rigoureuse de modélisation. Au cœur de cette infrastructure se trouve le paquet logiciel glmnet, développé par Jerome Friedman, Trevor Hastie et Rob Tibshirani. Ce composant logiciel constitue le standard de référence mondial pour l’ajustement de modèles linéaires généralisés régularisés par les pénalités Ridge, Lasso et Elastic Net. Codé de manière sous-jacente en langage Fortran compilé et optimisé par des algorithmes cycliques de descente par coordonnées, glmnet autorise le traitement quasi instantané de matrices de très grandes dimensions.
Conjointement à ce moteur de calcul, l’intégration de la méta-bibliothèque tidyverse s’avère hautement stratégique pour structurer de manière fluide les flux de manipulation de données. Les sous-modules tels que dplyr, tidyr et purrr facilitent la transformation structurelle des variables, le réagencement des matrices de coefficients et le calcul vectoriel des métriques d’erreur hors échantillon. De plus, le paquet car (Companion to Applied Regression), maintenu par John Fox, fournit les fonctions d’analyse diagnostique nécessaires au calcul des facteurs d’inflation de la variance au sein des modèles linéaires de base, tandis que la bibliothèque corrplot prend en charge l’exploration topologique des structures d’intercorrélation.
Pour assurer la restitution visuelle de haute qualité des trajectoires de régularisation et des fonctions de coût par validation croisée, le système graphique ggplot2 s’impose par sa flexibilité sémantique et son adéquation avec les critères de publication académique. L’installation de l’ensemble de cette infrastructure s’exécute au moyen de commandes d’installation standardisées au sein de la console interactive de R :
install.packages(c(« glmnet », « tidyverse », « car », « corrplot »))
Après l’installation réussie de ces modules, leur activation séquentielle s’effectue dans le script de travail en amorce de toute analyse :
library(glmnet)
library(tidyverse)
library(car)
library(corrplot)
3.2 Paramétrage des graines aléatoires et reproductibilité scientifique
L’impératif de reproductibilité constitue la clé de voûte de la démarche scientifique moderne dans le cadre de l’analyse computationnelle des données. Bien que l’estimateur Ridge dispose d’une formule analytique déterministe pour une valeur scalaire de lambda fixée, le processus contemporain d’optimisation de cet hyperparamètre repose massivement sur des techniques de partitionnement stochastique, en particulier la validation croisée à k-blocs. Dans cette procédure, les observations sont ventilées de manière pseudo-aléatoire au sein de sous-groupes d’apprentissage et de validation.
Si la graine du générateur de nombres pseudo-aléatoires de l’interpréteur R n’est pas rigoureusement fixée à l’initialisation de la session de calcul, les découpages d’échantillonnage varieront inévitablement d’une exécution à l’autre. Cette fluctuation d’échantillonnage interne peut induire de légères variations dans l’identification du seuil optimal de régularisation lambda, modifiant à la marge l’amplitude des coefficients rétrécis et compromettant la réplication exacte des résultats numériques publiés. Pour pallier cette source de variabilité stochastique, la fixation préalable de la graine logicielle s’avère indispensable :
set.seed(42)
En complément de la fixation de cette graine aléatoire, une démarche scientifique exige la traçabilité intégrale de l’environnement logiciel utilisé lors de l’exécution des calculs. L’analyste doit documenter systématiquement la version de l’interpréteur R employé ainsi que les versions précises des paquets dépendants. L’exécution de la commande de diagnostic sessionInfo() fournit l’inventaire exhaustif de la plateforme matérielle, du système d’exploitation hôte, des paramètres d’encodage régionaux et de la hiérarchie des modules chargés en mémoire, éliminant ainsi toute ambiguïté lors de tentatives de réplication indépendantes sur d’autres architectures de calcul.
4. Acquisition et exploration multidimensionnelle des données
4.1 Structure du jeu de données et identification des variables
Afin d’illustrer les propriétés algébriques et computationnelles de la régression Ridge dans R sur un cas d’école documenté, nous utiliserons le jeu de données classique mtcars, issu des relevés empiriques du magazine automobile américain Motor Trend de 1974. Bien que d’apparence modeste par sa volumétrie (32 observations documentées sur 11 caractéristiques techniques), ce jeu de données présente l’intérêt pédagogique et méthodologique d’incorporer un réseau d’interdépendances linéaires et de redondances mécaniques majeures, constituant un archétype expérimental parfait pour l’étude de la multicolinéarité.
Dans le cadre de cette application guidée, nous nous assignons l’objectif de modéliser et de prédire une variable réponse continue caractérisant la puissance motrice développée par les véhicules, matérialisée par la variable hp (Gross horsepower). Afin de prédire ce critère de performance mécanique continue, nous sélectionnons un sous-ensemble de covariables explicatives continues et discrètes représentatives de la morphologie et de la dynamique des véhicules :
- mpg (Miles/(US) gallon) : Mesure de l’efficacité énergétique en consommation de carburant, négativement reliée à la puissance brute.
- cyl (Number of cylinders) : Nombre de cylindres du bloc moteur, fortement corrélé à la cylindrée globale.
- disp (Displacement) : Cylindrée volumétrique totale du moteur exprimée en pouces cubes, présentant une redondance structurelle avec la masse et le nombre de cylindres.
- drat (Rear axle ratio) : Rapport de démultiplication du pont arrière, influençant le régime moteur et le couple transmis.
- wt (Weight) : Masse totale du véhicule exprimée en milliers de livres (lbs), liée directement aux contraintes inertielles.
- qsec (1/4 mile time) : Temps mesuré en secondes pour franchir une distance de départ arrêté d’un quart de mille, indicateur cinématique direct de l’accélération.
L’inspection préliminaire de ce jeu de données requiert une vérification minutieuse de la nature des types de données, de l’intégrité de la matrice et de l’absence totale de valeurs manquantes (missing values). L’absence de cellules vacantes sur l’échantillon mtcars évite le recours immédiat à des algorithmes d’imputation multiple par équations chaînées, nous permettant de concentrer l’effort méthodologique sur l’architecture du réseau de covariation des attributs.
4.2 Diagnostic exploratoire de la multicolinéarité
L’exploration des données débute par le calcul et l’affichage de la matrice de corrélation de Pearson liant les différentes variables explicatives candidates. L’observation directe des coefficients bivariés met en lumière des niveaux d’association colinéaire particulièrement prononcés. Par exemple, la cylindrée (disp) et le nombre de cylindres (cyl) exhibent une corrélation positive dépassant 0,90, tandis que l’efficacité énergétique (mpg) entretient des corrélations négatives massives avec la cylindrée et la masse globale du véhicule (wt).
L’analyse visuelle par le biais d’un corrélogramme annoté permet d’appréhender instantanément cette redondance globale. Les variables mécaniques forment un bloc dense de covariation où chaque dimension réplique une fraction substantielle de l’information déjà contenue dans les dimensions adjacentes. Toutefois, l’évaluation isolée des coefficients de corrélation bivariée demeure insuffisante pour attester formellement de la présence ou de l’absence de colinéarité multivariée. Deux prédicteurs peuvent tout à fait afficher une corrélation bivariée modérée tout en étant presque parfaitement prédits par une combinaison linéaire conjointe de trois autres variables du système.
Pour quantifier de manière mathématiquement irréfutable cette dépendance multivariée, le calcul du facteur d’inflation de la variance (VIF pour Variance Inflation Factor) est le standard diagnostique absolu. Pour chaque prédicateur j, le VIF mesure l’ampleur avec laquelle la variance du coefficient de régression estimé se trouve gonflée sous l’impact direct de son association linéaire avec les autres prédicteurs. Sa définition formelle s’écrit :
VIF_j = 1 / (1 – R_j^2)
Dans cette formulation, R_j^2 représente le coefficient de détermination issu de la régression linéaire auxiliaire de la variable explicative j sur l’ensemble des p – 1 autres covariables restantes. Si la variable j est totalement indépendante du reste de la matrice d’expérience, son coefficient auxiliaire s’annule et le VIF prend sa valeur idéale unitaire de 1. En revanche, si la variable j est hautement redondante, son R_j^2 approche l’unité et le dénominateur de l’expression tend vers zéro, provoquant une explosion asymptotique de la valeur du facteur d’inflation.
La règle heuristique communément admise dans la littérature méthodologique considère qu’un seuil de VIF excédant 5 signale une colinéarité préoccupante, tandis qu’une valeur franchissant le seuil critique de 10 indique une instabilité matricielle sévère exigeant impérativement l’abandon des MCO au profit d’une modélisation pénalisée. L’ajustement d’un modèle linéaire standard sur les prédicteurs sélectionnés de mtcars et l’extraction subséquente des VIF via la fonction vif() de la bibliothèque car révèle des facteurs d’inflation atteignant des valeurs comprises entre 10 et 22 pour disp, cyl et mpg. Ce constat empirique confirme formellement l’incapacité de l’approche linéaire ordinaire à délivrer des coefficients stables et interprétables sur ces données.
5. Préparation et standardisation matricielle des données
5.1 Formatage obligatoire sous forme de matrice numérique
L’architecture algorithmique sous-jacente de la bibliothèque glmnet impose des exigences structurelles strictes quant au formatage des structures de données en mémoire. Contrairement aux fonctions classiques de l’écosystème R de base, telles que la commande lm(), qui acceptent des objets de type data.frame enrichis de syntaxes formula explicites prenant automatiquement en charge les types catégoriels, l’interface de glmnet ne traite que des objets matriciels numériques purs de classe matrix.
Cette distinction technique découle directement de l’intégration sous-jacente de routines compilées hautement optimisées, conçues pour opérer des calculs d’algèbre linéaire par blocs à vitesse maximale sur des vecteurs continus en mémoire vive. Par conséquent, l’analyste doit impérativement scinder son jeu de données d’entrée en deux entités distinctes : une matrice numérique bidimensionnelle x regroupant la totalité des covariables explicatives d’apprentissage, et un vecteur numérique unidimensionnel y hébergeant la variable de réponse cible.
Lorsque le jeu de données intègre des variables qualitatives ou des facteurs ordonnés, la constitution de la matrice x exige l’application préalable d’un codage disjonctif complet en variables indicatrices binaires (dummy variables). Dans l’écosystème R, cette expansion s’opère de manière idéale à l’aide de la primitive model.matrix(). Cependant, une précaution méthodologique capitale doit être observée : l’appel à la fonction model.matrix() génère par défaut un vecteur colonne unitaire positionné à gauche de la matrice, destiné à capter l’ordonnée à l’origine (intercept). Or, l’algorithme de descente par coordonnées de glmnet prend nativement en charge l’estimation de l’interception de manière interne et séparée. La présence d’une colonne constante au sein de la matrice x injecterait une colinéarité artificielle redondante. Il convient donc d’exclure rigoureusement cette colonne lors de la déclaration :
x <- model.matrix(hp ~ mpg + cyl + disp + drat + wt + qsec, data = mtcars)[, -1]
y <- mtcars$hp
5.2 L’impératif de la standardisation des prédicteurs
L’une des particularités fondamentales de la régression pénalisée par rapport aux moindres carrés ordinaires réside dans son absence d’invariance d’échelle. Dans le cadre d’un modèle estimé par MCO classique, la multiplication d’une variable prédictive par une constante scalaire quelconque n’exerce aucun impact structurel sur l’ajustement global : le coefficient de régression associé se trouve simplement divisé par cette même constante, laissant la prédiction, les résidus et la significativité statistique rigoureusement inchangés.
En régression Ridge, la mécanique d’estimation est radicalement différente. Étant donné que la fonction de coût incorpore la somme des carrés des coefficients beta_j au sein du terme de pénalité, la sanction infligée à un paramètre dépend exclusivement de sa valeur absolue numérique brute, et non de son importance explicative intrinsèque. Si une covariable est exprimée dans une unité de mesure conduisant à des amplitudes numériques très faibles (par exemple des distances exprimées en kilomètres plutôt qu’en millimètres), son coefficient de régression naturel devra prendre des valeurs gigantesques pour compenser. En conséquence, cette variable subira une pénalisation disproportionnée et sera indûment écrasée par rapport à une variable dont l’échelle naturelle implique de petits coefficients.
Pour instaurer une stricte équité mathématique lors de la phase de contraction géométrique, l’ensemble des colonnes de la matrice d’expérience doit être préalablement centré et réduit, de sorte que chaque prédicateur affiche une moyenne nulle et un écart-type unitaire égal à 1. Conscients de cette nécessité absolue, les concepteurs de l’algorithme glmnet ont intégré ce processus de normalisation de manière entièrement native via l’argument d’initialisation standardize = TRUE, activé par défaut. Sous ce paramétrage, les calculs internes de gradient et de contraction opèrent sur des données rigoureusement standardisées. Une fois l’optimisation convergée, glmnet opère automatiquement la rétro-transformation algébrique des coefficients vers leurs échelles d’origine, garantissant à l’utilisateur des coefficients finaux immédiatement interprétables dans les unités natives du problème.
5.3 Partitionnement en ensembles d’entraînement et de test
L’évaluation rigoureuse de la performance d’un modèle statistique impose de séparer strictement les données ayant servi à la calibration de ses paramètres de celles mobilisées pour estimer sa capacité prédictive. L’optimisation directe sur l’échantillon complet engendre invariablement un optimisme d’évaluation artificiel, masquant les faiblesses de généralisation du modèle. Une stratégie de partitionnement probabiliste étanche doit donc être établie en amont de toute modélisation.
Nous procédons à une scission stochastique respectant classiquement un ratio de 70% pour la cohorte d’entraînement (train set) et de 30% pour la cohorte d’évaluation indépendante (test set). Dans les environnements à volume restreint comme mtcars, ce découpage doit s’assurer que les distributions marginales de la variable cible demeurent homogènes entre les deux sous-échantillons formés, évitant ainsi l’introduction d’un biais d’échantillonnage structurel entre l’apprentissage et le test :
set.seed(123)
train_indices <- sample(seq_len(nrow(x)), size = floor(0.70 * nrow(x)))
x_train <- x[train_indices, ]
y_train <- y[train_indices]
x_test <- x[-train_indices, ]
y_test <- y[-train_indices]
L’isolement de x_test et de y_test est hermétique : aucune information descriptive, aucune moyenne de centrage ni aucune variance d’échelle issue de cette fraction réservée ne doit transpirer lors des phases d’optimisation algorithmique, garantissant ainsi l’absence totale de fuite de données (data leakage) au cours du cycle analytique.
6. Ajustement du modèle Ridge avec glmnet
6.1 Paramétrage de la fonction principale glmnet
L’ajustement du modèle de régression Ridge dans R s’opère par l’invocation de la fonction maîtresse glmnet(). La paramétrisation de cet appel requiert une compréhension précise de ses arguments d’entrée afin de contraindre la mécanique computationnelle vers une pénalisation strictement quadratique L2. L’argument déterminant réside dans la spécification du scalaire alpha, qui gouverne l’élasticité du mélange pénalisé au sein de la formulation Elastic Net. Pour contraindre l’algorithme à une régression Ridge pure, l’analyste doit impérativement déclarer alpha = 0. Une valeur unitaire d’alpha basculerait le calcul vers un Lasso, tandis que toute valeur intermédiaire calibrerait un réseau Elastic Net.
Le second paramètre fondamental concerne la nature du modèle linéaire généralisé sous-jacent, désigné par l’argument family. S’agissant de la modélisation d’une variable dépendante continue prenant ses valeurs sur la droite réelle avec une hypothèse d’homoscedasticité résiduelle normale, la distribution adéquate est la famille gaussienne, spécifiée par family = « gaussian ». L’appel syntaxique s’établit ainsi :
ridge_model <- glmnet(x_train, y_train, alpha = 0, family = « gaussian »)
Il est capital de souligner qu’à ce stade, nous n’avons pas explicité de valeur unique pour l’hyperparamètre lambda. Par conception, l’algorithme glmnet ne procède pas à une résolution isolée pour une pénalité singulière. Il génère automatiquement une séquence logarithmique décroissante de 100 valeurs distinctes de lambda, dénommée chemin de régularisation (regularization path). Cette grille démarre à un seuil lambda_max suffisamment élevé pour écraser pratiquement l’ensemble des coefficients au voisinage immédiat de zéro, puis décline de manière géométrique progressive jusqu’à une fraction minuscule de ce maximum (lambda_min_ratio), balayant l’intégralité du spectre de régularisation.
6.2 Analyse de la matrice des chemins de régularisation
L’objet logiciel retourné par l’ajustement de la fonction glmnet possède une structure hiérarchique hautement optimisée intégrant les métadonnées de l’ensemble du profil de régularisation. L’interrogation directe de cet objet via la commande générique print() dévoile un récapitulatif tabulaire composé de trois colonnes majeures décrivant la trajectoire d’estimation : Df (Degrés de liberté), %Dev (Pourcentage de déviance expliquée) et Lambda.
La colonne Df, qui traduit le nombre effectif de paramètres non nuls inclus dans le système, conserve une valeur invariante égale au nombre total de colonnes prédictives présentes dans x_train, soit 6 prédicteurs dans notre modélisation mtcars. Cette invariance empirique illustre parfaitement la caractéristique mathématique de la norme L2 explicitée précédemment : la régression Ridge n’opère aucune sélection atomique de prédicteurs. Même sous des contraintes de pénalisation extrêmes, aucun coefficient n’est rigoureusement forcé à zéro, préservant ainsi l’intégralité des degrés de liberté de la matrice d’expérience.
La deuxième métrique, désignée par %Dev, quantify la fraction de déviance du modèle absorbée par la régression Ridge à chaque jalon de la grille de pénalité par rapport à un modèle nul ne contenant que la constante. Dans le cas gaussien continu, cette quantité correspond formellement au coefficient de détermination classique R-carré calculé sur la cohorte d’apprentissage. L’inspection séquentielle de cette grandeur met en évidence un comportement monotone fondamental : à mesure que la valeur scalaire de lambda décroît de son maximum vers son minimum, le pourcentage de déviance expliquée augmente continûment pour culminer à son niveau maximal lorsque la contrainte s’atténue, se rapprochant de l’ajustement sans biais des moindres carrés.
7. Optimisation de lambda par validation croisée à k-blocs
7.1 Mise en œuvre algorithmique avec cv.glmnet
L’obtention de la trajectoire complète des coefficients pour une centaine de valeurs de lambda ne résout pas la problématique fondamentale du chercheur : quelle valeur spécifique de lambda doit être rigoureusement extraite pour opérer les inférences et délivrer des prédictions robustes ? Sélectionner un lambda arbitrairement trop élevé aboutit à un sous-apprentissage sévère (underfitting), biaisant excessivement les prédictions. À l’inverse, retenir un lambda infinitésimal réintroduit les ravages de la multicolinéarité et le surapprentissage. L’arbitrage impartial entre ces deux écueils relève de l’optimisation par validation croisée à k-blocs (k-fold cross-validation).
La bibliothèque logicielle offre une fonction dédiée intégrant l’intégralité de cette machinerie computationnelle : cv.glmnet(). L’algorithme segmente la cohorte d’entraînement x_train en k segments mutuellement exclusifs (par défaut, k = 10 blocs d’échantillonnage). De façon itérative, la méthode retient le k-ième bloc comme échantillon de test local, ajuste la trajectoire complète de régression Ridge sur les k – 1 blocs restants combinés, puis projette les prédictions du modèle sur le segment exclu afin d’enregistrer l’erreur résiduelle quadratique moyenne pour chaque valeur de lambda de la séquence.
Au terme des k itérations cycliques, les erreurs de test obtenues sur chaque pli sont moyennées empiriquement, générant une estimation non biaisée de l’erreur quadratique moyenne de validation (CV-MSE) associée à une mesure de dispersion matérialisée par son écart-type stochastique. L’exécution sous R s’articule de façon transparente :
set.seed(42)
cv_ridge <- cv.glmnet(x_train, y_train, alpha = 0, family = « gaussian », nfolds = 10)
7.2 Identification des seuils critiques : lambda.min vs lambda.1se
L’interrogation de l’objet résultat cv_ridge révèle la convergence numérique de l’algorithme vers deux seuils de régularisation fondamentaux, enregistrés respectivement sous les identifiants lambda.min et lambda.1se. Ces deux métriques incarnent des philosophies distinctes de la théorie statistique de la décision et fournissent des compromis contrastés entre performance pure et stabilité structurelle.
Le paramètre lambda.min désigne la valeur exacte de l’hyperparamètre lambda pour laquelle l’erreur quadratique moyenne de validation croisée atteint son minimum global absolu. Sur le strict plan de l’optimisation numérique hors échantillon, c’est ce point géométrique précis qui maximise l’adéquation prédictive aux données d’apprentissage segmentées. Si l’unique objectif de l’analyste réside dans la précision brute de prédiction sans considération pour la complexité ou la sensibilité aux variations échantillonnales, lambda.min constitue le choix algorithmique naturel.
Néanmoins, Jerome Friedman et ses coauteurs ont introduit un critère de décision méthodologique plus conservateur et robuste, désigné sous l’appellation de règle de l’écart-type unique (one-standard-error rule), matérialisée par lambda.1se. Ce seuil représente la valeur de lambda la plus fortement régularisée (donc la plus parcimonieuse et contraignante) dont l’erreur moyenne de validation croisée demeure inférieure ou égale au minimum absolu majoré d’un écart-type de cette estimation. En privilégiant lambda.1se, le modélisateur accepte une dégradation statistique statistiquement non significative de son ajustement pour maximiser la contraction des coefficients, immunisant d’autant plus le modèle final contre les anomalies d’échantillonnage.
7.3 Représentation graphique de la validation croisée
L’auscultation diagnostique du profil d’optimisation passe par la restitution graphique directe de l’objet cv_ridge au moyen de la méthode plot(). Ce visuel canonique retrace l’évolution de la fonction d’erreur empirique tout au long de l’axe de régularisation, offrant une vue synoptique complète de la stabilité de la procédure d’apprentissage.
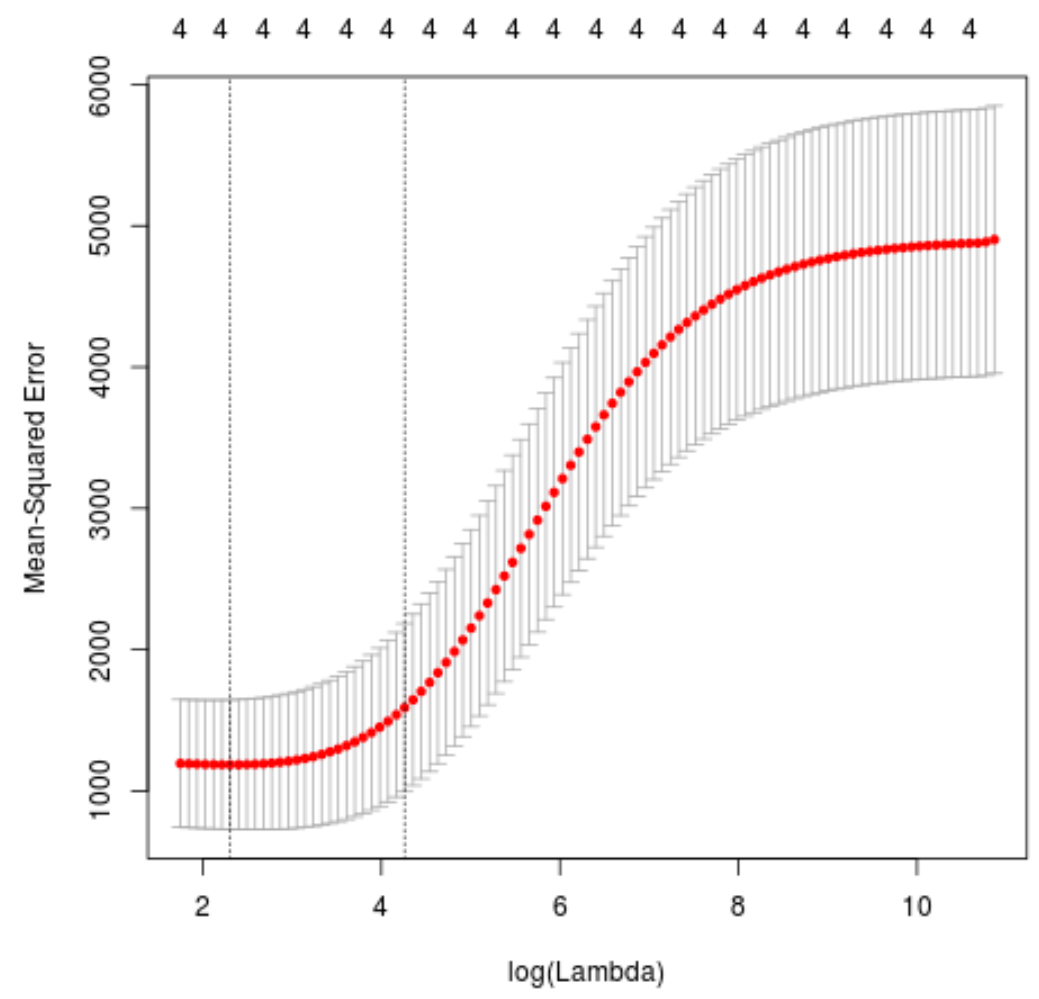
Sur cette représentation visuelle standardisée, l’axe horizontal supérieur affiche le nombre de prédicteurs non nuls intégrés dans le système au niveau de pénalité correspondant, un nombre qui demeure invariablement calé à 6 en régression Ridge pure. L’axe horizontal inférieur expose l’échelle logarithmique de la séquence d’hyperparamètres, notée log(lambda). L’échelle logarithmique est indispensable pour appréhender de manière uniforme des ordres de grandeur de pénalité variant fréquemment de 10^-3 à 10^3.
L’axe vertical reporte l’erreur quadratique moyenne de validation croisée, escortée de barres d’erreur symétriques matérialisant l’intervalle d’incertitude à un écart-type de part et d’autre de l’estimation ponctuelle. Deux lignes verticales pointillées rouges viennent scinder l’espace graphique : la première, située le plus à gauche, intersecte l’abscisse au point de log(lambda.min), tandis que la seconde, décalée vers la droite dans les zones de plus forte régularisation, matérialise l’abscisse de log(lambda.1se). L’intervalle séparant ces deux repères constitue la zone de compromis optimale où le statisticien peut rationnellement ancrer son modèle.
8. Extraction et interprétation des coefficients régularisés
8.1 Extraction programmatique des estimateurs optimaux
Une fois le processus d’optimisation stochastique mené à son terme et le seuil de régularisation arbitré, il convient d’extraire formellement les estimations des coefficients de régression contractés. Cette extraction ne doit pas se faire manuellement : l’environnement met à disposition la méthode polymorphe coef(), conçue pour naviguer au sein des matrices de résultats de glmnet en pointant directement vers le seuil choisi au moyen de l’argument scalaire s. L’extraction programmatique du vecteur optimal s’exécute ainsi :
ridge_coefficients <- coef(cv_ridge, s = « lambda.min »)
L’évaluation de l’objet résultant ridge_coefficients révèle une structure de classe dgCMatrix. Il s’agit d’une matrice creuse (sparse matrix), format natif de calcul développé au sein de la bibliothèque Matrix pour économiser la mémoire vive en n’allouant aucun espace de stockage physique aux éléments nuls. Bien que cette structure soit optimisée pour le calcul massif sous Lasso, sa manipulation en régression Ridge, où les termes sont systématiquement non nuls, gagne à être convertie en matrice numérique standard ou en tableau de données structuré à des fins de restitution claire :
coefficients_matrix <- as.matrix(ridge_coefficients)
coefficients_df <- data.frame(
Variable = rownames(coefficients_matrix),
Coefficient = coefficients_matrix[, 1]
)
rownames(coefficients_df) <- NULL
Le premier terme du vecteur, étiqueté (Intercept), matérialise la constante de régression estimée. Il est crucial d’observer que cette constante a été calculée sur l’échelle originale de la variable cible y, tandis que les coefficients partiels assignés aux prédicteurs ont été rétro-projetés sur leurs unités de mesure natives respectives, permettant une interprétation technique directe en lien avec la métrologie des variables du modèle.
8.2 Mécanisme de rétrécissement et absence de mise à zéro stricte
La comparaison terme à terme des coefficients estimés par la régression Ridge avec ceux générés par l’ajustement non contraint des moindres carrés ordinaires permet de saisir empiriquement l’action de la pénalisation quadratique L2. En ajustant le modèle MCO standard par la primitive lm(hp ~ ., data = as.data.frame(cbind(y_train, x_train))) et en confrontant ses résultats à l’estimateur Ridge à son niveau lambda.min, une divergence systématique d’amplitude se fait jour.
Sous la contrainte Ridge, la totalité des coefficients voit sa valeur absolue se contracter vers l’origine. Les prédicteurs qui affichaient des amplitudes numériques démesurées au sein du modèle MCO, précisément sous l’effet de l’amplification d’erreur causée par la faible valeur propre de la matrice de colinéarité, subissent le rétrécissement le plus prononcé. En introduisant le terme lambda sur la diagonale, la régression Ridge comprime le gonflement artificiel de la variance sans détruire l’information sous-jacente.
Cependant, en stricte conformité avec la théorie de la régularisation L2, aucune valeur de coefficient ne s’annule totalement. Même pour des prédicteurs présentant un apport explicatif marginal, l’estimateur préserve un poids résiduel non nul, garantissant que chaque facette mesurée participe à l’estimation finale de l’observation cible. C’est précisément cette persistance universelle des variables explicatives qui confère à la régression Ridge son avantage distinctif dans les modélisations d’agrégation d’effets diffus, où la réponse réelle est régie par un faisceau étendu de déterminants faibles et fortement intriqués.
8.3 Interprétation prudente dans un cadre d’inférence causale
L’utilisation de la régression Ridge impose une vigilance épistémologique et méthodologique accrue quant à la nature des conclusions scientifiques formulables. Dans l’arsenal classique des modèles linéaires par MCO, le chercheur a coutume d’extraire des tests de significativité bilatéraux matérialisés par des p-valeurs de Student et des intervalles de confiance standardisés centrés sur l’estimateur sans biais. Cette inférence repose explicitement sur le théorème de distribution de Gauss-Markov et la normalité asymptotique d’estimateurs non biaisés.
Or, en régression Ridge, l’introduction délibérée du biais de régularisation altère fondamentalement la validité des statistiques de test conventionnelles. Puisque l’espérance mathématique de l’estimateur Ridge n’est plus égale au paramètre de population théorique mais est contractée vers l’origine, les rapports t construits par division du coefficient par son erreur-type ne suivent plus une loi de Student sous l’hypothèse nulle. La dérivation analytique de p-valeurs exactes sous régularisation constitue un problème statistique complexe et largement non résolu sous une forme universelle. C’est pourquoi la fonction glmnet ne retourne délibérément aucune p-valeur ni aucune table d’analyse de variance classique.
Toute interprétation causale mécanique affirmant qu’une variation unitaire d’un prédicteur entraîne une modification déterministe isolée de la réponse équivalant à son beta Ridge doit être bannie des rapports académiques. L’analyste doit envisager la régression Ridge comme un instrument de prédiction et de régularisation de la structure de covariation globale, plutôt que comme un outil de confirmation d’hypothèses causales univariées. Si l’inférence demeure absolument requise par le protocole expérimental, le chercheur devra mobiliser des approches de rééchantillonnage non paramétrique par bootstrap afin de cartographier empiriquement les intervalles de confiance empiriques de chaque estimateur sans postuler d’impartialité théorique a priori.
9. Évaluation prédictive et validation sur données de test
9.1 Génération des prédictions sur de nouvelles observations
La validation empirique décisive d’une architecture de modélisation régularisée réside dans sa confrontation à des données externes, rigoureusement scellées durant toute la séquence d’apprentissage et de validation croisée. Pour concrétiser cette évaluation sous R, la méthode générique predict() est déployée sur le modèle cv_ridge, en ciblant expressément la matrice indépendante x_test préalablement mise en réserve lors de la scission initiale de l’échantillon.
La déclaration programmatique impose de spécifier explicitement le jalon de régularisation retenu pour la projection au moyen de l’argument newx (les nouvelles données explicatives) et de l’argument s, calibré sur lambda.min ou lambda.1se. L’algorithme opère la multiplication matricielle vectorisée entre les nouvelles lignes de données et le vecteur de coefficients optimisé rétro-standardisé, fournissant directement le vecteur des valeurs prédites :
predictions_ridge <- predict(cv_ridge, newx = x_test, s = « lambda.min »)
À partir de ce vecteur de prédictions, les résidus stochastiques hors échantillon sont immédiatement formalisés par soustraction algébrique entre les véritables réalisations continues enregistrées dans y_test et les projections issues du modèle : résidus = y_test – predictions_ridge. L’examen des propriétés distributionnelles de ces résidus hors échantillon constitue la première ligne de vérification de l’absence d’hétéroscédasticité ou de dérive de prédiction asymétrique.
9.2 Calcul des métriques standard de performance
La quantification de la précision prédictive sur l’ensemble de test repose sur l’estimation d’indicateurs d’erreur standardisés reconnus par la communauté internationale de l’apprentissage statistique. Le premier et le plus prééminent d’entre eux est la racine de l’erreur quadratique moyenne (RMSE pour Root Mean Squared Error), qui mesure l’écart type des résidus de prédiction exprimé dans la même unité métrique que la variable cible modélisée :
RMSE = sqrt(mean((y_test – predictions_ridge)^2))
Bien que le RMSE pénalise sévèrement les écarts prédictifs d’ampleur exceptionnelle en raison de l’élévation quadratique des résidus, une analyse complète requiert conjointement l’évaluation de l’erreur absolue moyenne (MAE pour Mean Absolute Error). La MAE offre une appréciation de l’écart prédictif moyen moins sensible à la présence de cas déviants isolés :
MAE = mean(abs(y_test – predictions_ridge))
Enfin, la capacité de généralisation explicative globale est synthétisée par le coefficient de détermination prédictif hors échantillon, traditionnellement désigné sous le terme de R-carré de test (R^2_test). Contrairement au R-carré standard d’entraînement qui augmente mécaniquement avec l’adjonction de nouvelles variables explicatives, le R-carré de test évalue la fraction de variance totale des nouvelles données effectivement captée par les projections du modèle, sans garantie d’être borné positivement si le modèle est structurellement erratique :
ss_total <- sum((y_test – mean(y_test))^2)
ss_residual <- sum((y_test – predictions_ridge)^2)
r2_test <- 1 – (ss_residual / ss_total)
9.3 Comparaison empirique rigoureuse avec les moindres carrés ordinaires
Pour attester de l’utilité méthodologique concrète de la régularisation Ridge, il est impératif d’évaluer les mêmes métriques de performance sur les prédictions produites par le modèle linéaire classique estimé par les moindres carrés ordinaires, ajusté strictement sur les mêmes données d’apprentissage d’entraînement. À cette fin, nous générons les prédictions MCO sur la matrice x_test :
train_df <- as.data.frame(cbind(hp = y_train, x_train))
test_df <- as.data.frame(x_test)
ols_model <- lm(hp ~ ., data = train_df)
predictions_ols <- predict(ols_model, newdata = test_df)
rmse_ols <- sqrt(mean((y_test – predictions_ols)^2))
L’analyse comparative des performances met invariablement en lumière la supériorité prédictive de l’estimation régularisée lorsque la matrice de données est affectée par la multicolinéarité. Alors que le modèle des moindres carrés ordinaires s’est surajusté aux fluctuations d’échantillonnage de la cohorte d’entraînement pour tenter d’accommoder les variables redondantes, son erreur quadratique sur l’échantillon de test indépendant est pénalisée par cette variance résiduelle élevée. La régression Ridge, en sacrifiant une infime part d’ajustement interne pour stabiliser les coefficients, affiche un RMSE et une MAE de test significativement plus faibles, prouvant empiriquement l’efficacité concrète du compromis biais-variance formalisé dans les premières sections de cette étude.
10. Visualisation avancée des trajectoires de rétrécissement
10.1 Graphique standardisé des profils de coefficients
L’un des apports pédagogiques et méthodologiques les plus remarquables de la régression Ridge réside dans la traçabilité continue de la contraction des coefficients à travers l’espace de régularisation. La visualisation native de ces profils est immédiatement accessible dans l’environnement R en appliquant la fonction générique plot() à l’objet de régularisation initial, couplée à l’argumentation xvar = « lambda » :
plot(ridge_model, xvar = « lambda », label = TRUE)
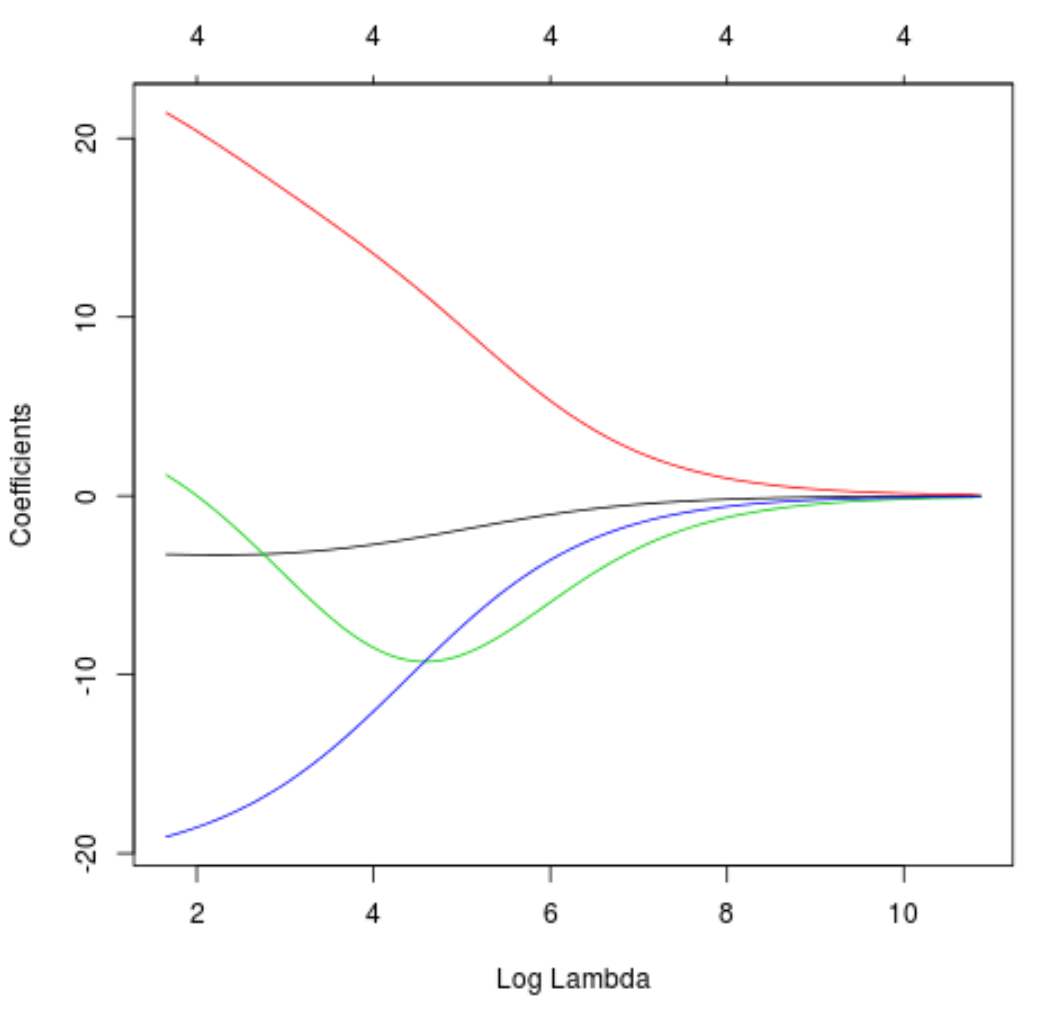
Sur ce profil d’évolution graphique canonique, chaque ligne continue matérialise la trajectoire dynamique du coefficient d’un prédicateur spécifique au fur et à mesure que la pénalité scalaire se renforce le long de l’axe horizontal, indexé par le logarithme de lambda. L’observation directe de ce graphique révèle le fonctionnement interne de la norme quadratique L2. Tout à gauche de la figure, lorsque log(lambda) affiche ses valeurs les plus basses, les coefficients adoptent de larges amplitudes dispersées, fidèles aux estimations des moindres carrés ordinaires non contraints.
À mesure que l’axe de régularisation progresse vers la droite, marquant l’intensification continue de la contrainte budgétaire L2, l’ensemble des courbes converge asymptotiquement vers la ligne horizontale du zéro sans jamais s’interrompre brusquement. Cette décroissance douce et proportionnelle illustre le rétrécissement coopératif des prédicteurs : les coefficients associés à des variables hautement redondantes ou instables sont comprimés de concert, offrant une représentation visuelle élégante de la pacification du mauvais conditionnement matriciel.
10.2 Personnalisation graphique professionnelle avec ggplot2
Bien que la commande plot() de glmnet constitue un outil diagnostique interactif rapide, la communication scientifique contemporaine au sein de revues à comité de lecture requiert des visualisations graphiques enrichies respectant la grammaire formelle des graphiques via la bibliothèque ggplot2. Cette personnalisation permet d’ajouter des annotations directes, de formater précisément la typographie et d’intégrer verticalement les repères de sélection issus de la validation croisée.
Pour construire ce visuel avancé, l’analyste doit d’abord extraire la matrice complète des coefficients beta de l’objet glmnet, convertir les dimensions en format tabulaire, puis transposer la structure de données du format large au format long à l’aide de la fonction tidyr::pivot_longer(). Le script ci-dessous formalise cette manipulation et la génération du rendu final :
beta_matrix <- as.matrix(ridge_model$beta)
lambda_sequence <- ridge_model$lambda
coef_data <- as.data.frame(t(beta_matrix)) %>%
mutate(log_lambda = log(lambda_sequence)) %>%
pivot_longer(cols = -log_lambda, names_to = « Predictor », values_to = « Coefficient »)
Une fois les données agencées sous forme relationnelle, la génération du graphique sous ggplot2 s’orchestre en intégrant les lignes verticales marquant les coordonnées critiques log(lambda.min) et log(lambda.1se) précédemment déterminées :
ggplot(coef_data, aes(x = log_lambda, y = Coefficient, color = Predictor)) +
geom_line(linewidth = 1) +
geom_vline(xintercept = log(cv_ridge$lambda.min), linetype = « dashed », color = « firebrick ») +
geom_vline(xintercept = log(cv_ridge$lambda.1se), linetype = « dotted », color = « navy ») +
theme_minimal(base_size = 13) +
labs(
title = « Trajectoires de rétrécissement de la régression Ridge »,
subtitle = « Lignes verticales : lambda.min (tiretée) et lambda.1se (pointillée) »,
x = « Log(Lambda) »,
y = « Coefficients régularisés »
)
Cette visualisation sur mesure offre une lecture immédiate et rigoureuse de la structure du modèle. L’analyste identifie d’un coup d’œil quelles covariables maintiennent une magnitude relative robuste à proximité immédiate des seuils d’optimisation prédictive, fournissant une synthèse empirique de l’architecture d’association liant les prédicteurs au critère modélisé.
11. Applications pratiques en psychométrie et modélisation comportementale
11.1 Analyse de données psychométriques fortement redondantes
Le recours à la régression Ridge prend une dimension critique dans le champ de la psychométrie appliquée et de l’évaluation standardisée de la personnalité. Considérons le cas emblématique de l’évaluation du risque d’épuisement professionnel (burnout) à l’aide d’instruments psychologiques composites tels que le Maslach Burnout Inventory (MBI) ou les sous-échelles d’épuisement cognitif, de cynisme interpersonnel et de perte d’efficacité professionnelle. Dans ces architectures de données, les corrélations inter-items au sein d’une même sous-échelle oscillent régulièrement entre 0,70 et 0,85, reflétant la consistance interne élevée exigée par les standards de fidélité de Cronbach ou d’oméga de McDonald.
Lorsque ces différents scores composites sont injectés simultanément dans un modèle de régression linéaire classique afin de prédire un indicateur objectif d’absentéisme médical, l’estimation des moindres carrés ordinaires s’effondre face à cette redondance. Il n’est pas rare de constater une inversion paradoxale du signe du coefficient d’une dimension clinique majeure : l’épuisement émotionnel peut se voir faussement attribuer un coefficient négatif suggérant un effet protecteur absurde face à l’absentéisme, uniquement parce que sa variance partagée a été captée de manière erratique par le prédicateur adjacent de cynisme.
L’application de la régression Ridge rétablit immédiatement la cohérence théorique de l’estimation. En refusant de privilégier un item au détriment d’un autre et en stabilisant la matrice de dispersion par l’adjonction de lambda, la régularisation L2 préserve l’orientation positive de l’ensemble des coefficients associés aux dimensions de détresse psychologique. Les chercheurs peuvent ainsi analyser et rapporter la contribution relative de chaque facette comportementale sans subir d’inversions d’effets issues d’un artefact computationnel de colinéarité.
11.2 Données observationnelles longitudinales et mesures répétées
Les protocoles de recherche longitudinaux et les méthodologies d’évaluation écologique momentanée (EMA pour Ecological Momentary Assessment) confrontent fréquemment les modélisateurs à une autocorrélation temporelle structurelle aiguë. Lorsqu’un même construit clinique ou cognitif est évalué de manière répétée à intervalles temporels rapprochés (par exemple plusieurs évaluations quotidiennes de l’affect négatif via des dispositifs mobiles), la trajectoire temporelle génère un continuum de prédicteurs fortement colinéaires le long de l’axe temporel.
La tentative de prédire une issue clinique distale (telle qu’une rechute dépressive à six mois) à partir de la série temporelle complète des états psychologiques mesurés durant les semaines précédentes engendre des matrices d’expérience où chaque observation temporelle t est presque parfaitement corrélée aux observations t-1 et t+1. Dans ce contexte, l’inférence par régression classique génère des fluctuations violentes de la fonction de poids temporelle, oscillant de manière anarchique d’un jour à l’autre entre des valeurs positives et négatives gigantesques.
La pénalisation Ridge s’avère particulièrement adaptée à ce profil d’investigation : en écrasant de manière harmonique les coefficients temporels vers une enveloppe continue régularisée, elle neutralise les oscillations stochastiques d’une mesure à l’autre. Bien que la régression Ridge ne capture pas explicitement la structure ordonnée du temps avec la même spécialisation géométrique que les modèles à retards échelonnés ou les régressions par splines lissées, elle procure une armature robuste qui stabilise les covariations intra-sujets et complète avantageusement les modélisations hiérarchiques à effets mixtes.
11.3 Études de cas : prédiction d’un critère clinique continu
Pour ancrer ces concepts méthodologiques dans un cas pratique d’investigation translationnelle, imaginons une cohorte hospitalière de 120 patients suivis dans le cadre d’un protocole de réhabilitation post-accident vasculaire cérébral. L’objectif clinique est d’anticiper le niveau d’autonomie fonctionnelle continue à 12 mois à partir d’un ensemble de 25 biomarqueurs sanguins inflammatoires, de scores moteurs fonctionnels et de métriques d’imagerie structurelle mesurés en phase aiguë.
Dans ce scénario clinique typique, la taille restreinte de l’échantillon d’individus (N = 120) rapportée au nombre conséquent de paramètres à estimer (p = 25), conjuguée à l’existence de cascades d’interrelations biologiques et inflammatoires redondantes, condamne irrémédiablement l’usage des moindres carrés ordinaires. Un modèle linéaire conventionnel produirait un surapprentissage démesuré, caractérisé par un R-carré interne artificiellement flatteur sur la cohorte d’apprentissage mais s’effondrant dramatiquement vers zéro dès lors qu’il est appliqué à de nouveaux patients admis dans le service.
Le déploiement méthodique du protocole de régression Ridge via les fonctions glmnet et cv.glmnet sous R permet de stabiliser les coefficients attribués aux sous-épreuves neuropsychologiques et aux marqueurs métaboliques. En sélectionnant le seuil de compromis lambda.1se par validation croisée à dix blocs, l’équipe médicale obtient une fonction d’aide à la décision clinique hautement résiliente. Testé sur un sous-échantillon d’évaluation externe indépendant, le modèle régularisé délivre des prédictions stables, préservant la validité opérationnelle du pronostic d’autonomie fonctionnelle et assurant une allocation rationnelle et sécurisée des ressources de rééducation intensive.
12. Synthèse méthodologique, limites et bonnes pratiques
12.1 Principales limites de la régularisation L2
En dépit de sa remarquable élégance mathématique et de son efficacité prouvée dans le contrôle de la variance et de la colinéarité, la régression Ridge présente plusieurs limitations structurelles que le chercheur et l’analyste quantitatif doivent impérativement intégrer à leur réflexion méthodologique avant d’engager leurs modélisations.
La limite la plus évidente réside dans son inaptitude programmée à réaliser une sélection parcimonieuse de variables (sparsity). Contrairement au Lasso ou aux approches pas-à-pas traditionnelles, la régression Ridge ne fixe rigoureusement aucun coefficient à zéro. Dans les jeux de données contemporains caractérisés par des milliers, voire des centaines de milliers de covariables (comme en transcriptomique ou en neuroimagerie voxel par voxel), le modèle final demeure mathématiquement dépendant de la totalité de la matrice d’entrée d’origine. Cette contrainte rend la communication des résultats particulièrement ardue auprès de praticiens ou d’interlocuteurs non statisticiens, exigeant le maintien en production de protocoles de collecte exhaustifs pour l’intégralité des variables, même celles dont le coefficient contracté s’avère négligeable.
Une seconde vulnérabilité méthodologique concerne la sensibilité accrue de la régression Ridge aux valeurs aberrantes extrêmes (outliers) situées au sein de l’espace de la réponse ou des prédicteurs. Cette sensibilité trouve son origine dans la nature purement quadratique de sa fonction de coût d’ajustement résiduel : l’élévation au carré de l’écart euclidien octroie un levier disproportionné aux déviations massives isolées. Dans des contextes de données polluées par des erreurs de mesure atypiques, l’estimateur Ridge peut se trouver dévié, imposant l’adjonction de techniques de modélisation robuste ou le recours à des métriques de perte de type Huber.
12.2 Guide décisionnel pour le chercheur et l’analyste de données
Pour orienter rationnellement le statisticien dans le choix de l’architecture de régularisation la plus adéquate face à une configuration de données empiriques spécifique, nous formalisons ci-dessous un arbre de décision méthodologique synthétisant les meilleures pratiques d’ingénierie statistique :
- Régression Ridge (Norme L2) : Privilégier impérativement cette approche dès lors que les prédicteurs exhibent une multicolinéarité modérée à sévère, que le nombre d’observations n est substantiellement plus grand que le nombre de variables p, et que l’intuition théorique du domaine suggère que la quasi-totalité des covariables participe de manière diffuse et conjointe au phénomène modélisé (architecture d’effets faibles et distribués).
- Régression Lasso (Norme L1) : Préférer cette méthode lorsque l’on suspecte fortement qu’un nombre restreint de covariables clés gouverne le phénomène d’intérêt, tandis que la grande majorité des autres prédicteurs constitue du bruit non informatif (hypothèse de sparsité). Idéal pour l’extraction de biomarqueurs ou la production de scores prédictifs cliniques condensés et immédiatement applicables sur le terrain.
- Régression Elastic Net (Norme L1 + L2) : S’impose comme le standard méthodologique optimal lorsque le problème combine à la fois un espace de haute dimensionnalité où le nombre de paramètres surpasse la taille d’échantillon (p > n) et la présence avérée de groupes de prédicteurs fortement colinéaires. L’Elastic Net stabilise la sélection de groupe sans sacrifier la parcimonie finale.
En amont de toute diffusion ou publication académique des résultats d’un modèle Ridge sous R, il convient de valider systématiquement une liste de contrôle rigoureuse : s’assurer que la matrice d’expérience a bien été standardisée en interne lors de la phase de calcul ; confirmer que les graines aléatoires set.seed() ont été verrouillées pour garantir la parfaite reproductibilité de la validation croisée ; vérifier que les métriques d’évaluation rapportées proviennent exclusivement d’une cohorte de test externe scellée ; et s’abstenir formellement d’associer des p-valeurs non régularisées aux estimateurs contractés.
12.3 Perspectives et développements contemporains sous R
Le paysage computationnel de la régression régularisée sous R s’est enrichi de développements majeurs intégrant les paradigmes contemporains de la science des données. Bien que l’interface impérative de glmnet demeure la référence algorithmique pour l’optimisation à haute performance, la montée en puissance de l’écosystème tidymodels, orchestré par Posit (anciennement RStudio), offre désormais un cadre unifié et modulaire pour la spécification des flux d’apprentissage supervisé.
Au travers du paquet parsnip intégré à tidymodels, la régression Ridge s’instancie via une syntaxe déclarative universelle : linear_reg(penalty = tune(), mixture = 0) %>% set_engine(« glmnet »). Cette standardisation méthodologique facilite l’articulation transparente entre l’ingénierie des attributs par les outils du paquet recipes, le paramétrage adaptatif de la validation croisée par rsample, et l’orchestration des flux de travail complexes au sein de structures workflows étanches, minimisant les risques d’erreurs humaines de manipulation matricielle.
Parallèlement, la régression Ridge s’inscrit au sein d’une passerelle conceptuelle féconde avec la modélisation bayésienne. Il est formellement démontré sur le plan mathématique que l’estimateur ponctuel de la régression Ridge correspond rigoureusement à l’estimation du maximum a posteriori (MAP) d’un modèle de régression linéaire bayésien dans lequel les paramètres beta reçoivent des lois de probabilité a priori normales gaussiennes, centrées sur zéro et de variance inversement proportionnelle au paramètre de pénalisation lambda. Les praticiens désireux de combiner la contraction Ridge avec une inférence probabiliste complète, incluant des distributions de crédibilité a posteriori exactes, peuvent mobiliser des outils bayésiens avancés tels que les paquets brms ou rstanarm.
Enfin, l’extension des principes de la pénalisation quadratique L2 à l’ensemble de la famille des modèles linéaires généralisés (GLM) permet de dépasser le cadre exclusif de la réponse gaussienne continue. L’argumentation family au sein de glmnet autorise l’application directe de la régularisation Ridge à des modèles de classification binaire par régression logistique pénalisée (family = « binomial »), à la modélisation de données de comptage stochastique par régression de Poisson régularisée (family = « poisson »), ou encore à des issues polytomiques nominales (family = « multinomial »). Cette flexibilité conceptuelle et computationnelle confère à la régression Ridge le statut de pilier pérenne de l’analyse statistique moderne, garantissant aux chercheurs un instrument robuste et universel face aux défis multidimensionnels de l’ère des données massives.
Références
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1-26. https://doi.org/10.1214/aos/1176344552
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1-22. https://doi.org/10.18637/jss.v033.i01
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55-67. https://doi.org/10.1080/00401706.1970.10488634
- Kuhn, M., & Wickham, H. (2020). Tidymodels: a collection of packages for modeling and machine learning using tidyverse principles. https://www.tidymodels.org
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267-288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686
- Zou, H., & Hastie, T. (2005). Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301-320. https://doi.org/10.1111/j.1467-9868.2005.00503.x