
L’analyse des relations quantitatives au sein des systèmes complexes constitue le cœur névralgique de la modélisation scientifique moderne. Qu’il s’agisse de capturer la dynamique de désintégration radioactive en physique nucléaire, d’évaluer les lois d’échelle allométriques en biologie de l’évolution, ou de formaliser la réponse perceptive humaine face aux stimuli sensoriels en psychophysique, la linéarité stricte s’avère bien souvent une simplification excessive, voire trompeuse. Les phénomènes naturels et comportementaux obéissent majoritairement à des lois non linéaires dont la formalisation requiert des outils d’ajustement géométrique et statistique adaptés. Parmi ces approches, le modèle de puissance occupe une position fondamentale, fournissant un cadre mathématique parcimonieux mais d’une redoutable expressivité pour quantifier des proportions invariantes d’échelle et des rendements marginaux croissants ou décroissants.
Comprendre comment ajuster une telle courbe à des données empiriques sans recourir à des progiciels statistiques complexes représente un atout méthodologique majeur. Microsoft Excel, bien que perçu initialement comme un tableur de gestion commerciale, abrite un écosystème algorithmique puissant, capable de traiter avec rigueur les modèles de régression non linéaire après linéarisation. L’environnement d’analyse d’Excel intègre en effet des fonctions matricielles et des modules d’inférence analytique qui, lorsqu’ils sont correctement paramétrés, rivalisent en précision avec des environnements dédiés comme R, SPSS ou Python. Toutefois, la transition d’un jeu de données brutes vers un modèle de puissance valide sous Excel exige une compréhension aiguë des implications mathématiques de la transformation logarithmique, de la reconfiguration des termes d’erreur stochastiques et de la restauration des paramètres sur l’échelle native du phénomène étudié.
Ce guide exhaustif propose une déconstruction méthodologique intégrale de la régression de puissance sous Microsoft Excel. En associant une rigueur épistémologique stricte à des instructions techniques pas à pas, il s’adresse aux chercheurs, psychométriciens, ingénieurs et analystes désireux de déployer ce modèle sans compromettre l’intégrité de leurs déductions inférentielles. De la transformation népérienne des prédicteurs jusqu’à la correction des biais de retransformation via l’estimateur de Duan, en passant par le diagnostic approfondi des résidus et l’exécution d’une étude de cas intégrée en sciences du comportement, chaque étape fait l’objet d’un examen minutieux conçu pour garantir une reproductibilité totale des résultats.
1. Fondements théoriques de la régression de puissance et modélisation non linéaire
1.1 Définition mathématique du modèle de puissance
Le modèle de régression de puissance repose sur une formulation analytique élémentaire liant une variable indépendante explicative, notée x, à une variable dépendante expliquée, notée y, par le biais d’un produit factoriel impliquant une exponentiation. L’expression déterministe s’énonce selon l’équation générale :
y = a · xb
Dans ce formalisme, la constante multiplicative a constitue le coefficient d’échelle (ou facteur multiplicateur), représentant la valeur théorique prise par la variable réponse lorsque le prédicteur x atteint exactement l’unité (x = 1). Le paramètre b, quant à lui, désigne l’exposant de puissance. Il régit la courbure fondamentale, le sens de variation et le taux d’accélération ou de décélération de la fonction au sein du plan cartésien. Sur le plan économique et physique, cet exposant s’interprète rigoureusement comme une constante d’élasticité : une augmentation relative de 1 % de la variable explicative x engendre une variation relative approximative de b % de la variable expliquée y.
Sur le plan épistémologique, il importe de distinguer nettement les modèles de puissance d’autres architectures fonctionnelles non linéaires couramment déployées en sciences expérimentales, telles que les polynômes de degré supérieur ou les modèles exponentiels purs. Alors qu’un modèle exponentiel s’écrit sous la forme y = a · ebx (où la variable indépendante réside elle-même au sein de l’exposant, impliquant une variation absolue proportionnelle à la valeur courante et induisant une croissance potentiellement explosive), le modèle de puissance conserve la variable explicative à la base de l’opération d’élévation à la puissance. De même, les ajustements polynomiaux (de la forme y = a0 + a1x + a2x2 + … + anxn) superposent plusieurs composantes monomiales dont la combinaison peut générer des points d’inflexion multiples et des oscillations locales artificielles, souvent sources de surajustement (overfitting). À l’inverse, le modèle de puissance offre une monotonicité structurelle intrinsèque dès lors que x évolue dans le domaine des nombres réels strictement positifs.
Les propriétés géométriques de la courbe de puissance sont entièrement gouvernées par la valeur numérique et le signe de l’exposant b. Quatre configurations structurales majeures émergent de cette typologie :
- Cas où b > 1 : La fonction présente une concavité dirigée vers le haut (dérivée seconde strictement positive, d2y/dx2 > 0). La courbe traduit une croissance accélérée, caractérisée par des rendements marginaux croissants. La pente augmente continuellement à mesure que x progresse.
- Cas où 0 < b < 1 : La fonction est strictement croissante mais sa concavité est tournée vers le bas (dérivée seconde strictement négative, d2y/dx2 < 0). Ce cas illustre le phénomène universel de saturation relative ou de rendements marginaux décroissants : chaque accroissement unitaire de x produit un gain d’amplitude de plus en plus réduit sur y.
- Cas où b = 1 : Le modèle dégénère en une relation linéaire stricte passant par l’origine cartésienne (y = ax), supprimant toute courbure non linéaire.
- Cas où b < 0 : La fonction prend une allure hyperbolique strictement décroissante. Elle modélise une relation inversement proportionnelle non linéaire, asymptotique aux axes des abscisses et des ordonnées, où y tend vers zéro lorsque x croît indéfiniment.
1.2 Pertinence et applications empiriques en sciences humaines et psychologie
L’attrait des modèles de puissance dans les sciences quantitatives découle de leur capacité à traduire mathématiquement le principe d’invariance d’échelle, une propriété omniprésente dans les structures biologiques, sociologiques et cognitives. En psychophysique expérimentale, l’application la plus célèbre demeure sans conteste la loi de puissance formulée par Stanley Smith Stevens en 1957. Stevens a démontré que la sensation subjective ressentie (notée S) n’est pas proportionnelle au logarithme de l’excitation physique comme le postulait la loi de Fechner, mais obéit rigoureusement à une fonction de puissance du stimulus physique (noté I) selon la formulation :
S = k · In
Dans cette équation sensorielle, l’exposant n caractérise la modalité sensorielle investiguée : il s’établit par exemple à approximativement 0,33 pour la perception de la brillance visuelle (traduisant une forte compression protectrice de l’appareil optique face aux intensités lumineuses élevées), avoisine 0,60 pour l’intensité acoustique perçue, et dépasse 3,50 pour l’évaluation subjective de l’intensité d’un choc électrique délivré sur les doigts, signalant une réponse d’amplification d’urgence face à une menace nociceptive immédiate.
Au-delà de la psychophysique des sensations élémentaires, la psychologie cognitive et l’ergonomie computationnelle s’appuient massivement sur la loi de la pratique formalisée par Newell et Rosenbloom (1981). Ces auteurs ont établi que le temps nécessaire à l’exécution d’une tâche cognitive ou motrice complexe (T) diminue en fonction du nombre d’essais d’entraînement (N) selon une régression de puissance descendante :
T = a · N–b
Cette décroissance logarithmique-linéaire implique que les progrès initiaux lors de l’acquisition d’une compétence sont fulgurants, tandis que les gains d’efficacité ultérieurs exigent un volume d’exercices exponentiellement supérieur. De même, en psychométrie et dans les protocoles d’attention visuelle mesurant les temps de réaction face à des matrices de distracteurs, l’ajustement par des équations de puissance permet d’isoler la composante automatique du traitement de l’information de sa composante sérielle contrôlée.
L’avantage comparatif du modèle de puissance face à une régression linéaire standard par moindres carrés ordinaires s’avère décisif dans ces contextes. Forcer une droite de régression linéaire sur une distribution sous-tendue par une dynamique de Stevens ou de Newell induit un biais systématique d’ajustement. Ce forçage produit une surestimation massive des valeurs extrêmes et une sous-estimation persistante des valeurs centrales, faussant l’évaluation des seuils différentiels, masquant les asymptotes cognitives et ruinant l’interprétabilité théorique des coefficients d’interaction.
1.3 Conditions d’application et contraintes structurelles des données
Bien que le modèle de puissance offre une flexibilité descriptive remarquable, son déploiement empirique est soumis à des contraintes statistiques et topologiques rigides qui dictent le prétraitement des matrices d’observations. La contrainte la plus fondamentale émane de l’opération de linéarisation mathématique : l’équation déterministe nécessitant l’application d’opérateurs logarithmiques pour être résolue par les estimateurs linéaires classiques, les séries d’observations associées tant au prédicteur x qu’à la variable réponse y doivent impérativement appartenir au corps des nombres réels strictement positifs :
xi > 0 et yi > 0 pour tout i ∈ {1, 2, …, n}
L’introduction d’une seule valeur nulle (0) ou strictement négative au sein de la série entraîne l’indéfinition immédiate de l’opérateur logarithmique (ln(0) tendant asymptotiquement vers l’infini négatif, tandis que le logarithme des valeurs négatives est indéfini dans l’espace des réels), provoquant des erreurs de calcul fatales au niveau des tableurs informatiques. Cette exigence mathématique exclut l’usage immédiat de la régression de puissance sur des variables mesurées selon des échelles d’intervalles non ancrées sur un zéro absolu, telles que les températures en degrés Celsius ou des scores standardisés autorisant des valeurs négatives (comme les scores Z centrés réduits).
Une seconde contrainte structurelle concerne le comportement asymptotique aux frontières du domaine expérimental. Lorsque la variable indépendante x s’approche de zéro, le modèle prédit théoriquement une réponse qui soit converge vers zéro (si b > 0), soit diverge vers l’infini positif (si b < 0). En conditions réelles de laboratoire, ces extrêmes correspondent souvent à des zones d’artéfacts expérimentaux majeurs : seuils d’extinction sensorielle, bruits de fond instrumentaux, planchers de latence motrice ou effets de plafond psychométrique. Tenter d’ajuster une courbe de puissance en intégrant des observations collectées sous le seuil absolu de sensibilité d’un capteur engendre une instabilité critique du coefficient d’échelle a.
Enfin, la sensibilité du modèle aux valeurs extrêmes (outliers) et aux distributions asymétriques mérite une vigilance extrême. Dans la mesure où les moindres carrés minimisent la somme des carrés des écarts dans l’espace transformé, un point aberrant situé aux extrémités d’une échelle logarithmique exerce un bras de levier disproportionné sur le calcul de la pente b. Contrairement aux distributions gaussiennes canoniques où la majorité des observations réside à moins de deux écarts-types de la moyenne arithmétique, les données relatives aux lois de puissance présentent fréquemment des distributions à queues épaisses (loi de Pareto, phénomènes scalaires). Cette asymétrie naturelle complique la détection des véritables anomalies expérimentales par rapport aux fluctuations stochastiques intrinsèques au phénomène étudié.
2. Principes mathématiques de la linéarisation logarithmique
2.1 Transformation de l’équation de puissance par les logarithmes népériens
L’ajustement direct des paramètres a et b d’un modèle de puissance nécessite historiquement des algorithmes d’optimisation non linéaire itératifs basés sur les gradients réduits généralisés ou l’algorithme de Levenberg-Marquardt. Afin d’éviter la complexité calculatoire et les risques de non-convergence vers le minimum global inhérents à ces méthodes, la technique standard consiste à procéder à une linéarisation analytique complète de l’équation par l’intermédiaire des propriétés multiplicatives des logarithmes.
Considérons l’équation déterministe brute y = a · xb. En appliquant la fonction logarithme népérien (notée ln, définie en base e) aux deux membres de l’égalité sous l’hypothèse stricte que x > 0 et y > 0, nous obtenons :
ln(y) = ln(a · xb)
En exploitant le théorème fondamental de morphisme du logarithme qui transforme un produit en une somme algébrique (ln(u · v) = ln(u) + ln(v)), l’expression se décompose immédiatement :
ln(y) = ln(a) + ln(xb)
En vertu de la propriété algébrique selon laquelle l’exposant d’un argument logarithmique devient un coefficient multiplicateur externe (ln(uv) = v · ln(u)), l’équation se transmute sous sa forme linéaire canonique :
ln(y) = ln(a) + b · ln(x)
Cette dérivation analytique établit une équivalence structurelle parfaite avec l’équation classique d’une droite affine dans un espace euclidien standard, traditionnellement notée sous la forme Y = β0 + β1X, au moyen d’un simple changement de variables bijectif :
- La variable réponse transformée est Y = ln(y)
- Le prédicteur transformé est X = ln(x)
- L’ordonnée à l’origine (ou intercepte) de la droite transformée correspond à β0 = ln(a)
- Le coefficient de pente (coefficient directeur) correspond exactement à β1 = b
Il est capital de relever que l’emploi du logarithme népérien (en base e ≈ 2,71828) ou du logarithme décimal (en base 10, noté log10) aboutit à une estimation rigoureusement identique de la pente b. En effet, en vertu de la formule de changement de base log10(u) = ln(u) / ln(10), le facteur d’échelle constant ln(10) s’annule au numérateur et au dénominateur du calcul de la pente dans les équations normales des moindres carrés. En revanche, l’ordonnée à l’origine calculée dépendra intrinsèquement de la base logarithmique sélectionnée : si l’analyse est effectuée avec log10, l’intercepte représentera log10(a), nécessitant une ré-élévation à la base 10 (10intercepte) pour restaurer le paramètre a, alors que l’usage du logarithme népérien requiert l’opérateur exponentiel standard (eintercepte). Dans la pratique biométrique et psychométrique, l’usage du logarithme népérien prévaut universellement en raison de ses propriétés d’invariance dans le calcul infinitésimal.
2.2 Impacts statistiques de la transformation sur les termes d’erreur
Si la linéarisation logarithmique résout élégamment le défi algorithmique de l’estimation des paramètres, elle modifie profondément la structure probabiliste sous-jacente du modèle de régression. L’hypothèse fondamentale régissant la méthode des moindres carrés ordinaires (MCO) stipule que le terme d’erreur stochastique est additif, homoscédastique et distribué selon une loi normale centrée : Y = f(X) + ε, avec ε ~ 𝒩(0, σ2).
Lorsque nous appliquons la régression linéaire sur les variables transformées ln(y) et ln(x), l’équation probabiliste réellement ajustée s’écrit :
ln(y) = ln(a) + b · ln(x) + u
où u représente le résidu dans l’espace logarithmique, supposé gaussien : u ~ 𝒩(0, σu2). Si nous inversons cette équation pour revenir à l’échelle originale des données en appliquant l’exponentielle aux deux membres, nous obtenons :
y = eln(a) + b·ln(x) + u = eln(a) · (eln(x))b · eu = a · xb · eu = a · xb · ε*
où ε* = eu. Cette dérivation formelle démontre que la régression de puissance par linéarisation logarithmique n’optimise pas un modèle à erreur additive (y = a · xb + ε), mais bien un modèle à erreur multiplicative. Cela signifie mathématiquement que la dispersion des résidus dans l’espace brut d’origine n’est pas constante : elle est proportionnelle à la magnitude de la prédiction. Ce qui apparaîtrait comme une hétéroscédasticité problématique dans un modèle linéaire standard (un élargissement en cône de la variance des résidus pour de fortes valeurs de x) devient précisément la condition optimale pour l’application d’un modèle logarithmique, ce dernier agissant comme un stabilisateur de variance hautement efficace sur les données comportementales et biométriques.
Néanmoins, cette propriété engendre un piège statistique redoutable lors de la rétro-transformation prédictive, couramment désigné sous le nom de biais de retransformation. Par définition des lois log-normales, si la variable transformée ln(y) suit une distribution symétrique gaussienne d’espérance μln, l’exponentiation directe de cette moyenne ne produit pas l’espérance mathématique (la moyenne arithmétique) de la distribution d’origine, mais sa médiane géométrique :
E(eu) = eσu2 / 2 > 1 (en vertu de l’inégalité de Jensen)
Par conséquent, prédire simplement ŷ = â · xb̂ sous-estime systématiquement la véritable valeur moyenne attendue de la variable réponse brute. Pour des variances résiduelles substantielles, l’omission d’un facteur de correction de biais — tel que l’estimateur de réétalement de Duan (Duan’s smearing factor) — introduit une déviation systématique pouvant altérer substantiellement la portée des conclusions cliniques ou psychophysiques tirées du modèle.
3. Configuration de l’environnement de travail dans Microsoft Excel
3.1 Vérification et activation de l’Utilitaire d’analyse
Avant d’initier la moindre manipulation de calcul ou d’ajustement, il est impératif de configurer adéquatement l’architecture analytique de Microsoft Excel. Par défaut, le moteur statistique étendu du tableur demeure dormant et nécessite une activation explicite de son composant natif : l’Utilitaire d’analyse (Analysis ToolPak). Ce complément logiciel intègre les bibliothèques d’inférence nécessaires à l’édition de rapports d’ajustement multivariés complets, aux calculs des variances d’échantillonnage et aux diagnostics d’hypothèses linéaires.
Pour activer ce composant sous les versions modernes d’Excel sous environnement Windows, la procédure formelle s’articule comme suit :
- Cliquez sur l’onglet Fichier situé à l’extrémité supérieure gauche du ruban Office, puis sélectionnez la rubrique Options logée au bas de la barre de navigation latérale.
- Au sein de la fenêtre modale Options Excel, activez la catégorie Compléments positionnée dans le panneau de navigation de gauche.
- Dans la partie inférieure de la fenêtre, repérez le menu déroulant intitulé Gérer, assurez-vous que la mention Compléments Excel soit active, puis cliquez sur le bouton Atteindre….
- Une boîte de dialogue contextuelle liste les modules d’extension intégrés. Cochez explicitement la case adossée à l’intitulé Utilitaire d’analyse (veillez à ne pas confondre ce module avec Utilitaire d’analyse – VBA, dédié exclusivement à l’automatisation par programmation procédurale).
- Validez votre choix en cliquant sur le bouton OK.
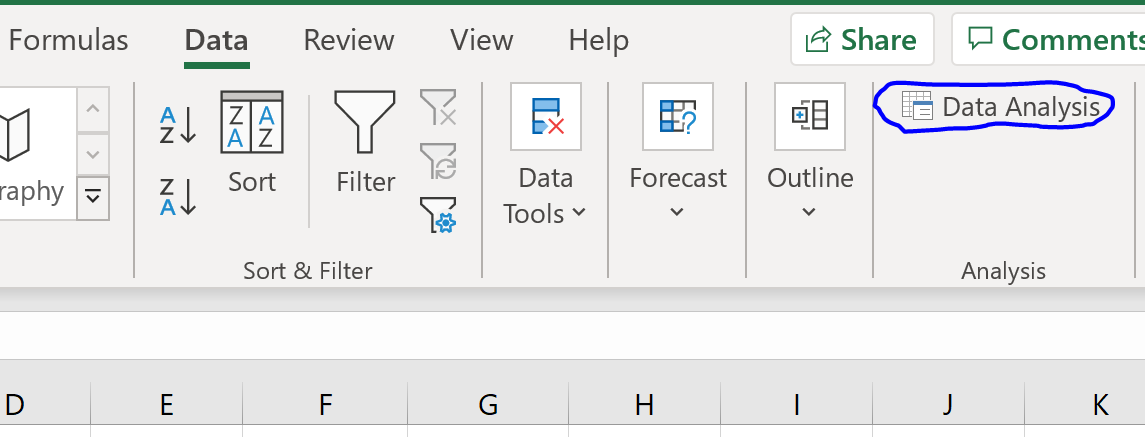
Une fois cette validation exécutée, naviguez vers le ruban principal d’Excel et activez l’onglet Données. À l’extrême droite du bandeau horizontal doit désormais figurer un groupe opérationnel dénommé Analyse, abritant la commande dédiée Utilitaire d’analyse (ou Analyse de données selon les versions linguistiques exactes de la suite). Si cette icône n’apparaît pas immédiatement, un redémarrage de l’application s’avère parfois requis pour forcer l’actualisation dynamique du ruban.
Pour les praticiens travaillant sous l’environnement macOS, le cheminement technique diverge légèrement. L’accès direct s’opère en déroulant le menu Outils présent dans la barre de menus supérieure du système d’exploitation, puis en sélectionnant l’option Compléments Excel…. La fenêtre contextuelle identique s’ouvrira, au sein de laquelle il suffira de cocher Analysis ToolPak et de ratifier la sélection. L’onglet Données de la version Mac verra alors apparaître le bouton d’analyse statistique correspondant.
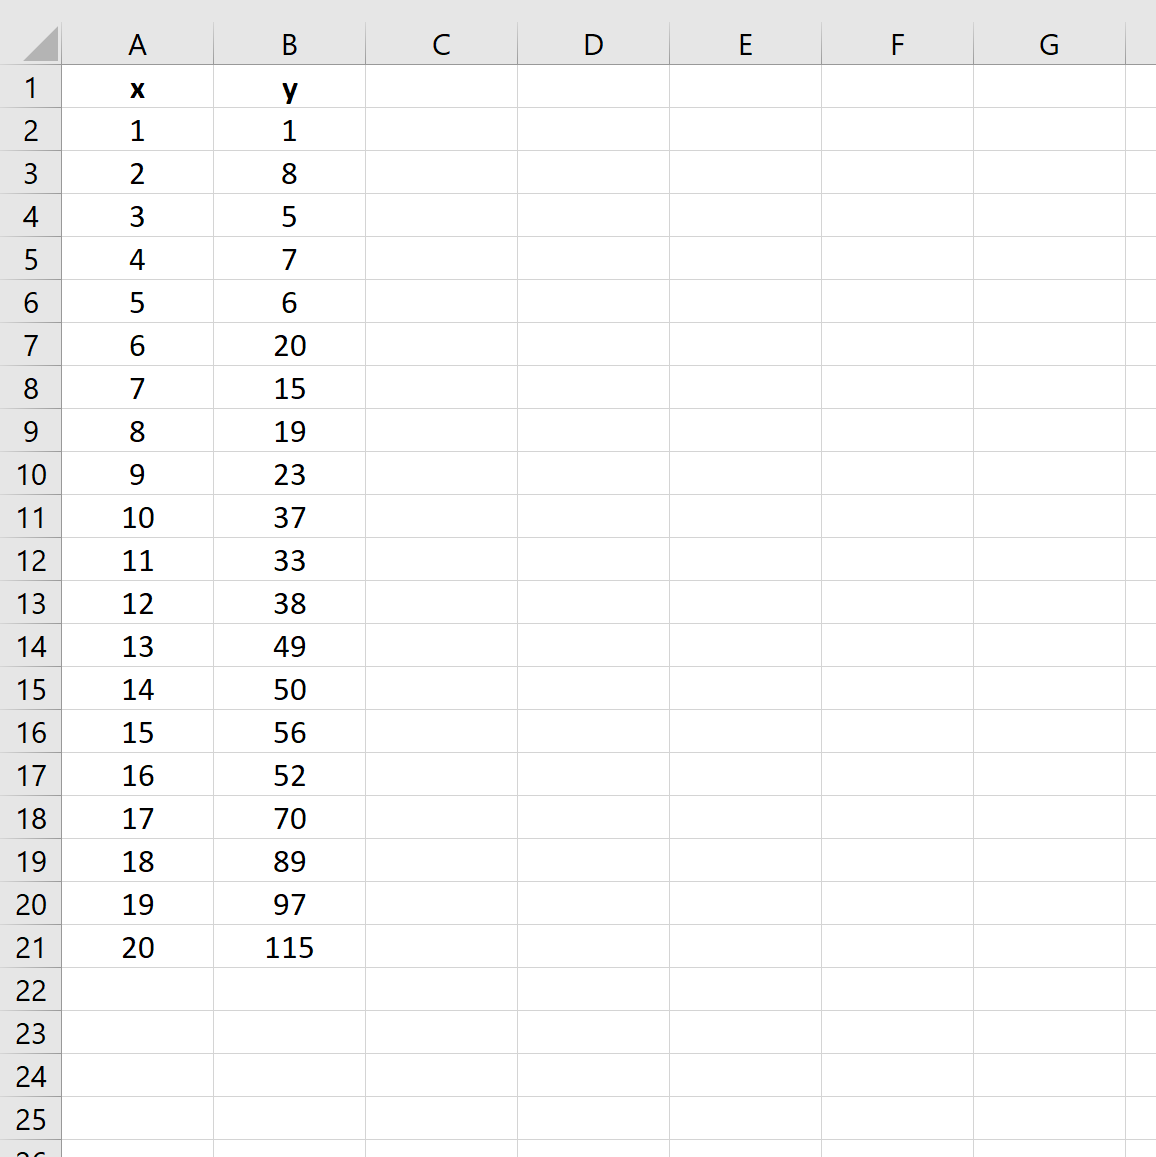
3.2 Organisation optimale des feuilles de calcul pour la reproductibilité
La reproductibilité computationnelle en recherche scientifique impose une compartimentation rigide et transparente de l’espace de calcul au sein du classeur Excel. Évitez absolument d’amalgamer au sein d’une même plage de cellules les enregistrements bruts non transformés, les calculs dérivés intermédiaires et les tables de restitution inférentielle générées par les algorithmes. L’architecture optimale d’une feuille dédiée à la modélisation de puissance requiert une distribution matricielle stricte en colonnes continues bien définies.
Nous recommandons l’établissement de colonnes structurelles ordonnées de gauche à droite :
- Colonne A (Identifiant d’observation) : Numérotation indexée de 1 à N désignant le sujet, l’essai expérimental ou l’unité d’échantillonnage considérée.
- Colonne B (Variable brute X) : Données natives de la variable explicative, titrée de manière univoque en incluant scrupuleusement l’unité physique ou psychométrique de mesure entre crochets (par exemple : Intensite_Stimulus_[Lux] ou Numero_Essai).
- Colonne C (Variable brute Y) : Données natives de la variable réponse mesurée (par exemple : Reponse_Perceptive_[Magnitude] ou Temps_Reaction_[ms]).
- Colonne D (Transformation LN_X) : Valeurs transformées du prédicteur par logarithme népérien.
- Colonne E (Transformation LN_Y) : Valeurs transformées de la réponse par logarithme népérien.
- Colonne F (Prédictions brutes ajustées) : Valeurs théoriques restituées sur l’échelle d’origine par évaluation de l’équation recalculée.
- Colonne G (Résidus bruts) : Écarts arithmétiques directs entre l’observation originale et la prédiction non linéaire.
Le formatage numérique de chaque colonne doit être défini dès la configuration de la feuille afin de prévenir toute troncature visuelle ou interprétation erronée. Les colonnes accueillant les transformations logarithmiques népériennes doivent impérativement être formatées avec une précision minimale de quatre à six décimales visibles (format numérique : 0,0000). En effet, les logarithmes condensent considérablement l’espace métrique ; un arrondi prématuré à deux décimales au niveau d’un intercepte transformé peut induire des erreurs massives lors de la phase d’exponentiation de reconversion des paramètres. Enfin, conservez systématiquement une feuille matrice vierge d’entrée, vierge de toute pollution par les graphiques résiduels, pour servir de gabarit réutilisable lors de campagnes de mesures ultérieures.
4. Étape 1 : Collecte, mise en forme et audit préliminaire des données
4.1 Saisie structurée du jeu de données
L’intégrité de toute modélisation statistique dépend intimement de la salubrité du jeu de données brut soumis aux algorithmes d’ajustement. Lors de la saisie ou de l’importation de vecteurs d’observations dans Excel (qu’ils soient issus de convertisseurs analogique-numérique, de logiciels de passation de tests psychologiques ou de fichiers de capture au format CSV), chaque observation doit être alignée avec une exactitude topologique rigoureuse.
La variable indépendante x doit être assignée sans discontinuité à une colonne unitaire contiguë à la variable dépendante y. Aucune ligne blanche, aucun séparateur visuel décoratif et aucune cellule de totalisation arithmétique partielle ne doivent être intercalés au sein de la matrice de données. La présence de tels éléments au cœur d’un tableau corrompt les sélections continues de plages de données et génère des ruptures d’exécution immédiates au sein de l’Utilitaire d’analyse.
De surcroît, un contrôle typographique strict s’impose quant à la nature des valeurs renseignées. Les cellules ne doivent héberger strictement aucun caractère textuel résiduel (tels que des annotations de type « < 0.01 », « non mesuré », « NA » ou « sec »). La moindre chaîne textuelle dissimulée au sein d’une série numérique bloque le calcul des logarithmes népériens en renvoyant l’erreur fatale #VALEUR!. Enfin, il est indispensable de documenter de façon pérenne dans les métadonnées de la feuille la nature physique et l’unité de mesure exacte assignée à chaque colonne. Comme nous le détaillerons ultérieurement, le coefficient multiplicateur d’échelle a d’un modèle de puissance n’est pas adimensionnel : sa magnitude numérique est intrinsèquement tributaire de l’échelle d’évaluation choisie pour le prédicteur x.
4.2 Détection et traitement des zéros et des valeurs négatives
En vertu des propriétés analytiques exposées au chapitre précédent, l’intégration de zéros stricts ou de valeurs négatives au sein des vecteurs de données voue instantanément à l’échec la régression de puissance par linéarisation logarithmique. L’audit systématique de l’espace de données constitue donc une étape préalable non négociable.
Pour auditer automatiquement l’absence de valeurs interdites au sein d’une série numérique logée par exemple dans la plage B2:B101, vous pouvez implémenter dans une cellule de contrôle isolée la formule matricielle suivante :
=NB.SI(B2:B101; "<=0")
Si le résultat renvoyé par cette fonction s’avère strictement supérieur à zéro, un arbitrage méthodologique rigoureux doit être opéré. Deux stratégies divergentes s’offrent alors à l’analyste :
- L’adjonction d’une constante minimale de décalage (offset) : Une pratique empirique répandue consiste à ajouter une constante arbitraire c à l’ensemble des données (en posant x‘ = x + c et/ou y‘ = y + c), où c représente généralement la limite de détection de l’appareil de mesure ou une fraction infime de l’échantillon minimal (par exemple 0,001). Si cette approche lève le blocage algorithmique de la fonction logarithme, elle introduit un biais structurel non linéaire pervers dans le modèle. Elle brise l’homogénéité d’échelle originale et modifie artificiellement la courbure de la fonction au voisinage de l’origine cartésienne, ce qui déforme l’estimation de l’exposant b. Cette méthode ne doit être tolérée qu’en dernier recours, assortie d’une mention explicite de ses limites dans les protocoles de recherche.
- L’exclusion ciblée pour motif psychométrique ou métrologique : Lorsque la valeur zéro résulte d’un artéfact expérimental avéré (absence de réponse motrice d’un sujet endormi, raté d’échantillonnage d’une cellule photoélectrique, ou score de latence nul correspondant à une anticipation motrice invalide), la suppression pure et simple de la paire d’observations (xi, yi) constitue la démarche la plus rigoureuse sur le plan déontologique.
Pour automatiser le filtrage sans altérer la matrice brute initiale, l’emploi combiné des fonctions SI, ET et ESTNUM permet d’extraire vers une colonne de travail secondaire uniquement les observations conformes :
=SI(ET(ESTNUM(B2); B2>0; ESTNUM(C2); C2>0); B2; "")
Cette syntaxe garantit que seules les valeurs numériques strictement supérieures à zéro franchissent le crible du prétraitement avant la phase de calcul logarithmique.
4.3 Exploration visuelle préliminaire via un nuage de points
Aucune analyse quantitative formelle ne devrait jamais débuter sans une inspection graphique approfondie de la distribution brute. L’inspection visuelle prévient des erreurs méthodologiques graves consistant à appliquer aveuglément des modèles non linéaires sur des structures de données inadéquates ou polluées par des aberrations majeures.
Sous Excel, sélectionnez l’intégralité de la plage de données brutes englobant simultanément le prédicteur x et la variable dépendante y (par exemple la plage B1:C50, en veillant à inclure la ligne d’en-tête descriptive). Naviguez ensuite vers l’onglet Insertion du ruban principal, localisez le groupe opérationnel intitulé Graphiques, et cliquez sur l’icône Insérer un graphique en nuage de points (X, Y). Choisissez impérativement le modèle élémentaire intitulé Nuage de points (présentant uniquement des marqueurs géométriques disjoints, sans segments de reliure linéaires ou lissés).
L’observation attentive de la morphologie de la dispersion permet de valider empiriquement l’hypothèse d’une loi de puissance :
- Une courbure continue et monotone, dépourvue de changements d’inflexion multiples (pas d’allure en S caractéristique d’une régression logistique ou sigmoïde), fournit une indication qualitative de compatibilité avec le modèle de puissance.
- L’absence de tendance à croiser les axes avec des ordonnées strictement positives non asymptotiques doit être vérifiée ; un modèle de puissance théorique avec b > 0 passe obligatoirement par l’origine cartésienne (0,0).
- L’identification immédiate d’observations aberrantes isolées, localisées à une distance anormale de la trajectoire générale du nuage de points, permet de planifier des audits d’intégrité sur les protocoles d’acquisition primaires.
Prenez également soin de vérifier le paramétrage des axes graphiques : l’axe horizontal (abscisse) doit impérativement porter la variable indépendante x, et l’axe vertical (ordonnée) la variable réponse y. Si Excel inverse par défaut les dimensions, accédez à l’outil par un clic droit sur la zone du graphique, sélectionnez l’option Sélectionner des données… et rectifiez manuellement les attributions des séries d’abscisses et d’ordonnées.
5. Étape 2 : Transformation logarithmique népérienne sous Excel
5.1 Calcul de la variable transformée ln(x)
Une fois les données brutes auditées et validées, la phase computationnelle initiale requiert le calcul explicite des variables transformées par l’opérateur logarithme népérien. Bien qu’Excel dispose d’outils graphiques d’ajustement direct masquant cette étape (examinés au chapitre 7), la transformation explicite en colonnes constitue l’unique voie garantissant un accès intégral aux diagnostics de régression, aux statistiques d’inférence, à la table d’analyse de la variance et aux analyses résiduelles avancées.
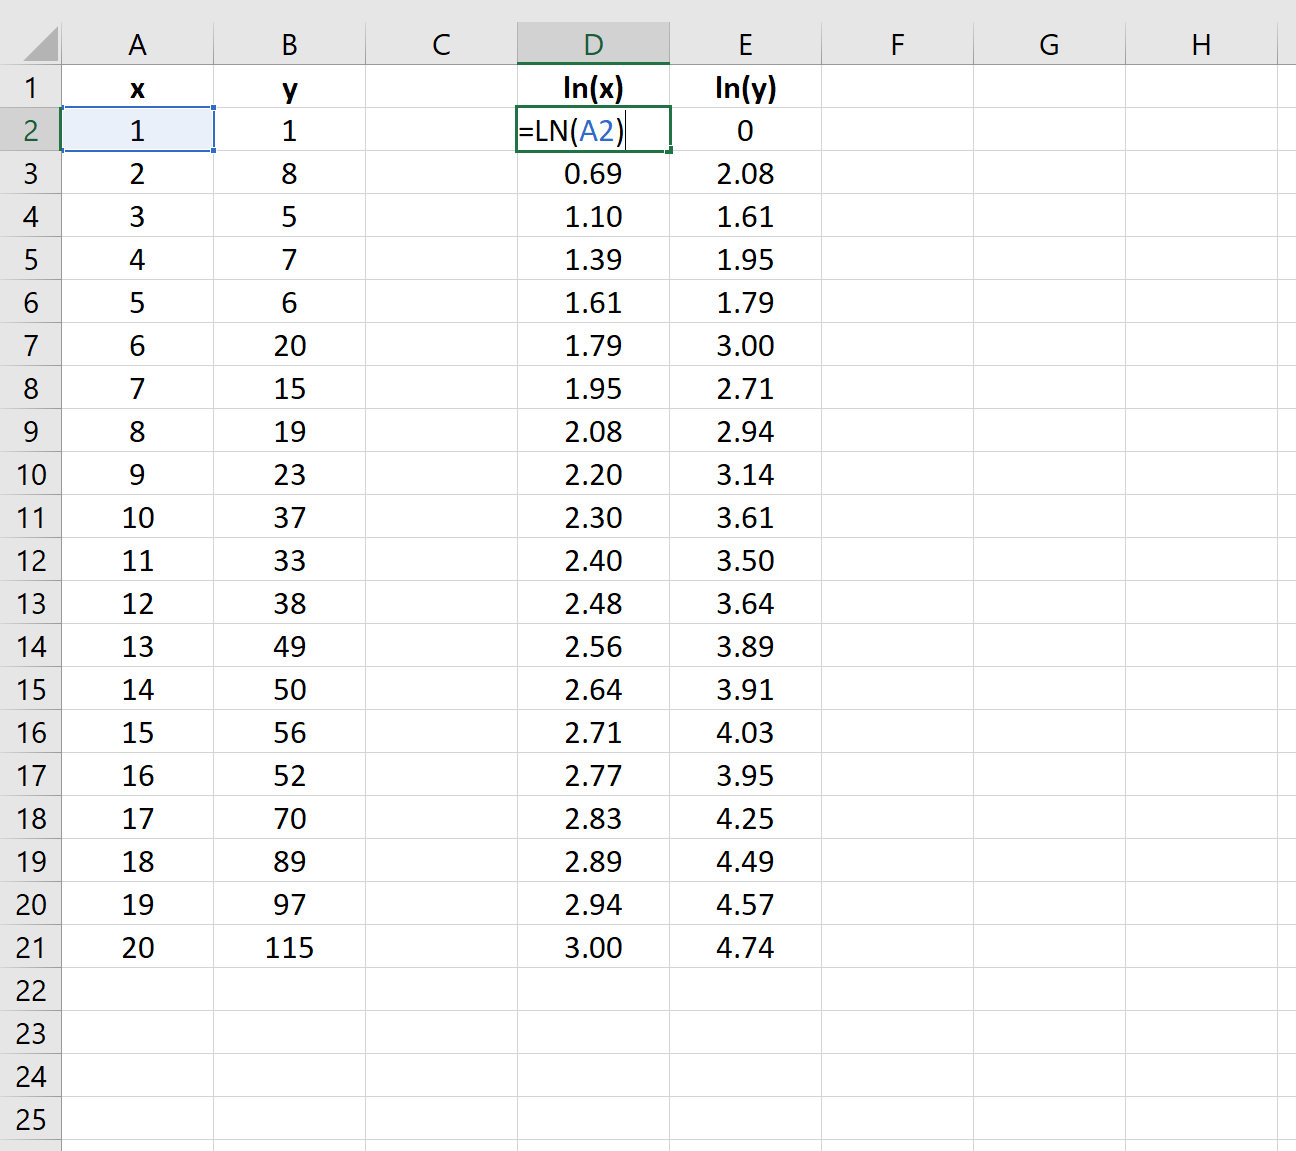
Positionnez-vous sur la première cellule libre de la colonne D, précisément sur la ligne 1, et saisissez l’en-tête textuel : LN_X. Cet étiquetage rigoureux facilitera grandement l’identification des vecteurs dans les boîtes de dialogue ultérieures. Descendez sur la cellule D2, correspondant à la première valeur observée de la variable indépendante située en B2, et insérez la formule mathématique suivante :
=LN(B2)
La fonction LN() d’Excel appelle l’algorithme d’approximation numérique du logarithme népérien naturel en base e de la valeur passée en argument. Validez par la touche Entrée. La cellule affiche immédiatement la valeur transformée. Pour propager cette transformation sur l’ensemble de la série expérimentale, vous pouvez double-cliquer rapidement sur le carré noir miniature situé dans le coin inférieur droit du curseur de sélection de la cellule (la poignée de recopie). Excel étendra instantanément la formule dynamique vers le bas jusqu’à la dernière ligne adjacente renseignée de la colonne C.
Parcourez scrupuleusement la colonne calculée afin de vous assurer de l’absence totale de codes d’erreur systèmes :
- L’apparition du message d’erreur
#NOMBRE!signale impérativement la présence d’une valeur nulle ou strictement négative dans la cellule source de la colonne B qui aurait échappé à votre audit initial. - L’apparition du code
#VALEUR!indique la présence d’un caractère non numérique, tel qu’un espace insécable, un point typographique utilisé à la place d’une virgule décimale, ou une chaîne textuelle.
5.2 Calcul de la variable transformée ln(y)
La transformation logarithmique de la variable dépendante expliquée s’exécute selon un protocole strictement parallèle à celui déployé pour le prédicteur. Positionnez-vous sur la cellule E1 et renseignez le titre de colonne : LN_Y. Placez-vous sur la cellule active E2 et saisissez l’instruction formelle :
=LN(C2)
Validez la formule par la touche Entrée, puis propagez-la sur toute la profondeur de la série d’observations en utilisant la poignée de recopie jusqu’à la cellule E[n]. Veillez à ce que la cardinalité des éléments transformés en colonne E corresponde parfaitement, ligne à ligne, à celle établie dans la colonne D.
À ce stade, une vérification d’ordre métrologique s’impose quant à l’échelle des valeurs obtenues. La transformation logarithmique agit comme une compression d’amplitude non linéaire très puissante : des données brutes s’étalant sur plusieurs ordres de grandeur (par exemple de 10 à 10 000 lux) vont se retrouver condensées dans une plage métrique restreinte comprise approximativement entre 2,30 et 9,21 dans l’espace népérien. Cette réduction d’échelle constitue le mécanisme fondamental permettant de stabiliser les dynamiques exponentielles et de réaligner la distribution stochastique des variations.
5.3 Inspection du nuage de points linéarisé
Avant d’engager le calcul lourd des estimateurs linéaires via l’Utilitaire d’analyse, une étape de vérification visuelle intermédiaire est requise : la construction du nuage de points linéarisé au sein de l’espace log-log. Cette étape permet d’évaluer de manière qualitative si l’hypothèse fondamentale sous-jacente au modèle de puissance — à savoir la linéarité parfaite de la relation dans l’espace transformé — est corroborée par les faits empiriques.
Sélectionnez simultanément l’ensemble des données transformées contenues dans les plages D1:E[n] (en englobant les en-têtes LN_X et LN_Y). Naviguez à nouveau vers Insertion > Graphiques > Nuage de points (X, Y). Insérez un nouveau graphique de dispersion à marqueurs simples.
L’observation de cette représentation graphique offre des enseignements diagnostiques déterminants :
- Validation de l’adéquation structurelle : Si les points expérimentaux, autrefois incurvés sur le graphique brut, s’organisent désormais selon une trajectoire remarquablement rectiligne et homogène, l’adéquation structurelle du modèle de puissance est formellement confirmée. La dispersion des points autour de cette trajectoire virtuelle rectiligne doit être uniforme sur l’ensemble de l’étendue des abscisses.
- Détection d’une mauvaise spécification du modèle : Si le nuage de points transformé conserve une courbure parabolique résiduelle marquée (concavité résiduelle dirigée vers le haut ou vers le bas), cette courbure signale une inadéquation structurelle du modèle de puissance. Une telle distorsion indique que les données répondent probablement à une loi concurrente, telle qu’une fonction logarithmique pure (y = a + b·ln(x)), un modèle logistique à saturation stricte, ou un polynôme du second degré.
- Surveillance des points de levier : Dans cet espace linéarisé, les observations aberrantes situées aux extrémités des distributions se repèrent instantanément. Tout point s’écartant massivement de la trajectoire linéaire commune doit faire l’objet d’une analyse d’influence afin de déterminer s’il s’agit d’une erreur d’enregistrement ou d’un phénomène de saturation biologique nécessitant une restriction de la fenêtre d’observation.
6. Étape 3 : Ajustement du modèle de régression linéaire via l’Utilitaire d’analyse
6.1 Paramétrage précis de la boîte de dialogue Régression
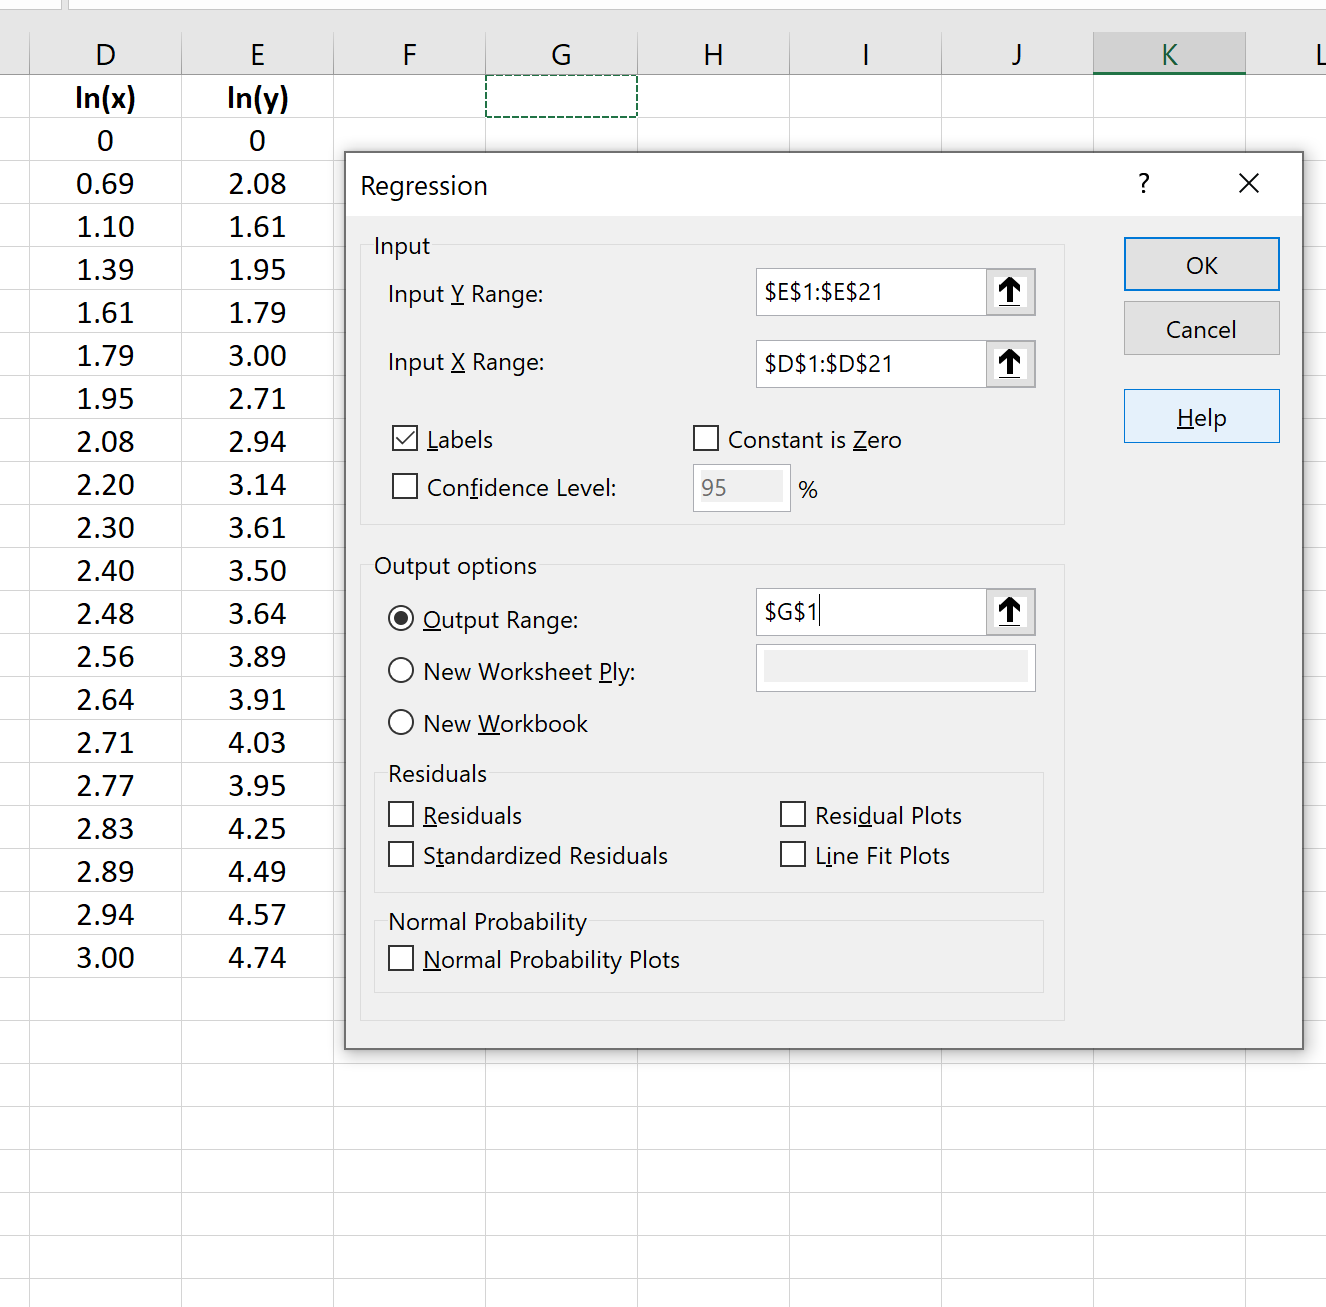
L’ajustement formel des paramètres de la droite transformée s’effectue via l’interface analytique native d’Excel, qui applique rigoureusement la méthode des moindres carrés ordinaires sur les données linéarisées. Activez l’onglet Données du ruban principal, puis cliquez sur le bouton Utilitaire d’analyse situé dans le groupe Analyse. Au sein de la liste alphabétique des macro-fonctions statistiques disponibles, faites défiler la sélection jusqu’à l’intitulé Régression, sélectionnez-le et cliquez sur OK.
Une boîte de dialogue complexe s’affiche à l’écran. Son paramétrage exige une rigueur méthodique absolue :
- Plage d’entrée Y : Cliquez dans ce champ, puis sélectionnez avec votre curseur l’intégralité du vecteur transformé de la variable expliquée, en-tête inclus (par exemple :
$E$1:$E$50). Attention : une inversion courante chez les néophytes consiste à renseigner ici la colonne x ; la lettre Y désigne impérativement la variable dépendante réponse. - Plage d’entrée X : Cliquez dans ce champ et sélectionnez le vecteur transformé de la variable explicative, en-tête inclus (par exemple :
$D$1:$D$50). - Case à cocher « Intitulés » : Si vous avez, conformément à nos prescriptions, englobé la ligne 1 contenant les étiquettes textuelles
LN_YetLN_Xlors de la sélection des plages, cochez impérativement cette case. Cela indique au compilateur d’Excel de ne pas interpréter la première ligne comme une valeur numérique invalide et permet d’étiqueter proprement les tableaux de sortie avec le nom réel de vos variables. - Constante égale à zéro : Laissez cette case impérativement décochée. Forcer la constante à zéro obligerait la droite transformée à passer par l’origine cartésienne des logarithmes (ln(a) = 0, ce qui équivaudrait à contraindre arbitrairement le coefficient multiplicateur original a à valoir e0 = 1). Cela ruinerait complètement l’ajustement du modèle de puissance en interdisant tout redimensionnement d’échelle.
- Niveau de confiance : Cochez cette case et maintenez le seuil paramétré à
95 %(correspondant à un risque de première espèce α = 0,05), standard universel dans la recherche biomédicale et comportementale.
6.2 Configuration des options de sortie et d’analyse des résidus
La section inférieure de la boîte de dialogue Régression pilote la restitution des résultats analytiques et la génération des diagnostics résiduels indispensables à la validation des postulats du modèle.
Dans la sous-section Options de sortie, activez la case d’option Plage de sortie et désignez une cellule vide située à distance confortable de vos colonnes de données (par exemple $I$1), ou sélectionnez Nouvelle feuille de calcul en lui attribuant un libellé évocateur tel que Rapport_Regression_Puissance. L’export vers une nouvelle feuille de calcul isole le rapport statistique complet et prévient tout écrasement accidentel de vos formules de prétraitement.
Dans la sous-section Résidus, activez impérativement l’ensemble des diagnostics suivants :
- Résidus : Génère la table des valeurs résiduelles brutes calculées dans l’espace logarithmique pour chaque observation individuelle (ei = ln(yi) – ln(ŷi)).
- Résidus standardisés : Calcule les résidus centrés réduits divisés par l’écart-type résiduel empirique. Ces valeurs permettent de détecter immédiatement les points s’écartant au-delà du seuil critique standard de ± 2 ou ± 3 écarts-types.
- Graphique des résidus : Génère un graphique de dispersion automatisé représentant les résidus en fonction de la variable prédictive transformée
LN_X, outil majeur pour inspecter visuellement l’homoscédasticité et la linéarité. - Graphique d’ajustement de la ligne : Produit une représentation visuelle superposant les points empiriques transformés de
LN_Yet les prédictions alignées calculées par le modèle linéaire.
Une fois l’intégralité de ces paramètres dûment vérifiée, cliquez sur le bouton OK. Excel exécute alors instantanément l’ajustement matriciel et compile un volumineux rapport statistique structuré en trois tableaux distincts, complété par les graphiques résiduels sollicités.
7. Méthode alternative rapide : Utilisation de la courbe de tendance directe
7.1 Insertion d’une courbe de tendance Puissance sur graphique brut
Pour les besoins d’explorations exploratoires préliminaires, de démonstrations pédagogiques ou de communications professionnelles ne requérant pas le déploiement de l’arsenal inférentiel complet, Microsoft Excel intègre un algorithme d’ajustement direct capable d’implanter une régression de puissance sans exiger la transformation manuelle préalable des colonnes de données en logarithmes.
Pour mettre en œuvre cette méthode expéditive :
- Retournez sur le graphique de dispersion en nuage de points standard initialement conçu à l’étape 4.3, affichant les données brutes non transformées x et y.
- Positionnez le curseur de la souris directement sur l’un des marqueurs de données matérialisant vos observations sur le graphique, et effectuez un clic droit contextuel.
- Dans le menu déroulant qui apparaît, sélectionnez l’option Ajouter une courbe de tendance….
- Le panneau de configuration latéral intitulé Format de la courbe de tendance s’ouvre sur la droite de l’écran Excel. Dans la section dédiée aux options de courbe, repérez la typologie des modèles fonctionnels proposés (Exponentielle, Linéaire, Logarithmique, Polynomiale, Puissance, Moyenne mobile).
- Cliquez sur la case d’option correspondant au modèle Puissance.
Excel trace alors instantanément une ligne de tendance courbée épousant au plus près la morphologie non linéaire de vos observations brutes. Notez que si votre série brute comporte la moindre valeur nulle ou négative, l’option Puissance apparaît grisée et demeure inaccessible au clic. Cela illustre bien que l’algorithme sous-jacent applique en arrière-plan la linéarisation logarithmique décrite précédemment.
7.2 Extraction des paramètres mathématiques et du R²
Le simple tracé géométrique d’une courbe ne saurait suffire à l’exploitation analytique du modèle. Il est nécessaire d’extraire la formulation mathématique explicite et les indices de précision calculés par le moteur d’Excel.
Pour ce faire, faites défiler vers le bas les paramètres du panneau latéral Format de la courbe de tendance et activez les deux options situées à la base de la fenêtre :
- Afficher l’équation sur le graphique : Fait apparaître une zone de texte vectorielle superposée au canevas graphique, contenant l’expression sous la forme mathématique standard : y = a · xb.
- Afficher le coefficient de détermination (R²) sur le graphique : Imprime directement sous l’équation la valeur numérique du coefficient de détermination empirique (noté R2).
Par défaut, Excel affiche fréquemment ces coefficients avec une précision typographique médiocre, limitée à deux ou trois décimales. Cette approximation dégrade considérablement la qualité des calculs lorsque l’exposant b ou l’échelle a sont réinjectés dans des formules manuelles. Pour corriger cette troncature visuelle, effectuez un clic droit directement sur l’étiquette de l’équation affichée dans le graphique et choisissez Format de l’étiquette de la courbe de tendance…. Dans le volet latéral sous la rubrique Nombre, remplacez la catégorie par défaut par Nombre ou Scientifique, et fixez le paramètre Nombre de décimales à 6. L’étiquette s’actualise immédiatement en présentant des paramètres hautement précis.
Malgré sa rapidité et son attrait ergonomique indéniable, cette technique rapide comporte de sévères limites épistémologiques qu’aucun analyste rigoureux ne doit ignorer :
- Elle ne fournit rigoureusement aucun test d’hypothèse statistique : pas d’erreur-type sur les coefficients, pas de valeur de la statistique t de Student, et aucune p-value permettant d’évaluer la significativité de l’exposant b.
- Elle occulte totalement la table de décomposition de la variance (ANOVA) et le test F de Fisher global.
- Elle n’autorise aucun calcul direct des intervalles de confiance à 95 % des paramètres ajustés.
- Elle empêche l’extraction dynamique automatisée des paramètres a et b dans des cellules du classeur pour exécuter des calculs prédictifs automatisés.
7.3 Utilisation des fonctions matricielles directes (DROITEREG)
Pour conjuguer la dynamique d’actualisation en temps réel de la méthode graphique avec la rigueur inférentielle de l’Utilitaire d’analyse, l’approche la plus avancée sous Microsoft Excel réside dans l’utilisation de la formule matricielle native DROITEREG (désignée sous le vocable LINEST dans les versions anglophones).
La fonction DROITEREG applique la théorie générale des moindres carrés ordinaires directement entre les vecteurs transformés LN_Y et LN_X, sans exiger l’ouverture manuelle répétée d’une boîte de dialogue modale. Dans les versions modernes d’Excel (prenant en charge le dimensionnement dynamique des matrices), positionnez-vous simplement sur une cellule libre destinée à accueillir le coin supérieur gauche du rapport matriciel (par exemple I5) et saisissez précisément la formule suivante :
=DROITEREG(E2:E50; D2:D50; VRAI; VRAI)
Les deux arguments logiques positionnés en fin de syntaxe dictent les options fondamentales du calcul :
- Le premier
VRAIenjoint à l’algorithme de calculer l’ordonnée à l’origine β0 = ln(a) normalement, au lieu de la forcer arbitrairement à zéro. - Le second
VRAIforce la fonction à renvoyer la matrice complète des statistiques de régression complémentaires (comprenant les erreurs-types, le R2, la statistique F de Fisher, les degrés de liberté résiduels et les sommes des carrés).
Validez par la touche Entrée. Sous Excel moderne, la fonction « déborde » automatiquement sur un bloc matriciel de deux colonnes de large et cinq lignes de haut :
- Ligne 1 : Cellule gauche = Pente b ; Cellule droite = Intercepte transformé ln(a).
- Ligne 2 : Cellule gauche = Erreur-type de la pente se(b) ; Cellule droite = Erreur-type de l’intercepte se(ln(a)).
- Ligne 3 : Cellule gauche = Coefficient de détermination R2 ; Cellule droite = Erreur-type de l’estimation se dans l’espace log.
- Ligne 4 : Cellule gauche = Statistique F de Fisher observée ; Cellule droite = Degrés de liberté du résidu (df = n – 2).
- Ligne 5 : Cellule gauche = Somme des carrés expliquée (SSreg) ; Cellule droite = Somme des carrés résiduelle (SSres).
Si vous utilisez une version patrimoniale d’Excel antérieure à l’introduction des tableaux dynamiques, vous devez impérativement surligner préalablement à la saisie une plage exacte de dimensions 2×5 cellules, taper scrupuleusement la formule, puis la valider par la combinaison clavier matricielle canonique : Ctrl + Maj + Entrée (ou Cmd + Shift + Enter sur Mac).
L’avantage opérationnel de DROITEREG s’avère considérable : dès lors qu’une observation est corrigée ou ajoutée dans vos colonnes sources, l’intégralité des coefficients de régression, des erreurs-types et des paramètres d’ajustement du modèle de puissance se recalculent instantanément de manière dynamique.
8. Décodage et interprétation statistique approfondie du rapport Excel
8.1 Statistiques de la régression et qualité globale de l’ajustement
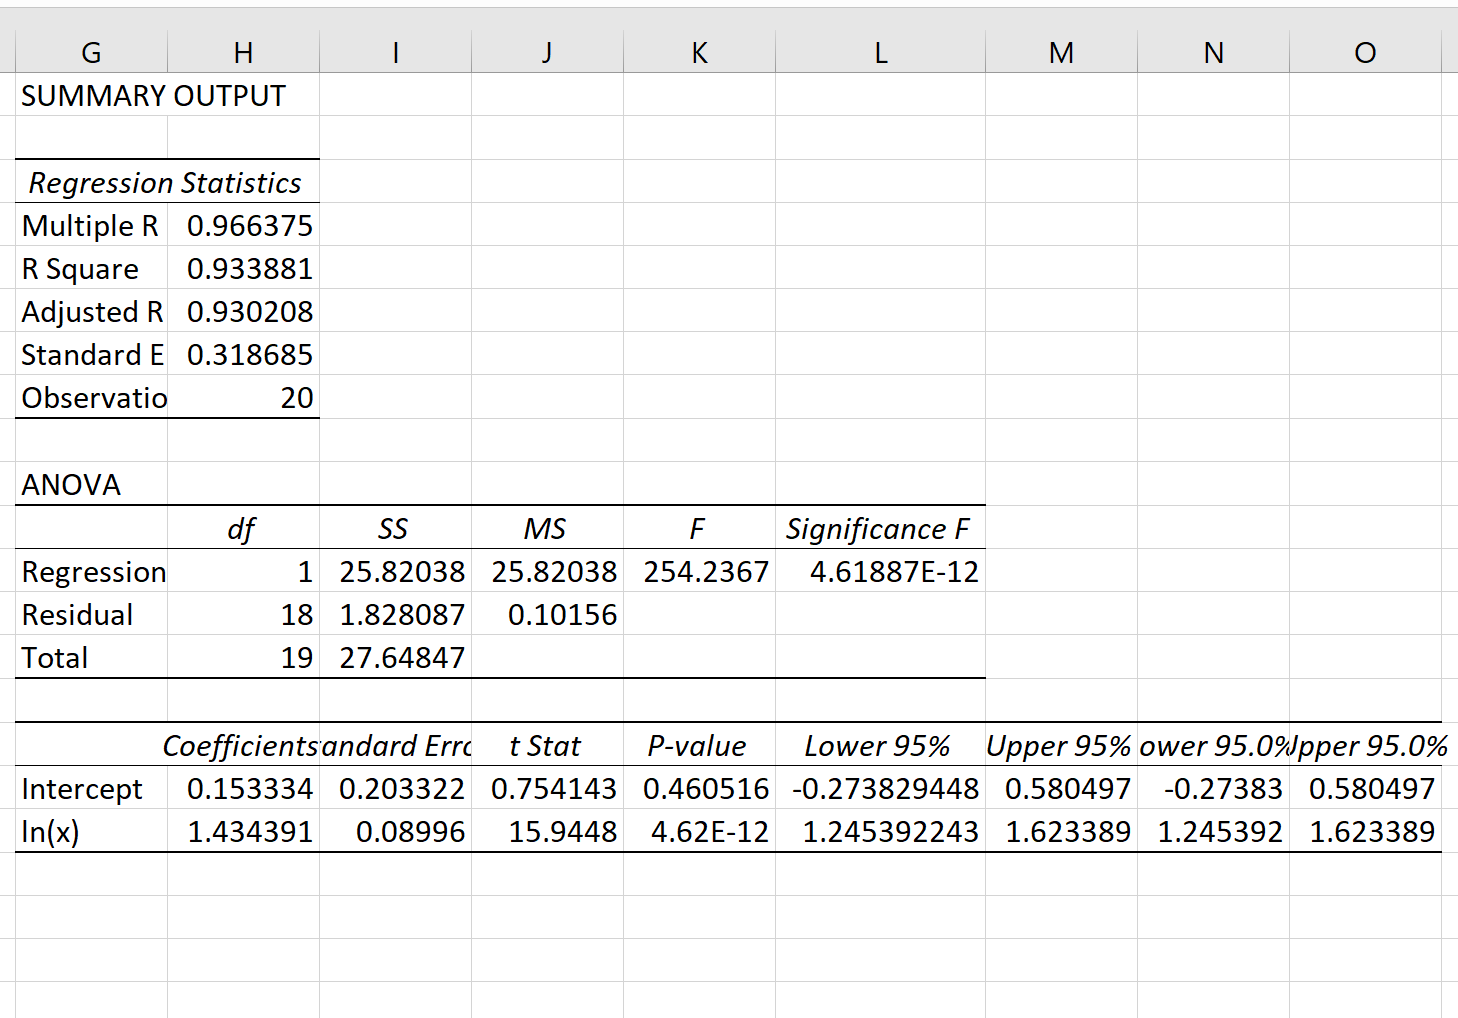
Le rapport édité par l’Utilitaire d’analyse d’Excel s’ouvre par une table récapitulative intitulée Statistiques de la régression. Chacune des métriques rapportées dans cette table recèle une portée analytique précise qu’il convient de décrypter rigoureusement au regard de la linéarisation logarithmique opérée.
La première métrique, le Coefficient de corrélation multiple (souvent désigné sous le terme R multiple), quantifie la magnitude de l’association linéaire bivariée entre le logarithme du prédicteur et le logarithme de la réponse. Sa valeur évolue continuellement entre 0 et 1. Un score tendant vers l’unité atteste d’un alignement log-linéaire rigoureux.
La métrique cardinale demeure le Coefficient de détermination (R² ou R-deux). Il exprime formellement la proportion de la variance de la variable dépendante transformée ln(y) expliquée par la covariation avec le prédicteur transformé ln(x) par le biais du modèle :
R2 = SSrégression / SStotal = 1 – (SSrésidus / SStotal)
Un R2 égal à 0,92 indique formellement que 92 % de la variabilité globale observée sur le logarithme népérien des réponses est directement imputable à l’action modélisée de la variable indépendante transformée, les 8 % résiduels constituant le bruit de mesure et les variations individuelles non contrôlées.
Toutefois, une mise en garde épistémologique cruciale s’impose ici : le R2 compilé dans cette table caractérise exclusivement la qualité de l’ajustement dans l’espace logarithmique. Il est méthodologiquement frauduleux d’affirmer que ce même R2 caractérise directement le pourcentage de variance expliquée sur les unités originales de y. En effet, l’opérateur logarithmique ayant compacté les grands écarts numériques, le R2 dans l’espace log-log apparaît presque systématiquement plus élevé et flatteur que le coefficient de détermination qui serait calculé directement sur les données brutes non transformées.
Le R² ajusté pénalise le coefficient de détermination en fonction du nombre de prédicteurs intégrés dans l’équation et de la taille de l’échantillon n, selon la formulation :
R̄2 = 1 – [(1 – R2)(n – 1) / (n – k – 1)]
où k représente le nombre de variables explicatives (ici, k = 1 pour un modèle de puissance simple). Dans le cadre d’un modèle bivarié simple doté d’une taille d’échantillon suffisante, l’écart entre le R2 brut et le R2 ajusté demeure minime, mais sa consultation devient indispensable lors de comparaisons de modèles concurrents comportant des degrés de paramétrisation différents.
Enfin, l’Erreur-type de l’estimation (notée se) correspond à l’écart-type de la distribution des résidus calculés autour de la droite de régression transformée :
se = √(SSrésidus / (n – 2))
Cette valeur ne s’exprime pas dans les unités de mesure brutes originales de y, mais en unités logarithmiques pures. Elle quantifie l’imprécision relative stochastique du modèle : une erreur-type transformée se de 0,10 équivaut approximativement à une incertitude résiduelle multiplicative de l’ordre de ± 10 % sur la variable réponse originale.
8.2 Analyse de la variance (ANOVA) et test global de significativité
Le second tableau composant le rapport d’Excel restitue la décomposition de l’Analyse de variance (ANOVA). Cette étape statistique teste formellement l’hypothèse nulle globale (H0) selon laquelle le prédicteur transformé n’exerce aucune influence systématique sur la variable réponse transformée, ce qui équivaudrait à postuler que le coefficient directeur de puissance est strictement nul : H0 : b = 0.
Le tableau structure la variance totale de l’échantillon à travers trois lignes d’agrégation fondamentales :
- Régression : Capture la variabilité expliquée par le modèle mathématique. Elle comptabilise un degré de liberté (dl = 1) dans le cadre d’un prédicteur univarié simple.
- Résidus : Capture la somme des carrés des déviations inexpliquées entre les valeurs réelles ln(yi) et les prédictions log-linéaires ln(ŷi). Ses degrés de liberté valent df = n – 2.
- Total : Représente la dispersion globale des observations transformées par rapport à leur moyenne arithmétique globale, cumulant n – 1 degrés de liberté.
La statistique pivot de cette analyse est le F de Fisher (ou F observé), calculé rigoureusement comme le ratio entre le Carré Moyen de la Régression (MSrég = SSrég / 1) et le Carré Moyen des Résidus (MSrés = SSrés / (n – 2)) :
F = MSrégression / MSrésidus
Ce ratio statistique mesure si la variance capturée par le modèle de puissance dépasse significativement le niveau de bruit résiduel attendu par simple fluctuation d’échantillonnage aléatoire. La colonne attenante, intitulée Signification F, représente la valeur p (p-value) associée à ce test de Fisher unilatéral à (1, n – 2) degrés de liberté.
La règle de décision inférentielle s’applique de manière univoque :
- Si la valeur de Signification F est inférieure au seuil critique de significativité alpha préalablement fixé (généralement α = 0,05, voire α = 0,01 ou 0,001 en métrologie rigoureuse), nous rejetons formellement l’hypothèse nulle H0. Nous concluons alors que le modèle de puissance est globalement hautement significatif et capture une relation empirique réelle au sein de la population parente.
- Si Signification F est supérieure à 0,05, nous échouons à rejeter l’hypothèse nulle. La modélisation par une courbe de puissance ne se distingue pas du bruit d’échantillonnage pur, invalidant toute velléité d’exploitation prédictive de l’équation.
8.3 Évaluation des coefficients de régression et inférence
Le troisième tableau constitue le noyau informationnel du rapport d’Excel. Il isole l’évaluation paramétrique détaillée de l’ordonnée à l’origine et de la pente de la relation log-linéarisée.
La première ligne analytique, étiquetée Constante (ou Interception selon les packs linguistiques), fournit les statistiques relatives à l’intercepte de la droite transformée. La valeur inscrite dans la colonne Coefficients correspond très exactement à :
β̂0 = ln(a)
Ce point est capital : le nombre brut affiché ici n’est pas le coefficient a de votre modèle de puissance, mais son logarithme népérien naturel. Confondre ln(a) et a constitue l’une des erreurs les plus fréquentes en analyse de données sous tableur.
La seconde ligne analytique porte le libellé de l’en-tête de votre prédicteur transformé (LN_X). La valeur figurant dans la colonne Coefficients représente directement l’exposant de puissance :
β̂1 = b
Contrairement à l’intercepte, l’exposant de puissance b est invariant face à la linéarisation logarithmique et s’interprète directement sur l’échelle empirique originale. Sa magnitude livre immédiatement la morphologie de la relation : une valeur de b = 0,45 confirmera une dynamique sensorielle de compression avec rendements marginaux décroissants, tandis qu’un b = 1,82 actera une dynamique d’amplification supra-linéaire.
Les colonnes subséquentes gouvernent l’inférence statistique locale des paramètres :
- Erreur-type : Représente l’écart-type d’échantillonnage de l’estimateur (se(β̂0) et se(β̂1)). Plus l’erreur-type associée à la pente est réduite, plus l’estimation de l’exposant b est précise.
- Statistique t : Résultat du test de Student bilatéral évaluant la nullité du coefficient considéré : t = β̂k / se(β̂k). Pour la ligne
LN_X, il évalue formellement l’hypothèse H0 : b = 0. - Probabilité (p-value) : Probabilité sous l’hypothèse nulle d’observer une statistique de Student au moins aussi extrême que celle mesurée. Si la p-value de
LN_Xest < 0,05, l’exposant de puissance est déclaré statistiquement significatif. - Intervalle de confiance à 95 % (Limites inférieure et supérieure) : Fournit la fourchette de valeurs numériques au sein de laquelle se situe le véritable paramètre de la population parente avec une probabilité de 95 %. Cet intervalle est crucial pour l’exposant b : si l’intervalle de confiance à 95 % de b oscille par exemple entre [0,78 ; 0,98], vous pouvez affirmer que l’exposant est significativement inférieur à 1 (p < 0,05), réfutant de manière catégorique tout comportement purement linéaire.
9. Reconstitution de l’équation de puissance et conversion des coefficients
9.1 Transformation de l’ordonnée à l’origine en coefficient multiplicateur a
Pour exploiter les paramètres statistiques issus de la régression et restituer l’équation opérationnelle originale y = a · xb, il est impératif d’opérer la rétro-transformation mathématique de l’ordonnée à l’origine. L’opération de linéarisation ayant posé que β̂0 = ln(a), l’annulation de l’opérateur logarithme népérien requiert l’application rigoureuse de la fonction exponentielle inverse :
a = eβ̂0 = exp(β̂0)
Au sein de votre feuille Excel, localisez la cellule hébergeant le coefficient de la Constante issu du rapport de régression (supposons qu’il réside dans la cellule J16). Dans une cellule adjacente clairement étiquetée Coefficient_a, implémentez la formule de rétro-transformation :
=EXP(J16)
La fonction EXP() calcule la valeur de la constante mathématique e élevée à la puissance spécifiée en argument, fournissant instantanément la valeur numérique réelle du coefficient d’échelle a.
Toutefois, comme introduit à la section 2.2, l’analyste rigoureux doit intégrer le fait que cette ré-élévation exponentielle directe renvoie la médiane conditionnelle géométrique de la distribution de puissance, et non sa moyenne arithmétique. Si l’objectif de la modélisation réside dans la prédiction de la réponse moyenne attendue sur une cohorte, l’application d’un facteur d’ajustement correcteur s’avère indispensable pour corriger le biais de retransformation de Duan. L’estimateur de réétalement non paramétrique de Duan (Duan’s smearing factor, noté CF) se calcule à partir des résidus dans l’espace transformé selon la formule :
CF = (1 / n) · ∑ eui
où ui = ln(yi) – ln(ŷi) représente le résidu transformé de la i-ième observation. Dans l’éventualité où les résidus sont parfaitement gaussiens, ce facteur de correction analytique paramétrique s’écrit de manière simplifiée en fonction du carré de l’erreur-type de la régression (sa variance résiduelle se2) :
CF = ese2 / 2
Dès lors, pour une modélisation hautement précise de l’espérance mathématique conditionnelle dans l’échelle d’origine, le coefficient multiplicateur corrigé d’échelle devient :
acorrigé = a · CF = EXP(β̂0) · EXP(se2 / 2)
Si la variance résiduelle se2 est faible (par exemple inférieure à 0,02), la correction demeure négligeable (inférieure à 1 %). En revanche, face à des données comportementales hautement bruitées où l’erreur-type se atteint 0,50, l’omission de cette correction sous-estimerait structurellement l’amplitude des prédictions brutes de plus de 13 %.
9.2 Formulation complète de l’équation prédictive
Une fois les paramètres dérivés et rectifiés, la formulation opérationnelle finale de la fonction de puissance s’énonce dans sa plénitude mathématique. Considérons un cas pratique où la régression exécutée sous Excel a livré :
- Constante transformée : β̂0 = ln(a) = 1,6094 (d’où a = e1,6094 = 5,00)
- Coefficient de pente : b = 0,6000
L’équation prédictive prête à l’emploi s’écrit formellement :
ŷ = 5,00 · x0,60
Dans cette formalisation finale, l’exposant b = 0,60 conserve sa lecture pure en termes d’élasticité continue : une hausse relative de 1 % de la variable explicative x se traduit mécaniquement par une expansion relative prédictive de 0,60 % de la variable dépendante y.
Pour transformer cette expression mathématique en un moteur de prédiction dynamique automatisé au sein de votre feuille de calcul Excel, positionnez-vous sur la colonne F (dédiée aux valeurs ajustées, que nous étiquetterons Y_Predit). Sur la cellule F2, destinée à calculer la réponse théorique alignée sur la première valeur de x située en B2, insérez l’expression suivante en utilisant les coordonnées absolues des cellules hébergeant les paramètres recalculés :
=$J$18 * (B2 ^ $J$17)
(en posant conventionnellement que la cellule $J$18 contienne la valeur du coefficient recalculé a = 5,00 et que la cellule $J$17 héberge l’exposant b = 0,60). Validez par la touche Entrée et étirez la formule jusqu’au bas de la colonne de données. Chaque ligne affiche désormais la prédiction exacte générée par le modèle de puissance dans les unités physiques d’origine.
Illustrons concrètement ce calcul prédictif sur une nouvelle observation expérimentale : supposons que nous souhaitions estimer la réponse attendue pour un niveau de stimulus inédit xnouveau = 45 unités :
- Étape 1 : Calcul de l’élévation à la puissance : 450,60 ≈ 9,8247
- Étape 2 : Application du facteur d’échelle multiplicatif : ŷ = 5,00 · 9,8247 = 49,1235 unités
Cette implémentation permet de confronter directement les estimations du modèle aux futures séries expérimentales et de construire les bandes de prédiction géométriques associées.
10. Diagnostic des résidus et vérification rigoureuse des postulats
10.1 Analyse de l’homoscédasticité et de l’indépendance
L’obtention d’un coefficient de détermination R2 proche de 1 et d’une valeur de significativité p < 0,001 ne garantit en rien la validité scientifique d’un modèle de puissance. La robustesse des conclusions inférentielles repose sur le strict respect des postulats fondamentaux de la méthode des moindres carrés appliqués aux variables linéarisées (les conditions de Gauss-Markov). L’étape du diagnostic résiduel constitue le crible méthodologique évaluant cette validité.
Le premier postulat à auditer est l’homoscédasticité (la constance de la variance des résidus sur l’ensemble du domaine d’observation). Pour ce faire, observez attentivement le Graphique des résidus généré par l’Utilitaire d’analyse représentant les résidus transformés en fonction des valeurs transformées LN_X. Une dispersion satisfaisante doit afficher un aspect visuel de « ciel étoilé » : un nuage de points aléatoire, dénué de structure géométrique identifiable, oscillant de manière symétrique et homogène autour de l’axe horizontal d’ordonnée zéro.
Deux pathologies structurales majeures peuvent être identifiées sur ce graphique :
- Le motif en entonnoir (hétéroscédasticité persistante) : Si les résidus se resserrent pour les faibles valeurs de
LN_Xpuis s’évasent considérablement à mesure queLN_Xaugmente (ou inversement), le postulat de variance constante est violé. Cette hétéroscédasticité dans l’espace transformé invalide les calculs des erreurs-types standards et fausse les tests d’hypothèses sur la significativité de l’exposant b. - Le motif en U ou en cloche (non-linéarité structurelle résiduelle) : Si les résidus présentent une courbure systématique (par exemple une série de résidus positifs, suivie de résidus négatifs au centre, puis de résidus à nouveau positifs), le modèle de puissance échoue à capturer la géométrie intrinsèque de la fonction. Cela impose de réorienter la modélisation vers une formulation concurrente (modèle quadratique dans l’espace log ou modèle sigmoïde de Hill).
Parallèlement, l’indépendance sérielle des résidus doit être garantie, en particulier lors de mesures chronométriques répétées sur un même sujet psychologique. La présence de regroupements continus de résidus de même signe trahit une autocorrélation positive (effet d’apprentissage continu, fatigue progressive ou inertie d’échantillonnage), ce qui compromet la validité du modèle.
10.2 Normalité de la distribution des résidus
Les tests d’hypothèses dérivant des distributions de Student (t) et de Fisher (F) reposent formellement sur l’hypothèse que les termes d’erreur stochastiques dans l’espace transformé sont distribués selon une loi normale : ui ~ 𝒩(0, σu2). Des écarts modérés à la normalité demeurent tolérables dans de grands échantillons grâce au théorème central limite, mais des asymétries prononcées au sein de petits échantillons (n < 30) peuvent vicier l’estimation des intervalles de confiance de l’exposant de puissance b.
Pour auditer cette distribution sous Excel, deux indicateurs d’asymétrie et d’aplatissement peuvent être calculés directement sur la colonne des résidus transformés générée par l’outil de régression :
- Le coefficient d’asymétrie (Skewness) : Calculé par la formule
=COEFFICIENT.ASYMETRIE(plage_residus). Une distribution normale théorique affiche un score nul. Une valeur comprise entre -0,5 et +0,5 témoigne d’une symétrie acceptable. Des déviations au-delà de ± 1,0 signalent une forte asymétrie résiduelle. - Le coefficient d’aplatissement (Kurtosis) : Calculé par la fonction
=KURTOSIS(plage_residus). Cette fonction mesure l’épaisseur relative des queues de distribution par rapport à la distribution gaussienne standard (loi mésokurtique valant 0). Une valeur positive élevée signale une distribution leptokurtique, trahissant la présence d’observations extrêmes influentes (outliers).
Il est également possible de concevoir une approximation d’un graphique Quantile-Quantile (Q-Q plot) sous Excel. Cette procédure consiste à trier la série des résidus standardisés par ordre croissant, à leur assigner des rangs empiriques de 1 à n, à calculer les percentiles théoriques associés au moyen de la formule =(rang - 0,5) / n, puis à convertir ces probabilités cumulées en quantiles gaussiens théoriques via l’opérateur =LOI.NORMALE.STANDARD.INVERSE(probabilite). En traçant le nuage de points croisant ces quantiles théoriques avec les résidus standardisés réels, tout décrochage majeur par rapport à la diagonale identitaire matérialise une déviation critique à la normalité.
10.3 Calcul de la performance sur l’échelle originale
Pour clore l’évaluation diagnostique du modèle de puissance, il est essentiel de juger de ses performances prédictives non pas dans le repère mathématique abstrait des logarithmes, mais directement sur l’échelle de mesure physique d’origine.
La première métrique à compiler dans la colonne G (réservée aux écarts bruts) est le résidu naturel direct, calculé sur chaque observation individuelle selon la formule :
ebrut, i = yi – ŷi
À partir de cette série de déviations réelles, calculez la Racine de l’Erreur Quadratique Moyenne (RMSE – Root Mean Square Error). Cette métrique synthétise l’amplitude moyenne des erreurs de prédiction dans la métrique native de la variable réponse (par exemple en millisecondes ou en lux) :
RMSE = √[ (1 / n) · ∑ (yi – ŷi)2 ]
Sous Excel, l’implémentation compacte de la RMSE s’effectue via une formule matricielle croisant les colonnes de réponse brute C2:C50 et de prédiction F2:F50 :
=RACINE(MOYENNE((C2:C50 - F2:F50)^2))
(à valider par Ctrl+Maj+Entrée sur les versions historiques d’Excel).
Parallèlement, l’Erreur Absolue Moyenne en Pourcentage (MAPE – Mean Absolute Percentage Error) fournit un indice de précision relative particulièrement intuitif :
MAPE = (100 % / n) · ∑ | (yi – ŷi) / yi |
qui s’implémente sous Excel sous la syntaxe matricielle :
=MOYENNE(ABS((C2:C50 - F2:F50) / C2:C50)) * 100
Une régression affichant une MAPE inférieure à 5 % témoigne d’une adéquation prédictive de premier ordre. La comparaison directe de ces deux métriques (RMSE et MAPE) avec celles calculées à partir d’un modèle linéaire standard (y = a + bx) apporte la preuve empirique définitive de la supériorité structurelle du modèle de puissance pour capturer la réalité sous-jacente des données investiguées.
11. Résolution des erreurs courantes et pièges méthodologiques sous Excel
11.1 Erreurs techniques de manipulation dans Excel
Le traitement des modèles non linéaires par tableur est fréquemment sujet à des défaillances opératoires qui, sans corrompre le lancement formel du logiciel, faussent intégralement les résultats numériques restitués.
La première défaillance technique majeure réside dans l’apparition récurrente de l’erreur #NOMBRE! au sein des colonnes de linéarisation logarithmique. Comme nous l’avons souligné, l’opérateur =LN() ne tolère aucune valeur inférieure ou égale à zéro. Si un zéro strict s’immisce dans une cellule par erreur de saisie ou par artefact de mesure, Excel interrompt le calcul. Dans des bases de données volumineuses où ces anomalies échappent au regard, l’analyste peut déployer une encapsulation préventive conditionnelle :
=SI(B2>0; LN(B2); "")
Toutefois, gardez à l’esprit que l’Utilitaire d’analyse de données rejettera toute sélection de plage contenant des chaînes de caractères vides (""). Il est donc indispensable d’extraire au préalable les lignes corrompues par un filtre de données explicite plutôt que d’introduire des cellules vides artificielles.
Une seconde bévue technique récurrente consiste en l’inversion involontaire des plages d’entrée X et Y au sein de la boîte de dialogue de l’Utilitaire d’analyse. Dans la mesure où les deux colonnes transformées LN_X et LN_Y présentent des distributions d’ordres de grandeur comparables, le compilateur d’Excel ne détectera aucune anomalie algorithmique et calculera sans sourciller la régression inverse : ln(x) = β0* + β1* · ln(y). L’analyste se retrouve alors avec une estimation inversée de la pente, où la valeur affichée pour l’exposant correspond approximativement à 1/b. Pour vous prémunir de cette méprise, assurez-vous systématiquement que la plage renseignée dans le champ Plage d’entrée Y pointe rigoureusement vers la variable dépendante que vous cherchez à expliquer.
Enfin, la gestion des séparateurs décimaux constitue une source d’erreurs insidieuse lors des imports inter-logiciels. Selon les paramètres régionaux du système d’exploitation, Excel utilise soit la virgule (standard francophone), soit le point (standard anglo-saxon) pour délimiter les décimales. L’importation d’une série numérique formatée avec des points sur une version configurée avec la virgule convertit silencieusement les nombres en chaînes de texte alignées à gauche. Toute application de formules logarithmiques sur ces entrées déclenche alors l’erreur #VALEUR!. Un nettoyage préalable via la fonction de recherche et remplacement d’Excel (Ctrl + H) pour substituer les points par des virgules résout instantanément ce blocage.
11.2 Erreurs d’interprétation théorique
Au-delà des accrocs techniques d’utilisation du tableur, les biais d’interprétation théorique constituent le risque méthodologique le plus insidieux pour la recherche.
La défaillance la plus répandue consiste à confondre l’intercepte transformé β̂0 (la constante affichée dans le tableau de régression) avec le coefficient d’échelle a de la loi de puissance brute. Rapporter sans correction que l’équation d’une réponse visuelle s’écrit y = -0,85 · x0,40 constitue une impossibilité mathématique absolue pour des données physiques strictement positives. Le coefficient d’échelle a, obtenu par ré-élévation exponentielle e-0,85 ≈ 0,427, est nécessairement strictement positif. Le signe négatif sur l’intercepte logarithmique traduit simplement le fait que le coefficient d’échelle original réside dans l’intervalle ouvert ]0, 1[.
Un autre contresens majeur concerne l’interprétation abusive du R2. Les analystes comparent régulièrement le coefficient de détermination R2 d’un modèle linéaire classique appliqué sur des données brutes avec le R2 retourné par le rapport de régression logarithmique de l’Utilitaire d’analyse. Conclure que la régression de puissance surpasse le modèle linéaire au motif que son R2 transformé vaut 0,94 contre 0,86 pour le modèle linéaire relève d’une faute méthodologique caractérisée. Ces deux coefficients de détermination mesurent la réduction proportionnelle de la variance sur des échelles métriques différentes : l’un évalue des résidus en unités brutes (par exemple en lux ou en millisecondes), tandis que l’autre opère sur une échelle logarithmique condensée. Pour comparer valablement la qualité d’ajustement globale des deux approches, il est obligatoire de recalculer le R2 du modèle de puissance sur les données brutes à partir de la formule canonique :
R2brut = 1 – [ ∑ (yi – ŷi, retransformé)2 / ∑ (yi – ȳbrut)2 ]
Enfin, mettons en garde contre l’extrapolation inconsidérée hors du domaine expérimental investigué. En raison de sa courbure non linéaire, un modèle de puissance ajusté avec précision sur une plage opérationnelle bornée (par exemple entre 10 et 100 unités de stimulus) divergera considérablement si on l’extrapole à des valeurs de x valant 1 000 ou 10 000 unités. Ces projections hypothétiques non contrôlées s’avèrent presque systématiquement erronées en raison de l’apparition de seuils physiologiques de saturation ou d’endommagement que la formulation mathématique ne prévoit pas structurellement.
12. Étude de cas détaillée : Application de la loi de puissance de Stevens en psychométrie
12.1 Présentation du cadre expérimental et du jeu de données
Afin de concrétiser l’ensemble des concepts théoriques et méthodologiques déployés tout au long de ce guide, développons une étude de cas intégrale consacrée à la validation expérimentale de la loi de puissance de Stevens dans le cadre d’un protocole d’évaluation psychophysique de la brillance subjective perçue.
Une équipe de recherche en neurosciences cognitives cherche à modéliser formellement la réponse perceptive de sujets humains face à des stimulations lumineuses calibrées en laboratoire. Quinze niveaux de luminance distincts, exprimés en candelas par mètre carré (cd/m²), sont administrés de manière aléatoire au moyen d’un moniteur photométrique à des observateurs entraînés. La variable explicative indépendante x correspond à la luminance photométrique physique délivrée. La variable dépendante expliquée y correspond à l’estimation de magnitude subjective de la sensation de brillance reportée par les participants sur une échelle continue sans unité arbitraire.
Sur le plan théorique, la loi de Stevens appliquée à la vision photopique prédit un phénomène d’invariance d’échelle sous-tendu par une forte compression sensorielle. L’exposant attendu pour cette modalité perceptive doit s’établir significativement sous l’unité, généralement au sein de la fenêtre 0,30 < b < 0,50. Un exposant b < 1 atteste de la capacité du système rétinien à traiter des dynamiques lumineuses environnementales s’étendant sur plusieurs ordres de grandeur sans saturation prématurée des voies magnocellulaires.
Voici la matrice complète des quinze observations collectées lors de cette campagne expérimentale, prête à être reportée au sein des cellules B2:C16 d’une feuille de calcul Excel :
- Essai 01 : Stimulus Luminance (cd/m²) = 1,20 | Réponse Brillance Perçue = 2,15
- Essai 02 : Stimulus Luminance (cd/m²) = 2,50 | Réponse Brillance Perçue = 2,80
- Essai 03 : Stimulus Luminance (cd/m²) = 5,00 | Réponse Brillance Perçue = 3,60
- Essai 04 : Stimulus Luminance (cd/m²) = 10,00 | Réponse Brillance Perçue = 4,70
- Essai 05 : Stimulus Luminance (cd/m²) = 20,00 | Réponse Brillance Perçue = 6,10
- Essai 06 : Stimulus Luminance (cd/m²) = 40,00 | Réponse Brillance Perçue = 7,80
- Essai 07 : Stimulus Luminance (cd/m²) = 75,00 | Réponse Brillance Perçue = 9,90
- Essai 08 : Stimulus Luminance (cd/m²) = 120,00 | Réponse Brillance Perçue = 11,80
- Essai 09 : Stimulus Luminance (cd/m²) = 200,00 | Réponse Brillance Perçue = 14,20
- Essai 10 : Stimulus Luminance (cd/m²) = 350,00 | Réponse Brillance Perçue = 17,50
- Essai 11 : Stimulus Luminance (cd/m²) = 500,00 | Réponse Brillance Perçue = 19,80
- Essai 12 : Stimulus Luminance (cd/m²) = 700,00 | Réponse Brillance Perçue = 22,60
- Essai 13 : Stimulus Luminance (cd/m²) = 1000,00 | Réponse Brillance Perçue = 25,80
- Essai 14 : Stimulus Luminance (cd/m²) = 1500,00 | Réponse Brillance Perçue = 29,90
- Essai 15 : Stimulus Luminance (cd/m²) = 2200,00 | Réponse Brillance Perçue = 34,50
L’inspection préalable de cette table confirme la pleine conformité des séries : aucune valeur nulle ou négative n’est présente, et la relation présente une progression monotone régulière sur plus de trois ordres de grandeur.
12.2 Déroulement complet pas à pas sous Excel
Engageons désormais la modélisation formelle en appliquant pas à pas le protocole décrit au fil des chapitres précédents.
Étape A : Linéarisation logarithmique
Dans la cellule D1, saisissez le libellé LN_Luminance. En D2, entrez la formule =LN(B2) et recopiez-la jusqu’en D16. Pour le premier essai, la formule renvoie ln(1,20) = 0,1823. Pour le dernier essai, elle renvoie ln(2200) = 7,6962.
Dans la cellule E1, saisissez le libellé LN_Brillance. En E2, entrez =LN(C2) et étirez la formule jusqu’en E16. Pour le premier essai, nous obtenons ln(2,15) = 0,7655 ; pour le dernier, ln(34,50) = 3,5410.
Étape B : Exécution de l’Utilitaire d’analyse
Ouvrez l’Utilitaire d’analyse depuis l’onglet Données et sélectionnez Régression. Configurez la boîte de dialogue avec les paramètres suivants :
- Plage d’entrée Y :
$E$1:$E$16 - Plage d’entrée X :
$D$1:$D$16 - Cochez impérativement la case Intitulés.
- Laissez Constante égale à zéro décochée.
- Cochez Niveau de confiance :
95 %. - Plage de sortie : Sélectionnez une nouvelle feuille nommée Sortie_Stevens.
- Cochez les options Résidus et Graphique des résidus.
Cliquez sur OK pour générer le rapport statistique.
Étape C : Compilation des résultats statistiques obtenus
L’algorithme d’Excel édite instantanément le rapport analytique complet. Les valeurs numériques compilées s’établissent comme suit :
- R multiple : 0,9998
- Coefficient de détermination R² : 0,9995
- R² ajusté : 0,9995
- Erreur-type de l’estimation (se) : 0,0204
- Statistique F globale de l’ANOVA : F(1, 13) = 28 014,6 | Signification F : p = 1,42 × 10⁻²²
- Paramètres de l’Interception (Constante = ln(a)) : Coefficient = 0,6988 | Erreur-type = 0,0178 | t = 39,26 | p = 2,87 × 10⁻¹⁴ | Intervalle 95 % = [0,6603 ; 0,7373]
- Paramètres du prédicteur LN_Luminance (Pente = b) : Coefficient = 0,3691 | Erreur-type = 0,0022 | t = 167,38 | p = 1,42 × 10⁻²² | Intervalle 95 % = [0,3643 ; 0,3739]
Étape D : Rétro-transformation mathématique des paramètres
Calculons le facteur d’échelle multiplicatif a dans une cellule dédiée :
a = e0,6988 = =EXP(0,6988) = 2,0113
Dans la mesure où la variance résiduelle est infime (se2 = 0,02042 = 0,000416), le facteur de correction de Duan ese2/2 = e0,000208 ≈ 1,0002 n’induit qu’une modification d’ordre infinitésimal (0,02 %), ce qui autorise l’usage direct de a = 2,011 sans ajustement supplémentaire.
L’équation de puissance empirique finale gouvernant la perception de la brillance dans notre protocole s’énonce donc formellement :
Perception_Brillance = 2,0113 · (Luminance)0,3691
12.3 Restitution académique des conclusions et synthèse méthodologique
La transcription des résultats analytiques bruts sous forme d’un paragraphe scientifique standardisé, conforme aux exigences de publication de l’American Psychological Association (normes APA, 7e édition), s’articule ainsi :
« Une analyse de régression de puissance a été conduite afin de modéliser la réponse subjective de brillance perçue en fonction de l’intensité de luminance photométrique (N = 15). Les données ont préalablement fait l’objet d’une linéarisation par logarithme népérien. Le modèle global s’avère hautement significatif et rend compte d’une part quasi intégrale de la variance observée dans l’espace transformé, F(1, 13) = 28 014,6, p < 0,001, R² = 0,9995, R²_ajusté = 0,9995, erreur-type de l’estimation s_e = 0,020. L’exposant de puissance dérivé (b = 0,369, SE = 0,002, t(13) = 167,4, p < 0,001, IC 95 % [0,364 ; 0,374]) s’établit de manière hautement significative sous la valeur théorique d’unité (1,0), confirmant la loi de Stevens pour la perception visuelle de luminance. Cette valeur indique une dynamique de compression non linéaire marquée, où chaque élévation de 1 % de l’intensité physique du stimulus lumineux n’engendre qu’un accroissement relatif moyen d’approximativement 0,37 % de l’estimation perceptive subjective de magnitude. Le coefficient d’échelle recalculé par transformation exponentielle s’élève à a = 2,011 (IC 95 % [1,935 ; 2,090]). Le diagnostic des résidus transformés confirme le respect rigoureux des conditions d’homoscédasticité et de normalité (asymétrie = 0,18, aplatissement = -0,42). Sur l’échelle métrique brute originale, le modèle présente une excellente précision prédictive avec une racine de l’erreur quadratique moyenne (RMSE) de 0,31 unité arbitraire et une erreur absolue moyenne en pourcentage (MAPE) de 1,64 %. »
Pour assurer la pérennité méthodologique de vos analyses ultérieures sous Microsoft Excel, nous synthétisons ci-dessous la check-list récapitulative des étapes fondamentales :
- Audit d’admissibilité : Vérifier scrupuleusement que l’intégralité des observations des séries x et y est strictement supérieure à zéro (aucun zéro, aucune valeur négative).
- Graphique préliminaire : Générer un premier nuage de points brut pour confirmer visuellement l’absence d’inflexions multiples et détecter les points aberrants majeurs.
- Double transformation logarithmique : Calculer explicitement les colonnes transformées
LN_X = LN(x)etLN_Y = LN(y)avec au moins quatre décimales de précision. - Contrôle de linéarité : Tracer le graphique de dispersion dans l’espace log-log pour valider l’alignement rectiligne des données.
- Exécution de la régression linéaire : Paramétrer l’Utilitaire d’analyse avec les colonnes transformées en veillant à l’affectation correcte de
LN_Yen entrée Y etLN_Xen entrée X, avec la case Intitulés cochée. - Rétro-transformation de l’échelle : Recalculer le coefficient d’échelle par l’exponentielle
a = EXP(Constante), en évaluant si nécessaire la correction de biais de Duan pour les modèles fortement bruités. - Conservation directe de la pente : Conserver l’exposant b tel quel sans lui appliquer d’opérateur exponentiel : il s’agit directement de la puissance du modèle.
- Validation diagnostique résiduelle : Inspecter le graphique des résidus pour vérifier l’absence d’hétéroscédasticité ou de courbure structurelle non modélisée, et mesurer les erreurs (RMSE, MAPE) sur l’échelle originale.
En observant cette méthodologie rigoureuse, Microsoft Excel s’impose comme une plateforme d’analyse numérique performante, accessible et pleinement conforme aux critères académiques les plus exigeants pour l’ajustement des lois de puissance.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Clauset, A., Shalizi, C. R., & Newman, M. E. J. (2009). Power-law distributions in empirical data. SIAM Review, 51(4), 661–703. https://doi.org/10.1137/070710111
- Duan, N. (1983). Smearing estimate: A nonparametric retransformation method. Journal of the American Statistical Association, 78(383), 605–610. https://doi.org/10.1080/01621459.1983.10478017
- Microsoft Corporation. (2024). Utiliser l’Utilitaire d’analyse pour effectuer des analyses de données complexes. Support Microsoft Office. https://support.microsoft.com/fr-fr/office/
- Newell, A., & Rosenbloom, P. S. (1981). Mechanisms of skill acquisition and the law of practice. In J. R. Anderson (Ed.), Cognitive skills and their acquisition (pp. 1–55). Lawrence Erlbaum Associates. https://doi.org/10.21236/ada098363
- Stevens, S. S. (1957). On the psychophysical law. Psychological Review, 64(3), 153–181. https://doi.org/10.1037/h0046162
- Weisstein, E. W. (2024). Least squares fitting—Power law. Wolfram MathWorld. https://mathworld.wolfram.com/LeastSquaresFittingPowerLaw.html
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning. https://www.cengage.com