
Dans le champ de l’analyse des données contemporaine, la modélisation statistique constitue le pont fondamental reliant l’observation empirique à la théorisation scientifique. Trop souvent, les analystes et chercheurs recourent de manière quasi réflexive au modèle de la régression linéaire simple, postulant une proportionnalité constante et immuable entre les variables étudiées. Pourtant, la réalité phénoménologique, qu’elle relève des sciences physiques, biologiques, économiques ou des sciences du comportement, se caractérise par une complexité intrinsèque où les dynamiques non linéaires prédominent. Les processus d’accélération, de saturation, de rendements décroissants ou de basculements critiques défient les approximations rectilignes et exigent des cadres mathématiques plus souples et expressifs.
La régression polynomiale s’affirme précisément comme l’extension naturelle et élégante du modèle linéaire général. En intégrant des termes élevés à des puissances successives au sein de l’équation de prédiction, elle permet de capturer la courbure inhérente aux phénomènes réels sans pour autant renoncer aux propriétés mathématiques avantageuses de l’estimation par la méthode des moindres carrés ordinaires. Ce compromis entre flexibilité fonctionnelle et tractabilité computationnelle en fait un outil incontournable pour quiconque cherche à extraire du sens à partir de jeux de données présentant des trajectoires curvilignes prononcées.
Bien que les environnements de programmation tels que le langage R ou Python dominent la recherche computationnelle avancée, la suite bureautique infonuagique Google Sheets s’est métamorphosée en une plateforme d’analyse quantitative remarquablement robuste, accessible et collaborative. Ce guide exhaustif a pour vocation d’articuler la théorie mathématique la plus rigoureuse avec la pratique concrète sous Google Sheets. Pas à pas, nous explorerons les fondements théoriques, la manipulation matricielle, le diagnostic des résidus, la prévention du surajustement et l’interprétation substantielle des courbes polynomiales appliquées aux dynamiques quantitatives.
1. Introduction épistémologique et théorique à la régression polynomiale
1.1 Définition et distinction par rapport à la régression linéaire simple
L’édifice de la statistique paramétrique classique repose largement sur le postulat fondamental de linéarité. Selon cette hypothèse opératoire, la variation attendue d’une variable dépendante est strictement proportionnelle à la variation d’une variable indépendante donnée, quelle que soit la position occupée sur le continuum de mesure. Dans l’investigation empirique des systèmes dynamiques complexes, cette supposition s’avère fréquemment réductrice, voire épistémologiquement trompeuse. Les processus psychologiques, organisationnels ou biologiques ne se conforment que très rarement à une trajectoire rectiligne indéfinie. L’observation de plafonds physiologiques, de réactions d’adaptation homéostatique ou de phénomènes d’épuisement révèle les limites inhérentes du modèle linéaire traditionnel et impose le recours à des formalismes capables d’épouser la courbure des données.
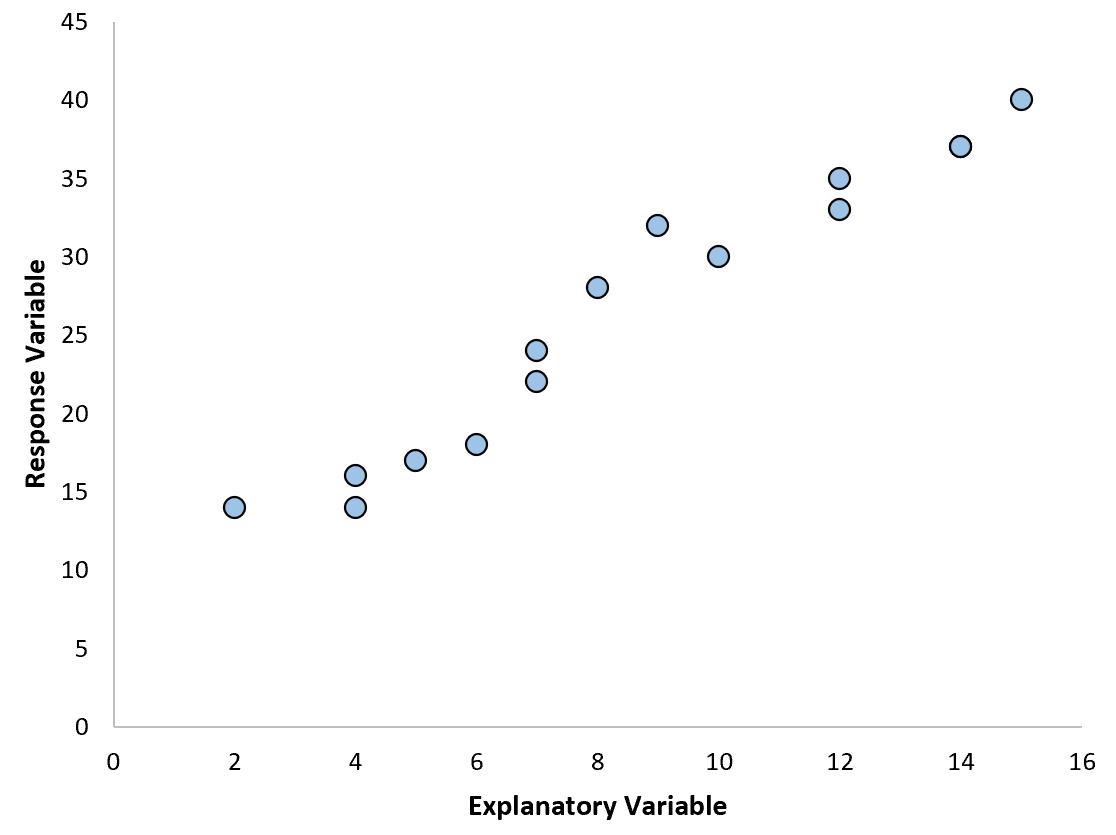
La régression polynomiale résout cette tension conceptuelle en étendant le modèle linéaire général aux relations curvilinéaires d’ordre supérieur. Sur le plan algébrique, une nuance capitale doit être immédiatement clarifiée : bien que la courbe résultante tracée dans le repère cartésien soit manifestement non linéaire, le modèle demeure rigoureusement linéaire au sens statistique du terme. Cette linéarité ne s’applique pas à la variable prédictive, mais aux paramètres d’estimation. L’équation canonique générale s’exprime sous la forme où la variable de réponse Y est fonction d’une somme pondérée d’une constante, d’un terme linéaire X, d’un terme quadratique X au carré, et potentiellement de termes d’ordres supérieurs jusqu’au degré polynomial k, auxquels s’ajoute un terme d’erreur stochastique.
La détermination du degré approprié du polynôme constitue une décision théorique et méthodologique majeure guidée par le principe de parcimonie scientifique, souvent désigné sous l’appellation de rasoir d’Ockham. L’élévation arbitraire du degré mathématique permet mécaniquement d’augmenter l’ajustement aux données observées en capturant chaque inflexion de l’échantillon. Toutefois, cette inflation paramétrique se fait presque toujours au détriment de la validité écologique et de la capacité de généralisation théorique. L’enjeu méthodologique réside donc dans l’identification du degré minimal nécessaire et suffisant pour traduire fidèlement la dynamique substantielle sous-jacente sans incorporer le bruit aléatoire inhérent à l’échantillonnage.
1.2 Pertinence de la régression polynomiale en psychologie quantitative
Dans le domaine de la psychologie quantitative et des sciences cognitives, la modélisation polynomiale revêt une pertinence heuristique exceptionnelle. L’une des illustrations les plus célèbres de relation curvilinéaire est incarnée par la loi de Yerkes-Dodson, formulée initialement en psychologie expérimentale. Ce principe postule que la relation entre le niveau d’éveil physiologique ou d’anxiété et la performance cognitive prend la forme d’un U inversé. Un niveau d’éveil trop faible engendre un déficit d’attention et de réactivité, tandis qu’un niveau d’éveil excessif désorganise les processus exécutifs et inhibe la mémoire de travail. Seul un degré polynomial d’ordre 2, c’est-à-dire une équation quadratique concave, permet d’isoler avec précision le point d’optimalité fonctionnelle où la performance atteint son acmé.
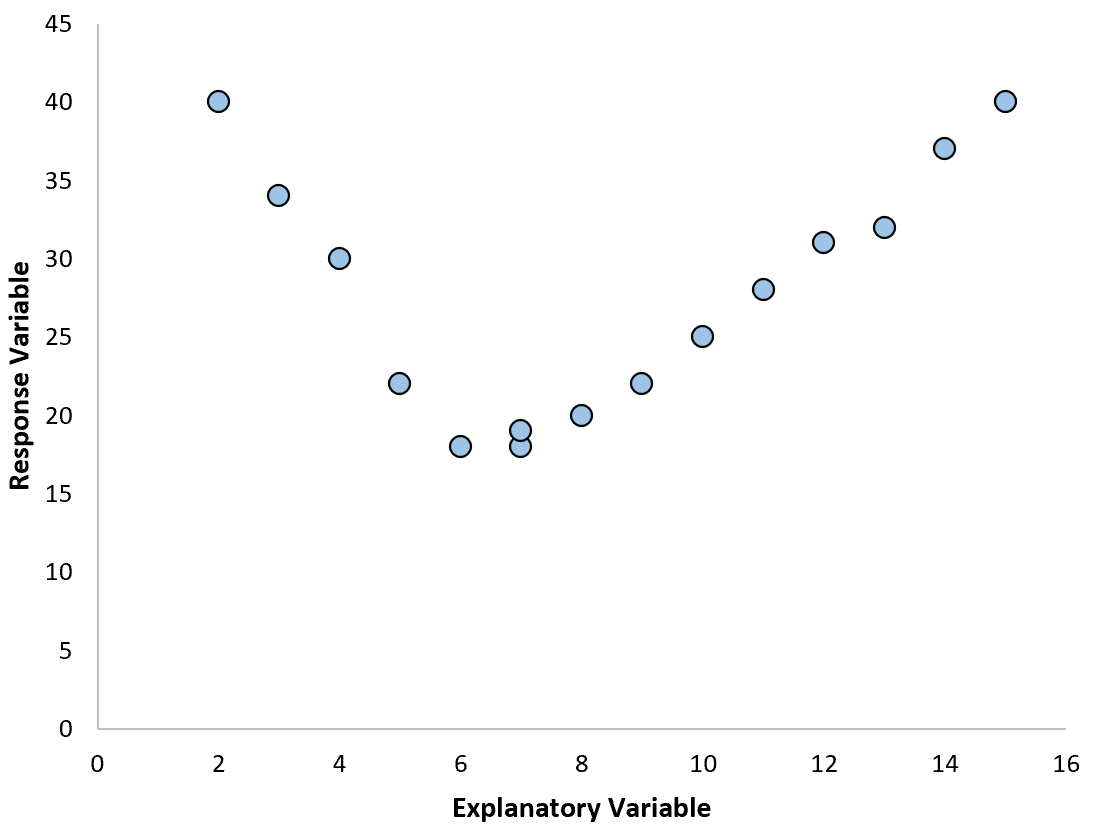
Au-delà de la modulation de l’éveil, l’étude longitudinale de l’acquisition des compétences mnésiques et motrices met en lumière des courbes d’apprentissage non linéaires. Ces dynamiques se caractérisent typiquement par une phase d’accélération initiale rapide, suivie d’une décélération progressive reflétant des effets de plafonnement mnésique ou de saturation cognitive. Tenter de résumer ces trajectoires d’acquisition au moyen d’un coefficient de pente unique masquerait les disparités fondamentales qui séparent les premiers stades de l’apprentissage des phases tardives de consolidation où le gain marginal par unité de temps décroît considérablement.
De façon analogue, l’analyse temporelle de la fatigue cognitive au cours de tâches prolongées et l’investigation de l’épuisement professionnel manifestent des comportements non linéaires marqués. Les premiers stades de l’effort peuvent être compensés par une mobilisation accrue des ressources d’autorégulation sans baisse visible d’efficience, avant qu’un point de bascule critique ne conduise à un effondrement abrupt de la vigilance. Enfin, la quantification des réponses affectives face à des stimuli environnementaux stressants met en évidence des seuils de réactivité et des dynamiques de sensibilisation que la modélisation quadratique et cubique permet de formaliser mathématiquement avec une fidélité inégalée par les approches purement linéaires.
1.3 Objectifs pédagogiques et méthodologiques du tutoriel
Ce présent guide didactique a été conçu pour équiper les étudiants, les chercheurs universitaires et les professionnels de l’analyse empirique d’un protocole opérationnel, rigoureux et intégralement reproductible au sein de l’environnement infonuagique Google Sheets. Trop souvent perçu comme un simple tableur dévolu à la comptabilité d’entreprise ou à la gestion logistique de base, Google Sheets dispose en réalité d’un moteur de calcul matriciel sophistiqué capable de rivaliser avec des progiciels spécialisés pour de nombreuses applications analytiques courantes.
L’approche pédagogique privilégiée repose sur une dialectique constante entre la commodité des interfaces graphiques et la profondeur des formules matricielles. Nous aborderons non seulement l’ajustement visuel de courbes de tendance par l’intermédiaire de l’éditeur de graphiques, mais nous plongerons également dans l’utilisation avancée de fonctions matricielles dédiées, telles que l’algorithme des moindres carrés implémenté dans la formule de régression linéaire multivariée. Cette double compétence garantit à la fois une compréhension intuitive des formes géométriques et une maîtrise computationnelle indispensable pour automatiser les prédictions et extraire les paramètres d’intérêt.
Enfin, une attention particulière sera dévolue au développement d’un esprit critique face aux métriques statistiques de sortie. L’analyste apprendra à ne pas se laisser séduire par des coefficients d’ajustement spectaculairement élevés mais potentiellement trompeurs, à diagnostiquer la viabilité des résidus par rapport aux hypothèses sous-jacentes du modèle classique, et à communiquer avec intégrité les limites inhérentes à toute tentative de modélisation mathématique du comportement humain.
2. Fondements mathématiques du modèle polynomial
2.1 Formulation algébrique et géométrie des courbes
La compréhension approfondie du modèle polynomial nécessite d’examiner attentivement son comportement géométrique et sa formalisation algébrique sous-jacente. Dans sa version du second degré, communément désignée sous le terme de modèle quadratique, l’équation s’écrit formellement comme la somme d’un terme constant, d’un terme proportionnel à X et d’un terme proportionnel à X élevé au carré. La géométrie de cette courbe dessine une parabole symétrique. Le signe attaché au coefficient du terme quadratique gouverne la concavité de la fonction : une valeur strictement négative engendre une courbure orientée vers le bas présentant un extremum maximal, tandis qu’une valeur positive confère une forme de cuvette orientée vers le haut dotée d’un extremum minimal.
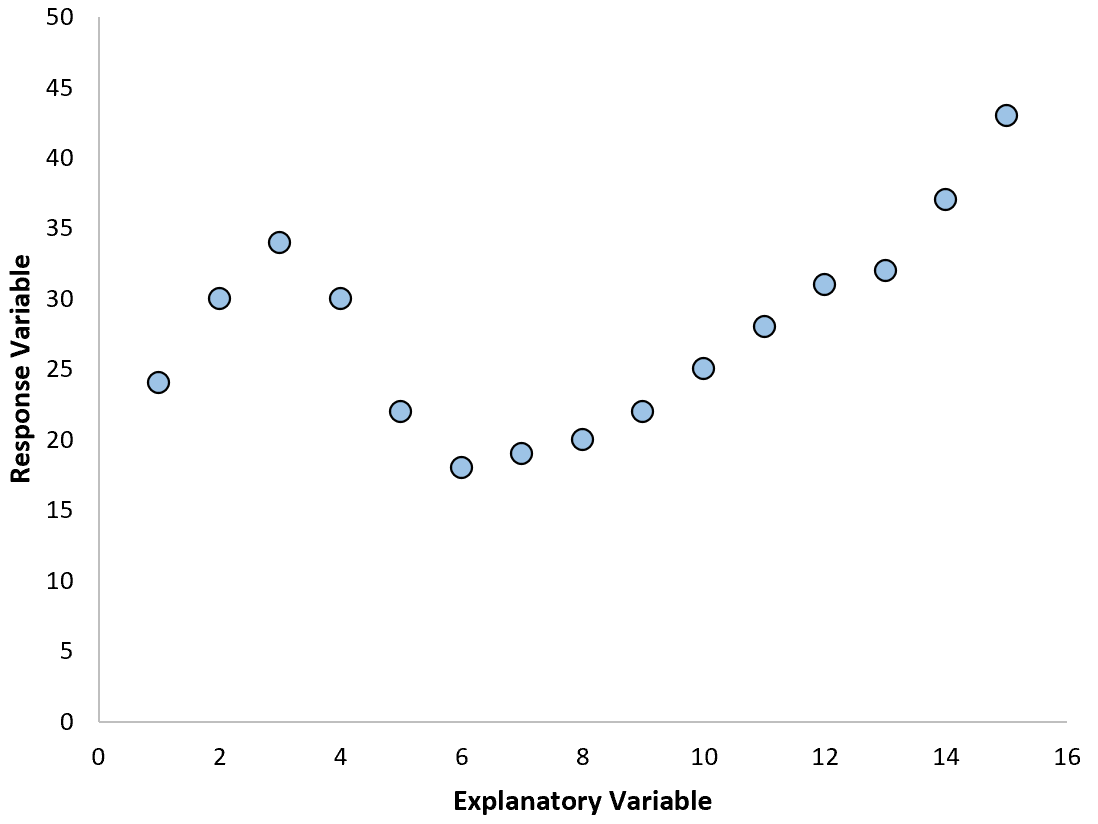
Le calcul différentiel permet de caractériser précisément les propriétés remarquables de cette trajectoire. En annulant la dérivée première de la fonction par rapport à la variable indépendante, on isole les coordonnées exactes du sommet de la parabole, point critique correspondant à l’optimum comportemental ou physique du système modélisé. La dérivée seconde, quant à elle, informe sur le taux d’accélération constant de la pente le long du continuum de X. Lorsque la modélisation intègre un degré cubique d’ordre 3, l’équation s’enrichit d’un terme en puissance trois. La géométrie résultante gagne la capacité d’arborer une trajectoire en S dotée d’un point d’inflexion où la concavité s’inverse, permettant de décrire des phases successives d’accélération, de décélération puis de nouvelle stabilisation asymptotique.
D’un point de vue matriciel et vectoriel, l’ajustement de ces courbes s’opère par une transformation linéaire de l’espace d’entrée. En traitant chaque puissance entière de la variable prédictive initiale comme une régresseur distinct et indépendant, le problème est ramené à une régression linéaire multiple dans un espace euclidien à dimensions multiples. Dès lors, les hypothèses classiques de Gauss-Markov demeurent pleinement applicables : linéarité des coefficients, absence d’erreur de spécification majeure, espérance conditionnelle nulle du terme d’erreur stochastique, et homoscédasticité des perturbations aléatoires autour de la fonction polynomiale estimée.
2.2 Le problème de la multicolinéarité structurelle
L’introduction délibérée de puissances successives d’une même variable explicative soulève inévitablement un écueil méthodologique de première grandeur : la multicolinéarité structurelle. Contrairement à la colinéarité empirique qui résulte de la corrélation fortuite entre deux variables distinctes observées dans la nature, la multicolinéarité structurelle est induite directement par la construction mathématique du modèle. Si une variable prédictive positive oscille sur un intervalle éloigné de zéro, il existe mathématiquement une très forte corrélation linéaire positive entre cette variable et son carré, et une corrélation encore plus marquée entre son carré et son terme cubique.
Cette interdépendance fonctionnelle entre les colonnes de la matrice des régresseurs engendre une instabilité numérique substantielle au moment de l’inversion de la matrice d’information dans le cadre des moindres carrés ordinaires. Sur le plan statistique, les conséquences se traduisent par une inflation spectaculaire de la variance des estimateurs de coefficients. Les erreurs-types associées aux différents paramètres s’élargissent dramatiquement, provoquant des tests de significativité de Student artificiellement non significatifs, alors même que le modèle global affiche un pouvoir prédictif élevé et une statistique de Fisher robuste.
Pour neutraliser efficacement cette distorsion computationnelle sans altérer en aucune façon la qualité globale de la prédiction ni la forme géométrique de la courbe ajustée, la littérature méthodologique préconise le centrage préalable des données. Cette opération élémentaire consiste à retrancher la moyenne arithmétique de l’échantillon à chaque mesure individuelle de la variable indépendante avant de calculer les termes élevés au carré ou au cube. Le centrage réduit de manière spectaculaire la corrélation artificielle entre la composante linéaire et la composante quadratique, stabilisant ainsi l’estimation des coefficients et facilitant grandement l’interprétation substantielle de l’ordonnée à l’origine, qui représente désormais la valeur prédite pour un sujet se situant exactement à la moyenne de l’échantillon.
2.3 Critères d’évaluation de la qualité de l’ajustement
L’évaluation quantitative de la fidélité avec laquelle l’équation polynomiale épouse les données repose sur la partition classique de la variance au sein de l’échantillon. La variabilité globale observée, mesurée par la somme totale des carrés des écarts à la moyenne, se décompose de manière orthogonale en deux entités mutuellement exclusives : la somme des carrés expliquée par le modèle polynomial et la somme des carrés résiduelle, qui agrège l’ensemble des déviations verticales non capturées entre les points observés et la courbe théorique estimée.
Le ratio de la somme des carrés expliquée sur la somme des carrés totale définit le coefficient de détermination R². Cette statistique comprise strictement entre 0 et 1 quantifie la proportion de variance de la variable dépendante qui est mathématiquement imputable à la fonction polynomiale choisie. Dans le contexte de données psychométriques ou expérimentales, un R² élevé atteste de la pertinence de l’équation pour résumer la tendance centrale du phénomène étudié.
Cependant, l’utilisation exclusive du coefficient de détermination traditionnel présente une faille théorique majeure dans le cadre polynomial : l’ajout systématique d’un degré polynomial supplémentaire entraîne mécaniquement une augmentation ou, dans le pire des cas, une stricte stagnation du coefficient R², même si le terme introduit n’entretient aucune relation de causalité avec le phénomène sous-jacent. Ce piège d’optimisation impose l’utilisation impérative du coefficient de détermination ajusté. En appliquant une pénalité fonction du nombre de paramètres estimés et de la taille de l’échantillon, le R² ajusté ne progresse que si le gain explicatif apporté par le nouveau degré compense largement la perte d’un degré de liberté, offrant ainsi une boussole rigoureuse pour contenir l’escalade paramétrique.
3. Étape 1 : Structuration et préparation des données dans Google Sheets
3.1 Conception d’une feuille de calcul conforme aux standards académiques
La réussite d’une modélisation statistique repose avant tout sur une organisation rigoureuse et standardisée de l’environnement de données. Dans Google Sheets, cette rigueur commence par l’adoption d’une architecture tabulaire conforme aux principes des données ordonnées (tidy data). Chaque ligne de la feuille doit impérativement représenter une unité d’observation unique — qu’il s’agisse d’un sujet expérimental, d’une session de mesure ou d’un instant temporel déterminé — tandis que chaque colonne doit être dédiée de façon exclusive à une variable clairement délimitée.
Pour implémenter une régression polynomiale dans des conditions optimales, la feuille de calcul doit accueillir la variable prédictive dans une colonne initiale, traditionnellement la colonne A, et la variable de réponse comportementale ou physiologique dans la colonne contiguë B. Les en-têtes situés sur la première ligne doivent expliciter avec précision le nom du construit mesuré ainsi que ses unités dimensionnelles respectives (par exemple, « Dose_Cafeine_mg » ou « Temps_Reaction_ms »). Cette clarification prévient toute méprise lors de l’assignation des axes graphiques et de la formulation mathématique ultérieure.
Une vigilance particulière doit être accordée au formatage des données numériques. Google Sheets adapte par défaut ses séparateurs décimaux selon les paramètres régionaux du compte utilisateur. Dans la sphère francophone, la virgule constitue le séparateur standard, tandis que les systèmes anglo-saxons recourent au point. Tout mélange accidentel de typographies risque de convertir des données numériques en chaînes textuelles inopérantes, rendant impossibles les calculs matriciels. L’analyste veillera à vérifier que l’alignement des cellules soit naturellement orienté vers la droite, signature visuelle indubitable d’une interprétation numérique valide par le moteur du tableur.
3.2 Création d’un jeu de données empirique simulé
Afin d’illustrer la démarche de manière tangible tout au long de ce protocole, nous construisons un scénario expérimental représentatif des recherches en ergonomie cognitive et en psychopharmacologie. Imaginons une étude examinant l’effet d’une substance stimulante sur l’efficacité du traitement visuo-spatial chez 15 cohortes de sujets soumis à des intensités croissantes de stimulation, échelonnées de 0 à 14 unités normalisées. Cette variable indépendante X est consignée méticuleusement dans les cellules s’étendant de A2 à A16.
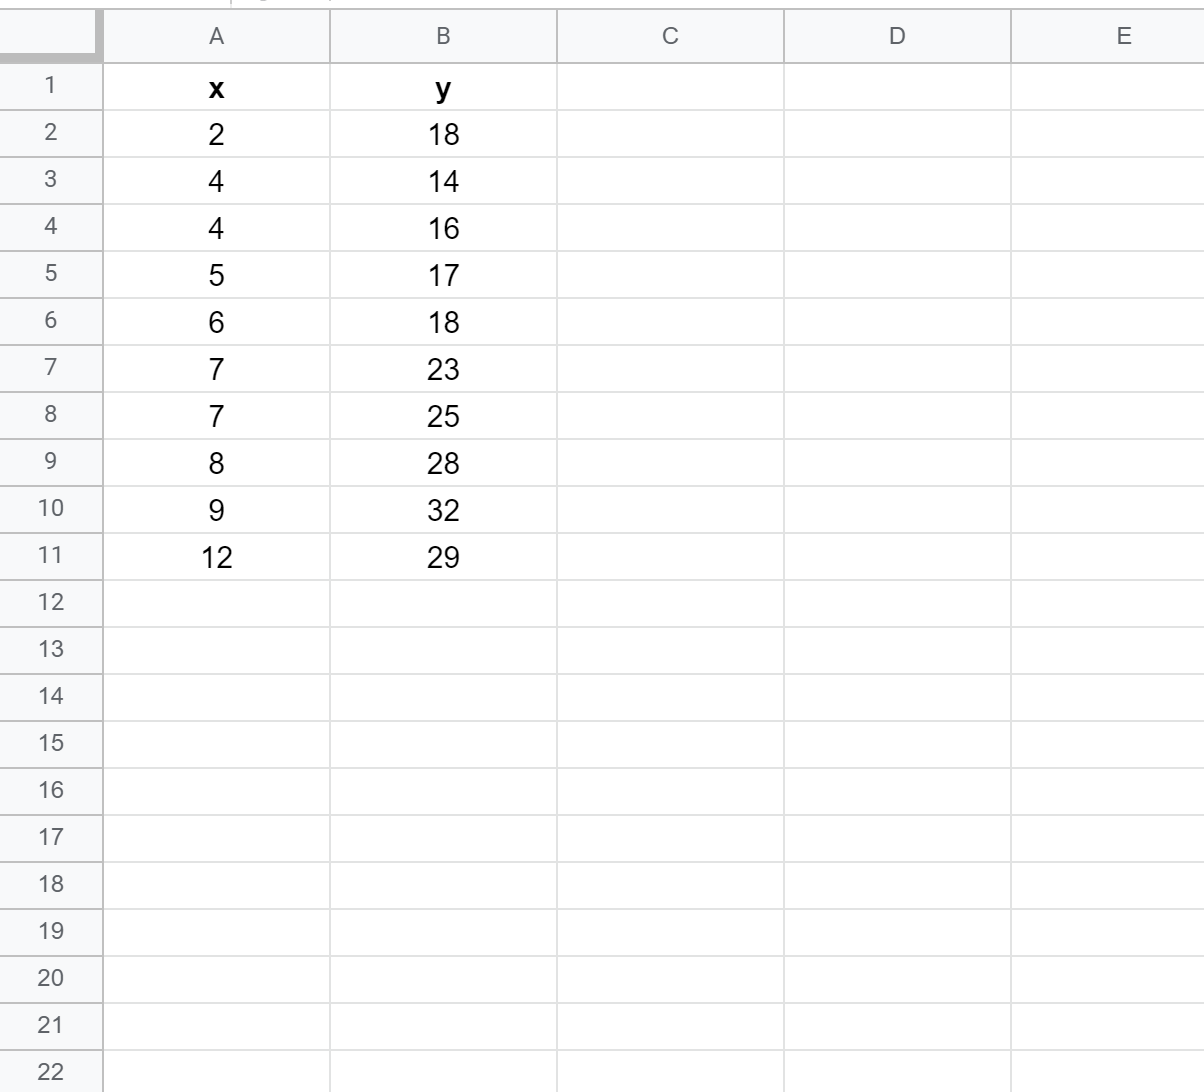
En face de chaque niveau de stimulation, la variable dépendante Y enregistre le score global à une épreuve de discernement perceptif complexe, consigné dans la plage B2:B16. À de faibles intensités de stimulus, le score moyen s’établit autour de 20 points. Au fur et à mesure que la stimulation progresse vers des intensités moyennes situées entre 6 et 8 unités, le score moyen s’élève progressivement pour atteindre un sommet remarquable culminant à environ 65 points. Au-delà de ce plateau optimal, l’augmentation continue du stimulus engendre une désorganisation attentionnelle progressive, faisant chuter le score sous la barre des 30 points pour les intensités maximales.
Avant d’engager toute procédure de modélisation mathématique, une inspection préalable s’impose pour valider l’intégrité de cette plage de données. L’analyste s’assurera de l’absence totale de cellules laissées vides de manière involontaire, d’incohérences de saisie ou de valeurs aberrantes grossières issues d’erreurs d’encodage. Cette étape de nettoyage et d’assainissement garantit que la courbure observée reflète fidèlement la dynamique substantielle envisagée et non un artefact numérique indésirable.
3.3 Prétraitement optionnel : le centrage de la variable explicative
Conformément aux principes mathématiques exposés précédemment, l’application d’un centrage sur la variable indépendante constitue une bonne pratique méthodologique lorsque des polynômes d’ordres 2 ou supérieurs sont envisagés. Dans notre feuille Google Sheets, cette transformation peut être réalisée avec une simplicité déconcertante sans nécessiter de macros complexes. Dans une cellule isolée, par exemple en D1, l’analyste insère la formule standard de calcul de la moyenne arithmétique : =MOYENNE(A2:A16).
Une nouvelle colonne, insérée en C et baptisée « X_Centre », accueillera les valeurs transformées. Dans la cellule C2, l’utilisateur encode l’expression soustractive référençant la cellule de moyenne de manière absolue : =A2-$D$1. En étirant cette formule vers le bas jusqu’à la rangée 16 via la poignée de recopie ou en appliquant la combinaison de touches Ctrl+D, chaque mesure individuelle se trouve désormais exprimée en écart par rapport à la moyenne globale de la cohorte expérimentale. La moyenne arithmétique de cette nouvelle série devient rigoureusement égale à zéro.
L’évaluation de l’opportunité d’utiliser cette variable centrée dépend des objectifs du chercheur. Si le but unique réside dans la simple projection graphique d’une ligne d’ajustement sur le nuage de points originel, le centrage n’est pas indispensable car l’interface visuelle de Google Sheets recalcule implicitement les correspondances spatiales. En revanche, si l’objectif implique l’extraction des coefficients statistiques via des fonctions matricielles pour isoler des effets principaux ou tester l’indépendance des termes, le centrage préalable devient une précaution incontournable pour assainir l’estimation des erreurs-types.
4. Étape 2 : Visualisation préliminaire par nuage de points (Scatterplot)
4.1 Insertion et configuration du graphique de dispersion
Toute entreprise d’ajustement statistique sérieuse doit impérativement débuter par une phase d’exploration visuelle. Ajuster un modèle mathématique à l’aveugle, sans avoir au préalable appréhendé la distribution spatiale des observations, expose l’analyste au risque d’imposer une structure théorique inadéquate à des données qui la réfutent. Pour amorcer cette visualisation dans Google Sheets, il convient de sélectionner avec précision la plage bivariée d’intérêt, en l’occurrence les cellules s’étendant de A1 à B16, en incluant délibérément la ligne d’en-tête pour préserver la labellisation des variables.
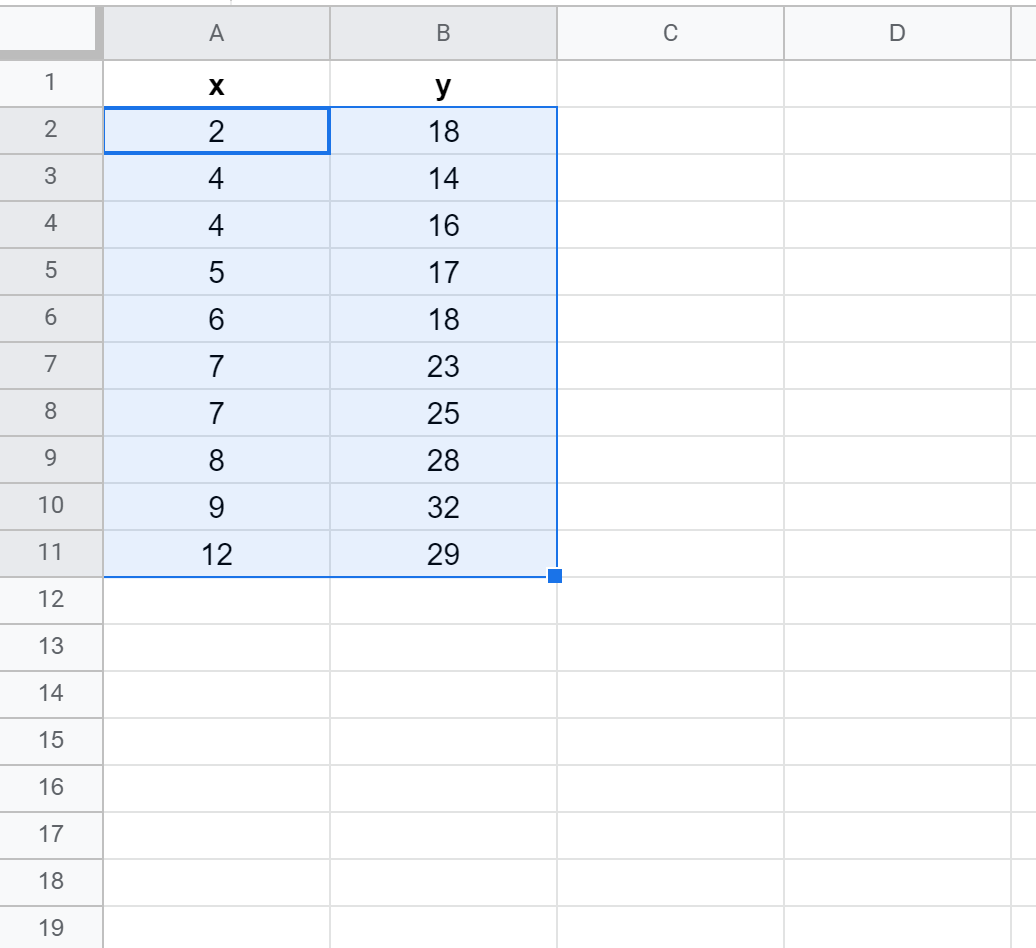
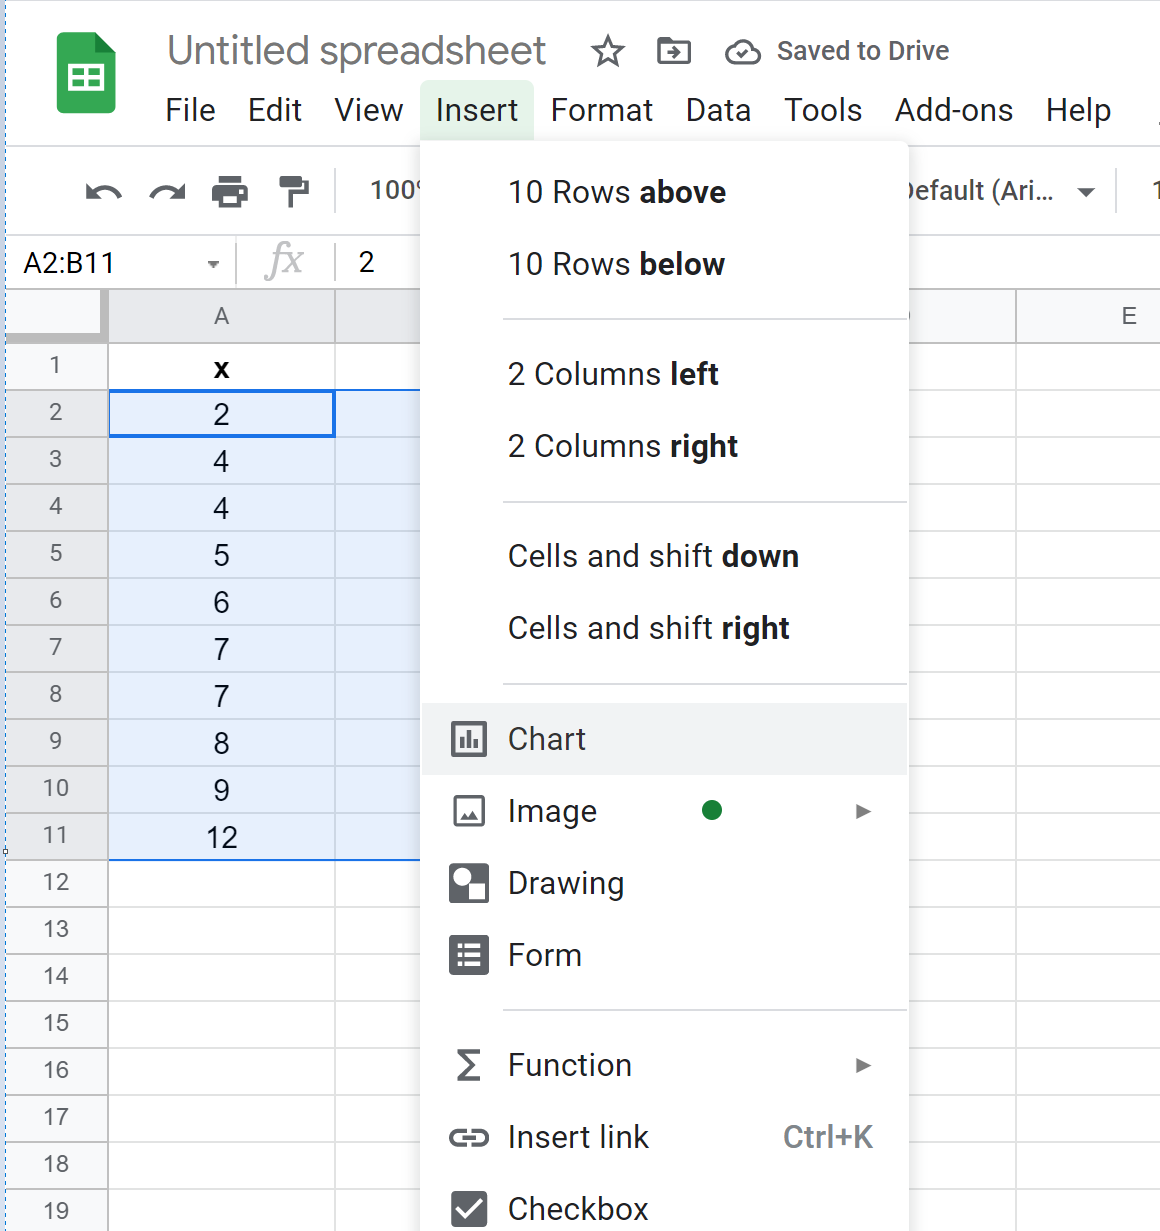
La sélection étant active, la navigation s’oriente vers la barre d’outils supérieure pour cliquer sur le menu « Insertion », puis sur la commande « Graphique ». L’application insère instantanément un objet graphique sur la feuille tout en déployant sur le flanc droit de l’écran l’Éditeur de graphique. Il arrive fréquemment que le moteur heuristique de Google Sheets assigne par défaut un type de visualisation inopportun, tel qu’un diagramme en bâtons ou une courbe temporelle reliée. L’analyste doit immédiatement corriger cette interprétation dans l’onglet « Configurer » de l’éditeur.
Sous la rubrique « Type de graphique », il convient de dérouler la sélection et d’opter formellement pour le « Graphique en nuage de points » (Scatter chart). Dès cet instant, les observations individuelles se matérialisent sous la forme de coordonnées discrètes non connectées. Il est crucial de vérifier méticuleusement au bas du volet de configuration que l’axe horizontal X est bien alimenté par la plage A1:A16 et que la série Y correspondante réfère sans ambiguïté à la colonne B1:B16, garantissant une orientation vectorielle irréprochable.
4.2 Personnalisation graphique et sémiologie visuelle
Un graphique scientifique ne se limite pas à afficher des données brutes ; il doit communiquer sans ambiguïté la nature des grandeurs physiques ou psychologiques mesurées, conformément aux règles fondamentales de la sémiologie graphique. Dans l’Éditeur de graphique, l’utilisateur bascule vers l’onglet « Personnaliser » afin de peaufiner la restitution visuelle. Le sous-menu « Titres des graphiques et des axes » permet d’attribuer un libellé rigoureux à l’axe des abscisses, en mentionnant explicitement l’entité et son étalon métrique, et de répéter l’opération pour l’axe vertical des ordonnées.
L’ajustement des échelles constitue l’étape subséquente pour prévenir toute distorsion perceptive. Par défaut, Google Sheets peut tronquer l’origine des axes ou, au contraire, étendre inutilement les marges, ce qui écrase artificiellement la trajectoire des points. En sélectionnant l’axe vertical dans l’éditeur, il est judicieux de fixer une valeur minimale et une valeur maximale encadrant fidèlement l’amplitude théorique de l’épreuve (par exemple de 0 à 80 points), conférant ainsi une stabilité visuelle exemplaire au dispositif d’observation.
Enfin, la morphologie des marqueurs mérite une optimisation minutieuse pour répondre aux standards de clarté académique. Dans le volet « Séries », la couleur des points d’observation peut être modifiée pour un ton sombre et contrasté, tandis que leur diamètre sera avantageusement calibré à environ 7 pixels. L’application d’une opacité légère à 80 % permet d’identifier visuellement d’éventuels chevauchements de mesures sans masquer les axes de coordonnées sous-jacents, posant les bases d’une lecture analytique sereine.
4.3 Inspection qualitative de la courbure des données
Une fois le nuage de points harmonieusement disposé dans l’espace graphique, l’analyste procède à une inspection qualitative approfondie de la disposition spatiale des données empiriques. Cette lecture préliminaire a pour vocation d’interroger la plausibilité de l’hypothèse de linéarité avant tout calcul formel. Dans notre jeu de données expérimental, le regard constate immédiatement que la trajectoire des points s’écarte sans équivoque d’une trajectoire rectiligne continue.
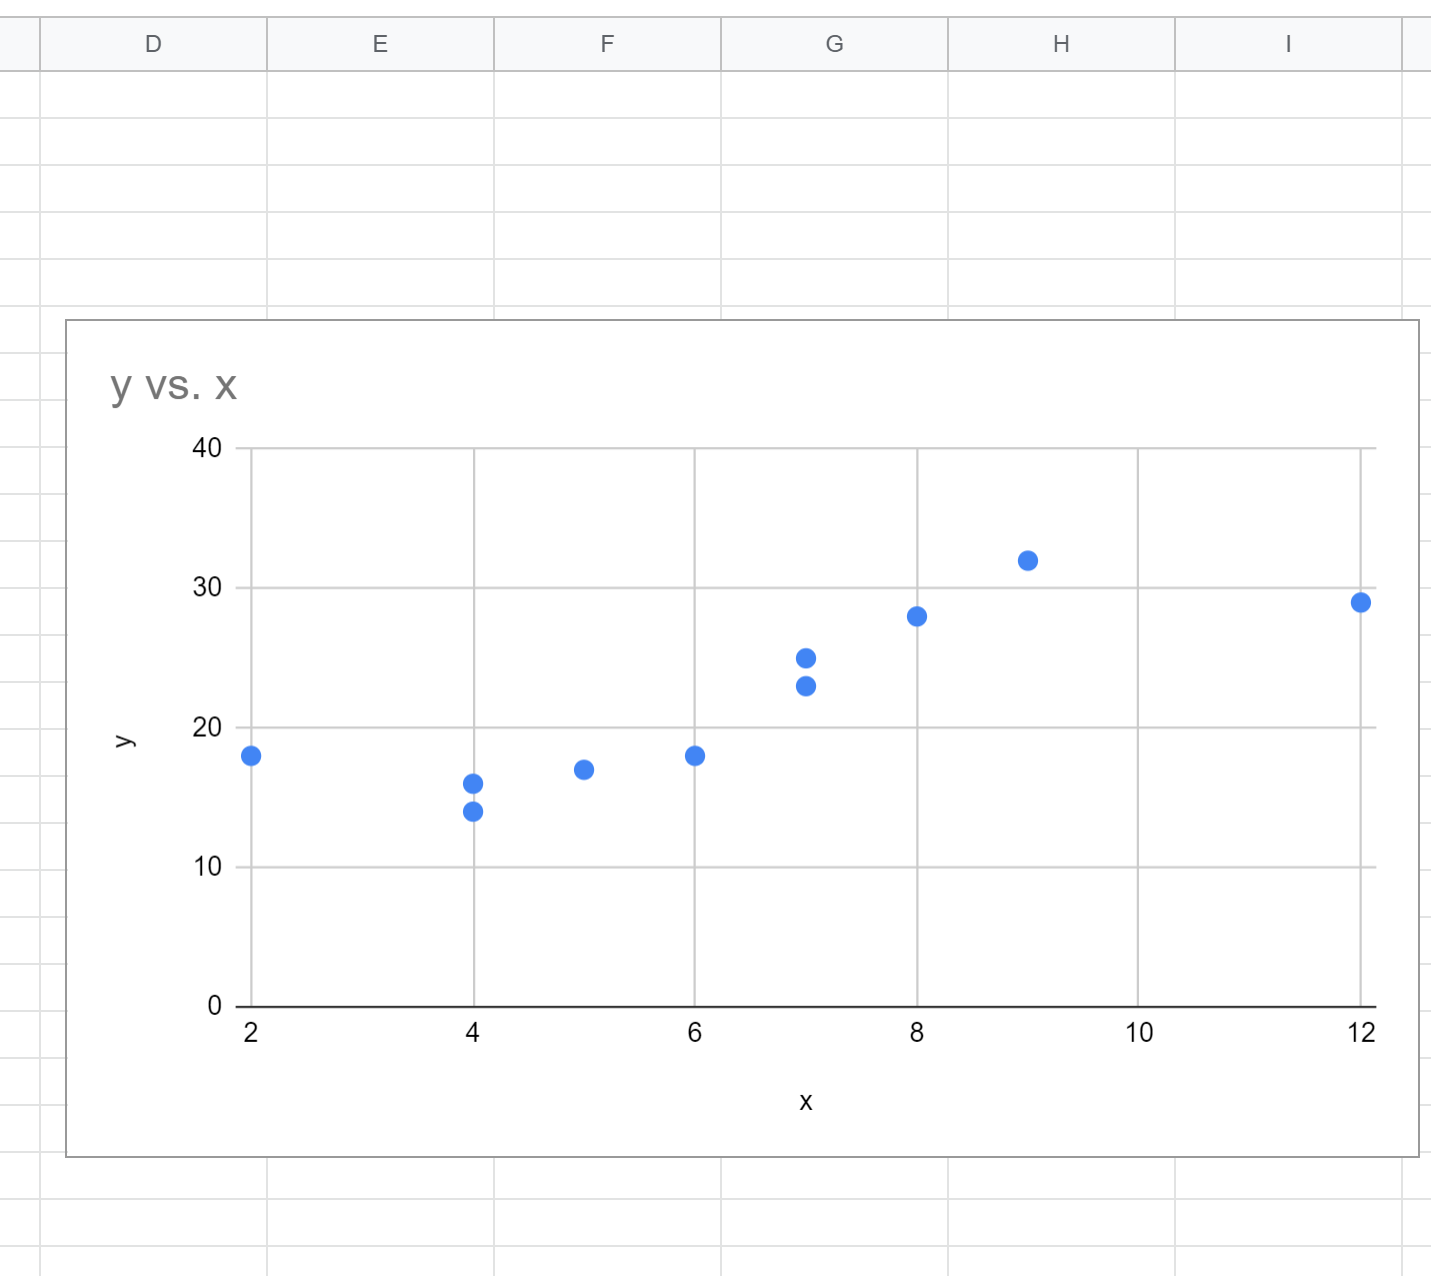
Les observations décrivent une arche harmonieuse, caractérisée par une pente initiale vigoureusement ascendante, un ralentissement progressif des gains à mi-parcours, une zone de bascule au sommet de la distribution, suivie d’une phase de déclin systématique et symétrique. Cette morphologie en cloche inversée indique avec une netteté manifeste la présence d’une relation concave. L’identification visuelle de ce point d’inversion oriente sans hésitation le chercheur vers l’hypothèse d’une dynamique régie au minimum par une fonction polynomiale du second degré.
Cette observation qualitative permet également d’effectuer un premier départage entre le bruit de mesure stochastique et la tendance structurelle globale. L’agencement régulier des points autour de cette forme parabolique, sans déviations excentriques incohérentes, corrobore la pertinence d’un ajustement continu. Le chercheur formule à ce stade l’hypothèse qu’un polynôme d’ordre 2 suffira à épuiser la majeure partie de la variance substantielle, tandis qu’un terme cubique ne s’imposerait que si une seconde inflexion venait à émerger dans les portions distales du graphique.
5. Étape 3 : Implémentation de la courbe de tendance polynomiale
5.1 Paramétrage de la courbe de tendance dans l’Éditeur de graphique
L’interface graphique interactive de Google Sheets offre un mécanisme d’ajustement direct permettant de superposer une courbe mathématique sur le nuage de points sans nécessiter dans l’immédiat la saisie de formules complexes. Pour activer cette fonctionnalité, l’analyste clique sur l’objet graphique préalablement inséré afin de rouvrir l’Éditeur de graphique sur le panneau latéral droit. La navigation s’oriente vers l’onglet « Personnaliser », puis explore la section déroulante intitulée « Séries ».
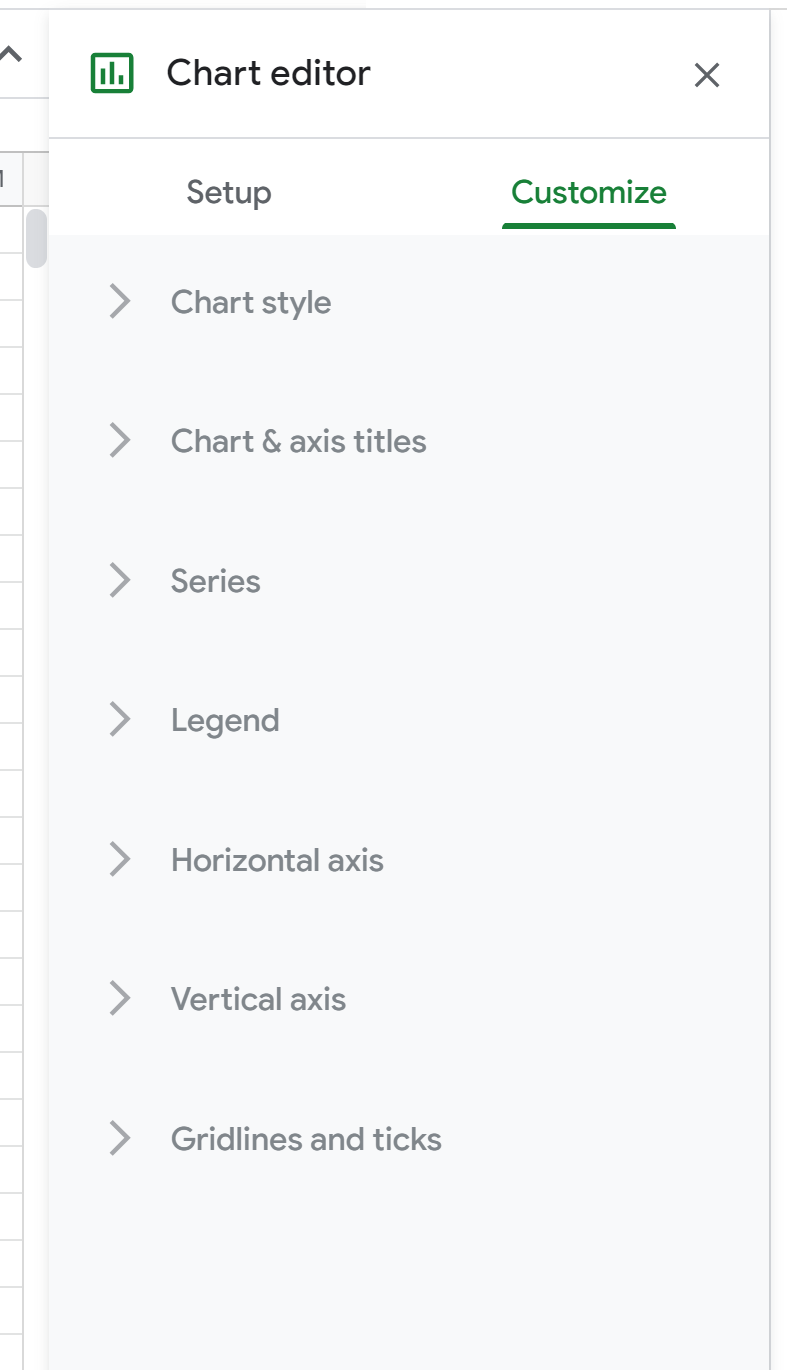
En faisant défiler les paramètres de configuration des séries de données vers le bas, on repère la case à cocher « Courbe de tendance ». Dès son activation par l’utilisateur, Google Sheets projette par défaut une régression linéaire simple rectiligne sur le nuage de points. Cette droite traverse maladroitement le groupe d’observations, coupant l’arc parabolique de façon flagrante en sous-estimant systématiquement les performances aux extrémités et en surestimant le niveau central. Cette dissonance graphique illustre de manière spectaculaire l’inadéquation du modèle rectiligne.
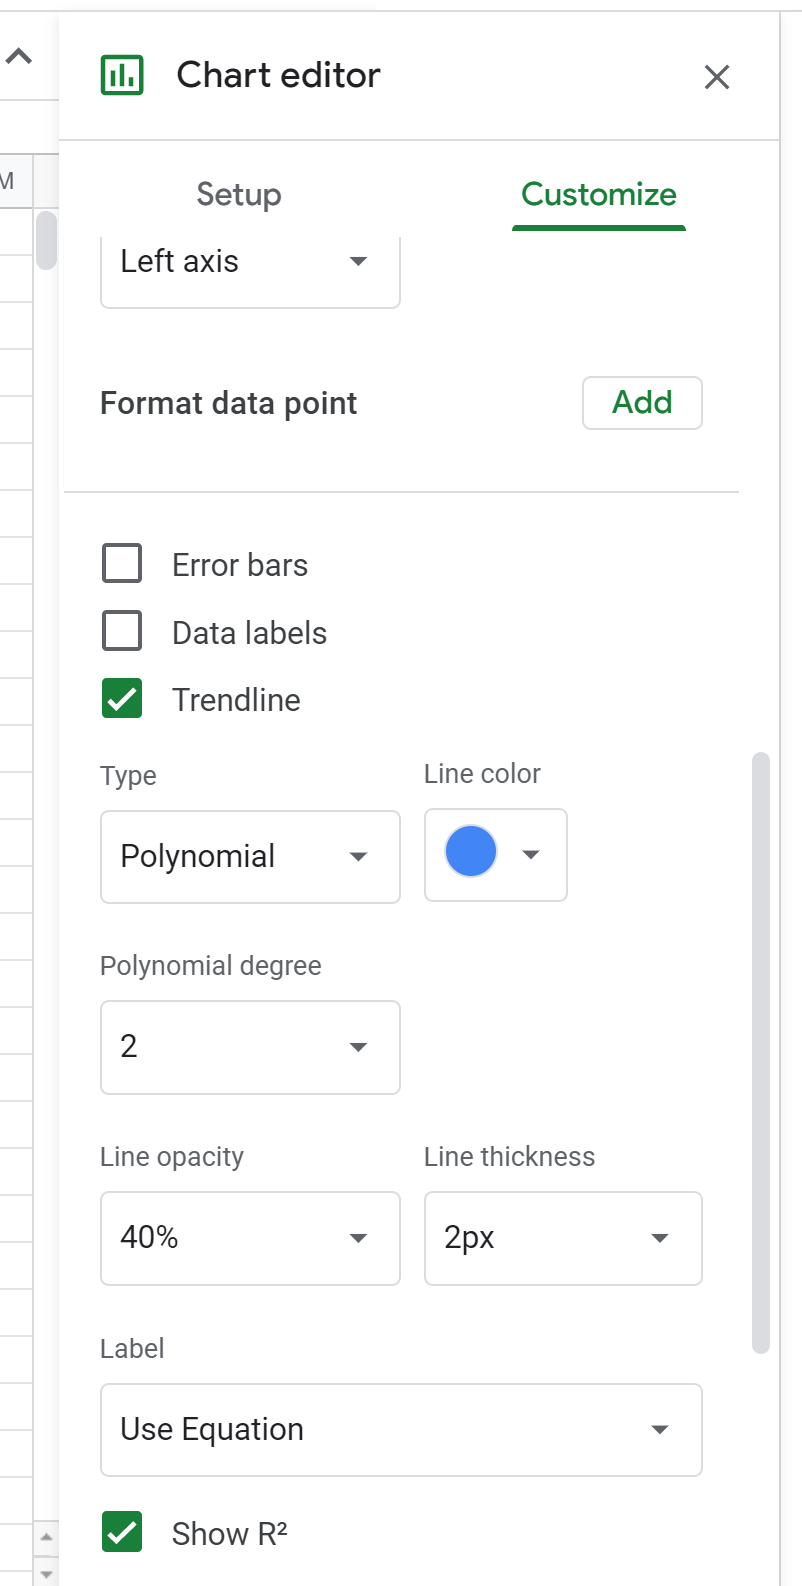
Pour corriger cette spécification, il convient de modifier le menu déroulant « Type » situé sous la case de la courbe de tendance, en substituant à l’option « Linéaire » le choix explicite « Polynomial ». Dès cette sélection opérée, une nouvelle commande contextuelle intitulée « Degré » émerge immédiatement dans l’interface. Par défaut, le système sélectionne le degré 2, correspondant précisément à la modélisation quadratique. Instantanément, la droite brisée fait place à une élégante parabole concave qui épouse avec une fidélité remarquable la courbure ascendante puis descendante de nos données comportementales.
5.2 Affichage des indicateurs mathématiques sur le graphique
La simple projection visuelle d’une trajectoire géométrique ne saurait suffire à l’investigation empirique ; le chercheur a besoin d’accéder aux paramètres algébriques précis gouvernant cette fonction. Pour contraindre Google Sheets à formaliser l’expression mathématique directement sur le canevas visuel, il suffit de manipuler le paramètre « Libellé » positionné quelques lignes en dessous de la sélection du type de courbe de tendance. En déployant cette liste d’options, l’utilisateur délaisse l’étiquette par défaut pour sélectionner sans équivoque « Utiliser l’équation ».
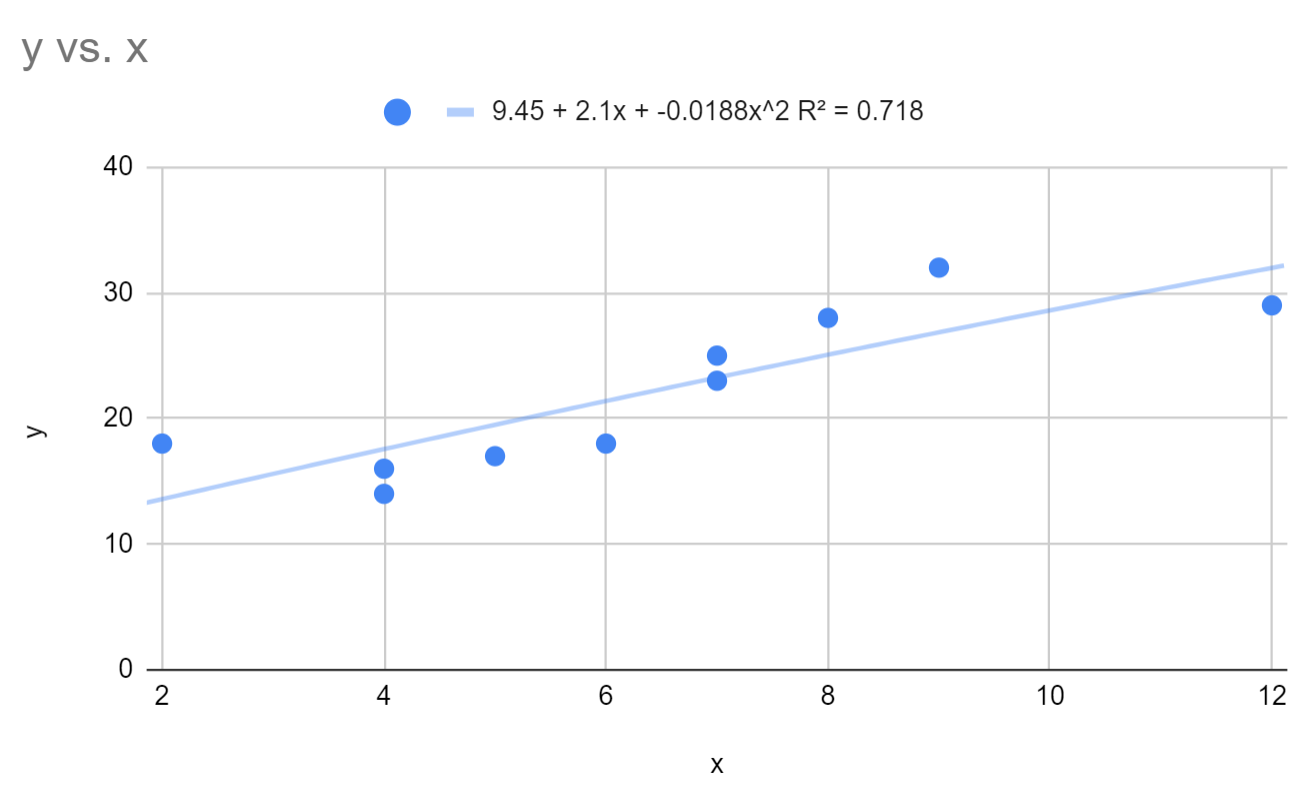
Aussitôt, la légende supérieure du graphique s’enrichit de l’expression mathématique exacte de la fonction ajustée. L’équation se présente sous une typographie normalisée révélant la constante ainsi que les coefficients scalaires attachés aux termes linéaires et quadratiques de la variable prédictive. Cette transcription textuelle constitue la formulation explicite du modèle prédictif déduit de l’échantillon empirique analysé.
Dans la foulée, il est impératif de cocher la case dédiée intitulée « Afficher R² ». Cette commande ordonne au tableur de calculer et d’afficher le coefficient de détermination associé à la courbe de régression active. Sa valeur s’inscrit immédiatement aux côtés de l’équation, offrant une première évaluation synthétique de la proportion de variance absorbée par la courbure polynomiale. Enfin, l’analyste veillera à contraster visuellement la ligne de tendance en sélectionnant une couleur distinctive et en ajustant son épaisseur à 4 pixels, facilitant ainsi son détachement perceptif par rapport aux points d’observation.
5.3 Exploration comparative des différents degrés polynomiaux
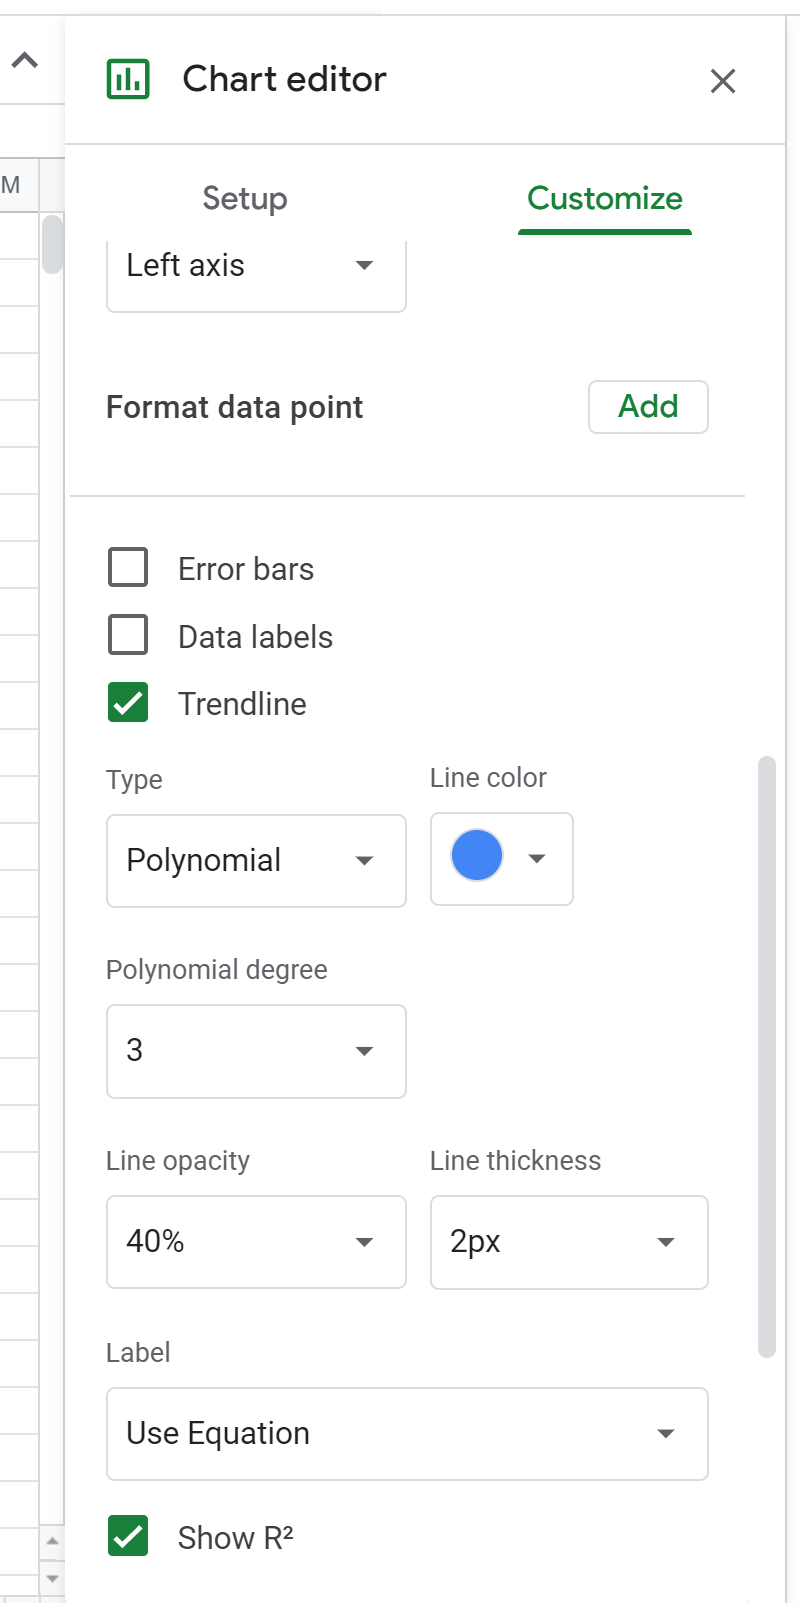
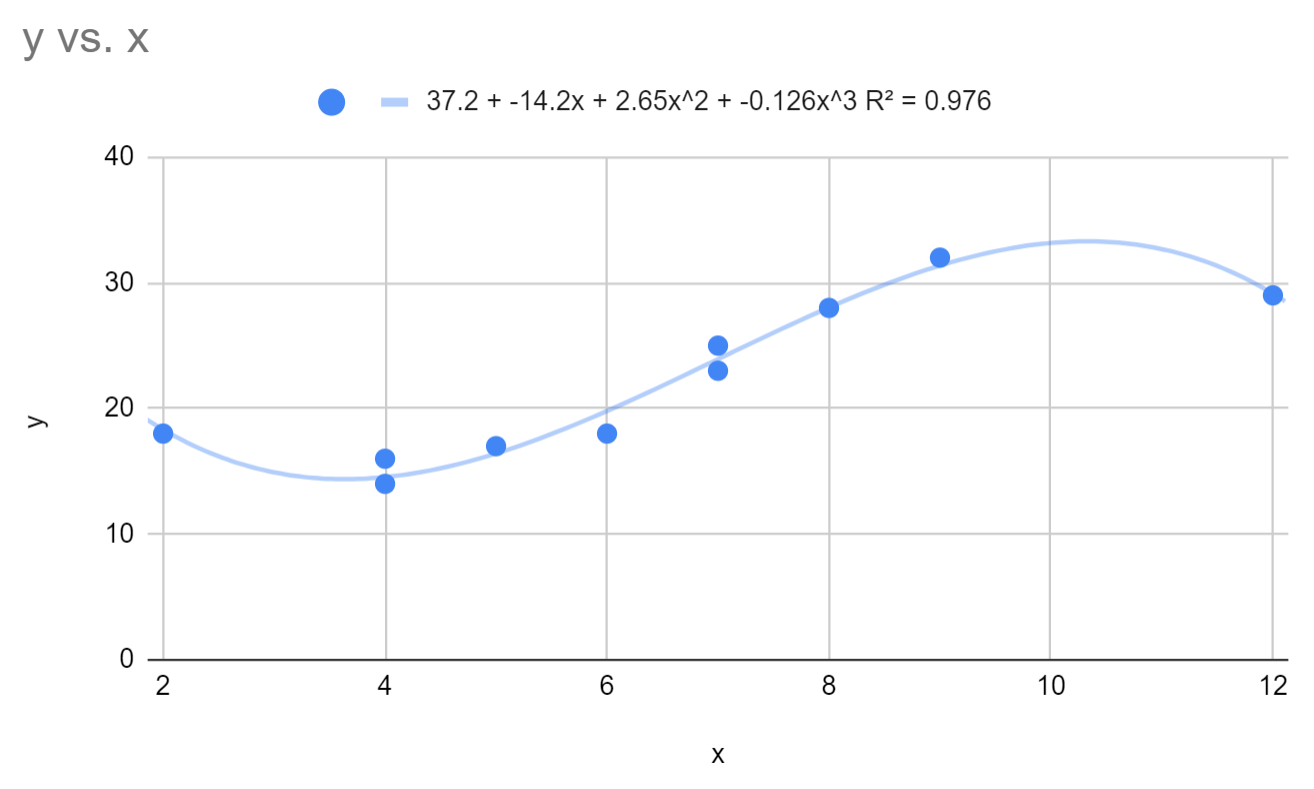
L’environnement ergonomique de Google Sheets permet d’explorer en temps réel l’impact de l’élévation de la complexité mathématique sur l’ajustement aux données. Dans l’Éditeur de graphique, la commande contextuelle « Degré » autorise une incrémentation séquentielle du polynôme, pouvant progresser du degré 2 jusqu’au degré 6. En sélectionnant le degré 3 (modèle cubique), l’analyste constate une infime modification de la trajectoire : la courbe s’assouplit légèrement aux abords des frontières sans modifier fondamentalement la topographie générale de la cloche.
Si l’on poursuit l’expérimentation en sélectionnant des ordres plus élevés, tels que le degré 5 ou le degré 6, un phénomène de déformation spectaculaire commence à se manifester visuellement. Au lieu d’épouser une tendance générale fluide, la courbe de régression commence à onduler de manière erratique, plongeant abruptement pour capturer un point légèrement en retrait ou s’envolant vertigineusement à l’approche des valeurs extrêmes de la distribution. Ces contorsions révèlent que l’algorithme s’efforce désormais d’interpoler chaque fluctuation idiosyncratique de l’échantillon.
Cette observation directe constitue une démonstration visuelle limpide des compromis de la modélisation polynomiale. Bien que le coefficient de détermination R² continue de progresser de manière purement incrémentale à chaque ajout d’un degré d’ordre supérieur, le gain visuel et théorique devient non seulement nul, mais préjudiciable. La trajectoire perd toute plausibilité substantielle. L’analyste conclut avec clairvoyance que le modèle quadratique d’ordre 2 représente l’ajustement optimal, alliant une fidélité empirique maximale à une simplicité structurelle indépassable.
6. Analyse et interprétation de l’équation polynomiale générée
6.1 Décodage de la syntaxe de l’équation Google Sheets
L’équation textuelle projetée sur le graphique par Google Sheets requiert une lecture analytique rigoureuse, car son agencement syntaxique obéit à des conventions typographiques particulières qui peuvent désorienter l’utilisateur non averti. Dans un modèle polynomial du second degré, l’expression adopte typiquement une structure structurée selon la syntaxe suivante : 18.4 + 12.1*x + -0.85*x^2. Il importe de décomposer scrupuleusement chaque élément de cette chaîne de caractères afin de lui assigner son rôle algébrique authentique.
Le premier terme isolé de toute variable représente l’ordonnée à l’origine (ou constante du modèle, conventionnellement notée b0). Il quantifie la valeur prédite pour la variable dépendante lorsque la variable explicative X est strictement égale à zéro. Le terme suivant, associé au facteur multiplicatif *x, constitue le coefficient de la composante linéaire de premier ordre (b1). Enfin, le terme combiné à l’opérateur d’exponentiation *x^2 correspond au coefficient de la composante quadratique (b2), dont la négativité confirme sans ambiguïté l’orientation concave de la trajectoire parabolique.
Une vigilance critique de premier ordre doit être portée à l’affichage des coefficients lorsque les variables mesurées présentent des amplitudes numériques considérables ou des ordres de grandeur infinitésimaux. Dans de telles circonstances, Google Sheets recourt automatiquement à la notation scientifique compacte, affichant des expressions sous la forme de 3.45E-03*x^2. Omettre de décoder cette convention d’écriture — signifiant en l’occurrence 0,00345 — conduirait à des erreurs de calcul catastrophiques lors de toute tentative de réutilisation manuelle de ces paramètres dans des prédictions extrapolées.
6.2 Interprétation substantive des paramètres dans un cadre comportemental
Au-delà de leur existence algébrique, les coefficients extraits de la régression polynomiale portent une signification théorique profonde dans l’analyse des processus psychologiques et comportementaux. L’ordonnée à l’origine (18,4 points dans notre modèle) matérialise le niveau de performance basal d’un individu totalement dépourvu de stimulation pharmacologique ou attentionnelle. C’est l’étalon d’efficience à l’état de repos absolu.
Le point le plus stratégique de l’analyse réside dans la détermination de l’optimum comportemental, c’est-à-dire le dosage d’intensité stimulant qui maximise avec exactitude la performance cognitive. Les règles fondamentales du calcul différentiel indiquent que le sommet d’une parabole s’établit au point précis où la dérivée première de la fonction s’annule. Pour une équation quadratique générale de la forme Y = b0 + b1*X + b2*X^2, la dérivée première s’énonce simplement : dY/dX = b1 + 2*b2*X. En égalisant cette dérivée à zéro et en réarrangeant les termes, on obtient la formule analytique du sommet : X_optimum = -b1 / (2*b2).
En substituant les coefficients estimés issus de notre régression dans cette formule, nous calculons : X_optimum = -12.1 / (2 * -0.85) = 7.12 unités de stimulation. L’analyste en déduit une recommandation opérationnelle d’une précision remarquable : l’administration de substance stimulante produit son bénéfice cognitif maximal à la dose très exacte de 7,12 unités. La dérivée seconde de la fonction, qui équivaut ici à 2*b2 = -1.70, quantifie quant à elle la vitesse constante à laquelle la pente se dégrade, fournissant une métrique directe de la sensibilité du système cognitif face au surdosage.
6.3 Évaluation critique du coefficient R² extrait du graphique
L’affichage d’un coefficient de détermination R² de l’ordre de 0,94 sur le graphique témoigne, de prime abord, d’une adéquation spectaculaire entre le modèle quadratique et la distribution des données recueillies. Cette statistique signifie formellement que 94 % de la variance totale constatée dans les scores de performance cognitive au sein de notre échantillon est directement expliquée par la trajectoire curvilinéaire du niveau de stimulation. Les 6 % restants relèvent de la variabilité résiduelle interindividuelle et des fluctuations stochastiques non mesurées.
Néanmoins, le chercheur aguerri se gardera d’une célébration prématurée face à un R² flatteur. L’interprétation isolée de cette métrique peut s’avérer un piège épistémologique pernicieux. Dans les échantillons comportant un nombre restreint d’unités d’observation, l’ajustement mécanique par les moindres carrés a tendance à surestimer le pouvoir explicatif réel du modèle en population générale, capturant des particularités fortuites propres à l’échantillon particulier sous observation.
Il est donc impératif de confronter systématiquement ce chiffre à la plausibilité théorique du domaine étudié. En psychologie cognitive et en sciences sociales, des coefficients excédant 0,90 sont extrêmement rares en dehors des environnements de laboratoire strictement contrôlés. Un R² exceptionnellement élevé doit inciter l’analyste à vérifier la taille de son échantillon, à contrôler l’absence d’observations redondantes ou d’artefacts d’agrégation, et à entreprendre sans délai des tests de significativité des paramètres par la méthode matricielle.
7. Méthode matricielle avancée : Utilisation de la fonction DROITEREG (LINEST)
7.1 Limites de la méthode graphique et justification de l’approche matricielle
Bien que l’insertion d’une courbe de tendance via l’Éditeur de graphique offre une gratification visuelle immédiate, cette démarche atteint très rapidement des limites méthodologiques infranchissables dans le cadre d’une démarche de recherche rigoureuse. La première de ces contraintes tient à la nature statique du libellé textuel : les coefficients de l’équation affichés sur l’image du graphique sont confinés dans un format typographique fermé, inaccessible aux calculs automatisés de la feuille. Il s’avère impossible de référencer dynamiquement ces valeurs dans d’autres cellules pour modéliser des prédictions ou calculer des intervalles d’estimation.
Par ailleurs, l’approche graphique omet des pans entiers de la statistique inférentielle moderne. Elle ne fournit aucune information quant aux erreurs-types associées à chaque coefficient individuel, dissimule les degrés de liberté, et passe sous silence la statistique globale de Fisher (F) ainsi que les intervalles de confiance indispensables pour juger si un terme quadratique ou cubique apporte une contribution statistiquement significative à la prédiction. L’analyste se trouve privé des moyens de valider rigoureusement l’apport d’un nouveau degré polynomial.
C’est précisément pour lever ces entraves fonctionnelles qu’il est indispensable de maîtriser la puissance des formules matricielles natives de Google Sheets, et tout particulièrement de la fonction DROITEREG (désignée sous l’appellation anglophone LINEST). Cet algorithme calcule la solution analytique exacte des équations normales par décomposition matricielle, restituant l’intégralité des paramètres du modèle sous la forme d’un tableau d’estimation complet, interactif et directement réexploitable pour la suite des analyses.
7.2 Construction des puissances de la variable indépendante
Pour exécuter une régression polynomiale au moyen de la fonction DROITEREG, il est indispensable de structurer explicitement les termes de puissance de la variable prédictive dans des colonnes adjacentes. L’algorithme des moindres carrés traite en effet chaque puissance entière comme un prédicteur linéaire distinct au sein d’une matrice multivariée. Si la variable prédictive X réside dans la colonne A (de A2 à A16), nous allons consacrer la colonne C à son carré X^2, et éventuellement la colonne D à son terme cubique X^3.
Au lieu de calculer manuellement ces puissances ligne par ligne, la méthode la plus élégante et robuste dans Google Sheets consiste à mobiliser la fonction matricielle dynamique ARRAYFORMULA. En saisissant dans l’en-tête de la colonne C, précisément en C2, l’expression : =ARRAYFORMULA(A2:A16^2), le tableur calcule instantanément l’élévation au carré de l’intégralité du vecteur de données sans qu’il soit nécessaire d’étirer la formule manuellement vers le bas. Si une modélisation cubique d’ordre 3 est explorée, la cellule D2 accueillera de manière analogue l’instruction : =ARRAYFORMULA(A2:A16^3).
Il importe de veiller scrupuleusement à l’alignement dimensionnel strict de ces matrices de données. Les plages de cellules contenant les variables prédictives transformées doivent comporter rigoureusement le même nombre de lignes que le vecteur de la variable de réponse Y situé en colonne B. Tout décalage spatial, ligne orpheline ou inclusion accidentelle d’une cellule de texte non conforme provoquerait une rupture immédiate de l’alignement dimensionnel et l’avortement du calcul d’inversion matricielle.
7.3 Syntaxe et exécution de la formule DROITEREG
La fonction DROITEREG déploie toute sa puissance analytique lorsqu’elle est sollicitée pour générer la table statistique complète du modèle. La syntaxe canonique à insérer dans une cellule libre de la feuille — par exemple en F2 — s’articule selon la formulation standard suivante : =DROITEREG(B2:B16, A2:C16, VRAI, VRAI). Le premier argument spécifie le vecteur vertical des réponses observées Y ; le second argument englobe de façon conjointe les deux colonnes de régresseurs adjacents, à savoir le terme linéaire et le terme quadratique (A2:C16) ; le troisième argument booléen, configuré à VRAI, ordonne le calcul de l’ordonnée à l’origine ; enfin, le quatrième paramètre booléen VRAI force la génération des statistiques inférentielles complémentaires.
Dès la validation de cette formule, Google Sheets génère une matrice rectangulaire structurée s’étendant dynamiquement sur 3 colonnes et 5 rangées. La lecture de cette matrice de sortie exige de connaître parfaitement ses conventions de disposition. La première ligne affiche l’ensemble des coefficients de régression estimés, mais ordonnés de droite à gauche selon une logique descendante de puissance : la colonne de gauche présente le coefficient du degré le plus élevé (b2, rattaché à X^2), la colonne centrale affiche le coefficient linéaire (b1, rattaché à X), et la colonne de droite indique l’ordonnée à l’origine (b0, la constante).
La deuxième ligne du tableau matriciel restitue avec la même orientation les erreurs-types respectives associées à chacun de ces coefficients. En divisant un coefficient donné par son erreur-type correspondante, l’analyste obtient instantanément la valeur du t de Student, permettant d’évaluer la significativité statistique de chaque terme au regard des tables de probabilité. La troisième ligne fournit le coefficient de détermination R² ainsi que l’erreur-type globale de l’estimation résiduelle. La quatrième ligne dévoile la statistique F de Fisher globale accompagnée des degrés de liberté du modèle, indispensables pour évaluer si l’ensemble de l’équation surpasse significativement l’hypothèse nulle d’absence totale d’effet. Enfin, la cinquième ligne détaille la somme des carrés de la régression et la somme des carrés des erreurs résiduelles.
8. Diagnostic des résidus et vérification des postulats statistiques
8.1 Calcul et génération des valeurs résiduelles
Un modèle statistique ne saurait être validé uniquement sur la base de sa capacité apparente à épouser un nuage de points ou sur la seule considération de statistiques globales favorables. L’étape cruciale de toute analyse quantitative réside dans l’examen minutieux de ce que le modèle échoue à expliquer : les résidus. Un résidu se définit rigoureusement comme la déviation individuelle verticale mesurée entre la valeur empirique réellement observée chez un participant et la valeur théorique prédite par l’équation de régression pour cette même coordonnée.
Dans notre environnement Google Sheets, l’analyste crée une colonne E dédiée aux valeurs prédites (baptisée « Y_Predit »). En exploitant les coefficients extraits de la matrice DROITEREG située en F2:H6, l’expression de prédiction s’encode en E2 sous la forme : =$H$2 + $G$2*A2 + $F$2*C2. Cette syntaxe applique scrupuleusement l’équation polynomiale à chaque niveau de stimulus. La formule est ensuite étendue sur toute la hauteur de la colonne pour calculer les prédictions individuelles correspondantes.
La colonne contiguë F, nommée « Residus », accueille alors la formulation arithmétique élémentaire de l’écart individuel : =B2-E2. Pour approfondir le diagnostic statistique, il est particulièrement pertinent de standardiser ces résidus dans une colonne G additionnelle en divisant chaque résidu brut par l’écart-type global de la série résiduelle (calculé via la formule ECARTYPE(F2:F16)). Des résidus standardisés dont la magnitude absolue dépasse le seuil critique de 2 ou 2,5 unités signalent immédiatement la présence d’observations aberrantes ou atypiques nécessitant une attention méthodologique vigilante.
8.2 Graphique de diagnostic de l’homoscédasticité
L’un des postulats fondamentaux garantissant l’optimalité de l’estimation par les moindres carrés ordinaires réside dans l’homoscédasticité. Cette propriété statistique exige que la variance des résidus demeure rigoureusement constante sur l’ensemble du continuum des valeurs prédites. L’émergence d’une hétéroscédasticité — c’est-à-dire une dispersion fluctuante de l’erreur — compromet gravement l’estimation des erreurs-types, faussant irrémédiablement les intervalles de confiance et les tests de Student subséquents.
Pour vérifier empiriquement la viabilité de ce postulat dans Google Sheets, l’analyste sélectionne la plage combinant les valeurs prédites (colonne E) et les résidus (colonne F) afin d’insérer un nouveau graphique en nuage de points. Ce graphique de diagnostic place les valeurs ajustées sur l’axe des abscisses horizontales et les perturbations résiduelles sur l’axe des ordonnées verticales. Une ligne horizontale de référence positionnée à l’ordonnée zéro est matérialisée mentalement ou graphiquement pour scinder les écarts positifs et négatifs.
L’examen critique de cette distribution spatiale recherche l’absence formelle de toute structure géométrique reconnaissable. Si les résidus se distribuent de manière aléatoire et uniforme, formant une bande de dispersion homogène de gauche à droite sans tendance expansive ni compressive, l’hypothèse d’homoscédasticité est jugée satisfaisante. En revanche, si la dispersion dessine une forme d’entonnoir (fan-shaped) s’élargissant à mesure que les prédictions croissent, l’hétéroscédasticité est avérée, imposant d’envisager des transformations logarithmiques ou le recours à des estimateurs de variance robustes.
8.3 Évaluation de la normalité et de l’indépendance des résidus
L’inférence statistique valide dans les petits échantillons repose conjointement sur l’hypothèse de la distribution normale des erreurs résiduelles. Les perturbations aléatoires doivent idéalement se comporter comme un bruit blanc gaussien symétrique centré sur zéro. Dans Google Sheets, la visualisation de cette propriété peut être approchée en sélectionnant la colonne des résidus et en insérant un graphique de type « Histogramme ».
L’analyste examine qualitativement la morphologie de la distribution ainsi matérialisée dans l’éditeur. Bien qu’un échantillon restreint de 15 observations manifeste inévitablement des irrégularités morphologiques, l’histogramme doit refléter un regroupement central prédominant autour de zéro avec une décroissance symétrique des fréquences vers les extrémités positives et négatives. L’absence d’asymétrie majeure (skewness) ou d’aplatissement anormal (kurtosis) conforte la légitimité des conclusions statistiques déduites du modèle.
Enfin, lorsque les données proviennent d’une administration temporelle séquentielle, l’absence d’autocorrélation résiduelle doit être soigneusement interrogée. Si un résidu positif à l’instant t est systématiquement suivi d’un résidu positif à l’instant t+1, cela traduit une dépendance sérielle qui viole l’indépendance des observations. En observant la régularité du tracé des résidus ordonnés chronologiquement, le chercheur s’assure qu’aucune oscillation ondulatoire résiduelle ne persiste, signe rassurant que la dynamique polynomiale a absorbé l’intégralité du signal structurel disponible.
9. Sélection du modèle optimal et prévention du surajustement (Overfitting)
9.1 Le compromis biais-variance appliqué à la régression polynomiale
Le dilemme central de tout apprentissage statistique réside dans l’arbitrage inévitable entre le biais et la variance. Le biais désigne l’erreur systématique résultant d’une modélisation trop simpliste d’un phénomène complexe, conduisant au sous-ajustement (underfitting). À l’opposé, la variance quantifie la sensibilité extrême des prédictions d’un modèle face aux fluctuations aléatoires et aux idiosyncrasies de l’échantillon d’apprentissage, aboutissant au fléau méthodologique du surapprentissage (overfitting).
Dans la régression polynomiale, ce compromis se manifeste de manière limpide au fil de l’incrémentation des puissances de X. Un polynôme de degré 1 (modèle linéaire rectiligne) souffre ici d’un biais élevé : incapable de capturer la courbure réelle de la loi de Yerkes-Dodson, il échoue à prédire la performance avec justesse, quel que soit l’échantillon analysé. À l’inverse, l’ajustement d’un polynôme de degré 5 ou 6 réduit le biais d’échantillonnage à un niveau presque nul, mais confère au modèle une variance démesurée. L’algorithme se met à modéliser le bruit de mesure stochastique au détriment direct du signal structurel pérenne.
Les manifestations de ce surajustement apparaissent avec une brutalité particulière aux frontières extrêmes du domaine des données observées. Entre deux points d’ancrage consécutifs, un polynôme d’ordre élevé peut subir des oscillations violentes et totalement imprévues, connues sous le nom de phénomène de Runge. En psychologie empirique, l’adoption d’un modèle surajusté condamne irrémédiablement toute perspective de réplication scientifique : le modèle échouera lamentablement à prédire les comportements d’une nouvelle cohorte d’individus, brisant la validité externe des conclusions publiées.
9.2 Calcul manuel des critères de sélection de modèles dans Google Sheets
Pour arbitrer scientifiquement le choix du degré sans se fier à une impression visuelle subjective, le calcul de critères d’information pénalisés s’avère indispensable. Bien que Google Sheets ne propose pas de commande unifiée native pour ces indicateurs, sa souplesse de calcul permet de les élaborer manuellement dans la feuille avec une grande rigueur. Le premier indicateur fondamental est le R² ajusté, dont l’expression mathématique s’écrit formellement : 1 - [(1 - R^2) * (n - 1) / (n - k - 1)], où n représente la taille de l’échantillon (15) et k le nombre de prédicteurs inclus dans le modèle (2 pour le quadratique, 3 pour le cubique).
L’implémentation du Critère d’Information d’Akaike (AIC) permet de franchir un palier supplémentaire dans la rigueur comparative. Dans le cadre de l’ajustement par moindres carrés avec hypothèse de résidus gaussiens, l’AIC peut être approché par la formulation mathématique : AIC = n * LN(SCR / n) + 2 * p, où SCR désigne la Somme des Carrés des Résidus (extraite directement de la cinquième ligne de la matrice DROITEREG) et p représente le nombre total de paramètres estimés, constante incluse (soit p = k + 1). Dans Google Sheets, la formule s’encode sans difficulté en référençant la cellule appropriée : =15*LN(SCR_cellule/15) + 2*3 pour le modèle quadratique.
De manière complémentaire, le Critère d’Information Bayésien (BIC), qui impose une pénalisation plus sévère pour la parcimonie paramétrique dans les échantillons larges, se calcule selon l’équation : BIC = n * LN(SCR / n) + p * LN(n). En calculant méthodiquement ces métriques pour les modèles d’ordres 1, 2, 3 et 4, l’analyste compare les scores obtenus. Le modèle théoriquement optimal est celui qui affiche la valeur d’AIC et de BIC la plus basse. Dans notre cas de figure expérimental, le modèle quadratique d’ordre 2 minimise simultanément ces deux critères d’information, établissant scientifiquement sa suprématie sur les ordres alternatifs.
9.3 Protocole de validation croisée par partitionnement
Lorsque la taille de l’échantillon est suffisante, la méthode reine pour attester de la résilience d’un modèle face au surajustement demeure la validation croisée empirique. Dans Google Sheets, cette procédure peut être mise en œuvre de manière pédagogique par un partitionnement manuel de la cohorte d’observations en deux ensembles distincts et mutuellement exclusifs : un échantillon d’apprentissage (training set) rassemblant approximativement 70 % des données, et un échantillon de test (hold-out set) préservant les 30 % restants.
Pour opérer cette division de façon impartiale, l’utilisateur insère une colonne temporaire alimentée par la fonction d’aléa =ALEA(), puis fige ces nombres aléatoires par un copier-coller des valeurs seules. Les données sont ensuite ordonnées selon cet index stochastique. L’équation polynomiale quadratique est alors calibrée via DROITEREG en utilisant exclusivement les lignes assignées à l’échantillon d’apprentissage.
Dans un second temps, les coefficients ainsi calibrés sur le jeu d’apprentissage sont appliqués pour prédire les scores des observations de l’échantillon de test, que le modèle n’a jamais rencontrées au cours de son ajustement. L’analyste calcule l’erreur quadratique moyenne de prédiction (RMSE) sur cet ensemble de validation indépendant. Si la RMSE de test demeure très proche de celle observée sur le jeu d’entraînement, le modèle fait preuve d’une excellente capacité de généralisation. Si, à l’inverse, l’erreur s’envole sur l’échantillon de test, le diagnostic de surajustement est formellement établi, justifiant le repli immédiat vers un modèle polynomial de degré inférieur.
10. Automatisation des prédictions et extrapolation contrôlée
10.1 Construction d’un simulateur de prédiction comportementale
L’une des vocations cardinales de la modélisation statistique appliquée réside dans sa finalité décisionnelle et prescriptive. Une fois les paramètres stabilisés et validés, la feuille de calcul peut être transformée en un outil d’aide à la décision interactif, permettant de prédire instantanément l’issue comportementale pour n’importe quelle valeur hypothétique de la variable indépendante sans avoir à redessiner le graphique ni manipuler de longues équations manuelles.
Pour implémenter ce simulateur prédictif dans Google Sheets, l’analyste réserve une cellule d’entrée interactive distincte, par exemple la cellule J2, matérialisée par un formatage visuel contrasté invitant l’utilisateur à renseigner une valeur hypothétique pour le niveau de stimulation X. Dans la cellule de restitution K2, l’analyste encode alors une formule dynamique exploitant les paramètres issus de la table matricielle. La fonction SOMMEPROD offre ici une élégance computationnelle remarquable lorsqu’elle est combinée avec un tableau d’exposants : =SOMMEPROD(F2:G2, J2^{2,1}) + H2, où F2 et G2 abritent les coefficients quadratiques et linéaires, et H2 l’ordonnée à l’origine.
Alternativement, la fonction native TENDANCE de Google Sheets peut être configurée pour réaliser des projections polynomiales directes. En saisissant l’expression matricielle : =TENDANCE(B2:B16, A2:A16^{1,2}, J2^{1,2}), le tableur calcule en arrière-plan la résolution des moindres carrés et délivre instantanément le score prédit correspondant à la valeur test saisie en J2. Cette interactivité confère à la feuille de calcul une utilité immédiate pour les praticiens qui souhaitent simuler des scénarios d’intervention en temps réel.
10.2 Le danger critique de l’extrapolation polynomiale
Si la régression polynomiale se révèle particulièrement performante pour interpoler des dynamiques à l’intérieur de l’espace empirique délimité par l’échantillon, son utilisation pour extrapoler des valeurs situées au-delà des bornes observées constitue un danger analytique de première magnitude. Ce péril découle de la nature algébrique des polynômes : dès que la variable indépendante franchit les limites de l’intervalle de calibration, le terme élevé à la puissance la plus forte prend rapidement un ascendant disproportionné sur tous les autres composantes.
Dans notre modèle quadratique d’ordre 2, calibré sur une étendue de stimulation comprise entre 0 et 14 unités, le terme négatif -0.85*X^2 gouverne implacablement la trajectoire au-delà de ces frontières. Si un analyste imprudent utilisait ce simulateur pour prédire le score cognitif associé à un dosage intensif de 25 unités, l’équation projetterait une performance de l’ordre de -200 points. Une telle prédiction est non seulement impossible sur une échelle psychométrique standard bornée positivement, mais théoriquement absurde sur le plan cognitif.
Ce phénomène de divergence explosive est encore plus redoutable avec les polynômes d’ordre 3, 4 ou 5, dont les branches s’envolent vers des infinis positifs ou négatifs à des vitesses vertigineuses. Il incombe donc au chercheur d’imposer des bornes de validité strictes à l’usage de son modèle. Dans la feuille de calcul, cette sécurité peut être automatisée en encapsulant la formule de prédiction dans une structure conditionnelle =SI(OU(J2<0, J2>14), "Erreur : Domaine d'extrapolation interdit", Formule_Prediction), garantissant une utilisation responsable et déontologique de la modélisation.
10.3 Visualisation de l’intervalle de confiance des prédictions
Toute prédiction ponctuelle isolée est conceptuellement incomplète si elle n’est pas accompagnée d’une mesure explicite de l’incertitude qui l’entoure. La variance d’échantillonnage implique que la véritable trajectoire de la population se situe à l’intérieur d’une fourchette d’indécision statistique qui a tendance à s’évaser significativement à mesure que l’on s’éloigne du centre de gravité des données. Dans Google Sheets, il est tout à fait envisageable de construire une approximation rigoureuse de ces bandes d’incertitude.
Pour concrétiser cette démarche, l’analyste crée deux colonnes auxiliaires bordant les prédictions en colonnes H et I, baptisées respectivement « Borne_Inf » et « Borne_Sup ». En exploitant l’erreur-type des résidus extraite de la troisième ligne de la sortie DROITEREG (désignons-la par se) et en sélectionnant la valeur critique de Student appropriée pour un seuil de confiance à 95 % (approximativement t = 2,179 pour 12 degrés de liberté), la marge d’erreur individuelle simplifiée peut être quantifiée par l’expression marge = 2.179 * se.
En retranchant cette marge à la valeur prédite pour la borne inférieure (=E2 - marge) et en l’additionnant pour la borne supérieure (=E2 + marge), on définit une enveloppe de prédiction à 95 %. En réintégrant ces deux séries sous forme de lignes continues discrètes sur le graphique initial, l’observateur perçoit immédiatement les zones où la prédiction est robuste et celles où l’incertitude s’élargit. Cette démarche visuelle incarne une communication scientifique honnête et responsable, soulignant que la précision des estimations mathématiques ne saurait effacer l’aléa inhérent à la mesure comportementale.
11. Limites méthodologiques de Google Sheets face aux logiciels statistiques dédiés
11.1 Contraintes de précision numérique et d’arrondi
En dépit de son accessibilité remarquable et de ses puissantes capacités de calcul en réseau, Google Sheets n’a pas été conçu originellement comme un moteur d’analyse statistique de précision pour la recherche de pointe. Sa première faiblesse réside dans la gestion de la précision à virgule flottante lors de l’élévation des variables à des puissances élevées. Lorsque les données brutes comportent des amplitudes considérables (par exemple des milliers d’unités), le calcul des termes d’ordre 3, 4 ou 5 engendre des nombres colossaux qui se heurtent rapidement aux contraintes d’arrondi de l’architecture de calcul Web, risquant de propager des erreurs d’annulation catastrophiques lors des soustractions matricielles.
Une autre limitation récurrente, source d’innombrables désagréments pour les analystes novices, provient de la troncature des coefficients textuels affichés sur les graphiques de Google Sheets. Comme nous l’avons souligné, l’interface graphique tronque souvent les paramètres à deux ou trois décimales significatives pour préserver la compacité visuelle de la légende. Si l’utilisateur recopie manuellement ces coefficients tronqués pour mener des calculs extérieurs sur de larges échelles de données, l’imprécision introduite par l’omission des décimales distales fausse substantiellement les prédictions résultantes.
Il est par conséquent impératif de souligner que seule la méthode matricielle via DROITEREG garantit un accès aux coefficients avec la plénitude de leur résolution numérique native sous-jacente. L’abandon systématique du report manuel des étiquettes graphiques au profit du référencement dynamique de la matrice de sortie constitue l’unique parade technique contre ces distorsions d’arrondi.
11.2 Absence de tests d’hypothèses avancés et de diagnostics intégrés
La seconde contrainte majeure de Google Sheets face à des progiciels universitaires tels que R, SPSS, SAS ou Stata relève de l’absence totale de modules d’inférence avancée préprogrammés. Dans un environnement dédié, l’évaluation de l’homoscédasticité s’effectue en une ligne de commande par l’exécution du test de Breusch-Pagan ou du test robuste de White, qui fournissent des p-values formelles pour rejeter ou confirmer l’hypothèse de variance constante.
Sous Google Sheets, l’analyste en est réduit à des approximations manuelles ou à une inspection graphique subjective, le tableur ne disposant d’aucune macro native pour implémenter ces routines d’inférence. De façon similaire, l’évaluation de la normalité des erreurs résiduelles ne peut pas s’appuyer sur un test formel de Shapiro-Wilk ou de Kolmogorov-Smirnov, faute de fonctions algorithmiques prêtes à l’emploi. Le calcul de la statistique de Durbin-Watson pour quantifier l’autocorrélation temporelle des résidus requiert lui aussi la construction fastidieuse de formules de différences décalées pas à pas.
Cette carence méthodologique impose à l’analyste un fardeau de vigilance accru. Si Google Sheets excelle dans l’ajustement initial et l’exploration pédagogique rapide de courbes polynomiales, il transfère l’intégralité de la responsabilité diagnostique sur les épaules du chercheur, lequel doit construire manuellement ses propres indicateurs de contrôle là où d’autres systèmes génèrent automatiquement des batteries complètes de diagnostics d’influence (distances de Cook, valeurs leviers ou DFBETAS).
11.3 Scénarios décisionnels : quand basculer vers R, Python ou SPSS
Face à ces contraintes objectives, il apparaît indispensable d’établir une grille d’arbitrage méthodologique définissant le seuil critique où l’utilisation de Google Sheets cesse d’être recommandée au profit d’écosystèmes spécialisés. Le premier facteur décisionnel est d’ordre volumétrique. Bien que Google Sheets gère honorablement des milliers de cellules, le traitement matriciel interactif de jeux de données longitudinaux comprenant des dizaines de milliers de lignes induit une latence de calcul perceptible, nuisant à la réactivité analytique.
Le second critère décisionnel réside dans la complexité structurelle des modèles à estimer. Si l’investigation empirique nécessite d’intégrer des termes d’interaction multivariés entre plusieurs prédicteurs continus et des variables catégorielles (par exemple modéliser une surface de réponse tridimensionnelle), ou si les observations présentent une structure emboîtée nécessitant des modèles mixtes linéaires non linéaires à effets aléatoires hiérarchiques, Google Sheets s’avère manifestement dépassé. Tenter de paramétrer de tels modèles au moyen de formules matricielles complexes constitue une entreprise excessivement risquée et vulnérable aux erreurs humaines.
Enfin, dès lors que l’objectif ultime concerne la publication d’un article dans une revue scientifique à comité de lecture imposant une chaîne de reproductibilité totale du traitement des données, le basculement vers un script R documenté (via RMarkdown ou Quarto) ou un carnet Jupyter Python s’impose comme le standard déontologique incontournable. Dans ce cas de figure, Google Sheets trouvera sa juste place comme outil d’encodage collaboratif préliminaire et de nettoyage de données de première intention, avant un export propre et structuré vers les environnements d’analyse computationnelle dédiés.
12. Guide de dépannage, bonnes pratiques et synthèse procédurale
12.1 Résolution des erreurs courantes dans Google Sheets
Dans la pratique concrète de la régression polynomiale sous Google Sheets, les praticiens se heurtent fréquemment à des messages d’erreur énigmatiques générés par le moteur de calcul. L’anomalie la plus répandue est l’affichage de l’erreur fatale #VALEUR! lors de l’exécution de la formule DROITEREG. Dans une écrasante majorité de circonstances, ce dysfonctionnement trahit une discordance dimensionnelle entre la matrice des variables indépendantes et le vecteur de la réponse observée. Il suffit qu’une cellule contienne un résidu textuel masqué, un espace invisible ou que la plage sélectionnée pour X comporte une ligne de plus ou de moins que celle de Y pour que le calcul matriciel s’interrompe.
Une autre manifestation troublante est l’apparition de l’erreur #REF!. Ce message se déploie lorsque la formule matricielle DROITEREG a besoin d’étendre son tableau de sortie sur un bloc de 3 colonnes par 5 lignes, mais qu’une cellule située dans ce périmètre d’expansion est déjà occupée par une donnée préexistante. L’algorithme refuse alors d’écraser le contenu et se bloque par sécurité. La résolution consiste simplement à dégager un espace vierge suffisant autour de la formule pour permettre l’épanouissement complet de la matrice.
Enfin, sur le plan graphique, des distorsions étranges de la courbe de tendance — qui semble parfois se recroiser sur elle-même ou dessiner des boucles aberrantes — résultent presque invariablement d’un ordonnancement défectueux de la variable d’abscisse. Si les valeurs de X ne sont pas triées de manière strictement ascendante avant de générer certains types de tracés connectés, l’affichage visuel s’en trouve profondément perturbé. Un tri préalable systématique de la plage de données sur la colonne X résout instantanément ce désagrément visuel.
12.2 Liste de contrôle (Checklist) pour la publication académique
Avant d’intégrer les résultats d’une modélisation polynomiale réalisée sous Google Sheets dans un mémoire universitaire, une thèse de doctorat ou un rapport d’évaluation technique, le respect d’une liste de contrôle méthodologique standardisée garantit la conformité aux exigences scientifiques les plus strictes :
- Justification théorique a priori : La forme curvilinéaire retenue (parabole quadratique, sigmoïde cubique) correspond-elle à une dynamique substantive attestée dans la littérature scientifique de référence, ou s’agit-il d’un simple expédient descriptif opportuniste ?
- Centrage des prédicteurs : La variable explicative a-t-elle été centrée sur sa moyenne arithmétique afin d’atténuer la multicolinéarité structurelle et de stabiliser l’estimation des erreurs-types ?
- Transparence inférentielle : Les coefficients ont-ils été extraits via
DROITEREGet rapportés systématiquement avec leurs erreurs-types associées, leurs valeurs de t de Student, leurs degrés de liberté et les p-values exactes afférentes ? - Présentation du R² ajusté : Le chercheur a-t-il évité le piège de ne rapporter que le R² brut, en mentionnant explicitement le R² ajusté et les critères d’information pénalisés (AIC/BIC) pour défendre le choix du degré polynomial ?
- Diagnostic formel des résidus : L’homoscédasticité, la normalité approximative et l’indépendance des résidus ont-elles été examinées graphiquement et jugées conformes aux postulats de Gauss-Markov ?
- Exclusion rigoureuse de l’extrapolation : Les projections dérivées du modèle s’abstiennent-elles formellement de toute tentative de prédiction en dehors du domaine empirique strictement échantillonné ?
- Reproductibilité computationnelle : La feuille de calcul Google Sheets a-t-elle été archivée avec ses formules vivantes et ses jeux de données bruts intègres, prête à être partagée en toute transparence dans le cadre de la science ouverte ?
12.3 Synthèse procédurale étape par étape pour le chercheur
En guise d’épilogue méthodologique, récapitulons la chaîne opératoire chronologique que tout analyste doit parcourir pour maîtriser l’ajustement polynomial sous Google Sheets avec efficience et sérénité. La première étape réside dans la saisie et le nettoyage rigoureux des données ordonnées dans les deux colonnes initiales, en s’assurant de la conformité du formatage numérique et du centrage facultatif mais recommandé du prédicteur.
La seconde phase engage la visualisation par nuage de points sans relier les observations. Cette inspection visuelle indispensable permet de repérer la concavité ou les points de bascule et de poser une hypothèse de travail quant au degré polynomial minimal susceptible de rendre compte du phénomène. L’activation de la courbe de tendance polynomiale dans l’éditeur fournit ensuite une première confirmation visuelle immédiate, complétée par l’affichage de l’équation et du R² de base.
La troisième phase déploie la machinerie matricielle par le calcul explicite des puissances de X au moyen d’ARRAYFORMULA et l’exécution méthodique de DROITEREG pour obtenir le tableau complet des estimations inférentielles. Les prédictions et les résidus sont ensuite dérivés dynamiquement dans des colonnes dédiées pour générer les graphiques de diagnostic d’homoscédasticité et d’absence de structure.
Enfin, la démarche s’achève par l’arbitrage parcimonieux du degré optimal au regard du R² ajusté et des critères d’information, suivi de la configuration d’un simulateur de prédiction strictement borné à l’intervalle d’observation. Si la relation sous-jacente présente une complexité asymétrique que même un polynôme d’ordre raisonnable ne parvient pas à capturer convenablement sans contorsions excessives, le chercheur fera preuve d’une salutaire maturité scientifique en délaissant les polynômes au profit d’approches non linéaires alternatives plus adaptées, telles que les régressions logistiques, les fonctions exponentielles saturables ou les splines de régression lissées au sein d’environnements computationnels spécialisés.
Références
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Montgomery, D. C., Peck, E. A., & Vining, G. G. (2012). Introduction to linear regression analysis (5th ed.). John Wiley & Sons.
- Schielzeth, H. (2010). Simple means to improve the interpretability of regression coefficients. Methods in Ecology and Evolution, 1(2), 103–113. https://doi.org/10.1111/j.2041-210X.2010.00012.x
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503