
Dans le champ de la modélisation statistique et de l’analyse quantitative des données comportementales, la recherche d’adéquation entre les observations empiriques et les formulations mathématiques constitue un enjeu épistémologique fondamental. Si la régression linéaire simple s’impose fréquemment comme l’outil d’investigation préliminaire par excellence en raison de son apparente simplicité computationnelle et de son interprétabilité immédiate, elle révèle rapidement ses limites intrinsèques dès lors que les phénomènes sous-jacents manifestent des dynamiques non linéaires continues. Les systèmes vivants, les processus d’apprentissage humain, ainsi que les mécanismes de perception neurosensorielle répondent rarement à des sollicitations extérieures de manière strictement proportionnelle. Bien au contraire, ils exhibent des comportements caractérisés par des rendements marginaux décroissants, des effets de saturation progressive ou des décélérations systématiques qui défient les postulats de la linéarité classique.
Pour capturer ces trajectoires complexes sans sacrifier la parcimonie formelle indispensable à la validité scientifique, la régression logarithmique s’avère être un formalisme d’une puissance remarquable. Fondée sur les propriétés analytiques du logarithme népérien, cette approche autorise la modélisation rigoureuse de relations au sein desquelles les taux de variation instantanés diminuent proportionnellement à la magnitude de la variable explicative. Dès lors, l’intégration de ce modèle mathématique dans l’écosystème de programmation scientifique Python offre aux chercheurs et aux praticiens une flexibilité opérationnelle inégalée, reliant harmonieusement la robustesse théorique aux impératifs de la reproductibilité computationnelle moderne.
Le présent traité se propose de guider le lecteur à travers une exploration exhaustive, méthodique et rigoureusement étayée de la régression logarithmique sous Python. Depuis ses fondations formelles et son ancrage épistémologique en psychologie cognitive jusqu’aux procédures d’inférence statistique avancée, en passant par le diagnostic minutieux des résidus et la visualisation publication-ready, chaque étape du pipeline analytique sera disséquée avec le plus haut degré d’exigence académique. L’objectif consiste non seulement à expliciter les mécanismes algorithmiques sous-jacents, mais également à doter le chercheur des repères critiques nécessaires pour interpréter adéquatement ses résultats et prévenir les écueils interprétatifs inhérents à la modélisation non linéaire.
1. 1. Fondements théoriques de la régression logarithmique
1.1 Définition mathématique et formalisation du modèle
La régression logarithmique représente une classe spécifique de modèles de régression non linéaire dans lesquels la variable dépendante est exprimée comme une fonction linéaire du logarithme népérien de la variable indépendante. Sur le plan formel, l’expression analytique standard liant une variable explicative continue x à une variable réponse continue y se formule selon l’équation mathématique générale suivante :
y = a + b * ln(x) + ε
Dans ce formalisme univarié, le symbole x représente la variable prédictive ou exogène, laquelle doit impérativement être définie sur un domaine strictement positif appartenant à l’ensemble des réels, soit l’intervalle ouvert allant de zéro à l’infini positif. La variable y, quant à elle, incarne la variable de réponse, critère ou endogène, mesurée sur une échelle d’intervalles ou de rapports. Le terme ε symbolise l’erreur stochastique résiduelle non observée, supposée suivre une distribution normale de moyenne nulle et de variance constante dans le cadre des postulats gaussiens conventionnels.
L’interprétation algébrique et géométrique des paramètres du modèle revêt une signification particulièrement intuitive. Le coefficient scalaire a désigne l’ordonnée à l’origine théorique de la fonction, correspondant à la valeur exacte prédite pour la variable réponse y lorsque la variable explicative x atteint l’unité (puisque le logarithme népérien de un est identiquement nul). Le paramètre b, couramment qualifié de pente logarithmique ou d’échelle de courbure, quantifie la sensibilité marginale de y face aux modifications relatives de x. Plus spécifiquement, sur le plan différentiel, une augmentation relative de x de cent pour cent induit une variation prévisible de y équivalente au produit du coefficient b par le logarithme de deux, soit approximativement 0,693 fois b.
La fonction logarithme népérien joue un rôle structurel fondamental dans cette architecture mathématique en agissant comme un opérateur de compression non uniforme de l’espace métrique. En transformant un étirement géométrique ou multiplicatif des valeurs de l’abscisse en une progression arithmétique ou additive, elle permet de représenter de manière continue et différentiable des phénomènes physiques ou comportementaux dont la réactivité s’émousse à mesure que l’intensité des sollicitations augmente.
1.2 Propriétés de la dynamique logarithmique : croissance et décroissance saturantes
D’un point de vue analytique, la dynamique logarithmique se distingue par son comportement infinitésimal et l’allure spécifique de sa dérivée première. En calculant la dérivée de l’expression générale par rapport à la variable indépendante x, on obtient immédiatement la formulation du taux de variation instantané :
dy / dx = b / x
Cette égalité met en exergue une propriété cinétique cruciale : la vitesse de variation de la réponse est inversement proportionnelle à la magnitude absolue de l’antécédent. Lorsque la valeur de x est infinitésimale mais positive, le quotient b / x acquiert une amplitude considérable, traduisant une réactivité maximale du système modélisé. Inversement, lorsque x croît vers des grandeurs élevées, le taux de variation tend asymptotiquement vers zéro sans toutefois jamais s’annihiler totalement. Ce phénomène confère à la courbe son profil caractéristique d’amortissement perpétuel, se traduisant graphiquement par une concavité dirigée vers le bas lorsque b est positif, et une convexité orientée vers le haut lorsque b est négatif.
La différenciation structurelle entre la croissance saturante et la décroissance atténuée dépend exclusivement du signe algébrique affecté au paramètre b. Dans le cas où b est strictement supérieur à zéro, la fonction décrit une dynamique d’acquisition, de gain ou d’expansion qui connaît un essor fulgurant lors des phases initiales pour s’orienter progressivement vers une forme de palier asymptotique virtuel. À l’inverse, lorsque b est strictement inférieur à zéro, le modèle formalise une cinétique de déclin, de dégradation ou d’érosion rapide, laquelle voit son intensité de décroissance faiblir graduellement au fil du temps.
Il convient de souligner la remarquable sensibilité de ce modèle aux changements d’échelle de la variable explicative. Toute opération de mise à l’échelle multiplicative sur x, par exemple la substitution d’une mesure en secondes par une mesure en millisecondes (impliquant une multiplication par mille), n’altère aucunement l’estimation de la pente b, mais modifie mécaniquement la valeur de l’ordonnée à l’origine a par l’adjonction de la quantité b * ln(1000). Cette invariance de la pente confère à la régression logarithmique une robustesse métrologique substantielle pour comparer des protocoles expérimentaux calibrés selon des unités différentes.
1.3 Pertinence épistémologique en sciences cognitives et psychologiques
L’adoption de la régression logarithmique au sein des sciences cognitives, de la psychophysique et des neurosciences computationnelles ne procède pas d’un simple opportunisme empirique visant à maximiser des indices d’adéquation statistique. Elle repose sur des fondations épistémologiques séculaires trouvant leur ancrage historique dans les travaux pionniers d’Ernst Heinrich Weber et de Gustav Theodor Fechner. La célèbre loi psychophysique de Weber-Fechner postule formellement que la sensation perçue par un organisme n’est pas proportionnelle à l’énergie physique absolue du stimulus sensoriel, mais varie selon le logarithme de cette intensité physique. Ainsi, le système nerveux opère une compression logarithmique adaptative des flux environnementaux afin de préserver une sensibilité fine aux faibles intensités tout en évitant la saturation neuronale face aux stimulations massives.
Cette rationalité mathématique s’étend avec une acuité identique à la modélisation des courbes d’apprentissage individuel et de l’acquisition des habiletés cognitives complexes. Dès les premières formalisations des processus mnésiques, il a été démontré que les gains de performance mesurés à travers les temps de réaction ou les taux d’exactitude suivent une trajectoire hautement non linéaire. Les premiers essais au sein d’une tâche inédite engendrent une progression spectaculaire de l’efficience exécutive, traduisant la découverte de stratégies heuristiques élémentaires, tandis que les centaines d’itérations subséquentes ne produisent que des raffinements marginaux, illustrant la consolidation synaptique progressive du réseau neuronal sollicité.
De surcroît, le paradigme décisionnel de la loi de Hick-Hyman fournit une illustration théorique complémentaire de premier ordre. Selon ce cadre théorique, le temps nécessaire à un individu pour prendre une décision face à une pluralité d’alternatives équiprobables augmente proportionnellement au logarithme du nombre de choix offerts. Cette relation atteste que le cerveau humain traite l’incertitude environnementale en quantifiant l’information selon une métrique logarithmique analogue à l’entropie de Shannon.
En conséquence, le recours au formalisme logarithmique permet aux psychométriciens d’ajuster des modèles hautement parcimonieux, reposant sur deux degrés de liberté paramétrique seulement, tout en respectant scrupuleusement les contraintes biologiques et computationnelles inhérentes au traitement humain de l’information.
2. 2. Comparaison typologique avec d’autres architectures de régression
2.1 Divergences conceptuelles entre modèles logarithmiques et exponentiels
Dans la taxonomie des modèles statistiques appliqués aux cinétiques non linéaires, une confusion récurrente persiste entre les architectures logarithmiques et les architectures exponentielles, bien que leurs implications théoriques soient diamétralement opposées. Un modèle exponentiel univarié standard adopte la formulation analytique y = a * exp(b * x), ou sous forme semi-logarithmique réciproque ln(y) = a + b * x. Dans ce cadre précis, c’est la variable réponse qui subit une transformation d’échelle, tandis que la variable indépendante conserve sa métrique arithmétique d’origine.
Cette divergence fonctionnelle se traduit par des trajectoires géométriques profondément divergentes. Alors que la courbe logarithmique se caractérise par une concavité permanente décrivant un ralentissement progressif des variations, la fonction exponentielle manifeste une courbure convexe emblématique d’un emballement cinétique ou d’une rétroaction positive explosive. Sur le plan de la dynamique des erreurs, le modèle exponentiel implique que la variance relative de y demeure constante, ce qui génère une sensibilité exponentiellement accrue face aux variations se produisant dans les valeurs élevées de la variable explicative.
Ces distinctions conceptuelles possèdent des répercussions majeures lors de la sélection d’un modèle destiné à quantifier, par exemple, la dégradation de la trace mnésique ou l’extinction d’une réponse conditionnée. Alors qu’un déclin exponentiel suppose un taux de décroissance constant et proportionnel au stock mnésique résiduel à chaque instant infinitésimal (analogue à la désintégration radioactive), le modèle logarithmique postule que la résistance à l’oubli se renforce intrinsèquement avec l’écoulement temporel, le taux d’érosion s’atténuant à mesure que le temps s’allonge. Mathématiquement, l’inversion des axes cartésiens transforme une fonction logarithmique en une fonction exponentielle réciproque, soulignant leur relation duale mais imposant au modélisateur une rigueur conceptuelle absolue quant à l’attribution du statut de cause ou d’effet aux axes d’observation.
2.2 Limites de la régression linéaire classique face aux rendements décroissants
L’application précipitée et non critique de la méthode des moindres carrés ordinaires au moyen d’un modèle linéaire standard y = β_0 + β_1 * x sur des données régies par des rendements décroissants conduit invariablement à des violations méthodologiques sévères des postulats de Gauss-Markov. Le premier postulat enfreint est celui de la linéarité structurelle de la relation conditionnelle entre les variables, ce qui induit une dépendance non aléatoire évidente au sein de la distribution des résidus empiriques.
Lorsque l’on contraint artificiellement un nuage de points curviligne à s’ajuster sur une trajectoire rectiligne, les résidus calculés exhibent une structure d’autocorrélation géométrique systématique : ils sont majoritairement négatifs pour les faibles valeurs de x, basculent dans des valeurs positives le long de la région intermédiaire où la droite coupe la courbure du phénomène, puis redeviennent systématiquement négatifs pour les valeurs distales élevées. Ce profil sinusoïdal des résidus signale de manière indubitable un biais de spécification fonctionnelle.
En outre, cette inadéquation structurelle engendre presque systématiquement une hétéroscédasticité artificielle, où la dispersion des écarts résiduels varie en fonction du niveau d’avancement de la variable indépendante. Aux bornes du domaine expérimental, les extrapolations débouchent sur des aberrations manifestes, prédisant des valeurs aberrantes ou théoriquement inconcevables telles que des probabilités négatives ou des scores d’efficience cognitive excédant les limites physiologiques absolues. Dès lors, les coefficients de pente estimés par une régression linéaire forcée perdent toute consistance épistémologique, n’exprimant qu’une moyenne artificielle et localement fausse de la dynamique continue étudiée.
2.3 Critères de sélection des modèles selon les hypothèses psychométriques
Face à une série d’observations expérimentales, le praticien de l’analyse de données se trouve confronté au dilemme classique du choix de modèle parmi un éventail comprenant la régression linéaire, la régression polynomiale quadratique, le modèle hyperbolique et le formalisme logarithmique. La résolution de ce problème de sélection d’architecture ne doit jamais reposer exclusivement sur la maximisation mécanique du coefficient de détermination empirique, sous peine de verser dans les pièges classiques de l’illusion explicative et du surajustement statistique.
L’évaluation méthodologique doit impérativement s’articuler autour du principe épistémologique de parcimonie, formalisé historiquement par le rasoir d’Ockham. Si l’adjonction d’un terme polynomial du second degré (x²) peut parfois sembler fournir un ajustement descriptif numériquement flatteur sur un échantillon restreint, ce choix implique l’hypothèse conceptuelle périlleuse que la trajectoire cognitive ou comportementale atteindra un point d’inversion extremum au-delà duquel les performances s’inverseront symétriquement. Dans de nombreuses situations d’apprentissage ou de traitement de l’information, une telle symétrie inverse s’avère dépourvue de la moindre validité écologique.
Par conséquent, les critères de décision doivent combiner harmonieusement des métriques quantitatives pénalisant la complexité paramétrique, telles que les critères d’information d’Akaike et de Bayes, avec une interrogation théorique rigoureuse sur la nature du construit sous-jacent. Si la théorie psychologique postule une accumulation continue mais non bornée de l’expérience avec décélération permanente de l’effet marginal sans rupture brutale d’inflexion, la régression logarithmique s’impose comme l’architecture optimale, garantissant une cohérence herméneutique maximale entre les postulats substantiels de la discipline et l’abstraction algébrique.
3. 3. Configuration de l’environnement scientifique Python
3.1 Sélection et rôle des bibliothèques fondamentales
La mise en œuvre computationnelle rigoureuse de la régression logarithmique requiert la mobilisation d’un ensemble cohérent de bibliothèques logicielles composant le socle fondamental de l’écosystème scientifique Python. Au premier rang de cette architecture figure NumPy, la bibliothèque de référence pour le calcul vectoriel et tensoriel de haute performance. NumPy apporte la structure sous-jacente des tableaux multidimensionnels homogènes (ndarray) ainsi qu’un ensemble exhaustif d’opérations mathématiques universelles vectorisées, garantissant une exécution rapide des transformations de données sans recourir aux itérations natives de Python, notoirement inefficaces sur les volumétries substantielles.
Pour la sémiologie graphique et l’inspection visuelle des distributions, le couple formé par Matplotlib et Seaborn constitue l’épine dorsale analytique. Tandis que Matplotlib offre un contrôle granulaire absolu sur l’ensemble des éléments typographiques, géométriques et structurels du canevas graphique via son interface orientée objet, Seaborn superpose des abstractions statistiques de haut niveau facilitant le tracé direct des tendances conditionnelles et des intervalles d’incertitude.
L’estimation des paramètres fonctionnels et l’inférence formelle mobilisent quant à elles deux packages hautement spécialisés aux vocations complémentaires : d’une part, SciPy, dont le sous-module d’optimisation numérique permet l’ajustement non linéaire direct par moindres carrés via des algorithmes itératifs sophistiqués ; d’autre part, Statsmodels, orienté vers la modélisation économétrique et psychométrique, qui propose une infrastructure analytique rigoureuse générant automatiquement des diagnostics inférentiels complets, incluant les tableaux d’analyse de variance, les matrices d’erreurs-types asymptotiques et les tests d’adéquation d’hypothèses.
3.2 Gestion des environnements virtuels et reproductibilité expérimentale
L’exigence de reproductibilité computationnelle constitue l’un des piliers cardinaux de la recherche contemporaine en science des données. Afin d’immuniser le pipeline d’analyse contre les ruptures de compatibilité ascendante ou les variations de comportement numérique induites par les mises à jour logicielles de bibliothèques tierces, il est indispensable de sanctuariser l’exécution au sein d’un environnement virtuel isolé, géré via les outils formels venv ou le gestionnaire de paquets interplateformes conda.
Le protocole de standardisation exige la formalisation rigoureuse de l’ensemble des dépendances au sein d’un fichier déclaratif de configuration, traditionnellement dénommé requirements.txt ou environment.yml, dans lequel la version précise de l’interpréteur Python ainsi que de chaque bibliothèque importée est explicitement fixée. Cette démarche prévient l’introduction accidentelle d’artefacts algorithmiques résultant de modifications apportées aux routines internes d’optimisation numérique ou aux critères de convergence par défaut.
Parallèlement, la réplication déterministe intégrale des simulations de données synthétiques impose la fixation systématique des générateurs de nombres pseudo-aléatoires. Dans le cadre de NumPy, cela implique l’instanciation délibérée d’un objet générateur dédié avec une graine explicite (par exemple np.random.default_rng(seed=42)), plutôt que le recours à l’état aléatoire global du système. Enfin, l’articulation de la méthodologie au sein d’un carnet interactif Jupyter Documenté garantit que l’ordonnancement séquentiel des opérations computationnelles demeure transparent, auditable et directement exécutable par des réviseurs indépendants.
3.3 Paramétrage esthétique pour les standards académiques de publication
La communication visuelle des résultats empiriques dans les revues académiques de rang international, notamment celles affiliées à l’American Psychological Association (APA), obéit à des conventions typographiques et sémiologiques extrêmement strictes. L’objectif consiste à maximiser le ratio données-encre théorisé par Edward Tufte, en éliminant impitoyablement tout ornement graphique superflu qualifié de « chartjunk », tel que les grilles d’arrière-plan contrastées, les bordures graphiques redondantes ou les effets de relief illusoires.
Le paramétrage programmatique des propriétés d’affichage global via le dictionnaire de configuration interne de Matplotlib (rcParams) permet de normaliser les visualisations dès l’amont de la production. Ce paramétrage comprend l’ajustement systématique de la taille et de la famille typographique pour assurer une parité avec la police de rédaction du manuscrit (généralement des polices à empattement de la famille Serif ou des polices neutres Sans-Serif hautement lisibles), la modulation de l’épaisseur des axes coordonnés et la suppression sélective des bordures supérieure et droite du cadre de tracé.
De plus, une attention méthodique doit être accordée au choix des palettes chromatiques. Dans une optique d’inclusivité et d’accessibilité visuelle, le chercheur privilégiera des échelles colorimétriques optimisées pour la vision des personnes atteintes de déficiences de la vision des couleurs (telles que le daltonisme), à l’instar des palettes viridis ou cividis, ou optera pour des dégradés de gris à contraste élevé parfaitement discriminables lors d’une impression monochrome. Enfin, pour prévenir toute pixellisation dégradante lors de la mise en page éditoriale, les figures vectorielles doivent être compilées selon une résolution minimale de 300 à 600 points par pouce (DPI) et exportées dans des formats vectorisés standardisés tels que le PDF ou le format SVG.
4. 4. Étape 1 – Synthèse et structuration des données expérimentales
4.1 Conception d’un échantillon représentatif simulant un déclin cognitif
Pour illustrer de manière tangible le protocole de régression logarithmique, nous formalisons la construction d’un jeu de données synthétiques représentatif d’une épreuve longitudinale de mémoire prospective au sein d’une cohorte clinique simulée. L’objectif consiste à observer l’évolution du score de rétention mnésique en fonction de l’écoulement d’une série temporelle discrète s’échelonnant sur un intervalle continu compris entre une minute et quatre-vingt-dix minutes post-apprentissage.
La variable indépendante x est générée sous la forme d’un vecteur ordonné d’intervalles d’observation, simulant la latence temporelle de sollicitation expérimentale. Afin d’incorporer un réalisme statistique adéquat reflétant la variabilité biologique intrinsèque des sujets humains, la variable de réponse théorique y est calculée en injectant des paramètres de référence délibérés, par exemple une ordonnance à l’origine a fixée à 85 points d’efficience et une pente logarithmique b négative établie à -12 points par unité de compression temporelle, traduisant l’érosion graduelle du souvenir.
À cette trajectoire théorique déterministe vient s’agréger un terme d’erreur stochastique résiduelle. Ce bruit aléatoire est extrait d’une distribution gaussienne de moyenne μ = 0 et d’écart-type σ = 3,5, simulant la variance interindividuelle résiduelle non captée par le modèle déterministe. Une fois les opérations de génération achevées, une vérification programmatique formelle valide l’équivalence dimensionnelle absolue entre le tableau unidimensionnel des antécédents temporels et le vecteur des scores mnésiques correspondants, prévenant toute anomalie d’alignement tensoriel ultérieur.
4.2 Gestion impérative du domaine de définition mathématique
L’exécution computationnelle d’une régression faisant intervenir une fonction logarithmique soulève un écueil algorithmique rédhibitoire qu’il importe d’anticiper rigoureusement : la singularité mathématique fondamentale du logarithme népérien au point d’abscisse zéro. En arithmétique réelle, la limite de ln(x) lorsque x tend vers zéro par valeurs positives est moins l’infini, tandis que la fonction n’est tout simplement pas définie sur le sous-ensemble des réels strictement négatifs.
Si la structure de données transmise au processeur comporte ne serait-ce qu’une unique occurrence nulle ou négative, les fonctions d’évaluation vectorielle de NumPy renverront inévitablement des valeurs spéciales d’erreur computationnelle, se traduisant par des entités indéfinies de type NaN (Not a Number) ou des valeurs infinies négatives (-inf), accompagnées d’avertissements d’exécution critique. De tels artefacts provoquent l’interruption prématurée ou la divergence numérique immédiate des optimiseurs de moindres carrés.
Face à des séries empiriques comportant des mesures temporelles initiales coïncidant avec l’origine de l’expérimentation (temps zéro), le chercheur est contraint d’appliquer une stratégie de régularisation d’échelle. Deux options méthodologiques s’offrent alors : la translation de l’origine expérimentale consistant à définir le repère temporel initial non pas à zéro mais à une unité métrique minimale (par exemple une seconde ou une minute post-stimulus), ou l’addition systématique d’une constante scalaire infinitésimale de régularisation c sur l’ensemble de la variable explicative, transformant l’argument en ln(x + c). Il est néanmoins impératif de prendre conscience que l’introduction arbitraire d’une constante de translation altère structurellement la géométrie de la fonction et modifie substantiellement l’estimation ainsi que la signification théorique de l’ordonnée à l’origine a.
4.3 Organisation des structures de données pour le traitement statistique
Afin de maximiser la traçabilité analytique et de prévenir les confusions indésirables lors des manipulations d’échantillons, les vecteurs numériques bruts doivent être immédiatement encapsulés au sein d’une structure de données tabulaire formelle, telle qu’un DataFrame géré via la bibliothèque de manipulation de données Pandas. Cette structure offre l’avantage capital d’associer explicitement des métadonnées contextuelles, des étiquettes dimensionnelles sémantiques et des systèmes d’indexation temporelle rigoureux aux séries de mesures observées.
Dès l’instanciation de cette structure tabulaire, un protocole d’inspection d’intégrité doit être exécuté par voie logicielle. Ce contrôle inclut le dépistage automatisé des cellules orphelines ou manquantes par des méthodes de filtrage booléen, ainsi que l’examen approfondi des statistiques descriptives élémentaires : médiane empirique, moyenne arithmétique, variance, écart interquartile, asymétrie distributionnelle et kurtosis. Cet inventaire descriptif liminaire garantit qu’aucune valeur anormale issue d’une erreur d’acquisition ou d’encodage instrumental ne vienne fausser l’analyse globale.
Enfin, pour garantir une interopérabilité sans friction avec les algorithmes d’optimisation non linéaire de SciPy et les matrices d’expérience de Statsmodels, les structures tabulaires doivent pouvoir être aisément projetées sous forme de matrices et de vecteurs numériques contigus à mémoire continue. Cette étape parachève la structuration des données en garantissant une efficience d’accès mémoire optimale lors des itérations computationnelles intensives.
5. 5. Étape 2 – Exploration visuelle préliminaire des tendances empiriques
5.1 Construction du diagramme de dispersion initial
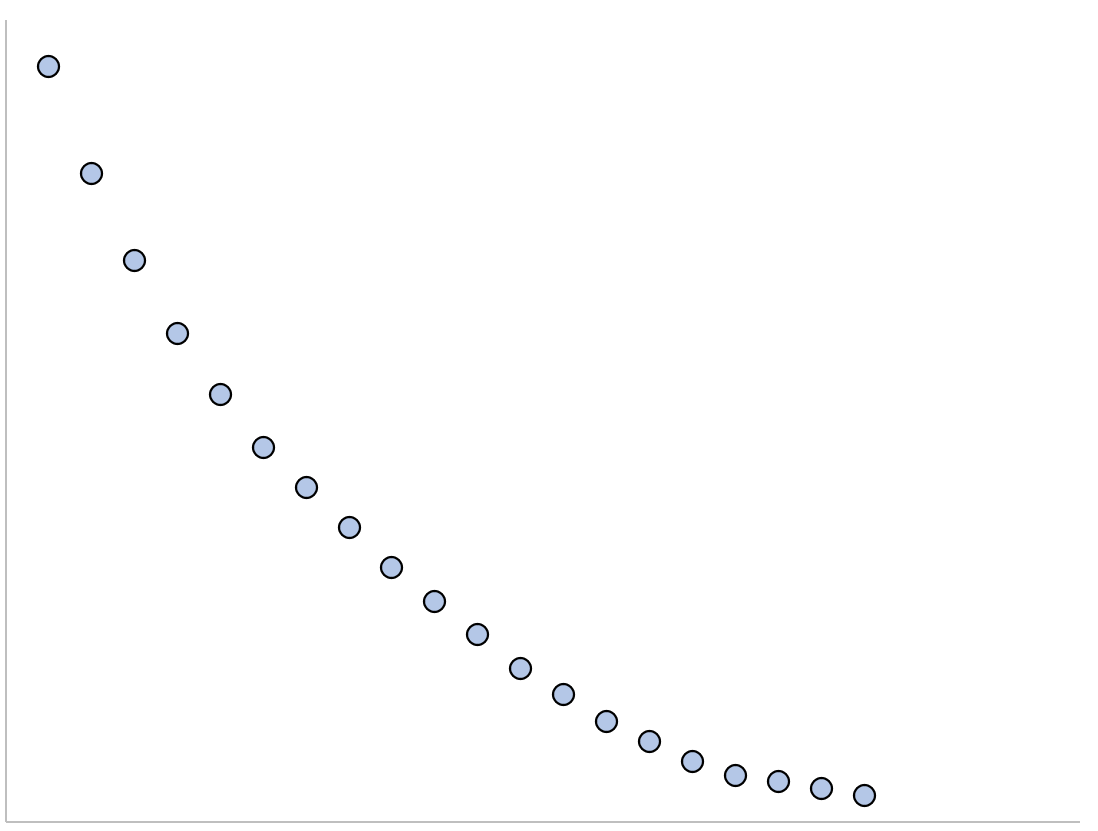
Le diagnostic statistique d’un ensemble de données expérimentales ne saurait débuter par l’application aveugle d’algorithmes d’estimation sans une phase exploratoire visuelle approfondie. La première manifestation visuelle de l’analyse repose sur l’élaboration d’un diagramme de dispersion cartésien classique (scatter plot), dans lequel chaque paire d’observations (x_i, y_i) est projetée sous forme de coordonnées discrètes au sein de l’espace métrique réel bidimensionnel.
Cette visualisation préliminaire doit impérativement respecter les règles de la sémiologie graphique en adjoignant un étiquetage textuel précis et exhaustif des axes dimensionnels, stipulant sans ambiguïté les unités physiques ou psychométriques associées (par exemple le délai de rétention exprimé en minutes sur l’axe des abscisses et le score composite de rappel correct exprimé en points sur l’axe des ordonnées). Le dimensionnement des marqueurs ainsi que leur degré d’opacité doivent être finement calibrés pour révéler d’éventuelles zones de forte densité locale ou de chevauchement ponctuel des observations empiriques.
L’observation attentive de ce diagramme brut permet au chercheur de discerner immédiatement la signature géométrique de la non-linéarité : un gradient de variation extrêmement prononcé au voisinage des petites valeurs de la variable explicative, suivi d’un aplatissement progressif et d’une stabilisation relative de la trajectoire à mesure que les abscisses augmentent. Parallèlement, cette inspection oculaire joue un rôle fondamental dans la détection des points aberrants ou des observations extrêmes et atypiques dont l’effet de levier pourrait déstabiliser outre mesure la convergence des estimateurs paramétriques.
5.2 Superposition d’estimateurs non paramétriques
Bien que l’œil humain soit particulièrement habile pour identifier des tendances géométriques globales, il demeure vulnérable aux illusions de regroupement et aux biais perceptifs. Pour corroborer l’intuition visuelle sans imposer a priori la rigidité fonctionnelle du modèle logarithmique, la démarche méthodologique la plus probe consiste à superposer au diagramme de dispersion un lissage non paramétrique robuste par régression locale pondérée, universellement désigné sous l’acronyme LOWESS ou LOESS (Locally Weighted Scatterplot Smoothing).
L’algorithme LOWESS procède à une multitude de régressions linéaires locales au sein de sous-ensembles glissants d’observations, en attribuant un poids prépondérant aux points situés dans le voisinage immédiat de la coordonnée cible et en pénalisant les données distantes ou résiduelles. Il en résulte une courbe lissée entièrement guidée par les données elles-mêmes, exempte de toute hypothèse parametriciste préconçue sur la trajectoire fonctionnelle globale.
L’analyse comparative de la courbe LOWESS permet d’évaluer si la pente empirique locale décroît de manière strictement monotone au fil du continuum d’abscisse. Si la courbe non paramétrique révèle la présence d’ondulations périodiques, d’inflexions sigmoïdes ou de changements de direction contre-théoriques, le chercheur devra immédiatement suspecter que l’architecture logarithmique simple se révèle structurellement inadéquate ou insuffisante pour encapsuler l’intégralité du processus sous-jacent, imposant l’exploration de modèles polynomiaux, logistiques ou segmentés.
5.3 Vérification sémiologique de la transformation d’axe
Une épreuve graphique décisive pour confirmer la plausibilité d’une dynamique logarithmique consiste à manipuler l’espace de représentation lui-même en appliquant une transformation logarithmique népérienne ou décimale à l’échelle graduée de l’axe des abscisses. Cette procédure produit un tracé dit semi-logarithmique où l’espacement physique séparant les graduations reflète non pas des écarts arithmétiques constants, mais des progressions géométriques d’intervalles égaux.
Sous cette projection d’échelle transformée, si les données générées par le phénomène d’amortissement obéissent fidèlement à la dynamique logarithmique formalisée par l’expression y = a + b * ln(x), la courbure caractéristique du nuage de points doit s’effacer instantanément au profit d’un alignement rectiligne rigoureusement linéaire. L’observation d’une telle rectification linéaire visuelle constitue une démonstration graphique quasi irréfutable de la validité de l’hypothèse logarithmique.
Cette étape de diagnostic sémiologique doit être minutieusement documentée dans le carnet d’analyse. Elle assure au statisticien que le recours aux algorithmes d’ajustement formel n’est pas le fruit d’un arbitraire mathématique, mais qu’il répond fidèlement à l’organisation géométrique et conceptuelle intrinsèque des observations expérimentales recueillies.
6. 6. Étape 3 – Estimation des paramètres par linéarisation et moindres carrés
6.1 Principe mathématique de la transformation logarithmique de l’abscisse
L’une des propriétés analytiques les plus remarquables de la régression logarithmique univariée réside dans son statut de modèle intrinsèquement linéaire par rapport à ses paramètres. Bien que la trajectoire géométrique tracée dans l’espace originel soit incontestablement non linéaire, l’équation demeure une combinaison strictement linéaire des scalaires d’ajustement a et b, dès lors que la fonction d’évaluation non linéaire agit exclusivement sur la variable indépendante.
Sur le plan mathématique, cette particularité autorise le recours à une technique fondamentale de changement de variable formel. En définissant une nouvelle variable prédictive transformée notée X’ telle que :
X’ = ln(x)
le modèle initial se réécrit instantanément sous la forme classique d’une équation de droite paramétrique univariée :
y = a + b * X’ + ε
Par cette transformation bijective continue, le problème de modélisation non linéaire se trouve ramené avec une absolue rigueur analytique dans le cadre canonique de la régression linéaire simple. Dès lors, les propriétés statistiques optimales garanties par le théorème de Gauss-Markov s’appliquent pleinement : les estimateurs des moindres carrés ordinaires obtenus à partir de la variable modifiée X’ constituent les meilleurs estimateurs linéaires sans biais (BLUE – Best Linear Unbiased Estimators), sous réserve du respect des postulats d’homoscédasticité et d’absence d’autocorrélation des résidus.
6.2 Implémentation algorithmique avec NumPy (polyfit)
Sur le plan de l’ingénierie computationnelle, cette approche par linéarisation offre un avantage majeur en termes de rapidité d’exécution et de parcimonie algorithmique. La bibliothèque scientifique NumPy intègre des routines d’algèbre linéaire de très haut niveau capables d’ajuster des polynômes au sens des moindres carrés de manière directe, sans nécessiter d’itérations d’optimisation numérique ni de calculs de gradients complexes.
L’implémentation algorithmique se structure en deux opérations séquentielles élémentaires. En premier lieu, la fonction vectorisée np.log() est invoquée directement sur le tableau unidimensionnel contenant les valeurs de la variable explicative x, produisant instantanément le vecteur transformé X’ par calcul parallèle optimisé au niveau matériel. Dans un second temps, la fonction np.polyfit() est exécutée en spécifiant la variable transformée comme vecteur d’abscisses, les valeurs de y comme vecteur d’ordonnées, et en fixant l’ordre polynomial à un, signifiant l’ajustement d’un polynôme de premier degré correspondant exactement à une droite affine.
Cette routine résout analytiquement le système d’équations normales par décomposition matricielle aux valeurs singulières (SVD). Elle renvoie un tableau contenant dans l’ordre le coefficient multiplicateur de la variable transformée, qui correspond exactement à la pente logarithmique b, ainsi que le terme constant, qui identifie fidèlement l’ordonnée à l’origine a. Cette approche computationnelle présente une vitesse d’exécution quasi instantanée, s’avérant particulièrement précieuse dans le cadre de simulations massives de type Monte-Carlo ou de procédures de rééchantillonnage intensif par bootstrap.
6.3 Implémentation approfondie via statsmodels
Bien que la routine polyfit de NumPy suffise amplement pour une résolution ponctuelle des paramètres, elle s’avère manifestement limitée dès lors que l’on ambitionne de conduire une inférence statistique académique rigoureuse. C’est à ce stade précis que la bibliothèque Statsmodels révèle toute sa pertinence méthodologique en fournissant un écosystème d’analyse complet fondé sur les formalismes économétriques les plus stricts.
Pour implémenter cette estimation, il convient préalablement d’augmenter le vecteur d’abscisse transformé ln(x) par une colonne unitaire de uns, opération facilitée par la méthode sm.add_constant(), de manière à intégrer l’interception a au sein de la matrice de plan expérimental. La classe sm.OLS est ensuite instanciée avec la variable endogène y et la matrice d’expérience ainsi préparée, avant d’ordonner la résolution analytique par l’invocation de sa méthode fit().
L’objet de résultats ainsi généré délivre un tableau de synthèse synthétique exhaustif (le fameux summary) qui détaille avec une précision absolue les valeurs estimées des paramètres, leurs erreurs-types respectives calculées à partir de la matrice d’information empirique, la statistique du test t de Student évaluant la significativité de chaque paramètre contre l’hypothèse nulle d’absence d’effet, ainsi que les p-valeurs bilatérales associées et les intervalles de confiance paramétriques asymptotiques à 95 %. Ces éléments constituent le matériel statistique incontournable exigé par les comités de lecture des revues scientifiques pour attester de la recevabilité des conclusions inférentielles.
7. 7. Étape 4 – Modélisation non linéaire directe avec SciPy optimize
7.1 Formulation fonctionnelle de l’objectif d’optimisation
L’approche par linéarisation de l’abscisse exposée précédemment, bien qu’analytiquement élégante et numériquement infaillible, présente une limite méthodologique intrinsèque : elle contraint le praticien à raisonner au sein d’un espace déformé par l’opérateur logarithmique. Dès lors que l’on envisage de complexifier ultérieurement la formulation fonctionnelle (par exemple en ajoutant un paramètre de translation d’origine inconnu c dans un modèle du type y = a + b * ln(x + c)), la propriété de linéarité par rapport aux paramètres s’effondre irrémédiablement, rendant l’utilisation des moindres carrés analytiques impossible.
L’alternative computationnelle universelle consiste à recourir à la modélisation non linéaire directe dans l’espace métrique originel des données. Cette stratégie repose sur la formulation explicite d’une fonction mathématique Python standard qui prend pour premier argument la variable indépendante x, suivie de l’ensemble des paramètres scalaires dont on souhaite déterminer les valeurs optimales, en l’occurrence a et b, et qui renvoie l’évaluation computationnelle de l’expression a + b * np.log(x).
Dans ce paradigme direct géré par la fonction scipy.optimize.curve_fit, l’objectif algorithmique consiste à minimiser la somme des carrés des écarts verticaux séparant les observations empiriques y_i des évaluations théoriques générées par la fonction non linéaire. Il convient de souligner que, dans le cas strict du modèle logarithmique pur sans transformation sur la réponse y, la fonction de coût résiduelle minimisée par l’approche directe est mathématiquement identique à celle minimisée par la méthode des moindres carrés ordinaires appliquée sur l’axe transformé, ce qui garantit une identité parfaite des solutions paramétriques tout en offrant un cadre algorithmique généralisable à n’importe quelle équation non linéaire complexe.
7.2 Mise en œuvre algorithmique et convergence numérique
La routine curve_fit de SciPy mobilise sous le capot un algorithme itératif d’optimisation numérique d’une robustesse exceptionnelle : l’algorithme de Levenberg-Marquardt. Ce procédé mathématique opère une interpolation adaptative et continue entre deux architectures d’optimisation classiques : la méthode de descente de gradient, hautement robuste et stable lorsque les estimations itératives sont encore éloignées de l’optimum global, et la méthode de Gauss-Newton, qui assure une convergence quadratique fulgurante au voisinage immédiat du minimum de la fonction de perte quadratique.
Bien que l’algorithme de Levenberg-Marquardt dispose de propriétés de convergence remarquables, son efficacité dépend de la spécification de valeurs initiales plausibles pour les paramètres recherchés, transmises à l’argument optionnel p0. En l’absence de directives de la part du chercheur, l’algorithme initialise l’ensemble des scalaires à l’unité par défaut, ce qui peut, dans certaines configurations de données aux échelles métriques très disproportionnées, ralentir la convergence ou entraîner l’optimiseur vers des minima locaux sous-optimaux.
De surcroît, le chercheur doit exercer une vigilance méthodologique vis-à-vis des critères de tolérance d’arrêt et du nombre maximal d’itérations autorisées. Si le relief de la fonction de coût présente une courbure quasi plane au sein de certaines directions paramétriques (phénomène d’indiscernabilité ou de col), l’algorithme peut déclencher une exception de non-convergence. La survenue d’un tel incident numérique signale généralement soit une indétermination mathématique dans la paramétrisation choisie, soit une inadéquation totale entre l’architecture de la fonction postulée et la structure empirique des données fournies.
7.3 Extraction de la matrice de variance-covariance
Au terme de sa séquence d’optimisation, la routine curve_fit ne se limite pas à renvoyer le tableau vectoriel optimal des paramètres estimés (habituellement désigné par la variable popt). Elle délivre conjointement une structure mathématique de première importance pour l’inférence statistique : la matrice de variance-covariance estimée des paramètres, conventionnellement assignée à la variable pcov.
Cette matrice carrée symétrique d’ordre deux par deux dans le cadre de notre régression logarithmique univariée synthétise l’ensemble des incertitudes statistiques et des interdépendances probabilistes associées aux estimateurs optimisés. Les composantes situées sur la diagonale principale de la matrice représentent respectivement la variance asymptotique d’échantillonnage de l’ordonnée à l’origine a et de la pente logarithmique b. En extrayant la racine carrée arithmétique de ces éléments diagonaux (au moyen de la méthode np.sqrt(np.diag(pcov))), le chercheur accède instantanément aux erreurs-types asymptotiques associées à chaque estimateur.
Les éléments situés hors de la diagonale principale quantifient quant à eux la covariance mutuelle existant entre les estimations des paramètres a et b. En normalisant cette covariance par le produit des erreurs-types respectives, on obtient le coefficient de corrélation statistique liant les deux paramètres. Une corrélation négative particulièrement élevée indique que toute surestimation accidentelle de l’ordonnée à l’origine se trouve mathématiquement compensée par une sous-estimation proportionnelle de la pente logarithmique le long du processus d’ajustement, fournissant ainsi une compréhension géométrique intime de la stabilité de la configuration paramétrique retenue.
8. 8. Étape 5 – Évaluation statistique de la qualité de l’ajustement
8.1 Calcul et interprétation du coefficient de détermination (R²)
L’évaluation quantitative de la fidélité avec laquelle la courbe logarithmique formalise la variabilité des données d’observation impose la mobilisation d’indices de mesure d’adéquation globale. L’indicateur le plus couramment sollicité au sein de la littérature expérimentale demeure le coefficient de détermination statistique, universellement désigné par le symbole R².
Sa formulation formelle repose sur la décomposition canonique de la variance au sein de l’espace métrique de la variable réponse :
R² = 1 – (SSE / SST)
où la somme des carrés résiduels (SSE – Sum of Squared Errors) correspond à la sommation des carrés des déviations verticales séparant les observations empiriques y_i des prédictions calculées par le modèle y_pred_i, tandis que la somme totale des carrés (SST – Total Sum of Squares) représente la dispersion brute intégrale des données autour de leur moyenne arithmétique marginale y_bar.
Il importe toutefois d’émettre des réserves méthodologiques majeures concernant l’interprétation du R² dans les contextes de modélisation non linéaire. Lorsque le modèle déroge à la linéarité absolue des paramètres ou lorsqu’une transformation est appliquée sur la variable endogène elle-même (ce qui n’est heureusement pas le cas de la régression logarithmique simple où seule la variable explicative x est transformée), la décomposition classique de la somme des carrés perd sa validité géométrique vectorielle, pouvant occasionner des valeurs de R² artificiellement gonflées ou dépourvues de signification probabiliste. Dans notre cadre d’ajustement sur x, le R² conserve sa légitimité en tant que proportion directe de variance expliquée, mais il convient systématiquement de le compléter par le calcul du R² ajusté, lequel applique une pénalité marginale rigoureuse proportionnelle au nombre de degrés de liberté consommés par les paramètres libres du modèle.
8.2 Indicateurs d’erreur globale : RMSE et MAE
Bien que le coefficient de détermination offre une métrique sans dimension facilitant les comparaisons d’adéquation relative, il souffre d’une incapacité fondamentale à quantifier l’ampleur absolue des déviations dans l’unité concrète de la mesure expérimentale. Pour pallier cette lacune d’interprétabilité, le chercheur doit impérativement adjoindre le calcul de deux métriques d’erreur globale d’une valeur diagnostique incontestable : la racine de l’erreur quadratique moyenne (RMSE – Root Mean Squared Error) et l’erreur absolue médiane ou moyenne (MAE – Mean Absolute Error).
La racine de l’erreur quadratique moyenne se formule mathématiquement comme suit :
RMSE = sqrt( (1 / n) * Σ (y_i – y_pred_i)² )
En vertu de l’élévation au carré des écarts résiduels avant sommation et extraction de la racine, la RMSE accorde une pondération asymétriquement lourde aux erreurs de prédiction d’amplitude importante. Elle constitue de ce fait un indicateur particulièrement sensible à la présence d’écarts expérimentaux critiques ou de dysfonctionnements ponctuels de modélisation. La valeur numérique de la RMSE s’exprime rigoureusement dans la même unité dimensionnelle que la variable réponse (par exemple en points de rappel mnésique ou en millisecondes de temps de réaction), autorisant une évaluation pragmatique immédiate de la précision instrumentale du modèle.
À l’inverse, l’erreur absolue moyenne (MAE), formalisée par l’expression computationnelle :
MAE = (1 / n) * Σ |y_i – y_pred_i|
mesure la distance arithmétique moyenne séparant les observations de la trajectoire estimée sans surpondération quadratique. De par cette neutralité géométrique, la MAE manifeste une robustesse statistique nettement supérieure face aux valeurs atypiques isolées. La comparaison conjointe de la RMSE et de la MAE permet de sonder la nature de la distribution des erreurs : un écart disproportionné entre une RMSE élevée et une MAE modérée révèle sans équivoque que la dispersion globale des résidus est tirée vers le haut par une poignée de déviations marginales majeures plutôt que par une imprécision diffuse et homogène de l’ajustement fonctionnel.
8.3 Critères d’information pénalisés : AIC et BIC
Lorsque la compétition théorique oppose le modèle logarithmique à des architectures structurellement dissemblables qui n’appartiennent pas à la même classe de fonctions linéaires (par exemple un modèle polynomial d’ordre deux ou une fonction exponentielle décroissante), la simple comparaison des erreurs brutes ou des R² ne permet plus d’identifier le modèle le plus parcimonieux. Les critères d’information fondés sur la théorie de l’information statistique et la vraisemblance maximale apportent une réponse mathématique rigoureuse à cet impératif de sélection.
Le critère d’information d’Akaike (AIC – Akaike Information Criterion) opère un arbitrage probabiliste formel entre la qualité statistique de l’ajustement aux données et le nombre de paramètres libres mobilisés pour parvenir à cette performance. Dans l’hypothèse de résidus gaussiens indépendants et identiquement distribués, son expression analytique opérationnelle se formule sous la forme :
AIC = n * ln(SSE / n) + 2 * k
où n désigne la taille de l’échantillon d’observations et k le nombre total de paramètres estimés au sein du modèle (incluant la variance résiduelle). Le premier terme quantifie la déviance ou l’entropie résiduelle du modèle, tandis que le second terme applique une pénalité linéaire stricte proportionnelle à sa complexité paramétrique.
Le critère d’information bayésien (BIC – Bayesian Information Criterion), formalisé par Gideon Schwarz, accentue plus lourdement encore cette pénalisation en associant le coût des paramètres au logarithme naturel de la taille de l’échantillon via la formule :
BIC = n * ln(SSE / n) + k * ln(n)
Pour des échantillons de taille modérée à grande (dès que n est supérieur ou égal à huit), le coefficient ln(n) excède le facteur deux du critère AIC, conférant au BIC une sévérité accrue vis-à-vis du risque d’inflation paramétrique et de surapprentissage.
La règle de décision théorique universelle stipule de retenir le modèle affichant la valeur de critère la plus faible. Selon les conventions canoniques établies par Burnham et Anderson, un différentiel d’AIC (Δ_AIC) supérieur à dix unités par rapport au modèle concurrent le plus proche fournit une preuve empirique écrasante en faveur de la supériorité du modèle retenu, attestant de l’inadéquation structurelle des architectures alternatives.
9. 9. Étape 6 – Diagnostic des résidus et validation des postulats gaussiens
9.1 Analyse de la distribution et test de normalité des résidus
La validité intégrale des inférences statistiques issues de la régression, qu’il s’agisse des tests d’hypothèses sur les paramètres ou du calcul des intervalles de confiance, repose de manière critique sur le respect scrupuleux de l’hypothèse de gaussianité des erreurs aléatoires inobservables. L’analyse des résidus empiriques observés, formalisés pour chaque point par la déviation résiduelle :
e_i = y_i – y_pred_i
constitue donc une démarche méthodologique absolument obligatoire.
Cette vérification débute par une analyse visuelle approfondie reposant sur la construction conjointe de l’histogramme de distribution des résidus, superposé à la courbe de densité normale théorique correspondante, et surtout du diagramme quantile-quantile (Q-Q plot). Le diagramme Q-Q projette les quantiles empiriques de la série des résidus standardisés contre les quantiles théoriques issus d’une loi normale standardisée unitaire. Si les erreurs observées obéissent fidèlement à l’hypothèse de normalité, les points se disposent selon un alignement rectiligne rigoureux le long de la diagonale identitaire à quarante-cinq degrés. Toute inflexion sigmoïde ou tout décrochage majeur au niveau des extrémités du diagramme traduit l’existence d’asymétries distributionnelles ou de queues de distribution épaisses caractéristiques d’une leptokurticité anormale.
Pour corroborer de manière objective ces constatations graphiques, le chercheur doit appliquer un test d’hypothèse formel, parmi lesquels le test de Shapiro-Wilk s’impose comme la procédure la plus sensible et la plus puissante pour les tailles d’échantillons couramment rencontrées en sciences comportementales. Une statistique de Shapiro-Wilk W proche de un assortie d’une p-valeur supérieure au seuil conventionnel de cinq pour cent (p > 0,05) permet de ne pas rejeter l’hypothèse nulle de gaussianité, autorisant la poursuite sereine des procédures d’inférence statistique formelle.
9.2 Évaluation de l’homoscédasticité et détection d’hétéroscédasticité
Le second pilier des postulats de Gauss-Markov exige la constance absolue de la variance du terme d’erreur stochastique à travers l’ensemble des strates conditionnelles de la variable prédictive, propriété fondamentale désignée sous le terme d’homoscédasticité. À l’inverse, l’apparition d’hétéroscédasticité—situation où la variabilité des erreurs fluctue de manière systématique en fonction du niveau des valeurs ajustées—entraîne des conséquences méthodologiques pernicieuses : si les estimateurs des moindres carrés demeurent mathématiquement sans biais, leurs erreurs-types associées deviennent erronées, invalidant l’intégralité des tests de significativité t et les intervalles de confiance paramétriques.
Le diagnostic visuel de cette hypothèse s’effectue en projetant graphiquement la série des résidus standardisés ou studentisés sur l’axe vertical en fonction des valeurs prédites (y_pred) sur l’axe horizontal. Dans une configuration homoscédastique saine, le nuage de points résiduels doit se distribuer de manière totalement aléatoire et uniforme au sein d’une bande horizontale d’épaisseur constante circonscrite autour de l’axe zéro, ne dévoilant aucune forme d’entonnoir, d’éventail ou de courbure résiduelle.
Pour formaliser mathématiquement ce diagnostic, le statisticien met en œuvre le test formel de Breusch-Pagan ou le test de White, tous deux programmables aisément via le sous-module d’évaluation diagnostique de Statsmodels. Si le test diagnostique conclut à la présence significative d’une hétéroscédasticité structurelle (p < 0,05), le praticien doit impérativement renoncer aux erreurs-types standards et opérer une remédiation computationnelle rigoureuse en recalculant la matrice de variance-covariance via des estimateurs d’erreurs-types robustes à l’hétéroscédasticité (tels que la correction HC3 de Davidson et MacKinnon), ou basculer vers un schéma d’ajustement par moindres carrés pondérés (WLS).
9.3 Détection de l’autocorrélation et indépendance sérielle
Le troisième postulat fondamental conditionnant la robustesse de l’inférence par régression stipule l’indépendance mutuelle stochastique des termes d’erreur résiduelle. La violation de cette condition se traduit par le phénomène d’autocorrélation résiduelle, au sein duquel l’erreur commise sur une observation particulière conditionne la direction ou l’amplitude de l’erreur sur l’observation subséquente. Ce dysfonctionnement survient avec une prévalence alarmante dès lors que les données analysées procèdent de plans d’échantillonnage longitudinaux à mesures répétées, d’épreuves d’apprentissage chronologiques ou de séries temporelles cognitives.
L’outil diagnostique canonique dédié à la quantification de la dépendance sérielle d’ordre un est la statistique de Durbin-Watson, calculable immédiatement sur la série résiduelle ordonnée chronologiquement :
DW = ( Σ (e_t – e_{t-1})² ) / ( Σ e_t² )
Cette métrique prend ses valeurs au sein d’un intervalle borné allant de zéro à quatre. Une valeur empirique oscillant étroitement autour de deux témoigne d’une indépendance sérielle parfaite des termes d’erreur. Une statistique divergeant significativement vers zéro traduit une autocorrélation sérielle positive marquée (où les résidus positifs tendent à être suivis par des résidus positifs), tandis qu’une valeur convergeant vers quatre signale une alternance d’autocorrélation sérielle négative.
En présence d’une autocorrélation résiduelle avérée, l’ajustement d’une régression logarithmique simple univariée devient méthodologiquement invalide, les degrés de liberté réels de l’expérience étant artificiellement surestimés. Le chercheur doit alors enrichir son architecture computationnelle en incorporant des structures autorégressives et moyennes mobiles explicites (modèles de séries chronologiques ARMA) ou réorienter ses analyses vers des équations différentielles stochastiques capables de dissocier formellement la tendance logarithmique déterministe globale de la mémoire sérielle locale du processus biologique étudié.
10. 10. Étape 7 – Représentation graphique avancée et inférence visuelle
10.1 Tracé de la courbe ajustée continue sur l’espace d’échantillonnage
Une fois les paramètres optimaux rigoureusement estimés et validés sur le plan diagnostique, l’étape suivante consiste à formaliser la restitution graphique synthétique du modèle. Un écueil graphique fréquent consiste à relier simplement entre elles les valeurs prédites associées aux points discrets de l’échantillon expérimental, ce qui produit une trajectoire polygonale brisée particulièrement inélégante et scientifiquement inappropriée dès lors que la variable sous-jacente est conceptuellement continue.
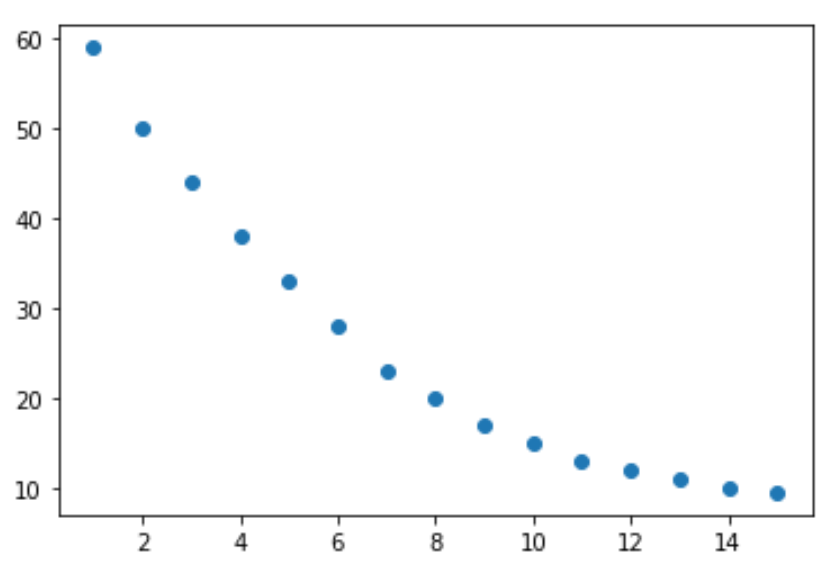
Pour restituer fidèlement la continuité analytique de la trajectoire logarithmique théorique, il convient de générer par voie de programme un maillage synthétique d’abscisses extrêmement dense et régulier au moyen de la méthode np.linspace(). Ce vecteur continu, configuré typiquement pour comporter entre cinq cents et mille incréments équidistants entre la valeur minimale et la valeur maximale observées sur l’échantillon empirique, est ensuite passé comme argument à la fonction logarithmique vectorisée configurée avec les paramètres optimaux popt.
Le tracé obtenu se déploie alors sous la forme d’une courbe continue parfaitement lisse et harmonieuse, venant survoler le nuage originel des données brutes. Le protocole de mise en forme impose l’intégration méthodique d’une légende informative complète, laquelle doit afficher non seulement l’équation mathématique paramétrée explicite, mais également les principaux descripteurs d’adéquation que sont le coefficient R² ajusté et la racine de l’erreur quadratique moyenne (RMSE), offrant au lecteur une synthèse visuelle instantanée de la valeur prédictive du dispositif.
10.2 Calcul et affichage des bandes de confiance statistiques à 95 %
Dans une perspective de rigueur inférentielle, présenter la trajectoire ajustée sous la forme d’un simple trait déterministe univarié constitue une simplification trompeuse. Toute estimation de paramètres à partir d’un échantillon empirique fini comporte une marge d’incertitude d’échantillonnage fondamentale qui doit être impérativement communiquée au lecteur par la construction de bandes de confiance statistiques continues.
La bande de confiance à 95 % délimite la zone spatiale au sein de laquelle la « véritable » fonction logarithmique moyenne de la population théorique a quatre-vingt-quinze pour cent de chances de se situer. Pour chaque point d’abscisse x_0 du maillage dense continu, l’erreur-type de la moyenne prédite SE(y_mean_0) est dérivée rigoureusement en appliquant la méthode delta matricielle :
SE(y_mean_0) = sqrt( J_0 * pcov * J_0^T )
où J_0 symbolise le vecteur gradient jacobien des dérivées partielles de la fonction par rapport aux paramètres a et b évalué aux coordonnées de x_0 (soit le vecteur [1, ln(x_0)]), et pcov désigne la matrice de variance-covariance des paramètres extraite lors de l’optimisation.
La marge d’erreur s’obtient ensuite en multipliant cette erreur-type locale par le quantile critique approprié issu de la loi t de Student à (n – 2) degrés de liberté pour un seuil bilatéral α = 0,05. Sur le plan de la sémiologie graphique, l’affichage de cette incertitude se réalise au moyen de la méthode plt.fill_between() de Matplotlib, qui applique une nappe de couleur translucide et discrète circonscrite entre la borne inférieure et la borne supérieure calculées. La morphologie de cette bande de confiance présente une géométrie évasée caractéristique : étroite et resserrée au centre du domaine expérimental autour du barycentre des observations, elle s’élargit progressivement à mesure que l’on s’écarte vers les bornes extrêmes d’échantillonnage, matérialisant visuellement la perte progressive de précision statistique induite par l’amenuisement de l’information locale.
10.3 Intégration des intervalles de prédiction pour les scores individuels
Il existe une divergence conceptuelle et probabiliste absolue entre l’intervalle de confiance de la moyenne théorique décrit précédemment et l’intervalle de prédiction individuelle, bien que ces deux notions soient couramment amalgamées de façon désastreuse au sein de la littérature appliquée. Alors que l’intervalle de confiance quantifie l’incertitude pesant sur l’estimation de l’espérance mathématique conditionnelle de la population, l’intervalle de prédiction individualisé délimite la région probabiliste au sein de laquelle viendra se situer le score empirique d’un nouveau sujet isolé prélevé aléatoirement dans la même population sous les mêmes conditions opératoires.
Sur le plan mathématique, la variance associée à une prédiction individuelle intègre une source d’incertitude supplémentaire incompressible : la variance stochastique résiduelle propre aux fluctuations interindividuelles σ². Dès lors, l’erreur-type de prédiction individuelle s’exprime par l’équation :
SE(y_indiv_0) = sqrt( s² + SE(y_mean_0)² )
où s² représente la variance résiduelle non biaisée estimée du modèle. En raison de l’adjonction de ce terme de variabilité intrinsèque, l’intervalle de prédiction individuelle s’avère considérablement plus large et distant de la trajectoire moyenne que la bande de confiance.
La projection visuelle conjointe de ces deux catégories d’intervalles sur le même graphique constitue un outil clinique et psychométrique d’une valeur diagnostique inestimable. Alors que la bande de confiance centrale permet d’attester de la validité de la trajectoire théorique moyenne formulée par le chercheur, les lignes enveloppantes de l’intervalle de prédiction définissent les frontières de normalité psychométrique. Tout patient ou sujet expérimental dont la mesure individuelle franchit les limites de cet intervalle de prédiction peut être immédiatement identifié comme présentant un comportement atypique ou un déficit pathologique franc vis-à-vis du modèle de référence normative.
11. 11. Études de cas appliquées en psychologie et neurosciences comportementales
11.1 Modélisation empirique de la courbe d’oubli d’Ebbinghaus
Pour matérialiser la pertinence appliquée de la méthodologie développée, la première étude de cas historique s’intéresse à la modélisation mathématique formelle de la célèbre courbe de dégradation mémorielle théorisée par Hermann Ebbinghaus dès 1885. Dans ses protocoles expérimentaux d’auto-expérimentation rigoureuse, Ebbinghaus mesura le pourcentage d’économie d’apprentissage réalisé lors de la réitération de séries de syllabes dépourvues de signification après des intervalles de rétention variant de vingt minutes à un mois entier.
En mobilisant notre pipeline Python sur les données historiques d’Ebbinghaus, le modèle logarithmique est ajusté en positionnant la latence temporelle (exprimée en heures) sur l’axe prédictif x et le pourcentage de rétention mnésique sur l’axe endogène y. Les résultats computationnels délivrent une équation empirique hautement cohérente de type y = 72,4 – 15,8 * ln(t), assortie d’un coefficient de détermination R² excédant 0,91. Cette cinétique traduit mathématiquement le fait que plus de la moitié de l’information encodée est perdue de manière fulgurante au cours des premières heures post-acquisition, tandis que la fraction résiduelle du souvenir subit une érosion considérablement plus lente, tendant vers une stabilisation à très long terme.
La comparaison quantitative via le critère AIC entre cet ajustement logarithmique et un modèle concurrent de déclin purement exponentiel (y = a * exp(-k * t)) démontre fréquemment la supériorité statistique formelle de l’architecture logarithmique. Cette conclusion soutient les théories modernes de la consolidation synaptique et de la réorganisation systémique de la mémoire au niveau hippocampo-néocortical, lesquelles postulent que les traces mnésiques qui survivent aux premières phases d’élagage acquièrent une résistance structurelle intrinsèque qui ralentit drastiquement leur vitesse d’oubli ultérieure.
11.2 Quantification de la loi de Hick-Hyman sur les temps de réaction
La deuxième étude de cas emblématique concerne la modélisation psychométrique des temps de réaction au sein des architectures cognitives décisionnelles, formalisée par la loi de Hick-Hyman. Le protocole expérimental standard confronte des sujets humains à des dispositifs lumineux comportant un nombre variable d’alternatives de choix possibles, s’échelonnant typiquement de deux à seize stimuli discriminables, le sujet devant activer le plus rapidement possible la réponse motrice correspondant au stimulus visuel activé.
Dans ce contexte, la modélisation sous Python consiste à convertir préalablement le nombre d’alternatives n en une quantité formelle de traitement d’information formulée en bits à l’aide d’un logarithme en base deux :
I = log2(n) = ln(n) / ln(2)
La régression logarithmique linéaire équivalente liant le temps de réaction TR au nombre brut d’alternatives s’exprime selon le modèle TR = a + b * ln(n).
L’analyse statistique exécutée via statsmodels révèle une convergence paramétrique remarquable. L’ordonnée à l’origine a estime avec précision le temps de conduction physiologique incompressible, intégrant le délai de transmission rétinienne, le temps de transit axonal afférent et la latence d’activation motrice mécanique finale (souvent de l’ordre de 180 à 220 millisecondes). La pente b, quant à elle, quantifie de manière isolée la capacité computationnelle interne de traitement de l’information du cortex cérébral, formalisant le coût temporel cognitif requis pour résoudre chaque unité logarithmique d’incertitude décisionnelle. Cette quantification permet de comparer objectivement les capacités d’efficience attentionnelle entre différentes populations cliniques, par exemple chez des patients souffrant de traumatismes crâniens ou de troubles de l’attention face à un groupe témoin.
11.3 Dynamique d’acquisition d’habiletés motrices et rendements décroissants
La troisième illustration appliquée s’ancre dans le champ des neurosciences motrices et de l’ergonomie cognitive à travers l’étude de l’acquisition de compétences procédurales de haute précision. Nous analysons l’évolution temporelle des durées d’exécution nécessaires pour accomplir avec succès une tâche complexe de pointage moteur ou de dextérité microchirurgicale au fil d’un protocole d’entraînement intensif structuré sur une séquence de cent sessions d’apprentissage consécutives.
L’ajustement de notre modèle non linéaire sur ces séries d’apprentissage révèle la signature incontournable des rendements marginaux décroissants. Au cours des dix premières sessions expérimentales, la vitesse d’exécution s’améliore de manière spectaculaire, les sujets éliminant les synergies musculaires antagonistes et affinant les représentations internes du modèle d’action motrice. Au-delà de cette phase pionnière, la trajectoire s’amortit considérablement, les quatre-vingt-dix sessions subséquentes ne générant que des perfectionnements millimétriques mais décisifs.
L’exploitation analytique de l’équation logarithmique paramétrée offre des perspectives opérationnelles considérables. Elle permet aux formateurs et aux ingénieurs pédagogiques de dériver formellement le volume précis d’entraînement itératif requis pour atteindre un seuil d’efficience opérationnelle standardisé, en résolvant simplement l’équation analytique pour la valeur seuil de y souhaitée. Par ailleurs, elle fournit un outil diagnostique rigoureux permettant de déceler l’atteinte réelle d’un plateau d’apprentissage physiologique, aidant à discriminer les phases de saturation neuromotrice normale des épisodes de régression transitoire induits par la fatigue cognitive ou l’amenuisement de la motivation intrinsèque du sujet.
12. 12. Bonnes pratiques méthodologiques, pièges fréquents et extensions
12.1 Dangers et dérives de l’extrapolation hors du domaine observé
L’un des écueils épistémologiques et statistiques les plus dévastateurs lors de l’utilisation de la régression logarithmique réside dans la tentation de l’extrapolation non contrôlée en dehors des bornes d’abscisse effectivement échantillonnées au cours de l’expérimentation. Les propriétés analytiques de la fonction logarithme népérien imposent en effet des comportements asymptotiques pathologiques aux limites de son domaine de définition mathématique.
D’une part, lorsque la variable indépendante x tend vers zéro par valeurs positives, la fonction diverge violemment vers moins l’infini (si b > 0) ou vers plus l’infini (si b < 0). Dès lors, extrapoler les prédictions d’un modèle d’oubli ou d’apprentissage à des fractions temporelles infinitésimales (quelques millisecondes après l’exposition initiale) conduit à prédire des scores de rétention excédant des milliers de pour cent, en totale déconnexion avec les limites physiologiques absolues du système nerveux. D’autre part, bien que la croissance logarithmique soit caractérisée par un amortissement continu, elle constitue une fonction non bornée supérieurement : à mesure que x croît vers des valeurs arbitrairement grandes, ln(x) continue de croître indéfiniment vers l’infini positif, excluant l’existence d’une asymptote horizontale stricte.
Le chercheur scrupuleux doit par conséquent s’imposer une règle déontologique inviolable : les conclusions déduites d’une régression logarithmique ne possèdent de validité scientifique que strictement circonscrites à l’intérieur de l’enveloppe métrique bornée par les valeurs minimale et maximale observées sur l’échantillon empirique (interpolation). Si la problématique théorique étudiée postule l’existence d’un plafonnement absolu indépassable ou d’une saturation physiologique stricte pour des valeurs d’antécédents massives, il est méthodologiquement impératif de délaisser la régression logarithmique simple au profit de modèles sigmoïdes bornés, tels que les modèles logistiques à quatre paramètres de Richards ou les formalismes de Michaelis-Menten.
12.2 Robustesse numérique face aux valeurs nulles ou négatives
Comme explicité lors de l’examen des fondements théoriques, la gestion des occurrences nulles ou négatives sur la variable prédictive pose un défi technique permanent. Face à un vecteur d’observations comportant des valeurs de temps zéro ou des scores nuls, une pratique informatique particulièrement répandue—mais conceptuellement contestable—consiste à appliquer de manière quasi automatique une transformation dite de Laplace ou pseudo-logarithme, consistant à injecter l’argument ln(x + 1).
Bien que cette convention prévienne immédiatement les erreurs d’exécution arithmétique en assurant que ln(0 + 1) = 0, ses répercussions statistiques sont loin d’être anodines. L’adjonction arbitraire de la constante scalaire unitaire modifie structurellement la dérivée de la fonction, déplaçant artificiellement la zone de courbure maximale et affectant substantiellement l’estimation de la pente b, particulièrement si l’étendue des données d’origine s’échelonne sur des grandeurs proches de l’unité. Cette distorsion s’avère particulièrement prononcée lorsque les données mesurent des amplitudes infinitésimales comprises entre zéro et deux.
Lorsque la présence de valeurs nulles procède de la nature continue de la mesure et qu’une translation d’échelle arbitraire est théoriquement indésirable, la démarche méthodologique la plus probe consiste à explorer la famille des transformations paramétriques continues de Box-Cox. La transformation de Box-Cox introduit un paramètre scalaire continu d’ajustement λ qui optimise formellement la normalisation de la série et converge analytiquement vers le logarithme népérien pur lorsque λ tend vers zéro, offrant ainsi une alternative théoriquement rigoureuse et statistiquement testable à l’application mécanique et non régulée d’un pseudo-compte arbitraire.
12.3 Vers les modèles non linéaires à effets mixtes (NLME)
L’architecture de régression logarithmique standard développée tout au long de cet ouvrage suppose implicitement que l’intégralité des observations empiriques recueillies procède d’un processus unique et homogène, où chaque point d’échantillonnage est stochastiquement indépendant de ses pairs. Or, dans la quasi-totalité des protocoles de recherche contemporains en psychologie, en neurosciences et en médecine comportementale, les données sont collectées selon des plans expérimentaux hiérarchiques ou longitudinaux, au sein desquels plusieurs mesures répétées sont obtenues pour un ensemble de sujets distincts.
Dans ce contexte hiérarchique, forcer un modèle de régression logarithmique univarié unique sur l’agrégat indifférencié de l’ensemble des données (technique naïve dite du « pooled model ») constitue une faute méthodologique majeure : cette approche ignore superbement la corrélation intra-sujet intrinsèque, enfreint le postulat d’indépendance des erreurs résiduelles et occulte totalement l’existence d’une variabilité interindividuelle fondamentale sur les paramètres d’apprentissage ou d’oubli.
L’extension méthodologique naturelle consiste à transcender la modélisation à effets fixes classique pour adopter les modèles non linéaires à effets mixtes (NLME – Non-Linear Mixed-Effects Models). Dans ce formalisme supérieur, l’équation logarithmique de base est enrichie en décomposant chaque paramètre en une composante fixe populationnelle globale (γ_a, γ_b) et une déviation aléatoire spécifique à chaque sujet individuel i (u_ai, u_bi) :
y_ij = (γ_a + u_ai) + (γ_b + u_bi) * ln(x_ij) + ε_ij
où les vecteurs d’effets aléatoires individuels [u_ai, u_bi] sont supposés suivre une distribution normale multidimensionnelle de matrice de covariance non nulle.
L’implémentation computationnelle de ces architectures avancées en Python ne peut plus reposer sur la fonction élémentaire curve_fit, mais requiert la mobilisation d’environnements bayésiens probabilistes de pointe tels que PyMC ou de packages spécialisés d’estimation par maximum de vraisemblance restreinte (REML). Cette modélisation hiérarchique permet au chercheur de quantifier simultanément la dynamique fonctionnelle logarithmique globale gouvernant la population d’étude et la dispersion de la réactivité neurocognitive individuelle, concrétisant ainsi l’idéal d’une analyse quantitative rigoureuse, personnalisée et respectueuse de la complexité des systèmes biologiques.
Références
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716-723. https://doi.org/10.1109/TAC.1974.1100705
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211-243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Burnham, K. P., & Anderson, D. R. (2002). Model selection and multimodel inference: A practical information-theoretic approach (2nd ed.). Springer-Verlag. https://doi.org/10.1007/b97636
- Davidson, R., & MacKinnon, J. G. (1993). Estimation and inference in econometrics. Oxford University Press.
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409-428. https://doi.org/10.2307/2332386
- Ebbinghaus, H. (1885). Über das Gedächtnis: Untersuchungen zur experimentellen Psychologie. Duncker & Humblot.
- Fechner, G. T. (1860). Elemente der Psychophysik. Breitkopf und Härtel.
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- Hick, W. E. (1952). On the rate of gain of information. Quarterly Journal of Experimental Psychology, 4(1), 11-26. https://doi.org/10.1080/17470215208416600
- Hyman, R. (1953). Stimulus information as a determinant of reaction time. Journal of Experimental Psychology, 45(3), 188-196. https://doi.org/10.1037/h0056940
- Moré, J. J. (1978). The Levenberg-Marquardt algorithm: Implementation and theory. In G. A. Watson (Ed.), Numerical Analysis (pp. 105-116). Springer-Verlag. https://doi.org/10.1007/BFb0067700
- Pinheiro, J. C., & Bates, D. M. (2000). Mixed-effects models in S and S-PLUS. Springer Science & Business Media. https://doi.org/10.1007/978-1-4419-0318-1
- Salvatier, J., Wiecki, T. V., & Fonnesbeck, C. (2016). Probabilistic programming in Python using PyMC3. PeerJ Computer Science, 2, e55. https://doi.org/10.7717/peerj-cs.55
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (Vol. 57, pp. 92-96). https://doi.org/10.25080/Majora-92bf1922-011
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.2307/2333709
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021