
Dans le paysage contemporain de l’apprentissage statistique et de l’économétrie appliquée, l’analyse prédictive et explicative se heurte fréquemment au fléau de la dimensionnalité ainsi qu’à l’omniprésence de structures de corrélation complexes au sein des matrices de conception. Lorsque le nombre de variables explicatives croît de manière significative par rapport au volume d’observations disponibles, ou lorsque les prédicteurs partagent une redondance informationnelle substantielle, le paradigme classique de l’estimation linéaire sans contrainte révèle des faiblesses structurelles majeures. Les estimateurs usuels voient leur variance s’envoler, anéantissant ainsi la capacité de généralisation des modèles sur des données non observées et rendant caduque toute tentative d’inférence causale rigoureuse.
Pour surmonter ces entraves méthodologiques, les techniques de régularisation statistique se sont imposées comme un standard incontournable de l’analyse moderne. Parmi ces méthodologies, la régression pénalisée dite du Least Absolute Shrinkage and Selection Operator (communément désignée par l’acronyme Lasso), introduite formellement dans la littérature par le statisticien Robert Tibshirani en 1996, constitue une rupture paradigmatique majeure. En mariant le principe du rétrécissement continu des coefficients d’ajustement à celui de la sélection parcimonieuse des covariables via une pénalité fondée sur la norme géométrique L1, le Lasso s’affranchit des limites traditionnelles de la sélection séquentielle de sous-ensembles tout en préservant une interprétabilité directe des grandeurs estimées.
Ce guide propose une analyse exhaustive, rigoureuse et étape par étape de la mise en œuvre de la régression Lasso au sein de l’environnement logiciel R. En articulant les fondements mathématiques indispensables de l’optimisation sous contrainte avec les impératifs pratiques du prétraitement des données, du réglage fin des hyperparamètres par validation croisée et de l’évaluation prédictive hors échantillon via le package de référence glmnet, ce document s’adresse aux chercheurs, analystes et praticiens soucieux de maîtriser l’ensemble de la chaîne de valeur algorithmique et inférentielle de cet outil fondamental.
1. Fondements théoriques et mathématiques de la régression Lasso
1.1 Limites des moindres carrés ordinaires (MCO)
L’estimation par les moindres carrés ordinaires (MCO) constitue le socle historique de l’inférence en régression linéaire. Ce paradigme repose sur la minimisation algébrique de la somme des carrés des résidus, communément désignée par le terme de résidus quadratiques (Residual Sum of Squares, ou RSS). Sous les hypothèses classiques du théorème de Gauss-Markov, lorsque les erreurs sont non corrélées, de variance constante et d’espérance nulle conditionnellement aux variables explicatives, l’estimateur des MCO jouit de la propriété d’être le meilleur estimateur linéaire non biaisé (BLUE). La solution analytique directe s’exprime alors classiquement par le produit matriciel de l’inverse de la matrice de Gram transposée avec le vecteur des observations cibles.
Cependant, cette élégance analytique se dégrade rapidement dès que le contexte empirique dévie des idéaux théoriques. En présence d’une dimensionnalité élevée, c’est-à-dire lorsque le nombre de covariables potentielles s’approche du nombre d’observations, ou dans le cas extrême où le nombre de paramètres surpasse la taille de l’échantillon, le problème devient mathématiquement indéterminé : la matrice de covariance empirique perd son plein rang et devient singulière, rendant son inversion strictement impossible sans régularisation. De surcroît, même lorsque l’inversion demeure numériquement réalisable, les moindres carrés souffrent d’une vulnérabilité critique face au phénomène de surapprentissage (overfitting). Le modèle ajuste non seulement le signal structurel sous-jacent, mais capture également les fluctuations stochastiques propres à l’échantillon d’entraînement.
Cette vulnérabilité découle directement de l’inflation de la variance de l’estimateur. Lorsque les prédicteurs présentent des intercorrélations marquées, le déterminant de la matrice d’information approche de zéro, induisant des valeurs propres extrêmement faibles. Par voie de conséquence, les éléments diagonaux de la matrice de covariance des estimateurs atteignent des amplitudes démesurées. Les coefficients estimés se caractérisent alors par une instabilité numérique notoire : de légères perturbations dans les données observées induisent des variations spectaculaires de signe et de magnitude dans les paramètres estimés, ruinant à la fois la validité prédictive et la crédibilité explicative du modèle.
1.2 Mécanisme de la pénalisation L1
La régression Lasso remédie aux apories des moindres carrés ordinaires en modifiant substantiellement la topologie de la fonction de coût à optimiser. Au lieu de minimiser exclusivement la somme des résidus au carré, le Lasso intègre un terme de pénalité additif proportionnel à la somme des valeurs absolues des coefficients de régression, ce qui correspond mathématiquement à la norme L1 du vecteur des paramètres. Formellement, la fonction objectif minimisée par le modèle s’énonce comme la somme de la moitié du RSS empirique et du produit d’un hyperparamètre positif non négatif, noté lambda, par la norme L1 du vecteur de régression, à l’exclusion du terme d’intersection (l’ordonnée à l’origine).
Le paramètre de régularisation lambda exerce une fonction de contrôle direct sur le compromis entre l’ajustement aux données et la complexité structurelle du modèle. Lorsque lambda est rigoureusement égal à zéro, le terme pénalisateur s’annule, ramenant instantanément le problème à l’optimisation non contrainte des moindres carrés ordinaires. Inversement, lorsque lambda tend vers l’infini, le coût associé à n’importe quel coefficient non nul devient prohibitif, forçant l’ensemble des coefficients de pente à converger asymptotiquement vers une valeur nulle absolue, ne laissant subsister dans le modèle que la moyenne globale de la variable réponse via la constante non pénalisée.
La propriété fondamentale et distinctive de la pénalité de norme L1, comparativement à la norme quadratique L2 utilisée dans la régression d’arête (Ridge), réside dans sa géométrie non différentiable à l’origine. Dans une formulation duale sous forme de contrainte d’optimisation de Karush-Kuhn-Tucker (KKT), minimiser les résidus sous une contrainte de plafond sur la somme des valeurs absolues revient à projeter les contours elliptiques quadratiques de la fonction de perte sur une boule unitaire de type losange ou polytope régulier. En raison des sommets pointus positionnés précisément sur les axes de coordonnées cartésiennes où un ou plusieurs coefficients s’annulent exactement, les lignes de niveau résiduel rencontrent très fréquemment la frontière de contrainte en ces sommets singuliers. Ce phénomène géométrique impose l’annulation stricte de certains coefficients, réalisant ainsi simultanément un rétrécissement des grandeurs et une sélection discrète de variables.
1.3 Le compromis biais-variance dans l’inférence Lasso
L’assise méthodologique du Lasso s’inscrit au cœur de la décomposition fondamentale de l’erreur quadratique moyenne (Mean Squared Error, MSE) en statistique prédictive. L’erreur de généralisation d’un estimateur vis-à-vis d’une grandeur sous-jacente se décompose de manière irréductible en la somme du carré de son biais, de sa variance d’échantillonnage et de la variance du bruit intrinsèque au phénomène étudié. Les estimateurs des MCO se caractérisent par un biais nul par construction, mais cette absence de distorsion théorique se paie au prix fort d’une variance d’échantillonnage potentiellement gigantesque en présence de haute dimension ou de corrélation.
Le Lasso introduit délibérément une distorsion systématique, c’est-à-dire un biais contrôlé, en contraignant les amplitudes des coefficients à se rapprocher du point d’origine. En contrepartie de ce biais contractif délibéré, l’espace des paramètres admissibles est drastiquement restreint, ce qui a pour conséquence immédiate d’amoindrir l’amplitude des fluctuations d’échantillonnage. En réduisant la variance des prédictions dans une proportion bien supérieure à l’accroissement quadratique du biais induit, l’application d’un paramètre lambda adéquat génère une baisse nette de l’erreur quadratique moyenne globale sur des cohortes de test indépendantes.
Sur le plan des propriétés de convergence asymptotique, le modèle résultant se distingue par sa parcimonie intrinsèque. En éliminant les prédicteurs dont le signal empirique est noyé par le bruit d’échantillonnage, le Lasso permet d’extraire une structure de représentation compacte et hautement informatif. Cette sparsité (ou parcimonie mathématique) confère au modèle une robustesse accrue face aux distorsions locales de l’échantillon, transformant un estimateur initialement instable en un dispositif prédictif résilient et performant sur le long terme.
2. La problématique de la multicollinéarité et la sélection de variables
2.1 Diagnostic de la multicollinéarité
La présence de fortes interdépendances linéaires entre plusieurs variables explicatives constitue l’un des défis les plus pernicieux de l’économétrie et de l’analyse multivariée. Pour quantifier l’intensité de ce phénomène avant toute modélisation, le praticien examine traditionnellement la matrice de corrélation bivariée ainsi que le facteur d’inflation de la variance (Variance Inflation Factor, ou VIF) associé à chaque variable. Le VIF mesure précisément la proportion dans laquelle la variance d’un coefficient de régression estimé se trouve gonflée en raison de la dépendance linéaire de ce prédicteur spécifique vis-à-vis de l’ensemble des autres variables indépendantes incluses dans l’équation.
Sur le plan de l’algèbre linéaire, la multicollinéarité se traduit par un conditionnement déplorable de la matrice d’information de Gram, définie par le produit matriciel de la transposée de la matrice de données avec elle-même. Lorsque deux ou plusieurs colonnes sont quasi-collinéaires, le déterminant de cette matrice tend vers zéro, et le ratio entre la plus grande et la plus petite valeur propre explose vers des valeurs extrêmes. Lors de l’inversion numérique nécessaire à l’obtention de la solution des moindres carrés, cette configuration engendre des erreurs d’arrondi critiques et une sensibilité pathologique aux moindres variations de mesure.
D’un point de vue inférentiel et causal, les conséquences s’avèrent désastreuses. Les erreurs-types des coefficients augmentent de façon disproportionnée, entraînant une chute drastique des statistiques de test de Student. En conséquence, des prédicteurs jouant pourtant un rôle déterminant sur le plan théorique peuvent sembler non significatifs d’un point de vue statistique. De surcroît, les estimations ponctuelles peuvent adopter des signes mathématiques contraires à toute logique mécanique ou empirique connue, interdisant formellement toute attribution causale fiable de l’impact individuel de chaque variable.
2.2 Sélection automatique de covariables
Face à la pléthore de prédicteurs potentiels, les analystes ont historiquement eu recours à des procédures heuristiques automatisées de sélection de variables, telles que les méthodes pas à pas descendantes (backward elimination), ascendantes (forward selection) ou bidirectionnelles (stepwise regression), basées sur des critères d’information d’Akaike (AIC) ou de Schwarz (BIC). Bien que largement disséminés dans les logiciels statistiques traditionnels, ces algorithmes gloutons souffrent de lacunes méthodologiques sévères : ils procèdent par décisions discrètes et séquentielles, ce qui induit une discontinuité stochastique majeure, biaise systématiquement les distributions d’échantillonnage des coefficients vers le haut, et génère des taux d’inclusion faussement optimistes.
À l’inverse, la régularisation continue incarnée par le Lasso traite l’arbitrage de sélection au sein d’un cadre d’optimisation global et continu. Plutôt que d’inclure ou d’exclure arbitrairement une variable sur la base d’un seuil p-valeur strict, l’algorithme comprime continûment l’ensemble des paramètres le long d’un continuum paramétrique régi par lambda. Les variables explicatives dont la force de corrélation partielle avec la variable réponse est insuffisante pour compenser le coût marginal imposé par la pénalité L1 voient leur magnitude réduite jusqu’à zéro de manière déterministe et fluide.
Ce processus de sélection continue présente l’immense avantage d’éliminer les covariables non pertinentes sans subir la volatilité inhérente aux algorithmes combinatoires discrets. Face à des prédicteurs purement bruités ou non porteurs d’information novatrice, le rétrécissement L1 garantit l’annulation stricte de leur coefficient d’impact, réduisant drastiquement le risque d’introduire des degrés de liberté superflus qui détériorent la robustesse prédictive du modèle sur des données non observées.
2.3 Pertinence méthodologique en modélisation complexe
La régression Lasso acquiert une pertinence méthodologique singulière dans les contextes de modélisation complexe caractérisés par de volumineux jeux d’indicateurs empiriques. On retrouve typiquement ces configurations dans les études épidémiologiques contemporaines, les analyses génomiques, le traitement du signal, ou encore les recherches en sciences comportementales et psychométriques où des batteries entières d’items d’échelles de mesure sont collectées simultanément pour appréhender des construits latents.
Dans ces disciplines, l’approche concurrente la plus répandue pour pallier la forte dimensionnalité consiste en l’extraction de composantes synthétiques, via des techniques projectives non supervisées comme l’analyse en composantes principales (ACP) ou la régression sur composantes principales (PCR). Bien que très efficaces pour assainir l’espace orthogonal des prédicteurs, ces méthodes de projection présentent le défaut majeur de détruire totalement l’interprétabilité directe des variables d’origine. Une composante principale résulte en effet d’une combinaison linéaire de l’intégralité des indicateurs initiaux, rendant la traçabilité des mécanismes explicatifs sous-jacents particulièrement opaque pour le décideur ou le chercheur.
Le Lasso offre une synthèse opérationnelle remarquable en opérant une réduction effective de dimensionnalité directement au sein de l’espace de mesure original. En opérant une sélection parcimonieuse sans projeter les données dans un espace latent orthogonal abstrait, l’algorithme préserve l’intelligibilité intrinsèque de chaque descripteur conservé. Le praticien dispose ainsi d’un sous-ensemble restreint de variables brutes, dotées de leurs unités physiques ou psychométriques initiales, facilitant l’implémentation opérationnelle et l’auditabilité réglementaire des conclusions issues du modèle prédictif.
3. Cadre comparatif : Lasso, Ridge et Elastic Net
3.1 Différenciation structurelle entre Lasso (L1) et Ridge (L2)
L’analyse comparative des techniques de régularisation impose une étude minutieuse des divergences structurelles existant entre la régression Lasso, fondée sur la pénalité L1, et la régression Ridge (ou régression d’arête de Tikhonov), ancrée dans la pénalité L2. Alors que le Lasso pénalise la fonction de perte par la somme des valeurs absolues des paramètres, la régression Ridge applique une contrainte proportionnelle à la somme des carrés de ces mêmes coefficients. Cette différence analytique en apparence modeste engendre des répercussions fondamentales sur le comportement asymptotique et la topologie des solutions générées.
Sur le plan géométrique, l’espace admissible de la régression Ridge est délimité par une hypersphère lisse et continûment différentiable. En conséquence, les lignes de contour elliptiques de la fonction de coût résiduelle rencontrent presque systématiquement la surface de contrainte en des points tangentiels situés à l’intérieur des quadrants, et non sur les axes coordonnés. Par conséquent, bien que la régression Ridge réduise continuellement l’amplitude de tous les coefficients vers zéro lorsque l’hyperparamètre de pénalité croît, elle n’annule jamais rigoureusement aucun paramètre à une valeur numérique exactement nulle. Le vecteur de coefficients demeure perpétuellement dense, interdisant toute sélection formelle de variables et contraignant le statisticien à conserver l’ensemble des prédicteurs dans l’équation finale.
Par ailleurs, leur comportement face à un ensemble de prédicteurs fortement collinéaires révèle une divergence comportementale majeure. La régression Ridge procède à un partage harmonieux du poids explicatif entre les variables redondantes : si deux prédicteurs présentent une corrélation presque parfaite, leurs coefficients régularisés par Ridge seront rétrécis de façon équitable et convergeront vers des valeurs quasi identiques. À l’opposé, la dynamique d’optimisation L1 du Lasso fait preuve d’une instabilité caractéristique en présence de collinéarité stricte : l’algorithme a tendance à sélectionner de manière quasi aléatoire l’un des prédicteurs du groupe corrélé tout en écrasant brutalement les coefficients des variables jumelles à zéro, ce qui peut nuire à l’interprétation théorique lorsque ces covariables possèdent une légitimité conceptuelle équivalente.
3.2 L’alternative de compromis de l’Elastic Net
Afin de concilier les vertus respectives de la sélection parcimonieuse du Lasso et du regroupement coopératif du Ridge, Zou et Hastie ont développé en 2005 la régression Elastic Net. Cette architecture hybride repose sur une pénalisation composite combinant de façon convexe les normes L1 et L2 à travers l’introduction d’un paramètre d’équilibrage scalaire traditionnellement dénoté par la lettre grecque alpha. Dans cette formulation, la pénalité globale pondère la norme L1 par alpha et la moitié de la norme L2 quadratique par le complément scalaire (1 – alpha), le tout modulé par l’hyperparamètre d’intensité globale lambda.
Cette formulation permet de corriger directement les deux faiblesses préjudiciables du Lasso classique. D’une part, lorsque plusieurs prédicteurs partagent un degré élevé de multicollinéarité, la composante Ridge L2 de l’Elastic Net force les coefficients de ces variables dépendantes à rétrécir conjointement en formant un groupe solidaire (grouping effect), éliminant ainsi le caractère erratique de la sélection unitaire propre au Lasso pur. D’autre part, la composante L1 assure que les groupes de covariables non corrélés au phénomène cible soient intégralement éliminés du système, préservant la capacité de production de représentations sparses et interprétables.
La règle empirique guidant le choix méthodologique s’appuie fréquemment sur le ratio entre le nombre de prédicteurs disponibles (p) et la taille de la cohorte d’observation (n). Lorsque le nombre de variables est très supérieur au volume de l’échantillon (p >> n), le Lasso ne peut mathématiquement sélectionner au maximum que n prédicteurs avant de saturer, ce qui constitue une limitation structurelle notable. L’Elastic Net lève cette borne théorique en autorisant la sélection d’un nombre de variables largement supérieur à la taille de l’échantillon tout en assurant une sélection de groupes stables, conférant au modélisateur une flexibilité indispensable pour traiter les jeux de données massifs contemporains.
4. Environnement logiciel et spécificités du package glmnet sous R
4.1 Architecture et performance de glmnet
L’écosystème open-source R propose une bibliothèque de référence absolue pour la mise en œuvre de la modélisation régularisée : le package glmnet, développé et maintenu par les pionniers de la discipline statistique Jerome Friedman, Trevor Hastie, Rob Tibshirani et Noah Simon. Loin d’être une simple surcouche de calcul matriciel standard, ce package se distingue par une architecture computationnelle de très haute performance, conçue pour minimiser la consommation de mémoire vive et maximiser la rapidité d’exécution sur de gigantesques volumes de données.
Le cœur de calcul de glmnet est intégralement programmé en langage Fortran compilé de bas niveau, tirant parti d’un algorithme extrêmement efficace de descente de coordonnées par blocs cycliques (cyclical coordinate descent). Au lieu de chercher à optimiser simultanément l’intégralité du vecteur de paramètres par des méthodes de second ordre coûteuses impliquant l’inversion répétée de matrices jacobiennes ou hessiennes, l’algorithme minimise la fonction de coût variable par variable de manière séquentielle, tout en fixant temporairement l’ensemble des autres coefficients à leur valeur courante. Grâce à la forme spécifique de la dérivée sous-différentielle de la pénalité L1, chaque étape unidimensionnelle admet une solution analytique explicite immédiate basée sur un opérateur de seuillage doux (soft-thresholding).
De plus, le package met en œuvre la méthode du chemin de régularisation entier (pathwise coordinate descent). L’algorithme calcule les solutions pour une grille séquentielle décroissante complète de valeurs d’hyperparamètres lambda. En utilisant la solution obtenue au lambda précédent comme point de départ chaud (warm start) pour initialiser l’optimisation au lambda suivant, le temps d’exécution requis pour déterminer la trajectoire de régularisation complète est considérablement réduit. L’environnement statistique s’enrichit également de dépendances structurelles incontournables comme le package Matrix pour la manipulation fluide des structures creuses et d’outils analytiques d’assistance graphique.
4.2 Exigences fondamentales de formatage des structures de données
L’utilisation pratique du package glmnet se distingue des conventions usuelles de modélisation sous R par des contraintes rigides imposées à la structure des données d’entrée. Contrairement aux fonctions classiques telles que lm() ou glm(), qui autorisent la formulation symbolique directe de modèles par le biais de formules textuelles appliquées à des conteneurs de type data.frame, glmnet refuse strictement ces objets de haut niveau pour des impératifs d’optimisation de bas niveau.
Le premier impératif concerne l’espace des covariables explicatives, qui doit être impérativement fourni à l’algorithme sous la forme d’un objet matriciel numérique continu de classe R matrix ou de classe creuse dgCMatrix. L’insertion d’un conteneur hétérogène comprenant des chaînes de caractères, des structures relationnelles ou des facteurs non recodés provoque l’interruption immédiate de l’interpréteur. De manière corollaire, la variable dépendante d’intérêt doit impérativement être formatée sous la forme d’un simple vecteur numérique continu pour un ajustement gaussien, dont la longueur coïncide strictement avec le nombre de lignes composant la matrice de conception des prédicteurs.
Pour gérer élégamment les variables catégorielles ou factorielles indispensables aux analyses empiriques, le praticien doit préalablement recourir à la fonction model.matrix() issue du package standard de statistiques de R. Cette fonction génère de façon automatisée le codage disjonctif complet en variables indicatrices binaires (dummy variables). Lors de cette étape matricielle préparatoire, une attention toute particulière doit être apportée à la suppression délibérée de la colonne constante unitaire représentant l’ordonnée à l’origine (intercept), car l’algorithme interne de glmnet gère et centre nativement la constante sans la soumettre à la pénalisation de rétrécissement L1.
5. Préparation rigoureuse et partitionnement des données empiriques
5.1 Structuration du jeu de données
Avant d’engager toute modélisation sous contrainte au moyen de glmnet, l’établissement d’une phase de structuration préalable des données s’avère indispensable pour garantir l’intégrité des calculs statistiques. Cette démarche débute par un recensement exhaustif et une typologie stricte des prédicteurs candidats. L’analyste doit isoler les variables quantitatives continues et les variables qualitatives ou discrètes, en s’assurant que ces dernières disposent d’un étiquetage clair et sans ambiguïté au sein de l’environnement de programmation.
L’étape suivante consiste à examiner scrupuleusement la variable cible afin de valider son alignement avec la fonction de perte postulée par le modèle régularisé. Dans le cadre d’un modèle Lasso linéaire gaussien conventionnel, la variable réponse doit impérativement afficher une continuité métrique adéquate et une absence de bornes d’écrêtement trop massives qui justifieraient plutôt l’usage de modèles tronqués ou de fonctions de lien spécifiques. Les échelles de mesure des différentes variables doivent être minutieusement répertoriées pour comprendre la distribution sous-jacente des grandeurs empiriques.
L’exigence computationnelle la plus impérieuse réside dans l’éradication absolue des données manquantes (valeurs NA ou NaN). Contrairement aux routines d’imputation interne propres à certains algorithmes arborescents non paramétriques, l’optimisation par descente de coordonnées de glmnet ne tolère aucune lacune informationnelle dans les matrices d’entrée. Deux voies méthodologiques se présentent alors au chercheur : l’exclusion pure et simple des observations incomplètes par filtrage des cas complets lorsque l’échantillon initial est très massif et que le mécanisme de perte est purement aléatoire, ou le déploiement d’un protocole d’imputation multivariée préalable afin de préserver la puissance d’échantillonnage de l’étude sans introduire de biais d’attrition systématique.
5.2 Partitionnement en ensembles d’entraînement et de test
Afin d’évaluer objectivement l’efficacité prédictive d’un modèle régularisé et de mesurer sans complaisance son aptitude à généraliser ses inférences sur une nouvelle cohorte d’observations, le protocole méthodologique impose un partitionnement étanche du corpus empirique global. La cohorte est subdivisée en deux sous-ensembles indépendants : une base d’entraînement (training set) dédiée à l’estimation des coefficients et à l’optimisation des hyperparamètres, et une base d’évaluation finale (testing set) strictement confinée pour l’audit des performances hors échantillon.
La reproductibilité formelle de ce processus stochastique impose la fixation préalable d’une graine de pseudo-aléatoire via la commande set.seed() dans l’espace de travail de R. Sans cette précaution technique élémentaire, toute tentative ultérieure de réplication numérique du protocole conduirait inévitablement à des partitions marginalement divergentes, modifiant subtilement la composition des matrices de conception et altérant la reproductibilité stricte des résultats statistiques publiés.
La distribution proportionnelle retenue respecte traditionnellement un ratio de 70/30 ou de 80/20 entre les données dévolues à l’entraînement algorithmique et celles assignées à l’évaluation terminale. L’impératif catégorique de cette phase réside dans la séparation hermétique des deux ensembles : aucune opération statistique de calcul de paramètres descriptifs, de normalisation métrique ou de sélection préliminaire d’indicateurs ne doit intégrer les observations réservées à l’ensemble de test, sous peine d’induire une fuite d’information stochastique (data leakage) hautement pernicieuse qui biaiserait à la hausse les performances prédictives estimées.
5.3 Extraction matricielle pour R
Une fois le partitionnement logique établi, le modélisateur doit matérialiser physiquement les structures de données au format d’algèbre linéaire exigé par les sous-programmes compilés de glmnet. Ce processus requiert la génération explicite de quatre objets R fondamentaux : deux matrices de conception de variables explicatives et deux vecteurs unidimensionnels regroupant les valeurs de la variable cible pour chaque partition empirique.
Pour le sous-ensemble d’apprentissage, la matrice désignée conceptuellement sous le vocable X_train est extraite en appliquant la fonction model.matrix() sur les covariables correspondantes, tout en veillant à retrancher explicitement la colonne d’intercept via la syntaxe de formule usuelle ~ . - 1. Simultanément, le vecteur de réponse correspondant, dénoté conventionnellement Y_train, est isolé sous une forme numérique pure. Ce protocole d’extraction est ensuite rigoureusement répété de façon strictement symétrique pour générer la matrice X_test et le vecteur Y_test constitutifs de l’ensemble d’évaluation.
La conclusion formelle de cette phase de préparation technique exige une validation dimensionnelle systématique des matrices et vecteurs ainsi créés au moyen des instructions d’inspection natives dim() et length(). Le chercheur doit s’assurer sans ambiguïté que le nombre de lignes de X_train coïncide fidèlement avec la dimension scalaire de Y_train, et qu’il en va strictement de même pour la paire X_test et Y_test. Toute divergence numérique dans le nombre de colonnes entre X_train et X_test révélerait une discontinuité fatale dans le codage des modalités factorielles, qui condamnerait d’emblée toute application prédictive ultérieure.
6. Standardisation et prétraitement des prédicteurs
6.1 Sensibilité intrinsèque de la pénalité aux échelles de mesure
L’incorporation d’une fonction de pénalité de rétrécissement au sein d’un critère de minimisation résiduelle altère drastiquement une propriété d’invariance fondamentale des moindres carrés ordinaires. En régression linéaire non contrainte, la transformation d’échelle linéaire ou le changement d’unité métrique appliqué à une variable explicative (par exemple, la conversion d’une distance de mètres en kilomètres) n’exerce absolument aucun effet sur la qualité globale de l’ajustement du modèle : le coefficient régresseur d’origine se trouve simplement multiplié ou divisé par le scalaire correspondant pour compenser l’amplitude de mesure sans modifier le pouvoir explicatif résiduel.
À l’inverse, l’optimisation sous contrainte de la norme L1 du Lasso traite la somme des valeurs absolues des coefficients de manière strictement homogène le long de la fonction d’objectif. Si deux variables prédictives exercent une influence substantielle équivalente sur le phénomène étudié, mais que la première est enregistrée sur une échelle numérique variant entre 0 et 1 alors que la seconde oscille entre 0 et 100 000, le coefficient de la première sera contraint d’adopter une amplitude des milliers de fois supérieure à celui de la seconde pour produire un impact mécanique analogue sur l’espérance conditionnelle.
Par conséquent, la pénalité L1 exercera une force de compression asymétrique dévastatrice sur la variable mesurée sur une petite échelle métrique. Son coefficient volumineux sera considéré par la fonction de coût comme excessivement onéreux à conserver, conduisant le modèle à écraser prématurément ce prédicteur à zéro, non pas en raison de son absence de pertinence explicative, mais en raison du simple choix arbitraire de son étalon de mesure. Pour rétablir une équité compétitive rigoureuse au sein du processus de sélection continue, le centrage et la réduction préalable de l’ensemble des colonnes de la matrice des covariables à une moyenne nulle et une variance unitaire s’imposent comme un prérequis théorique non négociable.
6.2 Gestion de la standardisation dans glmnet
Face à cet impératif métrologique déterminant, le package glmnet intègre un mécanisme interne automatisé de prétraitement spécifiquement pensé pour prémunir le statisticien contre toute erreur d’échelle. Par défaut, la routine principale d’estimation opère avec son argument interne standardize = TRUE activé en arrière-plan. Lorsque ce paramètre est validé, l’algorithme procède en amont à une normalisation invisible de chaque colonne de la matrice de conception, standardisant numériquement les prédicteurs pour que leur variance d’échantillonnage soit strictement unitaire avant de procéder aux cycles itératifs de descente de coordonnées.
L’élégance méthodologique de cette architecture réside dans son opacité fonctionnelle restituant des grandeurs immédiatement interprétables. Dès que la trajectoire d’optimisation converge et que les coefficients rétrécis sont définitivement fixés pour un lambda donné, glmnet applique instantanément une transformation inverse pour redimensionner automatiquement les valeurs estimées des coefficients à l’échelle originale des données brutes d’observation. L’utilisateur dispose ainsi de métriques dimensionnellement congruentes avec les variables initiales, ce qui simplifie grandement l’interprétation concrète des résultats.
Toutefois, une extrême vigilance s’impose si l’analyste décide d’opérer lui-même des transformations d’échelle préalables au moyen de la fonction native scale() de R. Dans ce contexte, appliquer une normalisation manuelle complète sur le jeu de données avant le partitionnement violerait directement le principe d’étanchéité méthodologique entre entraînement et test, en laissant infuser les moments statistiques des données d’évaluation dans la matrice d’apprentissage. Si une standardisation manuelle est requise, les moyennes et écarts-types empiriques doivent être scrupuleusement calculés uniquement sur X_train, puis réappliqués tels quels sur X_test pour interdire toute contamination informationnelle rétrograde.
7. Ajustement initial du modèle Lasso et analyse des chemins de régularisation
7.1 Exécution de l’algorithme principal
L’ajustement du modèle Lasso au sein de R s’effectue via l’invocation de la fonction maîtresse glmnet(), paramétrée rigoureusement sur les structures matricielles élaborées au cours de la phase de préparation. Le réglage fondamental qui gouverne l’orientation mathématique de la procédure réside dans l’argument alpha. Dans la formalisation algorithmique du package, fixer alpha = 1 contraint formellement le terme de pénalité à adopter exclusivement la norme L1, déclenchant le comportement de sélection parcimonieuse caractéristique du Lasso pur. Une valeur alpha = 0 orienterait les calculs vers le modèle Ridge L2, tandis qu’une valeur fractionnaire intermédiaire activerait le compromis Elastic Net.
Par défaut, la fonction ne calcule pas l’ajustement pour une seule valeur déterministe isolée de lambda, mais conçoit de manière autonome une trajectoire complète composée traditionnellement d’une séquence de 100 valeurs d’hyperparamètres espacées de façon logarithmique. L’algorithme débute son parcours par l’identification analytique de lambda.max, c’est-à-dire la valeur seuil minimale exacte pour laquelle l’intégralité des coefficients de régression se trouve écrasée à zéro sous l’effet d’une contrainte d’inégalité stricte de KKT. À partir de ce seuil supérieur, la grille décroît séquentiellement jusqu’à un lambda.min empirique déterminé par un ratio préétabli en fonction de la taille relative de la matrice de conception.
L’objet R renvoyé par cette routine d’exécution constitue une structure de classe complexe hautement optimisée. Il encapsule l’ensemble des matrices de coefficients calculées tout au long du cheminement d’optimisation, la séquence exacte des valeurs de lambda générées, le pourcentage d’écart résiduel ou de déviance expliqué à chaque point d’évaluation (%Dev), ainsi que les degrés de liberté associés (dénotés Df), lesquels correspondent rigoureusement au nombre total de covariables actives dotées d’un coefficient d’impact strictement non nul à chaque stade d’intensité de régularisation.
7.2 Visualisation du chemin de régularisation
L’analyse qualitative approfondie d’un modèle Lasso requiert l’inspection graphique immédiate de ce que la littérature statistique nomme le chemin de régularisation (regularization path). Dans l’écosystème logiciel R, cette représentation s’obtient de façon intuitive par l’application de la méthode graphique spécialisée plot() sur l’objet retourné par l’ajustement initial. Ce tracé synthétise de façon spectaculaire la dynamique différentielle de contraction des paramètres au fur et à mesure que la force de régularisation s’accentue ou se détend.
Sur cette représentation bidimensionnelle, chaque courbe continue retrace l’évolution de la valeur numérique d’un coefficient de régression spécifique en fonction d’un indice global de régularisation, fréquemment projeté par défaut sur la norme L1 totale du vecteur des paramètres ou sur l’échelle logarithmique de lambda. L’observateur assiste de visu au phénomène d’extinction progressive : lorsque la sévérité de la contrainte augmente, les coefficients des prédicteurs marginaux ou redondants décroissent rapidement et finissent par heurter de plein fouet l’axe horizontal d’annulation stricte pour ne plus jamais s’en détacher.
Cette visualisation fournit une richesse diagnostique inégalée pour le praticien. L’ordre d’entrée et de sortie des prédicteurs au sein de la matrice active renseigne précisément sur leur robustesse explicative relative. Les variables fondamentales associées à un signal puissant se distinguent par leur persistance à des niveaux élevés de pénalisation, maintenant une magnitude non nulle bien après que les indicateurs auxiliaires ont été éliminés. Cette trajectoire ordonnée matérialise l’essence même du processus de sélection continue sous contrainte géométrique.
8. Optimisation de l’hyperparamètre lambda par validation croisée
8.1 Mise en œuvre de la validation croisée K-fold
L’estimation de la trajectoire de régularisation fournit un ensemble continu de modèles viables, mais elle laisse ouverte la question fondamentale de l’identification de la valeur optimale du paramètre lambda pour garantir une performance prédictive maximale sur des observations futures. L’utilisation naïve de la métrique d’ajustement sur l’échantillon d’apprentissage conduirait inévitablement à sélectionner un lambda nul, réintroduisant l’intégralité des travers du surapprentissage. Pour résoudre cet arbitrage de manière rigoureusement empirique, le déploiement de la validation croisée K-fold (k-fold cross-validation) s’impose comme la méthodologie de référence.
Le principe fondamental consiste à partitionner pseudo-aléatoirement l’échantillon d’apprentissage global en k blocs disjoints d’égale dimension, la norme méthodologique fixant classiquement k = 10. De façon itérative, l’algorithme utilise k – 1 blocs pour ajuster la trajectoire du modèle Lasso, puis déploie les coefficients obtenus pour prédire les réponses des observations hébergées dans le bloc marginal délibérément laissé de côté. Cette opération d’évaluation étanche est répétée sur l’intégralité des k combinaisons possibles, garantissant que chaque donnée d’apprentissage soit évaluée exactement une fois en position d’extériorité statistique.
Dans l’environnement R, cette séquence est exécutée de façon entièrement automatisée au moyen de la fonction maîtresse cv.glmnet(). À l’instar des étapes précédentes, l’impératif de reproductibilité scientifique exige de figer la graine stochastique par set.seed() immédiatement avant l’appel de cette instruction. La fonction calcule l’erreur quadratique moyenne de validation croisée (Cross-Validated Mean Squared Error, CV-MSE) pour chacune des valeurs de la grille de lambda, et agrège les résultats pour estimer la distribution d’erreur de généralisation ainsi que son erreur-type d’échantillonnage associée.
8.2 Analyse comparative : lambda.min vs lambda.1se
L’interrogation de l’objet produit par cv.glmnet() met en lumière deux repères décisionnels primordiaux pour l’analyste de données, documentés sous les identifiants techniques lambda.min et lambda.1se. Ces deux valeurs cristallisent deux philosophies distinctes de l’optimisation sous contrainte et du compromis biais-variance, confrontant l’efficacité prédictive brute à l’exigence de sobriété théorique.
Le paramètre lambda.min désigne la valeur empirique exacte de l’hyperparamètre qui enregistre la moyenne d’erreur quadratique la plus faible le long du continuum de validation croisée. C’est l’optimum numérique absolu sur l’échantillon analysé. Si le seul et unique dessein de l’étude consiste à maximiser la précision prédictive brute sans se soucier du volume des descripteurs mobilisés ni de la volatilité d’échantillonnage des prédicteurs marginaux, lambda.min s’impose comme le choix logique immédiat du modélisateur.
À l’opposé, le repère lambda.1se incarne la mise en œuvre de la célèbre règle heuristique de parcimonie formalisée par Hastie et al., dite règle de l’écart-type unique (one-standard-error rule). Cette valeur correspond au lambda le plus élevé (et par conséquent au modèle le plus fortement régularisé et le plus sobre en nombre de paramètres) dont l’erreur prédictive moyenne demeure inférieure ou égale à la somme de l’erreur minimale de lambda.min et de son écart-type stochastique d’estimation. Choisir lambda.1se constitue une démarche prudente et robuste : elle sacrifie une fraction numériquement imperceptible et statistiquement non significative de performance brute sur l’autel d’une élimination accrue de variables superflues, réduisant le risque d’incorporer des faux positifs générés par les fluctuations d’échantillonnage.
8.3 Exploitation du graphique de validation croisée
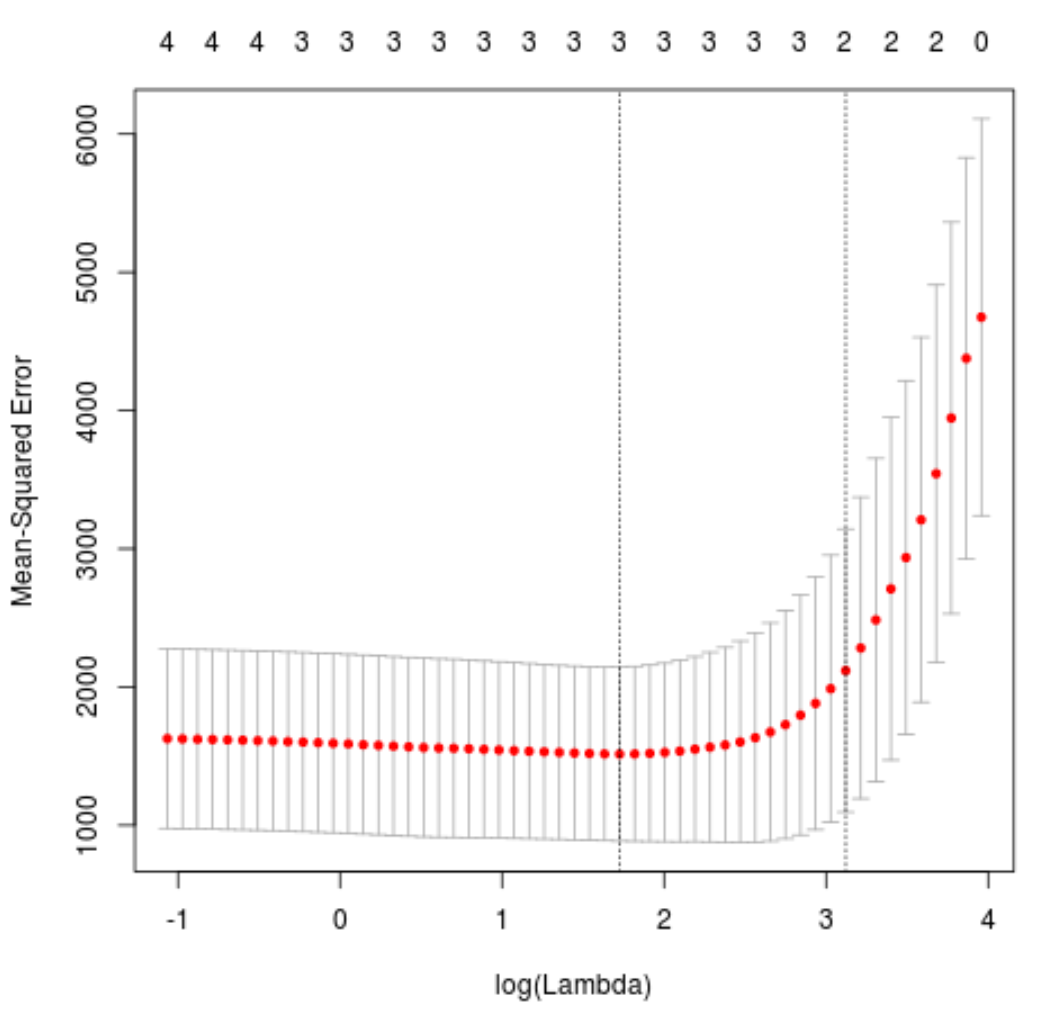
L’invocation de la fonction d’affichage graphique générique plot() appliquée directement à l’objet issu de cv.glmnet() produit l’une des figures de synthèse les plus déterminantes de l’apprentissage statistique sous R. Ce tracé permet d’auditer visuellement et instantanément la dynamique de sélection et d’appréhender le comportement structurel du modèle à travers l’éventail complet des intensités de régularisation testées.
Le graphique positionne sur son axe horizontal inférieur l’échelle logarithmique de lambda, tandis que l’axe vertical trace la trajectoire de l’erreur quadratique moyenne de validation croisée. Chaque point central correspond à l’estimation moyenne de l’erreur pour une valeur d’hyperparamètre donnée, enserré entre deux barres d’erreur verticales matérialisant l’intervalle de confiance d’échantillonnage à plus ou moins un écart-type. Deux lignes discontinues verticales traversent traditionnellement la composition, marquant précisément l’emplacement respectif de lambda.min à gauche et de lambda.1se vers la droite.
L’axe supérieur du tracé apporte une dimension analytique fondamentale en affichant dynamiquement le nombre de variables actives (les degrés de liberté Df) correspondant à chaque niveau de contrainte. L’interprétation séquentielle du tracé se décompose en trois phases distinctes :
- Sur l’aile gauche, où les valeurs de lambda sont excessivement faibles, l’absence de contrainte suffisante engendre un léger surajustement caractérisé par une remontée insidieuse de l’erreur de prédiction due à une variance excessive.
- Au centre, la courbe atteint un creux stable définissant la zone d’équilibre optimal entre biais contractif et variance d’échantillonnage.
- Sur l’aile droite, au-delà de
lambda.1se, l’erreur explose de manière exponentielle, signalant une zone de sous-ajustement critique (underfitting) où la pénalité surdimensionnée éradique sans discernement des prédicteurs essentiels au signal explicatif fondamental.
9. Extraction, interprétation et parcimonie des coefficients retenus
9.1 Extraction des matrices creuses (Sparse Matrix)
Une fois l’arbitrage théorique arrêté entre la performance pure de lambda.min et la frugalité méthodologique de lambda.1se, l’extraction de la configuration finale des coefficients du modèle Lasso est ordonnée au moyen de la commande générique coef(). Cette fonction interroge l’objet d’apprentissage en lui transmettant formellement la valeur exacte du lambda retenu via l’argument s. Le conteneur extrait se caractérise par une structure mathématique spécialisée issue du package Matrix, désignée sous l’appellation d’objet creux de classe dgCMatrix.
Dans la restitution textuelle générée par l’environnement R, les prédicteurs dont les coefficients ont été réduits à une nullité absolue par l’opérateur de seuillage doux ne sont pas affichés sous forme de zéros décimaux, mais sont symbolisés par de simples points typographiques de suspension (« . »). Cette formalisation computationnelle creuse n’est pas une simple coquetterie esthétique : elle allège massivement la mémoire requise par les systèmes statistiques lors du traitement de milliers de colonnes en omettant délibérément le stockage matriciel des coefficients nuls non informatifs.
Afin de transformer cette représentation matricielle creuse en un tableau de bord exploitable, l’analyste applique traditionnellement un court script de filtrage conditionnel sous R. En convertissant la structure dgCMatrix en une matrice conventionnelle dense ou en un tableau de données, il devient immédiat d’isoler exclusivement les descripteurs dont le coefficient de pondération est strictement différent de zéro. Ce protocole systématique livre la liste fermée des variables empiriquement sélectionnées par le Lasso, matérialisant de facto la réduction de dimensionnalité opérée au terme de la modélisation.
9.2 Interprétation substantielle des paramètres
L’attribution de sens aux grandeurs extraites impose une rigueur intellectuelle particulière, gouvernée par la nature contractile de l’opérateur L1. L’évaluation du signe mathématique associé à chaque coefficient conservé s’interprète de façon conventionnelle : un paramètre affecté d’un signe positif indique qu’une augmentation marginale de la covariable correspondante tire l’espérance mathématique de la réponse vers le haut, toutes choses étant égales par ailleurs, tandis qu’une valeur négative dénote une relation inverse.
Cependant, la quantification de l’amplitude absolue des coefficients requiert des précautions herméneutiques majeures. En raison du rétrécissement continu intrinsèque au Lasso, la magnitude des paramètres estimés subit un biais d’atténuation systématique dirigé vers l’origine : les grandeurs observées sous-estiment délibérément l’impact marginal effectif que l’on obtiendrait par une modélisation non contrainte. De surcroît, le praticien doit s’abstenir formellement de chercher à associer des p-valeurs (p-values) traditionnelles ou des intervalles de confiance gaussiens standards aux coefficients du Lasso au moyen des sorties logicielles ordinaires. La théorie classique de l’inférence par test de Student devient totalement invalide dans ce contexte, car la sélection préalable des variables opérée par le modèle sur les mêmes données distord profondément les lois de probabilité asymptotiques sous-jacentes (problème d’inférence post-sélection).
Quant aux prédicteurs définitivement exclus du modèle final et dont la contribution a été ramenée à zéro, leur éviction renvoie à une signification conceptuelle claire mais nuancée. L’algorithme atteste que l’information marginale véhiculée par ces indicateurs n’apporte aucun incrément explicatif statistiquement suffisant pour compenser le coût de complexité imposé par l’hyperparamètre lambda, conditionnellement à la présence des variables d’ores et déjà incluses dans le modèle actif. Cette exclusion ne signifie pas nécessairement que la variable évincée est dénuée de tout lien d’association bivarié avec la réponse, mais qu’elle se révèle redondante ou informationnellement dominée au sein du réseau de prédicteurs en présence.
10. Évaluation prédictive et validation sur données indépendantes
10.1 Génération des prédictions sur la matrice test
L’évaluation sans complaisance des mérites opérationnels du modèle Lasso trouve son aboutissement dans la confrontation des coefficients estimés avec l’échantillon de test indépendant, maintenu totalement vierge depuis la phase initiale de partitionnement. Cette démarche d’extériorité statistique garantit une mesure non biaisée de la capacité de généralisation de la structure mathématique apprise. Elle s’orchestre dans R par l’application de la méthode predict(), configurée spécifiquement pour les objets de régression pénalisée de classe glmnet.
L’appel de cette instruction nécessite le renseignement d’arguments rigoureusement typés. L’argument newx reçoit la matrice de test X_test, tandis que le paramètre s stipule avec une précision arithmétique la valeur exacte de l’hyperparamètre d’arbitrage (généralement lambda.min ou lambda.1se) retenue au terme de la validation croisée. Une rigueur méthodologique absolue s’impose quant à l’alignement des colonnes : la matrice X_test doit présenter un ordre de colonnes strictement identique, une structure de noms conforme et un encodage disjonctif parfaitement congruent avec ceux de la matrice d’entraînement X_train, sous peine de générer des vecteurs de projection erronés.
Le traitement algorithmique opère une multiplication matricielle directe entre les lignes de la nouvelle matrice de test et le vecteur extrait des coefficients régularisés, additionné du terme d’ordonnée à l’origine (intercept) non pénalisé. Le produit de cette transformation se matérialise sous la forme d’un vecteur continu d’estimations ponctuelles, regroupant pour chaque individu d’évaluation la réponse quantitative prédite par le modèle Lasso.
10.2 Métriques de performance globale
La quantification de la conformité empirique entre les valeurs réelles observées Y_test et les valeurs estimées générées par le modèle requiert le calcul d’un faisceau de métriques prédictives complémentaires. En premier lieu, la racine de l’erreur quadratique moyenne hors échantillon (Root Mean Squared Error, RMSE) constitue l’étalon de mesure par excellence. En appliquant une pénalité quadratique aux déviations résiduelles, la RMSE confère un poids prépondérant aux erreurs de prédiction de forte amplitude, offrant une jauge particulièrement sévère face aux décrochages locaux.
En parallèle, l’erreur absolue moyenne (Mean Absolute Error, MAE) apporte un éclairage complémentaire sur la performance médiane du dispositif. En sommant les écarts arithmétiques absolus sans élévation au carré préalable, la MAE se révèle nettement moins sensible aux valeurs extrêmes ou aberrantes résiduelles, traduisant l’amplitude de déviation type à laquelle l’utilisateur opérationnel peut légitimement s’attendre sur une observation quelconque.
Enfin, le coefficient de détermination hors échantillon (R² prédictif) clôt le diagnostic de validation globale. Contrairement au coefficient d’ajustement R² calculé sur l’échantillon d’apprentissage qui augmente mécaniquement avec l’addition de prédicteurs, le R² hors échantillon compare directement la variance résiduelle de validation à la variance totale intrinsèque de la cohorte de test. Cette grandeur mesure la proportion effective de variance empirique non observée expliquée de façon extrapolative par le modèle régularisé. Si le modèle surapprend de façon dramatique, cette métrique peut chuter vers des valeurs négatives, signalant qu’une simple moyenne empirique ferait une prédiction plus robuste que le modèle paramétré.
10.3 Comparaison empirique avec le modèle MCO standard
Pour mesurer sans ambiguïté le gain méthodologique apporté par l’approche Lasso, l’expérimentation statistique requiert la confrontation de ses résultats avec ceux d’une référence canonique : le modèle linéaire classique estimé par les moindres carrés ordinaires sur le même jeu de données d’apprentissage, via l’instruction native lm(). Ce banc d’essai comparatif permet de valider empiriquement si l’injection d’un biais délibéré par la norme L1 a effectivement jugulé l’inflation de la variance d’échantillonnage.
L’estimation des MCO est ainsi exécutée sur l’intégralité des covariables du jeu X_train, puis soumise au même protocole d’application prédictive sur la cohorte X_test pour dériver son vecteur résiduel indépendant. Les métriques d’erreur RMSE et MAE sont alors calculées selon une formulation mathématique rigoureusement symétrique pour les deux modèles en compétition. L’analyse des écarts de performance fait presque invariablement ressortir la supériorité prédictive du Lasso dès lors que la matrice de conception intègre un volume substantiel de variables bruitées ou corrélées.
Cette comparaison empirique met en évidence la valeur ajoutée du processus de régularisation : en éliminant les prédicteurs futiles et en tempérant les amplitudes extrêmes induites par la multicollinéarité chez les MCO, le modèle Lasso enregistre une baisse tangible de l’erreur quadratique moyenne sur les données de test. Le modélisateur démontre ainsi objectivement que la parcimonie structurelle ne s’est pas effectuée au détriment de l’expressivité empirique, mais a au contraire assaini la puissance de généralisation du système statistique.
11. Diagnostic des résidus et vérification de la robustesse
11.1 Analyse de la distribution des résidus
L’ajustement d’un modèle sous pénalité Lasso n’exonère nullement le statisticien de l’obligation méthodologique d’explorer rigoureusement le comportement des résidus d’estimation. Une modélisation prédictive performante ne saurait être validée si la structure des erreurs non expliquées témoigne d’une violation flagrante des postulats fondamentaux de régularité statistique ou trahit une incapacité structurelle du modèle linéaire à appréhender des motifs sous-jacents non linéaires.
L’investigation débute par l’examen de l’homoscédasticité, matérialisé par le tracé graphique de dispersion des résidus hors échantillon en fonction du vecteur des valeurs ajustées. L’observateur doit traquer toute configuration pathologique suggérant une hétéroscédasticité caractérisée, comme l’évasement en entonnoir de la variance résiduelle pour de grandes valeurs de prédiction, ou l’apparition de profils courbes témoignant d’effets de second ordre non modélisés. Les résidus doivent au contraire se disperser sous la forme d’un nuage aléatoire isotrope de moyenne nulle centré autour de la ligne horizontale d’indifférence.
De surcroît, le contrôle de la normalité distributionnelle des erreurs s’opère par l’examen conjoint du diagramme quantile-quantile (Q-Q plot) et du test de conformité de Shapiro-Wilk appliqué sur les résidus standardisés. L’inspection des queues de distribution s’avère particulièrement déterminante pour repérer les points de levier démesurés ou les observations aberrantes résiduelles. Des erreurs atypiques concentrées sur certains individus spécifiques peuvent révéler des sous-populations mal appréhendées par le modèle ou des anomalies de captation de données qui imposent un audit ciblé des bases sources.
11.2 Stabilité de sélection par rééchantillonnage (Bootstrap)
L’un des défis les plus pernicieux soulevés par l’exploitation pratique du Lasso réside dans la sensibilité stochastique de sa sélection de variables face aux variations marginales de l’échantillon d’apprentissage, en particulier lorsque plusieurs covariables partagent des niveaux élevés d’intercorrélation. Pour mesurer la fiabilité structurelle des prédicteurs retenus et s’assurer que leur sélection ne découle pas d’un artefact d’échantillonnage ponctuel, le déploiement d’un protocole de rééchantillonnage par bootstrap non paramétrique s’impose comme une méthodologie de confirmation indispensable.
La logique opérationnelle consiste à générer, par le biais d’une boucle algorithmique itérative sous R, une pluralité substantielle de répliques d’entraînement (couramment de 500 à 1 000 pseudo-échantillons) par tirage aléatoire avec remise parmi les observations de l’échantillon d’apprentissage d’origine. Pour chaque tirage bootstrap ainsi constitué, la chaîne complète d’optimisation par validation croisée cv.glmnet() est exécutée de façon étanche, et le vecteur booléen matérialisant l’inclusion ou l’exclusion de chaque variable prédictive est scrupuleusement archivé au niveau de l’hyperparamètre retenu.
L’agrégation transversale de ces centaines d’itérations permet de calculer la fréquence d’inclusion empirique associée à chaque prédicteur du jeu de données. Une covariable centrale dotée d’une véritable pertinence mécanique affichera un taux d’apparition avoisinant les 100 %, attestant de sa robustesse absolue face aux perturbations de l’échantillon. À l’inverse, des covariables dont la fréquence d’apparition fluctue autour des 20 ou 30 % témoignent d’une sélection fragile et instable, signalant à l’analyste que leur présence dans le modèle initial résultait d’une variabilité d’échantillonnage locale plutôt que d’un signal systématique avéré.
12. Bonnes pratiques méthodologiques, limites et extensions avancées
12.1 Limites inhérentes à l’approche Lasso
En dépit de sa remarquable puissance algorithmique et de son élégance mathématique incontestable, la régression Lasso présente des limitations intrinsèques que tout chercheur ou praticien se doit de maîtriser afin de prévenir toute conclusion méthodologiquement erronée. La première faiblesse majeure concerne son comportement structurellement instable en présence de blocs de prédicteurs hautement corrélés. Face à un groupe de variables caractérisées par une multicollinéarité extrême, la géométrie de la norme L1 conduit le Lasso à sélectionner de manière arbitraire une unique variable parmi le cluster et à écraser indistinctement les autres à zéro, ignorant délibérément la réalité systémique sous-jacente.
La seconde limitation fondamentale a trait à la nature uniforme de son rétrécissement paramétrique. La pénalité constante de norme L1 applique une force de compression d’intensité équivalente à l’ensemble des coefficients, quelle que soit leur magnitude sous-jacente. En conséquence, les prédicteurs exerçant des effets majeurs sur la variable réponse subissent un biais de rétrécissement constant et indésirable, conduisant à une sous-estimation systématique de leur amplitude réelle. Cette distorsion systématique dégrade la calibration probabiliste globale du modèle prédictif.
Enfin, sur le plan strictement asymptotique, le Lasso classique ne vérifie pas universellement ce que la théorie statistique désigne sous le terme de propriété d’oracle (oracle property). Un estimateur possède la propriété d’oracle s’il est capable, lorsque la taille d’échantillon grandit, d’identifier le véritable sous-ensemble de variables actives avec une probabilité tendant vers 1, tout en fournissant des estimations de coefficients asymptotiquement non biaisées et distribuées selon la même loi normale que si le véritable modèle sous-jacent avait été connu a priori. Le Lasso standard échoue fréquemment à concilier simultanément la consistance de la sélection et l’optimalité asymptotique de l’estimation.
12.2 Extensions : Lasso adaptatif et relaxation
Pour dépasser ces blocages asymptotiques sans abandonner les vertus de la régularisation continue, deux extensions algorithmiques sophistiquées ont été introduites et sont désormais accessibles au sein de l’écosystème R : le Lasso adaptatif (Adaptive Lasso) et le Lasso relaxé (Relaxed Lasso).
Le Lasso adaptatif, formalisé par Hui Zou en 2006, corrige le biais d’atténuation uniforme en modulant la pénalité L1 au moyen de poids d’ajustement spécifiques attribués à chaque coefficient individuel. Ces poids correctifs sont généralement calculés à partir des inverses des amplitudes de coefficients préalablement estimés par une méthode non biaisée ou faiblement pénalisée, telle que les MCO ou la régression Ridge. Ainsi, un prédicteur doté d’une forte assise empirique initiale se voit attribuer un poids pénalisateur minuscule, préservant son amplitude d’un rétrécissement abusif, tandis qu’une variable marginale se voit infliger une pénalité surdimensionnée qui précipite son élimination. Cette pondération différentielle restaure rigoureusement la propriété d’oracle.
Le Lasso relaxé (Relaxed Lasso), quant à lui, propose une résolution en deux étapes désormais nativement intégrée dans les versions récentes du package glmnet via l’argument relax = TRUE. Le principe consiste à scinder distinctement l’étape de sélection de variables et l’étape d’ajustement de magnitude. L’algorithme utilise d’abord la pénalité L1 pour délimiter le sous-ensemble optimal de variables actives, puis ajuste un modèle linéaire dépourvu de pénalité (ou doté d’une régularisation infinitésimale) exclusivement sur les covariables ainsi sélectionnées. Une interpolation linéaire gouvernée par un second hyperparamètre scalaire permet ensuite de calibrer le compromis idéal entre la version fortement rétrécie et la version décontractée non biaisée, réduisant substantiellement l’erreur quadratique moyenne globale.
12.3 Guide de synthèse pour la recherche empirique
L’aboutissement d’une recherche empirique articulée autour de la régression régularisée impose une discipline méthodologique rigoureuse afin d’assurer l’auditabilité et la reproductibilité absolue des scripts de calcul sous R. Le statisticien doit formaliser une chaîne de traitement séquentielle standardisée, débutant systématiquement par le scellement de la session d’analyse au moyen de set.seed() et l’archivage explicite des versions des bibliothèques logicielles mobilisées, à commencer par glmnet et Matrix, via l’appel de sessionInfo().
Le protocole empirique doit être consigné dans un journal d’exécution respectant scrupuleusement la chronologie opératoire :
- Vérification préalable de l’absence de valeurs manquantes et imputation étanche si nécessaire.
- Partitionnement hermétique des bases d’apprentissage et d’évaluation avant toute opération de centrage et réduction.
- Construction des matrices au format
matrixoudgCMatrixpar élimination des constantes redondantes au moyen demodel.matrix(). - Exécution de la validation croisée K-fold pour extraire de façon transparente les jalons d’arbitrage
lambda.minetlambda.1se. - Extraction formelle des coefficients retenus et validation empirique de leur robustesse structurelle par bootstrap non paramétrique.
- Audit des performances prédictives indépendantes (RMSE, MAE, R²) sur le jeu de test, accompagné du diagnostic graphique des résidus d’estimation.
Lors de la restitution des conclusions statistiques dans les publications académiques ou les rapports institutionnels, l’analyste doit s’abstenir de masquer la nature régularisée des résultats. Il convient d’exposer clairement la trajectoire de sélection, d’indiquer la proportion de covariables écartées par rapport au volume initial, et de commenter ouvertement le choix de l’hyperparamètre d’arbitrage en justifiant la préférence accordée à la parcimonie conceptuelle (lambda.1se) ou à l’efficacité prédictive pure (lambda.min). Cette transparence garantit l’intégrité scientifique des analyses et consolide la légitimité des décisions stratégiques ou cliniques étayées par la modélisation statistique.
Références
Bühlmann, P., & van de Geer, S. (2011). Statistics for high-dimensional data: Methods, theory and applications. Springer Science & Business Media. https://doi.org/10.1007/978-3-642-20192-9
Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
Hastie, T., Tibshirani, R., & Wainwright, M. (2015). Statistical learning with sparsity: The lasso and generalizations. CRC Press. https://doi.org/10.1201/b18401
Meinshausen, N. (2007). Relaxed lasso. Computational Statistics & Data Analysis, 52(1), 374–393. https://doi.org/10.1016/j.csda.2006.12.019
Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
Zou, H. (2006). The adaptive lasso and its oracle properties. Journal of the American Statistical Association, 101(476), 1418–1429. https://doi.org/10.1198/016214506000000735
Zou, H., & Hastie, T. (2005). Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301–320. https://doi.org/10.1111/j.1467-9868.2005.00503.x