
Dans le paysage contemporain de l’analyse computationnelle et de la science des données, l’environnement statistique R s’est imposé comme une référence épistémologique et technique incontournable. Sa flexibilité analytique, la richesse de son écosystème de paquets et sa rigueur mathématique permettent aux chercheurs et aux analystes d’extraire des structures signifiantes à partir de corpus empiriques complexes. Néanmoins, l’aboutissement d’un flux de traitement de données ne réside pas uniquement dans l’estimation de modèles statistiques ou la génération de visualisations vectorielles de pointe. Il implique fondamentalement la transmission, le partage et l’interopérabilité des résultats auprès de communautés pluridisciplinaires, d’organismes de régulation et de décideurs institutionnels dont les outils quotidiens demeurent ancrés dans l’usage des tableurs bureautiques, au premier rang desquels figure Microsoft Excel.
Le format de classeur Office Open XML, universalisé sous l’extension standardisée .xlsx, constitue de facto une lingua franca pour la restitution et l’inspection de données tabulaires au sein du tissu socio-économique et scientifique. Si les statisticiens privilégient volontiers les structures de données en mémoire vive telles que les data frames, les tibbles ou les data tables, les partenaires de recherche exigent régulièrement des supports d’information consolidés, lisibles et immédiatement opérationnels. Exporter des structures tabulaires matricielles depuis R vers un classeur unique structuré en plusieurs onglets thématiques répond à un impératif méthodologique crucial : réunir au sein d’une archive documentaire unitaire des données multidimensionnelles, des statistiques descriptives, des sorties de modélisation et des dictionnaires de variables, tout en prévenant l’éparpillement documentaire inhérent aux formats plats textuels.
La mise en œuvre d’une telle sérialisation soulève toutefois des interrogations techniques d’une grande technicité architecturale. Comment assurer une conversion fidèle des types de données primitifs de R vers les spécifications de typage propres à la norme ISO/IEC 29500 régissant les fichiers Excel ? Quelles sont les stratégies algorithmiques à déployer pour garantir la scalabilité des écritures face à des volumes de données conséquents, sans saturer les ressources de la mémoire vive ni dépendre de couches d’exécution externes instables comme l’environnement Java ? Le présent traité méthodologique explore de manière exhaustive les paradigmes, les bibliothèques logicielles et les patrons d’architecture permettant de maîtriser l’exportation de data frames multiples vers des classeurs Excel multi-feuilles, en offrant aux praticiens de la recherche les fondements nécessaires à la constitution de flux de travail reproductibles, robustes et élégamment documentés.
1. Introduction et fondements méthodologiques de l’exportation multiple sous R
1.1 Enjeux de la gestion des données multidimensionnelles en recherche empirique
La collecte de données au sein des protocoles scientifiques contemporains génère des ensembles de données d’une granularité et d’une hétérogénéité sans précédent. Dans des disciplines telles que les neurosciences comportementales, l’épidémiologie ou l’économétrie appliquée, un même paradigme expérimental implique la capture concomitante d’indices physiologiques continus, de mesures psychométriques discrètes, d’inventaires démographiques et de journaux d’événements temporels. Tenter de fusionner arbitrairement ces strates d’information au sein d’une unique table de données dénormalisée engendre une redondance structurelle massive, augmente le risque d’incohérences de saisie et compromet la validité interne des analyses ultérieures. À l’inverse, consigner chacune de ces dimensions dans des fichiers plats déconnectés, tels que des fichiers CSV distincts, pose des défis logistiques considérables en matière de gouvernance des données.
La dispersion d’un projet d’étude à travers des dizaines de fichiers CSV entraîne une rupture systémique de la traçabilité. Les métadonnées contextuelles s’égarent fréquemment au fil des transferts de répertoires, les versions de fichiers prolifèrent de façon anarchique et le risque d’analyser des tables désynchronisées s’accroît de manière exponentielle. L’adoption d’un classeur Excel unifié, structuré en onglets logiques et étanches, répond précisément à cette problématique organisationnelle. En regroupant les cohortes, les temps de mesure ou les niveaux d’agrégation statistique au sein d’un conteneur numérique singulier, le chercheur maintient l’intégrité relationnelle de son protocole tout en facilitant l’exploration interactive pour les pairs ne maîtrisant pas la ligne de commande.
Enfin, les impératifs de la science ouverte et de la reproductibilité imposent une gestion scrupuleuse des liens logiques entre données brutes, données nettoyées et paramètres d’estimation. L’organisation multi-feuilles offre la possibilité d’adjoindre directement aux données primaires un onglet dédié au dictionnaire des variables, un onglet consignant les métadonnées de collecte et un onglet exposant les paramètres de modélisation. Cette architecture documentaire intégrée consolide le cycle de vie de la donnée scientifique, facilitant l’évaluation par les pairs, les audits réglementaires et l’archivage pérenne au sein des entrepôts de données institutionnels.
1.2 Architecture logicielle de l’écosystème R pour les formats tabulaires
Pour appréhender les mécanismes d’exportation vers Microsoft Excel, il convient d’analyser les divergences architecturales fondamentales qui séparent le modèle objet de R de la norme de sérialisation OpenXML. Au sein de R, le data frame est une structure bidimensionnelle reposant sur une liste sous-jacente de vecteurs de longueurs identiques, où chaque colonne est soumise à un typage atomique strict (entier, flottant à double précision, chaîne de caractères, logique ou facteur). L’environnement d’exécution de R opère exclusivement en mémoire vive (RAM), ce qui permet des manipulations vectorielles ultra-rapides mais interdit toute persistance directe sans une étape explicite de sérialisation externe.
À l’opposé, un fichier Excel à extension .xlsx n’est pas un fichier binaire monolithique mais une archive compressée selon l’algorithme ZIP, respectant les spécifications des Open Packaging Conventions. À l’intérieur de ce conteneur se déploie une arborescence complexe de fichiers textuels rédigés en format XML (Extensible Markup Language). Chaque feuille de calcul correspond à un document XML distinct contenant la définition des cellules, de leurs coordonnées spatiales et de leurs typologies, tandis que des fichiers auxiliaires répertorient les chaînes partagées (shared strings), les relations typologiques (relationships) et les styles graphiques. Dès lors, le transfert d’un data frame depuis R vers une feuille Excel ne consiste pas en un simple déversement de mémoire, mais en une opération lourde de traduction sémantique et de composition de documents XML conformes aux schémas stricts de Microsoft.
L’histoire de cette interopérabilité au sein de la communauté R a été marquée par une quête constante d’optimisation. Les premières solutions logicielles nécessitaient l’intermédiation de technologies tierces lourdes et complexes à configurer, générant des incompatibilités récurrentes entre systèmes d’exploitation. L’avènement de bibliothèques modernes entièrement écrites en C ou en C++ et intégrées à R via Rcpp a profondément redéfini l’état de l’art, permettant une conversion directe, performante et dénuée de dépendances système contraignantes.
1.3 Objectifs pédagogiques et applications aux sciences comportementales
Ce guide méthodologique a pour vocation d’exposer avec exhaustivité les techniques programmatiques permettant de générer des classeurs Excel multi-feuilles à partir de R, en s’adressant aux chercheurs, biostatisticiens et ingénieurs de données confrontés à des architectures d’information complexes. Dans le champ des sciences comportementales, de la neuropsychologie et de la psychiatrie clinique, les protocoles expérimentaux requièrent fréquemment l’articulation de données provenant de sources disparates : batteries de tests cognitifs standardisés, électoencéphalographie, actimétrie, échelles psychométriques d’auto-évaluation et données sociodémographiques contextuelles.
La structuration recommandée tout au long de cet ouvrage repose sur la séparation rigoureuse des niveaux d’analyse au sein d’onglets individualisés : un premier onglet isolant les covariables de niveau sujet, un deuxième consignant les mesures répétées longitudinales, un troisième formalisant les métriques de performance comportementale à l’échelle des essais (trials), et un quatrième détaillant les codes d’imputation et les pondérations d’échantillonnage. Cette organisation modulaire garantit que l’intégrité référentielle, incarnée par un identifiant de sujet persistant et uniforme, demeure inviolable à travers l’ensemble des strates du classeur.
En automatisant l’intégralité du processus de génération de ces classeurs par le truchement de scripts programmatiques, le chercheur élimine définitivement les opérations manuelles de copier-coller au sein de l’interface graphique d’Excel. Ces manipulations manuelles représentent, selon l’ensemble de la littérature sur la bio-informatique et la reproductibilité, l’une des sources majeures d’altération accidentelle des données, d’écrasement silencieux de formules et de décalages dimensionnels des vecteurs. L’automatisation sous R sanctuarise le traitement des données et assure une traçabilité totale depuis l’extraction brute jusqu’à la production du livrable final.
2. Le package openxlsx : Architecture et avantages comparatifs
2.1 Indépendance vis-à-vis de l’environnement d’exécution Java
Pendant de nombreuses années, le package xlsx a constitué la solution dominante pour manipuler des classeurs Microsoft Excel depuis l’interpréteur R. Cependant, cette bibliothèque reposait fondamentalement sur le pont logiciel rJava et les bibliothèques Java Apache POI. Cette dépendance structurelle envers l’environnement d’exécution Java (JRE) a engendré d’innombrables obstacles méthodologiques et opérationnels. L’alignement des architectures matérielles (conflits récurrents entre les versions de R compilées en 64 bits et les machines virtuelles Java installées en 32 bits), la configuration manuelle fastidieuse des variables d’environnement telles que JAVA_HOME, et les dysfonctionnements sporadiques lors des mises à jour des distributions d’exploitation ont rendu les chaînes de traitement fragiles et difficilement exportables.
Le package openxlsx a constitué une rupture paradigmatique majeure dans cet écosystème en éliminant purement et simplement toute dépendance envers Java. Développé initialement par Alexander Walker, openxlsx prend en charge la création, la manipulation et l’écriture des fichiers .xlsx en dialoguant directement avec les spécifications du standard XML sans solliciter de machine virtuelle externe. Cette autonomie logicielle confère aux scripts d’analyse une portabilité absolue : un script exploitant openxlsx s’exécute de manière rigoureusement identique sur un poste de travail sous macOS, un environnement d’entreprise Windows ou un nœud de cluster de calcul intensif sous Linux Ubuntu ou Red Hat Enterprise, sans nécessiter la moindre installation préalable d’un composant système auxiliaire.
Cette simplification radicale des dépendances s’avère particulièrement bénéfique au sein des pipelines d’intégration continue (CI/CD) et des environnements virtualisés sous Docker. Le déploiement d’applications R Shiny ou de rapports dynamiques automatisés ne requiert plus l’allocation de conteneurs volumineux incluant les paquets logiciels du JDK, réduisant d’autant la surface de vulnérabilité informatique et les temps de compilation des environnements d’analyse.
2.2 Gestion de la mémoire et optimisation des temps d’écriture
Outre son indépendance logicielle, la supériorité technique de openxlsx réside dans son architecture interne hautement optimisée. La construction des structures XML sous-jacentes et la compression des archives ZIP sont déléguées à du code C++ natif via le pont technologique Rcpp. Cette conception permet d’éviter l’écueil classique de la saturation de mémoire heap souvent observé avec rJava, au sein duquel l’écriture de tables dépassant quelques dizaines de milliers de lignes provoquait inéluctablement des erreurs critiques de type java.lang.OutOfMemoryError.
Le package openxlsx gère l’allocation de la mémoire vive avec une efficacité remarquable en procédant à une sérialisation en flux continu (streaming). Plutôt que de conserver en mémoire l’intégralité du document XML décompressé sous la forme d’un arbre d’objets complexe, le package génère les flux textuels et les écrit directement sur le système de fichiers temporaire de façon séquentielle. Cette stratégie algorithmique prévient le gonflement artificiel de l’empreinte mémoire du processus R, permettant le traitement aisé de volumétries imposantes, courantes dans les études de suivi épidémiologique ou les registres médicaux longitudinaux totalisant des centaines de milliers d’enregistrements.
Les gains temporels obtenus sont substantiels : là où les anciennes bibliothèques basées sur Java exigeaient plusieurs minutes pour assembler et sérialiser un classeur de taille moyenne comportant une dizaine de feuilles riches en données, openxlsx réalise ces mêmes opérations en quelques fractions de seconde. Cette réactivité est essentielle lors des phases de développement itératif et d’exploration statistique, où la réexécution fréquente des scripts d’exportation ne doit pas freiner la dynamique de recherche.
2.3 Installation, chargement et configuration environnementale
L’intégration de openxlsx au sein de l’espace de travail s’effectue directement depuis les dépôts officiels du Comprehensive R Archive Network (CRAN). L’installation standard est amorcée via l’instruction standard d’installation des packages du système R. Dès lors que la machine de l’utilisateur dispose d’un environnement de compilation standard et des dépendances graphiques élémentaires (telles que le paquet zlib présent par défaut sur la quasi-totalité des architectures modernes), la mise à disposition de la bibliothèque est immédiate et ne nécessite aucun privilège d’administration système complexe.
Dans un script d’analyse destiné à être reproduit de manière rigoureuse, l’invocation du package s’accompagne avantageusement de la configuration d’options globales de comportement. R fournit un mécanisme de paramétrage de l’environnement permettant de définir de manière pérenne la typologie des formats d’affichage pour l’ensemble des sessions de travail. Il est hautement recommandé d’expliciter, dès l’amorce du script, les formats d’écriture par défaut des valeurs temporelles, des dates calendaires et des valeurs numériques à virgule flottante afin de neutraliser toute ambiguïté liée aux configurations locales de la machine hôte.
Par exemple, configurer l’option de formatage de date d’openxlsx au format normalisé ISO 8601 (AAAA-MM-JJ) garantit que les dates sérialisées seront immédiatement interprétées par Microsoft Excel comme des données chronologiques valides et non comme des chaînes de texte arbitraires, indépendamment des spécificités régionales de l’utilisateur final. De même, l’ajustement des options gérant la chaîne d’affichage des données non disponibles prévient l’introduction involontaire d’espaces insécables ou de symboles susceptibles d’induire en erreur les moteurs de calcul automatique du tableur.
3. Préparation et structuration des data frames pour l’exportation
3.1 Modélisation de données expérimentales et psychométriques
L’efficacité d’un processus d’exportation vers un format bureautique repose sur la qualité intrinsèque et la discipline de modélisation des objets en mémoire. En amont de toute invocation des fonctions de sérialisation, les données analytiques doivent être rigoureusement conditionnées au format rectangulaire canonique (tidy data), tel que conceptualisé par Hadley Wickham. Chaque colonne doit représenter sans équivoque une variable unidimensionnelle identifiable, et chaque ligne doit correspondre à une unité d’observation singulière. Dans le contexte des sciences psychologiques, il est fréquent de concevoir des jeux de données partitionnés reflétant les composantes théoriques de l’investigation empirique.
Considérons, à titre d’illustration méthodologique, une recherche évaluant l’impact du stress aigu sur les performances exécutives. La préparation programmatique des données sous R implique la constitution de plusieurs sous-ensembles logiques : premièrement, une table répertoriant les caractéristiques sociodémographiques des participants (âge, niveau d’éducation, sexe biologique, appartenance au groupe contrôle ou expérimental) ; deuxièmement, une table consignant les scores psychométriques bruts et standardisés issus d’échelles d’anxiété validées comme l’inventaire de Spielberger (STAI-Y) ; troisièmement, une table à haute densité temporelle récapitulant les temps de réaction et les taux d’erreur mesurés lors d’une épreuve cognitive standardisée de type Stroop ou N-Back.
Au sein de ces trois tables, les identifiants de sujets doivent faire l’objet d’une standardisation rigide. L’utilisation d’une typologie alphanumérique homogène (par exemple « SUBJ-001 », « SUBJ-002 ») est impérative afin d’éviter que des identifiants purement numériques ne soient interprétés par inadvertance comme des valeurs continues par Excel, ce qui risquerait d’induire des tris erratiques ou la perte des zéros initiaux de calage. Les variables qualitatives doivent être explicitement converties en facteurs pourvus de modalités étiquetées, et les chaînes textuelles libres doivent subir un nettoyage de leurs espaces périphériques via des fonctions de manipulation de chaînes afin de prévenir toute altération cosmétique lors du rendu dans les cellules du tableur.
3.2 Assemblage des structures de données en listes nommées
Le pivot algorithmique fondamental permettant à R de dialoguer avec les architectures multi-onglets des classeurs réside dans l’utilisation des listes nommées. Au sein de la théorie des types de R, une liste est un vecteur générique hétérogène capable de contenir des objets arbitraires de différentes natures et dimensions. Lorsqu’une liste est peuplée exclusivement de data frames et que chacun de ses éléments est associé à une étiquette textuelle (nom d’élément), elle constitue la représentation isomorphe parfaite d’un classeur Excel composé d’onglets individualisés.
La déclaration formelle de cette structure de métadonnées s’effectue en associant une clé textuelle sémantique à chaque objet tabulaire préparé en amont. L’étiquette de l’élément de liste déterminera de manière déterministe et automatique le nom qui sera attribué à l’onglet dans le classeur cible généré sur le disque. Il est donc indispensable d’élaborer une nomenclature concise, explicite et représentative de la teneur informationnelle de chaque sous-ensemble de données. Par exemple, l’association de clés explicites telles que « Demographie », « Echelles_Anxiete » et « Performances_Cognitives » structure immédiatement le document de sortie dans une optique de clarté documentaire maximale.
Il importe de souligner que le système de nommage des éléments de liste dans R tolère une grande variété de caractères qui ne sont pas nécessairement compatibles avec les restrictions imposées par la spécification technique de Microsoft Excel. L’attribution des clés textuelles doit donc être pensée de manière préventive en intégrant les contraintes de normalisation du format de destination, afin de proscrire toute rupture logicielle lors du processus de sérialisation automatique.
3.3 Vérification de la conformité dimensionnelle avant sérialisation
Avant d’engager les opérations d’écriture sur disque, il est indispensable d’implémenter des assertions programmatiques visant à valider la conformité des structures en mémoire. Dans un flux analytique automatisé, présumer de l’intégrité des tables sans contrôle préalable expose l’analyste à des corruptions de fichiers silencieuses ou à des interruptions de script bloquantes au cours de traitements par lots. La vérification dimensionnelle s’attache à confirmer que chaque data frame de la liste contient au minimum une ligne d’observation et une colonne de variable, et qu’aucune table n’est réduite à un état nul ou indéfini consécutif à une erreur de filtrage préalable.
Un autre point de vigilance capital concerne l’inspection des types d’objets imbriqués. L’écosystème du Tidyverse, et en particulier le formalisme des tibbles, autorise la création de colonnes imbriquées (list-columns) renfermant des sous-tables, des vecteurs ou des modèles statistiques complexes au sein même des cellules d’un data frame. De telles structures de données arborescentes sont fondamentalement incompatibles avec la nature bidimensionnelle plate des cellules d’une feuille de calcul Excel. Tout objet de cette nature doit faire l’objet d’un aplatissement préalable, d’une sérialisation textuelle ou d’une extraction vers un onglet indépendant.
L’utilisation de fonctions de contrôle automatisé permet d’interroger systématiquement les métadonnées de la liste. On vérifiera la non-duplication des noms de colonnes au sein d’une même table, l’homogénéité des formats de date et l’absence de noms de colonnes anonymes générés par défaut. La mise en œuvre de ces contrôles qualité préventifs garantit que l’objet composite transmis aux fonctions d’exportation présente un niveau de maturité structurelle parfait, prévenant toute anomalie lors de la génération du document final.
4. La méthode canonique : Utilisation directe de la fonction write.xlsx
4.1 Syntaxe fondamentale et mécanisme de dispatch
Pour la majorité des cas d’usage opérationnels ne nécessitant pas de mises en forme graphiques hautement individualisées cellule par cellule, la méthode canonique pour réaliser l’exportation multiple repose sur l’appel direct de la fonction write.xlsx exposée par le package openxlsx. Cette fonction constitue une interface de haut niveau conçue pour encapsuler de manière transparente la totalité des étapes intermédiaires : instanciation d’un classeur temporaire en mémoire vive, ajout ordonné des feuilles de calcul, injection matricielle des données et sérialisation binaire finale compressée vers le système de stockage physique.
Le comportement de la fonction write.xlsx est gouverné par un mécanisme de polymorphisme fonctionnel (dispatch dynamique selon la classe de l’argument principal). Lorsque le premier paramètre transmis à la fonction est un data frame unique, write.xlsx initialise un classeur composé d’un unique onglet portant conventionnellement le nom de la variable ou une désignation générique. En revanche, lorsque le praticien lui transmet une liste de data frames nommée, la fonction réagit de manière polymorphique en interprétant chaque élément de la structure hiérarchique comme une entité tabulaire autonome destinée à son propre onglet applicatif.
La signature de la fonction requiert obligatoirement la transmission du chemin d’accès au fichier de sortie, spécifié sous forme de chaîne de caractères absolue ou relative. L’élégance de cette conception réside dans son minimalisme : en une instruction fonctionnelle unique et déclarative, l’utilisateur orchestre la transition entre une structure de données multidimensionnelle complexe en mémoire et un document bureautique unifié pleinement conforme aux standards industriels.
4.2 Implémentation d’un cas d’étude reproductible
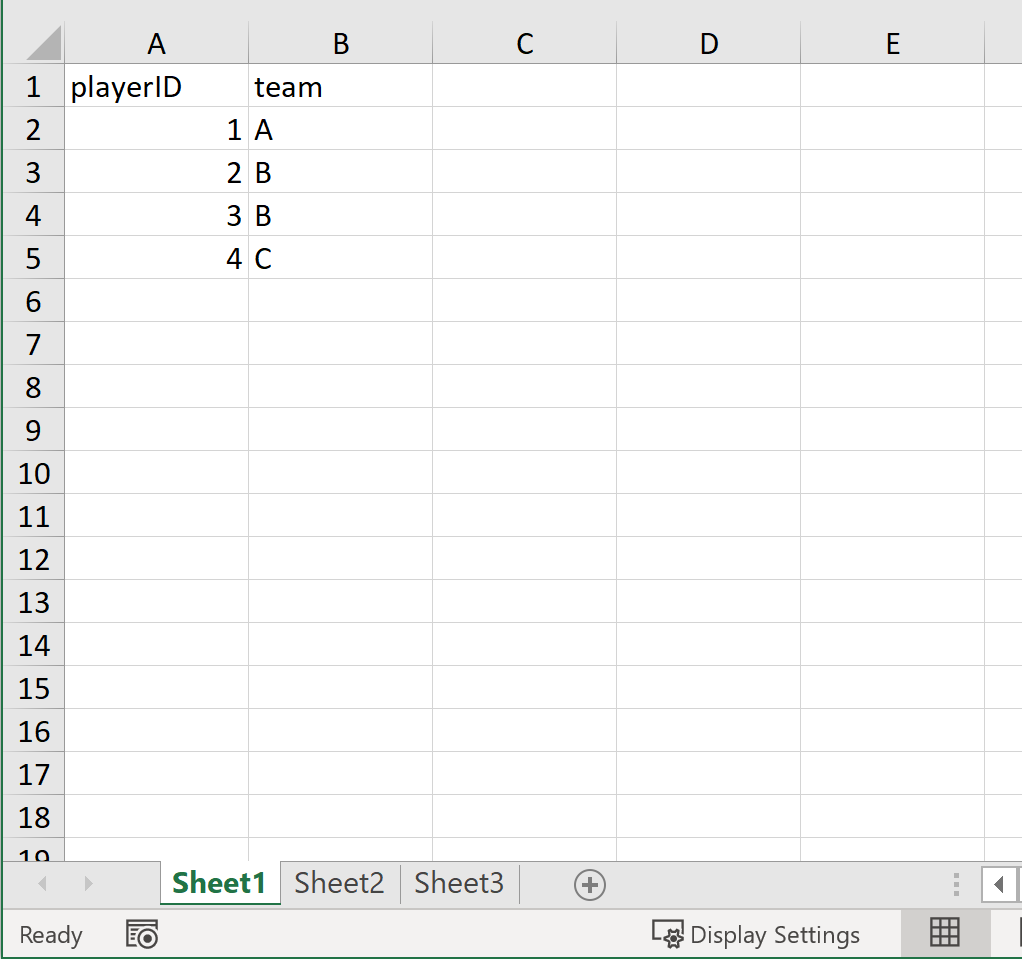
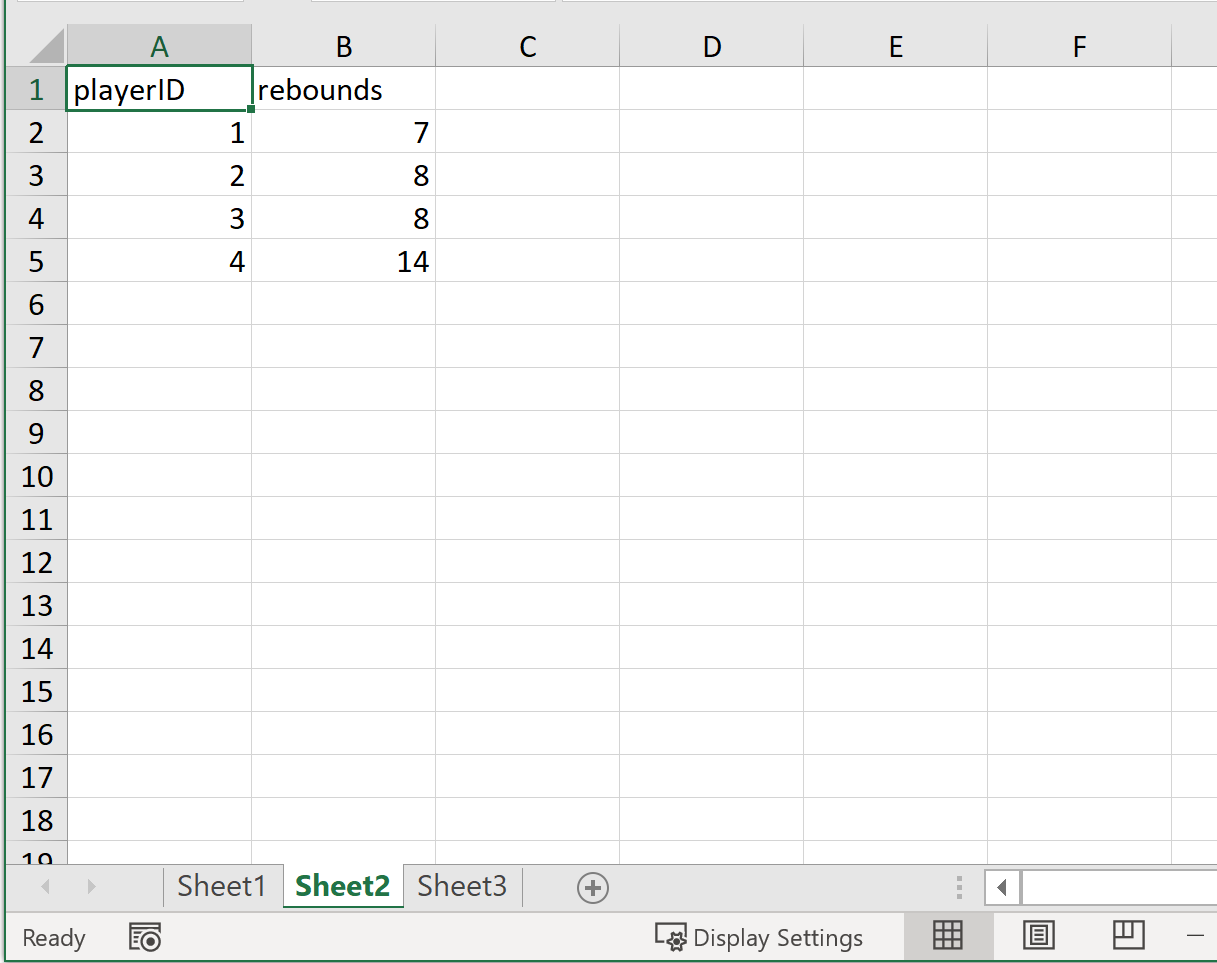
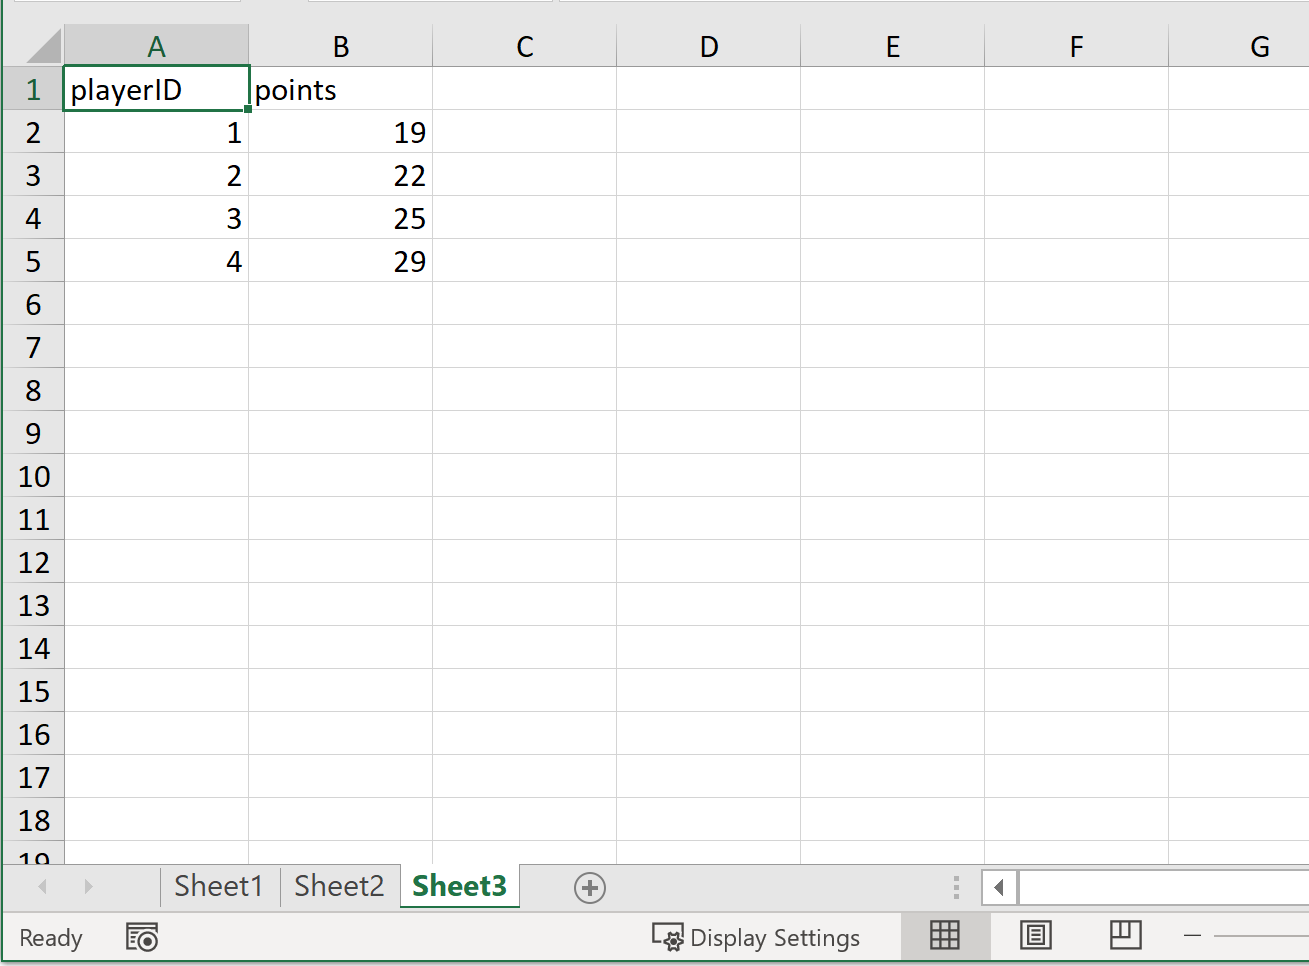
Afin de matérialiser ce paradigme méthodologique, examinons la mise en œuvre séquentielle d’un cas d’étude complet dans l’environnement R. Nous modélisons trois structures de données indépendantes : une première table encapsulant les données démographiques d’une cohorte clinique (identifiants, âges, assignation des groupes d’intervention), une deuxième consignant les scores psychométriques obtenus lors de visites successives, et une troisième récapitulant les paramètres pharmacocinétiques ou biologiques mesurés.
L’analyste instancie tout d’abord ces data frames en utilisant les types primitifs adéquats, en s’assurant que les identifiants de sujets partagent une stricte cohérence typographique. Ces trois tables sont ensuite agrégées au sein d’une variable de type liste, à laquelle on assigne formellement des noms explicites tels que « Cohorte_Patients », « Suivi_Psychometrique » et « Biomarqueurs_Cliniques ». Cette liste composite est alors transmise en premier argument de l’instruction write.xlsx, en désignant par exemple le chemin cible « Resultats_Protocole_Experimental.xlsx ».
L’exécution de cette instruction déclenche la création du fichier sur le disque sans intervention humaine ultérieure. L’ouverture subséquente du classeur dans un tableur confirme que le document intègre trois onglets distincts, agencés rigoureusement dans l’ordre de définition de la liste R, chaque onglet arborant le libellé textuel correspondant exactement aux clés de la liste. Les en-têtes de colonnes sont automatiquement reportés sur la première rangée de chaque feuille, et les enregistrements sont disposés de manière parfaitement alignée avec leurs types de données respectifs.
4.3 Paramétrage additionnel de write.xlsx
Bien que son comportement par défaut suffise à la production de fichiers bruts, la fonction write.xlsx dispose d’une riche panoplie d’arguments optionnels permettant d’affiner l’ergonomie documentaire sans basculer vers des architectures de code plus verbeuses. L’un des leviers les plus appréciés réside dans la gestion des filtres automatiques. En positionnant l’argument booléen dédié aux filtres d’en-tête à la valeur vraie, write.xlsx applique instantanément sur la première ligne de chaque onglet du classeur les listes déroulantes de filtrage et de tri natifs d’Excel, offrant ainsi à l’utilisateur final un confort d’inspection immédiat.
Un autre paramètre déterminant concerne la politique d’écrasement des fichiers préexistants, contrôlée via l’argument overwrite. Par défaut ou selon les versions, la présence d’un fichier homonyme dans le répertoire de travail cible peut générer un avertissement ou une interruption critique afin de prémunir le chercheur contre la destruction accidentelle de ses analyses antérieures. L’affectation explicite de la valeur vraie à cet argument est indispensable dans le contexte d’une exécution de script automatisée au sein d’un pipeline d’analyse dynamique, où la régénération programmée du document doit pouvoir écraser sans blocage les états antérieurs du classeur.
Enfin, la lisibilité visuelle d’un tableau Excel dépend substantiellement de l’ajustement de la largeur des colonnes. Par défaut, Excel applique une dimension uniforme qui conduit inévitablement à la troncature des libellés de colonnes longs ou au masquage partiel de certains nombres de grande magnitude. L’activation de l’argument d’ajustement automatique de la largeur (asTable ou les options de dimensionnement automatique des colonnes proposées par l’interface de haut niveau) force le moteur d’openxlsx à évaluer la longueur maximale du texte contenu dans chaque vecteur pour adapter dynamiquement la largeur métrique des colonnes correspondantes au sein du document généré.
5. Gestion programmatique granulaire avec l’objet Workbook
5.1 Instanciation et cycle de vie d’un objet Workbook
Lorsque les exigences de mise en forme, de structuration visuelle ou d’organisation spatiale dépassent les capacités fonctionnelles offertes par le verbe direct write.xlsx, il devient nécessaire de recourir au modèle objet orienté bas niveau exposé par le package openxlsx. Cette approche repose sur la manipulation explicite d’un objet en mémoire appartenant à la classe de référence Workbook. L’instanciation de cet objet s’opère par l’appel de la méthode createWorkbook, qui initialise une structure de données abstraite encapsulant l’intégralité des métadonnées, des feuilles, des styles et des relations qui constitueront le futur document Office Open XML.
L’utilisation programmatique de l’objet Workbook découple conceptuellement la phase de conception logique du document de sa sérialisation physique finale. L’analyste se trouve investi d’un contrôle absolu sur chaque étape du cycle de vie du classeur : il peut initialiser un classeur vierge, y injecter des propriétés documentaires formelles (nom de l’auteur, titre du projet, date de génération, commentaires de révision), déclarer des palettes de styles graphiques académiques, adjoindre séquentiellement des onglets, positionner des tableaux de données à des coordonnées cartésiennes précises et, in fine, valider la persistance du conteneur en invoquant la méthode saveWorkbook.
Ce paradigme déclaratif modulaire s’apparente à la construction d’un document graphique par couches successives. Il offre une résilience et une adaptabilité méthodologique majeures dans le contexte de protocoles expérimentaux institutionnels requérant des chartes graphiques normées ou la juxtaposition de tableaux statistiques multiples et de commentaires narratifs au sein d’une même feuille de calcul.
5.2 Insertion séquentielle de feuilles de calcul
Une fois l’objet classeur instancié en mémoire, l’aménagement de son arborescence interne s’effectue au moyen de la méthode impérative addWorksheet. Cette fonction enregistre formellement une nouvelle entité de feuille de calcul au sein de l’arborescence XML du classeur, en lui assignant une dénomination textuelle passée en argument. L’analyste est libre d’itérer autant de fois qu’il le souhaite sur cette fonction pour doter son classeur de la topologie multi-feuilles exacte requise par l’architecture du projet de recherche.
La méthode addWorksheet ne se borne pas à enregistrer un nom d’onglet ; elle permet de paramétrer finement le comportement intrinsèque de la feuille de calcul lors de son affichage ultérieur dans l’interface bureautique. L’analyste peut notamment stipuler si la feuille doit afficher par défaut la grille cartésienne de séparation des cellules, activer des options d’orientation pour l’impression (portrait ou paysage), ou encore configurer l’agencement visuel des règles de pagination. Il est également possible d’ajuster l’état de visibilité de l’onglet, en le déclarant visible, masqué ou très masqué (veryHidden), cette dernière option s’avérant utile pour dissimuler des tables de paramètres techniques aux yeux des évaluateurs finaux tout en les préservant dans la logique interne du document.
L’ordre séquentiel d’appel de la méthode addWorksheet détermine par défaut l’ordre physique d’apparition des onglets dans la barre de navigation inférieure de Microsoft Excel. Cette caractéristique permet d’organiser logiquement le cheminement de lecture de l’évaluateur, en plaçant systématiquement en première position l’onglet de synthèse conceptuelle ou de dictionnaire de données, avant de dérouler les onglets spécialisés renfermant les données quantitatives brutes et les résultats des modèles inférentiels.
5.3 Alimentation ciblée des zones matricielles par writeData
La population des données tabulaires au sein des feuilles déclarées s’opère par le truchement de la fonction writeData ou de sa variante structurelle writeDataTable. Contrairement au mécanisme global de write.xlsx qui déverse indifféremment le jeu de données à l’angle supérieur gauche de la feuille, writeData confère une flexibilité géométrique totale en permettant de spécifier explicitement les coordonnées de la cellule d’ancrage (numéro de ligne startRow et numéro de colonne startCol).
Cette granularité spatiale est fondamentale pour l’élaboration de rapports analytiques avancés. L’analyste n’est plus contraint d’occuper la première ligne par les en-têtes de colonnes de données. Il peut délibérément réserver les premières lignes de la feuille pour y insérer des blocs de métadonnées contextuelles rédigés sous forme de chaînes de caractères isolées : description détaillée de la procédure expérimentale, rappel de la date d’exécution de l’analyse statistique, version de l’interpréteur R employé et seuils de significativité retenus. La table de données empiriques vient ensuite s’ancrer de manière élégante sous ce préambule informatif, conférant au livrable un caractère autonome et auto-descriptif.
La distinction entre writeData et writeDataTable mérite une précision épistémologique. La première injecte les données sous forme d’une plage matricielle standard de cellules Excel, offrant une totale latitude quant à l’application ultérieure de formats typographiques sur-mesure. La seconde, en revanche, sérialise le data frame sous la forme d’un objet « Tableau Excel » officiel (ListObject au sens de Microsoft Office), conférant nativement à la structure des rayures chromatiques alternées (banded rows), des options de tri dynamiques préintégrées et la compatibilité avec la syntaxe de références structurées propre aux classeurs modernes.
6. Automatisation itérative pour volumes de données dynamiques
6.1 Approche fonctionnelle avec la famille apply et purrr
Dans un contexte de recherche empirique rigoureuse, le nombre et la nomenclature des sous-ensembles de données à exporter ne sont pas nécessairement connus à l’avance de manière statique. Les protocoles expérimentaux contemporains impliquent fréquemment des traitements multi-niveaux où des analyses similaires doivent être dupliquées à travers des cohortes démographiques distinctes, des centres d’acquisition hospitaliers multiples ou des conditions pharmacologiques variées. L’écriture manuelle d’instructions répétitives d’exportation pour chaque sous-ensemble violerait frontalement le principe DRY (Don’t Repeat Yourself) et introduirait une source majeure de vulnérabilité logicielle.
Le paradigme de la programmation fonctionnelle, incarné dans R de base par la famille des fonctions lapply et modernisé au sein de l’écosystème Tidyverse par le package purrr, offre une élégance computationnelle remarquable pour automatiser l’exportation multiple. En exploitant la fonction iwalk de purrr, l’analyste peut parcourir de manière itérative et vectorisée l’ensemble d’une liste nommée de data frames en manipulant simultanément la structure matricielle de la table (la valeur) et l’étiquette textuelle de l’élément (la clé ou l’indice).
Cette approche permet d’orchestrer la population d’un objet Workbook au sein d’une chaîne déclarative concise et fluide. Pour chaque itération déclenchée par iwalk, la routine ajoute dynamiquement la feuille de calcul correspondante à l’aide de l’étiquette courante, puis y injecte immédiatement les données associées en appliquant un schéma de formatage préétabli. Ce formalisme garantit que le flux s’ajuste dynamiquement à toute fluctuation du volume de cohortes en entrée : si le protocole intègre de nouveaux sous-groupes expérimentaux lors d’une vague ultérieure d’acquisition, l’architecture d’exportation s’adapte sans requérir la moindre modification structurelle du code analytique.
6.2 Structures itératives impératives et boucles for
Bien que le paradigme fonctionnel soit largement célébré pour sa concision expressive, l’approche impérative classique reposant sur la boucle for conserve une pertinence méthodologique indéniable, notamment au sein des protocoles nécessitant des contrôles d’exécution hautement séquentiels et des opérations de journalisation (logging) détaillées à chaque étape de sérialisation. La structure itérative impérative confère à l’analyste une visibilité totale sur l’état d’avancement du traitement et permet d’encadrer l’écriture de chaque feuille au moyen de structures de gestion d’exceptions.
Dans un schéma procédural traditionnel, l’analyste détermine préalablement le vecteur contenant les identifiants ou les clés de la liste de données à exporter. La boucle itère scrupuleusement sur la longueur de ce vecteur d’indexation. À l’intérieur du corps de boucle, des structures conditionnelles évaluent systématiquement la conformité de chaque sous-table avant d’autoriser l’appel à addWorksheet et writeData. Si un sous-ensemble présente des anomalies dimensionnelles ou des valeurs manquantes aberrantes, le script peut consigner l’incident dans un fichier journal d’audit sans interrompre l’exportation des cohortes subséquentes.
Ce formalisme procédural s’avère particulièrement pertinent lors de la manipulation d’architectures expérimentales hiérarchiques profondes, impliquant par exemple des croisements factoriels entre sujets, sessions temporelles et blocs de tâches cognitives. La boucle impérative permet de générer des intitulés d’onglets composites et dynamiques combinant les indices d’itération, tout en administrant des compteurs d’état en temps réel pour renseigner l’utilisateur sur la progression de l’écriture lors du traitement d’échantillons volumineux.
6.3 Scission automatique d’un jeu de données maître (Split-Export)
L’une des applications les plus puissantes de l’automatisation de l’exportation sous R consiste en la combinaison de la fonction native split avec les routines de sérialisation d’openxlsx. Il est extrêmement fréquent en recherche empirique de disposer d’une base de données maîtresse consolidée rassemblant des milliers d’observations, structurée selon une variable catégorielle structurante telle que le centre d’investigation clinique, l’année d’observation, la catégorie diagnostique ou le protocole de traitement administré.
La fonction base::split permet de désagréger instantanément ce data frame unique en une collection partitionnée de sous-tables étiquetées, où chaque élément de la liste résultante correspond à l’une des modalités uniques du facteur de scission retenu. L’opération s’effectue en une seule instruction vectorisée et préserve scrupuleusement la structure de typage de chaque variable d’origine.
Toutefois, avant de diriger cette liste vers le moteur d’exportation vers Excel, une étape d’assainissement systématique des libellés de modalités s’impose. Si le facteur de scission renferme des caractères incompatibles avec les normes syntaxiques d’Excel ou des chaînes textuelles dépassant les limites dimensionnelles de nomination des onglets, l’exportation est compromise. L’adjonction d’une routine de normalisation des noms de liste, procédant à la substitution des espaces par des traits de soulignement et à la troncature programmatique des libellés, assure une transition parfaite depuis la partition matricielle en mémoire vers l’arborescence du classeur unifié.
7. Mise en forme stylistique et typographie scientifique sous openxlsx
7.1 Conception et application de styles personnalisés
La communication scientifique moderne ne saurait se satisfaire d’une présentation brute et indigeste des sorties numériques. L’utilisabilité d’un document tabulaire repose sur sa hiérarchisation visuelle et sur le respect des standards typographiques établis par la communauté académique. Le package openxlsx excelle dans ce domaine en proposant un modèle dédié de composition de styles visuels via la fonction createStyle, permettant d’émuler l’esthétique sobre et rigoureuse des publications scientifiques normées par l’American Psychological Association (APA).
La fonction createStyle permet de paramétrer exhaustivement chaque attribut graphique d’une plage de cellules : famille de polices de caractères vectorielles (telles que Calibri, Arial ou Times New Roman), corps typographique en points pica, graisse des caractères, alignement textuel horizontal et vertical, rotation d’orientation des titres, bordures structurelles fines et motifs de remplissage chromatique. L’analyste peut ainsi concevoir un style institutionnel destiné spécifiquement aux en-têtes de colonnes, combinant par exemple un fond texturé d’une teinte grisâtre feutrée, un texte centré en gras et une double bordure inférieure marquant distinctement la rupture avec les rangées de données.
Le contrôle de la précision numérique représente un autre apport fondamental de cette stylisation programmatique. Dans Excel, les valeurs flottantes issues de calculs statistiques sous R peuvent s’afficher avec une profusion anarchique de décimales résiduelles, nuisant à la lisibilité générale. L’assignation de masques de formatage numérique explicites (numFmt = « 0.00 » pour les coefficients de régression ou numFmt = « 0.000 » pour les valeurs de p) garantit que les grandeurs estimées sont restituées avec une rigueur métrologique parfaite sans altérer la valeur numérique réelle sous-jacente stockée dans la cellule.
7.2 Mise en forme conditionnelle des indicateurs psychologiques
Au-delà de la mise en forme statique, openxlsx déploie des fonctionnalités avancées de mise en forme conditionnelle par le biais de la fonction conditionalFormatting. Cet outil permet d’automatiser l’inspection clinique ou psychométrique en signalant visuellement à l’évaluateur les données déviant des distributions normatives sans requérir une scrutation manuelle exhaustive de chaque case de la grille.
En psychologie clinique et en psychiatrie de recherche, les échelles diagnostiques exploitent des seuils critiques (cut-off points) validés empiriquement pour distinguer les scores subcliniques des manifestations pathologiques sévères. À l’aide de conditionalFormatting, l’analyste peut implémenter des règles logiques appliquant dynamiquement une chromaticité d’alerte (par exemple un remplissage pastel ambré ou rosé assorti d’un texte rouge sombre) dès lors que les valeurs d’une colonne excèdent un seuil théorique déterminé. La règle est injectée directement dans la logique interne de la feuille XML, signifiant que si les données viennent à être modifiées ultérieurement au sein d’Excel, la mise en évidence visuelle s’ajustera de façon dynamique et autonome.
Cette approche s’étend avec une remarquable pertinence à la représentation des matrices de corrélations ou d’associations statistiques. En paramétrant des échelles chromatiques continues dégradées (échelles bi-chromatiques ou tri-chromatiques gérées par l’argument ruleType = « colorScale »), l’analyste transforme un onglet de données brutes en une véritable carte thermique (heatmap) interactive intégrée au tableur. Les corrélations positives maximales, les indépendances linéaires nulles et les associations négatives se distinguent instantanément par des gradients chromatiques intuitifs, facilitant la communication des résultats exploratoires aux comités scientifiques et aux équipes cliniques non statisticiennes.
7.3 Calibrage ergonomique et accessibilité des tableaux
L’optimisation de l’expérience utilisateur au sein d’un classeur multi-feuilles implique une attention méticuleuse portée aux détails ergonomiques de navigation. L’un des écueils majeurs de l’exploration de tables comptant des centaines ou des milliers de lignes réside dans la disparition de la rangée des en-têtes dès que l’utilisateur fait défiler la page vers le bas. Pour pallier cette rupture d’intelligibilité, openxlsx expose la méthode freezePanes, permettant d’immobiliser de manière sélective les volets supérieurs ou latéraux de n’importe quel onglet.
Le figeage méthodique de la première ligne d’en-tête, conjugué si nécessaire au verrouillage de la première colonne assignée aux identifiants uniques des sujets, permet à l’examinateur de naviguer transversalement et longitudinalement au sein du corpus de données sans jamais perdre le repère sémantique de la variable observée ou de l’unité d’échantillonnage analysée. Cette simple précaution architecturale élève substantiellement le standard professionnel des livrables analytiques transmis aux organismes commanditaires.
L’accessibilité ergonomique requiert également un paramétrage adéquat de la largeur des colonnes par la méthode setColWidths. Bien que l’ajustement automatique calculé par le logiciel offre une première approximation satisfaisante, il tend parfois à produire des colonnes excessivement larges en présence de commentaires qualitatifs étendus ou, inversement, des dimensions étriquées pour des colonnes de données numériques dont le titre est bref. Définir des largeurs de colonnes harmonisées et fixes, adaptées à la nature prévisible de chaque variable, prévient la distorsion visuelle des documents et confère au classeur une rigueur graphique homogène d’un onglet à l’autre.
8. Approche alternative : Utilisation du package writexl
8.1 Architecture allégée et absence de dépendances compilées
Si le package openxlsx constitue la référence incontournable en matière de personnalisation esthétique et de manipulation granulaire d’objets de type classeur, il existe des contextes d’ingénierie où la sophistication graphique s’efface devant des impératifs stricts de légèreté, de vélocité brute et de minimalisme logiciel. Dans cette perspective, le package writexl, développé par Jeroen Ooms sous l’égide de l’organisation rOpenSci, représente une alternative méthodologique d’une remarquable puissance.
L’architecture de writexl repose sur l’intégration directe de la bibliothèque C standardisée libxlsxwriter. Contrairement à de nombreuses solutions concurrentes, writexl est conçu comme un composant logiciel entièrement autonome : il ne dépend ni d’un environnement Java externe, ni d’interpréteurs de scripts auxiliaires comme Perl ou Python, ni même de la bibliothèque Rcpp. L’ensemble de la logique de sérialisation OpenXML est compilé directement en code machine C ultra-optimisé, conférant au package une compacité extrême et une portabilité totale sur n’importe quel système d’exploitation moderne.
Cette légèreté architecturale en fait le candidat idéal pour les serveurs de production critiques, les environnements d’analyse conteneurisés hautement contraints en ressources et les chaînes de compilation automatisées. Sa maintenance technique est quasi nulle, réduisant drastiquement les risques de conflits lors du déploiement de scripts de recherche sur des infrastructures informatiques mutualisées au sein d’universités ou d’instituts de recherche biomédicale.
8.2 Syntaxe d’exportation multiple avec write_xlsx
Le parti pris philosophique de writexl est celui d’une simplicité fonctionnelle délibérée. Le package n’expose pas de modèle objet complexe, ne propose pas de notion de classeur persistant en mémoire et refuse délibérément la manipulation des styles typographiques avancés ou des formules interactives. Toute l’API de la bibliothèque se concentre autour d’une fonction unique et magistralement calibrée : write_xlsx.
Pour exporter une pluralité de data frames vers des feuilles Excel indépendantes avec writexl, la signature syntaxique est rigoureusement analogue à la méthode canonique observée précédemment. L’analyste transmet à la fonction une liste nommée de data frames comme premier argument, et spécifie le chemin du fichier cible en second argument :
- Chaque élément de la liste donne naissance à une feuille de calcul dédiée.
- L’intitulé de la feuille hérite directement et strictement du nom assigné à l’élément de la liste en mémoire R.
- Les types de données primitifs (entiers, réels, dates, booléens, chaînes textuelles) sont automatiquement transposés vers les équivalents natifs de la spécification Excel.
Ce comportement déterministe et l’absence de paramètres de mise en forme superflus réduisent au strict minimum le nombre de lignes de code nécessaires à l’exportation. Pour des chercheurs dont la préoccupation exclusive réside dans le transfert rapide de tables épurées sans visée de mise en page publicationnelle, writexl offre une clarté d’implémentation incomparable.
8.3 Arbitrage technique : openxlsx versus writexl
Face à la dualité de ces solutions majeures au sein de l’écosystème R, l’ingénieur de données ou le biostatisticien doit opérer un arbitrage technique éclairé en fonction des finalités précises assignées à ses livrables documentaires. Le tableau conceptuel ci-dessous synthétise les critères de décision méthodologiques régissant cette sélection :
- Vitesse de calcul et volumétrie brute : Grâce à son noyau écrit en C natif pur sans surcouches, writexl surpasse généralement openxlsx en termes de vitesse d’exécution lors de la sérialisation de jeux de données extrêmement massifs totalisant des centaines de milliers d’enregistrements répartis sur de multiples onglets. L’empreinte mémoire de writexl demeure également remarquablement stable durant le traitement.
- Capacités de formatage et stylisation : Sur ce plan, openxlsx s’impose de façon indiscutable. writexl ne permet aucune modification des polices, aucun surlignage couleur, aucune bordure personnalisée, ni aucun figeage des volets. Si le livrable est destiné à un comité de pilotage, à un promoteur industriel ou à un panel d’évaluateurs exigeant une présentation soignée, openxlsx est l’unique option viable.
- Reproductibilité et stabilité d’infrastructure : Pour l’archivage pur de données tabulaires brutes au sein d’entrepôts ou pour des tests unitaires récurrents dans des environnements d’intégration continue, la robustesse structurelle et l’absence totale de dépendances de writexl en font le choix le plus résilient et pérenne à long terme.
9. Gestion des encodages, valeurs manquantes et intégrité des données
9.1 Préservation de l’encodage textuel international (UTF-8)
L’un des défis méthodologiques les plus insidieux lors de l’exportation de données scientifiques réside dans l’altération silencieuse des caractères diacritiques, des alphabets non latins et des symboles mathématiques. Dans les études internationales, les enquêtes multilingues ou la saisie de réponses qualitatives ouvertes, la présence d’accents, de ligatures ou d’idéogrammes est courante. Une mauvaise gestion de l’encodage textuel conduit inévitablement à l’apparition de séquences de caractères corrompus (un phénomène désigné sous le terme de mojibake), ce qui compromet gravement l’intelligibilité et la crédibilité scientifique du jeu de données.
Le standard contemporain pour la transmission sans perte de texte est la norme universelle Unicode UTF-8. Les spécifications sous-jacentes du format Office Open XML imposent que tous les documents XML internes soient encodés en UTF-8. Tant openxlsx que writexl ont été architecturalement conçus pour respecter ce standard. Toutefois, des défaillances peuvent survenir en amont, lorsque les chaînes de caractères au sein de R ne sont pas explicitement marquées comme appartenant à l’encodage UTF-8, particulièrement sous les versions de Microsoft Windows historiques dont la locale par défaut exploitait des pages de codes restrictives comme Windows-1252 ou ISO 8859-1.
Il relève de la responsabilité méthodologique du chercheur de s’assurer de l’homogénéisation préalable de l’encodage de ses variables textuelles avant l’exportation. L’application systématique de fonctions de conversion comme enc2utf8 sur les colonnes de nature textuelle prévient toute déformation lors du passage au format bureautique. Cette rigueur garantit que les observations transcrites par les sujets de l’étude conserveront leur intégrité sémantique et phonétique exacte une fois le classeur inspecté dans des environnements linguistiques internationaux diversifiés.
9.2 Sérialisation et traçabilité des valeurs manquantes
En recherche quantitative, l’absence de donnée ne constitue pas une simple case vide ; elle est dotée d’une signification épistémologique et méthodologique fondamentale. La non-réponse d’un participant à un item de questionnaire, l’échec technique d’un capteur de mesure ou le retrait d’un patient d’une cohorte clinique répondent à des typologies de données manquantes distinctes (Missing Completely at Random, Missing at Random ou Missing Not at Random) qui orientent l’application des procédures d’imputation multiple ou de modélisation en information complète.
Au sein de l’environnement R, ces occurrences sont matérialisées de façon unifiée par la constante logique NA (Not Available). En revanche, la transposition de cette constante vers Excel soulève une ambiguïté : une cellule Excel peut soit être laissée intégralement vide (valeur nulle), soit contenir une chaîne de caractères explicite comme « NA », « #N/A » ou un code d’absence standardisé (par exemple -999 ou « MISSING »). Les fonctions d’exportation permettent de gouverner cette conversion via le paramètre na.string (ou équivalent selon la bibliothèque).
Laisser les valeurs manquantes sous forme de cellules vierges présente l’avantage d’une excellente compatibilité avec les formules de calcul internes d’Excel (qui ignorent généralement les cellules vides dans le calcul des moyennes ou des écarts-types). Néanmoins, cette pratique peut susciter une équivoque quant à savoir si la donnée était réellement manquante à l’origine ou si elle a été omise par erreur lors de la manipulation du fichier. À l’inverse, inscrire une chaîne explicite telle que « NA » permet de sanctuariser l’absence de donnée mais impose à tout utilisateur réimportant ultérieurement le fichier sous un autre logiciel statistique de spécifier formellement les paramètres de traitement de cette chaîne comme valeur non disponible.
9.3 Préservation des types et prévention des altérations automatiques
Le comportement heuristique de Microsoft Excel à l’égard de l’interprétation automatique des types de données constitue une cause de préoccupation majeure documentée dans la littérature biomédicale internationale. De nombreuses études ont démontré que des millions de publications génomiques contenaient des erreurs critiques de nomenclature scientifique, résultant de la conversion involontaire de symboles de gènes (tels que SEPT2 pour Septin 2 ou MARCH1 pour Membrane Associated Ring-CH-Type Finger 1) en dates calendaires arbitraires (2 septembre ou 1er mars) par le moteur de saisie d’Excel.
Ce risque d’altération typologique pernicieuse guette également les données en sciences comportementales et épidémiologiques. Des identifiants alphanumériques de participants comportant des tirets ou des zéros initiaux (comme « 00458-9 ») courent le risque permanent d’être tronqués sous forme d’entiers arithmétiques (« 4589 ») ou interprétés comme des soustractions arithmétiques. De même, des nombres décimaux étendus peuvent être subrepticement convertis en notation scientifique exponentielle, tronquant au passage des chiffres significatifs terminaux en raison des limitations de la précision flottante 64 bits de Microsoft.
Pour immuniser les données scientifiques contre ces dérives lors de l’exportation depuis R, il est impératif d’imposer un typage structurel rigide. Les variables d’identification doivent impérativement demeurer des vecteurs textuels (caractères) dans R. Lors de la sérialisation avec openxlsx, il convient d’expliciter le formatage textuel des colonnes concernées pour forcer le classeur cible à marquer ces cellules avec le type chaîne explicite (Shared String ou Inline String), interdisant définitivement au tableur d’appliquer ses règles de coercition implicite à l’ouverture du document.
10. Diagnostic des anomalies d’exportation et résolution des erreurs courantes
10.1 Gestion des restrictions syntaxiques propres à Excel
L’une des causes les plus fréquentes d’interruption abrupte des scripts de sérialisation multi-feuilles réside dans la violation inconsciente des contraintes syntaxiques formelles régissant la désignation des onglets dans Microsoft Excel. Le format OpenXML impose des règles strictes qui, si elles sont ignorées par le programmeur R, provoquent le rejet pur et simple de l’écriture ou la corruption structurelle de l’archive XML générée :
- Limite dimensionnelle stricte : Le nom d’une feuille de calcul ne peut en aucun cas excéder la longueur maximale absolue de 31 caractères Unicode. Des intitulés longs décrivant des conditions expérimentales élaborées doivent impérativement faire l’objet d’abréviations concertées ou de troncatures algorithmiques au sein de R avant l’affectation à la liste de données.
- Caractères prohibés : La nomenclature des onglets interdit absolument l’usage de sept symboles réservés au système de fichiers et à la syntaxe de formules : les deux-points (:), la barre oblique inverse (), la barre oblique (/), le point d’interrogation (?), l’astérisque (*), le crochet ouvrant ([) et le crochet fermant (]).
- Unicité des étiquettes : Deux onglets ne peuvent sous aucun prétexte arborer la même dénomination au sein d’un même classeur, la distinction étant en outre insensible à la casse (les dénominations « GroupeA » et « groupeA » sont jugées conflictuelles et mutuellement exclusives).
- Nommage vide ou périphérique : Un nom de feuille ne peut être réduit à une chaîne vide, ni débuter ou se terminer par une apostrophe simple (‘).
Pour neutraliser ces vulnérabilités de façon préventive, l’analyste chevronné intégrera dans ses fonctions d’exportation une routine de désinfection automatisée (sanitization). En utilisant des expressions régulières combinées à la fonction substr ou stringr::str_sub, le script purgera systématiquement tous les caractères illicites et tronquera les chaînes à 30 caractères avant de vérifier l’unicité du vecteur résultant à l’aide de la fonction make.unique.
10.2 Conflits de verrouillage de fichiers et d’entrées-sorties
Dans un contexte de recherche appliquée où l’analyste exécute son script de manière itérative tout en inspectant visuellement les résultats générés dans Microsoft Excel, l’erreur la plus récurrente relève du verrouillage d’accès au fichier (File Lock Error). Lorsqu’un utilisateur ouvre un classeur Excel sous un système d’exploitation de type Windows, le système d’exploitation ou l’application hôte applique immédiatement un verrou exclusif en écriture sur le fichier sous-jacent afin d’empêcher les conflits de modification concurrente.
Si le chercheur modifie ses paramètres statistiques sous R et réexécute son script de sérialisation alors que le classeur cible demeure ouvert en arrière-plan dans Excel, l’interpréteur R se heurte à un refus d’accès catégorique (Permission Denied). Cette tentative avortée déclenche une erreur critique de bas niveau qui stoppe net l’exécution du programme, une situation particulièrement pénalisante lors de traitements par lots longs et exigeants.
La parade méthodologique à ce problème organisationnel s’articule autour de plusieurs stratégies logicielles. La première consiste à implémenter un test programmatique préalable de disponibilité du fichier avant de lancer l’écriture lourde : le script tente d’ouvrir une connexion temporaire en écriture sur le chemin cible via la fonction file de R ; en cas d’échec capté par tryCatch, un message d’avertissement explicite somme l’utilisateur de fermer son instance bureautique avant de poursuivre. Une seconde approche consiste à insérer dans le nom du fichier de sortie un horodatage dynamique précis (timestamp), garantissant que chaque itération analytique produit un fichier physiquement distinct sans jamais entrer en collision avec des documents précédemment ouverts.
10.3 Gestion des dépassements de capacité mémoire sur volumétries extrêmes
Bien que Microsoft Excel se soit imposé comme l’outil universel de consultation bureautique, ses spécifications architecturales comportent des limites dimensionnelles infranchissables qu’aucun package R ne peut contourner. La spécification OpenXML plafonne de manière irrévocable la capacité d’une feuille de calcul unique à 1 048 576 lignes et 16 384 colonnes (de la colonne A à la colonne XFD). Tenter d’exporter un data frame volumineux issu par exemple d’enregistrements physiologiques continus à haute fréquence ou de séquençages génomiques dépassant ces plafonds provoque une erreur fatale ou une troncation non documentée des données.
Lorsque l’on manipule des corpus empiriques approchant ces grandeurs critiques, l’analyste doit réévaluer la pertinence même de l’usage du format .xlsx. Excel n’a jamais été conçu comme un système de gestion de bases de données relationnelles ni comme un format de stockage massif de données. Face à des volumétries excédant plusieurs millions d’enregistrements, la stratégie d’exportation doit impérativement s’orienter vers des formats colonnaires hautement compressés et performants tels que le format Apache Parquet via le package arrow, ou vers des bases de données autonomes intégrées de type SQLite.
Si la transmission sous forme de classeur Excel demeure une exigence contractuelle incontournable vis-à-vis du destinataire final, l’analyste doit mettre en œuvre une stratégie algorithmique de partitionnement vertical. Le jeu de données matriciel est alors découpé en blocs homogènes n’excédant pas quelques centaines de milliers de lignes, et chaque tranche est dirigée vers un onglet séquentiel dédié (par exemple « Donnees_Partie1 », « Donnees_Partie2 »). Concomitamment, l’invocation manuelle de la fonction de ramasse-miettes de R (gc) au sein de la boucle de sérialisation permet de libérer la mémoire vive au fur et à mesure de l’écriture, évitant l’effondrement du système d’exploitation par épuisement de la mémoire virtuelle.
11. Intégration dans les flux de recherche reproductible et rapports dynamiques
11.1 Automatisation dans les environnements R Markdown et Quarto
L’apogée de la recherche reproductible contemporaine réside dans l’intégration transparente des codes d’analyse, des visualisations graphiques et des textes explicatifs au sein d’environnements d’édition dynamique tels que Quarto et R Markdown. Dans ce paradigme de programmation lettrée (literate programming), le classeur multi-feuilles ne doit plus être perçu comme un artefact produit manuellement et indépendamment de l’étude, mais comme une annexe analytique générée dynamiquement au cours du processus même de compilation du manuscrit scientifique.
L’intégration s’opère par l’insertion de blocs de code (chunks) dédiés dans le document maître .qmd ou .Rmd. Ces blocs orchestrent la modélisation statistique, structurent la liste des tables de résultats et appellent les routines de sérialisation vers un répertoire de distribution standardisé (par exemple « sorties/classeurs/ »). L’inclusion d’options de bloc telles que include = FALSE permet d’exécuter ces processus d’exportation de façon totalement invisible lors de la compilation finale du document en PDF ou HTML, préservant ainsi la pureté visuelle du rapport narratif tout en assurant l’actualisation continue des classeurs Excel d’accompagnement.
Pour parachever l’ergonomie documentaire, le manuscrit compilé peut intégrer des hyperliens programmatiques dynamiques pointant directement vers les classeurs générés sur le disque local ou sur un serveur de stockage en nuage institutionnel. Cette synergie garantit une harmonie temporelle et mathématique absolue : le moindre recalcul d’un modèle statistique se répercute instantanément, d’un unique clic, sur le texte du rapport, les figures intégrées et la totalité des onglets du classeur Excel destiné aux auditeurs externes.
11.2 Chaînes de validation continue et tests unitaires
Au sein d’un laboratoire de recherche ou d’un département d’analyse industrielle soumis à des réglementations strictes (telles que les normes de bonnes pratiques de laboratoire ou les directives de la Food and Drug Administration), la génération d’un fichier de données doit être accompagnée de garanties formelles quant à son intégrité post-exportation. Le processus d’écriture sur disque ne peut être tenu pour infaillible par défaut ; il doit être validé au moyen de chaînes de validation continue intégrant des tests unitaires.
L’implémentation de cette validation consiste à concevoir une routine de rétro-contrôle (round-trip validation). Immédiatement après l’exécution de l’instruction de sauvegarde du classeur, le script sollicite un package de lecture indépendant et hautement rigoureux, tel que readxl, pour relire l’intégralité des feuilles de calcul contenues dans le fichier physique nouvellement créé. L’analyste déploie ensuite des assertions formelles à l’aide de paquets dédiés à la validation logicielle comme testthat :
- Vérification de la stricte correspondance du nombre d’onglets générés avec le nombre d’éléments initialement déclarés dans la liste R.
- Contrôle de l’équivalence exacte des dimensions matricielles (nombre de lignes et de colonnes) entre les data frames originaux et les tables réimportées.
- Comparaison mathématique des sommes de contrôle arithmétiques (checksums ou sommes de colonnes) pour s’assurer qu’aucune valeur n’a subi de troncature d’arrondi ou de glissement spatial lors du passage dans les cellules XML.
Cette approche d’assurance qualité formalisée neutralise toute contestation ultérieure quant à la fidélité des données diffusées aux partenaires de recherche, conférant aux livrables un niveau de robustesse technique conforme aux exigences des plus hauts standards de publication.
11.3 Encapsulation fonctionnelle au sein de pipelines d’analyse de données
Pour pérenniser le savoir-faire méthodologique et homogénéiser la production documentaire au sein d’une équipe de recherche, il est vivement déconseillé de réécrire manuellement des blocs d’exportation verbeux au sein de chaque script de projet. La meilleure pratique d’ingénierie statistique réside dans l’encapsulation fonctionnelle : concevoir une fonction d’enveloppe (wrapper function) générique, documentée et robuste, intégrée dans le package interne du laboratoire ou dans un script utilitaire mutualisé.
Une fonction d’enveloppe bien conçue assume la totalité des opérations de contrôle et de raffinement exposées tout au long de ce guide. Elle reçoit en arguments une liste de data frames, un chemin d’accès cible et un ensemble d’options d’affichage paramétrables. À l’intérieur de son corps d’exécution, elle procède automatiquement à :
- L’assainissement et la troncature préventive des noms d’éléments pour respecter les règles strictes de nomination des onglets Excel.
- La vérification de l’intégrité matricielle et la conversion sécurisée des encodages de caractères en UTF-8.
- L’instanciation de l’objet classeur et l’application d’une charte graphique institutionnelle uniformisée (polices, styles d’en-têtes, largeurs de colonnes, figeage systématique des volets supérieurs).
- L’insertion de filtres automatiques et la gestion du masquage conditionnel des valeurs manquantes.
- La sérialisation finale sur disque encadrée par des gestionnaires d’erreurs pour intercepter d’éventuels conflits de verrouillage d’écriture.
En déléguant ces responsabilités techniques à une fonction unitaire éprouvée, les chercheurs peuvent se consacrer pleinement à l’intelligence statistique de leurs analyses, tout en garantissant que l’ensemble des livrables de l’institution partagera une esthétique irréprochable et un standard technique uniforme.
12. Recommandations méthodologiques et archivage des données scientifiques
12.1 Application des principes FAIR à la sérialisation tabulaire
Dans le concert international de la gouvernance des données scientifiques, les principes FAIR (Facile à trouver, Accessible, Interopérable et Réutilisable) guident les politiques d’archivage des institutions académiques et des agences de financement de la recherche. Si les formats propriétaires comme Microsoft Excel ont parfois suscité des réserves parmi les puristes de l’open-source en raison de leur complexité historique, le format Office Open XML standardisé peut tout à fait s’inscrire dans une démarche FAIR rigoureuse dès lors qu’il est enrichi de métadonnées appropriées.
L’exploitation de l’architecture multi-onglets permet de matérialiser concrètement ces principes en intégrant systématiquement, en première position du classeur, un onglet dédié au dictionnaire de données (codebook). Cet onglet fondamental documente de façon exhaustive chaque variable figurant dans les autres feuilles du document : dénomination exacte de la colonne, label sémantique explicatif, unité de mesure métrologique, plage de valeurs admissibles, signification codifiée des modalités de facteurs et renvoi aux publications méthodologiques décrivant les échelles psychométriques ou les protocoles d’acquisition.
Il est tout aussi capital d’adjoindre un onglet consignant les métadonnées de provenance (provenance metadata). Cette section doit expliciter la date précise de génération du fichier, le numéro de version du code source R ayant produit l’archive, l’empreinte cryptographique des fichiers sources bruts, l’identifiant des auteurs et les licences juridiques régissant l’utilisation des données (telles que les licences Creative Commons). En convertissant le classeur en une unité auto-suffisante d’information, le chercheur s’assure que ses données demeureront parfaitement intelligibles et exploitables pour les générations futures de chercheurs, bien au-delà de la clôture du projet d’étude initial.
12.2 Considérations éthiques et anonymisation des jeux de données
L’exportation de corpus expérimentaux vers des formats bureautiques partagés soulève des responsabilités éthiques et juridiques impérieuses, notamment dans le cadre de la conformité avec le Règlement Général sur la Protection des Données (RGPD) en Europe ou les législations relatives à la protection de la vie privée dans le reste du monde. Avant toute diffusion d’un classeur multi-onglets en dehors du cercle restreint de l’équipe de recherche principale, des mesures drastiques d’anonymisation ou de pseudonymisation renforcée doivent être déployées.
Le risque majeur lors de la sérialisation réside dans la présence résiduelle d’identifiants directs ou d’éléments quasi-identifiants disséminés de manière subreptice à travers les différentes feuilles de calcul. Les variables telles que les noms patronymiques, prénoms, coordonnées de résidence, numéros de sécurité sociale, dates de naissance précises ou adresses IP doivent faire l’objet d’une purge irréversible en mémoire R avant l’assemblage de la liste de données. L’attribution d’identifiants pseudonymisés aléatoires et non réversibles doit être la règle absolue.
De surcroît, une vigilance spécifique s’impose quant aux propriétés masquées du document Excel. L’analyste doit s’assurer que le classeur généré ne renferme aucune feuille invisible ou très masquée (veryHidden) susceptible de contenir par inadvertance des clés de correspondance d’anonymisation ou des annotations cliniques confidentielles. De même, la purge des métadonnées du système d’exploitation et des identifiants d’auteurs au sein de l’objet Workbook constitue une mesure de précaution élémentaire pour prémunir l’institution contre toute fuite d’informations sensibles lors du téléversement des classeurs sur des dépôts de données publics ou semi-publics.
12.3 Synthèse procédurale et matrice décisionnelle
Au terme de ce traité d’ingénierie logicielle pour l’environnement R, il convient de cristalliser les choix technologiques sous la forme d’une matrice décisionnelle opérationnelle, guidant l’analyste vers la méthode la plus adaptée à ses contraintes spécifiques :
- Recours impératif à openxlsx : À privilégier dès lors que l’objectif principal est la conception de rapports finaux destinés à l’interaction humaine, requérant une mise en forme typographique professionnelle (styles APA, polices contrôlées, bordures fines), des ajustements ergonomiques indispensables (volets figés, filtres dynamiques, dimensionnement millimétré des colonnes) et des aides à la lecture clinique telles que la mise en forme conditionnelle et les gradients thermiques.
- Recours privilégié à writexl : À adopter prioritairement lorsque le protocole exige une vélocité computationnelle maximale sur des jeux de données de taille moyenne à grande, au sein d’environnements de production épurés (Docker, intégration continue) où la stabilité, l’absence absolue de dépendances compilées complexes et la pureté fonctionnelle en C priment sur toute considération ornementale.
- Transition vers des formats non-bureautiques (Parquet / SQLite) : Indispensable dès lors que la volumétrie globale des données franchit la limite physique structurelle d’Excel (1 048 576 lignes par feuille), ou lorsque les tables n’ont pas vocation à être inspectées visuellement par des tiers mais doivent s’insérer dans des architectures de calcul distribué ou d’archivage volumétrique haute performance.
L’évolution continue des interactions entre R et les suites bureautiques confirme que l’ouverture, la standardisation et l’absence de dépendances opaques représentent le fondement de la reproductibilité scientifique contemporaine. La maîtrise de ces architectures d’exportation confère aux praticiens de la recherche une autonomie méthodologique absolue, garantissant que la rigueur investie dans la modélisation statistique se prolongera fidèlement dans la transmission documentaire de leurs résultats.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
ISO/IEC. (2016). Information technology — Document description and processing languages — Office Open XML File Formats — Part 1: Fundamentals and Markup Language Reference (ISO/IEC standard No. 29500-1:2016). International Organization for Standardization. https://www.iso.org/standard/71691.html
Ooms, J. (2024). writexl: Export Data Frames to Excel ‘xlsx’ Format (R package version 1.5.0) [Logiciel informatique]. Comprehensive R Archive Network. https://cran.r-project.org/package=writexl
R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Schafer, J. L. (1997). Analysis of incomplete multivariate data. Chapman & Hall/CRC. https://doi.org/10.1201/9781439821862
Walker, A., & Schauberger, P. (2023). openxlsx: Read, Write and Edit xlsx Files (R package version 4.2.5.2) [Logiciel informatique]. Comprehensive R Archive Network. https://cran.r-project.org/package=openxlsx
Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
Wickham, H. (2019). Advanced R (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9781351201315
Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., Blomberg, N., Boiten, J.-W., da Silva Santos, L. B., Bourne, P. E., Bouwman, J., Brookes, A. J., Clark, T., Crosas, M., Dillo, I., Dumon, O., Edmunds, S., Evelo, C. T., Finkers, R., … Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3(1), Article 160018. https://doi.org/10.1038/sdata.2016.18
Ziemann, M., Eren, Y., & El-Osta, A. (2016). Gene name errors are still widespread in the scientific literature. Genome Biology, 17(1), Article 177. https://doi.org/10.1186/s13059-016-1044-7