
Dans le paysage foisonnant de la statistique théorique et appliquée, la distribution normale — popularisée sous les traits de la célèbre courbe en cloche de Gauss et Laplace — a longtemps exercé une véritable hégémonie conceptuelle. Enseignée comme le modèle de référence universel en raison de l’élégance mathématique du théorème central limite, elle tend à conditionner le regard du chercheur et du praticien, les incitant à postuler que tout phénomène naturel ou comportemental converge nécessairement vers un unique centre de gravité entouré de fluctuations symétriques. Pourtant, l’observation rigoureuse du monde réel dément avec constance cette simplification rassurante. De nombreux jeux de données empiriques refusent obstinément de s’ordonner autour d’une moyenne singulière et révèlent au contraire une morphologie plus complexe, fracturée par l’émergence de plusieurs centres d’attraction distincts.
Au cœur de ces architectures non standards se dresse la distribution bimodale, une configuration probabiliste fascinante caractérisée par la présence de deux sommets de densité bien différenciés, séparés par un creux relatif. Loin d’être une simple anomalie statistique ou un artefact expérimental négligeable, la bimodalité constitue l’empreinte mathématique de dynamiques sous-jacentes fondamentales : l’hétérogénéité latente d’un échantillon, la coexistence de deux sous-populations distinctes au sein d’une même métrique, l’existence d’états d’équilibre concurrents dans un système dynamique ou encore l’action de forces de polarisation au sein des sociétés humaines. Qu’il s’agisse de mesurer la taille corporelle d’une espèce présentant un dimorphisme sexuel marqué, de scruter les temps de réaction cognitive face à un conflit décisionnel ou d’évaluer la distribution des résultats académiques dans une cohorte scolaire hétérogène, la bimodalité met en échec les outils conventionnels de l’analyse univariée.
Aborder une distribution bimodale exige un changement de paradigme méthodologique. Réduire un tel profil à sa moyenne arithmétique et à son écart-type constitue une erreur interprétative majeure, susceptible de masquer des réalités concrètes fondamentales et de conduire à des conclusions scientifiques fallacieuses. Ce guide exhaustif explore en profondeur les fondements théoriques, les propriétés analytiques, les outils de détection rigoureux et les stratégies de modélisation mathématique adaptées à la distribution bimodale. En croisant les perspectives de la statistique mathématique, de la psychométrie, des sciences comportementales et de la science des données contemporaine, cet article offre une analyse définitive pour identifier, comprendre et traiter avec rigueur ces distributions à deux visages.
1. Définition fondamentale et concepts théoriques de la distribution bimodale
1.1 La notion de mode en statistique descriptive et distributionnelle
Pour appréhender la structure d’une distribution bimodale, il est indispensable de revisiter avec précision la définition statistique du mode, notion fréquemment simplifiée à l’excès dans les manuels élémentaires. En statistique descriptive discrète, le mode empirique représente conventionnellement la valeur de la variable aléatoire qui présente l’effectif ou la fréquence relative la plus élevée au sein d’un échantillon observé. Toutefois, cette approche basée sur le comptage direct devient inopérante dès lors que l’on traite des variables quantitatives continues. Pour ces dernières, la probabilité exacte d’observer une valeur ponctuelle $x$ est rigoureusement nulle, ce qui contraint à redéfinir le concept à travers la fonction de densité de probabilité, notée $f(x)$.
Dans le cadre continu, un mode ne se réduit pas nécessairement au maximum absolu (ou global) de la fonction de densité de probabilité. Il se définit de manière générale et rigoureuse comme tout maximum local de cette fonction $f$. Sur le plan géométrique, la courbe représentative de la densité présente en ce point une crête, un sommet où la pente s’annule avant de s’inverser. Si une fonction de densité continue et différentiable possède exactement deux maxima locaux distincts sur son domaine de définition, elle est formellement qualifiée de distribution bimodale. Cette caractérisation s’appuie directement sur les outils du calcul différentiel : le mode correspond à une valeur $x_m$ vérifiant l’annulation de la dérivée première de la fonction de densité, soit $f'(x_m) = 0$, conjuguée à une condition de concavité stricte stipulant que la dérivée seconde y est strictement négative, soit $f »(x_m) < 0$.
La distinction mathématique entre les distributions discrètes et continues présentant deux modes mérite également une attention conceptuelle. Dans le cas discret, la bimodalité s’observe par la présence de deux valeurs distinctes $k_1$ et $k_2$ du support telles que la fonction de masse vérifie $P(X = k_1) > P(X = k_1 \pm 1)$ et $P(X = k_2) > P(X = k_2 \pm 1)$. Dans le cas continu, les modes sont le résultat d’une concentration continue de masse de probabilité dans des voisinages infinitésimaux distincts. L’analyse de la concavité locale par l’intermédiaire de la dérivée seconde permet non seulement de certifier l’existence d’un pic, mais également de quantifier son acuité : une dérivée seconde fortement négative signale un pic étroit et fortement concentré, tandis qu’une valeur proche de zéro traduit un sommet aplati, annonçant une possible transition vers l’unimodalité sous l’effet de variations infinitésimales des paramètres régissant la loi de probabilité.
1.2 Morphologie et topologie des deux pics
L’observation topologique d’une distribution bimodale révèle une diversité morphologique qui dépasse largement le cas d’école idéalisé de deux cloches symétriques et identiques juxtaposées. La configuration morphologique d’une telle distribution est gouvernée par trois facteurs géométriques cardinaux : la hauteur respective des deux sommets, leur largeur (ou dispersion locale) et la profondeur du creux qui les sépare. Lorsque les deux modes atteignent exactement la même ordonnée, la distribution est dite parfaitement bimodale au sens strict des maxima globaux conjoints. Néanmoins, dans l’immense majorité des applications empiriques, l’un des pics domine l’autre en altitude ; on parle alors d’un mode majeur pour désigner le maximum global de densité et d’un mode mineur pour identifier le maximum local secondaire, lequel témoigne d’une densité de probabilité relative moindre mais statistiquement significative.
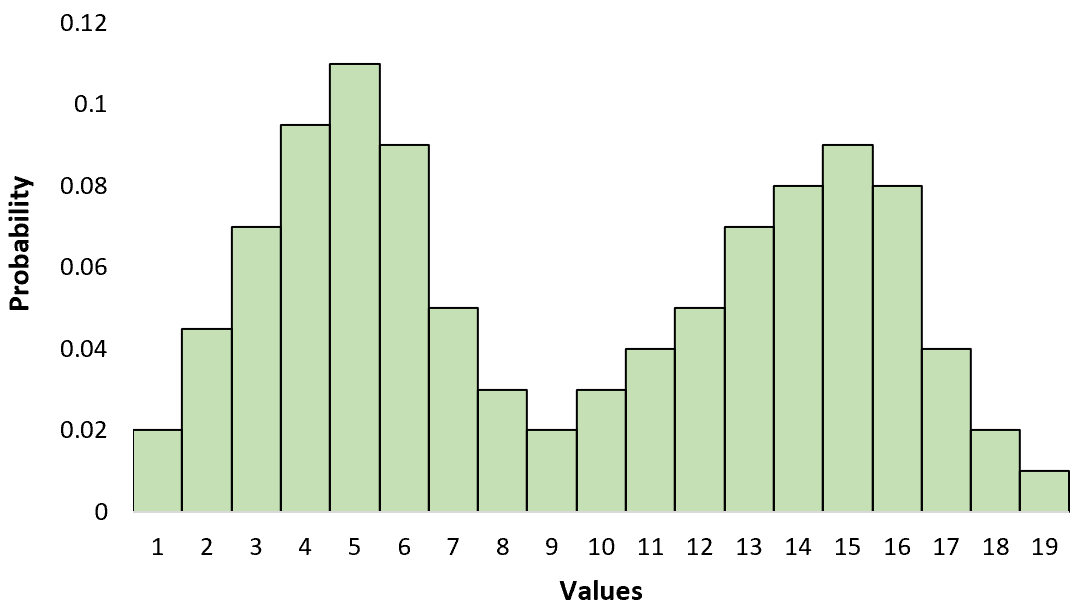
Entre ces deux sommets s’insère obligatoirement une dépression topologique dénommée l’antimode. L’antimode correspond au minimum local de la fonction de densité de probabilité situé dans l’intervalle délimité par les deux modes. Sa position analytique est régie par les mêmes conditions différentielles primaires que les modes ($f'(x_a) = 0$), mais se singularise par une convexité locale stricte, matérialisée par une dérivée seconde strictement positive : $f »(x_a) > 0$. La morphologie de l’antimode fournit une information cruciale sur la séparabilité des deux composantes probabilistes. Un antimode très profond, proche de zéro, indique une ségrégation quasi absolue entre les deux attracteurs de données, tandis qu’un antimode peu marqué, formant un méplat ou une cuvette peu profonde, traduit un recouvrement important des deux régimes distributionnels.
L’écartement inter-modes, défini comme la distance euclidienne $|x_{m,2} – x_{m,1}|$ séparant les deux abscisses modales, conditionne directement la résolution visuelle de la distribution. Cet écartement doit être interprété à la lumière des variances associées à chaque composante sous-jacente. Si la distance séparant les deux modes est nettement supérieure à la somme des largeurs à mi-hauteur des deux pics, la bimodalité se manifeste sous la forme d’une coupure nette et sans ambiguïté. En revanche, si cette distance diminue ou si la variance de l’une des sous-populations augmente significativement, le creux de l’antimode commence à se combler sous l’effet du chevauchement probabiliste, conduisant à une morphologie aplatie (platykurtique) qui brouille la frontière entre multimodalité et unimodalité étalée.
1.3 Place de la bimodalité au sein des lois multimodales
Sur le plan de la taxonomie distributionnelle, les lois de probabilité s’ordonnent selon une hiérarchie structurelle articulée autour du nombre de maxima locaux de leur fonction de densité : les distributions unimodales n’en possèdent qu’un seul, les distributions bimodales en possèdent exactement deux, et les distributions multimodales générales en comportent trois ou davantage (trimodales, tétramodales, voire $n$-modales). La bimodalité occupe une place conceptuelle centrale au sein de cet édifice, car elle représente le premier niveau de complexité non linéaire au-delà de l’unimodalité classique et constitue le prototype fondamental pour l’étude des phénomènes de bifurcation. L’émergence d’un second mode marque le basculement d’un système régi par un équilibre unique vers un système polarisé, structuré autour de deux états concurrents.
Il est fondamental de ne pas confondre une distribution bimodale avec une distribution unimodale présentant des queues de distribution épaisses ou lourdes (telles que les lois de Student à faibles degrés de liberté, les lois de Cauchy ou les lois de Pareto). Une distribution à queue lourde demeure régie par un processus d’attraction unimodal : la densité y décroît de manière monotone à mesure que l’on s’éloigne de son centre unique, bien que cette décroissance s’opère selon une loi de puissance plutôt qu’à un rythme exponentiel. À l’inverse, la bimodalité implique impérativement une inversion locale de monotonie : la fonction de densité cesse de décroître pour croître de nouveau à l’approche du second mode, créant une non-monotonie stricte qui est totalement absente des distributions unimodales étendues.
La confusion analytique entre étalement distributionnel et multimodalité réelle entraîne des conséquences méthodologiques délétères. Traiter une distribution bimodale asymétrique comme s’il s’agissait d’une loi normale contaminée par des valeurs aberrantes ou d’une loi log-normale étirée conduit immanquablement à ignorer la structure interne des données. Là où l’analyste naïf ne perçoit qu’une dispersion excessive ou une asymétrie gênante qu’il tente d’éradiquer par des artifices mathématiques, la statistique rigoureuse identifie la signature formelle d’une pluralité de processus générateurs de données fonctionnant simultanément au sein du phénomène observé.
2. Caractéristiques mathématiques et propriétés statistiques
2.1 Moments statistiques et mesures de dispersion
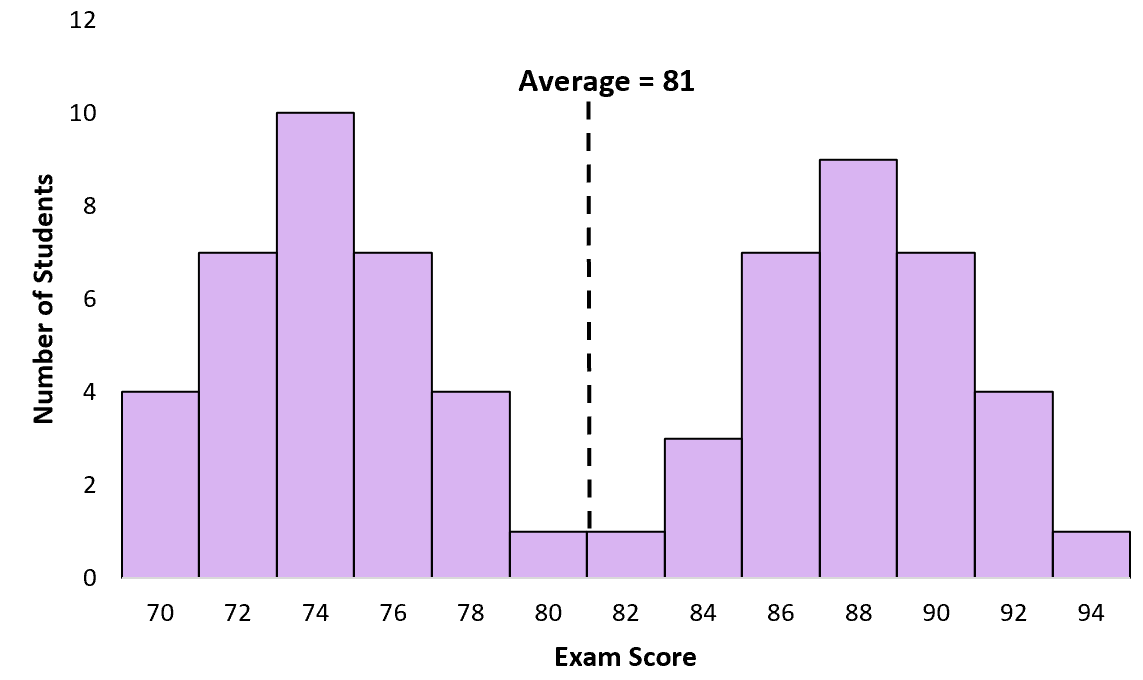
L’analyse des moments statistiques d’une variable aléatoire continue $X$ suivant une loi bimodale met en exergue des comportements fondamentaux qui défient l’intuition acquise au contact de la loi normale. Le premier moment centré sur l’origine, à savoir l’espérance mathématique ou moyenne arithmétique $\mathbb{E}[X] = \int_{-\infty}^{+\infty} x f(x) , dx$, illustre de manière spectaculaire cette divergence. Dans une distribution bimodale symétrique, la moyenne arithmétique se positionne exactement à mi-chemin entre les deux modes, coïncidant précisément avec l’abscisse de l’antimode $x_a$. Il s’ensuit un paradoxe statistique marquant : la moyenne réside dans la zone de la distribution où la densité d’observation est la plus faible, voire quasiment nulle. La moyenne ne résume donc en aucun cas une « valeur typique » ; elle désigne au contraire la valeur que les observations évitent activement.
Le second moment centré, qui définit la variance globale $\sigma^2 = \mathbb{E}[(X – \mathbb{E}[X])^2]$, obéit dans un contexte bimodal à la loi de décomposition de la variance (ou loi de la variance totale). Si l’on conceptualise la bimodalité comme l’amalgame probabiliste de deux composantes latentes indexées par une variable binaire $Z in {1, 2}$, la variance totale s’exprime formellement par la somme orthogonale de la variance intra-composante moyenne et de la variance inter-composante :
$$\mathrm{Var}(X) = \mathbb{E}[\mathrm{Var}(X|Z)] + \mathrm{Var}(\mathbb{E}[X|Z])$$
Dans cette équation, le terme de variance inter-composante $\mathrm{Var}(\mathbb{E}[X|Z]) = \pi_1 \pi_2 (\mu_1 – \mu_2)^2$ — où $\pi_1$ et $\pi_2$ représentent les poids respectifs des sous-populations et $\mu_1, \mu_2$ leurs moyennes propres — gonfle massivement la variance globale observée. La dispersion apparente du système ne traduit donc pas une imprécision ou une instabilité inhérente aux entités mesurées, mais reflète directement la distance structurelle séparant les deux centres d’attraction.
Concernant les moments d’ordre supérieur, le kurtosis (ou coefficient d’aplatissement) et le skewness (coefficient d’asymétrie) offrent des signatures diagnostiques majeures. Une distribution bimodale symétrique présente systématiquement une tendance marquée à la platykurticité : son kurtosis d’ordre 4 normalisé (excès de kurtosis, $\gamma_2$) est négatif, reflétant un déficit de masse au centre exact de la distribution par rapport aux flancs, contrairement au profil leptokurtique aigu de la loi normale standard où $\gamma_2 = 0$. Lorsque les amplitudes ou les effectifs des deux modes divergent, le skewness ($\gamma_1$) s’écarte brutalement de zéro : la prépondérance du mode dominant incline la distribution, produisant une traîne asymétrique qui déplace la médiane et la moyenne loin de l’antimode tout en maintenant la dualité des sommets.
2.2 L’antimode : définition analytique et seuil de séparation
L’antimode ne constitue pas simplement une curiosité topologique de la fonction de densité ; il représente un concept mathématique pivot pour la classification et la prise de décision statistique. Sur le plan analytique, la recherche de l’antimode procède de l’optimisation locale d’une fonction différentiable $f(x)$ sur un intervalle borné par les deux modes $x_{m,1}$ et $x_{m,2}$. Le point critique $x_a in ]x_{m,1}, x_{m,2}[$ satisfait rigoureusement au système différentiel :
$$\left{ \begin{\array}{l} f'(x_a) = 0 f »(x_a) > 0 \end{\array} right.$$
Cette convexité locale garantit que $x_a$ minimise la densité de probabilité au sein du corridor séparant les deux attracteurs. En vertu de cette propriété d’exclusion relative, l’abscisse de l’antimode constitue le seuil de séparation bayésien optimal pour découper la population globale en deux sous-groupes disjoints lorsque l’on ne dispose d’aucune autre variable auxiliaire. Assigner chaque observation $x$ à la classe 1 si $x < x_a$ et à la classe 2 si $x ge x_a$ minimise l'erreur de classification globale sous l'hypothèse de coûts d'erreur symétriques, car la densité d'ambiguïté informationnelle est précisément la plus faible en ce point d'inflexion concave-convexe inversé.
Néanmoins, l’estimation empirique de l’antimode est intrinsèquement vulnérable aux fluctuations d’échantillonnage et aux perturbations stochastiques. Contrairement aux modes, qui bénéficient d’une concentration élevée d’observations facilitant leur repérage par des estimateurs non paramétriques, l’antimode est par définition une zone de raréfaction des données. En conséquence, les estimateurs à noyau de la dérivée de la densité souffrent d’une variance asymptotique accrue dans le voisinage immédiat de $x_a$. Une petite variation de l’échantillon peut modifier sensiblement la position estimée de l’antimode, ce qui requiert l’application de techniques d’inférence robustes, telles que le rééchantillonnage par bootstrap, pour quantifier l’incertitude entourant ce seuil critique avant toute prise de décision opérationnelle.
2.3 Le coefficient de bimodalité de Sarle
Face à la complexité des tests non paramétriques lourds, la littérature psychométrique et statistique s’est dotée d’indicateurs synthétiques rapides pour évaluer la propension d’une distribution à présenter deux modes. Parmi ces instruments, le coefficient de bimodalité de Sarle (désigné fréquemment sous l’acronyme $BC$, pour Bimodality Coefficient) occupe une place prépondérante dans les suites logicielles d’analyse quantitative (comme SAS ou R). Ce coefficient établit une relation fonctionnelle directe entre le coefficient d’asymétrie empirique au carré ($\gamma_1^2$) et le coefficient d’aplatissement non centré (kurtosis classique, noté $\beta_2$ ou $kappa$, où $kappa = 3$ pour une loi normale). Sa formulation analytique standard pour un échantillon de taille $n$ s’énonce :
$$BC = \frac{\gamma_1^2 + 1}{\kappa}$$
Une variante corrigée pour les petits échantillons ajuste les degrés de liberté en intégrant la taille $n$, modifiant le dénominateur par un terme de compensation des biais d’échantillonnage. Le fondement théorique du coefficient de Sarle repose sur l’inégalité mathématique universelle reliant l’asymétrie et le kurtosis : pour toute distribution statistique, on démontre rigoureusement que $\kappa ge \gamma_1^2 + 1$. Cette borne inférieure absolue implique que le coefficient de Sarle est borné supérieurement par l’unité ($BC le 1$). La valeur de référence critique canonique, calculée pour la distribution uniforme continue — qui marque la frontière théorique absolue de l’absence totale de sommets — est établie précisément à :
$$BC_{\mathrm{crit}} = \frac{5}{9} \approx 0{,}555$$
En règle générale, toute distribution dont le coefficient de Sarle excède la valeur seuil de $5/9$ est présumée bimodale ou multimodale, tandis que les valeurs inférieures à $0{,}555$ suggèrent une tendance unimodale. Toutefois, l’utilisation de cet indicateur requiert un discernement critique scrupuleux. Le coefficient de Sarle perd de sa fiabilité face à des distributions dotées de queues extrêmement épaisses ou asymétriques : un kurtosis très élevé au dénominateur peut comprimer artificiellement le $BC$ sous le seuil critique malgré une bimodalité visuelle évidente au centre des données. Réciproquement, certaines lois fortement asymétriques mais strictement unimodales peuvent générer un $\gamma_1^2$ si démesuré qu’il propulse le $BC$ au-delà de $0{,}555$. Le coefficient de Sarle doit donc être appréhendé comme un outil de dépistage préliminaire rapide et non comme une preuve inférentielle définitive.
3. Distinction entre distributions unimodale, bimodale et multimodale
3.1 Comparaison approfondie avec la distribution gaussienne unimodale
La distribution normale standard $\mathcal{N}(\mu, \sigma^2)$ repose sur des hypothèses fondamentales d’unimodalité, de symétrie axiale parfaite autour du paramètre de position $\mu$, et d’amortissement exponentiel quadratique de ses queues de distribution régies par le paramètre d’échelle $\sigma$. Dans ce cadre paradigmatique idéal, le mode, la médiane et la moyenne coïncident rigoureusement en un point unique. Cette triple égalité constitue le socle sur lequel reposent la quasi-totalité des théorèmes de la statistique inférentielle paramétrique classique. Lorsqu’une distribution devient bimodale, l’ensemble de ces axiomes fondateurs s’effondre de manière simultanée.
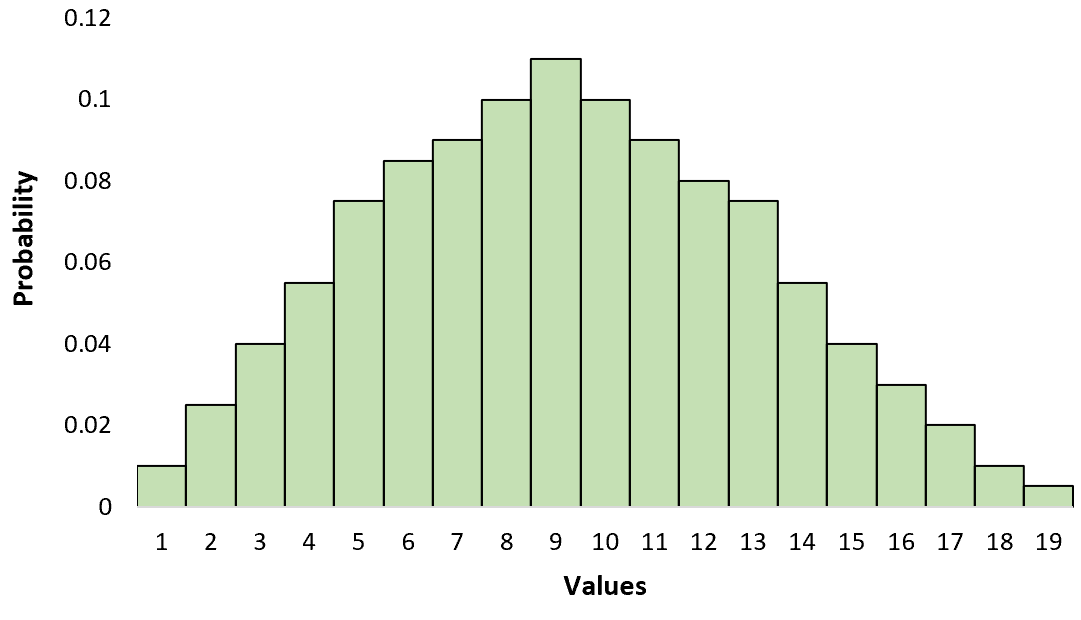
L’une des manifestations les plus périlleuses de cet effondrement réside dans la faillite totale de la célèbre règle empirique des trois sigmas. Sous l’hypothèse de normalité gaussienne, il est universellement admis qu’approximativement 68,27 % des données résident dans l’intervalle $[\mu – \sigma, \mu + \sigma]$, 95,45 % dans l’intervalle $[\mu – 2\sigma, \mu + 2\sigma]$, et 99,73 % dans l’intervalle $[\mu – 3\sigma, \mu + 3\sigma]$. Au sein d’une distribution bimodale bien résolue, cette géométrie probabiliste devient complètement caduque. L’intervalle central $[\mu – \sigma, \mu + \sigma]$ englobe fréquemment une proportion de données très inférieure aux 68 % théoriques, précisément parce que la masse de probabilité a migré vers les deux extrémités modales situées de part et d’autre de la moyenne, dépeuplant le centre sans pour autant respecter la cinétique gaussienne de décroissance.
Par conséquent, résumer une série de mesures bimodales par le simple couple $(\mu, \sigma)$ constitue une abstraction hautement dommageable. Non seulement ce résumé masque la réalité empirique fondamentale du phénomène — à savoir qu’il n’existe pas un individu ou un comportement moyen mais deux pôles distincts — mais il génère également des prédictions probabilistes totalement erronées lors des calculs d’intervalles de confiance ou de risques de dépassement de seuil. L’illusion persiste souvent en raison d’une invocation hâtive du théorème central limite : si celui-ci garantit que la moyenne empirique d’un grand nombre de variables aléatoires indépendantes tend asymptotiquement vers une loi normale, il ne transforme en aucun cas la distribution de la variable d’origine elle-même, laquelle demeure irréductiblement bimodale tant qu’une stratification contextuelle n’est pas opérée.
3.2 Conditions de séparation et distance critique de Cohen
L’émergence d’une véritable structure bimodale au sein d’un mélange continu de deux distributions normales dépend d’un équilibre mathématique précis entre la distance séparant leurs centres respectifs et la magnitude de leurs variances internes. Considérons le modèle théorique canonique résultant de la sommation équiprobable ($\pi_1 = \pi_2 = 0{,}5$) de deux densités gaussiennes $\mathcal{N}(\mu_1, \sigma^2)$ et $\mathcal{N}(\mu_2, \sigma^2)$ partageant une même variance commune $\sigma^2$. La question analytique fondamentale est la suivante : à partir de quel écart critique $|\mu_1 – \mu_2|$ la densité globale cesse-t-elle d’être unimodale pour voir apparaître deux sommets distincts entourant un antimode ?
La résolution analytique de ce problème, formalisée notamment par les travaux de Helguero puis développée dans le cadre de la théorie du signal et de la biométrie, démontre qu’une bimodalité n’émerge que si la distance standardisée — analogue au $d$ de Cohen — excède un seuil critique strict. Formellement, la fonction de densité composite présente deux maxima distincts si et seulement si :
$$|\mu_1 – \mu_2| > 2\sigma$$
Lorsque la distance séparant les deux moyennes est strictement inférieure à deux écarts-types ($|\mu_1 – \mu_2| < 2\sigma$), les deux composantes se fondent en un profil strictement unimodal. Lorsque la distance est exactement égale à $2\sigma$, la fonction de densité présente un sommet parfaitement plat au point médian : la dérivée seconde s'y annule en même temps que la dérivée première ($f'(\mu) = 0$ et $f''(\mu) = 0$), formant un point d'inflexion d'ordre supérieur. Cette zone frontière définit ce que les statisticiens nomment une distribution méplatée ou flat-topped.
Lorsque les variances des deux composantes sont inégales ($\sigma_1^2 ne \sigma_2^2$) ou que les proportions de mélange diffèrent ($\pi_1 ne \pi_2$), cette condition de bifurcation se complexifie considérablement. La composante dotée de la variance la plus large ou du poids le plus fort exerce une force d’attraction sur l’autre, repoussant le seuil d’apparition du second mode vers des distances inter-moyennes nettement plus élevées. Il existe ainsi une vaste zone grise paramétrique où, bien que les données soient issues de deux mécanismes générateurs distincts, la distribution observée conserve une apparence unimodale platykurtique, masquant l’hétérogénéité sous une fausse uniformité visuelle.
3.3 Complexité des systèmes multimodaux d’ordre supérieur
Si la distribution bimodale incarne le modèle élémentaire des architectures multimodales, l’extension aux systèmes trimodaux et $n$-modaux introduit une complexité combinatoire et analytique exponentielle. Dans une distribution présentant $k$ modes, la topologie de la fonction de densité de probabilité continue impose l’existence intercalaire d’au moins $k – 1$ antimodes locaux, créant une succession alternée de crêtes et de vallées. L’identification de ces points critiques multiples soulève des défis d’inférence considérables, en particulier lorsque l’on est confronté au phénomène bien documenté de la malédiction de la dimensionnalité dès lors que la variable analysée devient multivariée.
Pour appréhender cette complexité, la physique statistique et la dynamique non linéaire recourent fréquemment à l’analogie des paysages énergétiques. Dans ce formalisme issu des équations de Langevin et de Fokker-Planck, la fonction de densité de probabilité continue $f(x)$ est mise en correspondance bijective avec un potentiel effectif d’énergie libre $V(x)$ par la relation de Boltzmann-Gibbs :
$$f(x) propto \exp\left(-\frac{V(x)}{k_B T}\right) \quad iff \quad V(x) = -c \cdot \ln(f(x))$$
Dans ce cadre interprétatif profond, les modes de la distribution statistique correspondent exactement aux puits de potentiel (les états d’énergie minimale, c’est-à-dire les attracteurs stables du système), tandis que les antimodes représentent les barrières de potentiel (les points-selles ou états métastables instables). Une distribution bimodale matérialise ainsi un paysage à double puits de potentiel, séparés par une barrière que les observations ne peuvent franchir que sous l’action de fluctuations aléatoires ou de forçages externes significatifs. La généralisation à des structures d’ordre supérieur correspond à des paysages énergétiques complexes et rugueux (dits rugged landscapes), typiques des systèmes désordonnés, des repliements de protéines ou de la dynamique des opinions au sein de vastes réseaux interconnectés.
4. Causes sous-jacentes et genèse de la bimodalité
4.1 Hétérogénéité d’échantillon et mélanges latents
L’étiologie la plus fréquente d’une bimodalité observée dans des données empiriques réside dans l’hétérogénéité non contrôlée de l’échantillon, générant ce que la statistique formelle désigne sous le nom de mélange latent. Ce phénomène survient lorsqu’un protocole de recherche recueille des observations au sein d’une population globale sans identifier, mesurer ou contrôler une variable catégorielle binaire fondamentale qui pilote la valeur de la métrique quantitative observée. La cohorte analysée n’est pas homogène ; elle juxtapose deux sous-populations distinctes qui obéissent chacune à leur propre dynamique probabiliste.
Les variables démographiques, génétiques ou anatomiques fournissent une illustration canonique de cette dynamique. Le dimorphisme structurel au sein d’une espèce — qu’il s’agisse de la masse corporelle, du volume crânien ou des taux hormonaux — produit systématiquement une distribution bimodale si les individus mâles et femelles sont regroupés dans une série univariée indifférenciée. De même, en épidémiologie clinique, le regroupement dans un même panel de sujets sains et d’individus porteurs d’une affection asymptomatique induit fréquemment une bimodalité des biomarqueurs sanguins, avant même que le diagnostic formel n’ait été posé.
Dans ces configurations, la bimodalité n’est pas une propriété intrinsèque d’un processus continu indivisible, mais le sous-produit mécanique du masquage d’un facteur modérateur qualitatif majeur. Dès lors que cette variable latente dichotomique est identifiée et réintégrée dans le modèle d’analyse à titre de facteur de stratification ou de co-variable, la bimodalité globale s’évapore instantanément au niveau conditionnel : chacune des sous-populations retrouve une distribution unimodale normale ou quasi normale. Ce phénomène illustre avec force la nécessité d’une investigation contextuelle poussée face à tout profil bimodal découvert au cours d’une phase exploratoire.
4.2 Phénomènes de polarisation et boucles de rétroaction
Contrairement aux cas où la bimodalité découle de la simple juxtaposition passive de deux groupes préexistants, certains systèmes génèrent une bimodalité endogène par le jeu de dynamiques internes auto-renforçantes. Dans ces systèmes complexes — qu’ils soient biologiques, économiques ou sociologiques — des boucles de rétroaction positive opèrent pour amplifier des divergences initiales infinitésimales, précipitant les observations vers deux attracteurs terminaux stables et éliminant systématiquement les états intermédiaires.
Ce mécanisme est formellement décrit par la théorie des bifurcations dynamiques, et plus particulièrement par le modèle de la bifurcation en fourche supercritique (supercritical pitchfork bifurcation). Dans une telle configuration mathématique, l’état moyen central, qui constituait historiquement un attracteur stable unique, subit une déstabilisation sous l’effet de l’augmentation d’un paramètre de contrôle du système. L’état médian devient un répulsif instable, tandis que deux nouveaux états d’équilibre stables — l’un positif, l’autre négatif par rapport au centre — émergent simultanément. Les trajectoires individuelles sont dès lors inexorablement aspirées vers l’un de ces deux attracteurs sous l’effet du bruit ambiant.
Ce processus de ségrégation dynamique se rencontre fréquemment dans l’étude de la polarisation des opinions politiques au sein des réseaux d’influence, où la pression à la conformité intra-groupe et la diabolisation de l’exogroupe créent une instabilité de la position modérée. Il se manifeste avec la même rigueur dans les phénomènes d’épigénétique du développement cellulaire, où une cellule pluripotente bascule irréversiblement vers l’un de deux destins cellulaires distincts sous l’action d’un circuit génétique régulé par inhibition mutuelle croisée, ne laissant aucune place aux phénotypes hybrides ou intermédiaires.
4.3 Artéfacts métrologiques et contraintes d’instruments
Toute détection de bimodalité n’est pas nécessairement porteuse d’une vérité ontologique ou biologique profonde ; elle peut résulter d’imperfections substantielles introduites par la chaîne de mesure expérimentale elle-même. Les artefacts métrologiques représentent un piège classique pour le statisticien, capable de simuler une bimodalité spectaculaire au sein de données issues d’un phénomène sous-jacent rigoureusement unimodal.
L’un des mécanismes générateurs d’artefacts les plus fréquents résulte de l’action conjointe d’un effet de plancher (floor effect) et d’un effet de plafond (ceiling effect) sévères au sein d’une échelle de mesure dont la plage dynamique est inadaptée à la dispersion réelle de l’échantillon. Lorsqu’un instrument psychométrique ou un capteur physique est incapable d’enregistrer des valeurs en deçà d’un seuil minimum opérationnel $L_{\min}$ ou au-delà d’un plafond $L_{\max}$, toutes les observations théoriquement distribuées dans les queues normales se trouvent artificiellement censurées et compressées contre ces butées rigides. Cette accumulation forcée de points aux deux frontières de l’intervalle d’enregistrement crée deux pics artificiels de fréquence aux extrémités, donnant l’illusion trompeuse d’une distribution bimodale en cuvette.
D’autres distorsions métrologiques proviennent de variations drastiques de la sensibilité de l’instrument sur l’étendue de son spectre d’évaluation. Si un protocole d’enquête applique des pas de graduation très larges dans la zone médiane d’une échelle d’attitude et des graduations extrêmement fines aux extrémités, la fonction de densité empirique présentera des anomalies morphologiques induites par ce changement de résolution spatiale. De même, un biais d’ancrage méthodologique lors du recueil des données — par exemple, des formulations de questions orientant l’attention sur deux options contrastées — peut fragmenter artificiellement un continuum psychologique en deux blocs statistiques distincts.
5. La distribution bimodale en psychologie et sciences comportementales
5.1 Psychopathologie et continuité versus typologie
L’une des controverses épistémologiques les plus intenses de la psychiatrie et de la psychopathologie contemporaines réside dans l’opposition entre les modèles diagnostiques dimensionnels continus et les approches typologiques discontinues. Cette querelle théorique se cristallise directement autour de la forme de la distribution des scores obtenus aux inventaires cliniques standardisés, tels que l’inventaire de dépression de Beck (BDI-II) ou l’échelle d’anxiété de Hamilton (HAM-A).
Si la dépression majeure constitue une entité pathologique distincte, fonctionnellement séparée du fonctionnement psychique normal par une frontière qualitative, la distribution des scores au sein d’une cohorte représentative de la population générale incluant des patients psychiatriques devrait théoriquement présenter une morphologie bimodale. Le premier mode regrouperait la vaste majorité des individus sains ou subcliniques oscillant autour de scores minimaux, tandis que le second mode concentrerait les patients en phase dépressive aiguë autour d’un score d’intensité élevé, l’antimode fournissant alors le seuil de coupure diagnostique optimal. Si, au contraire, la souffrance affective se déploie selon un continuum dimensionnel sans rupture, la distribution globale demeurera strictement unimodale, quoique fortement asymétrique et étirée vers les scores pathologiques.
Les investigations psychométriques modernes révèlent que dans des échantillons cliniques mixtes, la bimodalité émerge fréquemment comme la marque tangible d’une transition de phase psychopathologique. Au-delà d’un certain seuil d’exposition au stress chronique ou à des événements de vie indésirables, les mécanismes régulateurs homéostatiques de l’individu cèdent brusquement sous l’effet d’une rupture de résilience, le faisant basculer d’un attracteur psychologique fonctionnel vers un état dépressif stable réfractaire. L’analyse des classes latentes et les modèles de mélanges de distributions appliqués à ces scores permettent ainsi de disséquer la dynamique de vulnérabilité sans imposer a priori un découpage catégoriel binaire arbitraire.
5.2 Psychologie cognitive et chronométrie mentale
En psychologie cognitive expérimentale, l’étude de la distribution des temps de réaction (TR) dans des paradigmes d’interférence et de décision sensorimotrice constitue une fenêtre privilégiée sur l’architecture du traitement de l’information par le cerveau humain. Alors que les temps de réaction simples adoptent généralement une forme unimodale asymétrique positive (modélisable par des lois ex-gaussiennes ou des lois de Wald), l’apparition d’une bimodalité dans la latence des réponses signale sans ambiguïté l’engagement de deux mécanismes neurocognitifs concurrents opérant à des vitesses de traitement divergentes.
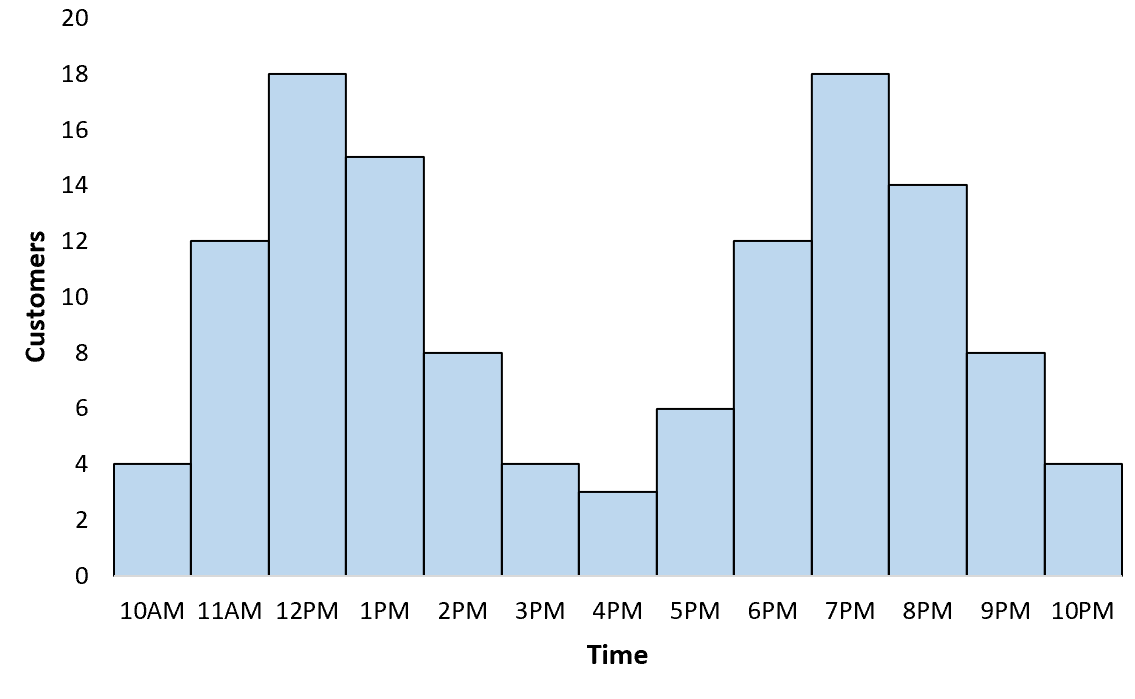
Cette configuration s’observe de manière spectaculaire dans l’analyse détaillée de la célèbre tâche de Stroop ou dans les épreuves d’interférence spatiale de Simon. Face à un stimulus hautement conflictuel (par exemple, le mot « ROUGE » imprimé à l’encre bleue), la distribution temporelle des réponses des participants peut se scinder en deux modes temporels distincts. Le premier pic, caractérisé par des latences très courtes (de l’ordre de 250 à 400 millisecondes), reflète l’action des processus automatiques descendants rapides — souvent associés au Système 1 heuristique — qui commettent fréquemment des erreurs en tentant de lire le mot. Le second pic, situé à des latences nettement plus tardives (entre 600 et 900 millisecondes), matérialise l’intervention délibérée et coûteuse du contrôle attentionnel exécutif — le Système 2 algorithmique — qui parvient à inhiber l’automatisme pour dénommer la couleur correcte.
Cette bimodalité chronométrique s’explique également par l’arbitrage stratégique vitesse-précision (speed-accuracy tradeoff). Lorsque les consignes expérimentales génèrent une ambiguïté sur la priorité de la tâche, certains participants alternent entre une stratégie d’anticipation risquée et une stratégie de vérification conservative. Dans le cadre des modèles de diffusion de décision de Ratcliff, cette dynamique correspond à une fluctuation du positionnement des frontières d’absorption du processus d’accumulation d’informations sensorielles, fragmentant la densité de sortie en deux régimes cinétiques distincts.
5.3 Psychologie sociale et polarisation des attitudes
Le champ de la psychologie sociale empirique et de la sociologie quantitative mobilise largement la distribution bimodale comme l’instrument statistique par excellence pour conceptualiser et quantifier la polarisation idéologique au sein du corps social. Lorsqu’une communauté est interrogée sur des thématiques éthiques, politiques ou civilisationnelles clivantes au moyen d’échelles de positionnement d’intervalles (allant par exemple de 0 pour une opposition totale à 10 pour une adhésion inconditionnelle), l’évolution temporelle de la distribution des réponses permet de diagnostiquer l’état de la cohésion républicaine ou communautaire.
Une société caractérisée par un consensus délibératif fonctionnel et une culture du compromis présente typiquement une distribution unimodale resserrée autour du centre politique ou modéré, avec des ailes marginales restreintes. En revanche, sous l’effet de dynamiques de radicalisation identitaire, de la diffusion d’infox et de l’agrégation au sein de bulles de filtres cognitives, on assiste à un creusement continu du centre — qui devient l’antimode de la distribution — au profit exclusif de deux modes massifs campés aux pôles extrêmes de l’échelle. Ce processus d’évidement modéré constitue la définition mathématique même de la polarisation d’attitude.
L’analyse distributionnelle permet de dépasser les illusions des moyennes nationales : une attitude sociétale dont la moyenne arithmétique reste miraculeusement stable à 5/10 au fil d’une décennie peut masquer une métamorphose explosive du paysage d’opinion, passant d’une cloche gaussienne unifiée centrée sur 5 à une configuration furieusement bimodale scindée à 10 % et 90 %. Seule la modélisation formelle de l’éloignement des modes et du dépeuplement de l’antimode fournit aux chercheurs les indices rigoureux de fragmentation sociologique nécessaires pour évaluer l’impact des algorithmes de recommandation sur les plateformes numériques d’échange d’idées.
5.4 Psychométrie et fonctionnement différentiel des items
Au sein de la psychométrie moderne, régie par les canons de la théorie de la réponse aux items (TRI), l’apparition d’une distribution bimodale des scores totaux ou du patron de réponse à une épreuve d’aptitude constitue un signal d’alarme méthodologique immédiat. L’un des postulats cardinaux des modèles logistiques de Rasch et de Birnbaum réside en effet dans l’unidimensionnalité stricte du trait latent mesuré ($\theta$) : le test doit évaluer une seule et unique aptitude cognitive ou psychologique à travers l’ensemble de ses items.
Si la distribution du trait latent estimé ou des scores bruts à un test d’intelligence ou de sélection révèle deux modes distincts, ce résultat trahit quasi systématiquement la violation du postulat d’unidimensionnalité par l’interférence d’une seconde variable cachée non maîtrisée. Cette distorsion se manifeste au niveau granulaire sous la forme d’un fonctionnement différentiel de l’item (DIF, Differential Item Functioning). Un item présente un DIF si des individus possédant le même niveau de compétence réelle sur le trait latent cible manifestent des probabilités distinctes de réussir l’item en raison de leur appartenance à des sous-groupes culturels, linguistiques ou éducatifs distincts.
De surcroît, des artefacts de formulation sémantique peuvent injecter de la bimodalité au sein d’échelles de Likert standard. Une formulation ambiguë comportant une double négation ou un énoncé complexe susceptible de deux interprétations diamétralement opposées conduit les répondants à se polariser massivement sur les options extrêmes de l’échelle (« tout à fait d’accord » vs « pas du tout d’accord »), désertant les catégories centrales. L’analyse rigoureuse de la structure distributionnelle permet ainsi aux ingénieurs du test d’épurer les inventaires psychométriques avant leur standardisation définitive.
6. Modélisation mathématique : Modèles de mélanges gaussiens (GMM)
6.1 Formulation théorique d’un mélange à deux composantes
L’approche paramétrique la plus élégante, robuste et féconde pour formaliser mathématiquement une distribution bimodale continue consiste à recourir à la théorie des modèles de mélanges finis (finite mixture models), et plus spécifiquement aux modèles de mélanges gaussiens (GMM, Gaussian Mixture Models). Dans ce cadre analytique probabiliste, une variable aléatoire continue $X$ est modélisée comme une combinaison convexe de deux fonctions de densité de probabilité normales distinctes. La fonction de densité composite globale s’exprime formellement par l’équation :
$$f(x; boldsymbol{\theta}) = \pi_1 \phi(x; \mu_1, \sigma_1^2) + \pi_2 \phi(x; \mu_2, \sigma_2^2)$$
où $\phi(x; \mu_k, \sigma_k^2) = \frac{1}{\sigma_k \sqrt{2\pi}} \exp\left( -\frac{(x – \mu_k)^2}{2\sigma_k^2} \right)$ représente la densité de la loi normale unimodale pour la composante $k in {1, 2}$, caractérisée par son espérance $\mu_k$ et sa variance $\sigma_k^2$. Les paramètres scalaires $\pi_1$ et $\pi_2$ désignent les poids de mélange (ou probabilités a priori d’appartenance aux composantes). Pour satisfaire aux axiomes de Kolmogorov et garantir l’intégration unitaire de la densité globale ($\int_{-\infty}^{+\infty} f(x) , dx = 1$), ces coefficients doivent impérativement obéir aux deux contraintes structurelles :
$$\pi_1 ge 0, \quad \pi_2 ge 0, \quad \text{a\vec} \quad \pi_1 + \pi_2 = 1$$
Le vecteur complet des paramètres à estimer s’écrit dès lors $boldsymbol{\theta} = (\pi_1, \mu_1, \sigma_1^2, \mu_2, \sigma_2^2)^T$. L’immense flexibilité de cette formulation réside dans son aptitude à capturer sans peine des structures profondément asymétriques et hétéroscédastiques. Contrairement aux modèles simplistes supposant des variances homogènes, un GMM complet permet à $\sigma_1^2$ d’être radicalement différent de $\sigma_2^2$. Il devient ainsi envisageable de modéliser une distribution associant un pic primaire très haut, aigu et étroit (faible variance et poids élevé) et un pic secondaire aplati, large et dispersé (forte variance et poids faible), reproduisant fidèlement les configurations empiriques les plus retorses.
6.2 L’algorithme Espérance-Maximisation (EM)
L’ajustement direct d’un modèle de mélange gaussien par la méthode du maximum de vraisemblance classique se heurte à une impossibilité analytique : en raison de la sommation située sous l’opérateur logarithmique dans la log-vraisemblance $\ln L(boldsymbol{\theta}) = \sum_{i=1}^n \ln[\sum_{k=1}^2 \pi_k \phi(x_i; \mu_k, \sigma_k^2)]$, il est impossible d’isoler explicitement les paramètres sous forme close par simple annulation du gradient. Pour résoudre ce problème non linéaire, la statistique computationnelle utilise universellement l’algorithme Espérance-Maximisation (EM), formalisé par Dempster, Laird et Rubin en 1977.
L’algorithme EM opère en postulant l’existence de variables latentes d’allocation inobservées $Z_i = (z_{i1}, z_{i2})$, où $z_{ik} = 1$ si la $i$-ème observation est issue de la composante $k$, et $z_{ik} = 0$ sinon. L’optimisation procède ensuite par un schéma itératif convergeant garanti vers un maximum local de vraisemblance, articulé en deux étapes fondamentales :
- L’étape E (Espérance) : À l’itération $(t)$, connaissant les paramètres courants $boldsymbol{\theta}^{(t)}$, on calcule pour chaque observation $x_i$ la probabilité a posteriori conditionnelle — dénommée la responsabilité $\gamma_{ik}$ — qu’elle appartienne à la composante $k$, par application rigoureuse du théorème de Bayes :
$$\gamma_{ik}^{(t)} = \mathbb{E}[z_{ik} mid x_i, boldsymbol{\theta}^{(t)}] = \frac{\pi_k^{(t)} \phi(x_i; \mu_k^{(t)}, \sigma_k^{2(t)})}{\sum_{j=1}^2 \pi_j^{(t)} \phi(x_i; \mu_j^{(t)}, \sigma_j^{2(t)})}$$ - L’étape M (Maximisation) : Munie de ces responsabilités probabilistes faisant office de coefficients de pondération, l’étape M réactualise analytiquement les composantes du vecteur de paramètres pour l’itération $(t+1)$ :
$$\pi_k^{(t+1)} = \frac{1}{n} \sum_{i=1}^n \gamma_{ik}^{(t)}$$
$$\mu_k^{(t+1)} = \frac{\sum_{i=1}^n \gamma_{ik}^{(t)} x_i}{\sum_{i=1}^n \gamma_{ik}^{(t)}}$$
$$\sigma_k^{2(t+1)} = \frac{\sum_{i=1}^n \gamma_{ik}^{(t)} (x_i – \mu_k^{(t+1)})^2}{\sum_{i=1}^n \gamma_{ik}^{(t)}}$$
Bien que d’une remarquable élégance mathématique, l’algorithme EM souffre de limitations bien répertoriées. Il fait preuve d’une grande sensibilité à ses conditions d’initialisation : un point de départ mal étalonné peut le piéger dans des optima locaux sous-optimaux. De surcroît, la surface de vraisemblance d’un GMM hétéroscédastique présente des singularités pathologiques où la variance d’une composante tend vers zéro ($\sigma_k^2 to 0$) au niveau d’une observation unique $x_i$, provoquant l’explosion de la vraisemblance vers l’infini. L’implémentation impose donc des pénalisations bayésiennes (priors régularisateurs sur les variances) pour assurer la convergence numérique vers des solutions statistiquement signifiantes.
6.3 Critères d’information et validation du nombre de composantes
L’estimation des paramètres d’un mélange à deux composantes ne prouve pas mathématiquement que $k = 2$ représente le modèle sous-jacent authentique de la population. Une distribution unimodale asymétrique empirique peut toujours être approximée de façon opportune par un mélange de deux gaussiennes sur-ajustées. Pour trancher de manière objective entre un modèle unimodal ($k = 1$) et un modèle bimodal ($k = 2$), la modélisation statistique mobilise des critères d’arbitrage pénalisés conciliant la qualité de l’ajustement à la parcimonie paramétrique.
Les deux indices les plus omniprésents sont le critère d’information d’Akaike (AIC) et le critère d’information bayésien (BIC, ou critère de Schwarz), formulés ainsi :
$$\mathrm{AIC} = -2\ln(\hat{L}) + 2p$$
$$\mathrm{BIC} = -2\ln(\hat{L}) + p \ln(n)$$
où $\hat{L}$ représente la valeur maximale de la fonction de vraisemblance optimisée, $p$ le nombre total de paramètres libres ($p = 2$ pour une loi normale simple ; $p = 5$ pour un mélange gaussien bimodal complet), et $n$ la taille de l’échantillon. Le BIC inflige une pénalité beaucoup plus sévère à la complexité structurelle ($p ln(n)$ face à $2p$) dès lors que $n ge 8$. Dans le contexte des modèles de mélanges, le BIC démontre une consistance asymptotique reconnue pour identifier la structure véritable, évitant le sur-apprentissage inhérent à l’AIC.
Toutefois, en raison de la non-régularité des conditions d’identifiabilité lors du passage de $k=1$ à $k=2$ (le paramètre de poids frontière $\pi_1 = 0$ se trouvant au bord de l’espace des paramètres admissibles), le test classique du rapport de vraisemblance ne suit pas la loi asymptotique du chi-deux de Wilks. Pour valider formellement la significativité du passage à un modèle bimodal, les statisticiens recourent à des tests de rapport de vraisemblance bootstrap paramétriques (comme le test de Lo-Mendell-Rubin). Enfin, la netteté de la séparation entre les deux groupes est quantifiée par l’entropie de classification normalisée, un indice borné entre 0 et 1 : des valeurs d’entropie supérieures à $0{,}80$ attestent que les deux composantes du mélange sont remarquablement individualisées, garantissant une allocation univoque des individus.
7. Méthodes de détection et tests statistiques de bimodalité
7.1 Exploration visuelle et estimation de densité par noyau (KDE)
L’exploration visuelle constitue historiquement la première démarche face à un jeu de données univarié. Cependant, l’instrument visuel traditionnel — l’histogramme classique — s’avère hautement précaire et souvent trompeur pour diagnostiquer une bimodalité. L’apparence de l’histogramme est captive de deux choix arbitraires de l’analyste : la largeur des classes (le pas de discrétisation ou bin width) et l’origine de l’ancrage des bornes. Une discrétisation excessivement grossière efface instantanément deux pics pourtant bien réels en les fusionnant dans un rectangle unique, tandis qu’un découpage trop fin pulvérise le continuum sous l’effet du bruit d’échantillonnage, générant une multitude de pics factices.
Pour s’affranchir de cette fragilité graphique, la statistique computationnelle recourt à l’estimation de densité par noyau (KDE, Kernel Density Estimation), formalisée par Rosenblatt et Parzen. Pour un échantillon ${x_1, x_2, dots, x_n}$, l’estimateur non paramétrique de la densité en tout point $x$ s’écrit :
$$\hat{f}_h(x) = \frac{1}{nh} \sum_{i=1}^n K\left( \frac{x – x_i}{h} \right)$$
où $K(\cdot)$ est une fonction noyau standardisée (le plus souvent la densité gaussienne unitaire) et $h > 0$ représente le paramètre de lissage ou largeur de fenêtre (bandwidth). Le comportement de cet estimateur est entièrement gouverné par le choix de $h$. Un lissage optimal obéit à un compromis mathématique rigide entre le biais d’estimation et sa variance :
- Si $h$ est surdimensionné (oversmoothing), l’estimateur gomme impitoyablement les singularités locales, comble les antimodes et ramène artificiellement une distribution fondamentalement bimodale vers un profil unimodal émoussé.
- Si $h$ est sous-dimensionné (undersmoothing), la variance explose : l’estimateur épouse chaque fluctuation stochastique locale de l’échantillon, créant des ondulations chaotiques et des dizaines de modes imaginaires sans fondement populationnel.
Les règles heuristiques usuelles, telles que la règle du pouce de Silverman ($h = 0{,}9 \min(\hat{\sigma}, \frac{\mathrm{IQR}}{1{,}34}) n^{-1/5}$), sont optimisées pour des densités mères gaussiennes et tendent mécaniquement à sur-lisser les structures bimodales, effaçant le second mode. Il est donc indispensable de recourir à des procédures de validation croisée par extraction (least-squares cross-validation) ou à des estimateurs de bande passante adaptatifs à largeur variable pour préserver la fidélité topologique des deux sommets.
7.2 Le test du dip de Hartigan (Hartigan’s Dip Test)
L’inspection graphique par noyau ne pouvant se substituer à une preuve probabiliste rigoureuse, la statistique non paramétrique a développé des tests d’hypothèses dédiés spécifiquement à la détection de la multimodalité. Le test le plus célèbre, le plus robuste et le plus élégant est sans conteste le test du dip de Hartigan, publié par J. A. Hartigan et P. M. Hartigan en 1985.
Le fondement mathématique du test du dip repose sur une analyse fonctionnelle globale de la fonction de répartition empirique $F_n(x)$ de l’échantillon. Hartigan formule l’hypothèse nulle universelle d’unimodalité :
$$H_0 : F in \mathcal{U} \quad \text{contre} \quad H_1 : F \notin \mathcal{U}$$
où $\mathcal{U}$ désigne la classe générale de toutes les fonctions de répartition dont la fonction de densité associée est strictement unimodale, indépendamment de sa variance, de son asymétrie ou de l’épaisseur de ses queues. Sur le plan de la répartition, une loi unimodale se caractérise par une fonction $F$ qui est convexe jusqu’au mode, puis concave au-delà. La statistique du Dip, notée $D_n$, mesure la distance de Kolmogorov-Smirnov minimale séparant la fonction de répartition empirique observée $F_n$ de la classe $\mathcal{U}$ de toutes les fonctions de répartition unimodales admissibles :
$$D_n = \inf_{G in \mathcal{U}} \sup_{x} |F_n(x) – G(x)|$$
Pour calculer cette statistique, l’algorithme des moindres concavités-convexités de Hartigan construit l’enveloppe convexe supérieure et l’enveloppe concave inférieure de $F_n$. La distribution asymptotique sous l’hypothèse nulle n’étant pas dérivable analytiquement sous forme simple, la détermination de la p-valeur s’effectue par comparaison de la statistique observée avec des tables de distribution simulées pour le cas le plus défavorable de l’hypothèse nulle : la distribution uniforme continue, qui maximise la probabilité d’erreur de première espèce.
Une valeur de $D_n$ significativement élevée ($p < 0{,}05$) conduit au rejet péremptoire de l'hypothèse nulle d'unimodalité, concluant formellement à l'existence d'au moins deux modes. L'atout déterminant du test du dip de Hartigan réside dans son immunité totale face à l'asymétrie : une distribution hautement asymétrique mais strictement unimodale (comme une loi exponentielle ou une loi log-normale extrême) ne fera jamais dévier le test vers un faux positif, ce qui lui confère une robustesse exceptionnelle.
7.3 Tests de bande passante critique et approches de Silverman
Une approche méthodologique alternative et complémentaire au test du dip a été inaugurée par B. W. Silverman en 1981, en exploitant les propriétés mathématiques directes de l’estimateur de densité par noyau gaussien. Silverman a démontré un résultat analytique fondamental : lorsque l’on utilise un noyau gaussien, le nombre de maxima locaux (modes) de la densité estimée $\hat{f}_h(x)$ est une fonction monotone non croissante de la largeur de bande $h$. Autrement dit, plus $h$ augmente, plus la fonction se lisse et plus le nombre de sommets diminue irréversiblement jusqu’à atteindre l’unimodalité stricte.
Fort de ce principe, Silverman définit la bande passante critique pour $k$ modes, notée $h_{\mathrm{crit}}(k)$, comme la borne inférieure exacte de l’ensemble des largeurs de bande produisant une fonction de densité possédant au plus $k$ modes :
$$h_{\mathrm{crit}}(k) = \inf \left{ h > 0 mid \hat{f}_h \text{ possède au plus } k \text{ modes} \right}$$
Pour tester l’hypothèse d’unimodalité ($k = 1$) contre l’alternative de bimodalité ($k ge 2$), on calcule la valeur empirique $h_{\mathrm{crit}}(1)$, c’est-à-dire la plus petite fenêtre requise pour obliger l’estimateur à gommer le second sommet. Si cette fenêtre critique s’avère particulièrement large, cela signifie qu’il a fallu infliger un sur-lissage violent pour éliminer le second mode, ce qui apporte la preuve empirique indirecte que ce second sommet possède une consistance statistique remarquable au sein des données d’origine.
L’évaluation de la significativité statistique de cette bande passante critique repose sur une procédure sophistiquée de bootstrap lissé (smoothed bootstrap). On génère des milliers d’échantillons synthétiques tirés non pas des données discrètes brutes, mais de la fonction de densité nulle $\hat{f}_{h_{\mathrm{crit}}(1)}$, renormalisée pour en préserver la variance unitaire. On recalcule ensuite $h_{\mathrm{crit}}^{*}$ pour chaque réplique bootstrap afin d’édifier la distribution empirique de la statistique sous $H_0$. Bien que très élégant et offrant une excellente puissance face à des mélanges gaussiens symétriques équilibrés, le test de Silverman présente une sensibilité documentée aux queues de distribution épaisses, qui peuvent parfois le conduire à surestimer le nombre de modes réels aux franges du support.
8. Enjeux et défis liés à l’échantillonnage et aux biais de mesure
8.1 Biais d’échantillonnage et recrutement dichotomique
L’apparition d’une bimodalité au sein d’un jeu de données quantitatives doit systématiquement inciter le chercheur à un examen critique approfondi de son protocole d’échantillonnage. Dans de nombreux cas pratiques, la distribution bimodale observée ne constitue pas une propriété générale de la population cible, mais le résultat direct d’un biais de recrutement dichotomique non maîtrisé au cours de la collecte des données.
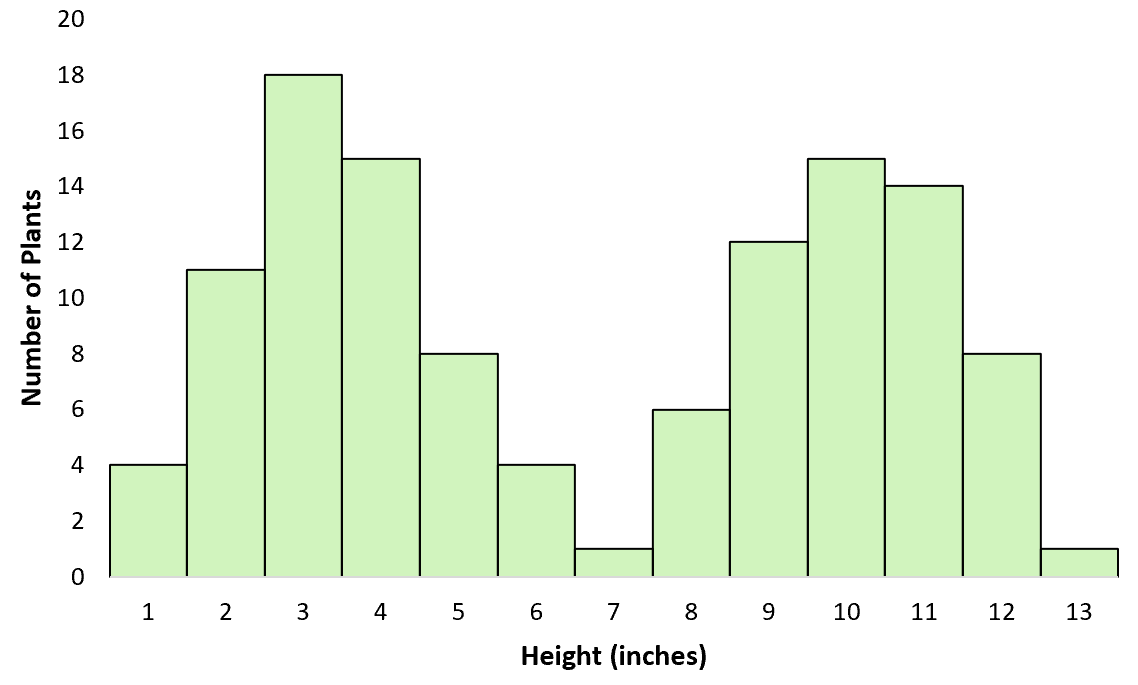
Ce phénomène survient fréquemment lorsque les chercheurs recrutent leur échantillon à travers deux canaux de communication ou deux environnements physiques distincts sans mesurer l’interaction propre à chaque canal. Par exemple, une étude portant sur le bien-être au travail recrutant simultanément ses participants via un forum de discussion d’employés en arrêt maladie de longue durée et via un réseau professionnel de cadres dirigeants en pleine ascension de carrière fusionne artificiellement deux cohortes extrêmes. Les individus situés aux niveaux d’épanouissement intermédiaires ne fréquentant aucun de ces deux canaux sélectifs, l’échantillon combiné présentera une distribution bimodale éclatée qui ne reflète aucunement la réalité distributionnelle de l’entreprise étudiée.
Un mécanisme analogue opère dans les études épidémiologiques longitudinales soumises à une attrition sélective. Si les individus modérément affectés par un traitement tendent à abandonner le protocole en cours de route — ne laissant subsister dans la cohorte que les répondants parfaits d’un côté et les sujets développant des effets indésirables massifs de l’autre —, la distribution finale des résultats sera trompeusement bimodale. Pour corriger ces distorsions dévastatrices lors de la phase d’inférence, il est impératif de mettre en œuvre des techniques rigoureuses de pondération statistique par recalage sur marges ou de post-stratification s’appuyant sur des recensements démographiques fiables de la population générale.
8.2 Agrégation spatiotemporelle et paradoxe de Simpson
La bimodalité peut également émerger par un processus d’illusion mathématique induit par l’agrégation aveugle de données spatiotemporelles. Ce piège d’analyse est une manifestation directe du célèbre paradoxe de Simpson appliqué à l’analyse distributionnelle continue : la combinaison de plusieurs sous-ensembles de données présentant chacun une distribution strictement unimodale et homogène peut engendrer une distribution globale composite intensément bimodale ou multimodale.
Considérons l’enregistrement d’une variable environnementale, telle que la température de l’eau d’un lac ou la concentration d’un polluant atmosphérique urbain, amalgamée sur une année complète sans discrimination calendaire. Si la station de mesure enregistre une distribution unimodale centrée sur des valeurs basses durant la saison hivernale, et une distribution également unimodale centrée sur des valeurs élevées durant la période estivale, la projection brute de l’ensemble des mesures dans un histogramme annuel univarié unique révélera deux modes saisonniers majestueux séparés par un antimode printanier et automnal. Conclure à la bimodalité intrinsèque du système physique serait erroné : à chaque instant $t$, l’état du système est parfaitement unimodal et prévisible.
Le même phénomène se manifeste lors de la mise en commun irréfléchie de données collectées sur des sites géographiques distincts ou au sein d’unités de production décentralisées. Si l’usine A opère à un rendement moyen de 40 unités avec un contrôle statistique optimal (loi normale étroite) et l’usine B à un rendement moyen de 80 unités selon une loi tout aussi normale, la mise en commun des rendements dans le tableau de bord corporatif sans étiquetage des unités donne l’illusion d’une bimodalité d’exploitation. L’analyste rigoureux doit donc impérativement désagréger les séries par strates contextuelles fondamentales (temps, espace, environnement technique) avant de conclure à la bimodalité d’une loi de probabilité fondamentale.
8.3 Granularité des instruments et réponses attractives
Un défi métrologique récurrent au sein des sciences humaines et de la recherche clinique provient de l’utilisation d’échelles de mesure ordonnées courtes dont la granularité numérique est trop faible pour capter un continuum. Lorsqu’une échelle psychométrique ne propose que 3, 5 ou 7 degrés de réponse (comme les échelles de Likert conventionnelles), le phénomène psychologique d’attraction des ancres extrêmes peut métamorphoser artificiellement une opinion unimodale diffuse en une bimodalité observée.
Ce biais cognitif d’ancrage opère particulièrement lors de l’emploi d’étiquettes verbales asymétriques. Si les échelons extrêmes sont libellés de manière valorisante (« Excellence absolue », « Accord total ») tandis que les catégories centrales sont rédigées sous une forme passive ou floue (« Neutre », « Sans opinion »), une fraction substantielle de répondants évite la zone d’indifférence perçue comme socialement peu désirable. Les réponses se déversent massivement vers les deux bornes, simulant une bimodalité d’expression qui ne correspond pas à la véritable structure de croyance interne des sujets.
De surcroît, le bruit de mesure d’arrondi numérique dans les instruments informatiques de basse précision produit des artefacts de résonance discrète. Si une métrique continue est grossièrement quantifiée avec des sauts de résolution irréguliers, des regroupements artificiels d’observations peuvent se concentrer autour des valeurs entières ou des seuils de troncature, générant une succession de modes et d’antimodes qui n’ont aucune réalité physique mais résultent exclusivement d’un convertisseur analogique-numérique déficient. L’examen des résidus de quantification constitue la parade méthodologique indispensable pour assainir les données avant modélisation.
9. Conséquences de la bimodalité sur l’inférence statistique et les tests d’hypothèses
9.1 Invalidation des tests paramétriques standards
L’impact d’une distribution bimodale non détectée sur la validité de l’inférence statistique paramétrique traditionnelle est dévastateur. L’immense majorité des démarches de test d’hypothèses enseignées et pratiquées dans les laboratoires — au premier rang desquelles figurent le test t de Student pour échantillons indépendants et l’analyse de variance (ANOVA) — reposent sur le postulat théorique strict de la normalité de la distribution de la variable dépendante ou, à tout le moins, de la normalité des résidus du modèle linéaire.
Lorsqu’une variable quantitative bimodale est soumise à un test t de Student comparant deux groupes, l’invalidation méthodologique opère à deux niveaux critiques :
- Distorsion massive de l’erreur standard et des taux d’erreur : La présence de deux modes gonfle artificiellement l’estimation de la variance globale de l’échantillon. L’erreur type de la moyenne se trouve dès lors erronée, ce qui fausse le calcul des degrés de liberté effectifs et conduit soit à une perte dramatique de puissance statistique (incapacité à déceler une différence réelle entre traitements), soit, dans d’autres configurations hétéroscédastiques, à une inflation exponentielle du taux d’erreur de première espèce ($\alpha$), faisant rejeter à tort l’hypothèse nulle d’égalité des traitements.
- Inanité épistémologique de la comparaison des moyennes : Quand bien même le test parviendrait à une significativité mathématique ($p < 0{,}01$), la conclusion comparant « la moyenne du groupe A » à « la moyenne du groupe B » s'avère scientifiquement vide de sens. Comparer des moyennes calculées dans des zones de densité quasi désertes (l'antimode) revient à mesurer la distance séparant deux entités empiriquement inexistantes, passant complètement à côté de l'effet réel du traitement — lequel aurait pu, par exemple, modifier le rapport de force entre les deux modes sans en déplacer les sommets.
L’injonction courante prétendant que « pour de grands échantillons ($n > 30$), la normalité n’a plus d’importance grâce au théorème central limite » constitue une incompréhension pernicieuse de la statistique. Si la distribution de la moyenne empirique converge en effet vers la loi normale, le test t teste l’hypothèse d’une différence de localisation d’une population globale homogène. En présence d’une bimodalité structurelle, c’est le modèle conceptuel univarié sous-jacent qui est disqualifié, rendant toute inférence paramétrique conventionnelle caduque et illusoire.
9.2 Impact dévastateur sur la régression linéaire et la corrélation
L’intégration d’une variable dépendante ou indépendante de nature bimodale au sein d’une régression linéaire ordinaire par les moindres carrés (OLS) provoque des distorsions géométriques et probabilistes majeures. Le modèle de régression classique suppose formellement l’homoscédasticité (constance de la variance des résidus sur tout le spectre prédictif) et l’indépendance de résidus distribués selon une loi normale centrée en zéro $\epsilon_i \sim \mathcal{N}(0, \sigma_\epsilon^2)$. La bimodalité viole systématiquement ces deux postulats cardinaux.
Lorsque la variable de réponse $Y$ est bimodale et conditionnée par un régresseur $X$ continu, les résidus de la régression linéaire héritent directement de cette bimodalité, formant deux strates disjointes dans le graphique des résidus face aux valeurs ajustées. En conséquence, les intervalles de prédiction générés par le modèle sont fondamentalement invalides : ils prédisent des valeurs qui se situent majoritairement au milieu de l’antimode — précisément là où aucune donnée réelle n’apparaît — tout en sous-estimant massivement l’incertitude dans le voisinage des deux modes réels.
De surcroît, la bimodalité d’une variable indépendante est la cause génératrice première des corrélations fallacieuses par effet de grappe (clustering effect). Deux nuages d’observations totalement non corrélés au sein de leurs sous-populations respectives peuvent présenter un coefficient de corrélation linéaire de Pearson extrêmement fort ($r > 0{,}80$) dès lors qu’ils sont éloignés l’un de l’autre dans l’espace bidimensionnel. Le premier mode agit comme un point d’ancrage massif à l’origine et le second mode comme un point de levier disproportionné à l’autre extrémité, imposant artificiellement la pente de la droite des moindres carrés. Le statisticien imprudent conclut à une dépendance linéaire puissante là où n’existe en réalité qu’une juxtaposition de deux sous-groupes indépendants.
9.3 Alternatives méthodologiques robustes et non paramétriques
Face à la faillite des méthodes conventionnelles, l’analyste de données doit réorienter son appareil inférentiel vers des méthodologies statistiques élaborées spécifiquement pour absorber la complexité des profils multimodaux sans introduire de biais d’interprétation. Les tests non paramétriques traditionnels basés sur les rangs — tels que le test de Wilcoxon-Mann-Whitney — sont souvent brandis comme la solution immédiate pour se libérer de l’hypothèse de normalité. Toutefois, leur utilisation en présence de bimodalité impose une extrême prudence. Le test de Wilcoxon ne teste l’égalité des médianes que sous l’hypothèse stricte que les deux distributions comparées ont exactement la même forme (hypothèse de translation pure). Si les deux groupes présentent des degrés de bimodalité distincts ou des proportions de modes asymétriques, le test de rang rejette l’hypothèse nulle sans que l’on puisse déterminer si la différence porte sur la tendance centrale, la dispersion ou la morphologie bimodale elle-même.
Les stratégies véritablement opérantes et adaptées reposent sur quatre familles méthodologiques majeures :
- Le rééchantillonnage non paramétrique (Bootstrap) : Les méthodes de bootstrap par centiles ou bootstrap BCa (biais-corrigé et accéléré) permettent d’estimer des intervalles de confiance robustes pour des paramètres non conventionnels (tels que la distance séparant les deux modes ou le ratio des hauteurs de pics) sans postuler la moindre fonction de densité théorique préalable.
- La régression par mélanges finis (Finite Mixture Regression – FMR) : Au lieu d’ajuster une droite de régression unique dénuée de pertinence au milieu des deux groupes, les modèles FMR estiment simultanément $k$ équations de régression conditionnelles distinctes couplées à des probabilités d’appartenance latentes, révélant la véritable relation prédictive au sein de chaque pôle modal.
- La régression quantile : Développée par Koenker et Bassett, la régression quantile s’affranchit de la modélisation de la moyenne conditionnelle. En ajustant des modèles sur des centiles contrastés (par exemple le 10-ème et le 90-ème centiles, qui correspondent respectivement aux deux modes), elle décrit avec une précision totale le comportement différentiel des deux attracteurs face aux variables prédictives.
10. Exemples concrets et études de cas empiriques
10.1 Comportements humains et rythmes sociétaux
Les dynamiques organisationnelles et temporelles des sociétés humaines abondent en manifestations bimodales spectaculaires. L’analyse chronologique de la mobilité urbaine au sein des métropoles mondiales fournit sans doute l’illustration la plus universellement reconnue de ce phénomène à travers la distribution temporelle des débits de circulation routière et de fréquentation des réseaux de transport collectif.
Si l’on compile le volume horaire d’automobiles transitant sur une autoroute périurbaine au cours d’une journée de semaine type (de 00h00 à 23h59), la fonction de densité horaire révèle invariablement deux crêtes massives : la pointe du matin (concentrée entre 07h30 et 09h00) correspondant aux déplacements domicile-travail et domicile-école, et la pointe du soir (située entre 17h00 et 18h30) traduisant les flux de retour pendulaire. L’intervalle méridien (de 11h30 à 14h00) forme un creux relatif significatif (l’antimode), interrompu la nuit par un effondrement complet du volume. Traiter l’heure médiane ou moyenne (approximativement 13h00) comme la référence temporelle pour dimensionner l’infrastructure de voirie ou programmer des travaux de voirie conduirait à une paralysie urbaine absolue : la politique d’aménagement urbain doit se calibrer sur la dynamique des deux sommets et non sur la fiction arithmétique de la moyenne journalière.
Ce même profil bimodal synchronisé par les rythmes socioculturels gouverne l’achalandage des services de restauration commerciale (avec deux sommets imperméables articulés autour du déjeuner à 12h30 et du dîner à 20h00), la courbe de charge de la consommation électrique nationale régie par les activités des ménages lors du réveil matinal et du retour au foyer, ainsi que le volume d’échanges de messages et de publications sur les plateformes numériques de réseaux sociaux, qui connaissent des affluences maximales à la mi-journée et en fin de soirée après les horaires de bureau.
10.2 Biologie évolutive et morphométrie animale
Dans les sciences du vivant, la distribution bimodale est fréquemment la signature directe de puissantes forces de sélection darwinienne favorisant les phénotypes extrêmes au détriment des conformations médianes. L’exemple historique majeur — documenté avec une précision remarquable par Peter et Rosemary Grant dans leurs études à long terme sur les îles Galápagos — réside dans la morphométrie du bec des géospizes (les fameux « pinsons de Darwin »), et notamment l’espèce Geospiza fortis.
Au sein d’écosystèmes insulaires soumis à des pressions alimentaires brutales, la distribution de l’épaisseur du bec de ces oiseaux adopte fréquemment une structure bimodale prononcée, façonnée par la sélection disruptive (ou diversifiante). Au cours des périodes de sécheresse prolongée, les sources végétales alimentaires se réduisent drastiquement à deux catégories de graines écologiquement viables : d’une part, des graines très volumineuses et extrêmement dures (comme celles de Tribulus cistoides), et d’autre part, des graines minuscules et tendres abritées dans des anfractuosités rocheuses. Les pinsons dotés d’un bec massif et puissant réussissent à concasser les graines dures (formant le premier mode morphologique), tandis que les oiseaux dotés d’un bec fin et précis exploitent efficacement les petites graines (formant le second mode). Les individus arborant un bec intermédiaire — correspondant à la moyenne — sont incapables de briser les grosses semences et manquent d’agilité pour saisir les graines minuscules : souffrant d’une fitness reproductive désastreuse, ils sont décimés par la faim, ce qui creuse l’antimode adaptatif.
Ce processus de ségrégation morphologique se retrouve de manière ubiquitaire dans la biomasse des écosystèmes marins compétitifs, où la prédation par taille crée des niches trophiques exclusives, ainsi que dans le dimorphisme sexuel morphologique extrême observable chez de nombreuses espèces d’insectes coléoptères, où les mâles arborent soit des mandibules gigantesques pour le combat territorial ouvert, soit des morphologies naines agiles sans appendices encombrants pour féconder furtivement les femelles, éliminant systématiquement les morphologies moyennes sous-optimales.
10.3 Éducation et performances aux évaluations académiques
L’analyse docimologique des résultats scolaires et universitaires confronte régulièrement les enseignants et les concepteurs d’épreuves à des distributions bimodales de notes. L’apparition d’un tel profil lors d’un examen sommatoire unifié (par exemple, un partiel de mathématiques supérieures, d’informatique théorique ou de physique quantique) constitue la radiographie d’une fracture pédagogique profonde au sein de la cohorte d’étudiants.
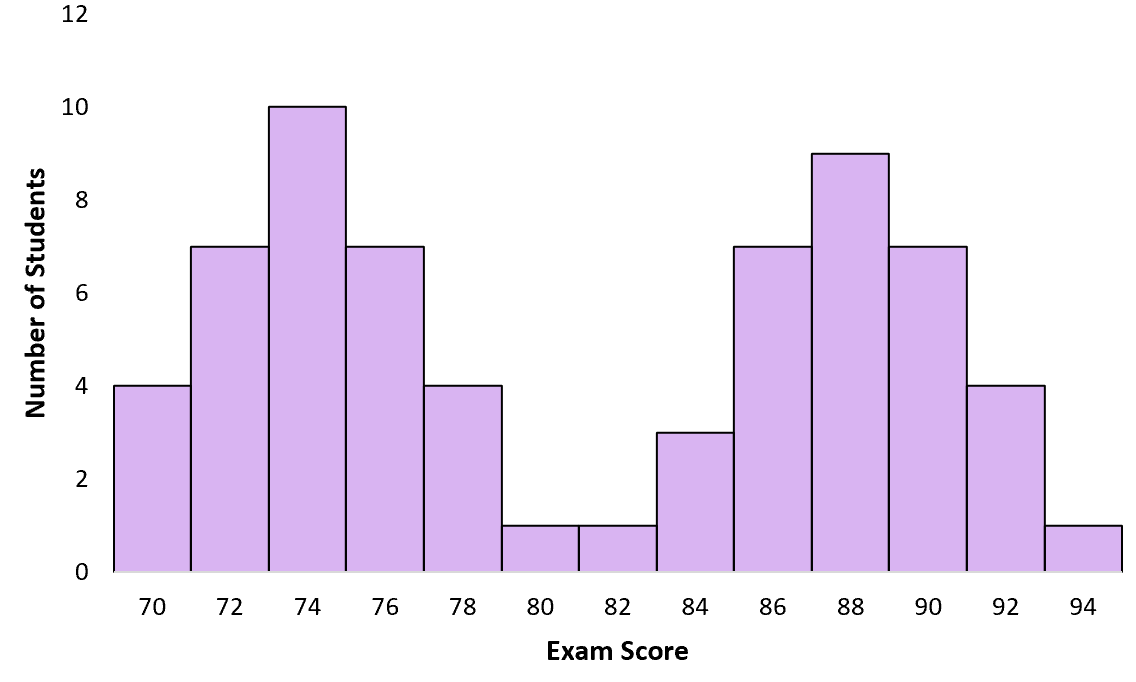
Dans un tel contexte, la courbe des scores s’articule autour de deux populations distinctes : un premier mode culmine dans les scores très bas (typiquement entre 02/20 et 06/20), tandis qu’un second mode se consolide dans les zones d’excellence (entre 14/20 et 18/20), la zone médiane (09/20 à 11/20) demeurant remarquablement clairsemée. Cette morphologie traduit l’échec pédagogique du modèle d’enseignement unique. Le premier groupe rassemble des apprenants ayant manqué l’acquisition d’un prérequis conceptuel fondamental à un stade précoce du cursus ; privés de cette clef logique cumulative, ils sont incapables de résoudre la moindre question complexe et échouent massivement. Le second groupe réunit des étudiants qui ont franchi le seuil d’abstraction critique et réussissent l’ensemble de l’épreuve avec aisance.
Publier une note « moyenne de la promotion » établie à 10,2/20 assortie d’un écart-type de 5,4 représente dans cette situation une aberration analytique. Cette moyenne donne l’illusion trompeuse d’une classe d’un niveau moyen convenable frôlant le seuil d’admission, alors qu’en réalité aucun étudiant individuel ne correspond à ce profil : la cohorte est fracturée en deux mondes étanches — un bloc en état d’échec critique immédiat et un bloc ayant assimilé les concepts avec maestria. La décision pédagogique requiert impérativement l’abandon de l’analyse univariée globale au profit d’un enseignement différencié et de remédiations ciblées post-stratification.
11. Stratégies de traitement et transformation des données bimodales
11.1 Décomposition, classification et stratification
Lorsqu’une analyse statistique met en évidence une structure bimodale dans une série de données, la démarche méthodologique la plus rigoureuse et la plus féconde ne consiste pas à tenter de réduire cette bimodalité par un artifice technique, mais à l’expliquer. La bimodalité doit être traitée comme une opportunité épistémologique : elle signale l’existence d’une structure sous-jacente qui attend d’être découverte et modélisée.
La première stratégie opérationnelle repose sur la stratification explicite de l’échantillon. L’analyste doit mobiliser l’ensemble des métadonnées et des variables auxiliaires collectées (attributs sociodémographiques, contextes expérimentaux, horodatages, spécifications des machines) pour identifier le facteur binaire — latent ou manifeste — dont la partition sépare au mieux les deux modes. Des algorithmes d’apprentissage automatique supervisé simples et interprétables, tels que les arbres de décision bivalents (CART), s’avèrent redoutablement efficaces pour cette tâche. En fixant comme variable cible l’affectation binaire à l’un des deux modes (déterminée en utilisant l’antimode comme frontière), l’arbre cartographie instantanément les prédicteurs qui expliquent le clivage.
Une fois le facteur modérateur identifié, le jeu de données d’origine est partitionné en deux sous-ensembles homogènes. Chaque sous-population fait ensuite l’objet d’une modélisation statistique univariée ou multivariée indépendante. Cette approche par décomposition conditionnelle restaure la validité des statistiques classiques au sein de chaque strate (les moyennes et écarts-types retrouvant leur pleine pertinence descriptive) tout en dégageant un gain spectaculaire de clarté explicative et de précision prédictive lors des extrapolations futures.
11.2 Inefficacité des transformations mathématiques classiques
Face à une distribution qui déroge à la loi normale, un réflexe méthodologique profondément enraciné chez de nombreux chercheurs consiste à appliquer une transformation mathématique non linéaire aux données — le logarithme népérien ($ln(x)$), la transformation racine carrée ($\sqrt{x}$), l’inverse ($1/x$), ou la famille paramétrique des transformations de Box-Cox et de Yeo-Johnson — dans l’espoir de rétablir la normalité souhaitée.
Si ces transformations s’avèrent souveraines pour corriger une asymétrie unimodale prononcée en comprimant les queues de distribution étirées vers la droite, elles sont totalement inopérantes pour résorber une véritable bimodalité structurelle. Sur le plan mathématique, une transformation strictement monotone et continue $g(x)$ (dont la dérivée première ne s’annule jamais) conserve intégralement l’ordre topologique des points critiques de la distribution : elle déplace les abscisses des modes et de l’antimode, et en altère la hauteur relative sous l’effet du terme jacobien $\frac{d}{dx}g^{-1}(y)$, mais elle ne peut en aucun cas supprimer le minimum local situé entre deux maxima locaux. Le creux de l’antimode demeure inaltérable.
Plus grave encore, l’application aveugle d’une transformation de Box-Cox à une distribution bimodale peut induire des distorsions préjudiciables : elle peut comprimer artificiellement un des modes tout en étirant l’autre, compliquant son interprétation sans jamais parvenir à la normalité convoitée. Il est donc fondamental de proclamer une règle d’or méthodologique : on ne transforme pas une distribution pour masquer sa bimodalité. La bimodalité n’est pas une nuisance d’échantillonnage que l’on doit éradiquer mathématiquement ; elle est une propriété empirique substantielle du phénomène mesuré, qui doit être respectée dans son ontologie et modélisée comme telle.
11.3 Modélisation directe de lois bimodales spécifiques
Lorsque la décomposition en sous-populations n’est pas envisageable — soit parce que la variable latente demeure inaccessible à l’investigation, soit parce que le système physique génère une bimodalité intrinsèque indivisible —, l’alternative consiste à modéliser la variable continue à travers des familles de lois de probabilité paramétriques conçues ab initio pour admettre la bimodalité.
Parmi ces modèles avancés figurent :
- Les distributions bêta bimodales : Alors que la loi bêta standard standardisée sur l’intervalle $[0, 1]$ est conventionnellement unimodale lorsque ses paramètres de forme vérifient $\alpha > 1$ et $\beta > 1$, des extensions généralisées ou des mélanges de lois bêta permettent d’ajuster avec une flexibilité extraordinaire des variables bornées présentant deux pics d’extrémités, courantes dans l’évaluation des proportions ou des ratios d’efficacité.
- Les modèles bimodal-normaux et lois asymétriques étendues : Les familles de distributions Alpha-Skew-Normal et leurs dérivés intègrent un paramètre d’asymétrie polynomial qui module le noyau gaussien classique pour faire émerger un second sommet contrôlé analytiquement par un nombre restreint de paramètres libres.
- Les modèles markoviens à changements de régime (Markov Switching Models) : Pour les séries temporelles qui alternent de façon récurrente entre deux états distributionnels stables — par exemple, les cycles économiques alternant entre périodes d’expansion et récessions sévères —, la distribution marginale globale est bimodale. Les modèles formalisés par James Hamilton modélisent la dynamique temporelle comme une chaîne de Markov cachée gouvernant les transitions stochastiques entre les deux attracteurs.
- L’analyse des classes latentes (LCA) : Adaptée aux profils de réponses polytomiques et continus, la LCA identifie formellement la proportion de répondants attachée à chaque classe de réponse, fournissant un cadre rigoureux pour l’inférence des populations sous-jacentes.
12. Perspectives contemporaines et applications avancées en science des données et psychométrie
12.1 Apprentissage automatique non supervisé et clustering
Dans l’écosystème de la science des données contemporaine et du machine learning, la gestion des distributions bimodales constitue la pierre angulaire des algorithmes d’apprentissage non supervisé. L’identification de deux modes au sein d’un espace de caractéristiques (feature space) est l’équivalent topologique direct de la détection de deux grappes ou clusters naturels au sein de la masse d’observations non étiquetées.
L’application d’algorithmes de partitionnement populaires tels que les k-moyennes (k-means) sur des données univariées ou multivariées bimodales nécessite une vigilance méthodologique extrême dès la phase d’initialisation. Une initialisation aléatoire malheureuse plaçant les deux centroïdes de départ au sein du même mode peut conduire l’algorithme à converger vers une sous-partition désastreuse de l’un des sommets, abandonnant l’autre mode à un résidu marginalisé. Le recours impératif à des heuristiques de dispersion géométrique, telles que l’algorithme k-means++ de David Arthur et Sergei Vassilvitskii, garantit que les centroïdes initiaux sont projetés à distance maximale l’un de l’autre, capturant immédiatement l’architecture bimodale du jeu de données.
Dans le domaine des modèles génératifs profonds, et tout particulièrement des réseaux antagonistes génératifs (GAN, Generative Adversarial Networks), la présence d’une densité cible bimodale ou multimodale confronte l’ingénieur à la pathologie majeure de l’effondrement de mode (mode collapse). Dans cette situation de défaillance algorithmique, le réseau générateur apprend à reproduire à la perfection l’un des deux modes pour duper le réseau discriminateur, mais ignore totalement le second pôle de données, éliminant arbitrairement la moitié de la diversité structurelle du phénomène réel. Les innovations récentes — telles que les Wasserstein GANs pénalisés par le gradient — visent précisément à contraindre le générateur à respecter l’intégralité de la géométrie de Wasserstein, préservant la dualité des modes et la profondeur exacte de l’antimode.
Par ailleurs, la localisation formelle de l’antimode joue un rôle novateur dans les systèmes de détection d’anomalies (outlier detection). Si l’on classe traditionnellement comme anormaux les points situés aux extrémités distales des queues de distribution, les observations qui viennent se positionner précisément au cœur de l’antimode représentent des anomalies structurelles d’un intérêt critique : ce sont des individus ou des signaux métastables qui échouent à converger vers l’un des deux attracteurs stables, signalant des défaillances de capteurs ou des états de transition exceptionnels.
12.2 Théorie des catastrophes et dynamiques non linéaires
L’étude mathématique approfondie de la bimodalité trouve un cadre théorique d’une prodigieuse fécondité dans la théorie des catastrophes, édifiée par le mathématicien français René Thom dans les années 1970. Cette branche de la topologie différentielle s’intéresse à la manière dont des variations continues et graduelles de paramètres de contrôle externes peuvent engendrer des transitions morphologiques abruptes, soudaines et discontinues au sein de systèmes dynamiques complexes.
Le modèle fondamental de la catastrophe de la fronce (cusp catastrophe) fournit la modélisation mathématique directe de l’émergence d’une distribution bimodale. La surface des états d’équilibre du système est régie par l’équation cubique des points critiques d’un potentiel dépendant de deux paramètres de contrôle (l’état d’asymétrie $\alpha$ et l’état de bifurcation $\beta$) :
$$V(x; \alpha, \beta) = \frac{1}{4}x^4 – \frac{1}{2}\beta x^2 – \alpha x$$
Lorsque le paramètre de bifurcation $\beta$ excède zéro, le potentiel énergétique cesse d’avoir un minimum unique pour adopter la forme emblématique d’un double puits de potentiel. La projection des états sur le plan de contrôle délimite une zone d’instabilité en forme de V (la fronce). À l’intérieur de cette région, le système dispose de deux états stables simultanés : sa distribution de probabilité y est strictement bimodale. Si un paramètre environnemental déplace lentement le système à travers la fronce, l’état individuel ne glisse pas doucement vers la nouvelle configuration : il subit un saut catastrophique soudain d’un mode à l’autre.
Ce formalisme modélise avec une élégance saisissante le phénomène physique et comportemental de l’hystérésis : la trajectoire suivie par un sujet lors de la transition du mode 1 vers le mode 2 sous l’effet d’une contrainte croissante n’est pas symétrique à celle qu’il emprunte lors de la décroissance de cette contrainte. Les applications abondent en psychologie clinique de la résilience, dans l’analyse des effondrements boursiers et dans la modélisation des transitions écologiques critiques (tipping points), où la bimodalité d’un écosystème constitue l’avertissement formel d’une bascule irréversible imminente.
12.3 Bonnes pratiques pour la recherche empirique et la publication académique
Face à la persistance d’erreurs méthodologiques et de biais de confirmation dans l’analyse des données de recherche, la communauté scientifique internationale s’accorde désormais sur un corpus de bonnes pratiques impératives encadrant l’identification, la présentation et le traitement des distributions bimodales dans les publications académiques à comité de lecture.
Sur le plan de la restitution graphique, il est désormais unanimement exigé de bannir définitivement les « graphiques en barres d’erreur » traditionnels (dynamite plots), lesquels masquent totalement la morphologie distributionnelle sous un rectangle opaque surmonté d’une barre d’écart-type trompeuse. Les standards modernes imposent l’adoption des graphiques en violon (violin plots) ou, idéalement, des raincloud plots (qui combinent sur une même vue l’estimation de densité par noyau, une boîte à moustaches robuste et le nuage de points bruts individuel superposé avec gigue aléatoire). Cette transparence visuelle permet aux évaluateurs et aux lecteurs de constater immédiatement la bimodalité et la profondeur de l’antimode.
Sur le plan rédactionnel et statistique, tout chercheur confronté à une structure bimodale dans son jeu de données doit respecter un protocole d’inférence rigoureux :
- Proscrire le signalement exclusif du couple classique moyenne / écart-type et lui substituer impérativement la déclaration conjointe des médianes et intervalles interquartiles par sous-groupe, ou mieux, des paramètres estimés du modèle de mélange ($\mu_1, \sigma_1, \mu_2, \sigma_2, \pi_1$).
- Appliquer systématiquement un test formel de multimodalité (Dip test de Hartigan ou test de bande passante critique de Silverman) avant de procéder à tout test d’hypothèse paramétrique conventionnel.
- Documenter avec une transparence totale les tentatives d’identification des variables de stratification latente avant toute tentative d’amalgamation globale.
- Pré-enregistrer (pre-registration) les protocoles analytiques de modélisation par mélanges afin d’éviter le dragage de données (p-hacking) consistant à subdiviser arbitrairement une cohorte pour fabriquer de fausses significativités statistiques.
En adoptant ces standards méthodologiques exigeants, la recherche empirique contemporaine s’assure que la distribution bimodale — loin d’être un obstacle mathématique encombrant — devienne un révélateur exceptionnel de la complexité intrinsèque des phénomènes naturels, sociétaux et humains.
Références
- Arthur, D., & Vassilvitskii, S. (2007). k-means++: The advantages of careful seeding. Proceedings of the Eighteenth Annual ACM-SIAM Symposium on Discrete Algorithms, 1027-1035. https://dl.acm.org/doi/10.5555/1283383.1283494
- Dempster, A. P., Laird, N. M., & Rubin, D. B. (1977). Maximum likelihood from incomplete data via the EM algorithm. Journal of the Royal Statistical Society: Series B (Methodological), 39(1), 1-22. https://doi.org/10.1111/j.2517-6161.1977.tb01600.x
- Grant, P. R., & Grant, B. R. (2002). Unpredictable evolution in a 30-year study of Darwin’s finches. Science, 296(5568), 707-711. https://doi.org/10.1126/science.1070315
- Hartigan, J. A., & Hartigan, P. M. (1985). The dip test of unimodality. The Annals of Statistics, 13(1), 70-84. https://doi.org/10.1214/aos/1176346577
- Koenker, R., & Bassett, G. (1978). Regression quantiles. Econometrica, 46(1), 33-50. https://doi.org/10.2307/1913643
- McLachlan, G. J., & Peel, D. (2000). Finite Mixture Models. John Wiley & Sons. https://doi.org/10.1002/0471721182
- Ratcliff, R., & McKoon, G. (2008). The diffusion decision model: Theory and data for two-choice decision tasks. Neural Computation, 20(4), 873-922. https://doi.org/10.1162/neco.2008.12-06-420
- Sarle, W. S. (1983). The Cubic Clustering Criterion (SAS Technical Report A-108). SAS Institute Inc.
- Silverman, B. W. (1981). Using kernel density estimates to investigate multimodality. Journal of the Royal Statistical Society: Series B (Methodological), 43(1), 97-99. https://doi.org/10.1111/j.2517-6161.1981.tb01155.x
- Silverman, B. W. (1986). Density Estimation for Statistics and Data Analysis. Chapman and Hall. https://doi.org/10.1201/9781315140919
- Thom, R. (1972). Stabilité structurelle et morphogénèse : Essai d’une théorie générale des modèles. W. A. Benjamin.