
Dans le champ foisonnant de l’analyse exploratoire des données (Exploratory Data Analysis), la visualisation graphique ne constitue pas un simple accessoire esthétique destiné à agrémenter un rapport de recherche ; elle s’érige en véritable instrument épistémologique de découverte et de vérification des postulats métrologiques. Face à l’inflation constante des volumes d’échantillonnage et à la complexification des protocoles empiriques en sciences biomédicales, cognitives et sociales, les chercheurs se heurtent fréquemment aux limites inhérentes aux statistiques récapitulatives classiques. La moyenne arithmétique et l’écart-type, bien qu’ancrés dans l’orthodoxie paramétrique, s’avèrent d’une vulnérabilité notoire dès lors que les distributions réelles s’écartent du modèle théorique de la loi normale. C’est précisément dans cette brèche méthodologique que s’insère la boîte à moustaches, ou diagramme de Tukey, dont la sobriété géométrique dissimule une puissance analytique remarquable.
Conçue pour restituer fidèlement la structure distributionnelle d’une variable continue sans contraindre les données à entrer dans un carcan distributionnel préconçu, la boîte à moustaches repose sur les statistiques d’ordre. En articulant son architecture autour du concept fondamental de quantiles, elle procure une synthèse compacte, résistante aux distorsions numériques et immédiatement interprétable. Pourtant, en dépit de son omniprésence dans les logiciels d’analyse statistique contemporains, son déploiement souffre trop souvent d’un manque de discernement théorique : employée de manière machinale ou concurrencée maladroitement par des figures inadéquates comme les diagrammes à barres d’erreurs, elle voit son potentiel diagnostique largement sous-exploité. Comprendre avec exactitude les fondements métrologiques de cet outil s’avère donc indispensable pour quiconque aspire à traiter les données quantitatives avec rigueur.
Le présent article propose une exploration approfondie de la boîte à moustaches, guidée par une interrogation centrale : quand et pourquoi convient-il d’adopter ce mode de représentation plutôt qu’une approche concurrente ? À travers l’examen détaillé de trois scénarios méthodologiques cardinaux — l’exploration de la forme distributionnelle intrinsèque d’une série, la comparaison intergroupes au sein de plans expérimentaux, et le diagnostic rigoureux des valeurs aberrantes —, ce guide exhaustif offre aux chercheurs, biostatisticiens et analystes de données un cadre conceptuel et pratique complet, de l’élaboration mathématique jusqu’à l’implémentation logicielle avancée.
1. Fondements théoriques et mathématiques de la boîte à moustaches
1.1 Origine épistémologique et invention par John Tukey
L’émergence de la boîte à moustaches s’inscrit au cœur d’une rupture paradigmatique majeure dans l’histoire de la statistique contemporaine. Durant les années 1970, le statisticien américain John Wilder Tukey constate avec gravité l’impasse dans laquelle s’enferme la recherche empirique, dominée de manière quasi exclusive par l’inférence confirmatoire et les tests d’hypothèses rigides hérités des travaux de Ronald Fisher, Jerzy Neyman et Egon Pearson. Dans son ouvrage fondateur de 1977 intitulé Exploratory Data Analysis, Tukey formalise une approche alternative, plaidant pour que les données puissent révéler leurs régularités et leurs anomalies avant toute formulation d’hypothèses probabilistes restrictives. La boîte à moustaches (originellement box-and-whisker plot) naît de cette volonté de doter les analystes d’un outil graphique non paramétrique, sobre et universellement applicable, capable de s’affranchir de la stricte hypothèse de normalité gaussienne.
Cette innovation répondait à une exigence métrologique concrète : fournir une représentation visuelle fidèle des distributions asymétriques, plurimodales ou fortement contaminées par des valeurs résiduelles, omniprésentes dans les sciences du comportement, la génétique et la sociologie naissante. L’adoption progressive du diagramme de Tukey dans les sciences comportementales et biométriques s’est imposée dès lors que les praticiens ont pris conscience de la fragilité des estimateurs classiques face aux violations des postulats paramétriques. Là où le calcul d’une moyenne et d’une variance tend à masquer l’hétérogénéité sous-jacente des cohortes de patients ou des groupes expérimentaux, la boîte à moustaches expose sans fard les propriétés réelles de l’échantillon collecté.
Au-delà de son efficacité analytique, la boîte de Tukey incarne le principe d’économie cognitive en matière de sémiotique graphique. Selon ce principe théorisé par les sciences cognitives appliquées à la visualisation des données, la charge mentale allouée au décodage visuel d’un graphique doit être minimale afin de libérer les ressources cognitives nécessaires à l’inférence scientifique de haut niveau. En synthétisant une infinité théorique de points de données à travers cinq marqueurs géométriques élémentaires, Tukey a réussi la synthèse parfaite entre compacité visuelle et densité informationnelle, permettant au cerveau humain d’appréhender instantanément la dispersion, le centrage et la dissymétrie d’une distribution sans recourir au traitement fastidieux de longues tables de données numériques.
1.2 Le résumé à cinq nombres : composantes fondamentales
L’armature conceptuelle de la boîte à moustaches repose sur une formalisation mathématique élégante désignée sous l’appellation de « résumé à cinq nombres » (five-number summary). Ce dispositif statistique synthétique d’ordre descriptif s’extrait directement des statistiques de rang de l’échantillon ordonné. Contrairement aux moments arithmétiques d’une variable qui dépendent de la sommation des valeurs absolues ou quadratiques, les cinq composantes de Tukey sont invariantes par rapport aux étalements asymétriques extrêmes et découlent exclusivement de la position séquentielle des observations triées par ordre croissant :
- Le minimum empirique : Il représente la plus petite valeur observée au sein de la série statistique, à l’exclusion délibérée des valeurs isolées qui se trouveraient qualifiées d’aberrantes selon les seuils géométriques prédéterminés. Il marque la borne inférieure effective de la distribution ordinaire.
- Le premier quartile ($Q_1$ ou 25e centile) : Valeur de la variable en dessous de laquelle se situent précisément 25 % des observations cumulées de la distribution ordonnée. Il délimite le point de transition structural entre le quart inférieur et la moitié centrale des données.
- La médiane ($Q_2$ ou 50e centile) : Paramètre fondamental de tendance centrale non paramétrique, la médiane partitionne l’échantillon en deux sous-ensembles strictement équi-probables de 50 % des effectifs chacun. Sa robustesse découle de son point de rupture théorique exceptionnel de 50 %, ce qui signifie qu’elle demeure inaltérée tant que la moitié des données n’est pas corrompue de manière arbitraire.
- Le troisième quartile ($Q_3$ ou 75e centile) : Point de partage statistique en deçà duquel se regroupent 75 % des valeurs observées, scellant ainsi la limite supérieure de la masse centrale de la cohorte et ouvrant sur le quart des scores les plus élevés.
- Le maximum empirique : La plus haute valeur mesurée dans la série qui ne satisfasse pas aux critères de singularité extrême fixés par les clôtures de Tukey, incarnant le sommet légitime de la variabilité non déviante.
Ce formalisme quinténaire ne requiert aucun prérequis quant à la symétrie ou à la continuité de la variable sous-jacente. Il garantit une décomposition robuste de l’espace échantillonnal en quatre segments équipotents, conférant ainsi au chercheur une vue d’ensemble immédiate sur la compacité des différentes strates de sa population d’étude.
1.3 Robustesse métrologique face aux statistiques paramétriques
D’un point de vue métrologique rigoureux, la supériorité de la boîte à moustaches sur les représentations fondées sur la moyenne et l’écart-type émerge de sa résilience mathématique face aux corruptions distributionnelles. Dans le paradigme paramétrique, la moyenne arithmétique possède un point de rupture (breakdown point) égal à $0$ (soit $1/N$). Cela signifie empiriquement qu’une seule observation erronée ou exceptionnellement déviante — qu’elle découle d’un artéfact expérimental, d’un bogue d’acquisition informatique ou d’une anomalie physiologique rare — suffit à déplacer la moyenne vers l’infini, faussant irrémédiablement l’interprétation de l’ensemble de la série.
À l’opposé, la médiane et l’écart interquartile mobilisés par le diagramme de Tukey manifestent une insensibilité structurelle à ces extrema pathologiques. La médiane ne réagit aucunement à l’amplitude d’une valeur extrême, ne tenant compte que de sa position ordinale relative. Si l’observation la plus élevée d’une cohorte de temps de réaction cognitive passe soudainement de $800\text{ ms}$ à $80,000\text{ ms}$ en raison d’un décrochage attentionnel du sujet, la moyenne de l’échantillon subit une inflation trompeuse et l’écart-type explose de manière exponentielle, suggérant faussement une dispersion généralisée. La boîte à moustaches, quant à elle, préserve l’intégrité intégrale de son corps central ($Q_1$, médiane, $Q_3$), reléguant simplement l’artefact sous la forme d’un point isolé à l’extrémité de l’axe métrique.
Cet avantage métrologique s’avère particulièrement prépondérant lors du dépouillement de scores psychométriques, cliniques ou socio-économiques intrinsèquement asymétriques, tels que les échelles de dépression ou les niveaux de revenus. En outre, le résumé à cinq nombres présente la propriété remarquable de préserver l’intégrité ordinale lors de transformations monotones des variables : appliquer une transformation logarithmique ou exponentielle sur les données brutes revient exactement à appliquer cette même fonction sur les quartiles d’origine, propriété que ne partagent absolument pas les estimateurs fondés sur les moments arithmétiques.
2. Anatomie structurelle et protocole de construction géométrique
2.1 Construction de la boîte centrale et de l’écart interquartile
L’élément morphologique dominant du graphique est constitué par le rectangle central, communément désigné sous le vocable de « boîte ». La boîte centrale est délimitée sur l’axe continu de la mesure par deux arêtes parallèles correspondant rigoureusement au premier quartile ($Q_1$) pour sa base inférieure (ou gauche) et au troisième quartile ($Q_3$) pour son arête supérieure (ou droite). La distance séparant ces deux jalons fondamentaux définit géométriquement et analytiquement l’écart interquartile (noté $IQR$, pour Interquartile Range), exprimé par la relation fondamentale :
$$\text{IQR} = Q_3 – Q_1$$
Cette distance mathématique représente la mesure de dispersion robuste par excellence. Sur le plan sémiotique et probabiliste, la surface contenue à l’intérieur de la boîte centrale englobe très exactement 50 % des observations de la population étudiée, concentrées autour du centre de masse de l’échantillon. L’amplitude spatiale de cette boîte offre ainsi un diagnostic optique immédiat de la variabilité centrale : une boîte ramassée signale une forte concentration des individus autour du milieu de la distribution, tandis qu’une boîte étirée trahit une hétérogénéité substantielle au cœur même de la cohorte.
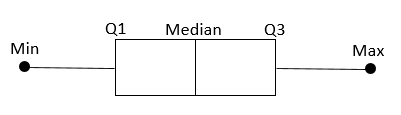
À l’intérieur de ce rectangle est impérativement tracée une ligne transversale matérialisant l’emplacement de la médiane ($Q_2$). L’examen de la position relative de cette ligne médiane au sein de la boîte fournit une indication visuelle décisive de l’asymétrie locale. Lorsque la ligne médiane divise la boîte en deux segments parfaitement égaux, les 25 % d’individus situés entre $Q_1$ et la médiane occupent un intervalle de valeurs strictement identique à celui des 25 % situés entre la médiane et $Q_3$, témoignant d’une parfaite symétrie centrale. En revanche, le rapprochement de la médiane vers le plancher ($Q_1$) ou vers le plafond ($Q_3$) dévoile instantanément une asymétrie de distribution, caractérisée par une forte densité locale d’un côté et un étalement compensatoire de l’autre.
2.2 Calcul et extension des moustaches conventionnelles
De chaque côté de la boîte centrale s’étendent des segments linéaires unidimensionnels appelés conventionnellement « moustaches » (ou whiskers). Loin d’être tracées de manière arbitraire, ces extensions géométriques obéissent à des règles algorithmiques strictes, dont la plus universellement reconnue dans la communauté scientifique demeure celle formalisée par John Tukey lui-même. Selon cette méthode canonique, on détermine préalablement des limites théoriques baptisées clôtures internes (inner fences) :
$$\text{Clôture Inférieure} = Q_1 – (1{,}5 \times \text{IQR})$$
$$\text{Clôture Supérieure} = Q_3 + (1{,}5 \times \text{IQR})$$
Une méprise extrêmement fréquente consiste à croire que les moustaches se terminent exactement à ces valeurs théoriques calculées. En réalité, selon la règle de Tukey, chaque moustache est tracée de l’arête de la boîte jusqu’à l’observation empirique la plus éloignée qui demeure à l’intérieur de ces clôtures. Ainsi, l’extrémité de la moustache correspond toujours à une valeur réelle effectivement mesurée dans l’échantillon, et non à une abstraction mathématique flottant dans le vide métrique.
Il importe toutefois de souligner l’existence de variantes historiques et techniques qui modifient la sémantique du tracé. Chez certains auteurs précurseurs comme Mary Eleanor Spear, ou dans certains progiciels non configurés, les moustaches sont parfois simplement calées sur les valeurs minimale et maximale absolues de l’ensemble de la série (modèle min-max pur). Bien que séduisante par sa simplicité, cette variante de Spear détruit l’une des fonctions fondamentales de la boîte à moustaches : l’isolement sélectif des valeurs discordantes. D’autres standards académiques relient parfois les moustaches aux 5e et 95e centiles, ou encore à la moyenne majorée ou minorée d’un ou deux écarts-types. Le choix de ces critères influe dramatiquement sur la perception visuelle de l’étalement des données et doit impérativement être documenté en légende de figure académique afin de prévenir toute méprise interprétative chez le lecteur scientifique.
2.3 Formalisation mathématique des clôtures et des points isolés
La puissance diagnostique de la boîte de Tukey réside dans sa typologie hiérarchique de l’atypisme numérique, fondée sur l’emboîtement de clôtures mathématiques internes et externes. Alors que les clôtures internes sont établies à $1{,}5 \times \text{IQR}$ des quartiles, Tukey a formalisé une seconde ligne de démarcation plus conservatrice, les clôtures externes (outer fences) :
$$\text{Clôture Externe Inférieure} = Q_1 – (3{,}0 \times \text{IQR})$$
$$\text{Clôture Externe Supérieure} = Q_3 + (3{,}0 \times \text{IQR})$$
Ces frontières spatiales permettent de ségréguer deux degrés de déviance au sein des données, matérialisés sous forme de symboles géométriques individualisés situés au-delà des terminaisons de moustaches :
- Les anomalies légères ou modérées (mild outliers) : Observations situées au-delà des clôtures internes mais en deçà des clôtures externes, comprises dans l’intervalle $[Q_1 – 3 \times \text{IQR} ,;, Q_1 – 1{,}5 \times \text{IQR}[$ ou $]Q_3 + 1{,}5 \times \text{IQR} ,;, Q_3 + 3 \times \text{IQR}]$. Elles sont traditionnellement représentées par de petits cercles évidés.
- Les anomalies extrêmes (extreme outliers) : Observations projetées au-delà des clôtures externes, soit au-delà de trois hauteurs de boîte par rapport aux quartiles ($< Q_1 – 3 \times \text{IQR}$ ou $> Q_3 + 3 \times \text{IQR}$). Dans les protocoles de publication rigoureux, elles sont identifiées par des astérisques ou des croix pour signaler leur caractère exceptionnellement suspect.
Le coefficient multiplicateur $1{,}5$ n’a pas été sélectionné au hasard par John Tukey. Sous l’hypothèse théorique d’une distribution normale parfaite, l’écart interquartile équivaut mathématiquement à environ $1{,}349$ fois l’écart-type ($\text{IQR} \approx 1{,}349,\sigma$). Les clôtures internes situées à $1{,}5 \times \text{IQR}$ correspondent approximativement aux bornes $\mu \pm 2{,}7,\sigma$. Dans ce cadre gaussien idéal, la probabilité théorique pour qu’une observation franchisse spontanément cette clôture s’établit à seulement $0{,}007$ (soit 0,7 % de l’échantillon, ou approximativement 1 point sur 140). Lorsque le volume d’échantillonnage s’accroît massivement ($N > 10,000$), l’apparition mécanique d’observations au-delà des clôtures devient mathématiquement inévitable, imposant au chercheur de ne point surinterpréter la présence de quelques points isolés sans une analyse conjointe des effectifs globaux.
3. Scénario 1 : Visualiser la distribution intrinsèque d’une série de données
3.1 Caractérisation immédiate de l’étalement et de l’asymétrie
Le premier scénario méthodologique majeur justifiant le recours sans réserve à la boîte à moustaches concerne l’analyse exploratoire univariée d’une série continue, dont l’objectif premier est d’en saisir la morphologie sans préjuger de sa fonction de densité. Dès le premier coup d’œil, le diagramme permet de catégoriser la structure de dispersion globale et locale de la variable. En observant conjointement la position de la médiane et les longueurs comparées des deux moustaches, le statisticien réalise un diagnostic express mais mathématiquement étayé de l’asymétrie statistique (skewness).
Dans le cas d’une asymétrie positive (distribution étalée à droite, fréquente dans les mesures biologiques ou économiques), la boîte à moustaches présente une configuration caractéristique : la ligne médiane se tasse vers le bas du rectangle (proche de $Q_1$), l’intervalle médian-$Q_3$ est nettement plus volumineux que l’intervalle $Q_1$-médiane, la moustache supérieure s’allonge de manière proéminente vers les valeurs élevées, et d’éventuels points atypiques parsèment la zone zénithale du graphique. À l’inverse, une asymétrie négative (distribution étalée vers la gauche) se manifestera visuellement par une compression sévère du compartiment inférieur de la boîte, une médiane plaquée contre le quartile supérieur $Q_3$ et une moustache inférieure anormalement étirée vers le pôle minimal.
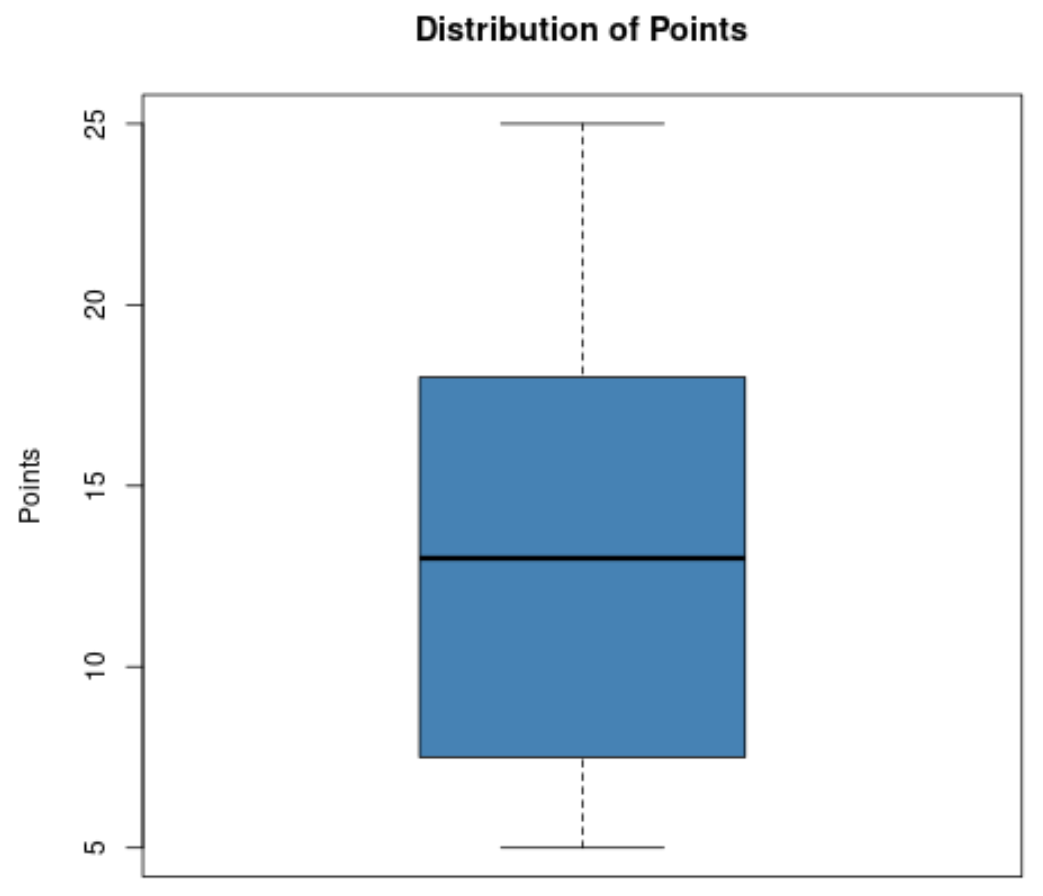
Cette évaluation immédiate de l’étalement s’opère sans qu’il soit nécessaire d’engager le calcul lourd et potentiellement biaisé de la variance empirique. En outre, la confrontation visuelle de la longueur relative des moustaches par rapport à la hauteur du rectangle central informe le chercheur sur l’aplatissement de la courbe (kurtosis). Une boîte très aplatie accompagnée de moustaches très longues et de points isolés trahit indubitablement une distribution leptokurtique à queues épaisses, avertissant l’analyste que les événements extrêmes s’y produisent avec une fréquence substantiellement plus forte que ce que postulerait une loi de Gauss standard.
3.2 Application psychométrique aux scores de traits et d’échelles
Dans les sciences du comportement, la neuropsychologie et la psychométrie, les chercheurs manipulent couramment des scores synthétiques issus de batteries d’items, telles que les échelles de Likert sommatées mesurant les dimensions de la personnalité (ex. l’inventaire NEO-PI-R ou le modèle Big Five) ou la sévérité sémiologique (ex. l’Inventaire de Dépression de Beck, BDI, ou l’échelle d’anxiété STAI de Spielberger). Dans ce cadre empirique précis, la boîte à moustaches s’avère un instrument d’une remarquable fécondité clinique et méthodologique.
Elle permet notamment de révéler instantanément les redoutables distorsions métrologiques que constituent les effets de plancher (floor effects) et de plafond (ceiling effects). Lorsqu’un test neuropsychologique d’évaluation de la mémoire de travail est administré à une cohorte de jeunes adultes sains hautement scolarisés, une boîte à moustaches dont le troisième quartile, la médiane et même le premier quartile se trouvent agglutinés au score maximal théorique de l’échelle alerte immédiatement l’expérimentateur : l’instrument s’avère incapable de discriminer les capacités cognitives supérieures au sein de cet échantillon en raison d’un manque criant de sensibilité de mesure.
De même, lors du dépistage de la détresse psychologique en population générale, l’immense majorité des sujets asymptomatiques accumule des scores quasi nuls, engendrant une boîte totalement écrasée sur l’origine du repère, tandis qu’une minorité souffrante s’étire en une longue traîne de points isolés vers le haut. La boîte à moustaches matérialise cette réalité clinique avec une honnêteté brute, prévenant la tentation fallacieuse de calculer des moyennes d’anxiété qui ne refléteraient aucun individu réel au sein de la cohorte. Elle permet enfin de vérifier visuellement si la dispersion des notes brutes autorise une normalisation standardisée en notes $T$ (moyenne 50, écart-type 10) ou en stanines avant toute exploitation diagnostique.
3.3 Avantages exploratoires face aux distributions non normales
L’hégémonie historique du paradigme gaussien a longtemps conduit les scientifiques à supposer la normalité univariée de leurs séries expérimentales par simple commodité computationnelle. Or, dans la réalité des laboratoires de psychologie expérimentale, d’ergonomie cognitive ou de neurophysiologie, les données se révèlent presque systématiquement non normales. L’archétype le plus frappant réside dans l’analyse des temps de réaction (TR) chronométriques enregistrés lors de tâches d’attention soutenue ou de discrimination perceptive.
Les distributions de temps de réaction cognitive sont structurellement contraintes par une barrière physiologique infranchissable (environ $100\text{ à }150\text{ ms}$ pour la conduction nerveuse sensorimotrice) et développent une traîne asymétrique prolongée vers les latences longues, obéissant typiquement à des lois de distribution de type ex-gaussienne, log-normale ou de Weibull. Recourir à des indicateurs classiques comme la moyenne et l’écart-type sur de telles données constitue une aberration analytique majeure : l’intervalle paramétrique conventionnel $[\text{Moyenne} – 2,\text{SD} ,;, \text{Moyenne} + 2,\text{SD}]$ déborde fréquemment sur des zones de temps de réaction négatives, dénuées de toute signification physique et biologique.
La boîte à moustaches de Tukey, affranchie de toute contrainte paramétrique, restitue avec fidélité la morphologie exacte de ces latences cognitives. Elle synthétise l’extrême densité des réponses correctes rapides tout en objectivant l’étirement unilatéral des latences dégradées par la fatigue sans provoquer la moindre distorsion de l’espace métrique. Pour les chercheurs confrontés à la communication de résultats empiriques bruts devant des comités scientifiques ou des autorités de régulation sanitaire, le diagramme de Tukey offre une transparence descriptive irréprochable, qui désamorce les critiques relatives à la violation des postulats sous-jacents aux modèles linéaires classiques.
4. Diagnostic de la forme distributionnelle dans le premier scénario
4.1 Détection des asymétries et des déviations univariées
L’utilisation de la boîte à moustaches comme outil de diagnostic distributionnel repose sur la lecture croisée de plusieurs indicateurs visuels de déviation. Si le statisticien souhaite apprécier le sens et l’intensité de l’asymétrie de sa série, il peut évaluer graphiquement un équivalent non paramétrique du coefficient d’asymétrie de Fisher-Pearson, souvent désigné dans la littérature sous le nom de coefficient d’asymétrie quartile de Bowley :
$$B = \frac{(Q_3 – Q_2) – (Q_2 – Q_1)}{Q_3 – Q_1}$$
Ce coefficient adimensionnel, strictement compris entre $-1$ et $+1$, traduit la dissymétrie des deux moitiés de la boîte centrale. Lorsque la médiane ($Q_2$) est exactement équidistante de $Q_1$ et de $Q_3$, le numérateur s’annule, confirmant la symétrie locale du cœur de la distribution. En transposant cette logique géométrique à la lecture de la boîte, l’analyste observe si le déséquilibre interne de la boîte est corroboré par le ratio de longueur entre les moustaches supérieure et inférieure. Un étirement conjoint de la demi-boîte supérieure et de la moustache haute, associé à un contingent d’anomalies unilatérales, valide définitivement l’asymétrie positive globale de la variable.
Ce repérage visuel précoce possède des implications méthodologiques déterminantes pour la trajectoire inférentielle de la recherche. Si la boîte à moustaches révèle une asymétrie univariée substantielle au sein d’échantillons de taille modeste, le recours aux tests paramétriques usuels (tels que le test $t$ de Student ou l’ANOVA) devient hautement hasardeux, ces tests perdant leur robustesse nominale dès lors que l’hypothèse de normalité et de symétrie résiduelle est violée. L’inspection attentive du tracé oriente alors d’emblée l’expérimentateur vers des modélisations plus adaptées : l’adoption de tests non paramétriques basés sur les rangs (test de Wilcoxon-Mann-Whitney, test de Kruskal-Wallis) ou l’application motivée de transformations mathématiques stabilisatrices préalables.
4.2 Limites de la boîte à moustaches face aux distributions multimodales
Bien que la boîte à moustaches constitue un instrument de synthèse d’une efficacité redoutable, il serait scientifiquement imprudent d’ignorer sa plus grande vulnérabilité architecturale : son incapacité intrinsèque à discriminer la multimodalité. Parce qu’elle n’agrège les données qu’à travers cinq points d’ancrage fixes ordonnés, elle comprime l’espace interne situé entre les quartiles sans renseigner le lecteur sur la densité continue locale qui s’y déploie.
Ainsi, une distribution parfaitement unimodale et symétrique de type gaussien générera une boîte rigoureusement identique à celle issue d’une distribution profondément bimodale symétrique (comportant deux bosses de part et d’autre d’un creux central profond, par exemple à $Q_1$ et $Q_3$ avec un vide d’observations au niveau de la médiane). Dans cette seconde configuration, la ligne médiane sera sagement positionnée au centre exact de la boîte, trompant l’observateur en lui suggérant une concentration optimale de points là où, en réalité, se trouve une absence quasi totale de données ! Cette cécité structurelle peut conduire à des erreurs d’interprétation désastreuses en pharmacologie ou en psychologie différentielle, masquant par exemple l’existence de deux sous-populations cliniques hétérogènes (les répondeurs et les non-répondeurs à un traitement).
Face à cet écueil critique, l’analyste avisé doit mobiliser des solutions visuelles alternatives ou complémentaires. Le couplage de la boîte à moustaches avec une courbe d’estimation par noyau de densité (KDE) permet de restituer immédiatement le profil ondulatoire de la distribution. C’est précisément pour surmonter cette faiblesse de la boîte de Tukey qu’ont été développés les diagrammes en violon (violin plots) et les diagrammes en bandelette (stripplots ou jitter plots), qui fusionnent l’armature des quantiles avec la densité de probabilité continue ou la projection exhaustive de chacun des points de données brutes sur l’axe des ordonnées.
5. Scénario 2 : Comparer deux ou plusieurs distributions expérimentales
5.1 Juxtaposition visuelle côte à côte de groupes d’étude
Le deuxième scénario d’utilisation incontournable — et sans conteste le plus fréquent dans les publications biomédicales et scientifiques internationales — concerne la comparaison multigroupes simultanée. Lorsque le protocole de recherche vise à évaluer l’effet d’un traitement, l’impact d’une condition d’amorçage ou l’influence d’un facteur démographique, le chercheur doit analyser de concert les distributions de plusieurs cohortes distinctes (ex. groupe contrôle versus groupes traités à différents dosages).
La force incomparable de la boîte à moustaches réside dans son extraordinaire compacité graphique, autorisant l’alignement horizontal ou vertical côte à côte de multiples distributions sur une échelle métrique commune strictement unifiée. Contrairement à la juxtaposition d’histogrammes individuels — qui devient rapidement illisible et visuellement saturée au-delà de trois conditions expérimentales en raison du chevauchement inextricable des barres et des polygones de fréquence —, la boîte de Tukey déploie une emprise spatiale minimale. On peut aisément disposer dix, quinze ou vingt boîtes parallèles sur une seule planche graphique sans altérer la clarté sémiologique du document.
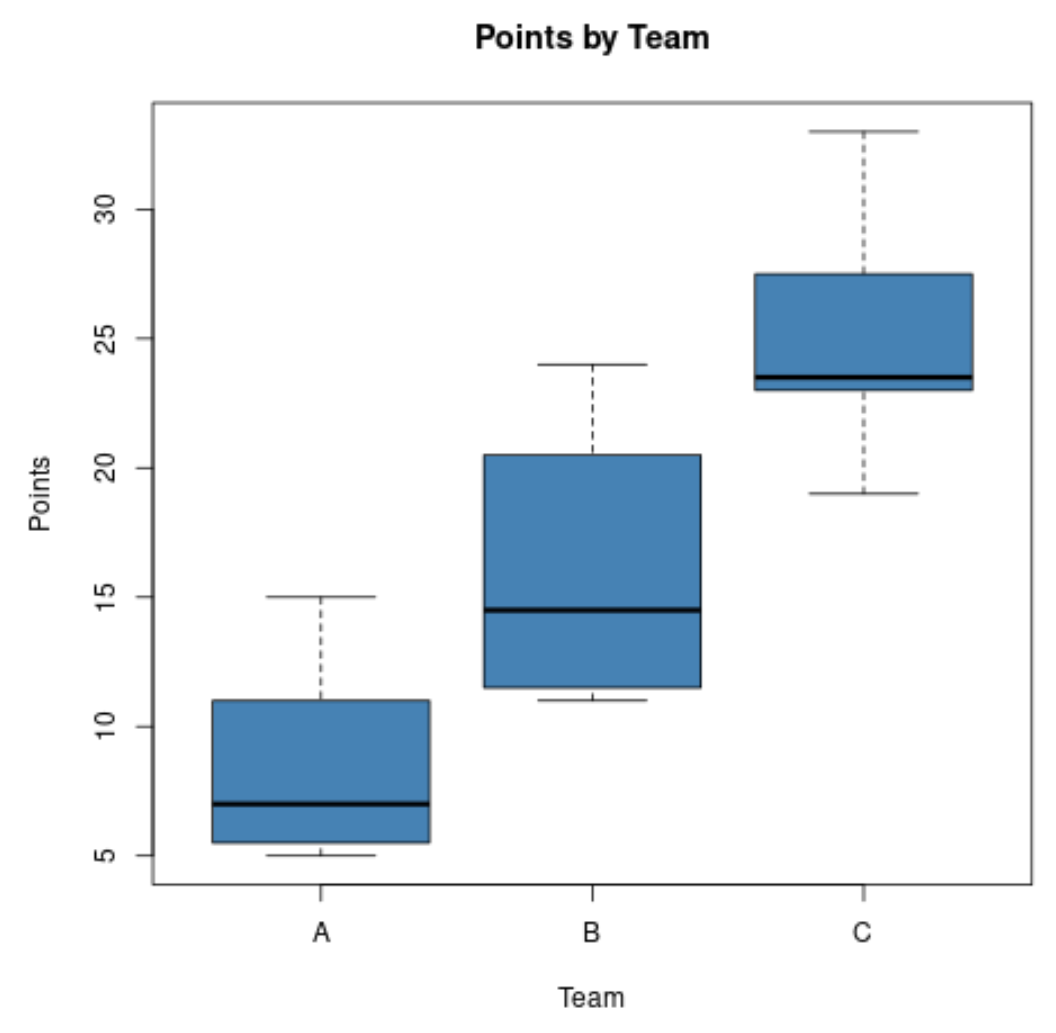
Cette disposition comparative juxtapose instantanément l’intégralité du profil distributionnel de chaque condition. L’observateur apprécie d’un unique balayage oculaire l’évolution graduelle des médianes d’un groupe à l’autre, les variations d’ampleur des écarts interquartiles et les glissements asymétriques consécutifs à l’administration d’une molécule ou à une manipulation expérimentale. Cette réduction drastique de la charge de travail cognitive s’avère particulièrement précieuse lors des réunions d’équipes pluridisciplinaires ou des présentations académiques, en focalisant immédiatement l’attention des chercheurs sur les patterns de réponse différentiels induits par les variables indépendantes manipulées.
5.2 Évaluation comparative des médianes et des tendances centrales
Dans un contexte comparatif, l’inspection visuelle ne saurait se limiter à constater un décalage spatial grossier entre deux boîtes centrales ; elle requiert des repères fiables pour apprécier si l’écart de rang observé entre les médianes est susceptible de refléter une divergence statistiquement significative. Conscient de ce besoin d’aide visuelle à la décision inférentielle, John Tukey et ses collaborateurs ont proposé une variante sophistiquée du graphique originel : la boîte à moustaches à encoches (notched box plot).
L’encoche consiste en un rétrécissement géométrique bilatéral des flancs de la boîte de part et d’autre de la médiane. L’intervalle couvert par cette indentation est calculé de manière probabiliste selon la formule canonique validée par McGill, Tukey et Larsen :
$$\text{Encoche} = Q_2 \pm 1{,}58 \times \frac{\text{IQR}}{\sqrt{N}}$$
Cet intervalle mathématique représente une estimation non paramétrique robuste de l’intervalle de confiance à 95 % de la médiane. Le multiplicateur $1{,}58$ a été formellement dérivé pour que, dans l’éventualité où deux distributions auraient des variances équivalentes, le non-chevauchement spatial des encoches de deux boîtes adjacentes corresponde avec une excellente approximation à un test d’hypothèse significatif au seuil critique de $\alpha = 0{,}05$.
L’intérêt didactique et méthodologique de ce dispositif est immense. Si les encoches de deux conditions cliniques (par exemple, un groupe recevant un placebo et un groupe recevant une psychothérapie ciblée) ne se recouvrent absolument pas sur l’axe vertical des ordonnées, le chercheur dispose d’une confirmation visuelle préliminaire très robuste d’une différence systématique entre les populations parentes, préalablement même à l’exécution formelle d’un test de Mann-Whitney ou d’un rééchantillonnage par bootstrap. À l’inverse, un chevauchement prononcé des encoches invite immédiatement à la prudence, indiquant que la variabilité d’échantillonnage suffit amplement à expliquer le différentiel de tendance centrale observé.
5.3 Comparaison de l’homogénéité des variances entre facteurs
Au-delà de la comparaison des valeurs médianes, l’analyse rigoureuse des plans expérimentaux exige impérativement la vérification de l’homoscédasticité, c’est-à-dire l’homogénéité des variances entre les différents niveaux du facteur étudié. L’hétéroscédasticité constitue en effet l’une des violations les plus insidieuses des postulats de l’analyse de variance classique (ANOVA), susceptible d’invalider la statistique $F$ de Fisher en gonflant dramatiquement le taux d’erreur de première espèce (rejet indu de l’hypothèse nulle).
La boîte à moustaches fournit une plateforme d’inspection visuelle inégalée pour diagnostiquer cette instabilité de variance préalablement aux calculs inférentiels. Il suffit à l’expérimentateur de confronter directement les hauteurs verticales comparées des boîtes centrales (les $\text{IQR}$) et l’envergure globale des moustaches de chaque cohorte :
- Si les boîtes centrales affichent des hauteurs rigoureusement comparables à travers l’ensemble des conditions expérimentales, l’hypothèse d’homogénéité de la dispersion intra-groupe gagne une forte plausibilité empirique, confortant la validité ultérieure des tests d’homogénéité formels (tels que le test de Levene ou de Bartlett).
- Si, en revanche, la boîte d’une condition expérimentale présente une hauteur trois ou quatre fois supérieure à celle de la condition témoin, le graphique met en lumière une importante hétérogénéité des variances.
Cette discordance de dispersion intra-condition possède souvent une haute valeur heuristique. Dans les essais cliniques pharmacologiques ou psychothérapeutiques, une forte dispersion survenant exclusivement dans le groupe traité signale fréquemment une variabilité de réponse individuelle inter-patients : le traitement ne déplace pas simplement la moyenne générale des sujets, il scinde la population entre d’excellents répondeurs dont les symptômes chutent drastiquement et des sujets réfractaires dont l’état demeure inchangé. La boîte de Tukey dévoile immédiatement ce phénomène d’amplification de variabilité que le simple rapport d’une moyenne et d’un test $t$ classique aurait complètement lissé et occulté.
6. Applications avancées du Scénario 2 en psychologie expérimentale
6.1 Plans factoriels et variables indépendantes multiples
L’exploitation comparative de la boîte à moustaches s’enrichit considérablement lors de la manipulation de plans expérimentaux factoriels complexes, impliquant le croisement de multiples variables indépendantes catégorielles (ex. plans factoriels $2 \times 2$ ou $2 \times 3$). Dans ces configurations méthodologiques exigeantes, l’analyste doit évaluer simultanément les effets principaux de chaque facteur et leurs potentielles interactions statistiques.
La flexibilité géométrique du diagramme de Tukey permet de ségréguer élégamment les niveaux factoriels par le biais d’un emboîtement visuel structuré, combinant la stratification spatiale le long de l’axe des abscisses et une différenciation sémantique par codage couleur distinct (palette chromatique appliquée au remplissage des boîtes). Dans une recherche étudiant l’effet conjoint du « Statut d’Âge » (Jeunes versus Âgés) et de la « Charge Attentionnelle » (Faible, Modérée, Élevée) sur les performances de rappel mnésique, les conditions de charge peuvent être distribuées séquentiellement en abscisse, tandis que pour chaque palier, deux boîtes accolées mais colorées différemment confrontent directement les deux classes d’âge.
Ce déploiement factoriel met en exergue les interactions de manière hautement intuitive. Si le différentiel de hauteur et d’altitude médiane entre les boîtes « Jeunes » et « Âgés » demeure rigoureusement constant sous charge faible et charge modérée, mais s’écarte brutalement de manière disproportionnée sous charge élevée en raison de l’effondrement spécifique de la boîte des sujets âgés, l’interaction statistique de type modération apparaît de façon flagrante aux yeux de l’expérimentateur. De même, pour les devis longitudinaux ou les mesures répétées intra-sujets (ex. évaluation du stress perçu pré-traitement, post-traitement et lors du suivi à six mois), la disposition ordonnée des boîtes successives matérialise fidèlement la cinétique temporelle du changement psychologique et la persistance de l’hétérogénéité interindividuelle au fil du temps.
6.2 Comparaisons inter-échantillons à effectifs inégaux
Un défi récurrent en recherche empirique réside dans la disparité numérique des groupes comparés, situation fréquente lors de l’étude de pathologies psychiatriques ou neurologiques rares comparées à de volumineuses cohortes témoins saines. Face à un déséquilibre quantitatif marqué (ex. $N_1 = 15$ patients atteints d’amnésie hippocampique versus $N_2 = 150$ participants contrôles), tracer deux boîtes de géométrie identique crée une dangereuse illusion d’équivalence métrologique.
Pour résoudre cette distorsion interprétative, Tukey a institué la technique des boîtes à largeur variable (variable-width box plots). Dans ce protocole géométrique perfectionné, la largeur horizontale de chaque boîte centrale n’est plus fixée de manière arbitraire et constante ; elle est asservie dynamiquement à la racine carrée de la taille de l’échantillon correspondant :
$$\text{Largeur} propto \sqrt{N}$$
Par ce procédé mathématique, une cohorte clinique restreinte de 16 individus se manifestera par une boîte centrale très étroite et élancée, signalant visuellement au lecteur la précarité statistique de l’estimation de ses quantiles, tandis qu’un groupe de contrôle massif composé de 400 sujets arborera un rectangle large et imposant, traduisant graphiquement sa formidable assise d’échantillonnage.
Cette pondération graphique prémunit le chercheur contre le risque de surinterpréter les anomalies marginales observables dans les petits effectifs ($N < 20$), où le calcul d'un centile s'avère hautement sensible à la fluctuation d'un seul individu. Lorsque des comparaisons inter-centres ou inter-instituts sont conduites à l'échelle nationale, cette standardisation dimensionnelle harmonise l'affichage tout en restituant honnêtement le poids épistémique réel de chaque établissement au sein du rapport d'évaluation.
7. Scénario 3 : Identifier et isoler rigoureusement les valeurs aberrantes
7.1 Le critère standard de Tukey pour la qualification des outliers
Le troisième scénario cardinal conférant à la boîte à moustaches son statut d’outil incontournable concerne la détection, la catégorisation et l’isolation méthodique des valeurs aberrantes ou atypiques (outliers). Dans l’histoire de la statistique inférentielle, la qualification d’une donnée comme déviante a longtemps reposé sur des approches probabilistes paramétriques hautement circulaires, à l’instar de la méthode fondée sur les scores standards centrés-réduits (scores $Z$). Selon cette pratique désuète, une observation est arbitrairement qualifiée d’aberrante dès lors que son score dépasse le seuil critique de $|Z| > 3{,}0$ ou $3{,}29$ :
$$Z_i = \frac{X_i – \bar{X}}{\text{SD}}$$
Or, ce raisonnement souffre d’une tare méthodologique majeure connue sous le nom d’effet de masquage (masking effect). La moyenne $\bar{X}$ et l’écart-type $\text{SD}$ étant eux-mêmes prodigieusement sensibles à la présence de valeurs extrêmes, une poignée d’anomalies monumentales au sein de l’échantillon va massivement gonfler le dénominateur $\text{SD}$ et décaler le numérateur, réduisant mécaniquement la magnitude relative de chaque score $Z$ individuel. Par conséquent, les valeurs les plus toxiques échappent à leur propre détection en contaminant préalablement l’instrument métrologique de leur mesure !
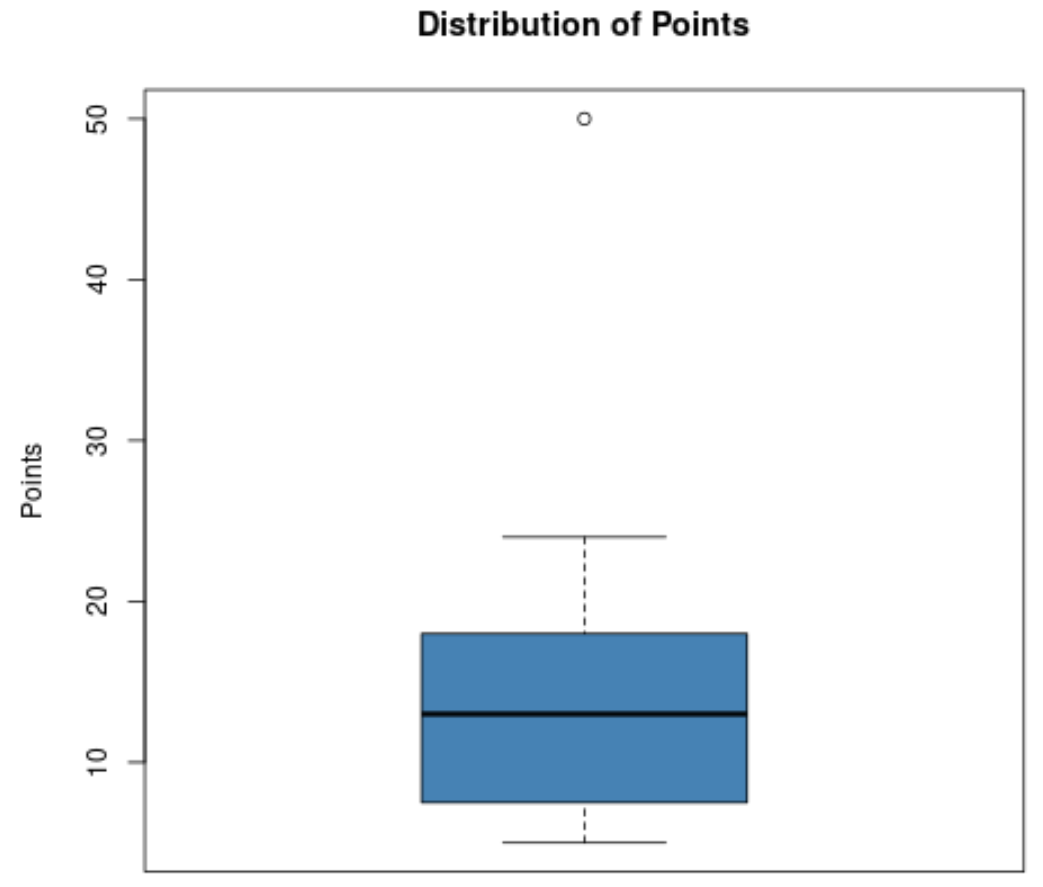
Le critère déterministe institué par John Tukey à travers sa boîte à moustaches coupe court à cette circularité vicieuse. Fondé exclusivement sur le premier quartile, le troisième quartile et l’écart interquartile ($\text{IQR}$), le calcul des barrières d’isolation ($Q_1 – 1{,}5 \times \text{IQR}$ et $Q_3 + 1{,}5 \times \text{IQR}$) s’opère à l’abri total de la déformation induite par les points déviants. Même si un tiers de la série statistique se trouve contaminé par des erreurs monumentales de saisie ou d’acquisition machine, l’écart interquartile préserve une stabilité exemplaire, permettant aux clôtures de Tukey de trancher net et de désigner avec une impartialité algorithmique absolue les observations qui violent le pacte distributionnel de la cohorte générale.
7.2 Détection d’anomalies dans les tâches de chronométrie mentale
L’apport diagnostique de cette propriété de résistance métrologique s’illustre particulièrement dans le traitement des paradigmes de chronométrie mentale en psychologie cognitive expérimentale et en neurosciences (tâches de Stroop, de Simon, d’amorçage sémantique ou d’inhibition motrice de type Go/No-Go). L’expérimentateur y recueille des milliers d’enregistrements de temps de réaction élémentaires, inévitablement parasités par des processus physiologiques exogènes non reliés à la tâche cognitive ciblée.
La boîte à moustaches permet alors d’opérer une ségrégation immédiate entre deux dynamiques d’artefacts aux propriétés physiques diamétralement opposées :
- Les réponses ultra-rapides d’anticipation motrice : Proposées en deçà de la clôture inférieure ($< Q_1 – 1{,}5 \times \text{IQR}$), ces latences excessivement brèves (ex. $80\text{ ms}$) sont physiologiquement incompatibles avec le temps incompressible requis pour la transduction rétinienne, le traitement cortical et la commande motrice pyramidale. La boîte de Tukey les isole nettement sous forme de points suspects au bas du graphique, guidant leur retrait automatique légitime pour cause de faux départ pré-stimulus.
- Les décrochages attentionnels et distractions cognitives : Projetées très au-delà de la clôture externe supérieure ($> Q_3 + 3 \times \text{IQR}$), des latences atteignant plusieurs secondes trahissent un clignement palpébral, une baisse de vigilance passagère ou une rêverie diurne du participant. Ces points s’accumulent au zénith du tracé en s’écartant radicalement de la terminaison de la moustache haute.
Grâce à la visualisation de Tukey, le chercheur s’affranchit du recours hasardeux à des fenêtres de coupe fixes appliquées à l’aveugle (comme le rejet universel des réponses en dehors de l’intervalle rigide $200\text{–}1500\text{ ms}$), stratégie simpliste qui ignore l’allongement naturel des latences chez les enfants ou les patients âgés. La boîte adapte dynamiquement le périmètre de détection au profil de variabilité intrinsèque de la sous-population examinée, assurant un nettoyage métrologique personnalisé qui optimise la puissance statistique des comparaisons factorielles ultérieures.
7.3 Surveillance des biais de réponse et erreurs de mesure
Dans l’exploitation des enquêtes sociologiques, des sondages d’opinion et des questionnaires psychométriques auto-rapportés standardisés, la boîte à moustaches constitue un pare-feu essentiel contre la contamination par des biais d’engagement ou des pannes matérielles. La collecte de données massives en ligne (via des plateformes telles que Prolific, Amazon Mechanical Turk ou Qualtrics) est fréquemment confrontée à la présence de participants inattentifs ou malveillants générant des réponses automatisées ou totalement aléatoires afin d’empocher rapidement leur rétribution financière.
L’évaluation des distributions du « temps total passé à répondre » (durée de passation) par boîte à moustaches permet de démasquer instantanément ces profils frauduleux. Les répondants expéditifs (speeders), ayant cliqué machinalement sur les items en trente secondes pour un inventaire requérant d’ordinaire quinze minutes d’introspection, apparaissent projetés de manière flagrante sous la clôture inférieure sous forme d’anomalies sévères. À l’autre extrémité, des durées s’étendant sur plusieurs heures dévoilent les participants ayant abandonné l’onglet de navigation ouvert avant d’y revenir épisodiquement.
De surcroît, le diagramme de Tukey prévient l’introduction accidentelle d’erreurs matérielles de saisie dans les bases de données institutionnelles. L’omission d’une virgule décimale lors de l’encodage manuel de l’indice de masse corporelle (IMC) transformant un score de $24{,}5$ en $245$ génère instantanément une anomalie extrême spectaculaire, immédiatement repérée lors de la phase préliminaire d’inspection exploratoire. Cette détection visuelle directe évite qu’une banale coquille typographique ne corrompe irrémédiablement le calcul d’une modélisation épidémiologique multivariée complexe.
8. Traitement méthodologique et éthique des observations isolées
8.1 Dilemme entre rejet statistique et signification clinique
Bien que la formalisation géométrique de John Tukey rende la mise en évidence des points isolés extraordinairement limpide, la question cruciale de leur traitement analytique confronte le chercheur à un véritable dilemme épistémologique et éthique. Une dérive méthodologique particulièrement délétère consiste à assimiler mécaniquement tout point projeté au-delà des clôtures à une impureté expérimentale devant être purement et simplement bannie de la base de données. Cette pratique d’éviction aveugle (dénoncée dans le champ de la méta-recherche sous le terme de data peeling) gonfle artificiellement le risque d’erreur de première espèce ($\alpha$) et fragilise la réplicabilité scientifique.
Dans le domaine des sciences biomédicales et de la psychopathologie cognitive, l’observation atypique ne constitue pas nécessairement une nuisance métrologique ; elle incarne fréquemment une opportunité heuristique majeure. Un patient manifestant une vitesse de récupération neuronale exceptionnelle ou un déclin cognitif atypiquement fulgurant sous un nouveau protocole thérapeutique ne représente pas une « erreur » : il reflète un phénotype clinique rare ou une singularité génétique d’un intérêt scientifique capital. Supprimer d’autorité cette donnée sous prétexte qu’elle dépasse le segment de la moustache de Tukey revient à stériliser délibérément la réalité empirique au profit d’un modèle théorique idéalisé.
La règle éthique en recherche rigoureuse impose de ne jamais procéder à l’exclusion d’une donnée sur la seule base de son statut d’outlier visuel. L’identification graphique par la boîte à moustaches doit agir comme un signal d’alerte méthodologique incitant à une vérification méticuleuse de la traçabilité de l’observation : y a-t-il eu un incident matériel rapporté lors du protocole expérimental ? Le capteur biomédical a-t-il saturé ? Le sujet a-t-il enfreint les consignes ? Si aucune justification contextuelle tangible ne vient expliquer l’anomalie, la donnée doit impérativement être maintenue au sein de l’échantillon, quitte à orienter les modélisations vers des méthodes statistiques tolérantes aux déviations massives.
8.2 Stratégies d’ajustement : winsorisation et transformations robustes
Lorsque le maintien intégral des valeurs atypiques menace de corrompre gravement la convergence ou la validité des modèles linéaires sans que leur suppression pure et simple ne soit méthodologiquement justifiable, plusieurs alternatives statistiques de conciliation s’offrent à l’analyste, au premier rang desquelles figure la winsorisation (nommée d’après le statisticien Charles Winsor).
La winsorisation consiste à ramener les valeurs situées au-delà des seuils de démarcation aux valeurs exactes des clôtures correspondantes (ou à des percentiles fixes préalablement stipulés, tels que les 5e et 95e centiles). Ainsi, une observation de temps de réaction atteignant $4500\text{ ms}$, identifiée comme anomalie majeure au-delà de la clôture de Tukey fixée à $1800\text{ ms}$, ne sera pas extirpée de l’échantillon mais réassignée à la valeur de $1800\text{ ms}$. Cette technique préserve l’effectif global de l’échantillon ($N$), conserve le rang ordinale élevé de l’observation dans la série, mais jugule radicalement son pouvoir de distorsion quadratique sur le calcul de la moyenne et de la matrice de covariance.
Une seconde démarche consiste à opérer une transformation mathématique non linéaire monotone guidée par la forme de la boîte à moustaches initiale. En présence d’une asymétrie positive persistante encombrée d’outliers unilatéraux, le chercheur peut appliquer une transformation logarithmique ($log(X)$ ou $log(X + 1)$), racine carrée ($\sqrt{X}$) ou la famille de transformations paramétriques de Box-Cox :
$$y^{(\lambda)} = \begin{\cases} \dfrac{y^\lambda – 1}{\lambda} &a\mp; \text{si } \lambda \neq 0 \ln(y) &a\mp; \text{si } \lambda = 0 \end{\cases}$$
Le contrôle de l’efficacité de cette manipulation s’opère de manière spectaculairement simple : il suffit de juxtaposer visuellement la boîte à moustaches de la variable brute et celle de la variable transformée. Si la transformation a opéré harmonieusement, la nouvelle boîte à moustaches révèle un centrage parfait de la médiane, une équipartition des moustaches et la réintégration harmonieuse de la quasi-totalité des points isolés dans le corps ordinaire de la distribution.
9. Analyse comparative : Boîte à moustaches versus représentations alternatives
9.1 Boîte à moustaches versus histogramme et polygone de fréquence
Pour choisir judicieusement son mode de restitution graphique, l’analyste doit apprécier avec précision les compromis fonctionnels qui séparent la boîte de Tukey de l’histogramme classique. L’histogramme et le polygone de fréquence possèdent une vertu descriptive incontournable : ils cartographient l’intégralité de la fonction de densité empirique, exposant sans ambiguïté les concavités locales, les creux et les sommets multiples d’une distribution complexe.
Cependant, l’histogramme souffre d’un biais méthodologique redoutable : sa sensibilité arbitraire au choix du découpage en classes (le paramètre binwidth). Selon que l’analyste opte pour la formule de Sturges, de Scott ou de Freedman-Diaconis, ou qu’il modifie légèrement l’origine du premier intervalle, la physionomie optique d’un histogramme peut varier considérablement, suggérant tantôt une distribution parfaitement unimodale, tantôt une succession chaotique de pics secondaires. La boîte à moustaches est totalement immunisée contre ce subjectivisme de discrétisation : les quantiles sont des entités mathématiques invariantes pour un algorithme d’interpolation donné.
De plus, l’histogramme capitule dès lors qu’il s’agit de comparer un nombre élevé de conditions. Superposer cinq histogrammes translucides sur un même repère engendre une superposition chromatique illisible, et juxtaposer cinq histogrammes séparés consomme un espace graphique démesuré. La boîte à moustaches s’impose donc comme la supérieure incontestable pour l’arbitrage spatial et la comparaison synthétique inter-conditions, tandis que l’histogramme demeure l’outil privilégié de l’exploration préliminaire univariée pour lever le doute sur une éventuelle multimodalité.
9.2 Boîte à moustaches versus diagramme en violon et raincloud plots
L’essor de la science ouverte (Open Science) et la crise de la réplicabilité ont stimulé le développement de représentations hybrides visant à dépasser les limites de la boîte à moustaches tout en conservant ses vertus de synthèse. Le diagramme en violon (violin plot), introduit par Hintze et Nelson en 1998, fusionne une boîte à moustaches miniaturisée avec une courbe symétrique d’estimation de densité par noyau (KDE). Cette géométrie renseigne immédiatement sur la présence d’éventuels étranglements ou ventres le long de la distribution, résolvant avec brio l’aveuglement de Tukey face aux distributions multimodales.
Poussant cette exigence de transparence méthodologique à son paroxysme, les graphiques en nuage de pluie (raincloud plots), conceptualisés par Allen et ses collaborateurs en 2019, combinent simultanément sur un même axe :
- Une demi-courbe de densité en lissage noyau évoquant un nuage en suspension ;
- Une boîte à moustaches traditionnelle située immédiatement en dessous pour fournir les repères rigoureux des quantiles et de la médiane ;
- La dispersion exhaustive de la totalité des points individuels bruts (le nuage de points avec gigue aléatoire, évoquant des gouttes de pluie tombant du nuage).
Si le raincloud plot incarne désormais le standard d’excellence pour la restitution transparente des études à effectifs modérés ($N < 500$) en neuroimagerie et en psychologie expérimentale, la boîte à moustaches classique conserve un avantage ergonomique indéniable pour les présentations grand public, les articles synthétiques ou les bases de données massives (Big Data). Face à plusieurs dizaines de milliers d’observations, l’affichage individuel de chaque point saturera inutilement le rendu vectoriel sans rien ajouter à la précision des cinq marqueurs cardinaux de Tukey.
9.3 Boîte à moustaches versus diagrammes à barres d’erreurs (Dynamite plots)
S’il est un combat méthodologique crucial que la boîte à moustaches a largement contribué à mener, c’est celui de l’éradication des infâmes « diagrammes en dynamite » (dynamite plots ou barres d’erreurs uni-directionnelles superposées à un rectangle plein partant de zéro). Dans ces figures encore trop présentes dans certaines revues médicales traditionnelles, la hauteur de la barre pleine représente la moyenne arithmétique de la variable continue, surmontée d’un minuscule segment figurant l’écart-type ou l’erreur standard de la moyenne (SEM).
Cette sémiotique est universellement fustigée par les statisticiens pour son opacité trompeuse. D’une part, elle consacre la majeure partie de l’encre graphique à matérialiser la distance séparant zéro de la moyenne, un espace totalement vide d’information dans la majorité des échelles non bornées à zéro. D’autre part, elle dissimule intégralement l’asymétrie de la distribution, la présence de valeurs aberrantes monstrueuses, la multimodalité et l’effectif réel de l’échantillon. Deux jeux de données aux comportements diamétralement opposés — l’un suivant une courbe de Gauss serrée et l’autre une distribution bimodale déséquilibrée truffée d’outliers — peuvent produire un diagramme en dynamite strictement identique !
C’est pourquoi les revues scientifiques de premier rang (comme le consortium Nature, PLOS ou le Journal of Neuroscience) bannissent désormais expressément ces représentations au profit des boîtes à moustaches ou de leurs extensions hybrides. Restaurer la boîte de Tukey, c’est redonner toute leur visibilité aux structures internes réelles de la variance et contraindre l’auteur d’un article à exposer la dispersion de ses observations sans aucune échappatoire cosmétique.
10. Écueils méthodologiques et limites interprétatives
10.1 Effets de taille d’échantillon et instabilité graphique
L’application machinale de la boîte à moustaches sans examen critique préalable des caractéristiques structurelles de l’échantillon peut conduire à de lourds contresens analytiques. La première défaillance majeure concerne le déploiement de l’outil sur de très faibles effectifs ($N < 15\text{ ou }20$). Les quantiles sont des métriques d'ordre fondées sur la partition probabiliste d'un continuum ordonné. Sur un échantillon minuscule de 8 ou 10 individus, découper la série en quarts implique que le premier quartile repose sur l'interpolation arbitraire de deux observations seulement. Il en découle une instabilité graphique critique : l'adjonction ou le retrait d'une seule observation anodine peut bouleverser radicalement la longueur relative des moustaches et la position de la médiane, conférant à la figure une fausse autorité de certitude statistique sur une base métrologique fragile.
Dans ce contexte d’effectifs réduits, il est impératif d’adjoindre systématiquement à la boîte le tracé individualisé de l’ensemble des points réels (via une dispersion aléatoire transversale dite jittering). Cette superposition permet au lecteur de constater d’emblée la rareté numérique sous-jacente et de pondérer en conséquence son jugement visuel.
À l’autre extrême du spectre d’échantillonnage, la manipulation de cohortes colossales ($N > 100,000$, courantes en bio-informatique ou en analyse des registres épidémiologiques) induit un phénomène pervers inverse : l’explosion mécanique du nombre de valeurs désignées comme atypiques par le critère de Tukey. Sous une distribution normale idéale, la probabilité théorique de se situer au-delà de $1{,}5 \times \text{IQR}$ s’établit à $0{,}007$. Sur un effectif de 500 000 participants, le graphique projettera donc de manière purement stochastique environ 3 500 « points aberrants », transformant les abords des moustaches en une traîne dense et informe de points noirs superposés. Dans cette situation, l’analyste devra ajuster les paramètres de son diagramme, par exemple en employant des boîtes pour grands volumes de données (letter-value plots de Hofman, Wickham et Kafadar), qui adaptent récursivement les fractions de quantiles au volume de l’échantillonnage.
10.2 Mauvaises interprétations récurrentes chez les chercheurs
En dépit de son apparente simplicité, la boîte à moustaches fait l’objet de contresens interprétatifs récurrents dans la littérature scientifique publiée. L’erreur la plus prégnante consiste à opérer une confusion cognitive systématique entre l’écart interquartile ($\text{IQR}$) matérialisé par la boîte et un intervalle de confiance à 95 % ($\text{IC}_{95%}$) de la moyenne. Il n’est pas rare de lire sous la plume d’auteurs débutants que « les groupes ne diffèrent pas car leurs boîtes se chevauchent », proposition métrologiquement erronée. L’écart interquartile décrit la dispersion intrinsèque des 50 % centraux de l’échantillon individuel, tandis que l’intervalle de confiance quantifie l’incertitude métrologique entourant l’estimation de la moyenne de la population, intervalle qui se resserre inversement à la racine carrée de l’effectif ($\sigma / \sqrt{N}$). Des boîtes qui se recouvrent largement peuvent masquer des médianes significativement distinctes à $p < 0{,}001$ si l'échantillon est volumineux !
Une seconde méprise classique réside dans l’assimilation hâtive de la ligne médiane à la moyenne arithmétique. Cette confusion pousse certains observateurs à chercher une adéquation arithmétique entre la position de la barre centrale et le calcul de bilans paramétriques décrits dans le texte principal, oubliant que la boîte de Tukey traduit des statistiques d’ordre et non des sommations scalaires.
Enfin, le troisième contresens réside dans la diabolisation immédiate des observations émergeant au-delà des moustaches. Considérer que tout point isolé matérialise une « erreur de mesure » à extirper d’urgence trahit une incompréhension radicale des fondements de la variabilité stochastique. L’analyste doit garder à l’esprit que la boîte à moustaches projette la métrique sur un continuum linéaire arbitraire, qui peut lui-même résulter d’une construction psychométrique non linéaire (comme des temps de réaction ou des scores d’anxiété exponentiels), et que la géométrie du graphique doit toujours être confrontée aux impératifs substantiels du champ scientifique étudié.
11. Implémentation computationnelle dans l’écosystème statistique académique
11.1 Génération avancée avec R et l’écosystème Tidyverse / ggplot2
Dans l’environnement de calcul statistique R, la construction d’une boîte à moustaches de standard académique s’articule préférentiellement autour du package ggplot2 (composante du méta-package tidyverse). L’approche repose sur la grammaire des graphiques développée par Leland Wilkinson et adaptée par Hadley Wickham. La fonction maîtresse geom_boxplot() procure une flexibilité computationnelle totale pour répondre aux trois scénarios méthodologiques examinés.
La déclaration canonique associe l’assignation esthétique des axes, la spécification d’arguments géométriques pour ajuster l’épaisseur des clôtures, et l’introduction d’encoches de significativité statistique via le paramètre boléen notch = TRUE. Pour matérialiser fidèlement l’assise d’échantillonnage de chaque groupe dans un plan comparatif à effectifs inégaux (Scénario 2), le statisticien mobilisera l’argument varwidth = TRUE, qui redimensionne automatiquement la largeur de chaque polygone selon la règle $\sqrt{N}$.
Afin de maximiser la transparence épistémique et d’éviter les écueils de la multimodalité masquée, le protocole de programmation moderne préconise la superposition d’un calque de points individuels à travers la commande geom_jitter(). En modulant l’amplitude de dispersion transversale (width = 0.2) et la transparence chromatique (alpha = 0.4), le chercheur enrichit le diagramme de Tukey d’une vision granulaire de la masse des observations brutes. Enfin, l’adjonction d’un marqueur visuel distinct pour signaler la moyenne arithmétique — rendue possible par la fonction stat_summary(fun = mean, geom = "point", shape = 18, size = 3, color = "red") — offre une confrontation immédiate et conjointe de la tendance centrale paramétrique face à la médiane robuste.
11.2 Programmation sous Python avec Seaborn et Matplotlib
Au sein de l’écosystème de programmation Python dédié à la science des données, les bibliothèques matplotlib et seaborn s’érigent en références majeures pour l’édition de visualisations publication-ready. La fonction seaborn.boxplot() abstrait la complexité du calcul des clôtures matricielles tout en s’interfaçant avec les structures de données tabulaires du package pandas.
Pour traiter les plans factoriels multidimensionnels complexes (Scénario 2), l’argument hue permet d’injecter une seconde variable indépendante catégorielle, opérant une ségrégation bicolore automatique des boîtes au sein de chaque modalité de l’axe principal. La gestion de l’atypisme numérique (Scénario 3) est finement paramétrable grâce à l’argument whis, qui gouverne le coefficient multiplicateur de l’écart interquartile (par défaut fixé à $1{,}5$, mais débrayable à $3{,}0$ pour isoler exclusivement les anomalies extrêmes, ou désactivable pour produire des moustaches min-max pures via whis=[0, 100]).
Pour parachever l’intégrité sémiotique du graphique sous Python, la communauté académique recourt couramment à l’hybridation avec la fonction seaborn.stripplot(dodge=True), projetant chaque point brut au cœur des boîtes factorielles correspondantes. En veillant à calibrer les palettes de couleurs pour garantir leur accessibilité aux lecteurs atteints de déficiences de la vision chromatique (comme les palettes viridis ou colorblind) et en exportant la figure finale via la méthode plt.savefig('figure.pdf', dpi=300, bbox_inches='tight'), le chercheur garantit une reproduction vectorielle haute définition parfaitement alignée sur les normes éditoriales de l’American Psychological Association (APA).
11.3 Réalisation dans les logiciels d’interface clinique (SPSS, JASP, Jamovi)
Pour les chercheurs et cliniciens évoluant hors des paradigmes de programmation scripturale, les progiciels statistiques à interface graphique utilisateur (GUI) proposent des modules dédiés à la boîte de Tukey hautement automatisés. Au sein d’IBM SPSS Statistics, la procédure s’exécute traditionnellement via le menu Analyse exploratoire (procédure EXAMINE). SPSS applique rigoureusement la taxonomie de Tukey : il affiche par défaut les anomalies modérées sous forme de petits cercles étiquetés du numéro de ligne de l’observation dans la matrice, et les anomalies extrêmes ($> 3 \times \text{IQR}$) sous la forme d’astérisques distincts. Cette traçabilité directe permet au praticien de faire l’aller-retour instantané entre le graphique et son dossier patient informatisé pour inspecter les données litigieuses.
Dans les environnements statistiques libres modernes d’inspiration bayésienne tels que JASP et Jamovi, conçus pour promouvoir la reproductibilité et la simplicité d’usage, l’obtention de la boîte à moustaches s’opère dans le sous-menu Descriptives. En un simple clic, l’utilisateur active simultanément l’affichage des boîtes à moustaches, la superposition des encoches de Tukey, et le déploiement latéral des données brutes en violon ou en distribution jitter.
Ces logiciels contemporains extraient simultanément le résumé à cinq nombres au sein de tableaux récapitulatifs dynamiques et permettent d’exporter directement les tracés vectoriels aux formats SVG ou PDF. L’interactivité poussée de JASP et Jamovi offre une inspection visuelle dynamique particulièrement propice à l’enseignement universitaire et à la rédaction médicale rapide, démocratisant l’accès aux meilleures pratiques de l’analyse exploratoire des données sans imposer l’apprentissage préliminaire d’une syntaxe de programmation.
12. Arbre décisionnel pour l’exploitation de la boîte à moustaches en recherche
12.1 Matrice de sélection de l’outil visuel selon les propriétés des données
Pour systématiser la démarche du chercheur et formaliser avec rigueur le moment opportun où la boîte à moustaches s’impose face aux représentations graphiques concurrentes, une matrice décisionnelle structurée peut être formulée sur la base de quatre paramètres métrologiques cardinaux : le niveau de mesure de la variable, la taille de l’échantillon ($N$), le nombre de groupes ou conditions expérimentales à juxtaposer ($K$), et l’existence suspectée d’une multimodalité sous-jacente.
L’algorithme de choix méthodologique s’articule selon les embranchements rationnels suivants :
- Cas 1 : Variable ordinale ou métrique discontinue discrète (items de Likert individuels, échelles de rangs) :
La boîte à moustaches conventionnelle est déconseillée car elle postule un continuum métrique et calcule des quantiles continus artificiels. Privilégier les diagrammes en barres divergentes empilées ou les mosaïques catégorielles. - Cas 2 : Variable continue, un seul échantillon global ($K = 1$), volume modéré ou élevé :
Si l’objectif est d’évaluer la forme de la loi de distribution, coupler l’histogramme de fréquences (pour vérifier l’absence d’ondulations multimodales) avec une boîte à moustaches univariée (pour isoler les clôtures et les outliers). - Cas 3 : Comparaison multigroupes ($K ge 3$), variable continue, distributions unimodales :
La boîte à moustaches (avec encoches si une aide inférentielle est recherchée) constitue le standard méthodologique absolu d’excellence en raison de son économie cognitive spatiale maximale. - Cas 4 : Comparaison de groupes ($K ge 2$), suspicion de multimodalité ou échantillons modérés ($N < 50$) :
Préférer impérativement les représentations hybrides intégratives : le diagramme en violon avec boîte à moustaches interne, ou idéalement le raincloud plot associant courbe de densité, quantiles et projection individualisée de l’ensemble des observations empiriques.
Cette matrice guide l’arbitrage entre la concision requise pour la communication scientifique grand format et l’exhaustivité indispensable à l’analyse diagnostique brute en laboratoire.
12.2 Checklist méthodologique pré-publication académique
Avant d’intégrer définitivement une planche de boîtes à moustaches au sein d’un manuscrit soumis à l’évaluation par les pairs (peer review), le chercheur se doit de passer au crible sa production graphique à travers une grille de contrôle méthodologique standardisée, prévenant ainsi les critiques récurrentes des rapporteurs statistiques :
- Explicitation absolue de la règle de calcul des moustaches : La légende de la figure indique-t-elle formellement la convention mathématique employée pour tracer les extrémités des moustaches (ex. « Les moustaches s’étendent jusqu’aux valeurs observées les plus extrêmes situées dans la limite de $1{,}5 \times \text{IQR}$ ») ?
- Spécification claire de la métrique centrale : La présence de la ligne médiane est-elle expressément mentionnée, et si une seconde marque indique la moyenne arithmétique (ex. un losange rouge), ce code sémiotique est-il documenté ?
- Déclaration transparente des effectifs réels ($N$) : Le volume de participants pour chaque groupe ou condition expérimentale est-il stipulé au-dessus ou en dessous de chaque boîte sur l’axe des abscisses (ex. $N = 45$, $N = 120$) ? Si des largeurs de boîtes proportionnelles à $\sqrt{N}$ sont utilisées, la légende le mentionne-t-elle ?
- Justification des données isolées : Les points projetés au-delà des moustaches sont-ils fidèlement représentés sans masque de troncature ? Tout point supprimé de l’analyse inférentielle subséquente fait-il l’objet d’une justification explicite et transparente dans la section méthodologique du manuscrit ?
- Cohérence épistémique inférentielle : Les tests statistiques rapportés dans le texte sont-ils congruents avec l’esprit du graphique ? Si la figure met en valeur la médiane en raison d’une forte asymétrie de distribution, le corps de l’article privilégie-t-il les tests non paramétriques robustes plutôt qu’une ANOVA paramétrique discordante ?
Le respect scrupuleux de ces exigences métrologiques garantit que la boîte à moustaches remplira pleinement son office d’instrument scientifique : transformer l’opacité d’une matrice brute en une démonstration graphique transparente, robuste et reproductible de la réalité empirique.
Références
- Allen, M., Poggiali, D., Whitaker, K., Marshall, T. R., & Kievit, R. A. (2019). Raincloud plots: A multi-platform tool for robust data visualization. Wellcome Open Research, 4, 63. https://doi.org/10.12688/wellcomeopenres.15191.1
- Hintze, J. L., & Nelson, R. D. (1998). Violin plots: A box plot-density trace synergism. The American Statistician, 52(2), 181–184. https://doi.org/10.1080/00031305.1998.10480559
- Hofmann, H., Wickham, H., & Kafadar, K. (2017). Letter-value plots: Boxplots for large data. Journal of Computational and Graphical Statistics, 26(3), 469–477. https://doi.org/10.1080/10618600.2017.1305277
- McGill, R., Tukey, J. W., & Larsen, W. A. (1978). Variations of box plots. The American Statistician, 32(1), 12–16. https://doi.org/10.1080/00031305.1978.10479236
- Rousselet, G. A., Foxe, J. J., & Bolam, J. P. (2016). A few simple steps to improve the description of group results in neuroscience. European Journal of Neuroscience, 44(9), 2647–2651. https://doi.org/10.1111/ejn.13400
- Spear, M. E. (1952). Charting statistics. McGraw-Hill.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), e1002128. https://doi.org/10.1371/journal.pbio.1002128
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer.