
Au cœur de la théorie des probabilités appliquées et de la modélisation des processus stochastiques, la distribution d’Erlang occupe une place éminente et singulière. Conçue initialement pour répondre aux défis techniques et logistiques posés par l’essor des réseaux téléphoniques au début du XXe siècle, cette loi de probabilité continue s’est progressivement émancipée de son champ d’application originel pour devenir un instrument analytique universel. En reliant de manière élégante les lois continues et les processus de comptage discrets, elle offre un cadre rigoureux pour formaliser le temps requis pour accomplir une suite ordonnée d’étapes indépendantes, chacune régie par un mécanisme exponentiel sans mémoire.
D’un point de vue structural, la loi d’Erlang représente un pont fondamental entre la distribution exponentielle — dont elle constitue la somme de variables indépendantes et identiquement distribuées — et la distribution Gamma, dont elle est la restriction exacte aux paramètres de forme entiers. Cette spécificité algébrique confère à la loi d’Erlang une tractabilité analytique remarquable : là où les distributions continues arbitraires imposent des approximations numériques complexes, la distribution d’Erlang permet des résolutions explicites et exactes grâce à des sommes finies de termes poissoniens. De ce fait, elle demeure une pierre angulaire dans la modélisation des phénomènes de flux, d’attente et de dégradation.
Le présent article propose une exploration exhaustive et approfondie de la distribution d’Erlang, depuis sa genèse historique au sein des centraux téléphoniques de Copenhague jusqu’à ses utilisations les plus contemporaines en biologie mathématique, en informatique distribuée et en sciences cognitives. À travers une analyse détaillée de ses fondements analytiques, de ses propriétés statistiques, de ses dynamiques de transition et de ses protocoles d’estimation, cette synthèse académique vise à offrir une compréhension globale de ce modèle probabiliste indispensable à l’ingénieur, au statisticien et au chercheur en sciences appliquées.
1. Introduction et genèse historique de la distribution d’Erlang
1.1 Les travaux fondateurs d’Agner Krarup Erlang
L’émergence de la distribution d’Erlang est indissociable du parcours intellectuel du mathématicien et ingénieur danois Agner Krarup Erlang (1878–1929). Embauché en 1908 par la Copenhagen Telephone Company (KTAS) sous l’impulsion de son directeur Frantz Johannsen, Erlang avait pour mission de rationaliser le fonctionnement d’un réseau alors en pleine explosion technologique. Au tournant du XXe siècle, la téléphonie subissait une mutation radicale : le passage progressif de la commutation entièrement manuelle, opérée par des standardistes, vers des dispositifs électromécaniques automatisés imposait une gestion rigoureuse des goulets d’étranglement.
Confronté à l’incapacité des ingénieurs de l’époque à quantifier scientifiquement la capacité optimale des faisceaux de câbles, Erlang aborda le problème non pas sous un angle purement empirique, mais par le prisme de la physique statistique et du calcul des probabilités. Ses observations méticuleuses au sein des centraux de Copenhague lui permirent de comprendre que les appels téléphoniques ne se présentaient pas de manière déterministe ou synchrone, mais constituaient un flux d’événements aléatoires discontinus. C’est dans ce laboratoire industriel qu’il jeta les bases de ce qui allait devenir la discipline fondamentale de l’ingénierie du trafic et de la stochastique appliquée.
En formulant l’hypothèse audacieuse que les durées de communication et les intervalles inter-arrivées pouvaient être décomposés en segments élémentaires, Erlang a ouvert la voie à la formalisation mathématique de l’encombrement des lignes. Ses travaux, publiés notamment en 1909 dans son mémoire inaugural The Theory of Probabilities and Telephone Conversations, démontrèrent pour la première fois comment modéliser mathématiquement les blocages de lignes d’abonnés et déterminer avec une précision rigoureuse le compromis économique entre le coût des infrastructures et la qualité de service ressentie par les usagers.
1.2 Le problème initial de commutation et du trafic téléphonique
Le problème physique auquel Erlang était confronté résidait dans l’asymétrie structurelle entre la demande des usagers et la capacité finie des centraux téléphoniques. D’une part, les appels entrants survenaient de façon purement imprévisible au fil de la journée ; d’autre part, la durée d’occupation des circuits par les conversations variait de manière sensible d’un abonné à l’autre. Dans un tel système, si un abonné tentait d’établir une liaison alors que l’ensemble des commutateurs ou des lignes de transmission disponibles était déjà sollicité, l’appel était irrémédiablement rejeté ou perdu, générant une friction technique et commerciale majeure.
Le dimensionnement optimal des réseaux nécessitait une approche novatrice. Construire un réseau capable d’absorber la demande maximale absolue sans aucun blocage aurait exigé des investissements matériels colossaux, économiquement insoutenables pour la compagnie de téléphone. À l’inverse, sous-dimensionner les installations entraînait un taux de saturation inacceptable et un engorgement perpétuel du système. La résolution de ce dilemme résidait dans le calcul de la probabilité exacte qu’un système composé d’un nombre déterminé de circuits tombe en état de blocage sous une charge de trafic donnée.
Erlang a formalisé ce trafic en introduisant une métrique adimensionnelle, qui portera plus tard son nom : l’erlang, défini comme le produit du taux moyen d’arrivée des appels par la durée moyenne de maintien de la communication. En traduisant les flux physiques en variables stochastiques, il a opéré une rupture épistémologique majeure, substituant aux règles de pouce approximatives et à l’empirisme d’atelier une véritable théorie probabiliste du trafic des télécommunications, universellement applicable à tout système d’acheminement de requêtes.
1.3 Naissance de la théorie des files d’attente
En modélisant mathématiquement les transitions d’état d’un réseau téléphonique, Agner Krarup Erlang ne s’est pas contenté de résoudre un problème d’ingénierie locale : il a fondé une branche entièrement nouvelle des mathématiques appliquées, la théorie des files d’attente. Le cœur de sa démarche consistait à formaliser le concept d’état d’équilibre statistique, selon lequel, en régime permanent, le flux de probabilité entrant dans un état donné du système compense rigoureusement le flux de probabilité qui en sort. Ce principe fondamental de balance globale a permis d’écrire des systèmes différentiels solubles décrivant l’évolution temporelle des congestions.
De ces recherches ont émergé deux équations célèbres qui dominent encore aujourd’hui l’ingénierie des réseaux : la formule d’Erlang B, dédiée aux systèmes sans attente où tout appel rejeté est perdu (modèle à pertes), et la formule d’Erlang C, applicable aux systèmes où les requêtes excédentaires sont placées dans un registre d’attente jusqu’à la libération d’un serveur (modèle à retard). La dérivation de ces lois exigeait une modélisation fine du temps de service, conduisant Erlang à envisager des durées qui n’étaient plus seulement distribuées selon une loi exponentielle simple, mais composées de plusieurs phases de service consécutives.
Cette conceptualisation des processus stochastiques par phases a établi les bases théoriques de la recherche opérationnelle contemporaine. L’influence d’Erlang s’est étendue bien au-delà des téléphones danois : ses concepts ont inspiré les travaux de mathématiciens comme David George Kendall, Félix Pollaczek et Andreï Kolmogorov, conférant aux structures stochastiques une portée universelle qui innerve aujourd’hui l’analyse des réseaux informatiques, les chaînes logistiques mondiales et l’optimisation des services de santé.
2. Définition mathématique et fonction de densité de probabilité
2.1 Formulation analytique de la densité de probabilité
La distribution d’Erlang est une distribution de probabilité continue définie sur le demi-axe des réels positifs. Elle est caractérisée par deux paramètres fondamentaux : un paramètre de forme, traditionnellement noté k, qui doit impérativement appartenir à l’ensemble des entiers strictement positifs (k ∈ ℕ* = {1, 2, 3, …}), et un paramètre d’intensité ou de taux, noté λ, qui est un nombre réel strictement supérieur à zéro (λ ∈ ℝ+*). Dans certaines formulations d’ingénierie, on substitue au taux λ un paramètre d’échelle noté μ ou θ, avec la relation d’inversion directe μ = 1 / λ.
Pour toute variable aléatoire continue X suivant une loi d’Erlang de paramètres k et λ, que l’on note de manière canonique X ~ Erlang(k, λ), la fonction de densité de probabilité (PDF, pour Probability Density Function) s’énonce rigoureusement pour tout x ≥ 0 selon l’expression analytique suivante :
f(x; k, λ) = [ λk · xk-1 · e-λx ] / (k – 1)!
Pour toute valeur strictement négative de la variable, c’est-à-dire pour x < 0, la fonction de densité est identiquement nulle : f(x; k, λ) = 0. Le dénominateur de cette fraction fait intervenir la factorielle (k – 1)!, qui agit comme la constante de normalisation indispensable pour garantir que l’intégrale de la densité sur son domaine de définition soit rigoureusement égale à l’unité :
∫0∞ f(x; k, λ) dx = 1
2.2 Décomposition structurelle de l’expression mathématique
Une analyse attentive de la fonction de densité de probabilité d’Erlang révèle qu’elle procède de la multiplication synergique de trois composantes distinctes mais complémentaires. La première composante est le facteur de normalisation et d’intensité globale, représenté par la quantité λk / (k – 1)!. Ce terme scalaire assure la cohérence dimensionnelle de la distribution, garantissant que l’aire totale délimitée par la courbe au-dessus de l’axe des abscisses demeure invariante et égale à un, quelles que soient les valeurs attribuées à k et λ.
La deuxième composante est le terme monomial ou polynomial xk-1. Ce facteur géométrique régit le comportement de la distribution au voisinage immédiat de l’origine (lorsque x tend vers 0). Lorsque k = 1, ce terme se réduit à x0 = 1, conférant à la densité sa valeur maximale dès l’origine. En revanche, dès que k ≥ 2, le monôme s’annule en x = 0 avec un ordre de multiplicité k – 1. Cela confère à la courbe une pente nulle à l’origine dès que k ≥ 3, traduisant une latence initiale où la probabilité qu’un événement survienne de manière instantanée est infinitésimale.
La troisième composante est le facteur exponentiel décroissant e-λx. Alors que le terme polynomial tire la distribution vers le haut au fur et à mesure que x augmente, l’exponentielle négative impose un amortissement asymptotique puissant dès que x devient grand. C’est précisément l’affrontement entre la croissance polynomiale et l’extinction exponentielle qui donne à la densité d’Erlang son profil unimodal asymétrique caractéristique, culminant en un sommet unique avant de décroître doucement vers zéro à l’infini.
2.3 Interprétation stochastique : somme de variables exponentielles
L’attrait conceptuel majeur de la distribution d’Erlang réside dans son interprétation probabiliste concrète. Soit une suite de k variables aléatoires indépendantes et identiquement distribuées (i.i.d.), notées Y1, Y2, …, Yk, où chaque variable Yi suit une distribution exponentielle de paramètre d’intensité λ, ce que l’on note Yi ~ Exp(λ). Si l’on définit la variable aléatoire X comme la somme arithmétique exacte de ces k composantes :
X = ∑i=1k Yi = Y1 + Y2 + … + Yk
Alors, en vertu des propriétés de clôture des distributions sous l’opération de convolution, la variable aléatoire X suit exactement une distribution d’Erlang de paramètres k et λ. La démonstration de cette propriété s’établit par récurrence au moyen du produit de convolution des densités. Pour deux variables exponentielles indépendantes Y1 et Y2 de paramètre λ, la densité de leur somme S2 = Y1 + Y2 s’écrit :
fS2(x) = ∫0x fY1(t) · fY2(x – t) dt = ∫0x λ e-λt · λ e-λ(x – t) dt = λ2 e-λx ∫0x dt = λ2 x e-λx
Cette expression coïncide rigoureusement avec la formule d’Erlang pour k = 2 puisque (2 – 1)! = 1! = 1. En réitérant cette convolution pas à pas jusqu’à l’ordre k, l’intégration successive des puissances de t fait émerger naturellement le terme factoriel (k – 1)! au dénominateur. Ce résultat offre une intuition physique immédiate : la loi d’Erlang modélise le temps d’attente total nécessaire pour observer l’accomplissement séquentiel de k phases indépendantes et consécutives, chacune présentant un taux d’avancement constant λ.
3. Paramétrisation : rôles des paramètres de forme et d’échelle
3.1 Le paramètre de forme k et sa contrainte d’intégralité
Le paramètre k, couramment désigné sous le terme de paramètre de forme (ou shape parameter), gouverne la morphologie intrinsèque de la courbe de densité et détermine le nombre d’étapes sous-jacentes du processus physique modélisé. La condition d’appartenance de k au corps des entiers naturels non nuls constitue la frontière séparatrice formelle entre la distribution d’Erlang et la distribution Gamma plus générale. Dans le cadre d’Erlang, k ne saurait être fractionnaire ou négatif : il quantifie obligatoirement une collection discrète d’étapes stochastiques identiquement distribuées.
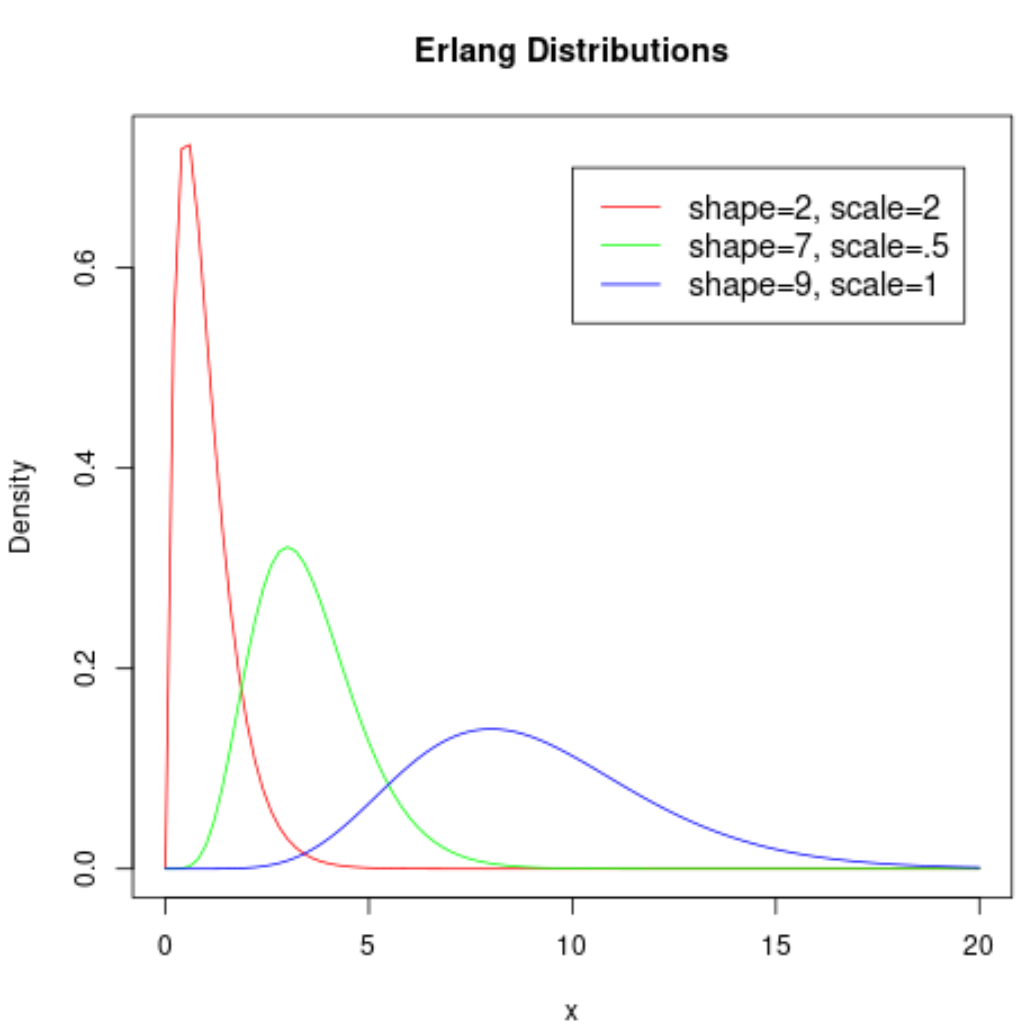
L’effet géométrique d’une incrémentation de la valeur de k est spectaculaire sur la morphologie de la distribution. Lorsque k = 1, la courbe présente une allure strictement décroissante avec une convexité continue et un pic maximal situé à l’origine. Dès que k = 2, le profil bascule vers une forme unimodale asymétrique, s’élevant depuis l’origine jusqu’à atteindre un sommet avant de redescendre. Lorsque k croît vers des valeurs élevées (par exemple k = 10, 20, 50), la distribution se symétrise progressivement, se resserre autour de sa valeur centrale et perd son étirement initial pour adopter un profil en cloche très marqué.
D’un point de vue systémique, l’augmentation de k traduit une régularisation du processus global. Plus le nombre d’étapes nécessaires pour atteindre l’événement final est grand, plus la variance relative du temps global se réduit par compensation mutuelle des fluctuations individuelles. Ce phénomène d’agrégation d’étapes élémentaires illustre de manière concrète la loi des grands nombres au sein d’un mécanisme de transmission séquentiel.
3.2 Paramètre d’échelle (μ) versus paramètre de taux (λ)
La littérature probabiliste et statistique utilise deux paramétrisations duales pour régir l’étalement horizontal de la distribution d’Erlang, une dualité qui exige une vigilance rigoureuse lors de la manipulation des équations ou de l’utilisation de progiciels statistiques. La première convention repose sur le paramètre de taux λ (souvent désigné par le terme anglais rate parameter). Ce paramètre quantifie la fréquence ou l’intensité temporelle à laquelle chaque phase élémentaire est franchie ; son unité physique est l’inverse d’un temps (par exemple, nombre de transitions par seconde, s-1).
La seconde convention recourt au paramètre d’échelle μ ou θ (scale parameter), défini comme l’inverse strict du taux :
μ = 1 / λ
Le paramètre d’échelle possède quant à lui la dimension physique d’une durée (secondes, heures, jours) et correspond exactement au temps moyen nécessaire pour achever une seule des k phases élémentaires. L’expression de la fonction de densité d’Erlang sous sa paramétrisation d’échelle s’écrit alors :
f(x; k, μ) = [ xk-1 · e-x / μ ] / [ μk · (k – 1)! ]
L’impact de ces paramètres sur la représentation géométrique est parfaitement prévisible. Une élévation du taux λ (ou une diminution symétrique de l’échelle μ) comprime horizontalement la distribution le long de l’axe temporel et en augmente corrélativement la hauteur maximale en raison de la contrainte d’intégrale unitaire. À l’inverse, une augmentation de l’échelle μ étire la courbe vers la droite, étalant la dispersion temporelle des observations et abaissant la valeur modale.
3.3 Dynamique comparative des courbes selon les variations paramétriques
L’analyse visuelle conjointe des variations de k et de λ met en lumière la remarquable plasticité de la famille des distributions d’Erlang. En ajustant adéquatement ce tandem de paramètres, l’analyste peut reproduire une gamme étendue de comportements probabilistes, allant de systèmes à forte imprévisibilité temporelle jusqu’à des mécanismes temporels quasi déterministes. Le tableau ci-dessous synthétise les comportements morphologiques en fonction des régimes paramétriques :
- Régime k = 1 (Loi exponentielle) : Dispersion maximale, absence totale de mémoire, valeur modale située en x = 0, pente initiale strictement négative égale à -λ2.
- Régime pour k modéré (k ∈ [2, 5]) : Apparition d’un maximum intérieur bien marqué, asymétrie positive forte (queue de distribution étirée vers la droite), probabilité nulle en x = 0.
- Régime pour k grand (k > 20) : Amortissement prononcé de l’asymétrie, resserrement de l’intervalle interquartile, convergence progressive de la forme globale vers une cloche gaussienne symétrique.
Le choix de privilégier l’une ou l’autre paramétrisation dépend principalement du domaine d’application. En ingénierie des télécommunications, en théorie des réseaux et dans l’étude des files d’attente markoviennes, l’usage du taux d’intensité λ est quasi systématique, car il s’intègre harmonieusement dans les matrices de générateurs infinitésimaux (matrices Q). En revanche, en fiabilité industrielle, en chronométrie expérimentale et en métrologie, l’emploi de l’échelle temporelle μ est souvent privilégié en raison de son interprétation directe comme délai moyen de réalisation.
4. Propriétés statistiques fondamentales et moments d’ordre supérieur
4.1 Espérance mathématique et mode
L’espérance mathématique, qui caractérise le centre de gravité probabiliste de la variable aléatoire, se calcule directement à partir de la propriété de linéarité de l’espérance appliquée à la somme des k variables exponentielles composantes. Sachant que l’espérance d’une variable exponentielle Yi ~ Exp(λ) est rigoureusement égale à 1 / λ, l’espérance d’une variable X ~ Erlang(k, λ) est donnée par :
E[X] = E[∑i=1k Yi] = ∑i=1k E[Yi] = k · (1 / λ) = k / λ
Sous la paramétrisation d’échelle, cette relation s’exprime simplement comme E[X] = k · μ. La dérivation du mode, défini comme la valeur de x en laquelle la fonction de densité de probabilité atteint son maximum absolu, s’obtient en annulant la dérivée première de f(x; k, λ) par rapport à x sur l’intervalle ouvert ]0, ∞[. En différenciant l’expression analytique :
d/dx [ f(x; k, λ) ] = [ λk / (k – 1)! ] · d/dx [ xk-1 e-λx ] = [ λk / (k – 1)! ] · [ (k – 1) xk-2 e-λx – λ xk-1 e-λx ]
En égalisant cette expression à zéro pour x > 0, on factorise par xk-2 e-λx, ce qui mène directement à l’équation linéaire (k – 1) – λx = 0. On en déduit l’expression exacte de la valeur modale :
Mode(X) = (k – 1) / λ = (k – 1) · μ (pour k ≥ 1)
Lorsque k = 1, le mode vaut rigoureusement 0, ce qui concorde avec la densité exponentielle décroissante. Pour toute valeur k ≥ 2, le mode est strictement positif mais demeure systématiquement inférieur à la moyenne arithmétique k / λ, ce qui démontre analytiquement l’asymétrie droite inhérente à la distribution.
4.2 Variance et indicateurs de dispersion
L’indépendance mutuelle des variables exponentielles sommé permet d’exploiter la propriété d’additivité de la variance pour les opérateurs stochastiques non corrélés. Pour une variable exponentielle élémentaire Yi, la variance théorique est donnée par Var(Yi) = 1 / λ2. Par conséquent, la variance de la distribution d’Erlang s’exprime selon la formule élégante :
Var(X) = Var(∑i=1k Yi) = ∑i=1k Var(Yi) = k / λ2 = k · μ2
L’écart-type σ(X), qui mesure l’incertitude absolue ou la dispersion des temps autour de la moyenne, est obtenu par la racine carrée de la variance, soit :
σ(X) = √k / λ = μ · √k
Un indicateur synthétique crucial en théorie des files d’attente et en fiabilité est le coefficient de variation (noté cv), défini comme le rapport sans dimension de l’écart-type sur l’espérance mathématique :
cv = σ(X) / E[X] = (√k / λ) / (k / λ) = 1 / √k
Cette relation démontre un principe d’ingénierie fondamental : le coefficient de variation de la distribution d’Erlang est strictement inférieur ou égal à 1 pour tout k ≥ 1, et il tend asymptotiquement vers zéro lorsque le nombre d’étapes k tend vers l’infini. Cela prouve mathématiquement que la distribution d’Erlang est structurellement « plus régulière » que la distribution exponentielle (pour laquelle cv = 1), ce qui en fait un outil de modélisation de choix pour les processus industriels maîtrisés présentant une variabilité résiduelle modérée.
4.3 Asymétrie et aplatissement (Skewness et Kurtosis)
Les propriétés morphologiques fines de la distribution d’Erlang sont décrites par ses moments centrés normalisés d’ordre trois et quatre. Le coefficient d’asymétrie de Fisher (skewness), noté γ1, permet de quantifier le degré de non-symétrie de la densité par rapport à sa moyenne :
γ1 = E[(X – E[X])3] / σ3(X) = (2 / √k)
Cette valeur étant strictement positive pour tout entier k fini, la distribution d’Erlang est invariablement asymétrique à droite, présentant une queue de distribution plus étirée vers les valeurs temporelles élevées. Toutefois, lorsque k devient arbitrairement grand, γ1 décroît vers zéro à un taux proportionnel à 1 / √k, traduisant une symétrisation progressive de la cloche.
Le coefficient d’aplatissement de Pearson ou kurtosis (β2) et l’excès de kurtosis (γ2 = β2 – 3) mesurent la lourdeur des queues de probabilité et l’acuité de son sommet par comparaison avec la loi normale :
β2 = E[(X – E[X])4] / σ4(X) = 3 + (6 / k)
γ2 = β2 – 3 = 6 / k
L’excès de kurtosis est strictement positif pour toute valeur finie de k, ce qui classe formellement la distribution d’Erlang parmi les lois leptokurtiques. La convergence conjointe de l’asymétrie vers 0 et de l’excès d’aplatissement vers 0 lorsque k → ∞ constitue la signature algébrique du théorème central limite : convenablement centrée et réduite, la distribution d’Erlang converge en loi vers la distribution normale standard N(0, 1) lorsque son nombre de phases devient infini.
4.4 Fonction génératrice des moments et fonction caractéristique
La fonction génératrice des moments (MGF), notée MX(t), offre un mécanisme puissant pour caractériser l’ensemble des moments d’une variable stochastique par simple dérivation analytique. Pour une variable X ~ Erlang(k, λ), elle est définie par l’espérance E[etX] sous réserve de convergence :
MX(t) = ∫0∞ etx · [ λk xk-1 e-λx / (k – 1)! ] dx = [ λk / (k – 1)! ] ∫0∞ xk-1 e-(λ – t)x dx
Cette intégrale converge de manière absolue si et seulement si la partie réelle de t vérifie la condition stricte t < λ. En effectuant le changement de variable u = (λ – t)x, on fait réapparaître la fonction gamma d’Euler Γ(k) = (k – 1)!, ce qui donne la formulation compacte :
MX(t) = ( 1 – t / λ )-k = [ λ / (λ – t) ]k
Cette factorisation sous la forme d’une puissance k-ième confirme immédiatement la structure convolutive de la loi, puisque la MGF d’une variable exponentielle isolée vaut (1 – t / λ)-1. La fonction caractéristique φX(t), quant à elle, s’obtient par prolongement analytique sur l’axe imaginaire pour tout t ∈ ℝ :
φX(t) = E[eitX] = ( 1 – it / λ )-k = [ λ / (λ – it) ]k
La fonction caractéristique présente l’avantage majeur d’être définie sur l’ensemble de la droite réelle sans restriction de convergence. Elle simplifie considérablement les calculs théoriques impliquant des combinaisons linéaires de durées d’Erlang indépendantes.
5. Fonction de répartition et calcul des probabilités cumulées
5.1 Expression analytique de la fonction de répartition
La fonction de répartition (CDF, pour Cumulative Distribution Function), notée F(x; k, λ), quantifie la probabilité cumulée que la variable aléatoire X prenne une valeur inférieure ou égale à un seuil temporel donné x. Par définition, elle résulte de l’intégration de la fonction de densité depuis l’origine jusqu’à la borne supérieure x :
F(x; k, λ) = P(X ≤ x) = ∫0x [ λk uk-1 e-λu / (k – 1)! ] du
Pour résoudre cette intégrale sans recourir à des quadratures numériques, on applique une succession de k – 1 intégrations par parties consécutives. À chaque étape, la dérivation abaisse la puissance de u tout en intégrant le terme exponentiel. Au terme de cette réduction récursive, la fonction de répartition d’Erlang se formalise sous la forme élégante d’un complément à un d’une somme finie de termes pondérés :
F(x; k, λ) = 1 – ∑n=0k-1 [ (λx)n / n! ] · e-λx (pour x ≥ 0)
Cette formule fermée revêt une importance capitale : elle élimine le besoin d’évaluer des intégrales transcendantes continues en réduisant le calcul probabiliste à l’évaluation d’une somme discrète de k termes élémentaires. Pour toute valeur négative x < 0, la fonction de répartition est identiquement nulle : F(x; k, λ) = 0.
5.2 Lien avec la fonction gamma incomplète
Sur le plan de l’analyse fonctionnelle avancée, l’intégrale définissant la fonction de répartition de la loi d’Erlang peut être exprimée à l’aide des fonctions eulériennes généralisées. En procédant au changement de variable adimensionnel s = λu dans l’intégrale de définition, on obtient :
F(x; k, λ) = [ 1 / (k – 1)! ] ∫0λx sk-1 e-s ds = γ(k, λx) / Γ(k) = P(k, λx)
Dans cette formulation, γ(k, λx) désigne la fonction gamma incomplète inférieure, définie analytiquement par l’intégrale paramétrée :
γ(a, z) = ∫0z ta-1 e-t dt
Le terme P(k, λx) = γ(k, λx) / Γ(k) correspond à la fonction gamma incomplète régularisée. Cette correspondance mathématique rigoureuse démontre que la somme finie de Poisson établie au paragraphe précédent n’est autre que l’expression développée de la fonction gamma incomplète lorsque son premier argument est un entier naturel non nul.
D’un point de vue algorithmique et informatique, cette passerelle vers les fonctions eulériennes est particulièrement précieuse. Elle permet aux bibliothèques de calcul numérique haute performance d’évaluer la fonction de répartition de distributions d’Erlang d’ordre très élevé (par exemple pour k > 500) sans subir les instabilités numériques ou les dépassements de capacité arithmétique (overflow) inhérents au calcul direct des factorielles ou des termes de Poisson exponentiels.
5.3 Fonction de survie et taux de défaillance
En ingénierie de la fiabilité, en actuariat et en analyse de survie, la fonction d’intérêt primaire est souvent la fonction de survie ou de fiabilité (notée R(x) ou S(x)), qui quantifie la probabilité qu’un système ne connaisse aucune défaillance avant l’instant x. Par complémentarité avec la fonction de répartition, elle s’écrit :
R(x; k, λ) = P(X > x) = 1 – F(x; k, λ) = ∑n=0k-1 [ (λx)n / n! ] · e-λx
Le taux de défaillance instantané (ou taux de hasard, désigné par h(x)), qui mesure le risque conditionnel d’extinction dans l’intervalle infinitésimal suivant sachant la survie jusqu’à l’instant x, est défini par le ratio entre la densité de probabilité et la fonction de survie :
h(x; k, λ) = f(x; k, λ) / R(x; k, λ) = [ λk xk-1 / (k – 1)! ] / [ ∑n=0k-1 (λx)n / n! ]
L’analyse dynamique de cette fonction h(x) révèle une rupture conceptuelle majeure :
- Lorsque k = 1, le taux de défaillance est rigoureusement constant : h(x) = λ. C’est l’expression exacte de la propriété d’amnésie (ou absence de mémoire) de la loi exponentielle.
- Dès que k ≥ 2, le taux de défaillance instantané vérifie h(0) = 0 et constitue une fonction strictement croissante et monotone de la variable temporelle x, convergeant asymptotiquement vers une valeur plafond égale à λ lorsque x → ∞ :
limx→∞ h(x; k, λ) = λ
Ce profil croissant caractérise un phénomène d’usure ou de vieillissement positif (classe IFR pour Increasing Failure Rate). Contrairement à un composant exponentiel qui ne s’use jamais, un système modélisé par une loi d’Erlang d’ordre supérieur à un accumule de la fatigue stochastique à mesure que les phases intermédiaires sont successivement franchies.
6. Relations structurales avec d’autres lois de probabilité
6.1 La distribution Gamma comme généralisation continue
La relation reliant la distribution d’Erlang à la distribution Gamma est analogue à celle reliant la factorielle standard à la fonction Gamma d’Euler. La loi Gamma est une distribution continue caractérisée par une densité identique dans sa forme analytique, mais dont le paramètre de forme — traditionnellement noté α au lieu de k — n’est plus assujetti à la contrainte d’intégralité et peut prendre n’importe quelle valeur réelle strictement positive (α ∈ ℝ+*) :
fGamma(x; α, β) = [ βα · xα-1 · e-βx ] / Γ(α)
La distribution d’Erlang est donc le cas particulier de la loi Gamma obtenu lorsque α = k ∈ ℕ*. Cette restriction aux entiers confère à la distribution d’Erlang une signification physique spécifique que la loi Gamma générale ne possède pas : celle d’une somme finie d’étapes markoviennes. Si la loi Gamma permet un ajustement statistique empirique parfois plus souple en acceptant des paramètres continus, elle perd en contrepartie la possibilité d’être interprétée directement comme une chaîne d’étapes exponentielles homogènes dans un espace d’états discret.
6.2 Identité avec la loi exponentielle
La distribution exponentielle constitue l’élément atomique de la distribution d’Erlang. Lorsque le paramètre de forme est fixé à l’unité (k = 1), la formule générale de la densité se simplifie instantanément :
f(x; 1, λ) = [ λ1 · x1-1 · e-λx ] / (1 – 1)! = [ λ · 1 · e-λx ] / 0! = λ e-λx
Cette identité algébrique rétablit la loi exponentielle standard. Ce n’est qu’exclusivement dans ce sous-cas dégénéré que la distribution d’Erlang bénéficie de la propriété d’absence de mémoire (memoryless property), formalisée par l’égalité P(X > s + t | X > s) = P(X > t). Dès que k ≥ 2, le passage d’une phase à la suivante garde la mémoire du temps écoulé, car le système s’est rapproché de l’achèvement de la dernière phase. La distribution d’Erlang peut ainsi être comprise comme un mécanisme mathématique visant à dépasser et contrôler la contrainte d’amnésie de l’exponentielle tout en conservant sa tractabilité algébrique.
6.3 Interactions avec le processus de Poisson
Il existe une dualité stochastique profonde et rigoureuse entre la distribution d’Erlang et le processus de Poisson. Considérons un processus ponctuel de Poisson homogène d’intensité constante λ, où les événements successifs surviennent de façon totalement aléatoire et indépendante dans le temps. Par construction même du processus, les intervalles temporels séparant deux événements consécutifs sont des variables aléatoires exponentielles indépendantes de paramètre λ.
En conséquence directe, le temps d’attente Tk nécessaire pour observer précisément l’occurrence du k-ième événement du processus de Poisson est la somme de k intervalles inter-arrivées exponentiels. Par définition, Tk suit donc rigoureusement une distribution d’Erlang de paramètres k et λ :
Tk ~ Erlang(k, λ)
Cette relation de réciprocité permet de démontrer la fonction de répartition d’Erlang par un simple raisonnement logique de comptage. Affirmer que le temps d’attente pour voir survenir le k-ième événement dépasse un instant donné t (c’est-à-dire Tk > t) équivaut rigoureusement à affirmer que le nombre total d’événements N(t) survenus durant l’intervalle [0, t] est strictement inférieur à k (soit au plus k – 1 événements). En exploitant la loi de Poisson de paramètre λt pour la variable de comptage N(t), on écrit immédiatement :
P(Tk > t) = P(N(t) ≤ k – 1) = ∑n=0k-1 [ (λt)n / n! ] · e-λt
Cette démonstration élégante établit l’isomorphisme parfait reliant la dynamique continue du temps d’attente d’Erlang à l’algèbre discrète du processus de comptage de Poisson.
6.4 Connexion avec la loi du Chi-deux
La distribution d’Erlang entretient également une parenté structurelle étroite avec la distribution du Chi-deux (χ2), un pivot méthodologique de la statistique inférentielle. La distribution du Chi-deux à ν degrés de liberté, notée χ2(ν), est un cas particulier de la loi Gamma où le paramètre de forme vaut α = ν / 2 et le paramètre de taux vaut β = 1 / 2 (ou échelle μ = 2).
Si l’on considère le cas où le nombre de degrés de liberté de la loi du Chi-deux est un entier pair, c’est-à-dire ν = 2k (avec k ∈ ℕ*), la distribution χ2(2k) coïncide exactement avec une distribution d’Erlang de paramètres k et d’intensité λ = 1/2 :
χ2(2k) ≡ Erlang(k, λ = 1/2)
De manière plus générale, si une variable aléatoire X suit une loi d’Erlang quelconque X ~ Erlang(k, λ), la transformation par changement d’échelle scalaire Y = 2λX produit une nouvelle variable aléatoire qui suit rigoureusement une distribution du Chi-deux à 2k degrés de liberté :
2λX ~ χ2(2k)
Cette équivalence est d’une grande portée pratique en statistique appliquée. Elle permet d’exploiter immédiatement les tables numériques hautement optimisées et les routines informatiques consacrées à la loi du Chi-deux pour construire des intervalles de confiance exacts ou réaliser des tests d’adéquation sur des paramètres de modèles erlangiens.
7. Rôle central dans la modélisation des files d’attente
7.1 La méthode des phases fictives d’Erlang
L’une des contributions méthodologiques les plus novatrices apportées par Agner Krarup Erlang à l’analyse stochastique est sans conteste la méthode des phases fictives (parfois qualifiée de méthode des étapes). Dans la théorie des files d’attente, l’hypothèse selon laquelle les temps de service ou les intervalles inter-arrivées suivent une distribution exponentielle est commode, car elle confère au système la propriété markovienne (processus sans mémoire) permettant une résolution analytique aisée via les chaînes de Markov à temps continu (CTMC).
Cependant, dans la quasi-totalité des contextes réels (télécoms, industrie, logistique), supposer un temps de service exponentiel est faux : la dispersion est trop forte et le mode en zéro est physiquement absurde. C’est ici qu’intervient le génie d’Erlang : pour modéliser une tâche dont la durée globale n’est pas exponentielle mais présente une variance plus restreinte, il propose de concevoir cette tâche comme le franchissement successif de k sous-étapes exponentielles séquentielles invisibles de l’extérieur. Dès qu’une phase s’achève, le client bascule instantanément dans la suivante ; le service complet n’est validé que lorsque la k-ième phase est purgée.
En enrichissant l’espace des états du système — c’est-à-dire en ne mémorisant plus seulement le nombre total de clients présents mais également l’indice exact de la phase en cours d’exécution — le processus stochastique global redevient strictement markovien. Cette technique d’expansion de l’espace d’états permet de convertir des systèmes non markoviens insolubles en systèmes d’équations de bilan linéaires à flux stationnaires solubles par l’algèbre matricielle classique.
7.2 L’architecture des systèmes de files d’attente M/E_k/1
Dans la notation standard de Kendall, le système M/Ek/1 désigne une file d’attente mono-serveur dotée d’un processus d’arrivée poissonnien de taux moyen Λ (la lettre M signifiant markovien), d’un temps de service modélisé selon une distribution d’Erlang à k phases de taux total μ (notée Ek), et d’un guichet unique de traitement. La durée moyenne d’un service complet est 1 / μ, et l’intensité de trafic est caractérisée par le taux d’occupation ρ = Λ / μ < 1 pour garantir la stabilité de la file.
L’utilisation de la distribution d’Erlang à k phases pour modéliser le temps de service exerce un impact bénéfique mesurable sur la performance du système. En vertu de la célèbre formule de Pollaczek-Khintchine, la longueur moyenne de la file d’attente Lq (nombre moyen de clients en attente avant accès au serveur) s’exprime en fonction du coefficient de variation cv du temps de service :
Lq = [ ρ2 · (1 + cv2) ] / [ 2 · (1 – ρ) ]
Comme démontré précédemment, pour une distribution d’Erlang, nous avons cv2 = 1 / k. En injectant cette relation dans la formule de Pollaczek-Khintchine, la formule devient :
Lq = [ ρ2 / (2(1 – ρ)) ] · [ 1 + 1/k ] = [ ρ2 · (k + 1) ] / [ 2k · (1 – ρ) ]
Cette équation illustre mathématiquement l’influence de la régularité du service sur la congestion du système. Dans une file purement exponentielle M/M/1 (équivalente à k = 1), le terme multiplicatif vaut (1 + 1)/2 = 1. En augmentant la valeur de k, le terme (k + 1) / (2k) décroît de manière monotone pour converger vers 1/2 lorsque k → ∞ (correspondant au système déterministe M/D/1). Ainsi, en substituant un service d’Erlang d’ordre élevé à un service exponentiel, on parvient à réduire de moitié la taille moyenne de la file d’attente et le temps d’attente des requêtes sans modifier le débit nominal du serveur.
7.3 Systèmes à arrivées erlangiennes E_k/M/1
À l’inverse des systèmes précédents, la file Ek/M/1 modélise une configuration où les temps séparant deux arrivées successives de clients obéissent à une distribution d’Erlang à k phases, tandis que la durée de service au guichet demeure purement exponentielle. Ce modèle intervient fréquemment dans les processus manufacturiers ou les systèmes logistiques où les pièces ou usagers n’arrivent pas de manière totalement erratique, mais ont préalablement franchi une succession de k postes de conditionnement ou de contrôle qui régulent et lissent leur flux.
L’analyse stochastique du système Ek/M/1 repose sur l’introduction d’un processus de Markov semi-régénératif. L’écriture des équations aux différences régissant les probabilités d’état stationnaires immédiatement avant l’arrivée d’un client montre que la distribution géométrique stationnaire dépend d’une racine unique r0 comprise strictement entre 0 et 1, solution de l’équation implicite caractéristique :
r = [ λ / (λ + μ(1 – r)) ]k
La présence du mécanisme d’arrivée erlangien atténue considérablement l’apparition de grappes d’arrivées (ou bursts). Par rapport à un processus de Poisson classique, les arrivées erlangiennes sont plus espacées de façon régulière dans le temps, ce qui diminue drastiquement la probabilité qu’une surtension instantanée sature le serveur d’attente, améliorant ainsi la résilience globale du réseau.
8. Applications en psychologie cognitive et modélisation comportementale
8.1 Chronométrie mentale et temps de réaction humaine
L’une des transpositions disciplinaires les plus fascinantes de la distribution d’Erlang concerne le champ de la psychologie expérimentale et de la chronométrie cognitive. Dès les années 1960, des chercheurs en neurosciences cognitives ont cherché à formaliser la distribution statistique des temps de réaction (TR) humains lors de tâches perceptives ou décisionnelles simples et complexes. Les enregistrements chronométriques montrent invariablement une courbe asymétrique à queue droite que la loi normale échoue systématiquement à décrire.
Dans ce contexte, la distribution d’Erlang fournit une analogie théorique puissante : l’hypothèse du traitement séquentiel par étapes. Selon ce modèle neuronal, la réponse motrice finale consécutive à l’apparition d’un stimulus sensoriel n’est pas un processus continu et indivisible, mais requiert l’exécution ordonnée d’un nombre entier k d’étapes de traitement neurocognitif indépendantes. Ces étapes englobent successivement :
- La transduction sensorielle périphérique (rétinienne ou cochléaire).
- Le relais thalamique et l’activation des aires corticales primaires.
- La catégorisation cognitive du stimulus au sein du cortex associatif.
- La sélection programmatique de la réponse comportementale adéquate.
- La commande motrice descendante et la latence neuromusculaire périphérique.
Si chacune de ces micro-étapes cérébrales possède une durée aléatoire distribuée selon une loi exponentielle de taux moyen homogène λ, le temps de réaction global résultant correspond avec une remarquable fidélité à une distribution d’Erlang à k phases. L’ajustement empirique de cette loi sur des cohortes de sujets permet ainsi d’inférer statistiquement le nombre probable de relais neuronaux impliqués dans la chaîne de traitement.
8.2 Modélisation de l’attention et des processus décisionnels
Dans les paradigmes contemporains de prise de décision rapide, comme le modèle de diffusion ou les modèles d’accumulation de preuves stochastiques (race models), la distribution d’Erlang est fréquemment mobilisée pour représenter la dynamique temporelle de franchissement des barrières attentionnelles. Lorsqu’un sujet humain doit discriminer deux alternatives perceptives conflictuelles, son cortex fronto-pariétal accumule séquentiellement des paquets d’informations neuronales (quanta d’évidence) jusqu’à dépasser un seuil critique d’activation.
Si l’on postule que chaque incrément informationnel élémentaire survient selon un processus de Poisson indépendant, le délai requis pour collecter le quota de k indices nécessaires pour arrêter définitivement la décision suit une distribution d’Erlang. Cette approche permet de modéliser avec élégance la variabilité intra-individuelle des temps de réponse : sous contrainte temporelle forte ou en situation de fatigue cognitive, le paramètre k reflète le niveau d’exigence probatoire fixé par le sujet, permettant de quantifier le compromis classique entre vitesse d’exécution et exactitude de la décision (speed-accuracy tradeoff).
8.3 Psychologie ergonomique et perception de l’attente
Au-delà de la chronométrie mentale fondamentale, la distribution d’Erlang trouve une application opérationnelle déterminante en psychologie ergonomique et dans la conception de l’expérience utilisateur (UX design). Des études comportementales approfondies ont démontré que l’anxiété, le stress cognitif et l’insatisfaction subjective ressentis par un utilisateur ou un usager lors d’une attente ne sont pas corrélés uniquement à la durée brute moyenne de cette attente, mais dépendent de façon prépondérante de sa variance perçue.
Un service caractérisé par un temps distribué selon une loi exponentielle (k = 1) génère un sentiment d’imprévisibilité et d’injustice temporelle en raison de sa queue lourde et de ses fluctuations chaotiques. En revanche, un service articulé selon une distribution d’Erlang de paramètre k élevé (par exemple k ≥ 8) présente une variance contractée qui confère à l’utilisateur un sentiment de prévisibilité rassurante. En ergonomie logicielle et dans l’ingénierie des services marchands, segmenter une attente globale en sous-phases visibles (barres de progression découpées en étapes logiques) permet de modifier la perception temporelle de l’opérateur en alignant l’expérience sur la dynamique d’une distribution d’Erlang maîtrisée.
9. Méthodes d’estimation statistique des paramètres
9.1 Estimation par la méthode des moments
L’estimation des paramètres k et λ à partir d’un échantillon empirique d’observations indépendantes x1, x2, …, xn constitue une problématique statistique classique mais spécifique en raison de la contrainte d’intégralité pesant sur k. La méthode des moments repose sur l’égalisation des moments théoriques de premier et second ordre avec leurs homologues empiriques calculés sur l’échantillon :
Moyenne empirique : x̄ = (1 / n) ∑i=1n xi
Variance empirique : s2 = [ 1 / (n – 1) ] ∑i=1n (xi – x̄)2
En exploitant les équations théoriques démontrées au paragraphe 4, nous établissons le système d’égalités :
E[X] = k / λ = x̄ et Var(X) = k / λ2 = s2
En divisant le carré de l’espérance par la variance, on isole le paramètre de forme k, puis on en déduit le taux λ :
k̃ = (x̄)2 / s2
λ̃ = x̄ / s2
Cependant, dans la quasi-totalité des contextes réels, le ratio empirique (x̄)2 / s2 donne un nombre réel fractionnaire non entier. Pour respecter le cadre formel de la distribution d’Erlang, il est indispensable de contraindre l’estimateur de k à l’ensemble des entiers naturels. La pratique canonique consiste à arrondir la valeur brute à l’entier le plus proche :
k̂ = max( 1, round( (x̄)2 / s2 ) )
Une fois cet entier k̂ fixé, on réajuste l’estimateur du paramètre de taux pour conserver l’exactitude de la moyenne observée : λ̂ = k̂ / x̄. Bien que simple et rapide à implémenter, cette méthode présente un biais pour les échantillons de petite taille.
9.2 Estimation par le maximum de vraisemblance
La méthode du maximum de vraisemblance (MLE) fournit des estimateurs asymptotiquement efficaces et non biaisés. Pour un échantillon de n réalisations indépendantes X = {x1, …, xn}, la fonction de vraisemblance conjointe s’écrit comme le produit des densités individuelles :
L(k, λ | X) = ∏i=1n [ λk xik-1 e-λxi / (k – 1)! ] = [ λnk / ((k – 1)!)n ] · ( ∏i=1n xi )k-1 · exp( -λ ∑i=1n xi )
Le passage au logarithme népérien permet d’obtenir la fonction de log-vraisemblance (ln L) :
ln L(k, λ) = n · k · ln(λ) – n · ln((k – 1)!) + (k – 1) ∑i=1n ln(xi) – λ ∑i=1n xi
Pour maximiser cette fonction, on examine en premier lieu la dérivée partielle par rapport au paramètre continu λ en supposant k temporairement fixé :
∂ ln L / ∂λ = (n · k / λ) – ∑i=1n xi = 0 ⇒ λ̂(k) = n · k / ∑i=1n xi = k / x̄
Ce résultat remarquable montre que pour toute valeur discrète de k, l’estimateur optimal du taux λ est strictement proportionnel à k divisé par la moyenne arithmétique. En réinjectant cette expression conditionnelle λ̂(k) dans la log-vraisemblance, on obtient la fonction de log-vraisemblance profilée ne dépendant plus que du paramètre entier k :
ln Lprof(k) = n · k · ln(k / x̄) – n · ln((k – 1)!) + (k – 1) ∑i=1n ln(xi) – n · k
En raison de la nature discrète de k ∈ {1, 2, 3, …}, la maximisation finale ne peut s’effectuer par annulation d’un gradient continu. On recourt donc à un algorithme de recherche par balayage séquentiel (grid search ou recherche linéaire) sur les entiers successifs k = 1, 2, 3, … jusqu’à observer une stricte diminution de la log-vraisemblance profilée, garantissant ainsi l’obtention du maximum global.
9.3 Approches bayésiennes et inférence moderne
L’inférence statistique bayésienne aborde l’estimation des paramètres de la distribution d’Erlang en traitant k et λ comme des variables aléatoires dotées de distributions a priori. Pour le paramètre d’intensité λ, la famille conjuguée naturelle (à k fixé) est constituée par la distribution Gamma :
λ ~ Gamma(α0, β0)
Grâce à la propriété de conjugaison algébrique, la distribution a posteriori conditionnelle de λ sachant les données X et sachant k est également une distribution Gamma actualisée :
p(λ | X, k) ~ Gamma( α0 + n · k, β0 + ∑i=1n xi )
Pour le paramètre de forme discret k, on lui assigne généralement une loi a priori non informative ou discrète uniforme bornée sur un intervalle réaliste [1, Kmax], ou encore une loi de Poisson tronquée. L’échantillonnage de la distribution conjointe a posteriori p(k, λ | X) ne pouvant être résolu analytiquement sous forme fermée, on déploie des algorithmes d’échantillonnage par chaînes de Markov Monte-Carlo (MCMC), tels que l’échantillonneur de Gibbs combiné à un pas de Metropolis-Hastings pour le paramètre discret k.
Cette méthodologie bayésienne présente des atouts considérables lorsque l’on manipule des données éparses ou des échantillons de très faible effectif (par exemple lors de l’étude d’accidents industriels rares), car elle intègre l’incertitude épistémique sur les paramètres et permet d’éviter les surajustements fréquents des méthodes fréquentistes.
10. Simulation numérique et génération de variables aléatoires
10.1 Méthode par sommation de variables exponentielles
La génération numérique de nombres pseudo-aléatoires distribués selon une loi d’Erlang s’appuie directement sur son théorème constructif fondamental. Pour simuler une variable aléatoire exponentielle de paramètre λ, l’algorithme standard utilise la méthode de la transformée inverse. Si U est une variable aléatoire uniformément distribuée sur l’intervalle ouvert ]0, 1[, alors la variable Y = -ln(U) / λ suit exactement une distribution exponentielle Exp(λ).
Pour engendrer une réalisation stochastique X d’une distribution d’Erlang de paramètres k et λ, il suffit donc d’additionner k réalisations exponentielles indépendantes :
X = ∑i=1k [ -ln(Ui) / λ ] = – (1 / λ) · ∑i=1k ln(Ui)
En exploitant les propriétés fondamentales du logarithme selon lesquelles la somme de logarithmes est égale au logarithme du produit, on optimise la formulation mathématique pour n’évaluer qu’un seul appel à la fonction transcendante ln() :
X = – (1 / λ) · ln( ∏i=1k Ui )
Cet algorithme direct de multiplication de k variables uniformes indépendantes est élégant, exact et d’une remarquable simplicité logique. Néanmoins, sa complexité temporelle est proportionnelle à O(k), ce qui signifie que le temps de calcul augmente de manière linéaire avec k. En outre, pour des valeurs de k particulièrement élevées (par exemple k > 100), le produit répété de nombres strictement compris entre 0 et 1 peut générer un sous-dépassement arithmétique (underflow), imposant de scinder le calcul ou de basculer vers des générateurs généraux de lois Gamma basés sur la méthode du rejet de Marsaglia et Tsang.
10.2 Implémentation algorithmique dans les environnements scientifiques
Les environnements modernes de calcul scientifique intègrent des modules hautement optimisés pour manipuler et générer des variables de distribution d’Erlang. Dans l’écosystème Python, la bibliothèque scientifique SciPy propose la classe spécialisée scipy.stats.erlang. Il convient de souligner que dans cette implémentation, la classe hérite directement de la loi Gamma, avec l’exigence explicite que le paramètre de forme soit un entier strict. Le paramétrage utilise l’argument a = k pour la forme et scale = 1 / λ pour l’échelle temporelle.
Dans l’environnement de programmation R, très prisé en bio-statistique et en actuariat, la loi d’Erlang ne dispose pas systématiquement d’un préfixe dédié propre (comme rerlang) mais s’exécute nativement et rigoureusement via les fonctions canoniques de la famille Gamma : dgamma(x, shape = k, rate = lambda) pour la densité et rgamma(n, shape = k, scale = 1 / lambda) pour la génération d’échantillons stochastiques, en contraignant explicitement la valeur attribuée au paramètre shape à un entier naturel.
Sous la plateforme logicielle MATLAB, la fonction gamrnd(k, 1/lambda) est couramment sollicitée pour produire des réalisations stochastiques vectorisées. Sur le plan des benchmarks de performance, les générateurs modernes implémentent des optimisations de bas niveau en C ou Fortran exploitant des registres vectoriels SIMD, permettant la génération simultanée de millions de réalisations erlangiennes en quelques fractions de seconde, même pour des structures de réseaux complexes.
10.3 Protocoles de validation et tests d’adéquation
Une fois les variables stochastiques générées ou ajustées sur des jeux de données réels, il est scientifiquement impératif de valider la conformité distributionnelle par des tests d’adéquation statistique rigoureux. Le test non paramétrique de Kolmogorov-Smirnov (K-S) est fréquemment déployé pour comparer la fonction de répartition empirique Fn(x) à la fonction de répartition théorique F(x; k, λ). La statistique de test Dn est définie par le supremum absolu des écarts :
Dn = supx | Fn(x) – F(x; k, λ) |
Si la valeur critique calculée est inférieure au seuil tabulé pour un niveau de signification α donné (habituellement α = 0,05), l’hypothèse nulle d’adéquation à la loi d’Erlang ne peut être rejetée. Le test d’adéquation du Chi-deux de Pearson offre une méthode alternative particulièrement robuste pour les effectifs importants, consistant à partitionner le domaine temporel en classes disjointes et à comparer les fréquences observées aux effectifs attendus calculés à partir de la fonction de répartition de la loi d’Erlang.
Enfin, sur le plan heuristique et qualitatif, le protocole diagnostique repose sur le tracé du diagramme quantile-quantile (Q-Q plot). Ce graphique projette les quantiles empiriques de l’échantillon observé en fonction des quantiles théoriques calculés pour la loi d’Erlang de paramètres estimés. Un alignement linéaire rectiligne des points le long de la bissectrice confirme l’adéquation du modèle, tandis que toute déviation systématique au niveau des extrémités graphiques signale des queues de distribution divergentes nécessitant une révision paramétrique.
11. Applications interdisciplinaires avancées
11.1 Ingénierie moderne des réseaux informatiques et télécoms
Bien que née dans les infrastructures téléphoniques à circuits commutés du XXe siècle, la distribution d’Erlang s’est imposée comme un concept fondamental au sein des architectures numériques contemporaines. Dans les réseaux de commutation par paquets, la transmission d’un datagramme IP à travers une chaîne séquentielle de commutateurs et de routeurs Internet implique la traversée ordonnée de plusieurs tampons mémoire (buffers) et opérations de routage. Chaque passage dans un nœud intermédiaire générant un temps de latence, la distribution du délai d’acheminement de bout en bout (jitter et latence totale) s’ajuste parfaitement à une loi d’Erlang d’ordre k, où k matérialise le nombre de sauts de routage (hop count).
Dans le domaine des télécommunications mobiles de cinquième et sixième génération (5G et 6G), la gestion dynamique de la bande passante sous contrainte stricte de Quality of Service (QoS) et d’ultra-fiabilité (protocoles URLLC pour Ultra-Reliable and Low-Latency Communications) exploite des modèles d’Erlang pour dimensionner le partitionnement virtuel des réseaux (network slicing). Les algorithmes d’admission d’appels et d’allocation spectrale calculent en temps réel les probabilités de blocage instantané et de mise en mémoire tampon des trames de données à l’aide des structures erlangiennes étendues.
De même, au sein des architectures en grappe (clusters de serveurs, architectures micro-services et informatique en nuage), le traitement d’une requête web complexe est couramment découpé en un pipeline séquentiel d’appels RPC (Remote Procedure Calls) non parallèles. La distribution d’Erlang sert alors à caractériser le temps global de complétion des requêtes distribuées et à détecter les micro-pannes induites par la dérive temporelle de serveurs applicatifs spécifiques.
11.2 Biologie mathématique et modélisation épidémiologique
En épidémiologie théorique et en santé publique computationnelle, la distribution d’Erlang joue un rôle stratégique pour dépasser les simplifications irréalistes des modèles compartimentaux classiques de type SEIR (Sensible – Exposé – Infecté – Rétabli). Dans le modèle historique de Kermack et McKendrick, le transfert des individus d’un compartiment à l’autre repose sur des équations différentielles linéaires impliquant des temps de séjour distribués selon une loi exponentielle.
Or, en réalité biologique, la période d’incubation d’un agent pathogène (virus ou bactérie) et la durée de la période infectieuse ne présentent jamais un taux d’élimination maximal au premier jour de la contamination : elles exigent une phase de prolifération intra-hôte minimale avant l’apparition des symptômes ou de la contagion. En remplaçant un compartiment d’exposition unique par une chaîne de k sous-compartiments consécutifs E1, E2, …, Ek, le temps d’incubation global suit automatiquement une distribution d’Erlang à k phases :
dE1/dt = β S I – k σ E1
dEj/dt = k σ Ej-1 – k σ Ej (pour j = 2, …, k)
Cette approche, validée expérimentalement lors de l’analyse des épidémies d’Ebola, de la grippe H1N1 et de la COVID-19, permet d’ajuster avec une fidélité nettement supérieure le temps d’incubation moyen et son étalement statistique sans quitter le cadre commode des systèmes d’équations différentielles ordinaires. Les projections sanitaires et l’évaluation de l’efficacité des mesures de mise en quarantaine gagnent ainsi en rigueur et en représentativité terrain.
À l’échelle cellulaire et moléculaire, la distribution d’Erlang est également appliquée à la modélisation de la cinétique enzymatique et du cycle de division cellulaire. Le passage d’une cellule par les phases successives de l’interphase (G1, S, G2) avant la mitose M nécessite l’accumulation d’un ensemble de déclencheurs biochimiques, chaque transition enzymatique élémentaire agissant comme une étape exponentielle au sein d’une distribution d’Erlang macroscopique.
11.3 Gestion des flux de patients en milieu hospitalier
L’optimisation des parcours de soins et de l’ingénierie hospitalière constitue un terrain d’élection pour la distribution d’Erlang. Les flux de patients se présentant dans les services d’urgence ou programmés pour des interventions chirurgicales au sein des blocs opératoires traversent des filières hautement normées comprenant un protocole médical strict découpé en phases :
- Accueil, enregistrement médico-administratif et tri initial par l’infirmière organisatrice (IOA).
- Examen médical et anamnèse initiale par le médecin urgentiste.
- Examens complémentaires d’imagerie médicale (scanner, radiographie, échographie) et analyses biologiques.
- Intervention thérapeutique, sédation ou pose de plâtre.
- Période d’observation clinique et organisation de la sortie ou du transfert vers un lit d’hospitalisation.
La durée totale de prise en charge d’un patient présente par conséquent une variance réduite par rapport à un simple processus exponentiel et s’ajuste avec une pertinence mathématique éprouvée à une loi d’Erlang à plusieurs phases. La modélisation conjointe de ces flux via des réseaux de files d’attente à serveurs multiples (modèles d’Erlang avec files d’attente étendues) permet aux gestionnaires de santé de calculer le taux de rotation optimal des brancards, de minimiser les temps de souffrance des patients en salle d’attente et de dimensionner de façon optimale les plannings du personnel médical soignant face aux variations de l’afflux quotidien.
12. Limites méthodologiques et distributions alternatives
12.1 Contraintes liées à la rigidité du paramètre entier
Malgré sa robustesse conceptuelle et son élégance analytique, la distribution d’Erlang souffre de limitations méthodologiques intrinsèques qu’un statisticien se doit de reconnaître. La première contrainte réside dans la discontinuité stricte du paramètre de forme k ∈ ℕ*. Alors que la variabilité d’un jeu de données empiriques issues du monde réel peut suggérer un paramètre de forme optimal de k = 2,43, la loi d’Erlang oblige l’analyste à un arbitrage artificiel en choisissant soit k = 2, soit k = 3.
Cette discontinuité pose un verrou mathématique majeur lors de la mise en œuvre d’algorithmes d’optimisation basés sur les gradients (comme la descente de gradient stochastique ou les algorithmes de quasi-Newton de type BFGS). L’absence de dérivabilité de la fonction de vraisemblance par rapport à l’entier k interdit toute optimisation conjointe différentiable directe, compliquant l’intégration de la distribution d’Erlang au sein d’architectures d’apprentissage automatique moderne ou de réseaux de neurones probabilistes.
De surcroît, le couplage structurel imposé par la distribution entre l’espérance E[X] = k / λ et la variance Var(X) = k / λ2 restreint le champ de ses applications possibles. Dans la loi d’Erlang, le coefficient de variation au carré vaut rigoureusement cv2 = 1 / k, ce qui signifie que le ratio de la variance sur le carré de la moyenne ne peut prendre que des fractions discrètes bien précises : 1, 1/2, 1/3, 1/4, etc. Dès lors qu’un système physique présente un comportement sur-dispersé (overdispersion), caractérisé par un coefficient de variation supérieur à un (cv > 1), la distribution d’Erlang est structurellement incapable de modéliser le phénomène.
12.2 Comparaison avec la loi Gamma générale et la loi de Weibull
Face aux contraintes inhérentes à la loi d’Erlang, les statisticiens recourent fréquemment à deux familles paramétriques concurrentes : la distribution Gamma générale et la distribution de Weibull. La distribution Gamma, en s’affranchissant de l’obligation d’un paramètre entier, élimine l’artéfact de troncature et autorise un lissage parfait des données tout en autorisant des méthodes d’ajustement différentiables globales.
La distribution de Weibull, quant à elle, s’appuie sur une formulation analytique différente de sa fonction de répartition :
FWeibull(x; k, λ) = 1 – e-(x / λ)k
La force de la loi de Weibull réside dans la flexibilité exceptionnelle de sa fonction de taux de défaillance instantané h(x). Alors que le taux de défaillance de la distribution d’Erlang est contraint de débuter à 0 et d’atteindre asymptotiquement un palier constant λ, la loi de Weibull permet de modéliser des taux de défaillance en loi de puissance pure : strictement décroissants pour k < 1 (mortalité infantile précoce), strictement constants pour k = 1, ou croissant de manière exponentielle sans plafonnement pour k > 1 (vieillissement accéléré ou fatigue mécanique structurelle).
L’arbitrage entre ces lois repose donc sur un compromis explicite : si le phénomène étudié procède manifestement d’une chaîne causale d’événements discrets successifs et doit être incorporé dans une chaîne de Markov, la distribution d’Erlang s’impose par sa cohérence mécanique. En revanche, pour des études purement phénomenologiques de survie de matériaux où le comportement aux extrêmes prévaut, la distribution de Weibull surpasse fréquemment le modèle erlangien.
12.3 Critères rigoureux de sélection de modèle
Afin de déterminer scientifiquement si l’utilisation d’une distribution d’Erlang est préférable à celle d’une loi Gamma générale, d’une loi de Weibull ou d’une loi log-normale, le statisticien applique des protocoles d’évaluation formels fondés sur la théorie de l’information. Les deux métriques les plus couramment mobilisées sont le critère d’information d’Akaike (AIC) et le critère d’information bayésien (BIC) :
AIC = 2p – 2 ln(L̂)
BIC = p · ln(n) – 2 ln(L̂)
Dans ces expressions mathématiques, p représente le nombre de paramètres libres estimés dans le modèle, n la taille effective de l’échantillon empirique, et ln(L̂) la valeur maximale de la log-vraisemblance obtenue à convergence. Ces critères opèrent un arbitrage quantitatif objectif entre la qualité de l’ajustement statistique sur les données (mesurée par la vraisemblance) et la complexité structurelle du modèle (pénalisée par le nombre de paramètres p).
Dans le cas d’une comparaison entre une distribution d’Erlang et une distribution Gamma continue, la loi d’Erlang bénéficie souvent d’un traitement avantageux : si la valeur estimée du paramètre continu de la loi Gamma est statistiquement indiscernable d’un entier naturel, le principe de parcimonie scientifique (ou rasoir d’Ockham) conduit à retenir le modèle d’Erlang en raison de sa plus grande simplicité théorique et de son interprétabilité physique directe dans l’analyse des systèmes complexes.
Références
Aalen, O. O., & Gjessing, H. K. (2001). Understanding the shape of the hazard rate: A process point of view. Statistical Science, 16(1), 1-14. https://doi.org/10.1214/ss/1009213285
Asmussen, S. (2003). Applied probability and queues (2nd ed.). Springer. https://doi.org/10.1007/b97237
Brockmeyer, E., Halstrøm, H. L., & Jensen, A. (1948). The life and works of A. K. Erlang. Copenhagen Telephone Company.
Cox, D. R. (1955). A use of complex probabilities in the theory of stochastic processes. Mathematical Proceedings of the Cambridge Philosophical Society, 51(2), 313-319. https://doi.org/10.1017/S030500410003022X
Erlang, A. K. (1909). The theory of probabilities and telephone conversations. Nyt Tidsskrift for Matematik B, 20, 33-39.
Erlang, A. K. (1917). Solution of some problems in the theory of probabilities of significance in automatic telephone exchanges. Elektroteknikeren, 13, 5-13.
Gross, D., Shortle, J. F., Thompson, J. M., & Harris, C. M. (2008). Fundamentals of queueing theory (4th ed.). John Wiley & Sons. https://doi.org/10.1002/9780470377048
Johnson, N. L., Kemp, A. W., & Kotz, S. (2005). Univariate discrete distributions (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471715816
Kendall, D. G. (1953). Stochastic processes occurring in the theory of queues and their analysis by the method of the imbedded Markov chain. The Annals of Mathematical Statistics, 24(3), 338-354. https://doi.org/10.1214/aoms/1177728975
Kleinrock, L. (1975). Queueing systems, Volume 1: Theory. John Wiley & Sons.
Luce, R. D. (1986). Response times: Their role in inferring elementary mental organization. Oxford University Press.
Nelson, R. (1995). Probability, stochastic processes, and queueing theory: The mathematics of computer performance modeling. Springer-Verlag. https://doi.org/10.1007/978-1-4757-2430-1
Ross, S. M. (2014). Introduction to probability models (11th ed.). Academic Press. https://doi.org/10.1016/C2012-0-06283-0
Tijms, H. C. (2003). A first course in stochastic models. John Wiley & Sons. https://doi.org/10.1002/047001363X