
Dans le champ contemporain de la science des données, l’analyse exploratoire constitue la pierre angulaire de toute démarche scientifique rigoureuse. Face à la prolifération de structures tabulaires multidimensionnelles et hétérogènes, le chercheur ou l’analyste ne peut se contenter d’inspections purement matricielles ou de calculs d’agrégats globaux décontextualisés. La véritable compréhension des phénomènes sous-jacents, qu’ils soient de nature économique, épidémiologique, industrielle ou sociologique, émerge de la capacité à disséquer l’information selon des sous-ensembles cohérents et à projeter visuellement ces partitions pour en révéler les dynamiques structurelles. L’environnement Python s’est imposé comme l’écosystème de référence pour cette typologie d’investigation, principalement grâce à la bibliothèque Pandas, véritable standard de fait pour la manipulation de données relationnelles en mémoire.
Au sein de cette bibliothèque, l’articulation entre l’opérateur de partitionnement statistique et les interfaces graphiques représente l’une des synergies computationnelles les plus puissantes. La conjonction de la primitive d’agrégation groupée avec les mécanismes de rendu visuel permet d’abstraire la complexité inhérente à l’itération manuelle, à l’extraction de sous-matrices et à la configuration unitaire d’éléments graphiques. Ce couplage syntaxique élégant transforme une opération d’ingénierie logicielle fastidieuse en un flux déclaratif fluide, permettant au praticien de formuler des hypothèses et de les confronter visuellement en une seule ligne d’instruction. L’objectif de cet article est d’exposer de manière exhaustive, systématique et académique la théorie et la mise en œuvre pratique de l’agrégation conjointe au traçage graphique au sein de Pandas.
À travers ce traité méthodologique, nous explorerons en profondeur l’ensemble du cycle de vie analytique lié aux opérations groupées. Nous aborderons la décomposition conceptuelle du triptyque canonique de transformation des données, analyserons la mécanique de l’évaluation paresseuse et détaillerons les deux grandes approches architecturales de visualisation : la superposition sur un repère cartésien partagé et la décomposition modulaire en sous-graphiques disjoints. Nous examinerons également les considérations relatives à l’empreinte mémoire, aux discontinuités temporelles, à la personnalisation de bas niveau sous l’interface Matplotlib, ainsi qu’aux stratégies d’optimisation indispensables au traitement d’échantillons massifs. Ce guide offre un cadre théorique et technique complet pour convertir des données brutes en visualisations explicatives et rigoureuses.
1. Introduction aux mécanismes d’agrégation et de visualisation avec Pandas
1.1 Importance de l’analyse exploratoire visuelle en science des données
L’analyse exploratoire des données, conceptualisée par John Tukey à la fin des années 1970, postule que l’analyse statistique ne doit pas être subordonnée de manière prématurée à des tests d’hypothèses rigides, mais doit d’abord consister en une recherche ouverte de régularités, d’asymétries, d’incohérences structurelles et d’anomalies. Dans ce paradigme, la visualisation n’est pas un simple artifice cosmétique destiné à la communication des résultats finaux, mais un instrument cognitif primaire d’investigation. La projection géométrique d’un ensemble de variables permet à l’œil humain d’appréhender instantanément des distributions multivariées, des non-linéarités complexes et des points d’inflexion que des métriques sommaires, telles que la moyenne empirique ou l’écart-type d’échantillon, dissimulent fréquemment sous des valeurs identiques, un paradoxe brillamment illustré par le célèbre quatuor d’Anscombe.
La difficulté majeure de l’analyse empirique contemporaine réside dans l’hétérogénéité des ensembles de données. Un indicateur global appliqué à l’ensemble d’une population occulte presque systématiquement des comportements diamétralement opposés au sein de sous-strates spécifiques, illustrant le redoutable paradoxe de Simpson. Dès lors, la nécessité méthodologique de synthétiser des ensembles complexes sans sacrifier la représentativité des sous-groupes impose une stratégie de partitionnement systématique. L’analyste doit être en mesure d’isoler des cohortes, d’évaluer leur cinétique propre et de comparer leurs trajectoires sans rompre la cohérence globale de l’analyse. C’est précisément à cette jonction critique que la visualisation groupée devient une exigence scientifique fondamentale.
L’intégration fluide d’un flux de travail unifié entre la manipulation tabulaire en mémoire et le rendu graphique constitue un prérequis pour maintenir l’agilité cognitive du chercheur. Lorsque l’extraction, la transformation, l’agrégation et l’affichage d’un jeu de données requièrent l’écriture de multiples boucles itératives et la gestion d’accumulateurs temporaires, le coût cognitif parasite détourne l’attention de l’analyste de l’interprétation des phénomènes réels. En fournissant une interface déclarative où la manipulation des structures de données déclenche directement la projection sur des axes graphiques, Pandas garantit une continuité opérationnelle indispensable. Cette transition sans couture de l’analyse descriptive élémentaire vers la modélisation statistique avancée pose les fondations de la détection de tendances et de l’ingénierie des variables prédictives.
1.2 Présentation des primitives groupby et plot
Au cœur de la syntaxe de manipulation de Pandas se trouvent deux opérateurs fondamentaux dont la composition engendre une expressivité analytique exceptionnelle : la méthode de partitionnement relationnel et le moteur graphique intégré. L’opérateur de groupement matérialise un moteur fonctionnel puissant capable de segmenter un tableau de données en sous-ensembles disjoints définis par les modalités d’une ou de plusieurs variables catégorielles ou ordinales. Cet opérateur ne modifie pas immédiatement la disposition physique des enregistrements en mémoire mais construit une topologie relationnelle sophistiquée qui servira de base à l’exécution ultérieure d’opérations vectorisées, garantissant ainsi une performance algorithmique de premier ordre lors des phases de traitement.
Concomitamment, la méthode de visualisation graphique de Pandas sert de passerelle d’abstraction de haut niveau construite directement au-dessus de la bibliothèque Matplotlib. Au lieu d’obliger l’utilisateur à instancier manuellement des figures, à allouer des objets de repères cartésiens, à convertir des séries temporelles en tableaux numériques et à formater les étiquettes typographiques une à une, Pandas encapsule ces opérations au sein d’une interface directe et cohérente. L’appel graphique hérite automatiquement des métadonnées contenues dans le tableau : le nom des colonnes devient l’étiquette des axes ou le titre des légendes, et l’index de la structure de données définit naturellement l’échelle de l’abscisse. Cette conservation du contexte sémantique tout au long du processus de tracé élimine les sources récurrentes d’erreurs d’attribution ou de décalage temporel.
La synergie syntaxique résultant de l’application successive de ces deux primitives permet de comprimer des séquences d’analyse complexes en une formulation concise et lisible. L’enchaînement des méthodes traduit directement l’intention analytique : segmenter les observations selon une clé taxonomique, isoler la variable d’intérêt métrique, puis projeter la distribution ou la série temporelle correspondante sur un support visuel configuré de façon idoine. Ce tutoriel a pour dessein méthodologique de démystifier cette articulation technique à travers des cas d’usage industriels et scientifiques typiques, qu’il s’agisse de comparer l’évolution chronologique des performances d’un catalogue de produits, d’auditer des cohortes de comportement d’utilisateurs ou d’analyser des métriques de capteurs industriels distribués.
2. Fondements théoriques du paradigme Split-Apply-Combine
2.1 Décomposition conceptuelle du triptyque de Hadley Wickham
Toute manipulation analytique rigoureuse opérée sur des données partitionnées s’inscrit dans le cadre formel du paradigme dit Split-Apply-Combine, formalisé pour la première fois par Hadley Wickham dans ses publications théoriques sur le calcul statistique distribué. Ce modèle de décomposition fonctionnelle décompose une transformation complexe en trois étapes séquentielles strictement délimitées, assurant à la fois clarté sémantique et modularité algorithmique. La compréhension intime de cette triade est indispensable pour anticiper le comportement des méthodes de tracé graphique et pour concevoir des architectures de calcul à faible empreinte computationnelle.
La première phase, qualifiée de fractionnement (Split), consiste à projeter un ensemble initial d’enregistrements dans une partition de sous-ensembles étanches en fonction des valeurs discrètes prises par un ensemble défini de clés catégorielles. Sur le plan de la théorie des ensembles, cette opération établit une relation d’équivalence où chaque classe regroupe la totalité des tuples partageant strictement la même signature de variables caractéristiques. Dans l’architecture de Pandas, ce processus ne duplique pas les données sous-jacentes de façon naïve, mais procède à la construction d’une table de hachage associant chaque clé unique à un vecteur d’entiers représentant les positions ordinales des lignes correspondantes au sein du bloc mémoire principal.
La deuxième phase, l’application (Apply), exécute une fonction opératoire indépendante et isolée sur chacun des sous-ensembles préalablement circonscrits. Cette fonction peut correspondre à une réduction d’échelle générant une valeur scalaire unique (comme le calcul d’une moyenne ou d’une variance), à une transformation conservant la dimension originelle (telle qu’une standardisation z-score intra-groupe), ou encore à un processus d’instanciation géométrique qui génère un tracé cartésien. Enfin, la phase de recombinaison (Combine) rassemble les différents artefacts produits par la phase d’application au sein d’une structure de données unifiée ou d’un canevas visuel unique. Cette recombinaison implique la résolution des dimensions résultantes, le réalignement formel des index de référence et la gestion cohérente des repères graphiques partagés ou disjoints.
L’impact de ce paradigme sur la complexité algorithmique et l’occupation de la mémoire vive est considérable. Si la fonction appliquée est purement vectorisée et s’exécute au sein des couches compilées sous-jacentes en langage C, le triptyque offre un passage à l’échelle quasi linéaire par rapport au nombre total de lignes. En revanche, si la phase d’application requiert l’instanciation de structures Python complexes pour chaque groupe unitaire ou génère des objets graphiques volumineux sans libération préalable des ressources, la consommation de mémoire vive peut croître de manière exponentielle en fonction de la cardinalité de la clé de partitionnement, provoquant d’importants goulots d’étranglement lors du traitement de gros volumes de données.
2.2 Spécificités de l’évaluation paresseuse dans les objets DataFrameGroupBy
L’une des caractéristiques fondamentales de l’architecture logicielle de Pandas réside dans le recours systématique à l’évaluation paresseuse (lazy evaluation) lors de l’instanciation des opérations de partitionnement. Lorsque l’analyste appelle la primitive de groupement sur une table de données, Pandas ne calcule aucune statistique agrégée et ne matérialise aucune sous-structure tabulaire sur le disque ou dans la mémoire vive. L’opération renvoie instantanément un objet spécialisé appartenant à la classe générique des regroupements de données. Cet objet intermédiaire agit comme un conteneur fonctionnel et différé, encapsulant la référence vers la structure source ainsi que le plan d’exécution déterminé par les clés de découpage.
À l’intérieur de cette structure interne, Pandas maintient deux composantes critiques : l’itérateur de groupes et un dictionnaire optimisé d’indices. Ce dictionnaire mappe chaque valeur de groupe unique à un tableau d’entiers pointant vers les positions physiques des lignes dans le stockage mémoire initial. L’évaluation effective des calculs est rigoureusement suspendue jusqu’au moment précis où une méthode terminale d’agrégation, de transformation ou de restitution graphique est explicitement invoquée sur cet objet. Ce mécanisme d’exécution différée empêche le gaspillage de ressources computationnelles lors de la définition de chaînes de traitement analytiques complexes composées de multiples filtres et jointures préalables.
Lorsque des commandes graphiques sont transmises directement à un tel objet de regroupement, le comportement de l’interpréteur diverge fondamentalement de celui observé lors d’une réduction scalaire classique. Alors qu’une fonction de réduction compile l’ensemble des résultats partiels en une nouvelle table de dimensions réduites, l’instruction graphique parcourt séquentiellement ou vectoriellement chacun des groupes logiques pour injecter des séries de coordonnées directement dans le sous-système de tracé de Matplotlib. Il ne s’agit plus de réduire la dimensionnalité des données vers un tableau récapitulatif, mais d’effectuer une cartographie sérielle où chaque partition est assignée à un artiste graphique particulier au sein de la scène visuelle active.
3. Préparation et structuration formelle du jeu de données expérimental
3.1 Définition de la structure tabulaire de référence
Pour illustrer de manière reproductible, rigoureuse et concrète les différentes stratégies d’agrégation et de tracé visuel, nous formalisons un cadre expérimental standardisé simulant le suivi longitudinal d’une série temporelle d’activité commerciale multicanal. Ce jeu de données synthétique mais hautement réaliste intègre trois colonnes majeures reflétant la complexité habituelle des environnements de production : une variable temporelle discrète continue, une variable catégorielle modélisant différentes gammes de produits, et une variable numérique continue mesurant le volume des ventes ou de la métrique analysée.
Sur le plan programmatique, la structure de référence s’instancie au sein d’un environnement Python via la définition explicite d’un dictionnaire de vecteurs séquentiels ensuite projeté dans un tableau Pandas. Le typage rigoureux de chaque vecteur est crucial pour prévenir toute dégradation de performance ou tout comportement erratique du moteur graphique. La variable chronologique représentant les jours d’observation est encodée sous la forme d’un entier ordinal ou d’une série d’horodatages formels. La variable décrivant les produits est instanciée sous la forme d’une chaîne de caractères explicite typée de préférence en tant que catégorie scalaire, tandis que les métriques de transaction sont stockées sous la forme de nombres à virgule flottante double précision conformes au standard IEEE 754.
Considérons un échantillon d’observations ordonnées décrivant trois segments de produits dénommés conventionnellement Alpha, Beta et Gamma, observés sur un intervalle chronologique continu de plusieurs jours consécutifs. Chaque ligne du tableau enregistre l’identifiant du jour, le label de la catégorie et le montant monétaire agrégé sur la période considérée. Avant toute manipulation analytique, une vérification rigoureuse de l’intégrité référentielle doit être opérée : confirmation formelle de l’absence de valeurs résiduelles nulles ou manquantes, vérification de l’homogénéité des types de données dans chaque colonne et validation de l’orthogonalité des facteurs temporels et catégoriels, garantissant que chaque modalité de produit dispose d’une trajectoire complète sur l’ensemble de l’horizon d’observation.
3.2 Enjeux de l’indexation dans les visualisations longitudinales
L’indexation constitue l’un des mécanismes les plus discriminants et les plus mal compris de Pandas, particulièrement lorsqu’il s’agit d’ordonnancer des représentations graphiques. Par défaut, lors de l’instanciation d’un tableau à partir d’un fichier source ou d’une structure itérative brute, un index entier implicite démarrant à zéro est automatiquement alloué. Si l’analyste déclenche une commande de tracé sans restructuration préalable de son indexation, l’interface graphique utilise mécaniquement cet index de position en tant que coordonnée d’abscisse (axe horizontal X), ce qui conduit invariablement à des visualisations incohérentes lorsque les données regroupent plusieurs entités observées aux mêmes dates de manière séquentielle entrelacée.
Pour conférer une dimension temporelle ou ordinale explicite à la visualisation, l’attribution formelle de la variable continue via la méthode d’affectation de l’index devient une étape obligatoire. En positionnant la dimension temporelle comme index principal du tableau de données, l’analyste modifie la sémantique intrinsèque de la structure : chaque ligne n’est plus simplement un enregistrement dans une liste désordonnée, mais un état du système associé à un jalon temporel précis. Lors de l’évaluation subséquente de la méthode de rendu graphique, le moteur de tracé extrait automatiquement les valeurs de cet index pour calibrer l’échelle, les graduations et les limites de l’axe des abscisses, assurant une lecture spatiale immédiatement interprétable.
La distinction entre une indexation implicite et explicite prend toute son acuité lors du traitement d’horodatages réels. Un index fondé sur des dates formelles active au sein du moteur de tracé des mécanismes spécialisés d’échantillonnage de graduations et de formatage chronologique, capables de grouper dynamiquement les repères visuels par jours, mois ou trimestres selon la résolution requise. À l’inverse, un index constitué d’entiers discrets impose un traitement arithmétique rigide qui exige une vigilance accrue quant à l’espacement des intervalles, sous peine d’induire en erreur le lecteur sur la régularité du processus observé. La configuration maîtrisée de cet axe directeur forme la condition sine qua non de toute interprétation scientifique valide.
4. Méthode 1 : Superposition de trajectoires multiples sur un axe unique
4.1 Implémentation technique via groupby().plot()
La première stratégie d’analyse comparative consiste à projeter simultanément l’ensemble des trajectoires associées à chaque modalité catégorielle sur un unique repère cartésien partagé. Cette approche vise à confronter directement les dynamiques relatives, les croisements de tendances et les écarts de performance au sein d’un même espace de coordonnées. Sa mise en œuvre technique avec Pandas repose sur une syntaxe compacte mais sophistiquée, articulant la définition préalable de l’index temporel, la sélection ciblée de la métrique quantitative, le découpage catégoriel et l’appel de la primitive graphique.
La procédure s’amorce par l’affectation de la variable chronologique en tant qu’index du tableau source, immédiatement suivie de l’opération de groupement opérée sur la colonne décrivant les catégories d’intérêt. L’expression analytique résultante isole ensuite la série numérique ciblée avant d’invoquer la fonction de tracé en activant explicitement l’argument de génération de la légende explicative. Sous le capot, le moteur de Pandas exploite le mécanisme de réutilisation implicite du repère cartésien courant (current axes ou gca) géré par la machine d’état de Matplotlib. À chaque itération sur les sous-groupes identifiés, l’interpréteur trace la courbe correspondante sur le repère actif sans purger la scène graphique, superposant ainsi méthodiquement chaque partition successive.
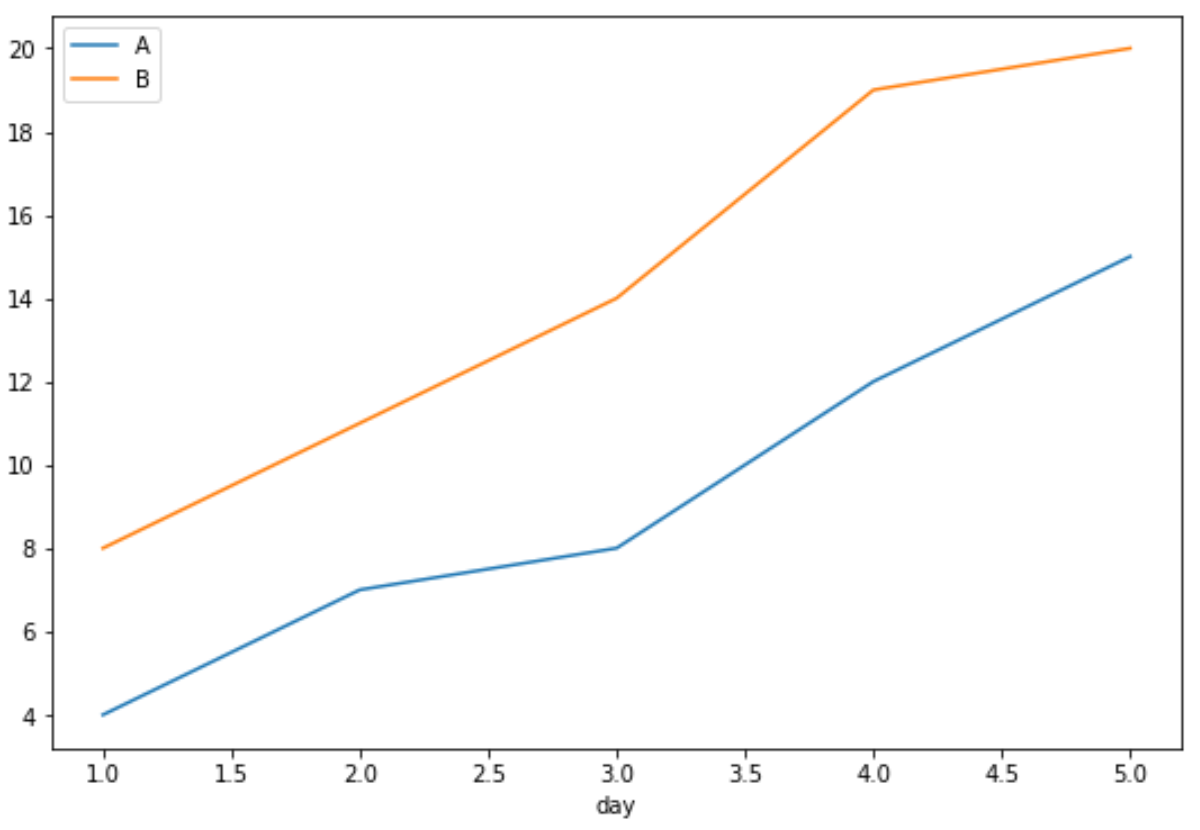
Cette réutilisation contextuelle de l’axe sous-jacent repose sur une convention de couplage étroit entre Pandas et la couche de rendu. Lors de l’évaluation de la boucle interne de l’itérateur de groupe, le composant graphique reçoit une référence vers le repère partagé et lui adjoint de nouvelles primitives géométriques de type lignes vectorielles. La figure resultante offre une lecture immédiate de la structure globale du phénomène. Toutefois, cette compacité d’exécution nécessite une attention particulière : si la figure active contient déjà des tracés résiduels issus de calculs antérieurs non purgés, la superposition s’opérera de manière désordonnée sur ces éléments historiques, soulignant l’importance d’encadrer ces instructions par des commandes explicites de réinitialisation de l’environnement graphique.
4.2 Gestion de la lisibilité et de la légende
Si la superposition des séries sur un repère unique s’avère élégante sur le plan du code, elle soulève des défis sémiologiques majeurs dès lors que la densité d’information augmente. La restitution d’une information scientifique rigoureuse exige que chaque trajectoire soit identifiable de manière univoque sans ambiguïté cognitive. Le paramétrage exhaustif de la légende constitue le premier levier de contrôle. L’argument dédié à la visibilité du cartouche de légende doit être explicitement configuré pour forcer l’étiquetage des cohortes en utilisant les modalités de la clé de partitionnement, transformant des codes alphanumériques arbitraires en descriptions sémantiquement transparentes pour l’observateur.
Le positionnement spatial du cartouche de légende représente une difficulté ergonomique classique. Par défaut, les algorithmes heuristiques cherchent à localiser la légende dans la zone du graphique présentant la plus faible densité de tracés. Néanmoins, dans les visualisations de séries temporelles fluctuantes, cette disposition automatisée tend à recouvrir des points de données critiques ou à chevaucher les courbes aux extrémités de l’intervalle. L’analyste doit intervenir sur l’objet de repère graphique renvoyé par la méthode pour ancrer formellement le cartouche à l’extérieur de la surface d’affichage utile, typiquement sur la marge latérale droite ou en bandeau supérieur, garantissant l’intégrité de la lecture géométrique.
L’attribution automatisée des palettes chromatiques standardisées doit également faire l’objet d’un examen critique. Les palettes cycliques par défaut de Matplotlib sont conçues pour des contrastes généraux mais s’avèrent inadaptées pour les personnes présentant des déficiences de la vision des couleurs (daltonisme) ou lors d’une impression monochrome sur support papier académique. De surcroît, les limites cognitives de la superposition visuelle sont rapidement atteintes : au-delà de cinq à sept trajectoires simultanées, le graphique bascule dans un enchevêtrement illisible souvent qualifié d’effet « plat de spaghettis ». Lorsque la cardinalité de la variable de groupement excède ce seuil perceptif, la stratégie du tracé unifié doit être impérativement abandonnée au profit d’une approche par décomposition spatiale.
5. Méthode 2 : Projection par sous-graphiques dédiés via pivot_table
5.1 Restructuration multidimensionnelle des données
Pour pallier la saturation cognitive inhérente à la superposition excessive de séries au sein d’un tracé unique, la seconde grande méthodologie repose sur le déploiement de « petits multiples » (small multiples), un principe d’affichage popularisé par Edward Tufte. Cette architecture visuelle consiste à projeter chaque modalité au sein de son propre sous-graphique indépendant, tout en maintenant des conventions d’échelles rigoureusement coordonnées. Au sein de l’écosystème Pandas, la voie royale pour orchestrer cette représentation élégante ne consiste pas à itérer manuellement sur une grille graphique, mais à procéder au préalable à une restructuration dimensionnelle matricielle des données à travers la primitive du tableau croisé dynamique.
Cette restructuration réalise une conversion fondamentale de la forme du tableau, transitant d’un format dit « long » ou « empilé » vers un format dit « large » ou « matriciel ». Dans le format long d’origine, chaque observation occupe une ligne distincte, et l’appartenance à une cohorte est codée par une modalité catégorielle répétée. L’opération de pivotement sélectionne la variable chronologique comme index des lignes, déploie les modalités uniques de la variable de groupement en tant que colonnes individuelles distinctes, et projette la métrique d’intérêt dans les cellules à l’intersection de ces deux coordonnées spatiales. Ce processus opère une véritable transposition relationnelle.
L’avantage fondamental de cette matrice pivotée réside dans son comportement face aux séries temporelles discordantes ou asynchrones. Si certaines catégories ne possèdent pas d’observations pour des jalons temporels spécifiques, le tableau croisé dynamique insère automatiquement des valeurs sentinelles de données manquantes (NaN) aux coordonnées correspondantes, réalignant formellement l’intégralité du continuum chronologique sur un index temporel unifié. De surcroît, la structure bidimensionnelle homogène résultante s’avère particulièrement adaptée à l’exécution de calculs vectorisés transversaux, facilitant le calcul de corrélations croisées, de sommes cumulées relatives ou d’écarts de dispersion d’une manière substantiellement plus efficiente que le parcours d’un objet de partitionnement non aligné.
5.2 Génération et configuration de grilles de tracés (subplots)
Une fois la table pivotée stabilisée sous sa forme matricielle étendue, la génération de la grille modulaire de visualisation s’effectue avec une remarquable concision syntaxique en mobilisant l’argument booléen dédié aux sous-graphiques au sein de la méthode de tracé intégrée. En valorisant ce paramètre à l’état vrai, Pandas décompose immédiatement chaque colonne de la matrice en un tracé distinct et isole chaque dynamique catégorielle dans son propre sous-graphique dédié. L’analyste s’affranchit ainsi intégralement de la manipulation manuelle des boucles d’itération et du partitionnement topologique de la figure.
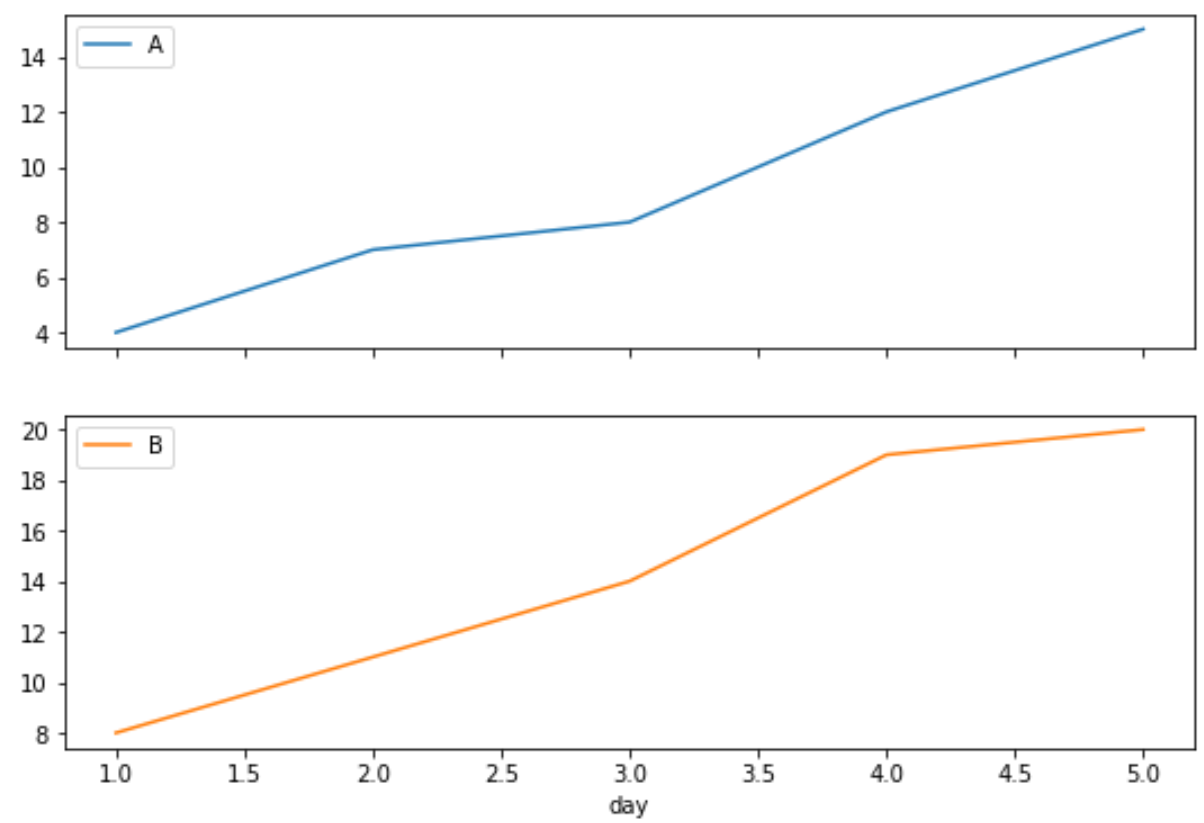
La modularisation de l’affichage s’accompagne d’options stratégiques de contrôle de la géométrie et de l’interdépendance des échelles métriques. Les paramètres de partage des axes horizontaux et verticaux (sharex et sharey) jouent un rôle déterminant dans l’honnêteté et la rigueur de la restitution scientifique. Par défaut, le partage de l’axe temporel permet une lecture synchronisée immédiate des variations simultanées à travers tous les sous-graphiques. À l’inverse, la décision de verrouiller ou d’individualiser l’axe vertical des ordonnées conditionne radicalement la perception de l’information : un axe Y partagé garantit la comparaison fidèle des amplitudes absolues entre catégories, tandis qu’un axe vertical libéré maximise la visibilité des micro-variations internes pour des cohortes dont les volumes absolus diffèrent de plusieurs ordres de grandeur.
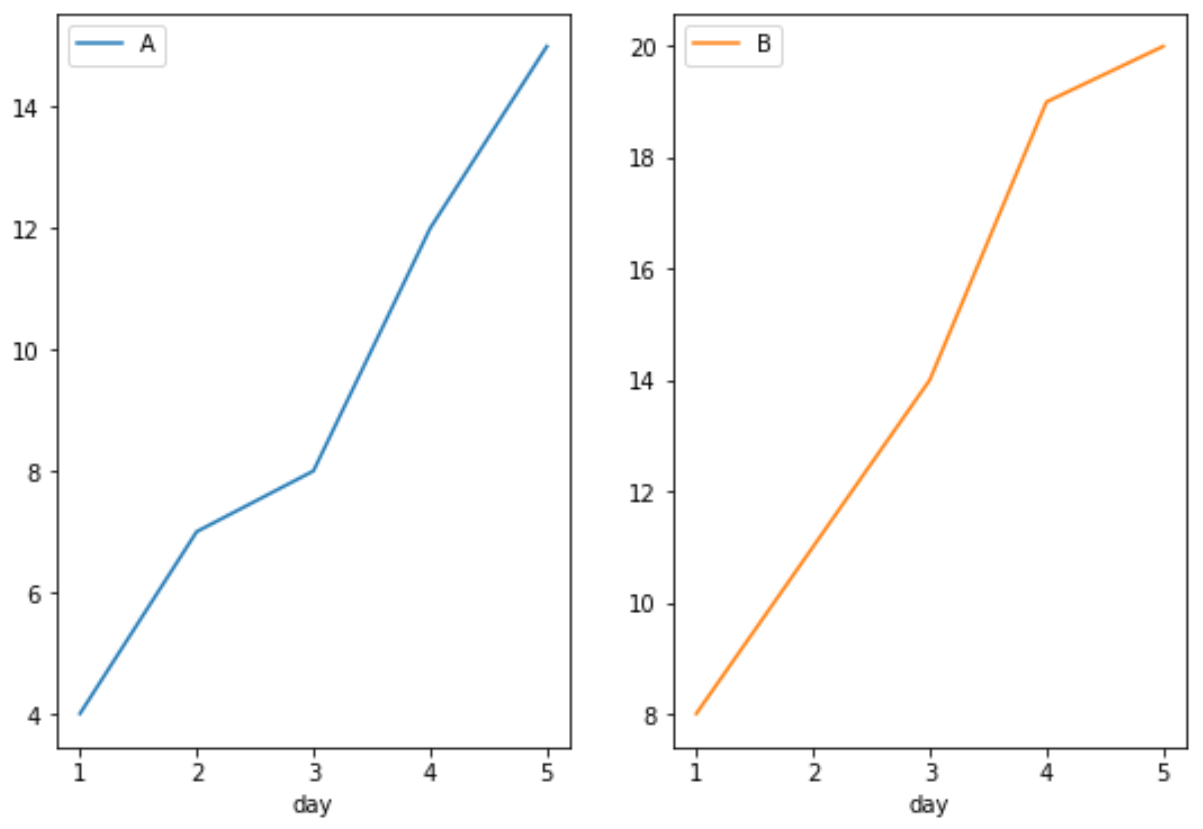
La configuration géométrique de la disposition spatiale s’affine au moyen de la définition explicite du canevas de lignes et de colonnes via l’argument d’agencement structurel (layout). L’utilisateur peut ainsi contraindre une grille de six catégories à s’afficher selon une matrice de deux lignes et trois colonnes, ou selon un agencement vertical unicolonne favorisant le balayage longitudinal chronologique. Cette flexibilité structurelle confère aux sous-graphiques générés par pivotement une supériorité ergonomique indiscutable dès lors qu’il s’agit d’analyser des tendances complexes, de diagnostiquer des périodicités asynchrones ou d’isoler des ruptures de régime propres à une composante singulière du système étudié.
6. Étude comparative approfondie : Approche directe versus Pivotement préalable
6.1 Comparaison de l’empreinte mémoire et de la complexité de calcul
Le choix entre l’exécution d’un tracé graphique directement issu d’un objet partitionné et le recours à une restructuration matricielle préalable par tableau croisé dynamique ne relève pas d’une simple préférence esthétique ou stylistique. Ce choix engage des mécanismes computationnels très contrastés, dont les répercussions sur l’empreinte en mémoire vive et le temps de calcul deviennent critiques à mesure que le volume des données sous-jacentes progresse vers les limites physiques de l’environnement de calcul.
L’approche directe mobilise l’itérateur de groupes de Pandas de manière séquentielle. Elle opère principalement sur les données stockées dans leur configuration colonnaire native sans nécessiter la duplication complète du tableau sous une nouvelle forme structurelle. L’empreinte mémoire résiduelle est donc minimale, le coût se concentrant principalement sur la création des métadonnées d’indices lors du fractionnement. En revanche, le coût algorithmique au niveau de l’interface graphique est tributaire d’appels séquentiels répétés vers l’API de Matplotlib. Chaque itération injecte un nouvel objet de type ligne dans le moteur de rendu, ce qui génère un surcoût d’appels interprétés en langage Python proportionnel à la cardinalité de la variable de groupement.
À l’opposé, la technique du pivotement matriciel impose une pénalité computationnelle initiale non négligeable. L’algorithme de pivotement doit réorganiser physiquement l’intégralité des données en mémoire, allouer une nouvelle matrice continue bidimensionnelle dont la taille correspond au produit cartésien du nombre de jalons temporels uniques et du nombre de catégories distinctes, puis renseigner les intersections par balayage. Si la matrice résultante présente un taux d’éparsité élevé (de nombreux jalons ne comportant aucune mesure pour certaines catégories), l’allocation mémoire alloue inutilement des volumes considérables pour stocker des valeurs manquantes. La dépense en mémoire vive peut alors doubler, voire tripler comparativement au format compact initial. Néanmoins, une fois cette matrice allouée, la phase de tracé bénéficie d’une vectorisation interne complète opérée par des blocs C optimisés, ce qui permet un affichage souvent plus rapide de l’ensemble des séries par rapport à la méthode itérative séquentielle.
| Critère d’évaluation | Approche directe (GroupBy) | Pivotement préalable (Pivot Table) |
|---|---|---|
| Empreinte mémoire vive | Optimale (données lues en place, sans duplication) | Élevée (création d’une nouvelle matrice dense avec NaNs) |
| Complexité temporelle de transformation | Très faible (indexation par table de hachage O(N)) | Modérée à élevée (tri, réalignement matriciel O(N log N)) |
| Rapidité de rendu graphique | Pénalisée par la boucle itérative en langage Python | Vectorisée et accélérée en interne pour les blocs Matplotlib |
| Gestion des séries asynchrones | Peut générer des artéfacts de liaison sur index disjoints | Réalignement temporel automatique sur l’index commun |
| Simplicité syntaxique | Idéale pour les analyses exploratoires immédiates | Exige une étape déclarative de transformation intermédiaire |
6.2 Critères taxonomiques de décision graphique
Le choix de la stratégie visuelle appropriée doit être guidé par une réflexion rigoureuse sur la structure dimensionnelle des données et la question scientifique posée. L’analyste doit éviter l’arbitraire graphique en confrontant son jeu de données à une typologie claire de critères sémiologiques et quantitatifs. La première variable de décision est la cardinalité de la clé catégorielle, c’est-à-dire le nombre de cohortes à représenter simultanément. Lorsque ce nombre est strictement inférieur ou égal à quatre, et que les séries partagent une même unité de mesure ainsi que des amplitudes comparables, le graphique superposé direct demeure le choix privilégié pour analyser avec précision les croisements et les variations relatives de court terme.
Dès lors que la cardinalité s’établit entre cinq et une vingtaine de modalités, la superposition devient cognitivement illisible. La décomposition par tableau croisé dynamique et projection en sous-graphiques s’impose alors comme la solution méthodologique de référence. L’isolation de chaque série sur sa surface dédiée supprime toute ambiguïté de lecture géométrique, tout en permettant au lecteur de procéder à des comparaisons transversales grâce à l’alignement des repères horizontaux. Cette approche par petits multiples brille particulièrement dans la mise en évidence d’hétérogénéités comportementales, telles que des régimes saisonniers inversés ou des décroissances localisées au sein d’une seule sous-catégorie.
Enfin, les impératifs de restitution éditoriale et académique orientent également ce choix architectural. Dans le cadre d’un rapport de synthèse destiné à l’impression ou d’une communication exécutive, l’espace d’affichage constitue une ressource rare et contrainte. La matrice de sous-graphiques, bien que sémiologiquement supérieure, consomme une surface considérable qui peut rendre son intégration délicate dans un format de page standardisé. L’analyste doit alors opérer un arbitrage éclairé entre la densité d’information du tracé unifié, quitte à n’y représenter qu’une sélection des trajectoires les plus saillantes ou des regroupements typologiques préalables, et la richesse analytique exhaustive des sous-graphiques modularisés.
7. Personnalisation avancée de l’esthétique et contrôle de l’interface Matplotlib
7.1 Manipulation directe des objets Axes et Figure
Bien que les méthodes de tracé intégrées à Pandas fournissent des représentations par défaut immédiatement exploitables, elles demeurent des abstractions de haut niveau conçues pour la commodité opérationnelle. Pour hisser une visualisation aux standards requis par les publications académiques ou les revues de direction, l’analyste doit s’affranchir des réglages automatisés et intervenir directement sur la hiérarchie des objets structurels sous-jacents de Matplotlib : la scène globale (Figure) et les repères cartésiens élémentaires (Axes).
Toute méthode graphique issue de Pandas renvoie systématiquement une référence vers l’objet de repère cartésien modifié, ou vers un tableau de ces objets lorsque le partitionnement en sous-graphiques est activé. La capture explicite de cette variable de retour au sein du script analytique déverrouille l’accès à l’intégralité des primitives de manipulation de bas niveau de Matplotlib. Par le biais de ces objets de repères, l’utilisateur peut paramétrer la typographie des titres d’axes, définir des formats de graduation numériques ou chronologiques personnalisés, contrôler la présence de quadrillages secondaires et moduler précisément l’espacement intérieur des marges.
Cette maîtrise de l’interface autorise une reconfiguration dynamique des limites spatiales au moyen des méthodes de bornage des axes horizontaux et verticaux. L’utilisateur peut ainsi neutraliser l’amplitude d’une anomalie statistique extrême pour focaliser l’attention du lecteur sur la dynamique centrale de la distribution, ou imposer un ancrage rigoureux du zéro à la base de l’axe vertical afin de ne pas exagérer visuellement des fluctuations infinitésimales. De surcroît, l’application de feuilles de styles académiques rigoureuses, qu’il s’agisse des thèmes fournis nativement par Matplotlib ou des configurations sophistiquées issues de l’écosystème Seaborn, permet d’harmoniser instantanément l’esthétique générale du tracé avec les exigences visuelles institutionnelles.
7.2 Enrichissement sémantique des visualisations
Une visualisation brute de séries groupées se limite souvent à transcrire une suite géométrique de points sans fournir de grille de lecture contextuelle. L’enrichissement sémantique d’un graphique consiste à injecter des balises contextuelles, des repères statistiques et des marqueurs discrets qui transforment un tracé descriptif en un véritable support d’argumentation scientifique, facilitant l’évaluation critique des écarts observés par rapport à des seuils normatifs ou des événements d’intérêt.
L’adjonction de lignes directrices de référence horizontales ou verticales constitue l’une des techniques d’enrichissement les plus efficientes. L’analyste peut implémenter ces jalons géométriques directement sur l’objet de repère cartésien pour matérialiser la moyenne empirique globale d’une métrique, un seuil réglementaire d’alerte ou la date d’entrée en vigueur d’une modification structurelle de politique industrielle. Cet enrichissement se prolonge avantageusement par la projection d’intervalles d’incertitude ou de plages de tolérance à l’aide de polygones d’ombrage translucides, permettant d’exposer la marge d’erreur stochastique associée à chaque groupe d’observation sans obstruer la visibilité de la courbe médiane principale.
Le contrôle chirurgical de la texture graphique des séries enrichit également l’intelligibilité de la projection. Au lieu de s’en remettre uniquement à la modulation des teintes colorimétriques, l’analyste avisé manipule simultanément l’épaisseur des traits vectoriels, l’ordonnancement des styles de tirets (lignes continues, pointillées ou mixtes) et la géométrie des marqueurs de points. Cette redondance sémiotique assure la lisibilité intégrale du document sur tout support de reproduction, y compris en cas de photocopie dégradée. Enfin, l’exportation des visualisations finales doit s’opérer dans des formats vectoriels haute résolution, tels que le PDF ou le SVG, qui préservent la netteté absolue des polices typographiques et des tracés géométriques à tous les facteurs d’agrandissement, garantissant une conformité sans compromis avec les normes éditoriales les plus strictes.
8. Gestion des anomalies structurelles : Valeurs manquantes et séries asynchrones
8.1 Traitement des discontinuités temporelles
Les jeux de données recueillis en conditions réelles présentent rarement une régularité chronologique immaculée. Les défaillances de capteurs, les interruptions d’activité calendaires ou les retards de consolidation transactionnelle introduisent des ruptures d’échantillonnage et des discontinuités temporelles qui mettent à l’épreuve les algorithmes d’agrégation et de rendu graphique. Si ces lacunes structurelles ne sont pas traitées de manière explicite et méthodologique avant le traçage, le moteur de visualisation peut générer de graves biais d’interprétation visuelle.
Le principal danger réside dans le comportement par défaut de l’interpolation linéaire mise en œuvre par le moteur de rendu. Lorsqu’une série temporelle subit une rupture de plusieurs semaines ou mois et que les enregistrements lacunaires sont simplement omis de la structure de données sous-jacente, le moteur de tracé relie mécaniquement le dernier point valide au point suivant par un segment de droite continu. Ce tracé crée un artefact de continuité factice qui dissimule la période d’inactivité sous un gradient trompeur. Pour prévenir cet écueil épistémologique, l’analyste doit procéder à une opération de rééchantillonnage explicite sur une grille temporelle uniforme avant d’engager le groupement.
Ce processus de régularisation temporelle, déployé via les primitives d’alignement de fréquence de Pandas, force l’insertion d’enregistrements formels porteurs de valeurs nulles (NaN) pour l’intégralité des jalons manquants au sein de chaque cohorte. Face à une valeur explicitement identifiée comme nulle, le moteur de rendu interrompt proprement le tracé vectoriel de la courbe correspondante, créant une césure visuelle manifeste sur l’axe des abscisses. Cette rupture géométrique signale instantanément au lecteur l’absence de mesure durant l’intervalle concerné, préservant ainsi l’intégrité scientifique du message transmis par la visualisation.
8.2 Stratégies d’imputation adaptées aux données groupées
Bien que l’omission visuelle des données manquantes garantisse la rigueur descriptive, certaines démarches d’analyse comparative ou de modélisation prédictive exigent d’estimer les valeurs absentes pour rétablir la continuité des séries. Néanmoins, l’application d’une stratégie d’imputation globale à l’ensemble du tableau de données constitue une grave erreur méthodologique, car elle applique aveuglément des dynamiques d’une cohorte à une autre dont les caractéristiques et les niveaux d’activité peuvent être profondément divergents.
L’imputation doit donc être impérativement contextualisée à l’échelle de chaque groupe en mobilisant la méthode de transformation intra-groupe fournie par l’objet partitionné de Pandas. Cette approche permet de propager des fonctions d’imputation adaptatives au sein de chaque sous-population de manière strictement isolée. Selon la dynamique stochastique du phénomène modélisé, l’analyste peut opter pour le maintien de la dernière observation valide vers l’avant (forward fill), une technique fréquente dans l’analyse des séries financières, pour une interpolation linéaire locale, ou pour des ajustements par splines polynomiales respectant la convexité des tendances adjacentes.
D’un point de vue sémiologique et éthique, toute trajectoire intégrant des valeurs imputées doit faire l’objet d’une signalétique explicite au sein de la visualisation finale. Il est recommandé de distinguer visuellement les segments reconstitués des segments empiriques authentiques en appliquant des codes stylistiques différenciés, par exemple en traçant les portions imputées au moyen de traits pointillés ou d’une opacité réduite. Cette précaution fondamentale permet à l’observateur d’évaluer le degré de confiance accordé aux différentes zones du tracé et d’apprécier en toute transparence l’impact potentiel des choix d’imputation sur les conclusions tirées de l’exploration graphique.
9. Diversification typologique des visualisations issues d’un GroupBy
9.1 Diagrammes en barres agrégés et empilés
Si les représentations linéaires longitudinales constituent un cas d’usage prédominant, l’articulation entre partitionnement et affichage graphique s’étend avec une remarquable efficacité à d’autres familles de diagrammes statistiques. Les diagrammes en barres représentent un instrument d’analyse incontournable dès lors qu’il s’agit de comparer des métriques scalaires discrètes, d’évaluer des volumes cumulés d’activité ou de quantifier des parts de marché relatives entre différentes entités organisationnelles.
L’instanciation de ces visualisations repose sur la spécification du type de tracé au sein de la méthode graphique intégrée, notamment via la déclaration des formes de barres verticales ou horizontales. Dans ce contexte analytique, l’opération de groupement est généralement associée à une fonction de réduction arithmétique formelle, telle que la sommation, le calcul de la moyenne empirique ou la mesure d’effectifs. La série agrégée résultante est ensuite directement projetée sous forme de rectangles proportionnels, l’index catégoriel alimentant les étiquettes de référence de manière native.
Lorsque l’analyse implique deux niveaux de variables catégorielles distincts, le diagramme en barres empilées déploie tout son potentiel heuristique. En activant l’argument d’empilement structurel, la méthode de tracé empile verticalement les contributions des différentes sous-catégories au sein d’une même barre globale de référence. Cette disposition met en relief à la fois l’évolution du total agrégé et la recomposition de la structure interne des contributions au fil du temps ou des segments observés. L’intégration de barres d’erreur empiriques, obtenues par le calcul vectorisé des écarts-types de chaque groupe, vient compléter cette panoplie graphique en fournissant une indication immédiate de la dispersion des observations sous-jacentes.
9.2 Distributions statistiques : Boîtes à moustaches et densités de probabilité
Les métriques de tendance centrale telles que la moyenne empirique présentent la faiblesse conceptuelle majeure de dissimuler l’asymétrie des données, leur dispersion et l’existence potentielle de valeurs extrêmes. L’analyse exploratoire rigoureuse impose donc d’examiner la forme complète de la distribution statistique propre à chaque sous-groupe. L’écosystème de Pandas répond à cette exigence par des méthodes dédiées à l’évaluation distributionnelle groupée, principalement au moyen des boîtes à moustaches (boxplots) et de l’estimation de densité par noyau (kernel density estimation).
La primitive de boîte à moustaches permet de cartographier instantanément la structure non paramétrique d’une variable continue à travers les différentes modalités d’une clé de regroupement. Le tracé généré met en évidence la médiane empirique, l’écart interquartile compris entre le premier et le troisième quartile, ainsi que les extensions délimitant les seuils au-delà desquels les observations sont classées comme des valeurs atypiques ou aberrantes (outliers). Cette projection spatiale synthétique autorise une comparaison transverse immédiate de l’hétéroscédasticité (l’inégalité des variances) et de la symétrie des cohortes sans exiger de postulat de normalité sous-jacent.
Pour affiner la compréhension de la morphologie des données, l’analyste peut convoquer l’estimation de densité de probabilité en paramétrant le type de tracé sur la méthode de lissage par noyau continu. Contrairement à un histogramme classique dont l’apparence varie considérablement selon la largeur et le point de départ des classes arbitraires sélectionnées, l’estimation par noyau produit une courbe continue reflétant la fonction de densité sous-jacente du phénomène. En superposant ou en déclinant en sous-graphiques les courbes de densité associées à chaque groupe, il devient aisé de détecter des distributions bimodales ou des concentrations anormales d’observations qui demeurent totalement invisibles lors d’un calcul d’agrégats scalaires conventionnel.
10. Agrégations multivariées et dimensions imbriquées
10.1 Groupements hiérarchiques sur plusieurs clés catégorielles
Dans les scénarios d’ingénierie statistique avancée, l’investigation empirique ne peut se confiner à une clé de classification unique. Les systèmes réels déploient des architectures hiérarchiques complexes où les observations s’imbriquent à travers plusieurs niveaux d’agrégation, tels qu’une décomposition par zone géographique, puis par catégorie de produit, et enfin par canal de distribution. La structure de partitionnement de Pandas absorbe cette complexité dimensionnelle avec une grande souplesse en acceptant une liste ordonnée de variables lors de l’appel de l’opérateur de groupement, engendrant un index multi-niveaux (MultiIndex) sur les lignes du tableau résultat.
L’exploitation graphique directe d’un tableau pourvu d’une hiérarchie d’indexation complexe requiert néanmoins une opération de désimbrication spatiale préalable. La méthode de désindexation (unstack) permet de faire pivoter un ou plusieurs niveaux de l’index hiérarchique pour les transformer en colonnes de premier niveau, opérant une transition dimensionnelle indispensable pour alimenter le moteur de tracé. En articulant habilement cette opération, l’analyste projette des informations tri-dimensionnelles sur un plan cartésien bidimensionnel standardisé sans dénaturer les dépendances hiérarchiques d’origine.
Cette approche permet d’agencer des représentations matricielles hautement informatives où les différents niveaux de partitionnement gouvernent conjointement la disposition des éléments graphiques. Par exemple, le niveau hiérarchique supérieur peut définir les grands blocs de la grille de sous-graphiques, tandis que le niveau intermédiaire structure la répartition des clusters de barres et que la métrique continue alimente la hauteur de ces mêmes barres. Cette hiérarchisation visuelle disciplinée préserve la traçabilité des interactions multivariées et permet d’isoler des effets de second ordre qui échappent aux analyses univariées superficielles.
10.2 Calcul et affichage simultané d’indicateurs composites
L’analyse d’un système complexe requiert fréquemment de confronter conjointement des métriques d’échelles et de natures hétérogènes. Dans le pilotage d’un système industriel ou financier, il est courant de devoir suivre simultanément le volume brut des flux opérationnels, la variabilité stochastique associée et le taux d’erreur unitaire. Pour concevoir de telles visualisations composites, l’analyste mobilise l’opérateur d’agrégation enrichi de Pandas, qui permet d’associer un dictionnaire formel liant chaque colonne ciblée à des fonctions statistiques spécifiques.
Le résultat de cette synthèse multivariée regroupe sur un même plan chronologique des colonnes aux dimensions non commensurables. L’affichage de ces séries sur un unique axe vertical détruirait l’intelligibilité du graphique, la série d’amplitude dominante écrasant la dynamique des séries de plus faible magnitude. Pour résoudre ce conflit topologique, l’architecture graphique de Matplotlib s’articule via la création d’axes verticaux jumeaux (twinx). Cette méthode génère un second repère cartésien vertical ancré sur la marge droite de la figure, qui partage rigoureusement l’abscisse horizontale originelle mais dispose de son propre étalonnage d’échelle indépendant.
La mise en œuvre de cette technique permet d’adjoindre, sur un tracé unique, des représentations en barres quantifiant des volumes absolus et des tracés en lignes décrivant des taux marginaux ou des écarts-types normalisés. Une telle articulation exige néanmoins une discipline rigoureuse lors de la formalisation des légendes et de l’identification des axes : l’analyste doit impérativement fusionner les cartouches de légendes issus des deux repères distincts et harmoniser les teintes des courbes avec celles des étiquettes d’axes correspondantes, fournissant au lecteur une boussole cognitive explicite pour décrypter sans ambiguïté les séries associées à chaque échelle métrique.
11. Optimisation computationnelle et traitement de volumétries massives
11.1 Consommation des ressources lors du rendu de gros volumes
L’une des limites structurelles les plus sévères de l’analyse visuelle interactive réside dans l’inadéquation fondamentale entre la volumétrie des données massives (Big Data) et la capacité d’absorption des moteurs de rendu graphique. Tenter de tracer directement un jeu de données contenant des dizaines de millions d’enregistrements via l’instruction combinée de partitionnement et de visualisation de Pandas conduit inexorablement à une saturation de la mémoire vive ou à un blocage prolongé de l’interpréteur Python. La raison en est géométrique : une scène graphique n’a pas vocation à matérialiser des millions de sommets vectoriels microscopiques qui viendront se superposer au sein d’un même pixel physique de l’écran.
La première stratégie d’optimisation fondamentale relève de l’ingénierie des types de données en amont de toute agrégation. Par défaut, Pandas alloue fréquemment des types textuels génériques très coûteux en mémoire vive pour stocker les variables catégorielles. En convertissant formellement ces colonnes textuelles vers le type natif catégoriel (category), l’analyste substitue aux chaînes de caractères redondantes un dictionnaire d’entiers optimisé. Cette transformation élémentaire réduit drastiquement l’empreinte en mémoire vive du tableau de données, divise par deux ou trois les temps d’exécution de la table de hachage lors de la phase de fractionnement, et accélère significativement les transmissions internes de structures vers l’interface de tracé.
La seconde mesure consiste à appliquer une politique systématique de décimation et de sous-échantillonnage préalable avant le déclenchement de l’affichage. L’analyste doit exploiter les fonctionnalités d’agrégation temporelle et spatiale pour ramener la densité des points de mesure à une résolution compatible avec les capacités de discernement de l’œil humain et les limites des dispositifs d’affichage standards, typiquement de l’ordre d’un millier de coordonnées le long de l’axe temporel. Le profilage rigoureux des temps d’exécution, instrumenté à l’aide de modules de diagnostic comme timeit ou cProfile, permet d’identifier précisément les verrous d’étranglement algorithmique et d’ajuster les fenêtres d’agrégation pour préserver la fluidité de l’exploration interactive.
11.2 Parallélisation et alternatives pour le Big Data
En dépit de son élégance syntaxique et de sa maturité technique, la bibliothèque Pandas repose historiquement sur une architecture computationnelle monothread. Les opérations d’agrégation et de transformation complexes exécutées sur des tableaux massifs ne tirent pas parti nativement de la multiplicité des cœurs de calcul équipant les processeurs modernes. Face à des volumes de données excédant la mémoire vive d’une machine individuelle ou exigeant des temps de traitement incompatibles avec la réactivité requise en phase d’exploration, l’analyste doit intégrer des moteurs de calcul distribués ou hautement parallélisés.
L’écosystème PyData contemporain offre des passerelles performantes vers des architectures modernes capables de surmonter ces limites matérielles. Des bibliothèques de calcul out-of-core et distribué telles que Dask permettent de scinder d’immenses jeux de données en partitions logiques traitées en parallèle sur l’ensemble des cœurs de calcul disponibles, voire sur un cluster distribué, tout en conservant une API rigoureusement calquée sur la syntaxe de Pandas. De même, des moteurs analytiques de dernière génération basés sur l’architecture Apache Arrow et compilés en langage Rust, tels que Polars, ou des moteurs relationnels intégrés orientés colonnes comme DuckDB, permettent de diviser les temps de partitionnement par un ou deux ordres de grandeur grâce à une parallélisation agressive et une vectorisation de bas niveau.
Dans ces architectures analytiques avancées, la séparation des responsabilités logicielles devient totale : le calcul de fractionnement, de filtrage lourd et d’agrégation statistique est déporté vers le moteur hautement optimisé (Polars, DuckDB ou Dask). Une fois les volumes massifs compressés sous forme d’agrégats de synthèse hautement concentrés, ces derniers sont réinjectés au format Pandas pour être confiés aux interfaces de tracé spécialisées. Pour les cas d’usage extrêmes exigeant le traçage continu de plusieurs millions de points sans aucune phase d’agrégation préalable (afin de repérer des structures ténues d’éparpillage statistique), le recours à des moteurs de rastérisation graphique dédiés en mémoire GPU, tels que Datashader, constitue la solution technologique d’excellence, assurant un rendu en temps réel tout en prévenant les biais de saturation visuelle.
12. Synthèse méthodologique et guide des meilleures pratiques
12.1 Checklist de rigueur scientifique pour l’analyse visuelle
Pour garantir la validité empirique des conclusions et assurer la parfaite reproductibilité des protocoles expérimentaux, toute production graphique issue de manipulations tabulaires doit se conformer à une discipline méthodologique rigoureuse. L’analyse exploratoire visuelle ne saurait être un exercice d’improvisation affranchi des standards scientifiques : elle engage directement la responsabilité analytique du chercheur dans la construction du savoir issu des données.
En premier lieu, une validation dimensionnelle exhaustive s’impose préalablement à toute interprétation. L’analyste doit vérifier que l’index temporel est exempt de ruptures dissimulées, que l’ordonnancement séquentiel est strictement monotone et que le typage des axes garantit l’alignement véridique des intervalles physiques. En second lieu, la proportionnalité des échelles visuelles constitue un impératif d’honnêteté intellectuelle absolu : la troncature arbitraire de l’axe des ordonnées pour amplifier artificiellement des variations infinitésimales doit être rigoureusement bannie, sauf justification mathématique formelle (telle que l’adoption d’une échelle logarithmique destinée à révéler des taux de croissance exponentiels).
En troisième lieu, la standardisation et la reproductibilité du flux de traitement doivent être scrupuleusement encadrées. Chaque manipulation opérée depuis le chargement du fichier brut jusqu’à l’export vectoriel de la figure doit être consignée au sein d’un script ou d’un carnet computationnel exécutable de bout en bout sans intervention manuelle. Les paramètres stylistiques, les choix d’imputation et les dictionnaires d’agrégation doivent être documentés de façon claire, permettant à tout pair scientifique de reproduire les tracés et d’auditer la chaîne de traitement sans ambiguïté.
12.2 Tableau récapitulatif des commandes et arbre de décision syntaxique
Afin d’offrir une référence opérationnelle immédiate pour le praticien confronté à des choix d’implémentation concrets, nous synthétisons ci-dessous l’arbre de décision syntaxique permettant d’orienter le développement vers la formulation la plus élégante et la plus efficiente en fonction des objectifs d’investigation fixés.
| Objectif d’analyse | Architecture recommandée | Formulation syntaxique conceptuelle | Avantage prépondérant |
|---|---|---|---|
| Superposition de quelques cohortes (N ≤ 4) | Approche directe GroupBy | Indexation temporelle, groupement catégoriel, sélection métrique et tracé unifié | Concision syntaxique maximale, faible empreinte mémoire |
| Comparaison de multiples cohortes (5 ≤ N ≤ 20) | Restructuration Pivot Table | Pivotement vers format large, puis tracé avec sous-graphiques modulaires activés | Clarté cognitive supérieure, synchronisation des échelles |
| Analyse de parts relatives et de volumes | Agrégation et Barres empilées | Groupement bivarié, sommation arithmétique, unstacking et tracé en barres empilées | Mise en évidence simultanée du total et des fractions |
| Audit de dispersion et détection d’anomalies | Distributionnelle (Boxplot / KDE) | Sélection catégorielle et numérique, tracé de boîtes à moustaches ou densités continues | Révélation de l’hétéroscédasticité et des valeurs extrêmes |
| Corrélation d’unités hétérogènes | Axes jumeaux (twinx) | Agrégation multivariée, tracé primaire, instanciation d’axe secondaire et tracé lié | Superposition fidèle sans distorsion des ordres de grandeur |
En conclusion de ce parcours méthodologique et computationnel, il convient de rappeler la portée épistémologique fondamentale de la visualisation de données dans la démarche empirique. Les fonctions logicielles sophistiquées offertes par Pandas et son intégration avec Matplotlib ne sont pas de simples outils de restitution ornementale. Elles forment l’appareil critique à travers lequel le chercheur interroge la structure même du réel codifié dans les données numériques. En maîtrisant les subtilités du partitionnement, de la recomposition matricielle et du rendu géométrique, l’analyste transforme une masse amorphe d’enregistrements en une narration visuelle rigoureuse, expressive et scientifique, capable de guider avec justesse la prise de décision et d’éclairer la compréhension des phénomènes complexes qui structurent notre monde contemporain.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Bertin, J. (1983). Semiology of graphics: Diagrams, networks, maps. University of Wisconsin Press.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1924-009
- McKinney, W. (2022). Python for data analysis: Data wrangling with pandas, NumPy, and Jupyter (3rd ed.). O’Reilly Media.
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2011). The split-apply-combine strategy for data analysis. Journal of Statistical Software, 40(1), 1–29. https://doi.org/10.18637/jss.v040.i01
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0