
Dans le domaine de l’analyse exploratoire de données et de la communication scientifique, la restitution graphique constitue une étape décisive pour la compréhension de structures empiriques complexes. La bibliothèque Pandas pour le langage Python s’est imposée comme la référence fondamentale pour la manipulation de données tabulaires. Si la représentation d’une variable unique le long d’une échelle catégorielle relève d’une procédure élémentaire, le déploiement simultané de multiples colonnes au sein d’un même diagramme à barres exige une compréhension fine des interactions sous-jacentes entre la structure matricielle des données, l’ordonnancement de l’index et le moteur de rendu graphique. Cette complexité s’accroît lorsque l’analyste cherche à préserver la lisibilité, la rigueur métrologique et la fidélité sémiotique des indicateurs présentés.
Le passage d’une perspective univariée à une perspective multivariée transforme la nature cognitive du graphique. Les diagrammes à barres multi-colonnes permettent non seulement d’évaluer les magnitudes absolues, mais également d’appréhender les dynamiques comparatives, les proportions relatives et les potentielles interactions entre facteurs expérimentaux ou observationnels. Qu’il s’agisse de comparer les performances de plusieurs modèles algorithmiques, d’examiner l’évolution de métriques biométriques au fil d’essais cliniques ou d’analyser des profils de réponses à des questionnaires psychométriques, la juxtaposition ou l’empilement de séries vectorielles sur un même système d’axes cartésiens répond à des critères formels stricts de disposition spatiale et de sémiotique graphique.
Le présent traité propose une analyse exhaustive et rigoureuse des méthodologies permettant de tracer plusieurs colonnes sous la forme d’un diagramme à barres avec Pandas. De la préparation structurale des données au format large jusqu’à la personnalisation typographique et chromatique de haut niveau via Matplotlib, nous explorerons les implications computationnelles, les arbitrages esthétiques et les fondements déontologiques indispensables à la production de visualisations conformes aux standards académiques et professionnels les plus exigeants.
1. Introduction à la visualisation multi-colonnes avec Pandas
1.1 Pertinence méthodologique de la comparaison multivariée
L’analyse statistique contemporaine se heurte fréquemment à la nécessité d’examiner de manière concomitante plusieurs variables dépendantes mesurées au sein d’un même ensemble de conditions expérimentales ou de catégories démographiques. Isoler chaque variable dans un graphique univarié distinct impose à l’observateur une charge cognitive substantielle, l’obligeant à mémoriser des repères géométriques disparates et à reconstruire mentalement des écarts d’amplitude d’une figure à l’autre. La visualisation multivariée au sein d’un système d’axes unifié neutralise cette friction perceptive en ancrant l’ensemble des descripteurs quantitatifs dans un cadre de référence géométrique commun.
Sur le plan des neurosciences cognitives et de la psychologie de la forme (Gestalt), la juxtaposition immédiate d’éléments graphiques exploite les principes fondamentaux de proximité spatiale, de similarité et de continuité. Lorsque des barres représentant des variables distinctes sont regroupées autour d’un même marqueur d’abscisse, le système visuel humain procède spontanément à une segmentation de haut niveau. Il en extrait non seulement les variations intra-groupes, c’est-à-dire l’écart entre les variables au sein d’une même modalité, mais également les tendances inter-groupes, à savoir la trajectoire globale de chaque variable d’une modalité à la suivante. Cette double lecture simultanée est particulièrement précieuse lors de l’étude des profils comportementaux ou des interactions factorielles où l’effet d’un traitement dépend intrinsèquement de la sous-dimension évaluée.
Dans le cadre précis de l’analyse quantitative de données comportementales, cliniques ou socio-économiques, les chercheurs sont constamment confrontés à des batteries de tests mesurant des construits latents complémentaires. À titre d’illustration, l’évaluation de la réactivité au stress chez une cohorte d’individus peut intégrer le rythme cardiaque moyen, la concentration salivaire en cortisol et un score auto-rapporté d’anxiété situationnelle. Projeter ces dimensions le long d’un diagramme à barres comparatif permet d’identifier instantanément des profils de divergence, tels qu’une dissociation psychophysiologique où les marqueurs neurovégétatifs s’élèvent tandis que le score subjectif demeure stationnaire. Cette rigueur méthodologique garantit que le rendu visuel devient un véritable instrument d’inférence et de découverte scientifique, bien au-delà de la simple illustration illustrative.
1.2 Architecture du moteur de rendu graphique dans Pandas
Pour exploiter pleinement les capacités graphiques de Pandas, il est indispensable de comprendre l’architecture logicielle sous-jacente qui lie la structure de données tabulaire à la chaîne de rendu vectoriel. Pandas n’intègre pas de moteur de rendu géométrique autonome développé ex nihilo ; la bibliothèque repose sur une couche d’abstraction supérieure encapsulant les primitives de la bibliothèque Matplotlib. Cette intégration s’opère par le biais de l’interface de programmation unifiée disponible via l’accesseur graphique de l’objet DataFrame, couramment invoqué par la méthode de tracé générale.
Lorsque cette méthode est sollicitée, Pandas convertit la géométrie des tableaux bidimensionnels en conteneurs d’objets graphiques gérés par Matplotlib. Cette translation implique la création ou l’identification d’une figure globale, qui sert de canevas spatial, et d’un ou plusieurs objets d’axes cartésiens, responsables de la gestion des échelles, des graduations et de la délimitation de la surface de traçage. L’encapsuleur de haut niveau de Pandas automatise de multiples opérations fastidieuses : il déduit automatiquement les limites des axes en fonction des extremums numériques des données, associe les modalités de l’index aux graduations de l’axe des abscisses, attribue des teintes différentielles aux variables et génère une légende explicative cohérente.
Toutefois, cette automatisation ne prive en aucun cas le chercheur d’un contrôle granulaire sur les éléments de bas niveau. L’appel de la fonction de tracé renvoie systématiquement une instance de l’objet d’axe de Matplotlib, ou un tableau multidimensionnel d’axes lorsque la décomposition en sous-graphiques est requise. Dès lors, le praticien conserve la possibilité d’intercepter cet objet pour en manipuler les propriétés intrinsèques : modification de la topologie des repères, ajout de lignes de référence paramétriques, altération de la typographie ou application de transformations affines. Cette dualité architecturale, conjuguant la concision déclarative de Pandas et la flexibilité impérative de Matplotlib, confère à l’écosystème Python une puissance d’expression inégalée pour le traitement des données empiriques.
1.3 Distinction entre séries univariées et matrices multivariées
D’un point de vue structurel et computationnel, le traçage d’une structure univariée, incarnée par la classe Series, diffère fondamentalement de celui d’une structure multivariée, représentée par la classe DataFrame. Une série temporelle ou catégorielle ne comporte qu’un vecteur unidimensionnel de valeurs numériques couplé à un axe d’indexation. Lorsqu’une telle série est projetée sous forme de diagramme à barres, l’algorithme d’affichage n’a qu’à positionner un rectangle unitaire au droit de chaque repère d’abscisse, sa hauteur correspondant exactement au scalaire associé. La complexité algorithmique et spatiale est ici minimale, ne requérant aucun arbitrage de décalage transversal.
À l’inverse, l’évaluation et la restitution simultanée de multiples colonnes depuis un DataFrame transforment le problème en une opération géométrique matricielle bidimensionnelle. Chaque enregistrement situé à l’intersection d’une ligne et d’une colonne devient un élément d’une sous-matrice dont les dimensions doivent être spatialisées. Pandas doit alors allouer, pour chaque modalité de l’axe horizontal, un intervalle spatial fini qui doit être subdivisé de manière équitable entre les différentes colonnes sélectionnées. Cette conversion requiert un calcul trigonométrique et arithmétique rigoureux afin de déterminer la largeur relative de chaque barre individuelle, la distance interstitielle entre les barres d’un même groupe et le pas séparant les conglomérats catégoriels consécutifs.
Sur le plan de l’allocation mémoire et des cycles de calcul, le traitement d’une matrice multivariée implique l’instanciation séquentielle d’une multiplicité de collections de rectangles (Rectangle Collections). Chaque colonne numérique donne naissance à une couche graphique distincte, dotée de son propre identifiant sémiotique, de ses métadonnées de rappel et de ses vecteurs de coordonnées cartésiennes. Une telle complexité computationnelle impose une organisation méthodique des données en amont : toute incohérence dans le formatage des colonnes ou la présence de types hétérogènes non convertibles en tenseurs à virgule flottante déclenchera des goulots d’étranglement lors du rendu ou des exceptions d’incompatibilité de type.
2. Fondements syntaxiques et structuration des données en entrée
2.1 Organisation des données au format large (Wide Format)
L’une des pierres angulaires d’une visualisation réussie avec Pandas réside dans la topologie structurelle de la table de données soumise à l’interpréteur. Le moteur de traçage intégré de Pandas a été historiquement optimisé pour exploiter le format dit « large » (Wide Format), par opposition au format « long » (Long Format ou Tidy Data). Dans une configuration large, chaque unité d’observation ou modalité temporelle est consignée sur une ligne unique, tandis que chaque variable dépendante ou sous-dimension quantitative occupe une colonne dédiée et distincte.
Cette disposition s’avère particulièrement adaptée à l’analyse multi-colonnes car elle établit une correspondance biunivoque entre l’organisation matricielle du DataFrame et l’affichage des séries sur le graphique : les colonnes définissent naturellement les séries comparées, leurs en-têtes textuels fournissent spontanément les intitulés de la légende, et les étiquettes de lignes structurent les repères de l’axe horizontal. En revanche, si les données sont structurées selon un format long où une colonne d’attribut identifie la variable et une colonne de valeur en rapporte la mesure, le moteur standard de tracé de Pandas échoue à segmenter automatiquement les barres en sous-groupes discrets sans un prétraitement matriciel préalable.
Pour transmuter un jeu de données du format long vers le format large requis, la bibliothèque offre des fonctions de restructuration hautement performantes, notamment la méthode de table de pivotement (pivot_table) et l’opération de désempilement (unstack). En spécifiant de manière rigoureuse les variables d’indexation, les colonnes pivots et la fonction d’agrégation mathématique (telle que la moyenne ou la médiane), le chercheur génère une matrice nettoyée dont les colonnes correspondent exactement aux composantes visuelles attendues sur le diagramme à barres. La maîtrise de ces transformations tabulaires constitue donc un prérequis méthodologique absolu avant tout appel aux routines de rendu.
2.2 Rôle et définition explicite de la variable d’axe horizontal (x)
Lors de la construction d’un diagramme à barres multivarié, la détermination de l’axe des abscisses régit l’ancrage spatial de l’ensemble de la composition visuelle. Dans l’API de Pandas, cet ancrage peut être stipulé de façon explicite par le biais de l’argument désignant l’abscisse (nommé x dans la signature de la méthode de tracé). Cet argument attend une chaîne de caractères correspondant strictement à l’un des en-têtes de colonnes présents dans le DataFrame.
L’assignation explicite de cet argument instruit le moteur graphique d’extraire la colonne désignée et de l’utiliser comme source exclusive des marqueurs catégoriels le long de la ligne de base. Les variables restantes dans la sélection tabulaire sont alors projetées en tant que grandeurs quantitatives sur l’axe des ordonnées. Cette approche s’avère hautement fonctionnelle pour manipuler des échelles qualitatives nominales (telles que des groupes expérimentaux ou des typologies démographiques), ordinales (comme des stades de développement ou des degrés de sévérité clinique) ou des jalons chronologiques discrets.
L’omission involontaire de la spécification de l’argument x engendre une modification substantielle du comportement algorithmique. Dans ce cas de figure, Pandas reporte son attention sur la structure interne de l’index du DataFrame pour établir la graduation horizontale. Si le DataFrame contient une colonne destinée à servir d’axe d’abscisse mais qui n’a pas été déclarée via cet argument ni préalablement convertie en index, cette colonne sera erronément interprétée comme une variable quantitative supplémentaire. Le graphique résultant tentera alors de tracer cette modalité sous la forme d’une série de barres numériques aux côtés des variables dépendantes légitimes, provoquant une distorsion majeure de la sémiotique visuelle et une saturation préjudiciable du tracé.
2.3 Indexation implicite versus indexation explicite
L’architecture de Pandas repose sur la notion d’index, structure de données unidimensionnelle immuable assurant l’alignement et la recherche rapide des enregistrements. Lors de l’invocation d’une routine graphique, la nature de cet index influence directement la topologie de l’axe horizontal. Lorsque les données sont initialisées sans indexation spécifique, Pandas applique un index de plage numérique par défaut (RangeIndex), composé d’une suite d’entiers consécutifs débutant à zéro. Si cet index implicite est utilisé pour le tracé, l’axe d’abscisse affichera de simples numéros d’indices, privant le lecteur de tout repère contextuel ou catégoriel.
Pour conférer une rigueur académique à la restitution visuelle, il est généralement préconisé d’adopter une stratégie d’indexation explicite. Cette démarche consiste à transférer la colonne identifiant les catégories directement dans l’index du DataFrame à l’aide de la méthode dédiée de définition d’index (set_index). Lorsqu’un DataFrame ainsi structuré est soumis à la méthode de tracé, il n’est plus nécessaire de renseigner l’argument horizontal ; le moteur de Pandas exploite automatiquement les labels de l’index pour formater les graduations de l’abscisse. Cette approche garantit une séparation conceptuelle nette entre l’axe de référence et le bloc matriciel des données dépendantes.
En outre, la manipulation d’index typés, tels que les index temporels (DatetimeIndex) ou les index catégoriels ordonnés (CategoricalIndex), offre des garanties majeures quant à la cohérence séquentielle de l’affichage. Un index catégoriel permet d’imposer un ordonnancement rigide non dicté par l’ordre alphabétique aléatoire des chaînes de caractères, mais fondé sur une progression logique prédéfinie (par exemple : « Faible », « Modéré », « Élevé »). De même, un index temporel permet à Pandas et Matplotlib d’ajuster dynamiquement l’espacement et la pagination des dates pour éviter les chevauchements textuels délétères.
3. Traçage de diagrammes à barres groupées côte à côte
3.1 Syntaxe canonique pour barres groupées standards
Le diagramme à barres groupées côte à côte représente la modalité standard de comparaison multivariée lorsque l’objectif principal est de confronter directement les magnitudes individuelles de plusieurs séries au sein de chaque niveau de facteur. La syntaxe canonique pour générer une telle configuration repose sur la sélection conjointe des colonnes d’intérêt suivie de l’appel à la fonction de traçage en spécifiant le type de graphique adéquat, généralement matérialisé par le paramètre désignant le genre de tracé (kind=’bar’).
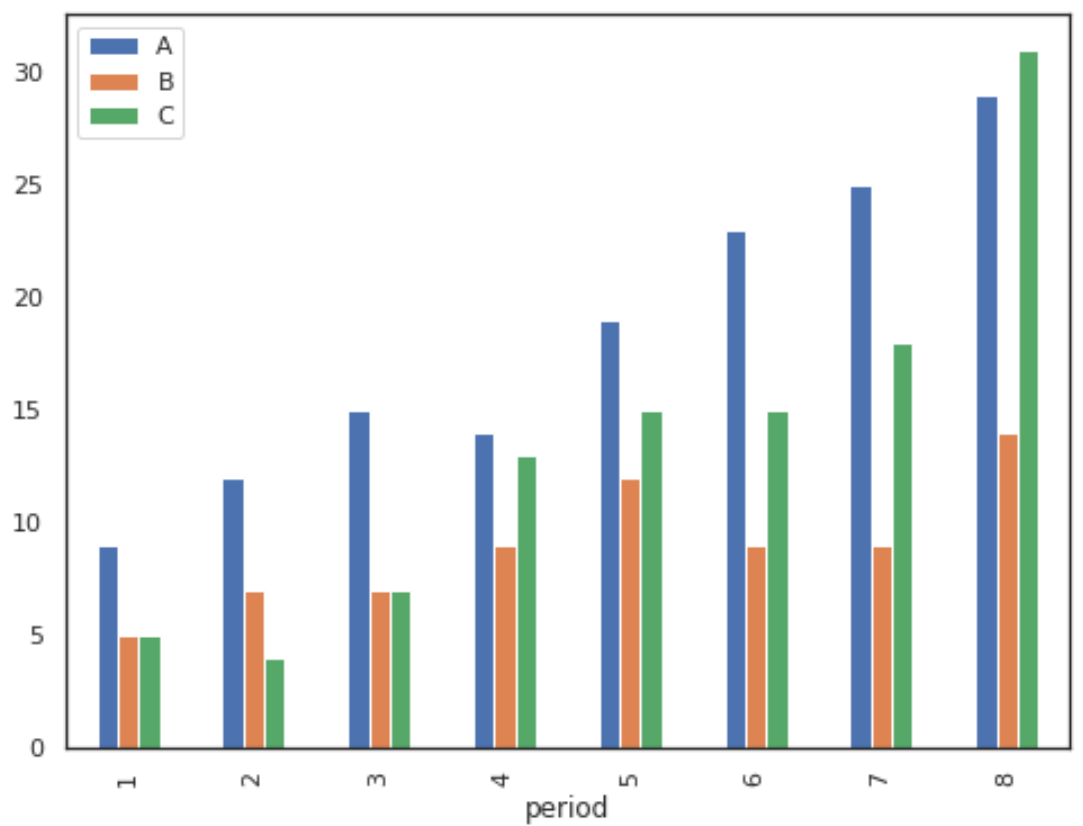
Lorsque cette instruction est exécutée sur un sous-ensemble tabulaire comportant par exemple une variable de partitionnement catégoriel et plusieurs colonnes de mesures numériques continues, l’interpréteur procède à une allocation séquentielle. Chaque colonne quantitative se voit assigner un index de décalage spatial spécifique au sein de l’intervalle attribué à la catégorie d’appartenance. Les barres sont alignées parallèlement les unes aux autres, le bord gauche de la deuxième barre jouxtant le bord droit de la première, créant ainsi un groupe unitaire compact immédiatement identifiable par le cortex visuel.
Ce mécanisme de partitionnement automatique assure que toutes les séries partagent une ligne de base stricte, ancrée à l’ordonnée zéro. Cette égalité de base fondamentale constitue la condition sine qua non permettant des comparaisons d’amplitudes précises et non biaisées. L’observateur peut alors juger des écarts en observant l’alignement relatif des sommets de barres, tirant parti de la supériorité éprouvée de la perception de position le long d’une échelle commune par rapport à l’estimation de longueurs déconnectées ou de surfaces angulaires.
3.2 Calcul géométrique du décalage et de la largeur des barres
Le dimensionnement spatial d’un diagramme à barres groupées obéit à des règles géométriques rigides orchestrées conjointement par Pandas et Matplotlib. Chaque graduation de l’axe des abscisses, correspondant à une ligne du DataFrame d’entrée, est assignée à une coordonnée centrale discrète, traditionnellement indexée par les entiers naturels 0, 1, 2, …, N-1. L’espace total imparti à chaque conglomérat catégoriel est régi par une fraction unitaire, par défaut établie à une valeur comprise entre 0.5 et 0.8 de la distance séparant deux graduations consécutives.
L’argument contrôlant la largeur (width), passé à la méthode de tracé, permet au chercheur de moduler cette allocation globale. Si une valeur de 0.8 est attribuée, cela signifie que 80 % de la distance inter-repères sera occupée par le conglomérat de barres, ménageant un espace interstitiel de 20 % pour séparer visuellement les modalités entre elles. Ce volume global de 0.8 est ensuite subdivisé de manière rigoureusement équitable par le nombre de colonnes sélectionnées pour le tracé. Ainsi, pour une comparaison impliquant quatre colonnes, chaque barre individuelle recevra une largeur géométrique de 0.2 unité cartésienne.
Une mauvaise calibration de ce paramètre peut induire des altérations perceptives sévères. Une largeur globale trop modeste génère des barres excessivement filiformes, distendant l’espace blanc et affaiblissant la saillance des contrastes de couleur. À l’inverse, une largeur approchant l’unité (width=1.0) élimine tout espacement inter-groupes ; les barres adjacentes de catégories distinctes entrent en contact physique, anéantissant la frontière gestaltiste entre les groupes expérimentaux et instillant une confusion visuelle profonde. L’optimisation proportionnelle de cet argument représente donc un levier majeur de clarté sémiotique.
3.3 Exemple d’application empirique : profils d’évaluation temporelle
Afin de concrétiser ces préceptes au sein d’un cas d’usage scientifique, considérons un protocole de recherche longitudinale en psychologie cognitive évaluant l’efficacité comparée de trois stratégies de remédiation mnésique chez des patients présentant des troubles attentionnels. L’évaluation s’étale sur huit intervalles temporels discrets (de l’évaluation basale à sept mois de suivi post-intervention). Les trois colonnes de variables dépendantes enregistrent respectivement les scores moyens de mémoire de travail, de fluence verbale et de contrôle inhibiteur.
La création programmatique d’un DataFrame de dimensions 8 par 4 (incluant la colonne d’horodatage ou de session) permet d’alimenter directement la routine de traçage. En invoquant la syntaxe de barres groupées avec une largeur standard de 0.75, nous obtenons une matrice visuelle où chaque session chronologique présente le trio de performances aligné côte à côte. Les variations morphologiques des hauteurs permettent de déduire immédiatement des trajectoires fonctionnelles différenciées.
L’analyse interprétative de cette géométrie vectorielle révèle, par exemple, que si le contrôle inhibiteur présente une progression quasi-linéaire tout au long des huit intervalles, la mémoire de travail atteint un plateau d’assimilation dès le quatrième mois, tandis que la fluence verbale manifeste une légère régression transitoire avant de se stabiliser. La restitution conjointe des trois colonnes sur un même graphique évite la dispersion de l’attention et met en exergue des phénomènes de synchronie ou de découplage chronologique qui seraient demeurés indétectables par l’examen fragmenté de séries statistiques isolées.
4. Sélection sélective et filtrage préalable des variables
4.1 Indexation par sous-ensemble explicite de listes
Dans le cours réel d’un projet d’analyse quantitative, un DataFrame brut contient couramment plusieurs dizaines, voire plusieurs centaines de colonnes, incluant des identifiants techniques, des données démographiques annexes, des scores bruts et des indicateurs dérivés. Lancer une procédure de tracé global sur une telle structure produit un encombrement catastrophique, le moteur graphique tentant de compresser une infinité de barres indiscernables au sein de chaque graduation.
La première technique de sélection sélective consiste à opérer une indexation par sous-ensemble explicite en utilisant la syntaxe idiomatique du double crochet de Pandas. En définissant une liste textuelle restreinte contenant exclusivement l’identifiant de la modalité horizontale et les deux ou trois métriques cibles, le chercheur circonscrit strictement le périmètre d’exécution de la méthode graphique. Cette réduction en amont élimine la présence de variables de bruit et optimise les temps d’exécution en allégeant les structures matricielles soumises aux calculs de décalage.
Il demeure cependant impératif de maintenir une cohérence dimensionnelle et référentielle stricte. La liste d’extraction doit impérativement préserver la variable d’axe d’abscisse si celle-ci n’a pas été préalablement assignée comme index structurel de la table. Si l’indexation explicite a été préalablement mise en œuvre via l’assignation de l’index, l’analyste peut se contenter d’extraire la liste des colonnes quantitatives pures, la méthode de tracé héritant spontanément de l’index sous-jacent sans risque de collision lexicale.
4.2 Sélection dynamique basée sur les types ou motifs de colonnes
Dans le contexte d’un pipeline de traitement automatisé ou d’une analyse exploratoire sur des bases de données volumineuses, l’énumération manuelle des variables devient rapidement fastidieuse et propice aux erreurs humaines. Pandas propose des mécanismes d’abstraction dynamique permettant d’isoler des cohortes de colonnes sur la base de critères typologiques ou de motifs lexicaux d’une grande puissance analytique.
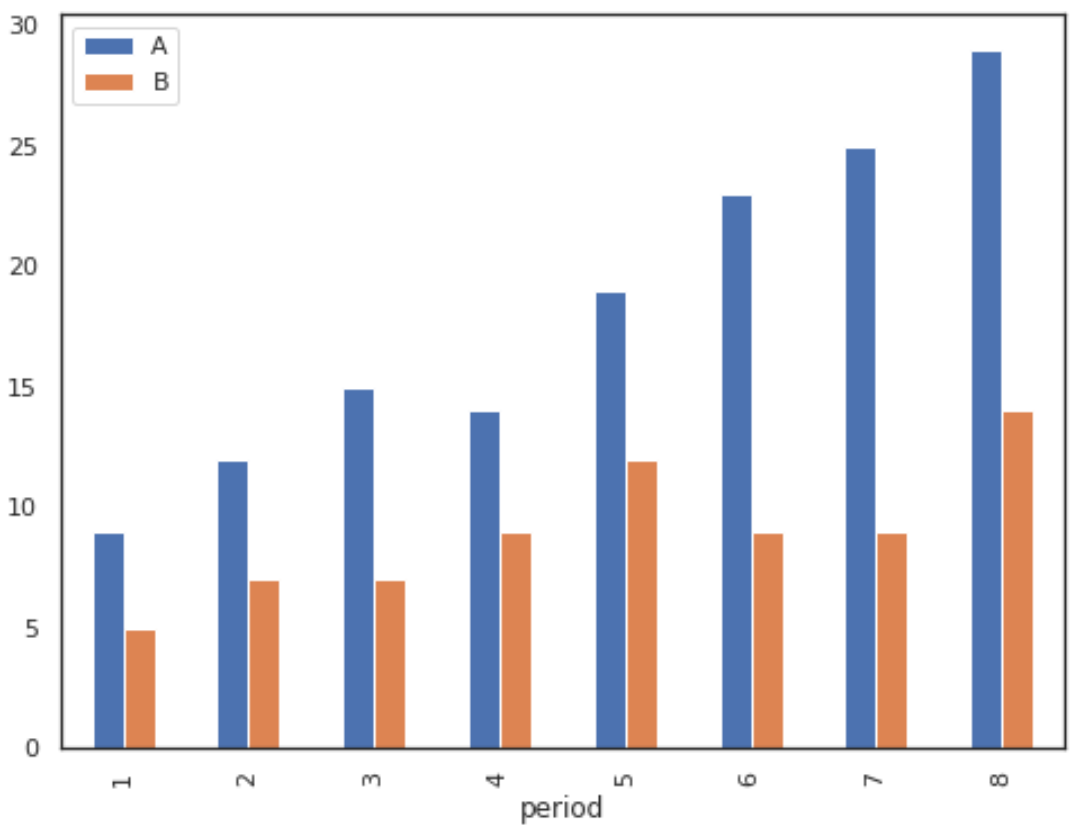
La méthode de sélection par type (select_dtypes) autorise le filtrage automatisé de la matrice afin de ne conserver que les champs numériques (tels que les entiers et les réels à virgule flottante), évacuant de facto les colonnes textuelles, temporelles ou booléennes non directement traçables sous forme d’amplitudes de barres. Concomitamment, la méthode de filtrage textuel par expressions régulières (filter avec l’argument regex) permet de capturer des grappes de colonnes respectant une convention de nommage standardisée (par exemple, toutes les variables dont l’identifiant débute par le préfixe désignant un sous-score spécifique ou un temps d’évaluation particulier).
En combinant ces méthodes de projection dynamique en une chaîne d’appels fluide, l’ingénieur de données peut concevoir des scripts d’une robustesse exemplaire. L’algorithme extrait dynamiquement le contingent de variables pertinentes, applique la transformation graphique et produit la figure sans nécessiter de modification manuelle du code lorsque de nouvelles métriques conformes aux motifs lexicaux sont ajoutées en amont dans l’entrepôt de données.
4.3 Gestion des sous-groupes asymétriques et variables binaires
Un défi méthodologique critique dans le traçage simultané de plusieurs colonnes réside dans la disparité potentielle des échelles de mesure et de distribution des grandeurs sélectionnées. Juxtaposer sur un même axe cartésien une variable continue s’étalant sur des magnitudes de l’ordre du millier (par exemple, des temps de réaction exprimés en millisecondes) et une variable d’amplitude modeste ou binaire comprise entre zéro et un (comme une précision de réponse probabiliste ou une proportion de succès) constitue une faute sémiotique majeure.
Dans une telle configuration géométrique, les barres associées à la variable de faible magnitude seront compressées contre la ligne de base du système de coordonnées, devenant de simples lignes pixelisées d’épaisseur négligeable, totalement dépourvues de lisibilité et insensibles aux variations relatives pourtant cruciales. L’amplitude démesurée de la première variable monopolise l’espace cartésien, instillant l’illusion erronée d’une invariance de la seconde métrique.
Pour prévenir cette distorsion, deux voies de remédiation doivent être rigoureusement arbitrées. La première consiste à appliquer des procédures de normalisation statistique préalables (telles que le centrage et la réduction pour obtenir des scores standardisés Z, ou la normalisation Min-Max restreignant l’amplitude sur l’intervalle unitaire). La seconde option consiste à renoncer au tracé sur un axe unique au profit d’un partitionnement en sous-graphiques disposant d’échelles verticales indépendantes. Ce discernement analytique garantit que la proximité géométrique n’induise pas de fausse comparabilité entre grandeurs ontologiquement hétérogènes.
5. Conception de graphiques à barres empilées (Stacked Bar Charts)
5.1 Activation et fonctionnement du paramètre stacked=True
Lorsque la finalité analytique ne repose plus principalement sur la comparaison directe des magnitudes individuelles de chaque variable, mais sur la décomposition d’un total global en ses constituants élémentaires, le modèle du diagramme à barres empilées (Stacked Bar Chart) s’impose comme le format d’élection. Dans l’écosystème Pandas, ce basculement paradigmatique s’opère par l’activation d’un argument booléen dédié à l’empilement (stacked=True).
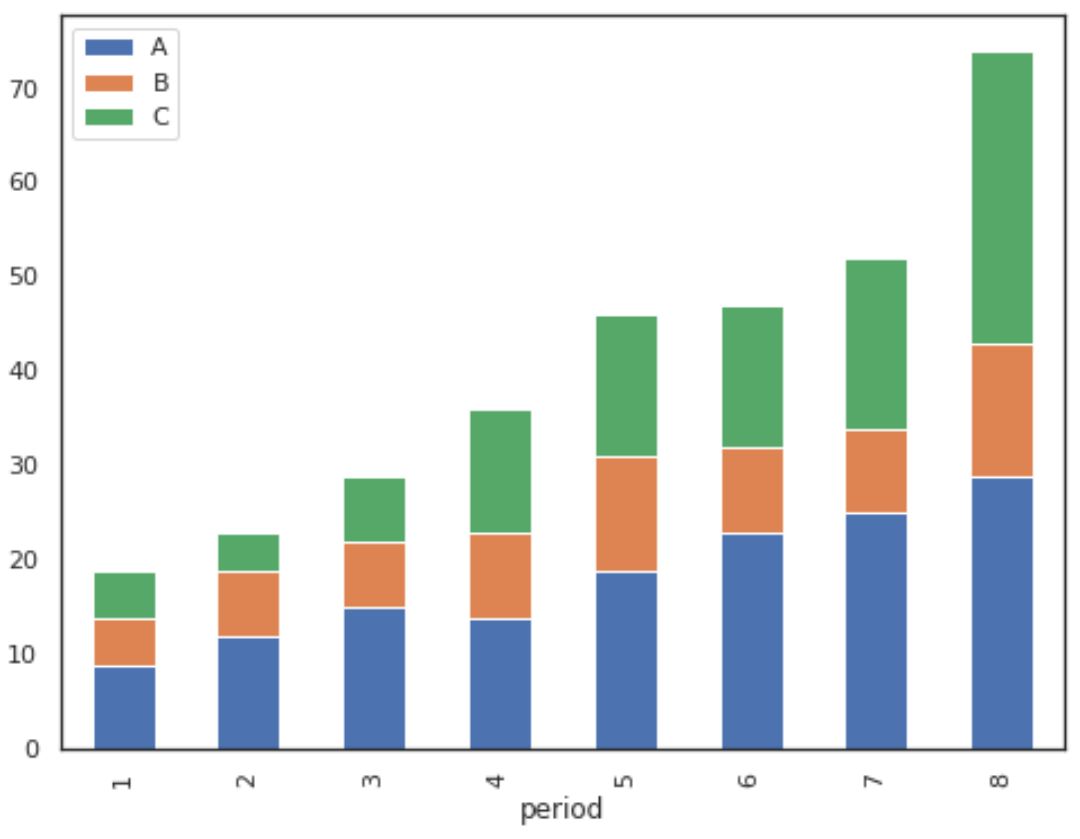
Sur le plan algorithmique, l’activation de cet argument modifie fondamentalement l’ancrage cartésien des segments de barres. Au lieu d’assigner à chaque colonne un décalage horizontal pour la juxtaposer sur la ligne de base zéro, Pandas et Matplotlib ordonnent une sommation cumulative sur l’axe des ordonnées. La première série sélectionnée est tracée à partir de l’ordonnée zéro. La deuxième série ne débute pas au niveau de la ligne de base, mais utilise le sommet supérieur de la première série comme plancher de départ géométrique. Ce processus s’itère récursivement pour l’ensemble des colonnes intégrées au calcul.
La syntaxe demeure remarquablement concise, requérant uniquement l’adjonction de ce paramètre au sein de l’instruction de tracé standard. Le rendu visuel consolide ainsi chaque catégorie en une barre unique dont la hauteur culminante représente exactement la somme arithmétique globale des variables sous-jacentes. Cette géométrie unifiée matérialise instantanément à la fois le volume macroscopique du phénomène étudié et la stratification microscopique des composantes qui le constituent.
5.2 Interprétation analytique des grandeurs cumulées
L’avantage cognitif prédominant du graphique à barres empilées réside dans sa capacité à communiquer simultanément deux niveaux d’information hiérarchique sans requérir d’efforts de calcul mental de la part du lecteur. Au niveau macroscopique, l’observateur évalue les fluctuations de la silhouette globale de la barre, identifiant immédiatement si l’activité agrégée, le coût total ou l’indice composite augmente ou régresse d’une condition à l’autre. Cette vue d’ensemble est cruciale pour appréhender les tendances de fond qui pourraient être masquées par la variabilité intrinsèque de sous-dimensions individuelles.
Au niveau microscopique, le graphique dévoile la structure interne de chaque barre, révélant la contribution relative ou absolue de chaque sous-composante. Dans le cadre d’études psychométriques employant des instruments de mesure multi-dimensionnels (comme une échelle de dépression décomposée en symptômes somatiques, cognitifs et affectifs), l’empilement permet de mettre en lumière des dynamiques de compensation. On peut ainsi observer une situation où deux groupes d’individus présentent un score total identique (matérialisé par des barres de hauteur rigoureusement équivalente), alors que la morphologie interne de leurs empilements démontre une prédominance exclusive de symptômes somatiques chez le premier groupe et une saturation de marqueurs affectifs chez le second.
Cette méthodologie d’affichage s’avère particulièrement puissante lors de l’exploration de processus cumulatifs ou d’équilibres budgétaires et temporels, où l’enveloppe globale est soumise à une contrainte physique ou institutionnelle stricte. En observant la fluctuation des segments colorés le long de la barre, l’analyste décèle instantanément les phénomènes de vases communicants, où l’accroissement d’une colonne s’opère au détriment mécanique d’une autre au sein d’un contingent stationnaire.
5.3 Limitations cognitives inhérentes à l’empilement
En dépit de son attrait visuel indéniable et de son efficience spatiale, le diagramme à barres empilées comporte des biais perceptifs documentés qui limitent son universalité méthodologique. L’obstacle cognitif majeur réside dans la perte d’une ligne de base commune pour l’ensemble des segments situés au-delà de la couche initiale. Seule la série placée au contact immédiat de l’axe des abscisses (la composante inférieure) bénéficie d’une référence fixe à zéro, autorisant des jugements de magnitude d’une fiabilité absolue.
Pour toutes les séries intermédiaires ou supérieures, le point de départ vertical de chaque segment dépend intrinsèquement des fluctuations d’épaisseur des couches qui lui sont sous-jacentes. Par conséquent, les limites inférieures et supérieures de ces segments varient de manière asynchrone le long de l’axe vertical. Le système visuel humain s’avère notoirement inefficace pour évaluer et comparer avec précision la longueur d’objets rectangulaires flottant librement dans l’espace sans ancrage fixe, ce qui induit une dégradation substantielle de la précision de jugement.
Cette instabilité de référence peut engendrer des illusions d’optique où une composante dont l’amplitude augmente réellement d’une modalité à l’autre peut paraître stagner ou même diminuer visuellement si la couche située directement sous elle subit une contraction massive. Dès lors, le chercheur doit exercer une vigilance épistémologique stricte : si l’objectif prédominant de la communication scientifique est de permettre une comparaison fine et quantitative des sous-composantes entre elles, le modèle groupé côte à côte doit être résolument préféré au modèle empilé.
6. Normalisation et graphiques à barres empilées à 100 %
6.1 Transformation vectorielle en pourcentages relatifs
Lorsque la préoccupation centrale de l’analyse porte non pas sur les volumes absolus, mais sur l’évolution des proportions relatives des composantes d’un groupe à un autre, la sommation brute du diagramme empilé perd de sa pertinence, en particulier lorsque les effectifs totaux des catégories sont fortement divergents. Dans cette conjoncture, la conversion des données brutes en un modèle d’empilement standardisé à 100 % constitue la réponse analytique optimale.
Cette approche requiert une transformation vectorielle préalable des données matricielles, que Pandas permet d’exécuter avec une grande élégance mathématique sans nécessiter de boucles itératives explicites. La procédure consiste à diviser chaque ligne du DataFrame par la somme arithmétique de cette même ligne le long de l’axe horizontal. Cette opération est réalisée par l’invocation coordonnée de la méthode de division vectorielle (div) et de la méthode de sommation matricielle (sum avec l’axe axis=1), en veillant à réaligner l’axe de diffusion (axis=0).
Sur le plan matriciel, cette transformation applique une normalisation L1 sur chaque vecteur ligne, convertissant les grandeurs scalaires hétérogènes en fractions univoques appartenant strictement à l’intervalle fermé [0, 1]. Lors de cette opération, une attention mathématique particulière doit être portée à la présence éventuelle de lignes entièrement constituées de valeurs nulles, dont la somme scalaire égale à zéro engendrerait des indéterminations arithmétiques conduisant à des valeurs indéfinies (NaN). Une gestion préventive de ces occurrences singulières est indispensable pour garantir l’intégrité du calcul vectoriel.
6.2 Construction graphique de distributions proportionnelles
Une fois le DataFrame normalisé sous forme de proportions relatives, le tracé s’exécute en réemployant la syntaxe canonique de l’empilement (kind=’bar’, stacked=True). La morphologie graphique résultante présente une caractéristique géométrique remarquable : l’ensemble des barres atteint rigoureusement la même élévation maximale, normalisée à la valeur scalaire 1.0 (ou 100 %). L’axe des ordonnées perd son statut de mesure de volume pour devenir une échelle pure de répartition distributionnelle.
Ce format neutralise intégralement les effets de disparité de taille d’échantillon entre les catégories d’abscisse. Considérons une comparaison sociologique portant sur la répartition de typologies comportementales (par exemple, comportements coopératifs, compétitifs ou individualistes) au sein de trois cohortes démographiques comptant respectivement 50, 5 000 et 500 000 individus. Un graphique en valeurs absolues rendrait la première cohorte totalement invisible et saturerait la troisième. Le tracé empilé à 100 % abolit cette distorsion d’échelle d’effectifs pour focaliser l’acuité visuelle exclusivement sur la structure interne de chaque groupe.
L’interprétation gagne alors en netteté : le lecteur peut suivre l’expansion ou la récession de la part relative de chaque modalité comportementale d’une condition à l’autre. Le modèle permet de mettre en lumière des basculements de majorité ou des émergences marginales avec une force démonstrative remarquable, tout en maintenant une élégance esthétique fondée sur l’alignement supérieur parfait de la silhouette graphique.
6.3 Formatage typographique des unités relatives
Bien que la matrice sous-jacente d’un graphique empilé à 100 % soit constituée de valeurs flottantes normalisées comprises entre zéro et un, laisser l’axe des ordonnées gradué sous forme décimale (de 0.0 à 1.0) engendre un frottement cognitif superflu. Dans les standards de communication académique et professionnelle, les distributions relatives s’expriment conventionnellement sous la forme de pourcentages explicites s’échelonnant de 0 % à 100 %.
L’implémentation de cette convention exige une intervention typographique sur l’objet d’axe cartésien fourni par Matplotlib, accessible via le sous-module des formateurs d’échelle (ticker). En assignant une instance de formatage de pourcentage (PercentFormatter avec une valeur de base de 1.0) au formateur principal de l’axe vertical, l’analyste ordonne à la chaîne de rendu de convertir automatiquement chaque marqueur décimal en sa représentation textuelle en pourcentage correspondante, supprimant les décimales redondantes pour un affichage épuré.
Cette rigueur de mise en forme doit s’étendre aux étiquettes des graduations et au titre de l’axe des ordonnées, qui doit explicitement porter la mention « Pourcentage relatif » ou « Proportion normalisée (%) ». Cette précaution sémiotique élimine toute ambiguïté pour le lecteur, confirmant sans équivoque que la hauteur constante des barres ne reflète pas une stationnarité des effectifs bruts, mais une contrainte distributionnelle imposée délibérément pour des impératifs d’analyse structurelle.
7. Personnalisation esthétique et sémiotique visuelle
7.1 Sélection et application de palettes de couleurs académiques
La couleur ne saurait être réduite à un simple artifice cosmétique ; elle constitue une variable rétinienne fondamentale au sens de la sémiologie graphique formalisée par Jacques Bertin. Dans le cadre d’un diagramme à barres multi-colonnes, la palette chromatique assure la fonction sémiotique critique de discrimination catégorielle. Pandas permet de piloter cette attribution chromatique au travers de deux paramètres majeurs : l’argument recevant une carte de couleurs prédéfinie (colormap) ou une liste explicite de codes de couleurs (color).
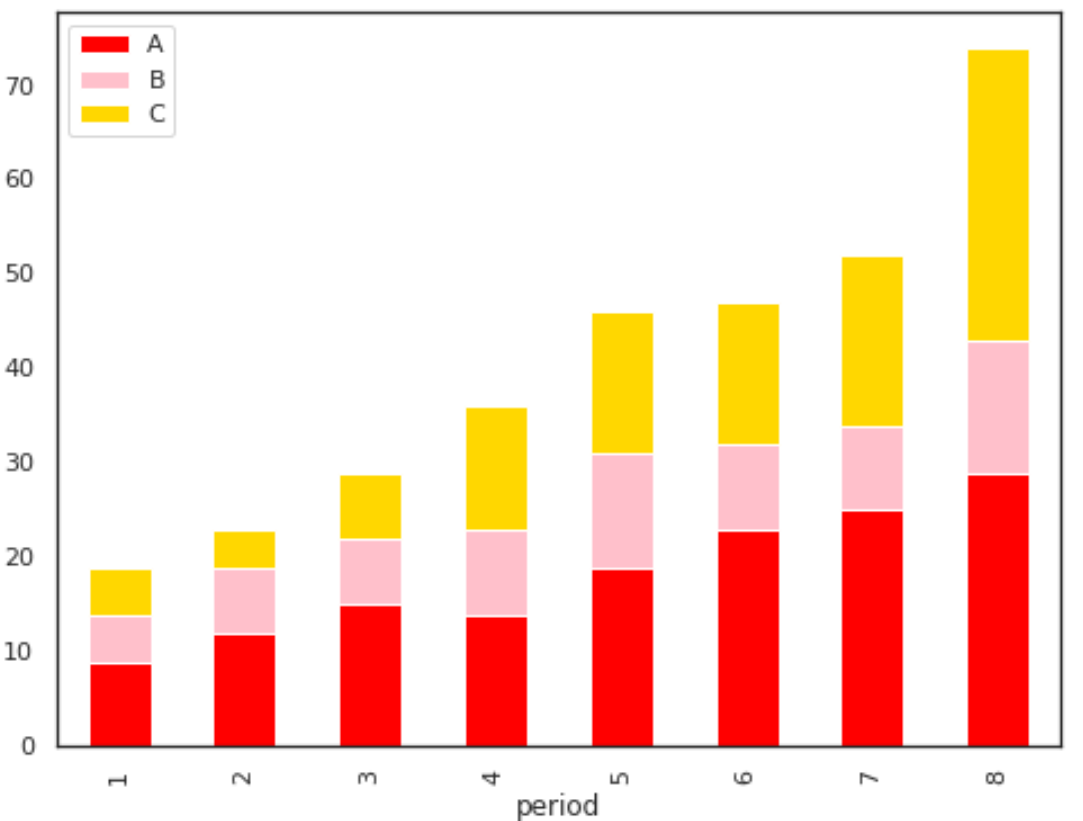
L’éthique et la rigueur de la publication scientifique moderne proscrivent l’usage des palettes de couleurs primaires saturées ou de spectres rainbow non uniformes qui induisent des discontinuités perceptives trompeuses et créent des hiérarchies visuelles artificielles. Il convient d’adopter des palettes perceptuellement uniformes développées scientifiquement pour la restitution des données, telles que les cartes Viridis, Cividis, Plasma ou Inferna, issues du corpus méthodologique de Matplotlib. Ces palettes garantissent que des écarts numériques d’égale magnitude soient perçus avec un contraste visuel constant sur l’ensemble du gradient chromatique.
De surcroît, la prise en compte de l’accessibilité visuelle pour les personnes affectées d’anomalies de la vision des couleurs (particulièrement le daltonisme de type deutéranopie et protanopie, affectant une proportion significative de la population masculine mondiale) constitue une obligation impérative. La palette Cividis, par exemple, a été mathématiquement optimisée pour demeurer parfaitement lisible et contrastée tant pour les trichromates que pour les individus présentant des déficiences de perception des teintes rouge-vert. Le choix chromatique devient ainsi le garant d’une transmissibilité scientifique universelle.
7.2 Contrôle des paramètres de surface et de bordure
La lisibilité d’un ensemble complexe de barres juxtaposées ou empilées repose grandement sur la netteté de délimitation de chaque polygone élémentaire. Deux paramètres graphiques permettent d’ajuster avec précision la matérialité visuelle des barres : l’opacité de surface et la nature des bordures périphériques.
Le paramètre de transparence (alpha), accepting des valeurs flottantes continues sur l’intervalle [0.0, 1.0], permet d’atténuer la saturation agressive de certaines teintes en instillant une légère transparence. Cette modération chromatique diminue la fatigue visuelle lors de la lecture de graphiques denses et permet d’assurer une meilleure intégration des quadrillages d’arrière-plan nécessaires au pointage précis des valeurs. Une valeur d’alpha calibrée autour de 0.85 confère généralement un équilibre visuel optimal entre présence graphique et douceur tonale.
Parallèlement, la définition explicite de bordures distinctives par l’emploi coordonné de l’argument désignant la couleur de contour (edgecolor) et de celui fixant l’épaisseur de ligne (linewidth) apporte un gain de contraste substantiel. L’application d’un contour fin sombre (ou blanc dans le cadre d’empilements denses) prévient le flou d’atténuation aux jonctions géométriques et individualise nettement chaque barre, en particulier sur les supports d’impression à faible résolution. Pour les publications strictement contraintes par le noir et blanc, l’analyste peut également enrichir ces surfaces de motifs de hachures (hatch), offrant une différenciation texturée indépendante de toute composante de teinte.
7.3 Dimensionnement géométrique et résolution de rendu
L’affichage équilibré d’un diagramme à barres multi-colonnes dépend de l’adéquation entre le volume d’informations affiché et la surface géométrique qui lui est allouée. La déformation la plus commune résulte de l’exécution du tracé au sein d’une figure aux dimensions par défaut trop exiguës, provoquant l’écrasement des barres, le chevauchement des labels d’axe et la relégation de la légende sur la zone de tracé utile.
Le dimensionnement s’opère par la spécification du paramètre de taille de figure (figsize), prenant en argument un tuple de scalaires définissant respectivement la largeur et la hauteur en pouces conventionnels. Ce ratio d’aspect doit être scrupuleusement ajusté au prorata du produit arithmétique entre le nombre de modalités d’abscisse et le nombre de colonnes comparées. Une étude comparative impliquant dix catégories temporelles et cinq séries métriques exige une largeur substantiellement supérieure à celle d’une simple comparaison binaire, afin de préserver une largeur individuelle de barre compatible avec la résolution perceptive de l’œil.
Enfin, l’exportation des figures vers des supports de publication scientifique ou des manuscrits académiques nécessite une gestion rigoureuse de la densité d’échantillonnage de points par pouce (dpi – dots per inch). Un rendu standard d’affichage sur moniteur (72 à 96 dpi) produit une pixellisation intolérable lors de l’impression papier ou du zoom numérique. La spécification explicite d’une résolution égale ou supérieure à 300 dpi, voire le recours systématique aux formats vectoriels évolutifs (SVG ou PDF), garantit que les tracés vectoriels de Pandas conservent une netteté géométrique chirurgicale, indépendamment des facteurs d’agrandissement ultérieurs.
8. Configuration avancée des axes, étiquettes et légendes
8.1 Gestion de l’orientation et de la lisibilité des étiquettes d’abscisse
Un désagrément récurrent inhérent aux diagrammes à barres verticaux impliquant des nomenclatures catégorielles détaillées réside dans l’empiètement mutuel des libellés textuels le long de l’axe des abscisses. Lorsque les noms des conditions expérimentales ou des sous-populations excèdent quelques caractères, la chaîne de rendu de Pandas tente de les disposer horizontalement, générant une superposition chaotique de caractères typographiques qui anéantit toute lisibilité.
L’API de tracé de Pandas intègre un paramètre de contrôle angulaire (rot) permettant d’imposer une rotation axiale aux étiquettes d’abscisse. Une rotation d’une inclinaison de 45 degrés, ou d’une verticalité stricte à 90 degrés, rétablit un espacement suffisant entre les marqueurs textuels. Toutefois, une rotation oblique à 45 degrés requiert impérativement un réalignement horizontal des points d’ancrage du texte (horizontal alignment – ha=’right’) au niveau de l’objet d’axe sous-jacent de Matplotlib, afin que la terminaison textuelle pointe avec exactitude vers la graduation cartésienne correspondante.
En outre, l’application d’une rotation importante entraîne une expansion mécanique de l’emprise spatiale occupée par la zone des étiquettes vers le bas de la figure, ce qui risque de tronquer les textes lors de l’enregistrement de l’image. Ce travers est neutralisé par l’invocation de routines d’ajustement automatique des marges périphériques, telles que la commande d’agencement compact (tight_layout) de Matplotlib ou la spécification de boîtes d’encadrement élastiques, garantissant que l’intégralité du lettrage soit préservée à l’intérieur du cadre visible de la figure.
8.2 Positionnement et sémantique de la légende explicative
Dans un diagramme à barres multi-colonnes, la légende explicative ne constitue pas un composant ornemental subsidiaire mais la clé sémiotique centrale qui permet de décoder la signification des codes chromatiques associés à chaque variable. Par défaut, Pandas extrait les noms bruts des colonnes de la matrice pour composer la légende, générant souvent des libellés cryptiques issus de la nomenclature informatique des bases de données (par exemple : ‘score_z_t1_corr’).
Le perfectionnement de la légende implique une reprise sémantique intégrale via les méthodes dédiées de l’objet Legend de Matplotlib. Il convient de substituer à ces identifiants bruts des formulations explicites, rédigées dans une typographie scientifique impeccable, assorties des unités physiques ou psychométriques de mesure. De plus, la position par défaut de la boîte de légende, dictée par des heuristiques d’évitement des données, vient régulièrement recouvrir le sommet de barres volumineuses, introduisant une interférence inacceptable.
Pour parer à ce défaut spatial, il est hautement recommandé d’expulser la boîte de légende en dehors de la surface active de traçage. Ce positionnement satellite est réalisé par l’argument d’ancrage dimensionnel relatif (bbox_to_anchor), fixant les coordonnées du coin d’ancrage de la légende en dehors des limites standard des axes (par exemple, sur la marge droite ou en position supérieure centrale). Si la disposition s’effectue au sommet du graphique, l’organisation de la légende selon une pluralité de colonnes horizontales parallèles (via l’argument de partitionnement ncol) permet de préserver l’équilibre morphologique de la page et d’optimiser l’espace vertical disponible.
8.3 Inclusion d’annotations directes de valeurs numériques
Bien que le système cartésien permette une estimation visuelle rapide des grandeurs grâce aux graduations de l’axe des ordonnées, de nombreux contextes décisionnels ou académiques exigent la restitution de la valeur numérique exacte sans obliger le lecteur à effectuer une projection oculaire fastidieuse vers l’axe latéral. L’insertion d’annotations textuelles directes sur les sommets des barres répond à cette exigence de précision métrologique.
Historiquement complexe et requérant des boucles itératives fastidieuses sur les coordonnées de chaque patch géométrique, cette opération a été extraordinairement simplifiée depuis l’introduction de la méthode d’étiquetage automatisé des barres (ax.bar_label) au sein de Matplotlib. Cette routine itère spontanément sur les conteneurs géométriques générés par Pandas pour calculer le centre de gravité de chaque sommet de barre et y apposer la chaîne de caractères correspondante avec un décalage spatial (padding) maîtrisé.
Cette fonctionnalité offre des options de formatage textuel poussées, permettant de spécifier des masques d’arrondi (comme la limitation stricte à deux décimales après la virgule pour les nombres réels), d’insérer des suffixes dimensionnels (tels que le symbole de pourcentage ou des abréviations monétaires) et de gérer la rotation du texte si les barres s’avèrent trop étroites pour héberger les chiffres horizontalement. L’adjonction de ces étiquettes d’amplitudes transforme le diagramme à barres en un outil d’une double nature, combinant la puissance de synthèse d’une géométrie globale et la précision documentaire d’un tableau chiffré exhaustif.
9. Traitement des valeurs manquantes et incohérences structurelles
9.1 Comportement du moteur de tracé face aux valeurs NaN
Dans tout processus réel de collecte empirique de données, la survenue de valeurs manquantes, encodées sous la forme de valeurs non numériques (NaN pour Not a Number), constitue une réalité inéluctable. L’analyste se doit d’appréhender le comportement mathématique et graphique du moteur de Pandas face à ces lacunes structurelles lorsqu’il projette plusieurs colonnes simultanément.
Lors de la confection d’un diagramme à barres groupées standards, la présence d’une valeur NaN au sein d’une ligne pour une colonne donnée n’interrompt pas brutalement l’exécution du script, mais induit une rupture géométrique. Pandas alloue l’espace spatial réservé à la barre concernée, mais la hauteur du rectangle correspondant est fixée à zéro. Il en résulte une discontinuité visuelle au sein du groupe catégoriel, matérialisée par un vide spatial asymétrique. Cette béance peut déconcerter l’observateur, qui ne peut déterminer visuellement si la donnée sous-jacente est rigoureusement égale à zéro ou si elle relève d’une absence absolue de recueil d’information.
Dans le contexte des graphiques à barres empilées, la gestion des NaN s’avère encore plus insidieuse. La sommation cumulative ignore implicitement les composantes manquantes (traitant le NaN comme un élément neutre d’addition zéro) et poursuit l’empilement des couches supérieures. Cette cascade silencieuse peut générer des distorsions analytiques sévères : un segment situé au-dessus d’une couche manquante s’affaisse pour reposer sur la couche précédente, modifiant totalement la topologie de l’empilement sans qu’aucun signal d’alarme sémiotique n’avertisse l’observateur de l’omission d’un facteur déterminant du total.
9.2 Stratégies de prétraitement avant restitution graphique
Face à ces périls d’interprétation, une hygiène de prétraitement rigoureuse s’impose de manière catégorique en amont de toute invocation de la méthode de visualisation. L’analyste doit formuler un arbitrage explicite quant au destin méthodologique accordé aux observations lacunaires, écartant tout traitement par défaut non documenté.
La première stratégie repose sur l’imputation formelle. Si la théorie scientifique sous-jacente le justifie (par exemple, dans le cas d’une absence de transaction équivalant strictement à un volume monétaire nul), l’analyste fait usage de la méthode de remplacement (fillna) pour convertir les valeurs manquantes en zéros explicites. Si l’évaluation relève de séries statistiques continues, des algorithmes d’imputation par la moyenne, la médiane ou des régressions d’espérance-maximisation peuvent être déployés afin de rétablir une estimation intègre de la grandeur manquante, la figure devant obligatoirement expliciter ce traitement en légende.
La seconde approche relève de l’élagage conservateur. Par l’emploi de la méthode de suppression des observations incomplètes (dropna), l’analyste évacue les lignes du DataFrame qui présentent des valeurs lacunaires sur le sous-ensemble de colonnes soumises au tracé. Cette opération garantit la plénitude mathématique de chaque groupe catégoriel affiché, au détriment potentiel d’une réduction de l’échantillon visible. Quelle que soit l’option retenue, la documentation transparente de ces arbitrages au sein du texte d’accompagnement de la figure conditionne la reproductibilité et la validité scientifique de l’analyse.
9.3 Harmonisation des types de données sous-jacents
Une source fréquente d’échecs d’exécution ou d’artéfacts graphiques aberrants lors de l’utilisation conjointe de plusieurs colonnes provient de l’hétérogénéité silencieuse des types de données (dtypes) au sein de la matrice. Il n’est pas rare qu’une colonne contenant des observations numériques soit typée par erreur comme une chaîne textuelle (type ‘object’) en raison de l’intrusion fortuite de caractères d’espacement ou de symboles alphanumériques lors de l’importation de fichiers tabulaires externes.
Lorsque Pandas rencontre une colonne textuelle alors qu’il tente d’exécuter un tracé quantitatif multivarié, le moteur peut lever une exception de rupture dimensionnelle ou, plus sournoisement, tenter de tracer chaque chaîne distincte comme une catégorie autonome, générant des milliers de barres filiformes insensées. Il est donc impératif de soumettre la matrice à une vérification typologique systématique et d’appliquer la fonction de conversion numérique (to_numeric) sur l’intégralité des colonnes sélectionnées avant le rendu graphique.
Par ailleurs, les colonnes destinées à l’axe d’abscisse gagnent à être formellement encapsulées au sein du type catégoriel ordonné (CategoricalDtype). Cette formalisation préserve la préséance logique des modalités d’évaluation indépendamment des tris lexicographiques instinctifs de la machine, éliminant le risque de voir une modalité temporelle comme le mois de « Décembre » s’intercaler avant « Janvier » sous la seule contrainte de l’alphabet latin.
10. Orientation horizontale : tracer plusieurs colonnes avec kind=’barh’
10.1 Syntaxe et adaptation spatiale pour l’orientation horizontale
L’espace géométrique d’une figure n’est pas contraint à une verticalité stricte. Pandas offre la possibilité de transposer le repère cartésien d’une rotation orthogonale complète en substituant au paramètre de barre standard son pendant horizontal explicite (kind=’barh’). Dans ce système cartésien inversé, l’axe des abscisses (axe horizontal) devient le vecteur des amplitudes quantitatives continues, tandis que l’axe des ordonnées (axe vertical) héberge la nomenclature des modalités catégorielles.
La syntaxe de commande demeure d’une stricte symétrie par rapport aux expressions antérieures : il suffit de cibler les colonnes matricielles et de stipuler ce genre de tracé pour que l’algorithme réorganise la géométrie des polygones. Les barres ne s’élèvent plus de bas en haut mais s’étirent de gauche à droite depuis la ligne de base verticale ancrée à l’abscisse zéro. La répartition multi-colonnes conserve ses propriétés de décalage transversal ou d’empilement selon que le paramètre stacked soit maintenu à sa valeur par défaut ou activé.
Une attention méthodologique particulière doit être portée à l’ordonnancement vertical des catégories. Par convention intrinsèque liée à la topologie des axes de Matplotlib, la première ligne du DataFrame est généralement dessinée en bas de l’axe vertical, la lecture progressant ascendantement vers le sommet. Si le protocole de communication exige que l’ordre de lecture épouse la direction naturelle de haut en bas conforme aux conventions textuelles occidentales, l’analyste doit explicitement inverser la séquence des lignes du DataFrame ou appliquer une inversion de direction sur l’axe des ordonnées (via l’instruction invert_yaxis de l’objet d’axe).
10.2 Avantages ergonomiques pour les nomenclatures textuelles denses
Le recours à l’orientation horizontale ne constitue pas une simple alternative stylistique ; il répond à un principe ergonomique fondamental lorsque les libellés de catégories comportent des intitulés longs, descriptifs et incompressibles. Ce cas de figure est omniprésent dans les sciences sociales, la psychologie et la santé publique, où les catégories correspondent souvent à des formulations de questions d’enquêtes, des descriptions d’effets indésirables ou des diagnostics nosologiques complexes.
Sur un diagramme à barres verticales, de telles dénominations obligent à des contorsions graphiques désastreuses : rotations angulaires extrêmes rendant la lecture pénible, césures aléatoires de mots, ou réduction agressive de la taille de police conduisant à l’inintelligibilité. Le diagramme horizontal supprime instantanément cette congestion. L’axe vertical offre une extension naturelle le long de la marge gauche de la figure, permettant d’aligner des phrases complètes de manière parfaitement horizontale et naturelle pour le regard.
La lecture séquentielle de gauche à droite permet à l’œil d’absorber l’intitulé conceptuel complet sans aucune torsion cervicale ou oculaire, avant de prolonger sa trajectoire de balayage linéaire le long de la barre pour en apprécier l’amplitude numérique. Cette fluidité de décodage minimise l’interférence cognitive et accélère l’assimilation des contrastes empiriques entre les colonnes comparées.
10.3 Combinaison de l’orientation horizontale et de l’empilement
La conjugaison de l’orientation horizontale et du principe d’empilement (kind=’barh’, stacked=True) atteint son expression méthodologique la plus aboutie dans le traitement et la visualisation des échelles d’attitudes de type Likert à items multiples. Les questionnaires d’évaluation psychométrique soumettent couramment des cohortes d’individus à des dizaines d’assertions mesurées sur des échelles graduées (par exemple, de « Pas du tout d’accord » à « Tout à fait d’accord »).
En structurant les données de façon à ce que chaque degré de réponse occupe une colonne spécifique d’un DataFrame normalisé à 100 %, l’affichage sous forme de barres horizontales empilées offre une vision panoramique exceptionnelle de la distribution des opinions sur l’ensemble de la batterie de tests. Chaque item de test occupe une ligne horizontale dédiée, ce qui permet d’empiler plusieurs dizaines d’items au sein d’une même planche sans saturation.
Une variante avancée de cette approche repose sur le concept d’échelles de Likert divergentes, où les colonnes représentant les modalités de désaccord sont dotées de valeurs mathématiques négatives, tandis que les modalités d’accord demeurent positives. Lors du tracé horizontal empilé, le graphique s’ancre sur une ligne de divergence centrale médiane zéro : les segments d’opposition se développent vers la gauche, les segments d’adhésion vers la droite, et les segments de neutralité se positionnent au centre. Ce format offre une force d’impact heuristique incomparable pour discerner instantanément les clivages et les consensus au sein d’un corpus d’évaluation.
11. Décomposition par sous-graphiques (Subplots) pour colonnes multiples
11.1 Partitionnement visuel via l’argument subplots=True
Lorsque le nombre de colonnes à évaluer simultanément s’accroît substantiellement (excédant typiquement quatre ou cinq variables continues) ou lorsque les dynamiques de distribution internes sont d’une telle densité que leur superposition au sein d’un conglomérat unique engendre une cacophonie visuelle, le principe de juxtaposition au sein d’un seul système cartésien montre ses limites. La solution canonique prescrite par l’ergonomie visuelle réside dans la fragmentation spatiale ordonnée.
L’API graphique de Pandas orchestre ce partitionnement avec une remarquable frugalité syntaxique via l’activation de l’argument de sous-graphiques (subplots=True). L’inclusion de cette instruction enjoint le moteur de traçage de dissocier les colonnes du DataFrame : au lieu de tenter de faire cohabiter l’ensemble des séries au sein d’un cadre unique, il instancie une collection géométrique de systèmes cartésiens indépendants, assignant une colonne unique à chaque sous-graphique.
L’organisation matricielle de ces sous-graphiques est configurée via le paramètre de disposition spatiale (layout), attendant un tuple spécifiant le nombre de lignes et de colonnes de la grille d’affichage (par exemple, layout=(2, 3) pour distribuer six variables sur deux rangées horizontales de trois figures). Cette décomposition sépare physiquement les flux d’informations tout en maintenant une structure de lecture cohérente et sérielle, incarnant à la perfection le concept des « petits multiples » (Small Multiples) théorisé par les pionniers de la visualisation de données.
11.2 Synchronisation et harmonisation des échelles de mesure
L’adoption d’une architecture décomposée en sous-graphiques introduit un risque méthodologique majeur : la divergence involontaire des échelles de mesure le long de l’axe des ordonnées. Par défaut, Matplotlib et Pandas tendent à optimiser le cadre de chaque sous-axe individuellement, calibrant les bornes d’ordonnées au plus près des extremums de la colonne spécifique qui y est affectée.
Cette indépendance asynchrone des échelles s’avère particulièrement fallacieuse pour le lecteur non averti. Deux colonnes affichant des barres d’une hauteur géométrique strictement identique au sein de deux sous-graphiques contigus donneront l’impression fallacieuse d’une magnitude équivalente, alors qu’un examen attentif des graduations révélera que le premier axe culmine à 10 unités tandis que le second s’élève à 10 000. L’estimation intuitive de l’observateur est ainsi lourdement induite en erreur.
Pour restaurer l’intégrité comparative indispensable à une interprétation rigoureuse, l’analyste doit impérativement activer la synchronisation des ordonnées en utilisant le paramètre de partage d’axe (sharey=True). Cette contrainte unifie l’ensemble des sous-graphiques sous une même échelle absolue, déterminée par le maximum absolu observé sur l’ensemble des colonnes. Dès lors, les hauteurs des barres deviennent rigoureusement comparables d’une vignette à l’autre, et les disparités réelles de volumes émergent avec une netteté incontestable.
11.3 Itération et contrôle granulaire sur les objets Axes
L’une des plus grandes forces de l’intégration de Pandas avec l’écosystème Matplotlib réside dans la nature de la valeur de retour générée lors de l’appel d’un tracé partitionné. L’invocation d’une routine de sous-graphiques retourne un tableau multidimensionnel d’objets cartésiens (NumPy ndarray of AxesSubplot objects), fournissant un point d’ancrage direct pour une personnalisation algorithmique de haut niveau.
Par le déploiement d’une boucle itérative parcourant les éléments de ce tableau aplati d’axes, l’analyste peut appliquer un contrôle chirurgical sur chaque unité d’affichage : personnalisation individuelle des titres de sous-graphiques, ajout de lignes de référence d’intervalles de confiance spécifiques, ou suppression sélective des bordures périphériques supérieures et droites pour alléger l’architecture visuelle. Cette granularité permet de dépasser les limitations des styles prédéfinis pour produire des planches de résultats d’une qualité conforme aux exigences des revues académiques les plus strictes.
Cette approche programmatique permet également de conditionner l’esthétique à la sémantique statistique. Il devient par exemple aisé d’instruire le script d’identifier le sous-graphique présentant la variance la plus élevée pour colorer sélectivement ses barres d’une teinte d’alerte spécifique, ou d’inscrire des astérisques de significativité statistique calculés automatiquement par un test d’hypothèse en amont. La visualisation cesse d’être une simple projection passive pour devenir le réceptacle dynamique d’une modélisation inférentielle complexe.
12. Bonnes pratiques de publication scientifique et erreurs fréquentes
12.1 Règles déontologiques et rigueur de mise à l’échelle
La visualisation de données quantitatives est régie par une déontologie scientifique stricte visant à prohiber toute manipulation perceptive de l’information empirique. Dans le contexte des diagrammes à barres, l’injonction morale et technique absolue consiste en l’ancrage indéfectible de la ligne de base à la valeur scalaire zéro. Cette règle découle de la nature sémiotique même de la barre : la dimension spatiale signifiante est la longueur intégrale du rectangle et non la seule position de son sommet.
Tronquer l’axe des ordonnées pour faire débuter l’échelle à une valeur arbitraire non nulle (par exemple, borner un axe entre 95 et 100 pour magnifier visuellement un écart de 2 %) constitue une dénaturation de l’évidence empirique assimilable à une faute méthodologique grave. Cette pratique démultiplie artificiellement la perception des disparités relatives, instillant l’illusion d’une divergence monumentale là où les données réelles ne traduisent qu’une fluctuation marginale. Les directives éditoriales de l’American Psychological Association proscrivent rigoureusement ces ruptures d’échelle insidieuses sur les diagrammes à barres.
Lorsque la variabilité des données d’un groupe de colonnes est ténue et se concentre au sommet d’une amplitude de base élevée, le diagramme à barres s’avère intrinsèquement inadapté pour retranscrire ces micro-variations. L’analyste rigoureux se doit alors de renoncer aux barres au profit de géométries vectorielles alternatives fondées sur la position relative de points, telles que les diagrammes de dispersion, les graphiques en lignes ou les tracés d’intervalles de confiance (Dot plots de Cleveland). Respecter la sémiotique des barres, c’est respecter la proportionnalité linéaire directe entre l’aire imprimée et la quantité mesurée.
12.2 Prévention de la surcharge informationnelle (Chartjunk)
Dans son traité fondateur sur la conception de l’information visuelle, le théoricien Edward Tufte a introduit le concept crucial de « ratio encre-données » (Data-Ink Ratio), stipulant qu’une fraction maximale de l’encre employée pour générer une figure doit être dévolue à la dissémination de l’information quantitative réelle. Tout élément graphique superflu qui n’apporte aucun éclairage analytique relève de la surcharge parasitaire (Chartjunk) et doit être impitoyablement éradiqué.
Les diagrammes à barres multi-colonnes sont particulièrement vulnérables à cette saturation ornementale. Les écueils les plus fréquents incluent l’usage de pseudo-reliefs en trois dimensions, l’adjonction d’ombres portées artificielles, l’application de dégradés chromatiques complexes au sein des barres et le déploiement de grilles cartésiennes excessivement denses et contrastées. Ces artifices n’apportent aucun surcroît d’intelligibilité ; au contraire, ils génèrent des vibrations optiques parasites (comme les effets de moiré) qui fatiguent le cortex visuel et altèrent le discernement des longueurs relatives.
L’optimisation formelle d’un graphique Pandas exige un décapage visuel méthodique : suppression des boîtes de contours superflues, allègement typographique des graduations, atténuation chromatique des lignes de guidage réduites à de discrets pointillés gris clair, et élimination des motifs texturés criards. La beauté d’une figure scientifique découle de sa clarté cristalline, où la géométrie pure des colonnes de données émerge sans entrave de l’arrière-plan.
12.3 Arbre décisionnel pour le choix du format de restitution
Pour clore ce traité et guider l’analyste dans ses arbitrages pratiques face à une matrice multivariée, il apparaît salutaire de formaliser un arbre décisionnel rigoureux synthétisant les conditions méthodologiques d’élection de chaque modalité de représentation graphique :
- Diagramme à barres groupées côte à côte (kind=’bar’ par défaut) : À privilégier impérativement lorsque l’objectif principal est la comparaison directe et précise des magnitudes individuelles de chaque variable d’une condition à l’autre. Requis lorsque les colonnes partagent la même unité physique de mesure, que leur nombre n’excède pas quatre ou cinq séries, et que les valeurs d’amplitudes demeurent dans des ordres de grandeur comparables.
- Diagramme à barres empilées absolues (kind=’bar’, stacked=True) : À mobiliser lorsque l’addition des variables détient une signification théorique concrète matérialisant une totalité holistique (décomposition d’un score total, d’une ressource temporelle ou d’un coût agrégé), et que la trajectoire macroscopique du tout prévaut sur la granularité fine des parties intermédiaires.
- Diagramme à barres empilées à 100 % (données normalisées + stacked=True) : Format souverain pour l’analyse des distributions relatives et des proportions compositionnelles, en particulier lorsque les effectifs bruts des catégories d’abscisse diffèrent profondément. À proscrire formellement si la connaissance de la variation des volumes absolus constitue un enjeu analytique déterminant.
- Orientation horizontale (kind=’barh’) : Recommandée de manière univoque dès lors que les intitulés catégoriels comportent plus de dix à quinze caractères textuels, ou dans le cadre du traitement de questionnaires psychométriques fondés sur des échelles de Likert denses à dimensions lexicales développées.
- Décomposition par sous-graphiques (subplots=True) : Indispensable dès que le nombre de colonnes dépasse cinq variables, que les métriques reposent sur des unités de mesure incommensurables imposant des échelles disjointes, ou lorsque la superposition au sein d’un même cadre visuel crée un encombrement géométrique irréversible.
En alignant ainsi la structure matricielle des données, l’architecture d’affichage de Pandas et les impératifs sémiotiques de la communication scientifique, le chercheur ou l’ingénieur de données s’assure que sa restitution graphique transmet l’essence de ses découvertes avec une fidélité, une rigueur et une élégance irréprochables.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7e éd.). American Psychological Association. https://apastyle.apa.org/
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions Gauthier-Villars. Mouton & Cie.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. Dans Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51-56). SciPy. https://pandas.pydata.org/
- Nuñez, J. R., Anderton, C. R., & Renslow, R. S. (2018). Optimizing colormaps with recognition of color vision deficiency to improve scientific communication. PLOS ONE, 13(7), e0199239. https://doi.org/10.1371/journal.pone.0199239
- The pandas development team. (2024). pandas-dev/pandas: Pandas (Version 2.2.0). Zenodo. https://doi.org/10.5281/zenodo.3509134
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2e éd.). Graphics Press. https://www.edwardtufte.com/
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wilke, C. O. (2019). Fundamentals of Data Visualization: A Primer on Making Informative and Compelling Figures. O’Reilly Media.