
L’édification de la pensée mathématique moderne repose sur un socle conceptuel dont la puissance n’a d’égale que l’apparente simplicité : la théorie des ensembles. Formalisée à la fin du XIXe siècle sous l’impulsion pionnière de Georg Cantor puis consolidée par les axiomes de Zermelo et Fraenkel, cette discipline fournit la grammaire universelle par laquelle les mathématiques contemporaines formulent leurs propositions, construisent leurs espaces et explorent les topologies de l’abstrait. Bien au-delà de la pure spéculation géométrique ou analytique, la manipulation d’agrégats d’objets partageant des propriétés déterminées constitue la matrice fondamentale de la logique formelle, de l’informatique théorique, du calcul des probabilités et des sciences cognitives contemporaines.
Au cœur de cette architecture résident les opérations ensemblistes fondamentales : l’union, l’intersection, le complémentaire et la différence. Ces opérations ne constituent pas de simples conventions d’écriture arithmétique transposées à des collections d’objets ; elles incarnent les mécanismes primaires de classification, de conjonction, d’exclusion et de négation qui structurent le raisonnement humain. Examiner leurs fondements épistémologiques, leurs propriétés algébriques intrinsèques et leurs représentations topologiques permet de comprendre comment s’articulent la rigueur déductive et la modélisation du réel, depuis la résolution de paradoxes d’autoréférence jusqu’à l’algèbre des décisions algorithmiques.
Le présent traité propose une exploration exhaustive de ces opérateurs fondamentaux, unissant l’exactitude analytique du formalisme booléen aux applications transversales les plus actuelles. À travers une progression méthodique traversant l’épistémologie ensembliste, la théorie de la mesure, la psychométrie clinique, l’analyse comparative qualitative et la modélisation neuro-cognitive, nous mettrons en lumière la manière dont ces outils gouvernent l’intelligibilité scientifique, révélant la profonde unité qui relie les équations de l’algèbre de Boole à la taxonomie du vivant et à la logique de la découverte scientifique.
1. Fondements épistémologiques et formalisation de la théorie des ensembles
1.1 Définition rigoureuse d’un ensemble et de ses éléments
La première formalisation systématique de la notion d’ensemble émerge sous la plume de Georg Cantor, qui définit en 1895 un ensemble comme une collection en un tout d’objets définis et distincts de notre intuition ou de notre pensée, appelés les éléments de cet ensemble. Cette approche, qualifiée rétrospectivement de théorie naïve des ensembles, postule que toute propriété intelligible permet de discriminer sans ambiguïté les entités qui appartiennent à une collection de celles qui en sont exclues. Néanmoins, l’apparition de contradictions internes insolubles a contraint les logiciens à abandonner l’intuition brute au profit d’une axiomatisation rigoureuse, initiée par Ernst Zermelo et complétée par Adolf Fraenkel avec l’axiome du choix (système ZFC). Dès lors, un ensemble n’est plus défini par une saisie intuitive de son contenu, mais par le réseau d’axiomes régissant la relation binaire fondamentale d’appartenance.
Sur le plan notationnel, la désignation d’un ensemble s’opère selon trois modalités structurales. La définition en extension énumère explicitement chaque membre de la collection entre accolades, une méthode fonctionnelle pour les collections finies de faible cardinalité mais inapplicable aux ensembles infinis. La définition en compréhension, pivot du formalisme axiomatisé par le schéma d’axiomes de compréhension restreinte, caractérise un ensemble par l’énoncé d’une condition d’appartenance prédicative, signifiant que l’ensemble réunit les éléments appartenant à un ensemble préexistant qui vérifient un prédicat donné. Enfin, la notation indicée associe les éléments ou sous-ensembles à un ensemble d’indices arbitraire, fournissant un formalisme indispensable pour manipuler des familles d’ensembles dénombrables ou indénombrables dans les démonstrations d’analyse supérieure.
Le principe d’appartenance repose sur une ontologie binaire stricte : pour tout objet et tout ensemble, la proposition d’appartenance est soit vraie, soit fausse, excluant tout état mitoyen ou toute graduation dans le paradigme classique. Il convient de distinguer avec une vigilance absolue la relation d’appartenance, qui lie un élément individuel à l’ensemble qui le contient, de la relation d’inclusion, qui ordonne deux ensembles dont l’un est intégralement contenu dans l’autre. Un élément peut appartenir à un ensemble sans être un sous-ensemble de celui-ci, de même qu’un singleton contenant cet élément est un sous-ensemble et non un élément de l’ensemble récepteur, sauf dans le cas précis des constructions ensemblistes hiérarchisées comme les ordinaux de von Neumann.
Cette armature définit le concept de cardinalité, mesurant la taille d’un ensemble indépendamment de la nature de ses éléments. Alors que la cardinalité d’un ensemble fini correspond trivialement au nombre naturel comptabilisant ses constituants, Cantor a révolutionné l’épistémologie en démontrant l’existence d’une hiérarchie infinie de grandeurs pour les ensembles infinis. Par le biais de bijections rigoureuses, il a prouvé que l’ensemble des entiers naturels possède la plus petite cardinalité infinie, qualifiée de dénombrable, tandis que l’ensemble des nombres réels possède une cardinalité strictement supérieure, non dénombrable, inaugurant l’exploration des transfinis.
1.2 L’ensemble universel et l’ensemble vide
L’analyse des structures ensemblistes exige la délimitation rigoureuse de deux entités conceptuelles polaires : l’ensemble universel et l’ensemble vide. Dans la pratique mathématique contemporaine régie par ZFC, la notion d’un ensemble absolu qui contiendrait toutes choses sans exception est rigoureusement proscrite car contradictoire. Pour contourner cette impasse, on définit l’ensemble universel de manière contextuelle ou relativisée, souvent noté U ou E, comme l’univers du discours au sein duquel s’effectuent toutes les opérations d’un domaine d’étude donné. Cet univers contextuel borne les prédicats analysés et fournit le cadre stable nécessaire pour donner un sens précis à la négation et aux opérations de complémentation.
À l’autre extrémité du spectre logico-mathématique se déploie l’ensemble vide, universellement noté par la lettre scandinave Ø introduite par le collectif Nicolas Bourbaki. L’ensemble vide est caractérisé par l’absence absolue de tout élément. Son existence est postulée formellement par l’axiome de l’ensemble vide ou déduite de l’axiome de séparation appliqué à une proposition contradictoire. Sur le plan ontologique, l’ensemble vide n’est pas synonyme de néant conceptuel ; il constitue un objet mathématique plein et entier, unique en vertu de l’axiome d’extensionnalité qui stipule que deux ensembles sont identiques s’ils possèdent exactement les mêmes éléments. Sa cardinalité est rigoureusement égale à zéro, et il constitue le sous-ensemble universel de toute collection concevable.
L’ensemble vide joue un rôle régulateur fondamental dans la cohérence des théories formelles. Sans lui, l’intersection de deux collections sans éléments communs serait une opération indéfinie, ce qui violerait le principe de clôture opérationnelle selon lequel l’action d’un opérateur interne sur des objets d’un système doit invariablement produire un objet appartenant à ce même système. En tant qu’élément absorbant ou neutre selon les lois de composition considérées, il garantit la complétude de l’algèbre booléenne sous-jacente. Il sert en outre de fondement constructiviste pour l’arithmétique ordinale, où le nombre zéro est identifié à l’ensemble vide, le nombre un à l’ensemble contenant l’ensemble vide, et chaque entier suivant à la réunion de ses prédécesseurs.
L’impératif d’une définition contrainte de l’universalité découle historiquement du paradoxe de Russell, énoncé par Bertrand Russell en 1901. Si l’on admet l’existence sans restriction d’un ensemble de tous les ensembles qui ne se contiennent pas eux-mêmes comme éléments, une aporie surgit immédiatement : cet ensemble doit-il s’appartenir à lui-même ? S’il s’appartient, il enfreint sa condition de définition et doit être exclu ; s’il ne s’appartient pas, il remplit la condition et doit donc s’inclure. Ce paradoxe a pulvérisé la théorie naïve cantorienne et établi définitivement qu’un référentiel universel non borné produit des antinomies fatales pour la vérité axiomatique.
1.3 Sous-ensembles, inclusion et ensemble des parties
La relation d’inclusion constitue le mécanisme directeur permettant d’ordonner les agrégats d’objets. Un ensemble A est dit sous-ensemble ou partie d’un ensemble B si et seulement si tout élément appartenant à A appartient également à B. Cette inclusion est qualifiée de large lorsqu’elle autorise la possibilité que A et B soient rigoureusement identiques, ce que formalise la notation standard. En revanche, l’inclusion stricte impose une contrainte supplémentaire : A est inclus dans B et il existe au moins un élément de B qui ne figure pas dans A. La double inclusion constitue la stratégie démonstrative fondamentale pour établir l’égalité de deux ensembles : démontrer que A égale B équivaut à prouver simultanément que A est inclus dans B et que B est inclus dans A.
À partir d’un ensemble fondamental E, l’esprit mathématique peut concevoir la totalité de ses sous-ensembles possibles. Cette méta-collection est désignée sous le nom d’ensemble des parties de E, traditionnellement symbolisé par P(E) ou 2E. Si E est un ensemble fini comprenant n éléments, la cardinalité de son ensemble des parties obéit à la loi exponentielle exacte 2n. Cette propriété combinatoire découle du fait que lors de la construction d’un sous-ensemble quelconque, chaque élément individuel de E fait l’objet d’un choix binaire indépendant : soit il est sélectionné pour figurer dans la partie, soit il en est exclu. Par conséquent, il existe deux possibilités pour le premier élément, deux pour le second, et ainsi de suite jusqu’au n-ième élément, engendrant un arbre combinatoire de 2 × 2 × … × 2 = 2n configurations distinctes.
La relation d’inclusion structure l’ensemble des parties selon une relation d’ordre partiel. Elle vérifie la réflexivité (tout ensemble est inclus dans lui-même), l’antisymétrie (si deux ensembles sont mutuellement inclus l’un dans l’autre, ils sont identiques) et la transitivité (si A est inclus dans B et B est inclus dans C, alors A est nécessairement inclus dans C). L’ordre est dit partiel car deux ensembles distincts ne sont pas nécessairement comparables par inclusion ; deux parties peuvent posséder des éléments disjoints ou des intersections partielles sans qu’aucune ne subordonne l’autre. Cet ordonnancement confère à l’ensemble des parties une géométrie algébrique remarquable connue sous le nom de treillis booléen.
Ce formalisme abstrait présente un parallélisme structural direct avec les typologies diagnostiques et catégorielles exploitées dans les sciences de l’esprit et de la vie. Dans les taxonomies psychiatriques ou cliniques contemporaines, chaque syndrome diagnostique est défini comme un ensemble de critères comportementaux et neurophysiologiques. L’inclusion correspond à l’emboîtement de profils syndromiques, l’ensemble des parties représente l’espace complet de toutes les constellations symptomatiques potentielles chez un individu, et la relation d’ordre partiel illustre formellement les hiérarchies de comorbidité sans imposer un continuum univarié artificiel.
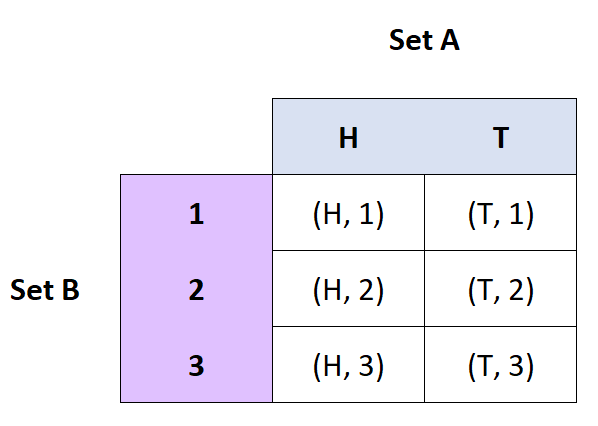
2. L’opération d’union : concepts fondamentaux et formalisme mathématique
2.1 Définition logique et notationnelle de l’union
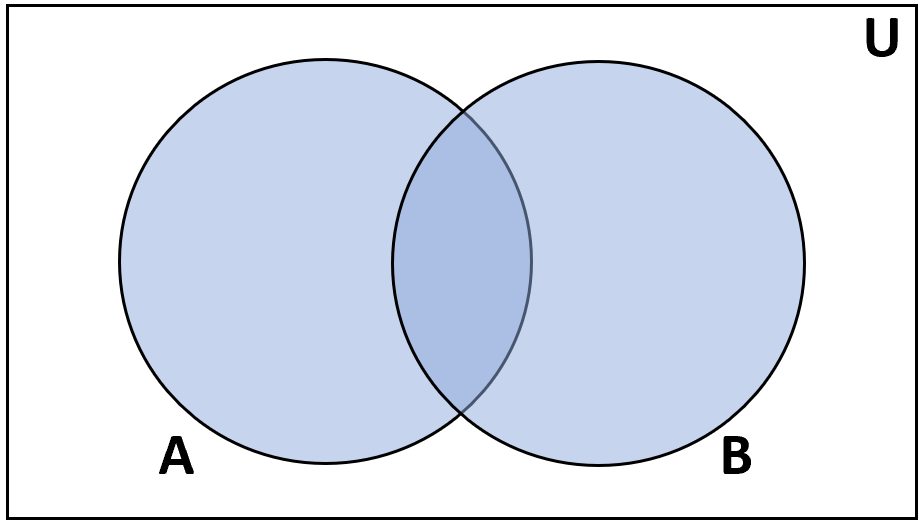
L’opération d’union rassemble au sein d’une entité unique l’ensemble des éléments appartenant à l’une ou l’autre de deux collections données, ou simultanément aux deux. Dans le symbolisme formel forgé par Giuseppe Peano, l’union des ensembles A et B est désignée par A ∪ B. Son armature analytique s’énonce selon le formalisme de compréhension :
A ∪ B = { x ∈ U | (x ∈ A) ∨ (x ∈ B) }
Le symbole logique central de cette définition est la disjonction inclusive. En logique propositionnelle standard, une disjonction inclusive est évaluée comme vraie dès lors qu’au moins un des opérandes est vrai, incluant le cas où les deux propositions sont vérifiées concurremment. Ainsi, pour qu’un élément quelconque appartienne à la réunion A ∪ B, il suffit qu’il vérifie la propriété d’appartenance à A, qu’il vérifie la propriété d’appartenance à B, ou qu’il satisfasse simultanément ces deux conditions. L’union traduit donc sur le plan ensembliste l’alternative non exclusive de la langue formelle.
Il est impératif d’opérer une différenciation tranchée entre cette disjonction inclusive et la disjonction exclusive (le « ou » exclusif du langage courant). Si l’union acceptait le principe du tiers exclu au niveau intensionnel, un élément appartenant simultanément à A et à B serait paradoxalement éliminé du rassemblement résultant, ce qui réduirait l’opération à la différence symétrique. La disjonction inclusive garantit que l’union cumule l’intégralité des domaines de validité respectifs de A et de B sans pénaliser leur coïncidence.
Ce formalisme binaire se généralise de façon naturelle à des collections comprenant un nombre quelconque d’ensembles. Si l’on considère une famille d’ensembles indicée par un ensemble d’indices I quelconque, fini, dénombrable ou indénombrable, l’union généralisée est notée ∪i∈I Ai et regroupe tous les éléments x pour lesquels il existe au moins un indice k dans I tel que x appartienne à Ak. Cette puissance d’extension permet d’agréger une infinité continue d’espaces sous-jacents, un mécanisme fondamental en analyse mathématique pour construire des ouverts et définir des topologies.
2.2 Propriétés algébriques fondamentales de l’union
L’union ensembliste n’est pas une simple agrégation mécanique ; elle est régie par une structure algébrique d’une parfaite cohérence interne. La première de ses propriétés est l’idempotence : l’union d’un ensemble avec lui-même reproduit invariablement cet ensemble unique (A ∪ A = A). Cette propriété reflète le principe selon lequel l’appartenance à un ensemble ne quantifie pas la multiplicité des occurrences d’un élément au sein de la collection ; un élément y réside ou n’y réside pas, rendant la répétition conceptuellement inactive.
La deuxième propriété fondamentale concerne l’existence d’un élément neutre pour l’opération. L’ensemble vide constitue cet élément neutre unique, ce qui signifie que l’union d’un ensemble quelconque A avec l’ensemble vide redonne l’ensemble A sans altération (A ∪ Ø = A). L’absence d’éléments au sein de Ø implique qu’aucun nouvel élément n’est introduit dans le domaine unifié. À l’inverse, si l’on applique l’opération d’union entre l’ensemble A et l’ensemble universel U qui délimite l’espace d’analyse, l’univers agit comme un élément absorbant : A ∪ U = U. Puisque chaque élément de A réside déjà par définition dans U, l’adjonction de A ne saurait excéder la frontière du référentiel global.
Sur le plan structural, l’union vérifie la commutativité et l’associativité. La commutativité stipule que l’ordre des opérandes est indifférent : A ∪ B = B ∪ A. Sa démonstration s’établit directement à partir de la commutativité de la disjonction logique sous-jacente. L’associativité garantit que lors du regroupement de trois ensembles ou davantage, le chaînage des opérations n’affecte pas l’extension finale : (A ∪ B) ∪ C = A ∪ (B ∪ C). Grâce à cette propriété, il est légitime d’omettre les parenthèses lors de l’écriture de réunions multiples.
Ces propriétés confèrent à l’ensemble des parties muni de l’union la structure d’un demi-groupe commutatif et idempotent (ou demi-treillis sup). Dans le cadre plus vaste d’une algèbre de Boole, ces régularités formelles s’articulent avec la négation et la conjonction pour assurer le théorème de clôture : toute combinaison finie d’unions de sous-ensembles d’un référentiel produit irrévocablement un sous-ensemble appartenant à ce même référentiel.
2.3 Exemples numériques et cas limites
Pour illustrer de manière concrète la dynamique de l’union, considérons deux ensembles finis d’entiers naturels définis en extension : A = {2, 4, 6, 8} et B = {6, 8, 10, 12}. L’application rigoureuse de la définition de l’union requiert la collecte de chaque élément figurant dans au moins l’un de ces deux répertoires. Bien que les valeurs 6 et 8 appartiennent simultanément aux deux ensembles, elles ne figurent qu’une seule fois dans la réunion finale par application de l’axiome d’extensionnalité : A ∪ B = {2, 4, 6, 8, 10, 12}. La cardinalité du résultat est de 6, et non de 8, illustrant immédiatement l’effet de neutralisation des redondances.
Dans l’hypothèse où les deux ensembles considérés sont mutuellement disjoints, à l’instar de C = {1, 3, 5} et D = {2, 4, 6}, l’union se réduit à la simple juxtaposition des éléments de chaque ensemble : C ∪ D = {1, 2, 3, 4, 5, 6}. Dans cette configuration géométrique d’éloignement absolu, la cardinalité de l’union coïncide rigoureusement avec la somme arithmétique des cardinalités individuelles de chaque opérande. Un autre cas remarquable est celui des ensembles emboîtés. Si nous posons E = {1, 2} et F = {1, 2, 3, 4}, il apparaît que E est un sous-ensemble strict de F (E ⊂ F). Par conséquent, l’union de ces deux ensembles est absorbée par le plus grand : E ∪ F = F = {1, 2, 3, 4}. L’union révèle ici sa nature d’opération de borne supérieure dans le treillis de l’inclusion.
L’impact de l’union sur la cardinalité des ensembles finis est régi par le théorème fondamental de l’inclusion-exclusion, énoncé pour deux ensembles sous la forme :
|A ∪ B| = |A| + |B| – |A ∩ B|
Cette relation fondamentale démontre que l’addition directe des cardinaux individuels |A| et |B| compte deux fois la portion commune constituée par l’intersection des deux domaines. Le terme correctif -|A ∩ B| rétablit l’équilibre comptable exact. Dans le cas de nos ensembles A et B précédents, le calcul analytique confirme : 4 + 4 – 2 = 6. Ce principe fournit l’outil prédictif central pour la combinatoire et le calcul probabiliste élémentaire.
3. L’opération d’intersection : analyse logique et structures communes
3.1 Formalisation rigoureuse de l’intersection
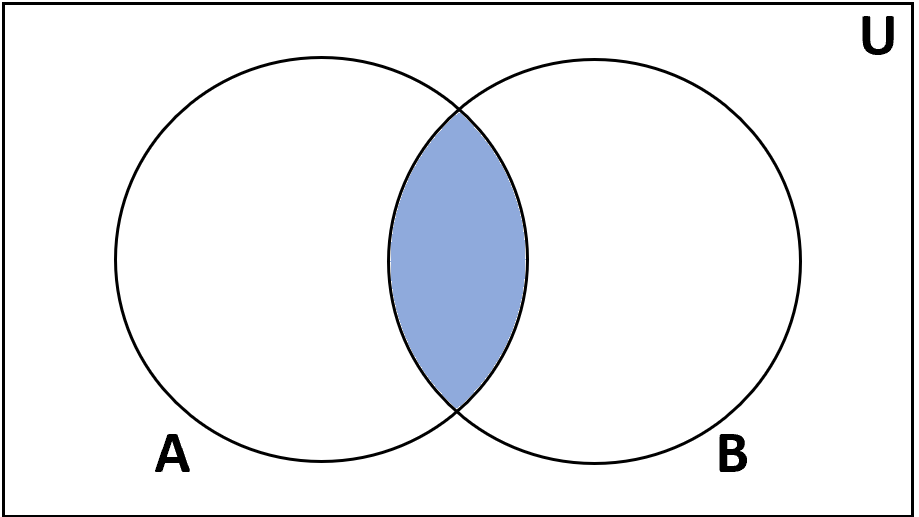
Si l’union exprime le rassemblement expansif, l’intersection incarne l’opération de sélection sélective par excellence. Elle identifie et isole la totalité des éléments qui partagent simultanément l’appartenance à deux ou plusieurs collections de référence. Symbolisée par l’opérateur en arche inversée ∩, introduit lui aussi par Peano, l’intersection de deux ensembles A et B se définit formellement par le schéma de compréhension prédicatif :
A ∩ B = { x ∈ U | (x ∈ A) ∧ (x ∈ B) }
Le pivot de cette équation réside dans la conjonction logique stricte, désignée par le symbole ∧. Selon la table de vérité canonique de la conjonction, la proposition composite (x ∈ A) ∧ (x ∈ B) ne revêt la valeur de vérité « vraie » que si et seulement si l’assertion x ∈ A est vraie ET l’assertion x ∈ B est simultanément vraie. Dès lors qu’un élément fait défaut à l’un des deux ensembles, fût-il omniprésent dans l’autre, sa candidature au sein de l’espace d’intersection est immédiatement rejetée.
L’intersection s’étend de manière analogue aux familles d’ensembles de taille arbitraire. Pour une famille indicée quelconque {Ai}i∈I, l’intersection généralisée notée ∩i∈I Ai recueille les entités x telles que pour tout indice i appartenant à I, la relation x ∈ Ai soit rigoureusement satisfaite. L’intersection fonctionne ainsi comme un filtre logique continu : à mesure que le nombre d’ensembles intersectés s’accroît, les contraintes imposées à chaque élément s’accumulent, entraînant une restriction monotone ou au mieux une stagnation de l’extension de l’ensemble résultant.
3.2 Ensembles disjoints et vacuité de l’intersection
Une configuration fondamentale dans l’étude des structures d’ensembles survient lorsque deux collections ne partagent aucun élément commun. Dans cette conjoncture, l’intersection des deux ensembles produit rigoureusement l’ensemble vide : A ∩ B = Ø. Deux ensembles vérifiant cette condition sont qualifiés d’ensembles disjoints ou mutuellement exclusifs. Cette vacuité de l’intersection traduit l’incompatibilité logique des critères d’appartenance : aucun objet dans l’univers du discours ne peut satisfaire concurremment les prédicats distincts assignés aux deux classes.
Lorsque cette propriété de disjonction est étendue à une collection complète de sous-ensembles non vides {A1, A2, …, Ak} d’un ensemble référentiel E, et que l’union de tous ces sous-ensembles reconstitue fidèlement l’ensemble initial E, cette collection reçoit le titre de partition de E. Une partition découpe l’univers de référence en cellules étanches sans perte ni superposition d’éléments :
- Chaque sous-ensemble est non vide : pour tout i, Ai ≠ Ø.
- Les sous-ensembles sont deux à deux disjoints : pour tout i ≠ j, Ai ∩ Aj = Ø.
- Leur réunion reconstitue l’espace complet : ∪i Ai = E.
L’exactitude méthodologique exige de distinguer avec précision les ensembles mutuellement exclusifs des ensembles collectivement exhaustifs. Des sous-ensembles sont mutuellement exclusifs lorsqu’ils ne se recouvrent nulle part (leurs intersections prises deux à deux sont vides), mais ils ne couvrent pas nécessairement l’intégralité de l’univers contextuel. Ils sont collectivement exhaustifs lorsque leur union absorbe la totalité de l’univers, bien qu’ils puissent comporter de vastes zones de chevauchement. Une partition correspond précisément à la synthèse de ces deux contraintes, instaurant un cadre taxinomique idéal où chaque élément de l’univers se voit assigner une place unique et non ambiguë.
3.3 Propriétés algébriques intrinsèques
L’intersection dispose d’un ensemble de lois algébriques qui font écho, par une parfaite relation de dualité, aux propriétés de l’union. Elle est tout d’abord idempotente : l’intersection d’un ensemble avec lui-même reproduit identiquement l’ensemble d’origine (A ∩ A = A). Sélectionner les éléments qui appartiennent à A et qui appartiennent à A ne modifie en rien la collection envisagée, confirmant la nature non additive de la conjonction ensembliste.
Dans la dynamique de l’intersection, les rôles des éléments remarquables se trouvent exactement inversés par rapport à l’union. L’ensemble universel U fait office d’élément neutre unique pour l’intersection : pour tout ensemble A sous-jacent à cet univers, A ∩ U = A. Puisque l’univers contient la totalité des entités envisageables dans le modèle, le confronter à A par un filtre conjonctif préserve l’intégralité des éléments de A. Inversement, l’ensemble vide se comporte comme un élément absorbant : pour tout sous-ensemble A, la relation A ∩ Ø = Ø est universellement vérifiée. L’absence absolue d’éléments au sein de Ø interdit par principe la validation de toute conjonction d’appartenance.
L’intersection est en outre commutative (A ∩ B = B ∩ A) et associative :
(A ∩ B) ∩ C = A ∩ (B ∩ C)
La validité de ces théorèmes se démontre formellement par le principe de double inclusion : tout élément résidant dans (A ∩ B) ∩ C appartient simultanément à A ∩ B et à C, ce qui implique qu’il réside dans A, dans B et dans C, validant son intégration au sein de A ∩ (B ∩ C), et réciproquement. Enfin, l’intersection est intimement liée à la relation d’ordre d’inclusion par une équivalence fondamentale : affirmer que A est inclus dans B équivaut à énoncer que A ∩ B = A. Cette équivalence démontre que l’intersection fonctionne comme un opérateur de borne inférieure (ou infimum) au sein du treillis de l’ensemble des parties.
4. Le complémentaire ensembliste : négation et référentiel universel
4.1 Définition formelle et dépendance contextuelle
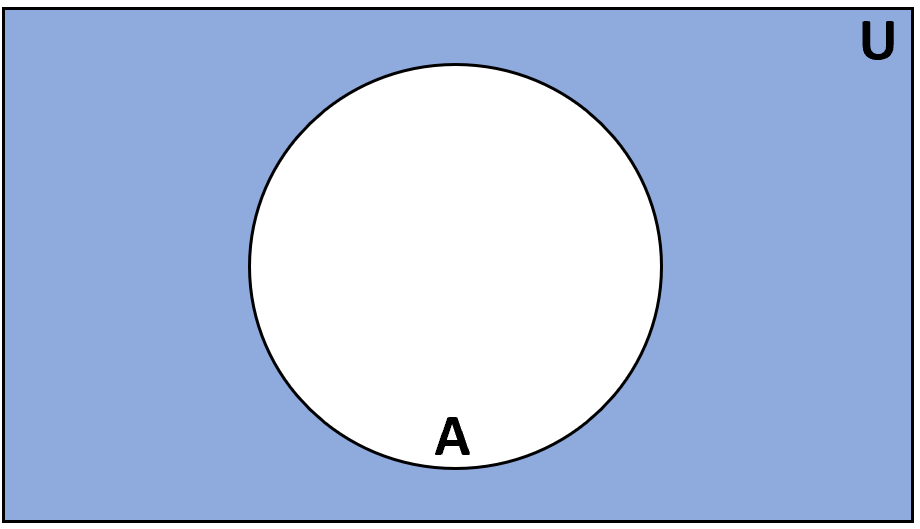
L’opération de complémentation constitue la transposition ensembliste directe de l’opérateur de négation logique. Alors que l’union et l’intersection manipulent des collections d’objets pour en agréger ou en filtrer les composants, le complémentaire extrait d’un référentiel tout ce qui n’appartient pas à l’ensemble considéré. Le complémentaire absolu d’un sous-ensemble A, noté selon les traditions typographiques Ac, CU(A) ou Ā (A barre), est rigoureusement défini comme l’ensemble des éléments de l’univers U qui ne satisfont pas la condition d’appartenance à A :
Ac = { x ∈ U | ¬(x ∈ A) } = { x ∈ U | x ∉ A }
Cette formalisation met en lumière une dépendance épistémologique cruciale : la validité et la consistance d’un ensemble complémentaire sont tributaires de la définition préalable et non équivoque de l’univers du discours U. Sans une délimitation rigoureuse de ce référentiel, la notion de « tout ce qui n’appartient pas à A » devient une absurdité logique sans borne. Par exemple, si l’ensemble A désigne le groupe des nombres pairs, son complémentaire n’a de signification mathématique que si l’univers est explicité : si U désigne l’ensemble des entiers naturels, Ac représente les nombres impairs ; mais si U désigne l’ensemble de tous les nombres réels ou l’ensemble des concepts philosophiques, Ac englobera une infinité continue de grandeurs fractionnaires ou d’abstractions conceptuelles.
Le passage au complémentaire traduit donc formellement la négation logique propositionnelle. À chaque prédicat unaire P(x) définissant un ensemble en compréhension correspond un prédicat contradictoire ¬P(x) délimitant son complémentaire. Dans les démonstrations formelles, cette opération permet de passer d’une preuve directe à un raisonnement par l’absurde, en établissant la non-vacuité ou l’incohérence interne d’un espace complémentaire.
4.2 Lois de complémentarité et involutivité
L’opérateur de complémentation obéit à un ensemble de théorèmes structuraux d’une importance cardinale dans l’algèbre de Boole. Le premier d’entre eux est le principe d’involution, stipulant que l’application réitérée du complémentaire restitue fidèlement l’ensemble d’origine sans la moindre altération :
(Ac)c = A
Cette propriété reflète l’équivalence logique fondamentale de la double négation classique : affirmer qu’il est faux qu’un élément n’appartienne pas à A revient rigoureusement à certifier qu’il appartient à A.
Les deux lois cardinales suivantes formalisent les principes aristotéliciens de la pensée rationnelle. D’une part, l’union d’un ensemble quelconque avec son propre complémentaire reconstitue intégralement l’univers de discours : A ∪ Ac = U. Cette égalité matérialise le principe du tiers exclu, selon lequel tout élément concevable dans le modèle d’analyse doit obligatoirement résider soit au sein de A, soit au sein de son complémentaire, aucune troisième voie n’étant concevable. D’autre part, l’intersection d’un ensemble et de son complémentaire est invariablement vide : A ∩ Ac = Ø. Cette seconde relation incarne le principe de non-contradiction, interdisant formellement qu’une entité puisse simultanément posséder une propriété et son exacte négation.
De ces théorèmes découlent les propriétés aux bornes du système de complémentation. Le complémentaire de l’ensemble universel correspond à l’ensemble vide, car aucun élément ne peut résider en dehors de la totalité délimitée (Uc = Ø). Réciproquement, le complémentaire de l’ensemble vide englobe l’univers tout entier (Øc = U), l’absence totale de contrainte d’exclusion ouvrant l’intégralité du champ référentiel. La complémentation apparaît ainsi comme une symétrie axiale parfaite inversant les polarités du treillis ensembliste.
4.3 Applications au raisonnement contrefactuel et dichotomique
La logique de la complémentation structure en profondeur la modélisation des raisonnements contrefactuels et alternatifs au sein des sciences cognitives et de la théorie de la décision. Dans un arbre de décision formalisé, formuler l’hypothèse « que se serait-il passé si l’événement A ne s’était pas produit ? » revient à projeter l’ensemble des états du monde possibles sur le sous-espace complémentaire Ac. L’évaluation rigoureuse de la causalité repose sur la comparaison systématique entre les trajectoires observables issues de A et les trajectoires potentielles confinées au sein du sous-ensemble Ac.
Néanmoins, la cognition humaine manifeste des distorsions systématiques face à l’analyse des espaces complémentaires. De nombreux travaux en psychologie du raisonnement ont mis en évidence le biais de confirmation et la difficulté à appréhender les événements non survenus. Tandis que l’esprit cartographie avec aisance les occurrences directes d’un phénomène (l’ensemble A), il éprouve une charge cognitive substantiellement plus élevée pour quantifier et conceptualiser la dispersion hétérogène des éléments composant Ac. Cette asymétrie perceptive conduit fréquemment à sous-estimer la probabilité a priori des événements complémentaires, générant des illusions prédictives majeures.
Enfin, l’épistémologie de la complémentation impose une distinction nette entre l’absence d’une propriété et la présence d’une propriété opposée. Confondre le complémentaire Ac (l’absence de la caractéristique A) avec un ensemble B doté d’attributs inverses constitue une dérive logique fréquente, qualifiée de faux dilemme. L’ensemble complémentaire est une catégorie purement négative englobant une multiplicité d’états hétérogènes dont le seul dénominateur commun est de ne pas satisfaire la condition d’appartenance à A.
5. La différence d’ensembles et la différence symétrique
5.1 La différence relative (complément relatif)
La différence d’ensembles, également qualifiée de complément relatif et symbolisée par la barre oblique inversée ou le signe de soustraction formel (A B ou A – B), constitue l’opération d’extraction différentielle par excellence. Elle permet d’isoler l’ensemble des éléments qui appartiennent à une collection de départ sans appartenir à une seconde collection concurrente. Son écriture en compréhension se déploie selon la syntaxe suivante :
A B = { x ∈ U | (x ∈ A) ∧ (x ∉ B) }
Cette formulation analytique révèle immédiatement que la différence relative peut s’exprimer de manière équivalente comme l’intersection du premier ensemble avec le complémentaire absolu du second :
A B = A ∩ Bc
Cette équivalence est d’une grande valeur computationnelle car elle permet de réduire une opération différentielle à la composition d’une négation et d’une conjonction élémentaires.
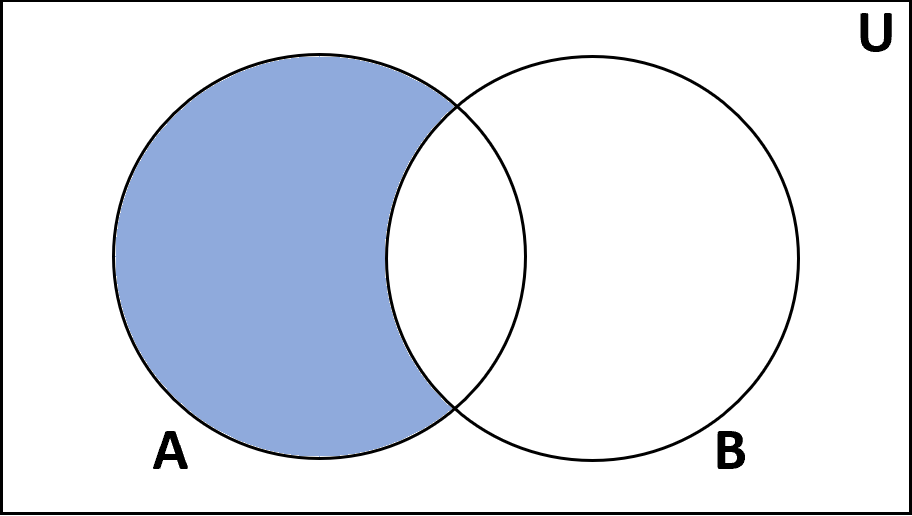
Contrairement à l’union et à l’intersection, la différence d’ensembles se caractérise par une non-commutativité absolue : A B ≠ B A dès lors que A et B ne sont pas rigoureusement identiques. Par exemple, si l’on pose A = {1, 2, 3} et B = {3, 4, 5}, l’extraction différentielle A B génère l’ensemble {1, 2}, tandis que l’opération inverse B A produit {4, 5}. Ces deux ensembles résultants sont strictement disjoints, soulignant la directionalité vectorielle de l’opération : A B élague A de ses adhérences avec B, sans se préoccuper des éléments singuliers propres à B.
L’analyse différentielle présente plusieurs cas limites notables :
- Si deux ensembles sont mutuellement disjoints (A ∩ B = Ø), la différence laisse le premier ensemble inchangé : A B = A.
- Si le premier ensemble est intégralement inclus dans le second (A ⊆ B), l’élagage est total et l’opération produit l’ensemble vide : A B = Ø.
- La soustraction d’un ensemble par lui-même s’annihile universellement : A A = Ø.
- La soustraction de l’ensemble vide laisse l’ensemble intact : A Ø = A, tandis que soustraire un ensemble de l’ensemble vide produit le vide : Ø A = Ø.
5.2 La différence symétrique : structure et applications
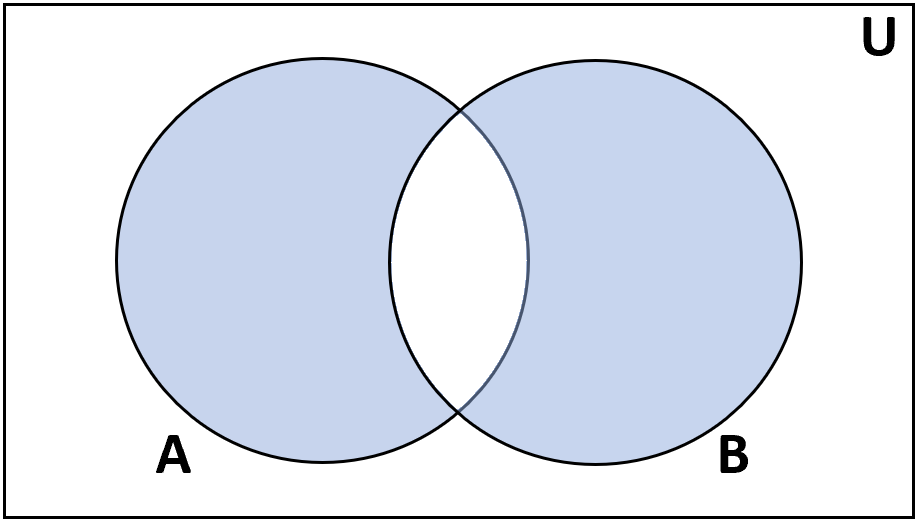
Alors que la différence relative privilégie l’asymétrie d’un ensemble orienté par rapport à un autre, la différence symétrique réconcilie l’opération de séparation dans une structure parfaitement commutative. Traditionnellement notée à l’aide du symbole delta majuscule A Δ B ou du cercle muni d’un signe d’addition A ⊕ B, la différence symétrique recueille l’ensemble des éléments qui appartiennent soit à A, soit à B, mais formellement pas aux deux à la fois. Elle correspond point par point à l’opérateur logique de disjonction exclusive (le « XOR » des algèbres informatiques).
La différence symétrique peut se formaliser à travers deux définitions équivalentes reliant les opérateurs fondamentaux étudiés précédemment :
A Δ B = (A B) ∪ (B A)
A Δ B = (A ∪ B) (A ∩ B)
La première équation appréhende la différence symétrique comme la réunion des résidus singuliers issus de chaque ensemble après élimination de leur vis-à-vis. La seconde équation la conçoit comme l’évacuation intégrale de la portion commune (l’intersection) hors de l’espace global englobé par l’union.
Sur le plan de l’algèbre générale, la différence symétrique confère à l’ensemble des parties P(E) une structure algébrique remarquable : (P(E), Δ) constitue un groupe abélien (ou commutatif). Elle vérifie la commutativité universelle (A Δ B = B Δ A) et l’associativité :
(A Δ B) Δ C = A Δ (B Δ C)
L’ensemble vide fait office d’élément neutre unique au sein de ce groupe, puisque pour tout sous-ensemble A, A Δ Ø = A. De surcroît, chaque élément constitue son propre inverse (structure d’auto-inversion ou d’involution de groupe) : A Δ A = Ø. Cette architecture fait de la différence symétrique le candidat privilégié pour implémenter des systèmes cryptographiques à masque jetable, des codes correcteurs d’erreurs (codes de Hamming) et des calculs de distance métrique dans les espaces de configuration complexes.
5.3 Distinction comparative des opérateurs de séparation
Pour appréhender l’utilité respective de la différence relative et de la différence symétrique, il s’avère constructif de confronter leurs propriétés opératoires au sein d’une matrice d’analyse comparée :
- Commutativité : Fausse pour la différence relative (A B ≠ B A) ; Rigoureusement vraie pour la différence symétrique (A Δ B = B Δ A).
- Associativité : Fausse pour la différence relative ((A B) C ≠ A (B C)) ; Vraie pour la différence symétrique ((A Δ B) Δ C = A Δ (B Δ C)).
- Élément neutre : Uniquement à droite pour la différence (A Ø = A, mais Ø A = Ø) ; Symétrique et universel pour Δ (A Δ Ø = Ø Δ A = A).
- Interprétation logique : Conjonction avec négation (P ∧ ¬Q) pour la différence ; Disjonction exclusive (P ⊻ Q) pour la différence symétrique.
Dans les sciences empiriques et l’analyse différentielle de données, ces deux opérateurs de séparation remplissent des fonctions diagnostiques spécialisées. La différence relative est utilisée pour isoler les variables résiduelles après le contrôle statistique d’un facteur confusionnel ou pour extraire des populations cliniques spécifiques débarrassées de critères d’exclusion. Elle agit comme un outil d’élagage directionnel.
En revanche, la différence symétrique sert d’opérateur métrique pour évaluer la distance de désaccord entre deux modèles de classification ou deux observateurs indépendants. Si deux algorithmes de segmentation d’imagerie médicale délimitent deux zones tumorales A et B, l’intersection mesure la concordance parfaite, tandis que la différence symétrique A Δ B quantifie précisément le volume d’incertitude et de désaccord global entre les estimateurs. Plus le cardinal de cette différence symétrique se rapproche de zéro, plus la fidélité inter-juges converge vers l’unité.
6. Propriétés algébriques fondamentales et lois de composition
6.1 Distributivité croisée des opérateurs
L’une des architectures formelles les plus élégantes de la théorie des ensembles réside dans la double distributivité liant l’union et l’intersection. Contrairement à l’arithmétique standard où la multiplication est distributive sur l’addition mais où l’addition n’est jamais distributive sur la multiplication, l’algèbre des ensembles manifeste une parfaite symétrie croisée. L’union est rigoureusement distributive sur l’intersection :
A ∪ (B ∩ C) = (A ∪ B) ∩ (A ∪ C)
Et réciproquement, l’intersection est distributive sur l’union :
A ∩ (B ∪ C) = (A ∩ B) ∪ (A ∩ C)
La preuve analytique de la première loi s’établit par une chaîne d’équivalences propositionnelles. Soit un élément x appartenant au membre de gauche A ∪ (B ∩ C). Cela signifie que x ∈ A ou x ∈ (B ∩ C), ce qui s’écrit logiquement (x ∈ A) ∨ ((x ∈ B) ∧ (x ∈ C)). Par distributivité fondamentale du connecteur de disjonction logique sur la conjonction dans le calcul des propositions, cette affirmation équivaut rigoureusement à ((x ∈ A) ∨ (x ∈ B)) ∧ ((x ∈ A) ∨ (x ∈ C)). Cette dernière formule affirme que x appartient à (A ∪ B) et que x appartient simultanément à (A ∪ C), établissant son appartenance à l’intersection de ces deux ensembles. La réciproque s’effectuant par réversibilité stricte des équivalences, l’égalité est scellée sans appel.
Cette rupture théorique avec l’arithmétique élémentaire souligne la singularité des structures booléennes. Alors que l’addition usuelle ne s’infiltre pas à travers les produits scalaires, la topologie des ensembles autorise l’éclatement conjonctif d’un filtre ou son expansion disjonctive, fournissant une souplesse calculatoire essentielle pour réordonner des prédicats complexes et simplifier des architectures logiques.
6.2 Lois d’absorption et simplification logique
Les lois d’absorption constituent un mécanisme de compression syntaxique propre aux structures de treillis et à l’algèbre propositionnelle. Elles énoncent que l’interaction emboîtée d’une union et d’une intersection impliquant les mêmes opérandes élimine l’un des composants redondants. Les deux équations cardinales d’absorption s’écrivent :
A ∪ (A ∩ B) = A
A ∩ (A ∪ B) = A
La démonstration de la première loi par double inclusion est d’une clarté limpide. D’une part, il est trivial que tout élément x ∈ A appartient à l’union A ∪ (A ∩ B) en vertu de la définition de l’union (inclusion immédiate). D’autre part, soit un élément y ∈ A ∪ (A ∩ B). Deux éventualités se présentent : soit y ∈ A, ce qui valide l’inclusion dans A ; soit y ∈ (A ∩ B), ce qui exige impérativement que y ∈ A et y ∈ B, confirmant là encore que y réside nécessairement dans A. Les deux inclusions étant vraies, l’égalité s’impose. La démonstration de la seconde loi procède d’un cheminement analogue en exploitant l’inclusion évidente de A ∩ (A ∪ B) dans A et le fait que tout élément de A réside simultanément dans A et dans A ∪ B.
En logique computationnelle et en ingénierie décisionnelle, ces lois d’absorption jouent un rôle assainissant. Elles permettent de simplifier les arbres de décision diagnostiques multivariés où des critères complexes s’entrecroisent. Lorsqu’un algorithme formule une condition d’inclusion stipulant qu’un sujet doit présenter le critère A, ou présenter simultanément le critère A et la caractéristique secondaire B, l’application de la loi d’absorption permet de court-circuiter l’évaluation de B, allégeant la charge de calcul sans aucune perte de spécificité.
6.3 Structure d’algèbre de Boole de l’ensemble des parties
Lorsque l’on synthétise l’ensemble de ces propriétés opératoires au sein d’une structure englobante, l’ensemble des parties d’un univers U, muni de l’union, de l’intersection et de la complémentation, réalise formellement les axiomes d’une algèbre de Boole, traditionnellement notée par le sextuplet formel :
(P(U), ∪, ∩, c, Ø, U)
Pour mériter rigoureusement cette dénomination mathématique, la structure vérifie point par point les postulats axiomatiques d’Edward Huntington :
- La commutativité des deux lois de composition interne (∪ et ∩).
- La distributivité mutuelle de chaque opérateur sur l’autre.
- L’existence d’éléments neutres distincts pour chaque opération (Ø pour la réunion, U pour l’intersection).
- L’existence pour tout élément A d’un élément complémentaire unique Ac satisfaisant les critères de complémentarité (A ∪ Ac = U et A ∩ Ac = Ø).
Cette formalisation établit un isomorphisme parfait entre l’algèbre des ensembles et le calcul propositionnel classique à deux valeurs de vérité. À l’ensemble des parties correspond l’espace des propositions logiques ; à l’union correspond la disjonction (∨) ; à l’intersection correspond la conjonction (∧) ; au complémentaire correspond la négation (¬) ; à l’ensemble vide correspond la contradiction systématique (le Faux) ; et à l’ensemble universel correspond la tautologie universelle (le Vrai).
Ce parallélisme assure que tout théorème démontré au sein de la logique propositionnelle trouve une traduction immédiate et valide en théorie des ensembles, et vice-versa. Il s’agit de la clé de voûte de l’informatique moderne : les processeurs physiques opèrent des calculs sur des états de tension binaire en appliquant des portes logiques dont l’agencement matériel est rigoureusement dicté par l’algèbre de Boole modélisant les intersections et réunions de flux de bits.
7. Les lois de De Morgan et le principe de dualité
7.1 Énoncé et preuves rigoureuses des lois de De Morgan
Formulées au XIXe siècle par le logicien et mathématicien britannique Augustus De Morgan, les lois qui portent son nom décrivent la manière dont l’opérateur de complémentation interagit avec l’union et l’intersection. Elles établissent que le passage au complémentaire permute la nature de l’opération sous-jacente, transformant l’union en intersection et l’intersection en union selon deux équations fondamentales :
(A ∪ B)c = Ac ∩ Bc
(A ∩ B)c = Ac ∪ Bc
La première loi énonce que le complémentaire d’une union est égal à l’intersection des complémentaires. Pour en déployer la démonstration rigoureuse, procédons par équivalences analytiques successives sur un élément arbitraire x de l’univers U :
x ∈ (A ∪ B)c ⇔ ¬(x ∈ A ∪ B) (par définition du complémentaire)
⇔ ¬((x ∈ A) ∨ (x ∈ B)) (par définition de l’union)
⇔ ¬(x ∈ A) ∧ ¬(x ∈ B) (par application des lois de De Morgan en logique propositionnelle)
⇔ (x ∈ Ac) ∧ (x ∈ Bc) (par passage aux négations ensemblistes)
⇔ x ∈ (Ac ∩ Bc) (par définition de l’intersection)
L’équivalence logique étant rigoureusement bidirectionnelle à chaque étape, l’identité des deux ensembles est démontrée sans recours à la disjonction des cas. La seconde loi se démontre selon une trame parfaitement symétrique en inversant les connecteurs ∨ et ∧.
Ces théorèmes se généralisent sans aucune restriction aux familles indicées quelconques, qu’elles soient finies, dénombrables ou composées d’une infinité indénombrable d’espaces :
(∪i∈I Ai)c = ∩i∈I Aic
(∩i∈I Ai)c = ∪i∈I Aic
Cette puissance de généralisation fait des lois de De Morgan une charnière dans la théorie de la topologie générale, notamment pour prouver que le complémentaire d’une union arbitraire d’ouverts constitue une intersection quelconque de fermés.
7.2 Le principe de dualité en théorie des ensembles
L’existence des lois de De Morgan et la symétrie de l’algèbre de Boole constituent la manifestation visible d’un théorème métathéorique fondamental : le principe de dualité. En théorie des ensembles, toute relation d’égalité ou d’inclusion universellement valide reliant des sous-ensembles par les opérateurs d’union, d’intersection et de complémentation conserve une validité absolue si l’on applique une règle de substitution systématique transformant simultanément :
- Chaque occurrence de l’opérateur d’union (∪) en intersection (∩).
- Chaque occurrence de l’opérateur d’intersection (∩) en union (∪).
- Chaque occurrence de l’ensemble vide (Ø) en ensemble universel (U).
- Chaque occurrence de l’ensemble universel (U) en ensemble vide (Ø).
- Chaque relation d’inclusion (⊆) en relation d’inclusion inversée (⊇).
La proposition ainsi transformée est qualifiée d’énoncé dual. L’intérêt méthodologique de ce principe réside dans une économie démonstrative majeure : dès lors qu’un théorème ensembliste est formellement démontré, son théorème dual est automatiquement validé sans qu’il soit nécessaire de reconstruire une nouvelle preuve. Par exemple, la preuve de la distributivité de l’intersection sur l’union découle immédiatement par dualité de la preuve de la distributivité de l’union sur l’intersection.
Sur le plan computationnel, ce principe permet d’adapter des algorithmes conçus pour maximiser des espaces d’exclusion vers des architectures destinées à minimiser des contraintes d’inclusion, assurant un gain substantiel de temps de calcul dans la compilation des requêtes de bases de données distribuées.
7.3 Applications pratiques à la simplification de critères logiques
L’application concrète des lois de De Morgan intervient dès qu’il est nécessaire de désimbriquer des systèmes d’exclusion conditionnelle complexes. Considérons un protocole de sélection pour un essai clinique international où l’accès à une thérapie ciblée est refusé aux sujets répondant à la condition complexe suivante : « présenter une défaillance hépatique (H) OU présenter simultanément une insuffisance rénale (R) et un âge inférieur à 18 ans (A) ». L’ensemble d’exclusion s’écrit formellement :
Exclusion = H ∪ (R ∩ A)
Pour déterminer précisément les caractéristiques des patients éligibles, il faut déterminer le complémentaire de cet ensemble d’exclusion. En appliquant mécaniquement la première loi de De Morgan puis la distributivité, l’analyste transforme l’équation :
Éligibilité = (H ∪ (R ∩ A))c
= Hc ∩ (R ∩ A)c
= Hc ∩ (Rc ∪ Ac)
Par application finale de la distributivité de l’intersection sur l’union, la condition se traduit sous forme de critères directement vérifiables en pratique médicale :
Éligibilité = (Hc ∩ Rc) ∪ (Hc ∩ Ac)
Le clinicien identifie immédiatement les deux profils autorisés : le sujet doit être exempt de trouble hépatique ET être indemne d’insuffisance rénale, OU être exempt de trouble hépatique ET être âgé d’au moins 18 ans. Cette clarification évite les contresens d’interprétation inhérents à la manipulation intuitive de conditions d’exclusion composites.
8. Modélisation graphique : diagrammes de Venn, d’Euler et de Carroll
8.1 Sémantique et topologie des diagrammes de Venn
Pour visualiser les rapports logiques reliant les ensembles, les représentations graphiques constituent un auxiliaire pédagogique et heuristique central. Conçus par le mathématicien et philosophe britannique John Venn en 1880, les diagrammes éponymes reposent sur une topologie plane rigoureuse. Un diagramme de Venn représente l’univers contextuel sous la forme d’un rectangle englobant, à l’intérieur duquel chaque ensemble est matérialisé par une courbe fermée simple (typiquement des cercles ou des ellipses). La contrainte sémantique maîtresse imposée par Venn est l’exhaustivité combinatoire : toutes les intersections concevables entre les ensembles représentés doivent impérativement être matérialisées par des régions spatiales distinctes du plan, indépendamment du fait que ces intersections soient vides ou peuplées dans une application spécifique.
Pour un ensemble de n collections, le plan doit être partitionné en exactement 2n régions fermées et disjointes, qualifiées de cellules fondamentales ou minitermes. Pour deux ensembles, le diagramme déploie 4 zones : l’extérieur des ensembles (le complémentaire de leur union), la portion exclusive de A (A B), la portion exclusive de B (B A) et la zone centrale de recouvrement (A ∩ B). Pour trois ensembles, le plan délimite rigoureusement 8 zones d’adjacence mutuelle.
Néanmoins, la topologie des diagrammes de Venn se heurte à une limite géométrique documentée dès que l’on tente de dépasser trois ensembles en utilisant de simples cercles. Il a été formellement démontré qu’il est topologiquement impossible de construire un diagramme de Venn pour quatre ensembles en n’utilisant que quatre disques circulaires fermés tout en préservant la totalité des 16 intersections requises sans créer de régions disjointes parasites. Pour surmonter cette barrière, il est nécessaire de recourir à des ellipses imbriquées ou à des polygones non convexes complexes, formalisés notamment par les constructions de Branko Grünbaum et Anthony Edwards.
8.2 Diagrammes d’Euler versus diagrammes de Venn
Il est fréquent dans la littérature scientifique de confondre les diagrammes de Venn avec les diagrammes imaginés un siècle plus tôt par le savant suisse Leonhard Euler. Pourtant, leur divergence épistémologique est profonde. Tandis que le diagramme de Venn impose une représentation combinatoire préalable de toutes les zones possibles (quitte à hachurer a posteriori celles qui s’avèrent vides), le diagramme d’Euler ajuste sa géométrie à l’état réel des inclusions et disjonctions du problème traité.
Dans un diagramme d’Euler, une zone n’est dessinée que si elle contient des éléments réels ou si elle exprime une possibilité logique admise par les prémisses. Ainsi, si deux ensembles A et B sont mutuellement disjoints (A ∩ B = Ø), le diagramme d’Euler représentera deux cercles spatialement distants ne partageant aucune frontière de contact. De même, si A est un sous-ensemble strict de B, le cercle de A sera intégralement tracé à l’intérieur de l’espace délimité par le cercle de B.
Cette plasticité confère aux diagrammes d’Euler une supériorité cognitive marquée lors de la restitution d’analyses taxonomiques ou de structures hiérarchiques complexes. En éliminant les zones de vacuité superflues qui alourdissent visuellement les diagrammes de Venn, Euler réduit la surcharge d’attention et prévient les erreurs d’interprétation chez le lecteur non mathématicien. Le diagramme de Venn demeure néanmoins le modèle d’excellence pour valider formellement la validité déductive des syllogismes sans présupposer de la vacuité empirique des classes en présence.
8.3 Les diagrammes de Lewis Carroll et tables de Karnaugh
Face aux impasses géométriques des courbes fermées continues au-delà de trois ensembles, Charles Lutwidge Dodgson (plus connu sous son nom de plume de Lewis Carroll) a proposé en 1896 une modélisation spatiale matricielle et orthogonale. Les diagrammes de Lewis Carroll abandonnent les cercles au profit de carrés et rectangles subdivisés par des cloisons orthogonales intérieures, formant un damier d’appartenance.
Dans cette architecture, un prédicat divise un carré unitaire en deux bandes verticales (par exemple A à gauche, Ac à droite). Un deuxième prédicat coupe le carré par une partition horizontale (B en haut, Bc en bas), engendrant quatre cases représentatives des intersections croisées. L’adjonction d’un troisième prédicat s’opère par l’inscription d’un cadre intérieur découpant le centre de chaque case, et un quatrième prédicat se traduit par une subdivision symétrique des zones internes. Cette méthode permet de visualiser sans distorsion topologique les intersections de 4, 5 ou 6 ensembles de manière rigoureuse.
Ce formalisme carrollien constitue l’ancêtre direct des tables de Karnaugh (développées en 1953 par Maurice Karnaugh), utilisées en ingénierie informatique pour la minimisation des circuits logiques booléens. Les tables de Karnaugh transposent la continuité géométrique des diagrammes continus en une matrice discrète bidimensionnelle ordonnée selon le code Gray (où une seule variable change d’état logique entre deux cellules adjacentes). Cette transition de la géométrie continue vers les méthodes tabulaires discrètes résout le problème de l’explosion dimensionnelle et permet d’isoler visuellement les regroupements d’éléments unifiables pour simplifier des expressions contenant de nombreuses variables logiques.
9. Applications fondamentales au calcul des probabilités et à la statistique
9.1 L’univers des événements et la tribu (sigma-algèbre)
L’édification moderne du calcul des probabilités, accomplie par Andreï Kolmogorov en 1933, repose sur la traduction intégrale des phénomènes aléatoires dans le formalisme de la théorie de la mesure et des ensembles. Au point de départ de tout modèle probabiliste se trouve l’univers des possibles, traditionnellement désigné par la lettre grecque oméga majuscule Ω. Cet univers constitue l’ensemble référentiel exhaustif regroupant la totalité des réalisations élémentaires concevables (les événements élémentaires ω) d’une expérience aléatoire déterminée.
Dans ce cadre formel, un événement probabiliste n’est rien d’autre qu’un sous-ensemble de l’univers Ω. Néanmoins, lorsque l’univers Ω est infini et non dénombrable (comme dans le cas de mesures de temps, de poids ou d’activités neurobiologiques continues), l’attribution d’une probabilité cohérente à n’importe quel sous-ensemble de l’ensemble des parties P(Ω) conduit aux apories de l’indécidabilité de la mesure (illustrées de façon saisissante par le paradoxe de Banach-Tarski). Il devient donc impératif de restreindre l’espace des événements mesurables à une structure ensembliste spécifique qualifiée de tribu ou σ-algèbre (sigma-algèbre), usuellement notée F.
Pour qu’une famille F de sous-ensembles de Ω soit qualifiée de tribu, elle doit satisfaire trois axiomes de stabilité constitutifs :
- L’univers global appartient à la famille : Ω ∈ F.
- Stabilité par passage au complémentaire : si un événement A réside dans F, son complémentaire Ac = Ω A appartient obligatoirement à F.
- Stabilité par union dénombrable : pour toute suite dénombrable d’événements (An)n∈ℕ appartenant à F, leur réunion infinie ∪n=1∞ An appartient obligatoirement à F.
Ces conditions garantissent que toutes les opérations ensemblistes élémentaires (intersections finies et dénombrables, différences, réunions) appliquées à des événements mesurables génèrent de nouveaux événements dont la probabilité demeure calculable au sein du triplet probabilisé (Ω, F, P).
9.2 Mesure de probabilité et formules d’addition
Une mesure de probabilité P est une fonction définie sur la tribu F et à valeurs dans l’intervalle réel [0, 1], respectant l’axiome d’adjonction unitaire P(Ω) = 1 et le principe de σ-additivité : pour toute suite dénombrable d’événements deux à deux disjoints, la probabilité de leur union est rigoureusement égale à la somme infinie de leurs probabilités individuelles. Dès lors, les opérations ensemblistes élémentaires se convertissent instantanément en lois de calcul probabiliste.
La probabilité du complémentaire découle de la partition de l’univers : P(Ac) = 1 – P(A). Pour l’union de deux événements non disjoints, la formule de l’addition probabiliste traduit fidèlement le principe d’inclusion-exclusion :
P(A ∪ B) = P(A) + P(B) – P(A ∩ B)
Cette relation fondamentale met en exergue l’effet de compensation géométrique : sommer aveuglément les mesures de A et de B attribue un double poids de probabilité à la surface de convergence conjonctive modélisée par l’intersection A ∩ B.
Pour une collection de n événements interconnectés, cette équation se généralise dans la monumentale formule du crible de Poincaré :
P(∪i=1n Ai) = ∑i=1n P(Ai) – ∑1≤i<j≤n P(Ai ∩ Aj) + ∑1≤i<j<k≤n P(Ai ∩ Aj ∩ Ak) – … + (-1)n-1 P(∩i=1n Ai)
Cette alternance de corrections additives et soustractives garantit un calibrage probabiliste sans faille, démontrant la dépendance des statistiques mathématiques envers l’algèbre des intersections croisées.
9.3 Probabilité conditionnelle, indépendance et règle de Bayes
L’introduction d’une information partielle modifie l’espace de référence d’une expérience aléatoire. Cette mise à jour s’effectue par le concept de probabilité conditionnelle, qui restreint l’univers effectif Ω à un sous-ensemble particulier B (sous réserve que P(B) > 0). La probabilité conditionnelle de l’événement A sachant que l’événement B est réalisé se définit formellement par le ratio de la mesure de leur intersection sur la mesure de l’ensemble conditionnant :
P(A | B) = P(A ∩ B) / P(B)
Cette formulation révèle que la probabilité conditionnelle évalue la proportion de la masse de l’intersection qui se situe au sein de la région délimitée par B. Dans cette optique, deux événements A et B sont dits stochastiquement indépendants si et seulement si l’occurrence de B n’altère pas la probabilité de A, ce qui se traduit par la factorisation exacte de la mesure de leur intersection : P(A ∩ B) = P(A) × P(B).
L’architecture ensembliste atteint son plein potentiel inférentiel lors de la décomposition de l’univers par une partition finie {B1, B2, …, Bk} d’événements disjoints et exhaustifs. En vertu du théorème des probabilités totales, tout événement A de la tribu peut être découpé en une somme d’intersections disjointes :
A = ∪i=1k (A ∩ Bi)
P(A) = ∑i=1k P(A ∩ Bi) = ∑i=1k P(A | Bi) P(Bi)
En croisant cette formule avec la définition de la probabilité conditionnelle, on dérive le théorème de Bayes formulé ensemblistement :
P(Bj | A) = (P(A | Bj) P(Bj)) / (∑i=1k P(A | Bi) P(Bi))
Cette équation orchestre l’inversion probabiliste fondamentale : elle évalue la vraisemblance d’une cause sous-jacente Bj à la lumière de l’observation empirique de l’effet A, fournissant le cadre logique du paradigme bayésien contemporain qui gouverne l’apprentissage machine et les sciences cognitives de la décision.
10. Applications en psychologie cognitive et modélisation des concepts
10.1 Théories de la catégorisation : vision classique versus floue
L’étude de la catégorisation humaine constitue un terrain privilégié pour observer les interactions entre théorie formelle des ensembles et psychologie cognitive. La conception classique de la catégorisation, héritée de la tradition aristotélicienne et dominante jusqu’au milieu du XXe siècle, postule que les concepts mentaux sont des ensembles nets définis par une liste de traits sémantiques ou critères individuellement nécessaires et conjointement suffisants. Dans ce paradigme, déterminer si un spécimen appartient à la catégorie « oiseau » consiste à évaluer l’intersection rigoureuse de ses caractéristiques (vertébré ∩ muni de plumes ∩ ovipare ∩ à sang chaud). L’appartenance est strictement binaire : l’objet fait partie de l’ensemble ou s’en trouve totalement exclu, sans variabilité graduée.
Cette approche classique a été profondément remise en question par les travaux empiriques d’Eleanor Rosch sur la théorie des prototypes. Rosch a mis en évidence que les catégories naturelles ne se comportent pas comme des ensembles cantoristes aux frontières étanches. Les individus attribuent des degrés de typicalité variables aux éléments d’une même catégorie : un moineau est jugé beaucoup plus représentatif de la classe des oiseaux qu’un manchot ou une autruche, bien que tous partagent les attributs biologiques de l’espèce. Les frontières conceptuelles se révèlent poreuses et instables selon le contexte sociocognitif.
Pour formaliser cette réalité sans abandonner la rigueur de l’analyse, la psychologie contemporaine s’appuie sur la théorie des ensembles flous (fuzzy sets), introduite en 1965 par Lotfi Zadeh. Dans un ensemble flou, la fonction indicatrice binaire classique à valeurs dans {0, 1} est remplacée par une fonction d’appartenance continue μA(x) assignant à chaque élément un degré de vérité compris dans l’intervalle réel [0, 1]. Les opérateurs ensemblistes traditionnels sont alors redéfinis par des t-normes et t-conormes : l’intersection floue correspond généralement au minimum des degrés d’appartenance (μA∩B(x) = min(μA(x), μB(x))), tandis que l’union floue adopte l’opérateur maximum (μA∪B(x) = max(μA(x), μB(x))). Cette modélisation offre un cadre mathématique capable d’épouser les nuances sémantiques de la pensée intuitive.
10.2 Biais de jugement logique et erreur de conjonction
L’observation du jugement probabiliste intuitif révèle des écarts remarquables entre les prescriptions formelles de la théorie des ensembles et les raisonnements spontanés de l’esprit humain. La démonstration la plus célèbre de ce décalage a été apportée en 1983 par les psychologues Amos Tversky et Daniel Kahneman à travers le problème de Linda, mettant en lumière l’erreur de conjonction (conjunction fallacy).
Dans cette expérience princeps, les participants prennent connaissance de la description d’une jeune femme fictive, Linda, activement impliquée dans les causes sociales et la justice distributive. Invités à ordonner la vraisemblance de plusieurs assertions la concernant, une écrasante majorité de sujets (y compris des cohortes dotées d’une formation poussée en statistique) classe la proposition composite « Linda est employée de banque et militante féministe » comme plus probable que la proposition simple « Linda est employée de banque ». Sur le plan ensembliste et probabiliste, ce jugement constitue une violation frontale de la règle de monotonie de l’intersection :
(A ∩ B) ⊆ A ⟹ P(A ∩ B) ≤ P(A)
L’ensemble des personnes répondant simultanément aux deux caractéristiques est nécessairement un sous-ensemble de la population globale des employés de banque ; sa mesure ne peut en aucun cas excéder celle du sur-ensemble englobant.
Tversky et Kahneman ont démontré que cette dérive dérive de l’utilisation de l’heuristique de représentativité : au lieu d’évaluer une inclusion ensembliste, l’esprit évalue le degré de similarité entre le profil narratif de Linda et le stéréotype mental de la militante féministe. L’erreur de conjonction illustre comment l’architecture sémantique de l’intersection peut être court-circuitée par des associations de saillance cognitive. De manière symétrique, l’erreur d’inclusion ou la surévaluation intuitive de l’union conduit fréquemment à agréger des risques distincts sans retrancher l’intersection, faussant la perception globale de la vulnérabilité dans les prises de décision critiques.
10.3 Théorie de l’intégration des attributs et attention sélective
Au niveau des processus neuro-visuels précoces, la théorie des ensembles fournit le modèle descriptif utilisé pour formaliser l’attention sélective. Dans sa théorie fondatrice de l’intégration des traits (Feature Integration Theory), Anne Treisman a postulé que le système perceptif humain analyse le champ visuel à travers des cartes fonctionnelles indépendantes et parallèles, spécialisées dans l’extraction de dimensions univariées (couleur, orientation des lignes, mouvement, taille).
Lorsqu’un individu doit détecter une cible différant des distracteurs par une caractéristique unique (par exemple un élément rouge parmi des éléments verts), la détection s’opère de manière automatique et pré-attentionnelle (effet de pop-out), ce qui équivaut à identifier l’ensemble non vide d’une caractéristique unitaire. En revanche, lorsque la cible est définie par la conjonction de deux attributs ou davantage (par exemple un rectangle rouge et horizontal au milieu de rectangles rouges verticaux et de rectangles verts horizontaux), l’opération cognitive bascule : la cible se situe à l’intersection formelle des deux classes de traits :
Cible = Rouge ∩ Horizontal
La détection de cette intersection conjonctive requiert la focalisation spatio-temporelle de l’attention sélective sur chaque région du champ visuel pour lier les cartes neuronales distinctes au sein d’un même espace de coordonnées. Le temps de réaction augmente alors de manière linéairement proportionnelle au nombre de distracteurs, matérialisant le coût computationnel que représente la résolution d’une intersection en temps réel pour le cortex cérébral. L’attention sélective agit ici comme un filtre spatial réalisant l’intersection physique des flux d’information, tandis que l’inhibition des distracteurs s’apparente à une opération de complémentation active qui extrait le signal pertinent du bruit sensoriel.
11. Applications en psychométrie, nosologie et analyse de données comportementales
11.1 Modélisation de la comorbidité psychiatrique et diagnostique
L’organisation de la nosologie psychiatrique contemporaine, exemplifiée par le Manuel diagnostique et statistique des troubles mentaux (DSM-5), repose sur une structure de classification polythétique directement dérivée des opérations de la théorie des ensembles. Un trouble mental donné n’est pas défini par un critère unique et invariable, mais par une union disjonctive de sous-ensembles de symptômes. Par exemple, pour valider le diagnostic d’épisode dépressif majeur, un patient doit présenter au moins cinq symptômes parmi une liste de neuf critères préétablis, incluant obligatoirement au moins l’un des deux symptômes cardinaux. Cette formulation par combinatoire d’unions génère une importante hétérogénéité nosologique interne : deux individus peuvent recevoir une étiquette nosologique rigoureusement identique tout en ne partageant qu’un seul symptôme en commun sur le plan clinique.
Cette structuration éclaire la question de la comorbidité diagnostique, c’est-à-dire la cooccurrence fréquente de deux diagnostics distincts (par exemple le trouble dépressif majeur et le trouble d’anxiété généralisée) chez un même individu. L’approche ensembliste permet de décomposer cette comorbidité en deux composantes analytiques :
- La comorbidité artéfactuelle ou de recouvrement, résultant du fait que l’intersection des critères diagnostiques des deux entités (Trouble A ∩ Trouble B) contient des critères partagés (troubles du sommeil, fatigue, difficultés de concentration). Cette zone de recouvrement symptomatique génère mathématiquement une probabilité accrue de validation conjointe sans qu’il y ait nécessairement deux étiologies distinctes.
- La comorbidité étiologique réelle, qui persiste lorsque l’on applique l’opération de différence ensembliste pour épurer les diagnostics de leurs critères communs : Trouble A (Trouble A ∩ Trouble B). Si une corrélation statistiquement significative demeure entre les ensembles résiduels après cette soustraction, l’existence d’une vulnérabilité biologique ou environnementale commune est corroborée.
Le diagnostic différentiel en psychiatrie et en médecine générale utilise ainsi la différence relative pour déterminer la singularité clinique d’un patient et éviter les redondances nosologiques artificielles.
11.2 Théorie classique des tests et validité de contenu
En psychométrie, l’élaboration et la validation des instruments de mesure (échelles d’anxiété, tests de quotient intellectuel, inventaires de personnalité) s’ancrent dans une modélisation ensembliste du domaine comportemental. Dans le cadre de la théorie classique des tests et de l’évaluation de la validité de contenu, le construit psychologique à mesurer est conceptualisé comme un univers infini ou univers d’items (UItems) rassemblant l’ensemble exhaustif des comportements et manifestations possibles du phénomène.
Un questionnaire psychométrique n’est rien d’autre qu’un sous-ensemble fini I extrait de cet univers (I ⊂ UItems). La validité de contenu dépend de la manière dont ce sous-ensemble échantillonne l’univers de référence. Si le construit comprend plusieurs facettes conceptuelles disjointes (F1, F2, …, Fm formant une partition de UItems), le test doit vérifier que ses propres sous-ensembles d’items interceptent équitablement chaque facette : |I ∩ Fk| > 0 pour tout k, tout en minimisant la présence d’items résidant dans le complémentaire (UItems)c, qui matérialiseraient une contamination par un construit non pertinent.
Lors de l’évaluation de la validité convergente et discriminante de deux échelles psychométriques X et Y, les corrélations observées reflètent directement la géométrie de leurs intersections conceptuelles. La décomposition de la variance d’un score au test s’analyse comme une partition de l’espace des variations : la variance vraie partagée correspond à l’intersection des domaines des tests, la variance spécifique correspond à la différence relative de chaque échelle épurée de la portion partagée, et la variance d’erreur représente le résidu complémentaire non explicable par la structure du construit.
11.3 Analyse comparative qualitative (QCA) en sciences comportementales
Développée par le sociologue et méthodologiste Charles Ragin, l’analyse comparative qualitative (QCA ou Qualitative Comparative Analysis) constitue une innovation méthodologique majeure reliant les données empiriques à l’algèbre booléenne et à la théorie des ensembles. La QCA s’affranchit des postulats de la régression statistique linéaire classique (additivité et causalité isolée des variables indépendantes) pour appréhender les phénomènes humains et sociaux sous l’angle de relations de causalité complexe, d’équifinalité et d’asymétrie.
Dans l’approche QCA, les cas empiriques (individus, cohortes cliniques, organisations institutionnelles) et les résultats observés sont traités comme des ensembles. Une condition causale X est qualifiée de condition nécessaire à la production du résultat Y si et seulement si l’ensemble des cas où le résultat Y est présent constitue un sous-ensemble de l’espace où la condition X est présente :
Y ⊆ X (le résultat implique nécessairement la présence de la condition)
Inversement, une condition X est reconnue comme une condition suffisante pour déclencher le résultat Y si l’ensemble des cas manifestant la condition X est intégralement inclus dans l’ensemble des cas présentant le résultat :
X ⊆ Y (la condition suffit à elle seule à induire le résultat)
La QCA utilise l’union et l’intersection booléennes pour formaliser l’équifinalité : un même résultat comportemental peut émerger de trajectoires causales distinctes modélisées par une union de configurations conjonctives : Y = (A ∩ B) ∪ (C ∩ Dc). Par ailleurs, elle modélise l’asymétrie causale : l’explication de l’absence d’un comportement (Yc) ne correspond pas simplement à l’opposé des conditions ayant induit sa présence, mais exige une minimisation par les lois de De Morgan pour isoler les configurations singulières menant à la non-réalisation du phénomène.
12. Implémentation algorithmique, calcul formel et synthèse méthodologique
12.1 Structures de données et algorithmique des ensembles
La transposition des opérations ensemblistes dans le domaine du calcul numérique et de l’informatique appliquée s’appuie sur des structures de données optimisées selon les volumétries traitées. Dans les environnements d’analyse de données tels que Python (type natif set) ou le langage R (fonctions union(), intersect(), setdiff()), l’implémentation repose principalement sur des tables de hachage (hash tables). L’utilisation du hachage permet de vérifier l’appartenance d’un élément (x ∈ A) avec une complexité temporelle moyenne idéale en temps constant, soit O(1). L’intersection de deux ensembles contenant respectivement n et m éléments requiert ainsi un temps d’exécution asymptotique de l’ordre de O(min(n, m)), tandis que l’union s’exécute en O(n + m), garantissant des temps de réponse acceptables pour l’analyse de grands volumes de données.
Toutefois, lorsque les calculs doivent être appliqués à des jeux de données massifs (tels que des matrices de voxels en neuro-imagerie cérébrale, des alignements génomiques à haut débit ou des réseaux d’interactions comportementales à large échelle), les tables de hachage rencontrent une barrière d’occupation mémoire due aux collisions et aux pointeurs d’adresses. L’architecture algorithmique privilégie alors les vecteurs de bits (bit arrays ou bitmaps). Dans cette structure, un univers fini et ordonné de N éléments possibles est modélisé par une chaîne contiguë de N bits en mémoire vive, où le k-ième bit vaut 1 si l’élément appartient à l’ensemble et 0 en cas d’absence.
L’avantage computationnel des vecteurs de bits réside dans le parallélisme des processeurs modernes : les opérations d’union, d’intersection et de complémentaire sont converties en instructions logiques élémentaires appliquées simultanément sur des registres de 64 ou 512 bits (instructions vectorielles SIMD) :
- L’union ensembliste s’exécute par l’opérateur matériel
ORau niveau des bits. - L’intersection ensembliste s’exécute par l’opérateur matériel
ANDau niveau des bits. - Le complémentaire s’exécute par l’opérateur matériel de négation
NOT. - La différence relative s’effectue par la combinaison
A AND (NOT B). - La différence symétrique s’exécute instantanément via l’instruction machine
XOR.
Cette optimisation matérielle réduit le traitement des opérations ensemblistes à des cycles d’horloge machine directs, autorisant la manipulation en temps réel de gigaoctets de données matricielles multidimensionnelles.
12.2 Résolution de problèmes complexes : études de cas pas à pas
Afin de synthétiser la maîtrise pratique de ces outils logico-mathématiques, examinons la décomposition formelle d’un problème méthodologique complexe à travers une étude de cas appliquée à l’épidémiologie comportementale.
Énoncé du problème : Un laboratoire de santé publique évalue une cohorte de 1 000 adolescents pour identifier des profils de risque associant trois conduites : la consommation régulière de tabac (ensemble T), la sédentarité extrême (ensemble S) et l’insomnie chronique (ensemble I). Les observations empiriques recueillies fournissent les données cardinales suivantes :
- Effectif total de la cohorte : |U| = 1000
- Consommateurs de tabac : |T| = 250
- Sujets sédentaires : |S| = 320
- Sujets insomniaques : |I| = 210
- Sujets associant tabac et sédentarité : |T ∩ S| = 100
- Sujets associant tabac et insomnie : |T ∩ I| = 80
- Sujets associant sédentarité et insomnie : |S ∩ I| = 70
- Sujets cumulant les trois facteurs de risque : |T ∩ S ∩ I| = 40
Objectif analytique : L’équipe doit déterminer le nombre exact de sujets ne présentant rigoureusement aucun de ces trois risques, ainsi que la proportion d’individus présentant exactement deux facteurs de risque combinés (sans cumul du troisième).
Résolution analytique par étapes :
Étape 1 : Calcul de l’union des trois facteurs de risque
Pour quantifier l’ensemble des individus affectés par au moins une conduite à risque (|T ∪ S ∪ I|), nous appliquons le théorème d’inclusion-exclusion pour trois ensembles :
|T ∪ S ∪ I| = (|T| + |S| + |I|) – (|T ∩ S| + |T ∩ I| + |S ∩ I|) + |T ∩ S ∩ I|
|T ∪ S ∪ I| = (250 + 320 + 210) – (100 + 80 + 70) + 40
|T ∪ S ∪ I| = 780 – 250 + 40 = 570
Il ressort que 570 individus présentent au moins l’un des trois comportements évalués.
Étape 2 : Détermination du complémentaire universel
L’ensemble des adolescents totalement indemnes de ces trois facteurs correspond au complémentaire de l’union dans l’univers de discours U. En appliquant la première loi de De Morgan étendue :
(T ∪ S ∪ I)c = Tc ∩ Sc ∩ Ic
|Tc ∩ Sc ∩ Ic| = |U| – |T ∪ S ∪ I| = 1000 – 570 = 430
L’effectif préservé de tout facteur de risque est de 430 sujets.
Étape 3 : Calcul des sous-ensembles d’intersection exclusive double
Pour isoler les sujets présentant exactement deux risques, nous devons soustraire l’intersection triple de chacune des intersections prises deux à deux :
- Tabac et sédentarité exclusivement : |(T ∩ S) I| = |T ∩ S| – |T ∩ S ∩ I| = 100 – 40 = 60
- Tabac et insomnie exclusivement : |(T ∩ I) S| = |T ∩ I| – |T ∩ S ∩ I| = 80 – 40 = 40
- Sédentarité et insomnie exclusivement : |(S ∩ I) T| = |S ∩ I| – |T ∩ S ∩ I| = 70 – 40 = 30
La réunion de ces trois sous-ensembles étant mutuellement disjointe par construction, leur somme directe nous livre le nombre total d’adolescents cumulant exactement deux risques : 60 + 40 + 30 = 130 sujets, soit 13 % de la population globale. Cette résolution décompose les sous-espaces de la cohorte sans ambiguïté ni double comptage.
12.3 Synthèse critique et portée épistémologique
L’exploration méthodique des opérations sur les ensembles révèle leur fonction de langage régulateur pour la clarification de la démarche scientifique. Loin de se cantonner à une manipulation symbolique désincarnée, l’union, l’intersection, le complémentaire et la différence constituent les opérateurs logiques par lesquels l’esprit structure le chaos des données empiriques, délimite ses objets d’étude et vérifie la validité interne de ses inférences. Qu’il s’agisse de concevoir des topologies d’espaces probabilisés, de cartographier la complexité d’un tableau clinique ou d’optimiser l’exécution de requêtes booléennes distribuées, la maîtrise de ces opérateurs conditionne la précision des modèles théoriques face à la réalité.
Toutefois, une réflexion épistémologique contemporaine impose de reconnaître la complémentarité dialectique reliant les représentations discrètes de l’algèbre ensembliste et les modèles statistiques continus. Si la théorie classique des ensembles offre un cadre normatif d’une rigueur indiscutable, les phénomènes naturels et comportementaux oscillent fréquemment entre frontières nettes et transitions graduées. La formalisation rigoureuse des concepts gagne ainsi à articuler les formalismes booléens de Zermelo-Fraenkel avec les extensions probabilistes et floues, garantissant que l’exactitude de l’abstraction mathématique serve fidèlement la description de la complexité empirique.
Références
Bourbaki, N. (1970). Théorie des ensembles. Éléments de mathématique. Hermann.
Cantor, G. (1895). Beiträge zur Begründung der transfiniten Mengenlehre. Mathematische Annalen, 46(4), 481–512. https://doi.org/10.1007/BF02124929
De Morgan, A. (1847). Formal Logic: or, The Calculus of Inference, Necessary and Probable. Taylor and Walton.
Edwards, A. W. F. (2004). Cogwheels of the Mind: The Story of Venn Diagrams. Johns Hopkins University Press.
Euler, L. (1768). Lettres à une princesse d’Allemagne sur divers sujets de physique et de philosophie. Académie Impériale des Sciences de Saint-Pétersbourg.
Fraenkel, A. A., Bar-Hillel, Y., & Levy, A. (1973). Foundations of Set Theory (2nd rev. ed.). North-Holland Publishing Company.
Halmos, P. R. (1960). Naive Set Theory. D. Van Nostrand Company.
Kahneman, D., & Tversky, A. (1982). Judgments of and by representativeness. In D. Kahneman, P. Slovic, & A. Tversky (Eds.), Judgment under Uncertainty: Heuristics and Biases (pp. 84–98). Cambridge University Press. https://doi.org/10.1017/CBO9780511809477.007
Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Springer.
Peano, G. (1889). Arithmetices principia, nova methodo exposita. Fratres Bocca.
Ragin, C. C. (1987). The Comparative Method: Moving Beyond Qualitative and Quantitative Strategies. University of California Press.
Ragin, C. C. (2008). Redesigning Social Inquiry: Fuzzy Sets and Beyond. University of Chicago Press. https://doi.org/10.7208/chicago/9780226702797.001.0001
Rosch, E. (1975). Cognitive representations of semantic categories. Journal of Experimental Psychology: General, 104(3), 192–233. https://doi.org/10.1037/0096-3445.104.3.192
Russell, B. (1903). The Principles of Mathematics. Cambridge University Press.
Treisman, A. M., & Gelade, G. (1980). A feature-integration theory of attention. Cognitive Psychology, 12(1), 97–136. https://doi.org/10.1016/0010-0285(80)90005-5
Tversky, A., & Kahneman, D. (1983). Extensional versus intuitive reasoning: The conjunction fallacy in probability judgment. Psychological Review, 90(4), 293–315. https://doi.org/10.1037/0033-295X.90.4.293
Venn, J. (1880). On the diagrammatic and mechanical representation of propositions and reasonings. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 9(59), 1–18. https://doi.org/10.1080/14786448008626877
Zadeh, L. A. (1965). Fuzzy sets. Information and Control, 8(3), 338–353. https://doi.org/10.1016/S0019-9958(65)90241-X
Zermelo, E. (1908). Untersuchungen über die Grundlagen der Mengenlehre. I. Mathematische Annalen, 65(2), 261–281. https://doi.org/10.1007/BF01449999