
La représentation graphique des distributions statistiques constitue le socle fondamental de toute démarche empirique rigoureuse. Au sein des sciences contemporaines, qu’il s’agisse des neurosciences cognitives, de la psychologie différentielle, de l’économétrie ou de la bio-informatique, les chercheurs sont constamment confrontés à la nécessité d’examiner et de communiquer la structure sous-jacente de données complexes. Si les indicateurs paramétriques traditionnels tels que la moyenne arithmétique et l’écart-type demeurent prépondérants dans la littérature, ils échouent fréquemment à restituer la véritable morphologie des distributions réelles, lesquelles s’écartent régulièrement de l’idéal théorique de la loi normale. L’occultation de l’asymétrie, de l’aplatissement ou de la présence de valeurs extrêmes peut induire des biais d’interprétation substantiels, menant parfois à des conclusions inférentielles erronées.
C’est dans ce contexte méthodologique que la boîte à moustaches, ou diagramme en boîte, s’impose comme un instrument d’analyse exploratoire et confirmatoire d’une puissance inégalée. En synthétisant visuellement la dispersion, la tendance centrale et les frontières extrêmes d’une variable continue, elle offre une perspective synthétique et robuste face aux artéfacts distributionnels. Lorsque cette approche est déclinée sous une modalité groupée, permettant la mise en regard simultanée de multiples sous-populations ou conditions expérimentales, elle devient la clé de voûte de la comparaison intergroupes, révélant en un coup d’œil les divergences de localisation, les hétérogénéités de variance et les dynamiques factorielles sous-jacentes.
Dans l’écosystème open-source moderne, le langage de programmation Python s’est imposé comme la référence pour l’analyse computationnelle et la science des données. Au cœur de cet environnement, les bibliothèques Matplotlib et Seaborn fournissent une infrastructure logicielle d’une flexibilité remarquable pour la génération de visualisations de données de niveau publication. Ce guide encyclopédique se propose d’explorer en profondeur la théorie, l’ingénierie logicielle et les subtilités esthétiques requises pour concevoir des boîtes à moustaches par groupe irréprochables, alliant rigueur statistique, conformité aux standards académiques internationaux et élégance sémiotique.
1. Introduction aux boîtes à moustaches groupées en analyse de données
1.1 Définition et pertinence épistémologique du boxplot
La boîte à moustaches, conceptualisée à l’origine par le statisticien américain John W. Tukey en 1970 sous l’appellation de schematic plot avant d’être officialisée dans son ouvrage fondateur de 1977 intitulé Exploratory Data Analysis, représente une révolution paradigmatique dans la façon d’appréhender les distributions empiriques. Dans une tradition statistique historiquement dominée par l’hypothèse de normalité et la suprématie des estimateurs gaussiens, Tukey a plaidé pour une approche non paramétrique, résistante aux distorsions numériques et capable de faire émerger la structure des données sans imposer de modèle a priori. La boîte à moustaches incarne cette philosophie en s’appuyant exclusivement sur les statistiques d’ordre, c’est-à-dire les quantiles, qui demeurent insensibles aux variations aberrantes des valeurs extrêmes.
L’avantage épistémologique fondamental du boxplot par rapport aux classiques diagrammes en bâtons ou aux graphiques illustrant la moyenne assortie d’intervalles de confiance réside dans sa capacité à préserver l’intégrité informationnelle de la distribution. Tandis qu’une moyenne peut être dramatiquement décalée par une unique mesure corrompue et qu’un écart-type masque totalement une éventuelle bimodalité ou une asymétrie positive prononcée, la boîte à moustaches expose sans détour l’étalement réel des cinquante pour cent centraux des observations ainsi que la longueur relative des queues de distribution. Pour le praticien des sciences comportementales ou cliniques, cette transparence est indispensable : elle permet de s’assurer que les inférences formulées ne reposent pas sur une illusion géométrique induite par des résumés numériques excessivement réducteurs.
En outre, l’évaluation de la dispersion dans des contextes non gaussiens constitue un défi méthodologique récurrent. Dans des disciplines telles que la psychophysique, la chronométrie mentale ou la génomique, les variables d’intérêt telles que les temps de réaction ou les taux d’expression transcriptionnelle adoptent quasi systématiquement des profils asymétriques à queue lourde, fréquemment assimilables à des lois log-normales ou de Weibull. Dans de telles circonstances, recourir à la boîte à moustaches groupée permet une comparaison visuelle directe et fidèle entre cohortes, évitant aux investigateurs de postuler hâtivement une symétrie qui n’existe pas dans le phénomène étudié.
1.2 Rôle de Matplotlib et Seaborn dans l’écosystème Python
La mise en œuvre informatique de ces concepts repose, au sein de l’univers Python, sur une architecture logicielle hautement stratifiée. À la base de cette pyramide computationnelle se trouve Matplotlib, bibliothèque fondamentale développée par John D. Hunter au début des années 2000. Matplotlib fournit une interface de programmation orientée objet exhaustive qui modélise chaque élément graphique sous la forme d’une hiérarchie rigoureuse : la figure principale sert d’espace récepteur, les conteneurs d’axes délimitent les zones de coordonnées cartésiennes, et une multitude d’objets primitifs, tels que les lignes, les polygones et les textes, en constituent le tissu visuel. Cette granularité extrême confère à Matplotlib une puissance sans équivalent pour l’ajustement millimétrique de chaque attribut typographique ou vectoriel, mais elle exige en contrepartie une verbosité programmatique parfois contraignante lors de l’exécution d’analyses exploratoires courantes.
C’est précisément pour surmonter cette barrière ergonomique que la bibliothèque Seaborn, conçue par Michael Waskom, a été introduite en tant que surcouche statistique de haut niveau bâtie directement sur le moteur de rendu de Matplotlib. Seaborn abstrait la complexité syntaxique sous-jacente en s’interfaçant nativement avec les structures de données tabulaires proposées par Pandas. Au lieu d’exiger du chercheur qu’il ventile manuellement ses matrices et calcule individuellement les coordonnées géométriques de chaque segment de droite, Seaborn prend en charge de manière déclarative l’agrégation, le regroupement catégoriel, la gestion automatique des palettes chromatiques et le calcul rigoureux des statistiques descriptives nécessaires au tracé.
L’articulation entre ces deux outils ne doit cependant pas être perçue sous l’angle de la substitution, mais bien sous celui de la complémentarité symbiotique. Si Seaborn excelle dans la composition rapide et esthétiquement raffinée de figures statistiques multifactorielles, la maîtrise de l’infrastructure sous-jacente de Matplotlib demeure impérative pour quiconque souhaite personnaliser les propriétés matérielles d’un graphique afin de satisfaire aux exigences drastiques des comités de lecture des revues savantes. L’alliance harmonieuse de la concision déclarative de Seaborn et du contrôle microscopique offert par Matplotlib constitue ainsi le standard d’excellence pour la recherche quantitative contemporaine et reproductible.
1.3 Objectifs de la comparaison intergroupes
L’intégration de regroupements catégoriels au sein des visualisations par boîtes à moustaches répond à plusieurs impératifs heuristiques essentiels. Le premier objectif réside dans la mise en évidence immédiate des disparités de tendance centrale entre différentes conditions expérimentales ou strates démographiques. En observant l’alignement horizontal ou vertical des médiatrices au sein des boîtes, le chercheur évalue intuitivement si un traitement thérapeutique induit un décalage substantiel du comportement d’une cohorte par rapport à un groupe placebo, ou si des disparités structurelles émergent entre divers segments socio-économiques au sein d’une enquête sociologique d’envergure.
Le second dessein fondamental concerne l’analyse visuelle de la variabilité et de l’asymétrie locale. Deux groupes expérimentaux peuvent parfaitement présenter des médianes strictement identiques tout en différant de manière drastique quant à leur hétérogénéité interne. La boîte à moustaches groupée permet de discerner instantanément si un sous-groupe présente une dispersion restreinte, témoignant d’une réponse homogène à un stimulus, tandis qu’un autre manifesterait un étalement considérable suggérant la présence de sous-populations sous-jacentes ou d’une variabilité interindividuelle prononcée. Cette évaluation de l’hétérogénéité des variances constitue une étape diagnostique primordiale pour l’analyste.
Enfin, ce dispositif graphique opère comme un filtre de validation des postulats nécessaires à l’application ultérieure des tests d’inférence statistique. Avant de mobiliser des modèles paramétriques avancés, tels que l’analyse de variance univariée ou multivariée, il est impératif de vérifier le postulat d’homoscédasticité, qui stipule l’égalité des variances intra-groupes. La confrontation directe des hauteurs de boîtes et de la portée des moustaches offre une vérification empirique rapide. En cas de violations manifestes, le chercheur sera alerté sur la nécessité d’adopter des alternatives non paramétriques robustes, telles que le test de Kruskal-Wallis, ou de recourir à des transformations de variables stabilisatrices de variance.
2. Fondements statistiques de la boîte à moustaches
2.1 Décomposition du résumé à cinq nombres
La structure anatomique d’une boîte à moustaches découle directement de la méthode du résumé à cinq nombres formalisée par l’école d’analyse exploratoire des données. Cette formalisation repose sur la division ordinale rigoureuse d’un échantillon univarié ordonné en quartiles. Le cœur du dispositif est constitué par le rectangle central, dont la base inférieure délimite le premier quartile, couramment désigné sous le symbole Q1 ou vingt-cinquième centile. Cette valeur seuil indique précisément que 25 % des observations de l’échantillon lui sont inférieures ou égales, tandis que 75 % lui sont supérieures. À l’opposé, la bordure supérieure de la boîte correspond au troisième quartile, ou Q3, correspondant au soixante-quinzième centile, en dessous duquel se situent les trois quarts des points de données enregistrés.
À l’intérieur de ce réceptacle rectangulaire, une barre transversale marque l’emplacement de la médiane, ou Q2, qui scinde la distribution en deux moitiés équiprobables. La hauteur physique de la boîte matérialise l’écart interquartile, désigné par le sigle IQR d’après la terminologie anglophone Interquartile Range, et obtenu par la différence arithmétique rigoureuse entre Q3 et Q1. L’écart interquartile constitue une mesure fondamentale de la dispersion des données, dotée d’une résistance absolue face aux perturbations numériques extrêmes : son point de rupture théorique est de 25 %, ce qui signifie qu’un quart des observations peuvent être altérées arbitrairement sans modifier indûment cette métrique d’étalement.
La confrontation entre la position de la médiane et les frontières interquartiles fournit des informations directes sur la forme distributionnelle. Lorsque la médiane est positionnée à équidistance absolue de Q1 et de Q3, la boîte suggère une symétrie locale remarquable au sein du cœur des données. Inversement, une médiane comprimée contre le quartile inférieur signale une forte asymétrie positive vers la droite, où les données supérieures s’étirent de manière disproportionnée. Cette divergence structurelle entre médiane et moyenne est un indicateur diagnostique précieux que le statisticien averti examine systématiquement pour juger de la pertinence des estimateurs de position classiques.
2.2 Règles d’identification des valeurs aberrantes
Au-delà du corps rectangulaire central, la boîte à moustaches déploie des segments rectilignes linéaires, désignés sous le terme de moustaches, dont la portée dépend de règles computationnelles déterministes. Dans la formulation canonique établie par John Tukey, ces segments ne s’étendent pas aveuglément vers les valeurs minimales et maximales absolues de la distribution, mais s’arrêtent aux observations les plus extrêmes situées à l’intérieur de clôtures statistiques internes rigoureusement définies. La clôture interne inférieure est fixée à la coordonnée mathématique Q1 moins 1,5 fois l’écart interquartile, tandis que la clôture interne supérieure correspond à Q3 plus 1,5 fois cet même écart interquartile.
Toute donnée empirique se déployant au-delà de ces frontières virtuelles est catégorisée sous l’étiquette de valeur aberrante, ou outlier, et fait l’objet d’une matérialisation graphique individualisée au moyen de glyphes spécifiques, le plus souvent des disques ou des losanges. La littérature statistique opère par ailleurs une distinction fondamentale entre les valeurs aberrantes modérées, localisées entre les clôtures internes et les clôtures externes situées à 3,0 fois l’écart interquartile, et les valeurs aberrantes sévères ou extrêmes, qui franchissent ce second seuil critique. Dans une distribution suivant une loi normale standard théorique, la probabilité qu’une observation franchisse le seuil de 1,5 fois l’écart interquartile est infinitésimale, s’élevant à environ 0,7 % de l’effectif total.
Cette sensibilité diagnostique confère au boxplot une valeur prépondérante dans l’analyse des queues de distribution. Face à des distributions à queue lourde, la prolifération de marqueurs de dispersion au-delà des moustaches alerte immédiatement l’analyste sur la non-conformité gaussienne du processus générateur de données. Dès lors, ces points atypiques cessent d’être perçus comme de simples erreurs de saisie ou des artéfacts métrologiques pour devenir des objets d’investigation statistique à part entière, incitant à une exploration qualitative approfondie de la cohorte d’échantillonnage.
2.3 Application aux cohortes de recherche en psychologie
Dans le domaine des sciences psychologiques et des neurosciences comportementales, l’application de boîtes à moustaches segmentées par cohortes expérimentales constitue une procédure analytique standard. Considérons à titre d’illustration l’évaluation des scores psychométriques d’anxiété clinique ou l’enregistrement de temps de réaction dans des paradigmes d’inhibition cognitive comme la tâche de Stroop. Au sein de tels protocoles, les sujets sont typiquement répartis entre un groupe contrôle et plusieurs sous-groupes cliniques diagnostiqués pour divers troubles de l’humeur. La juxtaposition de boîtes à moustaches univariées pour chacun de ces groupes fournit une cartographie détaillée du profil cognitif de chaque population.
Ce protocole visuel permet notamment d’identifier avec acuité les biais de mesure inhérents aux paradigmes comportementaux. Une boîte anormalement contractée dans une cohorte clinique peut trahir un effet plancher ou un effet plafond au niveau de l’échelle d’évaluation utilisée, révélant une insensibilité métrologique du questionnaire face aux états affectifs extrêmes. Parallèlement, l’apparition de temps de latence cognitive extraordinairement dilatés sous forme de valeurs aberrantes isolées peut refléter des épisodes de décrochage attentionnel ou des micro-sommeils chez certains patients, données qui devront être documentées ou traitées avant toute étape de modélisation inférentielle.
Sur le plan méthodologique formel, cette exploration visuelle préalable conditionne la validité des conclusions issues des analyses paramétriques multivariées. L’analyse de variance à mesures répétées ou l’analyse de covariance supposent fondamentalement que la variance de l’erreur résiduelle demeure constante à travers l’ensemble des modalités du facteur expérimental. En observant des hauteurs de boîtes radicalement dissemblables entre les groupes de recherche, le chercheur détecte sans ambiguïté une violation de cette hypothèse d’homoscédasticité, justifiant le recours à des ajustements de degrés de liberté selon la procédure de Welch ou la transition vers des modèles linéaires mixtes plus flexibles.
3. Configuration de l’environnement de développement Python
3.1 Installation et gestion des dépendances
L’édification d’un flux de travail analytique robuste et reproductible exige une isolation préalable de l’environnement d’exécution logiciel. Dans les projets de traitement de données scientifiques, il est impératif d’éviter l’installation anarchique de bibliothèques au niveau du système d’exploitation global, pratique risquant d’engendrer des conflits insolubles entre versions de dépendances partagées. L’utilisation d’outils d’isolation tels que le module standard venv de Python ou le gestionnaire d’environnements Conda s’impose comme le premier standard technique à respecter scrupuleusement.
Pour initialiser un environnement de recherche optimal, il convient d’installer une pile logicielle cohérente intégrant les versions stables les plus récentes de NumPy pour le calcul matriciel, de Pandas pour la manipulation tabulaire de structures de données, de Matplotlib pour le moteur de composition graphique et de Seaborn pour l’abstraction statistique déclarative. Cette démarche garantit non seulement l’accès aux optimisations d’exécution les plus récentes, mais prévient également les ruptures d’interface logicielle fréquentes lors des transitions entre versions majeures.
Au-delà de la phase initiale d’installation, la reproductibilité informatique intégrale impose la formalisation rigoureuse de cet état logiciel au sein d’un descripteur déclaratif, traditionnellement matérialisé par un fichier texte de configuration de type requirements. Cette formalisation fige de manière univoque la version exacte de chaque paquetage mobilisé lors de la phase de production scientifique. Ce document permet ainsi à tout évaluateur indépendant ou collaborateur de recherche d’instancier un environnement computationnel identique au bit près, préservant la fidélité des tracés graphiques à travers le temps et les plates-formes matérielles.
3.2 Importation conventionnelle des modules scientifiques
Une fois l’environnement configuré, l’amorce de tout script d’analyse statistique doit respecter les conventions de codage adoptées par l’ensemble de la communauté scientifique internationale. Les modules fondamentaux sont importés sous des pseudonymes standardisés qui garantissent l’intelligibilité immédiate du code source. Matplotlib est traditionnellement mobilisé via son sous-module pyplot sous l’alias plt, tandis que Seaborn est importé sous l’identifiant canonique sns, hommage historique au personnage de fiction Samuel Norman Seaborn. Les structures de données tabulaires et les tableaux multidimensionnels sont quant à eux pris en charge par l’importation de Pandas sous le préfixe pd et de NumPy sous le préfixe np.
Dès l’initialisation du script, il est essentiel de paramétrer le backend graphique de Matplotlib, c’est-à-dire le moteur d’arrière-plan chargé de matérialiser les figures géométriques sur l’écran ou de les compiler sous forme de fichiers binaires. Selon que l’analyse est conduite au sein d’un environnement interactif comme Jupyter Notebook ou exécutée en mode batch non surveillé sur un serveur de calcul distant, le choix du backend, interactif ou statique orienté vers la vectorisation, conditionne la rapidité et la fiabilité du pipeline de traitement.
Dans ce cadre initial, une directive méthodologique critique consiste à configurer globalement la densité de pixels par pouce, désignée par le paramètre de résolution DPI via le dictionnaire de configuration de base de Matplotlib. Pour une visualisation interactive sur écran haute définition ou pour la préparation d’épreuves d’impression typographique d’une netteté parfaite, il est recommandé de fixer ce paramètre à une valeur d’au moins 300 points par pouce dès l’entête du programme, neutralisant d’emblée toute pixellisation inopportune lors de la phase de composition graphique préliminaire.
3.3 Définition de styles globaux et thèmes graphiques
La dimension esthétique d’un graphique statistique ne relève pas d’une simple coquetterie ornementale ; elle gouverne la charge cognitive imposée au lecteur et détermine l’efficacité de la transmission informationnelle. Seaborn simplifie considérablement cette étape d’harmonisation visuelle grâce à sa fonction de configuration de thème généralisé. Cette directive unique permet de réinitialiser instantanément l’ensemble des paramètres d’apparence de Matplotlib, harmonisant les couleurs d’arrière-plan, la présence ou l’absence de grilles cartésiennes, ainsi que le dimensionnement proportionnel des éléments géométriques.
Pour les publications destinées aux périodiques académiques, les styles visuels épurés sont rigoureusement privilégiés. Le thème whitegrid, caractérisé par un fond blanc immaculé soutenu par une grille orthogonale grise d’une extrême discrétion, favorise une lecture précise des coordonnées quantitatives sans surcharger l’espace visuel. Alternativement, le thème ticks supprime totalement les grilles internes pour ne conserver que les graduations le long des axes, éliminant tout artéfact graphique superflu conformément aux principes de frugalité sémiotique préconisés par Edward Tufte.
Enfin, la cohérence typographique globale du document exige une standardisation des familles de polices de caractères. L’attribution d’une typographie vectorielle sans empattement universelle, telle que Arial ou Helvetica, au travers des paramètres textuels de configuration globale de Matplotlib, garantit une intégration fluide des figures au sein des manuscrits scientifiques rédigés sous des processeurs de texte professionnels ou des moteurs de composition typographique de type LaTeX.
4. Structuration et typologie des jeux de données
4.1 Format long (Tidy Data) : Définition et avantages
L’efficience computationnelle et la clarté syntaxique lors de la génération de figures statistiques dépendent au premier chef de la structure topologique du jeu de données sous-jacent. Le paradigme dominant en science des données moderne est celui du format long, théorisé et formalisé par le statisticien Hadley Wickham sous le concept de données ordonnées ou tidy data. Dans cette architecture de données rigoureuse, chaque variable du modèle conceptuel correspond à une colonne unique, chaque unité observationnelle distincte est matérialisée par une ligne individuelle, et chaque case de la matrice ne contient qu’une seule valeur scalaire atomique.
L’adéquation entre le format long et les fonctions de haut niveau de Seaborn est structurelle. Lorsqu’un jeu de données est ordonné de la sorte, les arguments d’encodage visuel de la fonction de tracé s’associent naturellement avec les en-têtes de colonnes du tableau Pandas : une variable identifiant le groupe expérimental est déclarée pour l’axe catégoriel horizontal, une variable quantifiant la mesure continue est assignée à l’axe métrique vertical, et d’éventuels facteurs modérateurs secondaires peuvent être intégrés sans aucune manipulation matricielle préalable.
Ce formalisme facilite également les opérations de filtrage dynamique et de segmentation hiérarchique au sein de l’environnement analytique. La sélection de sous-échantillons, l’exclusion ciblée de valeurs aberrantes identifiées ou l’éclatement conditionnel d’une cohorte selon des critères démographiques multiples s’exécutent avec une simplicité conceptuelle totale, préservant la traçabilité des transformations algorithmiques et la reproductibilité des visualisations produites.
4.2 Format large : Caractéristiques et cas d’usage
À l’opposé du paradigme ordonné, le format large demeure historiquement très répandu dans la pratique de la recherche de terrain, en particulier au sein des sciences humaines et de la psychométrie. Dans une structure tabulaire au format large, chaque colonne représente une condition expérimentale distincte, un palier temporel de mesure ou une modalité spécifique d’un traitement factoriel, tandis que chaque ligne correspond à un participant ou à une entité physique unique. Les cellules du tableau contiennent directement les mesures quantitatives relevées pour chaque condition associée à l’individu.
Cette topologie s’avère intuitive lors de la saisie manuelle de données ou de l’administration de protocoles expérimentaux à mesures répétées, où un même sujet est évalué successivement lors d’une phase pré-test, puis au cours d’une phase post-test et enfin lors d’une session de suivi différée. Elle permet à l’expérimentateur de vérifier visuellement l’exhaustivité de ses acquisitions sujet par sujet sur un même tableur matriciel.
Néanmoins, le format large révèle d’importantes limites structurelles dès que la complexité du dispositif expérimental s’accroît. Il s’avère particulièrement malcommode lorsqu’il s’agit d’intégrer des facteurs d’interaction croisés, tels que le croisement entre un traitement pharmacologique et le genre biologique des participants, ou de gérer des protocoles déséquilibrés comportant des fractions significatives de valeurs manquantes non aléatoires. Les bibliothèques statistiques modernes peinent à automatiser les regroupements sémiologiques lorsque les informations catégorielles sont dispersées à travers les en-têtes de colonnes plutôt que consolidées sous forme de métadonnées factorielles unifiées.
4.3 Opérations de transformation avec Pandas
Face à cette dualité structurelle, la maîtrise des primitives de réorganisation de formes matricielles fournies par la bibliothèque Pandas constitue une compétence cardinale pour l’analyste. La transformation primordiale consiste à convertir une table déployée en format large vers sa représentation normalisée en format long, opération connue sous le terme de fonte de données et exécutée au moyen de la fonction melt de Pandas. Cette fonction déconstruit les colonnes sélectionnées pour les transposer sous la forme de paires composées d’un identifiant de variable catégorielle et de la valeur numérique correspondante.
Inversement, le retour temporaire vers une vue synthétique au format large ou l’agrégation de résumés numériques multidimensionnels peut être opéré à l’aide de la méthode pivot_table de Pandas. Cette instruction permet de restructurer le tableau en repositionnant les modalités d’une variable factorielle sous forme de colonnes nouvelles, tout en autorisant l’application conjointe de fonctions d’agrégation statistique telles que la médiane ou l’écart interquartile pour chaque cellule de l’intersection factorielle.
Durant ces séquences de restructuration morphologique des matrices de données, il convient de porter une attention vigilante à la gestion des index hiérarchiques et à la vérification de la complétude dimensionnelle. La vérification explicite des types de données vectorielles suite à une fonte garantit que les variables de regroupement nouvellement générées sont explicitement typées en tant que variables catégorielles ou textuelles, et que la variable de mesure n’a pas subi de coercition indésirable altérant la nature continue de ses valeurs scalaires.
5. Construction de boîtes à moustaches avec des données au format long
5.1 Syntaxe canonique avec Seaborn
L’édification d’une boîte à moustaches comparative au moyen de Seaborn s’articule autour d’une interface déclarative hautement optimisée pour les structures de données ordonnées en format long. L’appel canonique à la fonction boxplot de Seaborn s’effectue en déclarant explicitement le DataFrame source via le paramètre de données data, puis en assignant à l’argument x le nom de la colonne catégorielle hébergeant les étiquettes de groupes et à l’argument y la chaîne textuelle désignant la colonne abritant la variable numérique continue. Seaborn prend alors en charge, de manière totalement transparente pour l’opérateur, l’ensemble des étapes d’extraction vectorielle, de calcul des percentiles spécifiques à chaque groupe et de composition géométrique des éléments de tracé.
Cette approche délègue au moteur interne de la bibliothèque l’association spatiale des entités graphiques le long de l’axe des abscisses. Les étiquettes textuelles correspondant aux différents niveaux du facteur catégoriel sont automatiquement détectées, indexées séquentiellement sous la forme d’emplacements discrets le long de l’axe horizontal, et les résumés à cinq nombres sont compilés indépendamment pour chaque cohorte. Le chercheur s’affranchit ainsi de toute boucle d’itération programmatique complexe ou de manipulation manuelle d’index.
Il est par ailleurs fondamental de noter que bien que l’instruction procède de l’espace de noms de Seaborn, le tracé résultant s’inscrit rigoureusement sur un conteneur d’axes issu de l’architecture Matplotlib. Cette imbrication technique garantit que l’objet graphique généré demeure totalement réceptif aux méthodes de personnalisation fines de bas niveau de Matplotlib, offrant le compromis idéal entre productivité analytique initiale et liberté totale de configuration géométrique subséquente.
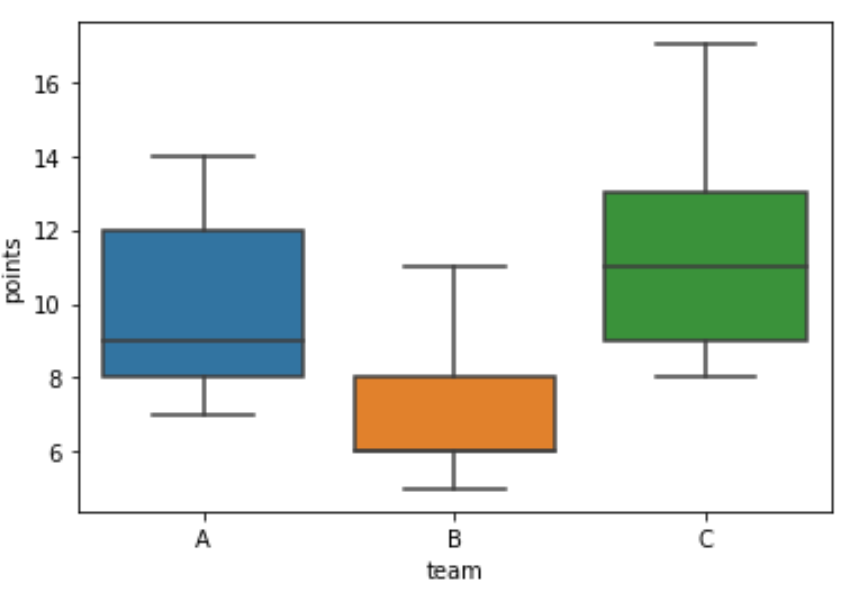
5.2 Implémentation d’un cas expérimental concret
Afin de concrétiser la logique opératoire de cette architecture logicielle, considérons la simulation d’un protocole expérimental évaluant la flexibilité cognitive de participants soumis à trois protocoles d’entraînement distincts : un groupe sous condition témoin sans intervention, un groupe bénéficiant d’un entraînement cognitif informatisé standardisé, et un troisième groupe engagé dans un programme d’activité physique aérobie combinée à des exercices de remédiation exécutive. Le jeu de données simulé est instancié sous la forme d’un tableau Pandas ordonné en format long, regroupant cent cinquante observations individuelles réparties de façon équilibrée entre les trois modalités expérimentales.
La génération du tracé comparatif s’exécute par l’invocation de la méthode sns.boxplot en renseignant la variable catégorielle de protocole sur l’axe horizontal et le score de performance cognitive sur l’ordonnée métrique. Seaborn procède à l’agencement parallèle des trois boîtes à moustaches, conférant à chaque cohorte une spatialisation cartésienne distincte. L’observateur est immédiatement en mesure de procéder à une lecture analytique critique de la disposition relative des rectangles centraux : le groupe d’entraînement combiné dévoile une élévation substantielle de sa médiane, couplée à une translation vers le haut de son intervalle interquartile comparativement à la cohorte témoin.
Ce diagnostic graphique immédiat permet également d’apprécier la symétrie interne des scores au sein de chaque modalité de traitement. Dans l’éventualité où la cohorte témoin présenterait une boîte écrasée vers le bas avec une moustache supérieure démesurément étirée, l’investigateur identifierait instantanément une asymétrie distributionnelle caractérisée par quelques performances isolées brillantes au sein d’une majorité d’individus aux scores modestes. Cette granularité descriptive transcende totalement l’information délivrée par un simple tableau de moyennes comparées.
5.3 Tri et agencement explicite des groupes
Par défaut, Seaborn agence les catégories le long de l’axe des abscisses en suivant l’ordre d’apparition initiale des modalités au sein des lignes du tableau de données, ou selon l’ordre alphabétique standard si les données sont encodées sous forme de chaînes de caractères. Cet ordonnancement fortuit ou purement lexical s’avère fréquemment sous-optimal sur le plan heuristique et peut nuire gravement à la clarté du récit scientifique exposé. Pour conférer à la figure une structure logique rigoureuse, il est impératif d’utiliser le paramètre order de la fonction boxplot.
L’argument order accepte une séquence ordonnée de chaînes textuelles stipulant explicitement l’agencement spatial souhaité de gauche à droite sur le graphique. Cette disposition peut être dictée par une chronologie expérimentale naturelle, débutant impérativement par le groupe de contrôle de référence, suivi séquentiellement des différentes gradations thérapeutiques ou temporelles. Cet ordonnancement cartésien structuré permet au lecteur de balayer visuellement la progression expérimentale de manière naturelle et sans friction cognitive.
Dans un contexte d’analyse purement exploratoire où aucune hiérarchie expérimentale préétablie n’existe, une stratégie sémiologique hautement efficace consiste à trier les groupes selon la valeur ascendante ou descendante de leur médiane respective. Ce tri algorithmique est aisément implémenté en extrayant au préalable les médianes par groupe via la méthode d’agrégation groupby de Pandas, puis en passant la liste ordonnée des index résultants au paramètre order. Cette disposition géométrique harmonieuse accentue l’intelligibilité des disparités intergroupes et confère une élégance graphique immédiate au document final.
6. Construction de boîtes à moustaches avec des données au format large
6.1 Tracé direct à partir d’un DataFrame au format large
Bien que la rigueur méthodologique incite à la normalisation systématique des données vers le format long, la flexibilité opérationnelle de Seaborn et de Matplotlib autorise la génération directe de boîtes à moustaches à partir d’une structure matricielle au format large. Dans cette configuration géométrique, le chercheur sélectionne directement un sous-ensemble de colonnes numériques au sein de son tableau Pandas et transmet cette sous-matrice à l’argument de données data de la fonction sns.boxplot, en omettant délibérément de renseigner les paramètres x et y.
Le moteur d’interprétation de Seaborn adapte automatiquement son comportement en présence de cette saisie matricielle bidimensionnelle : chaque colonne de la table fournie est automatiquement projetée sous la forme d’une boîte à moustaches indépendante, alignée le long de l’axe des catégories. Les en-têtes textuels des colonnes sélectionnées sont directement extraits et convertis en étiquettes d’identification cartésienne au droit des graduations correspondantes. Cette modalité d’exécution offre un gain de temps appréciable lors des phases exploratoires rapides, dispensant le praticien de l’écriture d’instructions de fonte tabulaire intermédiaires.
Un atout substantiel de ce mode opératoire réside dans sa robustesse face aux tableaux de données déséquilibrés contenant des tailles d’échantillons hétérogènes. Si la colonne relative à une condition expérimentale comporte un volume substantiel de valeurs manquantes notées NaN par rapport aux autres colonnes, Seaborn neutralise localement ces cellules défaillantes pour chaque colonne respective, calculant le résumé statistique à cinq nombres sur les données empiriquement observées sans bloquer le processus global de composition graphique.
6.2 Comparaison fonctionnelle entre format large et format fondu
Sur le plan de l’ingénierie logicielle et de la maintenabilité des pipelines analytiques, la confrontation entre le format large et le format long fondu soulève d’importants arbitrages techniques. Le tracé direct en format large présente des performances computationnelles marginalement supérieures sur de très petits jeux de données, dans la mesure où il contourne l’allocation en mémoire vive d’un nouveau tableau expansé en longueur et élimine la surcharge liée à l’indexation de facteurs catégoriels répétés sur des milliers de lignes.
Toutefois, cette économie de calcul dérisoire est largement contrebalancée par une rigidité structurelle rédhibitoire dès lors que l’analyse se complexifie. Le tracé direct sur colonnes isolées interdit strictement l’utilisation des fonctionnalités multivariées avancées de Seaborn, au premier rang desquelles figure le paramètre d’éclatement factoriel secondaire par la couleur hue. Dès lors qu’un expérimentateur souhaite décomposer les performances de ses conditions expérimentales selon une strate démographique additionnelle, l’approche en format large devient tout bonnement impraticable.
En conséquence, la recommandation méthodologique préconisée par les spécialistes de l’ingénierie des données scientifiques demeure univoque : hormis pour des contrôles visuels fugaces au cours du nettoyage préliminaire des données, il convient de procéder systématiquement à la conversion morphologique vers le format long. Cette pratique assure une standardisation pérenne du code source, optimise son interopérabilité avec les autres modules de l’écosystème statistique Python et garantit une évolutivité sans limite du raffinement visuel de la figure.
6.3 Exemple pratique : Évolution temporelle pré-test et post-test
Pour illustrer la mobilisation raisonnée du format large, analysons le cas d’une étude clinique longitudinale comparant l’évolution des scores d’anxiété de patients mesurés à trois étapes successives d’un protocole d’intervention psychologique : lors de l’admission initiale pré-test, à l’issue immédiate du cycle de prise en charge post-test, et lors d’un bilan de suivi consolidation à six mois. Les données brutes issues des fiches de recueil sont typiquement enregistrées dans une matrice comportant les identifiants anonymisés des patients en index de ligne et trois colonnes quantitatives dédiées à chacun des trois jalons chronologiques.
L’affichage simultané des trois conditions au moyen de l’instruction sns.boxplot appliquée à la sélection des trois colonnes permet une confrontation visuelle immédiate des distributions temporelles. Le chercheur peut ainsi observer la translation progressive de la boîte centrale vers les scores inférieurs d’anxiété entre la phase pré-test et la phase post-test, matérialisant visuellement l’efficacité thérapeutique du protocole, ainsi que la persistance de cette amélioration lors de la mesure à six mois.
Il importe néanmoins de souligner une précaution méthodologique cardinale lors de l’interprétation d’un boxplot issu de mesures répétées : la boîte à moustaches conventionnelle traite chaque colonne comme une entité marginale indépendante, masquant totalement la trajectoire intra-individuelle des sujets. Deux individus peuvent échanger leurs positions respectives au sein de la distribution sans que la morphologie globale de la boîte n’en soit affectée. Dès lors, si le boxplot en format large synthétise parfaitement l’évolution de la distribution de la cohorte prise dans sa globalité, il ne dispense nullement de mener des analyses spécifiques pour données appariées afin de quantifier la variance intra-sujet.
7. Méthodes natives avec Matplotlib pur
7.1 Utilisation de la fonction plt.boxplot()
Bien que Seaborn propose une interface abstraite d’un grand confort ergonomique, la compréhension intime de la fonction originelle boxplot disponible dans le module pyplot de Matplotlib demeure une condition indispensable pour tout chercheur aspirant à un contrôle architectural absolu sur ses figures. À la différence des routines de Seaborn qui ingèrent des DataFrames Pandas, la fonction de bas niveau plt.boxplot opère directement sur des structures de données fondamentales, telles que des vecteurs unidimensionnels NumPy ou des listes imbriquées de tableaux continus.
Pour générer une comparaison de distributions avec Matplotlib pur, l’analyste doit préalablement isoler manuellement les données relatives à chaque condition expérimentale au sein d’une liste ordonnée de tableaux scalaires. Lors de l’invocation de la fonction, le premier argument obligatoire est cette structure séquentielle contenant les différents sous-échantillons. Matplotlib procède alors à l’évaluation algorithmique des statistiques de Tukey et dessine chaque boîte à moustaches à une coordonnée discrète entière le long de l’axe des abscisses, positionné par défaut aux entiers un, deux, jusqu’au nombre total de groupes analysés.
L’assignation des désignations textuelles sous chaque boîte requiert une spécification explicite via l’argument labels, ou tick_labels selon les évolutions de versions de l’API de Matplotlib. L’utilisateur doit impérativement fournir une séquence textuelle dont la longueur coïncide rigoureusement avec le nombre de vecteurs transmis en entrée, sous peine de déclencher des incohérences d’affichage ou des exceptions de dimensionnement vectoriel. Cette approche primitive réclame davantage d’écriture de code préparatoire mais garantit une indépendance totale vis-à-vis des couches d’abstraction de plus haut niveau.
7.2 Extraction et manipulation du dictionnaire de composants
L’un des traits les plus puissants et méconnus de la fonction plt.boxplot de Matplotlib réside dans sa valeur de retour. Loin de se contenter de produire un effet graphique secondaire sur le canevas, la fonction renvoie à l’utilisateur un dictionnaire Python extrêmement exhaustif contenant les références directes vers l’ensemble des instances d’objets graphiques élémentaires générés au cours du processus. Ce dictionnaire segmente la figure en six clés fondamentales : les boîtes, les moustaches, les bornes horizontales d’extrémités dites caps, les lignes médiatrices, les marqueurs de moyenne et les glyphes de valeurs aberrantes.
Chacune de ces entrées vectorielles regroupe une liste d’objets géométriques de type Line2D ou PathPatch que le programmeur peut manipuler itérativement a posteriori pour en modifier les propriétés matérielles au niveau le plus microscopique. Il devient ainsi envisageable d’adresser une boucle de commande spécifique aux éléments de la liste des médiatrices pour assigner sélectivement une épaisseur de trait singulière, un style de tiretement spécifique ou une coloration différenciée à chaque médiane de groupe sans devoir recompiler l’intégralité du graphique.
Cette granularité chirurgicale permet des raffinements visuels impossibles à obtenir par des déclarations globales de haut niveau. Un chercheur peut par exemple décider de coder graphiquement la robustesse d’un groupe en modulant l’opacité alpha des moustaches en fonction directe de la taille effective de l’échantillon de chaque cohorte, ou encore styliser les bornes d’extrémités selon des critères sémiologiques personnalisés. Cette dissociation complète entre le moteur de calcul statistique et les propriétés de rendu vectoriel constitue le cœur de la philosophie logicielle de Matplotlib.
7.3 Approche orientée objet via Axes.boxplot()
Dans la pratique moderne du développement scientifique avec Matplotlib, l’utilisation de l’interface procédurale reposant sur les commandes directes pyplot est formellement déconseillée au profit de l’architecture orientée objet via les méthodes du conteneur d’axes. Cette méthode débute par l’instanciation programmatique explicite d’un objet Figure, représentant la toile globale du document, et d’un ou plusieurs conteneurs d’objets Axes délimitant les zones effectives de traçage, classiquement générés au travers de l’instruction plt.subplots.
Le tracé de la boîte à moustaches par groupe est alors sollicité en appelant directement la méthode boxplot attachée à l’instance d’axe dédiée. Cette approche encapsulée garantit que l’intégralité des opérations de modification spatiale, telles que l’attribution du titre principal, le calibrage des échelles logarithmiques ou le réglage des bordures périphériques, s’applique exclusivement et de manière déterministe à l’espace de coordonnées spécifié, neutralisant tout risque d’altération collatérale involontaire d’autres figures ouvertes en mémoire vive.
La comparaison entre cette démarche orientée objet pure et l’approche Seaborn met en lumière un arbitrage classique en génie logiciel : si Seaborn offre une concision syntaxique inégalable et une gestion native des métadonnées catégorielles, la méthode orientée objet native de Matplotlib procure une isolation modulaire indispensable à la conception automatisée de figures composites complexes, composées d’une mosaïque de sous-graphiques interconnectés régis par des contraintes typographiques rigoureusement compartimentées.
8. Personnalisation esthétique et sémiologique des figures
8.1 Harmonisation des palettes chromatiques
L’assignation chromatique au sein d’une boîte à moustaches groupée dépasse la simple dimension cosmétique ; elle obéit aux lois strictes de la psychophysique de la perception visuelle et de la sémiologie graphique formalisées par Jacques Bertin. L’usage anarchique de couleurs saturées issues de l’espace colorimétrique traditionnel RVB standard induit des illusions perceptives néfastes, l’œil humain attribuant inconsciemment un poids et une importance asymétriques à des teintes de luminance dissemblable. Pour pallier ces distorsions, il est impératif d’adopter des palettes perceptuellement uniformes telles que les cartes développées par ColorBrewer ou la famille des palettes Viridis et Cividis.
Un impératif déontologique et méthodologique majeur concerne la prise en compte des déficiences de la vision des couleurs, qui affectent environ 8 % de la population masculine mondiale, principalement sous la forme du daltonisme deutéranope ou protanope. L’association conflictuelle du rouge et du vert pour distinguer deux groupes expérimentaux doit être bannie de la littérature scientifique au profit de contrastes reposant sur des axes chromatiques bleu-orangé ou jaune-bleu, garantissant une lisibilité intégrale pour l’ensemble du lectorat international, y compris lors d’une reproduction photomécanique en niveaux de gris.
La nature sémantique de la variable de regroupement doit également guider la sélection du nuancier. Lorsque les groupes matérialisent un facteur nominal sans hiérarchie intrinsèque, comme l’appartenance à différentes régions géographiques, des palettes catégorielles qualitatives aux teintes distinctes mais à la luminosité calibrée sont requises. En revanche, lorsque le groupement traduit une variable ordinale continue discrétisée, telle que des paliers successifs de dosage pharmacologique, l’emploi d’une palette séquentielle monotone, déployant une gradation continue de saturation, communique intuitivement la progression ordinale du protocole.
8.2 Ajustement géométrique des éléments graphiques
L’occupation spatiale et le dimensionnement géométrique des composantes du boxplot exercent une influence déterminante sur l’équilibre esthétique général de la planche de résultats. Le paramètre de largeur width, présent tant au sein de Seaborn que de Matplotlib, régit l’encombrement horizontal relatif de chaque boîte par rapport à l’intervalle séparant deux graduations consécutives. Une largeur excessive engendre une sensation d’étouffement visuel, tandis qu’une valeur trop exiguë confère aux boîtes une silhouette filiforme dégradant la perception de l’écart interquartile. Une proportion comprise entre 0,5 et 0,7 constitue l’étalon d’or pour un confort de lecture optimal.
Par défaut, l’instruction originelle de Matplotlib trace les rectangles centraux sous forme de contours linéaires vides sans coloration de remplissage interne. Pour activer la modélisation de polygones pleins susceptibles de recevoir des nuances chromatiques et des transparences, il est impératif d’activer le paramètre booléen patch_artist à l’état vrai. Cette activation débloque l’accès aux modifications du coefficient de transparence alpha, dont le réglage judicieux, couramment étalonné autour d’une valeur de 0,7, permet d’adoucir la présence visuelle des boîtes tout en assurant une visibilité parfaite des éléments éventuellement superposés en arrière-plan.
De surcroît, la stylisation des traits périphériques requiert une standardisation millimétrée. L’épaisseur des contours linéaires, contrôlée via le paramètre linewidth, doit être calibrée pour s’harmoniser avec la force typographique des polices de caractères environnantes. L’activation ou la suppression des bornes transversales d’extrémités coiffant les moustaches, paramétrée par l’argument caps, participe également à l’épuration du tracé, la tendance contemporaine de l’édition scientifique privilégiant l’omission de ces butées pour un rendu visuel minimaliste et contemporain.
8.3 Paramétrage typographique et textuel des axes
La rigueur scientifique d’une illustration statistique se mesure à l’exactitude et à la clarté de son appareil textuel. Chaque axe cartésien doit être affublé d’une étiquette descriptive formulée sans acronyme obscur, spécifiant rigoureusement entre parenthèses ou entre crochets les unités physiques ou psychométriques de la métrique mesurée. L’omission des unités de mesure constitue l’une des défaillances éditoriales les plus fréquemment sanctionnées par les comités de lecture des revues savantes internationales.
Lorsque la variable catégorielle comporte un nombre substantiel de groupes ou que les désignations des modalités s’avèrent textuellement étendues, les étiquettes de l’axe des abscisses sont susceptibles de se chevaucher horizontalement, rendant l’ensemble illisible. La résolution élégante de ce problème repose sur l’orientation angulaire contrôlée des graduations textuelles à l’aide de la méthode d’ajustement des propriétés des graduations d’axes de Matplotlib. Une rotation comprise entre 30 et 45 degrés, couplée à un alignement horizontal du texte calé à droite de son point d’ancrage, garantit une lisibilité irréprochable sans altérer l’harmonie géométrique du canevas.
Enfin, l’inscription d’un titre informatif au-dessus de la figure ou l’intégration d’un sous-titre contextuel apportant des précisions quantitatives sur la taille totale de l’échantillon consolidé enrichit considérablement l’appareil critique de la figure. Ces éléments typographiques, calibrés avec des tailles de corps harmonieusement échelonnées, garantissent l’autonomie sémantique complète de l’illustration, laquelle doit pouvoir être appréhendée et comprise intégralement sans exiger du lecteur un renvoi permanent au corps du texte principal.
9. Visualisation multivariée : Intégration de sous-groupes par facteur secondaire
9.1 Utilisation de l’argument ‘hue’ dans Seaborn
Dans la recherche contemporaine, les phénomènes étudiés sont rarement réductibles à l’action unilatérale d’un unique facteur d’influence. L’exploration de dispositifs factoriels croisés, où l’effet d’un traitement primaire est susceptible d’être modulé par une caractéristique secondaire telle que le genre, le profil génétique ou la classe d’âge, requiert une modélisation visuelle bivariée. Au sein de Seaborn, cette opération analytique sophistiquée s’exécute avec une fluidité déconcertante grâce à la mobilisation du paramètre hue.
En assignant à ce paramètre le nom de la colonne du tableau de données contenant la seconde variable catégorielle, Seaborn dédouble automatiquement chaque boîte à moustaches principale en autant de sous-boîtes qu’il existe de modalités au sein de ce facteur additionnel. Par défaut, le mécanisme graphique active l’argument d’évitement spatial dodge, positionnant les différentes sous-boîtes côte à côte au droit de chaque graduation de l’axe horizontal. Cette disposition symétrique offre une ergonomie optimale pour évaluer visuellement d’éventuels effets d’interaction statistique : si l’écart entre les sous-groupes s’inverse ou s’annule selon la modalité du traitement primaire observée, la présence d’une interaction est graphiquement flagrante.
Ce moteur d’agencement multivarié démontre une robustesse exemplaire face aux plans expérimentaux incomplets ou structurellement déséquilibrés. Dans l’éventualité où certaines cellules factorielles croisées ne recèleraient aucune observation empirique, Seaborn préserve scrupuleusement l’alignement spatial relatif sans décaler de façon trompeuse les autres conditions, empêchant toute confusion lors de l’examen comparatif des différentes strates de la population étudiée.
9.2 Configuration rigoureuse de la légende scientifique
L’introduction d’un facteur secondaire par encodage chromatique rend immédiatement indispensable l’adjonction d’une légende explicative. Cependant, l’intégration automatisée par défaut de cet encart textuel constitue fréquemment une source de dégradation de la figure lorsqu’elle vient masquer des portions substantielles de la distribution ou des marqueurs de valeurs aberrantes. La maîtrise de l’agencement spatial et de la composition sémantique de la légende représente donc une compétence sémiologique cruciale.
Au travers de l’interface de gestion de légende de Matplotlib, l’opérateur dispose de la faculté d’ancrer cet encadré à des coordonnées cartésiennes absolues ou relatives. Il est ainsi hautement recommandé de rejeter la légende en dehors de la zone active de traçage des données, par exemple sur le flanc droit du canevas ou dans sa bordure supérieure, garantissant une absence totale d’occlusion visuelle des données empiriques. Cette translation géométrique s’opère par le réglage combiné de la boîte d’ancrage délimitée par le paramètre bbox_to_anchor et des arguments de positionnement cardinal.
Parallèlement, les descripteurs textuels internes de la légende doivent être soumis à un nettoyage éditorial méticuleux. Les abréviations techniques ou les appellations cryptiques de variables issues des bases de données informatiques brutes doivent être systématiquement remplacées par des étiquettes en langage naturel, rigoureusement typographiées. Enfin, dans les configurations graphiques où la structure même du dessin ou des annotations textuelles directes rendent la lecture de la légende redondante, sa neutralisation complète via la commande legend.remove permet d’épurer l’espace visuel conformément au principe d’économie de moyens.
9.3 Superposition de boîtes et de points individuels (Strip/Swarm plots)
Malgré l’élégance synthétique du résumé à cinq nombres, la boîte à moustaches souffre d’un angle mort intrinsèque : elle demeure totalement aveugle à la densité locale des données sous-jacentes. Une boîte à moustaches issue d’une distribution unimodale continue peut présenter une silhouette rigoureusement indifférenciable de celle générée par une distribution présentant un creux central prononcé flanqué de deux modes distincts. Pour remédier à cette vulnérabilité diagnostique majeure, la pratique contemporaine de l’analyse statistique préconise la superposition directe des données empiriques brutes sur le tracé de la boîte.
Cette hybridation méthodologique s’opère dans Seaborn en superposant à la fonction sns.boxplot un appel complémentaire à la fonction stripplot ou swarmplot sur le même conteneur d’axes cartésiens. Le tracé de type nuage de points individuel projette chaque participant sous la forme d’un glyphe ponctuel. L’activation de la gigue stochastique, contrôlée par l’argument jitter, disperse latéralement et de façon aléatoire les points superposés le long de l’axe catégoriel, évitant ainsi le chevauchement absolu des coordonnées identiques et matérialisant instantanément les concentrations de forte densité d’observations.
L’exécution harmonieuse de cette superposition repose sur un calibrage subtil des transparences et des échelles géométriques. Les boîtes à moustaches sous-jacentes doivent être configurées avec une coloration neutre ou désaturée et une transparence affirmée, tandis que les marqueurs individuels du stripplot sont dessinés avec un diamètre restreint et une légère opacité. Ce dispositif composite fournit le niveau de transparence analytique le plus achevé qui soit : il préserve la clarté synthétique des quartiles tout en révélant sans fard la texture granulaire de la réalité empirique observée.
10. Diagnostic statistique avancé et détection des valeurs aberrantes
10.1 Personnalisation des marqueurs de points atypiques (fliers)
L’identification des points situés au-delà des clôtures de Tukey, techniquement désignés sous le terme de fliers dans la nomenclature logicielle de Matplotlib, revêt une importance diagnostique majeure. La modification de leur morphologie géométrique permet de guider l’attention de l’analyste vers ces anomalies potentielles. Le dictionnaire flierprops constitue la passerelle technique permettant d’ajuster spécifiquement la taille, la couleur de contour, la teinte de remplissage ainsi que le glyphe géométrique symbolisant ces données singulières.
Dans certaines circonstances de restitution publique ou lorsque l’objectif se focalise exclusivement sur la tendance centrale de cohortes massives comportant des milliers d’individus, la prolifération excessive de ces marqueurs peut créer une saturation visuelle préjudiciable à la lisibilité. Seaborn et Matplotlib autorisent l’occultation délibérée de ces points atypiques par le basculement de l’argument booléen showfliers à l’état faux. Cette décision éditoriale doit néanmoins être entourée de garanties déontologiques strictes : le chercheur est tenu d’expliciter sans ambiguïté dans la légende que des observations extrêmes ont été soustraites à l’affichage visuel afin de ne pas induire l’audience en erreur sur l’étalement réel de l’échantillon.
Sur le plan de l’analyse inférentielle, la mise en évidence graphique d’un point atypique isolé doit inciter l’analyste à croiser ce diagnostic géométrique avec des métriques d’influence plus formelles, telles que la distance de Cook ou l’effet de levier calculés dans le cadre d’un modèle de régression linéaire. Ce recoupement méthodique permet de discriminer avec discernement les véritables aberrations métrologiques, nécessitant une correction ou une exclusion documentée, des fluctuations naturelles caractéristiques d’un phénomène complexe à forte variabilité idiosyncrasique.
10.2 Visualisation de l’intervalle de confiance : Boîtes crantées (Notched Boxplots)
Pour conférer à la boîte à moustaches une portée inférentielle directe sans alourdir le graphique d’annotations chiffrées additionnelles, John Tukey a imaginé une variante géométrique particulièrement ingénieuse : la boîte crantée, ou notched boxplot. Cette configuration s’active instantanément sous Matplotlib et Seaborn en assignant la valeur vraie au paramètre booléen notch. La boîte subit alors un rétrécissement symétrique de part et d’autre de sa médiane, matérialisant visuellement un intervalle de confiance autour de cet estimateur de position centrale.
Le calcul de l’amplitude de ce cran repose sur un fondement mathématique rigoureux : la largeur de l’encoche est calibrée à 1,57 fois l’écart interquartile divisé par la racine carrée de la taille de l’échantillon considéré. Cette formule empirique établit un intervalle de confiance à environ 95 % pour la comparaison bilatérale des médianes de deux cohortes. Dès lors, la règle de décision visuelle formulée par Tukey s’applique avec une simplicité remarquable : si les crans de deux boîtes juxtaposées ne se chevauchent aucunement le long de l’axe des ordonnées, l’investigateur peut conclure avec un niveau de confiance statistique solide que les véritables médianes de ces deux populations diffèrent significativement.
Il importe toutefois de formuler une mise en garde méthodologique fondamentale quant à la robustesse de cet indicateur en présence d’échantillons de taille congrue. Lorsque l’effectif d’un groupe s’avère restreint, typiquement inférieur à une vingtaine d’unités, l’amplitude mathématique de l’intervalle de confiance s’accroît de manière disproportionnée, au point où les limites du cran peuvent s’étendre au-delà des quartiles Q1 ou Q3. Ce phénomène pathologique se traduit par une silhouette géométrique inversée dite en papillon, signalant visuellement que la taille de cohorte est insuffisante pour autoriser une inférence robuste sur la base de la médiane.
10.3 Représentation simultanée de la moyenne arithmétique
Bien que la boîte à moustaches soit fondamentalement érigée autour de la médiane pour privilégier la résistance aux perturbations distributionnelles, la confrontation directe entre la médiane et la moyenne arithmétique constitue l’un des diagnostics de symétrie les plus puissants offerts à l’analyste. Matplotlib et Seaborn intègrent une directive permettant d’insérer le calcul et l’affichage de la moyenne au cœur de la boîte via l’activation du paramètre showmeans à l’état vrai.
Par défaut, l’activation de ce paramètre projette un simple marqueur ponctuel à la coordonnée exacte de la moyenne empirique du groupe. L’opérateur peut en outre enrichir cette représentation en mobilisant le dictionnaire de configuration meanprops, afin de personnaliser la forme géométrique du symbole, fréquemment paramétré sous la forme d’un triangle inversé ou d’un losange régulier d’une teinte contrastante. Une alternative graphique hautement appréciée dans les publications consiste à matérialiser la moyenne sous la forme d’une seconde barre transversale s’étendant d’un bord à l’autre de la boîte au moyen de l’argument meanline, en lui attribuant un style de tiretement pointillé pour la distinguer formellement de la médiane continue sous-jacente.
La valeur heuristique de cette double représentation est considérable. Dans une distribution rigoureusement normale et symétrique, la moyenne arithmétique et la médiane coïncident de manière quasi absolue au centre géométrique de la boîte. En revanche, un décalage substantiel de la moyenne vers le haut ou vers le bas par rapport à la ligne médiane fournit un indicateur sans équivoque d’une déformation asymétrique de la distribution ou de la présence de valeurs aberrantes unilatérales qui tirent artificiellement la moyenne vers elles, confirmant immédiatement la pertinence d’adopter des méthodes non paramétriques pour l’inférence ultérieure.
11. Exportation et conformité aux standards de publication scientifique
11.1 Respect des normes graphiques APA (American Psychological Association)
La mise en forme d’illustrations destinées à l’édition savante impose une discipline sémiotique stricte, formalisée notamment par les manuels de style des grandes sociétés savantes, au premier rang desquelles figure l’American Psychological Association (APA). Les normes éditoriales de l’APA proscrivent rigoureusement ce que le théoricien de l’information Edward Tufte qualifiait de chartjunk, c’est-à-dire l’ensemble des éléments ornementaux dépourvus de valeur informationnelle directe, tels que les arrière-plans colorés, les ombrages superflus ou les bordures d’encadrement lourdes.
Pour aligner une figure générée sous Python sur ces exigences académiques, plusieurs modifications d’épuration s’avèrent impératives. Il convient d’éliminer les lignes de cadrage supérieure et droite de l’axe au moyen de la méthode spine de Matplotlib ou de l’instruction d’épuration sns.despine offerte par Seaborn. Cette intervention isole l’espace graphique le long des deux seules lignes directrices fonctionnelles que constituent l’abscisse et l’ordonnée. Parallèlement, l’impression papier traditionnelle imposant des contraintes budgétaires et techniques, la figure doit être conçue pour conserver une intelligibilité absolue lorsqu’elle est transposée en nuances de gris ou lorsqu’elle mobilise des motifs de hachures géométriques discrètes.
Enfin, la localisation des métadonnées explicatives obéit à un protocole standardisé. Contrairement aux visualisations destinées à la presse ou aux médias numériques, les figures académiques conformes aux normes APA évitent l’inscription d’un titre massif au sommet du canevas graphique. L’identification de la figure et l’exposé de son appareil critique sont systématiquement rejetés au sein d’une note de figure typographiée placée immédiatement sous l’illustration, spécifiant la nature des indicateurs statistiques déployés, la signification des moustaches et la taille effective des cohortes examinées.
11.2 Spécifications d’exportation haute résolution
L’étape finale de production d’une figure scientifique réside dans sa compilation numérique et son enregistrement sur disque sous des formats répondant aux critères techniques d’imprimerie professionnelle. Les éditeurs académiques rejettent catégoriquement les captures d’écran informelles ou les fichiers matriciels compressés à basse résolution de type JPEG standard, qui génèrent des artéfacts de flou inacceptables lors des opérations de composition typographique. L’instruction fondamentale de sauvegarde plt.savefig constitue le point de convergence de cette exigence technique.
La dichotomie essentielle oppose ici les formats matriciels haute définition aux formats vectoriels purs. Si une exportation sous forme de matrice de points est sollicitée, les formats sans perte de compression tels que le TIFF ou le PNG doivent être privilégiés, en renseignant impérativement un paramètre de résolution d’au moins 300 points par pouce (dpi=300), voire 600 DPI pour les schémas comportant des détails linéaires fins. Néanmoins, pour une restitution typographique idéale, la sauvegarde sous un format vectoriel évolutif tel que le PDF, le SVG ou l’EPS demeure la recommandation d’excellence, assurant que le redimensionnement de l’illustration par l’imprimeur s’opère sans aucune dégradation de la netteté des segments ou des textes.
Lors de l’appel à la fonction d’enregistrement, l’utilisation systématique de l’argument bbox_inches=’tight’ est une prescription opérationnelle indispensable. Cette option ordonne à Matplotlib de recalculer dynamiquement la boîte englobante de la figure afin d’inclure l’intégralité des étiquettes d’axes, des graduations et des annotations textuelles périphériques, neutralisant définitivement le problème récurrent des légendes accidentellement tronquées en bordure de page. De surcroît, le paramétrage explicite de l’argument transparent à l’état faux garantit la production d’un fond blanc opaque pérenne, évitant les déconvenues de superposition sur des maquettes de mise en page professionnelles.
11.3 Automatisation de grilles multifactorielles avec FacetGrid
Lorsque le dispositif de recherche intègre un nombre élevé de facteurs expérimentaux croisés, la tentative de concentrer l’ensemble des informations au sein d’un unique conteneur d’axes par l’accumulation de couleurs secondaires mène inévitablement à une saturation visuelle désastreuse. L’approche méthodologique adéquate consiste alors à sérialiser la visualisation sous la forme d’une matrice de petits multiples ou sous-graphiques, instanciée de manière automatisée grâce à la classe FacetGrid de Seaborn ou son wrapper fonctionnel de haut niveau catplot.
Cette architecture déclarative permet de conditionner le tracé de boîtes à moustaches par groupe selon une troisième ou quatrième variable indépendante en assignant ces facteurs aux paramètres de colonnes ou de lignes du canevas global. Le moteur logiciel génère alors une grille parfaitement harmonisée où chaque case de la matrice accueille la boîte à moustaches d’un sous-groupe spécifique. Ce déploiement sériel favorise une comparaison synoptique immédiate sans aucune surcharge cognitive pour l’évaluateur.
Une caractéristique primordiale de ce dispositif automatisé réside dans le verrouillage dynamique des échelles cartésiennes via le paramètre sharey activé à l’état vrai. En imposant une échelle métrique strictement identique le long de l’axe des ordonnées pour l’intégralité des sous-graphiques de la planche, le système prévient tout biais de jugement visuel qui résulterait d’un réétalonnage opportuniste des amplitudes verticales entre les différentes cases factorielles. Cette rigueur structurelle garantit une fidélité d’interprétation irréprochable dans les protocoles de recherche longitudinaux ou multicentriques.
12. Dépannage méthodique et optimisation du flux de travail
12.1 Résolution des erreurs courantes de typage et de syntaxe
Dans la conduite quotidienne de projets de traitement de données sous Python, l’émergence d’anomalies graphiques inattendues trouve fréquemment sa source dans des incohérences de typage sous-jacentes au sein des structures Pandas. L’erreur la plus prévalente consiste à charger une variable catégorielle de regroupement dont les modalités sont encodées sous forme de nombres entiers, comme des codes de centres hospitaliers ou des identifiants numériques de traitement. Par défaut, Matplotlib et Seaborn sont susceptibles d’interpréter ces colonnes comme des variables continues, tentant de les projeter le long d’une échelle métrique linéaire plutôt que de les traiter comme des entités discrètes distinctes.
La résolution chirurgicale de ce dysfonctionnement requiert une coercition de type explicite préalable en mobilisant la méthode astype(‘category’) de Pandas sur la série considérée. Cette instruction signale formellement au moteur statistique la nature ordinale ou nominale de la colonne, restaurant instantanément un positionnement cartésien régulier et équidistant des différentes boîtes sur l’axe des catégories. De la même manière, la présence inopinée de chaînes textuelles au sein d’une colonne de mesure continue, issue par exemple de la saisie de caractères d’échappement pour noter des données manquantes, doit être neutralisée par la conversion forcée via la fonction to_numeric assortie de l’argument de coercition des erreurs.
Un autre écueil méthodologique récurrent concerne l’altération du tracé des moustaches induite par des valeurs manquantes mal déclarées. Si les routines modernes de Seaborn intègrent des filtres de purge automatiques pour isoler les cellules nulles, l’exécution d’un tracé direct en Matplotlib pur peut générer des comportements silencieusement erratiques ou des avertissements d’exécution cryptiques lorsque des vecteurs NumPy contiennent des valeurs non numériques non filtrées. L’application systématique d’une validation d’intégrité matricielle avant toute phase de composition graphique constitue la règle d’or pour prévenir ces désagréments.
12.2 Gestion des chevauchements d’étiquettes sur les cohortes nombreuses
Lorsque le champ d’investigation s’étend à un nombre considérable de groupes de comparaison, tel qu’une étude épidémiologique contrastant les données sanitaires d’une quarantaine de régions géographiques, la disposition verticale classique des boîtes à moustaches atteint ses limites géométriques. L’axe horizontal des abscisses devient incapable d’accueillir l’intégralité des dénominations textuelles sans induire des compressions typographiques illisibles ou des angles de rotation tellement agressifs qu’ils ralentissent la lecture du document.
La parade sémiologique la plus élégante et efficiente consiste alors à opérer une permutation intégrale des coordonnées en basculant la figure dans une orientation horizontale. Au sein de Seaborn, cette métamorphose spatiale s’accomplit avec une concision remarquable en inversant simplement l’assignation des paramètres : la variable continue de mesure est attribuée à l’argument x, tandis que la variable factorielle catégorielle est assignée à l’argument y. Les boîtes à moustaches se déploient dès lors horizontalement de manière empilée le long de l’axe vertical.
Cette orientation spatiale procure un espace horizontal quasi illimité pour aligner les désignations textuelles complètes de chaque cohorte, facilitant une lecture naturelle de gauche à droite sans aucune contorsion visuelle. Pour parachever cette mise en forme sur des cohortes particulièrement volumineuses, l’opérateur peut mobiliser le module standard textwrap de Python afin d’insérer des retours à la ligne automatisés au sein des libellés particulièrement étendus, tout en calibrant dynamiquement la hauteur verticale totale de la figure proportionnellement au nombre total de sous-groupes examinés.
12.3 Bonnes pratiques de codage pour la recherche reproductible
L’aboutissement d’un flux de travail analytique d’excellence ne réside pas uniquement dans l’esthétique statique d’une figure achevée, mais dans la pérennité, la modularité et la transparence de l’infrastructure logicielle qui en a permis la génération. L’écriture de scripts monolithiques informels au sein desquels les étapes de chargement, de manipulation matricielle et d’instruction graphique s’entremêlent sans ordre logique constitue une source majeure de non-reproductibilité scientifique. Il est impératif d’encapsuler l’ensemble des routines de tracé au sein de fonctions Python documentées, acceptant des paramètres explicites et dotées d’instructions de documentation exhaustives.
Dans cette perspective d’ingénierie rigoureuse, la traçabilité de l’environnement d’exécution informatique doit être garantie par l’adjonction systématique d’outils d’audit logiciel en conclusion des scripts analytiques. L’utilisation de bibliothèques spécialisées telles que watermark ou session_info permet d’imprimer automatiquement en fin de journal d’exécution l’horodatage exact de la compilation, la référence matérielle de la machine hôte, ainsi que les numéros de version précis de Python, Matplotlib, Seaborn et Pandas mobilisés lors de la genèse des figures.
Enfin, dans le cadre du mouvement international en faveur de la science ouverte, le chercheur contemporain est encouragé à déposer publiquement l’intégralité de ses scripts de génération graphique sur des archives pérennes et auditables telles que le portail Open Science Framework ou la plate-forme Zenodo, assortis d’identifiants d’objets numériques pérennes (DOI). Cette transparence absolue garantit que la communauté scientifique mondiale est en mesure de reproduire, d’auditer et d’enrichir les visualisations de données publiées, élevant ainsi la boîte à moustaches groupée du rang de simple artefact visuel à celui de preuve scientifique irréfutable et reproductible.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McGill, R., Tukey, J. W., & Larsen, W. A. (1978). Variations of box plots. The American Statistician, 32(1), 12–16. https://doi.org/10.1080/00031305.1978.10479236
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1924-00a
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley Publishing Company.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0