
La modélisation graphique des données quantitatives constitue l’un des piliers fondamentaux de la démarche scientifique moderne. Dans les disciplines empiriques contemporaines, de la biostatistique à l’économétrie en passant par les sciences cognitives et la psychométrie expérimentale, la capacité à synthétiser visuellement des phénomènes complexes conditionne directement la validité des inférences produites par le chercheur. Si le nuage de points bidimensionnel classique permet d’appréhender avec clarté les relations bivariées fondamentales, telles que la corrélation linéaire, la dispersion ou l’hétéroscédasticité, il montre rapidement ses limites dès lors qu’il s’agit d’intégrer des interactions d’ordre supérieur au sein d’un même espace géométrique unifié.
L’introduction d’une dimension chromatique au sein d’une projection orthogonale offre une opportunité remarquable d’étendre la bande passante informationnelle d’une figure sans en compromettre la lisibilité structurelle. En assignant une variable quantitative continue ou ordonnée au canal de la couleur, le praticien transforme un simple diagramme de dispersion en une cartographie multidimensionnelle dense et expressive. Cette transition méthodologique requiert néanmoins une maîtrise technique et épistémologique absolue des outils sous-jacents afin d’éviter les écueils perceptifs, les distorsions d’échelles et les biais interprétatifs qui guettent l’analyste imprudent.
Cet article se propose d’explorer de manière exhaustive, systématique et rigoureuse les mécanismes régissant la coloration par valeur des nuages de points au sein de la bibliothèque de référence Matplotlib. En articulant les fondements de la syntaxe de programmation avec les préceptes théoriques de la sémiologie graphique et de la psychophysique visuelle, ce guide fournit aux chercheurs, analystes de données et ingénieurs les clés conceptuelles indispensables pour concevoir des visualisations conformes aux normes éditoriales des plus grandes revues scientifiques internationales.
1. Introduction aux représentations multidimensionnelles avec matplotlib.pyplot.scatter
1.1 La nécessité d’une troisième dimension visuelle dans l’analyse de données
L’exploration visuelle de données empiriques se heurte immédiatement aux contraintes physiques imposées par le plan euclidien bidimensionnel constitué par la feuille de papier ou l’écran d’ordinateur. Lorsque deux axes cartésiens orthogonaux sont mobilisés pour représenter deux variables continues fondamentales, l’analyste épuise l’ensemble des degrés de liberté spatiaux élémentaires. Or, les phénomènes naturels et humains se caractérisent presque universellement par des structures multivariées où l’interaction entre deux facteurs est systématiquement modulée ou confondue par un troisième terme. Tenter de résumer de tels systèmes à travers une série fragmentée de graphiques bivariés disjoints impose une charge cognitive considérable au lecteur, contraint de reconstruire mentalement un hyper-espace géométrique que la mise en page refuse de matérialiser.
La projection d’une variable supplémentaire sur le canal visuel chromatique constitue une réponse élégante et efficace à ce verrou méthodologique. Selon les principes établis par la théorie de la sémiologie graphique, la couleur possède une capacité d’intégration immédiate et pré-attentive au sein du cortex visuel humain. Alors que la position spatiale informe sur les coordonnées structurales principales, la modulation de la teinte, de la saturation et de la luminance permet d’encoder simultanément une mesure d’intensité, un gradient thermique, une probabilité d’occurrence ou un niveau de performance psychologique sans altérer la topologie des points d’observation.
Dans les contextes de psychométrie appliquée et d’analyse comportementale, cette troisième dimension visuelle se révèle particulièrement déterminante. Considérons une expérience évaluant le temps de réaction en fonction de l’intensité d’un stimulus perceptif : l’intégration du niveau d’anxiété de base de chaque participant sous la forme d’un gradient de couleur continu permet de révéler instantanément des sous-populations cliniques, des dynamiques de compensation cognitive ou des phénomènes de saturation physiologique qui demeureraient invisibles dans un tracé monochrome classique.
1.2 Le rôle central de Matplotlib dans l’écosystème scientifique Python
Au cœur de l’écosystème computationnel du langage Python, la bibliothèque Matplotlib occupe une place nodale incontournable, consolidée par plus de deux décennies de développements communautaires continus et de validation académique. Conçue initialement pour reproduire la flexibilité graphique des environnements matriciels de calcul scientifique, Matplotlib repose sur une architecture orientée objet modulaire extrêmement sophistiquée. Cette organisation distingue rigoureusement la surface de rendu, le canevas abstrait, les systèmes de coordonnées et les collections de primitives géométriques, offrant un contrôle granulaire sans équivalent sur le moindre élément constitutif d’un tracé.
La puissance opérationnelle de Matplotlib réside dans son interopérabilité native avec les structures de données fondamentales que sont les tableaux multidimensionnels de la bibliothèque NumPy et les séries temporelles ou tabulaires de Pandas. Loin d’être une simple couche d’affichage superficielle, Matplotlib traite les structures matricielles sous-jacentes par des mécanismes d’indexation vectorisée et de masquage booléen optimisés en langage C. Cette synergie technique permet de traiter des collections de données comprenant des dizaines de milliers de points avec une latence d’exécution minime et une empreinte mémoire rigoureusement maîtrisée.
Dans la perspective d’une publication dans des revues scientifiques à comité de lecture, Matplotlib représente l’étalon de référence pour la production de figures vectorielles haute fidélité. Sa capacité à paramétrer avec une exactitude typographique les unités de mesure, la rastérisation sélective d’éléments denses, le rendu des formules mathématiques via le moteur de composition typographique TeX et la gestion intégrale des profils de couleur assure une reproductibilité totale des visualisations, condition sine qua non de l’intégrité de la communication scientifique contemporaine.
1.3 Distinction conceptuelle entre couleur fixe et encodage sémantique
Il est impératif d’établir, dès les prolégomènes de notre démarche, une distinction conceptuelle fondamentale entre l’application d’une couleur fixe à des fins purement esthétiques et l’encodage sémantique d’une variable par l’intermédiaire de la couleur. Dans le premier cas, le choix chromatique relève de la cosmétique graphique ou de l’identité institutionnelle : assigner une teinte bleue ou grise uniforme à l’ensemble des marqueurs vise simplement à garantir la netteté visuelle ou le contraste par rapport à l’arrière-plan. Cette approche ne transmet aucune information analytique supplémentaire et maintient la dimensionnalité de la figure à un niveau strictement bivarié.
À l’inverse, l’encodage sémantique assujettit la modalité chromatique de chaque point à une règle de projection fonctionnelle déterministe reliant l’espace des données scalaires à un espace colorimétrique calibré. La couleur devient alors un estimateur visuel direct d’un paramètre latent ou manifeste. Cette démarche implique une responsabilité épistémologique majeure de la part du chercheur. Une mauvaise sélection d’échelle de couleur ou une distorsion de la fonction de transfert peut en effet introduire des artefacts perceptifs fallacieux, faisant émerger des discontinuités artificielles ou masquant des variations réelles et cliniquement significatives.
L’évitement de ces biais interprétatifs chez le lecteur académique requiert une compréhension fine de la manière dont le système visuel décode la luminance et la chromaticité. Un encodage sémantique rigoureux doit impérativement préserver les relations d’ordre et de distance mathématiques : si deux observations présentent des valeurs scalaires proches, leurs représentations chromatiques respectives doivent être perçues comme voisines, sans transition abrupte injustifiée par les données sous-jacentes. C’est à la formalisation de cette rigueur que sont dédiées les fonctions spécialisées de Matplotlib.
2. Fondements syntaxiques et paramètres clés : x, y, s, c et cmap
2.1 Analyse rigoureuse de la signature de matplotlib.pyplot.scatter
La fonction scatter hébergée au sein du module pyplot de Matplotlib, ainsi que sa méthode équivalente intégrée aux objets d’axes cartésiens, présente une signature d’une grande richesse paramétrique. D’un point de vue formel, cette fonction accepte comme arguments obligatoires deux vecteurs désignés conventionnellement par x et y, qui fixent la localisation spatiale de chaque entité au sein du plan euclidien. Ces arguments requièrent impérativement des structures de données unidimensionnelles de longueur strictement identique, qu’il s’agisse de listes Python natives, de vecteurs NumPy ou de séries extraites d’un tableau de données Pandas.
Sous le capot, l’exécution de cette fonction ne génère pas une succession de marqueurs individuels indépendants, ce qui entraînerait une surcharge rédhibitoire pour l’interpréteur, mais instancie un objet composite hautement optimisé de type PathCollection. Cette classe encapsule l’ensemble des coordonnées géométriques, des propriétés de bordure, des gradients d’échelle et des allocations colorimétriques au sein d’une structure matricielle unifiée. Cette conception architecturale garantit une rapidité de rendu remarquable, car le pipeline graphique peut alors déléguer le calcul des primitives vectorielles aux bibliothèques graphiques de bas niveau du système d’exploitation.
Toutefois, la manipulation de vecteurs de dimensions divergentes ou de formats mal alignés engendre immédiatement des interruptions d’exécution explicites. Une attention méticuleuse doit donc être portée à l’homogénéité des types de données injectés : la conversion implicite d’itérables hétérogènes ou de tableaux contenant des chaînes de caractères corrompues dans les coordonnées x et y compromet irrévocablement la construction de la collection graphique sous-jacente.
2.2 Le rôle discriminant du paramètre c
Le paramètre c constitue le levier opérationnel central permettant de transmuter un tracé spatial conventionnel en une visualisation enrichie par la valeur. Contrairement au paramètre color, qui attend une spécification scalaire fixe ou une séquence uniforme désignant une teinte immuable appliquée à l’ensemble des éléments, l’argument c est conçu spécifiquement pour absorber un vecteur de valeurs numériques scalaires. Lorsqu’un tableau de nombres flottants ou entiers est passé à ce paramètre, Matplotlib active automatiquement son moteur de normalisation interne pour établir la correspondance entre chaque valeur et un indice chromatique calculé.
Il convient de souligner avec insistance que l’argument c supporte différentes typologies d’entrées. Il peut recevoir une liste de spécifications de couleurs individuelles sous forme de chaînes de caractères, un tableau bidimensionnel représentant des triplets Rouge-Vert-Bleu ou des quadruplets incluant le canal alpha, ou encore, et c’est là son usage le plus puissant dans notre contexte, un vecteur unidimensionnel de données quantitatives brutes. Dans cette dernière configuration, le système effectue une projection mathématique continue sans exiger du chercheur qu’il calcule manuellement les codes hexadécimaux ou les intensités spectrales associées.
La robustesse de ce mécanisme repose sur la stricte concordance dimensionnelle entre le vecteur c et les vecteurs de coordonnées spatiales x et y. Si la dimension du tableau numérique fourni au paramètre c diffère ne serait-ce que d’une seule unité de celle des positions cartésiennes, l’interpréteur génère une exception de non-concordance de forme, interdisant le tracé afin de prévenir toute attribution erronée d’un score à une observation spatiale inadéquate.
2.3 L’argument cmap et son articulation avec c
L’attribution de données quantitatives à l’argument c ne saurait produire d’effet intelligible sans l’intervention conjointe du paramètre cmap, acronyme désignant une colormap ou table de correspondance chromatique. Une colormap dans Matplotlib est une instance dérivée de la classe de base Colormap, chargée d’associer de manière déterministe un intervalle de valeurs scalaires normalisées comprises entre zéro et un à une succession continue ou segmentée de coordonnées dans l’espace chromatique.
L’articulation entre c et cmap fonctionne selon un schéma séquentiel rigoureux : les valeurs brutes fournies à c sont d’abord soumises à une étape de normalisation qui les projette sur l’intervalle unitaire standardisé, puis cette valeur normalisée est transmise à l’objet cmap qui en extrait la composition spectrale correspondante. Si le développeur omet de renseigner explicitement l’argument cmap, Matplotlib applique par défaut sa palette institutionnelle standardisée, conçue pour offrir un comportement perceptif optimal dans la majorité des contextes généraux.
Il est fondamental de comprendre qu’un appel au paramètre cmap en l’absence d’une assignation vectorielle numérique au paramètre c est totalement inopérant. L’argument de palette ne possède en effet aucune prise conceptuelle sur une couleur statique définie textuellement. Ce couplage structurel souligne l’importance d’une manipulation synchronisée de ces deux arguments pour toute analyse visant à traduire visuellement une amplitude physique ou psychométrique continue.
2.4 Modulation de la morphologie des marqueurs avec le paramètre s
En complémentarité directe avec les propriétés colorimétriques régies par c et cmap, le paramètre s permet de moduler dynamiquement la taille géométrique des marqueurs au sein du nuage de points. Il est crucial de noter, sur le plan métrologique, que la valeur assignée à s ne correspond pas au rayon ou au diamètre linéaire du point d’observation, mais bien à sa superficie superficielle exprimée en points typographiques au carré, conformément aux conventions typographiques internationales où un point équivaut à un soixante-douzième de pouce.
Cette distinction géométrique est d’une importance capitale pour l’analyse des données : l’œil humain percevant les grandeurs bidimensionnelles à travers l’aire couverte plutôt qu’à travers une longueur unidirectionnelle, calibrer s sur la surface garantit que le stimulus visuel produit croît proportionnellement à la grandeur sous-jacente mesurée. L’analyste peut ainsi encoder simultanément quatre dimensions sur un support plat : deux coordonnées cartésiennes orthogonales via x et y, un indice d’intensité via c, et une métrique de masse, d’effectif ou de variance résiduelle via s.
Néanmoins, l’accumulation conjointe de variations chromatiques et de variations de surface impose une réserve méthodologique stricte. Une amplification excessive de la taille des points engendre rapidement des phénomènes d’occlusion visuelle et d’encombrement graphique sévères, où les marqueurs volumineux masquent irrémédiablement les points adjacents plus discrets. Inversement, une réduction trop prononcée rend le gradient de couleur intérieur imperceptible à l’œil nu, le cerveau peinant à identifier la teinte d’un point dont la surface angulaire sur la rétine devient marginale.
3. Préparation et structuration des données multidimensionnelles avec Pandas
3.1 Structuration optimale d’un DataFrame pour la visualisation
L’intégrité et la clarté d’un pipeline de visualisation scientifique reposent invariablement sur la qualité de la mise en forme initiale des structures de données en amont de l’appel aux modules graphiques. Dans l’écosystème Python, l’utilisation de la bibliothèque Pandas s’impose comme le standard méthodologique pour orchestrer les données expérimentales. Un tableau de données (DataFrame) structuré de manière optimale doit impérativement respecter les principes de l’organisation rigoureuse des données (dite forme rangée ou *tidy data*), où chaque rangée matérialise une unité observationnelle unique et chaque colonne incarne une variable spécifique mesurée selon un protocole déterminé.
Dans le cadre d’un protocole de recherche empirique, par exemple en psychométrie, une telle structure garantit l’alignement intrinsèque de toutes les variables dépendantes et indépendantes associées à chaque sujet ou essai expérimental. Les mécanismes d’indexation explicite offerts par Pandas évitent les désynchronisations accidentelles qui surviennent fréquemment lors de la manipulation de multiples tableaux unidimensionnels isolés. De surcroît, la syntaxe d’accès vectorisé permet d’extraire simultanément les trois ou quatre séries d’intérêt en une instruction unitaire, préservant la cohérence référentielle des données injectées dans le nuage de points.
L’adoption de cette discipline architecturale facilite considérablement les itérations exploratoires. Lorsqu’il s’avère nécessaire de commuter rapidement la variable assignée à l’axe des ordonnées ou de modifier la métrique colorimétrique, la présence d’un tableau propre et typé permet de réassigner les colonnes au sein des arguments de la fonction graphique sans devoir réécrire l’algorithme d’extraction sous-jacent.
3.2 Nettoyage et conversion des types de données
Préalablement à toute injection de données au sein du paramètre c de la méthode de dispersion, une phase d’audit typologique s’avère indispensable. Les données brutes issues de collectes expérimentales comportent fréquemment des artéfacts d’importation, tels que des nombres encodés sous forme de chaînes de caractères alphanucléaires en raison de séparateurs décimaux hétérogènes ou de symboles non conformes. Le passage d’une telle série à l’argument c provoque inévitablement une erreur d’interprétation ou l’application indésirable d’un encodage catégoriel arbitraire là où un gradient continu était légitimement attendu.
La détection et le traitement des valeurs manquantes constituent un autre défi analytique crucial. La présence de valeurs indéfinies ou nulles au sein d’une série assignée à la couleur engendre par défaut un comportement silencieux problématique dans Matplotlib : les observations correspondantes sont généralement exclues du tracé ou affichées avec une transparence totale, modifiant la topologie apparente de l’échantillon sans avertissement explicite. L’analyste doit choisir de manière transparente et documentée entre une imputation statistique rigoureuse, fondée par exemple sur l’espérance conditionnelle, ou une exclusion préalable explicite des enregistrements incomplets.
Enfin, la nature mathématique de la variable destinée à piloter le paramètre c doit être validée avec précision. S’il s’agit d’une grandeur quantitative continue, le type de données doit être explicitement converti en nombres à virgule flottante standardisés à double précision. Cette opération garantit que les calculs de distance et les algorithmes d’interpolation spectrale exécutés par les routines internes s’opèrent avec une précision numérique optimale, préservant la fidélité des micro-variations chromatiques.
3.3 Extraction sous forme de structures compatibles avec Matplotlib
Bien que les versions récentes de Matplotlib offrent une compatibilité syntaxique native avec les objets Pandas par l’intermédiaire de l’argument data, une compréhension technique approfondie exige de savoir comment s’effectue la conversion sous-jacente vers les structures de la bibliothèque NumPy. Lorsque l’on transmet une série Pandas à une fonction de tracé, la bibliothèque effectue une extraction de la mémoire sous la forme d’un tableau unidimensionnel contigu. Dans des contextes de traitement de jeux de données volumineux, cette opération peut générer des duplications d’allocation si elle n’est pas anticipée.
Il est dès lors fréquemment recommandé, dans le cadre de protocoles d’analyse computationnelle intensive, de réaliser une extraction explicite des tableaux NumPy sous-jacents via les accesseurs dédiés de l’interface de programmation de Pandas. Cette démarche garantit une désensibilisation totale de la couche de visualisation vis-à-vis des index complexes ou des métadonnées contextuelles qui pourraient ralentir le traitement des primitives graphiques. Elle permet également de s’assurer de la contiguïté en mémoire des blocs numériques, facteur prépondérant dans l’accélération des calculs de rastérisation vectorielle.
Au cours de cette étape de préparation, la vérification programmatique de l’égalité absolue de longueur entre les vecteurs cartésiens x, y et le vecteur de couleur c s’impose comme une bonne pratique incontournable. L’intégration d’assertions formelles ou de blocs conditionnels de validation prévient l’apparition d’exceptions cryptiques au cœur du moteur de rendu, assurant une traçabilité sans faille du pipeline d’analyse de données.
4. Mise en œuvre élémentaire : Coloration continue d’un nuage de points
4.1 Construction pas à pas d’un premier exemple reproductible
La mise en œuvre pratique de la coloration continue d’un diagramme de dispersion s’articule autour d’un enchaînement méthodique d’instructions canoniques. Dans une approche orientée objet, qui constitue la norme stylistique recommandée pour toute production scientifique, la première étape consiste à instancier un objet figure flanqué d’un ou plusieurs systèmes d’axes cartésiens. Cette configuration initiale offre une toile d’accueil vierge sur laquelle les différentes couches géométriques pourront être superposées de manière ordonnée et prédictible.
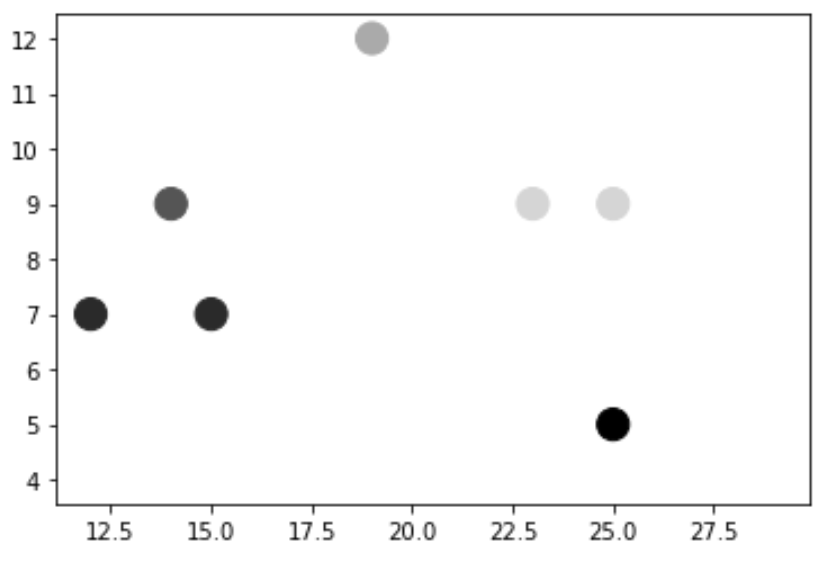
Considérons la simulation d’un ensemble de données quantitatives continues issues d’une distribution normale multivariée. Les deux premières dimensions représentent par exemple deux mesures de performance psychomotrice tandis que la troisième dimension reflète la concentration sérique d’un biomarqueur de fatigue neuromusculaire. Pour matérialiser ce protocole, l’appel à la méthode scatter du gestionnaire d’axes s’effectue en lui transmettant successivement la première variable sur l’abscisse, la seconde variable sur l’ordonnée, et en spécifiant l’argument c avec le vecteur correspondant au biomarqueur.
À cet instant, la fonction procède à l’évaluation des bornes statistiques de la variable de coloration, normalise dynamiquement les valeurs individuelles et restitue une collection vectorielle prête pour l’affichage. L’appel subséquent aux fonctions de rendu permet d’observer l’émergence immédiate du nuage de points dont chaque élément arbore une teinte proportionnelle à sa valeur sur la troisième dimension expérimentale.
4.2 Fonctionnement du mappage linéaire par défaut
Le comportement algorithmique par défaut déployé par Matplotlib lors de l’assignation d’un vecteur continu à l’argument c repose sur une projection affine linéaire standardisée. Le système inspecte le vecteur numérique fourni, en extrait la valeur minimale absolue et la valeur maximale absolue, puis instancie de manière implicite un objet de normalisation linéaire élémentaire. Cette fonction mathématique projette l’intervalle de mesure empirique sur le segment fermé zéro à un, établissant une bijection stricte entre l’espace des données et l’espace de la palette de couleurs.
Ce mécanisme garantit que la valeur la plus basse de l’échantillon se voit attribuer la couleur située à l’extrémité inférieure de la palette chromatique sélectionnée, tandis que la valeur maximale atteint l’extrémité supérieure du gradient. Les observations intermédiaires sont interpolées linéairement le long de cette trajectoire spectrale. Si cette automatisation se révèle d’une efficacité remarquable pour l’exploration initiale de données uniformément distribuées, elle présente des limites interprétatives majeures en l’absence d’un étalonnage contextuel explicite.
En effet, cette projection par défaut est intrinsèquement sensible aux artefacts d’échantillonnage. Dès lors qu’une variable présente une distribution fortement asymétrique ou comporte des valeurs singulières atypiques, la majorité des observations se retrouve comprimée dans une sous-fraction minuscule de l’espace chromatique, privant l’observateur de la capacité à discerner les variations internes fines du gros de l’échantillon. L’analyste doit donc impérativement garder la maîtrise de ce processus de normalisation.
4.3 Diagnostic des anomalies d’alignement géométrique
Lors de la manipulation pratique de structures multidimensionnelles complexes, l’analyste se heurte régulièrement à des dysfonctionnements syntaxiques ou dimensionnels. L’erreur la plus répandue réside dans l’incompatibilité de forme entre les tableaux passés aux coordonnées cartésiennes et la série injectée dans le paramètre c. Lorsque des données proviennent de sous-ensembles filtrés indépendamment ou de sources hétérogènes mal appariées, l’interpréteur Python interrompt le tracé en levant une exception de type ValueError, signalant que la dimension de la matrice de couleur ne coïncide pas avec le nombre de coordonnées spatiales fournies.
Un autre écueil subtil provient des décalages d’indexation au sein des séries Pandas. Si les séries utilisées pour l’abscisse, l’ordonnée et la couleur ne partagent pas un index commun rigoureusement synchronisé, des mécanismes de réalignement implicite ou des opérations d’assemblage antérieures mal configurées peuvent corrompre la correspondance logique entre un point géométrique et son attribut chromatique. Le tracé généré demeure syntaxiquement valide mais devient scientifiquement faux, attribuant à un sujet le score d’un autre sans que le moteur graphique ne signale d’anomalie visible.
La prévention de ces dérives méthodologiques impose une politique de validation pré-graphique rigoureuse. L’utilisation systématique de contrôles de cohérence dimensionnelle et la vérification de l’intégrité relationnelle des séries par l’intermédiaire de fonctions d’assertion permettent de certifier que chaque coordonnée spatiale est rigoureusement associée à sa valeur chromatique légitime avant que ne débute le processus de rastérisation vectorielle.
5. Maîtrise des palettes de couleurs (cmap) : Théorie visuelle et perception
5.1 Classification systématique des palettes Matplotlib
Le choix d’une table de correspondance chromatique (colormap) ne saurait relever d’une simple préférence subjective : il obéit à des règles taxonomiques strictes dictées par la nature mathématique de la variable visualisée. Matplotlib propose une bibliothèque considérable de palettes prédéfinies, structurées méthodologiquement en trois grandes familles fonctionnelles : les palettes séquentielles, les palettes divergentes et les palettes qualitatives. La méconnaissance de cette taxonomie constitue la source principale de confusions sémiotiques dans la littérature scientifique.
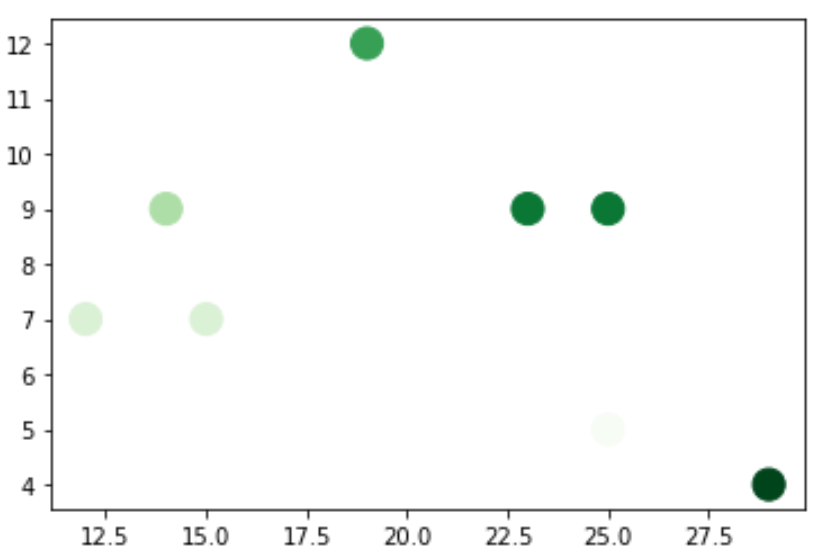
Les palettes séquentielles sont caractérisées par une progression monotone de la luminance et sont exclusivement destinées à représenter des grandeurs continues ordonnées possédant une directionnalité naturelle, allant d’une faible intensité vers une intensité élevée. Les palettes divergentes, quant à elles, sont conçues autour d’un point central neutre à haute luminance duquel divergent symétriquement deux teintes contrastées vers des saturations sombres ; elles s’imposent pour les variables bipolaires, les anomalies par rapport à une moyenne de référence ou les gradients de corrélation s’étendant de moins un à plus un.
Enfin, les palettes qualitatives exploitent des variations abruptes de teintes à luminance et saturation comparables. Dépourvues de toute notion d’ordre intrinsèque, elles sont strictement réservées aux variables catégorielles nominales, telles que des groupes expérimentaux distincts, des diagnostics psychiatriques différentiels ou des classes taxonomiques. Employer une palette séquentielle pour des données nominales ou une palette qualitative pour un continuum quantitatif constitue une erreur méthodologique rédhibitoire.
5.2 Psychophysique de la vision et palettes perceptuellement uniformes
La psychophysique visuelle démontre de longue date que l’appareil perceptif humain ne réagit pas de manière linéaire aux variations de longueurs d’onde lumineuses. Notre système visuel est intrinsèquement beaucoup plus sensible aux micro-variations de luminance, c’est-à-dire à la brillance perçue, qu’aux changements purs de chromaticité. Dès lors, si une colormap présente une progression de luminance non monotone, l’observateur percevra des discontinuités géométriques illusoires, appelées bandes de Mach artificielles, créant l’illusion de frontières ou de plateaux de données qui n’existent aucunement dans la distribution empirique mesurée.
Pour éradiquer ces artéfacts délétères, la communauté des développeurs de Matplotlib a développé des colormaps dites perceptuellement uniformes, incarnées par les célèbres palettes Viridis, Plasma, Inferno et Magma. Ces palettes sont mathématiquement étalonnées pour que toute distance euclidienne constante au sein de l’espace des données corresponde à une distance de discrimination perceptuelle rigoureusement identique dans l’espace colorimétrique standardisé CAM02-UCS de la Commission Internationale de l’Éclairage. La progression de la luminance y est strictement monotone et continue du début à la fin de l’échelle.
Cette rigueur de conception offre un avantage opérationnel majeur pour la recherche : la préservation absolue de l’information lors d’une impression monochrome sur papier physique. En convertissant une figure basée sur la palette Viridis en niveaux de gris purs, la structure topologique et les gradients d’intensité demeurent parfaitement déchiffrables, les teintes les plus claires correspondant sans ambiguïté aux valeurs maximales de l’échelle.
5.3 Accessibilité universelle et prise en compte du daltonisme
L’éthique de la diffusion scientifique contemporaine exige que les représentations graphiques soient universellement déchiffrables par l’ensemble de la communauté des pairs, sans exclusion des individus présentant des singularités de la vision chromatique. Les déficiences de perception des couleurs, regroupées sous le terme générique de daltonisme, affectent approximativement huit pour cent de la population masculine et un demi pour cent de la population féminine d’ascendance européenne, principalement sous les formes de la deutéranopie (insensibilité au vert) et de la protanopie (insensibilité au rouge).
Dans ce contexte, l’utilisation historique de la palette arc-en-ciel traditionnelle, désignée sous le label Jet dans les anciens environnements graphiques, représente un contresens scientifique absolu. Non seulement la palette Jet présente de multiples oscillations de luminance induisant des artefacts d’échantillonnage visuel massifs, mais elle repose sur la transition rouge-vert, devenant totalement indifférenciable pour une fraction significative de lecteurs académiques. L’emploi de telles échelles discrédite l’accessibilité méthodologique des publications.
À cet égard, la palette Cividis constitue l’étalon d’or de l’inclusivité graphique moderne. Dérivée par des protocoles d’optimisation mathématique spécifiques, Cividis est calibrée pour offrir une uniformité perceptuelle rigoureuse aussi bien aux individus pourvus d’une vision trichromatique standard qu’à ceux atteints de deutéranopie ou de protanopie. L’adoption systématique de palettes inclusives témoigne de l’engagement du chercheur en faveur d’une transmission transparente et universelle du savoir expérimental.
6. Intégration et personnalisation rigoureuse de la barre de couleur (Colorbar)
6.1 Mécanique d’instanciation de plt.colorbar
Un nuage de points dont la couleur encode une grandeur scalaire demeure strictement inexploitable sur le plan quantitatif en l’absence d’une clé de déchiffrage explicite : la barre de couleur (Colorbar). Sur le plan structurel dans Matplotlib, une colorbar n’est pas un simple ornement décoratif mais un système d’axes cartésiens autonome et dédié, dont la fonction unique consiste à projeter la palette de couleurs utilisée parallèlement à une échelle numérique graduée. L’instanciation correcte de cet élément requiert une compréhension précise des liaisons logiques entre les objets graphiques.
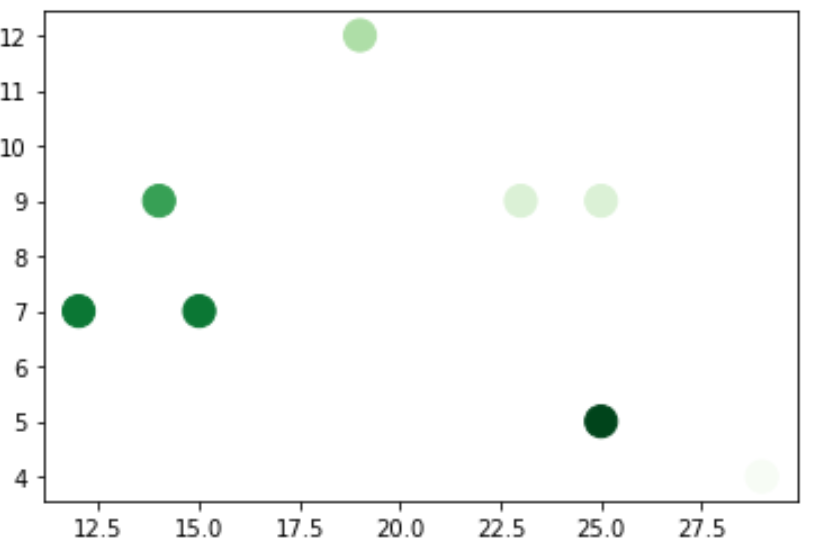
Lors de l’appel à la méthode scatter, celle-ci retourne en sortie une référence vers l’objet PathCollection qu’elle vient de matérialiser. Pour lier formellement la barre de couleur à cette collection spécifique, il est indispensable de transmettre cet objet comme premier argument scalaire à la fonction de création de la barre de couleur. Cette liaison permet à la colorbar d’interroger directement la collection pour en extraire la colormap active, l’algorithme de normalisation sous-jacent et les bornes numériques effectives sans nécessiter de redéfinition manuelle redondante.
Dans une architecture orientée objet rigoureuse, on privilégiera l’invocation de la méthode colorbar rattachée directement à l’objet figure parent, en lui indiquant explicitement l’axe cartésien d’ancrage par le biais de l’argument ax. Cette démarche prévient les altérations inattendues de la mise en page lors de l’intégration du tracé au sein de canevas multipanneaux complexes comprenant plusieurs sous-graphiques juxtaposés.
6.2 Calibration des graduations, bornes et étiquetage sémantique
La valeur informative d’une barre de couleur dépend intimement de la précision métrologique de ses annotations. Laisser l’algorithme de placement automatique déterminer seul l’emplacement des graduations numériques (ticks) peut conduire à des espacements inadéquats ou à des approximations préjudiciables à la rigueur de l’interprétation. Le chercheur doit pouvoir intervenir directement sur les graduations majeures et mineures en fournissant une séquence explicite de points de repère reflétant les seuils théoriques ou normatifs pertinents du champ disciplinaire étudié.
Au-delà des valeurs numériques cardinales, l’attribution d’un libellé dimensionnel complet s’avère impérative. Ce titre d’échelle doit comporter la désignation explicite du concept psychométrique ou physiologique quantifié, accompagnée obligatoirement de ses unités de mesure scientifiques standardisées, insérées entre crochets ou parenthèses conformément aux normes éditoriales internationales. L’omission des unités de mesure réduit le gradient chromatique à une abstraction purement qualitative dénuée de valeur reproductible.
Le formatage textuel des valeurs numériques associées aux graduations mérite également un contrôle typographique strict. Grâce aux formateurs de texte intégrés à Matplotlib, l’analyste peut contraindre l’affichage d’un nombre déterminé de décimales significatives, évitant ainsi les artefacts visuels désordonnés où alternent sans logique des entiers simples et des fractions flottantes à haute densité de caractères, ce qui nuit à l’esthétique générale de la publication.
6.3 Ajustements géométriques avancés et synchronisation d’axes
L’intégration d’une barre de couleur verticale à droite d’un système d’axes cartésiens provoque inévitablement une réduction mécanique de la largeur de ce dernier afin d’accueillir la nouvelle géométrie. Ce comportement automatique peut perturber l’alignement spatial global, particulièrement lorsque plusieurs graphiques sont disposés verticalement sur une même colonne d’une planche de résultats. La maîtrise des paramètres géométriques de la colorbar est alors indispensable pour rétablir une parfaite harmonie visuelle.
Des arguments spécialisés permettent de contrôler précisément la morphologie de la barre. Le paramètre fraction dicte la proportion de l’axe parent qui sera allouée à la barre de couleur, tandis que le paramètre pad spécifie l’intervalle spatial vide séparant le tracé principal de son échelle chromatique. De plus, l’argument aspect ajuste le ratio de proportionnalité entre la longueur longitudinale de la barre et son épaisseur transversale, permettant d’éviter l’écueil classique d’une barre trop massive dominant excessivement le nuage de points lui-même.
Pour les compositions éditoriales de très haut niveau, l’utilisation conjointe du module mpl_toolkits.axes_grid1 et de sa classe make_axes_locatable offre une alternative supérieure à l’ajustement automatique. En créant un diviseur d’axes géométrique déterministe, le chercheur peut allouer à la colorbar une enclave spatiale rigoureusement contrainte dont la hauteur s’adapte mathématiquement à celle de l’axe de dispersion principal au pixel près, garantissant un alignement impeccable quelles que soient les dimensions finales de la fenêtre de rendu.
7. Gestion des variables discrètes et catégorielles dans l’espace colorimétrique
7.1 Encodage des facteurs qualitatifs en indicateurs entiers
Bien que le recours au paramètre c soit majoritairement associé à la cartographie de variables quantitatives continues, l’analyse multivariée implique fréquemment l’exploration de facteurs qualitatifs discrets, tels que des cohortes expérimentales, des génotypes distincts ou des sous-groupes nosographiques en psychiatrie. Matplotlib ne dispose pas nativement d’un mécanisme de conversion automatique de chaînes de caractères textuelles arbitraires en positions chromatiques déterministes au sein de scatter ; une étape préliminaire d’encodage structurel s’avère donc requise.
Cette opération consiste à traduire la série nominale en un vecteur numérique d’indicateurs entiers (dits labels ou codes entiers). L’utilisation de l’infrastructure pandas.Categorical permet de formaliser cette transition de manière particulièrement robuste et reproductible. En définissant explicitement les modalités de la variable et leur hiérarchie, Pandas attribue à chaque observation un code numérique séquentiel invariant, garantissant que la correspondance établie entre les groupes théoriques et les identifiants discrets demeure immuable tout au long du script.
Une vigilance particulière doit être accordée à l’ordre d’assignation de ces entiers. Dans le cas d’une échelle ordinale, comme des stades d’évolution d’une pathologie cognitive, les entiers doivent scrupuleusement refléter la progression sous-jacente du phénomène afin que le gradient chromatique final conserve une cohérence sémantique univoque lors de la lecture transversale du graphique.
7.2 Configuration des colormaps discrètes et BoundaryNorm
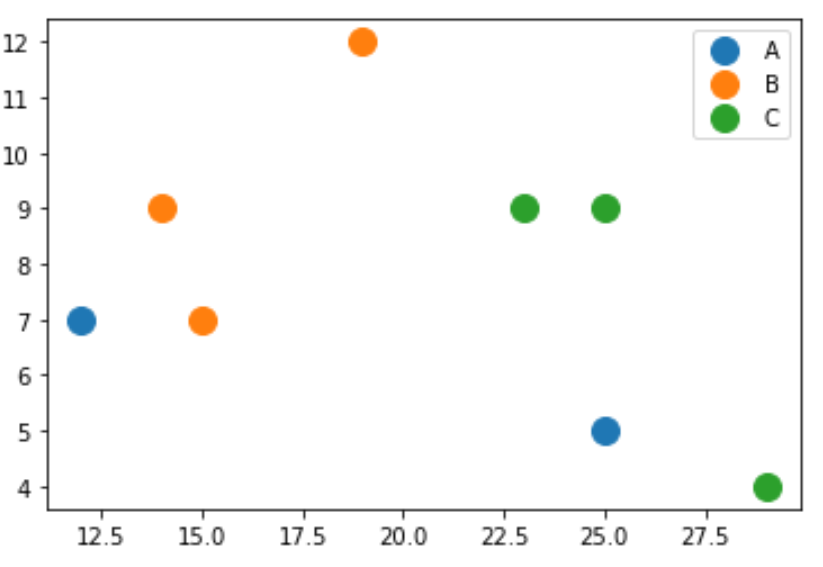
L’affichage de facteurs qualitatifs ou d’indicateurs discrets ne saurait tolérer l’usage d’une colormap continue interpolée linéairement. Si un chercheur associe des codes entiers à une palette continue sans précaution, le moteur graphique générera des nuances intermédiaires ambiguës le long des marqueurs, suggérant faussement l’existence d’états transitionnels entre des catégories par définition mutuellement exclusives. Pour remédier à cette dérive, l’emploi coordonné d’une palette qualitative et de la classe de normalisation BoundaryNorm s’avère indispensable.
La classe BoundaryNorm permet de segmenter l’espace numérique en une série d’intervalles discrets parfaitement étanches définis par une liste de frontières arithmétiques. Chaque intervalle délimité est ensuite mis en correspondance biunivoque avec une case chromatique unique d’une colormap segmentée. Ainsi, toute valeur tombant au sein d’une tranche donnée reçoit une couleur identique, uniforme et franche, sans le moindre lissage spectral sur les bordures de la catégorie.
Les palettes conçues expressément pour cet usage sont sélectionnées parmi les séries qualitatives de Matplotlib, telles que tab10, Set2 ou Paired. Ces jeux de teintes présentent des contrastes chromatiques optimisés assurant une discrimination instantanée entre les catégories, même lorsque celles-ci se trouvent spatialement enchevêtrées au cœur des zones les plus denses du nuage de points.
7.3 Remplacement de la colorbar continue par une légende catégorielle
Dès lors qu’une variable catégorielle discrète est cartographiée par la couleur, le maintien d’une barre de couleur verticale standard devient méthodologiquement inapproprié et esthétiquement confus. Une colorbar graduée continue véhicule en effet l’illusion d’une continuité dimensionnelle en totale contradiction avec la nature discontinue des classes analysées. La substitution de la barre de couleur par une légende discrète conventionnelle constitue la règle d’or de la publication scientifique.
Matplotlib fournit à cet effet un mécanisme d’extraction programmatique hautement performant via la méthode legend_elements attachée à l’instance de PathCollection produite par le tracé. Cette fonction inspecte automatiquement les partitions chromatiques appliquées au nuage de points et restitue un tuple contenant une liste de marqueurs représentatifs fictifs et une séquence d’étiquettes textuelles correspondantes. Le chercheur peut alors réinjecter ces éléments directement au sein de la méthode legend du système d’axes.
Ce procédé permet de substituer instantanément aux codes entiers artificiels les libellés nominaux textuels complets des groupes d’étude, garantissant une clarté sémantique immédiate. Le positionnement spatial de cette légende doit ensuite être minutieusement ajusté, soit au sein d’une zone libre d’observations à l’intérieur du tracé, soit ancré à l’extérieur immédiat du cadre géométrique afin de prévenir tout masquage accidentel de données empiriques critiques.
8. Normalisation des données et mise à l’échelle chromatique
8.1 Contrôle des limites dynamiques via vmin et vmax
L’attribution dynamique des bornes minimale et maximale par le moteur de tracé automatique de Matplotlib, bien que fonctionnelle lors des phases initiales de découverte, se révèle fréquemment inadaptée aux exigences d’une analyse quantitative rigoureuse. Les arguments vmin et vmax de la méthode scatter offrent la possibilité de forcer manuellement les limites dynamiques de la fonction de normalisation, accordant à l’expérimentateur un contrôle souverain sur la sensibilité chromatique de la représentation.
En fixant délibérément vmin et vmax à des valeurs théoriques pertinentes, plutôt qu’aux extrema empiriques d’un échantillon singulier, le chercheur s’assure d’une reproductibilité parfaite de l’étalonnage à travers différentes expériences. Si deux jeux de données collectés indépendamment doivent être confrontés côte à côte, le verrouillage de leurs paramètres vmin et vmax respectifs sur des bornes identiques est une condition stricte pour autoriser toute comparaison visuelle valide d’un panneau à l’autre sans induire en erreur le lecteur.
Par ailleurs, la modulation de ces seuils permet de focaliser la résolution spectrale sur une sous-plage particulièrement critique du phénomène analysé. En resserrant les bornes autour d’un intervalle d’intérêt spécifique, on amplifie le contraste chromatique au sein de cette région, révélant des micro-variations masquées par l’échelle globale. Il convient toutefois de documenter rigoureusement ce choix afin d’avertir le public que les valeurs excédant ces limites se trouvent arbitrairement saturées aux teintes extrêmes de la palette.
8.2 Normalisations mathématiques avancées : LogNorm et SymLogNorm
Les distributions empiriques issues de l’expérimentation biologique, comportementale ou socio-économique présentent couramment des asymétries majeures ou des structures obéissant à des lois de puissance, où la grande majorité des observations s’agglutine au voisinage de zéro tandis qu’une queue de distribution ténue s’étend sur plusieurs ordres de grandeur. Soumettre un tel échantillon à une normalisation linéaire standard conduit inévitablement à un échec graphique : la quasi-totalité des points arbore la teinte initiale de la palette, tandis que seuls quelques rares individus extrêmes bénéficient de l’ensemble du gradient chromatique.
Pour résoudre cette distorsion, Matplotlib intègre au sein de son module matplotlib.colors la classe de transformation logarithmique LogNorm. En substituant cette instance à la normalisation linéaire par le paramètre norm de la fonction scatter, l’espacement de la palette devient géométrique plutôt qu’arithmétique. Chaque décade d’amplitude occupe dès lors un espace chromatique équivalent, permettant de discriminer simultanément les variations subtiles des faibles grandeurs et les écarts macroscopiques des valeurs élevées.
Dans les contextes plus complexes où la distribution de la variable comprend simultanément des valeurs positives, des valeurs négatives et des zéros parfaits, la classe SymLogNorm s’impose. Cette normalisation applique une échelle logarithmique symétrique de part et d’autre d’un intervalle linéaire résiduel situé autour de zéro, évitant ainsi la singularité mathématique indéfinie inhérente au logarithme d’un nombre négatif ou nul, tout en préservant l’intelligibilité des amplitudes extrêmes dans les deux polarités.
8.3 Normalisations centrées et asymétriques avec TwoSlopeNorm
De nombreuses grandeurs scientifiques ne tirent pas leur sens de leurs extrema absolus mais de leur positionnement par rapport à une valeur charnière fondamentale, telle qu’un point de zéro théorique, un seuil de bascule homéostatique ou une moyenne normative de population. Dans de telles configurations, la visualisation se doit d’exploiter une palette divergente articulée impérativement autour de cette valeur d’ancrage. Toutefois, les distributions empiriques se caractérisent presque universellement par une asymétrie d’amplitude entre leurs branches positive et négative.
Si l’on applique une normalisation linéaire symétrique naïve à une distribution dont les valeurs s’étendent de moins dix à plus cent avec un centre à zéro, la teinte neutre de la palette divergente sera mécaniquement rejetée au voisinage de quarante-cinq, dénaturant totalement l’interprétation du tracé. La classe TwoSlopeNorm, anciennement désignée sous le terme DivergingNorm, a été spécifiquement développée pour pallier cette anomalie structurelle.
Cette classe de normalisation permet de définir de manière totalement indépendante la borne minimale (vmin), le centre sémantique neutre (vcenter) et la borne maximale (vmax). Elle génère deux gradients d’interpolation linéaires continus mais présentant des pentes différentielles de part et d’autre du point central. Grâce à cette souplesse mathématique, le point neutre de la palette divergente est ancré de façon immuable sur la valeur théorique désignée, tout en exploitant la totalité du spectre chromatique disponible pour cartographier les variations empiriques de chaque côté de l’équilibre.
9. Combinaison synchronisée de la taille (s) et de la couleur (c) pour l’analyse multivariée
9.1 Cartographie visuelle à quatre dimensions sur plan bidimensionnel
L’intégration synchronisée des arguments spatiaux (x, y), du gradient chromatique (c) et de la superficie des marqueurs (s) autorise la projection simultanée de quatre variables quantitatives continues distinctes au sein d’une représentation graphique unifiée. Cette approche constitue le sommet de la densité sémiotique accessible sur un plan bidimensionnel. Dans les protocoles expérimentaux sophistiqués, elle permet de visualiser d’un seul coup d’œil les interactions croisées entre des déterminants multiples sans recourir à des décompositions factorielles fractionnées.
Prenons l’exemple d’une étude en neuropsychologie cognitive : l’analyste peut projeter l’âge chronologique des participants sur l’abscisse, le score d’efficience mnésique sur l’ordonnée, le niveau d’activité électroencéphalographique sur le canal de couleur c, et la latence moyenne de réponse psychomotrice sur le paramètre de taille s. Une telle construction permet de repérer immédiatement si les sujets âgés conservant une mémoire vive élevée présentent une signature neurophysiologique compensatoire spécifique modulée par un ralentissement moteur systématique.
Toutefois, la réussite d’une telle cartographie requiert une hiérarchisation perceptuelle rigoureuse conforme aux principes de Bertin. L’œil humain traite avec une efficacité décroissante la position spatiale, la luminance chromatique, la taille surfacique puis la tonalité spectrale pure. Les variables correspondant aux hypothèses de recherche primaires doivent donc impérativement être réservées aux axes spatiaux et au canal de couleur, tandis que la modulation de taille doit être dévolue à une variable d’impact secondaire ou à un descripteur d’échantillonnage tel que l’effectif ou le niveau de confiance statistique.
9.2 Atténuation des phénomènes de chevauchement (Overplotting)
Dès lors que le volume d’observations injecté dans un nuage de points s’accroît substantiellement, l’analyste se trouve confronté au phénomène critique de chevauchement visuel ou d’occlusion sémiotique (*overplotting*). Ce problème est considérablement aggravé lorsque les marqueurs se voient assigner simultanément des teintes variées et des superficies volumineuses : les points tracés lors des dernières itérations du pipeline graphique recouvrent et oblitèrent physiquement les observations antérieures, créant un biais de perception systématique en faveur des données situées à la fin du jeu de données.
Pour juguler cette dérive et préserver la densité locale de l’information, plusieurs stratégies complémentaires doivent être combinées. La première consiste à calibrer le paramètre alpha, qui régit la transparence optique des marqueurs. En attribuant à alpha une valeur fractionnaire comprise entre zéro et un, la superposition de multiples points engendre une augmentation cumulative de la densité optique, révélant avec netteté les cœurs de distribution fortement concentrés au sein du nuage.
Une seconde approche décisive consiste à trier méthodiquement le DataFrame en amont du rendu graphique. Selon la problématique de recherche, on pourra choisir d’ordonner les rangées de manière aléatoire afin de neutraliser tout biais d’empilement systématique, ou au contraire trier le tableau en fonction de la valeur de coloration c. Cette dernière technique garantit que les observations présentant les intensités les plus marquées émergent au premier plan de la scène graphique, prévenant leur ensevelissement sous la masse des scores moyens.
9.3 Évaluation critique de la charge cognitive et de l’intelligibilité
Si la possibilité technique de concentrer quatre dimensions distinctes au sein d’un tracé unifié démontre la flexibilité opérationnelle de Matplotlib, elle ne doit pas faire oublier les contraintes neurocognitives qui limitent la bande passante interprétative du cerveau humain. La multiplication anarchique des stimuli sensoriels au sein d’une surface réduite engendre rapidement une surcharge cognitive pénalisante, connue sous le concept d’encombrement graphique (*visual clutter*), qui paralyse la capacité de synthèse analytique du lecteur.
Face à une saturation combinée de gradients de couleurs, de cercles de diamètres discordants et de coordonnées spatiales complexes, le système visuel peine à extraire spontanément des corrélations globales sans devoir procéder à un décodage séquentiel fastidieux point par point. L’analyste doit donc s’interroger en permanence sur la plus-value scientifique réelle de chaque canal additionnel : l’adjonction de la taille des marqueurs apporte-t-elle un éclairage indispensable à la confirmation de l’hypothèse centrale ou ne constitue-t-elle qu’un artifice démonstratif superflu ?
La règle méthodologique prépondérante réside dans la sobriété architecturale. Lorsque la complexité des interactions observées l’exige, il est souvent scientifiquement plus judicieux de fragmenter l’analyse en une matrice de petits graphiques multiples (*small multiples*), où chaque panneau représente un sous-ensemble homogène de la variable secondaire, plutôt que de contraindre la totalité des données à cohabiter au sein d’une unique arène visuelle illisible.
10. Gestion des valeurs aberrantes, données manquantes et artefacts graphiques
10.1 Influence distorsive des valeurs aberrantes sur l’échelle de couleur
L’intégrité de la restitution visuelle d’un gradient de données par l’intermédiaire de la couleur est extrêmement vulnérable à la présence de valeurs aberrantes (*outliers*). En raison du comportement par défaut qui indexe linéairement les bornes vmin et vmax sur les extrema absolus de l’échantillon, un point isolé présentant un score pathologique ou résultant d’un artéfact expérimental de mesure étirera de manière disproportionnée la dynamique de la colormap à son seul profit.
La conséquence immédiate de cette distorsion est la compression pernicieuse de la quasi-totalité des observations saines au sein d’une bande de couleur excessivement étroite et uniforme, privant le chercheur de la capacité d’observer les variances et les covariations réelles de son échantillon. Ce phénomène s’avère particulièrement trompeur en analyse exploratoire, car il peut masquer l’existence de bimodalisations structurales au sein de la population cible sous une fausse apparence d’homogénéité spectrale.
La parade méthodologique recommandée consiste à découpler les bornes de normalisation des extrema bruts en exploitant des seuillages statistiques robustes fondés sur les percentiles de la distribution. En calant vmin sur le premier ou deuxième percentile et vmax sur le quatre-vingt-dix-huitième ou quatre-vingt-dix-neuvième percentile de la variable, on assure une absorption équilibrée de la diversité interne des données par le spectre chromatique, tout en neutralisant l’effet dévastateur des artefacts périphériques d’enregistrement.
10.2 Traitement spécifique des valeurs manquantes (NaN)
Dans tout recueil de données empiriques d’envergure, l’incomplétude observationnelle représente une réalité inévitable. L’intégration de vecteurs comportant des valeurs indéfinies (NaN) au sein du paramètre c constitue une source fréquente de dysfonctionnements silencieux ou d’ambiguïtés sémiotiques majeures. Par défaut, les primitives géométriques dont la coordonnée de couleur est indéfinie sont soit totalement omises du rendu, soit dessinées avec une transparence totale, ce qui prive le lecteur de la connaissance spatiale d’une observation existante dont seule la troisième dimension est inconnue.
Cette approche est méthodologiquement regrettable : le fait qu’un sujet d’expérience présente une valeur manquante sur une variable secondaire ne doit pas masquer sa position cartésienne fondamentale sur les deux axes principaux. Pour résoudre ce problème, l’objet colormap de Matplotlib dispose d’une méthode spécialisée hautement précieuse : set_bad. Cette méthode permet de définir explicitement la couleur exacte qui sera attribuée à toute valeur non définie rencontrée lors du cycle de rastérisation.
Il est préconisé d’assigner à la méthode set_bad une teinte neutre désaturée et facilement différenciable des couleurs de la palette active, comme un gris anthracite médian ou un hachurage discret, tout en maintenant son opacité. Cette décision méthodologique permet d’assurer une ségrégation rigoureuse entre l’absence constatée d’une mesure et une valeur numérique nulle, prévenant ainsi toute confusion interprétative préjudiciable lors de l’audit critique des résultats de recherche.
10.3 Gestion des extensions de barre de couleur (extend)
Lorsque le praticien fait le choix méthodologique conscient de contraindre artificiellement les bornes de normalisation au moyen des paramètres vmin et vmax pour éliminer l’influence de points aberrants ou focaliser la résolution spectrale, il contracte une dette d’intégrité déontologique vis-à-vis de son lectorat. Les points dont les valeurs scalaires se situent en deçà de vmin ou au-delà de vmax reçoivent en effet les teintes d’extrémité saturées de la colormap, devenant impossibles à distinguer visuellement d’observations situées exactement aux frontières choisies.
L’argument extend de la fonction colorbar a été spécifiquement conçu pour matérialiser cette troncature délibérée avec une transparence scientifique absolue. En assignant la valeur ‘both’, ‘min’ ou ‘max’ à ce paramètre, Matplotlib modifie la morphologie géométrique des extrémités de la barre de couleur, en y ajoutant des terminaisons triangulaires fléchées en lieu et place des traditionnels rectangles plats. Cette modification structurelle signale immédiatement à l’observateur averti que l’échelle continue de part et d’autre des valeurs limites affichées.
L’intégration de ces flèches d’extension permet de concilier la lisibilité optimale du corps central de la distribution avec le respect strict des exigences de vérifiabilité scientifique. Le lecteur comprend instantanément que les marqueurs arborant la teinte du triangle supérieur possèdent des grandeurs excédant la graduation terminale, garantissant une honnêteté intellectuelle irréprochable dans la communication des données expérimentales.
11. Personnalisation esthétique avancée pour les publications académiques
11.1 Configuration des paramètres globaux avec rcParams
La soumission d’articles de recherche auprès des éditeurs scientifiques internationaux requiert une harmonisation typographique et graphique sans faille de l’ensemble des figures du manuscrit. Régler laborieusement la taille des polices, les épaisseurs de traits ou l’espacement des étiquettes à l’intérieur de chaque appel individuel de fonction constitue une approche inefficace, source inépuisable d’incohérences de mise en page. Matplotlib offre un centre de contrôle centralisé via son dictionnaire global de configuration système : rcParams.
En intervenant sur ce registre en tout début de script, le chercheur peut imposer un thème stylistique institutionnel reproductible qui gouvernera uniformément toutes les instanciations de tracés subséquentes. On pourra ainsi configurer la famille typographique par défaut pour utiliser des polices avec empattement compatibles avec les maquettes d’imprimerie classiques, ou activer le moteur interne de rendu LaTeX pour obtenir un rendu irréprochable des symboles grecs, indices et exposants mathématiques présents au sein des axes cartésiens et des titres de barres de couleur.
Ce niveau de personnalisation global permet également d’affiner l’épaisseur des bordures extérieures des tracés, la densité et le style des grilles d’arrière-plan, ainsi que la couleur par défaut des lignes d’axes. Cette rigueur globale confère aux productions visuelles une signature esthétique hautement professionnelle, répondant d’emblée aux exigences éditoriales les plus strictes des comités de lecture académiques.
11.2 Annotations sémantiques et mise en exergue de données critiques
Un diagramme de dispersion enrichi par la couleur atteint son plein potentiel explicatif lorsqu’il intègre des repères sémantiques contextuels venant éclairer la trajectoire des données observées. Laisser un nuage de points sans guidage analytique impose au lecteur une interprétation purement inférentielle. L’utilisation conjointe des méthodes d’annotation textuelle fléchée (annotate) et de projection de lignes de tendance paramétriques permet d’orienter le regard vers les singularités empiriques déterminantes.
Lorsqu’un profil psychométrique atypique émerge de l’espace tridimensionnel (par exemple un individu présentant une vitesse de réaction fulgurante couplée à un taux d’erreur paradoxalement nul et un niveau de stress exceptionnel), l’ancrage d’un segment de texte fléché permet d’expliciter immédiatement le statut clinique de ce cas singulier. La méthode annotate de Matplotlib offre un contrôle vectoriel millimétrique sur la position du marqueur source, le décalage spatial de l’étiquette textuelle et la courbure de la flèche de liaison.
Parallèlement, la superposition discrète de droites de régression linéaire ou de courbes d’ajustement non linéaires issues de modèles statistiques permet d’ancrer le nuage de points dans un cadre théorique robuste. Il convient toutefois de veiller scrupuleusement à ce que ces courbes structurelles soient dessinées avec des contrastes et des épaisseurs subtils, afin de ne pas masquer les gradients chromatiques des points individuels situés en arrière-plan, garantissant un équilibre harmonieux entre données empiriques brutes et inférences modélisées.
11.3 Exportation vectorielle haute définition pour les revues scientifiques
L’étape ultime du pipeline de visualisation scientifique réside dans la compilation et l’exportation du canevas graphique vers un support de stockage numérique pérenne. L’erreur la plus critique commise à ce stade consiste à exporter des visualisations denses dans des formats matriciels comprimés ou à faible résolution (tels que des fichiers JPEG ou PNG à soixante-douze points par pouce), ce qui engendre une pixellisation floue désastreuse dès que le document est agrandi ou imprimé sur papier glacé par l’éditeur.
Les revues internationales exigent rigoureusement des formats vectoriels haute fidélité tels que le format PDF (Portable Document Format) ou EPS (Encapsulated PostScript). Dans ces formats, chaque point, segment de graduation, contour de marqueur et glyphe typographique est conservé sous forme d’équation géométrique mathématique autonome, autorisant un agrandissement infini sans la moindre dégradation de netteté. Matplotlib excelle dans cette tâche en générant des fichiers vectoriels légers et rigoureusement conformes aux standards d’imprimerie.
Lors de l’appel à la fonction d’enregistrement savefig, il est indispensable de spécifier l’argument bbox_inches avec la valeur ‘tight’. Cette instruction commande au moteur graphique de recalculer dynamiquement la boîte d’encombrement englobante de la figure au moment exact de l’écriture sur disque, éliminant ainsi les marges blanches inutiles et prévenant la troncature accidentelle des titres de barres de couleur périphériques ou des annotations textuelles situées en marge du tracé principal.
12. Étude de cas empirique complète : Analyse multivariée en psychométrie quantitative
12.1 Contexte de recherche et description du protocole expérimental
Pour parachever cette exploration méthodologique, nous proposons la mise en œuvre pratique intégrale d’un protocole expérimental appliqué au champ de la psychométrie différentielle et des neurosciences comportementales. Imaginons une étude clinique contrôlée portant sur une cohorte de cent cinquante participants soumis à une tâche informatisée d’attention sélective en environnement de stress aigu contrôlé (par exemple le protocole expérimental d’immersion d’un membre dans l’eau glacée, couramment désigné sous le nom de test de pression à froid).
Le protocole recueille quatre variables quantitatives continues standardisées pour chaque participant :
- L’axe des abscisses (X) encode le score d’anxiété-trait mesuré par l’inventaire psychométrique standardisé de Spielberger.
- L’axe des ordonnées (Y) matérialise le temps de latence moyen de réaction psychomotrice exprimé en millisecondes lors de la tâche d’attention soutenue.
- Le canal de couleur (c) capture la réactivité endocrinienne au stress, mesurée par la variation relative du taux de cortisol salivaire libre entre la ligne de base et l’acmé post-stress.
- La surface du marqueur (s) traduit le pourcentage d’erreurs commises par inhibition défaillante durant la tâche expérimentale.
L’hypothèse théorique sous-jacente postule que l’anxiété-trait et la latence psychomotrice présentent une corrélation globale modulée de manière critique par la réactivité cortisolaire : les sujets hautement réactifs sur le plan biologique devraient s’isoler dans une région spécifique de l’espace bivarié, affichant simultanément des temps de réponse paradoxalement écourtés mais au prix d’un taux de fautes substantiellement supérieur, illustrant le classique compromis entre vitesse et précision cognitive.
12.2 Implémentation complète du script de traitement et de rendu
L’implémentation de cette visualisation s’opère selon une architecture orientée objet sans faille, respectant scrupuleusement l’ensemble des préceptes théoriques, d’accessibilité et de sémiologie graphique détaillés tout au long de cet ouvrage. Les modules fondamentaux NumPy, Pandas, Matplotlib.pyplot et Matplotlib.colors sont mobilisés conjointement pour forger un canevas graphique prêt pour la publication académique.
Le script procède tout d’abord à la fixation d’une graine de reproductibilité pseudo-aléatoire, garantissant l’invariance absolue des résultats lors de compilations successives. Les données synthétiques mais calibrées sur des paramètres réels de distribution psychométrique sont générées et rassemblées dans un tableau Pandas structuré. Une normalisation de type TwoSlopeNorm est sélectionnée pour piloter le paramètre c, car la réactivité cortisolaire est une variable divergente centrée sur une valeur de référence nulle (stabilité endocrinienne absolue), avec des variations physiologiques négatives et positives asymétriques.
La palette divergente Cividis ou RdBu_r est articulée avec cette normalisation pour garantir une lecture univoque du gradient physiologique, tandis que l’argument alpha est calibré pour assurer la lisibilité à travers les superpositions éventuelles. Enfin, une barre de couleur rigoureusement alignée à l’aide d’un diviseur d’axes, pourvue de flèches d’extension bidirectionnelles et flanquée d’un titre dimensionnel métrologique précis, vient compléter le dispositif. L’ensemble est finalisé par une exportation vectorielle haute fidélité paramétrée avec des marges d’encombrement strictes.
12.3 Interprétation analytique et conclusion méthodologique
L’examen du tracé résultant de ce protocole rigoureux démontre immédiatement la supériorité épistémologique d’un diagramme de dispersion coloré par valeur sur une simple modélisation bivariée tabulaire. Le regard analytique décèle instantanément une structuration topologique profonde au sein de la population étudiée : tandis que les individus présentant une réactivité cortisolaire neutre (teintes médianes) s’alignent le long d’une trajectoire médiane stable, le sous-groupe des hyper-réactifs au cortisol (teintes extrêmes) dévie systématiquement vers des temps de réaction minimaux couplés à des cercles géométriquement hypertrophiés, confirmant avec éclat l’hypothèse d’une désinhibition sous stress aigu.
En synthèse, la maîtrise de la méthode scatter de Matplotlib et de ses arguments nodaux c, s et cmap transcende la simple exécution de commandes informatiques. Elle incarne un véritable langage de description scientifique où chaque décision graphique — de la sélection de la métrique de normalisation à la formulation du titre de la barre de couleur — engage directement la responsabilité méthodologique du chercheur face à ses données empiriques.
Si des bibliothèques de plus haut niveau telles que Seaborn ou des moteurs interactifs comme Plotly offrent des raccourcis séduisants pour l’exploration superficielle rapide, Matplotlib demeure le socle irremplaçable sur lequel repose l’ensemble de l’édifice de la visualisation scientifique en Python. Sa flexibilité granulaire absolue, conjuguée au respect rigoureux des lois de la psychophysique et de la sémiologie graphique, constitue la garantie ultime d’une restitution objective, inclusive et reproductible des découvertes empiriques de la recherche contemporaine.
Références
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions Gauthier-Villars. https://monoskop.org/images/8/87/Bertin_Jacques_Semiologie_Graphique.djvu
- Crameri, F., Shephard, G. E., & Heron, P. J. (2020). The misuse of colour in science communication. Nature Communications, 11(1), 1–10. https://doi.org/10.1038/s41467-020-19160-7
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1922-00a
- Nuñez, J. R., Anderton, C. R., & Renslow, R. S. (2018). Optimizing colormaps with recognition of color vision deficiency to improve analysis of large datasets. PLOS ONE, 13(7), e0199239. https://doi.org/10.1371/journal.pone.0199239
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Van der Walt, S., Colbert, S. C., & Varoquaux, G. (2011). The NumPy array: A structure for efficient numerical computation. Computing in Science & Engineering, 13(2), 22–30. https://doi.org/10.1109/MCSE.2011.37
- Ware, C. (2019). Information visualization: Perception for design (4th ed.). Morgan Kaufmann. https://doi.org/10.1016/C2017-0-02237-1