
L’histoire de la psychologie scientifique et des sciences comportementales est intimement liée à la recherche de régularités formelles capables de traduire la complexité des conduites humaines en lois quantifiables. Dès l’émergence des premiers laboratoires de psychophysique au dix-neuvième siècle, les pionniers de la discipline ont nourri l’ambition de mathématiser les liens unissant les stimulations environnementales aux réponses perceptives, affectives et cognitives. Dans cette quête d’intelligibilité, le modèle de régression linéaire classique s’est imposé comme l’instrument d’analyse prédominant, offrant un cadre élégant, accessible et directement interprétable pour évaluer le poids prédictif d’une variable indépendante sur un critère comportemental donné.
Pourtant, cette prédominance méthodologique s’est construite au prix d’une simplification ontologique majeure : le postulat implicite selon lequel la nature psychologique opère de manière strictement proportionnelle et invariante. Or, l’observation clinique, la psychométrie différentielle, les neurosciences cognitives et la psychologie organisationnelle démontrent de façon convergente que la réalité de l’appareil psychique désobéit presque systématiquement à cette linéarité idéale. Les phénomènes d’épuisement, les seuils de saturation de l’attention, les bascules motivationnelles ou les dynamiques d’apprentissage présentent des inflexions, des optima locaux et des décélérations brutales qui échappent par essence à la modélisation en ligne droite.
Face à ce décalage entre la structure des processus biopsychosociaux et les outils censés les quantifier, la régression polynomiale constitue une passerelle analytique indispensable. En enrichissant l’architecture des moindres carrés ordinaires par l’introduction de termes d’ordres supérieurs, cette approche permet de capturer les courbures sous-jacentes du vivant sans abandonner les propriétés mathématiques rigoureuses du modèle linéaire général. Ce traité se propose de parcourir de manière exhaustive les fondements épistémologiques, les déclinaisons mathématiques, les arbitrages méthodologiques et les applications cliniques de la modélisation curvilinéaire au sein des sciences de l’esprit.
1. Les fondements conceptuels de la régression en psychologie empirique
1.1 Limites épistémologiques du modèle linéaire simple dans l’étude du comportement
L’adhésion inconditionnelle au modèle linéaire simple repose sur l’hypothèse d’une constance absolue du taux de variation marginal : chaque incrément unitaire de la variable explicite $X$ est présumé engendrer une modification identique, en direction et en intensité, de la variable dépendante $Y$. Cette invariance structurelle constitue un postulat commode sur le plan computationnel, mais elle s’avère particulièrement fragile lorsqu’elle est confrontée à la dynamique du fonctionnement psychique. Dans l’étude des fonctions exécutives, par exemple, supposer qu’une augmentation de la charge mentale produit une détérioration continue et constante de la performance mnésique occulte les phases initiales où la mobilisation des ressources attentionnelles compense parfaitement, voire surpasse, l’exigence de la tâche.
De surcroît, le modèle linéaire simple s’avère structurellement incapable d’intégrer l’existence de seuils de saturation cognitive. Le traitement de l’information par le système nerveux central obéit à des contraintes neurobiologiques et architecturales finies, formalisées notamment par la théorie de la charge cognitive. Lorsqu’un sujet atteint la limite de sa mémoire de travail, l’adjonction d’intrants informationnels supplémentaires ne produit plus une progression proportionnelle du traitement, mais induit un plafonnement immédiat suivi d’une désorganisation qualitative des conduites. Modéliser de tels régimes au moyen d’une droite unique équivaut à projeter un artefact géométrique rigide sur une réalité dynamique hautement adaptative.
D’un point de vue inférentiel, les conséquences d’une telle mauvaise spécification du modèle sont désastreuses. Imposer une trajectoire rectiligne sur des données intrinsèquement courbées gonfle artificiellement la variance résiduelle non expliquée, réduisant drastiquement la puissance statistique et précipitant le chercheur dans le piège de l’erreur de type II : conclure à l’absence d’effet d’une variable alors que celle-ci exerce une influence déterminante mais non monotone. Inversement, l’estimation des erreurs-types s’en trouve biaisée, ce qui peut paradoxalement générer des erreurs de type I le long de segments spécifiques du continuum. La modélisation curvilinéaire s’impose ainsi non comme un raffinement technique superficiel, mais comme un impératif méthodologique destiné à restaurer la validité écologique de la recherche comportementale.
1.2 La fausse hypothèse de linéarité universelle en psychométrie
La psychométrie classique, bien qu’ayant développé des trésors de sophistication pour calibrer la fidélité et la validité des instruments, repose fréquemment sur l’illusion d’une proportionnalité constante au sein des échelles de mesure. Qu’il s’agisse d’échelles de Likert mesurant la détresse psychologique ou de tests standardisés évaluant le quotient intellectuel, l’agrégation de scores bruts postule implicitement que l’écart séparant un score de 20 à 30 possède la même signification psychologique sous-jacente que l’écart séparant un score de 70 à 80. Cette équidistance nominale masque le fait que les processus sous-jacents répondent à des lois de rendements décroissants ou d’accélérations soudaines.
L’apprentissage humain et l’acquisition de compétences motrices ou langagières illustrent avec acuité cette méprise. Au cours des phases initiales d’exposition à un paradigme expérimental, les gains d’apprentissage sont massifs et rapides ; puis, à mesure que l’expertise s’établit, les améliorations marginales deviennent infinitésimales pour chaque heure de pratique supplémentaire. Une régression linéaire reliant le temps d’entraînement à l’efficacité opératoire échoue à rendre compte de cette transition, sous-estimant systématiquement les performances initiales tout en prédisant des niveaux d’expertise absurdes et infinis à long terme.
Parallèlement, la statistique descriptive bivariée se trouve compromise par l’application aveugle du coefficient de corrélation produit-moment de Pearson. Ce coefficient mesure strictement la force d’une association linéaire. Face à une distribution parfaitement curvilinéaire, symétrique et en cloche, le coefficient $r$ de Pearson peut s’effondrer jusqu’à une valeur nulle ($r = 0$), laissant croire faussement à l’indépendance statistique de deux dimensions qui sont en réalité associées de manière déterministe. Cette distorsion des indices fondamentaux d’association exige des psychomètres une émancipation vis-à-vis du carcan linéaire classique.
1.3 Transition conceptuelle vers l’ajustement curvilinéaire
Opérer une transition vers l’ajustement curvilinéaire ne requiert pas l’abandon des édifices mathématiques éprouvés de la statistique inférentielle. Au contraire, l’un des atouts conceptuels majeurs de la régression polynomiale réside dans la préservation intégrale du cadre d’interprétation des moindres carrés ordinaires. Le chercheur continue d’évoluer au sein d’une méthode familière dont les estimateurs possèdent des propriétés analytiques optimales, tout en élargissant considérablement le spectre des trajectoires empiriques modélisables.
Il importe de clarifier une distinction théorique fondamentale, source récurrente de confusion chez les praticiens : la distinction entre un processus comportemental non linéaire et une formulation statistique linéaire par rapport aux paramètres. Un modèle peut parfaitement refléter une réalité physiologique ou cognitive non linéaire tout en demeurant une équation linéaire au sens de l’algèbre matricielle. En traitant les puissances successives d’une variable indépendante comme des prédicteurs distincts, l’analyste exploite l’appareillage de la régression multiple conventionnelle pour capturer des trajectoires courbes, sans devoir recourir à des algorithmes itératifs d’optimisation non linéaire complexe.
Cette transition analytique est historiquement et méthodologiquement impulsée par l’exploration visuelle approfondie des distributions de données. Avant même de statuer sur le modèle théorique définitif, l’inspection minutieuse du nuage de points et l’analyse graphique des résidus constituent l’acte fondateur de la démarche. Lorsque la projection des résidus en fonction des valeurs prédites dessine une parabole ou une onde sinueuse plutôt qu’une dispersion aléatoire et homogène en forme de nuage nébuleux, la structure empirique des données signale elle-même l’inadéquation de la droite et la nécessité d’introduire des composantes curvilinéaires.
2. Formalisation mathématique de la régression polynomiale
2.1 Définition de l’équation générale et de ses paramètres
La régression polynomiale d’une variable dépendante continue $Y$ sur une variable indépendante continue $X$ étend le modèle bivarié standard en intégrant les puissances successives du prédicteur jusqu’à un ordre scalaire entier $h$. La formulation générale de ce modèle déterministe et probabiliste pour le $i$-ième individu de l’échantillon s’exprime formellement par l’expression suivante :
$$Y_i = \beta_0 + \beta_1 X_i + \beta_2 X_i^2 + \beta_3 X_i^3 + dots + \beta_h X_i^h + \varepsilon_i$$
Dans cette formalisation mathématique, chaque paramètre remplit une fonction structurelle rigoureusement définie :
- $\beta_0$ représente le terme constant ou l’ordonnée à l’origine, correspondant à la valeur espérée de $Y$ lorsque le prédicteur $X$ est strictement égal à zéro.
- $\beta_1$ formalise la pente linéaire instantanée ou le gradient directionnel au point d’origine $X = 0$.
- $\beta_2$ quantifie l’accélération ou le taux d’inflexion quadratique, déterminant l’ouverture et l’orientation de la parabole.
- $\beta_k$ (pour tout $k ge 3$) module les courbures d’ordres supérieurs, introduisant des points de transition et d’inversion supplémentaires.
- $\varepsilon_i$ incarne le terme d’erreur stochastique, lequel agrège les variations comportementales non mesurées, les erreurs psychométriques inhérentes aux instruments et les fluctuations aléatoires du milieu expérimental.
Les postulats distributionnels associés à cette composante résiduelle demeurent classiques : les résidus $\varepsilon_i$ sont postulés indépendants et identiquement distribués selon une loi normale d’espérance nulle et de variance constante $\sigma^2$, soit symboliquement $\varepsilon_i \sim \mathcal{N}(0, \sigma^2)$. L’inférence statistique sur les paramètres $\beta_k$ (tests de Student, intervalles de confiance) repose directement sur la validité de cette hypothèse fondamentale.
2.2 Le degré polynomial et sa signification géométrique
La morphologie géométrique adoptée par la fonction de régression est dictée par la valeur de l’exposant maximal $h$. L’élévation de $X$ au carré ($h = 2$) produit une trajectoire parabolique caractéristique. Si le coefficient quadratique $\beta_2$ est strictement positif ($\beta_2 > 0$), la courbe est convexe, tournée vers le haut, dessinant une silhouette en « U » qui met en évidence un extremum minimal unique. Inversement, si $\beta_2 < 0$, la fonction est strictement concave, dessinant une trajectoire en « U inversé » qui culmine en un extremum maximal. Cette propriété géométrique offre un support direct pour quantifier les optimums de fonctionnement cognitif ou physiologique.
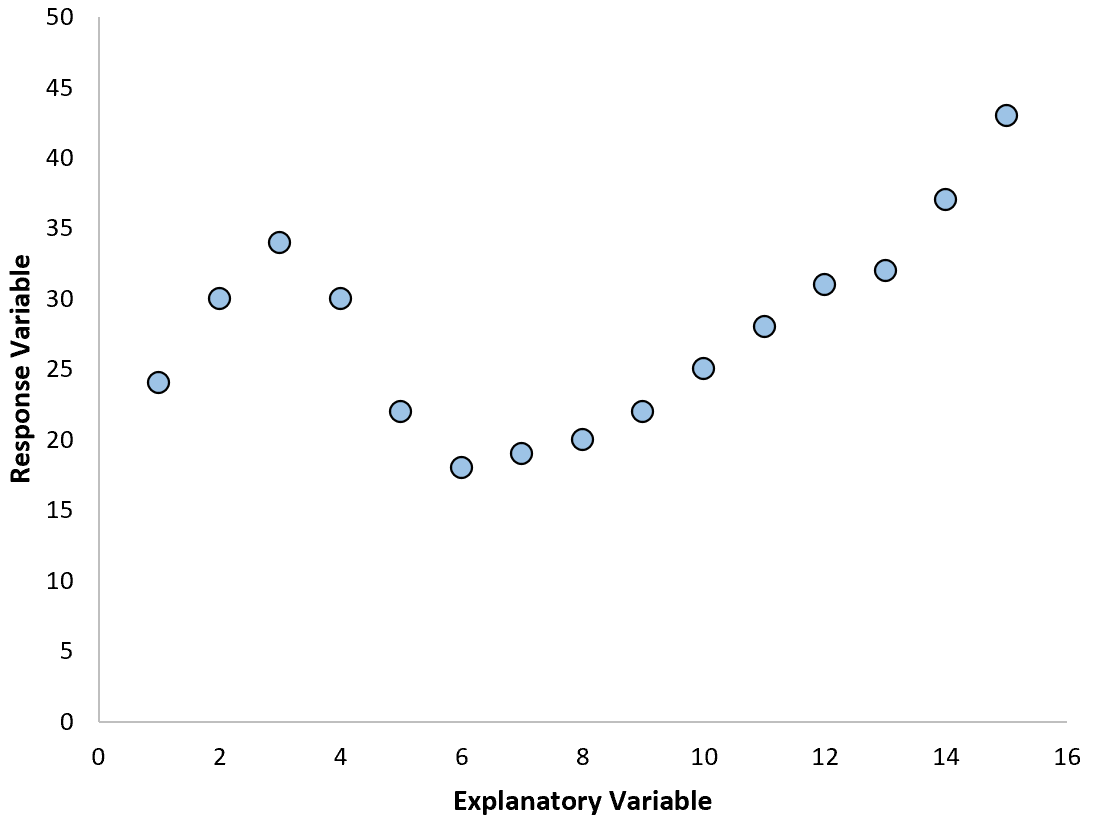
L’introduction d’un degré cubique ($h = 3$) dote la courbe d’un degré de liberté supplémentaire en permettant l’apparition d’un point d’inflexion où la concavité change de signe. Géométriquement, le polynôme de degré 3 affiche une forme en « S » ou en « N », capable de représenter une phase initiale d’accélération suivie d’un plateau temporaire, puis d’une nouvelle reprise de croissance ou d’un déclin prononcé. Cette géométrie asymétrique s’avère particulièrement adaptée à la modélisation de transitions de phases ou de seuils d’apprentissage où un palier sépare deux dynamiques comportementales distinctes.
Il convient également d’examiner le comportement asymptotique des queues de distribution, conditionné par la parité du degré $h$. Lorsque le degré maximal est pair, les deux branches extrêmes de la fonction évoluent vers la même direction infinie ($+\infty$ ou $-\infty$) lorsque $X to \pm\infty$. En revanche, pour un degré impair, les extrémités divergent vers des directions opposées. Cette propriété mathématique impose une mise en garde critique : en dehors de l’intervalle empirique des observations, les trajectoires polynomiales s’écartent très brutalement de toute plausibilité théorique, les valeurs projetées tendant vers l’infini à une vélocité proportionnelle à $X^h$.
2.3 La linéarité intrinsèque par rapport aux paramètres
La dénomination de « régression polynomiale » peut induire une ambiguïté quant à sa nature mathématique exacte. Il est crucial d’établir que la régression polynomiale demeure un cas particulier de la régression linéaire générale. La condition formelle de linéarité en économétrie et en biostatistique ne concerne nullement la forme géométrique des variables observables dans l’espace euclidien, mais la relation liant les coefficients inconnus $\beta$ à l’espérance conditionnelle du critère.
Pour démontrer cette propriété, considérons la dérivée partielle de l’espérance conditionnelle $\mathbb{E}(Y|X)$ par rapport à un coefficient quelconque $\beta_k$. Pour toute puissance $k in {0, 1, dots, h}$, nous avons :
$$\frac{\partial,\mathbb{E}(Y|X)}{\partial,\beta_k} = X^k$$
Cette dérivée partielle dépend exclusivement de la variable observée $X^k$ et ne fait intervenir aucun des autres paramètres du modèle. Par conséquent, l’équation demeure intrinsèquement linéaire dans l’espace vectoriel des paramètres $\beta$, bien qu’elle soit non linéaire dans l’espace structural de la variable prédictive $X$.
Cette linéarité paramétrique confère un avantage analytique exceptionnel sur les modèles non linéaires intrinsèques (tels que les modèles logistiques à quatre paramètres ou les exponentielles de Gompertz). L’estimation des coefficients ne nécessite aucune procédure itérative complexe dépendante de valeurs initiales arbitraires ou sujette aux blocages dans des minima locaux. Elle s’effectue via une solution analytique directe et fermée, universellement stable, garantissant l’obtention sans équivoque des meilleurs estimateurs linéaires sans biais au sens du théorème de Gauss-Markov.
3. Phénoménologie des relations non linéaires en sciences psychologiques
3.1 La loi de Yerkes-Dodson et l’activation psychophysiologique
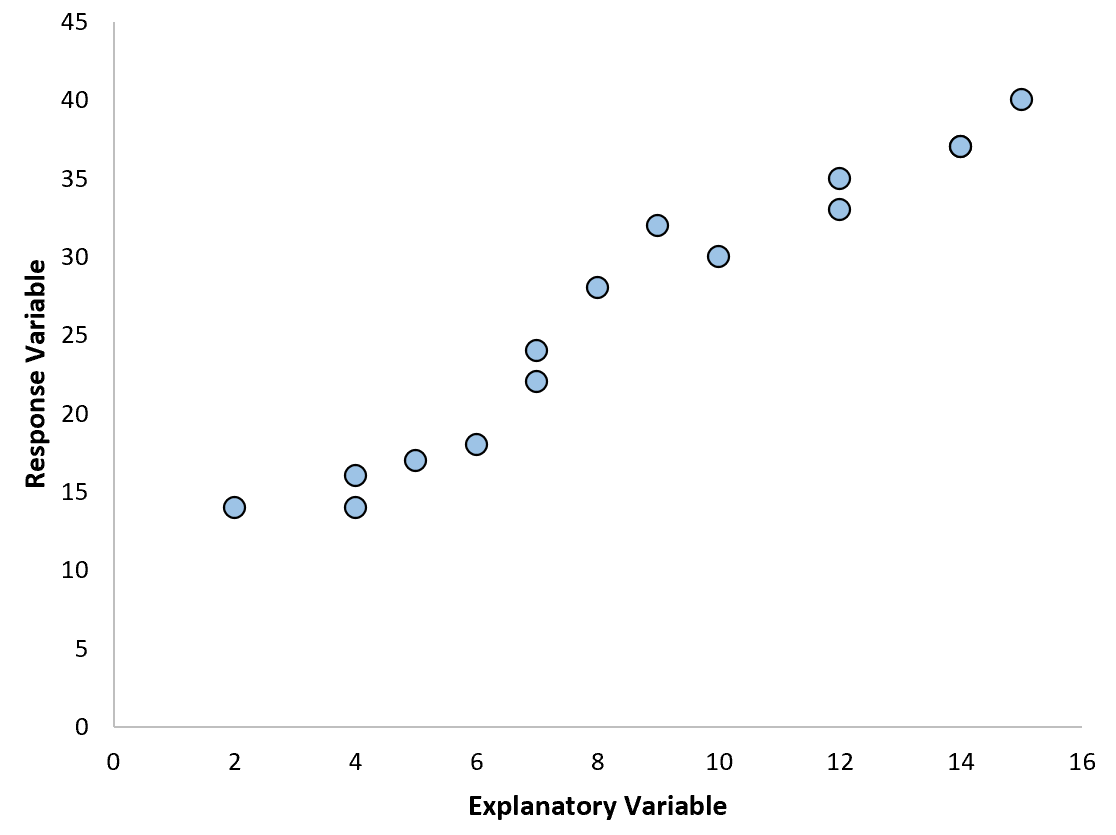
L’illustration historique et canonique des relations curvilinéaires en psychologie comportementale réside incontestablement dans la loi de Yerkes-Dodson, formulée initialement en 1908. Ce principe fondamental stipule que l’efficience de la performance cognitive ou motrice est une fonction non linéaire de l’état d’éveil neurovégétatif ou de l’anxiété. À des niveaux d’activation très faibles, l’hypovigilance et la distractibilité entravent l’exécution de la tâche ; inversement, une hyperactivation physiologique induit une focalisation attentionnelle excessive, un stress invalidant et un désengagement opérationnel, précipitant l’effondrement des performances.
Ce phénomène se formalise idéalement sous la forme d’une parabole en U inversé modélisée par une régression quadratique :
$$\text{Performance}_i = \beta_0 + \beta_1,\text{Arousal}_i + \beta_2,\text{Arousal}_i^2 + \varepsilon_i \quad (\text{a\vec } \beta_2 < 0)$$
L’estimation mathématique du niveau optimal d’éveil psychophysiologique s’obtient directement en calculant la dérivée première de la fonction par rapport à la variable explicative et en annulant ce gradient :
$$\frac{d,\text{Performance}}{d,\text{Arousal}} = \beta_1 + 2\beta_2,\text{Arousal}^* = 0 implies \text{Arousal}^* = -\frac{\beta_1}{2\beta_2}$$
Sur le plan empirique, cette dérivation analytique fournit aux cliniciens et ergonomes une métrique exacte pour identifier le point de bascule au-delà duquel l’intensification des exigences émotionnelles ou physiologiques cesse d’être adaptative pour devenir pathogène, guidant ainsi les protocoles d’optimisation de la performance sportive ou opérationnelle.
3.2 L’épuisement professionnel et la charge de travail
Dans le domaine de la psychologie de la santé au travail et de l’ergonomie organisationnelle, la relation unissant la charge de travail objective à l’épuisement émotionnel des salariés manifeste des dynamiques de seuil hautement sophistiquées. L’augmentation des sollicitations professionnelles est fréquemment tolérée sans préjudice majeur sur le bien-être tant qu’elle n’excède pas les ressources adaptatives globales du travailleur. Dès lors qu’un seuil critique est franchi, la fatigue cesse de progresser linéairement pour subir une accélération quadratique ou cubique conduisant au syndrome d’épuisement professionnel ou burnout.
L’introduction d’un terme cubique s’avère particulièrement pertinente lorsqu’on étudie les cohortes de soignants ou de cadres soumis à un stress prolongé. Les données révèlent souvent un premier palier d’adaptation où les mécanismes de régulation du stress contiennent les manifestations délétères, suivi d’une détérioration brutale, avant d’atteindre un état asymptotique terminal de dépersonnalisation et de détresse chronique où la symptomatologie se stabilise à un étiage alarmant. Un modèle polynomial de degré 3 permet de capturer avec fidélité ces ruptures d’allure fonctionnelle sans segmenter artificiellement l’échantillon.
De plus, la dynamique de rétablissement psychologique post-stress manifeste une asymétrie remarquable. Le temps requis pour restaurer l’homéostasie affective après une phase d’épuisement ne correspond nullement au rythme auquel cet épuisement s’est constitué. Ces phénomènes d’hystérésis comportementale, documentés dans les modèles d’effort-récupération, impliquent que les fonctions polynomiales représentent un outil de choix pour décrire comment des décharges progressives d’heures supplémentaires induisent des bénéfices dégressifs ou des détériorations non linéaires sur la santé perçue des opérateurs.
3.3 Trajectoires développementales et déclin cognitif lié à l’âge
L’étude de l’intelligence fluide, de la vitesse de traitement et des fonctions mnésiques à travers l’ensemble de l’arc de vie (lifespan developmental psychology) constitue un terrain d’application privilégié pour la modélisation polynomiale d’ordre 3. L’évolution de ces compétences sur huit décennies d’existence ne saurait en aucun cas être résumée par un indice de corrélation linéaire ou par une parabole simpliste.
Durant l’enfance et l’adolescence, l’ontogenèse cérébrale, marquée par une myélinisation intense et la synaptogenèse préfrontale, se traduit par une acquisition foudroyante de la vitesse de traitement de l’information. Cette progression rapide tend à ralentir à l’orée de la troisième décennie de vie, débouchant sur une phase de stabilité relative ou de déclin très modéré durant l’âge adulte intermédiaire. Enfin, à l’approche de la sénescence, les processus d’involution neurobiologique précipitent une nouvelle accélération non linéaire des déficits exécutifs.
Un polynôme cubique intègre précisément cette suite développementale :
$$\text{Vitesse}_i = \beta_0 + \beta_1,\text{Âge}_i + \beta_2,\text{Âge}_i^2 + \beta_3,\text{Âge}_i^3 + \varepsilon_i$$
Cette formulation permet d’isoler simultanément le point d’inflexion où la maturation cognitive cède le pas au déclin initial, ainsi que le seuil critique de l’âge mûr où le déclin s’accélère, autorisant des analyses comparatives robustes entre cohortes ou sous-groupes cliniques (patients sains versus porteurs de biomarqueurs neurodégénératifs précoces).
4. Estimation des paramètres et méthode des moindres carrés ordinaires
4.1 Formulation matricielle adaptée aux puissances polynomiales
L’estimation des coefficients de la régression polynomiale s’inscrit pleinement dans la mécanique matricielle de l’estimateur des Moindres Carrés Ordinaires (MCO). Pour un échantillon de $N$ participants et un polynôme de degré $h$, les variables indépendantes sont disposées dans une matrice de design augmentée, désignée classiquement sous le nom de matrice de Vandermonde, de dimension $N \times (h + 1)$ :
$$\mathbf{X} = \begin{\bmatrix}
1 &a\mp; X_1 &a\mp; X_1^2 &a\mp; dots &a\mp; X_1^h
1 &a\mp; X_2 &a\mp; X_2^2 &a\mp; dots &a\mp; X_2^h
\vdots &a\mp; \vdots &a\mp; \vdots &a\mp; \ddots &a\mp; \vdots
1 &a\mp; X_N &a\mp; X_N^2 &a\mp; dots &a\mp; X_N^h
\end{\bmatrix}, \quad
\mathbf{Y} = \begin{\bmatrix} Y_1 Y_2 \vdots Y_N \end{\bmatrix}, \quad
boldsymbol{\beta} = \begin{\bmatrix} \beta_0 \beta_1 \vdots \beta_h \end{\bmatrix}$$
Le vecteur des coefficients optimaux minimisant la somme des carrés des écarts s’obtient analytiquement par la résolution algébrique de l’équation normale des moindres carrés :
$$\hat{boldsymbol{\beta}} = (\mathbf{X}^T \mathbf{X})^{-1} \mathbf{X}^T \mathbf{Y}$$
Néanmoins, la structure spécifique de cette matrice de Vandermonde engendre des difficultés computationnelles majeures. Dès lors que $X$ prend des valeurs numériques élevées ou que le degré $h$ augmente, les colonnes successives deviennent quasi-colinéaires. Il en résulte que le déterminant de la matrice de dispersion produit $\mathbf{X}^T \mathbf{X}$ tend vers des valeurs infinitésimales. Cette singularité matricielle imminente amplifie dramatiquement l’instabilité numérique des algorithmes d’inversion matricielle, provoquant des erreurs d’arrondi susceptibles de fausser les estimations statistiques sur des machines à précision flottante conventionnelle.
4.2 Vérification des hypothèses de Gauss-Markov
Pour que l’estimateur matriciel $\hat{boldsymbol{\beta}}$ conserve ses propriétés théoriques fondamentales d’invariance, de convergence et d’efficacité statistique (estimateur BLUE : Best Linear Unbiased Estimator), les postulats du modèle de Gauss-Markov doivent faire l’objet d’un scrupuleux contrôle empirique. L’évaluation de l’indépendance et de l’homoscédasticité des résidus s’avère singulièrement délicate dans le cadre des ajustements curvilinéaires.
L’homoscédasticité suppose que la variance des erreurs $\sigma^2$ demeure invariante sur l’ensemble du continuum de la variable prédictive $X$. Or, dans les investigations psychologiques, il est fréquent d’observer une variance résiduelle s’évasant aux valeurs extrêmes de la trajectoire comportementale. Par exemple, si une régression quadratique ajuste avec précision les temps de réaction pour des intensités de stimulus moyennes, les sujets placés dans des conditions d’activation extrêmes présentent une hétérogénéité de réponse substantiellement accrue, violant ce postulat fondamental.
Par ailleurs, l’indépendance conditionnelle des erreurs implique l’absence stricte d’autocorrélation ($\text{Cov}(\varepsilon_i, \varepsilon_j) = 0$ pour $i ne j$). Cette exigence est particulièrement critique lorsque les régressions polynomiales sont déployées sur des devis longitudinaux ou des séries temporelles comportementales où les mesures répétées introduisent des dépendances sérielles. Ignorer de telles corrélations intragroupes produit une sous-estimation systématique des erreurs-types des coefficients polynomiaux, gonflant artificiellement les statistiques $t$ et les risques d’inférences erronées.
4.3 Diagnostic de l’hétéroscédasticité le long du spectre polynomial
Face au risque d’hétéroscédasticité induit par la non-linéarité des dynamiques mesurées, le recours à des tests d’inférence diagnostiques formalisés s’impose. Le test classique de Breusch-Pagan, bien qu’éprouvé, peut manquer de puissance face à des modélisations polynomiales si la variance d’erreur dépend elle-même des termes d’ordre supérieur du régresseur. Il convient d’adapter la formulation du test en régressant les carrés des résidus standardisés $e_i^2$ sur la totalité des colonnes de la matrice de Vandermonde :
$$e_i^2 = \gamma_0 + \gamma_1 X_i + \gamma_2 X_i^2 + dots + \gamma_h X_i^h + \nu_i$$
Pour une sensibilité accrue ne postulant pas de schéma d’hétéroscédasticité a priori, le test général de White est particulièrement recommandé, car il intègre les termes d’interaction et les puissances sans présumer d’une distribution normale des erreurs structurelles.
Lorsque le diagnostic confirme une violation substantielle du postulat d’homogénéité de la variance résiduelle, la stratégie de repli standardisée consiste à préserver les estimations de pente obtenues par les moindres carrés, tout en corrigeant la matrice de variance-covariance des paramètres via l’estimateur sandwich robuste de Huber-White (connu sous le nom d’estimateur HC3 ou HC4 en petits échantillons) :
$$\text{Var}_{\text{robuste}}(\hat{boldsymbol{\beta}}) = (\mathbf{X}^T \mathbf{X})^{-1} \left( \mathbf{X}^T \mathbf{\Omega} \mathbf{X} \right) (\mathbf{X}^T \mathbf{X})^{-1}$$
où $\mathbf{\Omega}$ est une matrice diagonale construite à partir des résidus transformés, garantissant une inférence statistique non biaisée même en présence d’anomalies de dispersion résiduelle le long du spectre polynomial.
5. Le dilemme biais-variance et le surapprentissage en modélisation psychologique
5.1 Mécanique du surapprentissage avec des polynômes élevés
L’élévation du degré polynomial offre au modèle une plasticité géométrique croissante, créant chez le chercheur une dangereuse illusion d’ajustement. Chaque degré additionnel incrémente mécaniquement le coefficient de détermination ($R^2$), la courbe adoptant des ondulations de plus en plus resserrées pour aller capturer chaque point d’observation individuel. Ce comportement matérialise l’expression même du dilemme biais-variance (bias-variance tradeoff) en apprentissage statistique : la diminution du biais d’ajustement empirique s’opère au détriment d’une explosion exponentielle de la variance d’échantillonnage.
Dès lors que le degré $h ge 4$, le polynôme cesse de modéliser le processus psychologique latent pour commencer à modéliser le bruit de mesure idiosyncrasique inhérent à l’échantillon collecté. Les scores psychométriques et les temps de réaction sont structurellement entachés d’une variabilité intra-individuelle (fatigue transitoire, distraction, fluctuations attentionnelles) qui ne reflète aucune loi comportementale stable. Un modèle hautement sur-ajusté intègre ce bruit aléatoire comme s’il s’agissait d’un phénomène déterministe réplicable.
La conséquence immédiate de cette sur-flexibilité est l’effondrement de la validité écologique et de la transférabilité du modèle. Confronté à un nouvel échantillon de validation issu de la même population clinique ou expérimentale, le modèle polynomial d’ordre élevé affiche des erreurs quadratiques prédictives considérables, souvent largement supérieures à celles d’un modèle linéaire simple. La réplicabilité scientifique, pierre angulaire de la psychologie contemporaine, se trouve alors directement compromise par cette sophistication mathématique mal maîtrisée.
5.2 Le phénomène d’oscillation aux frontières
Au-delà de la capture du bruit expérimental, les polynômes de degrés élevés sont sujets à une pathologie géométrique redoutable théorisée en analyse numérique par Carl Runge en 1901 : le phénomène de Runge. Lorsqu’on interpole des points de données équidistants au moyen d’un polynôme dont le degré augmente, l’erreur d’ajustement ne converge pas uniformément vers zéro ; au contraire, elle se met à diverger de façon spectaculaire et oscillatoire aux abords immédiats des bornes de l’intervalle de définition.
En contexte psychologique, ce phénomène produit des artefacts méthodologiques graves. Si l’on étudie l’effet de l’anxiété sur l’efficience décisionnelle avec un polynôme de degré 5, la fonction peut se comporter de manière raisonnable au centre de la distribution empirique, puis plonger vers des scores négatifs impossibles ou s’envoler de façon vertigineuse aux extrêmes du continuum clinique (sujets à anxiété minimale ou maximale). Ces oscillations frontalières ne correspondent à aucune réalité psychologique et constituent de purs mirages computationnels.
Ces dérives disqualifient formellement toute tentative d’extrapolation en dehors du champ précis des valeurs empiriquement observées dans l’échantillon. Un modèle linéaire simple extrapolera avec un risque mesuré et proportionnel ; un modèle polynomial d’ordre supérieur extrapolera avec une instabilité chaotique, prédisant des états cognitifs aberrants à la moindre sollicitation hors des frontières d’étalonnage expérimental.
5.3 Régularisation statistique comme alternative à la sur-flexibilité
Lorsque la complexité théorique du phénomène psychologique exige une modélisation hautement flexible, mais que le risque de divergence polynomiale menace la stabilité des estimations, les techniques de régularisation statistique constituent une alternative mathématique robuste. Plutôt que de contraindre arbitrairement le degré du polynôme, ces approches intègrent l’ensemble des puissances tout en appliquant une pénalité financière sur la norme vectorielle des coefficients $\beta$.
La régression de Tikhonov ou régression Ridge (pénalisation $L_2$) minimise la fonction de perte augmentée de la somme des carrés des coefficients :
$$\mathcal{L}_{\text{Ridge}}(boldsymbol{\beta}) = \sum_{i=1}^N \left( Y_i – \sum_{k=0}^h \beta_k X_i^k \right)^2 + \lambda \sum_{k=1}^h \beta_k^2$$
Le paramètre d’accordage $lambda$ rétracte uniformément les coefficients vers zéro sans les annuler complètement. Cela comprime la variance matricielle et atténue drastiquement les oscillations anarchiques aux frontières, stabilisant l’ajustement polynomial sur l’ensemble de l’étendue des prédicteurs.
Pour sa part, l’opérateur de sélection et de rétraction absolue Lasso (pénalisation $L_1$) applique une pénalité sur la somme des valeurs absolues des coefficients :
$$\mathcal{L}_{\text{Lasso}}(boldsymbol{\beta}) = \sum_{i=1}^N \left( Y_i – \sum_{k=0}^h \beta_k X_i^k \right)^2 + \lambda \sum_{k=1}^h |\beta_k|$$
La géométrie de la contrainte $L_1$ possède la propriété singulière d’annuler strictement certains coefficients lorsque $lambda$ s’accroît, opérant une sélection parcimonieuse automatique des degrés polynomiaux pertinents. L’arbitrage empirique entre régularisation et parcimonie permet d’atteindre un point d’équilibre optimal entre le biais théorique et la précision prédictive.
6. Sélection méthodique du degré polynomial optimal
6.1 Critères d’information pénalisée
Pour arbitrer objectivement entre des modèles de degrés polynomiaux croissants sans succomber à la tentation du gonflement artificiel du $R^2$, l’usage des critères d’information pénalisée constitue le premier standard de sélection méthodologique. Ces indices mesurent la qualité relative d’adéquation du modèle tout en infligeant un malus proportionnel au nombre de paramètres libres estimés, récompensant ainsi la parcimonie scientifique.
Le Critère d’Information d’Akaike (AIC), fondé sur la minimisation de la divergence de Kullback-Leibler entre le modèle statistique et le véritable processus générateur de données, s’exprime par l’équation suivante :
$$\text{AIC} = 2k – 2\ln(\hat{L})$$
où $k = h + 2$ désigne le nombre total de paramètres estimés (constante, coefficients polynomiaux et variance résiduelle $\sigma^2$) et $\hat{L}$ représente la valeur maximale de la fonction de vraisemblance du modèle. L’AIC privilégie la performance prédictive à long terme dans des échantillons similaires.
À l’inverse, le Critère d’Information Bayésien de Schwarz (BIC) impose une pénalisation beaucoup plus sévère pour les paramètres additionnels en intégrant la taille effective de l’échantillon $N$ :
$$\text{BIC} = \ln(N)k – 2\ln(\hat{L})$$
En psychologie différentielle, où les cohortes dépassent fréquemment plusieurs centaines de participants, $ln(N) > 2$, ce qui conduit le BIC à pénaliser fortement les polynômes de degrés élevés au bénéfice des degrés plus parcimonieux (généralement quadratiques ou cubiques). La pratique rigoureuse commande de calculer de concert l’AIC et le BIC : une convergence de ces deux indices vers le même degré polynomial fournit un argument méthodologique décisif pour retenir cette architecture.
6.2 Validation croisée k-fold et partitionnement des données
Bien que les critères pénalisés fournissent une estimation asymptotique élégante, l’évaluation empirique directe de l’erreur prédictive par partitionnement des données s’avère indispensable pour neutraliser tout surajustement structural. La procédure de validation croisée k-fold consiste à fractionner de manière pseudo-aléatoire l’échantillon initial en $K$ sous-ensembles (plis) de cardinalités équivalentes.
À chaque itération $j in {1, dots, K}$, le modèle polynomial de degré $h$ est ajusté sur les données réunies des $K-1$ plis d’entraînement, puis projeté sans modification pour prédire les critères comportementaux du $j$-ième pli réservé (pli de test). L’Erreur Quadratique Moyenne de Prédiction Croisée (CV-RMSE) est agrégée sur les $K$ passes :
$$\text{CV-RMSE}(h) = \sqrt{\frac{1}{N} \sum_{j=1}^K \sum_{i in \mathcal{P}_j} \left( Y_i – \hat{Y}_{i,-j}^{(h)} \right)^2}$$
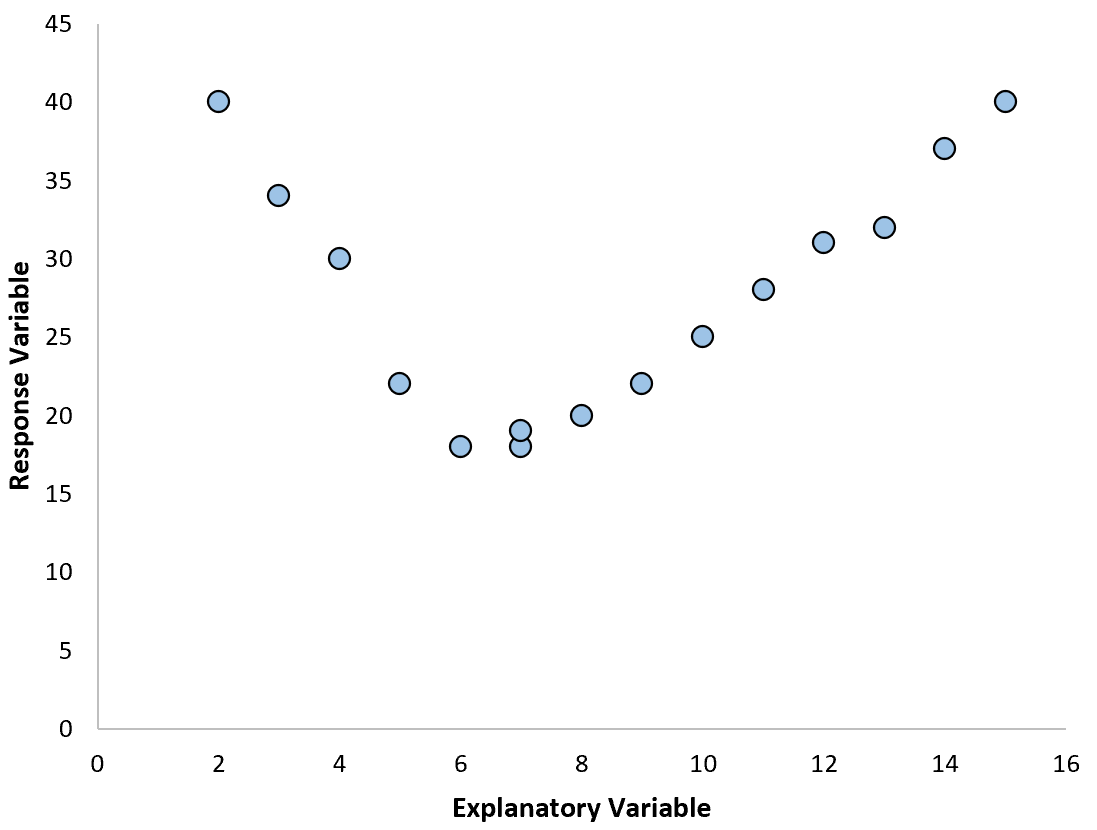
Cette approche protège l’investigateur contre les anomalies d’échantillonnage. En répétant cette opération pour des degrés polynomiaux consécutifs ($h in {1, 2, 3, 4, 5}$), la courbe de l’erreur de test dessine typiquement une trajectoire en « U » : elle décroît jusqu’au degré optimal reflétant la complexité du processus psychologique, avant de diverger abruptement pour les ordres supérieurs. Le degré sélectionné correspond rigoureusement à l’abscisse de l’erreur de test minimale.
6.3 Comparaisons hiérarchiques de modèles emboîtés
Sur le plan de l’inférence hypothético-déductive, la régression polynomiale bénéficie d’une propriété structurelle idéale : les modèles de degrés polynomiaux successifs sont hiérarchiquement emboîtés. Le modèle linéaire ($M_1$) est un sous-modèle strict du modèle quadratique ($M_2$), qui est lui-même un sous-modèle du modèle cubique ($M_3$), chaque niveau supérieur consistant à fixer le paramètre $\beta_h = 0$ dans le modèle précédent.
Cette imbrication autorise le recours au test du rapport de vraisemblance et au test $F$ incrémental de changement de variance expliquée ($\Delta R^2$). Pour évaluer l’apport statistiquement significatif du passage d’un modèle d’ordre $h-1$ à un modèle d’ordre $h$, la statistique de Fisher s’exprime comme suit :
$$F_{\text{incrémental}} = \frac{(R_h^2 – R_{h-1}^2) / 1}{(1 – R_h^2) / (N – h – 1)}$$
Cette statistique suit une loi de Fisher-Snedecor à $1$ et $N – h – 1$ degrés de liberté sous l’hypothèse nulle $H_0: \beta_h = 0$.
Le principe de parcimonie scientifique impose une règle de décision asymétrique : un degré polynomial supérieur ne doit être retenu que si et seulement si l’accroissement $\Delta R^2$ est statistiquement significatif au seuil préalablement défini (généralement $\alpha = 0{,}05$), et sous réserve expresse que cette augmentation représente une variance substantielle et théoriquement justifiable, évitant ainsi d’intégrer des courbures anecdotiques induites par des échantillons massifs.
7. Le problème de la multicolinéarité structurelle et ses solutions
7.1 Nature de la colinéarité induite par l’élévation à la puissance
Le talon d’Achille de la régression polynomiale réside dans l’apparition inévitable et mécanique d’une multicolinéarité structurelle sévère. Contrairement à la multicolinéarité classique observée en régression multiple standard (due à des intercorrélations non voulues entre des mesures distinctes du sujet, comme l’anxiété-état et le névrosisme), la colinéarité polynomiale est mathématiquement engendrée par l’opération d’exponentiation du régresseur $X$.
Dès lors que la variable prédictive $X$ est mesurée sur une échelle positive dont la moyenne est sensiblement décalée de zéro (ce qui est le cas de la quasi-totalité des échelles psychométriques et des mesures chronométriques), la corrélation brute entre $X$ et $X^2$, voire entre $X^2$ et $X^3$, atteint des niveaux vertigineux, souvent compris entre $r = 0{,}90$ et $r = 0{,}99$. Cette relation quasi-parfaite s’observe sur les coefficients du Facteur d’Inflation de la Variance (VIF), dont la valeur franchit couramment le seuil critique d’alarme ($VIF > 10$ ou $VIF > 50$).
Les conséquences analytiques de cette dégénérescence géométrique sont sévères :
- Inflation massive des erreurs-types des coefficients $\hat{\beta}_k$, ce qui réduit dramatiquement leur significativité statistique individuelle (tests $t$ non significatifs alors que le modèle global affiche un $R^2$ élevé).
- Sensibilité extrême des coefficients à l’ajout ou à la suppression d’une seule observation aberrante.
- Inversion contre-intuitive des signes des coefficients, le terme linéaire pouvant devenir négatif en présence d’un terme quadratique positif, ruinant toute tentative de lecture substantive directe des estimations partielles.
7.2 Le centrage sur la moyenne comme standard méthodologique
La parade méthodologique universellement consacrée pour désamorcer la multicolinéarité structurelle consiste à appliquer une opération géométrique de centrage sur la moyenne de l’échantillon avant de procéder à l’élévation aux puissances polynomiales. Soit $\bar{X}$ l’espérance empirique de la variable prédictive ; la variable centrée est définie par $X_c = X – \bar{X}$.
Le modèle quadratique centré s’écrit alors :
$$Y_i = \beta_0^* + \beta_1^* (X_i – \bar{X}) + \beta_2^* (X_i – \bar{X})^2 + \varepsilon_i$$
En soustrayant la moyenne, les valeurs positives et négatives de part et d’autre de zéro se compensent symétriquement lors de la mise au carré, ce qui ramène la corrélation linéaire entre $(X – \bar{X})$ et $(X – \bar{X})^2$ à une valeur proche de zéro (exactement égale à zéro si la distribution marginale de $X$ est parfaitement symétrique). Les VIF s’effondrent immédiatement pour revenir sous le seuil d’indépendance acceptable.
Il est capital de souligner que cette transformation modifie profondément la signification substantielle des coefficients inférieurs :
- Le coefficient $\beta_2^*$ demeure strictement invariant ($\beta_2^* = \beta_2$), garantissant que l’estimation de la courbure pure n’est nullement altérée par le centrage.
- Le coefficient $\beta_1^*$ représente désormais la pente linéaire instantanée de la courbe au point moyen de l’échantillon ($X = \bar{X}$), et non plus à la valeur irréaliste $X = 0$.
- L’ordonnée à l’origine $\beta_0^*$ devient la moyenne espérée de $Y$ pour un individu moyen sur le continuum prédictif, ce qui réhabilite l’intelligibilité clinique directe des estimations de base.
7.3 L’approche par polynômes orthogonaux
Pour s’affranchir définitivement de toute redondance colinéaire, en particulier dans le cadre de devis expérimentaux contrôlés comportant des pas de stimulation équidistants, l’emploi des polynômes orthogonaux représente la solution algébrique la plus élégante. Cette méthodologie repose sur la décomposition de la trajectoire en une somme de fonctions polynomiales discrètes orthogonales au sens du produit scalaire des espaces fonctionnels, telle que formalisée par les fonctions de Tchebychev ou les polynômes de Legendre discrétisés.
Dans ce cadre, la matrice de régression est transformée de telle sorte que :
$$\sum_{i=1}^N P_j(X_i) P_k(X_i) = 0 \quad \text{pour tout } j ne k$$
Chaque terme polynomial orthogonal successif ($P_1(X), P_2(X), P_3(X)$) est strictement non corrélé à tous les autres régresseurs du système. La matrice d’information $\mathbf{X}^T \mathbf{X}$ devient strictement diagonale.
Cette orthogonalité confère des propriétés théoriques exceptionnelles : l’addition ou l’éviction d’un terme cubique ou d’ordre supérieur ne modifie aucunement la valeur numérique estimée du coefficient linéaire ou quadratique. De plus, la somme totale des carrés expliquée ($SS_{\text{régression}}$) se décompose exactement en une somme arithmétique de composantes indépendantes, chacune étant exclusivement attribuable à la tendance linéaire, quadratique ou cubique pure, permettant des décompositions de variance rigoureuses dans les analyses de variance factorielles pour mesures répétées.
8. Interprétation substantielle des coefficients et points d’inflexion
8.1 Dérivation différentielle et calcul des extremums
La supériorité de la régression polynomiale sur des approches algorithmiques purement opaques réside dans sa traçabilité différentielle intégrale. Dans un modèle polynomial du second degré, l’intérêt clinique réside rarement dans les coefficients bruts pris isolément, mais dans l’identification des points critiques où le comportement s’inverse ou culmine. Soit le modèle estimé :
$$\hat{Y} = \hat{\beta}_0 + \hat{\beta}_1 X + \hat{\beta}_2 X^2$$
La dérivée première de cette fonction caractérise le taux de changement instantané du phénomène psychologique :
$$\frac{d\hat{Y}}{dX} = \hat{\beta}_1 + 2\hat{\beta}_2 X$$
L’annulation de ce gradient différentiel ($d\hat{Y}/dX = 0$) identifie les coordonnées de l’extremum local :
$$X_{\text{extremum}} = -\frac{\hat{\beta}_1}{2\hat{\beta}_2}$$
En substituant cette coordonnée dans le modèle d’origine, on obtient la valeur prédite correspondante $\hat{Y}_{\text{extremum}}$. Ce calcul prend une importance primordiale lorsqu’il s’agit de quantifier la posologie optimale d’une intervention psycho-éducative, la charge de travail induisant le minimum d’erreurs opératoires, ou le niveau d’excitation affective maximisant les scores de mémoire de travail.
Toutefois, la simple obtention ponctuelle de $X_{\text{extremum}}$ ne suffit pas sur le plan inférentiel ; ce ratio de deux estimateurs aléatoires présente une variance d’échantillonnage qu’il convient d’encadrer. La méthode Delta fournit l’approximation asymptotique de la variance de cet extremum :
$$\text{Var}(X_{\text{extremum}}) \approx \left( \frac{\partial X^*}{\partial \hat{\beta}_1} \right)^2 \text{Var}(\hat{\beta}_1) + \left( \frac{\partial X^*}{\partial \hat{\beta}_2} \right)^2 \text{Var}(\hat{\beta}_2) + 2 \left( \frac{\partial X^*}{\partial \hat{\beta}_1} \right) \left( \frac{\partial X^*}{\partial \hat{\beta}_2} \right) \text{Cov}(\hat{\beta}_1, \hat{\beta}_2)$$
Grâce à cette dérivation matricielle, le praticien est en mesure de calculer l’intervalle de confiance à 95% de l’optimum comportemental, attestant de la robustesse de l’estimation clinique.
8.2 Sens de la courbure et dérivée seconde
Si la dérivée première éclaire la direction et l’inversion de tendance, la dérivée seconde renseigne sur l’accélération et les propriétés de concavité de la structure fonctionnelle. Pour une parabole, la dérivée seconde est une constante scalaire :
$$\frac{d^2\hat{Y}}{dX^2} = 2\hat{\beta}_2$$
Le signe mathématique de ce terme dicte sans équivoque la nature phénoménologique de la trajectoire : une valeur négative signale une concavité globale (U inversé, caractérisant les lois de saturation et les processus d’efficience adaptative optimale), tandis qu’une valeur positive démontre une convexité absolue (U direct, décrivant typiquement des dynamiques de vulnérabilité où l’indice de souffrance psychologique s’emballe aux extrémités du spectre adaptatif).
Dans le cas des polynômes du troisième degré ($h = 3$), la dérivée seconde dépend linéairement de la variable indépendante :
$$\frac{d^2\hat{Y}}{dX^2} = 2\hat{\beta}_2 + 6\hat{\beta}_3 X$$
L’annulation de cette dérivée seconde identifie le point d’inflexion critique :
$$X_{\text{inflexion}} = -\frac{\hat{\beta}_2}{3\hat{\beta}_3}$$
En ce point précis de la cinétique psychologique, la courbure bascule : le système cesse d’accélérer pour commencer à décélérer (ou inversement). En neuropsychologie du développement, cette coordonnée repère le moment précis de la vie où la maturation synaptique maximale commence à perdre son élan initial au profit d’une phase de consolidation structurale.
8.3 Calcul et visualisation des effets marginaux
Une erreur récurrente chez les utilisateurs non statisticiens consiste à interpréter le coefficient $\hat{\beta}_1$ comme un effet moyen global, à la manière d’une pente de régression multiple conventionnelle. En présence de puissances polynomiales, cette interprétation est non seulement fausse, mais dénuée de sens théorique : le prédicteur $X$ n’a pas « un » effet, mais une infinité d’effets locaux dépendant instantanément du niveau auquel le sujet est évalué.
L’effet marginal conditionnel de $X$ sur $Y$ s’évalue mathématiquement par sa dérivée partielle :
$$\text{Effet Marginal}(X) = \frac{\partial \hat{Y}}{\partial X} = \hat{\beta}_1 + 2\hat{\beta}_2 X + 3\hat{\beta}_3 X^2 + dots + h\hat{\beta}_h X^{h-1}$$
Pour communiquer valablement ces résultats, il convient d’abandonner l’idée d’une métrique de coefficient unique et d’adopter des visualisations graphiques de l’effet marginal le long de quantiles prédéfinis du prédicteur (10e, 25e, 50e, 75e et 90e percentiles). Ce graphique associe à chaque valeur de $X$ son effet marginal local bordé de son intervalle de confiance à 95% dérivé de la matrice de covariance des erreurs.
Cette approche désagrégée met en évidence des vérités empiriques fascinantes : une variable peut exercer un impact marginal statistiquement positif et stimulant pour les sujets situés dans le décile inférieur de la distribution, devenir rigoureusement neutre (effet marginal nul) pour la médiane de la population, et basculer en un effet marginal négatif et invalidant pour les déciles supérieurs. L’honnêteté scientifique requiert d’expliciter cette hétérogénéité d’impact plutôt que de la lisser sous une moyenne arithmétique globale illusoire.
9. Visualisation graphique et communication des résultats selon les normes scientifiques
9.1 Construction de représentations graphiques rigoureuses
L’intelligibilité d’une régression polynomiale repose sur une restitution graphique sans compromis. L’époque où un modèle statistique pouvait être condensé dans un simple tableau de coefficients est révolue. La représentation d’une trajectoire curvilinéaire exige la superposition harmonieuse du nuage de points des observations empiriques brutes (avec une transparence alpha adaptée pour limiter l’occlusion des données denses) et de la courbe prédite par le modèle polynomial retenu.
La courbe moyenne prédite doit obligatoirement être ceinturée d’intervalles de confiance ponctuels à 95%, visualisés sous la forme d’un ruban semi-transparent. Ces bandes de confiance reflètent l’incertitude liée à l’estimation des paramètres du modèle ; elles se resserrent naturellement au barycentre de l’échantillon pour s’évaser progressivement vers les marges de la distribution, illustrant visuellement la perte de précision statistique aux extrêmes du prédicteur.
Pour les applications cliniques et diagnostiques individuelles, il est éminemment recommandé de distinguer formellement les bandes de confiance des bandes de prédiction. Alors que la bande de confiance quantifie la variabilité de la moyenne théorique conditionnelle $\mathbb{E}(Y|X)$, la bande de prédiction englobe la variabilité attendue d’un sujet individuel pris isolément (en intégrant la variance résiduelle $\sigma^2$). Cette distinction graphique évite aux praticiens d’attribuer une portée diagnostique déterministe à une trajectoire qui comporte une marge de dispersion individuelle considérable.
9.2 Analyse visuelle avancée des résidus
La validation empirique d’un ajustement polynomial ne s’achève pas à l’inspection de la courbe de régression ; elle culmine dans l’analyse visuelle approfondie de ses résidus standardisés ou studentisés. La représentation graphique des résidus en fonction des valeurs ajustées $\hat{Y}_i$ ou des valeurs du prédicteur $X_i$ constitue le banc d’essai diagnostique ultime.
Dans un modèle polynomial correctement spécifié, les résidus doivent se distribuer de manière homogène, aléatoire et isotrope au-dessus et en-dessous de l’axe horizontal d’ordonnée zéro, sans afficher la moindre structure morphologique résiduelle. Si l’observateur perçoit une silhouette parabolique ou une ondulation en forme de vaguelette le long de l’axe horizontal, ce pattern démontre de manière infaillible un sous-ajustement (underfitting) : le degré polynomial choisi est insuffisant et une composante d’ordre supérieur réclame son inclusion dans le modèle.
Parallèlement, le graphique des résidus doit intégrer l’identification méthodique des observations aberrantes et des points à fort levier structurel. L’inspection conjointe des résidus studentisés et de la distance de Cook est impérative. Une observation qui cumule un résidu élevé et un levier fort (située aux extrémités du domaine de définition d’un polynôme de degré 3, par exemple) est susceptible d’exercer une traction disproportionnée sur la courbure globale du modèle. De tels points critiques doivent faire l’objet d’analyses de sensibilité systématiques (modèle avec versus sans les points influents) avant toute publication formelle.
9.3 Conformité avec les normes de restitution académique (APA)
La restitution académique d’une régression polynomiale au sein des revues scientifiques indexées exige le respect scrupuleux des normes de l’American Psychological Association (APA 7e édition). L’exposé des résultats doit comporter un tableau synthétique structuré hiérarchiquement présentant les modèles emboîtés successifs de façon transparente :
Pour chaque modèle d’ordre croissant (Modèle 1 : Linéaire, Modèle 2 : Quadratique, Modèle 3 : Cubique), le tableau doit préciser le coefficient de détermination global $R^2$, le coefficient ajusté $R^2_{\text{adj}}$, l’accroissement de variance expliquée $\Delta R^2$, ainsi que la statistique du test $F$ incrémental associée à ses degrés de liberté et à sa p-valeur exacte. Pour chaque paramètre polynomial individuel, il convient de renseigner le coefficient non standardisé ($B$) avec son erreur-type asymptotique ($SE$), le coefficient standardisé ($\beta$), et le test de Wald associé ($t$ et sa p-valeur).
Sur le plan narratif, l’écriture doit expliciter la nature de la courbure sans jargon réducteur. Les termes d’ordres polynomiaux doivent être formellement nommés (« effet linéaire », « composante quadratique », « composante cubique »). Il est crucial d’indiquer explicitement si les variables prédictives ont subi un centrage préliminaire sur la moyenne ou une orthogonalisation, condition indispensable pour que la communauté scientifique puisse répliquer les analyses et interpréter sans ambiguïté la valeur du coefficient linéaire $B_1$ et de l’ordonnée à l’origine $B_0$.
10. Comparaison critique avec les approches alternatives de modélisation non linéaire
10.1 Régression polynomiale contre modèles additifs généralisés (GAM)
Face à la modélisation des relations non linéaires, le chercheur contemporain dispose d’un vaste éventail d’outils statistiques au sein duquel la régression polynomiale et les Modèles Additifs Généralisés (GAM, basés sur des splines de lissage pénalisées) représentent deux paradigmes épistémologiques distincts.
La régression polynomiale relève de la modélisation paramétrique globale. Elle impose une fonction mathématique fermée et rigide qui traverse l’ensemble de l’espace d’échantillonnage : une modification de quelques points de données situés à l’extrémité droite du spectre modifie inévitablement la trajectoire estimée à l’extrémité gauche. Les GAM, quant à eux, s’appuient sur des fonctions d’interpolation locales (les splines) raccordées en des nœuds méthodiques le long du domaine de mesure. Cette modularité locale permet aux GAM de capturer des courbures asymétriques très spécifiques sans risquer les distorsions globales propres aux polynômes.
Néanmoins, cette plasticité des GAM a un coût : ils relèvent d’une approche semi-paramétrique dont la généralisabilité théorique est plus complexe à formaliser sous une équation concise. La régression polynomiale conserve une supériorité absolue en termes d’élégance analytique et de parcimonie formelle dès lors que le phénomène comportemental étudié correspond fidèlement à une fonction polynomiale connue (parabole de Yerkes-Dodson, trajectoire développementale cubique). Elle permet des dérivations directes d’optima et s’intègre trivialement dans des algorithmes de reporting standardisés.
10.2 Régression par morceaux et seuils de rupture (splines linéaires)
Une seconde alternative pragmatique est la régression par morceaux (piecewise regression ou splines linéaires), qui modélise la relation au moyen de plusieurs segments de droites reliés par des points de discontinuité ou nœuds de transition (knot points). Cette méthode est théoriquement désignée lorsque le processus cognitif ou physiologique étudié subit des changements de régimes qualitatifs brusques plutôt qu’une transition progressive et continue.
En psychopathologie expérimentale, l’impact d’une exposition traumatique peut manifester un seuil de rupture strict : en deçà d’un certain seuil d’intensité stresseur, l’organisme compense parfaitement (pente nulle) ; au-delà, les capacités de coping s’effondrent et les manifestations de détresse augmentent de façon drastique selon une pente linéaire constante. Modéliser ce type de phénomène abrupt avec une fonction polynomiale lisse et arrondie atténue la netteté du seuil et force artificiellement une courbure là où réside une cassure angulaire structurelle.
Toutefois, la régression par morceaux requiert d’identifier préalablement les localisations spatiales des seuils de rupture, soit via des hypothèses a priori étayées cliniquement, soit par des algorithmes d’optimisation (méthodes de régression segmentée de type Davies ou Muggeo). Si la transition biologique réelle est continue et progressive — ce qui est le cas général de la neuromodulation et des réponses psychophysiologiques —, la régression polynomiale s’avère infiniment plus réaliste et évite de découper artificiellement une dynamique holistique en compartiments rectilignes arbitraires.
10.3 Modèles non linéaires à base de fonctions asymptotiques
Une limite structurelle incontournable de la régression polynomiale réside dans son incapacité mathématique à plafonner vers des asymptotes horizontales stables. Les processus de psychologie sensorielle, formalisés par les lois de Weber, de Fechner et de Stevens, ainsi que les modèles d’apprentissage à long terme, aboutissent inéluctablement à un plateau de saturation absolu : la capacité d’absorption cognitive ou la sensibilité perceptive ne saurait croître indéfiniment, mais elle ne décroît pas non plus systématiquement après avoir atteint son acmé.
Lorsqu’on tente de modéliser un plateau comportemental saturant au moyen d’un polynôme de degré 2, la courbe, après avoir atteint son sommet, est structurellement obligée de redescendre symétriquement, dessinant une détérioration fictive là où se trouve en réalité un simple plafonnement continu. Pour contourner ce biais, il est impératif d’orienter le choix méthodologique vers des modèles non linéaires intrinsèques régis par des fonctions exponentielles négatives, logistiques ou de Michaelis-Menten :
$$Y = \frac{\theta_1 X}{\theta_2 + X} + \varepsilon \quad \text{ou} \quad Y = \alpha – \beta e^{-\gamma X} + \varepsilon$$
Ces formulations intègrent explicitement un paramètre d’asymptote horizontal dont la valeur numérique correspond directement à la capacité biologique maximale du sujet. Bien que l’estimation de ces équations nécessite des algorithmes itératifs non linéaires (tels que Gauss-Newton ou Levenberg-Marquardt), elles surpassent théoriquement les polynômes dès lors que l’hypothèse d’une réinversion de tendance est exclue par la théorie substantielle du phénomène.
11. Étude de cas empirique : Dynamique de la mémoire de travail sous stress temporel
11.1 Protocole expérimental et description de la base de données
Afin d’illustrer la mise en œuvre pratique intégrale de la régression polynomiale, examinons une étude empirique contrôlée portant sur l’impact de la contrainte temporelle sur l’empan mnésique complexe. L’expérience a mobilisé un échantillon probabiliste de $N = 320$ jeunes adultes sains soumis à une batterie informatisée d’épreuves de mise à jour mnésique (tâche du N-back adaptatif). La variable indépendante manipulée au cours de sessions standardisées correspond au temps imparti accordé pour valider chaque item décisionnel, échelonné expérimentalement de 200 millisecondes (situation d’urgence extrême) à 2000 millisecondes (temporalité confortable), par pas contrôlés de 200 millisecondes.
La variable dépendante retenue est le score de précision globale corrigé pour les fausses alarmes ($d’$ de la théorie de la détection du signal). Une vérification psychométrique préalable confirme l’absence d’effets plancher ou plafond massifs au sein de l’échantillon. L’hypothèse neuropsychologique posée postule une trajectoire curvilinéaire quadratique : à de très faibles allocations temporelles, le manque de temps empêche le transfert d’information vers les réseaux préfrontaux, générant une performance quasi-nulle. L’augmentation du temps disponible induit une hausse rapide et substantielle des scores, mais cette amélioration tend à décélérer au fur et à mesure que la mémoire de travail atteint ses limites intrinsèques de rétention, traduisant une dynamique en U inversé asymétrique ou une décélération continue.
11.2 Mise en œuvre pas-à-pas sous R et Python
L’opérationnalisation du protocole analytique impose un premier travail de standardisation des prédicteurs chronométriques pour juguler la multicolinéarité. Sous l’environnement statistique R, la démarche débute par l’ajustement séquentiel d’une hiérarchie de modèles emboîtés, en exploitant les contrastes orthogonaux ou le centrage des scores :
La modélisation s’articule par l’estimation conjointe du modèle linéaire simple m_lin <- lm(score ~ temps_c, data = df), du modèle quadratique m_quad <- lm(score ~ temps_c + I(temps_c^2), data = df), et du modèle cubique m_cub <- lm(score ~ temps_c + I(temps_c^2) + I(temps_c^3), data = df), où temps_c matérialise le temps de décision préalablement centré sur sa moyenne empirique ($1100\text{ ms}$). La fonction anova(m_lin, m_quad, m_cub) est sollicitée pour produire l’arbitrage par le test $F$ incrémental.
Sous l’écosystème Python (exploitant les bibliothèques numpy, scipy et statsmodels), l’ingénierie statistique consiste à déployer PolynomialFeatures(degree=2, include_bias=False) conjointement avec StandardScaler au sein d’une chaîne de traitement Pipeline. Cette architecture permet d’extraire la matrice de covariance corrigée et d’automatiser le calcul de l’erreur quadratique de test via cross_val_score à 10 plis. Les résultats convergent vers la sélection indiscutable du modèle d’ordre 2 : le gain de variance expliquée par le modèle quadratique est massif ($\Delta R^2 = 0{,}24$, $F(1, 317) = 112{,}4$, $p < 0{,}001$), tandis que l'inclusion du terme cubique ne génère aucune amélioration significative ($\Delta R^2 = 0{,}002$, $F(1, 316) = 0{,}84$, $p = 0{,}36$).
11.3 Interprétation neuropsychologique et implications pratiques
L’estimation paramétrique finale issue du modèle quadratique centré affiche des grandeurs hautement informatives :
$$\hat{\text{Score}}_i = 3{,}14 + 0{,}0032,(\text{Temps}_c) – 0{,}0000021,(\text{Temps}_c^2)$$
La pente linéaire instantanée au centre de gravité temporel ($1100\text{ ms}$) est significativement positive ($B = 0{,}0032$, $p < 0{,}001$), attestant qu'à ce niveau temporel médian, chaque milliseconde supplémentaire allouée au traitement accroît encore l'efficience mnésique. Cependant, le terme quadratique est négatif et statistiquement déterminant ($B = -0{,}0000021$, $p < 0{,}001$), validant l'hypothèse d'une concavité prononcée de la courbe de réponse.
Le calcul de l’extremum fonctionnel par dérivation identifie le seuil temporel au-delà duquel l’allocation temporelle n’apporte plus aucun gain comportemental mesurable :
$$\text{Temps}^* = \bar{X} – \frac{\hat{\beta}_1^*}{2\hat{\beta}_2^*} = 1100 – \frac{0{,}0032}{2 \times (-0{,}0000021)} = 1100 + 761{,}9 = 1861{,}9\text{ ms}$$
Ce résultat fournit un éclairage fondamental pour l’ergonomie cognitive et l’ingénierie des systèmes critiques (aéronautique, salles de surveillance médicale). Il démontre qu’allonger le délai de réponse au-delà d’environ 1860 millisecondes n’améliore nullement la robustesse des décisions opératoires : le système cognitif a pleinement saturé sa mémoire opérationnelle. Toute contrainte temporelle située en dessous de $850\text{ ms}$ précipite en revanche un effondrement exponentiel de l’exactitude mnésique, identifiant la zone temporelle à proscrire impérativement dans la conception des interfaces humain-machine sécurisées.
12. Recommandations méthodologiques et écueils à éviter
12.1 Guide décisionnel pour le chercheur en sciences humaines
Afin de prémunir les chercheurs en psychologie et en sciences comportementales contre l’arbitraire analytique, le recours à un protocole décisionnel formalisé est vivement encouragé. La première étape consiste à fonder impérativement le choix d’une spécification curvilinéaire sur un socle théorique préexistant ou sur des constats empiriques hautement convergents documentés dans la littérature spécialisée. La régression polynomiale ne doit jamais être mobilisée comme un outil de fouille de données opportuniste (p-hacking).
Le second verrou décisionnel concerne la puissance statistique et la taille effective de l’échantillon. L’estimation fiable de paramètres d’ordres supérieurs réclame une densité de données bien supérieure à celle requise par un modèle linéaire simple. Pour estimer convenablement une trajectoire quadratique ($h = 2$) avec une puissance de $1 – \beta = 0{,}80$ et une taille d’effet modérée, un échantillon minimal de $N ge 150$ observations valides est requis. Pour un polynôme cubique ($h = 3$), il est imprudent de déployer le modèle sur des cohortes inférieures à $N ge 300$, sous peine de voir les estimations de l’inflexion polluées par des artefacts d’échantillonnage locaux.
L’arbre de décision doit systématiquement intégrer l’alternative des splines ou des modèles non linéaires saturants. Si la théorie psychologique postule formellement un seuil d’épuisement terminal sans remontée, le modèle de Gompertz ou une régression logistique à paramètres continus doit prévaloir sur le polynôme. Si la trajectoire est pressentie comme continue mais hautement asymétrique, les modèles GAM régularisés doivent être priorisés pour éviter les oscillations artificielles de bordure.
12.2 Écueils interprétatifs fréquents dans la littérature
La littérature académique en sciences sociales regorge de contresens analytiques liés à l’usage non maîtrisé des termes polynomiaux. Le premier écueil réside dans la surinterprétation d’un extremum mathématique localisé en dehors des bornes réelles d’échantillonnage. Trouver un point de bascule théorique à une valeur $X^* = 145$ alors que l’échelle psychométrique administrée plafonne structurellement à un score de 100 constitue un non-sens : la fonction empirique observée sur le terrain d’étude n’est pas en « U », elle est simplement monotone et décélératrice sur l’intervalle réel.
Le second écueil, fréquent lors des analyses hâtives de sorties logicielles, consiste à omettre le centrage sur la moyenne et à conclure à tort à l’absence d’effet linéaire sous prétexte que le coefficient $\hat{\beta}_1$ présente une p-valeur supérieure au seuil canonique de $0{,}05$. Dans un modèle quadratique non centré, $\hat{\beta}_1$ quantifie exclusivement la pente instantanée lorsque $X$ vaut zéro ; si la valeur zéro est dénuée de sens psychologique ou se situe très loin du nuage de données réelles, ce test statistique est parfaitement dénué de pertinence substantive.
Enfin, il convient de rappeler fermement que la significativité statistique d’un coefficient polynomial de degré élevé n’équivaut jamais à sa pertinence théorique ou clinique. Sur des méga-bases de données de plusieurs dizaines de milliers de sujets, un terme de puissance $X^4$ peut afficher une significativité formelle ($p < 0{,}001$) tout en n'expliquant qu'une fraction infime de variance additionnelle ($\Delta R^2 = 0{,}0001$). L'analyste doit faire preuve de discernement épistémologique et refuser la tentation d'intégrer des degrés polynomiaux supplémentaires dépourvus de magnitude clinique tangible.
12.3 Intégration dans les modèles multiniveaux et longitudinaux
La frontière la plus féconde de la modélisation polynomiale réside aujourd’hui dans son hybridation avec les modèles linéaires à effets mixtes (HLM, Hierarchical Linear Models) et l’analyse de courbes de croissance latentes. Les études contemporaines en psychologie cognitive et en psychopathologie développementale collectent de manière croissante des données longitudinales intensives (méthodologie de l’évaluation écologique momentanée, ou EMA), où chaque individu est évalué à de multiples reprises le long de son quotidien.
Dans ce contexte hiérarchique où les mesures répétées de niveau 1 sont imbriquées au sein des individus de niveau 2, la régression polynomiale multiniveau permet de décomposer l’architecture de la trajectoire en composantes fixes (la courbure moyenne partagée par l’ensemble de la cohorte) et en composantes aléatoires (les variations idiosyncrasiques de chaque individu autour de cette courbure). L’équation structurelle pour le temps d’observation $t$ du sujet $i$ prend la forme suivante :
$$Y_{ti} = \beta_{0i} + \beta_{1i} (\text{Temps}_{ti} – \bar{T}) + \beta_{2i} (\text{Temps}_{ti} – \bar{T})^2 + \varepsilon_{ti}$$
avec :
$$\beta_{0i} = \gamma_{00} + u_{0i}, \quad \beta_{1i} = \gamma_{10} + u_{1i}, \quad \beta_{2i} = \gamma_{20} + u_{2i}$$
Cette spécification permet de modéliser le fait que certains patients dépressifs manifestent une rémission quadratique rapide et durable suite à une psychothérapie ($u_{2i} 0$). L’association de ces paramètres polynomiaux aléatoires à des covariables de niveau individuel (traits de personnalité, biomarqueurs génétiques) ouvre des perspectives méthodologiques considérables pour une médecine comportementale et une psychologie de précision rigoureusement adossées aux lois de la modélisation non linéaire.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage Publications.
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989X.7.1.19
- Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). Sage Publications.
- Singer, J. D., & Willett, J. B. (2003). Applied longitudinal data analysis: Modeling change and event occurrence. Oxford University Press. https://doi.org/10.1093/acprof:oso/9780195152968.001.0001
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
- Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503