
Dans le domaine de l’économétrie, de la psychométrie et des sciences quantitatives appliquées, la modélisation statistique repose sur une quête perpétuelle d’équilibre entre la simplification parcimonieuse du réel et la fidélité empirique aux observations recueillies. L’ajustement d’un modèle de régression linéaire par la méthode des moindres carrés ordinaires suppose implicitement que chaque individu statistique participe de manière démocratique et homogène à l’estimation des paramètres structuraux. Or, dans les jeux de données complexes et écologiques, cette hypothèse d’homogénéité est régulièrement violée par la présence d’observations singulières. Certaines unités d’échantillonnage exercent une attraction démesurée sur les estimateurs, infléchissant les pentes de régression, modifiant artificiellement les ordonnées à l’origine et faussant la structure résiduelle globale au point de menacer la reproductibilité des inférences scientifiques.
Face à ce défi méthodologique majeur, les statisticiens ont longtemps été contraints d’examiner séparément les résidus univariés d’une part, et l’excentricité spatiale des prédicteurs d’autre part. Cette approche fragmentée laissait planer un angle mort analytique critique : un individu peut présenter un résidu d’apparence modeste précisément parce qu’il a tiré le plan de régression vers lui, dissimulant ainsi sa propre nocivité dans le calcul résiduel conventionnel. L’avènement des techniques de diagnostic moderne, initié dans le dernier tiers du XXe siècle, a permis de formaliser l’impact global qu’exerce une observation unique sur l’ensemble de la surface de prédiction. Au cœur de cette révolution conceptuelle se trouve la distance de Cook, un indicateur d’influence globale devenu l’étalon-or du diagnostic de régression.
Comprendre, quantifier et interpréter la distance de Cook ne relève pas d’un simple raffinement technique destiné aux puristes de l’algèbre matricielle ; il s’agit d’une exigence épistémologique fondamentale pour tout chercheur ou praticien soucieux de la robustesse de ses conclusions. Le présent traité propose une déconstruction exhaustive de cette métrique fondamentale : depuis ses racines conceptuelles d’omission unitaire jusqu’aux équations de projection matricielle, en passant par ses applications concrètes sous les environnements R, Python, SPSS et SAS, ses implications psychométriques et son intégration dans les protocoles de publication conformes aux exigences de l’American Psychological Association (APA).
1. Introduction aux points influents dans les modèles de régression linéaire
1.1 Le postulat de stabilité des moindres carrés ordinaires
La régression linéaire par la méthode des moindres carrés ordinaires (MCO) constitue le socle historique et opérationnel de l’analyse multivariée contemporaine. Son élégance repose sur la minimisation de la somme du carré des résidus, une propriété mathématique conférant aux estimateurs de Gauss-Markov le statut de meilleurs estimateurs linéaires non biaisés (BLUE) sous réserve du respect rigoureux des postulats classiques. Néanmoins, cette optimisation quadratique porte en elle le germe d’une vulnérabilité structurelle extrême : en élevant au carré les écarts entre les valeurs observées et les valeurs ajustées, la fonction de perte pénalise de manière exponentielle les déviations importantes. Par conséquent, une observation éloignée du barycentre de la distribution se voit octroyer un poids disproportionné dans le système d’équations normales, ce qui fragilise mécaniquement l’ensemble des inférences tirées de l’échantillon.
Cette sensibilité structurelle compromet directement la validité interne des modèles explicatifs. Lorsque quelques individus statistiques exercent une attraction asymétrique sur l’hyperplan de régression, les estimateurs ponctuels des coefficients angulaires cessent de refléter la tendance centrale de la population sous-jacente pour devenir les témoins captifs de particularismes d’échantillonnage. Les conséquences sur l’inférence sont délétères : les erreurs types des estimateurs peuvent être artificiellement dilatées ou compressées, les statistiques de test associées (tests t de Student et tests F de Fisher) perdent leur étalonnage nominal, et les intervalles de confiance construits sur ces fondations deviennent fallacieux. L’instabilité de la variance résiduelle induite par ces distorsions rend le modèle hautement erratique face à toute tentative de réplication indépendante.
Les enjeux soulevés par cette fragilité intrinsèque des MCO deviennent particulièrement aigus dans les sciences du comportement humain, la psychométrie, la médecine translationnelle et la sociologie quantitative. Dans ces disciplines, les données empiriques proviennent de systèmes dynamiques complexes caractérisés par une variabilité interindividuelle considérable, des distributions fréquemment asymétriques et des erreurs de mesure non négligeables. La modélisation de construits psychologiques latents — tels que les scores de détresse psychologique, les temps de réaction informatisés ou les quotients de développement cognitif — génère inévitablement des configurations où des observations atypiques émergent sans que l’on puisse immédiatement discerner s’il s’agit d’artéfacts méthodologiques ou de véritables expressions de la diversité phénotypique humaine. Ignorer l’impact structurel de ces données sur les estimations paramétriques équivaut à bâtir un échafaudage interprétatif sur des sables mouvants.
1.2 Définition et typologie des observations problématiques
La rigueur méthodologique exige une clarification terminologique stricte, car le langage statistique courant tend à agréger sous le vocable générique de « valeurs aberrantes » des réalités géométriques et probabilistes profondément distinctes. Pour naviguer efficacement dans le diagnostic de régression, il convient d’opérer une partition analytique rigoureuse entre trois concepts fondamentaux : la valeur aberrante (outlier), le point de levier (high-leverage point) et l’observation influente (influential observation). Ces entités mathématiques n’occupent pas le même espace dans le modèle linéaire et ne génèrent pas les mêmes altérations sur l’estimation des paramètres.
Une valeur aberrante désigne spécifiquement une observation présentant un résidu important, c’est-à-dire un écart substantiel entre sa valeur observée pour la variable dépendante et la valeur prédite par le modèle conditionnellement à ses prédicteurs. L’anomalie se situe ici principalement dans l’espace de la réponse (l’axe Y dans une régression simple). À l’inverse, un point de levier correspond à une observation dont les coordonnées dans l’espace multidimensionnel des variables explicatives (l’espace X) se situent à une distance considérable du centroïde formé par la moyenne des régresseurs. Le levier est une mesure d’isolement factoriel strictement indépendante de la variable dépendante Y ; il traduit une opportunité structurelle de peser sur le modèle, mais ne préjuge pas de l’actualisation de ce potentiel perturbateur.
L’observation influente, quant à elle, représente l’intersection critique de ces dimensions géométriques : il s’agit d’un point dont la présence modifie substantiellement les résultats fondamentaux de la régression, notamment les coefficients estimés, leurs erreurs types ou la variance expliquée globale. Le mécanisme de traction exercé par un point combinant un fort levier et un résidu discordant s’apparente à l’action d’un levier physique : plus une masse s’éloigne du pivot (levier fort), plus la force requise pour faire basculer le plan de régression est minime. Sur le plan décisionnel, ces observations génèrent deux écueils symétriques majeurs : le risque de fausse découverte statistique (erreur de type I), où un coefficient devient artificiellement significatif sous la seule impulsion d’un sujet isolé, et le risque d’omission d’un effet réel (erreur de type II), où une véritable relation de causalité est masquée par un point discordant venant aplatir la pente de la trajectoire.
1.3 Origine historique et rôle fondamental de la métrique de R. Dennis Cook
Jusqu’au milieu des années 1970, le diagnostic des modèles de régression linéaire demeurait prisonnier d’une approche réductrice, essentiellement cantonnée à l’inspection visuelle univariée des résidus ordinaires ou standardisés. Les analystes cherchaient les observations présentant les écarts les plus spectaculaires par rapport au modèle, sans disposer d’outils analytiques permettant de quantifier l’effet rétroactif d’une observation sur la géométrie même de l’ajustement. Cette limitation conceptuelle laissait les praticiens démunis face au phénomène d’écrasement ou d’absorption : un point doté d’un levier extrême possède une telle capacité d’attraction sur l’hyperplan des moindres carrés qu’il force le modèle à passer à proximité immédiate de ses propres coordonnées, réduisant ainsi son résidu apparent à une valeur trompeusement anodine.
La rupture épistémologique intervient en 1977, lorsque le statisticien américain R. Dennis Cook publie dans la revue de référence Technometrics son article séminal intitulé « Detection of Influential Observation in Linear Regression ». Cook y propose une formulation mathématique révolutionnaire permettant de dépasser l’analyse univariée des résidus pour embrasser une perspective matricielle globale. Son intuition fondamentale consiste à évaluer l’impact d’une observation non pas sur son propre résidu, mais sur le comportement conjoint de l’ensemble du système de prédiction. Il s’agit de répondre à une interrogation limpide : dans quelle mesure le vecteur des valeurs ajustées pour l’ensemble des n participants de l’échantillon changerait-il si l’on supprimait totalement la i-ème observation du processus d’estimation ?
L’introduction de la métrique de Cook a constitué un saut qualitatif majeur pour les statistiques appliquées. En combinant au sein d’une expression synthétique et élégante la mesure de l’erreur prédictive et la distance géométrique dans l’espace factoriel, Cook a fourni aux chercheurs un instrument standardisé capable de résumer en un scalaire unique la perturbation globale infligée au modèle. Cette avancée a ouvert la voie à une approche diagnostique proactive, systématique et intégrée, transformant la détection des anomalies empiriques d’un art artisanal subjectif en une véritable discipline d’assurance qualité des inférences quantitatives.
2. Fondements théoriques et conceptuels de la distance de Cook
2.1 Le principe du rééchantillonnage par omission unitaire (Jackknife)
La mécanique conceptuelle de la distance de Cook s’enracine directement dans la logique non paramétrique du rééchantillonnage par omission unitaire, universellement désignée sous l’appellation anglophone de méthode leave-one-out ou approche Jackknife, popularisée par Maurice Quenouille et John Tukey. L’architecture intellectuelle de cette démarche repose sur une expérience de pensée computationnelle rigoureuse : si l’on suspecte qu’une unité d’observation perturbe l’intégrité du modèle global, la méthode la plus objective pour mesurer son influence réelle consiste à réajuster le modèle en son absence délibérée et à documenter les variations paramétriques consécutives.
Considérons un échantillon composé de n observations et modélisé par une équation de régression multivariée comportant p paramètres à estimer (incluant l’ordonnée à l’origine). Soit $\hat{\beta}$ le vecteur complet des coefficients estimés par les moindres carrés sur la totalité des données disponibles. Définissons ensuite $\hat{\beta}_{(-i)}$ comme le vecteur des coefficients obtenu lorsque le même modèle linéaire est réestimé sur le sous-ensemble tronqué comprenant $n – 1$ observations, la i-ème observation ayant été intégralement retirée de la matrice des données. La différence vectorielle $\hat{\beta} – \hat{\beta}_{(-i)}$ traduit le déplacement immédiat qu’imprime l’individu i à l’ensemble des coefficients angulaires du système.
Toutefois, une simple différence vectorielle brute serait inexploitable en pratique, car chaque coefficient de régression possède ses propres unités de mesure et ses propres échelles de variance. Pour agréger cette divergence multidimensionnelle en une quantité scalaire rigoureusement interprétable, Cook a appliqué les principes de la distance statistique de Mahalanobis. Cette métrique pondère le vecteur des différences $\hat{\beta} – \hat{\beta}_{(-i)}$ par la matrice de variance-covariance des estimateurs du modèle complet. Ce faisant, le déplacement de chaque coefficient est standardisé et mis en perspective avec les corrélations structurelles existant entre l’ensemble des régresseurs du modèle.
2.2 Mesure globale du déplacement des valeurs ajustées
Bien que la formulation basée sur le déplacement des paramètres $\hat{\beta}$ soit fondamentale, la distance de Cook possède une équivalence géométrique duale particulièrement intuitive : elle quantifie la somme normalisée des écarts quadratiques induits sur les valeurs prédites de l’ensemble de l’échantillon. En d’autres termes, la métrique de Cook ne se contente pas de scruter l’impact sur l’individu retiré ; elle évalue dans quelle mesure les prédictions calculées pour tous les autres individus (du premier au n-ième) oscillent suite à l’extraction de l’observation i.
Mathématiquement, soit $\hat{y}_j$ la valeur ajustée pour la j-ème observation sous le modèle complet, et $\hat{y}_{j(-i)}$ la valeur ajustée pour cette même observation lorsque le modèle a été calibré sans l’individu i. La distance de Cook synthétise la somme sur tous les $j in {1, dots, n}$ des carrés de ces variations d’ajustement, pondérée par le nombre de régresseurs et la variance de l’erreur résiduelle. Cette perspective collective est déterminante : elle préserve le chercheur de la myopie consistant à évaluer l’influence d’un point uniquement à l’aune de sa propre précision prédictive. Un individu peut parfaitement modifier les prédictions de dizaines d’autres sujets sans que sa propre prédiction ne semble aberrante.
Une propriété mathématique cruciale de cette formulation réside dans son invariance d’échelle face aux transformations linéaires des variables explicatives. Si l’analyste décide de convertir une variable prédictive exprimée en centimètres en mètres, ou de soustraire une constante pour centrer un score psychométrique, la distance de Cook calculée pour chaque observation demeure strictement identique. Cette robustesse géométrique confère à la métrique de Cook une universalité indispensable pour les comparaisons inter-échantillons et inter-modèles.
2.3 Place de la distance de Cook dans le diagnostic de régression
L’évaluation de la validité d’un modèle linéaire requiert une chaîne séquentielle de vérifications méthodologiques. La distance de Cook n’intervient pas de manière isolée ; elle s’inscrit au cœur d’un processus diagnostique holistique, assurant l’articulation entre la phase exploratoire de détection des données aberrantes et la phase confirmatoire de validation des hypothèses de recherche. Dans le protocole classique de validation des MCO, le chercheur s’attache à vérifier la normalité des résidus, l’homoscédasticité de la variance d’erreur, la linéarité des relations fonctionnelles et l’absence de multicolinéarité sévère.
Cependant, tous ces diagnostics traditionnels sont eux-mêmes excessivement sensibles à la présence de données influentes. Par exemple, une hétéroscédasticité apparente peut être intégralement générée par deux ou trois observations excentrées situées aux extrémités de la distribution des prédicteurs, alors que le processus générateur sous-jacent est parfaitement homoscédastique. De même, un test de normalité des résidus de Shapiro-Wilk peut rejeter l’hypothèse nulle d’orthogonalité distributionnelle à cause d’une unique observation hautement distante, masquant le fait que 99 % des données se conforment idéalement à la courbe de Gauss. L’analyse de la distance de Cook apporte ainsi une clé de déchiffrement essentielle pour discerner les pathologies globales du modèle des artefacts locaux.
Le statut épistémologique unique de la distance de Cook procède de sa nature synthétique. Tandis que l’examen des résidus studentisés informe sur la plausibilité conditionnelle de la réponse et que l’analyse des valeurs de levier documente l’atypisme structurel des régresseurs, la métrique de Cook fusionne ces deux dimensions orthogonales au sein d’une équation unifiée. Elle agit comme un filtre de sécurité statistique garantissant que les conclusions théoriques formulées par l’investigateur reflètent une réalité partagée par la collectivité des données plutôt que la singularité anecdotique d’un sous-ensemble infinitésimal d’individus.
3. Décomposition mathématique et formulation analytique
3.1 Anatomie de la formule standard de la distance de Cook
Bien que la définition initiale de la distance de Cook repose sur l’estimation récursive de $n + 1$ modèles de régression (le modèle complet et les $n$ modèles tronqués par omission unitaire), Dennis Cook a démontré une remarquable propriété computationnelle : il est possible d’extraire exactement la distance de Cook pour l’ensemble des observations à partir des seules sorties algébriques du modèle complet, sans réajustement séquentiel itératif. Cette élégance algorithmique s’exprime dans la formule opérationnelle standard de la distance de Cook pour la i-ème observation :
$$D_i = \frac{e_i^2}{p \cdot \text{MSE}} \cdot \frac{h_{ii}}{(1 – h_{ii})^2}$$
Dans cette formulation canonique, chaque composant analytique joue un rôle structurel rigoureusement articulé :
- $e_i$ représente le résidu ordinaire brut de la i-ème observation, défini par la différence algébrique simple entre la valeur observée et la valeur ajustée ($y_i – \hat{y}_i$). Lorsqu’il est combiné avec le terme résiduel, il permet de construire le résidu standardisé ou studentisé interne.
- $p$ désigne le nombre total de paramètres estimés par le modèle de régression, ce qui inclut systématiquement la constante (l’ordonnée à l’origine $\beta_0$) et l’ensemble des $k$ coefficients de pente associés aux prédicteurs ($p = k + 1$).
- $\text{MSE}$ (Mean Squared Error, ou carré moyen des résidus $s^2$) correspond à l’estimateur non biaisé de la variance de l’erreur conditionnelle, calculé par le ratio de la somme des carrés résiduels divisée par les degrés de liberté résiduels ($n – p$).
- $h_{ii}$ constitue la valeur de levier (leverage) propre à la i-ème observation, issue du i-ème élément diagonal de la matrice de projection orthogonale $H$, communément appelée « matrice chapeau » (hat matrix).
En introduisant le résidu standardisé interne $r_i = e_i / (\sqrt{\text{MSE}} \cdot \sqrt{1 – h_{ii}})$, la formulation analytique peut être condensée sous une expression encore plus transparente quant à ses mécanismes sous-jacents :
$$D_i = \frac{r_i^2}{p} \cdot \frac{h_{ii}}{1 – h_{ii}}$$
Cette forme alternative met immédiatement en lumière le fait que la distance de Cook est proportionnelle au carré du résidu standardisé $r_i^2$ pondéré par un facteur non linéaire croissant du levier, $h_{ii} / (1 – h_{ii})$.
3.2 Interaction multiplicative entre levier et résidu
L’aspect le plus fascinant et le plus déterminant de la distance de Cook réside dans sa structure multiplicative. L’influence d’un point n’est en aucun cas une fonction additive de son atypisme résiduel et de son excentricité factorielle ; elle résulte d’une stricte conjonction géométrique. Pour qu’une observation génère une valeur de $D_i$ substantielle, elle doit simultanément posséder un résidu important et un levier substantiel. Cette réalité algébrique induit plusieurs comportements asymptotiques remarquables qu’il convient de décomposer minutieusement.
Examinons en premier lieu le cas d’une observation caractérisée par un fort levier ($h_{ii}$ très élevé), mais dont la variable dépendante se situe exactement sur la trajectoire prédite par les autres données (résidu $e_i \approx 0$). Dans ce scénario, malgré son isolement extrême dans l’espace multidimensionnel des prédicteurs, le produit s’annule en raison de la quasi-nullité de $r_i^2$. Cette observation confirme la tendance générale définie par le reste de la cohorte ; elle contribue même à stabiliser l’estimation des pentes en réduisant leurs erreurs types. Ce point n’est nullement influent au sens déstabilisateur du terme ; il s’agit d’une observation d’ancrage conforme.
Considérons à l’opposé le cas d’un individu présentant un résidu colossal ($r_i^2$ très grand), mais situé au barycentre parfait des variables explicatives (levier minimal, $h_{ii} \approx 1/n$). Dans cette configuration, le ratio $h_{ii} / (1 – h_{ii})$ adopte une valeur infinitésimale. Même si le résidu est spectaculaire sur l’axe vertical, l’absence de bras de levier empêche ce point d’infléchir les pentes de régression. Son influence sera presque exclusivement limitée à une translation verticale de l’ordonnée à l’origine et à un gonflement de l’erreur quadratique moyenne, sans distorsion majeure de la dynamique vectorielle des coefficients explicatifs.
Ce n’est que lorsque ces deux pathologies se conjuguent — un point situé loin du centre de gravité des prédicteurs qui, de surcroît, refuse de se conformer à la relation linéaire sous-jacente — que l’effet multiplicateur explose. Le dénominateur $(1 – h_{ii})$ convergeant vers zéro à mesure que le levier approche de l’unité, la distance de Cook croît de façon hyperbolique, traduisant le basculement destructeur de l’hyperplan de régression sous l’effet de ce point pivot aberrant.
3.3 Formulation alternative matricielle
Pour appréhender la portée statistique formelle de la métrique, il est nécessaire de s’élever au niveau de sa représentation matricielle originelle. Soit $X$ la matrice des régresseurs de dimension $n \times p$ et $Y$ le vecteur des observations de dimension $n \times 1$. L’estimateur classique des moindres carrés ordinaires s’exprime par la résolution algébrique $\hat{\beta} = (X’X)^{-1}X’Y$. En appliquant le principe d’omission unitaire, la distance de Cook se formalise par la forme quadratique suivante :
$$D_i = \frac{(\hat{\beta} – \hat{\beta}_{(-i)})’ (X’X) (\hat{\beta} – \hat{\beta}_{(-i)})}{p \cdot s^2}$$
Cette expression révèle la profondeur de la construction mathématique élaborée par Dennis Cook. La matrice $X’X$ n’est autre que la métrique riemannienne naturelle de l’espace des paramètres, directement proportionnelle à l’inverse de la matrice de variance-covariance asymptotique des estimateurs MCO, puisque $\text{Var}(\hat{\beta}) = \sigma^2 (X’X)^{-1}$. Par conséquent, le numérateur de la distance de Cook mesure très exactement la distance statistique (ou distance de Mahalanobis) entre le vecteur des paramètres du modèle complet $\hat{\beta}$ et celui du modèle tronqué $\hat{\beta}_{(-i)}$, évaluée au regard de la géométrie de dispersion globale de l’échantillon.
Sous les hypothèses classiques de normalité des perturbations stochastiques ($\varepsilon \sim \mathcal{N}(0, \sigma^2 I)$), une telle forme quadratique divisée par $p \cdot s^2$ présente une analogie formelle directe avec la construction d’une région de confiance ellipsoïdale conjointe pour les paramètres de régression. Bien que la quantité $D_i$ ne suive pas rigoureusement une loi de Fisher au sens distributionnel strict en raison de la dépendance stochastique induite par le processus de sélection séquentielle, Dennis Cook a démontré que la valeur numérique de $D_i$ peut être directement comparée aux fractiles critiques de la distribution théorique de Fisher-Snedecor $F(p, n – p)$. Cette équivalence confère à la métrique une assise probabiliste robuste, reliant l’amplitude du déplacement paramétrique à un niveau de confiance géométrique dans l’espace de Wald.
4. Distinction systématique entre résidus, levier et influence
4.1 Les résidus et leurs formes normalisées
L’une des erreurs méthodologiques les plus pernicieuses en statistique appliquée consiste à fonder l’identification des points atypiques exclusivement sur l’inspection visuelle des résidus bruts $e_i = y_i – \hat{y}_i$. Cette pratique comporte un piège mathématique fondamental : les résidus bruts ne possèdent pas la même variance sur l’ensemble de l’échantillon. En effet, la variance théorique du i-ème résidu brut est gouvernée par la relation $\text{Var}(e_i) = \sigma^2 (1 – h_{ii})$. Il s’ensuit qu’une observation située aux confins de l’espace des prédicteurs (affichant un levier $h_{ii}$ très élevé) aura mécaniquement un résidu brut d’une variance très faible, tendant vers zéro lorsque le levier tend vers l’unité.
Pour remédier à cette hétérogénéité intrinsèque, la théorie statistique a introduit deux niveaux successifs de standardisation. Le premier niveau est le résidu standardisé (ou résidu studentisé interne), défini par :
$$r_i = \frac{e_i}{\sqrt{\text{MSE} \cdot (1 – h_{ii})}}$$
Ce ratio corrige la variance locale en divisant l’erreur observée par son écart-type théorique estimé sur l’ensemble de l’échantillon. Toutefois, cette normalisation conserve une faiblesse : si le point $i$ est exceptionnellement aberrant, il tire vers le haut la valeur globale de la variance résiduelle $\text{MSE}$, réduisant artificiellement son propre score standardisé au dénominateur.
Pour contourner ce biais d’auto-atténuation, les statisticiens ont formalisé le résidu studentisé supprimé (ou résidu studentisé externe, résidu jackknife), désigné par $t_i$ :
$$t_i = \frac{e_i}{\sqrt{\text{MSE}_{(-i)} \cdot (1 – h_{ii})}}$$
Dans cette formulation, $\text{MSE}_{(-i)}$ représente le carré moyen des erreurs résiduelles recalculé en omettant délibérément la i-ème observation. Si le point $i$ est aberrant, son exclusion entraîne une chute spectaculaire de $\text{MSE}_{(-i)}$, ce qui propulse la valeur de $t_i$ vers des sommets hautement détectables. Cependant, même sous sa forme studentisée externe la plus aboutie, le résidu ne documente que la dimension verticale de l’écart prédictif sans intégrer la capacité de déstabilisation géométrique du point dans l’espace multidimensionnel.
4.2 Le levier (leverage) et l’espace des variables prédictives
Le levier (leverage) matérialise l’éloignement d’une observation par rapport au cœur de la distribution conjointe des prédicteurs. Sur le plan matriciel, il s’extrait des éléments diagonaux de la matrice de projection $H = X(X’X)^{-1}X’$. Cette matrice porte le nom suggestif de « matrice chapeau » car elle transforme le vecteur des valeurs observées $Y$ en vecteur des valeurs ajustées $\hat{Y}$, agissant selon la relation vectorielle $\hat{Y} = HY$. L’élément diagonal $h_{ii}$ quantifie donc la dérivée partielle de la prédiction $\hat{y}_i$ par rapport à l’observation $y_i$ ($\partial \hat{y}_i / \partial y_i = h_{ii}$).
Les propriétés mathématiques de cet indicateur sont particulièrement bien délimitées dans la littérature statistique :
- Chaque élément diagonal est strictement borné : pour un modèle avec constante, on a la contrainte analytique $1/n le h_{ii} le 1$.
- La trace de la matrice chapeau (la somme des éléments diagonaux) est égale au nombre de paramètres du modèle : $\sum_{i=1}^n h_{ii} = \text{tr}(H) = p$.
- Par conséquent, la valeur moyenne théorique du levier au sein de tout échantillon est exactement égale à $\bar{h} = p/n$.
Sur la base de ces propriétés, les critères diagnostiques conventionnels établissent des seuils d’alerte objectifs. Une observation est formellement qualifiée de point de fort levier lorsque sa valeur dépasse le double de la moyenne empirique, soit $h_{ii} > 2p/n$. Dans le cadre de protocoles d’investigation plus conservateurs ou appliqués à de très grands échantillons, un seuil plus strict de $h_{ii} > 3p/n$ est régulièrement adopté. Un levier élevé isole des profils multivariés extrêmement atypiques dans la matrice des variables indépendantes — par exemple, un sujet combinant un niveau d’anxiété clinique extrême avec un âge exceptionnellement bas et un statut socio-économique particulièrement élevé.
4.3 L’influence comme produit de l’erreur et de l’excentricité
L’assimilation conceptuelle entre levier, résidu et influence peut être clarifiée par une cartographie orthogonale bidimensionnelle articulant l’axe vertical de l’écart prédictif (résidus studentisés) et l’axe horizontal de l’isolement factoriel (valeurs de levier). Cette décomposition structure l’espace diagnostic en quatre quadrants fonctionnels bien distincts :
Le premier quadrant regroupe les observations à faible levier et faible résidu. Il constitue la matrice centrale des données bien ajustées, représentatives du phénomène étudié et conformes aux postulats du modèle. Le deuxième quadrant concerne les points à faible levier mais fort résidu. Il s’agit des valeurs aberrantes conventionnelles : ces sujets dévient notablement de la prédiction mais, étant situés à proximité du centre de gravité des variables explicatives, ils n’ont pas le pouvoir de faire basculer le plan d’ajustement. Ils dégradent la précision globale en augmentant la variance de l’erreur sans altérer fondamentalement l’orientation des pentes.
Le troisième quadrant contient les observations à fort levier et faible résidu. Ces cas, bien qu’isolés dans l’espace des covariables, tombent précisément sur la trajectoire tracée par le reste de la population. Ils n’induisent aucun biais d’estimation sur les coefficients et renforcent au contraire la robustesse mathématique des pentes de régression en apportant des ancrages distants cohérents. Enfin, le quatrième quadrant rassemble les observations combinant un fort levier et un fort résidu : ce sont les observations influentes au sens strict. Ce sont précisément ces points qui génèrent des valeurs massives de distance de Cook et qui menacent de subvertir les conclusions scientifiques d’une recherche quantitative.
5. Seuils critiques et critères de décision statistique
5.1 Le critère historique basé sur la distribution F de Fisher
Dans sa publication originale de 1977, R. Dennis Cook a ancré son critère de décision statistique dans la théorie des ellipsoïdes de confiance conjointe. Il a suggéré que l’ampleur de la perturbation induite par une observation $i$ devait être mise en perspective avec la distribution de référence de Fisher-Snedecor comportant $p$ et $n – p$ degrés de liberté, notée $F(p, n – p)$. Selon la proposition initiale de Cook, un point d’échantillonnage doit être qualifié d’excessivement influent si sa distance $D_i$ dépasse le cinquantième centile (la médiane) de la distribution $F$, c’est-à-dire :
$$D_i > F_{0.50}(p, n – p)$$
L’interprétation théorique de ce seuil historique est fascinante : si la suppression de la i-ème observation déplace le vecteur des paramètres estimés $\hat{\beta}_{(-i)}$ au-delà de la frontière de l’ellipsoïde de confiance à 50 % centré sur $\hat{\beta}$, cela signifie que cette observation unique à elle seule déplace l’estimation globale des coefficients vers une région que le reste de l’échantillon ne considère comme vraisemblable qu’avec une probabilité inférieure à une chance sur deux.
Bien que séduisant sur le plan formel, ce critère de Fisher s’est avéré excessivement permissif dans la pratique empirique moderne. La médiane d’une distribution $F(p, n – p)$ fluctue généralement autour de valeurs oscillant entre 0,7 et 1,1 pour des configurations d’échantillons courantes. Dans les études contemporaines mobilisant des centaines ou des milliers de participants, une observation peut exercer une traction dévastatrice sur un sous-ensemble critique de variables sans jamais atteindre une telle valeur seuil. L’exigence consistant à attendre qu’un point franchisse le 50e centile de Fisher avant d’intervenir a été jugée trop laxiste par la communauté méthodologique, incitant les statisticiens à élaborer des seuils plus sensibles et plus adaptés aux impératifs de détection précoce.
5.2 Le seuil empirique universel D_i supérieur à 1
En réponse à la complexité d’évaluation du seuil de Fisher dans les routines de calcul manuel de l’époque, une règle pragmatique universelle s’est progressivement cristallisée dans la littérature sous l’impulsion de manuels de référence en économétrie et en biométrie. Cette règle stipule qu’une observation doit être systématiquement auditée et considérée comme potentiellement destructrice dès lors que sa distance de Cook franchit le seuil unitaire absolu :
$$D_i > 1$$
Ce seuil de coupure unitaire s’appuie sur une simplification élégante de la distribution de Fisher : pour un nombre modéré de paramètres et un échantillon de taille moyenne, $F_{0.50}(p, n – p) \approx 1$. Fixer la frontière critique à l’unité offre aux analystes un repère mnémotechnique direct, universellement partagé et aisément communicable. Dans les sciences appliquées, une valeur de $D_i > 1$ est considérée comme un signal d’alarme indiscutable indiquant qu’une observation unique modifie substantiellement le modèle à elle seule.
Cependant, l’application aveugle du seuil universel $D_i > 1$ expose l’analyste à des angles morts méthodologiques majeurs. Dans les échantillons de taille modeste (par exemple $n = 30$), un point générant un $D_i = 0,85$ peut induire un renversement complet du signe d’une corrélation sans franchir la barre fatidique de 1. Inversement, dans les méga-échantillons (tels que ceux issus des registres de santé publique ou des données massives de consommation), le phénomène de dilution fait qu’aucun individu ne parvient jamais à atteindre $D_i = 1$, quand bien même certains profils atypiques exerceraient une traction locale anormale. Le seuil unitaire manque d’élasticité face à la taille de l’échantillon.
5.3 Le seuil dépendant de la taille de l’échantillon : 4 / n ou 4 / (n – p – 1)
Pour conférer au diagnostic une sensibilité proportionnelle à l’inertie de l’échantillon analysé, les statisticiens ont développé des heuristiques relatives fonction de l’effectif total $n$. L’heuristique la plus largement adoptée dans la recherche quantitative contemporaine fixe la frontière critique à :
$$D_i > \frac{4}{n}$$
Le fondement mathématique de cette règle relative découle directement de la formulation condensée de la distance de Cook. Sachant que la valeur attendue moyenne de la distance de Cook dans un modèle correctement spécifié est approximativement de l’ordre de $1/n$ ou de $1/(n – p)$, tout individu dont la métrique excède quatre fois cette valeur moyenne présente une déviation statistique notable justifiant une investigation approfondie. Cette formule présente l’immense avantage d’ajuster automatiquement son niveau d’exigence à la taille de la cohorte : plus l’échantillon est volumineux, plus le seuil devient fin et sensible.
Pour les régressions multivariées complexes impliquant un nombre élevé de covariables par rapport au nombre d’observations, une formulation alternative encore plus conservative et rigoureuse est régulièrement préconisée dans la littérature méthodologique spécialisée :
$$D_i > \frac{4}{n – k – 1} \quad \text{ou} \quad D_i > \frac{4}{n – p}$$
Cette spécification tient explicitement compte de la réduction des degrés de liberté consécutive à l’introduction d’un grand nombre de prédicteurs. Néanmoins, l’analyste doit garder à l’esprit que l’abaissement mécanique du seuil critique dans les très grands jeux de données (par exemple, pour $n = 10,000$, le seuil $4/n$ équivaut à 0,0004) multiplie considérablement le taux de faux positifs. Dans ces contextes, un grand nombre de sujets franchissent la limite statistique sans pour autant menacer la stabilité pratique des coefficients.
5.4 Synthèse et choix contextuel du critère analytique
Le choix d’un seuil critique ne saurait relever d’un automatisme algorithmique déconnecté de l’objectif épistémologique de l’étude. Le chercheur doit calibrer sa sévérité diagnostique selon une matrice contextuelle articulant la finalité de la recherche, la taille de l’échantillon et le coût d’une erreur d’inférence. Le tableau conceptuel suivant synthétise les critères de décision analytique selon la configuration de la recherche :
| Contexte de recherche | Taille de l’échantillon | Seuil recommandé | Implication méthodologique principale |
|---|---|---|---|
| Études exploratoires / pilotes | Petite ($n < 50$) | $D_i > 4/n$ ou $D_i > 4/(n-p)$ | Haute sensibilité : identifier tout individu capable de déstabiliser un échantillon fragile. |
| Vérification d’hypothèses / confirmatoire | Moyenne ($50 le n le 500$) | $D_i > 4/n$ couplé à $D_i > 0,5$ | Équilibre : isoler les cas suspects sans pénaliser la variance naturelle de l’échantillon. |
| Recherches épidémiologiques / Big Data | Grande ($n > 500$) | Inspection des percentiles extrêmes (top 0,1 %) ou $D_i > 1$ | Éviter l’hyper-détection artificielle de faux positifs induite par le seuil $4/n$. |
| Validation clinique standard | Toute taille | $D_i > 1$ | Seuil absolu d’urgence : intervention impérative pour préserver la validité de l’inférence. |
Il est impératif, pour prévenir tout biais de sélection ou risque de p-hacking masqué, que le choix de ce seuil critique soit rigoureusement spécifié et justifié a priori dans le plan d’analyse de la recherche, avant toute inspection interactive des données empiriques.
6. Méthodes de visualisation et diagnostic graphique
6.1 Le graphique séquentiel des distances de Cook (Index Plot)
L’exploration visuelle constitue le complément indispensable de l’analyse computationnelle des points influents. La première modalité de représentation graphique, et la plus classique, est le tracé séquentiel des distances de Cook, universellement désigné sous le terme d’Index Plot. Ce graphique dispose sur son axe horizontal l’identifiant séquentiel unique de chaque unité d’observation (de $1$ à $n$, respectant l’ordre de recueil ou la clé primaire de la base de données) et sur son axe vertical l’amplitude scalaire de la distance de Cook $D_i$ correspondante.
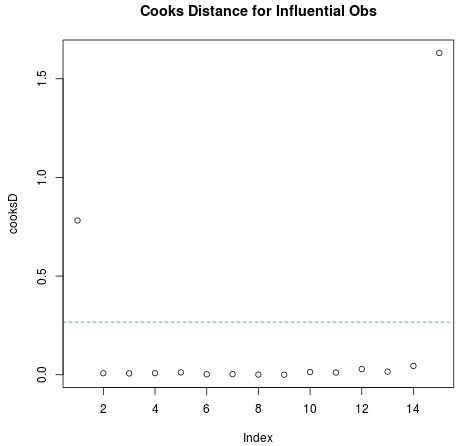
Dans un jeu de données sain et homogène, l’Index Plot présente l’aspect d’un semis régulier de points ou de fines barres verticales oscillant à de très faibles altitudes, formant une ligne de base relativement compacte le long de l’axe horizontal. L’émergence d’une observation pathologique se signale visuellement de façon fulgurante par l’apparition d’un « gratte-ciel » ou d’un pic isolé s’extrayant radicalement de la masse. L’adjonction sur le graphique de lignes de référence horizontales en pointillés — matérialisant typiquement le seuil libéral $4/n$ et le seuil strict unitaire $D_i = 1$ — permet à l’analyste de classer instantanément les observations en fonction de leur dangerosité statistique.
Au-delà de la détection de cas isolés, le graphique séquentiel offre un avantage heuristique remarquable pour l’audit du recueil des données : il permet d’identifier d’éventuels effets d’agglomération temporelle. Si l’on constate qu’une série d’observations hautement influentes se succède consécutivement dans l’ordre de passation d’un protocole expérimental, cela peut trahir une défaillance technique d’un instrument de mesure à un moment précis du protocole, un relâchement des consignes par un assistant de recherche particulier, ou un événement contextuel perturbateur survenu au sein du laboratoire.
6.2 Le graphique des résidus en fonction du levier avec courbes de niveau
La représentation la plus sophistiquée et la plus complète sur le plan de l’information statistique est sans conteste le diagramme bidimensionnel croisant les résidus standardisés ou studentisés sur l’axe des ordonnées et les valeurs de levier $h_{ii}$ sur l’axe des abscisses. Ce graphique matérialise visuellement la décomposition multiplicative formulée par Dennis Cook, en articulant les deux dimensions fondamentales de l’atypisme d’un individu statistique.
L’apport majeur de ce graphique réside dans la superposition de lignes de niveau ou d’isocontours correspondant à des valeurs constantes de la distance de Cook (courbes d’iso-influence pour $D = 0,5$ et $D = 1$). Ces courbes adoptent l’allure d’hyperboles asymptotiques venant contraindre les régions extrêmes de l’espace graphique :
- Dans la région où le levier $h_{ii}$ est modeste, les courbes d’isocontour sont très éloignées de l’axe horizontal, ce qui signifie qu’un individu doit posséder un résidu gigantesque pour atteindre un statut d’influence notable.
- À mesure que le levier se rapproche de la marge droite du graphique, les courbes de niveau plongent dramatiquement vers l’axe des abscisses, illustrant visuellement la vulnérabilité du modèle : pour un levier extrême, un résidu même infime suffit à franchir les zones de criticité statistique.
Cette visualisation permet d’appréhender en un coup d’œil la typologie exacte des anomalies. Un point situé en haut à gauche du graphique sera immédiatement diagnostiqué comme une valeur aberrante pure sans influence structurelle majeure. Un point situé en bas à droite sera classé comme un levier sain. Enfin, toute observation s’aventurant dans le quadrant supérieur droit ou inférieur droit au-delà des courbes d’isocontour $D = 1$ est immédiatement épinglée comme une menace de premier ordre pour la stabilité du modèle.
6.3 Diagrammes de bulles et matrices de dispersion augmentées
Pour contextualiser l’influence au cœur même des relations bivariées ou multivariées étudiées, les diagrammes de dispersion augmentés constituent un instrument pédagogique et diagnostique d’une rare éloquence. Le principe repose sur l’enrichissement d’un nuage de points classique ($Y$ en fonction de $X$) par l’intégration de la distance de Cook comme variable esthétique de dimensionnement : le diamètre géométrique de chaque point (ou bulle) est modulé proportionnellement à sa valeur de $D_i$.
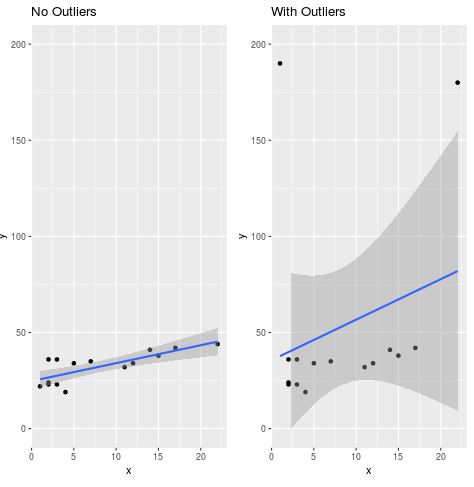
Dans ce type de visualisation, l’analyste perçoit immédiatement l’impact mécanique d’un point influent sur la ligne de régression tracée à travers les données. Si la droite d’ajustement est inclinée vers le haut sous l’effet d’une énorme bulle située dans le coin supérieur droit du graphe, alors que la quasi-totalité des petites bulles forme un nuage horizontal ou descendant, l’artefact apparaît avec une évidence irréfutable. L’observateur saisit intuitivement comment ce point unique agit comme un pôle magnétique qui a infléchi la trajectoire globale du modèle.
Dans le cadre de régressions multivariées complexes comportant de nombreux prédicteurs, cette approche s’étend aux matrices de diagrammes de dispersion (scatterplot matrices). En colorant ou en dimensionnant les données selon leur distance de Cook globale à travers l’ensemble des projections bidimensionnelles croisées, l’investigateur peut démasquer les courbures locales et les sous-groupes dissimulés qui demeurent totalement invisibles lors d’une inspection séquentielle univariée.
7. Implémentation technique et calculs avancés sous le langage R
7.1 Extraction via les fonctions de base du moteur R
Le langage statistique open source R intègre nativement l’ensemble des fonctionnalités nécessaires au calcul et au diagnostic exhaustif de la distance de Cook au sein de sa distribution de base (base R). L’ajustement initial s’opère par l’intermédiaire de la fonction fondamentale lm(), laquelle génère un objet de classe régression linéaire renfermant toutes les structures matricielles requises. L’extraction computationnelle directe du vecteur des distances de Cook s’effectue sans aucune dépendance externe grâce à l’appel de la fonction dédiée cooks.distance().
Considérons l’exemple théorique d’un modèle estimant un score d’épuisement professionnel (Burnout) à partir du niveau de charge cognitive et du nombre d’heures de travail hebdomadaires. L’ajustement et l’extraction de la métrique d’influence s’orchestrent par les commandes élémentaires :
modele_lineaire <- lm(Burnout ~ Charge_Cognitive + Heures_Travail, data = donnees_psychologie)
distances_cook <- cooks.distance(modele_lineaire)
Le moteur graphique interne de R propose une suite diagnostique hautement efficiente accessible par l’application de la méthode générique plot() sur l’objet du modèle. Deux configurations d’arguments sont spécifiquement consacrées à l’évaluation de l’influence globale :
L’exécution de l’instruction plot(modele_lineaire, which = 4) génère instantanément l’Index Plot des distances de Cook, annotant automatiquement les trois observations les plus perturbatrices de l’échantillon par leurs numéros de ligne respectifs. De manière complémentaire, l’instruction plot(modele_lineaire, which = 5) affiche le diagramme des résidus standardisés en fonction du levier statistique, matérialisant en surimpression les courbes de niveau critiques pour $D = 0,5$ et $D = 1$.
7.2 Automatisation du filtrage avec tidyverse et broom
Dans les flux de traitement de données contemporains répondant aux standards de la science des données reproductible, l’interaction avec les modèles statistiques s’articule préférentiellement autour des paquets de l’écosystème tidyverse et du paquet d’uniformisation broom. La fonction augment() du paquetage broom offre une passerelle analytique d’une fluidité remarquable en annexant directement l’ensemble des diagnostics de régression — incluant les résidus standardisés (.std.resid), les valeurs de levier (.hat) et les distances de Cook (.cooksd) — au tableau de données originel sous forme d’un tibble enrichi.
Cette standardisation facilite grandement l’automatisation du filtrage algorithmique et la mise en œuvre de tests d’intégrité statistique au moyen des verbes du paquet dplyr. L’analyste peut implémenter une règle de détection programmée pour isoler de manière déterministe l’ensemble des participants excédant le seuil dynamique $4/n$ :
library(broom)
library(dplyr)
donnees_diagnostiquees <- augment(modele_lineaire)
seuil_critique <- 4 / nrow(donnees_psychologie)
cas_influents <- donnees_diagnostiquees %>% filter(.cooksd > seuil_critique)
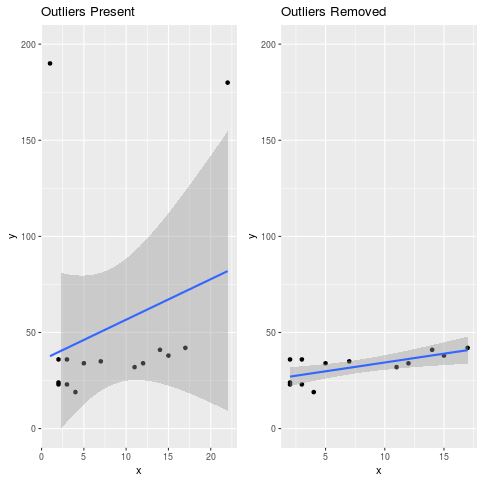
Cette approche matricielle intégrée permet d’exécuter avec une grande concision syntaxique des analyses de robustesse automatisées : l’analyste peut comparer en parallèle les coefficients du modèle complet avec ceux d’un modèle réestimé sur les données purgées des cas suspects, documentant ainsi dans un pipeline transparent le déplacement exact de la trajectoire paramétrique.
7.3 Visualisations avancées et interactives avec ggplot2 et car
Pour les besoins de communication scientifique à haute résolution ou la préparation de manuscrits destinés aux revues internationales à comité de lecture, la bibliothèque spécialisée car (Companion to Applied Regression), développée par John Fox et Sanford Weisberg, propose une interface graphique extrêmement puissante via sa fonction influencePlot(). Cette commande produit un diagnostic visuel multidimensionnel synthétisant sur une figure unique le levier en abscisse, le résidu studentisé externe en ordonnée, et la distance de Cook matérialisée par l’aire surfacique proportionnelle des cercles.
En parallèle, l’utilisation directe de ggplot2 confère une flexibilité typographique et géométrique totale pour concevoir des visualisations personnalisées hautement informatives. Il devient possible de construire un tracé séquentiel de Cook enrichi de gradients de couleurs reflétant l’amplitude du levier, d’ajouter des étiquettes textuelles dynamiques (via le paquet ggrepel) ciblant spécifiquement les participants dont $D_i$ franchit les bornes méthodologiques, et de tracer des bandes de confiance explicites documentant les limites de décision empiriques.
Cette maîtrise de la visualisation graphique avancée sous R constitue un atout décisif pour l’investigateur : elle transforme un ensemble abstrait de scalaires matriciels en une argumentation visuelle rigoureuse, immédiatement intelligible pour les évaluateurs et garante d’une totale transparence dans le processus d’évaluation des données empiriques.
8. Calcul de la distance de Cook sous Python, SPSS et SAS
8.1 Mise en œuvre analytique sous Python avec Statsmodels
Dans l’écosystème de programmation scientifique Python, la modélisation économétrique et le diagnostic approfondi des moindres carrés reposent principalement sur la bibliothèque spécialisée Statsmodels. Contrairement à Scikit-Learn qui oriente délibérément son architecture vers la prédiction algorithmique brute et le déploiement opérationnel, Statsmodels reproduit fidèlement la philosophie computationnelle des logiciels statistiques académiques traditionnels, fournissant un accès exhaustif aux propriétés distributionnelles des estimateurs et à leurs diagnostics d’influence.
L’estimation s’initie par l’intermédiaire du module statsmodels.formula.api.ols, autorisant une écriture des équations sous la syntaxe symbolique standard de Wilkinson-Rogers. Une fois l’ajustement réalisé, l’extraction des métriques d’influence est orchestrée par l’instanciation de la classe OLSInfluence :
import statsmodels.formula.api as smf
from statsmodels.stats.outliers_influence import OLSInfluence
reg = smf.ols('Burnout ~ Charge_Cognitive + Heures_Travail', data=df).fit()
diagnostic = OLSInfluence(reg)
(distance_cook, p_valeurs) = diagnostic.cooks_distance
La méthode cooks_distance retourne un tuple de deux séries Pandas contenant respectivement la distance de Cook calculée pour chaque observation et la p-valeur associée dérivée de la distribution de Fisher théorique. Statsmodels intègre également des fonctions graphiques directes telles que influence_plot() ou plot_index(), facilitant l’incorporation immédiate de ces diagnostics d’intégrité statistique au sein des calepins électroniques (Jupyter Notebooks) couramment déployés en recherche computationnelle.
8.2 Procédure d’extraction pas à pas dans SPSS
Le logiciel commercial IBM SPSS Statistics dispose de routines automatisées permettant d’extraire la distance de Cook sans recourir obligatoirement à la programmation scriptée, bien que l’utilisation de la syntaxe demeure la méthode recommandée pour garantir la reproductibilité des analyses. À travers l’interface utilisateur graphique, la procédure s’articule selon une séquence d’étapes rigoureuses :
- Accéder au menu supérieur et naviguer vers : Analyser $\rightarrow$ Régression $\rightarrow$ Linéaire…
- Assigner les variables correspondantes dans les champs Dépendante et Indépendante(s).
- Cliquer sur le bouton Enregistrer… (Save) situé sur le panneau latéral droit de la boîte de dialogue.
- Au sein de la sous-fenêtre contextuelle, localiser la section intitulée Distances et cocher expressément la case Distance de Cook. Valider en cliquant sur Poursuivre, puis sur OK.
À l’issue de cette manipulation, SPSS ne modifie pas les sorties tabulaires de sa fenêtre de résultats, mais exécute une modification structurelle directe dans l’éditeur de données (Data View) : une nouvelle colonne standardisée est automatiquement annexée à l’échantillon, traditionnellement libellée sous le nom de variable COO_1. Pour les chercheurs privilégiant le mode scripté, cette opération s’exécute de manière limpide au moyen de la syntaxe de commande :
REGRESSION
/DEPENDENT Burnout
/METHOD=ENTER Charge_Cognitive Heures_Travail
/SAVE COOK(COO_1).
L’analyste peut ensuite mobiliser le générateur de graphiques de SPSS pour construire un diagramme de dispersion séquentiel de COO_1 en fonction du numéro de cas ou filtrer interactivement les participants dépassant les frontières critiques conventionnelles.
8.3 Syntaxe SAS et modules d’analyse diagnostique
Au sein du progiciel SAS (Statistical Analysis System), référence historique dans les contextes de recherche biomédicale et d’essais cliniques rigoureusement audités, le diagnostic des observations influentes est géré nativement au cœur de la procédure PROC REG. L’architecture de SAS propose une articulation d’une remarquable puissance combinant instructions de sortie de données et exploitation du système graphique interactif ODS Graphics (Output Delivery System).
L’extraction programmée de la distance de Cook requiert l’adjonction de l’instruction OUTPUT, couplée à l’option analytique COOKD=. L’exemple de code standard se déploie selon la syntaxe suivante :
proc reg data=WORK.DONNEES_PSYCHOLOGIE plots(only)=diagnostics(unpack);
model Burnout = Charge_Cognitive Heures_Travail / influence r;
output out=WORK.DIAGNOSTICS_SORTIE cookd=Distance_Cook rstudent=Residu_Studentise;
run;
quit;
L’activation de l’option plots(only)=diagnostics(unpack) ordonne au moteur SAS de générer automatiquement un panneau complet de graphiques diagnostiques haute fidélité, incluant le tracé individuel des distances de Cook et le croisement des résidus studentisés externes avec la matrice de levier. De surcroît, l’option influence insérée dans l’instruction model génère des tableaux exhaustifs documentant les métriques complémentaires d’omission unitaire, permettant une confrontation croisée immédiate entre la distance de Cook, les résidus RSTUDENT et les statistiques DFFITS.
9. Interprétation contextuelle des points influents en psychologie
9.1 Erreurs de codage, de saisie et artéfacts expérimentaux
L’identification d’une distance de Cook franchissant les seuils de criticité statistique ne constitue pas en soi une finalité analytique ; elle marque le point de départ d’une enquête diagnostique et conceptuelle exigeante. En psychologie empirique et dans les sciences du comportement, la première étiologie à explorer systématiquement face à un point hautement influent relève de l’artefact méthodologique pur, de l’erreur typographique de saisie ou d’une défaillance dans le traitement initial de l’information.
Dans les protocoles de recherche reposant encore sur une transcription manuelle de questionnaires papier, l’inversion de deux chiffres adjacents (saisir par exemple un âge de 81 ans au lieu de 18 ans) ou l’omission d’une virgule décimale dans un temps de réaction informatisé peut propulser une observation vers des zones de levier et de résidu totalement déconnectées de la réalité empirique. De façon tout aussi récurrente, les erreurs de recodage d’items inversés au sein d’échelles de mesure psychométriques de type Likert (omettre d’inverser un item de polarité négative au sein d’une échelle d’estime de soi) créent des profils de réponses incohérents et mathématiquement déstabilisateurs.
Dans les paradigmes expérimentaux informatisés mesurant la chronométrie mentale (tâches de Stroop, protocoles d’amorçage attentionnel, tâches de détection de signaux), des anomalies de conversion d’unités — telles que l’amalgame accidentel entre secondes et millisecondes — génèrent instantanément des valeurs aberrantes de levier extrême. Face à toute observation épinglée par la métrique de Cook, la diligence élémentaire du chercheur impose de revenir aux sources brutes : auditer les formulaires originaux, vérifier les journaux d’enregistrement informatique (logs) et s’assurer qu’aucun bogue d’encodage algorithmique n’est venu corrompre la matrice de calcul.
9.2 Non-respect des consignes, distraction et réponses aléatoires
Lorsque les vérifications instrumentales confirment l’absence d’erreurs techniques ou matérielles de saisie, l’analyste doit impérativement examiner la validité écologique du comportement d’évaluation du participant. Dans les protocoles de recherche contemporains — singulièrement ceux administrés en ligne via des plateformes de crowdsourcing telles que Prolific ou Amazon Mechanical Turk —, le désengagement cognitif et les stratégies de réponse non attentionnelles constituent une source massive de distorsion statistique.
Ces profils problématiques se manifestent régulièrement sous la forme d’un comportement d’alignement uniforme et mécanique des réponses (connu sous le terme de straightlining), où un sujet coche invariablement la modalité centrale ou le score maximal d’une échelle du premier au dernier item sans lire les énoncés. Ce comportement brise artificiellement les corrélations théoriques inter-items et engendre des résidus colossaux au sein des modèles multivariés. L’adjonction d’items de contrôle de l’attention (attention checks ou instructed response items du type : « Pour valider votre attention, veuillez sélectionner la case Tout à fait d’accord ») s’avère ici décisive pour croiser le diagnostic de Cook avec une preuve comportementale de non-respect manifeste des consignes.
De même, l’inspection fine des données paratitiques — notamment les temps de latence de lecture par page web — apporte des indices diagnostiques cruciaux. Un individu complétant une batterie de personnalité de 240 items en moins de trois minutes produit une empreinte chronométrique incompatible avec les processus fondamentaux de la compréhension lexicale humaine. Une telle observation, lorsqu’elle ressort avec une distance de Cook critique, ne reflète pas une variation psychologique authentique mais un bruit stochastique toxique devant être traité selon des protocoles d’exclusion stricts et documentés.
9.3 Hétérogénéité sous-jacente et sous-populations cliniques non identifiées
L’écueil le plus dommageable consisterait toutefois à présumer que toute observation influente est le produit d’une erreur technique ou d’une négligence du participant. Dans les sciences psychologiques et psychiatriques, un point affichant une forte distance de Cook peut constituer l’indicateur le plus précieux et le plus informatif de l’ensemble du jeu de données : il peut signaler la présence d’une sous-population clinique non diagnostiquée ou d’une hétérogénéité distributionnelle latente que le modèle linéaire global a échoué à théoriser.
Considérons une recherche portant sur la relation linéaire entre le niveau de stress perçu et la performance mnésique au sein d’un échantillon non clinique. Un participant affichant un niveau de stress exceptionnellement haut couplé à une performance mnésique extraordinairement effondrée générera une distance de Cook spectaculaire. Une inspection qualitative de son dossier peut révéler un antécédent de traumatisme crânien non spécifié dans les critères d’exclusion initiaux, ou une comorbidité dissociative sévère. Ce sujet n’appartient pas à la même population statistique que les autres unités de l’échantillon ; son comportement témoigne d’un régime fonctionnel qualitativement différent.
De surcroît, dans le champ de la psychologie de la personnalité et de l’étude des talents exceptionnels (haut potentiel cognitif, créativité divergente extrême), les individus situés aux confins des distributions statistiques ne constituent pas des défaillances du modèle, mais les représentants les plus éclatants de la diversité de l’architecture humaine. Éliminer aveuglément ces points sous prétexte qu’ils compliquent l’obtention d’un seuil de significativité $p < 0,05$ constitue une mutilation épistémologique majeure. Cette « désinfection » artificielle des données réduit la variance écologique réelle de l'échantillon et produit une illusion de prédictibilité linéaire qui s'effondrera inévitablement lors des tentatives de réplication externe.
10. Protocole de prise de décision : Supprimer, conserver ou ajuster
10.1 L’arbre décisionnel face à une observation influente
La découverte d’une observation franchissant les seuils critiques de la distance de Cook impose la mise en œuvre d’un protocole d’arbitrage méthodique et structuré. L’analyste ne doit jamais céder à l’arbitraire d’une réaction binaire immédiate consistant à supprimer ou ignorer le point suspect. L’arbre décisionnel suivant opérationnalise la démarche scientifique recommandée en trois phases séquentielles indépendantes :
Étape 1 : L’audit de conformité factuelle et de traçabilité des données brutes. L’analyste examine en premier lieu si l’observation est entachée d’une erreur d’enregistrement, de transcription ou d’encodage démontrable. Si l’erreur est factuellement établie et que l’information originale correcte est irrécupérable, l’observation doit être formellement rejetée. Si l’information originale est disponible dans les archives brutes (cahier de passation papier ou journal système), la valeur erronée est corrigée et le modèle réajusté sans exclusion de l’unité d’observation.
Étape 2 : L’évaluation de l’appartenance à la population cible. Si la valeur est factuellement exacte, l’analyste détermine si le participant satisfait rigoureusement à l’ensemble des critères d’admissibilité théoriques de la population sous étude. Si le profil révèle une violation flagrante des critères d’inclusion (par exemple, un individu sous médication psychotrope lourde au sein d’une étude portant sur la cognition non clinique), le retrait est justifié sur le plan théorique et doit être consigné avec transparence dans la section méthodologique du rapport.
Étape 3 : L’exécution d’analyses de sensibilité comparatives. Si l’observation est factuellement irréprochable et provient indiscutablement d’un membre légitime de la population cible, le principe déontologique fondamental stipule qu’elle ne peut pas être éliminée unilatéralement. L’analyste procède alors à une analyse de sensibilité rigoureuse, en ajustant le modèle sur deux trajectoires parallèles : l’une incluant la totalité de l’échantillon et l’autre excluant les points influents, afin de quantifier explicitement la robustesse des conclusions tirées.
10.2 Les écueils méthodologiques de la suppression systématique
La tentation d’éliminer automatiquement les observations influentes représente l’un des dévoiements méthodologiques les plus fréquents de la recherche quantitative. Cette pratique procède souvent d’une motivation fallacieuse : expurger les données des éléments discordants afin d’abaisser artificiellement la valeur p sous le seuil symbolique de 0,05 et d’optimiser le coefficient de détermination $R^2$. Une telle démarche relève du biais de sélection et s’apparente à une forme insidieuse de falsification statistique.
L’exclusion sélective et non justifiée de points influents distord gravement la distribution d’échantillonnage des estimateurs. En tronquant de manière asymétrique les queues de distribution, le chercheur génère une sous-estimation systématique de l’erreur quadratique moyenne réelle et provoque une inflation artificielle des tailles d’effet rapportées (Cohen’s d, coefficients de régression standardisés $\beta$). Ce phénomène fabrique de fausses certitudes en attribuant au modèle une précision clinique illusoire qui masque l’instabilité fondamentale du phénomène étudié face aux conditions du monde réel.
Enfin, sur le plan de la validité écologique et externe, une théorie scientifique dont les démonstrations empiriques s’effondrent dès lors que l’on réintègre deux ou trois individus atypiques au sein d’une cohorte de deux cents participants ne possède aucune applicabilité généralisable. Le retrait opportuniste de cas influents fragilise la chaîne de reproductibilité de la science, constituant l’un des moteurs silencieux mais dévastateurs de la crise de la réplication qui traverse les disciplines contemporaines.
10.3 Approches alternatives : Winsorisation, régression robuste et transformations
Lorsque des observations influentes légitimes menacent la validité des moindres carrés ordinaires sans qu’il soit méthodologiquement défendable de les supprimer, l’analyste dispose d’un arsenal d’approches statistiques alternatives élégantes permettant de préserver l’intégrité de l’information tout en désamorçant leur potentiel destructeur.
La première stratégie repose sur les techniques de transformation mathématique non linéaire des variables continues. Lorsque l’influence extrême d’un sous-ensemble d’individus résulte d’une asymétrie distributionnelle sévère (distributions log-normales de temps de réaction, scores financiers, dosages hormonaux), l’application d’une transformation logarithmique, d’une transformation par racine carrée ou de la méthode paramétrique généralisée de Box-Cox permet de compresser les échelles extrêmes. Cette normalisation géométrique rapproche naturellement les points de fort levier du centroïde global, réduisant drastiquement leur distance de Cook sans amputer l’échantillon d’un seul participant.
Une seconde approche consiste à appliquer la technique de winsorisation (Winsorization). Contrairement au rognage (trimming) qui supprime physiquement les observations extrêmes, la winsorisation réassigne la valeur d’une donnée atypique au centile acceptable le plus proche (par exemple, ramener toute valeur excédant le 95e centile exactement à la valeur de ce 95e centile). Cette procédure préserve le rang et la structure ordinale de l’information tout en bornant strictement l’effet de levier mécanique exercé sur les estimateurs.
Enfin, l’alternative la plus robuste et la plus formelle sur le plan statistique réside dans l’abandon des MCO au profit des méthodes de régression linéaire robuste. Les estimateurs M développés par Peter Huber et les estimateurs à haute efficacité de type MM-estimators substituants à la fonction de perte quadratique des fonctions d’influence bornées (telles que la fonction biséquarrée de Tukey). Ces algorithmes pondèrent de manière itérative chaque observation : un individu conforme reçoit un poids de 1, tandis qu’une observation affichant un résidu démesuré ou un levier toxique voit son poids décroître continûment vers zéro. La régression robuste permet ainsi d’estimer des coefficients fidèles à la dynamique majoritaire des données sans nécessiter la moindre décision arbitraire d’exclusion.
11. Indicateurs diagnostiques complémentaires de l’influence
11.1 La métrique DFFITS et la prédiction individuelle
Bien que la distance de Cook s’impose comme l’indicateur d’influence omnibus par excellence, un diagnostic approfondi exige de confronter ses verdicts à d’autres métriques spécialisées issues de la théorie du rééchantillonnage par omission unitaire. Parmi celles-ci, l’indicateur DFFITS (différence des valeurs ajustées standardisée, Difference in Fits), introduit par Belsley, Kuh et Welsch en 1980, occupe une position de premier plan.
La distinction conceptuelle entre la distance de Cook et DFFITS réside dans leur champ de focalisation géométrique. Alors que la distance de Cook mesure l’impact cumulé de l’omission d’une observation sur l’ensemble du vecteur des prédictions de l’échantillon tout entier, la métrique DFFITS quantifie le changement standardisé induit spécifiquement sur la propre valeur prédite du cas exclu. La formulation mathématique de DFFITS pour la i-ème observation s’exprime par :
$$\text{DFFITS}_i = \frac{\hat{y}_i – \hat{y}_{i(-i)}}{\sqrt{\text{MSE}_{(-i)} \cdot h_{ii}}} = t_i \cdot \sqrt{\frac{h_{ii}}{1 – h_{ii}}}$$
Où $t_i$ représente le résidu studentisé supprimé (externe). Cette formulation met en exergue l’étroite parenté algébrique reliant les deux approches : pour un individu donné, la distance de Cook et le carré de la métrique DFFITS sont directement proportionnels selon la relation mathématique exacte :
$$D_i = \frac{\text{MSE}_{(-i)}}{\text{MSE}} \cdot \frac{\text{DFFITS}_i^2}{p}$$
Les seuils d’alerte conventionnels pour DFFITS reposent sur la borne critique $| \text{DFFITS}_i | > 2 \sqrt{p/n}$ dans les échantillons de taille moyenne ou grande. Cet indicateur se révèle d’une sensibilité redoutable pour détecter les individus dont la position atypique altère principalement la modélisation de leur propre région factorielle sans nécessairement perturber l’ajustement des régions distantes du plan de régression.
11.2 Les métriques DFBETAS et l’instabilité des coefficients individuels
La distance de Cook présente une caractéristique qui, dans certaines circonstances analytiques précises, peut s’avérer une limitation : elle est strictement globale et non directionnelle. Un scalaire $D_i$ élevé indique que le vecteur $\hat{\beta}$ s’est significativement déplacé, mais il est rigoureusement incapable d’informer le chercheur sur l’identité spécifique des coefficients angulaires affectés par ce déplacement, ni sur la direction (positive ou négative) de cette distorsion. Pour pénétrer au cœur de cette dynamique fine, l’investigateur doit solliciter la métrique DFBETAS (différence des bêtas standardisée).
La métrique DFBETAS évalue de façon granulaire et indépendante l’impact de l’omission unitaire sur chaque coefficient de régression $\beta_j$ pris individuellement. Pour la i-ème observation et le j-ème prédicteur (avec $j in {0, 1, dots, k}$), la statistique est formalisée par le rapport :
$$\text{DFBETAS}_{j(i)} = \frac{\hat{\beta}_j – \hat{\beta}_{j(-i)}}{\text{SE}_{(-i)}(\hat{\beta}_j)}$$
Où le dénominateur représente l’erreur-type de l’estimateur $\hat{\beta}_j$ recalculée en omettant la i-ème observation. Le seuil de décision universellement reconnu pour signaler une instabilité critique sur un coefficient est donné par la règle :
$$| \text{DFBETAS}_{j(i)} | > \frac{2}{\sqrt{n}}$$
L’utilisation conjointe de la distance de Cook et de DFBETAS offre un niveau de discernement épistémologique indispensable. Imaginons qu’une recherche psychologique teste l’effet novateur d’une intervention thérapeutique ($\beta_1$) en contrôlant pour cinq covariables sociodémographiques. Une observation affichant une distance de Cook significative peut ne perturber que les coefficients de contrôle, laissant le paramètre théorique d’intérêt $\beta_1$ parfaitement stable. À l’inverse, une observation affichant une distance de Cook modeste peut concentrer l’intégralité de sa déformation vectorielle sur $\beta_1$, faisant basculer sa significativité statistique. L’inspection des DFBETAS protège le chercheur contre le risque critique de valider une hypothèse théorique sur la foi d’un artefact imputable à un unique participant.
11.3 La variance résiduelle avec COVRATIO
Au-delà de l’impact exercé sur les valeurs ajustées et les coefficients de pente, une observation singulière peut altérer en profondeur la précision générale de l’ensemble des inférences statistiques du modèle en déstabilisant la matrice de variance-covariance des estimateurs. Pour quantifier cette dimension structurelle de l’influence, la statistique COVRATIO mesure le ratio entre le déterminant de la matrice de variance-covariance des coefficients réestimée sans la i-ème observation et le déterminant de la matrice de variance-covariance du modèle complet :
$$\text{COVRATIO}_i = \frac{det\left(\widehat{\text{Var}}(\hat{\beta}_{(-i)})\right)}{det\left(\widehat{\text{Var}}(\hat{\beta})\right)} = \frac{1}{\left(\frac{n – p – 1 + t_i^2}{n – p}\right)^p \cdot (1 – h_{ii})}$$
L’interprétation de la statistique COVRATIO s’articule autour de la valeur seuil nominale de 1, avec des zones critiques définies par l’intervalle d’alerte empirique $| \text{COVRATIO}_i – 1 | > 3p/n$ :
- Une valeur de $\text{COVRATIO}_i > 1 + 3p/n$ indique que l’inclusion de la i-ème observation réduit la précision globale de l’estimation des paramètres en gonflant artificiellement le volume de l’ellipsoïde de confiance conjointe. L’omission de cette observation améliorerait la précision statistique du système.
- Une valeur de $\text{COVRATIO}_i < 1 – 3p/n$ indique à l'inverse que l'observation, en apportant un levier important mais bien aligné sur la pente générale, contracte significativement l'ellipsoïde de confiance, améliorant la précision globale du modèle.
La triangulation simultanée de la distance de Cook, des DFBETAS et de COVRATIO confère au statisticien une vision stéréoscopique absolue de la topologie de ses données. Cette batterie d’indicateurs complémentaires garantit qu’aucune facette de l’influence — qu’elle touche à la prédiction globale, aux pentes locales ou à la matrice de covariance — n’échappe à l’œil critique de l’investigateur.
12. Pratiques de publication, transparence et intégrité scientifique
12.1 Normes de transparence selon les standards de l’APA
L’American Psychological Association (APA), dans ses directives de publication méthodologique codifiées au sein du Journal Article Reporting Standards (JARS-Quant), a considérablement renforcé ses exigences de rigueur éditoriale concernant le traitement des données atypiques et influentes. Les standards scientifiques contemporains interdisent formellement la pratique d’une « épuration silencieuse » des bases de données, dans laquelle des participants seraient soustraits des échantillons d’analyse sans mention explicite, détaillée et justifiée au sein du manuscrit publié.
Dans la section « Méthode » (sous-section « Participants » ou « Analyses statistiques »), les auteurs sont expressément tenus de spécifier :
- Le nombre initial exact d’observations recueillies avant toute opération de nettoyage.
- Les métriques diagnostiques mobilisées pour évaluer l’atypisme et l’influence statistique (par exemple, la distance de Cook couplée aux résidus studentisés externes et au levier).
- Les seuils de décision quantitatifs rigoureusement appliqués (par exemple, l’application du critère $D_i > 4/n$ ou du seuil universel $D_i > 1$), en précisant les références méthodologiques fondant ce choix.
- Le nombre d’observations identifiées comme franchissant ces seuils et le détail des justifications ayant présidé à leur maintien, à leur transformation ou à leur exclusion.
Ces exigences de divulgation visent à restaurer la reproductibilité des protocoles de recherche et à empêcher les altérations opportunistes de données visant à transformer des résultats marginaux ou non significatifs en effets statistiquement validés.
12.2 Présentation des analyses de robustesse en annexes
Afin de concilier la concision éditoriale du corps principal d’un article et le devoir de transparence intégrale imposé par la science ouverte, la pratique académique exemplaire consiste à intégrer systématiquement des analyses de sensibilité ou de robustesse au sein des annexes méthodologiques (Supplementary Materials). Cette démarche est vivement encouragée par les comités de lecture des revues internationales de premier rang.
La concrétisation de cette approche s’opère généralement par la publication d’un tableau comparatif structuré présentant en miroir l’ajustement du modèle de régression linéaire sous deux conditions distinctes :
| Prédicteurs du modèle | Modèle complet ($n = 250$) Coefficient $\beta$ (SE) [p] | Modèle sans points influents ($n = 246$) Coefficient $\beta$ (SE) [p] | Variation relative (%) de l’estimation |
|---|---|---|---|
| Constante ($\beta_0$) | 12,45 (1,34) [p < 0,001] | 14,10 (1,12) [p < 0,001] | + 13,2 % |
| Charge cognitive ($\beta_1$) | 0,42 (0,08) [p = 0,002] | 0,39 (0,07) [p = 0,003] | – 7,1 % |
| Heures de travail ($\beta_2$) | 0,18 (0,09) [p = 0,048] | 0,09 (0,08) [p = 0,261] | – 50,0 % |
| Statistiques globales | $R^2 = 0,24$ ; $F(2, 247) = 39,0$ | $R^2 = 0,21$ ; $F(2, 243) = 32,3$ | $\Delta R^2 = – 0,03$ |
Un tel tableau documente immédiatement l’impact empirique des observations influentes sur la stabilité des inférences. Dans cet exemple théorique, l’effet de la charge cognitive ($\beta_1$) demeure robuste et significatif dans les deux configurations, témoignant d’une réelle solidité empirique. En revanche, l’effet des heures de travail ($\beta_2$) perd totalement sa significativité statistique dès l’extraction des quatre points influents identifiés par la distance de Cook, passant de $p = 0,048$ à $p = 0,261$. Cette divulgation honnête et sans fard permet aux pairs d’interpréter les résultats avec toute la nuance scientifique requise, prévenant la diffusion de conclusions hâtives fondées sur des artefacts d’échantillonnage.
12.3 Pré-enregistrement des protocoles de nettoyage de données
L’ultime rempart contre la dérive du p-hacking et l’instrumentalisation des diagnostics de régression réside dans le pré-enregistrement formel des protocoles d’analyse sur des registres scientifiques publics et immuables, tels que l’Open Science Framework (OSF) ou AsPredicted. Le mouvement contemporain de la science ouverte préconise de sanctuariser les règles de gestion des données atypiques avant même le début de la collecte des observations.
Dans un plan de pré-enregistrement rigoureux, l’investigateur spécifie à l’avance les équations formelles qu’il utilisera, les critères précis de la distance de Cook retenus (en explicitant formellement l’usage du seuil $D_i > 4/n$ ou du seuil unitaire), ainsi que l’algorithme décisionnel qui sera appliqué si des points influents sont détectés. Le chercheur trace ainsi une frontière méthodologique infranchissable entre les analyses confirmatoires — strictement encadrées par le protocole pré-enregistré — et les analyses exploratoires post-hoc guidées par les particularismes empiriques observés lors de l’audit des données.
Cette discipline méthodologique garantit la pleine robustesse épistémologique de la recherche quantitative. En élevant la gestion des observations influentes d’un bricolage rétrospectif opportuniste au rang de protocole d’assurance qualité documenté et transparent, la communauté scientifique consolide la fiabilité de ses modèles et réaffirme son engagement indéfectible envers la vérité empirique et l’intégrité de la découverte scientifique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Cook, R. D. (1979). Influential observations in linear regression. Journal of the American Statistical Association, 74(365), 169–174. https://doi.org/10.1080/01621459.1979.10481634
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman and Hall.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725285
- Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114
- Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471725382
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with python. In Proceedings of the 9th Python in Science Conference (Vol. 57, pp. 61–66). https://doi.org/10.25080/Majora-92bf1922-011
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686