
L’analyse statistique au sein des sciences psychologiques contemporaines repose en grande partie sur l’art et la rigueur de la modélisation linéaire. Qu’il s’agisse d’évaluer l’impact d’une thérapie cognitivo-comportementale sur la réduction de symptômes anxieux, de quantifier l’effet de la charge cognitive sur le temps de réaction, ou d’explorer les médiations complexes entre traits de personnalité et résilience émotionnelle, les chercheurs recourent continuellement à la régression linéaire sous la méthode des moindres carrés ordinaires. Cet édifice inférentiel, d’une élégance mathématique indéniable, n’est cependant pas inconditionnel : sa validité repose sur un ensemble de postulats fondamentaux formalisés notamment par le théorème de Gauss-Markov. Parmi ces réquisits méthodologiques, l’hypothèse de variance constante des erreurs conditionnelles — communément désignée sous le terme d’homoscédasticité — occupe une place à la fois pivotale et fréquemment sous-estimée dans la pratique de recherche courante.
L’omission de la vérification de cette hypothèse de variance constante engendre des distorsions statistiques majeures qui menacent directement l’édifice scientifique de la psychologie empirique. Si l’estimation ponctuelle des coefficients de régression conserve sous certaines conditions son absence de biais, l’estimation de leur incertitude — matérialisée par l’erreur-type — se trouve irrémédiablement compromise dès lors que la variance des perturbations fluctue le long du continuum prédictif. Les conséquences pratiques de ce phénomène sont redoutables : des intervalles de confiance artificiellement comprimés, des valeurs p fallacieusement significatives et, in fine, une prolifération alarmante de faux positifs qui alimente la crise de la reproductibilité affectant la psychologie clinique, cognitive et sociale depuis plus d’une décennie.
Le présent traité propose une déconstruction exhaustive de l’hypothèse de variance constante, alliant une formalisation mathématique rigoureuse à une contextualisation clinique et psychométrique approfondie. À travers l’examen minutieux de sa nature algébrique, de ses implications géométriques, de ses manifestations empiriques à travers l’hétéroscédasticité, ainsi que de ses méthodes diagnostiques visuelles et inférentielles, cet article offre un guide complet destiné aux chercheurs et praticiens de la modélisation statistique. Un cas d’étude détaillé, articulé autour de la relation entre le stress perçu et les performances de la mémoire de travail, servira de fil conducteur pour illustrer les pièges méthodologiques usuels et exposer la panoplie des solutions correctives contemporaines, depuis les transformations de variables jusqu’aux estimateurs de variance robustes et aux modèles additifs généralisés pour l’emplacement, l’échelle et la forme.
1. Introduction aux modèles de régression linéaire en psychologie et à leurs postulats
1.1 Le rôle fondamental de la régression linéaire en sciences du comportement
Dans l’arsenal méthodologique des sciences du comportement, la régression linéaire s’érige comme le cadre d’analyse par excellence pour examiner, formaliser et prédire des dynamiques psychologiques complexes. Contrairement aux approches purement corrélationnelles qui se bornent à constater une covariation symétrique entre deux mesures, le modèle de régression linéaire structure explicitement une asymétrie fonctionnelle. Il établit une distinction épistémologique cruciale entre la variable réponse (ou variable critère, traditionnellement notée Y), qui incarne le phénomène psychologique dont on cherche à expliquer la variabilité, et les variables explicatives (ou prédicteurs, covariables, notées X), qui opérationnalisent les déterminants théoriques, environnementaux ou individuels présumés.
Cette modélisation s’applique avec une pertinence singulière à l’étude des relations causales et prédictives impliquant des variables psychologiques tant observables (comme le temps de latence motrice ou des biomarqueurs physiologiques) que latentes (telles que l’intelligence fluide, l’estime de soi ou les dimensions psychopathologiques déduites d’échelles d’auto-évaluation). L’estimation des paramètres de régression fournit aux chercheurs des métriques quantifiées traduisant le poids relatif de chaque facteur dans l’explication du comportement humain. Toutefois, l’interprétation substantielle de ces paramètres repose sur une chaîne d’inférence déductive dont la robustesse dépend intégralement de la conformité des données empiriques avec les postulats du modèle probabiliste sous-jacent.
La puissance explicative de la méthode des moindres carrés ordinaires (MCO) découle directement de son ancrage dans le cadre de Gauss-Markov. Lorsque les données respectent scrupuleusement les postulats de ce cadre théorique, les coefficients estimés bénéficient de propriétés mathématiques optimales qui confèrent aux tests de signification une validité incontestable. Dès lors que l’un de ces postulats vacille, la transposition des résultats statistiques vers des conclusions cliniques ou théoriques s’expose à des erreurs d’interprétation substantielles, rendant impérative une compréhension approfondie des conditions de validité du modèle.
1.2 Vue d’ensemble des postulats classiques des moindres carrés ordinaires (MCO)
L’estimation par les moindres carrés ordinaires exige la satisfaction conjointe de plusieurs axiomes théoriques qui garantissent la régularité et la précision des inférences. Le premier de ces axiomes est la linéarité de la relation mathématique reliant les régresseurs à la variable dépendante. Ce postulat stipule que la moyenne conditionnelle de Y s’exprime comme une combinaison linéaire des paramètres associés aux prédicteurs. Toute non-linéarité fondamentale non modélisée (comme une relation curvilinéaire ou en cloche) induit une spécification erronée du système statistique, faussant irrémédiablement l’ensemble des métriques d’ajustement.
Le deuxième axiome majeur réside dans l’indépendance des erreurs de mesure et l’absence corrélative d’autocorrélation entre les termes résiduels. Chaque observation doit apporter une quantité d’information stochastiquement indépendante de celle fournie par les autres observations de l’échantillon. Cette hypothèse est régulièrement compromise dans les protocoles longitudinaux, les mesures répétées ou les échantillonnages en grappes où les facteurs contextuels non observés génèrent une covariance résiduelle intra-sujet ou intra-groupe non négligeable.
Le troisième réquisit concerne la normalité distributionnelle des termes d’erreur, postulat dont la portée est particulièrement critique au sein des échantillons de taille finie. Si le théorème central limite offre une protection asymptotique pour l’estimation des coefficients dans les cohortes massives, la normalité des erreurs conditionnelles demeure une condition sine qua non pour que les statistiques de test usuelles (tests t de Student et tests F de Fisher) suivent exactement les distributions théoriques tabulées servant au calcul des valeurs p.
Enfin, le quatrième pilier, au cœur des analyses du présent article, réside dans la condition d’homogénéité de la variance des résidus — ou homoscédasticité. Ce postulat énonce formellement que la variabilité du terme d’erreur doit demeurer rigoureusement invariable sur l’ensemble du continuum défini par les valeurs prédites de la variable réponse. Il interdit toute modulation de l’incertitude résiduelle en fonction de l’amplitude des variables indépendantes, garantissant ainsi que l’incertitude du modèle s’applique uniformément à chaque profil individuel analysé.
1.3 Importance spécifique de l’évaluation des postulats avant l’interprétation clinique ou théorique
Dans la recherche empirique, la tentation est vive de considérer la vérification des postulats statistiques comme une formalité accessoire, subordonnée à l’obtention convoitée de seuils de significativité statistique inférieurs au seuil conventionnel de 0,05. Or, l’omission ou la négligence de cette étape diagnostique expose l’investigateur à des biais d’inférence dévastateurs, notamment lors de la validation d’échelles psychométriques ou du calibrage d’outils d’évaluation clinique standardisés. Par exemple, si une échelle mesurant le risque suicidaire présente une variance d’erreur bien plus marquée chez les individus présentant des scores très élevés, l’intervalle de prédiction associé à un score critique sera sous-estimé, induisant un faux sentiment de précision diagnostique aux lourdes conséquences thérapeutiques.
En psychologie expérimentale, l’impact direct des violations de ces postulats se traduit par une chute drastique de la reproductibilité des résultats d’une cohorte à l’autre. Des modèles estimés sur des structures de variance instables capturent le bruit idiosyncratique des échantillons initiaux au détriment du signal psychologique réel. De telles analyses surestiment systématiquement la robustesse des effets mis en évidence, contribuant activement à l’incapacité ultérieure des laboratoires indépendants à répliquer les conclusions publiées.
Dès lors, l’évaluation méthodique et exhaustive des postulats préalablement à toute interprétation théorique ne relève nullement d’un perfectionnisme mathématique stérile, mais d’une impérieuse nécessité déontologique et scientifique. Tout manuscrit académique se réclamant de la rigueur scientifique se doit d’exposer de manière transparente les diagnostics de régression effectués, permettant aux pairs d’évaluer la solidité des fondations probabilistes sur lesquelles reposent les théories comportementales avancées.
2. Définition conceptuelle et formulation mathématique de la variance constante
2.1 Formulation formelle de l’homoscédasticité
La formulation théorique de l’homoscédasticité s’articule au sein de l’algèbre probabiliste des modèles linéaires généraux. Considérons un modèle de régression linéaire multiple spécifié pour un échantillon de n observations indépendantes :
Yi = β0 + β1Xi1 + β2Xi2 + … + βkXik + εi
où Yi représente la variable réponse observée pour l’individu i, Xij désigne la valeur prise par le j-ème prédicteur pour ce même individu, β rassemble les paramètres vectoriels inconnus de la régression, et εi figure le terme d’erreur stochastique non observable. L’hypothèse de variance constante, formulée conditionnellement à la matrice des prédicteurs X, s’énonce selon l’expression mathématique fondamentale suivante :
Var(εi | X) = σ2, ∀ i ∈ {1, 2, …, n}
Cette équation stipule que la variance conditionnelle de chaque perturbation aléatoire εi est égale à un paramètre scalaire unique et invariant σ2, indépendamment des valeurs spécifiques prises par les régresseurs pour l’observation considérée. Autrement formulé, l’espérance mathématique du carré de l’erreur conditionnelle est constante :
E(εi2 | X) – [E(εi | X)]2 = E(εi2 | X) = σ2
puisque le modèle suppose classiquement que l’espérance conditionnelle des erreurs est nulle, soit E(εi | X) = 0.
Il est impératif d’opérer une distinction conceptuelle nette entre la variance marginale de la variable dépendante Var(Y) et la variance conditionnelle des erreurs Var(ε | X). La variance marginale Var(Y) quantifie la dispersion totale non conditionnelle des scores de la population autour de leur moyenne générale ; elle intègre la variabilité expliquée par l’ensemble des prédicteurs ainsi que la variabilité résiduelle. En revanche, la variance conditionnelle Var(ε | X) isole la dispersion des observations autour de la droite ou de l’hyperplan de régression ajusté. L’homoscédasticité n’exige aucunement que les prédicteurs ou que la réponse possèdent des variances particulières, mais impose rigoureusement que la part de variabilité résiduelle inexpliquée conserve une amplitude identique en tout point de l’espace multidimensionnel défini par les variables explicatives.
2.2 Signification statistique et géométrique de l’hypothèse
Sur le plan géométrique, l’hypothèse de variance constante se matérialise dans un espace bidimensionnel ou multidimensionnel par la formation d’un couloir de dispersion d’une largeur parfaitement uniforme encadrant l’hyperplan de régression. Si l’on imagine un nuage de points dans le plan cartésien où l’axe des abscisses représente un score d’exposition environnementale et l’axe des ordonnées une réponse comportementale, l’homoscédasticité implique que l’enveloppe de dispersion verticale des observations empiriques autour de la droite de tendance conserve une épaisseur constante de l’extrême gauche à l’extrême droite du graphique.
Cette géométrie régulière reflète l’hypothèse sous-jacente d’équiprobabilité des amplitudes d’écart : la probabilité qu’une observation s’écarte de la valeur prédite d’une distance donnée (par exemple plus ou moins deux unités-écarts types) est rigoureusement identique, que cette prédiction porte sur une valeur basse, intermédiaire ou exceptionnellement élevée du prédicteur. Aucune zone du spectre explicatif ne présente une concentration anormale d’imprécision ou de dispersion élargie.
Sur le versant théorique de l’inférence statistique, ce postulat est le pivot du célèbre théorème de Gauss-Markov. Ce dernier démontre que, sous les conditions d’exogénéité stricte, d’absence d’autocorrélation et d’homoscédasticité, l’estimateur des moindres carrés ordinaires constitue le « Meilleur Estimateur Linéaire Non Biaisé » (communément désigné sous l’acronyme anglophone BLUE : Best Linear Unbiased Estimator). Le qualificatif de « meilleur » signifie ici que la variance d’échantillonnage de cet estimateur est minimale au sein de l’ensemble de tous les estimateurs linéaires sans biais possibles. Dès lors que l’homoscédasticité est rompue, l’estimateur MCO perd irrévocablement cette propriété d’efficacité optimale, ouvrant la voie à des alternatives mathématiques plus performantes.
2.3 Traduction conceptuelle en recherche psychologique
Transposée dans le domaine de la recherche psychologique et psychométrique, l’hypothèse d’homoscédasticité traduit le postulat fondamental de l’uniformité de la précision de mesure d’un construit à travers tous les niveaux prédits. Dans le cadre de la théorie classique des tests comme dans celui des modélisations dimensionnelles de la psychopathologie, faire l’hypothèse d’une variance constante revient à affirmer que notre modèle mathématique prédit le phénomène avec le même degré de certitude — ou la même marge d’erreur stochastique — chez tous les sujets, quel que soit leur profil sur les variables évaluées.
Considérons l’évaluation d’un trouble psychiatrique, comme le trouble dépressif majeur ou le trouble d’anxiété généralisée. L’homoscédasticité implique que l’invariance de l’erreur d’estimation demeure absolue, que l’on évalue un individu présentant une symptomatologie subclinique très légère ou un patient hospitalisé affichant une détresse psychologique extrême. Le modèle présuppose que les processus psychologiques non pris en compte dans l’équation de régression (les facteurs résiduels aléatoires) n’exercent pas un bruit plus prononcé chez les patients sévèrement atteints que chez les témoins sains.
Ce postulat sous-tend également la comparabilité méthodologique entre sous-groupes situés à des pôles opposés du continuum psychologique. Accepter l’homoscédasticité sans vérification préalable revient à assumer arbitrairement qu’un modèle d’apprentissage cognitif prédit les capacités de mémorisation avec une exactitude identique chez les personnes présentant un déficit intellectuel, chez les individus de la moyenne populationnelle et chez les profils à haut potentiel intellectuel. Si, en réalité, les stratégies cognitives se diversifient à mesure que le niveau intellectuel s’accroît, la dispersion des performances augmentera mécaniquement, rompant cette comparabilité et faussant l’estimation des paramètres du modèle.
3. La nature des résidus dans la modélisation statistique
3.1 Différenciation entre erreurs théoriques et résidus observés
Une rigueur conceptuelle absolue exige de distinguer formellement les termes d’erreur théoriques des résidus empiriques issus de l’échantillonnage. Les erreurs théoriques, désignées par la lettre grecque εi, sont des entités purement probabilistes et inobservables. Elles représentent l’écart véritable entre la réponse observée d’un individu dans la population parente et sa valeur théorique exacte, générée par la fonction génératrice sous-jacente inconnue :
εi = Yi – (β0 + ∑ βjXij)
À l’opposé, les résidus observés, notés ei (ou parfois ri ou ε̂i), constituent des grandeurs empiriques directement calculables à partir des estimations numériques des paramètres obtenues sur l’échantillon d’étude :
ei = Yi – Ŷi = Yi – (b0 + ∑ bjXij)
où Ŷi représente la valeur prédite (ou ajustée) pour le sujet i, et bj les estimations MCO des coefficients réels βj.
Cette distinction n’est pas purement sémantique : elle implique des propriétés algébriques contrastées. Alors que les erreurs théoriques εi sont postulées mutuellement indépendantes dans le modèle standard, les résidus empiriques ei sont intrinsèquement corrélés entre eux en raison des contraintes algébriques imposées par la méthode des moindres carrés. En effet, l’algorithme des MCO force la somme (et donc la moyenne) des résidus à être exactement égale à zéro :
∑ ei = 0
et impose une orthogonalité stricte entre les résidus et chaque variable prédictive :
∑ eiXij = 0, ∀ j
Ces k + 1 contraintes linéaires réduisent d’autant les degrés de liberté du système statistique. Par conséquent, pour estimer sans biais la variance résiduelle globale non conditionnelle σ2, le dénominateur de la somme des carrés des résidus (SSE) doit être ajusté pour refléter ces degrés de liberté résiduels :
s2 = MSE = SSE / (n – k – 1) = ∑ ei2 / (n – k – 1)
où n est le nombre total de participants et k le nombre de prédicteurs inclus dans le modèle.
3.2 Typologie des résidus pour le diagnostic psychométrique
Dans l’arsenal du psychométricien confronté au diagnostic de variance, les résidus bruts ei présentent des limitations opérationnelles sévères. Exprimés dans l’unité de mesure originale de la variable dépendante (qu’il s’agisse de millisecondes pour des temps de réponse ou de points sur une échelle d’anxiété), ils ne permettent pas une comparaison aisée entre études utilisant des instrumentations métrologiques divergentes, et leur variance dépend intimement du levier (leverage) exercé par chaque observation dans l’espace des prédicteurs.
Pour pallier ces écueils, la statistique inférentielle a développé les résidus standardisés (ou résidus semi-étudiantisés). Ceux-ci sont obtenus en divisant chaque résidu brut par l’écart-type résiduel global estimé du modèle :
zi = ei / s
Bien que cette transformation z-score confère aux résidus une métrique sans dimension facilitant le repérage initial des écarts atypiques, elle ne prend pas en compte le fait que la variance théorique des résidus n’est pas constante d’une observation à l’autre, même lorsque l’hypothèse d’homoscédasticité est parfaitement respectée dans la population.
C’est pourquoi l’étalon diagnostique de référence repose sur les résidus studentisés (également qualifiés de résidus standardisés de façon interne ou externe). En intégrant la matrice de projection orthogonale (connue sous le nom de matrice « chapeau » ou hat matrix, H), la distance de levier hii de chaque individu par rapport au centroïde des prédicteurs est explicitement intégrée. Le résidu studentisé interne s’écrit :
ri = ei / [s √(1 – hii)]
En poussant la rigueur plus loin, le résidu studentisé externe (ou résidu supprimé studentisé) remplace s par s(i), l’écart-type résiduel recalculé sur un échantillon dont l’observation i a été momentanément exclue. Cette opération supprime l’influence locale d’une valeur aberrante sur sa propre échelle résiduelle, faisant des résidus studentisés externes un outil d’une sensibilité incomparable pour déceler des aberrations de variance ou des points de levier destructeurs.
3.3 Comportement attendu des résidus sous l’hypothèse de variance constante
Lorsque le modèle de régression linéaire sous-jacent est parfaitement spécifié et que l’hypothèse de variance constante est scrupuleusement vérifiée, le comportement distributionnel des résidus répond à des propriétés probabilistes rigoureuses. En tout point du continuum prédictif défini par les valeurs ajustées Ŷ, l’espérance conditionnelle des résidus doit demeurer rigoureusement nulle :
E(e | Ŷ) = 0
Ce résultat traduit le fait qu’il n’existe aucun biais localisé de sous-estimation ou de surestimation prédictive.
Sur le plan de la variance, la dispersion empirique de ces résidus doit refléter un processus stochastique pur. En d’autres termes, l’écart quadratique moyen des résidus conditionnellement à Ŷ doit afficher une horizontalité parfaite :
Var(e | Ŷ) = σ2 (1 – h)
On ne doit déceler aucune agrégation spatiale, aucun resserrement dans certaines tranches de score, ni aucun étalement disproportionné à l’autre extrémité de la métrique. L’absence totale de dépendance fonctionnelle entre l’amplitude absolue des résidus (|ei|) et les estimations modélisées (Ŷi) constitue la signature théorique intangible de la variance constante.
4. L’hétéroscédasticité : caractérisation de la violation de l’hypothèse
4.1 Définition et typologies de l’hétéroscédasticité
L’hétéroscédasticité désigne la négation formelle du postulat d’homoscédasticité. Mathématiquement, elle survient dès lors que la variance des termes d’erreur conditionnels cesse d’être un paramètre scalaire fixe et devient une fonction dépendant de l’observation spécifique ou des valeurs prises par les prédicteurs :
Var(εi | X) = σi2
où l’indice i signale sans équivoque que la dispersion résiduelle fluctue au gré des individus ou des configurations de variables.
Cette instabilité de variance se manifeste sous diverses architectures stochastiques que l’analyste se doit de catégoriser. La typologie la plus courante en sciences du comportement est l’hétéroscédasticité monotone. Dans cette configuration, la variance conditionnelle des erreurs augmente de façon continue et irréversible (ou, plus rarement, diminue continuellement) à mesure que le niveau du prédicteur croît. La modélisation mathématique classique de cette forme monotone exprime souvent σi2 comme proportionnelle à une puissance d’une variable explicative, selon une relation telle que σi2 = σ2 × Xiγ, avec γ > 0.
À l’inverse, l’hétéroscédasticité non monotone ou segmentée expose des dynamiques structurellement plus complexes. La variance d’erreur peut se trouver comprimée aux valeurs médianes du prédicteur tout en explosant aux deux extrémités de la distribution (structure biconvexe), ou inversement, présenter une dispersion maximale au centre du spectre distributionnel. Ce cas de figure émerge fréquemment lorsque des seuils critiques de variables latentes déclenchent des basculements qualitatifs dans l’organisation psychologique des sujets, modifiant la régularité de leurs patrons de réponse.
4.2 Origines méthodologiques fréquentes en psychologie
L’émergence de l’hétéroscédasticité au sein des données psychologiques découle le plus souvent des propriétés intrinsèques des instruments de mesure psychométriques et des caractéristiques de l’appareil cognitif humain. En premier lieu figurent les effets de plancher et de plafond, omniprésents dans les questionnaires d’auto-évaluation de la psychopathologie tels que le Beck Depression Inventory (BDI-II) ou le questionnaire général d’anxiété (GAD-7). Au sein d’une population générale saine, une part prépondérante des participants sélectionne le score minimal absolu (« 0 » ou absence totale de détresse).
Cette troncature artificielle de la distribution par l’instrument de mesure comprime drastiquement la variabilité résiduelle pour les faibles valeurs de détresse prédite : les résidus y sont quasi nuls. À mesure que les scores prédits progressent vers des niveaux cliniques, la liberté de dispersion des réponses individuelles s’accroît, engendrant mécaniquement une augmentation massive de la variance résiduelle le long du continuum de sévérité.
Une seconde source méthodologique réside dans l’hétérogénéité structurelle des compétences cognitives. L’investigation empirique de la performance démontre fréquemment que les individus disposant de capacités intellectuelles ou attentionnelles très développées recourent à un répertoire de stratégies de résolution de problèmes beaucoup plus vaste que les individus en difficulté. Tandis que ces derniers échouent de façon relativement uniforme face à des items de complexité élevée, les sujets hautement performants affichent des comportements adaptatifs variés, produisant une instabilité de variance marquée au sommet de l’échelle des aptitudes.
Enfin, les mesures chronométriques, emblématiques de la psychologie cognitive expérimentale, génèrent une hétéroscédasticité quasi systématique. Les distributions des temps de réaction ou des latences motrices sont physiologiquement asymétriques positives (décrites par des lois ex-gaussiennes ou log-normales). Dans ces conditions, la variabilité intra- et inter-individuelle s’avère presque toujours couplée à la moyenne : plus un participant est lent en moyenne pour traiter un stimulus complexe, plus l’écart-type de ses temps de réaction individuels est substantiel, induisant une variance résiduelle croissante avec les temps prédits.
4.3 Sous-groupes et variables modératrices non intégrées
Sur le plan de la spécification théorique, l’hétéroscédasticité constitue bien souvent le symptôme d’une omission méthodologique : l’échec de l’expérimentateur à identifier et modéliser une variable modératrice fondamentale. Lorsque l’impact d’un prédicteur principal X1 sur la réponse Y dépend silencieusement du niveau d’une variable tierce Z non mesurée ou négligée dans l’équation, le terme d’erreur ε absorbe l’effet interactif non spécifié. Si Z possède une distribution asymétrique au sein des strates de X1, l’hétérogénéité des pentes individuelles se répercute sous la forme d’une variance d’erreur hétéroscédastique.
En psychologie clinique et développementale, ce phénomène s’observe de façon aiguë lors de l’omission de caractéristiques différentielles majeures telles que la trajectoire développementale liée à l’âge, l’identité de genre, ou des typologies de personnalité contrastées. La variabilité intra-individuelle des symptômes dépressifs chez l’adolescent présente, par exemple, des fluctuations sans commune mesure avec celle observée chez l’adulte d’âge mûr. L’estimation d’un modèle unique de prédiction ignorant cette différenciation statutaire génère une variance résiduelle clivée selon les tranches d’âge.
De surcroît, l’agrégation inadéquate d’échantillons hétérogènes constitue un facteur aggravant. Dans les protocoles multicentriques ou les méta-analyses sur données individuelles, compiler des données collectées sous des conditions de passation discordantes (par exemple, des évaluations en laboratoire rigoureusement contrôlées combinées à des passations non supervisées en ligne via des plateformes participatives) introduit une hétérogénéité structurelle. Les contextes expérimentaux distraits ou instables gonflent l’erreur résiduelle de façon différentielle, détruisant l’homoscédasticité globale du modèle agrégé.
5. Conséquences statistiques de la rupture de l’hypothèse de variance constante
5.1 Préservation de l’absence de biais des coefficients
Face à la constatation empirique de l’hétéroscédasticité, il importe d’élucider avec précision les segments du modèle qui demeurent mathématiquement fiables et ceux qui se trouvent corrompus. La première propriété essentielle à relever concerne la justesse ponctuelle des paramètres : l’estimateur des moindres carrés ordinaires demeure strictement sans biais, même en présence d’une violation substantielle de l’hypothèse de variance constante.
La démonstration algébrique de ce postulat découle directement de la formulation matricielle de l’estimateur MCO :
b = (XTX)-1XTY = (XTX)-1XT(Xβ + ε) = β + (XTX)-1XTε
Pour évaluer le biais d’un estimateur, on calcule l’espérance mathématique de son écart par rapport au paramètre réel β, conditionnellement à X :
E(b | X) = β + (XTX)-1XT E(ε | X)
Dès lors que l’hypothèse d’exogénéité stricte est respectée — c’est-à-dire que l’espérance conditionnelle des termes d’erreur est rigoureusement nulle, E(ε | X) = 0 —, le second terme s’annule identiquement, et nous obtenons :
E(b | X) = β
Cette égalité confirme formellement que l’hétéroscédasticité n’altère en rien l’absence de biais des coefficients de régression. Les pentes estimées et l’ordonnée à l’origine convergent en moyenne vers les véritables paramètres de la population. Pour le chercheur en psychologie, ce résultat signifie que l’amplitude estimée d’un effet principal (par exemple, le taux de réduction des scores d’anxiété par heure de thérapie) demeure en moyenne exacte sur le plan ponctuel. La faille ne réside pas dans le coefficient lui-même, mais dans la métrique probabiliste servant à évaluer son incertitude.
5.2 Invalidation des erreurs-types et de la matrice de covariance
Si les coefficients ponctuels conservent leur intégrité, l’estimation conventionnelle de leur précision est en revanche totalement compromise. Sous le régime de l’homoscédasticité, la matrice de variance-covariance théorique des coefficients b prend une forme simplifiée remarquable :
Var(b | X) = σ2 (XTX)-1
Cette formule classique constitue la base analytique de l’ensemble des logiciels statistiques conventionnels (SPSS, R fonction lm de base, SAS) pour calculer les erreurs-types des prédicteurs (les Standard Errors, SE).
Toutefois, dès lors que la condition de variance constante est rompue, la matrice de covariance réelle des erreurs conditionnelles n’est plus une matrice scalaire σ2In, mais une matrice diagonale hétérogène Σ = diag(σ12, σ22, …, σn2). Dans ces conditions statistiques réelles, la véritable matrice de variance-covariance des coefficients estimés devient :
Var(b | X) = (XTX)-1 (XT Σ X) (XTX)-1
L’application machinale de la formule classique s2(XTX)-1 en lieu et place de cette formulation exacte aboutit, dans la quasi-totalité des configurations empiriques rencontrées en psychologie, à une sous-estimation substantielle des erreurs-types réelles des coefficients. L’ordinateur calcule des marges d’erreur trop faibles, générant un gonflement artificiel de la précision perçue des estimations. Par voie de conséquence, la statistique globale F d’ajustement du modèle ainsi que les statistiques de validité des équations structurelles se trouvent également biaisées, invalidant la métrique de comparaison des modèles concurrents.
5.3 Conséquences sur l’inférence statistique et les tests d’hypothèses
L’effondrement de la justesse du calcul des erreurs-types entraîne dans son sillage la défaillance des mécanismes de test d’hypothèses. Le calcul de la statistique de Wald ou du test t de Student pour éprouver la significativité de l’effet d’un prédicteur (H0: βj = 0) repose sur le ratio :
t = bj / SE(bj)
Puisque le dénominateur SE(bj) issu des formules ordinaires est artificiellement comprimé par l’hétéroscédasticité, la valeur calculée de la statistique t se trouve artificiellement majorée. Il en résulte un effondrement des valeurs p associées, induisant une explosion massive du taux d’erreur de première espèce (le risque α). Le chercheur conclut ainsi péremptoirement à l’existence d’un effet psychologique statistiquement significatif alors même que les données empiriques ne reflètent qu’un artéfact induit par la dispersion instable du bruit de mesure.
Simultanément, les intervalles de confiance construits selon la formule standard bj ± tcritique × SE(bj) se révèlent excessivement étroits. Ils procurent une illusion de précision métrologique trompeuse, piégeant les théoriciens de la psychologie dans des certitudes infondées quant à la taille réelle de l’effet examiné. Dans le domaine de la recherche translationnelle et des essais d’interventions comportementales, un tel écueil méthodologique conduit à déclarer l’efficacité de thérapies innovantes sur la base d’estimations incertaines, compromettant l’éthique de la recherche appliquée et pénalisant les patients.
6. Diagnostic visuel de la variance constante : le graphique des résidus
6.1 Construction du graphique des valeurs ajustées contre les résidus
Face aux risques d’invalidation inférentielle, l’investigateur doit impérativement déployer des procédures diagnostiques préalables. Au sein de ces investigations, l’examen graphique occupe une place méthodologique primordiale, incarnant la première ligne de défense de l’analyste. Le dispositif fondamental de ce diagnostic repose sur la construction cartésienne du graphique des valeurs ajustées contre les résidus (communément dénommé diagramme Residuals vs Fitted).
Pour ériger ce graphique avec une rigueur statistique irréprochable, l’analyste doit impérativement positionner sur l’axe horizontal des abscisses les valeurs prédites par le modèle (Ŷ), tandis que l’axe vertical des ordonnées accueille les résidus du modèle. Ce traçage ne peut mathématiquement s’effectuer qu’a posteriori, après que le modèle a fait l’objet d’une estimation globale de ses paramètres. Reporter les scores bruts d’un unique prédicteur en abscisse s’avère instructif en régression simple, mais masque en régression multiple les dynamiques d’hétéroscédasticité multidimensionnelles résultant de combinaisons linéaires complexes.
Le choix de la métrique résiduelle employée conditionne fortement l’efficacité diagnostique. Si les résidus bruts offrent une première perspective, il est hautement préférable d’utiliser les résidus studentisés externes (ou standardisés), car ils s’affranchissent des variations d’effet de levier le long du continuum prédictif. Par ailleurs, pour accentuer la visibilité des dérives d’échelle, les représentations dites d’emplacement-échelle (Scale-Location plot), qui projettent la racine carrée des résidus standardisés absolus (√|ri|) en regard des valeurs ajustées, constituent une alternative graphique d’une sensibilité supérieure pour identifier visuellement les tendances d’expansion de variance.
6.2 Interprétation d’un profil homoscédastique conforme
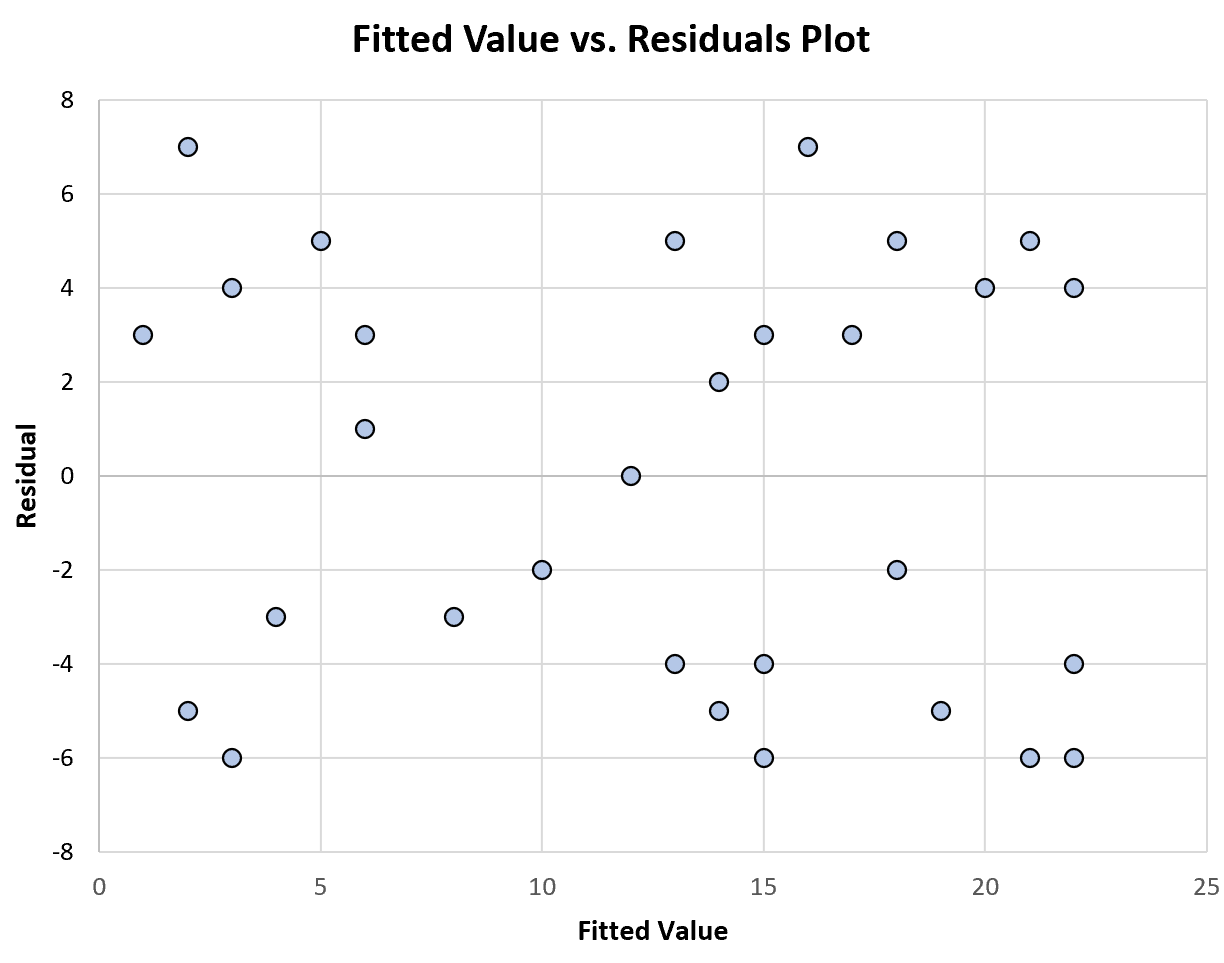
L’évaluation visuelle d’un graphique de résidus requiert une acculturation sémiotique précise. Lorsque l’hypothèse de variance constante est parfaitement satisfaite au sein de l’échantillon, le nuage de points adopte une morphologie stochastique caractéristique : celle d’une bande horizontale d’épaisseur rigoureusement uniforme, évoquant un nuage aléatoire de forme rectangulaire sans aucune structure directionnelle repérable.
Dans ce scénario conforme, les résidus gravitent de façon symétrique autour de la ligne horizontale d’ordonnée zéro (y = 0), reflétant le respect simultané de la linéarité et de la moyenne conditionnelle nulle. Aucune trajectoire curviligne ne vient courber l’ensemble. Mais surtout, la largeur de la dispersion verticale du nuage demeure strictement invariable depuis les prédictions les plus faibles situées à l’extrême gauche du graphe jusqu’aux prédictions les plus élevées situées à l’extrême droite.
De surcroît, un profil homoscédastique irréprochable se signale par l’absence d’îlots de points isolés ou d’observations aberrantes capables d’altérer unilatéralement l’estimation de la variance locale. L’observateur constate une densité d’espacement homogène le long de la bande, attestant que le bruit aléatoire affectant la mesure psychologique opère avec la même intensité probabiliste, quel que soit l’état théorique prédit par le modèle.
6.3 Reconnaissance visuelle des motifs d’hétéroscédasticité
Dès lors que la variance conditionnelle des erreurs est compromise, le graphique des résidus se charge de motifs morphologiques révélateurs de la pathologie statistique sous-jacente. La manifestation visuelle la plus emblématique est sans conteste le profil dit en entonnoir, en éventail ou en mégaphone. Dans cette configuration, le nuage de points débute à gauche par une dispersion résiduelle extrêmement resserrée autour de la ligne centrale, pour ensuite s’évaser progressivement de manière exponentielle vers la droite du graphe. Ce patron traduit sans équivoque une hétéroscédasticité monotone où la certitude prédictive se dégrade continuellement à mesure que le score prédit s’élève.
D’autres topologies de dispersion témoignent de perturbations spécifiques du construit psychologique mesuré. Une configuration en sablier ou en losange — caractérisée par une forte dispersion aux scores prédits intermédiaires et une compression bilatérale aux extrêmes — traduit typiquement l’influence de contraintes de seuil ou d’un échantillonnage stratifié combinant des groupes cliniques extrêmement homogènes aux pôles et des profils mixtes plus instables au centre.
Il importe enfin de mettre en garde l’analyste contre les configurations mixtes sinusoïdales ou en vagues. Ces profils oscillants traduisent le plus souvent une violation conjointe de la linéarité fondamentale et de la variance constante, résultant de l’omission d’un terme polynomial dans le modèle. De telles anomalies graphiques soulignent que le diagnostic des résidus n’évalue pas seulement la variance, mais constitue une véritable radiographie de la cohérence interne du modèle.
7. Tests inférentiels formels pour tester la variance constante
7.1 Le test de Breusch-Pagan et sa variante de Koenker
Si l’inspection visuelle demeure incontournable, elle doit impérativement être consolidée par des procédures inférentielles formelles échappant à la subjectivité inhérente à l’interprétation perceptive des graphiques. Le test de Breusch-Pagan (1979) s’affirme historiquement comme l’épreuve statistique de référence pour tester l’hypothèse nulle d’homoscédasticité :
H0: σ12 = σ22 = … = σn2 = σ2
Le principe mathématique de ce test consiste à régresser les carrés des résidus standardisés issus du modèle primaire sur l’ensemble des variables prédictives (ou sur les valeurs prédites). Si l’hypothèse nulle est vérifiée, ces régresseurs ne doivent posséder aucun pouvoir explicatif sur la variance des erreurs résiduelles. La statistique du multiplicateur de Lagrange (LM) suit alors asymptotiquement une loi du Chi-deux dont les degrés de liberté correspondent au nombre de prédicteurs auxiliaires testés :
LM = (1/2) × ESS ∼ χ2(k)
où ESS représente la somme des carrés expliquée de la régression auxiliaire.
Cependant, le test classique de Breusch-Pagan présente une vulnérabilité méthodologique critique : il fait l’hypothèse stricte que les erreurs théoriques sont normalement distribuées. Dans les contextes psychologiques réels où l’asymétrie et l’aplatissement (kurtosis) s’écartent fréquemment de la loi normale, le test de Breusch-Pagan génère une proportion dramatique de rejets fallacieux de l’homoscédasticité, confondant leptokurticité et hétéroscédasticité.
Pour remédier à cette hypersensibilité, la variante de Koenker (1981) — également appelée test de Breusch-Pagan studentisé — s’avère indispensable. Koenker a reformulé la statistique de test en modifiant le facteur de normalisation afin qu’il prenne en compte le kurtosis empirique réel des résidus de l’échantillon :
LMKoenker = n × R2auxiliaire ∼ χ2(k)
Cette correction de studentisation confère au test une robustesse remarquable face aux écarts de normalité, en faisant l’outil inférentiel paramétrique privilégié pour l’investigation des données psychométriques asymétriques.
7.2 Le test de White pour l’hétéroscédasticité générale
Bien que performant, le test de Breusch-Pagan-Koenker postule une relation linéaire entre les prédicteurs et la variabilité des résidus. Afin de s’affranchir de toute hypothèse quant à la forme fonctionnelle que pourrait revêtir l’hétéroscédasticité, Halbert White a proposé en 1980 un test d’une portée générale remarquable. Le test de White permet de détecter des structures d’instabilité de variance hautement non linéaires sans exiger de l’investigateur qu’il formule une spécification a priori de la relation mathématique perturbatrice.
Le protocole analytique du test de White repose sur l’ajustement d’une régression auxiliaire où la variable dépendante est le carré des résidus ordinaires ei2, et où l’ensemble des régresseurs originaux, leurs carrés respectifs (termes quadratiques Xj2) ainsi que tous leurs produits croisés (interactions Xj × Xl) sont simultanément injectés dans l’équation. La statistique de test est déduite directement du coefficient de détermination R2 issu de cette régression auxiliaire globale :
W = n × R2 ∼ χ2(p)
où les degrés de liberté p correspondent au nombre total de paramètres explicatifs intégrés dans la régression auxiliaire.
Cette exhaustivité structurelle confère au test de White la capacité de capturer des architectures d’hétéroscédasticité complexes et asymétriques courantes dans l’étude des processus comportementaux. Toutefois, cette puissance diagnostique s’accompagne d’un inconvénient majeur : l’inflation rapide des termes explicatifs. Dès lors qu’un modèle psychologique intègre cinq ou six prédicteurs, le calcul de tous les carrés et interactions croisées engloutit un nombre prohibitif de degrés de liberté. Dans les échantillons psychologiques de taille modeste, cette dispersion des degrés de liberté anéantit la puissance du test de White, le rendant alors inopérant.
7.3 Limites inhérentes aux tests statistiques de variance
L’utilisation non critique des tests inférentiels de variance expose le chercheur à des écueils méthodologiques bien documentés. Le premier réside dans la sur-sensibilité inhérente aux tests d’hypothèses nuls appliqués au sein des cohortes psychologiques de grande taille. Lorsque la taille de l’échantillon N atteint des proportions massives (comme dans les bases de données d’épidémiologie psychiatrique ou les études de cohortes nationales comptant plusieurs milliers de participants), la puissance statistique devient démesurée.
Dans ce contexte, des déviations infimes, mathématiquement négligeables et dépourvues de tout impact pratique sur la justesse des erreurs-types, déclenchent invariablement des valeurs p hautement significatives (p < 0,001). L’investigateur se voit alors poussé à tort de rejeter l’hypothèse de variance constante et d’engager des corrections analytiques complexes non justifiées.
À l’autre extrémité du spectre méthodologique, les études pilotes, cliniques ou neuroscientifiques recourant à des échantillons réduits (par exemple N < 50) souffrent d’une sous-puissance statistique critique face aux tests de variance. Une hétéroscédasticité sévère, susceptible de biaiser drastiquement les erreurs-types et de tripler l’erreur de type I, peut parfaitement passer inaperçue lors d’un test de Breusch-Pagan faute d’un effectif suffisant pour atteindre le seuil de rejet conventionnel.
Dès lors, les standards méthodologiques contemporains proscrivent formellement le recours à un critère décisionnel binaire dogmatique fondé exclusivement sur le franchissement du seuil p = 0,05. La communauté scientifique recommande unanimement une démarche diagnostique intégrée, articulant de façon concomitante l’évaluation morphologique des graphiques de résidus, les indices numériques d’effet de variance et les résultats contextualisés des tests inférentiels.
8. Exemple concret en psychologie : Modélisation du stress perçu et de la performance cognitive
8.1 Contexte de l’étude et collecte des données psychométriques
Afin d’ancrer ces considérations mathématiques dans la réalité opérationnelle de la recherche comportementale, examinons un exemple empirique concret. Une équipe de neuropsychologues et de chercheurs en psychologie cognitive s’intéresse à l’influence exercée par le stress psychologique chronique sur l’efficience des fonctions exécutives supérieures, plus spécifiquement sur la mémoire de travail. Pour ce faire, une cohorte diversifiée de n = 250 participants volontaires (âgés de 18 à 45 ans) est recrutée afin de se soumettre à un protocole standardisé en laboratoire.
La variable prédictive (le stress perçu) est opérationnalisée à l’aide de l’échelle d’auto-évaluation psychométrique validée Perceived Stress Scale à 10 items (PSS-10, Cohen et al., 1983). Cette échelle fournit un score dimensionnel continu s’étendant de 0 (absence complète de stress perçu) à 40 (stress subjectif d’une sévérité critique). La variable dépendante (la performance cognitive) est évaluée par l’administration informatisée d’une épreuve cognitive réputée de charge mnésique continue : la tâche 2-back (variante visuo-spatiale du paradigme n-back). Le score composite de performance correspond au coefficient standardisé de précision discriminative (indice d’ de la théorie de détection du signal), ajusté pour pénaliser les omissions et les fausses alarmes, où des valeurs élevées reflètent une précision mnésique optimale.
8.2 Ajustement du modèle de régression linéaire initial
L’équipe d’investigateurs formule un modèle de régression linéaire univarié unitaire visant à prédire le score d’efficience cognitive (Performance) à partir du niveau de stress perçu (Stress) :
Performancei = β0 + β1 × Stressi + εi
L’application algorithmique des moindres carrés ordinaires sur l’échantillon empirique fournit les estimations paramétriques suivantes :
b0 = 3,854 (ordonnée à l’origine) ; b1 = -0,058 (pente) ; R2 = 0,382
L’équation de prédiction calculée pour chaque individu s’établit dès lors à :
Ŷi = 3,854 – 0,058 × Stressi
L’examen naïf des métriques de sortie conventionnelles révèle une corrélation bivariée inverse marquée (r = -0,618). L’erreur-type ordinaire du coefficient de pente est initialement calculée à SE(b1) = 0,0047, aboutissant à une statistique de Student colossale de :
t = -0,058 / 0,0047 = -12,34 (p < 0,00001)
En se fondant aveuglément sur ces chiffres fournis par leur logiciel de traitement statistique, les chercheurs pourraient conclure prématurément à un effet inhibiteur massif et remarquablement précis du stress perçu sur la mémoire de travail, assorti d’intervalles de confiance conventionnels à 95 % exceptionnellement étroits : [-0,067 ; -0,049].
8.3 Mise en évidence empirique de la variance non constante
Toutefois, la modélisation statistique ne s’achève pas à l’estimation des coefficients. Conformément aux réquisits méthodologiques, l’analyste procède au calcul explicite des résidus empiriques observés pour l’ensemble des 250 participants :
ei = Performancei – Ŷi
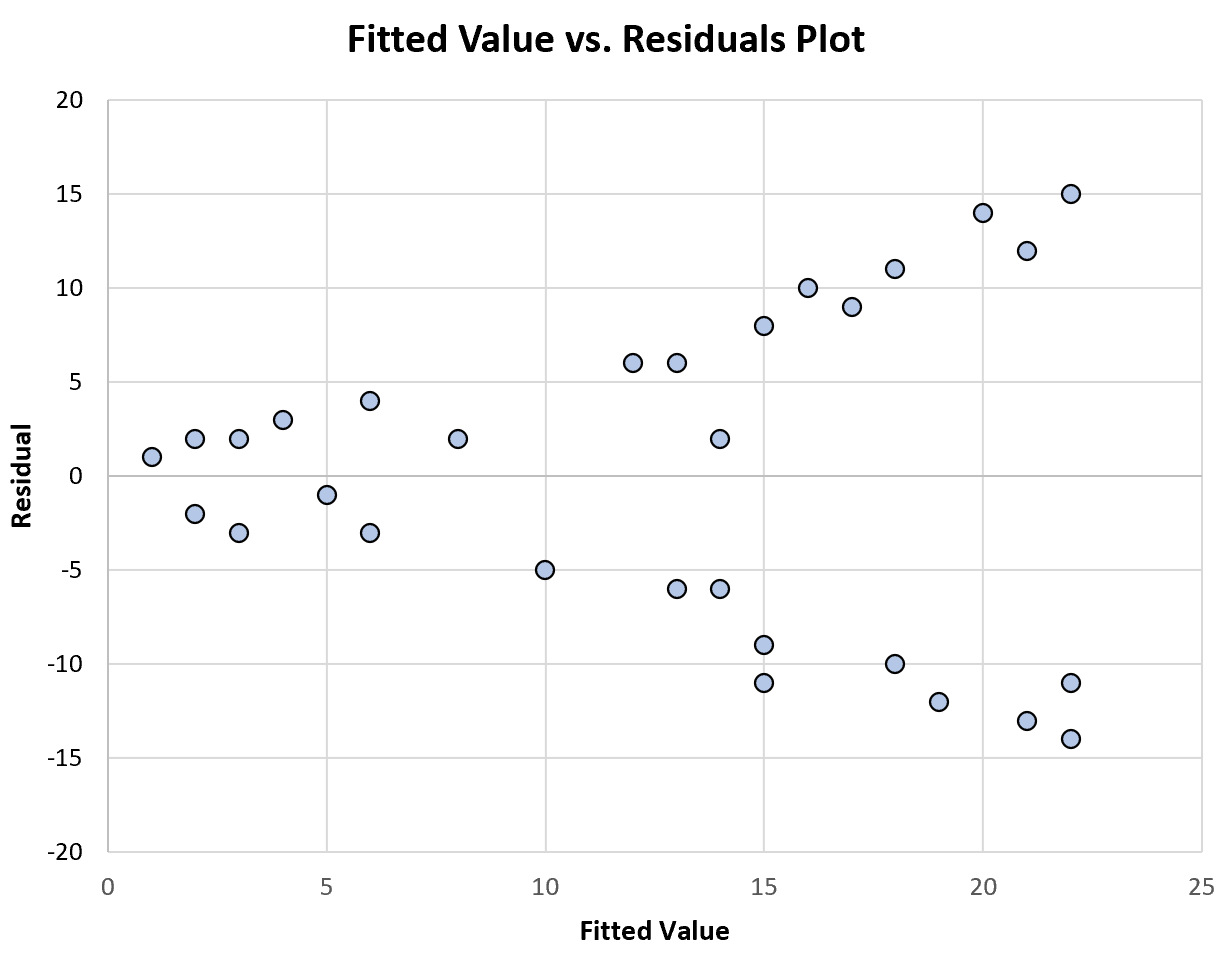
puis projette graphiquement ces résidus standardisés en regard des valeurs prédites de performance cognitive au sein du diagramme de diagnostic visualisé ci-dessus.
La morphologie du graphique révèle immédiatement une altération majeure du postulat de variance constante. Pour les valeurs de prédiction cognitive élevées (associées aux participants signalant un score de stress très faible, Stress < 10), les résidus apparaissent extrêmement resserrés autour de la droite centrale, formant un fuseau dense de variance restreinte (slocal ≈ 0,18). En revanche, au fur et à mesure que le niveau de stress augmente et que la performance prédite diminue, la variabilité résiduelle subit une expansion spectaculaire : pour les scores de stress intenses (Stress > 30), les résidus s’écartent violemment de part et d’autre de l’axe, atteignant une dispersion presque quadruple (slocal ≈ 0,72). L’aspect visuel adopte l’archétype parfait de la forme en entonnoir évasé.
L’administration conjointe du test formel de Breusch-Pagan-Koenker vient corroborer ce constat clinique de façon sans appel :
LMKoenker = 38,42 ; df = 1 ; p < 0,0000001
L’hypothèse d’homoscédasticité doit être catégoriquement rejetée. L’explication neuropsychologique de cette hétéroscédasticité s’éclaire à la lumière de la théorie du contrôle exécutif : face à un stress environnemental minime, les individus opèrent de façon uniformément proche de leur potentiel cognitif de base, maintenant une régularité de performance sans faille. Sous l’emprise d’un stress massif, les dynamiques psychologiques se fragmentent : certains individus mobilisent des ressources compensatoires et des stratégies de régulation émotionnelle leur permettant de préserver un niveau de mémoire de travail intact, tandis que d’autres s’effondrent sous le poids de pensées intrusives débordant leur mémoire de travail. Cette variabilité inter-individuelle accrue sous stress extrême induit directement l’hétéroscédasticité observée, interdisant toute utilisation non corrigée des erreurs-types ordinaires.
9. Stratégies de remédiation par transformations mathématiques de la réponse
9.1 Transformation logarithmique et racine carrée
Historiquement et techniquement, la première ligne de remédiation face à la rupture du postulat de variance constante réside dans l’application d’une fonction mathématique non linéaire à la variable réponse Y, dans le but explicite de compresser la dispersion conditionnelle aux valeurs élevées et d’homogénéiser ainsi l’enveloppe résiduelle. Ce procédé de stabilisation de variance se justifie théoriquement par la méthode delta, qui montre que si l’écart-type résiduel est proportionnel à la moyenne conditionnelle (σi ∝ E(Yi)), la transformation de la variable par son logarithme naturel :
Y* = ln(Y)
rend la variance de Y* asymptotiquement indépendante de sa moyenne, rétablissant ainsi l’homoscédasticité.
Cette approche s’impose quasi universellement dans le traitement des échelles chronométriques (temps de réaction en millisecondes) ou lors du dosage de métabolites biologiques associés au stress psychologique, comme le cortisol salivaire ou la protéine C-réactive, dont la variabilité explose naturellement avec l’amplitude mesurée. Lorsque l’expansion de la variance résiduelle est modérée ou proportionnelle à la racine de la moyenne (processus poissonnien de comptage, comme le nombre d’erreurs commises à une épreuve neuropsychologique), la transformation racine carrée :
Y* = √Y
permet de corriger l’hétéroscédasticité sans infliger une compression aussi brutale que celle opérée par le logarithme.
Néanmoins, le recours à ces transformations mathématiques modifie structurellement la signification substantielle de l’équation modélisée. L’effet linéaire additif originel se convertit en un modèle multiplicatif ou exponentiel. Dans un modèle spécifié en semi-logarithme (ln(Y) = β0 + β1X), le coefficient β1 n’indique plus une augmentation brute d’unités de réponse par unité de prédicteur, mais un pourcentage relatif de modification de la réponse ([exp(β1) – 1] × 100 %), ce qui complexifie la transmission des conclusions auprès des cliniciens et des professionnels de terrain.
9.2 La famille des transformations de Box-Cox
Plutôt que de procéder à des essais empiriques successifs guidés par de simples intuitions (logarithme, inverse, racine carrée), les statisticiens George Box et David Cox ont formalisé en 1964 une méthode algorithmique unifiée permettant de sélectionner objectivement la transformation paramétrique optimale. La famille de transformations de Box-Cox applique une transformation de puissance modulée par un paramètre continu unique noté λ (lambda) :
Y(λ) = (Yλ – 1) / λ si λ ≠ 0
Y(λ) = ln(Y) si λ = 0
L’identification de la valeur optimale de λ s’effectue par l’estimation du maximum de vraisemblance profilée. L’algorithme passe en revue une plage continue de valeurs potentielles de λ (usuellement comprise entre -2 et +2) et sélectionne la valeur mathématique exacte qui maximise conjointement la normalité des résidus et l’homoscédasticité du système linéaire.
Cette élégance méthodologique s’assortit toutefois de deux contraintes analytiques rigoureuses. En premier lieu, la formulation classique de Box-Cox exige de façon impérative que l’ensemble des valeurs observées de la variable dépendante Y soient strictement positives (Y > 0). Si les scores psychométriques comportent des valeurs négatives ou nulles (fréquentes lors de l’usage d’indices standardisés z ou de scores de changement), l’opérateur doit adjoindre une constante additive arbitraire de décalage c (Y + c), dont l’amplitude influe sur la valeur estimée de λ.
En second lieu, l’interprétation d’un modèle estimé sous un paramètre λ non standard (par exemple λ = 0,38) constitue un défi herméneutique insurmontable : exprimer l’efficience cognitive en unités de (Performance0,38 – 1) / 0,38 prive le résultat de toute résonance écologique ou clinique immédiate, imposant d’astreignantes rétro-transformations pour communiquer les intervalles de prédiction finaux.
9.3 Mises en garde sur l’utilisation abusive des transformations de variables
Si les transformations mathématiques ont constitué la panacée méthodologique du siècle passé, la psychométrie contemporaine adopte une posture beaucoup plus circonspecte à leur égard. Transformer une variable modifie fondamentalement la métrique sous-jacente du construit théorique investigué. L’intervalle séparant deux points sur l’échelle transformée ne possède plus la même signification selon que l’on se situe au début ou à la fin du spectre distributionnel.
Cette altération métrologique devient particulièrement préjudiciable lorsqu’il s’agit de repérer des seuils diagnostiques standardisés. Les échelles cliniques (par exemple l’indice de détresse péri-traumatique ou l’inventaire d’épuisement professionnel de Maslach) disposent de scores de coupure établis par consensus médical sur la base de scores bruts additifs. Déformer mathématiquement la variable dépendante invalide ces scores repères et complique considérablement l’intégration des résultats au sein de synthèses quantitatives ultérieures ou de méta-analyses systématiques.
Par ailleurs, une transformation non linéaire inadéquate appliquée dans le seul but de comprimer l’hétéroscédasticité peut avoir pour effet pervers d’induire une non-linéarité artificielle dans la relation reliant les régresseurs à la moyenne de la variable réponse. Le remède devient alors pire que le mal : en tentant de régulariser la dispersion des résidus, l’analyste altère la justesse même des coefficients de pente, ruinant l’architecture logique de son modèle explicatif.
10. Méthodes d’estimation alternatives sans transformation de données
10.1 Erreurs-types robustes à l’hétéroscédasticité (estimateurs de White/Huber)
Face aux limites herméneutiques des transformations de variables, la statistique moderne privilégie une stratégie radicalement distincte : conserver scrupuleusement la métrique brute originale de la variable psychologique, préserver l’estimation MCO non biaisée des coefficients, et substituer au calcul ordinaire de la matrice de covariance un estimateur asymptotique robuste à l’hétéroscédasticité (dit estimateur « sandwich » de Huber-White).
L’architecture de l’estimateur sandwich repose sur la séparation structurelle de la formule de covariance matricielle :
Varrobuste(b) = (XTX)-1 [XT Ω X] (XTX)-1
Le « pain » extérieur de la structure sandwich est matérialisé par (XTX)-1, tandis que la « viande » centrale Ω consiste en une matrice diagonale estimant la variance résiduelle propre à chaque observation empirique.
Diverses déclinaisons algorithmiques de cette matrice centrale ont été développées afin d’optimiser les performances de l’estimateur en fonction de la taille de l’échantillon :
- HC0 : Formulation asymptotique originale de White (1980), où Ω = diag(ei2). Bien qu’irréprochable au sein d’échantillons massifs (N > 500), HC0 tend à sous-estimer significativement les erreurs-types réelles dans les petits échantillons, maintenant une inflation indésirable du risque de type I.
- HC1 : Modification élémentaire introduite par MacKinnon et White (1985), appliquant un facteur de correction d’échelle dépendant des degrés de liberté globaux : n / (n – k – 1). L’amélioration reste marginale face à de fortes hétérogénéités locales.
- HC2 : Formulation intégrant les valeurs de levier diagonalisées de la matrice chapeau : Ω = diag(ei2 / (1 – hii)). Cette pondération compense l’atténuation systématique de la variance des résidus pour les observations exerçant une forte influence spatiale.
- HC3 : Correction avancée préconisée par Davidson et MacKinnon (1993), divisant les carrés résiduels par le carré du complément de levier : Ω = diag(ei2 / (1 – hii)2).
Les simulations de Monte Carlo conduites spécifiquement sur des données comportementales et cliniques (Long & Ervin, 2000) désignent sans équivoque la variante HC3 comme l’étalon méthodologique par excellence. HC3 maintient un contrôle parfait de l’erreur de première espèce (α ≤ 0,05), même sous des régimes d’hétéroscédasticité sévère et en présence d’échantillons modestes (N ≤ 50). En psychologie contemporaine, le recours systématique aux erreurs-types robustes HC3 constitue la démarche préférentielle dès lors que la variance des perturbations présente une instabilité non corrigible.
10.2 Régression par les moindres carrés pondérés (WLS)
Bien que l’usage des erreurs-types robustes HC3 assainisse parfaitement l’inférence statistique (tests t et intervalles de confiance redevenus valides), il ne restitue pas la propriété d’efficacité optimale aux coefficients estimés : sous hétéroscédasticité, l’estimateur MCO ne constitue plus le meilleur estimateur linéaire non biaisé (perte du statut BLUE). Si l’objectif du chercheur est de maximiser la précision prédictive et d’obtenir des estimateurs de variance minimale, la méthode des moindres carrés pondérés (Weighted Least Squares, WLS) — cas particulier des moindres carrés généralisés (GLS) — s’impose d’un point de vue analytique.
Le principe fondamental de la régression WLS consiste à moduler l’influence de chaque sujet dans le calcul de l’ajustement linéaire en fonction de la fiabilité de sa mesure. Mathématiquement, chaque observation i se voit attribuer un poids statistique wi inversement proportionnel à la variance de son terme d’erreur conditionnel :
wi = 1 / σi2
Les observations caractérisées par un bruit stochastique modeste (faible variance résiduelle) reçoivent un poids élevé dans le système d’optimisation ; inversement, les points entachés d’une dispersion résiduelle massive sont fortement minorés dans le calcul de la fonction de perte minimisée :
SWLS = ∑ wi (Yi – Ŷi)2
La mise en œuvre pratique de la régression WLS se heurte cependant à une difficulté technique majeure : la véritable fonction de variance conditionnelle σi2 est strictement inconnue dans les protocoles psychologiques transversaux conventionnels (faute de mesures répétées permettant de calculer directement une variance intra-sujet). L’analyste doit dès lors recourir aux moindres carrés pondérés réalisables (FGLS) : modéliser dans un premier temps la variance des résidus MCO en fonction des régresseurs, extraire les prédictions de cette variance pour calculer les poids estimés ŵi, puis estimer l’équation finale pondérée. Toute erreur de spécification dans ce modèle auxiliaire de variance dégrade les propriétés de l’estimateur final, exigeant une grande prudence méthodologique.
10.3 Modèles linéaires généralisés pour l’emplacement et l’échelle (GAMLSS)
L’approche la plus avancée et épistémologiquement la plus féconde pour traiter la variance non constante consiste à ne plus considérer l’hétérogénéité de la variance comme une nuisance méthodologique qu’il conviendrait de neutraliser, mais comme un objet de modélisation psychologique substantiel à part entière. Cette révolution conceptuelle est incarnée par le cadre des modèles additifs généralisés pour l’emplacement, l’échelle et la forme (Generalized Additive Models for Location, Scale and Shape, GAMLSS), formalisé par Rigby et Stasinopoulos (2005).
Au sein de l’architecture GAMLSS, l’analyste ne spécifie pas une équation unique restreinte à l’espérance conditionnelle (le paramètre d’emplacement μ), mais spécifie conjointement et explicitement un sous-modèle de régression pour le paramètre d’échelle (la variance ou l’écart-type σ), voire pour les paramètres de forme (asymétrie ν et aplatissement τ). Les deux équations sont estimées simultanément par des algorithmes d’optimisation de vraisemblance pénalisée :
g1(μi) = β0 + ∑ βjXij (modèle pour la moyenne)
g2(σi) = γ0 + ∑ γjZij (modèle pour la variabilité résiduelle)
où g1(·) et g2(·) représentent des fonctions de lien appropriées (la fonction logarithmique étant généralement retenue pour g2 afin de contraindre l’écart-type σi à des valeurs strictement positives).
Dans notre étude sur le stress et la cognition, un modèle GAMLSS permettrait non seulement de quantifier la dégradation moyenne de la mémoire de travail sous stress (βstress < 0), mais également d’établir formellement que l’instabilité cognitive augmente sous stress aigu (γstress > 0). Cette modélisation permet d’identifier précisément les prédicteurs individuels ou cliniques (comme l’âge ou la réserve cognitive) capables d’amortir cette dérive de variance. L’hétéroscédasticité cesse d’être une anomalie technique pour devenir une source majeure d’intelligibilité neuropsychologique.
11. L’homoscédasticité dans les plans factoriels et les modèles multiniveaux
11.1 Équivalence avec l’homogénéité des variances en ANOVA
Il existe une correspondance mathématique directe entre l’homoscédasticité en régression linéaire et le postulat classique d’homogénéité des variances (ou isovariance) dans l’analyse de variance (ANOVA). L’ANOVA ne constitue en réalité qu’un cas particulier du modèle linéaire général, où la matrice des prédicteurs X est composée exclusivement de variables qualitatives discrètes codées sous forme d’indicatrices (variables muettes ou codage d’effet). Dès lors, affirmer que les résidus d’une régression sont homoscédastiques équivaut rigoureusement à postuler que les variances de l’erreur d’échantillonnage sont strictement identiques d’un groupe expérimental à l’autre :
σ12 = σ22 = … = σk2
Pour éprouver cette homogénéité dans les dispositifs factoriels, les chercheurs recourent traditionnellement au test de Levene (ou à sa variante modernisée par Brown et Forsythe utilisant les médianes plutôt que les moyennes des groupes afin de maximiser la robustesse contre la non-normalité), ainsi qu’au test de Bartlett. Toutefois, l’impact d’une violation de ce postulat dépend de la configuration d’échantillonnage mise en œuvre :
- Plans factoriels équilibrés : Lorsque les effectifs sont strictement identiques dans chaque condition expérimentale (n1 = n2 = … = nk), l’ANOVA bénéficie d’une résilience remarquable face aux hétérogénéités de variance modérées. L’inflation du risque de première espèce demeure généralement contrôlée.
- Plans factoriels déséquilibrés : Dès lors que les tailles d’échantillons divergent substantiellement d’un groupe à l’autre, la rupture de l’homogénéité des variances devient problématique. Si les groupes les plus restreints en effectif présentent les variances d’erreur les plus volumineuses, le test F de Fisher ordinaire devient excessivement libéral, induisant un taux alarmant de fausses découvertes statistiques. Si, inversement, les grands groupes affichent la plus forte dispersion, le test devient ultra-conservateur, laminant la puissance statistique de l’expérimentation.
Dans ce contexte factoriel hétérogène, les corrections de Welch ou l’ANOVA de Brown-Forsythe s’imposent pour préserver la validité de l’inférence causale issue des plans expérimentaux de laboratoire.
11.2 Variance résiduelle dans les modèles mixtes et hiérarchiques (HLM)
L’expansion contemporaine des protocoles d’évaluation écologique momentanée (Ecological Momentary Assessment, EMA) et des devis d’échantillonnage des expériences (Experience Sampling Method, ESM) a propulsé les modèles de régression multiniveaux (ou modèles hiérarchiques mixtes, HLM) au premier rang de l’analyse comportementale. Dans ces configurations complexes, le postulat de variance constante doit être réexaminé à chaque niveau hiérarchique de l’architecture d’échantillonnage.
Au niveau 1 (le niveau intra-individuel des mesures répétées au fil des jours ou des heures), l’homoscédasticité suppose que la variance des résidus d’un participant spécifique autour de sa propre trajectoire d’humeur demeure stable au fil du temps et ne varie pas selon les contextes environnementaux. Au niveau 2 (le niveau inter-individuel), le postulat impose que cette variance d’erreur intra-sujet σe2 soit strictement identique pour tous les participants inclus dans l’étude :
eti ∼ N(0, σe2), ∀ i
Cette double hypothèse est presque systématiquement violée dans les données écologiques réelles. Les patients souffrant de troubles bipolaires ou d’un trouble de personnalité borderline affichent une variabilité affective intra-journalière nettement supérieure à celle observée chez des témoins sains. Imposer une structure matricielle résiduelle homoscédastique globale contraint arbitrairement l’ensemble des trajectoires à une dispersion moyenne trompeuse.
L’omission de cette hétérogénéité de variance au niveau 1 déforme substantiellement l’estimation des composantes de la variance des effets aléatoires au niveau 2 (la matrice G des ordonnées et pentes aléatoires) et gonfle les erreurs-types associées aux interactions transniveaux. Les logiciels contemporains de modélisation mixte (comme les paquetages lme4 ou nlme sous R) permettent de spécifier des matrices de variance résiduelle hétérogènes dépendant explicitement des caractéristiques des sous-groupes cliniques (via des arguments de type weights = varIdent(form = ~ 1 | GroupeClinique)), garantissant ainsi une conformité rigoureuse avec la complexité empirique des données dynamiques.
12. Recommandations méthodologiques et directives de publication académique
12.1 Protocole systématique de vérification pour les chercheurs en psychologie
Afin de prémunir les chercheurs contre les biais d’inférence et d’ancrer les pratiques statistiques dans les plus hauts standards méthodologiques, nous recommandons l’adoption d’un protocole décisionnel séquentiel en trois étapes distinctes préalablement à toute conclusion inférentielle :
Étape 1 : Inspection visuelle systématique des résidus. Immédiatement après l’ajustement de tout modèle de régression linéaire, l’investigateur doit générer et inspecter deux graphiques diagnostiques fondamentaux : le graphique des valeurs prédites contre les résidus studentisés externes, et le graphique d’emplacement-échelle (Scale-Location plot). L’attention doit se focaliser sur l’absence de motif en entonnoir, en sablier ou d’ondulations non linéaires, vérifiant l’uniformité de l’épaisseur de dispersion sur l’ensemble de la plage des scores prédits.
Étape 2 : Confirmation par des épreuves de robustesse distributionnelle. L’impression graphique doit être complétée par l’exécution du test de Breusch-Pagan avec correction de studentisation de Koenker. Si la taille de l’échantillon est restreinte (N ≤ 100) et que le modèle comporte peu de prédicteurs, le test de White sera conjointement appliqué pour traquer d’éventuelles modulations non linéaires de la variance. L’investigateur interprétera les seuils de significativité en tenant compte de la puissance de l’échantillon, sans fétichisme dogmatique autour de la valeur p = 0,05.
Étape 3 : Sélection motivée de la stratégie analytique. En cas de mise en évidence d’une hétéroscédasticité confirmée :
- Si la métrique de la variable dépendante s’y prête de façon indiscutable (temps de réaction bruts, marqueurs biologiques), une transformation mathématique théoriquement justifiée (logarithmique) peut être envisagée.
- Dans tous les cas impliquant des échelles psychométriques ordinales, des scores cliniques composites ou des mesures standardisées, l’analyste privilégiera le maintien des scores bruts originaux couplé à l’estimation de la matrice de covariance par des erreurs-types robustes HC3.
- Si l’hétérogénéité de la variance constitue en elle-même un vecteur de compréhension psychologique, la bascule vers des modèles GAMLSS ou des régressions multiniveaux hétéroscédastiques sera priorisée.
12.2 Conformité aux standards de publication scientifique (APA 7e édition)
Les directives éditoriales actuelles de l’American Psychological Association (APA 7e édition) ainsi que les recommandations internationales du Journal Article Reporting Standards (JARS-Quant) imposent une transparence absolue quant à la validation des postulats d’inférence statistique. Les sections « Résultats » des publications académiques ne peuvent plus se contenter d’aligner des coefficients de régression sans apporter la preuve méthodologique de la validité distributionnelle de leurs erreurs.
Les auteurs ont l’obligation explicite d’insérer une description documentée des vérifications diagnostiques entreprises. Si l’homoscédasticité a été confirmée, la statistique de test appropriée doit être formellement rapportée dans le corps du texte (par exemple : « L’inspection des graphiques des résidus studentisés couplée au test de Breusch-Pagan-Koenker n’a révélé aucune violation significative du postulat d’homoscédasticité, χ²(3) = 2,41, p = 0,491 »).
Dès lors qu’une hétérogénéité de variance a été constatée et corrigée, l’article doit impérativement expliciter l’utilisation d’erreurs-types robustes en spécifiant le modèle algorithmique exact employé (idéalement HC3), en rapportant les degrés de liberté ajustés et les nouveaux intervalles de confiance à 95 %. Dans une perspective de science ouverte (Open Science Framework, OSF), les chercheurs sont instamment invités à déposer leurs scripts d’analyse complets (fichiers de syntaxe R, JASP ou Python) ainsi que les représentations graphiques diagnostiques haute résolution au sein des annexes méthodologiques en ligne, permettant un examen critique approfondi lors du processus d’évaluation par les pairs.
12.3 Checklist finale pour l’évaluation de la variance constante
Avant de finaliser tout rapport psychométrique ou manuscrit de recherche clinique, l’analyste s’assurera d’avoir validé l’intégralité des points de contrôle rassemblés au sein de la grille d’auto-évaluation suivante :
- [ ] Les résidus analysés pour le diagnostic de variance sont-ils des résidus studentisés (internes ou externes) prenant en considération la distance de levier des observations individuelles ?
- [ ] L’éventail de dispersion verticale des points sur le graphique Residuals vs Fitted conserve-t-il une morphologie rectangulaire uniforme sur la totalité de l’axe horizontal des prédictions ?
- [ ] A-t-on formellement vérifié qu’un apparent motif d’hétéroscédasticité en entonnoir ne dissimule pas une spécification incomplète du modèle (omission d’un terme curvilinéaire ou d’une interaction majeure) ?
- [ ] Le test de Breusch-Pagan employé intègre-t-il la correction de studentisation de Koenker afin de se prémunir contre l’impact trompeur d’une distribution asymétrique ou leptokurtique des erreurs ?
- [ ] En cas de recours aux erreurs-types robustes, a-t-on explicitement privilégié l’estimateur HC3, reconnu comme la méthode la plus performante pour maîtriser l’erreur de type I en sciences du comportement ?
- [ ] Si une transformation mathématique non linéaire a été appliquée, les coefficients sont-ils interprétés dans le strict respect de leur métrique modifiée sans extrapolations indues sur l’échelle originale ?
- [ ] L’interprétation théorique et clinique finale repose-t-elle sur des intervalles de prédiction dont la marge d’erreur reflète fidèlement la variabilité réelle propre à chaque niveau d’analyse des sujets ?
La mise en œuvre consciencieuse et systématique de cette démarche méthodologique constitue le rempart le plus sûr contre la dissémination de faux positifs en sciences humaines. En conférant à l’hypothèse de variance constante l’attention analytique qu’elle exige rigoureusement, la psychologie empirique s’assure de bâtir ses théories explicatives et ses applications cliniques sur des fondations statistiques inébranlables.
Références
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211-243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287-1294. https://doi.org/10.2307/1911963
- Cohen, S., Kamarck, T., & Mermelstein, R. (1983). A global measure of perceived stress. Journal of Health and Social Behavior, 24(4), 385-396. https://doi.org/10.2307/2136404
- Davidson, R., & MacKinnon, J. G. (1993). Estimation and inference in econometrics. Oxford University Press.
- Koenker, R. (1981). A note on studentizing a test for heteroscedasticity. Journal of Econometrics, 17(1), 107-112. https://doi.org/10.1016/0304-4076(81)90062-2
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217-224. https://doi.org/10.1080/00031305.2000.10474549
- MacKinnon, J. G., & White, H. (1985). Some heteroskedasticity-consistent covariance matrix estimators with improved finite sample properties. Journal of Econometrics, 29(3), 305-325. https://doi.org/10.1016/0304-4076(85)90022-5
- Rigby, R. A., & Stasinopoulos, D. M. (2005). Generalized additive models for location, scale and shape. Journal of the Royal Statistical Society: Series C (Applied Statistics), 54(3), 507-554. https://doi.org/10.1111/j.1467-9876.2005.00510.x
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817-838. https://doi.org/10.2307/1912934