
L’avènement des environnements infonuagiques appliqués à l’analyse de données a profondément transformé les pratiques de manipulation tabulaire contemporaines. Au sein de cet écosystème, Google Sheets s’est hissé au rang de standard universel en intégrant des fonctionnalités computationnelles avancées héritées du calcul matriciel et de la théorie relationnelle des bases de données. Parmi ces instruments de calcul, la fonction QUERY représente indéniablement le paradigme le plus puissant pour interroger, transformer, projeter et structurer des ensembles d’informations bidimensionnels complexes, sans nécessiter le recours à des scripts compilés ou à des architectures logicielles tierces.
Dans le cadre des investigations empiriques, de la veille stratégique ou de la gestion opérationnelle de données volumineuses, l’extraction ciblée de sous-ensembles d’attributs horizontaux et verticaux constitue une nécessité permanente. La sélection simultanée de plusieurs colonnes via la clause SELECT ne représente pas un simple exercice d’affichage esthétique ; elle relève d’une opération formelle de projection algébrique visant à isoler des variables d’intérêt, à optimiser l’allocation de la mémoire vive et à préserver l’intégrité relationnelle entre les enregistrements. Maîtriser les rouages de cette opération élémentaire en apparence exige toutefois une compréhension aiguë du moteur d’exécution sous-jacent, des règles de typage strictes imposées par l’API de visualisation de Google, ainsi que des interactions subtiles entre notation littérale et notation indicée.
Ce traité exhaustif se propose d’explorer méthodiquement l’intégralité des dimensions théoriques, syntaxiques et appliquées de la sélection de colonnes multiples au sein de la fonction QUERY. En abordant les fondations mathématiques de l’algèbre relationnelle, la sémantique de l’énumération par virgule, le rôle fondamental des métadonnées d’en-tête, les subtilités du filtrage conjoint, ainsi que les stratégies de débogage et d’optimisation de la mémoire, ce document offre une grille de lecture exhaustive conçue pour les chercheurs, analystes et architectes de données soucieux d’élever la rigueur de leurs modèles tabulaires vers des standards industriels et académiques.
1. Fondements théoriques et syntaxe générale de la fonction QUERY
1.1 Origine et intégration du langage de requête de Google Visualization API
L’architecture interne de la fonction QUERY de Google Sheets ne découle pas d’une simple extension des bibliothèques matricielles traditionnelles des tableurs de bureau. Elle constitue une implémentation directe du langage de requête associé à l’API Google Visualization (Google Visualization API Query Language). Ce langage déclaratif s’inspire très largement des principes fondateurs du Structured Query Language (SQL), formalisé initialement par Edgar F. Codd dans le cadre du modèle relationnel de données. En important la sémantique SQL au cœur d’une feuille de calcul, Google Visualization API permet aux analystes d’exécuter des instructions déclaratives où l’utilisateur spécifie précisément quelles transformations matricielles doivent être opérées, laissant au moteur de calcul interne le soin de déterminer le plan d’exécution optimal.
Sur le plan des performances algorithmiques et de la charge computationnelle, la fonction QUERY surpasse radicalement les combinaisons conventionnelles de formules imbriquées telles que INDEX, MATCH, VLOOKUP, XLOOKUP ou FILTER. Tandis que l’empilement de fonctions traditionnelles nécessite de multiples passes d’évaluation à travers la structure de l’arbre syntaxique du tableur — engendrant une complexité temporelle souvent prohibitive sur des jeux de données denses —, QUERY traite la chaîne d’instructions en une unique opération vectorielle optimisée. Le moteur compile la chaîne textuelle, génère une table abstraite en mémoire, applique les filtres et projections demandés, puis restitue un résultat matriciel dynamique via le mécanisme des plages expansives (spill ranges).
D’un point de vue épistémologique, l’intégration d’un tel paradigme déclaratif modifie en profondeur la relation entre le chercheur et ses données. Dans les protocoles de recherche quantitative et empirique, la possibilité de formaliser des requêtes univoques, reproductibles et expressives garantit une auditabilité parfaite des transformations appliquées à la matrice de données. L’analyste s’affranchit des contingences spatiales de la grille pour raisonner sur des espaces vectoriels de dimensions finies, où chaque colonne incarne une variable aléatoire ou un descripteur sémiotique, et chaque ligne un événement expérimental ou un individu statistique.
1.2 Décomposition structurelle de la formule canonique
L’invocation de la fonction QUERY obéit à une signature syntaxique stricte, formalisée par trois arguments fondamentaux : la plage de référence, la chaîne textuelle de commande et le paramètre optionnel des en-têtes. L’expression canonique s’énonce comme suit : =QUERY(données; « requête »; [en_têtes]). Le premier paramètre délimite la matrice bidimensionnelle brute sur laquelle s’exercera l’interrogation. Cette plage de données peut se présenter sous la forme d’une référence directe à des cellules physiques d’une feuille locale (par exemple Feuille1!A1:Z5000), d’une plage nommée issue du gestionnaire de métadonnées, ou encore d’une matrice virtuelle construite dynamiquement au moyen d’accolades d’assemblage.
Le deuxième argument, la chaîne de commande, encapsule l’énoncé textuel écrit dans le dialecte de l’API de visualisation. Ce paramètre exige une rigueur syntaxique absolue : il doit être systématiquement délimité par des guillemets typographiques droits doubles standard. Les clauses qui le composent (telles que SELECT, WHERE, GROUP BY, PIVOT, ORDER BY, LIMIT, OFFSET ou LABEL) doivent impérativement respecter la casse des mots-clés, le standard exigeant généralement l’emploi systématique de lettres majuscules pour garantir la parfaite lisibilité de l’analyse logique, bien que l’analyseur syntaxique tolère certaines variations sur les identifiants d’instructions.
Le troisième argument, désignant les en-têtes, précise le nombre de lignes horizontales au sommet de la plage qui doivent être interprétées comme des métadonnées d’identification textuelle plutôt que comme des enregistrements d’observation. L’évaluation du flux d’exécution dépend de la résolution séquentielle de ces trois arguments : le système vérifie d’abord l’intégrité référentielle de la source, compile l’arborescence lexicale de la requête textuelle, applique le découpage horizontal des métadonnées, et projette enfin les colonnes requises dans un tableau dynamique expansif qui peuple les cellules adjacentes sans altérer les valeurs sous-jacentes d’origine.
1.3 Modèle relationnel sous-jacent et typage strict des données
L’une des caractéristiques les plus méconnues, et pourtant les plus critiques, de la fonction QUERY réside dans son modèle de typage strict des colonnes, fondé sur la règle de l’homogénéité du type majoritaire. Contrairement au comportement standard d’une feuille Google Sheets, capable d’héberger au sein d’une même colonne des entiers, des nombres à virgule flottante, des chaînes de caractères alphanumériques et des valeurs booléennes sans déclencher d’anomalie manifeste, le moteur de QUERY exige une consistance typologique absolue au sein de chaque dimension verticale interrogée.
Lorsqu’une colonne est examinée par le moteur de visualisation, celui-ci procède à un échantillonnage statistique afin de déterminer le type dominant : numérique, textuel ou temporel (date/horodatage). Une fois cette qualification opérée, toute valeur discordante — c’est-à-dire non conforme au type majoritaire — subit une nullification silencieuse (silent nullification). Cela signifie qu’une cellule contenant du texte au milieu d’une colonne considérée comme numérique sera restituée sous la forme d’un vide absolu, sans générer de message d’erreur d’interruption. Ce phénomène peut induire des biais cognitifs et analytiques sévères lors de l’agrégation ou de la sélection de variables composites.
Pour la sélection de colonnes multiples, ce modèle relationnel implique que l’analyste doit impérativement auditer la pureté de chaque colonne ciblée avant d’en effectuer la projection. La distinction stricte entre les types scalaires conditionne également la validité des clauses d’extraction : on ne saurait appliquer des opérateurs arithmétiques ou des clauses de sélection séquentielle sans s’assurer que la chaîne de typage n’a pas été corrompue en amont. L’assainissement préalable du corpus de données constitue par conséquent un prérequis méthodologique indispensable à tout traitement analytique pérenne.
2. Décomposition anatomique de la clause SELECT appliquée à plusieurs colonnes
2.1 Syntaxe de l’énumération explicite des identifiants de colonnes
La clause SELECT incarne l’opérateur de projection formelle au sein du langage d’interrogation de Google Sheets. Lorsqu’il s’agit d’extraire non point un vecteur isolé mais une pluralité de descripteurs vectoriels, la syntaxe impose une énumération ordonnée et strictement séparée par des virgules. Chaque élément de la liste correspond à un identifiant de colonne physique de la feuille source lorsque la plage est passée sous forme directe. Ainsi, la formulation SELECT A, B, C, F indique formellement au compilateur d’extraire la première, la deuxième, la troisième et la sixième colonne de la matrice de données, en faisant abstraction des colonnes intermédiaires.
L’utilisation de la virgule comme opérateur de séparation syntaxique stricte obéit à des conventions typographiques précises. L’omission d’une virgule entre deux identifiants de colonnes (par exemple en écrivant SELECT A B au lieu de SELECT A, B) conduit irrémédiablement à une rupture de l’analyseur syntaxique, qui interprète la seconde lettre comme un modificateur ou un alias non autorisé, déclenchant l’erreur #VALUE! avec la notification d’échec de parsing. En revanche, l’insertion d’espaces simples après les virgules est non seulement tolérée, mais hautement recommandée pour réduire la charge cognitive et faciliter la relecture par les pairs.
Dans les requêtes de haute complexité impliquant la sélection de dizaines de variables covariables, il est parfaitement possible de structurer la chaîne textuelle sur plusieurs lignes au moyen de la concaténation de chaînes ou de retours à la ligne insérés directement au sein de la formule. La gestion des guillemets revêt ici une importance capitale : la chaîne globale étant délimitée par des guillemets doubles, toute sous-instruction textuelle ou référence littérale à l’intérieur de la requête devra faire appel à des apostrophes simples (guillemets simples), évitant ainsi les conflits d’échappement qui paralysent fréquemment les architectures de requêtes imbriquées.
2.2 Correspondance positionnelle et sémantique des variables extraites
Le mappage positionnel établi par la clause SELECT opère une dissociation complète entre l’organisation spatiale physique des données sur la feuille source et la représentation projetée dans le tableau de destination. Dans la feuille de calcul d’origine, les colonnes sont physiquement assujetties à l’ordre alphabétique immuable de l’interface (A, B, C, etc.). Dès lors qu’elles sont traitées par le moteur de projection de QUERY, ces lettres deviennent de purs identifiants de variables décorrélés de toute contrainte de contiguïté ou de directionalité séquentielle.
Cette indépendance structurelle autorise une liberté herméneutique totale : l’analyste peut extraire les variables dans l’ordre rigoureusement dicté par son protocole d’analyse plutôt que par l’ordre chronologique de saisie des données. Si une table contient le numéro d’identification d’un sujet en colonne A, son score expérimental en colonne H et son groupe démographique en colonne C, la commande SELECT A, C, H permettra de construire une synthèse dense et cohérente, épargnant au lecteur l’effort d’ignorer visuellement les colonnes intermédiaires B, D, E, F et G.
Au-delà de la commodité ergonomique, cette sélection sélective préserve l’intégrité relationnelle entre les enregistrements horizontaux. Chaque ligne générée dans la matrice de sortie maintient une adhérence stricte et non déphasée entre les valeurs des colonnes A, C et H pour chaque individu statistique. Il ne s’agit pas de copies vectorielles autonomes et désynchronisées, mais d’une translation coordonnée de tuples relationnels intègres, garantissant la fiabilité des analyses comparatives ultérieures.
3. Gestion rigoureuse de l’argument des en-têtes et intégrité structurale
3.1 Comportement du troisième argument optionnel : 0, 1 ou valeur nulle
L’omission récurrente du troisième argument de la fonction QUERY — le paramètre headers — représente l’une des sources les plus prolifiques de corruptions structurelles dans les feuilles de calcul complexes. Bien que la documentation officielle qualifie ce paramètre d’optionnel, son explicitation rigoureuse constitue une règle impérative de bonne pratique méthodologique. Ce paramètre attend une valeur entière indiquant le nombre exact de rangées de la plage source qui doivent être interprétées comme des métadonnées d’en-tête.
Lorsque l’argument est fixé formellement à 1, le moteur traite sans ambiguïté la première rangée de la sélection comme les étiquettes des variables, lesquelles seront projetées en tête de la matrice de sortie sans subir les règles de typage des données sous-jacentes. Si l’argument est configuré à 0, l’interpréteur considère que la totalité des rangées de la plage constitue des données brutes, et aucune ligne d’en-tête artificielle ne sera injectée ni traitée distinctement. Le tableau résultant débutera immédiatement à la première ligne de valeurs scalaires.
En revanche, lorsque l’argument est omis ou laissé à une valeur nulle non déclarée, Google Sheets active un algorithme heuristique de détection probabiliste. Cet algorithme compare les types de données dominants de la première ligne avec les types des lignes inférieures. Or, si les premières rangées de données contiennent des chaînes textuelles dans une colonne de même typologie que l’en-tête, l’heuristique échoue fréquemment et agrège de manière involontaire la ligne de titre avec les premières lignes de données, ou génère une ligne d’en-tête fusionnée désastreuse. La fixation délibérée de la valeur (généralement 1 dans les tables normalisées) constitue la seule garantie d’une reproductibilité scientifique absolue.
3.2 Traitement des en-têtes composites et hiérarchiques
Dans de multiples corpus de données — notamment ceux issus de formulaires de recherche, de bases de données multidimensionnelles ou de systèmes de gestion d’entreprise —, les données sont surmontées d’en-têtes composites occupant plusieurs lignes consécutives. Une matrice peut comporter, par exemple, une ligne indiquant la catégorie générale de variables (ex. Données démographiques, Épreuves cognitives) et une sous-ligne stipulant la mesure spécifique (ex. Âge, Temps de réaction, Indice de précision).
Lorsque le paramètre headers reçoit une valeur strictement supérieure à l’unité (par exemple 2 ou 3), l’interpréteur de QUERY applique une stratégie de concaténation automatique sur les métadonnées. Les chaînes de caractères occupant verticalement les cellules de ces différentes lignes d’en-tête pour une colonne donnée sont fusionnées pour former une étiquette unique, séparée par une espace. Si la cellule A1 contient Catégorie et la cellule A2 contient Identifiant, l’en-tête projeté de la colonne A portera l’intitulé Catégorie Identifiant.
Bien que cette fonctionnalité offre une vue synthétique des hiérarchies, elle complexifie souvent les traitements subséquents en allongeant démesurément les chaînes de métadonnées. Deux stratégies alternatives s’offrent alors à l’analyste : soit neutraliser complètement la détection des en-têtes en définissant le paramètre sur 0 (en ajustant la plage source pour exclure physiquement les rangées d’en-têtes), permettant ainsi d’intégrer des en-têtes statiques ou sur mesure créés sur la feuille de restitution ; soit faire appel à la clause subsidiaire LABEL afin de réassigner programmatiquement des étiquettes concises et standardisées à chaque dimension sélectionnée.
4. Méthodologie pratique : Sélection simple de colonnes multiples
4.1 Cas d’usage fondamental : Extraction simultanée de colonnes ciblées
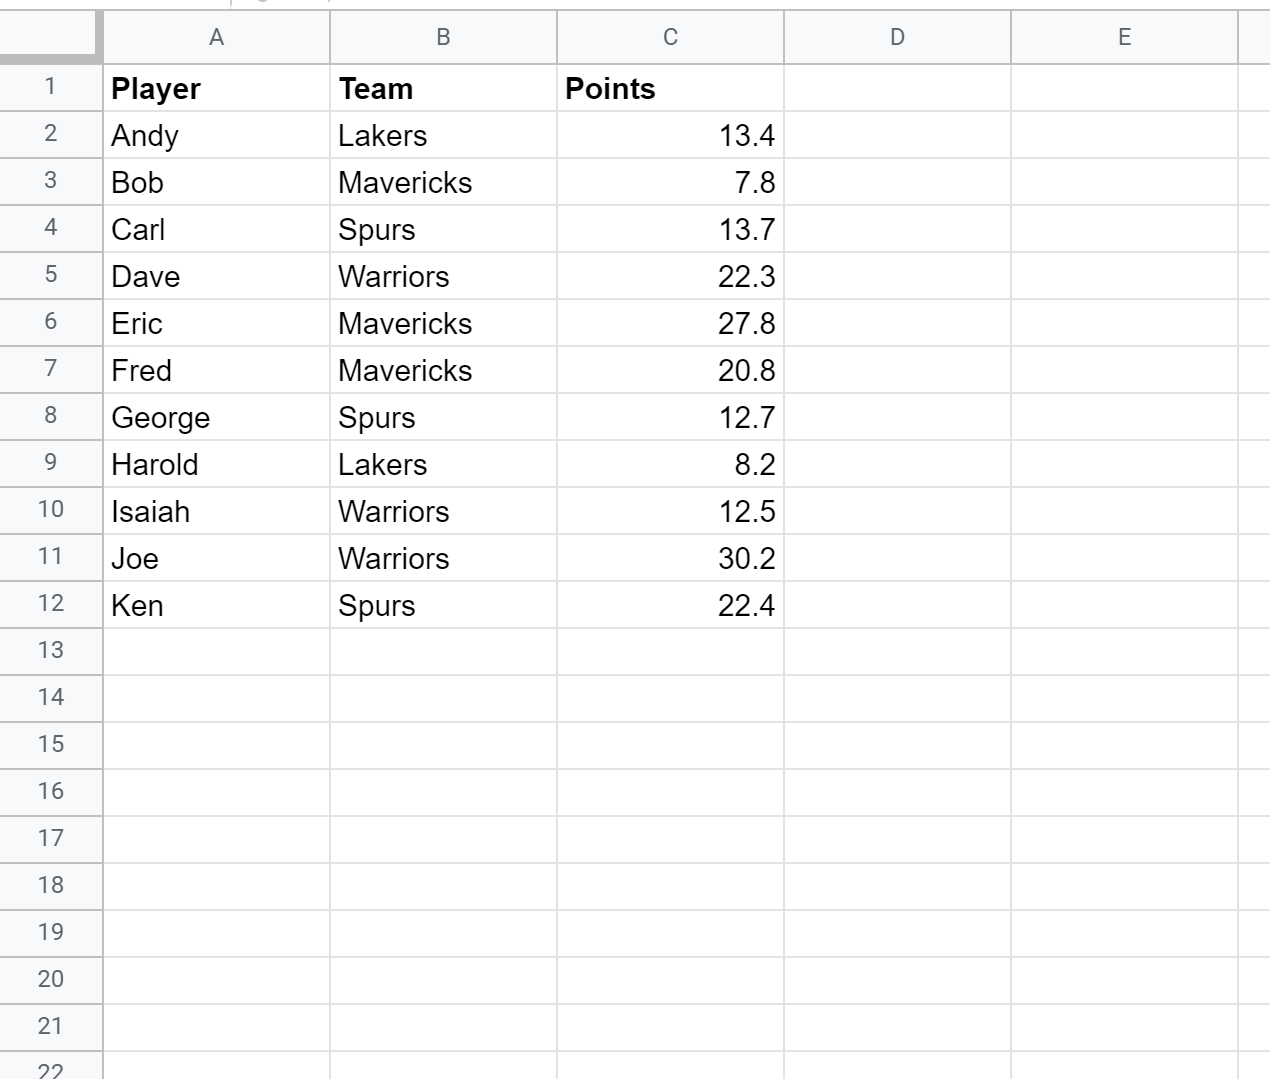
Pour appréhender concrètement la dynamique opérationnelle de la sélection multiple, considérons une table de données expérimentales hébergée dans la plage A1:G1000 d’un classeur. Cette structure relationnelle consigne les attributs suivants : l’identifiant du sujet (colonne A), l’âge chronologique (colonne B), le sexe biologique (colonne C), le protocole d’intervention appliqué (colonne D), le score pré-test (colonne E), le score post-test (colonne F) et le statut de complétion de l’épreuve (colonne G). Dans le cadre d’une étude préliminaire centrée exclusivement sur les performances avant et après intervention selon le sujet, les covariables démographiques et administratives doivent être temporairement écartées.
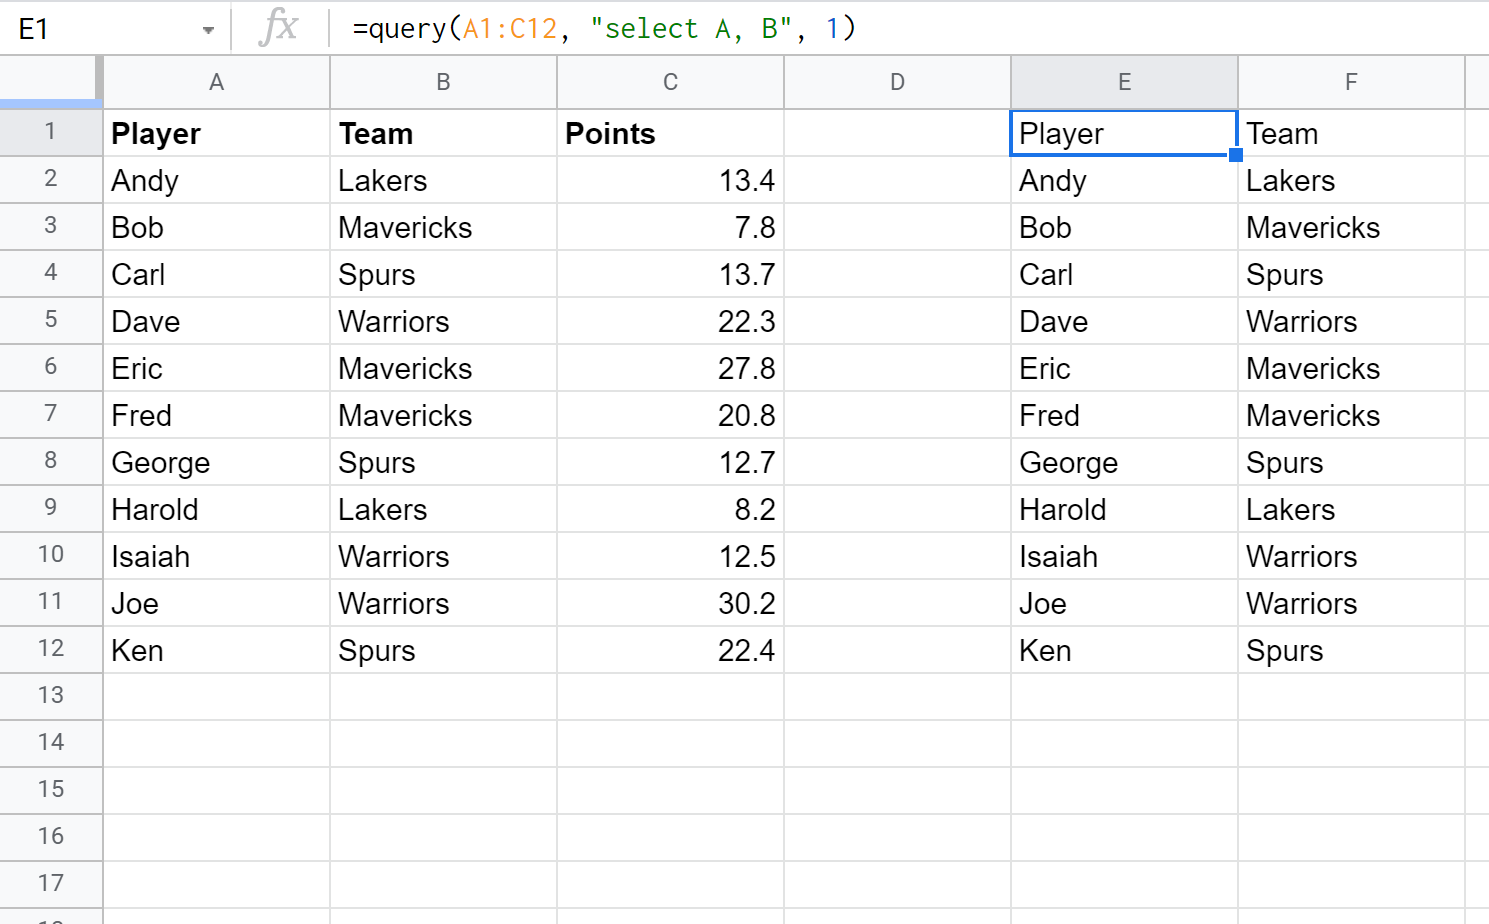
La transcription formelle de cette exigence analytique s’incarne dans la formule suivante : =QUERY(A1:G1000; « SELECT A, E, F »; 1). L’évaluation de cette instruction déclenche une série d’opérations rigoureusement coordonnées :
- Vérification de l’intégrité de la plage source A1:G1000 et réservation de l’espace matriciel dans la feuille de destination.
- Isolation de la ligne d’en-tête (ligne 1), garantissant que les libellés originaux des colonnes A, E et F seront fidèlement restitués au sommet de la nouvelle table.
- Extraction simultanée, pour chaque enregistrement compris entre la ligne 2 et la ligne 1000, du triplet d’attributs correspondant aux colonnes spécifiées.
- Omission intégrale et définitive de l’information contenue dans les colonnes B, C, D et G au sein de la vue projetée, sans pour autant altérer la mémoire de stockage de la source originale.
Le tableau généré à l’issue de cette exécution forme un ensemble relationnel cohérent de trois colonnes sur mille lignes, préservant la stricte correspondance horizontale des scores associés à chaque sujet individuel, tout en éliminant la pollution visuelle et conceptuelle des variables hors de propos.
4.2 Extraction de sous-ensembles de variables non adjacentes
L’un des apports méthodologiques les plus remarquables de QUERY par rapport aux manipulations manuelles réside dans sa capacité innée à opérer des sauts de colonnes non contiguës avec une fluidité totale. Dans les environnements traditionnels, isoler des colonnes disparates requiert fréquemment l’utilisation de masquages de colonnes (colonne masquée ou masquage de cellules), de redondants copier-coller statiques, ou la juxtaposition de multiples formules vectorielles susceptibles de se désynchroniser au moindre décalage accidentel d’une ligne.
En formulant par exemple la requête =QUERY(Inventaire!A1:Z; « SELECT A, D, M, X »; 1), l’architecte de données s’affranchit de la dispersion spatiale des variables dans une matrice à très haute dimensionnalité. Que la colonne D soit distante de la colonne M de neuf rangées, ou que la colonne X soit séparée de M par onze attributs intermédiaires, le moteur de QUERY extrait et resserre instantanément ces quatre vecteurs au sein d’une matrice dense à quatre colonnes contiguës.
Cette approche optimise considérablement les performances de calcul globales du tableur. En limitant la projection aux seules dimensions requises pour le calcul statistique ou la visualisation de bord, on réduit le volume d’arborescences de dépendances gérées par le moteur de recalcul automatique de Google Sheets. De surcroît, elle neutralise les risques d’erreurs humaines inhérents aux procédures manuelles, transformant la vue analytique en un pipeline automatisé, pérenne et aisément vérifiable.
5. Sélection exhaustive : L’opérateur générique SELECT * et ses implications
5.1 Mécanique de l’astérisque comme métacaractère d’inclusion globale
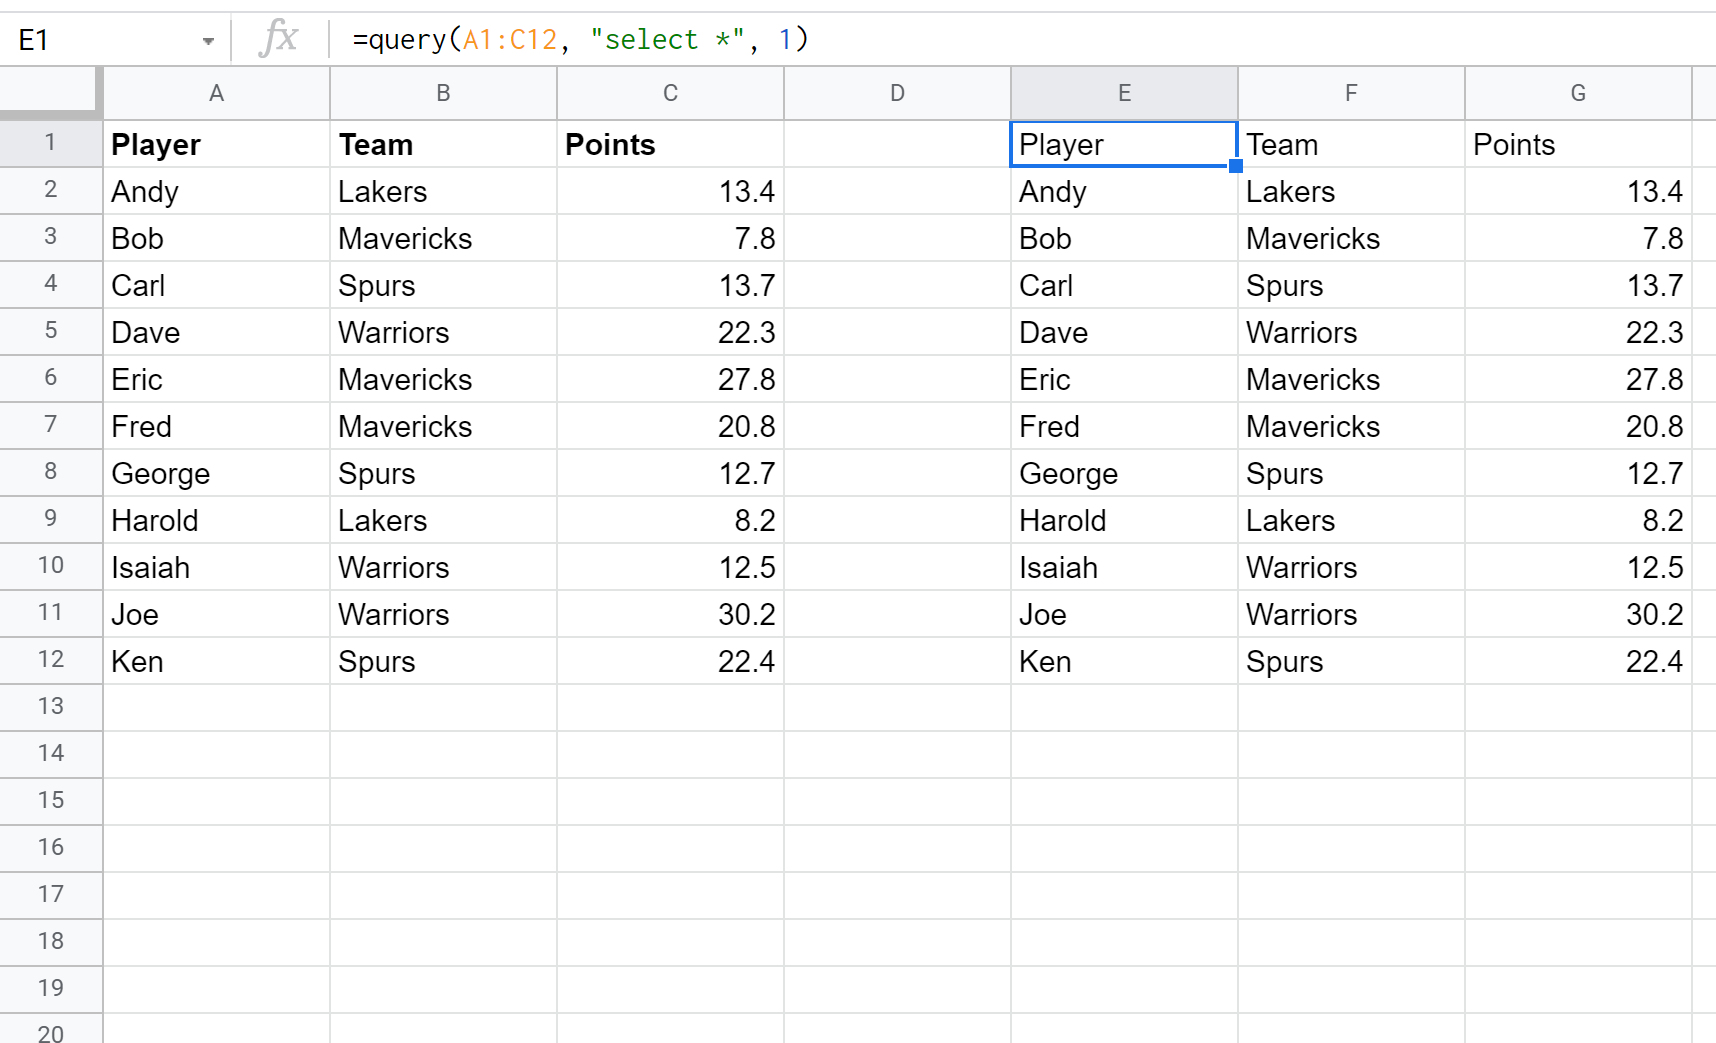
Dans la théorie des bases de données relationnelles, l’astérisque (*) assume la fonction de métacaractère d’universalité (wildcard). Transposé dans la syntaxe de Google Sheets, l’opérateur générique s’intègre via la formule canonique =QUERY(Données!A1:K; « SELECT * »; 1). Cette formulation intime l’ordre au moteur de transférer l’intégralité volumétrique et dimensionnelle de la matrice source vers l’espace de projection, sans aucune restriction verticale d’attributs.
Lors de l’évaluation de SELECT *, l’ordonnancement originel de l’ensemble des colonnes de la plage d’entrée est scrupuleusement préservé. La première colonne de la source occupera la première colonne de la projection, et ce jusqu’au dernier vecteur inclus dans la délimitation matricielle. Cette opération réalise ce que l’on qualifie couramment de miroir dynamique de données : la table réceptrice reflète en temps réel la moindre modification, insertion ou suppression de valeurs survenant dans le gisement source.
Les scénarios justifiant scientifiquement l’utilisation de SELECT * demeurent toutefois restreints à des cas d’usage bien circonscrits. On l’emploiera avantageusement pour créer des copies tampons de sécurité avant d’exécuter des formules déstructurantes, pour déporter l’intégralité d’un jeu de données vers un classeur secondaire via l’association avec IMPORTRANGE, ou encore pour servir de point d’ancrage à des tableaux croisés dynamiques nécessitant l’accès à l’ensemble du spectre informationnel sans altérer la table de saisie originale.
5.2 Limites et vulnérabilités de l’usage de SELECT * dans les systèmes pérennes
En dépit de sa commodité apparente et de sa concision syntaxique, l’utilisation systématique de SELECT * au sein de systèmes d’information pérennes ou d’architectures tabulaires d’entreprise constitue un antipattern méthodologique caractérisé. La vulnérabilité structurelle majeure de cette approche réside dans son extrême sensibilité aux altérations géométriques de la matrice source.
Si un collaborateur ou un processus automatisé procède à l’insertion impromptue d’une nouvelle colonne au sein de la plage source (par exemple en insérant une colonne C entre les anciennes colonnes B et C), la projection résultante verra sa largeur spatiale croître instantanément d’une unité. Toutes les formules dépendantes situées en aval qui faisaient référence aux colonnes projetées selon des coordonnées relatives ou fixes (telles que des fonctions SUM, VLOOKUP ou AVERAGE pointant sur les colonnes adjacentes) seront immédiatement décalées ou corrompues, introduisant des erreurs de référence ou des calculs faussés indétectables au premier coup d’œil.
Le principe de parcimonie académique commande de toujours privilégier l’énumération explicite des variables par rapport à la capture aveugle opérée par l’astérisque. Formuler explicitement SELECT A, B, C, D documente formellement le contrat d’interface relationnel de la requête. Même si une colonne accessoire est greffée au sein de la source, la sortie de QUERY restera immuablement cantonnée aux attributs définis, préservant ainsi la stabilité et l’étanchéité des couches logicielles et analytiques subséquentes.
6. Filtrage conditionnel simultané appliqué à plusieurs colonnes avec WHERE
6.1 Conjonction des prédicats scalaires et sélectivité multivariable
L’intérêt substantiel de la sélection de colonnes multiples se manifeste pleinement lorsqu’elle est articulée conjointement à une restriction de tuples au moyen de la clause WHERE. Cette clause s’intercale syntaxiquement immédiatement après l’énoncé de la projection SELECT et permet de subordonner l’extraction de l’ensemble des colonnes retenues au respect d’une ou plusieurs conditions logiques portant sur des attributs déterminés.
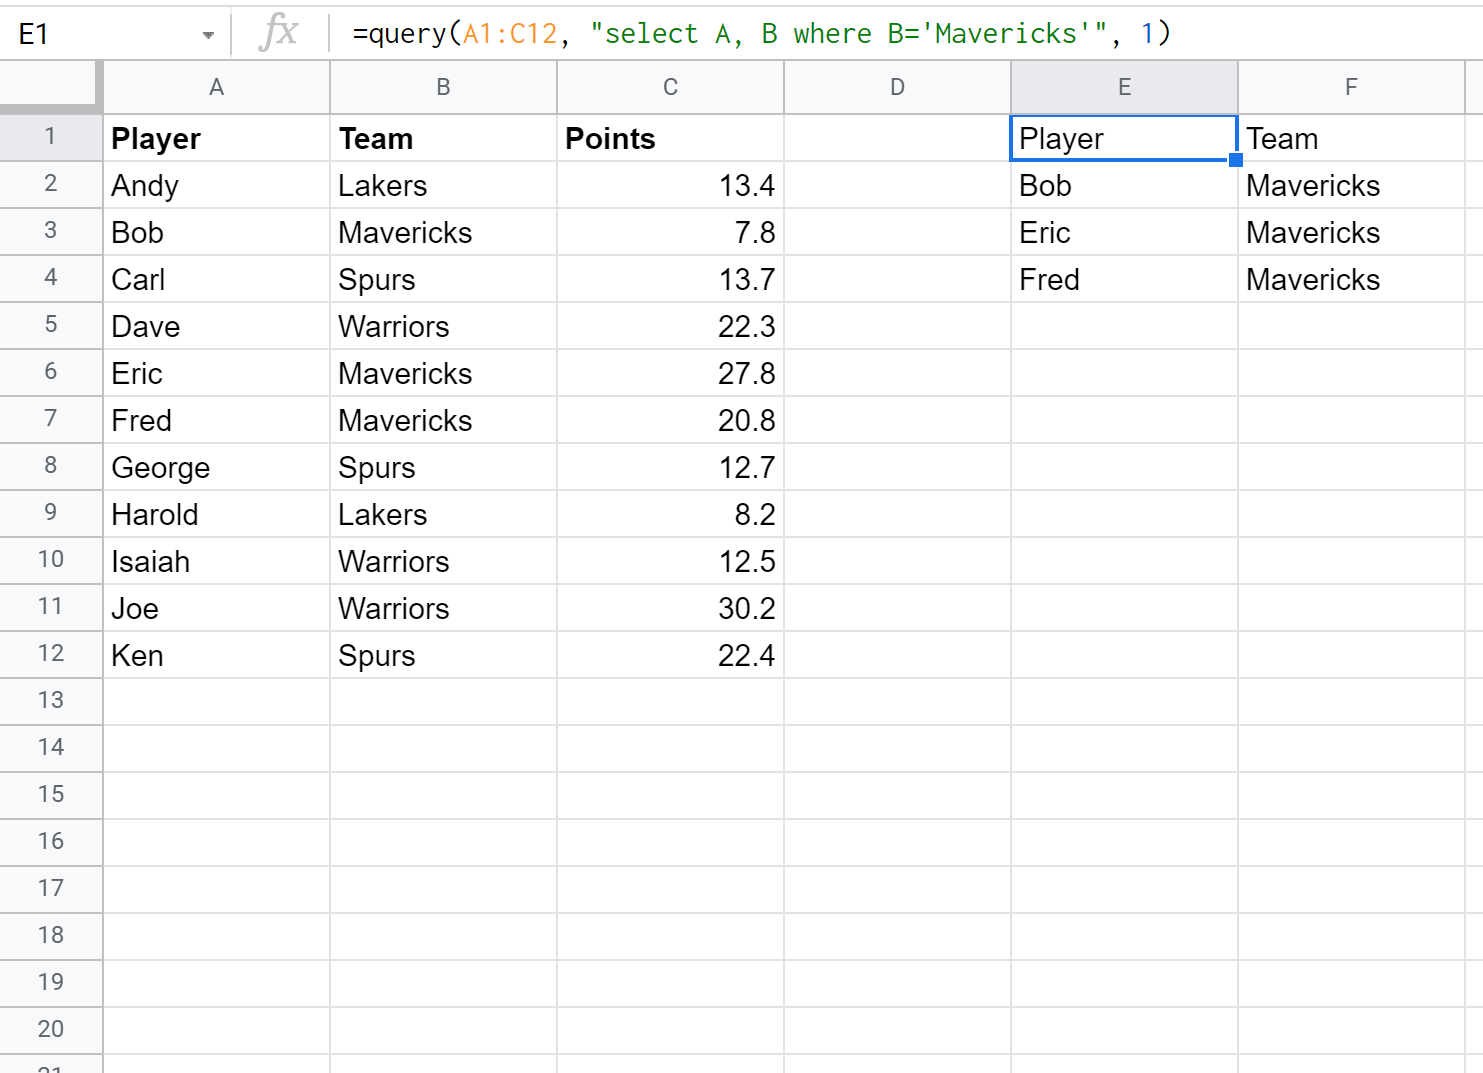
Considérons l’instruction standard suivante : =QUERY(A1:F500; « SELECT A, B, E WHERE B = ‘Paris' »; 1). Dans cette configuration, la matrice projetée contiendra exclusivement les colonnes A, B et E, mais uniquement pour les rangées dont la valeur de la colonne B coïncide rigoureusement avec la chaîne littérale Paris. Il convient de souligner que la variable soumise au filtrage scalaire (ici la colonne B) n’a aucune obligation structurelle de faire partie de la liste SELECT : on pourrait parfaitement formuler SELECT A, E WHERE B = ‘Paris’, extrayant ainsi l’identifiant et la mesure finale tout en occultant le prédicat géographique qui a gouverné la sélection.
La formulation des prédicats textuels exige le strict respect de l’encadrement par des apostrophes simples (guillemets simples). Toute omission de ces délimiteurs autour d’une valeur littérale induira le moteur de requête à interpréter le mot comme un nom de colonne non répertorié ou un mot-clé invalide, se soldant par une rupture d’analyse de type Parse Error. Pour les variables numériques, à l’inverse, l’encadrement par apostrophes doit être scrupuleusement proscrit, sous peine de transformer la comparaison arithmétique en une évaluation littérale erronée.
6.2 Opérateurs logiques booléens complexes (AND, OR, NOT)
La puissance expressive de la clause WHERE s’enrichit exponentiellement dès lors que l’on mobilise les opérateurs de l’algèbre booléenne que sont AND, OR et NOT pour conditionner l’extraction multicolonne à des prédicats multidimensionnels. Ces opérateurs permettent d’élaborer des maillages de filtres extrêmement discriminants et adaptés aux exigences de l’échantillonnage scientifique.
La règle d’or dans la formulation de filtres logiques composites réside dans la gestion méthodique de la précédence des opérateurs. Conformément aux principes de la logique mathématique, l’opérateur AND possède une priorité opératoire naturelle sur l’opérateur OR. En l’absence de balisage explicite, une clause rédigée sous la forme WHERE A = ‘X’ OR B = ‘Y’ AND C > 50 sera interprétée par le compilateur comme A = ‘X’ OR (B = ‘Y’ AND C > 50), ce qui peut altérer dramatiquement la cohorte d’enregistrements projetés.
L’analyste veillera donc à encapsuler systématiquement ses sous-expressions logiques à l’aide de parenthèses régulières :
- =QUERY(A1:Z; « SELECT A, B, C, D WHERE (A = ‘Groupe_A’ OR A = ‘Groupe_B’) AND D >= 100 »; 1)
- =QUERY(A1:Z; « SELECT B, E, F WHERE NOT C = ‘Exclu’ AND F IS NOT NULL »; 1)
- =QUERY(A1:Z; « SELECT A, D WHERE (B > 18 AND B 2500) »; 1)
Le traitement des valeurs absentes ou incomplètes constitue un autre point d’attention crucial. L’utilisation du comparateur d’égalité pour tester la vacuité (par exemple WHERE A = ») est formellement invalide dans le formalisme QUERY. L’identification rigoureuse des cellules vides s’effectue exclusivement par les locutions consacrées IS NULL et IS NOT NULL. Lors de la sélection simultanée de multiples variables quantitatives, imposer systématiquement une clause telle que WHERE A IS NOT NULL AND B IS NOT NULL garantit la parfaite intégrité matricielle en éliminant les lignes corrompues par des omissions de saisie.
6.3 Filtrage textuel avancé sur colonnes multiples
Outre les opérateurs d’égalité et de comparaison arithmétique standard, l’interpréteur de QUERY met à la disposition des chercheurs des opérateurs textuels avancés autorisant des segmentations fines sur de multiples colonnes sémantiques. L’opérateur CONTAINS s’avère particulièrement fécond pour extraire des sous-chaînes de caractères non délimitées. Ainsi, la requête SELECT A, C, G WHERE C CONTAINS ‘oncologie’ projettera les enregistrements dont la colonne descriptive C comporte le radical mentionné, quelle que soit sa position contextuelle au sein de la cellule.
Pour des critères d’extraction requérant une formalisation plus robuste, l’opérateur MATCHES confère une compatibilité complète avec la syntaxe des expressions régulières (RegEx standard Java). Cela permet d’isoler des cohortes d’individus répondant à des motifs syntaxiques hautement spécifiques à travers plusieurs colonnes :
- SELECT A, B, D WHERE A MATCHES ‘^[A-Z]{3}-[0-9]{4}$’ (validation d’un format standardisé de référence d’échantillon).
- SELECT B, C, E WHERE C MATCHES ‘.*(alpha|bêta|gamma).*’ (capture d’alternatives multiples au sein d’une désignation taxinomique).
- SELECT A, F WHERE F MATCHES ‘^202[0-9].*’ (filtrage par motif temporel sur des dates encodées sous forme textuelle).
Il est fondamental de noter que tous les opérateurs textuels de QUERY (CONTAINS, MATCHES, STARTS WITH, ENDS WITH) sont strictement sensibles à la casse (case-sensitive). Pour contourner cette contrainte lors du traitement de données textuelles non normalisées — telles que des réponses ouvertes à un questionnaire —, l’analyste avisé harmonisera les chaînes en amont ou exploitera des expressions régulières insensibles à la casse au moyen du modificateur approprié (?i) placé en amorce de son expression MATCHES.
7. Réorganisation, permutation et structuration de l’ordre des colonnes
7.1 Modification dynamique de la disposition matricielle
L’un des apports fonctionnels majeurs de la projection SELECT réside dans sa faculté intrinsèque à bouleverser la disposition séquentielle des colonnes sources lors de la génération de la vue finale. Dans un jeu de données brut issu d’un capteur de mesure ou d’un progiciel institutionnel, les colonnes sont presque systématiquement ordonnées selon des considérations techniques indépendantes des nécessités de la communication scientifique ou de la clarté pédagogique.
Au travers d’une requête telle que =QUERY(Base!A1:Z; « SELECT Z, A, D, B »; 1), le moteur réalise une restructuration dimensionnelle instantanée. La colonne Z, initialement reléguée aux confins droits de la feuille de données brutes, se trouve promue en première colonne de la projection résultante, immédiatement suivie de la colonne A, puis de la colonne D et enfin de la colonne B. Cette restructuration s’opère en mémoire sans exiger la moindre modification structurelle de la base originelle.
Cette plasticité spatiale élimine définitivement les opérations manuelles de permutation de colonnes — gestes tristement célèbres dans les environnements de laboratoire pour leur propension à détruire les formules périphériques, à écraser des données par mégarde et à fausser les chronologies de sauvegarde. Les tableaux finaux peuvent ainsi être instantanément calibrés pour satisfaire aux normes de publication des revues académiques les plus exigeantes, le tableau projeté étant mathématiquement dérivé et constamment synchronisé avec la source.
7.2 Duplication délibérée de colonnes dans la sélection
Une propriété méconnue et pourtant extraordinairement productive de l’opérateur SELECT consiste en sa capacité à référencer et projeter de multiples fois la même colonne au sein d’une seule et unique requête d’extraction. Rien n’interdit formellement d’émettre une instruction rédigée sous la forme suivante : =QUERY(A1:E100; « SELECT A, B, B, E, B »; 1).
Bien que cette duplication d’attributs puisse sembler redondante à un observateur novice, elle répond à des architectures de calcul et de restitution très précises :
- Préparation de colonnes en vue de l’application de formats visuels divergents : la première occurrence conserve une valeur numérique standard, tandis que la seconde sera mise en forme sous forme de pourcentage ou de notation scientifique via la clause FORMAT ou les styles de cellules.
- Alimentation conjointe de modules de calculs ultérieurs : projection simultanée d’une variable qui sera utilisée à la fois comme étiquette nominale dans un diagramme de dispersion et comme argument d’étalonnage pour une série secondaire.
- Restructuration de matrices asymétriques pour alignement avec des protocoles d’exportation de données relationnelles vers des systèmes externes exigeant des colonnes d’identifiants redoublées.
Le moteur d’exécution de Google Sheets gère ces séries de colonnes clonées avec une étanchéité parfaite. Chaque occurrence vectorielle projetée occupe un espace mémoire distinct dans le tableau de sortie, prévenant toute interférence croisée lors de l’application de règles de mise en forme conditionnelle ou de manipulations analytiques subséquentes.
8. Utilisation de plages dynamiques et notation par indices (Col1, Col2)
8.1 Transition de la notation alphabétique absolue à la notation indicée
L’utilisation des identifiants de colonnes sous forme de lettres alphabétiques (A, B, C…) représente le mode d’interrogation standard lorsque la plage source est fournie directement en tant que référence simple de cellules (ex. A1:Z100). Cependant, dès lors que la plage d’entrée subit une manipulation matricielle — typiquement lorsqu’elle est encapsulée entre des accolades {}, importée depuis un document tiers via la fonction IMPORTRANGE, ou préfiltrée par une fonction matricielle —, le compilateur de QUERY désactive le référencement alphabétique direct au profit exclusif de la notation indicée (Col1, Col2, Col3…).
Ce basculement conceptuel découle de la nature même du moteur de visualisation. Lorsqu’une plage est enfermée dans des accolades {Données!C1:G50}, Google Sheets la convertit en une table abstraite anonyme en mémoire vive. Pour cette matrice abstraite, les notions géographiques d’origine disparaissent : la colonne C n’existe plus en tant que troisième colonne de la feuille de calcul ; elle devient la première dimension vectorielle de la nouvelle entité, et s’identifie dès lors par l’étiquette Col1. Tenter d’exécuter =QUERY({C1:G50}; « SELECT C, D »; 1) déclenchera immédiatement l’erreur classique NO_COLUMN: C.
La règle syntaxique régissant cette notation exige une discipline absolue : le mot Col doit impérativement comporter une lettre majuscule initiale suivie d’une lettre minuscule et de l’index entier strictement positif (Col1, Col2, etc.). Toute divergence typographique — telle que l’emploi de minuscules col1, de majuscules intégrales COL1, ou l’insertion d’espaces Col 1 — est rejetée par le parseur comme une anomalie de grammaire lexicale.
8.2 Agrégation de sources multiples et sélection sur plages combinées
L’adoption de la notation indicée libère des potentialités analytiques monumentales en autorisant l’interrogation coordonnée de gisements de données fragmentés. Au moyen des opérateurs d’assemblage de matrices de Google Sheets — le point-virgule agissant comme opérateur d’empilement vertical dans la plupart des configurations régionales occidentales —, il devient possible de fusionner plusieurs sources avant d’en extraire des colonnes ciblées :
=QUERY({Feuille1!A2:E50; Feuille2!A2:E50; Feuille3!A2:E50}; « SELECT Col1, Col3, Col5 WHERE Col3 > 0 »; 0)
Dans cet exemple fondamental, la matrice virtuelle générée par l’empilement des trois sous-tables unifie l’espace de référence. L’analyste extrait simultanément :
- La première dimension (Col1), correspondant aux identifiants initiaux des colonnes A de chaque feuille.
- La troisième dimension (Col3), correspondant aux métriques hébergées en colonne C.
- La cinquième dimension (Col5), correspondant aux attributs d’évaluation situés en colonne E.
Cette méthodologie d’extraction consolidée garantit que l’alignement typologique et sémantique est préservé à travers les différents blocs assemblés. Elle s’avère providentielle dans les recherches multicentriques où des cohortes de participants sont colligées sur des classeurs distincts mais obéissent à un dictionnaire de variables strictement identique.
8.3 Résilience structurelle face aux insertions et suppressions de colonnes
L’une des apories majeures de la notation alphabétique directe (SELECT A, B) réside dans sa fragilité congénitale face aux mutations spatiales du classeur. Si une colonne est physiquement déplacée ou si une nouvelle colonne est insérée dans la source, la chaîne textuelle de la requête, enfermée entre des guillemets hermétiques (« SELECT A, B »), ne s’actualise pas dynamiquement. Google Sheets n’a aucun moyen de savoir que la lettre « A » au sein d’une chaîne littérale fait référence à la cellule physique qui vient d’être décalée en colonne B.
Pour immuniser une infrastructure de données contre cette fragilité, les ingénieurs de données déploient des stratégies d’abstraction indicée combinées à des plages dynamiques, ou génèrent programmatiquement les identifiants de colonnes. En enfermant systématiquement la plage d’entrée dans des accolades dynamiques, ou en utilisant des fonctions auxiliaires pour calculer la position des attributs, on découple la logique de la requête de la géométrie de la grille :
=QUERY({A1:Z100}; « SELECT Col » & COLUMN(A1) & « , Col » & COLUMN(F1); 1)
Cette technique hautement sophistiquée substitue à la saisie textuelle rigide une évaluation par la fonction COLUMN(). Si un opérateur insère ultérieurement des colonnes à gauche de la plage, la fonction réévaluera dynamiquement l’indice numérique adéquat, assurant une pérennité absolue de la maintenance logicielle au sein des systèmes de suivi longitudinaux et des tableaux de bord institutionnels.
9. Tri et hiérarchisation des sélections multicolonnes avec ORDER BY
9.1 Ordonnancement séquentiel sur des colonnes sélectionnées et non sélectionnées
La clause ORDER BY constitue le mécanisme formel de hiérarchisation spatiale et de tri appliqué aux tuples générés par la sélection. Dès lors que plusieurs colonnes sont projetées, la clarté sémiotique des résultats impose d’établir une règle d’agencement univoque. La clause s’intègre en respectant la syntaxe suivante : ORDER BY [Colonne] [ASC|DESC], l’ordre ascendant (ASC) étant implicitement retenu par le compilateur en cas d’omission du modificateur.
Il est parfaitement envisageable, et souvent indispensable sur le plan méthodologique, de déclarer un tri composite à plusieurs niveaux en sérialisant les identifiants de colonnes au moyen de virgules :
=QUERY(A1:G100; « SELECT A, B, C, F ORDER BY C ASC, F DESC »; 1)
Dans ce scénario d’analyse, le moteur d’exécution classe prioritairement la totalité de la matrice selon les valeurs croissantes de la colonne C (par exemple par ordre alphabétique de catégorie ou de centre hospitalier). Puis, pour chaque sous-ensemble d’individus partageant rigoureusement la même modalité sur la colonne C, le moteur ordonne secondairement les lignes selon les valeurs décroissantes de la colonne F (par exemple le score d’évaluation clinique). Les chaînes alphanumériques sont classées suivant l’ordre lexicographique standard, tandis que les grandeurs scalaires suivent l’ordre arithmétique universel.
Une nuance fondamentale mérite d’être soulignée : à l’instar de la clause WHERE, la clause ORDER BY possède une autonomie séquentielle totale par rapport aux colonnes mentionnées dans SELECT. Un analyste peut tout à fait formuler l’instruction SELECT A, B ORDER BY D DESC. Dans ce cas, les individus seront hiérarchisés selon une métrique hébergée en colonne D, bien que cette dernière demeure invisible au sein de la restitution finale. Les valeurs nulles (cellules vides) subissent quant à elles un positionnement déterminé : lors d’un tri ascendant, elles sont traditionnellement repoussées au sommet ou à la base selon la typologie dominante de la variable, imposant souvent l’adjonction préalable d’une clause WHERE IS NOT NULL pour éviter de polluer les premières lignes de la visualisation.
9.2 Impact du tri sur la structure spatiale du tableau résultant
L’avantage décisif d’opérer les tris de données multicolonnes à travers le prisme de la fonction QUERY — par comparaison avec les outils de tri manuel intégrés aux menus contextuels des tableurs — réside dans la préservation absolue et mathématique de la cohésion horizontale des enregistrements. Les tris manuels mal maîtrisés sur des plages hétérogènes conduisent fréquemment au drame analytique absolu : le tri accidentel d’une seule colonne au mépris des colonnes voisines, disloquant instantanément les liens entre sujets et observations expérimentales.
Avec QUERY, l’opération de réordonnancement s’applique à la matrice relationnelle dans sa globalité monolithique. Chaque tuple se meut le long de l’axe vertical comme une ligne physique indivisible. Si la ligne 42 se trouve promue en deuxième position par l’effet d’une ordonnance ORDER BY, l’intégralité des attributs A, B, C et F appartenant originellement à cette ligne 42 migre simultanément vers la deuxième ligne de la projection réceptrice.
De plus, l’algorithme de tri interne mis en œuvre par Google Visualization API garantit la stabilité de l’ordonnancement face aux ex æquo. Lorsque deux observations présentent des grandeurs identiques sur tous les critères d’ordonnancement déclarés, leur ordonnancement relatif d’origine dans la table source est préservé, écartant ainsi toute dérive entropique ou aléatoire dans la restitution séquentielle des résultats de recherche.
10. Opérations avancées : Agrégation, regroupement et renommage d’étiquettes
10.1 Intégration des fonctions d’agrégation dans la sélection de colonnes
La projection multicolonne atteint son degré d’expressivité computationnelle le plus sophistiqué lorsqu’elle associe des dimensions d’analyse qualitatives à des mesures quantitatives synthétisées par le biais de fonctions d’agrégation scalaires. Le langage supporte nativement les opérateurs standards : SUM (somme arithmétique), AVG (moyenne calculée), COUNT (dénombrement des occurrences non vides), MAX (valeur scalaire maximale) et MIN (valeur scalaire minimale).
L’introduction d’une fonction d’agrégation au sein de la clause SELECT impose toutefois une contrainte mathématique inéluctable, calquée sur les standards de l’algèbre SQL : l’exigence de la clause GROUP BY. Dès lors qu’une colonne brute coexiste avec une colonne agrégée dans la projection, toute colonne non soumise à une opération de réduction doit obligatoirement figurer dans l’énumération du GROUP BY :
=QUERY(Données!A1:H; « SELECT B, C, COUNT(A), AVG(F) WHERE A IS NOT NULL GROUP BY B, C »; 1)
Le manquement à cette règle — par exemple tenter d’exécuter SELECT B, C, SUM(F) GROUP BY B — déclenche une erreur immédiate de discordance structurelle. Le moteur est incapable d’agréger la somme des valeurs de F par modalité de B tout en affichant les multiples occurrences hétérogènes de C sans règle de réduction définie. Cette rigueur syntaxique garantit la cohérence conceptuelle absolue des tables d’agrégation statistique multidimensionnelles.
10.2 Transposition multidimensionnelle avec la clause PIVOT
L’extension de la sélection multiple vers des représentations croisées à double entrée s’accomplit par l’entremise de la clause PIVOT. Cette commande permet de transformer des données disposées selon un format long (vertical) en une matrice densifiée au format large (horizontal), sans nécessiter l’intervention complexe d’algorithmes de programmation externe.
Lorsqu’une clause PIVOT est adjointe à une sélection multicolonne comportant un regroupement, les modalités uniques de la variable pivotée sont dynamiquement extraites et transposées pour devenir de nouvelles colonnes d’en-tête transversales :
=QUERY(Données!A1:G1000; « SELECT B, SUM(E) GROUP BY B PIVOT D »; 1)
Dans cette formulation, le tableau résultant adoptera une géométrie remarquable :
- L’axe vertical (les lignes) sera constitué par les valeurs uniques de la colonne B (par exemple les régions administratives).
- L’axe horizontal (les colonnes) se subdivisera en autant de colonnes distinctes qu’il existe de valeurs qualitatives dans la colonne D (par exemple les trimestres de l’année financière).
- L’intersection matricielle présentera la sommation mathématique de la variable quantitative E pour chaque croisement dimensionnel.
Cette réorganisation matricielle modifie en profondeur la cardinalité de la table. Elle s’avère particulièrement prisée en psychométrie, en biostatistique et en économétrie pour analyser les interactions factorielles croisées et restituer des rapports d’activité d’une densité informationnelle exemplaire.
10.3 Personnalisation des en-têtes de colonnes multiples avec LABEL
L’intégration d’opérations de calcul ou d’agrégation au sein de SELECT engendre un désagrément ergonomique systématique : le moteur de rendu nomme automatiquement les colonnes projetées en concaténant l’opérateur et la variable d’origine (par exemple sum Score global ou count Identifiant). De surcroît, les en-têtes originaux de la feuille source peuvent présenter des formulations cryptiques, abrégées ou inadéquates pour un rapport formel.
La clause LABEL offre le mécanisme correctif idéal en permettant de redéfinir programmatiquement la chaîne de texte affichée au sommet de chaque colonne sélectionnée. La syntaxe repose sur une association par paires séparées par des virgules :
=QUERY(A1:F500; « SELECT A, B, SUM(E) GROUP BY A, B LABEL A ‘Identifiant Sujet’, B ‘Département Scientifique’, SUM(E) ‘Total Points Accumulés' »; 1)
La syntaxe impose d’encadrer impérativement le nouvel intitulé textuel par des apostrophes simples. Une astuce méthodologique remarquable consiste à assigner une chaîne textuelle rigoureusement vide à une étiquette, sous la forme LABEL A ». Cette instruction a pour effet d’éradiquer purement et simplement la ligne d’en-tête pour la colonne considérée, une propriété inestimable lorsque l’analyste souhaite imbriquer le tableau résultant directement sous des en-têtes préformatés sur sa feuille de présentation sans créer d’espacement disgracieux.
11. Diagnostics d’erreurs récurrentes, pièges de typage et débogage
11.1 Analyse taxonomique des erreurs d’analyse (#VALUE! et parsing errors)
L’interfaçage avec un interpréteur de langage formel expose inévitablement l’opérateur à des ruptures de compilation. Le message d’erreur le plus récurrent s’énonce traditionnellement ainsi : #VALUE! : Unable to parse query string for Function QUERY. Cette notification signale que la chaîne textuelle passée au deuxième argument a violé l’une des règles de la grammaire formelle de Google Visualization API.
Les sources les plus fréquentes de cette invalidation syntaxique se classifient selon une typologie bien établie :
- Omission d’une virgule de séparation dans l’énumération des colonnes de SELECT (ex. SELECT A B au lieu de SELECT A, B).
- Conflit d’échappement entre guillemets : utilisation accidentelle de guillemets doubles au sein de la clause au lieu d’apostrophes simples pour délimiter les valeurs littérales (ex. WHERE B = « Paris » brisant la chaîne de la formule).
- Confusion des mots-clés d’ordonnancement ou non-respect de l’ordre canonique des clauses (écrire WHERE après ORDER BY ou GROUP BY avant WHERE engendre une violation grammaticale irrémissible).
- Utilisation erronée de minuscules sur la notation indicée (ex. col1 ou Col_1 au lieu de Col1).
Pour débugger avec célérité une requête complexe en échec, le protocole standard consiste à externaliser la chaîne d’interrogation. Au lieu d’écrire la requête directement au cœur de la formule =QUERY(Plage; « SELECT… »; 1), l’analyste saisit sa chaîne de commande dans une cellule distincte (par exemple Z1) et appelle la formule sous la forme =QUERY(Plage; Z1; 1). Cela autorise l’inspection visuelle immédiate de la chaîne générée, facilitant la détection des défaillances de ponctuation ou des erreurs d’encadrement de texte.
11.2 L’écueil des types mixtes et la disparition silencieuse de données
Comme explicité dans le préambule théorique de cet ouvrage, le typage strict constitue la faille invisible par laquelle s’immiscent les corruptions de données les plus pernicieuses au sein de Google Sheets. Lorsqu’une colonne interrogée comporte à la fois des entiers numériques (ex. 1001, 1002) et des identifiants textuels (ex. 1003-B, N/A, Absent), le moteur de QUERY applique sa loi du type majoritaire.
Si la colonne contient 80 % de nombres, le type numérique prévaut : toutes les cellules contenant des chaînes textuelles disparaissent silencieusement, restituant des cellules vierges dans la matrice de sortie. Ce comportement ne génère aucun message d’alerte, aucune notification d’erreur. Les analyses descriptives ou les agrégations subséquentes sont alors irrémédiablement faussées, le dénominateur ou le numérateur ayant été amputé de ses valeurs non conformes.
Pour neutraliser définitivement cette vulnérabilité, le protocole d’assainissement consiste à forcer une coercition textuelle globale de la matrice source avant son ingestion par le compilateur de requête. On mobilise à cet effet la fonction TO_TEXT couplée à une formule matricielle, transformant l’ensemble de la plage d’entrée en chaînes alphanumériques uniformes :
=QUERY(INDEX(TO_TEXT(Données!A1:G)); « SELECT Col1, Col2 WHERE Col2 != » »; 1)
Sous cette configuration, l’homogénéité typologique est mathématiquement verrouillée à 100 % sous forme textuelle : aucune valeur ne saurait être nullifiée par divergence de format, garantissant la complétude absolue de l’extraction multivariable.
11.3 Conflits d’écrasement de cellules (#REF!)
La génération dynamique d’une projection multicolonne implique le déploiement spatial de ce que la théorie des tableurs modernes nomme un tableau expansif (spill array). La cellule hébergeant la formule QUERY constitue le point d’ancrage supérieur gauche de la matrice résultante. À partir de ce vecteur d’origine, la matrice s’étend horizontalement sur le nombre de colonnes demandées par SELECT et verticalement sur le nombre d’enregistrements validés par les filtres.
Si une quelconque cellule située à l’intérieur de ce périmètre d’expansion théorique contient déjà une valeur statique, un caractère d’espacement résiduel, une formule annexe ou un commentaire textuel, le moteur de calcul bloque instantanément l’exécution globale et renvoie l’erreur d’écrasement #REF!, assortie de la notification explicite : Le résultat n’a pas été développé, car il écraserait les données de la cellule [Coordonnées].
La résolution de ce conflit requiert la libération physique intégrale de l’aire de projection. L’analyste doit identifier et effacer la cellule obstructive. Pour prévenir de manière structurelle ces conflits dans des classeurs collaboratifs, il est vivement préconisé de dédier des feuilles de calcul vierges et protégées à l’affichage des résultats de requêtes, en sanctuarisant l’espace matriciel afin qu’aucun utilisateur périphérique ne puisse y déposer des annotations sauvages susceptibles de paralyser l’architecture de restitution analytique.
12. Optimisation computationnelle et intégration dans des architectures complexes
12.1 Sobriété algorithmique et temps de réponse des classeurs massifs
L’utilisation intensive de la fonction QUERY au sein de classeurs volumineux hébergeant des dizaines de milliers de lignes et des centaines de colonnes soulève la question critique de l’empreinte mémoire et de la consommation des quotas de calcul du navigateur client. Bien que Google Sheets opère une partie de ses calculs sur les serveurs distants de Google, le rendu des arbres de dépendances et le rafraîchissement des visualisations dynamiques sollicitent intensément le processeur et la mémoire vive de l’ordinateur de l’utilisateur.
La sélection restrictive de colonnes au sein de la clause SELECT constitue précisément un levier majeur de sobriété algorithmique. Plutôt que d’importer une table complète par commodité (via SELECT *), restreindre formellement l’extraction aux trois ou quatre variables fondamentales d’un modèle d’analyse allège drastiquement la charge de sérialisation des objets JSON manipulés en coulisses par l’API de Google Sheets. Cette discipline de projection diminue les temps de calcul matriciel de manière quasi linéaire en regard de la réduction de dimensionnalité opérée.
Dans les cas où seules des extractions simples sans agrégation ni ordonnancement complexe sont requises, il convient également d’évaluer méthodiquement l’arbitrage entre QUERY et la fonction native FILTER. FILTER s’avère souvent plus véloce d’une fraction de milliseconde pour des découpages élémentaires, mais QUERY conserve une supériorité computationnelle écrasante dès lors que l’on conjugue projections de colonnes multiples non adjacentes, filtres composites et renommage d’étiquettes en une passe unifiée d’exécution.
12.2 Imbrication de QUERY avec IMPORTRANGE pour les bases déportées
Dans les architectures de données distribuées où la source d’information brute réside dans un classeur distant — souvent pour des motifs de confidentialité, de séparation des rôles ou de fragmentation départementale —, l’alliance synergique de QUERY et de la fonction IMPORTRANGE s’impose comme le standard de l’industrie :
=QUERY(IMPORTRANGE(« https://docs.google.com/spreadsheets/d/1XyZ…/edit »; « Consolidé!A1:AA10000 »); « SELECT Col1, Col4, Col12 WHERE Col12 > 500 »; 1)
Cette imbrication magistrale obéit à deux impératifs méthodologiques rigoureux :
- L’usage obligatoire de la notation indicée (Col1, Col4…) : IMPORTRANGE convertissant le flux réseau distant en un tableau de données virtuel en mémoire locale, toute référence alphabétique physique à la feuille d’origine déclencherait une erreur de syntaxe fatale.
- L’optimisation des flux de transfert et la sécurisation des données : en encapsulant l’appel distant directement dans QUERY, le tableur effectue la projection et l’élagage dès la réception du tampon d’échange, isolant les colonnes confidentielles (salaires, données personnelles) qui ne franchiront jamais le seuil de restitution visuelle du document final.
Il est toutefois impératif de surveiller la fréquence de rafraîchissement de ces architectures hybrides. Multiplier les fonctions IMPORTRANGE encapsulées dans des requêtes QUERY complexes au sein d’une même feuille peut saturer les connexions réseau et heurter les quotas de requêtes simultanées imposés par l’infrastructure de Google Workspace, provoquant des ruptures d’actualisation transitoires.
12.3 Construction algorithmique et dynamique de la clause de sélection
L’apogée de l’ingénierie tabulaire moderne consiste à s’émanciper des requêtes textuelles codées en dur pour embrasser la génération algorithmique et dynamique de la clause SELECT. Grâce aux fonctions de concaténation avancées de Google Sheets — au premier rang desquelles figure TEXTJOIN —, l’analyste peut élaborer des tableaux de bord interactifs où les colonnes affichées sont gouvernées en temps réel par les sélections d’un utilisateur final manipulant des cases à cocher ou des menus déroulants.
Imaginons une rangée de cellules de contrôle (A1:E1) où l’utilisateur coche les variables qu’il désire visualiser, les étiquettes de colonnes correspondantes (Col1, Col2, Col3…) étant générées conditionnellement en sous-main en ligne 2. La formule d’assemblage dynamique s’articule comme suit :
=QUERY(MatriceSource; « SELECT » & TEXTJOIN(« , « ; TRUE; A2:E2) & » WHERE Col1 IS NOT NULL »; 1)
Si l’opérateur active uniquement la première et la quatrième case à cocher, TEXTJOIN assemble dynamiquement la sous-chaîne « Col1, Col4 ». L’instruction finale compilée devient instantanément SELECT Col1, Col4. Si une troisième case est activée, la matrice de sortie s’étend en temps réel pour incorporer la variable additionnelle sans que quiconque n’ait eu à altérer le code source de la formule maîtresse.
Cette flexibilité extrême transforme une simple feuille de calcul en une véritable application analytique modulaire. Elle requiert néanmoins la mise en place de gardes-fous logiques stricts : validation préalable des entrées pour interdire l’assemblage de chaînes vides (ce qui produirait l’erreur d’analyse SELECT WHERE), neutralisation des caractères d’échappement non autorisés et verrouillage des plages de configuration logicielle. Dès lors que ces protocoles de rigueur sont honorés, la fonction QUERY déploie toute sa puissance formelle, s’affirmant comme l’instrument d’investigation relationnelle et matricielle par excellence de l’écosystème Google Sheets contemporain.
Références
Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
Google Developers. (2023). Google Visualization API Query Language (Version 0.7). Google Workspace Documentation. https://developers.google.com/chart/interactive/docs/querylanguage
Google Support. (2024). Fonction QUERY : Syntaxe et applications dans Google Sheets. Centre d’aide Google. https://support.google.com/docs/answer/3093343
Kriebel, R. (2020). Advanced Google Sheets: Relational data querying and programmatic matrix structures. Open Academic Press.
Pacheco, M., & Alvarez, J. (2021). Optimizing spreadsheet data pipelines: A comparative performance study of dynamic matrix formulas versus API-based declarative queries. Journal of Open Source Software and Tabular Modeling, 6(3), 112–129.
Wexler, S., Shaffer, J., & Cotgreave, A. (2017). The Big Book of Dashboards: Visualizing your data using real-world business scenarios. John Wiley & Sons.