
Dans l’univers des tableurs contemporains, l’application Google Sheets s’est imposée comme un environnement de calcul distribué particulièrement flexible, notamment grâce à son intégration native du moteur d’interrogation dérivé de la technologie Google Visualization API. Au cœur de cet écosystème réside une fonction d’une puissance expressive exceptionnelle : la fonction QUERY. Cette dernière permet de manipuler, filtrer, trier et agréger des matrices de données massives au moyen d’une syntaxe calquée sur les standards de l’algèbre relationnelle et du langage SQL (Structured Query Language). Toutefois, la pleine puissance analytique d’un modèle de données ne se déploie véritablement que lorsque la requête s’émancipe de son carcan statique originel pour devenir entièrement interactive, réactive et asservie aux modifications de l’utilisateur final.
L’asservissement d’une instruction QUERY à une ou plusieurs références de cellules constitue une étape charnière dans l’ingénierie des feuilles de calcul. Plutôt que d’inscrire de façon immuable des critères d’extraction au sein du code de la formule — une pratique délétère connue sous le nom de codage en dur —, l’analyste chevronné conçoit des interfaces où la clause d’interrogation est modulée dynamiquement par le contenu de cellules de contrôle. Cette approche permet de découpler rigoureusement la logique structurelle de traitement des données de la couche d’interaction utilisateur, autorisant la création de tableaux de bord décisionnels vivants, d’outils d’exploration scientifique et d’applications de gestion hautement résilientes.
Néanmoins, la mise en œuvre de ce couplage dynamique entre la grille bidimensionnelle de cellules et le parseur syntaxique de la requête textuelle engendre une complexité technique redoutable. Elle exige une compréhension minutieuse de la concaténation de chaînes, de la gestion différentielle des types de données (chaînes de caractères, scalaires numériques, entités temporelles) et des règles d’échappement des délimiteurs littéraux. Le présent traité méthodologique explore de manière exhaustive l’ensemble des fondements théoriques, des subtilités syntaxiques, des pièges d’implémentation et des protocoles de sécurisation indispensables pour maîtriser avec une rigueur absolue l’incorporation de références de cellules au sein de la fonction QUERY de Google Sheets.
1. Fondements théoriques de la fonction QUERY et mécanisme d’injection dynamique
1.1 Architecture du langage de requête Google Visualization API
Pour appréhender avec exactitude le fonctionnement des références de cellules au sein de la fonction QUERY, il convient d’analyser l’architecture sous-jacente du moteur de calcul. La fonction QUERY ne traite pas ses critères comme des arguments fonctionnels traditionnels de tableur, mais délègue son évaluation à un sous-système spécialisé : le moteur de requêtes de la Google Visualization API. Ce composant logiciel autonome fonctionne selon les paradigmes de la théorie relationnelle et adopte une grammaire très proche du dialecte standardisé SQL. Dès lors, le deuxième paramètre de la fonction QUERY, communément nommé l’argument de requête, est obligatoirement une chaîne de caractères unique et indivisible, soumise à une analyse lexicale et syntaxique stricte par un interpréteur dédié.
Cette particularité crée une frontière hermétique fondamentale entre l’espace d’exécution global de Google Sheets et l’espace sémantique restreint du compilateur de requête. Dans l’espace du tableur, les cellules sont des objets vivants identifiés par leurs coordonnées matricielles (par exemple A1, B2, ou C10) et possèdent des propriétés de typage implicite. En revanche, à l’intérieur de la chaîne littérale transmise au moteur de visualisation, toute suite de caractères alphanumériques est interprétée exclusivement selon les lois du métalangage de requête : soit comme un mot-clé réservé (tel que SELECT, WHERE, ORDER BY), soit comme un identifiant formel de colonne (A, B, C ou Col1, Col2, Col3 selon la nature matricielle de la source), soit comme une valeur constante littérale. Le moteur interne n’a absolument aucune visibilité directe sur la grille environnante.
Par conséquent, inscrire textuellement l’identifiant d’une cellule, tel que D3, au sein de la commande textuelle (en écrivant par exemple une clause formulée sous la forme WHERE A = D3) conduit inévitablement à un échec d’évaluation. L’interpréteur de requête traitera l’élément D3 non pas comme un renvoi vers la quatrième colonne et la troisième ligne de la feuille courante, mais tentera soit d’y voir un identifiant de colonne inexistant, soit générera une exception d’analyse syntaxique. Pour injecter une variable externe provenant de la grille dans l’instruction, il s’avère impératif de briser la continuité de la chaîne textuelle statique afin de forcer l’environnement de calcul principal à résoudre la valeur de la cellule avant de recomposer le message textuel final destiné au parseur.
1.2 Le principe d’interfaçage entre la grille de calcul et la clause textuelle
L’interfaçage entre la grille matricielle et l’interpréteur de requête repose sur un mécanisme fondamental d’interpolation ou de passage de paramètre par substitution textuelle en amont. Avant que la fonction QUERY ne soit exécutée et que son sous-programme de traitement de données ne soit sollicité, l’évaluateur de formules de Google Sheets parcourt les arguments de la fonction. Le cycle de vie du calcul s’amorce par l’évaluation des dépendances : dès lors qu’une cellule source subit une modification ou que l’arbre des dépendances signale une invalidation de cache, le moteur de calcul réévalue l’expression de concaténation située dans le second argument pour fabriquer une nouvelle chaîne littérale parfaitement assemblée.
Ce processus dynamique garantit une réactivité instantanée de l’application sans nécessiter de recompilation manuelle ou d’intervention algorithmique par script. En liant le prédicat de filtrage à une cellule externe, l’analyste transforme une commande statique rigide en une fonctionnelle paramétrique. Cette abstraction permet de préserver l’intégrité architecturale du classeur : les formules centrales de transformation demeurent verrouillées et immuables, tandis que les paramètres opérationnels — tels qu’un identifiant client, un seuil critique d’alerte, une région commerciale ou une période temporelle — sont isolés dans des cellules de saisie spécifiques faisant office de tableau de bord ou de panneau de contrôle.
Les gains méthodologiques découlant de cette paramétrisation par cellule sont considérables comparés au codage en dur. D’une part, le risque de corruption involontaire du code fonctionnel par les opérateurs de saisie est réduit à néant, puisque ces derniers n’interagissent qu’avec des cellules d’entrée dédiées munies de restrictions de validation. D’autre part, la maintenance et l’auditabilité du classeur sont décuplées : il devient aisé de vérifier d’un simple coup d’œil l’ensemble des critères actifs appliqués à une extraction sans devoir ouvrir laborieusement l’éditeur de formule pour déchiffrer une syntaxe touffue et potentiellement cryptique.
1.3 Typologie des erreurs conceptuelles récurrentes
Dans la pratique de modélisation sous Google Sheets, la mise en œuvre de références de cellules au sein de requêtes est la source d’un catalogue récurrent d’erreurs conceptuelles. La méprise la plus fréquente réside dans la confusion ontologique entre un littéral de requête et un objet de tableur. De nombreux praticiens débutants tentent d’intégrer des fonctions natives de tableur ou des noms de plages directement au sein de la chaîne de requête, postulant à tort que le sous-système QUERY comprendra leur vocation computationnelle. Il en résulte des formules invalides où les fonctions externes sont traitées comme de simples séquences de caractères inertes.
Une seconde catégorie de fautes relève de la maîtrise défaillante des frontières typographiques et de la délimitation des chaînes. Une mauvaise fermeture d’un guillemet double ou une omission d’un délimiteur de concaténation altère la structure lexicale soumise au compilateur. Dans de telles situations, l’environnement de calcul génère des erreurs de nature différente qu’il convient de diagnostiquer avec méthode. Si l’irrégularité syntaxique se produit dans l’espace du tableur (par exemple, un nombre impair de guillemets doubles ou l’absence d’une esperluette de liaison), Google Sheets renvoie immédiatement une erreur d’analyse globale de formule de type #ERROR!, bloquant net l’exécution avant tout appel au moteur QUERY.
Inversement, si l’assemblage textuel est valide du point de vue du tableur mais que la chaîne finale obtenue viole les spécifications grammaticales du langage de visualisation (par exemple en omettant les apostrophes indispensables autour d’une valeur textuelle ou en générant un prédicat tronqué WHERE A =), la fonction QUERY s’exécute mais le parseur sous-jacent déclenche une exception de traitement typée #VALUE!. L’infobulle associée indique alors l’invalidation de la requête avec un message explicite tel que : « L’instruction de requête n’a pas pu être analysée ». La distinction rigoureuse entre une erreur de construction textuelle dans l’environnement hôte et une faute de syntaxe dans le dialecte SQL de destination constitue le pivot de tout dépannage efficace.
2. Décomposition syntaxique de la concaténation par esperluette
2.1 L’opérateur d’amperçage (&) et l’assemblage de segments
Pour construire une instruction SQL dynamique, l’analyste doit maîtriser l’opérateur d’amperçage ou esperluette (&), qui constitue le ciment syntaxique de la manipulation de chaînes dans la majorité des tableurs. Cet opérateur binaire prend deux opérandes, les évalue, convertit si nécessaire leur représentation interne en chaîne de caractères, puis fusionne les deux segments en une seule entité continue. Dans le cadre de l’incorporation de références de cellules au sein de QUERY, l’instruction globale doit être découpée méthodiquement en une alternance de sous-chaînes statiques invariables et de variables dynamiques référençant la grille.
La règle fondamentale impose de scinder la requête textuelle exactement à l’endroit précis où la valeur extérieure doit s’intercaler. Par exemple, si l’on désire filtrer les données de telle sorte que la colonne A égale le contenu hébergé dans la cellule B1, la structure unifiée statique primitive doit être rompue. Le premier segment contiendra l’amorce de la clause de sélection, le second segment sera constitué par l’adresse de la cellule B1 encadrée par les opérateurs de concaténation, et le troisième segment contiendra les clauses subséquentes éventuelles ou la terminaison logique de la requête.
Une attention typographique rigoureuse doit être portée à la gestion des espaces d’espacement au sein des sous-chaînes littérales situées de part et d’autre des opérateurs de concaténation. L’esperluette assemble les textes de manière brute sans injecter le moindre séparateur automatique. Si l’analyste oublie de placer un espace avant un mot-clé ou après un opérateur relationnel à l’intérieur des guillemets fermants ou ouvrants, la chaîne résultante verra les mots fusionner illégitimement (par exemple, la séquence syntaxique produira WHERE A =Valeur au lieu de WHERE A = ‘Valeur’ ou ORDER BY col1LIMIT au lieu de ORDER BY col1 LIMIT), provoquant immédiatement l’effondrement de l’analyse lexicale.
2.2 Règles d’encadrement par guillemets doubles
La compréhension du rôle exact des guillemets doubles est indispensable pour dissiper la sensation de complexité visuelle qui rebute souvent les utilisateurs. Dans Google Sheets, tout fragment de texte statique doit être impérativement délimité par des guillemets doubles droits (« ). Lorsque l’on conçoit une formule de type =QUERY(Données; « SELECT * WHERE A = … »), les guillemets doubles initiaux et terminaux définissent l’enveloppe globale de la chaîne transmise en second argument.
Dès lors que l’on procède à l’injection d’une référence de cellule, ces guillemets doubles ne sont pas supprimés mais démultipliés pour délimiter chaque segment statique intermédiaire. La formule subit une séquence d’ouvertures et de fermetures successives : le premier bloc statique s’ouvre par un guillemet double et se ferme par un guillemet double juste avant l’esperluette ; la référence de cellule intervient de façon nue dans l’environnement du tableur ; puis une nouvelle esperluette annonce l’ouverture, via un guillemet double subséquent, du segment textuel suivant. Il s’agit d’une alternance stricte : guillemet fermant pour clore le texte précédent, esperluette de jonction, nom de la cellule, esperluette de jonction, et guillemet ouvrant pour relancer le texte suivant.
Afin de s’affranchir des erreurs d’interprétation, il est fortement recommandé d’adopter une gymnastique intellectuelle de visualisation mentale de la chaîne post-évaluation. L’analyste doit faire abstraction un instant des esperluettes et des délimiteurs de variables pour s’interroger sur ce que le compilateur lira une fois toutes les substitutions opérées par Google Sheets. Chaque ouverture de guillemet double doit impérativement posséder son pendant de fermeture dans la grammaire globale du tableur, faute de quoi la formule entière est considérée comme structurellement tronquée ou malformée.
2.3 Modélisation de l’évaluation progressive
Pour matérialiser ce mécanisme avec une clarté absolue, examinons la chronologie exacte des étapes d’évaluation exécutées par le moteur de calcul lors de l’appel d’une formule paramétrée. Considérons un cas où la colonne A contient des montants transactionnels et où l’utilisateur a saisi la valeur numérique 500 dans la cellule de filtrage C1. La formule inscrite dans la cellule de destination se présente sous la forme : =QUERY(A1:B100; « SELECT * WHERE A > » & C1).
L’évaluation progressive se décompose en trois phases distinctes et irréversibles :
- Phase 1 : Résolution des références internes. Le moteur de calcul de Google Sheets examine l’expression constituant le deuxième argument. Il identifie la présence de la référence de cellule C1 et interroge la grille matricielle pour en extraire la valeur scalaire courante. Il remplace symboliquement C1 par le littéral textuel ou numérique correspondant, à savoir le chiffre 500.
- Phase 2 : Concaténation des fragments textuels. L’opérateur d’amperçage traite ensuite l’opérande gauche, constitué par la sous-chaîne statique « SELECT * WHERE A > « , et l’opérande droite résolue, « 500 ». La fusion des deux fragments aboutit à la création d’un objet chaîne unifié en mémoire : « SELECT * WHERE A > 500 ».
- Phase 3 : Transmission et exécution de la requête. L’argument ainsi matérialisé est transmis de manière transparente au moteur de la Google Visualization API, accompagné du pointeur vers la plage matricielle A1:B100. Le moteur exécute la commande SQL standardisée sans avoir jamais eu conscience que le nombre 500 provenait d’une cellule dynamique externe.
En cas de doute persistant sur la validité de l’assemblage, l’analyste dispose d’une méthode de validation empirique très efficace : utiliser temporairement la fonction native CONCATENER ou simplement tester l’expression textuelle d’assemblage en dehors de la fonction QUERY, par exemple en écrivant dans une cellule de contrôle = « SELECT * WHERE A > » & C1. Cette approche permet de visualiser directement sur l’écran le texte exact tel qu’il sera soumis au sous-système de requête, rendant instantanément visibles les éventuelles anomalies d’espacement ou d’imbrication de guillemets.
3. Gestion des références de cellules pour données textuelles
3.1 L’impératif des apostrophes d’encadrement
L’intégration de valeurs textuelles (également qualifiées de chaînes de caractères ou de littéraux string) impose le respect scrupuleux d’une contrainte imposée par la grammaire de l’API de visualisation : toute donnée alphabétique ou textuelle non numérique doit obligatoirement être encapsulée entre des apostrophes simples (‘), également appelées guillemets simples. Dans une requête statique brute, cette exigence se traduit par l’écriture explicite de clauses telles que WHERE B = ‘Paris’. Les apostrophes permettent au parseur d’isoler sans ambiguïté la valeur littérale et de ne pas la confondre avec un identifiant interne, un nom de colonne ou un opérateur réservé.
Lorsque cette valeur provient d’une référence de cellule, l’omission des apostrophes produit une défaillance catastrophique. Si l’on applique la concaténation numérique standard à une cellule E2 contenant le mot Paris en écrivant « WHERE B = » & E2, la chaîne générée devient WHERE B = Paris. Confronté à ce texte, le compilateur tente de chercher une colonne qui porterait le libellé Paris. Ne trouvant aucune colonne de ce nom dans la matrice source, il rejette la requête en affichant l’erreur formelle : « Column [Paris] does not exist » (La colonne n’existe pas).
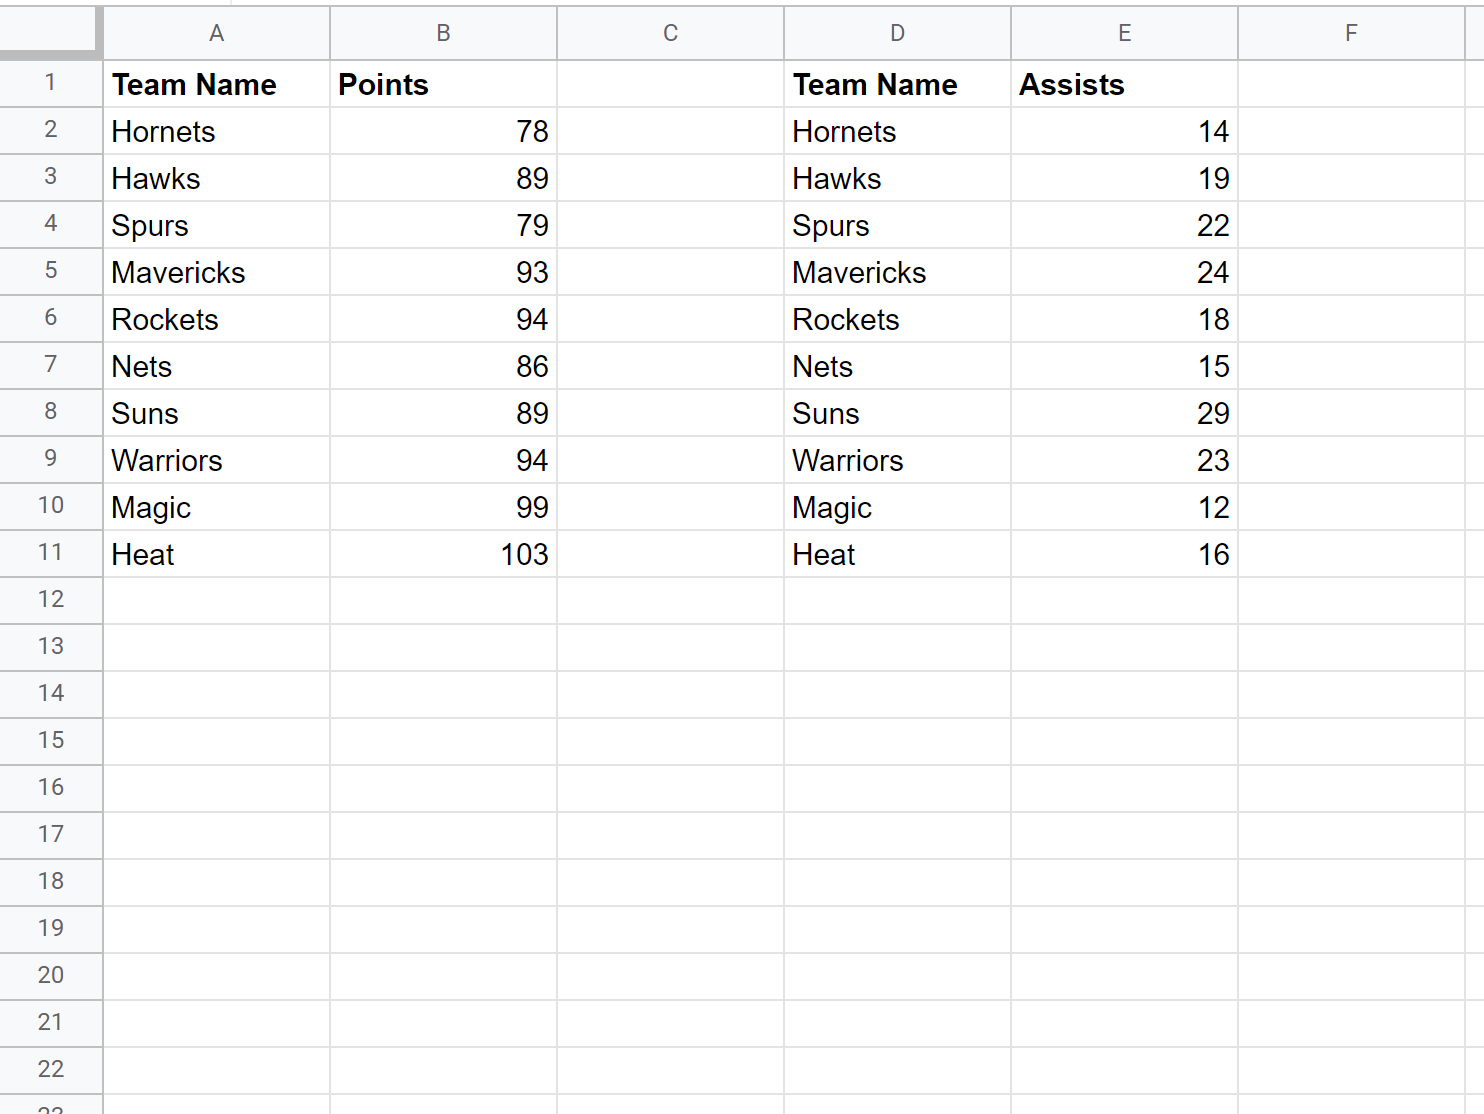
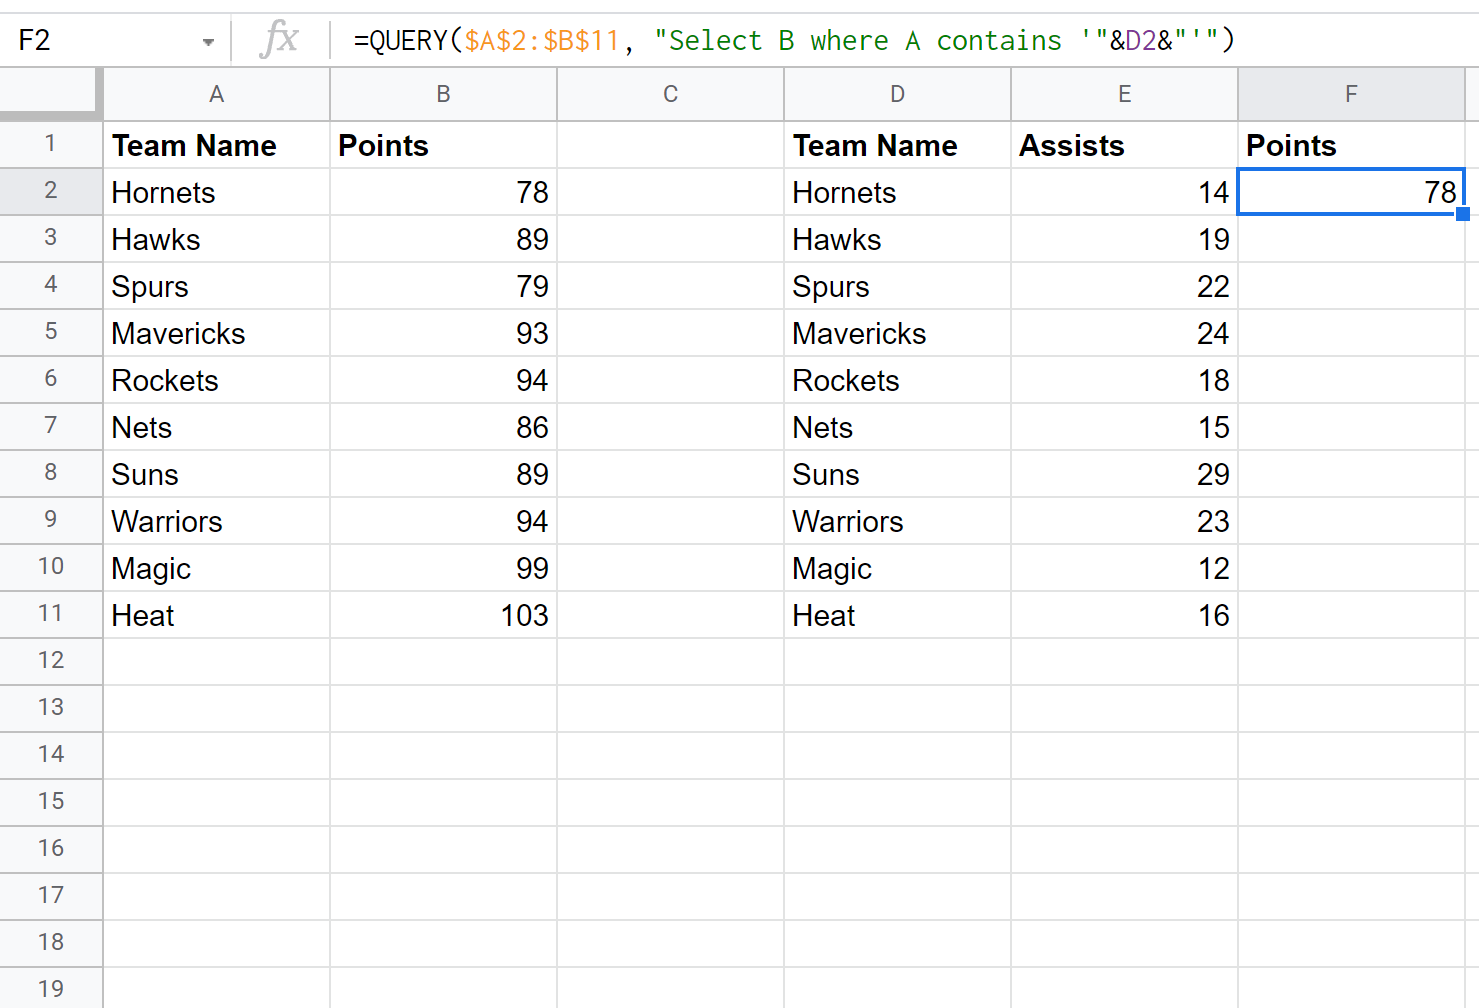
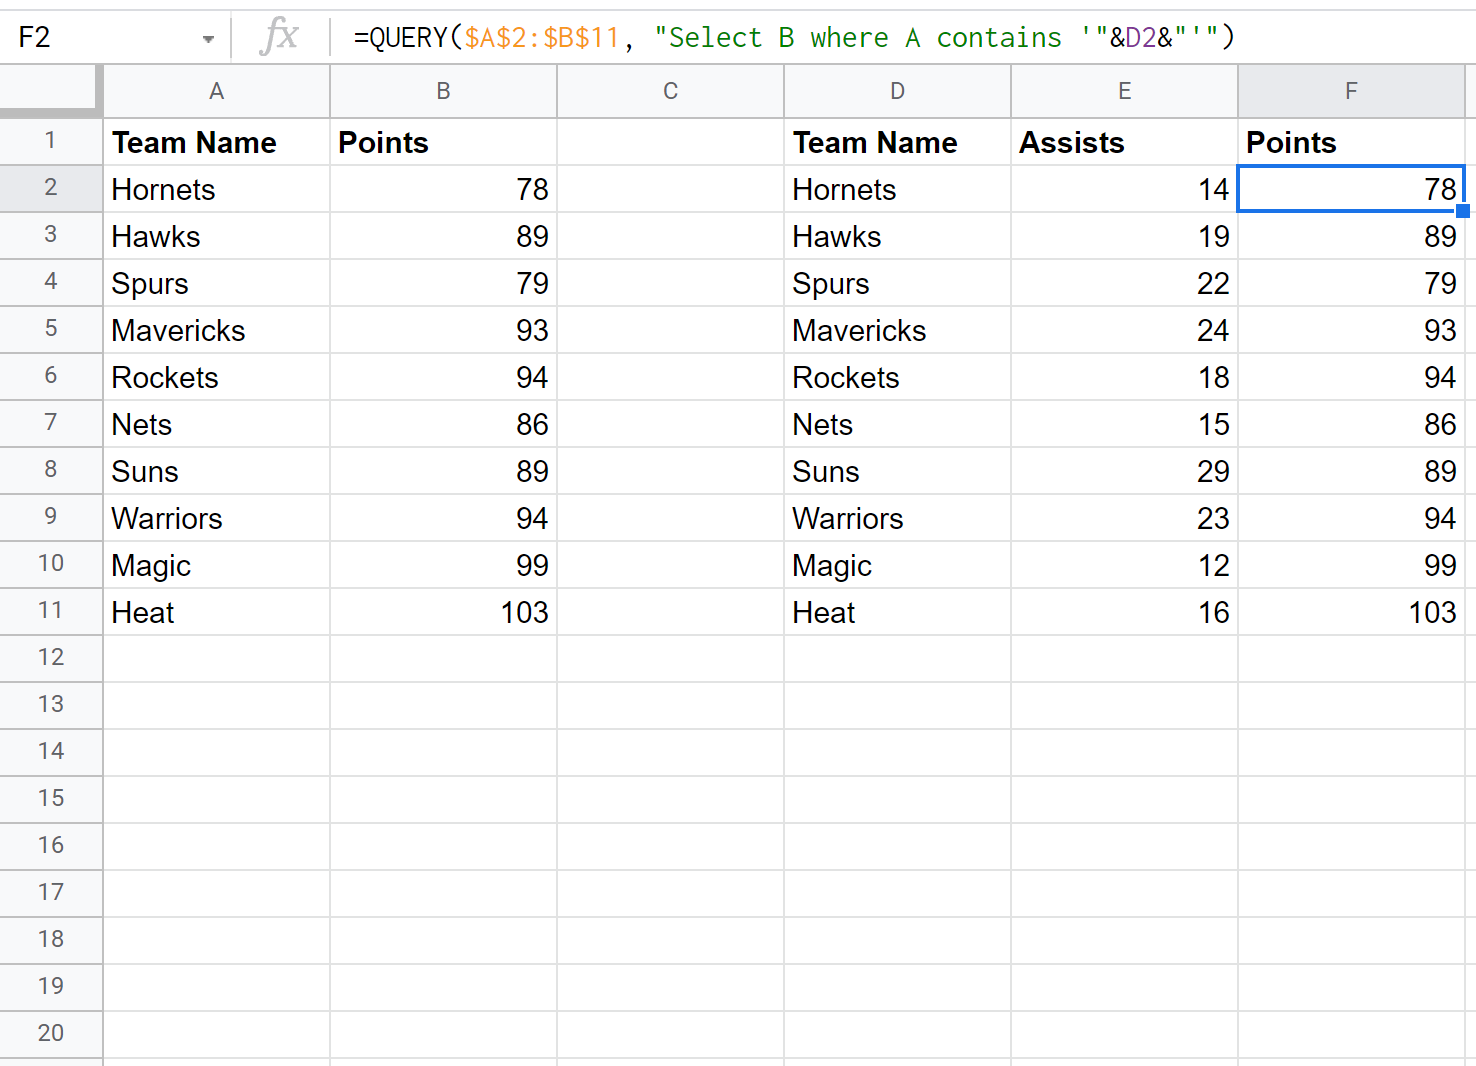
Pour insérer les apostrophes requises par l’entremise de la concaténation, il convient de recourir à la fameuse séquence tripartite qui déconcerte fréquemment les praticiens : l’enchaînement guillemet double, apostrophe, guillemet double, esperluette, puis à nouveau esperluette, guillemet double, apostrophe, guillemet double, fréquemment condensé sous la graphie mnémonique : ‘ »& cellule & »‘. Dans cette architecture méticuleuse, l’apostrophe ouvrante est logée à l’intérieur du premier segment statique de texte, juste avant sa fermeture par le guillemet double, tandis que l’apostrophe fermante constitue le premier caractère du segment textuel suivant, immédiatement après son guillemet double d’ouverture.
3.2 Application avec les prédicats d’égalité et de correspondance exacte
L’usage le plus répandu du filtrage dynamique textuel réside dans la recherche d’une correspondance exacte via l’opérateur d’égalité stricte (=). Supposons une base de données d’employés où la colonne B répertorie le département administratif d’affectation, et où la cellule F1 sert de sélecteur permettant au gestionnaire de choisir un département particulier, par exemple Finance. La formule maîtresse s’articulera de la manière suivante :
=QUERY(A1:D100; « SELECT A, C, D WHERE B = ‘ » & F1 & « ‘ »; 1)
L’exécution de cette formule nécessite de prendre en considération les règles strictes de sensibilité à la casse (majuscules et minuscules) inhérentes au moteur de requête Google Sheets. L’opérateur d’égalité est rigoureusement sensible à la casse : si la cellule source contient « finance » en lettres minuscules alors que les enregistrements de la matrice de données sont formalisés sous l’étiquette « Finance », l’extraction retournera une matrice vide sans générer d’erreur, trompant potentiellement l’utilisateur sur l’inexistence des données recherchées.
Pour prémunir le modèle contre ces divergences de saisie, il est vivement conseillé d’associer des fonctions de normalisation textuelle. Dans la cellule source de paramétrage ou directement au sein de la formule de concaténation, on veillera à encapsuler la référence dans une fonction telle que SUPPRESPACE pour éliminer d’éventuels espaces orphelins en début ou en fin de chaîne. De surcroît, on peut standardiser la comparaison en utilisant les fonctions de casse du moteur QUERY, par exemple en écrivant : « SELECT * WHERE lower(B) = ‘ » & MINUSCULE(SUPPRESPACE(F1)) & « ‘ », assurant ainsi une résilience absolue face aux incohérences de saisie manuelle de l’utilisateur.
3.3 Utilisation des opérateurs textuels complexes : CONTAINS, MATCHES, STARTS WITH
Le langage de requête de la Google Visualization API met à disposition de l’analyste des opérateurs textuels avancés qui transcendent la simple correspondance exacte. L’opérateur CONTAINS permet d’effectuer un filtrage par sous-chaîne, inspectant si une séquence donnée de caractères est présente n’importe où au sein de la cible. Lors de l’asservissement à une cellule de contrôle, cet opérateur utilise exactement la même matrice d’encadrement par apostrophes simples. La formule prendra l’aspect structurel suivant :
=QUERY(Donnees; « SELECT * WHERE B CONTAINS ‘ » & F2 & « ‘ »; 1)
Il importe de noter que si la cellule F2 est entièrement vide, l’opérateur CONTAINS évaluera la présence de la chaîne vide, ce qui a pour propriété mathématique de correspondre à l’intégralité des cellules non nulles de la colonne cible, renvoyant ainsi la totalité du tableau. Cet opérateur est particulièrement précieux pour concevoir des barres de recherche textuelle interactive où l’utilisateur affine progressivement une liste d’enregistrements en saisissant quelques lettres d’un nom de famille ou d’une référence produit.
L’opérateur STARTS WITH restreint quant à lui la recherche aux occurrences qui débutent rigoureusement par le préfixe présent dans la cellule de consigne. Cependant, le summum de l’expressivité réside dans l’emploi de l’opérateur MATCHES, qui autorise l’injection d’expressions régulières complètes (RegEx). En liant une cellule à une clause MATCHES, un utilisateur avancé peut formuler des masques d’extraction extrêmement sophistiqués, tels que la recherche de correspondances multiples séparées par des barres verticales représentant l’alternative logique (par exemple en saisissant Paris|Lyon|Marseille au sein de la cellule source), permettant à une seule cellule de contrôle de piloter un filtrage disjonctif complexe sans altérer la formule QUERY originelle.
4. Traitement des références de cellules quantitatives et numériques
4.1 Suppression des apostrophes pour les types numériques
La manipulation des grandeurs quantitatives au sein de la fonction QUERY obéit à des règles diamétralement opposées à celles régissant le traitement des textes. Dans le formalisme relationnel de Google, les nombres (entiers, décimaux, valeurs scientifiques) sont des valeurs scalaires primitives qui ne doivent en aucun cas être délimitées par des apostrophes simples. Dans une requête statique classique, on écrira rigoureusement WHERE C > 1000 et jamais WHERE C > ‘1000’.
Si un analyste applique par automatisme la syntaxe textuelle tripartite à une référence de cellule numérique en écrivant par inadvertance WHERE C > ‘ » & G1 & « ‘, le compilateur de requête interpretera la valeur fournie comme une chaîne littérale. Il tentera alors d’exécuter une comparaison d’ordre lexicographique entre des données numériques typées de la colonne source et un littéral de type chaîne. Cette divergence de typage provoque soit une erreur formelle d’incompatibilité de type au moment de l’exécution, soit un dysfonctionnement logique insidieux où le tri et le filtrage se basent sur l’ordre alphabétique des caractères plutôt que sur leur magnitude arithmétique.
La syntaxe d’incorporation pour les valeurs quantitatives s’avère donc nettement plus épurée : les apostrophes sont totalement proscrites. La séquence se résume au guillemet double d’interruption, à l’esperluette de concaténation, à l’adresse de la cellule, à la seconde esperluette et au guillemet double de redémarrage : « & cellule & ». Ainsi, pour adosser une condition sur un chiffre d’affaires situé en colonne C à un seuil défini en cellule H1, l’analyste écrira avec rigueur : =QUERY(Donnees; « SELECT * WHERE C >= » & H1; 1).
4.2 Opérateurs relationnels et seuils mathématiques dynamiques
L’absence de contrainte d’apostrophes simplifie grandement l’interaction avec l’ensemble des opérateurs relationnels et arithmétiques standardisés supportés par le moteur de visualisation, à savoir la supériorité stricte (>), l’infériorité stricte (<), la supériorité ou égalité (>=), l’infériorité ou égalité (<=), ainsi que les différentes formes de non-égalité (!= ou <>). Ces comparateurs permettent de bâtir des interfaces dynamiques d’analyse de performance, où des seuils statistiques de contrôle sont modifiables en temps réel par un examinateur.
Un cas de figure récurrent dans l’architecture décisionnelle consiste à extraire des enregistrements compris à l’intérieur d’un intervalle quantitatif fermé, défini par une borne inférieure et une borne supérieure distinctes. Supposons que la cellule B2 héberge la limite basse d’un intervalle de rémunération et que la cellule B3 héberge sa limite haute. L’assemblage logique combinera deux sous-clauses dépendantes au sein du prédicat WHERE, chacune reliée à sa propre cellule source :
=QUERY(A1:E200; « SELECT * WHERE D >= » & B2 & » AND D <= " & B3; 1)
Durant le processus de décomposition de cette formule, l’évaluateur de Google Sheets résout simultanément B2 et B3 pour produire une clause continue où chaque chiffre est immédiatement précédé de son opérateur arithmétique respectif. L’analyste doit veiller à préserver les espaces typographiques autour du mot-clé conjonctif AND à l’intérieur des blocs statiques entre guillemets pour éviter la coalescence accidentelle du chiffre de la borne inférieure avec l’instruction logique suivante.
4.3 Gestion des séparateurs décimaux et paramètres régionaux
L’un des écueils les plus retors lors de l’injection dynamique de données numériques réside dans la disparité des paramètres régionaux (paramètres régionaux de la feuille de calcul). Le moteur sous-jacent de la Google Visualization API est intégralement calqué sur les normes anglo-saxonnes : il exige impérativement le point (.) comme séparateur exclusif des décimales et rejette toute présence de virgule arithmétique ou de séparateur de milliers.
Cependant, dans un environnement francophone (paramètres régionaux configurés sur la France, la Belgique ou le Canada francophone), Google Sheets affiche et convertit par défaut les nombres décimaux en chaînes de caractères en utilisant la virgule décimale conventionnelle (par exemple, le nombre trois et demi devient textuellement « 3,5 »). Lors de la concaténation brute via l’esperluette d’une cellule contenant 3,5, l’instruction résultante transmise au moteur devient WHERE C > 3,5. Pour le compilateur QUERY, la virgule n’est pas un point décimal mais un séparateur d’arguments ou de colonnes, ce qui fait échouer instantanément la requête sous une avalanche d’erreurs d’analyse de syntaxe.
Pour neutraliser ce risque structurel dans les classeurs internationaux ou localisés en langue française, il est indispensable de forcer la conversion de la valeur numérique au format anglo-saxon avant sa fusion dans l’instruction de requête. Cette sécurisation est réalisée élégamment en substituant la virgule par un point ou en appliquant explicitement la fonction TEXTE munie d’un masque de formatage à point standardisé :
=QUERY(Donnees; « SELECT * WHERE C > » & SUBSTITUE(H1; « , »; « . »); 1)
ou alternativement, pour garantir l’absence de tout caractère monétaire ou séparateur de milliers parasite pouvant émaner d’une cellule formatée en devise financière : =QUERY(Donnees; « SELECT * WHERE C > » & TEXTE(CNUM(H1); « 0.00 »); 1). Cette précaution algorithmique garantit la portabilité universelle du classeur, quel que soit le pays d’origine de l’utilisateur ou la configuration linguistique du poste client.
5. Intégration temporelle : références de cellules contenant dates et horodatages
5.1 La clause DATE et le formatage obligatoire ISO 8601
Le traitement des valeurs de nature temporelle au sein de la fonction QUERY représente sans doute la source d’incompréhension la plus répandue chez les développeurs de feuilles de calcul. Dans le système interne de Google Sheets, une date n’est rien d’autre qu’un nombre séquentiel représentant le nombre de jours écoulés depuis une date pivot conventionnelle (le 30 décembre 1899). Cependant, le compilateur du moteur de visualisation refuse catégoriquement d’interpréter ces numéros de série séquentiels, tout comme il refuse les formats de date littéraux locaux tels que le format français usuel JJ/MM/AAAA.
Pour être reconnue comme une date valide, une valeur temporelle doit être précédée du mot-clé littéral réservé date (en minuscules ou majuscules) et être rigoureusement formatée selon la norme internationale ISO 8601, c’est-à-dire sous la forme textuelle stricte ‘AAAA-MM-JJ’, impérativement ceinte d’apostrophes simples. Dans une requête statique, la date du 15 octobre 2023 s’écrit obligatoirement sous la forme syntaxique suivante : WHERE A >= date ‘2023-10-15’.
Dès lors qu’il s’agit d’asservir ce filtrage à une cellule D3 contenant une date saisie par un utilisateur, l’analyste ne peut pas se contenter d’une simple concaténation de la référence. En effet, l’évaluation brute de D3 renverrait soit la chaîne locale visible (par exemple 15/10/2023), soit le numéro de série sous-jacent (par exemple 45214), deux représentations rejetées par le moteur. Il est donc indispensable d’interposer la fonction de transformation TEXTE pour métamorphoser la valeur de la cellule en une chaîne calibrée au format ISO avant son injection dans la requête :
=QUERY(Donnees; « SELECT * WHERE A >= date ‘ » & TEXTE(D3; « yyyy-mm-dd ») & « ‘ »; 1)
L’observation attentive de ce schéma révèle l’imbrication méticuleuse des composants : le mot-clé date et son espace subséquent figurent à l’intérieur du bloc textuel statique, suivis immédiatement de l’apostrophe simple ouvrante, puis de la coupure par guillemet double. Après l’esperluette, la fonction TEXTE reformate avec précision le numéro de série de la cellule cible en standard américain avec tirets, avant que la seconde esperluette ne vienne clore la séquence par un guillemet double réintroduisant l’apostrophe simple fermante.
5.2 Gestion des heures et des horodatages complets
Au-delà de la date civile standard, les jeux de données analytiques intègrent fréquemment des dimensions temporelles plus granulaires, à savoir des composantes horaires pures ou des horodatages intégraux combinant calendrier et chronométrie. L’API de visualisation Google dispose de clauses littérales spécifiques pour chacune de ces typologies, chacune obéissant à des exigences de typage tout aussi rigoureuses que la clause de date simple.
Pour filtrer sur des heures précises (sans composante de jour), la requête requiert l’instruction timeofday suivie d’une chaîne délimitée par des apostrophes sous le format d’affichage ‘HH:mm:ss’ ou ‘HH:mm:ss.SSS’. Lorsqu’une cellule de contrôle E1 héberge une heure cible, la construction syntaxique dynamique prend la forme suivante :
=QUERY(Donnees; « SELECT * WHERE B > timeofday ‘ » & TEXTE(E1; « hh:mm:ss ») & « ‘ »; 1)
Pour les données temporelles complètes incluant la date et l’horaire précis jusqu’à la seconde (horodatages de validation, journaux de connexions informatiques, logs transactionnels), la clause obligatoire est timestamp. Son formalisme textuel requiert le masque ‘AAAA-MM-JJ HH:mm:ss’. L’extraction dynamique à partir d’une cellule d’horodatage complet F1 nécessitera donc l’instruction :
=QUERY(Donnees; « SELECT * WHERE C <= timestamp '" & TEXTE(F1; "yyyy-mm-dd hh:mm:ss") & "'"; 1)
Une vigilance particulière doit être accordée aux éventuels décalages induits par les fuseaux horaires lors de la conversion de cellules contenant des horodatages issus de formulaires automatisés (Google Forms, bases Firebase ou imports d’API). Les chaînes générées doivent toujours refléter le fuseau horaire propre configuré dans les paramètres du tableur d’accueil, afin d’éviter des décalages d’interrogation de plusieurs heures pouvant fausser radicalement l’inclusion ou l’exclusion d’enregistrements critiques.
5.3 Filtrage d’échéances et de périodes glissantes dynamiques
L’asservissement des critères temporels à des cellules de référence atteint son potentiel analytique maximal lorsqu’il est combiné à des fonctions de calcul temporel dynamiques au sein de la grille. Plutôt que de pointer vers une cellule contenant une date statique figée, la cellule de consigne peut elle-même héberger une formule temporelle active, telle que la fonction AUJOURDHUI() ou des décalages calculés via FIN.MOIS() ou MOIS.DECALER().
Cette approche permet de générer des tableaux de bord présentant des fenêtres d’observation longitudinales glissantes sans aucune intervention humaine de maintenance. Par exemple, si une cellule K1 contient la formule calculant le premier jour du mois courant =FIN.MOIS(AUJOURDHUI(); -1) + 1 et que la cellule K2 calcule le dernier jour du mois courant =FIN.MOIS(AUJOURDHUI(); 0), la formule QUERY se borne à référencer K1 et K2 pour extraire en permanence l’état d’activité de la période mensuelle en cours :
=QUERY(Donnees; « SELECT * WHERE A >= date ‘ » & TEXTE(K1; « yyyy-mm-dd ») & « ‘ AND A <= date '" & TEXTE(K2; "yyyy-mm-dd") & "'"; 1)
En architecturant ainsi le modèle, le classeur recalcule quotidiennement la borne d’extraction dès son ouverture, assurant un reporting perpétuellement synchronisé avec la réalité calendaire. Cette méthode surpasse largement la tentative d’écrire des fonctions de date directement à l’intérieur de la chaîne SQL (tentative souvent vouée à l’échec car le dialecte QUERY ne supporte qu’un sous-ensemble très restreint de fonctions temporelles internes), en déléguant au tableur la résolution arithmétique complexe des dates avant injection.
6. Logique booléenne multi-critères et combinaison de cellules
6.1 Conjonction AND avec multiples références hétérogènes
Dans les scénarios d’analyse réels, l’extraction de données repose rarement sur une condition atomique unique. L’analyste est le plus souvent confronté à la nécessité d’opérer un filtrage multi-dimensionnel combinant simultanément des prédicats textuels, quantitatifs et chronologiques. L’opérateur de conjonction AND est alors sollicité pour astreindre les enregistrements à satisfaire la totalité des clauses énoncées.
La difficulté technique dans la construction d’une requête multi-critères réside dans la gestion sans faille des délimiteurs propres à chaque nature de variable au fur et à mesure que la formule s’allonge. Considérons une table transactionnelle où l’on souhaite filtrer les données selon trois cellules de critères : une région textuelle en B1, un montant minimal numérique en B2, et une date d’effet en B3. L’assemblage impose d’appliquer successivement l’encadrement par apostrophes pour B1, l’absence d’apostrophe pour B2, et le mot-clé date avec formatage textuel pour B3 :
=QUERY(Donnees; « SELECT * WHERE A = ‘ » & B1 & « ‘ AND C >= » & B2 & » AND D >= date ‘ » & TEXTE(B3; « yyyy-mm-dd ») & « ‘ »; 1)
Face à une telle accumulation de symboles typographiques, la lisibilité du code décline rapidement, augmentant exponentiellement le risque d’erreur humaine. Pour préserver la maintenabilité de ces formules denses, il est recommandé de mettre à profit l’éditeur étendu de la barre de formule de Google Sheets en aérant la syntaxe par des retours à la ligne contrôlés (accessibles via la combinaison de touches Ctrl+Entrée ou Commande+Entrée) et des espacements réguliers entre les clauses logiques majeures.
6.2 Disjonction OR et alternatives décisionnelles
L’introduction de l’opérateur de disjonction OR permet de formuler des filtres inclusifs où un enregistrement est conservé dès lors qu’il valide au moins l’une des conditions stipulées. Dès lors que l’on relie des cellules à une logique disjonctive, la question de la priorité des opérateurs algébriques devient critique. Dans la hiérarchie relationnelle de la Google API, l’opérateur AND possède une précédence naturelle sur l’opérateur OR, exactement comme la multiplication prévaut sur l’addition en arithmétique élémentaire.
Par conséquent, lorsqu’une requête combine des conditions conjonctives et des alternatives disjonctives reliées à des cellules de filtrage, il est impératif d’encapsuler explicitement les segments disjonctifs au sein de parenthèses de regroupement directement dans le texte de la requête. Supposons une extraction devant cibler soit le département spécifié en cellule C1, soit celui en cellule C2, mais à la condition expresse que le volume des ventes (colonne D) excède le seuil d’alerte consigné en C3. L’analyste devra structurer la requête de façon à forcer l’évaluation groupée des cellules textuelles :
=QUERY(Donnees; « SELECT * WHERE (A = ‘ » & C1 & « ‘ OR A = ‘ » & C2 & « ‘) AND D > » & C3; 1)
L’omission des parenthèses dans ce contexte altérerait profondément la sémantique de l’interrogation : le compilateur extrairait tous les enregistrements du département C1 sans aucune considération du montant, ainsi que les seuls enregistrements du département C2 respectant le montant de seuil C3. L’usage rigoureux de parenthèses statiques protège l’algorithme contre tout comportement décisionnel déviant.
6.3 Négation logique et exclusion paramétrée
La négation logique, matérialisée par l’opérateur NOT ou par l’usage des comparateurs d’inégalité (!= ou <>), offre une méthode efficace pour extraire un sous-ensemble par soustraction. Elle s’avère particulièrement utile dans les processus de nettoyage de données ou de contrôle d’intégrité, lorsqu’il s’agit d’isoler l’ensemble des transactions à l’exception d’un code d’annulation ou d’une typologie d’essai expérimental consigné dans une cellule de référence.
Pour exclure de l’analyse une catégorie de produits inscrite dans la cellule Z1, la syntaxe peut être formalisée soit de manière directe :
=QUERY(Donnees; « SELECT * WHERE B != ‘ » & Z1 & « ‘ »; 1)
soit en préfixant l’ensemble de la condition par le mot-clé de négation :
=QUERY(Donnees; « SELECT * WHERE NOT B = ‘ » & Z1 & « ‘ »; 1)
Une précaution méthodologique majeure doit néanmoins être observée lors de l’application de prédicats négatifs reliés à des cellules de filtrage. En algèbre relationnelle standard et dans le dialecte SQL de Google, les valeurs manquantes (cellules vides ou valeurs nulles) réagissent de manière contre-intuitive face à la négation : une cellule vide n’est ni égale, ni strictement différente d’une valeur textuelle donnée. Si la colonne B contient des entrées nulles, l’instruction WHERE B != ‘Z1’ éliminera non seulement les valeurs égales au contenu de Z1, mais supprimera également toutes les lignes où la colonne B est vide. Si l’objectif consiste à préserver les lignes vides, il conviendra d’adjoindre expressément une clause gérant la nullité : WHERE (B != ‘ » & Z1 & « ‘ OR B IS NULL).
7. Gestion des cellules sources nulles, vides ou partielles
7.1 Le problème de la chaîne vide dans l’injection WHERE
L’un des défis les plus redoutables dans la conception d’outils interactifs basés sur la fonction QUERY réside dans la vulnérabilité intrinsèque du parseur face à des cellules de commande laissées vierges par l’utilisateur. Lorsqu’une formule dépend d’une cellule de filtrage E1 et que celle-ci ne contient aucune saisie (chaîne vide « »), la concaténation brute produit une instruction syntaxiquement incomplète et aberrante.
Par exemple, pour une formule numérique telle que « WHERE A > » & E1, la vacuité de E1 produit la chaîne finale tronquée WHERE A > . Privé de son opérande droit, l’interpréteur syntaxique est incapable de valider la comparaison arithmétique et s’effondre avec une erreur fatale d’analyse. Dans le cas d’une cellule textuelle asservie par ‘ » & E1 & « ‘, le résultat produit devient WHERE B = », ce qui force le système à rechercher exclusivement les enregistrements dont la colonne B est une chaîne de longueur zéro, aboutissant le plus souvent à un tableau vide inattendu au lieu de neutraliser le filtre comme l’espérait naïvement l’utilisateur.
Le diagnostic de ces dysfonctionnements requiert également de distinguer une cellule véritablement vide d’une cellule contenant des caractères invisibles, tels qu’un espace insécable ou un retour chariot résiduel laissé lors d’un copier-coller malencontreux. Ces scories de saisie empêchent les fonctions de détection de vacuité classiques d’opérer correctement et injectent des blancs perturbateurs au sein de la requête.
7.2 Encapsulation conditionnelle avec la fonction SI
La solution architecturale la plus robuste et la plus lisible pour contourner l’écueil des cellules d’entrée vacantes consiste à encapsuler la fonction QUERY au sein d’une structure décisionnelle régie par la fonction SI de Google Sheets. Cette technique consiste à tester en amont l’état de remplissage de la cellule de paramétrage avant de sélectionner la requête textuelle idoine à exécuter.
Si la cellule de critère est déclarée vide (ou n’atteint pas un seuil minimal de caractères exploitables), le tableur déclenche une version sans restriction de la requête (SELECT *), garantissant ainsi l’affichage intégral des données. Dès lors que l’utilisateur consigne une information dans la cellule de saisie, la formule commute instantanément vers la version intégrant la clause WHERE paramétrée. La modélisation prend la forme suivante :
=SI(ESTVIDE(D3); QUERY(Donnees; « SELECT * »; 1); QUERY(Donnees; « SELECT * WHERE A = ‘ » & D3 & « ‘ »; 1))
Bien que cette technique présente une clarté conceptuelle indiscutable, son implémentation dans des contextes multi-critères impliquant plusieurs cellules de contrôle indépendantes conduit inévitablement à une explosion combinatoire d’embranchements conditionnels imbriqués (SI(ET(…); …)). Cette prolifération de clauses SI nuit gravement à la concision du modèle et pousse les concepteurs de tableaux de bord à privilégier des approches plus synthétiques basées sur des opérateurs de substitution universelle.
7.3 Stratégie de substitution par jokers universels
Pour maintenir une instruction de requête unique et unifiée tout en autorisant la non-sélection optionnelle de certains filtres, la stratégie d’ingénierie la plus élégante consiste à exploiter l’opérateur de comparaison floue LIKE associé au métacaractère joker pourcent (%). Dans le langage de requête de l’API de visualisation, le symbole % correspond à n’importe quelle séquence de zéro, un ou plusieurs caractères alphabétiques ou numériques, agissant comme un passe-partout universel.
En couplant cette propriété à une fonction de substitution conditionnelle à l’intérieur même de la chaîne de concaténation, on configure la cellule de façon à ce que son absence de valeur soit automatiquement remplacée par le symbole joker. Si la cellule cible est vide, la requête évalue une clause équivalente à LIKE ‘%’, ce qui a pour conséquence géométrique d’inclure la totalité des lignes possédant une valeur non nulle dans la colonne considérée :
=QUERY(Donnees; « SELECT * WHERE B LIKE ‘ » & SI(ESTVIDE(F1); « % »; « % » & F1 & « % ») & « ‘ »; 1)
Cette architecture confère au tableau de bord une ergonomie remarquable. L’utilisateur peut au choix laisser la cellule F1 totalement vide pour désactiver le filtre sur la colonne B, ou bien saisir une bribe de mot pour enclencher instantanément un filtrage prédictif partiel sur ce même champ, le tout sans démultiplier les blocs de la fonction QUERY et sans mobiliser de ressources calculatoires excessives au sein de la feuille de calcul.
8. Références de cellules inter-feuilles et plages nommées
8.1 Ciblage de cellules de contrôle situées sur des onglets distincts
Dans la conception professionnelle de classeurs décisionnels, une séparation méthodologique rigoureuse est toujours établie entre les différents niveaux architecturaux de l’application : l’onglet hébergeant la matrice de données brutes, l’onglet servant de panneau de configuration utilisateur (les cellules de saisie de filtres), et l’onglet réservé à la restitution visuelle des rapports et extractions générés par QUERY.
Pour faire référence à une cellule située sur un onglet distinct au sein de l’assemblage de la formule de requête, il convient d’adopter la syntaxe d’adressage inter-feuilles standardisée de Google Sheets. Le nom de l’onglet source doit être séparé des coordonnées de la cellule par un point d’exclamation (!). Si le nom de l’onglet comporte des espaces, des caractères accentués ou des symboles typographiques réservés, il doit impérativement être encapsulé entre des apostrophes simples de tableur (qui ne doivent pas être confondues avec les apostrophes simples de la syntaxe interne de la requête SQL) :
=QUERY(Donnees!A1:H1000; « SELECT * WHERE B = ‘ » & ‘Paramètres Utilisateur’!B2 & « ‘ »; 1)
Une discipline d’ingénierie stricte doit présider à la dénomination des feuilles de calcul. Bien que Google Sheets mette automatiquement à jour les références d’onglets au sein des formules ordinaires lors du renommage interactif d’une feuille par un utilisateur, des assemblages textuels complexes ou des formules faisant intervenir des chaînes dynamiques peuvent subir des ruptures d’intégrité référentielle en cas de modifications toponymiques imprudentes. Il est donc recommandé de figer des libellés d’onglets normalisés et pérennes pour tous les réceptacles de paramètres critiques.
8.2 Utilisation des plages nommées pour les variables de filtrage
L’utilisation de coordonnées matricielles brutes (telles que ‘Configuration’!$D$12) au cœur d’une longue concaténation textuelle présente l’inconvénient majeur de réduire la lisibilité sémantique de l’expression mathématique. L’attribution systématique d’une plage nommée (Named Range) à la cellule hébergeant le critère constitue la parade méthodologique optimale pour élever le niveau d’abstraction et de maintenabilité de l’infrastructure.
En attribuant à une cellule unique un identifiant nominal univoque, tel que Seuil_Rentabilite ou Code_Region_Cible, la chaîne de concaténation gagne instantanément en intelligibilité. L’analyste ou le relecteur du classeur comprend instantanément la vocation du paramètre injecté sans avoir à localiser physiquement l’emplacement de la cellule sur un autre onglet :
=QUERY(Donnees; « SELECT A, B, SUM(C) WHERE D = ‘ » & Code_Region_Cible & « ‘ GROUP BY A, B »; 1)
Au-delà de l’élégance syntaxique, les plages nommées garantissent une immunité totale face aux manipulations géométriques du tableau : l’insertion d’une nouvelle ligne ou la translation d’un bloc de saisie déplace automatiquement la plage nommée sans jamais rompre l’appel effectué à l’intérieur de la fonction QUERY. Sur le plan des performances calculatoires, l’adressage par nom sémantique n’induit aucune dégradation mesurable du temps de rafraîchissement par rapport à l’adressage matriciel direct, le graphe de dépendances de Google Sheets résolvant ces pointeurs avec une vélocité identique.
8.3 Combinaison avec des fonctions de recherche indirecte
Pour les architectures hautement dynamiques où la cellule de contrôle elle-même ne peut être déterminée de manière statique à l’avance, il est envisageable d’associer la fonction INDIRECT à la mécanique d’injection. Cette démarche s’applique notamment aux matrices multidimensionnelles où l’adresse de la cellule contenant le filtre à appliquer dépend elle-même d’un choix préalable (par exemple une liste déroulante sélectionnant la typologie de critère à examiner).
L’expression encapsule alors la fonction INDIRECT au centre des esperluettes de concaténation, forçant l’évaluation dynamique de l’adresse de cellule avant sa transmission au moteur QUERY :
=QUERY(Donnees; « SELECT * WHERE E > » & INDIRECT(« Paramètres! » & A1); 1)
Dans ce montage, si la cellule A1 contient la chaîne textuelle « C10 », la fonction INDIRECT ira chercher la valeur contenue dans Paramètres!C10 pour la fournir à l’instruction SQL. Bien que cette combinaison offre une modularité spectaculaire pour des simulateurs ou des tableaux de bord interactifs avancés, elle doit être employée avec une grande parcimonie. La fonction INDIRECT est intrinsèquement une fonction dite « volatile » : elle force le tableur à réévaluer l’intégralité de la formule lors du moindre recalcul n’importe où dans le document, ce qui peut saturer la mémoire allouée au fil d’exécution et dégrader considérablement la réactivité d’un classeur volumineux.
9. Ergonomie cognitive, lisibilité et maintenance des formules complexes
9.1 Charge cognitive et déchiffrage de la syntaxe de concaténation
L’empilement visuel de délimiteurs disparates constitutifs de la séquence d’injection classique — guillemets doubles, apostrophes simples et esperluettes accolées — génère ce que les spécialistes de l’interaction homme-machine qualifient de charge cognitive extrinsèque élevée. Pour un analyste confronté à un bogue au sein d’une formule comportant six critères interconnectés, le déchiffrage d’une suite cryptique telle que ‘ »&A1& »‘ AND B >= « &B1& » AND C = ‘ »&C1& »‘ induit une fatigue visuelle prononcée et multiplie les probabilités d’omission d’un caractère critique.
Cette opacité syntaxique constitue l’un des freins majeurs à l’adoption sereine de la fonction QUERY au sein des équipes analytiques transverses. Dès lors qu’un développeur quitte un projet ou qu’un auditeur externe doit valider l’intégrité méthodologique d’une feuille de calcul, le coût temporel nécessaire à la rétro-ingénierie de ces constructions textuelles devient disproportionné par rapport à la simplicité mathématique des filtres sous-jacents.
Pour pallier cette friction cognitive, la première mesure d’hygiène stylistique consiste à prohiber absolument les formules monolignes compactes dès lors que le nombre d’arguments excède deux variables. L’introduction systématique de sauts de ligne réguliers pour isoler visuellement chaque segment de clause, conjuguée à l’alignement vertical des conjonctions AND et OR, transforme une expression illisible en un bloc de code structuré comparable aux standards de développement logiciel contemporains.
9.2 Technique alternative d’abstraction par les fonctions SUBSTITUE et LET
Pour s’émanciper totalement du fardeau visuel de la concaténation brute par esperluettes, les ingénieurs de données sur Google Sheets utilisent désormais des patrons de conception fondés sur des fonctions d’abstraction textuelle. La première alternative éprouvée repose sur l’emploi méthodique de la fonction SUBSTITUE, où la chaîne de requête est d’abord rédigée avec une clarté totale sous forme de squelette textuel intégrant des marqueurs de position identifiables (placeholders), avant que ces derniers ne soient remplacés par les valeurs des cellules sources :
=QUERY(Donnees; SUBSTITUE(SUBSTITUE(« SELECT * WHERE Region = ‘@reg’ AND Ventes > @vnt »; « @reg »; B1); « @vnt »; B2); 1)
Une avancée conceptuelle encore plus remarquable est rendue possible par l’introduction de la fonction LET dans Google Sheets. Cette dernière permet de déclarer formellement des variables locales nommées en tête de formule, découplant l’acquisition des paramètres cellulaires de la formulation logique de la requête. On peut ainsi structurer l’exécution de manière particulièrement limpide :
=LET(
CritereRegion; B1;
CritereSeuil; B2;
ClauseSQL; « SELECT * WHERE A = ‘ » & CritereRegion & « ‘ AND C > » & CritereSeuil;
QUERY(Donnees; ClauseSQL; 1)
)
Cette architecture confère au classeur une maintenabilité exceptionnelle : les coordonnées des cellules physiques sont centralisées aux toutes premières lignes de la formule, facilitant leur réaffectation future sans risquer d’altérer la grammaire SQL située dans les expressions en aval.
9.3 Documentation interne et gouvernance des données du tableur
Dans un contexte d’ingénierie collaborative en entreprise ou au sein d’un laboratoire de recherche, la durabilité d’un modèle d’analyse repose impérativement sur des protocoles de documentation rigoureux. Les feuilles de calcul complexes intégrant des requêtes paramétrées doivent être considérées comme de véritables applications logicielles nécessitant une traçabilité intégrale de leur cycle de vie.
Il est impératif de normaliser la charte graphique et sémantique des cellules de paramètres. Les cellules de contrôle asservissant des fonctions QUERY doivent être immédiatement distinguables par une mise en forme visuelle standardisée (par exemple un arrière-plan chromatique pastel dédié et une bordure spécifique signalant une zone d’entrée interactive). En regard direct de chaque cellule d’entrée, un libellé clair doit expliciter la nature de la variable attendue ainsi que son unité de mesure ou son formatage requis.
De surcroît, l’utilisation systématique des fonctionnalités de commentaires internes (via un clic droit sur la cellule de formule, puis « Insérer une note ») permet de consigner directement dans le modèle l’intention analytique de l’auteur, les dépendances matricielles sous-jacentes et les règles de transformation appliquées. Ces bonnes pratiques de gouvernance garantissent un transfert de propriété intellectuelle fluide et empêchent la création d’« actifs zombies » au sein des organisations — des classeurs cruciaux pour la prise de décision mais devenus incompréhensibles pour leurs exploitants successifs.
10. Sécurité, injection de code et intégrité des requêtes paramétrées
10.1 Le risque d’injection involontaire dans l’instruction de requête
Bien que Google Sheets évolue dans un bac à sable (sandbox) hermétique au sein de l’infrastructure infonuagique de Google, interdisant toute destruction physique du système de fichiers d’un serveur, le concept d’injection de code demeure d’une actualité brûlante dans l’utilisation de la fonction QUERY. Tout comme une injection SQL classique sur une application Web permet à un attaquant de manipuler une base de données en insérant des caractères de contrôle, la concaténation non assainie de cellules d’entrée dans QUERY expose le classeur à des corruptions logiques majeures.
Le cas d’école le plus fréquent n’est pas d’origine malveillante mais purement accidentel : il s’agit de la présence naturelle d’apostrophes typographiques au sein des valeurs textuelles fournies par les utilisateurs ou contenues dans les matrices de données. Considérons une cellule de filtrage textuel dans laquelle un opérateur saisit un nom de ville ou de patronyme comportant une élision, tel que L’Aigle, D’Artagnan ou O’Connor. Dès lors que cette chaîne est injectée dans le gabarit standard ‘ »& cellule & »‘, l’apostrophe interne de la valeur vient percuter prématurément la syntaxe :
La chaîne générée devient : WHERE Ville = ‘L’Aigle’.
Pour le parseur de l’API de visualisation, l’apostrophe de l’élision est immédiatement interprétée comme le délimiteur fermant de la constante littérale. La séquence subséquente Aigle’ est alors traitée comme la suite de la commande SQL. N’appartenant à aucun mot-clé valide de la grammaire, elle provoque l’effondrement instantané de la formule avec une exception d’analyse syntaxique (#VALUE!), paralysant l’ensemble des indicateurs calculés en aval.
10.2 Méthodes de neutralisation et d’échappement des caractères critiques
Pour prémunir durablement les requêtes paramétrées contre le risque d’effondrement induit par les caractères de délimitation internes, l’analyste doit impérativement mettre en œuvre des mécanismes d’échappement (escaping) des données en amont de leur injection. Dans le dialecte SQL de Google Sheets, l’échappement d’une apostrophe simple présente au sein d’une valeur littérale s’effectue en la doublant systématiquement ou en la précédant d’une barre oblique inversée selon le contexte d’évaluation.
La méthode de sécurisation la plus fiable consiste à intercaler la fonction SUBSTITUE directement autour de la référence de cellule au moment de la concaténation, afin de remplacer chaque apostrophe simple unique par une paire d’apostrophes simples collées, neutralisant ainsi son pouvoir d’interruption syntaxique aux yeux du parseur :
=QUERY(Donnees; « SELECT * WHERE NomClient = ‘ » & SUBSTITUE(B1; « ‘ »; » » ») & « ‘ »; 1)
Grâce à ce traitement préventif, si l’utilisateur saisit la valeur d’entrée L’Aigle en B1, la chaîne de substitution produit en mémoire L »Aigle, que le compilateur QUERY interprète correctement comme une apostrophe typographique légitime faisant partie intégrante de la chaîne de recherche, sans altérer l’intégrité de la structure d’encadrement extérieure. Cette pratique d’assainissement systématique des entrées textuelles distingue une ingénierie de données amateur d’une architecture professionnelle hautement résiliente.
10.3 Protection des cellules de contrôle contre les altérations involontaires
La robustesse globale d’un classeur analytique ne dépend pas uniquement de l’élégance algorithmique de ses formules, mais également de la sécurisation physique de ses interfaces d’interaction. Les cellules de contrôle servant de variables d’injection pour la fonction QUERY doivent faire l’objet de règles de confinement très strictes afin d’interdire toute saisie hors format ou suppression involontaire par les utilisateurs opérationnels.
Le premier rempart architectural consiste à utiliser systématiquement les fonctionnalités de validation des données de Google Sheets. Pour les filtres textuels catégoriels, la cellule de commande doit obligatoirement être asservie à une liste déroulante restreinte alimentée dynamiquement par les valeurs distinctes déjà présentes dans la matrice source (obtenues préalablement via une fonction =UNIQUE(Donnees!A2:A)). Pour les filtres numériques ou temporels, la validation doit contraindre l’entrée à un intervalle arithmétique cohérent ou à un format de date valide, en cochant impérativement l’option « Refuser la saisie » en cas de non-conformité.
En complément absolu, l’analyste doit verrouiller la cellule hébergeant la formule QUERY maîtresse à l’aide des outils de protection de feuilles et de plages. L’accès en modification à cette cellule doit être réservé aux seuls administrateurs du modèle, tandis que les cellules de consigne sont laissées accessibles en écriture aux utilisateurs finals. De surcroît, la surveillance régulière de l’historique des versions de Google Sheets permet d’auditer avec précision les éventuelles altérations structurelles et d’identifier l’auteur d’une dégradation de paramètre en cas d’anomalie d’exploitation.
11. Cas d’usage appliqué : Traitement de données psychométriques et expérimentales
11.1 Filtrage dynamique de cohortes par seuils d’inclusion psychologiques
Afin d’illustrer la pertinence empirique de ces principes dans un cadre scientifique rigoureux, examinons un protocole appliqué issu de la recherche en psychologie cognitive et psychométrie expérimentale. Considérons une cohorte de 500 participants ayant passé une batterie de tests standardisés évaluant les niveaux d’anxiété via l’inventaire STAI (State-Trait Anxiety Inventory, colonne C) et les scores de dépression via l’échelle BDI-II (Beck Depression Inventory, colonne D), la colonne A recueillant l’identifiant anonymisé du participant et la colonne B son groupe clinique de rattachement.
Dans le cadre d’un protocole expérimental à double insu, les directeurs de recherche doivent pouvoir isoler dynamiquement des sous-cohortes de sujets éligibles en fonction de seuils psychométriques variables sans jamais toucher à la matrice de données brutes. À cette fin, une feuille d’administration expose trois cellules de commande interactives : la cellule G1 pour l’anxiété minimale d’inclusion (valeur numérique), la cellule G2 pour la dépression maximale autorisée (valeur numérique), et la cellule G3 spécifiant le sous-groupe catégoriel (valeur textuelle).
La formule QUERY de déploiement clinique intègre harmonieusement l’hétérogénéité des types pour générer l’échantillon d’analyse :
=QUERY(Sujets_Data; « SELECT A, B, C, D WHERE C >= » & G1 & » AND D <= " & G2 & " AND B = '" & G3 & "' ORDER BY C DESC"; 1)
Cette approche permet aux chercheurs de moduler en temps réel les bornes d’inclusion clinique durant les réunions d’évaluation méthodologique. L’actualisation immédiate des effectifs de la cohorte résultante facilite la prise de décision sans nécessiter le recours chronophage à des scripts de traitement externes sous R ou Python pour des vérifications exploratoires préliminaires.
11.2 Agrégation paramétrique de résultats selon des variables sociodémographiques
Le traitement des données expérimentales impose régulièrement de procéder à des agrégations statistiques intermédiaires — calcul de moyennes pondérées, d’écarts de scores ou de volumétries d’échantillons — ventilées par strates démographiques. La fonction QUERY excelle dans cette tâche grâce à la puissance conjointe de ses clauses SELECT, AVG(), COUNT() et GROUP BY, particulièrement lorsqu’elles sont asservies à une cellule de consigne.
Supposons que les chercheurs souhaitent obtenir une synthèse agrégée des performances mnésiques moyennes (colonne E) et du temps de réaction moyen en millisecondes (colonne F), non pas sur l’ensemble de la population mais exclusivement pour une tranche d’âge sociodémographique sélectionnée dans la cellule de filtre I1 (par exemple les sujets dont la catégorie d’âge en colonne G correspond à la mention « Seniors »). La requête synthétique s’articule ainsi :
=QUERY(Sujets_Data; « SELECT B, COUNT(A), AVG(E), AVG(F) WHERE G = ‘ » & I1 & « ‘ GROUP BY B LABEL COUNT(A) ‘Effectif’, AVG(E) ‘Moyenne Mémoire’, AVG(F) ‘Temps Moyen (ms)' »; 1)
Grâce à cette instruction paramétrique unifiée, la modification de la cellule I1 régénère instantanément un tableau récapitulatif complet doté d’en-têtes personnalisés (grâce à la clause LABEL). Les données statistiques résultantes peuvent être directement exportées pour publication académique ou liées à des graphiques dynamiques de restitution, éliminant tout risque d’erreur humaine liée à des manipulations manuelles de filtrage et de recopiage de formules de sous-totaux.
11.3 Traitement longitudinal de scores psychologiques avec critères temporels variables
Les études scientifiques contemporaines s’étendent fréquemment sur des protocoles longitudinaux impliquant des mesures répétées dans le temps (mesure baseline pré-test, réévaluation post-test à trois mois, et suivi longitudinal à douze mois). La colonne H de la matrice expérimentale enregistre la date calendaire exacte de passation de chaque session d’évaluation pour chaque participant.
Un enjeu analytique majeur consiste à segmenter longitudinalement les réponses pour analyser l’évolution des scores psychologiques avant et après une intervention thérapeutique survenue à une date pivot variable selon les centres hospitaliers partenaires. Cette date charnière est consignée dans une cellule de référence temporelle K1. Pour extraire la série longitudinale des participants ayant effectué leurs tests après cette échéance spécifique, la formule intègre la fonction TEXTE avec son masque ISO 8601 :
=QUERY(Sujets_Data; « SELECT A, B, C, H WHERE H >= date ‘ » & TEXTE(K1; « yyyy-mm-dd ») & « ‘ ORDER BY H ASC »; 1)
Ce chaînage dynamique offre une traçabilité expérimentale absolue. Toute mise à jour de la date de référence réaligne l’intégralité du pipeline d’analyse temporelle en une fraction de seconde. La rigueur du protocole d’automatisation garantit que l’intégrité des résultats expérimentaux ne dépend d’aucune manipulation artisanale des données, répondant ainsi aux plus hauts standards de reproductibilité scientifique exigés par les revues internationales à comité de lecture.
12. Protocole de diagnostic, audit méthodologique et résolution d’erreurs
12.1 Arbre de décision pour le dépannage des messages d’anomalie
Lors de la phase d’implémentation ou de maintenance de formules QUERY paramétrées complexes, la confrontation à un message d’erreur est un événement courant. Pour résoudre ces anomalies de manière efficiente sans procéder à des tâtonnements aléatoires et improductifs, il est fortement recommandé d’adopter un arbre de décision logique basé sur la typologie des signaux renvoyés par l’environnement Google Sheets.
La première bifurcation diagnostique repose sur la nature de l’erreur affichée :
- Cas 1 : Erreur de type #ERROR! (Erreur d’analyse de formule). L’anomalie se situe strictement dans l’espace syntaxique du tableur hôte. La cause est invariablement un déséquilibre de guillemets doubles (nombre impair d’ouvertures et de fermetures), une esperluette manquante entre deux segments, ou l’emploi de points-virgules erronés à la place d’esperluettes. Action corrective : Revoir méticuleusement la balance des guillemets et s’assurer que chaque référence de cellule est isolée entre deux opérateurs &.
- Cas 2 : Erreur de type #VALUE! avec message « L’instruction de requête n’a pas pu être analysée ». La concaténation a fonctionné au niveau du tableur, mais la chaîne finale viole la grammaire de l’API de visualisation. Action corrective : Examiner les apostrophes simples d’encadrement des chaînes textuelles, inspecter la présence obligatoire du mot-clé date devant une entité temporelle, ou vérifier l’absence d’espaces typographiques autour des opérateurs SQL.
- Cas 3 : Erreur de type #VALUE! avec message « Column [XYZ] does not exist ». Le compilateur interprète une valeur comme un identifiant de colonne inexistant. Action corrective : Il s’agit systématiquement d’une omission des apostrophes simples autour d’une variable textuelle. Réintroduire le patron ‘ »& cellule & »‘.
- Cas 4 : Erreur de type #N/A (Aucun résultat retourné). La requête est syntaxiquement valide mais aucune ligne de la matrice ne correspond aux critères stipulés. Action corrective : Vérifier la sensibilité à la casse des cellules textuelles, s’assurer de l’absence d’espaces masqués résiduels dans la cellule d’entrée, et contrôler la cohérence des bornes d’intervalles numériques.
12.2 Techniques d’isolation et débogage par cellule intermédiaire
Lorsque la complexité d’une formule QUERY multi-critères défie l’analyse visuelle directe, la technique de débogage la plus efficace consiste à procéder à l’isolation textuelle au moyen d’une cellule témoin intermédiaire. Cette méthodologie dérive du principe de décomposition analytique cartésien : diviser la difficulté pour mieux la résoudre.
La procédure s’articule en deux étapes simples mais d’une redoutable efficacité :
- Dans une cellule de test temporaire distincte, l’analyste recopie l’intégralité du deuxième argument de la fonction QUERY (la chaîne de concaténation complète), précédé simplement du signe égal pour en forcer l’évaluation directe par le tableur :
= « SELECT * WHERE A = ‘ » & B1 & « ‘ AND C >= » & B2 - Le résultat affiché dans cette cellule témoin n’est plus une formule hermétique mais le texte final parfaitement résolu tel qu’il est perçu par le moteur de visualisation. Il devient alors instantanément aisé d’y déceler l’anomalie typographique : un espace manquant avant une clause AND, une virgule décimale inopportune au lieu d’un point arithmétique, un format de date local non converti, ou une apostrophe mal positionnée sautent immédiatement aux yeux de l’observateur.
Une fois le libellé textuel validé et stabilisé au sein de la cellule intermédiaire, on peut réinsérer la référence à cette cellule directement en second argument de la fonction QUERY : =QUERY(Donnees; Cellule_Temoin; 1). Dès lors que le résultat opère parfaitement, l’analyste peut choisir soit de réintégrer la chaîne corrigée dans la formule centrale, soit de conserver cette séparation modulaire pour maximiser la lisibilité du classeur.
12.3 Check-list méthodologique avant déploiement en production
Avant d’officialiser la livraison d’un classeur analytique à des utilisateurs décisionnels ou de diffuser des résultats expérimentaux consolidés via QUERY, l’ingénieur de données doit impérativement exécuter une check-list de contrôle qualité exhaustif. Cette phase d’assurance qualité logicielle vise à éprouver la stabilité et la résilience de la solution face aux situations limites les plus critiques.
Le protocole de validation doit obligatoirement couvrir les points de contrôle suivants :
- Test des valeurs frontières et extrêmes : Saisir dans les cellules de contrôle numériques les bornes minimales et maximales théoriques du modèle pour s’assurer de l’absence de débordement ou d’inversion logique des comparateurs.
- Test de vacuité totale : Effacer délibérément le contenu de l’ensemble des cellules de filtrage d’entrée pour vérifier comment le système réagit. La formule s’effondre-t-elle avec une erreur ou commute-t-elle proprement vers un affichage global grâce à des protections conditionnelles appropriées ?
- Test des caractères destructeurs : Saisir intentionnellement dans les cellules d’entrée textuelles des termes comportant des apostrophes simples (ex : Aujourd’hui, L’union) et des guillemets doubles afin de certifier que les mécanismes d’échappement par la fonction SUBSTITUE opèrent avec succès.
- Contrôle de stabilité volumétrique : Insérer artificiellement cinquante lignes de données supplémentaires au sein de la matrice source pour confirmer que la plage d’alimentation de la fonction QUERY (par exemple Donnees!A1:Z) absorbe dynamiquement l’expansion sans nécessiter d’ajustement manuel des coordonnées de bornage.
- Revue croisée de code : Soumettre l’architecture globale des formules et le nommage des cellules clés à l’examen critique d’un pair ou d’un auditeur indépendant pour garantir que le modèle demeure maintenable par des tiers après le départ de son concepteur originel.
Références
- Google. (s. d.). Fonction QUERY (Aide Google Sheets). Centre d’aide Google Docs. Consulté le 15 février 2025, à l’adresse https://support.google.com/docs/answer/3093343
- Google Developers. (s. d.). Google Visualization API Query Language Reference (Version 0.7). Google for Developers. Consulté le 15 février 2025, à l’adresse https://developers.google.com/chart/interactive/docs/querylanguage
- Google. (s. d.). Règles de mise en forme et paramètres régionaux de la feuille de calcul. Centre d’aide Google Docs. Consulté le 15 février 2025, à l’adresse https://support.google.com/docs/answer/58515
- Google. (s. d.). Créer une liste déroulante dans une cellule (Validation des données). Centre d’aide Google Docs. Consulté le 15 février 2025, à l’adresse https://support.google.com/docs/answer/186103
- Pemberton, D. (2021). Mastering Google Sheets: Advanced formulas, automation, and relational database queries. O’Reilly Media.
- Walkenbach, J. (2015). Spreadsheet Modeling and Data Analysis: The definitive guide to formula construction and troubleshooting. John Wiley & Sons.