
L’analyse contemporaine des données tabulaires au sein des environnements infonuagiques requiert des instruments capables de concilier expressivité syntaxique, puissance computationnelle et adaptabilité fonctionnelle. Dans l’écosystème Google Workspace, la fonction QUERY incarne l’aboutissement de cette convergence méthodologique en transposant les paradigmes de l’algèbre relationnelle et du langage SQL (Structured Query Language) directement au cœur des feuilles de calcul. Contrairement aux approches matricielles conventionnelles qui juxtaposent une multitude de fonctions imbriquées au détriment de la lisibilité et des performances de calcul, l’interpréteur de requêtes de Google Sheets opère une abstraction déclarative permettant d’interroger, de projeter et d’agréger des matrices multidimensionnelles volumineuses à l’aide d’instructions textuelles compactes.
La véritable complexité analytique émerge dès lors qu’une simple extraction linéaire ne suffit plus à isoler les observations signifiantes. L’investigation empirique, le contrôle de gestion prédictif, l’épidémiologie quantitative ou le pilotage d’indicateurs de performance clés exigent fréquemment l’application simultanée ou alternative de plusieurs filtres logiques. La clause WHERE se transforme alors en un espace critique d’arbitrage logique où s’entrecroisent des prédicats conjonctifs, des conditions disjonctives, des bornes chronologiques et des correspondances de motifs textuels. La maîtrise de ces mécanismes constitue une compétence fondamentale pour quiconque souhaite concevoir des architectures informationnelles robustes, dynamiques et pérennes au sein de Google Sheets.
Le présent traité expose de manière exhaustive l’ensemble des fondements théoriques, des formulations syntaxiques et des considérations architecturales indispensables à la mise en œuvre de critères multiples dans la fonction QUERY. De la logique booléenne élémentaire régissant les opérateurs AND et OR jusqu’aux subtilités algorithmiques de l’évaluation court-circuit, en passant par le typage strict des données temporelles et l’optimisation des flux d’exécution, cette étude détaillée propose un parcours d’ingénierie logicielle appliqué à l’exploitation experte de données tabulaires.
1. Fondements théoriques de la fonction QUERY et de la clause WHERE
1.1 Architecture du langage de requête de l’API Google Visualization
La fonction QUERY ne procède pas d’un moteur de calcul interne standard propre aux formules arithmétiques traditionnelles des tableurs. Elle constitue en réalité une interface d’interopérabilité directe avec le langage de requête de l’API Google Visualization. Cette genèse architecturale confère à la fonction une filiation directe avec le standard de modélisation relationnelle défini par Edgar F. Codd, tout en imposant des contraintes d’exécution spécifiques dictées par les technologies web sous-jacentes. L’évaluation s’effectue par la sérialisation d’une chaîne de caractères représentant l’instruction logique, laquelle est ensuite transmise à un interpréteur syntaxique dédié chargé de compiler le texte en un arbre syntaxique abstrait avant d’itérer sur la structure matricielle source.
Cette conception implique que l’ensemble des règles de sélection, de projection et d’agrégation réside au sein d’un bloc textuel unique passé en second argument de la fonction. Contrairement aux mécanismes distribués des fonctions natives matricielles, l’API impose un typage monolithique par colonne. Lorsqu’une plage de cellules est soumise à la fonction, le compilateur procède à une analyse statistique de chaque colonne pour en déterminer le type prédominant : chaîne textuelle, nombre décimal, date, horodatage ou valeur booléenne. Toute valeur minoritaire présentant une dissonance de type vis-à-vis de la majorité établie est systématiquement considérée comme une valeur nulle (null), ce qui altère radicalement l’intégrité des filtres conditionnels subséquents.
Face aux architectures basées sur des fonctions imbriquées telles que FILTER, SUMIFS ou des arborescences de IFS, l’utilisation de QUERY apporte une réduction substantielle de la charge cognitive liée à la maintenance des formules. Là où une chaîne de fonctions classiques impose de répliquer les coordonnées de plages vectorielles pour chaque prédicat logique additionnel, l’instruction QUERY s’appuie sur une référence unique à la table matricielle d’origine et désigne les colonnes par leurs identifiants alphabétiques littéraux (A, B, C) ou positionnels (Col1, Col2, Col3). Il en résulte une séparation nette entre les données brutes et la logique de traitement, assurant une portabilité et une modularité structurelle incomparables pour les applications analytiques complexes.
1.2 Rôle structurel de la clause WHERE dans l’extraction sélective
Au sein de la grammaire formelle du langage de visualisation, la clause WHERE opère comme le tamis sélectif primaire. Sur le plan de la logique mathématique, elle correspond à l’opérateur de restriction (ou sélection) de l’algèbre relationnelle, formellement noté à l’aide de la lettre grecque sigma (σ). Son rôle structurel consiste à évaluer, de façon unitaire et séquentielle pour chaque ligne de la matrice de données, un prédicat logique dont la résultante booléenne détermine sans ambiguïté l’inclusion ou l’exclusion du tuple correspondant dans l’ensemble de sortie projeté.
Le traitement ligne par ligne repose sur une évaluation déterministe où chaque champ de la ligne active est confronté aux expressions déclarées dans le prédicat. Si la proposition logique globale relative à un tuple s’évalue à TRUE, la ligne conserve sa position et transite vers les étapes ultérieures du pipeline de traitement, telles que l’agrégation (GROUP BY), le tri (ORDER BY) ou le dimensionnement (LIMIT, OFFSET). À l’inverse, si l’évaluation produit un résultat FALSE ou indéterminé par suite d’une référence à une valeur nulle non explicitement prise en charge, la ligne est irrémédiablement écartée de la mémoire tampon de restitution.
Cette sélection sélective exerce un impact direct et immédiat sur la réduction de dimensionnalité des matrices manipulées. En réduisant drastiquement la cardinalité de l’échantillon dès les premières phases du cycle computationnel, la clause WHERE restreint l’empreinte mémoire requise pour l’exécution des opérations complexes ultérieures. Dans le contexte de jeux de données massifs approchant les limites imposées par Google Sheets (plusieurs millions de cellules), l’optimisation rigoureuse de ce prédicat représente la méthode par excellence pour endiguer la dégradation des temps de réponse et éviter la saturation du thread principal d’exécution JavaScript du navigateur.
2. Syntaxe fondamentale et logique booléenne des opérateurs AND et OR
2.1 Algèbre booléenne appliquée aux requêtes tabulaires
L’articulation de critères d’extraction multiples repose sur les lois fondamentales de l’algèbre de Boole, formalisées au XIXe siècle par George Boole et adaptées depuis lors aux sciences computationnelles. Dans l’écosystème de la fonction QUERY, la composition logique s’établit principalement par l’intermédiaire des conjonctions (AND) et des disjonctions (OR). La conjonction logique exige la simultanéité stricte de validité des propositions : l’expression globale (P AND Q) n’est déclarée vraie que si et seulement si le prédicat P est vrai et le prédicat Q est simultanément vrai. Dans une perspective ensembliste, l’opérateur AND modélise rigoureusement l’intersection de sous-ensembles géométriques au sein de l’espace d’échantillonnage.
À l’opposé, la disjonction logique OR concrétise l’union ensembliste inclusive. L’assertion (P OR Q) s’évalue à l’état vrai dès lors qu’au moins l’une des conditions périphériques est satisfaite, englobant ainsi les occurrences où P est vrai, où Q est vrai, ainsi que les configurations où les deux prédicats coïncident dans la vérité. Cette caractéristique inclusive doit être distinguée de la disjonction exclusive (XOR), non implémentée nativement sous forme d’opérateur lexical dans l’interpréteur de Google Sheets, et qui nécessiterait une décomposition logique plus lourde pour isoler les cas d’incompatibilité mutuelle.
L’implémentation de ces opérateurs impose une discipline typographique rigoureuse au niveau syntaxique. Les mots-clés AND et OR doivent obligatoirement être rédigés en lettres majuscules afin de garantir leur détection immédiate par l’analyseur lexical de l’API. De surcroît, chaque proposition atomique de comparaison doit être délimitée de manière explicite : les littéraux textuels doivent impérativement être ceints d’apostrophes simples (par exemple 'Paris'), tandis que les valeurs numériques demeurent brutes afin d’éviter toute ambiguïté sémantique entre une variable arithmétique et une étiquette textuelle.
2.2 Comparateurs arithmétiques et relationnels utilisables avec les critères
Pour construire des prédicats élémentaires combinables par la suite via des opérateurs booléens, l’analyste dispose d’un éventail complet de comparateurs relationnels normalisés. L’égalité stricte s’exprime à l’aide de l’opérateur =, tandis que la non-égalité peut être formulée indistinctement via != ou la notation canonique SQL <>. Ces opérateurs d’équivalence s’appliquent aussi bien aux dimensions qualitatives (chaînes de caractères) qu’aux dimensions quantitatives (nombres scalaires, dates, pourcentages décimaux), sous réserve d’une conformité absolue des types de données en présence.
Les comparaisons d’ordre exploitent les symboles séquentiels traditionnels : strictement supérieur (>), strictement inférieur (<), supérieur ou égal (>=), et inférieur ou égal (<=). Lorsqu’ils s’appliquent à des variables quantitatives, leur sémantique renvoie à la topologie classique de la droite réelle. En revanche, lorsqu’ils sont appliqués à des chaînes textuelles, ces comparateurs adoptent une logique de classement lexicographique basée sur les valeurs de points de code Unicode de chaque caractère successif, ce qui engendre des comportements parfois surprenants si des conventions de normalisation de casse ne sont pas scrupuleusement appliquées en amont.
La cohérence d’évaluation dépend d’une règle fondamentale : l’interdiction des comparaisons hétérogènes directes. Tenter d’évaluer si une colonne numérique est supérieure à un littéral textuel (par exemple une clause erronée du type WHERE A > '100' alors que la colonne A contient des entiers) conduit inéluctablement à un échec d’interprétation ou à l’expulsion intégrale des données lors du traitement. Une compréhension aiguë des relations d’ordre et de la typologie des champs est le prérequis inviolable à toute architecture de filtrage multicritère sophistiquée.
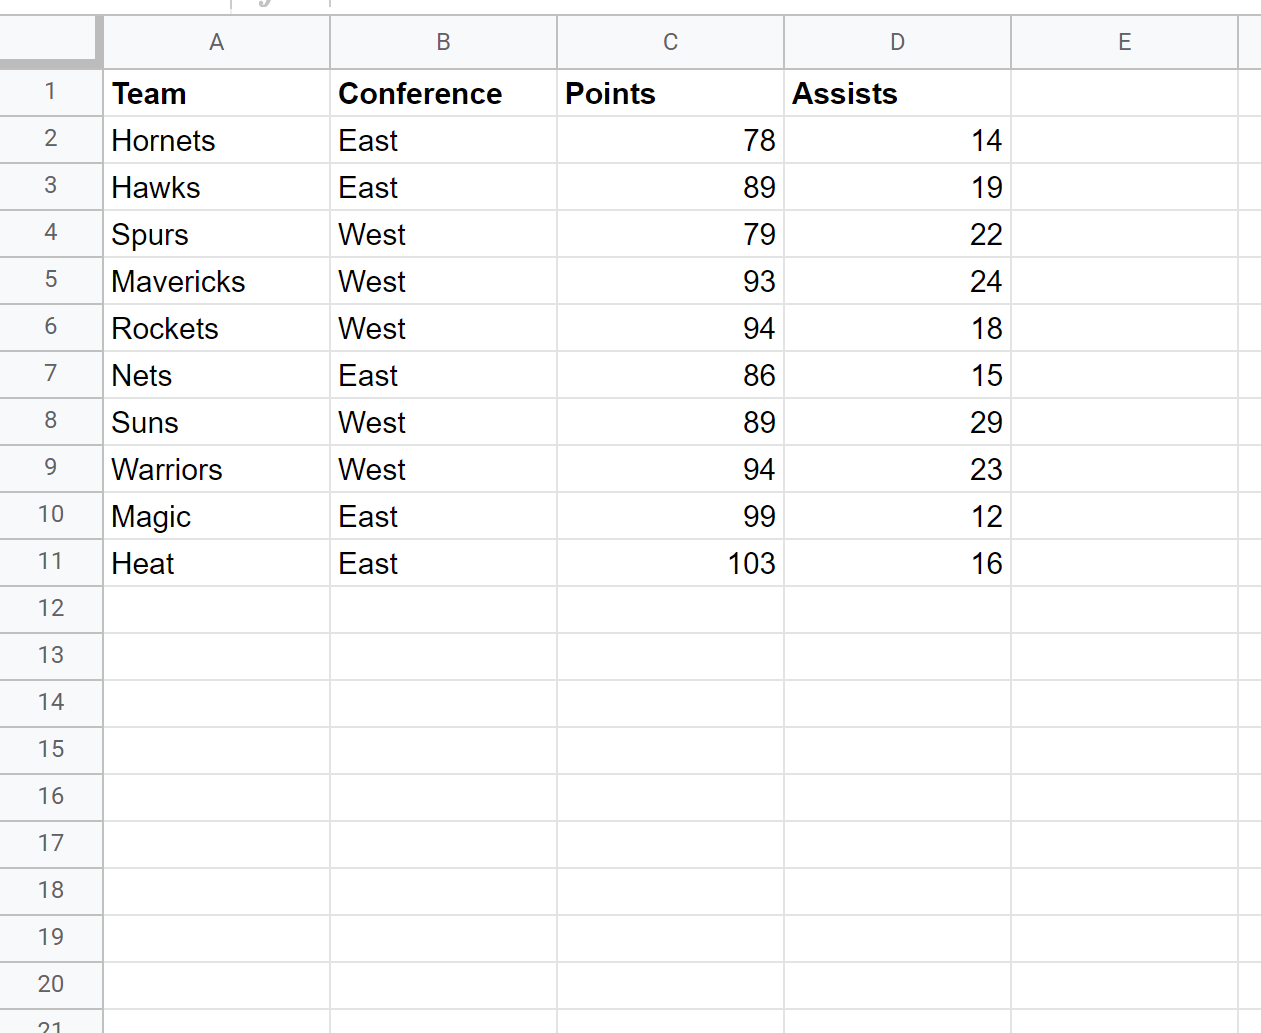
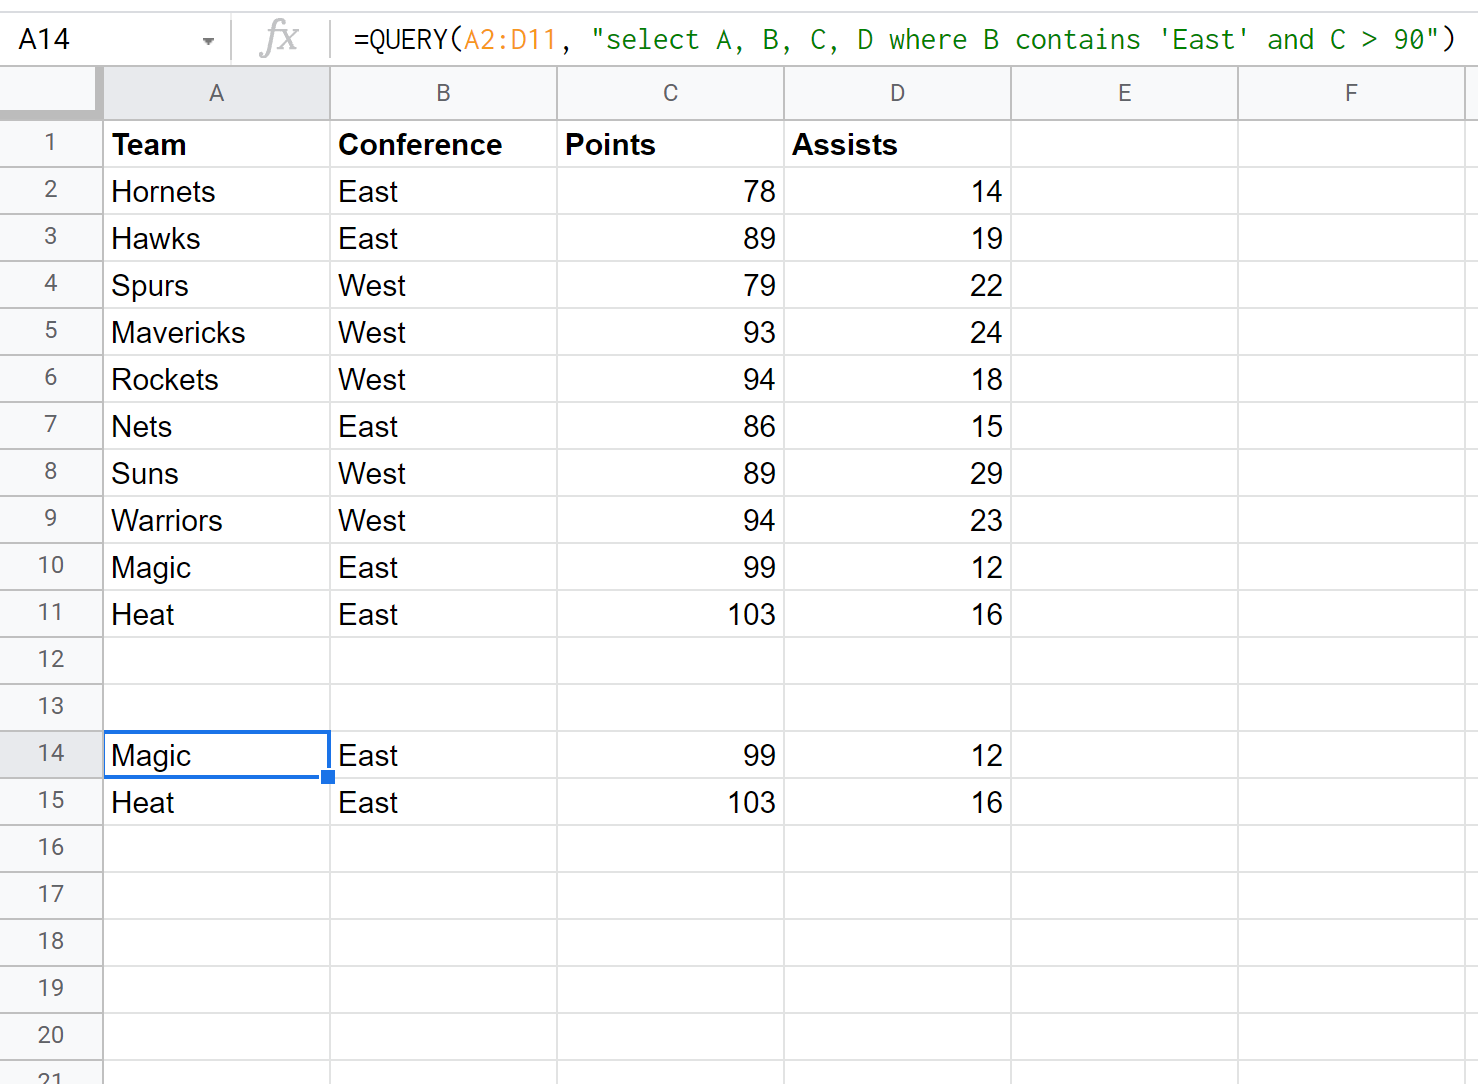
3. Implémentation rigoureuse de l’opérateur AND pour le filtrage cumulatif
3.1 Filtrage simultané sur une dimension catégorielle et une variable quantitative
Le cas d’usage le plus omniprésent en ingénierie décisionnelle réside dans la sélection simultanée d’un segment catégoriel spécifique et d’une plage de performance quantitative. Considérons une matrice opérationnelle s’étendant de la cellule A1 à E1000, dans laquelle la colonne B consigne le secteur géographique d’une transaction financière sous forme de chaîne de caractères, et la colonne D enregistre le montant brut facturé sous forme de valeur monétaire décimale. Si l’objectif analytique consiste à restreindre l’affichage aux transactions conclues dans la région « Europe » dont la valorisation excède strictement 15 000 euros, l’intersection logique s’exprime par la syntaxe canonique suivante :
=QUERY(A1:E1000; "SELECT * WHERE B = 'Europe' AND D > 15000"; 1)
Sur le plan structurel, le moteur de calcul lit la première ligne après l’en-tête, évalue si la valeur textuelle de la colonne B correspond bit à bit à la séquence de caractères « Europe », puis vérifie si le champ numérique de la colonne D satisfait à l’inégalité stricte. L’opérateur AND garantit que si une transaction affiche un montant de 25 000 euros mais se situe dans le secteur « Asie », la condition globale s’effondre à FALSE, écartant la ligne sans ambiguïté. De même, une vente européenne s’élevant à 12 000 euros est immédiatement rejetée.
Cette conjonction assure une étanchéité absolue de l’intersection mathématique. L’ordre des facteurs autour du connecteur AND n’exerce aucune influence sur le résultat sémantique final en vertu de la commutativité universelle de la conjonction logique. Toutefois, il est fortement recommandé sur le plan méthodologique d’aligner l’ordre des prédicats sur la structure chronologique ou hiérarchique de l’analyse afin de maximiser l’intelligibilité de la formule pour les auditeurs du modèle de données.
3.2 Multiplication des conditions cumulatives sur trois colonnes ou plus
L’extension de la granularité d’un filtre analytique requiert souvent de concaténer séquentiellement trois prédicats logiques ou davantage. Lorsque les critères d’extraction s’accumulent pour cerner un micro-segment hautement spécifique, la clause WHERE enchaîne les opérateurs AND au sein d’une chaîne syntaxique linéaire. En reprenant la matrice précédente, supposons que nous souhaitions isoler les opérations relatives au secteur « Europe » (colonne B), dont le montant surpasse 15 000 euros (colonne D), exécutées par le commercial référencé sous le matricule « ID_44 » (colonne C), et dont le délai de règlement constaté excède 60 jours (colonne E).
La transcription opérationnelle prend la forme d’un chaînage déclaratif univoque :
=QUERY(A1:E1000; "SELECT A, B, C, D, E WHERE B = 'Europe' AND D > 15000 AND C = 'ID_44' AND E > 60"; 1)
L’intégration de conditions cumulatives multiples impose une vigilance accrue quant à l’exhaustivité et à la consistance interne des filtres. Plus le nombre de prédicats conjonctifs croît, plus la probabilité de sur-sélectivité augmente, pouvant mener à des sous-ensembles vides sans qu’aucune erreur de syntaxe logicielle ne soit signalée par le tableur. Chaque variable additionnelle introduit une contrainte géométrique restrictive qui divise l’espace d’échantillonnage initial.
Il est par conséquent crucial, lors de la conception d’arborescences de filtres multicritères complexes, de valider préalablement la distribution univariée de chaque variable. L’analyste s’assurera ainsi qu’aucun critère ne soit intrinsèquement incompatible avec un autre (par exemple exiger qu’un champ catégoriel soit égal à une valeur A tout en imposant dans la même conjonction qu’il soit égal à une valeur B non superposable), ce qui produirait une contradiction formelle insoluble et une matrice résultante désespérément vierge.
4. Déploiement de l’opérateur OR pour la sélection inclusive et disjonctive
4.1 Union de critères au sein d’une même colonne
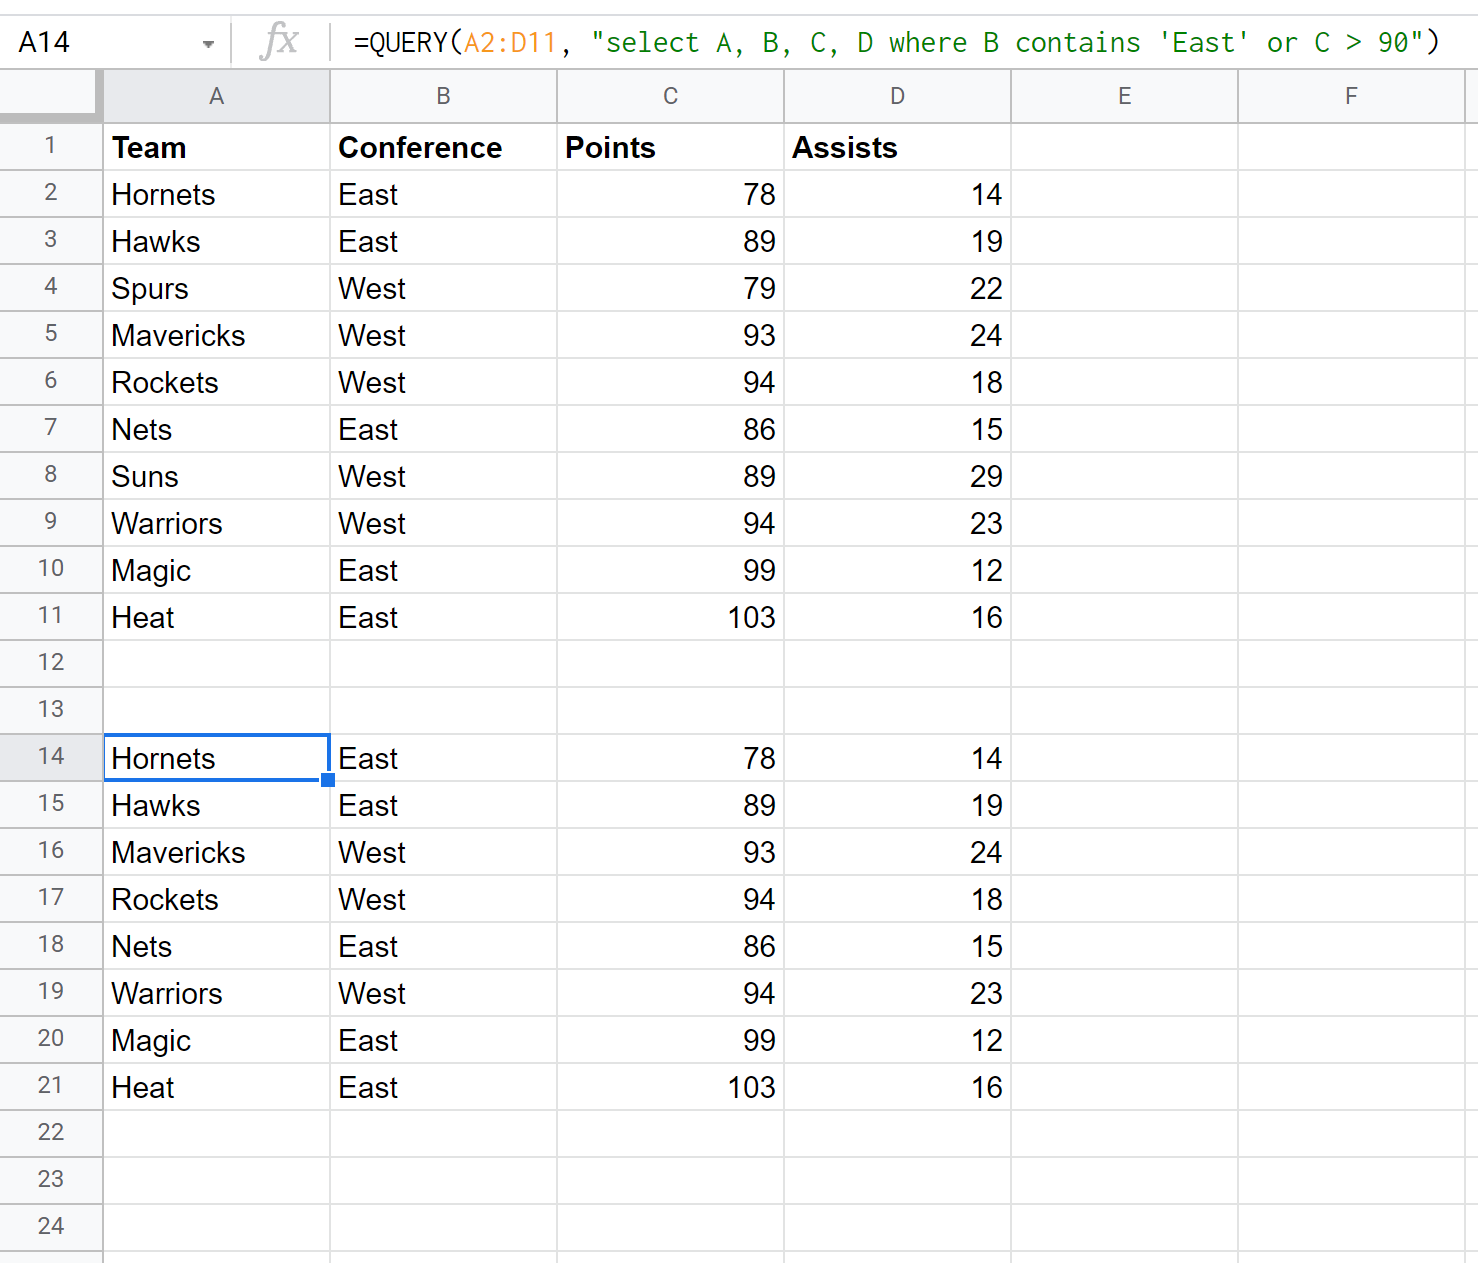
Le recours à la disjonction logique OR intervient principalement lorsqu’il s’agit d’élargir le périmètre de sélection en agrégeant plusieurs modalités d’une même dimension analytique. Dans les configurations où une entité d’observation peut appartenir indifféremment à plusieurs classes catégorielles mutuellement exclusives, l’utilisation de l’opérateur AND serait absurde, une cellule ne pouvant contenir simultanément deux états scalaires distincts. L’opérateur OR matérialise l’union de ces ensembles d’occurrences sans nécessiter de fractionner la table ou d’exécuter de multiples requêtes combinées par des opérateurs d’empilement matriciel.
Considérons l’extraction de toutes les lignes d’un registre de stocks dont le statut de disponibilité (colonne F) correspond soit à la valeur « En rupture », soit à la désignation « En réapprovisionnement ». La formulation rigoureuse impose la répétition formelle de l’identifiant de la colonne dans chaque terme de l’expression disjonctive :
=QUERY(A1:H500; "SELECT * WHERE F = 'En rupture' OR F = 'En réapprovisionnement'"; 1)
L’omission de l’identifiant de la colonne constitue l’un des pièges les plus répandus pour les praticiens habitués au langage naturel. Une formulation tronquée de type WHERE F = 'En rupture' OR 'En réapprovisionnement' provoque immédiatement un rejet catégorique de l’interpréteur, sanctionné par une erreur d’analyse syntaxique (PARSE_ERROR). L’interpréteur de l’API Google Visualization n’implémente pas nativement d’opérateur d’appartenance à un ensemble discret (tel que l’opérateur IN du standard SQL relationnel ANSI). Par conséquent, chaque modalité doit être expressément reliée à sa colonne de rattachement au sein d’une équation relationnelle complète.
Bien que des alternatives syntaxiques utilisant des expressions régulières (détaillées dans les sections ultérieures de cet ouvrage) permettent de compresser cette écriture, la disjonction explicite par OR demeure la méthode la plus lisible et la moins exigeante sur le plan des ressources computationnelles pour les énumérations courtes comportant deux ou trois alternatives qualitatives.
4.2 Disjonction appliquée à des colonnes hétérogènes
La puissance d’expression de l’opérateur OR s’illustre particulièrement lorsqu’il est mobilisé de manière transversale sur des colonnes de natures totalement distinctes. Cette configuration permet de mettre en lumière des observations répondant à des critères d’alerte dissemblables, par exemple pour isoler des anomalies opérationnelles ou des cas de figure déviants dans le cadre d’un audit de conformité.
Imaginons un dispositif d’évaluation de la solvabilité de comptes clients consigné dans une matrice tabulaire : la colonne G enregistre les arriérés de paiement exprimés en nombre de jours (grandeur numérique continue), tandis que la colonne H consigne une notation de risque qualitative attribuée par un organisme externe sous forme d’étiquettes alphanumériques (« Douteux », « Critique », « Standard »). Un auditeur financier souhaitant filtrer tout compte présentant soit un dépassement d’échéance supérieur à 90 jours, soit une notation dégradée explicitement égale à « Critique », formulera l’instruction suivante :
=QUERY(A1:K2000; "SELECT A, B, G, H WHERE G > 90 OR H = 'Critique'"; 1)
Le comportement du moteur d’exécution face aux cellules vides requiert ici une vigilance absolue. Si un enregistrement comporte une valeur nulle ou non renseignée au sein de la colonne G, mais que sa colonne H arbore la valeur « Critique », l’évaluation de la branche disjonctive droite retourne TRUE. L’instruction valide donc l’inclusion intégrale de la ligne sans être entravée par le vide structurel du champ arithmétique. Cette résilience intrinsèque de la disjonction constitue un avantage précieux pour l’exploration de bases de données hétérogènes, mais elle exige une modélisation rigoureuse pour éviter que des données manquantes ne masquent des incohérences fondamentales.
5. Combinaison complexe de AND et OR : Priorité logique et parenthésage
5.1 Ordre d’évaluation par défaut des prédicats logiques
À l’instar des opérateurs arithmétiques où la multiplication et la division prévalent naturellement sur l’addition et la soustraction, les opérateurs booléens sont assujettis à des règles formelles de précédence au sein du compilateur de requêtes. Dans le formalisme de l’API Google Visualization, l’opérateur de conjonction AND possède une priorité d’évaluation hiérarchique absolue sur l’opérateur de disjonction OR. Cette caractéristique signifie qu’en l’absence de modificateurs explicites, le moteur compile les prédicats adjacents liés par un AND en une unité relationnelle indivisible avant d’incorporer les expressions périphériques rattachées par un OR.
Pour appréhender les conséquences directes de cette préséance sur l’intégrité des résultats, examinons une requête théorique formulée sans précaution de balisage :
SELECT * WHERE Région = 'Nord' OR Région = 'Sud' AND Ventes > 50000
En vertu de la précédence native, l’interpréteur décompose cette expression sous la forme logique d’une alternative entre deux branches : d’une part, l’appartenance à la région ‘Nord’, et d’autre part, la conjonction stricte de l’appartenance à la région ‘Sud’ et d’un niveau de ventes excédant 50 000 unités. Par conséquent, toute ligne affiliée à la région ‘Nord’ sera systématiquement projetée en sortie, y compris celles dont le chiffre de ventes est égal à zéro ou négatif. L’intention analytique initiale, qui visait manifestement à sélectionner les performances supérieures à 50 000 unités au sein de la zone géographique composite formée par le Nord et le Sud, se trouve ainsi totalement dénaturée par une lecture asymétrique de l’arbre booléen.
5.2 Utilisation des parenthèses comme modificateurs d’arborescence logique
L’introduction délibérée de parenthèses au sein de la chaîne de sélection permet de neutraliser la précédence par défaut et d’imposer un ordre d’évaluation conforme aux exigences conceptuelles du modèle décisionnel. Les parenthèses agissent comme des délimiteurs de sous-arbres syntaxiques : toute expression logée à l’intérieur d’une paire de parenthèses est résolue dans son intégralité préalable avant que sa résultante booléenne ne soit mise en relation avec les composantes externes de l’instruction.
En reprenant l’anomalie structurelle exposée précédemment, la rectification sémantique rigoureuse s’écrit :
=QUERY(A1:G; "SELECT * WHERE (Région = 'Nord' OR Région = 'Sud') AND Ventes > 50000"; 1)
Grâce à cette encapsulation, le moteur de calcul agrège d’abord les deux conditions géographiques au sein d’une disjonction unifiée : la condition intermédiaire s’évalue à vrai si l’enregistrement relève de l’un ou l’autre des deux territoires. Dans un second temps, le compilateur procède à la conjonction de cette résultante avec le seuil quantitatif de performance, garantissant ainsi que seules les lignes satisfaisant simultanément à l’appartenance zonale et à l’exigence d’efficience commerciale franchissent le filtre sélectif.
Cette maîtrise de l’encadrement syntaxique autorise la construction d’architectures décisionnelles hautement sophistiquées, modélisant par exemple des structures logiques de type (A AND B) OR (C AND D). Une telle syntaxe permet de comparer des profils de performance asymétriques au sein d’une requête unique :
=QUERY(A1:Z; "SELECT * WHERE (A = 'Cadre' AND E > 80000) OR (A = 'Employé' AND E > 45000)"; 1)
Dans ce scénario, chaque sous-condition représente un calibrage de rémunération adapté au statut hiérarchique, sans qu’aucune interférence croisée ne vienne altérer l’évaluation respective des deux catégories d’effectifs.
6. Typage des données et formatage des critères multiples
6.1 Traitement des critères numériques purs
La précision de la fonction QUERY repose sur un respect scrupuleux des conventions d’écriture propres aux différents types de scalaires supportés par l’API Google Visualization. Pour les variables quantitatives pures (entiers relatifs, nombres décimaux à virgule flottante), la règle primordiale impose l’absence absolue de tout délimiteur de chaîne de caractères. Contrairement aux chaînes textuelles, insérer un nombre entre apostrophes le convertit instantanément en un littéral textuel dans l’analyseur syntaxique, rompant ainsi toute compatibilité avec une colonne typée numériquement.
De surcroît, le séparateur décimal admis au sein de la chaîne d’instruction textuelle est exclusivement le point typographique (.), conformément aux standards de programmation internationaux, et ce indépendamment des paramètres régionaux configurés dans votre feuille de calcul (lesquels peuvent employer la virgule comme délimiteur décimal dans l’interface utilisateur). Dès lors, pour filtrer une colonne C contenant des taux de rendement compris strictement entre 4,5 % et 12,8 %, les critères quantitatifs doivent être déclarés sous leur forme décimale brute ponctuée :
=QUERY(A1:E; "SELECT * WHERE C >= 0.045 AND C <= 0.128"; 1)
Il est impératif de souligner que les formats visuels appliqués aux cellules sources — tels que les symboles monétaires (€, $), les séparateurs de milliers ou le suffixe de pourcentage (%) — n’altèrent en rien la valeur sous-jacente stockée en mémoire. Le prédicat logique de la clause WHERE doit systématiquement s’adresser à la valeur numérique sous-jacente non formatée. Tenter d’intégrer une chaîne telle que WHERE C >= '4.5%' engendre une divergence structurelle fatale conduisant à l’invalidation pure et simple du filtre.
6.2 Traitement des chaînes de caractères et de la sensibilité à la casse
Les données textuelles (chaînes de caractères) nécessitent d’être encapsulées de manière systématique à l’aide de guillemets simples (ou apostrophes dactylographiques '...'). Cette encapsulation permet à l’interpréteur de différencier les constantes lexicales des mots-clés réservés du langage (à l’instar de SELECT, WHERE, AND, TRUE) et des identifiants structurels de colonnes. Une chaîne dépourvue de cette protection sera traitée par erreur comme une référence d’identifiant inexistant, provoquant une interruption immédiate du processus d’analyse.
Une caractéristique déterminante de l’API réside dans son traitement strictement sensible à la casse (case sensitivity) lors de l’usage des opérateurs relationnels standards. L’assertion B = 'Technologie' rejettera catégoriquement un enregistrement hébergeant la chaîne « technologie » ou « TECHNOLOGIE ». Cette sensibilité binaire peut s’avérer dommageable lors de l’exploitation de jeux de données composites alimentés manuellement par plusieurs collaborateurs, où les variations de casse sont monnaie courante.
Pour neutraliser cette contrainte et instaurer une tolérance totale vis-à-vis de la typographie, il convient de mobiliser les fonctions scalaires de conversion de casse intégrées au langage de requête, à savoir lower() ou upper(). En appliquant la transformation à la fois sur l’identifiant de la colonne et sur la constante de référence, l’analyste homogénéise le champ de comparaison :
=QUERY(A1:D; "SELECT * WHERE lower(B) = 'technologie' AND C > 100"; 1)
Par ce procédé élégant, quelle que soit la morphologie de la chaîne stockée dans la cellule (qu’il s’agisse de « TechNoLogie », « TECHNOLOGIE » ou « technologie »), la conversion à la volée en minuscules garantit la détection positive de l’occurrence, préservant la robustesse du filtrage multicritère face aux approximations de saisie.
6.3 Prise en charge des dates temporelles comme critères combinés
La manipulation des grandeurs chronologiques au sein de la fonction QUERY requiert une rigueur protocolaire exceptionnelle qui déroute fréquemment les utilisateurs chevronnés de tableurs. En raison de sa structure calquée sur les types de données de l’API de visualisation, une date ne peut pas être injectée sous forme de chaîne brute classique ou de numéro de série de date sous-jacent. Elle doit obligatoirement être précédée du mot-clé déclarateur date et suivre scrupuleusement la norme internationale ISO 8601, formalisée selon le patron d’écriture strict AAAA-MM-JJ.
Pour restreindre une extraction tabulaire aux transactions formalisées au cours d’un intervalle temporel fermé — par exemple l’intégralité de l’exercice fiscal 2024 —, la clause WHERE doit combiner deux prédicats d’ordre temporel conjoints via l’opérateur AND :
=QUERY(A1:F; "SELECT * WHERE A >= date '2024-01-01' AND A <= date '2024-12-31'"; 1)
Toute déviation par rapport à ce schéma formel (telle que l’omission du mot-clé date ou l’usage d’un agencement régional de type date '31/12/2024') se solde invariablement par une erreur d’exécution. Le compilateur attend l’annotation d’un littéral typé et ne tentera aucune conversion implicite.
Lorsque la dimension temporelle incorpore une composante horaire précise (horodatages complets), le langage substitue au mot-clé précédent le marqueur datetime, lequel exige le format unifié datetime 'AAAA-MM-JJ HH:MM:SS'. Enfin, pour les enregistrements exclusivement horaires déconnectés de toute ancre calendaire, l’instruction recourt au mot-clé timeofday associé à la syntaxe timeofday 'HH:MM:SS'. La maîtrise de ces déclarateurs typés permet de sculpter des fenêtres d’observation temporelles d’une précision millimétrique au sein des bases d’événements volumineuses.
7. Exploitation des opérateurs de recherche textuelle avancée avec critères logiques
7.1 L’opérateur CONTAINS combiné aux clauses logiques
Au-delà de la stricte égalité morphologique, l’exploration de corpus de données opérationnelles nécessite fréquemment d’interroger le contenu informationnel interne d’un champ sémantique sans exiger la concordance intégrale du texte. À cette fin, le langage de requête propose l’opérateur relationnel CONTAINS. Celui-ci évalue si une sous-chaîne textuelle spécifique est physiquement présente au sein de la cible considérée. Tout comme pour l’égalité classique, CONTAINS est intrinsèquement sensible à la casse, rendant souvent judicieux l’emploi conjoint de la fonction lower().
Dans un contexte multicritère, cet opérateur autorise l’intersection de motifs thématiques avec des filtres quantitatifs ou catégoriels. Supposons une base d’inventaire informatique dont la colonne B recense la désignation commerciale des équipements et la colonne D leur quantité en réserve. Pour isoler l’ensemble des postes de travail portables de la marque « Dell » dont le niveau de stock résiduel est strictement inférieur à 5 unités, l’instruction s’articule ainsi :
=QUERY(A1:E500; "SELECT A, B, D WHERE B CONTAINS 'Dell' AND D < 5"; 1)
Il est fondamental de dissocier conceptuellement CONTAINS de l’opérateur d’égalité =. Alors que B = 'Dell' postule l’identité absolue du contenu de la cellule avec le mot « Dell » (rejetant toute mention additionnelle telle que « Dell Latitude 5420 »), B CONTAINS 'Dell' valide l’inclusion dès lors que la séquence de quatre octets consécutifs D-e-l-l apparaît n’importe où dans la trame textuelle. La combinaison de plusieurs prédicats CONTAINS via des opérateurs AND ou OR permet d’exécuter des recherches documentaires thématiques très performantes directement dans Google Sheets.
7.2 L’opérateur STARTS WITH et ENDS WITH en contexte multicritère
Le traitement des nomenclatures codifiées, des identifiants industriels, des numéros de séries normalisés ou des nomenclatures comptables fait largement appel à des conventions de préfixes et de suffixes. Pour exploiter ces architectures d’encodage sans recourir immédiatement à l’arsenal plus lourd des moteurs d’expressions régulières, le langage de Google Visualization met à disposition les opérateurs spécialisés STARTS WITH (commence par) et ENDS WITH (se termine par).
Considérons un plan comptable généralisé consigné dans une feuille de calcul : la colonne A répertorie les numéros de comptes d’imputation sous forme textuelle, la colonne B leur intitulé littéral, et la colonne C le solde net constaté. Si un auditeur souhaite extraire l’ensemble des comptes de charges de personnel dont l’identifiant débute formellement par le préfixe « 64 » tout en isolant parallèlement les comptes de dotations aux amortissements débutant par « 68 », le tout pour des montants débiteurs supérieurs à 10 000 euros, la requête mobilise harmonieusement parenthèses, disjonctions de préfixes et conjonction arithmétique :
=QUERY(A1:D; "SELECT A, B, C WHERE (A STARTS WITH '64' OR A STARTS WITH '68') AND C > 10000"; 1)
Symétriquement, l’opérateur ENDS WITH permet d’interroger les terminaisons textuelles récurrentes, par exemple pour isoler des fichiers hébergés selon leur extension de dénomination (Nom ENDS WITH '.pdf') ou identifier des comptes auxiliaires sectorisés par un suffixe géographique constant. Bien que ces opérateurs d’ancrage soient nettement plus performants sur le plan computationnel que l’exploration globale d’une sous-chaîne via CONTAINS, leur utilisation intensive sur des plages excédant plusieurs centaines de milliers de lignes requiert une modélisation préalable épurée afin d’éviter tout ralentissement du rafraîchissement dynamique des classeurs.
7.3 Utilisation de l’opérateur MATCHES et des expressions régulières
L’opérateur MATCHES constitue l’instrument le plus perfectionné et le plus dense de l’arsenal de filtrage textuel de la fonction QUERY. Il introduit la puissance d’analyse du moteur des expressions régulières (Regex) au cœur même de la clause WHERE. Contrairement aux implémentations Regex permissives qui valident les correspondances partielles au fil de l’eau, l’opérateur MATCHES impose que le motif régulier s’ajuste à l’intégralité de la chaîne analysée, du premier au dernier caractère.
L’un des avantages conceptuels majeurs de MATCHES dans la formulation de critères multiples réside dans sa capacité intrinsèque à synthétiser en une expression atomique concise de longues chaînes d’opérateurs OR. Par exemple, au lieu d’aligner fastidieusement une succession de clauses disjonctives pour sélectionner des données réparties entre la France, la Belgique, la Suisse et le Luxembourg, il est possible d’exploiter la barre verticale de disjonction (le métacaractère de tuyau |) propre aux expressions régulières :
=QUERY(A1:E; "SELECT * WHERE B MATCHES 'France|Belgique|Suisse|Luxembourg' AND D > 5000"; 1)
L’association des métacaractères d’alternance avec les opérateurs logiques permet de résoudre des problèmes d’une haute complexité structurelle. Si l’on doit filtrer des identifiants alphanumériques complexes (colonne A) respectant une nomenclature stricte — tels que deux lettres quelconques suivies de trois chiffres et d’un suffixe précis — tout en exigeant qu’une colonne de valorisation (colonne C) se situe dans une fourchette spécifique, MATCHES fournit une solution d’une densité syntaxique sans égale :
=QUERY(A1:D; "SELECT * WHERE A MATCHES '[A-Z]{2}[0-9]{3}-(FR|BE)' AND C > 1000"; 1)
Cette condensation logique allège considérablement la complexité de l’arbre syntaxique abstrait généré par l’API de visualisation, permettant de substituer des prédicats disjonctifs multiples par une règle de grammaire régulière unifiée particulièrement véloce.
8. Paramétrage dynamique des critères via références de cellules externes
8.1 Technique de concaténation de chaînes avec l’opérateur &
Dans un contexte professionnel abouti, la codification « en dur » de critères figés au sein de la chaîne textuelle de la requête constitue un anti-patron de conception. Elle condamne l’utilisateur final à modifier manuellement la syntaxe interne de la formule dès qu’un paramètre opérationnel fluctue, augmentant exponentiellement le risque de corruption de code. L’ingénierie des feuilles de calcul impose de déporter les paramètres de filtrage vers des cellules de contrôle externes dédiées, puis d’injecter dynamiquement leur contenu au sein du flux d’instruction via des opérations de concaténation exploitant l’opérateur esperluette (&).
Cette technique exige une gymnastique intellectuelle rigoureuse concernant la fermeture et la réouverture des guillemets délimitant la chaîne de requête, ainsi que l’incorporation méticuleuse des apostrophes indispensables à la reconnaissance des littéraux. Considérons une cellule d’entrée H1 hébergeant un nom de ville, et une cellule H2 définissant un montant plancher de facturation. Pour injecter ces critères conjoints dans une requête pointant vers la matrice A1:E100, la construction procède par segmentations textuelles successives :
=QUERY(A1:E100; "SELECT * WHERE A = '" & H1 & "' AND C >= " & H2; 1)
Analysons la décomposition structurelle de cette formule : le premier bloc littéral s’achève par une apostrophe simple logée juste avant le premier guillemet double ("SELECT * WHERE A = '"). L’esperluette insère ensuite la valeur textuelle résidant dans H1. La seconde esperluette renoue avec un segment textuel qui s’ouvre par une apostrophe simple destinée à clore le littéral de la première condition, suivie de l’opérateur logique et du nom du champ suivant ("' AND C >= "). Enfin, la valeur purement numérique de la cellule H2 est injectée sans la moindre apostrophe, conformément à la grammaire des scalaires arithmétiques.
L’omission d’une seule apostrophe ou l’inversion d’un guillemet double perturbe immédiatement le moteur lexical, déclenchant l’incompréhension totale de l’instruction. Il est donc hautement recommandé de décomposer ces assemblages pas à pas lors des phases de prototypage.
8.2 Paramétrage dynamique des critères de date
L’injection dynamique de dates issues de cellules externes représente le paroxysme de la technicité d’assemblage dans Google Sheets. Comme explicité précédemment, le compilateur de l’API Visualization exige que les dates soient formatées selon la nomenclature date 'AAAA-MM-JJ'. Or, une cellule standard hébergeant une date stocke fondamentalement un nombre de jours écoulés depuis le 30 décembre 1899, et la simple concaténation de cette cellule (via & G1) n’injectera pas une chaîne temporelle normée, mais le numéro de série sous-jacent (par exemple le nombre 45292 pour une date de 2024), provoquant un effondrement immédiat du prédicat.
Pour contourner ce verrouillage structurel, il est impératif de contraindre la conversion textuelle de la cellule source au format canonique ISO à l’aide de la fonction native TEXTE (ou TEXT en syntaxe anglaise) directement au sein du segment de concaténation. Si la cellule Z1 contient la borne chronologique inférieure et la cellule Z2 la borne supérieure, l’architecture dynamique s’établit selon le canevas suivant :
=QUERY(A1:F; "SELECT * WHERE B >= date '" & TEXTE(Z1; "yyyy-mm-dd") & "' AND B <= date '" & TEXTE(Z2; "yyyy-mm-dd") & "'"; 1)
Cette modélisation assure une étanchéité absolue face aux variations régionales de formatage. Quels que soient les paramètres linguistiques du poste client ou les coutumes typographiques de saisie de l’utilisateur (affichage en format français JJ/MM/AAAA ou américain MM/DD/YYYY), la fonction TEXTE standardise rigoureusement la chaîne transmise à l’interpréteur sous la forme normalisée yyyy-mm-dd. Le déclarateur date prend ainsi tout son sens, et le compilateur traite l’intervalle avec une fiabilité déterministe totale.
8.3 Création d’un tableau de bord de filtrage interactif
L’application par excellence du paramétrage dynamique réside dans l’élaboration d’interfaces décisionnelles interactives où des gestionnaires sélectionnent divers filtres à l’aide de menus déroulants et de cases d’options sans jamais manipuler le code source des requêtes. Le défi architectural majeur d’un tel dispositif réside dans la gestion des cellules de sélection laissées vierges par l’utilisateur : une cellule vide ne doit pas bloquer la requête, mais être interprétée comme l’absence d’exigence sur la variable correspondante (condition de neutralité sélective équivalente à un joker universel).
Pour matérialiser cette souplesse au sein de la fonction QUERY, la démarche la plus élégante consiste à exploiter une condition disjonctive interne articulée autour de la détection de vacuité de la cellule de commande, ou à construire dynamiquement la chaîne d’instruction au moyen d’arborescences conditionnelles en amont. En utilisant des prédicats d’équivalence logique directement dans la clause WHERE, on obtient une formule résiliente :
=QUERY(A1:E1000; "SELECT * WHERE ('" & H1 & "' = '' OR A = '" & H1 & "') AND ('" & H2 & "' = '' OR B = '" & H2 & "')"; 1)
Examinons la mécanique sous-jacente : si la cellule de saisie H1 ne contient aucun texte, le sous-segment '" & H1 & "' = ''" se résout en '' = '', une identité tautologique universellement évaluée à TRUE. Par conséquent, en vertu de l’opérateur OR, l’intégralité du premier bloc entre parenthèses s’évalue à vrai, et ce indépendamment de la valeur réelle stockée dans la colonne A de la base de données. Le filtre sur la colonne A est donc virtuellement désactivé. Si, en revanche, l’utilisateur sélectionne un critère précis dans H1, l’assertion de vacuité s’effondre à FALSE, contraignant le moteur à évaluer l’égalité stricte A = 'Critère'.
Cette conception modulaire permet de concevoir des panneaux de commande complets intégrant une multiplicité de critères optionnels indépendants, offrant une expérience utilisateur digne des meilleures applications professionnelles sur mesure.
9. Négation et gestion des valeurs absentes dans les critères multiples
9.1 L’opérateur NOT et les lois de De Morgan appliquées à QUERY
L’inversion logique constitue un levier algorithmique puissant pour simplifier l’expression de conditions complexes. L’opérateur unaire NOT permet de nier formellement l’état de vérité d’un prédicat individuel ou d’un bloc conditionnel entier. Son positionnement syntaxique intervient immédiatement avant l’expression booléenne à réfuter. Par exemple, pour extraire toutes les transactions n’appartenant pas à la région « Ouest », l’expression s’écrit conventionnellement WHERE NOT A = 'Ouest', syntaxiquement équivalente à l’opérateur d’exclusion WHERE A != 'Ouest'.
Toutefois, la manipulation de la négation prend une dimension structurelle supérieure dès lors qu’elle s’applique à des expressions composées impliquant les conjonctions et les disjonctions, régies par les célèbres théorèmes formalisés par le mathématicien Augustus De Morgan. Les deux théorèmes fondamentaux s’énoncent comme suit :
- La négation d’une conjonction équivaut à la disjonction des négations : NOT (P AND Q) ⇔ (NOT P) OR (NOT Q)
- La négation d’une disjonction équivaut à la conjonction des négations : NOT (P OR Q) ⇔ (NOT P) AND (NOT Q)
Une mauvaise interprétation de ces lois algébriques lors de la rédaction de clauses WHERE engendre des failles logiques majeures. Supposons qu’un gestionnaire veuille exclure de son extraction les commandes qui sont à la fois marquées comme « Soldées » (colonne B) et passées par le client « Alpha » (colonne C). S’il commet l’erreur de formuler sa clause sous la forme WHERE NOT B = 'Soldées' AND NOT C = 'Alpha', il exclura indûment toutes les commandes du client Alpha (même non soldées) ainsi que toutes les commandes soldées d’autres clients. L’instruction correcte respectant la conjonction d’exclusion impose l’encadrement global de la paire :
=QUERY(A1:E; "SELECT * WHERE NOT (B = 'Soldées' AND C = 'Alpha')"; 1)
L’application rigoureuse des théorèmes de De Morgan permet d’alléger la rédaction des prédicats tout en garantissant une étanchéité logique sans faille lors de l’épuration de grands ensembles de données.
9.2 Traitement des valeurs manquantes avec IS NULL et IS NOT NULL
La présence de valeurs absentes (cellules vides) au sein d’une matrice pose un défi récurrent dans l’exécution des filtres multicritères. Dans la logique triadique de l’algèbre relationnelle, une valeur manquante n’est ni égale, ni strictement supérieure ou inférieure à une quelconque valeur constante : son statut d’évaluation demeure indéterminé (NULL). Par conséquent, les opérateurs arithmétiques ou textuels standards tels que =, !=, ou > ne peuvent en aucun cas être mobilisés pour identifier ou filtrer la vacuité.
Pour répondre à cette contrainte, le langage met à disposition les prédicats unaires spécifiques IS NULL (est nul / est vide) et son pendant négatif IS NOT NULL (n’est pas vide). L’association de ces opérateurs avec des conditions cumulatives ou disjonctives s’avère indispensable pour assainir les données préalablement aux calculs d’agrégation ou d’analyse. Par exemple, pour cibler les opérations commerciales dont le matricule de commande est formellement renseigné (colonne A) mais pour lesquelles la date effective de règlement (colonne D) fait encore défaut, la requête s’articule ainsi :
=QUERY(A1:G; "SELECT * WHERE A IS NOT NULL AND D IS NULL"; 1)
L’intégration systématique de IS NOT NULL s’impose particulièrement lors de l’application de filtres multicritères sur des colonnes ouvertes s’étendant jusqu’au bas de la feuille de calcul (de type A2:E). En l’absence de vérification sur la présence de données, Google Sheets scanne des milliers de lignes vierges résiduelles, ce qui peut fausser les décomptes statistiques ou provoquer l’affichage d’un volume substantiel d’enregistrements vides dans le tableau de sortie. L’inclusion de la clause A IS NOT NULL en tête de condition conjonctive constitue une règle d’or d’hygiène logicielle pour sceller définitivement les bornes utiles de la plage exploitée.
10. Optimisation computationnelle et performances des requêtes volumineuses
10.1 Impact du volume de données sur le temps de recalcul
Bien que Google Sheets opère comme une application infonuagique administrée sur les serveurs distants de Google, le recalcul et l’évaluation de la fonction QUERY sont assujettis aux contraintes d’allocation de mémoire vive et de cycles processeur du thread d’exécution JavaScript attribué au client dans le navigateur web. L’application récursive de filtres multicritères lourds sur des bases matricielles comportant des dizaines de milliers d’enregistrements peut rapidement induire des latences perceptibles lors des phases de rafraîchissement des documents.
Le coût computationnel varie considérablement selon la nature sémantique des opérateurs mobilisés au sein de la clause WHERE. Les comparaisons arithmétiques binaires pures (=, >, <) sur des scalaires numériques ou des dates représentent le niveau d’exécution le plus véloce, car elles se traduisent directement par des opérations élémentaires au niveau des registres machines. À l’opposé, les opérateurs de traitement textuel exploratoire — au premier rang desquels figurent CONTAINS et l’opérateur d’expressions régulières MATCHES — exigent la mise en œuvre d’algorithmes de fouille séquentielle de motifs dont la complexité algorithmique temporelle peut croître de manière exponentielle en présence de chaînes textuelles longues ou désordonnées.
De surcroît, le dimensionnement de la plage matricielle déclarée en premier argument exerce une influence déterminante. Référencer paresseusement l’intégralité d’une feuille via la syntaxe QUERY(A:Z; ...) contraint l’interpréteur à instancier en mémoire virtuelle des millions de cellules potentiellement orphelines, dont l’évaluation et l’exclusion ultérieure par la clause WHERE consument inutilement des cycles de calcul précieux. L’optimisation commence par un calibrage rigoureux de la plage matricielle active (par exemple A1:G15000), limitant le rayon d’action de l’algorithme au seul espace utile des observations avérées.
10.2 Bonnes pratiques de structuration des prédicats pour l’optimisation
L’optimisation des requêtes complexes repose sur une organisation réfléchie des prédicats logiques au sein de la chaîne de sélection. Bien que le formalisme déclaratif du langage masque les détails de bas niveau de l’interpréteur, ce dernier applique des stratégies classiques d’évaluation court-circuit (short-circuit evaluation). Dès lors qu’une sous-condition reliée par un opérateur AND s’évalue à faux, le moteur abandonne instantanément le calcul des prédicats ultérieurs pour la ligne en cours, sachant que la proposition globale est irrémédiablement compromise.
Par conséquent, la règle architecturale d’optimisation fondamentale stipule de positionner en tête de clause WHERE le critère le plus hautement restrictif et le moins gourmand en calcul :
- Placer en priorité absolue les clauses d’élimination de vacuité (
A IS NOT NULL) et les égalités numériques simples. - Insérer en position intermédiaire les sélections catégorielles strictes sur chaînes courtes.
- Reléguer systématiquement en queue de condition les filtres d’expressions régulières complexes (
MATCHES) ou les recherches partielles de sous-chaînes (CONTAINS).
En structurant la chaîne selon cette gradation sélective, la majeure partie de la matrice est élaguée par des opérations arithmétiques ultra-rapides, réservant l’exécution coûteuse des moteurs Regex à la fraction résiduelle d’enregistrements déjà qualifiés. Enfin, il convient d’éviter l’imbrication redondante de fonctions scalaires multiples au sein de la chaîne (multiplier les appels à lower() sur des dizaines de milliers de lignes) en privilégiant, lorsque cela est possible, un nettoyage et une normalisation préalables des données au sein de colonnes techniques d’ingestion.
11. Diagnostic et résolution systématique des erreurs de syntaxe multicritère
11.1 Résolution de l’erreur d’analyse #VALUE! (PARSE_ERROR)
L’erreur générique #VALUE! (affichant le libellé explicatif d’interruption Unable to parse query string) constitue le signal d’alarme universel émis par l’API Google Visualization lorsqu’une instruction textuelle contrevient à la grammaire lexicale formelle du langage. Face à une clause multicritère composite combinant plusieurs opérateurs AND et OR, l’origine de l’anomalie peut être particulièrement ardue à isoler sans une méthodologie de diagnostic rigoureuse.
Les sources prépondérantes de défaillance syntaxique se regroupent en quatre typologies récurrentes :
- Déficit ou inversion d’encadrement des littéraux : Omission de l’apostrophe de fermeture autour d’une chaîne textuelle ou insertion erronée d’apostrophes autour d’une valeur numérique ou d’un nom de colonne.
- Déséquilibre des parenthèses : Rupture de la parité arborescente se traduisant par un nombre de parenthèses ouvrantes différent du nombre de parenthèses fermantes.
- Conflit d’identifiants de colonnes : Utilisation d’identifiants alphabétiques (A, B) sur une matrice issue d’un traitement intermédiaire virtuel (créée entre accolades
{...}), laquelle exige impérativement la nomenclature positionnelle formelleCol1, Col2, Col3. - Collisions de guillemets lors de la concaténation dynamique : Mauvaise gestion des espaces séparateurs ou rupture de l’alternance entre guillemets simples et guillemets doubles.
Pour déboguer efficacement une instruction complexe en échec, il est fortement conseillé de déployer une stratégie d’isolation modulaire pas à pas. La méthode consiste à déconstruire provisoirement la clause WHERE pour ne conserver que la projection initiale (SELECT *), puis à réintroduire les prédicats logiques de manière unitaire, l’un après l’autre. En testant successivement chaque condition, l’analyste identifie avec certitude le segment précis responsable de la rupture de compilation.
11.2 Gestion des résultats vides (erreur de tableau de sortie sans ligne)
Une requête syntaxiquement parfaite peut néanmoins déboucher sur une anomalie d’exploitation lorsqu’aucun enregistrement de la matrice source ne répond à l’ensemble des conditions formulées. Dans cette conjoncture, l’interpréteur de Google Sheets renvoie un résultat vide qui se solde fréquemment par l’apparition d’un message d’erreur d’affichage de type #N/A stipulant que la requête n’a extrait aucune ligne exploitable (Query completed with an empty output).
Ce phénomène découle presque toujours d’une incohérence d’ingénierie logique, typiquement l’application de critères mutuellement exclusifs orchestrés par un opérateur AND au lieu d’un opérateur OR (par exemple rechercher les observations où la colonne A vaut simultanément « Paris » et « Lyon »). Si l’absence d’occurrences correspond à une réalité conjoncturelle normale de l’exploitation, il est indispensable de neutraliser l’impact visuel et fonctionnel de cette notification d’absence en encapsulant la fonction QUERY au sein de la fonction de sécurité native SIERREUR (ou IFERROR) :
=SIERREUR(QUERY(A1:E1000; "SELECT * WHERE A = 'Paris' AND B > 50000"; 1); "Aucun résultat validé")
Parallèlement, une attention méticuleuse doit être portée au troisième argument facultatif de la fonction QUERY, qui consigne le nombre de lignes d’en-tête de la matrice. Si cet argument est omis ou valorisé à -1, le moteur tente de deviner heuristiquement la présence d’en-têtes. Lorsqu’une requête multicritère vide est retournée, cette détection heuristique déraille fréquemment, transformant la première ligne de données pures en un faux en-tête typologique. Déclarer formellement la valeur numérique de cet argument (usuellement 1 pour indiquer la présence d’une ligne d’en-tête unique) garantit la préservation absolue de l’intégrité de la structure tabulaire quel que soit le volume de lignes sélectionnées.
12. Études de cas réelles et modélisation analytique avancée
12.1 Analyse de données de recherche quantitative avec critères croisés
Afin de concrétiser l’ensemble des préceptes théoriques exposés dans ce traité, considérons un protocole expérimental mené dans le cadre d’une recherche clinique multicentrique. La base matricielle globale, consignée dans une feuille de calcul nommée Cohorte_Data sur la plage A1:G50000, structure les dimensions suivantes :
- Colonne A : Numéro d’anonymisation du patient (Chaîne textuelle standardisée)
- Colonne B : Âge chronologique révolu (Valeur numérique scalaire)
- Colonne C : Sexe biologique du sujet (Modalités catégorielles : ‘F’, ‘M’)
- Colonne D : Bras d’inclusion au protocole (Modalités : ‘Placebo’, ‘Molécule_A’, ‘Molécule_B’)
- Colonne E : Taux de biomarqueur sérique post-traitement (Valeur flottante décimale)
- Colonne F : Date d’inclusion au protocole (Format temporel calendaire)
- Colonne G : Signalement d’effets indésirables majeurs (Valeur booléenne ou ‘OUI’/’NON’)
L’équipe de biostatisticiens mandatée pour l’étude souhaite isoler une sous-population hautement qualifiée pour tester la significativité statistique d’une réponse clinique exceptionnelle. La population cible doit obéir au profil croisé suivant : il s’agit d’extraire l’ensemble des sujets féminins de plus de 45 ans révolus ou des sujets masculins de plus de 50 ans, ayant obligatoirement reçu la thérapie active (Molécule_A ou Molécule_B, excluant de facto le bras Placebo), incorporés au cours de l’année civile 2023, et présentant un taux sérique résiduel strictement supérieur à 12,5 tout en n’ayant signalé aucun effet indésirable majeur.
La transcription intégrale de cette problématique multicritère en une formule unitaire QUERY déploie un équilibre complet de parenthèses, de disjonctions régulières et d’ancrages typés :
=QUERY(Cohorte_Data!A1:G50000; "SELECT A, B, C, D, E WHERE ((C = 'F' AND B > 45) OR (C = 'M' AND B > 50)) AND D MATCHES 'Molécule_A|Molécule_B' AND F >= date '2023-01-01' AND F <= date '2023-12-31' AND E > 12.5 AND G = 'NON'"; 1)
Cette requête illustre la quintessence de la sélection relationnelle au sein de Google Sheets : l’arborescence encapsulée ((C = 'F' AND B > 45) OR (C = 'M' AND B > 50)) assure l’asymétrie voulue des critères physiologiques d’inclusion par sexe sans interférence mutuelle, l’opérateur MATCHES comprime l’alternative thérapeutique en un motif concis, l’intervalle temporel ISO encadre la temporalité de l’étude, et les prédicats quantitatifs terminaux parachèvent l’épuration du sous-ensemble analytique avec une pureté méthodologique irréprochable.
12.2 Suivi opérationnel et reporting de performance multidimensionnel
Dans un contexte d’ingénierie managériale et de gouvernance d’entreprise, la fonction QUERY agit comme le moteur computationnel central des tableaux de bord dynamiques. Imaginons une direction des opérations supervisant un portefeuille transversal de projets informatiques globaux consignés dans un tableau opérationnel Portfolio_Tracker occupant la plage A1:H. Les métriques suivies englobent le statut d’avancement (colonne C : « En cours », « En attente », « Livré », « Bloqué »), la date limite contractuelle (colonne E), le budget consommé en euros (colonne F), et le score de criticité stratégique noté de 1 à 5 (colonne H).
Pour piloter les comités de direction hebdomadaires, le contrôleur de gestion a pour mission de générer une table d’alerte automatisée identifiant tous les chantiers en dérive critique. Un projet est considéré comme critique s’il satisfait à l’une des deux conditions d’urgence opérationnelle suivantes :
- Il est au statut « En cours » ou « Bloqué », son échéance contractuelle arrive à expiration dans le mois courant ou est déjà dépassée (date cible antérieure au 1er juillet 2024 dans le cadre de notre simulation), et sa criticité est maximale (score égal à 4 ou 5).
- Son budget consommé surpasse 100 000 euros alors que son statut opérationnel est toujours consigné comme « En attente », caractérisant une anomalie d’imputation financière nécessitant un arbitrage immédiat.
La modélisation de cette règle d’alerte multidimensionnelle s’exécute par la juxtaposition de deux macro-blocs conjonctifs unifiés par une disjonction centrale :
=QUERY(Portfolio_Tracker!A1:H; "SELECT A, C, E, F, H WHERE (C MATCHES 'En cours|Bloqué' AND E < date '2024-07-01' AND H >= 4) OR (C = 'En attente' AND F > 100000) ORDER BY H DESC, F DESC"; 1)
Outre l’application impeccable des filtres logiques multicritères, cette instruction adjoint une clause d’ordonnancement structurel ORDER BY qui organise automatiquement les données extraites selon une double clé descendante : les projets présentant les scores de criticité les plus élevés sont projetés au sommet du tableau, suivis par l’importance des montants financiers engagés. Les résultats projetés peuvent alors être instantanément interfacés avec des modules graphiques de reporting ou des mécanismes de mise en forme conditionnelle dynamique, fournissant à l’état-major décisionnel un outil de pilotage stratégique en temps réel fondé sur une rigueur architecturale sans compromis.
Références
Google. (2024). Fonction QUERY de Google Sheets. Centre d’aide Google Docs. https://support.google.com/docs/answer/3093343
Google Developers. (2023). Google Visualization API Query Language Reference (Version 0.7). Google Chart Tools Documentation. https://developers.google.com/chart/interactive/docs/querylanguage
International Organization for Standardization. (2016). Information technology — Database languages — SQL — Part 2: Foundation (SQL/Foundation) (ISO/IEC 9075-2:2016). ISO. https://www.iso.org/standard/63555.html
Mendelsohn, E., & Boole, G. (2011). An investigation of the laws of thought on which are founded the mathematical theories of logic and probabilities. Cambridge University Press.
Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.