
Dans le paradigme contemporain du traitement et de l’ingénierie des données sur tableur, l’application infonuagique Google Sheets s’est progressivement métamorphosée. Elle est passée du statut de simple carnet de calcul matriciel bidimensionnel à celui de véritable moteur de traitement analytique relationnel léger. Cette mutation fonctionnelle repose en grande partie sur l’implémentation de la fonction QUERY, un outil computationnel singulier qui transpose la puissance déclarative du langage SQL (Structured Query Language) au cœur d’un environnement distribué sur le Web. Cependant, l’usage quotidien en milieu académique, institutionnel ou entrepreneurial se heurte inévitablement à un obstacle structurel récurrent : la fragmentation de l’information à travers une multitude d’onglets au sein d’un même classeur, voire à travers plusieurs classeurs distincts dispersés dans l’écosystème infonuagique.
Le cloisonnement des données en feuilles distinctes répond fréquemment à des impératifs organisationnels pragmatiques, tels que l’archivage chronologique (par semaines, mois ou trimestres), la sectorisation géographique ou la répartition par cohorte expérimentale. Néanmoins, lorsque vient le moment d’élaborer une synthèse transversale, d’extraire des indicateurs de performance agrégés ou de modéliser des corrélations statistiques, cette architecture dispersée devient une entrave analytique majeure. La fonction QUERY, lorsqu’elle est combinée avec les capacités d’encapsulation matricielle vectorielle natives de Google Sheets, offre une réponse d’une puissance et d’une élégance remarquables. Elle permet de виртуаliser la consolidation des données sans jamais altérer ni dupliquer physiquement les enregistrements primaires, assurant ainsi la préservation rigoureuse de l’intégrité référentielle du modèle d’information.
Le présent traité vise à disséquer, avec une rigueur méthodologique et théorique absolue, l’ensemble des mécanismes sous-tendant l’interrogation multi-feuilles via la fonction QUERY. De la sémantique de l’API de visualisation sous-jacente à la gestion fine des typologies de variables, en passant par les opérateurs matriciels littéraux, la réorganisation dynamique des projections et l’intégration de flux inter-classeurs, cet ouvrage se veut le guide de référence définitif pour les analystes, ingénieurs et chercheurs désireux d’exploiter le plein potentiel computationnel de leur écosystème de données distribuées.
1. Fondements théoriques de la fonction QUERY et de l’interrogation multi-feuilles
1.1 Origine et intégration du langage Google Visualization API Query
Pour appréhender pleinement le fonctionnement de la fonction QUERY, il est indispensable de comprendre son architecture d’exécution sous-jacente. Contrairement aux fonctions arithmétiques standard de Google Sheets, qui sont évaluées directement par le moteur de calcul JavaScript interne du tableur dans le navigateur ou sur des serveurs d’évaluation transactionnels, QUERY constitue une passerelle directe vers le langage de requête de l’API Google Visualization. Cette API a été initialement conçue pour permettre à des applications tierces d’interroger dynamiquement des sources de données tabulaires hébergées sur les infrastructures de Google afin de générer des visualisations graphiques interactives.
L’implémentation de cette technologie au sein même des feuilles de calcul confère à l’analyste un interpréteur déclaratif quasi identique au standard SQL-92. Alors qu’une approche impérative classique contraint l’utilisateur à décrire la procédure algorithmique exacte pour parvenir à un résultat (par exemple, imbriquer des conditions logiques à travers des boucles itératives simulées par des fonctions matricielles), la logique déclarative de QUERY permet de spécifier uniquement l’état final désiré des données. L’utilisateur formule sa demande à travers des clauses sémantiques universelles telles que SELECT, WHERE, GROUP BY, PIVOT ou ORDER BY, déléguant au moteur d’exécution l’optimisation des parcours d’index et le filtrage des tuples.
Sur le plan de l’efficience computationnelle, cette architecture surpasse très largement les constructions traditionnelles fondées sur des enchevêtrements de fonctions RECHERCHEV (VLOOKUP), INDEX combiné à EQUIV (MATCH), ou encore les formulations matricielles étendues de type SOMME.SI.ENS (SUMIFS). Alors que ces dernières nécessitent une réévaluation individuelle pour chaque cellule de destination — multipliant la complexité algorithmique par le produit du nombre de cellules calculées et du nombre d’enregistrements sources —, la fonction QUERY traite l’intégralité du volume de données en une seule passe d’évaluation en mémoire. Il en résulte une empreinte mémoire minimisée, un temps de recalcul drastiquement réduit et une prévention efficace des blocages de fil d’exécution au sein du navigateur client.
1.2 Nécessité méthodologique de la consolidation des données cloisonnées
Dans la pratique scientifique, médicale et organisationnelle, la fragmentation longitudinale des données constitue une réponse naturelle à des contraintes opérationnelles immédiates. Par exemple, un laboratoire de recherche recueillant des biomarqueurs auprès d’une cohorte clinique consigne fréquemment les relevés dans des onglets dédiés à chaque visite hebdomadaire ou mensuelle. De même, un département financier segmente volontiers ses registres comptables par exercice budgétaire ou par filiale territoriale. Si cette approche garantit une excellente ergonomie de saisie au niveau local et limite les risques de corruption accidentelle d’enregistrements tiers par les opérateurs de terrain, elle fragmente dramatiquement le schéma global des données.
D’un point de vue cognitif, la manipulation de classeurs compartimentés impose une charge mentale considérable à l’analyste. Devoir basculer constamment d’une feuille à l’autre pour extraire des totaux partiels, vérifier des concordances de libellés ou copier manuellement des sous-ensembles d’enregistrements génère une fatigue attentionnelle propice à l’introduction d’erreurs humaines silencieuses. Ces consolidations manuelles détruisent la traçabilité des transformations et rendent l’audit des modèles particulièrement fastidieux.
La consolidation dynamique opérée par la fonction QUERY résout cette aporie en maintenant une séparation stricte entre la couche de persistance des données (les feuilles de saisie brutes) et la couche de présentation ou d’analyse (la feuille de consolidation). En évitant tout copier-coller statique, le modèle respecte scrupuleusement le principe fondamental d’intégrité référentielle : toute modification, adjonction ou suppression survenue dans l’un des onglets sources se répercute instantanément, de manière purement algorithmique et déterministe, au sein de la vue unifiée. Il n’existe ainsi qu’une seule source de vérité, virtualisée à la demande sans duplication matérielle d’octets.
1.3 Vue d’ensemble de l’architecture matricielle dans l’environnement Google
Pour réaliser l’exploit d’interroger plusieurs structures de données distinctes comme s’il s’agissait d’une table unique et cohérente, Google Sheets s’appuie sur son moteur de manipulation matricielle en mémoire vive. Lorsque plusieurs plages de cellules discontinues sont regroupées au sein d’une expression syntaxique spécifique, l’interpréteur de calcul ne les évalue plus comme des pointeurs géographiques statiques liés à la grille de la feuille de calcul, mais les transmute instantanément en un objet vectoriel ou matriciel multidimensionnel abstrait.
Cette matrice en mémoire vive possède une existence transitoire : elle est instanciée lors de la phase de résolution de la formule, soumise aux transformations relationnelles dictées par la requête, puis déchargée dès que la grille de sortie a été peuplée par le mécanisme de propagation matricielle (débordement dynamique des résultats sur les cellules adjacentes). Cette abstraction permet de découpler totalement la logique d’interrogation de la topologie physique du classeur. Que les données proviennent d’une plage contiguë de dix lignes sur une même feuille ou de cinq fragments dispersés à travers des onglets mutuellement isolés, le moteur de visualisation reçoit en entrée un flux matriciel rectangulaire parfaitement homogène.
Néanmoins, cette flexibilité s’accompagne de contraintes architecturales inhérentes aux limites de calcul infonuagique. Google Sheets alloue un quota déterminé de ressources mémoire et de cycles CPU pour chaque classeur. La construction de matrices virtuelles volumineuses — particulièrement lorsqu’elles impliquent des dizaines de milliers de lignes ou des évaluations croisées répétées — peut heurter les limites d’exécution du tableur, matérialisées par des erreurs de dépassement de capacité ou des dégradations sensibles de la réactivité de l’interface graphique. Une compréhension méticuleuse des mécanismes d’assemblage matriciel est donc indispensable pour concevoir des requêtes à la fois performantes et architecturalement viables.
2. Anatomie des matrices littérales et syntaxe d’empilement
2.1 Le rôle fondamental des accolades dans la construction vectorielle
L’élément syntaxique fondamental permettant la coalescence de structures de données éparses dans Google Sheets réside dans l’utilisation des accolades ({ }). En programmation informatique et en analyse matricielle, les accolades délimitent ce que la documentation technique officielle nomme les tableaux littéraux (array literals). Ces constructeurs matriciels indiquent à l’interpréteur de formules qu’il ne doit pas traiter les arguments comme une énumération séquentielle de paramètres de fonction, mais plutôt comme une instruction d’assemblage vectoriel régie par des opérateurs dimensionnels précis.
Il existe deux dimensions fondamentales de concaténation matricielle : horizontale et verticale. La concaténation horizontale combine des plages côte à côte, augmentant le nombre de colonnes de la matrice résultante tout en conservant une hauteur de ligne commune. À l’inverse, la concaténation verticale superpose des plages de cellules les unes au-dessus des autres, augmentant le nombre total de lignes de la structure finale tout en exigeant une largeur dimensionnelle rigoureusement identique. Dans le cadre de l’interrogation de plusieurs feuilles recensant des cohortes similaires ou des enregistrements temporels successifs, c’est l’empilement vertical qui constitue l’opération nodale.
L’interpréteur évalue les expressions encapsulées entre accolades de gauche à droite et de haut en bas. Lorsqu’il rencontre une première plage de cellules, par exemple Feuille1!A2:D50, il charge les coordonnées et valeurs correspondantes dans le registre vectoriel actif, puis lit l’opérateur de liaison pour déterminer l’axe d’adjonction de la plage subséquente, par exemple Feuille2!A2:D50. L’agencement correct de ces opérateurs constitue la clé de voûte de toute consolidation de données réussie.
2.2 Sémiotique des délimiteurs : points-virgules et barres obliques inverses
La sémantique des délimiteurs matriciels dans Google Sheets est conditionnée par les paramètres régionaux du classeur (locale), une particularité qui désoriente fréquemment les analystes habitués à naviguer entre environnements anglophones et francophones. Dans les paramètres régionaux francophones (France, Belgique, Suisse, Canada francophone), où la virgule est conventionnellement réservée comme séparateur décimal arithmétique standard, l’interpréteur de calcul a dû adapter sa table de symboles d’assemblage matriciel.
Dans la configuration régionale française standard :
- Le point-virgule (;) opère comme le délimiteur de saut de ligne, c’est-à-dire l’opérateur d’empilement vertical. Placer un point-virgule entre deux références de plages ordonne au système de positionner la seconde structure directement sous la dernière ligne de la première structure.
- La barre oblique inverse (), ou antislash, opère comme le délimiteur d’extension de colonne, c’est-à-dire l’opérateur de concaténation horizontale. Placer ce symbole entre deux plages commande au moteur d’accoler la seconde structure immédiatement à droite de la dernière colonne de la première.
À titre de comparaison, dans les classeurs configurés selon les normes régionales des États-Unis ou du Royaume-Uni (où le point fait office de séparateur décimal), la virgule (,) sert à concaténer horizontalement et le point-virgule (;) demeure l’opérateur vertical. Ainsi, la formule formulée {Plage1; Plage2} en environnement francophone réalise un empilement vertical parfait. La méconnaissance de ces variations sémiotiques locales représente l’une des causes les plus fréquentes d’erreurs d’analyse syntaxique lors du portage de modèles de calcul entre filiales internationales d’une même organisation.
2.3 Règles d’homogénéité dimensionnelle pour la coalescence de plages
L’assemblage matriciel est régi par une contrainte algébrique stricte : l’isomorphisme dimensionnel sur l’axe orthogonal à la direction de la fusion. En termes mathématiques simples, lorsque l’on procède à un empilement vertical au moyen de points-virgules, chaque sous-matrice constitutive doit obligatoirement posséder un nombre de colonnes rigoureusement identique. Si la première matrice comprend cinq colonnes (par exemple de la colonne A à la colonne E), toutes les matrices subséquentes convoquées dans le constructeur matriciel doivent impérativement comporter cinq colonnes.
Toute tentative de combiner une plage de dimensions 100 x 4 avec une plage de dimensions 50 x 3 au sein d’une instruction telle que {Feuille1!A1:D100; Feuille2!A1:C50} sera immédiatement rejetée par le moteur de calcul avec une erreur de type #VALUE! (ou #VALEUR!). Le message d’anomalie indiquera sans équivoque que les paramètres du tableau littéral ne présentent pas des largeurs congruentes, empêchant la constitution d’une forme géométrique rectangulaire cohérente en mémoire.
Par ailleurs, au-delà de la stricte conformité dimensionnelle géométrique, la coalescence matricielle exige une vigilance méthodologique extrême concernant l’ordonnancement qualitatif des variables. Bien que le moteur de calcul assemble sans protester deux plages ayant le même nombre de colonnes, si la troisième colonne de la première feuille contient des montants monétaires tandis que la troisième colonne de la seconde feuille héberge des adresses électroniques, la matrice résultante souffrira d’une corruption sémantique majeure. L’homogénéité des schémas d’attributs entre chaque feuille source constitue donc un prérequis fonctionnel incontournable.
3. La transition syntaxique : de la référence alphabétique aux identifiants Col1 et Col2
3.1 Mécanisme d’abstraction référentielle imposé par les matrices virtuelles
L’un des tournants conceptuels les plus déroutants pour l’utilisateur migrant d’une requête simple sur feuille unique vers une requête multi-feuilles réside dans l’abandon complet des références alphabétiques conventionnelles de colonnes. Dans une requête classique ciblant une plage physique directe, par exemple =QUERY(Feuille1!A1:D100; « SELECT A, B WHERE C > 50 »), le moteur fait directement correspondre les identifiants littéraux A, B et C aux coordonnées géographiques visibles de la feuille de calcul hôte.
Toutefois, dès lors que la source de données est encapsulée entre des accolades matricielles pour réaliser une fusion, la formule prend la forme =QUERY({Feuille1!A1:D100; Feuille2!A1:D100}; « … »). À cet instant précis, la source transmise au moteur QUERY n’est plus une adresse de plage issue de la grille de calcul, mais une matrice anonyme résidant dans la mémoire vive de l’application. Cette matrice virtuelle a perdu tout ancrage spatial avec le système de coordonnées matricielles standard du classeur. Elle ne possède plus de colonne A, B ou C native, mais simplement un agencement ordonné de vecteurs colonnes indicés séquentiellement.
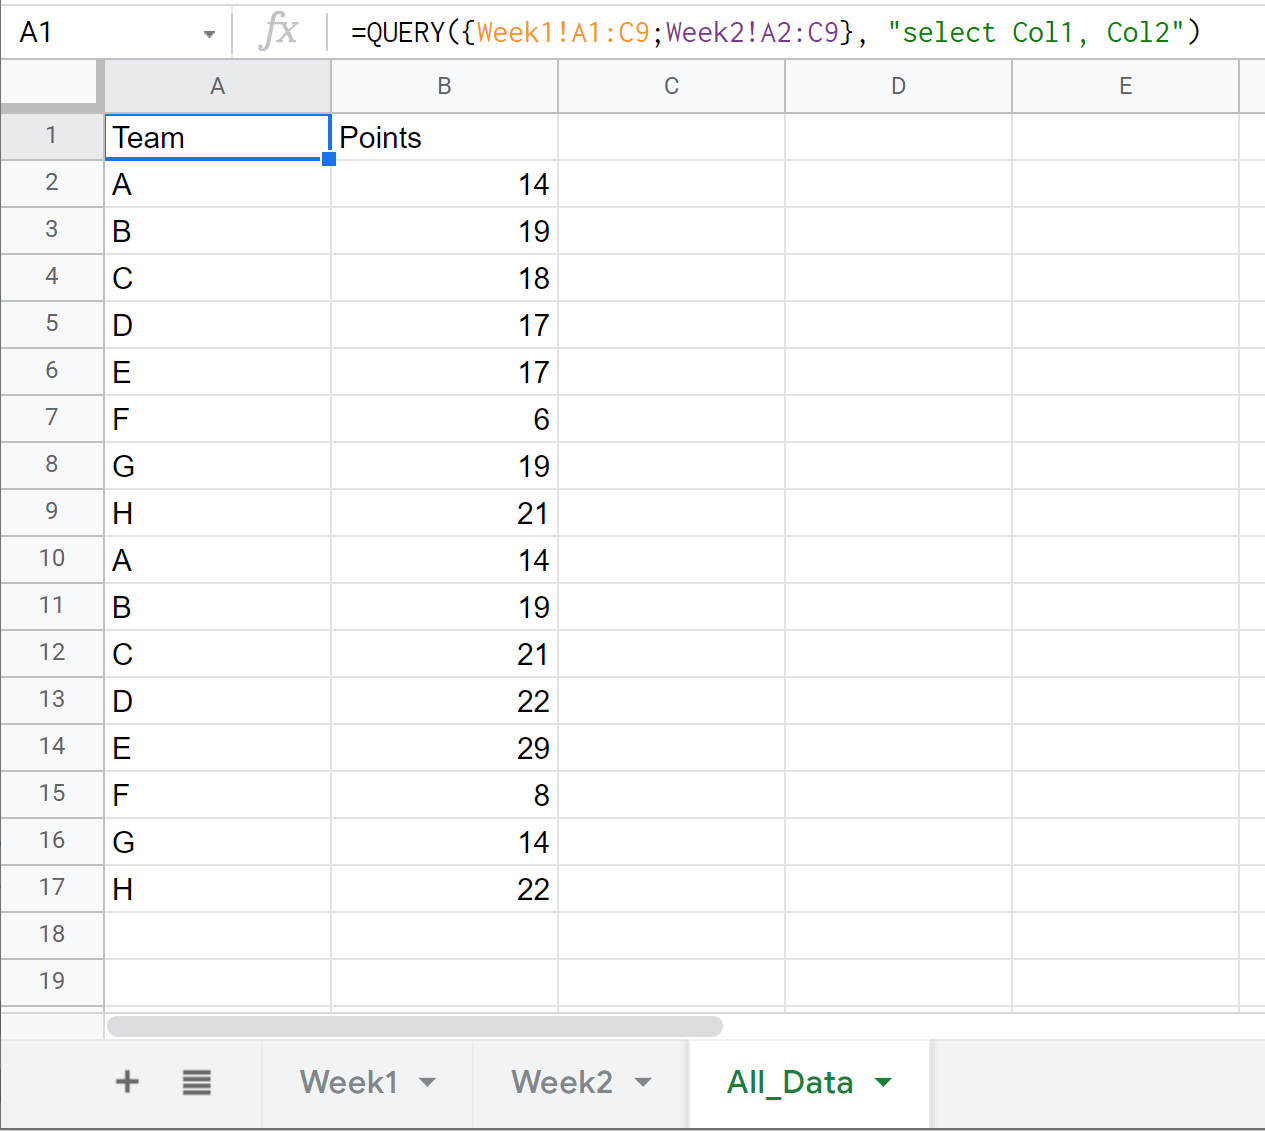
Pour interroger cet objet décorrélé de l’espace de travail physique, l’API de visualisation Google impose une nomenclature générique standardisée fondée sur la position relative : les identifiants positionnels Col1, Col2, Col3, jusqu’à ColN, où N correspond au nombre total de colonnes composant la matrice assemblée. Ignorer cette règle d’abstraction référentielle et tenter d’utiliser les lettres alphabétiques sur une matrice entre accolades provoque instantanément une erreur sémantique sévère émise par le moteur de parsing SQL.
3.2 Sensibilité à la casse et typologie des identifiants positionnels
L’interpréteur de requêtes de l’API Google Visualization applique une politique de sensibilité à la casse particulièrement intransigeante vis-à-vis des identifiants positionnels. Le descripteur de colonne doit être orthographié impérativement avec une lettre majuscule C suivie des lettres minuscules ol, immédiatement accolées à l’indice numérique entier représentant la colonne, sans aucun espace intercalaire : Col1, Col2, Col3.
Toute déviation typographique par rapport à cette norme stricte entraîne l’échec immédiat de la requête. Des formulations erronées telles que col1 (entièrement en minuscules), COL1 (intégralement en capitales) ou Col 1 (avec une espace entre le radical et le chiffre) déclencheront une erreur de syntaxe de type #VALUE!, accompagnée de l’explication lapidaire : « Impossible d’analyser la chaîne de requête pour la fonction QUERY ». Le compilateur de l’API ne reconnaît pas ces formes comme des identifiants valides et les interprète à tort comme des noms de champs non déclarés ou des commandes invalides.
Il est par ailleurs fondamental de ne jamais dépasser l’indice numérique maximal autorisé par la dimension de la matrice d’entrée. Si votre tableau littéral fusionne des plages composées de quatre colonnes chacune, la matrice résultante aura précisément pour dimension en largeur Col1, Col2, Col3 et Col4. Toute référence dans la clause SELECT ou WHERE à un identifiant inexistant tel que Col5 provoquera un dépassement de limite de structure (IndexOutOfBounds) et suspendra instantanément l’exécution de la requête.
3.3 Comparaison empirique des syntaxes directes et indirectes
Pour mesurer la rupture paradigmatique opérée par le passage à la syntaxe positionnelle, il convient de confronter empiriquement les deux modes de formulation à travers un tableau d’analyse comparative :
- Requête directe sur plage physique unitaire :
Formule : =QUERY(Donnees!A2:E; « SELECT A, C, E WHERE B = ‘Validé' »)
Comportement : Le moteur se connecte aux colonnes physiques réelles. Si un utilisateur insère physiquement une colonne entre A et B dans la feuille source, Google Sheets met généralement à jour la référence dans la formule de façon dynamique. En revanche, l’interrogation simultanée de plusieurs sources est impossible. - Requête indirecte sur matrice virtuelle empilée :
Formule : =QUERY({DonneesNord!A2:E; DonneesSud!A2:E}; « SELECT Col1, Col3, Col5 WHERE Col2 = ‘Validé' »)
Comportement : Le moteur traite une table virtuelle abstraite. L’interrogation multi-sources devient native et totalement transparente. Néanmoins, les identifiants étant figés sous forme textuelle au sein de la chaîne de requête (« SELECT Col1… »), l’insertion arbitraire d’une nouvelle colonne au milieu des données sources ne mettra pas à jour la position textuelle déclarée, décalant silencieusement les correspondances de colonnes.
Ce comparatif souligne l’impératif absolu d’une rigoureuse discipline de gouvernance des données : lorsque vous optez pour la puissance de la syntaxe ColN sur matrices multiples, les schémas des tables d’origine doivent être formellement verrouillés et documentés afin d’éviter que des réorganisations structurelles manuelles n’altèrent la logique d’extraction du modèle de synthèse.
4. Protocole d’interrogation basique : Consolidation intégrale sans projection sélective
4.1 Formulation élémentaire du modèle d’empilement direct
La mise en œuvre opérationnelle la plus élémentaire de la fonction QUERY appliquée à des environnements partitionnés consiste à exécuter une fusion brute de l’intégralité des données disponibles sans appliquer immédiatement de restriction sur les lignes ou les colonnes. Ce protocole représente l’analogue fonctionnel d’une opération relationnelle de type UNION ALL exécutée sur des tables réparties.
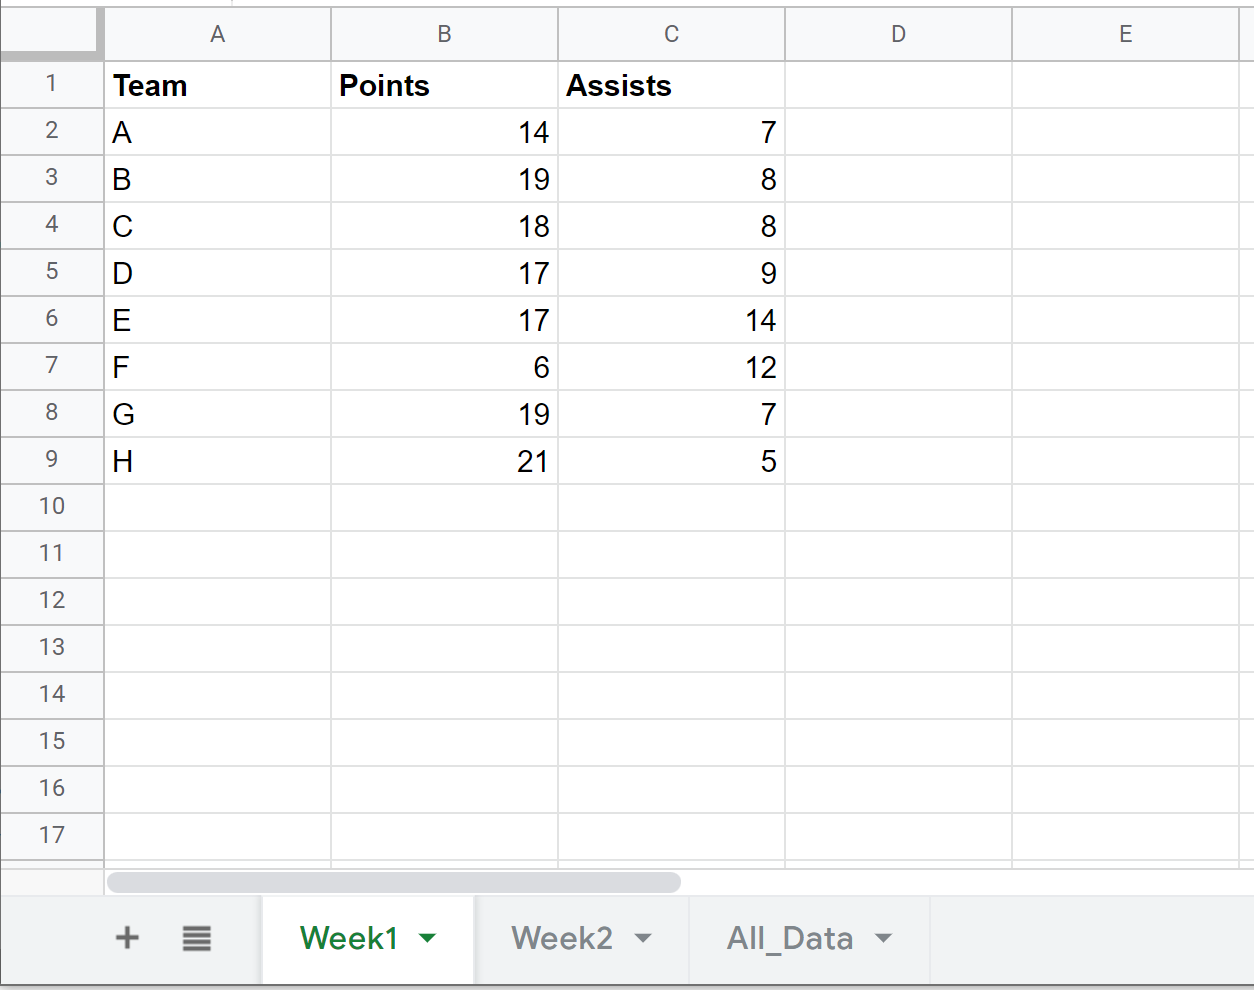
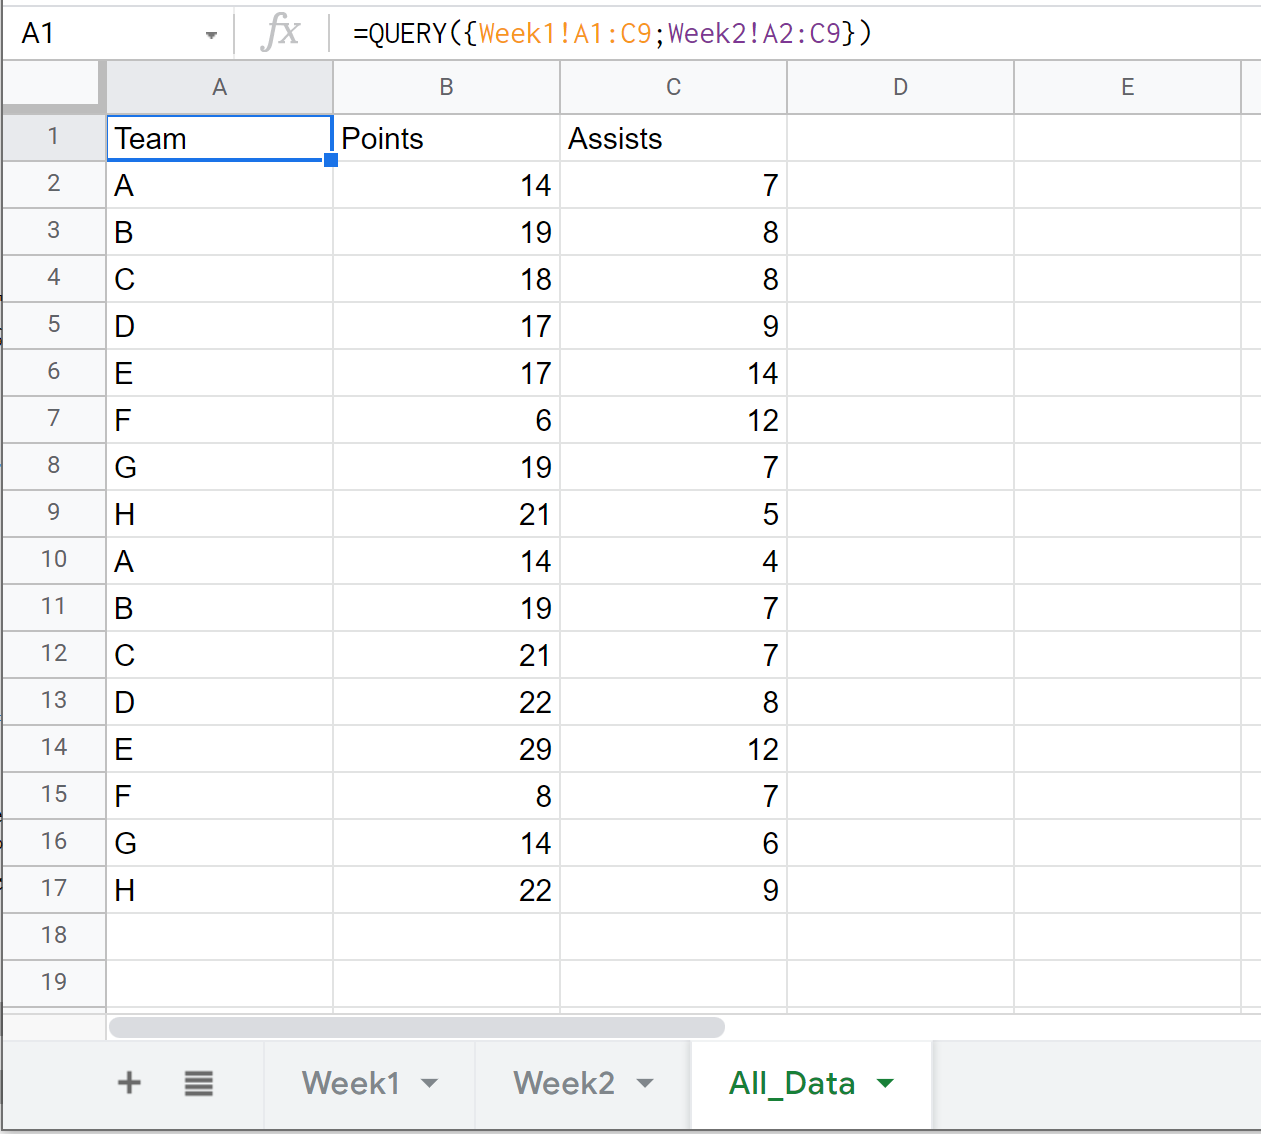
Considérons l’expression générique suivante : =QUERY({Feuille1!A1:C9; Feuille2!A1:C9}). Dans cette configuration, le second argument traditionnel de la fonction QUERY — à savoir la chaîne d’instructions textuelle — est purement et simplement omis, ou implicitement assimilé à l’instruction universelle SELECT *. Lors de l’évaluation de cette cellule par le moteur de calcul de Google Sheets, l’ordonnanceur d’événements commence par charger en mémoire vive le premier bloc de données (lignes 1 à 9 de la feuille 1), puis, guidé par le point-virgule d’empilement vertical, procède à l’adjonction séquentielle du second bloc (lignes 1 à 9 de la feuille 2).
Le résultat généré à l’écran produit une structure continue s’étendant sur 18 lignes et 3 colonnes. La fonction QUERY agit ici comme une pompe d’ingestion ultra-rapide qui récupère l’objet matriciel issu du constructeur vectoriel et le restitue intégralement sur la grille cible via le mécanisme natif de dispersion matricielle (spill array). Cette formule constitue le point de départ absolu de tout processus de consolidation avant d’y greffer des couches d’intelligence analytique supplémentaires.
4.2 Étude de cas : Fusion de cohortes d’évaluation temporelle
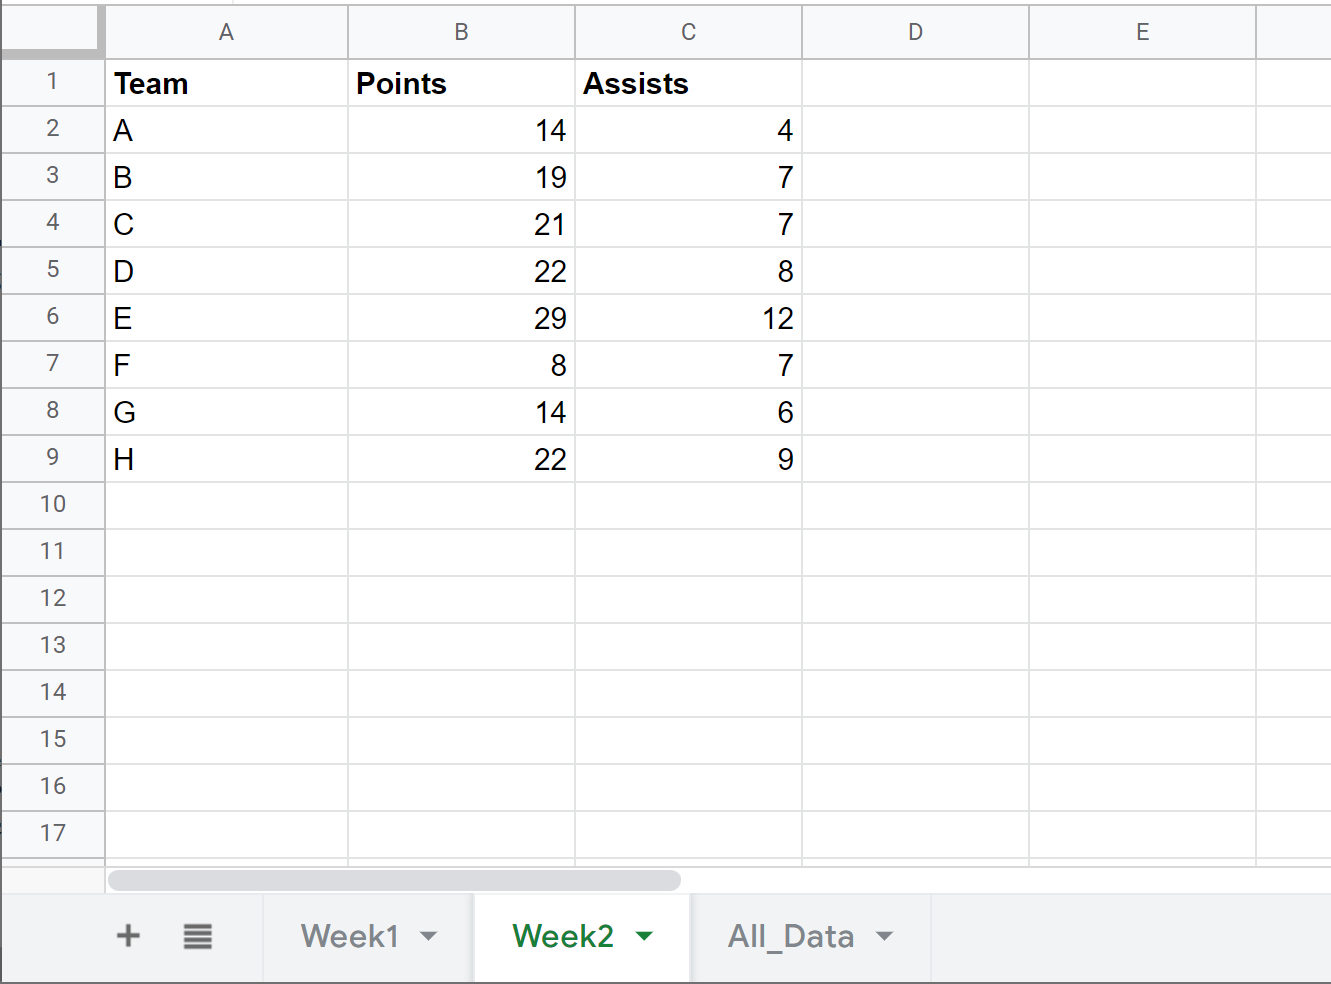
Afin d’illustrer la mécanique concrète de cette approche, analysons une étude de cas appliquée à l’évaluation des performances sportives au sein d’un centre d’entraînement athlétique. Les données physiologiques et biomécaniques des athlètes sont relevées de façon hebdomadaire par des préparateurs distincts au sein de deux onglets réservés : Semaine1 et Semaine2.
Chacun de ces onglets présente la structure d’attributs standard suivante répartie sur les colonnes A à C :
- Colonne A : Identifiant unique de l’athlète (chaîne textuelle, ex. : « ATH-001 »).
- Colonne B : Fréquence cardiaque moyenne à l’effort (valeur numérique entière, exprimée en battements par minute).
- Colonne C : Puissance mécanique maximale développée (valeur numérique décimale, exprimée en watts).
En formulant sur un troisième onglet de récapitulation la commande =QUERY({Semaine1!A2:C15; Semaine2!A2:C15}), l’analyste sportif obtient une vue longitudinale immédiate et consolidatede de l’ensemble des séances d’entraînement sans avoir eu à intervenir manuellement sur les données brutes. L’ordonnancement séquentiel des observations est parfaitement préservé : les quatorze enregistrements de la première semaine sont restitués aux lignes 1 à 14 de la feuille de synthèse, immédiatement suivis par les quatorze enregistrements de la seconde semaine aux lignes 15 à 28. Cette continuité temporelle forme le socle indispensable pour les futures analyses de séries chronologiques ou d’évolution de la charge d’entraînement.
4.3 Diagnostics des retombées immédiates sur l’intégrité des données
L’exécution de cette consolidation directe engendre des retombées immédiates sur la structure sous-jacente des données qui doivent faire l’objet d’une surveillance diagnostique rigoureuse par l’analyste. Premièrement, il convient de souligner que le moteur QUERY préserve scrupuleusement la nature typologique des valeurs sources : les nombres conservent leurs propriétés arithmétiques, les chaînes de texte demeurent concaténables et les formats temporels (horodatages et dates) maintiennent leur encodage séquentiel sous-jacent, bien que leur formatage d’affichage visuel (par exemple la police, la couleur ou le nombre de décimales apparentes) puisse nécessiter une réapplication de style sur la plage de sortie.
Deuxièmement, le comportement de la formule face à des cellules d’origine générées par d’autres formules de calcul internes est totalement transparent : QUERY évalue et extrait exclusivement la valeur résultante finale présente en mémoire au moment du calcul, ignorant délibérément la complexité des formules imbriquées qui ont pu générer ces valeurs sur les feuilles mères. Cela élimine tout risque de rupture de dépendance cyclique ou de décalage de pointeurs de cellules relatifs.
Cependant, une faille majeure de cette consolidation naïve sans sélection apparaît immédiatement lorsque les plages d’entrée intègrent par mégarde les libellés de colonnes : si vous déclarez {Semaine1!A1:C15; Semaine2!A1:C15}, la ligne d’en-tête de la seconde semaine se retrouve insérée arbitrairement au milieu de votre tableau consolidé (à la ligne 16), brisant la pureté du typage de la colonne et polluant les futurs calculs statistiques. Ce constat met en lumière la nécessité d’implémenter des mécanismes de projection et de filtrage sophistiqués.
5. Projection sélective de variables : Filtrage des colonnes via SELECT
5.1 Syntaxe formelle de l’extraction ciblée sur matrices assemblées
Dans la grande majorité des projets d’ingénierie décisionnelle, la fusion exhaustive de toutes les colonnes sources s’avère non seulement inutile, mais néfaste pour la clarté opérationnelle des tableaux de bord. Les feuilles de recueil contiennent couramment des métadonnées techniques, des horodatages de saisie superflus ou des notes de service qui n’ont aucune valeur dans une vue consolidée finale. C’est ici qu’intervient la clause de projection relationnelle SELECT.
Appliquée à une matrice assemblée entre accolades, la syntaxe d’extraction sélective prend la forme rigoureuse suivante : =QUERY({Feuille1!A1:E50; Feuille2!A1:E50}; « SELECT Col1, Col2, Col4 »). Dans ce schéma, l’expression transmet au moteur l’instruction explicite de charger la matrice virtuelle à cinq colonnes, mais de n’émettre vers la grille de sortie que le premier, le deuxième et le quatrième vecteur de cette structure. Les colonnes intermédiaires (Col3) ou terminales (Col5) sont totalement élaguées dès la phase d’évaluation en mémoire, sans gaspillage de bande passante ni encombrement de l’interface.
La ponctuation au sein de la chaîne de commande SQL obéit à des conventions universelles : chaque identifiant positionnel doit être rigoureusement séparé du suivant par une virgule, idéalement suivie d’une espace pour garantir une lisibilité humaine optimale (bien que l’interpréteur tolère l’absence d’espaces). Il est formellement interdit de placer une virgule après le dernier identifiant projeté (par exemple « SELECT Col1, Col2, »), sous peine de déclencher immédiatement une exception d’analyse syntaxique (Parse Error).
5.2 Réorganisation ordonnée et permutation de variables virtuelles
L’un des avantages les plus remarquables de la clause SELECT réside dans sa capacité à restructurer dynamiquement l’ordre physique d’apparition des variables sans modifier d’un iota l’agencement structurel des feuilles sources d’origine. Cette propriété d’interversion permet de s’affranchir totalement de la rigidité spatiale traditionnelle des tableurs.
Supposons un cas où l’analyste souhaite placer la colonne de score final (positionnée en Col5 dans les données de saisie) en tête de son rapport d’audit, suivie de l’identifiant de l’opérateur (positionné en Col1), tout en ignorant délibérément les autres variables. Il lui suffit de formuler sa projection selon l’ordonnancement désiré : =QUERY({Feuille1!A2:E; Feuille2!A2:E}; « SELECT Col5, Col1 »). Le moteur reconstruit instantanément une nouvelle table bidimensionnelle où l’ancienne cinquième colonne devient la première, et l’ancienne première devient la seconde.
Cette plasticité projectionnelle autorise également la duplication délibérée de colonnes au sein d’une même matrice de sortie. Il est parfaitement licite d’écrire « SELECT Col1, Col2, Col2 » dans l’hypothèse où l’analyste souhaiterait ultérieurement appliquer un formatage numérique différent sur la troisième colonne ou s’en servir comme point d’ancrage pour un calcul dérivé complémentaire. La projection sélective agit ainsi comme un véritable outil de restructuration schématique à la volée.
5.3 Attribution d’étiquettes personnalisées via la clause LABEL
Lorsque la fonction QUERY exécute des transformations, des réorganisations ou des calculs sur des colonnes consolidées, les en-têtes générés par défaut peuvent s’avérer austères, cryptiques ou inadéquats pour une présentation institutionnelle. Pour pallier ce déficit d’expressivité sémantique, l’API met à disposition la clause d’étiquetage LABEL.
La clause LABEL se greffe à la fin de l’instruction de requête et permet d’associer un alias textuel hautement descriptif à chaque identifiant positionnel projeté. Sa syntaxe s’articule comme suit : =QUERY({Feuille1!A2:D; Feuille2!A2:D}; « SELECT Col1, Col2, Col4 LABEL Col1 ‘Code Athlète’, Col2 ‘Nom Patronyme’, Col4 ‘Vitesse de Pointe (km/h)' »). Les règles grammaticales imposent que chaque libellé personnalisé soit impérativement encadré par des apostrophes droites simples (‘), tandis que les paires d’assignations d’étiquettes sont séparées les unes des autres par une virgule.
Une astuce ergonomique essentielle consiste à utiliser la clause LABEL pour supprimer purement et simplement les en-têtes automatiques lorsque l’on souhaite injecter les données consolidées directement sous une ligne d’en-tête personnalisée préexistante dans la feuille de destination. Il suffit pour cela d’assigner une chaîne vide entre deux apostrophes simples consécutives : « SELECT Col1, Col2 LABEL Col1 », Col2 » ». Cette technique garantit une intégration esthétique invisible et sans bavure au sein des tableaux de bord les plus exigeants.
6. Filtrage conditionnel appliqué à des ensembles de données partitionnés
6.1 Application de prédicats logiques avec la clause WHERE
La consolidation de volumes importants issus de plusieurs sources débouche inévitablement sur la nécessité de restreindre l’analyse à un sous-ensemble d’enregistrements présentant un intérêt méthodologique précis. La clause WHERE incarne l’opérateur de restriction algébrique par excellence, filtrant les lignes de la matrice virtuelle avant leur émission finale.
Dans un contexte d’empilement multi-feuilles, le prédicat de filtrage s’applique de manière totalement transversale sur l’ensemble des partitions. Si nous énonçons la commande =QUERY({AtelierA!A2:D; AtelierB!A2:D}; « SELECT Col1, Col2, Col3 WHERE Col3 >= 100 »), l’algorithme examine séquentiellement chaque tuple consolidé et ne retient que ceux dont la valeur numérique présente dans la troisième colonne satisfait rigoureusement au test d’inégalité arithmétique. Les enregistrements de l’Atelier A et de l’Atelier B sont ainsi évalués selon un standard métrologique uniforme.
Il est fondamental de respecter scrupuleusement la distinction typologique imposée par le parseur SQL :
- Les valeurs numériques sont comparées sans délimiteur : WHERE Col3 > 50 ou WHERE Col4 <= 0.05.
- Les littéraux textuels doivent obligatoirement être encapsulés entre des apostrophes simples : WHERE Col2 = ‘Conforme’ ou WHERE Col1 = ‘URGENT’. Omettre ces apostrophes conduirait le compilateur à chercher une colonne inexistante portant ce nom, générant un plantage immédiat.
- Les valeurs booléennes s’écrivent sous leur forme littérale non apostrophée : WHERE Col5 = TRUE.
6.2 Composition booléenne complexe : AND, OR et NOT
L’environnement décisionnel moderne exige fréquemment l’évaluation de règles d’exclusion et d’inclusion multifactorielles. La clause WHERE supporte l’ensemble des opérateurs logiques booléens classiques : la conjonction AND, la disjonction OR, et la négation NOT, permettant de modéliser des arbres de décision d’une grande complexité.
Lors de la manipulation de matrices provenant de feuilles hétérogènes, il arrive régulièrement qu’une condition doive s’adapter à des typologies divergentes entre sources. Considérez l’instruction suivante : « SELECT Col1, Col2, Col3 WHERE (Col2 = ‘Actif’ AND Col3 > 500) OR (Col2 = ‘Prioritaire’ AND Col3 > 250) ». L’utilisation méthodique des parenthèses de groupement est ici cruciale pour fixer explicitement la préséance des évaluations logiques et neutraliser l’ambiguïté inhérente à la distributivité des opérateurs booléens.
De surcroît, l’opérateur de négation NOT s’avère particulièrement précieux pour expurger instantanément des catégories entières de données indésirables dispersées dans les onglets sources. Une clause telle que WHERE NOT Col1 CONTAINS ‘TEST’ garantit qu’aucun enregistrement d’évaluation technique préalable ou de saisie provisoire ne viendra fausser les statistiques de production consolidées de l’entreprise.
6.3 Filtrage textuel avancé par expressions régulières et correspondances partielles
Pour le traitement de données textuelles qualitatives, les simples égalités de chaînes se révèlent souvent insuffisantes face aux variations de nomenclature des opérateurs de saisie. La fonction QUERY intègre nativement des comparateurs lexicaux sophistiqués d’une remarquable puissance sémantique :
- CONTAINS : Évalue si une chaîne de caractères contient une sous-chaîne cible. Exemple : WHERE Col2 CONTAINS ‘Clinique’ valide indifféremment « Clinique Pasteur », « Centre Clinique Universitaire » ou « Suivi clinique ». Attention, cet opérateur est strictement sensible à la casse.
- STARTS WITH : Vérifie la coïncidence sur les premiers caractères du champ. Exemple : WHERE Col1 STARTS WITH ‘EXP-2024’ permet d’extraire exclusivement les cohortes d’expérimentation initiées au cours de l’exercice 2024.
- ENDS WITH : Filtre les enregistrements en fonction de leur désinence textuelle. Exemple : WHERE Col4 ENDS WITH ‘_FR’ permet d’isoler les entités rattachées au périmètre linguistique français.
- MATCHES : L’opérateur ultime de filtrage textuel, capable d’évaluer des expressions régulières (RegEx) complètes basées sur le standard syntaxique Java.
L’utilisation de la clause WHERE Col2 MATCHES ‘(?i).*(nord|sud).*’ illustre la puissance de cet outil : l’indicateur modificateur (?i) neutralise totalement la sensibilité à la casse, tandis que la structure regex globale sélectionne simultanément tous les enregistrements mentionnant la région « nord » ou la région « sud », peu importe leur position dans le texte et l’utilisation de majuscules ou de minuscules sur chacune des feuilles sources.
7. Gestion rigoureuse des lignes d’en-tête et normalisation structurelle
7.1 Le paramètre facultatif d’en-tête et ses répercussions
La signature officielle de la fonction QUERY se compose de trois arguments distincts : QUERY(données; requête; [en-têtes]). Alors que la communauté des utilisateurs a pris la fâcheuse habitude d’omettre systématiquement le troisième paramètre facultatif [en-têtes], cette négligence méthodologique est la cause principale de comportements aberrants lors de l’interrogation de matrices combinées.
Lorsque ce paramètre n’est pas explicitement renseigné par l’utilisateur, l’interpréteur de Google Sheets tente d’inférer statistiquement le nombre de lignes d’en-tête en analysant la composition typologique des premières lignes de la matrice. Si votre première ligne contient du texte (les libellés des colonnes) alors que les lignes suivantes hébergent des données purement numériques, le système devine avec succès qu’il existe un en-tête unique. En revanche, si vos données sources comportent de nombreuses chaînes textuelles dans les premières observations, le moteur peut basculer de manière imprévisible en mode d’inférence erronée, fusionnant arbitrairement les deux ou trois premières lignes de données pour créer un en-tête composite tentaculaire au sommet de votre tableau.
Pour garantir un déterminisme mathématique absolu et immuniser vos modèles contre ces approximations algorithmiques, il est impératif de toujours formaliser le troisième argument :
- Fixez l’argument à 0 si votre matrice virtuelle ne comporte strictement aucun en-tête (par exemple lorsque vos plages commencent délibérément à la ligne de données A2).
- Fixez l’argument à 1 si la première ligne de votre structure matricielle représente les intitulés nominatifs des colonnes.
7.2 Élimination algorithmique des en-têtes intermédiaires redondants
L’empilement vertical de plusieurs feuilles de calcul génère un problème récurrent bien connu des praticiens de la modélisation : le phénomène de l’en-tête intercalaire parasite. Si un analyste assemble trois onglets via l’instruction naïve {Feuille1!A1:D; Feuille2!A1:D; Feuille3!A1:D}, les libellés de colonnes de la feuille 2 et de la feuille 3 se retrouvent mécaniquement injectés au cœur du flux de données, perturbant les futurs tris et corrompant les calculs d’agrégation.
Deux méthodologies complémentaires permettent de neutraliser ce dysfonctionnement structurel :
- La méthode de segmentation géométrique des plages : Elle consiste à intégrer l’en-tête de colonnes exclusivement sur la toute première feuille du tableau littéral, puis à faire débuter toutes les plages subséquentes à la deuxième ligne. L’expression devient alors : =QUERY({Feuille1!A1:D; Feuille2!A2:D; Feuille3!A2:D}; « SELECT * »; 1). Cette approche garantit une matrice pure dès son instanciation.
- La méthode du filtrage négatif dans la clause WHERE : Si les plages sont automatisées ou dynamiques et ne permettent pas une segmentation manuelle fine, l’analyste peut éliminer les en-têtes parasites par éviction logique au sein de la requête : =QUERY({Feuille1!A1:D; Feuille2!A1:D}; « SELECT * WHERE Col1 != ‘Identifiant’ AND Col1 IS NOT NULL »; 1). Les lignes contenant le texte descriptif d’en-tête de la seconde feuille sont ainsi interceptées et supprimées du flux de sortie de manière algorithmique.
7.3 Homogénéisation des typologies de données dominantes
L’un des secrets les mieux gardés de l’architecture de Google Sheets réside dans sa gestion singulière des typologies de données au sein d’une même colonne : la règle dite du type majoritaire à 80 %. Contrairement aux bases de données relationnelles formelles (PostgreSQL, Oracle, MySQL) qui imposent un schéma strict et figé par table, Google Sheets tolère la présence de types hétérogènes (nombres, textes, dates, booléens) au sein d’une même colonne.
Cependant, lorsque cette colonne est ingérée par la fonction QUERY via l’API Google Visualization, le moteur applique une contrainte drastique de normalisation : il analyse les données de la colonne et détermine quel est le type majoritaire (présent à plus de 80 %). Une fois ce verdict posé, toutes les cellules déviant de ce type majoritaire sont purement et simplement converties en valeurs nulles (NULL / vides) lors de l’exécution de la requête. Si une colonne contient 900 nombres et 100 observations textuelles (telles que « Non Déterminé » ou « N/A »), la fonction QUERY retournera des cellules vides pour ces 100 occurrences textuelles, provoquant une perte de données totalement silencieuse.
Pour contrer ce phénomène dévastateur lors de la fusion multi-feuilles :
- Assurez une discipline de codage rigoureuse : si une mesure est manquante, utilisez des encodages numériques conventionnels (comme -999 ou NaN) plutôt que du texte arbitraire si la colonne est majoritairement numérique.
- Si la colonne doit impérativement accueillir des formats hybrides, forcez préventivement l’ensemble de la colonne au format texte brut au moyen de la fonction de formatage ou via l’adjonction d’une apostrophe de préfixe avant la consolidation.
8. Tri, agrégation et regroupement sur des matrices combinées
8.1 Ordonnancement global des ensembles consolidés via ORDER BY
Lorsque des données provenant de multiples partitions sont assemblées dans une matrice virtuelle, l’ordre d’affichage par défaut reflète strictement la hiérarchie spatiale de l’empilement : d’abord tous les enregistrements de la première feuille, puis ceux de la deuxième, et ainsi de suite. Cet ordonnancement segmenté est rarement adapté à une analyse transversale cohérente. La clause ORDER BY permet de restaurer un tri global déterministe sur l’ensemble des données combinées.
La formulation syntaxique s’établit en désignant l’identifiant positionnel cible assorti du modificateur d’orientation : ASC pour un ordonnancement croissant (ordre alphabétique ou valeur numérique ascendante, appliqué par défaut) ou DESC pour un ordonnancement décroissant. Exemple : =QUERY({Nord!A2:D; Sud!A2:D}; « SELECT Col1, Col2, Col3 ORDER BY Col3 DESC »). Ici, les données des deux régions géographiques sont immédiatement fusionnées et reclassées de manière unifiée, du score le plus élevé au score le plus faible.
Le tri peut également être configuré de façon multi-factorielle pour résoudre les égalités sur plusieurs niveaux hiérarchiques. Il suffit de lister les colonnes séparées par des virgules : ORDER BY Col2 ASC, Col3 DESC. Dans ce scénario, les tuples sont d’abord ordonnés par ordre alphabétique de la variable 2 (par exemple le département), puis, au sein de chaque département, classés selon la valeur décroissante de la variable 3. Concernant le comportement des cellules vides (NULL), le standard de l’API Google Visualization les place systématiquement au sommet lors d’un tri ascendant et au bas lors d’un tri descendant, un comportement qu’il convient d’anticiper pour la présentation de vos bilans.
8.2 Calculs statistiques transversaux avec GROUP BY
La puissance analytique véritable de la fonction QUERY s’exprime pleinement lors de l’agrégation de données compartimentées. Plutôt que de consolider passivement des listes d’enregistrements individuels, la clause GROUP BY permet de condenser instantanément des milliers de lignes éparpillées sur plusieurs feuilles en un tableau de synthèse synthétique, exécutant en temps réel des calculs statistiques fondamentaux.
Le moteur supporte l’ensemble des fonctions d’agrégation mathématique du standard SQL :
- SUM(ColN) : Calcule la somme arithmétique globale d’une variable quantitative.
- AVG(ColN) : Établit la moyenne pondérée arithmétique de la variable.
- COUNT(ColN) : Dénombre le nombre d’occurrences non nulles de la variable.
- MAX(ColN) et MIN(ColN) : Extraient respectivement la borne supérieure et la borne inférieure observées.
L’application d’un regroupement obéit à une règle d’intégrité relationnelle universelle : toute colonne figurant dans la clause SELECT qui ne fait pas l’objet d’une fonction d’agrégation doit impérativement figurer dans la clause GROUP BY. Une instruction telle que =QUERY({Semaine1!A2:E; Semaine2!A2:E}; « SELECT Col2, SUM(Col4), AVG(Col5) GROUP BY Col2 ») est parfaitement valide : elle génère un état récapitulatif par catégorie (Col2), calculant pour chacune la somme des volumes de la colonne 4 et la moyenne des performances de la colonne 5 sur l’ensemble combiné des deux semaines d’observation.
8.3 Transformation multidimensionnelle avec la clause PIVOT
Pour hisser la restitution analytique au niveau des tableaux croisés dynamiques institutionnels les plus avancés, l’API met à disposition la clause PIVOT. Cette commande unique permet de transposer les valeurs discrètes d’une colonne qualitative en une série de nouvelles colonnes horizontales, réalisant ainsi une transformation matricielle bidimensionnelle complexe en une ligne de calcul unique.
Considérons la formule : =QUERY({T1!A2:D; T2!A2:D}; « SELECT Col1, SUM(Col3) GROUP BY Col1 PIVOT Col2 »). Dans ce schéma opérationnel :
- Les valeurs uniques de Col1 (par exemple les références de produits) définiront les étiquettes verticales de chaque ligne de sortie.
- Les valeurs distinctes de Col2 (par exemple les canaux de distribution : « Boutique », « En ligne », « Grossiste ») seront automatiquement converties en nouvelles colonnes transversales au sommet du tableau.
- Les cellules à l’intersection des lignes et des colonnes contiendront la somme agrégée des montants de Col3 correspondant précisément à ce croisement factoriel.
L’utilisation combinée de GROUP BY et de PIVOT sur des matrices virtuelles multi-feuilles remplace avantageusement des heures de manipulations fastidieuses via l’outil d’interface graphique de tableau croisé dynamique de Google Sheets, tout en garantissant un rafraîchissement dynamique et automatisé à la moindre mise à jour des onglets de données sources.
9. Interrogation dynamique avec plages ouvertes et exclusion des enregistrements nuls
9.1 Implémentation de plages extensibles non bornées
Dans un contexte opérationnel réel, les feuilles de saisie ne constituent pas des référentiels statiques figés ; elles sont continuellement enrichies par l’adjonction de nouveaux enregistrements au fil des jours, des transactions ou des collectes expérimentales. Définir des plages fermées et rigides (telles que A2:E50) contraindrait l’ingénieur à modifier manuellement la borne d’indexation de sa formule à chaque nouvelle vague d’enregistrement, introduisant un risque élevé d’obsolescence du modèle.
Pour concevoir un pipeline d’ingestion véritablement dynamique, la meilleure pratique consiste à exploiter la syntaxe des plages ouvertes, en omettant délibérément l’indice de fin de ligne. L’assemblage s’écrit alors : {Janvier!A2:D; Fevrier!A2:D}. Grâce à cette notation extensible, chaque nouvelle ligne saisie sur l’un des onglets sources est automatiquement absorbée lors de l’évaluation subséquente de la formule, garantissant une évolutivité totale du tableau de bord sans la moindre intervention humaine de maintenance.
Néanmoins, cette flexibilité architecturale entraîne un effet secondaire redoutable : en ouvrant la plage jusqu’au bas physique de la feuille de calcul (souvent jusqu’à la millième ou dix-millième ligne), la matrice en mémoire intègre des milliers de lignes spectrales totalement vides situées sous les données réelles saisies. Sans précaution particulière, ces enregistrements nuls satureront votre matrice consolidée.
9.2 Filtrage systématique des enregistrements vides avec IS NOT NULL
La présence de ces lignes fantômes au sein de la matrice consolidée a des répercussions immédiates : lors d’un tri ascendant, des centaines de cellules vides sont présentées en premier lieu, reléguant vos données réelles tout en bas de la grille. De plus, les opérations d’agrégation de type COUNT peuvent se retrouver artificiellement faussées. Pour assainir la matrice, l’implémentation de la clause IS NOT NULL est impérative.
La syntaxe canonique d’une requête multi-feuilles dynamique robuste s’énonce ainsi :
=QUERY({S1!A2:E; S2!A2:E}; « SELECT Col1, Col2, Col3 WHERE Col1 IS NOT NULL »)
Le choix de la colonne pivot affectée à ce test est d’une importance capitale : vous devez systématiquement cibler une variable structurellement obligatoire, c’est-à-dire un identifiant unique ou une clé primaire d’enregistrement qui ne peut en aucun cas être vide pour une observation valide. Dès que l’évaluateur rencontre une ligne où Col1 ne contient aucune donnée, cette ligne est instantanément éliminée du flux de traitement. Cette barrière logique permet de combiner la souplesse absolue des plages ouvertes extensibles avec la netteté chirurgicale d’un tableau de données délimité, optimisant par ailleurs la vitesse de calcul en réduisant le volume final de cellules à restituer dans le DOM du navigateur.
9.3 Maintenance d’un modèle d’ingestion robuste et évolutif
Pour assurer la pérennité d’un système décisionnel bâti sur des requêtes multi-feuilles distribuées, la rigueur méthodologique doit s’étendre à la gouvernance globale du classeur. Dans un environnement collaboratif où plusieurs utilisateurs opèrent sur les feuilles sources, le risque qu’un intervenant non averti renomme un onglet, intervertisse deux colonnes ou modifie la structure physique d’une feuille est omniprésent.
Pour immuniser vos modèles de données contre ces aléas opérationnels :
- Verrouillez la géométrie des onglets sources : Utilisez les fonctionnalités de protection des plages de Google Sheets pour interdire l’insertion ou la suppression anarchique de colonnes au sein des feuilles mères par les utilisateurs de saisie.
- Isolez visuellement les cellules maîtresses : Appliquez une convention graphique claire (fond de couleur standardisé, bordures distinctives) et masquez la formule maîtresse sur une feuille de traitement protégée pour éviter toute altération accidentelle du code SQL.
- Documentez explicitement les alias matriciels : Intégrez une note de service ou un commentaire formel au-dessus de la cellule de calcul récapitulant la cartographie des champs (par exemple : « Note : Col1 = Identifiant Patient, Col2 = Âge, Col3 = Pression Artérielle »). Cette précaution garantit qu’un auditeur externe ou un successeur puisse immédiatement appréhender et maintenir la formule sans avoir à déconstruire manuellement chaque composante matricielle du système.
10. Interrogation inter-classeurs : Synergie entre IMPORTRANGE et QUERY
10.1 Extension de l’espace de données au-delà d’un fichier unique
Jusqu’à présent, nous avons examiné la coalescence de structures dispersées au sein d’un même classeur physique. Toutefois, les architectures de systèmes d’information distribués exigent fréquemment de consolider des données hébergées dans des fichiers Google Sheets totalement distincts. Cette séparation physique est indispensable pour fragmenter les droits d’accès confidentiels ou pour contourner les limitations de volume propres à un fichier unitaire. C’est ici que se déploie la synergie remarquable entre la fonction IMPORTRANGE et le moteur QUERY.
La fonction IMPORTRANGE prend deux arguments textuels fondamentaux : l’identifiant URL universel (ou la clé de fichier chiffrée) du classeur distant, et la référence de la plage ciblée au sein de celui-ci. Pour fusionner plusieurs classeurs distants, il suffit d’imbriquer une pluralité d’instructions IMPORTRANGE au sein du constructeur matriciel d’accolades, puis d’encapsuler le tout dans une fonction QUERY :
=QUERY({IMPORTRANGE(« cle_classeur_alpha »; « Donnees!A2:E »); IMPORTRANGE(« cle_classeur_beta »; « Donnees!A2:E »)}; « SELECT Col1, Col2, Col4 WHERE Col1 IS NOT NULL AND Col5 > 0 »; 0)
Il est impératif de noter que la première instanciation d’un appel IMPORTRANGE vers un classeur distant requiert une poignée de main cryptographique d’autorisation. Une fenêtre contextuelle impose au propriétaire du classeur hôte de cliquer sur le bouton « Autoriser l’accès » afin de lier formellement les deux documents. Si vous tentez d’imbriquer directement plusieurs fonctions IMPORTRANGE inédites au sein d’une matrice complexe, la formule globale échouera silencieusement sans afficher le bouton d’autorisation. La règle méthodologique d’or consiste à tester et autoriser individuellement chaque IMPORTRANGE dans des cellules d’essai isolées avant de procéder à leur assemblage définitif au sein de l’instruction QUERY maîtresse.
10.2 Architecture distribuée pour la collecte d’informations multi-sources
L’alliance de QUERY et d’IMPORTRANGE constitue l’épine dorsale d’architectures d’entreprise élégantes et sécurisées, structurées selon le modèle de la topologie en étoile (Hub and Spoke). Prenons l’exemple d’un réseau de cliniques de santé réparties sur l’ensemble d’un territoire national :
- Chaque clinique locale dispose de son propre classeur Google Sheets sécurisé, strictement réservé au personnel soignant régional, garantissant le respect scrupuleux du secret médical et du Règlement Général sur la Protection des Données (RGPD). Les données sensibles d’autres centres ne sont pas physiquement présentes sur le site.
- La direction générale médicale gère un classeur central unifié (le Hub). Ce fichier maître convoque, via un assemblage matriciel d’appels IMPORTRANGE, les extraits anonymisés de l’ensemble des cliniques satellites.
- La fonction QUERY filtre, réordonne et agrège en continu ces flux déportés, restituant un tableau de bord épidémiologique consolidé en temps réel sans jamais donner aux équipes régionales d’accès transversal aux registres de leurs homologues.
Cette approche distribue la charge de calcul, isole physiquement les risques de fausse manipulation et offre un modèle d’une robustesse exceptionnelle face aux pannes ou corruptions locales.
10.3 Comparaison de performance entre consolidation interne et externe
Si la consolidation inter-classeurs via IMPORTRANGE élargit infiniment l’horizon spatial de traitement des données, elle introduit des coûts computationnels et des goulets d’étranglement réseau qu’il convient de jauger avec lucidité :
- Consolidation intra-classeur pure : Le calcul s’exécute intégralement au sein de la mémoire locale allouée au conteneur de données du document. La latence est quasi nulle (de l’ordre de quelques millisecondes), et la fiabilité de rafraîchissement est absolue car aucune dépendance réseau externe n’est convoquée.
- Consolidation inter-classeurs (IMPORTRANGE) : Chaque plage distante requiert un appel HTTPS crypté à travers les micro-services de Google, soumis aux files d’attente réseau et aux mécanismes de cache intermédiaire. Le temps de recalcul global s’en trouve dégradé, oscillant de quelques secondes à plusieurs dizaines de secondes lors de sollicitations volumineuses.
- Vulnérabilité aux ruptures transitoires : Si l’un des classeurs satellites distants subit un ralentissement ponctuel d’évaluation ou une révocation momentanée de droits, l’ensemble de la matrice unifiée globale du Hub peut basculer en statut d’erreur #REF! par contagion transactionnelle.
Il est donc préconisé de limiter l’assemblage matriciel direct d’appels IMPORTRANGE à un maximum raisonnable de cinq à dix classeurs simultanés. Au-delà de ce seuil critique, la mise en place d’une feuille intermédiaire de stockage tampon ou le recours à des scripts d’actualisation asynchrone programmés devient impératif.
11. Diagnostics d’erreurs récurrentes et résolution des anomalies syntaxiques
11.1 Autopsie de l’erreur #VALUE! liée aux incohérences matricielles
L’erreur matérialisée par le drapeau rouge #VALUE! (ou #VALEUR!) constitue l’écueil le plus universellement rencontré lors de la construction de requêtes sur matrices combinées. Lorsque cette anomalie survient, l’infobulle d’aide contextuelle affiche généralement le diagnostic suivant : « Une erreur de tableau littéral s’est produite : les valeurs de ligne n’ont pas la même taille ».
Cette défaillance géométrique découle systématiquement d’une asymétrie dimensionnelle en largeur entre les composantes du tableau littéral. Pour identifier la source exacte de la discordance :
- Déconstruisez visuellement chaque plage insérée entre les accolades d’empilement.
- Vérifiez méticuleusement les lettres de bornage : si la première plage est définie par Feuille1!A2:D (soit 4 colonnes : A, B, C, D) et que la seconde plage est formulée par mégarde Feuille2!A2:E (soit 5 colonnes : A, B, C, D, E), le moteur se trouve dans l’impossibilité physique de juxtaposer verticalement ces deux polygones en un rectangle unifié.
- Dans l’éventualité où la feuille 2 posséderait structurellement une colonne de moins que la feuille 1 et que son schéma physique ne puisse être altéré, l’analyste chevronné peut restaurer l’isomorphisme en insérant une colonne virtuelle factice remplie de chaînes vides. On combinera alors des accolades horizontales à l’intérieur de l’empilement vertical pour égaliser les largeurs : {Feuille1!A2:D; {Feuille2!A2:C INDEX(Feuille2!A2:A; « »)}}.
11.2 Résolution des erreurs d’analyse #ERROR! et de formulation SQL
Le message d’alerte laconique #ERROR! (Erreur d’analyse de formule) signale une violation purement typographique ou lexicale lors de la transmission de l’instruction au processeur de calcul du tableur. Il importe de distinguer deux niveaux distincts d’erreurs d’analyse :
- L’erreur d’analyse du tableur natif : Elle survient lorsque des parenthèses ou des accolades ne sont pas rigoureusement équilibrées (nombre d’ouvrantes différent du nombre de fermantes), ou lorsque le délimiteur d’arguments principal est erroné (utilisation intempestive d’une virgule au lieu d’un point-virgule dans une locale française pour séparer les trois paramètres majeurs de la fonction QUERY).
- L’erreur d’analyse du compilateur SQL Visualization : Elle se produit lorsque le tableur valide l’encapsulation de la fonction, mais que le moteur SQL rejette le texte contenu dans la chaîne de commande (renvoyant une erreur contextuelle détaillée). Les causes les plus fréquentes incluent :
- La tentative anachronique d’utiliser les identifiants alphabétiques (« SELECT A » au lieu de « SELECT Col1 ») sur une source matricielle virtuelle entre accolades.
- Une faute de frappe dans la casse de l’identifiant positionnel (par exemple Col 1 avec espace, ou COL1 en majuscules).
- L’omission d’apostrophes simples autour d’un prédicat textuel dans une clause de filtrage (ex : WHERE Col2 = Paris au lieu de WHERE Col2 = ‘Paris’).
- L’oubli d’échapper une apostrophe réelle contenue dans une chaîne textuelle de filtrage. Si vous cherchez le mot « L’enfant », vous devez dédoubler l’apostrophe ou échapper le caractère sous peine de tronquer prématurément la clause textuelle SQL.
11.3 Gestion des retours vides et traitement par la clause IFERROR
Un comportement parfaitement normal de la fonction QUERY, mais souvent source de panique pour les utilisateurs finaux, réside dans le rejet pur et simple sous forme d’erreur #N/A lorsqu’aucun enregistrement de la matrice source ne valide les conditions restrictives de la clause WHERE. L’infobulle déclare alors froidement : « La requête a renvoyé un résultat vide ».
Dans une optique d’ergonomie et de restitution professionnelle au sein d’un tableau de bord de direction, il est intolérable de laisser prospérer des cellules d’erreur rouge vif dans l’interface visuelle. La solution méthodologique consiste à encapsuler systématiquement l’intégralité de l’instruction d’interrogation au sein de la fonction défensive SI.ERREUR (ou IFERROR) :
=SI.ERREUR(QUERY({Feuille1!A2:C; Feuille2!A2:C}; « SELECT Col1, Col2 WHERE Col3 = ‘Invalide' »); « Aucun enregistrement discordant détecté. »)
Grâce à ce blindage structurel, si la requête relationnelle identifie des anomalies, elle les restitue immédiatement sous forme de tableau ; si aucune anomalie n’existe, l’erreur #N/A est immédiatement interceptée par la fonction englobante, qui injecte en lieu et place une mention textuelle élégante, explicite et rassurante pour l’opérateur.
12. Optimisation cognitive et computationnelle des feuilles de calcul à grande échelle
12.1 Impact de la réévaluation matricielle sur la fluidité logicielle
L’ingénierie des données sur les applications infonuagiques partagées obéit à des lois d’économie de ressources computationnelles rigoureuses. Chaque formule complexe instanciée dans une cellule consomme une fraction de la bande passante processeur accordée par les fermes de serveurs de calcul de Google. La fonction QUERY, en particulier lorsqu’elle opère sur de volumineuses matrices virtuelles combinées, déclenche une charge d’évaluation non négligeable.
Le piège récurrent dans lequel tombent les analystes consiste à multiplier de manière anarchique des dizaines de formules QUERY identiques ou redondantes sur différentes pages de synthèse. Par exemple, instancier une première requête pour extraire les données du Nord, une deuxième pour extraire celles du Sud, et une troisième pour calculer une somme globale, chacune reconstruisant indépendamment la même matrice d’entrée en mémoire vive. Cette prolifération désordonnée multiplie inutilement les cycles de sérialisation et d’instanciation vectorielle.
Pour rationaliser l’arbre de dépendance computationnel du classeur :
- Fondez votre architecture sur le principe de la centralisation unique : n’exécutez qu’une seule consolidation matricielle globale maîtresse vers une table pivot intermédiaire.
- Pointez ensuite l’ensemble de vos formules d’affichage analytique dérivées sur cette table consolidée unitaire, plutôt que de contraindre le processeur à ré-empiler les données brutes sources des dizaines de fois à travers le document.
- Évitez l’introduction d’éléments volatils non contrôlés (tels que la fonction MAINTENANT() ou AUJOURDHUI()) au sein de la chaîne de requête, car leur instanciation entraîne une réévaluation permanente et ininterrompue de l’intégralité du modèle matriciel à chaque mouvement de curseur d’un utilisateur connecté.
12.2 Bonnes pratiques ergonomiques pour la conception de classeurs institutionnels
L’excellence en matière de développement de classeurs institutionnels ne se mesure pas uniquement à l’ingéniosité des formules employées, mais avant tout à la maintenabilité et à la lisibilité de l’écosystème pour les équipes de collaborateurs. Pour élever vos productions aux meilleurs standards de l’ingénierie logicielle, nous préconisons la mise en place d’une ségrégation méthodologique stricte en trois couches étanches :
- La couche d’ingestion (Input Layer) : Composée exclusivement des onglets réservés à la collecte et à la saisie des données brutes par les opérateurs ou les automates de collecte. Aucun calcul complexe, aucune requête matricielle ne doit résider sur ces pages. Les en-têtes sont figés, documentés et protégés en écriture.
- La couche de transformation (Processing Layer) : Hébergée sur des onglets dédiés, fréquemment masqués aux regards des utilisateurs novices. C’est ici que sont logées les formules QUERY de consolidation transversale, d’assainissement et de calculs matriciels intermédiaires.
- La couche de restitution (Presentation Layer) : Dévolue aux tableaux de bord de synthèse, aux visualisations graphiques et aux rapports de direction. Cette couche lit exclusivement les sorties produites par la couche de transformation, offrant une interface épurée, sécurisée et ergonomique.
Parallèlement, imposez une convention de nommage typographique standardisée et immuable pour les onglets sources : bannissez impérativement les caractères spéciaux, les accents complexes ou les espaces superflus dans le libellé des onglets (préférez Data_2024_Q1 à Données du 1er Trimestre !!). Cette sobriété prévient les erreurs de parsing d’apostrophes d’échappement lors de la rédaction de vos plages matricielles.
12.3 Alternatives et solutions complémentaires pour les volumes massifs
Bien que la fonction QUERY combinée à l’empilement matriciel offre une flexibilité sans égale pour la plupart des projets décisionnels courants, l’analyste chevronné se doit de reconnaître avec discernement les frontières architecturales de l’environnement Google Sheets. L’application est structurellement bridée par un plafond absolu de dix millions de cellules par document, et commence à manifester des signes tangibles de ralentissement dès que les matrices virtuelles en mémoire manipulent des centaines de milliers de points de données simultanés.
Lorsque ces limites de saturation sont atteintes, il convient de basculer vers des paradigmes technologiques complémentaires plus robustes :
- Google Apps Script : L’environnement d’automatisation basé sur JavaScript permet de programmer des routines d’ingestion par lots (batch processing) s’exécutant de manière asynchrone la nuit. Le script lit les différentes feuilles, effectue la fusion et les agrégations de manière programmatique, et injecte directement les valeurs statiques résultantes dans la feuille cible, supprimant l’intégralité de la charge de calcul dynamique en temps réel supportée par les formules.
- Connecteurs BigQuery et bases SQL relationnelles : Pour les organisations manipulant des volumes de données excédant les dizaines de millions d’enregistrements, la transition vers l’entrepôt de données infonuagique Google BigQuery via les Feuilles connectées (Connected Sheets) représente la démarche canonique. La logique déclarative SQL acquise sur la fonction QUERY se transpose alors directement à une échelle pétabytaire sans modifier les interfaces de restitution familières des décideurs.
En synthèse, la maîtrise de l’interrogation multi-feuilles par la fonction QUERY transcende le simple savoir-faire technique bureautique : elle constitue le véritable pivot méthodologique permettant de transformer un simple tableur collaboratif en un système relationnel puissant, agile et pérenne, garantissant l’intégrité et la clarté analytique de vos modèles d’information organisationnels les plus exigeants.
Références
- Google. (s. d.). Fonction QUERY : Référence officielle de l’aide Google Docs. Centre d’aide Google. Consulté le 24 octobre 2023, sur https://support.google.com/docs/answer/3093197
- Google Developers. (2023). Google Visualization API Query Language (Version 0.7). Google Cloud Platform. Consulté le 15 novembre 2023, sur https://developers.google.com/chart/interactive/docs/query_language
- Google. (s. d.). Utilisation des tableaux dans Google Sheets (Array Literals). Centre d’aide Google. Consulté le 12 décembre 2023, sur https://support.google.com/docs/answer/6208276
- Google. (s. d.). Fonction IMPORTRANGE : Importation de données depuis une autre feuille de calcul. Centre d’aide Google. Consulté le 8 janvier 2024, sur https://support.google.com/docs/answer/3093340
- International Organization for Standardization. (2016). Information technology — Database languages — SQL — Part 2: Foundation (SQL/Foundation) (Norme ISO/IEC n° 9075-2:2016). ISO. https://www.iso.org/standard/63555.html
- PostgreSQL Global Development Group. (2023). PostgreSQL 16.0 Documentation. PostgreSQL Documentation Project. Consulté le 5 février 2024, sur https://www.postgresql.org/docs/16/
- Google Cloud. (2024). Présentation de BigQuery : Entrepôt de données d’entreprise hautement évolutif. Google Cloud Documentation. Consulté le 14 mars 2024, sur https://cloud.google.com/bigquery/docs/introduction
- Friedl, J. E. (2006). Mastering Regular Expressions (3e éd.). O’Reilly Media.