
L’avènement des environnements infonuagiques collaboratifs a profondément métamorphosé les pratiques d’analyse exploratoire et de restitution de données au sein des organisations contemporaines. Parmi ces outils, Google Sheets s’est imposé comme un vecteur d’agilité décisionnelle, démocratisant l’accès à des calculs matriciels complexes autrefois réservés à des logiciels statistiques dédiés ou à des progiciels de gestion intégrés lourds. Au cœur de cet écosystème fonctionnel réside le tableau croisé dynamique, véritable passerelle computationnelle capable de condenser des dizaines de milliers d’enregistrements bruts en une structure synthétique intelligible. Toutefois, la simple génération d’une telle matrice bidimensionnelle ne constitue que la première phase d’un processus d’intellection beaucoup plus vaste : sans une mise en forme sémiotique, typographique et chromatique rigoureuse, la donnée condensée demeure un agrégat hostile à la perception cognitive humaine.
Le formatage d’un tableau croisé dynamique ne relève aucunement d’un artifice esthétique superficiel ou d’une coquetterie de présentation ; il participe directement de l’ingénierie cognitive et de la sémiologie graphique. Dans un contexte où les décideurs sont confrontés à une saturation informationnelle chronique, l’architecture visuelle du rapport tabulaire doit fonctionner comme un filtre de clarification intellectuelle. Chaque tracé de bordure, chaque modulation de contraste chromatique, chaque choix d’alignement spatial et chaque arrondi décimal influent de manière mesurable sur la charge mentale imposée au lecteur. Un tableau mal configuré engendre des phénomènes d’interférence cognitive, ralentit l’identification des points de bascule opérationnels et induit des risques d’interprétation erronée susceptibles de compromettre des orientations stratégiques majeures.
Le présent traité méthodologique expose un protocole exhaustif, pas-à-pas, destiné à transformer une instance matricielle brute dans Google Sheets en un artefact d’aide à la décision hautement standardisé, ergonomique et visuellement irréprochable. En articulant les impératifs techniques propres au moteur de calcul de la plateforme californienne avec les principes fondamentaux de la psychologie de la perception et du design d’information, ce guide propose un cheminement structural complet. De la normalisation hygiénique du schéma relationnel sous-jacent jusqu’à l’automatisation du style via des scripts d’entreprise, l’analyste découvrira ici les clefs pour convertir l’opacité quantitative en une architecture de clarté décisionnelle.
1. Introduction méthodologique aux tableaux croisés dynamiques et à l’ergonomie cognitive
1.1 Fondements conceptuels de l’agrégation de données dans Google Sheets
L’agrégation de données au moyen d’une table de contingence multidimensionnelle repose sur une opération formelle de réduction d’orthogonalité. Dans son état brut, un jeu de données relationnel se présente sous la forme d’une matrice de microdonnées dans laquelle chaque ligne représente une observation discrète et chaque colonne un attribut variable. Si cette organisation canonique est idéale pour le traitement séquentiel et les requêtes par bases de données relationnelles, elle se révèle parfaitement inadaptée à la perception humaine dès lors que l’échantillon excède quelques dizaines d’occurrences. Le tableau croisé dynamique opère ainsi une projection vectorielle : il projette les attributs catégoriels selon deux axes perpendiculaires (les dimensions de ligne et les dimensions de colonne) et applique à leur intersection une fonction mathématique réductrice (somme, moyenne arithmétique, comptage d’occurrences, variance empirique ou médiane).
L’avantage fonctionnel cardinal de cette architecture réside dans son caractère non destructif. Contrairement à des formules d’extraction manuelle matricielle telles que SUMIFS ou QUERY qui peuvent altérer la structure du feuillet en cas de manipulation inadéquate, le moteur de tableau croisé dynamique de Google Sheets maintient un découplage absolu entre la mémoire persistante de la source et la couche de visualisation dynamique. Cette indépendance transactionnelle permet à l’analyste de réorganiser, permuter, imbriquer ou masquer des dimensions sans jamais corrompre la traçabilité des observations primaires, favorisant ainsi une exploration heuristique itérative.
Ce processus de synthèse multidimensionnelle concrétise la transition critique du paradigme de la donnée brute vers celui de l’information structurée. Là où la donnée n’est qu’une collection de faits désincarnés dépourvus de contexte sémantique, l’information émerge de la mise en relation des variables et de la contextualisation de leurs fréquences relatives. Dans les environnements organisationnels modernes, cette étape intermédiaire constitue le prérequis indispensable à l’élaboration du savoir opérationnel et de la décision stratégique, conférant au tableau croisé une responsabilité épistémologique majeure.
1.2 La théorie de la charge cognitive appliquée à la mise en forme tabulaire
La transmission efficace de l’information quantitative est régie par la théorie de la charge cognitive formulée par John Sweller, laquelle postule que la mémoire de travail humaine dispose d’une capacité de traitement intrinsèquement limitée. Dans le cadre de la lecture d’une matrice tabulaire, trois charges coexistent : la charge intrinsèque (inhérente à la complexité des concepts mathématiques ou économiques représentés), la charge essentielle (consacrée à la construction mentale de schémas logiques par l’analyste) et la charge extrinsèque (induite par la manière dont l’information est mise en page et présentée). Tout défaut d’agencement visuel—qu’il s’agisse d’un contraste criard, d’un quadrillage agressif ou d’une désorganisation typographique—gonfle artificiellement la charge extrinsèque au détriment direct des ressources cérébrales allouées à la compréhension stratégique.
Pour juguler cette déperdition cognitive, l’analyste doit mobiliser les lois de la Gestalt, une branche de la psychologie de la forme théorisée au début du XXe siècle par des figures comme Max Wertheimer et Kurt Koffka. Dans une grille de calculs, la loi de proximité exige que les indicateurs fonctionnellement interdépendants soient regroupés dans un même espace topologique délimité, tandis que la loi de similarité prescrit qu’à des données de même nature sémantique (par exemple, des pourcentages de marge bénéficiaire) soient appliqués des attributs morphologiques identiques (police, corps, couleur). La loi de continuité et celle de clôture guident quant à elles le tracé parcimonieux des lignes séparatrices, assurant que l’œil du réviseur circule le long des vecteurs horizontaux et verticaux sans buter sur des artefacts graphiques discordants.
Enfin, l’ancrage visuel structurel joue un rôle primordial dans l’atténuation des biais d’interprétation quantitative. Lorsqu’un lecteur aborde un tableau complexe, son regard est spontanément capté par les zones de forte luminance, les masses textuelles imposantes ou les irrégularités de contour. Si ces points de fixation optique ne coïncident pas précisément avec les centres de gravité informationnels de la matrice (les totaux généraux, les seuils critiques de rupture ou les ratios d’alerte), le jugement cognitif est dévié vers des éléments secondaires, induisant un biais de focalisation délétère. Le formatage rigoureux devient ainsi le garant de la fidélité interprétative de l’observateur.
1.3 Objectifs didactiques du protocole de formatage pas-à-pas
L’ambition de ce document est d’établir une norme opératoire standardisée, reproductible et scientifiquement articulée pour la mise en forme des synthèses de données dans l’environnement applicatif Google Sheets. Trop souvent, la finalisation stylistique d’un rapport est abandonnée à l’arbitraire subjectif, aux humeurs chromatiques de l’opérateur ou aux réglages par défaut de la plateforme, qui brillent par leur neutralité aseptisée mais manquent cruellement de raffinement ergonomique. En formalisant une progression méthodique séquentielle, ce guide fournit aux auditeurs, contrôleurs de gestion, ingénieurs d’affaires et scientifiques de données une grille de référence industrielle.
L’adoption d’un tel protocole se traduit immédiatement par une compression mesurable du délai d’extraction cognitive de l’information. Des métriques clés telles que le temps de première fixation sur l’écart budgétaire, la précision d’identification d’une valeur aberrante ou le taux d’erreur dans l’association d’une grandeur à sa modalité catégorielle se trouvent optimisées de manière significative. Le gain d’efficience temporelle pour les comités de direction ou les équipes d’audit se chiffre en dizaines d’heures annuelles à l’échelle d’un département analytique.
Le périmètre méthodologique investigué ici dépasse la simple manipulation des options graphiques de surface. Il englobe la préparation amont des structures tabulaires, la mécanique interne du compilateur de pivot de Google Sheets, l’application rationnelle de palettes chromatiques conformes aux standards d’accessibilité visuelle, la modélisation mathématique de dimensions dérivées et le contrôle programmatique via Google Apps Script. Ce protocole se veut un pont entre la science des données et la communication visuelle de haut niveau.
2. Étape 1 : Préparation rigoureuse et structuration du jeu de données source
2.1 Normalisation de la structure tabulaire primaire
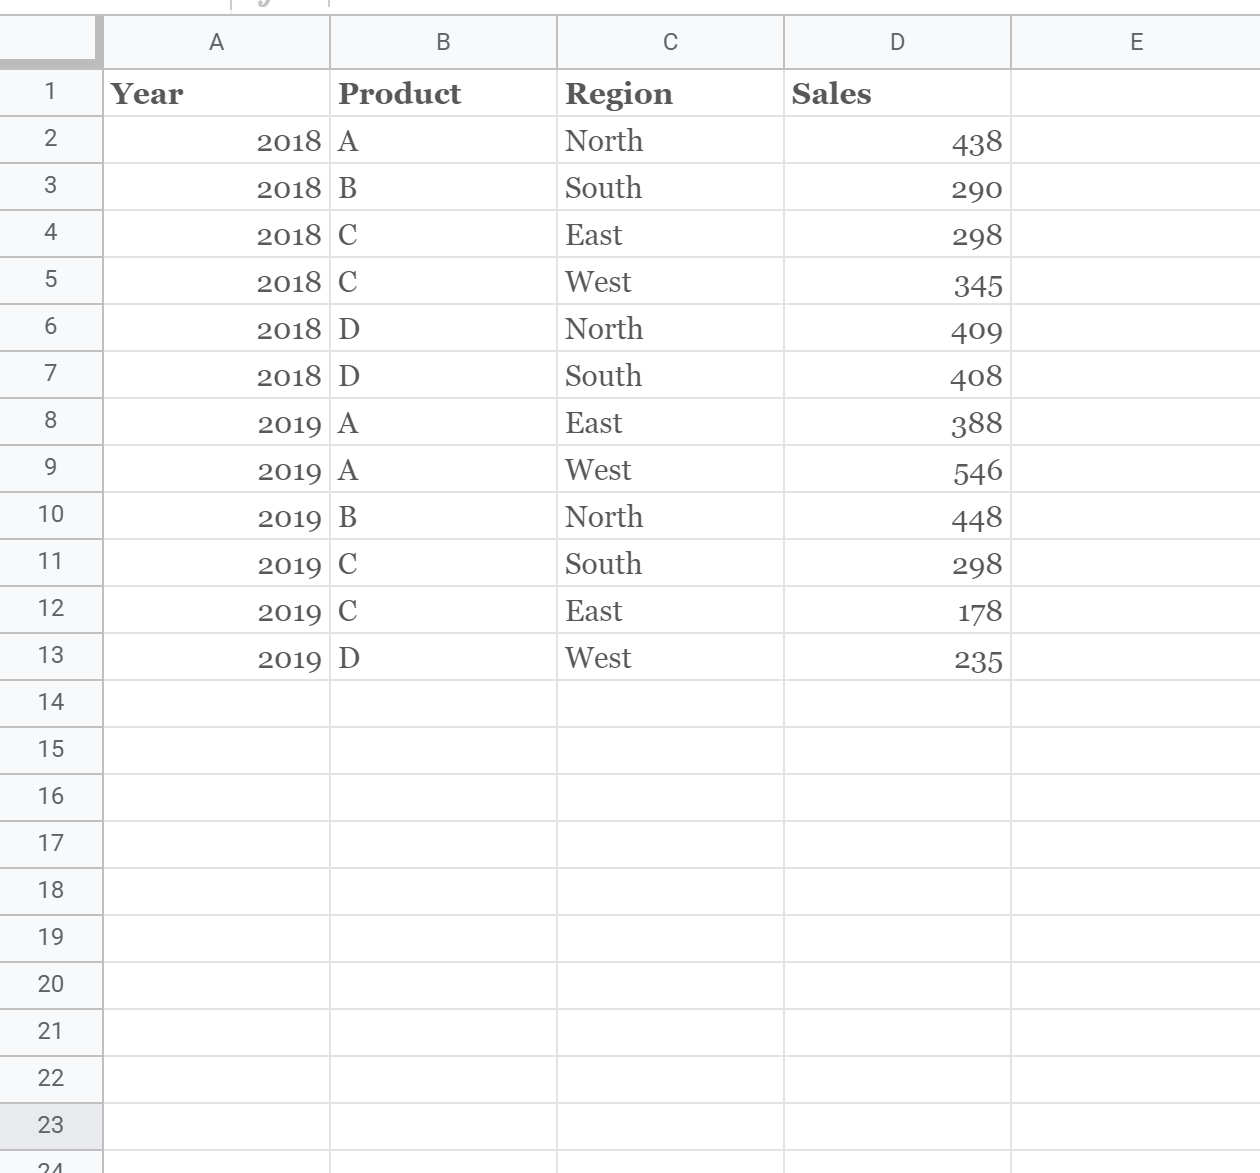
L’adage informatique « Garbage in, garbage out » trouve une résonance particulièrement vive dans la génération des tableaux croisés dynamiques. Avant même d’activer le moindre composant de calcul matriciel, l’analyste doit impérativement auditer l’architecture de la feuille d’enregistrement primaire. Celle-ci doit se conformer de manière intransigeante aux préceptes de la première forme normale des bases de données relationnelles telle que définie par Edgar F. Codd. Concrètement, la première ligne du classeur doit être réservée exclusivement aux en-têtes de colonnes, lesquels doivent porter des étiquettes canoniques uniques, concises et sémantiquement transparentes, proscrivant formellement l’usage de synonymes ambigus ou de cases laissées vierges.
L’un des obstacles les plus invalidants réside dans la présence de cellules fusionnées au sein de la plage source. Bien que fréquemment exploitées dans les modèles comptables manuels pour des raisons de mise en page décorative, les cellules fusionnées détruisent la régularité indicielle de la matrice sous-jacente. Pour l’interpréteur de Google Sheets, seule la cellule supérieure gauche d’une fusion héberge la valeur réelle, les autres étant considérées comme nulles. Cela provoque une fragmentation dévastatrice lors des opérations d’indexation et de regroupement, fragmentant les données sous des étiquettes artificielles vides. Toutes les fusions de cellules doivent donc être déconstruites sans exception.
De surcroît, la matrice de données doit être purgée de toute ligne de totalisation intermédiaire ou de ligne de rupture vide introduite pour aérer artificiellement la lecture humaine. Le tableau source est un espace computationnel réservé à la machine, non un tableau de bord destiné à la consultation finale. Chaque ligne doit correspondre à une observation unitaire irréductible, et la granularité temporelle ou spatiale doit demeurer parfaitement homogène d’un bout à l’autre du registre.
2.2 Typologie et cohérence des variables sous-jacentes
La robustesse d’un tableau croisé dynamique dépend directement de la propreté ontologique des variables mobilisées. Celles-ci se scindent fondamentalement en deux familles : les dimensions qualitatives (ou attributs discrets de classification, comme une région, un canal d’acquisition ou une catégorie de produit) et les métriques quantitatives continues ou scalaires (comme un chiffre d’affaires hors taxes, un coût marginal ou un volume de transaction). Tout brouillage entre ces deux typologies compromet le comportement des fonctions d’agrégation de la feuille de calcul.
Une pathologie récurrente dans Google Sheets concerne l’hétérogénéité des types de données au sein d’une même colonne. L’insertion accidentelle d’un caractère alphanumérique ou d’une espace insécable dans une colonne censée héberger des valeurs flottantes entraîne une conversion implicite de la cellule au format texte par le moteur de parsing. Dès lors, lorsqu’une fonction d’agrégation arithmétique comme SOMME est assignée à ce champ dans le tableau croisé dynamique, les occurrences textuelles sont purement et simplement ignorées ou traitées comme des zéros, faussant subrepticement l’exactitude comptable de la synthèse.
De même, la manipulation de chaînes de caractères exige une discipline d’uniformisation drastique. Les variations lexicales mineures—qu’il s’agisse d’une divergence de casse (ex. « France », « france », « FRANCE »), d’une espace finale superflue ou d’accents omis—sont interprétées par l’algorithme d’indexation comme des modalités catégorielles distinctes. L’application préventive de fonctions telles que SUPPRESPACE, MAJUSCULE ou PROPRE est essentielle pour prémunir le tableau croisé contre une prolifération anormale de lignes et de colonnes orphelines.
2.3 Nettoyage préventif et traitement des valeurs manquantes
L’absence de données constitue une source majeure de dégradation visuelle et fonctionnelle dans un tableau de contingence. Lorsqu’une cellule source est laissée vide, le tableau croisé dynamique de Google Sheets tend à générer une ligne ou une colonne affublée de l’étiquette (vide), laquelle dégrade immédiatement le prestige visuel du rapport et complique la lecture des hiérarchies. L’analyste méthodique se doit donc d’appliquer une politique explicite d’imputation ou d’exclusion avant de générer le rapport final.
Selon les exigences analytiques du domaine d’application, deux stratégies d’imputation prévalent : le remplacement des valeurs scalaires manquantes par une valeur neutre conventionnelle (typiquement le chiffre zéro pour les métriques additives) ou l’attribution explicite d’une étiquette qualitative standardisée telle que « Non documenté », « Non applicable » ou « Indéterminé ». Ce traitement peut être automatisé au sein de la plage source en exploitant les formules matricielles IFBLANK ou des fonctions logiques conditionnelles. Cette démarche élimine radicalement l’apparition de groupements informes lors du pivotement.
Enfin, la vérification de l’intégrité référentielle impose la purge des doublons stochastiques résultant d’erreurs de saisie ou d’extractions redondantes depuis des systèmes tiers. L’outil natif de suppression des doublons de Google Sheets ou l’invocation de la formule UNIQUE au sein d’une feuille de préparation intermédiaire permet d’assainir la population statistique. Ce n’est qu’au terme de ce méticuleux travail d’hygiène relationnelle que la table brute peut être qualifiée de prête pour le processus d’instanciation dynamique.
3. Étape 2 : Génération matricielle et configuration de l’éditeur de tableau
3.1 Sélection de la plage et initialisation de l’instance dynamique
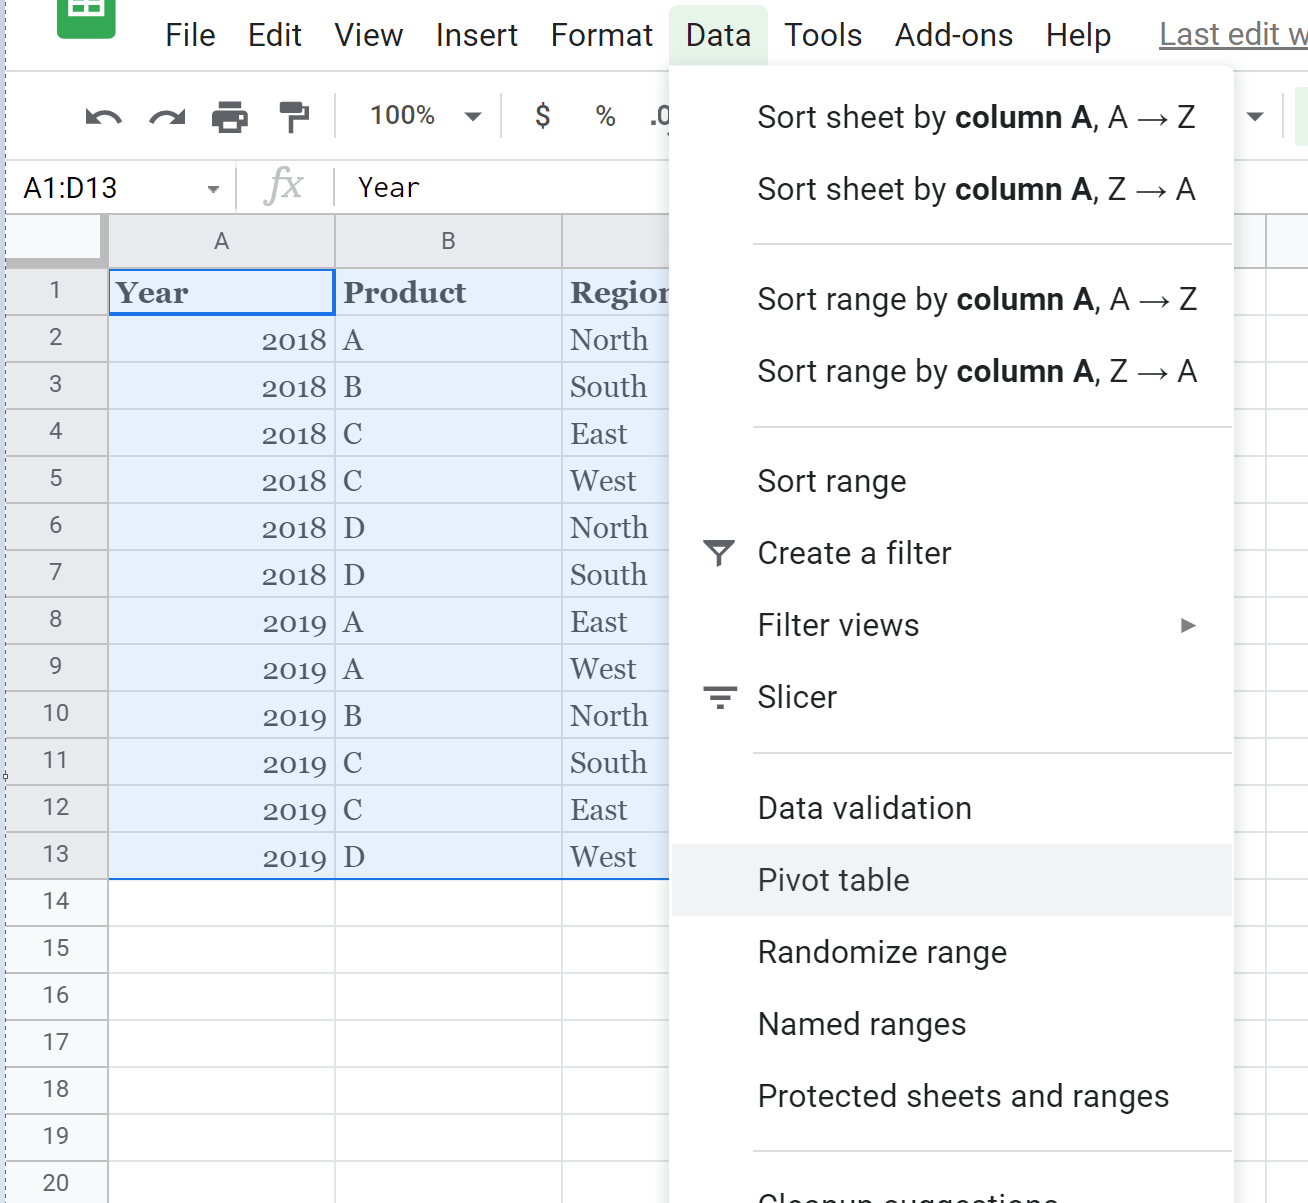
Pour garantir la pérennité architecturale d’un tableau croisé dynamique face à l’expansion future des flux de données, il est rigoureusement déconseillé de baser l’agrégation sur une sélection rectangulaire statique fermée de type A1:G150. Dans une structure organisationnelle vivante, de nouvelles transactions sont insérées quotidiennement ; une plage statique contraindrait l’analyste à redéfinir manuellement les coordonnées de référence à chaque mise à jour, avec le risque critique d’omettre des pans entiers de l’échantillon. Il convient impérativement d’adopter des plages ouvertes, par exemple A1:G, ou, de manière encore plus robuste, de convertir la source en une plage nommée via le menu Données > Plages nommées.
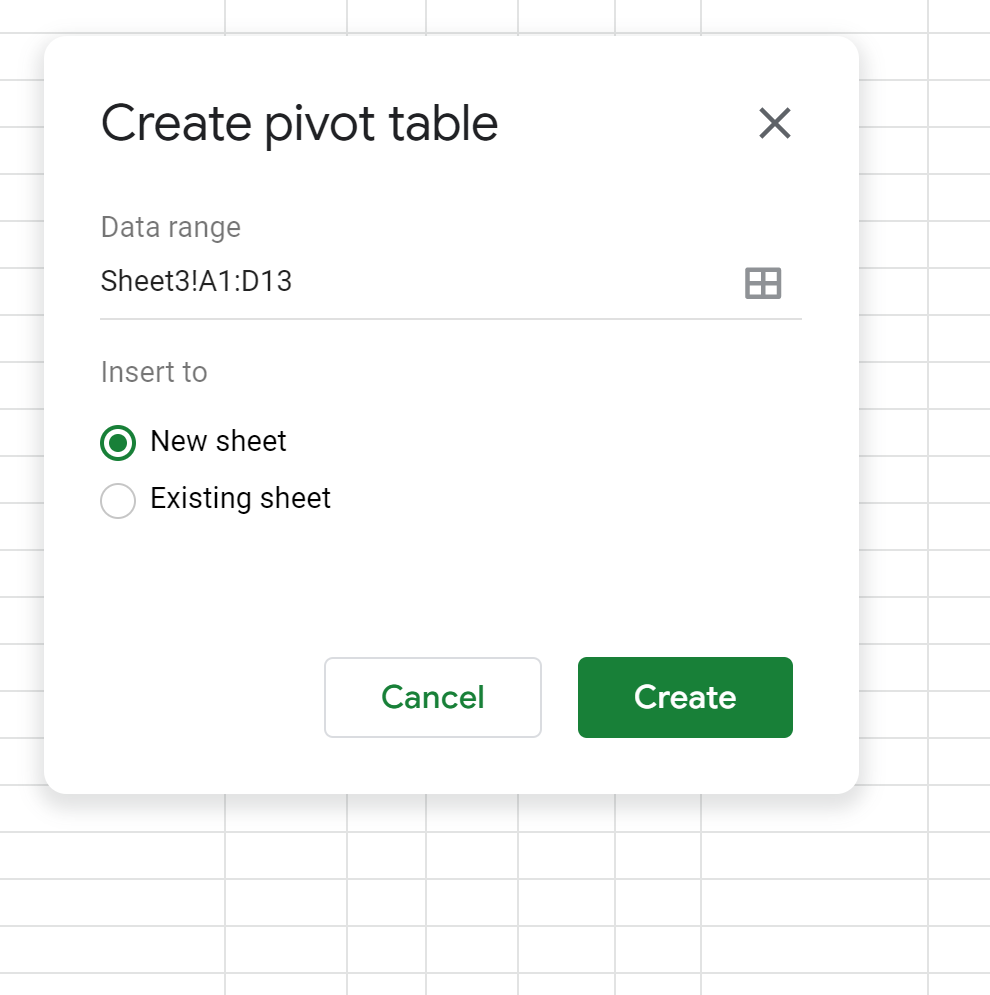
L’initialisation de l’instance s’effectue en accédant au ruban supérieur via Insertion > Tableau croisé dynamique. À cette étape, l’environnement applicatif soumet un arbitrage architectural décisif : l’implantation de la nouvelle table sur la feuille active courante ou sur un onglet vierge dédié. Sauf impératif de confrontation visuelle directe sur un micro-échantillon, la bonne pratique de modélisation préconise l’isolation absolue du tableau dynamique sur un onglet indépendant.
Cette ségrégation topologique répond à un principe d’étanchéité opérationnelle. Un tableau croisé dynamique est une entité élastique dont les dimensions varient intrinsèquement en fonction des filtres appliqués et de la cardinalité des données amont. En hébergeant l’instance dynamique sur un onglet autonome, l’analyste écarte tout risque d’écrasement accidentel de cellules tierces ou de collisions spatiales dommageables, tout en offrant une liberté totale pour la scénographie graphique ultérieure.
3.2 Architecture fonctionnelle de l’éditeur latéral
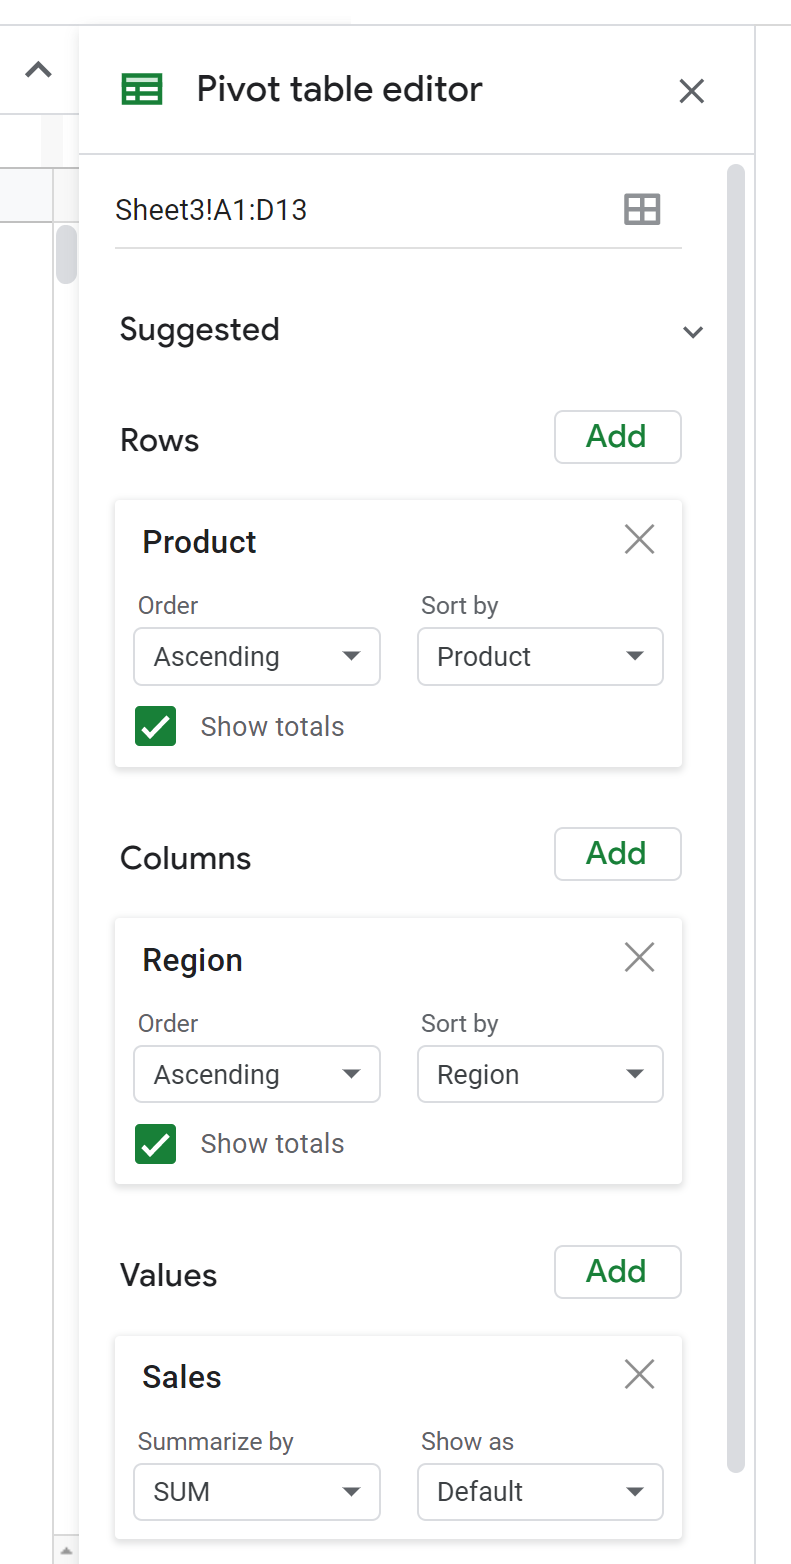
Dès l’instanciation de la matrice, le panneau de configuration latéral s’ouvre sur le flanc droit de l’interface Google Sheets. Ce module d’ingénierie visuelle se subdivise en quatre compartiments fonctionnels cardinaux : Lignes, Colonnes, Valeurs et Filtres. La distribution judicieuse des dimensions entre ces quadrants conditionne non seulement la complexité de calcul, mais détermine également l’intelligibilité immédiate de la synthèse pour l’observateur humain.
La règle sémiotique élémentaire dicte d’allouer à l’axe des Lignes les dimensions présentant la cardinalité la plus élevée ou possédant un ordre séquentiel naturel (comme une hiérarchie géographique ou une liste étendue de nomenclatures de produits). L’œil humain possède une capacité d’exploration verticale assistée par le défilement bien supérieure à sa capacité de balayage horizontal. L’axe des Colonnes doit quant à lui être réservé aux attributs catégoriels à faible dispersion discrète, tels que les trimestres d’un exercice comptable, les statuts de validation d’un flux de travail ou des segments démographiques restreints (rarement plus de quatre ou cinq modalités).
Dans l’espace réservé aux Valeurs, le choix de la métrique s’accompagne impérativement de la sélection de l’opérateur d’agrégation congruent. Si la fonction SUM demeure l’option par défaut pour les grandeurs monétaires ou volumétriques additives, les indicateurs d’intensité, d’âge moyen ou de ratios tarifaires imposent l’emploi de AVERAGE, voire de MEDIAN lorsque la distribution statistique présente une forte asymétrie. L’agencement des champs au sein de chaque quadrant s’effectue par glisser-déposer, l’ordre relatif d’empilement définissant la hiérarchie d’imbrication arborescente des dimensions.
3.3 Visualisation de l’état brut préliminaire avant mise en forme
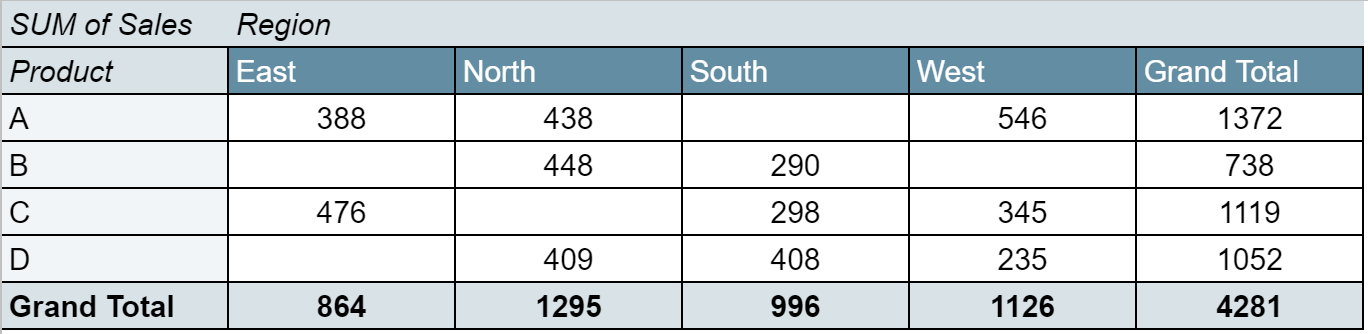
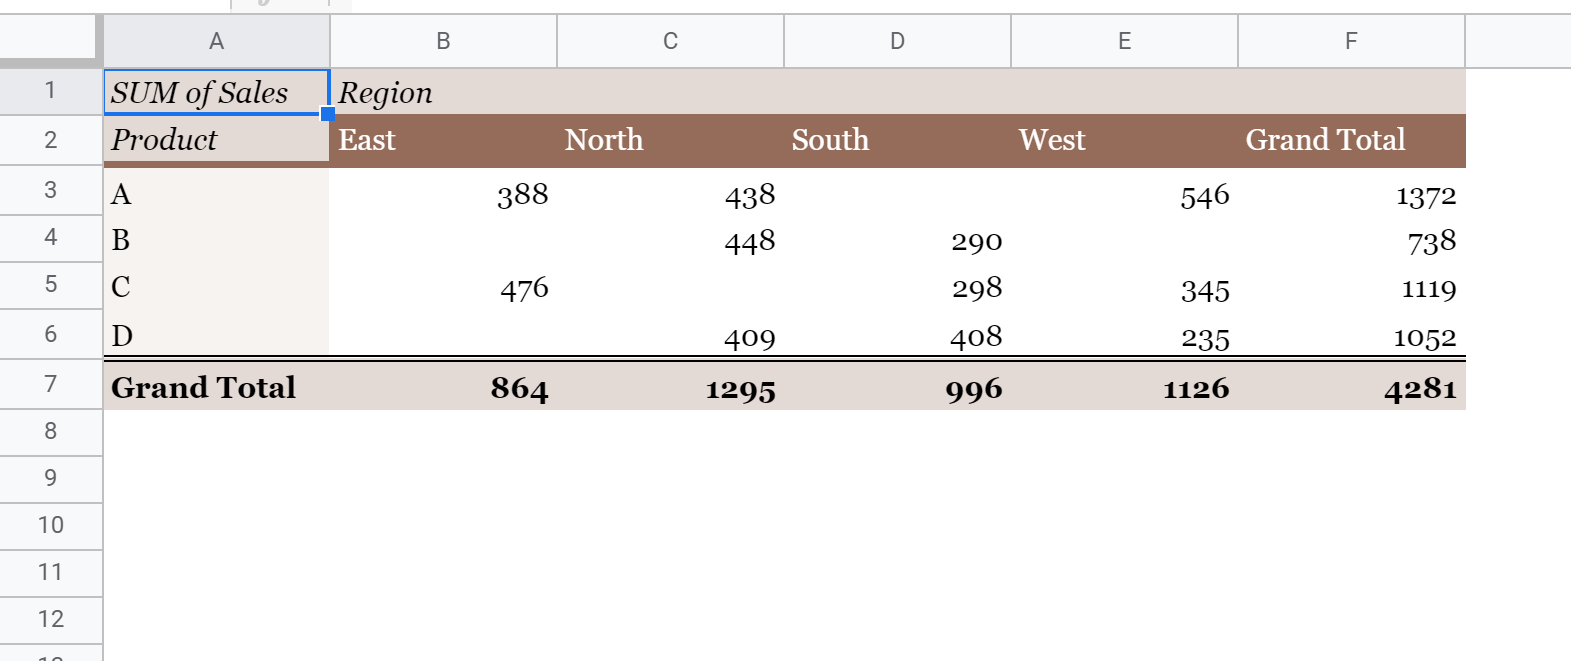
À l’issue de cette configuration structurelle préliminaire, Google Sheets génère une projection matricielle brute dont l’apparence par défaut souligne cruellement l’absence de visée éditoriale. Cette vue primaire constitue le point de départ de notre démarche de réhabilitation ergonomique. L’analyste consciencieux doit poser un diagnostic clinique précis sur cet état brut pour inventorier l’ensemble des ruptures visuelles qui altèrent le confort de lecture.
Le premier défaut manifeste réside dans la rigidité des alignements par défaut : les libellés de lignes sont plaqués contre la bordure gauche sans marge interne protectrice, tandis que les données scalaires sont renvoyées à droite avec un nombre discordant de décimales flottantes. Les étiquettes générées automatiquement héritent mécaniquement de préfixes computationnels inélégants (tels que « Somme de Chiffre d’Affaires » ou « Nombre de Identifiant Client »), qui alourdissent inutilement la surface textuelle sans apporter de valeur herméneutique additionnelle.
De plus, l’absence de distinction tonale entre les lignes de détail et les lignes de totalisation crée une monotonie typographique où l’œil de l’observateur se perd, incapable d’isoler instantanément les centres de gravité décisionnels. Les contrastes de contours fournis par le thème générique du logiciel manquent d’affirmation hiérarchique. Cette vue préliminaire matérialise l’état d’entropie informationnelle que le protocole de mise en forme subséquent a précisément pour mission d’éradiquer.
4. Étape 3 : Application et personnalisation avancée des thèmes chromatiques
4.1 Psychologie des couleurs et perception des contrastes
L’introduction de pigments colorés au sein d’un document d’entreprise n’obéit pas à des considérations artistiques désincarnées, mais à des principes neurophysiologiques stricts régissant la perception visuelle. Selon la théorie de la vision formulée dans le cadre de la colorimétrie moderne, la rétine humaine interprète les formes à travers des canaux distincts de luminance et de chrominance. Les disparités de luminance constituent le facteur fondamental de la netteté et de la reconnaissance des caractères alphanumériques. Par conséquent, toute sélection chromatique doit garantir un ratio de contraste rigoureusement calibré entre le texte informatif et le fond de la cellule.
Les recommandations internationales d’accessibilité, à l’instar des Web Content Accessibility Guidelines (WCAG 2.1) développées par le W3C, préconisent un ratio de contraste minimal de 4,5:1 pour le texte de taille courante afin de prévenir toute fatigue oculaire prématurée et d’assurer une lisibilité optimale aux observateurs souffrant de déficiences perceptives (dyschromatopsies). Dans l’univers de la présentation tabulaire, les fonds d’en-tête saturés de couleurs primaires vives créent un phénomène de parasitage sensoriel connu sous le nom de vibration chromatique, qui perturbe l’attention de l’analyste.
Il est donc méthodologiquement impératif de privilégier des tons feutrés, des teintes désaturées et des variations harmonieuses de gris ardoise, d’anthracite, de bleus minéraux ou de nuances sablonneuses. Ces palettes neutres permettent de concevoir un cadre reposant où la couleur pure est rare, précieuse et réservée exclusivement à l’alerte contextuelle ou à l’identification immédiate de points nodaux dans l’architecture de la matrice.
4.2 Sélection et application des thèmes prédéfinis
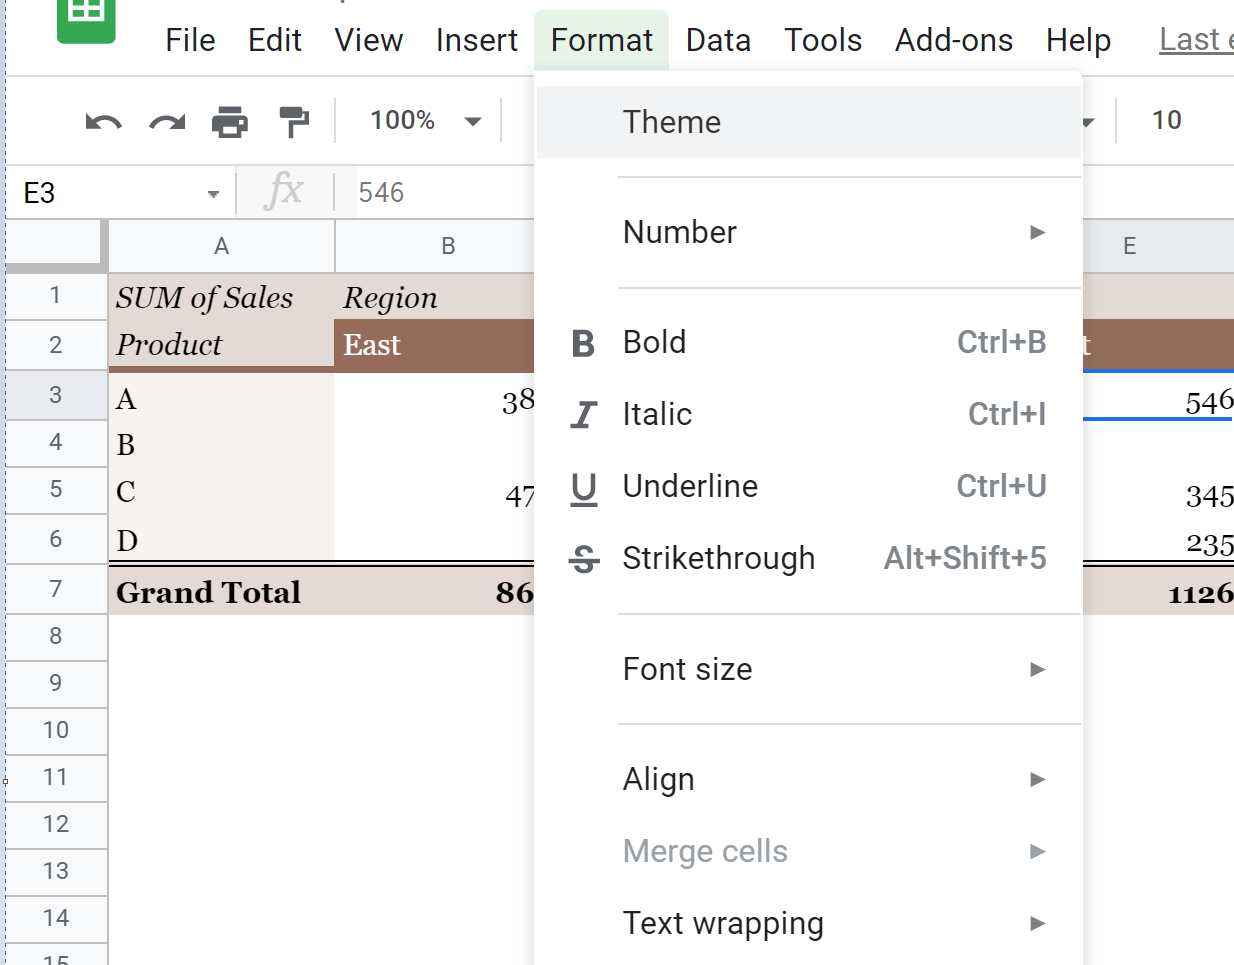
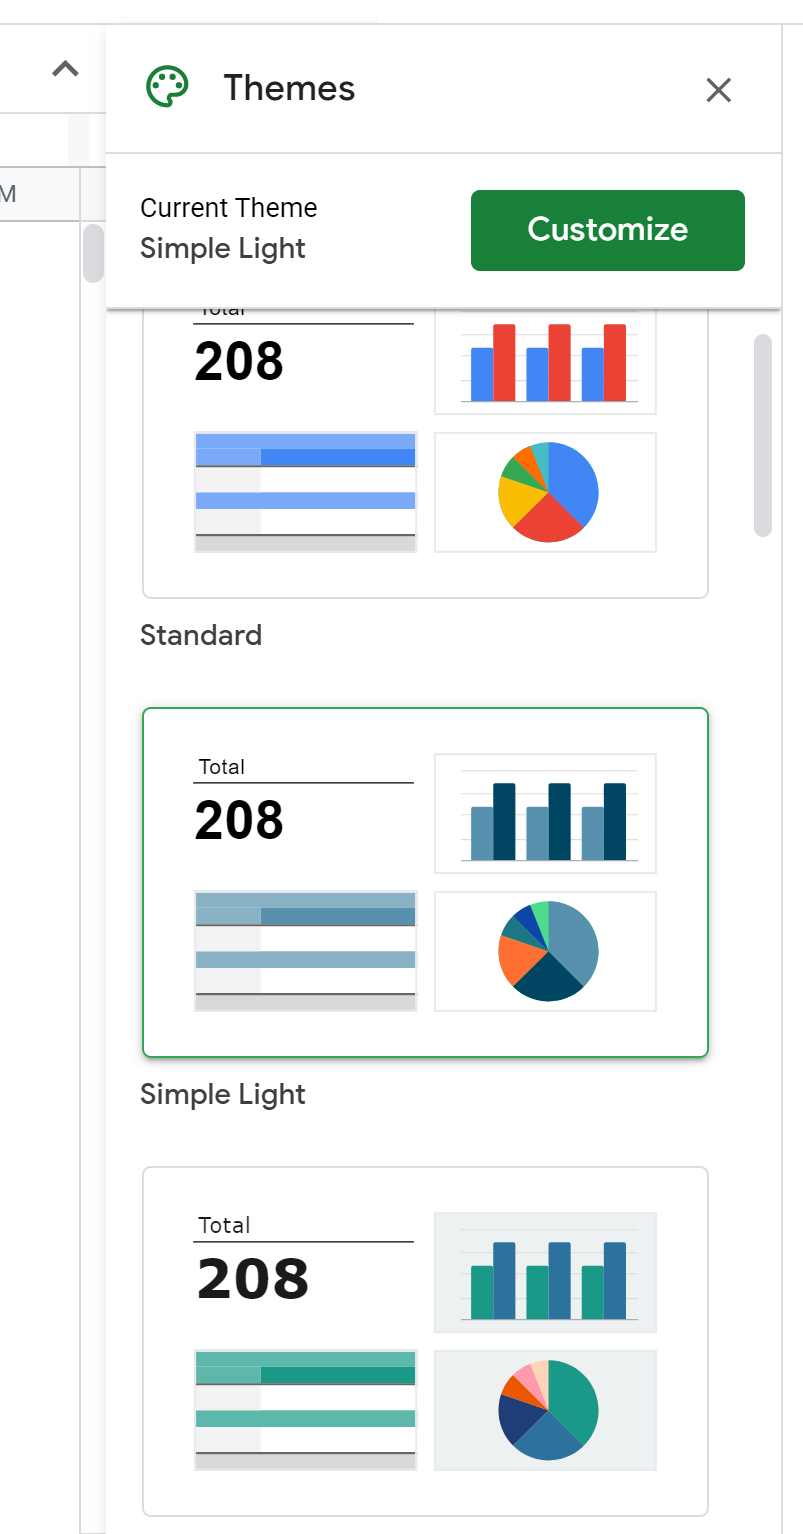
Google Sheets intègre un moteur de styles systémiques accessible via le menu supérieur Format > Thème. Ce panneau déploie une bibliothèque de styles standardisés préconçus, harmonisant automatiquement les polices de caractères, les teintes dominantes des graphiques et les palettes d’accentuation applicables aux composants interactifs du classeur. Pour une exploitation dans un contexte académique, financier ou institutionnel, l’analyste écartera d’emblée les propositions aux tonalités tapageuses pour s’orienter vers les thèmes épurés tels que « Simple doux », « Simplifié » ou « Courant ».
L’activation d’un thème prédéfini possède une vertu organisationnelle incontestable : elle assure une cohérence stylistique globale à travers l’intégralité des onglets du classeur. Les tableaux croisés dynamiques créés héritent instantanément des conventions tonales définies au niveau du classeur hôte. Cela évite le piège classique des classeurs composites où cohabitent de manière anarchique des matrices aux styles dépareillés, trahissant un manque d’égards professionnel et une absence de gouvernance documentaire.
Toutefois, les réglages natifs proposés par ces thèmes génériques requièrent presque toujours un travail d’ajustement sur mesure. Bien qu’ils posent un socle satisfaisant, ils ne prennent pas spécifiquement en considération la densité d’information inhérente aux grands volumes de calculs comptables ou statistiques. L’application d’un thème prédéfini doit ainsi être comprise comme une initialisation structurelle, une base de travail propre à être sublimée par une personnalisation chromatique d’une précision chirurgicale.
4.3 Personnalisation fine de la palette chromatique institutionnelle
La crédibilité d’une analyse institutionnelle ou directoriale est renforcée lorsque la scénographie du tableau épouse avec fidélité l’identité visuelle et la charte graphique de l’organisation commanditaire. Dans le panneau latéral des thèmes de Google Sheets, l’analyste dispose du bouton Personnaliser, lui octroyant une maîtrise absolue sur les valeurs chromatiques fondamentales par l’attribution manuelle de codes hexadécimaux stricts (format #RRGGBB).
Le protocole de paramétrage de cette charte impose d’assigner à la couleur primaire (qui teintera l’en-tête du tableau croisé dynamique) une nuance sombre et autoritaire—par exemple un bleu marine corporatif (#1A365D) ou un vert sauge dense (#234E52)—tandis que le texte superposé sera systématiquement forcé en blanc pur (#FFFFFF) ou blanc cassé pour sanctuariser le contraste de luminance. La couleur d’accentuation secondaire doit être tempérée par un coefficient de clarté élevé afin de servir d’ombrage délicat pour les niveaux de sous-totalisation, par exemple un bleu acier pastel à 10 % d’opacité.
Une fois cette configuration scellée, il est recommandé de créer un modèle pérenne. Bien que Google Sheets ne dispose pas à ce jour d’une fonction native de sauvegarde des thèmes sous forme de fichiers externes transportables, la duplication d’un onglet étalon configuré ou l’emploi de classeurs modèles d’équipe permet de propager sans friction cette harmonie chromatique personnalisée à travers l’ensemble de l’organisation.
5. Étape 4 : Gestion des bordures, de la trame et de la densité spatiale
5.1 Principes de délimitation géométrique et théorie du contour
Dans la sémiologie graphique classique initiée par Jacques Bertin dans son ouvrage séminal Sémiologie Graphique, le contour n’a d’autre légitimité que d’isoler des plans informationnels disjoints. Dans la pratique répandue mais erronée des tableurs, les utilisateurs ont coutume de saturer les matrices d’un quadrillage noir omniprésent recouvrant la totalité des cellules. Cette surcharge de bordures engendre un phénomène d’« effet de grille » ou d’interférence optique qui perturbe l’attention de l’œil, fragmentant l’information visuelle au lieu de l’unifier organiquement.
La rigueur méthodologique commande d’établir une distinction fondamentale entre les bordures dites structurelles—qui matérialisent les transitions majeures entre l’en-tête, le corps de données et les calculs de clôture—et les grilles auxiliaires. Les grilles par défaut générées par le logiciel doivent être considérées comme des guides de construction temporaires. Dans le cadre de la publication finale, ces lignes de séparation interne doivent être soit complètement supprimées pour laisser respirer la composition, soit atténuées en adoptant un niveau de gris extrêmement pâle (ex. #E2E8F0) et un trait de très faible calibre.
L’adage canonique du design de données formulé par Edward Tufte sous le concept de ratio « Data-to-Ink » stipule que la proportion d’encre (ou de pixels) consacrée à la communication de données réelles par rapport à l’encre totale doit tendre vers son maximum. Appliqué aux tableaux croisés dynamiques, ce principe impose d’éliminer impitoyablement l’intégralité des bordures verticales intérieures. Les colonnes étant naturellement séparées par des alignements spatiaux cohérents, le maintien de segments verticaux superflus ne produit qu’une pollution graphique stérile.
5.2 Configuration méthodique des bordures dans Google Sheets
L’implémentation concrète de cette structure géométrique épurée s’articule via le sélecteur de bordures positionné au centre de la barre d’outils principale de Google Sheets. Après avoir circonscrit l’intégralité du périmètre du tableau croisé dynamique, l’analyste commencera par purger toutes les bordures préexistantes en sélectionnant l’option Effacer les bordures. Cette opération initiale rétablit une virginité spatiale propice à une reconstruction ordonnée.
L’étape suivante consiste à appliquer une ligne supérieure affirmée au-dessus de la ligne d’en-tête canonique, immédiatement suivie par une séparation horizontale sous-jacente d’un calibre plus fin (0,5 pt ou trait pointillé discret) isolant les intitulés des variables par rapport à la première rangée d’occurrences quantitatives. Pour les ruptures intermédiaires marquant les sous-totaux hiérarchiques, une simple ligne horizontale gris perle assure un guidage visuel non invasif.
Le couronnement structurel de la matrice s’opère sur la rangée finale réservée au Total général. Conformément aux conventions de la typographie financière et comptable universelle, cette ligne terminale doit être surmontée d’une bordure horizontale simple de calibre moyen marquant l’arrêt des additions partielles, et scellée en sa base inférieure par un double tracé horizontal parallèle (option Double bordure inférieure). Cette convention sémiotique signale sans équivoque à l’esprit de l’auditeur que le périmètre arithmétique de la démonstration est définitivement clos.
5.3 Ajustement de l’espacement et du volume respiratoire des cellules
L’encombrement spatial d’un tableau croisé dynamique contribue massivement au sentiment d’illisibilité. Par défaut, Google Sheets attribue aux lignes une hauteur standard de 21 pixels, qui contraint le texte à occuper presque l’intégralité de l’espace vertical disponible. Les caractères touchent virtuellement les filets de bordure, induisant une tension perceptuelle néfaste pour le confort oculaire.
Une mise en forme rigoureuse requiert de redéfinir la hauteur des lignes de données. En sélectionnant l’ensemble des rangées du tableau croisé, puis via un clic droit sélectionnant Redimensionner les lignes, l’analyste spécifiera manuellement une hauteur comprise entre 26 et 30 pixels. Cet apport marginal de 5 à 9 pixels crée une marge de sécurité optique supérieure et inférieure (le « coussin » respiratoire), qui découple le contenu textuel des limites matérielles de la cellule.
Il convient de procéder à une manœuvre analogue pour la largeur des colonnes. Une erreur fréquente consiste à se reposer exclusivement sur le double-clic d’ajustement automatique, lequel calibre la colonne sur la chaîne textuelle la plus longue. Cela génère des largeurs anarchiques où des colonnes de données homogènes présentent des envergures disparates. L’harmonisation visuelle exige d’uniformiser la largeur des colonnes numériques partageant une même nature scalaire (par exemple, fixer un pas immuable de 110 pixels pour chaque colonne mensuelle), garantissant ainsi un équilibre rythmique sur le plan horizontal.
6. Étape 5 : Typographie, alignement textuel et hiérarchisation sémiotique
6.1 Conventions d’alignement spatial selon la nature des données
L’alignement spatial au sein d’une cellule ne relève d’aucun choix décoratif discrétionnaire : il obéit à des conventions logiques formelles visant à faciliter la comparaison instantanée des données. Une déviation de ces normes détruit la capacité de scan oculaire de l’utilisateur. Dans Google Sheets, l’analyste doit impérativement veiller à respecter un triptyque fondamental d’alignement selon la typologie sémantique des champs manipulés.
En premier lieu, toutes les étiquettes textuelles, les descriptions catégorielles et les dimensions nominales doivent impérativement être justifiées à gauche. L’écriture occidentale s’effectuant de gauche à droite, l’œil ancre son point de repère sur le bord gauche pour initier le déchiffrage lexical. Tout centrage de texte crée une ligne d’attaque irrégulière qui force le système visuel à rechercher le commencement de chaque mot, ralentissant de fait la vitesse d’appréhension.
Inversement, l’intégralité des grandeurs scalaires, valeurs monétaires, pourcentages et comptages arithmétiques doit être rigoureusement alignée à droite. Cette règle mécanique cardinale garantit que les unités, les dizaines, les centaines et les décimales soient parfaitement alignées verticalement sur des colonnes invisibles identiques. L’analyste peut ainsi estimer visuellement l’ordre de grandeur d’un montant d’après sa seule extension spatiale vers la gauche. Enfin, le centrage doit demeurer réservé de manière restrictive aux codes normalisés de longueur fixe (tels que les codes ISO de pays à deux lettres, les codes postaux ou les dates brèves standardisées au format AAAA-MM-JJ).
6.2 Sélection typographique et optimisation de la lisibilité
Le choix de la famille de polices de caractères représente un facteur déterminant dans la vitesse d’assimilation d’un jeu de données quantitatif. Pour des documents tabulaires sous Google Sheets, il convient de proscrire de manière catégorique les polices décoratives, les polices de style cursif ainsi que les fontes traditionnelles à empattements prononcés (sérifs) comme Times New Roman, dont les déliés délicats créent un flou perceptif sur les écrans numériques de moyenne résolution.
L’excellence fonctionnelle commande d’employer exclusivement des polices sans empattement (sans-serif) hautement lisibles et réputées pour la pureté de leur dessin vectoriel. Parmi le catalogue intégré de Google Fonts, la police Inter s’impose comme l’étalon-or contemporain grâce à son dessin spécifiquement élaboré pour les interfaces logicielles denses. D’autres options professionnelles incontournables incluent Roboto, Lato et Open Sans. L’analyste portera une attention particulière à la sélection de polices intégrant des chiffres tabulaires (à chasse fixe), où chaque chiffre de 0 à 9 occupe rigoureusement la même largeur d’espacement, interdisant toute déformation d’alignement vertical lors des colonnes d’additions.
La gestion de l’échelle des corps typographiques doit être maintenue dans une fourchette étroite pour préserver l’harmonie générale. L’usage recommande un corps de 11 ou 12 points pour le titre général de section, un corps de 10 points en demi-gras pour les en-têtes de colonnes, un corps standard de 9 ou 10 points pour le corps régulier des occurrences de données, et enfin un corps de 10 points en graisse soutenue pour les totalisations finales. Tout emploi de corps inférieurs à 8 points est proscrit afin de préserver l’acuité visuelle du réviseur.
6.3 Codification hiérarchique par les attributs de texte
La typographie ne transmet pas uniquement des caractères alphanumériques ; elle véhicule une hiérarchie d’importance relative grâce à la modulation calculée de ses attributs de graisse, d’inclinaison et de casse. Dans un tableau croisé dynamique mal canalisé, une utilisation frénétique de la graisse grasse dilue sa force d’avertissement. La graisse doit être soumise à une règle d’économie stricte : elle n’a droit de cité que pour démarquer les agrégats de synthèse, les totaux généraux et les en-têtes de colonnes primaires.
L’attribut italique remplit une fonction sémiotique distincte : il sert à désigner la donnée périphérique, dérivée ou méthodologique. L’analyste averti l’emploiera pour styliser les sous-totaux intermédiaires, les notes de bas de tableau ou les étiquettes signalant des métriques calculées en pourcentage de participation relative. L’italique introduit une rupture stylistique douce qui indique à l’intellect du lecteur qu’il n’observe pas une mesure primaire, mais une interprétation arithmétique secondaire.
Enfin, la normalisation de la casse textuelle doit être arrêtée de manière méthodique. Il convient d’éviter la composition d’en-têtes en capitales intégrales (majuscules d’imprimerie), qui transforment les mots en blocs rectangulaires uniformes et dégradent la vitesse de reconnaissance lexicale globale. Il est préférable d’appliquer la règle du « Title Case » (majuscule initiale à chaque terme significatif) ou celle de la phrase standard, en veillant à la standardisation orthographique la plus rigoureuse sur l’ensemble des modalités affichées.
7. Étape 6 : Formatage numérique des grandeurs scalaires et monétaires
7.1 Standardisation monétaire et précision décimale
Rien ne décrédibilise davantage un tableau de bord analytique que l’exhibition de données financières présentées sous forme de nombres décimaux bruts dépourvus de symbole d’appartenance ou affichant des résidus de calcul à huit décimales flottantes (ex. 14523.83920194). Cette absence de calibrage révèle une négligence technique inacceptable en environnement décisionnel. Tout tableau croisé dynamique hébergeant des grandeurs économiques doit faire l’objet d’une standardisation monétaire rigoureuse.
L’analyste appliquera le symbole monétaire approprié selon les normes internationales ISO 4217 (tel que l’euro €, le dollar US $ ou la livre sterling £). Cependant, pour éviter d’alourdir le corps de données par la répétition mécanique du symbole monétaire sur plusieurs centaines de cellules adjacentes, une pratique ergonomique éprouvée consiste à incorporer la devise dans l’en-tête même de la colonne (ex. « Chiffre d’Affaires Brut (k€) ») et à ne formater les cellules intérieures que sous une configuration numérique standard dotée de séparateurs de milliers.
La question de la précision décimale impose un arbitrage rationnel fondé sur l’envergure des flux examinés. Dans un reporting financier stratégique portant sur des millions d’unités monétaires, l’affichage des centimes constitue une fausse précision sans valeur décisionnelle qui obstrue la clarté globale. Il est recommandé de masquer intégralement les décimales par le bouton de réduction dédié dans la barre d’outils, ou d’exprimer les grandeurs en milliers d’unités. L’insertion systématique de l’espace fine insécable (ou de la virgule selon la locale géographique configurée) en tant que séparateur de milliers est un prérequis non négociable pour autoriser une lecture instantanée des échelles de grandeur.
7.2 Représentation scientifique des pourcentages et ratios
Les indicateurs de performance s’expriment fréquemment sous forme de taux de pénétration, de marges relatives ou de pourcentages d’évolution interannuelle. Dans son moteur natif, Google Sheets stocke les pourcentages sous la forme de fractions décimales comprises entre 0 et 1 (ainsi, 0,154 correspond à 15,4 %). L’omission de l’application du format pourcentuel transforme la lecture en un exercice arithmétique inutilement fastidieux pour le décideur.
L’assignation du format Pourcentage via le ruban de commande ou le raccourci clavier Ctrl+Maj+5 assure une restitution normalisée immédiate. Contrairement aux valeurs monétaires agrégées, les grandeurs pourcentuelles exigent le maintien strict d’une, voire de deux décimales de précision (ex. 14,2 %). L’absence de décimale sur un ratio de rentabilité peut masquer des écarts opérationnels considérables, tandis qu’un excès de décimales (au-delà de deux) noie l’indicateur sous un bruit statistique trompeur.
Une vigilance mathématique absolue s’impose quant à l’équilibre arithmétique des sommes de pourcentages. Lorsqu’un tableau croisé dynamique déploie la répartition proportionnelle d’une grandeur au sein de ses différentes catégories, l’analyste doit veiller à ce que la ligne de totalisation générale affiche scrupuleusement la mention 100,0 %. Tout décalage apparent résultant d’arrondis cumulatifs non contrôlés crée un sentiment d’incohérence susceptible d’entamer la confiance de l’auditoire envers l’intégrité des calculs présentés.
7.3 Création de formats numériques personnalisés
Les formats numériques prédéfinis dans Google Sheets ne répondent pas toujours aux exigences esthétiques et fonctionnelles des rapports de haut niveau. Pour franchir ce palier d’excellence, l’analyste doit recourir aux masques de saisie personnalisés en empruntant le chemin d’accès Format > Nombre > Format numérique personnalisé. La syntaxe structurelle d’un masque comprend jusqu’à quatre segments distincts séparés par des points-virgules : [Positif];[Négatif];[Zéro];[Texte].
Cette puissante syntaxe permet de résoudre élégamment la problématique des nombres négatifs. Dans la grande tradition de la comptabilité anglo-saxonne et internationale, les grandeurs négatives ne doivent pas être affublées d’un signe moins conventionnel (-), souvent trop discret et source de méprises lors d’un examen diagonal, mais encapsulées au sein de parenthèses fermées. Un masque tel que #,##0.00;(#,##0.00);"-" assurera que tout déficit financier apparaisse sans ambiguïté sous la forme (1 250,50).
De surcroît, le troisième segment du masque susmentionné permet d’opérer une substitution sémantique capitale : la neutralisation des valeurs nulles. L’accumulation de zéros mathématiques au cœur d’une matrice complexe sature inutilement le champ visuel. En prescrivant un tiret cadratin ou demi-cadratin discret ("-") en guise de masque pour les occurrences strictement égales à zéro, l’analyste libère la vue du réviseur, concentrant instantanément son attention sur les cellules hébergeant une activité quantitative effective.
8. Étape 7 : Implémentation des règles de mise en forme conditionnelle
8.1 Cartographie thermique par dégradés de couleurs continus
La mise en forme conditionnelle sous forme d’échelle de couleurs (ou cartographie thermique / heat map) est un instrument puissant pour transformer une grille dense de nombres en une surface d’exploration intuitive. En attribuant à chaque cellule une nuance chromatique calculée proportionnellement à son intensité mathématique, l’analyste permet à l’observateur de repérer en quelques millisecondes les îlots de concentration de performance ou les poches d’anomalie au sein du tableau croisé dynamique.
Toutefois, la maîtrise technique de cette fonctionnalité requiert le bannissement impératif des échelles tricolores stridentes de type « feu tricolore » (rouge pur – jaune vif – vert éclatant), qui créent une cacophonie visuelle épuisante et stigmatisante. L’excellence ergonomique privilégie des dégradés bicolores doux fondés sur une seule famille tonale—par exemple, du blanc immaculé pour la valeur minimale vers un bleu acier profond pour la valeur maximale. Si une échelle divergente s’avère indispensable (pour illustrer des écarts budgétaires positifs et négatifs autour d’un seuil neutre), une transition partant d’un bordeaux assourdi vers un vert pin tempéré en transitant par un gris perle neutre garantira une distinction élégante.
Un piège méthodologique critique guette ici l’utilisateur inexpérimenté : l’incorporation accidentelle des lignes de sous-totaux et de totaux généraux dans la plage d’application du dégradé. Les totaux écrasant naturellement l’échelle quantitative par leur magnitude supérieure, ils réduisent l’intégralité des cellules de données individuelles à des teintes imperceptibles proches du zéro. La règle de mise en forme conditionnelle doit donc être assignée de manière chirurgicale, en ciblant exclusivement la sous-matrice des données transactionnelles, à l’exclusion absolue des bordures d’agrégation.
8.2 Seuils critiques et balisage d’alerte contextuelle
En complément des échelles thermiques continues, la mise en valeur conditionnelle basée sur des critères booléens stricts constitue le fer de lance de la gestion par exception (Management by Exception). Il s’agit de configurer l’interface pour qu’elle n’allume un signal visuel que lorsque la grandeur mesurée enfreint un seuil opérationnel critique prédéterminé, tel qu’un retard de livraison excédant 15 jours, un taux d’attrition client supérieur à 5 % ou une marge brute négative.
Pour implémenter ce dispositif dans Google Sheets, l’analyste accède au panneau latéral via Format > Règle de mise en forme conditionnelle, sélectionne le mode Une seule couleur et spécifie l’opérateur logique congruent (par exemple Inférieur à ou La formule personnalisée est). Il est fondamental que le style d’alerte demeure d’une sobriété exemplaire. Un aplat rouge vif saturé combiné à une police grasse clignotante choque le lecteur et détruit le professionnalisme du support. On lui substituera avantageusement un remplissage rose poudré délicat (#FCE8E6) couplé à une police carmin sombre (#C5221F).
Cette retenue chromatique garantit que l’anomalie saute aux yeux sans pour autant déclencher une anxiété cognitive disproportionnée. Le balisage contextuel ne doit pas saturer le tableau : si plus de 10 % des cellules s’illuminent en mode alerte, le dispositif perd instantanément son efficacité différentielle. L’analyste doit alors recalibrer ses seuils pour ne capter que l’exceptionnelle déviance statistique.
8.3 Audit des conflits de règles et hiérarchie d’application
Dans les tableaux croisés dynamiques complexes de Google Sheets, la superposition successive de multiples règles de mise en forme conditionnelle peut aboutir à des conflits d’affichage imprévus ou à des ralentissements d’exécution chroniques. L’environnement applicatif évalue les règles selon un ordre séquentiel vertical strict, de haut en bas, au sein du panneau latéral dédié. Dès qu’une cellule valide les conditions de la première règle rencontrée, cette dernière s’applique et neutralise potentiellement les règles subordonnées.
Il est donc essentiel de procéder à un audit méthodique de la pile de conditions en faisant glisser les règles d’exception les plus critiques et les plus spécifiques au sommet de la hiérarchie prioritaire, tandis que les échelles continues plus globales doivent être reléguées en queue de peloton. L’analyste vérifiera avec minutie que les formules personnalisées mobilisant des adresses relatives s’ajustent fidèlement lors de l’extension automatique de la taille du tableau croisé.
Enfin, une prolifération démesurée de règles conditionnelles engendre une dégradation sensible des performances de recalcul sur les navigateurs web des utilisateurs distants. Chaque modification de filtre ou d’imbrication de variable force le compilateur JavaScript de Google Sheets à réévaluer la totalité du maillage logique. Pour garantir une expérience de navigation d’une fluidité sans faille, le nombre total de règles appliquées à une même feuille d’agrégation ne devrait idéalement jamais excéder cinq ou six directives coordonnées.
9. Étape 8 : Restructuration des totaux, sous-totaux et regroupements catégoriels
9.1 Modélisation des regroupements hiérarchiques
L’un des atouts analytiques majeurs du tableau croisé dynamique réside dans sa faculté de réagréger à la volée des variables de forte dispersion discrète en classes hiérarchiques porteuses de sens. L’exemple le plus emblématique concerne la dimension temporelle : une liste brute de transactions horodatées au jour le jour est totalement inexploitable pour dégager une tendance macroéconomique. Le regroupement chronologique structurel est ici indispensable.
Dans Google Sheets, cette transformation s’exécute avec une remarquable élégance fonctionnelle. Par un clic droit appliqué directement sur n’importe quelle étiquette de date au sein du tableau croisé, l’analyste sélectionne la commande Créer un groupe de dates pour le tableau croisé dynamique. Le logiciel propose alors un spectre d’agrégation standardisé : Année, Trimestre, Mois, Jour de la semaine ou combinaisons composées (ex. Année-Mois). Cette segmentation automatique s’opère sans qu’il soit nécessaire de créer des colonnes de calcul auxiliaires dans le jeu de données source, allégeant d’autant la volumétrie du modèle.
Une démarche analogue peut être déployée sur des variables scalaires continues (telles que le panier moyen, l’âge d’une cohorte ou le revenu disponible) via la création de groupes d’intervalles numériques. En assignant une valeur de départ, une valeur de clôture et un pas d’échantillonnage constant (par exemple, des tranches d’âge de 10 ans), l’analyste transforme une variable quantitative continue en une distribution de fréquences catégorielle, fournissant ainsi une base idéale pour la production d’histogrammes et d’analyses de segmentation démographique.
9.2 Gestion stratégique des totaux généraux et intermédiaires
La présence automatique et indiscriminée de sous-totaux pour chaque strate hiérarchique imbriquée constitue l’un des facteurs majeurs de congestion visuelle dans les modèles tabulaires par défaut. Si la synthèse partielle est hautement informative pour les niveaux hiérarchiques de rang supérieur, elle devient une nuisance répétitive lorsqu’elle est appliquée à des segments ne comportant qu’une unique modalité sous-jacente. L’analyste doit exercer une gouvernance délibérée sur l’activation de ces commutateurs.
Dans l’éditeur latéral, sous chaque champ de ligne ou de colonne, une case à cocher intitulée Afficher les totaux permet de débrayer sélectivement cette agrégation. La bonne pratique impose de supprimer les sous-totaux pour les dimensions les plus profondes de l’arborescence afin d’éviter des répétitions tautologiques où la sous-totalisation redit rigoureusement le montant de la ligne unique qui la précède. Concernant l’implantation spatiale, l’utilisateur peut choisir d’implanter les totaux en haut de groupe (façon tableau de bord exécutif) ou traditionnellement en bas de groupe.
Pour le total général terminal, son maintien est impératif car il constitue la borne supérieure de vérification de l’intégrité du calcul. Néanmoins, sa mise en forme doit marquer une rupture stylistique sans équivoque avec le reste du corps tabulaire. Il sera doté d’une nuance de fond légèrement différenciée (un gris ciment ou une nuance pastel issue de la couleur primaire du thème), d’une typographie consolidée en demi-gras et de la double bordure inférieure consacrée, formalisant l’aboutissement mathématique de la démonstration.
9.3 Contrôle du niveau de granularité par réduction arborescente
La charge informationnelle d’un tableau croisé dynamique comportant de multiples dimensions imbriquées peut être considérablement allégée par le déploiement de l’interactivité arborescente. Google Sheets intègre une fonctionnalité d’effondrement et d’expansion de nœuds, matérialisée par de petits commutateurs iconographiques fléchés positionnés en marge des étiquettes dimensionnelles.
L’analyste peut activer ou désactiver cette capacité d’arborescence dynamique directement au sein de l’éditeur latéral en modulant l’option Réduire les boutons. Lorsqu’elle est déployée judicieusement, cette fonctionnalité permet d’offrir à l’audience une vue exécutive hautement synthétique par défaut—où seules les grandes catégories maîtresses et leurs totaux respectifs sont visibles au premier regard—tout en conférant à l’auditeur curieux la liberté d’explorer la granularité sous-jacente par un simple clic de souris.
Ce contrôle ergonomique de la granularité répond parfaitement aux impératifs d’une diffusion transversale de l’information. Un membre du comité de direction pourra se contenter de la vue consolidée sans être submergé par les détails microscopiques, tandis qu’un analyste opérationnel déploiera les ramifications spécifiques à son unité d’affaires pour en examiner les composantes unitaires. La structure matricielle devient ainsi un artefact adaptatif capable de satisfaire des niveaux d’exigence herméneutique hétérogènes.
10. Étape 9 : Intégration de champs calculés et formalisation des métriques dérivées
10.1 Syntaxe mathématique et implémentation dans l’éditeur
Bien que la compilation des grandeurs primaires (sommes et dénombrements) réponde à la plupart des besoins fondamentaux, l’investigation analytique avancée exige fréquemment la construction d’indicateurs synthétiques inédits n’existant pas explicitement au sein de la table relationnelle de départ. L’insertion de champs calculés au sein de l’instance dynamique comble précisément cette lacune en permettant d’exécuter des opérations mathématiques directes sur les variables agrégées.
Pour incorporer une mesure dérivée, l’opérateur clique sur Ajouter en regard de la section Valeurs de l’éditeur latéral et sélectionne l’option Champ calculé. L’attribution d’une formule requiert une rigueur syntaxique exemplaire : les intitulés des colonnes sources doivent être invoqués avec une fidélité absolue à l’orthographe originale. Si un libellé de colonne comporte des espaces intercalaires ou des caractères spéciaux, il doit impérativement être encapsulé entre des apostrophes droites simples ou des guillemets selon la configuration (ex. 'Chiffre d'Affaires Brut' / 'Unités Vendues') pour déjouer toute erreur d’analyse lexicale du compilateur.
Une distinction méthodologique capitale—source d’erreurs récurrentes chez les praticiens non avertis—doit être formulée entre la somme des ratios et le ratio des sommes. Dans Google Sheets, un champ calculé calcule la formule sur les agrégats consolidés et non sur les lignes individuelles de données primaires. Ainsi, l’équation Marge / Chiffre d'Affaires divisera la somme totale des marges de la sélection par la somme totale du chiffre d’affaires, produisant fidèlement le taux de marge consolidé exact, au lieu de faire la moyenne stérile des pourcentages de chaque ligne élémentaire.
10.2 Modes d’affichage relatif des valeurs agrégées
L’analyse quantitative ne se limite pas à l’observation de volumes bruts ; elle s’enrichit considérablement de la mise en perspective des contributions relatives de chaque entité à l’ensemble macroéconomique. Dans l’éditeur de tableau croisé dynamique de Google Sheets, la sous-section Afficher comme présente au sein de chaque métrique de valeur offre des alternatives d’affichage proportionnel extrêmement puissantes sans exiger la moindre ligne de code mathématique.
Parmi les options disponibles, trois modes d’affichage relatif méritent une utilisation systématique :
- % de la colonne : Cet opérateur exprime la valeur de chaque cellule sous forme de pourcentage de la somme cumulée de sa colonne d’appartenance, facilitant la comparaison de la structure interne des coûts ou des ventes entre différents exercices fiscaux.
- % de la ligne : Ce mode rapporte la cellule au total horizontal de la rangée, idéal pour examiner l’évolution de la part de marché relative d’une division géographique au fil du temps.
- % du total général : Il quantifie le poids absolu d’une cellule spécifique par rapport à la masse entière des observations contenues dans le tableau.
Dès lors que l’un de ces modes relatifs est enclenché, l’analyste doit impérativement réviser le libellé de l’en-tête de la colonne correspondante. L’étiquette générée par défaut par le logiciel est souvent tronquée ou ambiguë ; elle doit être remplacée manuellement par une description cristalline telle que « Contribution au CA Global (%) » afin d’écarter toute équivoque quant à la base de calcul mobilisée.
10.3 Validation de la rigueur arithmétique et élimination des artefacts
L’introduction de calculs fractionnaires expose inévitablement la matrice à l’apparition d’artefacts informatiques disgracieux, au premier rang desquels figure la redoutée notification d’erreur #DIV/0! consécutive à une division par une valeur nulle ou non renseignée. L’apparition de telles chaînes d’erreur brise l’harmonie visuelle du rapport et projette une impression de négligence technique préjudiciable.
Pour neutraliser préventivement ces anomalies arithmétiques, l’analyste chevronné encapsulera systématiquement les équations de ses champs calculés au sein de la fonction défensive SIERREUR ou IFERROR. Ainsi, une formule de ratio s’écrira avec prudence : SIERREUR(Marge / Chiffre d'Affaires; 0). Cette disposition garantit que si une division indéterminée survient, le compilateur renverra immédiatement un zéro arithmétique neutre, lequel pourra ensuite être élégamment masqué par le masque de saisie personnalisé abordé à l’étape 6.
De surcroît, l’ordre d’évaluation mathématique des opérateurs doit être validé avec un soin méticuleux. L’emploi explicite de parenthèses de priorité est vivement recommandé pour neutraliser toute ambiguïté relative à la précédence canonique de la multiplication et de la division sur l’addition et la soustraction. Enfin, une fois le champ calculé stabilisé, il convient de lui attribuer immédiatement son formatage numérique définitif (pourcentage, devise ou décimale), car Google Sheets réinitialise trop souvent le style du nouveau champ vers une disposition numérique brute par défaut.
11. Étape 10 : Filtrage dynamique, segments visuels et interactivité de lecture
11.1 Configuration des filtres structurels dans le tableau
L’intégrité d’un tableau croisé dynamique repose sur la pertinence du sous-ensemble de données qu’il se propose de soumettre à l’examen. Le compartiment Filtres de l’éditeur latéral constitue le mécanisme primordial d’exclusion des données périphériques ou hors périmètre. Google Sheets y propose deux méthodes opératoires distinctes : le filtrage par éléments discrets et le filtrage par condition logique.
Le filtrage par éléments consiste à cocher ou décocher manuellement les modalités catégorielles de la variable au sein d’une arborescence de cases à cocher. Si cette approche s’avère commode pour un ajustement ponctuel sur un échantillon figé, elle présente un risque méthodologique majeur d’obsolescence : toute nouvelle modalité apparaissant ultérieurement dans la base de données source sera automatiquement intégrée ou exclue selon le mode de sélection initial, conduisant potentiellement à des dérives de périmètre non surveillées.
Pour sanctuariser la pérennité du rapport, l’analyste préférera systématiquement le filtrage par condition, qui applique des règles d’évaluation booléennes immuables (ex. Le texte contient, La date est postérieure à ou La formule personnalisée est). Cette méthode formalise l’intention analytique de manière explicite et assure un traitement parfaitement reproductible, immunisé contre les variations futures des données primaires. Il convient toutefois de garder constamment à l’esprit que toute exclusion de données modifie immédiatement l’assiette de calcul des totaux généraux, imposant d’en faire mention explicite dans les légendes du tableau.
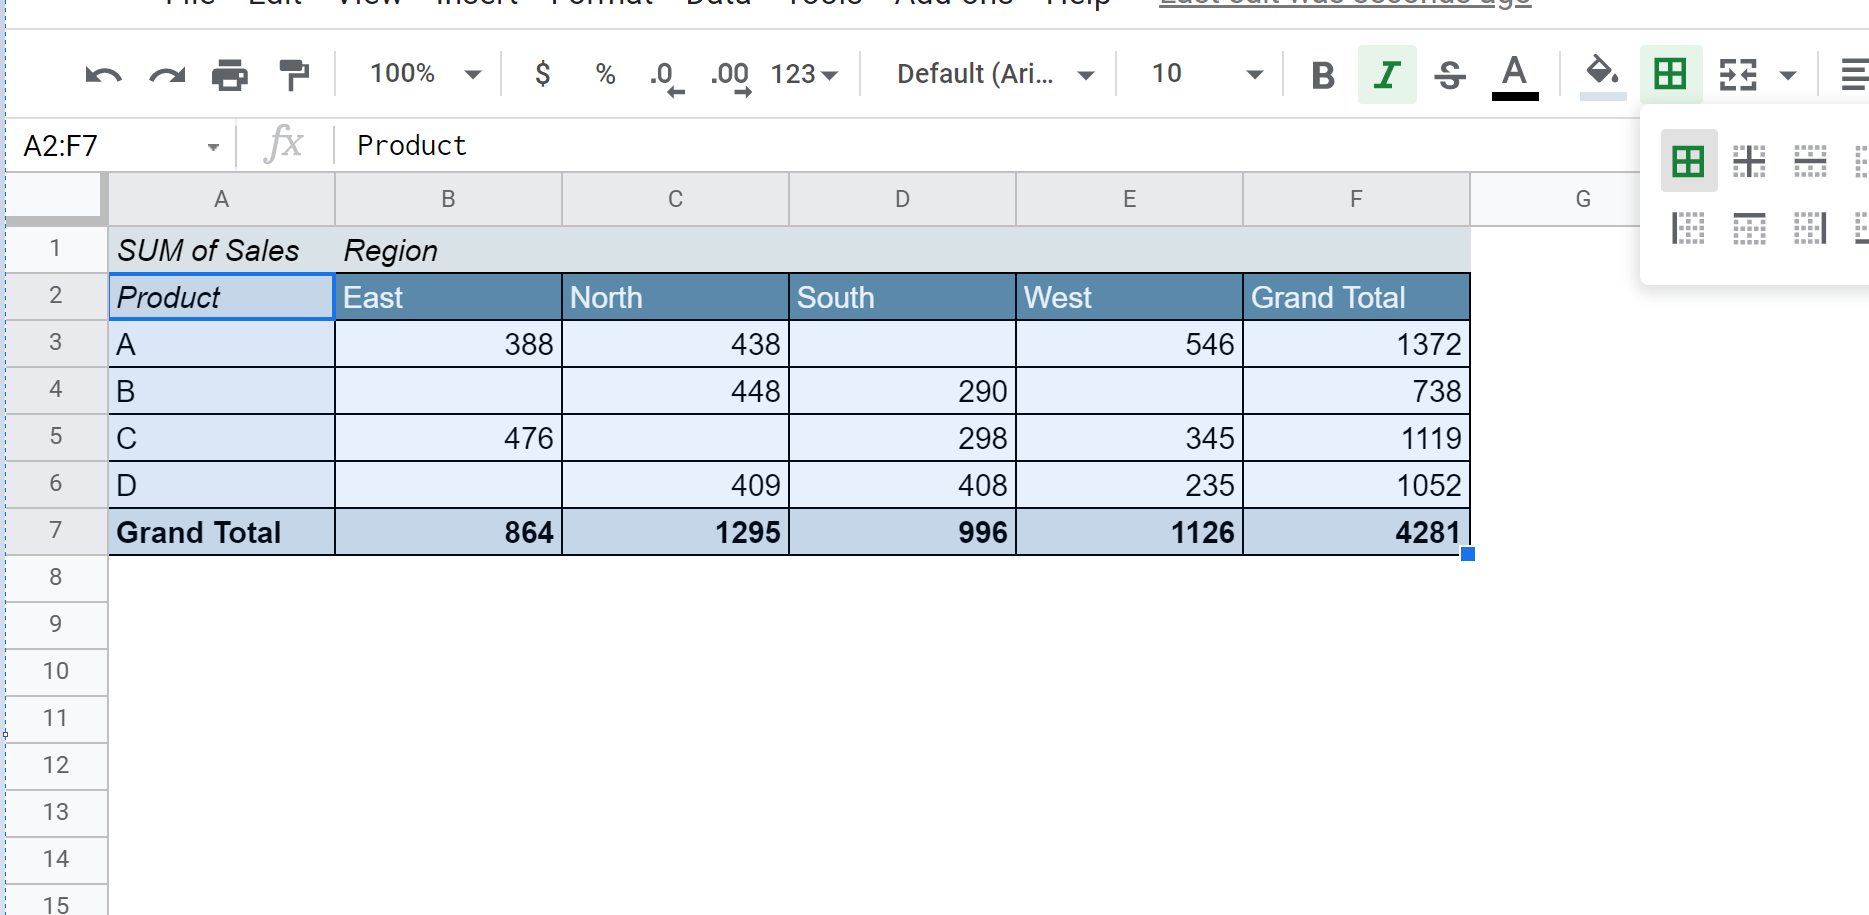
11.2 Déploiement ergonomique des segments de contrôle
Si les filtres structurels intégrés dans l’éditeur latéral sont puissants, ils demeurent inaccessibles ou excessivement complexes pour un utilisateur final consultant le classeur en mode de lecture seule ou ne disposant pas d’une expertise avancée sur le logiciel. L’introduction de segments (communément désignés sous le terme de slicers) répond précisément à cette exigence d’ergonomie démocratique.
Pour incorporer un segment, l’analyste sélectionne le tableau croisé dynamique puis se rend dans le menu Données > Ajouter un segment. Ce contrôleur interactif flottant se positionne sur la surface du feuillet sous la forme d’un sélecteur graphique autonome relié au tableau. En manipulant ce panneau, tout collaborateur peut filtrer instantanément les dimensions du tableau croisé sans jamais avoir à ouvrir l’éditeur latéral d’ingénierie logicielle.
L’insertion d’un segment impose une réflexion d’intégration spatiale rigoureuse. Le segment ne doit en aucun cas chevaucher la matrice de données ni flotter de manière erratique sur le feuillet. La bonne pratique architecturale commande d’aménager une « zone de pilotage » ou un bandeau supérieur dédié, au-dessus du tableau croisé dynamique, où les segments sont alignés horizontalement avec un espacement symétrique. La palette chromatique du segment doit être personnalisée via ses options de style pour refléter exactement les codes couleur du thème institutionnel retenu, fusionnant ainsi harmonieusement l’interactivité au design global.
11.3 Préservation de l’architecture visuelle face à la volatilité dynamique
La nature même d’un tableau croisé interactif est de se dilater ou de se contracter au gré des sélections opérées par les filtres et les segments. Ce comportement adaptatif peut paradoxalement détruire le travail d’orfèvre réalisé sur l’agencement des colonnes et la mise en page générale si certaines précautions techniques ne sont pas scrupuleusement prises.
Lorsque le filtrage isole un sous-ensemble ne comportant aucune observation valide, Google Sheets peut réagir en affichant un tableau vide ou en réduisant brutalement la largeur des colonnes à une taille minimale standard. Pour prémunir le tableau contre ces sauts de mise en page disgracieux, l’analyste peut verrouiller la largeur des colonnes en évitant l’ajustement automatique et en attribuant des cotes fixes en pixels, voire en insérant des en-têtes dimensionnels d’une largeur textuelle calibrée faisant office de butoirs physiques.
De plus, l’expérience utilisateur en mode de consultation partagée impose d’auditer les droits d’accès. Si le rapport est destiné à être exploré par un public hétérogène sans risque de défiguration accidentelle de ses règles de style, la protection de la plage ou de la feuille entière (Données > Protéger les feuilles et les plages) doit être verrouillée, tout en autorisant expressément l’usage des segments aux utilisateurs disposant des droits de commentaire ou de lecture. L’intégrité esthétique de l’œuvre se trouve ainsi définitivement mise à l’abri des manipulations hasardeuses.
12. Étape 11 : Automatisation, maintenance du style et reproductibilité
12.1 Duplication et transfert de styles via l’outil de reproduction
Une fois le protocole de formatage méticuleusement appliqué à une instance dynamique de référence, la duplication manuelle de ces réglages sur des dizaines d’autres tableaux croisés dispersés au sein d’un classeur représenterait une tâche chronophage et génératrice d’erreurs. L’exploitation intelligente des mécanismes de clonage de format devient alors incontournable.
L’outil Peindre le format (icône de rouleau à peinture dans la barre d’outils) permet de capturer d’un clic l’intégralité des attributs d’une cellule source (police, corps, couleur d’arrière-plan, alignement, masques numériques et bordures) pour les propager par simple balayage sur une plage cible. Toutefois, ce clonage de surface rencontre une limite technique structurelle lorsqu’il est appliqué directement sur des zones dynamiques de Google Sheets : il n’altère que les propriétés graphiques des cellules matérielles sans transférer les logiques internes de configuration de l’éditeur latéral (telles que le calcul de pourcentages relatifs ou l’invisibilité des totaux redondants).
La méthode la plus robuste pour synchroniser des tableaux aux architectures similaires consiste à dupliquer intégralement l’onglet modèle configuré (via un clic droit sur l’onglet > Dupliquer), puis à rediriger la source de données de la nouvelle instance vers la nouvelle plage cible au sein de l’éditeur. De cette manière, le tableau hérite intrinsèquement de l’ensemble des réglages typographiques, dimensionnels, chromatiques et mathématiques sans déperdition, garantissant une uniformité visuelle absolue d’un volet d’analyse à l’autre.
12.2 Création de modèles institutionnels réutilisables
Dans un contexte d’ingénierie d’entreprise, la standardisation ne peut dépendre de l’effort individuel consenti par chaque analyste à chaque nouveau projet ; elle doit être matérialisée dans un artefact institutionnel normatif : le classeur modèle (Template). La conception d’un tel classeur étalon constitue la clé de voûte de la gouvernance des données d’une direction analytique.
Ce classeur modèle doit intégrer une feuille de documentation liminaire récapitulant les standards adoptés : la palette chromatique autorisée avec ses codes hexadécimaux stricts, la hiérarchie des polices de caractères, les règles d’espacement des cellules et les formats numériques normalisés. Il comporte également plusieurs instances types de tableaux croisés dynamiques pré-paramétrés et prêts à l’emploi, connectés à des tables de démonstration fictives mais structurellement conformes.
Pour sanctuariser ce standard, le classeur maître doit être déposé dans l’espace des modèles d’entreprise de l’organisation sur Google Drive, ou configuré avec des accès en lecture stricte forçant l’utilisateur à en faire une copie avant toute modification. Les plages critiques contenant les règles méthodologiques et les segments peuvent être verrouillées via les mécanismes de protection native, empêchant toute dérive stylistique au fil des révisions collaboratives ultérieures.
12.3 Automatisation par Google Apps Script des tâches de formatage
Pour éliminer définitivement l’arbitraire humain et les pertes de temps associées au formatage manuel répétitif, le recours à l’environnement de développement intégré Google Apps Script représente le degré ultime de sophistication technique. En manipulant l’API JavaScript fournie par la plateforme, l’ingénieur de données peut concevoir des scripts capables de formater un tableau croisé dynamique en une fraction de seconde avec une précision mathématique absolue.
Les classes fondamentales PivotTable et Range permettent d’accéder programmatique ment à l’ensemble des composants structurels de la matrice. Un script d’automatisation peut ainsi parcourir les lignes de la table, identifier de manière autonome la rangée finale réservée aux totaux généraux, lui assigner instantanément la double bordure inférieure réglementaire, appliquer les masques numériques monétaires personnalisés sur les plages scalaires et contraindre la hauteur des rangées à exactement 28 pixels.
De surcroît, ces procédures écrites en Apps Script peuvent être couplées à des déclencheurs événementiels (triggers) de type onEdit ou programmés à intervalles temporels réguliers (ex. chaque nuit après l’ingestion automatisée des flux de données depuis l’entrepôt de données). Dès que les données sources sont rafraîchies, le script s’exécute silencieusement en arrière-plan pour restaurer l’intégrité stylistique, redresser les alignements et réaligner la palette chromatique sur la charte officielle, sanctuarisant ainsi la perfection du rapport sans exiger la moindre intervention manuelle.
13. Synthèse, audit de lisibilité et bonnes pratiques de publication
13.1 Grille d’évaluation heuristique de la qualité visuelle du tableau
Au terme du parcours de configuration et avant toute dissémination du rapport auprès des instances décisionnelles ou de la communauté scientifique, l’analyste doit soumettre son artefact à une évaluation heuristique rigoureuse. Cette démarche d’assurance qualité vise à valider la conformité du document au regard des canons de l’ergonomie cognitive et du design d’information.
Cette grille d’audit méthodique peut être formalisée sous la forme d’une liste de points de contrôle critiques à passer en revue de manière systématique :
- Intégrité du ratio Data-to-Ink : Toutes les bordures verticales ont-elles été éliminées ? Le quadrillage d’arrière-plan est-il inexistant ou maintenu à un niveau de gris quasi imperceptible ?
- Orthogonalité des alignements : Les libellés textuels sont-ils tous justifiés à gauche et l’intégralité des grandeurs scalaires strictement alignée à droite ?
- Stabilité et précision numérique : Les valeurs monétaires sont-elles débarrassées de décimales superflues ? Les pourcentages affichent-ils une précision constante et leur somme boucle-t-elle exactement à 100,0 % ?
- Sobriété sémiotique : La couleur vive est-elle confinée aux seules alertes conditionnelles d’exception, en évitant toute saturation agressive des fonds de cellules ?
- Transparence méthodologique : Les intitulés d’en-têtes sont-ils débarrassés des scories automatiques du compilateur (ex. « Somme de… ») et explicitent-ils clairement les unités métriques employées ?
Un test empirique d’une redoutable efficacité consiste enfin à soumettre le tableau durant cinq secondes à un observateur témoin non initié, puis à lui retirer le support. Si le cobaye est incapable de formuler en une phrase la conclusion majeure portée par le tableau (le centre de gravité de la rentabilité, l’anomalie la plus saillante ou la tendance chronologique dominante), le tableau pèche par encombrement cognitif et doit être immédiatement réélagué.
13.2 Protocoles d’exportation académique et d’intégration documentaire
La vie d’un tableau croisé dynamique ne s’arrête pas aux frontières de son classeur d’origine : il est fréquemment vocation à être exporté vers des supports de communication pérennes tels que des mémoires académiques, des rapports annuels imprimés au format PDF, ou des projections exécutives sur Google Docs et Google Slides. Cette transition inter-applicative exige des ajustements techniques spécifiques pour éviter toute dégradation visuelle.
Lors de la préparation d’une exportation physique ou d’une impression en document PDF (via Fichier > Imprimer), l’analyste doit veiller avec la plus haute vigilance à la gestion des sauts de page. Rien ne nuit davantage à la lisibilité que le scindement horizontal d’un tableau croisé entre deux pages distinctes. Il convient de forcer l’orientation en mode paysage si l’envergure des colonnes l’impose, de contraindre l’échelle d’impression sur l’option Ajuster à la largeur, et surtout d’activer impérativement le commutateur Répéter les lignes d’en-tête sous l’onglet de mise en page. Cette directive assure que chaque page imprimée conserve sa boussole sémiologique supérieure si la matrice s’étend sur plusieurs feuillets successifs.
Concernant l’intégration dynamique au sein de présentations Google Slides ou de documents Google Docs, il est impératif d’exploiter le mécanisme de liaison dynamique lors du collage (option Associer à la feuille de calcul). Ce pont logiciel maintient une synchronisation vivante : toute modification ultérieure apportée aux filtres ou aux formats du tableau source dans Google Sheets pourra être répercutée d’un simple clic sur le bouton de mise à jour dans le document final de présentation, préservant ainsi la cohérence des chiffres communiqués à travers l’ensemble des vecteurs de publication institutionnels.
13.3 Perspectives sur l’évolution des interfaces d’analyse visuelle
L’ingénierie de la restitution tabulaire de données traverse actuellement une mutation fondamentale impulsée par la convergence de l’intelligence artificielle générative et des moteurs de calcul décisionnel cloud. Les fonctionnalités d’assistance algorithmique—incarnées par des modèles d’apprentissage intégrés tels que Google Gemini dans l’espace Google Workspace—commencent déjà à suggérer des restructurations de champs et des raffinements esthétiques automatisés basés sur la détection sémantique de la nature des variables compilées.
Cependant, l’automatisation de plus en plus poussée du traitement matriciel ne rend aucunement caduque la maîtrise des principes fondamentaux de l’ergonomie visuelle par l’analyste humain ; elle l’élève au contraire au rang de compétence stratégique distinctive. À l’heure où les générateurs automatisés peuvent produire des dizaines de représentations graphiques et de tableaux de bord de Business Intelligence (BI) en quelques fractions de seconde, la capacité d’exercer un jugement critique éclairé, de purger le bruit sémiotique et d’orchestrer une scénographie cognitive rigoureuse demeure l’apanage exclusif de l’intelligence humaine.
La rigueur formelle appliquée aux tableaux croisés dynamiques dans Google Sheets s’affirme en définitive comme un invariant de la communication quantitative contemporaine. Loin d’être un simple exercice de cosmétique bureautique, le formatage méthodique constitue un acte d’éthique intellectuelle : il témoigne d’un profond respect pour le temps et l’attention du lecteur, garantissant que la complexité inhérente aux grands ensembles de données ne se transforme jamais en obscurité, mais devienne au contraire un vecteur de compréhension lucide, d’action résolue et d’impact stratégique durable.
Références
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions de l’École des Hautes Études en Sciences Sociales (EHESS). Paris : Mouton & Gauthier-Villars.
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
- Few, S. (2012). Show me the numbers: Designing tables and graphs to enlighten (2e éd.). Burlingame, CA : Analytics Press.
- Google Workspace. (2023). Créer et utiliser des tableaux croisés dynamiques. Centre d’aide Google Docs. https://support.google.com/docs/answer/1272900
- Koffka, K. (1935). Principles of Gestalt psychology. New York : Harcourt, Brace & World.
- Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257–285. https://doi.org/10.1207/s15516709cog1202_4
- Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Cheshire, CT : Graphics Press.
- Wertheimer, M. (1923). Untersuchungen zur Lehre von der Gestalt. II. Psychologische Forschung, 4(1), 301–350. https://doi.org/10.1007/BF00410640
- World Wide Web Consortium (W3C). (2018). Web content accessibility guidelines (WCAG) 2.1. W3C Recommendation. https://www.w3.org/TR/WCAG21/