
Dans le champ de la modélisation statistique appliquée aux sciences humaines, sociales et comportementales, l’ajustement d’un modèle de régression linéaire constitue l’une des démarches analytiques les plus fondamentales. Les chercheurs cherchent constamment à caractériser la nature des relations unissant différentes variables empiriques, qu’il s’agisse de mesurer l’impact du stress perçu sur la performance cognitive, de quantifier l’efficacité d’un protocole psychothérapeutique ou de prédire le rendement académique en fonction d’indicateurs socio-émotionnels. Néanmoins, l’estimation d’une droite de régression par la méthode des moindres carrés ordinaires ne représente que la première étape d’un processus diagnostique rigoureux. Déterminer une fonction mathématique optimale ne garantit en rien que celle-ci offre une précision suffisante pour appuyer des décisions cliniques, organisationnelles ou sociétales fiables.
C’est précisément à cette jonction critique entre modélisation théorique et réalité empirique qu’intervient l’erreur type de l’estimation (souvent désignée par Se ou σest). Alors que les indices d’association relative, à l’instar du coefficient de détermination ou du coefficient de corrélation de Pearson, renseignent sur la proportion de variance partagée ou la force globale de la liaison, ils demeurent aveugles à la métrique brute de la variable observée. L’erreur type de l’estimation comble ce vide méthodologique en mesurant la dispersion concrète des données autour de la fonction de régression, exprimée directement dans l’unité d’origine de la variable dépendante. Elle fournit ainsi aux cliniciens et aux méthodologistes une estimation tangible de l’amplitude typique des erreurs prédictives commises par le modèle.
La compréhension approfondie de cette métrique s’avère indispensable pour quiconque souhaite interpréter correctement la robustesse d’un modèle statistique. Trop souvent confondue avec l’erreur type de la moyenne, l’erreur quadratique moyenne ou la simple variance des erreurs, l’erreur type de l’estimation possède des propriétés algébriques, géométriques et probabilistes singulières. Ce guide exhaustif explore de façon détaillée les fondements mathématiques, les procédures de dérivation manuelle, les protocoles computationnels sous Excel, R et IBM SPSS, ainsi que les implications méthodologiques majeures de l’erreur type de l’estimation dans le contexte de la recherche contemporaine.
1. Introduction conceptuelle à l’erreur type de l’estimation en régression
1.1 Définition formelle et terminologie statistique
L’erreur type de l’estimation mesure la précision avec laquelle un modèle de régression linéaire estime les valeurs réelles de la variable dépendante. Sur le plan formel, elle quantifie l’écart quadratique moyen entre les valeurs observées au sein d’un échantillon empirique et les valeurs prédites par la droite de régression des moindres carrés ordinaires. Contrairement aux coefficients adimensionnels, cette métrique conserve rigoureusement l’échelle de mesure originale de la variable prédite, ce qui lui confère une valeur pragmatique immédiate pour les praticiens soucieux de connaître l’ampleur moyenne des déviations exprimée en points de score, en millisecondes ou en milligrammes.
Dans la littérature scientifique internationale, la notation standard fluctue selon que l’on aborde le paramètre populationnel ou son estimateur échantillonnal. On rencontre couramment la notation σest ou σy|x pour désigner l’écart-type théorique de la population des résidus conditionnellement aux valeurs de la variable indépendante, tandis que les symboles Se, sy.x ou encore RSE (pour Residual Standard Error dans l’écosystème du logiciel R) qualifient la statistique calculée sur un échantillon empirique. Cette notation rigoureuse rappelle que la dispersion mesurée est conditionnelle : il s’agit de la variabilité des données résiduelles après avoir soustrait l’effet systématique du prédicteur linéaire.
Le rôle fondamental de l’erreur type de l’estimation réside dans l’évaluation de la proximité physique des observations par rapport à l’hypersurface ou à la droite ajustée. Alors qu’une estimation ponctuelle issue de l’équation de régression n’indique qu’une valeur centrale théorique (l’espérance conditionnelle), la dispersion des résidus formalisée par Se matérialise l’enveloppe probabiliste d’incertitude dans laquelle la majorité des observations réelles sont susceptibles de se situer. C’est l’étalon par excellence de la précision prédictive absolue d’un système de variables.
1.2 Pertinence méthodologique dans la recherche empirique
Dans le domaine des sciences humaines et sociales, la variabilité interindividuelle et la présence inévitable de bruit de mesure imposent des contraintes méthodologiques sévères. Lors de l’évaluation de modèles prédictifs régissant des comportements humains, postuler qu’un individu correspondra rigoureusement à la prédiction d’une équation linéaire relève d’une illusion mécaniste. L’erreur type de l’estimation offre le cadre nécessaire pour quantifier cette incertitude inhérente, fournissant un ancrage probabiliste indispensable à toute application diagnostique ou pronostique sérieuse.
Dans les protocoles psychométriques, la distinction entre la corrélation théorique et la précision prédictive pratique se révèle cruciale. Un modèle corrélant des habiletés visuospatiales avec le succès à des épreuves motrices complexes peut afficher un coefficient de Pearson très élevé (par exemple, r = 0,85), ce qui suggère une association statistiquement solide. Toutefois, si la variance intrinsèque de la variable dépendante est immense, l’erreur type de l’estimation correspondante peut s’avérer trop large pour autoriser une prédiction individuelle utilisable dans un cadre de sélection professionnelle ou de remédiation cognitive ciblée. La dépendance exclusive aux indices de corrélation masque souvent l’inaptitude d’un modèle à délivrer des prévisions cliniquement acceptables.
La recherche translationnelle exige ainsi de confronter systématiquement l’ampleur de Se aux seuils de significativité clinique minimale. Si l’erreur type d’un modèle prédisant l’intensité des symptômes anxieux dépasse l’écart critique caractérisant une rémission thérapeutique, le modèle, bien que statistiquement valide à l’échelle de la population, devient méthodologiquement caduc pour l’évaluation individualisée des patients. Cette dialectique entre validité globale et applicabilité ponctuelle situe l’erreur type de l’estimation au cœur de la rigueur scientifique appliquée.
1.3 Différenciation fondamentale : résidus, variance et erreur type
L’articulation théorique de l’erreur type repose sur une hiérarchie conceptuelle rigoureuse débutant par l’observation du résidu individuel. Pour un individu statistique donné, noté i, le résidu représente la divergence arithmétique simple entre la valeur observée empiriquement (yi) et la valeur projetée par le modèle linéaire (ŷi). Ce résidu, symbolisé par ei = yi – ŷi, constitue une quantité signée : un résidu positif signale une sous-estimation par le modèle, tandis qu’un résidu négatif traduit une surestimation. Pris isolément, chaque résidu reflète l’erreur d’ajustement relative à un point précis de l’espace d’observation.
En vertu du principe des moindres carrés ordinaires, la somme arithmétique de ces résidus simples est rigoureusement égale à zéro, ce qui interdit l’usage d’une moyenne directe des écarts pour évaluer l’erreur globale. L’étape analytique subséquente consiste donc à élever chaque résidu au carré, éliminant ainsi les signes négatifs et accordant un poids plus lourd aux déviations de grande magnitude. La somme de ces carrés individuels constitue la somme des carrés résiduels (notée SSE pour Sum of Squared Errors). En divisant cette somme par les degrés de liberté adéquats de l’échantillon, on obtient la variance résiduelle (ou carré moyen des erreurs, MSE), qui synthétise la variance des données conditionnellement au modèle, mais exprimée dans une unité quadratique abstraite.
L’erreur type de l’estimation apparaît alors comme le terme final de cette chaîne de dérivation : elle correspond à l’extraction de la racine carrée arithmétique de la variance résiduelle. Cette opération ultime permet de ramener l’indice de dispersion à l’unité de mesure directe de la variable dépendante. L’erreur type de l’estimation représente par conséquent l’écart-type de la distribution empirique des résidus, complétant le cycle analytique allant de la déviation ponctuelle à la métrique de précision globale.
2. Fondements mathématiques et formulation algébrique
2.1 Formule populationnelle théorique
Dans un cadre purement théorique où l’on disposerait des observations exhaustives pour l’ensemble d’une population cible finie de taille N, l’erreur type de l’estimation populationnelle, notée σest ou σy|x, se définit comme l’écart quadratique moyen des déviations verticales par rapport à la droite de régression paramétrique. L’expression formelle s’écrit comme suit :
σest = √ [ Σ(yi – ŷi)² / N ]
Le numérateur de cette fraction regroupe la somme des carrés des erreurs, Σ(yi – ŷi)², calculée pour chaque membre de la population complète. Ce terme agrège l’ensemble de la variabilité qui n’a pu être capturée par la combinaison linéaire du modèle. Le dénominateur N reflète quant à lui l’intégralité des unités statistiques répertoriées, ne nécessitant aucun ajustement pour perte d’information puisque les véritables paramètres de régression de la population (β0 et β1) sont postulés connus de manière exacte et non estimés à partir d’un fragment empirique.
Sous l’angle asymptotique et probabiliste, cette formulation suppose que les erreurs se distribuent de façon continue et stationnaire sur toute l’étendue du domaine de la variable indépendante. Lorsque la taille de la population tend vers l’infini, la distribution limite de l’erreur converge vers une loi normale centrée d’écart-type σest, à condition que soient respectées les hypothèses de base du modèle linéaire gaussien classique définies par la théorie de Gauss-Markov.
2.2 Ajustement échantillonnal et degrés de liberté
Dans la pratique de la recherche scientifique, il est virtuellement impossible d’accéder à l’ensemble d’une population statistique. Les analystes opèrent exclusivement sur des échantillons restreints comprenant n observations. Si l’on appliquait directement la formule populationnelle en divisant la somme des carrés résiduels par n, l’estimateur résultant souffrirait d’un biais systématique à la baisse : il sous-estimerait la véritable dispersion des erreurs dans la population générale, en raison du fait que la droite des moindres carrés est mathématiquement configurée pour minimiser la somme des carrés au sein de cet échantillon précis.
Afin de corriger ce biais et de garantir l’obtention d’un estimateur sans biais de la variance résiduelle de la population, il convient de substituer à n le nombre réel de degrés de liberté résiduels. Dans le cadre d’une régression linéaire simple univariée, le dénominateur devient n – 2 :
Se = √ [ Σ(yi – ŷi)² / (n – 2) ]
La déduction de deux degrés de liberté s’explique par la nécessité d’estimer préalablement deux paramètres inconnus à partir des données : la pente empirique (b1) et la constante ou ordonnée à l’origine (b0). Chaque paramètre estimé impose une contrainte linéaire stricte sur les résidus, réduisant d’autant la dimensionnalité de l’espace dans lequel ils peuvent fluctuer librement. Sur les petits échantillons fréquemment manipulés en psychologie expérimentale (par exemple n = 15 ou n = 20), l’impact de ce correctif est majeur : diviser par n – 2 plutôt que par n accroît notablement la valeur de Se, empêchant le chercheur de surestimer indûment la précision de son modèle.
Cette logique s’étend naturellement à la régression linéaire multiple impliquant k prédicteurs distincts. Dans ce cadre étendu, le dénominateur s’ajuste pour devenir n – k – 1, où k représente le nombre de variables explicatives et le terme additionnel un correspond à l’ordonnée à l’origine. Ainsi, plus un modèle intègre de régresseurs, plus il consomme de degrés de liberté, ce qui pénalise mécaniquement l’erreur type de l’estimation si les covariables additionnelles ne réduisent pas drastiquement la somme des carrés résiduels.
2.3 Lien avec la somme des carrés des résidus (SSE)
L’erreur type de l’estimation est intimement liée à la décomposition classique de la variabilité globale en analyse de variance (ANOVA). L’architecture sous-jacente repose sur le théorème fondamental de partition de la variance, qui stipule que la somme des carrés totale des écarts par rapport à la moyenne générale (SST pour Total Sum of Squares) se scinde parfaitement en deux composantes additives mutuellement orthogonales : la somme des carrés expliquée par la régression (SSR pour Regression Sum of Squares) et la somme des carrés des erreurs résiduelles (SSE) :
SST = SSR + SSE
Dans ce formalisme, la somme des carrés résiduels s’exprime par SSE = Σ(yi – ŷi)². L’erreur type de l’estimation peut dès lors être redéfinie de manière synthétique comme la racine carrée de la moyenne quadratique des résidus (MSE) :
Se = √ [ SSE / (n – p) ]
où p représente le nombre total de coefficients estimés dans le modèle linéaire (dans le cas univarié simple, p = 2). Cette écriture met en lumière le fait que Se dépend directement de la variance non capturée par le système d’explication linéaire.
Sur le plan calculatoire, avant l’avènement des calculateurs numériques modernes, le calcul manuel direct de chaque résidu individuel (yi – ŷi) représentait une source récurrente d’erreurs d’arrondi. Les statisticiens exploitaient une dérivation algébrique simplifiée, déduite des équations normales des moindres carrés, permettant de calculer SSE à partir des sommes brutes sans évaluer individuellement les valeurs prédites :
SSE = Σy² – b0Σy – b1Σxy
En substituant cette équivalence dans l’expression de Se, on obtient une équation computationnelle directe :
Se = √ [ (Σy² – b0Σy – b1Σxy) / (n – 2) ]
Cette formulation démontre la dépendance directe de l’erreur type vis-à-vis des produits croisés et des moments d’ordre deux des variables étudiées, facilitant l’évaluation rapide de la variance résiduelle dans les analyses computationnelles séquentielles.
3. Interprétation géométrique et comportement de la dispersion
3.1 Topographie des points autour de la droite de régression
Pour appréhender l’erreur type de l’estimation de manière intuitive, il est particulièrement instructif d’adopter une perspective géométrique dans un repère cartésien bidimensionnel. L’équation de régression ŷ = b0 + b1x définit une trajectoire rectiligne représentant la tendance centrale des données conditionnellement à x. Chaque point expérimental individuel (xi, yi) se positionne à une certaine distance de cette droite. L’erreur type de l’estimation ne mesure pas la distance euclidienne orthogonale la plus courte séparant le point de la droite, mais spécifiquement la distance verticale, mesurée le long de l’axe des ordonnées.
Cette focalisation sur la composante verticale découle du statut théorique asymétrique conféré aux deux variables : la variable indépendante x est postulée comme mesurée sans erreur ou contrôlée par le protocole expérimental, tandis que toute l’incertitude aléatoire se concentre sur la variable dépendante y. Géométriquement, l’erreur type matérialise l’épaisseur du nuage de points au-dessus et en dessous de la ligne médiane de régression.
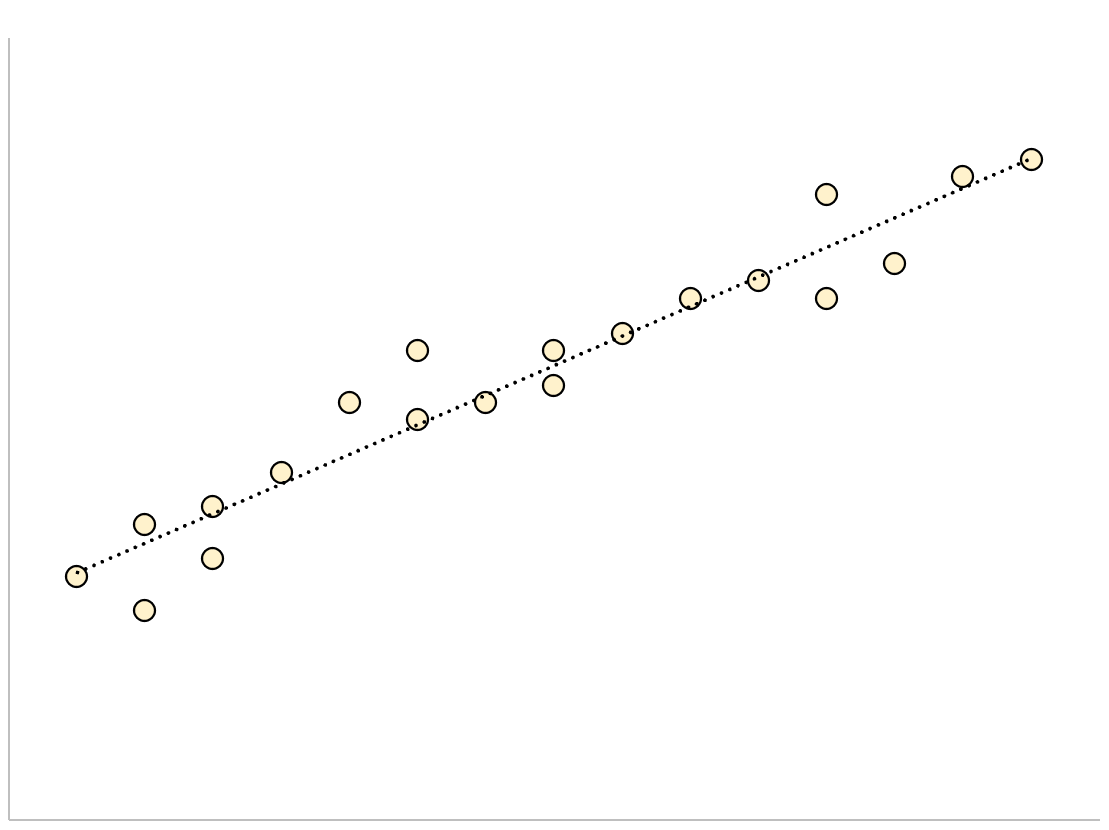
Sur le plan topographique, on peut conceptualiser l’erreur type comme la demi-largeur d’un couloir de dispersion s’étendant de part et d’autre de la droite. Sous l’hypothèse de normalité des résidus, une bande délimitée par ŷ ± 1 Se contient environ 68 % de l’ensemble des points d’observation de l’échantillon, tandis qu’une bande délimitée par ŷ ± 2 Se regroupe approximativement 95 % des observations empiriques. La pente de la droite (b1) oriente la trajectoire centrale, mais c’est l’erreur type qui régit l’expansion volumétrique de cette enveloppe de points.
3.2 Cas d’une erreur type de l’estimation faible
L’observation empirique d’une valeur de Se particulièrement basse indique une compacité exceptionnelle du nuage de points le long de l’axe de régression. Dans une telle configuration, les données observées s’alignent étroitement le long de la fonction linéaire, attestant que la part de variabilité aléatoire non modélisée demeure minime au regard de la précision globale du système de mesure.
Dans les disciplines empiriques comme la psychophysique, la neuropsychologie ou l’analyse des temps de réaction, une erreur type réduite traduit une remarquable homogénéité de la réponse comportementale ou cognitive. Par exemple, si un modèle évalue la latence d’une réponse motrice en fonction de l’intensité d’un stimulus visuel et affiche une erreur type de quelques millisecondes seulement, cela démontre que la dynamique temporelle du sujet ou du groupe étudié obéit à des contraintes neurobiologiques régulières, peu parasitées par des fluctuations attentionnelles parasites ou du bruit instrumentale.
Sur le plan décisionnel, une erreur type ténue renforce considérablement la fiabilité des inférences individualisées. Le praticien peut formuler des prédictions ciblées en conservant un degré élevé de certitude : l’écart entre la réalité clinique qui sera observée ultérieurement et la projection issue du modèle a de fortes probabilités d’être négligeable. Cela atteste d’une capacité explicative optimale du prédicteur sélectionné, signalant que les variables prépondérantes ont été correctement intégrées au modèle mathématique.
3.3 Cas d’une erreur type de l’estimation élevée
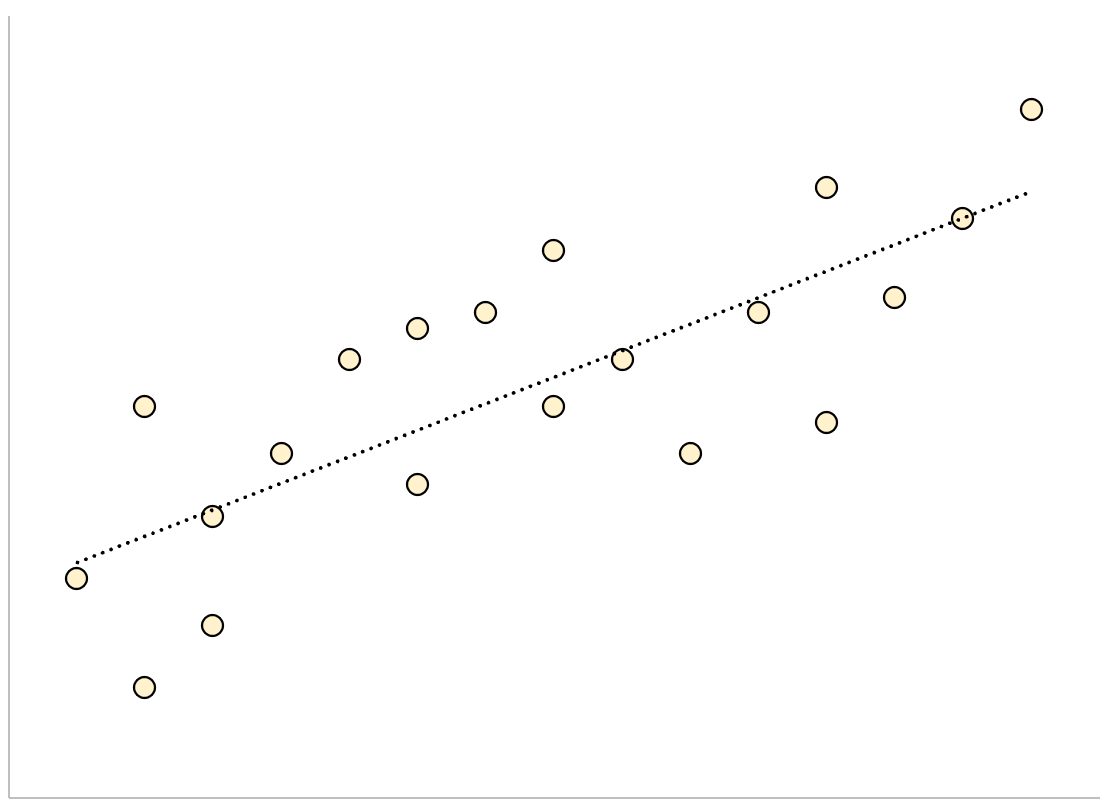
À l’opposé, une valeur élevée de Se témoigne d’un éclatement spatial marqué des observations autour de la droite de régression. Le nuage de points se caractérise par une dispersion verticale volumineuse, suggérant que des individus partageant rigoureusement le même niveau sur la variable explicative x manifestent des valeurs remarquablement divergentes sur la variable dépendante y.
Cette dispersion volumineuse est le symptôme direct de l’influence de facteurs non contrôlés ou de sources massives d’erreur de mesure. En psychologie clinique et sociale, une erreur type étendue reflète souvent la nature multifactorielle du phénomène investigué : vouloir expliquer un construit aussi complexe que la rechute dépressive ou l’épuisement professionnel à l’aide d’un prédicteur isolé aboutit immanquablement à une erreur type considérable. Le phénomène sous-jacent est régulé par une constellation d’antécédents biologiques, environnementaux et biographiques absents du modèle univarié.
L’exploitation pratique d’un modèle caractérisé par une erreur type massive comporte des risques substantiels, particulièrement dans les contextes diagnostiques, thérapeutiques ou légaux. Des marges d’incertitude trop dilatées rendent toute prédiction individuelle virtuellement inutilisable : annoncer qu’un sujet obtiendra un score d’efficience intellectuelle compris entre 80 et 130 n’apporte aucune valeur informative exploitable. Dans une telle conjoncture, le chercheur se trouve dans l’obligation théorique d’enrichir sa spécification, soit en intégrant des covariables explicatives additionnelles par le truchement d’une régression multiple, soit en explorant des dynamiques non linéaires capables d’épouser plus fidèlement la courbure des données.
4. Comparaison critique avec d’autres indicateurs de performance
4.1 Erreur type de l’estimation (Se) versus Coefficient de détermination (R²)
Dans la restitution standard des analyses de régression, le coefficient de détermination (R²) et l’erreur type de l’estimation (Se) coexistent systématiquement. Cependant, leurs fonctions diagnostiques sont radicalement dissemblables. Le coefficient de détermination est un indice de proportion sans dimension, normalisé entre 0 et 1, mesurant la fraction relative de variance globale de la variable dépendante absorbée par le modèle mathématique. En revanche, Se constitue une métrique absolue, intrinsèquement ancrée dans l’unité de mesure concrète de y.
Cette divergence conceptuelle entraîne des comportements méthodologiques fondamentaux face à la variabilité de la variable indépendante x. Si un expérimentateur augmente artificiellement l’étendue d’échantillonnage de x (en recrutant des participants aux valeurs extrêmes), la variance totale de y s’accroît généralement, ce qui provoque une hausse mécanique du R² sans que la précision intrinsèque du modèle n’ait changé d’un iota. À l’inverse, l’erreur type de l’estimation fait preuve d’une relative stabilité face à cette manipulation, dès lors que l’hypothèse d’homoscédasticité est respectée. Se reflète la variance purement résiduelle, indépendamment de l’amplitude globale de dispersion de x.
Il est ainsi parfaitement possible d’observer des modèles statistiques arborant un R² apparemment impressionnant (par exemple, 0,85) mais assorti d’une erreur type tellement vaste qu’elle interdit toute application concrète fiable, notamment lorsque la variance initiale du phénomène est astronomique. Réciproquement, un R² modeste (par exemple, 0,25) peut s’accompagner d’une erreur type extrêmement restreinte si la variabilité de base de la variable dépendante est faible. Pour l’ingénieur, le médecin ou le psychologue clinicien, Se s’avère systématiquement plus informatif pour la décision pragmatique que le R², car il décrit directement l’écart maximal probable en unités réelles.
4.2 Erreur type de l’estimation versus Erreur quadratique moyenne (RMSE)
Dans la littérature contemporaine, et plus spécifiquement au confluent de la statistique inférentielle traditionnelle et de l’apprentissage automatique (machine learning), une confusion récurrente persiste entre l’erreur type de l’estimation (Se) et l’erreur quadratique moyenne de la régression, couramment dénommée RMSE (Root Mean Squared Error). Bien que ces deux statistiques quantifient conceptuellement l’écart quadratique moyen des résidus, leur différence repose sur le traitement mathématique du dénominateur :
RMSE = √ [ Σ(yi – ŷi)² / n ]
Se = √ [ Σ(yi – ŷi)² / (n – p) ]
Le calcul du RMSE divise la somme des carrés résiduels par la taille brute de l’échantillon n, omettant sciemment toute pénalisation relative à l’estimation des paramètres libres du modèle. Cette démarche prédomine dans les paradigmes d’apprentissage supervisé, où l’accent est placé sur la minimisation pure de la perte empirique calculée sur un ensemble de validation ou de test indépendant (cross-validation). En revanche, la statistique classique recourt impérativement à Se, intégrant la correction n – p indispensable à l’inférence théorique et à l’exactitude des tests d’hypothèses unilatéraux ou bilatéraux.
Sur le plan asymptotique, lorsque la taille de l’échantillon n s’élève vers des magnitudes importantes (par exemple n > 500), la divergence numérique entre Se et RMSE devient infinitésimale et statistiquement négligeable. Néanmoins, pour des cohortes expérimentales réduites courantes en neuroimagerie ou en recherche clinique pilote, omettre la correction des degrés de liberté biaise l’appréciation de l’erreur prédictive de manière substantielle.
4.3 Erreur type de l’estimation versus Erreur type de la moyenne (SEM)
L’homonymie partielle entre l’erreur type de l’estimation (notée Se) et l’erreur type de la moyenne (fréquemment notée SEM pour Standard Error of the Mean) engendre de graves erreurs d’interprétation dans les publications scientifiques. L’erreur type de la moyenne renvoie à la distribution d’échantillonnage de la moyenne arithmétique d’une seule variable : elle mesure la précision avec laquelle la moyenne d’un échantillon estime la véritable moyenne paramétrique inconnue de la population. Sa formulation canonique est :
SEM = s / √n
où s est l’écart-type de l’échantillon et n sa taille.
Le tableau suivant met en lumière les caractéristiques discriminantes séparant formellement ces deux indices statistiques fondamentaux :
| Critère de comparaison | Erreur type de l’estimation (Se) | Erreur type de la moyenne (SEM) |
|---|---|---|
| Objet d’évaluation | Dispersion des observations individuelles autour d’une fonction de régression conditionnelle. | Fluctuation d’échantillonnage de la moyenne d’une variable isolée autour du paramètre populationnel μ. |
| Formulation algébrique | √ [ Σ(y – ŷ)² / (n – 2) ] | s / √n |
| Sensibilité à la taille (n) | Converge vers une constante non nulle (σest) à mesure que n augmente. | Décroît systématiquement vers zéro à mesure que n tend vers l’infini. |
| Finalité clinique/pratique | Prédire l’incertitude associée à un score individuel unique. | Déterminer la précision d’une estimation agrégée à l’échelle d’un groupe. |
Il est donc conceptuellement fautif de substituer l’un à l’autre. Le SEM s’atténue indéfiniment lorsque la taille de la cohorte s’accroît, alors que Se ne tend aucunement vers zéro : il se stabilise autour de la véritable variabilité résiduelle inhérente au phénomène sous-jacent. Utiliser le SEM pour quantifier l’incertitude prédictive d’une régression constitue une faute méthodologique majeure conduisant à une sous-estimation alarmante des risques prédictifs.
4.4 Erreur absolue moyenne (MAE) et impact des valeurs extrêmes
L’arbitrage entre l’erreur type de l’estimation et l’erreur absolue moyenne (MAE pour Mean Absolute Error) repose sur le traitement accordé aux observations atypiques ou aberrantes (outliers). Le MAE se définit comme la moyenne arithmétique simple des valeurs absolues des résidus :
MAE = (1 / n) Σ|yi – ŷi|
Cette approche linéaire traite chaque déviation de manière strictement proportionnelle à sa magnitude : une erreur d’ajustement de 10 unités pèse exactement dix fois plus qu’une déviation d’une seule unité.
À l’inverse, l’erreur type de l’estimation élève chaque résidu au carré préalablement à la sommation. Par conséquent, elle applique une pénalisation quadratique sévère aux grands écarts : une erreur de 10 unités contribue à hauteur de 100 à la somme des carrés, soit cent fois plus qu’une erreur unitaire. Il en résulte que Se démontre une sensibilité extrême à la présence d’une ou deux valeurs atypiques au sein de la distribution. Un point de levier fortement excentré peut suffire à faire doubler la valeur de l’erreur type de l’estimation, altérant la perception de la précision globale du modèle sur l’ensemble de l’échantillon.
Dans les contextes de recherche où les instruments de recueil génèrent une fraction inévitable d’artefacts extrêmes (par exemple, des données issues de capteurs électrodermaux ou d’enregistrements électroencéphalographiques non nettoyés), le recours comparatif au MAE permet de détecter si l’élévation de Se reflète une imprécision générale du modèle ou si elle découle exclusivement de la distorsion infligée par quelques observations pathologiques isolées.
5. Les postulats statistiques conditionnant la validité de l’estimation
5.1 Homoscédasticité et constance de la variance d’erreur
L’utilisation légitime et l’interprétation probabiliste de l’erreur type de l’estimation reposent sur le respect impératif de plusieurs hypothèses formulées dans le théorème de Gauss-Markov. Parmi celles-ci, le postulat d’homoscédasticité (ou homogénéité de la variance résiduelle) occupe une position centrale. Cette hypothèse stipule que la variance conditionnelle des erreurs doit demeurer rigoureusement invariable sur l’ensemble du domaine de variation de la variable explicative :
Var(εi | xi) = σ² pour tout i
Lorsque cette condition n’est pas remplie, le modèle souffre d’hétéroscédasticité : la dispersion des résidus se dilate ou se contracte en fonction des valeurs du prédicteur, prenant couramment l’apparence visuelle d’un entonnoir ou d’un cône sur les diagrammes diagnostiques.
L’émergence d’une hétéroscédasticité produit des conséquences sévères sur la pertinence de l’erreur type de l’estimation. Si la variance des erreurs s’élargit pour les valeurs élevées de x, rapporter une statistique unique et synthétique Se conduit à une double erreur d’appréciation : l’analyste sous-estime drastiquement l’incertitude prédictive dans la zone de forte dispersion, tout en surestimant l’incertitude dans la zone où les résidus sont étroitement resserrés. L’outil diagnostique de référence consiste à inspecter systématiquement le graphique bidimensionnel des résidus standardisés disposés sur l’axe des ordonnées en regard des valeurs prédites (ŷ) placées sur l’axe des abscisses. L’absence de structure géométrique identifiable, traduisant un nuage rectangulaire homogène de dispersion aléatoire, atteste de la validité de l’homoscédasticité.
5.2 Normalité de la distribution des résidus
Le second postulat fondamental conditionnant l’usage inférentiel de Se concerne la normalité de la distribution des erreurs résiduelles. Il est impératif que les résidus suivent une loi normale dans la population parente :
εi ~ N(0, σ²)
Ce postulat est la clé de voûte autorisant l’application de la célèbre règle empirique (ou règle 68-95-99,7) à l’erreur type de l’estimation. Sous cette hypothèse, le chercheur peut déduire analytiquement que 68,27 % des observations futures se distribueront dans l’intervalle ŷ ± 1 Se, que 95,45 % se situeront dans ŷ ± 2 Se, et que 99,73 % seront intégrées dans l’intervalle ŷ ± 3 Se.
Si la distribution des résidus s’avère asymétrique (présentant un coefficient d’asymétrie prononcé) ou leptokurtique (à queues lourdes), l’interprétation standardisée de Se s’effondre. Bien que l’erreur type de l’estimation demeure une mesure descriptive valide de l’écart quadratique moyen au sein de l’échantillon présent, elle perd son aptitude à définir des seuils de probabilité précis pour les intervalles de prédiction futurs. Les outils méthodologiques recommandés pour valider cette normalité incluent l’examen visuel des diagrammes quantile-quantile normaux (Q-Q plots), sur lesquels les quantiles des résidus standardisés doivent s’aligner sur la diagonale théorique, ainsi que l’administration de tests paramétriques d’adéquation tels que le test de Shapiro-Wilk ou le test de Kolmogorov-Smirnov avec correction de Lilliefors.
5.3 Linéarité structurelle et indépendance résiduelle
Le postulat de linéarité suppose que la véritable relation unissant les variables x et y peut être fidèlement décrite par une équation polynomiale de degré un. Lorsqu’un phénomène physiologique ou comportemental sous-jacent obéit à une trajectoire curvilinéaire (telle que la loi de Yerkes-Dodson décrivant une relation en U inversé entre niveau d’éveil et performance cognitive), forcer l’ajustement d’une droite de régression linéaire simple produit une distorsion structurelle des résidus. Les erreurs ne sont plus réparties de façon aléatoire autour du modèle : elles manifestent des déviations systématiques positives aux extrémités et négatives au centre, ou vice versa.
Cette violation altère profondément la nature de Se. La somme des carrés résiduels agrège alors non seulement le bruit aléatoire incompressible, mais également l’erreur structurelle imputable à la mauvaise spécification du modèle mathématique. L’erreur type de l’estimation s’en trouve artificiellement gonflée, traduisant l’inaptitude du modèle à capturer la géométrie intrinsèque des processus observés.
Parallèlement, l’hypothèse d’indépendance résiduelle exige que les erreurs d’observation successives ne manifestent aucune corrélation entre elles :
Cov(εi, εj) = 0 pour tout i ≠ j
Cette condition est particulièrement vulnérable dans les devis de mesures répétées ou les études longitudinales en psychologie cognitive. Lorsque des participants fournissent des réponses sélectives à travers plusieurs sessions temporelles, les résidus tendent à exhiber une autocorrélation sérielle (souvent évaluée par le test statistique de Durbin-Watson). L’autocorrélation invalide le calcul conventionnel des degrés de liberté n – 2, conduisant à une sous-estimation systématique de l’erreur type et générant des tests de significativité artificiellement trop optimistes.
6. Calcul manuel étape par étape à partir d’un exemple concret
6.1 Présentation du cas psychologique : Anxiété et performance académique
Afin de concrétiser les principes algébriques et géométriques explicités précédemment, considérons une étude expérimentale conduite auprès d’étudiants universitaires soumis à un examen terminal standardisé. Les chercheurs s’intéressent à l’impact du niveau d’anxiété pré-examen sur la performance finale obtenue. L’anxiété est évaluée à l’aide d’une échelle psychométrique validée générant un score composite variant de 1 à 10 (variable indépendante X), tandis que la performance est mesurée par la note finale obtenue à l’examen sur une échelle de 0 à 100 points (variable dépendante Y).
L’échantillon retenu comprend 10 participants sélectionnés aléatoirement (n = 10). Le tableau ci-dessous collige les données empiriques brutes enregistrées pour chaque sujet :
| Participant (i) | Score d’anxiété (X) | Note d’examen (Y) | Produit (X · Y) | Carré de X (X²) | Carré de Y (Y²) |
|---|---|---|---|---|---|
| 1 | 2 | 88 | 176 | 4 | 7744 |
| 2 | 3 | 85 | 255 | 9 | 7225 |
| 3 | 4 | 82 | 328 | 16 | 6724 |
| 4 | 5 | 78 | 390 | 25 | 6084 |
| 5 | 6 | 75 | 450 | 36 | 5625 |
| 6 | 7 | 70 | 490 | 49 | 4900 |
| 7 | 8 | 62 | 496 | 64 | 3844 |
| 8 | 8 | 68 | 544 | 64 | 4624 |
| 9 | 9 | 60 | 540 | 81 | 3600 |
| 10 | 10 | 52 | 520 | 100 | 2704 |
| Total (Σ) | 62 | 720 | 4189 | 448 | 53074 |
L’objectif analytique consiste à modéliser la relation linéaire unissant l’anxiété à la note d’examen, puis à dériver manuellement l’erreur type de l’estimation afin de déterminer avec quelle précision le niveau d’anxiété permet d’anticiper la note finale d’un individu.
6.2 Détermination des paramètres du modèle linéaire
Avant d’accéder au calcul de la variabilité résiduelle, il est indispensable de déterminer les paramètres constitutifs de la droite des moindres carrés ordinaires : la pente b1 et la constante b0. Débutons par l’extraction des moyennes arithmétiques pour les deux distributions :
X̄ = ΣX / n = 62 / 10 = 6,20
Ȳ = ΣY / n = 720 / 10 = 72,00
La pente empirique de régression se définit algébriquement par le ratio entre la covariance empirique non standardisée de X et Y et la variance empirique de X. En exploitant directement les sommes brutes issues du tableau :
b1 = [ ΣXY – (ΣX · ΣY) / n ] / [ ΣX² – (ΣX)² / n ]
Insérons les données numériques colligées :
Numérateur : 4189 – (62 · 720) / 10 = 4189 – 4464 = -275
Dénominateur : 448 – (62)² / 10 = 448 – 384,4 = 63,6
Nous pouvons dès lors déduire la valeur exacte de la pente :
b1 = -275 / 63,6 ≈ -4,323899
Cette pente négative indique qu’en moyenne, pour chaque incrément d’un point supplémentaire sur l’échelle d’anxiété pré-examen, la note académique décroît de façon systématique d’environ 4,32 points. L’ordonnée à l’origine s’obtient alors en réinjectant les moyennes des variables :
b0 = Ȳ – b1X̄ = 72,00 – (-4,323899 · 6,20) = 72,00 + 26,808174 = 98,808174
L’équation prédictive formelle du modèle de régression linéaire simple s’établit par conséquent comme suit :
ŷ = 98,8082 – 4,3239(X)
6.3 Calcul matriciel des valeurs prédites et des résidus individuels
L’équation d’ajustement étant formellement établie, il convient à présent de générer la prédiction théorique ŷi pour chacun des 10 participants de l’échantillon empirique, d’isoler l’écart résiduel (yi – ŷi), puis d’élever chaque résultat au carré afin de former la somme des carrés des erreurs (SSE).
| Sujet (i) | X | Y observé | Y prédit (ŷ) | Résidu (y – ŷ) | Résidu au carré (y – ŷ)² |
|---|---|---|---|---|---|
| 1 | 2 | 88 | 90,1604 | -2,1604 | 4,6673 |
| 2 | 3 | 85 | 85,8365 | -0,8365 | 0,6997 |
| 3 | 4 | 82 | 81,5126 | +0,4874 | 0,2376 |
| 4 | 5 | 78 | 77,1887 | +0,8113 | 0,6582 |
| 5 | 6 | 75 | 72,8648 | +2,1352 | 4,5591 |
| 6 | 7 | 70 | 68,5409 | +1,4591 | 2,1290 |
| 7 | 8 | 62 | 64,2170 | -2,2170 | 4,9151 |
| 8 | 8 | 68 | 64,2170 | +3,7830 | 14,3111 |
| 9 | 9 | 60 | 59,8931 | +0,1069 | 0,0114 |
| 10 | 10 | 52 | 55,5692 | -3,5692 | 12,7392 |
| Total (Σ) | 62 | 720 | 720,0002 | -0,0002 ≈ 0 | 44,9277 |
Ce tableau matriciel illustre plusieurs propriétés cardinales de la régression par la méthode des moindres carrés ordinaires. D’une part, la somme des valeurs prédites (720,00) est rigoureusement identique à la somme des valeurs observées empiriquement. D’autre part, la somme algébrique des déviations résiduelles est égale à zéro (aux approximations d’arrondi décimal près). Enfin, la sommation de la dernière colonne nous fournit directement la quantité fondamentale recherchée :
SSE = Σ(yi – ŷi)² = 44,9277
6.4 Application finale de la formule et déduction de Se
Disposant de la somme des carrés des erreurs résiduelles et du nombre d’unités statistiques formant l’échantillon expérimental (n = 10), nous procédons à l’application finale de la formule d’estimation corrigée pour les degrés de liberté :
ddl = n – 2 = 10 – 2 = 8
La première étape réside dans la détermination de la variance résiduelle de l’échantillon (carré moyen des erreurs) :
s²e = MSE = SSE / (n – 2) = 44,9277 / 8 = 5,61596
L’erreur type de l’estimation s’obtient alors en extrayant la racine carrée de cette variance conditionnelle :
Se = √5,61596 ≈ 2,3698 points
L’interprétation verbale contextualisée de cette grandeur se formule de la façon suivante : en utilisant l’équation linéaire ŷ = 98,81 – 4,32(X) pour estimer les notes académiques sur la base de l’anxiété pré-examen, l’erreur moyenne type commise sur l’échantillon d’étudiants est d’approximativement 2,37 points de note. Si l’on postule la normalité de la distribution des résidus, environ deux tiers des notes réelles des étudiants se situeront dans une fenêtre de ± 2,37 points autour de leur note prédite, et plus de 95 % des performances académiques individuelles se matérialiseront dans un intervalle de ± 4,74 points (soit deux fois l’erreur type) par rapport au score projeté.
7. Procédure d’obtention de l’erreur type sous Microsoft Excel
7.1 Structuration et saisie des colonnes de données
Microsoft Excel constitue l’un des environnements logiciels les plus répandus dans les administrations académiques et les laboratoires de recherche pour l’organisation primaire et le criblage préliminaire des données expérimentales. Pour conduire une estimation sans faille de l’erreur type de la régression, une organisation matricielle rigoureuse s’impose dès l’étape de saisie brute dans la feuille de calcul.
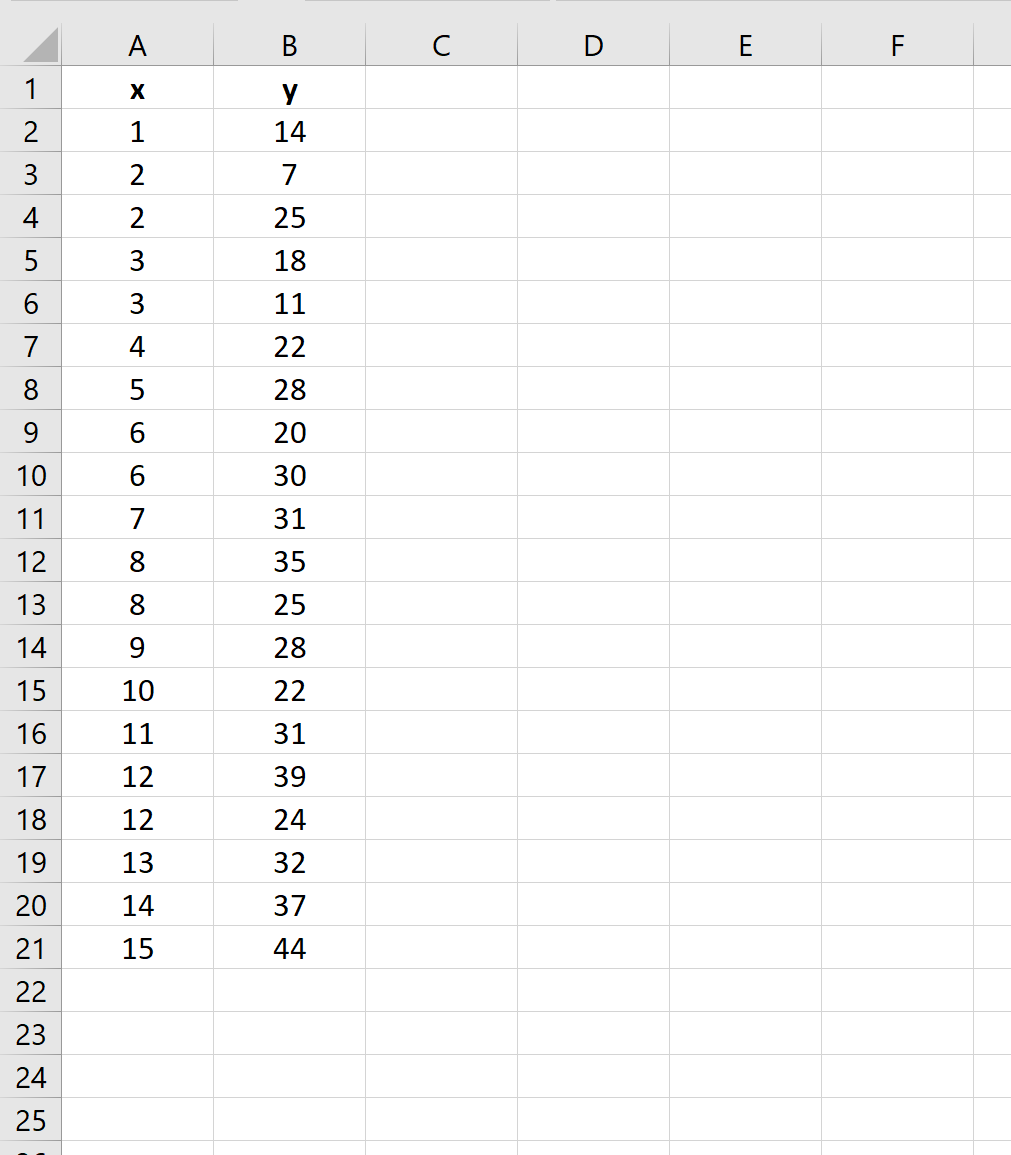
Il convient de structurer les données sous forme de colonnes adjacentes strictement délimitées. Par convention méthodologique, la colonne A accueillera les valeurs numériques relatives à la variable dépendante Y (par exemple, les scores de performance académique s’étendant de la cellule A2 à A11), tandis que la colonne B recevra les mesures associées à la variable explicative X (les niveaux d’anxiété placés de la cellule B2 à B11). La première ligne du tableau doit impérativement être réservée aux étiquettes textuelles de variables afin de garantir une traçabilité parfaite.
Avant d’exécuter la moindre formule computationnelle, il est capital de s’assurer de l’intégrité du typage des données. Excel ne doit identifier aucun résidu textuel, caractère d’espacement involontaire ou séparateur décimal non conforme (par exemple, une virgule au lieu d’un point selon les configurations régionales linguistiques du système d’exploitation). De surcroît, la présence de cellules vides au sein de l’une des plages désignées fausserait instantanément le calcul matriciel, générant des messages d’erreur d’incompatibilité dimensionnelle.
7.2 Utilisation de la fonction native ERREUR.TYPE.REG
L’application tableur intègre une fonction native algorithmique spécialement configurée pour délivrer directement l’erreur type de l’estimation sans exiger la construction de tableaux d’étapes fastidieux. Il s’agit de la commande ERREUR.TYPE.REG (ou STEYX dans les versions anglophones du logiciel). Sa syntaxe d’exécution formelle s’articule comme suit :
=ERREUR.TYPE.REG(données_y ; données_x)
Un écueil classique commis par de nombreux utilisateurs occasionnels réside dans l’inversion involontaire de l’ordre d’insertion des arguments. La syntaxe d’Excel impose de déclarer en premier lieu la plage correspondant aux valeurs de la variable dépendante Y, puis de renseigner en second lieu le vecteur des valeurs de la variable indépendante X. Pour notre cas empirique développé en section 6, la formule dynamique s’écrira précisément :
=ERREUR.TYPE.REG(A2:A11 ; B2:B11)
Dès la validation de l’instruction, Excel renvoie instantanément la valeur exacte 2,369802. L’atout déterminant de cette fonction réside dans sa réactivité dynamique : si l’analyste modifie la valeur de performance ou d’anxiété d’un participant quelconque au sein de la matrice, l’erreur type de l’estimation est recalculée de manière synchrone, offrant un outil précieux pour conduire des analyses de sensibilité ou simuler l’exclusion temporaire d’observations potentiellement aberrantes.
7.3 Extraction via le module Utilitaire d’analyse statistique
Pour obtenir un aperçu analytique complet incluant l’ensemble des métriques inférentielles, l’utilisation du complément officiel Utilitaire d’analyse (Analysis ToolPak) d’Excel est particulièrement préconisée. Si ce module n’apparaît pas dans l’onglet « Données », son activation s’effectue via le menu Fichier > Options > Compléments > Gérer : Compléments Excel > Cocher « Utilitaire d’analyse ».
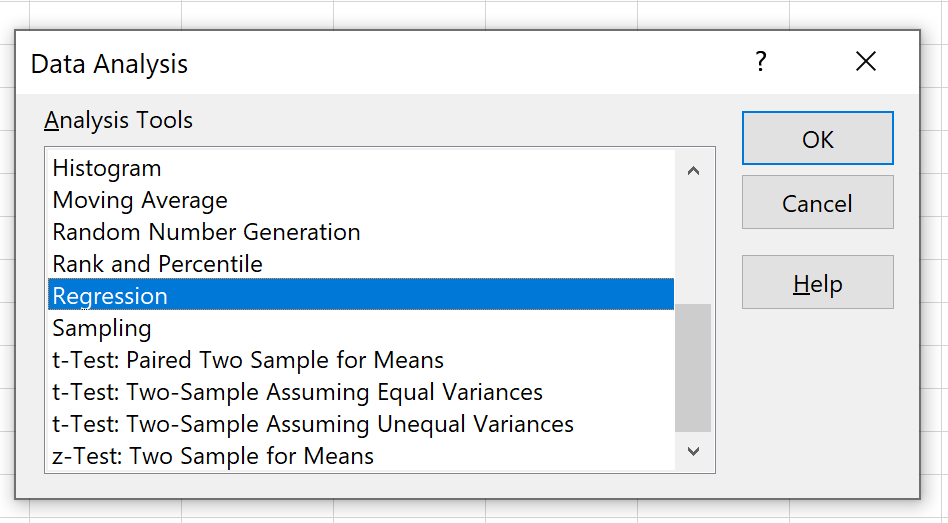
Une fois le module activé, la procédure opérationnelle se déploie à travers les étapes suivantes :
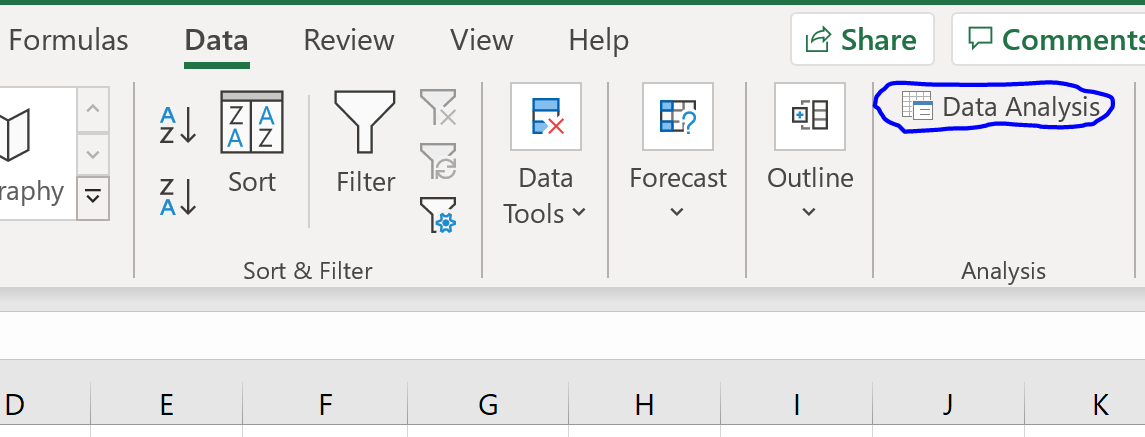
- Cliquer sur le bouton Utilitaire d’analyse situé à l’extrémité droite de l’onglet « Données ».
- Faire défiler la liste des algorithmes disponibles et sélectionner l’élément Régression, puis confirmer par « OK ».
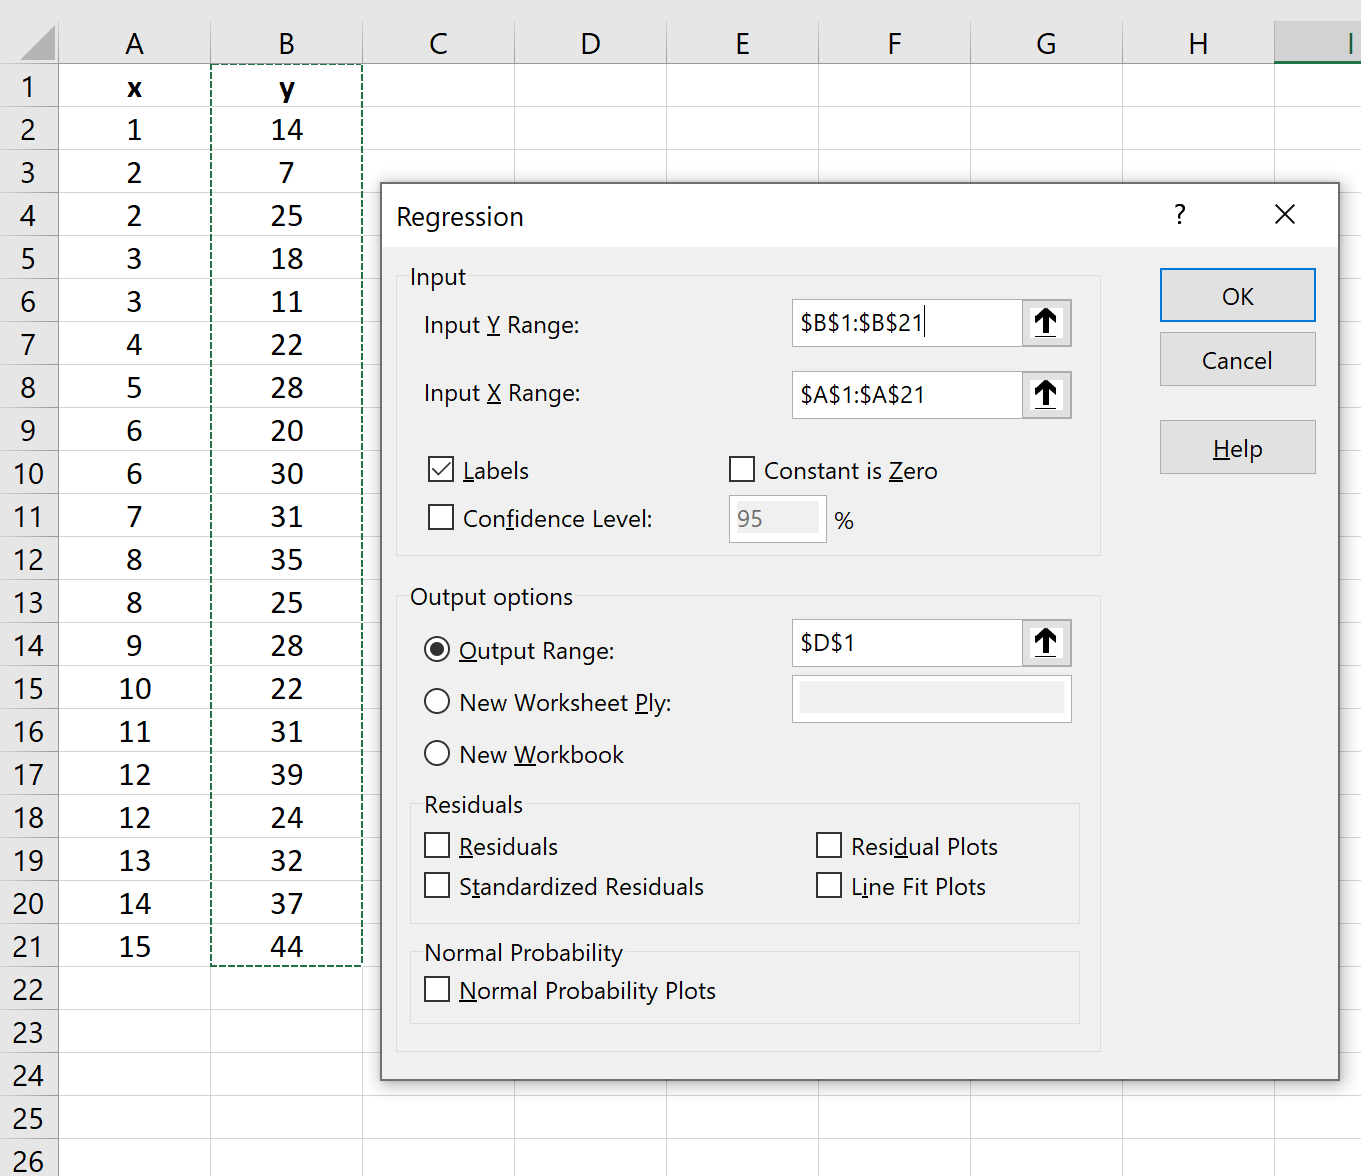
- Dans le champ intitulé Plage d’entrée Y, sélectionner la plage continue contenant la variable dépendante avec son étiquette (ex. :
$A$1:$A$11). - Dans le champ Plage d’entrée X, sélectionner la plage contenant le prédicteur avec son en-tête (ex. :
$B$1:$B$11). - Cocher impérativement la case Intitulés si les noms de colonnes ont été inclus dans la sélection.
- Définir la zone de sortie souhaitée sur une nouvelle feuille de calcul, puis valider.
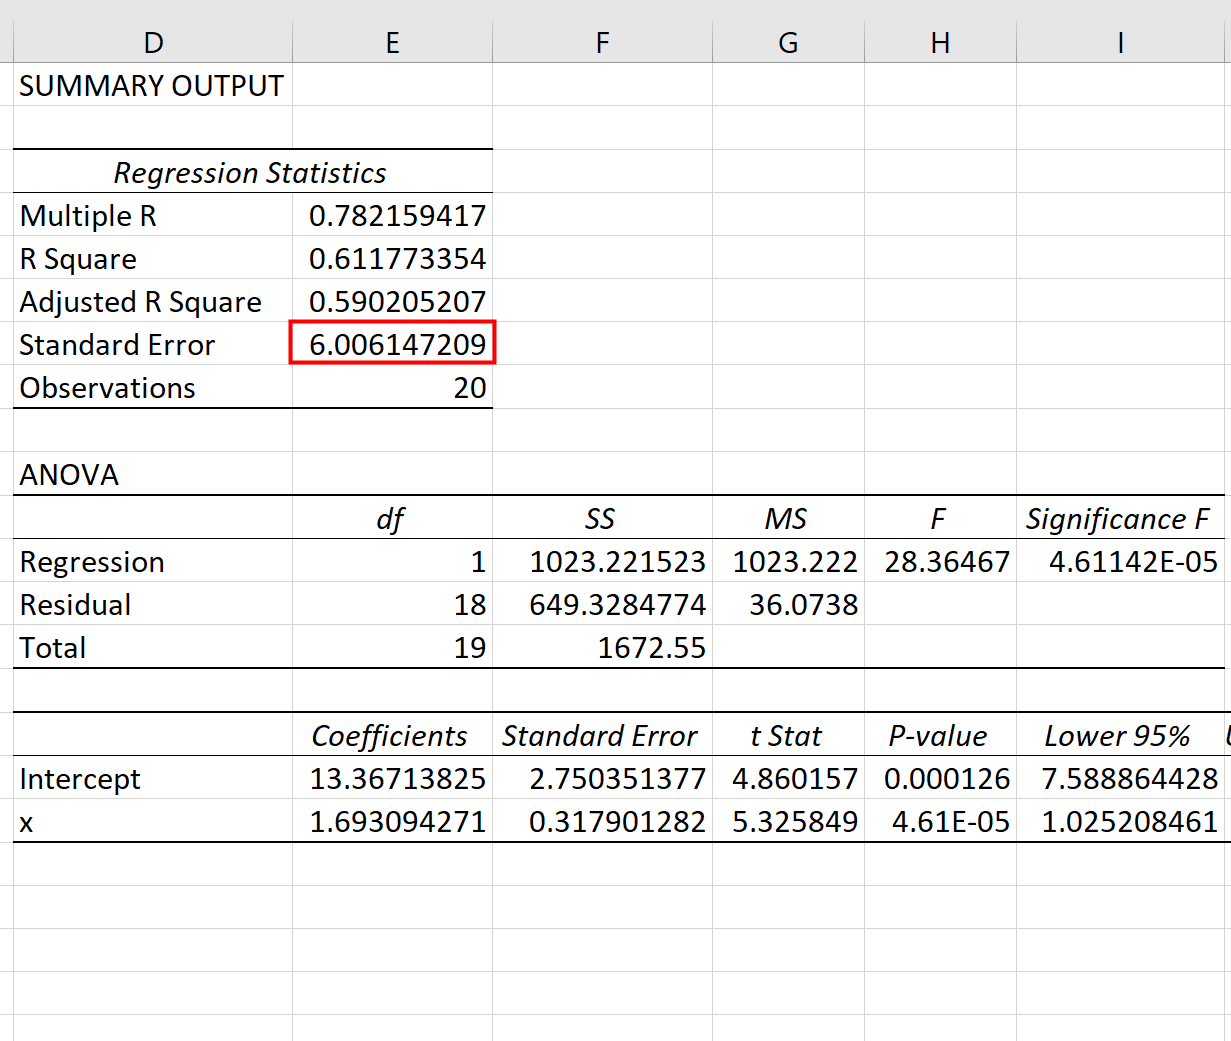
Le module génère instantanément un ensemble de trois tableaux analytiques structurés. L’erreur type de l’estimation se localise immédiatement dans le premier tableau intitulé Statistiques de la régression, à la quatrième ligne, sous l’étiquette exacte Erreur-type. Dans notre exemple, la table rapportera simultanément le coefficient de détermination R² (0,937), le coefficient R² ajusté (0,929), le R multiple (0,968) et l’erreur type (2,37). Le second tableau présente l’analyse de variance (ANOVA), permettant d’observer la somme des carrés résiduels (Résidus SS = 44,93) et le carré moyen des erreurs (MS = 5,62), confirmant la stricte concordance arithmétique de la modélisation.
8. Mise en œuvre dans les environnements statistiques avancés : R et SPSS
8.1 Extraction et interprétation sous R
Le langage open source et environnement de calcul R constitue la référence contemporaine pour le traitement statistique avancé en recherche universitaire. L’ajustement d’un modèle de régression linéaire univariée ou multiple s’y effectue au moyen de la fonction fondamentale lm() (pour Linear Model). L’attribution du modèle à un objet dédié permet ensuite d’en extraire l’ensemble des propriétés statistiques.
Pour reproduire le cas empirique exposé précédemment, le script canonique s’articule comme suit :
anxiete <- c(2, 3, 4, 5, 6, 7, 8, 8, 9, 10)
notes <- c(88, 85, 82, 78, 75, 70, 62, 68, 60, 52)
modele_reg <- lm(notes ~ anxiete)
summary(modele_reg)
Lors de l’exécution de la commande de synthèse globale summary(), l’interpréteur R génère une sortie détaillée dans la console. L’erreur type de l’estimation se repère vers le bas de la sortie, sous la désignation anglophone canonique :
Residual standard error: 2.37 on 8 degrees of freedom
La formulation adoptée par R met en exergue les degrés de liberté résiduels (8 degrees of freedom), soulignant la division par n – 2. Pour les chercheurs développant des chaînes de calcul automatisées, des fonctions de rééchantillonnage (bootstrap) ou des procédures de simulation de Monte-Carlo, l’extraction programmatique directe de cette grandeur s’avère particulièrement aisée sans avoir à parser la sortie textuelle. Il suffit d’interroger l’élément scalaire sigma encapsulé dans le résumé :
summary(modele_reg)$sigma
ou d’appliquer directement la fonction d’extraction générique issue du package de base :
sigma(modele_reg)
Cette commande renvoie immédiatement la valeur numérique sous forme d’un flottant double précision (2.369802), facilitant son réemploi dans les scripts computationnels de diagnostic.
8.2 Lecture des sorties dans le logiciel IBM SPSS
Le logiciel propriétaire IBM SPSS Statistics demeure extrêmement implanté dans les laboratoires de psychologie, de psychiatrie et de sciences de l’éducation. L’exécution d’une régression linéaire sous cet environnement requiert une suite d’actions standardisées via l’interface graphique :
- Naviguer dans la barre des menus : Analyse > Régression > Linéaire…
- Transférer la variable de performance académique (« Notes ») dans l’encadré désigné Dépendante.
- Transférer la variable d’anxiété (« Anxiete ») dans l’encadré désigné Indépendante(s).
- S’assurer que la méthode sélectionnée est bien « Entrée » (Enter).
- Optionnel : Dans le sous-menu « Statistiques », cocher les cases Intervalles de confiance et Diagnostics des observations.
- Valider la procédure en cliquant sur le bouton « OK ».
La fenêtre d’affichage des résultats (Viewer) présente alors plusieurs matrices successives. Le point focal pour le diagnostic de l’erreur type se situe dans le tableau intitulé Récapitulatif des modèles (Model Summary). Ce tableau structure ses colonnes selon l’enchaînement classique : Modèle, R, R-deux, R-deux ajusté, et enfin Erreur standard de l’estimation (traduction française consacrée par SPSS pour Std. Error of the Estimate). La cellule correspondante affiche sans équivoque la valeur 2,370.
Par ailleurs, SPSS permet, via le sous-menu « Enregistrer… » (Save…) de la boîte de dialogue de régression, de créer de nouvelles colonnes dans la matrice de données active contenant les valeurs prédites non standardisées ainsi que les résidus bruts, standardisés et studentisés. Cette fonctionnalité offre aux chercheurs la possibilité de tester empiriquement les hypothèses d’homoscédasticité et de normalité directement via les modules graphiques d’analyse exploratoire du logiciel.
8.3 Validation croisée de la cohérence algorithmique entre outils
La triangulation algorithmique entre le calcul algébrique manuel, les formules tabulaires d’Excel, les scripts de R et les sorties d’IBM SPSS atteste d’une stricte concordance des résultats numériques obtenus. Dans l’ensemble de ces écosystèmes, l’erreur type de l’estimation converge invariablement vers la valeur unifiée de 2,3698 (arrondie à 2,37 selon les normes de reporting). Cette stabilité confirme que, malgré des choix d’étiquetage parfois divergents (Residual standard error dans R, Erreur-type dans Excel, Erreur standard de l’estimation dans SPSS), la machinerie statistique sous-jacente respecte le même cadre d’évaluation fondé sur les moindres carrés ordinaires corrigés pour n – 2 degrés de liberté.
Néanmoins, des divergences d’affichage peuvent ponctuellement survenir lors du traitement de données issues d’échantillons complexes. Celles-ci découlent quasi exclusivement de deux écueils méthodologiques : d’une part, la gestion des valeurs manquantes (SPSS excluant les observations incomplètes par défaut de manière observationnelle alors que R exige la déclaration de na.action = na.exclude pour préserver la structure indicielle), et d’autre part, les troncatures d’arrondi intermédiaires lors des calculs manuels versus la précision flottante 64 bits des calculateurs numériques. La recherche quantitative contemporaine impose d’adhérer aux standards de précision computationnelle en consignant au minimum deux à trois décimales significatives pour l’ensemble des indicateurs de dispersion résiduelle.
9. Construction d’intervalles de prédiction fondés sur l’erreur type
9.1 Distinction entre intervalle de confiance et intervalle de prédiction
L’une des contributions fondamentales de l’erreur type de l’estimation réside dans son rôle pivot pour la modélisation des zones de prévisibilité stochastique. Il s’avère néanmoins impératif de dissiper une confusion classique en inférence linéaire : la séparation formelle entre l’intervalle de confiance pour la moyenne conditionnelle et l’intervalle de prédiction pour une observation individuelle.
L’intervalle de confiance vise à estimer l’emplacement de l’espérance théorique E(Y | X = x0). Il cherche à délimiter la zone où se situe la moyenne de la sous-population d’individus partageant la valeur prédictive x0. Puisque l’estimation d’une moyenne bénéficie de l’effet d’agrégation d’échantillonnage, l’incertitude associée à cette espérance est relativement étroite, s’atténuant à mesure que la cohorte globale croît.
À l’opposé, l’intervalle de prédiction ambitionne de déterminer la valeur qui sera enregistrée pour un nouvel individu unique (Ynew) présentant la caractéristique x0. Dans ce cas de figure, l’incertitude se scinde en deux composantes irréductibles : l’erreur d’échantillonnage liée à l’estimation des paramètres de la droite (pente et constante) ET la variabilité résiduelle inhérente à chaque individu singulier autour de cette droite. Cette seconde composante, précisément mesurée par Se, ne s’annule jamais, quelle que soit l’ampleur de l’échantillon d’entraînement. C’est pourquoi un intervalle de prédiction individuel est systématiquement et notablement plus étendu qu’un simple intervalle de confiance de la moyenne.
9.2 Formulation mathématique de l’intervalle de prédiction individuel
L’expression mathématique formelle définissant les bornes d’un intervalle de prédiction à un niveau de confiance 1 – α pour une valeur observée spécifique x0 s’articule comme suit :
ŷ0 ± tα/2, n-2 · Se · √ [ 1 + 1/n + (x0 – X̄)² / Σ(xi – X̄)² ]
L’examen minutieux des termes constituant cette formule explicite la topologie probabiliste de la prédiction :
- ŷ0 représente la prédiction ponctuelle calculée à partir de la droite ajustée : ŷ0 = b0 + b1x0.
- tα/2, n-2 correspond à la valeur critique bilatérale issue de la distribution de Student pour un niveau de signification α (par exemple, 2,306 pour α = 0,05 avec 8 ddl).
- Se matérialise l’erreur type de l’estimation de l’échantillon.
- Le radical agrège les trois sources d’incertitude combinées : le terme 1 symbolise la variance individuelle incompressible de la nouvelle observation ; le terme 1/n formalise l’incertitude liée à l’estimation du barycentre (X̄, Ȳ) ; et le rapport quadratique (x0 – X̄)² / Σ(xi – X̄)² reflète le bras de levier lié à l’éloignement de x0 par rapport au centre de gravité des données.
Ce dernier élément démontre géométriquement que les frontières de l’intervalle de prédiction ne sont pas deux droites parallèles, mais adoptent la morphologie de courbes hyperboliques s’évasant à mesure que l’on s’écarte de la moyenne X̄. Plus on cherche à extrapoler le modèle vers des valeurs extrêmes du prédicteur, plus l’incertitude individuelle gonfle de façon non linéaire.
9.3 Application pragmatique : prévision du score d’un individu
Supposons qu’un nouvel étudiant se présente à l’examen avec un score d’anxiété mesuré à x0 = 7. Déterminons l’intervalle de prédiction à 95 % (α = 0,05) pour sa future note d’examen, à partir des paramètres dérivés à la section 6.
Étape 1 : Calcul de la valeur prédite ponctuelle :
ŷ0 = 98,8082 – 4,3239(7) = 68,5409 points
Étape 2 : Identification de la valeur critique de Student pour 8 degrés de liberté :
t0,025 ; 8 = 2,306
Étape 3 : Calcul des termes sous le radical :
Nous savons que n = 10, X̄ = 6,20, et Σ(xi – X̄)² = 63,60. Dès lors :
(x0 – X̄)² = (7 – 6,20)² = (0,80)² = 0,64
Facteur sous radical = √ [ 1 + 1/10 + 0,64 / 63,60 ] = √ [ 1 + 0,10 + 0,010063 ] = √ [ 1,110063 ] ≈ 1,053595
Étape 4 : Calcul de la marge d’erreur globale (ME) :
ME = 2,306 · 2,3698 · 1,053595 ≈ 5,7576 points
Étape 5 : Formulation de l’intervalle de prédiction à 95 % :
IP95% = [ 68,5409 – 5,7576 ; 68,5409 + 5,7576 ] = [ 62,78 ; 74,30 ]
Sur le plan pratique et déontologique, ce résultat signifie que nous pouvons affirmer avec un degré de confiance de 95 % que cet étudiant spécifique obtiendra une note comprise entre 62,8 et 74,3 points. L’amplitude de cet intervalle (environ 11,5 points) est conditionnée par l’erreur type Se. Dans un cadre de sélection ou d’orientation clinique, une telle amplitude met en garde contre l’illusion de certitude qu’une prédiction ponctuelle isolée (68,5) aurait pu faussement véhiculer.
10. Applications empiriques dans la recherche psychologique et comportementale
10.1 Psychométrie et précision des scores de tests
Dans le domaine de la psychométrie contemporaine et de la Théorie Classique des Tests (TCT), l’erreur type de l’estimation joue un rôle fondamental lors du développement, de la standardisation et de l’abréviation de batteries d’évaluation cognitive ou de personnalité. Lorsqu’une équipe de psychométriciens conçoit une version raccourcie d’un instrument d’évaluation (par exemple, une version en 10 items d’une échelle originelle de dépression qui en comportait 50), la question méthodologique centrale réside dans la fidélité avec laquelle l’échelle abrégée permet d’estimer le score complet.
L’ajustement d’un modèle de régression reliant le score de la forme courte (X) au score composite de la forme intégrale (Y) permet d’extraire directement Se. Dans ce contexte, l’erreur type de l’estimation matérialise l’incertitude encourue en substituant la passation rapide au protocole approfondi. Si Se se révèle inférieur à l’erreur type de mesure intrinsèque du test lui-même, l’équivalence psychométrique est validée empiriquement, autorisant des économies substantielles de temps de passation sans compromettre le diagnostic individuel.
Cette logique prévaut également dans les protocoles de calibration croisée d’instruments alternatifs mesurant des construits théoriquement analogues, tels que l’équivalence entre différentes échelles de quotient intellectuel ou d’efficience mnésique. L’erreur type de l’estimation sert alors d’indicateur normé d’interchangeabilité diagnostique.
10.2 Psychologie clinique et suivi thérapeutique
L’évaluation rigoureuse de l’efficacité des interventions psychothérapeutiques repose largement sur la modélisation de trajectoires individuelles de changement. En psychologie clinique, les praticiens cherchent à anticiper la diminution des symptômes (évaluée par des inventaires cliniques comme le BDI pour la dépression ou le BAI pour l’anxiété) au terme d’un nombre déterminé de séances, sur la base de covariables initiales telles que la sévérité initiale, la durée du trouble ou l’alliance thérapeutique perçue.
L’intégration de l’erreur type de l’estimation au sein de ces modèles de trajectoire permet d’établir les frontières du changement cliniquement significatif et de définir l’indice de changement fiable (Reliable Change Index ou RCI). Lorsqu’un patient présente, à l’issue de sa prise en charge, un score clinique s’écartant de la valeur prédite par le modèle d’une distance supérieure à 2 Se, le clinicien dispose d’un critère empirique robuste :
- Si l’écart est positif dans le sens de l’amélioration, cela atteste d’une réponse thérapeutique exceptionnellement robuste dépassant les simples fluctuations probabilistes de l’échantillon.
- Si l’écart traduit une absence d’évolution ou une dégradation supérieure à 2 Se, le patient est identifié comme suivant une trajectoire atypique ou non répondeur, nécessitant une réévaluation immédiate de la stratégie d’intervention.
L’erreur type de l’estimation agit ainsi comme une balise de régulation clinique, évitant de labelliser indûment comme « succès thérapeutique » ou « échec » des oscillations de scores qui ne représentent que le bruit résiduel standard du modèle prédictif.
10.3 Neurosciences cognitives et ergonomie organisationnelle
Les neurosciences appliquées et l’ergonomie cognitive fournissent un autre terrain d’application majeur pour Se. Dans les environnements à haut risque professionnel (contrôle de la navigation aérienne, quart opérationnel dans le secteur de l’énergie nucléaire, médecine d’urgence hospitalière), la prédiction de l’altération de la vigilance sous l’effet de la privation de sommeil est un enjeu vital.
Des modèles de régression prédisent la dégradation des temps de réaction psychomoteurs (PVT) en fonction de la durée continue d’éveil ou du nombre d’heures consécutives de veille active. L’erreur type de l’estimation reflète ici la variabilité interindividuelle de résistance à la fatigue. Deux opérateurs soumis à 24 heures d’éveil ne réagissent pas de manière identique : l’ampleur de Se renseigne les ingénieurs ergonomes sur la dispersion comportementale prévisible au sein des équipes.
Dans la modélisation de la charge mentale de travail en fonction de la densité de sollicitations sensorielles ou de flux d’informations simultanés, Se permet de définir les marges de tolérance cognitive des systèmes homme-machine. Un modèle dont l’erreur type est trop ample signale aux concepteurs d’interfaces l’impossibilité de garantir un niveau de vigilance stable chez l’ensemble des opérateurs, imposant la mise en place de dispositifs de sécurité autonomes en compensation de l’incertitude humaine non modélisée.
11. Facteurs influençant l’ampleur de l’erreur type et techniques d’optimisation
11.1 Effets de la taille d’échantillon et de la variabilité résiduelle
Une incompréhension méthodologique fréquente consiste à postuler que l’augmentation de la taille de l’échantillon d’entraînement (n) provoque mécaniquement une réduction de l’erreur type de l’estimation vers zéro. Cette intuition est inexacte, car elle confond Se avec l’erreur type de la moyenne (SEM). Se est un estimateur de la variance conditionnelle intrinsèque de la population σest. Dès lors, lorsque n s’accroît, la valeur empirique de Se ne s’effondre pas : elle se stabilise asymptotiquement autour de la véritable valeur paramétrique du bruit résiduel.
Toutefois, l’accroissement de la taille de l’échantillon exerce une influence stabilisatrice majeure sur la précision d’estimation de Se lui-même. Sur des échantillons restreints, la variance résiduelle empirique est sujette à d’importantes fluctuations d’échantillonnage, ce qui se traduit par des degrés de liberté limités (n – 2) et dilate considérablement les valeurs critiques issues de la table de Student. L’augmentation de n consolide l’estimation des paramètres de régression et resserre les intervalles de prédiction décrits à la section 9.
Lors de la planification d’une étude quantitative, les analyses de puissance a priori ne doivent pas seulement viser la détection d’une pente statistiquement non nulle (β1 ≠ 0), mais doivent également calibrer la taille d’échantillon requise pour borner l’erreur type de l’estimation en dessous d’un seuil critique prédéterminé, assurant ainsi la viabilité opérationnelle des futures prédictions individuelles.
11.2 Rôle de la fidélité des instruments de mesure psychologiques
L’erreur type de l’estimation est directement tributaire de la qualité métrologique des instruments mobilisés pour recueillir les variables X et Y. En vertu des équations classiques de la théorie de la mesure, la variance observée d’un score composite empirique est la résultante additive de sa variance vraie et de la variance d’erreur de mesure non systématique :
Var(Obs) = Var(Vrai) + Var(Erreur)
Lorsque la fidélité (ou consistance interne, classiquement quantifiée par le coefficient alpha de Cronbach ou l’oméga de McDonald) de la variable dépendante Y ou du prédicteur X est dégradée, cette variance d’erreur instrumentale vient directement s’agréger aux déviations résiduelles de la régression. Le modèle linéaire ne peut différencier le bruit de mesure aléatoire de l’incapacité théorique du prédicteur à expliquer le phénomène. L’erreur type Se s’en trouve artificiellement gonflée par un phénomène d’atténuation métrologique.
Pour optimiser et comprimer la magnitude de l’erreur type de l’estimation sans altérer la nature conceptuelle du modèle, le chercheur doit agir en amont sur le contrôle expérimental :
- Recourir à des échelles de mesure standardisées démontrant d’excellents indices de fidélité (α ≥ 0,85).
- Multi-opérationaliser les construits par l’agrégation de multiples items convergents afin de lisser l’erreur de mesure idiosyncrasique.
- Standardiser rigoureusement les conditions environnementales de passation (insonorisation, luminosité constante, consignes d’administration numérisées) afin de minimiser les sources externes de bruit expérimental.
11.3 Spécification du modèle et adjonction de prédicteurs pertinents
Le levier analytique le plus puissant pour réduire structurellement l’erreur type de l’estimation réside dans l’optimisation de la spécification du modèle mathématique, notamment par la transition de la régression linéaire simple vers la régression multiple. Lorsqu’un prédicteur unique laisse une part substantielle de variance inexpliquée, l’introduction judicieuse d’une ou plusieurs covariables théoriquement pertinentes permet de transférer une fraction de la somme des carrés résiduels (SSE) vers la somme des carrés de régression (SSR).
Cependant, cette démarche d’adjonction de variables explicatives implique un arbitrage méthodologique subtil lié aux degrés de liberté. Comme explicité à la section 2, chaque nouvelle variable introduite au sein de l’équation prédictive consomme un degré de liberté additionnel au dénominateur : n – k – 1. Dès lors, deux dynamiques antagonistes entrent en compétition :
- Si le nouveau prédicteur apporte une contribution explicative substantielle, la diminution du numérateur (SSE) est nettement supérieure à la réduction unitaire du dénominateur, ce qui produit une diminution nette de Se.
- Si, en revanche, le prédicteur additionnel n’est que faiblement ou pas du tout corrélé à la variable dépendante conditionnellement aux autres variables, la réduction de SSE est dérisoire et ne compense pas la perte du degré de liberté au dénominateur. Dans ce cas de figure, l’erreur type de l’estimation augmente paradoxalement, dégradant la précision globale du système.
L’optimisation de Se impose ainsi l’adoption d’un principe de parcimonie (le rasoir d’Ockham) : sélectionner le modèle qui minimise l’erreur type de l’estimation sans recourir à un surparamétrage artificiel, en s’appuyant sur des critères formels de sélection de modèles tels que le critère d’information d’Akaike (AIC) ou le critère d’information bayésien (BIC).
12. Limites méthodologiques, pièges d’interprétation et recommandations de restitution
12.1 Dépendance à l’échelle de mesure et absence de standardisation
La principale caractéristique de l’erreur type de l’estimation — son ancrage dans la métrique concrète de la variable dépendante — constitue simultanément sa plus grande limite méthodologique lorsqu’il s’agit d’effectuer des comparaisons inter-études. Se est une statistique non standardisée, dépendante de l’unité de mesure choisie par l’expérimentateur.
Par exemple, si un modèle prédit le temps de traitement cognitif en secondes, il affichera une erreur type de l’estimation de, disons, 0,25 seconde. Si un autre laboratoire choisit arbitrairement de coder la même variable dépendante en millisecondes, le modèle mathématique ajusté sur les mêmes données présentera exactement la même précision intrinsèque, mais son erreur type de l’estimation affichera la valeur brute de 250 millisecondes. Sur le plan purement numérique, une valeur de 250 peut sembler considérablement plus vaste qu’une valeur de 0,25, alors qu’il s’agit d’une stricte identité d’ajustement masquée par un facteur d’échelle.
Cette dépendance à l’échelle interdit toute comparaison directe de la valeur absolue de Se entre des modèles prédisant des construits dissemblables ou exploitant des métriques divergentes. Pour comparer la précision relative de modèles opérant sur des échelles distinctes, les méthodologistes doivent faire appel à des métriques relatives complémentaires, telles que :
- Le coefficient de variation résiduel : défini par le ratio entre l’erreur type de l’estimation et la moyenne arithmétique de la variable dépendante (CVres = Se / Ȳ), exprimé en pourcentage.
- La standardisation préalable de l’ensemble des variables (transformation en scores Z), ramenant l’erreur type à une fraction de l’écart-type de référence de la distribution cible.
12.2 Surajustement (overfitting) et écueil de la validité interne
Un écueil statistique majeur guettant les chercheurs lors de l’optimisation de modèles prédictifs complexes réside dans le phénomène de surajustement (overfitting). Lorsqu’un analyste intègre un grand nombre de variables explicatives ou des termes polynomiaux d’ordre élevé sur un échantillon restreint, la méthode des moindres carrés configure l’équation pour épouser fidèlement chaque fluctuation idiosyncrasique et chaque artefact d’échantillonnage présent dans le jeu de données.
Dans cette configuration, l’erreur type de l’estimation calculée sur cet échantillon de dérivation (ou échantillon d’apprentissage) chute de manière spectaculaire, créant une illusion d’hyper-précision. Cependant, ce modèle hautement surajusté présente une validité externe catastrophique : lorsqu’il est confronté à de nouvelles observations indépendantes issues de la même population, les résidus prédictifs explosent et l’erreur type réelle de généralisation se révèle infiniment plus volumineuse que l’estimation interne optimiste initiale.
Pour prévenir ce biais et restituer une valeur réaliste de l’erreur d’estimation généralisable, il est impératif d’adopter des protocoles méthodologiques de validation croisée (k-fold cross-validation ou validation par leave-one-out). L’évaluation de l’erreur prédictive sur les plis de test exclus offre une estimation non biaisée de la variance résiduelle véritable, garantissant que les conclusions formulées reflètent la dynamique réelle de la population et non un mirage mathématique propre à l’échantillon d’analyse.
12.3 Recommandations académiques et normes de reporting de l’APA
L’American Psychological Association (APA), dans la 7e édition de son manuel de publication officiel, prescrit des normes strictes de transparence méthodologique pour la restitution des analyses de régression. Rendre compte uniquement du coefficient de détermination ou des valeurs p des coefficients de pente est formellement jugé insuffisant pour asseoir la réplicabilité et l’évaluation critique des travaux scientifiques.
Les recommandations canoniques de l’APA imposent une déclaration conjointe et équilibrée des statistiques d’ajustement global, combinant indices relatifs et métriques absolues. Dans le corps du texte d’un article ou sous forme de tableaux de synthèse standardisés, les auteurs doivent systématiquement renseigner :
- Les coefficients de régression non standardisés (b) accompagnés de leurs erreurs types respectives (SEb).
- Les coefficients standardisés (β).
- Les intervalles de confiance à 95 % entourant les paramètres non standardisés.
- Le coefficient de détermination global (R²) et le coefficient de détermination ajusté (R²adj).
- Le test de significativité global de la régression avec ses degrés de liberté associés (la statistique F de l’ANOVA).
- L’erreur type de l’estimation (Se), expressément identifiée dans son unité de mesure d’origine.
Un modèle de rédaction textuelle conforme aux normes actuelles de l’APA se structure ainsi :
« Le modèle de régression linéaire simple reliant le niveau d’anxiété pré-examen à la performance académique s’est révélé statistiquement significatif, F(1, 8) = 119,42, p < 0,001. L’anxiété explique 93,7 % de la variance de la note d’examen (R² = 0,937 ; R²ajusté = 0,929). L’équation de régression obtenue (ŷ = 98,81 – 4,32X) indique qu’une augmentation d’un point d’anxiété s’accompagne d’une réduction moyenne de 4,32 points de note (IC à 95 % [-5,25 ; -3,40]). Enfin, l’erreur type de l’estimation s’établit à Se = 2,37 points, fournissant l’amplitude moyenne de dispersion résiduelle individuelle autour de la trajectoire modélisée. »
Cette approche garantit au lecteur une vision panoramique et non tronquée de la performance analytique : l’association relative est validée par R² et F, la direction et l’amplitude de l’effet sont circonscrites par b et son intervalle de confiance, tandis que la précision prédictive individuelle concrète est rigoureusement bornée par l’erreur type de l’estimation.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Draper, N. R., & Smith, H. (1998). Applied regression analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118625590
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Cengage Learning.
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- Pedhazur, E. J. (1997). Multiple regression in behavioral research: Explanation and prediction (3rd ed.). Wadsworth Thomson Learning.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wilcox, R. R. (2017). Understanding and applying basic statistical methods using R. John Wiley & Sons. https://doi.org/10.1002/9781119061403