
Dans le champ de l’analyse statistique et de la théorie des probabilités, la caractérisation morphologique d’une distribution de données constitue l’une des étapes fondamentales de l’exploration empirique et de l’inférence scientifique. Qu’il s’agisse d’évaluer des paramètres physiologiques en médecine, de calibrer des instruments psychométriques en sciences du comportement ou de modéliser des risques en ingénierie financière, la structure géométrique d’un ensemble d’observations détermine la validité des modèles mathématiques employés. Au cœur de cette taxonomie des formes distributionnelles se trouve le concept de distribution unimodale, une configuration spatiale caractérisée par l’émergence d’un unique pic de fréquence ou de densité autour duquel s’organisent les valeurs observées.
L’unimodalité représente bien plus qu’une simple commodité géométrique ou une simplification pédagogique. Elle constitue le postulat tacite sur lequel repose la quasi-totalité de la statistique paramétrique classique développée depuis le XIXe siècle, des travaux pionniers de Carl Friedrich Gauss à ceux de Karl Pearson. Lorsqu’une distribution présente un sommet unique et non ambigu, les mesures de tendance centrale acquièrent une signification substantive : elles résument fidèlement le centre de gravité d’une population supposée homogène vis-à-vis du phénomène mesuré. À l’inverse, ignorer la structure modale d’un ensemble de données — par exemple en appliquant aveuglément des moyennes et des écarts-types à des configurations multimodales — expose le chercheur à des erreurs d’interprétation systémiques, masquant des sous-populations distinctes derrière des agrégats artificiels.
Cet article propose une analyse approfondie et exhaustive de la distribution unimodale, allant de ses fondements mathématiques rigoureux et de ses propriétés probabilistes formelles jusqu’à ses applications concrètes en biométrie, en psychométrie et en ergonomie cognitive. À travers une exploration détaillée des indicateurs de tendance centrale, des coefficients d’asymétrie et d’aplatissement, des méthodes de diagnostic graphique et des tests non paramétriques formels d’unimodalité, cette synthèse offre aux chercheurs, analystes de données et étudiants un cadre conceptuel et pratique pour identifier, modéliser et interpréter rigoureusement les distributions à sommet unique.
1. Introduction fondamentale à la distribution unimodale en statistique
1.1 Origine conceptuelle et définition liminaire de l’unimodalité
L’émergence du concept de « mode » en théorie statistique s’inscrit dans la transition historique du calcul probabiliste formel vers l’analyse des données d’observation au cours du XIXe siècle. C’est sous la plume de statisticiens pionniers comme Karl Pearson que la notion de mode a été rigoureusement formalisée pour désigner la valeur la plus fréquente au sein d’une série statistique, venant compléter les notions préexistantes de moyenne arithmétique et de médiane. Dès les prémices de la biométrie moderne, la distinction entre les séries de données présentant une seule valeur typique dominante et celles en manifestant plusieurs est apparue comme une condition sine qua non de la compréhension des mécanismes générateurs de données.
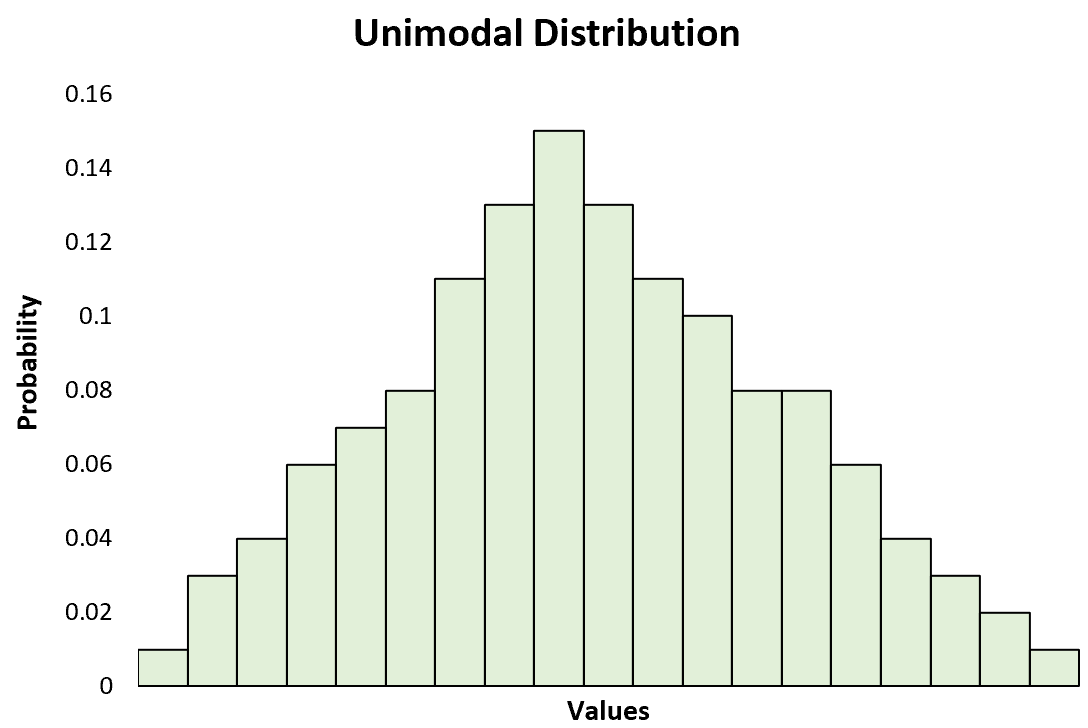
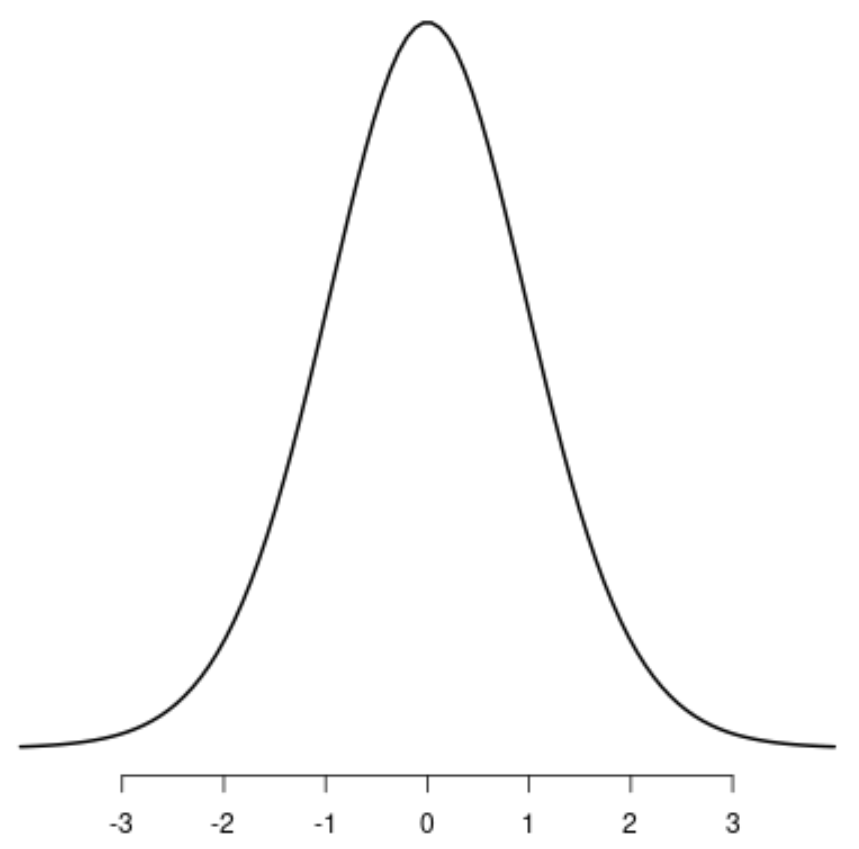
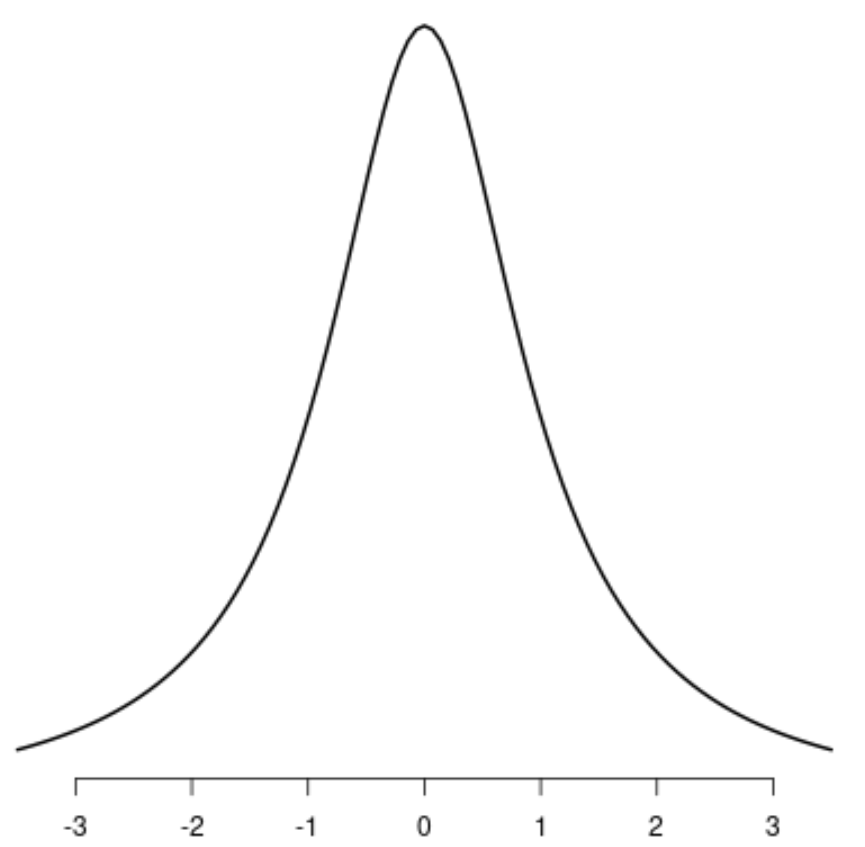
D’un point de vue géométrique fondamental, une distribution est qualifiée d’unimodale lorsqu’elle présente un pic unique et distinct sur sa représentation graphique. Dans le cadre d’une variable aléatoire continue, cela correspond à une fonction de densité de probabilité qui croît de manière monotone jusqu’à atteindre un sommet global unique, avant de décroître de façon tout aussi monotone vers zéro. Le point d’abscisse où cette densité atteint son maximum absolu constitue précisément le mode de la distribution. Cette configuration spatiale exclut la présence d’autres sommets locaux distincts ou de plateaux étendus qui fragmenteraient le profil topologique de la courbe.
La distinction entre variables discrètes et continues est déterminante dans l’observation et la formalisation du mode. Pour une variable discrète, la fonction de masse de probabilité associe à chaque valeur admissible une probabilité ponctuelle non nulle. Le mode correspond alors à la modalité ou à la valeur entière pour laquelle la masse de probabilité est strictement supérieure à celle des valeurs adjacentes. Pour une variable continue, la probabilité d’observer une valeur ponctuelle exacte étant formellement nulle en vertu des propriétés de la mesure de Lebesgue, le mode est appréhendé par le biais de la fonction de densité, ou de façon approchée par l’intervalle de classe présentant l’effectif le plus élevé au sein d’un histogramme préalablement discrétisé.
La pertinence de la structure unimodale dans la modélisation scientifique réside dans son adéquation conceptuelle avec l’hypothèse d’homogénéité populationnelle. L’observation d’un pic unique au sein d’un échantillon empirique signale généralement que les entités observées sont issues d’un même processus stochastique ou d’une population partageant des caractéristiques fonctionnelles communes. À l’inverse, l’apparition de plusieurs modes reflète fréquemment la superposition ou le mélange non identifié de sous-populations distinctes gouvernées par des régimes paramétriques divergents.
1.2 Importance de la distribution unimodale en psychologie quantitative
Dans le domaine de la psychologie quantitative et de la psychométrie, le postulat d’unimodalité occupe une place architecturale dans les modèles de traits latents. Selon la théorie classique des tests (TCT) ainsi que la théorie de la réponse aux items (TRI), un attribut psychologique non directement observable — qu’il s’agisse d’un trait de personnalité comme l’extraversion ou d’une aptitude cognitive générale — est postulé comme variant de manière continue au sein de la population générale selon une distribution unimodale, le plus souvent approximée par une loi normale. Cette hypothèse conditionne la façon dont les scores bruts sont standardisés et transformés en échelles standardisées telles que les scores z, les stanines ou les échelles de Wechsler.
La standardisation des instruments d’évaluation repose intrinsèquement sur la préservation de cette unimodalité au sein des échantillons normatifs. Lors du calibrage d’un test psychométrique, les psychométriciens s’assurent que les items retenus permettent une différenciation graduelle et continue des individus sans induire de partition artificielle de l’échantillon. Une distribution unimodale symétrique ou modérément asymétrique garantit que la vaste majorité des participants se situe à proximité relative de la performance moyenne, conférant ainsi aux échelons de mesure une validité constructuelle robuste.
Sur le plan structural, l’homogénéité des cohortes de référence en psychologie cognitive dépend de la vérification empirique de l’unimodalité. Si l’administration d’une tâche de mémoire de travail ou de temps de réaction révèle une configuration bimodale, cela indique fréquemment que deux stratégies cognitives fondamentalement divergentes ont été mobilisées par les participants, ou que l’échantillon contient un sous-groupe non diagnostiqué présentant des altérations neurofonctionnelles. L’unimodalité atteste donc de l’unicité du mécanisme cognitif sous-jacent mesuré par la tâche expérimentale.
Enfin, sur le versant de la psychologie clinique et de la neuropsychologie, l’interprétation des scores individuels déviant de la zone sommitale centrale tire tout son sens de l’unimodalité. Dans une distribution unimodale, la rareté statistique est directement fonction de la distance euclidienne par rapport au mode central. Un clinicien peut ainsi interpréter une performance située à deux ou trois écarts-types de la moyenne comme une déviation pathologique ou une excellence exceptionnelle précisément parce que la fréquence d’occurrence diminue de manière continue et prévisible à mesure que l’on s’éloigne du sommet de la distribution de référence.
2. Définition mathématique et propriétés formelles de l’unimodalité
2.1 Formalisme probabiliste de la fonction de densité unimodale
Pour formaliser rigoureusement l’unimodalité dans le cadre de la théorie de la mesure, considérons une variable aléatoire réelle continue $X$ définie sur un espace probabilisé $(\Omega, \mathcal{F}, \mathbb{P})$, admettant une fonction de densité de probabilité $f: \mathbb{R} to [0, +\infty[$ par rapport à la mesure de Lebesgue. Selon la définition formelle introduite par Aleksandr Khinchin en 1936, la distribution de $X$ est dite unimodale autour d’un mode $m in \mathbb{R}$ si sa fonction de répartition $F(x) = \mathbb{P}(X le x)$ est convexe sur l’intervalle $]-\infty, m[$ et concave sur l’intervalle $]m, +\infty[$.
Dans l’hypothèse où la fonction de densité $f$ est différentiable, cette condition géométrique se traduit directement par l’analyse de ses dérivées. Le mode $m$ constitue un extremum local et global vérifiant l’annulation de la dérivée première :
$$f'(m) = 0 \quad \text{a\vec} \quad f »(m) < 0$$
De surcroît, l’exigence d’unimodalité stricte impose que la fonction présente une monotonie stricte de part et d’autre de ce point singulier : pour tout couple $(x_1, x_2)$ tel que $x_1 < x_2 le m$, on a $f(x_1) le f(x_2)$, et pour tout couple $(x_1, x_2)$ tel que $m le x_1 < x_2$, on a $f(x_1) ge f(x_2)$. Il en résulte l'existence d'un supremum unique sur l'ensemble de définition :
$$f(m) = \sup_{x in \mathbb{R}} f(x)$$
Pour les variables aléatoires discrètes prenant des valeurs dans l’ensemble des entiers relatifs $\mathbb{Z}$, la formulation s’adapte en termes de différences finies sur la fonction de masse $p_k = \mathbb{P}(X = k)$. Une distribution discrète est unimodale s’il existe un entier $m$ tel que la suite $(p_k)$ est croissante pour $k le m$ et décroissante pour $k ge m$, c’est-à-dire que $p_{k} – p_{k-1} ge 0$ pour tout $k le m$ et $p_{k+1} – p_k le 0$ pour tout $k ge m$. Dans le cas particulier où il existe deux entiers consécutifs $m$ et $m+1$ tels que $p_m = p_{m+1} = \max_k p_k$, la distribution est parfois qualifiée d’unimodale à sommet plat ou biconnectée, bien que la littérature probabiliste rigoureuse privilégie le concept d’intervalle modal fermé.
2.2 Lois de probabilité théoriques strictement unimodales
L’archétype par excellence de la distribution unimodale en statistique est sans conteste la distribution normale ou gaussienne, notée $\mathcal{N}(\mu, \sigma^2)$. Sa fonction de densité, définie par :
$$f(x) = \frac{1}{\sigma \sqrt{2\pi}} \exp\left( -\frac{(x – \mu)^2}{2\sigma^2} \right)$$
présente une symétrie bilatérale parfaite autour de son espérance $\mu$. En dérivant cette fonction, il apparaît immédiatement que l’unique solution à $f'(x) = 0$ se trouve en $x = \mu$, confirmant l’unimodalité stricte de la loi gaussienne. En ce point unique convergent simultanément la moyenne, la médiane et le mode.
Une autre famille fondamentale de lois unimodales asymétriques est représentée par la distribution log-normale, essentielle pour modéliser des variables strictement positives telles que les temps de réponse cognitive ou les revenus économiques. Si $Y \sim \mathcal{N}(\mu, \sigma^2)$, alors $X = exp(Y)$ suit une loi log-normale de paramètres $\mu$ et $\sigma$. Sa densité atteint son mode en un point strictement inférieur à la médiane et à la moyenne :
$$m = \exp(\mu – \sigma^2)$$
Ce décalage structural illustre la capacité d’une distribution unimodale à héberger une asymétrie droite prononcée tout en maintenant un unique centre de gravité probabiliste.
De façon analogue, la loi Gamma de paramètres de forme $\alpha > 0$ et d’intensité $\beta > 0$ présente une dynamique unimodale conditionnelle. Lorsque $\alpha > 1$, la fonction de densité possède un mode unique localisé en :
$$m = \frac{\alpha – 1}{\beta}$$
alors que pour $\alpha le 1$, la densité devient strictement décroissante sur $]0, +\infty[$, plaçant son maximum à la frontière en zéro (configuration dite monotone ou dégénérée). Dans l’univers discret, la loi de Poisson de paramètre $lambda > 0$ affiche également une unimodalité stricte avec un mode situé à l’entier $lfloor lambda rfloor$ (ou deux modes adjacents si $lambda$ est un entier strictement positif).
Enfin, la distribution de Student (loi $t$) à $\nu$ degrés de liberté constitue une variante unimodale symétrique capitale pour l’inférence statistique sur de petits échantillons. Possédant un mode invariant en $x = 0$, elle se distingue de la loi normale par des queues de distribution plus épaisses gouvernées par une décroissance polynomiale plutôt qu’exponentielle, offrant ainsi une robustesse accrue face aux observations extrêmes.
2.3 Invariance et transformations mathématiques du pic unique
L’étude des transformations mathématiques appliquées aux variables aléatoires unimodales révèle des propriétés algébriques et géométriques fondamentales quant à la préservation de la structure modale. Sous l’effet d’une transformation affine de la forme $Y = aX + b$ avec $a in \mathbb{R}^*$ et $b in \mathbb{R}$, l’unimodalité est rigoureusement conservée. Si la variable continue $X$ admet pour mode $m_X$, la variable transformée $Y$ possède un mode unique $m_Y$ donné par la relation linéaire directe :
$$m_Y = a \cdot m_X + b$$
Cette invariance sous les translations et les changements d’échelle justifie mathématiquement les opérations de standardisation des scores (telles que le passage des notes brutes aux notes T ou aux quotients intellectuels standardisés) sans altérer la topologie unimodale originelle des distributions.
La situation se complexifie substantiellement lorsque l’on applique des transformations non linéaires, telles que les transformations logarithmiques, exponentielles ou de la famille Box-Cox. Soit $g: \mathbb{R} to \mathbb{R}$ un difféomorphisme strictement croissant. La densité de probabilité de la variable $Y = g(X)$ s’exprime par :
$$f_Y(y) = f_X(g^{-1}(y)) \cdot left| \frac{d}{dy} g^{-1}(y) right|$$
En raison de la présence du terme jacobien $\frac{d}{dy} g^{-1}(y)$, le mode de la variable transformée $Y$ ne coïncide généralement pas avec l’image du mode de $X$ par la fonction $g$. Autrement dit, $m_Y ne g(m_X)$, sauf dans des cas dégénérés. Cependant, si le jacobien varie lentement par rapport aux variations de $f_X$, l’unimodalité globale est préservée, bien que la position relative du sommet subisse un glissement directionnel.
Une propriété mathématique remarquable concerne la stabilité de l’unimodalité sous l’opération de convolution. Si $X$ et $Y$ sont deux variables aléatoires indépendantes admettant chacune une distribution unimodale, leur somme $Z = X + Y$ n’est pas nécessairement unimodale dans le cas général. Toutefois, le célèbre théorème de Wintner (1956) stipule que la convolution de deux distributions unimodales et symétriques engendre toujours une distribution strictement unimodale et symétrique. De même, les lois dites « unimodales fortes » — dont la densité est log-concave, c’est-à-dire que $ln f(x)$ est une fonction concave sur son support — forment une classe fermée sous l’addition : la somme de deux variables aléatoires indépendantes à densités log-concaves demeure invariablement unimodale.
3. Typologie comparative : Distributions unimodales, bimodales et multimodales
3.1 Distinction formelle avec la distribution bimodale
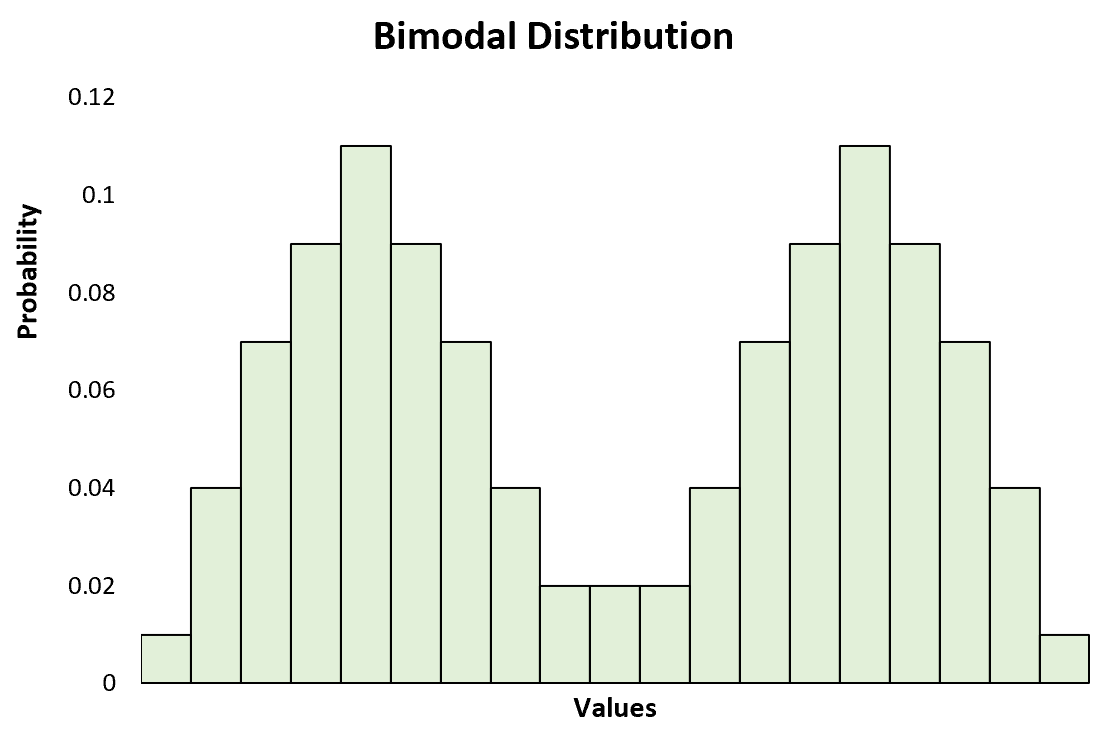
Pour appréhender pleinement la spécificité de la distribution unimodale, il convient de la contraster avec la configuration bimodale. Formellement, une distribution est qualifiée de bimodale lorsqu’elle possède deux maxima locaux distincts séparés par un minimum local ou « creux » (en anglais, antimode). Sur le plan de l’analyse fonctionnelle différentielle, la densité $f(x)$ d’une loi bimodale présente au moins trois racines réelles pour l’équation $f'(x) = 0$ : deux points vérifiant $f »(x) 0$ (la dépression centrale).
Sur le plan substantiel, l’émergence d’une bimodalité trahit presque systématiquement la présence d’un mélange latent de deux sous-populations aux propriétés hétérogènes. Si l’on agrège au sein d’une même base de données une variable biométrique comme la capacité vitale pulmonaire sans séparer les individus selon leur sexe biologique, le profil distributionnel global adoptera une morphologie bimodale, reflétant la superposition des deux moyennes de groupes sous-jacents distincts.
En psychologie sociale et politique, la bimodalité constitue l’empreinte mathématique classique de la polarisation des attitudes. Lorsqu’un questionnaire mesure l’adhésion à une réforme controversée sur une échelle de Likert continue, une distribution unimodale centrée indique un consensus sociétal modéré, tandis qu’une distribution bimodale caractérise un clivage binaire aigu, avec deux cohortes fermement ancrées aux pôles opposés de l’échelle et une désertion massive de la zone centrale médiane.
Il existe un danger méthodologique majeur nommé « bimodalité artificielle », engendré par des artefacts de mesure ou des biais d’agrégation. Une fausse agrégation de variables causant une distribution bimodale peut survenir lorsque des items d’un test présentent des formulations inversées mal calibrées ou lorsque des échelles d’évaluation sont saturées aux bornes par des répondants adoptant des stratégies de réponse défensives ou extrêmes, créant ainsi des sommets artificiels qui ne reflètent en rien la structure du trait psychologique latent étudié.
3.2 La distribution multimodale comme généralisation complexe
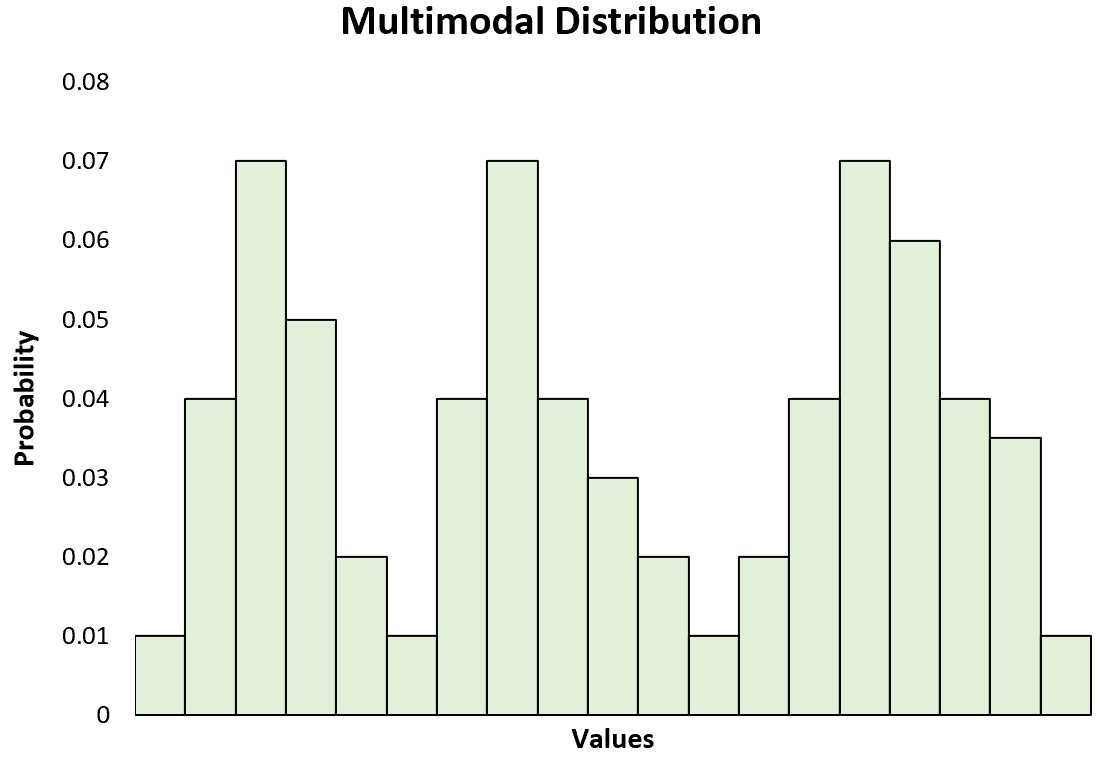
La distribution multimodale représente l’extension supérieure de cette complexité morphologique, caractérisée par la coexistence de trois pics locaux ou plus au sein de l’espace d’observation. Dans un tel contexte, la fonction de densité oscille de manière répétée, alternant points de concavité et de convexité locales. La modélisation analytique directe d’un tel paysage probabiliste s’avère particulièrement ardue à l’aide des familles paramétriques conventionnelles à faible nombre de paramètres.
Pour traiter et théoriser ces architectures complexes, la statistique moderne s’appuie massivement sur la théorie des modèles de mélange de lois gaussiennes (couramment désignés par l’acronyme GMM pour Gaussian Mixture Models). Dans ce cadre, la fonction de densité multimodale globale $f(x)$ est modélisée comme une combinaison convexe de $K$ densités unimodales gaussiennes pondérées par des coefficients de mélange $\pi_k$ :
$$f(x) = \sum_{k=1}^K \pi_k , \mathcal{N}(x mid \mu_k, \sigma_k^2) \quad \text{a\vec} \quad \sum_{k=1}^K \pi_k = 1 \quad \text{et} \quad \pi_k ge 0$$
Dans les grandes cohortes épidémiologiques ou les bases de données psychiatriques massives, la détection d’une multimodalité au sein d’un score de détresse psychologique permet de révéler des trajectoires psychopathologiques hétérogènes. Au lieu de considérer l’échantillon comme un ensemble homogène dérivant d’un centre commun, l’approche par mélange de lois identifie des sous-groupes cliniques latents : un groupe résilient (sommet bas), un groupe symptomatique transitoire (sommet intermédiaire) et un groupe sévèrement atteint (sommet haut).
Toutefois, la présence de multiples modes complique drastiquement l’estimation paramétrique. L’optimisation de la fonction de log-vraisemblance par des algorithmes standards tels que l’algorithme espérance-maximisation (EM) se heurte fréquemment à la prolifération d’optima locaux dans l’espace des paramètres. L’analyste s’expose à retenir des solutions sous-optimales ou instables, soulignant le contraste net entre la simplicité robuste de l’estimation sur distributions unimodales et la fragilité inhérente aux espaces multimodaux.
3.3 Tableau comparatif des dynamiques distributionnelles
Afin de synthétiser les distinctions théoriques et pratiques régissant ces différentes structures de distribution, le tableau ci-dessous met en parallèle leurs propriétés mathématiques, leurs implications méthodologiques et les critères de modélisation afférents.
| Critère de comparaison | Distribution Unimodale | Distribution Bimodale | Distribution Multimodale |
|---|---|---|---|
| Nombre de maxima locaux | Exactement 1 sommet global unique. | Exactement 2 sommets locaux distincts. | 3 sommets locaux ou plus. |
| Hypothèse de population sous-jacente | Population homogène issue d’un processus stochastique unique. | Mélange de deux sous-populations distinctes ou bifurcation. | Système complexe composé de multiples classes latentes. |
| Pertinence de la moyenne arithmétique | Optimale : résume fidèlement le centre de masse des données. | Trompeuse : tombe fréquemment dans le creux central peu peuplé. | Inappropriée : ne renseigne sur aucun des agrégats réels. |
| Complexité paramétrique | Faible (2 à 4 paramètres : position, échelle, asymétrie). | Modérée (5 paramètres minimum pour un mélange binaire). | Élevée (croissance linéaire avec le nombre de classes latentes). |
| Tests statistiques adéquats | Statistique paramétrique standard (test $t$, ANOVA, régression linéaire). | Modèles de mélange, modèles à seuil ou régression logistique. | Modèles de mélanges finis (GMM), clustering non supervisé, modèles non paramétriques. |
| Critères de décision statistique | Non-rejet de l’hypothèse nulle d’unimodalité (Dip test $p > 0{,}05$). | Rejet de l’unimodalité ; convergence vers 2 classes via l’indice BIC/AIC. | Rejet de l’unimodalité ; minimisation de l’information bayésienne pour $K ge 3$. |
4. Mesures de tendance centrale et dispersion dans une distribution unimodale
4.1 Relations spatiales entre mode, médiane et moyenne
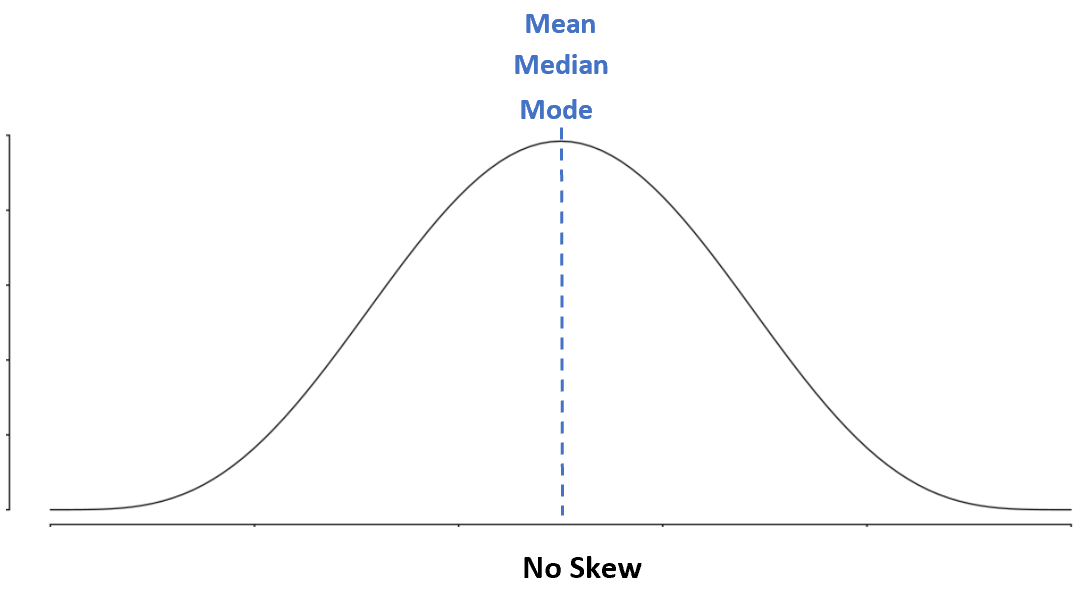
L’un des apports majeurs de l’analyse distributionnelle réside dans la compréhension des relations spatiales régissant les trois principaux indicateurs de tendance centrale : le mode, la médiane et la moyenne arithmétique. Dans une distribution unimodale rigoureusement symétrique — dont l’archétype est la courbe en cloche gaussienne — ces trois métriques convergent parfaitement vers un point unique :
$$\text{Mode} = \text{Médiane} = \text{Moyenne}$$
Cette triade fusionnée constitue le pivot géométrique idéal de la modélisation statistique classique.
Dès lors que la distribution unimodale s’écarte de la symétrie sous l’effet de contraintes physiques, biologiques ou cognitives, un décalage spatial systématique s’opère entre ces trois paramètres. Dans une distribution présentant une asymétrie positive (ou étalement vers la droite), les valeurs exceptionnellement élevées situées dans la longue queue supérieure exercent un effet de levier gravitationnel sur la moyenne arithmétique. La médiane, indexée sur le 50e centile cumulé, résiste partiellement à cette traction, tandis que le mode demeure fixé au sommet de la densité de fréquence. L’ordre de grandeur spatial s’établit invariablement selon la hiérarchie :
$$\text{Mode} < \text{Médiane} < \text{Moyenne}$$
À l’inverse, dans le cas d’une asymétrie négative (ou étalement vers la gauche), la traction des scores très faibles étire la moyenne vers la gauche, établissant la relation réciproque :
$$\text{Moyenne} < \text{Médiane} < \text{Mode}$$
Pour quantifier approximativement ces glissements au sein de distributions unimodales modérément asymétriques, Karl Pearson a formulé une relation heuristique célèbre, connue sous le nom de règle empirique de Pearson :
$$\text{Mode} \approx \text{Moyenne} – 3 \cdot (\text{Moyenne} – \text{Médiane})$$
Cette relation indique que la médiane parcourt environ les deux tiers de la distance séparant le mode de la moyenne. Bien qu’approximative et invalidée dans des distributions présentant des formes pathologiques ou des courbures abruptes, cette règle souligne la dépendance géométrique étroite liant les trois mesures au profil morphologique du sommet central.
En matière de robustesse face aux valeurs aberrantes extrêmes, ces indicateurs affichent une vulnérabilité différentielle prononcée. Le mode se révèle intrinsèquement ultra-robuste aux valeurs aberrantes lointaines : l’ajout d’observations extrêmes à plusieurs dizaines d’écarts-types du centre ne modifie aucunement la position du pic local, tant que la densité sommitale reste inchangée. La médiane offre un point de rupture (breakdown point) remarquable de 50 %, supportant la contamination d’une moitié des données sans diverger vers l’infini. La moyenne arithmétique, en revanche, présente un point de rupture théorique nul (0 %) : une unique observation arbitrairement extrême suffit à déplacer la moyenne sans limite, illustrant son instabilité substantielle dans les distributions unimodales asymétriques à queues lourdes.
4.2 Indicateurs de variabilité et largeur du pic
La simple localisation du sommet modal d’une distribution ne suffit pas à en épuiser la description ; il est indispensable d’en quantifier la dispersion et le resserrement structural. Les paramètres traditionnels que sont l’écart-type ($\sigma$) et la variance ($\sigma^2$) décrivent la dispersion globale des observations autour de la moyenne arithmétique. Dans une distribution unimodale symétrique, l’écart-type dicte directement l’acuité du sommet : un écart-type restreint génère un profil aigu et resserré, signalant une forte homogénéité des individus autour de la valeur centrale, tandis qu’un grand écart-type aplatit la morphologie globale de la courbe.
Toutefois, dès lors que l’unimodalité s’accompagne d’une asymétrie marquée ou d’une queue de distribution étendue, l’écart-type perd de sa pertinence en tant que descripteur exclusif de la largeur du pic. L’analyste se tourne alors préférentiellement vers l’écart interquartile (IQR pour Interquartile Range), défini par la différence entre le troisième et le premier quartile :
$$\text{IQR} = Q_3 – Q_1$$
L’IQR offre une mesure d’échelle non paramétrique robuste qui circonscrit exactement les 50 % centraux de la masse probabiliste entourant la médiane et le mode. Cette métrique demeure insensible aux fluctuations extrêmes des queues de distribution, assurant une quantification fidèle de la compacité de la distribution au voisinage du sommet.
En métrologie physique, en spectroscopie et dans l’analyse acoustique des signaux psychophysiologiques, la géométrie du pic unimodal est fréquemment évaluée par la largeur à mi-hauteur, universellement désignée sous le terme de FWHM (Full Width at Half Maximum). La FWHM représente la distance horizontale séparant les deux points de la fonction de densité où l’ordonnée est égale à exactement la moitié de la valeur maximale atteinte au mode :
$$\text{FWHM} = |x_{\text{droite}} – x_{\text{gauche}}| \quad \text{où} \quad f(x_{\text{droite}}) = f(x_{\text{gauche}}) = \frac{f(m)}{2}$$
Pour une loi normale théorique de variance $\sigma^2$, un calcul analytique direct établit une relation constante entre la FWHM et l’écart-type :
$$\text{FWHM} = 2 \sqrt{2 \ln 2} \cdot \sigma \approx 2{,}3548 \cdot \sigma$$
Cette mesure de largeur est particulièrement précieuse pour apprécier l’acuité d’un pic sans être biaisé par l’épaisseur des queues distributionnelles lointaines.
Enfin, la présence de queues épaisses (dites également queues lourdes ou leptocurtiques) exerce une influence déstabilisatrice sur les indices de dispersion quadratiques. Même en présence d’une unimodalité parfaite, si la probabilité de décroissance asymptotique suit une loi de puissance ($P(X > x) \sim x^{-\alpha}$) plutôt qu’une décroissance exponentielle gaussienne, la variance empirique peut diverger ou manifester une instabilité d’échantillonnage extrême. Dans de telles configurations unimodales non standards, le recours aux estimateurs d’échelle robustes, tels que la déviation absolue par rapport à la médiane (MAD, Median Absolute Deviation), devient méthodologiquement indispensable pour caractériser fidèlement la géométrie de la distribution.
5. Morphologie de la distribution : Asymétrie et Aplatissement
5.1 Influence du coefficient d’asymétrie (Skewness)
La morphologie tridimensionnelle d’une distribution unimodale ne se résume pas à son échelle et à sa localisation ; elle dépend intrinsèquement de son moment centré d’ordre trois standardisé, connu sous le nom de coefficient d’asymétrie ou skewness de Pearson ($\gamma_1$). Formellement défini par :
$$\gamma_1 = \mathbb{E}\left[ \left( \frac{X – \mu}{\sigma} \right)^3 \right] = \frac{\mu_3}{\sigma^3}$$
ce paramètre sans dimension quantifie le degré d’écart bilatéral de la distribution par rapport à un axe de symétrie vertical passant par le centre.
Lorsque $\gamma_1 = 0$, la distribution est parfaitement symétrique (ou quasi symétrique). Les profils de part et d’autre du mode se reflètent harmonieusement, impliquant que chaque écart positif par rapport au centre est statistiquement compensé par un écart négatif d’amplitude et de probabilité équivalentes. C’est l’équilibre classique de la loi normale standard.
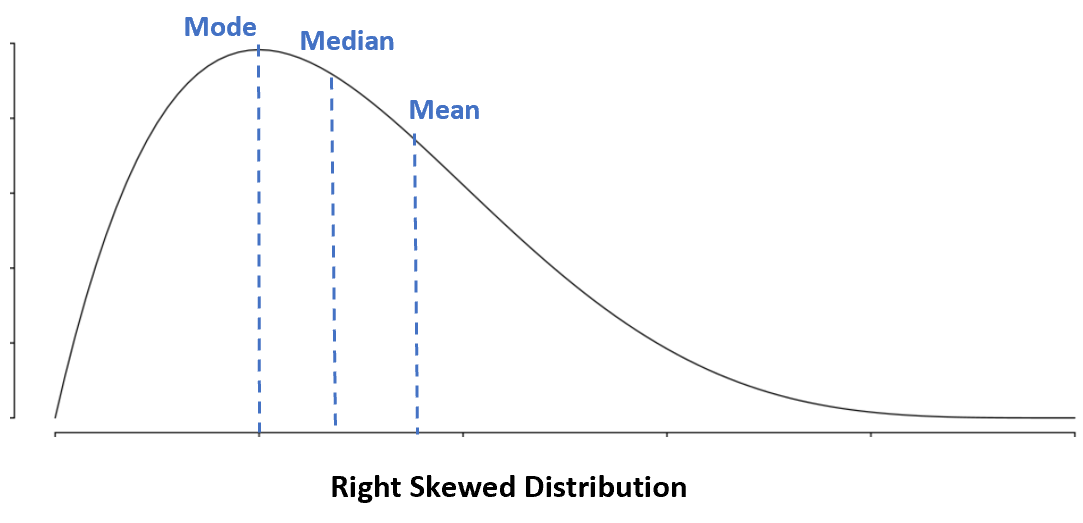
Une valeur positive du coefficient d’asymétrie ($\gamma_1 > 0$) correspond à une asymétrie positive (étalement vers la droite). Dans cette morphologie unimodale, la masse principale des observations reste fortement condensée vers les scores modestes, formant un pic abrupt sur la gauche de la courbe, tandis qu’une queue effilée s’étire en direction des valeurs positives extrêmes. Ce profil est prépondérant dans l’analyse des temps d’accès lexical, des revenus financiers ou des seuils de tolérance à la douleur.
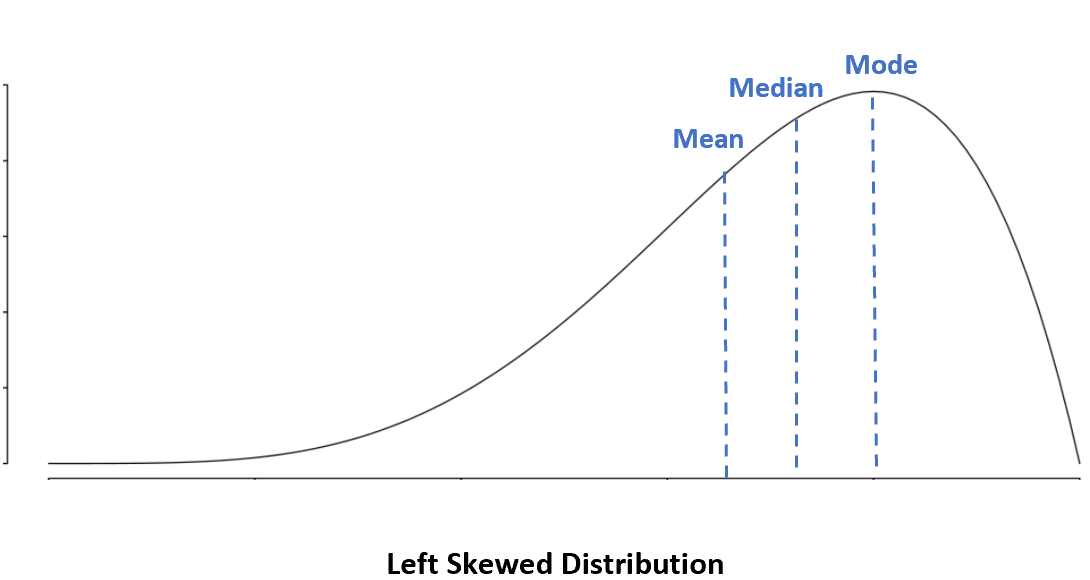
À l’inverse, un coefficient négatif ($\gamma_1 < 0$) signale une asymétrie négative (étalement vers la gauche). Le sommet unimodal se situe dans la portion supérieure de l’axe des abscisses, tandis que la queue de distribution s’étend vers les valeurs inférieures. En psychologie clinique et en santé publique, ce phénomène s’observe de manière spectaculaire lors de l’évaluation de la qualité de vie dans des cohortes saines : la très grande majorité des individus rapporte des niveaux de satisfaction élevés (pic modal à droite), tandis qu’une minorité vulnérable tire la queue vers des scores extrêmement bas.
L’impact de l’asymétrie sur les seuils diagnostiques en psychologie clinique est capital. Lorsque les praticiens utilisent des seuils coupés à un nombre fixe d’écarts-types (par exemple, la règle conventionnelle du score $z > +2{,}00$ pour diagnostiquer une pathologie), l’hypothèse sous-jacente de symétrie gaussienne biaise gravement les estimations de prévalence. Si la distribution empirique unimodale présente une forte asymétrie droite, la proportion d’individus excédant le seuil sera substantiellement supérieure aux 2,28 % théoriques attendus sous la loi normale, conduisant à des surdiagnostics massifs si la structure morphologique n’a pas été préalablement normalisée ou modélisée via des percentiles réels.
5.2 Rôle du coefficient d’aplatissement (Kurtosis)
Complétant l’asymétrie, le moment centré d’ordre quatre standardisé, ou coefficient d’aplatissement (kurtosis de Pearson, noté $\beta_2$, ou son excès d’aplatissement $\gamma_2 = \beta_2 – 3$), mesure la propension de la distribution unimodale à concentrer sa masse dans son sommet et ses queues plutôt que dans ses flancs intermédiaires :
$$\gamma_2 = \frac{\mathbb{E}[(X – \mu)^4]}{\sigma^4} – 3$$
Ce coefficient permet d’affiner l’analyse de la morphologie du sommet modal et de la vulnérabilité aux événements extrêmes.
Une distribution présentant un excès de kurtosis nul ($\gamma_2 = 0$) est qualifiée de mésocurtique. Elle adopte le profil de courbure exact de la distribution gaussienne, où la décroissance des probabilités depuis le mode vers les extrémités s’effectue selon une cinétique exponentielle quadratique ordonnée.
Lorsque $\gamma_2 > 0$, la distribution est dite leptocurtique. Elle se singularise par un pic modal aigu, étroit et hyper-concentré, accompagné de queues de distribution lourdes et épaisses. Dans une telle structure unimodale, la probabilité d’observer des valeurs très proches du mode est supérieure à celle d’une loi normale de même variance, mais la probabilité d’observer des valeurs extraordinairement distantes du mode est également beaucoup plus élevée. Ce phénomène leptocurtique est fréquemment observé dans les séries de rendements boursiers à haute fréquence et dans les temps de fixation oculaire lors de tâches de lecture experte.
À l’opposé, une distribution platycurtique ($\gamma_2 < 0$) présente un sommet aplati, émoussé, parfois comparé à une colline arrondie, tout en conservant scrupuleusement une unique zone sommitale sans scission bimodale. Les queues de distribution sont légères et s'éteignent rapidement. L'exemple limite de la platycurticité unimodale est la distribution uniforme continue (bien que cette dernière possède une densité constante sur un intervalle compact, la privant d'un mode strict unique au sens différentiel).
Les conséquences statistiques de la leptocurticité sur les procédures d’inférence sont profondes. L’erreur-type des estimateurs conventionnels — notamment la variance de l’échantillon — dépend directement de l’amplitude du kurtosis d’ordre quatre :
$$operatorname{Var}(S^2) = \frac{2\sigma^4}{n-1} + \frac{\gamma_2 \sigma^4}{n}$$
Si la distribution sous-jacente est fortement leptocurtique ($\gamma_2 gg 0$), la variabilité d’échantillonnage de la variance augmente dramatiquement. Il en découle que les intervalles de confiance paramétriques calibrés sur l’hypothèse normale sous-estiment systématiquement l’incertitude réelle, produisant des taux d’erreur de première espèce (alpha) gonflés lors de l’application de tests d’hypothèse classiques.
6. Exemple 1 : Le poids des nouveau-nés en biométrie
6.1 Modélisation empirique du poids néonatal
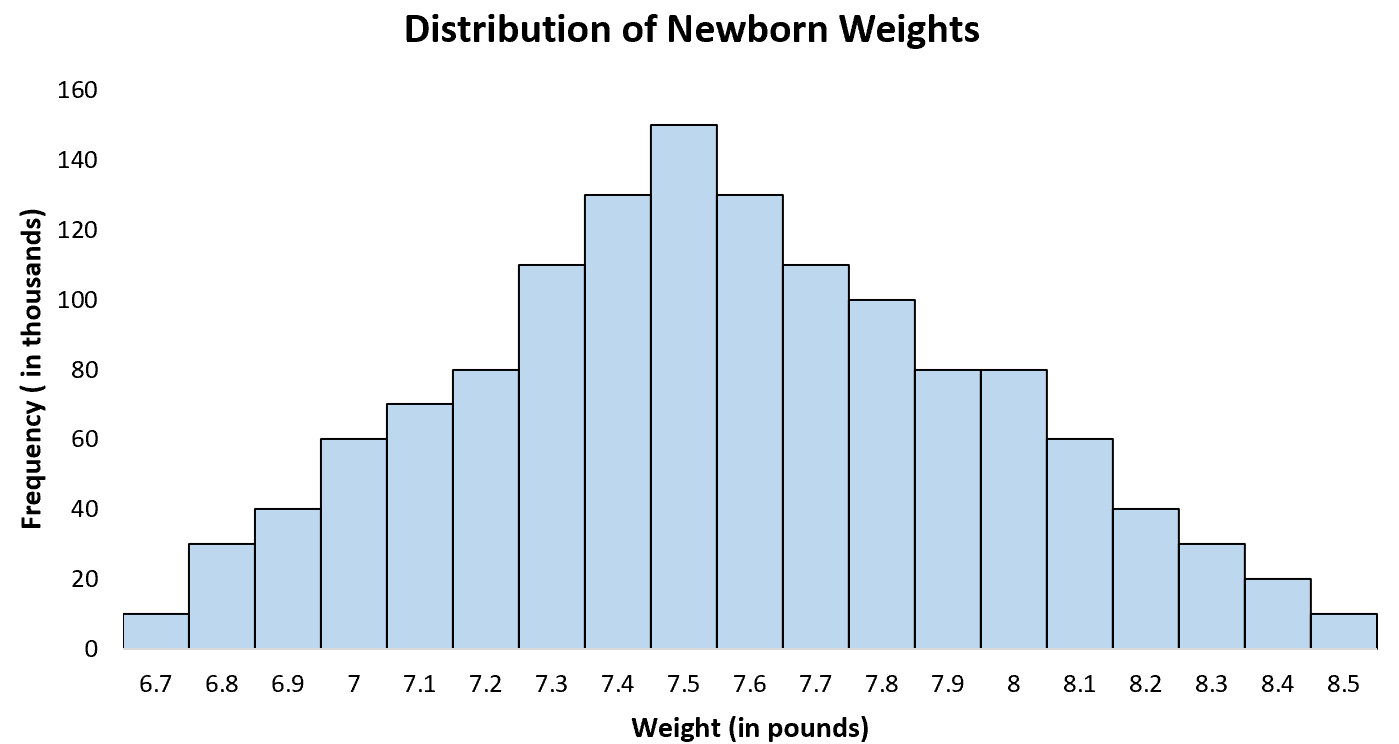
L’étude biométrique du poids de naissance chez les nourrissons humains offre une démonstration empirique exemplaire d’une distribution unimodale quasi parfaite à l’échelle d’une espèce biologique entière. Lorsque l’on compile les données issues des grands registres hospitaliers mondiaux et des cohortes néonatales de l’Organisation Mondiale de la Santé (OMS), la distribution pondérale des enfants nés à terme (entre la 37e et la 41e semaine de gestation) se structure de façon spectaculaire autour d’un pic modal universel oscillant entre 3,3 et 3,5 kilogrammes (soit environ 7,5 livres chez les nourrissons de sexe masculin).
La courbe de densité empirique construite à partir de plusieurs centaines de milliers d’observations affiche une convergence remarquable avec la courbe en cloche de Gauss. De part et d’autre du mode central, la fréquence des naissances décroît de manière continue et symétrique : les nouveau-nés pesant moins de 2,5 kg (qualifiés de petit poids de naissance) et ceux excédant 4,5 kg (macrosomie fœtale) occupent les queues lointaines de la distribution avec des probabilités faibles et régulières.
Cette stabilité transversale du mode à travers des populations géographiquement, ethniquement et socio-économiquement disparates constitue l’un des faits les plus remarquables de la physiologie comparée. Bien que des décalages mineurs de quelques centaines de grammes existent entre différentes populations sous l’effet de facteurs nutritionnels ou d’altitudes variables, la structure géométrique unimodale demeure rigoureusement invariante. L’absence totale de fragmentation bimodale au sein d’une cohorte homogène de naissances à terme valide la robustesse du modèle continu unimodal en pédiatrie.
6.2 Pressions évolutives et stabilisation de l’unimodalité
L’émergence de cette distribution unimodale stricte dans la biologie humaine ne résulte pas d’un simple hasard probabiliste ; elle représente le produit tangible d’une pression sélective millénaire théorisée en biologie évolutive sous le nom de sélection stabilisante. Dans une publication fondatrice de 1951, Mary Noel Karn et Lionel Penrose ont apporté la preuve mathématique que la mortalité néonatale était fonction de la déviation du poids par rapport à la moyenne centrale de la population.
La courbe de mortalité périnatale en fonction du poids de naissance présente une forme caractéristique en U. Aux extrémités distributionnelles, le risque létal augmente de manière exponentielle : les nourrissons de très faible poids encourent des risques massifs de détresse respiratoire, d’hypothermie et d’immaturité métabolique, tandis que les nourrissons de fort poids (macrosomes) font face à des risques critiques de dystocie des épaules, de traumatismes obstétricaux et de rupture utérine chez la parturiente lors de l’accouchement en milieu naturel. Le minimum mathématique de cette fonction de mortalité coïncide quasi exactement avec le sommet modal de la distribution empirique.
Au fil des générations, cette pression sélective bidirectionnelle a canalisé le patrimoine génétique gouvernant la durée de gestation, le flux trophoblastique placentaire et la croissance fœtale vers une valeur centrale optimale, éliminant continuellement les génotypes codant pour des phénotypes pondéraux extrêmes. L’unimodalité biométrique observée aujourd’hui reflète donc l’homogénéisation physiologique profonde d’un compromis obstétrical adaptatif.
Dans la pratique néonatale contemporaine, cette distribution unimodale sert de matrice formelle pour l’élaboration des courbes de percentiles de croissance intra-utérine. Grâce à la décroissance régulière et prévisible des densités autour du mode, les tables pédiatriques de Fenton ou d’Intergrowth-21st partitionnent la distribution en centiles (3e, 10e, 50e, 90e, 97e centiles). Un nourrisson positionné sous le 10e centile modal est immédiatement identifié comme présentant un retard de croissance intra-utérin (RCIU), déclenchant une surveillance métabolique ciblée, ce qui illustre l’utilité clinique directe de la géométrie unimodale.
7. Exemple 2 : Les scores aux tests standardisés (ACT et QI)
7.1 Distribution des scores au test d’aptitude académique (ACT)
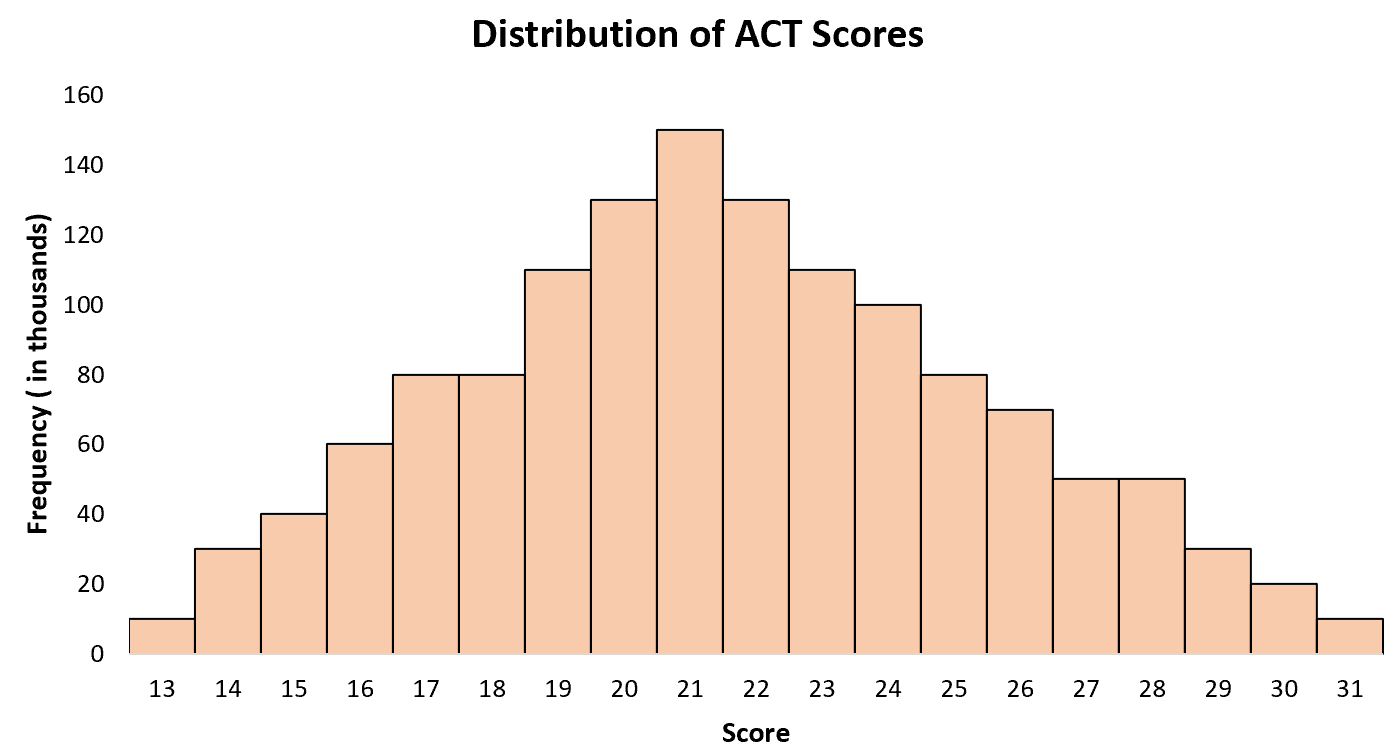
Le test de l’ACT (American College Testing), passé annuellement par près de deux millions d’élèves du secondaire aux États-Unis pour l’accès aux études supérieures, illustre de façon paradigmatique l’ingénierie psychométrique d’une distribution unimodale au sein d’une métrique d’évaluation standardisée. L’échelle composite finale du test s’étend de 1 à 36 points. L’examen des données nationales d’attribution des scores révèle une concentration modale extrêmement marquée autour de la valeur médiane de 21 points, dessinant une cloche d’une parfaite régularité géométrique.
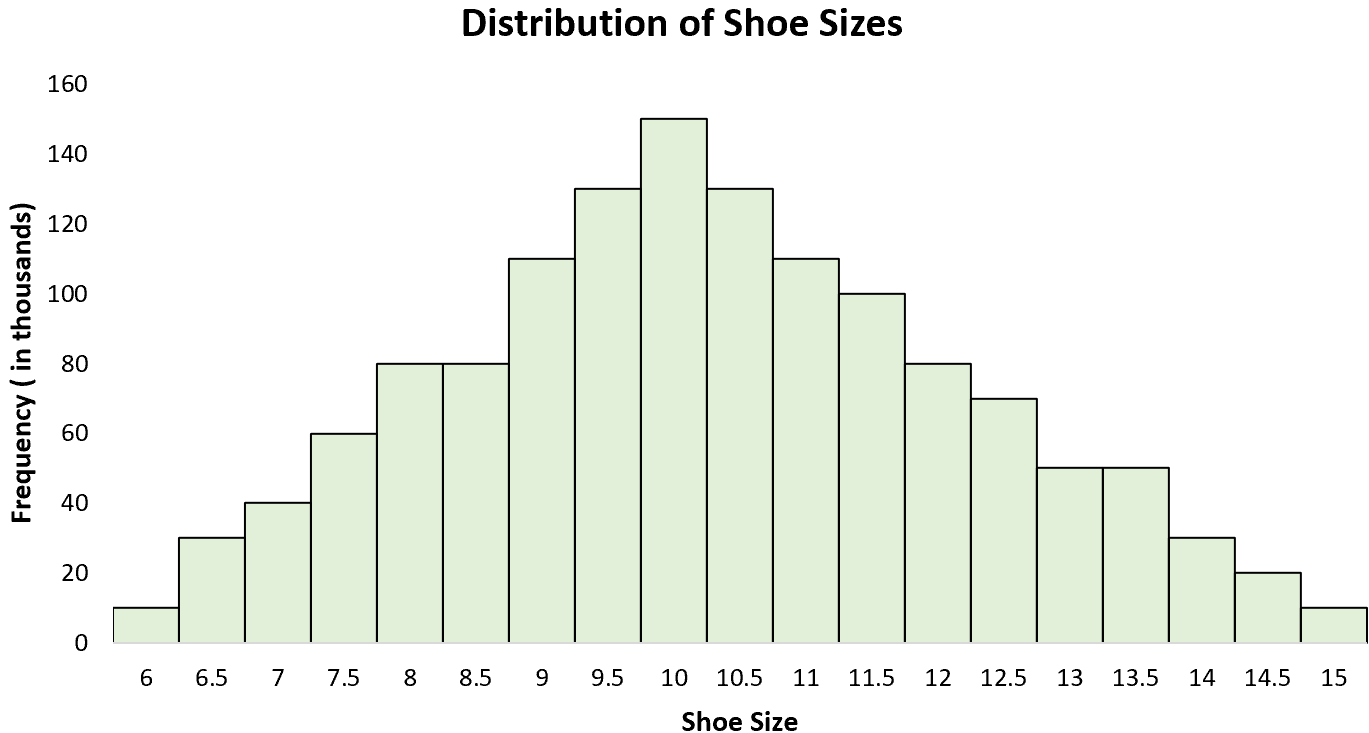
Cette morphologie unimodale n’est pas fortuite : elle découle d’un calibrage méticuleux des banques d’items fondé sur les modèles logistiques de la théorie de la réponse aux items (TRI). Les concepteurs du test sélectionnent des questions présentant des niveaux de difficulté et des indices de discrimination savamment étagés sur l’ensemble du continuum de compétence. Cette procédure d’équilibrage élimine expressément tout phénomène de saturation :
- L’effet de plancher (floor effect), où une majorité d’items trop complexes accumulerait artificiellement un sommet modal aux scores minimaux.
- L’effet de plafond (ceiling effect), où une profusion de questions triviales condenserait un pic modal au score maximal de 36.
L’élimination de ces distorsions garantit la pérennité d’un sommet central unique et stable.
L’exploitation de ces scores par les bureaux d’admission universitaire s’appuie directement sur les rangs centiles dérivés de la géométrie unimodale sous-jacente. Puisque la distribution est unimodale et symétrique, une variation de deux points au voisinage immédiat du mode (par exemple, passer de 20 à 22 points) traverse une densité massive d’individus, modifiant le rang centile de l’étudiant de plus de 15 points de pourcentage. En revanche, le même différentiel de deux points situé dans la queue supérieure de la distribution (passer de 33 à 35) n’induit qu’une translation minime du rang centile (de 98 % à 99 %), car les fréquences d’apparition se raréfient de manière abrupte à mesure que l’on s’écarte du sommet modal.
7.2 Standardisation du quotient intellectuel (Wechsler)
L’exemple le plus formalisé de construction délibérée d’une distribution unimodale en psychologie quantitative est incarné par les échelles d’intelligence de Wechsler (notamment la WAIS-IV pour les adultes et le WISC-V pour les enfants). Historiquement, le concept initial de quotient intellectuel formulé par William Stern correspondait à un ratio arithmétique :
$$\text{QI classique} = \left( \frac{\text{Âge mental}}{\text{Âge chronologique}} \right) \times 100$$
Ce ratio engendrait des distributions empiriques instables, fortement asymétriques et non comparables d’une tranche d’âge à l’autre.
David Wechsler a révolutionné cette approche en instaurant le principe du QI de déviation standardisé. Par ce mécanisme mathématique, les scores bruts composites de performance cognitive sont contraints, par normalisation directe, d’épouser une loi gaussienne strictement unimodale de paramètres formellement fixés par convention :
$$\mu = 100 \quad \text{et} \quad \sigma = 15$$
L’unimodalité devient ici le cadre structurel normatif régissant la métrologie de l’intelligence humaine.
La puissance du modèle unimodal réside dans la clarté de l’interprétation diagnostique qu’il confère à la rareté statistique. Dans cette distribution centrée sur 100 :
- Environ 68,26 % de la population se regroupe dans l’intervalle $[85, 115]$, soit à un écart-type du mode central.
- L’intervalle $[70, 130]$ englobe 95,44 % de la population.
- Les zones cliniques extrêmes se situent au-delà de deux écarts-types : un score inférieur à 70 délimite le critère statistique associé à la déficience intellectuelle (environ 2,28 % de la population), tandis qu’un score excédant 130 caractérise le haut potentiel intellectuel (HPI), selon une proportion strictement symétrique.
Sur le plan de la validation théorique, l’invariance factorielle de cette distribution unimodale à travers les groupes d’âge et les cultures a conforté l’hypothèse de l’existence d’un facteur g (facteur général d’intelligence) théorisé par Charles Spearman. L’observation constante d’un continuum unimodal robuste dénué de tout creux structurel réfute empiriquement les théories typologiques prétendant subdiviser l’humanité en catégories cognitives hermétiques, confirmant que l’intelligence se déploie selon un continuum sans rupture qualitative brutale.
8. Exemple 3 : Les caractéristiques morphologiques (Pointures de chaussures)
8.1 Observation distributionnelle de la taille des pieds masculins
L’analyse morphométrique des mensurations corporelles chez l’être humain adulte offre un terrain d’application concret pour illustrer la convergence de variables discrètes vers des topologies unimodales continues. Si l’on étudie la distribution des pointures de chaussures masculines au sein d’une population adulte homogène en Europe occidentale, la fréquence d’apparition s’organise autour d’un mode hautement proéminent positionné à la taille 43 (correspondant approximativement à la taille 10 sur l’échelle standardisée des États-Unis).
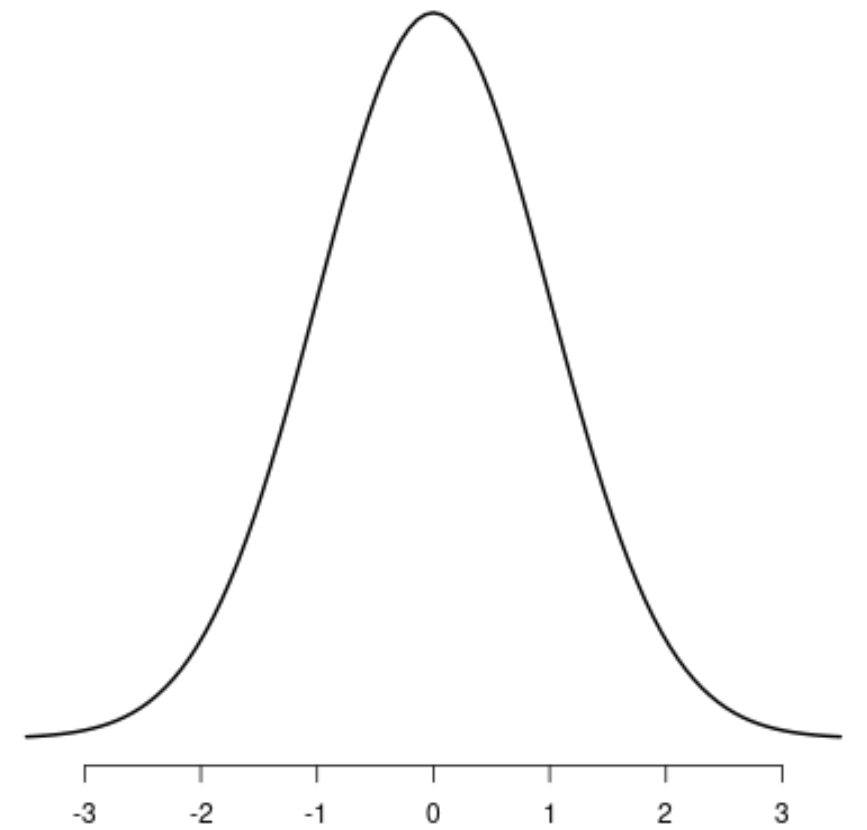
Bien que la pointure commerciale soit une variable fondamentalement discrète (mesurée par pas d’un point ou d’une demi-pointure selon les normes de la verge de Paris ou du point anglais), la distribution empirique des effectifs de vente converge avec une régularité frappante vers une enveloppe unimodale continue. De la même manière que pour le poids de naissance, les fréquences d’individus chaussant du 40 ou du 46 décroissent de façon quasi symétrique par rapport au mode central, devenant marginales aux bornes extrêmes telles que la pointure 38 ou 49.
Il importe de souligner que la conservation de cette unimodalité stricte requiert une stratification démographique rigoureuse. Si un analyste compile les données de pointures de manière brute sans distinguer les sexes biologiques, la distribution résultante perd immédiatement son unimodalité parfaite pour adopter une forme bimodale élargie. Le mode féminin (positionné autour de la pointure 38) et le mode masculin (autour du 43) se chevauchent, générant une courbe à sommet double ou un profil fortement aplati (platycurtique). Ce phénomène rappelle que l’unimodalité des données biométriques dépend impérativement du contrôle des covariables démographiques sous-jacentes.
8.2 Applications pratiques dans l’industrie et l’ergonomie
La morphologie unimodale de la taille des pieds et des proportions anatomiques sous-tend l’ensemble des modèles économiques de gestion logistique et prédictive de l’industrie de la confection. Pour un fabricant de chaussures, modéliser la demande future en s’appuyant sur la fonction de densité de probabilité unimodale permet d’optimiser l’allocation des capacités de production. La commande de matières premières et la répartition des volumes industriels sont calibrées directement sur les hauteurs relatives de la courbe : le ratio de fabrication de la pointure modale 43 est calculé pour être plusieurs dizaines de fois supérieur à celui des pointures situées dans les queues distributionnelles, minimisant ainsi les coûts de surstockage et les risques de rupture logistique.
En ergonomie industrielle et en conception des postes de travail, la géométrie unimodale conditionne l’optimisation des espaces d’activité cognitive et motrice. Les ingénieurs concepteurs ne peuvent dimensionner un cockpit d’avion ou un poste de commande militaire en se basant sur le mythe de « l’homme moyen ». La présence d’une distribution unimodale impose une stratégie d’ingénierie adaptative :
- L’espace central est conçu pour accueillir sans réglage le sommet modal de la population (environ 50 à 60 % des utilisateurs).
- Des mécanismes d’ajustement modulaires (glissières de sièges, colonnes de direction télescopiques) couvrent l’intervalle allant du 5e au 95e percentile de la distribution anatomique.
Les coûts marginaux associés à la prise en compte des fractions de population situées dans les queues extrêmes (les percentiles inférieurs à 5 % et supérieurs à 95 %) sont particulièrement critiques en ingénierie aérospatiale. L’équipement d’un pilote dont la corpulence se situe à trois écarts-types du mode exige des adaptations sur-mesure excessivement onéreuses, illustrant les contraintes financières et techniques directes imposées par la décroissance rapide de la masse de probabilité dans les extrémités d’une distribution unimodale.
9. Méthodes graphiques et exploratoires pour identifier l’unimodalité
9.1 L’histogramme et le problème du choix de la largeur de classe
L’histogramme constitue historiquement l’instrument graphique de prédilection pour l’exploration préliminaire de la distribution d’une variable continue. Pourtant, son apparente simplicité dissimule un piège méthodologique redoutable : la morphologie observée (et singulièrement le nombre de modes apparents) dépend de façon critique du choix de la largeur des classes (bin width, notée $h$) et de l’origine de partitionnement de l’axe des abscisses.
Deux risques méthodologiques symétriques menacent l’analyste lors de la discrétisation d’un échantillon empirique :
- Le sous-lissage (undersmoothing), engendré par le choix d’une largeur de classe excessivement étroite ($h to 0$). Dans cette situation, la variabilité stochastique locale induit une multiplicité de pics parasites artificiels, trompant l’observateur en simulant une multimodalité complexe là où la loi sous-jacente est rigoureusement unimodale.
- Le sur-lissage (oversmoothing), résultant d’une largeur de classe excessivement large ($h to \infty$). Les classes trop vastes agrègent des sous-groupes structurellement hétérogènes, écrasant les dépressions réelles et masquant une véritable bimodalité sous une apparence fallacieuse d’unimodalité robuste.
Pour neutraliser cette subjectivité, la statistique exploratoire s’est dotée de règles empiriques formalisées pour calculer la largeur optimale de classe. La formule classique de Sturges :
$$k = 1 + \log_2(n) = 1 + 3{,}322 \log_{10}(n)$$
repose sur une hypothèse implicite de distribution sous-jacente gaussienne et tend à sur-lisser drastiquement les échantillons massifs ($n > 1000$). Pour une détection fidèle de l’unimodalité, la règle de Freedman-Diaconis s’impose comme une alternative robuste, affranchie des distorsions liées aux valeurs extrêmes :
$$h = 2 \cdot \frac{\text{IQR}(X)}{n^{1/3}}$$
En fondant le découpage sur l’écart interquartile plutôt que sur l’écart-type, cette règle garantit une résolution spatiale équilibrée, préservant la netteté du sommet modal tout en évitant la prolifération de micro-pics artéfactuels dans les queues de distribution.
9.2 L’estimation par noyau de densité (Kernel Density Estimation)
Pour s’émanciper des frontières arbitraires imposées par le découpage en classes de l’histogramme, l’estimation non paramétrique par noyau de densité — introduite par Emanuel Parzen et Murray Rosenblatt — s’est imposée comme le standard d’excellence de l’analyse distributionnelle exploratoire. Soit un échantillon de variables aléatoires i.i.d. $(X_1, X_2, dots, X_n)$. L’estimateur à noyau $\hat{f}_h(x)$ en tout point $x$ s’exprime par la sommation pondérée :
$$\hat{f}_h(x) = \frac{1}{n h} \sum_{i=1}^n K\left( \frac{x – X_i}{h} \right)$$
où $K(\cdot)$ est une fonction noyau (satisfaisant $\int K(u) du = 1$, le plus souvent choisie comme la densité gaussienne standard) et $h > 0$ représente le paramètre de lissage ou largeur de bande (bandwidth).
Le comportement de l’estimateur vis-à-vis de l’unimodalité dépend intégralement de la valeur attribuée au paramètre $h$. Si $h$ est trop restreint, la densité estimée affiche des oscillations locales microscopiques autour de chaque point d’échantillonnage, démultipliant artificiellement les modes locaux. Si $h$ est démesurément large, le noyau lisse aveuglément les caractéristiques structurelles fines, arrondissant les pics aigus et fusionnant des modes adjacents distincts.
La littérature statistique recommande d’abandonner les méthodes heuristiques de lissage (comme la règle empirique de Silverman) dès lors que l’on suspecte un écart à la normalité. Des approches sophistiquées comme la méthode plug-in de Sheather-Jones ou les algorithmes d’optimisation par validation croisée (cross-validation) minimisent le risque d’intégration quadratique moyenne de l’erreur (MISE) :
$$\text{MISE}(h) = \mathbb{E} \left[ \int \left( \hat{f}_h(x) – f(x) \right)^2 dx \right]$$
L’inspection de la dérivée seconde de l’estimateur à noyau $\hat{f} »_h(x)$ permet une détection rigoureuse des zones de concavité et de convexité, autorisant la confirmation graphique incontestable d’un sommet unique sur l’ensemble du domaine de variation des données.
9.3 Diagrammes de dispersion et boîtes à moustaches (Boxplots)
Si la boîte à moustaches (boxplot) de John Tukey demeure l’un des outils graphiques les plus répandus en analyse de données, elle manifeste une incapacité structurelle totale à détecter la multimodalité. Un boxplot traditionnel repose exclusivement sur cinq statistiques d’ordre fondamentales : le minimum, le premier quartile ($Q_1$), la médiane ($Q_2$), le troisième quartile ($Q_3$) et le maximum (ou les valeurs clôturant les moustaches à $1{,}5 \times \text{IQR}$).
Par construction géométrique, une distribution rigoureusement unimodale et une distribution fortement bimodale mais symétrique (composée de deux sommets séparés par un gouffre central profond coïncidant avec la médiane) peuvent engendrer des boxplots strictement identiques. L’analyste se basant uniquement sur cet affichage conclura à tort à l’existence d’une distribution unimodale régulière centrée sur la médiane, masquant la fracture structurelle scindant la population en deux blocs hermétiques.
Pour surmonter cette carence diagnostique majeure, la communauté scientifique a développé et généralisé les diagrammes en violon (violin plots). Ces représentations hybrides intègrent au cœur du graphique les repères quartiles du boxplot conventionnel, tout en les enveloppant d’une estimation miroir par noyau de densité (KDE) sur les flancs latéraux. Le diagramme en violon combine ainsi la robustesse métrique des percentiles et la fidélité topologique de la fonction de densité, rendant immédiatement visible l’étranglement caractéristique de l’antimode en cas de bimodalité, ou l’évasement continu d’un pic unimodal.
En complément, les graphiques quantile-quantile (Q-Q plots) permettent de tester la conformité d’une distribution unimodale empirique à une distribution théorique de référence (telle que la loi normale). Lorsque la distribution empirique est unimodale et symétrique, les points s’alignent le long de la bissectrice à 45 degrés. Une courbure systématique en « S » ou en virgule met en relief les écarts d’asymétrie ou d’aplatissement, tandis que les observations aberrantes déconnectées de la trajectoire linéaire sont immédiatement isolées, évitant qu’elles ne soient confondues avec des modes secondaires émergents.
10. Tests statistiques formels pour l’évaluation de l’unimodalité
10.1 Le test du dip de Hartigan (Hartigan’s Dip Test)
L’inspection visuelle des histogrammes et des courbes de densité ne pouvant se substituer à une démarche de confirmation probabiliste, le développement de tests d’hypothèse formels s’est avéré indispensable. Parmi ces procédures non paramétriques, le test du dip de Hartigan (Hartigan & Hartigan, 1985) constitue la référence théorique et opérationnelle incontournable pour statuer sur l’unimodalité d’un ensemble de données.
Le fondement mathématique du test repose sur le concept de distance morphologique entre la fonction de répartition empirique $F_n(x)$ d’un échantillon et l’espace fonctionnel $\mathcal{U}$ constitué par l’ensemble de toutes les fonctions de répartition théoriques strictement unimodales. Le « dip » (noté $D_n$) mesure le supremum de la différence absolue minimale entre $F_n$ et n’importe quelle fonction $F in \mathcal{U}$ :
$$D_n = \inf_{F in \mathcal{U}} \sup_{x in \mathbb{R}} |F_n(x) – F(x)|$$
Algorithmiquement, le calcul du dip s’effectue par l’ajustement de la plus petite enveloppe convexe mineure et de la plus grande enveloppe concave majeure encadrant la fonction de distribution empirique de l’échantillon ordonné.
Le cadre inférentiel du test du dip de Hartigan s’articule autour des hypothèses suivantes :
- Hypothèse nulle ($H_0$) : La distribution sous-jacente de la population est unimodale (avec la distribution uniforme comme cas limite le moins favorable conférant la valeur maximale au dip sous $H_0$).
- Hypothèse alternative ($H_1$) : La distribution de la population présente au moins deux modes distincts (multimodalité).
Dans les environnements d’analyse statistique tels que R (via le package diptest) ou Python (via le module scipy ou des bibliothèques spécialisées), l’obtention d’une $p$-valeur supérieure au seuil d’alpha conventionnel ($p > 0{,}05$) indique l’incapacité de rejeter l’hypothèse nulle, concluant à la conformité formelle des données avec une structure unimodale. À l’inverse, une $p$-valeur inférieure à 0,05 atteste de l’existence statistiquement significative d’une dépression (antimode) séparant deux sommets ou plus.
La sensibilité du dip test est toutefois modérément dépendante de la taille de l’échantillon. Si le test excelle à éviter les faux positifs sur des échantillons restreints, sa puissance statistique peut décliner lorsque deux sous-populations sont excessivement imbriquées (mélanges gaussiens à modes très rapprochés dont les moyennes sont séparées par une distance inférieure à deux écarts-types, $| \mu_1 – \mu_2 | < 2\sigma$), une situation où la scission modale reste infinitésimale.
10.2 Le test de Silverman basé sur la largeur de bande critique
Une alternative non paramétrique tout aussi féconde repose sur les travaux de Bernard Silverman (1981), qui a formulé un test d’unimodalité s’appuyant directement sur les propriétés de l’estimation de densité par noyau gaussien. Le test de Silverman exploite une élégante propriété mathématique propre au noyau normal : lorsque la largeur de bande de lissage $h$ augmente de manière continue de 0 vers l’infini, le nombre de modes $k$ de la fonction de densité estimée $\hat{f}_h$ décroît de façon strictement monotone.
Le protocole consiste à déterminer la largeur de bande critique, notée $h_{\text{crit}}$, définie comme l’infimum des largeurs de fenêtre pour lesquelles l’estimateur de densité $\hat{f}_h$ présente au plus un mode :
$$h_{\text{crit}} = \inf \left{ h > 0 mid \hat{f}_h \text{ possède au plus 1 mode} \right}$$
Si la distribution empirique est intrinsèquement multimodale, une largeur de fenêtre $h_{\text{crit}}$ très élevée sera requise pour gommer artificiellement les creux de la courbe et forcer l’unimodalité, tandis qu’une distribution naturellement unimodale requiert un lissage modeste pour éliminer les micro-bruits de mesure.
La calibration de la signification statistique de $h_{\text{crit}}$ est réalisée par des méthodes intensives de rééchantillonnage bootstrap non paramétrique lissé :
- Des pseudo-échantillons sont générés itérativement sous l’hypothèse nulle à partir de la distribution estimée $\hat{f}_{h_{\text{crit}}}$, recentrée et rééchelonnée pour en préserver la variance unitaire.
- Sur chaque réplique bootstrap, la largeur de bande critique nécessaire pour atteindre l’unimodalité est recalculée.
- La $p$-valeur finale correspond à la proportion d’itérations bootstrap où la largeur critique simulée excède la valeur empirique $h_{\text{crit}}$ observée sur l’échantillon originel.
Sur le plan computationnel, le test de Silverman impose une charge algorithmique substantielle due aux simulations bootstrap répétées, ce qui le rend nettement plus exigeant en temps de calcul que le dip test de Hartigan. Par ailleurs, des analyses asymptotiques ont démontré que le test de Silverman tend à être conservateur sur les queues de distribution étendues. Il offre néanmoins une flexibilité théorique exceptionnelle en autorisant le test d’hypothèses d’ordre supérieur, telles que tester la présence d’au plus $k$ modes ($H_0 : k = 2$ contre $H_1 : k ge 3$).
10.3 Tests de normalité comme indicateurs indirects d’unimodalité
Dans la pratique analytique courante, les chercheurs utilisent fréquemment des tests d’ajustement à la loi normale, tels que le test de Shapiro-Wilk, le test d’Anderson-Darling ou le test de Kolmogorov-Smirnov (adapté par Lilliefors), comme étape de détection préliminaire. Ces outils calculent la déviation maximale ou la corrélation des résidus de l’échantillon vis-à-vis d’une distribution normale théorique.
Toutefois, une confusion conceptuelle critique doit impérativement être dissipée : l’absence de normalité n’implique en aucun cas une absence d’unimodalité. Une distribution unimodale peut être fortement asymétrique (comme la loi log-normale, la loi Gamma ou la loi de Weibull), ou intensément leptocurtique (comme la loi de Student ou la loi de Laplace), violant radicalement l’hypothèse nulle d’un test de Shapiro-Wilk ($p < 0{,}001$) tout en conservant une unimodalité morphologique absolue et irréprochable. Rejeter la normalité ne permet donc aucunement de conclure à l'existence d'une scission multimodale.
Pour dépasser cette ambiguïté au sein des approches paramétriques, il est opportun de coupler ces diagnostics à des procédures de comparaison de modèles fondées sur les ratios de vraisemblance (Likelihood Ratio Tests) appliqués aux modèles de mélanges gaussiens finis. En confrontant un modèle à composante unique ($K = 1$, unimodal par définition) à un modèle à deux composantes ($K = 2$, potentiellement bimodal) via des critères d’information pénalisés tels que l’AIC (Akaike Information Criterion) ou le BIC (Bayesian Information Criterion) :
$$\text{BIC} = -2 \ln(\hat{L}) + k \cdot \ln(n)$$
l’analyste dispose d’un critère décisionnel formel. Si le modèle $K = 1$ minimise le critère d’information bayésien face aux modèles $K ge 2$, l’hypothèse d’une population structurellement unimodale est solidement confirmée, même si les tests de normalité classique sont simultanément rejetés en raison d’une asymétrie de forme.
11. Implications diagnostiques et modélisation en sciences du comportement
11.1 Le modèle continu de la santé mentale et ses distributions unimodales
L’étude de la distribution empirique des scores de détresse psychologique et de symptomatologie psychiatrique a provoqué une révolution paradigmatique dans les sciences du comportement. Historiquement, la nosographie psychiatrique classique — incarnée par les éditions successives du Manuel diagnostique et statistique des troubles mentaux (DSM de l’American Psychiatric Association) — reposait sur une vision catégorielle binaire : les individus étaient classifiés comme « malades » ou « sains », postulant tacitement une scission bimodale de la population entre une cohorte asymptomatique et une cohorte pathologique.
Or, lorsque l’on administre des instruments d’évaluation psychométrique validés de la dépression ou de l’anxiété — tels que l’Inventaire de Dépression de Beck (BDI-II) ou le Questionnaire de Santé du Patient (PHQ-9) — au sein d’échantillons épidémiologiques représentatifs de la population générale, les données ne révèlent jamais de structure bimodale. Les scores se déploient systématiquement selon une distribution unimodale continue, caractérisée par une forte asymétrie positive :
- Le mode le plus prononcé se situe sur le score 0 ou les valeurs minimales adjacentes (représentant les personnes n’éprouvant que peu ou pas de souffrance psychique).
- La fréquence des scores décroît de façon continue, graduelle et monotone en direction des niveaux de sévérité clinique élevés, formant une queue de distribution étirée vers la droite sans le moindre creux séparateur.
Cette réalité morphologique a contraint la recherche contemporaine à formaliser le modèle dimensionnel de la santé mentale, opérationnalisé notamment à travers le cadre nosologique HiTOP (Hierarchical Taxonomy of Psychopathology). La santé mentale n’est plus envisagée comme une entité discrète, mais comme un continuum quantitatif unifié le long duquel les individus se distribuent selon des gradients d’intensité continue.
Cette géométrie unimodale soulève néanmoins un dilemme diagnostique et pragmatique considérable pour la pratique clinique : comment justifier scientifiquement un seuil de coupure catégoriel strict (par exemple, déclarer un individu cliniquement déprimé à partir d’un score $ge 10$ au PHQ-9) lorsqu’il n’existe aucune discontinuité géométrique ni creux de distribution pour étayer cette frontière ? Le positionnement du seuil relève d’une convention pragmatique d’optimisation entre sensibilité et spécificité (via les courbes ROC), mais ne correspond à aucune césure naturelle dans la distribution du phénomène, exposant les diagnostics frontaliers à une inévitable instabilité temporelle.
11.2 Phénomènes de split de distribution : Quand l’unimodalité disparaît
Si la stabilité d’une distribution unimodale reflète un équilibre systémique au sein d’une population ou d’un processus psychophysiologique, l’apparition soudaine d’une bifurcation — appelée « splitting distributionnel » — constitue un indicateur diagnostique de première importance. Ce basculement morphologique, où une distribution originellement unimodale éclate pour devenir bimodale, signale la rupture d’un état stationnaire sous l’influence d’une contrainte contextuelle ou d’une décompensation fonctionnelle.
Un tel phénomène s’observe avec une grande clarté en psychologie cognitive expérimentale lors de tâches de conflit exécutif, à l’instar du classique effet Stroop ou de la tâche d’amorçage négatif. Dans des conditions contrôlées congruentes, la distribution des temps de réaction (TR) des participants adopte un profil unimodal asymétrique standard (loi ex-gaussienne). En revanche, sous forte pression d’interférence cognitive ou chez des sujets présentant des dysfonctionnements du cortex préfrontal dorso-latéral, la distribution des temps de réaction se scinde fréquemment en deux modes distincts :
- Un premier sommet modal rapide, correspondant aux essais résolus par automatisation cognitive directe.
- Un second pic modal retardé, matérialisant les échecs transitoires de l’inhibition motrice où le système exécutif a dû réengager une boucle de contrôle attentionnel consciente et laborieuse.
De même, sur le plan psychosocial, des chocs systémiques violents (catastrophes sanitaires, effondrements économiques, guerres) peuvent fracturer la résilience unimodale d’une communauté. Une cohorte dont l’indice de bien-être était uniformément centré autour d’un mode fonctionnel peut, sous l’effet du traumatisme, se polariser en deux groupes hermétiques : un groupe résilient absorbant l’impact sans transition de phase, et un groupe vulnérable dérivant vers des états chroniques de stress post-traumatique, créant une bimodalité sociétale nette.
Pour modéliser mathématiquement ces transitions dynamiques, les sciences cognitives computationnelles ont recours aux équations différentielles stochastiques non linéaires et à la théorie des catastrophes de René Thom. Dans le modèle de dérive-diffusion (Diffusion Decision Model) utilisé en neurosciences décisionnelles, l’accumulation de preuves neuronales peut être modélisée sous forme de paysages de potentiel à un puits (unimodalité) qui, sous l’action d’un paramètre de contrôle critique, bifurquent vers un système à double puits de potentiel (bimodalité), rendant compte de la transition entre stabilité et indécision comportementale.
12. Limites méthodologiques et recommandations pour la recherche empirique
12.1 Pièges fréquents dans l’inférence fondée sur l’unimodalité
L’analyse des distributions unimodales est émaillée d’écueils interprétatifs dont le plus pernicieux est sans doute le sophisme écologique (ou erreur de réification du mode). Ce biais cognitif et méthodologique consiste à imputer mécaniquement les propriétés de la valeur modale centrale à n’importe quel individu prélevé aléatoirement dans la cohorte. Même au sein d’une distribution unimodale parfaitement conformée, le mode ne représente que la valeur de densité maximale relative ; il n’implique nullement que la majorité absolue des individus se confonde avec lui. Décrire l’individu moyen ou modal comme représentatif de l’ensemble d’une population diversifiée constitue une simplification abusive, particulièrement dangereuse en ergonomie ou en médecine personnalisée.
Un deuxième piège récurrent réside dans l’assimilation hâtive entre unicité du pic statistique et unicité de la cause sous-jacente. L’observation d’une morphologie unimodale propre n’offre aucune garantie formelle qu’un processus étiologique unique soit à l’œuvre. Le théorème central limite stipule que la superposition ou la somme d’une multitude de variables aléatoires indépendantes (ou faiblement corrélées) d’impacts infinitésimaux converge asymptotiquement vers une loi normale unimodale, indépendamment de la nature univariée ou multivariée des facteurs originels. L’unimodalité d’un trait psychologique phénotypique peut ainsi masquer une architecture génétique hautement polygénique combinée à des influences environnementales multifactorielles intriquées.
Par ailleurs, l’impact des erreurs de mesure instrumentale et du bruit aléatoire sur la morphologie des données empiriques constitue une cause majeure d’aveuglement méthodologique. Un bruit stochastique additif de forte variance agit mathématiquement comme un opérateur de convolution lissante sur la distribution sous-jacente :
$$f_{\text{observée}}(x) = (f_{\text{réelle}} * f_{\text{bruit}})(x)$$
Ce sur-lissage physique a pour conséquence directe d’estomper, d’aplanir et d’effacer les dépressions réelles d’une distribution sous-jacente qui était en réalité bimodale ou trimodale, la transformant artificiellement en une courbe unimodale pseudo-gaussienne. Ignorer la structure multimodale réelle étouffée par un instrument de mesure imprécis conduit le chercheur à agréger des sous-populations distinctes, ruinant la validité interne des modèles explicatifs ultérieurs.
12.2 Bonnes pratiques méthodologiques pour les publications scientifiques
Afin de prémunir la littérature scientifique contre les approximations distributionnelles et d’accroître la reproductibilité des résultats en psychologie quantitative et en sciences empiriques, un ensemble de lignes directrices rigoureuses doit gouverner la publication des données :
- Bannir la réduction aux seuls indices ponctuels : Les auteurs doivent proscrire la pratique consistant à résumer une distribution continue à la seule moyenne arithmétique accompagnée de son écart-type ($\mu \pm \sigma$). Il est impératif de rapporter systématiquement la triade complète (moyenne, médiane, mode), complétée par les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) avec leurs erreurs-types respectives.
- Systématiser la visualisation morphologique complète : Les diagrammes en barres d’erreurs traditionnels (qui occultent totalement la morphologie distributionnelle) doivent être définitivement remplacés par des graphiques combinés de type raincloud plots ou diagrammes en violon adossés aux tracés individuels des points de données (jittered strip charts) et aux courbes de densité KDE.
- Pratiquer des tests formels d’unimodalité : Préalablement à tout ajustement par des modèles linéaires généraux (ANOVA, régressions standard), les chercheurs doivent formaliser l’évaluation de l’unimodalité en rapportant les métriques du test du dip de Hartigan ou du test de Silverman, en explicitant le non-rejet de l’hypothèse nulle ($p > 0{,}05$).
- Transparence absolue sur les algorithmes de lissage : Lors du tracé des courbes de densité par noyau, les publications doivent divulguer explicitement la nature mathématique de la fonction noyau employée ($K$) ainsi que l’algorithme exact de sélection de la largeur de bande (ex. validation croisée ou méthode de Sheather-Jones), éliminant ainsi toute manipulation esthétique discrétionnaire.
- Réaliser des analyses de sensibilité et de sous-groupes : Il est recommandé d’inclure des analyses de sensibilité testant la stabilité du pic modal à travers des stratifications démographiques pertinentes (sexe, âge, niveau d’éducation), afin de garantir que l’unimodalité globale apparente ne dissimule pas des sous-populations compensatoires artificiellement agglomérées.
Références
American Psychiatric Association. (2013). Diagnostic and statistical manual of mental disorders (5th ed.). American Psychiatric Publishing. https://doi.org/10.1176/appi.books.9780890425596
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
Hartigan, J. A., & Hartigan, P. M. (1985). The Dip Test of Unimodality. The Annals of Statistics, 13(1), 70–84. https://doi.org/10.1214/aos/1176346577
Karn, M. N., & Penrose, L. S. (1951). Birth weight and gestation time in relation to maternal age, parity and infant survival. Annals of Eugenics, 16(1), 330–364. https://doi.org/10.1111/j.1469-1809.1951.tb02485.x
Khinchin, A. Y. (1938). On unimodal distributions. Izvestiya Nauchno-Issledovatel’skogo Instituta Matematiki i Mekhaniki Tomskogo Gosudarstvennogo Universiteta, 2, 1–7.
Parzen, E. (1962). On Estimation of a Probability Density Function and Mode. The Annals of Mathematical Statistics, 33(3), 1065–1076. https://doi.org/10.1214/aoms/1177704472
Pearson, K. (1895). Contributions to the mathematical theory of evolution.—II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343–414. https://doi.org/10.1098/rsta.1895.0010
Rosenblatt, M. (1956). Remarks on Some Nonparametric Estimates of a Density Function. The Annals of Mathematical Statistics, 27(3), 832–837. https://doi.org/10.1214/aoms/1177728190
Sheather, S. J., & Jones, M. C. (1991). A Reliable Data-Based Bandwidth Selection Method for Kernel Density Estimation. Journal of the Royal Statistical Society: Series B (Methodological), 53(3), 683–690. https://doi.org/10.1111/j.2517-6161.1991.tb01857.x
Silverman, B. W. (1981). Using Kernel Density Estimates to Investigate Multimodality. Journal of the Royal Statistical Society: Series B (Methodological), 43(1), 97–99. https://doi.org/10.1111/j.2517-6161.1981.tb01155.x
Silverman, B. W. (1986). Density estimation for statistics and data analysis. Chapman and Hall. https://doi.org/10.1007/978-1-4899-3324-9
Spearman, C. (1904). « General Intelligence, » objectively determined and measured. The American Journal of Psychology, 15(2), 201–292. https://doi.org/10.2307/1412107
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.
Wintner, A. (1956). Cauchy’s stable distributions and the law of the iterated logarithm. American Journal of Mathematics, 78(4), 856–861. https://doi.org/10.2307/2372476