
Dans le champ de l’analyse statistique et du traitement des données quantitatives, l’hypothèse de normalité ou d’unimodalité constitue bien souvent un postulat commode, mais fréquemment trompeur. Les chercheurs et analystes formés au paradigme classique de la statistique paramétrique ont développé le réflexe quasi automatique d’appréhender toute distribution à travers le prisme rassurant de la courbe en cloche de Gauss. Pourtant, la réalité empirique issue des sciences du comportement, de la biologie, de l’économie ou de la neuropsychologie défie régulièrement cette élégante simplification en révélant des structures sous-jacentes bien plus complexes, caractérisées par la présence simultanée de multiples sommets de densité.
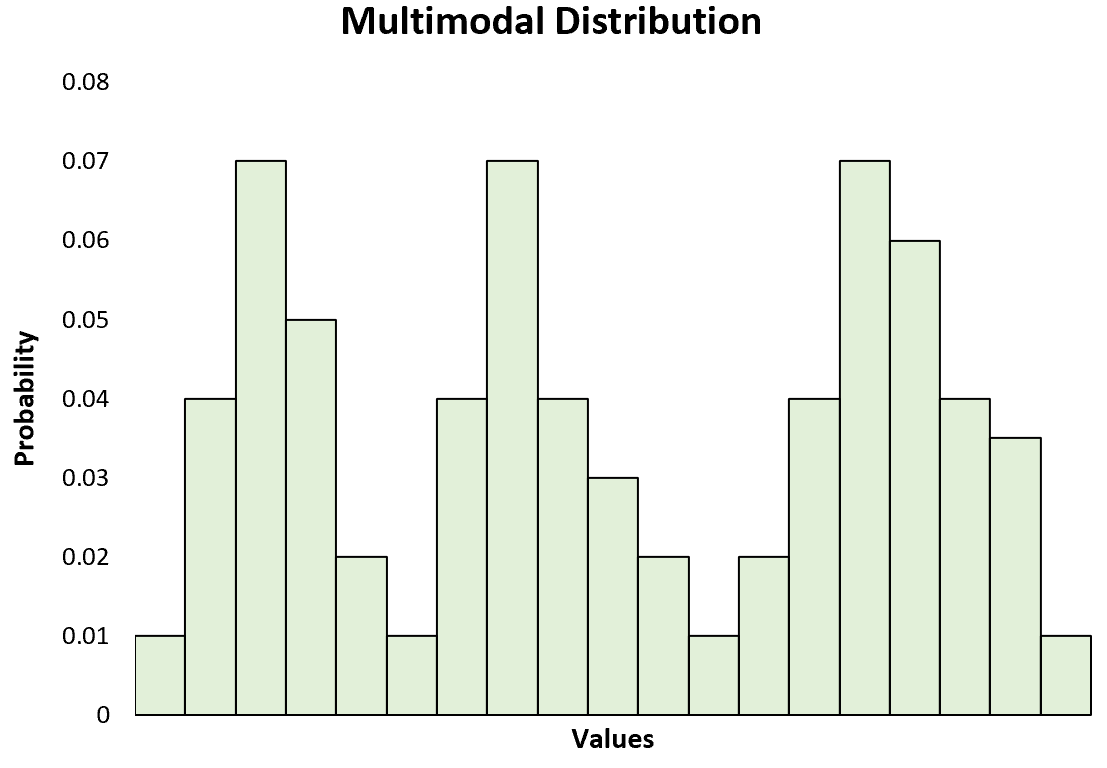
Une distribution multimodale représente une configuration probabiliste fondamentale où la fonction de densité présente au moins deux maxima locaux distincts. Loin de constituer une simple anomalie ou une nuisance statistique nécessitant d’être corrigée ou neutralisée par des transformations mathématiques ad hoc, la multimodalité constitue un signal informatif de premier ordre. Elle trahit le plus souvent l’existence de mécanismes générateurs hétérogènes, de sous-populations cachées ou de dynamiques de bifurcation non linéaires qui échappent complètement aux indicateurs de tendance centrale traditionnels tels que la moyenne arithmétique ou la médiane.
Comprendre la nature, les causes et les implications méthodologiques des distributions multimodales est indispensable pour quiconque souhaite analyser des données réelles sans commettre de graves erreurs d’inférence. Cet article se propose d’explorer de manière exhaustive l’ensemble des dimensions théoriques, diagnostiques et pratiques liées à la multimodalité, depuis ses fondements mathématiques jusqu’à ses applications concrètes dans les sciences empiriques, tout en exposant les outils logiciels modernes permettant de modéliser avec rigueur ces architectures distributionnelles complexes.
1. Fondements théoriques et définition mathématique de la distribution multimodale
1.1 Définition formelle du mode statistique
Dans la théorie des probabilités et la statistique descriptive, le concept de mode statistique désigne fondamentalement la valeur de la variable aléatoire pour laquelle la fonction de densité de probabilité, dans le cas continu, ou la fonction de masse, dans le cas discret, atteint son niveau le plus élevé. Contrairement à la moyenne arithmétique qui dépend de l’intégrale pondérée de l’ensemble des valeurs observées, le mode constitue un indicateur strictement local de concentration maximale. Cette nature locale est essentielle pour comprendre la dynamique des distributions complexes : là où la moyenne opère une synthèse globale qui lisse les disparités, le mode identifie précisément le point d’attraction le plus dense au sein de l’espace des réalisations possibles.
Une distinction fondamentale doit impérativement être établie entre le mode global, parfois qualifié de mode absolu, et les modes locaux ou relatifs. Le mode global correspond au point d’abscisse où la densité de probabilité atteint son supremum absolu sur tout le support de la distribution. À l’inverse, un mode local représente une valeur ponctuelle entourée d’un voisinage immédiat au sein duquel la densité de probabilité est strictement inférieure à celle observée en ce point, même si cette densité locale demeure inférieure au sommet absolu de la distribution. Dans une perspective de modélisation avancée, chaque mode local reflète un équilibre probabiliste stable ou un état attracteur singulier généré par le processus sous-jacent.
Sur le plan mathématique formel, pour une variable aléatoire continue $X$ caractérisée par une fonction de densité de probabilité $f(x)$ au moins deux fois continûment dérivable sur un intervalle ouvert de son domaine de définition, les modes correspondent aux solutions de l’équation différentielle relative à la dérivée première :
$$f'(x) = 0$$
Cette condition nécessaire d’extrémum local doit être complétée par la condition suffisante de concavité stricte, laquelle impose que la dérivée seconde de la fonction de densité en ce point critique soit strictement négative :
$$f »(x) < 0$$
Si la dérivée seconde s’avère strictement positive, le point critique correspond à un antimode ou creux de densité. Enfin, dans le cadre discret où la variable prend des valeurs dans un ensemble dénombrable, le calcul modal repose sur les tables de fréquences et la fonction de masse : une valeur discrète $k$ est un mode si sa probabilité ponctuelle est supérieure ou égale à celles de ses voisins immédiats, traduisant ainsi un pic de dénombrement empirique non aléatoire.
1.2 Propriétés d’une fonction de densité de probabilité multimodale
L’analyse structurelle d’une fonction de densité multimodale ne peut se limiter à l’énumération de ses sommets ; elle exige une étude approfondie de la topologie de la courbe, notamment des zones d’évidement qui séparent les différents pics. Ces dépressions relatives, appelées techniquement antimodes, correspondent mathématiquement aux minima locaux de la fonction de densité continue, caractérisés par une dérivée première nulle ($f'(x) = 0$) associée à une dérivée seconde strictement positive ($f »(x) > 0$). La profondeur relative de ces creux et leur distance spatiale par rapport aux sommets adjacents fournissent des indications précieuses quant au degré de séparation effectif des sous-processus stochastiques qui composent l’ensemble de la distribution.
Un aspect critique réside dans la variabilité intrinsèque et la dispersion spécifique qui caractérisent chacun des modes pris isolément. Dans la quasi-totalité des contextes empiriques réels, les composantes d’une distribution multimodale ne partagent ni la même variance ni la même symétrie. Chaque pic peut présenter une dispersion très étroite traduisant un phénomène très déterministe ou fortement contrôlé, tandis qu’un autre sommet au sein de la même distribution peut s’étendre sur une plage considérable, reflétant une instabilité ou une hétérogénéité résiduelle au sein de cette sous-population spécifique. Cette hétéroscédasticité locale complique notablement l’estimation des paramètres globaux.
De surcroît, les distributions multimodales manifestent presque systématiquement une absence marquée de symétrie globale, combinée à des asymétries locales orientées dans des directions opposées autour des différents modes. Cette configuration a un impact profond sur les moments d’ordre supérieur de la distribution. Le coefficient d’asymétrie statistique (skewness) devient extrêmement sensible à l’espacement relatif et aux poids respectifs des différents sous-groupes, tandis que le coefficient d’aplatissement (kurtosis) présente des comportements apparemment paradoxaux : la présence de plusieurs bosses produit fréquemment une distribution platykurtique globale (kurtosis inférieur à celui de la loi normale) en raison de l’étalement de la masse de probabilité sur une large zone centrale, alors même que chaque composante individuelle peut être localement leptokurtique.
1.3 Distinction entre distributions unimodales, bimodales et multimodales
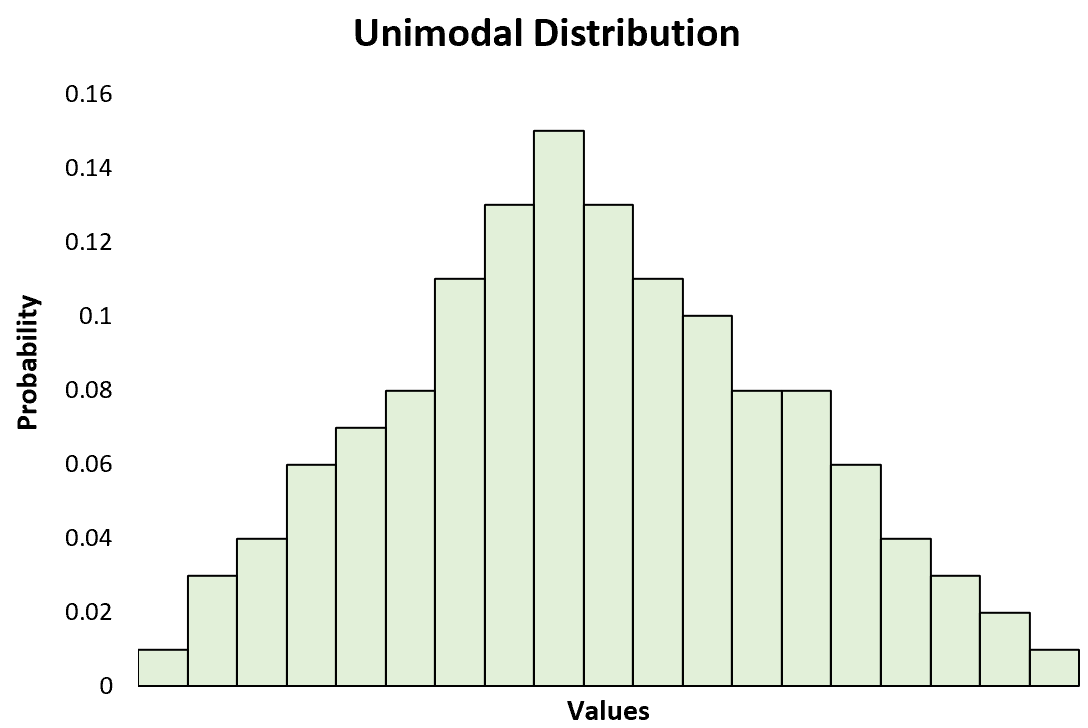
Dans l’arsenal classique des méthodes quantitatives, la distribution unimodale constitue le point de repère universel. Qu’il s’agisse de la loi normale, de la loi log-normale, de la loi de Student ou de la distribution Gamma, ces modèles supposent l’existence d’un unique pôle central vers lequel convergent les observations, les fluctuations périphériques étant interprétées comme des erreurs de mesure ou du bruit aléatoire indépendant. Ce cadre théorique s’appuie massivement sur le théorème central limite, qui postule que la somme d’un grand nombre de variables aléatoires indépendantes et identiquement distribuées tend inévitablement vers une loi gaussienne parfaitement unimodale.
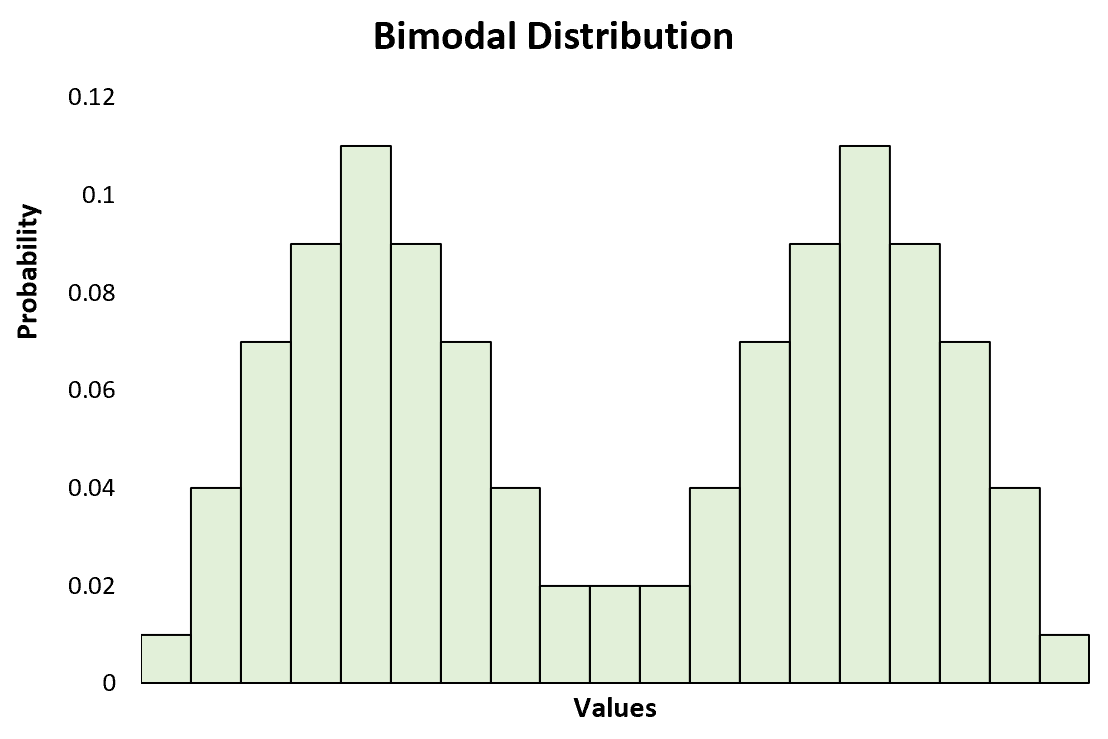
La distribution bimodale représente le premier seuil de complexification et le cas particulier le plus intensément documenté de la multimodalité. Caractérisée par l’émergence de deux sommets séparés par un antimode unique, elle traduit typiquement la présence de deux régimes d’états stables ou la coexistence de deux groupes distincts au sein d’une même métrique d’observation. Cette configuration bimodale peut être symétrique, les deux pics ayant une amplitude et une largeur identiques, ou fortement asymétrique, l’un des sommets dominant largement l’autre en volume de probabilité, ce qui rend son identification d’autant plus subtile lorsque les effectifs d’échantillonnage sont modestes.
La généralisation théorique conduit aux distributions trimodales et d’ordres supérieurs, où trois modes distincts ou davantage structurent le paysage de probabilité. Toutefois, sur le plan épistémologique et méthodologique, une mise en garde s’impose : toute irrégularité ou ondulation observée sur un échantillon empirique ne doit pas être assimilée hâtivement à un mode réel. L’aléa d’échantillonnage produit fréquemment des grappes éphémères de données qui miment une structure multimodale sans qu’aucun processus génératif déterministe ne la sous-tende. Une distinction conceptuelle stricte doit être maintenue entre la multimodalité structurelle d’une population parente et les artefacts modaux transitoires issus des fluctuations stochastiques d’un échantillon fini.
2. Identification visuelle et techniques graphiques de détection
2.1 L’histogramme et l’impact du choix des classes
L’histogramme demeure la méthode graphique la plus universellement déployée pour une première prise de contact avec la distribution d’une variable quantitative continue. Pourtant, sous son apparente simplicité descriptive, cet outil recèle des pièges méthodologiques considérables, en particulier lorsqu’il s’agit d’évaluer la modalité d’un ensemble de données. La morphologie d’un histogramme dépend de manière totalement critique de deux décisions arbitraires de l’analyste : la largeur des intervalles (le bin width) et la position de l’origine de départ du découpage. Une variation mineure de ces paramètres peut radicalement transformer l’aspect visuel du graphique, créant de toutes pièces une apparence de multimodalité ou, inversement, masquant totalement des sommets réels.
Le sur-lissage et le sous-lissage constituent les deux écueils symétriques de cette approche. Lorsqu’un chercheur choisit une largeur de classe excessivement grande (sur-lissage), plusieurs modes distincts tombent à l’intérieur d’un même intervalle d’agrégation, forçant la distribution à paraître unimodale et homogène. À l’opposé, la sélection d’intervalles trop étroits (sous-lissage) expose la représentation graphique aux fluctuations microscopiques du tirage d’échantillonnage, générant un profil haché où de multiples pics factices apparaissent, donnant l’illusion trompeuse d’une distribution hautement multimodale.
Pour limiter cette part d’arbitraire, la littérature statistique a formalisé plusieurs règles empiriques de sélection de la largeur optimale de classe. La règle de Sturges, formulée dans les années 1920, repose sur une hypothèse implicite de distribution gaussienne et s’avère particulièrement inadaptée pour révéler des modes multiples en sous-estimant drastiquement le nombre nécessaire d’intervalles. La règle de Scott pallie partiellement ces défauts en liant la largeur des classes à l’écart-type de l’échantillon et à la racine cubique de sa taille ($3.49 \times s \times n^{-1/3}$). Néanmoins, pour les distributions fortement asymétriques ou potentiellement multimodales, la règle de Freedman-Diaconis s’impose comme la solution de référence la plus robuste, car elle fonde son calcul sur l’écart interquartile ($IQR$) plutôt que sur l’écart-type :
$$h = 2 \times IQR \times n^{-1/3}$$
En limitant l’influence des valeurs extrêmes sur le paramétrage, cette méthode préserve mieux les creux et les sommets réels.
2.2 L’estimation par noyau de la densité (Kernel Density Estimation)
Face aux limites fondamentales et à la nature discontinue de l’histogramme, l’estimation par noyau de la densité (communément désignée par l’acronyme KDE pour Kernel Density Estimation) représente une avancée majeure pour l’analyse continue des formes distributionnelles. Initiée par Rosenblatt et Parzen, cette technique non paramétrique remplace le découpage en boîtes rigides par l’application d’une fonction de pondération lisse, appelée noyau, centrée sur chaque point de données observé. La courbe finale de densité est obtenue en sommant mathématiquement l’ensemble de ces petites collines individuelles sur l’ensemble de l’axe réel.
La formulation générale de l’estimateur par noyau s’écrit de la manière suivante pour un échantillon de taille $n$ composé de variables indépendantes :
$$\hat{f}_h(x) = \frac{1}{nh} \sum_{i=1}^{n} K\left(\frac{x – X_i}{h}\right)$$
où $K(\cdot)$ est le noyau choisi (par exemple le noyau gaussien standard ou le noyau d’Épanechnikov) et $h$ représente le paramètre de lissage, traditionnellement appelé la fenêtre ou bandwidth. Si le choix du type de noyau influe marginalement sur l’esthétique locale de la courbe (le noyau d’Épanechnikov offrant une efficacité asymptotique optimale en termes d’erreur quadratique moyenne intégrée), c’est la valeur du paramètre de lissage $h$ qui exerce une autorité absolue sur la révélation ou l’oblitération de la multimodalité.
Une fenêtre $h$ trop large va sur-agréger les données et écraser les antimodes, transformant une bimodalité flagrante en un plateau unimodal diffus. Inversement, un $h$ excessivement resserré va créer un mode artificiel au-dessus de chaque grappe fortuite de deux ou trois observations. Bien que des règles automatiques basées sur la minimisation de l’erreur quadratique existent — telles que la règle empirique de Silverman ou l’algorithme par substitution (plug-in) de Sheather-Jones —, ces méthodes automatiques reposent souvent sur des suppositions d’unimodalité qui biaisent le résultat final. C’est pourquoi la validation visuelle rigoureuse nécessite une approche multi-échelles, consistant à observer le comportement des dérivées et le nombre de modes émergents le long d’une trajectoire continue de variations de la fenêtre $h$.
2.3 Représentations alternatives : graphiques en violon et nuages de points
Si la courbe de densité continue surmonte les tares de l’histogramme, la boîte à moustaches conventionnelle conçue par John Tukey (boxplot) souffre d’un angle mort méthodologique colossal : elle est par construction incapable de révéler une distribution multimodale. Une boîte à moustaches n’affiche que la médiane, les charnières quartiles ($Q_1$ et $Q_3$) et les valeurs extrêmes. Par conséquent, une distribution parfaitement unimodale et une distribution intensément bimodale présentant un vide absolu de données au niveau de leur médiane commune produiront rigoureusement le même diagramme en boîte. Fonder un diagnostic de forme sur ce seul outil constitue une source fréquente d’erreurs d’interprétation dans la recherche quantitative.
Pour remédier à cette cécité graphique, les graphiques en violon (violin plots) combinent les atouts de la boîte à moustaches avec une estimation par noyau de la densité, projetée de façon symétrique de part et d’autre d’un axe central. Ce tracé permet d’identifier instantanément le resserrement central (l’antimode) et les renflements périphériques (les modes), tout en conservant les repères traditionnels des quantiles. L’observateur visualise ainsi immédiatement si la dispersion mesurée par l’intervalle interquartile traduit une variabilité homogène autour du centre ou l’écartement mécanique de deux bosses distinctes.
En complément des graphiques en violon, la visualisation directe des points individuels au moyen de diagrammes de dispersion unidimensionnels intégrant un bruit aléatoire perpendiculaire (procédé connu sous le terme de jittering) ou de tracés en bandes (strip charts) offre une garantie indispensable de contrôle qualitatif. Ce procédé permet à l’analyste de constater de ses propres yeux la densité de points bruts dans les zones de crêtes et la raréfaction effective dans les antimodes, évitant ainsi d’être berné par des illusions de lissage issues du KDE. Enfin, dans les configurations bivariées ou multivariées, les graphiques de contours topographiques permettent de cartographier la présence de modes multiples dans un espace à plusieurs dimensions, révélant des topologies d’îlots distincts au sein de la variété des données.
3. Origines et causes sous-jacentes de la multimodalité
3.1 Hétérogénéité des sous-populations non observées
Dans l’immense majorité des applications en sciences empiriques, l’apparition d’une distribution multimodale ne découle pas d’une loi physique fondamentale à dynamique unique, mais résulte de l’agrégation non identifiée de plusieurs sous-populations distinctes au sein d’un échantillon composite. Lorsqu’un chercheur collecte des mesures sur un groupe sans contrôler rigoureusement l’ensemble des variables modératrices ou discriminantes, l’échantillon global se comporte comme un modèle de mélange latent. Chaque sous-groupe possède ses propres paramètres de localisation (sa moyenne propre) et d’échelle (sa variance propre), et leur superposition brute sur un même axe métrique engendre des pics multiples.
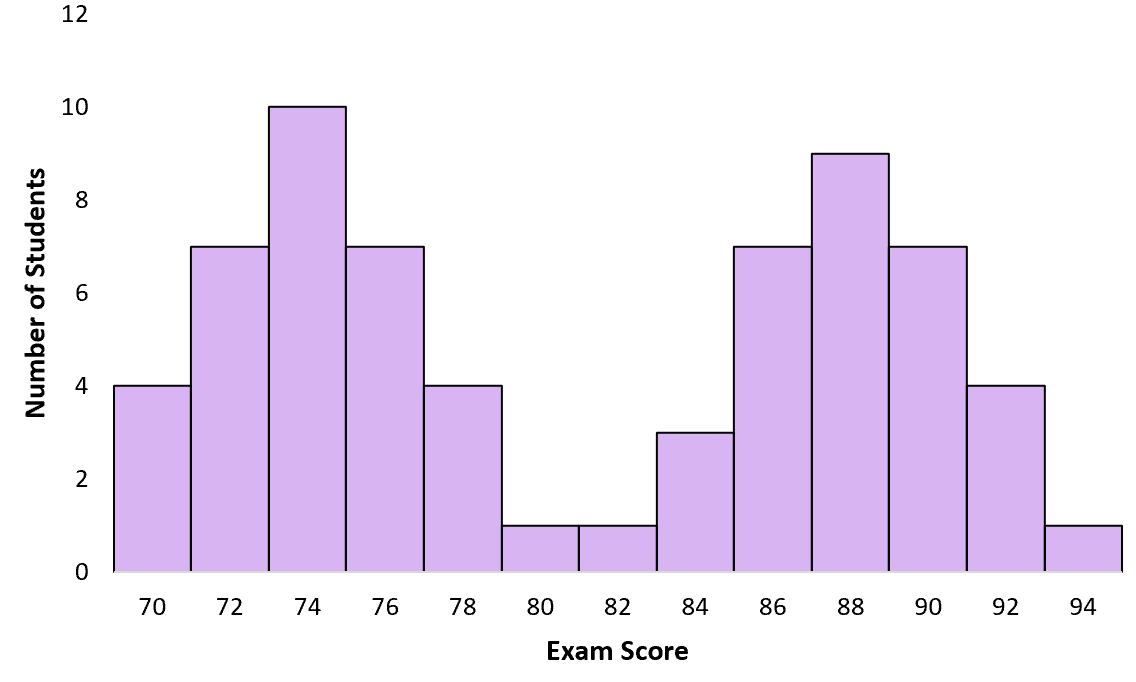
Les facteurs démographiques constituent l’illustration la plus élémentaire de cette dynamique. Par exemple, la distribution de la taille corporelle à l’âge adulte au sein d’un échantillon mixte de femmes et d’hommes engendre une distribution bimodale bien documentée : la composante féminine présente un pic moyen d’environ 165 cm tandis que la composante masculine culmine autour de 178 cm. Si le facteur biologique du sexe n’est pas codé ou est omis dans le plan d’analyse, la variable brute « taille » apparaîtra intrinsèquement bimodale, bien que chacun des sous-groupes soit rigoureusement unimodal et normal pris isolément. Les stratifications par tranches d’âge, niveaux d’éducation ou catégories socioprofessionnelles produisent des phénomènes structurellement identiques.
Le phénomène prend une dimension plus critique encore dans les recherches médicales et épidémiologiques où des échantillons comprennent simultanément des individus sains et des patients présentant des pathologies subcliniques ou asymptomatiques non encore détectées. L’absence de diagnostic préalable produit des distributions bimodales dans des biomarqueurs sanguins ou des paramètres physiologiques, où le pic secondaire signale la présence clandestine de la cohorte pathologique. De même, les effets d’écosystèmes géographiques non contrôlés ou les variations de protocoles expérimentaux entre différents sites de collecte introduisent des fragmentations analogues au sein de cohortes massives.
3.2 Phénomènes de seuil et transitions non linéaires
Toutes les distributions multimodales ne résultent pas de simples mélanges passifs de sous-groupes stables ; nombre d’entre elles trouvent leur origine dans des mécanismes endogènes de transition non linéaire et de comportement de seuil. Dans les systèmes dynamiques complexes étudiés en psychologie cognitive, en sociologie quantitative ou en neurobiologie, les variables d’intérêt ne réagissent pas toujours de manière proportionnelle et graduelle aux variations de leur environnement. Au contraire, ces systèmes traversent fréquemment des points critiques au-delà desquels le comportement global bascule brutalement d’un état d’équilibre vers un autre totalement différent, selon une dynamique de type tout-ou-rien.
Ce type de comportement est formalisé mathématiquement par la théorie des catastrophes de René Thom et par les modèles de bifurcation dynamique. Lorsqu’un paramètre de contrôle externe varie continûment, le potentiel sous-jacent du système peut passer d’une configuration mono-puits (comportant un seul minimum d’énergie, donc un mode unique d’équilibre) à une configuration à double puits (présentant deux états stables séparés par une barrière d’instabilité). Au niveau macroscopique, les mesures effectuées sur des individus engagés dans ces dynamiques révéleront deux pics prononcés correspondant aux deux états attracteurs stables, le creux intermédiaire représentant l’état métastable ou transitoire dans lequel aucun individu ne peut séjourner durablement.
En neuropsychologie, un exemple frappant réside dans les phénomènes de basculement de l’attention ou de saturation des capacités de la mémoire de travail : confronté à une surcharge cognitive progressive, le sujet ne dégrade pas linéairement sa performance milliseconde par milliseconde. Il maintient son niveau d’efficacité jusqu’à un seuil de rupture précis où le traitement contrôlé s’effondre, faisant chuter le système dans un régime de performance dégradé. De même, dans les dynamiques d’épuisement professionnel ou de décompensation anxio-dépressive, les indicateurs d’adaptation manifestent des distributions bimodales révélant l’absence de continuum fonctionnel intermédiaire lorsque les ressources d’adaptation sont brutalement submergées.
3.3 Artéfacts méthodologiques et biais de mesure
L’analyste méticuleux doit toujours envisager une hypothèse moins noble mais omniprésente sur le terrain empirique : la multimodalité peut être le pur produit d’un dysfonctionnement instrumental ou d’un biais méthodologique introduit lors de la collecte des données. Une échelle de mesure défectueuse, mal étalonnée ou inadaptée à la population cible peut altérer de façon dramatique la géométrie de la distribution observée et projeter des pics tout à fait artificiels là où la réalité sous-jacente est parfaitement continue et unimodale.
L’un des mécanismes les plus répandus est l’apparition conjointe d’effets de plancher ou d’effets de plafond. Lorsqu’un instrument psychométrique ou une épreuve cognitive s’avère trop facile pour une fraction des participants et trop difficile pour une autre, les scores s’agglutinent massivement aux bornes extrêmes de l’échelle. L’accumulation mécanique de scores minimaux (par exemple 0/20) et maximaux (20/20) génère deux modes artificiels proéminents aux frontières du domaine de définition. Ces sommets ne reflètent en aucun cas la véritable distribution de la compétence latente des sujets, mais signalent simplement l’incapacité de l’instrument à discriminer les variations en deçà et au-delà de ses seuils de sensibilité.
Par ailleurs, la formulation même des items dans les questionnaires d’évaluation peut provoquer des groupements de réponses totalement biaisés. Les formulations suggestives, l’usage de double négation ou l’utilisation de repères d’ancrage sémantiquement ambigus sur les échelles d’attitudes incitent les répondants à se polariser arbitrairement sur certaines graduations spécifiques, générant des micro-modes factices. Enfin, une cause fréquente d’artefact multimodal réside dans l’agrégation imprudente de métriques issues d’instruments différents censés mesurer le même construit théorique, mais dont les fonctions de calibrage ou les distributions d’erreurs respectives ne sont pas équivalentes, créant ainsi des décalages d’échelle qui déchirent la distribution globale en plusieurs fragments discordants.
4. Modélisation statistique par les modèles de mélange fini
4.1 Principe des modèles de mélange gaussien (GMM)
Face à une distribution multimodale qu’il convient de ne plus simplement observer mais de formaliser mathématiquement, le cadre probabiliste des modèles de mélanges finis s’impose comme l’étalon d’or. Parmi ceux-ci, les modèles de mélanges gaussiens (GMM pour Gaussian Mixture Models) occupent une place centrale en raison de leur prodigieuse flexibilité mathématique et de leur capacité prouvée à approximer n’importe quelle fonction de densité continue arbitraire pour peu que le nombre de composantes soit suffisant. Ce formalisme part du principe théorique qu’une densité multimodale globale $f(x)$ peut être décomposée en une combinaison linéaire convexe de plusieurs sous-densités unimodales normales.
Sur le plan analytique, la fonction de densité d’un modèle de mélange composé de $K$ classes gaussiennes s’exprime par la relation suivante :
$$f(x | boldsymbol{\Theta}) = \sum_{k=1}^{K} \pi_k , \mathcal{N}(x | \mu_k, \sigma_k^2)$$
Dans cette formulation, $\mathcal{N}(x | \mu_k, \sigma_k^2)$ représente la densité de probabilité normale de la $k$-ième composante, définie par son espérance propre $\mu_k$ et sa variance propre $\sigma_k^2$. Les coefficients $\pi_k$ incarnent les proportions de mélange ou poids relatifs de chaque composante dans la population globale. Ces poids doivent impérativement satisfaire aux conditions strictes de positivité et de normalisation stochastique :
$$\pi_k ge 0 \quad \text{pour tout } k in {1, dots, K} \quad \text{et} \quad \sum_{k=1}^{K} \pi_k = 1$$
La puissance conceptuelle des GMM réside dans le fait qu’ils ne présupposent pas une symétrie globale : chaque composante gaussienne possède sa propre échelle de variabilité. La superposition de sous-composantes aux moyennes et variances asymétriques permet de générer des architectures multimodales dotées d’antimodes de profondeurs variées et de pics d’amplitudes totalement disparates, tout en conservant l’élégance analytique des paramètres normaux pour chaque sous-groupe latent.
4.2 L’algorithme Espérance-Maximisation (EM)
L’estimation des paramètres inconnus d’un mélange gaussien — à savoir le vecteur global $boldsymbol{\Theta} = {\pi_1, dots, \pi_K, \mu_1, dots, \mu_K, \sigma_1^2, dots, \sigma_K^2}$ — ne peut être réalisée par les méthodes analytiques classiques d’annulation directe du gradient de la fonction de vraisemblance. En effet, l’équation issue du logarithme de la vraisemblance contient une somme à l’intérieur du terme logarithmique, ce qui rend toute résolution algébrique explicite impossible. Pour contourner ce blocage fondamental, Arthur Dempster, Nan Laird et Donald Rubin ont formalisé en 1977 l’algorithme Espérance-Maximisation (EM), une procédure itérative magistrale dédiée à l’estimation en présence de variables latentes.
L’algorithme EM procède en deux phases récursives jusqu’à convergence numérique :
- L’étape d’espérance (Étape E) : En s’appuyant sur les estimations courantes des paramètres obtenues à l’itération précédente, l’algorithme calcule la probabilité conditionnelle a posteriori que chaque observation $x_i$ appartienne à la composante $k$. Cette quantité, souvent qualifiée de responsabilité probabiliste $\gamma_{ik}$, est déterminée par le théorème de Bayes :
$$\gamma_{ik} = \frac{\pi_k , \mathcal{N}(x_i | \mu_k, \sigma_k^2)}{\sum_{j=1}^{K} \pi_j , \mathcal{N}(x_i | \mu_j, \sigma_j^2)}$$ - L’étape de maximisation (Étape M) : En utilisant ces responsabilités fractionnaires comme pondérations empiriques, l’algorithme réactualise analytiquement les paramètres de chaque groupe pour maximiser la log-vraisemblance espérée :
$$\mu_k^{\text{nouveau}} = \frac{\sum_{i=1}^{n} \gamma_{ik} x_i}{\sum_{i=1}^{n} \gamma_{ik}}, \quad (\sigma_k^2)^{\text{nouveau}} = \frac{\sum_{i=1}^{n} \gamma_{ik} (x_i – \mu_k^{\text{nouveau}})^2}{\sum_{i=1}^{n} \gamma_{ik}}, \quad \pi_k^{\text{nouveau}} = \frac{1}{n} \sum_{i=1}^{n} \gamma_{ik}$$
Si l’algorithme EM garantit théoriquement une augmentation monotone de la vraisemblance à chaque itération successive jusqu’à atteindre un point stationnaire, sa vulnérabilité majeure réside dans sa forte dépendance aux valeurs d’initialisation. L’espace des paramètres d’un modèle de mélange fini présente un paysage de vraisemblance hautement non convexe parsemé d’optima locaux pernicieux. De surcroît, l’algorithme est exposé au risque de solutions dégénérées : si une composante en vient à centrer sa moyenne exactement sur une observation isolée et que sa variance converge vers zéro, la fonction de vraisemblance explose vers l’infini, produisant un artéfact numérique dépourvu de pertinence scientifique.
4.3 Sélection du nombre optimal de composantes
L’un des défis théoriques les plus ardus dans l’application des modèles de mélange fini réside dans la détermination objective du nombre optimal de composantes latentes $K$. Augmenter indéfiniment le nombre de gaussiennes permet d’améliorer mécaniquement l’ajustement du modèle aux données observées et d’accroître continuellement la valeur de la log-vraisemblance maximale. Cependant, cette surenchère paramétrique expose directement l’analyste au surajustement (overfitting), capturant les fluctuations stochastiques du bruit d’échantillonnage comme s’il s’agissait de véritables sous-groupes structurels.
Pour arbitrer rigoureusement entre la qualité d’ajustement statistique et la parcimonie conceptuelle, les chercheurs recourent traditionnellement aux critères d’information pénalisés. Le critère d’information d’Akaike (AIC) et surtout le critère d’information bayésien (BIC) constituent les repères les plus fréquemment mobilisés. Le BIC intègre une pénalité proportionnelle au logarithme de la taille de l’échantillon multiplié par le nombre de paramètres libres estimés, ce qui le rend généralement plus conservateur et mieux adapté à l’identification de la dimensionnalité réelle d’un mélange. Le critère ICL (Integrated Completed Likelihood) va encore plus loin en pénalisant non seulement le nombre de paramètres, mais également l’entropie de la classification, favorisant ainsi les mélanges offrant une séparation nette et sans ambiguïté entre les sous-populations.
Néanmoins, les tests de rapport de vraisemblance classiques entre modèles emboîtés ($K-1$ composantes contre $K$ composantes) ne respectent pas les conditions de régularité asymptotique de Wilks, car le modèle à $K-1$ classes se situe à la frontière de l’espace des paramètres du modèle à $K$ classes (lorsque l’un des poids $\pi_k$ s’annule). Pour contourner cette impasse mathématique, le test du rapport de vraisemblance bootstrapé (BLRT pour Bootstrapped Likelihood Ratio Test) s’est imposé comme la procédure la plus rigoureuse : il génère empiriquement la distribution de l’écart de vraisemblance sous l’hypothèse nulle par rééchantillonnage de Monte-Carlo, fournissant ainsi une p-valeur exacte et non faussée par les anomalies asymptotiques.
5. Manifestations empiriques en psychologie cognitive et neuropsychologie
5.1 Distribution des temps de réaction et processus cognitifs
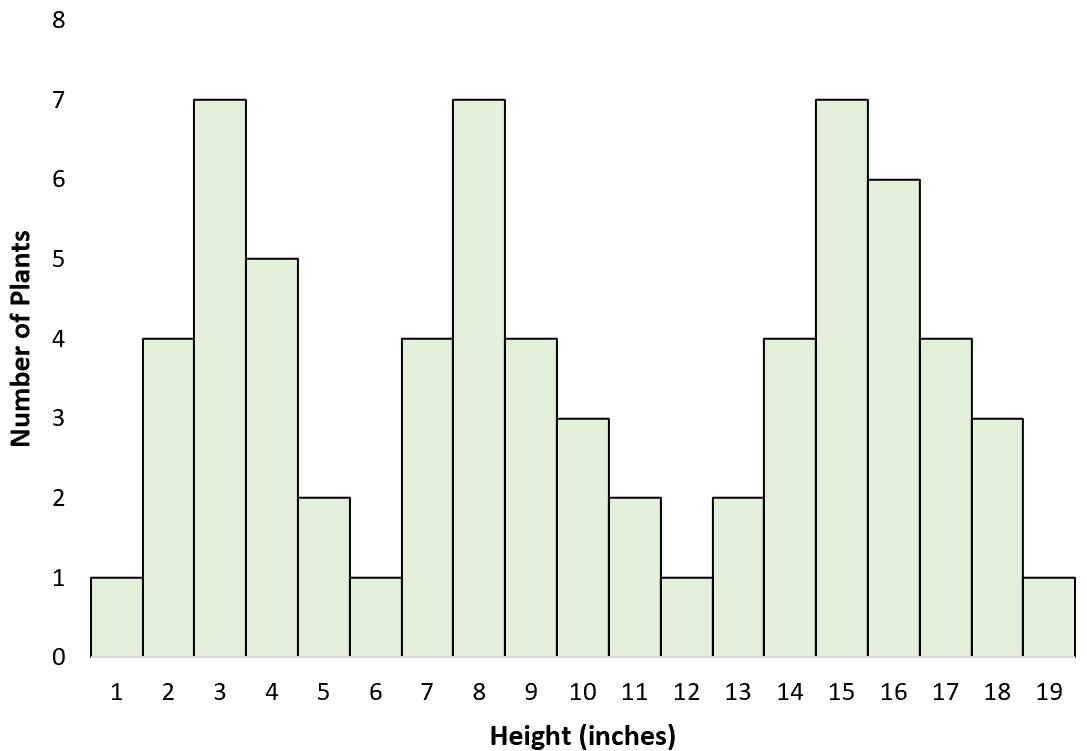
En psychologie cognitive expérimentale, l’analyse de la latence de réponse, communément appelée temps de réaction (TR), constitue l’une des voies royales pour sonder la micro-architecture des opérations mentales. Or, les chronométries de réponses humaines ne suivent pratiquement jamais une loi gaussienne unimodale symétrique. Très souvent, les chercheurs observent des distributions étirées vers la droite ou présentant de franches caractéristiques multimodales, trahissant la coexistence temporelle de processus cognitifs qualitativement dissociés au sein d’une même tâche comportementale.
Une bimodalité prononcée dans les temps de réaction traduit généralement la compétition entre deux modes de contrôle exécutif : les processus automatisés ultra-rapides et les processus contrôlés plus lents mais délibérés. Lors d’une tâche de compatibilité stimulus-réponse comme la célèbre tâche de Stroop ou la tâche de Simon, les réponses congruentes déclenchent un pic précoce généré par la voie perceptivo-motrice automatique directe, tandis que les situations de conflit cognitif nécessitent l’inhibition du réflexe immédiat et l’intervention du cortex préfrontal, projetant un second pic temporel décalé de plusieurs centaines de millisecondes. Modéliser ces distributions complexes à l’aide de densités ex-gaussiennes ou via le modèle de diffusion de Ratcliff permet d’extraire la vitesse d’accumulation de l’information décisionnelle tout en isolant les composantes modales non décisionnelles.
Par ailleurs, la multimodalité des TR s’avère particulièrement informative pour étudier les fluctuations de la vigilance et les ruptures attentionnelles intermittentes. Dans les paradigmes d’attention soutenue, un sous-groupe de réponses anormalement lentes forme fréquemment un mode périphérique tardif, lequel correspond mathématiquement aux épisodes transitoires d’égarement de l’esprit (mind-wandering) ou d’éclipse attentionnelle. De manière analogue, un pic modal extrêmement abrupt situé sous la barre des 150 millisecondes trahit souvent l’émission d’erreurs d’anticipation ou de réponses impulsives générées avant même la finalisation du traitement sensoriel complet du stimulus cible.
5.2 Stratégies d’apprentissage et de résolution de problèmes
L’observation d’une distribution multimodale lors d’épreuves de résolution de problèmes complexes ne signale pas une variabilité aléatoire de la compétence des sujets, mais constitue l’indice par excellence d’une hétérogénéité qualitative des stratégies cognitives déployées. Lorsque des individus sont confrontés à des dilemmes arithmétiques, spatiotemporels ou logiques, ils n’adoptent pas une démarche homogène modulée par une simple vitesse d’exécution variable : ils se subdivisent naturellement en classes stratégiques mutuellement exclusives.
Dans les tâches emblématiques de raisonnement conditionnel, telles que la tâche de sélection de Wason, les distributions des taux de réussite ou des temps de délibération manifestent une bimodalité spectaculaire. Un premier pic modal regroupe l’immense majorité des participants qui se fondent sur des heuristiques intuitives d’appariement perceptif immédiat, aboutissant de façon ultra-rapide à un schéma d’erreur systématique. Le second mode, nettement plus restreint en volume, rassemble les individus appliquant un raisonnement logique déductif formel, mobilisant des ressources de métacognition coûteuses et générant des temps de traitement considérablement allongés.
Ces profils bimodaux ou multimodaux se manifestent également avec une grande clarté le long des processus d’acquisition de compétences complexes. Au cours de l’apprentissage d’un logiciel complexe ou de la maîtrise d’un jeu de stratégie, la courbe globale de performance ne progresse pas de manière uniformément lisse. La distribution transversale des performances d’une cohorte d’apprenants fait apparaître des modes distincts correspondant aux différents stades de compétence : le mode des novices reposant sur des règles procédurales rigides, le mode des intermédiaires en phase de consolidation, et le mode des experts mobilisant une reconnaissance de configurations globales instantanée.
5.3 Évaluations neuropsychologiques et profils de déficits
Dans le domaine de la neuropsychologie clinique, la multimodalité est au cœur même de la pratique du diagnostic différentiel. Les batteries d’évaluation standardisées ne visent pas à ordonner des individus le long d’une échelle homogène sans aspérités, mais à détecter des dissociations cognitives majeures qui scindent les scores de performance en sous-groupes cliniquement significatifs. La présence de modes distincts permet de matérialiser les frontières séparant les altérations pathologiques franches du vieillissement cognitif normal ou des mécanismes d’adaptation résiduels.
Dans l’évaluation de la démence de type Alzheimer au stade précoce, les tests de mémoire épisodique verbale (tels que le test de rappel libre / rappel indicé à 16 items de Grober et Buschke) révèlent de manière systématique une distribution bimodale au sein d’une cohorte de patients consultant pour des plaintes mnésiques. Le premier pic rassemble les patients souffrant d’une atteinte hippocampique dégénérative avérée, totalement incapables de bénéficier de l’indiçage sémantique pour récupérer les informations stockées. Le second mode englobe les patients présentant un déclin lié à des troubles attentionnels ou dépressifs (pseudo-démence), chez qui l’indiçage permet une normalisation quasi complète de la restitution.
De surcroît, la plasticité cérébrale et les phénomènes de compensation cognitive introduisent des modes intermédiaires inattendus. Chez les patients ayant subi un accident vasculaire cérébral ou un traumatisme crânien, les épreuves évaluant les fonctions exécutives ou la fluence verbale manifestent fréquemment une trimodalité : un mode regroupant les déficits majeurs sans récupération, un mode intermédiaire reflétant la mise en œuvre laborieuse de stratégies de suppléance neuronale par l’hémisphère controlatéral, et un mode supérieur réunissant les patients présentant une récupération complète sans séquelles fonctionnelles mesurables.
6. Applications en psychométrie et évaluation de la personnalité
6.1 Polarisation des attitudes et échelle de Likert
L’utilisation massive d’échelles de Likert dans les enquêtes d’opinion, les sondages sociopolitiques et la psychologie sociale empirique confronte régulièrement les chercheurs au phénomène classique de la polarisation des attitudes. Lorsqu’un questionnaire aborde des sujets éthiques, politiques ou sociétaux fortement clivants (tels que les droits fondamentaux, l’immigration ou les régulations environnementales), la distribution empirique des réponses s’éloigne radicalement de l’attraction centrale unimodale pour se scinder en deux bastions antagonistes.
Cette configuration produit une courbe en « U » ou un profil bimodal prononcé où les fréquences maximales se concentrent sur les points d’ancrage extrêmes (par exemple « 1 – Pas du tout d’accord » et « 7 – Tout à fait d’accord »). Ce profil est amplifié par l’évitement de la neutralité : les répondants ayant des convictions affirmées considèrent le point central (« 4 – Ni en accord ni en désaccord ») comme inacceptable, provoquant un vide structurel au cœur de la distribution. En outre, le style de réponse extrême (Extreme Response Style), qui correspond à un biais cognitif individuel incitant systématiquement à cocher les échelons terminaux indépendamment du contenu sémantique de l’item, renforce artificiellement la bimodalité observée.
Les conséquences de cette bimodalité sur les propriétés métrologiques des échelles sont dévastatrices. Le calcul de la cohérence interne via le traditionnel coefficient alpha de Cronbach repose sur l’hypothèse de linéarité et de normalité multivariée des items. En présence de distributions de réponses fortement polarisées et multimodales, l’alpha de Cronbach est sévèrement distordu, générant soit une surévaluation artificielle de la fidélité due à l’inflation des corrélations extrêmes, soit une sous-estimation dramatique de la cohérence dimensionnelle réelle de l’instrument.
6.2 Approche typologique versus approche par traits continus
L’histoire de la psychologie de la personnalité est traversée par un débat épistémologique fondamental qui oppose le modèle dimensionnel des traits continus et le modèle catégoriel des types psychologiques. Le modèle dimensionnel dominant, incarné par le paradigme du Big Five (Ouverture, Conscienciosité, Extraversion, Agréabilité, Névrosisme), postule que les individus se distribuent le long de continuums normaux et unimodaux, la majorité de la population se situant au centre de la courbe. En revanche, les théories typologiques d’inspiration jungienne, popularisées par des outils comme le MBTI, affirment qu’il existe des configurations discontinues mutuellement exclusives scindant la population en profils discrets distincts.
Pour trancher scientifiquement ce différend, l’analyse de la multimodalité joue un rôle d’arbitre déterminant. Si la personnalité humaine relevait fondamentalement d’une structure typologique réelle, la distribution empirique des scores bruts sur une dimension psychologique majeure (par exemple, la propension à l’extraversion) devrait manifester une bimodalité structurelle indiscutable, avec un creux de densité significatif séparant le pôle des introvertis de celui des extravertis. Or, les méta-analyses psychométriques contemporaines démontrent de façon accablante que les traits de personnalité mesurés par des instruments rigoureusement validés suivent des distributions obstinément unimodales, infirmant empiriquement l’hypothèse de types naturels étanches au profit d’un continuum homogène.
Ce questionnement s’étend également à la théorie de l’attachement chez l’adulte. Alors que la tradition clinique catégorisait les individus en types d’attachement rigides (sécure, évitant, anxieux-ambivalent), les avancées basées sur la taxométrie ont démontré que l’anxiété et l’évitement de l’attachement se déploient le long de dimensions continues multivariées. L’apparition apparente de groupes distincts résulte trop souvent de l’imposition de découpages arbitraires sur des distributions continues plutôt que de la présence de modes empiriques authentiques.
6.3 Fonctionnement différentiel des items (DIF)
Dans la construction et la validation de tests psychométriques standardisés à fort enjeu (évaluations scolaires nationales, concours de recrutement, tests neuropsychologiques d’aptitude cognitive), l’émergence d’une distribution multimodale des scores composites peut constituer l’alerte précoce d’une anomalie psychométrique majeure : le fonctionnement différentiel des items (connu sous le sigle DIF pour Differential Item Functioning). Un item manifeste un DIF lorsqu’des individus partageant un niveau de compétence latente identique ont une probabilité différente de réussir cet item en fonction de leur appartenance à des sous-groupes démographiques, culturels ou linguistiques distincts.
Lorsqu’un test standardisé comporte plusieurs items entachés d’un DIF systématique, l’échantillon global de standardisation va présenter une morphologie multimodale déconcertante. Cette configuration traduit le fait que l’instrument n’évalue plus une variable unilatérale pure, mais mesure conjointement l’aptitude cible et une variable parasite non contrôlée, telle que l’aisance lexicale ou la familiarité avec un contexte culturel spécifique. Le sommet secondaire reflète alors la pénalisation collective subie par le sous-groupe défavorisé par la formulation des items, rompant l’équité fondamentale de la mesure.
Pour neutraliser ces dérives méthodologiques, les psychométriciens mobilisent des modèles de classes latentes appliqués aux items (Latent Class Analysis ou modèles de Rasch à classes latentes). Ces algorithmes permettent de déceler si la multimodalité globale des scores découle d’un fonctionnement hétérogène de certains items et d’identifier mathématiquement les items problématiques. En éliminant ou en reformulant les questions génératrices de DIF, on restaure l’invariance de mesure de l’instrument et l’homogénéité distributionnelle nécessaire à une comparaison valide et équitable des performances individuelles.
7. Pertinence en psychopathologie et psychiatrie clinique
7.1 Continuum versus catégories diagnostiques nosologiques
Le champ de la nosologie psychiatrique contemporaine est le théâtre d’une refondation théorique majeure opposant les modèles catégoriels traditionnels — portés par les successives éditions du Manuel diagnostique et statistique des troubles mentaux (DSM-5) et de la Classification internationale des maladies (CIM-11) — aux approches purement dimensionnelles comme le système RDoC (Research Domain Criteria) ou la taxonomie HiTOP (Hierarchical Taxonomy of Psychopathology). La question scientifique pivot qui sous-tend ce débat est éminemment distributionnelle : la pathologie mentale constitue-t-elle l’extrémité quantitative d’un continuum normal ou représente-t-elle une entité nosologique discontinue et distincte ?
Pour fonder scientifiquement la validité d’une catégorie diagnostique comme une entité discrète réelle (un taxon naturel), la démonstration empirique d’une distribution bimodale au sein de la population générale ou clinique est une condition nécessaire. Un creux d’antimode marqué doit séparer la population générale saine du groupe de patients atteints du trouble. Si une telle séparation est absente et que la sévérité des symptômes suit une décroissance continue unimodale de type loi de puissance ou exponentielle, l’instauration d’un seuil diagnostique rigide (par exemple imposer 5 symptômes sur 9 pour caractériser un épisode dépressif majeur) ne relève plus d’une frontière biologique naturelle, mais d’une convention clinique arbitraire.
Les investigations psychométriques à large échelle sur les troubles affectifs et anxieux indiquent que la symptomatologie dépressive se déploie massivement sur un continuum sans fracture modale évidente. En revanche, certains phénotypes cliniques spécifiques, tels que les formes sévères de mélancolie avec caractéristiques psychotiques ou les épisodes maniaques aigus des troubles bipolaires de type I, manifestent des discontinuités distributionnelles plus prononcées. Ces données suggèrent que si la détresse psychologique commune est dimensionnelle, certaines pathologies psychiatriques lourdes constituent d’authentiques régimes morbides séparés par des gouffres de probabilité.
7.2 Trajectoires de rechute et comportements addictifs
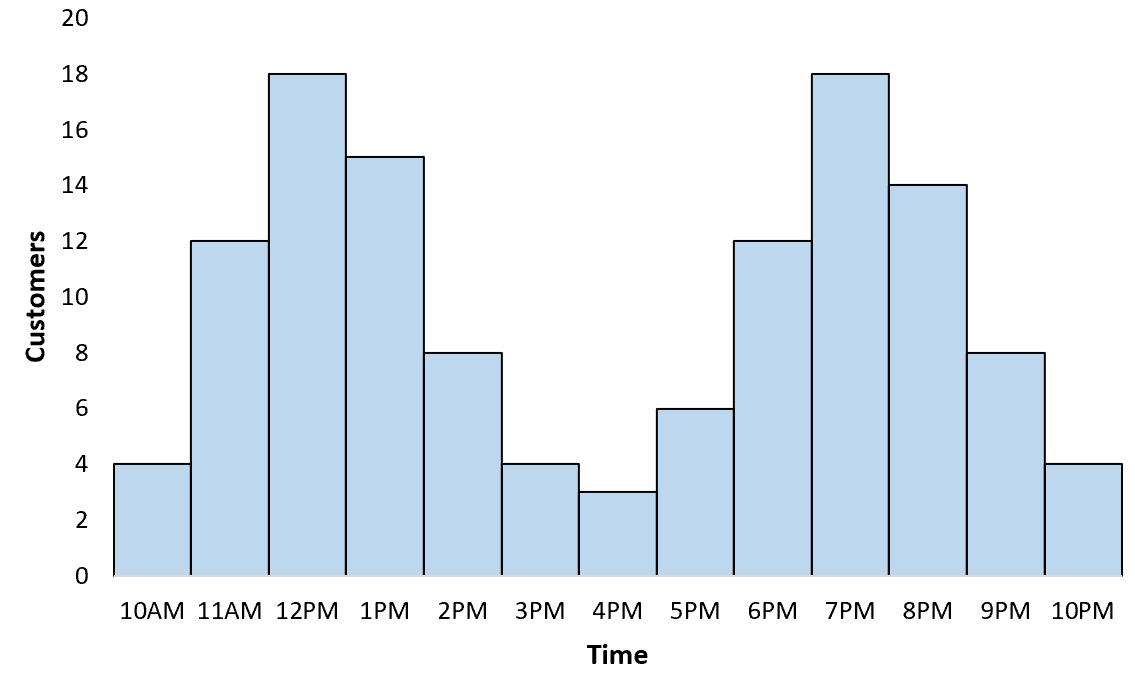
L’étude longitudinale des addictions et des comportements de dépendance pharmacologique met en lumière des distributions de consommation qui défient toute tentative d’ajustement par des modèles linéaires unimodaux. Qu’il s’agisse de la dépendance à l’alcool, au tabac, aux opioïdes ou des addictions comportementales comme le jeu d’argent pathologique, la métrique mesurant la fréquence ou la quantité des consommations quotidiennes est intrinsèquement bimodale.
Cette configuration distributionnelle se matérialise par deux modes diamétralement opposés. Le premier sommet, massif, est localisé à la valeur zéro stricte, regroupant les sujets en situation d’abstinence totale pérenne ou temporaire. Le second mode, situé à une distance considérable sur l’axe d’intensité, rassemble les individus engagés dans une consommation compulsive active et incontrôlée, caractérisée par une forte tolérance pharmacologique. L’espace intermédiaire entre l’abstinence absolue et la consommation lourde est largement déserté par les patients dépendants : les comportements de consommation contrôlée ou modérée y constituent un état hautement instable qui bascule rapidement vers l’un des deux extrêmes.
Ces dynamiques se manifestent également à travers les trajectoires temporelles de récidive observées dans le cours évolutif des troubles bipolaires ou des troubles de l’usage de substances. Lorsqu’on trace la distribution du temps écoulé avant la survenue d’un nouvel épisode décompensatoire aigu après une rémission clinique, on n’observe pas une décroissance unimodale régulière. On identifie fréquemment un premier mode précoce traduisant des rechutes fulgurantes chez des patients réfractaires ou soumis à des stresseurs environnementaux massifs, suivi d’une période d’accalmie relative, puis d’un mode tardif regroupant les rechutes liées à l’érosion progressive de l’observance thérapeutique au fil des années.
7.3 Endophénotypes et biomarqueurs en psychiatrie
La recherche de biomarqueurs neurobiologiques objectifs constitue l’un des chantiers les plus novateurs de la psychiatrie computationnelle contemporaine. Dans cette perspective, la découverte de distributions multimodales au niveau physiologique, électrophysiologique ou génomique offre une clé précieuse pour surmonter l’hétérogénéité syndromique des classifications cliniques actuelles, en révélant des endophénotypes fonctionnels sous-jacents.
Un exemple paradigmatique concerne les anomalies du traitement de l’information auditive mesurées par l’onde P300 en électroencéphalographie (potentiels évoqués cognitifs). Lorsqu’on analyse l’amplitude ou la latence de l’onde P300 au sein d’une cohorte hétérogène de patients diagnostiqués schizophrènes selon les critères généraux du DSM, la distribution de ces métriques neurophysiologiques révèle une configuration nettement bimodale. Cette séparation sépare les patients présentant un déficit neuro-développemental profond de la connectivité corticale (caractérisé par une réduction drastique de la P300) de ceux dont le profil électrophysiologique est indiscernable de celui des sujets témoins sains, suggérant des trajectoires étiologiques totalement distinctes masquées sous une même étiquette symptomatique de surface.
De surcroît, la multimodalité des biomarqueurs s’avère décisive pour la pharmacogénomique prédictive. Dans les protocoles évaluant la réponse clinique aux antidépresseurs de nouvelle génération ou aux stabilisateurs de l’humeur comme le lithium, la distribution du taux de réduction des scores cliniques post-traitement est très souvent bimodale : elle isole un mode de « non-répondeurs » complets d’un mode de « répondeurs complets », l’efficacité partielle étant paradoxalement minoritaire. L’identification de ces sous-populations neurobiologiques disjointes permet d’orienter le développement d’algorithmes d’apprentissage machine vers une psychiatrie de précision individualisée.
8. Tests statistiques formels et diagnostics de multimodalité
8.1 Le test du dip de Hartigan (Hartigan’s Dip Test)
L’inspection visuelle des histogrammes et des courbes d’estimation de densité, bien qu’indispensable lors de la phase exploratoire initiale, demeure intrinsèquement subjective et vulnérable aux biais de confirmation de l’analyste. Pour établir avec certitude scientifique si une distribution empirique s’écarte significativement de l’unimodalité, le recours à un test d’hypothèse formel s’avère indispensable. Dans cet arsenal inférentiel, le test du dip de Hartigan (publié par John Hartigan et P. M. Hartigan en 1985) s’impose comme l’outil non paramétrique le plus rigoureux, le plus élégant et le plus universellement reconnu.
Le fondement théorique du test du dip repose sur une comparaison géométrique entre la fonction de répartition empirique d’un échantillon, notée $F_n(x)$, et l’espace fonctionnel $\mathcal{U}$ regroupant l’ensemble de toutes les fonctions de répartition théoriques strictement unimodales. La statistique de test, appelée le « dip » ($D_n$), quantifie la distance suprémale (la divergence maximale absolue) qui sépare la fonction de répartition observée de la fonction de répartition unimodale asymptotique la plus proche possible :
$$D_n = \inf_{F in \mathcal{U}} \sup_{x} |F_n(x) – F(x)|$$
L’hypothèse nulle ($H_0$) stipule que la distribution parente sous-jacente est unimodale, la distribution uniforme sur un segment étant utilisée comme le cas le plus défavorable (le moins favorable au rejet de $H_0$) pour garantir un niveau de test conservateur. Si la statistique $D_n$ calculée sur les données excède la valeur critique tabulée pour la taille d’échantillon considérée, l’hypothèse d’unimodalité est formellement rejetée au seuil $\alpha$, concluant à l’existence statistiquement robuste d’au moins deux modes réels. Ce test bénéficie d’une remarquable puissance statistique et s’avère totalement insensible aux asymétries locales monotones qui trompent si fréquemment les observateurs visuels.
8.2 Le test de Silverman par lissage critique
Une démarche méthodologique alternative, profondément ancrée dans le cadre de l’estimation non paramétrique par noyau de densité, a été développée par le statisticien Bernard Silverman en 1981. Le test de Silverman propose une conceptualisation novatrice du diagnostic de modalité en articulant l’inférence statistique autour de la notion de « paramètre de lissage critique » ($h_{\text{critique}}$).
Le principe fondamental s’énonce comme suit : considérons l’estimateur par noyau gaussien d’une distribution empirique. Lorsque la largeur de fenêtre $h$ est extrêmement grande, la courbe estimée est obligatoirement unimodale ; à mesure que $h$ se contracte vers zéro, de multiples sommets commencent séquentiellement à émerger. Pour tester formellement l’hypothèse que la distribution possède au plus $k$ modes contre l’alternative qu’elle en comporte davantage ($k+1$ ou plus), Silverman définit la bande passante critique $h_{\text{critique}}^{(k)}$ comme la plus petite valeur de la fenêtre $h$ pour laquelle la densité estimée $\hat{f}_h$ présente au maximum $k$ modes. Une valeur empirique anormalement élevée de ce seuil critique indique que la séparation des modes dans les données est si prononcée qu’il faut un lissage colossal pour forcer la fonction à paraître unimodale.
Pour évaluer la significativité statistique de ce paramètre critique sans faire d’hypothèses distributionnelles restrictives, Silverman recourt à une procédure de rééchantillonnage par bootstrap non paramétrique. On génère des milliers d’échantillons simulés à partir de la densité lissée sous l’hypothèse nulle ($k$ modes avec $h = h_{\text{critique}}^{(k)}$), puis on recalcule le lissage critique sur chaque réplique pour dériver la p-valeur empirique. Bien que le test classique de Silverman soit réputé pour son caractère légèrement conservateur (tendance à minorer le taux de rejet effectif sous certaines conditions de variance hétérogène), des corrections modernes basées sur des calibrations de bootstrap lissé ont restauré sa pleine compétitivité méthodologique face au test du dip.
8.3 Approches basées sur la taxométrie de Meehl
Dans les sciences psychologiques et psychiatriques, la mise en évidence formelle de catégories réelles (ou « taxons ») face à des variations purement dimensionnelles a été révolutionnée par les travaux épistémologiques et méthodologiques de Paul Meehl. Face à l’incapacité des corrélations traditionnelles à distinguer un vrai groupe bimodal discret d’une distribution continue non normale, Meehl a développé un ensemble de procédures regroupées sous le vocable de taxométrie.
Parmi ces techniques spécialisées, la procédure MAMBAC (Mean Above Minus Below A Cut) et la procédure MAXCOV (Maximum Covariance) sont les plus célèbres :
- La méthode MAMBAC : Elle consiste à opérer une succession de coupures dichotomiques le long d’une première variable indicatrice ($X$), et à calculer pour chaque seuil la différence entre la moyenne des scores situés au-dessus de la coupure et celle des scores situés en dessous sur une seconde variable indicatrice ($Y$). Si la structure sous-jacente est purement dimensionnelle et unimodale, la courbe obtenue prend une forme concave sans inflexion marquée. Si la distribution cache un taxon bimodal réel, la courbe MAMBAC affiche un pic pointu proéminent localisé précisément au point de scission optimal séparant les deux catégories.
- La technique MAXCOV : Elle découpe l’espace d’une variable de référence en tranches chevauchantes successives et évalue la covariance locale entre deux autres indicateurs au sein de chaque tranche. La covariance conditionnelle atteint un sommet maximal spectaculaire au niveau de la frontière taxométrique où le mélange des deux sous-groupes est le plus équilibré, alors qu’elle s’effondre à l’intérieur des sous-groupes homogènes.
Pour sécuriser les conclusions taxométriques contre les artéfacts de distribution asymétrique, les analyses modernes comparent systématiquement les courbes empiriques obtenues à des jeux de données pseudo-aléatoires simulés de façon redondante sous deux conditions théoriques strictes : un modèle dimensionnel continu reproduisant la matrice de corrélation observée et un modèle catégoriel à deux classes latentes. L’indice CCFI (Curve Fit Index) synthétise cette confrontation : une valeur proche de 1 valide sans réserve l’existence d’une structure latente bimodale ou multimodale, tandis qu’une valeur convergeant vers 0 confirme l’unicité dimensionnelle fondamentale du phénomène.
9. Conséquences méthodologiques de l’omission d’une distribution multimodale
9.1 Échec et tromperie des statistiques de tendance centrale
L’omission ou la méconnaissance d’une distribution multimodale lors de la phase initiale d’analyse quantitative déclenche une cascade de distorsions méthodologiques majeures, dont la plus immédiate et dévastatrice concerne l’effondrement conceptuel des statistiques de tendance centrale. Depuis les premiers cycles universitaires, l’usage de la moyenne arithmétique est inculqué comme le résumé numérique par défaut de toute série de données quantitatives continues. Or, dans un univers multimodal, la moyenne arithmétique perd toute validité descriptive et devient une abstraction mathématique profondément trompeuse.
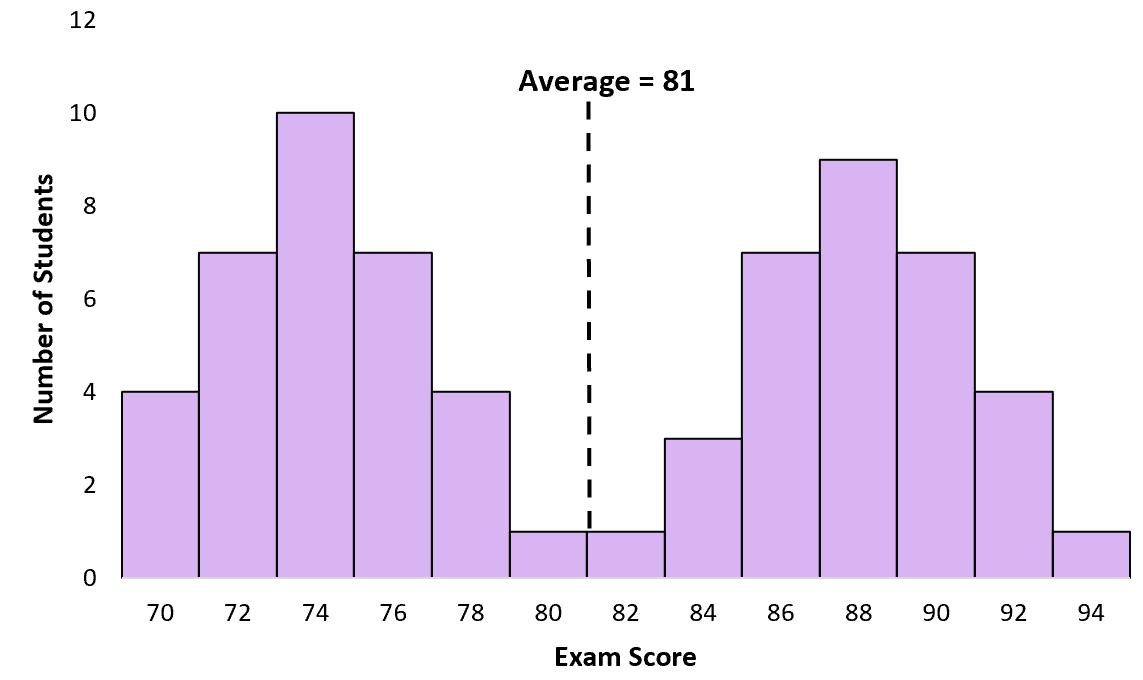
L’exemple archétypal de cet échec réside dans une distribution bimodale symétrique composée de deux cohortes d’effectifs égaux centrées respectivement autour de -10 et de +10, avec un vide modal absolu autour de zéro. La moyenne arithmétique globale calculée sur cet échantillon sera très exactement de 0. Pourtant, cette valeur centrale ne représente absolument personne dans la réalité empirique : elle se situe dans un no man’s land de densité nulle, un antimode où la probabilité d’observer un individu réel est rigoureusement inexistante. Proclamer que le « score moyen » du groupe est nul constitue un contresens scientifique caractérisé qui masque la réalité fondamentale du phénomène, à savoir une polarisation radicale entre deux états incompatibles.
La médiane ne constitue nullement une alternative salvatrice dans ces configurations : bien qu’elle soit robuste aux valeurs aberrantes périphériques, elle reste condamnée à désigner un point médian qui peut tout autant tomber dans une crevasse d’antimode. De surcroît, la dispersion globale évaluée par l’écart-type subit une distorsion catastrophique : en calculant les écarts par rapport à une moyenne fantôme située dans le vide central, l’écart-type global explose, agrégeant mécaniquement l’écartement macroscopique entre les deux bosses avec la variabilité interne réelle de chaque sous-groupe, donnant l’illusion trompeuse d’une variance intra-populationnelle titanesque.
9.2 Violation des postulats des tests paramétriques
Le mépris de la multimodalité conduit inéluctablement au naufrage des outils d’inférence statistique paramétrique traditionnels. L’immense majorité des méthodes déployées dans les publications biomédicales et comportementales — au premier rang desquelles figurent le test t de Student pour échantillons indépendants, l’analyse de variance (ANOVA) et les modèles de régression linéaire par moindres carrés ordinaires (OLS) — reposent de manière inaliénable sur l’hypothèse de normalité et d’homoscédasticité des résidus du modèle.
Lorsqu’un chercheur applique une ANOVA sur des groupes expérimentaux au sein desquels la variable dépendante abrite une sous-structure multimodale non modélisée, les postulats de base volent en éclats :
- Les résidus du modèle linéaire manifestent une multimodalité incompressible, rendant caduque la loi de distribution théorique de la statistique $F$ de Fisher-Snedecor.
- L’hétéroscédasticité irréductible induite par les variances inégales des sous-composantes gonfle de manière incontrôlée les taux de fausses alertes (erreur de type I) ou dégrade tragiquement la sensibilité du test (erreur de type II).
- Une altération pernicieuse émerge lorsque la multimodalité découle d’un tiers-facteur masqué : le célèbre paradoxe de Simpson peut alors inverser totalement le signe d’une corrélation apparente au niveau global par rapport aux relations réelles qui opèrent à l’intérieur de chaque mode sous-jacent.
Poursuivre des calculs inférentiels sur de telles données revient à injecter des prémisses fausses dans une machine mathématique rigoureuse : les conclusions publiées relatives aux tailles d’effet ($d$ de Cohen, $\eta^2$ partiel) et aux p-valeurs affichées ne possèdent alors aucune validité scientifique robuste, exposant directement les études au syndrome de la crise de réplication.
9.3 Biais dans les modèles prédictifs et d’apprentissage machine
Dans l’ère contemporaine des mégadonnées et de l’intelligence artificielle, l’impact néfaste d’une distribution multimodale ignorée ne s’estompe pas ; il s’amplifie au sein des architectures prédictives automatisées. Les algorithmes de régression standard (régression linéaire multiple, régression Ridge ou Lasso) ajustent un hyperplan unique visant à minimiser l’erreur quadratique globale. Confrontés à une variable cible multimodale, ces algorithmes tracent une prédiction intermédiaire qui traverse les antimodes, échouant lamentablement à prédire fidèlement les réalisations des différents groupes réels.
Par ailleurs, les mécanismes d’optimisation numérique sous-jacents aux modèles d’apprentissage automatique, singulièrement la descente de gradient stochastique (SGD) et ses variantes modernes (Adam, RMSprop), rencontrent d’immenses difficultés de convergence face à des fonctions de perte induites par des données multimodales. L’espace des coûts devient tourmenté et hautement non convexe, piégeant les optimiseurs dans des minima locaux sous-optimaux dont ils peinent à s’extraire sans hyperparamétrages sophistiqués de recuit simulé ou de régularisation bayésienne.
Enfin, les algorithmes non linéaires d’apprentissage machine hautement flexibles, tels que les arbres de décision profonds ou les réseaux de neurones denses, risquent de réagir à la multimodalité par un surapprentissage (overfitting) pathologique. Pour épouser les creux et les bosses de distributions multimodales mal comprises, le modèle va démultiplier ses paramètres libres et découper l’espace de manière fragmentée, apprenant par cœur les singularités d’échantillonnage de chaque pic mineur au lieu d’abstraire la véritable fonction génératrice sous-jacente, ruinant ainsi toute capacité de généralisation sur des jeux de données indépendants.
10. Stratégies d’analyse face à des données multimodales
10.1 Stratification et analyse en sous-groupes explicites
Dès lors que le diagnostic de multimodalité a été formellement posé, la démarche méthodologique prioritaire consiste à tenter de démêler le mélange en identifiant les facteurs manifestes responsables du fractionnement distributionnel. Si la structure à plusieurs modes reflète l’influence d’une variable nominale ou discrète observable mais omise dans le plan d’expérience (comme le sexe biologique, le protocole hospitalier de collecte, le pays d’origine ou une catégorie d’âge spécifique), la solution la plus directe et la plus transparente réside dans la stratification méthodique de l’échantillon.
La stratification consiste à scinder le jeu de données initial en autant de sous-échantillons homogènes qu’il y a de modalités de la variable modératrice discriminante. Une fois cette partition opérée, l’analyste vérifie formellement si la distribution de la variable d’intérêt retrouve une forme unimodale gaussienne à l’intérieur de chaque strate isolée. Si l’unimodalité est restaurée intra-groupe, l’architecture inférentielle paramétrique classique redevient applicable, à condition de procéder à des modélisations multiniveaux ou hiérarchiques qui incorporent explicitement la structure emboîtée des observations sans perdre la puissance de l’analyse globale.
Néanmoins, cette stratégie d’analyse en sous-groupes explicites doit être maniée avec une prudence méthodologique rigoureuse. Le partitionnement systématique d’un échantillon réduit mécaniquement la taille effective des sous-groupes ($n_k$), amputant considérablement la puissance statistique requise pour détecter des effets d’interaction subtils. De plus, la multiplication non planifiée de découpages rétrospectifs (la tentation du « subgroup snooping ») gonfle dramatiquement le risque de faux positifs, transformant des artéfacts d’échantillonnage en fausses découvertes scientifiques si aucune correction pour comparaisons multiples n’est rigoureusement adossée au protocole.
10.2 Modélisation par classes latentes (Latent Class Analysis)
Lorsque la multimodalité ne peut être expliquée par aucune variable manifeste immédiatement disponible dans le jeu de données, la stratification manuelle s’avère totalement impuissante. Dans cette situation, la véritable cause du mélange réside dans l’action d’une variable nominale inobservée, enfouie dans la structure des covariations : une variable latente. La réponse méthodologique de référence repose alors sur l’analyse des classes latentes (LCA pour Latent Class Analysis) ou les modèles de mélange structurels (Finite Mixture Modeling).
Contrairement aux algorithmes de partitionnement déterministe rigide (tels que les k-moyennes ou la classification hiérarchique ascendante), l’approche par classes latentes repose sur un paradigme probabiliste rigoureux fondé sur la théorie du maximum de vraisemblance :
- Chaque individu n’est pas assigné brutalement à un groupe exclusif, mais reçoit une distribution de probabilités d’appartenance a posteriori pour chacune des classes latentes identifiées.
- L’algorithme estime conjointement les paramètres statistiques internes de chaque groupe latent (moyennes, covariances) et la proportion démographique relative de chaque profil au sein de la population parente.
- Cette méthode s’étend remarquablement aux contextes de suivi temporel grâce aux modèles de mélanges de trajectoires latentes (Latent Class Growth Analysis et GMM longitudinaux).
Dans ces protocoles longitudinaux répétés, la trajectoire d’évolution d’une pathologie chronique ou le développement d’une compétence cognitive peut présenter une distribution multimodale au terme du suivi. La modélisation par classes latentes permet de désagréger cette complexité terminale en trajectoires développementales distinctes : par exemple un groupe à rémission rapide, un groupe à chronicité stationnaire et un groupe à détérioration rapide, chacun caractérisé par sa propre fonction d’ajustement mathématique.
10.3 Approches non paramétriques et régressions robustes
Lorsque l’objectif de la recherche ne consiste pas à disséquer la distribution en sous-populations identifiables mais à évaluer l’effet d’interventions expérimentales ou de prédicteurs environnementaux sur un phénomène qui refuse obstinément de se conformer à un mélange paramétrique standard, l’analyste doit impérativement abandonner les modèles linéaires classiques au profit de méthodes robustes et non paramétriques.
La régression quantile, formalisée par Roger Koenker et Gilbert Bassett, représente l’un des outils les plus formidables face aux données multimodales. Alors que la régression des moindres carrés cherche à modéliser la variation de l’espérance conditionnelle moyenne — laquelle peut être dénuée de sens dans un creux modal —, la régression quantile permet de modéliser séparément l’effet des variables explicatives à différents centiles spécifiques de la distribution cible (par exemple le 10e, le 25e, le 50e, le 75e et le 90e centile). Cette approche permet de découvrir que le traitement expérimental n’a aucun impact sur le centre de la distribution, mais qu’il déplace vigoureusement le mode supérieur vers la droite, révélant une information clinique cruciale totalement masquée par les régressions standard.
D’autres solutions d’ingénierie statistique contemporaine incluent les Modèles Additifs Généralisés (GAM pour Generalized Additive Models), qui remplacent les coefficients linéaires rigides par des fonctions de lissage non paramétriques capables d’épouser la géométrie complexe des données sans imposition formelle préalable. Dans l’arène de l’apprentissage automatique, les algorithmes de partitionnement récursif comme les forêts aléatoires (Random Forests) ou le boosting de gradient (XGBoost, LightGBM) s’avèrent naturellement résilients face aux distributions multimodales : en découpant l’espace prédictif par seuillages orthogonaux successifs, ils isolent naturellement les différents modes au sein de branches spécifiques de l’arbre, neutralisant les risques de modélisation erronée.
11. Outils logiciels et implémentation pratique sous R et Python
11.1 Mise en œuvre sous l’environnement R
L’environnement statistique libre R constitue historiquement la plateforme la plus riche, la plus féconde et la plus méticuleusement auditée pour l’analyse fondamentale et appliquée des distributions multimodales. Une chaîne de traitement rigoureuse débute invariablement par l’investigation non paramétrique de l’unimodalité. Le package diptest offre la mise en œuvre de référence du test du dip de Hartigan via la fonction dip.test(), délivrant instantanément la statistique $D_n$ et sa p-valeur exacte calculée contre la distribution uniforme simulée.
Pour la modélisation statistique formelle des mélanges finis continus, le package mclust s’impose comme le standard international incontesté. Conçu par Chris Fraley et Adrian Raftery, ce package exécute des modèles de mélanges gaussiens univariés et multivariés en explorant de manière automatisée une grande variété de contraintes géométriques (variances égales ou inégales, formes et orientations variables). La fonction phare Mclust() calcule systématiquement le critère BIC sur une plage de composantes latentes prédéterminée (par exemple de $K=1$ à $K=9$), sélectionne automatiquement l’architecture optimale et extrait les responsabilités probabilistes pour chaque observation avec une robustesse numérique exceptionnelle.
Dans le domaine spécifique de la psychométrie et de la recherche taxométrique, le package RTaxometrics intègre l’ensemble des protocoles méthodologiques formulés par Meehl, permettant d’exécuter d’un bloc les analyses MAMBAC, MAXCOV et d’estimer les indices CCFI confrontés à des distributions simulées. Enfin, sur le plan de la visualisation avancée, le célèbre écosystème ggplot2 enrichi de l’extension ggridges permet de déployer des graphiques en crêtes de densité (ridgeline plots) d’une clarté esthétique et technique remarquable, facilitant la comparaison de la dynamique modale à travers de multiples conditions expérimentales ou temporelles.
11.2 Traitement des distributions multimodales sous Python
Dans l’écosystème open-source Python, devenu incontournable en science des données et en apprentissage machine, les outils dédiés au traitement des distributions multimodales sont extrêmement matures, portés par des bibliothèques hautement optimisées. Pour la détection graphique et l’estimation de densité non paramétrique, les bibliothèques scipy.stats et statsmodels fournissent des implémentations complètes de l’estimateur par noyau KDE (notamment via gaussian_kde), permettant d’ajuster finement la bande passante selon les règles de Scott ou de Silverman.
La référence absolue pour l’inférence des modèles de mélange au sein de la boîte à outils d’apprentissage automatique est la classe GaussianMixture intégrée au module sklearn.mixture de la bibliothèque scikit-learn. Cet outil implémente l’algorithme Espérance-Maximisation complet avec support natif pour matrices de covariance sphériques, diagonales, liées ou pleines. Les attributs bic() et aic() permettent d’écrire des boucles d’évaluation pour déceler le minimum pénalisé du nombre de clusters cachés, tandis que la méthode predict_proba() génère directement les responsabilités conditionnelles latentes sous forme de matrices NumPy.
Pour les chercheurs désireux d’adopter une posture bayésienne complète face à la multimodalité, la bibliothèque de modélisation probabiliste PyMC offre des capacités hors du commun. Elle permet de construire des modèles de mélanges infinis via des processus de Dirichlet (Dirichlet Process Mixture Models), où le nombre de composantes $K$ n’a plus besoin d’être fixé arbitrairement a priori par l’analyste mais est directement inféré à partir des données sous forme de distribution a posteriori via des algorithmes d’échantillonnage de Monte-Carlo par chaînes de Markov (MCMC comme l’échantillonneur NUTS). Enfin, la bibliothèque seaborn permet de cartographier instantanément ces distributions au moyen de fonctions évoluées telles que kdeplot() ou violinplot().
11.3 Directives méthodologiques pour la reproductibilité
L’exploitation de modèles probabilistes complexes face à des données multimodales impose des standards de rigueur méthodologique accrus pour garantir la stricte reproductibilité des résultats scientifiques publiés. L’une des failles les plus documentées dans la littérature concerne la non-fixation des graines aléatoires (random seeds). L’algorithme EM convergeant vers des optima locaux dépendant étroitement de son initialisation stochastique, tout rapport de recherche doit explicitement renseigner la graine d’initialisation logicielle employée sous R ou Python pour permettre aux pairs de reproduire scrupuleusement le partitionnement obtenu.
De surcroît, les chercheurs doivent proscrire le compte-rendu sélectif des seuls indices d’ajustement favorables à leur hypothèse théorique. Il est méthodologiquement impératif de documenter de manière exhaustive :
- L’ensemble des critères comparatifs testés sur une plage étendue de classes (AIC, BIC, sample-adjusted BIC, critère ICL et p-valeurs du BLRT).
- L’entropie de classification finale, qui synthétise la précision de l’assignation des sujets aux différentes composantes modales (une entropie supérieure à 0.80 signalant une séparation satisfaisante).
- La taille minimale absolue de la plus petite composante latente extraite, pour s’assurer qu’un mode ne regroupe pas une fraction marginale inférieure à 1% ou 2% de l’effectif total, signe révélateur d’un artéfact numérique d’échantillonnage plutôt que d’un profil structurellement valide.
Enfin, la transparence scientifique exige que les scripts de prétraitement, les routines de filtrage des valeurs extrêmes et les éventuelles transformations non linéaires appliquées aux données brutes soient mis à disposition de la communauté dans des dépôts ouverts (tels que l’Open Science Framework ou GitHub). Modifier le seuillage de troncation d’une distribution continue modifie substantiellement la géométrie des creux et des sommets : seule une traçabilité totale du code de calcul permet de certifier l’intégrité épistémologique du diagnostic de multimodalité.
12. Synthèse conceptuelle et perspectives de recherche
12.1 Évolution épistémologique : de l’anomalie à l’information biologique
L’histoire de la pensée statistique appliquée aux sciences humaines et du vivant a longtemps été marquée par ce que l’on pourrait qualifier de « dogme gaussien ». Sous l’influence historique des pères fondateurs de la biométrie comme Francis Galton et Karl Pearson, l’idéal-type de la distribution normale a été érigé en norme universelle régissant la variabilité des phénomènes naturels. Dans ce paradigme réducteur, toute déviation marquée par rapport à la courbe en cloche unimodale — et singulièrement l’émergence de sommets secondaires — a été historiquement traitée comme une imperfection de mesure, une hérésie d’échantillonnage ou un bruit résiduel destiné à être lissé ou éliminé par des transformations de variables.
Nous assistons aujourd’hui à une bascule épistémologique radicale. La multimodalité s’est affranchie de son statut péjoratif d’anomalie pour devenir un signal informationnel de première grandeur. Elle constitue le révélateur le plus direct de l’hétérogénéité intrinsèque des systèmes complexes. En biologie moléculaire, en écologie comportementale ou en sciences cognitives, la présence de modes disjoints témoigne de l’existence de niches d’adaptation différenciées, de commutateurs génétiques bistables ou de sous-systèmes fonctionnels aux dynamiques autonomes.
Ce changement de regard méthodologique s’inscrit au cœur de la transition vers une science personnalisée et stratifiée. Prétendre résumer une population hétérogène par un indicateur unique moyen constitue une violence épistémologique qui invisibilise les sous-groupes structurels qui la composent. Admettre la multimodalité, c’est accepter la pluralité des mécanismes générateurs de données et bâtir des architectures théoriques suffisamment amples pour rendre compte simultanément de multiples régimes d’équilibre au sein d’un même phénomène.
12.2 Défis posés par les mégadonnées (Big Data) et l’IA
L’avènement contemporain des mégadonnées et de l’intelligence artificielle n’a pas simplifié la question de la multimodalité ; il en a au contraire décuplé la complexité mathématique et les défis d’ingénierie statistique. Dans des ensembles de données massifs englobant des millions de transactions numériques, de trajectoires de mobilité ou d’enregistrements physiologiques passifs issus de capteurs connectés, les tests d’hypothèse classiques subissent une distorsion d’échelle bien connue : leur puissance statistique convergeant vers 1, la moindre fluctuation microscopique devient formellement « statistiquement significative ».
Cette sensibilité extrême pose le problème aigu de la détection de micro-modes factices. Dans un jeu de données de dix millions d’observations, l’application automatique d’un algorithme non paramétrique sans régularisation drastique peut révéler des dizaines d’ondulations modales infimes n’ayant strictement aucune pertinence phénoménologique ou clinique. La statistique contemporaine doit ainsi développer des critères de significativité substantielle capables de dissocier les modes structurels profonds des ondulations locales résultant de l’accumulation massive de bruits non gaussiens hautement corrélés.
Parallèlement, la multimodalité explose aujourd’hui dans des espaces de haute dimension (high-dimensional data) tels que les vecteurs d’encodage textuel des grands modèles de langage (LLM), les connectomes cérébraux complets en neuro-imagerie fonctionnelle ou les profils d’expression transcriptomique en cellule unique (single-cell RNA sequencing). Dans ces espaces mathématiques à plusieurs centaines ou milliers de dimensions, les modes ne sont plus de simples bosses sur un graphique univarié, mais des sous-variétés différentielles (manifolds) d’une complexité topologique vertigineuse. Le développement d’algorithmes d’apprentissage profond auto-adaptatifs fondés sur la théorie géométrique de l’information et les flux normalisateurs (normalizing flows) représente l’une des frontières les plus actives de la recherche en intelligence artificielle pour modéliser avec fidélité ces distributions multivariées fragmentées.
12.3 Recommandations aux chercheurs et praticiens
Au terme de cette exploration transversale des distributions multimodales, plusieurs directives méthodologiques fondamentales s’imposent à tout praticien, ingénieur de données ou chercheur désireux d’assurer la rigueur scientifique de ses investigations quantitatives :
- Systématiser l’exploration visuelle préliminaire : Aucun calcul inférentiel ne doit être déclenché sans un examen visuel minutieux des distributions brutes à l’aide d’outils sensibles aux discontinuités, en privilégiant systématiquement les graphiques en violon et les estimations par noyau (KDE) multi-fenêtres au détriment des boîtes à moustaches conventionnelles et des histogrammes mal étalonnés.
- Proscrire l’automatisme de la moyenne : Face à toute variable continue, la vérification de l’unimodalité doit constituer un prérequis absolu avant tout calcul de moyenne arithmétique ou d’écart-type. En présence avérée d’un antimode central, l’analyste doit impérativement rapporter les modes locaux et les densités correspondantes plutôt qu’une valeur centrale vide de réalité empirique.
- Substituer les mélanges probabilistes aux découpages empiriques : Il convient d’abandonner définitivement les dichotomisations arbitraires (telles que le clivage par la médiane ou des seuillages cliniques ad hoc non prouvés) pour fragmenter des populations hétérogènes. Seuls les modèles formels de mélange fini (GMM) ou l’analyse des classes latentes offrent la garantie mathématique de préserver l’incertitude de classification sans dégrader la variance des construits.
- Rénover la formation méthodologique : Il est urgent que les cursus universitaires en sciences biomédicales, humaines et sociales réforment leurs enseignements de statistique quantitative en désacralisant le dogme normal. Former les futurs praticiens à la reconnaissance des distributions multimodales et à la manipulation des modèles non linéaires constitue la condition nécessaire pour bâtir une science plus robuste, plus réplicable et plus fidèle à l’infinie richesse des systèmes réels.
Références
Dempster, A. P., Laird, N. M., & Rubin, D. B. (1977). Maximum likelihood from incomplete data via the EM algorithm. Journal of the Royal Statistical Society: Series B (Methodological), 39(1), 1-22. https://doi.org/10.1111/j.2517-6161.1977.tb01600.x
Fraley, C., & Raftery, A. E. (2002). Model-based clustering, discriminant analysis, and density estimation. Journal of the American Statistical Association, 97(458), 611-631. https://doi.org/10.1198/016214502760047131
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
Hartigan, J. A., & Hartigan, P. M. (1985). The dip test of unimodality. The Annals of Statistics, 13(1), 70-84. https://doi.org/10.1214/aos/1176346577
Koenker, R., & Hallock, K. F. (2001). Quantile regression. Journal of Economic Perspectives, 15(4), 143-156. https://doi.org/10.1257/jep.15.4.143
McLachlan, G. J., & Peel, D. (2000). Finite Mixture Models. John Wiley & Sons. https://doi.org/10.1002/0471721182
Meehl, P. E. (1995). Bootstraps taxometrics: Solving the classification problem in psychopathology without gold standards. American Psychologist, 50(4), 266-275. https://doi.org/10.1037/0003-066X.50.4.266
Nylund, K. L., Asparouhov, T., & Muthén, B. O. (2007). Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Structural Equation Modeling: A Multidisciplinary Journal, 14(4), 535-569. https://doi.org/10.1080/10705510701575396
Parzen, E. (1962). On estimation of a probability density function and mode. The Annals of Mathematical Statistics, 33(3), 1065-1076. https://doi.org/10.1214/aoms/1177704472
Ratcliff, R. (1978). A theory of memory retrieval. Psychological Review, 85(2), 59-108. https://doi.org/10.1037/0033-295X.85.2.59
Rosenblatt, M. (1956). Remarks on some nonparametric estimates of a density function. The Annals of Mathematical Statistics, 27(3), 832-837. https://doi.org/10.1214/aoms/1177728190
Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605-610. https://doi.org/10.1093/biomet/66.3.605
Sheather, S. J., & Jones, M. C. (1991). A reliable data-based bandwidth selection method for kernel density estimation. Journal of the Royal Statistical Society: Series B (Methodological), 53(3), 683-690. https://doi.org/10.1111/j.2517-6161.1991.tb01857.x
Silverman, B. W. (1981). Using kernel density estimates to investigate multimodality. Journal of the Royal Statistical Society: Series B (Methodological), 43(1), 97-99. https://doi.org/10.1111/j.2517-6161.1981.tb01155.x
Silverman, B. W. (1986). Density Estimation for Statistics and Data Analysis. Chapman and Hall/CRC. https://doi.org/10.1201/9781315140919
Thom, R. (1972). Stabilité structurelle et morphogénèse : essai d’une théorie générale des modèles. W. A. Benjamin.
Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
van der Eijk, C. (2001). Measuring agreement in ordered categorical data: An application to satisfaction with European Union policies. Quality and Quantity, 35(3), 325-341. https://doi.org/10.1023/A:1010374104122