
L’investigation scientifique des phénomènes psychologiques, des dynamiques comportementales et des processus cognitifs repose fondamentalement sur la capacité du chercheur à transformer des observations qualitatives et disparates en données quantitatives exploitables. Face à la complexité intrinsèque de l’appareil psychique et à l’hétérogénéité des conduites humaines, la quantification ne peut se réduire à une simple accumulation d’occurrences empiriques. L’acte de mesurer exige un cadre métrologique rigoureux capable de contextualiser les données brutes, d’en extraire les régularités structurelles et de neutraliser les artéfacts induits par les fluctuations expérimentales ou d’échantillonnage. Dans cette perspective, la statistique descriptive constitue le premier niveau d’intelligibilité des sciences du comportement, fournissant les outils analytiques indispensables pour appréhender la variabilité interindividuelle et intra-individuelle.
Au cœur de cette démarche de modélisation quantitative se trouve le concept de distribution de fréquences relatives. Tandis que le dénombrement brut fige l’analyste dans les limites étroites d’un collectif d’observation particulier, la conversion des fréquences absolues en proportions relatives opère une abstraction mathématique déterminante. Elle permet d’affranchir l’analyse de l’effectif total observé pour situer chaque événement, chaque réponse psychométrique ou chaque manifestation symptomatique au sein d’un espace probabilisable et normé. Cette démarche ne constitue pas une simple commodité arithmétique ; elle incarne un changement de paradigme épistémologique où l’observation singulière prend sens à l’aune de sa contribution à la structure globale de l’échantillon ou de la population parente.
L’objectif de cet article est d’examiner exhaustivement les fondements théoriques, les propriétés mathématiques formelles, les déclinaisons méthodologiques et les applications cliniques et psychométriques de la distribution de fréquences relatives. À travers une décomposition analytique rigoureuse, nous explorerons comment cet outil élémentaire, pourtant incontournable, sert de passerelle entre le recueil empirique brut, la modélisation statistique avancée, l’évaluation psychologique standardisée et les exigences contemporaines de la recherche en sciences humaines.
1. Introduction conceptuelle et fondements théoriques en psychologie
L’édification de la psychologie en tant que discipline scientifique à la fin du dix-neuvième siècle a été indissociable de la querelle des méthodes et de la nécessité d’objectiver les états mentaux. Dès lors que les pionniers de la psychophysique et de la psychométrie ont entrepris de quantifier les sensations, les aptitudes cognitives et les traits de personnalité, le problème du traitement des données catégorielles et discrètes s’est imposé avec acuité. La distribution de fréquences relatives s’est avérée être le dispositif matriciel permettant de conférer un statut d’invariance d’échelle aux observations comportementales.
1.1 Définition épistémologique de la fréquence relative
D’un point de vue épistémologique, la distinction fondamentale entre la fréquence absolue (désignée conventionnellement par la notation ni ou fabs) et la fréquence relative (notée fi, pi ou rf) repose sur le principe de relativisation contextuelle. La fréquence absolue traduit le comptage brut des occurrences d’une modalité ou d’un événement au sein d’un ensemble d’observations. Bien qu’elle possède une utilité comptable immédiate, elle demeure ontologiquement dépendante du volume global de l’échantillon investigué. Deux cohortes cliniques dénombrant respectivement 50 manifestations d’un comportement agressif ne peuvent être assimilées si la première réunit 100 individus et la seconde 10 000. La fréquence relative résout cette aporie en instituant un rapport de proportionnalité structurel :
Ce rapport, défini comme le quotient de la fréquence absolue observée pour une modalité spécifique par la taille totale de l’échantillon, transforme une métrique extensive (dépendante de la taille du système) en une métrique intensive (indépendante de l’extension de l’échantillon). Dans le domaine de l’évaluation des comportements observables, ce saut qualitatif permet d’ancrer l’empirisme dans une logique d’homologie relationnelle. Historiquement, l’essor de la psychométrie descriptive sous l’impulsion de Francis Galton et de Karl Pearson a coïncidé avec l’abandon progressif des simples tables d’énumération au profit de structures proportionnelles, autorisant l’émergence des concepts fondamentaux de norme, de profil type et de déviation statistique.
1.2 Pertinence de la mesure dans les sciences comportementales
Dans l’écosystème des sciences comportementales, l’observation brute s’avère particulièrement vulnérable aux biais de sélection et aux variations contingentes des effectifs expérimentaux. Contextualiser les occurrences individuelles au sein d’une population de référence constitue le prérequis méthodologique de toute inférence clinique valide. La distribution de fréquences relatives atténue mécaniquement les distorsions d’échelle inhérentes aux protocoles cliniques où les effectifs sont par nature inégaux, à l’image des comparaisons entre des groupes d’affections rares et des groupes témoins prélevés en population générale.
Au-delà de la neutralisation des disparités numériques, l’usage des fréquences relatives concourt directement à la standardisation des observations. Lorsqu’un praticien administre une échelle d’évaluation comportementale standardisée, l’assignation d’une valeur brute n’offre aucun ancrage clinique intrinsèque. En revanche, rapporter cette observation à la fréquence relative avec laquelle elle se manifeste dans le groupe normatif autorise une lecture probabiliste des signes cliniques. Un symptôme observé chez 2 % d’une population clinique référante ne revêt pas la même signification diagnostique ni le même pronostic qu’une manifestation partagée par 65 % de cette même cohorte, transformant ainsi la sémiologie psychiatrique en une démarche objectivable guidée par les lois de la fréquence.
1.3 Transition de l’observation brute à la métrique normalisée
Le passage méthodologique de la consignation brute issue des protocoles de laboratoire à une métrique normalisée représente un processus d’épuration analytique. Dans les paradigmes expérimentaux en psychologie cognitive — qu’il s’agisse de tâches de temps de réaction catégorisées, de détection de signaux ou de protocoles de choix forcé —, l’analyste fait face à des flux massifs de données binaires ou multinomiales. Le maintien de ces résultats sous la forme de comptages désordonnés encombre l’espace interprétatif et obscurcit les régularités structurelles sous-jacentes.
En substituant aux dénombrements de base des fractions et des proportions, la recherche s’aligne fidèlement sur les postulats centraux de la théorie classique des tests (TCT). Cette dernière postule que le score observé est la résultante d’un score vrai composite pollué par une erreur de mesure aléatoire. L’adoption d’une distribution de fréquences relatives permet d’engager un premier travail de filtration du bruit expérimental en stabilisant les estimations autour de ratios invariants, préparant ainsi l’architecture analytique nécessaire aux estimations ultérieures de fidélité, de cohérence interne et de sensibilité diagnostique.
2. Propriétés mathématiques et axiomes régissant la distribution
Pour prétendre au statut d’instrument scientifique rigoureux, la distribution de fréquences relatives ne saurait être appréhendée comme un simple artifice graphique ou un résumé descriptif informel. Elle repose sur un appareil axiomatique emprunté à la théorie des ensembles et à l’algèbre élémentaire, conférant à ses résultats une cohérence interne déductive et universelle. Ces propriétés mathématiques constituent les garde-fous préservant les praticiens des erreurs logiques lors de l’agrégation ou de la comparaison de sous-populations.
2.1 Axiome de bornage et non-négativité
Le fondement primordial régissant la fréquence relative réside dans son axiome d’inclusion au sein du corps des nombres réels, formellement défini sur l’intervalle fermé unitaire :
Pour toute modalité catégorielle ou tout intervalle continu i au sein d’une partition d’observations, la fréquence relative associée fi vérifie impérativement la double inégalité :
0 ≤ fi ≤ 1
Cette borne découle directement de la définition ensembliste de la sous-population par rapport à l’ensemble référent universel. Dans la mesure où la fréquence absolue ni d’un sous-ensemble est contrainte par le nombre total d’unités statistiques observées N, avec l’assertion stricte 0 ≤ ni ≤ N (en excluant par définition axiomatique tout comptage d’observations négatif, impossible empiriquement), le rapport arithmétique ni / N est mathématiquement borné par zéro à sa borne inférieure et par l’unité à sa borne supérieure.
Sur le plan sémantique, l’échelle décimale comprise entre 0,00 et 1,00 présente une équivalence bijective stricte avec l’échelle des pourcentages, évoluant continûment de 0 % à 100 %. Une valeur nulle, fi = 0, signale l’absence absolue de manifestation de la caractéristique étudiée au sein du référentiel empirique constitué, tandis qu’une valeur unitaire, fi = 1 (ou 100 %), indique une condition d’omniprésence unanime, où chaque unité statistique de l’échantillon partage sans exception la même modalité comportementale ou clinique.
2.2 Principe de fermeture et sommation unitaire
La seconde contrainte structurelle, qualifiée de principe de fermeture ou de condition de normalisation unitaire, postule que la sommation exhaustive de toutes les fréquences relatives associées aux modalités mutuellement exclusives et collectivement exhaustives d’une variable doit être rigoureusement égale à l’unité :
Considérons une partition discrète composée de k catégories distinctes C1, C2, …, Ck. La formulation mathématique s’établit comme suit :
∑(i=1 à k) fi = ∑(i=1 à k) (ni / N) = (1 / N) ∑(i=1 à k) ni
Puisque la partition est exhaustive et sans chevauchement, la somme des effectifs partiels est rigoureusement identique à l’effectif global :
∑(i=1 à k) ni = N, d’où il découle immédiatement que (1 / N) × N = 1 (soit 100 %).
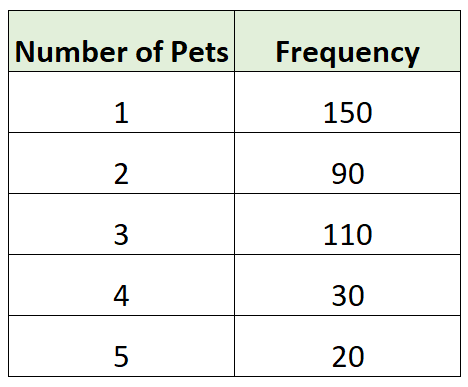
Cette propriété de fermeture garantit la validité interne du tableau de contingence ou de distribution. Dans la pratique du calcul statistique sur grand échantillon, des discordances marginales peuvent survenir en raison des arrondis numériques appliqués aux fractions décimales (conduisant par exemple à des sommes empiriques équivalant à 0,9999 ou 1,0001). Ces écarts résiduels, loin de refléter une défaillance de la structure théorique, relèvent de la précision de la machine informatique et nécessitent des procédures de compensation analytique ou de conservation sous forme de fractions rationnelles irréductibles.
2.3 Critères d’invalidité et violations axiomatiques
L’infraction aux propriétés axiomatiques susmentionnées agit comme un signal infaillible de défaillance méthodologique ou de distorsion expérimentale. Lorsqu’un tableau de distribution de fréquences produit une sommation différente de l’unité (∑ fi ≠ 1), deux typologies d’anomalies structurelles doivent être diagnostiquées sans délai :
- Le déficit sommatoire (∑ fi < 1) : Cette anomalie atteste de l’existence de données non documentées, d’abandons de participants en cours d’évaluation (phénomène de drop-out longitudinal) ou de l’omission d’une modalité de réponse non répertoriée lors du codage initial.
- L’excès sommatoire (∑ fi > 1) : Ce phénomène signale une violation de l’hypothèse d’exclusion mutuelle des catégories d’observation. Cela survient couramment lorsque des items à choix multiples ou des manifestations cliniques comorbides sont codés de manière erronée sous la forme d’un vecteur univarié standard, entraînant un double comptage des unités d’observation.
Face à ces incohérences tabulaires, les protocoles de rectification mathématique imposent soit la réévaluation du dénominateur d’inclusion, soit la reformulation de la variable en composantes indicatrices booléennes séparées, de sorte que chaque modalité fasse l’objet de sa propre distribution binaire élémentaire conforme aux postulats de Kolmogorov.
3. Méthodologie formelle de calcul et formalisme algorithmique
La conversion systématique d’une masse brute d’observations cliniques ou psychométriques en une structure de distribution ordonnée répond à une méthodologie computationnelle précise. L’automatisation contemporaine offerte par les langages de programmation scientifique ne dispense nullement le chercheur d’une compréhension granulaire des opérations arithmétiques et des choix conventionnels présidant au traitement numérique.
3.1 Algorithme fondamental de conversion des données
Le protocole algorithmique régissant la génération d’une distribution de fréquences relatives se déploie selon une séquence invariante en quatre phases opérationnelles distinctes :
- Phase 1 : Définition et apurement de la matrice : Délimitation du cadre d’échantillonnage et isolation de la variable cible X. Les valeurs aberrantes générées par des erreurs matérielles de saisie doivent être éliminées pour fixer l’effectif valide final N.
- Phase 2 : Énumération par partitionnement catégoriel : Dénombrement systématique du nombre d’unités d’analyse associées à chaque état discret xk de la variable étudiée, produisant l’ensemble ordonné des fréquences absolues {n1, n2, …, nk}.
- Phase 3 : Division vectorielle : Application du terme normalisateur scalaire (1 / N) à chaque composante du vecteur des effectifs partiels, générant le vecteur des fréquences relatives {f1, f2, …, fk}.
- Phase 4 : Calibrage de la précision et vérification sommatoire : Application des conventions métrologiques de troncature ou d’arrondi à la décimale requise (généralement trois décimales pour les proportions, une à deux décimales pour les pourcentages), puis contrôle algorithmique de la condition de fermeture.
Ce formalisme assure que chaque palier d’abstraction statistique demeure parfaitement traçable, garantissant l’auditabilité et la reproductibilité des résultats conformément aux normes de la science ouverte.
3.2 Typologie des formats d’expression numérique
L’expression numérique des fréquences relatives peut adopter trois formalisations distinctes, chacune répondant à des exigences de communication et de rigueur analytique particulières :
| Format d’expression | Propriétés formelles | Contexte préférentiel d’utilisation | Perception psychologique |
|---|---|---|---|
| Fractions rationnelles (a / b) | Précision absolue, invariance face aux erreurs d’arrondi résiduelles. | Modélisation théorique, calculs de probabilités formels, petits échantillons. | Plus abstraite, calculatoire, moins intuitive pour les praticiens. |
| Valeurs décimales (0,000 à 1,000) | Continuité arithmétique directe, alignement avec l’opérateur probabiliste. | Calculs de modélisation intermédiaire, matrices de transition de Markov. | Perçue comme technique, neutre, privilégiée dans les rapports métrologiques. |
| Pourcentages (0,0 % à 100,0 %) | Amplification d’échelle par un facteur 100 facilitant la différentiation visuelle. | Restitution clinique, publications grand public, rapports épidémiologiques. | Clarté cognitive immédiate, saisie intuitive des ordres de grandeur. |
Le choix du format d’affichage ne relève pas d’une simple préférence esthétique. Les études en cognition numérique indiquent que les praticiens de santé mentale évaluent les risques diagnostiques et les probabilités de récidive comportementale de manière significativement plus précise lorsqu’ils sont formulés sous forme de pourcentages ou de ratios comparés directs, limitant les distorsions cognitives inhérentes au traitement des très petites décimales.
3.3 Exemple canonique appliqué : inventaire de traits anxieux
Afin d’illustrer la séquence de calcul, examinons un protocole psychométrique portant sur une cohorte clinique de référence composée de N = 400 adolescents soumis à l’évaluation d’un inventaire d’anxiété généralisée. L’échelle sépare l’intensité des manifestations somatiques et cognitives en quatre modalités ordonnées mutuellement exclusives : Minime, Léger, Modéré, et Sévère.
Le recueil empirique brut dénombre les effectifs absolus suivants : n1 (Minime) = 64 sujets ; n2 (Léger) = 148 sujets ; n3 (Modéré) = 124 sujets ; n4 (Sévère) = 64 sujets. La somme de contrôle vérifie que 64 + 148 + 124 + 64 = 400.
L’application de l’algorithme génère les fréquences relatives suivantes :
- f(Minime) = 64 / 400 = 0,160, soit 16,0 % de la cohorte ;
- f(Léger) = 148 / 400 = 0,370, soit 37,0 % de la cohorte ;
- f(Modéré) = 124 / 400 = 0,310, soit 31,0 % de la cohorte ;
- f(Sévère) = 64 / 400 = 0,160, soit 16,0 % de la cohorte.
La sommation des proportions unitaire confirme l’intégrité métrologique du calcul : 0,160 + 0,370 + 0,310 + 0,160 = 1,000 (rigoureusement 100,0 %). Sur le plan de l’interprétation diagnostique, cette distribution révèle que près des deux tiers de la population suivie (68,0 % si l’on cumule les strates modérée et légère) présentent un niveau d’endossement symptomatique intermédiaire, fournissant une cartographie indispensable pour orienter les protocoles de prise en charge psychothérapeutique prioritaire.
4. Applications pratiques en psychométrie et évaluation clinique
Loin de se cantonner à la simple synthèse descriptive, la distribution de fréquences relatives constitue la matrice opérationnelle sur laquelle reposent les décisions diagnostiques, l’optimisation des épreuves psychométriques et la modélisation des interactions au sein des groupes humains.
4.1 Analyse de la difficulté et de la discrimination des items
En psychométrie, le développement de batteries d’évaluation cognitive ou d’instruments de personnalité impose un calibrage strict de chaque item composant le test. L’indicateur classique d’intensité ou de difficulté d’un item dichotomique (noté traditionnellement p) n’est autre que la fréquence relative des sujets ayant validé ou résolu avec succès ledit item par rapport à l’échantillon d’étalonnage. Si un problème logico-mathématique est soumis à 1 000 participants et que 850 le réussissent, la fréquence relative de succès est de p = 0,85.
L’analyse de la distribution des fréquences de réponses permet de diagnostiquer deux écueils métrologiques majeurs :
- L’effet de plafond (ceiling effect) : Caractérisé par une fréquence relative d’endossement approchant 1,00 (par exemple, p > 0,95). L’item s’avère incapable de différencier les sujets situés dans les tranches supérieures de la compétence mesurée.
- L’effet de plancher (floor effect) : Caractérisé par une fréquence relative oscillant près de zéro (p < 0,05). L’item est excessivement discriminant vers le haut ou indéchiffrable, générant une variance nulle inexploitable pour l’évaluation standard.
Dans l’évaluation de la symptomatologie dépressive à travers des questionnaires auto-rapportés comme l’inventaire de dépression de Beck, la distribution des fréquences relatives sur chaque modalité d’un item fournit une cartographie précieuse de la sévérité du signe clinique, indiquant à partir de quel seuil proportionnel un comportement bascule de la variation normale vers l’indice psychopathologique.
4.2 Épidémiologie des troubles mentaux et critères diagnostiques
L’épidémiologie psychiatrique s’appuie massivement sur les distributions de fréquences relatives pour objectiver la prévalence des troubles psychiques et guider les politiques de santé publique. Les manuels nosographiques internationaux, tels que le Manuel diagnostique et statistique des troubles mentaux (DSM-5-TR) ou la Classification internationale des maladies (CIM-11), structurent leurs critères en s’adossant aux taux d’occurrence relative observés au sein d’études épidémiologiques de grande envergure.
L’utilité clinique des distributions relatives s’illustre particulièrement dans l’analyse de la comorbidité. En mesurant la fréquence relative avec laquelle un trouble de l’usage de substances survient conjointement à un trouble de l’humeur au sein d’une cohorte psychopathologique, les chercheurs peuvent distinguer les associations purement fortuites des véritables syndromes duaux interconnectés par des facteurs de vulnérabilité étiologique communs. Cette approche statistique évite de surcharger inutilement les nomenclatures diagnostiques de catégories redondantes qui ne correspondraient à aucune entité sémiologique autonome.
4.3 Étude des comportements observés en psychologie sociale
Dans le périmètre de la psychologie sociale expérimentale, l’analyse porte fréquemment sur des comportements discrétisés enregistrés lors de situations contrôlées, comme des jeux de biens publics, des dilemmes sociaux ou des scénarios d’obéissance et de conformité inspirés des travaux de Milgram et d’Asch. Les variables dépendantes se déclinent en choix binaires (coopération versus défection) ou ordonnés (niveaux d’aide apportée à un tiers en détresse).
La compilation des fréquences relatives de comportements prosociaux permet d’évaluer avec une grande finesse l’adhésion aux normes contextuelles du groupe. En comparant les distributions de fréquences de conformisme obtenues sous différentes conditions d’amorçage cognitif (par exemple, avec ou sans regard évaluatif d’autrui), les psychologues sociaux démontrent comment des variations minimes de l’environnement physique ou symbolique modifient substantiellement la distribution des réponses individuelles, sans pour autant exiger la modification de la personnalité profonde des sujets engagés.
5. Distributions de fréquences relatives cumulées et percentiles
Lorsque la variable mesurée possède des propriétés d’ordre intrinsèques (variables ordinales ou variables d’intervalle et de rapport discrétisées), l’analyse statistique s’enrichit considérablement par l’adjonction d’une dimension séquentielle : la distribution cumulative. Cette dernière permet de déterminer la part relative des observations se situant en deçà ou au-delà d’un niveau critique prédéfini.
5.1 Construction de la fréquence relative cumulée
La fréquence relative cumulée (notée conventionnellement Fi ou CRF) résulte de la sommation itérative et monotone croissante des fréquences relatives simples calculées depuis la catégorie la plus basse jusqu’à la catégorie d’intérêt k :
Fk = ∑(j=1 à k) fj
Cette sommation séquentielle confère à la métrique cumulée plusieurs propriétés théoriques invariables :
- Monotonie non décroissante : Pour tout indice j > i, la relation Fj ≥ Fi est strictement vérifiée, car chaque fréquence relative élémentaire est obligatoirement non négative (fj ≥ 0).
- Convergence unitaire asymptotique : Lorsque le calcul atteint la modalité finale de l’échelle ordonnée (K), la valeur cumulée atteint invariablement FK = 1,00 (soit 100,0 % de la distribution).
L’intérêt de la distribution cumulative réside dans sa faculté à caractériser le positionnement contextuel d’un individu. Un score psychologique brut n’a aucune signification isolée ; en revanche, affirmer qu’un participant présente un score d’impulsivité associé à une fréquence relative cumulée de 0,92 indique formellement que 92 % de la cohorte d’étalonnage exhibe des scores équivalents ou inférieurs aux siens, traduisant un profil d’hypersensibilité comportementale particulièrement atypique.
5.2 Dérivation des rangs percentiles en évaluation cognitive
Le rang percentile constitue sans doute l’une des applications directes les plus célèbres de la fréquence relative cumulée au sein des tests cognitifs standardisés, à l’image des épreuves d’intelligence comme le WISC (Wechsler Intelligence Scale for Children) ou les matrices progressives de Raven. Le rang percentile transforme la fréquence relative cumulée en un nombre entier compris entre 1 et 99, localisant le sujet au sein de centiles théoriques réguliers.
Une distinction métrologique critique doit impérativement être maintenue entre le pourcentage brut d’items réussis et le rang percentile. Si un candidat résout 70 % des énigmes d’un test psychométrique complexe, cette valeur décrit une performance absolue interne à l’épreuve. Si, sur le plan normatif, cette réussite brute de 70 % le positionne au-dessus de 94 % des individus de son groupe d’âge, son rang percentile s’établit à 94 (ce qui correspond, sur une distribution gaussienne de quotient intellectuel de moyenne 100 et d’écart-type 15, à un QI approximatif de 123). La fréquence relative cumulée réalise précisément cette opération de conversion entre la métrique empirique de l’instrument et la métrique normative de la population de standardisation.
5.3 L’ogive de Galton et sa lecture clinique
Sur le plan de la géométrie analytique, la représentation graphique d’une distribution de fréquences relatives cumulées prend le nom d’ogive de Galton (ou courbe sigmoïde des pourcentages cumulés). Tracée dans un plan cartésien où l’axe des abscisses porte les limites supérieures des classes de scores et l’axe des ordonnées affiche la fréquence cumulée (variant de 0 à 1 ou de 0 % à 100 %), l’ogive présente une morphologie en « S » hautement informative.
La lecture clinique de l’ogive offre des repères visuels immédiats :
- Identification des mesures de position centrale : La projection orthogonale de la valeur ordonnée 0,50 (50 %) sur la courbe permet de déterminer visuellement la médiane empirique de l’échantillon. De même, les projections à 0,25 et 0,75 isolent instantanément le premier et le troisième quartile, délimitant ainsi l’écart interquartile représentatif du cœur de la distribution.
- Repérage des zones de forte densité : La pente de l’ogive traduit fidèlement la concentration des observations. Une ascension verticale très raide indique une région où un faible accroissement du score concentre une proportion majeure de participants (zone de forte densité de variance). Inversement, un plateau horizontal signale une raréfaction des observations au sein des scores considérés.
L’ogive constitue ainsi un instrument d’analyse séquentielle indispensable lors des phases pilotes d’étalonnage psychométrique, permettant de vérifier d’un coup d’œil si l’épreuve discrimine équitablement les individus sur l’ensemble du continuum d’aptitude.
6. Modes de représentation visuelle des fréquences relatives
La communication scientifique et la sémiologie clinique exigent une sélectivité rigoureuse dans les modalités de visualisation des distributions de fréquences relatives. Les choix graphiques ne sont pas neutres ; ils structurent la perception visuelle des données et peuvent, s’ils sont mal exécutés, induire des interprétations fallacieuses quant à la morphologie réelle des phénomènes comportementaux observés.
6.1 Histogrammes de fréquences relatives
L’histogramme de fréquences relatives constitue le format standard par excellence pour représenter les variables quantitatives continues préalablement discrétisées en classes d’amplitudes contrôlées. Contrairement à l’histogramme des comptages bruts dont l’axe vertical affiche l’effectif ni, l’histogramme de fréquences relatives calibre son ordonnée sur les proportions décimales ou les pourcentages.
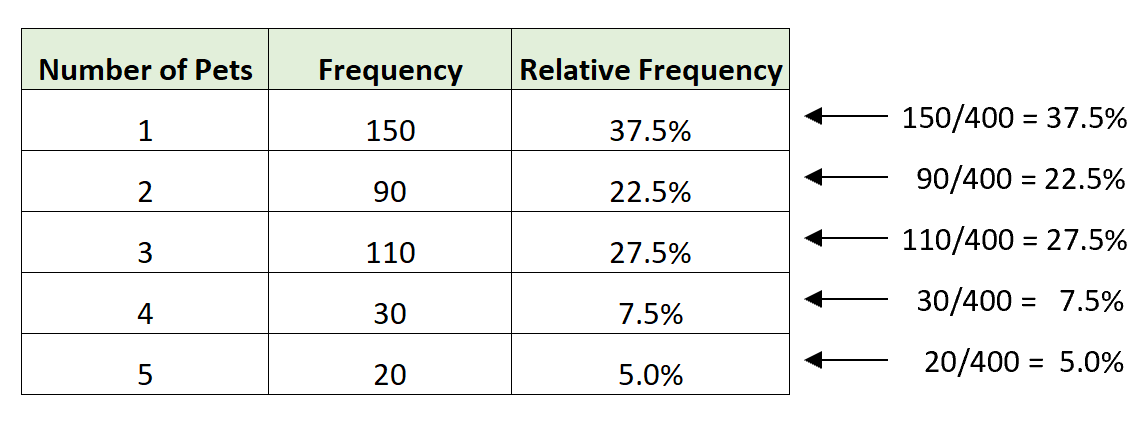
Dans ce cadre géométrique rigoureux, la surface de chaque rectangle dressé au-dessus d’un intervalle est proportionnelle à la fréquence relative associée à cet intervalle. Lorsque la largeur des classes est constante (ce qui représente la norme méthodologique recommandée), la hauteur du rectangle est strictement égale à la fréquence relative de la classe. Cette configuration offre un accès immédiat à la morphologie globale de la série statistique, permettant d’identifier sans ambiguïté :
- L’asymétrie de la distribution (skewness) : Une longue traîne s’étirant vers la droite révèle une asymétrie positive (comme c’est systématiquement le cas pour les temps de réaction ou les comportements d’agression en population non clinique), tandis qu’une queue de distribution étirée vers la gauche indique une asymétrie négative.
- L’aplatissement (kurtosis) : Le caractère leptocurtique (pic central extrêmement accusé et queues épaisses) ou platycurtique (distribution aplatie à faible densité centrale) apparaît instantanément, renseignant sur la dispersion structurelle des traits psychologiques investigués.
6.2 Polygones de fréquences et courbes de densité lissées
Le polygone de fréquences relatives est une figure géométrique fermée construite en reliant par des segments linéaires successifs les points dont l’abscisse correspond au centre géométrique (milieu) de chaque classe et l’ordonnée à la fréquence relative correspondante. La courbe s’ancre sur l’axe horizontal en reliant artificiellement deux classes adjacentes imaginaires de fréquence nulle situées aux extrémités extrêmes de la distribution.
Le polygone présente un avantage analytique majeur par rapport à l’histogramme : il autorise la superposition graphique directe de plusieurs distributions de fréquences relatives sur le même repère cartésien, sans qu’aucun masquage visuel n’altère la lecture. Il est ainsi aisé de comparer le profil d’attention soutenue d’une cohorte diagnostiquée avec un TDAH à celui d’un groupe contrôle apparié.
Sur le plan conceptuel, lorsque la taille de l’échantillon N croît indéfiniment vers l’infini et que l’amplitude des intervalles de classes tend vers zéro, le polygone de fréquences relatives converge asymptotiquement vers une courbe de densité continue. Cette passerelle graphique anticipe l’ajustement du modèle empirique aux distributions théoriques formelles, au premier rang desquelles trône la courbe normale de Gauss-Laplace, modèle de référence des scores psychométriques standardisés.
6.3 Diagrammes en secteurs et barres comparatives
Pour le traitement des variables nominales qualitatives pures (dépourvues de tout ordre sous-jacent, comme l’appartenance socioculturelle, l’orientation diagnostique catégorielle ou les typologies d’attachement), le recours aux histogrammes constitue une erreur métrologique grave, ces derniers postulant une continuité de l’axe des abscisses qui n’existe pas. Deux formats s’imposent alors :
- Le diagramme à barres disjointes (bar chart) : Les modalités y sont figurées par des rectangles séparés par des espaces réguliers (pour signifier la discontinuité ontologique des catégories). L’ordonnée indique la fréquence relative. Ce format est universellement recommandé par la communauté scientifique en raison de la remarquable acuité du système visuel humain à comparer des longueurs linéaires alignées sur un même axe de référence.
- Le diagramme en secteurs circulaires (pie chart) : Chaque part angulaire est rigoureusement proportionnelle à la fréquence relative de la catégorie, l’angle au centre θ valant θ = fi × 360°. Malgré sa popularité dans les médias non spécialisés, la psychologie cognitive et la visualisation de données déconseillent formellement son usage scientifique en présence de plus de trois catégories : l’œil humain évalue très imparfaitement les aires circulaires et les variations d’angles obliques, ce qui biaise l’estimation relative des proportions.
De surcroît, les représentations tridimensionnelles (fausses barres en 3D ou camemberts inclinés) doivent être rigoureusement bannies de l’écriture scientifique : les effets d’optique introduits par la perspective distordent drastiquement les proportions visibles, violant les règles déontologiques élémentaires de fidélité métrologique.
7. Comparabilité inter-groupes et standardisation d’échantillons
L’un des apports méthodologiques les plus décisifs de la distribution de fréquences relatives réside dans sa capacité à opérer des comparaisons rigoureuses et non biaisées entre des ensembles empiriques dont les volumétries de départ diffèrent de manière substantielle.
7.1 Résolution de l’asymétrie des tailles d’échantillon
Dans la conduite de la recherche clinique ou quasi-expérimentale, l’équilibrage parfait des effectifs au sein des différents bras d’une étude constitue une situation idéale rarement observée. Considérons un protocole évaluant l’efficacité d’une nouvelle approche psychothérapeutique : pour des contraintes d’inclusion et de consentement éclairé, le groupe clinique expérimental ne réunit que N1 = 45 patients hospitalisés, tandis que la cohorte témoin extraite d’une base de données épidémiologique intègre N2 = 1 350 individus tout-venant.
Tenter d’analyser la répartition des manifestations anxieuses sévères à l’aide des effectifs absolus rendrait toute juxtaposition visuelle ou analytique totalement stérile : la masse numérique du groupe témoin écraserait celle du groupe expérimental. La conversion immédiate des dénombrements en fréquences relatives normalise le dénominateur de référence, effaçant mécaniquement l’effet d’effectif brut. Il devient alors instantanément manifeste si la proportion d’anxiété sévère dans le groupe clinique (par exemple, 27 / 45 = 0,600 soit 60 %) surpasse celle mesurée dans la population de contrôle (par exemple, 162 / 1350 = 0,120 soit 12 %), permettant d’engager les calculs ultérieurs de risque relatif ou d’odds ratio sans artefact d’échelle.
7.2 Contrôle des déséquilibres démographiques
Lorsqu’un échantillon psychologique n’est pas issu d’un tirage aléatoire pur au sein de la population générale, sa composition sociodémographique (répartition des sexes, tranches d’âge, niveaux d’instruction) reflète souvent des biais de recrutement significatifs. La distribution des fréquences relatives observées sur la variable dépendante doit alors être pondérée ou post-stratifiée pour neutraliser ces facteurs de confusion.
La standardisation directe consiste à recalculer une distribution de fréquences relatives composite en appliquant aux fréquences relatives conditionnelles mesurées dans chaque sous-strate empirique (par exemple, les femmes âgées de 18 à 25 ans) les poids relatifs réels observés dans la population parente de recensement. Cette méthodologie de standardisation garantit que le profil de réponse restitué dans le rapport de recherche reflète fidèlement la dynamique comportementale de la population cible, plutôt que les distorsions contingentes de l’échantillonnage de convenance.
7.3 Études longitudinales et suivi temporel des tendances
Dans les devis de recherche longitudinaux — qu’il s’agisse de suivre des cohortes d’enfants sur plusieurs décennies pour observer l’émergence des compétences socio-émotionnelles ou de mesurer l’évolution d’une pathologie neurodégénérative chez les personnes âgées —, les investigateurs font face au fléau inévitable de l’attrition des participants (déménagements, désistements, décès).
Si une cohorte initiale compte 800 participants au temps T0 et ne comprend plus que 520 individus au temps T3 cinq ans plus tard, le dénombrement absolu des conduites à risque (usage de toxiques, absentéisme) donnerait l’illusion fallacieuse d’une diminution des problèmes de comportement simplement causée par le rétrécissement numérique de l’échantillon. L’analyse rigoureuse de la dynamique temporelle repose exclusivement sur le suivi longitudinal des distributions de fréquences relatives. C’est l’évolution de la proportion relative des sujets manifestant le comportement à chaque vague de test qui fournit le véritable indicateur de trajectoire développementale, permettant de statuer avec certitude sur la stabilité ou l’aggravation des profils psychologiques investigués.
8. Passerelle fondamentale vers la théorie des probabilités
L’importance de la distribution de fréquences relatives dépasse largement le champ de la description descriptive élémentaire. Elle constitue l’infrastructure conceptuelle sur laquelle s’échafaude l’édifice de la statistique inférentielle et du calcul des probabilités, opérant la synthèse entre l’observation du monde réel et la formalisation mathématique de l’incertitude.
8.1 Approche fréquentiste et loi empirique des grands nombres
L’articulation théorique unissant la fréquence relative observée et la probabilité intrinsèque d’un événement psychologique s’enracine dans la définition fréquentiste formalisée notamment par Richard von Mises et consolidée par les théorèmes fondamentaux de Jacques Bernoulli et Émile Borel. Selon cette perspective, la probabilité théorique P(A) d’un événement A est formellement définie comme la limite asymptotique vers laquelle converge sa fréquence relative lorsque le nombre d’épreuves indépendantes et identiquement distribuées tend vers l’infini :
P(A) = lim(N → ∞) (nA / N)
La loi empirique des grands nombres postule que pour un échantillon de taille N suffisamment vaste, la distribution empirique des fréquences relatives constitue une approximation consistante et non biaisée de la loi de probabilité sous-jacente régissant la génération des comportements observés. Cette propriété fournit le fondement légitime autorisant les psychologues à inférer des mécanismes cognitifs universels à partir de l’observation d’un collectif fini d’individus représentatifs.
8.2 Distributions discrètes versus distributions continues
Dans la formalisation statistique des phénomènes mentaux, la nature de la distribution de fréquences relatives dépend intimement de l’espace d’état de la variable dépendante :
- Variables discrètes : La distribution de fréquences relatives correspond directement à une fonction de masse empirique. Chaque valeur isolée possède une masse de fréquence relative assignable, dont la somme est égale à 1. C’est le modèle régissant le nombre de rechutes dépressives, le nombre de fratries ou les scores sur des échelles de Likert fermées.
- Variables continues : Pour des métriques continues non dénombrables (comme les latences chronométriques des temps de réaction mesurées à la milliseconde près, ou l’activité électrodermale), la probabilité ou la fréquence relative associée à une valeur mathématique ponctuelle exacte est théoriquement nulle. La distribution s’exprime alors à travers des tranches d’intervalles infinitésimaux via la fonction de densité empirique. La fréquence relative devient l’intégrale de la fonction sur un intervalle délimité par les bornes [a, b], représentant la surface sous la courbe sur cette plage spécifique.
La maîtrise de cette dichotomie conceptuelle évite les confusions heuristiques courantes lors de la transition entre la statistique descriptive d’échantillon et la modélisation paramétrique sur population.
8.3 Inférence statistique et erreur d’échantillonnage
Puisqu’un échantillon n’est qu’une fraction finie de la population cible, la distribution de fréquences relatives mesurée sur une cohorte (souvent désignée par la notation d’échantillon p̂) est inéluctablement sujette à des fluctuations d’échantillonnage aléatoires autour de la proportion paramétrique véritable de la population (désignée par p).
La théorie de l’échantillonnage permet de quantifier précisément l’incertitude entourant toute fréquence relative observée. En vertu du théorème central limite, pour une taille d’échantillon N adéquate (usuellement N ≥ 30, avec les conditions N × p ≥ 5 et N × (1 – p) ≥ 5), la distribution d’échantillonnage de la fréquence relative converge vers une distribution normale de moyenne p et d’écart-type représenté par l’erreur type de la proportion (SE) :
SE = √[ p̂(1 – p̂) / N ]
Cette formulation analytique conduit directement à la construction des intervalles de confiance (généralement fixés à 95 % sous le multiplicateur critique z = 1,96). Présenter une distribution de fréquences relatives sans rappeler, au moins implicitement, l’amplitude de l’erreur type associée reviendrait à attribuer aux proportions mesurées une certitude absolue démentie par les lois universelles de l’inférence probabiliste.
9. Discrétisation des variables continues et gestion des intervalles
L’élaboration d’une distribution de fréquences relatives à partir d’une variable quantitative continue exige une opération méthodologique délicate : la discrétisation, ou partitionnement en classes d’intervalles. Si cette phase de regroupement des données est menée de manière arbitraire, elle risque de dénaturer profondément la structure de l’information comportementale et d’induire des conclusions cliniques biaisées.
9.1 Règles empiriques de partitionnement en classes
Pour déterminer le nombre optimal de classes (noté k) nécessaires pour résumer adéquatement une série continue de N observations sans perdre les détails morphologiques critiques de la distribution, le statisticien s’appuie sur plusieurs algorithmes normatifs :
- La règle de Sturges : Formule classique historiquement très répandue, définie par :
k = 1 + log2(N) ≈ 1 + 3,322 × log10(N)
Cette heuristique repose sur l’hypothèse sous-jacente d’une distribution normale parente. Elle donne d’excellents résultats pour des échantillons modérés (N compris entre 30 et 200), mais tend à sous-estimer drastiquement le nombre de classes (provoquant un sur-lissage excessif) lorsque les effectifs deviennent volumineux. - La règle de Scott : Elle privilégie la recherche de la largeur optimale de bande passante h en minimisant l’erreur quadratique moyenne intégrée, formulée par :
h = 3,49 × s / N1/3 (où s représente l’écart-type de l’échantillon).
Cette approche s’adapte remarquablement bien aux variables psychométriques présentant une cloche symétrique fluide. - L’approche de Freedman-Diaconis : Particulièrement robuste face aux distributions asymétriques ou polluées par des valeurs aberrantes cliniques fréquentes en psychiatrie, cette formule fonde la largeur d’intervalle sur l’écart interquartile (IQR) :
h = 2 × IQR / N1/3
Le sous-découpage (choisir un nombre de classes trop restreint) efface la variance comportementale et masque la présence éventuelle de sous-populations bimodales. Inversement, le sur-découpage (multiplier excessivement les intervalles étroits) pulvérise l’échantillon en micro-effectifs aléatoires, ruinant la lisibilité de la distribution.
9.2 Délimitation rigoureuse des bornes de classes
Une fois la largeur de classe fixée, l’établissement des frontières d’intervalles doit obéir à des conventions topologiques strictes pour garantir que chaque donnée continue soit orientée vers une boîte unique, conformément aux principes d’exclusion mutuelle et d’exhaustivité.
Les intervalles sont formellement notés sous forme d’intervalles semi-ouverts, le standard préférentiel en sciences humaines étant la convention ouverte à gauche et fermée à droite : ]a, b], signifiant que la borne inférieure a est exclue de la classe tandis que la borne supérieure b y est rigoureusement incluse (ou alternativement le format fermé à gauche et ouvert à droite, [a, b[). L’absence de rigueur dans l’affichage de ces bornes sur les formulaires de codage entraîne systématiquement des ambiguïtés insolubles lors du classement des scores tombant pile sur la frontière géométrique.
Dans les configurations spécifiques où les impératifs cliniques imposent l’usage de classes d’amplitudes inégales (par exemple, pour regrouper les âges en phases de développement psychomoteur : petite enfance, adolescence, âge adulte), la fréquence relative simple ne peut plus être directement cartographiée sur la hauteur de l’histogramme. Il devient impératif d’introduire la notion de densité de fréquence relative, en divisant la fréquence relative de chaque classe par son amplitude correspondante (di = fi / hi), afin que la surface du graphique demeure la seule garante fidèle de la proportionnalité des observations.
9.3 Impact du partitionnement sur les conclusions cliniques
Les décisions arbitraires prises lors du partitionnement en classes peuvent avoir des répercussions directes sur le diagnostic clinique et l’orientation thérapeutique des patients. Ce phénomène est illustré par les artéfacts statistiques créés par les seuils de sévérité des tests psychopathologiques.
Considérons une échelle clinique évaluant l’idéation suicidaire sur un continuum de scores allant de 0 à 60. Si l’investigateur regroupe de manière large les intervalles en définissant la classe de « crise imminente » à partir d’un score supérieur à 45, il peut amalgamer des sujets présentant des tableaux cliniques profondément hétérogènes. Une telle agrégation statistique excessive opacifie la présence de grappes de sujets présentant une vulnérabilité accrue à 50 ou 55 points. Préserver fidèlement la variance comportementale exige d’ajuster les intervalles en respectant les articulations cliniquement signifiantes identifiées par la littérature psychiatrique empirique, plutôt que d’imposer un découpage mécanique purement géométrique.
10. Biais d’interprétation, écueils métrologiques et limites
En dépit de son élégance mathématique et de son apparente simplicité opératoire, la distribution de fréquences relatives est exposée à de multiples dérives d’interprétation. Les erreurs métrologiques commises lors de la lecture des proportions peuvent altérer gravement la portée des conclusions scientifiques et conduire à des décisions erronées dans la pratique appliquée.
10.1 L’illusion de représentativité sur micro-échantillons
L’un des biais cognitifs et statistiques les plus dévastateurs en recherche clinique est l’expression de pourcentages calculés sur des micro-échantillons (typiquement des cohortes de taille N < 30, voire N < 10 dans le cadre d’études de cas ou de protocoles exploratoires). L’esprit humain possède une fâcheuse tendance à attribuer aux pourcentages une valeur d’universalité indépendante de la masse sous-jacente.
Affirmer solennellement dans un rapport que « 66,7 % des patients ont répondu favorablement au protocole de remédiation cognitive » lorsque le protocole n’a été administré qu’à 3 participants (dont 2 ont présenté une amélioration) relève d’une illusion rhétorique majeure. Sur un effectif aussi restreint, le changement de statut d’un unique participant déplace artificiellement la distribution de fréquences relatives de 33,3 points de pourcentage. Pour prévenir cette distorsion interprétative, les règles internationales de déontologie méthodologique imposent une contrainte intangible : aucune fréquence relative ou pourcentage ne doit être mentionné sans être explicitement accompagné de la citation de l’effectif brut réel d’inclusion, sous la forme canonique « 66,7 % (n = 2/3) ».
10.2 Confusion entre fréquence relative et significativité clinique
Une fréquence relative quantifie l’abondance d’un événement au sein d’un groupe ; elle ne dit absolument rien, en soi, de sa gravité, de son impact adaptatif ou de sa pathogénicité clinique. Confondre rareté statistique et pathologie relève d’une erreur d’attribution séculaire dans l’histoire de la psychologie différentielle.
D’une part, des manifestations comportementales présentant une fréquence relative infinitésimale au sein de la population générale (comme un score de créativité verbale situé à f < 0,01) n’ont aucune connotation morbide et peuvent témoigner d’un fonctionnement hautement adaptatif. D’autre part, des conduites associées à une fréquence relative particulièrement élevée (par exemple, la prévalence relative des symptômes d’épuisement professionnel ou de détresse psychologique chez les étudiants en période d’examens, pouvant dépasser 50 %) ne cessent pas pour autant de constituer des états pathologiques requérant une intervention clinique prioritaire.
La métrique des fréquences relatives doit donc obligatoirement être articulée avec des mesures d’intensité symptomatique, des évaluations de l’altération fonctionnelle de la qualité de vie et des estimations standardisées de la taille d’effet (d de Cohen, η²), seules capables de fonder la significativité clinique au-delà du simple comptage proportionnel.
10.3 Distorsions graphiques et manipulations rhétoriques
La communication visuelle des fréquences relatives constitue un terrain fertile pour la manipulation involontaire ou délibérée des données. La stratégie de distorsion la plus répandue consiste en la troncature artificielle de l’axe des ordonnées.
Sur un diagramme à barres affichant les taux de réponse relative à deux thérapies (par exemple 52 % contre 48 %), faire débuter l’axe vertical à 45 % au lieu de zéro engendre une fausse rupture visuelle qui magnifie disproportionnellement l’écart observable : la barre de 52 % apparaît visuellement quatre fois plus haute que celle de 48 %, induisant chez le lecteur une perception totalement erronée de supériorité thérapeutique écrasante. De même, la fusion arbitraire ou le réordonnancement a posteriori de catégories au sein d’une échelle ordonnée pour fabriquer artificiellement une majorité relative conforme aux hypothèses initiales de l’expérimentateur viole les normes éthiques de transparence guidant la recherche scientifique contemporaine.
11. Traitement computationnel et implémentation sous logiciels statistiques
Dans la pratique contemporaine des laboratoires et des institutions de soins, la génération des distributions de fréquences relatives ne s’effectue plus manuellement mais s’intègre au sein de pipelines logiciels avancés. La maîtrise opérationnelle des langages de programmation et des progiciels d’analyse est devenue indispensable pour assurer un traitement sans faille des grands jeux de données.
11.1 Génération et manipulation automatisée sous environnement R
Le langage open-source R représente le standard international pour l’analyse computationnelle des données psychométriques. La production d’une table élémentaire de fréquences relatives s’articule canoniquement autour de la combinaison des fonctions primitives table() et prop.table() :
Dans ce cadre, la fonction table() dénombre les occurrences discrètes d’un vecteur de données comportementales, après quoi prop.table() divise vectoriellement chaque cellule par la somme totale unitaire. Les psychologues s’appuient fréquemment sur l’écosystème enrichi tidyverse, et plus particulièrement sur la bibliothèque dplyr, pour opérer des agrégations coordonnées et fluides sur des structures complexes de données expérimentales :
En employant la séquence associant l’instruction de partitionnement group_by() et le calcul de synthèse summarise(), l’analyste isole les fréquences absolues par catégorie avant d’en dériver la colonne proportionnelle en rapportant la sous-somme au nombre total d’enregistrements validés via l’opérateur n() / sum(n()).
Pour la restitution graphique de haute précision, le paquet ggplot2 offre une flexibilité incomparable. La construction d’un histogramme de fréquences relatives s’exécute en paramétrant l’esthétique de l’ordonnée pour court-circuiter le décompte brut automatique au moyen de la syntaxe interne aes(y = after_stat(prop)) au sein de la couche géométrique geom_bar(), garantissant une normalisation visuelle instantanée des profils tracés.
11.2 Procédures standards sous IBM SPSS Statistics
Le logiciel commercial IBM SPSS Statistics demeure extrêmement implanté dans les structures hospitalières et universitaires pour l’analyse des données d’évaluation clinique standardisées. La production des distributions relatives y relève d’une routine intégrée accessible par l’arborescence des menus ou par l’interpréteur de syntaxe dédié.
L’exécution de la commande de base FREQUENCIES VARIABLES = NomDeLaVariable génère de manière automatique un tableau de contingence complet comportant quatre colonnes normalisées :
- Frequency : La fréquence absolue brute (ni).
- Percent : Le pourcentage brut calculé sur l’intégralité du fichier, incluant sans distinction les données manquantes (missing values).
- Valid Percent : La véritable fréquence relative clinique d’intérêt, calculée en retranchant systématiquement du dénominateur les données manquantes dues aux refus de réponse ou aux items ignorés par les patients. C’est cette métrique spécifique qui respecte rigoureusement l’axiome de sommation unitaire sur le sous-ensemble investigué.
- Cumulative Percent : La sommation séquentielle des pourcentages valides, fournissant l’équivalent direct de la distribution des percentiles empiriques du groupe testé.
SPSS autorise également l’application de filtres booléens temporaires (via la directive TEMPORARY / SELECT IF) permettant de ventiler instantanément ces distributions de fréquences relatives par strates diagnostiques ou démographiques distinctes.
11.3 Modélisation matricielle en Python avec Pandas et Seaborn
Dans le domaine émergent des technologies de la santé comportementale et de la modélisation neuropsychologique par apprentissage automatique, le langage Python s’impose comme une référence majeure, grâce à son architecture de bibliothèques scientifiques hautement optimisées.
La manipulation de données univariées et tabulaires repose sur la structure de données DataFrame de la bibliothèque Pandas. Pour générer instantanément une série ordonnée de fréquences relatives à partir d’un ensemble de réponses cliniques, l’analyste invoque directement la méthode value_counts() enrichie de son paramètre de normalisation booléen :
L’instruction vectorielle s’écrit de manière concise sous la forme serie_scores.value_counts(normalize=True), générant en sortie les fractions relatives associées à chaque modalité ordonnée de la variable cible. Si des valeurs manquantes doivent être neutralisées, le paramètre dropna=True garantit l’alignement immédiat sur le formalisme unitaire.
Pour la restitution graphique intégrée au flux d’exploration statistique, la bibliothèque Seaborn permet un interfaçage direct avec les fonctions de distribution probabilistes. L’appel de la fonction histplot() avec le paramètre dédié stat="proportion" ou stat="percent" transforme le tracé en un histogramme de fréquences relatives sans exiger de recalculs matriciels préalables par l’utilisateur, optimisant ainsi le développement de pipelines de prétraitement automatisés.
12. Synthèse théorique et normes de restitution selon l’APA 7
L’aboutissement du travail de quantification psychométrique réside dans la communication rigoureuse et standardisée des résultats au sein des cercles académiques, des dossiers médicaux ou auprès du grand public. Cette ultime étape impose une conformité sans compromis avec les normes éditoriales de la psychologie scientifique.
12.1 Exigences formelles des publications scientifiques contemporaines
La 7e édition du manuel de publication de l’American Psychological Association (APA) définit avec une extrême minutie les standards typographiques et méthodologiques encadrant la restitution des fréquences relatives et des pourcentages dans les articles soumis aux revues à comité de lecture.
Les prescriptions directrices imposent notamment les règles formelles suivantes :
- La double citation systématique : Tout pourcentage ou toute fréquence relative rapportée dans le corps du texte ou dans les tableaux récapitulatifs doit être indissociable de la mention de l’effectif absolu correspondant. Le formatage standard adopte la formulation : n = 45 (22,5 %) ou alternativement « 22,5 % des sujets (n = 45) ». Cette directive garantit que le lecteur puisse toujours évaluer la robustesse de l’échantillon source.
- La standardisation de la précision décimale : Sauf impératif métrologique exceptionnel lié à l’analyse de mégadonnées épidémiologiques massives, l’APA préconise d’arrondir les pourcentages à une seule décimale (par exemple, 42,7 % et non 42,738 %). De même, les fractions décimales de fréquences relatives simples (inférieures à 1) s’affichent avec deux ou trois décimales précédées d’un zéro à gauche de la virgule (ex. f = 0,34), car le paramètre métrologique théorique de proportion peut excéder formellement l’unité dans d’autres contextes scalaires.
- La typographie des symboles : Les lettres symbolisant les statistiques calculées sur un échantillon sont composées en italique sans empattement dans le flux de texte standard (par exemple, N pour la taille globale du groupe, n pour le sous-effectif, et p pour la proportion).
Le respect scrupuleux de cette grammaire éditoriale évite l’ambiguïté sémiotique et favorise l’intégration transparente des résultats dans les futures méta-analyses quantitatives.
12.2 Intégration didactique dans la restitution au patient ou grand public
L’un des défis majeurs du psychologue clinicien ou du neuropsychologue réside dans l’étape de restitution du bilan d’évaluation au patient et à sa famille. Confrontés à des concepts abstraits d’écarts-types ou de scores standardisés en échelle de notes T ou Z, les individus profanes sont enclins à développer des représentations distordues, génératrices d’une anxiété iatrogène marquée.
La fréquence relative — particulièrement sous son avatar de fréquence relative cumulée ou de rang percentile — constitue le vecteur de communication pédagogique par excellence. Expliquer posément à un parent qu’un score de raisonnement perceptif situé au 15e percentile « signifie que si l’on réunissait 100 enfants du même âge dans une pièce, environ 85 réussiraient plus brillamment cette tâche et 15 obtiendraient un résultat similaire ou plus fragile » permet d’ancrer le diagnostic dans une réalité concrète et immédiatement appréhensible.
Néanmoins, le professionnel doit veiller à prévenir le contresens fréquent consistant pour le patient à assimiler le percentile à une note scolaire sur cent (en pensant à tort qu’un 15e percentile équivaut à un 15/20). La clarté de l’explication probabiliste relative protège l’alliance thérapeutique et favorise une acceptation éclairée des préconisations de remédiation neuropsychologique proposées.
12.3 Perspectives futures dans l’analyse distributionnelle comportementale
À l’ère de la psychiatrie computationnelle, du profilage numérique et des mégadonnées (Big Data), l’exploitation des distributions de fréquences relatives franchit un saut qualitatif sans précédent. L’intégration de capteurs biométriques passifs, de l’évaluation écologique instantanée (Ecological Momentary Assessment, EMA) via les ordiphones et des traces comportementales issues des interactions en ligne alimente en flux continu des bases d’observation gigantesques.
Dans ce contexte hautement dynamique, la fréquence relative ne s’appréhende plus comme un cliché statique et figé obtenu à un instant T lors d’une passation de test en cabinet. Elle devient une fonction continue du temps, modélisée en temps réel pour traquer les micro-fluctuations d’endossement de symptômes dépressifs ou les cycles d’instabilité émotionnelle au cours de la journée d’un individu. De surcroît, ces distributions empiriques massives servent de substrat direct pour l’entraînement algorithmique des réseaux neuronaux profonds appliqués au dépistage psychopathologique précoce. Les distributions de fréquences relatives confirment ainsi leur statut d’invariant scientifique : un outil mathématique forgé aux débuts de la psychométrie moderne, mais dont la puissance explicative et adaptative continue de structurer les frontières les plus avancées des sciences comportementales contemporaines.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Boring, E. G. (1950). A history of experimental psychology (2nd ed.). Appleton-Century-Crofts.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Galton, F. (1889). Natural inheritance. Macmillan.
- Hacking, I. (2006). The emergence of probability: A philosophical study of early ideas about probability, induction and statistical inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511817557
- Howell, D. C. (2016). Statistical methods for psychology (9th ed.). Cengage Learning.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Pearson, K. (1895). Contributions to the mathematical theory of evolution.—II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343–414. https://doi.org/10.1098/rsta.1895.0010
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Von Mises, R. (1981). Probability, statistics and truth (2nd rev. English ed.). Dover Publications.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4