
L’analyse exploratoire et la modélisation statistique de données quantitatives continues se heurtent fréquemment à des singularités structurelles inhérentes aux mesures empiriques : présences d’asymétries prononcées, queues de distribution épaisses, valeurs extrêmes aberrantes ou relations non linéaires hautement complexes avec des variables d’intérêt. Face à ces défis, la discrétisation — processus consistant à convertir une variable continue en une série ordonnée d’intervalles discrets — s’affirme comme une technique pivot en ingénierie des caractéristiques et en statistique descriptive. Parmi l’arsenal des méthodologies de partitionnement disponibles, la discrétisation à fréquence égale (également connue sous le vocable de découpage par quantiles) occupe une place privilégiée par sa capacité intrinsèque à régulariser les effectifs et à s’adapter organiquement à la morphologie probabiliste sous-jacente des données observées.
En exploitant l’écosystème scientifique de Python — articulé autour de bibliothèques fondamentales telles que NumPy, Pandas et Scikit-Learn —, le praticien dispose d’outils hautement optimisés pour implémenter ce partitionnement. Toutefois, l’application rigoureuse de la discrétisation par quantiles ne saurait se limiter à l’exécution machinale d’une fonction logicielle. Elle requiert une compréhension aiguë de ses fondements mathématiques, des compromis informationnels induits par le regroupement d’observations, de la gestion des ex æquo, ainsi que des répercussions concrètes sur les modèles prédictifs ultérieurs et la validité inférentielle des conclusions tirées.
Ce traité exhaustif se propose d’examiner de manière systématique l’intégralité du cycle conceptuel, méthodologique, algorithmique et appliqué de la discrétisation à fréquence égale en Python. De la théorie mathématique de l’équirépartition de la masse probabiliste à la mise en œuvre de pipelines industriels de modélisation, en passant par des études de cas détaillées en sciences comportementales et des analyses comparatives de performance computationnelle, cet article offre un guide définitif pour transformer des flux de données continues en représentations discrètes robustes, reproductibles et porteuses de sens statistique.
1. Introduction aux méthodes de discrétisation de données continues en Python
1.1 Définition conceptuelle et utilité méthodologique du binning
La discrétisation, couramment désignée dans la littérature anglo-saxonne sous le terme de binning ou de data quantization, correspond formellement à une transformation mathématique surjective qui applique une variable aléatoire continue, définie sur un sous-ensemble des nombres réels, vers un ensemble fini de symboles catégoriels ordonnés. Cette opération substitue à une infinité indénombrable de valeurs potentielles un nombre restreint d’intervalles fermés à gauche ou à droite, partitionnant ainsi le support empirique de la variable en segments mutuellement exclusifs et conjointement exhaustifs. L’objectif premier de cette abstraction est de condenser l’information brute tout en préservant les variations macroscopiques essentielles de la distribution d’origine.
Sur le plan méthodologique, cette transformation joue un rôle cardinal dans l’atténuation du bruit statistique de mesure. Dans de nombreuses disciplines expérimentales, les fluctuations infinitésimales enregistrées par les capteurs ou les échelles d’évaluation ne reflètent pas des variations fonctionnelles de la grandeur mesurée, mais découlent d’imperfections métrologiques ou d’aléas d’échantillonnage. En regroupant les données dans des réservoirs discrets, l’analyste lisse ces perturbations parasites, améliorant ainsi le rapport signal sur bruit. De surcroît, la discrétisation simplifie drastiquement la complexité computationnelle de certains algorithmes d’apprentissage automatique, notamment les réseaux bayésiens ou les modèles fondés sur des tables de contingence, dont la convergence analytique dépend de variables qualitatives.
Enfin, la conversion d’une échelle continue en modalités catégorielles accroît significativement l’interprétabilité des distributions empiriques pour les spécialistes de domaine. Dans un contexte industriel, médical ou sociologique, il s’avère souvent plus intelligible de manipuler des cohortes définies (telles que des strates d’exposition, des groupes d’âge normés ou des niveaux de criticité) que des valeurs réelles continues dénuées de repères contextuels. En ingénierie des caractéristiques (feature engineering), cette stratégie permet également d’incorporer des non-linéarités complexes au sein d’architectures linéaires en autorisant l’apprentissage d’un coefficient distinct par classe discrète.
1.2 Typologie des méthodes de découpage : approches supervisées et non supervisées
L’analyse typologique des techniques de discrétisation distingue fondamentalement deux paradigmes directeurs : les approches supervisées, régies par l’existence et l’optimisation conjointe d’une variable cible (dépendante), et les approches non supervisées, opérant de manière autonome à partir des seules propriétés intrinsèques de la variable candidate. Les algorithmes supervisés — tels que la discrétisation par entropie minimale de Fayyad et Irani, ou les méthodes fondées sur la statistique du Chi-deux comme ChiMerge — déterminent les frontières d’intervalles en maximisant l’homogénéité de classe ou le pouvoir discriminant vis-à-vis d’un critère externe. Bien que puissantes pour optimiser des métriques prédictives immédiates, ces méthodes introduisent un couplage fort avec la variable dépendante, ce qui peut aggraver les risques de surapprentissage (overfitting) si la validation croisée n’est pas rigoureusement compartimentée.
À l’opposé, les approches non supervisées s’abstiennent de tout recours à un signal de supervision externe. Elles traitent la variable continue comme une entité isolée dont la géométrie unidimensionnelle doit être respectée. Historiquement, les praticiens ont souvent recouru à des heuristiques rigides, comme le découpage à largeur fixe, qui scinde l’intervalle total entre le minimum et le maximum en segments d’égale amplitude spatiale. Toutefois, cette rigidité structurelle présente des limites inhérentes majeures : en présence de regroupements asymétriques ou de queues étirées, certaines classes se retrouvent surpeuplées tandis que d’autres demeurent désespérément vides, annihilant toute possibilité de comparaison statistique robuste.
La discrétisation non supervisée par préservation de la masse probabiliste apporte une réponse élégante à cet écueil. En calibrant les frontières non pas sur des écarts métriques arbitraires, mais sur la densité effective des observations, elle préserve la topologie locale des données sans instiller le moindre biais induit par une quelconque cible prédictive. Cette neutralité fondamentale confère au partitionnement non supervisé une reproductibilité universelle à travers des corpus de données variés, garantissant que la discrétisation reflète la structure empirique réelle plutôt qu’un artefact d’optimisation locale.
1.3 Présentation formelle du partitionnement à fréquence égale
Le partitionnement à fréquence égale, couramment nommé discrétisation quantile, repose sur un principe mathématique d’une clarté absolue : imposer que chaque intervalle résultant comprenne rigoureusement le même nombre d’observations empiriques. Pour un échantillon ordonné de $n$ individus partitionné en $k$ classes distinctes, chaque intervalle est calibré de telle sorte qu’il contienne approximativement $n/k$ données, modulo les contraintes arithmétiques d’indivisibilité. Les bornes d’intervalles ne sont donc plus espacées uniformément sur la droite réelle, mais correspondent directement aux quantiles empiriques de la variable analysée.
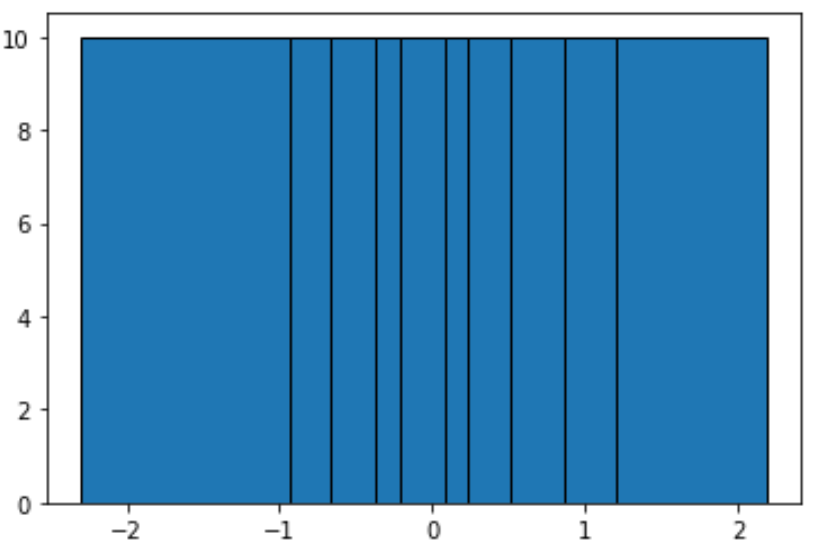
Cette méthodologie possède la propriété remarquable d’épouser fidèlement la forme sous-jacente de la fonction de densité de probabilité de la variable continue. Dans les régions du support où la densité de probabilité est maximale — c’est-à-dire là où les observations sont fortement agglomérées, comme autour du mode d’une loi gaussienne —, l’algorithme génère des intervalles très resserrés spatialement afin d’éviter l’accumulation excessive d’effectifs. Inversement, dans les régions de faible densité, telles que les queues de distribution ou les zones de transition clairsemées, les intervalles s’étirent sur de larges étendues numériques pour capturer le contingent d’individus requis.
Ce mécanisme différencie catégoriquement la discrétisation à fréquence égale du découpage à largeur fixe (equal-width binning). Alors que ce dernier maintient constante la dimension spatiale $\Delta x$ au détriment d’une fluctuation parfois extrême des effectifs de classe $n_i$, la méthode à fréquence égale fige les effectifs $n_i \approx \text{constante}$ et autorise la largeur métrique $\Delta x_i$ à fluctuer dynamiquement. Il en découle une stabilisation mécanique de la variance d’échantillonnage au sein de chaque modalité, éliminant de facto le problème statistique classique des catégories quasi-vides qui déstabilisent les estimateurs et minent la puissance des tests inférentiels.
2. Fondements mathématiques et statistiques de la discrétisation par quantiles
2.1 Théorie des quantiles et division de la distribution empirique
Sur le plan mathématique formel, soit une variable aléatoire réelle continue $X$ caractérisée par une fonction de répartition cumulative $F_X(x) = \mathbb{P}(X le x)$, supposée strictement croissante et continue sur son support. Le quantile d’ordre $p$, avec $p in (0, 1)$, est défini comme l’unique valeur $x_p$ vérifiant l’identité fonctionnelle inverse :
$$x_p = F_X^{-1}(p) = \inf { x in \mathbb{R} mid F_X(x) ge p }$$
Pour partitionner la distribution en $k$ classes d’égale fréquence, l’espace des probabilités est subdivisé en $k$ segments de mesure identique $1/k$. Les seuils théoriques de démarcation correspondent alors aux fractiles d’ordre $j/k$ pour $j in {1, 2, dots, k-1}$, complétés par la borne inférieure et la borne supérieure du support. En pratique, la fonction de répartition théorique $F_X$ est inconnue, et le statisticien doit opérer sur la fonction de répartition empirique $F_n(x)$ déduite d’un échantillon fini de taille $n$ ordonné par statistiques d’ordre $X_{(1)} le X_{(2)} le dots le X_{(n)}$.
Le calcul des seuils empiriques requiert l’interpolation des rangs statistiques non entiers. Si le produit $p \cdot n$ ne correspond pas à un indice discret, diverses méthodes d’interpolation linéaire peuvent être appliquées entre deux statistiques d’ordre consécutives. Par construction, cette procédure garantit une équirépartition de la masse empirique de probabilité : chaque intervalle $I_j = (x_{(j-1)/k}, x_{j/k}]$ capture une proportion d’observations égale à $1/k$. Une propriété mathématique fondamentale de cette approche réside dans son invariance stricte sous toute transformation monotone croissante. Si l’on applique à $X$ une fonction strictement croissante $g$, les nouveaux seuils de discrétisation correspondent exactement aux images par $g$ des seuils initiaux, préservant ainsi intégralement la structure d’appartenance des individus aux différentes classes.
2.2 Comparaison structurelle : fréquence égale versus largeur égale
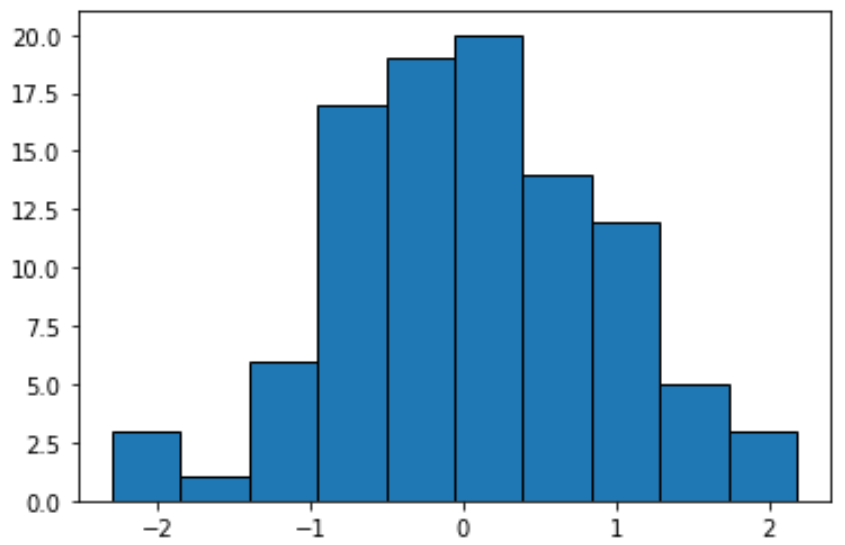
L’analyse comparative entre la méthode à fréquence égale et la méthode à largeur égale met en lumière des divergences géométriques et statistiques profondes. La discrétisation à largeur égale partitionne l’intervalle $[X_{(1)}, X_{(n)}]$ en $k$ segments de longueur constante $h = (X_{(n)} – X_{(1)})/k$. Cette approche manifeste une vulnérabilité extrême face aux distributions asymétriques ou parasitées par des valeurs aberrantes (outliers). Si une observation isolée se situe à une distance considérable de la masse principale des données, l’étendue globale est démesurément étirée. Il en résulte que l’écrasante majorité des données se retrouve confinée dans un ou deux intervalles initiaux, tandis que les intervalles intermédiaires demeurent déserts et que l’observation extrême monopolise la dernière classe.
À l’inverse, le partitionnement par quantiles neutralise totalement l’influence perturbatrice des valeurs extrêmes sur la distribution des effectifs. Quelle que soit la distance séparant une valeur aberrante du centre de la distribution, celle-ci est simplement assignée à l’intervalle le plus élevé sans modifier l’équilibre démographique des autres classes. Les effectifs marginaux demeurent rigoureusement uniformisés. Cette propriété induit une déformation non linéaire contrôlée de l’espace métrique d’origine : l’échelle continue est contractée dans les zones de faible densité et dilatée dans les régions de haute concentration spatiale. Cette déformation géométrique est précisément ce qui confère à la méthode sa robustesse statistique en analyse de données multidimensionnelles.
2.3 Impact sur l’entropie et la conservation de l’information
D’un point de vue informationnel, la qualité d’une discrétisation peut être évaluée à l’aune de la théorie de l’information de Claude Shannon. L’entropie d’une variable aléatoire discrète $Y$ prenant $k$ modalités avec des probabilités marginales $p_j = \mathbb{P}(Y = j)$ est formalisée par :
$$H(Y) = -\sum_{j=1}^{k} p_j \log_2(p_j)$$
Cette fonctionnelle atteint son maximum mathématique absolu lorsque toutes les probabilités marginales sont strictement égales, soit $p_j = 1/k$ pour tout $j in {1, dots, k}$, auquel cas $H(Y) = \log_2(k)$. Par conséquent, la discrétisation à fréquence égale maximise l’entropie de Shannon de la variable discrétisée résultante. En évitant toute concentration asymétrique de probabilité sur un petit sous-ensemble de modalités, elle assure une dispersion maximale de l’incertitude et prévient la perte prématurée de capacité discriminante.
En minimisant la redondance informationnelle, cette méthode tend à préserver une variance intra-classe homogène sous l’angle de la théorie des rangs, bien que la variance métrique euclidienne intra-classe puisse varier selon l’étirement spatial des intervalles. En outre, lorsqu’on quantifie l’écart entre la distribution continue originale et sa représentation approchée par escalier à l’aide de la divergence de Kullback-Leibler, le partitionnement par quantiles garantit que chaque région élémentaire contribue de manière équilibrée à l’espérance de l’information de discrimination, évitant ainsi que des singularités locales ne dominent outrageusement la perte globale d’information.
3. Configuration de l’environnement Python et modélisation des jeux de données
3.1 Déploiement de l’écosystème de calcul scientifique
L’exploitation de la discrétisation par quantiles requiert une installation rigoureuse et cohérente de l’environnement de calcul scientifique Python. Les piliers fondamentaux de cet écosystème comprennent NumPy pour les opérations matricielles vectorisées, Pandas pour la manipulation structurée de séries et de tableaux de données hétérogènes, SciPy pour l’accès aux distributions probabilistes et aux fonctions d’optimisation, ainsi que Matplotlib et Seaborn pour la sémiologie graphique des résultats. Il est impératif d’isoler ces dépendances logicielles au sein d’un environnement virtuel dédié (via venv ou conda) afin de prémunir les chaînes de traitement contre les incompatibilités de versions entre bibliothèques sous-jacentes.
La reproductibilité computationnelle constitue une exigence déontologique et méthodologique incontournable en science des données. Dans la mesure où la génération de données synthétiques et les protocoles de validation croisée impliquent des composantes stochastiques, l’initialisation explicite des générateurs de nombres pseudo-aléatoires s’avère indispensable. Dans les versions modernes de NumPy, cela s’opère par l’instanciation formelle d’un objet générateur via np.random.default_rng(seed) plutôt que par l’utilisation de l’ancien état global np.random.seed(). Cette pratique assure une isolation thread-safe et garantit que l’ordonnancement des tirages probabilistes demeure rigoureusement réplicable sur différentes architectures matérielles.
La structure d’un script d’initialisation standardisé peut être configurée de la manière suivante :
import numpy as np
import pandas as pd
import scipy.stats as stats
import matplotlib.pyplot as plt
import seaborn as sns
# Initialisation du générateur aléatoire pour la reproductibilité
SEED = 42
rng = np.random.default_rng(SEED)
3.2 Génération de distributions gaussiennes standardisées
Pour auditer avec précision le comportement des algorithmes de discrétisation, il convient en premier lieu de modéliser une référence distributionnelle symétrique et dépourvue d’asymétrie empirique marquée. La loi normale centrée réduite $\mathcal{N}(0, 1)$ représente le modèle théorique d’élection. Un échantillon synthétique de grande taille, par exemple $N = 10,000$ observations, permet de minimiser la variance d’échantillonnage et de vérifier l’adéquation asymptotique des seuils quantiles calculés avec les fractiles théoriques de la distribution gaussienne.
La génération vectorisée s’effectue via l’instruction rng.normal(loc=0.0, scale=1.0, size=10000). Une fois l’échantillon matérialisé sous la forme d’un tableau NumPy ou d’une série Pandas, un examen scrupuleux des métriques descriptives s’impose. La moyenne empirique $\bar{x}$ doit osciller dans un voisinage immédiat de $0.0$, l’écart-type empirique $s$ autour de $1.0$, le coefficient d’asymétrie (skewness) de Fisher-Pearson au voisinage de $0.0$, et le coefficient d’aplatissement (excess kurtosis) au voisinage de $0.0$. La validation de ces indicateurs confirme que l’échantillon se conforme rigoureusement aux postulats théoriques régissant la loi normale avant tout engagement dans la phase de segmentation.
3.3 Modélisation de distributions asymétriques et leptokurtiques
Bien que la loi normale serve d’étalon méthodologique, les distributions rencontrées en pratique s’écartent très fréquemment de cette symétrie idéale. Pour éprouver la résilience de la discrétisation à fréquence égale dans des contextes adverses, il est indispensable de synthétiser des distributions fortement asymétriques et leptokurtiques. La loi exponentielle, caractérisée par une fonction de densité décroissante monotone $f(x) = \lambda e^{-\lambda x}$ pour $x ge 0$, et la loi log-normale, issue de l’exponentiation d’une variable gaussienne $\ln(X) \sim \mathcal{N}(\mu, \sigma^2)$, offrent des bancs d’essai idéaux pour évaluer la dispersion spatiale des quantiles le long de queues de distribution étirées.
La simulation d’une distribution log-normale avec des paramètres $\mu = 0$ et $\sigma = 1.25$ engendre un étirement substantiel vers la droite, ponctué d’observations d’intensités considérables. Pour accentuer la rigueur de l’évaluation, une contamination artificielle par des valeurs aberrantes (outliers extrêmes) peut être injectée en substituant à une infime fraction des données (par exemple $0.5%$) des valeurs situées à plusieurs dizaines d’écarts-types de la moyenne empirique. L’inspection comparative préliminaire des quantiles d’ordre élevé ($90%$, $95%$, $99%$) met en exergue l’amplitude phénoménale des écarts métriques dans ces zones marginales, soulignant l’inadéquation absolue d’une discrétisation à pas fixe sur de telles structures empiriques.
4. Implémentation algorithmique élémentaire avec NumPy
4.1 Calcul vectorisé des seuils via la fonction quantile
L’implémentation de bas niveau de la discrétisation par quantiles repose sur la détermination analytique précise des seuils de démarcation séparant les $k$ classes souhaitées. Avec la bibliothèque NumPy, le vecteur des probabilités cumulées est d’abord instancié de manière équidistante à l’aide de la fonction np.linspace(0, 1, k + 1). Cette commande génère un tableau de scalaires borné par $0.0$ et $1.0$, comprenant $k+1$ valeurs de référence. Par exemple, pour un découpage en quartiles ($k=4$), les probabilités requises sont ${0.0, 0.25, 0.50, 0.75, 1.0}$.
L’extraction des valeurs de rupture empiriques correspondantes est opérée par la fonction vectorisée np.quantile() (ou son synonyme np.percentile()). Il convient de souligner que NumPy propose jusqu’à neuf méthodes différentes d’interpolation linéaire via le paramètre method (anciennement interpolation), alignées sur la nomenclature établie par Hyndman et Fan en 1996. Le comportement par défaut (method='linear') procède à une interpolation affine continue entre les valeurs d’indices discrets adjacents lorsque le rang théorique $q(n-1)$ ne correspond pas à un entier. Le vecteur résultant de cette étape contient exactement $k+1$ bornes numériques ordonnées de façon strictement croissante :
$$\text{seuils} = [b_0, b_1, b_2, dots, b_k] \quad \text{a\vec } b_0 = X_{(1)} \text{ et } b_k = X_{(n)}$$
Cette approche garantit l’inclusion exhaustive de l’ensemble du support empirique, de la plus petite valeur observée jusqu’au maximum de l’échantillon.
4.2 Segmentation et indexation indicielle avec `numpy.digitize`
Une fois les bornes quantiles solidement établies dans un tableau unidimensionnel, l’assignation de chaque point d’observation continue à son intervalle de rattachement est réalisée de façon hautement optimisée par la fonction np.digitize. Cette dernière prend en arguments le tableau de données continues $X$ et le vecteur des seuils internes, puis renvoie un tableau d’entiers correspondant aux indices des classes discrètes attribuées. Sous le capot, np.digitize met en œuvre un algorithme de recherche binaire (similaire à std::upper_bound ou std::lower_bound en C++), garantissant une complexité temporelle logarithmique de l’ordre de $\mathcal{O}(n \log k)$ pour la phase d’affectation.
Un paramétrage critique de np.digitize réside dans le booléen right. Par défaut, right=False, ce qui implique que les intervalles sont considérés comme ouverts à droite et fermés à gauche : $[b_{j-1}, b_j)$. À l’inverse, l’assignation right=True modélise des intervalles fermés à droite et ouverts à gauche : $(b_{j-1}, b_j]$. Ce dernier choix est généralement préféré en statistique descriptive pour garantir que le premier intervalle englobe sa borne minimale après un ajustement infinitésimal de celle-ci, ou en utilisant le vecteur complet des seuils internes :
probas = np.linspace(0, 1, k + 1)
bins = np.quantile(data, probas)
# Légère extension de la borne inférieure pour inclure le minimum strict si right=True
bins[0] -= 1e-9
indices = np.digitize(data, bins, right=True)
Cette manipulation garantit une conformité dimensionnelle absolue : le vecteur d’indices résultant possède une longueur strictement identique à l’échantillon initial, avec des valeurs entières comprises rigoureusement entre $1$ et $k$.
4.3 Audit des fréquences absolues par classe discrétisée
L’étape conclusive d’une implémentation élémentaire consiste à auditer avec minutie la distribution des fréquences absolues obtenues au sein de chaque modalité discrétisée. La fonction np.bincount() constitue l’outil le plus véloce pour dénombrer les occurrences d’entiers non négatifs. Alternativement, l’instruction np.unique(indices, return_counts=True) offre une vision simultanée des identifiants de classes et de leurs effectifs effectifs respectifs.
Dans un contexte idéal où la taille d’échantillon $n$ est un multiple entier exact du nombre de classes $k$ et où aucune observation ne partage une valeur numérique identique, le décompte obtenu doit être rigoureusement invariant : chaque classe compte précisément $n/k$ observations. Cependant, dans les conditions réelles d’échantillonnage, des fluctuations minimes d’au plus une unité par classe apparaissent mécaniquement en raison des arrondis arithmétiques lors de la division de $n$ par $k$. L’audit statistique doit quantifier la variance de ces effectifs marginaux : toute déviation substantielle par rapport à l’équiprobabilité théorique signale la présence d’ex æquo concentrés sur un même seuil quantile, un problème structurel complexe qui requiert des arbitrages méthodologiques spécifiques.
5. Mise en œuvre avancée avec Pandas : Maîtrise exhaustive de `qcut`
5.1 Architecture et paramètres fondamentaux de `pandas.qcut`
La bibliothèque Pandas offre une abstraction de haut niveau particulièrement élégante et robuste pour le partitionnement à fréquence égale via sa fonction native pd.qcut. Contrairement à la combinaison manuelle d’instructions NumPy, qcut a été spécifiquement conçue pour s’interfacer avec les structures de données pd.Series et pd.DataFrame, encapsulant le calcul des fractiles, l’affectation indicielle et la sérialisation des intervalles au sein d’un type de données optimisé.
La signature de base de la fonction s’articule autour de l’instruction pd.qcut(x, q, labels=None, retbins=False, precision=3, duplicates='raise'). Le paramètre q accepte soit un entier scalaire spécifiant le nombre de quantiles d’égale fréquence à découper (par exemple q=10 pour des déciles), soit une séquence ordonnée de flottants compris entre $0$ et $1$ définissant des quantiles asymétriques personnalisés (par exemple [0, 0.1, 0.5, 0.9, 1.0]). L’objet renvoyé par défaut est une pd.Series typée Categorical dont chaque élément est un intervalle formel de la classe pandas.Interval, garantissant que chaque enregistrement conserve explicitement la trace des bornes numériques qui définissent sa cohorte.
Si l’argument optionnel retbins=True est renseigné, la fonction retourne un tuple composé de la série catégorielle discrétisée et d’un tableau NumPy énumérant les frontières empiriques calculées. Cette fonctionnalité s’avère indispensable pour documenter les seuils exacts ayant présidé à la segmentation et pour permettre leur réapplication déterministe sur des jeux de données ultérieurs.
5.2 Personnalisation des intervalles et nomenclature sémantique
L’un des avantages majeurs de pd.qcut réside dans sa flexibilité pour contextualiser sémantiquement les modalités résultantes. L’affichage d’intervalles numériques semi-ouverts (tels que (12.45, 23.81]) peut altérer la lisibilité des rapports de synthèse ou surcharger la mémoire lors du traitement de jeux de données massifs. Grâce à l’argument labels, l’utilisateur a la possibilité de mapper immédiatement un vecteur d’identifiants qualitatifs sur les classes générées. Ce vecteur doit posséder une dimension rigoureusement identique au nombre de quantiles $k$.
Par exemple, lors de la création de quartiles de performance, on pourra spécifier labels=['Faible', 'Moyen_Inférieur', 'Moyen_Supérieur', 'Élevé']. Lorsque des étiquettes textuelles sont fournies, Pandas conserve la nature ordonnée de la catégorie sous-jacente (ordered=True), ce qui permet d’effectuer des tris logiques, des sélections par inégalités ordinales et des représentations graphiques instantanément ordonnées. De surcroît, le paramètre precision permet de brider le nombre de décimales conservées dans le libellé textuel des intervalles lorsque les étiquettes par défaut sont conservées, évitant ainsi la prolifération de chaînes de caractères excessivement verbeuses générées par les imprécisions des flottants à double précision.
Enfin, si la finalité de la discrétisation réside dans l’intégration au sein d’un modèle statistique, l’utilisateur peut passer labels=False pour forcer le retour d’un tableau d’entiers scalaires indexés de $0$ à $k-1$. Cette modalité allège considérablement la consommation de mémoire vive et accélère l’interfaçage avec des bibliothèques externes ne supportant pas le type catégoriel natif de Pandas.
5.3 Résolution des conflits de quantiles non distincts avec l’option `duplicates`
Dans la pratique de l’ingénierie des données, l’écueil le plus fréquent lors de l’application aveugle de pd.qcut réside dans le déclenchement de l’exception ValueError: Bin edges must be unique. Cette erreur survient lorsque la distribution empirique comporte une répétition massive d’une même valeur numérique — par exemple, un jeu de données où $40%$ des observations sont nulles. Dans cette configuration, plusieurs quantiles théoriques successifs coïncident spatialement (le quantile à $20%$ et le quantile à $40%$ valent tous deux rigoureusement $0.0$), ce qui rend les bornes d’intervalles non distinctes et brise la condition de monotonicité stricte requise pour définir des intervalles semi-ouverts valides.
Pour contourner ce blocage algorithmique, Pandas intègre le paramètre duplicates, qui accepte la valeur 'drop' (la valeur par défaut étant 'raise'). Lorsque duplicates='drop' est explicité, pd.qcut élimine automatiquement les seuils redondants avant de procéder à la segmentation. Bien que cette option prévienne le plantage de l’interpréteur Python, elle entraîne une implication statistique majeure que l’analyste se doit de maîtriser : le nombre final d’intervalles effectivement générés sera strictement inférieur au paramètre $k$ initialement sollicité.
Il en résulte une asymétrie marquée dans les effectifs résiduels : la classe regroupant la valeur hyper-fréquente capturera un effectif disproportionné, brisant ainsi le postulat d’équirépartition parfaite. Le tableau ci-dessous illustre l’impact de ce phénomène selon la configuration retenue :
- duplicates=’raise’ : Déclenchement d’une exception fatale dès qu’au moins deux seuils quantiles sont identiques. Aucun objet n’est produit.
- duplicates=’drop’ : Suppression silencieuse des seuils superflus. La discrétisation s’exécute, mais produit un nombre de classes $k’ < k$, générant un intervalle à effectif massif pour la valeur répétée.
L’utilisation de duplicates='drop' exige donc un audit systématique a posteriori du nombre réel de modalités obtenues et de leurs effectifs consolidés.
6. Intégration dans les chaînes de traitement de Scikit-Learn
6.1 Configuration de `KBinsDiscretizer` avec la stratégie quantile
Dans le cadre du développement de systèmes d’apprentissage automatique industrialisés, la modularité et l’interopérabilité dictent l’usage des composants standardisés de la bibliothèque Scikit-Learn. La classe sklearn.preprocessing.KBinsDiscretizer matérialise l’état de l’art pour incorporer des transformations de partitionnement au sein d’arbres de traitement complexes (Pipelines). Cette classe supporte formellement la discrétisation à fréquence égale par le biais de son argument strategy='quantile'.
L’instanciation s’articule autour de trois paramètres structurants : n_bins, qui détermine le nombre de classes cibles souhaité ; encode, qui régit le format mathématique de l’encodage de sortie ; et strategy, fixé ici rigoureusement à 'quantile'. Le paramètre encode conditionne la topologie des tenseurs produits :
encode='onehot': Renvoie une matrice creuse (scipy.sparse.csr_matrix) contenant un codage disjonctif complet (variables indicatrices binaires), idéal pour alimenter des modèles linéaires régularisés.encode='onehot-dense': Produit une matrice NumPy dense similaire au codage précédent, mais exigeante en mémoire vive.encode='ordinal': Renvoie un tableau unidimensionnel d’entiers scalaires indexés de $0$ à $n_bins – 1$, parfait pour l’intégration dans des architectures fondées sur des arbres de décision.
Une fois la méthode fit() exécutée, les seuils empiriques déterminés sur chaque caractéristique sont sérialisés et accessibles via l’attribut public bin_edges_, sous la forme d’un tableau d’objets NumPy contenant les coordonnées spatiales de chaque démarcation.
6.2 Prévention des fuites de données dans un pipeline d’apprentissage
L’un des apports majeurs de l’utilisation de KBinsDiscretizer réside dans sa conformité architecturale avec le paradigme fit / transform, garantissant l’étanchéité absolue entre les partitions de données. En statistique prédictive, la fuite de données (data leakage) désigne la contamination vicieuse des informations de l’ensemble de test ou de validation dans la phase d’apprentissage. Calculer des quantiles globaux sur l’intégralité d’un jeu de données avant d’effectuer la scission entre entraînement et test constitue une violation méthodologique grave : les frontières résultantes encapsuleraient la distribution d’observations censées être rigoureusement invisibles pour le modèle.
L’encapsulation de KBinsDiscretizer(strategy='quantile') au sein d’un objet sklearn.pipeline.Pipeline éradique totalement ce risque. Lors de l’évaluation par validation croisée (via cross_val_score ou GridSearchCV), la méthode fit est appelée exclusivement et hermétiquement sur le pli d’entraînement (training fold). Les frontières calculées sont ensuite appliquées de façon purement déterministe via la méthode transform sur le pli d’évaluation. Si la distribution du pli de test subit une dérive locale, la méthode projettera néanmoins les données selon les repères du pli d’apprentissage, fournissant ainsi une estimation non biaisée des capacités de généralisation réelles de la chaîne prédictive.
6.3 Gestion des valeurs hors bornes lors de l’inférence
L’application d’un transformateur de discrétisation préalablement ajusté sur de nouveaux flux de données en production soulève la question critique de la prise en charge des valeurs sortant des limites observées lors de la phase d’entraînement. Dans un environnement opérationnel réel, il est statistiquement inévitable qu’une nouvelle observation présente une valeur inférieure au minimum historique $X_{(1)}^{\text{train}}$ ou supérieure au maximum historique $X_{(n)}^{\text{train}}$.
La classe KBinsDiscretizer gère cette éventualité par une politique de projection conservative (clipping implicite). Toute nouvelle donnée $x_{\text{new}} < X_{(1)}^{\text{train}}$ est systématiquement indexée dans le premier compartiment (classe $0$), tandis que toute observation $x_{\text{new}} > X_{(n)}^{\text{train}}$ est imputée dans le dernier compartiment disponible (classe $k-1$). Cette approche assure une robustesse opérationnelle totale : la chaîne de traitement ne génère aucune valeur manquante ni aucune erreur d’exécution hors limites (out-of-bounds error). Toutefois, cette résilience a pour corollaire un tassement potentiel des effectifs dans les classes extrêmes si le flux inférentiel subit une dérive de covariable (covariate shift) caractérisée par un étalement structurel des valeurs réelles vers de nouveaux extrêmes.
7. Analyse comparative et visualisation graphique des distributions discrétisées
7.1 Construction d’histogrammes comparatifs avec Matplotlib et Seaborn
La mise en évidence graphique des propriétés respectives des différentes approches de discrétisation constitue une étape indispensable pour valider intuitivement l’homogénéisation des cohortes. À l’aide des bibliothèques Matplotlib et Seaborn, il est possible d’élaborer des panneaux graphiques comparatifs juxtaposant la discrétisation à largeur égale et le binning à fréquence égale sur un même jeu de données asymétrique.
Dans un histogramme à largeur fixe généré sur une distribution log-normale, la sémiologie graphique révèle une asymétrie saisissante : les rectangles initiaux concentrent une hauteur spectaculaire, matérialisant l’agglutination de l’essentiel de l’échantillon, tandis que les barres associées aux intervalles de droite deviennent invisibles à l’œil nu tant leur effectif est négligeable. Cette configuration visuelle illustre l’échec de la méthode à largeur constante à discerner les micro-variations au sein du cœur de la distribution.
À l’inverse, l’histogramme représentant la discrétisation par quantiles affiche une topologie radicalement distincte. Si l’on trace le diagramme des fréquences relatives avec des largeurs d’intervalles physiques variables, ou si l’on représente simplement les effectifs par modalité ordonnée, chaque barre présente rigoureusement la même hauteur. C’est l’axe des abscisses qui subit une modulation plastique : les classes situées au cœur de la distribution sont extrêmement fines, tandis que les rectangles marginaux s’élargissent considérablement pour capturer l’effectif invariant imposé par le modèle quantile.
7.2 Tracé de la fonction de répartition empirique et repérage des seuils
La modélisation de la fonction de répartition empirique (Empirical Cumulative Distribution Function, ou ECDF) offre le cadre visuel le plus rigoureux pour appréhender la mécanique spatiale du binning par quantiles. En projetant la fonction cumulative monotone croissante $F_n(x)$ sur un repère bidimensionnel, l’analyste peut tracer des lignes de projection horizontales équidistantes sur l’axe des ordonnées aux coordonnées $y_j = j/k$ pour $j in {0, 1, dots, k}$.
En projetant orthogonalement ces points d’intersection vertébraux vers l’axe des abscisses, on visualise instantanément la genèse des frontières quantiles. Dans les sections où la courbe de l’ECDF présente une pente abrupte — correspondant au pic de la fonction de densité de probabilité —, l’espace horizontal séparant deux seuils consécutifs est infinitésimal. À l’inverse, dès que la courbe cumulative s’infléchit et adopte une trajectoire quasi-horizontale (caractéristique des queues de distribution), l’espacement projectif sur l’axe réel s’étire de façon spectaculaire. Cette représentation graphique rend immédiatement intelligible la manière dont le binning à fréquence égale concentre son pouvoir de résolution dans les zones où la densité d’information empirique est maximale.
7.3 Évaluation quantitative de l’uniformité des classes
Au-delà de l’inspection visuelle, la conformité d’une discrétisation par quantiles doit être validée à l’aide de métriques statistiques formelles attestant de l’équirépartition effective des données segmentées. Le test d’adéquation du Chi-deux de Pearson ($\chi^2$) représente le standard statistique pour évaluer l’hypothèse nulle d’uniformité $H_0 : p_1 = p_2 = dots = p_k = 1/k$. La statistique de test s’écrit :
$$\chi^2 = \sum_{j=1}^{k} \frac{(O_j – E_j)^2}{E_j}$$
où $O_j$ désigne l’effectif empirique observé dans la classe $j$, et $E_j = n/k$ correspond à l’effectif théorique attendu. Sous l’hypothèse nulle et pour une distribution sans doublons massifs, la statistique $\chi^2$ doit être infinitésimale et la p-valeur associée très proche de $1.0$, confirmant l’absence de déviation par rapport à la distribution uniforme discrète.
Conjointement, le calcul du coefficient de Gini appliqué au vecteur des effectifs permet de quantifier le degré d’inégalité démographique entre les différentes classes. Un coefficient de Gini égal à $0.0$ traduit une parfaite égalité des effectifs, tandis qu’une valeur convergeant vers $1.0$ signale une concentration pathologique. En présence de données continues continues pures, le partitionnement par quantiles produit systématiquement un indice de Gini théoriquement nul (aux arrondis d’échantillonnage près). Toute élévation notable de cet indice constitue un indicateur diagnostique signalant la présence d’ex æquo massifs ayant forcé la fusion de classes.
8. Gestion des cas limites et écueils méthodologiques complexes
8.1 Concentrations de valeurs identiques et masses de Dirac empiriques
L’obstacle méthodologique le plus sévère rencontré lors de la discrétisation par quantiles réside dans la présence de singularités empiriques, couramment qualifiées de masses de Dirac, provoquées par l’accumulation massive d’observations strictement identiques. Ce phénomène survient classiquement en présence de variables contraintes à seuil (par exemple, des montants de dépenses d’assurance où $85%$ des valeurs sont strictement nulles) ou d’effets de plancher et de plafond métrologiques.
Lorsque la masse de probabilité concentrée sur un point unique $x_0$ excède la fraction théorique allouée à une classe, soit $\mathbb{P}(X = x_0) > 1/k$, les formules de quantiles s’effondrent : plusieurs fractiles successifs s’égalisent sur $x_0$. Dans cette situation, scinder arbitrairement les observations identiques dans des classes distinctes viole le principe de cohérence fonctionnelle (deux individus rigoureusement identiques se verraient assigner des étiquettes différentes). Pour résoudre cette aporie, deux stratégies prévalent :
- Le partitionnement hybride conditionnel : Isoler en amont la singularité discrète dans une modalité spécifique (par exemple, la classe Zéro), puis appliquer la discrétisation par quantiles exclusivement sur le sous-ensemble résiduel strictement continu ($X > 0$). C’est la méthode statistiquement la plus propre.
- Le bruitage stochastique contrôlé (jittering) : Injecter un bruit aléatoire uniforme ou gaussien d’amplitude infinitésimale $\epsilon ll \sigma_X$ pour briser artificiellement les ex æquo. Bien qu’elle permette à l’algorithme d’aboutir à des effectifs strictement égaux, cette approche introduit une stochasticité dans le classement individuel qui peut s’avérer indéfendable dans des contextes réglementaires ou médicaux rigoureux.
8.2 Traitement rigoureux des données manquantes
La présence de valeurs manquantes (représentées par np.nan en Python) constitue un défi analytique qui nécessite une doctrine claire. Par défaut, tant pd.qcut que KBinsDiscretizer ignorent les valeurs nulles lors du calcul des seuils quantiles : les fractiles sont estimés exclusivement sur le sous-ensemble des données observées valides. Toutefois, le comportement d’assignation ultérieur diverge substantiellement selon les outils.
Dans Pandas, pd.qcut propage les valeurs manquantes : les enregistrements contenant NaN conservent la modalité NaN dans la série catégorielle résultante. Si cette propagation est conceptuellement rigoureuse, elle expose les modèles d’apprentissage ultérieurs à des plantages si ceux-ci ne supportent pas nativement les données manquantes. Une pratique courante en ingénierie statistique consiste à traiter l’absence de donnée comme une modalité informative à part entière. Dans cette perspective, la variable discrétisée est complétée par l’ajout d’une catégorie dédiée (par exemple 'Manquant' ou l’indice -1) via la méthode add_categories() et fillna() de Pandas.
À l’inverse, l’imputation préalable de valeurs manquantes par des statistiques univariées simples (telles que la moyenne ou la médiane) avant l’exécution du binning par quantiles est formellement déconseillée. En effet, imputer $10%$ de données manquantes par la médiane crée instantanément une masse de Dirac artificielle au centre de la distribution, provoquant l’effondrement des quantiles médians et déclenchant les erreurs de seuils non uniques précédemment détaillées.
8.3 Détermination optimale du nombre de classes k
La sélection du paramètre hyper-paramétrique $k$, représentant le nombre d’intervalles de discrétisation, engage un arbitrage fondamental entre granularité descriptive et stabilité statistique. Si $k$ est trop faible, l’analyste détruit une quantité excessive de variance continue, privant les modèles ultérieurs d’une information discriminant utile (sous-ajustement). À l’inverse, si $k$ est surdimensionné, l’effectif par classe $n/k$ s’amenuise drastiquement, augmentant l’erreur standard des estimateurs au sein de chaque strate et favorisant le surapprentissage empirique.
Les règles heuristiques usuelles formulées pour l’élaboration d’histogrammes fournissent un premier repère analytique, bien qu’elles aient été conçues originellement pour le binning à largeur égale :
- Règle de Sturges : $k = 1 + \lceil \log_2(n) \rceil$, calibrée pour des distributions normales de taille modérée ($n < 200$).
- Règle de Rice : $k = \lceil 2 n^{1/3} \rceil$, plus agressive et mieux adaptée aux volumes d’échantillons contemporains.
- Règle de Freedman-Diaconis : Fondée sur l’écart interquartile (IQR), particulièrement robuste face aux asymétries et queues lourdes.
Dans un cadre prédictif supervisé, la voie la plus rigoureuse consiste à traiter $k$ comme un hyper-paramètre soumis à une optimisation systématique par validation croisée (grid search). L’évaluation conjointe de critères d’information pénalisés tels que l’AIC (Akaike Information Criterion) ou le BIC (Bayesian Information Criterion) permet d’identifier formellement le point d’inflexion où l’accroissement de résolution informationnelle cesse de compenser le coût de complexité associé à l’augmentation du nombre de classes.
9. Applications empiriques en psychométrie et sciences comportementales
9.1 Standardisation et étalonnage des scores de tests psychométriques
En psychométrie et en évaluation des compétences cognitives, la discrétisation à fréquence égale constitue le fondement mathématique de l’étalonnage des scores bruts. Les instruments de mesure psychologique, tels que les tests de quotient intellectuel ou les inventaires de personnalité, génèrent fréquemment des distributions de scores bruts asymétriques ou parasitées par des biais de désirabilité sociale (notamment dans les échelles d’évaluation comportementale).
L’application d’un partitionnement par quantiles permet d’opérer une normalisation non linéaire de ces grandeurs brutes en les traduisant en échelles normées universelles. L’étalonnage en stanines (pour standard nine) subdivise ainsi la population en neuf cohortes standardisées, tandis que l’étalonnage en déciles ou en centiles fournit des repères immédiatement opérationnels pour le diagnostic clinique ou la sélection professionnelle. En imposant une fréquence rigoureusement contrôlée au sein d’une population de référence normée, le praticien s’assure que le positionnement relatif d’un sujet est indépendant des déformations d’échelle locales inhérentes à la difficulté intrinsèque des items du test.
9.2 Catégorisation des temps de réaction chronométriques
L’analyse des temps de réaction en psychologie cognitive expérimentale confronte systématiquement le chercheur à des distributions de latence caractérisées par une asymétrie droite prononcée et une longue traînée d’observations lentes (modélisées usuellement par des lois ex-gaussiennes ou des lois de Wald). La discrétisation à largeur constante sur de telles données est méthodologiquement proscrite, car elle isole les essais les plus lents dans des classes anecdotiques tout en condensant les variations subtiles des réponses ultra-rapides au sein d’un contingent monolithique.
Le recours à la discrétisation à fréquence égale permet de segmenter les temps de réponse en strates de vélocité homogènes (par exemple en quintiles : réponses ultra-rapides, rapides, médianes, lentes, et très lentes). Cette catégorisation équilibrée facilite la mise en œuvre subséquente d’analyses de variance factorielles (ANOVA) à mesures répétées ou de régressions logistiques multinomiales visant à modéliser la probabilité de commission d’erreurs cognitives en fonction de la tranche de latence, garantissant que chaque cellule du plan expérimental dispose d’une puissance statistique strictement constante.
9.3 Segmentation des échelles de Likert et indices d’attitude
Dans les enquêtes d’opinion et les recherches attitudinales, l’agrégation de multiples items de type Likert (échelles ordinales de 1 à 5 ou 1 à 7) au sein d’un score composite global aboutit à une métrique pseudo-continue. Ces indices multidimensionnels présentent fréquemment des agglomérations préférentielles liées à des biais d’acquiescement ou d’évitement des extrêmes.
Pour isoler des groupes de répondants contrastés dans des protocoles quasi-expérimentaux, la discrétisation par quantiles assure la constitution de sous-groupes démographiquement comparables (par exemple : cohortes d’attitude défavorable, neutre et hautement favorable par découpage en terciles). Cette égalisation artificielle des effectifs consolide la robustesse des comparaisons inter-groupes en prévenant les déséquilibres d’échantillons qui dégradent l’homoscédasticité (égalité des variances) requise par les modèles linéaires classiques, préservant ainsi l’intégrité inférentielle des conclusions expérimentales.
10. Évaluation comparative des performances computationnelles
10.1 Benchmark de vitesse : NumPy pur versus Pandas versus Scikit-Learn
L’efficience computationnelle de la discrétisation par quantiles devient un critère d’arbitrage capital dès lors que les volumes de données atteignent des millions d’enregistrements. Le coût algorithmique sous-jacent de l’opération est fondamentalement dominé par la complexité temporelle du tri partiel ou complet nécessaire à l’extraction des quantiles empiriques, soit une borne asymptotique inférieure en $\mathcal{O}(n \log n)$ pour un tri complet, ou en $\mathcal{O}(n)$ pour des algorithmes de sélection approchée de type introselect (exploités par np.partition).
Un profilage temporel systématique mené à l’aide du module standard timeit sur des échelles d’échantillonnage s’étendant de $10^4$ à $10^7$ observations révèle des divergences notables d’ordre de grandeur :
- NumPy pur (
np.quantile+np.digitize) : Présente les temps d’exécution les plus fulgurants, bénéficiant d’une vectorisation compilée en C et d’un surcoût d’encapsulation quasi nul. Sur $10^6$ éléments, l’opération s’exécute typiquement en quelques dizaines de millisecondes. - Pandas (
pd.qcut) : Accuse un surcoût temporel mesurable (typiquement un facteur multiplicatif de $2\times$ à $4\times$ par rapport à NumPy), induit par la création de l’objetCategorical, la vérification formelle des index et la gestion logicielle des métadonnées d’intervalles. - Scikit-Learn (
KBinsDiscretizer) : Se positionne à un niveau intermédiaire d’efficience lors de la phasetransform, mais présente une phasefitextrêmement compétitive grâce à l’optimisation des routines NumPy sous-jacentes.
10.2 Empreinte mémoire et passage à l’échelle sur données massives
L’empreinte sur la mémoire vive (RAM) représente le second facteur déterminant lors du traitement de jeux de données massifs. La transformation d’une colonne de flottants double précision (float64, occupant 8 octets par élément) en différents formats discrétisés engendre des répercussions matérielles massives qu’il convient de modéliser avec lucidité.
L’utilisation non précautionneuse de encode='onehot-dense' au sein de KBinsDiscretizer avec un nombre élevé de classes $k$ provoque une explosion de l’allocation mémoire : un tableau de taille $n \times 1$ est dilaté en une matrice de dimension $n \times k$, multipliant la consommation volumétrique par un facteur proportionnel à $k$. Pour prévenir la saturation de la mémoire vive (Out-Of-Memory error), l’encodage sparse (csr_matrix) ou l’encodage ordinal sur des entiers non signés à faible encombrement (uint8, occupant seulement 1 octet par élément et suffisant pour représenter jusqu’à 256 classes) doit être impérativement privilégié.
Dans Pandas, bien que le type Categorical soit économe par rapport à des chaînes de caractères brutes grâce à un dictionnaire d’entiers sous-jacent, le traitement de jeux de données dépassant la capacité de la mémoire physique impose le recours à des architectures de calcul par morceaux (chunking via pd.read_csv(..., chunksize=...)) ou à des cadres distribués tels que Dask ou PySpark, au sein desquels l’estimation des quantiles est approximée via des algorithmes de streaming probabilistes.
10.3 Optimisations vectorisées et parallélisation
Pour optimiser le passage à l’échelle sur des architectures multiprocesseurs, l’analyste peut tirer parti de plusieurs axes de rationalisation technique. D’une part, lorsque la précision absolue des frontières n’est pas requise au centième près, l’emploi d’algorithmes de calcul de quantiles approchés — tels que l’algorithme T-Digest ou le sketch HdrHistogram — permet d’estimer les démarcations avec une complexité temporelle linéaire en une seule passe sur les données, tout en autorisant une fusion triviale des calculs parallélisés sur plusieurs cœurs de calcul.
D’autre part, lorsque la discrétisation doit être appliquée simultanément sur plusieurs centaines de caractéristiques d’une base de données volumineuse, l’exécution itérative boucle par boucle sous Pandas devient un goulot d’étranglement majeur. La configuration de KBinsDiscretizer(..., n_bins=k, strategy='quantile') exploite la vectorisation multivariée native de Scikit-Learn, exécutant les segmentations colonne par colonne au sein de boucles compilées en langage C, réduisant drastiquement les allers-retours au ramasse-miettes (garbage collector) de Python et minimisant les copies défensives d’objets en mémoire vive.
11. Influence de la discrétisation par quantiles sur les modèles prédictifs
11.1 Comportement des modèles linéaires et de régression logistique
L’intégration de variables continues discrétisées par quantiles au sein de modèles linéaires généralisés (GLM), tels que la régression linéaire ordinaire ou la régression logistique binaire, produit des effets structurels profonds. En codant les intervalles issus de qcut sous la forme de variables indicatrices (one-hot encoding, en omettant une modalité de référence pour prévenir toute collinéarité stricte), on s’affranchit totalement du postulat restrictif de linéarité globale liant la variable explicative continue $X$ au logit ou à la cible $Y$.
Cette discrétisation permet au modèle d’ajuster une fonction en escalier capable de capturer des non-linéarités complexes, des relations non monotones en forme de cloche ($U$-inversé) ou des effets de seuil brutaux qu’une régression linéaire standard serait fondamentalement incapable de déceler sans adjonction de termes polynomiaux fastidieux. En outre, la discrétisation par quantiles neutralise totalement le bras de levier disproportionné exercé par les valeurs aberrantes sur l’estimation des hyperplans de régression, conférant une stabilité remarquable aux coefficients calculés.
Le revers de cette transformation réside dans la perte irréversible de l’information de variation intra-classe : deux individus situés aux extrémités opposées d’un même intervalle reçoivent rigoureusement la même estimation paramétrique, ce qui peut dégrader la variance résiduelle expliquée ($R^2$) par rapport à une modélisation continue parfaitement spécifiée.
11.2 Impact sur les algorithmes à base d’arbres décisionnels
Dans le domaine des algorithmes fondés sur des partitions récursives d’arbres décisionnels — englobant les forêts aléatoires (Random Forests) et les architectures d’amplification de gradient telles que XGBoost ou LightGBM —, la discrétisation univariée continue préalable est conceptuellement redondante. En effet, ces modèles sont par essence invariants sous toute transformation monotone croissante des caractéristiques : l’algorithme procède intrinsèquement à la recherche exhaustive du point de coupure optimal en ordonnant les valeurs réelles observées.
Toutefois, sur le plan strictement opérationnel et computationnel, la pré-discrétisation par quantiles apporte des gains d’efficience colossaux. C’est précisément le principe moteur d’architectures modernes de Gradient Boosting telles que LightGBM ou la classe HistGradientBoostingClassifier de Scikit-Learn. En substituant aux valeurs continues continues réelles un nombre restreint de compartiments entiers par quantiles (typiquement 256 classes), l’algorithme réduit la recherche des meilleures scissions à l’évaluation d’un histogramme discret de dimension finie au lieu d’un tri exhaustif $\mathcal{O}(n \log n)$ à chaque nœud d’arbre, accélérant ainsi l’entraînement d’un ordre de grandeur sans compromettre la performance prédictive finale.
11.3 Effets sur le calcul des corrélations et métriques d’association
La substitution d’une échelle quantitative continue par une échelle ordonnée discrétisée modifie substantiellement la nature et la magnitude des métriques de corrélation bivariées. Le coefficient de corrélation linéaire de Bravais-Pearson ($r$), conçu pour évaluer la stricte collinéarité métrique, subit un phénomène d’atténuation mathématique systématique consécutif au regroupement en classes. L’amplitude de cette atténuation est inversement proportionnelle au nombre de partitions $k$ retenues.
En revanche, le coefficient de corrélation des rangs de Spearman ($rho$) manifeste une résilience exceptionnelle face au partitionnement à fréquence égale. Dans la mesure où la discrétisation préserve rigoureusement l’ordre de tri macroscopique des données d’origine, le rang moyen des individus au sein des cohortes demeure parfaitement aligné sur leurs rangs initiaux, stabilisant l’estimation de l’association ordinale.
Pour quantifier l’association non linéaire entre variables discrétisées, le recours à des métriques non paramétriques de théorie de l’information — telles que l’information mutuelle empirique $I(X; Y)$ ou le coefficient $V$ de Cramér dérivé du tableau de contingence croisé — s’avère particulièrement fécond. L’égalisation préalable des fréquences marginales sur l’axe des abscisses et des ordonnées élimine les déséquilibres structurels dans les tables de contingence, garantissant que les métriques d’association reflètent fidèlement la force du couplage stochastique sans être parasitées par des dissymétries d’échantillonnage.
12. Guide de synthèse méthodologique, reproductibilité et déploiement
12.1 Sauvegarde et persistance des paramètres de partitionnement
Le déploiement industriel d’une chaîne de traitement intégrant une discrétisation par quantiles requiert une rigueur absolue quant à la persistance des artefacts de calcul. Les frontières d’intervalles $b_0, b_1, dots, b_k$ déterminées lors de la phase d’apprentissage ne doivent sous aucun prétexte être recalculées dynamiquement sur les données de production : elles constituent des paramètres d’état figés au même titre que les poids synaptiques d’un réseau de neurones ou les coefficients d’une régression.
Deux méthodologies canoniques permettent d’assurer cette sérialisation déterministe au sein de l’écosystème Python :
- La sérialisation binaire via Joblib ou Pickle : Consiste à sauvegarder l’instance complète de l’objet
KBinsDiscretizerou du pipeline Scikit-Learn préalablement ajusté à l’aide de l’instructionjoblib.dump(discretizer, 'binning_model.joblib'). Cette approche garantit la restauration exacte de l’état interne de l’objet, incluant ses attributs optimisésbin_edges_. - L’exportation déclarative au format JSON : Consiste à extraire le tableau
bin_edges_sous forme de liste de flottants et à la persister dans un fichier de configuration textuel structuré. Cette méthode présente l’avantage décisif de l’interopérabilité multilangage, permettant à des moteurs d’inférence codés en C++, Java ou Go de réappliquer les seuils quantiles Python avec une fidélité arithmétique absolue.
12.2 Protocole de test unitaire et de surveillance de la qualité des données
Dans un contexte de production continue, la surveillance de la robustesse des opérations de discrétisation doit faire l’objet de procédures de tests unitaires et de métriques d’observabilité automatisées. Un protocole d’assurance qualité exhaustif doit comporter un faisceau d’assertions formelles vérifiées systématiquement à chaque inférence par lots :
Tout d’abord, une assertion doit valider l’exhaustivité de l’assignation : aucune observation d’entrée ne doit générer d’indice indéfini ou de classe hors limites, et la somme des effectifs discrets doit égaler scrupuleusement le nombre total d’enregistrements soumis. Ensuite, des tests de détection de glissement de distribution (data drift) doivent auditer la distribution des effectifs observés sur les flux entrants en appliquant périodiquement un test du Chi-deux contre la distribution uniforme théorique calculée sur le jeu d’entraînement.
Si la statistique de test dévie brutalement et que certaines classes deviennent désertes tandis que d’autres s’hypertrophient, cela signale formellement une rupture dans la dynamique génératrice des données réelles. Une alerte d’observabilité doit alors être immédiatement levée pour notifier l’équipe d’ingénierie statistique de la nécessité de réétalonner les quantiles de référence sur un échantillon actualisé.
12.3 Arbre décisionnel pour le choix d’une méthode de discrétisation
Pour clore ce guide méthodologique, il est opportun de synthétiser les arbitrages techniques sous la forme d’un arbre décisionnel unifié orientant le praticien vers la stratégie de discrétisation optimale en fonction des propriétés morphologiques de son jeu de données et de ses objectifs finaux :
- Cas 1 : La variable présente une distribution uniforme ou symétrique sans valeurs extrêmes majeures, et l’interprétabilité physique de l’échelle d’origine est primordiale.
$\rightarrow$ Recommandation : Privilégier la discrétisation à largeur égale (pd.cut). Elle préserve la signification métrique intuitive des intervalles au détriment d’une légère fluctuation démographique sans gravité. - Cas 2 : La variable présente une forte asymétrie, une queue de distribution étirée ou des valeurs aberrantes massives, et l’objectif est d’alimenter un modèle statistique ou d’assurer des groupes comparables.
$\rightarrow$ Recommandation : Déployer rigoureusement la discrétisation à fréquence égale (pd.qcutouKBinsDiscretizer(strategy='quantile')). Elle neutralise les valeurs extrêmes et stabilise la puissance statistique par cellule. - Cas 3 : La distribution empirique présente une masse de Dirac majeure (surabondance d’une même valeur numérique, ex. zéros massifs).
$\rightarrow$ Recommandation : Mettre en œuvre une approche hybride conditionnelle. Extraire la modalité discrète spécifique dans une catégorie isolée, puis appliquer la discrétisation par quantiles exclusivement sur la composante résiduelle continue. - Cas 4 : L’opération s’intègre au sein d’une chaîne prédictive de Machine Learning régularisée.
$\rightarrow$ Recommandation : Intégrer formellementKBinsDiscretizerau sein d’unPipelineScikit-Learn couplé à une optimisation d’hyper-paramètres (choix de $k$) par validation croisée, garantissant la prévention absolue de toute fuite d’information.
Références
Dougherty, J., Kohavi, R., & Sahami, M. (1995). Supervised and unsupervised discretization of continuous features. In Machine Learning Proceedings 1995 (pp. 194-202). Morgan Kaufmann. https://doi.org/10.1016/B978-1-55860-377-6.50032-3
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361-365. https://doi.org/10.1080/00031305.1996.10473566
McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51-56). https://doi.org/10.25080/Majora-92bf1924-003
Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., … & Duchesnay, É. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825-2830. https://jmlr.org/papers/v12/pedregosa11a.html
Shannon, C. E. (1948). A mathematical theory of communication. The Bell System Technical Journal, 27(3), 379-423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65-66. https://doi.org/10.1080/01621459.1926.10502161