
Dans le champ foisonnant de la statistique descriptive et de la sémiotique visuelle des données, la restitution graphique ne constitue point un simple artifice d’illustration superficiel, mais s’affirme plutôt comme un vecteur cognitif d’inférence, de théorisation et de prise de décision. La visualisation des données engage des paradigmes ontologiques fondamentaux relatifs à la nature du mesurable : comment traduire l’infinie complexité du réel sous forme de surfaces, de hauteurs et de coordonnées spatiales immédiatement saisissables par l’intellect ? Au sein de cette armature analytique, le diagramme de Pareto et l’histogramme occupent des positions à la fois omniprésentes et paradoxalement confuses. Souvent assimilés à tort l’un à l’autre par les praticiens novices en raison de leur recours partagé à des barres verticales, ces deux artefacts obéissent pourtant à des logiques mathématiques, épistémologiques et fonctionnelles rigoureusement orthogonales.
L’assimilation abusive entre l’histogramme — instrument par excellence de l’estimation empirique de la densité de probabilité au sein d’un continuum métrique — et le diagramme de Pareto — dispositif déterministe de priorisation catégorielle fondé sur l’asymétrie cumulative — engendre de fréquentes dérives interprétatives. En sciences comportementales, en psychométrie, en ergonomie cognitive et dans la gestion des processus cliniques, une telle confusion ne relève pas d’une banale imprécision sémantique : elle oblitère la structure sous-jacente des données, masque les topologies distributionnelles et corrompt les diagnostics d’action. Choisir entre ces deux outils implique de trancher un dilemme méthodologique central : cherche-t-on à modéliser la variabilité stochastique d’une variable quantitative, ou tente-t-on d’isoler une hiérarchie causale au sein d’une typologie d’événements discrets ?
Cet article propose une exploration comparative, exhaustive et critique du diagramme de Pareto et de l’histogramme. En disséquant leurs genèses historiques respectives, leurs architectures morphologiques, leurs exigences de mesure, leurs processus computationnels et leurs impacts sur la cognition visuelle, nous établirons une grille de démarcation définitive. De l’analyse algorithmique des largeurs d’intervalles aux retombées cliniques de la bimodalité en passant par le traitement de la traîne longue des facteurs résiduels, nous fournirons au chercheur et au praticien les repères nécessaires pour manier ces deux géants de la statistique avec une rigueur irréprochable.
1. Introduction épistémologique et distinction fondamentale entre le diagramme de Pareto et l’histogramme
1.1 Contexte historique et origines mathématiques des deux instruments
L’émergence conjointe du diagramme de Pareto et de l’histogramme au tournant des XIXe et XXe siècles reflète la maturation des statistiques descriptives modernes et leur spécialisation progressive face à des impératifs épistémologiques distincts. Le diagramme de Pareto tire son fondement conceptuel des travaux pionniers de l’économiste et sociologue italien Vilfredo Pareto. Dans son Cours d’économie politique (1896), Pareto met en exergue un phénomène d’asymétrie frappant dans la distribution de la richesse nationale, constatant qu’environ 80 % des terres du Royaume d’Italie sont détenues par 20 % de la population. Toutefois, la formalisation de cette observation sociologique sous la forme d’un graphique opérationnel d’ingénierie et de gestion de la qualité ne revient pas à Pareto lui-même, mais à Joseph Moses Juran. Dans les années 1940 et 1950, Juran extrapole cette loi de concentration empirique aux défaillances industrielles, baptisant le principe « les quelques facteurs vitaux et les nombreux facteurs triviaux » (the vital few and the trivial many), et institue le diagramme hybride mêlant barres décroissantes et courbe cumulative pour piloter la réduction des défauts.
En miroir, l’histogramme s’ancre dans une trajectoire purement biométrique et probabiliste, indissociable de l’essor des mathématiques appliquées britanniques. Forgé par le statisticien Karl Pearson en 1891 lors de ses conférences fondatrices sur l’évolution et l’hérédité, le terme « histogramme » trouve son étymologie dans le grec ancien histos (le mât, ou tout élément dressé verticalement) et gramma (le tracé, l’écrit). Confronté à la variabilité continue des mesures anatomiques humaines — longueurs de crânes, tailles corporelles, envergures d’organes —, Pearson ressent la nécessité impérieuse de transcender le simple relevé de données brutes pour visualiser concrètement l’approximation empirique d’une fonction de densité de probabilité continue. L’histogramme naît ainsi comme un réceptacle géométrique destiné à capturer la dispersion stochastique continue, là où le tracé de Pareto sera plus tard érigé en instrument de focalisation sélective pour l’action corrective.
Cette divergence généalogique sanctionne une séparation téléologique fondamentale : tandis que Pearson cherche à approcher les lois naturelles invisibles de la variation biologique par le découpage rationnel d’un continuum, Juran adapte une dynamique de pouvoir socio-économique en un algorithme pragmatique de tri catégoriel. L’histoire des statistiques descriptives modernes témoigne ainsi de cette bifurcation précoce entre modélisation de la dispersion théorique et hiérarchisation stratégique des causes opérationnelles, deux visions du monde qui conditionnent encore aujourd’hui l’usage de ces représentations dans la recherche scientifique.
1.2 Définitions formelles et objectifs primaires de visualisation
D’un point de vue formel, le diagramme de Pareto se définit comme une visualisation graphique hybride composée d’un diagramme en colonnes et d’une ligne polygonale cumulative. Les modalités qualitatives, ou classes discrètes d’un phénomène, y sont disposées sur l’axe des abscisses par ordre strictement décroissant de leurs effectifs ou de leurs coûts pondérés. L’axe vertical primaire mesure l’amplitude absolue ou relative de chaque modalité individuelle, tandis qu’un axe vertical secondaire, gradué de 0 à 100 %, accueille l’ogive cumulative représentant la fonction de répartition empirique discrète des facteurs agrégés. L’objectif primaire du diagramme de Pareto est éminemment décisionnel : il vise à séparer visuellement, sans ambiguïté cognitive, la minorité des causes générant la majorité des effets observés, guidant ainsi l’optimisation des ressources et la sélectivité stratégique.
À l’inverse, l’histogramme se définit en théorie des probabilités et en statistique comme une estimation non paramétrique de la densité de probabilité d’une variable aléatoire continue. Structurellement, il consiste en une succession de rectangles contigus dressés au-dessus d’intervalles disjoints et adjacents, nommés « classes » ou bins, qui partitionnent l’ensemble de définition de la variable métrique. La caractéristique géométrique fondamentale de l’histogramme réside dans le fait que c’est la surface de chaque rectangle — et non pas simplement sa hauteur — qui est rigoureusement proportionnelle au nombre d’observations tombant dans la classe correspondante. L’objectif primaire de l’histogramme réside dans la caractérisation morphologique d’une distribution : apprécier la tendance centrale, jauger la variance, identifier l’asymétrie, détecter la présence d’un aplatissement anomal (kurtosis) et démasquer une éventuelle multimodalité révélatrice de sous-populations sous-jacentes.
La différenciation conceptuelle entre hiérarchie causale et dispersion stochastique est irréductible. Le diagramme de Pareto comprime l’espace d’information pour hiérarchiser et discriminer, opérant une réorganisation délibérée de l’axe horizontal guidée par l’amplitude du signal. L’histogramme préserve fidèlement la géométrie sous-jacente de l’espace métrique pour laisser émerger les propriétés émergentes de la distribution naturelle. Dès lors, le choix de l’un ou l’autre de ces instruments influe directement sur la teneur épistémique de la communication scientifique, transmettant soit un impératif d’action ciblée, soit un portrait holistique de la variabilité mesurée.
1.3 Pertinence comparée dans le champ des sciences comportementales
Dans le domaine des sciences comportementales, de la psychologie clinique et des neurosciences cognitives, ces deux modes de visualisation jouent des rôles complémentaires mais strictement non interchangeables. L’histogramme s’impose comme l’outil privilégié de l’investigation psychométrique et neurocognitive fondamentale. Lors de la standardisation d’un test psychométrique, comme le quotient intellectuel ou les échelles de dépression standardisées (par exemple le BDI-II), la distribution des scores bruts au sein d’un échantillon normatif doit impérativement être documentée au moyen d’un histogramme. Cette représentation permet au chercheur de s’assurer de la normalité des scores, d’identifier les effets de plancher ou de plafond, et d’observer la dispersion des latences de réponse mesurées en millisecondes lors de tâches d’attention sélective (comme la tâche de Stroop ou d’inhibition de type Go/No-Go).
Le diagramme de Pareto trouve quant à lui un terrain d’application fécond en psychologie appliquée, en ergonomie organisationnelle et dans l’ingénierie des interventions comportementales. Qu’il s’agisse de documenter la typologie des erreurs cognitives commises par des pilotes de ligne lors de phases critiques de vol, de classer les sources récurrentes d’interruptions de tâches chez les soignants en unités de soins intensifs, ou de recenser les déclencheurs proximaux de crises au sein d’une cohorte de patients souffrant de trouble panique, Pareto permet d’isoler immédiatement les cibles thérapeutiques ou préventives à plus fort levier d’impact. L’analyste du comportement ne cherche pas ici à mesurer une variance continue, mais à quantifier la récurrence de comportements discrets hautement préjudiciables.
L’adéquation méthodologique repose donc sur le paradigme de recherche retenu. Si le protocole vise à vérifier la conformité d’une échelle à un modèle théorique gaussien ou à quantifier l’hétérogénéité d’un trait latent continu, l’histogramme constitue l’unique choix valide. Si le protocole s’inscrit dans une perspective d’optimisation comportementale, de diagnostic d’incidents critiques ou d’ingénierie de la résilience organisationnelle, le diagramme de Pareto offre une lisibilité décisionnelle inaccessible aux formats distributionnels classiques.
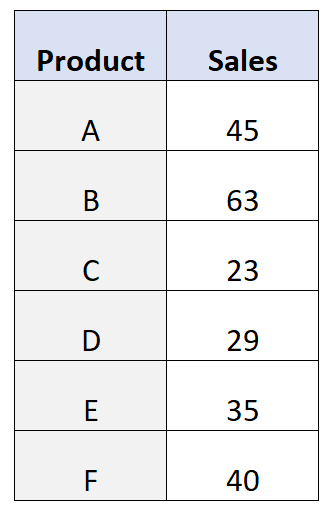
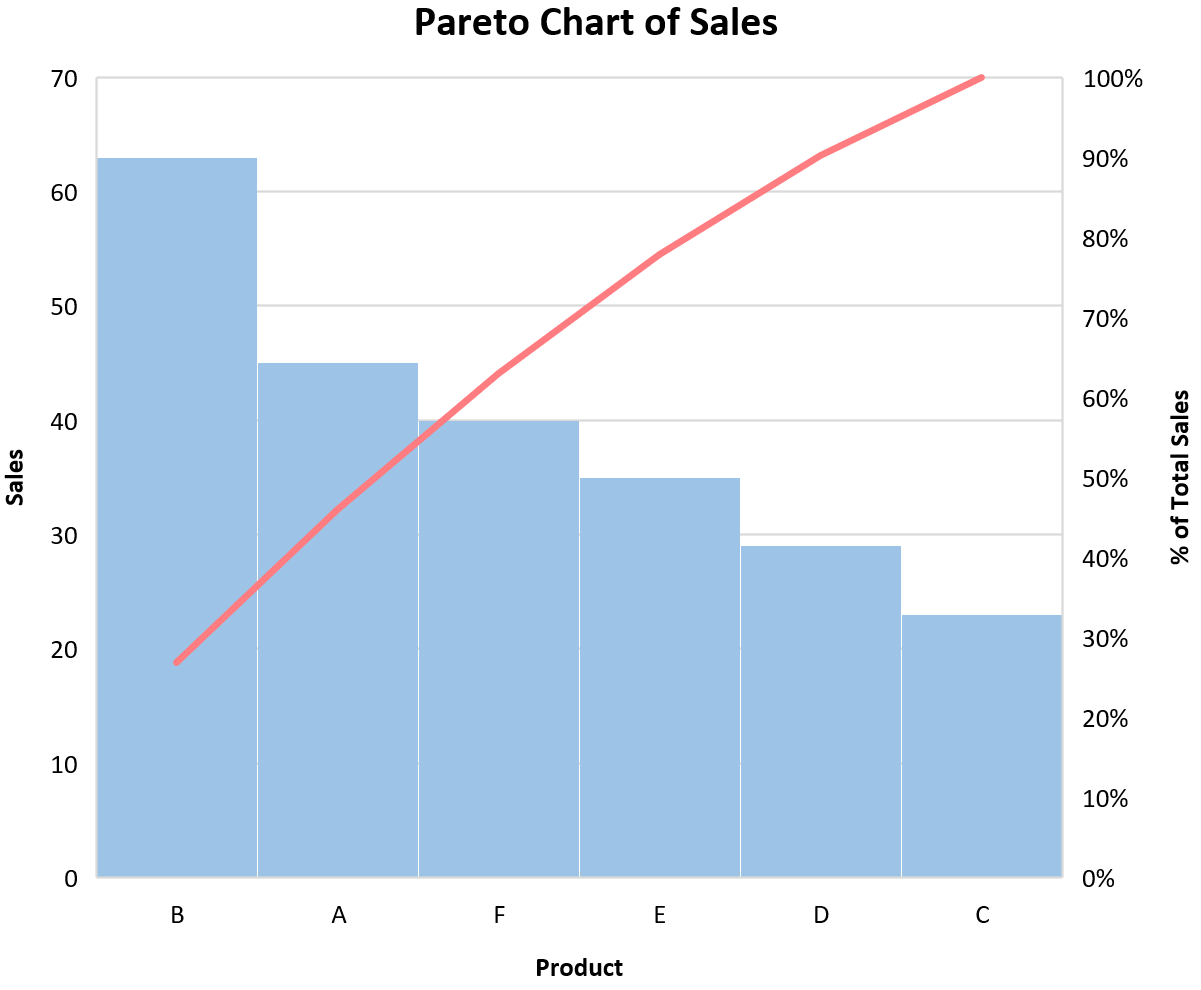
2. Fondements théoriques et morphologie structurelle du diagramme de Pareto
2.1 Architecture du double axe ordonné et interprétation de la courbe cumulative
L’anatomie graphique du diagramme de Pareto repose sur une géométrie rigoureuse à double échelle verticale, conçue pour synchroniser deux niveaux d’information statistique sur un même plan projectif. L’axe vertical primaire, systématiquement positionné sur la gauche, quantifie l’amplitude brute ou relative des événements discrets étudiés. Selon la nature de l’investigation, cette échelle peut mesurer des fréquences d’occurrence pures (nombres d’erreurs, effectifs de patients, dénombrements de symptômes), ou des métriques continues pondérées de gravité (heures de productivité perdues, coûts financiers induits, indices composites de sévérité clinique). Les rectangles verticaux érigés le long de cet axe ne se touchent généralement pas, matérialisant visuellement la nature discrète et mutuellement exclusive des catégories nominales représentées.
L’axe vertical secondaire, disposé sur la marge droite du tracé, accueille quant à lui la fonction de répartition empirique, invariablement calibrée de 0 % à 100 %. Sur cette armature vient se greffer un polygone de fréquences cumulées, souvent dénommé « ogive » en référence aux constructions de Francis Galton. Cette courbe prend son origine au sommet de la première barre — la modalité prépondérante — et progresse de façon strictement monotone croissante en connectant l’extrémité supérieure droite de chaque rectangle successif, pour culminer au niveau exact des 100 % au droit de la dernière catégorie nominale. Chaque point nodal de cette ligne brisée exprime mathématiquement la somme partielle des proportions des facteurs déjà recensés :
$$S_k = \sum_{i=1}^{k} p_i \quad \text{a\vec} \quad p_i = \frac{n_i}{N}$$
L’intérêt cognitif de cette construction réside dans la lecture visuelle immédiate des points d’inflexion. Lorsque la pente de l’ogive s’adoucit brutalement, formant un coude manifeste, l’analyste décèle le seuil au-delà duquel l’adjonction de nouvelles catégories n’apporte qu’un gain marginal d’explication ou de couverture du problème. Cette rupture topologique marque la frontière opérationnelle entre l’espace d’intervention prioritaire et le bruit de fond systémique.
2.2 L’opérationnalisation du principe des 80/20 en recherche empirique
Le fondement théorique sous-tendant l’usage du diagramme de Pareto est le principe éponyme des 80/20, également formalisé sous le vocable de « loi de rareté des facteurs » ou d’asymétrie de distribution. Transposé aux sciences du comportement et à la recherche clinique, ce postulat stipule qu’approximativement 80 % des conséquences délétères observées au sein d’un système émergent de l’action de 20 % seulement des causes potentielles identifiées. En psychologie de la santé, par exemple, il a été fréquemment observé qu’une part minoritaire de déterminants contextuels (tels que la rupture de l’alliance thérapeutique ou la présence de comorbidités addictives) rend compte de la grande majorité des échecs d’adhésion aux traitements chroniques.
Il importe toutefois de dissiper une confusion théorique largement répandue : le ratio 80/20 ne constitue nullement une constante universelle mathématiquement contraignante, ni une identité dont la somme arithmétique devrait nécessairement égaler cent. En réalité, le couplage (80, 20) est purement fortuit et illustratif ; la distribution sous-jacente des événements rares et hautement impactants est régie par des fonctions à décroissance en loi de puissance, de type :
$$P(X > x) \sim x^{-\alpha}$$
Selon la valeur du paramètre de forme $\alpha$, la concentration réelle peut s’établir à des ratios de 70/30, 90/10, voire 95/5. Dans l’investigation empirique, formaliser l’asymétrie consiste donc à tester le degré d’hétérogénéité des causalités plutôt qu’à rechercher dogmatiquement un seuil fixe de 80 %. Lorsque $\alpha le 1$, la distribution présente une variance infinie et une concentration phénoménale, justifiant pleinement la focalisation radicale sur le tout premier facteur. Lorsque $\alpha > 2$, la distribution tend vers une uniformité relative où le diagramme de Pareto perd de sa superbe décisionnelle, les barres affichant des hauteurs comparables qui témoignent d’une causalité diffuse et multifactorielle.
2.3 Traitement spécifique de la catégorie résiduelle des autres facteurs
Une règle méthodologique et ergonomique cardinale dans la morphologie du diagramme de Pareto concerne la gestion de la longue traîne des modalités mineures par l’instauration d’une catégorie résiduelle, usuellement désignée sous l’étiquette « Autres » ou « Facteurs divers ». Dans tout système complexe, le recensement exhaustif des étiologies ou des typologies de défaillance génère une multiplicité de catégories incidentes n’apparaissant qu’une ou deux fois. Maintenir chacune de ces modalités sous forme de barre individuelle encombrerait stérilement l’axe horizontal, violant le principe d’économie cognitive (la charge cognitive extrinsèque théorisée par John Sweller) et diluant la force visuelle des facteurs vitaux.
Pour remédier à cette dispersion sémiotique, le protocole standard prescrit de plafonner l’affichage à un nombre restreint de catégories dominantes — généralement entre cinq et neuf, conformément aux capacités d’empan de traitement visuel humain — et d’agréger toutes les modalités subséquentes en une unique classe composite terminale. Toutefois, cette pratique introduit une exception structurelle au principe de monotonie : bien que la catégorie « Autres » puisse cumuler une fréquence absolue supérieure à celle de l’avant-dernière barre individuelle en raison de l’agrégation, elle doit impérativement être reléguée à l’extrême droite du graphique, immédiatement avant le terme de l’ogive cumulative.
Cette agrégation résiduelle n’est pas sans danger épistémologique. Si le chercheur applique un seuil de coupure trop brutal, il s’expose au risque de masquer, au sein de ce conglomérat hétéroclite, des signaux faibles précurseurs ou des facteurs causaux rares mais d’une criticité létale (par exemple, un effet secondaire médicamenteux rarissime mais fatal en pharmacovigilance psychiatrique). Le statisticien doit donc s’assurer que l’agrégat résiduel ne contient que des variables intrinsèquement homogènes dans leur bénignité, sous peine de commettre une erreur systématique d’escamotage qualitatif.
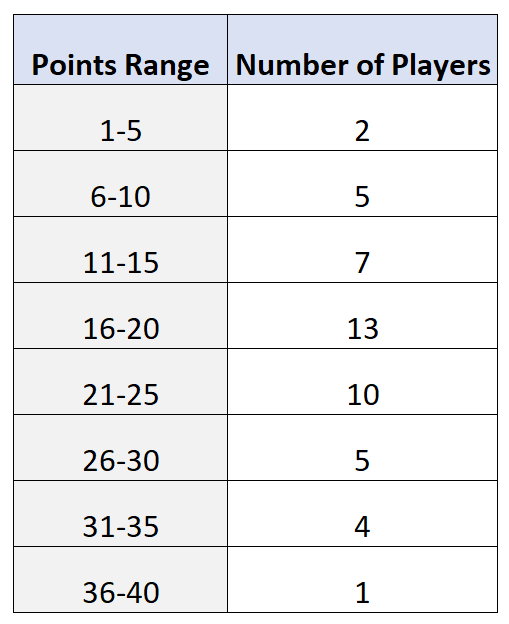
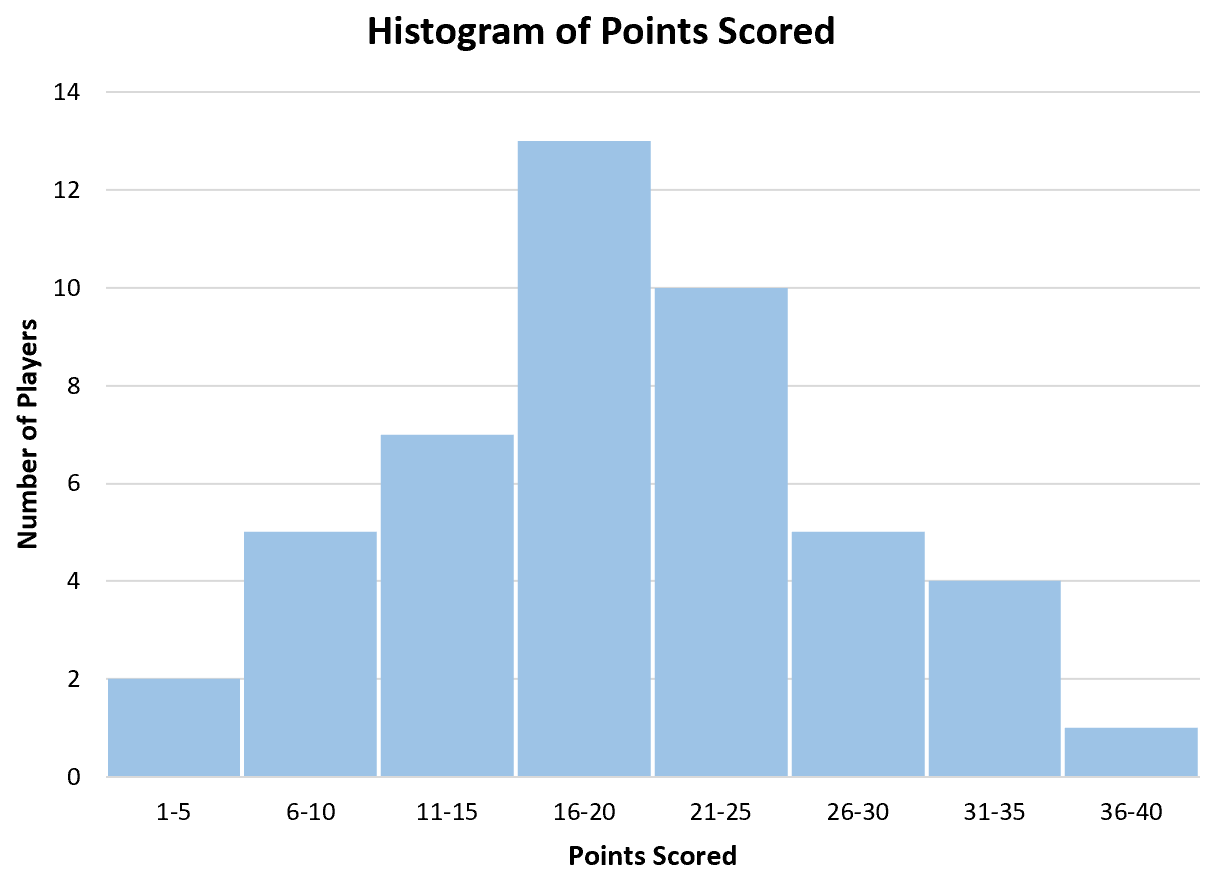
3. Fondements théoriques et morphologie structurelle de l’histogramme
3.1 La segmentation en classes et la notion d’intervalles contigus
L’armature conceptuelle de l’histogramme repose sur la discrétisation spatiale d’un continuum mathématique par la création d’intervalles contigus, exhaustifs et mutuellement exclusifs, conventionnellement appelés « classes » (ou bins). L’axe horizontal ne représente nullement une collection arbitraire d’étiquettes qualitatives, mais incarne l’axe réel $\mathbb{R}$ des nombres, porteur d’une topologie métrique intrinsèque. De cette nature découle une règle morphologique intangible qui sépare radicalement l’histogramme du diagramme à barres : l’absence absolue d’espacement physique entre les rectangles successifs. Chaque frontière droite d’un rectangle constitue rigoureusement la frontière gauche du rectangle adjacent, traduisant visuellement la continuité sous-jacente du phénomène physique ou psychologique mesuré (comme le temps, la masse, ou le score continu d’un potentiel évoqué en électroencéphalographie).
Le partitionnement de l’axe des abscisses soulève un défi algorithmique critique : comment calibrer la largeur de classe $h$ de manière optimale ? Un découpage trop fin ($h$ infinitésimal) transforme l’histogramme en un peigne hérissé de pics clairsemés dominés par le bruit stochastique d’échantillonnage ; à l’inverse, un découpage trop large ($h$ démesuré) écrase la structure interne de la distribution sous un bloc informe, masquant la présence d’asymétries ou de multimodalités vitales. Pour pallier l’arbitraire subjectif, la littérature biométrique a forgé plusieurs formulations analytiques fondatrices :
- La règle de Sturges (1926) : Reposant sur l’hypothèse implicite d’une distribution sous-jacente rigoureusement normale, elle préconise un nombre de classes $k = 1 + \log_2(n) \approx 1 + 3{,}322 \log_{10}(n)$, où $n$ est la taille de l’échantillon. Cette formule se révèle notoirement inadaptée pour les très grands échantillons ($n > 1000$) ou les distributions fortement asymétriques, car elle tend à sous-estimer dramatiquement le nombre de classes requis.
- La règle de Scott (1979) : Formulée dans une optique de minimisation de l’erreur quadratique moyenne intégrée de l’estimateur de densité, elle définit la largeur idéale par $h = 3{,}49 , s , n^{-1/3}$, où $s$ représente l’écart-type de l’échantillon.
- La formule de Freedman-Diaconis (1981) : Plus robuste face aux valeurs aberrantes grâce au recours à des statistiques d’ordre non paramétriques, elle calcule la largeur de classe selon $h = 2 , \text{IQR} , n^{-1/3}$, où $\text{IQR}$ figure l’écart interquartile ($Q_3 – Q_1$).
Le paramétrage rigoureux de ce maillage constitue l’étape liminaire incontournable garantissant que l’histogramme agira comme un révélateur objectif, et non comme un filtre déformant, de la réalité distributionnelle étudiée.
3.2 Densité de probabilité, surface des rectangles et variabilité
L’incompréhension la plus pernicieuse entourant l’histogramme concerne l’interprétation de la verticalité de ses composants. Dans l’esprit du public profane et des logiciels de tableur grand public, la hauteur d’une barre est systématiquement assimilée à l’effectif brut d’individus. Or, dans la théorie mathématique de Pearson, le principe régulateur absolu de l’histogramme réside dans le fait que la fréquence d’une classe est directement proportionnelle à la surface géométrique du rectangle érigé au-dessus d’elle, et non à sa simple élévation verticale :
$$\text{Aire du rectangle} = \text{Largeur de classe } (h_i) \times \text{Hauteur } (f_i) propto \text{Effectif } (n_i)$$
Cette distinction conceptuelle prend une importance vitale dès lors que l’on manipule des histogrammes à pas variable (classes de largeurs inégales). Si une classe présente une amplitude double des autres afin de regrouper des valeurs clairsemées dans les extrêmes, sa hauteur brute doit impérativement être divisée par deux pour conserver une densité d’observations exacte par unité métrique. L’axe vertical n’indique plus alors un dénombrement cardinal pur, mais une densité de fréquence empirique, définie par le ratio de la fréquence relative sur la largeur de l’intervalle :
$$d_i = \frac{p_i}{h_i} = \frac{n_i}{N \times h_i}$$
Sous cette normalisation rigoureuse, la somme de l’ensemble des aires des rectangles équivaut exactement à 1. L’histogramme matérialise ainsi une fonction de densité empirique $\hat{f}(x)$ qui, en vertu du théorème de Glivenko-Cantelli et des lois de convergence asymptotique, tend à converger vers la véritable fonction de densité de probabilité continue $f(x)$ de la population parente lorsque la taille de l’échantillon $n to \infty$ et que simultanément $h to 0$. L’histogramme permet donc à l’analyste d’évaluer visuellement la masse de probabilité, d’estimer intuitivement le centre de gravité de la variable (tendance centrale), la largeur de sa dispersion (variance spatiale) et la présence d’hétéroscédasticités structurelles.
3.3 Évaluation de la normalité et des anomalies distributionnelles
En recherche psychologique et clinique, l’histogramme sert de première ligne de diagnostic exploratoire pour soumettre les données quantitatives aux tests de plausibilité distributionnelle avant tout déploiement de modèles linéaires généraux (ANOVA, régressions multiples, modélisation par équations structurelles). La lecture visuelle attentive du profil géométrique permet de déceler instantanément deux violations fondamentales de la normalité : l’asymétrie (skewness) et l’aplatissement (kurtosis).
Une distribution présentant une asymétrie positive (étalement vers la droite) affiche une concentration dense de rectangles à gauche et une longue queue s’effilochant vers les valeurs élevées, configuration omniprésente dans la mesure des temps de réaction psychomoteurs, des dépenses de soins psychiatriques ou des taux plasmatiques de cortisol sous stress aigu. Inversement, une asymétrie négative (étalement vers la gauche) révèle un tassement vers les valeurs maximales, typique des tests cognitifs trop faciles générant un effet de plafond sévère. L’aplatissement permet quant à lui de distinguer les distributions leptokurtiques (hautement pointues avec des queues épaisses, signalant une forte fréquence d’événements extrêmes) des distributions platykurtiques (profil aplati et diffus).
Au-delà de ces moments statistiques, l’histogramme est l’unique instrument graphique capable d’exposer immédiatement la bimodalité ou la multimodalité d’une distribution continue. L’observation de deux sommets proéminents séparés par une vallée au sein d’un échantillon clinique ne relève jamais du hasard statistique : elle trahit de manière quasi univoque l’existence de deux sous-populations physiologiquement ou psychologiquement hétérogènes artificiellement amalgamées au sein de la même cohorte (par exemple, des répondeurs versus non-répondeurs à une molécule pharmacologique, ou des patients présentant des variants génétiques polymorphiques distincts). L’histogramme force ainsi le clinicien à renoncer à l’illusion d’une moyenne unique représentative pour investiguer la stratification latente de ses sujets.
4. Nature des variables et échelles de mesure : typologie quantitative vs qualitative
4.1 L’échelle nominale et ordinale au cœur du diagramme de Pareto
L’éligibilité d’un jeu de données au tracé d’un diagramme de Pareto dépend rigoureusement de la position de la variable mesurée au sein de la célèbre typologie des échelles de mesure de Stanley Smith Stevens (1946). Le diagramme de Pareto est organiquement conçu pour opérer sur des échelles nominales et, sous certaines conditions strictes, ordinales. Par essence, une variable nominale catégorise les entités observées selon des critères d’équivalence et d’exclusion mutuelle, sans qu’aucune relation métrique de distance, d’addition ou de zéro naturel n’existe entre les attributs. En psychopathologie descriptive, les données se présentent massivement sous cette forme : typologies d’erreurs cognitives (inférence arbitraire, surgénéralisation, pensée dichotomique), motifs d’admission en service d’urgence psychiatrique, ou déclencheurs phobiques spécifiques.
Dans cette configuration, l’attribution d’un ordre sur l’axe des abscisses ne préexiste pas aux données : elle est générée a posteriori par le chercheur, par l’entremise exclusive du dénombrement des effectifs. La variable nominale est ainsi convertie en une échelle de décision pragmatique, où le rang horizontal reflète fidèlement le poids causal de chaque facteur dans le problème global analysé. Lorsque la variable initiale est de nature ordinale (par exemple, des stades de sévérité clinique allant de minime à catastrophique), le recours au diagramme de Pareto requiert une vigilance méthodologique extrême. En ordonnant les modalités selon leur fréquence décroissante, le diagramme brise inéluctablement l’ordre intrinsèque naturel de la variable ordinale (le stade « léger » pouvant se retrouver relégué après le stade « sévère » si ce dernier est plus fréquent). Ce bris délibéré de la hiérarchie naturelle n’est conceptuellement défendable que si la finalité de l’étude est expressément de prioriser l’allocation de ressources opérationnelles selon la fréquence d’apparition, au détriment de la progression phénoménologique de l’état clinique.
4.2 L’échelle d’intervalle et de rapport indissociable de l’histogramme
À l’opposé diamétral des catégories discrètes de Stevens, l’histogramme exige comme condition sine qua non l’existence d’une variable quantitative continue, articulée sur une échelle d’intervalle (où les distances entre valeurs sont égales, mais où le zéro est conventionnel, telle la température en degrés Celsius ou les scores standardisés d’échelles de personnalité) ou sur une échelle de rapport (pourvue d’un zéro absolu non arbitraire, telles la latence temporelle, la pression artérielle ou la concentration salivaire d’alpha-amylase).
Le tracé d’un histogramme repose sur le postulat mathématique intangible que l’espace sous-jacent est topologiquement ordonné et doté d’une métrique euclidienne. Chaque point de l’abscisse possède un antécédent et un successeur prédéterminés par les propriétés formelles du corps des nombres réels. De ce fait, appliquer un histogramme à des étiquettes purement qualitatives — par exemple, ériger des rectangles contigus pour représenter des catégories de diagnostics nosologiques selon le DSM-5 — relève du contresens méthodologique absolu. L’accolement des rectangles suggérerait fallacieusement au cortex visuel de l’observateur qu’il existe une transition continue et un ordre métrique naturel entre un trouble obsessionnel-compulsif et un épisode dépressif caractérisé, ce qui constitue une aberration épistémologique majeure.
Une zone de convergence technique concerne toutefois les variables quantitatives discrètes à large étendue numérique (telles que le nombre de bouffées d’anxiété éprouvées par mois ou le décompte de pas quotidiens). Bien que formellement discrètes, ces variables peuvent être assimilées à des variables « pseudo-continues » et visualisées légitimement sous forme d’histogramme, à la condition expresse que le nombre de valeurs distinctes soit suffisamment grand pour justifier un regroupement par classes contiguës sans masquer la structure mathématique fondamentale du phénomène.
4.3 Le cas particulier du découpage catégoriel de données quantitatives
Il survient fréquemment, dans la pratique de la recherche translationnelle, que des investigateurs opèrent une transformation en amont de variables quantitatives continues pour les forcer artificiellement dans le moule d’un diagramme de Pareto. Cette opération, souvent qualifiée de discrétisation ou de binarisation (par exemple, transformer l’âge continu d’une cohorte en tranches d’âge discrètes, ou classifier des taux d’hémoglobine glyquée en catégories ordinales de gravité), permet de traiter une variable métrique comme un jeu de facteurs causaux concurrents afin d’évaluer quelles tranches de la population consomment le plus de ressources médicales.
Si cette approche s’avère recevable d’un point de vue managérial ou médico-économique, elle s’accompagne inéluctablement d’un coût méthodologique colossal : la perte irréversible d’information statistique. Réduire une variable continue à quelques boîtes nominales anéantit la finesse de la distribution, lisse artificiellement les variations locales et augmente drastiquement le risque d’erreurs de type I et II dans les inférences ultérieures (comme l’a magistralement démontré Jacob Cohen dans ses plaidoyers contre la dichotomisation systématique). Pour qu’une telle transition d’une représentation par histogramme vers un diagramme de Pareto soit statistiquement et scientifiquement justifiable, trois critères minimaux doivent être satisfaits :
- Les seuils de découpage doivent être théoriquement fondés sur des consensus cliniques standardisés et préétablis, et non déterminés de façon opportuniste après inspection exploratoire des données (interdiction du data dredging).
- L’objectif de l’analyse doit viser explicitement une décision catégorielle binaire ou sélective (par exemple, l’inclusion d’une tranche d’âge prioritaire dans une campagne de vaccination ciblée).
- Le chercheur doit obligatoirement fournir, en matériel supplémentaire ou en vis-à-vis, l’histogramme continu non discrétisé afin de permettre à la communauté scientifique d’évaluer la forme distributionnelle réelle exempte d’artéfacts de discrétisation.
5. Principes de tri et agencement spatial : ordre décroissant versus continuité séquentielle
5.1 L’impératif algorithmique du tri par rangs dans le diagramme de Pareto
L’essence computationnelle et visuelle du diagramme de Pareto repose sur l’application rigoureuse d’un algorithme de tri préalable des observations. Contrairement aux diagrammes à barres standardisés qui peuvent être structurés selon un ordre alphabétique, chronologique ou thématique arbitraire, le diagramme de Pareto impose l’ordonnancement mathématique strict de ses catégories selon une fonction de tri décroissant :
$$n_{(1)} ge n_{(2)} ge n_{(3)} ge dots ge n_{(k)}$$
Cette propriété de monotonicité décroissante n’est pas un choix esthétique accessoire ; elle est le moteur même du fonctionnement de l’outil. En contraignant les données à adopter cette pente descendante systématique de gauche à droite, le graphique aligne la trajectoire visuelle sur l’ordre de priorité décisionnelle. Le système cognitif de l’observateur est instantanément capté par la première barre érigée à l’extrême gauche, qui synthétise la problématique majeure, puis glisse naturellement le long de la pente pour évaluer la vitesse d’atténuation du signal.
Cette réorganisation spatiale a pour corollaire la destruction pure et simple de tout ordre logique antérieur des modalités. Si l’on étudie par exemple les défaillances de sécurité d’un laboratoire de recherche comportementale selon les étapes temporelles du protocole expérimental, l’ordonnancement de Pareto déstructurera la chronologie expérimentale pour regrouper en tête les phases les plus accidentogènes, indépendamment de leur moment de survenue. Cette rupture est sciemment consentie : le gain en lisibilité hiérarchique compense l’amputation de la séquence temporelle ou thématique.
5.2 La préservation stricte de la topologie métrique dans l’histogramme
Toute velléité de réordonner les barres d’un histogramme selon leur effectif décroissant relèverait d’une hérésie géométrique absolue. Dans un histogramme, l’agencement horizontal est captif de la topologie immuable de l’ensemble des nombres réels. L’axe des abscisses progresse impérativement de la valeur minimale observée vers la valeur maximale observée, de gauche à droite :
$$x_0 < x_1 < x_2 < dots < x_k$$
La morphologie globale de la figure (l’alternance de creux, de vallées, de plateaux et de dômes) est le reflet fidèle de la densité empirique locale d’individus à chaque palier du continuum métrique. Réordonner les classes d’un histogramme pour faire figurer la classe modale en première position, suivie de la deuxième classe la plus remplie, détruirait instantanément les relations de voisinage spatial entre intervalles adjacents. Cela anéantirait toute perception de la variance, rendrait invisible l’asymétrie, transformerait une distribution bimodale en une illusion d’unimodalité décroissante et priverait l’analyste de tout repère d’extrapolation distributionnelle.
L’histogramme exige donc de l’analyste le respect scrupuleux de l’espace métrique : les classes vides doivent rester visibles sous la forme d’intervalles de hauteur nulle, car un vide au sein d’une distribution constitue en soi une information scientifique de premier ordre (signalant une rupture de continuité, un artefact de mesure ou un effet de troncature dans l’échantillonnage).
5.3 Comparaison fonctionnelle de l’impact sémiotique de l’agencement
L’analyse sémiotique comparée des deux représentations graphiques démontre qu’elles activent des mécanismes neuro-visuels et des structures d’inférence profondément divergentes chez l’observateur humain, comme le synthétise le cadre d’analyse de Jacques Bertin dans sa Sémiologie graphique.
Le diagramme de Pareto agit comme un instrument de focalisation sélective et de réduction de complexité. L’œil est irrésistiblement guidé vers la gauche par la hauteur dominante de la première barre et la montée abrupte initiale de l’ogive cumulative. L’artefact graphique génère un « effet d’entonnoir cognitif », canalisant immédiatement l’attention exécutive vers la zone de décision critique. Il impose une lecture téléologique orientée vers l’action corrective : « Voici où réside l’inefficience principale, voici ce qu’il convient de traiter en premier lieu ».
L’histogramme opère au contraire comme une cartographie holistique de l’hétérogénéité d’un phénomène. La lecture visuelle n’est pas polarisée sur un point d’impact unique, mais requiert une inspection panoramique globale et intégrative. L’analyste balaie l’ensemble de l’axe pour évaluer la dispersion globale, juger de la symétrie par rapport au point médian, scruter les deux queues de distribution à la recherche d’observations aberrantes ou extrêmes, et apprécier la régularité des transitions de pente. Le diagramme de Pareto dit à l’expérimentateur où intervenir ; l’histogramme lui révèle comment la nature s’est déployée dans l’espace de mesure.
6. Le rôle de la courbe cumulative face aux fonctions de densité théorique
6.1 L’intégration cumulée dans le diagramme de Pareto : lecture et utilité
L’élément distinctif le plus manifeste qui orne le diagramme de Pareto est sa courbe polygonale cumulative superposée, qui formalise visuellement l’intégration discrète des proportions relatives d’observations au fur et à mesure que l’on progresse dans la hiérarchie décroissante des causes. Cette ligne brisée transforme un simple inventaire de fréquences en un dispositif d’évaluation de la couverture décisionnelle globale.
Dans la pratique clinique ou d’ingénierie hospitalière, la courbe cumulative permet de résoudre graphiquement des questions d’arbitrage coût-bénéfice sans nécessiter de calculs algébriques complexes. Par exemple, si une direction d’établissement de santé se fixe l’objectif stratégique d’éliminer 70 % des événements indésirables graves survenus en psychiatrie de crise, il lui suffit de tracer une ligne horizontale partant de la graduation 70 % sur l’axe vertical secondaire de droite, de repérer son point d’intersection avec l’ogive cumulative, puis d’abaisser une perpendiculaire vers l’axe des abscisses. Les barres situées à gauche de cette coordonnée désignent immédiatement la combinaison minimale de facteurs étiologiques qu’il est impératif d’éradiquer pour satisfaire le mandat fixé.
La pente locale de l’ogive fournit en outre une indication directe du rendement marginal décroissant de toute intervention future : plus la pente s’infléchit et s’horizontalise, plus l’effort consenti pour adresser les facteurs correspondants procurera un bénéfice clinique ou opérationnel dérisoire. L’ogive de Pareto est donc par excellence une métrique d’efficience pragmatique.
6.2 La superposition de courbes de densité sur l’histogramme
L’histogramme s’enrichit lui aussi fréquemment de lignes courbes superposées, mais celles-ci poursuivent une visée d’adéquation théorique et de vérification paramétrique, radicalement distincte de la fonction cumulative de Pareto. La démarche canonique consiste à ajuster sur l’histogramme empirique normalisé en densité une fonction de densité de probabilité théorique calculée à partir des paramètres de l’échantillon (généralement la moyenne empirique $\bar{x}$ et l’écart-type empirique $s$). Dans la majorité des études biométriques, il s’agit d’une courbe de Gauss (distribution normale) :
$$f(x) = \frac{1}{s \sqrt{2\pi}} \exp\left( -\frac{1}{2} \left(\frac{x – \bar{x}}{s}\right)^2 \right)$$
Cette superposition visuelle offre un test de conformité immédiat : l’histogramme se coule-t-il harmonieusement sous la cloche théorique, ou laisse-t-il transparaître des saillies, des asymétries ou des queues anormalement lourdes ? Dans une perspective non paramétrique contemporaine, les statisticiens superposent de plus en plus fréquemment une courbe d’estimation de densité par noyau (Kernel Density Estimation ou KDE). Cette technique génère une estimation lisse et continue de la distribution sous-jacente sans imposer d’a priori théorique contraignant, permettant de s’affranchir des artéfacts visuels induits par le découpage arbitraire en classes :
$$\hat{f}_h(x) = \frac{1}{n h} \sum_{i=1}^{n} K\left(\frac{x – X_i}{h}\right)$$
Ces superpositions sur l’histogramme ont une vocation strictement inférentielle : elles permettent d’évaluer la validité des postulats de distribution préalable avant d’engager des modélisations statistiques lourdes.
6.3 Différences fondamentales d’inférence statistique
L’opposition entre la courbe cumulative de Pareto et la fonction de densité ajustée sur un histogramme consacre deux paradigmes d’inférence statistique profondément dissociés :
- Le diagramme de Pareto relève d’une logique déterministe et décisionnelle : Il traite l’échantillon collecté comme un système fini de pertes, d’erreurs ou d’occurrences qu’il s’agit de résorber. L’inférence porte sur l’optimisation des interventions et l’allocation rationnelle de ressources limitées au sein d’une organisation ou d’un dispositif expérimental. Les hypothèses probabilistes sur la population mère y sont généralement secondaires.
- L’histogramme s’inscrit au cœur de la statistique inférentielle probabiliste et stochastique : Les données collectées n’y sont jamais envisagées comme une fin en soi, mais comme une instanciation empirique d’un processus générateur latent infiniment reproductible. L’ajustement d’une courbe de densité sert à conjecturer la forme de la loi de probabilité de la population d’origine, à autoriser la généralisation des résultats, et à justifier l’application de tests inférentiels paramétriques (tels que les tests $t$ de Student ou les modèles ANOVA de variance factorielle).
Ces deux approches se complètent remarquablement dans la recherche séquentielle moderne : l’histogramme permet de modéliser le comportement général des variables continues, tandis que le diagramme de Pareto intervient pour disséquer les typologies discrètes d’erreurs ou de sous-performances révélées par cette première modélisation.
7. Applications méthodologiques en recherche psychologique et comportementale
7.1 Usages du diagramme de Pareto en psychologie appliquée et organisationnelle
En psychologie du travail, en ergonomie cognitive et en psychiatrie communautaire, le diagramme de Pareto constitue un outil de diagnostic opérationnel inestimable. Considérons le champ de la santé mentale au travail et de l’ergonomie organisationnelle : lorsqu’un chercheur évalue l’épuisement professionnel (burnout) au sein de vastes organisations hospitalières ou industrielles, il collige souvent une multitude de plaintes subjectives et de signalements d’incidents critiques. Le déploiement d’un diagramme de Pareto permet de ségréger instantanément la masse informe des récriminations : les micro-irritants relationnels quotidiens, bien que très bruyants émotionnellement, s’effacent fréquemment derrière deux ou trois stresseurs structurels majeurs (par exemple, le manque chronique d’autonomie décisionnelle ou l’opacité des plannings de garde), qui concentrent à eux seuls plus de 80 % de la charge mentale délétère mesurée.
De même, dans la gestion des protocoles thérapeutiques en ambulatoire pour les troubles addictifs ou dépressifs sévères, l’attrition des patients (abandon thérapeutique ou drop-out) représente une menace méthodologique et clinique constante. La catégorisation et l’ordonnancement par Pareto des motifs déclarés d’abandon (tels que les effets indésirables sédatifs, l’inaccessibilité géographique des consultations, le fardeau financier ou la stigmatisation sociale perçue) permettent aux équipes soignantes d’ajuster leur protocole d’engagement. Plutôt que de disperser des ressources financières dans une refonte globale du programme, l’institution focalise ses efforts sur la résorption du premier motif vital (par exemple, la mise en place de téléconsultations pour juguler l’inaccessibilité géographique), neutralisant ainsi la majeure partie des risques d’abandon précoce.
Enfin, dans l’audit des erreurs humaines au sein des blocs opératoires ou des cockpits d’aviation, le diagramme de Pareto est l’instrument roi de la culture de sécurité. Il catégorise les glissements et les lapsus d’attention selon les classifications de James Reason, orientant les formations récurrentes de gestion des ressources de l’équipage (Crew Resource Management) vers les failles de communication prépondérantes.
7.2 Usages de l’histogramme en psychométrie et neurosciences quantitatives
Dans l’univers de la psychométrie quantitative et des neurosciences cognitives, l’histogramme s’impose comme un instrument d’étalonnage et de contrôle de la validité de construit irremplaçable. Lors de la construction et de la validation empirique d’une batterie neuropsychologique d’évaluation de la mémoire de travail ou des fonctions exécutives, le chercheur doit obligatoirement inspecter l’histogramme de répartition des scores obtenus par les sujets sains afin de cartographier la métrologie du test. Une répartition unimodale, symétrique et bien centrée témoigne de l’efficience de l’instrument à discriminer équitablement les individus tout au long de l’étendue des aptitudes cognitives latentes.
En neurosciences cognitives computationnelles, l’histogramme est systématiquement sollicité pour étudier la dynamique temporelle des processus mentaux via l’analyse des distributions de temps de réaction (TR). Les temps de réaction ne suivent jamais une loi normale canonique : ils exhibent invariablement une queue étirée vers la droite modélisable par une distribution ex-Gaussienne (combinaison d’une composante normale et d’une composante exponentielle) ou une distribution de Wald. L’observation minutieuse de l’histogramme des TR fournit aux neuroscientifiques des indices précieux sur les paramètres fondamentaux de l’accumulation d’information neuronale vers un seuil de décision motrice (modèle de dérive-diffusion de Ratcliff). Tout artéfact d’échantillonnage, tel que l’anticipation motrice prématurée (visible sous la forme d’un pic artificiel isolé à des latences inférieures à 150 millisecondes), est immédiatement détecté par l’analyse fine des premières classes de l’histogramme.
De surcroît, en imagerie par résonance magnétique fonctionnelle (IRMf) et en électrophysiologie quantitative, les chercheurs exploitent l’histogramme pour vérifier les distributions spatiales des voxels activés, les amplitudes des potentiels évoqués cognitifs (comme la P300 ou la N400) et pour contrôler les postulats d’homoscedasticité et de normalité des résidus avant d’injecter ces mégadonnées dans des modèles d’analyse multivariée.
7.3 Combinaison séquentielle des deux outils dans les protocoles de recherche
Loin de s’exclure mutuellement, le diagramme de Pareto et l’histogramme trouvent leur plus haute valeur méthodologique lorsqu’ils sont orchestrés conjointement et séquentiellement au sein de protocoles d’investigation complexes en santé comportementale. Cette dialectique permet de faire dialoguer harmonieusement les dimensions quantitatives continues et les dimensions qualitatives catégorielles d’un même jeu de données.
Considérons un protocole de recherche translationnelle visant à optimiser la prise en charge de la douleur chronique en milieu hospitalier universitaire. La méthodologie séquentielle se déploie selon une logique rigoureuse :
- Phase 1 (Caractérisation par histogramme) : Les cliniciens mesurent l’intensité globale de la douleur au moyen d’une échelle visuelle analogique continue (EVA, de 0 à 100 mm) sur une cohorte de 1 000 patients. L’érection d’un histogramme des scores d’EVA révèle une distribution bimodale flagrante : un premier groupe dense centré autour de 35 mm (douleur modérée contrôlée), et un second dôme proéminent émergeant au-delà de 75 mm (douleur réfractaire hyperalgique). L’histogramme valide l’existence d’une sous-population clinique spécifique et permet de fixer un seuil empirique de ségrégation à 70 mm.
- Phase 2 (Isolement et priorisation par Pareto) : L’équipe isole alors exclusivement le sous-groupe des patients réfractaires ($EVA ge 70$). Une analyse qualitative approfondie collige les facteurs contextuels et iatrogènes associés à chaque poussée douloureuse aiguë chez ces sujets. Un diagramme de Pareto est ensuite tracé sur ces motifs qualitatifs discrets (sous-dosage morphinique, anxiété d’anticipation nocturne, délais d’administration infirmière, mobilisations kinesthésiques inappropriées). L’ogive de Pareto met en lumière que deux facteurs seulement (le retard d’administration et l’anxiété nocturne) sont impliqués dans 82 % des crises sévères.
Cette synergie méthodologique illustre parfaitement la complémentarité des instruments : l’histogramme identifie objectivement où se situe la frontière de l’anomalie au sein du continuum, tandis que le diagramme de Pareto ordonne les leviers d’action pour résorber cette anomalie.
8. Biais cognitifs et perception visuelle dans l’interprétation des deux représentations
8.1 Facteurs humains et principes gestaltistes appliqués aux graphiques
L’efficacité de la transmission d’une information statistique repose fondamentalement sur la manière dont les propriétés spatiales d’un tracé graphique stimulent les mécanismes pré-attentionnels et les lois gestaltistes de l’organisation perceptive dans le cortex visuel humain (lois théorisées par Max Wertheimer, Wolfgang Köhler et développées par Stephen Few en sémiologie moderne). Les structures de l’histogramme et du diagramme de Pareto exploitent des leviers psychophysiques radicalement opposés.
Dans l’histogramme, la perception est régie au premier chef par la loi de proximité et la loi de continuité. En accolant étroitement les rectangles sans aucun intervalle de séparation spatiale, l’histogramme induit une sensation visuelle d’unité organique et de fluidité topologique. Le système visuel de l’analyste ne perçoit pas une collection de piliers atomisés, mais fusionne les rectangles contigus en une silhouette paysagère d’ensemble (un profil distributionnel continu). C’est cette intégration gestaltiste pré-attentive qui rend la détection d’un creux distributionnel ou d’un second sommet si instantanée et intuitive.
Dans le diagramme de Pareto, c’est la saillance perceptive par contraste et la loi de bonne continuité de la ligne cumulative qui dominent la cognition. Les espaces intercalaires ménagés entre les barres forcent le système visuel à encoder chaque rectangle comme une entité discrète autonome, bloquant la fusion perceptuelle continue propre à l’histogramme. L’œil est irrémédiablement attiré par la rupture d’échelle que constitue la barre inaugurale de gauche, magnifiée par la verticalité initiale de la pente de l’ogive. Toutefois, la présence simultanée du double axe vertical (fréquences absolues à gauche, pourcentages cumulés à droite) engendre une interférence perceptive et une surcharge cognitive accrue : l’analyste commet régulièrement l’erreur de relier mentalement la hauteur d’une barre à l’échelle de droite, ou d’imputer indûment l’inclinaison de l’ogive à la dernière barre parcourue.
8.2 Biais d’ancrage et heuristiques de jugement chez l’analyste
L’interprétation de ces deux artefacts graphiques est vulnérable à des biais cognitifs et heuristiques de jugement systématiques (documentés dans les travaux de Daniel Kahneman et Amos Tversky), susceptibles d’égarer le chercheur ou le gestionnaire de données :
- Le biais d’ancrage dans le diagramme de Pareto : La disposition décroissante impose un ancrage psychologique massif sur les deux premières barres affichées. Ce stimulus visuel prépondérant génère une heuristique de focalisation aveugle, conduisant fréquemment les praticiens à disqualifier et ignorer totalement la « longue traîne » des modalités résiduelles. En épidémiologie ou en santé au travail, cette négligence peut être funeste : une constellation de causes mineures peu fréquentes peut, par synergie systémique et effet cumulatif différé, provoquer des défaillances catastrophiques plus destructrices que l’impact d’une cause modale hautement prévisible.
- L’illusion de normalité face à l’histogramme : Face à un histogramme grossièrement tracé sur un échantillon d’effectif modeste, le cerveau humain — guidé par un biais de complétion gestaltiste (loi de fermeture) et un biais de confirmation — a une tendance quasi irrésistible à plaquer mentalement une forme gaussienne symétrique sur des données qui s’avèrent fondamentalement dissymétriques ou plurimodales. Cette propension à voir des cloches normales partout conduit à valider abusivement des tests statistiques paramétriques là où des analyses de rangs s’imposent impérativement.
- Le biais d’ajustement arbitraire des classes (binning bias) : Dans l’histogramme, l’expérimentateur peut succomber, inconsciemment ou sciemment, à la tentation de modifier manuellement la largeur et le point d’origine des classes jusqu’à ce que la distribution adopte le profil morphologique correspondant à son hypothèse de recherche (camouflage d’un creux indésirable ou mise en relief factice d’un mode), invalidant ainsi toute neutralité scientifique.
8.3 Recommandations psychotechniques pour une visualisation non biaisée
Pour immuniser l’analyste contre ces écueils psychovisuels et préserver la rigueur épistémique de la communication scientifique, des directives ergonomiques et psychotechniques précises doivent être scrupuleusement observées lors de l’édition graphique :
- Pour le diagramme de Pareto :
- Verrouiller systématiquement l’origine de l’axe vertical primaire à zéro absolu ; toute troncature artificielle du bas de l’axe amplifie visuellement de manière disproportionnée les écarts entre barres, biaisant l’évaluation de l’asymétrie.
- Normaliser la palette chromatique en utilisant une teinte monochrome neutre (comme un bleu ardoise ou un gris acier) pour les barres d’amplitude, et réserver une couleur contrastée (un rouge carmin ou un bordeaux profond) exclusivement pour la ligne cumulative, afin de désynchroniser nettement les deux plans d’information visuelle.
- Limiter strictement le nombre de catégories individuelles affichées à un maximum de 7 à 9 barres, en consolidant le solde dans une catégorie résiduelle « Autres » clairement labellisée et grisée, pour respecter l’empan de mémoire de travail de l’utilisateur.
- Pour l’histogramme :
- Sélectionner la largeur des classes au moyen d’algorithmes objectifs et standardisés (règles de Freedman-Diaconis ou de Scott), en documentant explicitement la formule retenue dans les notes de bas de figure.
- Maintenir l’accolement géométrique intégral des rectangles sans aucun interstice, tout en utilisant une bordure fine et subtile (d’une teinte légèrement plus foncée que le remplissage) pour préserver la distinction des intervalles sans rompre la continuité de masse.
- Afficher systématiquement, en légende ou en incrustation textuelle, les paramètres descriptifs fondamentaux de la distribution : la taille de l’échantillon $N$, la moyenne $\bar{x}$, l’écart-type $s$, ainsi que les indices quantifiés d’asymétrie (skewness) et d’aplatissement (kurtosis), évitant ainsi que l’observateur ne s’en remette à une pure conjecture oculaire.
9. Analyse comparative des processus de construction mathématique et logicielle
9.1 Algorithmes sous-jacents : tri vectoriel vs discrétisation par classes
Sur le plan de l’architecture logicielle et de l’algorithmique numérique, la génération d’un diagramme de Pareto et celle d’un histogramme reposent sur des pipelines de traitement de données fondamentalement divergents en termes de complexité computationnelle et de transformation vectorielle.
Le pipeline algorithmique du diagramme de Pareto opère sur un tableau de contingence de paires clé-valeur $(\text{catégorie}, n_i)$ et se décompose en trois séquences déterministes :
- Tri vectoriel décroissant : Application d’un algorithme de tri (tel que le Quicksort ou le Timsort) sur le vecteur des fréquences avec une complexité temporelle asymptotique moyenne de $\mathcal{O}(k \log k)$, où $k$ est le nombre de catégories uniques.
- Calcul des sommes cumulées : Calcul séquentiel du vecteur préfixe des sommes partielles :
$$C_j = \sum_{m=1}^{j} n_{(m)}$$
permettant de dériver le vecteur des pourcentages cumulés normalisés par la taille totale de l’échantillon $N$. - Interpolation discrète : Projection géométrique des coordonnées de l’ogive cumulative aux sommets droits de chaque rectangle préalablement trié.
Le pipeline algorithmique de l’histogramme opère quant à lui sur un vecteur continu unidimensionnel brut d’observations scalaires $X = [x_1, x_2, dots, x_n]$ et met en œuvre un processus de partitionnement d’espace métrique :
- Détermination des bornes extrêmes : Balayage du vecteur pour identifier les extrema absolus $x_{\min} = \min(X)$ et $x_{\max} = \max(X)$, avec une complexité linéaire $\mathcal{O}(n)$.
- Génération du maillage : Calcul de la largeur optimale de classe $h$ selon l’estimateur choisi, puis génération d’un vecteur de points de coupure contigus :
$$B = [b_0, b_1, dots, b_k] \quad \text{a\vec} \quad b_0 le x_{\min} \quad \text{et} \quad b_k ge x_{\max}$$ - Discrétisation et hachage (binning) : Dénombrement des occurrences tombant dans chaque intervalle semi-ouvert $[b_{j-1}, b_j[$ (ou fermé à droite selon la convention choisie). Cette opération repose généralement sur un partitionnement direct par calcul d’index d’entier :
$$\text{Index}(x_i) = \left\lfloor \frac{x_i – b_0}{h} \right\rfloor$$
s’exécutant en temps linéaire $\mathcal{O}(n)$. - Calcul des densités locales : Normalisation de chaque effectif par le produit $(n \times h)$ pour obtenir les hauteurs de densité d’aire.
Le traitement rigoureux des cas limites aux frontières d’intervalles ouverts et fermés constitue un point névralgique de la robustesse computationnelle de l’histogramme, un enjeu totalement absent de la logique discrète du tracé de Pareto.
9.2 Implémentation dans les logiciels de référence (R, Python, SPSS, Jamovi)
L’exécution pratique de ces visualisations au sein des environnements d’analyse de données modernes met en exergue des disparités d’implémentation syntaxique notables, révélatrices de la nature des packages mobilisés.
Dans l’environnement de programmation statistique R, l’histogramme relève des fonctions graphiques primitives fondamentales via l’instruction hist(x, breaks = "FD", freq = FALSE), qui intègre nativement la règle de Freedman-Diaconis et la normalisation en densité de probabilité. L’adjonction d’une estimation par noyau s’effectue avec une fluidité déconcertante par lines(density(x)). Sous la grammaire des graphiques ggplot2, l’histogramme s’instancie via geom_histogram(aes(y = after_stat(density)), binwidth = ...). À l’opposé, le diagramme de Pareto n’existe pas en tant que géométrie native de base dans ggplot2 ; il requiert soit le recours à un package spécialisé dans le contrôle qualité statistique tel que qcc (fonction pareto.chart()), soit une manipulation manuelle complexe articulant un pré-tri par dplyr, le calcul explicite de cumsum(), et l’usage sophistiqué de la commande sec_axis() pour calibrer et synchroniser l’axe vertical secondaire.
Sous Python, la dichotomie s’exprime à travers les bibliothèques Matplotlib et Seaborn. L’histogramme bénéficie de fonctions hautement optimisées : plt.hist(data, bins='auto', density=True) ou sns.histplot(data, kde=True), qui délèguent les calculs de partitionnement aux algorithmes vectoriels sous-jacents de NumPy (notamment numpy.histogram). Le tracé d’un diagramme de Pareto requiert en revanche une programmation explicite : structuration des données sous forme d’un DataFrame pandas, tri vectoriel via sort_values(ascending=False), calcul de la fonction cumulative par cumsum(), et instanciation impérative d’un second objet d’axe superposé au moyen de ax2 = ax1.twinx() pour tracer la courbe cumulative polygonale au-dessus des barres discrètes.
Dans les environnements logiciels dédiés aux sciences sociales à interface graphique comme SPSS ou Jamovi, l’histogramme est directement intégré aux menus d’exploration descriptive initiale et aux modules de vérification des postulats de l’analyse de régression. Le diagramme de Pareto, en revanche, se trouve historiquement relégué au sous-menu spécialisé de contrôle de la qualité industrielle (Quality Control Charts) dans SPSS, ou requiert l’installation de modules communautaires tiers dans Jamovi, attestant de son statut d’outil d’ingénierie appliquée plutôt que d’instrument d’investigation psychométrique standard.
9.3 Sensibilité aux variations d’échantillonnage et instabilité graphique
Un aspect critique de la dynamique computationnelle réside dans la résilience différentielle des deux instruments face aux fluctuations stochastiques d’échantillonnage, particulièrement lorsque la taille de l’échantillon $n$ est restreinte ($n < 50$).
L’histogramme présente une vulnérabilité et une instabilité morphologique notoires en contexte de faible échantillonnage. La forme générale de la figure peut être radicalement métamorphosée par le simple déplacement arbitraire de l’origine de l’intervalle inaugural $b_0$ d’une fraction de millimètre, ou par la modification marginale de la largeur $h$. De faibles variations d’échantillonnage peuvent faire basculer un histogramme d’un profil apparemment symétrique vers une apparence asymétrique ou faire émerger des fausses vallées bimodales dépourvues de toute réalité biologique ou psychologique sous-jacente. L’analyste doit donc faire preuve d’une prudence extrême avant d’inférer des propriétés structurelles à partir d’un histogramme reposant sur une cohorte réduite.
Le diagramme de Pareto démontre quant à lui une robustesse structurelle nettement supérieure en ce qui concerne les modalités dominantes de tête. En vertu de la loi des grands nombres appliquée aux fréquences catégorielles multinomiales, les catégories constituant les facteurs majeurs du système émergent avec une avance statistique telle que les fluctuations d’échantillonnage modifient rarement leur rang relatif sur l’abscisse. En revanche, l’instabilité du diagramme de Pareto se concentre intégralement dans sa partie droite : la hiérarchie au sein de la traîne des facteurs résiduels mineurs oscille de manière chaotique d’un échantillon à l’autre. Pour évaluer formellement cette stabilité, les chercheurs recourent de plus en plus à des techniques de rééchantillonnage non paramétrique par bootstrap (tirages avec remise répétés des milliers de fois), permettant de calculer des intervalles de confiance à 95 % autour du rang de chaque modalité et de valider mathématiquement la suprématie des facteurs vitaux isolés.
10. Erreurs fréquentes d’interprétation et confusions méthodologiques courantes
10.1 L’espacement entre barres : un marqueur sémiotique fréquemment ignoré
L’une des fautes sémiotiques les plus universellement répandues dans la littérature scientifique de niveau intermédiaire réside dans l’ignorance délibérée ou accidentelle de la signification méthodologique portée par l’espacement physique séparant les rectangles verticaux. Pour le lecteur profane, qu’une barre touche ou ne touche pas sa voisine relève d’une coquetterie de mise en page graphique. D’un point de vue épistémologique et statistique, il s’agit pourtant d’une violation flagrante de la convention de représentation de l’information.
Dans un diagramme de Pareto (comme dans tout diagramme à barres nominal), la présence obligatoire d’un interstice blanc entre chaque rectangle signale au cerveau la discontinuité catégorielle ontologique du phénomène. Il n’existe pas d’espace intermédiaire, de continuum ou de zone de transition entre la modalité « Erreur de posologie médicamenteuse » et la modalité « Omission de signature de consentement éclairé » ; ce sont des classes distinctes, étanches, discrètes. L’espace blanc est le gardien de cette séparation conceptuelle.
Inversement, dans l’histogramme, l’accolement obligatoire et absolu des barres est l’affirmation géométrique de la continuité spatiale et métrique du continuum. Chaque rectangle partage ses frontières verticales avec ses voisins directs. Ériger un histogramme avec des rectangles disjoints séparés par des espaces blancs constitue une erreur méthodologique grave : cela transmet fallacieusement l’idée que les valeurs métriques situées aux frontières des classes ont été escamotées ou n’existent pas dans la nature. Cette bévue est malheureusement encouragée par les logiciels bureautiques généralistes (tels que Microsoft Excel), qui tracent par défaut des diagrammes en colonnes disjointes pour des données continues, alimentant une confusion conceptuelle dévastatrice chez les étudiants et les jeunes chercheurs.
10.2 Assimilation fautive entre histogramme et diagramme à barres simple
Une confusion épistémologique pernicieuse consiste à employer indifféremment les termes « histogramme » et « diagramme à barres » (ou graphique en bâtons) pour désigner n’importe quel arrangement de rectangles verticaux. Si cette méprise lexicale est tolérée dans le langage vernaculaire, elle est rigoureusement inacceptable dans une publication scientifique régie par les standards de l’American Psychological Association (APA 7th edition).
Le tableau d’incompatibilité conceptuelle est absolu :
- Un diagramme à barres simple compare des grandeurs discrètes associées à des catégories qualitatives indépendantes. La hauteur de la barre porte à elle seule toute la valeur de mesure, sa largeur physique sur le papier est totalement arbitraire et dépourvue de sens numérique, et l’ordre des barres peut être remanié sans altérer la vérité mathématique du jeu de données.
- Dans l’histogramme authentique, la largeur de la barre représente rigoureusement une distance métrique $\Delta x = h$, sa hauteur est une densité de fréquence mathématique, sa surface encode la proportion stochastique, et son ordonnancement spatial est inaltérable sous peine de détruire le sens de la distribution de variance empirique.
Nommer « histogramme » un diagramme à barres illustrant le nombre de dépressions majeures par catégorie socioprofessionnelle trahit une méconnaissance profonde des concepts statistiques élémentaires, et discrédite immédiatement l’expertise méthodologique des auteurs auprès des comités de lecture des revues à fort facteur d’impact.
10.3 Fausse attribution du principe 80/20 à des données distributionnelles continues
Une autre dérive conceptuelle fréquente réside dans la tentative inappropriée et stérile de projeter la rhétorique du principe de Pareto (la règle des 80/20) sur des distributions quantitatives continues de nature intrinsèquement normale ou quasi-gaussienne.
Il est fondamental de distinguer la distribution empirique de Pareto (l’outil graphique de gestion basé sur le dénombrement de catégories) de la loi de distribution de Pareto continue au sens de la théorie des probabilités (une loi continue à queue lourde modélisant des phénomènes d’extrême concentration, comme la taille des métropoles ou les citations d’articles scientifiques). Les praticiens séduits par la popularité du concept managérial des 80/20 tentent parfois d’isoler « les 20 % des patients qui expliquent 80 % de la variance » au sein d’une distribution de scores d’anxiété mesurée sur une échelle de Likert continue étalée selon une cloche gaussienne parfaite.
Or, dans une distribution normale unimodale et symétrique, une telle concentration asymétrique n’existe tout simplement pas mathématiquement. Dans une loi normale :
- L’intervalle centré $[\mu – \sigma, \mu + \sigma]$ regroupe approximativement 68,27 % de la population totale.
- L’intervalle $[\mu – 2\sigma, \mu + 2\sigma]$ concentre 95,45 % des observations.
- La masse est condensée au cœur de la distribution, et les extrémités s’atténuent selon une décroissance exponentielle rapide (en $\mathcal{O}(e^{-x^2})$).
Chercher à forcer un modèle 80/20 sur un phénomène gaussien procède d’un délire méthodologique : c’est confondre la variance homogène distribuée autour d’une moyenne collective avec l’asymétrie radicale d’une loi de puissance. L’histogramme est l’instrument qui protège le chercheur contre cette hallucination théorique, en lui rappelant visuellement l’absence d’asymétrie de Pareto dans son jeu de données métriques.
11. Études de cas comparatives appliquées aux données cliniques et organisationnelles
11.1 Cas 1 : Analyse des interruptions de travail en contexte hospitalier psychiatrique
Afin d’illustrer la suprématie opérationnelle du diagramme de Pareto dans les contextes d’ingénierie organisationnelle et de facteurs humains, examinons une étude d’ergonomie hospitalière conduite au sein d’une unité fermée d’urgences psychiatriques. L’équipe d’encadrement constate un taux alarmant d’erreurs de transcription d’ordonnances et d’incidents médicamenteux. Une observation naturaliste continue de 300 heures est diligentée, au cours de laquelle 850 interruptions de tâches subies par le personnel infirmier lors des phases critiques de dispensation pharmacologique sont scrupuleusement enregistrées et catégorisées selon leur nature étiologique.
Les données qualitatives discrètes recueillies sont synthétisées dans un diagramme de Pareto standardisé. L’abscisse accueille les diverses catégories de perturbation identifiées : « Appels téléphoniques entrants non urgents », « Sollicitations verbales directes par des collègues », « Interpellations spontanées par des patients en déambulation », « Alarmes intempestives de moniteurs médicaux », « Recherches de matériel manquant dans la pharmacie », « Entrées inopinées de visiteurs », et « Pannes du terminal informatique ».
Le tracé morphologique de Pareto révèle une asymétrie dévastatrice :
- La première barre, « Appels téléphoniques non urgents », concentre à elle seule 48 % des interruptions ($n = 408$).
- La deuxième barre, « Sollicitations verbales par des collègues », totalise 27 % des occurrences ($n = 229$).
- La troisième barre, « Recherches de matériel manquant », regroupe 12 % des cas ($n = 102$).
L’ogive cumulative grimpe à 75 % dès la deuxième modalité et culmine à 87 % à la troisième barre. Les quatre autres catégories se partagent les miettes d’une traîne marginale. La conclusion décisionnelle s’impose d’elle-même avec une clarté limpide : pour juguler près de 90 % des ruptures de charge cognitive des infirmiers, la direction n’a nullement besoin d’engager des audits informatiques dispendieux ou de restreindre drastiquement les visites des familles. Deux interventions ciblées suffisent : sanctuariser la salle de préparation médicamenteuse en déviant systématiquement les appels téléphoniques vers un secrétariat d’accueil, et instaurer le port d’un « gilet d’isolement » signalant aux collègues l’interdiction formelle de solliciter verbalement l’infirmier pendant la dispensation. L’approche par Pareto a permis d’optimiser radicalement l’ingénierie humaine par une économie maximale de moyens.
11.2 Cas 2 : Évaluation des scores d’anxiété préopératoire chez des patients adultes
Considérons à présent une investigation de psychologie clinique hospitalière portant sur l’anxiété préopératoire ressentie par 500 patients adultes la veille d’une intervention chirurgicale lourde sous anesthésie générale. Les investigateurs administrent l’échelle validée APAIS (Amsterdam Preoperative Anxiety and Information Scale), qui fournit un score d’anxiété globale continu s’échelonnant sur une échelle de rapport de 0 à 30 points.
Dans ce paradigme de recherche, l’érection d’un diagramme de Pareto est totalement proscrite : la variable mesurée est métrique, intrinsèquement continue, et n’a aucune vocation à être hiérarchisée par catégories nominales déconnectées. Les chercheurs déploient donc un histogramme de densité de probabilité, en calibrant le maillage selon la règle de Freedman-Diaconis, ce qui aboutit à une largeur d’intervalle $h = 2{,}5$ points.
L’inspection du profil morphologique de l’histogramme apporte une découverte clinique majeure que le calcul aveugle d’une moyenne arithmétique globale ($\bar{x} = 15{,}2$) aurait irrémédiablement escamotée :
- Loin de se conformer à une cloche gaussienne symétrique unique, l’histogramme dévoile une structure rigoureusement bimodale.
- Un premier mode proéminent et étroit émerge dans l’intervalle $[7{,}5 – 10]$, regroupant des patients présentant une anxiété adaptative modérée et normale face à l’acte chirurgical.
- Une vallée profonde caractérisée par des effectifs quasi nuls s’observe dans l’intervalle $[15 – 17{,}5]$.
- Un second mode très marqué réapparaît brutalement au-delà de 20 points, culminant dans l’intervalle $[22{,}5 – 25]$.
Ce diagnostic visuel transforme la compréhension du phénomène par les anesthésistes et les psychologues de liaison. Il met en lumière que la cohorte ne réagit pas de manière homogène avec une simple dispersion de variance autour d’une moyenne centrale, mais se sépare en deux populations qualitativement distinctes : des individus régulant adéquatement leur stress émotionnel, et un groupe spécifique développant une panique préopératoire aiguë incontrôlée. Cette révélation, rendue possible par la seule géométrie contiguë de l’histogramme, permet d’adapter sur-le-champ le protocole clinique : prescription d’une prémédication anxiolytique ciblée et intervention de psychologues cliniciens exclusivement réservées aux patients composant le second mode de distribution, évitant la sur-médication inutile de la première sous-population.
11.3 Cas 3 : Étude mixte de la défection d’un protocole de remédiation cognitive
Pour illustrer la fertilisation croisée des deux méthodologies graphiques, examinons une étude clinique mixte consacrée à l’analyse de l’abandon thérapeutique (défection) au sein d’un programme longitudinal de remédiation cognitive assistée par ordinateur, étalé sur 24 semaines et proposé à 200 patients stabilisés présentant des troubles du spectre schizophrénique.
Le protocole analytique articule magistralement les deux instruments selon leurs prérogatives respectives :
Dans un premier temps, les investigateurs s’interrogent sur la dynamique chronologique de l’attrition. Ils tracent l’histogramme de la durée continue de maintien dans le programme (mesurée en semaines effectives d’assiduité avant la rupture) pour les 82 sujets ayant abandonné. L’histogramme affiche une asymétrie positive dramatique : les classes contiguës des semaines $[0 – 2]$ et $[2 – 4]$ concentrent à elles seules plus de 60 % de l’aire totale sous la distribution, formant un pic abrupt suivi d’un effondrement rapide et d’un plateau linéaire jusqu’à la 24e semaine. L’histogramme valide ainsi une conclusion temporelle irréfutable : la vulnérabilité à l’abandon n’est pas un processus progressif et diffus dans le temps, mais un choc précoce ultra-concentré durant le premier mois d’engagement thérapeutique.
Dans un second temps, l’équipe cherche à comprendre les déterminants causaux de cet effondrement inaugural. Pour les patients ayant décroché durant ces quatre premières semaines critiques, ils dépouillent les entretiens semi-directifs de sortie et recensent les motifs déclarés d’abandon sous forme de catégories qualitatives discrets. Ils bâtissent alors un diagramme de Pareto de ces justifications étiologiques. L’ordonnancement par Pareto et la courbe cumulative révèlent instantanément que deux catégories (« Sentiment de stigmatisation face aux exercices informatisés jugés trop infantilisants » et « Fatigue cognitive consécutive aux créneaux horaires programmés en fin de journée ») rendent compte de 84 % des abandons précoces.
Grâce à la complémentarité des deux outils, l’équipe hospitalière a d’abord calibré le quand (le créneau temporel d’extrême vulnérabilité via l’histogramme), puis identifié le pourquoi et le comment agir (les leviers prioritaires de réingénierie pédagogique via Pareto), augmentant significativement le taux de rétention lors des cohortes ultérieures.
12. Synthèse décisionnelle : critères de sélection entre diagramme de Pareto et histogramme
12.1 Arbre décisionnel pour le chercheur et le praticien de la psychologie
Afin de prémunir le chercheur, l’étudiant en master et le praticien contre toute erreur d’aiguillage méthodologique lors de la conception de leurs publications ou de leurs rapports d’audit, nous formalisons ci-dessous un arbre décisionnel rationnel, décliné sous forme de logigramme discursif étape par étape :
- Étape 1 : Quelle est l’ontologie de la variable primaire mesurée ?
- Cas A : La variable est qualitative nominale (catégories pures d’erreurs, typologies nosologiques, classes discrètes non métriques) ou ordinale sans continuité métrique → Exclure formellement l’histogramme. S’orienter vers l’Étape 2.
- Cas B : La variable est quantitative continue (mesurée sur échelle d’intervalle ou de rapport : temps, latence, score psychométrique continu, concentration biologique, masse) → S’orienter vers l’histogramme (Étape 3).
- Étape 2 : Quelle est la finalité téléologique de la visualisation catégorielle ?
- Option A1 : L’objectif est de prioriser rationnellement des actions correctives, d’isoler les facteurs causaux vitaux selon une logique d’efficience opérationnelle et de mesurer la couverture cumulative d’un problème → Construire impérativement un Diagramme de Pareto (tri décroissant obligatoire, double axe vertical, courbe cumulative superposée, catégorie résiduelle « Autres » en fin de parcours).
- Option A2 : L’objectif est simplement de comparer les fréquences de catégories selon leur ordre thématique, chronologique ou alphabétique naturel, sans volonté de hiérarchisation décisionnelle → Tracer un diagramme à barres simples standardisé (en maintenant les espaces inter-barres).
- Étape 3 : Quelle est la finalité analytique sur la variable quantitative continue ?
- Option B1 : L’objectif est de modéliser la densité de probabilité empirique, d’évaluer la normalité, de diagnostiquer la dispersion (variance, écart-type), de déceler des bimodalités sous-jacentes ou de contrôler les postulats paramétriques préalables → Construire un Histogramme de densité (classes contiguës sans espace inter-barres, calibrage de classe via Freedman-Diaconis ou Scott, surface proportionnelle aux effectifs, superposition éventuelle d’une courbe normale ou d’un noyau KDE).
- Option B2 : L’objectif managérial exige exceptionnellement de transformer cette variable métrique en tranches de décision prioritaires → Justifier théoriquement le découpage en classes discrètes basées sur des seuils cliniques normés, puis basculer vers un diagramme de Pareto (en documentant obligatoirement la perte de variance associée).
12.2 Tableau comparatif exhaustif des propriétés dimensionnelles et statistiques
Le tableau analytique ci-dessous récapitule de manière systématique l’ensemble des divergences structurales, sémiotiques, métrologiques et interprétatives séparant irrémédiablement le diagramme de Pareto de l’histogramme.
| Dimension d’analyse | Diagramme de Pareto | Histogramme |
|---|---|---|
| Fondateur historique & Domaine initial | Vilfredo Pareto & Joseph M. Juran (Économie & Contrôle qualité industriel) | Karl Pearson (Biométrie & Théorie mathématique des probabilités) |
| Téléologie première | Décisionnelle, priorisation opérationnelle, allocation sélective de ressources | Exploratoire et inférentielle, modélisation de la dispersion et de la forme distributionnelle |
| Nature de la variable (Échelle de Stevens) | Qualitative nominale ou ordinale discrète (parfois quantitative préalablement discrétisée) | Quantitative continue (échelles d’intervalle ou de rapport) ou discrète à très large étendue |
| Topologie de l’axe horizontal (Abscisse) | Discrète, catégorielle non métrique ; ordre défini a posteriori par le tri statistique | Continue, métrique $\mathbb{R}$ ; ordre naturel croissant immuable de gauche à droite |
| Principe d’ordonnancement spatial | Monotonicité décroissante stricte des hauteurs de barres ($n_{(1)} ge n_{(2)} dots$) | Ordre numérique séquentiel naturel ($x_0 < x_1 < dots < x_k$) ; interdiction absolue de trier |
| Continuité géométrique (Espaces inter-barres) | Espaces intercalaires blancs obligatoires (marquant la discontinuité des attributs) | Contiguïté absolue obligatoire sans aucun espace blanc (marquant la continuité du continuum) |
| Architecture des axes verticaux | Double axe vertical : primaire à gauche (effectifs/coûts), secondaire à droite (0-100 %) | Axe vertical unique : densité empirique de fréquence $d_i$ (ou effectif si les classes sont égales) |
| Propriété géométrique d’encodage | La hauteur pure du rectangle encode l’amplitude ou le coût direct de la modalité | L’aire du rectangle encode la proportion stochastique de l’échantillon ($\text{Aire} propto n_i$) |
| Tracé courbe superposé | Ogive cumulative polygonale de Galton représentant la fonction de répartition empirique | Courbe de Gauss théorique paramétrique ou densité lissée par noyau non paramétrique (KDE) |
| Gestion des valeurs mineures / queues | Agrégation obligatoire de la longue traîne au sein d’une boîte résiduelle « Autres » en queue | Préservation scrupuleuse des classes clairsemées ou vides aux extrémités (analyse des queues) |
| Détection morphologique spécifique | Point d’inflexion du coude signalant la frontière entre facteurs vitaux et bruit résiduel | Tendance centrale, variance, asymétrie (skewness), aplatissement (kurtosis), bimodalité |
| Sensibilité au paramétrage | Faible sur les catégories dominantes ; instabilité confinée à la queue résiduelle | Critique : extrême sensibilité de la forme globale au choix de la largeur de classe $h$ |
Lors de la rédaction des légendes et des commentaires textuels associés dans les manuscrits scientifiques (selon les prescriptions du manuel de publication APA 7e édition), les chercheurs veilleront à respecter une terminologie rigoureuse. Pour un diagramme de Pareto, la légende doit explicitement stipuler la métrique de tri, la taille totale d’occurrences $N$, le seuil de couverture représenté par l’ogive, et la composition de la catégorie résiduelle le cas échéant. Pour un histogramme, la légende doit obligatoirement expliciter la règle de discrétisation mise en œuvre pour le calcul de la largeur de classe $h$, l’éventuelle troncature des queues, la nature exacte de l’axe vertical (densité normalisée ou fréquences d’échantillonnage), ainsi que l’estimateur théorique superposé.
12.3 Perspectives futures dans l’analyse interactive et la science des données comportementales
L’irruption contemporaine des mégadonnées (Big Data), de l’intelligence artificielle et des technologies de capture comportementale continue (telles que le phénotypage numérique via capteurs pour smartphone, les enregistrements actimétriques longitudinaux ou l’oculométrie à haute fréquence) reconfigure profondément l’usage et la morphologie du diagramme de Pareto et de l’histogramme.
Dans les tableaux de bord analytiques interactifs contemporains (développés sous R Shiny, Dash Plotly ou des plateformes décisionnelles d’entreprise), ces visualisations statiques se muent en environnements dynamiques hautement adaptatifs. L’histogramme moderne bénéficie de curseurs dynamiques permettant à l’analyste de modifier en temps réel la largeur des classes $h$ ou d’alterner instantanément entre l’histogramme traditionnel et une estimation par noyau adaptatif à fenêtre variable, éliminant ainsi les biais de perception liés à un partitionnement figé. De surcroît, le couplage de l’histogramme avec le brushing (sélection interactive de zones de données) permet d’isoler une sous-population au sein d’un mode spécifique pour observer immédiatement sa répercussion spatiale sur d’autres visualisations multivariées concomitantes.
Le diagramme de Pareto subit une métamorphose analogue grâce à la navigation hiérarchique dynamique (mécanismes de drill-down). Confronté à une catégorie résiduelle « Autres » ou à une barre majeure englobant une multiplicité d’événements, l’analyste peut désormais cliquer sur le rectangle incriminé pour déployer instantanément un sous-diagramme de Pareto emboîté de second niveau, fracturant la modalité globale en ses micro-déterminants causaux sous-jacents. Cette décomposition itérative préserve la clarté du niveau macroscopique tout en offrant une profondeur d’exploration microscopique immédiate.
Toutefois, face à cette prolifération de représentations algorithmiques automatisées, le chercheur en sciences humaines et comportementales doit plus que jamais demeurer le garant de l’intégrité méthodologique. La sophistication esthétique d’un tableau de bord interactif ne saurait en aucun cas compenser une défaillance de raisonnement épistémologique : quelle que soit la puissance de calcul sous-jacente, l’impératif de distinguer rigoureusement la dispersion stochastique d’une métrique continue (redevable de l’histogramme) de la sélection prioritaire d’événements discrets (redevable de Pareto) demeure le socle inaltérable de toute interprétation scientifique valide.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions Gauthier-Villars.
Cohen, J. (1983). The cost of dichotomization. Applied Psychological Measurement, 7(3), 249-253. https://doi.org/10.1177/014662168300700301
Few, S. (2012). Show me the numbers: Designing tables and graphs to enlighten (2nd ed.). Analytics Press.
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
Juran, J. M. (1951). Quality control handbook. McGraw-Hill.
Kahneman, D. (2011). Thinking, fast and slow. Farrar, Straus and Giroux.
Pareto, V. (1896). Cours d’économie politique. Librairie F. Rouge.
Pearson, K. (1895). Contributions to the mathematical theory of evolution. II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343-414. https://doi.org/10.1098/rsta.1895.0010
Ratcliff, R., & McKoon, G. (2008). The diffusion decision model: Theory and data for two-choice decision tasks. Neural Computation, 20(4), 873-922. https://doi.org/10.1162/neco.2008.12-06-420
Reason, J. (1990). Human error. Cambridge University Press. https://doi.org/10.1017/CBO9781139062367
Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605-610. https://doi.org/10.1093/biomet/66.3.605
Silverman, B. W. (1986). Density estimation for statistics and data analysis. Chapman and Hall. https://doi.org/10.1201/9781315140919
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65-66. https://doi.org/10.1080/01621459.1926.10502161
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124-1131. https://doi.org/10.1126/science.185.4157.1124
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0