
La gestion rigoureuse des dimensions temporelles constitue l’un des piliers méthodologiques fondamentaux de l’ingénierie des données et de l’analyse statistique contemporaine. Au sein d’environnements tabulaires distribués tels que Google Sheets, la manipulation des données chronologiques oscille perpétuellement entre deux impératifs souvent contradictoires : d’une part, la nécessité computationnelle de traiter des variables numériques continues ou discrètes optimisées pour le calcul algorithmique et l’indexation matricielle ; d’autre part, l’exigence cognitive d’offrir des représentations sémantiques textuelles immédiatement intelligibles pour l’analyste humain et les décideurs. Cette tension s’exprime avec une acuité particulière lors de la conversion bidirectionnelle entre les dénominations nominales des mois calendaires et leurs équivalents ordinaux numériques.
La conversion entre le nom et le numéro d’un mois dépasse largement le cadre d’une simple commodité syntaxique d’affichage. Dans les protocoles de recherche quantitative, les architectures d’entrepôts de données décisionnels (Business Intelligence) ou les modélisations économétriques longitudinales, la mutation d’un identifiant temporel textuel en scalaire entier conditionne la validité des tris chronologiques, l’agrégation par séries temporelles et l’interopérabilité des flux d’informations. Une mauvaise interprétation d’une chaîne de caractères représentant un mois ou une troncature erronée issue d’une coercition de type implicite peut corrompre irrémédiablement l’intégrité référentielle de vastes cohortes expérimentales.
Cet article se propose d’explorer de manière exhaustive, analytique et critique l’ensemble des mécanismes mathématiques, des architectures logicielles et des stratégies algorithmiques permettant d’orchestrer la transmutation réciproque des représentations mensuelles dans le moteur de calcul de Google Sheets. À travers une déconstruction minutieuse des fonctions natives, des astuces arithmétiques fondées sur le calendrier sériel, des formules matricielles vectorisées, ainsi que des automatisations par scripts d’entreprise, nous fournirons un cadre théorique et pratique complet pour garantir une robustesse absolue dans le traitement de vos séries temporelles.
1. Fondements théoriques et représentation sérielle du temps dans Google Sheets
1.1 Architecture du système de dates sérielles et valeur sous-jacente
Pour appréhender avec rigueur les transformations de variables temporelles dans Google Sheets, il convient d’analyser en premier lieu l’ontologie même du temps telle qu’elle est implémentée dans le moteur de calcul sous-jacent. À l’instar des standards établis historiquement par Lotus 1-2-3 puis perpétués par Microsoft Excel, Google Sheets ne stocke pas les dates sous forme de chaînes sémantiques complexes, ni même sous forme d’objets temporels structurés en mémoire vive lors des calculs bas niveau. Le tableur repose sur un système universel de date sérielle, où chaque instant correspond à un nombre réel flottant à double précision. Dans ce référentiel continu, le point d’origine temporel, ou epoch, est formellement fixé au 30 décembre 1899 à minuit (valeur sérielle 0,0).
Cette convention historique implique que le nombre entier 1 équivaut au 31 décembre 1899, tandis que les jours subséquents sont incrémentés d’une unité entière par période de vingt-quatre heures révolue. Les fractions décimales sont rigoureusement réservées à la subdivision intrajournalière, représentant les heures, minutes et secondes. Il existe donc une distinction ontologique absolue entre la valeur numérique brute résidant dans la mémoire de la cellule et la couche de présentation visuelle régie par les masques de formatage. Lorsqu’un utilisateur visualise la mention « Janvier » ou la séquence « 01/01/2024 », la cellule peut abriter un entier sériel précis (dans ce dernier cas, 45292), ou au contraire une chaîne littérale pure de caractères alphabétiques dépourvue de toute charge chronologique native.
L’impact de ce mode de stockage sur la cohérence des calculs chronologiques est substantiel. Dès lors qu’une date est appréhendée sous son format sériel natif, les opérations différentielles, les incrémentations périodiques et les comparaisons d’antériorité relèvent d’une arithmétique scalaire élémentaire d’une grande fiabilité. En revanche, l’introduction de données temporelles sous forme de saisies purement textuelles brise cette continuité mathématique. Le moteur de calcul se trouve alors contraint d’appliquer des heuristiques d’inférence lexicale pour tenter de réassigner une valeur sérielle au texte, introduisant une vulnérabilité systémique liée aux paramètres régionaux et aux ambiguïtés morphologiques de la langue utilisée.
1.2 Enjeux cognitifs et structuration des données en sciences empiriques
La modélisation de séries de données chronologiques dans les sciences empiriques — qu’il s’agisse de la biométrie, de l’économétrie ou de la sociologie quantitative — confronte invariablement le chercheur à un arbitrage cognitif et structurel. L’esprit humain traite avec une aisance remarquable les identifiants sémantiques complets tels que « Septembre » ou « Octobre », car ils évoquent instantanément des contextes qualitatifs, des rythmes saisonniers ou des repères socioculturels immuables. Cependant, cette lisibilité nominale humaine s’avère particulièrement toxique lorsqu’elle est confrontée à des algorithmes de tri standardisés. Un tri ascendant standard appliqué à une colonne de noms de mois textuels organisera inévitablement les données selon l’ordre alphabétique : Août, Avril, Décembre, Février, et ainsi de suite. Ce phénomène altère entièrement la topologie temporelle des séries observées.
Pour préserver la structure naturelle des flux chronologiques, il devient impératif d’associer ou de substituer à ces chaînes des variables ordinales discrètes s’étendant strictement de 1 à 12. L’homogénéisation des identifiants temporels selon cette échelle de rang permet de réduire drastiquement la charge cognitive lors de la lecture des visualisations graphiques tout en restaurant la capacité du système à exécuter des tris chronologiques sans faille. Dans le cadre d’études longitudinales s’étalant sur plusieurs années, l’ambiguïté textuelle est décuplée par la récurrence des cycles mensuels. La mention isolée « Mars » ne possède aucune validité univoque si elle n’est pas assortie d’un index d’année ou convertie en un jalon sériel rigoureux.
La standardisation internationale des variables chronologiques répond à cet impératif d’interopérabilité. L’adoption de conventions de codage rigoureuses permet la fédération de bases de données distribuées et facilite la réplication expérimentale des résultats de recherche. La transformation maîtrisée du nom du mois vers son rang ordinal, et inversement, constitue l’opération élémentaire par laquelle l’analyste fait transiter une information d’un état de présentation destiné à la diffusion vers un état computationnel destiné à l’agrégation statistique avancée, au calcul de covariances ou à l’application de filtres spectraux.
1.3 Typologie des formats de mois : ordinaux, nominaux et abréviations
D’un point de vue typologique, les représentations mensuelles au sein des environnements numériques se segmentent en trois catégories majeures, présentant chacune des propriétés mathématiques et syntaxiques distinctes. La première catégorie regroupe les formats ordinaux discrets, incarnés par les nombres entiers s’étendant de 1 pour janvier à 12 pour décembre. Ces entiers constituent une échelle de rang parfaite, invariant sous les transformations affines monotones. Ils permettent des calculs modulaires élémentaires — tels que l’arithmétique modulo 12 pour déterminer les décalages de cycles — et s’avèrent universels d’un point de vue linguistique. Ils ne souffrent d’aucun biais de traduction et autorisent un stockage binaire extrêmement compact.
La deuxième catégorie comprend les formes nominales intégrales, caractérisées par des chaînes alphabétiques complètes. Sur le plan sémantique, ces dénominations possèdent le degré d’explicitation le plus élevé, éliminant tout risque de confusion avec des identifiants de jours ou des indices de catégories non temporelles. Toutefois, leur manipulation algorithmique est vulnérable aux variations typographiques, à la sensibilité à la casse (majuscules et minuscules), aux erreurs diacritiques (présence ou absence d’accents sur des termes comme « Février » ou « Août »), ainsi qu’à la présence pernicieuse d’espaces insécables ou résiduels introduits lors des saisies manuelles ou des transferts de fichiers plats.
Enfin, la troisième catégorie englobe les formes tronquées ou abréviations, généralement standardisées sous la forme de trigrammes alphabétiques (par exemple : « Jan », « Fév », « Mar » ou « Sep »). Ces formats réduits constituent un compromis d’ingénierie visuelle, fréquemment exploité dans la conception de tableaux de bord condensés ou d’axes d’abscisses sur des visualisations denses. Cependant, la réduction de la chaîne textuelle augmente la sensibilité aux conventions orthographiques locales et peut engendrer des collisions sémantiques ou des échecs d’analyse lexicale lorsque les algorithmes de reconnaissance de formes n’ont pas été calibrés pour gérer les points abréviatifs ou les divergences d’écoles typographiques entre normes francophones et internationales. La préservation de l’intégrité référentielle nécessite une formalisation mathématique de chaque étape de conversion entre ces catégories hétérogènes.
2. Analyse mathématique de la formule =TEXTE(A1*29; « mmmm »)
2.1 Mécanisme arithmétique et exploitation de l’intervalle de 29 jours
L’une des approches les plus ingénieuses et élégantes pour transformer un entier ordinal compris entre 1 et 12 en sa désignation textuelle exhaustive repose sur l’exploitation d’une propriété arithmétique singulière du calendrier sériel de Google Sheets via l’expression :
=TEXTE(A1*29; « mmmm »)
Pour comprendre le fonctionnement interne de cette formule, il faut analyser les valeurs scalaires produites par le produit de la cellule source A1 avec le coefficient 29, et examiner la correspondance de ces scalaires dans le calendrier sériel démarrant à l’epoch du 30 décembre 1899. Si la cellule A1 contient la valeur 1, le produit scalaire est égal à 29. Dans le système de numérotation sérielle de Google Sheets, le jour 29 correspond rigoureusement au 28 janvier 1900. La fonction de formatage extrait alors le mois de cette date sérielle, produisant avec succès le libellé « Janvier ».
Si la cellule A1 contient l’entier 2, le produit 2 * 29 génère la valeur 58, qui équivaut sériellement au 26 février 1900. En poursuivant cette progression arithmétique linéaire pour chaque entier jusqu’à 12, on constate que le pas constant de 29 jours garantit que le produit tombera systématiquement à l’intérieur du mois cible correspondant, sans jamais franchir prématurément le seuil du mois suivant. La sélection du coefficient 29 relève d’une optimisation déterministe rigoureuse : il s’agit du plus grand entier inférieur à la durée du mois le plus court du calendrier grégorien, à savoir le mois de février, qui compte 28 jours en année non bissextile (l’année 1900 n’étant pas bissextile selon les règles du calendrier grégorien séculaire).
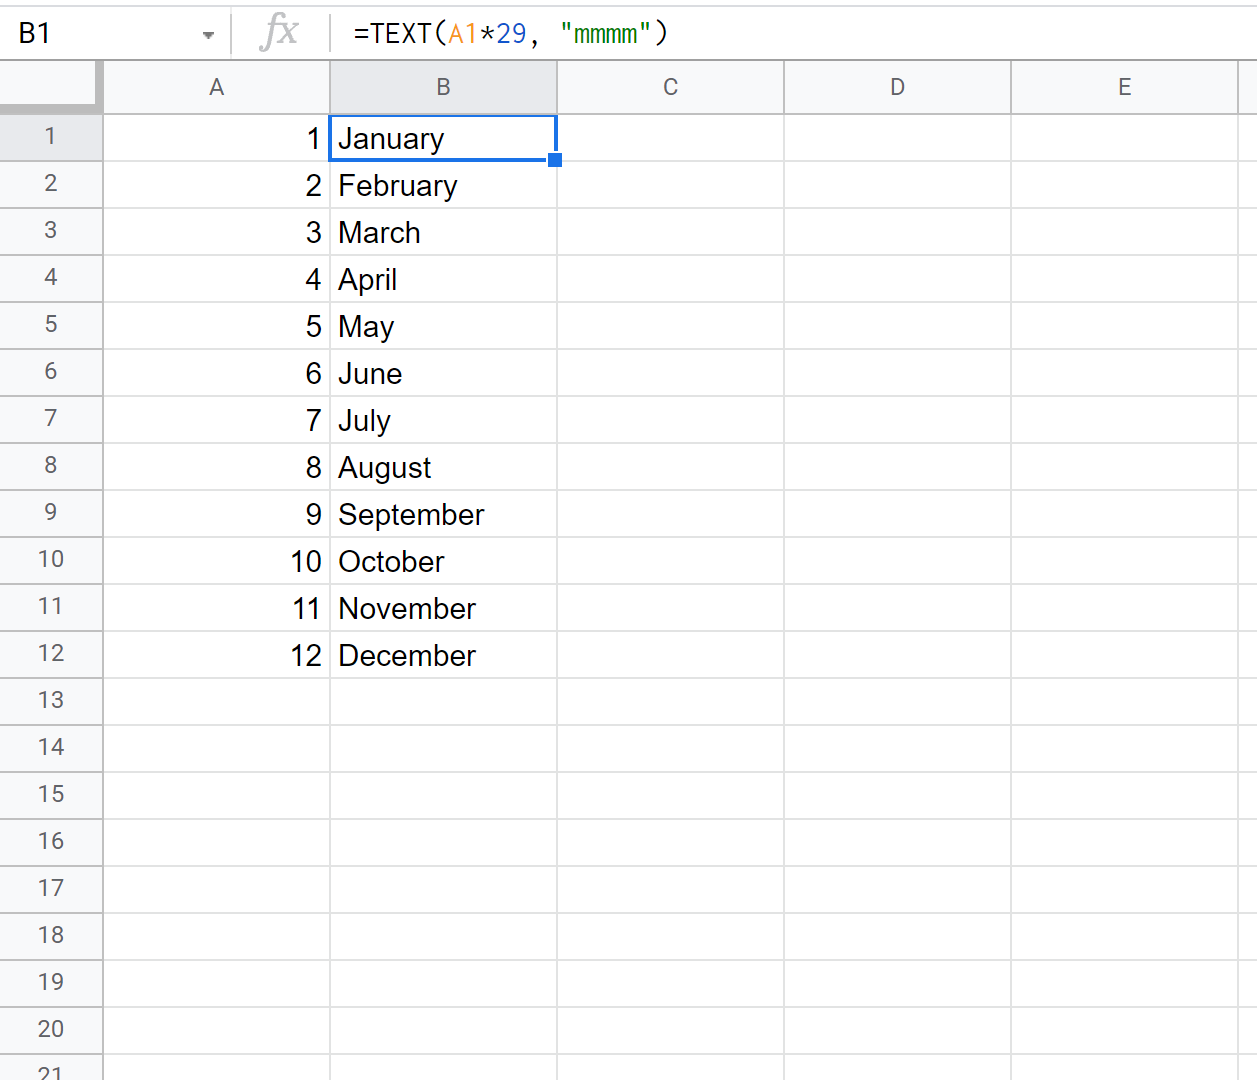
L’utilisation d’un coefficient alternatif tel que 30 ou 31 engendrerait une défaillance arithmétique structurelle. Par exemple, avec un coefficient de 30, pour A1 égal à 2, le produit sériel serait 60. Or, dans le système sériel de Google Sheets (qui reproduit par souci de rétrocompatibilité le bogue historique d’Excel considérant à tort 1900 comme une année bissextile), la valeur 60 correspond au 29 février 1900, et la valeur 61 au 1er mars 1900. Un pas de 30 jours risquerait ainsi d’anticiper le passage aux mois subséquents en raison de l’irrégularité structurelle de la durée des mois (alternance de 30 et 31 jours, et anomalie de février). Le multiplicateur 29 constitue l’intervalle invariant minimal assurant une bijection exacte entre l’espace ordinal {1, 2, …, 12} et la séquence ordonnée des douze mois de l’année 1900.
2.2 Syntaxe formelle et masques de formatage de la fonction TEXTE
La fonction TEXTE assure la conversion d’une valeur numérique en chaîne de caractères en lui appliquant un masque de formatage prédéfini. La syntaxe générale de l’instruction s’énonce comme suit :
TEXTE(nombre; format)
Dans l’expression étudiée, le premier argument correspond à l’entier sériel généré par la projection arithmétique, tandis que le second argument est le masque contextuel « mmmm ». Le parseur interne du moteur de feuille de calcul interprète la répétition quadruple du caractère « m » comme une directive impérative ordonnant la restitution de la nomenclature nominale complète du mois, sans troncature, et alignée sur la configuration linguistique active du classeur.
Le moteur de calcul applique un processus d’évaluation strict en deux phases. Dans un premier temps, l’expression scalaire A1*29 est résolue dans le domaine numérique flottant. Si la cellule A1 contient une valeur décimale résiduelle (par exemple 1,4), le parseur évalue la partie entière de la date résultante tout en intégrant la composante fractionnaire dans l’axe continu du temps. Néanmoins, tant que la fluctuation fractionnaire ne propulse pas le scalaire au-delà de la frontière sérielle du mois concerné, l’isolation de la composante mensuelle demeure stable. Dans un second temps, le moteur extrait la portion mensuelle de la date calculée et effectue une recherche lexicale dans sa table de localisation interne pour convertir l’entier mensuel (compris entre 1 et 12) dans la chaîne textuelle correspondante.
Il convient de souligner que le résultat produit par cette fonction est dépourvu de toute nature numérique ou sérielle : il s’agit d’une chaîne scalaire de type texte pur. Par conséquent, cette cellule ne pourra plus faire l’objet direct d’additions temporelles ou d’opérations géométriques sans une reconversion inverse. L’argument de formatage agit comme un filtre d’isolation sémantique qui extrait l’essence nominale du mois tout en rejetant les composantes relatives au jour sériel et à l’année sous-jacente.
2.3 Génération de formats réduits avec le masque « mmm »
Lorsque les contraintes spatiales d’une interface tabulaire ou les exigences de lisibilité d’un graphique de dispersion l’imposent, la syntaxe de formatage peut être ajustée pour générer des abréviations standardisées. La substitution du masque « mmmm » par le masque ternaire « mmm » au sein de la même architecture de calcul permet d’obtenir directement le trigramme alphabétique représentatif du mois :
=TEXTE(A1*29; « mmm »)
Cette formulation compacte ordonne au parseur de renvoyer la chaîne textuelle tronquée officielle définie par les conventions typographiques régionales. En configuration française, les valeurs de sortie correspondront respectivement à « janv. », « févr. », « mars », « avr. », « mai », « juin », « juil. », « août », « sept. », « oct. », « nov. », et « déc. ». On observera que la localisation francophone de Google Sheets intègre parfois des points abréviatifs ou des formes à quatre lettres pour certains mois spécifiques afin de respecter les normes de l’Imprimerie nationale, contrairement à la norme anglophone stricte qui produit invariablement des trigrammes purs (« Jan », « Feb », « Mar », etc.).
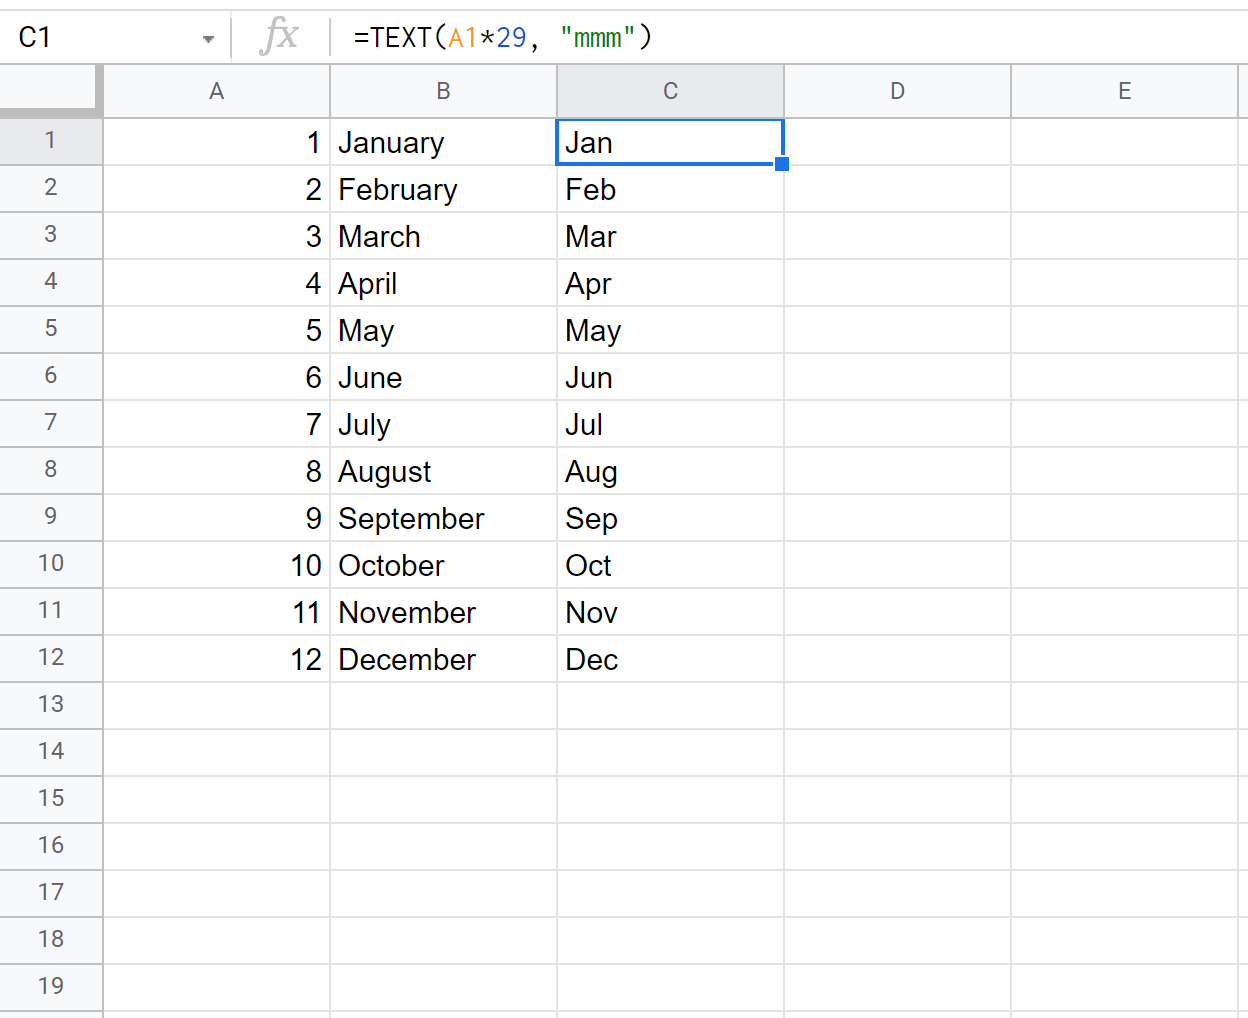
L’utilisation du masque « mmm » standardise les affichages matriciels et densifie les rapports de synthèse sans nécessiter la mise en œuvre de colonnes de calcul auxiliaires ou d’opérations de découpage de chaînes par des fonctions comme GAUCHE ou STXT. De surcroît, la cohérence structurelle du vecteur texte généré via « mmm » est garantie par le moteur interne, évitant les incohérences de casse qui résulteraient de saisies hétérogènes rédigées par des opérateurs humains distincts lors de la phase de saisie primaire des enregistrements.
3. Méthodes alternatives pour transformer un numéro en nom de mois
3.1 Exploitation explicite de la fonction DATE combinée à TEXTE
Bien que la formule fondée sur le coefficient 29 séduise par sa concision, la rigueur académique appliquée à l’ingénierie logicielle préconise souvent une formulation plus explicite, supprimant toute constante magique dont la présence pourrait dérouter un auditeur de modèles financiers ou statistiques. L’expression canonique la plus documentée et la plus sûre repose sur l’instanciation conjointe des fonctions DATE et TEXTE :
=TEXTE(DATE(2024; A1; 1); « mmmm »)
Dans cette construction, la fonction DATE reçoit trois arguments rigoureusement typés : l’année d’observation (ici arbitrairement fixée à 2024, une année civile neutre), le numéro ordinal du mois contenu dans la variable A1, et le jour du mois, fixé de façon invariante à 1. Cette déclaration force le moteur de Google Sheets à instancier une structure temporelle formelle et non ambiguë, exempte de tout artifice lié aux particularités de l’année 1900.
L’immunité conceptuelle de cette méthode face aux perturbations de calendrier est absolue. En fixant le jour à 1, la formule s’affranchit totalement des fluctuations de longueur des mois et élimine tout risque de basculement accidentel vers le mois suivant. Le choix d’une année contemporaine comme 2024 garantit en outre une parfaite conformité avec le calendrier grégorien moderne, éliminant les anomalies sérielles historiques associées aux premières versions des moteurs tabulaires. Pour les équipes pluridisciplinaires chargées de maintenir des infrastructures statistiques de grande envergure, la lisibilité sémantique de =TEXTE(DATE(…)) facilite considérablement l’audit de code et atteste d’une démarche d’ingénierie méthodique exempte d’approximations empiriques.
3.2 Utilisation de la fonction CHOISIR pour un mappage déterministe
Une approche conceptuellement divergente consiste à s’émanciper totalement du moteur sériel temporel pour traiter la problématique sous l’angle exclusif de la logique propositionnelle discrète. La fonction CHOISIR permet de bâtir une structure vectorielle purement déterministe, réalisant une projection directe entre l’index ordinal et un ensemble fini de constantes textuelles :
=CHOISIR(A1; « Janvier »; « Février »; « Mars »; « Avril »; « Mai »; « Juin »; « Juillet »; « Août »; « Septembre »; « Octobre »; « Novembre »; « Décembre »)
Cette architecture présente une vertu fondamentale : l’indépendance linguistique absolue vis-à-vis des paramètres régionaux de la feuille de calcul. Quelle que soit la langue configurée sur le compte Google de l’utilisateur ou la localisation du classeur hôte (qu’il soit localisé aux États-Unis, en Allemagne ou au Japon), la valeur renvoyée sera invariablement la chaîne définie littéralement dans la formule. Cette caractéristique est cruciale pour les consortiums internationaux dont les classeurs transitent entre des filiales opérant dans des espaces linguistiques hétérogènes, où l’exécution d’une fonction dépendante de la localisation pourrait introduire des désynchronisations d’affichage.
Toutefois, cette robustesse linguistique a pour contrepartie une verbosité syntaxique notable et un coût de maintenance accru. Toute modification du formatage (par exemple, le passage vers une graphie en minuscules ou abrégée) requiert une modification manuelle ou par script des douze arguments scalaires de la fonction. De plus, la fonction CHOISIR est dépourvue de tolérance aux erreurs d’arrondi : la présence d’une valeur décimale dans A1 nécessite une troncature explicite via la fonction ENT ou TRONQUE pour prévenir des comportements indéterminés du parseur.
3.3 Indexation par table de correspondance avec RECHERCHEV ou INDEX/EQUIV
Dans les architectures de bases de données relationnelles ou les modèles tabulaires normalisés selon la troisième forme normale (3NF), il est généralement déconseillé d’incorporer des listes de constantes textuelles directement au sein du code des formules analytiques. La séparation stricte de la logique métier et des données de référence dicte alors l’emploi d’une table de correspondance dédiée (lookup table), interrogeable par les fonctions de recherche standardisées comme RECHERCHEV ou le couplage vectoriel INDEX / EQUIV.
Soit une matrice de référence positionnée sur une feuille dédiée nommée « Dimensions », s’étendant sur la plage A1:B12, où la première colonne contient les index séquentiels de 1 à 12 et la seconde héberge les désignations textuelles correspondantes. La résolution s’opère via la formule :
=RECHERCHEV(A1; Dimensions!$A$1:$B$12; 2; FAUX)
Ou, de manière encore plus robuste et insensible aux réorganisations de colonnes :
=INDEX(Dimensions!$B$1:$B$12; EQUIV(A1; Dimensions!$A$1:$A$12; 0))
Cette méthodologie découple intégralement la structure décisionnelle des définitions nominales. Si le protocole expérimental requiert ultérieurement l’adjonction de nomenclatures supplémentaires — telles que des trigrammes normalisés, des désignations bilingues ou des codes de classification budgétaire associés à chaque mois —, il suffit d’adjoindre des dimensions vectorielles à la table sans jamais altérer les formules de calcul réparties sur des millions de lignes au sein du classeur transactionnel. Si cette approche impose une consommation résiduelle de mémoire vive pour le stockage et l’indexation de la table matricielle, son impact sur le temps de recalcul dynamique demeure infinitésimal sur des architectures d’échelles conventionnelles, tout en conférant une traçabilité d’entreprise exemplaire.
4. Déconstruction logique de l’expression =MOIS(A1&1)
4.1 Concaténation implicite et coercition de type de données
La transformation inverse, consistant à extraire la valeur ordinale comprise entre 1 et 12 à partir d’un nom de mois textuel, confronte le moteur de Google Sheets à un problème complexe d’analyse lexicale. Contrairement à la génération textuelle, qui est déterministe, la dérivation d’un entier à partir d’une chaîne arbitraire nécessite une interprétation contextuelle. À cet égard, la formule idiopathique la plus répandue et la plus synthétique s’articule comme suit :
=MOIS(A1&1)
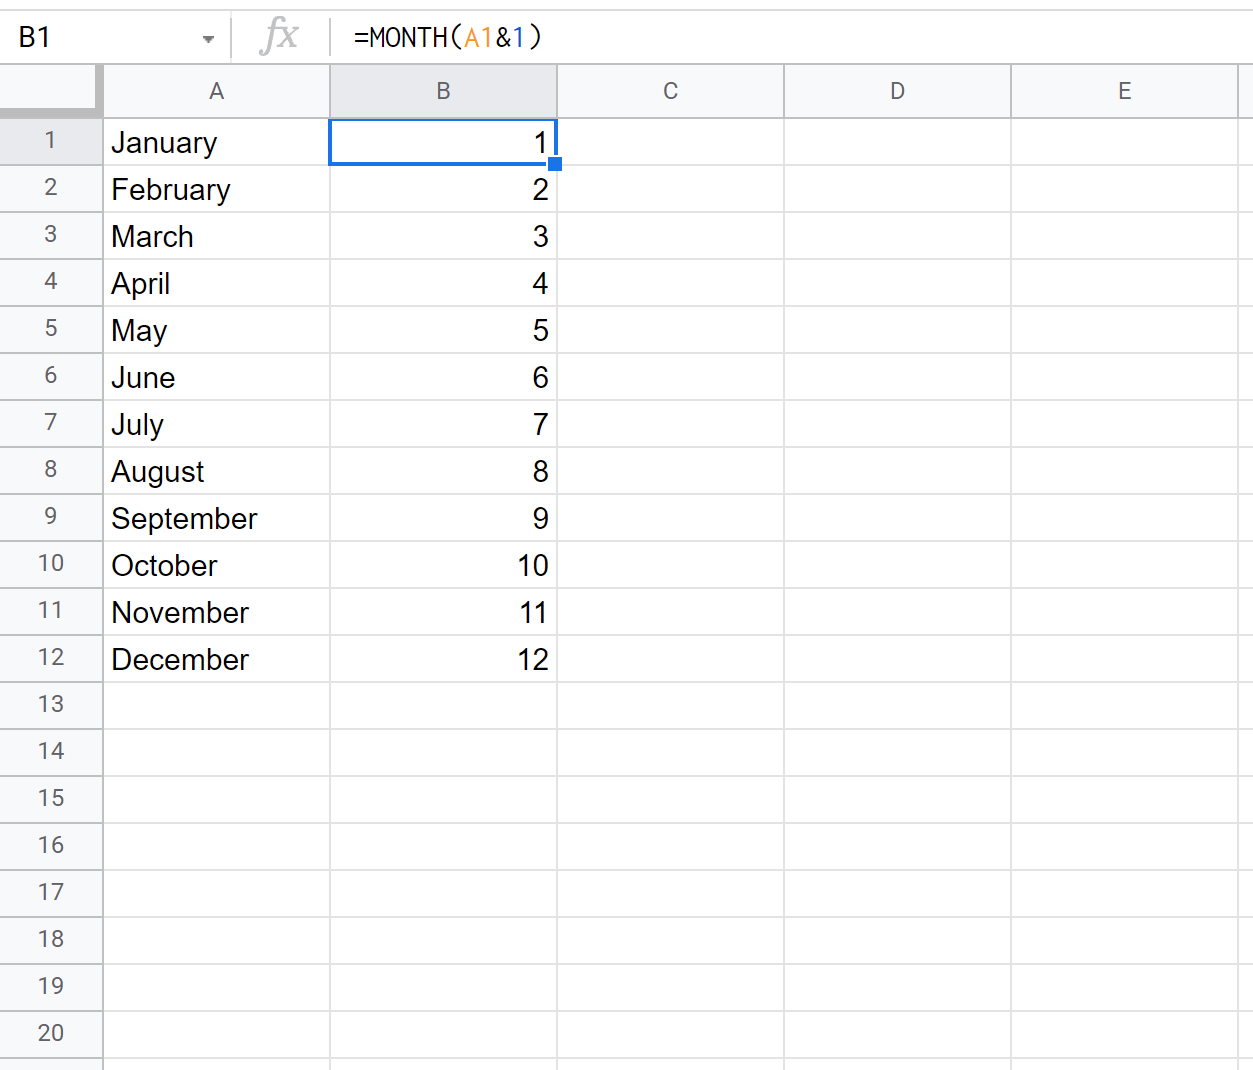
Le fonctionnement interne de cette formule repose sur une coercition de type implicite rendue possible par l’opérateur de concaténation perluète (&). Lorsque la cellule A1 héberge la chaîne « Janvier », l’opération binaire A1&1 génère une nouvelle chaîne de caractères combinée : « Janvier1 ». Dans le système d’inférence de Google Sheets, la juxtaposition d’une dénomination textuelle de mois et d’un chiffre scalaire est immédiatement interprétée par le sous-système de validation lexicale comme la représentation abrégée d’une entité calendaire : le 1er jour du mois considéré pour l’année civile en cours.
Ce mécanisme exploite le comportement permissif du parseur d’entrées, conçu à l’origine pour faciliter la saisie rapide au clavier sans imposer de séparateurs de dates stricts tels que les barres obliques ou les tirets. L’attribution automatique de l’année courante est totalement transparente : si nous sommes en 2024, le moteur résout en interne la chaîne « Janvier1 » sous la forme d’un objet sériel correspondant au 01/01/2024. Il est remarquable d’observer que cette inférence s’exécute sans intervention de la fonction DATEVAL, le moteur tabulaire effectuant dynamiquement un transtypage contextuel dès lors que la chaîne en argument est consommée par une fonction attendant un paramètre formellement temporel.
4.2 Extraction de l’entier ordinal via la fonction MOIS
Une fois la chaîne concaténée résolue sous forme sérielle, la fonction MOIS prend le relais pour isoler le rang ordinal du mois. La syntaxe canonique de cette fonction est :
MOIS(date_sérielle)
Le principe opératoire de la fonction MOIS consiste à décoder l’entier sériel interne et à extraire la composante mensuelle normalisée sur l’intervalle fermé [1, 12]. Dans le cas de notre chaîne « Janvier1 », la fonction MOIS décode la date sérielle associée et renvoie immédiatement l’entier 1. Pour une saisie textuelle « Décembre », la concaténation produit « Décembre1 », que le moteur convertit en 01/12/[Année_Courante], permettant à la fonction MOIS d’extraire la valeur 12.
Cette méthode possède une efficience computationnelle remarquable car elle mobilise des routines internes en langage machine optimisées pour l’analyse lexicale rapide des dates. Elle absorbe sans difficulté les formes nominales complètes et présente une tolérance native remarquable envers les variations de casse : « JANVIER », « janvier » ou « JanVieR » aboutissent rigoureusement au même résultat. Toutefois, la limite intrinsèque de cette coercition réside dans son opacité structurelle. Si un utilisateur insère une chaîne textuelle corrompue, un anglicisme non reconnu par la localisation locale ou un terme comportant une coquille typographique, la concaténation produira un assemblage illégitime (par exemple « Jnavier1 ») que le moteur ne pourra convertir en date sérielle, provoquant une interruption brutale du calcul et la levée d’une exception sous la forme d’une erreur d’évaluation tabulaire.
4.3 Variantes syntaxiques alternatives via DATEVAL
Pour les analystes désireux de conférer une traçabilité accrue à leurs modèles tout en évitant les inférences automatiques implicites du moteur de calcul, il est possible d’expliciter chaque étape de la conversion lexicale en décomposant l’opération via la fonction DATEVAL :
=MOIS(DATEVAL(A1 & » 1, 2024″))
Dans ce schéma analytique formalisé, la chaîne soumise à l’évaluation lexicale est volontairement structurée selon un schéma syntaxique complet comprenant le séparateur d’espace, le jour ordinal et une constante d’année explicite. La fonction DATEVAL valide la conformité textuelle de la chaîne composite et procède à sa conversion déterministe en numéro de série séquentiel. La fonction MOIS intervient ensuite sur une valeur numérique garantie, supprimant l’incertitude liée à l’assignation volatile de l’année système courante.
L’incorporation explicite de DATEVAL s’avère particulièrement pertinente au sein des arbres de formules complexes et imbriquées, où les mécanismes d’inférence implicite de Google Sheets peuvent occasionnellement échouer en fonction du contexte d’évaluation matricielle. Par ailleurs, cette formulation explicite rend le diagnostic d’erreur beaucoup plus limpide : si la chaîne nominale est invalide, l’erreur #VALEUR! est immédiatement isolée au niveau de l’instruction DATEVAL, confirmant à l’analyste que le défaut structurel réside dans l’inintelligibilité textuelle de la cellule source et non dans la logique arithmétique globale du modèle.
5. Traitement des abréviations et des variations typographiques
5.1 Gestion des formes nominales tronquées et acronymes mensuels
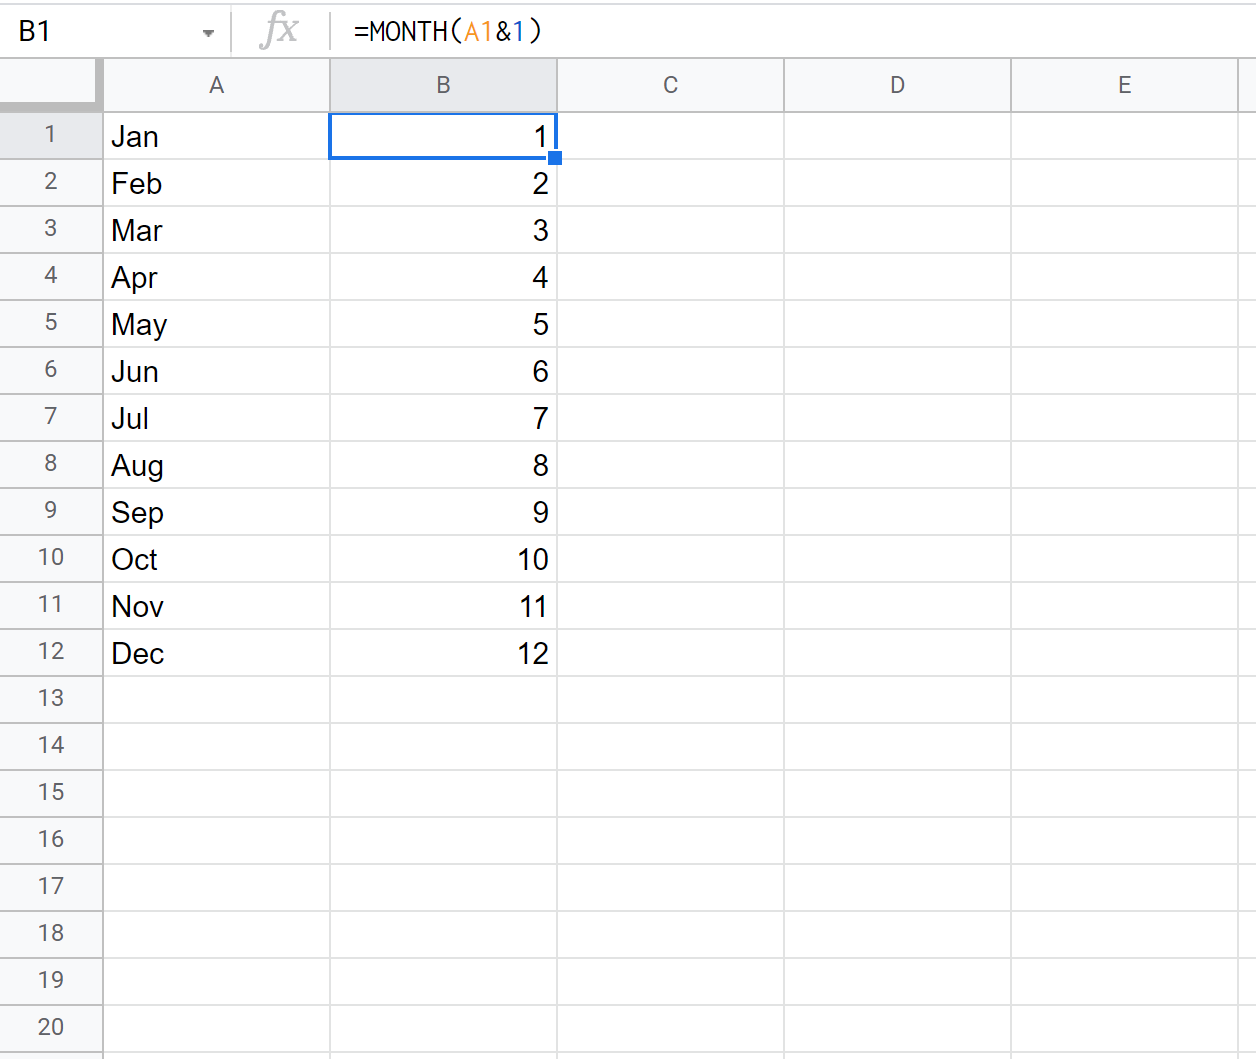
Dans les jeux de données non nettoyés issus de captations hétérogènes, les dénominations mensuelles se présentent fréquemment sous forme d’abréviations ou d’acronymes. La formule idiomatique =MOIS(A1&1) démontre une capacité d’absorption variable face à ces chaînes tronquées, étroitement conditionnée par les tables lexicographiques régionales intégrées à Google Sheets. Dans un environnement francophone, les trigrammes conventionnels tels que « Jan », « Mar », ou « Déc » sont généralement reconnus avec succès lorsqu’ils sont adossés au chiffre 1, le parseur inférant correctement la référence calendaire sous-jacente.
Cependant, des divergences de comportement notables surgissent dès lors que l’abréviation intègre ou omet un point abréviatif. Par exemple, la chaîne « févr. » (comportant un point terminal conformément aux prescriptions typographiques académiques) concaténée avec le chiffre 1 produit l’assemblage « févr.1 ». Le moteur lexical de Google Sheets peut échouer à reconnaître cette forme comme une entité temporelle valide, la présence du point perturbant la détection automatique de la séquence numérique. Pour immuniser le modèle contre ce phénomène, il est nécessaire de procéder à un nettoyage textuel préalable au moyen de la fonction SUBSTITUE :
=MOIS(SUBSTITUE(A1; « . »; « ») & 1)
Une attention particulière doit être portée aux mois dont le libellé complet est intrinsèquement court, à l’instar de « Mai », « Juin » ou « Août ». Pour ces occurrences, la frontière entre le nom complet et l’abréviation disparaît. Le modèle de conversion lexicale doit s’assurer qu’aucune routine d’épuration tronquant arbitrairement les chaînes aux trois premiers caractères ne soit appliquée sans discernement, sous peine d’altérer des termes déjà conformes.
5.2 Impact de la casse, des accents et des espaces insécables
L’intégrité du traitement des données textuelles chronologiques est constamment compromise par des irrégularités morphologiques invisibles à l’œil nu sur l’interface graphique. Bien que le moteur lexical de Google Sheets fasse preuve d’une insensibilité native relative à la casse (autorisant un traitement indifférencié des majuscules et des minuscules), il se montre particulièrement vulnérable aux anomalies d’encodage diacritique et à la présence de caractères d’espacement résiduels.
Lors de l’importation de fichiers structurés au format CSV provenant de systèmes d’information historiques ou de bases de données dont l’encodage UTF-8 a été corrompu en ISO-8859-1 (Latin-1), les caractères accentués subissent fréquemment des phénomènes de mojibake. Un terme tel que « Février » se transforme alors en « Février », tandis qu’« Août » devient « Août ». Ces chaînes altérées provoquent irrémédiablement l’échec des fonctions d’inférence temporelle. Parallèlement, l’extraction de données depuis des progiciels de gestion intégrée (ERP) injecte fréquemment des espaces insécables (code ASCII 160 ou entité Unicode U+00A0) en début ou en fin de chaîne, que l’œil humain confond aisément avec des espaces standards (code ASCII 32).
Pour assainir méthodologiquement les vecteurs textuels avant d’initier la conversion vers le rang ordinal, il est impératif d’encapsuler la cellule source au sein d’un pipeline d’épuration combinant les fonctions SUPPRESPACE et EPURAGE :
=MOIS(SUPPRESPACE(EPURAGE(A1)) & 1)
La fonction EPURAGE élimine sans exception les 32 premiers caractères de contrôle non imprimables du code ASCII, tandis que SUPPRESPACE supprime les espaces redondants en tête et en queue de chaîne, consolidant ainsi la conformité de l’entrée textuelle avant l’étape de coercition lexicale.
5.3 Détection et correction des erreurs de saisie récurrentes
Lorsque la chaîne textuelle est altérée par des fautes d’orthographe récurrentes (« Janveir », « Septembree », « Appril »), la coercition automatique est vouée à l’échec. Deux approches méthodologiques permettent de pallier ces défaillances de saisie manuelle. La première consiste à sécuriser le processus en amont en interdisant formellement l’entrée libre au moyen de règles de validation des données restreignant les saisies à une liste close et immuable de dénominations contrôlées.
La seconde approche, purement corrective et déployée a posteriori, repose sur la substitution conditionnelle fondée sur la reconnaissance de motifs par expressions régulières au moyen de la fonction REGEXREPLACE. Cette technique permet de normaliser les occurrences déviantes avant l’extraction ordinale :
=MOIS(REGEXREPLACE(A1; « (?i)^janv.* »; « Janvier ») & 1)
Le modificateur contextuel (?i) confère à l’expression régulière une insensibilité totale à la casse, tandis que le métacaractère chapeau (^) et l’étoile quantificatrice permettent de capturer toute chaîne débutant par la séquence de lettres « janv » et de la réécrire sous la forme canonique « Janvier ».
Dans les environnements analytiques critiques où les volumes de données interdisent toute maintenance manuelle, des heuristiques plus avancées reposant sur le calcul de la distance d’édition de Levenshtein peuvent être mobilisées via Google Apps Script pour mapper automatiquement les saisies corrompues vers le nom de mois le plus proche sur le plan phonétique ou orthographique. Cette mesure d’ingénierie garantit la résilience des flux computationnels face aux approximations de l’opérateur humain.
6. Localisation linguistique et internationalisation des conversions
6.1 Influence des paramètres régionaux de la feuille de calcul
L’un des écueils méthodologiques les plus insidieux dans la manipulation des fonctions temporelles de Google Sheets réside dans la dépendance structurelle du parseur envers les paramètres régionaux (locale) du classeur. Les fonctions de formatage et d’extraction telles que =TEXTE() et =MOIS() n’opèrent pas dans un univers sémantique abstrait et universel : elles interagissent de manière dynamique avec les paramètres de configuration définis sous le menu Fichier > Paramètres > Paramètres régionaux.
Cette dépendance engendre des ruptures computationnelles sévères lors du partage transnational de documents. Si un classeur configuré avec des paramètres régionaux français (France) reçoit une colonne contenant des chaînes textuelles issues d’un flux anglophone (par exemple : « January », « February », « March »), l’expression =MOIS(A1&1) retournera systématiquement une exception de type #VALEUR!. Le parseur français est structurellement incapable d’inférer une date valide à partir de la chaîne « January1 », l’étiquette n’existant pas dans sa matrice lexicographique locale.
De manière analogue, la syntaxe même des formules varie selon la région sélectionnée. Les pays francophones utilisant la virgule comme séparateur décimal conventionnel, les arguments de fonctions doivent impérativement être séparés par des points-virgules (;). À l’inverse, les environnements anglo-saxons recourent à la virgule (,). Bien que Google Sheets opère une traduction automatique de la syntaxe des formules lors du basculement des paramètres régionaux d’un classeur, il n’applique aucune rétro-traduction automatique sur les chaînes de texte brutes résidant dans les cellules. La portabilité des données textuelles chronologiques exige donc une stratégie d’émancipation vis-à-vis des réglages locaux.
6.2 Conversions translinguistiques sans altération des paramètres globaux
Pour traiter des corpus de données multilingues au sein d’un document sans altérer la localisation globale du classeur, l’analyste doit instaurer une couche d’abstraction logicielle découplée de la langue de l’interface. La méthode la plus élégante consiste à déployer une matrice de transcodage universelle intégrant l’ensemble des dénominations dans les langues sources attendues.
Une alternative native particulièrement créative dans l’écosystème Google consiste à exploiter la puissance de la fonction GOOGLETRANSLATE pour standardiser dynamiquement les chaînes nominales vers la langue locale de traitement avant de déclencher l’extraction sérielle :
=MOIS(GOOGLETRANSLATE(A1; « auto »; « fr ») & 1)
Ce flux algorithmique opère en trois temps : le système identifie automatiquement la langue source de la dénomination mensuelle hébergée dans la cellule A1 (qu’il s’agisse d’anglais, d’espagnol, d’allemand ou d’italien), traduit cette chaîne en français standardisé, puis opère la concaténation implicite avec l’entier 1 pour extraire le numéro ordinal via la fonction MOIS.
Bien que cette solution présente une polyvalence remarquable, elle introduit une latence d’exécution proportionnelle au nombre de requêtes HTTP transmises aux serveurs de traduction de Google. Pour des volumes massifs excédant plusieurs milliers de lignes, il est impératif d’abandonner l’appel d’API externe au profit d’une matrice relationnelle rigide basée sur les standards de nomenclature chronologique internationale, garantissant une résolution instantanée en mémoire vive locale sans consommation de quota réseau.
6.3 Gestion des formats de date internationaux et de l’interopérabilité
L’interopérabilité des systèmes d’information distribués requiert une stricte conformité avec les normes internationales de représentation temporelle, au premier rang desquelles trône la norme ISO 8601. Cette norme préconise la représentation calendaire sous la forme descendante immuable AAAA-MM-JJ (ou YYYY-MM-DD), qui neutralise toute équivoque entre le quantième du jour et l’identifiant ordinal du mois.
L’inversion structurelle entre les conventions de notation américaine (Mois/Jour/Année) et continentale européenne (Jour/Mois/Année) est à l’origine d’un volume considérable d’erreurs d’interprétation dans les données scientifiques et financières mondiales. Lorsqu’une date est saisie sous la forme numérique « 04/05/2024 », le système américain y décèle le 5 avril, tandis que le système européen y lit le 4 mai. Lors des phases de conversion entre le nom et le numéro de mois, il est donc primordial de s’assurer que les chaînes numériques générées ne prêtent à aucune confusion d’interprétation.
Pour garantir une portabilité transfrontalière absolue lors de l’exportation de données vers des formats ouverts tels que CSV, JSON ou des bases de données SQL, l’ingénieur de données doit systématiquement convertir les dénominations textuelles en entiers ordinaux formatés avec un zéro de remplissage (padding zero) pour les mois d’un seul chiffre :
=TEXTE(MOIS(A1&1); « 00 »)
Cette précaution garantit que le mois de janvier apparaîtra sous la chaîne « 01 » et novembre sous la chaîne « 11 ». L’ordonnancement alphanumérique standard de ces identifiants coïncidera alors parfaitement et sans exception avec l’ordre chronologique naturel des cycles temporels.
7. Formules matricielles et traitement à grande échelle avec ARRAYFORMULA
7.1 Vectorisation de la conversion de numéros vers les noms
Dans le paradigme du traitement de données tabulaires à haute performance, l’étirement manuel ou le copier-coller répétitif de formules scalaires le long d’une colonne de plusieurs dizaines de milliers de lignes constitue une anti-méthode absolue. Ce procédé dégrade les performances du classeur, alourdit inutilement la structure XML du fichier et introduit des risques de rupture de logique lors de l’insertion ultérieure de nouveaux enregistrements. La résolution élégante de ce problème repose sur la vectorisation algorithmique via la fonction ARRAYFORMULA.
Pour déployer la transformation mathématique d’une colonne entière de numéros de mois (plage A2:A) en leurs équivalents textuels complets, on utilisera une construction matricielle encapsulée :
=ARRAYFORMULA(SI(ESTVIDE(A2:A); « »; TEXTE(A2:A*29; « mmmm »)))
L’analyse de cette expression matricielle révèle une gestion rigoureuse des limites dimensionnelles. L’instruction vectorielle ARRAYFORMULA ordonne au moteur de calcul de traiter la plage de cellules A2:A non pas comme une suite d’entités isolées, mais comme un vecteur colonne unique à une dimension. Le test logique SI(ESTVIDE(A2:A); « »; …) constitue une condition de garde indispensable. En l’absence de ce garde-fou, la formule matricielle tenterait d’évaluer l’intégralité des cellules de la colonne jusqu’à la limite structurelle de la grille de calcul (soit potentiellement des dizaines de milliers de lignes vides), multipliant la valeur zéro par 29 et produisant une prolifération indésirable de mentions « Décembre » (le jour sériel 0 correspondant au 30 décembre 1899).
Grâce à cette formulation vectorisée, l’arbre de calcul est compilé une fois pour toutes par le moteur de Google Sheets. Dès qu’un utilisateur ou un système automatisé insère une nouvelle valeur numérique dans la plage A2:A, la désignation textuelle correspondante est instantanément projetée dans la colonne adjacente, sans nécessiter la moindre intervention humaine sur le modèle tabulaire.
7.2 Traitement matriciel pour la conversion inverse de noms vers les numéros
La vectorisation de la conversion réciproque — consistant à transmuter un vecteur textuel de noms de mois en une colonne d’entiers ordinaux — mobilise une logique conceptuelle analogue, exploitant la réactivité matricielle de l’opérateur de concaténation :
=ARRAYFORMULA(SI(A2:A= » »; « »; MOIS(A2:A & 1)))
Dans cette configuration, l’opérateur perluète (&) n’agit plus sur un scalaire isolé, mais procède à la diffusion matricielle de l’opération sur l’ensemble des éléments de la collection A2:A. Chaque chaîne textuelle non vide est séquentiellement concaténée avec le caractère « 1 » au sein de la mémoire vive du processeur, générant un vecteur intermédiaire de chaînes calendaires. La fonction MOIS est ensuite invoquée pour projeter instantanément les entiers scalaires correspondants sur l’intervalle vectoriel de sortie.
La stabilité de cette formule matricielle en environnement de production repose sur la propreté absolue du vecteur source. Si une seule cellule de la plage A2:A héberge une entrée textuelle aberrante ou une chaîne non convertible, l’évaluation matricielle ne s’interrompt pas globalement, mais renvoie ponctuellement l’erreur #VALEUR! sur l’indice de ligne concerné, tout en poursuivant l’évaluation correcte des autres éléments du vecteur. Cette résilience opérationnelle est fondamentale pour le traitement de flux continus de données volumineuses où l’interruption totale du flux par blocage d’exception ne peut être tolérée.
7.3 Alternatives modernes avec les fonctions LAMBDA et BYROW
Bien qu’ARRAYFORMULA constitue le pilier historique de la programmation matricielle dans Google Sheets, l’introduction des abstractions fonctionnelles basées sur le calcul lambda a profondément transformé l’architecture des modèles de données avancés. L’exploitation conjointe des fonctions BYROW et LAMBDA offre une alternative moderne d’une modularité et d’une rigueur sémantique supérieures :
=BYROW(A2:A; LAMBDA(ligne; SI(ESTVIDE(ligne); « »; MOIS(ligne & 1))))
L’opérateur BYROW applique une fonction de rappel anonyme de manière itérative sur chaque ligne du vecteur désigné par le premier argument. La variable locale « ligne » agit comme un paramètre formel au sein de la clôture lexicale définie par l’expression LAMBDA. Cette formulation présente plusieurs avantages déterminants sur le plan computationnel. Premièrement, elle segmente rigoureusement l’espace mémoire alloué à chaque évaluation de cellule, réduisant les risques de dépassement de pile lors de traitements sur des plages de données très vastes. Deuxièmement, elle facilite l’adjonction de conditions de test et de transformation complexes qui s’avèrent parfois impossibles à vectoriser directement avec ARRAYFORMULA en raison des limitations intrinsèques de certaines fonctions natives ne supportant pas les matrices (telles que ET ou OU logiques).
En outre, ces structures peuvent être encapsulées sous la forme de Fonctions Nommées directement intégrées au gestionnaire de formules du classeur. L’analyste peut ainsi déclarer une fonction personnalisée réutilisable, par exemple CONVERTIR_NOM_EN_MOIS(vecteur), masquant totalement la complexité algorithmique sous-jacente pour les utilisateurs finaux du modèle tabulaire.
8. Diagnostic des erreurs et protocoles de validation des données
8.1 Typologie des erreurs courantes : #VALEUR!, #REF! et décalages logiques
Dans le cycle de vie d’un modèle tabulaire exploitant des conversions de temporalité, les anomalies de calcul se manifestent selon une taxonomie précise d’erreurs qu’il convient de savoir diagnostiquer rigoureusement. L’exception la plus fréquente est sans conteste l’erreur d’évaluation typologique matérialisée par l’identifiant #VALEUR!. Dans le contexte de la conversion textuelle vers le rang ordinal, cette interruption survient inévitablement lorsque l’analyseur lexical est confronté à une chaîne qui ne correspond à aucune convention morphologique reconnue (par exemple une faute de frappe comme « Marss », ou une chaîne vide contenant des caractères d’espacement résiduels non épurés).
Une seconde catégorie d’anomalies, plus pernicieuse car invisible lors d’une inspection de premier niveau, concerne les décalages logiques induits par des valeurs numériques hors bornes. Si un utilisateur applique la formule arithmétique =TEXTE(A1*29; « mmmm ») alors que la cellule A1 héberge un entier strictement supérieur à 12 ou inférieur à 1, aucun message d’erreur d’interruption n’est émis par le système. Le moteur de calcul se contente de poursuivre l’évaluation de la progression sérielle le long de l’axe temporel de l’année 1900 ou de plonger dans des dates antérieures à l’epoch. Par exemple, si A1 héberge la valeur 13, le produit 13 * 29 = 377 projette la date sérielle au 12 janvier 1901. La fonction renvoie alors « Janvier », créant une illusion d’exactitude tout en falsifiant entièrement la métrique sous-jacente par une collision de projection cyclique.
Enfin, l’erreur #REF! se manifeste principalement dans les configurations matricielles vectorisées ou les modèles fondés sur des tables de correspondance matricielles. Dans le cas d’ARRAYFORMULA, elle signale généralement un conflit de collision dimensionnelle : la formule matricielle tente d’écrire des résultats dans des cellules de sortie qui sont déjà occupées par des constantes textuelles, des valeurs scalaires ou des formules résiduelles indépendantes. Dans le cas de RECHERCHEV, cette erreur dénonce une altération structurelle de la plage matricielle déclarée consécutive à la suppression inopinée d’une colonne de référence au sein de la feuille dimensionnelle.
8.2 Stratégies d’encapsulation défensive avec SIERREUR et SI.NON.DISP
Pour conférer à un modèle tabulaire une qualité industrielle, il est fondamental de ne jamais laisser des messages d’erreur non interceptés polluer l’interface de travail ou fausser les étapes ultérieures d’agrégation statistique. La stratégie d’ingénierie préconise l’encapsulation défensive des routines de conversion au sein de structures de contrôle d’exception, principalement via les fonctions SIERREUR et SI.NON.DISP.
L’interception de l’erreur lexicale lors de la conversion d’un nom de mois vers son équivalent numérique s’organise selon la syntaxe défensive suivante :
=SIERREUR(MOIS(A1&1); « Mois non reconnu »)
Dans ce scénario, si l’analyse lexicale échoue en générant une exception #VALEUR!, l’erreur est interceptée par la couche supérieure et immédiatement neutralisée au profit d’un marqueur sémantique d’alerte explicite ou d’une valeur sentinelle standardisée (telle que la valeur zéro ou une cellule nulle « »).
Toutefois, une rigueur méthodologique accrue commande d’opérer une différenciation diagnostique entre une cellule véritablement corrompue et une absence licite de données. L’utilisation indiscriminée de SIERREUR masque toutes les anomalies indistinctement, y compris des erreurs structurelles graves d’arborescence comme #REF! ou #NOM?. Dans les architectures reposant sur des tables de référence avec RECHERCHEV, il est infiniment préférable de recourir à l’instruction SI.NON.DISP :
=SI.NON.DISP(RECHERCHEV(A1; Dimensions!$A$1:$B$12; 2; FAUX); « Clé absente »)
Ce formalisme cible exclusivement l’échec de mise en correspondance relationnelle (#N/A) sans occulter d’éventuelles corruptions de structure au sein du modèle tabulaire, garantissant une observabilité parfaite pour l’administrateur de données.
8.3 Règles strictes de validation des données en amont
La prévention des anomalies de typologie à la source constitue la mesure la plus efficace pour préserver l’intégrité des chaînes de calcul. Google Sheets offre un moteur de validation des saisies extrêmement sophistiqué, permettant de verrouiller les cellules d’entrée selon des critères mathématiques ou des règles d’expression formelles.
Pour les cellules destinées à recevoir des entiers ordinaux représentatifs des mois, il est impératif d’instaurer une règle de validation par Nombre entier, assortie d’une condition d’encadrement strict : la valeur doit être comprise entre 1 et 12. Toute tentative de saisie d’un nombre décimal, d’un entier négatif ou d’une valeur scalaire excédant 12 est immédiatement rejetée par l’interface utilisateur, assortie d’un message d’invalidation pédagogique interdisant la dérive du modèle.
Pour les colonnes accueillant des désignations textuelles, la meilleure pratique consiste à abandonner totalement la saisie libre au profit d’une règle de validation par Liste d’éléments ou Liste à partir d’une plage, configurée en mode menu déroulant. Cette approche contraint l’utilisateur final à sélectionner la dénomination mensuelle parmi un jeu fermé et immuable de valeurs prédéfinies rigoureusement nettoyées (excluant toute variation orthographique, toute omission d’accent ou toute injection d’espace insécable). En supprimant structurellement l’aléa humain lors de la phase de captation primaire, l’analyste s’assure que les routines de conversion aval fonctionneront de manière pérenne et sans aucune défaillance d’inférence.
9. Intégration avancée avec QUERY, FILTER et les tableaux croisés
9.1 Manipulation des mois au sein des requêtes SQL avec QUERY
La fonction QUERY représente le module d’interrogation et de transformation le plus puissant de Google Sheets, reposant sur une implémentation native du langage de requête Google Visualization API Query Language (assimilable à un sous-ensemble standard de SQL). Dès lors que l’on traite des volumétries substantielles de séries chronologiques, l’extraction et la conversion des dimensions mensuelles directement au sein de la chaîne de requête présente un gain substantiel d’efficience par rapport à la multiplication de colonnes auxiliaires de calcul.
Le moteur de la fonction QUERY intègre une fonction scalaire temporelle native dédiée : month(). Il convient toutefois de formuler une mise en garde méthodologique fondamentale concernant le comportement de cet opérateur. Contrairement à la fonction matricielle standard =MOIS() qui renvoie des entiers indexés de 1 à 12, la fonction month() du langage QUERY est indexée sur une base zéro (zero-based indexation), héritée des spécifications historiques des moteurs JavaScript et Java. Ainsi, pour une date située au mois de janvier, month() renverra 0, tandis que pour le mois de décembre, elle renverra 11.
Pour agréger des métriques de vente ou des signaux expérimentaux par mois ordinal au moyen de QUERY, il est donc impératif de corriger arithmétiquement ce décalage d’indice au sein même de la clause SELECT :
=QUERY(A1:B1000; « SELECT month(A)+1, SUM(B) WHERE A IS NOT NULL GROUP BY month(A)+1 LABEL month(A)+1 ‘Numéro du Mois' »)
Cette syntaxe compacte extrait la composante chronologique de la colonne temporelle A, incrémente le résultat scalaire d’une unité pour réaligner l’indice sur l’intervalle humain standard [1, 12], groupe l’ensemble des enregistrements de la variable métrique B selon cette clé mensuelle, et calcule la somme cumulée correspondante, le tout sans recourir à aucune colonne intermédiaire de transformation au sein de la feuille de calcul source.
9.2 Filtrage conditionnel dynamique basé sur les conversions mensuelles
L’orchestration de tableaux de bord analytiques interactifs exige fréquemment le filtrage conditionnel dynamique de matrices de données complexes en fonction d’un paramètre mensuel sélectionné par l’utilisateur, que ce dernier interagisse via un numéro ordinal ou une désignation nominale. La fonction FILTER combinée aux mécanismes de conversion à la volée permet d’isoler des sous-ensembles d’enregistrements sans altérer l’intégrité de la table maîtresse.
Supposons une table transactionnelle située sur la plage A2:C1000, dont la première colonne abrite les dates d’observation sérielles, et un sélecteur utilisateur situé en cellule E1 où le gestionnaire sélectionne un nom de mois textuel (par exemple « Octobre »). Pour extraire instantanément l’intégralité des transactions appartenant à ce mois précis, la formule s’énonce comme suit :
=FILTER(A2:C1000; MOIS(A2:A) = MOIS(E1&1))
L’évaluation de cette expression témoigne d’une grande compacité algorithmique. Le membre gauche de la condition d’égalité évalue matriciellement le vecteur chronologique A2:A pour produire un vecteur d’entiers ordinaux s’étendant de 1 à 12. Le membre droit convertit dynamiquement la chaîne nominale sélectionnée en cellule E1 en son entier correspondant (ici 10 pour octobre) via le mécanisme de concaténation unitaire déconstruit précédemment. La fonction FILTER procède ensuite à la sélection des lignes satisfaisant strictement l’équivalence logique. Si l’utilisateur modifie l’entrée textuelle en sélectionnant « Avril », la conversion s’ajuste instantanément et régénère l’affichage en quelques millisecondes, offrant une ergonomie applicative parfaite exempte de toute redondance de calcul.
9.3 Restructuration temporelle au sein des tableaux croisés dynamiques
Les tableaux croisés dynamiques (Pivot Tables) constituent un instrument indispensable pour la synthèse multidimensionnelle de vastes cohortes de données. Néanmoins, l’introduction de dimensions temporelles textuelles dans ces environnements analytiques expose fréquemment l’utilisateur à un comportement hautement problématique : le désordre de tri alphabétique. Lorsqu’une colonne héberge des noms de mois générés sous forme de chaînes textuelles simples, le tableau croisé dynamique applique par défaut un tri lexical ascendant, regroupant les données dans un ordre totalement dénué de cohérence chronologique (Avril précédant Août, lui-même précédant Décembre).
Pour résoudre définitivement cette distorsion au sein des tableaux croisés dynamiques de Google Sheets, deux stratégies d’ingénierie peuvent être déployées. La première méthode consiste à conserver la date sérielle native complète au sein de la table de données source, puis à exploiter la fonctionnalité intégrée de Création d’un groupe temporel croisé. En effectuant un clic droit sur l’en-tête de colonne chronologique au sein du tableau croisé, l’analyste peut ordonner le regroupement automatique par « Mois ». Le moteur interne de Google Sheets gère alors l’affichage textuel (« Janvier », « Février »…) tout en conservant l’index sériel sous-jacent pour exécuter un tri chronologique rigoureusement ordonné du premier au douzième mois.
La seconde méthode, particulièrement indiquée lorsque les données sources ne comportent initialement qu’un libellé textuel, consiste à adjoindre à la table primaire une colonne calculée contenant l’identifiant ordinal combiné au libellé textuel, structurée sous la forme d’un code chronologique composé :
=TEXTE(MOIS(A1&1); « 00 ») & » – » & A1
Cette expression génère des étiquettes auto-triantes standardisées (« 01 – Janvier », « 02 – Février », …, « 12 – Décembre »). Lorsque cette dimension hybride est incorporée comme axe de regroupement dans le tableau croisé dynamique, le tri alphabétique standard coïncide alors parfaitement et nativement avec l’ordre chronologique logique des données, garantissant une lecture immédiate et sans ambiguïté pour les évaluateurs du rapport financier ou scientifique.
10. Automatisation programmatique via Google Apps Script
10.1 Développement de fonctions personnalisées (UDF) de conversion
Bien que l’arsenal des fonctions natives de Google Sheets couvre la grande majorité des cas d’usage, le développement de fonctions personnalisées ou User-Defined Functions (UDF) via Google Apps Script (reposant sur un environnement d’exécution JavaScript conforme à la norme ECMAScript moderne) permet d’encapsuler des logiques de conversion hautement complexes, d’assurer une gestion d’erreurs granulaire et de normaliser les flux de traitement pour l’ensemble des utilisateurs d’une organisation.
L’écriture d’un parseur dédié transformant un nom de mois textuel en entier ordinal standardisé s’articule autour d’une fonction JavaScript pure, exploitant les capacités natives d’internationalisation de l’objet Intl ou le recours à des dictionnaires immuables à haute performance :
function CONVERTIR_MOIS_EN_NUMERO(chaineMois) {
if (!chaineMois || typeof chaineMois !== ‘string’) {
return « »;
}
const moisNormalise = chaineMois.trim().toLowerCase()
.normalize(« NFD »).replace(/[u0300-u036f]/g, « »);
const dictionnaire = {
‘janvier’: 1, ‘janv’: 1, ‘jan’: 1,
‘fevrier’: 2, ‘fevr’: 2, ‘fev’: 2,
‘mars’: 3, ‘mar’: 3,
‘avril’: 4, ‘avr’: 4,
‘mai’: 5,
‘juin’: 6,
‘juillet’: 7, ‘juil’: 7, ‘jul’: 7,
‘aout’: 8, ‘aou’: 8,
‘septembre’: 9, ‘sept’: 9, ‘sep’: 9,
‘octobre’: 10, ‘oct’: 10,
‘novembre’: 11, ‘nov’: 11,
‘decembre’: 12, ‘dece’: 12, ‘dec’: 12
};
const resultat = dictionnaire[moisNormalise];
if (resultat !== undefined) {
return resultat;
} else {
throw new Error(« Dénomination de mois non reconnue : » + chaineMois);
}
}
Cette fonction personnalisée transcende les limites des formules tabulaires classiques. Elle intègre un pipeline de normalisation Unicode éliminant les accents diacritiques via la décomposition NFD combinée à une expression régulière, assurant par exemple l’assimilation parfaite de « Février », « fevrier », ou « FÉVR. » vers le même index entier 2.
L’adjonction de balises de documentation JSDoc en tête de script permet en outre d’intégrer formellement la fonction dans le système d’auto-complétion de Google Sheets, guidant les utilisateurs finaux sur la nature des arguments attendus et prévenant les erreurs de syntaxe dès la frappe dans l’interface tabulaire.
10.2 Batch processing et manipulation directe des plages de cellules
L’exécution répétée de fonctions personnalisées (UDF) au sein de milliers de cellules individuelles peut dégrader drastiquement la réactivité d’un classeur, chaque appel de fonction UDF imposant un surcoût d’interopérabilité entre le moteur de calcul et l’interpréteur Apps Script. Dès lors que l’on traite des volumes massifs de données, l’ingénierie logicielle préconise l’emploi de routines de traitement par lots (batch processing) manipulant directement les structures vectorielles en mémoire vive via l’API avancée de Google Sheets.
Le paradigme de traitement par lots repose sur une règle absolue : minimiser drastiquement les interactions avec le serveur d’affichage en regroupant les lectures et les écritures en deux opérations uniques. Le script ci-dessous illustre l’assainissement et la conversion d’une colonne entière de dates hétérogènes :
function executerConversionMasse() {
const feuille = SpreadsheetApp.getActiveSpreadsheet().getActiveSheet();
const derniereLigne = feuille.getLastRow();
if (derniereLigne < 2) return;
// Lecture vectorielle unique de l'intégralité de la plage
const plageSource = feuille.getRange(2, 1, derniereLigne – 1, 1);
const valeurs = plageSource.getValues();
const matriceResultat = [];
for (let i = 0; i = 1 && cellule <= 12) {
// Conversion ordinal vers nominal
const dateObjet = new Date(2024, cellule – 1, 1);
matriceResultat.push([Utilities.formatDate(dateObjet, Session.getScriptTimeZone(), "MMMM")]);
} else {
matriceResultat.push(["Donnée Invalide"]);
}
}
// Écriture vectorielle unique du vecteur de sortie
const plageCible = feuille.getRange(2, 2, matriceResultat.length, 1);
plageCible.setValues(matriceResultat);
}
Ce script procède à l'extraction de l'ensemble de la colonne A en un seul appel réseau via getValues(), instancie un vecteur de résultat en mémoire JavaScript, itère à très haute vitesse sur les dizaines de milliers d’enregistrements, puis réinjecte l’intégralité des résultats transmutés dans la colonne B par un appel unique à setValues(). Le gain d’efficience computationnelle est colossal, réduisant des traitements tabulaires de plusieurs minutes à une fraction de seconde, tout en supprimant la charge de recalcul dynamique continu sur le processeur du client.
10.3 Sécurisation typologique et gestion des exceptions en JavaScript
Dans le cadre d’automatisations d’entreprise intégrées à des pipelines CI/CD ou des déclencheurs événementiels continus (comme le trigger onEdit ou les exécutions planifiées par horloge système), la robustesse du code de conversion temporelle face à des typologies aberrantes constitue un impératif critique. L’absence de vérification rigoureuse des types primitifs en amont de l’évaluation peut précipiter le crash du script et laisser des tables transactionnelles dans un état d’incohérence partielle.
La mise en place de structures de contrôle défensives fondées sur des blocs try...catch permet d’intercepter les exceptions d’évaluation et de consigner les anomalies dans un journal d’audit sans interrompre le traitement du reste du jeu de données :
function convertirNomMoisSecurise(chaineEntree) {
try {
if (chaineEntree === null || chaineEntree === undefined || chaineEntree === « ») {
return null;
}
// Test de coercition : si la cellule contient déjà un nombre
if (typeof chaineEntree === ‘number’) {
if (chaineEntree >= 1 && chaineEntree <= 12) {
return Math.floor(chaineEntree);
}
throw new RangeError("L'entier ordinal est hors bornes [1-12] : " + chaineEntree);
}
const parseurTemp = new Date(Date.parse(chaineEntree + " 1, 2024"));
const indexMois = parseurTemp.getMonth();
if (isNaN(indexMois)) {
throw new TypeError("Échec de résolution de la chaîne temporelle : " + chaineEntree);
}
return indexMois + 1;
} catch (erreur) {
Logger.log("[Journal d'Audit – Anomalie Temporelle] : " + erreur.message);
return "#ERREUR_CONVERSION";
}
}
Ce modèle défensif garantit que chaque anomalie d'entrée est scrupuleusement interceptée, catégorisée et journalisée. Les données déviantes sont immédiatement repérées par une chaîne sentinelle explicite dans la feuille de calcul, permettant aux ingénieurs de données de procéder à des actions de remédiation ciblées sans jamais compromettre la continuité fonctionnelle du système d'information global.
11. Applications méthodologiques dans la recherche empirique et comportementale
11.1 Structuration des séries chronologiques dans les protocoles longitudinaux
Dans les protocoles de recherche longitudinale en psychologie expérimentale, en épidémiologie ou en sociologie comportementale, la temporalité ne constitue pas simplement un paramètre d’enregistrement : elle structure la matrice d’analyse au sein de laquelle s’expriment les dynamiques de variation des variables d’intérêt. Les participants sont évalués à des intervalles répétés (temps de passage T1, T2, …, Tn) fréquemment calqués sur le calendrier civil pour des raisons de logistique de terrain.
La conversion rigoureuse entre les désignations textuelles recueillies sur les carnets de bord numériques des sujets (par exemple : « Suivi de Mars », « Évaluation d’Avril ») et les index mensuels scalaires est indispensable pour formaliser les équations d’estimation généralisées (GEE) ou les modèles linéaires mixtes (LMM). L’assignation d’un rang ordinal de 1 à 12 permet de calculer précisément les intervalles inter-visites réels en jours ou en mois fractionnaires, autorisant la modélisation statistique de la décrue ou de l’apprentissage comportemental en fonction du temps continu.
L’absence d’une standardisation rigoureuse lors de cette étape préparatoire introduit des risques majeurs de biais de mesure. Une confusion entre l’index ordinal d’un mois et son rang de recueil protocolaire peut conduire à agréger des données comportementales printanières avec des mesures automnales, masquant des covariations déterminantes. La traçabilité algorithmique de la conversion garantit que chaque observation empirique est ancrée à son échelle de temps physique réelle au sein de la matrice analytique finale.
11.2 Agrégation de signaux comportementaux et saisonnalité des données
Les signaux comportementaux captés dans les études empiriques — qu’il s’agisse de l’humeur autodéclarée, des niveaux d’activité motrice captés par actimétrie ou des comportements d’achat impulsifs — manifestent quasi systématiquement des variations périodiques saisonnières. Pour étudier scientifiquement ces chronobiologies individuelles ou collectives, il est impératif d’isoler la composante cyclique annuelle des tendances de fond.
La transformation des dates complètes en identifiants mensuels ordinaux invariants (de 1 pour janvier à 12 pour décembre) permet de réaliser des agrégations interannuelles synchronisées. L’analyste peut ainsi empiler plusieurs années d’observation pour calculer des indicateurs de tendance centrale (médianes, moyennes tronquées) par tranche mensuelle consolidée, neutralisant les fluctuations aléatoires interannuelles pour mettre en lumière la signature saisonnière fondamentale de la variable étudiée :
=MOYENNE.SI.ENS(Donnees!B:B; Donnees!A:A; « >=01/01/2020 »; ARRAYFORMULA(MOIS(Donnees!A:A)); 5)
Cette structure permet de calculer la moyenne des mesures uniquement pour les mois de mai sur l’ensemble de la période d’observation post-2020.
Cette étape de normalisation scalaire est également le prérequis indispensable au calcul de moyennes mobiles centrées ou à la mise en œuvre de procédures de désaisonnalisation avancées, couramment mobilisées dans les analyses de séries chronologiques économiques et comportementales. L’attribution univoque de l’indice mensuel garantit que les algorithmes de filtrage fréquentiel opèrent sur des fenêtres temporelles régulières et mathématiquement comparables.
11.3 Intégrité méthodologique et reproductibilité des chaînes de traitement
La crise de la reproductibilité qui traverse les sciences expérimentales contemporaines a mis en exergue le rôle délétère des transformations manuelles non documentées au sein des tableurs de recherche. Le fait de modifier manuellement le formatage d’une colonne de dates, de corriger des noms de mois à la volée ou d’effectuer des tris arbitraires sans consigner formellement les règles de transformation appliquées brise la chaîne de traçabilité scientifique et interdit toute vérification externe indépendante par les pairs.
L’application exclusive de fonctions de conversion transparentes, formalisées et mathématiquement vérifiables (telles que l’exploitation canonique de =TEXTE(DATE(…)) ou d’expressions matricielles =ARRAYFORMULA(…)) garantit que chaque état de la donnée est strictement déductible de son état antérieur. Aucune intervention subjective de l’expérimentateur ne vient polluer le jeu de données primaires.
De surcroît, la documentation explicite des protocoles de normalisation typographique au sein d’un dictionnaire de données (codebook) accompagnant la publication des données ouvertes (Open Data) assure la parfaite interopérabilité des archives scientifiques. Les scripts d’analyse rédigés sous R, Python ou Julia peuvent alors importer les classeurs Google Sheets en s’appuyant sur des identifiants temporels universels, éliminant tout risque de désynchronisation de format ou de corruption d’index lors des phases de réplication expérimentale.
12. Synthèse comparative, performances algorithmiques et guide décisionnel
12.1 Matrice d’évaluation des performances et de robustesse des formules
Pour éclairer l’arbitrage technique de l’ingénieur de données, il convient de synthétiser les caractéristiques opérationnelles, la robustesse structurelle et l’empreinte computationnelle des principales méthodes de conversion disséquées tout au long de cette monographie. Le tableau comparatif suivant formalise cette analyse multicritère :
| Méthode / Formule | Direction | Robustesse Linguistique | Complexité Algorithmique | Sensibilité au Volume | Biais / Risques Majeurs |
|---|---|---|---|---|---|
| =TEXTE(A1*29; « mmmm ») | Numéro vers Nom | Dépendante des paramètres locaux | Très faible (O(1)) | Excellente scalabilité | Valeurs aberrantes si A1 hors bornes [1-12] |
| =TEXTE(DATE(2024; A1; 1); « mmmm ») | Numéro vers Nom | Dépendante des paramètres locaux | Faible (O(1)) | Excellente scalabilité | Verbosité syntaxique modérée |
| =CHOISIR(A1; « Jan »; …) | Numéro vers Nom | Indépendance absolue | Très faible (O(1)) | Performances optimales | Coût de maintenance lourd, pas de flexibilité |
| =MOIS(A1&1) | Nom vers Numéro | Strictement liée à la langue du classeur | Moyenne (coercition lexicale) | Très bonne réactivité | Erreur #VALEUR! sur abréviations non gérées |
| =INDEX / EQUIV (Table) | Bidirectionnelle | Universelle (selon table dédiée) | Moyenne (O(log n) avec index) | Excellente si optimisée | Consommation mémoire de la table auxiliaire |
| Google Apps Script (UDF) | Bidirectionnelle | Personnalisable à l’infini | Élevée (surcoût runtime V8) | Dégradation sévère sur grands volumes scalaires | Latence réseau et limites de quotas d’exécution |
L’analyse de ces paramètres démontre avec clarté qu’aucune approche ne détient une supériorité absolue en toutes circonstances. Le choix d’une architecture de conversion relève d’une optimisation sous contraintes dépendant des impératifs d’interopérabilité linguistique, de la volumétrie globale des enregistrements et du niveau d’expertise des collaborateurs appelés à faire évoluer le modèle tabulaire.
12.2 Arbre décisionnel pour le choix de la méthode optimale
Afin de guider méthodologiquement le choix de l’analyste face à un cas d’usage concret, les critères décisionnels s’articulent selon l’arborescence logique suivante :
Pour la conversion d’un numéro de mois vers son nom :
1. Si le classeur est destiné à une diffusion internationale multilingue sans altération possible des paramètres régionaux : adopter impérativement la méthode déterministe =CHOISIR() ou une table de correspondance matricielle bilingue via =INDEX/EQUIV.
2. Si le modèle s’inscrit dans un cadre institutionnel localisé pérenne et privilégie la rigueur académique et la maintenabilité par des tiers : déployer la formule formelle =TEXTE(DATE(2024; A1; 1); « mmmm »).
3. Si l’espace au sein des cellules de formule est restreint et que la compacité algorithmique prime dans un environnement sous contrôle strict : exploiter l’élégance arithmétique de =TEXTE(A1*29; « mmmm »).
Pour la conversion inverse d’un nom de mois vers son numéro ordinal :
1. Si le jeu de données est volumineux, propre et respecte rigoureusement la langue du classeur : mobiliser l’expression idiomatique =MOIS(A1&1), idéalement vectorisée au sein d’un conteneur =ARRAYFORMULA().
2. Si les données sources sont susceptibles de comporter des coquilles typographiques, des variations d’accents ou des abréviations multilingues disparates : router le flux vers une fonction personnalisée robuste via Google Apps Script opérant un nettoyage phonétique et Unicode en mémoire, ou vers une table de correspondance exhaustive intégrant l’ensemble des alias textuels autorisés.
3. Si le résultat final est destiné à un reporting opérationnel dynamique sans colonne de calcul auxiliaire : intégrer l’extraction directement au sein d’une clause =QUERY() ou d’un prédicat =FILTER().
12.3 Perspectives d’évolution des moteurs de calcul tabulaires
Le traitement des dimensions temporelles au sein des environnements de feuilles de calcul en nuage se situe à l’aube de mutations technologiques substantielles. L’intégration croissante de modèles d’intelligence artificielle générative et de modules d’inférence sémantique au cœur même des moteurs de calcul (tels que Gemini pour Google Workspace) tend à redéfinir la frontière historique entre données textuelles brutes et valeurs computationnelles sérielles.
À terme, les moteurs tabulaires évolueront vers des architectures capables de déduire contextuellement la nature temporelle d’une chaîne textuelle sans exiger de l’analyste la mise en œuvre de formules de coercition explicites telles que la concaténation artificielle A1&1. L’inférence contextuelle permettra d’identifier instantanément qu’un terme alphabétique isolé se rapporte à un cycle mensuel, d’adapter automatiquement la résolution linguistique à la nationalité du lecteur sans modifier les données sous-jacentes, et d’exécuter des tris chronologiques naturels directement sur des représentations nominales.
Néanmoins, quelle que soit la sophistication future des interfaces d’assistance automatisée, la compréhension fine des invariants mathématiques, de la représentation sérielle du temps et des mécanismes d’évaluation matricielle demeurera une compétence indispensable pour tout architecte de données. La rigueur logique et l’exhaustivité des protocoles de conversion exposés au sein de cet article constituent le rempart fondamental garantissant la validité pérenne des calculs, la reproductibilité des analyses scientifiques et la fiabilité absolue des décisions managériales fondées sur l’exploitation des séries chronologiques.
Références
- Google. (2024). Fonction TEXTE – Aide Éditeurs Google Docs. Support Google. https://support.google.com/docs/answer/3094139
- Google. (2024). Fonction MOIS – Aide Éditeurs Google Docs. Support Google. https://support.google.com/docs/answer/3093052
- Google. (2024). Fonction DATE – Aide Éditeurs Google Docs. Support Google. https://support.google.com/docs/answer/3092969
- Google. (2024). Utiliser des formules matricielles dans Google Sheets. Support Google. https://support.google.com/docs/answer/3093275
- Google Developers. (2024). Google Apps Script: Spreadsheet Service (SpreadsheetApp). Google Developers Reference. https://developers.google.com/apps-script/reference/spreadsheet
- International Organization for Standardization. (2019). Date and time — Representations for information interchange (ISO Standard No. 8601-1:2019). https://www.iso.org/standard/70907.html
- Microsoft. (2024). Système de dates 1900 et 1904 dans Excel. Microsoft Learn. https://learn.microsoft.com/fr-fr/office/troubleshoot/excel/1900-and-1904-date-system
- ECMA International. (2023). ECMAScript 2023 Language Specification (14th edition, Standard ECMA-262). https://www.ecma-international.org/publications-and-standards/standards/ecma-262/