
Dans le domaine de l’analyse quantitative et du traitement des données expérimentales, la gestion des observations aberrantes constitue un défi méthodologique fondamental. Présentes au sein de presque toutes les distributions empiriques, qu’il s’agisse de temps de réaction en neurosciences cognitives, d’indicateurs biométriques ou de métriques psychométriques issues d’auto-questionnaires, les valeurs extrêmes exercent une influence disproportionnée sur les estimateurs paramétriques classiques. La moyenne arithmétique et la variance, hautement sensibles aux queues de distribution épaisses, s’en trouvent fréquemment déformées, induisant une inflation artificielle de l’erreur type et compromettant la validité des inférences statistiques subséquentes, telles que les analyses de variance ou les régressions linéaires.
Face à cet écueil, les chercheurs oscillent souvent entre deux extrêmes méthodologiques : d’une part, l’exclusion pure et simple des sujets déviants, une pratique d’élagage radicale qui ampute la taille d’échantillon et expose l’analyse à des biais d’attrition non aléatoires ; d’autre part, la conservation non corrigée de données contaminées par des erreurs de mesure ou des artéfacts techniques, ruinant la puissance des tests inférentiels. La winsorisation, procédure statistique robuste introduite au milieu du XXe siècle, offre une solution intermédiaire d’une remarquable élégance conceptuelle. En modifiant les valeurs extrêmes pour les ramener à des seuils percentiles prédéterminés sans supprimer aucune ligne d’observation, elle préserve intégralement la taille de la cohorte tout en circonscrivant l’impact délétère des queues de distribution.
Bien que les environnements de programmation tels que R ou Python soient couramment mobilisés pour ce type de nettoyage, une part considérable du traitement préliminaire des données s’effectue au sein d’environnements tabulaires comme Microsoft Excel. Ce logiciel, omniprésent dans les laboratoires et les structures de recherche appliquée, dispose des capacités algorithmiques nécessaires pour exécuter des winsorisations rigoureuses, transparentes et reproductibles. Ce guide exhaustif explore les fondements mathématiques de la technique, explicite les critères de paramétrage des seuils, et détaille pas à pas l’implémentation pratique de la winsorisation dans Excel à travers différentes architectures de formules, depuis les structures logiques conditionnelles classiques jusqu’aux fonctions matricielles dynamiques modernes et aux flux automatisés Power Query.
1. Introduction théorique à la winsorisation en recherche quantitative
1.1 Définition et origine conceptuelle de la winsorisation
La winsorisation tire son nom du biostatisticien américain Charles P. Winsor (1895–1951), figure marquante de la biométrie quantitative à l’Université Johns Hopkins. Bien que Winsor n’ait pas formalisé cette approche dans un article programmatique unique, le principe fondamental a été synthétisé, baptisé et popularisé par le statisticien John Tukey lors de ses travaux séminaux sur les statistiques robustes et l’analyse exploratoire des données au début des années 1960. Le précepte informel attribué à Winsor stipulait que l’ensemble des observations empiriques suit approximativement une loi normale, pourvu que l’on prenne soin de modérer les extrémités les plus instables.
Le principe sous-jacent de la transformation winsorisée réside dans la modification ciblée des données extrêmes sans réduction de la taille globale de l’échantillon ($N$). Contrairement aux approches de suppression qui éliminent purement et simplement les lignes d’observations jugées hors normes, la winsorisation procède à un remplacement ordonné. Les valeurs situées au-delà d’un percentile supérieur défini sont ramenées exactement à la valeur de ce percentile, tandis que les valeurs inférieures au percentile bas retenu sont élevées à la valeur de ce seuil inférieur. Il en résulte une distribution tronquée aux bornes mais dont l’effectif statistique total demeure strictement invariant.
Cette approche se différencie fondamentalement de l’élagage (ou trimming), qui consiste à amputer l’échantillon de ses $k$ pourcents supérieurs et inférieurs. Sur le plan mathématique, l’estimateur de moyenne winsorisée présente des propriétés asymptotiques distinctes de la moyenne arithmétique classique et de la moyenne élaguée. Alors que l’élagage altère les degrés de liberté lors des tests d’hypothèse ultérieurs et peut déstabiliser les matrices de covariance en cas de données multivariées, la moyenne winsorisée offre un point de rupture (breakdown point) paramétrable qui immunise le centre de la distribution contre les perturbations localisées, tout en maintenant la complétude de la structure matricielle de la base de données.
1.2 Pertinence de la méthode dans le traitement des valeurs aberrantes
L’argument central en faveur de l’adoption de la winsorisation dans les protocoles de recherche empirique repose sur la préservation intégrale de la puissance statistique. Dans les protocoles expérimentaux complexes où le coût d’acquisition par sujet est élevé ou lorsque les cohortes cliniques sont réduites, la perte d’un participant suite à l’exclusion d’un score extrême sur une variable isolée peut compromettre l’équilibre expérimental. La winsorisation permet de retenir l’ensemble des sujets au sein du modèle global sans sacrifier les degrés de liberté requis pour l’évaluation des contrastes factoriels.
Parallèlement, la technique constitue un rempart efficace contre les artéfacts de mesure et les erreurs matérielles d’encodage. Dans les environnements expérimentaux modernes reposant sur des dispositifs de captation numérique ou des saisies manuelles massives, des anomalies ponctuelles peuvent survenir sans que l’observation entière doive être invalidée. En ramenant une latence anormale ou un score physiologique aberrant à la borne acceptable la plus proche, la winsorisation neutralise le levier excessif qu’exercerait ce point singulier sur la droite de régression ou sur le calcul de la dispersion.
Enfin, la winsorisation préserve scrupuleusement la structure ordinale globale de la distribution de données. Contrairement aux méthodes de substitution par la médiane ou par la moyenne, qui écrasent la hiérarchie des rangs en positionnant les données contaminées au centre même de la distribution, la winsorisation conserve le statut d’extrême de l’observation. Un sujet ayant obtenu le score le plus élevé de la cohorte conservera, après traitement, un rang supérieur ou égal à l’ensemble de ses pairs, garantissant ainsi que l’information directionnelle relative ne soit pas oblitérée.
1.3 Applications spécifiques en psychométrie et sciences comportementales
Dans le domaine des sciences comportementales, de la neuropsychologie et de la psychométrie, la winsorisation s’impose comme un standard méthodologique dans de nombreux protocoles expérimentaux. L’un des exemples les plus emblématiques concerne le traitement des temps de réaction (TR) issus de paradigmes cognitifs informatisés tels que les tâches de Stroop, d’amorçage sémantique ou d’inhibition motrice. Dans ces contextes, un temps de réaction particulièrement long traduit souvent une déconnexion attentionnelle transitoire plutôt qu’un traitement cognitif authentique, tandis qu’un TR excessivement court reflète une anticipation motrice involontaire. La winsorisation permet de régulariser ces réponses atypiques sans altérer la variance systématique liée aux conditions expérimentales.
De même, sur les échelles d’évaluation psychologique et les questionnaires d’auto-évaluation de type Likert multipoints, certains répondants adoptent des comportements de réponse polarisés ou présentent des profils d’adhésion extrême qui ne reflètent pas adéquatement le construit latent étudié. L’application d’un seuillage winsorisé sur les scores factoriels composites permet d’atténuer l’impact des biais de réponse individuels sans introduire de données manquantes dans les matrices factorielles confirmatoires.
Enfin, la winsorisation s’avère déterminante pour corriger les effets de contamination dans les données auto-rapportées à grande échelle, telles que les estimations monétaires, les temps passés sur des écrans ou la fréquence de comportements à risque. Dans ces jeux de données, les distributions présentent presque systématiquement une asymétrie positive majeure (right-skewed) assortie d’une traîne d’observations invraisemblables. Le rabattement de ces traînes vers des percentiles extrêmes mais réalistes restaure la compatibilité des données avec les prérequis distributionnels de la modélisation statistique standard.
2. Fondements mathématiques et paramétrage des seuils percentiles
2.1 Choix et justification des niveaux de coupure
Le paramétrage d’une winsorisation dépend de la sélection critique des seuils percentiles d’écrêtage, désignés conventionnellement par la fraction de coupure $\alpha$. Le modèle symétrique standard le plus largement documenté dans la littérature statistique est la winsorisation à 90 % (parfois dénommée winsorisation bilatérale à 10 %, soit $\alpha = 0,05$ à chaque extrémité). Dans cette configuration, les observations se situant en dessous du 5e percentile ($P_{05}$) sont rehaussées pour égaler la valeur de $P_{05}$, tandis que les observations dépassant le 95e percentile ($P_{95}$) sont abaissées à la valeur exacte de $P_{95}$. Ce compromis est réputé offrir une robustesse optimale face aux contaminations modérées sans altérer excessivement la variance d’échantillons de taille moyenne ($N$ compris entre 30 et 200).
Pour les cohortes plus volumineuses issues d’enquêtes épidémiologiques ou de banques de données massives (où $N$ dépasse fréquemment plusieurs milliers d’observations), une approche plus conservative est préconisée, typiquement fixée à 98 % ($\alpha = 0,01$, seuils positionnés aux 1er et 99e percentiles). Dans ces conditions d’échantillonnage large, l’erreur type de la moyenne est déjà intrinsèquement réduite par la taille de l’effectif, et le risque d’altérer des observations légitimes impose de limiter l’intervention aux anomalies les plus flagrantes situées aux extrêmes absolus.
Il convient également d’envisager la winsorisation unilatérale lorsque la plausibilité biologique, physique ou théorique ne justifie l’écrêtage que d’une seule queue de distribution. Par exemple, les distributions de temps d’apprentissage ou de coûts financiers possèdent une borne inférieure naturelle à zéro ne nécessitant aucun ajustement, tandis que leur extrémité supérieure peut s’étendre indéfiniment de manière pathologique. En toute circonstance, la justification théorique du seuil doit impérativement être établie a priori dans le plan d’analyse statistique afin de prémunir le chercheur contre les dérives du p-hacking, qui consisterait à faire varier les percentiles de coupure de façon itérative jusqu’à l’obtention d’un résultat significatif.
2.2 Impacts sur les moments de la distribution
Sur le plan distributionnel, la winsorisation modifie profondément les quatre premiers moments statistiques de l’échantillon : l’espérance mathématique, la variance, l’asymétrie (skewness) et l’aplatissement (kurtosis). L’impact le plus direct se manifeste sur les moments d’ordre supérieur. En contractant artificiellement les queues de distribution vers le corps central, la winsorisation induit une réduction substantielle du coefficient d’aplatissement. Les distributions leptokurtiques, caractérisées par un pic aigu et des traînes lourdes, sont régularisées vers des profils se rapprochant de la distribution normale standard, favorisant ainsi le respect des postulats sous-jacents aux modèles linéaires généralisés.
L’asymétrie subit également une correction majeure, en particulier lorsque la winsorisation s’applique à des distributions fortement biaisées unilatéralement. Le rabattement des observations périphériques vers la borne opposée de la traîne réduit considérablement la distance séparant la moyenne de la médiane, stabilisant ainsi la structure de covariance globale du système de variables. La dispersion globale, mesurée par la variance et l’écart-type, subit une contraction mécanique immédiate puisque les écarts à la moyenne les plus considérables sont rabotés.
Cette contraction de la variance a une répercussion directe sur l’erreur type de la moyenne, laquelle se trouve mécaniquement réduite. Il importe toutefois de souligner une nuance mathématique cruciale : l’application non ajustée des formules conventionnelles d’erreur type sur des données winsorisées peut conduire à une sous-estimation artificielle de l’incertitude d’échantillonnage. En statistique mathématique formelle, le calcul de l’intervalle de confiance d’une moyenne winsorisée requiert l’estimation conjointe de la variance élaguée correspondante pour corriger la perte d’indépendance introduite par la répétition artificielle des valeurs de seuil aux extrémités du jeu de données.
3. Structuration méthodologique du jeu de données dans Excel
3.1 Organisation tabulaire et typage des variables
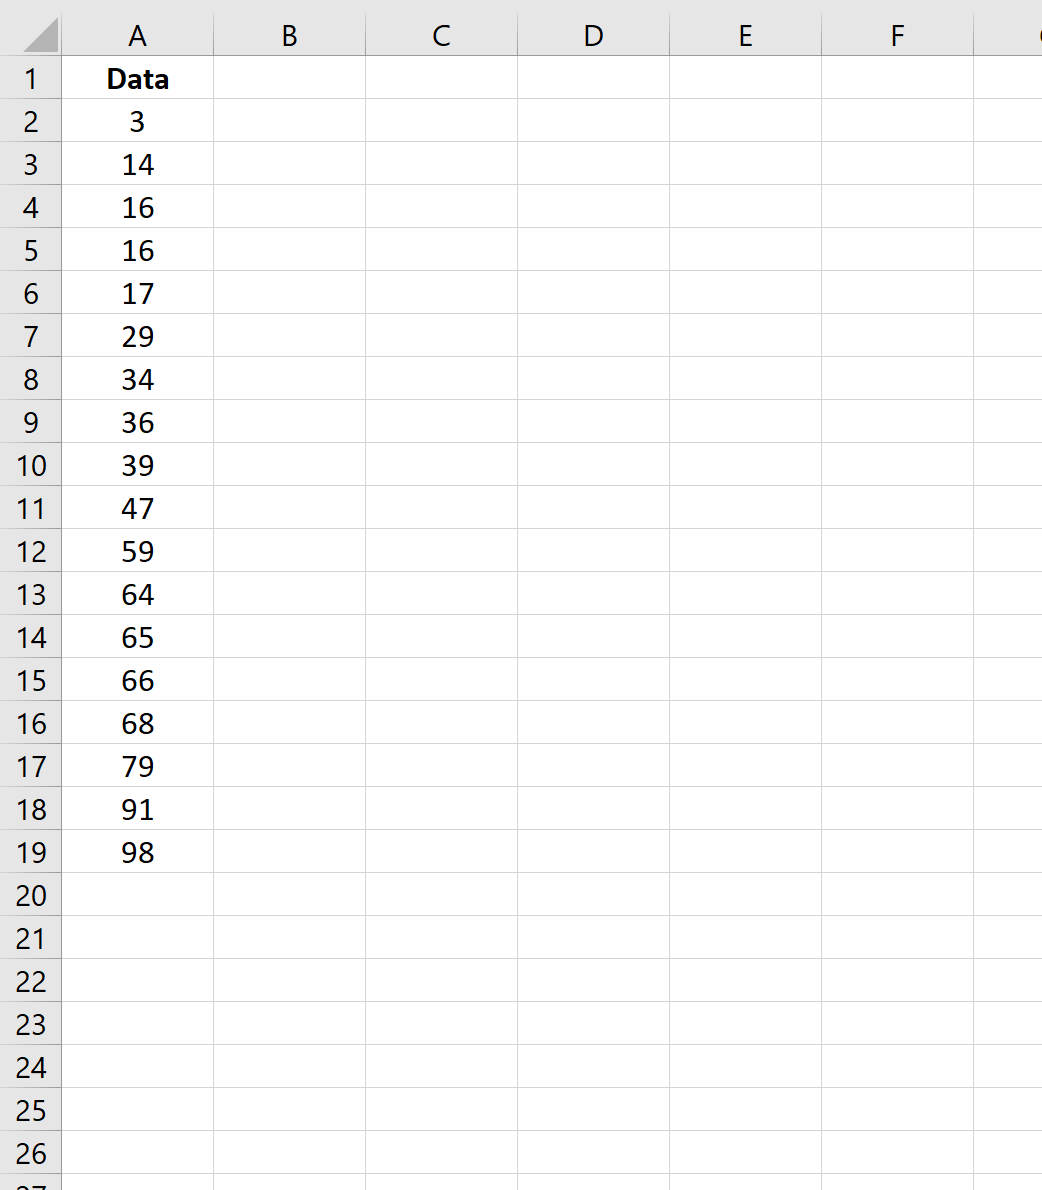
Avant d’initier toute formule de transformation dans Microsoft Excel, une structuration rigoureuse de la feuille de calcul s’avère indispensable pour garantir la validité computationnelle et prévenir les corruptions silencieuses de données. Le jeu de données doit impérativement adopter une disposition matricielle normalisée de type données rectangulaires ordonnées (ou format tidy). Dans cette configuration, chaque ligne correspond sans exception à une unité observationnelle unique (sujet, participant, session expérimentale), tandis que chaque colonne est strictement dédiée à une variable identifiée (identifiant unique, variables indépendantes, covariables et variables dépendantes quantitatives continues).
Le typage des cellules numériques doit faire l’objet d’une vérification méticuleuse. Excel peut parfois convertir implicitement des chaînes textuelles en nombres ou, inversement, interpréter des saisies comportant des séparateurs décimaux inadéquats (virgules versus points, selon la configuration régionale du système d’exploitation) comme des chaînes de caractères. Une telle anomalie textuelle au sein d’une série continue est alors totalement ignorée par les fonctions de percentiles natives d’Excel, introduisant un biais invisible dans l’estimation des seuils de troncature.
Une distinction sans équivoque doit par ailleurs être opérée entre les données manquantes réelles et les valeurs nulles structurelles. Dans une enquête comportementale ou un test neuropsychologique, une case vide ou une mention NA reflète l’absence d’observation, alors qu’une valeur numérique égale à 0 représente une mesure quantitative valide. Toute confusion entre ces deux statuts risque d’ancrer le percentile inférieur à zéro de façon totalement fallacieuse, dénaturant ainsi l’ensemble de la procédure de winsorisation.
3.2 Archivage de sécurité et traçabilité des données brutes
Le principe cardinal de l’analyse reproductible en environnement de feuille de calcul est l’immutabilité absolue des données primaires sources. Il est formellement prohibé d’écraser la colonne de données brutes d’origine par les valeurs winsorisées. Les données brutes doivent être sanctuarisées au sein de colonnes dédiées, clairement libellées avec un suffixe explicite tel que _RAW ou _BRUT, et idéalement verrouillées contre les modifications accidentelles via les options de protection des cellules de la feuille Excel.
Chaque variable subissant une winsorisation doit être générée dans une nouvelle colonne adjacente, nommée de manière descriptive, par exemple Score_W90 pour indiquer un seuillage symétrique aux percentiles 5 et 95. Cette duplication fonctionnelle assure une totale traçabilité méthodologique, permettant à tout auditeur ou réviseur scientifique de confronter à chaque instant la donnée initiale transformée à son état natif.
Enfin, il est vivement recommandé d’intégrer dans l’en-tête de la feuille de calcul ou dans un onglet dédié aux métadonnées un journal de bord analytique. Ce bloc de documentation doit consigner précisément la date de la transformation, l’auteur de la manipulation, la formule algorithmique employée, ainsi que la justification théorique ayant prévalu au choix des percentiles de coupure, conformément aux critères de transparence de la science ouverte (Open Science).
4. Calcul des percentiles seuils avec les fonctions natives d’Excel
4.1 Divergence entre CENTILE.INCLURE et CENTILE.EXCLURE
Depuis la refonte de son moteur statistique dans sa version 2010, Microsoft Excel propose deux fonctions distinctes pour l’évaluation des percentiles continus : CENTILE.INCLURE (équivalent anglais PERCENTILE.INC) et CENTILE.EXCLURE (équivalent anglais PERCENTILE.EXC). Il convient de comprendre la divergence mathématique sous-jacente à ces deux algorithmes d’interpolation afin d’effectuer un choix conforme aux standards de la discipline visée.
La fonction CENTILE.INCLURE repose sur un calcul d’interpolation linéaire le long des rangs fractionnaires normalisés sur l’intervalle fermé $[0 ; 1]$. Dans ce modèle, pour un vecteur ordonné de $N$ éléments, le rang du $k$-ième percentile est déterminé par la formule d’interpolation $R = 1 + k \times (N – 1)$. Cette fonction accepte sans restriction toute valeur de $k$ comprise entre 0 et 1 inclus, ce qui garantit qu’il sera toujours possible de dériver une borne inférieure et supérieure, y compris sur des échantillons de petite taille.
À l’inverse, la fonction CENTILE.EXCLURE calcule les positions relatives sur un intervalle ouvert non inclusif, en utilisant la formule de rang $R = k \times (N + 1)$. En conséquence mathématique directe, cette fonction ne peut interpoler que pour des valeurs de $k$ strictement supérieures à $1 / (N + 1)$ et inférieures à $N / (N + 1)$. Si un chercheur tente d’évaluer le 1er percentile ($k = 0,01$) sur un échantillon de 50 sujets avec CENTILE.EXCLURE, Excel renverra systématiquement l’erreur #NOMBRE!, car la taille d’échantillon est insuffisante pour exclure les rangs extrêmes avec ce modèle d’interpolation. Dans la pratique courante en sciences humaines et sociales, c’est la fonction CENTILE.INCLURE qui constitue la norme par défaut de fait en raison de sa stabilité sur l’ensemble du domaine de définition.
4.2 Syntaxe pratique pour l’extraction des bornes inférieure et supérieure
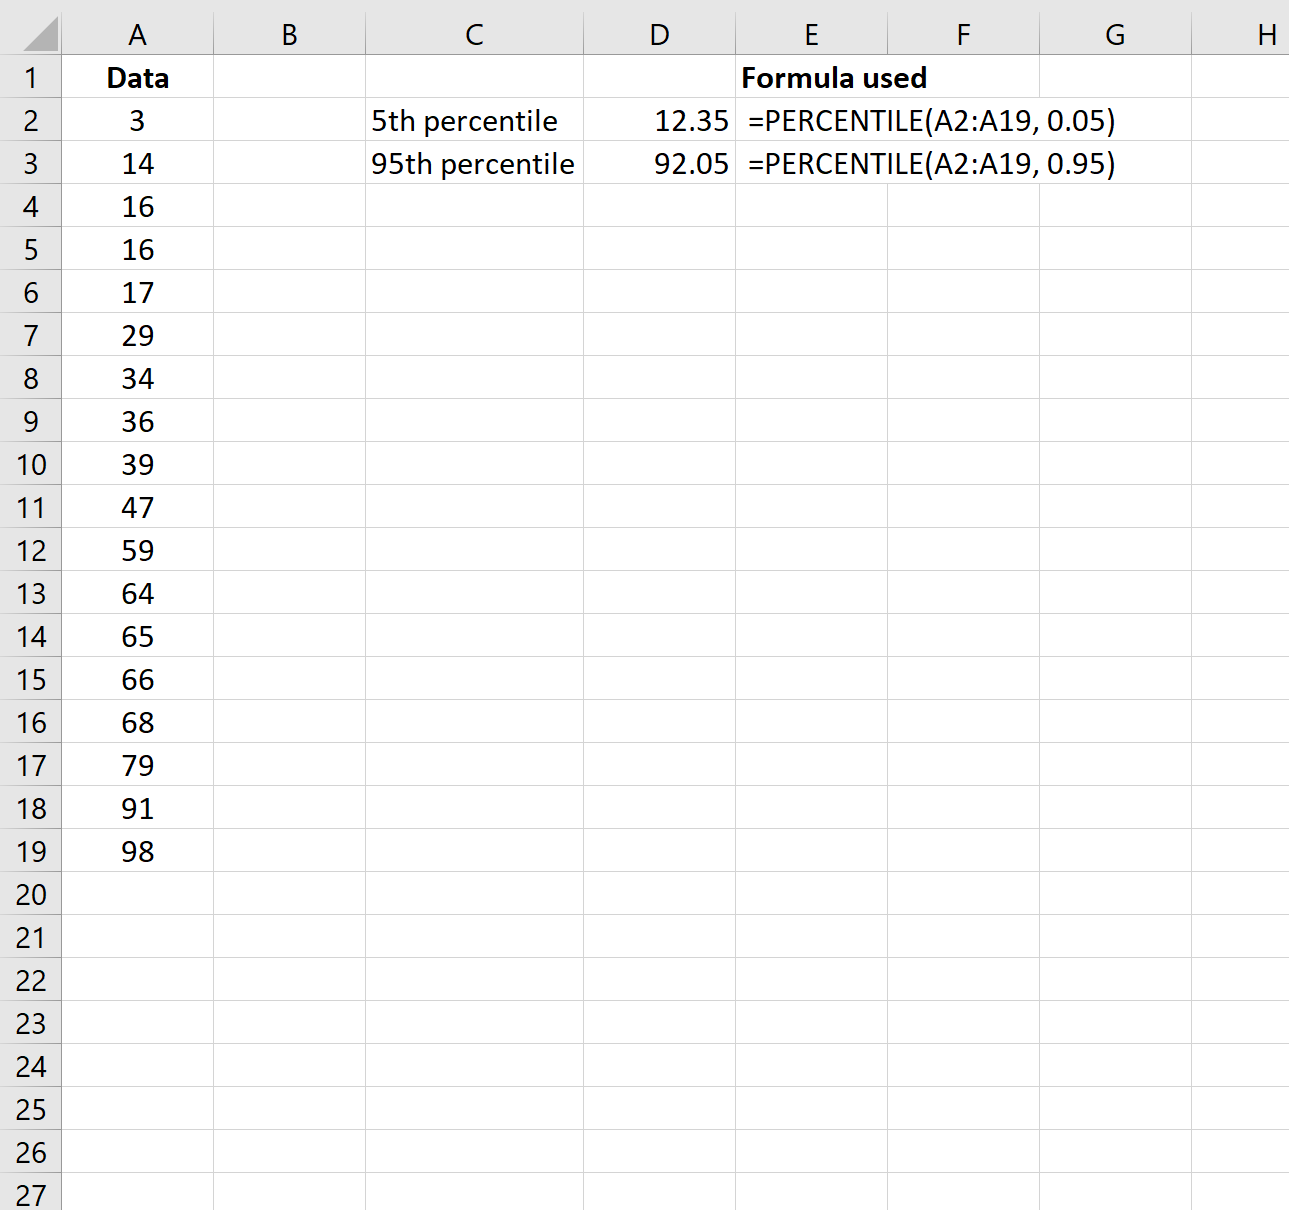
Pour implémenter de manière sécurisée les seuils au sein d’une feuille Excel, il est fortement déconseillé d’insérer les formules de calcul des percentiles directement à l’intérieur de chaque cellule de la variable à winsoriser. Cette pratique dégraderait les temps de calcul et multiplierait inutilement les risques d’erreur de frappe. La démarche optimale consiste à calculer les bornes une fois pour toutes au sein de cellules de référence dédiées, idéalement disposées au-dessus du tableau de données ou dans un panneau de paramètres latéral.
Supposons que la variable quantitative brute réside dans la colonne A, de la ligne 2 à la ligne 101 (soit $N = 100$). Dans la cellule D1, assignée à la borne inférieure pour une winsorisation symétrique à 90 %, la formule s’écrit formellement :
=CENTILE.INCLURE($A$2:$A$101; 0,05)
Dans la cellule adjacente D2, allouée à la borne supérieure (95e percentile), la formulation s’établit selon la syntaxe suivante :
=CENTILE.INCLURE($A$2:$A$101; 0,95)
L’utilisation scrupuleuse des symboles dollar ($) pour verrouiller la référence matricielle $A$2:$A$101 en mode d’adressage absolu est impérative. Sans ce verrouillage, tout copier-coller ou étirement ultérieur des formules induirait un glissement progressif de la plage de calcul des seuils vers le bas, corrompant de façon asymétrique l’estimation statistique.
4.3 Validation des seuils obtenus
Dès l’extraction des bornes calculées en D1 et D2, une inspection critique de plausibilité statistique doit être engagée. Cette étape de validation repose sur la comparaison immédiate de ces valeurs avec les métriques centrales non paramétriques de la distribution : la médiane (50e percentile) et les premier et troisième quartiles ($Q_1$ et $Q_3$, correspondant respectivement aux 25e et 75e percentiles). Une incohérence structurelle, telle qu’un 5e percentile anormalement proche de la médiane comparativement à la distance séparant la médiane du 95e percentile, fournit un signal d’alarme quant à une asymétrie aiguë de l’échantillon ou à la présence d’une accumulation artificielle d’observations identiques (par exemple, un effet de plancher massif).
Il importe également de quantifier en amont le volume exact d’observations qui seront modifiées par l’opération de coupure. Cette estimation anticipée s’obtient aisément en formulant une vérification de comptage conditionnel dans des cellules de contrôle :
=NB.SI($A$2:$A$101; "<" & D1) pour l’extrémité basse, et =NB.SI($A$2:$A$101; ">" & D2) pour l’extrémité haute.
La somme des données touchées par les seuils doit être rigoureusement cohérente avec le niveau $\alpha$ théorique choisi. Si les comptages réels divergent trop largement de la fraction attendue (par exemple, si plus de 15 % des points d’un échantillon de 100 sujets sont inférieurs au 5e percentile en raison d’égalités multiples), le chercheur devra réévaluer l’adéquation de la winsorisation continue face à un modèle adapté aux variables discrètes ou semi-continues.
5. Méthode 1 : Winsorisation par imbrication logique conditionnelle
5.1 Architecture algorithmique de la fonction SI imbriquée
La méthode la plus intuitive sur le plan didactique pour concrétiser une winsorisation dans Excel repose sur l’exploitation de la fonction logique SI (équivalent anglophone IF) sous une forme doublement imbriquée. L’architecture décisionnelle reproduit scrupuleusement la définition par morceaux de l’opérateur de winsorisation en analyse mathématique. Cet algorithme évalue successivement deux propositions conditionnelles exclusives avant d’allouer la valeur finale de la variable transformée.
Dans un premier temps, l’algorithme teste si l’observation individuelle est strictement inférieure au seuil critique minimal autorisé. Si cette condition s’avère vraie, la fonction interrompt son évaluation et attribue immédiatement la valeur du percentile inférieur. Dans le cas contraire, le processus s’aiguille vers la seconde branche décisionnelle : il teste si l’observation outrepasse le seuil critique supérieur. Si cette proposition est validée, la valeur du percentile haut est assignée. Enfin, si l’observation n’enfreint ni la borne inférieure ni la borne supérieure, l’algorithme conclut que la valeur se situe dans le cœur empirique de la distribution et préserve la valeur brute originale sans lui appliquer la moindre altération numérique.
5.2 Implémentation syntaxique pas à pas
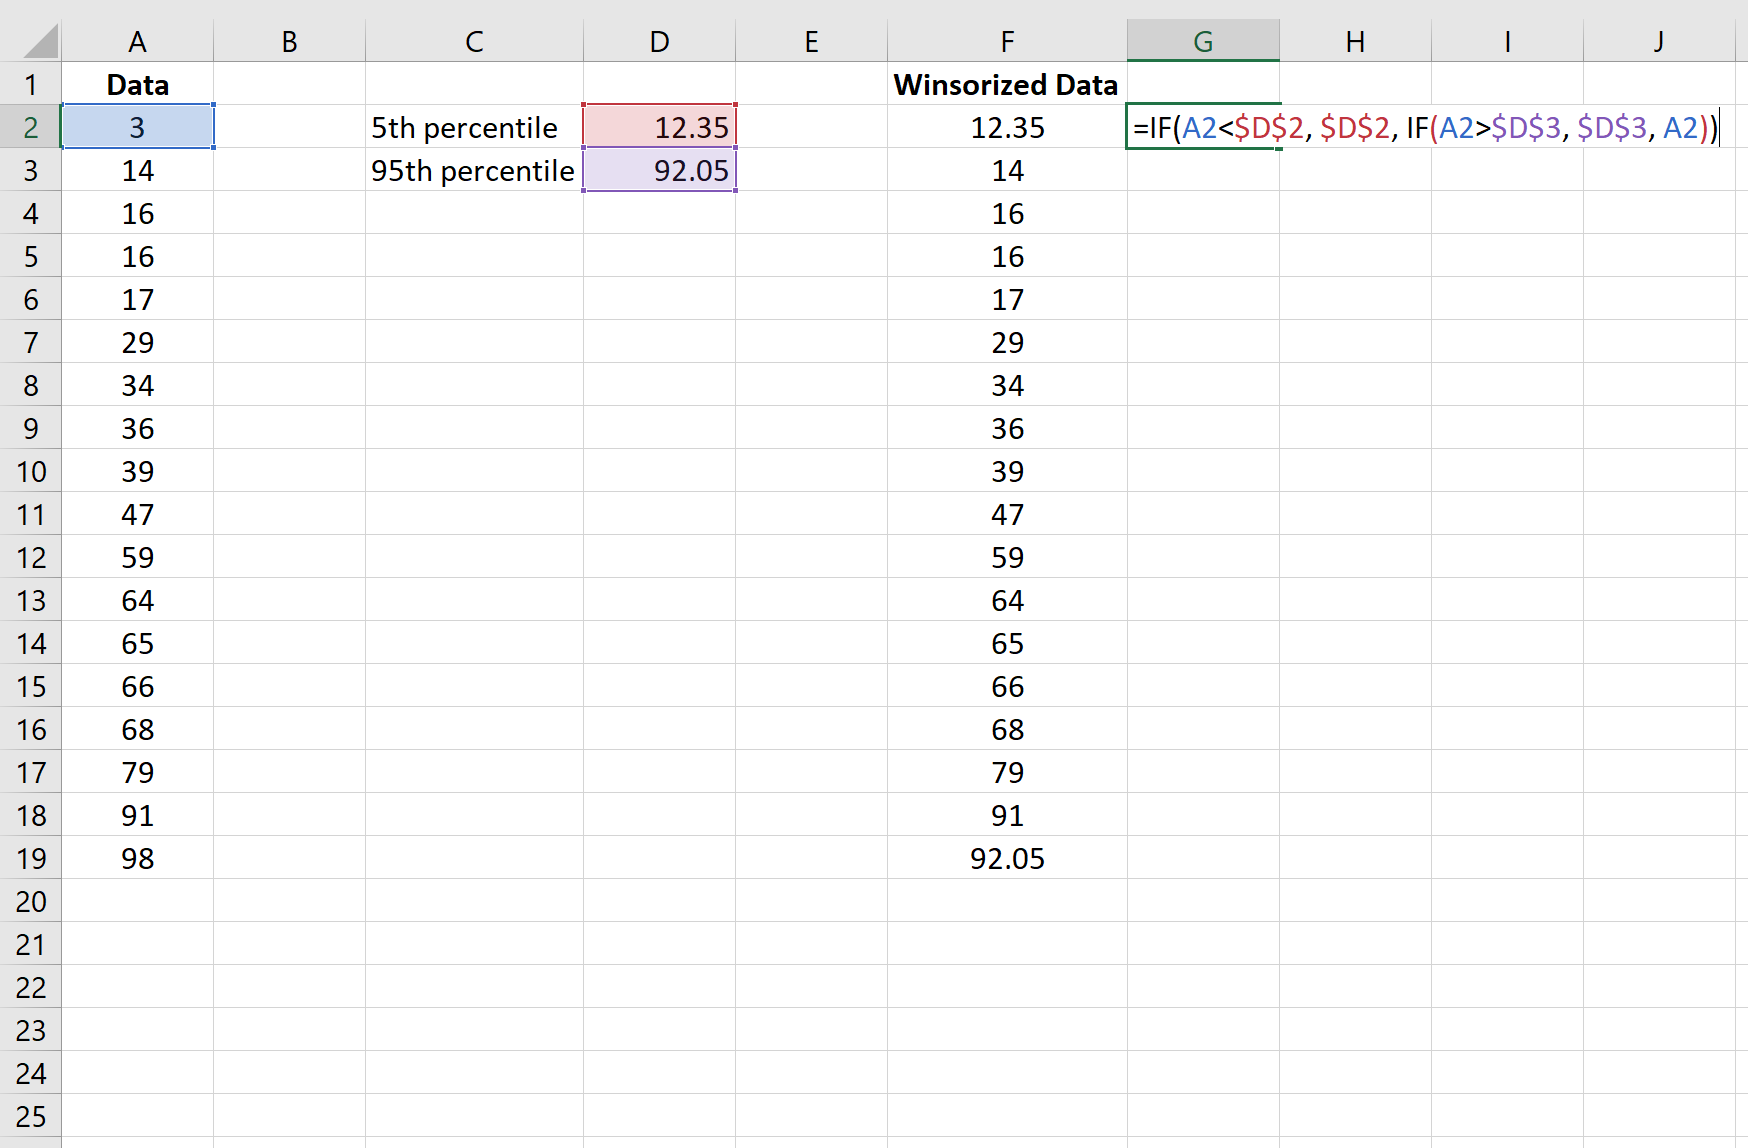
Considérons la mise en pratique de cette approche au sein du classeur. La valeur brute d’un sujet donné réside dans la cellule A2, la borne inférieure (5e percentile) a été préalablement calculée et figée dans la cellule $D$1, et la borne supérieure (95e percentile) est localisée en $D$2. Dans la cellule réceptrice B2, marquant le début de la série transformée, la formule canonique complète s’exprime comme suit :
=SI(A2<$D$1; $D$1; SI(A2>$D$2; $D$2; A2))
Une attention particulière doit être portée au traitement des valeurs frontières, c’est-à-dire les observations dont la magnitude est rigoureusement identique aux percentiles de coupure. Dans la syntaxe stipulée, l’emploi exclusif d’opérateurs stricts d’inégalité (< et >) garantit que les observations exactement situées sur les bornes tombent naturellement dans la troisième branche résiduelle, conservant leur valeur nominale sans distorsion ni conflit de calcul.
Une fois l’équation insérée et validée dans la cellule B2, son déploiement le long de l’ensemble de la colonne d’analyse s’exécute avec fluidité en positionnant le curseur sur la poignée de recopie (le carré miniature situé à l’angle inférieur droit de la cellule active) et en effectuant un double-clic gauche. Excel propage alors la formule verticalement jusqu’au niveau de la dernière ligne adjacente renseignée de la colonne A, en ajustant automatiquement la référence relative A2 vers A3, A4, etc., tout en maintenant rigoureusement les références fixes vers les seuils $D$1 et $D$2.
5.3 Avantages et contraintes de l’approche logique
Le principal avantage comparatif de cette construction logique réside dans sa lisibilité intellectuelle universelle. Tout lecteur profane en programmation ou réviseur scientifique non initié aux raccourcis matriciels peut appréhender instantanément le mécanisme d’encadrement en inspectant la syntaxe. De surcroît, cette structure conditionnelle offre une modularité pédagogique indéniable si l’analyste souhaite associer à la modification numérique un code textuel d’alerte ou un système de balisage binaire permettant d’indexer précisément les lignes ayant fait l’objet d’une correction.
Néanmoins, l’approche par fonctions conditionnelles imbriquées comporte des limites ergonomiques et opérationnelles dès lors que le protocole gagne en complexité. Si la winsorisation doit s’opérer non plus globalement, mais au travers de conditions factorielles croisées (par exemple, appliquer des seuils différents selon le sexe des participants et leur tranche d’âge), l’arbre logique devient extrêmement verbeux. La multiplication des parenthèses ouvrantes et fermantes augmente considérablement la probabilité d’erreurs de syntaxe et rend le débogage de la feuille fastidieux sur de vastes jeux de données expérimentales.
6. Méthode 2 : Winsorisation compacte via les fonctions MIN et MAX
6.1 Principe mathématique de l’encadrement numérique
D’un point de vue de calcul formel, l’opération de winsorisation correspond rigoureusement à une fonction d’écrêtage bilatéral (clamping dans le vocabulaire informatique), qui contraint mathématiquement une variable libre à évoluer dans un intervalle continu borné $[B_{\inf} ; B_{\sup}]$. Cette compression géométrique de l’espace des données s’exprime élégamment sans exiger de structures conditionnelles ramifiées, par la composition séquentielle de deux opérateurs algébriques élémentaires : le maximum et le minimum.
Le mécanisme opère en deux étapes distinctes mais coordonnées. En premier lieu, l’évaluation de l’expression MAX(x; Borne_Inf) assure une saturation par le bas : si la valeur $x$ est plus petite que la borne inférieure prescrite, la fonction renvoie mécaniquement la valeur de ladite borne ; si $x$ lui est supérieur, la valeur brute est conservée intacte. En second lieu, l’encapsulation de ce premier résultat à l’intérieur de l’opérateur supérieur MIN( ... ; Borne_Sup) accomplit la troncature par le haut : si l’expression interne excède le plafond admissible, la fonction la sature à la valeur de la borne supérieure, sans quoi elle laisse transiter la valeur intacte.
6.2 Formulation algébrique condensée dans la feuille de calcul
L’implémentation pratique de cette saturation géométrique dans la grille de calcul Excel se distingue par une compacité remarquable. En reprenant nos repères de cellules initiaux, où la mesure brute se trouve en A2, le percentile plancher en $D$1 et le percentile plafond en $D$2, la formule matricielle condensée s’énonce simplement :
=MIN(MAX(A2; $D$1); $D$2)
L’ordre des opérations peut être inversé (c’est-à-dire =MAX(MIN(A2; $D$2); $D$1)) sans altérer d’un iota le résultat final, en vertu des propriétés de commutativité et d’associativité propres aux fonctions de sélection de rang. Cette expression ne mobilise que deux niveaux d’emboîtement élémentaires, éliminant totalement les parenthèses complexes et les cascades d’arguments inhérentes aux tests logiques.
Sur des classeurs renfermant plusieurs centaines de milliers d’enregistrements, cette formulation condensée offre une vitesse d’exécution supérieure sur le plan computationnel. Le moteur de calcul interne d’Excel optimise les opérations sur les primitives arithmétiques directes de manière plus efficiente que les embranchements conditionnels à évaluation paresseuse générés par la fonction SI. L’architecture du classeur en devient allégée, plus robuste, et remarquablement protégée contre les erreurs de manipulation par les utilisateurs secondaires.
7. Automatisation moderne via Power Query et formules matricielles dynamiques
7.1 Pipeline de traitement via Power Query sans macros
Pour les cohortes massives ou les projets de recherche intégrant des phases d’acquisition de données longitudinales continues, l’injection de formules directement dans la grille de calcul peut devenir source d’alourdissement du fichier et d’erreurs humaines lors des extensions manuelles de plages. L’environnement Power Query, intégré nativement aux versions modernes d’Excel, offre un puissant moteur d’extraction, de transformation et de chargement (ETL) permettant d’automatiser entièrement la winsorisation au sein d’un pipeline étanche sans écrire la moindre ligne de code Visual Basic (VBA).
Le processus débute par la transformation de la plage de données brutes en un tableau Excel structuré (raccourci Ctrl + L ou Ctrl + T), que l’on charge dans Power Query via l’onglet Données > À partir d’une table/d’une plage. Dans l’éditeur Power Query, le calcul des seuils percentiles se réalise élégamment au moyen du langage de script M. Bien que Power Query ne possède pas d’icône d’interface directe pour les percentiles, la fonction native M List.Percentile permet d’extraire les paramètres désirés. L’analyste peut générer une requête intermédiaire calculant le seuil inférieur via l’expression :
List.Percentile(TableauSource[Score], 0.05)
et parallèlement pour la borne supérieure :
List.Percentile(TableauSource[Score], 0.95)
Une fois ces valeurs scalaires matérialisées dans les étapes appliquées de la requête, l’utilisateur insère une colonne personnalisée au sein de la table principale en stipulant la règle conditionnelle de saturation :
if [Score] < SeuilInf then SeuilInf else if [Score] > SeuilSup then SeuilSup else [Score]
L’immense valeur ajoutée de cette approche réside dans sa réactivité dynamique : dès qu’une nouvelle vague de données expérimentales est ajoutée à la table Excel de base, un simple clic droit sur le tableau de sortie suivi de la commande Actualiser réexécute l’intégralité du pipeline, recalculant les percentiles sur l’échantillon élargi et appliquant l’écrêtage instantanément.
7.2 Utilisation des fonctions matricielles récentes (LET et LAMBDA)
Avec l’introduction du moteur de calcul matriciel dynamique dans Microsoft 365, Excel a franchi un cap majeur en intégrant des paradigmes de programmation fonctionnelle. Les fonctions LET et LAMBDA permettent désormais d’encapsuler la winsorisation dans des fonctions personnalisées modulaires et ultra-performantes, déployables sur des vecteurs entiers sans nécessiter aucune opération manuelle de recopie vers le bas.
La fonction LET permet d’allouer des variables intermédiaires locales au sein d’une unique cellule de calcul, évitant ainsi le recours à des cellules extérieures de paramètres. Pour traiter un tableau de valeurs continues stocké dans la plage dynamique A2:A1000, la formule s’articule de la manière suivante :
=LET(

  valeurs; A2:A1000;

  p_bas; CENTILE.INCLURE(valeurs; 0,05);

  p_haut; CENTILE.INCLURE(valeurs; 0,95);

  SI(valeurs < p_bas; p_bas; SI(valeurs > p_haut; p_haut; valeurs))

)
Cette expression matricielle se propage spontanément (phénomène de déversement ou spill) sur l’ensemble des lignes correspondantes. Pour franchir un degré supérieur d’abstraction et rendre cette opération pérenne à travers l’ensemble du classeur, il est possible de consigner cette logique au sein d’une fonction réutilisable baptisée WINSORIZE via le Gestionnaire de noms en mobilisant la fonction LAMBDA :
=LAMBDA(vecteur; alpha; LET(

  b_inf; CENTILE.INCLURE(vecteur; alpha);

  b_sup; CENTILE.INCLURE(vecteur; 1 - alpha);

  MIN(MAX(vecteur; b_inf); b_sup)

))
Dès lors que ce nom est validé dans l’environnement du classeur, n’importe quel collaborateur ou chercheur peut formuler dans n’importe quelle cellule de la feuille : =WINSORIZE(A2:A1000; 0,05), obtenant instantanément l’écrêtage matriciel complet sans se préoccuper de l’architecture algorithmique sous-jacente.
8. Winsorisation de données expérimentales stratifiées ou groupées
8.1 Nécessité méthodologique de la winsorisation intra-groupe
L’une des erreurs méthodologiques les plus insidieuses rencontrées dans la littérature expérimentale concerne l’application d’une winsorisation globale unifiée sur un jeu de données rassemblant des conditions contrastées ou des sous-populations hétérogènes. Dans un plan factoriel comparant un groupe clinique (atteint d’un déficit neurologique avéré) à un groupe témoin sain, les distributions fondamentales des variables de performance différent structurellement en termes de moyenne et d’étalement de variance.
Si l’analyste applique un percentile global indifférencié calculé sur l’agrégat des deux groupes, les valeurs de l’extrémité basse proviendront presque exclusivement du groupe clinique, tandis que les valeurs rabotées de l’extrémité haute appartiendront majoritairement au groupe contrôle. Cette altération asymétrique induit une grave distorsion des propriétés fondamentales de l’échantillon, pouvant aller jusqu’à l’annihilation artificielle de la différence inter-groupe réelle (paradoxe de Simpson) ou, inversement, à la création fallacieuse d’une interaction inexistante. Le respect rigoureux du postulat d’indépendance impose donc une winsorisation conditionnelle intra-groupe (ou stratifiée), où les seuils sont dérivés et appliqués de manière autonome au sein de chaque strate expérimentale.
8.2 Combinaison des fonctions CENTILE et SI matricielles conditionnelles
Pour extraire les seuils de percentiles conditionnels par groupe dans les versions classiques d’Excel, il convient de coupler la fonction CENTILE.INCLURE avec une fonction SI configurée sous forme de filtre matriciel. Prenons pour cas de figure un ensemble expérimental où les identifiants de groupe (« Controle » versus « Clinique ») sont spécifiés dans la plage $B$2:$B$150, tandis que les données d’évaluation résident dans la colonne quantitative $C$2:$C$150.
Pour calculer le 5e percentile spécifique aux seuls participants de la condition « Controle », l’expression matricielle se formule ainsi :
=CENTILE.INCLURE(SI($B$2:$B$150="Controle"; $C$2:$C$150); 0,05)
Dans les versions héritées d’Excel (versions antérieures à Microsoft 365), cette formule doit impérativement être validée au clavier en pressant simultanément les touches Ctrl + Maj + Entrée (CSE), ce qui entraîne son encapsulation automatique par le logiciel entre des accolades d’affichage {...}. Dans les versions modernes équipées du moteur matriciel natif, une simple pression sur la touche Entrée suffit.
Parallèlement, les versions récentes d’Excel offrent la fonction dédiée FILTRE, dont la syntaxe s’avère infiniment plus lisible et moins sujette aux erreurs de validation matricielle :
=CENTILE.INCLURE(FILTRE($C$2:$C$150; $B$2:$B$150="Controle"); 0,05)
Cette écriture explicite isole le sous-ensemble de données désiré en mémoire vive avant de soumettre les valeurs retenues au calcul du percentile, garantissant une étanchéité totale entre les conditions de l’étude.
8.3 Implémentation d’une table de paramètres de seuils croisés
Lorsque le protocole de recherche comporte de multiples niveaux de facteurs (par exemple 4 groupes de traitement et 2 cohortes d’âge, soit 8 cellules expérimentales distinctes), la multiplication des formules conditionnelles locales engendre un risque critique d’incohérence. La meilleure pratique d’ingénierie des données consiste à structurer une table auxiliaire récapitulative des paramètres statistiques.
Ce tableau croisé comportera en colonnes les étiquettes exactes des modalités de groupe, la taille d’échantillon associée ($n$), ainsi que les deux seuils calculés (Seuil_Bas et Seuil_Haut) au moyen des formules FILTRE documentées ci-dessus. Ensuite, au sein de la table principale de données de recueil, l’attribution dynamique des bornes appropriées à chaque ligne individuelle s’opère par le biais des fonctions d’interrogation relationnelle, telles que RECHERCHEV ou le binôme moderne INDEX / EQUIV (ou la fonction RECHERCHEX).
L’expression de calcul d’écrêtage en ligne 2 s’écrira alors en substituant aux références absolues statiques une référence dynamique indexée sur la modalité d’appartenance du sujet :
=MIN(MAX(C2; RECHERCHEX(B2; TableGroupes[Groupe]; TableGroupes[Seuil_Bas])); RECHERCHEX(B2; TableGroupes[Groupe]; TableGroupes[Seuil_Haut]))
Cette architecture sépare formellement les paramètres analytiques généraux de l’exécution ligne par ligne. Le jeu de données en acquiert une robustesse optimale pour les vérifications de reproductibilité et facilite les audits externes de cohérence lors des processus de révision par les pairs.
9. Diagnostics statistiques comparatifs post-transformation dans Excel
9.1 Évaluation de la normalité et des indices distributionnels
La validation scientifique d’une procédure de winsorisation requiert une analyse comparative formelle des propriétés de la distribution avant et après l’application du seuillage. L’objectif premier est de s’assurer que la transformation a effectivement jugulé l’instabilité des queues sans introduire de distorsions intempestives sur la tendance centrale de l’échantillon. Microsoft Excel intègre nativement une gamme de fonctions statistiques adaptées à cette fin.
La première vérification porte sur la concordance de la tendance centrale, via les fonctions MOYENNE et MEDIANE. Si la moyenne winsorisée présente un déplacement substantiel par rapport à la moyenne initiale sans que la médiane n’ait varié, ce décalage atteste que la moyenne brute était préalablement tirée par une traîne asymétrique, désormais normalisée par l’écrêtage. La stabilisation de la dispersion s’examine au travers de l’écart-type d’échantillon calculé via ECARTYPE.STANDARD, qui doit manifester une contraction proportionnelle à l’importance des valeurs périphériques traitées.
Le contrôle de l’amélioration de la normalité repose quant à lui sur deux métriques de forme majeures : l’asymétrie et l’aplatissement. L’analyste évalue le coefficient d’asymétrie au moyen de la fonction COEFFICIENT.ASYMETRIE (équivalent de l’estimateur non biaisé de Fisher-Pearson). Une distribution satisfaisant aux critères paramétriques standards doit présenter un coefficient contenu entre $-1$ et $+1$. L’aplatissement s’évalue quant à lui via la fonction KURTOSIS, qui renvoie l’excès d’aplatissement par rapport à la loi normale de référence (pour laquelle l’indice vaut 0). Le tableau suivant synthétise l’implémentation de ces fonctions de contrôle :
| Métrique Statistique | Fonction Excel (Série Brute) | Fonction Excel (Série Winsorisée) | Objectif Distributionnel Visé |
|---|---|---|---|
| Tendance Centrale | =MOYENNE(A2:A101) |
=MOYENNE(B2:B101) |
Convergence étroite vers la médiane |
| Écart-Type Échantillon | =ECARTYPE.STANDARD(A2:A101) |
=ECARTYPE.STANDARD(B2:B101) |
Stabilisation de la variance empirique |
| Asymétrie (Skewness) | =COEFFICIENT.ASYMETRIE(A2:A101) |
=COEFFICIENT.ASYMETRIE(B2:B101) |
Rapprochement de l’intervalle [-0,5 ; +0,5] |
| Aplatissement (Excess Kurtosis) | =KURTOSIS(A2:A101) |
=KURTOSIS(B2:B101) |
Atténuation des valeurs leptokurtiques (> 2) |
9.2 Visualisation graphique comparative intégrée
L’exploration purement numérique des coefficients doit s’accompagner d’une inspection visuelle explicite. Excel propose, au sein de sa palette de graphiques statistiques, l’outil idéal pour juger de l’impact de la winsorisation : le diagramme en boîte à moustaches (boxplot). Pour réaliser ce comparatif visuel, il suffit de sélectionner simultanément la colonne de données brutes et la colonne transformée correspondante, puis de naviguer dans le ruban vers Insertion > Graphiques recommandés > Boîte et moustaches.
Sur le graphique généré, la confrontation directe des deux représentations met immédiatement en lumière l’action mécanique de l’algorithme. Sur la boîte à moustaches de la série brute, les valeurs aberrantes sont représentées sous forme de points individuels isolés au-delà des segments terminaux des moustaches (les bornes de Tukey définies conventionnellement par $1,5 \times \text{IQR}$). Sur la boîte à moustaches de la série winsorisée, l’analyste observe la disparition complète de ces points flottants périphériques : ils sont réabsorbés exactement à la terminaison des moustaches ou intégrés dans le périmètre du percentile extrême retenu.
Une seconde approche graphique féconde consiste à construire des histogrammes de distribution superposés ou côte à côte (disponibles également dans les outils de graphiques d’Excel ou via l’utilitaire d’analyse de données). L’histogramme post-transformation illustre avec une parfaite transparence l’accumulation discrète caractéristique de fréquences se produisant exactement au niveau des deux barres frontières, tandis que la géométrie générale du corps central de la distribution demeure strictement inchangée.
10. Analyse comparative : Winsorisation face aux techniques alternatives
10.1 Winsorisation versus élagage pur (trimming)
Le choix entre la winsorisation et l’élagage pur (trimming) constitue un débat classique en statistique méthodologique. L’élagage pur consiste à retrancher de l’échantillon une proportion $\alpha$ des valeurs les plus basses et les plus hautes, ne conservant que le sous-ensemble central pour estimer la moyenne élaguée. Si cette démarche élimine intégralement l’influence perturbatrice des extrémités, elle présente l’inconvénient majeur de réduire la taille globale de l’échantillon de $2\alpha \times N$ unités d’observation.
Dans le cadre de l’inférence statistique sur de petits effectifs ($N < 30$), cette perte substantielle d’individus dégrade sévèrement les degrés de liberté lors de l’application de tests paramétriques (tests de Student ou ANOVA), diminuant corrélativement la puissance statistique du test. De surcroît, dans les protocoles factoriels à mesures répétées où chaque participant subit plusieurs conditions successives, l’élagage d’une seule mesure aberrante force fréquemment l’élimination cas-par-cas du participant sur l’ensemble du protocole pour préserver l’équilibre de la table matricielle, ce qui amplifie dramatiquement les biais d’attrition.
La winsorisation résout élégamment cette impasse en substituant aux observations discordantes une estimation bornée qui conserve l’individu dans la cohorte computationnelle. L’estimateur winsorisé possède un comportement asymptotique d’une remarquable stabilité mathématique face aux distributions à queues modérément polluées, tout en autorisant le chercheur à déployer ses modèles d’analyse multivariée standard sans devoir restructurer son plan d’expérience.
10.2 Winsorisation versus transformations logarithmiques ou racine carrée
Une alternative conventionnelle très répandue pour remédier à l’asymétrie positive et aux queues lourdes réside dans l’application de transformations mathématiques non linéaires, au premier rang desquelles figurent la fonction logarithmique ($y = ln(x)$ ou $y = \log_{10}(x)$) et la racine carrée ($y = \sqrt{x}$). Bien que ces transformations s’exécutent avec une parfaite simplicité dans Excel au moyen de formules telles que =LN(A2), elles soulèvent des difficultés d’ordre épistémologique et interprétatif non négligeables.
Le principal écueil des transformations non linéaires réside dans la dénaturation de l’échelle de mesure originale. Exprimer des temps de latence en « logarithmes de millisecondes » ou des scores de détresse psychologique en « unités de racine carrée » complique profondément l’interprétation clinique ou théorique des amplitudes d’effet (effect sizes). La reconstitution de la moyenne originale à partir de la moyenne des données transformées exige le recours à des exponentiations qui ne renvoient pas à la moyenne arithmétique initiale, mais à une moyenne géométrique intrinsèquement biaisée.
Par ailleurs, la fonction logarithmique est formellement indéfinie pour les valeurs nulles ou négatives, nécessitant l’adjonction arbitraire d’une constante de décalage (par exemple $ln(x + 1)$), dont la magnitude conditionne arbitrairement les résultats statistiques de l’analyse inférentielle. La winsorisation préserve rigoureusement l’unité métrique naturelle de l’instrument de mesure initial (des millisecondes demeurent des millisecondes, des points d’échelle demeurent des points d’échelle), facilitant la lecture directe, la communication des résultats et l’intégration des données au sein de méta-analyses ultérieures.
10.3 Winsorisation versus techniques d’imputation robuste
Dans l’arsenal des statistiques robustes contemporaines, les estimateurs $M$ développés par Peter Huber, ainsi que les algorithmes basés sur la médiane des écarts absolus (MAD) ou les moindres carrés élagués (LTS de Rousseeuw), constituent des solutions mathématiques avancées pour modéliser des séries corrompues. Ces estimateurs n’assignent pas un seuil rigide discontinu, mais pondèrent dynamiquement chaque résidu en fonction de sa distance au centre de distribution via des fonctions de perte spécifiques.
Néanmoins, la mise en œuvre effective des estimateurs de Huber ou de Hampel requiert des procédures algorithmiques itératives par réestimation pondérée successive (méthode IRLS : Iteratively Reweighted Least Squares). La construction d’un tel moteur au sein des grilles standards d’Excel se révèle particulièrement complexe et instable, obligeant le plus souvent les chercheurs à basculer vers des environnements de codage spécialisés tels que le package robustbase de R ou les modules statsmodels de Python.
La winsorisation se positionne précisément comme une approximation déterministe d’une robustesse éprouvée, exécutable nativement au sein de n’importe quel tableur sans la moindre ligne de code compilé. Elle fournit une protection largement suffisante contre les artéfacts expérimentaux ordinaires tout en offrant une transparence algorithmique totale, aisément vérifiable par des pairs ou des étudiants au sein d’une feuille de travail partagée.
11. Erreurs méthodologiques et pièges techniques fréquents dans Excel
11.1 Erreurs courantes de manipulation algorithmique
L’exécution de manipulations statistiques dans Excel est intrinsèquement vulnérable à certaines méprises syntaxiques qui, si elles ne génèrent pas nécessairement de messages d’erreur explicites du type #VALEUR!, corrompent silencieusement les distributions calculées. L’erreur la plus prévalente réside sans conteste dans l’omission de l’ancrage absolu par l’opérateur dollar ($) lors de la désignation de la plage d’échantillonnage au sein des fonctions CENTILE.INCLURE.
Considérons l’expression erronée =CENTILE.INCLURE(A2:A100; 0,05) écrite en cellule B2 et étirée vers le bas. À la ligne 20, la formule interroge silencieusement la plage A20:A118, incorporant des cellules vides sous le tableau et amputant le calcul des dix-neuf premières observations réelles de la cohorte. Les seuils fluctuent alors artificiellement de ligne en ligne, produisant une série pseudo-winsorisée totalement dénuée de sens statistique.
Un autre piège classique réside dans l’inclusion involontaire de libellés textuels d’en-tête à l’intérieur de la plage vectorielle (par exemple en formulant A1:A100 au lieu de A2:A100). Si la fonction CENTILE.INCLURE ignore les chaînes textuelles dans le calcul de rang, cette imprécision peut déstabiliser d’autres fonctions imbriquées ou altérer les indices de dénombrement conditionnel. Enfin, il convient de veiller scrupuleusement à l’encodage des fractions de centiles : stipuler par mégarde 0,5 au lieu de 0,05 n’écrête pas le 5e percentile inférieur, mais remplace la moitié inférieure entière de l’échantillon par la médiane, détruisant instantanément la moitié de la structure informationnelle du jeu de données.
11.2 Biais statistiques et dérives d’intégrité scientifique
Au-delà des maladresses syntaxiques pures, l’application de la winsorisation peut être le vecteur de dérives méthodologiques sévères compromettant la validité scientifique des conclusions publiées. Le premier risque conceptuel réside dans la sur-winsorisation. L’écrêtage excessif d’une proportion disproportionnée de l’échantillon (par exemple fixer des seuils symétriques à 20 %, soit $\alpha = 0,20$, modifiant 40 % des points expérimentaux) engendre une compression artificielle massive de la variance résiduelle.
Cette variance déflatée a pour effet immédiat de gonfler artificiellement les ratios $F$ lors d’analyses de variance et de faire chuter de manière illégitime les valeurs de $p$ lors de tests de Student, multipliant exponentiellement le risque d’erreur de première espèce (rejet erroné de l’hypothèse nulle, ou faux positif). L’analyste se trouve alors dans une situation où il s’auto-persuade de la significativité de son effet expérimental, alors que celle-ci n’est que la conséquence directe d’un écrasement forcé du dénominateur de son test statistique.
La seconde dérive majeure concerne le p-hacking post-hoc ou la recherche orientée de confirmation. Ajuster de manière discrétionnaire les niveaux de coupure percentile (tester alternativement 1 %, 2,5 %, 5 %, puis 7 % jusqu’à ce que la valeur $p$ de l’effet principal franchisse le seuil conventionnel de 0,05) constitue une violation manifeste des standards d’intégrité scientifique. La winsorisation ne doit en aucun cas être employée comme un outil de fabrication de significativité statistique, mais exclusivement comme une procédure a priori ou exploratoire de neutralisation d’artéfacts de mesure réels et identifiés.
12. Directives de rédaction académique et exigences de reproductibilité
12.1 Conformité aux normes internationales de publication (APA)
Lors de la soumission de manuscrits scientifiques au sein de revues à comité de lecture régies par les normes de l’American Psychological Association (APA 7th edition) ou de consortiums biomédicaux équivalents, la transparence relative au traitement des données aberrantes fait l’objet d’un examen minutieux. Il est formellement inadmissible d’affirmer de manière laconique au sein d’une note de bas de page que « les données aberrantes ont été nettoyées ». Le protocole de transformation doit être détaillé avec la plus haute précision méthodologique au sein de la sous-section Analyses statistiques ou Préparation des données de la section Méthode.
La rédaction académique doit obligatoirement expliciter les quatre éléments directeurs suivants :
- La justification théorique et empirique motivant le recours à la winsorisation de préférence à l’élagage classique ou aux transformations non linéaires d’échelles.
- Les seuils de coupure percentiles exacts adoptés (par exemple : seuils bilatéraux fixés aux 5e et 95e percentiles empiriques).
- L’algorithme computationnel spécifique mobilisé au sein du logiciel (en mentionnant expressément l’interpolation linéaire conforme à la fonction
CENTILE.INCLUREd’Excel). - Le volume exact d’observations ayant effectivement subi une altération numérique consécutive à l’application de la règle, exprimé à la fois en effectif brut ($n$) et en pourcentage relatif vis-à-vis de la cohorte totale étudiée.
Une formulation exemplaire conforme aux standards académiques internationaux s’énonce comme suit : « Afin de régulariser la distribution asymétrique des temps de réaction sans amputer l’effectif d’échantillon, les latences extrêmes ont été soumises à une winsorisation bilatérale symétrique à 90 % (seuils établis aux 5e et 95e percentiles via l’algorithme d’interpolation linéaire continue de Microsoft Excel). Cette procédure a conduit à la modification de 12 observations sur un total de 240 mesures expérimentales (soit 5,0 % de l’agrégat). Les analyses de variance subséquentes ont été conduites sur les données transformées, et une analyse de sensibilité parallèle menée sur les scores bruts a confirmé la robustesse des effets principaux observés. »
12.2 Stratégies d’ouverture des données et archivage reproductible
À l’ère de la science ouverte (Open Science), la mise à disposition des matériaux de recherche sur des dépôts institutionnels publics certifiés, tels que l’Open Science Framework (OSF), Zenodo ou Dryad, s’impose comme une exigence incontournable pour toute équipe de recherche visant l’excellence. L’utilisation d’un logiciel propriétaire comme Microsoft Excel pour la préparation de données ne dispense aucunement des règles strictes de reproductibilité computationnelle.
Pour garantir une réplicabilité intégrale de l’analyse, le classeur Excel mis en ligne doit faire l’objet d’une organisation méthodique et documentée :
- L’onglet principal doit comporter la matrice primaire des données brutes, strictement inaltérée et purgée de toute formule destructive.
- Un onglet secondaire clairement identifié doit regrouper l’ensemble des formules de winsorisation actives, permettant à tout évaluateur d’auditer les dépendances de calcul et les références de cellules sans risque de rupture relationnelle.
- Un onglet de documentation (fichier README ou dictionnaire des données) doit référencer l’intégralité des variables, spécifier l’unité de mesure physique, détailler la signification de chaque code d’erreur et expliciter les conditions expérimentales.
Enfin, afin d’assurer l’interopérabilité à long terme et de prémunir les données contre l’obsolescence des logiciels propriétaires, les jeux de données finaux préparés doivent impérativement être exportés et archivés sous forme de fichiers texte universels à délimitation standardisée (format CSV codé en UTF-8 ou TSV). Cette étape garantit que des collègues travaillant sous d’autres environnements (R, Python, Julia, SPSS ou JASP) puissent importer et répliquer immédiatement l’ensemble des modélisations statistiques avec une fidélité numérique absolue.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Dixon, W. J. (1960). Simplified estimation from censored normal samples. The Annals of Mathematical Statistics, 31(2), 385–391. https://doi.org/10.1214/aoms/1177705900
Hampel, F. R., Ronchetti, E. M., Rousseeuw, P. J., & Stahel, W. A. (1986). Robust statistics: The approach based on influence functions. John Wiley & Sons.
Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
Ratcliff, R. (1993). Methods for dealing with reaction time outliers. Psychological Bulletin, 114(3), 510–532. https://doi.org/10.1037/0033-2909.114.3.510
Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471725382
Tukey, J. W. (1962). The future of data analysis. The Annals of Mathematical Statistics, 33(1), 1–67. https://doi.org/10.1214/aoms/1177704711
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02381-8
Winsor, C. P. (1932). The Gompertz curve as a growth curve. Proceedings of the National Academy of Sciences, 18(1), 1–8. https://doi.org/10.1073/pnas.18.1.1