
Dans le paysage contemporain de la modélisation statistique et de la science des données, l’analyse des processus de comptage occupe une place centrale, à la croisée de la théorie des probabilités et de la recherche empirique appliquée. Si les distributions continues, au premier rang desquelles figure la loi Normale, ont longtemps dominé les pratiques d’inférence en raison du théorème central limite et de leur commodité analytique, elles se révèlent fondamentalement inadéquates lorsqu’il s’agit de modéliser des événements discrets, dénombrables et intrinsèquement non négatifs. La loi de Poisson, formulée au XIXe siècle par le mathématicien français Siméon Denis Poisson, constitue l’armature formelle canonique pour appréhender la fréquence d’occurrences d’événements stochastiques se déployant au sein d’un continuum temporel, spatial ou expérimental déterminé.
Dans des disciplines telles que les neurosciences computationnelles, l’épidémiologie clinique, la psychométrie quantitative et les sciences du comportement, les chercheurs sont régulièrement confrontés à des données caractérisées par une asymétrie marquée et un plancher naturel à zéro : nombre d’impulsions synaptiques par unité de temps, fréquence de rechutes symptomatiques, survenue d’erreurs d’attention ou dénombrement de micro-comportements lors de paradigmes d’observation standardisés. Tenter d’appliquer des régressions linéaires par moindres carrés ordinaires à de tels jeux de données engendre des prédictions absurdes, telles que des occurrences négatives, tout en violant de manière flagrante les postulats d’homoscédasticité et de normalité des résidus. C’est ici que l’adoption d’un cadre probabiliste fondé sur la loi de Poisson s’impose comme un impératif méthodologique rigoureux.
L’écosystème open-source Python, propulsé par des bibliothèques scientifiques de premier ordre comme NumPy, SciPy et Statsmodels, offre aujourd’hui un environnement computationnel d’une puissance et d’une flexibilité exceptionnelles pour implémenter ces modélisations. Du calcul analytique exact des fonctions de masse aux régressions linéaires généralisées complexes intégrant des variables d’exposition et des corrections de surdispersion, l’ingénierie statistique moderne permet d’extraire des inférences d’une granularité et d’une fiabilité sans précédent. Cet article propose une exploration exhaustive, théorique et computationnelle, de la distribution de Poisson en Python, guidant le statisticien, le chercheur ou le praticien de la donnée à travers les fondements mathématiques, l’échantillonnage algorithmique, le diagnostic paramétrique et les architectures de régression avancées.
1. Fondements théoriques et mathématiques de la loi de Poisson
1.1 Définition formelle et propriétés stochastiques
La distribution de Poisson est une loi de probabilité discrète décrivant le nombre d’événements indépendants survenant dans un intervalle fixe de temps ou d’espace, sous réserve que ces événements se produisent avec un taux moyen constant et indépendamment du temps écoulé depuis le dernier événement. Soit une variable aléatoire discrète notée X, représentant le décompte total des occurrences observées. On dit que X suit une loi de Poisson de paramètre d’intensité λ (strictement positif), ce que l’on note conventionnellement X ~ Poisson(λ). La fonction de masse de probabilité (Probability Mass Function, ou PMF) s’exprime analytiquement pour tout entier naturel k appartenant à l’ensemble des entiers non négatifs selon l’équation fondamentale : P(X = k) = (λk × e-λ) / k!, où le symbole e désigne la constante d’Euler (base du logarithme naturel) et k! représente la factorielle de l’entier k.
La validité mathématique d’un processus de Poisson homogène repose sur trois axiomes probabilistes rigoureux : la stationnarité, l’indépendance incrémentale et l’absence de simultanéité stricte (propriété de rareté ou d’ordre). La stationnarité stipule que la probabilité d’occurrence d’un événement au sein d’un intervalle infinitésimal dt ne dépend que de la durée de cet intervalle et demeure invariante par translation temporelle, s’écrivant formellement sous la forme λ × dt + o(dt). L’indépendance incrémentale exige que le nombre d’événements observés dans deux intervalles temporels disjoints soit constitué de variables aléatoires mutuellement indépendantes, ce qui confère au processus sa structure de Markov sans mémoire. Enfin, la condition d’ordre impose que la probabilité d’observer deux événements ou plus simultanément dans un intervalle infinitésimal dt tende vers zéro plus vite que la durée de l’intervalle lui-même, soit formellement o(dt).
Une caractéristique mathématique cardinale et distinctive de la loi de Poisson réside dans sa propriété intrinsèque d’équidispersance. Contrairement à la majorité des lois statistiques où les moments d’ordre un et deux sont paramétrés de manière autonome, la loi de Poisson impose une égalité stricte entre son espérance mathématique et sa variance : E(X) = Var(X) = λ. Cette contrainte d’équidispersance signifie que lorsque le nombre moyen d’occurrences augmente, l’incertitude absolue mesurée par la dispersion autour de la moyenne croît exactement au même rythme, induisant un écart-type équivalent à la racine carrée de λ. Sur le plan asymptotique, la loi de Poisson apparaît comme la limite naturelle d’une loi binomiale B(n, p) lorsque le nombre d’essais n tend vers l’infini tandis que la probabilité de succès élémentaire p tend vers zéro, le produit n × p convergeant vers une constante finie λ. Cette convergence, établie par la loi des événements rares, justifie empiriquement l’usage de Poisson pour approximer des dynamiques discrètes dans des échantillons volumineux où chaque opportunité individuelle d’événement présente une probabilité infinitésimale de se concrétiser.
1.2 Pertinence méthodologique en sciences du comportement et psychométrie
Dans le domaine des sciences du comportement, de la psychologie cognitive et de la recherche psychométrique, la capture quantitative des conduites humaines confronte systématiquement le chercheur à des phénomènes d’une nature fondamentalement discontinue. Lors de protocoles expérimentaux chronométrés ou d’épreuves d’évaluation des fonctions exécutives, les variables dépendantes prennent fréquemment la forme d’un nombre discret de lapsus attentionnels, de saccades oculaires déviantes, d’omissions ou d’erreurs de commission. Dans ces contextes, assimiler ces métriques de performance à une distribution continue gaussienne constitue une erreur épistémologique et méthodologique majeure : les scores de comptage sont bornés inférieurement par zéro, présentent une asymétrie positive intrinsèque particulièrement accusée chez les sujets sains performants, et affichent une variance structurellement corrélée au niveau moyen de performance.
L’utilisation de la distribution de Poisson permet aux psychométriciens de modéliser avec précision la fréquence de survenue de manifestations cliniques au sein de cohortes longitudinales, telles que les épisodes de panique hebdomadaires chez des patients diagnostiqués avec un trouble anxieux généralisé, ou les accès d’agressivité chez des individus présentant des dysfonctionnements du lobe frontal. Dans ces cohortes, la majorité des observations se concentre autour de valeurs très faibles, voire nulles, tandis qu’une minorité présente des accumulations atypiques. Le cadre probabiliste de Poisson offre une fondation robuste pour quantifier ces fréquences relatives sans recourir à des transformations mathématiques artificielles (telles que la transformation logarithmique ou la racine carrée) qui dénaturent l’échelle de mesure originale et complexifient l’interprétation des effets cliniques réels.
Sur le plan théorique, la distinction entre un processus continu gaussien et un processus de comptage poissonnien repose sur l’ontologie même de la variable mesurée. Les variables continues résultent généralement de l’agrégation additive d’une multitude de perturbations infinitésimales (conformément au théorème central limite), ce qui génère une morphologie symétrique en cloche. À l’inverse, les processus de comptage discrets reflètent l’accumulation ponctuelle de transitions d’état qualitatives au sein d’un système dynamique. Chaque occurrence représente un saut quantique dans la trajectoire du sujet observé. Reconnaître cette nature discrète via la loi de Poisson permet d’ancrer les analyses psychométriques dans des hypothèses génératives cohérentes avec la réalité neurobiologique et cognitive sous-jacente.
2. Configuration de l’environnement Python et bibliothèques scientifiques
2.1 Écosystème informatique pour l’analyse probabiliste
L’exécution efficace et reproductible d’analyses probabilistes fondées sur la loi de Poisson requiert une infrastructure computationnelle robuste au sein de l’environnement Python. Le socle scientifique moderne repose sur l’interaction coordonnée de plusieurs bibliothèques spécialisées : NumPy pour les calculs matriciels vectorisés de haute performance, SciPy pour l’évaluation des fonctions probabilistes exactes et des algorithmes d’optimisation numérique, Matplotlib et Seaborn pour la sémiotique visuelle et le rendu graphique de publications académiques, et enfin Statsmodels pour l’inférence formelle dans le cadre des modèles linéaires généralisés.
Au cœur de cette architecture, le sous-module scipy.stats met à disposition la classe poisson, une entité logicielle dédiée qui encapsule la totalité des opérations mathématiques nécessaires à la manipulation de la distribution : calcul de la densité discrète, fonctions de répartition, fonctions de survie, quantiles et échantillonnage pseudo-aléatoire. L’avantage computationnel majeur de l’implémentation offerte par SciPy réside dans son interfaçage avec des bibliothèques compilées en C et Fortran (telles que Cephes), garantissant une précision numérique optimale même lorsque les paramètres d’intensité atteignent des ordres de grandeur extrêmes, évitant ainsi les erreurs d’arrondi ou les pertes de précision machine courantes dans les calculs arithmétiques naïfs.
Afin de garantir la stricte reproductibilité computationnelle exigée par les standards de la science ouverte, le déploiement de ces analyses doit impérativement s’opérer au sein d’environnements virtuels isolés, configurés via des gestionnaires d’environnements comme Conda ou virtualenv. Cette isolation permet de figer les versions exactes des dépendances mathématiques et d’éliminer les dérives comportementales consécutives aux mises à jour des paquets. De surcroît, la standardisation des structures de données via les tableaux multidimensionnels ndarray de NumPy garantit une allocation contiguë en mémoire vive, maximisant l’efficacité de la vectorisation CPU lors du traitement d’échantillons massifs comprenant plusieurs centaines de milliers d’observations comportementales.
2.2 Contrôle de l’aléa et reproductibilité expérimentale
La crédibilité d’un pipeline de simulations probabilistes repose entièrement sur la maîtrise du déterminisme sous-jacent à la génération de nombres pseudo-aléatoires. Dans les versions antérieures de Python et de NumPy, l’usage prédominant reposait sur la fonction numpy.random.seed() et l’état global du générateur RandomState, fondé sur l’algorithme Mersenne Twister (MT19937). Cependant, l’ingénierie statistique moderne a abandonné ce paradigme au profit de l’architecture modulaire introduite avec NumPy 1.17, centrée sur la classe Generator instanciée par numpy.random.default_rng().
Le nouveau paradigme repose par défaut sur l’algorithme PCG64 (Permuted Congruential Generator), qui surpasse rigoureusement le Mersenne Twister tant en termes de vitesse computationnelle que de propriétés statistiques, notamment en ce qui concerne la période, l’équidistribution dans des dimensions élevées et la résistance aux tests de complexité stochastique de la suite TestU01. Pour assurer une reproductibilité absolue, le chercheur doit instancier un générateur explicite en lui fournissant un entier non négatif constant comme graine stochastique : rng = np.random.default_rng(seed=42). Cette instance locale de générateur encapsule son propre état, éliminant les interférences potentielles entre différentes sections du code ou lors de l’exécution parallèle sur des cœurs multiples.
Dans le cadre de publications académiques soumises à des comités de lecture stricts, les directives de transparence méthodologique exigent désormais la divulgation explicite de la graine stochastique utilisée, de l’architecture matérielle sous-jacente et de la version précise des générateurs. Cette rigueur permet à des tiers de reproduire à l’identique les tirages de Monte-Carlo, de recalculer les intervalles de confiance empiriques et d’attester de la robustesse des conclusions tirées des simulations de modèles de comptage.
3. Génération d’échantillons aléatoires de Poisson
3.1 Échantillonnage stochastique avec SciPy et NumPy
L’échantillonnage de variables aléatoires suivant une loi de Poisson constitue l’étape fondamentale de toute modélisation stochastique, de la vérification de puissance statistique à la validation empirique d’estimateurs. Deux approches programmatiques majeures coexistent dans l’écosystème Python : l’utilisation de la méthode poisson.rvs() issue de scipy.stats et l’utilisation de la méthode rng.poisson() native au générateur NumPy moderne. Tandis que la première s’intègre harmonieusement dans les flux de travail orientés vers la théorie statistique formelle en autorisant la manipulation d’objets probabilistes continus ou discrets génériques, la seconde est optimisée pour des débits de génération massifs au sein de simulations de Monte-Carlo exigeant des millions d’itérations.
La signature de la fonction rng.poisson(lam, size) permet un contrôle vectorisé avancé sur la forme des échantillons générés. Le paramètre d’intensité lam peut être spécifié sous la forme d’un scalaire pour générer un échantillon homogène, ou sous la forme d’un tableau multidimensionnel représentant des taux variables selon différentes conditions expérimentales. Le paramètre size définit quant à lui les dimensions du tenseur de sortie. Par exemple, pour simuler un protocole comportemental impliquant cinquante participants soumis chacun à dix sessions d’observation consécutives, une simple définition de la taille sous la forme du tuple size=(50, 10) permet de générer instantanément une matrice structurée où chaque élément représente le nombre d’occurrences poissonniennes attendues pour un sujet et une session donnés.
La validation empirique des données synthétiques générées constitue une précaution indispensable avant toute utilisation subséquente. Cette vérification s’opère en calculant la moyenne empirique et la variance empirique de l’échantillon synthétique pour les confronter directement au paramètre nominal λ injecté dans le générateur. Pour des tailles d’échantillon substantielles, en vertu de la loi forte des grands nombres et du théorème central limite, l’écart relatif entre la moyenne empirique observée, la variance d’échantillon et le paramètre λ doit décroître à un taux d’ordre O(1/√N), confirmant que le moteur algorithmique reproduit fidèlement la dynamique théorique d’équidispersance attendue.
3.2 Simulation de trajectoires temporelles et processus d’arrivée
Une compréhension approfondie de la distribution de Poisson nécessite d’examiner sa genèse dynamique dans le temps : le processus ponctuel de Poisson homogène. Ce processus ne se limite pas à comptabiliser un total final d’occurrences au terme d’un intervalle fixe ; il caractérise la trajectoire continue des instants d’apparition de chaque événement individuel. Une propriété mathématique fondamentale établit une dualité stricte entre la distribution de Poisson et la distribution Exponentielle : si le nombre d’événements dans un intervalle de durée unitaire suit une loi de Poisson de paramètre λ, alors les durées séparant deux événements successifs (les intervalles inter-arrivées) sont des variables aléatoires indépendantes et identiquement distribuées suivant une loi exponentielle de paramètre d’échelle β = 1/λ (ou de taux λ).
Sur le plan computationnel en Python, la simulation d’une telle trajectoire comportementale s’effectue en générant d’abord un vecteur d’intervalles inter-arrivées à l’aide de la méthode rng.exponential(scale=1/lam, size=n_events). En appliquant ensuite la fonction de somme cumulative np.cumsum() sur ce vecteur d’intervalles, on obtient le vecteur exact des temps d’arrivée stochastiques sur l’axe temporel. Le processus de comptage cumulatif N(t) s’obtient alors en dénombrant, pour toute valeur temporelle continue t, le nombre d’instants d’arrivée strictement inférieurs ou égaux à t, matérialisant ainsi une fonction en escalier non décroissante typique des processus de sauts.
Cette approche dynamique est particulièrement féconde lors de la modélisation de protocoles de conditionnement opérant ou de vigilance continue, où la latence de réponse et la fréquence globale d’action fournissent des indices complémentaires sur l’état cognitif de l’organisme. De plus, l’analyse sérielle de ces trajectoires permet d’identifier empiriquement d’éventuelles ruptures de stationnarité : si l’intensité λ fluctue au cours du temps en raison de la fatigue cognitive ou de l’apprentissage du sujet, les intervalles inter-arrivées cessent d’être identiquement distribués, révélant la transition vers un processus de Poisson non homogène que les tests d’indépendance temporelle et de corrélation sérielle permettent de caractériser formellement.
4. Calcul des probabilités ponctuelles : La fonction de masse (PMF)
4.1 Implémentation computationnelle de la fonction PMF
La quantification exacte des probabilités associées à des configurations discrètes précises constitue le socle de l’inférence probabiliste. Dans l’écosystème SciPy, l’évaluation de la fonction de masse s’effectue via l’instruction scipy.stats.poisson.pmf(k, mu), où k désigne l’entier non négatif (ou le tableau d’entiers) dont on souhaite évaluer la vraisemblance, et mu correspond au paramètre d’intensité λ. Sur le plan conceptuel, on pourrait être tenté d’implémenter cette fonction de manière directe en Python pur en traduisant fidèlement la formule analytique par une combinaison de la fonction math.exp(), d’une puissance entière et de math.factorial(). Cependant, une telle approche naïve se heurte immédiatement à des limites numériques infranchissables.
Le calcul explicite de la factorielle k! induit un dépassement de capacité arithmétique (overflow) dès que k dépasse la valeur 170 dans les environnements à virgule flottante standard IEEE 754 à double précision (64 bits), générant une valeur infinie non traitable. De manière symétrique, pour des valeurs substantielles de λ, le terme e-λ décroît rapidement vers zéro, provoquant un phénomène d’évanouissement arithmétique (underflow). L’implémentation algorithmique au sein de SciPy contourne élégamment ces écueils computationnels en exploitant la fonction log-gamma, notée Γ(k+1), qui généralise la factorielle aux nombres réels tout en opérant dans le domaine logarithmique avant toute exponentiation finale.
Pour des calculs statistiques requérant une fidélité numérique extrême, notamment lors de l’estimation de la fonction de vraisemblance conjointe sur des échantillons volumineux, il est vivement recommandé d’utiliser directement la méthode scipy.stats.poisson.logpmf(k, mu). Cette fonction évalue directement le logarithme naturel de la probabilité ponctuelle selon l’identité mathématique : ln[P(X=k)] = k × ln(λ) – λ – ln(Γ(k+1)). En éliminant tout recours à l’exponentiation intermédiaire et en transformant les produits et divisions en sommes et soustractions vectorisées, logpmf préserve une précision optimale jusqu’aux limites de la résolution machine, garantissant la stabilité des algorithmes d’optimisation non linéaires associés aux estimations paramétriques.
4.2 Applications pratiques au calcul de probabilités exactes
L’application rigoureuse de la fonction PMF permet de répondre avec une précision analytique absolue à des questions fondamentales posées lors de protocoles expérimentaux. Considérons une tâche de temps de réaction sélectif où le taux moyen d’erreurs d’anticipation motrice par bloc d’essais standardisé a été empiriquement étalonné à λ = 2,5. Le calcul de la probabilité exacte qu’un participant réalise un bloc sans commettre la moindre erreur (soit k = 0) s’obtient simplement par l’évaluation de poisson.pmf(0, mu=2.5), ce qui donne analytiquement e-2,5 ≈ 0,0821, soit approximativement 8,21% de chances théoriques.
De façon symétrique, l’analyse de sensibilité de la probabilité ponctuelle constitue un outil diagnostique puissant pour étudier la vulnérabilité d’un modèle face à des perturbations du paramètre de charge attentionnelle ou d’activation comportementale. Grâce à la vectorisation inhérente aux bibliothèques Python, il est possible de fournir simultanément un vecteur de valeurs pour k et un tableau multidimensionnel pour mu. Le moteur de calcul diffuse (broadcasting) les opérations arithmétiques pour produire un tenseur de probabilités exactes sans qu’il soit nécessaire de recourir à des boucles itératives explicites en langage de haut niveau, lesquelles pénaliseraient dramatiquement les temps d’exécution.
Cette approche vectorisée permet de cartographier instantanément les profils de réponses discrets attendus selon différentes strates expérimentales. Par exemple, en confrontant un groupe contrôle (λ = 1,2) à un groupe soumis à un stresseur aigu (λ = 3,8), l’évaluation conjointe de poisson.pmf(k=np.arange(0, 10), mu=[[1.2], [3.8]]) génère une matrice bivariée détaillée décrivant la redistribution complète de la masse de probabilité vers les valeurs élevées sous l’effet du stress, fournissant ainsi des hypothèses statistiques précises et quantifiables pour tester la puissance d’un protocole empirique envisagé.
5. Calcul des probabilités cumulées : Fonctions CDF et SF
5.1 Évaluation de la fonction de répartition cumulative (CDF)
Dans de nombreuses situations décisionnelles et expérimentales, le statisticien ne s’intéresse pas uniquement à la probabilité d’observer un nombre précis d’occurrences, mais cherche à évaluer la probabilité globale qu’une variable aléatoire n’excède pas un certain seuil critique. La fonction de répartition cumulative (Cumulative Distribution Function, ou CDF) répond formellement à cette exigence en calculant la somme des probabilités ponctuelles pour toutes les valeurs inférieures ou égales à une valeur entière k donnée : F(k) = P(X ≤ k) = ∑i=0k P(X=i). Au sein de l’environnement SciPy, cette grandeur est calculée via la fonction scipy.stats.poisson.cdf(k, mu).
La CDF constitue l’instrument privilégié pour déterminer la probabilité d’observer des décomptes compris dans un intervalle fermé défini par deux bornes entières a et b, avec a ≤ b. En vertu des axiomes de Kolmogorov pour les probabilités discrètes, la probabilité d’appartenance à cet intervalle s’obtient par la différence stricte : P(a ≤ X ≤ b) = P(X ≤ b) – P(X ≤ a – 1). En syntaxe Python, cette expression se traduit de façon concise et vectorisée par l’opération arithmétique : poisson.cdf(b, mu) - poisson.cdf(a - 1, mu). Cette formulation permet de résoudre instantanément des problématiques liées au contrôle de conformité clinique, telles que la détermination du pourcentage de sujets dont le décompte de symptômes se maintient dans une plage de tolérance prédéfinie.
De manière complémentaire, la fonction quantile ou fonction de point de pourcentage (Percent Point Function, notée PPF) constitue l’inverse formel de la fonction de répartition. Implémentée dans SciPy sous l’instruction scipy.stats.poisson.ppf(q, mu), elle renvoie le plus petit entier k tel que la probabilité cumulative F(k) soit supérieure ou égale à la probabilité continue q spécifiée (avec 0 ≤ q ≤ 1). En psychométrie, la fonction poisson.ppf permet de construire des normes d’étalonnage et d’identifier les valeurs seuils critiques au-delà desquelles un score de déviance comportementale est considéré comme statistiquement atypique à un niveau α conventionnel (par exemple en évaluant poisson.ppf(0.95, mu) pour établir le seuil du 95e centile).
5.2 Calcul des probabilités de dépassement avec la fonction de survie (SF)
Dans l’analyse des risques et la détection d’anomalies comportementales, la métrique la plus déterminante est fréquemment la probabilité qu’une variable aléatoire de comptage dépasse strictement un niveau critique k, ce qui correspond à la queue de distribution supérieure : P(X > k). Alors qu’il est courant de calculer cette quantité par l’expression arithmétique naïve 1 - poisson.cdf(k, mu), cette pratique présente une vulnérabilité numérique sévère connue sous le nom d’annulation catastrophique.
L’annulation catastrophique survient en arithmétique à virgule flottante lorsqu’on soustrait deux nombres d’une grandeur quasi identique. Si la probabilité cumulative poisson.cdf(k, mu) est égale à 0,9999999998, la soustraction de cette valeur à 1 entraîne la perte de la quasi-totalité des chiffres significatifs dans le résultat final, réduisant drastiquement la précision de l’évaluation stochastique. Pour parer à cette dégradation numérique, SciPy implémente la fonction de survie dédiée (Survival Function), accessible via scipy.stats.poisson.sf(k, mu), qui calcule directement l’intégrale de la fonction gamma incomplète complémentaire sans passer par la soustraction intermédiaire avec l’unité, préservant ainsi une fidélité numérique maximale jusqu’au dernier bit de mantisse.
Pour l’analyse d’événements exceptionnellement rares situés dans les queues de distribution extrêmes — par exemple, l’évaluation de la survenue inattendue d’accidents critiques ou de crises psychiatriques sévères — le recours à la méthode scipy.stats.poisson.logsf(k, mu) s’impose de façon catégorique. En renvoyant directement le logarithme naturel de la probabilité de dépassement, logsf permet de manipuler des p-valeurs infinitésimales (de l’ordre de 10-50 ou au-delà) sans risque d’effondrement à zéro par underflow machine. Cela confère aux chercheurs une précision chirurgicale pour repérer des comportements hors normes au sein de vastes banques de données observationnelles.
6. Visualisation avancée des distributions de Poisson
6.1 Représentation graphique de la masse de probabilité
La communication scientifique et la validation intuitive des modèles reposent sur une restitution graphique rigoureuse et esthétique des structures distributionnelles. Contrairement aux variables continues dont la densité de probabilité est représentée par des courbes lissées continues, la nature discrète de la loi de Poisson impose une sémiotique visuelle spécifique : l’utilisation exclusive de diagrammes en bâtons verticaux (bar plots) ou de diagrammes en tiges (stem plots). Tracer une courbe continue reliant les points de masse d’une distribution de Poisson constitue une erreur méthodologique formelle, car cela suggère faussement que la variable peut prendre des valeurs fractionnaires ou décimales entre deux entiers successifs.
En utilisant les bibliothèques Matplotlib et Seaborn au sein de Python, le chercheur peut élaborer des visualisations répondant aux critères éditoriaux des revues scientifiques les plus exigeantes. Un tracé académique exemplaire implique de définir un ensemble discret d’entiers via k = np.arange(0, max_k), de calculer la masse de probabilité théorique à l’aide de poisson.pmf(k, mu), et de représenter chaque valeur sous forme d’une barre discrète d’épaisseur contrôlée, centrée précisément sur l’entier d’abscisse. L’adjonction de marqueurs circulaires au sommet de chaque bâton renforce la lisibilité de la concentration ponctuelle de probabilité.
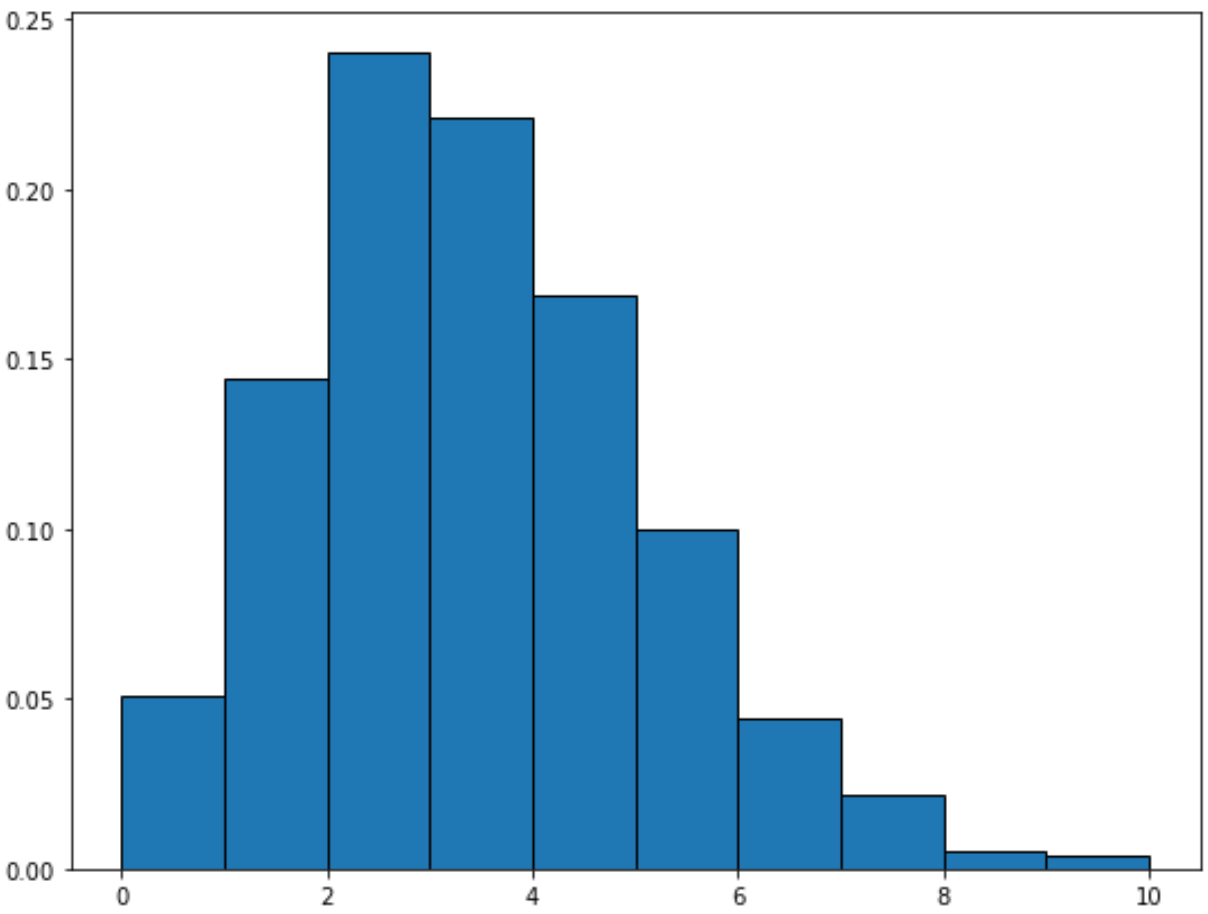
Lors de la confrontation d’un modèle théorique à des données empiriques recueillies sur le terrain, une pratique analytique essentielle consiste à superposer l’histogramme de fréquences relatives d’un échantillon réel avec la fonction de masse de Poisson théorique paramétrée par la moyenne estimée. Pour éviter tout artefact visuel, les intervalles de classe (bins) de l’histogramme empirique doivent être explicitement configurés pour être alignés sur les nombres entiers avec des largeurs unitaires (par exemple, bins=np.arange(-0.5, max_obs + 1.5, 1)). Lorsque l’analyse s’étend aux queues de distribution où les probabilités deviennent infimes, le basculement de l’axe des ordonnées en échelle logarithmique (plt.yscale('log')) permet d’inspecter visuellement l’ajustement du modèle sur toute l’étendue de l’espace d’état sans que les faibles effectifs ne soient invisibilisés par l’écrasement visuel lié à l’échelle linéaire.
6.2 Comparaison visuelle sous variation du paramètre lambda
L’exploration visuelle de la loi de Poisson révèle une dynamique morphologique remarquable à mesure que son paramètre d’intensité λ varie. Lorsque λ est inférieur à l’unité, la fonction de masse de probabilité présente une décroissance monotone stricte et une asymétrie positive prononcée, le mode de la distribution étant invariablement positionné à zéro. Pour des valeurs intermédiaires de λ (entre 1 et 5), la distribution devient unimodale et développe une morphologie asymétrique caractéristique, présentant une traîne étalée vers les entiers positifs élevés, reflétant l’impossibilité de descendre en dessous du plancher zéro tout en autorisant des occurrences occasionnelles élevées.
Lorsque λ croît pour atteindre des valeurs supérieures à 10 ou 15, la morphologie distributionnelle subit une métamorphose graduelle vers une symétrie quasi parfaite. En vertu du théorème central limite, la distribution de Poisson de paramètre λ converge asymptotiquement vers une loi Normale de paramètres μ = λ et σ2 = λ. La construction d’un graphique multi-panneaux sous Seaborn permet d’illustrer visuellement cette transition stochastique : en traçant côte à côte les profils probabilistes pour des valeurs de λ s’échelonnant de 1 à 30, on constate graphiquement la résorption progressive du coefficient d’asymétrie théorique (qui décroît selon la loi 1/√λ) et de l’aplatissement ou kurtosis (qui décroît selon 1/λ).
Pour visualiser la dynamique cumulative sans recourir à des approximations trompeuses, la fonction de répartition CDF doit quant à elle être impérativement tracée sous forme de graphique en escalier (step plot), à l’aide de la méthode plt.step(..., where='post'). Cette représentation traduit visuellement la nature mathématique discontinue de F(k), caractérisée par des sauts discrets d’amplitude égale à P(X=k) situés exclusivement aux coordonnées entières, et demeurant parfaitement constante entre deux entiers consécutifs. Ce niveau de précision sémiotique garantit que les supports visuels respectent scrupuleusement la réalité probabiliste sous-jacente lors des communications scientifiques et des soutenances de thèses.
7. Estimation paramétrique et ajustement de modèles
7.1 Estimation par le maximum de vraisemblance (MLE)
L’ajustement d’un modèle probabiliste de Poisson sur des données empiriques consiste à identifier la valeur du paramètre d’intensité λ qui maximise la probabilité d’avoir généré l’échantillon observé. Soit un échantillon de n observations indépendantes et identiquement distribuées y = (y1, y2, …, yn). La fonction de vraisemblance conjointe L(λ ; y) correspond au produit continu des fonctions de masse individuelles. En prenant le logarithme naturel de cette fonction, on obtient la log-vraisemblance analytique : ln L(λ ; y) = ∑i=1n [yi ln(λ) – λ – ln(yi!)].
Pour dériver l’estimateur du maximum de vraisemblance (Maximum Likelihood Estimator, ou MLE), noté λ̂, on calcule la dérivée première de la log-vraisemblance par rapport au paramètre λ, appelée fonction de score : d[ln L]/dλ = (∑ yi) / λ – n. En annulant cette équation de score pour déterminer le point critique stationnaire, on aboutit au résultat fondamental : λ̂ = (∑ yi) / n = ȳ. L’estimateur du maximum de vraisemblance d’une loi de Poisson coïncide donc exactement avec la moyenne arithmétique empirique de l’échantillon. Cet estimateur présente des propriétés statistiques exemplaires : il est sans biais (E[λ̂] = λ), converge en probabilité vers la valeur réelle du paramètre (consistance), et atteint la borne inférieure de Cramér-Rao, ce qui en fait un estimateur efficace de variance minimale.
La précision de cette estimation se quantifie à travers le calcul de l’erreur standard asymptotique. En dérivant une seconde fois la log-vraisemblance, on obtient l’information de Fisher observée : I(λ) = – d2[ln L]/dλ2 = (∑ yi) / λ2 = n / λ. La variance asymptotique de l’estimateur correspond à l’inverse de l’information de Fisher, soit Var(λ̂) = λ / n, dont la racine carrée fournit l’erreur standard : SE(λ̂) = √(λ̂ / n). En Python, ce calcul permet d’établir immédiatement des intervalles de confiance de Wald asymptotiques à 95% selon l’expression classique [λ̂ - 1.96 * SE, λ̂ + 1.96 * SE], ou d’inverser le test du rapport de vraisemblance pour construire des intervalles de profil de vraisemblance particulièrement fiables lorsque la taille de l’échantillon n est réduite.
7.2 Diagnostic graphique de l’ajustement empirique
L’estimation ponctuelle du paramètre ne garantit en aucun cas que la loi de Poisson constitue une modélisation acceptable pour le jeu de données considéré. L’évaluation de la qualité de l’ajustement requiert le déploiement d’un diagnostic graphique systématique visant à détecter visuellement d’éventuelles divergences locales entre la réalité empirique et le modèle théorique sous-jacent. L’outil graphique fondamental dans ce domaine est le diagramme Quantile-Quantile (Q-Q plot), qui confronte les quantiles empiriques de l’échantillon aux quantiles théoriques calculés par la fonction poisson.ppf.
En raison de la nature discontinue des variables de comptage, les graphiques Q-Q standards génèrent des alignements horizontaux artificiels (liés aux valeurs discrètes répétées) qui entravent la détection d’anomalies fines. Pour contourner ce biais, les statisticiens ont recours aux résidus continus randomisés par jittering ou, plus rigoureusement, à des diagrammes de suspension connus sous le terme académique de « hanging rootograms » introduits par John Tukey. Dans un rootogramme de suspension, l’axe de référence horizontal n’est pas le zéro, mais la courbe théorique de Poisson tracée à l’échelle de la racine carrée. Les barres représentant les fréquences empiriques observées sont littéralement « suspendues » à la courbe théorique.
L’avantage diagnostique majeur de l’échelle en racine carrée réside dans la stabilisation de la variance des fluctuations d’échantillonnage, permettant d’accorder un poids visuel identique aux déviations observées sur les fréquences élevées (proches de l’origine) et sur les fréquences faibles (en queues de distribution). Si l’ajustement est optimal, le bas des barres suspendues oscille aléatoirement autour de la ligne horizontale zéro. En revanche, si l’on observe que la barre à l’origine (k = 0) plonge profondément sous l’axe zéro tandis que les barres intermédiaires restent surélevées, le diagnostic est sans équivoque : les données présentent une inflation structurelle de zéros que le modèle de Poisson simple est intrinsèquement incapable de capturer.
8. Tests d’adéquation et validation statistique
8.1 Test d’adéquation du Chi-carré de Pearson
Au-delà de l’inspection graphique, la validation de l’ajustement d’une loi de Poisson exige une quantification probabiliste formelle reposant sur des tests d’hypothèses statistiques. Le test classique le plus largement employé est le test d’adéquation du Chi-carré de Pearson (Χ2). L’hypothèse nulle (H0) stipule que les données observées ont été générées par une distribution de Poisson de paramètre λ, contre l’hypothèse alternative (H1) que la distribution réelle dévie significativement de cette structure théorique.
La statistique de Pearson s’exprime sous la forme Χ2 = ∑j=1K [(Oj – Ej)2 / Ej], où Oj représente l’effectif empirique observé dans la modalité ou classe de comptage j, et Ej désigne l’effectif attendu sous l’hypothèse nulle, calculé par le produit de la taille d’échantillon totale par la probabilité théorique de Poisson : Ej = n × P(X = j ; λ̂). L’application rigoureuse de ce test est soumise à la célèbre règle de Cochran : aucune classe théorique ne doit comporter un effectif attendu strictement nul, et au moins 80% des classes doivent présenter un effectif théorique supérieur ou égal à 5. Si cette condition est enfreinte, les classes adjacentes situées en queue de distribution doivent être impérativement agrégées.
Une précaution computationnelle essentielle concerne la correction des degrés de liberté (ddl) de la statistique. En utilisant la fonction scipy.stats.chisquare(f_obs, f_exp, ddof=1), le chercheur doit explicitement renseigner l’argument ddof=1 (degree of freedom offset). Cette spécification informe l’algorithme qu’un paramètre libre (λ) a été préalablement estimé à partir des données elles-mêmes, ce qui réduit le nombre effectif de degrés de liberté à K – 1 – 1 = K – 2 (où K représente le nombre final de classes après agrégation). Omettre cet argument constitue une erreur méthodologique courante qui surestime systématiquement les degrés de liberté, gonfle artificiellement la p-valeur et expose l’analyste à un risque d’erreur de type II en acceptant à tort un modèle inadéquat.
8.2 Évaluation formelle de l’équidispersance
La contrainte d’équidispersance — postulée par l’égalité stricte E(X) = Var(X) = λ — constitue le talon d’Achille de la loi de Poisson. Dans les applications comportementales réelles, cette hypothèse est quasi systématiquement violée au profit d’un phénomène de surdispersion (overdispersion), où la variance empirique dépasse largement la moyenne. Plus rarement, certains processus compétitifs ou d’inhibition spatio-temporelle induisent une sous-dispersion (underdispersion), caractérisée par une variance significativement inférieure à la moyenne. L’évaluation formelle de cette propriété commence par le calcul de l’indice de dispersion de Fisher : D = s2 / ȳ, où s2 désigne la variance d’échantillon non biaisée et ȳ la moyenne arithmétique.
Pour déterminer si un indice de dispersion déviant de l’unité relève d’une simple fluctuation d’échantillonnage ou d’une propriété structurelle des données, on peut utiliser la statistique d’adéquation de dispersion définie par : d = (n – 1) × D = ∑i=1n (yi – ȳ)2 / ȳ. Sous l’hypothèse nulle d’équidispersance de Poisson, cette statistique suit asymptotiquement une loi du Chi-carré à n – 1 degrés de liberté. En évaluant la survie de cette statistique via scipy.stats.chi2.sf(d, df=n-1), on obtient la probabilité critique d’observer une telle déviation sous le postulat poissonnien.
L’ignorance d’une surdispersion entraîne des conséquences désastreuses sur l’inférence statistique. Lorsqu’un modèle de Poisson standard est appliqué à des données surdispersées, il sous-estime dramatiquement la variance réelle des paramètres estimés. Les erreurs standards produites par les logiciels sont alors artificiellement comprimées, ce qui gonfle les statistiques de test de Wald, rétrécit indûment les intervalles de confiance et conduit à des p-valeurs faussement significatives. Ce mécanisme déclenche une inflation catastrophique du taux d’erreur de type I, conduisant le chercheur à déclarer des effets expérimentaux statistiquement signifiants qui ne sont en réalité que de purs artefacts générés par la variabilité non modélisée.
9. Régression de Poisson avec Statsmodels
9.1 Fondements du modèle linéaire généralisé (GLM) de Poisson
L’extension de la modélisation de Poisson à l’étude des relations causales ou associatives entre un décompte d’occurrences et un ensemble de covariables prédictives s’effectue dans le cadre formel des Modèles Linéaires Généralisés (Generalized Linear Models, ou GLM), théorisé par Nelder et Wedderburn. Dans cette structure mathématique, la variable dépendante Yi est supposée suivre conditionnellement une distribution de Poisson de paramètre λi dépendant des prédicteurs observés pour chaque individu i. Comme l’espérance mathématique conditionnelle E(Yi | xi) = λi est strictement contrainte d’être positive, une régression linéaire standard est proscrite.
Le GLM résout cette incompatibilité topologique en introduisant une fonction de lien canonique : le logarithme naturel. Le modèle relie le prédicteur linéaire ηi au taux moyen conditionnel selon l’expression formelle : ln(λi) = ηi = β0 + β1 xi1 + β2 xi2 + … + βp xip. En appliquant l’inverse de la fonction de lien (l’exponentiation), le taux moyen d’événements s’exprime sous une forme structurellement multiplicative : λi = exp(ηi) = exp(β0) × ∏j=1p exp(βj xij). Cette spécification garantit de façon déterministe que λi demeure strictement supérieur à zéro pour toute combinaison finie des variables explicatives.
Une problématique méthodologique cruciale concerne la variabilité des durées ou des volumes d’observation entre les sujets. Si un participant est observé pendant deux heures tandis qu’un autre n’est évalué que durant trente minutes, leurs décomptes bruts ne sauraient être comparés directement sans introduire un biais massif. Le cadre GLM résout cette distorsion par l’introduction d’un terme d’exposition, ou « offset ». Soit ti la durée d’exposition du sujet i, le taux d’incidence par unité de temps devient λi / ti. L’équation de régression se reformule alors par : ln(λi / ti) = β’ xi, ce qui équivaut algébriquement à : ln(λi) = ln(ti) + β’ xi. Dans Statsmodels, l’intégration de ce terme s’effectue simplement en spécifiant le logarithme de l’exposition via le paramètre offset=np.log(temps), contraignant son coefficient de régression à être rigoureusement fixé à l’unité sans faire l’objet d’une estimation libre.
9.2 Estimation, inférence et interprétation des paramètres
Au sein de la bibliothèque Statsmodels, l’implémentation opérationnelle de cette modélisation s’articule via le module statsmodels.formula.api.glm, qui autorise la syntaxe de formules symboliques inspirée du langage R (Patsy). La modélisation s’exécute en instanciant l’objet de régression avec la spécification explicite de la famille exponentielle : smf.glm('y ~ x1 + x2', data=df, family=sm.families.Poisson()).fit(). L’algorithme d’estimation numérique sous-jacent repose sur la méthode des moindres carrés repondérés itérativement (Iteratively Reweighted Least Squares, ou IRLS), qui garantit la convergence rapide vers le maximum global de vraisemblance.
L’interprétation des coefficients estimés β̂j requiert une attention méthodologique particulière en raison de la présence du lien logarithmique. Un coefficient β̂j n’indique pas une modification additive directe du nombre d’événements, mais une modification de l’espérance logarithmique. Pour conférer une signification empirique tangible aux résultats, les statisticiens calculent les ratios de taux d’incidence (Incidence Rate Ratios, ou IRR) en prenant l’exponentielle des coefficients : IRRj = exp(β̂j). Un IRR de 1,25 associé à une covariable binaire indique que la présence du facteur expérimental multiplie le taux d’incidence moyen des événements par un facteur 1,25 (soit une élévation relative de 25% du taux de comptage), toutes les autres variables étant maintenues constantes.
L’évaluation de la qualité globale du modèle de régression s’effectue en examinant conjointement la déviance résiduelle (Residual Deviance) et le critère d’information d’Akaike (AIC). La déviance résiduelle mesure la divergence de vraisemblance entre le modèle ajusté et un modèle saturé théorique qui prédirait parfaitement chaque observation. Dans un modèle de Poisson parfaitement spécifié et équidispersé, la déviance résiduelle doit être approximativement égale à ses degrés de liberté résiduels (rapport Déviance / ddl ≈ 1). Si ce ratio dépasse substantiellement la valeur de 1,5 ou 2, il met en lumière une violation sévère des hypothèses du modèle, signalant une sous-spécification des prédicteurs ou la présence massive de surdispersion, imposant le passage à des formulations plus sophistiquées.
10. Traitement de la surdispersion et extensions avancées
10.1 Modèle de régression binomiale négative
Lorsque le diagnostic d’adéquation conclut à la présence irréductible d’une surdispersion, le modèle de Poisson standard doit être abandonné au profit d’architectures assouplissant la contrainte d’équidispersance. La solution théorique la plus féconde et la plus élégante réside dans le modèle de régression binomiale négative, qui peut être conceptuellement formulé comme un mélange continu Poisson-Gamma. Dans ce cadre génératif, on postule que le taux d’intensité individuel λi n’est pas une constante déterministe liée uniquement aux covariables, mais incorpore une hétérogénéité non observée modélisée par une variable latente stochastique εi, telle que : λi* = λi × exp(εi).
Si l’on fait l’hypothèse que la quantité exp(εi) suit une distribution Gamma de moyenne unitaire et de variance α, l’intégration analytique de cette variable latente hors de la fonction de vraisemblance conjointe engendre une loi marginale binomiale négative (spécifiquement la variante NB2). L’espérance mathématique de cette distribution demeure strictement identique à celle du modèle de Poisson : E(Yi | xi) = μi. En revanche, sa fonction de variance quadratique intègre explicitement le paramètre de dispersion α : Var(Yi | xi) = μi + α μi2. Lorsque le paramètre α tend vers zéro, le terme quadratique s’annule et le modèle binomial négatif converge asymptotiquement vers le modèle de Poisson standard.
Dans l’écosystème Python, l’ajustement s’exécute à l’aide de statsmodels.discrete.discrete_model.NegativeBinomial ou directement via le module GLM avec la famille sm.families.NegativeBinomial(alpha=...). L’estimation fournit conjointement les coefficients de régression et une estimation numérique précise du paramètre de dispersion α. La confrontation statistique formelle entre le modèle de Poisson et le modèle binomial négatif s’opère par le biais d’un test du rapport de vraisemblance (Likelihood Ratio Test, ou LRT). Étant donné que l’hypothèse nulle α = 0 se situe sur la frontière de l’espace des paramètres admissibles (α ≥ 0), la distribution asymptotique de la statistique de test suit un mélange 50:50 de masse de Dirac en zéro et de Chi-carré à un degré de liberté (χ20:1), imposant une correction de la p-valeur par division par deux pour tester rigoureusement le gain d’ajustement offert par la binomiale négative.
10.2 Modèles à inflation de zéros (Zero-Inflated Poisson)
Une autre pathologie fréquente des données de comptage en sciences psychologiques et cliniques est l’excès anormal de décomptes nuls, bien supérieur à ce que même une loi binomiale négative peut prédire. Ce phénomène survient fréquemment lorsque la population étudiée est composée d’un mélange hétérogène de deux sous-populations distinctes : les « zéros structurels » et les « zéros aléatoires ». Par exemple, dans une étude évaluant la consommation quotidienne de substances addictives, un décompte nul peut émaner soit d’un individu strictement abstinent par principe (zéro structurel, probabilité nulle de consommer), soit d’un consommateur actif qui n’a fortuitement pas consommé le jour de l’évaluation (zéro stochastique de comptage).
Le modèle Zero-Inflated Poisson (ZIP) répond théoriquement à cette dualité en combinant un processus binaire logistique et un processus de comptage de Poisson. La structure générative s’exprime selon une distribution conditionnelle bivariée : la variable Yi prend la valeur 0 avec une probabilité ωi + (1 – ωi) e-λi, et prend toute valeur entière strictement positive k (k ≥ 1) avec la probabilité (1 – ωi) × (λik e-λi) / k!. La proportion de zéros structurels ωi est modélisée par une régression logistique standard dépendant de prédicteurs spécifiques, tandis que le taux d’incidence λi de la sous-population active est simultanément gouverné par la régression de Poisson canonique.
Statsmodels propose l’implémentation de cette architecture via la classe statsmodels.discrete.count_model.ZeroInflatedPoisson. L’arbitrage statistique rigoureux entre un modèle de Poisson standard à régresseurs identiques et un modèle ZIP s’effectue historiquement via le test de Vuong (1989). Ce test non emboîté évalue la moyenne et la variance des différences de log-vraisemblance individuelles entre les deux modèles. Une statistique de Vuong standardisée supérieure à +1,96 fournit une preuve asymptotique écrasante en faveur de la supériorité du modèle à inflation de zéros, confirmant empiriquement l’existence d’une sous-population structurellement exempte de manifestations comportementales.
11. Étude de cas intégrée en sciences psychologiques
11.1 Formulation du protocole expérimental et prétraitement des données
Afin d’ancrer ces concepts théoriques dans la réalité de la pratique computationnelle, développons une étude de cas empirique complète inspirée d’un paradigme de recherche en neuropsychologie expérimentale. L’objectif scientifique est d’examiner l’impact de deux conditions de stress aigu (induction par stress social de Trier versus condition contrôle de relaxation neutre) et du niveau d’anxiété-trait (mesuré par le score STAI, covariable continue centrée) sur la fréquence de comportements compulsifs de vérification observés lors d’une tâche de mémoire de travail sous contrainte temporelle. Cent vingt participants ont été randomisés dans les deux conditions expérimentales.
La première phase computationnelle en Python consiste à importer le jeu de données au moyen de la bibliothèque Pandas et à procéder à un audit descriptif rigoureux. L’exécution de df.info() et df.describe() permet de s’assurer de l’absence de valeurs manquantes, de vérifier l’intégrité des types entiers non négatifs pour la variable dépendante comptage_verifications, et d’encoder la condition expérimentale sous forme de variable catégorielle binaire. L’analyse descriptive exploratoire révèle que le groupe contrôle affiche une moyenne de vérifications de 2,13 avec une variance empirique de 2,31, suggérant une équidispersance remarquable au sein de cette modalité.
En revanche, l’inspection descriptive du groupe soumis au stresseur aigu met en évidence une moyenne empirique de 5,84 accompagnée d’une variance de 11,42, attestant d’une nette déviation par rapport au postulat d’équidispersance au niveau conditionnel. L’histogramme marginal met en évidence un plancher massif à zéro et une forte asymétrie positive. L’analyste se trouve ici dans la configuration d’école où l’application d’un modèle d’analyse de variance classique (ANOVA) violerait de façon critique les postulats d’homogénéité des variances (homoscédasticité) et de normalité des résidus, justifiant indiscutablement le recours aux modèles linéaires généralisés discrets.
11.2 Pipeline complet d’analyse, de modélisation et de communication
Le pipeline analytique débute par l’estimation d’un modèle linéaire généralisé de Poisson avec Statsmodels, spécifiant une formule qui intègre l’effet principal de la condition de stress, l’effet de l’anxiété-trait et leur terme d’interaction multiplicatif : modele_poisson = smf.glm('verifications ~ condition * anxiete_trait', data=df, family=sm.families.Poisson()).fit(). L’inspection des résultats met en évidence une déviance résiduelle de 184,3 pour 116 degrés de liberté résiduels, engendrant un ratio de dispersion de 1,59 qui signale une surdispersion résiduelle modérée mais substantielle.
Face à ce diagnostic, l’analyste exécute dans un second temps un modèle binomial négatif afin de neutraliser le biais d’erreur standard : modele_nb = smf.negativebinomial('verifications ~ condition * anxiete_trait', data=df).fit(). L’estimation convergée révèle un paramètre de surdispersion α statistiquement différent de zéro (p < 0,01), et une amélioration significative du critère d’information d’Akaike (AIC passant de 542,1 pour Poisson à 498,4 pour la binomiale négative). L’extraction des ratios de taux d’incidence (IRR) via np.exp(modele_nb.params) et de leurs intervalles de confiance à 95% via np.exp(modele_nb.conf_int()) permet de constater que la condition de stress aigu multiplie le taux moyen de vérifications compulsives par 2,41 (IC à 95% [1,82 ; 3,18], p < 0,001), tandis que l’interaction montre que cet effet est significativement potentialisé chez les sujets présentant une anxiété-trait élevée.
Conformément aux standards de publication académique prescrits par l’American Psychological Association (APA, 7e édition), la transcription textuelle des résultats doit s’énoncer de façon standardisée : « Une régression binomiale négative a été ajustée pour prédire le nombre de comportements compulsifs de vérification en fonction de la condition expérimentale et de l’anxiété-trait. Le modèle binomial négatif s’est révélé significativement supérieur au modèle de Poisson standard (Χ2 de déviance = 45,7, p < 0,001, AIC = 498,4). L’induction de stress aigu induit une augmentation significative du taux d’incidence des vérifications compulsives (IRR = 2,41, IC 95% [1,82 ; 3,18], z = 6,12, p < 0,001). Par ailleurs, l’interaction entre la condition et le score d’anxiété-trait est significative (β = 0,18, SE = 0,05, IRR = 1,20, p < 0,001), indiquant que l’élévation des comportements de vérification induite par le stresseur est d’autant plus marquée que les individus possèdent une vulnérabilité anxieuse dispositionnelle élevée. » Cette formalisation rigoureuse clôture un cycle d’analyse méthodologiquement irréprochable.
12. Bonnes pratiques computationnelles et pièges à éviter
12.1 Stabilité numérique et optimisation des calculs
L’exécution de pipelines computationnels probabilistes à grande échelle impose une vigilance constante quant à l’efficacité algorithmique et la préservation de la stabilité numérique. L’un des pièges les plus insidieux réside dans la gestion des valeurs extrêmes du paramètre d’intensité λ. Lorsque λ excède des magnitudes substantielles (typiquement λ > 1000, ce qui peut se produire lors de l’agrégation de clics de navigation Web ou d’événements neurophysiologiques à haute fréquence), l’utilisation directe des fonctions exactes de Poisson engendre des coûts de calcul prohibitifs et des instabilités arithmétiques. Dans ce régime asymptotique spécifique, il est théoriquement et computationnellement légitime de substituer à la loi de Poisson une approximation gaussienne continue de paramètres μ = λ et σ2 = λ, en intégrant systématiquement une correction de continuité de ±0,5 sur les bornes entières.
Une seconde bonne pratique impérative, évoquée précédemment mais cardinale dans toute programmation d’estimateurs personnalisés, réside dans le calcul systématique des fonctions de log-vraisemblance dans l’espace logarithmique pur. Toute opération consistant à calculer d’abord des probabilités brutes pour en extraire ultérieurement le logarithme via np.log(poisson.pmf(...)) doit être bannie du code de production ; elle doit être impérativement remplacée par l’évaluation native de poisson.logpmf(...). Cette discipline élimine à la source tout risque de sous-dépassement arithmétique (underflow) face à des événements situés dans les queues de distribution extrêmes, où la densité brute s’effondre en deçà du plus petit nombre flottant normalisé traitable par le microprocesseur (environ 2,22 × 10-308 pour le format double précision IEEE 754).
Enfin, la vérification de l’intégrité logicielle de vos pipelines de données exige l’intégration de tests unitaires automatisés structurés (à l’aide de frameworks comme pytest). Ces tests doivent valider de façon déterministe que les générateurs stochastiques renvoient des décomptes strictement entiers, que le passage d’arguments non conformes (tels qu’un paramètre d’intensité λ négatif ou nul) lève immédiatement des exceptions appropriées (ValueError), et que les estimateurs programmés retrouvent les paramètres théoriques cibles avec une marge d’erreur conforme aux théorèmes asymptotiques sur des jeux de données de test calibrés.
12.2 Erreurs méthodologiques et conceptuelles fréquentes
Au-delà de la technique logicielle, le succès d’une modélisation statistique repose sur la lucidité conceptuelle de l’analyste face aux pièges méthodologiques courants. L’erreur la plus prévalente dans la littérature consiste à assimiler une variable continue fortement positivement asymétrique (telle qu’un temps de réaction mesuré en millisecondes ou un revenu financier) à une variable de comptage poissonnienne. Même si ces distributions présentent visuellement une morphologie analogue avec un étalement vers la droite, les temps de réaction sont des grandeurs physiques continues régies par des distributions telles que la loi Ex-Gaussienne, Gamma ou Lognormale. La loi de Poisson ne peut être appliquée qu’à des grandeurs strictement dénombrables issues d’un processus de comptage fondamentalement discret.
Un second piège conceptuel critique réside dans l’omission de la dépendance temporelle sérielle ou spatiale entre les événements observés. L’hypothèse fondamentale régissant un processus de Poisson homogène exige une stricte indépendance mutuelle entre chaque occurrence : l’apparition d’un événement au temps t ne doit en aucun cas modifier la probabilité qu’un autre événement survienne à l’instant t + dt. Or, dans de nombreux phénomènes psychologiques et biologiques (comme les crises d’épilepsie, les accès de colère ou les défaillances motrices), l’apparition d’une occurrence déclenche une période réfractaire d’inhibition ou, à l’inverse, une cascade d’excitation temporelle (phénomène de contagion ou processus de Hawkes autostimulant). Traiter ces dynamiques en grappes (clustering) par un modèle de Poisson standard induit un biais d’autocorrélation sévère qui fausse complètement la structure de dépendance du phénomène.
Enfin, une attention rigoureuse doit être portée au protocole d’échantillonnage clinique. Lorsque les données sont collectées exclusivement auprès d’individus ayant consulté un service de soins au moins une fois, les valeurs nulles (zéro occurrence) sont par construction exclues du plan d’observation. L’analyste se trouve alors confronté à un échantillon tronqué à zéro. Tenter d’ajuster une régression de Poisson standard sur de telles données biaise mécaniquement l’estimation de λ vers le haut. Il est indispensable, dans une telle situation d’échantillonnage tronqué, d’utiliser des architectures adaptées dites de Poisson tronqué à zéro (Zero-Truncated Poisson, ou ZTP), qui reparamètrent formellement la fonction de masse conditionnelle en divisant l’expression standard par 1 – e-λ, rétablissant ainsi la validité théorique et la précision inférentielle de la modélisation.
Références
- Agresti, A. (2015). Foundations of Linear and Generalized Linear Models. John Wiley & Sons. https://www.wiley.com/en-us/Foundations+of+Linear+and+Generalized+Linear+Models-p-9781118730034
- Cameron, A. C., & Trivedi, P. K. (2013). Regression Analysis of Count Data (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9781139013567
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- Hilbe, J. M. (2011). Negative Binomial Regression (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511973420
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- Lambert, D. (1992). Zero-inflated Poisson regression, with an application to defects in manufacturing. Technometrics, 34(1), 1-14. https://doi.org/10.2307/1269547
- Nelder, J. A., & Wedderburn, R. W. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370-384. https://doi.org/10.2307/2344614
- Poisson, S. D. (1837). Recherches sur la probabilité des jugements en matière criminelle et en matière civile, précédées des règles générales du calcul des probabilités. Bachelier, Imprimeur-Libraire pour les Mathématiques, Paris. https://gallica.bnf.fr/ark:/12148/bpt6k299901
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (Vol. 57, pp. 92-96). https://doi.org/10.25080/Majora-92bf1922-011
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2
- Vuong, Q. H. (1989). Likelihood ratio tests for model selection and non-nested hypotheses. Econometrica, 57(2), 307-333. https://doi.org/10.2307/1912557