
Dans l’univers des probabilités discrètes et de la modélisation statistique appliquée aux sciences humaines, expérimentales et sociales, l’estimation précise de l’occurrence temporelle ou séquentielle d’un phénomène donné constitue une problématique fondamentale. Qu’il s’agisse d’évaluer la latence d’une réponse cognitive dans un protocole expérimental, de mesurer l’efficacité d’un protocole d’apprentissage chez un sujet ou d’étudier la défaillance d’un composant électronique au sein d’un laboratoire de métrologie, les chercheurs se heurtent invariablement à la question du temps d’attente discret. La loi géométrique s’impose alors comme le modèle stochastique de référence pour décrire le nombre d’essais indépendants nécessaires avant d’observer le tout premier succès. Sa formulation mathématique élégante et ses propriétés analytiques singulières en font un outil incontournable de la recherche contemporaine.
Afin de manipuler ces lois sans s’exposer à la lourdeur calculatoire d’itérations combinatoires manuelles, la calculatrice graphique de la famille Texas Instruments, et plus particulièrement la TI-84 Plus sous toutes ses déclinaisons contemporaines, s’est imposée comme le standard d’ingénierie pédagogique et scientifique le plus répandu. Intégrant un micro-système d’exploitation dédié aux méthodes quantitatives, cette machine met à disposition des praticiens deux fonctions spécialisées : la commande de densité de probabilité discrète geometpdf() et la commande de fonction de répartition cumulée geometcdf(). Malgré leur apparente simplicité syntaxique, leur mise en œuvre requiert une compréhension conceptuelle rigoureuse, tant sur le plan des définitions probabilistes sous-jacentes que sur celui de la gestion interne des arguments par le processeur.
Ce guide exhaustif a pour vocation d’analyser de manière approfondie l’intégralité du cycle d’exploitation de ces deux commandes sur la plateforme TI-84. En combinant démonstrations mathématiques formelles, protocoles pas à pas, cas pratiques issus de la psychologie et des sciences du comportement, programmation d’algorithmes et analyse critique des pièges syntaxiques, cet article vise à doter les étudiants, universitaires et analystes des compétences techniques requises pour mener des inférences fiables et reproductibles, conformes aux exigences académiques les plus strictes.
1. Introduction aux distributions géométriques et aux fonctions de la TI-84
1.1 Définition théorique de la loi géométrique
La distribution géométrique prend racine dans la théorie des processus stochastiques à temps discret, plus précisément au sein des séquences d’épreuves de Bernoulli. Un processus de Bernoulli est caractérisé par une succession finie ou infinie d’expériences aléatoires vérifiant trois axiomes fondamentaux : chaque épreuve ne tolère que deux issues mutuellement exclusives et exhaustives (conventionnellement désignées par « succès » et « échec »), le résultat de chaque essai est strictement indépendant des réalisations antérieures et postérieures, et la probabilité élémentaire de succès, notée scalairement p, demeure invariable tout au long du processus, avec son complémentaire q = 1 – p caractérisant la probabilité de l’échec.
Sur cette base axiomatique, la variable aléatoire discrète géométrique, traditionnellement notée X, modélise le rang ordinal de l’essai lors duquel survient le tout premier succès. Il s’ensuit que le support de cette variable correspond à l’ensemble des entiers naturels strictement positifs, soit l’ensemble des entiers supérieurs ou égaux à un. Il importe de souligner qu’une convention alternative existe dans la littérature scientifique, définissant la variable comme le nombre d’échecs précédant l’occurrence initiale du succès, ce qui décale le support vers l’ensemble des entiers naturels incluant zéro. Dans le cadre de l’architecture logicielle de la TI-84, la première convention — celle du rang d’apparition du succès — est universellement adoptée.
Cette distribution s’avère particulièrement puissante pour formaliser les mécanismes de temps de réponse, l’acquisition de patterns comportementaux en neurosciences ou encore la résistance aux stimuli aversifs. Dès lors que l’hypothèse de stationnarité du paramètre p est corroborée par l’observation empirique, la distribution géométrique fournit un cadre paramétrique robuste permettant de quantifier la rareté ou la prévisibilité d’événements critiques au sein de séries temporelles quantifiées.
1.2 Rôle et pertinence de la calculatrice TI-84 en analyse statistique
Depuis son introduction, la famille des calculatrices TI-84 Plus (incluant les versions Silver Edition, monochrome et les déclinaisons modernes TI-84 Plus CE munies d’écrans couleur haute résolution) constitue un vecteur essentiel de numérisation du calcul probabiliste. Équipée d’une architecture articulée autour de microprocesseurs Zilog Z80 ou eZ80 cadencés à des fréquences optimisées pour l’arithmétique en virgule flottante, la machine exécute des routines compilées en langage machine hautement optimisées pour le calcul combinatoire et les distributions statistiques.
L’avantage métrologique de ces dispositifs réside dans leur capacité à délivrer des approximations numériques d’une précision de quatorze chiffres significatifs, minimisant ainsi les erreurs de troncature et d’arrondi inhérentes aux calculs manuels itératifs d’exponentiation. En conditions d’examen académique standardisé ou au sein de laboratoires de terrain dénués de stations de calcul informatique complexes, la standardisation des microprogrammes de Texas Instruments assure une parfaite homogénéité des résultats statistiques. L’évolution de l’environnement TI-OS a par ailleurs introduit des interfaces adaptatives facilitant l’accès aux distributions discrètes sans sacrifier la rigueur syntaxique du moteur de calcul sous-jacent.
1.3 Présentation liminaire des commandes geometpdf() et geometcdf()
Le système d’exploitation de la TI-84 encapsule les calculs géométriques au travers de deux opérateurs spécialisés : geometpdf() et geometcdf(). Le suffixe « pdf » correspond à l’acronyme anglo-saxon de probability density function, désignant ici par abus de langage usuel la fonction de masse de probabilité (FMP) propre aux variables discrètes. Cette commande a pour objectif d’évaluer la probabilité ponctuelle exacte que le premier succès survienne précisément à un essai spécifié. À l’inverse, l’opérateur « cdf », signifiant cumulative distribution function, implémente la fonction de répartition cumulative (FDC), quantifiant la probabilité agrégée que l’événement recherché se concrétise au plus tard lors d’un essai frontière déterminé.
La distinction entre ces deux primitives conditionne l’exactitude des calculs statistiques. L’omission ou la confusion de leurs signatures algorithmiques respectives constitue l’une des sources majeures d’aberration numérique chez les praticiens. Il est donc impératif de maîtriser la dimensionnalité des arguments attendus par le processeur : le paramètre scalaire p représentant le taux de succès unitaire et la variable scalaire ou vectorielle x définissant la borne temporelle ou ordinale de l’évaluation.
2. Fondements mathématiques : Modélisation probabiliste et variables géométriques
2.1 Formulation rigoureuse de la fonction de masse de probabilité (FMP)
Considérons une suite d’épreuves de Bernoulli indépendantes où la probabilité élémentaire de survenue de l’événement cible est mesurée par le réel p appartenant à l’intervalle ouvert ]0, 1[. La réalisation du premier succès au rang exactement égal à k, notée formellement par l’événement probabiliste {X = k}, nécessite la réalisation conjointe et ordonnée de deux conditions indépendantes : l’obtention systématique d’un échec lors des k – 1 premières itérations consécutives, suivie de la matérialisation immédiate d’un succès lors de la k-ième tentative.
En vertu de l’indépendance stochastique postulée par le processus de Bernoulli, la probabilité de l’intersection de ces événements correspond au produit strict de leurs probabilités marginales respectives. Dès lors, la fonction de masse de probabilité s’énonce comme suit :
P(X = k) = (1 – p)^(k – 1) * p, pour tout entier k appartenant à l’ensemble {1, 2, 3, …}.
Cette formulation met en lumière la nature intrinsèquement géométrique de la suite des probabilités associées aux entiers successifs. En effet, le rapport entre deux probabilités successives P(X = k + 1) / P(X = k) est strictement constant et égal à la raison géométrique q = 1 – p. La somme totale des probabilités sur l’ensemble du support discret converge rigoureusement vers l’unité, validant ainsi la condition de normalisation probabiliste de Kolmogorov au travers de la formule classique de la série géométrique convergente de raison inférieure à un.
Une propriété remarquable et fondamentale de cette distribution réside dans son « absence de mémoire » (propriété d’amnésie stochastique). Pour tout couple d’entiers naturels strictement positifs (m, n), la probabilité conditionnelle vérifie l’égalité :
P(X > m + n | X > m) = P(X > n).
Cette caractéristique implique que le système ne conserve aucune trace de son historique d’échecs : la probabilité de devoir patienter au moins n essais additionnels sachant que le succès ne s’est pas manifesté durant les m premières épreuves demeure rigoureusement identique à la probabilité initiale d’attendre au moins n essais. En analyse psychologique ou comportementale, ce phénomène sert d’hypothèse nulle pour tester si un organisme apprend au fil des essais ou s’il opère selon un mécanisme stochastique stationnaire sans effet de fatigue ni de maturation progressive.
2.2 Fonction de répartition cumulative (FDC) et sommations partielles
La fonction de répartition cumulative d’une variable aléatoire discrète permet de calculer la probabilité que cette variable prenne une valeur inférieure ou égale à une borne déterminée. Dans le cas de la loi géométrique, l’événement {X ≤ k} correspond à l’union disjointe des événements élémentaires {X = 1}, {X = 2}, …, {X = k}. La probabilité cumulée s’obtient alors en effectuant la sommation finie suivante :
P(X ≤ k) = ∑ [p * (1 – p)^(i – 1)] pour i variant de 1 à k.
En factorisant par le terme constant p et en exploitant la formule algébrique de la somme partielle d’une progression géométrique de raison 1 – p, l’expression se simplifie de manière spectaculaire :
P(X ≤ k) = p * [ (1 – (1 – p)^k) / (1 – (1 – p)) ] = p * [ (1 – (1 – p)^k) / p ] = 1 – (1 – p)^k.
Cette relation analytique fermée possède une interprétation probabiliste intuitive directe : l’événement complémentaire de {X ≤ k} est l’événement {X > k}, qui signifie qu’aucun succès ne s’est produit au cours des k premiers essais. La probabilité d’essuyer k échecs consécutifs étant égale à (1 – p)^k en vertu de l’indépendance des tirages, la probabilité d’enregistrer au moins un succès durant cet intervalle correspond rigoureusement à son complémentaire à l’unité. Lorsque k croît vers l’infini, le terme (1 – p)^k décroît exponentiellement vers zéro (puisque 0 < 1 – p < 1), garantissant que la fonction de répartition converge de façon asymptotique et monotone vers 1.
2.3 Moments statistiques et indicateurs de tendance centrale
La caractérisation d’une variable géométrique requiert le calcul formel de ses moments d’ordre un et deux, permettant de quantifier son espérance mathématique et sa dispersion autour du centre de gravité stochastique. L’espérance mathématique, notée E(X), représente le nombre moyen d’essais nécessaires pour observer l’émergence du premier succès. Elle est définie par la série infinie :
E(X) = ∑ [k * p * (1 – p)^(k – 1)] pour k allant de 1 à l’infini.
En dérivant terme à terme la série géométrique usuelle par rapport à la raison q, on démontre de manière formelle que :
E(X) = 1 / p.
Ainsi, si un comportement cognitif particulier présente une probabilité d’apparition de 0,20 lors de chaque sollicitation expérimentale, il faudra en moyenne 1 / 0,20 = 5 sollicitations pour que ce comportement se manifeste pour la première fois. La variance, mesure de la dispersion quadratique moyenne des réalisations observées autour de l’espérance, se déduit via le théorème de König-Huygens par le calcul de E(X^2) – [E(X)]^2. Sa dérivation analytique produit l’égalité :
Var(X) = (1 – p) / p^2.
L’écart-type associé correspond à la racine carrée de cette variance : σ(X) = √(1 – p) / p. Cette relation souligne que lorsque la probabilité élémentaire p s’avère particulièrement faible, l’écart-type tend vers des valeurs considérables, indiquant une volatilité extrême du temps d’attente discret avant la réalisation du premier succès.
3. Navigation et localisation des commandes sur la calculatrice TI-84
3.1 Accès au sous-menu des distributions statistiques (DISTR)
L’environnement logiciel de la TI-84 centralise l’ensemble de ses générateurs probabilistes au sein d’un répertoire système unifié accessible via le sous-menu des distributions. Contrairement aux fonctions arithmétiques standard directement cartographiées sur le clavier physique, l’accès à ce gestionnaire statistique requiert une combinaison séquentielle de touches conçue pour éviter toute saisie accidentelle en mode calculatoire général.
Pour faire apparaître le menu DISTR, l’utilisateur doit impérativement presser en premier lieu la touche jaune ou bleue 2nd située dans l’angle supérieur gauche du pavé de commande, puis actionner immédiatement la touche VARS située sur la rangée supérieure des flèches directionnelles. Cette action sollicite l’interruption logicielle routant l’affichage vers la table des distributions de probabilité continues et discrètes précompilées dans la ROM de l’appareil.
L’écran principal présente alors une liste ordonnée comprenant initialement les fonctions de distribution normale (normalpdf, normalcdf, invNorm), de Student, de Fisher et du Chi-carré. Les commandes géométriques étant localisées en bas d’arborescence, il est nécessaire de faire défiler le curseur vers le bas à l’aide de la flèche directionnelle descendante, ou plus efficacement, d’utiliser la flèche ascendante pour remonter immédiatement depuis le haut de la liste vers ses dernières entrées.
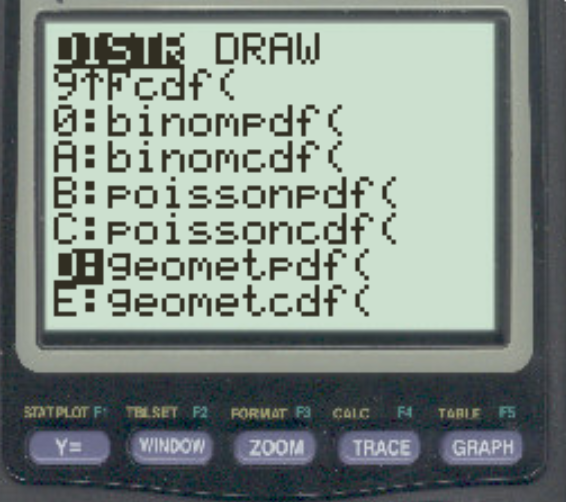
Selon la version spécifique du microcode installé sur la machine (systèmes d’exploitation OS 2.55 MP pour TI-84 Plus classique ou versions OS 5.x pour TI-84 Plus CE), les commandes geometpdf( et geometcdf( se positionnent invariablement au niveau des items alphanumériques E et F, ou D et E sur certaines éditions antérieures. Pour un appel instantané sans défilement visuel, le praticien peut appuyer directement sur les touches alphanumériques correspondantes (par exemple en pressant ALPHA puis COS pour l’entrée E, ou ALPHA puis TAN pour l’entrée F), optimisant ainsi la vitesse d’exécution lors d’épreuves chronométrées.
3.2 Configuration des assistants graphiques (Stat Wizards)
L’interface homme-machine de la TI-84 intègre un mécanisme d’assistance à la saisie nommé « Stat Wizards ». Cette fonctionnalité contextuelle modifie radicalement l’agencement visuel lors de la sélection d’une fonction statistique. Pour contrôler l’état de cette option, il convient d’accéder au menu global en pressant la touche MODE, puis de descendre le curseur jusqu’à la ligne désignée sous l’étiquette STAT WIZARDS.
Lorsque cette option est positionnée sur ON, l’appel de geometpdf() ou geometcdf() ne renvoie pas immédiatement le texte de la fonction sur la ligne de calcul active, mais déclenche un formulaire interactif structuré en champs distincts. Ce formulaire invite explicitement l’opérateur à renseigner la valeur scalaire de la probabilité de succès (champ p:), la valeur ordinale cible de l’évaluation (champ x value:), puis à positionner le curseur sur l’instruction Paste avant de valider par la touche ENTER.
Lorsque l’option est paramétrée sur OFF — configuration fréquemment imposée lors de protocoles de test stricts ou prévalant sur les anciens matériels TI-83 Plus —, l’interpréteur injecte directement la chaîne textuelle brute geometpdf( sur la fenêtre principale (Home Screen). Dans cette configuration, l’utilisateur est tenu de saisir manuellement les arguments sous forme d’une liste ordonnée séparée par des virgules strictes, avant de fermer obligatoirement la parenthèse finale. Bien que le mode avec assistant offre une sécurité cognitive appréciable contre les inversions d’arguments, la maîtrise de la syntaxe textuelle brute demeure indispensable pour l’écriture de scripts TI-Basic ou la manipulation avancée de structures matricielles.
4. Maîtriser la fonction geometpdf() : Syntaxe, paramètres et calculs ponctuels
4.1 Paramétrage formel de la fonction geometpdf()
La commande geometpdf() requiert une conformité syntaxique absolue avec la grammaire interne du compilateur TI-OS. Sa structure formelle canonique s’exprime selon le modèle fonctionnel à deux arguments :
geometpdf(p, x)
Dans ce formalisme, le premier paramètre, p, représente la probabilité élémentaire invariante d’occurrence du succès au cours d’un essai unitaire. Ce nombre réel doit impérativement respecter le domaine de définition ouvert 0 < p < 1. Toute tentative d’affectation d’une valeur négative, nulle, unitaire ou strictement supérieure à l’unité déclenche immédiatement un blocage d’exécution matériel via une exception logicielle système.
Le second paramètre, x, correspond au rang numérique précis de l’essai lors duquel la survenue du premier succès doit être évaluée. Dans le cadre de calculs scalaires standards, cet argument doit être un nombre entier naturel non nul, tel que x ∈ {1, 2, 3, …}. Si l’utilisateur saisit une valeur décimale non entière pour x, le processeur de la TI-84 procède généralement à une troncature implicite vers l’entier inférieur ou génère une erreur d’argument selon la révision logicielle du système d’exploitation.
Il est par ailleurs fondamental de noter que l’interpréteur de la TI-84 autorise le polymorphisme du second argument : en lieu et place d’un entier scalaire, l’utilisateur peut insérer une liste numérique explicite (par exemple {1, 2, 3, 4}) ou une variable de liste prédéfinie (telle que L1). Dans cette configuration vectorielle, la commande retourne simultanément un vecteur de probabilités ponctuelles correspondant à chaque valeur de rang contenue dans la liste source, une flexibilité particulièrement utile lors du traçage de diagrammes de probabilités.
4.2 Procédure pas à pas d’exécution d’un calcul ponctuel
Afin d’illustrer la cinématique opératoire complète sur l’interface de la TI-84, décrivons la procédure séquentielle visant à évaluer une probabilité ponctuelle via l’assistant Stat Wizard :
- Actionner la séquence 2nd puis VARS pour convoquer le catalogue DISTR.
- Sélectionner l’entrée correspondant à geometpdf( à l’aide des flèches ou de la touche alphanumérique dédiée, puis valider par ENTER.
- Dans la boîte de dialogue contextuelle, positionner le curseur en regard du champ p: et encoder la valeur décimale du paramètre probabiliste en utilisant le point décimal standard du clavier numérique.
- Descendre au champ x value: par la flèche inférieure et entrer l’entier ordinal représentant le rang d’occurrence visé.
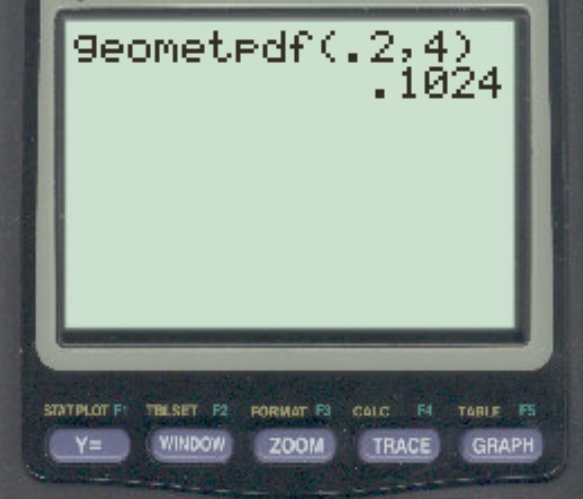
- Sélectionner l’option Paste et valider par ENTER : l’interpréteur retranscrit automatiquement la commande complète sur l’écran de travail sous la forme geometpdf(p, x).
- Presser une dernière fois ENTER pour solliciter l’unité arithmétique et obtenir le résultat final.
La sortie numérique délivrée par la calculatrice apparaît sur la partie droite de l’écran. Selon l’ordre de grandeur de la quantité évaluée, le système affiche le nombre en notation décimale conventionnelle ou bascule de façon autonome en notation scientifique normalisée (par exemple 3.456E-4 pour désigner 3,456 × 10^-4). Pour convertir mentalement ou formellement ce résultat en pourcentage d’occurrence théorique, il convient de translater le séparateur décimal de deux crans vers la droite, ou de multiplier le registre de dernier résultat Ans par 100.
4.3 Cas pratique d’application : Détection d’un trait psychologique lors d’un test
Afin de concrétiser la mise en œuvre de cette fonction dans un contexte de recherche expérimentale, examinons le protocole suivant issu de la psychologie différentielle. Un laboratoire s’intéresse à l’identification d’un trait de personnalité atypique, caractérisé par un mode de traitement perceptif singulier. D’après les enquêtes épidémiologiques de standardisation, ce trait possède une prévalence stable de 15 % au sein de la population générale adulte, soit un paramètre de succès fixé à p = 0,15.
L’expérimentateur administre un test de dépistage standardisé à des volontaires convoqués de manière strictement indépendante et aléatoire. Le chercheur souhaite déterminer avec une rigueur mathématique exacte la probabilité que le tout premier participant manifestant ce trait cognitif soit précisément le 5-ième sujet interrogé, ce qui implique que les quatre premiers participants testés en sont rigoureusement dépourvus.
Sur la TI-84, la traduction algorithmique immédiate de cette requête se formalise par la commande :
geometpdf(0.15, 5)
Après validation sur la machine, l’écran retourne la valeur décimale suivante : 0.0783009375, soit approximativement 7,83 %. Afin de vérifier l’exactitude de ce résultat et de valider la conformité de l’algorithme interne de la machine avec le formalisme de la FMP, l’opérateur peut procéder à l’évaluation arithmétique manuelle directe :
P(X = 5) = (1 – 0,15)^(5 – 1) * 0,15 = (0,85)^4 * 0,15 = 0,52200625 * 0,15 = 0,0783009375.
La concordance absolue entre le calcul manuel et la sortie de la commande geometpdf() atteste de la parfaite application par le système TI-OS de la loi de probabilité discrète associée au processus de Bernoulli.
5. Maîtriser la fonction geometcdf() : Probabilités cumulées et fonctions de répartition
5.1 Paramétrage formel et comportement cumulatif de geometcdf()
Alors que la commande précédente se concentre exclusivement sur un point isolé du support discret, la fonction geometcdf() matérialise l’intégration séquentielle de la loi géométrique. Sa signature formelle adopte une syntaxe similaire :
geometcdf(p, x)
Néanmoins, son comportement algorithmique sous-jacent diffère substantiellement. Lorsqu’elle est exécutée pour un couple de paramètres (p, x), l’instruction ne calcule pas simplement le produit ponctuel de l’échec et du succès, mais procède à la sommation dynamique discrète de l’ensemble des probabilités élémentaires associées aux entiers allant de 1 jusqu’à la borne supérieure x incluse. En d’autres termes, elle résout l’équation :
geometcdf(p, x) = P(X ≤ x) = ∑ [geometpdf(p, i)] pour i = 1 à x.
Grâce à la dérivation analytique exposée dans les fondements mathématiques, le microcontrôleur de la TI-84 n’exécute généralement pas une boucle itérative d’additions successives — qui serait computationnellement inefficace pour des valeurs de x très élevées —, mais évalue directement l’expression close factorisée 1 – (1 – p)^x. Lorsque le paramètre x est fixé à l’unité (x = 1), les deux commandes geometpdf(p, 1) et geometcdf(p, 1) renvoient une valeur rigoureusement identique égale à p, illustrant la cohérence structurelle aux limites de la distribution.
5.2 Exécution standard pour les probabilités d’occurrence au plus tard à l’essai x
L’utilisation canonique de la fonction geometcdf() intervient dès lors qu’une problématique probabiliste soulève la question de la survenue d’un événement dans un intervalle débutant au commencement de l’expérience et se clôturant à une borne terminale explicite. Les locutions linguistiques associées sont typiquement : « au plus tard à l’essai x », « au cours des x premières tentatives », ou encore « avant ou pendant la x-ième épreuve ».
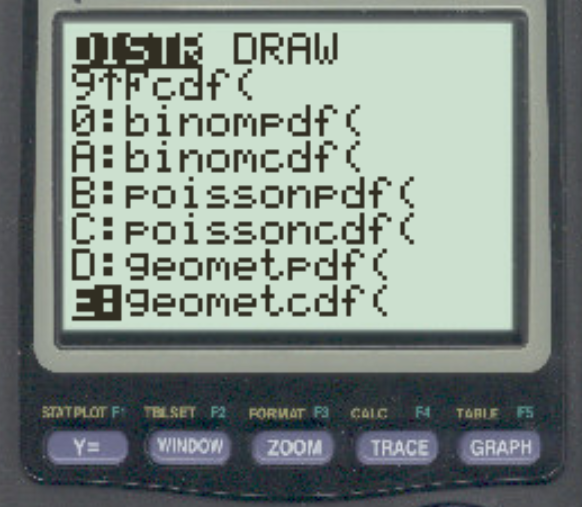
Au niveau de l’interface graphique de la TI-84, la saisie s’effectue via le même cheminement que pour la fonction de densité, en sélectionnant cette fois-ci l’entrée étiquetée geometcdf( au sein du catalogue DISTR (accessible par 2nd puis VARS). La vitesse de convergence de la probabilité cumulée vers l’asymptote horizontale y = 1 est dictée par la grandeur scalaire du paramètre p. Plus p est élevé, plus le terme complémentaire (1 – p)^x s’éteint rapidement, signifiant qu’une quasi-certitude d’observation du succès est atteinte dès les premières itérations de l’expérience.
5.3 Cas d’étude : Réussite à une tâche cognitive complexe avant un seuil critique
Considérons un protocole de neuropsychologie clinique visant à évaluer la flexibilité cognitive de patients cérébro-lésés au travers d’une tâche de résolution de problème non verbale informatisée (par exemple une adaptation informatisée du test de classement de cartes de Wisconsin). À chaque présentation d’un nouveau pattern, la probabilité intrinsèque qu’un patient découvre la règle latente de catégorisation par essai-erreur sans consigne explicite est estimée à p = 0,22.
Le protocole expérimental fixe un seuil d’interruption méthodologique : si le sujet ne parvient pas à dégager la règle au cours des 4 premières tentatives, la procédure est suspendue afin de prévenir l’installation d’une fatigue cognitive excessive. Le chercheur se propose donc d’évaluer la probabilité qu’un sujet réussisse à identifier la règle avant ce seuil d’interruption, ce qui se traduit rigoureusement par l’inégalité probabiliste P(X ≤ 4).
Sur la calculatrice TI-84, la saisie de l’opérateur cumulatif s’articule comme suit :
geometcdf(0.22, 4)
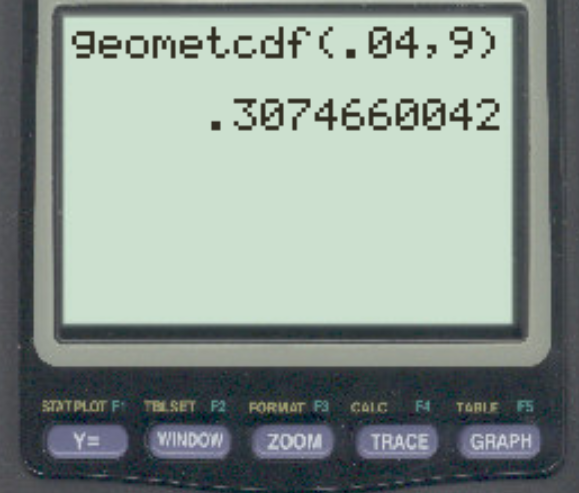
L’évaluation immédiate par le système d’exploitation produit le résultat numérique suivant : 0.62985184. Cette mesure indique qu’environ 62,99 % des patients sous ces hypothèses expérimentales réussiront à valider la tâche avant la coupure méthodologique. En comparaison, l’évaluation ponctuelle au seul quatrième essai via geometpdf(0.22, 4) n’aurait retourné que (0,78)^3 * 0,22 = 0,10440336, soit environ 10,44 %. Cette divergence spectaculaire met en relief la fonction d’agrégation exercée par geometcdf(), qui intègre les probabilités associées aux réussites survenues aux essais 1, 2, 3 et 4.
6. Distinctions critiques entre geometpdf() et geometcdf() : Quand utiliser quelle commande
6.1 Analyse linguistique et mathématique des énoncés de recherche
L’un des écueils majeurs rencontrés par les étudiants et les analystes quantitatifs réside dans la transcription erronée du langage naturel vers l’opérateur algorithmique approprié. La formulation des questions de recherche comporte fréquemment des nuances sémantiques subtiles qui modifient radicalement la structure mathématique de l’inégalité à résoudre. Une ambiguïté sur la frontière d’un ensemble discret produit invariablement un biais systématique de calcul.
Pour prévenir ces confusions récurrentes, il est indispensable de formaliser une grille d’équivalence rigoureuse entre les syntagmes usuels de la littérature scientifique et les expressions exécutables sur la calculatrice TI-84 :
- « Exactement au k-ième essai » : implique un événement ponctuel unique {X = k}. Opérateur requis : geometpdf(p, k).
- « Au plus tard au k-ième essai » ou « Au cours des k premiers essais » : traduit l’inégalité large {X ≤ k}. Opérateur requis : geometcdf(p, k).
- « Strictement avant le k-ième essai » : correspond à l’inégalité stricte {X < k}, équivalente sur le treillis des entiers à {X ≤ k – 1}. Opérateur requis : geometcdf(p, k – 1).
- « Strictement après le k-ième essai » ou « Nécessite plus de k essais » : caractérise l’événement complémentaire {X > k}. Opérateur requis : 1 – geometcdf(p, k).
- « Au plus tôt au k-ième essai » ou « Au moins k essais nécessaires » : définit l’inégalité large {X ≥ k}, réductible à {X > k – 1}. Opérateur requis : 1 – geometcdf(p, k – 1).
Une vigilance particulière doit être portée aux termes « avant » et « après ». Dans un contexte discret, « avant l’essai 5 » exclut structurellement l’essai 5, rendant le calcul sur la base de geometcdf(p, 5) mathématiquement faux et méthodologiquement invalide.
6.2 Comparaison matricielle des sorties numériques
Pour appréhender visuellement et numériquement le mécanisme de divergence entre la masse ponctuelle et la répartition cumulative, il est instructif d’observer le comportement comparé des deux commandes pour un même paramètre stochastique, par exemple p = 0,30, sur les six premiers rangs ordinaux :
- Pour x = 1 : geometpdf(0.3, 1) = 0,3000 | geometcdf(0.3, 1) = 0,3000 (stricte égalité initiale).
- Pour x = 2 : geometpdf(0.3, 2) = 0,2100 | geometcdf(0.3, 2) = 0,5100 (0,30 + 0,21).
- Pour x = 3 : geometpdf(0.3, 3) = 0,1470 | geometcdf(0.3, 3) = 0,6570 (0,51 + 0,147).
- Pour x = 4 : geometpdf(0.3, 4) = 0,1029 | geometcdf(0.3, 4) = 0,7599.
- Pour x = 5 : geometpdf(0.3, 5) = 0,0720 | geometcdf(0.3, 5) = 0,8319.
- Pour x = 6 : geometpdf(0.3, 6) = 0,0504 | geometcdf(0.3, 6) = 0,8824.
L’observation séquentielle de ces vecteurs démontre de manière frappante la dualité structurelle des opérateurs : alors que la fonction de masse pdf décroît de manière strictement monotone au fur et à mesure que les échecs s’accumulent (en raison de la multiplication répétée par la raison q = 0,70), la fonction cumulative cdf affiche une croissance concave monotone, se rapprochant asymptotiquement de la certitude empirique (valeur 1).
6.3 Règles décisionnelles pour le choix algorithmique
Face à une problématique de modélisation sur calculatrice, l’analyste peut s’appuyer sur un protocole décisionnel séquentiel clair. La première interrogation concerne le caractère ponctuel ou étendu de l’hypothèse : s’agit-il d’évaluer la probabilité d’une issue survenant à une date discrète précise et isolée ? Si la réponse est affirmative, la commande geometpdf() est l’unique outil adéquat.
Si la problématique engage une accumulation d’épreuves, la seconde interrogation porte sur les bornes de l’intervalle : le domaine d’intérêt débute-t-il au premier essai et s’étend-il jusqu’à une limite supérieure ? Dans ce cas, la primitive geometcdf() répond directement à la demande. Si l’intervalle d’intérêt correspond à un dépassement de seuil ou à un encadrement fini bilatéral, geometcdf() doit être combinée à des opérations algébriques de complémentation ou de soustraction de sous-ensembles, selon les règles de calcul des probabilités sur variables discrètes.
7. Applications pratiques en recherche comportementale et psychologique
7.1 Conditionnement opérant et programmes de renforcement
Dans le paradigme expérimental du conditionnement opérant initié par B.F. Skinner, les dispositifs de renforcement intermittent constituent un objet d’étude classique. Au sein d’un programme à ratio variable (noté VR pour Variable Ratio), la délivrance d’une récompense (renforçateur primaire tel qu’une boulette de nourriture ou renforçateur secondaire) survient de manière aléatoire autour d’une moyenne prédéfinie, simulant fidèlement la cinématique probabiliste de la distribution géométrique.
Supposons qu’un modèle animal en chambre de Skinner soit soumis à un protocole de renforcement où la probabilité unitaire d’obtention de la récompense à chaque pression sur un levier est fixée à p = 0,08 (ce qui équivaut à un programme VR de moyenne théorique 1 / 0,08 = 12,5 appuis). Les chercheurs s’intéressent à la résistance à l’extinction et à la régularité du comportement d’appui. Ils cherchent à calculer la probabilité que l’animal doive actionner le levier au moins 20 fois avant d’obtenir son premier renforcement.
Cette condition « au moins 20 fois » correspond formellement à l’inégalité P(X ≥ 20), qui équivaut à affirmer que les 19 premières tentatives n’ont produit aucun renforcement : P(X > 19). La saisie computationnelle sur la TI-84 s’exprime par :
1 – geometcdf(0.08, 19)
Le résultat généré par l’appareil est 0.20511, signifiant qu’il existe environ 20,51 % de chances que l’animal subisse une série d’au moins 19 échecs consécutifs avant d’être récompensé au 20-ième essai ou au-delà. Cette quantification permet aux psychologues expérimentalistes d’établir des lignes de base rigoureuses pour distinguer le comportement stochastique normal d’une altération motivationnelle liée à des lésions cérébrales spécifiques.
7.2 Psychométrie et validation d’items dans les tests standardisés
En psychométrie et en théorie de la mesure éducative, l’évaluation des propriétés diagnostiques des tests standardisés fait un usage étendu des distributions géométriques. Considérons un questionnaire à choix multiples comportant quatre options par item, dont une seule est correcte. Si un candidat répond de manière totalement aléatoire (sans aucune maîtrise cognitive du domaine testé), la probabilité de sélectionner la réponse exacte par pur hasard sur un item donné est de p = 0,25.
Un responsable d’évaluation souhaite détecter les stratégies de devinette systématique chez des étudiants en situation de décrochage. Il cherche à déterminer la probabilité qu’un sujet répondant au hasard fournisse sa première réponse correcte précisément à son sixième item exploré :
geometpdf(0.25, 6)
La calculatrice retourne 0.059326, soit une probabilité d’environ 5,93 %. Parallèlement, si l’on souhaite savoir quelle est la probabilité qu’un tel candidat n’obtienne sa première réponse exacte qu’après le huitième essai (reflétant une série d’au moins 8 échecs consécutifs), l’analyste exécutera :
1 – geometcdf(0.25, 8), ce qui donne (0,75)^8 = 0,10011, soit approximativement 10,01 %.
De telles estimations permettent aux méthodologistes d’étalonner la longueur critique des batteries de tests afin d’empêcher que des stratégies aléatoires ne produisent des scores aberrants susceptibles de biaiser l’étalonnage psychométrique général.
7.3 Études observationnelles et dynamique des interactions sociales
Dans le domaine de la psychologie sociale observationnelle et de l’éthologie humaine, les chercheurs étudient fréquemment le temps d’attente avant la manifestation spontanée de conduites prosociales ou de comportements coopératifs au sein d’un groupe en interaction. Les sessions d’observation sont alors découpées en intervalles temporels discrets réguliers (par exemple des tranches de deux minutes), chaque intervalle étant codé de manière binaire selon qu’une interaction prosociale a débuté ou non.
Sous l’hypothèse nulle d’indépendance temporelle et de stationnarité du climat social (probabilité constante p qu’un acte de coopération s’initie au cours d’un intervalle donné), la loi géométrique fournit le cadre d’analyse prédictif de référence. Si des interventions psychosociales visent à promouvoir l’altruisme au sein d’une collectivité, l’efficacité de ces médiations se traduit concrètement par une modification significative du paramètre empirique p. L’utilisation des fonctions geometpdf() et geometcdf() sur TI-84 permet ainsi aux chercheurs de terrain de comparer instantanément la distribution observée des délais d’attente à la distribution théorique stationnaire, servant d’assise au calcul de tests d’adéquation du Chi-carré.
8. Calculs de probabilités complémentaires : Intervalles stricts, dépassements et seuils minimaux
8.1 Évaluation des probabilités de dépassement strict P(X > k)
Dans de nombreuses applications d’ingénierie et de recherche expérimentale, la question centrale ne porte pas sur la rapidité d’apparition du succès, mais au contraire sur la probabilité que le processus tarde anormalement à se concrétiser. Mathématiquement, cela revient à évaluer la queue de distribution à droite, formalisée par la probabilité de dépassement strict P(X > k).
Par définition de l’événement complémentaire sur l’ensemble probabilisé universel, la somme de la probabilité cumulée jusqu’à k et de la probabilité de dépasser strictement k est égale à 1. La formulation standardisée sur la calculatrice TI-84 s’écrit donc :
1 – geometcdf(p, k)
Toutefois, sur le plan de l’élégance analytique et de la métrologie computationnelle, il convient de se rappeler que l’événement {X > k} équivaut rigoureusement à l’obtention de k échecs successifs initiaux. Sa probabilité analytique exacte est donc tout simplement :
P(X > k) = (1 – p)^k
Sur la TI-84, l’analyste dispose ainsi de deux méthodes d’évaluation : soit par la commande cumulative complémentée 1 – geometcdf(p, k), soit par l’élévation directe à la puissance (1 – p)^k. Sur des valeurs extrêmes de k ou des probabilités p infinitésimales, le calcul direct par exponentiation présente l’avantage théorique d’éviter les potentielles imprécisions liées à la soustraction de deux nombres à virgule flottante très proches de l’unité (phénomène de perte de précision relative par annulation catastrophique dans l’arithmétique IEEE 754 émulée par le processeur).
8.2 Traitement des inégalités larges au seuil minimal P(X >= k)
L’évaluation d’un seuil minimal large, formalisé par P(X ≥ k) (« au moins k essais requis pour observer le succès »), représente la source la plus fréquente d’erreur de codage chez les utilisateurs de la TI-84. En effet, l’inclusion de la borne inférieure k dans l’événement cible modifie la structure du complémentaire.
Puisque la variable X évolue exclusivement sur l’ensemble des entiers naturels, l’événement strictement complémentaire de {X ≥ k} n’est pas {X ≤ k}, mais bien l’ensemble discret {X ≤ k – 1}. En conséquence, la traduction algorithmique exacte sur la machine TI-84 s’établit impérativement selon la syntaxe :
1 – geometcdf(p, k – 1)
L’omission de cette décrémentation unitaire constitue une erreur systématique connue sous le nom de « décalage d’un cran » (ou off-by-one error en informatique théorique). Prenons un exemple concret avec p = 0,40 et cherchons à calculer P(X ≥ 3) :
- L’événement {X ≥ 3} correspond à l’union disjointe de {X = 3}, {X = 4}, {X = 5}, … Sa probabilité théorique exacte est (1 – p)^2 = (0,60)^2 = 0,36.
- La formulation correcte sur TI-84 est 1 – geometcdf(0.4, 2), qui renvoie rigoureusement 1 – 0,64 = 0,36.
- Si l’utilisateur commet l’erreur de saisir 1 – geometcdf(0.4, 3), la calculatrice soustrait également la probabilité de l’essai 3 (qui vaut 0,144), délivrant un résultat erroné de 0,216.
L’application rigoureuse du décalage d’indice k – 1 est donc une condition absolue de validité lors du traitement d’inégalités larges unilatérales à gauche.
8.3 Calcul de probabilités encadrées sur un intervalle borné P(a <= X <= b)
Les protocoles d’investigation exigent fréquemment de déterminer la probabilité que le premier succès se concrétise à l’intérieur d’une fenêtre temporelle bornée, délimitée par deux valeurs ordinales a et b, avec 1 ≤ a ≤ b. La formalisation mathématique de cette requête est P(a ≤ X ≤ b).
En vertu des propriétés d’additivité des mesures de probabilité sur des intervalles disjoints, la probabilité d’un tel segment discret se décompose en la différence de deux fonctions de répartition cumulatives : la probabilité accumulée jusqu’à la borne supérieure b, de laquelle on retranche la probabilité de tous les événements survenus strictement avant la borne inférieure a, c’est-à-dire jusqu’à l’entier a – 1 :
P(a ≤ X ≤ b) = P(X ≤ b) – P(X ≤ a – 1)
La transcription syntaxique directe en une seule ligne de commande sur l’écran d’accueil de la TI-84 s’écrit :
geometcdf(p, b) – geometcdf(p, a – 1)
Dans l’éventualité où l’intervalle est défini par des inégalités strictes P(a < X < b), le principe de discrétisation impose d’ajuster les deux indices aux entiers immédiatement intérieurs au domaine : la borne supérieure effective devient b – 1 et la borne inférieure soustraite devient a. La ligne de calcul sur la TI-84 prend alors la forme canonique :
geometcdf(p, b – 1) – geometcdf(p, a)
Cette méthodologie par différence cumulative optimise le temps de calcul et élimine le risque d’erreurs inhérent à l’addition manuelle de multiples termes de densité geometpdf() sur des intervalles de grande amplitude.
9. Représentation graphique des distributions géométriques sur TI-84
9.1 Génération de vecteurs de données dans l’éditeur de listes (STAT LIST)
Au-delà du simple calcul de scalaires probabilistes, la calculatrice TI-84 offre des outils graphiques permettant de visualiser les propriétés fonctionnelles de la loi géométrique. La première étape méthodologique consiste à peupler la mémoire de la machine avec les valeurs discrètes de la distribution en exploitant l’éditeur de listes statistiques.
Pour ce faire, l’utilisateur accède à l’éditeur en pressant la touche STAT, puis en sélectionnant la première option 1:Edit…. Afin de définir la séquence des rangs ordinaux d’essais dans la liste L1, il est recommandé de se placer sur l’en-tête de la colonne L1 (de manière à surligner le titre L1) et d’utiliser la commande génératrice de suite seq(), accessible via le menu LIST (touches 2nd puis STAT, sous-menu OPS, option 5:seq(). Par exemple, pour générer les entiers de 1 à 20, l’opérateur valide la formule :
seq(I, I, 1, 20) puis ENTER.
La colonne L1 se remplit instantanément des valeurs ordinales 1 à 20. L’opérateur déplace ensuite son curseur sur l’en-tête de la liste adjacente L2 pour calculer l’ensemble des probabilités associées en une opération vectorielle globale. Pour une probabilité unitaire fixée à p = 0,20, il suffit de saisir sur l’en-tête de L2 :
geometpdf(0.20, L1) puis ENTER.
L’environnement TI-OS évalue instantanément la commande sur chaque élément de L1 et stocke les résultats correspondants dans L2. Il est possible de contrôler la validité de la troncature en calculant la somme des probabilités de L2 via la commande sum(L2) (trouvée dans LIST > MATH) : le résultat doit être très proche de 1, confirmant la représentativité du support discret tronqué.
9.2 Configuration des tracés statistiques (STAT PLOT)
Une fois les listes L1 et L2 convenablement peuplées, il convient de paramétrer l’affichage graphique de la distribution géométrique. Ce tracé s’effectue au travers du gestionnaire statistique graphique accessible en pressant successivement 2nd puis Y= (menu STAT PLOT). Il est prudent de désactiver préalablement toute équation analytique résiduelle stockée dans le menu fonctionnel Y= afin d’éviter la superposition de tracés parasites.
Dans l’écran de configuration du Plot1, l’utilisateur procède aux ajustements suivants :
- Positionner l’état du tracé sur On en appuyant sur ENTER.
- Dans la rangée Type, sélectionner la troisième icône figurant un histogramme en bâtons.
- Dans le champ Xlist, s’assurer que la variable L1 est affectée (obtenue par 2nd puis 1).
- Dans le champ Freq (Fréquence), remplacer le chiffre 1 par défaut par le nom de la liste contenant les probabilités calculées, à savoir L2 (obtenue par 2nd puis 2).
Le calibrage de la fenêtre de visualisation s’avère déterminant pour obtenir un rendu lisible. En pressant la touche WINDOW, l’utilisateur configure manuellement les paramètres dimensionnels : Xmin = 0.5, Xmax = 20.5, Xscl = 1 (de manière à ce que chaque barre corresponde exactement à un essai unitaire centré sur un entier), Ymin = 0, et Ymax ajusté légèrement au-dessus de la probabilité maximale (par exemple 0.25 si p = 0,20). Bien que l’outil d’ajustement automatique ZoomStat (touche ZOOM puis option 9) soit disponible, un paramétrage manuel de la fenêtre garantit une stabilité d’affichage bien supérieure pour les variables discrètes.
9.3 Analyse visuelle de la décroissance exponentielle discrète
L’affichage final généré en pressant la touche GRAPH révèle la morphologie géométrique caractéristique de la loi. En activant la fonction d’exploration dynamique TRACE, un curseur interactif se positionne sur le sommet de chaque rectangle, affichant en bas d’écran l’intervalle de l’essai ainsi que la valeur exacte de la probabilité associée stockée dans L2.
L’observation visuelle met en évidence plusieurs propriétés fondamentales de la loi géométrique :
- Le mode de la distribution est systématiquement localisé au tout premier essai (x = 1), où la probabilité atteint sa valeur maximale égale à p.
- Le profil présente une décroissance géométrique continue à convexité positive marquée, illustrant l’amortissement rapide des probabilités sous l’action du coefficient réducteur 1 – p.
- La distribution manifeste une forte asymétrie positive (ou étalement vers la droite / positive skewness). La queue de distribution s’étend théoriquement vers l’infini, matérialisant le fait qu’aucun plafond fini n’interdit formellement la prolongation indéfinie d’une suite d’échecs, même si leur probabilité globale devient infinitésimale.
En modifiant la valeur de p dans la liste L2, l’observateur visualise immédiatement l’impact de ce paramètre sur la vitesse d’écrasement de la courbe : une valeur de p proche de 1 provoque un effondrement vertical quasi immédiat dès le deuxième essai, tandis qu’une valeur de p très faible étire le profil horizontalement, rapprochant visuellement le graphe d’une fonction décroissante à très faible pente.
10. Gestion des erreurs fréquentes, syntaxe incorrecte et validation des résultats
10.1 Diagnostic des messages d’erreur système récurrents
Lors de la manipulation des fonctions de probabilité sur la TI-84, le système d’exploitation peut interrompre l’exécution et afficher des écrans d’exception matérielle ou logicielle. Comprendre l’origine de ces erreurs système permet un dépannage rapide :
- ERR:DOMAIN : Ce message survient lorsque l’un des arguments fournis viole le domaine de validité mathématique de la distribution. C’est typiquement le cas si l’utilisateur entre une probabilité de succès p ≤ 0 ou p > 1, ou s’il soumet un rang d’essai non valide tel que x ≤ 0 (par exemple geometpdf(0.2, 0) ou geometpdf(0.2, -3)).
- ERR:SYNTAX : Cette erreur indique une rupture de la grammaire textuelle du microcode. Elle est généralement provoquée par l’absence d’une virgule séparatrice entre p et x, l’oubli de la parenthèse de clôture, ou l’utilisation accidentelle du symbole négatif d’opération « – » au lieu du moins unaire « (-) ».
- ERR:DATA TYPE : Ce message signale l’envoi d’un type de variable incompatible avec le moteur d’intégration statistique, par exemple l’injection accidentelle d’une variable de matrice, d’une chaîne de caractères (String) ou d’un nombre complexe dans les arguments de la fonction.
- ERR:DIM MISMATCH : Cette exception se produit lors d’opérations vectorielles combinant plusieurs listes (par exemple geometpdf(L1, L2)) si les listes concernées ne possèdent pas un nombre d’éléments rigoureusement identique.
Face à ces interruptions, l’appui sur l’option 2:Goto présente sur l’écran d’erreur permet de repositionner instantanément le curseur à l’endroit précis de la ligne de saisie où l’anomalie logique a été détectée, facilitant ainsi sa correction immédiate.
10.2 Divergences de définition mathématique et décalage d’indices
Une source critique de non-reproductibilité des résultats statistiques réside dans le fractionnement épistémologique de la définition de la loi géométrique au sein de la communauté scientifique. Comme évoqué précédemment, deux définitions concurrentes coexistent :
- Convention TI-84 (loi du rang d’essai) : La variable aléatoire X compte le nombre total d’essais jusqu’au premier succès inclus. Le support est l’ensemble des entiers strictement positifs : {1, 2, 3, …}. L’espérance vaut E(X) = 1 / p.
- Convention alternative (loi du nombre d’échecs) : La variable aléatoire Y mesure uniquement le nombre d’échecs accumulés avant la survenue du premier succès. Son support englobe zéro : {0, 1, 2, …}. L’espérance devient E(Y) = (1 – p) / p.
Ce décalage structural engendre une relation de translation triviale : X = Y + 1. Par conséquent, si un chercheur ou un manuel théorique formule une question selon la convention du nombre d’échecs (« quelle est la probabilité d’enregistrer 4 échecs avant le premier succès ? »), l’application directe de geometpdf(p, 4) sur la calculatrice constituera une erreur conceptuelle, car la TI-84 évaluerait alors la probabilité que le succès survienne au 4-ième essai (soit après 3 échecs seulement). Pour obtenir le résultat adéquat, le praticien doit impérativement translater son indice de saisie vers geometpdf(p, 4 + 1) = geometpdf(p, 5).
10.3 Protocoles de vérification croisée et cohérence numérique
Afin de s’assurer de l’exactitude des calculs avant la consignation des données dans des rapports scientifiques ou des copies d’examen, plusieurs heuristiques de contrôle rapide peuvent être appliquées :
- Vérification par la probabilité complémentaire : S’assurer systématiquement que la relation d’égalité geometcdf(p, k) + (1 – p)^k = 1 est respectée à la précision machine près.
- Vérification par l’espérance mathématique : Comparer la position du rang x par rapport à l’espérance théorique 1 / p. Si x est substantiellement inférieur à 1 / p, la probabilité cumulée geometcdf(p, x) doit impérativement être inférieure à 1 – 1/e ≈ 0,632 (propriété limite remarquable de la loi géométrique pour les valeurs faibles de p).
- Contrôle analytique manuel ponctuel : Procéder à une évaluation manuelle par exponentiation brute (1 – p)^(x – 1) * p pour vérifier la concordance des premiers chiffres significatifs.
11. Automatisation et programmation TI-Basic pour les distributions géométriques
11.1 Conception d’un script d’analyse géométrique interactive
Pour les utilisateurs amenés à traiter des séries de données répétitives ou désireux de disposer d’une suite logicielle complète regroupant l’ensemble des indicateurs de la loi géométrique sur un écran unique, le langage de programmation interprété embarqué TI-Basic offre une solution optimale. L’environnement permet d’écrire des scripts structurés alternant saisies protégées, calculs distribués et affichage formaté.
Pour initialiser un nouveau programme, l’utilisateur presse la touche PRGM, se déplace vers l’onglet NEW, sélectionne 1:Create New et nomme son script par un identifiant clair tel que GEOMSTAT. L’algorithme complet est structuré de la façon suivante :
En premier lieu, l’instruction ClrHome réinitialise l’affichage. L’algorithme sollicite ensuite la saisie interactive des deux paramètres à l’aide de l’instruction Prompt P, X. Une boucle de validation logique conditionnelle vérifie la conformité des paramètres : si P ≤ 0 ou P ≥ 1 ou X ≤ 0, le programme affiche un message d’alerte et s’interrompt via la commande Stop.
Dans la section de traitement mathématique, le script procède simultanément au calcul de la probabilité ponctuelle geometpdf(P, X) stockée dans la variable numérique A, de la fonction de répartition geometcdf(P, X) stockée dans B, de la probabilité de dépassement strict (1 – P)^X stockée dans C, et des moments théoriques que sont l’espérance 1 / P stockée dans E et l’écart-type √(1 – P) / P stocké dans S.
La section terminale du code gère l’affichage formel des sorties académiques via une succession d’instructions Disp :
- Affichage de « P(X=K): » suivi de la valeur de A.
- Affichage de « P(X<=K): » suivi de la valeur de B.
- Affichage de « P(X>K): » suivi de la valeur de C.
- Affichage de « ESPERANCE: » suivi de la valeur de E.
- Affichage de « ECART-TYPE: » suivi de la valeur de S.
Ce programme autonome permet d’obtenir en une seule seconde d’exécution une vue analytique exhaustive de la distribution sans risque d’erreur d’indice ou d’inattention syntaxique.
11.2 Simulation empirique de Monte-Carlo d’un processus géométrique
Au-delà du calcul purement déterministe des formules probabilistes, la calculatrice TI-84 peut être programmée pour exécuter des simulations stochastiques de Monte-Carlo, modélisant concrètement l’aléa d’épreuves de Bernoulli répétées. Ce type d’expérimentation in silico s’avère particulièrement démonstratif pour appréhender la variabilité d’échantillonnage et la loi des grands nombres appliquée à la psychologie cognitive.
L’algorithme de simulation s’articule autour du générateur pseudo-aléatoire interne de la TI-84, commandé par la fonction rand (accessible via MATH > PRB > 1:rand). Pour simuler la recherche du premier succès avec une probabilité P, le script initialise un compteur d’essais C à zéro. Il engage ensuite une boucle conditionnelle non bornée de type While dont la condition de maintien stipule que le nombre aléatoire tiré uniformément sur l’intervalle [0, 1[ demeure strictement supérieur ou égal à P :
À chaque itération de la boucle, le compteur C est incrémenté d’une unité : C + 1 → C. Dès qu’un tirage aléatoire produit une valeur strictement inférieure au seuil P, la condition de succès est satisfaite, la boucle s’interrompt, et la dernière valeur du compteur C est incrémentée une ultime fois pour comptabiliser l’essai victorieux.
En imbriquant cette routine à l’intérieur d’une boucle itérative exécutée par exemple N = 200 fois et en stockant chaque réalisation de C dans une liste statistique L3, l’utilisateur peut ensuite calculer la moyenne empirique de cette liste via mean(L3). La comparaison entre la moyenne simulée et l’espérance théorique 1 / P offre une démonstration expérimentale saisissante de la convergence stochastique, tout en permettant de visualiser l’extrême variabilité individuelle des temps d’attente réels.
12. Synthèse comparative, bonnes pratiques académiques et limites de l’outil
12.1 Comparaison globale : Loi géométrique vs Lois binomiale et de Poisson
La maîtrise de la modélisation statistique repose sur la capacité à sélectionner le modèle probabiliste le plus fidèle à la dynamique intrinsèque du recueil de données. Une clarification comparative entre les trois grandes lois discrètes de l’analyse comportementale s’impose :
- Loi géométrique : Se focalise sur le nombre d’essais indépendants variables nécessaires pour parvenir à un nombre fixe d’un unique succès (le premier). Elle est régie par un horizon temporel non borné a priori et modélise des questions de latence ou de temps d’attente jusqu’à l’occurrence initiale. Commandes : geometpdf / geometcdf.
- Loi binomiale : Modélise le nombre variable de succès observés au cours d’un nombre strictement fixe et prédéterminé n d’essais de Bernoulli indépendants. Le support est borné entre 0 et n. Commandes associées : binompdf / binomcdf.
- Loi binomiale négative : Constitue la généralisation directe de la loi géométrique. Elle quantifie le nombre d’essais nécessaires pour obtenir non pas un seul, mais un nombre entier fixe r de succès au cours d’épreuves de Bernoulli.
- Loi de Poisson : Modélise le nombre d’événements rares survenant au cours d’un continuum continu de temps ou d’espace fixé, sans structure d’épreuves discrètes individualisées. Commandes associées : poissonpdf / poissoncdf.
- Loi exponentielle : Représente le pendant strictement continu de la loi géométrique. Elle modélise le temps physique continu écoulé avant l’apparition d’un événement au sein d’un processus sans mémoire de Poisson.
Cette distinction conceptuelle fondamentale doit guider la phase de conceptualisation de toute analyse : dès lors que le protocole s’arrête impérativement dès l’instant où l’événement survient, la distribution géométrique s’impose mécaniquement face au modèle binomial.
12.2 Standards de restitution dans la rédaction scientifique (normes APA)
Lors de la rédaction de thèses, de mémoires universitaires ou d’articles soumis à des revues à comité de lecture affiliées à l’American Psychological Association (normes APA 7e édition), la restitution des inférences probabilistes calculées sur TI-84 doit répondre à des critères méthodologiques stricts de rigueur et de reproductibilité.
Il est impératif de stipuler explicitement dans la section méthodologique les paramètres du modèle : la définition opérationnelle du « succès », la justification empirique de l’indépendance des essais, la valeur précise du taux scalaire p retenu, ainsi que l’outil de calcul mobilisé (ex. : « Les probabilités cumulées ont été estimées sous environnement TI-OS 5.6 via la primitive geometcdf »). Les résultats probabilistes doivent être rapportés sous la forme exacte d’égalités probabilistes formelles :
« La probabilité qu’un sujet réponde avec succès avant la quatrième tentative suit une loi géométrique de paramètre p = 0,22 et s’établit à P(X ≤ 4) = 0,630 ».
Les règles de typographie des normes APA imposent que les symboles statistiques unilatéraux (tels que p, X, k, M, SD) soient composés en italique. Les probabilités doivent être arrondies à deux ou trois décimales après la virgule, sans omission du zéro initial si l’espace probabilisé le justifie, ou sans zéro initial si la grandeur ne peut structurellement jamais dépasser 1 selon certaines interprétations strictes des tables de test (bien que la notation standard p = .063 ou P = 0,063 doive rester homogène tout au long du manuscrit).
12.3 Limites intrinsèques de la TI-84 et perspectives computationnelles
Bien que la calculatrice TI-84 Plus CE demeure un instrument didactique et opérationnel remarquable, il importe d’avoir conscience de ses limitations computationnelles intrinsèques dans le contexte de la science des données contemporaine. L’appareil est limité par la capacité de son adressage mémoire RAM statique et par la vitesse de traitement de son microprocesseur 8/16 bits, ce qui interdit le traitement massif de méga-données (big data) ou l’exécution de simulations stochastiques excédant quelques milliers d’itérations.
Pour le traitement de jeux de données empiriques volumineux ou l’ajustement de modèles géométriques généralisés non stationnaires (où le paramètre p varie dans le temps en fonction de courbes d’apprentissage ou de lassitude), le chercheur devra naturellement effectuer la transition vers des langages d’analyse de données professionnels tels que le logiciel open-source R (via les fonctions natives dgeom(x, prob) et pgeom(q, prob) — attention, R utilise la convention du nombre d’échecs !), l’écosystème Python avec la bibliothèque SciPy (module scipy.stats.geom), ou des suites graphiques dédiées aux sciences humaines comme JASP ou SPSS.
Néanmoins, la maîtrise opérationnelle de la TI-84 conserve toute sa pertinence épistémologique : en contraignant l’utilisateur à expliciter mentalement la nature ponctuelle ou cumulative de ses requêtes statistiques et en offrant une rétroaction graphique et arithmétique immédiate, elle constitue le vecteur d’apprentissage le plus formateur pour ancrer durablement la compréhension des distributions discrètes.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Feller, W. (1968). An introduction to probability theory and its applications (Vol. 1, 3rd ed.). John Wiley & Sons.
Hogg, R. V., McKean, J. W., & Craig, A. T. (2019). Introduction to mathematical statistics (8th ed.). Pearson.
Ross, S. M. (2014). A first course in probability (9th ed.). Pearson.
Skinner, B. F. (1953). Science and human behavior. Macmillan.
Texas Instruments. (2020). TI-84 Plus CE reference guide. Texas Instruments Incorporated. https://education.ti.com
Wackerly, D. D., Mendenhall, W., & Scheaffer, R. L. (2014). Mathematical statistics with applications (7th ed.). Cengage Learning.