
L’analyse empirique moderne repose sur une tension fondamentale entre l’abstraction algorithmique du traitement programmatique et la nécessité concrète d’une appréhension intuitive des structures d’information. Dans l’écosystème du langage GNU R, largement plébiscité par la communauté scientifique internationale pour la modélisation statistique, l’exploration initiale des données constitue une étape déterminante du cycle de recherche. Avant de procéder aux ajustements de modèles linéaires généralisés, à des imputations de données manquantes ou à des réductions factorielles de dimension, le chercheur ou l’analyste doit impérativement confronter ses hypothèses formelles à la matérialité de son corpus numérique. Cette étape critique, traditionnellement désignée sous le vocable d’analyse exploratoire des données initiée par John Tukey, ne saurait s’accomplir de manière optimale par le seul truchement de synthèses numériques réductrices telles que la moyenne, l’écart-type ou la médiane.
Au cœur de cette démarche diagnostique, la fonction View() s’érige comme l’un des instruments les plus emblématiques et les plus immédiatement accessibles mis à la disposition des utilisateurs de R, en particulier au sein de l’environnement de développement intégré Posit RStudio. Conçue initialement pour combler le fossé entre la ligne de commande scriptée et l’ergonomie visuelle familière des tableurs de type matriciel, cette commande transforme une structure tabulaire bidimensionnelle abstraite en un canevas dynamique, navigable et interactif. Loin d’être un simple artifice d’affichage cosmétique, View() opère comme un analyseur de cohérence structurelle, permettant d’embrasser d’un seul coup d’œil l’architecture globale d’une table, la typologie de ses colonnes, la présence de motifs de vacuité documentaire et la distribution empirique des valeurs observées.
Toutefois, l’usage efficient de la fonction View() exige une compréhension technique rigoureuse qui transcende la simple saisie de son libellé en console. Maîtriser cet outil implique de connaître avec précision son architecture sous-jacente — orchestrée autour de bibliothèques JavaScript virtualisées —, ses contraintes syntaxiques immuables, ses modalités d’interaction avec l’interpréteur R, ainsi que ses frontières opérationnelles face à la manipulation de jeux de données massifs. En explorant en profondeur les subtilités du tri interactif, du filtrage par attributs et de la projection tabulaire des données expérimentales ou psychométriques, cet article propose une cartographie exhaustive des usages méthodologiques, techniques et épistémologiques de la fonction View() dans R, garantissant une intégration harmonieuse au sein de flux de travail reproductibles et scientifiquement rigoureux.
1. Introduction à l’inspection visuelle des données et à la fonction View() dans R
1.1 Importance de l’exploration visuelle préliminaire des données
L’exploration visuelle préliminaire constitue le premier rempart méthodologique contre les biais d’analyse et les erreurs de spécification dans tout projet de science des données. Dans les disciplines quantitatives, les chercheurs sont fréquemment confrontés à des jeux de données complexes issus de capteurs, de questionnaires en ligne ou d’extractions de bases de données relationnelles. À ce stade précoce du flux analytique, la formulation d’indicateurs de tendance centrale ou de dispersion globale peut masquer des anomalies rédhibitoires. Un décalage d’un seul séparateur décimal, une chaîne de caractères tronquée ou une convention d’encodage inadéquate pour les valeurs manquantes peuvent corrompre l’ensemble d’une régression statistique subséquente. L’inspection directe permet d’identifier immédiatement ces artefacts de mesure qui échappent aux filtres algorithmiques initiaux.
Le passage conceptuel de la ligne de commande brute à la vue tabulaire interactive représente une transition cognitive essentielle. Bien que l’interpréteur de commandes R soit d’une puissance expressive inégalée pour la transformation vectorisée, il impose une représentation séquentielle et fragmentée de l’information. L’affichage d’un tableau directement dans la console génère fréquemment un saut de ligne automatique lorsque le nombre de colonnes excède la largeur du terminal, rendant la lecture synoptique quasiment impraticable. À l’inverse, l’adoption d’un paradigme visuel bidimensionnel restaure la spatialité naturelle du tableau de données, favorisant la détection d’associations contingentes entre variables adjacentes et l’évaluation immédiate de la complétude du protocole de recueil.
Cette pertinence du contrôle direct est d’autant plus manifeste dans le domaine des sciences comportementales, de la psychométrie et de la recherche clinique. Au sein de ces disciplines, les données collectées ne correspondent pas seulement à des grandeurs physiques régies par des lois déterministes, mais à des construits latents mesurés à travers des échelles psychologiques, des inventaires d’attitudes ou des chronométries motrices. Les incohérences de saisie, les réponses uniformes systématiques traduisant un désengagement du participant, ou les scores aberrants situés en dehors des bornes théoriques d’un test standardisé nécessitent une vigilance visuelle contextualisée que les fonctions d’agrégation automatisées ont tendance à lisser prématurément.
1.2 Définition et rôle de la fonction View() dans l’écosystème RStudio
La fonction View() constitue une routine intégrée au langage R, historiquement affiliée au package utilitaire de base utils, mais profondément transfigurée par son intégration au sein de l’environnement de développement intégré RStudio. Sa vocation première réside dans l’invocation d’un visualiseur interactif de type feuille de calcul, instancié dans un panneau dédié de l’interface graphique. Plutôt que de contraindre l’analyste à contempler un flux textuel statique défilant dans l’invite de commande, l’exécution de cette commande mobilise une couche de rendu visuel permettant d’examiner les données sous forme d’une grille matricielle propre, organisée rigoureusement selon les axes des coordonnées d’observations (lignes) et de variables (colonnes).
Il existe une divergence architecturale fondamentale entre l’affichage console standard, produit par la simple saisie du nom de l’objet ou par l’évaluation de la fonction print(), et l’onglet dynamique généré par View(). L’affichage en console est statique, éphémère et tributaire de la mémoire tampon du terminal ; une fois les lignes imprimées, elles ne peuvent être ni réordonnées ni filtrées sans exécuter de nouvelles instructions R. En revanche, l’onglet ouvert par View() demeure persistant au cours de la session de travail. Il cohabite avec l’éditeur de scripts et la console, offrant des fonctionnalités d’interrogation visuelle en temps réel qui ne polluent pas le journal d’exécution de la console R.
Sur le plan historique, le visualiseur R de base reposait sur des boîtes de dialogue développées via des bibliothèques graphiques natives telles que Tcl/Tk (à travers la fonction fix() ou des fenêtres X11 sous les systèmes de type Unix). Ces interfaces rudimentaires présentaient une ergonomie limitée et une instabilité chronique lors de la manipulation de structures de données hétérogènes. La refonte complète de ce mécanisme opérée par Posit (anciennement RStudio) a ancré View() au cœur du flux de travail moderne, en substituant aux fenêtres contextuelles du système d’exploitation une interface web intégrée, fluide et parfaitement harmonisée avec le reste des composants de développement.
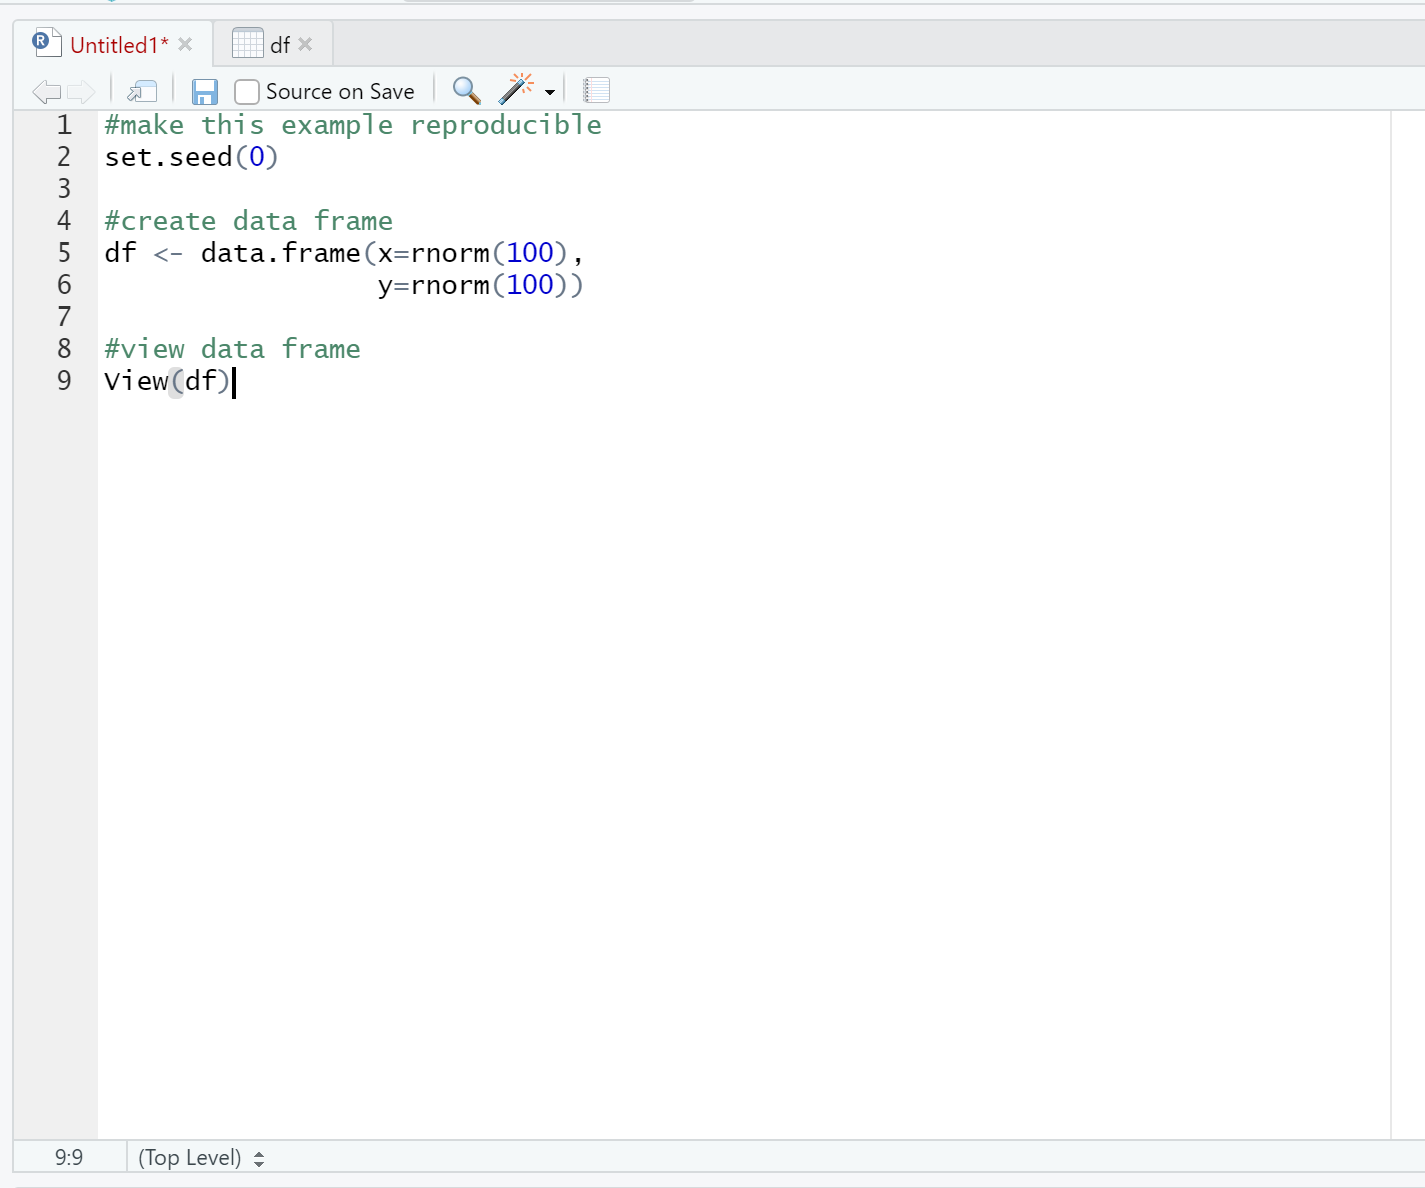
1.3 Architecture sous-jacente du visualiseur RStudio
L’implémentation moderne de la fonction View() au sein de RStudio repose sur une passerelle technologique sophistiquée unissant le moteur d’évaluation C/C++ sous-jacent de R aux technologies du web moderne. Lorsque l’instruction View(data) est validée, RStudio ne procède pas à une conversion brute de l’intégralité du jeu de données en une chaîne de texte matricielle. Il sérialise l’objet R dans un format optimisé et délègue son rendu visuel à un composant client basé sur la bibliothèque JavaScript libre DataTables, encapsulée au sein de l’architecture Chromium qui propulse l’environnement de bureau de RStudio.
Un aspect technique fondamental de cette architecture réside dans le mécanisme de virtualisation des lignes (souvent désigné sous le terme de DOM virtualization ou rendu différé). Au lieu d’instancier des centaines de milliers de balises de cellules au sein de l’arborescence du document HTML — ce qui saturerait instantanément la mémoire vive allouée au processus de rendu de l’interface —, le visualiseur ne matérialise à l’écran que les lignes qui correspondent précisément à la fenêtre visible du moniteur. Au fur et à mesure que l’utilisateur déplace la barre de défilement, les éléments antérieurs sont immédiatement détruits dans l’arbre d’affichage tandis que les nouvelles données sont injectées dynamiquement via des requêtes asynchrones internes vers la session R.
Il est toutefois crucial de souligner une caractéristique déterministe de ce système : la vue tabulaire ainsi générée est totalement déconnectée et non réactive. Cela signifie que la fenêtre d’affichage constitue un instantané figé (un snapshot) de l’état structurel et mémoriel de l’objet R au moment exact où la commande View() a été exécutée. Si l’analyste modifie ultérieurement le jeu de données dans la console — par exemple en ajoutant une nouvelle colonne, en imputant des valeurs ou en supprimant des observations —, l’onglet du visualiseur ne mettra pas à jour sa projection de manière automatique. Pour synchroniser l’affichage avec la nouvelle réalité mémorielle de l’objet, il est impératif de relancer explicitement la commande ou de cliquer sur l’icône de rafraîchissement présente dans l’en-tête de la fenêtre d’inspection.
2. Fondements syntaxiques et spécificités techniques de View()
2.1 Syntaxe formelle et sensibilité à la casse
L’une des particularités les plus déroutantes pour les praticiens débutant sur R réside dans l’intransigeance syntaxique de la fonction View(), tout particulièrement en ce qui concerne le respect de la sensibilité à la casse. Contrairement à une écrasante majorité de fonctions natives de R — qui adoptent généralement une typographie en minuscules complètes conformément aux directives de style modernes du CRAN (telles que print(), summary(), plot() ou str()) —, la fonction d’affichage visuel exige formellement une lettre capitale initiale : le « V » majuscule est rigoureusement obligatoire.
Cette spécificité formelle trouve son origine historique dans les premières versions du langage S, ancêtre direct de R développé au sein des laboratoires Bell par John Chambers et ses collaborateurs. Dans cette architecture originelle, les fonctions interférant directement avec les périphériques graphiques et les systèmes de fenêtrage de l’OS étaient conventionnellement baptisées avec une majuscule pour marquer leur statut privilégié d’opérateurs d’interface, par opposition aux fonctions de manipulation interne de vecteurs. Bien que le langage ait largement évolué vers des nomenclatures plus standardisées, cette trace archaïque a été préservée dans le package utils au nom de la rétrocompatibilité des scripts élaborés au cours des décennies antérieures.
L’omission de cette majuscule conduit invariablement à la génération d’un message d’erreur d’exécution caractéristique dans la console R : Error in view(data) : could not find function "view". Cette erreur survient parce que l’environnement global de recherche ne localise aucun symbole correspondant à cette désignation en minuscules dans les tables de symboles des packages actuellement attachés. Bien que certains sous-systèmes récents ou surcouches d’environnement tolèrent ou réexportent des alias alternatifs, l’écriture académique et professionnelle requiert une adhésion inconditionnelle à la signature canonique View() afin de prévenir tout échec de reproductibilité lors de l’exécution sur des installations R standardisées.
2.2 Arguments acceptés et types d’objets compatibles
D’un point de vue structural, la fonction View() accepte prioritairement deux arguments formels, dont la définition rigoureuse peut être consultée dans la documentation technique du moteur R :
x: L’objet de données que l’analyste souhaite examiner. Cet argument est strictement obligatoire. Il doit être convertible en une représentation matricielle ou tabulaire bidimensionnelle.title: Une chaîne de caractères scalaire (vecteur de type character de longueur 1) permettant de définir explicitement le titre textuel affiché dans l’onglet du visualiseur de RStudio. Si cet argument est omis par l’utilisateur, l’interpréteur extrait automatiquement l’expression déparsee (le nom littéral de la variable passée au premier argument) pour baptiser l’onglet.
La polyvalence de View() s’illustre à travers le spectre étendu des structures de données qu’elle est capable d’ingérer. Les structures natives de type data.frame, les structures enrichies issues de l’écosystème Tidyverse nommées tibble, ainsi que les matrices numériques ou textuelles homogènes (matrix) sont traitées de manière optimale. Face à une matrice de corrélation ou une table de contingence bidimensionnelle produite par la fonction table(), View() procède à une conversion interne instantanée pour restituer les dimensions orthogonales avec leurs noms de lignes (rownames) et noms de colonnes (colnames) respectifs.
En revanche, le comportement du visualiseur face à des architectures asymétriques ou hiérarchiques présente des nuances substantielles. Lorsqu’un simple vecteur atomique (numérique, caractère ou logique) est passé en argument, R l’enveloppe temporairement dans une structure univariée à une seule colonne pour permettre son rendu. En présence d’une liste complexe non rectangulaire — c’est-à-dire une liste contenant des sous-listes de longueurs hétérogènes, des modèles statistiques instanciés ou des éléments arbitraires —, le visualiseur de RStudio bascule automatiquement vers une interface hiérarchique arborescente (Object Explorer). Bien que cette modalité soit précieuse pour disséquer des objets JSON ou des structures S4 imbriquées, elle s’écarte du paradigme matriciel standard de la feuille de calcul.
2.3 Interaction avec l’environnement global
L’évaluation de la fonction View() au sein de l’environnement global (.GlobalEnv) présente des particularités fondamentales qu’il convient de disséquer pour éviter toute mauvaise interprétation des mécanismes mémoriels de R. L’utilisateur peut choisir d’exécuter View() directement sur un objet préalablement stocké dans la mémoire de travail (par exemple View(mes_donnees)) ou d’y injecter une expression R évaluée à la volée, telle qu’une chaîne de transformation combinant des opérations d’agrégation ou de sélection : View(subset(mes_donnees, age > 25)).
Dans le premier scénario, le visualiseur associe l’onglet au pointeur de l’objet nommé ; dans le second scénario, l’expression est résolue dans un environnement temporaire anonyme, et le résultat est copié dans la structure de données alimentant la passerelle JavaScript. Si l’argument title n’est pas stipulé, l’onglet affichera l’intégralité de la syntaxe de l’expression imbriquée, ce qui peut nuire à la clarté visuelle de l’espace de développement en cas de formules complexes. C’est précisément dans cette configuration que la spécification d’un titre intelligible via View(..., title = "Cohorte_Filtree") démontre toute son utilité ergonomique.
Il est primordial d’assimiler le principe d’indépendance hermétique de la session : les manipulations interactives conduites au sein du visualiseur — qu’il s’agisse du reclassement des lignes par clic sur une colonne ou de l’application de critères d’exclusion via les menus déroulants de filtrage — n’ont rigoureusement aucun impact rétroactif sur l’objet résidant dans l’environnement global. Les filtres ne modifient pas l’assignation originale ; ils ne détruisent aucune donnée en mémoire et ne génèrent aucune variable dérivée dans l’espace de travail. Le visualiseur agit exclusivement comme une interface d’observation passive, sanctuarisant les structures mémorielles contre toute altération accidentelle induite par des manipulations manuelles involontaires.
3. Configuration de l’environnement de travail et reproductibilité
3.1 Initialisation du générateur pseudo-aléatoire
Dans le cadre de l’investigation méthodologique, la démonstration de protocoles analytiques requiert fréquemment l’usage de jeux de données synthétiques générés par simulation stochastique. L’emploi de données simulées permet de contrôler parfaitement les paramètres distributionnels théoriques et d’illustrer sans ambiguïté les mécanismes de visualisation. Toutefois, pour qu’une démarche scientifique conserve sa valeur probatoire et pédagogique, la génération de ces nombres aléatoires doit être rigoureusement reproductible sur n’importe quelle station de calcul indépendante.
Le langage R utilise par défaut l’algorithme de Mersenne-Twister pour dériver des suites de nombres pseudo-aléatoires à partir d’un état interne déterminé. L’instruction set.seed() est la commande fondamentale qui permet d’ancrer cet état interne en spécifiant une graine initiale entière. Lorsque la graine est explicitement initialisée, l’ensemble des tirages probabilistes subséquents — qu’ils suivent une loi normale, binomiale, de Poisson ou uniforme — s’exécute selon une séquence immuable et parfaitement déterminée, annihilant toute divergence liée au hasard informatique lors de la réexécution du script.
La portée de cette précaution dans les publications académiques en psychologie et en statistiques appliquées est considérable. Un jeu de données simulé sans initialisation préalable de la graine conduira inévitablement à des valeurs légèrement différentes lors de chaque compilation, modifiant les scores minimaux et maximaux, déplaçant l’emplacement exact des observations atypiques et rendant les captures d’écran de l’interface View() discordantes par rapport aux calculs des étudiants ou des réviseurs. La fixation systématique de la graine via set.seed(12345) en préambule à tout protocole de simulation garantit une cohérence absolue entre le code source et les représentations tabulaires observées.
3.2 Génération de variables simulées continues
Pour illustrer la mise en œuvre pratique de View(), nous pouvons élaborer un jeu de données synthétique reflétant des métriques expérimentales plausibles. La génération de variables aléatoires continues s’articule préférentiellement autour de la fonction native rnorm(), qui permet d’échantillonner des valeurs issues d’une distribution gaussienne univariée en spécifiant la taille de l’échantillon n, la moyenne théorique mean et l’écart-type sd.
Considérons, à titre d’illustration, la simulation d’un indice cognitif standardisé (tel qu’un quotient de performance ou un score de mémoire de travail) calibré sur une moyenne théorique de 100 unités avec un écart-type de 15 unités, modélisé conjointement avec une mesure de temps de réaction chronométrique exprimée en millisecondes, centrée sur une moyenne de 450 ms avec une variance résiduelle de 50 ms. Le paramétrage rigoureux de ces distributions assure que la structure générée présente des caractéristiques morphologiques analogues à celles recueillies lors de passations réelles en laboratoire de psychologie expérimentale.
Le contrôle de la distribution statistique des données synthétiques s’opère par la confrontation des paramètres théoriques injectés dans rnorm() aux estimateurs empiriques calculés a posteriori. Grâce à la loi des grands nombres, la distribution empirique converge asymptotiquement vers la distribution théorique. L’analyste peut ainsi introduire intentionnellement des déviations ou des covariances contrôlées entre variables continues afin de préparer le terrain à des investigations visuelles détaillées au sein du visualiseur, notamment en observant la dispersion conjointe des indicateurs de performance.
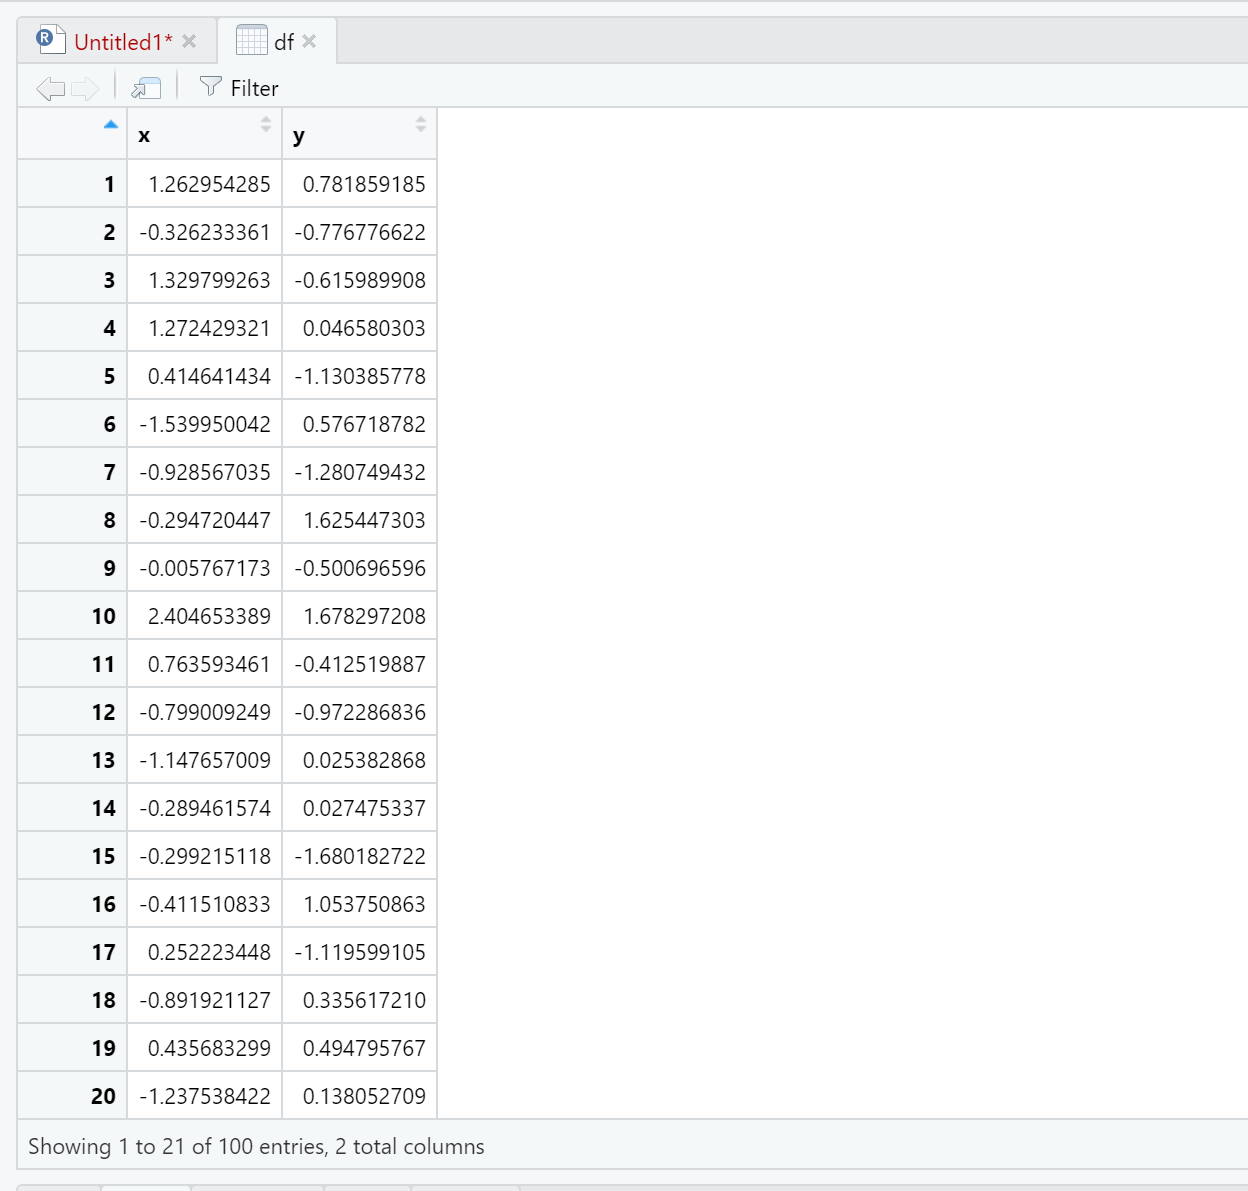
3.3 Vérification de la structure de l’espace de travail
Avant d’engager des procédures de visualisation graphique ou d’interroger interactivement des objets tabulaires, une hygiène de programmation rigoureuse exige une validation de l’état de l’espace de travail R. Cette vérification prévient les collisions d’identifiants, l’écrasement de variables préexistantes et la persistance d’objets obsolètes résidant dans la mémoire de la session en cours. La commande ls() liste exhaustivement l’ensemble des symboles actuellement instanciés dans l’environnement global, permettant de s’assurer de la présence exclusive des structures requises.
Conjointement à l’inventaire des identifiants, l’auscultation méticuleuse de la structure interne des objets est traditionnellement confiée à la fonction str() (abréviation de structure). Cette routine fondamentale renvoie une synthèse textuelle compacte précisant la classe de l’objet (par exemple 'data.frame'), le volume total d’observations, le nombre de variables enregistrées, ainsi qu’un aperçu typologique immédiat du mode de stockage de chaque vecteur univarié (entier, réel à double précision, chaîne textuelle, facteur). Cette analyse préliminaire dans la console fournit les repères formels indispensables à l’interprétation des éléments qui seront ensuite déployés graphiquement par View().
Il est également opportun de veiller à ce que l’environnement RStudio fonctionne avec des dépendances minimales et saines. Bien que View() ne requière strictement aucun package externe pour opérer — étant une fonction intrinsèque intégrée à l’installation standard de R et enrichie par l’exécutable même de RStudio —, des interférences peuvent survenir lorsque des bibliothèques tierces redéfinissent des méthodes d’affichage. Vérifier l’intégrité de la session constitue donc un préalable indispensable pour garantir la stabilité du moteur de rendu interne et prévenir tout dysfonctionnement de l’interface.
4. Création et manipulation d’un jeu de données pour View()
4.1 Construction d’un data.frame de démonstration
Pour fonder les démonstrations techniques ultérieures sur un cas d’école solide et parfaitement documenté, nous procédons à l’assemblage d’un tableau de données bidimensionnel canonique via la fonction data.frame(). Ce jeu de données synthétique regroupera 100 observations distinctes représentant des sujets individuels soumis à une épreuve psychométrique standardisée, intégrant des mesures quantitatives continues et des indicateurs nominaux.
Le code d’instanciation met en jeu deux vecteurs continus principaux, arbitrairement baptisés score_cognitif et temps_reaction, auxquels s’adjoint un identifiant unique pour chaque participant sous la forme d’une chaîne textuelle séquentielle (ID_001 à ID_100). L’attribution d’étiquettes de colonnes claires, explicites et dépourvues de caractères diacritiques ou d’espaces typographiques constitue une règle de bonne pratique essentielle pour assurer la lisibilité immédiate au sein du visualiseur et éviter les dysfonctionnements dans les requêtes de filtrage ultérieures.
Dès l’exécution de l’assignation, la vérification dimensionnelle formelle s’accomplit par l’invocation des fonctions scalaires dim(), nrow() et ncol(). La confirmation que la structure englobe précisément 100 lignes et le nombre attendu de colonnes atteste de la parfaite vectorisation des composantes lors de l’assemblage matriciel. L’intégrité structurelle étant scellée, le tableau devient immédiatement éligible à une inspection complète par le moteur de View().
4.2 Intégration de variables catégorielles et facteurs
Un tableau de données expérimental ne saurait se cantonner à des grandeurs numériques pures ; la structuration des protocoles scientifiques dépend intrinsèquement de variables qualitatives définissant les conditions de test, les cohortes épidémiologiques ou les statuts expérimentaux. Dans R, ces grandeurs qualitatives sont représentées par le type factor, une structure interne où des étiquettes textuelles (niveaux ou levels) sont mappées sur des entiers discrets sous-jacents.
Pour enrichir notre démonstration, nous injectons au sein du tableau deux variables catégorielles distinctes : une variable groupe partitionnant aléatoirement l’échantillon entre un groupe « Contrôle » et un groupe « Expérimental », et une variable condition_stress ordonnée selon trois modalités croissantes (« Faible », « Modéré », « Élevé »). L’usage explicite de la fonction factor(), assorti de son argument logique ordered = TRUE pour cette dernière, confère une sémantique ordinale robuste à l’indicateur.
L’intégration de ces facteurs met en exergue les capacités de traitement différentiel de la fonction View(). Au sein de la grille interactive de RStudio, les colonnes factorielles ne sont pas affichées comme des codes numériques cryptiques, mais sous leur libellé textuel explicite. Cette projection fidèle des niveaux de facteurs évite les confusions habituelles de codage (comme l’assimilation du chiffre 1 au groupe contrôle ou à la condition expérimentale) et permet de valider instantanément à l’écran la répartition visuelle des participants au sein des différentes strates de l’échantillonnage.
4.3 Vérification des types de données dans le tableau
L’étape précédant immédiatement l’affichage graphique consiste à exécuter un contrôle strict de la classe de chaque colonne composant le tableau de données. Une erreur courante lors de l’importation de fichiers externes (CSV, TSV, XLSX) réside dans la conversion implicite d’une variable numérique en chaîne de caractères (character) à la suite de la présence accidentelle d’une lettre ou d’un symbole typographique au sein d’une seule cellule. Ce basculement altère dramatiquement le comportement du visualiseur, notamment en modifiant l’ordre logique du tri interactif.
L’utilisation de la fonction vectorisée sapply(df, class) offre un diagnostic instantané et exhaustif de la typologie des colonnes hébergées au sein du data.frame. Elle permet de certifier que les variables quantitatives possèdent bien le type numeric ou integer, que les descripteurs nominaux sont encapsulés sous le type factor ou character, et que les éventuelles variables logiques d’exclusion sont préservées sous forme de booléens logical.
La prévention de ces conversions indésirables en amont garantit une interaction harmonieuse avec le visualiseur. Lorsque le moteur JavaScript de View() reçoit des données correctement typées, il configure automatiquement les composants de contrôle adéquats : des curseurs d’intervalles métriques pour les variables numériques continues, des menus d’exclusion sélective pour les facteurs discrets, et des champs de recherche textuelle à tolérance syntaxique pour les identifiants littéraux. L’hygiène typologique structure ainsi directement la qualité de l’expérience d’exploration visuelle.
5. Utilisation pratique de View() : Navigation et exploration interactive
5.1 Lancement de la commande et ouverture de l’onglet
L’appel opérationnel du visualiseur s’effectue traditionnellement par la soumission directe de l’instruction View(df) dans l’invite de la console interactive de RStudio. Dès la validation de la ligne de commande, le logiciel réagit instantanément en créant un nouvel onglet positionné par défaut dans le panneau supérieur gauche de l’environnement, aux côtés des fichiers de scripts R ou R Markdown en cours d’édition. L’onglet porte le nom de la variable inspectée ou le titre personnalisé préalablement transmis via l’argument dédié.
Il convient de noter qu’il existe une voie d’accès ergonomique alternative ne requérant aucune saisie syntaxique : au sein du panneau « Environment » de RStudio, chaque objet tabulaire répertorié présente à l’extrémité droite de sa ligne une minuscule icône figurant une grille de feuille de calcul. Un simple clic sur cette icône ou sur le libellé textuel de l’objet déclenche l’exécution implicite et automatique de la fonction View() dans la console, instanciant l’onglet d’inspection sans nécessiter l’écriture manuelle du code.
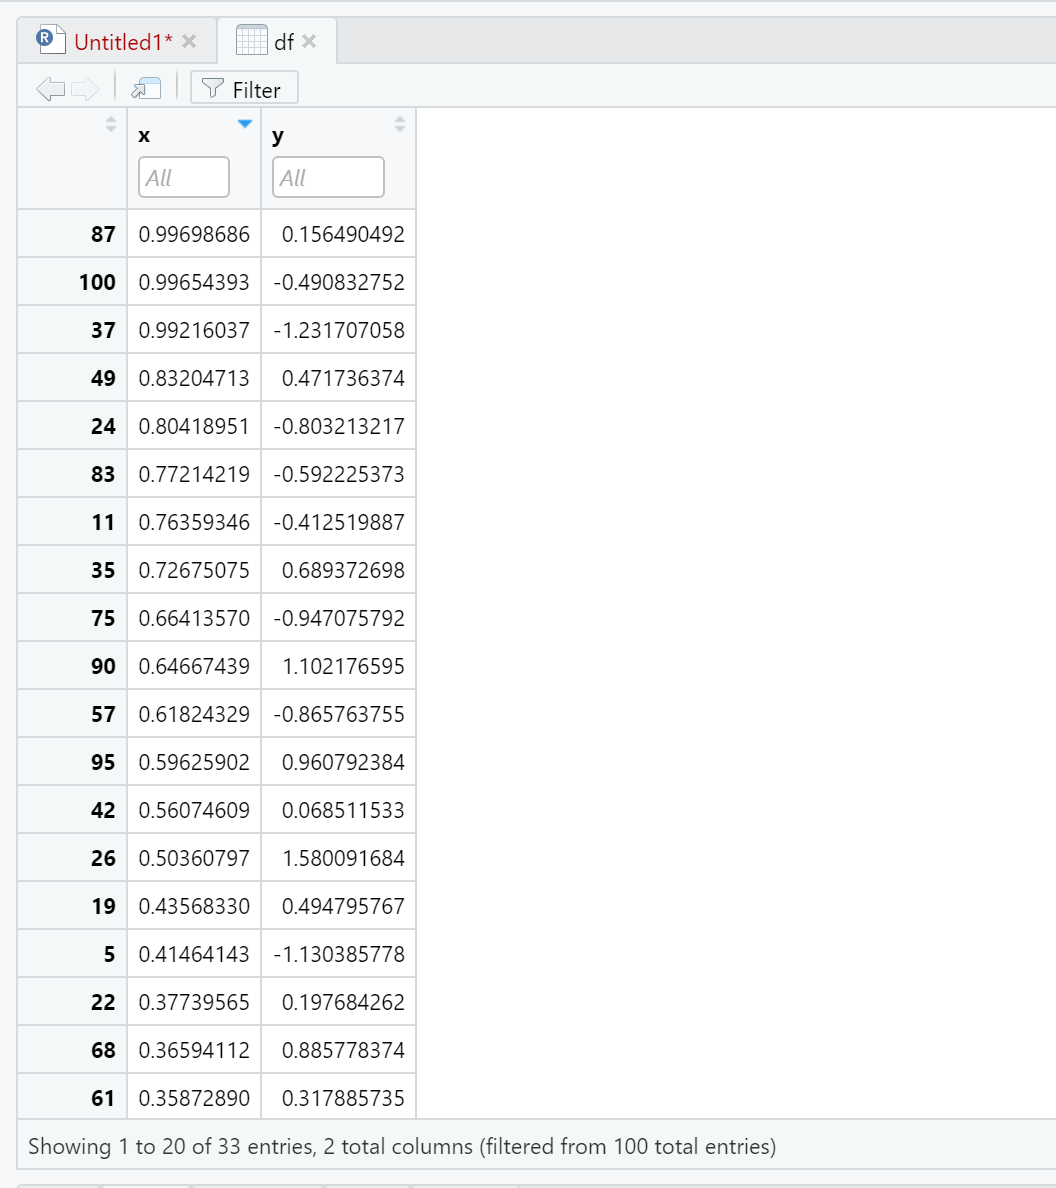
Dès l’ouverture de cet onglet, l’attention de l’analyste doit se porter sur la barre d’état située dans le coin inférieur droit de la vue tabulaire. Cette zone d’affichage métrique fournit un relevé instantané des dimensions globales du jeu de données, indiquant explicitement le nombre total de lignes observées et le nombre de colonnes actives. En cas d’application de filtres interactifs ultérieurs, cet indicateur se mettra dynamiquement à jour pour signaler le volume précis d’observations répondant aux critères retenus (par exemple Showing 1 to 25 of 100 entries (filtered from 100 total entries)), offrant ainsi un retour quantitatif constant sur l’ampleur de la réduction opérée.
5.2 Défilement vertical et horizontal à travers les observations
La navigation cinématique à travers les données visualisées repose sur une implémentation fluide du défilement matriciel. Lorsque le jeu de données comporte un volume d’enregistrements supérieur à la hauteur physique disponible dans la fenêtre d’affichage, une barre de défilement vertical s’active. Grâce à la technologie de rendu différé évoquée précédemment, le défilement s’effectue sans aucune latence perceptible, les données étant interrogées et injectées dans le DOM visuel en temps réel avec une fluidité comparable à celle des progiciels bureautiques dédiés.
Une caractéristique ergonomique majeure réside dans la préservation systématique de l’en-tête de colonnes lors de la progression vers le bas de la table (mécanisme de sticky header). Quelle que soit la profondeur d’exploration au sein des observations — qu’il s’agisse de la centième ou de la dix-millième ligne —, les intitulés de variables demeurent rigoureusement ancrés au sommet de la grille. Cette disposition prévient toute perte de repère contextuel et élimine le risque d’attribuer par inadvertance une métrique de temps de réaction à une colonne de scores de test lors du passage en revue d’observations éloignées.
Le défilement horizontal répond aux mêmes exigences lorsque le nombre de variables descriptives excède la largeur du panneau. La première colonne non nommée, affichant les numéros d’indexation originale des lignes ou les rownames, demeure fixée sur la bordure gauche lors du balayage latéral. Cette persistance visuelle permet à l’analyste d’inspecter l’ensemble des descripteurs transversaux d’un même sujet expérimental sans jamais perdre de vue son identifiant matriciel de ligne, facilitant ainsi le repérage horizontal de profils atypiques ou d’enregistrements lacunaires comportant de multiples occurrences de valeurs manquantes (NA).
5.3 Détachement de la fenêtre du visualiseur
Bien que l’intégration par onglet au sein du panneau d’édition de RStudio soit parfaitement adaptée aux configurations de travail courantes sur ordinateur portable, elle peut s’avérer contraignante lors de l’exécution d’analyses nécessitant une confrontation simultanée et permanente entre le code source et les données brutes. Pour pallier cette contrainte d’espace, RStudio propose une fonctionnalité de détachement de la fenêtre graphique via l’icône « Show in new window » (matérialisée par une petite fenêtre surmontée d’une flèche diagonale divergente) située dans la barre d’outils supérieure de l’onglet.
L’activation de cette commande extrait immédiatement le visualiseur du conteneur parent de RStudio pour l’instancier au sein d’une fenêtre indépendante native gérée par le système d’exploitation. Cette capacité d’émancipation présente des atouts ergonomiques considérables, en particulier dans les environnements de travail professionnels dotés d’une configuration multi-écrans. L’analyste peut assigner son moniteur principal au développement scripté, à la rédaction de rapports analytiques et à la génération de tracés graphiques, tout en déportant sur un moniteur secondaire la vue tabulaire intégrale de ses données brutes ou de ses tables de contingence.
Il convient toutefois de gérer cette multiplication des fenêtres détachées avec discernement. Chaque instance de visualisation détachée mobilise des ressources de rendu graphique indépendantes au sein de l’architecture Chromium de RStudio. L’ouverture simultanée d’un nombre excessif de visualiseurs détachés sur des jeux de données volumineux peut induire une contention de mémoire vive et fragmenter l’attention cognitive du chercheur. Il est donc recommandé de refermer méthodiquement les fenêtres d’inspection périphériques dès lors que la phase de diagnostic visuel ponctuel d’une sous-structure est achevée.
6. Tri interactif des données au sein du visualiseur RStudio
6.1 Mécanisme du tri ascendant et descendant
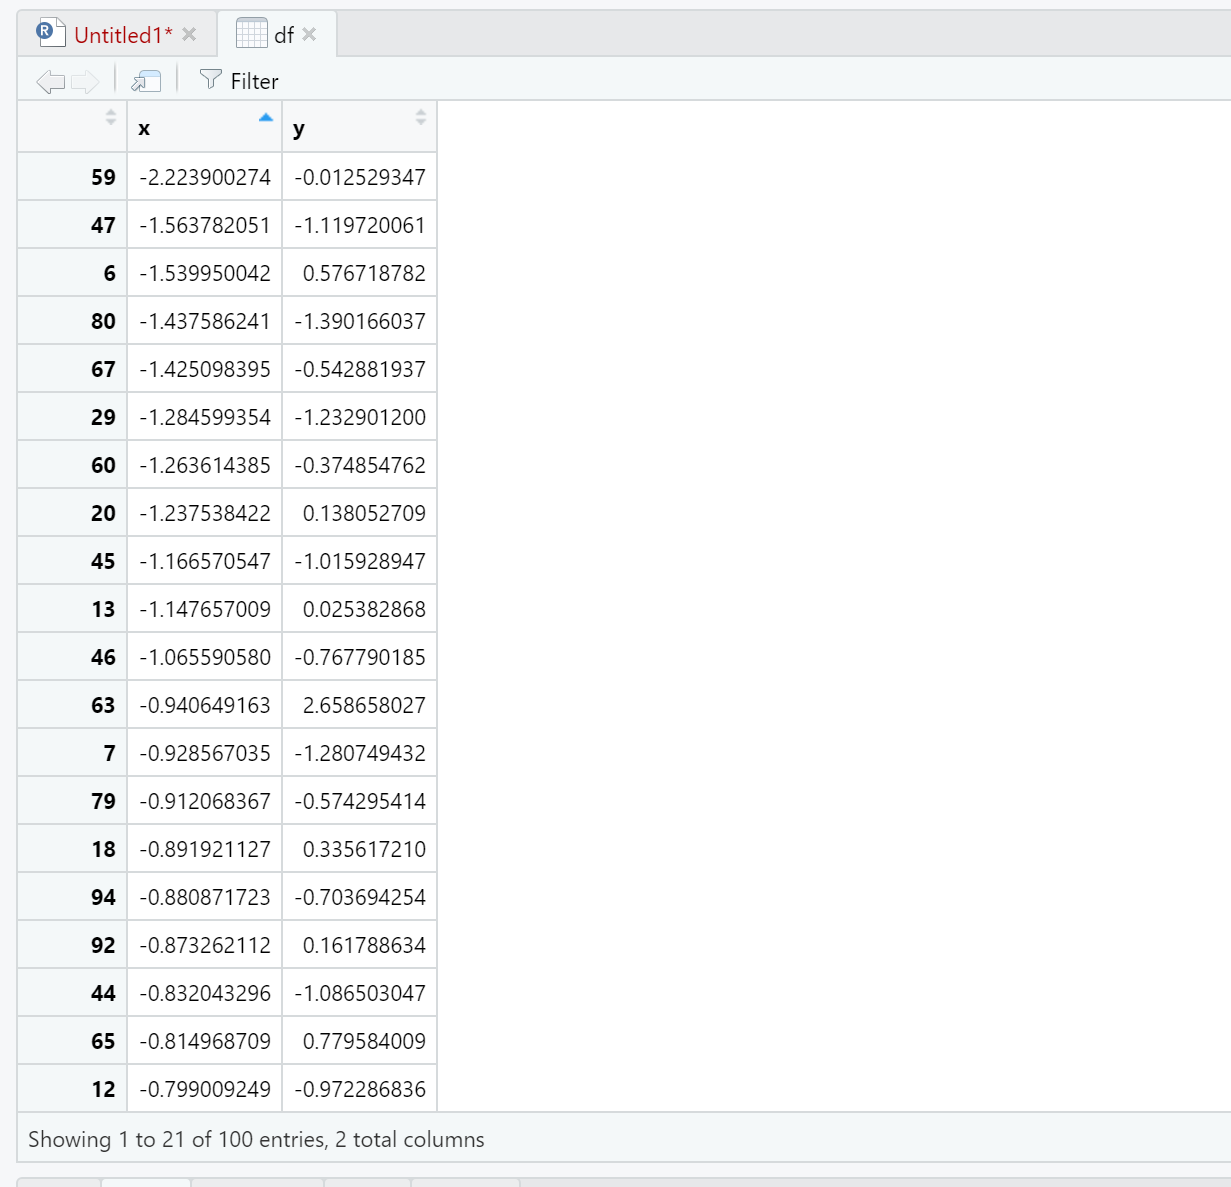
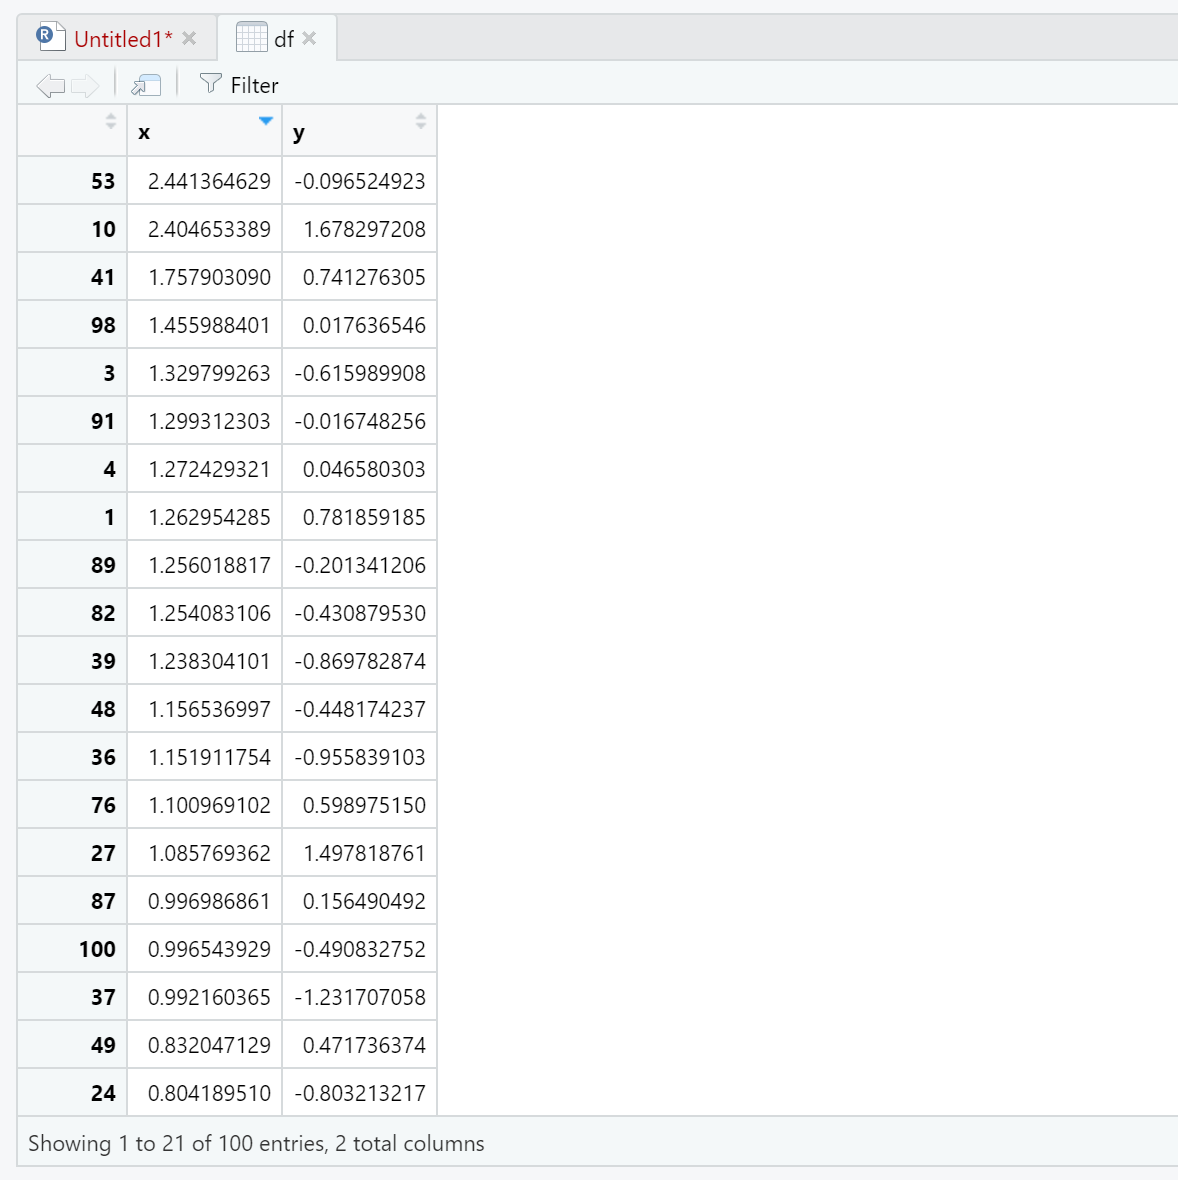
L’exploration visuelle ne saurait se limiter à une contemplation passive d’une séquence statique d’enregistrements ; elle exige la capacité d’ordonner dynamiquement les données pour en révéler la structure hiérarchique. Au sein du visualiseur de RStudio, cette opération s’accomplit avec une simplicité déconcertante grâce à l’implémentation de déclencheurs d’événements sur les en-têtes de colonnes. Un clic gauche unitaire sur l’intitulé d’une variable réorganise instantanément l’intégralité du tableau selon un ordre croissant (ascendant) des valeurs de cette colonne spécifique.
Un second clic consécutif sur le même en-tête inverse immédiatement l’algorithme d’ordonnancement, réorganisant le tableau selon un ordre décroissant (descendant). Le visualiseur intègre des indices graphiques discrets mais sans équivoque pour signaler l’état de l’ordonnancement : une petite flèche orientée vers le haut atteste d’un tri croissant, tandis qu’une flèche dirigée vers le bas matérialise le tri décroissant. Les colonnes non impliquées dans le tri conservent des indicateurs bidirectionnels neutres.
Ce mécanisme de tri prend en charge intelligemment la sémantique sous-jacente des types de données. Face à des colonnes numériques, le tri respecte scrupuleusement l’ordre arithmétique continu (nombres négatifs en tête lors d’un tri ascendant, suivis des fractions décimales et des entiers positifs). Pour les variables textuelles, le visualiseur applique un ordonnancement lexicographique strict basé sur les conventions de la table de caractères Unicode/ASCII. Pour les variables factorielles, le tri respecte la hiérarchie explicite définie par les niveaux du facteur (levels) si celui-ci est ordonné, ou l’ordre alphabétique de leurs étiquettes dans le cas contraire, assurant une conformité parfaite entre structure logique et représentation visuelle.
6.2 Effets du tri sur l’ordre interne des observations
Il est impératif d’ancrer fermement une distinction méthodologique fondamentale qui prévient de nombreuses méprises chez les nouveaux utilisateurs de R : le tri opéré au sein du visualiseur n’altère en rien l’agencement interne des données hébergées dans la mémoire vive de la session R. Cette manipulation est exclusivement circonscrite à la couche de présentation graphique déléguée au composant JavaScript. L’objet df résidant dans l’espace global demeure rigoureusement identique à lui-même, conservant l’ordre originel d’indexation de ses lignes tel qu’il a été initialisé ou importé.
Cette indépendance structurelle est visuellement attestée par la colonne grise non nommée située à l’extrême gauche de la grille, qui affiche les identifiants ou numéros de lignes d’origine. Lorsqu’un tri est appliqué sur une variable (par exemple pour faire remonter les scores les plus élevés au sommet de la vue), on constate immédiatement que les numéros d’indexation de cette première colonne ne se réécrivent pas séquentiellement de 1 à 100 : ils se dispersent et reflètent la position originale qu’occupait chaque observation avant l’application du tri visuel. Ce comportement préserve la traçabilité absolue des coordonnées d’enregistrement.
Si l’analyste souhaite répercuter cet ordonnancement de manière permanente dans la mémoire de travail pour les calculs ultérieurs, il doit impérativement formaliser cette opération par voie scripturale dans la console ou dans son programme. Il mobilisera alors la fonction d’indexation native df[order(df$score_cognitif), ] ou les verbes déclaratifs du package dplyr via l’instruction df %>% arrange(score_cognitif). L’inspection interactive via View() sert ainsi de guide exploratoire pour identifier quel ordonnancement programmatique s’avère pertinent à consigner dans le code de production.
6.3 Tri appliqué à des données expérimentales
L’application concrète du tri interactif constitue un levier d’investigation exceptionnel lors du traitement de données expérimentales en psychologie ou en neurosciences cognitives. L’un des premiers réflexes méthodologiques face à une variable de latence temporelle (temps de réaction) consiste à appliquer un tri ascendant immédiat. Cette manœuvre permet d’isoler au sommet de la table les valeurs chronométriques les plus infinitésimales. Dans le contexte d’une tâche d’attention soutenue, un temps de réaction inférieur à 150 millisecondes trahit immanquablement une réponse prématurée ou anticipatoire, physiologiquement incompatible avec le délai incompressible de transmission neuromusculaire et d’intégration visuelle.
Réciproquement, le basculement en tri descendant permet de projeter instantanément les scores maximaux au regard de l’analyste. Cette approche permet de détecter sans délai les valeurs aberrantes (outliers) susceptibles de fausser les estimateurs paramétriques, telles que des latences excédant plusieurs secondes consécutives à une déconcentration temporaire du sujet ou à une défaillance technique du matériel d’enregistrement. Le chercheur peut ainsi évaluer l’étendue de l’asymétrie distributionnelle sans avoir à tracer préalablement de diagrammes de dispersion ou de boîtes à moustaches.
Dans le domaine de l’évaluation psychométrique par questionnaires, le tri ascendant ou descendant sur des scores factoriels permet d’examiner minutieusement le comportement des individus situés aux extrêmes de la distribution normale (les percentiles d’ordre très faible ou très élevé). L’analyste peut alors parcourir horizontalement les réponses détaillées données par ces sujets particuliers aux différents items spécifiques pour s’assurer de la cohérence interne de leurs trajectoires de réponse et vérifier qu’aucune anomalie de codage n’est venue distordre artificiellement leur statut de cas limite.
7. Filtrage dynamique et exploration de sous-ensembles via View()
7.1 Activation et configuration des filtres de colonnes
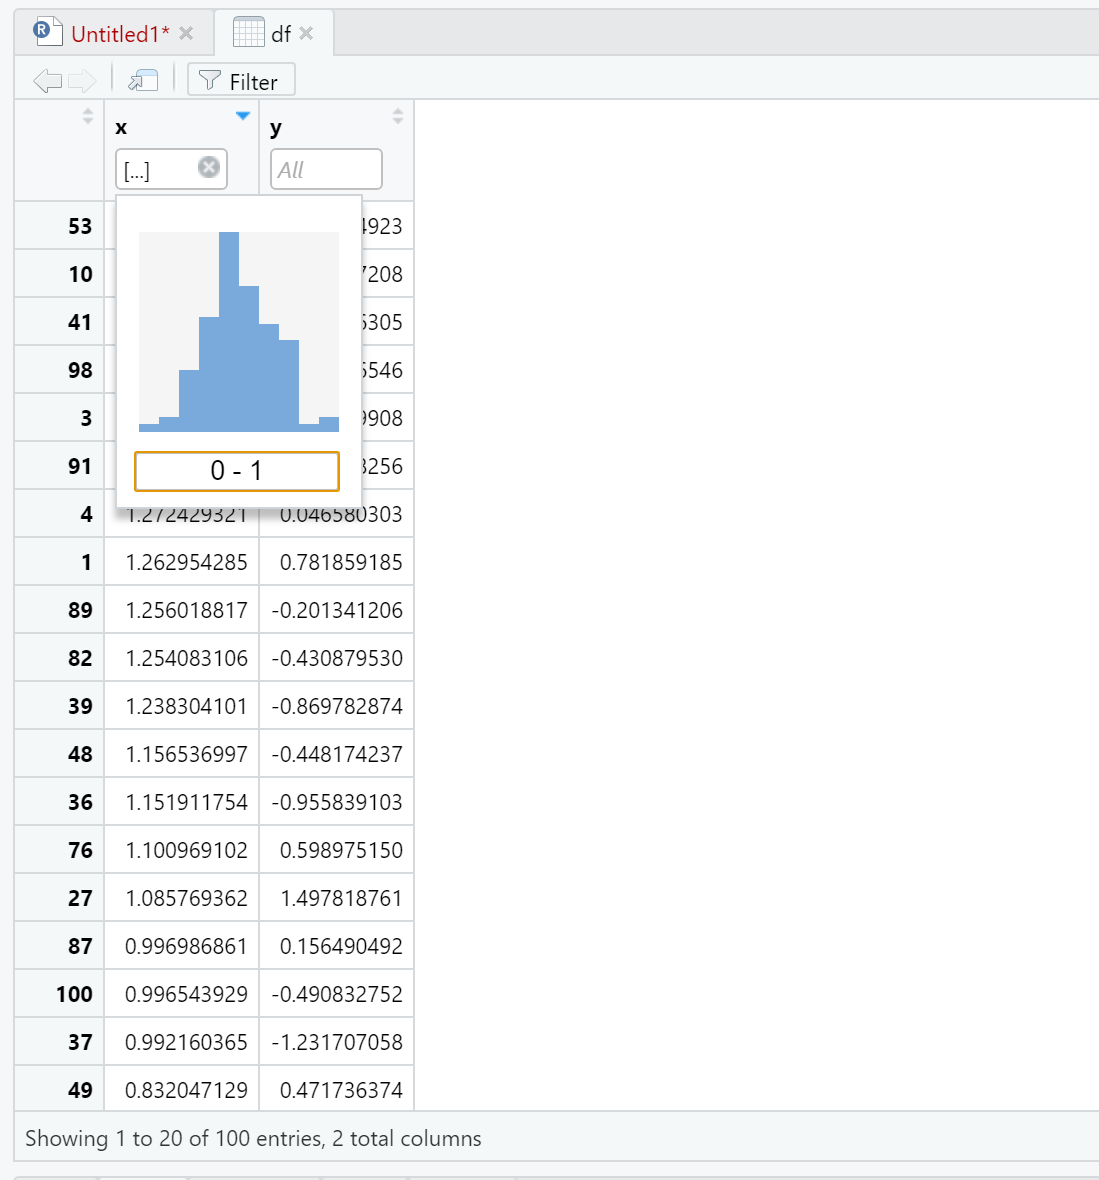
Au-delà du simple ordonnancement hiérarchique, la fonction View() dans RStudio intègre un puissant moteur de requêtage dynamique grâce à son bouton « Filter », disposé dans la barre d’outils supérieure de l’onglet, immédiatement à droite de la loupe de recherche textuelle globale. L’enfoncement de ce bouton déclenche le déploiement immédiat d’une sous-barre d’en-tête positionnée directement entre le nom de chaque variable et la première ligne d’observation du tableau.
Cette interface de filtrage adapte dynamiquement ses composants de saisie en fonction de la nature typologique rigoureuse de la colonne sous-jacente :
- Pour les variables de type
numericouinteger, RStudio instancie un double curseur interactif accompagné de deux champs textuels délimitant respectivement les bornes inférieure (valeur minimale) et supérieure (valeur maximale) de l’intervalle observable. - Pour les variables de type
factor, l’interface déploie un sélecteur à cases à cocher répertoriant l’exhaustivité des niveaux valides du facteur, autorisant l’inclusion ou l’exclusion discrète de modalités spécifiques. - Pour les variables de type
character, le visualiseur affiche une zone de saisie textuelle permettant la recherche d’occurrences ou d’expressions régulières élémentaires.
L’ergonomie de ce dispositif autorise le cumul simultané de multiples contraintes de restriction à travers plusieurs colonnes indépendantes. L’analyste peut ainsi, en quelques manipulations intuitives, restreindre l’observation aux seuls sujets du groupe « Expérimental », ayant validé la condition de stress « Élevé », et présentant simultanément un score cognitif compris entre 90 et 115 unités. La grille matricielle rafraîchit immédiatement son affichage pour ne présenter que les enregistrements satisfaisant à l’intersection logique (l’opérateur booléen ET) de l’ensemble des prédicats formulés.
7.2 Filtrage de plages numériques et de chaînes de caractères
L’exploitation des filtres de plages numériques offre une finesse d’investigation particulièrement précieuse pour sonder la distribution des observations. Les curseurs d’intervalles peuvent être manipulés soit par glissement mécanique des curseurs d’extrémités le long de la barre de graduation, soit par la saisie numérique directe de valeurs cibles au sein des champs délimiteurs. Lorsque l’analyste restreint la borne supérieure d’un score de performance, le visualiseur occulte instantanément tous les enregistrements excédant ce plafond, facilitant l’évaluation qualitative de la densité des données au sein de sous-segments spécifiques de l’espace métrique.
En ce qui concerne le filtrage textuel des identifiants ou des variables qualitatives non factorisées, le moteur JavaScript sous-jacent applique par défaut une recherche par sous-chaîne sans contrainte d’ancrage. La saisie de la séquence numérique "05" dans le filtre de la variable identifiant isolera immédiatement les enregistrements portant des codes tels que "ID_005", "ID_050", ou toute autre modalité incorporant cette suite ordonnée de caractères. L’utilisation conjointe de négations ou de jokers rudimentaires permet également de localiser des identifiants mal formés ou des saisies discordantes au sein de bases documentaires hétérogènes.
Une dimension cruciale du filtrage réside dans la gestion des données manquantes. Dans R, l’absence d’observation est formellement encodée par la constante logique NA (Not Available). Dans l’interface de filtrage de RStudio, les valeurs NA sont isolées et signalées par des sélecteurs spécifiques au sein des colonnes factorielles ou textuelles, permettant à l’utilisateur de choisir délibérément de masquer ces cas pour examiner la structure des données complètes, ou au contraire de n’afficher que les lignes déficitaires afin d’auditer l’étendue et la structure systématique de la vacuité d’information au sein du protocole expérimental.
7.3 Limites opérationnelles du filtrage interactif
Bien que le filtrage interactif au sein de l’onglet View() présente un attrait ergonomique indéniable lors des phases de familiarisation avec les données, il s’accompagne d’une limitation méthodologique absolue qu’il est indispensable de reconnaître : l’interface ne propose aucun mécanisme d’exportation directe ou de rétro-injection du sous-ensemble ainsi filtré vers l’environnement de programmation actif. Il est impossible d’assigner le résultat visible d’un filtrage View() à un nouvel objet R via un clic de souris ou une quelconque commande de menu contextuel.
Cette impossibilité fonctionnelle, loin de constituer une lacune de conception de la part des ingénieurs de RStudio, relève d’une décision architecturale consciente visant à préserver l’impératif de reproductibilité scientifique. Si les analystes extrayaient des sous-échantillons par des opérations manuelles de filtrage graphique non scriptées, la chaîne de traitement analytique serait immédiatement rompue, interdisant à tout chercheur tiers de reproduire rigoureusement l’arborescence des critères d’exclusion retenus. L’outil graphique est conçu pour voir, jamais pour modifier ou créer de la donnée persistante.
En conséquence, le filtrage interactif via View() doit être méthodologiquement cantonné à un rôle de prospection heuristique préliminaire. Dès lors que l’analyste a identifié, par ce biais visuel, un sous-ensemble d’observations méritant une analyse spécifique, il est impératif de traduire immédiatement ces contraintes sous forme de code formel dans le script d’analyse. Cette formalisation s’accomplit au moyen des opérateurs d’extraction vectorisée usuels (df_filtre <- subset(df, score_cognitif >= 100 & groupe == "Controle")) ou via le verbe dplyr::filter(). Cette discipline garantit la traçabilité intégrale, l’auditabilité et la reproductibilité des réductions d’échantillons opérées.
8. Application pratique en psychométrie et sciences comportementales
8.1 Scénario d’un questionnaire d’évaluation de l’anxiété
Pour illustrer la portée concrète de l’inspection visuelle dans les sciences de l’esprit et du comportement, analysons le protocole de recueil d’un inventaire clinique d’évaluation de l’anxiété, composé d’une batterie d’items ordonnés de type Likert en cinq points (échelonnés de 1 pour « Jamais » à 5 pour « Presque toujours »). Dans ce scénario type, une cohorte de sujets remplit une série de vingt énoncés mesurant divers aspects somatiques, émotionnels et cognitifs de la détresse psychologique.
L’ouverture de cette matrice de réponses au sein de View() constitue une étape clinique fondamentale pour auditer la qualité des passations. Le balayage visuel horizontal des lignes de données permet de déceler instantanément des patrons de non-réponse ou des comportements de réponse biaisés, à l’instar de l’effet d’acquiescement systématique ou de complétion stéréotypée (où un participant coche invariable et paresseusement la modalité médiane « 3 » ou l’extrémité « 5 » sur l’ensemble des items du formulaire). La mise en évidence visuelle de ces rangées uniformes alerte immédiatement le psychométricien sur la non-validité écologique de certaines passations.
De surcroît, le visualiseur s’avère irremplaçable pour contrôler l’intégrité du recodage des items dits « inversés ». Dans toute échelle standardisée robuste, certains énoncés sont formulés positivement afin de neutraliser les biais de réponse unilatéraux, nécessitant une inversion arithmétique de leur échelle de notation (où un score initial de 5 devient 1, et inversement) avant le calcul du score global. L’inspection simultanée des colonnes brutes et des colonnes recodées au sein de View() offre une validation visuelle immédiate et intuitive de la parfaite application des formules de translation numérique avant d’engager le calcul de l’alpha de Cronbach ou l’ajustement d’un modèle d’équations structurelles.
8.2 Contrôle des données chronométriques en psychologie cognitive
Dans le domaine de la chronométrie mentale et des neurosciences expérimentales, les protocoles expérimentaux génèrent des volumes massifs d’événements discrets : une tâche de détection sérielle de signaux ou une tâche de Stroop implique couramment des centaines d’essais répétés pour chaque participant. La structure tabulaire résultante superpose des indicateurs d’exactitude binaire (succès ou échec) et des temps de réaction continus mesurés à la milliseconde près.
L’interrogation de ces jeux de données via View() permet de contrôler visuellement le couplage critique entre la précision de la réponse et la vitesse d’exécution (le compromis vitesse-précision, ou speed-accuracy trade-off). En appliquant un filtre interactif pour n’afficher que les essais catégorisés en échec, l’expérimentateur peut immédiatement inspecter la distribution des latences résiduelles. Il identifie ainsi aisément si les erreurs sont préférentiellement cantonnées dans la zone des temps ultra-courts — signifiant un comportement impulsif où le sujet répond avant l’intégration perceptuelle du stimulus — ou si elles s’étalent sur des temps anormalement longs, suggérant des décrochages attentionnels ou des épisodes d’hésitation cognitive majeure.
De plus, l’inspection interactive des séquences chronologiques d’essais au moyen de la vue tabulaire permet de mettre en lumière des effets d’apprentissage progressif (traduits par un raccourcissement progressif des temps de réponse au fil des lignes d’indexation pour un même sujet) ou, à l’inverse, l’apparition d’une fatigue cognitive marquée, caractérisée par une augmentation erratique de la variabilité intra-individuelle des latences au cours des derniers blocs d’évaluation. Ce niveau d’observation granulaire, directement accessible dans View(), nourrit des hypothèses de modélisation dynamique qui demeureraient invisibles sous de simples moyennes agrégées par sujet.
8.3 Détection d’anomalies qualitatives et erreurs d’encodage
L’un des apports les plus décisifs de la fonction View() réside dans sa capacité à exposer crûment les anomalies qualitatives et les corruptions typographiques au sein des identifiants et des variables catégorielles. Dans les protocoles de recherche multicentriques, la saisie des identifiants des participants fait souvent l’objet d’erreurs humaines subtiles : l’insertion d’un espace typographique résiduel en fin de chaîne ("ID_012 " vs "ID_012"), l’utilisation erronée de la lettre majuscule « O » à la place du chiffre zéro (« 0 »), ou des variations inopinées dans l’usage des séparateurs (tirets courts contre tirets bas).
Bien que ces micro-divergences textuelles soient presque indétectables lors d’une impression console globale en raison du flux continu des caractères, elles apparaissent avec une netteté remarquable dans les cellules alignées de la grille View(). Plus encore, l’ouverture du menu de filtrage sur la colonne des identifiants ou des groupes expose instantanément ces anomalies, le visualiseur créant des catégories distinctes pour chaque variante typographique. L’analyste est ainsi alerté d’un problème d’encodage qui, s’il n’avait pas été repéré, aurait provoqué la scission silencieuse d’un même participant en deux cohortes artificielles lors des procédures ultérieures d’agrégation via group_by().
Enfin, l’examen visuel tabulaire joue un rôle éthique et déontologique de premier plan en matière de conformité avec les réglementations sur la protection des données personnelles (telles que le RGPD en Europe). Avant toute cession d’un jeu de données expérimental à un tiers ou avant son téléversement sur un entrepôt de données de recherche publique (Open Science Framework, Zenodo), une revue exhaustive au sein de View() permet de certifier l’absence totale de données directement ou indirectement nominatives (noms, dates de naissance précises, adresses IP) ayant échappé aux protocoles d’anonymisation automatisés, prévenant ainsi toute compromission fortuite de la confidentialité des sujets humains engagés dans la recherche.
9. Gestion des grands jeux de données et limites de performance de View()
9.1 Seuils d’affichage et troncature des colonnes
Bien que la conception technique de la fonction View() soit hautement optimisée pour un usage exploratoire régulier, elle rencontre des limites physiques structurelles lorsqu’elle est confrontée à des jeux de données dits massifs (Big Data). Le premier seuil critique auquel se heurtent fréquemment les analystes concerne le plafonnement arbitraire imposé par l’environnement RStudio sur le nombre maximal de variables visualisables simultanément.
Par défaut, pour préserver la réactivité de l’interface graphique et éviter une consommation excessive de bande passante au sein du pont de communication C++/JavaScript, RStudio tronque l’affichage tabulaire lorsqu’une table excède un certain volume dimensionnel. Dans les versions contemporaines, la limite par défaut est communément fixée à 50 colonnes (ou 1 000 colonnes selon la configuration spécifique de mémoire allouée et la version de RStudio) et 1 000 colonnes maximales affichées simultanément. Lorsque ce seuil est franchi — une situation courante en transcriptomique, en bio-informatique ou dans les paradigmes de neuro-imagerie MEG/EEG où chaque voxel ou capteur correspond à une dimension —, le visualiseur n’affiche qu’un sous-ensemble de colonnes et avertit l’utilisateur au bas de la page par un message indiquant la troncature délibérée des variables restantes.
Bien qu’il soit techniquement envisageable de repousser ces seuils en reconfigurant les variables d’environnement globales de RStudio (notamment via l’assignation de directives telles que rstudio.max.columns dans le fichier d’initialisation .Rprofile), cette pratique doit être mise en œuvre avec une extrême circonspection. Forcer le visualiseur à charger simultanément plusieurs milliers de colonnes dégrade lourdement les performances de la session et conduit inévitablement à une saturation des cycles de traitement de l’interface graphique.
9.2 Consommation mémoire et gel d’interface
L’utilisation imprudente de View() sur des structures de données géantes — dépassant couramment le million d’enregistrements et plusieurs centaines d’attributs complexes — engendre des risques tangibles d’instabilité logicielle. Bien que la virtualisation des lignes protège le rendu HTML immédiat, le processus de sérialisation et de transfert de la structure depuis la mémoire vectorielle de base de R vers la mémoire allouée au conteneur web de RStudio nécessite une empreinte RAM substantielle.
Lorsqu’un jeu de données approche les limites de la mémoire vive disponible sur la machine hôte, l’exécution de View() peut déclencher une séquence d’essoufflement mémoriel (memory paging excessif vers le disque swap). Les symptômes typiques de cet état de saturation se matérialisent par le gel complet de l’interface de RStudio, l’impossibilité d’interrompre l’opération via le bouton d’arrêt d’urgence (icône « Stop » de la console), et occasionnellement le crash brutal de la session R (accompagné du message fatal R Session Aborted). Ce phénomène entraîne la perte irrémédiable de l’ensemble des objets non sauvegardés résidant dans l’espace de travail actif.
De plus, l’exécution d’opérations de tri interactif sur des tables colossales au sein du visualiseur mobilise des routines de réordonnancement JavaScript sur le thread principal de rendu. Si la puissance processeur dédiée est insuffisante, l’interface utilisateur peut cesser de répondre temporairement, générant des alertes du système d’exploitation relatives à un processus en souffrance. Dès lors, il apparaît indispensable d’anticiper la volumétrie des structures avant de formuler aveuglément des appels à la commande View().
9.3 Techniques de sous-échantillonnage pour inspection sécurisée
Pour contourner ces contraintes de performance tout en préservant le bénéfice incontestable d’un contrôle visuel interactif, la démarche la plus élégante et professionnelle consiste à soumettre à View() des sous-ensembles échantillonnés et représentatifs des données, plutôt que la totalité indivisible du corpus géant. Cette approche associe la sécurité de calcul à la finesse du diagnostic.
Une première technique d’une extrême simplicité consiste à restreindre l’inspection aux premières ou aux dernières observations du tableau par l’application conjointe des fonctions canoniques head() ou tail(). L’instruction View(head(table_massive, 1000)) ne soumettra au visualiseur qu’une tranche sécurisée de mille lignes, fournissant un aperçu suffisant pour vérifier l’alignement des colonnes, la syntaxe des identifiants et la typologie des attributs sans solliciter de manière critique la mémoire vive du système.
Lorsque le chercheur suspecte des distorsions ou des hétérogénéités distribuées de manière non uniforme le long de la table, le recours à un échantillonnage pseudo-aléatoire uniforme s’avère considérablement plus représentatif. En mobilisant l’écosystème dplyr, l’instruction suivante réalise une projection visuelle idéale :
View(dplyr::slice_sample(table_massive, n = 500), title = "Echantillon_Aleatoire")
Ce protocole extrait un sous-ensemble stochastique non biaisé, préservant la distribution empirique des valeurs extrêmes et la représentativité des facteurs, tout en garantissant une réactivité maximale et une stabilité absolue au sein de l’environnement graphique de RStudio.
10. Erreurs courantes, débogage et résolution des dysfonctionnements
10.1 Résolution de l’erreur ‘could not find function « view »‘
L’incident technique le plus récurrent associé à la fonction d’affichage tabulaire demeure indubitablement la survenue de l’erreur d’exécution : Error in view(data) : could not find function "view". Comme exposé lors de l’analyse syntaxique, ce dysfonctionnement découle directement de l’omission de la majuscule initiale, l’utilisateur ayant saisi par réflexe typographique le vocable en minuscules complètes.
Une confusion supplémentaire s’est toutefois immiscée au sein de la communauté avec l’essor du métapackage tidyverse. Dans certaines versions périphériques de packages satellites, des développeurs ont occasionnellement introduit des fonctions capsules (wrappers) baptisées view() en minuscules, destinées précisément à intercepter cette coquille fréquente pour rediriger l’exécution vers la véritable routine utils::View(). Par conséquent, un analyste peut constater avec perplexité que la commande view(df) fonctionne parfaitement dans un script où la bibliothèque tibble ou l’ensemble tidyverse a été préalablement chargé en mémoire via l’instruction library(), mais échoue immédiatement lors de l’exécution dans une session R vierge.
Pour prévenir cette source de vulnérabilité et garantir une reproductibilité universelle indépendante des bibliothèques attachées au fil de l’eau, la discipline méthodologique impose de bannir définitivement l’alias minuscule des pratiques d’écriture de code. L’analyste rigoureux s’astreindra à utiliser invariablement la graphie canonique View() avec sa majuscule formelle. En cas d’ambiguïté au sein d’environnements d’exécution complexes, il est même recommandé de préfixer formellement la commande par son espace de nommage d’origine : utils::View(df), éliminant ainsi toute équivoque pour l’interpréteur de symboles.
10.2 Comportement de View() en environnement sans interface graphique (CLI / Serveur)
Une complication majeure survient lorsque des scripts R sont exécutés dans des environnements dépourvus d’interface utilisateur graphique (headless environments), tels que des serveurs distants interrogés exclusivement via des sessions de terminal SSH, des conteneurs d’intégration continue (Docker), ou des plateformes de calcul distribué (HPC). Dans ces configurations purement textuelles en ligne de commande (CLI), l’interpréteur de commandes R ne dispose d’aucun serveur d’affichage X11 ni d’aucun moteur de rendu web pour matérialiser la feuille de calcul interactive.
Dans un tel contexte d’exécution terminale nue, l’appel à la fonction View() produit généralement un résultat dégradé : R bascule automatiquement sur une routine textuelle d’urgence qui imprime l’intégralité du jeu de données sous forme brute directement dans le flux standard de la console (similaire à l’appel de la fonction print()), submergeant instantanément le terminal de l’utilisateur sous des millions de caractères non formatés. Dans d’autres circonstances, l’appel déclenche un avertissement ou une erreur d’exécution explicite indiquant l’indisponibilité du périphérique d’affichage graphique (no display name and no $DISPLAY environment variable).
Une exception notable concerne le déploiement de RStudio Server. Dans cette architecture centralisée où le moteur de calcul R réside sur un serveur distant mais où l’interaction s’effectue via un navigateur web client, la fonction View() conserve sa pleine opérabilité. L’environnement RStudio Server intercepte l’appel système et redirige les flux de données nécessaires vers l’onglet DataTables de l’interface du navigateur distant. Néanmoins, pour les flux de production automatisés non interactifs, il est impératif de proscrire formellement tout appel à View() afin d’éviter tout blocage de processus en attente de fermeture de session.
10.3 Échec d’affichage d’objets non tabulaires
Une incompréhension fréquente chez les praticiens concerne le périmètre structural des objets admissibles par le visualiseur. Bien que View() ingère sans difficulté les structures bidimensionnelles classiques, elle n’est pas conçue pour afficher directement des objets statistiques complexes hautement paramétrés, tels que les instances renvoyées par des fonctions d’estimation de modèles linéaires ou mixtes : modele <- lm(score_cognitif ~ groupe, data = df).
Si l’analyste exécute inconsidérément View(modele), le visualiseur de RStudio ne produit pas une synthèse tabulaire ordonnée des coefficients, des erreurs standards et des valeurs p comme l’utilisateur pourrait naïvement l’anticiper. L’environnement déclenche son visualiseur hiérarchique d’arborescence d’objets (Object Explorer), exposant l’architecture interne brute du modèle sous forme d’une liste imbriquée complexe d’éléments C/R : les vecteurs de résidus, les valeurs prédites, la matrice de projection de rang, les termes de formule, etc. Cette vision hautement technique et déstructurée s’avère généralement dénuée d’intérêt pour l’évaluation diagnostique courante.
Pour convertir ces objets statistiques denses en formats tabulaires immédiatement exploitables et inspectables par View(), le chercheur doit préalablement solliciter des fonctions de standardisation d’informations. L’écosystème broom fournit à cet égard des instruments méthodologiques d’une efficacité remarquable. L’instruction combinée :
View(broom::tidy(modele), title = "Coefficients_Modele")
permet de contraindre les estimateurs du modèle statistique sous forme d’un tableau rectangulaire propre (tidy data frame), parfaitement compréhensible pour le visualiseur, où chaque coefficient est rigoureusement aligné avec son écart-type, sa statistique de test de Student et sa probabilité critique associée.
11. Comparaison avec les alternatives programmatiques et interactives
11.1 Outils textuels d’inspection rapide : head(), str() et summary()
Pour situer avec précision la valeur ajoutée de la fonction View() au sein de la boîte à outils du data scientist, il est indispensable de la confronter aux routines d’inspection textuelle historiques de R base. Les trois fonctions les plus représentatives de ce paradigme console sont head(), str() et summary(). Chacune de ces commandes répond à un impératif diagnostique spécifique mais présente des limites inhérentes que la vue interactive permet de transcender.
La commande head(df, n = 6) assure une visualisation immédiate des premières lignes de la structure directement dans le terminal. Sa force réside dans son instantanéité absolue et dans le fait qu’elle ne rompt pas le flux séquentiel de travail dans la console. Cependant, dès lors que le nombre de colonnes s’accroît, l’affichage se disloque horizontalement, rendant impossible la consultation simultanée de variables situées aux deux extrémités de la table. La fonction str() excelle dans l’inventaire des types de données et de la longueur des vecteurs, mais n’offre aucune intuition quant à la distribution empirique ou à la présence de patrons anormaux dans les données. Quant à summary(), elle fournit des métriques paramétriques condensées (quartiles, minima, maxima, moyennes), mais agrège tellement l’information qu’elle gomme totalement la vision individuelle des observations atypiques.
L’avantage cardinal de ces routines textuelles réside néanmoins dans leur parfaite persistance au sein des journaux d’exécution et des rapports compilés : leurs résultats sont inscrits dans le flux de sortie de la console, ce qui permet de les intégrer organiquement dans des comptes-rendus automatisés, une tâche pour laquelle la fonction View() est par essence totalement inopérante.
11.2 Visualiseurs de données enrichis : skimr et tibble::glimpse()
Face aux limites des outils textuels de R base, l’écosystème contemporain a développé des alternatives d’inspection en console particulièrement sophistiquées. Au premier rang de celles-ci figure la fonction glimpse() du package tibble. Conçue explicitement pour pallier les écueils de str() face aux tableaux denses, glimpse() transpose visuellement l’affichage : les variables sont présentées verticalement sous forme de lignes, et les premières observations défilent horizontalement sur toute la largeur disponible de la console. Cette approche garantit la lisibilité de chaque colonne, quel que soit leur nombre total, sans jamais provoquer de saut de ligne destructeur.
Une étape supérieure dans le raffinement de l’inspection programmatique est franchie avec le package skimr. La fonction skim(df) génère directement dans le terminal une analyse diagnostique d’une densité informationnelle exceptionnelle. Pour chaque variable, skimr quantifie avec précision le taux de complétude, le nombre de valeurs manquantes, la moyenne, l’écart-type, ainsi que les percentiles. Plus impressionnant encore, il dessine au sein même de la console textuelle un micro-histogramme miniature (en caractères typographiques Unicode) représentant la morphologie distributionnelle de la variable en question.
Bien que ces outils modernes réduisent considérablement le coût cognitif de l’exploration descriptive dans la console et surpassent View() pour l’évaluation globale d’une cohorte, ils ne sauraient remplacer l’ergonomie d’une interface tabulaire navigable lorsqu’il s’agit de repérer visuellement des croisements complexes entre valeurs individuelles ou d’isoler manuellement un enregistrement particulier au sein d’une matrice complexe.
11.3 Packages interactifs avancés : DT, reactable et editData
Pour les contextes où l’interaction tabulaire de type feuille de calcul doit être partagée avec des tiers ou intégrée au sein de livrables formels, la communauté R a développé des bibliothèques interactives de pointe qui étendent et surpassent les fonctionnalités natives de View(). Le package DT s’impose comme la référence hégémonique dans ce domaine. En encapsulant directement la bibliothèque DataTables dans des documents R Markdown, Quarto ou des applications web interactives Shiny via la fonction datatable(df), il permet de générer des tableaux interactifs d’une richesse visuelle remarquable, dotés de boutons de téléchargement (CSV, PDF, Excel), de recherches globales et de mises en forme conditionnelles élaborées.
Dans un registre encore plus contemporain, le package reactable, fondé sur la technologie JavaScript React, offre des performances de rendu exceptionnelles et une modularité esthétique accrue. Il autorise l’intégration native de barres de progression graphiques directement au sein des cellules tabulaires, l’imbrication dynamique de tableaux secondaires déroulants (row expanding), et un contrôle typographique millimétré, surpassant largement le cadre fonctionnel volontairement dépouillé de la fonction View() de base.
Enfin, pour les situations singulières où une intervention manuelle directe sur les valeurs matricielles est requise, le package editData comble le vide historique laissé par la désuétude de la fonction native fix(). Alors que View() interdit strictement toute altération de la cellule affichée, editData déploie une interface graphique permettant de modifier interactivement le contenu d’un enregistrement, de supprimer ou d’ajouter des lignes, et de renvoyer l’objet rectifié directement dans l’environnement global de R. Ce tableau comparatif synthétise les propriétés respectives de ces différents instruments :
- View() : Intégré nativement, consultation passive uniquement, sans modification de l’objet, restreint à l’interactivité au sein de RStudio.
- DT / reactable : Nécessite l’installation de packages externes, orienté vers la publication HTML interactive et les applications Shiny, capacités de personnalisation graphique majeures.
- editData : Outil dédié à l’édition manuelle interactive de cellules matricielles avec persistance rétroactive dans l’espace de travail.
- head() / glimpse() : Outils textuels stricts en console, non interactifs, persistants dans les flux d’exécution et indispensables à l’automatisation.
12. Bonnes pratiques méthodologiques et intégration dans le flux d’analyse
12.1 Séparation stricte entre exploration et manipulation des données
L’hygiène de programmation et la rigueur méthodologique imposent une frontière hermétique entre la phase d’exploration visuelle ponctuelle et la chaîne formelle de manipulation des données au sein des scripts de recherche. L’une des déviances les plus pernicieuses observées chez les praticiens consiste à laisser des instructions View() insérées au milieu de leurs scripts de nettoyage ou de modélisation statistique.
Cette pratique constitue une infraction majeure aux standards de l’ingénierie logicielle et de la science ouverte. Lorsqu’un script R contenant un appel à View() est exécuté en mode non interactif via la commande système Rscript analyse.R, ou lorsqu’un document computationnel reproductible est compilé via le processus de tricotage (knitting sous R Markdown ou compilation sous Quarto), l’interpréteur se heurte à une commande d’interface graphique interactive non résoluble. Cette situation peut provoquer une interruption brutale du pipeline de calcul, générer des avertissements bloquants ou dégrader l’intégrité du document final en tentant de matérialiser un onglet graphique dans un flux de rendu statique en PDF ou en LaTeX.
La règle méthodologique cardinale stipule donc que l’instruction View() doit être rigoureusement cantonnée à l’interaction directe et éphémère dans la console de commande RStudio. Si un analyste l’utilise au sein d’un script en phase de développement exploratoire pour contrôler la structure d’une table intermédiaire, il a l’obligation formelle de commenter (# View(df)) ou d’éradiquer purement et simplement cette ligne avant de figer son script, de versionner son code sur un dépôt Git ou de lancer la génération automatisée de ses rapports d’analyse.
12.2 Documentation des constatations issues de la visualisation
L’exploration visuelle par le visualiseur ne doit jamais demeurer un acte cognitif éphémère et informel dont il ne subsiste aucune trace explicite dans le protocole de recherche. Lorsqu’un chercheur scrute son jeu de données à travers View(), chaque constatation critique — qu’il s’agisse de la découverte d’un participant ayant produit des temps de réponse invariablement identiques, d’une rupture d’encodage sur une cohorte, ou d’une valeur biologique physiologiquement impossible — doit faire l’objet d’une documentation systématique et rigoureuse.
Cette documentation méthodologique s’effectue traditionnellement au sein du carnet de laboratoire computationnel ou directement en commentaire dans le script d’ingestion de données. L’observation visuelle doit immédiatement donner lieu à la rédaction d’une règle d’exclusion ou de redressement formalisée sous forme d’instruction algorithmique vérifiable. L’analyste traduira ainsi une constatation visuelle (« le sujet 42 présente une valeur d’anxiété de 99 ») en un test logique explicite d’assertion et de nettoyage (df <- df[df$anxiete <= 5, ] ou application d’un filtre avec journalisation de l’exclusion).
Ce processus de traduction systématique garantit que la démarche scientifique demeure intégralement transparente et reproductible. Les opérations de nettoyage ne sont plus tributaires de la mémoire subjective du chercheur manipulant des fenêtres de tableur, mais sont adossées à un registre décisionnel consigné où chaque exclusion d’observation est explicitement motivée, chiffrée et reproductible par n’importe quel réviseur indépendant examinant le code source de l’étude.
12.3 Synthèse procédurale pour une inspection optimale des données
Pour conclure cette cartographie exhaustive et outiller de manière opérationnelle le praticien, il est opportun de condenser les préceptes développés tout au long de cet article au sein d’un protocole méthodologique standardisé. Cette synthèse procédurale en cinq étapes ordonnées définit la trajectoire optimale à adopter lors de l’accueil de tout nouveau jeu de données au sein de l’environnement R :
- Validation de l’intégrité globale en console : Avant toute tentative de visualisation graphique, évaluer les dimensions et la conformité typologique générale de la table au moyen des commandes natives non intrusives
dim(df),sapply(df, class)ettibble::glimpse(df). - Sécurisation dimensionnelle avant affichage : Quantifier le volume d’enregistrements. Si la table excède plusieurs dizaines de milliers de lignes ou plusieurs centaines d’attributs, dériver immédiatement un échantillon représentatif via
dplyr::slice_sample()ou isoler un fragment circonscrit avechead()pour préserver la mémoire vive du système. - Lancement contrôlé du visualiseur interactif : Exécuter la commande canonique rigoureuse
View(df_echantillon, title = "Audit_Initial")en observant scrupuleusement la majuscule formelle pour déployer le canevas de navigation de RStudio. - Audit interactif ciblé :
- Actionner le tri descendant et ascendant sur les métriques critiques pour sonder les bornes empiriques, identifier les valeurs aberrantes (outliers) et détecter d’éventuels artefacts d’encodage.
- Déployer le bouton Filter pour isoler les modalités qualitatives, vérifier l’absence d’erreurs de saisie textuelle dans les identifiants et cartographier la structure spatiale des valeurs manquantes (
NA).
- Formalisation programmatique et sanctuarisation du code : Traduire immédiatement l’ensemble des détections visuelles en syntaxe programmatique formelle de sous-ensemble ou d’imputation au sein du script de recherche, puis supprimer méthodiquement toute référence textuelle à
View()avant l’archivage ou l’automatisation du flux d’analyse.
En respectant scrupuleusement cette architecture de travail, le chercheur ou l’ingénieur de données tire le meilleur parti des fonctionnalités ergonomiques avancées offertes par l’écosystème Posit RStudio, tout en sanctuarisant la rigueur technique, l’efficacité computationnelle et la reproductibilité fondamentale qui constituent le socle inaliénable de la recherche scientifique contemporaine.
Références
- Chambers, J. M. (2008). Software for data analysis: Programming with R. Springer Science & Business Media. https://doi.org/10.1007/978-0-387-75936-4
- Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), aac4716. https://doi.org/10.1126/science.aac4716
- Posit team. (2024). RStudio: Integrated Development Environment for R. Posit Software, PBC. https://posit.co/
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.r-project.org/
- Robinson, D., Hayes, A., & Couch, S. (2023). broom: Convert statistical analysis objects into tidy tibbles (R package version 1.0.5). CRAN. https://CRAN.R-project.org/package=broom
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley Publishing Company.
- Waring, E., Quinn, M., McNamara, A., Arino de la Rubia, E., Zhu, H., & Ellis, S. (2022). skimr: Compact and flexible summaries of data (R package version 2.1.5). CRAN. https://CRAN.R-project.org/package=skimr
- Wickham, H., & Grolemund, G. (2017). R for data science: Import, tidy, transform, visualize, and model data. O’Reilly Media.
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686
- Xie, Y., Cheng, J., & Tan, X. (2024). DT: A wrapper of the JavaScript library ‘DataTables’ (R package version 0.33). CRAN. https://CRAN.R-project.org/package=DT