
L’analyse statistique des variables qualitatives nominales représente l’un des piliers méthodologiques fondamentaux de la recherche contemporaine en sciences comportementales, sociales, médicales et économiques. Lorsque les observations ne se limitent plus à un choix binaire dichotomique mais s’étendent à un ensemble fini d’issues mutuellement exclusives et collectivement exhaustives, le modèle binomial conventionnel cède le pas à la distribution multinomiale. Cette généralisation mathématique sophistiquée permet d’évaluer la probabilité conjointe d’observer une configuration précise d’effectifs répartis à travers plusieurs classes qualitatives, sous l’hypothèse d’épreuves répétées et indépendantes assorties de probabilités catégorielles invariantes.
Dans la pratique courante des laboratoires de recherche, des cellules d’évaluation clinique et des cabinets d’études quantitatives, le recours aux grands progiciels de calcul statistique spécialisés n’est pas toujours immédiat ni indispensable. Microsoft Excel, largement disponible et doté d’un puissant moteur de calcul matriciel, offre un environnement analytique remarquablement polyvalent pour concevoir, implémenter, vérifier et visualiser des modèles probabilistes multinomiaux. Néanmoins, l’évaluation sans faille de telles distributions requiert une compréhension rigoureuse des mécanismes de la combinatoire, des propriétés d’asymptotique numérique, ainsi que des limites inhérentes à la précision arithmétique en virgule flottante standard.
Ce traité exhaustif expose de manière systématique l’ensemble des fondements théoriques, des formulations mathématiques et des protocoles d’implémentation pratique de la loi multinomiale au sein de Microsoft Excel. En abordant successivement les fonctions natives du tableur, les stratégies d’optimisation logarithmique par la fonction log-gamma pour surmonter le débordement de capacité, les formulations matricielles dynamiques de dernière génération, l’automatisation via Visual Basic for Applications (VBA), ainsi que les tests d’adéquation statistiques, cet ouvrage constitue un manuel méthodologique intégral destiné aux chercheurs, analystes de données, psychomètres et biostatisticiens soucieux de rigueur et d’exactitude numérique.
1. Fondements théoriques de la distribution multinomiale en recherche quantitative
1.1 Définition et propriétés fondamentales du modèle multinomial
La distribution multinomiale s’impose sur le plan mathématique comme la généralisation directe de la loi binomiale dans le contexte d’expérimentations aléatoires dont les résultats possibles sont catégorisés selon un nombre fini k de modalités qualitatives nominales, mutuellement exclusives et exhaustivement répertoriées, avec k strictement supérieur ou égal à deux. Tandis que l’épreuve de Bernoulli classique scinde l’univers des possibles en une alternative binaire arbitraire définie par le succès ou l’échec, le processus multinomial capture la complexité inhérente aux phénomènes polytomiques du monde réel, où chaque unité statistique est assignée à une et une seule classe parmi les k catégories disponibles.
L’application rigoureuse du cadre probabiliste multinomial requiert l’adhésion stricte à un ensemble d’axiomes fondamentaux régissant le protocole de génération des données. En premier lieu, l’expérimentation doit reposer sur un nombre fini et préalablement fixé d’épreuves indépendantes, communément noté n. L’indépendance statistique des observations implique formellement que l’issue enregistrée lors de la m-ième tentative ne conditionne en aucune manière la distribution des probabilités des issues subséquentes. Cette condition est rigoureusement satisfaite soit dans le cadre d’un échantillonnage aléatoire simple opéré avec remise au sein d’une population d’effectif fini, soit lors d’un échantillonnage sans remise issu d’une population dont la taille peut être considérée comme virtuellement infinie par rapport à l’échantillon prélevé.
En second lieu, le modèle impose une condition d’homogénéité temporelle ou séquentielle : le vecteur des probabilités catégorielles, noté (p1, p2, …, pk), doit demeurer rigoureusement constant tout au long des n tirages. Chaque paramètre pi désigne la probabilité marginale invariable qu’une unité sélectionnée aléatoirement appartienne à la modalité i. Par construction, ces paramètres doivent satisfaire à la contrainte de complétude probabiliste, laquelle énonce que la somme arithmétique de toutes les probabilités catégorielles élémentaires doit être strictement égale à l’unité unitaire :
Somme de pi pour i variant de 1 à k = 1, avec la condition d’appartenance fermée où chaque pi est compris dans l’intervalle [0, 1].
Sur le plan méthodologique, cette architecture théorique confère à la loi multinomiale un statut prééminent pour formaliser l’analyse des choix discrets polytomiques, des dynamiques comportementales complexes et des décisions séquentielles en psychologie cognitive et expérimentale. Lorsque des sujets humains sont confrontés à des alternatives décisionnelles multiples ou expriment des jugements subjectifs stratifiés, le cadre multinomial fournit le socle probabiliste d’échantillonnage indispensable à l’inférence quantitative.
1.2 Différenciation formelle entre modèles binomial, multinomial et hypergéométrique
L’exactitude des conclusions inférentielles repose sur l’adéquation conceptuelle entre la structure empirique du protocole d’échantillonnage et la loi de distribution postulée. Pour appréhender les frontières opérationnelles de la distribution multinomiale, il convient d’opérer une distinction analytique avec les distributions binomiale et hypergéométrique univariée ou multivariée, en portant une attention particulière à la structure de dépendance inter-épreuves et à la finitude de la population parente.
La distribution binomiale se révèle conceptuellement équivalente à une loi multinomiale tronquée au cas particulier minimaliste où k = 2. Néanmoins, tenter d’agréger arbitrairement un continuum qualitatif multidimensionnel sous une bannière dichotomique génère une perte substantielle d’information statistique. La binarisation artificielle de variables nominales à modalités multiples dissimule les corrélations négatives intrinsèques unissant les différentes catégories et interdit l’analyse différentielle des choix de substitution. Par exemple, si un participant doit choisir entre trois thérapies, fusionner deux modalités pour se ramener à un test binomial oblitère les dynamiques sous-jacentes d’attractivité relative entre les modalités fusionnées.
La démarcation entre le modèle multinomial et la loi hypergéométrique multivariée se focalise quant à elle sur la modalité d’échantillonnage appliquée aux populations finies d’effectif N. Si les n observations sont extraites sans remise d’une population de taille restreinte, la probabilité d’occurrence d’une modalité spécifique lors de l’épreuve suivante varie de manière déterministe en fonction des tirages antérieurs déjà consommés. La loi hypergéométrique multivariée capture exactement ce mécanisme de tirage dépendant. Cependant, lorsque le ratio d’échantillonnage (défini par n / N) demeure inférieur au seuil conventionnel de 0,05 (ou 5 %), l’impact de l’altération marginale des effectifs de la population devient statistiquement négligeable.
Ignorer l’absence de remise dans un contexte où la population source est petite induit une sous-estimation systématique de la précision des estimateurs. Plus précisément, la variance théorique sous le modèle hypergéométrique intègre un facteur multiplicatif de correction pour population finie, égal à (N – n) / (N – 1), qui est strictement inférieur à l’unité. Utiliser à tort la distribution multinomiale dans ces conditions revient à surestimer la variance échantillonnale, ce qui gonfle artificiellement le risque de commettre une erreur de type II (non-rejet d’une hypothèse nulle fausse) lors des tests de significativité.
1.3 Applications empiriques en sciences psychologiques et comportementales
Les sciences psychologiques et les disciplines comportementales connexes exploitent de manière intensive la loi multinomiale pour asseoir la modélisation statistique de données catégorielles complexes issues d’enquêtes ou de protocoles expérimentaux. L’un des domaines d’application les plus fertiles concerne l’analyse psychométrique des patrons de réponses aux inventaires de personnalité standardisés, tels que le NEO Personality Inventory Revised (NEO-PI-R) ou les matrices d’évaluation de la symptomatologie clinique. Les items de ces instruments reposent systématiquement sur des échelles polytomiques ordonnées ou graduées, dont l’ensemble des réponses pour une cohorte suit sous l’hypothèse nulle d’invariance un vecteur multinomial théorique.
Dans le domaine des neurosciences cognitives et de l’économie comportementale, les protocoles décisionnels confrontent fréquemment les agents à des choix simultanés ou séquentiels impliquant de multiples options concurrentes, caractérisées par des combinaisons distinctes de gains probabilistes et de pertes potentielles. La distribution multinomiale sert alors de distribution d’échantillonnage de référence pour calibrer les modèles de choix discret, tester l’hypothèse de rationalité parfaite contre des modèles de rationalité limitée, et estimer la vraisemblance des déviations comportementales observées dans des tâches de loteries polytomiques.
La nosographie et la classification diagnostique en psychopathologie constituent un autre champ majeur d’investigation. Face aux syndromes psychiatriques complexes présentant des profils symptomatiques comorbides hétérogènes, les cliniciens catégorisent souvent les patients au sein de typologies qualitatives plurielles (par exemple, phénotypes dépressifs mélancoliques, atypiques, mixtes ou anxieux). L’assignation probabiliste des individus à ces catégories nosologiques repose sur des modèles multinomiaux latents qui permettent d’évaluer la représentativité respective de chaque sous-groupe épidémiologique.
Enfin, en psychologie politique et en sociologie électorale, la modélisation des préférences citoyennes au sein de systèmes démocratiques multipartites constitue le cas d’usage canonique par excellence. La répartition des intentions de vote parmi un ensemble de k formations politiques rivales ne peut s’aborder rationnellement sous l’angle de lois univariées indépendantes. L’analyse conjointe des reports de voix, de la volatilité électorale et de l’incertitude sondagière exige une formulation multinomiale explicite afin d’estimer avec rigueur la probabilité d’émergence d’assemblées sans majorité absolue ou de coalitions atypiques.
2. Formulation mathématique et décomposition des composantes probabilistes
2.1 Équation analytique de la fonction de masse multinomiale
L’architecture probabiliste de la distribution multinomiale s’exprime à travers une fonction de masse multivariée qui assigne une probabilité ponctuelle exacte à chaque vecteur d’effectifs observés réalisables. Soit un vecteur aléatoire d’effectifs discrets X = (X1, X2, …, Xk) décrivant les comptages d’individus ou d’événements observés respectivement dans chacune des k catégories nominales au terme de n épreuves. La fonction de masse s’énonce formellement selon l’expression mathématique classique :
P(X1 = x1, X2 = x2, …, Xk = xk) = [ n! / (x1! * x2! * … * xk!) ] * (p1^x1 * p2^x2 * … * pk^xk)
Cette formulation n’est valide que sous la double contrainte déterministe que chaque effectif observé xi soit un nombre entier naturel non négatif (xi supérieur ou égal à 0) et que la somme arithmétique de ces effectifs observés soit rigoureusement égale au volume global de l’échantillon n, soit la sommation de xi pour i allant de 1 à k égale à n. Si l’un des composants du vecteur déroge à ces règles de cohérence élémentaires, la probabilité associée est identiquement nulle.
L’analyse structurale de cette équation révèle qu’elle procède du produit de deux entités mathématiques aux rôles sémantiques distincts mais complémentaires :
- Le premier terme, [ n! / (x1! * x2! * … * xk!) ], désigne le coefficient multinomial. Issu de l’analyse combinatoire fondamentale, il dénombre avec exactitude la quantité globale de permutations distinctes et ordonnées qu’il est possible de constituer avec n éléments discernables lorsqu’ils sont segmentés en k sous-groupes d’effectifs indiscernables respectifs (x1, x2, …, xk).
- Le second terme, constitué par le produit continu des probabilités marginales élevées à leurs puissances d’effectifs respectives, soit Produit de (pi^xi) pour i variant de 1 à k, quantifie la probabilité probabiliste élémentaire d’une séquence temporelle spécifique arbitraire présentant exactement cette configuration de réalisations successives.
En agrégeant l’ensemble de ces séquences élémentaires équiprobables par le truchement multiplicatif du coefficient multinomial, l’équation détermine de manière exhaustive la probabilité conjointe non conditionnelle attachée au vecteur de comptage synthétique.
2.2 Moments d’ordre un et deux : Espérance, variance et covariance
L’exploration des propriétés analytiques de la loi multinomiale impose l’examen détaillé de ses moments d’ordre un et deux, lesquels décrivent respectivement la tendance centrale, la dispersion intrinsèque et la topologie des dépendances mutuelles unissant les variables composant le système.
L’espérance mathématique de la variable aléatoire Xi, correspondant au comptage attendu au sein de la i-ième modalité nominale, présente une forme linéaire univariée particulièrement intuitive :
E(Xi) = n * pi
Ce résultat théorique démontre que l’effectif marginal théorique de chaque catégorie est simplement proportionnel au volume d’échantillonnage global pondéré par la probabilité a priori de ladite classe. De manière analogue, la variance marginale de chaque modalité considérée isolément s’apparente à celle d’une distribution binomiale marginale :
Var(Xi) = n * pi * (1 – pi)
Cependant, l’élément structural le plus distinctif de la distribution multinomiale réside dans l’existence d’une dépendance stochastique négative obligatoire entre toutes les paires distinctes de variables de comptage. Pour tout indice i différent de j, la covariance théorique s’établit selon l’équation négative stricte :
Cov(Xi, Xj) = –n * pi * pj
Le signe négatif invariant de cette covariance matérialise l’effet direct de la contrainte budgétaire d’échantillonnage imposée par la taille fixe n. Puisque le total des comptages est plafonné déterministement à n, l’assignation d’un individu additionnel à la catégorie i restreint mécaniquement le nombre d’individus pouvant être alloués aux autres catégories restantes. Il s’ensuit que la matrice de variance-covariance associée au vecteur X n’est jamais diagonale et présente des propriétés de singularité algébrique : son rang est borné à k – 1, illustrant le fait qu’il ne subsiste que k – 1 degrés de liberté stochastiques réels dans le système.
2.3 Propriétés asymptotiques et convergence distributionnelle
Lorsque la taille d’échantillon globale n croît vers l’infini tout en maintenant le vecteur des probabilités catégorielles p invariant, le comportement de la fonction de masse multinomiale est régi par les grands théorèmes limites de l’analyse stochastique. En vertu du théorème central limite multivarié, le vecteur standardisé des comptages converge asymptotiquement en loi vers une distribution normale multidimensionnelle dégénérée de dimension k, caractérisée par un vecteur moyen nul et une matrice de variance-covariance singulière de rang k – 1.
Cette convergence vers la normalité multivariée constitue le fondement théorique sous-jacent à l’utilisation universelle de la statistique de test du Chi-carré formulée par Karl Pearson. En définissant les écarts normalisés quadratiques entre les effectifs observés Xi et les effectifs attendus E(Xi) = n * pi, la statistique sommative :
Statistique Chi-carré = Somme de [ (Xi – n * pi)^2 / (n * pi) ] pour i variant de 1 à k
converge en loi vers une distribution théorique du Chi-carré continue possédant exactement k – 1 degrés de liberté.
Toutefois, cette convergence asymptotique repose sur des approximations mathématiques qui se dégradent brutalement dès lors que les effectifs théoriques attendus n * pi chutent en deçà de seuils critiques. Selon les règles empiriques classiques établies par William Gemmell Cochran, l’approximation asymptotique du Chi-carré demeure recevable à la condition expresse que pas plus de 20 % des catégories n’affichent un effectif théorique inférieur à 5, et qu’aucune modalité n’admette un effectif théorique inférieur à 1. Lorsque ces critères ne sont pas scrupuleusement satisfaits, l’approximation du Chi-carré engendre des distorsions majeures du taux d’erreur de première espèce, rendant le calcul probabiliste multinomial exact absolument impératif au sein de feuilles de calcul analytiques.
3. Fonctions natives d’Excel dédiées aux factorielles et à la combinatoire
3.1 Exploitation de la fonction FACT pour les factorielles simples
Microsoft Excel intègre dans sa bibliothèque mathématique standard un ensemble d’opérateurs algorithmiques permettant d’évaluer les briques élémentaires de la combinatoire, au premier rang desquelles figure la fonction de factorielle simple, dont la syntaxe standard est =FACT(nombre). Cette fonction calcule le produit continu de tous les entiers positifs non nuls inférieurs ou égaux à l’argument numérique spécifié, selon la définition conventionnelle où factorielle de m équivaut à 1 * 2 * … * m.
Le comportement opérationnel de la fonction FACT exige la prise en compte de règles syntaxiques précises :
- Si l’argument transmis correspond à un nombre réel décimal positif, Excel opère une troncature unilatérale automatique de la fraction pour ne conserver que la partie entière avant d’exécuter la séquence multiplicative.
- Conformément aux conventions universelles de l’analyse combinatoire, l’évaluation de l’argument nul,
=FACT(0), retourne exactement la valeur entière 1. - La saisie d’un argument strictement négatif provoque le renvoi immédiat du code d’erreur standard
#NOMBRE!.
Le point critique régissant l’emploi de cette fonction réside dans la limitation matérielle imposée par l’architecture arithmétique d’Excel, alignée sur la norme de virgule flottante double précision standard IEEE 754. Le plus grand entier dont le processeur interne d’Excel est capable de calculer la factorielle exacte sans déclencher de débordement arithmétique immédiat est 170. Dès lors que l’utilisateur saisit la formule =FACT(171), le résultat dépasse le seuil maximal représentable dans le système (approximativement 1,7976931348623158e+308), provoquant la génération irrémédiable de l’erreur #NOMBRE!. Cette contrainte technique interdit l’usage naïf de factorielles isolées dès que la taille d’échantillon n excède 170 observations.
3.2 Calcul direct du coefficient avec la fonction MULTINOMIALE
Conscients des défis inhérents à l’évaluation combinatoire, les concepteurs d’Excel ont implémenté une fonction analytique spécialisée dédiée à l’évaluation directe des coefficients multinomiaux : la fonction =MULTINOMIALE(valeur1; [valeur2]; ...). Cette fonction accepte en paramètres une suite d’arguments entiers positifs ou une plage cellulaire continue unique de type vecteur (par exemple A1:A5) représentant les effectifs empiriques (x1, x2, …, xk).
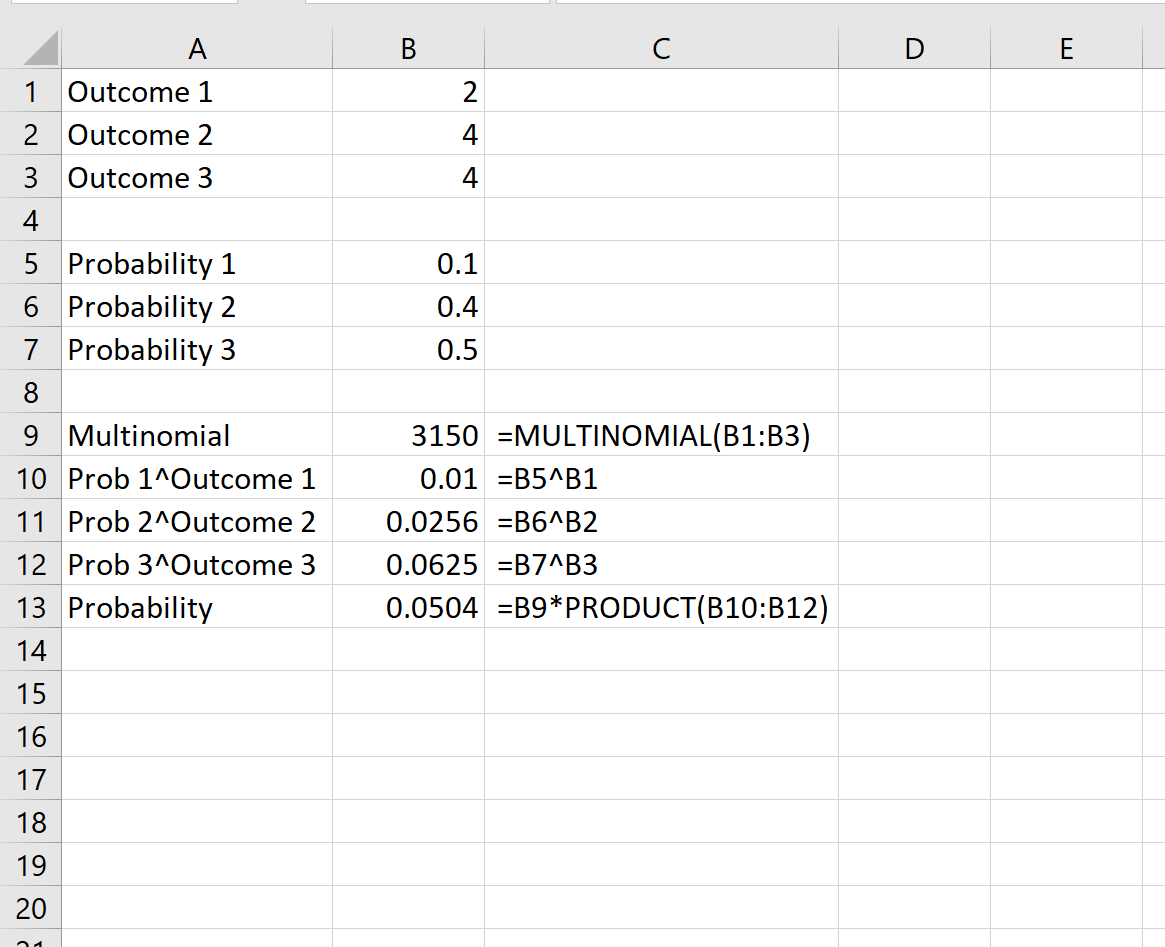
Sur le plan fonctionnel, l’appel à =MULTINOMIALE(x1; x2; ...; xk) effectue en une seule opération interne le calcul mathématique correspondant au rapport combinatoire complet :
Coefficient = FACT(Somme(xi)) / [ FACT(x1) * FACT(x2) * … * FACT(xk) ]
La sommation des arguments catégorielles pour déterminer la taille totale de l’échantillon n est donc totalement automatisée par le moteur du tableur. Cette fonction présente des avantages méthodologiques remarquables par rapport à l’assemblage manuel de factorielles simples chaînées. Elle permet de factoriser en interne certaines divisions récursives et d’éviter les erreurs d’arrondi décimal cumulées résultant de multiples fractions intermédiaires.
Toutefois, la fonction MULTINOMIALE demeure soumise à la même restriction de plafond global : si la sommation arithmétique de l’ensemble des arguments passés dans la fonction franchit le seuil fatidique de 170 (autrement dit si n est supérieur à 170), la fonction renvoie instantanément le code d’erreur #NOMBRE!, même si chacun des sous-effectifs individuels xi demeure très inférieur à cette limite. Son emploi direct sans artifice algorithmique doit donc demeurer circonscrit aux cohortes expérimentales de petite à moyenne dimension.
3.3 Calcul de la probabilité conjointe par les puissances et produits
Une fois le coefficient combinatoire résolu par l’entremise de la fonction native appropriée, l’évaluation de la probabilité multinomiale conjointe exige le calcul du terme de vraisemblance élémentaire, formalisé par le produit continu des probabilités catégorielles élevées à leurs puissances d’effectifs respectives. Deux voies d’implémentation opérationnelle s’offrent au modélisateur dans l’environnement standard d’Excel.
La méthode analytique standard consiste à utiliser l’opérateur arithmétique d’élévation à la puissance (le symbole chapeau ^) ou formellement la fonction native =PUISSANCE(nombre; puissance) au niveau de chaque cellule catégorielle individuelle. Dans une organisation colonnaire classique, si la probabilité théorique p1 est stockée dans la cellule C2 et l’effectif associé x1 dans la cellule B2, le calcul unitaire s’énonce simplement =C2^B2. La concaténation de toutes les composantes catégorielles s’effectue ensuite par le recours à la fonction de produit matriciel :
=PRODUIT(plage_puissances)
Pour les versions d’Excel prenant en charge les calculs matriciels dynamiques (notamment Microsoft 365 et Office 2021), cette étape peut être élégamment compactée au sein d’une unique formule matricielle vectorisée sans générer de colonnes de calculs intermédiaires artificielles :
=MULTINOMIALE(B2:B6) * PRODUIT(C2:C6 ^ B2:B6)
L’évaluation de cette expression requiert une rigueur absolue quant à l’alignement des plages de données d’entrée. Les vecteurs d’effectifs et de probabilités doivent posséder des dimensions géométriques strictement identiques. Une discordance de dimensionnalité entre les cellules sélectionnées induit une rupture de correspondance dans le produit matriciel, débouchant sur l’erreur fatale #VALEUR! ou faussant radicalement le calcul probabiliste sans générer d’alerte explicite.
4. Protocole de structuration d’une feuille de calcul multinomiale sous Excel
4.1 Organisation architecturale et normalisation de la matrice de données
La conception d’un modèle statistique au sein d’un tableur obéit à des normes strictes d’ergonomie et de cloisonnement conceptuel pour prévenir les corruptions de données et garantir l’auditabilité externe des calculs. L’organisation architecturale optimale d’une feuille d’évaluation multinomiale standardisée repose sur une ségrégation physique nette entre trois zones fonctionnelles distinctes :
- Une zone de saisie des paramètres d’entrée fondamentaux et des métadonnées contextuelles (identifiant de l’étude, effectif global attendu n, description des modalités).
- Une zone de calcul tabulaire structurée de manière strictement colonnaire accueillant les vecteurs de variables empiriques et théoriques.
- Une zone de synthèse et d’affichage des indicateurs probabilistes finaux et des diagnostics d’adéquation.
La matrice de calcul principale doit obligatoirement être ordonnée autour de colonnes dédiées et normalisées : la colonne A répertorie les identifiants textuels et étiquettes nominales des k catégories ; la colonne B héberge les effectifs discrets observés ou simulés xi ; la colonne C accueille les probabilités marginales théoriques ou a priori pi associées à chaque modalité.
L’application rigoureuse du Gestionnaire de noms d’Excel est vivement préconisée pour les projets scientifiques. En nommant la plage des comptages réels Vecteur_X (par exemple pour $B$2:$B$6) et la plage des probabilités normatives Vecteur_P (pour $C$2:$C$6), la formule de calcul générale s’affranchit des références cellulaires brutes pour gagner en clarté sémantique et éliminer tout risque d’erreur lors des opérations de recopie de formules.
4.2 Implémentation de vérifications logiques et de validation des données
L’intégrité numérique d’un classeur probabiliste dépend de la mise en place de dispositifs de contrôle automatisés interdisant la saisie ou le traitement de valeurs contradictoires avec les axiomes de Kolmogorov. La première mesure préventive consiste à appliquer une règle de Validation des données sur la plage Vecteur_P. Cette règle doit exiger formellement un format décimal strictement positif et restreindre les saisies à l’intervalle semi-ouvert ]0, 1].
Le second verrouillage méthodologique réside dans le contrôle de la contrainte unitaire de fermeture probabiliste. Dans une cellule dédiée au diagnostic de cohérence, l’implémentation d’un test logique d’adéquation de la somme des probabilités est indispensable. En raison des микро-approximations résiduelles inhérentes au stockage binaire des fractions décimales par les processeurs informatiques, tester une stricte égalité binaire via =SOMME(Vecteur_P)=1 peut générer de faux rejets erronés. On lui préférera un test d’arrondi numérique ou un encadrement par un seuil infinitésimal epsilon :
=SI(ABS(SOMME(Vecteur_P)-1)<0,0000001; "PARAMÈTRES CONFORMES"; "ERREUR: SOMME DES P NON UNITAIRE")
De manière symétrique, la somme arithmétique des effectifs observés SOMME(Vecteur_X) doit être formellement comparée à la constante expérimentale déclarée n. L’encapsulation des calculs dérivés au sein de fonctions de protection conditionnelles de type SIERREUR permet de juguler instantanément la propagation des exceptions numériques, en interceptant de manière explicite les tentatives d’évaluation portant sur des arguments non conformes.
4.3 Automatisation de l’évaluation de la fonction de masse
L’automatisation du calcul de la probabilité exacte au sein de la feuille Excel implique la consolidation harmonieuse des différentes briques combinatoires préalablement paramétrées. Dans la cellule de sortie désignée pour héberger la probabilité finale du vecteur observé, la syntaxe d’assemblage direct peut être structurée de la manière suivante :
=SI(ET(ABS(SOMME(C2:C6)-1)<0,0000001; SOMME(B2:B6)=B$8); MULTINOMIALE(B2:B6) * PRODUIT(C2:C6^B2:B6); "Contraintes violées")
où B$8 contient l’effectif global n prédéfini pour l’expérimentation.
Afin de prévenir toute méprise lors de la lecture des résultats statistiques, le formatage d’affichage de la cellule hébergeant cette probabilité finale doit être soigneusement calibré. Les probabilités conjointes multivariées atteignant fréquemment des ordres de grandeur infinitésimaux dès que la dimension k ou l’effectif n augmente, le choix d’un format de pourcentage standard à deux décimales s’avère souvent inapproprié, risquant d’afficher un trompeur 0,00 %. Il est impératif d’adopter soit un format de notation scientifique haute précision (par exemple 0,000000E+00), soit une précision décimale fixe étendue à au moins six ou huit chiffres significatifs.
Parallèlement à la probabilité ponctuelle, le tableau d’analyse gagne à intégrer une colonne d’espérance marginale =B$8*C2 et une colonne d’écart-type théorique univarié =RACINE(B$8*C2*(1-C2)) pour chacune des catégories. Ces repères paramétriques offrent au modélisateur une grille de lecture immédiate pour jauger de l’éloignement d’une configuration observée par rapport au centre de gravité théorique de la distribution.
5. Cas pratique n°1 : Préférences d’opinion publique et choix électoraux
5.1 Mise en situation expérimentale et cadre paramétrique
Afin d’illustrer de manière pragmatique les procédures analytiques précédemment formalisées, examinons une étude standard d’opinion publique portant sur les intentions de vote lors d’une consultation électorale tripartite locale. Dans cette circonscription, les données historiques fiabilisées et les grandes tendances démoscopiques agrégées permettent d’établir les probabilités théoriques a priori suivantes pour l’ensemble du corps électoral : le Candidat A rallie une intention de vote minoritaire fixée à pA = 0,10 (10 %) ; le Candidat B rassemble un courant d’adhésion consolidé de pB = 0,40 (40 %) ; enfin, le Candidat C bénéficie du soutien de la moitié de l’électorat avec pC = 0,50 (50 %). La condition de fermeture est parfaitement vérifiée : 0,10 + 0,40 + 0,50 = 1,00.
Un analyste politique réalise un micro-sondage de confirmation sous la forme d’un échantillonnage aléatoire simple de n = 10 votants indépendants. À l’issue de cette collecte d’opinions, la répartition empirique des suffrages constatée s’établit selon le vecteur d’effectifs réels suivant :
- Candidat A : xA = 2 suffrages observés
- Candidat B : xB = 4 suffrages observés
- Candidat C : xC = 4 suffrages observés
La sommation des effectifs observés équivaut rigoureusement à l’échantillon nominal : 2 + 4 + 4 = 10. La problématique inférentielle consiste à déterminer la probabilité exacte théorique d’observer par simple fluctuation d’échantillonnage une telle répartition tripartite sous l’hypothèse de validité stricte des intentions de vote de référence.
5.2 Déroulement pas-à-pas des opérations de calcul dans le tableur
L’implémentation opérationnelle de cette étude au sein d’une feuille Excel vierge s’opère selon une séquence d’étapes standardisées particulièrement directes. Dans la plage cellulaire A2:A4, nous saisissons respectivement les identifiants textuels Candidat A, Candidat B, Candidat C. La plage B2:B4 héberge les effectifs de votes observés : 2 en B2, 4 en B3 et 4 en B4. La plage C2:C4 accueille les paramètres probabilistes théoriques : 0,10 en C2, 0,40 en C3 et 0,50 en C4.
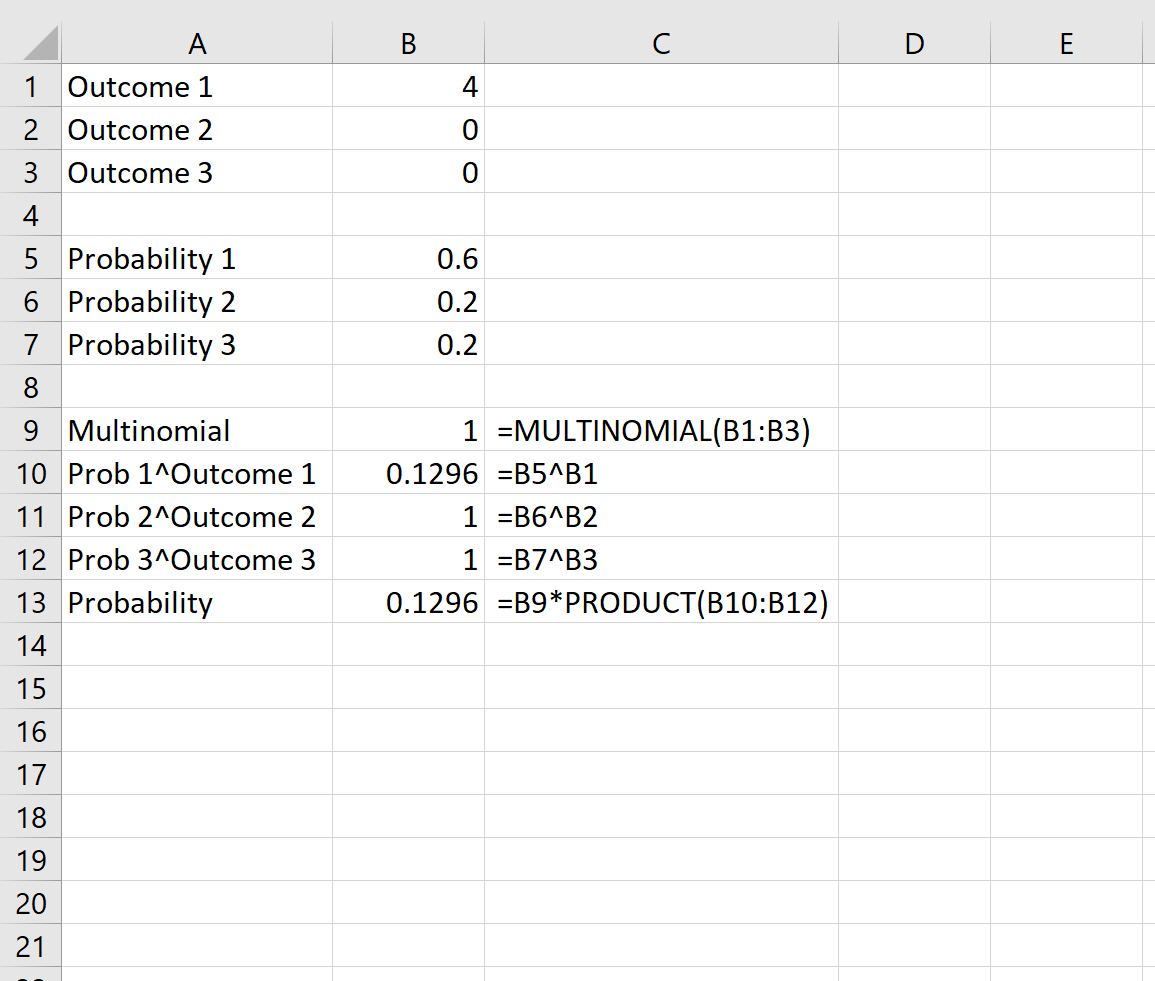
Le calcul du coefficient combinatoire multinomial s’effectue dans une cellule dédiée en saisissant la formule native :
=MULTINOMIALE(B2:B4)
L’évaluation mathématique correspondante, soit 10! / (2! * 4! * 4!), équivaut à 3 628 800 / (2 * 24 * 24) = 3 150 permutations distinctes. Le tableur retourne exactement la valeur entière 3150.
L’étape ultérieure évalue la composante de probabilité conjointe élémentaire dans une cellule contiguë en mobilisant la fonction de calcul vectoriel :
=PRODUIT(C2:C4^B2:B4)
L’évaluation numérique décompose le produit des puissances : (0,10^2) * (0,40^4) * (0,50^4) = 0,01 * 0,0256 * 0,0625 = 0,000016. En effectuant le produit croisé final dans une cellule de synthèse par la formule :
=MULTINOMIALE(B2:B4) * PRODUIT(C2:C4^B2:B4)
le résultat affiché est rigoureusement égal à 3 150 * 0,000016 = 0,0504. La probabilité précise d’obtenir cette exacte répartition électorale dans un tirage de 10 personnes s’élève donc formellement à 5,04 %.
5.3 Sensibilité du résultat aux fluctuations d’échantillonnage
L’exploitation de la feuille de calcul permet d’analyser la sensibilité paramétrique du modèle en explorant la variabilité probabiliste de configurations alternatives concurrentes. Par exemple, si l’on examine le vecteur d’équipartition relative x = (3, 3, 4), le coefficient multinomial s’élève à 10! / (3! * 3! * 4!) = 4 200 arrangements. Cependant, la pénalisation probabiliste imposée par la rareté relative du candidat A (0,10^3 = 0,001) compresse brutalement le terme de puissance conjointe, aboutissant à une probabilité finale de seulement 1,72 %.
À l’inverse, l’évaluation du vecteur modal théorique, correspondant à la configuration exacte des espérances mathématiques vectorielles E(X) = 10 * (0,10; 0,40; 0,50) = (1, 4, 5), révèle la dynamique distributionnelle du système. Pour ce profil modal précis, le coefficient combinatoire vaut 10! / (1! * 4! * 5!) = 1 260 permutations, et la probabilité globale générée par la formule atteint le pic distributionnel de 0,1008, soit 10,08 %.
Ces comparaisons directes soulignent un enseignement méthodologique capital en analyse d’opinion publique : au sein d’un espace d’états combinatoires discret comportant pour n = 10 et k = 3 exactement 66 configurations possibles, la configuration la plus probable (le mode) ne dépasse guère 10 % de chances de survenue empirique. Dès lors, observer un profil différent de l’espérance mathématique (comme le profil 2, 4, 4 affichant 5,04 %) ne constitue aucunement une anomalie statistique significative, mais traduit simplement la dispersion stochastique attendue dans les échantillons de taille restreinte.
6. Cas pratique n°2 : Réponses polytomiques aux échelles d’évaluation en psychologie
6.1 Cadre méthodologique : Échelle de Likert à cinq niveaux
Le second cas pratique aborde un enjeu classique de psychométrie clinique et de validation d’instruments de mesure psychologique : l’analyse des profils de réponse à un item polytomique ordinal extrait d’une échelle standardisée d’évaluation de l’anxiété situationnelle. L’item soumet le patient à une assertion symptomatique cotée selon une échelle de Likert à cinq degrés d’intensité gradués :
- Modalité 1 : Pas du tout
- Modalité 2 : Un peu
- Modalité 3 : Modérément
- Modalité 4 : Beaucoup
- Modalité 5 : Extrêmement
Un étalonnage normatif rigoureux, consolidé auprès d’une population de référence générale de 10 000 sujets non cliniques, a permis de figer la distribution normative des réponses théoriques selon le vecteur probabiliste suivant : p = (0,35; 0,30; 0,20; 0,10; 0,05). Cette distribution asymétrique positive caractérise le profil psychométrique d’un item discriminant au sein d’une population saine, où les manifestations symptomatiques aiguës demeurent rares.
Une unité de soins psychiatriques spécialisée accueille une cohorte consécutive de n = 25 nouveaux patients admis pour troubles de l’adaptation. Les réponses colligées à cet item révèlent la répartition empirique suivante : 2 patients répondent « Pas du tout » (x1 = 2), 4 « Un peu » (x2 = 4), 6 « Modérément » (x3 = 6), 8 « Beaucoup » (x4 = 8) et 5 « Extrêmement » (x5 = 5). Le total des observations correspond précisément à l’effectif n = 25. La problématique diagnostique consiste à évaluer la probabilité d’occurrence exacte d’un tel pattern de réponses sous l’hypothèse nulle que ces patients proviennent d’une population conforme à l’étalonnage normatif général.
6.2 Feuille de calcul analytique et traitement multivarié
La structuration de l’analyse dans Microsoft Excel s’organise sur la plage de cellules A2:E6. La colonne A liste les libellés des cinq niveaux de Likert. La colonne B héberge le vecteur d’effectifs observés B2:B6 = {2; 4; 6; 8; 5}. La colonne C enregistre le vecteur des probabilités théoriques de référence C2:C6 = {0,35; 0,30; 0,20; 0,10; 0,05}.
L’évaluation du coefficient multinomial pour une cohorte de 25 sujets et 5 catégories nécessite le calcul combinatoire suivant :
25! / (2! * 4! * 6! * 8! * 5!)
Saisie dans la cellule D2, la formule native :
=MULTINOMIALE(B2:B6)
fournit un volume combinatoire impressionnant de 1 089 728 640 000 permutations distinctes. Ce résultat illustre avec éloquence la prolifération combinatoire qui s’opère dès lors que la taille d’échantillon atteint quelques dizaines d’unités.
L’évaluation du terme de puissance conjointe des probabilités s’effectue au sein de la cellule D3 via la syntaxe matricielle :
=PRODUIT(C2:C6^B2:B6)
L’évaluation du produit continu génère une probabilité élémentaire extrêmement faible : (0,35^2) * (0,30^4) * (0,20^6) * (0,10^8) * (0,05^5) = 1,9808e-20. Le produit final de ces deux grandeurs dans la cellule de probabilité conjointe :
=D2 * D3
retourne exactement la probabilité ponctuelle de 0,00000021585, soit une probabilité de survenue de l’ordre de 2,16 chances sur dix millions d’échantillons similaires.
6.3 Implications diagnostiques et prise de décision clinique
L’obtention d’une probabilité ponctuelle infinitésimale de 2,16e-7 pour la configuration observée ne suffit pas à elle seule à caractériser la nature de l’écart psychométrique. Pour donner un sens clinique à ce résultat, il est nécessaire de confronter le vecteur empirique observé au vecteur des effectifs théoriques attendus E(Xi) = 25 * pi, calculé dans une colonne adjacente :
- Catégorie 1 : Observé = 2 vs Attendu = 8,75 (Déficit symptomatique majeur)
- Catégorie 2 : Observé = 4 vs Attendu = 7,50 (Sous-représentation)
- Catégorie 3 : Observé = 6 vs Attendu = 5,00 (Légère sur-représentation)
- Catégorie 4 : Observé = 8 vs Attendu = 2,50 (Sur-représentation critique)
- Catégorie 5 : Observé = 5 vs Attendu = 1,25 (Sur-représentation critique)
Cette lecture croisée démontre que la rareté statistique de l’échantillon ne découle pas d’une simple dérive stochastique neutre, mais d’un glissement massif de l’ensemble de la distribution vers les degrés de sévérité les plus alarmants (modalités 4 et 5). Les effectifs cumulés sur les niveaux de haute anxiété atteignent 13 patients observés contre seulement 3,75 attendus selon la norme.
Sur le plan de la démarche scientifique et de la décision thérapeutique, ce résultat apporte une validation statistique formelle : la cohorte admise dans ce service ne peut en aucun cas être considérée comme issue de la population générale saine. Ce type d’analyse quantitative sous Excel permet d’étayer solidement les rapports d’évaluation clinique, d’objectiver l’efficacité de dispositifs de triage diagnostique et de détecter d’éventuels biais d’échantillonnage avant de lancer des essais interventionnels lourds.
7. Dépassement des limites numériques d’Excel par l’approche log-gamma
7.1 Origine et nature du débordement arithmétique (Erreur #NOMBRE!)
L’un des défis méthodologiques majeurs auxquels sont confrontés les analystes de données modélisant la loi multinomiale sous Excel réside dans l’incapacité structurelle des fonctions combinatoires classiques à traiter des échantillons de taille quantitativement significative. Ce phénomène d’interruption logicielle, matérialisé par l’apparition du code d’erreur #NOMBRE!, trouve son origine dans les fondements mêmes du standard arithmétique régissant le processeur de calcul du tableur.
Microsoft Excel implémente rigoureusement la norme internationale IEEE 754 relative à la représentation en virgule flottante double précision (sur 64 bits). Dans cette architecture binaire, la plage dynamique des nombres réels positifs représentables est strictement bornée par une borne supérieure absolue établie à (2 – 2^-52) * 2^1023, ce qui équivaut approximativement à 1,7976931348623158 * 10^308. Corrélativement, le nombre positif normalisé le plus proche de zéro est borné à 2^-1022, soit environ 2,2250738585072014 * 10^-308.
Dès lors que l’on manipule la fonction =FACT(n) ou la fonction =MULTINOMIALE(x1:xk) pour une taille totale n supérieure ou égale à 171, le numérateur n! franchit instantanément cette frontière matérielle supérieure :
170! vaut environ 7,257 * 10^306 (valeur valide dans Excel)
171! vaut environ 1,241 * 10^309 (dépassement de capacité et renvoi de l’erreur #NOMBRE!)
Parallèlement, la multiplication répétée de probabilités catégorielles marginales strictement inférieures à un engendre un problème symétrique de sous-dépassement arithmétique (underflow), où le produit continu s’effondre en deçà de 10^-308 pour être arrondi arbitrairement à zéro absolu. L’analyste se trouve donc pris en étau entre deux impasses numériques incompatibles avec l’évaluation directe de grands échantillons.
7.2 Propriétés de la fonction LNGAMMA appliquée aux factorielles
La solution mathématique universelle pour contourner ces barrières matérielles consiste à abandonner l’évaluation multiplicative brute des nombres gigantesques au profit de l’addition algébrique de leurs logarithmes népériens. Dans ce cadre analytique, la fonction Gamma d’Euler joue un rôle clé en tant que prolongement continu de la factorielle sur le plan complexe :
Gamma(n + 1) = n!
Excel dispose d’une fonction native hautement optimisée calculant directement le logarithme naturel de la fonction Gamma : la fonction =LNGAMMA(nombre). Par identité mathématique fondamentale, le logarithme népérien de la factorielle d’un nombre entier n s’évalue sans aucune approximation préalable par la relation exacte :
ln(n!) = LNGAMMA(n + 1)
En appliquant l’opérateur logarithme népérien aux deux membres de l’équation de la fonction de masse multinomiale, le produit complexe se métamorphose en une suite d’additions et de soustractions de grandeurs scalaires parfaitement maniables :
ln[ P(X = x) ] = ln(n!) – Somme de ln(xi!) + Somme de [ xi * ln(pi) ]
En substituant les factorielles logarithmiques par leurs expressions Gamma respectives, l’équation maîtresse de la log-vraisemblance multinomiale prend la forme canonique suivante :
ln[ P(X = x) ] = LNGAMMA(n + 1) – Somme de [ LNGAMMA(xi + 1) ] + Somme de [ xi * LN(pi) ]
L’intérêt algorithmique est décisif : la fonction LNGAMMA peut manipuler sans aucune difficulté des nombres dépassant 100 000 (LNGAMMA(100001) vaut environ 1 051 299, ce qui demeure à des années-lumières de la limite de 10^308). Le risque de débordement combinatoire est ainsi entièrement éliminé.
7.3 Mise en œuvre concrète de la formule log-multinomiale dans la feuille
La mise en œuvre pratique de cette architecture logarithmique au sein d’une feuille Excel garantit une stabilité numérique absolue quel que soit l’effectif d’échantillon considéré. Soit une étude portant sur un effectif de n = 1 000 sujets segmentés en quatre catégories (k = 4), dont les effectifs observés x résident en B2:B5 et les probabilités marginales p en C2:C5.
Dans une cellule dédiée à l’évaluation de la log-probabilité, la formule matricielle globale s’implémente en une ligne d’une remarquable concision :
=LNGAMMA(SOMME(B2:B5)+1) - SOMME(LNGAMMA(B2:B5+1)) + SOMMEPROD(B2:B5; LN(C2:C5))
Cette expression réalise simultanément :
- Le calcul du logarithme du numérateur n! via
LNGAMMA(SOMME(B2:B5)+1). - Le calcul vectoriel et la sommation des logarithmes des dénominateurs catégoriels xi! via
SOMME(LNGAMMA(B2:B5+1)). - Le produit scalaire pondéré des effectifs par les logarithmes des probabilités catégorielles via la fonction native
SOMMEPROD.
Pour recouvrer la probabilité conjointe conventionnelle à partir de ce résultat logarithmique intermédiaire (stocké par exemple dans la cellule D10), il suffit d’appliquer la fonction exponentielle inverse standard :
=EXP(D10)
Si la valeur logarithmique est excessivement négative (inférieure à environ -708), la fonction EXP renverra naturellement la valeur numérique 0, matérialisant l’atteinte de la limite d’underflow. Néanmoins, l’analyste conserve dans la cellule D10 la log-probabilité exacte non altérée, permettant la comparaison de modèles et le calcul de rapports de vraisemblance (log-likelihood ratios) avec une précision analytique totale.
8. Modélisation dynamique avancée via les formules matricielles et LAMBDA
8.1 Exploitation du moteur matriciel dynamique (Excel 365 et versions récentes)
L’introduction du moteur de calcul matriciel dynamique au sein des versions modernes de Microsoft Excel a transformé l’ingénierie des feuilles de calcul en éliminant le recours aux anciennes formules validées par la combinaison Ctrl+Maj+Entrée. Cette architecture permet aux formules de propager dynamiquement (spill) des matrices de dimensions variables sans nécessiter de recopies manuelles vers le bas.
Appliqué à la modélisation multinomiale, ce moteur matriciel autorise la vectorisation intégrale des opérations combinatoires sur de larges collections de scénarios expérimentaux concurrents. Supposons qu’un protocole d’analyse comportementale nécessite l’évaluation simultanée de 50 vecteurs d’effectifs observés différents pour un même vecteur de probabilités normatives fixé. Plutôt que de dupliquer des formules complexes sur 50 lignes distinctes, l’utilisation synchronisée des fonctions d’itération modernes permet de traiter l’ensemble du jeu de données en mémoire vive.
La fonction SOMMEPROD, nativement matricielle sur toutes les versions d’Excel, demeure le moteur vectoriel le plus performant pour agréger sans boucle explicite les composantes scalaires des vecteurs. Associée à des fonctions de génération de séquences continues telles que SEQUENCE, elle offre la possibilité de générer et de tester des distributions de probabilités de manière dynamique lors d’analyses de sensibilité multivariées complexes.
8.2 Création d’une fonction réutilisable personnalisée avec LAMBDA
L’apport méthodologique le plus structurant d’Excel 365 réside indubitablement dans l’avènement de la fonction LAMBDA. Cette innovation permet de concevoir et d’encapsuler des fonctions personnalisées sur-mesure sans recourir au langage VBA, en s’appuyant exclusivement sur le moteur de calcul fonctionnel de la feuille de calcul.
Il devient ainsi possible de définir formellement une fonction réutilisable universelle baptisée PROBA_MULTINOMIALE_EXACTE, acceptant deux arguments vectoriels d’entrée : le vecteur des comptages observés et le vecteur des probabilités théoriques. La syntaxe générique de la fonction LAMBDA s’établit selon la formulation log-gamma optimisée :
=LAMBDA(vecteur_x; vecteur_p; EXP(LNGAMMA(SOMME(vecteur_x)+1) - SOMME(LNGAMMA(vecteur_x+1)) + SOMMEPROD(vecteur_x; LN(vecteur_p))))
Le déploiement opérationnel de cette fonction s’exécute selon un protocole rigoureux en trois étapes :
- Accéder à l’onglet Formules du ruban Excel, puis cliquer sur l’utilitaire Gestionnaire de noms.
- Créer une nouvelle entrée nominale en renseignant l’intitulé formel
PROBA_MULTINOMIALE_EXACTEdans le champ d’étiquetage. - Coller textuellement l’expression LAMBDA ci-dessus dans la zone de saisie Fait référence à : et valider.
Dès cet instant, la fonction se comporte comme une fonction native officielle du tableur. L’utilisateur peut l’appeler au sein de n’importe quelle cellule du classeur via la syntaxe intuitive =PROBA_MULTINOMIALE_EXACTE(B2:B6; C2:C6). Cette encapsulation garantit une étanchéité méthodologique absolue, empêche l’altération involontaire de la logique algorithmique et préserve l’élégance architecturale de la feuille.
8.3 Déploiement des fonctions REDUCE et SCAN pour les calculs combinatoires de masse
L’exploration avancée des propriétés d’un espace d’échantillonnage multinomial exige fréquemment le calcul de probabilités cumulées sur un ensemble de partitions combinatoires candidates (par exemple pour sommer les probabilités de tous les vecteurs dont la vraisemblance est inférieure à un seuil donné). Les fonctions d’ordre supérieur récemment intégrées à Excel, spécifiquement REDUCE et SCAN, ouvrent la voie à des itérations matricielles fonctionnelles d’une formidable puissance.
La fonction REDUCE permet d’agréger une matrice d’éléments en une valeur scalaire unique en appliquant une expression LAMBDA accumulatrice personnalisée. Par exemple, si une table matricielle génère sur 100 lignes consécutives 100 vecteurs distincts d’effectifs simulés, REDUCE permet d’accumuler séquentiellement leurs probabilités multinominales respectives sans nécessiter d’instructions conditionnelles complexes :
=REDUCE(0; PlageVecteurs; LAMBDA(accumulateur; vecteur_courant; accumulateur + PROBA_MULTINOMIALE_EXACTE(vecteur_courant; Vecteur_P)))
La fonction SCAN opère selon une logique similaire, mais au lieu de ne restituer que la somme finale consolidée, elle injecte sur la feuille de calcul le tableau complet des résultats intermédiaires cumulés. Cela permet de tracer en temps réel la courbe de répartition cumulative empirique d’un ensemble de profils de réponses polytomiques. Ces innovations algorithmiques hissent Excel au niveau des environnements statistiques spécialisés tout en assurant une portabilité multiplateforme intégrale sur Excel Web et les systèmes mobiles.
9. Automatisation via Visual Basic for Applications (VBA)
9.1 Architecture algorithmique d’une fonction personnalisée (UDF)
Bien que les fonctionnalités matricielles dynamiques modernes et les formules LAMBDA apportent des solutions puissantes, le recours au langage procédural Visual Basic for Applications (VBA) demeure une démarche prépondérante dans les organisations maintenant des parcs hétérogènes de versions du tableur ou nécessitant une intégration poussée au sein de routines d’automatisation complexes. La création d’une fonction définie par l’utilisateur (User Defined Function ou UDF) requiert une architecture logicielle robuste prenant en charge la validation des types, le dimensionnement des structures et l’interception des exceptions.
L’intégration de la fonction s’amorce par l’ouverture de l’éditeur VBE (via le raccourci conventionnel Alt + F11), suivie de l’insertion d’un module de code standard. L’architecture de la fonction repose sur la signature suivante :
Public Function MultinomialeProbabilite(ByVal PlageX As Range, ByVal PlageP As Range) As Variant
La première exigence algorithmique consiste à valider la conformité dimensionnelle des arguments transmis. La fonction doit vérifier que PlageX.Count est strictement égal à PlageP.Count et que le nombre d’éléments est au minimum égal à deux. Tout déséquilibre structurel doit immédiatement interrompre l’exécution et renvoyer une erreur explicite telle que CVErr(xlErrValue).
Dans un deuxième temps, le code extrait les données cellulaires vers des tableaux de variables mémoire typées en double précision (Double), minimisant drastiquement les allers-retours consommateurs de ressources entre le processeur VBA et l’interface de la feuille Excel. Une vérification de la fermeture probabiliste de la plage de probabilités p est exécutée via une tolérance numérique stricte (par exemple 1e-7).
9.2 Implémentation du code VBA optimisé contre le débordement
Pour immuniser l’UDF contre l’écueil du débordement arithmétique #NOMBRE!, l’algorithme VBA interne doit impérativement reproduire la logique de sommation logarithmique en exploitant la méthode WorksheetFunction.GammaLn. Cette approche permet de traiter sans ralentissement des échantillons de dizaines de milliers d’observations.
Le corps logique du script VBA s’articule autour des instructions opératoires suivantes :
- Initialisation des accumulateurs de log-vraisemblance et de l’effectif global n à zéro.
- Parcours séquentiel des éléments catégoriels via une boucle
For i = 1 To kpour accumuler l’effectif totalTotalN = TotalN + ArrX(i). - Déduction du terme logarithmique du numérateur combinatoire :
LogVraisemblance = Application.WorksheetFunction.GammaLn(TotalN + 1). - Itération décrémentielle et sommative au sein de la boucle : pour chaque indice i, soustraction de
Application.WorksheetFunction.GammaLn(ArrX(i) + 1)et addition du produit probabilisteArrX(i) * Log(ArrP(i)). - Conversion finale protégée par l’intermédiaire de la fonction exponentielle
MultinomialeProbabilite = Exp(LogVraisemblance).
L’intégration d’un gestionnaire d’interception d’erreurs (On Error GoTo GestionnaireErreur) garantit la résilience applicative globale. Si la grandeur logarithmique cumulée s’avère excessivement basse (induisant un underflow lors du passage par la fonction Exp), le gestionnaire force l’assignation de la valeur zéro sans bloquer l’évaluation du reste de la feuille de calcul. L’optimisation algorithmique du code ainsi formulé permet de renseigner plusieurs centaines de milliers d’évaluations multinomiales par seconde.
9.3 Génération de vecteurs aléatoires multinomiaux en VBA (Simulation de Monte-Carlo)
L’évaluation des propriétés d’échantillonnage de modèles psychométriques ou de dispositifs décisionnels complexes requiert fréquemment le recours à des simulations stochastiques de Monte-Carlo. VBA constitue un outil performant pour implémenter un générateur pseudo-aléatoire de vecteurs multinomiaux basé sur la méthode d’inversion empirique par la roulette (roulette-wheel selection).
L’algorithme de génération procède selon la logique constructive suivante :
- À partir du vecteur de probabilités d’entrée p de dimension k, le script construit en préambule le vecteur des probabilités cumulées croissantes : c1 = p1, c2 = p1 + p2, …, ck = 1,0.
- Un tableau mémoire de compteurs de dimensions k, initialisé à zéro, est alloué pour héberger les effectifs simulés résultants.
- Une boucle itérative s’exécute exactement n fois (représentant les n tirages individuels de l’échantillon). À chaque itération, un nombre pseudo-aléatoire uniforme u est tiré dans l’intervalle [0, 1[ par la commande native
Rnd. - Une recherche dichotomique ou une boucle de comparaison séquentielle détermine le plus petit indice j satisfaisant à la condition u < cj. Le compteur associé à la catégorie j est alors incrémenté d’une unité :
Compteurs(j) = Compteurs(j) + 1.
En encapsulant cette procédure au sein d’une macro simulant 10 000 tirages consécutifs, le modélisateur génère un panorama empirique exhaustif des fluctuations de distribution. La confrontation des fréquences d’apparition relatives ainsi obtenues avec les probabilités multinomiales exactes dérivées des équations analytiques fournit une validation empirique de la qualité du générateur et offre une visualisation concrète de la loi des grands nombres à l’œuvre.
10. Tests d’adéquation statistique et relation avec le Chi-carré de Pearson
10.1 Test exact multinomial versus test asymptotique du Chi-carré d’adéquation
Dans la conduite rigoureuse de recherches quantitatives, l’analyste ne se contente généralement pas de calculer la probabilité d’une configuration isolée ; il cherche à tester formellement l’hypothèse nulle (H0) selon laquelle un échantillon observé provient bien d’une population gouvernée par le vecteur probabiliste théorique postulé p. Deux méthodologies statistiques concurrentes coexistent : le test asymptotique classique du Chi-carré d’adéquation de Pearson et le test exact multinomial.
Le test du Chi-carré synthétise la déviation globale des données à travers une métrique quadratique continue unique, dont la p-valeur de décision est déduite d’une loi théorique asymptotique continue. Bien que commode et universellement implanté, ce test souffre de faiblesses critiques : il s’agit d’une approximation qui présuppose des effectifs attendus suffisamment élevés dans chaque classe. Dès lors que l’échantillon est de faible taille ou que certaines probabilités théoriques sont marginales, l’approximation asymptotique s’effondre, générant des p-valeurs biaisées conduisant à des décisions d’inférence erronées.
Le test exact multinomial s’affranchit de toute hypothèse distributionnelle asymptotique continue. Par définition, la p-valeur exacte d’un vecteur empirique observé xobs correspond à la somme cumulative des probabilités multinomiales de toutes les configurations vectorielles possibles x qui présentent une probabilité théorique inférieure ou égale à celle de l’échantillon observé :
p-valeur exacte = Somme de P(X = x) pour toutes les configurations x satisfaisant P(X = x) <= P(X = xobs)
Le test exact constitue donc la référence méthodologique absolue pour calibrer les décisions de rejet d’hypothèse nulle sur de petits échantillons, le tableur Excel offrant l’environnement idéal pour effectuer cette sommation exhaustive sans approximations trompeuses.
10.2 Calcul de la statistique du Chi-carré d’adéquation sous Excel
Pour apprécier la concordance empirique entre la méthode asymptotique et le cadre exact, il convient de maîtriser l’évaluation séquentielle du test du Chi-carré standard au sein d’une feuille de calcul Excel. Cette démarche se déploie à travers un schéma tabulaire colonnaire standardisé.
Supposons la présence des effectifs observés oi dans la plage B2:B6 et des probabilités normatives pi dans la plage C2:C6, avec un effectif total n consigné en cellule B8. L’enchaînement des formules statistiques s’établit comme suit :
- Calcul de la colonne des effectifs théoriques attendus ei dans la plage
D2:D6via la relation élémentaire :=B$8 * C2(recopiée vers le bas). - Calcul de la colonne des résidus standardisés quadratiques partiels dans la plage
E2:E6par la formule :=(B2 - D2)^2 / D2. - Agrégation de la statistique empirique globale du Chi-carré dans une cellule de synthèse via la formule de sommation :
=SOMME(E2:E6).
L’estimation de la p-valeur asymptotique unilatérale droite s’effectue directement à l’aide de la fonction statistique spécialisée native d’Excel :
=LOI.KHIDEUX.DROITE(statistique_chicarre; degres_liberte)
où les degrés de liberté correspondent formellement au nombre total de modalités qualitatives diminué d’une unité, soit =LIGNES(B2:B6) - 1. Cette p-valeur fournit le seuil critique conventionnel qui sera valablement comparé à la p-valeur issue de la procédure combinatoire exacte.
10.3 Construction d’un test exact pour petits échantillons dans le tableur
L’implémentation pratique d’un test multinomial exact au sein d’Excel nécessite l’énumération de l’ensemble de l’espace d’échantillonnage, c’est-à-dire la génération de toutes les partitions d’entiers non négatifs dont la somme est égale à n pour k catégories données. Si cette tâche peut sembler ardue, elle s’avère particulièrement aisée pour des systèmes à trois ou quatre classes de taille modérée.
Le protocole opératoire sous Excel s’articule autour de trois phases distinctes :
- Énumération combinatoire : Dans une grille tabulaire dédiée, l’ensemble des combinaisons exhaustives réalisables est déployé ligne par ligne (par exemple, pour n = 6 et k = 3, il existe 28 partitions ordonnées distinctes allant de (6,0,0) à (0,0,6)).
- Évaluation de la vraisemblance vectorielle : Pour chaque ligne de partition générée, la probabilité multinomiale exacte est calculée dans une colonne adjacente en mobilisant la formule matricielle ou la fonction
PROBA_MULTINOMIALE_EXACTEprécédemment formulée. - Filtrage et sommation conditionnelle : Une cellule de référence stocke la probabilité exacte associée au vecteur empiriquement observé lors de l’expérimentation. Dans la colonne de décision sommative, une formule conditionnelle évalue la règle de rejet :
=SI(Probabilite_Ligne <= Probabilite_Observee + 0,000000001; Probabilite_Ligne; 0)
La sommation finale de cette colonne de filtrage produit la véritable p-valeur exacte non paramétrique du test multinomial. Si cette somme cumulative s’avère inférieure au seuil alpha conventionnel de 0,05, le chercheur rejette formellement l’hypothèse nulle d’adéquation probabiliste, avec la certitude d’une rigueur mathématique exempte de toute distorsion d’approximation asymptotique.
11. Visualisation graphique et communication des profils de probabilités
11.1 Conception de graphiques comparatifs entre distributions observées et attendues
La transmission claire et rigoureuse des conclusions quantitatives issues de la modélisation multinomiale requiert une restitution graphique conforme aux normes professionnelles de communication scientifique, telles que les préconisations de l’American Psychological Association (APA). La représentation de base consiste en un histogramme groupé bivarié juxtaposant les fréquences absolues observées et les effectifs théoriques attendus pour chacune des k catégories nominales.
Pour concevoir cette visualisation au sein d’Excel, l’analyste sélectionne la plage de données englobant les étiquettes nominales et les deux colonnes de comptages (observés et attendus), puis génère un graphique de type Histogramme groupé. Les choix chromatiques doivent privilégier la sobriété et la lisibilité : des teintes contrastées mais non agressives (par exemple, un bleu acier profond pour la distribution observée et un gris ardoise tramé pour la distribution théorique de référence).
L’enrichissement méthodologique capital réside dans l’intégration de barres d’erreur de dispersion statistique sur la série des effectifs théoriques attendus. Dans Excel, ces barres ne doivent pas être paramétrées avec des pourcentages fixes arbitraires, mais doivent refléter l’écart-type théorique propre à chaque modalité multinomiale, soit racine de [ n * pi * (1 – pi) ]. En affectant cette plage de variances univariées personnalisées aux barres d’erreur du graphique, le lecteur visualise instantanément si les effectifs observés se situent à l’intérieur de l’intervalle de fluctuation normale ou s’ils s’en écartent de manière atypique.
11.2 Représentation de la distribution conjointe pour des systèmes tri-catégoriels
Lorsque le modèle statistique investigue exactement trois catégories qualitatives nominales (k = 3), l’espace d’échantillonnage présente une géométrie bidimensionnelle intrinsèque en raison de la contrainte budgétaire x1 + x2 + x3 = n. Cette propriété mathématique permet d’exploiter des visualisations multivariées avancées, au premier rang desquelles figure le diagramme ternaire (ou triangle de de Finetti).
Bien que le catalogue graphique natif d’Excel n’intègre pas directement d’option ternaire prédéfinie, il est parfaitement réalisable de modéliser cette géométrie à l’aide d’un Graphique en nuage de points (X, Y) par le truchement d’une transformation en coordonnées cartésiennes barycentriques :
Coordonnée X = p2 + 0,5 * p3
Coordonnée Y = (racine de 3 / 2) * p3
En projetant le nuage de points de toutes les configurations d’échantillonnage possibles et en modulant la taille ou la couleur des marqueurs en fonction de leur probabilité multinomiale respective, l’analyste génère une carte topologique de densité probabiliste remarquable. Le point d’échantillonnage clinique empirique peut alors être surimposé au graphique avec un marqueur distinctif rouge vif, permettant d’apprécier son positionnement relatif par rapport au barycentre de gravité théorique du système.
11.3 Interprétation sémantique et clinique des profils multinomiaux
L’interprétation finale des indices probabilistes calculés ne saurait se limiter à l’énoncé mécanique de métriques arithmétiques abstraites. Le chercheur doit opérer une traduction sémantique contextualisée et rigoureuse des probabilités ponctuelles et des p-valeurs obtenues, en préservant une distinction nette entre la significativité statistique d’une configuration et la taille de son effet substantiel.
Dans la rédaction de sections de résultats statistiques respectant les standards académiques, il convient de documenter systématiquement l’ensemble des paramètres structuraux du modèle : le volume d’échantillon nominal n, le vecteur complet des probabilités a priori de référence (p), le vecteur des comptages observés (x), la valeur de la statistique de test (Chi-carré de Pearson avec ses degrés de liberté associés ou valeur de la probabilité exacte multinomiale cumulée) et le niveau exact de la p-valeur de décision.
Une attention particulière doit être portée à l’expression de l’incertitude : une probabilité ponctuelle isolée très faible ne signifie pas nécessairement que le modèle théorique est inadapté, car dans de vastes espaces combinatoires, tous les états discrets possèdent individuellement des probabilités infinitésimales. C’est l’accumulation ordonnée des densités de probabilités (la p-valeur exacte) confrontée à la directionnalité substantielle des écarts catégoriels qui permet de conclure valablement à la présence d’un profil comportemental, psychologique ou électoral statistiquement singulier.
12. Diagnostics, erreurs récurrentes et guide de bonnes pratiques d’audit
12.1 Typologie des erreurs fonctionnelles courantes sous Excel
L’implémentation de la distribution multinomiale au sein d’un tableur expose l’analyste à une variété de pièges techniques et d’erreurs algorithmiques récurrentes qu’il convient de savoir diagnostiquer avec célérité :
- L’erreur
#VALEUR!: Elle survient de manière privilégiée lors de dysfonctionnements de typage des données. La cause la plus insidieuse provient souvent de la présence d’espaces insécables invisibles ou de caractères typographiques introduits lors de copier-coller depuis des pages Web ou des fichiers PDF, convertissant des données numériques en chaînes de texte que les fonctionsMULTINOMIALEouSOMMEPRODne peuvent traiter. - L’erreur
#NOMBRE!: Comme explicité précédemment, elle découle invariablement du franchissement du seuil arithmétique supérieur de la fonction factorielle (n supérieur ou égal à 171) lors de l’emploi naïf des fonctions natives standard, ou de la transmission accidentelle d’arguments d’effectifs négatifs. - Le biais résiduel d’arrondi décimal : Ce problème silencieux, encore plus pernicieux qu’un code d’erreur explicite, se manifeste lorsque la somme du vecteur des probabilités p s’établit par exemple à
0,999999999999999ou1,000000000000002au lieu de 1 strict, suite à des divisions intermédiaires non normalisées. Ce micro-écart fausse imperceptiblement l’ensemble de la distribution sans déclencher d’alerte système. - L’erreur de dimensionnement matriciel : Survient lors de l’application de formules vectorisées sur des plages cellulaires de longueurs inégales (par exemple un vecteur
xde 5 cellules face à un vecteurpde 4 cellules), provoquant l’injection de valeurs d’erreur#N/Adans les calculs dépendants.
12.2 Grille d’audit et procédures de validation pour classeurs statistiques
La fiabilisation d’un classeur d’analyse probabiliste destiné à des publications scientifiques ou à des prises de décision critiques impose le déploiement d’une procédure d’audit qualité normalisée. Les fonctionnalités intégrées de l’onglet Formules d’Excel fournissent un premier niveau d’inspection indispensable : les commandes Repérer les antécédents et Repérer les dépendants permettent de tracer graphiquement le flux logique des données et de vérifier qu’aucune cellule parasite n’a été indûment incorporée dans les produits matriciels.
Il est impératif d’intégrer une cellule de contrôle global sur la feuille, servant de témoin d’intégrité systémique. Cette cellule exploite une formule conditionnelle consolidant l’ensemble des contraintes du modèle multinomial :
=SI(ET(SOMME(Vecteur_X)=Effectif_N; ABS(SOMME(Vecteur_P)-1)<1E-7; MIN(Vecteur_X)>=0; MIN(Vecteur_P)>0); "MODÈLE INTÈGRE"; "ANOMALIE PARAMÉTRIQUE")
Une fois les équations vérifiées, la protection structurelle de la feuille via le menu Protéger la feuille doit être activée. En verrouillant l’accès aux cellules abritant les formules algorithmiques et en ne laissant déverrouillées que les zones strictes de saisie des données d’entrée, on immunise le modèle contre tout écrasement accidentel de syntaxe lors des manipulations quotidiennes.
Enfin, la règle d’or de la validation statistique consiste à soumettre un jeu de données test à une double vérification croisée externe. L’analyste exécutera en parallèle un script succinct sous le langage statistique de référence R (via la commande native dmultinom(x, size, prob)) ou sous Python via la bibliothèque SciPy (scipy.stats.multinomial.pmf). L’obtention d’une concordance de résultats stricte jusqu’à la huitième décimale atteste de la parfaite intégrité du modèle Excel.
12.3 Recommandations méthodologiques pour la pérennité des analyses
La pérennité, l’auditabilité et la reproductibilité des analyses quantitatives conduites sur tableur représentent un impératif déontologique majeur dans la recherche contemporaine. Trop souvent, des classeurs complexes deviennent inutilisables après le départ de leur concepteur en raison d’un manque criant de documentation interne. Tout classeur multinomial doit obligatoirement débuter par une feuille de garde dédiée consignant les métadonnées de l’étude : intitulés des projets, noms des opérateurs, date de versionnement, hypothèses théoriques sous-jacentes et explicitation détaillée des acronymes utilisés.
L’arbitrage entre les différentes solutions techniques présentées dans cet ouvrage doit être guidé par une analyse pragmatique de l’environnement de déploiement et des compétences de l’équipe utilisatrice :
- Pour des échantillons de taille modeste (n < 150) et des besoins d’évaluation ponctuels au sein d’équipes pluridisciplinaires utilisant des versions variées d’Excel, la solution combinatoire standard par la fonction
=MULTINOMIALE()demeure la plus simple et la plus universellement compréhensible. - Pour des flux de production modernes et pérennes au sein d’environnements Microsoft 365 récents, la méthode de log-vraisemblance par
LNGAMMAencapsulée dans une fonction personnaliséeLAMBDAreprésente l’optimum méthodologique absolu : elle allie élégance mathématique, immunité totale contre le débordement numérique et absence de dépendance envers les macros VBA. - Pour les protocoles de calcul intensif nécessitant des simulations itératives de Monte-Carlo ou l’évaluation de millions de configurations combinatoires, l’automatisation via des modules VBA optimisés en mémoire vive demeure la voie la plus performante.
En respectant scrupuleusement l’ensemble de ces préceptes théoriques, méthodologiques et logiciels, le chercheur transforme Microsoft Excel en un laboratoire d’investigation probabiliste d’une rigueur et d’une précision analytique irréprochables, pleinement capable de soutenir les exigences des recherches quantitatives contemporaines de haut niveau.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://apastyle.apa.org/
- Cochran, W. G. (1952). The chi-square test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315-345. https://doi.org/10.1214/aoms/1177729380
- Cochran, W. G. (1954). Some methods for strengthening the common chi-square tests. Biometrics, 10(4), 417-451. https://doi.org/10.2307/3001616
- Costa, P. T., & McCrae, R. R. (1992). Revised NEO Personality Inventory (NEO-PI-R) and NEO Five-Factor Inventory (NEO-FFI) professional manual. Psychological Assessment Resources.
- IEEE. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE Computer Society. https://doi.org/10.1109/IEEESTD.2019.8766229
- Johnson, N. L., Kemp, A. W., & Kotz, S. (2005). Univariate discrete distributions (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471715816
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 1-55.
- Microsoft Corporation. (2023). Documentation relative aux fonctions Excel : MULTINOMIALE, FACT, LNGAMMA et LAMBDA. Microsoft Learn. https://support.microsoft.com/fr-fr/excel
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine Series 5, 50(302), 157-175. https://doi.org/10.1080/14786440009463897