
L’analyse statistique moderne repose sur une tension fondamentale entre la simplification nécessaire des données empiriques et la préservation de leur fidélité structurelle. Confrontés à des ensembles d’observations complexes issus de protocoles expérimentaux, d’évaluations psychométriques ou de suivis longitudinaux, les chercheurs et praticiens doivent condenser l’information sans en occulter la forme sous-jacente. Si la statistique paramétrique classique s’est longtemps appuyée sur le couple moyenne-écart-type, cette approche montre ses limites face aux distributions asymétriques, tronquées ou contaminées par des valeurs atypiques. C’est précisément dans cette brèche méthodologique que s’inscrit le résumé à cinq nombres (ou five-number summary), véritable pierre angulaire de l’analyse exploratoire des données.
Conçu pour fournir un diagnostic instantané de la tendance centrale, de la dispersion et de la symétrie d’une distribution sans postuler l’hypothèse de normalité, le résumé à cinq nombres agrège la valeur minimale, le premier quartile, la médiane, le troisième quartile et la valeur maximale. Loin d’être un simple artifice d’école, cette synthèse d’ordre fournit les fondations géométriques indispensables à la construction des diagrammes en boîte (boxplots) et permet aux analystes d’identifier les discontinuités distributionnelles majeures. Pour les étudiants, enseignants et chercheurs en sciences sociales, cognitives et biomédicales, la maîtrise instrumentale de cet outil s’avère indispensable pour mener des explorations préliminaires rigoureuses sur le terrain ou en laboratoire.
Au cœur de cette pratique analytique, la gamme de calculatrices Texas Instruments, et plus particulièrement la TI-84 Plus sous toutes ses variantes (Standard, Silver Edition et Color Edition), constitue le standard technologique le plus pérenne au sein des cursus universitaires et des centres de recherche. Sa puissance de traitement matriciel et son environnement logiciel dédié à la statistique univariée permettent d’extraire instantanément ces cinq métriques à partir de listes de données brutes ou pondérées. Ce guide exhaustif détaille la méthodologie statistique sous-jacente, la manipulation pas-à-pas de l’instrument, l’interprétation avancée des indicateurs numériques et leur traduction graphique, tout en abordant les implications psychométriques et les diagnostics d’erreurs computationnelles.
1. Introduction théorique au résumé à cinq nombres en analyse descriptive
1.1 Origine conceptuelle et utilité en analyse exploratoire
Le résumé à cinq nombres puise ses fondements épistémologiques dans les travaux pionniers du mathématicien et statisticien américain John W. Tukey, qui a formalisé au cours des années 1970 le paradigme de l’Analyse Exploratoire des Données (AED ou Exploratory Data Analysis). À une époque où l’informatique naissante privilégiait une approche purement confirmatoire dominée par le test d’hypothèses gaussiennes et l’estimation de paramètres d’ordre deux, Tukey a soutenu la nécessité d’examiner la structure interne brute des observations avant toute modélisation probabiliste rigide. L’objectif premier de cette démarche consiste à réduire la complexité informationnelle d’une série numérique sans altérer sa géométrie fondamentale, en isolant les points de repère structurants de la distribution ordonnée.
Cette approche non paramétrique brille par sa robustesse statistique face aux distributions hautement asymétriques, omniprésentes dans l’étude des processus cognitifs et comportementaux. Contrairement aux estimateurs classiques du premier et du second moment que sont la moyenne arithmétique et la variance empirique, les indicateurs d’ordre ne subissent pas la distorsion induite par l’étirement des queues de distribution ou par la présence de points isolés exceptionnels. Le résumé à cinq nombres offre une lecture transversale immédiate qui ne requiert aucune supposition préalable quant à l’appartenance des données à une famille paramétrique spécifique, ce qui en fait un outil de découverte indispensable lors des phases de criblage expérimental.
Il ne s’agit pas pour autant de rejeter les mesures paramétriques, mais d’établir une complémentarité méthodologique féconde. Alors que la moyenne et l’écart-type résument parfaitement les lois symétriques mésocurtiques sans queues épaisses, le résumé à cinq nombres agit comme un garde-fou diagnostique. La comparaison entre la moyenne et la médiane, tout comme la confrontation de l’écart-type avec l’intervalle interquartile, permet de quantifier instantanément le degré de non-normalité d’une distribution. Ainsi, le résumé à cinq nombres sert à la fois d’outil descriptif autonome et de test informel de validité des postulats régissant les inférences statistiques ultérieures.
1.2 Pertinence pour la modélisation psychométrique et comportementale
Dans les champs disciplinaires de la psychométrie, de la neuropsychologie et des sciences comportementales, la mesure est confrontée à des contraintes structurelles d’échelle. La plupart des instruments standardisés, qu’il s’agisse de questionnaires de personnalité ou d’échelles de dépression comme l’inventaire de Beck, produisent des scores situés sur des échelles ordinales ou au mieux d’intervalles approximatifs. L’évaluation de la variabilité interindividuelle sur ces échelles nécessite des indicateurs statistiques qui respectent l’ordre de classement sans présupposer une équidistance parfaite entre les échelons de mesure. Le résumé à cinq nombres s’adapte naturellement à cette exigence en ancrant son analyse sur les rangs des sujets plutôt que sur des opérations arithmétiques linéaires.
Cette caractéristique s’avère critique lors du traitement de variables comportementales temporelles, telles que les temps de réaction dans des tâches d’attention sélective ou de flexibilité cognitive. Ces latences de réponse présentent invariablement une asymétrie positive prononcée, caractérisée par une accumulation massive d’observations rapides et une queue étirée vers les valeurs lentes correspondant à des décrochages attentionnels passagers. Le calcul de la moyenne et de l’écart-type sur de telles séries produit une surestimation systématique du temps typique d’exécution et masque la dispersion réelle du noyau central des performances. L’usage de la médiane et des quartiles permet de caractériser le fonctionnement cognitif modal sans recourir à des transformations logarithmiques arbitraires qui compliquent l’interprétation clinique.
De surcroît, le résumé à cinq nombres permet aux praticiens d’évaluer d’un seul coup d’œil la dispersion globale et la dispersion médiane d’un échantillon clinique. L’amplitude totale, définie par l’écart entre le minimum et le maximum, délimite l’espace des réponses effectives observées au sein du groupe, tandis que l’écart séparant le premier du troisième quartile capture le comportement de la moitié centrale des sujets. Cette décomposition immédiate favorise une analyse différentielle fine, essentielle par exemple pour distinguer un profil clinique hétérogène, où l’élargissement de l’intervalle interquartile traduit une variabilité intrinsèque accrue, d’un profil homogène affecté par une observation aberrante isolée.
1.3 Propriétés mathématiques fondamentales de la distribution ordonnée
D’un point de vue mathématique formel, le calcul du résumé à cinq nombres repose sur l’algèbre des statistiques d’ordre. Soit un échantillon de $n$ variables aléatoires réelles observées $X_1, X_2, dots, X_n$. La première étape algorithmique consiste à réordonner ces observations selon une relation d’ordre partiel non stricte, conduisant à la série ordonnée notée $X_{(1)} le X_{(2)} le dots le X_{(n)}$, où l’indice entre parenthèses désigne le rang statistique de chaque observation. Cette transformation transforme l’ensemble brut non structuré en une distribution empirique cumulative $F_n(x)$, sur laquelle les cinq valeurs de synthèse sont rigoureusement indexées en tant que percentiles empiriques d’ordre 0, 25, 50, 75 et 100.
L’une des caractéristiques analytiques les plus élégantes des statistiques d’ordre réside dans leur invariance face à toute transformation monotone strictement croissante. Si une fonction de transformation $g(x)$ vérifie $g'(x) > 0$ sur l’ensemble de définition des observations, alors les statistiques d’ordre de la série transformée $Y_i = g(X_i)$ vérifient rigoureusement $Y_{(k)} = g(X_{(k)})$. Cette propriété d’équivariance monotone implique que la médiane et les quartiles des données transformées sont précisément les transformées de la médiane et des quartiles d’origine. Cette invariance contraste avec le comportement de la moyenne arithmétique, qui ne respecte cette relation que sous des transformations strictement affines ($g(x) = ax + b$), ce qui confère au résumé à cinq nombres une stabilité conceptuelle supérieure sur les données psychophysiques soumises à des modélisations logarithmiques ou exponentielles.
Enfin, la résistance empirique des composantes du résumé à cinq nombres peut être formellement caractérisée par leur point de rupture asymptotique. Le point de rupture mesure la proportion minimale d’observations arbitrairement aberrantes qu’un échantillon peut contenir avant que l’estimateur ne puisse être entraîné vers l’infini positif ou négatif. Alors que la moyenne arithmétique et l’écart-type possèdent un point de rupture nul de $0/n$ (une seule observation aberrante suffisant à contaminer le résultat à l’infini), la médiane atteint le point de rupture théorique maximal possible de $0{,}5$ (soit 50 % de contamination tolérée). Les quartiles $Q_1$ et $Q_3$ affichent quant à eux un point de rupture de 25 %. Cette résilience interne garantit que le cœur du résumé à cinq nombres demeure une description fidèle de la population sous-jacente, même en présence d’artefacts d’acquisition de données.
2. Les cinq indicateurs fondamentaux : définitions et interprétations statistiques
2.1 Le minimum et le maximum : l’étendue absolue de l’échantillon
La première et la dernière composante du résumé à cinq nombres constituent les frontières observationnelles de la distribution empirique. Le minimum, noté mathématiquement $X_{(1)} = \min_{1 le i le n} X_i$, correspond à la borne inférieure stricte de l’échantillon recueilli. Symétriquement, le maximum, désigné par $X_{(n)} = \max_{1 le i le n} X_i$, représente la borne supérieure absolue. La soustraction arithmétique directe entre ces deux métriques définit l’étendue globale ou amplitude totale de la série ($E = X_{(n)} – X_{(1)}$). Cette métrique quantifie l’espace dimensionnel complet au sein duquel toutes les données expérimentales sont contenues, offrant un cadre géométrique immédiat pour l’analyse descriptive.
En raison de leur nature intrinsèque de statistiques d’ordre extrêmes, le minimum et le maximum sont particulièrement vulnérables aux bruits de mesure, aux erreurs de codage de données et aux fluctuations d’échantillonnage. Contrairement aux trois mesures centrales, le point de rupture du minimum et du maximum est strictement nul ($1/n$). Une simple erreur de saisie typographique décalant une virgule décimale ou ajoutant un zéro superflu altère instantanément l’amplitude totale de façon spectaculaire. Il est donc fondamental de ne jamais interpréter ces deux bornes isolément, mais de les analyser systématiquement en relation étroite avec les quartiles sous-jacents afin d’identifier si ces extrêmes résultent d’un étalement régulier de la queue de distribution ou d’un accident instrumental discontinu.
Dans les contextes d’évaluation psychologique et psychométrique, l’examen minutieux du minimum et du maximum s’avère particulièrement fécond pour détecter les effets de plancher (floor effects) et les effets de plafond (ceiling effects). Si le minimum observé coïncide avec le score le plus bas théoriquement atteignable sur une échelle de mesure clinique (par exemple, un score de zéro sur une échelle d’évaluation de la détresse émotionnelle), la présence d’une proportion substantielle d’observations agrégées à cette valeur signale que l’instrument s’avère incapable de discriminer les degrés de sévérité subcliniques. Réciproquement, un maximum confondu avec le plafond de l’épreuve indique un test trop accessible, empêchant la mesure précise des performances exceptionnelles chez les sujets à haut potentiel cognitif.
2.2 La médiane : le pivot central de la série ordonnée
La médiane, conventionnellement notée $Med$ ou $Q_2$, constitue le second quartile et le cinquantième centile de la distribution. Elle représente formellement la valeur numérique qui scinde l’échantillon ordonné en deux sous-groupes de cardinalités strictement égales, de sorte qu’exactement 50 % des observations lui soient inférieures ou égales et 50 % lui soient supérieures ou égales. Sa formulation mathématique explicite dépend de la parité de l’effectif total $n$. Si $n$ est impair, la médiane correspond précisément à la valeur centrale occupant le rang $(n + 1)/2$ au sein de la série ordonnée :
$$Med = X_{\left(\frac{n+1}{2}\right)}$$
À l’inverse, si l’effectif $n$ est pair, il n’existe pas d’observation physique centrale unique ; la médiane statistique est alors conventionnellement définie comme la demi-somme arithmétique des deux observations centrales occupant respectivement les rangs $n/2$ et $(n/2) + 1$ :
$$Med = \frac{X_{\left(\frac{n}{2}\right)} + X_{\left(\frac{n}{2}+1\right)}}{2}$$
Sur le plan de l’optimisation mathématique, la médiane se distingue par une propriété remarquable : elle minimise la somme des écarts absolus des observations par rapport à un point central arbitraire $c$. En d’autres termes, elle constitue la solution exacte du problème variationnel $\min_{c} \sum_{i=1}^n |X_i – c|$, ce qui correspond à l’ajustement optimal sous la norme $L_1$. En revanche, la moyenne arithmétique minimise la somme des carrés des écarts (norme $L_2$). Cette divergence fonctionnelle explique l’insensibilité structurelle de la médiane face aux valeurs atypiques : modifier la valeur d’une observation extrême sans modifier son rang par rapport au centre de la série ne déplace absolument pas la médiane, alors que la moyenne se trouve immédiatement déplacée dans la direction de la perturbation.
Dans la standardisation des tests psychologiques et des échelles d’aptitude cognitive telles que les échelles de Wechsler (WAIS, WISC), la médiane sert d’ancrage fondamental pour le calcul des rangs percentiles. Un score brut équivalant à la médiane positionne précisément l’individu au cinquantième percentile de la population de référence, signifiant qu’il surpasse ou égale la moitié exacte de la cohorte d’étalonnage. Cette correspondance directe en termes de probabilité cumulative confère à la médiane une intelligibilité clinique immédiate pour la restitution de profils neuropsychologiques auprès des patients et des équipes multidisciplinaires, surpassant la compréhension souvent abstraite des scores $Z$ dérivés de la moyenne arithmétique.
2.3 Les quartiles Q1 et Q3 : segmentation de la masse distributionnelle
Les premier et troisième quartiles, universellement désignés par les symboles $Q_1$ et $Q_3$, agissent comme des délimiteurs structurels qui subdivisent la masse empirique des données ordonnées en quatre segments contenant chacun un quart (25 %) de l’effectif total. Le premier quartile $Q_1$, ou vingt-cinquième centile, représente la valeur sous laquelle se situent 25 % des observations les plus basses et au-dessus de laquelle s’ordonnent les 75 % restants. Conceptuellement, il peut être appréhendé comme la médiane de la moitié inférieure de la série statistique. Symétriquement, le troisième quartile $Q_3$, ou soixante-quinzième centile, sépare les 75 % des valeurs inférieures des 25 % des valeurs les plus élevées de l’échantillon, s’apparentant à la médiane de la moitié supérieure des observations.
La distance linéaire séparant ces deux jalons quantiles constitue l’écart interquartile (noté $IQR$ pour Interquartile Range), défini par la relation formelle :
$$IQR = Q_3 – Q_1$$
Cet indicateur de dispersion non paramétrique mesure l’étendue spatiale couverte par le noyau central de 50 % des observations empiriques. Tout comme la médiane, l’écart interquartile présente une remarquable stabilité et une robustesse élevée face aux fluctuations des queues de distribution. Alors que l’écart-type peut être artificiellement dilaté par une poignée de données aberrantes en raison de l’élévation des écarts au carré, l’écart interquartile conserve sa signification physique invariante, fournissant un étalon fiable de la variabilité typique au sein du groupe étudié.
Il importe toutefois de souligner qu’il n’existe pas de consensus universel absolu pour l’interpolation discrète des quartiles lorsque les indices ne tombent pas sur des valeurs entières. Diverses méthodes algorithmiques coexistent dans la littérature statistique, telles que les formulations documentées par Hyndman et Fan, les « charnières de Tukey » (hinges) et les approximations de Moore et McCabe. Les calculatrices de la gamme Texas Instruments, dont la TI-84, adoptent une convention spécifique consistant à exclure formellement la médiane du calcul des sous-médianes lorsque l’effectif global $n$ est impair. Bien que ces divergences algorithmiques n’engendrent que des variations marginales sur les échantillons de taille moyenne ou élevée, la connaissance de la logique interne propre à l’instrument évite les incertitudes lors de la validation manuelle de calculs de quartiles.
3. Présentation de la calculatrice TI-84 Plus et configuration préalable
3.1 Spécificités techniques des modèles de la gamme TI-84
La famille des calculatrices graphiques TI-84 Plus comprend plusieurs générations d’appareils qui partagent une architecture logicielle commune tout en présentant des raffinements matériels progressifs. Le modèle standard TI-84 Plus, commercialisé au début des années 2000, repose sur un microprocesseur Zilog Z80 cadencé à 15 MHz et dispose d’un affichage à cristaux liquides monochrome de 96 par 64 pixels. La déclinaison Silver Edition a introduit une mémoire flash accrue et une fréquence d’horloge commutable à 15 MHz pour accélérer les opérations de traitement sur les tables volumineuses. L’itération la plus contemporaine, la TI-84 Plus CE (Color Edition), intègre un processeur eZ80 cadencé à 48 MHz et un écran rétroéclairé haute résolution de 320 par 240 pixels capable d’afficher des graphiques statistiques en couleur.
Malgré ces disparités matérielles, le système d’exploitation interne (l’OS de TI, qu’il s’agisse des révisions 2.55MP sur les modèles monochromes ou des versions 5.x sur les modèles CE) assure une compatibilité ascendante quasi-parfaite au niveau des bibliothèques de calcul statistique. Les algorithmes d’analyse descriptive univariée, de gestion de l’espace mémoire matriciel et d’optimisation des représentations graphiques sont fonctionnellement identiques d’un modèle à l’autre. Le passage à la technologie d’affichage haute résolution de la TI-84 Plus CE procure néanmoins un confort visuel déterminant pour l’analyse exploratoire, permettant de superposer distinctement plusieurs diagrammes en boîte colorés sur un repère cartésien précis sans subir le crénelage inhérent aux écrans monochromes d’ancienne génération.
Le système d’exploitation de ces appareils gère les séries de données par le biais de structures matricielles unidimensionnelles appelées « listes ». La mémoire vive (RAM) de la calculatrice réserve par défaut six registres d’accès direct, désignés de L1 à L6, préconfigurés pour accueillir des valeurs numériques scalaires codées en virgule flottante sur 9 octets (format Texas Instruments à mantisse décimale). Cette architecture interne garantit une précision algorithmique de 14 chiffres significatifs avec un exposant variant de $-99$ à $+99$, éliminant de facto les erreurs d’arrondi lors du tri séquentiel des observations nécessaires à l’établissement des statistiques d’ordre.
3.2 Initialisation matérielle et vérification de la mémoire
Avant d’engager tout protocole de saisie et de traitement statistique, il est impératif d’auditer l’état de la mémoire vive de la calculatrice afin de prévenir d’éventuels dépassements de capacité ou des conflits avec des variables résiduelles issues de sessions de calcul antérieures. Pour vérifier l’intégrité de la mémoire sur la TI-84, l’opérateur doit solliciter la fonction de gestion mémoire en pressant successivement la touche jaune ou bleue 2nd puis la touche + (marquée en surimpression MEM). Cette action déclenche l’apparition du menu contextuel MEMORY.
À partir de cet écran, la sélection de l’option 1:Check RAM... (ou 1:Vérif RAM... selon la langue de l’OS) permet de visualiser instantanément l’espace de mémoire vive libre exprimé en octets. Une exécution fluide des algorithmes de tri et le tracé sans artefact des graphiques statistiques requièrent un minimum de 1 000 à 2 000 octets de RAM disponible. Si la mémoire résiduelle est saturée par des programmes tiers volumineux ou des matrices résiduelles complexes, il convient de libérer de l’espace via l’option 2:Mem Management/Delete... en ciblant spécifiquement les éléments obsolètes sans altérer les registres système indispensables.
Un autre réglage d’initialisation fondamental concerne l’activation du module interactif Stat Wizards, introduit dans les versions d’OS récentes pour guider la saisie des arguments de fonction statistique. Pour s’assurer de sa configuration adéquate, pressez la touche MODE, puis faites défiler les options à l’aide des flèches de navigation jusqu’à repérer la ligne STAT WIZARDS. Positionnez le curseur clignotant sur l’état ON et appuyez sur la touche ENTER pour valider. Ce réglage garantit l’affichage d’écrans de paramétrage explicites lors de l’appel des routines de traitement univarié, sécurisant ainsi la désignation des listes sources et des fréquences associées.
3.3 Nettoyage et réinitialisation des listes d’édition
L’une des causes les plus récurrentes d’erreurs d’inférence en milieu académique provient de la contamination d’un nouveau jeu de données par des valeurs préexistantes oubliées en queue de liste. Si une série expérimentale actuelle ne comporte que 10 observations alors que la liste mémoire L1 contenait précédemment 25 valeurs, le simple écrasement des dix premières lignes laissera subsister les quinze dernières observations de l’ancienne série, faussant irrémédiablement le résumé à cinq nombres. Deux stratégies de nettoyage s’offrent alors à l’utilisateur : l’effacement sélectif préalable ou la purge globale par commande.
La méthode la plus rapide et la plus sûre consiste à exécuter la commande dédiée ClrList (Clear List). Pour y accéder depuis l’écran de calcul standard (l’écran d’accueil accessible via la combinaison 2nd MODE pour faire QUIT), appuyez sur la touche STAT, puis sélectionnez l’option 4:ClrList au sein du sous-menu EDIT. L’instruction est alors imprimée sur l’écran d’accueil, dans l’attente de ses arguments. Indiquez la liste ciblée en saisissant la combinaison correspondant au nom de la liste, par exemple 2nd 1 pour afficher L1, puis terminez par ENTER. L’appareil affiche la notification de confirmation Done, attestant que le vecteur L1 a été totalement purgé de son contenu sans détruire la variable elle-même.
Il arrive fréquemment qu’au cours de manipulations erronées dans l’éditeur de listes, un utilisateur supprime accidentellement la colonne L1 ou L2 elle-même en utilisant la touche DEL sur l’en-tête de colonne, faisant ainsi disparaître la liste de l’interface visuelle. Dans une telle situation de collision logicielle, il ne sert à rien de paniquer ou de réinitialiser complètement l’appareil : il suffit d’accéder au menu STAT, de sélectionner la commande 5:SetUpEditor et d’appuyer sur ENTER. Cette routine interne restaure immédiatement la configuration géométrique native de l’éditeur matriciel en réinstallant les six listes fondamentales L1 à L6 dans leur ordre numérique canonique.
4. Étape 1 : Saisie et organisation rigoureuse des données dans les listes
4.1 Accès à l’éditeur matriciel de listes
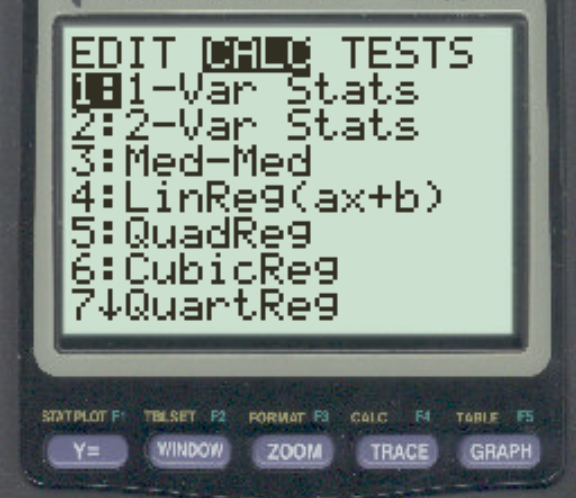
L’interface de saisie et de manipulation directe des observations sur la calculatrice TI-84 repose sur un éditeur matriciel plein écran. Pour pénétrer dans cet environnement, appuyez sur la touche physique STAT située sur la partie supérieure droite du pavé numérique. Cette commande ouvre un menu subdivisé en trois onglets fonctionnels horizontaux : EDIT, CALC et TESTS. Par défaut, le curseur se positionne sur l’onglet EDIT et surligne la première option numérotée 1:Edit.... Validez ce choix en pressant la touche ENTER ou en appuyant directement sur la touche numérique 1.
L’écran affiche instantanément l’éditeur matriciel structuré sous forme de colonnes adjacentes. Les en-têtes de colonnes indiquent les identifiants des listes actives, principalement L1, L2, et L3 (les listes L4, L5, L6 étant accessibles par défilement horizontal vers la droite à l’aide des touches directionnelles). Chaque colonne se compose d’une succession de lignes indexées, chaque cellule étant conçue pour héberger une valeur scalaire unique. Au bas de l’écran, une ligne d’état affiche des informations critiques sur la cellule actuellement surlignée par le curseur rectangulaire, adoptant la syntaxe canonique NOM_LISTE(INDICE) = VALEUR, par exemple L1(1)= lorsque le curseur pointe vers la toute première case de la première liste.
Cette structure matricielle offre une lisibilité optimale pour la gestion des séries univariées. La compréhension de l’adressage mémoire interne est primordiale : la calculatrice alloue dynamiquement des cellules à mesure que les données sont introduites séquentiellement. Il est donc impossible de laisser des cellules vides ou de sauter une ligne au sein d’une même liste sans provoquer une discontinuité que le système d’exploitation refuserait de valider, garantissant ainsi l’intégrité de la série statistique collectée.
4.2 Protocoles d’encodage précis des observations
Le processus d’encodage exige une rigueur méthodique afin d’éviter l’introduction de bruits d’échantillonnage non désirés. Le curseur étant positionné sur la ligne 1 de la liste cible (par convention L1 pour une série univariée simple), l’opérateur saisit la première valeur numérique brute à l’aide du clavier numérique. Durant la composition de la valeur, les chiffres s’affichent sur la ligne d’état inférieure. Pour consigner formellement la valeur dans le registre mémoire de la cellule, il est obligatoire d’appuyer sur la touche ENTER. Dès la validation, la valeur est ancrée dans la matrice et le curseur d’édition descend automatiquement vers la ligne immédiatement inférieure, prête pour la saisie suivante.
Il importe de respecter scrupuleusement les conventions typographiques matérielles de Texas Instruments, qui diffèrent des standards informatiques génériques sur deux points majeurs. Premièrement, le séparateur décimal doit obligatoirement être composé via la touche physique point décimal . située entre les touches zéro et (-). L’utilisation erronée de la virgule de séparation syntaxique (touche , située au-dessus de la touche 7) bloquera l’encodage ou déclenchera une erreur logicielle. Deuxièmement, la saisie d’observations négatives requiert l’usage exclusif de la touche de négation unaire (-) positionnée en bas à droite du clavier, et non pas de la touche de soustraction arithmétique binaire - (opérateur de soustraction situé sur la colonne de droite), sous peine de générer l’interruption logicielle ERR:SYNTAX.
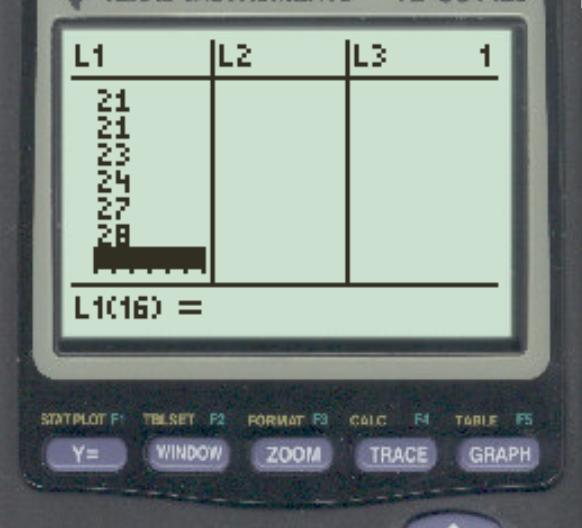
Tout au long de l’encodage, le praticien doit garder une vigilance constante sur l’indicateur d’indice de ligne situé sur la ligne d’état au bas de l’écran. Après avoir saisi la dernière valeur de son échantillon empirique, l’observateur doit vérifier que l’indice de la prochaine cellule vide, matérialisé par L1(n+1)=, est exactement égal à l’effectif théorique attendu majoré d’une unité. Par exemple, pour une cohorte expérimentale comportant formellement $n = 15$ sujets, le curseur doit se stabiliser sur L1(16)= au terme de la séquence de frappe. Tout écart sur cet indice signale immédiatement une omission ou un doublon dans la transcription des scores bruts.
4.3 Contrôle qualité et correction des anomalies de frappe
Une fois la phase d’entrée numérique achevée, un protocole rigoureux d’assurance qualité statistique impose une relecture intégrale de la série ordonnée ou désordonnée présente dans la mémoire active. La navigation au sein de la colonne s’opère de manière intuitive à l’aide des touches directionnelles fléchées ▲ (Haut) et ▼ (Bas). Chaque déplacement du curseur met à jour la ligne d’état inférieure, permettant de vérifier la conformité exacte de la valeur stockée avec la feuille de recueil des données cliniques originale.
Si une valeur erronée est identifiée en cours d’audit, plusieurs mécanismes correctifs peuvent être déployés selon la nature de l’anomalie. Si le score est simplement inexact mais que la structure de l’échantillon est préservée, il suffit de positionner le curseur sur la cellule défectueuse, de composer directement la valeur correcte sur le pavé numérique et d’appuyer sur ENTER pour écraser la valeur antérieure. Dans l’éventualité où une observation parasite se serait glissée indûment dans la liste (créant un effectif surnuméraire), positionnez le curseur sur la cellule incriminée et pressez la touche physique DEL (Delete) : la valeur est instantanément retirée de la mémoire et les cellules inférieures se décalent mécaniquement vers le haut d’un cran.
À l’inverse, si l’audit révèle l’omission d’une observation au cœur de la série, il n’est aucunement requis de ressaisir l’ensemble de la colonne. Placez le curseur sur la ligne qui doit succéder à la valeur manquante, puis engagez la combinaison de touches 2nd puis DEL (correspondant à l’instruction en surimpression INS pour Insert). La calculatrice crée instantanément une cellule vide indexée à la position courante en repoussant l’ensemble des données suivantes vers le bas. Il ne reste plus qu’à taper la valeur omise et à presser la touche ENTER pour sceller la complétude du jeu de données. Une fois l’intégrité de la liste L1 formellement validée, quittez l’éditeur matriciel en exécutant la commande 2nd MODE (QUIT) pour regagner l’écran de calcul principal.
5. Étape 2 : Exécution de la commande 1-Var Stats sur la TI-84
5.1 Navigation vers le sous-menu de calcul statistique
L’extraction algorithmique du résumé à cinq nombres s’effectue via le module de traitement univarié intégré au système d’exploitation de la calculatrice. Pour amorcer ce processus computationnel, appuyez de nouveau sur la touche physique STAT, qui réaffiche l’interface de contrôle statistique. À ce stade, utilisez la touche directionnelle fléchée droite ► pour translater la sélection active de l’onglet EDIT vers l’onglet central CALC (Calculs).
Le sous-menu CALC regroupe l’ensemble des moteurs d’inférence et d’ajustement de modèles statistiques disponibles sur la machine. La première instruction de la liste, numérotée 1:1-Var Stats (abréviation pour One-Variable Statistics ou Statistiques à une variable), constitue le programme algorithmique dédié à la caractérisation exhaustive d’une seule série scalaire. La seconde option, 2:2-Var Stats, est exclusivement réservée à l’analyse bivariée d’échantillons appariés visant des corrélations ou des régressions croisées, et ne doit en aucun cas être sollicitée pour l’extraction d’un résumé à cinq nombres univarié, sous peine d’exiger obligatoirement deux listes synchrones de mêmes dimensions.
Pour activer l’utilitaire 1-Var Stats, l’opérateur peut indifféremment appuyer sur la touche numérique 1 ou laisser le curseur surbriller la première ligne et appuyer sur la touche ENTER. La transition visuelle qui s’opère alors dépend étroitement du modèle matériel de la TI-84 et de la configuration du système d’exploitation, distinguant les interfaces modernes guidées par assistant des syntaxes classiques en ligne de commande.
5.2 Paramétrage des invites de calcul sur TI-84 Plus CE
Sur les calculatrices contemporaines telles que la TI-84 Plus CE ou les modèles TI-84 Plus équipés d’un OS récent disposant de l’option STAT WIZARDS: ON, l’appel de l’utilitaire génère un formulaire de configuration structuré à l’écran, composé de trois champs distincts : List:, FreqList:, et Calculate. Cette interface ergonomique vise à éliminer toute erreur de syntaxe en guidant explicitement l’attribution des variables d’entrée.
Le premier champ, intitulé List:, attend la désignation formelle du vecteur de données contenant les observations brutes à traiter. Par défaut, la machine y inscrit automatiquement l’identifiant L1. Si vos données sont effectivement logées dans ce registre, conservez cette sélection. Si vous avez encodé vos données dans une autre liste (par exemple L2), vous devez impérativement actualiser ce champ en pressant la combinaison de touches appropriée, comme 2nd 2 pour invoquer L2. Le second champ, désigné par FreqList: (Liste de fréquences ou de pondérations), permet de spécifier un vecteur auxiliaire recensant les occurrences de chaque valeur dans le cas d’une distribution groupée en tableau d’effectifs.
Dans la configuration standard où chaque ligne de votre liste L1 représente une mesure empirique individuelle unique non groupée, ce champ FreqList: doit absolument rester vierge de tout caractère. Si une variable résiduelle y est inscrite par défaut (comme L2), déplacez le curseur sur cette ligne avec la flèche ▼ et pressez la touche CLEAR pour effacer l’entrée. Le maintien erroné d’une liste de fréquences arbitraire entraînerait une pondération asymétrique catastrophique des observations ou bloquerait le calcul par une erreur d’incompatibilité de dimensions. Une fois les paramètres ajustés, positionnez le curseur sur l’intitulé Calculate et appuyez sur la touche ENTER pour déclencher le calcul statistique.
5.3 Syntaxe pour les modèles anciens sans interface guidée
Dans l’éventualité où vous opérez sur une calculatrice TI-84 Plus de première génération dont le système d’exploitation n’a pas été mis à jour, ou si le module Stat Wizards a été délibérément désactivé via le menu MODE, la sélection de l’option 1:1-Var Stats ne génère aucun formulaire guidé. Au lieu de cela, la commande textuelle brute 1-Var Stats est immédiatement imprimée sur l’écran d’accueil de la calculatrice, le curseur clignotant se positionnant juste après le texte dans l’attente des arguments syntaxiques d’exécution.
Si vos données résident dans la première liste par défaut L1, le moteur d’interprétation interne de Texas Instruments applique une convention de raccourci par omission : appuyer directement sur la touche ENTER sans spécifier d’argument après la chaîne 1-Var Stats ordonne à la machine d’exécuter l’analyse univariée sur le registre L1 avec une pondération unitaire implicite. L’algorithme se déploie alors instantanément.
Si la série à analyser se situe dans un autre registre de données (par exemple L3), ou si vous devez traiter une série pondérée par une liste de fréquences associées (les valeurs étant dans L1 et leurs fréquences respectives dans L2), vous devez impérativement composer manuellement la syntaxe attendue en utilisant la touche virgule , (située au-dessus de la touche 7) comme séparateur lexical formel. La syntaxe rigoureuse s’énonce comme suit :
1-Var Stats L3 (pour une liste non pondérée distincte de L1)
1-Var Stats L1,L2 (pour une liste de données L1 pondérée par la liste de fréquences L2)
Toute omission du séparateur virgule ou tout accolement direct de deux noms de listes sans délimiteur provoquera l’interruption logicielle immédiate ERR:SYNTAX, vous contraignant à rééditer la ligne de commande sur l’écran d’accueil avant de pouvoir extraire les métriques.
6. Lecture et extraction détaillée des cinq valeurs statistiques
6.1 Défilement vertical des résultats statistiques univariés
Dès la validation de l’instruction 1-Var Stats, le processeur de la TI-84 exécute en une fraction de seconde l’ensemble des opérations algébriques : tri croissant en mémoire tampon, sommation des puissances pour les moments d’ordre un et deux, et repérage des positions quantiles. L’écran de la calculatrice se remplit alors d’une série de résultats statistiques univariés. Toutefois, en raison de la compacité physique de l’écran, seule la première moitié des indicateurs calculés est visible immédiatement.
Cette première page d’affichage présente exclusivement les métriques paramétriques classiques : la moyenne arithmétique de l’échantillon désignée par $\bar{x}$, la somme des valeurs $\sum x$, la somme des carrés $\sum x^2$, l’écart-type d’échantillon corrigé non biaisé $S_x$ (divisé par $n-1$), l’écart-type de population théorique $\sigma_x$ (divisé par $n$), ainsi que l’effectif total validé de l’échantillon noté $n$. Les composantes du résumé à cinq nombres ne figurent pas sur ce panneau supérieur. L’utilisateur doit impérativement prêter attention à la présence d’un petit triangle sombre pointant vers le bas (▼), situé sur la marge gauche de la dernière ligne affichée.
Ce glyphe directionnel indique que le flux de données calculé s’étend au-delà de la limite visuelle basse de l’écran LCD. Pour accéder aux statistiques d’ordre non paramétriques, l’opérateur doit actionner la touche directionnelle fléchée ▼ (Bas) de manière répétée. Chaque impulsion fait glisser l’affichage vers le bas, occultant progressivement les indicateurs gaussiens supérieurs pour révéler le bloc complet du résumé à cinq nombres regroupé à la base de la sortie numérique.
6.2 Identification nominative des cinq composantes clés
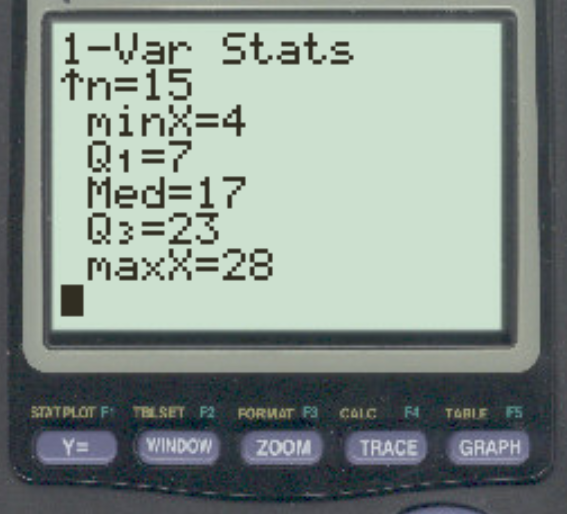
Le bloc inférieur de l’écran de sortie de la commande 1-Var Stats regroupe très exactement, dans un ordre séquentiel vertical rigoureusement standardisé, les cinq indicateurs constitutifs formalisés par Tukey. L’opérateur doit savoir décrypter précisément la taxonomie abrégée propre au système d’exploitation de Texas Instruments :
minX: Représente la borne inférieure absolue de la série, c’est-à-dire le Minimum observé dans l’échantillon ($X_{(1)}$). Cette valeur est la plus petite mesure relevée parmi toutes les observations encodées.Q1: Désigne le Premier Quartile (vingt-cinquième centile de l’échantillon empirique). Il s’agit de la coupure numérique sous laquelle se situent 25 % des observations les plus faibles de la distribution.Med: Abréviation formelle pour la Médiane de la distribution (deuxième quartile ou cinquantième centile). C’est le centre de gravité positionnel scindant la série ordonnée en deux sous-ensembles de taille identique.Q3: Désigne le Troisième Quartile (soixante-quinzième centile). Il établit le seuil en deçà duquel se distribuent 75 % des données et au-delà duquel se situe le quart supérieur des mesures.maxX: Matérialise la borne supérieure extrême de la série ordonnée, à savoir le Maximum statistique observé ($X_{(n)}$).
Ces cinq descripteurs forment une partition ordonnée étanche de la distribution empirique. Leur extraction conjointe permet de documenter instantanément l’architecture positionnelle de l’échantillon sans nécessiter le recours à des opérations de tri manuel laborieuses et sujettes à des erreurs matérielles de reclassement.
6.3 Interprétation contextuelle immédiate de l’écran de synthèse
Dès que le bloc des cinq nombres est rendu visible à l’écran, une série de contrôles analytiques doit être menée par le praticien. La première vérification porte sur l’indicateur d’effectif $n$ affiché juste au-dessus de minX. Cet effectif doit coïncider avec le nombre réel d’observations collectées sur le terrain expérimental. Une discordance sur la valeur de $n$ signale qu’une cellule de la liste L1 a été accidentellement omise ou qu’une valeur parasite a été intégrée lors de la phase d’encodage, invalidant mécaniquement l’exactitude positionnelle des rangs de quartiles calculés par la machine.
Le second contrôle repose sur la validation de la cohérence monotone de la séquence affichée. En vertu des propriétés fondamentales des statistiques d’ordre, les cinq nombres doivent obligatoirement vérifier la relation d’inégalité large continue suivante :
$$\text{minX} le \text{Q1} le \text{Med} le \text{Q3} le \text{maxX}$$
Toute anomalie apparente sur cette chaîne ordonnée (qui ne pourrait résulter que d’une corruption de la mémoire vive ou d’une mauvaise désignation de liste) révélerait une incohérence computationnelle majeure.
Enfin, l’écran de synthèse permet une évaluation diagnostique préliminaire de la symétrie distributionnelle sans nécessiter de calcul complexe. L’analyste compare mentalement la distance séparant la médiane du minimum ($\text{Med} – \text{minX}$) à la distance séparant le maximum de la médiane ($\text{maxX} – \text{Med}$). De même, la confrontation des écarts internes $(\text{Med} – \text{Q1})$ et $(\text{Q3} – \text{Med})$ offre un aperçu immédiat de la symétrie du cœur de la distribution. Une divergence sensible entre ces longueurs indique que la série dévie d’une structure normale symétrique et présente une asymétrie positive ou négative qu’il conviendra de caractériser plus en détail.
7. Traitement d’un jeu de données concret étape par étape
7.1 Présentation du jeu de données expérimental
Afin d’illustrer la manipulation instrumentale et la démarche interprétative sur un cas concret, considérons une recherche en psychologie cognitive portant sur l’impact de la surcharge mentale sur le contrôle attentionnel. Un échantillon composé de $n = 15$ adultes a été soumis à une épreuve informatisée standardisée mesurant le nombre d’erreurs d’inhibition cognitive commises lors d’une tâche de type Stroop sous contrainte temporelle sévère. Le choix délibéré d’une taille d’échantillon impaire permet d’illustrer le calcul d’une médiane correspondant à un élément physique unique de la série ordonnée.
Les scores bruts relevés de manière non ordonnée auprès des quinze participants sont les suivants :
$$14, \quad 8, \quad 23, \quad 4, \quad 17, \quad 28, \quad 7, \quad 19, \quad 12, \quad 26, \quad 21, \quad 6, \quad 24, \quad 27, \quad 18$$
Avant d’engager le traitement numérique sur la calculatrice, une inspection exploratoire suggère une dispersion marquée des scores, s’étendant d’erreurs résiduelles faibles chez les sujets les plus efficients jusqu’à des défaillances massives d’inhibition chez d’autres. L’objectif est d’extraire rigoureusement le résumé à cinq nombres sur la TI-84, de dériver l’écart interquartile empirique et de statuer sur la symétrie globale de la performance du groupe expérimental.
7.2 Démonstration opérationnelle intégrale sur l’émulateur TI-84
Engageons la démarche complète sur l’interface de la calculatrice TI-84 :
- Allumez l’appareil en pressant la touche
ON, puis accédez au gestionnaire de données en appuyant surSTATsuivi deENTERpour ouvrir l’éditeur1:Edit.... - Si la liste
L1contient des données antérieures, remontez le curseur sur le label d’en-têteL1à l’aide de la flèche▲, appuyez sur la toucheCLEAR, puis redescendez avec la touche▼pour vider la colonne instantanément. - Procédez à la saisie séquentielle des quinze scores dans la colonne
L1: tapez14puisENTER,8puisENTER, et ainsi de suite jusqu’à la dernière valeur18puisENTER. Vérifiez au bas de l’écran que la ligne d’état indiqueL1(16)=, attestant de l’encodage exact de 15 mesures. - Pressez la combinaison de touches
2ndMODE(QUIT) pour regagner l’écran de base. - Appuyez sur la touche
STAT, déplacez le curseur vers l’ongletCALCavec la flèche►, et sélectionnez1:1-Var Statsen validant parENTER. - Sur l’écran du formulaire d’aide (Stat Wizard), confirmez que
List:pointe surL1, laissez le champFreqList:parfaitement vide, positionnez le curseur surCalculateet appuyez surENTER. (Sur les modèles anciens, validez simplement l’instruction1-Var Stats L1en appuyant surENTER). - Le tableau de résultats apparaît. Pressez la flèche directionnelle
▼de manière répétée pour faire défiler la fenêtre jusqu’aux cinq derniers paramètres.
L’écran de la calculatrice affiche précisément les valeurs numériques suivantes :
$$\text{minX} = 4$$
$$\text{Q1} = 7$$
$$\text{Med} = 17$$
$$\text{Q3} = 23$$
$$\text{maxX} = 28$$
7.3 Analyse réflexive de la distribution obtenue
L’extraction instrumentale brute étant achevée, il convient de procéder à une analyse statistique approfondie des résultats fournis par la machine. En ordonnant manuellement la série pour vérifier le mécanisme interne de la TI-84, nous obtenons la séquence de statistiques d’ordre :
$$4, ; 6, ; 7, ; 8, ; 12, ; 14, ; 17, ; 18, ; 19, ; 21, ; 23, ; 24, ; 26, ; 27, ; 28$$
Pour un effectif impair de $n = 15$, le rang physique de la médiane est rigoureusement déterminé par $(15 + 1)/2 = 8$. La huitième observation de la série ordonnée est effectivement le nombre 17, ce qui valide précisément le résultat Med = 17 extrait par la TI-84. La calculatrice subdivise ensuite les données en excluant la médiane pour calculer les quartiles : la moitié inférieure se compose des 7 observations situées sous la médiane ($4, 6, 7, 8, 12, 14, 17$), dont la médiane (rang $(7+1)/2 = 4$) est 7, confirmant Q1 = 7. La moitié supérieure se compose des 7 observations au-dessus de la médiane ($18, 19, 21, 23, 24, 26, 27, 28$), dont la médiane est 23, confirmant Q3 = 23.
À partir de ces métriques, nous déduisons l’écart interquartile empirique de l’épreuve :
$$IQR = Q_3 – Q_1 = 23 – 7 = 16$$
L’amplitude interquartile ($16$) révèle que 50 % des participants se concentrent sur un intervalle d’erreurs relativement étalé par rapport à l’étendue totale ($maxX – minX = 28 – 4 = 24$).
Examinons désormais la symétrie de la distribution. Calculons les distances reliant la médiane aux bornes extrêmes d’une part, et aux quartiles d’autre part :
$$\text{Med} – \text{minX} = 17 – 4 = 13 \quad \text{versus} \quad \text{maxX} – \text{Med} = 28 – 17 = 11$$
$$\text{Med} – \text{Q1} = 17 – 7 = 10 \quad \text{versus} \quad \text{Q3} – \text{Med} = 23 – 17 = 6$$
Cette comparaison spatiale met en lumière une légère divergence structurelle : l’écart entre le premier quartile et la médiane ($10$) est nettement plus étendu que celui séparant la médiane du troisième quartile ($6$). Cette configuration démontre que les performances au sein de la moitié centrale des sujets sont plus dispersées parmi les scores faibles et modérés, traduisant une concentration plus dense des observations dans la zone supérieure des erreurs d’inhibition. La distribution présente ainsi une asymétrie modérée sur son noyau médian, une information diagnostique cruciale que la simple moyenne arithmétique ($\bar{x} \approx 16{,}93$) aurait été totalement incapable de révéler.
8. Représentation graphique : tracer un diagramme en boîte sur TI-84
8.1 Configuration des fonctions graphiques et effacement des équations
Le résumé à cinq nombres constitue le socle direct de construction du diagramme en boîte ou boîte à moustaches (boxplot), formalisé par John Tukey pour matérialiser visuellement les quantiles d’une distribution. La TI-84 intègre un moteur graphique performant capable de générer ces tracés à partir des listes d’observations. Toutefois, avant d’engager le traçage d’une boîte statistique, il est impératif d’assainir l’environnement cartésien de la calculatrice pour éviter toute interférence graphique préjudiciable à la lisibilité des données.
La source de conflit la plus fréquente provient de la présence d’équations algébriques résiduelles stockées dans l’éditeur de fonctions analytiques. Si une fonction analytique telle que $Y_1 = 2X + 1$ demeure activée, la calculatrice tracera simultanément la droite affine par-dessus le diagramme en boîte lors de l’actualisation de l’écran, saturant la zone d’affichage. Pour éliminer ce risque, pressez la touche physique Y= située tout en haut à gauche sous l’écran. Examinez attentivement chacune des lignes d’équations Y1=, Y2=, etc. Si une expression y est inscrite, placez le curseur sur celle-ci et appuyez sur la touche CLEAR pour purger la mémoire de l’équation. Assurez-vous également qu’aucun symbole d’égalité n’apparaît en surbrillance inversée.
Quittez ensuite cet éditeur via la combinaison 2nd MODE (QUIT). Cette purge garantit que l’écran graphique sera intégralement dédié à la représentation spatiale des statistiques univariées de l’échantillon, préservant la précision diagnostique des axes de coordonnées.
8.2 Paramétrage du menu Stat Plot
La configuration du rendu visuel s’effectue au sein du menu dédié aux tracés statistiques. Pour y accéder, appuyez sur la combinaison de touches 2nd suivie de Y= (accès direct à la fonction en surimpression STAT PLOT). L’écran liste les quatre registres graphiques disponibles : Plot1..., Plot2..., Plot3..., et 4:PlotsOff. Sélectionnez le premier graphique en appuyant sur ENTER pour configurer Plot1.
Au sein de la fenêtre de paramétrage de Plot1, effectuez les réglages méthodiques suivants :
- État d’activation (
Plot1) : Le curseur clignote sur l’alternativeOn/Off. Positionnez la surbrillance surOnet validez parENTERpour activer le traceur. - Typologie graphique (
Type:) : La ligne propose six icônes représentant respectivement un nuage de points, un tracé de lignes jointes, un histogramme, un diagramme en boîte avec détection des valeurs aberrantes (première boîte avec petits points isolés adjacents), un diagramme en boîte classique standard sans discrimination des moustaches (seconde boîte aux moustaches pleines), et une courbe de probabilité normale. Pour une analyse rigoureuse conforme aux standards de l’AED, déplacez le curseur vers la quatrième icône (la première boîte à moustaches avec détection des valeurs isolées) et validez avecENTER. - Spécification de la source (
Xlist:) : Indiquez la liste contenant vos observations brutes en pressant2nd1pour afficherL1. - Facteur de fréquence (
Freq:) : Consignez impérativement la valeur1pour signifier que chaque cellule deL1représente une unité statistique singulière. - Marquage des valeurs aberrantes (
Mark:) : Choisissez le glyphe d’affichage pour les points atypiques (petit carré, croix ou point minuscule selon votre préférence visuelle). - Couleur (sur les modèles TI-84 Plus CE) : Définissez la teinte de rendu de votre tracé (par exemple
BLUE) via le sélecteur colorimétrique.
8.3 Ajustement automatique de la fenêtre via ZoomStat
Une erreur fréquente consiste à presser immédiatement la touche GRAPH après avoir paramétré le menu STAT PLOT. Dans la majorité des cas, l’écran graphique qui s’affiche demeure désespérément vide ou ne présente qu’une portion tronquée du diagramme. Ce phénomène s’explique par le fait que la fenêtre cartésienne par défaut de la machine est calée sur des coordonnées standard ($X in [-10, 10]$ et $Y in [-10, 10]$). Si vos scores expérimentaux sont supérieurs à 10 (comme notre jeu de données s’échelonnant de 4 à 28), la boîte est tracée en dehors du champ de vision de l’écran.
Pour remédier instantanément à cette discordance dimensionnelle sans avoir à calculer manuellement les bornes dans le menu WINDOW, le système d’exploitation de la TI-84 propose une routine d’optimisation automatisée baptisée ZoomStat. Appuyez sur la touche physique ZOOM située au centre de la rangée supérieure de touches de commandes. Faites défiler le menu vertical jusqu’à l’option numérotée 9:ZoomStat, ou appuyez directement sur la touche numérique 9 de votre clavier.
L’algorithme ZoomStat scrute immédiatement les données stockées dans la liste déclarée (L1), extrait les extrema réels ($X_{(1)}$ et $X_{(n)}$), et redimensionne instantanément les échelles horizontale ($Xmin, Xmax, Xscl$) et verticale ($Ymin, Ymax$) de la fenêtre graphique pour centrer parfaitement le diagramme en boîte avec des marges d’affichage idéales. Le boxplot apparaît alors au centre de l’écran, matérialisant visuellement le résumé à cinq nombres : le rectangle central s’étend de $Q_1$ à $Q_3$, scindé en son sein par le trait vertical matérialisant la médiane, tandis que les moustaches horizontales s’étirent de part et d’autre pour rejoindre le minimum et le maximum.
Une fonctionnalité analytique particulièrement puissante consiste alors à presser la touche physique TRACE. Dès son activation, un curseur clignotant en forme de croix s’ancre directement sur la ligne de la médiane au centre de la boîte, tandis que la ligne d’état inférieure affiche explicitement l’identifiant et la valeur : Med=17. En actionnant les touches directionnelles horizontales ◄ (Gauche) et ► (Droite), l’opérateur déplace dynamiquement le curseur de jalon en jalon. La calculatrice saute successivement sur le premier quartile (Q1=7), la borne inférieure (minX=4), puis vers la droite sur le troisième quartile (Q3=23) et enfin sur la borne supérieure (maxX=28). Cette navigation interactive lie la forme géométrique globale aux valeurs numériques du résumé à cinq nombres.
9. Détection et analyse des valeurs aberrantes via le résumé à cinq nombres
9.1 Formulation mathématique de la règle des clôtures de Tukey
L’une des contributions méthodologiques majeures du résumé à cinq nombres réside dans sa capacité à fournir une règle formelle, déterministe et objective pour l’identification des observations atypiques ou aberrantes (outliers), sans nécessiter le calcul d’un écart-type fortement contaminé par ces mêmes anomalies. Cette procédure statistique s’articule autour du concept des clôtures de Tukey (Tukey’s Fences), qui utilisent l’écart interquartile ($IQR = Q_3 – Q_1$) comme étalon invariable d’échelle de dispersion.
À partir des quartiles de l’échantillon, Tukey a défini deux barrières critiques intérieures, appelées clôture intérieure inférieure ($CII$) et clôture intérieure supérieure ($CIS$), au moyen des équations fondamentales suivantes :
$$CII = Q_1 – 1{,}5 \times IQR$$
$$CIS = Q_3 + 1{,}5 \times IQR$$
Toute observation empirique $X_i$ qui franchit ces frontières (vérifiant la condition $X_i CIS$) est formellement catégorisée comme une valeur aberrante modérée (ou valeur suspecte). Le coefficient d’extension $1{,}5$ a été déterminé par John Tukey sur des bases probabilistes : pour une distribution théorique parfaitement gaussienne, l’intervalle délimité par $[Q_1 – 1{,}5 \times IQR, ; Q_3 + 1{,}5 \times IQR]$ englobe approximativement 99,3 % de la population, ce qui signifie que la probabilité d’observer un point en dehors de ces clôtures par simple fluctuation d’échantillonnage n’est que de l’ordre de 0,7 % ($p \approx 0{,}007$).
Au-delà de ces frontières intérieures, Tukey a établi une seconde démarcation pour isoler les anomalies structurelles majeures : les clôtures extérieures, définies par :
$$CEI = Q_1 – 3 \times IQR$$
$$CES = Q_3 + 3 \times IQR$$
Les observations situées au-delà de ces clôtures extérieures ($X_i CES$) sont qualifiées de valeurs aberrantes extrêmes. Dans le cadre d’un modèle normal théorique, l’occurrence d’un tel écart présente une probabilité infinitésimale de l’ordre de un sur plusieurs centaines de milliers d’observations, signalant presque à coup sûr une erreur instrumentale, un artifice expérimental ou un sujet issu d’une sous-population non conforme au modèle de référence.
9.2 Visualisation instrumentale des valeurs isolées sur TI-84
La calculatrice TI-84 met en œuvre avec une rigueur absolue la règle des clôtures de Tukey lors du tracé du diagramme en boîte modifié (l’icône de boxplot avec points distincts sélectionnée au sein du menu STAT PLOT). Contrairement au diagramme en boîte rudimentaire qui étend aveuglément ses moustaches jusqu’au minimum ($X_{(1)}$) et au maximum ($X_{(n)}$) absolus de la série, le boxplot modifié applique l’algorithme d’élagage géométrique de Tukey.
Sous ce modèle opératoire, les moustaches de la boîte ne se terminent pas aux clôtures théoriques elles-mêmes (car celles-ci correspondent rarement à des scores physiques observés dans l’échantillon), mais s’arrêtent précisément sur les « valeurs adjacentes ». La valeur adjacente inférieure correspond à la plus petite observation de la série qui demeure supérieure ou égale à la clôture intérieure inférieure ($X_{(i)} ge CII$). Réciproquement, la valeur adjacente supérieure correspond à la plus grande observation de l’échantillon restant inférieure ou égale à la clôture intérieure supérieure ($X_{(i)} le CIS$).
Toute observation qui excède ces valeurs adjacentes est exclue du corps continu du graphique et se trouve représentée sous la forme d’un symbole géométrique autonome (point, croix ou carré selon la configuration du champ Mark) flottant au-delà de l’extrémité des moustaches. Lorsque l’opérateur active l’outil TRACE sur la TI-84, la navigation par les flèches horizontales parcourt séquentiellement la moustache jusqu’à la valeur adjacente, puis saute directement sur chacun des points aberrants isolés en imprimant au bas de l’écran leur valeur exacte sous la dénomination syntaxique conventionnelle (par exemple X=52). Cette fonctionnalité permet de repérer instantanément la présence, l’amplitude et la multiplicité des contaminations distributionnelles sans nécessiter de balayage manuel fastidieux de l’ensemble de la liste brute.
9.3 Conséquences méthodologiques en recherche comportementale
L’identification formelle de données atypiques via la règle de Tukey et le résumé à cinq nombres soulève des enjeux méthodologiques et épistémologiques cruciaux au sein des sciences comportementales et de la recherche clinique. Il est impératif de rappeler qu’une valeur aberrante ne doit jamais être supprimée d’un fichier de données de manière automatique ou arbitraire. L’exclusion aveugle de points extrêmes constitue une violation grave de l’éthique scientifique, susceptible de biaiser artificiellement la significativité statistique des tests d’inférence en réduisant indûment la variance résiduelle.
Face à une observation isolée décelée par la TI-84, l’expérimentateur doit mener une enquête diagnostique rigoureuse. La première hypothèse à examiner est celle de l’artefact technique : une valeur d’âge de 250 ans dans une étude développementale ou un temps de réaction de 12 millisecondes dans une tâche visuelle humaine relèvent manifestement de coquilles de saisie matérielle ou de faux départs musculaires enregistrés par les capteurs. Dans cette hypothèse exclusive, la rectification de l’entrée typographique ou son élimination formelle s’impose comme une mesure d’assainissement évidente.
En revanche, lorsque la mesure anormale reflète fidèlement la réponse clinique ou comportementale d’un sujet (par exemple, un temps de réaction particulièrement long de 3 500 ms chez un patient victime d’un traumatisme crânien ou souffrant de troubles sévères du maintien attentionnel), la valeur atypique est porteuse d’une signification neurocognitive fondamentale. Elle témoigne de l’hétérogénéité biologique réelle du phénomène exploré. Dans de telles circonstances, l’analyste doit renoncer à l’emploi de statistiques paramétriques sensibles (moyenne et variance) au profit du maintien du résumé à cinq nombres et de modèles statistiques non paramétriques (tels que les tests de Mann-Whitney ou de Kruskal-Wallis), ou adopter des techniques d’élagage standardisées (comme la winsorisation ou le calcul de moyennes tronquées), en documentant de façon exhaustive et transparente chaque arbitrage méthodologique au sein des protocoles de publication académique.
10. Diagnostics d’erreurs courantes et dépannage technique sur TI-84
10.1 Résolution des erreurs de syntaxe et de dimensions
L’exécution des routines statistiques sur la calculatrice TI-84 est fréquemment interrompue par des messages d’anomalie logicielle dont l’opacité cryptique désarçonne régulièrement les utilisateurs moins avertis. L’une des interruptions les plus classiques est l’erreur ERR:DIM MISMATCH (Erreur : Incompatibilité de dimensions). Ce blocage intervient systématiquement lorsque la calculatrice est appelée à exécuter un calcul univarié pondéré via l’instruction 1-Var Stats L1,L2 (ou via les champs List: et FreqList: de l’assistant interactif) alors que les deux listes matricielles impliquées ne partagent pas exactement la même longueur vectorielle. Si la liste L1 contient 15 valeurs et la liste L2 en contient 14, le processeur interrompt immédiatement le calcul par mesure d’intégrité matricielle. La résolution impose de regagner l’éditeur STAT 1:Edit pour réaligner rigoureusement la taille des deux séries associées.
Une autre interruption fréquente prend la forme du message ERR:STAT NO LIST (Erreur : Aucune liste statistique). Cette notification signale que l’opérateur a référencé un identifiant de liste qui a été totalement purgé de la mémoire active ou dont le pointeur a été dégradé lors d’une session de programmation. Pour restaurer l’accès aux variables matricielles fondamentales, il convient d’exécuter la commande réparatrice SetUpEditor accessible via la séquence de touches STAT, puis choix 5:SetUpEditor et validation par ENTER, ce qui reconstitue instantanément l’architecture interne des listes L1 à L6.
Enfin, l’interruption universelle ERR:SYNTAX (Erreur de syntaxe) survient lors d’une saisie non conforme sur l’écran de calcul principal, le plus souvent causée par l’usage du tiret de soustraction opératoire binaire - au lieu du signe négatif unaire (-) pour coder une valeur négative, ou par l’insertion de virgules décimales redondantes au sein de la commande 1-Var Stats. La sélection systématique de l’option 2:Goto proposée par l’écran d’erreur repositionne immédiatement le curseur clignotant sur le caractère précis à l’origine du rejet de syntaxe, permettant une rectification instantanée du paramètre fautif.
10.2 Rectification des conflits d’affichage graphique
Lors de la transition vers la représentation graphique du résumé à cinq nombres sous forme de diagramme en boîte, les utilisateurs sont fréquemment confrontés au message d’erreur bloquant ERR:WINDOW RANGE (Erreur : Plage de la fenêtre). Cette rupture logicielle se manifeste lorsque les paramètres d’échelle cartésienne sont incohérents au sein de l’éditeur WINDOW, typiquement lorsque la borne minimale déclarée sur l’axe des abscisses est supérieure ou égale à la borne maximale correspondante ($Xmin ge Xmax$), ou lorsque l’incrément de graduation $Xscl$ est négatif ou nul. Pour purger instantanément ce conflit géométrique, l’utilisateur n’a nul besoin de modifier les registres numériques à la main : il lui suffit d’appeler la fonction ZOOM 9:ZoomStat, qui recalcule et réassigne automatiquement des bornes dimensionnellement cohérentes avec les données actives.
Une autre défaillance d’affichage classique concerne le message ERR:INVALID DIM (Erreur : Dimension non valide) qui survient immédiatement après avoir appuyé sur la touche GRAPH. Cette interruption indique que l’un des trois graphiques statistiques (Plot1, Plot2 ou Plot3) est configuré sur l’état On et pointe vers une liste statistique qui s’avère totalement vide de données. Pour pallier ce conflit de configuration, accédez au gestionnaire de tracés via la combinaison 2nd Y=, puis sélectionnez l’option 4:PlotsOff suivie de ENTER pour désactiver simultanément tous les tracés. Réactivez ensuite de manière isolée et exclusive l’unique graphique Plot1 dédié à votre liste de mesures effective.
De même, si le graphique obtenu apparaît saturé de courbes géométriques aléatoires ou de paraboles parasites dégradant la visibilité de la boîte à moustaches, le problème réside dans des équations analytiques résiduelles actives. Ouvrez le menu Y=, supprimez rigoureusement toutes les expressions polynomiales à l’aide de la touche CLEAR, et désactivez les fonctions matricielles parasites pour préserver la totale pureté du repère statistique.
10.3 Prévention de la corruption et perte accidentelle des données
Dans un contexte d’évaluation expérimentale prolongée ou d’examens académiques, la perte soudaine de séries de données minutieusement encodées peut avoir des conséquences désastreuses. Pour immuniser vos listes statistiques contre les risques de décharge subite de la batterie ou les purges accidentelles déclenchées par l’utilisation inconsidérée de la commande ClrList, le système d’exploitation de la TI-84 intègre un mécanisme d’archivage matériel de mémoire non volatile.
Pour verrouiller et sanctuariser une liste de données (par exemple L1), accédez au menu de gestion mémoire via 2nd + (MEM), puis choisissez l’option 2:Mem Management/Delete.... Naviguez ensuite jusqu’à la sous-section 4:List... et appuyez sur ENTER pour afficher le catalogue de toutes les listes présentes dans l’appareil. Déplacez le curseur en face du label de la liste ciblée (L1) et pressez la touche ENTER. Un petit astérisque symbolique (*) vient immédiatement s’imprimer à la gauche du nom de la variable, certifiant que celle-ci a été basculée de la mémoire vive volatile (RAM) vers la mémoire de stockage permanente (Flash ROM Archive).
Une fois une variable ainsi archivée, elle demeure protégée contre toute suppression accidentelle, et son contenu sera préservé même en cas d’extraction complète des piles ou d’exécution de la commande de réinitialisation basique de la RAM (RAM Reset). Toutefois, il est important de noter que pour rééditer dynamiquement le contenu de cette liste dans la grille matricielle ou pour lui assigner de nouvelles observations numériques, l’utilisateur devra obligatoirement opérer la démarche inverse (désarchivage via l’instruction UnArchive L1 disponible dans le catalogue des commandes 2nd 0) afin de réinjecter la variable dans la mémoire de calcul opérationnelle.
11. Applications pratiques en psychométrie et sciences du comportement
11.1 Standardisation et étalonnage des échelles d’évaluation
Dans le domaine de l’ingénierie psychométrique, la transformation de scores bruts issus d’épreuves d’évaluation en notes étalonnées standardisées représente une étape méthodologique fondamentale pour autoriser l’interprétation diagnostique interindividuelle. Alors que l’étalonnage classique en scores $Z$ ou en notes $T$ s’appuie sur la moyenne et l’écart-type sous l’hypothèse sous-jacente d’une distribution normale des aptitudes latentes, de multiples échelles d’évaluation clinique et comportementale produisent des distributions fortement biaisées où l’application d’un étalonnage linéaire gaussien conduirait à de graves erreurs de catégorisation diagnostique.
Le résumé à cinq nombres offre l’infrastructure positionnelle requise pour construire des étalonnages non paramétriques fondés sur les rangs percentiles et les quantiles de classement. Le premier quartile $Q_1$, la médiane $Med$ et le troisième quartile $Q_3$ scindent naturellement la population de référence en quatre classes standardisées de taille équivalente (quartiles d’étalonnage). Cette segmentation permet d’attribuer instantanément un rang ordinal rigoureux au score brut d’un patient sans présupposer une quelconque régularité distributionnelle. Un sujet dont le score se situe entre le minimum et $Q_1$ appartient au premier quart de la cohorte clinique (déficit marqué ou performance très faible), tandis qu’un score compris entre la médiane et $Q_3$ le positionne au cœur de la moyenne haute de l’échantillon normatif.
De plus, cette démarche s’avère déterminante pour l’établissement de seuils cliniques de décision (cut-off scores) objectifs. Dans le dépistage d’affections psychopathologiques ou de déficiences attentionnelles, la démarcation matérialisée par le troisième quartile $Q_3$ (ou son extrapolation vers le quatre-vingt-dixième centile via l’échelle des quantiles) est couramment exploitée par les commissions de standardisation comme seuil d’alerte clinique préliminaire. Tout patient franchissant la clôture supérieure délimitée par la frontière interquartile est automatiquement aiguillé vers des investigations neuropsychologiques approfondies, garantissant un protocole d’orientation clinique fondé sur des repères positionnels d’une robustesse mathématique irréprochable.
11.2 Comparaison de groupes expérimentaux dans les protocoles de recherche
L’un des défis majeurs rencontrés par les chercheurs en sciences du comportement réside dans l’analyse différentielle de deux conditions expérimentales au sein de plans factoriels à petits effectifs, fréquents lors d’essais cliniques préliminaires ou d’études d’imagerie fonctionnelle. Face à de tels protocoles où les postulats d’homoscédasticité (égalité des variances) et de normalité des résidus ne peuvent être décemment vérifiés, le recours aux représentations comparatives juxtaposées permises par la TI-84 offre une puissance diagnostique inégalée.
Considérons un protocole expérimental opposant un groupe contrôle recevant un placebo à un groupe expérimental soumis à un entraînement métacognitif intensif avant le passage d’une tâche de mémoire de travail. L’expérimentateur encode les performances du groupe contrôle dans la liste matricielle L1 et celles du groupe traité dans la liste L2. En invoquant séquentiellement la routine 1-Var Stats L1 puis 1-Var Stats L2, le praticien extrait instantanément les deux résumés à cinq nombres correspondants, ce qui autorise une comparaison directe de l’évolution de la tendance centrale et de la dispersion :
Il devient dès lors trivial de vérifier si le traitement expérimental a engendré un simple déplacement translationnel de la médiane (effet additif pur) ou s’il s’est accompagné d’une contraction sensible de l’écart interquartile ($IQR_{L2} < IQR_{L1}$), traduisant une homogénéisation des compétences au sein de la cohorte soumise à l'entraînement cognitif. Cette analyse numérique se double d'une confirmation graphique déterminante sur la TI-84 : en configurant simultanément le tracé Plot1 sur la liste L1 et le tracé Plot2 sur la liste L2 au sein du menu STAT PLOT, puis en déclenchant ZoomStat, l’écran de la calculatrice affiche deux boîtes à moustaches superposées parallèlement sur le même axe cartésien horizontal.
Cette visualisation synchrone permet d’apprécier en un clin d’œil le chevauchement ou la dissociation des intervalles interquartiles des deux conditions. La non-intersection de la boîte centrale du groupe expérimental avec celle du groupe contrôle constitue une indication visuelle forte en faveur de l’efficacité substantielle de l’intervention testée, fournissant des bases descriptives solides avant l’exécution de tests de rangs appariés ou indépendants.
11.3 Évaluation de la fidélité et de l’asymétrie des distributions de scores
Dans l’analyse des propriétés métrologiques d’un nouvel instrument de test psychologique, la caractérisation précise de la forme de distribution des scores bruts constitue un prérequis incontournable pour statuer sur la fidélité et la sensibilité de l’épreuve. Le résumé à cinq nombres opère comme un outil d’inspection directe de l’asymétrie statistique (skewness) sans exiger le calcul de moments d’ordre supérieur (tels que le coefficient d’asymétrie de Fisher-Pearson $g_1$), dont la stabilité asymptotique est notoirement défaillante sur des échantillons restreints en neuropsychologie clinique.
L’évaluation de l’asymétrie s’articule autour de l’analyse différentielle des longueurs des demi-boîtes et des moustaches du diagramme fourni par les cinq nombres :
- Distribution Symétrique : La distance entre le premier quartile et la médiane est rigoureusement égale à la distance séparant la médiane du troisième quartile ($Med – Q_1 \approx Q_3 – Med$), et la longueur de la moustache inférieure est sensiblement identique à celle de la moustache supérieure ($Q_1 – minX \approx maxX – Q3$). Dans cette configuration, la médiane coïncide approximativement avec la moyenne arithmétique.
- Distribution Asymétrique Positive (étalée à droite) : La médiane se positionne très près du premier quartile, contractant la moitié gauche de la boîte centrale, tandis que la distance séparant la médiane du troisième quartile ($Q_3 – Med$) et la longueur de la moustache supérieure ($maxX – Q_3$) s’étirent de manière disproportionnée. Ce schéma est typique des épreuves de latence attentionnelle ou de dépistage de pathologies rares où la vaste majorité des sujets sains cumule des scores minimaux.
- Distribution Asymétrique Négative (étalée à gauche) : La médiane est accolée au troisième quartile, la moitié supérieure de la distribution est fortement comprimée, tandis que la moustache inférieure s’allonge vers les valeurs basses ($Med – Q_1 gg Q_3 – Med$). Ce profil traduit classiquement un effet de plafond ou une épreuve trop élémentaire sur laquelle la plupart des participants atteignent le score maximal possible.
Cette analyse de symétrie, couplée au contrôle de l’homogénéité de l’intervalle interquartile entre différents sous-échantillons d’âge ou de niveau socio-éducatif, assure aux chercheurs un contrôle continu et immédiat sur la validité interne de leurs instruments d’évaluation sans nécessiter l’exportation des données brutes vers des logiciels statistiques lourds sur ordinateur.
12. Comparaison avec d’autres méthodes d’analyse descriptive et synthèse méthodologique
12.1 Limites inhérentes au résumé à cinq nombres
Malgré son élégance mathématique et sa remarquable résistance face aux contaminations aberrantes, le résumé à cinq nombres n’est pas exempt de limites méthodologiques intrinsèques. L’analyste rigoureux doit être parfaitement conscient des angles morts structurels inhérents à cette technique de réduction dimensionnelle. La principale défaillance du résumé à cinq nombres réside dans son incapacité totale à rendre compte de la multimodalité d’une distribution. Étant exclusivement basé sur des coupures quantiles séquentielles, le résumé à cinq nombres est rigoureusement incapable de distinguer une distribution strictement unimodale continue d’une distribution bimodale ou trimodale présentant des creux de densité majeurs.
Deux sous-populations distinctes agrégées artificiellement au sein d’une même liste peuvent afficher une médiane et des quartiles parfaitement similaires à ceux d’une distribution unimodale homogène, masquant l’existence d’une scission structurale sous-jacente au sein de l’échantillon. De surcroît, le résumé à cinq nombres fait fi de la densité interne des observations logées entre les quartiles : il ne fournit aucun renseignement sur l’espacement exact ou le regroupement localisé des scores à l’intérieur de l’intervalle interquartile.
Pour contourner ces limitations inhérentes, la bonne pratique en analyse exploratoire impose de ne jamais utiliser le résumé à cinq nombres de manière exclusivement isolée, mais de le coupler systématiquement avec des représentations de densité empirique, telles que les histogrammes à pas modulables ou les tracés d’estimation de densité par noyau (Kernel Density Estimation). Sur la TI-84, ce couplage s’opère très facilement en configurant le tracé statistique Plot1 sous forme d’histogramme de fréquences, permettant d’inspecter visuellement l’unimodalité de la distribution avant d’interpréter le diagramme en boîte dérivé du résumé à cinq nombres.
12.2 Confrontation avec le résumé paramétrique moyenne-écart-type
Le débat classique opposant le résumé non paramétrique à cinq nombres (Médiane / $IQR$) au couple paramétrique classique (Moyenne / Écart-type) ne doit pas être abordé sous l’angle d’une exclusion mutuelle, mais sous celui d’une adéquation probabiliste aux propriétés du modèle d’échantillonnage sous-jacent. Le tableau suivant synthétise les critères de démarcation et de convergence entre ces deux philosophies de description statistique :
Lorsque la distribution des observations empiriques satisfait rigoureusement au postulat de normalité gaussienne mésocurtique, le couple moyenne-écart-type constitue le résumé statistique optimal au sens de la théorie de l’information de Fisher, car il mobilise l’intégralité des valeurs pour calculer des estimateurs sans biais à variance minimale. Cependant, dès lors que la série s’éloigne du modèle gaussien sous l’effet d’une asymétrie marquée, d’un étalement leptocurtique ou d’erreurs sporadiques d’acquisition, la moyenne et l’écart-type perdent leur représentativité descriptive en dérivant de manière spectaculaire.
Dans ce contexte non gaussien, le résumé à cinq nombres s’impose comme l’alternative universelle la plus fidèle et la plus robuste. Conformément aux recommandations édictées par les normes méthodologiques de l’American Psychological Association (APA Style), les chercheurs sont formellement encouragés à documenter conjointement ces deux types de métriques ou à opter explicitement pour le résumé positionnel à cinq nombres dès lors que les tests de normalité d’usage (tels que le test de Shapiro-Wilk) révèlent une déviation statistiquement significative de la symétrie paramétrique.
12.3 Bonnes pratiques rédactionnelles pour la restitution scientifique
L’extraction instrumentale du résumé à cinq nombres sur la calculatrice TI-84 ne constitue que la première phase du travail de recherche ; la restitution formelle de ces résultats au sein de mémoires universitaires, de thèses de doctorat ou d’articles scientifiques arbitrés exige le strict respect de conventions typographiques et rédactionnelles établies. Les normes internationales proscrivent l’insertion de captures d’écran brutes de calculatrices ou de transcriptions textuelles informelles au sein du corps du texte scientifique.
Dans les tableaux statistiques de synthèse descriptive, le résumé à cinq nombres doit être présenté sous une structure tabulaire claire et standardisée. Les métriques doivent être clairement désignées dans les en-têtes de colonnes par leurs symboles académiques conventionnels : effectif total ($n$), minimum ($Min$ ou $X_{(1)}$), premier quartile ($Q_1$), médiane ($Med$), troisième quartile ($Q_3$), et maximum ($Max$ ou $X_{(n)}$). Il est d’usage d’y adjoindre une colonne spécifiant l’écart interquartile dérivé ($IQR$). Les abréviations propriétaires propres à l’interface machine de Texas Instruments (telles que minX ou maxX) doivent impérativement être converties vers la typographie scientifique standardisée lors de la phase finale de rédaction.
Lorsque ces indicateurs sont insérés directement au fil du texte, les résultats doivent être énoncés avec précision entre parenthèses selon une formulation normée, telle que : « L’évaluation du contrôle inhibiteur des participants sous contrainte temporelle révèle une dispersion asymétrique des erreurs (Med = 17, IQR = 16, Min = 4, Max = 28, Q1 = 7, Q3 = 23, n = 15) ». Si des valeurs aberrantes sont détectées via la règle des clôtures de Tukey et visualisées sur le boxplot de la calculatrice, l’auteur doit expliciter clairement le nombre de sujets concernés, leurs scores exacts ainsi que la justification méthodologique motivant leur traitement ou leur maintien au sein des analyses statistiques subséquentes, garantissant ainsi une reproductibilité et une transparence totale des protocoles empiriques déployés.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473541
- Texas Instruments. (2020). TI-84 Plus CE graphing calculator guidebook. Texas Instruments Incorporated. https://education.ti.com/en/guidebooks
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley Publishing Company. https://www.jstor.org/stable/2683398
- Velleman, P. F., & Hoaglin, D. C. (1981). Applications, basics, and computing of exploratory data analysis. Duxbury Press.