
Dans le domaine de l’analyse quantitative, de la modélisation statistique et de l’ingénierie des données, la caractérisation précise des relations fonctionnelles entre grandeurs observables constitue un impératif méthodologique récurrent. L’environnement de feuille de calcul Microsoft Excel, universellement déployé dans les contextes académiques, industriels et financiers, offre un ensemble d’outils analytiques sophistiqués permettant d’ajuster des modèles prédictifs linéaires sur des corpus empiriques. Au cœur de cette démarche d’ajustement réside l’évaluation de la pente d’une courbe de tendance, un paramètre fondamental quantifiant la vitesse et le sens de variation d’une variable réponse par rapport à un stimulus ou un facteur explicatif donné.
Cependant, l’extraction et l’exploitation de ce coefficient angulaire sous Excel ne se résument pas à une simple manipulation visuelle ou à l’insertion superficielle d’un tracé graphique. Selon les finalités de l’investigateur — qu’il s’agisse de la production de rapports scientifiques normalisés, du calcul dynamique au sein d’architectures tabulaires automatisées, ou de la conduite d’inférences statistiques rigoureuses —, plusieurs méthodologies coexistent au sein du logiciel. Chacune de ces approches présente des propriétés formelles distinctes, des niveaux de précision algorithmiques variables et des contraintes d’implémentation spécifiques qu’il convient de maîtriser rigoureusement pour éviter toute dérive d’interprétation ou biais calculatoire.
Ce traité méthodologique exhaustif explore en profondeur l’ensemble des protocoles requis pour extraire, évaluer et contextualiser la pente d’une courbe de tendance linéaire dans Microsoft Excel. De la formalisation mathématique des moindres carrés ordinaires à l’exploitation des formules matricielles dynamiques modernes telles que DROITEREG, en passant par l’analyse critique des étiquettes graphiques et la gestion systématique des artefacts numériques, ce guide procure un cadre conceptuel et opératoire complet destiné aux chercheurs, analystes et praticiens soucieux de rigueur analytique.
1. Introduction théorique et fondements mathématiques de la pente dans Excel
1.1 Définition de la pente dans le cadre de la modélisation linéaire
Dans la théorie classique de l’analyse de régression univariée, la relation mathématique liant une variable explicative indépendante, conventionnellement désignée par la notation $X$, à une variable dépendante continue ou critère, notée $Y$, s’exprime sous la forme d’un modèle affine canonique formalisé par l’équation $Y = \beta_1 X + \beta_0 + \varepsilon$. Dans cette structure relationnelle, le terme $\beta_1$ représente le coefficient de pente, tandis que $\beta_0$ matérialise l’ordonnée à l’origine, et $varepsilon$ traduit la composante stochastique ou le résidu d’estimation inhérent à toute mesure empirique non déterministe.
D’un point de vue conceptuel et physique, la pente incarne le taux de variation marginal ou instantané observé entre les deux grandeurs mesurées. Elle explicite avec exactitude de combien d’unités scalaires la variable réponse $Y$ se modifie consécutivement à une augmentation infinitésimale ou unitaire d’exactement une unité de la variable prédictive $X$. Lorsque l’ajustement est estimé sur un échantillon discret de couples d’observations $(x_i, y_i)$, la pente calculée par Microsoft Excel découle strictement de la méthode des moindres carrés ordinaires, laquelle vise à minimiser la somme quadratique des écarts verticaux entre les valeurs observées et les valeurs ajustées correspondantes. L’estimateur de la pente $b_1$, approximation ponctuelle du paramètre théorique $\beta_1$, est ainsi régi par le ratio fondamental de la covariance empirique des deux variables sur la variance empirique de la variable indépendante :
$$b_1 = \frac{\sum_{i=1}^{n} (x_i – \bar{x})(y_i – \bar{y})}{\sum_{i=1}^{n} (x_i – \bar{x})^2} = \frac{\text{Cov}(X,Y)}{\text{Var}(X)}$$
Il est capital d’opérer une différenciation méthodologique absolue entre la magnitude géométrique issue de la représentation visuelle du graphique et l’intensité mathématique intrinsèque de la relation. L’aspect visuel de la droite affichée au sein de la fenêtre de traçage dépend étroitement du calibrage dimensionnel des axes, des ratios d’aspect des fenêtres et des facteurs d’échelle arbitraires choisis par l’utilisateur ou configurés par défaut par le moteur graphique. En revanche, le paramètre numérique de pente demeure un invariant fonctionnel strict, indépendant des artifices d’affichage et tributaire uniquement des unités de mesure métrologiques associées aux séries de données distribuées.
1.2 Pertinence de l’analyse de tendance en recherche quantitative
L’inférence quantitative moderne, appliquée aux sciences expérimentales, à l’épidémiologie, à l’économétrie ainsi qu’à la psychométrie, accorde une valeur heuristique centrale à l’estimation des tendances linéaires. Modéliser la trajectoire de réponses biologiques, comportementales ou cinétiques au moyen d’une courbe de régression permet de réduire la complexité dimensionnelle d’un phénomène dynamique à un couple intelligible de paramètres scalaires stables, facilitant la comparaison interindividuelle ou intergroupe.
Dans les paradigmes expérimentaux longitudinaux, l’investigation porte fréquemment sur la vitesse d’adaptation, d’apprentissage ou de dégénérescence d’un système à l’épreuve du temps. Au sein de ces protocoles, la pente traduit directement la vitesse moyenne du changement par unité temporelle (exprimée par exemple en millisecondes par session, en microgrammes par millilitre par heure ou en points d’indice par cycle annuel). L’évaluation de l’amplitude de ce vecteur d’évolution permet de trancher avec acuité entre des hypothèses théoriques divergentes relatives à l’efficacité d’un traitement thérapeutique, à la robustesse d’un alliage mécanique ou à la réactivité d’un marché financier face à un choc macroéconomique.
De surcroît, la quantification formelle de la pente au sein d’échantillons continus constitue le prérequis impératif pour l’extrapolation et l’interpolation statistiques. En l’absence d’une mesure exacte du coefficient directeur, toute tentative de prédiction des valeurs de $Y$ hors du spectre d’observation immédiat s’avère structurellement invalide. La régression offre ainsi le substrat algorithmique indispensable pour transformer des observations brutes fragmentées en un système déductif prédictif cohérent.
1.3 Distinction rigoureuse entre pente et coefficient de corrélation
Une confusion persistante dans la littérature empirique et les rapports d’analyse de données consiste à assimiler indûment la valeur de la pente $b_1$ à celle du coefficient de corrélation linéaire de Pearson, universellement désigné par la lettre $r$. Bien que ces deux descripteurs statistiques soient intrinsèquement liés et partagent rigoureusement le même signe arithmétique — déterminé par le numérateur covariant commun —, leurs propriétés de distribution et leurs significations scientifiques respectives divergent radicalement.
Le coefficient de corrélation de Pearson $r$ est une grandeur adimensionnelle, normalisée et bornée de manière invariable sur l’intervalle fermé $[-1 ; 1]$. Il quantifie avec précision la force, l’homogénéité et la colinéarité de l’association linéaire entre deux grandeurs, indépendamment de toute considération d’échelle physique. En contrepartie, la pente $b_1$ est une métrique dimensionnée, hautement dépendante des unités matérielles adoptées lors du mesurage : elle s’exprime systématiquement dans l’unité de la variable dépendante divisée par l’unité de la variable indépendante (par exemple en $\text{kg}\cdot\text{m}^{-2}$, en volts par seconde ou en euros par unité produite).
La relation analytique formelle unissant ces deux indices met en exergue le rôle fondamental du rapport des dispersions marginales :
$$b_1 = r \cdot \frac{s_y}{s_x}$$
où $s_y$ et $s_x$ symbolisent respectivement les écarts-types empiriques des distributions $Y$ et $X$. Il découle immédiatement de cette identité qu’une relation caractérisée par un alignement quasi-parfait des observations sur la droite de régression ($r \approx 0,99$) peut parfaitement présenter une pente infime si la variance de $Y$ est très faible au regard de celle de $X$. Réciproquement, une pente de très forte amplitude numérique peut être associée à un coefficient de corrélation médiocre en présence d’une dispersion résiduelle massive. Conférer à la pente une signification intrinsèque de force d’association constitue donc un contresens méthodologique majeur.
2. Structuration préalable et préparation des jeux de données
2.1 Organisation tabulaire conforme des variables prédictives et critères
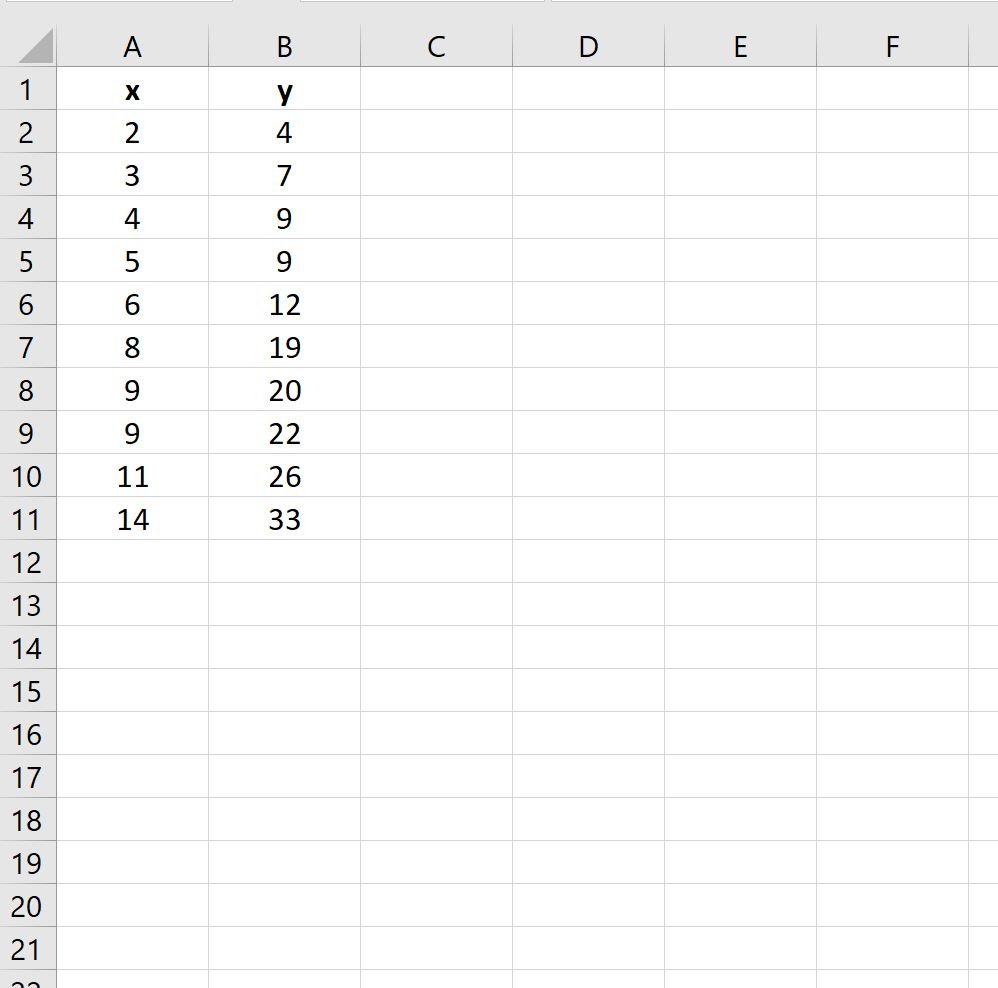
Pour qu’Excel déploie ses routines d’ajustement sans introduire de distorsions fonctionnelles latentes, les données expérimentales brutes doivent impérativement être structurées selon une architecture matricielle plane et orthogonale. Le standard d’agencement le plus robuste impose la distribution des observations en colonnes adjacentes strictes au sein d’une même feuille de calcul, chaque ligne représentant un individu statistique, un instant de mesure ou une unité d’échantillonnage unique.
Par convention opératoire et pour optimiser le fonctionnement natif des assistants graphiques de Microsoft Excel, la variable indépendante (explicative, conventionnellement $X$) doit systématiquement occuper la colonne située immédiatement à gauche de celle assignée à la variable dépendante (réponse, conventionnellement $Y$). Bien que certaines formules avancées permettent de s’affranchir de cet ordre spatial, les moteurs d’inférence graphique présument par défaut que la première série sélectionnée correspond aux abscisses et la seconde aux ordonnées.
Chaque colonne doit débuter par un en-tête univoque, concis et textuel, placé sur une seule et unique ligne (idéalement la ligne 1). Cet intitulé doit expliciter sans équivoque la nature du mesurage et spécifier impérativement les unités physiques employées entre parenthèses ou crochets. Tout mélange de données numériques et de descriptions textuelles au sein du corps du tableau doit être formellement banni afin de préserver l’intégrité référentielle des plages matricielles lors de leur manipulation calculatoire ultérieure.
2.2 Assainissement et nettoyage systématique des données tabulaires
Avant d’engager la moindre procédure de modélisation mathématique sous Excel, un contrôle qualité exhaustif du corpus tabulaire s’avère indispensable. Les lacunes d’observation, matérialisées par des cellules totalement vides ou comportant des valeurs textuelles erronées (telles que les mentions « non disponible », « N/A » ou des tirets typographiques), induisent des ruptures de contiguïté sévères. Si les graphiques d’Excel gèrent parfois les cellules manquantes en interpolant le tracé ou en créant des discontinuités, les fonctions statistiques formelles peuvent rejeter la sélection ou biaiser l’échantillonnage effectif.
Une vigilance particulière doit être accordée au formatage interne des cellules. Il n’est pas rare, consécutivement à des importations de fichiers CSV ou de bases de données relationnelles SQL mal configurées, que des valeurs numériques soient encodées sous forme de chaînes textuelles arbitraires. Une cellule numérique stockée comme texte se reconnaît fréquemment à son alignement spontané sur la gauche de la case ou à l’apparition d’un indicateur triangulaire vert dans son angle supérieur. Ces artefacts neutralisent les fonctions statistiques analytiques telles que PENTE, qui ignorent silencieusement ces entrées, conduisant à des estimations fondées sur des degrés de liberté erronés.
Enfin, le traitement préliminaire des aberrations statistiques impose l’application d’un protocole rigoureux d’identification des valeurs extrêmes ou invraisemblables. Ces observations suspectes doivent faire l’objet d’une vérification d’encodage par rapport aux registres d’acquisition primaires. Si une correction manuelle n’est pas possible, leur exclusion de l’espace d’estimation doit être consignée et motivée afin de préserver la représentativité du vecteur résultant.
2.3 Vérification des hypothèses distributionnelles requises
L’estimation linéaire par les moindres carrés ne possède de validité scientifique que si certaines propriétés distributionnelles sous-jacentes sont raisonnablement satisfaites par les séries analysées. La première exigence repose sur la continuité métrique des grandeurs considérées. Les variables $X$ et $Y$ doivent impérativement appartenir à des échelles d’intervalles ou de rapports ; tenter d’ajuster une courbe de tendance linéaire sur des variables strictement ordinales codées numériquement (telles que des échelles de Likert à faible granularité) produit des coefficients de pente dépourvus de rigueur interprétative.
Il est pareillement crucial d’analyser l’histogramme des distributions pour détecter d’éventuels phénomènes de saturation, communément appelés effets de plancher ou de plafond. Si l’instrumentation de mesure borne arbitrairement la variable $Y$ au-delà d’un seuil critique, la droite de régression subira une déviation mécanique majeure : la pente estimée se trouvera artificiellement atténuée comparativement à la véritable cinétique sous-jacente du phénomène naturel.
Enfin, la robustesse géométrique de la droite dépend de la taille effective de l’échantillon ($n$). Un échantillon trop restreint (par exemple $n < 10$) confère à l’estimateur de la pente une variance d’échantillonnage excessivement volatile : le retrait ou l’adjonction d’une seule observation excentrique suffit à inverser la trajectoire du vecteur modélisé. Un compromis méthodologique prudent exige généralement la disposition d’un effectif suffisant garantissant la convergence asymptotique des paramètres selon le théorème central limite.
3. Génération et configuration du graphique en nuage de points
3.1 Procédure d’insertion via le ruban de commandes Excel
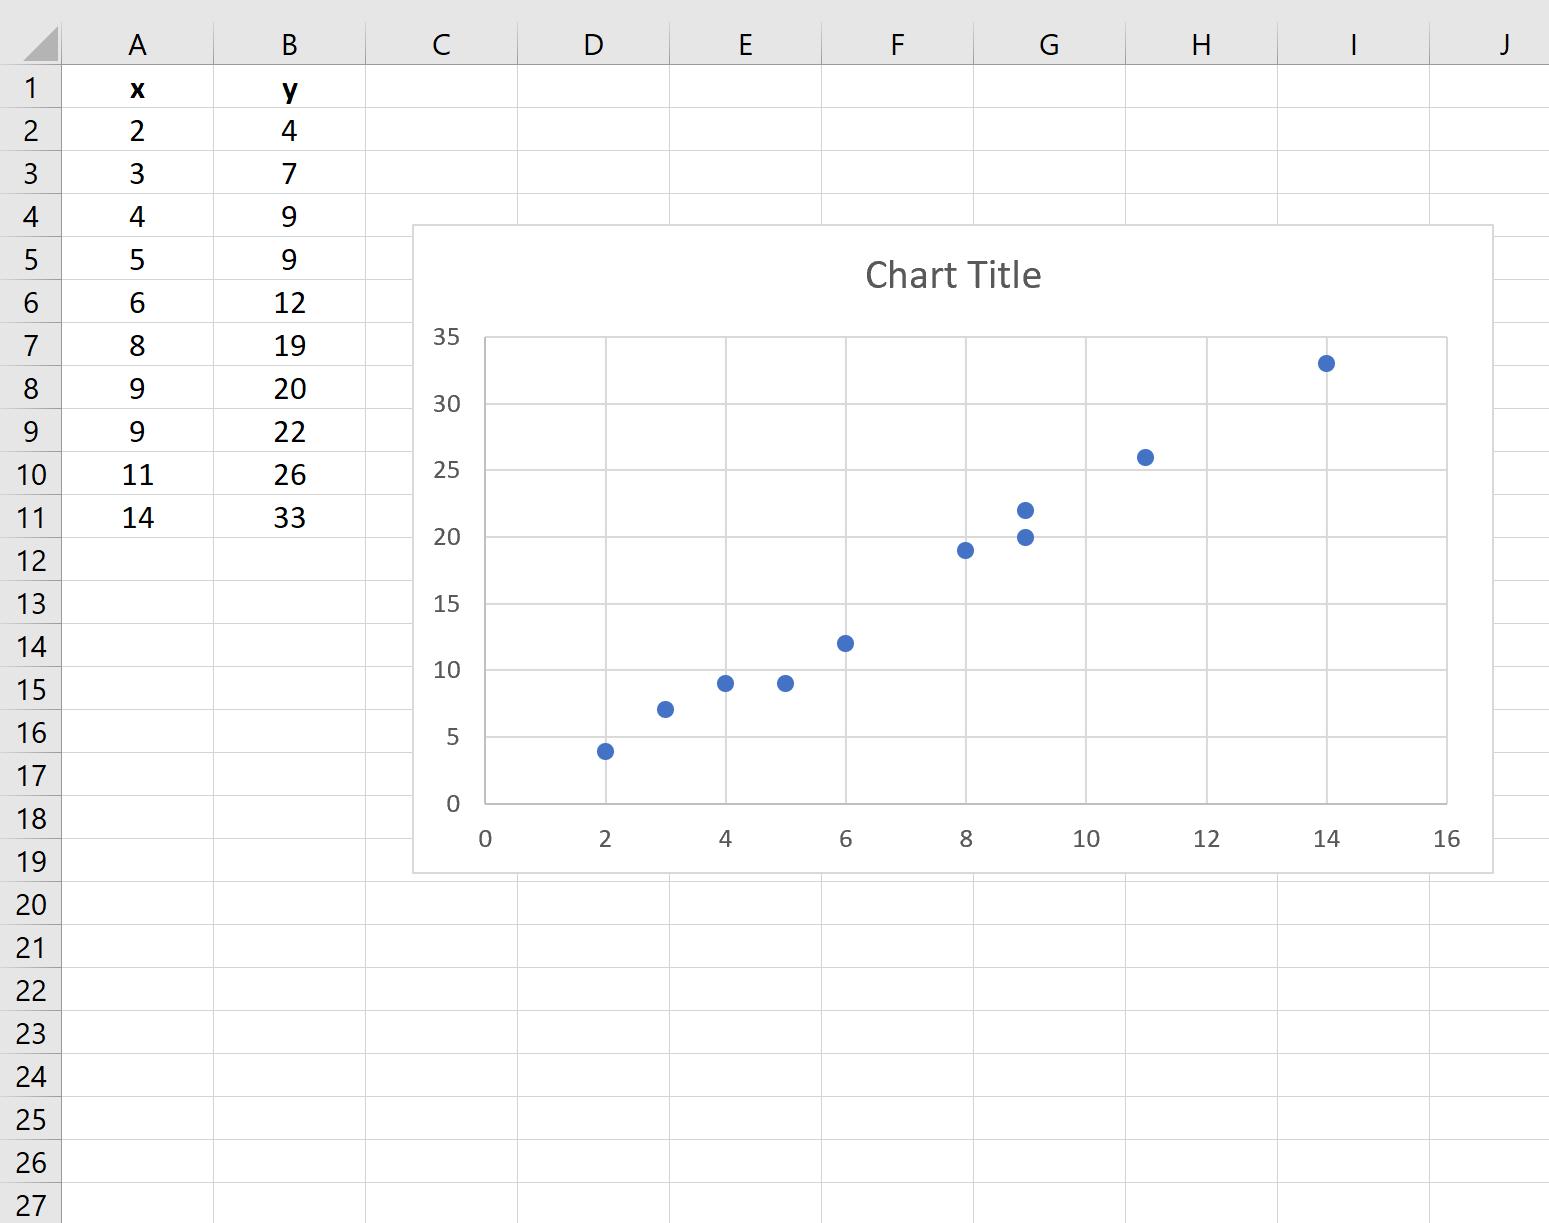
L’accès à la matérialisation graphique de la pente dans Excel requiert obligatoirement le déploiement d’un type de diagramme spécifique : le nuage de points cartésien (désigné techniquement sous le label Diagramme de dispersion XY). Les graphiques en courbes standards ou les histogrammes à barres, bien que d’apparence similaire pour un œil non averti, traitent systématiquement l’axe des abscisses comme une succession de catégories ordinales discrètes uniformément espacées, indépendamment de la valeur mathématique réelle des étiquettes d’abscisse.
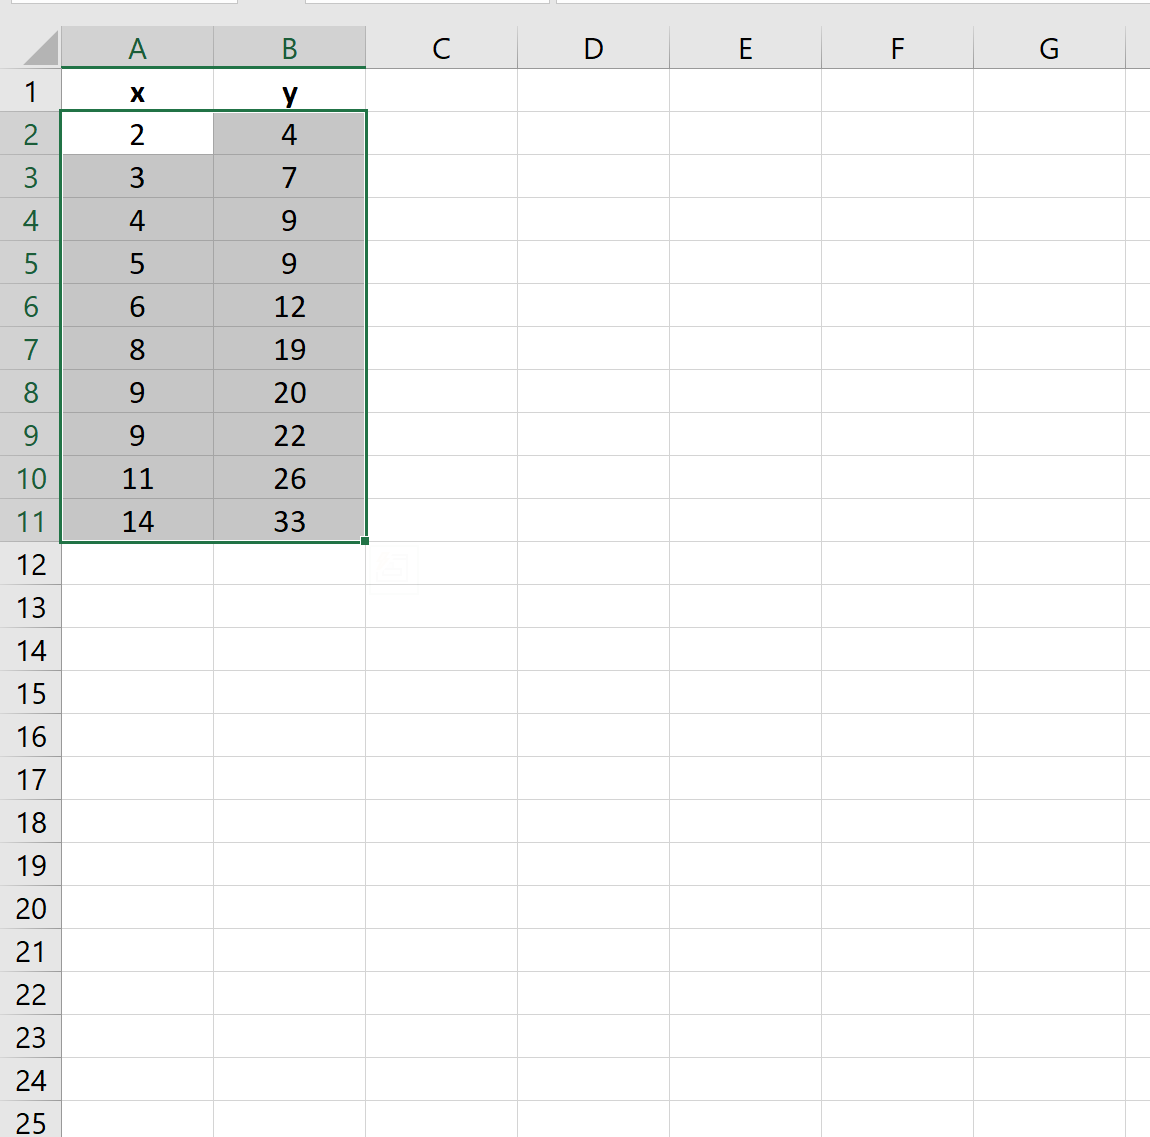
Pour initier la construction, l’opérateur doit sélectionner la plage de cellules bidimensionnelle contiguë englobant les données de la variable explicative et de la variable réponse. Si les colonnes intègrent des en-têtes textuels sur la première ligne, il est hautement conseillé de les intégrer à la sélection active, ce qui permettra à Excel de labelliser automatiquement les séries au sein de son gestionnaire interne de graphiques.
L’utilisateur navigue ensuite méthodiquement vers le ruban de commandes principal, sélectionne l’onglet Insertion, puis identifie le groupe d’outils intitulé Graphiques. À l’intérieur de ce volet, il convient de cliquer sur l’icône représentant un repère cartésien parsemé de points non reliés, puis de sélectionner rigoureusement l’option intitulée Nuage de points (ou « Nuage de points uniquement »). Il faut proscrire expressément à ce stade les variantes proposant des segments de droite reliant arbitrairement les points ou des lissages splines, ces artifices créant une pollution visuelle parasite qui dissimule la véritable distribution du nuage empirique.
3.2 Validation de l’orientation respective des axes cartésiens
Dès l’insertion du conteneur graphique sur la surface de travail, un contrôle métrologique impératif s’impose : la vérification de l’attribution des axes cartésiens. En raison de certaines anomalies de sélection ou d’agencements inhabituels dans la grille de calcul, Excel peut inverser par inadvertance les variables, assignant la variable indépendante $X$ sur l’axe vertical des ordonnées et la variable réponse $Y$ sur l’axe horizontal des abscisses. Une telle inversion produit une pente géométrique réciproque ($\approx 1/b_1$), faussant dramatiquement toute déduction subséquente.
Pour auditer cette assignation, l’observateur compare les valeurs d’échelle minimale et maximale des axes avec l’amplitude numérique de ses données brutes. En cas de discordance constatée, il convient d’effectuer un clic droit directement sur la zone de traçage du graphique et d’activer l’élément contextuel Sélectionner des données. La boîte de dialogue modale qui s’affiche répertorie les séries enregistrées dans le volet latéral gauche intitulé « Entrées de légende (Série) ».
En sélectionnant la série active puis en activant la commande Modifier, l’opérateur accède aux champs d’adresses absolues explicites régissant le tracé : Valeurs de la série X et Valeurs de la série Y. Il suffit alors de corriger manuellement les plages référencées pour rétablir sans équivoque la variable causale ou temporelle sur l’axe des abscisses ($X$) et la variable observée sur le plan des ordonnées ($Y$).
3.3 Optimisation visuelle et calibration des échelles métriques
La configuration graphique par défaut générée par Microsoft Excel privilégie fréquemment une extension des échelles débutant obligatoirement à la valeur zéro. Si cette pratique est souhaitable pour les diagrammes en bâtons, elle constitue une entrave visuelle sévère dans le cadre de l’analyse par nuage de points lorsque les observations se concentrent au sein d’une fenêtre de mesure étroite très éloignée de l’origine (par exemple des températures oscillant entre 100°C et 105°C ou des dates calendaires récentes codées en numéros de série).
Cette configuration engendre un regroupement dense et compact des points dans un angle périphérique du graphique, laissant un vaste espace stérile au centre et masquant la dispersion réelle du modèle. L’ajustement s’opère par un double-clic sur l’axe concerné (horizontal ou vertical), action provoquant le déploiement instantané du volet latéral intitulé Format de l’axe. Sous la rubrique symbolisée par un histogramme à trois colonnes (« Options d’axe »), l’analyste affine manuellement les paramètres de Limites (valeurs minimale et maximale).
Il est recommandé de calibrer les unités principales de graduation de manière à former un maillage décimal ou métrique cohérent (pas de 1, 5, 10, etc.), exempt de fractions irrationnelles. Parallèlement, l’application d’une charte chromatique sobre — points de dispersion en teinte sombre, taille de marqueur modérée sans contours superflus, et fond de tracé totalement vierge de remplissage coloré — assure une lisibilité conforme aux critères stricts de la diffusion scientifique.
4. Insertion protocolaire de la courbe de tendance linéaire
4.1 Accès aux commandes d’éléments graphiques contextuels
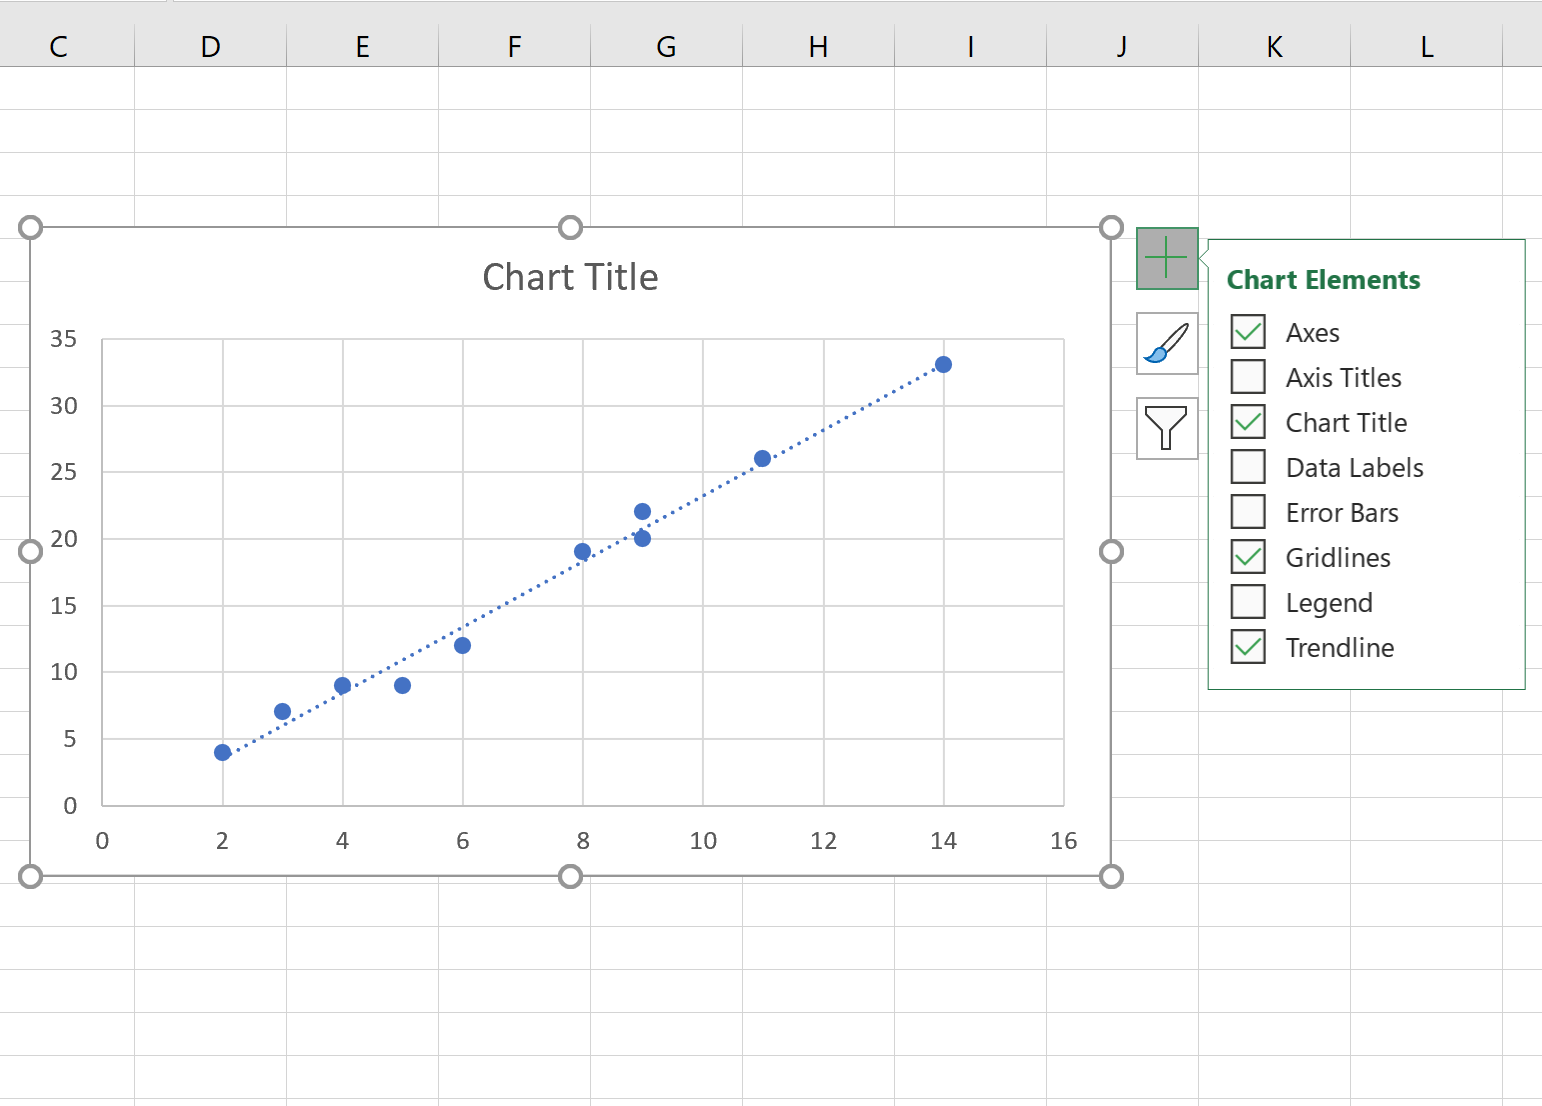
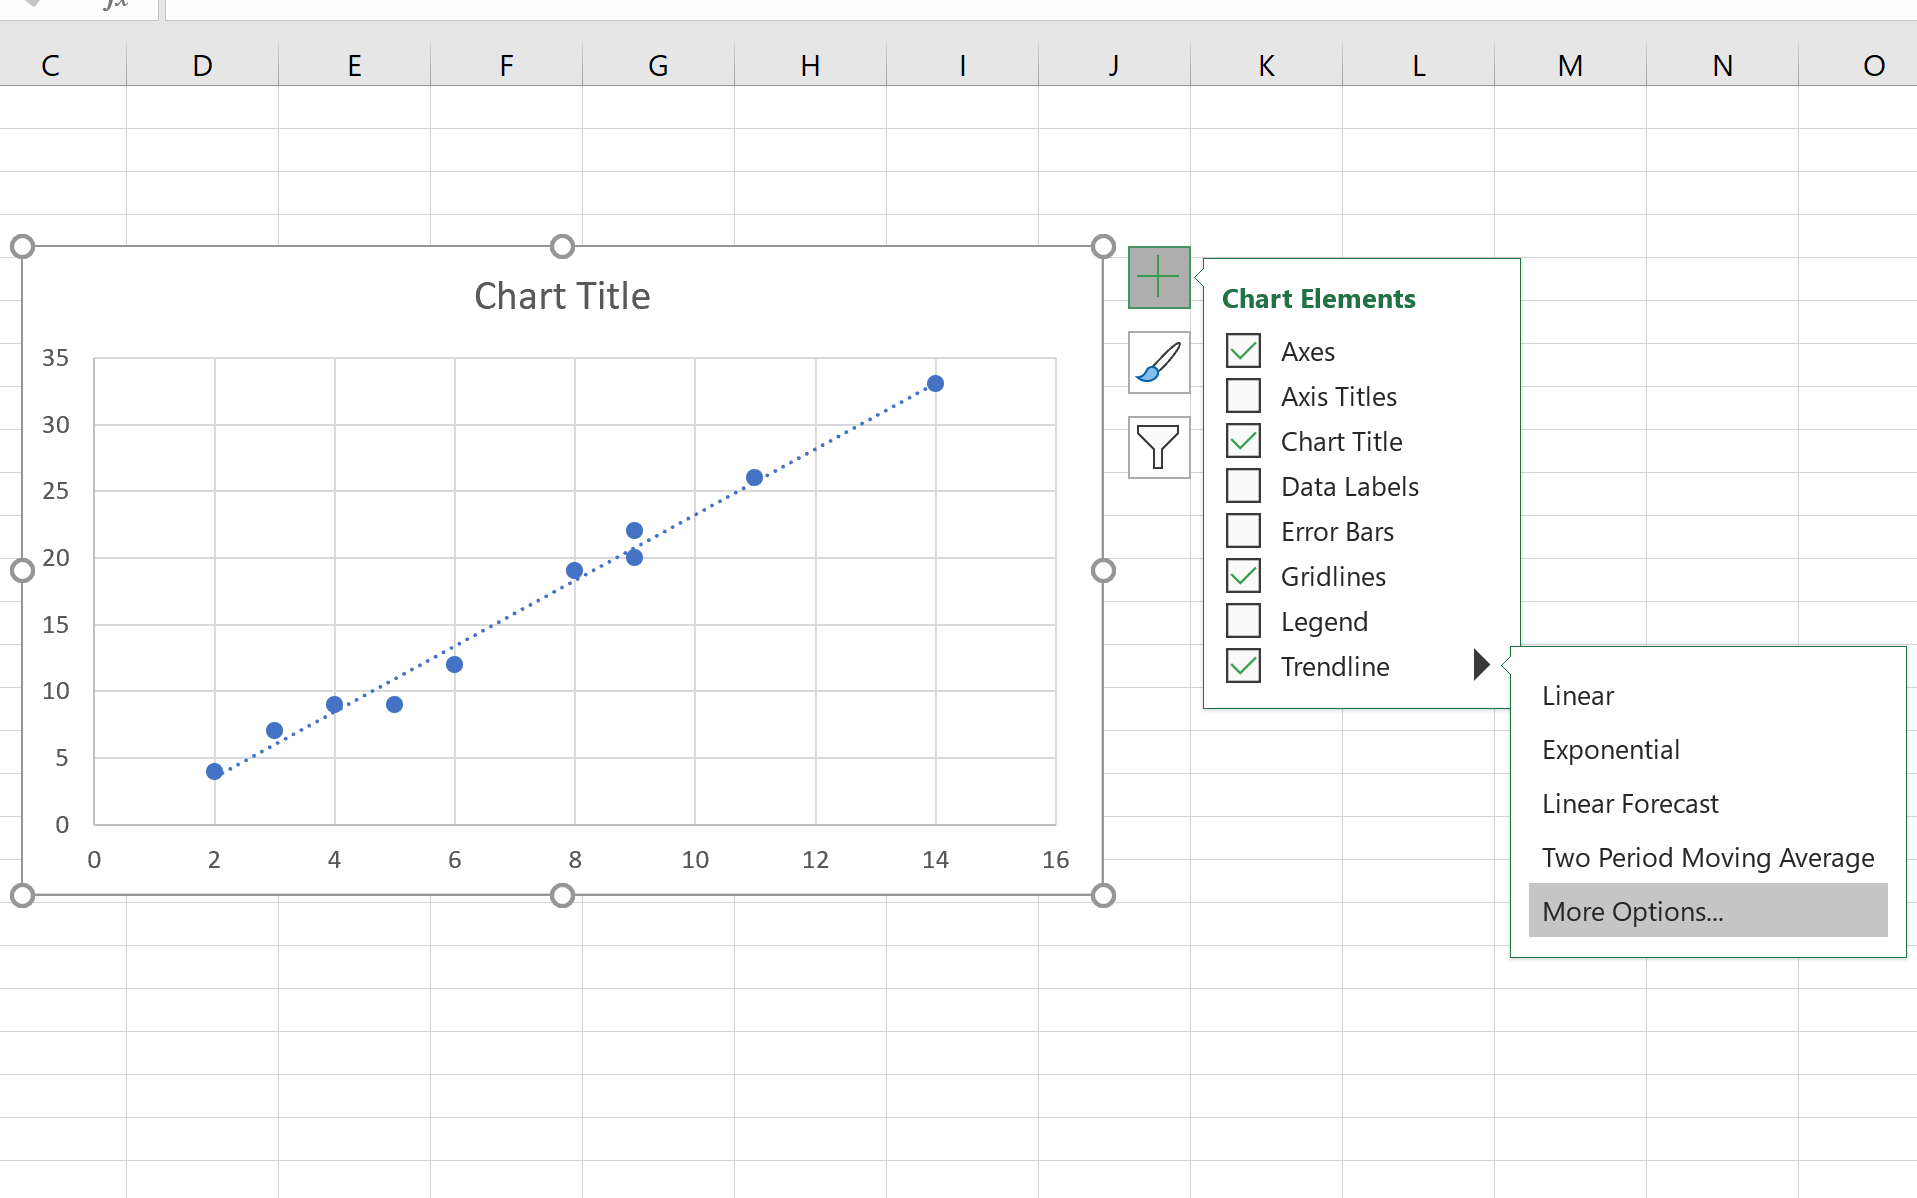
L’adjonction de l’estimateur des moindres carrés sur le nuage de dispersion s’exécute par l’activation des couches d’annotation vectorielles d’Excel. Lorsque l’objet graphique est sélectionné par un clic simple sur sa bordure périphérique, une série d’icônes contextuelles flottantes apparaît dans son angle supérieur droit. La commande la plus directe est matérialisée par un bouton arborant une croix verte (« Éléments de graphique »).
En déroulant la liste exhaustive des composants disponibles, l’opérateur identifie l’entrée intitulée Courbe de tendance. Le simple survol de cet intitulé affiche une flèche de sous-menu proposant une prévisualisation dynamique des modèles fondamentaux. Une méthodologie alternative tout aussi robuste consiste à positionner le curseur de la souris directement au-dessus de l’un quelconque des points de données du nuage, d’effectuer un clic droit pour solliciter le menu contextuel, puis de sélectionner la commande explicite Ajouter une courbe de tendance….
Cette action génère instantanément la surimposition d’un trait linéaire en tiretés traversant la nuée de points, calibré algorithmiquement par les fonctions internes de régression du tableur. Simultanément, Excel ancre sur le côté droit de l’espace de travail le volet modal contextuel dédié à son paramétrage exhaustif.
4.2 Sélection du modèle théorique linéaire par rapport aux alternatives
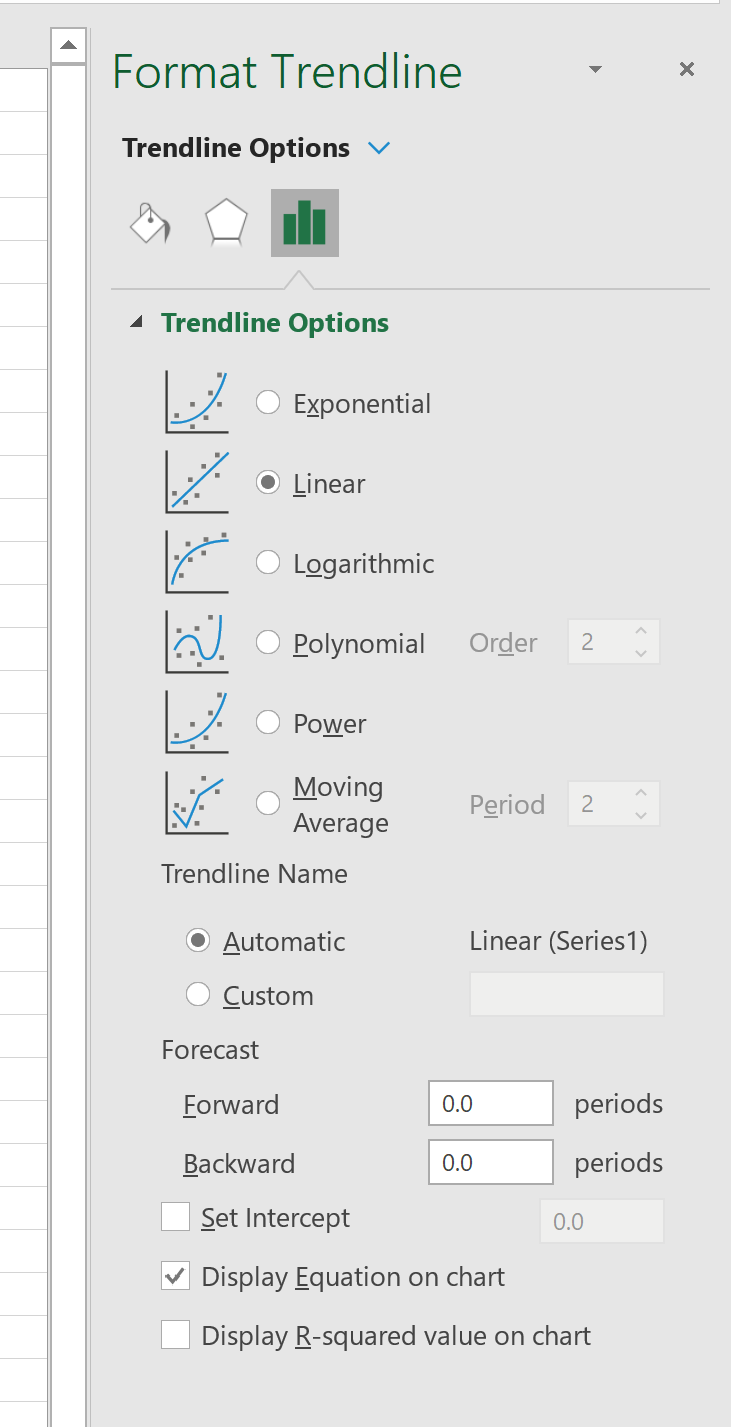
Le moteur d’estimation d’Excel offre un spectre étendu de modèles d’ajustement mathématiques : exponentiel, linéaire, logarithmique, polynomial (avec paramétrage du degré d’ordre 2 à 6), puissance et moyenne mobile. Bien que certaines dynamiques cinétiques ou de saturation relèvent légitimement de fonctions transcendantes, la modélisation standard du taux de variation unitaire impose la sélection catégorique et exclusive du modèle Linéaire, matérialisé par un bouton radio spécifique au sommet du panneau de contrôle.
Il importe de rejeter systématiquement l’écueil courant consistant à adopter un modèle polynomial de degré élevé sous le prétexte fallacieux qu’il épouse plus étroitement les fluctuations du nuage de données. Ce phénomène de surapprentissage statistique (ou overfitting) dégrade l’interprétabilité physique des coefficients et confère à la pente locale une variabilité chaotique totalement dépourvue de valeur extrapolative. La linéarité demeure l’hypothèse de parcimonie par excellence, résumant l’orientation structurelle globale.
Un autre paramètre d’une sensibilité méthodologique aiguë réside dans la case à cocher intitulée Définir l’interception (parfois libellée « Définir l’ordonnée à l’origine »). Ce paramètre contraint arbitrairement la droite d’ajustement à traverser l’axe des ordonnées à une valeur fixée a priori (généralement zéro). Sauf dans le cas exceptionnel de lois physiques fondamentales invariables où la nullité de $X$ implique par nécessité ontologique absolue la nullité parfaite de $Y$ (loi de Beer-Lambert en spectrophotométrie, par exemple), ce forçage doit demeurer impérativement désactivé. Contraindre l’interception introduit un biais systématique majeur dans l’estimation de la pente, altérant profondément la minimisation résiduelle des moindres carrés.
4.3 Accès au volet latéral de formatage avancé
Pour accéder au contrôle absolu des métriques et de la typographie de la courbe, l’utilisateur doit mobiliser le volet latéral intitulé Format de la courbe de tendance. Si ce panneau ne s’est pas déployé spontanément lors de l’insertion, un simple double-clic gauche sur la ligne matérialisant la courbe de tendance au sein du graphique l’active sans délai.
Ce volet se subdivise verticalement en trois sections fonctionnelles identifiables par leurs pictogrammes respectifs : le pot de peinture (« Remplissage et trait »), le polygone en relief (« Effets ») et l’histogramme (« Options de courbe de tendance »). La première section autorise la modification de la trame graphique : il est hautement judicieux de remplacer le style en tiretés d’origine par un trait plein et continu, doté d’une largeur calibrée (par exemple 1,5 pt) et d’une teinte chromatique contrastant nettement avec les marqueurs de points (comme un bleu cobalt sur des points gris anthracite).
La troisième section (« Options de courbe de tendance »), située sous le pictogramme de l’histogramme, recèle l’ensemble des commutateurs analytiques régissant l’algorithme sous-jacent. C’est en faisant défiler ce panneau spécifique vers sa base que l’on découvre les fonctionnalités fondamentales permettant d’extraire textuellement la valeur de la pente.
5. Extraction directe de la pente via l’équation du graphique
5.1 Activation de l’option d’affichage textuel de l’équation
La méthode la plus immédiate et historiquement la plus répandue pour visualiser sans délai la pente d’un ajustement linéaire consiste à projeter son formalisme mathématique directement sur le canevas graphique. Dans la section inférieure du volet latéral des options de courbe de tendance précédemment décrit, l’analyste repère la case à cocher formulée textuellement comme suit : Afficher l’équation sur le graphique.
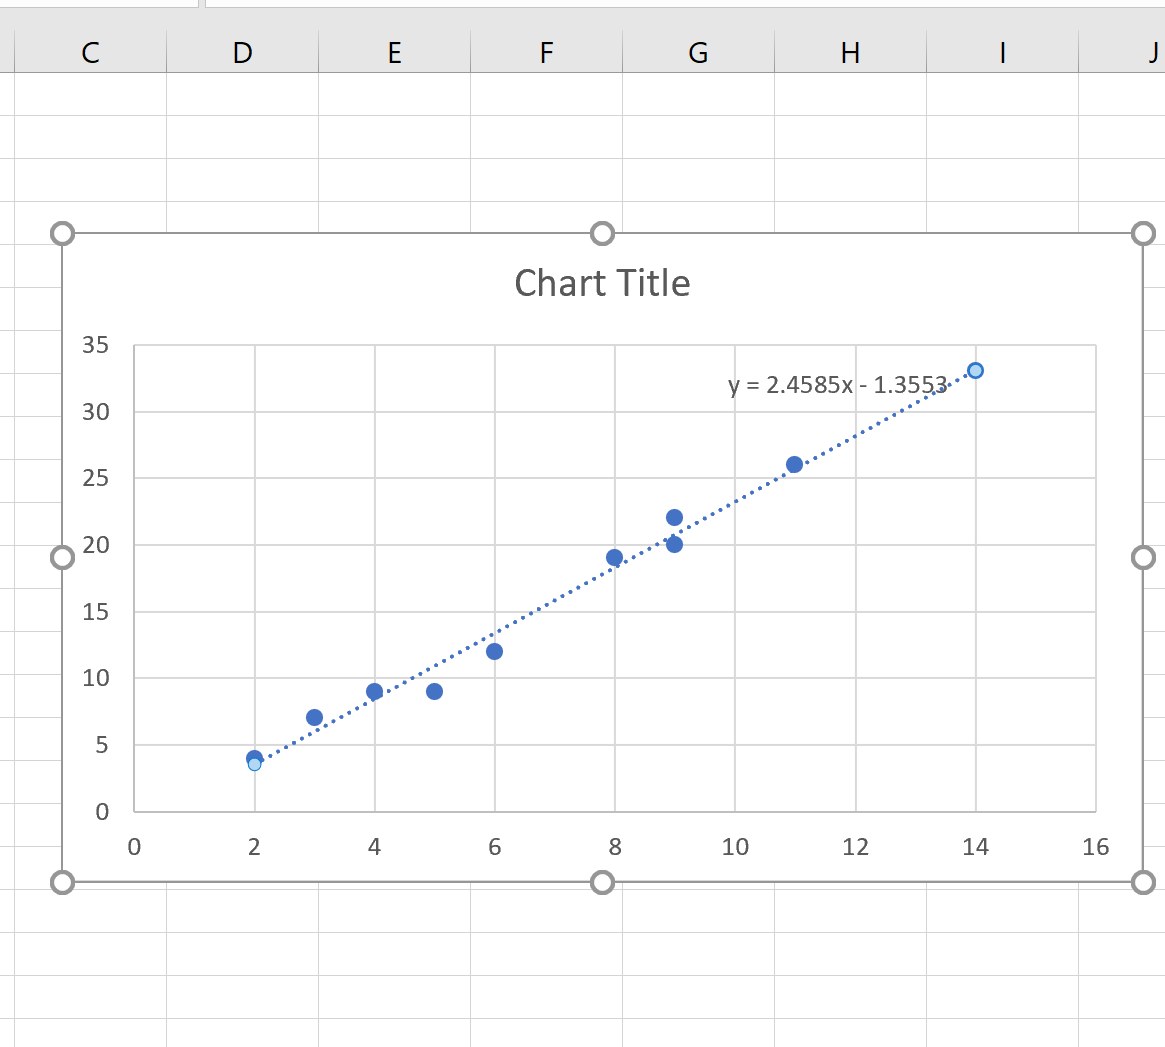
Dès l’activation de ce commutateur, une boîte d’annotation textuelle vectorielle apparaît instantanément dans la zone de traçage. Cet objet graphique indépendant, encadré par défaut de bordures transparentes, contient l’expression mathématique formelle de la droite d’ajustement. Pour assurer une lisibilité optimale exempte de toute ambiguïté visuelle, il convient de manipuler cet objet par glisser-déposer vers une zone exempte de points ou de graduations parasites, idéalement dans un quadrant vierge du repère cartésien.
Il est en outre essentiel de veiller à la typographie de cette étiquette. En sélectionnant le cadre de l’équation, l’analyste peut modifier, via l’onglet Accueil du ruban, la taille de police (en privilégiant au moins 9 à 10 points) et s’assurer de l’absence totale de transparence afin que les valeurs ne se fondent pas dans d’éventuelles lignes de quadrillage sous-jacentes.
5.2 Décomposition anatomique de l’équation affichée
L’équation générée automatiquement par le moteur graphique d’Excel adopte invariablement la syntaxe anglo-saxonne standardisée des fonctions affines, formulée comme suit :
$$y = ax + b \quad \text{ou} \quad y = mx + p$$
Dans cette formulation textuelle, la lettre minuscule isolée $x$ représente la variable indépendante continue modélisée le long de l’axe horizontal, tandis que la variable $y$ incarne le prédicteur estimé projeté verticalement. La valeur numérique accolée immédiatement à gauche de la lettre $x$, agissant mathématiquement en qualité de coefficient multiplicateur, constitue la pente exacte de la régression.
Si la relation empirique liant les variables s’avère inversement proportionnelle, un signe arithmétique négatif unitaire ($-$) précède immédiatement ce multiplicateur décimal, attestant formellement d’une décroissance monotone. La seconde grandeur numérique, positionnée à la suite du signe d’addition ou de soustraction sommatif, incarne la constante d’interception (l’ordonnée à l’origine $b$), spécifiant le point géométrique où la droite prolongée coupe rigoureusement l’axe vertical lorsque l’abscisse $x$ s’annule strictement.
5.3 Incrémentation de la précision décimale de la pente affichée
L’un des pièges les plus redoutables guettant les utilisateurs non avertis d’Excel réside dans la troncature d’affichage par défaut de l’équation graphique. Dans sa configuration d’usine, le tableur tronque fréquemment les coefficients à un format standard de deux à trois chiffres significatifs. Si cette approximation demeure acceptable pour une simple inspection qualitative, elle génère des erreurs de calcul dramatiques lorsque la pente est exploitée subséquemment pour recalculer manuellement des prédictions à partir de grandes grandeurs.
Considérons par exemple un cas où la pente mathématique réelle vaut $0,00041852$. Excel tronquera l’équation sous la formulation succincte $y = 0,0004x + b$. Réinjecter le coefficient tronqué $0,0004$ dans un calcul volumique portant sur des millions d’unités induit une dérive résiduelle de près de 5 %, totalement inacceptable sur le plan métrologique. Pour pallier cette limitation native, il est indispensable de forcer la résolution numérique de l’étiquette :
- Sélectionner d’un clic méticuleux la zone de texte hébergeant l’équation au sein du graphique pour faire apparaître sa bordure de sélection ponctuée de poignées carrées.
- Effectuer un clic droit sur cette bordure et sélectionner l’option Format de l’étiquette de courbe de tendance….
- Au sein du volet latéral qui s’ouvre, cliquer sur l’icône de diagramme (« Options d’étiquette ») et dérouler la section intitulée Nombre.
- Remplacer la catégorie initiale « Standard » ou « Général » par la catégorie explicite Nombre ou Scientifique.
- Ajuster le champ Nombre de décimales à une valeur élevée (typiquement entre 6 et 10 décimales selon la granularité requise).
Cette manipulation contraint le moteur graphique à restituer la totalité de la précision en virgule flottante calculée en mémoire, éliminant tout biais lié aux arrondis visuels.
6. Calcul programmatique de la pente avec la fonction PENTE
6.1 Syntaxe formelle et prérequis de la fonction native
Si la capture de la pente via l’étiquette graphique satisfait les impératifs d’illustration, elle présente une vulnérabilité opérationnelle majeure : la valeur demeure confinée au sein d’une couche vectorielle fermée, inexploitable de façon dynamique par les autres cellules du classeur. Pour intégrer le coefficient de pente au sein d’une chaîne de traitement automatisée, le recours aux fonctions natives de feuille de calcul est impératif.
La formule standard dédiée par excellence à cette tâche sous la déclinaison francophone de Microsoft Excel est la fonction PENTE. Elle possède une équivalence stricte dans les versions anglophones internationales sous la dénomination standardisée SLOPE. Sa syntaxe canonique se structure selon l’agencement argumentaire suivant :
=PENTE(y_connus; x_connus)
Les arguments y_connus et x_connus doivent obligatoirement être instanciés sous forme de plages continues de cellules (par exemple B2:B101 et A2:A101) ou de constantes matricielles fermées. Le prérequis dimensionnel non négociable réside dans la parité métrique absolue des deux vecteurs : le nombre d’éléments scalaires composant la plage des ordonnées doit être scrupuleusement identique à celui de la série des abscisses. Tout déséquilibre dans la cardinalité des plages engendre instantanément le renvoi d’une erreur d’incompatibilité de type #N/A.
6.2 Risque majeur lié à l’interversion involontaire des arguments
L’écueil ergonomique le plus insidieux et le plus universellement constaté dans l’implémentation de la fonction PENTE réside dans l’ordre séquentiel de ses arguments. Contrairement à la pratique cartésienne usuelle et à l’intuition cognitive qui incitent spontanément à stipuler la variable $X$ en premier puis la variable $Y$ en second (conformément à la nomenclature des repères $(X,Y)$), la conception architecturale d’Excel impose de manière inflexible la sélection prioritaire des ordonnées $Y$.
L’inversion involontaire des arguments — c’est-à-dire l’écriture fautive de =PENTE(x_connus; y_connus) — ne provoque l’émission d’aucun message d’alerte logiciel ni d’aucune erreur de syntaxe. Le tableur exécute le calcul avec une impassibilité algorithmique totale, mais procède en réalité à l’estimation mathématique de la fonction réciproque $X = f(Y)$. La valeur renvoyée est approximativement proportionnelle à l’inverse mathématique de la véritable pente ($1/b_1$), ce qui dénature radicalement l’ensemble des déductions inférentielles subséquentes.
Pour prévenir cette erreur critique lors de séances de calcul intensives, il est recommandé aux analystes d’adopter la règle mnémotechnique universelle dite de « l’élévation prioritaire » : la pente s’évaluant par le ratio du dénivelé vertical sur le déplacement horizontal ($\Delta Y / \Delta X$), la fonction d’Excel appelle nécessairement le composant vertical $Y$ en première position dans sa signature d’appel.
6.3 Avantages calculatoires de la cellule dédiée face à l’étiquette graphique
L’encapsulation de la pente au sein d’une cellule matricielle dédiée via la formule PENTE confère à l’architecture du classeur un niveau de robustesse computationnelle sans commune mesure avec la manipulation manuelle des étiquettes graphiques. En premier lieu, la valeur résultante est stockée nativement sous le format de virgule flottante double précision conforme à la norme internationale IEEE 754. Cela garantit une précision interne atteignant jusqu’à 15 chiffres significatifs, éliminant totalement les risques d’artefacts cumulatifs lors des calculs subséquents.
En second lieu, l’évaluation par formule garantit une actualisation dynamique continue (réactivité événementielle). Si de nouvelles données sont introduites dans les tables ou si des valeurs aberrantes font l’objet d’un ajustement correctif immédiat, le résultat de la fonction PENTE se recalcule à la volée, en temps réel, garantissant une synchronisation absolue des tableaux de bord et des indicateurs de synthèse.
Enfin, la valeur hébergée dans la cellule cible peut être immédiatement injectée au sein d’autres équations prédictives complexes ou combinée avec la fonction ORDONNEE.ORIGINE (correspondant à l’équivalent anglophone INTERCEPT) afin de reconstruire dynamiquement des séries estimées complètes au moyen d’expressions telles que =ORDONNEE.ORIGINE(Y;X) + PENTE(Y;X) * X_nouveau.
7. Estimation indicielle complète avec la fonction DROITEREG
7.1 Principes fondamentaux de la formule matricielle linéaire
Pour les contextes scientifiques et économétriques exigeant une profondeur inférentielle rigoureuse, la simple obtention ponctuelle du coefficient de pente s’avère insuffisante. L’environnement Excel intègre un moteur d’estimation matricielle de premier ordre au travers de la fonction DROITEREG (strictement désignée sous le nom LINEST en déclinaison internationale). La signature d’appel globale de cette formule se structure comme suit :
=DROITEREG(y_connus; [x_connus]; [constante]; [stats])
Le paramètre booléen constante spécifie si l’ordonnée à l’origine doit être calculée normalement (VRAI ou omis) ou forcée à zéro (FAUX). Le commutateur fondamental pour l’analyse structurelle réside dans l’argument stats : lorsqu’il est instancié à VRAI, la formule ne renvoie pas un résultat scalaire unitaire, mais engendre une matrice rectangulaire structurée comportant jusqu’à cinq lignes et deux colonnes (ou davantage en cas de régression multiple), résumant l’intégralité du tableau d’analyse de la variance (ANOVA) et des paramètres de régression.
Au sein de cette matrice résultante, le tout premier élément scalaire positionné sur la première ligne et la première colonne (coordonnées matricielles $(1,1)$) correspond rigoureusement au coefficient de pente linéaire. Si l’analyste désire extraire exclusivement cette valeur sans subir l’étalement de la matrice complète sur sa feuille, il est d’usage académique de combiner DROITEREG avec la fonction INDEX dans la syntaxe compacte suivante :
=INDEX(DROITEREG(Plage_Y; Plage_X); 1; 1)
7.2 Obtention de l’erreur type associée à la pente
L’avantage décisif qui surclasse DROITEREG par rapport à la fonction basique PENTE réside dans sa capacité à quantifier avec exactitude l’incertitude d’échantillonnage grevant la pente estimée. Lorsque l’argument stats est activé via la formule =DROITEREG(Plage_Y; Plage_X; VRAI; VRAI), le tableur restitue, immédiatement sous le coefficient de pente (à l’emplacement matriciel $(2,1)$), l’erreur type relative de la pente, conventionnellement formalisée par le descripteur statistique $s_{b1}$ ou $SE(b_1)$.
L’erreur standard de la pente mesure la dispersion théorique de la distribution d’échantillonnage du coefficient. Elle constitue la brique opératoire fondamentale permettant au statisticien de tester l’hypothèse nulle d’absence d’effet ($H_0: \beta_1 = 0$). L’analyste en déduit la statistique du test de Student au moyen de la formule classique :
$$t_{\text{calc}} = \frac{b_1}{s_{b1}}$$
Cette valeur permet ultérieurement de borner les intervalles de confiance paramétriques (typiquement à 95 % ou 99 %) entourant la pente observée. Ce niveau de précision inférentielle est strictement inaccessible par l’intermédiaire du tracé visuel de la courbe de tendance ou de la simple formule PENTE, ce qui fait de DROITEREG le standard incontournable des publications savantes.
7.3 Mise en œuvre des matrices dynamiques modernes
Dans les versions contemporaines de Microsoft Excel (intégrant le moteur de calcul matriciel dynamique introduit avec Microsoft 365 et Excel 2021), la manipulation de DROITEREG a bénéficié d’une refonte ergonomique majeure. Historiquement, l’extraction de la matrice globale requérait une sélection manuelle préalable d’une plage de $5 \times 2$ cellules vierges, la saisie scrupuleuse de la formule, puis la validation par la combinaison complexe de touches Ctrl + Maj + Entrée (formules CSE).
Désormais, le moteur d’exécution gère le comportement de débordement automatique (connu sous le terme technique de spill). La simple validation par la touche standard Entrée d’une formule telle que =DROITEREG(B2:B50; A2:A50; VRAI; VRAI) au sein d’une unique cellule entraîne spontanément la projection de la matrice complète sur les cellules adjacentes vers la droite et vers le bas, entourée d’une fine bordure bleutée indicative.
Cette modernisation algorithmique autorise une interopérabilité sans précédent. On peut par exemple référencer la pente dynamiquement depuis une autre section du classeur par l’opérateur de plage propagée (en employant le symbole dièse #), ou imbriquer des fonctions de traitement matriciel sans jamais risquer de blocages logiciels liés à des verrouillages matriciels statiques obsolètes.
8. Extraction automatisée de la pente par formules textuelles
8.1 Cas d’usage spécifiques de l’analyse textuelle de l’étiquette
Dans certains contextes professionnels dégradés, les analystes sont confrontés à des classeurs hébergeant des graphiques élaborés dont les séries de données sources primaires ont été détruites, masquées par des mots de passe cryptographiques ou déconnectées à la suite d’un collage de type image vectorielle liée. Dans d’autres circonstances, il s’agit de concevoir des protocoles d’audit automatisés visant à contrôler la conformité entre l’expression mathématique affichée aux décideurs sur le canevas graphique et les valeurs réelles hébergées dans les matrices du classeur.
Dans ces configurations hautement spécifiques où seule la métadonnée textuelle de l’étiquette de courbe de tendance est accessible ou extraite via un script d’automatisation, il s’avère nécessaire de mobiliser des techniques d’analyse syntaxique (ou parsing) par formules textuelles avancées afin d’extraire la composante numérique représentative de la pente.
8.2 Combinaisons de fonctions textuelles pour isoler le multiplicateur
La reconstitution algorithmique du coefficient de pente à partir de la chaîne textuelle générée par le graphique implique le traitement de chaînes dont le formalisme standard débute invariablement par les caractères y = et se poursuit jusqu’au délimiteur pivot matérialisé par la variable x. Le protocole d’extraction textuelle sous Excel requiert la mise en œuvre conjointe des fonctions STXT, CHERCHE et CNUM.
Supposons que la chaîne complète de l’équation soit stockée dans la cellule D2 sous la forme littérale "y = 3,14159x + 12,8". La démarche s’opère selon les étapes de calcul suivantes :
- Repérer l’indice de position du signe d’égalité (« = »), lequel marque la frontière gauche du sous-segment d’intérêt, via la formule
CHERCHE("="; D2). - Localiser l’indice de position de la variable « x », laquelle scelle la frontière droite de la pente, au moyen de
CHERCHE("x"; D2). - Isoler la séquence numérique intermédiaire au moyen de la fonction STXT. Le point de départ est défini par la position de l’égalité incrémentée de deux caractères (pour sauter le signe égal et l’espace consécutif), et la longueur d’extraction équivaut à la distance séparant « x » de l’égalité, diminuée de deux unités.
- Convertir le résidu textuel résultant en une entité numérique flottante authentique par l’application terminale de la fonction CNUM.
La formalisation consolidée s’exprime dans la cellule réceptrice sous l’instruction intégrée suivante :
=CNUM(EPURAGE(SUBSTITUE(STXT(D2; CHERCHE("="; D2) + 1; CHERCHE("x"; D2) - CHERCHE("="; D2) - 1); " "; "")))
8.3 Limites inhérentes et vulnérabilités de l’extraction par chaîne
Il importe de souligner avec gravité la fragilité structurelle extrême de cette méthodologie par chaîne de caractères. Toute variation minime de l’environnement linguistique du système d’exploitation — notamment le passage d’une localisation francophone usant de la virgule décimale à une configuration anglo-saxonne utilisant le point — est susceptible de générer des erreurs critiques de type #VALEUR! lors de l’évaluation par CNUM.
De plus, si la régression intègre des coefficients exprimés en notation scientifique (par exemple 1,23E-04x), ou si la pente est unitaire (formulation abrégée y = x + b où le chiffre 1 est implicite et omis par Excel), les fonctions de découpage textuel échouent lamentablement ou extraient des segments incohérents. En conséquence, la communauté scientifique et les experts en modélisation préconisent de reléguer cette pratique au rang de solution de secours d’ultime recours, en privilégiant systématiquement le recalcul natif par les fonctions mathématiques PENTE ou DROITEREG dès lors que l’accès aux données sources demeure possible.
9. Interprétation analytique et portée scientifique de la pente obtenue
9.1 Évaluation du sens et de la grandeur physique du coefficient
L’extraction numérique de la pente ne constitue pas l’aboutissement de la démarche empirique, mais bien le point de départ de son interprétation scientifique. La première dimension d’analyse concerne l’orientation directionnelle du coefficient, signalée par sa polarité arithmétique. Une pente strictement supérieure à zéro ($b_1 > 0$) atteste d’une dynamique de covariance positive : une élévation de l’amplitude de la variable indépendante s’accompagne systématiquement d’un accroissement moyen pondéré de la variable réponse.
Inversement, une polarité négative ($b_1 < 0$) caractérise une relation de substitution ou d’amortissement, traduisant une diminution proportionnelle du critère consécutivement à l’accroissement du stimulus. Cependant, l’ampleur brute du coefficient doit impérativement être rapportée aux échelles de mesurage sous-jacentes. Une pente en apparence négligeable (par exemple $b_1 = 0,00002$) peut revêtir un impact sociétal ou clinique massif si elle quantifie le taux de mortalité additionnel par unité d’exposition à un polluant atmosphérique mesuré en microgrammes par mètre cube sur des populations de plusieurs millions d’individus.
D’un point de vue méthodologique, une pente tendant asymptotiquement vers zéro ($b_1 \approx 0$) requiert une prudence interprétative extrême. Elle indique que les variations de la variable explicative $X$ ne génèrent aucune altération linéaire mesurable de l’espérance mathématique de la variable dépendante $Y$. Il serait toutefois épistémologiquement erroné d’en déduire une absence totale de relation fonctionnelle : une relation parfaitement déterministe mais strictement quadratique (courbe en U) présente une pente linéaire moyenne rigoureusement nulle sur l’ensemble de sa période sans pour autant que les grandeurs soient indépendantes.
9.2 Complémentarité obligatoire avec le coefficient de détermination R²
Pour fonder un jugement analytique éclairé, l’interprétation du coefficient de pente doit être systématiquement corrélée à celle du coefficient de détermination, universellement désigné sous le symbole $R^2$. Sous Excel, ce paramètre peut être juxtaposé immédiatement sous l’équation de régression sur le graphique en cochant l’option contextuelle Afficher le coefficient de détermination (R-carré) sur le graphique au sein du volet des options de courbe de tendance, ou calculé dynamiquement au moyen de la formule native COEFFICIENT.DETERMINATION (équivalent de RSQ en version internationale) :
=COEFFICIENT.DETERMINATION(Plage_Y; Plage_X)
Le $R^2$, dont l’amplitude est circonscrite entre 0 et 1 (soit de 0 % à 100 %), spécifie la fraction de la variance totale de la variable dépendante $Y$ expliquée par le modèle de régression linéaire linéaire par rapport à la variance totale non expliquée. Une confusion commune consiste à croire qu’une pente de forte inclinaison géométrique garantit nécessairement un ajustement statistique robuste. Cette présomption est erronée :
| Configuration empirique | Amplitude de la pente ($b_1$) | Adéquation ($R^2$) | Interprétation analytique |
|---|---|---|---|
| Cas de figure A | Élevée ($b_1 gg 0$) | Faible ($R^2 < 0,15$) | Effet marginal théorique fort, mais prédictions ponctuelles extrêmement bruitées et peu fiables. |
| Cas de figure B | Faible ($b_1 \approx 0,01$) | Élevée ($R^2 > 0,95$) | Effet marginal discret, mais certitude prédictive quasi déterministe à l’échelle de l’échantillon. |
La pente quantifie la magnitude physique du transfert d’état entre grandeurs, tandis que le $R^2$ atteste de la conformité du modèle linéaire par rapport au bruit expérimental stochastique.
9.3 Examen de la linéarité sous-jacente par l’analyse des résidus
L’acceptation scientifique de la pente issue de la méthode des moindres carrés repose sur le postulat fondamental de linéarité structurale. L’application mécanique d’une droite de tendance sur des jeux de données présentant des courbures morphologiques prononcées constitue une faute méthodologique sévère qui fausse l’intégralité du raisonnement causal.
L’outil le plus décisif pour valider la légitimité de la pente réside dans l’analyse de la distribution des résidus d’estimation, définis pour chaque observation $i$ par la différence arithmétique simple entre la valeur empirique mesurée et la valeur théorique projetée par la droite : $e_i = y_i – \hat{y}_i$. Si le postulat de linéarité est pleinement satisfait, le nuage des résidus représenté graphiquement en fonction de la variable $X$ doit présenter une répartition purement homoscédastique et aléatoire, formant une bande horizontale stationnaire sans structure géométrique discernable.
En revanche, si les résidus dessinent une configuration en arche parabolique, une sinusoïde ou un entonnoir s’évasant de manière asymétrique, cela démontre péremptoirement que la pente linéaire obtenue ne constitue qu’un agrégat macroscopique artificiel masquant une non-linéarité fondamentale ou une hétéroscédasticité sous-jacente. Dans de telles conditions, le modèle linéaire doit être formellement révoqué au profit d’une modélisation polynomiale ou de transformations logarithmiques préalables.
10. Diagnostics, erreurs récurrentes et résolution des anomalies
10.1 Résolution de l’erreur d’annulation ou de division par zéro
L’incident algorithmique le plus abrupt rencontré lors de l’exécution des fonctions de régression sous Excel se manifeste par l’apparition de l’erreur fatale #DIV/0! au sein de la cellule de calcul. Dans le cadre de l’évaluation de la pente, cette anomalie ne provient presque jamais d’une division explicite par un zéro littéral au sein du tableau de bord, mais d’une dégénérescence sous-jacente du dénominateur de l’équation des moindres carrés.
Comme explicité dans le cadre théorique initial, l’estimateur de la pente requiert impérativement le calcul de la somme quadratique des écarts à la moyenne des abscisses : $\sum (x_i – \bar{x})^2$, laquelle représente la variance empirique de la variable explicative. Si cette grandeur s’annule, le calcul mathématique devient formellement indéterminé, entraînant l’émission du code d’erreur logicielle. Les causes profondes de cette situation sont doubles :
- Invariance totale de la variable explicative : l’ensemble des valeurs contenues dans la plage assignée aux abscisses $X$ est rigoureusement identique (par exemple une série temporelle où la date est accidentellement restée constante sur toutes les lignes).
- Problème de sélection matricielle : la plage référencée ne cible qu’une seule ligne d’observation ($n=1$), rendant la mesure de variance intrinsèquement impossible à quantifier.
Pour prévenir cette défaillance au sein de classeurs partagés ou d’outils automatisés, il convient de sécuriser l’évaluation par l’encapsulation de la formule dans une conditionnelle logique préalable contrôlant la variance de l’échantillon, au moyen de structures de programmation défensive telles que :
=SI(VAR.P(Plage_X)>0; PENTE(Plage_Y; Plage_X); "Erreur : Variance nulle sur X")
10.2 Anomalies causées par les incohérences de formats régionaux
La coexistence internationale de standards typographiques antagonistes constitue un foyer permanent de corruption de données sous Microsoft Excel. La sphère francophone et la majorité des pays d’Europe continentale emploient historiquement la virgule comme séparateur décimal canonique (ex : 12,5), tandis que le monde anglo-saxon et les systèmes de gestion de bases de données informatiques imposent universellement le point décimal (ex : 12.5).
Lorsqu’un opérateur importe une table de mesures scientifiques compilée sur un instrument de laboratoire configuré à la norme anglo-saxonne vers une instance locale d’Excel configurée selon les paramètres régionaux français, le logiciel échoue fréquemment à interpréter les points comme des délimiteurs de fractions continues. Les valeurs incriminées sont immédiatement converties en chaînes textuelles muettes. Par voie de conséquence :
- Les fonctions PENTE et DROITEREG excluent silencieusement ces cellules du calcul matriciel, ce qui conduit à un rétrécissement artificiel de l’échantillon d’analyse pouvant déboucher sur l’erreur
#DIV/0!ou sur une variance aberrante. - Le nuage de points refuse d’afficher les observations textuelles sur les échelles métriques, créant un décalage massif entre le tracé de la droite et la distribution physique attendue.
Pour assainir ces anomalies sans altérer manuellement des milliers de lignes, il est préconisé de mobiliser l’outil natif Convertir (situé sous l’onglet Données du ruban). À la troisième étape de cet assistant d’analyse séquentielle, le bouton Avancé… permet de stipuler explicitement que le séparateur décimal de la source d’origine est un point, contraignant Excel à opérer la transmutation immédiate de l’ensemble de la série vers des nombres décimaux standardisés.
10.3 Distorsion de la pente par la présence de valeurs atypiques
L’une des limitations fondamentales inhérentes à la méthode des moindres carrés ordinaires réside dans sa vulnérabilité structurelle absolue face aux points de données atypiques ou extrêmes, communément qualifiés d’aberrations (outliers) ou de points de levier (high leverage points). Étant donné que le critère d’optimisation mathématique minimise le carré des distances résiduelles, une observation isolée déviant massivement de la trajectoire générale exerce une force d’attraction disproportionnée sur l’orientation de la droite d’ajustement.
L’introduction d’un unique point de levier asymétrique dans un échantillon comportant plusieurs dizaines d’observations saines peut suffire à faire basculer une pente significativement positive vers une orientation horizontale neutre, voire inverser son signe global. Ce phénomène détruit la fidélité de la modélisation en substituant à la tendance structurelle du corpus l’artefact idiosyncrasique d’un seul enregistrement accidenté.
Pour documenter rigoureusement l’influence de ces anomalies, il est impératif d’adopter un protocole d’analyse de sensibilité comparatif :
- Évaluer et consigner la valeur nominale de la pente $b_1$ sur l’intégralité du corpus original au moyen de la fonction PENTE.
- Déployer un calcul de distance de Cook ou un seuillage d’écart-type résiduel (typiquement l’identification des résidus standardisés excédant l’intervalle $[-3 ; +3]$).
- Procéder à une exclusion expérimentale ciblée de la valeur incriminée et recalculer instantanément la pente épurée.
- Rendre compte formellement des deux métriques au sein du rapport d’analyse pour expliciter sans dissimulation le degré de dépendance du modèle vis-à-vis des observations extrêmes.
11. Modélisation comparative de pentes multi-groupes sous Excel
11.1 Superposition de séries multiples au sein d’un même graphique
L’investigation scientifique contemporaine implique rarement l’examen d’un groupe expérimental isolé. Il s’avère bien plus fréquent d’analyser la réponse différentielle de plusieurs cohortes ou conditions expérimentales (par exemple groupe témoin versus groupe traité sous différentes concentrations pharmacologiques). Pour apprécier visuellement les contrastes fonctionnels d’évolution, il est hautement avantageux de superposer plusieurs courbes de tendance au sein d’un repère cartésien unique.
Pour concrétiser cette structuration sous Excel, les données brutes doivent être réparties en organisant une colonne commune assignée aux abscisses $X$ et plusieurs colonnes consécutives dédiées respectivement aux critères $Y_1, Y_2, dots, Y_k$. Lors de l’incorporation du graphique en nuage de points, l’opérateur configure l’insertion de séries multiples par le panneau de dialogue Sélectionner des données, en attribuant à chaque série la plage de valeurs d’ordonnées qui lui est propre.
Une fois les séries matérialisées sur la zone de traçage, l’opérateur procède à l’adjonction séquentielle de courbes de tendance indépendantes pour chaque cohorte. Il est alors d’une importance capitale de veiller à une stricte différenciation chromatique et morphologique : attribuer par exemple une droite continue pourpre à la cohorte expérimentale et une droite d’ajustement d’un gris neutre au groupe témoin. L’affichage contextuel des équations associées doit être méticuleusement organisé par l’analyste afin d’éviter tout chevauchement textuel confus.
11.2 Calcul de pentes différentielles par application de filtres conditionnels
Lorsque le classeur agrège des dizaines de milliers d’enregistrements agencés sous la forme d’un grand registre d’acquisition tabulaire plat où une colonne spécifique code l’appartenance à un groupe sous forme de métadonnée catégorielle (par exemple « Traitement A », « Traitement B »), scinder manuellement le tableau en multiples sous-colonnes devient une opération inefficace et propice aux erreurs de manipulation.
L’environnement moderne d’Excel permet de résoudre cette complexité grâce à l’association synergique des fonctions dynamiques matricielles, notamment par le couplage de la fonction PENTE avec la fonction FILTRE. Cette formulation de pointe autorise le calcul instantané du coefficient de pente d’un sous-groupe arbitraire sans jamais altérer l’intégrité de la table maîtresse. La syntaxe opérationnelle s’agence comme suit :
=PENTE(FILTRE(Tableau[Mesure_Y]; Tableau[Groupe]="Traitement A"); FILTRE(Tableau[Mesure_X]; Tableau[Groupe]="Traitement A"))
Cette expression évalue dynamiquement les critères logiques, extrait en mémoire centrale les seuls vecteurs répondant à la condition d’appartenance à la cohorte « Traitement A », et alimente instantanément l’algorithme des moindres carrés. En déclinant cette instruction dans un tableau récapitulatif synthétique, l’analyste obtient un monitoring dynamique continu des pentes différentielles de chaque groupe d’étude.
11.3 Interprétation visuelle du croisement ou du parallélisme des droites
L’observation simultanée de multiples courbes de tendance linéaires sur un même graphique fournit des indications heuristiques fondamentales sur les mécanismes fonctionnels sous-jacents, notamment l’existence d’effets modérateurs ou d’interactions statistiques au sens de l’analyse factorielle de variance (ANOVA à mesures répétées ou régression modérée) :
- Parallélisme structural : Lorsque deux courbes de tendance relatives à deux sous-populations distinctes progressent de concert sans converger ni diverger, leurs pentes respectives sont approximativement égales ($b_{1(A)} \approx b_{1(B)}$). Sur le plan expérimental, cette géométrie démontre une absence totale d’effet d’interaction : l’amplitude du changement provoqué par la variable indépendante s’applique de manière uniforme et constante, indépendamment de la strate ou de la modalité factorielle considérée.
- Convergence et sécante (croisement d’axes) : Lorsque les droites d’ajustement ne sont pas parallèles et convergent jusqu’à s’entrecroiser dans l’espace d’évaluation, les pentes sont formellement différentielles ($b_{1(A)} \neq b_{1(B)}$). Ce croisement signale la présence irréfutable d’un effet modérateur : l’intensité, voire le sens du transfert entre la variable indépendante et le critère dépend étroitement du sous-groupe analysé.
Toutefois, la plus grande retenue épistémologique s’impose face à l’inspection visuelle. Constater un écart géométrique entre deux pentes sur un canevas graphique d’Excel ne prouve pas formellement que cette différence soit statistiquement significative. Seule la conduite d’un test formel d’homogénéité des coefficients de régression — reposant sur l’évaluation d’un terme d’interaction multiplicatif ($X \times \text{Groupe}$) dans le cadre d’un modèle linéaire généralisé avec la formule DROITEREG — permet d’affirmer avec certitude que la divergence des pentes n’est pas imputable aux simples fluctuations de l’échantillonnage.
12. Normes de restitution académique et synthèse méthodologique
12.1 Conformité du graphique aux standards stricts de publication
La transcription d’un graphique élaboré sous Excel vers un manuscrit destiné à la publication académique ou à l’évaluation par des comités de lecture scientifique (conformément aux normes internationales telles que celles de l’American Psychological Association – APA) exige l’élimination méticuleuse de l’ensemble des éléments décoratifs superflus générés par défaut par le logiciel. L’esthétique scientifique obéit à un principe fondamental d’optimisation du ratio données/encre, théorisé par Edward Tufte.
Le protocole de standardisation implique la purge intégrale des quadrillages secondaires et principaux de la zone de traçage, ces lignes grisées perturbant la perception fine des trajectoires de pente. Les bordures d’encadrement externes du conteneur graphique doivent être supprimées en sélectionnant la modalité « Aucun trait » dans les options de bordure de forme, évitant d’emprisonner les données dans un rectangle lourd et inesthétique.
Chaque axe cartésien doit obligatoirement être doté d’un intitulé formel explicitant la grandeur physique considérée ainsi que son unité métrologique légale internationale, conventionnellement notée entre parenthèses ou crochets (par exemple : Temps de réaction (ms), Concentration sérique ($\mu\text{mol}\cdot\text{L}^{-1}$)). La courbe de tendance doit être tracée d’un trait continu sobre, contrasté mais suffisamment fin pour ne pas masquer les centres géométriques des marqueurs empiriques sous-jacents.
12.2 Transcription formelle de la pente dans un rapport de recherche
Au sein du corps textuel d’un mémoire de recherche, d’une thèse de doctorat ou d’un rapport technique d’ingénierie, la mention de la pente issue d’un calcul d’ajustement linéaire ne doit jamais apparaître de manière isolée ou décontextualisée. Les standards de restitution scientifique requièrent l’exposition conjointe des paramètres fonctionnels, de l’erreur d’échantillonnage et de la significativité inférentielle associée.
La formalisation conventionnelle s’articule selon la codification typographique standard suivante :
« L’analyse par régression linéaire simple révèle que l’élévation de la température induit un accroissement significatif de la cinétique enzymatique, caractérisé par un coefficient de pente $b = 1,48$ ($SE = 0,12$), $t(48) = 12,33$, $p < 0,001$, avec un modèle expliquant 76 % de la variance totale observée ($R^2 = 0,76$). »
Pour assurer la transparence et la reproductibilité computationnelle du protocole expérimental, il est également recommandé d’expliciter dans la section méthodologique du manuscrit les fonctions logicielles précises employées pour l’extraction des données. Mentionner formellement l’exploitation de la fonction DROITEREG d’Excel pour l’estimation de la matrice d’incertitude garantit une auditabilité parfaite par les pairs examinateurs.
12.3 Tableau synoptique comparatif des approches Excel
Afin de guider rationnellement l’analyste vers la méthode d’extraction de pente la plus efficiente en fonction de ses contraintes opérationnelles, le tableau synoptique suivant résume les caractéristiques fondamentales, les forces et les vulnérabilités inhérentes aux différentes démarches disponibles au sein de l’écosystème Microsoft Excel :
| Méthode d’extraction | Domaine d’application privilégié | Avantages distinctifs | Inconvénients majeurs |
|---|---|---|---|
| Équation sur graphique | Exploration visuelle rapide, présentations orales, figures didactiques. | Affichage immédiat sans nécessiter la saisie de formules sur la feuille de calcul. | Valeur textuelle isolée, risque élevé d’erreurs dues aux arrondis par défaut, actualisation non chaînable. |
| Fonction PENTE (SLOPE) | Tableaux de bord d’exploitation courante, séries temporelles univariées récurrentes. | Syntaxe simple et concise, recalcul dynamique instantané, précision standard à virgule flottante. | Risque d’inversion des arguments $Y$ et $X$, absence totale d’évaluation de l’erreur-type ou de statistiques inférentielles. |
| Fonction DROITEREG (LINEST) | Recherche académique de pointe, économétrie, mémoires et publications scientifiques. | Extraction de l’erreur type, accès au tableau complet d’ANOVA, intégration moderne aux matrices dynamiques. | Complexité syntaxique accrue, nécessite l’usage d’INDEX pour isoler le terme de pente de manière compacte. |
| Formules textuelles (STXT/CHERCHE) | Audit de classeurs verrouillés tiers, récupération sur modèles orphelins. | Permet d’extraire la pente textuelle lorsque les plages de cellules sources sont inaccessibles. | Instabilité syntaxique critique, haute sensibilité aux séparateurs régionaux (point/virgule). |
En synthèse, l’analyste rigoureux privilégiera systématiquement la méthode d’extraction graphique lors des phases de prototypage visuel ou de vérification préliminaire de la linéarité, pour ensuite asseoir l’architecture définitive de ses modèles de calcul sur les fonctions programmatiques stables PENTE ou DROITEREG. Cette discipline méthodologique garantit l’élaboration de classeurs d’analyse pérennes, robustes et conformes aux plus hauts standards de la science des données appliquée.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Microsoft Corporation. (2023). PENTE (PENTE, fonction). Support Microsoft. https://support.microsoft.com/fr-fr/office/pente-pente-fonction-04144358-1549-43a0-b996-0158a1f68744
- Microsoft Corporation. (2023). DROITEREG (DROITEREG, fonction). Support Microsoft. https://support.microsoft.com/fr-fr/office/droitereg-droitereg-fonction-81030999-122e-4cb8-9c43-029fa4e86cdb
- Microsoft Corporation. (2023). COEFFICIENT.DETERMINATION (COEFFICIENT.DETERMINATION, fonction). Support Microsoft. https://support.microsoft.com/fr-fr/office/coefficient-determination-coefficient-determination-fonction-d71d643e-79da-411a-827d-9dc8d374466b
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Wooldridge, J. M. (2020). Introductory Econometrics: A Modern Approach (7th ed.). Cengage Learning.