
Dans l’écosystème contemporain de l’ingénierie des données et de l’analyse décisionnelle, le tableur demeure un instrument prépondérant de modélisation, de structuration et de restitution de l’information quantitative et qualitative. Au sein de cet environnement, la manipulation ordonnée des enregistrements constitue l’un des actes opératoires les plus élémentaires, mais paradoxalement l’un des plus déterminants pour la validité des inférences subséquentes. Alors qu’un tri à plat univarié répond à des interrogations linéaires et simplistes, la réalité empirique des phénomènes économiques, sociologiques, cliniques ou logistiques impose presque systématiquement l’examen concomitant de multiples dimensions. L’aptitude à sérier un ensemble de données selon plusieurs variables hiérarchisées — opération communément désignée sous le vocable de tri multicritère ou tri imbriqué — représente ainsi un prérequis méthodologique fondamental pour tout analyste soucieux de rigueur scientifique et d’efficience opérationnelle.
L’environnement logiciel Microsoft Excel offre une panoplie exhaustive de mécanismes dédiés à l’ordonnancement multidimensionnel, s’étendant des boîtes de dialogue interactives conventionnelles aux moteurs d’évaluation matricielle dynamique introduits dans ses itérations les plus récentes. Toutefois, la maîtrise superficielle de ces interfaces dissimule fréquemment des incompréhensions théoriques relatives à l’algèbre relationnelle sous-jacente, à la préservation de l’intégrité référentielle des matrices de données et aux biais cognitifs induits par une hiérarchisation inadéquate des attributs. Un tri mal articulé ne se borne pas à désorganiser l’affichage : il peut corrompre irrémédiablement la cohésion d’une base de données par désolidarisation vectorielle, ou masquer des distributions statistiques sous-jacentes indispensables à la prise de décision stratégique.
Ce traité exhaustif se propose d’examiner avec une minutie académique et pratique l’intégralité des dimensions afférentes au tri multicritère dans Excel. De la préparation physico-structurelle des plages cellulaires jusqu’à l’automatisation programmatique par l’entremise du langage M de Power Query et du modèle objet de VBA, en passant par l’exploitation avancée de la fonction matricielle réactive TRIERPAR, chaque section détaillera les principes directeurs, les contraintes algorithmiques et les cas d’application concrets. En adoptant une posture alliant rigueur méthodologique et clarté procédurale, cet ouvrage constitue une référence définitive pour transformer la manipulation des données tabulaires en un levier d’investigation analytique irréprochable.
1. Fondements conceptuels et intérêt méthodologique du tri multicritère dans Excel
1.1 Définition et structure de la hiérarchie de tri
Le tri multicritère, ou tri imbriqué, se définit formellement comme une opération de permutation ordonnée appliquée aux lignes d’un tableau bidimensionnel, guidée par une succession ordonnée de clés de tri, également nommées attributs ou variables d’arbitrage. Contrairement au tri à plat monocritère, qui classe une matrice sur la base exclusive des valeurs contenues dans une colonne unique, le tri multidimensionnel instaure une hiérarchie stricte entre les dimensions d’analyse. Au sommet de cette architecture trône le critère primaire, qui dicte la macro-segmentation de la population statistique observée. Ce n’est que lorsque deux ou plusieurs observations présentent des valeurs strictement identiques au sein de ce premier vecteur — situation d’ex æquo ou de collision de valeurs — que le moteur d’évaluation sollicite le critère secondaire pour départager les enregistrements.
Cette logique d’arbitrage en cascade peut se propager théoriquement jusqu’au niveau n-ième, chaque niveau tertiaire ou subsidiaire n’intervenant que si l’indiscernabilité persiste aux échelons supérieurs. D’un point de vue mathématique, cette démarche s’apparente à l’établissement d’un ordre lexicographique sur l’espace produit des domaines des variables considérées. Ce processus garantit une partition logique des données en sous-ensembles homogènes, au sein desquels la granularité fine de l’information se révèle progressivement sans jamais altérer l’ordonnancement macroscopique établi par le niveau primaire.
L’impact d’une telle organisation sur la lisibilité des ensembles de données massifs et complexes est substantiel. Dans une table de plusieurs dizaines de milliers d’enregistrements, la consultation brute engendre une saturation perceptive immédiate. Le tri multicritère restructure l’espace visuel en agrégats implicites, permettant à l’observateur d’isoler mentalement des blocs taxonomiques cohérents avant d’analyser les variations intra-groupes. Cette technique transforme un amas désordonné d’occurrences en une arborescence séquentielle lisible, facilitant considérablement le repérage d’anomalies, la comparaison de sous-populations et la vérification visuelle préliminaire aux analyses économétriques ou statistiques poussées.
1.2 Dimensions cognitives et analytiques de l’organisation des données
Au-delà de la pure logistique informatique, la formalisation de l’ordre d’affichage des données revêt une dimension épistémologique et cognitive cruciale, théorisée notamment par la théorie de la charge cognitive appliquée aux interfaces d’information. L’exploration empirique d’un jeu de données non structuré impose au système exécutif humain une charge cognitive extrinsèque considérable : l’analyste doit allouer des ressources attentionnelles significatives pour localiser, mémoriser temporairement et rapprocher des éléments dispersés. En imposant un tri multicritère rigoureusement pensé, le tableau réduit cette friction cognitive, libérant de la bande passante mentale pour le traitement analytique intrinsèque et la génération d’hypothèses heuristiques.
Par ailleurs, un désordre visuel ou un tri unilatéral non représentatif est souvent le vecteur de biais d’interprétation pernicieux, tels que le biais de saillance ou le biais d’ancrage. Lorsqu’un tableau est trié selon un critère unique et accessoire, l’œil de l’observateur est irrésistiblement attiré par les extrêmes de cette variable spécifique, ce qui peut oblitérer des tendances sous-jacentes majeures distribuées selon d’autres variables orthogonales. La structuration multicritère prévient ces distorsions en offrant un cadre de lecture délibéré, où les facteurs de confusion potentiels sont neutralisés par une stratification ordonnée systématique.
Cette standardisation de l’affichage favorise l’émergence d’une pensée analytique structurée, alignée sur la taxinomie inhérente au champ disciplinaire étudié. En classant les entités selon une hiérarchie déductive allant du général au particulier, l’analyste s’oblige à expliciter le modèle causal ou classificatoire sous-jacent à sa démarche. Le tri multicritère cesse alors d’être une simple commodité cosmétique pour devenir un instrument de formalisation méthodologique, garantissant que l’agencement matériel des cellules reflète avec fidélité la structure ontologique du phénomène sous observation.
1.3 Cas d’usage représentatifs dans le traitement de données
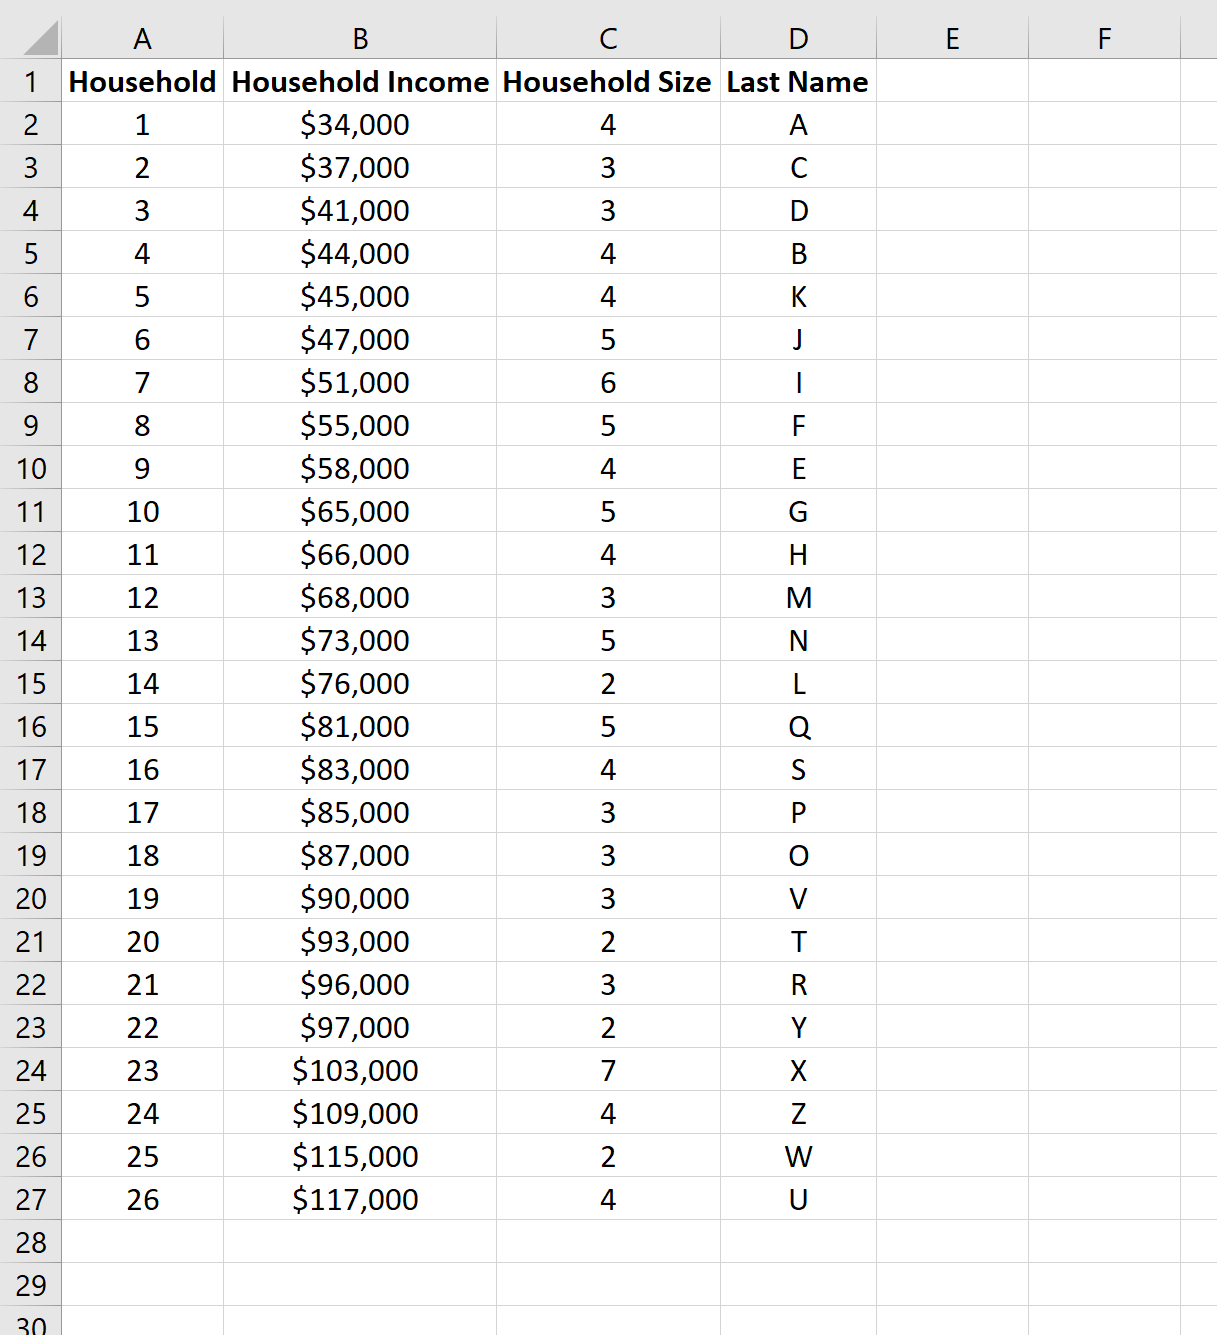
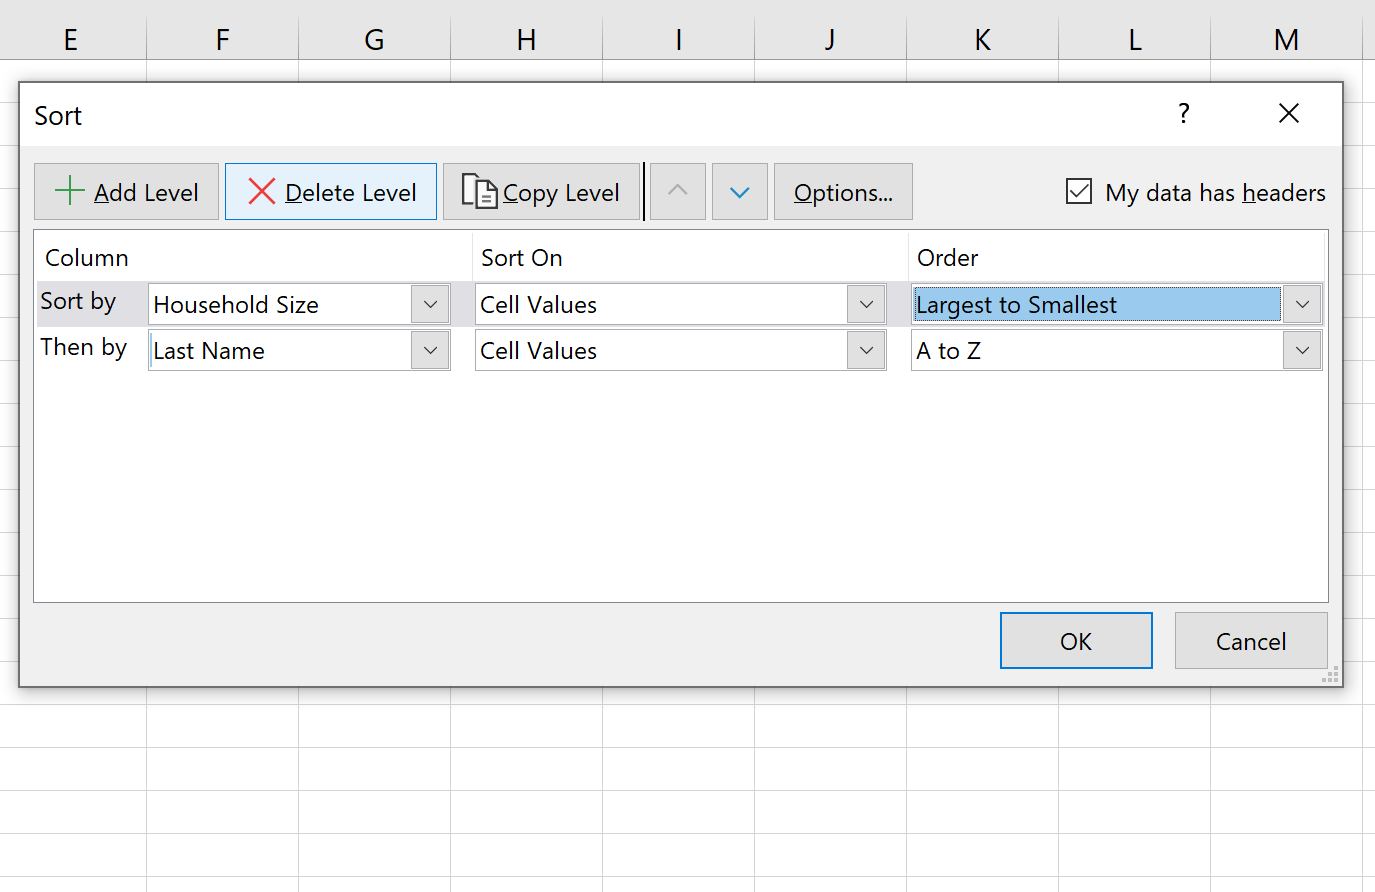
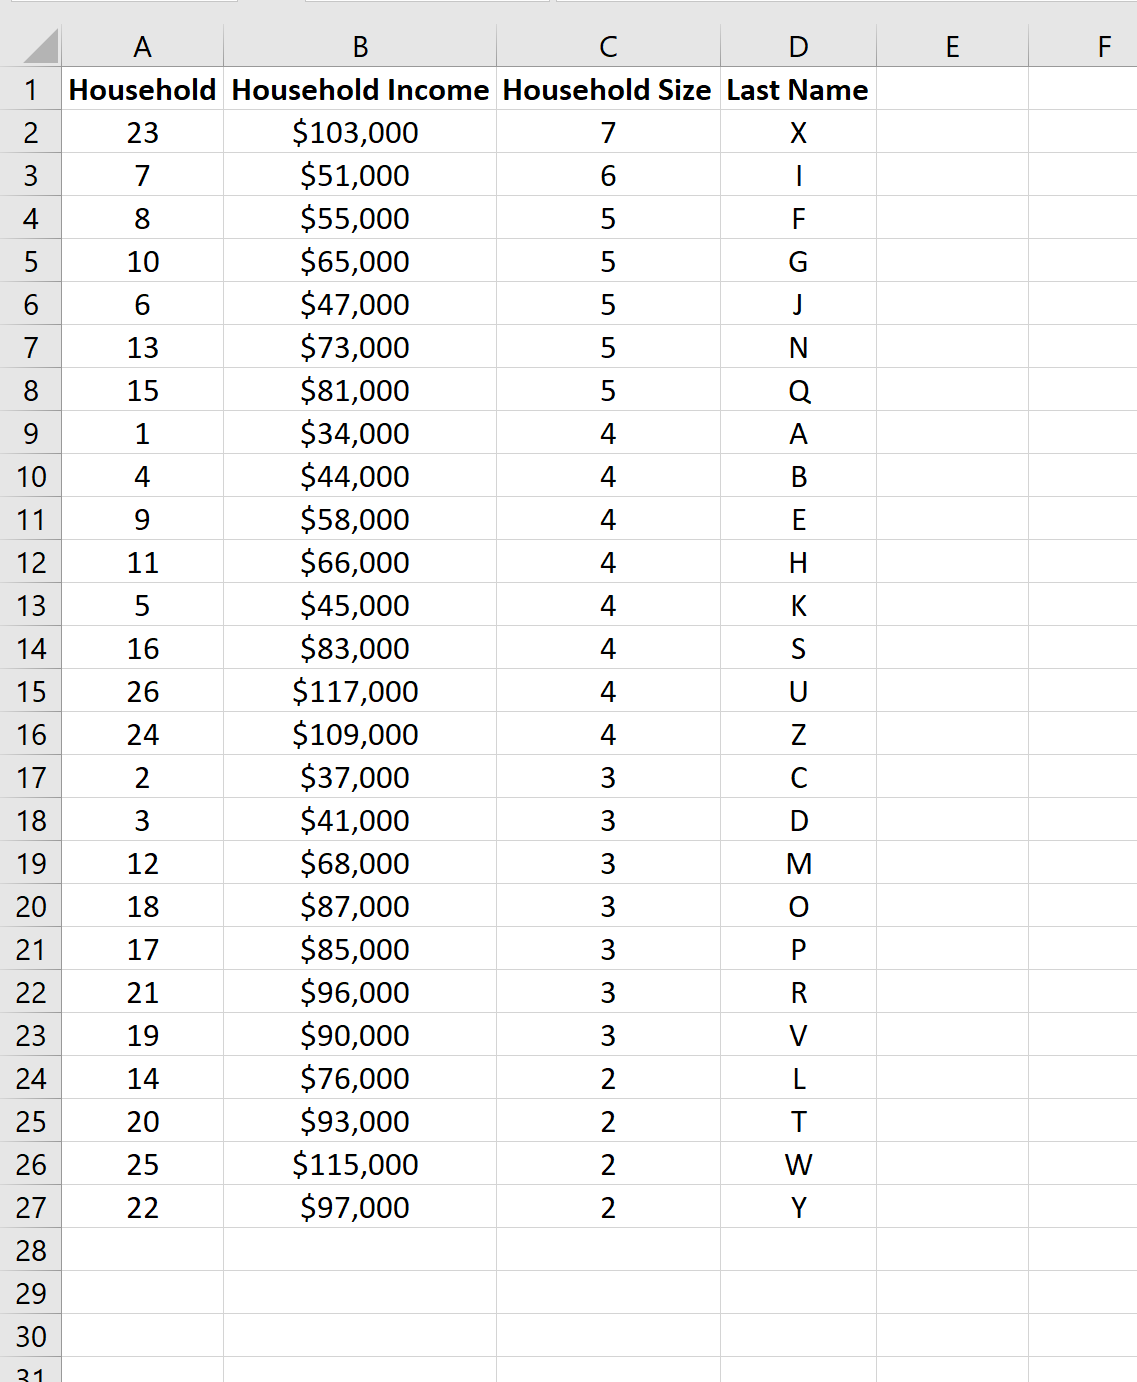
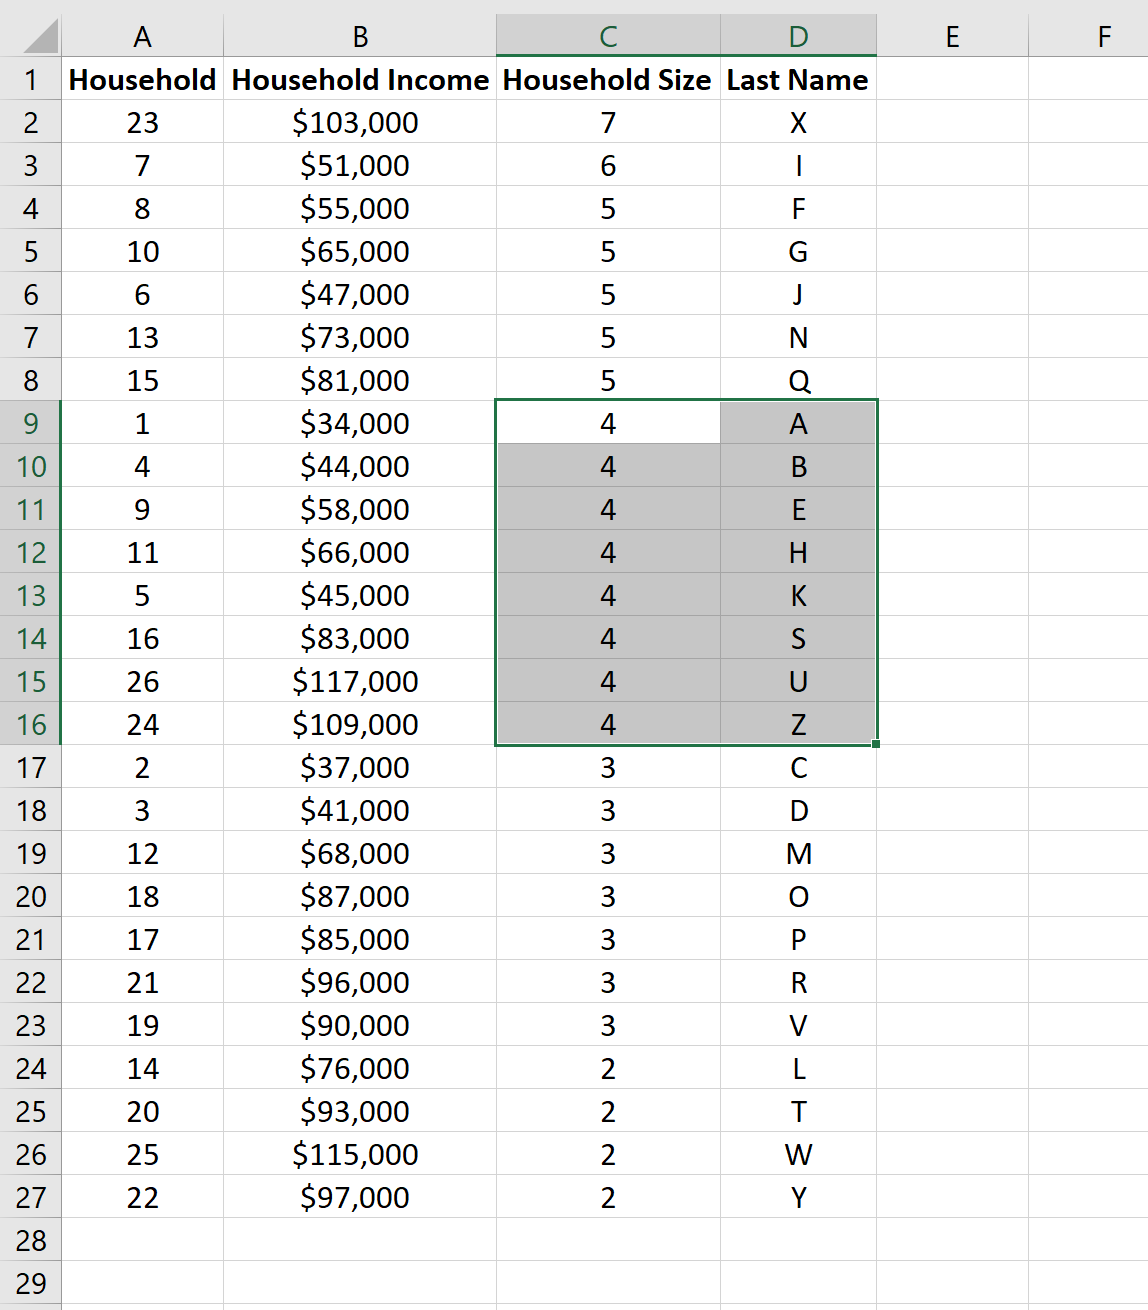
Les illustrations empiriques du tri multicritère abondent dans l’ensemble des disciplines quantitatives. Dans le domaine de la démographie sociale et de l’épidémiologie, considérons la gestion d’un registre d’enquêtes populationnelles. Une organisation méthodique consistera fréquemment à opérer un tri primaire selon la taille du ménage (variable quantitative discrète, ordre croissant), suivi d’un tri secondaire fondé sur le niveau de revenu disponible (variable continue, ordre décroissant), pour s’achever sur un tri tertiaire alphabétique des patronymes (variable nominale qualitative). Une telle cascade permet d’agréger immédiatement les unités domestiques par strate de composition, d’observer instantanément les disparités économiques internes à chaque strate, tout en conservant une méthode standardisée et déterministe pour localiser un individu donné en cas d’ex æquo financier.
Dans la sphère du contrôle de gestion et de la comptabilité analytique d’entreprise, la consolidation des flux transactionnels requiert une taxinomie temporelle et monétaire rigoureuse. L’analyste financier procèdera usuellement à une sériation primaire par année comptable (ordre décroissant pour placer les périodes les plus récentes au sommet de la feuille), complétée par un niveau secondaire articulé autour du centre de coût ou de la typologie budgétaire (ordre alphabétique), et finalisée par un niveau tertiaire gouverné par le montant décaissé (ordre décroissant). Ce découpage met en lumière les engagements financiers les plus critiques de l’exercice en cours, tout en maintenant la traçabilité des lignes secondaires au sein de chaque périmètre opérationnel.
Enfin, en psychométrie et dans les sciences du comportement, l’évaluation de batteries de tests standardisés administre l’agencement des sujets selon une combinatoire tripartite : d’abord la cohorte d’appartenance ou le groupe expérimental (facteur intersujets primaire), ensuite le genre ou la catégorie d’âge (variable démographique modératrice secondaire), et enfin le percentile de performance global obtenu au test psychométrique (variable d’efficacité tertiaire). Ce protocole de tri permet de visualiser en un coup d’œil si des patterns de dispersion anormaux se manifestent de façon asymétrique entre les groupes de contrôle et les cohortes expérimentales, démontrant la puissance diagnostique d’un agencement tabulaire multidimensionnel maîtrisé.
2. Préparation et assainissement préalable de la plage de données
2.1 Intégrité structurelle du tableau
Avant d’initier la moindre opération de tri dans Microsoft Excel, l’analyste doit impérativement auditer l’intégrité structurelle de la plage de travail. La vulnérabilité majeure des tables brutes réside dans la présence de discontinuités topologiques, matérialisées par des lignes ou des colonnes entièrement vides intercalées au sein du corpus. Si ces interstices peuvent sembler anodins à l’observateur non averti, ils constituent des barrières infranchissables pour les algorithmes de détection automatique d’Excel. En l’absence d’une sélection explicite préalable, l’outil délimite la « région active » (CurrentRegion) à la première ligne ou colonne vide rencontrée, tronquant ainsi la base et appliquant le tri à une fraction seulement de l’échantillon, ce qui rompt définitivement la contiguïté logique des données.
Un autre écueil technique rédhibitoire concerne l’usage inconsidéré de cellules fusionnées au sein de la matrice à sérier. La fusion de cellules altère fondamentalement l’adressage bidimensionnel standard du modèle matriciel d’Excel, dans la mesure où seule la cellule supérieure gauche de la plage fusionnée conserve la valeur sous-jacente, tandis que les cellules adjacentes virtuelles sont techniquement affectées d’une valeur nulle ou vide. Lors de l’exécution d’un tri multicritère, la présence d’une seule cellule fusionnée engendre l’apparition systématique d’une boîte d’erreur modale signalant l’incompatibilité de l’opération (« Cette opération requiert que les cellules fusionnées soient de taille identique »), bloquant purement et simplement le processus jusqu’à la défusion complète de la zone.
L’homogénéité typologique des données représente le troisième pilier de cet assainissement préliminaire. Au sein d’un même champ vectoriel (colonne), la coexistence de données numériques pures et de représentations textuelles de nombres (souvent induites par des imports défaillants de systèmes ERP) génère des aberrations d’ordonnancement critiques. De surcroît, la désignation des variables via des en-têtes explicites, univoques et positionnés rigoureusement sur une unique ligne terminale avant le premier enregistrement factuel conditionne l’aptitude d’Excel à différencier le métadonnées des données de fond. Tout sous-titre composite ou en-tête multi-lignes non formalisé doit être proscrit ou refondu en une nomenclature standardisée.
2.2 Sélection sécurisée de la zone de tri
Le risque méthodologique le plus dévastateur lors de l’exécution d’un tri réside dans la désynchronisation accidentelle des colonnes, un phénomène catastrophique que les spécialistes des bases de données désignent sous le terme de rupture d’intégrité référentielle intra-ligne. Si un utilisateur sélectionne manuellement une seule colonne ou un sous-ensemble arbitraire de colonnes avant de lancer une commande de tri élémentaire, et qu’il ignore l’avertissement d’extension de sélection émis par le système, Excel réordonnera exclusivement la zone en surbrillance. Les attributs triés se trouveront alors réaffectés à des enregistrements tiers, corrompant irrémédiablement l’historicité et la véracité factuelle de l’ensemble du classeur sans espoir de reconstitution simple si les modifications sont sauvegardées.
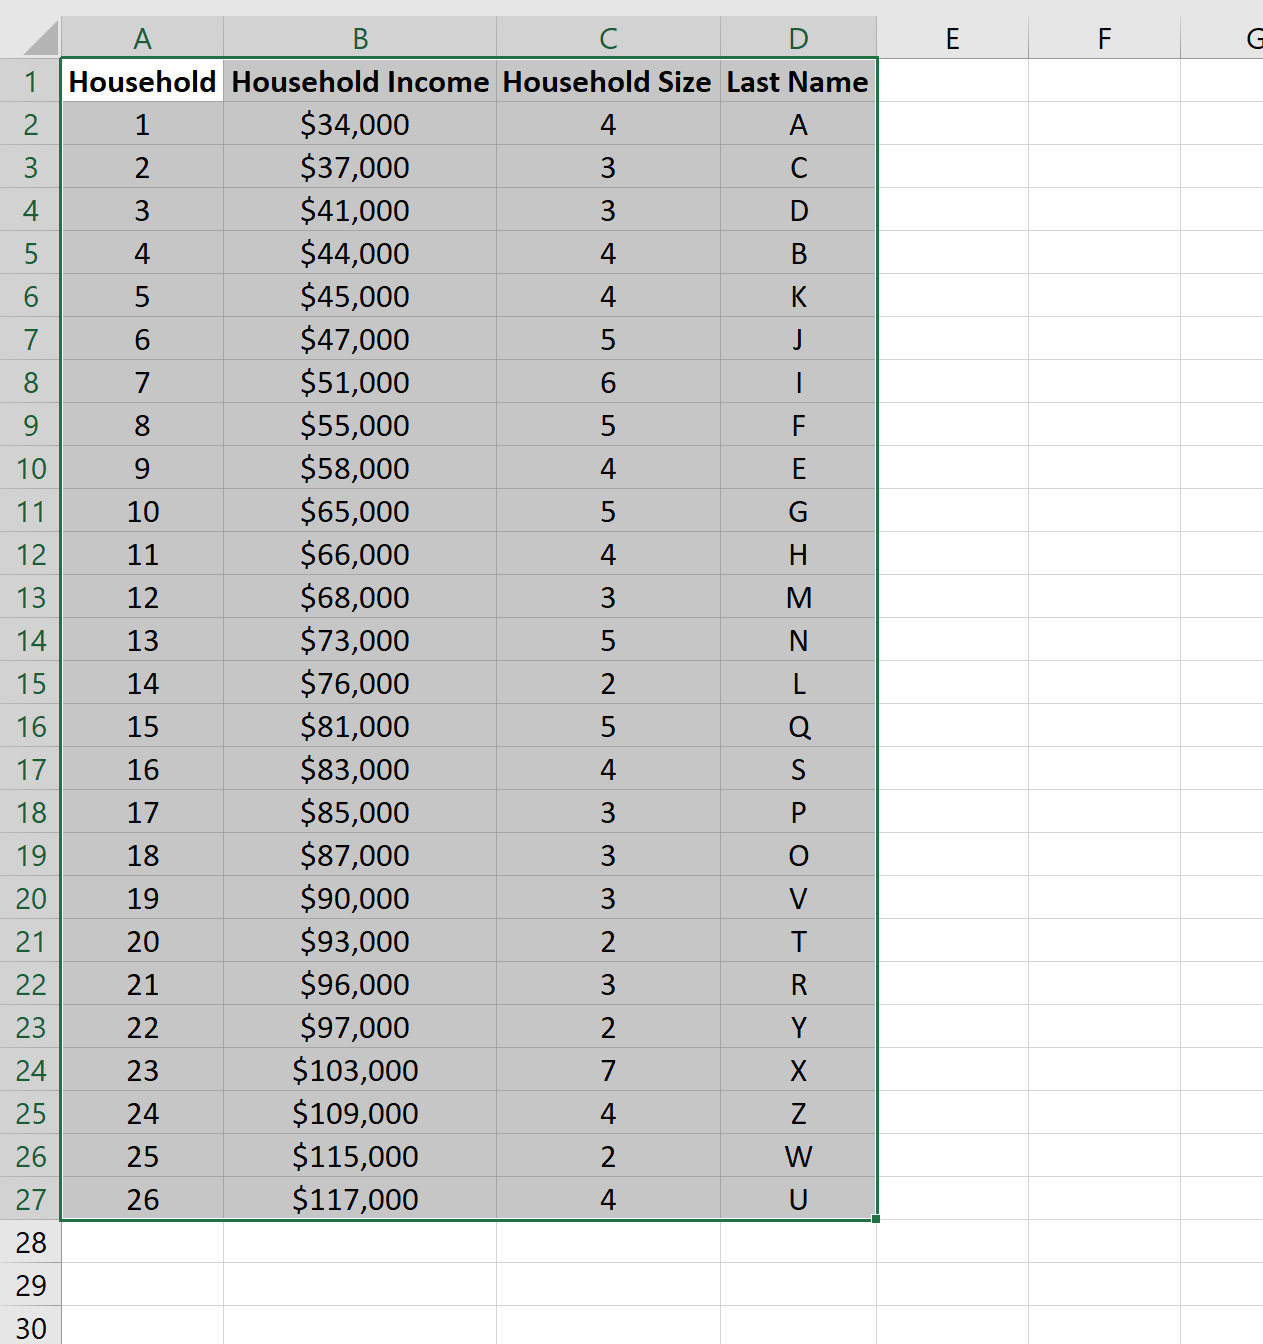
Pour immuniser ses processus contre ce péril, le praticien doit s’approprier les protocoles de sélection globale déterministes. Le recours aux raccourcis clavier structurels constitue ici une garantie absolue. En positionnant le pointeur actif au sein du tableau et en actionnant la combinaison Ctrl+A (ou Ctrl+Shift+Espace), l’utilisateur commande l’expansion immédiate de la zone de sélection à l’intégralité du bloc de cellules contiguës, englobant sans faille l’ensemble des colonnes satellites associées aux lignes d’enregistrement. Alternativement, le positionnement sur la cellule d’ancrage supérieure gauche (A1 ou première cellule de métadonnées) suivi de l’instruction Ctrl+Shift+Fin permet d’étendre la sélection jusqu’aux limites extrêmes de la surface active du feuillet de calcul.
Il est par ailleurs fondamental de comprendre le fonctionnement du moteur heuristique de détection interne d’Excel. Lorsqu’aucune cellule multiple n’est expressément surlignée et que seule une cellule unitaire au sein du tableau est active lors de l’invocation du module de tri, Excel procède de manière autonome à une analyse topologique environnante pour déterminer les frontières du tableau. Bien que cette fonctionnalité soit remarquablement efficiente sur des jeux de données parfaitement assainis, elle demeure tributaire de l’absence de ruptures de contiguïté mentionnées précédemment. Dès lors, la sélection manuelle exhaustive ou, mieux encore, la conversion de la plage en Tableau Structuré (abordée ultérieurement) demeure l’unique approche garantissant une sécurité transactionnelle absolue.
3. Procédure standard : l’interface de tri personnalisé pas à pas
3.1 Accès au module de tri avancé
Pour transcender les limitations intrinsèques des boutons de tri rapide univarié (marqués des symboles A-Z et Z-A), qui s’exécutent instantanément sur la colonne de la cellule active au détriment de toute combinatoire, l’utilisateur doit obligatoirement mobiliser l’interface modale dédiée au tri avancé. L’invocation de ce panneau de configuration s’opère principalement par deux trajectoires ergonomiques au sein du ruban fluent de Microsoft Excel, chacune répondant à des logiques de flux de travail distinctes mais convergeant vers le même moteur d’exécution.
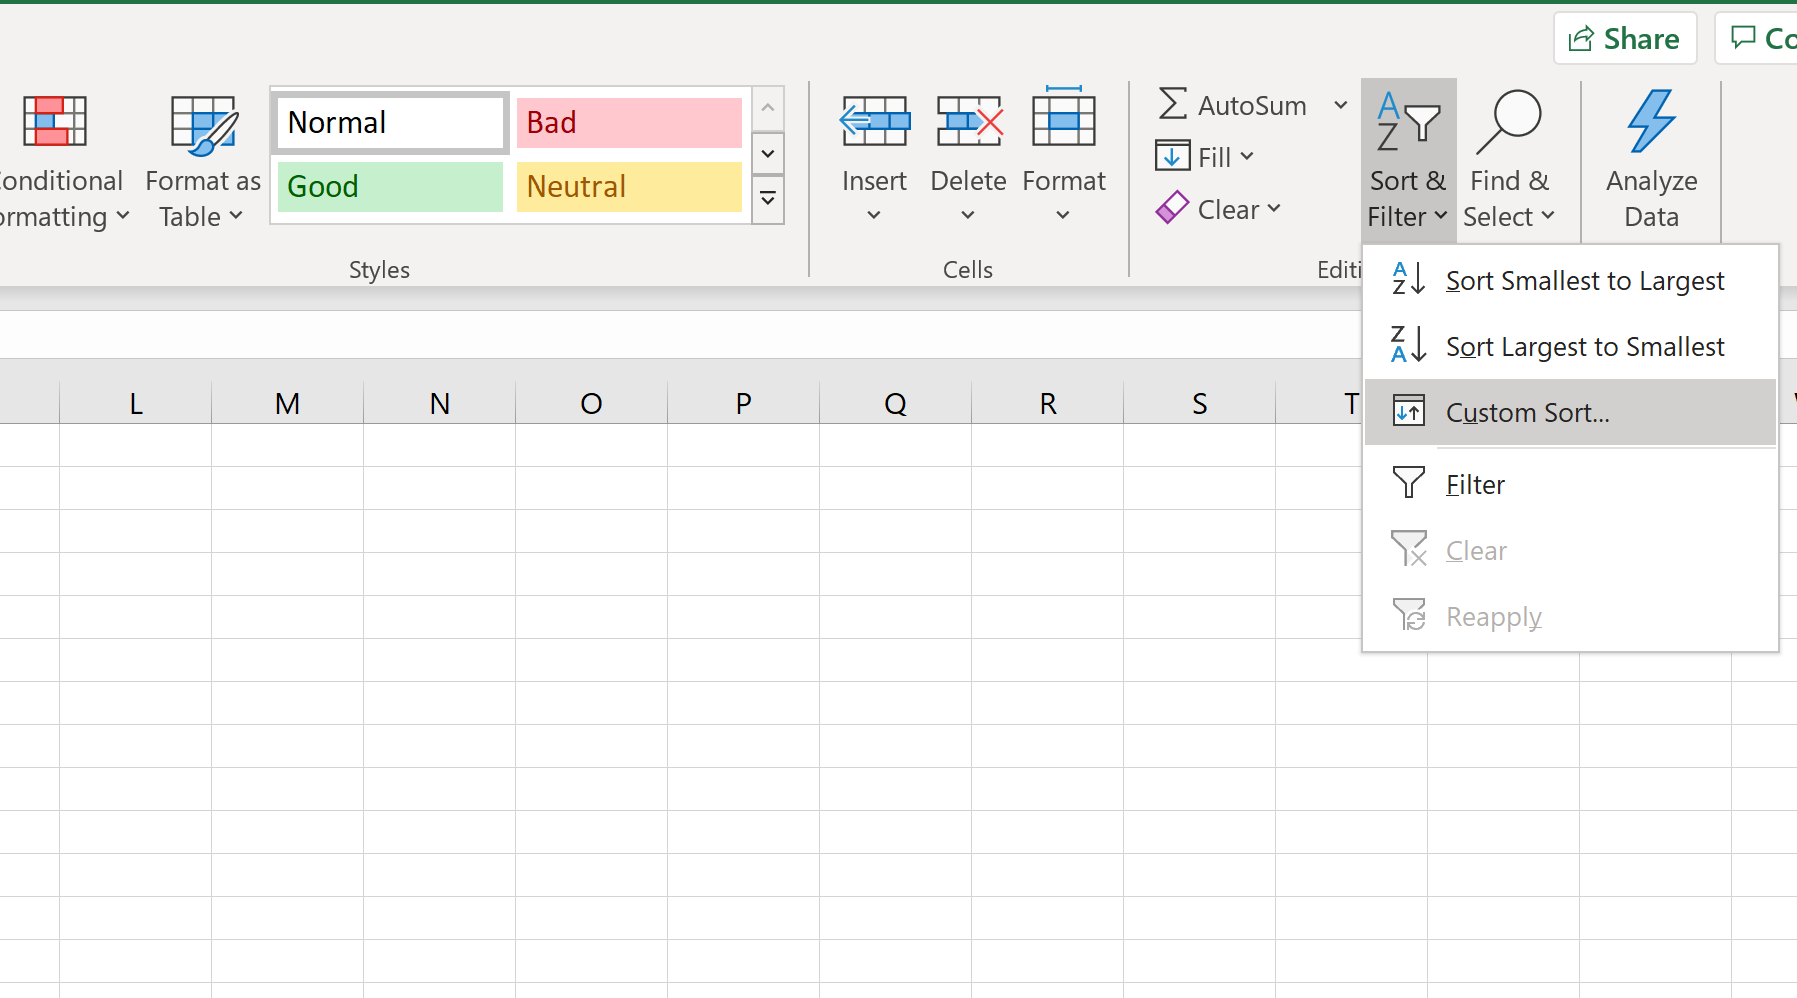
La première voie, privilégiée lors des phases de mise en forme et d’édition rapide, réside dans l’onglet « Accueil ». En naviguant vers l’extrémité droite du bandeau au sein du groupe fonctionnel « Édition », l’utilisateur clique sur le menu déroulant « Trier et filtrer », puis sélectionne expressément l’instruction « Tri personnalisé… ». Cette manipulation a pour effet d’interrompre le flux d’édition direct et d’invoquer la boîte de dialogue modale au premier plan, suspendant toute interaction avec la grille sous-jacente tant que les paramètres n’ont pas été arrêtés ou répudiés.
La seconde trajectoire, structurellement plus conforme aux canons de la gestion de données, s’effectue via l’onglet « Données » du ruban. Au cœur du groupe d’outils stratégique intitulé « Trier et filtrer », un bouton grand format libellé « Trier », flanqué de l’icône représentative d’un entonnoir et des alphabets superposés, permet d’atteindre exactement le même module en un clic unique. Cette boîte de dialogue constitue le véritable centre névralgique de l’ordonnancement tabulaire, offrant un environnement graphique dédié à l’empilement, la modulation, la hiérarchisation et la temporisation de multiples clauses d’ordonnancement successives.
3.2 Configuration de l’option des en-têtes
Dès l’apparition de la fenêtre modale de tri, l’impératif procédural prioritaire consiste à vérifier le statut d’une case à cocher située invariablement dans le quadrant supérieur droit de l’interface : « Mes données ont des en-têtes ». Cette option binaire exerce une influence déterminante sur le comportement algorithmique de l’outil et conditionne la préservation des métadonnées du tableau. Si cette case est cochée, Excel isole d’emblée la première ligne de la plage sélectionnée, la soustrayant aux règles de permutation physique pour la sanctuariser en tant que rangée d’étiquettes descriptives.
Les répercussions d’un paramétrage erroné à ce niveau sont immédiatement préjudiciables. Si la case demeure décochée alors que le tableau comporte des libellés textuels, la première ligne de titres sera assimilée à un enregistrement régulier d’observations ; elle se trouvera ainsi précipitée au beau milieu du tableau lors de l’application d’un tri alphabétique ou numérique, détruisant la lisibilité du document. À l’inverse, si l’option est activée par inadvertance sur un tableau dépourvu d’en-têtes, la toute première ligne de données empiriques sera exclue du tri et figée artificiellement au sommet de la matrice, introduisant un biais majeur dans les analyses.
Sur le plan de l’utilisabilité, l’activation correcte de cette case transforme radicalement la lisibilité du paramétrage subséquent. Au lieu de proposer des références génériques et abstraites fondées sur les dénominations matérielles des colonnes de la feuille de calcul (telles que « Colonne A », « Colonne B », etc.), les menus déroulants de sélection des variables affichent désormais explicitement les libellés réels des champs (ex. « Identifiant_Sujet », « Date_Admission », « Score_Standardise »). Cette explicitation sémantique réduit de manière exponentielle les risques d’erreur humaine lors de la désignation des clés de tri.
3.3 Exécution et validation de la commande de tri
Une fois les critères d’ordonnancement minutieusement instanciés au sein de la matrice de commande, l’analyste procède à une dernière phase de contrôle visuel en périphérie de la boîte modale. Il convient d’observer attentivement la trame de surbrillance semi-transparente qui encadre le jeu de données en arrière-plan afin de confirmer que la surface d’application coïncide rigoureusement avec les frontières physiques attendues du corpus d’étude. La moindre incohérence spatiale doit conduire à l’annulation immédiate de l’opération via le bouton « Annuler » ou la touche d’échappement pour réajuster la sélection d’origine.
Lorsque la cohérence des paramètres et du périmètre est attestée, la validation définitive s’opère par l’actionnement du bouton « OK ». À cet instant précis, le moteur interne d’Excel exécute un algorithme d’ordonnancement en mémoire vive (historiquement dérivé de variantes optimisées du QuickSort et du Timsort), réalisant la permutation physique synchrone de l’ensemble des tuples (lignes) de la base de données. L’interface se referme pour laisser place au jeu de données réorganisé selon la cascade d’instructions spécifiée.
Il importe de souligner que, dans l’éventualité où l’analyste constaterait une anomalie post-exécution — qu’il s’agisse d’un ordre inversé ou de l’omission d’une dimension critique —, l’état antérieur de la matrice demeure récupérable à court terme grâce à la pile de journalisation transactionnelle du logiciel. La commande standard d’annulation (Ctrl+Z) permet de restaurer la disposition spatiale exacte antérieure au tri. Toutefois, cette faculté de réversibilité s’éteint dès lors que le classeur fait l’objet d’un enregistrement physique sur disque ou que des opérations de calcul fermant la session d’annulation interviennent, soulignant l’importance d’une vérification immédiate post-tri.
4. Hiérarchisation et gestion des niveaux de critères
4.1 Configuration du niveau primaire de tri
Le niveau primaire de tri, identifié par la mention invariable « Trier par » sur la première rangée de la boîte de dialogue, gouverne souverainement l’agencement global de la structure matricielle. C’est à ce niveau que l’analyste doit affecter la variable structurelle majeure, celle qui définit le regroupement catégoriel le plus vaste ou la métrique cardinale d’analyse. La sélection s’effectue au moyen du premier menu déroulant de gauche, qui expose l’exhaustivité des noms de colonnes répertoriés dans la ligne d’en-tête sanctuarisée.
Le second champ de configuration, intitulé « Trier sur », autorise la spécification de la nature sous-jacente de l’attribut pris en considération pour l’évaluation. Si l’écrasante majorité des cas d’usage académiques et industriels repose sur les « Valeurs de cellules », l’architecture d’Excel permet également d’asseoir le tri sur des caractéristiques sémiotiques visuelles : la « Couleur de cellule », la « Couleur de police » ou les « Indicateurs de mise en forme conditionnelle ». L’analyste veille à maintenir l’option par défaut « Valeurs de cellules » pour toute manipulation à vocation statistique rigoureuse, les attributs visuels n’offrant aucune garantie de distribution formelle.
Enfin, le troisième paramètre détermine l’« Ordre » de sériation mathématique ou lexical. Suivant la typologie de la variable sélectionnée, l’interface adapte dynamiquement les options proposées : « De A à Z » ou « De Z à A » pour les entités textuelles, « Du plus petit au plus grand » ou « Du plus grand au plus petit » pour les variables scalaires numériques, et « Du plus ancien au plus récent » ou inversement pour les coordonnées chronologiques. Ce choix dicte la polarité du gradient selon lequel la première segmentation de la population statistique s’organisera visuellement sur l’axe vertical du tableur.
4.2 Ajout et paramétrage des niveaux secondaires et tertiaires
Lorsque le niveau primaire est assidûment calibré, l’introduction d’un second niveau décisionnel intervient pour traiter la variance résiduelle au sein des strates homogènes du premier niveau. Cette adjonction s’opère par le truchement du bouton « Ajouter un niveau », disposé sur la barre d’outils supérieure de la boîte modale de tri. Cette action génère instantanément une ligne subordonnée dans le panneau de commande, introduite par le connecteur logique « Puis par ». Cette syntaxe explicite parfaitement la subordination temporelle et logique du processus de tri en cascade.
Au sein de cette strate secondaire, l’analyste sélectionne la variable d’arbitrage destinée à départager les ex æquo. À titre d’exemple, au sein d’une cohorte d’individus préalablement triée de façon ascendante par « Département de résidence », le second niveau peut être paramétré pour classer les observations par « Date de naissance » croissante. Ainsi, tous les sujets résidant dans une même unité géographique se trouveront sériés chronologiquement, sans qu’à aucun moment la chronologie des naissances ne vienne perturber la contiguïté territoriale instituée par le niveau primaire.
L’opération peut être réitérée pour instaurer un niveau tertiaire, voire quaternaire, en sollicitant à nouveau le mécanisme « Ajouter un niveau ». Chaque palier additionnel dispose d’une étanchéité de paramétrage totale : il est parfaitement licite d’associer un tri alphabétique ascendant au niveau 1, un tri numérique descendant au niveau 2, et un tri fondé sur une liste de valeurs personnalisées au niveau 3. Excel tolère l’empilement d’un nombre considérable de niveaux (jusqu’à 64 critères simultanés), une capacité technique qui excède très largement les seuils de saturation cognitive humaine et les besoins réels des modélisations tabulaires les plus sophistiquées.
4.3 Réorganisation et suppression de niveaux
L’ordre séquentiel dans lequel les critères sont disposés au sein de la boîte de dialogue revêt une importance capitale : l’inversion de deux lignes de commande modifie drastiquement le résultat macroscopique du tri. Conscients de cette sensibilité structurelle, les concepteurs du logiciel ont intégré des commandes de réorganisation dynamique de l’arborescence. Les boutons fléchés « Monter » et « Descendre », positionnés à proximité immédiate de la commande d’ajout de niveau, permettent de translater verticalement un critère sélectionné pour modifier son rang dans la hiérarchie logique sans devoir réinitialiser manuellement l’intégralité de la configuration.
L’inversion de la hiérarchie produit une redistribution radicale de l’espace tabulaire. Si l’on prend l’exemple d’une base combinant « Pays d’origine » et « Montant des ventes », positionner le « Pays » en tête puis le « Montant » génère une vue sectorisée géographiquement où l’on observe la distribution des ventes à l’intérieur de chaque nation. Inverser ces deux critères — placer le « Montant des ventes » en niveau primaire et le « Pays » en niveau secondaire — désagrège totalement la cohérence géographique pour établir un classement global des transactions financières mondiales, le pays n’intervenant plus que pour départager d’éventuelles transactions de montants rigoureusement identiques.
Enfin, la rationalisation des critères implique également la capacité d’élaguer les dimensions obsolètes ou redondantes. En sélectionnant un niveau de tri devenu superflu et en activant le bouton « Supprimer un niveau », l’analyste retire immédiatement la variable de la chaîne de décision algorithmique. Cette opération s’avère hautement recommandée pour alléger le traitement des calculs et éviter l’introduction de contraintes de tri fantômes susceptibles de masquer des regroupements naturels ou de ralentir le rafraîchissement des vues de données complexes.
5. Typologies d’ordres de tri selon la nature des variables
5.1 Tri quantitatif : variables numériques discrètes et continues
Le traitement des variables quantitatives scalaires dans l’environnement de tri d’Excel repose sur l’évaluation de la valeur algébrique pure des cellules concernées. Qu’il s’agisse de variables discrètes (telles que le dénombrement d’enfants par foyer ou le nombre de jours d’hospitalisation) ou de variables continues (comme un cours boursier, un taux de change ou une mesure thermométrique), le moteur applique les relations d’ordre mathématique fondamentales. L’option « Du plus petit au plus grand » applique un ordre strictement croissant, tandis que « Du plus grand au plus petit » instaure une séquence décroissante rigoureuse.
La gestion des valeurs négatives respecte scrupuleusement l’arithmétique sur la droite des réels : une valeur de -50 sera classée comme inférieure à une valeur de -10, se positionnant ainsi en amont de cette dernière lors d’un tri croissant. De même, les zéros absolus s’intercalent rigoureusement entre les valeurs négatives et les valeurs positives. En ce qui concerne les valeurs numériques exprimées en notation scientifique exponentielle (par exemple 1,5E+06 pour 1 500 000 ou 2,3E-04 pour 0,00023), Excel évalue la magnitude réelle sous-jacente et non la chaîne de caractères typographique, assurant un positionnement ordinal parfaitement exact dans la distribution.
Cependant, l’analyste doit impérativement déjouer le piège classique des nombres indûment formatés en chaînes textuelles. Lorsqu’un nombre est précédé d’une apostrophe apostrophée ou issu d’une extraction logicielle défaillante lui conférant le type « Texte », le moteur d’Excel n’applique plus l’ordre mathématique mais l’ordre lexicographique. Dès lors, le nombre « 100 » sera classé avant le chiffre « 2 », dans la mesure où le caractère typographique initial « 1 » précède le caractère « 2 » dans la table des caractères ASCII/Unicode. Ce dysfonctionnement, s’il n’est pas identifié et corrigé en amont, invalide complètement la dimension quantitative du tri multicritère.
5.2 Tri qualitatif : chaînes textuelles et sensibilité à la casse
L’ordonnancement des variables qualitatives nominales ou ordinales stockées sous forme de texte obéit aux conventions lexicographiques universelles, matérialisées dans l’interface par les orientations « De A à Z » et « De Z à A ». Dans son paramétrage standard, Excel applique un tri insensible à la casse (case-insensitive), ce qui implique qu’il n’établit aucune distinction hiérarchique intrinsèque entre les caractères minuscules et leurs équivalents majuscules. Ainsi, les chaînes « DUPONT », « Dupont » et « dupont » sont appréhendées comme rigoureusement équivalentes par le comparateur logique au niveau primaire, leur ordre d’apparition relatif demeurant alors dicté par leur positionnement historique antérieur dans la table.
Toutefois, pour les applications lexicographiques spécialisées, la linguistique computationnelle ou la gestion de nomenclatures normalisées sensibles à la typographie, il est possible de contraindre Excel à appliquer une stricte sensibilité à la casse. Cette activation s’opère en accédant au bouton « Options… » logé au sommet de la boîte de dialogue de tri, puis en cochant l’instruction explicite « Respecter la casse ». Sous ce régime, l’ordre lexicographique attribue une priorité discriminante aux majuscules vis-à-vis des minuscules (ou inversement selon le schéma d’encodage régional), départageant formellement des enregistrements textuels qui apparaissaient jusqu’alors comme des doublons parfaits.
Un autre défi inhérent au tri textuel réside dans le traitement des caractères diacritiques (accents, cédilles, trémas), des ligatures et des symboles typographiques non standards. Par défaut, les versions francophones de Microsoft Excel appliquent les règles de collation de l’environnement linguistique du système d’exploitation, alignées sur les préconisations du consortium Unicode. Les caractères accentués sont généralement traités au même rang que leurs homologues non accentués lors de la première passe, n’intervenant comme critères de départage qu’en cas d’équivalence textuelle intégrale du reste de la chaîne. Il est dès lors capital d’homogénéiser l’orthographe lexicale au préalable afin d’éviter la ségrégation artificielle de catégories identiques (ex. « Région » vs « Region »).
5.3 Tri chronologique : dates, heures et horodatages
La dimension temporelle constitue l’un des axes de tri multicritère les plus répandus dans les systèmes d’information décisionnels. Pour que l’ordonnancement chronologique s’opère avec une fidélité absolue, il est impératif d’intégrer la mécanique sérielle interne de Microsoft Excel. Pour le logiciel, une date n’est en aucun cas une entité sémantique autonome ni une suite de caractères séparés par des barres obliques ; il s’agit d’un nombre entier séquentiel représentant le nombre de jours écoulés depuis le point d’origine conventionnel fixé au 1er janvier 1900. De façon analogue, une heure ou un horodatage complet correspond à la fraction décimale de ce nombre sériel, comprise entre 0,0 (00:00:00) et 0,99999 (23:59:59).
Lorsque cette conformité typologique est respectée, le menu de tri affiche sans ambiguïté les options chronologiques « Du plus ancien au plus récent » et « Du plus récent au plus ancien ». Le tri s’exécute alors avec une fluidité parfaite, positionnant un événement survenu le « 15/03/2023 » rigoureusement avant un événement survenu le « 02/01/2024 », bien que la chaîne textuelle « 02 » soit typographiquement inférieure à la chaîne « 15 ». Tout le travail de l’analyste consiste à s’assurer qu’aucune date n’a été corrompue et stockée sous forme de texte pur, situation fréquente lors de l’intégration de données internationales présentant une divergence entre le format jour/mois/année européen et le format mois/jour/année anglo-saxon.
Dans le cadre d’un tri hiérarchisé à plusieurs niveaux impliquant des dates, la cohérence temporelle devient l’élément structurant de l’analyse longitudinale. Par exemple, l’agencement d’un historique médical ou d’un registre de pannes industrielles gagne à être structuré avec l’identifiant de la machine ou du patient en niveau 1, la date de l’incident en niveau 2 (croissant), et l’heure précise d’enregistrement en niveau 3 (croissant). Cet agencement reconstitue fidèlement la cinématique temporelle propre à chaque entité suivie, permettant d’extraire instantanément des indicateurs de récurrence, des durées de survie ou des intervalles moyens entre défaillances sans perturbation visuelle.
6. Utilisation des listes personnalisées pour un tri sémantique
6.1 Dépasser la contrainte alphabétique et numérique
Dans de multiples disciplines opérationnelles et méthodologiques, les catégories descriptives ne répondent ni à une stricte progression arithmétique, ni à un ordre lexicographique naturel. Un tri alphabétique appliqué à une échelle d’évaluation de la gravité d’un incident produira la séquence « Critique », « Élevé », « Faible », « Moyen », une suite dépourvue de toute logique managériale ou ergonomique. De même, les jours calendaires sériés alphabétiquement (« Dimanche », « Jeudi », « Lundi », « Mardi »…) détruisent la cinétique temporelle hebdomadaire indispensable à l’analyse de séries temporelles périodiques.
Pour s’affranchir de ce carcan purement formel, Microsoft Excel intègre un mécanisme d’une remarquable puissance cognitive : les listes personnalisées (Custom Lists). Ce dispositif permet à l’utilisateur de substituer à l’ordre lexicographique aveugle un ordonnancement sémantique dicté par les exigences métier ou les conventions doctrinales du domaine d’expertise concerné. Les dimensions qualitatives ordinales, telles que les échelles de Likert utilisées en psychologie (« Fortement en désaccord », « En désaccord », « Neutre », « D’accord », « Fortement d’accord »), retrouvent ainsi leur cohérence vectorielle au sein des tris tabulaires.
L’intégration d’un tri sémantique au sein d’une cascade multicritère enrichit considérablement les capacités analytiques du tableau. Il devient par exemple possible de définir un tri primaire sur la criticité opérationnelle d’un portefeuille de projets selon la séquence personnalisée « Urgence absolue », « Haute priorité », « Routine », puis de lui adjoindre un tri secondaire chronologique classique sur la date d’échéance. Le gestionnaire dispose alors d’une feuille de route où les priorités qualitatives dictent la sectorisation fondamentale du tableau, les sous-tâches étant quant à elles séquencées selon leur imminence temporelle.
6.2 Création et intégration d’une liste personnalisée
L’implémentation opérationnelle d’une liste personnalisée s’opère au niveau des paramètres fondamentaux de l’environnement applicatif Excel. Pour formaliser une nouvelle échelle ordinale, la trajectoire méthodologique impose de se diriger vers l’onglet « Fichier » du ruban, d’activer l’entrée « Options », puis de sélectionner la rubrique « Options avancées ». En faisant défiler le panneau latéral jusqu’au groupe fonctionnel « Général », l’analyste actionne le bouton intitulé « Modifier les listes personnalisées… ». Cette manipulation ouvre un panneau de configuration dédié à la gestion des référentiels sémantiques mémorisés dans l’instance locale du logiciel.
Deux modalités d’instanciation s’offrent alors à l’opérateur. La première consiste en une saisie manuelle directe au sein de la zone textuelle « Entrées de la liste », chaque élément de la séquence ordonnée devant être consigné sur une ligne distincte par le truchement de la touche d’entrée. La seconde méthode, nettement plus rapide et exempte de coquilles typographiques, consiste à importer directement les modalités ordonnées à partir d’une plage de cellules préexistante dans la feuille de calcul. L’utilisateur sélectionne la zone de cellules vectorielle à l’aide de la mire de sélection, puis valide par le bouton « Importer ». La nouvelle taxinomie s’intègre immédiatement à la bibliothèque de listes permanentes du classeur.
L’exploitation de cette séquence au sein de l’interface de tri multicritère devient dès lors triviale. Lors de la configuration de l’un des niveaux de la hiérarchie (qu’il soit primaire, secondaire ou tertiaire), l’opérateur se positionne sur la colonne concernée, conserve le paramètre de base « Trier sur : Valeurs de cellules », mais déroule le troisième menu (« Ordre ») pour y sélectionner la mention « Liste personnalisée… ». Une interface modale contextuelle permet de désigner la liste préalablement enregistrée. Dès la validation finale, Excel applique l’ordonnancement sémantique strict défini par l’analyste, traitant chaque enregistrement selon son indice de position au sein de la liste formalisée.
7. Le tri multicritère dynamique par formule avec TRIERPAR
7.1 Syntaxe formelle de la fonction TRIERPAR (SORTBY)
L’avènement du moteur de calcul matriciel dynamique dans les versions contemporaines de Microsoft Excel (Microsoft 365 et Office 2021) a révolutionné la manipulation des données en introduisant un paradigme résolument déclaratif et non destructif. Au cœur de cette métamorphose se situe la fonction TRIERPAR (connue sous l’appellation SORTBY dans les environnements anglophones). Contrairement à l’interface de tri classique qui réorganise physiquement les cellules de la plage source en modifiant leur disposition spatiale permanente, la fonction TRIERPAR procède par projection : elle lit une matrice d’origine et génère, dans une zone réceptrice distincte, un tableau dérivé intégralement réordonné, sans altérer d’un iota les données natives.
La syntaxe canonique de l’instruction TRIERPAR s’articule autour d’une combinatoire d’arguments vectoriels ordonnés par paires, formulée comme suit :
=TRIERPAR(tableau; par_tableau1; [ordre1]; [par_tableau2; ordre2]; ...)
Le premier argument, impératif, correspond à la matrice globale de données que l’on désire restituer. Les couples d’arguments subséquents matérialisent formellement la hiérarchie multicritère : par_tableau1 spécifie le premier vecteur dimensionnel servant de référence de tri, tandis que ordre1 en dicte la polarité (la constante scalaire 1 commandant un tri croissant, alors que la constante -1 impose un tri décroissant). L’analyste peut empiler consécutivement les couples par_tableau2; ordre2 et suivants pour modéliser des niveaux secondaires et tertiaires d’arbitrage en cascade.
7.2 Cas pratique et mise en œuvre matricielle
Pour illustrer la mise en œuvre pratique de cette architecture algorithmique, concevons un environnement d’analyse de la performance commerciale logé au sein de la plage cellulaire A2:D500. Ce tableau comprend respectivement les colonnes « Région » (A), « Vendeur » (B), « Date_Vente » (C) et « Montant » (D). Supposons que les exigences analytiques imposent de trier l’intégralité du jeu de données selon une triple exigence : en premier lieu par ordre alphabétique de « Région » (croissant), en deuxième lieu selon le « Montant » de transaction (décroissant afin d’isoler les signatures majeures), et enfin chronologiquement selon la « Date_Vente » (du plus ancien au plus récent) en cas de parité monétaire parfaite.
L’opérateur positionne alors son curseur d’insertion au sein de la cellule supérieure gauche de la zone de restitution dédiée (par exemple F2) et formule l’instruction matricielle suivante :
=TRIERPAR(A2:D500; A2:A500; 1; D2:D500; -1; C2:C500; 1)
Dès l’évaluation de la formule, le moteur matriciel calcule instantanément l’agencement optimal et déploie le résultat sous la forme d’une plage propagée (matérialisée par une frontière de propagation bleue caractéristique). Cette approche offre des bénéfices monumentaux pour l’ingénierie de tableaux de bord automatisés. Toute modification, insertion ou suppression d’un enregistrement au sein de la matrice source A2:D500 est répercutée en temps réel au sein de la projection ordonnée en F2, éliminant définitivement la corvée de réexécution manuelle des commandes de tri interactives du ruban.
De surcroît, la fonction TRIERPAR présente une composabilité algébrique exceptionnelle avec l’ensemble des fonctions matricielles contemporaines d’Excel. Elle peut être imbriquée sans friction au sein d’une fonction FILTRE pour n’ordonner qu’un sous-ensemble conditionnel d’observations, ou combinée avec la fonction UNIQUE pour produire des nomenclatures de synthèse hiérarchisées et purgées de tout doublon résiduel, matérialisant ainsi un pipeline de traitement de données hautement sophistiqué au sein d’une unique ligne de formule.
7.3 Gestion des contraintes techniques et erreurs courantes
L’exploitation de la fonction TRIERPAR est toutefois soumise à des contraintes dimensionnelles strictes dont la violation se solde par l’interruption des calculs et l’affichage d’erreurs logicielles explicites. La contrainte géométrique prépondérante réside dans l’obligation d’isométrie dimensionnelle : l’ensemble des vecteurs fournis en arguments de tri (par_tableau1, par_tableau2, etc.) doivent présenter une hauteur matricielle (nombre de lignes) rigoureusement identique à celle de la matrice source tableau. Si l’utilisateur tente d’évaluer =TRIERPAR(A2:D500; A2:A450; 1), Excel renverra invariablement l’erreur #VALEUR!, l’inadéquation de granularité interdisant tout alignement indiciel.
L’écueil ergonomique le plus fréquemment rencontré lors du déploiement des formules matricielles propagées concerne l’interférence spatiale, sanctionnée par l’erreur modale #PROPAGATION! (ou #SPILL! en environnement anglophone). Cette situation d’erreur survient dès lors qu’une cellule non vide, qu’elle contienne un caractère textuel invisible, une constante numérique, un espace ou même une formule concurrente, est détectée à l’intérieur de l’empreinte spatiale géométrique requise pour le déploiement intégral de la matrice résultante. La résolution impose de localiser et d’évacuer tout obstacle physique dans la trajectoire de déversement pour que la matrice puisse se matérialiser spontanément.
Enfin, il est impératif d’intégrer les barrières d’interopérabilité descendante afférentes à cette technologie. Les fonctions matricielles dynamiques comme TRIERPAR sont formellement absentes des déclinaisons historiques d’Excel antérieures aux versions 2021 et Microsoft 365 (telles qu’Excel 2019, 2016 ou 2013). Si un classeur incorporant de telles instructions est ouvert sur un poste de travail équipé d’une mouture héritée, la formule est enveloppée d’accolades orphelines ou convertie en code mort restituant l’erreur critique #NOM?, soulignant l’obligation d’un audit préalable du parc logiciel avant tout déploiement institutionnel de solutions matricielles.
8. Tri multicritère dans l’écosystème des Tableaux Structurés (ListObject)
8.1 Avantages intrinsèques de l’objet Tableau pour le tri
Dans l’ingénierie moderne des classeurs Excel, l’abandon des plages cellulaires standard au profit de l’objet formel Tableau Structuré — désigné techniquement sous l’identifiant ListObject dans le modèle d’objet de l’application — constitue la recommandation méthodologique la plus unanime. Un tableau structuré, instancié par la commande Ctrl+L ou Ctrl+T, confère au jeu de données un statut d’entité relationnelle fermée et autonome. Sur le plan opérationnel du tri multicritère, cette transition technique éradique de manière structurelle les risques les plus critiques de corruption de données.
Le bénéfice sécuritaire primordial réside dans la cohésion vectorielle indestructible garantie par l’objet Tableau. Au sein d’un ListObject, chaque ligne forme un tuple relationnel indissociable : il est rigoureusement impossible pour un utilisateur néophyte de trier accidentellement une colonne isolée en désolidarisant ses valeurs du reste des attributs satellites. L’action de trier, quel que soit le vecteur d’en-tête sollicité, engage systématiquement et intégralement l’ensemble des colonnes constitutives de l’entité tabulaire, préservant ainsi l’intégrité référentielle absolue de chaque enregistrement individuel.
De surcroît, le tableau structuré intègre un mécanisme d’autoréférencement dynamique extrêmement précieux pour la pérennité des flux d’analyse. Toute adjonction ultérieure de nouvelles observations, qu’elle s’effectue par saisie interactive sur la rangée terminale ou par déversement automatisé de flux externes, est instantanément incorporée dans le périmètre structurel de la table. La hiérarchie de tri multicritère précédemment configurée est alors immédiatement consciente de cette extension géométrique, permettant une maintenance évolutive sans obligation de redéfinir manuellement les limites spatiales de la plage.
8.2 Procédure opérationnelle sur un tableau structuré
L’exécution d’un tri multicritère au sein d’un Tableau Structuré bénéficie d’une ergonomie enrichie, matérialisée par l’intégration native de boutons de filtrage et de tri logés directement dans les cellules d’en-tête de chaque colonne. Si l’utilisateur clique sur le glyphe triangulaire d’une colonne donnée, il accède à un menu contextuel direct permettant d’initier un tri rapide. Toutefois, pour orchestrer une véritable hiérarchie multicritère sans friction, il est recommandé de mobiliser la boîte de dialogue standard « Tri personnalisé », accessible depuis le ruban alors que le curseur est placé n’importe où à l’intérieur de l’objet Tableau.
Au sein de cette interface, les colonnes sont identifiées de manière univoque par leurs références structurées (le nom explicite du champ textuel), sanctuarisées contre toute altération. Mais l’une des élégances fonctionnelles majeures de l’objet Tableau réside dans sa lisibilité sémiotique post-exécution : contrairement aux plages standard qui ne conservent aucun indice graphique pérenne de l’opération de tri une fois la boîte fermée, le Tableau Structuré imprime des indicateurs fléchés minuscules mais perceptibles au sein même des boutons d’en-tête des colonnes impliquées, attestant de l’existence d’un ordre actif.
Enfin, l’articulation entre le tri multicritère et l’usage des segments visuels (Slicers) décuple l’efficience de l’exploration analytique. Lorsqu’un utilisateur filtre dynamiquement un Tableau Structuré par l’entremise de segments tactiles pour n’isoler par exemple qu’une sous-division opérationnelle ou un trimestre budgétaire spécifique, l’ordonnancement multicritère sous-jacent (ex. criticité décroissante puis montant décroissant) demeure rigoureusement actif et préservé au sein de la sous-population visible. La hiérarchie logique subsiste à travers les opérations de partitionnement interactif, assurant une cohérence de présentation permanente.
9. Tri multicritère basé sur les attributs visuels et la mise en forme
9.1 Critères reposant sur la couleur de cellule et de police
Bien que l’analyse statistique rigoureuse privilégie toujours l’exploitation directe des valeurs atomiques sous-jacentes, les flux d’information managériaux recourent abondamment à la stylisation chromatique pour attirer l’attention décisionnelle sur des sous-populations critiques. Excel reconnaît cette dimension sémiotique en intégrant formellement les caractéristiques graphiques au sein de la chaîne de décision du module de tri multicritère. L’opérateur peut ainsi structurer un ordonnancement fondé sur la « Couleur de cellule » (remplissage d’arrière-plan) ou la « Couleur de police » (nuance typographique des caractères textuels).
Lors de la configuration d’un tel niveau, le deuxième champ de la boîte de dialogue est configuré sur l’attribut chromatique souhaité, ce qui entraîne l’apparition immédiate d’un sélecteur contextuel affichant l’intégralité du nuancier de couleurs effectivement détecté au sein de la colonne examinée. L’analyste choisit la teinte spécifique sur laquelle fonder la discrimination, puis spécifie son orientation spatiale : « En haut » (pour propulser les cellules porteuses de cette couleur au sommet de la hiérarchie visuelle) ou « En bas » (pour les reléguer au terme du tableau).
La puissance méthodologique de ce dispositif culmine dans sa fusion avec des critères quantitatifs ou qualitatifs conventionnels. Considérons un audit financier de comptes clients : le niveau de tri primaire peut être assigné à la « Couleur de cellule » pour regrouper prioritairement au sommet toutes les créances manuellement surlignées en rouge par les contrôleurs de gestion. Les niveaux secondaire et tertiaire peuvent quant à eux être assignés respectivement au « Montant impayé » (valeurs numériques, ordre décroissant) et au « Nom du débiteur » (valeurs textuelles, ordre de A à Z). Les enregistrements critiques sont ainsi immédiatement visibles, tout en demeurant parfaitement ordonnés intérieurement.
9.2 Intégration des jeux d’icônes de mise en forme conditionnelle
Au-delà des aplats de couleur bruts, les mécanismes modernes de mise en forme conditionnelle d’Excel génèrent fréquemment des jeux d’icônes sémantiques : feux tricolores signalétiques, flèches directionnelles de tendance ou drapeaux d’alerte, calibrés automatiquement en fonction de seuils statistiques percentiles ou de formules conditionnelles. L’interface de tri personnalisé prend pleinement en charge ces représentations graphiques sous la rubrique « Icône de mise en forme conditionnelle » au sein du sélecteur de nature d’évaluation.
L’élaboration d’un tri multicritère fondé sur ces icônes impose la mise en place d’un empilement de niveaux successifs pour reconstituer l’intégralité de l’ordre hiérarchique du jeu d’icônes. Puisque l’interface ne peut placer simultanément qu’un seul symbole au sommet par ligne de commande, l’analyste procèdera de manière incrémentale : le niveau 1 élèvera l’icône « Feu vert » au sommet ; un niveau secondaire dupliqué sur la même colonne élèvera ensuite l’icône « Feu orange » au sommet (se positionnant immédiatement sous les feux verts) ; les feux rouges se trouvant ipso facto relégués à la base par déduction logique.
Cette méthodologie déploie des bénéfices cognitifs considérables au sein des salles de contrôle opérationnelles, des comités de direction et du monitoring clinique d’essais thérapeutiques. Elle convertit un jeu de signaux faibles dispersés dans une vaste matrice en un tableau de bord dynamique stratifié par état de criticité, tout en permettant d’adosser un critère de départage analytique (tel que la durée d’exposition ou le volume de ressources mobilisées) pour sérier rigoureusement les observations partageant une même classe d’alerte iconographique.
10. Automatisation du tri multicritère via Power Query et VBA
10.1 Tri multicritère dans Power Query (Get & Transform)
Dans le cadre de flux de travail d’entreprise industrialisés et reproductibles, l’exécution manuelle d’un tri multicritère via l’interface graphique d’Excel présente des limites substantielles, notamment en termes de traçabilité d’audit et de vulnérabilité aux erreurs de manipulation. L’outil ETL intégré Power Query (Get & Transform) offre une alternative architecturale d’une robustesse exceptionnelle. Dans Power Query, toute opération de tri est formalisée sous forme d’une étape de transformation déclarative immuable, transcrite automatiquement dans le langage fonctionnel sous-jacent : le langage M.
L’application d’un tri séquentiel multicritère dans l’éditeur de Power Query s’exécute visuellement en sélectionnant successivement les colonnes cibles tout en maintenant la touche Ctrl enfoncée, ou en déclenchant les tris les uns après les autres selon un ordre chronologique inverse pour respecter la cascade logique. Sous le capot, l’interpréteur compile ces instructions en une instruction fonctionnelle hautement optimisée régie par la primitive Table.Sort. La syntaxe M générée adopte la structure canonique suivante :
= Table.Sort(Source, {{"Departement", Order.Ascending}, {"ChiffreAffaires", Order.Descending}, {"NomClient", Order.Ascending}})
L’avantage décisif de cette approche réside dans sa reproductibilité déterministe absolue. Lorsque les fichiers sources d’origine font l’objet d’une actualisation périodique (mise à jour quotidienne d’extractions de bases SQL, réception de nouveaux fichiers CSV), le tableau de sortie réplique instantanément le protocole de tri multicritère sans la moindre intervention humaine. Les données sont ingérées, assainies, sériées dans le respect scrupuleux de l’arborescence algorithmique codée en dur dans l’étape M, puis déversées dans la feuille de calcul avec une conformité structurelle constante.
10.2 Automatisation procédurale par macro VBA
Pour les scénarios d’automatisation nécessitant une interaction dynamique avec l’interface classique d’Excel, la programmation procédurale via Visual Basic for Applications (VBA) demeure un standard industriel incontournable. Depuis l’introduction d’Excel 2007, le modèle d’objet de l’application a profondément refondu son architecture de tri en instanciant l’objet spécialisé SortFields, rattaché à la collection Worksheet.Sort. Cette approche moderne remplace avantageusement la méthode obsolète Range.Sort en offrant un contrôle programmatique granulaire sur chaque palier de la hiérarchie.
Un script VBA professionnel dédié à l’exécution d’un tri multicritère récurrent doit impérativement adopter une structure défensive rigoureuse. La première action procédurale consiste obligatoirement à purger la collection de critères préexistante via la commande SortFields.Clear, sous peine de voir de nouvelles règles de tri s’agréger de façon anarchique aux anciens paramètres mémorisés par la feuille lors de sessions antérieures. Ensuite, les différents critères sont empilés séquentiellement à l’aide de la méthode SortFields.Add2, en précisant pour chaque ligne la clé vectorielle, le type d’attribut évalué et l’orientation ordinale.
L’architecture de script ci-après explicite l’implémentation standard d’un tri à triple niveau sur une table positionnée sur la feuille active :
L’analyste configure la plage de travail via une variable objet, purge les filtres résiduels avec ActiveSheet.Sort.SortFields.Clear, puis empile consécutivement les clés de tri. Le premier critère cible le champ de tête en spécifiant xlSortOnValues et xlAscending. Le deuxième niveau s’articule sur la colonne monétaire sous la directive xlDescending, tandis que le troisième échelon arbitre les équivalences par un retour alphabétique croissant. La procédure s’achève par la configuration des propriétés de l’objet With ActiveSheet.Sort, où l’on spécifie la plage d’action exhaustive via .SetRange, la présence effective d’en-têtes avec .Header = xlYes, l’absence de sensibilité à la casse par .MatchCase = False, et l’orientation verticale conventionnelle via .Orientation = xlTopToBottom, avant de déclencher la réorganisation physique irréversible au moyen de l’instruction finale .Apply.
11. Diagnostics, erreurs fréquentes et pièges cognitifs
11.1 Anomalies de formatage et typage masqué
Les dysfonctionnements les plus déconcertants observés lors de l’exécution d’un tri multicritère découlent presque invariablement d’anomalies cryptiques logées au cœur de la typologie des cellules. L’anomalie la plus pernicieuse réside dans la contamination des chaînes de caractères par des espaces résiduels, et tout particulièrement par l’espace insécable (code ASCII 160 ou entité Unicode U+00A0), fréquemment injecté lors de l’importation de données financières issues du web ou de progiciels de gestion intégrée (ERP). Cet espace invisible positionné au début d’une cellule contraint Excel à classer le terme bien avant ses homologues réguliers commençant par le caractère « A », créant un sentiment d’incohérence algorithmique totale.
Pour assainir ces impuretés lexicographiques, l’application isolée de la fonction native SUPPRESPACE s’avère souvent inopérante face au code 160. L’analyste vigilant utilisera conjointement des formules d’assainissement substitutives composées, combinant la fonction SUBSTITUE(cellule; CAR(160); "") avec SUPPRESPACE, pour évacuer l’intégralité des parasites typographiques avant d’engager le processus de tri multicritère.
Une problématique symétrique concerne le typage masqué des variables numériques et temporelles. Des nombres stockés sous forme de texte se dérobent aux lois de l’arithmétique ordinale pour adopter un comportement alphabétique erratique. Pour pallier cette anomalie structurelle sans reconstruire manuellement le classeur, l’outil « Convertir » (accessible au sein de l’onglet « Données ») constitue l’arme de remédiation par excellence. En validant l’assistant de conversion sans spécifier de délimiteur particulier, Excel force une réévaluation typologique de l’ensemble de la colonne, convertissant instantanément les pseudo-textes en valeurs scalaires numériques ou en numéros de série de dates reconnus par le comparateur interne.
11.2 Traitement des valeurs manquantes et cellules vides
L’administration des valeurs manquantes représente une divergence fondamentale entre la logique mathématique abstraite et l’implémentation algorithmique propriétaire de Microsoft Excel. Dans un modèle théorique d’analyse de données, l’analyste peut souhaiter positionner les données absentes (valeurs Null ou NaN) soit au point d’origine, soit au terme de la distribution, selon la nature conservatrice ou pénalisante de son hypothèse d’étude. Dans Excel, le comportement du moteur de tri est immuable et non paramétrable : les cellules vides sont systématiquement reléguées à l’extrémité finale de la plage triée.
Cette relégation s’applique de manière invariable, que l’ordre de tri sélectionné soit croissant ou décroissant. Si cette convention permet d’épurer visuellement le tableau en regroupant les données complètes au sommet, elle engendre des risques méthodologiques notables dans les tris multicritères complexes. Une observation comportant une cellule vide sur le critère primaire se trouvera immédiatement précipitée au fond du classeur, privant ses attributs secondaires (qui auraient pu présenter une criticité exceptionnelle) de toute visibilité et de tout pouvoir d’arbitrage.
Pour neutraliser ce comportement déterministe lorsque la démarche scientifique ou le protocole de gestion l’exige, l’opérateur doit recourir à des techniques d’imputation préalable ou de codage explicite des absences. L’utilisation de l’outil « Rechercher et sélectionner » > « Atteindre les constantes… » permet d’isoler les cellules vides d’une colonne vectorielle pour y injecter une valeur sentinelle standardisée (par exemple -9999 pour les séries numériques quantitatives, ou la chaîne [Non Renseigné] pour les attributs qualitatifs). Cette substitution garantit que les observations incomplètes seront triées selon une logique parfaitement maîtrisée et contrôlée par l’analyste.
11.3 Biais d’analyse induits par un tri erroné
Les conséquences d’une mauvaise orchestration du tri multicritère dépassent largement le cadre du simple désagrément cosmétique : elles constituent une source majeure de biais analytiques capables de vicier des rapports décisionnels stratégiques. Le piège le plus insidieux réside dans la confusion cognitive entre corrélation apparente et artefact de consécution spatiale. Lorsqu’un tableau est ordonné selon deux variables consécutives, la proximité visuelle immédiate d’enregistrements présentant des caractéristiques proches peut suggérer à l’esprit humain un lien de causalité ou une interdépendance fonctionnelle qui n’est en réalité que le pur produit de l’algorithme de classement arbitraire.
Un autre biais redoutable est le biais d’ancrage, amplifié par la prédominance visuelle accordée au niveau primaire de tri. L’analyste qui parcourt un rapport tabulaire accorde une importance disproportionnée aux cinquante premières lignes affichées au sommet du document. Si le tri primaire a été adossé à une variable secondaire ou mal isolée, l’évaluation globale de la santé de l’échantillon ou de la rentabilité de l’entreprise s’en trouvera faussée, les segments les moins performants pouvant être occultés par simple refoulement vers le bas de page.
Enfin, la rupture d’intégrité référentielle par omission partielle de colonnes lors de la sélection manuelle constitue l’accident analytique par excellence. Si les colonnes descriptives de libellés sont triées indépendamment des clés d’identifiants uniques (IDs primaires), la base de données subit une mutation silencieuse catastrophique : l’historique d’un patient se trouve attribué à un autre, les comptes bancaires se mélangent aux soldes de tiers, anéantissant toute validité statistique. La présence et la vérification continue d’une clé primaire invariable constituent le seul rempart absolu contre ce risque de corruption totale.
12. Synthèse méthodologique et bonnes pratiques pour l’analyste
12.1 Protocole de contrôle qualité post-tri
Afin de certifier l’exactitude de ses livrables tabulaires, tout professionnel de l’analyse de données doit instaurer un protocole d’assurance qualité systématique et standardisé, déployé immédiatement après l’exécution de tout tri multicritère. Ce rituel de contrôle repose en premier lieu sur la technique de la « ligne témoin ». Avant d’engager une réorganisation matricielle d’envergure, l’analyste mémorise ou documente précisément les attributs complets d’une ligne d’enregistrement spécifique (idéalement caractérisée par des valeurs singulières, comme un identifiant remarquable, un montant atypique et une date précise). Post-tri, l’analyste localise cet enregistrement et s’assure de l’alignement horizontal parfait de ses composants vectoriels pour valider la non-désynchronisation des colonnes.
La documentation formelle de la logique de sériation constitue le second pilier du contrôle qualité. Un tableau de bord ou une annexe méthodologique ne devrait jamais exposer un jeu de données trié sans expliciter, sous forme de note de bas de page ou dans le dictionnaire de données associé, la règle de cascade appliquée (ex. : « Données sériées prioritairement par Secteur Géographique (A-Z), secondairement par Marge Nette Décroissante »). Cette transparence épistémologique garantit la parfaite reproductibilité des conclusions par des auditeurs tiers.
Enfin, la règle d’or absolue de la gouvernance des données sous tableur réside dans la sanctuarisation de la réversibilité. Avant toute opération de tri destructif sur une plage non structurée, il est impératif d’insérer à l’extrême gauche de la matrice une colonne d’indexation continue, intitulée conventionnellement Ordre_Original ou Index_Initial, incrémentée de 1 à N sur l’ensemble des tuples. Cet index matériel constitue l’empreinte spatiale originelle de la base de données. Quelle que soit la complexité des tris multicritères ultérieurement appliqués, il suffira d’ordonner le tableau selon cet index séquentiel pour restaurer instantanément l’état primitif intègre du jeu de données.
12.2 Arbre de décision pour le choix de la méthode optimale
Face à la pluralité des mécanismes d’ordonnancement offerts par l’écosystème Excel contemporain, l’analyste gagne à formaliser ses choix techniques au moyen d’un arbre de décision standardisé, articulé autour de trois métriques discriminantes : la volumétrie des données, la fréquence de rafraîchissement requise et le degré de technicité de l’utilisateur final du classeur.
Pour les analyses exploratoires ad hoc, portant sur des volumes modérés (moins de 50 000 lignes) et ne nécessitant pas de mises à jour récurrentes, la boîte de dialogue standard « Tri personnalisé » appliquée sur une plage assainie ou sur un Tableau Structuré demeure la méthode la plus directe, la plus universellement compréhensible et la plus rapide à exécuter. Au sein de cet usage direct, le Tableau Structuré (ListObject) doit être systématiquement préféré à la plage ordinaire pour des impératifs d’intégrité référentielle.
Lorsque le contexte opérationnel impose la construction de tableaux de bord interactifs, d’interfaces de consultation dynamiques ou de restitutions de données en direct où la matrice source ne doit sous aucun prétexte être modifiée manuellement, l’usage des formules matricielles réactives centrées sur la fonction TRIERPAR s’impose sans rival. Cette approche offre une flexibilité de mise en page remarquable et assure un rafraîchissement temps réel sans maintenance manuelle, sous réserve que l’environnement logiciel du parc utilisateur supporte les fonctions dynamiques d’Excel moderne.
Enfin, dès lors que l’analyste fait face à des flux de données industriels à volumétrie massive (dépassant plusieurs centaines de milliers d’enregistrements), provenant d’extractions disparates et nécessitant une récurrence programmée (hebdomadaire, journalière), l’automatisation via Power Query constitue la décision architecturale de référence. La transformation est isolée du modèle d’affichage, documentée dans le moteur M et exécutée avant l’injection des données dans la grille de calcul. Le recours aux macros VBA sera quant à lui réservé aux scénarios d’interactivité applicative complexe ou à l’intégration au sein de processus existants non compatibles avec les outils décisionnels modernes du tableur.
Références
Alexander, M., & Kusleika, R. (2022). Excel 2021 All-in-One For Dummies. John Wiley & Sons.
Carlberg, C. (2019). Statistical Analysis: Microsoft Excel 2019. Pearson Education.
Jelen, B., & Syrstad, T. (2022). Microsoft Excel 2019 VBA and Macros. Microsoft Press.
Microsoft Support. (s. d.). Trier des données dans une plage ou un tableau. Microsoft Corporation. Consulté le 12 mai 2024, à l’adresse https://support.microsoft.com/fr-fr/office/trier-des-donn%C3%A9es-dans-une-plage-ou-un-tableau-62d0b2cf-2a60-49b8-b803-4e0fa30a70e6
Microsoft Support. (s. d.). Fonction TRIERPAR. Microsoft Corporation. Consulté le 12 mai 2024, à l’adresse https://support.microsoft.com/fr-fr/office/fonction-trierpar-35045146-e8da-46e2-9da2-97f300f66313
Sweller, J. (2011). Cognitive load theory. Dans J. P. Mestre & B. H. Ross (Éds.), The Psychology of Learning and Motivation: Cognition in Education (Vol. 55, p. 37–76). Academic Press. https://doi.org/10.1016/B978-0-12-387691-1.00002-8
The Unicode Consortium. (2023). The Unicode Standard, Version 15.1.0. The Unicode Consortium. https://www.unicode.org/versions/Unicode15.1.0/
Winston, W. (2021). Microsoft Excel Data Analysis and Business Modeling (Office 2021 and Microsoft 365) (7e éd.). Microsoft Press.