
La modélisation statistique en sciences du comportement repose traditionnellement sur des postulats distributionnels stricts dont la méconnaissance compromet directement la validité interne des inférences expérimentales. Dans le cadre de la psychologie quantitative, des neurosciences cognitives et de la psychiatrie computationnelle, les métriques recueillies — qu’il s’agisse de chronométries de latence, de décomptes d’erreurs d’inhibition ou d’échelles composites de détresse psychologique — dévient systématiquement de la symétrie idéale postulée par le modèle linéaire général. Confrontés à des distributions asymétriques, étirées ou hétéroscédastiques, les chercheurs se heurtent aux limites intrinsèques des tests paramétriques classiques, tels que l’analyse de variance ou les régressions linéaires par moindres carrés ordinaires, dont la puissance statistique s’effondre face aux violations structurelles des données empiriques.
Face à cette réalité méthodologique, la transformation non linéaire des variables constitue une approche mathématique établie, visant à réaligner les observations continues sur les exigences de l’espace gaussien. Loin d’être un artifice cosmétique ou une manipulation opportuniste, le recours aux opérateurs de compression scalaire — notamment les transformations logarithmiques, par racine carrée et par racine cubique — obéit à des propriétés analytiques précises régies par la famille des transformations de puissances de Tukey. Chaque fonction possède une dynamique différentielle spécifique, un domaine de définition propre et une affinité théorique étroite avec la nature du processus cognitif ou physiologique sous-jacent à la mesure.
L’avènement de l’écosystème de programmation scientifique Python, articulé autour des bibliothèques NumPy, Pandas et SciPy, offre désormais un environnement computationnel idéal pour diagnostiquer rigoureusement la non-normalité, appliquer des transformations vectorisées adaptées et contrôler leurs effets métrologiques. Cet article propose un examen exhaustif et didactique des fondements théoriques, des formulations mathématiques et des protocoles d’implémentation logicielle des transformations univariées en Python, complété par une réflexion épistémologique sur l’interprétabilité des métriques rééchelonnées et les écueils analytiques inhérents aux pratiques contemporaines de recherche.
1. Fondements théoriques de la distribution normale en recherche psychologique
1.1 Le postulat de normalité dans l’analyse inférentielle paramétrique
L’analyse inférentielle paramétrique, pierre angulaire de la statistique appliquée à la psychologie expérimentale, s’appuie sur le formalisme mathématique hérité des travaux de Gauss et de Laplace. Des procédures fondamentales telles que le test t de Student et l’analyse de variance (ANOVA) reposent sur l’hypothèse explicite que la variable dépendante — ou, plus rigoureusement, la distribution des résidus d’erreur du modèle linéaire — suit une distribution normale au sein de chaque population ou condition expérimentale. Mathématiquement, ce postulat garantit que la statistique de décision suive rigoureusement la distribution théorique tabulée (loi t ou loi F de Fisher-Snedecor), permettant ainsi d’attribuer une probabilité d’erreur de première espèce (le risque alpha) parfaitement contrôlée.
Lorsque cette hypothèse de normalité est violée de manière substantielle, la mécanique inférentielle se déséquilibre. La conséquence immédiate sur l’erreur de type I réside dans une instabilité du taux de faux positifs empiriques, qui peut soit s’envoler au-delà du seuil nominal (rejet abusif de l’hypothèse nulle), soit se comprimer artificiellement, entraînant un conservatisme excessif. Plus dommageable encore pour l’avancement empirique, la puissance statistique (1 – bêta) subit une érosion sévère : l’asymétrie ou la lourdeur des queues de distribution gonfle artificiellement la variance d’échantillonnage, masquant des tailles d’effet réelles et conduisant à des erreurs de type II répétées. Ces distorsions sont omniprésentes dans l’étude des variables psychométriques telles que les temps de réaction, les inventaires d’anxiété clinique ou les latences d’orientation attentionnelle, où les individus manifestent des variabilités fortement idiosyncrasiques.
Une confusion méthodologique fréquente consiste à invoquer le théorème central limite comme une panacée universelle garantissant la validité des tests paramétriques dès lors que la taille d’échantillon atteint un seuil conventionnel, souvent fixé à trente participants par groupe. Or, il convient de distinguer avec rigueur la robustesse asymptotique des estimateurs de moyenne et la sensibilité aiguë des tests statistiques appliqués à des échantillons expérimentaux restreints ou modérés, typiques des protocoles en neuro-imagerie ou en psychophysique (souvent compris entre quinze et quarante sujets). Pour ces tailles d’échantillon, les déviations de forme distributionnelle ne sont nullement neutralisées par la convergence asymptotique, et la distorsion des statistiques F ou t demeure prégnante, justifiant pleinement une intervention corrective sur les échelles de mesure.
1.2 Origine des asymétries distributionnelles en sciences comportementales
L’émergence systématique de distributions asymétriques en psychologie n’est pas un dysfonctionnement de la collecte, mais l’expression directe de la nature des phénomènes cognitifs et des instruments métrologiques employés. L’une des sources prépondérantes de non-normalité découle des effets de borne inhérents aux outils d’évaluation : les effets de plancher et de plafond. Dans un questionnaire clinique mesurant la dépression ou l’idéation suicidaire administré à une cohorte non clinique, la vaste majorité des répondants sélectionne la modalité minimale, générant une accumulation massive de zéros ou de scores planchers. Inversement, une tâche cognitive trop accessible produit une saturation de scores maximaux (effet de plafond), déformant irrémédiablement la distribution vers la gauche.
Sur le plan neuro-computationnel, les processus sous-tendant les dynamiques comportementales sont intrinsèquement multiplicatifs plutôt qu’additifs. La vitesse de traitement de l’information, par exemple, dépend d’une succession de relais synaptiques en chaîne, d’intégrations dendritiques et de cascades de décisions visuo-motrices. En vertu d’un corollaire du théorème central limite appliqué aux variables log-normales, le produit de multiples variables aléatoires positives indépendantes converge vers une distribution fortement étirée vers les valeurs positives (skewness droite). Ainsi, les temps de réaction manifestent structurellement une limite physiologique infranchissable (environ cent millisecondes chez l’humain sain), suivie d’un pic de réponses modales, puis d’une longue traîne de réponses tardives correspondant à des ruptures attentionnelles ou à des hésitations délibérées.
Cette asymétrie est encore exacerbée par la présence inévitable de valeurs extrêmes dans les cohortes cliniques ou atypiques. Contrairement aux artefacts techniques de mesure qui peuvent être éliminés, ces observations reflètent fidèlement la variabilité écologique de la population étudiée. Il s’avère dès lors indispensable d’établir une distinction formelle entre l’asymétrie positive, caractérisée par une queue de distribution s’étirant vers les valeurs supérieures et une moyenne systématiquement supérieure à la médiane, et l’asymétrie négative, beaucoup plus rare mais observable dans les mesures de performance motrice hautement entraînée, où les observations s’empilent au sommet de l’échelle avec une queue descendante vers les faibles performances.
1.3 Objectifs mathématiques et métrologiques de la transformation de données
Face à la dissymétrie des observations, l’application d’une fonction mathématique univariée vise en premier lieu le rapprochement géométrique de la distribution empirique vers le profil de la loi normale standard. En appliquant une fonction non linéaire monotone continue, on opère une modification différentielle de l’espacement spatial entre les observations : les zones denses sont étirées tandis que les régions clairsemées situées dans les queues sont comprimées. Ce redéploiement permet d’éliminer l’asymétrie unilatérale, d’ajuster l’aplatissement (kurtosis) et d’autoriser l’utilisation sécurisée de la moyenne arithmétique et de l’écart-type comme descripteurs d’échantillonnage suffisants.
Le second objectif fondamental, souvent plus déterminant pour la validité de l’ANOVA que la normalité stricte, réside dans l’homogénéisation des variances résiduelles entre conditions expérimentales, désignée formellement sous le terme de stabilisation de l’hétéroscédasticité. Dans les systèmes biologiques et comportementaux, il existe fréquemment une relation fonctionnelle directe entre le niveau de la moyenne d’un groupe et son étendue de dispersion (l’écart-type augmentant proportionnellement à la magnitude de la réponse). En appliquant une transformation appropriée, cette covariation systématique moyenne-variance est neutralisée, restaurant ainsi l’homoscédasticité requise par les modèles linéaires additifs.
Enfin, la transformation poursuit deux visées métrologiques fondamentales : la linéarisation des relations fonctionnelles et le respect scrupuleux de l’échelle d’origine. De nombreux processus cognitifs exhibent des courbes dose-réponse sigmoïdales ou des décélérations exponentielles ; le rééchelonnement transforme ces trajectoires complexes en relations affines faciles à paramétrer par régression. Sur le plan de la théorie de la mesure de Stevens, il est crucial de souligner qu’une transformation strictement monotone conserve intacte la hiérarchie ordinale des sujets : si le participant A présentait une latence cognitive supérieure au participant B sur l’échelle brute, cette relation d’ordre strict est préservée sans aucune ambiguïté après transformation.
2. Diagnostic distributionnel et détection de la non-normalité avec Python
2.1 Mesures quantitatives de la forme distributionnelle
L’évaluation rigoureuse d’une distribution expérimentale débute par l’extraction des moments statistiques d’ordre supérieur, lesquels synthétisent quantitativement l’asymétrie et la morphologie des queues. Le coefficient d’asymétrie (skewness), correspondant au troisième moment centré normalisé, s’exprime mathématiquement comme l’espérance du cube de l’écart à la moyenne divisée par le cube de l’écart-type. Dans une distribution parfaitement symétrique, cette valeur s’annule strictement. En pratique psychométrique, une valeur comprise entre -0,5 et +0,5 dénote une symétrie relative acceptable pour les analyses standards, tandis qu’une valeur excédant +1,0 signale une asymétrie prononcée imposant un réexamen métrologique.
Le quatrième moment centré, l’aplatissement ou kurtosis, quantifie pour sa part la propension de la distribution à concentrer sa masse de probabilité dans les queues extrêmes par rapport à son centre. Selon la convention de Fisher (kurtosis excessif), la valeur de référence de la loi normale est fixée à zéro. Une valeur positive indique un profil leptokurtique, caractérisé par un sommet pointu et des queues épaisses chargées en valeurs aberrantes potentielles, tandis qu’un coefficient négatif traduit une allure platykurtique, plus diffuse et aplatie que la courbe de Gauss.
Dans l’écosystème Python, ces deux métriques s’obtiennent directement au moyen des fonctions spécialisées du module statistique de SciPy, à savoir scipy.stats.skew et scipy.stats.kurtosis. Il convient toutefois de paramétrer scrupuleusement l’argument de biais d’échantillonnage (bias=False) afin d’obtenir des estimateurs non biaisés, particulièrement cruciaux lors du traitement de petits groupes expérimentaux. Une erreur méthodologique critique consisterait à appliquer des seuils couperets dogmatiques : un skewness de 1,1 ne doit pas entraîner une décision binaire mécanique sans considérer conjointement la taille d’échantillon, le domaine de mesure et la robustesse du modèle statistique envisagé.
2.2 Tests d’hypothèse formels pour la normalité
Au-delà de la description morphologique, l’évaluation inférentielle formalise le diagnostic au travers de tests d’adéquation statistiques dédiés. Pour les échantillons de taille modérée ou restreinte (N inférieur à cinquante), la procédure de référence demeure indiscutablement le test de Shapiro-Wilk, implémenté dans l’écosystème via scipy.stats.shapiro. Ce test évalue la corrélation linéaire entre les quantiles ordonnés de l’échantillon empirique et les scores normaux attendus théoriques. Son pouvoir de détection des déviations tant au niveau de l’asymétrie que de l’aplatissement en fait le standard méthodologique dominant dans la littérature expérimentale.
Pour des cohortes plus substantielles, le test omnidirectionnel de D’Agostino-Pearson, accessible via scipy.stats.normaltest, combine les transformations des coefficients de skewness et de kurtosis en une statistique globale distribuée selon une loi du Chi-deux à deux degrés de liberté. Ce test présente l’avantage analytique de dissocier les composantes de non-normalité, facilitant ainsi l’identification de la source exacte du rejet du modèle gaussien.
Toutefois, l’usage de ces tests formels confronte le chercheur à un paradoxe méthodologique classique lié à la dépendance de la puissance statistique vis-à-vis de N. Sur de volumineuses cohortes (N excédant plusieurs centaines d’observations), le test de Shapiro-Wilk devient excessivement puissant et rejette systématiquement l’hypothèse nulle pour des déviations infimes, mathématiquement tangibles mais d’une innocuité totale pour la validité du modèle linéaire. Inversement, sur de micro-échantillons (N inférieur à vingt), le manque structurel de puissance peut masquer des asymétries dramatiques. Dès lors, la règle de l’art impose de croiser impérativement la significativité statistique avec l’amplitude des descripteurs de forme et l’inspection descriptive.
2.3 Exploration visuelle haute résolution via Matplotlib et Seaborn
L’appréciation visuelle constitue le rempart indispensable contre les pièges interprétatifs des métriques purement numériques. L’outil premier de cette approche est l’histogramme empirique, enrichi d’une estimation de densité par noyau non paramétrique (KDE) construite au moyen de la bibliothèque Seaborn via sa fonction seaborn.histplot. L’adjonction de cette courbe continue lissée permet de s’abstraire des effets de discrétisation liés au choix arbitraire de la largeur des intervalles (bins) et de révéler immédiatement la présence d’une asymétrie unilatérale ou d’un profil bimodal sous-jacent.
Le second pilier de la sémiologie graphique est le diagramme quantile-quantile (Q-Q plot), obtenu en associant Matplotlib et la fonction scipy.stats.probplot. En projetant les quantiles de l’échantillon empirique contre les quantiles théoriques d’une distribution normale standard, le Q-Q plot traduit toute non-normalité en une déviation géométrique par rapport à la diagonale idéale d’identité. Une courbure convexe systématique dénonce une asymétrie positive nette, une courbure concave une asymétrie négative, tandis qu’une configuration en « S » signale des queues de distribution leptokurtiques ou platykurtiques.
Enfin, la boîte à moustaches (boxplot), paramétrée via seaborn.boxplot, offre une visualisation condensée de la médiane, de l’écart interquartile et de l’étalement relatif des barres d’erreur inférieure et supérieure, mettant instantanément en exergue les valeurs atypiques unilatérales. Pour standardiser cette démarche diagnostique dans un script Python reproductible, il est vivement recommandé d’agencer un canevas graphique unifié à plusieurs sous-panneaux articulé par la commande matplotlib.pyplot.subplots(1, 3, figsize=(18, 5)), intégrant simultanément l’histogramme avec KDE, le diagramme quantile-quantile et la boîte à moustaches descriptive.
3. Cadre mathématique des transformations non linéaires univariées
3.1 La famille des transformations de puissance selon Tukey
L’approche formelle de la normalisation continue des distributions asymétriques trouve son cadre théorique le plus élégant dans la famille des transformations de puissances introduite par le statisticien John Tukey. Cette formalisation postule qu’une série d’observations positives peut être rééchelonnée de manière continue en élevant la variable originale à une puissance déterminée notée lambda. Mathématiquement, l’opérateur s’énonce comme la variable x élevée à la puissance lambda lorsque ce paramètre est strictement différent de zéro, et correspond à la transformation logarithmique népérienne lorsque lambda s’annule formellement.
L’essence de cette échelle repose sur le principe mécanique de compression ou d’expansion scalaire progressive. Lorsque l’exposant lambda est inférieur à l’unité (valeurs fractionnaires telles que 1/2 ou 1/3), la fonction applique un effet de contraction d’échelle non linéaire dont l’intensité augmente à mesure que la valeur de x s’élève. Les intervalles séparant des scores élevés sont comprimés, tandis que les intervalles séparant des scores faibles sont relativement élargis, opérant ainsi un rapprochement spatial des quantiles supérieurs vers le barycentre de la distribution.
Ce comportement géométrique compense l’étirement unilatéral des distributions à asymétrie droite. Il est capital de remarquer la continuité analytique remarquable de cette famille : à mesure que la puissance fractionnaire décroît et s’approche de zéro par valeurs positives, l’opérateur scalaire converge vers la fonction logarithmique naturelle. La transformation logarithmique ne constitue donc pas une singularité computationnelle isolée, mais l’aboutissement continu d’une compression géométrique de plus en plus drastique au sein de l’échelle unifiée de Tukey.
3.2 Comparaison fonctionnelle entre transformations logarithmiques, racines carrées et cubiques
Dans l’éventail des solutions offertes par les puissances de Tukey, trois transformations dominent la pratique scientifique en raison de leurs propriétés mathématiques remarquables : la transformation logarithmique (lambda = 0), la racine cubique (lambda = 1/3) et la racine carrée (lambda = 1/2). Elles forment une hiérarchie ordonnée de sévérité de compression, permettant d’adapter la force corrective à l’intensité de l’asymétrie constatée empiriquement.
Cette gradation s’appréhende intuitivement par l’examen de leurs dérivées premières respectives, qui dictent le taux de variation local de l’échelle transformée. La dérivée de la racine carrée décroît proportionnellement à l’inverse du double de la racine de la variable, conférant un gradient de compression modéré. La racine cubique présente une dérivée s’atténuant encore plus vite avec l’augmentation de la grandeur mesurée. Enfin, la dérivée du logarithme naturel, égale à l’inverse direct de la variable (1/x), présente la décroissance la plus abrupte lorsque x tend vers l’infini, conférant au logarithme un pouvoir de neutralisation des queues lourdes nettement supérieur aux puissances fractionnaires.
Sur le plan des critères de sélection analytiques, le chercheur basera son arbitrage sur l’ampleur numérique du coefficient d’asymétrie initial. Pour une distribution affectée d’une asymétrie positive bénigne à modérée (skewness compris typiquement entre +0,5 et +1,2), la racine carrée s’avère parfaitement calibrée, prévenant le risque de sur-correction. Si l’asymétrie est plus marquée ou si les queues s’étirent de façon prononcée (skewness oscillant entre +1,0 et +2,0), la racine cubique offre un compromis robuste. Enfin, face à des distributions exponentielles ou log-normales sévèrement asymétriques (skewness supérieur à +2,0), seul le logarithme déploie l’énergie de compression suffisante pour rétablir une symétrie acceptable.
3.3 Contraintes structurelles du domaine de définition mathématique
L’application d’opérateurs non linéaires se heurte immédiatement aux frontières de leurs domaines de définition dans l’ensemble des nombres réels. La contrainte la plus rigide pèse sur l’opérateur logarithmique classique, strictement indéfini pour les valeurs négatives et pour la valeur nulle. Dans un environnement numérique comme Python, évaluer le logarithme naturel de zéro renvoie une indétermination mathématique matérialisée par une valeur infinie négative (-inf), tandis que les valeurs négatives déclenchent une valeur non numérique (NaN) accompagnée d’avertissements de calcul critique.
La transformation par la racine carrée présente un domaine de définition légèrement plus étendu : elle admet le zéro dans l’ensemble des réels positifs, mais demeure rigoureusement inapplicable aux observations négatives sans recourir au corps des nombres complexes, dépourvus de sens physique direct en psychométrie. La racine cubique, en revanche, jouit d’une propriété algébrique singulière et majeure : en tant que puissance impaire, elle est continue et parfaitement définie sur la totalité de l’axe des réels, de l’infini négatif à l’infini positif, préservant sans artifice les mesures présentant des valeurs négatives ou nulles.
Pour contourner les impossibilités computationnelles du logarithme et de la racine carrée sur des jeux de données contenant des zéros ou de faibles valeurs négatives, la littérature propose classiquement l’adjonction d’une constante de décalage arbitraire, formalisée par la transformation de la variable (x + c). Toutefois, cette translation d’échelle altère la courbure différentielle de l’opérateur non linéaire. Le choix de la constante c modifie la sensibilité relative de la fonction au voisinage immédiat de l’origine et peut induire des artefacts de distribution non négligeables, imposant une justification mathématique explicite.
4. La transformation logarithmique en théorie : Principes psychométriques et propriétés
4.1 Fondements de la loi psychophysique de Weber-Fechner
L’utilisation de la transformation logarithmique en sciences cognitives s’enracine profondément dans l’histoire même de la psychologie scientifique à travers la formulation de la loi de Weber-Fechner. À la fin du XIXe siècle, Ernst Weber et Gustav Fechner ont démontré que l’intensité de la sensation subjective perçue n’augmente pas de manière linéaire avec l’intensité physique du stimulus, mais proportionnellement au logarithme de cette grandeur. Pour qu’une sensation croisse selon une progression arithmétique, la stimulation sensorielle sous-jacente doit progresser selon une suite géométrique multiplicative.
Cette architecture logarithmique régit un spectre étendu de processus neurophysiologiques, de la perception de l’intensité lumineuse et auditive jusqu’à l’estimation subjective des durées temporelles et la numérosité approximative chez l’animal et l’humain. Lorsqu’un protocole expérimental mesure des chronométries comportementales (latences motrices, temps d’accès lexical, temps d’identification perceptive), les distributions observées reflètent fidèlement cette métrique interne multiplicative. De ce fait, modéliser ces données par une loi log-normale n’est pas une simple commodité statistique a posteriori, mais une reconnaissance de la structure fonctionnelle de l’appareil cognitif.
La transformation logarithmique convertit ainsi les modèles multiplicatifs d’erreurs en modèles purement additifs, pleinement compatibles avec le formalisme des moindres carrés ordinaires. La variabilité d’une mesure comportementale s’exprime naturellement en termes proportionnels (une fluctuation de 10 % autour de la performance modale) plutôt qu’en millisecondes absolues. L’application du logarithme stabilise cette variabilité proportionnelle, convertissant un écart multiplicatif invariant en un écart additif constant et garantissant une adéquation remarquable avec les exigences de l’inférence gaussienne.
4.2 Comportement mathématique face aux asymétries sévères
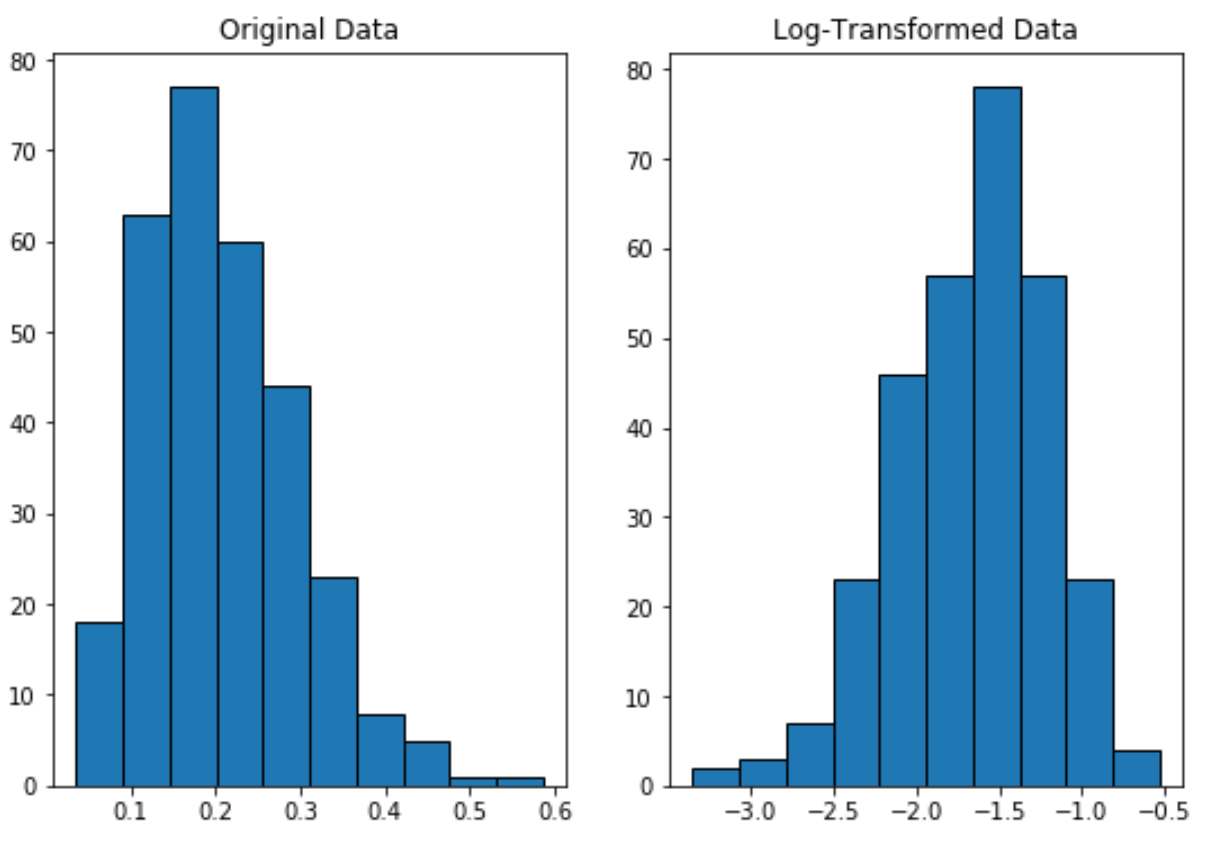
Face à des séries quantitatives caractérisées par un étalement exponentiel de l’asymétrie positive, le logarithme naturel déploie une efficacité de régularisation qu’aucun polynôme classique ne peut égaler. Sa courbure concave agit comme un compresseur dynamique à gain décroissant : les valeurs extrêmes situées dans le dernier décile, qui pèsent démesurément sur le calcul de la moyenne arithmétique et menacent de faire basculer l’inférence dans l’erreur, sont ramenées à une distance euclidienne modérée du centre de gravité des données.
Cet amortissement s’avère particulièrement précieux dans le traitement éthique et robuste des observations atypiques. Dans de nombreux paradigmes d’attention visuelle ou de prise de décision sous stress, certains participants manifestent occasionnellement des latences extrêmement longues, dues à des micro-sommeils ou des décrochages attentionnels passagers. Supprimer arbitrairement ces données introduit un biais de sélection inacceptable ; la transformation logarithmique permet au contraire de conserver l’intégralité de la cohorte expérimentale en atténuant la force de levier de ces points extrêmes sans mutiler le jeu de données.
Sur le plan computationnel, les chercheurs s’interrogent fréquemment sur le choix de la base du logarithme : népérienne (base e), décimale (base 10) ou binaire (base 2). Mathématiquement, ces fonctions ne diffèrent que par un facteur multiplicatif d’échelle constant égal à l’inverse du logarithme de la base considérée. Par conséquent, les formes distributionnelles transformées sont rigoureusement identiques, les coefficients de skewness et de kurtosis demeurent strictement invariants, et les résultats des tests d’hypothèse tels que l’ANOVA sont parfaitement isomorphes quelle que soit la base sélectionnée. Le choix relève uniquement de la commodité d’interprétation humaine des grandeurs rééchelonnées.
4.3 Gestion analytique du zéro et des valeurs négatives
L’écueil récurrent de la transformation logarithmique réside dans l’impossibilité de calculer le logarithme d’une valeur nulle ou négative, situation récurrente face à des scores d’anxiété basés sur des échelles de Likert ou des données de précision comportementale. Pour pallier cette divergence asymptotique vers l’infini négatif en zéro, la pratique statistique usuelle prescrit la transformation formalisée par log(x + c), où c représente une constante positive rigoureusement choisie, la solution la plus standardisée étant la transformation unitaire log(x + 1).
Toutefois, l’adjonction de cette constante de translation n’est pas neutre sur le plan métrologique. La fonction log(x + c) perd la propriété d’invariance d’échelle propre au logarithme strict. De plus, la morphologie finale de la distribution transformée dépend substantiellement de l’ordre de grandeur relatif de la constante c par rapport à l’échelle des données brutes. Si les valeurs observées sont comprises entre 0,01 et 0,5, ajouter une constante de 1 domine mathématiquement la dynamique de la variable et compresse la variabilité naturelle de manière excessive, créant un artefact de distribution artificielle.
Le risque méthodologique le plus sévère survient lorsqu’une proportion substantielle de l’échantillon présente une valeur rigoureusement égale à zéro (modèles dits « zero-inflated »). Dans cette configuration, la transformation log(x + 1) ne normalise aucunement les données : elle rassemble simplement l’ensemble des zéros en un point fixe discret à l’origine (puisque log(1) = 0), créant une barrière verticale artificielle suivie d’une traîne continue. Cette distribution hybride bimodalise artificiellement l’espace de mesure et viole frontalement le postulat de continuité requis par l’inférence paramétrique, imposant le recours à d’autres architectures de modélisation.
5. Implémentation pas-à-pas de la transformation logarithmique en Python
5.1 Environnement computationnel et génération de données asymétriques
L’implémentation opérationnelle sous Python nécessite un environnement scientifique robuste, reposant sur l’initialisation explicite des modules fondamentaux de calcul vectoriel, de manipulation tabulaire et de modélisation statistique. Pour garantir la reproductibilité absolue des simulations et analyses présentées, le processus débute par la fixation déterministe de la graine aléatoire au moyen de la méthode numpy.random.seed(42), stabilisant ainsi le générateur pseudo-aléatoire sous-jacent.
Afin de simuler fidèlement une cohorte expérimentale en psychologie cognitive, nous construisons un jeu de données synthétique représentant les temps de réaction de deux cents participants soumis à une tâche d’attention sélective complexe. Ces latences sont générées selon une loi log-normale continue, caractérisée par une forte asymétrie droite et la présence de temps de traitement tardifs. Les observations simulées sont ensuite encapsulées au sein d’une structure de données bidimensionnelle ordonnée via la classe pandas.DataFrame.
Cette organisation tabulaire optimise les calculs ultérieurs en exploitant la vectorisation native des tableaux NumPy sous-jacents, éliminant tout recours inefficace à des boucles itératives Python standards. Elle offre en outre un cadre unifié pour consigner dans des colonnes dédiées les scores bruts, les variables transformées ainsi que les résidus d’ajustement, assurant une parfaite traçabilité des opérations de prétraitement au sein du pipeline d’analyse de données comportementales.
5.2 Syntaxe d’application vectorielle avec NumPy
Pour appliquer une transformation logarithmique élémentaire sur des variables comportementales strictement positives, NumPy met à disposition la fonction vectorisée ultra-rapide numpy.log(), qui opère directement sur les colonnes d’un DataFrame Pandas en exécutant l’évaluation du logarithme népérien au niveau de chaque élément mémoire en langage C sous-jacent. Cette syntaxe concise se matérialise par l’assignation directe : df['log_rt'] = np.log(df['raw_rt']).
Dans les configurations métrologiques où le jeu de données comporte des valeurs nulles légitimes (comme le décompte de symptômes dépressifs mineurs ou le nombre d’erreurs commises), il est impératif d’écarter l’expression manuelle np.log(df['score'] + 1) au profit de la méthode optimisée numpy.log1p(). Cette fonction implémente un algorithme d’analyse numérique spécifiquement conçu pour préserver une précision absolue en virgule flottante lorsque la variable x s’approche très étroitement de zéro, évitant ainsi les erreurs d’arrondi et d’annulation catastrophique inhérentes aux représentations standard à double précision (IEEE 754).
Préalablement à toute réutilisation de la série transformée dans un modèle d’ANOVA ou de régression, le protocole algorithmique doit impérativement exécuter une vérification d’intégrité de la mémoire. Il s’agit de s’assurer de l’absence totale de valeurs non numériques ou infinies générées par inadvertance. Cette validation s’opère au moyen de l’expression conditionnelle logique np.isfinite(df['log_rt']).all(), complétée par df['log_rt'].isna().sum(), garantissant que l’intégralité du vecteur transformé réside sans ambiguïté dans l’espace des réels exploitables.
5.3 Validation graphique et comparative avant/après
L’évaluation de l’efficacité de la transformation logarithmique s’appuie sur une double validation, numérique et graphique. Sur le plan quantitatif, les coefficients d’asymétrie et de kurtosis doivent être extraits avant et après intervention via scipy.stats.skew et scipy.stats.kurtosis. Le succès de l’opération se traduit classiquement par une réduction drastique du skewness, qui passe typiquement d’une valeur initiale fortement positive (par exemple +1,85) à une magnitude proche de zéro (par exemple +0,12), témoignant du rééquilibrage géométrique de la distribution.
Sur le plan visuel, une restitution haute résolution s’obtient en traçant un canevas comparatif côte à côte au moyen de Matplotlib. Le panneau de gauche affiche l’histogramme des scores bruts avec l’estimation de densité KDE, sur lequel s’observe l’étirement prononcé de la queue droite. Le panneau de droite restitue la distribution de la variable transformée df['log_rt'], sur laquelle on superpose graphiquement la courbe d’une distribution normale théorique paramétrée par la moyenne et l’écart-type de l’échantillon transformé via la méthode scipy.stats.norm.pdf.
Pour parachever ce diagnostic visuel, deux diagrammes quantile-quantile superposés sont générés via scipy.stats.probplot. L’inspection attentive révèle comment la courbure fortement non linéaire de la série brute se redresse de façon remarquable pour s’aligner de manière quasi parfaite sur la droite de référence à quarante-cinq degrés sur la série logarithmique, attestant formellement de la conformité du nouveau vecteur de données avec les hypothèses de normalité du modèle linéaire paramétrique.
6. La transformation par la racine carrée : Cadre théorique et processus de Poisson
6.1 Modélisation des données de comptage en psychologie
Dans une multiplicité de contextes expérimentaux et cliniques, les variables collectées ne sont pas des grandeurs continues, mais des variables discrètes dénombrables positives prenant des valeurs entières (0, 1, 2, …). Les illustrations abondent en sciences comportementales : nombre de fautes commises lors d’une tâche d’interférence motrice, nombre de tics moteurs enregistrés lors d’une session d’observation standardisée, ou fréquence d’accès compulsifs rapportés par un patient durant un intervalle d’échantillonnage temporel.
Ces variables de comptage sont structurellement issues d’un processus stochastique sous-jacent régi, sous des hypothèses d’indépendance temporelle des événements, par la distribution théorique de Poisson. Une caractéristique mathématique intrinsèque et immuable de la loi de Poisson réside dans l’équidispersion stricte : son espérance mathématique est théoriquement et rigoureusement égale à sa variance. Par conséquent, dans tout plan expérimental factoriel où les scores suivent une dynamique de Poisson, les groupes ou conditions exhibant les moyennes les plus élevées présenteront systématiquement les variances les plus importantes.
Cette covariation systématique constitue une violation frontale de l’hypothèse d’homoscédasticité indispensable à l’analyse de variance à mesures répétées ou inter-groupes. C’est ici qu’intervient le théorème fondamental de stabilisation de la variance, établi par la méthode delta en calcul statistique. Ce théorème démontre que si l’on applique une fonction non linéaire f(x) à une variable aléatoire dont la variance est une fonction connue de sa moyenne, il est possible de stabiliser la variance locale afin qu’elle devienne complètement indépendante de la valeur moyenne du groupe. Pour un processus poissonnien où la variance égale la moyenne, la fonction mathématique stabilisatrice idoine est indiscutablement la fonction racine carrée.
6.2 Intensité modérée de compression sur l’asymétrie modérée
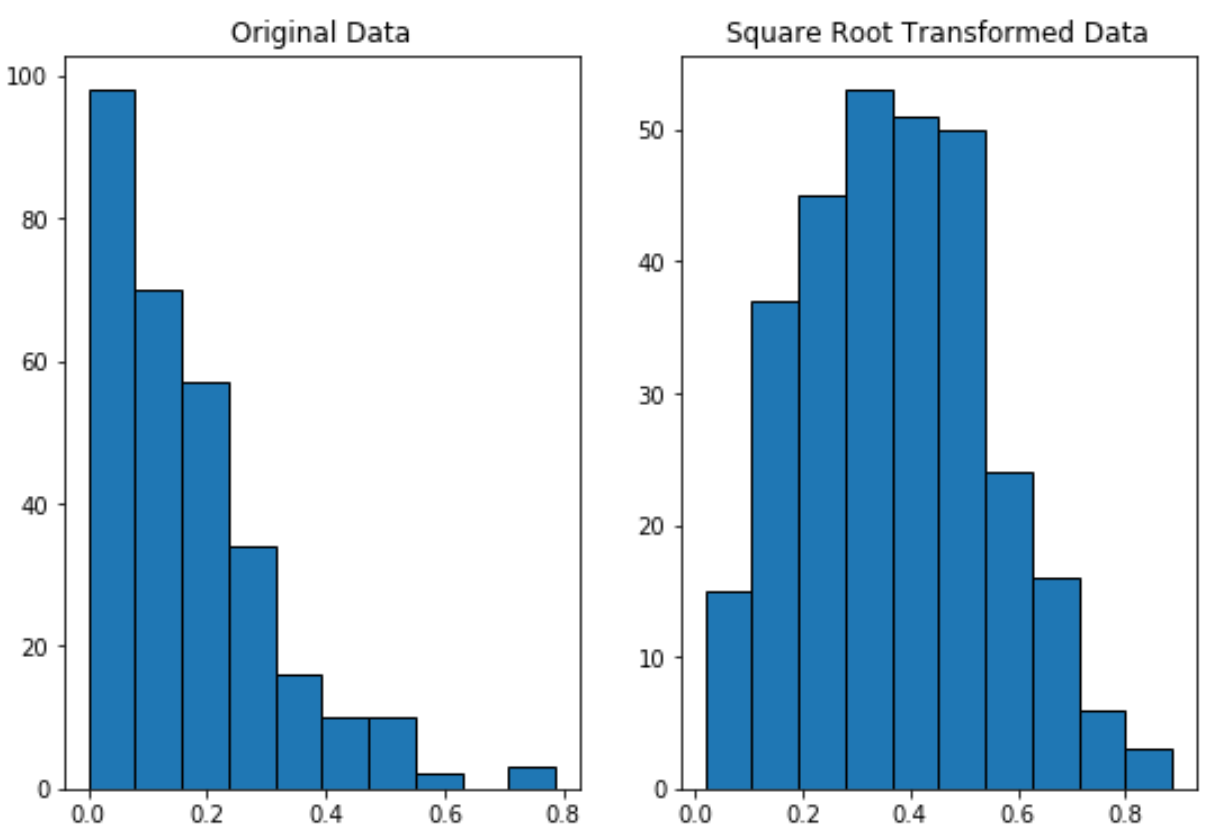
Sur l’échelle des transformations de puissances de Tukey, l’opérateur racine carrée (correspondant à l’exposant fractionnaire lambda = 0,5) se positionne à mi-chemin entre la conservation stricte de l’échelle d’origine (lambda = 1) et l’action vigoureuse de la transformation logarithmique (lambda = 0). Cette position médiane lui confère un profil fonctionnel particulièrement précieux caractérisé par une intensité de compression modérée.
Le défaut récurrent d’une application irréfléchie de la fonction logarithmique sur des variables présentant une asymétrie droite légère réside dans la sur-correction : l’opérateur compresse si durement les valeurs supérieures qu’il déforme la partie centrale de la distribution et engendre une asymétrie gauche résiduelle tout aussi problématique. La racine carrée prévient précisément cet écueil analytique en opérant une décélération progressive et mesurée de l’échelle métrique. Elle constitue donc le traitement optimal lorsque le coefficient d’asymétrie empirique se situe dans un intervalle modéré, généralement compris entre +0,5 et +1,5.
Sur le plan topologique, la racine carrée préserve nettement mieux que le logarithme l’espacement relatif et la discernabilité des observations situées dans les petites et moyennes amplitudes numériques. Les contrastes entre les faibles scores ne sont pas étirés de manière artificielle, ce qui évite de gonfler excessivement la variance d’échantillonnage au voisinage immédiat de l’origine tout en résorbant l’étirement graduel de la queue de distribution supérieure.
6.3 Variantes formelles pour les scores nuls
Bien que la fonction racine carrée classique soit formellement continue et dérivable sur l’ensemble des réels positifs et admette la valeur zéro sans provoquer de singularité asymptotique vers l’infini, la stabilisation de la variance qu’elle produit se dégrade sensiblement lorsque les décomptes expérimentaux sont très faibles (taux moyens inférieurs à 5 ou présence substantielle de zéros). Face à cette limite méthodologique, les statisticiens ont développé des formulations mathématiques enrichies.
La première variante majeure est la formulation proposée par Maurice Bartlett, qui substitue à l’opérateur direct l’expression racine carrée de la variable incrémentée de 0,5 : sqrt(y + 0.5). L’adjonction de ce terme correctif d’un demi-point compense la discontinuité intrinsèque des petites valeurs discrètes et accélère la convergence asymptotique de la variance vers une constante stable pour des processus de comptage à très faible intensité d’occurrence.
La seconde formulation, théoriquement supérieure et particulièrement recommandée par Murray Freeman et John Tukey pour les micro-échantillons, est la transformation double stabilisatrice définie par la somme de la racine de la variable et de la racine de la variable augmentée de un : sqrt(y) + sqrt(y + 1). Ce raffinement algébrique assure une homogénéisation optimale des variances résiduelles qui converge vers une valeur asymptotique normalisée d’exactement 0,25. L’exploitation de ces variantes prémunit le chercheur contre les fluctuations parasites de l’hétéroscédasticité dans les protocoles d’évaluation clinique comportementale.
7. Implémentation pas-à-pas de la transformation par la racine carrée en Python
7.1 Traitement de variables discrètes via NumPy et Pandas
L’application computationnelle de la racine carrée s’intègre avec une grande fluidité dans le pipeline scientifique standardisé sous Python. Pour simuler une expérience type en neuropsychologie cognitive, considérons la mesure du nombre total d’erreurs d’inhibition motrice commises par soixante participants au cours d’une variante informatisée de la tâche de Stroop. Ces décomptes sont générés aléatoirement selon un processus de Poisson paramétré par un taux moyen modéré au moyen de numpy.random.poisson(lam=4.5, size=60) et intégrés dans un DataFrame Pandas.
L’exécution de la transformation standard s’opère vectoriellement par l’appel direct de la fonction native numpy.sqrt() sur la série d’intérêt, matérialisée par l’assignation : df['sqrt_errors'] = np.sqrt(df['errors']). Si l’analyste fait le choix méthodologique d’appliquer la correction sophistiquée de Freeman-Tukey pour optimiser la stabilisation, la syntaxe NumPy autorise une formulation vectorielle élégante et optimisée sans aucune instanciation d’itérateur : df['ft_errors'] = np.sqrt(df['errors']) + np.sqrt(df['errors'] + 1).
Préalablement à cette évaluation fonctionnelle, la bonne pratique algorithmique impose de valider la non-négativité stricte du vecteur d’entrée au moyen d’une assertion logique défensive de type assert (df['errors'] >= 0).all(), "Erreur : présence de scores négatifs incompatibles avec la racine carrée.". Cette précaution garantit qu’aucune valeur absente ou code d’erreur de saisie négatif n’engendre silencieusement des valeurs NaN qui vicieraient l’ensemble de la chaîne d’analyse paramétrique ultérieure.
7.2 Comparaison de l’homoscédasticité inter-groupes
L’intérêt premier de la transformation par racine carrée sur des données de comptage réside dans le rétablissement de l’homogénéité des variances entre conditions expérimentales. Pour en apporter la démonstration computationnelle, simulons trois groupes de participants (par exemple : Groupe Témoin, Groupe Lésion Frontale, Groupe Trouble de l’Attention) présentant des moyennes d’erreurs contrastées (respectivement 2, 8 et 18 erreurs), induisant naturellement une forte hétéroscédasticité mécanique sous le régime de Poisson.
L’évaluation rigoureuse de cette hétérogénéité s’exécute formellement sous Python grâce au test de Levene disponible dans le module scipy.stats.levene, paramétré de préférence sur la médiane (center='median') pour maximiser sa robustesse intrinsèque. Appliqué sur les données brutes d’erreurs, le test renvoie une statistique de Levene hautement significative (p < 0,001), contraignant le chercheur à récuser la validité de l'ANOVA classique pour cause de violation sévère de l'homoscédasticité.
À l’issue de l’application de la transformation par la racine carrée sur l’ensemble de la variable dépendante, la réévaluation du test de Levene sur les données rééchelonnées met en évidence une chute spectaculaire de la statistique de test et un retour de la p-value au-delà du seuil conventionnel de non-signification (p > 0,05). Cette homogénéisation se matérialise graphiquement de manière limpide par la génération de boîtes à moustaches comparatives avant/après avec Seaborn, illustrant l’égalisation remarquable de la hauteur des boîtes interquartiles entre les trois conditions expérimentales.
7.3 Diagnostics graphiques des résidus
L’ultime étape diagnostique repose sur l’examen minutieux des résidus d’ajustement du modèle statistique linéaire sous-jacent. En exploitant la bibliothèque Statsmodels (via statsmodels.formula.api.ols), nous pouvons ajuster un modèle linéaire expliquant les erreurs en fonction de l’appartenance groupale, puis extraire les résidus standardisés et les valeurs prédites par le modèle.
Sur les données brutes non transformées, le nuage de points croisant les valeurs ajustées en abscisse et les résidus en ordonnée adopte une forme géométrique évasée hautement pathologique, désignée sous le terme de profil en entonnoir (funnel shape) : la dispersion verticale des résidus s’accroît proportionnellement à la magnitude des valeurs prédites, signant sans équivoque une hétéroscédasticité structurelle corrélée au niveau de la moyenne.
Après application de la transformation par racine carrée sur la variable d’erreur, le tracé de ce même graphique de diagnostic résiduel révèle la disparition complète de la morphologie en entonnoir au profit d’une bande horizontale de dispersion homogène et aléatoire autour de la droite horizontale d’ordonnée zéro. Conjointement, le tracé de densité KDE des résidus confirme le retour d’une symétrie quasi parfaite et l’extinction des traînes lourdes, attestant que le modèle transformé satisfait désormais rigoureusement aux postulats fondamentaux des moindres carrés ordinaires.
8. La transformation par la racine cubique : Mécanique mathématique et prise en compte des valeurs négatives
8.1 Intérêt de la racine cubique face aux limites des racines paires
L’arsenal des transformations univariées se heurte à une limitation structurelle majeure dès lors que les données empiriques comportent des grandeurs négatives. Les transformations logarithmiques et par racine carrée échouent mathématiquement sur ces domaines sauf à introduire des constantes de translation arbitraires qui dénaturent la métrologie du signal. La racine cubique (f(x) = x^(1/3)) s’impose précisément ici comme une solution analytique d’une élégance exceptionnelle en étendant son domaine de définition à l’ensemble complet des nombres réels, de l’infini négatif à l’infini positif.
Cette propriété s’avère providentielle dans le cadre des plans d’expérimentation psychologique utilisant des scores différentiels ou des mesures de soustraction. En psychométrie de l’apprentissage ou en psychopathologie expérimentale, les chercheurs analysent fréquemment des scores d’évolution calculés par la soustraction de la mesure initiale à la mesure finale (score post-test diminué du score pré-test), ou des indices de coût attentionnel résultant du différentiel chronométrique entre conditions incongruentes et congruentes (effet Stroop ou amorçage négatif). Ces métriques oscillent structurellement autour d’un point zéro neutre et possèdent des composantes positives et négatives substantielles.
Sur le plan fondamental de l’analyse mathématique, la racine cubique est une fonction impaire continue, satisfaisant rigoureusement à l’identité remarquable f(-x) = -f(x). Cette propriété confère une équité de traitement directionnel parfaite : une détérioration de performance de -8 millisecondes subit exactement la même déformation géométrique qu’une amélioration de +8 millisecondes, le signe négatif étant scrupuleusement préservé. L’amplitude relative est comprimée selon une loi de puissance rigoureusement identique de part et d’autre de l’origine, sans rupture de continuité ni dérive métrique.
8.2 Comportement face à l’asymétrie positive et négative
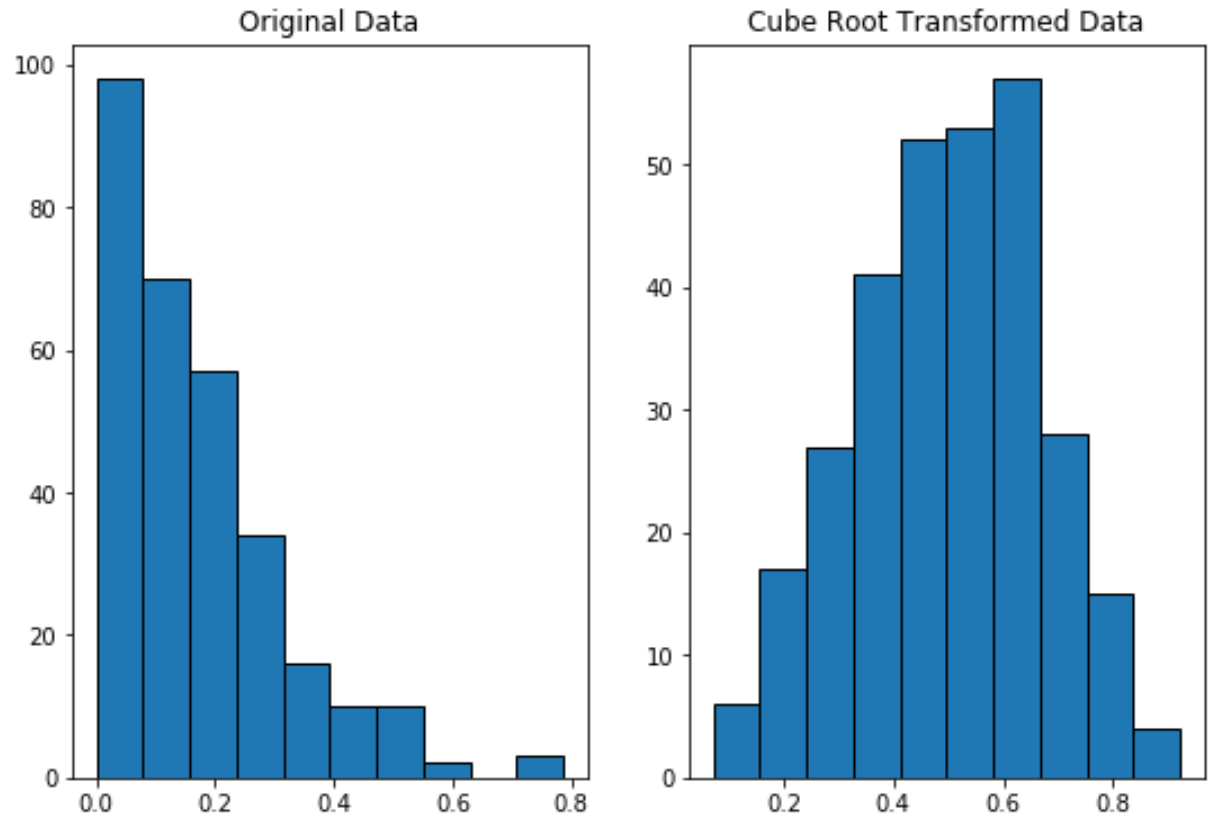
Sur l’échelle des transformations de Tukey, la racine cubique correspond à l’exposant rationnel lambda = 1/3 (environ 0,33). Elle se positionne de manière intermédiaire entre la racine carrée (0,50) et le logarithme népérien (qui constitue la limite quand lambda tend vers 0). Sa capacité de contraction non linéaire s’avère donc plus incisive que celle de la racine carrée, permettant de juguler des asymétries plus rebelles sans encourir les instabilités numériques du logarithme.
Une vertu cardinale de la transformation par la racine cubique réside dans son aptitude à traiter simultanément les distributions bimodales ou leptokurtiques présentant des valeurs aberrantes bilatérales réparties de part et d’autre du centre de gravité. Dans de multiples échelles d’humeur affective ou d’orientation politique, les réponses individuelles s’agrègent sur des pôles opposés avec des étirements symétriques des deux queues de distribution. Les fonctions de transformation asymétriques traditionnelles sont impuissantes face à ces profils bidirectionnels.
En compressant avec une force mathématique identique les queues d’observations situées simultanément dans les valeurs fortement positives et fortement négatives, la racine cubique réduit substantiellement le kurtosis d’échantillonnage excessif. Elle ramène les extrêmes bilatéraux vers la région centrale sans disloquer la distribution, constituant une alternative méthodologique infiniment supérieure aux transformations segmentées par morceaux (piecewise transformations) qui tronçonnent artificiellement l’échantillon à l’origine en appliquant des règles hétérogènes selon le signe des scores.
8.3 Légitimité de la racine cubique en modélisation psychologique
La légitimité épistémologique de la racine cubique en modélisation comportementale repose en premier lieu sur son indépendance absolue vis-à-vis des constantes de translation subjectives. Alors que le recours à la fonction log(x + c) contraint l’expérimentateur à choisir arbitrairement la valeur de c (induisant des variations non contrôlées sur les p-values finales et les tailles d’effet), la racine cubique ne requiert aucun paramètre d’ajustement ad hoc : elle s’applique directement sur les données brutes telles qu’elles ont été émises par le sujet expérimental.
Cette neutralité paramétrique garantit une préservation sans faille de l’interprétabilité du zéro psychologique. Dans les indices de biais cognitif, le zéro ne représente pas une absence d’information, mais l’état d’équilibre parfait : l’absence stricte de biais attentionnel en faveur des stimuli menaçants vis-à-vis des stimuli neutres. La racine cubique maintient scrupuleusement cet ancrage métrologique à l’origine (la racine cubique de 0 demeurant exactement 0), évitant la translation artificielle des repères théoriques établis.
Enfin, la racine cubique présente une stabilité numérique remarquable au sein des architectures computationnelles itératives complexes, telles que l’ajustement de modèles à effets mixtes linéaires (LMM) ou les systèmes d’équations structurelles (SEM). En arrondissant les gradients extrêmes de variance sans engendrer les singularités locales typiques des fonctions asymptotiques, elle favorise la convergence rapide des algorithmes d’optimisation par maximum de vraisemblance, prévenant l’apparition de matrices de covariance singulières ou non définies positives.
9. Implémentation pas-à-pas de la transformation par la racine cubique en Python
9.1 Résolution des pièges de calcul avec NumPy et valeurs négatives
L’application computationnelle de la racine cubique dans le langage Python constitue un terrain fertile pour un piège de programmation classique lié à la sémantique de l’opérateur d’exponentiation arithmétique. Si un praticien non averti tente d’évaluer la racine cubique d’un vecteur Pandas ou NumPy comportant des scores négatifs au moyen de la syntaxe apparemment intuitive array ** (1/3), l’interpréteur Python applique les règles formelles de l’analyse complexe. Pour tout nombre réel négatif, cette opération renvoie une valeur appartenant au corps des nombres complexes, assortie d’une partie imaginaire non nulle.
L’apparition de ces composantes complexes interrompt immédiatement l’exécution des modules statistiques de SciPy ou Statsmodels, incapables de traiter des nombres imaginaires dans des fonctions de vraisemblance réelles. Pour s’affranchir définitivement de ce piège, l’écosystème NumPy fournit une fonction native universelle hautement optimisée : numpy.cbrt() (abréviation mathématique de cubic root). Cette fonction est spécifiquement programmée pour opérer strictement dans le corps des nombres réels, renvoyant avec une exactitude absolue la racine cubique réelle signée pour tout scalaire ou vecteur d’entrée : np.cbrt(-8.0) renverra ainsi immédiatement -2.0.
À titre d’alternative analytique équivalente, il est instructif de conceptualiser cette transformation par la combinaison de la fonction signe et de la valeur absolue : np.sign(x) * np.abs(x) ** (1/3). Cependant, l’évaluation des benchmarks de performance démontre que numpy.cbrt() surpasse cette formulation composée en vitesse de calcul et en précision numérique, évitant des calculs d’arrondi intermédiaires sur les très grands volumes de données.
9.2 Pipeline de traitement complet sur jeu de données empirique
Pour illustrer le déploiement opérationnel d’un pipeline complet, considérons un jeu de données simulant les scores d’évolution clinique de cent vingt patients suivis en thérapie cognitivo-comportementale pour un trouble panique. La variable d’intérêt représente la variation du score sur une échelle standardisée d’évitement agoraphobique (score post-thérapie moins score pré-thérapie). Ce vecteur comporte naturellement des scores négatifs substantiels (améliorations cliniques notables), des scores nuls (stagnation) et des scores positifs (détériorations symptomatiques).
Le traitement débute par l’importation de la série au sein d’un DataFrame Pandas, suivi de l’encapsulation de la transformation dans une fonction dédiée garantissant la propreté du flux de données. Cette fonction applique de façon vectorisée df['cbrt_delta'] = np.cbrt(df['raw_delta']), tout en assurant le contrôle automatique de l’intégrité de l’index et la préservation de la typologie des métadonnées associées.
Le pipeline intègre également la détection et la gestion sécurisée des codes sentinelles souvent rencontrés dans les bases de données psychiatriques (tels que les codes -99 ou 999 matérialisant l’absence de réponse numérique). Ces valeurs sentinelles doivent impérativement être converties en np.nan préalablement au calcul de numpy.cbrt(), garantissant que l’opérateur mathématique ne transforme pas un code administratif manquant en un point numérique réel aberrant.
9.3 Représentation analytique et contrôle de la courbure
La validation métrologique de la transformation par la racine cubique passe par l’examen de sa courbe de transfert et de son action sur la géométrie distributionnelle. Dans un premier temps, il est didactique de tracer la fonction de transfert en représentant la variable transformée en fonction de la variable brute sur l’intervalle d’observation expérimental : le tracé matérialise une courbe en « S » traversant l’origine sans discontinuité, illustrant comment les valeurs positives et négatives sont symétriquement comprimées à mesure qu’elles s’écartent de zéro.
Dans un second temps, le contrôle quantitatif repose sur la comparaison des coefficients d’asymétrie calculés par scipy.stats.skew. Dans les configurations où la distribution des différences présentait une longue traîne de régressions comportementales asymétriques, l’application de la racine cubique résorbe ce déséquilibre de manière spectaculaire, recentrant le troisième moment au voisinage immédiat de zéro.
Pour apprécier le rétablissement de la symétrie sans subir l’arbitraire du découpage des histogrammes, l’outil analytique le plus rigoureux demeure la fonction de répartition empirique continue (ECDF), visualisable avec la fonction seaborn.ecdfplot. En traçant l’ECDF de la variable transformée par racine cubique, on observe une symétrie quasi idéale de la sigmoïde autour de la valeur médiane, prouvant le retour à un équilibre distributionnel compatible avec les modèles paramétriques linéaires.
10. Évaluation comparative approfondie des trois transformations sous Python
10.1 Mise en place d’un protocole d’expérimentation comparée
Pour déterminer avec rigueur la transformation optimale face à un jeu de données expérimental singulier, le praticien ne doit pas s’en remettre à une intuition subjective, mais déployer un protocole d’expérimentation statistique comparative systématique. À cet effet, il convient de développer une fonction Python d’évaluation automatisée, capable de confronter en parallèle la distribution d’origine et ses dérivées normalisées par les trois opérateurs fondamentaux : logarithme (log1p), racine carrée (sqrt) et racine cubique (cbrt).
Ce protocole est étalonné sur un échantillon expérimental simulant des données de neuro-imagerie fonctionnelle ou des latences d’orientation visuelle (deux cent cinquante observations continues strictement positives et fortement asymétriques). Afin de rendre les métriques de dispersion parfaitement comparables entre des échelles dont les unités physiques diffèrent désormais, l’algorithme applique une standardisation z-score préalable à chaque vecteur transformé, ramenant chaque série à une moyenne d’exactement zéro et un écart-type unitaire.
Sur chaque série ainsi normalisée en échelle, le protocole extrait de façon systématique une batterie unifiée d’indicateurs quantitatifs d’adéquation distributionnelle : le coefficient d’asymétrie non biaisé de Fisher, l’excès de kurtosis, ainsi que la statistique de test W et la p-value issue du test formel de normalité de Shapiro-Wilk.
10.2 Matrice décisionnelle automatisée basée sur les métriques statistiques
Les résultats extraits sont consolidés au sein d’un DataFrame récapitulatif Pandas structuré comme une véritable matrice décisionnelle d’aide à l’arbitrage méthodologique. Cette matrice calcule pour chaque condition la distance absolue à la symétrie idéale, matérialisée par la valeur absolue du skewness, ainsi que la déviation absolue à l’aplatissement mésokurtique théorique, définie par la valeur absolue du kurtosis excessif.
Un algorithme de sélection multicritère désigne automatiquement la fonction mathématique dominante selon une règle séquentielle stricte : la transformation retenue est celle qui minimise la somme pondérée des déviations absolues de forme (|skewness| + 0,5 * |kurtosis|), sous réserve explicite que la p-value du test de Shapiro-Wilk excède le seuil d’invalidation conventionnel de 0,05. La table descriptive Pandas est ensuite formatée avec une mise en valeur visuelle conditionnelle permettant d’identifier immédiatement les transformations qui échouent à rétablir la normalité.
L’algorithme intègre également une alerte méthodologique critique : si aucune des trois transformations fondamentales ne parvient à hisser la p-value de Shapiro-Wilk au-dessus du seuil de 0,05 ou si le skewness résiduel demeure supérieur en valeur absolue à 0,5, le script conclut formellement à l’échec des solutions univariées simples et préconise l’abandon des transformations d’échelle au profit d’approches non paramétriques ou de modèles linéaires généralisés.
10.3 Visualisation synthétique globale multi-panneaux
Pour parachever ce protocole comparatif, la programmation d’une figure multi-panneaux unifiée offre un diagnostic visuel sans équivoque. En instanciant une grille graphique sous Matplotlib composée de quatre lignes et deux colonnes (figsize=(16, 18)), le script associe à chaque série distributionnelle (données brutes, racine carrée, racine cubique, logarithme) son histogramme enrichi de l’estimation KDE sur la colonne de gauche, et son diagramme quantile-quantile d’alignement sur la colonne de droite.
L’alignement vertical strict des graphiques Q-Q permet à l’expérimentateur de suivre avec une lisibilité totale l’évolution géométrique de la normalisation : on observe la courbure convexe initiale se détendre modérément sous l’effet de la racine carrée, s’assouplir davantage sous la racine cubique, et se redresser rigoureusement sur la droite identitaire sous l’action du logarithme (ou, à l’inverse, basculer dans une concavité indésirable traduisant une sur-correction par sur-compression logarithmique).
Afin de conformer cette restitution visuelle aux exigences strictes de publication scientifique (notamment les standards de l’American Psychological Association), le canevas est épuré : palette chromatique sobre et contrastée, suppression des bordures superflues, affichage dynamique des coefficients de skewness et de p-values directement incrustés en légende textuelle sur chaque panneau. Le script Python s’achève par l’exportation directe du graphique en haute résolution vectorielle vers un fichier PDF ou SVG au moyen de plt.savefig('comparaison_distributions.pdf', dpi=300, bbox_inches='tight').
11. Interprétation des paramètres statistiques et méthodologie de rétro-transformation
11.1 Le défi de l’interprétabilité des échelles transformées
Si la transformation mathématique des variables résout avec une indéniable efficacité les obstacles de l’inférence paramétrique, elle introduit en contrepartie un défi méthodologique majeur : l’obscurcissement de l’interprétabilité des mesures comportementales. Une fois qu’une série de latences chronométriques a été convertie par un opérateur non linéaire, la métrique résultante perd tout ancrage phénoménologique intuitif. Il est rigoureusement impossible pour un chercheur en neuropsychologie de conceptualiser ou de communiquer cliniquement ce que représente concrètement « une racine carrée de millisecondes » ou « une unité logarithmique népérienne de temps de décision ».
Cette opacité métrologique affecte directement l’interprétation des modèles de régression et des analyses de variance. Dans un modèle linéaire paramétrique standard, le coefficient de régression (la pente bêta) exprime l’incrément constant attendu sur la variable dépendante pour chaque élévation unitaire d’un prédicteur. Sur une échelle transformée par le logarithme, ce coefficient ne reflète plus un changement absolu constant, mais un taux de variation proportionnel relatif, dont la traduction dans l’unité métrologique originale requiert une reformulation algébrique spécifique.
L’erreur la plus répandue dans les publications scientifiques consiste à appliquer la fonction de rétro-transformation (la fonction inverse) directement sur la moyenne calculée sur l’échelle transformée, en postulant implicitement que l’inverse de la moyenne des transformées équivaut à la moyenne des valeurs brutes. Cette confusion repose sur la méconnaissance d’un théorème mathématique fondamental : l’inégalité de Jensen. Cette loi stipule que pour toute fonction f(x) strictement convexe ou concave, l’espérance de la fonction d’une variable aléatoire n’est jamais égale à la fonction de l’espérance de cette variable. Traiter ces deux grandeurs comme interchangeables induit un biais d’estimation systématique qui fausse les conclusions descriptives.
11.2 Calcul de la rétro-transformation et estimation des moyennes géométriques
Pour restaurer l’intelligibilité des paramètres statistiques dans l’espace métrologique d’origine, le chercheur doit mobiliser les opérateurs inverses rigoureux tout en caractérisant exactement la nature de l’indicateur obtenu. Dans le cas de la transformation logarithmique népérienne, la fonction réciproque est la fonction exponentielle numpy.exp(). Lorsque l’on calcule la moyenne arithmétique des scores transformés par le logarithme, puis que l’on applique l’exponentielle à cette valeur, le résultat obtenu ne correspond nullement à la moyenne arithmétique originale, mais à la moyenne géométrique rigoureuse des observations initiales.
La moyenne géométrique constitue un indicateur de tendance centrale particulièrement robuste pour les distributions asymétriques positives, car elle est naturellement insensible aux étirements extrêmes des valeurs supérieures. Dans un rapport de recherche, le chercheur mentionnera donc explicitement que les moyennes rééchelonnées rapportées correspondent à des moyennes géométriques rétro-transformées, offrant une estimation centrale beaucoup plus fidèle que la moyenne arithmétique polluée par la queue de distribution.
Pour les transformations par racine carrée et par racine cubique, les opérateurs réciproques correspondent respectivement à l’élévation au carré (puissance 2) et à l’élévation au cube (puissance 3). Toutefois, en vertu de l’inégalité de Jensen, élever au carré la moyenne des racines sous-estime structurellement la moyenne arithmétique réelle de la population d’une quantité égale à la variance d’échantillonnage de la racine carrée. Pour corriger ce biais d’estimation, la littérature statistique propose des facteurs d’ajustement correctifs (facteurs de correction de Laurent ou développements en séries de Taylor), qui peuvent être codés au sein de fonctions Python dédiées afin de restituer des estimations non biaisées de l’espérance originale.
11.3 Calcul et rétro-projection des intervalles de confiance
L’estimation ponctuelle de la tendance centrale demeure incomplète sans la caractérisation de son incertitude d’échantillonnage au travers des intervalles de confiance. Une erreur méthodologique critique consisterait à rétro-transformer l’erreur-type calculée sur l’échelle normale pour tenter de reconstituer un intervalle symétrique dans l’échelle d’origine. La variabilité d’échantillonnage ne pouvant être dissociée de la courbure de la transformation, l’erreur-type n’a aucun sens physique direct une fois inversée.
La méthodologie scientifiquement rigoureuse repose sur la technique de rétro-projection non linéaire des bornes d’intervalle. Le protocole s’articule séquentiellement comme suit : en premier lieu, le chercheur calcule l’intervalle de confiance paramétrique classique à 95 % sur l’échelle transformée, où les postulats de normalité sont respectés, en utilisant la loi normale standard ou la loi t de Student via scipy.stats.t.interval. Cet intervalle possède des bornes inférieure et supérieure parfaitement symétriques autour de la moyenne transformée.
Dans un second temps, l’analyste applique la fonction réciproque (exponentielle, carré ou cube) individuellement sur la borne inférieure et sur la borne supérieure de l’intervalle de confiance calculé. Par cette opération de projection monotone, on obtient un intervalle de confiance délimité dans l’unité de mesure originale. Propriété remarquable : cet intervalle reconstitué n’est plus symétrique autour de l’estimation centrale rétro-transformée, mais asymétrique, reflétant avec une fidélité mathématique éclatante l’asymétrie écologique réelle du phénomène comportemental sous-jacent.
12. Limites méthodologiques, alternatives modernes et recommandations éthiques
12.1 Critiques épistémologiques de la normalisation forcée des données
En dépit de son élégance algébrique et de sa commodité historique, la transformation non linéaire univariée fait l’objet de réserves épistémologiques croissantes dans la littérature méthodologique contemporaine. La critique fondamentale porte sur le risque d’altération des relations écologiques naturelles unissant les construits psychologiques. En déformant l’échelle des observations, l’opérateur non linéaire modifie la structure des interactions entre facteurs au sein de l’analyse de variance : une interaction statistiquement significative sur l’échelle brute peut disparaître après transformation logarithmique, ou inversement, un effet purement additif peut se trouver artificiellement doté d’une interaction fallacieuse générée par la non-linéarité de l’outil mathématique.
Un autre péril éthique majeur réside dans la tentation du dragage de données (data snooping) ou de la manipulation opportuniste des résultats (p-hacking). Face à une p-value ambiguë (par exemple p = 0,067), un chercheur peu scrupuleux ou inconscient des biais de confirmation peut tester successivement une racine carrée, puis une racine cubique, puis un logarithme jusqu’à identifier empiriquement la transformation particulière qui fait franchir au résultat le seuil magique de signification (p < 0,05). Cette flexibilité computationnelle post-hoc invalide totalement le contrôle théorique de l'erreur de type I.
Enfin, la dissémination d’échelles transformées hétérogènes complique dramatiquement l’effort de synthèse cumulative propre aux méta-analyses. Comparer des tailles d’effet standardisées (comme le d de Cohen ou le coefficient êta-carré partiel) calculées sur des grandeurs logarithmiques avec des études publiées sur des scores originaux nécessite des corrections analytiques complexes souvent omises. Pour garantir l’intégrité de la recherche, la communauté scientifique préconise désormais instamment le pré-enregistrement formel des protocoles statistiques (sur des registres ouverts tels que l’Open Science Framework), contraignant l’expérimentateur à expliciter la fonction de transformation choisie préalablement à toute inspection des données.
12.2 Alternatives contemporaines : Modèles Linéaires Généralisés (GLM) et non-paramétrie
L’essor fulgurant de la puissance computationnelle au cours des deux dernières décennies a rendu possible le déploiement généralisé d’alternatives statistiques beaucoup plus élégantes que la transformation forcée des échelles : les Modèles Linéaires Généralisés (GLM) et les méthodes d’inférence par rééchantillonnage robuste. Introduits par Nelder et Wedderburn, les GLM permettent de s’affranchir du postulat d’erreur gaussienne en modélisant directement la distribution naturelle sous-jacente du processus générateur de données.
Plutôt que de contraindre par artifice des données chronométriques positives asymétriques à entrer dans le cadre gaussien via un logarithme, le chercheur moderne peut ajuster un modèle linéaire généralisé fondé sur une famille de distribution Gamma ou Log-Normale avec une fonction de lien idoine. De même, les données discrètes de comptage d’erreurs trouvent leur modélisation optimale naturelle dans les régressions de Poisson ou les modèles binomial négatif (en cas de surdispersion de variance). Sous Python, la bibliothèque Statsmodels permet de paramétrer ces architectures avec une rigueur extrême au moyen du module statsmodels.api.GLM.
Parallèlement aux GLM, les approches par rééchantillonnage non paramétrique — au premier rang desquelles figure le bootstrap computationnel — constituent une solution universelle d’une puissance redoutable. En tirant plusieurs milliers de rééchantillons avec remise à partir de la distribution empirique observée, le bootstrap génère des distributions d’échantillonnage empiriques pour n’importe quel paramètre (moyennes, différences, coefficients de pente) sans formuler aucune hypothèse a priori sur la forme analytique de la population. Cette flexibilité affranchit totalement l’analyse des contraintes de normalité et d’homoscédasticité.
12.3 Guide de bonnes pratiques pour le chercheur en sciences comportementales
Pour naviguer avec rigueur et intégrité au sein de cet espace décisionnel, le chercheur en sciences comportementales et cognitives adoptera une démarche séquentielle standardisée. L’exploration initiale des données doit systématiquement reposer sur l’association conjointe d’un diagnostic graphique haute résolution (histogrammes avec KDE, Q-Q plots) et d’un inventaire des descripteurs de forme (skewness et kurtosis non biaisés). Si la non-normalité constatée découle de contraintes métrologiques connues (comptages de Poisson, latences multiplicatives), le recours à la modélisation directe par GLM doit être privilégié en première intention.
Si la transformation de puissance demeure l’option choisie — pour des raisons de conformité avec des paradigmes historiques ou de commodité algorithmique —, le choix de la fonction mathématique doit être strictement guidé par la nature des données : la racine carrée pour les décomptes et asymétries positives modérées (+0,5 à +1,5) ; la racine cubique pour les variables incluant des valeurs négatives ou de forts kurtosis bilatéraux ; le logarithme pour les asymétries sévères exponentielles strictement positives. L’implémentation logicielle sous Python s’appuiera rigoureusement sur les fonctions vectorisées natives préservant l’intégrité numérique (numpy.log1p, numpy.cbrt, numpy.sqrt).
Dans la section méthodologique des articles de recherche, une transparence absolue est requise : mention explicite de la transformation retenue et de sa justification théorique, signalement de toute constante de décalage introduite, présentation des graphiques de résidus post-transformation, et restitution systématique des statistiques descriptives finales à la fois sur l’échelle d’analyse et sous forme rétro-transformée dans l’unité physique initiale. Enfin, l’archivage pérenne et public du code Python d’analyse ainsi que des données brutes au sein d’entrepôts ouverts (tels que GitHub ou Zenodo) constitue aujourd’hui le garant ultime de la reproductibilité computationnelle et de la crédibilité scientifique des découvertes en psychologie quantitative.
Références
- Bartlett, M. S. (1936). The square root transformation in analysis of variance. Supplement to the Journal of the Royal Statistical Society, 3(1), 68–78. https://doi.org/10.2307/2983678
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Fechner, G. T. (1860). Elemente der Psychophysik. Breitkopf und Härtel.
- Freeman, M. F., & Tukey, J. W. (1950). Transformations related to the angular and the square root. The Annals of Mathematical Statistics, 21(4), 607–611. https://doi.org/10.1214/aoms/1177729756
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Jensen, J. L. W. V. (1906). Sur les fonctions convexes et les inégalités entre les valeurs moyennes. Acta Mathematica, 30(1), 175–193. https://doi.org/10.1007/BF02418571
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1921-00a
- Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370–384. https://doi.org/10.2307/2344614
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (pp. 92–96). https://doi.org/10.25080/Majora-92bf1921-011
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021