
L’analyse des séries temporelles constitue l’un des piliers méthodologiques les plus universels et déterminants de la recherche empirique moderne. De la modélisation des fluctuations macroéconomiques à l’étude des signaux neurophysiologiques en électroencéphalographie, en passant par le suivi des trajectoires climatiques séculaires ou la détection d’anomalies au sein d’infrastructures industrielles connectées, la capacité à appréhender le comportement d’une variable à travers le temps représente une condition sine qua non de la découverte scientifique. Dans cet univers quantitatif, la visualisation graphique transcende le simple rôle d’illustration pour devenir un outil heuristique majeur, permettant au chercheur comme au praticien de révéler des régularités sous-jacentes, d’identifier des ruptures structurelles et de valider des hypothèses dynamiques complexes qu’un simple examen tabulaire dissimulerait inévitablement.
Au sein de l’écosystème du langage Python, la bibliothèque Matplotlib s’est imposée comme le standard de référence pour la création graphique de précision, alliant une flexibilité de bas niveau à une expressivité sans égale dans la littérature informatique. Conçue à l’origine par John D. Hunter pour émuler la puissance graphique d’environnements mathématiques spécialisés, elle fournit aujourd’hui l’infrastructure visuelle fondamentale sur laquelle reposent des bibliothèques de haut niveau telles que Pandas ou Seaborn. Tracer une série temporelle dans Matplotlib nécessite toutefois une compréhension approfondie de ses mécanismes internes : la gestion de l’ordonnancement chronologique des abscisses, la conversion sémantique des objets temporels, le formatage rigoureux des axes et l’application stricte des règles de la sémiologie graphique contemporaine conditionnent directement la fidélité de l’interprétation empirique.
Ce guide exhaustif a pour ambition d’offrir une exploration magistrale et sans compromis des techniques de visualisation des séries chronologiques sous Matplotlib. À travers une progression didactique rigoureuse, nous examinerons successivement les fondements théoriques de la structure des données temporelles, la mécanique intime de l’API orientée objet de Matplotlib, les subtilités de manipulation du module spécialisé matplotlib.dates, ainsi que les stratégies de comparaison multivariée, de lissage statistique et d’optimisation pour la publication académique. Conçu selon les exigences de rigueur de la recherche universitaire et de l’ingénierie avancée, ce traité fournit les bases conceptuelles et opératoires indispensables pour transformer des flux de données chronologiques bruts en représentations visuelles irréprochables, immédiatement exploitables pour la décision stratégique ou la diffusion scientifique.
1. Introduction aux séries temporelles et fondements de Matplotlib
1.1 Définition conceptuelle et portée analytique d’une série temporelle
Sur le plan mathématique et épistémologique, une série temporelle se définit formellement comme une collection ordonnée d’observations quantitatives ou qualitatives indexées selon une dimension chronologique univoque et strictement monotone. Contrairement aux jeux de données transversaux où les observations individuelles sont réputées statistiquement indépendantes et identiquement distribuées, la nature intrinsèque des séries chronologiques repose sur la dépendance sérielle. Chaque observation porte en elle l’empreinte inertielle de ses états antérieurs, introduisant des phénomènes d’autocorrélation, d’hétéroscédasticité conditionnelle et de mémoire longue qui requièrent une méthodologie d’analyse radicalement spécifique. Dans les disciplines expérimentales et psychométriques, l’ordonnancement séquentiel s’avère fondamental pour capturer la dynamique temporelle d’un apprentissage, l’extinction progressive d’une réponse cognitive ou l’évolution des marqueurs physiologiques d’un sujet soumis à des stimuli répétés.
Une distinction conceptuelle capitale doit être établie entre les processus discrets et les dynamiques continues. Si la réalité physique sous-jacente s’écoule de manière ininterrompue au fil du temps, l’observateur scientifique ne peut en appréhender qu’une manifestation échantillonnée à intervalles réguliers ou sporadiques. Cette discrétisation pose la question centrale de la résolution temporelle et du théorème d’échantillonnage, car une fréquence d’acquisition inadaptée risque de masquer des phénomènes oscillatoires cruciaux ou d’introduire des artefacts d’aliasing visuel et mathématique. Dès lors, l’acte de tracer une courbe reliant des points de mesure temporels successifs constitue un choix méthodologique d’interpolation implicite, dont la justification épistémique dépend intimement de la nature continue ou discontinue du phénomène investigué.
Dans ce contexte analytique, la visualisation de données temporelles poursuit des objectifs précis et hiérarchisés. Le premier niveau fonctionnel réside dans l’identification immédiate de la tendance séculaire, c’est-à-dire l’orientation globale à long terme que suit le signal en s’affranchissant du bruit haute fréquence. Le deuxième niveau s’intéresse à la détection de cycles périodiques, qu’ils soient d’origine calendaire comme la saisonnalité économique ou d’origine biologique comme les rythmes circadiens. Enfin, la visualisation constitue la méthode de criblage exploratoire la plus efficace pour identifier les ruptures de niveau, les changements soudains de variance et les anomalies ponctuelles. Ces événements critiques, lorsqu’ils sont isolés dans de simples tableaux de chiffres, passent aisément inaperçus, alors qu’une projection graphique rigoureusement calibrée alerte instantanément l’œil analytique sur l’existence d’une perturbation singulière dans le protocole de mesure.
1.2 L’écosystème Python pour le traitement des données chronologiques
La puissance de Python dans le traitement et la modélisation des données séquentielles découle directement de l’interopérabilité organique de ses bibliothèques de calcul scientifique. Au cœur de cette architecture, Matplotlib assume le rôle de moteur de rendu fondamental. Si des structures de données spécialisées comme les séries et DataFrames de Pandas offrent une flexibilité inégalée pour le filtrage, l’alignement temporel, le rééchantillonnage et l’imputation, elles s’appuient substantiellement sur les mécanismes graphiques sous-jacents de Matplotlib pour concrétiser visuellement leurs opérations. De son côté, NumPy fournit l’infrastructure de bas niveau gérant les vecteurs d’entiers et de flottants avec une efficacité mémoire optimale, permettant à l’interpréteur de manipuler des millions d’instants sans dégradation rédhibitoire des performances de rendu.
L’intégration entre les structures de type datetime natives de Python, les tableaux typés datetime64 de NumPy et les index spécialisés DatetimeIndex de Pandas s’opère de manière transparente mais exige une vigilance constante de la part du chercheur. Matplotlib a développé au fil des années des convertisseurs internes sophistiqués capables de traduire ces différents formats d’horodatage en coordonnées spatiales bidimensionnelles précises. Dans le cadre d’une démarche de recherche académique ou industrielle, cette chaîne d’outils garantit une reproductibilité expérimentale absolue : un script graphique Python documenté avec précision permet de régénérer à l’identique une figure complexe à partir de données brutes actualisées, éliminant ainsi les aléas manuels et les imprécisions inhérents aux logiciels de traitement graphique par interface utilisateur graphique fermée.
Sur le plan architectural, Matplotlib présente une dualité de paradigmes qu’il est impératif de maîtriser dès l’abord du sujet. D’une part, l’interface fonctionnelle pyplot, conçue à l’origine pour reproduire fidèlement l’environnement de commande procédurale de MATLAB, permet d’exécuter des tracés rapides en maintenant implicitement un état global de la figure en cours. D’autre part, l’approche orientée objet structure l’espace graphique sous la forme d’une hiérarchie d’objets explicites où chaque conteneur de figure et chaque sous-espace de projection possède ses propres méthodes et attributs. Si la méthode procédurale conserve une certaine utilité pour des tests exploratoires éphémères sur console interactive, seule l’approche orientée objet confère le contrôle chirurgical nécessaire pour élaborer des visualisations scientifiques complexes, multi-échelles et conformes aux critères de rigueur des revues internationales de premier rang.
1.3 Configuration rigoureuse de l’environnement de travail
La mise en place d’un environnement graphique professionnel débute invariablement par un protocole d’importation standardisé et rigoureux. Il est d’usage académique universel d’importer le module pyplot de Matplotlib sous l’alias conventionnel plt, la bibliothèque de manipulation tabulaire Pandas sous l’alias pd, et la bibliothèque mathématique vectorielle NumPy sous l’alias np. En complément indispensable pour les séries chronologiques, le module datetime de la bibliothèque standard de Python ainsi que le sous-module spécialisé matplotlib.dates doivent être explicitement chargés dans l’espace de noms du script. Cette discipline d’importation assure la clarté du code source et garantit que tout lecteur versé dans l’analyse de données pourra identifier sans ambiguïté l’origine des fonctions et des classes mobilisées dans le pipeline de traitement.
La pérennité et la portabilité des scripts d’analyse imposent une gestion stricte des dépendances logicielles et de la compatibilité des versions. Les mécanismes de gestion des fuseaux horaires, les règles d’interpolation des dates manquantes et les algorithmes de sélection automatique des graduations sur les axes ont connu des raffinements notables au fil des versions majeures de Matplotlib et de Pandas. Il convient dès lors de documenter systématiquement dans l’en-tête de l’analyse ou au sein d’un fichier de configuration les versions précises des paquets utilisés. L’utilisation d’environnements virtuels isolés permet de sanctuariser les conditions d’exécution et de prévenir les comportements graphiques divergents induits par d’éventuelles dépréciations fonctionnelles ou des altérations d’API entre générations successives de bibliothèques.
Enfin, l’optimisation esthétique et éditoriale d’un projet visuel gagne à être centralisée en amont à travers la configuration des paramètres globaux de Matplotlib, désignés sous le terme de rcParams. Au lieu de surcharger individuellement chaque fonction de tracé par des arguments redondants concernant la taille des polices, l’épaisseur des traits de repère, la résolution de tramage ou la famille typographique, le chercheur avisé modifie directement ce dictionnaire de configuration globale au début de son script. En ajustant des paramètres fondamentaux tels que la résolution en points par pouce pour l’affichage interactif et l’exportation, la typographie par défaut pour les notations mathématiques, et la disposition géométrique standard des marges, on s’assure d’une cohérence sémiotique absolue à travers l’ensemble des figures générées au cours d’une campagne expérimentale.
2. Préparation et structuration rigoureuse des données chronologiques
2.1 Conversion et validation des objets temporels avec datetime
L’erreur la plus insidieuse lors du traitement informatique de séries temporelles réside dans le traitement involontaire des dates en tant que chaînes de caractères textuelles non interprétées. Lorsqu’un fichier de données issu d’un capteur ou d’un registre administratif est chargé en mémoire, les estampilles temporelles se présentent quasi systématiquement sous la forme de chaînes de caractères brutes. Si ces chaînes sont transmises telles quelles à un moteur graphique, celui-ci les interprétera comme de simples variables qualitatives catégorielles. Il en résultera une distribution spatiale uniforme des points le long de l’axe horizontal, totalement découplée des véritables intervalles physiques écoulés entre les mesures, occultant ainsi les accélérations ou les décélérations intrinsèques au phénomène sous observation.
Pour remédier à cette dérive méthodologique, il est impératif d’assurer l’encodage précis des timestamps au moyen de structures d’horodatage authentiques. La classe datetime du module homonyme permet d’instancier des objets encapsulant avec exactitude l’année, le mois, le jour, l’heure, la minute, la seconde et la microseconde. L’analyse syntaxique des chaînes textuelles s’opère canoniquement via la fonction strptime pour des flux séquentiels élémentaires, ou de façon massivement parallélisée au moyen de la méthode to_datetime proposée par Pandas. Cette dernière fonction déploie des heuristiques de détection intelligentes mais requiert, pour une robustesse absolue, la spécification explicite du schéma de formatage afin d’éviter toute ambiguïté dramatique entre les conventions calendaires anglo-saxonnes et européennes concernant l’inversion du mois et du jour.
La validation de l’intégrité temporelle implique également la résolution rigoureuse des disparités de fuseaux horaires et la détection des changements d’heure saisonniers. Dans les jeux de données télémétriques internationaux ou financiers à haute fréquence, une mesure non géolocalisée temporellement peut engendrer des discontinuités aberrantes ou des sauts chronologiques artificiels lors des transitions entre temps standard et heure d’été. Il est recommandé, dans toute démarche analytique rigoureuse, de convertir systématiquement l’ensemble des horodatages vers le Temps Universel Coordonné (UTC) en amont de toute modélisation graphique, éliminant ainsi toute confusion contextuelle tout en garantissant une comparabilité absolue entre flux de données provenant de longitudes géographiques divergentes.
2.2 Structuration matricielle des séries temporelles avec Pandas
L’organisation optimale d’une série temporelle destinée à une exploitation graphique poussée repose sur la construction d’un DataFrame Pandas méthodologiquement structuré. Dans cette architecture matricielle, l’axe temporel ne doit pas simplement subsister sous la forme d’une colonne de données conventionnelle, mais être promu au rang d’index explicite, configuré spécifiquement comme un DatetimeIndex. Cette configuration confère à l’objet tabulaire des propriétés analytiques majeures : la sélection temporelle par tranches calendaires devient native, le découpage par périodes s’opère de manière déclarative, et Matplotlib peut interroger directement les métadonnées de l’index pour en déduire les propriétés structurelles de la série sans opération de conversion intermédiaire.
Une fois le DatetimeIndex institué, la vérification de la monotonie de la séquence temporelle constitue une étape de contrôle qualité non négociable. Une série chronologique valide se doit d’être strictement monotone croissante. La présence de mesures désordonnées, consécutives par exemple à l’agrégation non ordonnée de plusieurs fichiers journaux ou à des latences de transmission asynchrones au sein d’un réseau de capteurs, provoquera lors du tracé linéaire un effet de va-et-vient graphique chaotique, la ligne de rendu revenant rétroactivement vers la gauche avant de repartir vers la droite. L’application systématique d’un tri chronologique par la méthode sort_index rétablit la stricte causalité séquentielle nécessaire à un affichage géométrique limpide et mathématiquement valide.
Le traitement méthodologique des valeurs manquantes et des observations asynchrones représente le second impératif de la structuration des données. Dans tout protocole expérimental réel, des interruptions de mesure peuvent survenir du fait de pannes d’alimentation, de saturations matérielles ou de pertes de paquets réseau. Deux approches conceptuelles s’offrent alors au chercheur. La première consiste à préserver les valeurs nulles sous forme de valeurs non définies, signalant explicitement au moteur graphique une interruption de la ligne de tracé afin de matérialiser fidèlement l’absence d’information. La seconde réside dans une interpolation statistique contrôlée, qu’elle soit linéaire, polynomiale ou par splines cubiques, dont la validité dépend strictement de la dynamique d’inertie inhérente au système étudié et des justifications théoriques avancées dans le rapport de recherche.
2.3 Génération de jeux de données empiriques simulés
Dans le cadre de l’apprentissage méthodologique, de la validation d’algorithmes ou de la formalisation de protocoles de test unitaire, la capacité à générer des séries temporelles synthétiques complexes s’avère indispensable. L’utilisation conjointe des générateurs vectoriels de NumPy et des outils calendaires de Pandas permet de créer des trajectoires longitudinales simulant avec un réalisme parfait le comportement de systèmes réels. La fonction date_range de Pandas offre une flexibilité incomparable pour engendrer des séquences d’horodatages d’une régularité absolue, en permettant de paramétrer finement la date d’origine, la date terminale, le nombre total d’itérations ou la fréquence sous-jacente, qu’elle soit exprimée en millisecondes, en jours ouvrés ou en semestres calendaires.
Pour construire une série synthétique représentative d’un phénomène empirique, il convient de composer mathématiquement plusieurs éléments dynamiques distincts. On associera généralement à une dérive tendancielle déterministe, qu’elle soit linéaire, exponentielle ou logistique, une ou plusieurs composantes harmoniques sinusoïdales destinées à simuler les périodicités saisonnières à différentes échelles temporelles. À cette structure systématique s’ajoute une composante stochastique, classiquement modélisée par un bruit blanc gaussien ou un processus autorégressif intégré, qui introduit la variabilité aléatoire inhérente à tout système physique, écologique ou macroéconomique réel.
La standardisation du format de ces données synthétiques constitue le garant de leur parfaite interopérabilité avec les différentes méthodes de tracé de Matplotlib. En encapsulant les vecteurs temporels et les réalisations aléatoires au sein d’un DataFrame rigoureusement typé, le chercheur s’assure que toutes les opérations ultérieures de manipulation, de filtrage statistique, d’étiquetage sémantique et de rendu graphique s’effectueront sans friction technique. Cette approche permet en outre d’évaluer la résilience des représentations graphiques face à des variations extrêmes du rapport signal sur bruit et d’anticiper la lisibilité des visualisations avant le déploiement opérationnel sur des données de terrain réelles.
3. Tracé fondamental d’une série temporelle univariée
3.1 Syntaxe de base et exécution avec plt.plot()
Le tracé d’une série temporelle univariée repose fondamentalement sur la mise en relation bidimensionnelle d’un vecteur d’abscisses représentant l’écoulement chronologique et d’un vecteur d’ordonnées quantifiant la grandeur sous observation. Au niveau le plus direct de l’interface fonctionnelle de Matplotlib, cette opération est orchestrée par la fonction plt.plot(). Lorsqu’on lui transmet des dates sous forme d’objets compatibles et des valeurs numériques d’égale dimension, la fonction engage un processus complexe d’analyse géométrique : elle évalue les étendues des deux séries, calcule les bornes extrêmes nécessaires pour contenir l’intégralité des points, projette les coordonnées dans un système de repère orthonormé virtuel et trace des segments de droite reliant consécutivement chaque paire de coordonnées adjacentes.
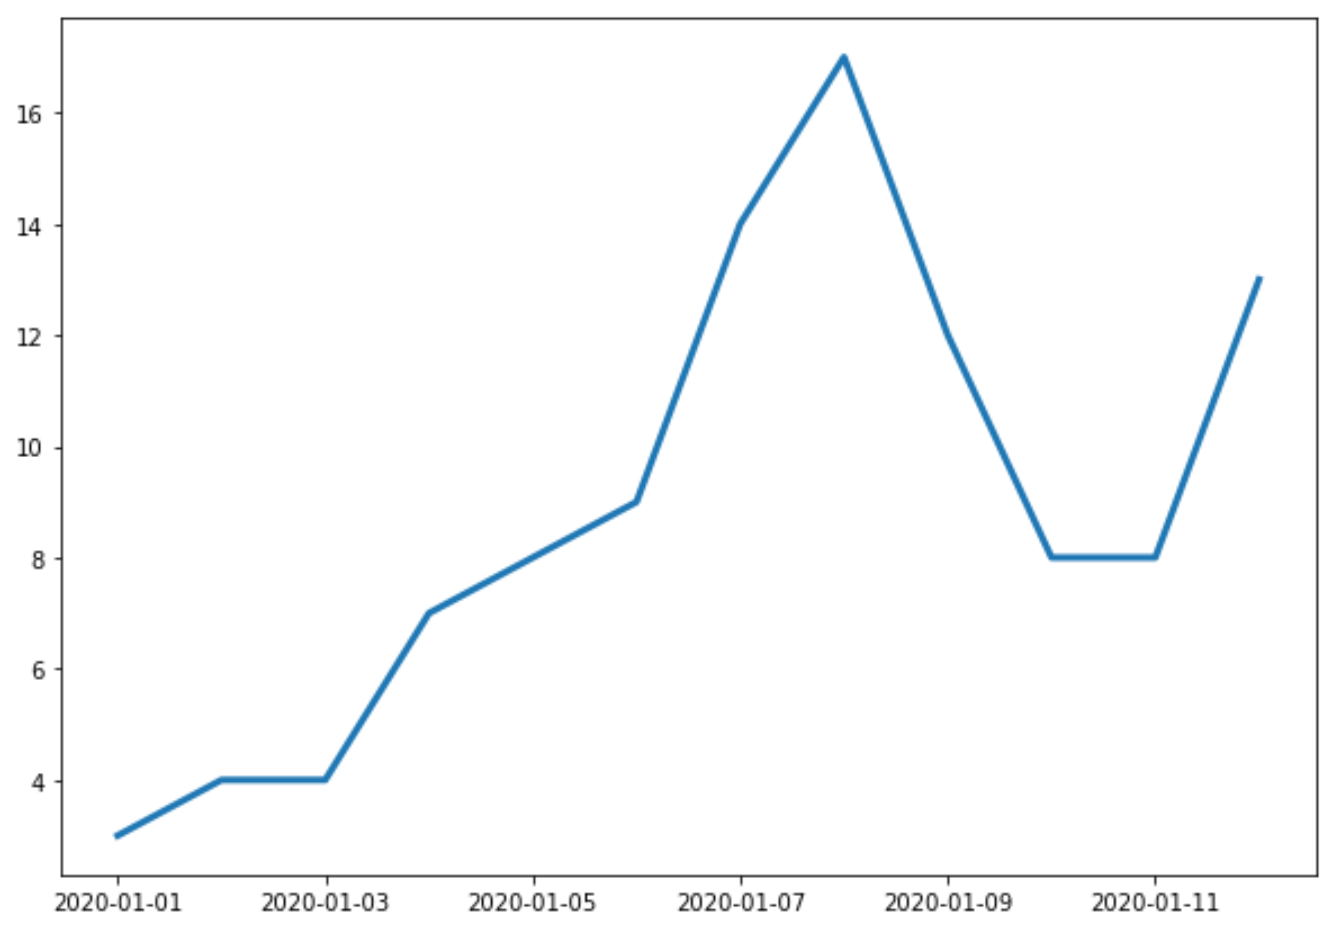
Le comportement par défaut de l’interpréteur graphique mérite une attention particulière. En l’absence de directives de configuration explicites, Matplotlib applique des choix heuristiques prédéfinis concernant la couleur de la ligne, l’échelle des axes et le placement des graduations. Si les abscisses correspondent à des objets temporels authentiques, le système active automatiquement ses mécanismes de mise à l’échelle temporelle pour graduer l’axe de manière intelligible. Cependant, cette automatisation montre rapidement ses limites dès lors que la série présente une densité d’échantillonnage élevée ou des particularités périodiques qui échappent aux règles génériques du moteur de rendu, ce qui nécessite une intervention manuelle du programmeur sur la structure de l’affichage.
L’aboutissement de la séquence de tracé fonctionnelle s’effectue par l’invocation de la commande plt.show(). Cette instruction ordonne au backend graphique actif d’ouvrir une fenêtre de visualisation interactive ou de compiler le rendu final dans le carnet de travail numérique utilisé. Il importe de souligner que cette commande finalise le cycle de vie de la figure courante dans le modèle impératif : une fois le rendu exécuté et la fenêtre fermée, l’état graphique interne est réinitialisé, ce qui signifie que toute tentative ultérieure d’ajouter des annotations ou de modifier des styles sur cette même figure s’appliquera en réalité à un nouveau canevas vierge, source récurrente d’incompréhension pour les praticiens non avertis.
3.2 Exemple pratique initial : suivi des ventes journalières
Afin de concrétiser ces principes fondamentaux, considérons le cas d’usage canonique d’un suivi de ventes commerciales journalières enregistrées sur un horizon de douze jours consécutifs. Ce scénario élémentaire permet d’illustrer la chaîne de traitement complète, depuis l’instanciation de la structure de données jusqu’à l’examen critique du rendu brut. En créant un tableau de dates s’étendant du premier au douze janvier d’une année donnée, et en lui associant une série de réalisations quantitatives simulant un chiffre d’affaires quotidien en milliers d’unités monétaires, nous obtenons une matrice temporelle minimale mais parfaitement opérationnelle pour un tracé immédiat.
Le passage direct de ces deux vecteurs à la fonction de tracé engendre un graphique épuré qui met instantanément en lumière les oscillations du chiffre d’affaires au fil de la période. Le chercheur peut immédiatement ajuster des paramètres stylistiques élémentaires pour améliorer la lisibilité du tracé : l’argument linewidth, par exemple, permet de calibrer la présence optique du trait de tracé sur la surface graphique. Un trait excessivement fin peine à guider l’attention visuelle et peut disparaître lors de l’impression sur support papier ou de la réduction d’échelle, tandis qu’un trait disproportionnellement épais masque les fluctuations subtiles du signal et engendre des imprécisions géométriques au niveau des sommets et des creux locaux.
Toutefois, l’évaluation critique de ce tracé brut initial révèle des lacunes flagrantes au regard des standards de la communication scientifique. Bien que les données soient fidèlement reliées, l’absence de titre contextuel plonge le lecteur dans l’incertitude quant à la nature exacte de la variable mesurée. Les axes ne mentionnent ni les unités de mesure sur l’axe vertical, ni la qualification explicite de l’axe temporel horizontal. De surcroît, les étiquettes de dates générées automatiquement par le moteur par défaut peuvent se chevaucher ou présenter des indications horaires superflues pour un enregistrement strictement quotidien. Cet état de fait démontre avec éclat que le tracé brut ne constitue que l’embryon d’une véritable figure scientifique finalisée.
3.3 Approche orientée objet : fig, ax = plt.subplots()
Pour dépasser les contraintes inhérentes au modèle procédural et asseoir ses visualisations sur une base logicielle pérenne, il est impératif d’adopter sans réserve le paradigme orienté objet de Matplotlib. Cette approche s’articule autour de l’instruction fondamentale fig, ax = plt.subplots(). Cette commande instancie simultanément deux entités distinctes : un conteneur Figure, qui représente l’espace global du canevas graphique incluant les marges, les éventuelles légendes externes et les métadonnées de rendu, et un ou plusieurs conteneurs Axes, qui incarnent les zones de dessin effectives délimitées par leurs repères de coordonnées, leurs axes respectifs et leurs éléments de tracé spécifiques.
Dans ce modèle, toute opération graphique cesse d’être une fonction globale anonyme pour devenir une méthode explicitement invoquée sur l’objet de destination. Ainsi, au lieu d’appeler plt.plot(), on exécutera ax.plot(). Cette distinction méthodologique garantit une traçabilité totale des modifications apportées au graphique. L’état interne du système graphique n’est plus implicite ni dépendant de l’ordre d’exécution de commandes dispersées au sein du script, mais rigoureusement encapsulé dans des instances identifiables, ce qui s’avère absolument déterminant dès lors que l’on manipule des figures complexes comprenant de multiples panneaux analytiques interconnectés.
L’approche orientée objet offre également des gains d’efficience considérables dans le cadre du développement modulaire et de l’ingénierie logicielle. Il devient possible de concevoir des fonctions de traçage spécialisées recevant un objet de type Axes en paramètre, réalisant des opérations d’habillage graphique avancées sur cet axe spécifique, puis le restituant au flux principal du programme sans interférer avec d’autres figures ouvertes simultanément en mémoire. Cette modularité constitue le socle indispensable pour automatiser la génération récurrente de rapports scientifiques ou pour intégrer des visualisations de séries chronologiques au sein d’applications analytiques industrielles complexes.
4. Personnalisation sémantique : titres, étiquettes et grille analytique
4.1 Définition des métadonnées textuelles de haut niveau
Dans la communication scientifique et technique, une visualisation graphique ne saurait se suffire à elle-même sans un appareil textuel explicite et rigoureusement hiérarchisé. La première composante de cette armature informative est le titre du graphique, défini par la méthode ax.set_title(). Loin d’être un simple libellé ornemental, le titre doit formuler une proposition sémantique claire : il précise la variable sous observation, la population ou le système expérimental étudié, ainsi que la fenêtre temporelle embrassée par les données. Un titre formulé de manière trop vague, tel que « Évolution temporelle », contraint le lecteur à un effort de déchiffrement cognitif inutile, là où une formulation précise permet une assimilation instantanée de l’objet de la recherche.
Le contrôle typographique du titre contribue directement à la clarté de la restitution visuelle. Matplotlib offre une paramétrisation chirurgicale de la fonte de caractères à travers des arguments dédiés. Le paramètre fontsize régit l’échelle optique du titre, qui doit affirmer son autorité visuelle sans pour autant écraser l’espace dévolu au tracé des données lui-même. L’argument fontweight permet d’appliquer une graisse typographique plus affirmée, renforçant la démarcation entre le titre principal et d’éventuels sous-titres secondaires. Enfin, la distance de séparation verticale par rapport au cadre de tracé, gérée par le paramètre pad, prévient tout contact visuel inélégant entre les lettres descendantes du texte et la bordure supérieure de l’espace de données.
Le positionnement spatial du titre constitue un choix sémiologique qui répond à des normes de mise en page précises. Si le centrage horizontal demeure le comportement par défaut le plus répandu, l’alignement sur la marge gauche de la zone de traçage, obtenu au moyen de l’argument loc=’left’, gagne une faveur croissante au sein de la littérature de pointe et des organes de presse statistique de premier ordre. Cette disposition s’aligne naturellement sur le sens de lecture occidental traditionnel, guidant le regard depuis l’intitulé de la variable directement vers l’origine de l’axe des ordonnées, instaurant ainsi une fluidité perceptive optimale qui minimise la charge cognitive du lecteur lors de la découverte de la figure.
4.2 Étiquetage rigoureux des axes dimensionnels
L’étiquetage des axes dimensionnels relève de la stricte déontologie scientifique et mathématique. Tracer une courbe sans désigner formellement les grandeurs mesurées transforme une démarche d’investigation rigoureuse en une simple esquisse illustrative dénuée de valeur probante. La méthode ax.set_xlabel() permet de caractériser l’axe des abscisses. Dans le cadre d’une série temporelle, bien que la nature chronologique de l’axe paraisse souvent évidente de prime abord, il demeure indispensable d’indiquer l’unité de temps fondamentale adoptée ou le fuseau horaire de référence, particulièrement lorsque l’échelle sous-jacente relève d’une granularité infra-journalière ou d’un calendrier expérimental relatif découplé des dates absolues.
Sur l’axe des ordonnées, la rigueur s’impose avec une acuité accrue via la méthode ax.set_ylabel(). L’étiquette ne doit pas uniquement nommer la grandeur observée, mais préciser sans équivoque son unité de mesure physique, financière ou statistique normalisée, idéalement consignée entre crochets ou parenthèses conformément aux standards internationaux. L’omission des unités ou l’emploi d’abréviations non documentées constitue l’une des sources majeures d’erreur d’interprétation dans l’analyse de données expérimentales. Il convient en outre de veiller à ce que la typographie de l’étiquette verticale s’accorde harmonieusement avec celle des graduations chiffrées, afin de maintenir une hiérarchie optique cohérente le long du segment vertical.
L’ergonomie de lecture des axes passe également par un réglage soigné du padding, qui définit l’intervalle spatial séparant l’étiquette textuelle des repères chiffrés de l’axe. Lors de l’utilisation de valeurs numériques d’ordonnées élevées comportant de nombreux chiffres significatifs ou des signes négatifs, les graduations peuvent empiéter sur l’espace dévolu à l’étiquette descriptive si les marges par défaut s’avèrent insuffisantes. L’ajustement explicite de ce paramètre d’espacement garantit que chaque composante textuelle dispose d’une respiration visuelle suffisante, préservant la distinction nette entre les valeurs numériques quantitatives et la dénomination sémantique de la variable.
4.3 Intégration d’une grille de repérage fonctionnelle
L’adjonction d’une grille de repérage analytique, orchestrée par la méthode ax.grid(), répond à un impératif fonctionnel majeur : permettre au lecteur d’évaluer avec précision la valeur quantitative d’un point à un instant donné sans devoir recourir à un instrument de mesure physique extérieur. Cependant, l’intégration d’une grille soulève un arbitrage sémiologique délicat, théorisé notamment par Edward Tufte dans ses travaux sur le ratio encre-données. Une grille trop agressive sur le plan chromatique ou typographique encombre l’espace visuel d’un bruit géométrique parasite qui concurrence directement la trajectoire de la série temporelle et fatigue prématurément le système visuel de l’analyste.
Pour concilier utilité géométrique et sobriété perceptive, la différenciation entre la grille principale et la grille secondaire offre une solution méthodologique élégante. La grille principale s’aligne rigoureusement sur les graduations majeures de l’axe, matérialisant les jalons temporels et quantitatifs déterminants du repère. La grille secondaire, activée en ciblant les graduations mineures, dessine un maillage plus serré mais requiert un traitement graphique d’une grande discrétion. En attribuant à ces lignes de repère des épaisseurs minimales et des motifs discontinus comme les pointillés ou les tirets fins, le chercheur offre un outil de lecture de haute précision tout en reléguant la structure de repérage à l’arrière-plan cognitif de l’image.
La modulation de l’opacité au moyen de l’argument alpha constitue le levier ultime d’ajustement de la grille analytique. En réduisant l’opacité des traits de grille à des fractions légères de leur valeur maximale, on dissout littéralement la dureté visuelle des lignes géométriques pour n’en conserver qu’un murmure spatial. Le contraste demeure suffisant pour guider l’extrapolation optique de l’œil le long des axes, mais s’efface totalement devant la densité continue de la courbe temporelle. Le choix d’une teinte neutre, telle qu’un gris moyen, permet de garantir que la grille ne rentre à aucun moment en conflit chromatique avec les codes de couleur thématiques attribués aux séries de données tracées au premier plan.
5. Maîtrise avancée du formatage des axes temporels avec matplotlib.dates
5.1 Le module matplotlib.dates et le concept de date numéraire
Pour maîtriser pleinement la manipulation des axes temporels dans Matplotlib, il est indispensable de comprendre le modèle mathématique interne utilisé par la bibliothèque pour convertir des temporalités humaines en coordonnées géométriques continues. Contrairement à une idée reçue, Matplotlib ne trace pas directement des dates au sens informatique usuel du terme. Il s’appuie sur une transformation d’échelle sous-jacente opérée par le module spécialisé matplotlib.dates, qui convertit chaque objet temporel en un nombre réel à virgule flottante, représentant le nombre ordinal de jours écoulés depuis une époque de référence arbitraire fixée par convention au premier janvier de l’an 0001 du calendrier grégorien étendu.
Dans ce modèle ordinal, les fractions de journée sont tout naturellement encodées par la partie décimale du nombre flottant : ainsi, une unité entière correspond exactement à un cycle de vingt-quatre heures, une demi-unité à une durée de douze heures, et ainsi de suite jusqu’aux fractions infinitésimales de seconde. Cette projection continue confère au moteur de tracé la capacité d’interpoler des positions géométriques avec une rigueur mathématique absolue le long d’une droite continue d’abscisses. Cependant, cette abstraction impose une contrainte majeure : le développeur doit orchestrer la traduction inverse, c’est-à-dire faire correspondre à ces nombres réels continus des repères visuels compréhensibles pour l’être humain, matérialisés sous forme d’années, de trimestres, de mois ou d’horaires journaliers.
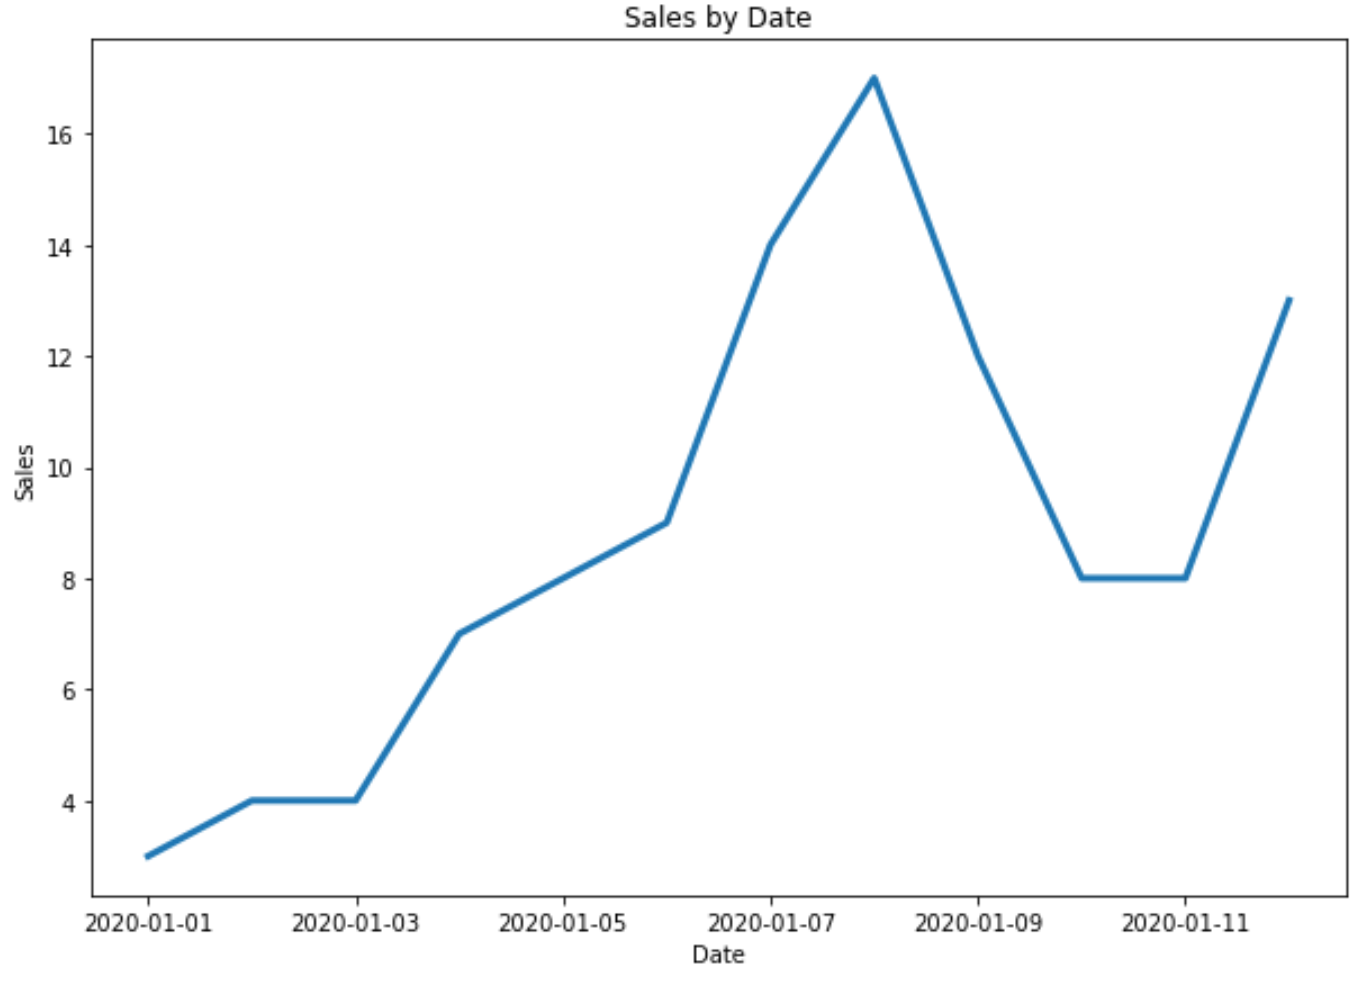
C’est précisément l’objet des deux grandes familles de classes fournies par le module matplotlib.dates : les localisateurs de graduations (Locators) d’une part, et les formateurs syntaxiques d’étiquettes (Formatters) d’autre part. Les premiers assument la responsabilité exclusivement géométrique de déterminer où, sur l’axe continu des abscisses, des repères visuels doivent être implantés. Les seconds ont pour mission de convertir la valeur flottante ordinale sous-jacente à chaque repère en une chaîne de caractères calendaire textuelle conforme aux exigences de l’analyste. La dissociation formelle de ces deux responsabilités confère à Matplotlib une flexibilité architecturale inégalée pour résoudre n’importe quel défi d’affichage chronologique, des séries millénaires aux signaux physiques ultra-rapides.
5.2 Localisateurs de graduations majeurs et mineurs
Le contrôle de la densité spatiale des graduations temporelles s’exécute par l’entremise des méthodes ax.xaxis.set_major_locator() et ax.xaxis.set_minor_locator(). Le module matplotlib.dates met à la disposition du praticien une panoplie de classes spécialisées adaptées à chaque granularité calendaire imaginable. Pour des séries s’étalant sur plusieurs décennies ou siècles, la classe YearLocator permet de fixer des repères annuels stricts, en acceptant des paramètres de pas pour espacer les repères tous les cinq ou dix ans. Pour des échelles intermédiaires, MonthLocator et WeekdayLocator offrent des leviers d’ancrage périodiques alignés sur les réalités saisonnières ou professionnelles de l’activité humaine.
Pour des études longitudinales à haute résolution s’étendant sur quelques semaines ou mois, la classe DayLocator permet de contraindre l’implantation des marques de repère à un pas journalier déterminé. En passant par exemple l’argument interval=2, on force le tracé d’une graduation tous les deux jours, empêchant ainsi la saturation visuelle qui découlerait de l’affichage de chaque unité journalière individuelle sur un axe de longueur finie. L’usage conjoint d’un localisateur majeur positionné sur le premier jour de chaque semaine et d’un localisateur mineur implanté sur chaque jour individuel permet de structurer la lecture du temps de manière hiérarchique et remarquablement intuitive pour l’esprit humain.
Lorsque la série temporelle est soumise à des filtres interactifs dynamiques ou lorsque le script graphique doit s’adapter automatiquement à des jeux de données d’étendues calendaires imprévisibles à l’avance, l’utilisation de la classe AutoDateLocator s’avère particulièrement judicieuse. Cet algorithme sophistiqué analyse en temps réel la portée mathématique de la fenêtre visible sur l’axe horizontal et commute dynamiquement d’une granularité annuelle à une granularité mensuelle, journalière ou horaire en fonction du facteur d’agrandissement actif. Cette automatisation intelligente supprime le besoin de recalculer manuellement les espacements d’axes tout en préservant une densité de graduations toujours optimale et exempte de chevauchements typographiques.
5.3 Formatage syntaxique des dates affichées
La transformation sémantique des positions géométriques en mentions textuelles intelligibles s’opère par l’association d’un objet DateFormatter à l’axe des abscisses, via la méthode ax.xaxis.set_major_formatter(). Cette classe s’appuie sur la syntaxe universelle de formatage strftime, offrant un contrôle absolu sur la composition textuelle de la date. Ainsi, des descripteurs de formatage permettent d’extraire sélectivement l’année sur quatre chiffres ou sur deux chiffres, le mois sous forme numérique ou sous forme d’abréviation alphabétique, le quantième du mois, l’heure en format militaire et les fractions de seconde avec la précision requise par l’investigation.
La concision lexicale constitue la règle d’or du formatage des axes temporels. Surcharger les étiquettes en répliquant inutilement des informations d’année et de mois sur chaque graduation journalière dégrade lourdement la clarté visuelle de l’ensemble. Il est méthodologiquement bien plus élégant d’adopter un formatage synthétique n’affichant que l’information discriminante sur les graduations régulières, et de déporter la mention du contexte global dans l’étiquette de l’axe ou dans le titre du panneau. Cette parcimonie scripturale permet de préserver un espace négatif substantiel entre les blocs textuels, condition fondamentale d’une lecture rapide et sans effort cognitif parasitaire.
L’adaptation culturelle et linguistique du formatage des dates représente un autre aspect clé de l’exercice académique. Par défaut, Matplotlib exploite la configuration régionale standard du système d’exploitation hôte, ce qui conduit fréquemment à la génération d’abréviations de mois en langue anglaise. Pour des publications savantes ou des rapports institutionnels exigeant une stricte conformité avec les conventions typographiques francophones, le chercheur peut modifier temporairement la localisation linguistique de l’interpréteur via le module standard locale. Cette manipulation garantit l’affichage harmonieux des noms de mois en français, évitant ainsi les dissonances orthographiques au sein d’un document rédigé dans la langue de Molière.
5.4 Orientation et ergonomie visuelle des étiquettes d’abscisse
L’un des désagréments graphiques les plus fréquents lors du tracé de séries temporelles réside dans le chevauchement horizontal des chaînes de caractères calendaires le long de l’axe des abscisses. En raison de leur longueur textuelle intrinsèque, des étiquettes disposées horizontalement entrent facilement en collision dès lors que la densité des graduations dépasse un certain seuil critique. Pour éliminer cette congestion typographique, la rotation géométrique des étiquettes offre une parade technique immédiate. En appliquant une inclinaison angulaire contrôlée, on réduit drastiquement l’encombrement horizontal de chaque mention, permettant d’aligner une densité de graduations nettement supérieure sur une même largeur de canevas.
Bien qu’il soit techniquement possible de paramétrer manuellement cette rotation via la méthode plt.xticks(rotation=45) ou en agissant sur les propriétés textuelles de chaque étiquette d’axe, Matplotlib propose une méthode native remarquablement plus sophistiquée : fig.autofmt_xdate(). Conçue spécialement pour les séries chronologiques, cette fonction automatise non seulement l’inclinaison angulaire des étiquettes selon un angle conventionnel optimal, mais procède également à un ajustement chirurgical de leur point d’ancrage géométrique horizontal. Les étiquettes sont automatiquement alignées par leur bord droit sur le trait de graduation correspondant, ce qui élimine tout flottement optique et prévient les erreurs de parallaxe visuelle quant à l’assignation temporelle exacte de chaque graduation.
Enfin, l’ergonomie visuelle globale de l’axe temporel est indissociable d’un calibrage rigoureux des frontières de traçage au moyen de la méthode ax.set_xlim(). Par défaut, Matplotlib ajoute souvent des marges blanches de quelques pourcents de part et d’autre des données extrêmes. Si cette marge s’avère utile pour des nuages de points conventionnels, elle nuit souvent à la lecture des séries temporelles en créant des zones de vide temporel avant la première mesure et après la dernière. En calant explicitement les limites de l’axe sur la date initiale et la date terminale réelles de l’échantillon, on ancre la série de manière franche et équilibrée dans les contours géométriques du cadre de dessin.
6. Styles de rendu visuel, marqueurs de points et palettes chromatiques
6.1 Typologie et modulation des lignes continues
Dans la sémiologie graphique appliquée aux séries chronologiques, la modulation stylistique de la ligne continue ne constitue pas un choix purement décoratif, mais un vecteur fondamental de différenciation conceptuelle. Matplotlib offre une riche taxonomie de motifs de ligne, englobant les traits continus stricts, les tirets réguliers, les pointillés fins et les combinaisons mixtes alternant traits et points. Dans une analyse multivariée, il est scientifiquement judicieux d’attribuer la ligne continue aux données empiriques brutes ou à la trajectoire principale, tandis que les motifs discontinus sont traditionnellement réservés à des représentations secondaires telles que des extrapolations prédictives, des seuils normatifs théoriques ou des trajectoires contrefactuelles simulées.
L’épaisseur de la ligne, gouvernée par l’argument linewidth, exerce une influence déterminante sur la hiérarchie perceptive de la figure. En neurobiologie de la vision, les contrastes d’épaisseur constituent des signaux pré-attentifs puissants qui orientent instantanément la focalisation du regard de l’observateur. Une ligne maîtresse dotée d’une épaisseur substantielle s’imposera immédiatement au premier plan cognitif, tandis que des séries contextuelles d’arrière-plan, tracées avec un trait effilé, continueront de fournir une information comparative sans pour autant rivaliser avec l’objet central de la démonstration. Cet équilibre des forces graphiques prévient la surcharge mentale et guide l’analyse dans l’ordre de priorité défini par le chercheur.
La gestion de la transparence chromatique au moyen du paramètre alpha apporte une réponse élégante au problème récurrent de l’occultation visuelle lors du tracé de séries denses ou bruitées. Lorsqu’un signal chronologique présente une forte dispersion ou lorsqu’une multitude de trajectoires individuelles sont tracées conjointement, la superposition de traits totalement opaques engendre des aplats informes qui masquent la densité sous-jacente des observations. En abaissant le coefficient d’opacité à une valeur intermédiaire, les segments qui se croisent s’enrichissent mutuellement par cumul optique, révélant naturellement les zones de forte concentration de données et conférant une translucidité analytique de premier ordre au graphique.
6.2 Mise en évidence des observations discrètes par les marqueurs
Si la ligne continue matérialise l’hypothèse d’une continuité sous-jacente du phénomène physique ou économique, les marqueurs géométriques réaffirment l’existence discrète des mesures réelles sur le terrain. L’argument marker permet de ponctuer la courbe temporelle par une grande diversité de formes géométriques normalisées : cercles, carrés, triangles orientés, losanges ou croix. L’introduction de marqueurs s’avère particulièrement indispensable lorsque le pas d’échantillonnage de la série temporelle est irrégulier dans le temps, car elle signale sans équivoque au lecteur l’emplacement exact des actes de mesure, l’empêchant de confondre un segment linéaire d’interpolation longue avec une phase de stabilité parfaite du signal.
La configuration géométrique fine des marqueurs implique un dosage harmonieux de leur dimension et de leurs contours. L’argument markersize détermine l’échelle spatiale de la forme, qui doit être suffisamment affirmée pour être repérée sans pour autant générer une constellation géométrique étouffante. Pour maximiser la lisibilité optique, Matplotlib permet de dissocier la teinte interne du marqueur de sa frontière externe via les arguments markerfacecolor et markeredgecolor, complétés par le paramètre markeredgewidth qui règle l’épaisseur de la bordure. L’emploi d’un intérieur blanc ou d’une teinte contrastée cerclée par la couleur dominante de la courbe produit un détachement visuel exemplaire qui fait ressortir chaque observation individuelle au-dessus de la ligne de tracé.
Il importe toutefois de souligner le danger sémiologique majeur d’une utilisation indifférenciée des marqueurs sur des séries à haute fréquence temporelle. Si l’on applique des marqueurs circulaires à un signal comportant plusieurs milliers de points d’enregistrement, les symboles géométriques se chevaucheront inévitablement jusqu’à former une bande noire continue et illisible, annihilant toute distinction fine du signal. Les marqueurs doivent donc être réservés aux séries comportant un nombre d’observations modéré, ou être appliqués de manière sélective à des sous-échantillons périodiques ou à des événements critiques remarquables à l’aide de masques logiques d’indexation booléenne.
6.3 Sélection chromatique académique et accessibilité
La sélection chromatique dans une figure scientifique engage directement l’intégrité de la transmission des résultats et l’universalité de l’accès à la connaissance. L’usage anarchique de couleurs vives non coordonnées, souvent issues de palettes par défaut mal calibrées, engendre des distorsions de perception notables et peut rendre un graphique totalement indéchiffrable pour la fraction substantielle de la population masculine et féminine présentant des déficiences de la vision des couleurs, telles que le daltonisme sous ses différentes formes de deutéranopie ou de protanopie.
Pour répondre à cet impératif d’accessibilité universelle, il est vivement recommandé d’abandonner les contrastes binaires rouge-vert traditionnels au profit de palettes perceptuellement uniformes et certifiées adaptées aux déficiences visuelles. Les colormaps contemporaines intégrées à Matplotlib, à l’instar de Viridis, Plasma, Cividis ou Inferno, ont été conçues selon des principes mathématiques stricts garantissant que la progression de la luminance perçue est rigoureusement linéaire et monotone. Ainsi, même lorsqu’une figure imprimée en niveaux de gris ou observée par un individu daltonien est examinée, la hiérarchie quantitative et la distinction des différentes courbes demeurent parfaitement préservées sans aucune perte d’intelligibilité.
Dans un contexte de publication professionnelle ou académique, il est de bonne pratique de formaliser sa charte chromatique au moyen de codes hexadécimaux précis. L’attribution de teintes sobres et institutionnelles, telles que des bleus profonds, des ocres éteints ou des gris ardoise, confère aux figures un caractère de sérieux et de rigueur formelle. En définissant explicitement ces identifiants chromatiques sous forme de variables immuables au début de son pipeline de visualisation, le chercheur s’assure d’une harmonie visuelle exemplaire entre les différentes planches de données composant un mémoire de thèse, une communication de conférence ou un rapport d’évaluation stratégique.
7. Visualisation de séries chronologiques multiples et comparatives
7.1 Superposition de plusieurs courbes sur un repère unique
L’analyse comparative de dynamiques temporelles concomitantes constitue l’une des démarches les plus fécondes de l’investigation empirique. La méthode la plus intuitive pour opérer ce rapprochement réside dans la superposition directe de plusieurs séries au sein d’un même repère cartésien, par des invocations successives de la méthode ax.plot() sur le conteneur Axes partagé. Cette approche permet de confronter instantanément la synchronisation des pics et des creux, de mettre en évidence des relations de phase ou d’estimer visuellement l’élasticité de la réponse d’une variable à l’impulsion induite par une autre sur une chronologie commune.
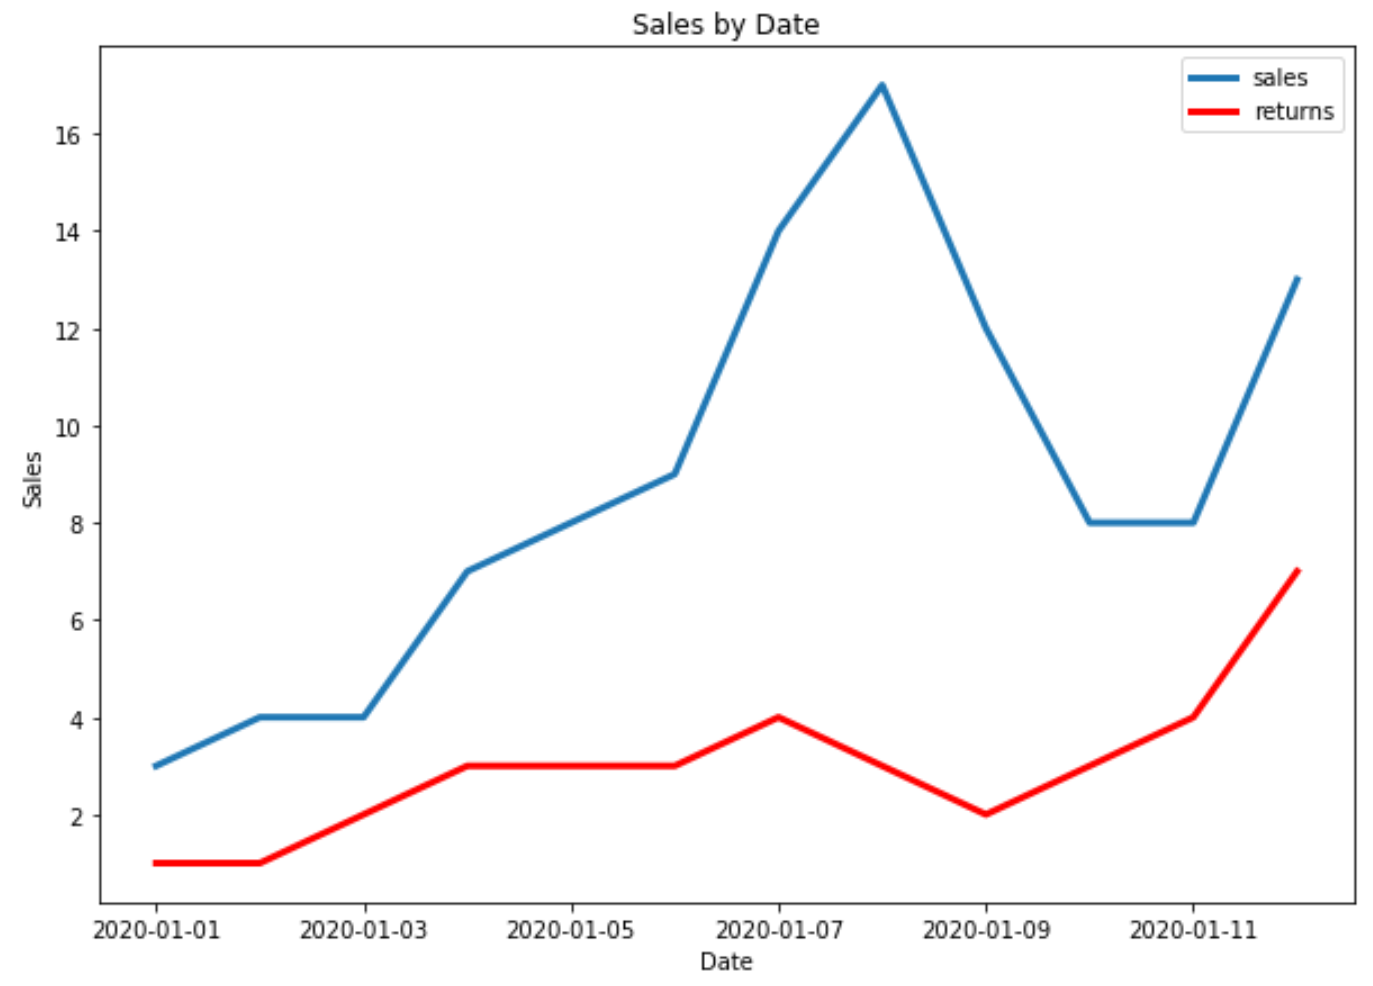
La condition méthodologique absolue d’une telle superposition réside dans l’alignement temporel rigoureux des données. Dans les protocoles réels, les différentes séries comparées ne partagent pas nécessairement une régularité d’échantillonnage identique ni des dates de début et de fin parfaitement synchrones. L’utilisation conjointe des mécanismes d’alignement d’index de Pandas garantit que chaque observation est rigoureusement projetée à sa coordonnée temporelle exacte, évitant ainsi le risque fatal de juxtaposer des points désynchronisés comme si les mesures avaient été opérées au même instant.
La présence d’une légende exhaustive et impeccablement positionnée devient dès lors un élément critique de l’architecture graphique. L’argument label doit être soigneusement renseigné lors de chaque appel à ax.plot(), formalisant le descripteur sémantique de chaque série. L’affichage est ensuite matérialisé par l’instruction ax.legend(). L’argument loc permet d’assigner une localisation optimale à la boîte de légende pour éviter qu’elle ne vienne masquer des fluctuations cruciales de la courbe. Dans les cas où l’espace intérieur est saturé, la légende peut être déportée à l’extérieur du cadre au moyen de l’argument bbox_to_anchor, préservant ainsi l’intégralité du champ de tracé pour l’observation des données.
7.2 Gestion des doubles axes ordonnés (Twin Axes)
Lorsque les séries temporelles soumises à la comparaison mesurent des grandeurs physiques de natures distinctes ou évoluent dans des ordres de grandeur radicalement hétérogènes, la superposition directe sur une échelle verticale unique s’avère impossible. Une variable fluctuant entre zéro et un sera complètement écrasée et visualisée comme une ligne horizontale plate si elle partage un axe des ordonnées calibré pour une grandeur évoluant entre des milliers et des millions d’unités. Pour résoudre cette divergence d’échelles tout en maintenant la simultanéité de la lecture temporelle, Matplotlib propose la technique du double axe vertical, articulée autour de la méthode ax.twinx().
L’exécution de la méthode ax.twinx() génère un nouvel objet Axes qui partage exactement la même coordonnée horizontale et la même échelle d’abscisses que l’axe initial, mais dispose d’un axe vertical totalement indépendant, positionné sur le bord droit du cadre de traçage. Le chercheur peut alors affecter une série à l’axe primaire gauche et l’autre série à l’axe secondaire droit. Pour prévenir tout biais cognitif d’association, il est impératif d’appliquer une règle de liaison chromatique absolue : l’étiquette descriptive, les repères chiffrés et la ligne de l’axe vertical doivent adopter exactement la même couleur que la courbe temporelle à laquelle ils se réfèrent, guidant le regard sans ambiguïté vers la référence de lecture appropriée.
Malgré sa commodité technique, l’utilisation de doubles axes ordonnés doit faire l’objet d’une grande prudence méthodologique et statistique. De nombreux théoriciens de la visualisation soulignent le risque inhérent de manipulation visuelle involontaire : en modifiant arbitrairement les bornes minimales et maximales des deux axes verticaux, un analyste peut fabriquer artificiellement des croisements visuels de courbes ou exagérer des corrélations de surface qui ne correspondent à aucune réalité mathématique sous-jacente. L’expérimentateur doit veiller à ancrer ses échelles sur des zéros signifiants ou à standardiser préalablement ses séries sous forme de scores centrés-réduits si l’objectif prioritaire réside dans la démonstration d’une co-mouvement statistique véritable.
7.3 Techniques de distinction pour séries concurrentes denses
Lorsque l’investigation empirique exige la comparaison non plus de deux ou trois séries, mais d’une dizaine ou d’une centaine de trajectoires simultanées, comme c’est le cas lors du suivi de cohortes cliniques ou d’analyses sectorielles exhaustives, les méthodes de différenciation chromatique standard s’effondrent sous le poids d’un phénomène de saturation optique désigné sous le terme de graphique en spaghetti. Face à ce désordre visuel où une multitude de lignes entrelacées s’annulent mutuellement, des stratégies sémiologiques plus subtiles doivent être mobilisées pour restaurer la lisibilité du message scientifique.
La stratégie de focalisation par mise en retrait sélective constitue l’une des solutions les plus élégantes. Elle consiste à attribuer à l’ensemble des séries secondaires non prioritaires une teinte grise uniforme et un coefficient de transparence modéré, créant une nappe de fond texturée qui matérialise l’enveloppe globale de variabilité de la population étudiée. Par-dessus ce fond neutralisé, la série cible ou la trajectoire moyenne de référence est tracée avec une couleur contrastée et une épaisseur nettement renforcée. De cette manière, l’observateur perçoit instantanément la trajectoire d’intérêt spécifique tout en conservant la mise en contexte fondamentale offerte par l’ensemble des données périphériques.
Une autre technique de pointe réside dans le remplacement des légendes conventionnelles par l’étiquetage direct en terminaison de courbe. Dans un graphique dense, les allers-retours oculaires constants entre une boîte de légende distante et les segments de ligne fatiguent le regard et augmentent le risque d’erreur d’identification. En plaçant une annotation textuelle concise directement à l’extrémité droite de chaque courbe temporelle, à la coordonnée exacte de sa dernière valeur enregistrée, on établit une liaison sémiotique immédiate entre le tracé géométrique et son identité nominale, offrant un confort de lecture optimal même au sein de présentations visuelles extrêmement denses en contenu quantitatif.
8. Partitionnement visuel : grilles de sous-graphiques chronologiques
8.1 Décomposition en sous-graphiques avec plt.subplots()
Lorsque la multiplicité des grandeurs mesurées ou la complexité des dynamiques temporelles interdit toute superposition sur un repère unique sous peine d’illisibilité totale, la décomposition de l’espace graphique en une matrice ordonnée de sous-graphiques représente la démarche la plus rigoureuse. La fonction plt.subplots() permet d’instancier de manière programmatique une grille comportant un nombre déterminé de lignes et de colonnes de sous-espaces de projection distincts. L’objet Axes retourné prend alors la forme d’un tableau multidimensionnel d’éléments, que le chercheur peut indexer pour diriger chaque série chronologique vers son panneau dédié.
Cette approche permet d’isoler chaque métrique au sein de son univers d’échelle propre, éliminant ainsi toute distorsion géométrique ou ambiguïté de repère vertical. Le scientifique peut ainsi juxtaposer l’évolution d’une variable environnementale continue, des comptages d’événements discrets et des indicateurs de taux de variation sans risque de parasitage visuel réciproque. Chaque panneau conserve la maîtrise intégrale de ses attributs stylistiques, de ses étiquetages dimensionnels et de ses seuils d’alerte spécifiques, tout en s’inscrivant au sein d’une œuvre graphique globale parfaitement coordonnée et homogène.
La maîtrise de la disposition spatiale et de la respiration géométrique entre les panneaux matriciels s’avère indispensable pour éviter que les étiquettes de graduation d’un graphique supérieur ne chevauchent le titre du graphique placé directement sous lui. L’invocation finale de la méthode tight_layout() permet d’ajuster automatiquement les marges globales et les espaces inter-panneaux en calculant dynamiquement l’encombrement des boîtes d’encadrement des différents textes. Pour des configurations encore plus contraignantes, la méthode subplots_adjust() offre un paramétrage millimétrique manuel des marges supérieure, inférieure, latérale, ainsi que des espacements horizontaux et verticaux entre les repères.
8.2 Partage de l’axe temporel (sharex=True)
Dans une configuration matricielle de séries temporelles superposées verticalement, l’activation du partage d’axe temporel via l’argument sharex=True constitue un impératif méthodologique absolu. Cette option contraint l’ensemble des panneaux composant la colonne graphique à adopter une échelle temporelle rigoureusement identique et parfaitement alignée sur le plan géométrique. Toute translation horizontale ou modification de la fenêtre temporelle visible sur l’un des graphiques se répercute instantanément sur tous les autres, garantissant une synchronisation temporelle inaltérable d’un bout à l’autre de l’analyse visuelle.
Les gains sémiologiques découlant de ce couplage structurel sont considérables. Matplotlib procède automatiquement à l’élagage des étiquettes d’abscisses redondantes sur l’ensemble des panneaux supérieurs, ne conservant les mentions de dates chiffrées que sur la bordure inférieure du dernier graphique de la colonne. Cette suppression méthodique des doublons textuels allège considérablement la charge visuelle globale de la planche, libérant une surface de dessin substantielle pour le déploiement des courbes de données elles-mêmes, tout en guidant naturellement l’observateur le long d’une ligne de temps commune et sans ambiguïté.
Sur le plan de l’investigation interactive, le partage d’abscisses déploie des vertus d’exploration exceptionnelles au sein des environnements d’analyse interactifs. Lorsque l’analyste utilise les outils d’agrandissement ou de panoramique horizontal sur une zone d’intérêt spécifique au sein d’un panneau donné, l’ensemble des panneaux couplés glissent et se redimensionnent de concert avec une parfaite fluidité. Cette corrélation dynamique permet d’examiner instantanément le comportement de l’ensemble des indicateurs du système lors d’un événement critique donné, révélant les causalités en cascade et les temps de latence inter-variables avec une clarté analytique inégalable.
8.3 Affichage en petits multiples (Small Multiples)
Popularisé par la littérature statistique classique et institutionnalisé par les grands concepteurs de systèmes visuels, le concept des petits multiples repose sur la répétition sérielle d’une même structure graphique élémentaire pour visualiser différentes cohortes, catégories expérimentales ou sous-ensembles géographiques. Appliquée aux séries temporelles, cette technique permet de comparer l’évolution chronologique d’une variable cible à travers une multiplicité de contextes distincts en éliminant tout risque de superposition encombrante ou de confusion chromatique.
La mise en œuvre technique de cette approche repose sur l’itération programmatique à travers une collection ordonnée de modalités. Au sein d’une boucle logicielle concise, le script parcourt les sous-groupes de données, filtre les séries correspondantes et les projette sur la case matricielle appropriée au sein de la grille générale. Chaque sous-graphique bénéficie d’un étiquetage minimaliste indiquant la dénomination du sous-ensemble analysé, tout en maintenant des paramètres de tracé, des épaisseurs de trait et des colorimétries rigoureusement uniformes d’un panneau à l’autre, favorisant ainsi la mémorisation immédiate du motif graphique par le cerveau humain.
Le succès cognitif des petits multiples est intimement corrélé au maintien strict de repères d’échelle verticaux cohérents entre l’ensemble des panneaux matriciels. Si chaque sous-graphique ajustait librement ses bornes d’ordonnées au plus près de ses propres extrema locaux, le lecteur serait conduit à surévaluer des variations infinitésimales chez un groupe stable et à sous-estimer des dérives spectaculaires chez un autre. L’uniformisation de l’amplitude verticale via le paramètre sharey=True s’avère donc indispensable pour garantir que les inclinaisons de pentes et les hauteurs de sommets traduisent des réalités mathématiques rigoureusement comparables à l’échelle de l’ensemble de la population étudiée.
9. Annotations qualitatives, seuils critiques et intervalles temporels
9.1 Mise en relief d’événements discrets avec plt.annotate()
L’interprétation statistique des séries chronologiques dépasse largement l’analyse des signaux lissés ; elle implique fondamentalement la contextualisation d’événements contingents qui viennent perturber la régularité du cours des observations. Qu’il s’agisse d’un changement de politique monétaire dans une série macroéconomique, de l’introduction d’un traitement médicamenteux dans un essai thérapeutique ou de la survenue d’un incident opérationnel sur un système industriel, la méthode ax.annotate() offre la puissance sémantique nécessaire pour relier un commentaire analytique textuel précis à une coordonnée spatio-temporelle chirurgicale.
La syntaxe de la méthode ax.annotate() se distingue par sa capacité à gérer deux jeux de coordonnées cartésiennes dissociés : le point d’ancrage physique de l’événement cible sur la courbe temporelle, et l’emplacement de déport du cartouche textuel explicatif. Cette dissociation permet de positionner l’explication dans une zone dégagée du graphique pour préserver la lisibilité de la trajectoire, tandis qu’une flèche directionnelle vectorielle personnalisée relie le texte au point focal. Les propriétés de cette flèche, configurées via le dictionnaire arrowprops, permettent de contrôler sa couleur, son épaisseur, sa courbure et la géométrie de sa pointe terminale avec un niveau de précision académique.
L’habillage typographique de l’annotation peut être complété par l’adjonction d’une boîte d’encadrement configurée via l’argument bbox. En dotant le texte d’un fond subtilement coloré, de bordures arrondies et d’une légère transparence, on isole le message textuel des lignes de grille sous-jacentes qui pourraient en altérer la lisibilité. Cette rigueur dans le marquage des ruptures contextuelles transforme un simple tracé de données en un document d’investigation richement documenté, capable d’exposer de manière persuasive les liens de causalité entre interventions extérieures et perturbations structurelles de la série observée.
9.2 Tracé de lignes de référence temporelles et de seuils de niveau
L’évaluation quantitative des séries temporelles requiert fréquemment la confrontation du signal avec des repères invariants, qu’il s’agisse de jalons calendaires prédéterminés ou de seuils de criticité normatifs. La méthode ax.axvline() permet d’implanter une ligne de repérage verticale continue s’étendant sur toute la hauteur de l’espace de traçage, à une date exacte de l’abscisse. Cet outil est idéal pour matérialiser visuellement la frontière entre une période d’entraînement et une phase de test prédictif dans un modèle de machine learning, ou pour signaler l’instant précis d’un choc structurel exogène au sein d’une dynamique expérimentale.
Symétriquement, l’intégration de seuils quantitatifs horizontaux s’effectue au moyen de la méthode ax.axhline(). Cette fonction projette une ligne parallèle à l’axe des abscisses à une valeur constante ordonnée, permettant de figurer un seuil réglementaire environnemental, une limite d’alerte en contrôle de procédé statistique ou la moyenne séculaire de la variable sous étude. Le tracé de ces repères horizontaux permet à l’œil d’opérer instantanément une partition binaire entre les phases de conformité et les phases de dépassement critique le long de l’axe temporel sans nécessiter de calcul mental fastidieux.
La sobriété stylistique demeure le critère déterminant dans la mise en œuvre de ces lignes de référence. Dans la mesure où elles incarnent des concepts théoriques ou normatifs passifs et non des flux de données dynamiques réels, elles doivent impérativement s’effacer devant le tracé de la série observée. L’adoption d’un style discontinu en tirets légers, l’emploi de teintes désaturées comme le gris ou l’anthracite, et la modération de leur épaisseur structurelle garantissent que ces marqueurs assument pleinement leur fonction de boussole cognitive sans surcharger le premier plan analytique de la figure.
9.3 Surbrillance de périodes et bandes de confiance avec axvspan et fill_between
L’investigation temporelle s’intéresse souvent moins à des instants infinitésimaux isolés qu’à des intervalles temporels continus caractérisés par des conditions contextuelles singulières, telles que des phases de récession économique, des périodes nocturnes dans des études métaboliques ou des saisons de confinement sanitaire. La méthode ax.axvspan() offre une solution géométrique native pour baliser ces durées étendues. En lui transmettant une date de début et une date de fin, la fonction génère un polygone vertical transparent recouvrant l’intégralité de la bande temporelle concernée sur toute la hauteur du repère.
L’application d’un coefficient de transparence alpha particulièrement doux sur ce polygone de surbrillance constitue une règle fondamentale d’hygiène visuelle. La couleur de la zone ombrée doit agir comme un filtre de contextualisation discret à travers lequel la série de mesures et les lignes de repère demeurent parfaitement visibles. L’adjonction d’un libellé textuel sobre au sommet de la bande d’encadrement permet de qualifier sémantiquement la période d’un coup d’œil, offrant ainsi une grille de lecture chronologique immédiate qui explicite les variations structurelles observables sur la série pendant cet intervalle particulier.
Au-delà de la contextualisation par intervalles, la communication scientifique exige très souvent la matérialisation graphique de l’incertitude statistique entourant les estimations temporelles. La méthode ax.fill_between() permet d’ombrer l’espace spatial compris entre deux courbes d’ordonnées partageant le même axe temporel. Cette méthode constitue l’outil de référence pour représenter des intervalles de confiance paramétriques, des écarts interquartiles empiriques ou des zones d’erreur standard de mesure autour d’une courbe moyenne centrale. En nuançant cette nappe d’incertitude d’une teinte coordonnée à celle de la trajectoire maîtresse mais atténuée par une transparence prononcée, on restitue avec fidélité l’amplitude probabiliste des phénomènes sans en compromettre l’élégance formelle.
10. Transformation des données et lissage statistique pour l’affichage
10.1 Calcul et visualisation de moyennes mobiles (Rolling Statistics)
Les données chronologiques brutes issues de mesures physiques, biométriques ou financières se caractérisent fréquemment par une forte dispersion à haute fréquence qui peut obscurcir la trajectoire fondamentale sous-jacente. L’application d’opérateurs de lissage statistique permet de filtrer ce bruit aléatoire pour restituer l’épine dorsale de l’évolution séculaire. Au sein de l’écosystème scientifique Python, l’association de la méthode .rolling() de Pandas et du moteur graphique de Matplotlib fournit un dispositif analytique d’une puissance et d’une simplicité remarquables pour exécuter cette opération de débruitage.
La technique de restitution graphique la plus robuste sur le plan épistémique consiste à superposer la série brute non modifiée et la trajectoire lissée sur un même panneau de coordonnées. La série brute est classiquement tracée avec un trait très effilé et une transparence prononcée, formant un halo texturé qui documente l’intégralité de la variabilité réelle du signal et ne dissimule aucun extrema ponctuel. Par-dessus cette trame d’observations fondamentales, la courbe issue de la moyenne mobile est projetée avec un trait d’épaisseur supérieure et une teinte vive et saturée, permettant à l’œil d’extraire instantanément la dynamique moyenne sans être distrait par la turbulence stochastique locale.
Le choix de la fenêtre temporelle de calcul implique un arbitrage méthodologique fondamental qu’il convient de documenter rigoureusement dans la communication de la figure. Une fenêtre excessivement étroite ne parvient pas à filtrer efficacement le bruit à haute fréquence, tandis qu’une fenêtre démesurément large lisse les retournements de tendance réels et introduit un déphasage temporel substantiel. En effet, les moyennes mobiles arithmétiques standards induisent un retard temporel mécanique proportionnel à la demi-longueur de la fenêtre, décalant visuellement les sommets et les creux vers la droite de l’axe. La prise de conscience de ce biais de phase est capitale pour prévenir des interprétations causales erronées quant à l’antériorité de certains franchissements de seuils.
10.2 Rééchantillonnage temporel et agrégation périodique
Lorsque l’étendue temporelle d’une série atteint plusieurs décennies ou siècles, la projection de mesures individuelles journalières ou horaires n’apporte aucun gain d’information et surcharge inutilement les mémoires d’affichage ainsi que les capacités de résolution de l’œil humain. L’opération de rééchantillonnage temporel, pilotée par la méthode .resample() de Pandas, permet de convertir la fréquence d’observation vers une maille chronologique supérieure, qu’elle soit hebdomadaire, mensuelle, trimestrielle ou annuelle, en agrégeant les mesures selon une fonction statistique rigoureusement définie.
Le choix de la fonction d’agrégation conditionne radicalement la nature mathématique et la signification du graphique résultant. Si le calcul de la moyenne périodique s’impose naturellement pour lisser un indice thermique ou une tension artérielle, des flux d’énergie consommée, des volumes de transactions ou des cumuls de précipitations pluviométriques exigent impérativement l’application d’une somme cumulative pour conserver leur sens physique. Le scientifique peut également opter pour le suivi d’agrégats de dispersion, comme l’écart-type ou les quantiles périodiques, afin d’observer non plus seulement le niveau moyen de la variable, mais l’évolution de son instabilité au fil des cycles calendaires.
Sur le plan visuel, les séries temporelles agrégées se prêtent remarquablement bien à des hybridations graphiques combinant courbes continues et diagrammes en barres périodiques. Il est par exemple très éclairant de tracer la tendance continue d’un indicateur de santé publique sous la forme d’une ligne fine, tout en matérialisant en arrière-plan les volumes de consultations mensuels cumulés sous la forme d’histogrammes verticaux discrets au moyen de la méthode ax.bar(). Cette combinaison offre une lecture à double niveau, reliant la cinétique du signal qualitatif aux masses volumétriques d’observations qui en constituent le substrat empirique.
10.3 Décomposition élémentaire de séries temporelles
L’analyse approfondie d’une dynamique chronologique complexe culmine souvent dans l’exercice classique de décomposition en composantes non observables, fondement de la modélisation économétrique et environnementale moderne. Tout signal chronologique empirique peut en effet être modélisé comme la sommation additive ou la résultante multiplicative de trois dynamiques superposées : une tendance déterministe à long terme qui traduit l’inertie lourde du système, une composante saisonnière périodique stable reflétant les cycles calendaires ou environnementaux réguliers, et un résidu stationnaire non prévisible assimilable à un bruit stochastique pur.
L’extraction algorithmique de ces composantes, réalisée traditionnellement via les modules d’analyse de séries temporelles de Statsmodels, trouve son prolongement visuel indispensable dans une mise en page graphique multi-panneaux synchronisée sous Matplotlib. La structure de restitution canonique se compose de quatre sous-graphiques superposés verticalement, partageant une même échelle temporelle d’abscisses : le panneau supérieur présente la série originale non altérée, le second isole la tendance séculaire lissée, le troisième expose le motif harmonique saisonnier récurrent, et le panneau inférieur révèle l’évolution temporelle des résidus aléatoires.
Ce partitionnement visuel des composantes fondamentales offre des vertus heuristiques majeures pour l’analyste et le modélisateur. Il permet de vérifier d’un seul coup d’œil si la saisonnalité postulée présente bien une amplitude stationnaire à travers le temps ou si elle s’amplifie avec le niveau de la tendance, validant ou infirmant par là-même l’hypothèse d’un modèle additif au profit d’un modèle multiplicatif. De surcroît, l’examen visuel des résidus stationnaires au bas de la planche permet de détecter immédiatement d’éventuelles poches d’hétéroscédasticité ou la persistance d’autocorrélations sérielles qui trahiraient une mauvaise spécification du modèle mathématique sous-jacent.
11. Optimisation technique, pièges courants et performance
11.1 Écueils fréquents liés à la gestion des dates et résolutions
Dans la pratique quotidienne de l’ingénierie des données et de la recherche expérimentale, de nombreux pièges méthodologiques et informatiques guettent l’analyste lors de la représentation graphique des temporalités. Le premier écueil, de nature insidieuse, concerne l’importation de dates sous forme de chaînes de caractères catégorielles non converties. Lorsque Matplotlib reçoit une séquence de chaînes textuelles, il assigne à chaque élément une coordonnée entière discrète selon son rang d’apparition. Si la série comporte des interruptions chronologiques imprévues, comme des interruptions d’enregistrement de capteurs durant les week-ends ou des arrêts de machines, la courbe masquera complètement ces absences en connectant directement les dates adjacentes par un segment d’écartement fixe, faussant radicalement la perception de la continuité physique du phénomène.
Le second défi technique majeur relève de la manipulation des fuseaux horaires et de la distinction formelle entre horodatages sans fuseau assigné (dits naïfs) et horodatages géo-référencés (dits conscients de leur fuseau). Si un script tente de juxtaposer au sein d’un même graphique une série indexée en UTC avec une série locale non convertie ou enrichie d’un fuseau spécifique, Matplotlib lèvera des exceptions d’incompatibilité de types ou décalera silencieusement les courbes de plusieurs heures, introduisant des déphasages causaux purement artificiels. La discipline de standardisation universelle vers un référentiel UTC explicite avant toute manipulation graphique s’impose donc comme une règle d’or absolue pour garantir l’intégrité de la restitution spatio-temporelle.
Enfin, l’apparition de micro-décalages temporels causés par des erreurs d’arrondi sur les flottants ordinaux représente un piège subtil mais dévastateur sur les séries infra-journalières à haute résolution. Matplotlib encodant les dates sous forme de jours flottants, la conversion de fractions de millisecondes ou de microsecondes peut conduire à des pertes de précision numérique marginales au-delà de plusieurs décennies d’enregistrement cumulé. Pour des visualisations physiques ultra-précises nécessitant une fidélité sub-seconde, il est méthodologiquement recommandé d’exprimer l’axe horizontal en secondes relatives écoulées depuis le déclenchement de l’événement plutôt que d’employer l’échelle calendaire grégorienne standard.
11.2 Optimisation des performances pour données massives (High-Frequency Data)
L’accélération exponentielle de la collecte d’informations dans les domaines de la télémétrie satellitaire, des transactions financières algorithmiques et des capteurs de l’Internet des Objets confronte régulièrement le chercheur à des jeux de données temporelles englobant des millions, voire des centaines de millions d’enregistrements individuels. Tenter de tracer directement une telle masse de points via un appel classique à ax.plot() conduit inexorablement à une saturation de la mémoire vive, à des gels prolongés du processus d’affichage et à la génération de fichiers vectoriels volumineux totally inexploitables par les visionneuses de documents standard.
Face à ce défi de passage à l’échelle, la première ligne de défense méthodologique repose sur des stratégies de décimation intelligente et de réduction de charge en amont de l’étape de tracé. L’application d’algorithmes de simplification de tracés, tels que l’algorithme de Ramer-Douglas-Peucker ou l’algorithme Largest Triangle Three Buckets (LTTB), permet de réduire d’un facteur cent ou mille le nombre de points d’une série temporelle tout en préservant scrupuleusement la visibilité de l’ensemble des extrema locaux, des ruptures de pente et de la silhouette globale du signal. Ces filtres géométriques garantissent une fidélité visuelle parfaite tout en allégeant radicalement la charge de calcul imposée au moteur de rendu graphique.
Une optimisation technique complémentaire majeure au sein de Matplotlib réside dans le recours au mode de rendu rasterisé pour les éléments de tracé extrêmement denses, via l’activation de l’argument rasterized=True lors de l’appel à la fonction de traçage. Dans cette configuration hybride de haut niveau, l’ensemble des éléments structurels de la figure, tels que le cadre cartésien, les axes, les titres, les annotations textuelles et les repères de graduation, demeurent conservés sous forme vectorielle d’une netteté parfaite dans le document PDF ou SVG final. En revanche, le corps de la courbe temporelle dense est compilé sous forme d’une matrice de pixels à haute définition directement sur le canevas, garantissant une fluidité de lecture absolue et une taille de fichier finale remarquablement compacte.
11.3 Exportation vectorielle et matricielle haute définition
L’ultime étape du flux de travail analytique consiste à exporter la figure temporelle conçue avec Matplotlib vers un format de fichier pérenne, adapté aux canaux de diffusion de la recherche que sont les manuscrits d’articles scientifiques, les présentations orales en amphithéâtre ou les portails de diffusion web. Cette opération cruciale s’exécute par l’invocation méthodique de la méthode fig.savefig(). Une maîtrise approfondie des paramètres de cette méthode conditionne directement l’absence de flou typographique, la lisibilité des détails géométriques fins et l’intégration esthétique harmonieuse de l’image dans le document récepteur final.
Le choix du format de fichier engage une décision fondamentale entre représentations vectorielles et matricielles. Pour les revues académiques à comité de lecture et les impressions professionnelles sur papier, les formats vectoriels purs tels que le Portable Document Format (PDF) ou le Scalable Vector Graphics (SVG) doivent être impérativement privilégiés. Ces formats encodent les tracés sous forme d’équations géométriques d’infinie précision, permettant aux relecteurs d’agrandir indéfiniment la figure sans aucune pixellisation des lignes ni des textes. À l’inverse, pour l’intégration au sein de rapports web ou de présentations diapositives, le format matriciel PNG représente le standard d’excellence en raison de sa compression sans perte et de son universalité de prise en charge.
Lors d’une exportation au format matriciel PNG, le calibrage de la résolution spatiale via le paramètre dpi (dots per inch) s’avère capital. Alors qu’une résolution standard de cent points par pouce suffit pour un affichage interactif transitoire, les standards de la typographie savante internationale exigent un minimum rigoureux de trois cents points par pouce pour garantir un piqué irréprochable des symboles et des indices mathématiques. De concert avec cette résolution, l’application systématique de l’argument bbox_inches=’tight’ permet d’élaguer dynamiquement les marges blanches excédentaires entourant le graphique, assurant un cadrage parfait de l’image au plus près des étiquettes d’axes les plus périphériques et des mentions de copyright éventuelles.
12. Étude de cas empirique complète : analyse longitudinale appliquée
12.1 Présentation du jeu de données et scénario d’analyse
Pour parachever ce traité méthodologique par une démonstration magistrale intégrant la totalité des préceptes théoriques et des raffinements techniques examinés, nous concevons une étude de cas empirique complète fondée sur une analyse longitudinale multi-variables déployée sur un horizon continu de trois cent soixante-cinq jours consécutifs. Le scénario d’analyse simule le suivi haute précision d’une variable environnementale complexe au sein d’une station d’observation écologique isolée, soumise aux aléas climatiques saisonniers, à des perturbations météorologiques ponctuelles et à des interventions de calibration humaine documentées au fil du temps.
La structure mathématique du jeu de données synthétique reflète avec exactitude la complexité des systèmes naturels réels. La série temporelle fondamentale intègre une composante tendancielle monotone représentant un réchauffement séculaire continu sur l’année, sur laquelle se greffent une oscillation harmonique annuelle majeure simulant les saisons astronomiques et une pulsation harmonique plus rapide modélisant des cycles météorologiques infra-mensuels. À cette armature systématique s’ajoute un processus stochastique autorégressif introduisant un bruit corrélé dans le temps, ainsi que deux chocs exogènes marqués simulant des épisodes météorologiques extrêmes de courte durée au cours de la période d’observation.
Le jeu de données comprend également une série de mesures d’incertitude expérimentale associées à chaque pointage quotidien, modélisant la marge d’erreur dynamique des capteurs instrumentaux en fonction des conditions ambiantes. Enfin, le protocole intègre la survenue d’un événement institutionnel discret marquant l’application d’un protocole correctif à une date calendaire prédéterminée, ainsi qu’une période étendue de sécheresse hydrologique de plusieurs semaines consécutives. L’ensemble de ces données est structuré de manière rigoureuse au sein d’un DataFrame Pandas indexé par un DatetimeIndex quotidien continu, prêt pour une orchestration graphique de haut vol sous Matplotlib.
12.2 Écriture et exécution pas à pas du script complet
L’orchestration graphique de cette étude longitudinale s’articule autour d’un pipeline complet exécuté selon les canons les plus stricts de l’approche orientée objet. Le chercheur initialise l’environnement par l’instanciation conjointe de la Figure et d’un conteneur Axes dimensionné avec générosité pour valoriser l’étendue temporelle du signal. Le tracé s’amorce par la matérialisation de l’intervalle de variabilité météorologique continue : la méthode ax.fill_between() déploie une nappe subtilement colorée délimitant les bornes supérieure et inférieure de l’incertitude de mesure autour de la trajectoire empirique journalière brute, conférant immédiatement de la profondeur physique au champ expérimental.
Sur ce premier socle d’incertitude, la série des observations journalières est projetée au moyen de la méthode ax.plot(), configurée avec un trait discret, une faible épaisseur et une transparence calibrée pour témoigner de la texture réelle du signal sans saturer le regard. Directement superposée à cette trame brute, une moyenne mobile centrée calculée sur une fenêtre de trente jours est tracée avec une ligne continue d’épaisseur affirmée et une couleur chaude contrastée, concrétisant visuellement la tendance saisonnière désaisonnalisée. Cette superposition multi-échelle permet d’apprécier d’un même coup d’œil la fidélité de l’échantillonnage de terrain et la trajectoire de fond épurée de ses fluctuations haute fréquence.
Le script incorpore ensuite l’appareil contextuel qualitatif indispensable. La méthode ax.axvspan() déploie un rectangle vertical d’un ocre très doux sur la période calendaire correspondant aux semaines de sécheresse, offrant un arrière-plan explicatif immédiat à l’inflexion inhabituelle observée sur la courbe durant cet intervalle. Concomitamment, une ligne verticale pointillée fine est projetée par ax.axvline() à la date exacte du changement de protocole expérimental, accompagnée d’une flèche directrice vectorielle générée par ax.annotate(). Cette annotation guide le regard vers le point de rupture structurelle tout en fournissant une boîte textuelle d’explication sémantique limpide et décollée de la trajectoire de mesure.
La mise aux normes de l’infrastructure d’axes mobilise l’ensemble des modules d’ingénierie temporelle explorés précédemment. L’axe des abscisses reçoit un MonthLocator paramétré pour implanter un jalon majeur au premier jour de chaque mois calendaire, complété par un DayLocator mineur rythmant l’espace tous les sept jours. Un objet DateFormatter traduit les repères majeurs sous une forme synthétique alliant le nom abrégé du mois et l’année. La méthode autofmt_xdate() applique ensuite l’inclinaison angulaire optimale pour garantir l’absence de tout chevauchement textuel, tandis qu’une grille principale discrète en traits pointillés et une légende enrichie de descripteurs typographiques achèvent de transformer le script en une planche visuelle prête pour la publication.
12.3 Restitution critique et synthèse méthodologique
L’examen critique de la figure scientifique composite ainsi produite permet de synthétiser les règles d’or qui doivent gouverner la conception graphique de séries chronologiques dans un cadre professionnel ou universitaire. En premier lieu, la figure fait la démonstration éclatante de la supériorité de l’étagement sémantique sur la simple restitution géométrique brute : chaque élément tracé assume une fonction épistémique précise dans la hiérarchie de la lecture, de l’enveloppe d’incertitude contextuelle jusqu’au commentaire d’annotation ciblé, sans qu’aucun composant ne concurrence inutilement l’attention visuelle au détriment des autres.
En second lieu, la figure illustre le principe fondamental de frugalité graphique théorisé par les grands maîtres de la sémiologie contemporaine. La grille analytique s’efface dans une translucidité mesurée, les bordures d’axes conservent une finesse exemplaire, les annotations s’organisent dans les respirations négatives de l’espace de données et la palette chromatique restreinte privilégie la clarté cognitive sur l’exubérance spectaculaire. Cette sobriété assure une transmission fluide et sans ambiguïté du message statistique, éliminant tout risque de biais interprétatif chez le lecteur ou le décideur institutionnel auquel le document est destiné.
En conclusion de ce parcours méthodologique, il apparaît indéniable que la maîtrise conjointe des structures temporelles de Pandas et des capacités de modélisation visuelle de bas et haut niveau de Matplotlib constitue une compétence capitale pour tout scientifique des données moderne. Loin d’être une simple compétence technique instrumentale, l’art de tracer une série temporelle relève d’une discipline intellectuelle rigoureuse où rigueur mathématique, fidélité empirique et clarté esthétique s’unissent pour donner corps et sens à l’insaisissable écoulement du temps.
Références
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). https://doi.org/10.25080/Majora-92bf1922-00a
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098