
Dans le paysage contemporain de l’ingénierie, des sciences fondamentales et de l’analyse quantitative, la transposition visuelle de relations formelles constitue une étape incontournable du raisonnement méthodologique. Qu’il s’agisse de modéliser une cinétique chimique, d’analyser la réponse transitoire d’un circuit électrique ou d’évaluer la trajectoire d’un actif financier soumis à une dynamique stochastique, la formulation mathématique abstraite trouve dans sa représentation graphique un ancrage heuristique irremplaçable. Le logiciel Microsoft Excel, omniprésent au sein des laboratoires, des bureaux d’études et des institutions financières, offre un écosystème de calcul numérique et de rendu visuel d’une puissance insoupçonnée, pourvu qu’il soit appréhendé avec la rigueur métrologique et algorithmique appropriée.
Pourtant, la démarche consistant à tracer une équation dans un tableur est fréquemment abordée de manière superficielle ou empirique, au détriment de l’intégrité scientifique des résultats. L’illusion d’une continuité parfaite masquée par les algorithmes de lissage du logiciel dissimule des enjeux fondamentaux : la discrétisation d’un continuum mathématique sur un maillage fini, l’impact des approximations de calcul en virgule flottante régies par la norme IEEE 754, ou encore le choix déterminant entre les paradigmes d’affichage matriciel et catégoriel. Sans une compréhension préalable des mécanismes sous-jacents, l’utilisateur s’expose à des erreurs d’interprétation critiques, allant de la distorsion d’échelles au phénomène d’aliasing numérique.
Ce guide encyclopédique se propose d’explorer, de manière exhaustive et didactique, l’ensemble des fondements théoriques, des méthodologies algorithmiques et des protocoles graphiques nécessaires pour tracer avec une exactitude irréprochable toute forme d’équation au sein d’Excel. Des relations affines élémentaires aux systèmes dynamiques non linéaires, en passant par les oscillations harmoniques et les formulations paramétriques dynamiques, chaque étape fait l’objet d’une analyse systématique. L’ambition de ce traité est de transformer le tableur conventionnel en un véritable laboratoire virtuel d’expérimentation fonctionnelle et de publication scientifique.
1. Fondements théoriques de la modélisation mathématique sous Excel
1.1 La représentation graphique comme instrument d’analyse scientifique
La visualisation fonctionnelle transcende la simple illustration esthétique pour s’ériger en un puissant instrument d’investigation épistémologique. En confrontant l’esprit humain à la forme spatiale d’une fonction, elle mobilise les capacités de perception visuelle pour détecter instantanément des propriétés qualitatives globales : régimes asymptotiques, brisures de symétrie, bifurcations ou zones de transition abrupte. Dans les sciences appliquées, le passage d’une formulation analytique purement symbolique à une distribution géométrique constitue le pont indispensable entre la théorie prescriptive et l’observation empirique.
Toutefois, la transition d’un modèle continu défini sur l’ensemble des réels $\mathbb{R}$ vers l’environnement numérique discret d’un tableur impose une traduction sémantique rigoureuse. L’équation formelle $y = f(x)$ ne peut être visualisée que par l’intermédiaire d’une série finie de couples ordonnés $(x_i, y_i)$. Cette distribution discrète observable devient alors un substitut d’analyse dont la fidélité dépend intrinsèquement de la méthode de partitionnement de la variable indépendante. La comparaison géométrique des courbes théoriques avec des relevés expérimentaux permet de valider ou de réfuter des hypothèses fondamentales quant à la nature des lois gouvernant le phénomène étudié.
Il importe de souligner les limites inhérentes à la discrétisation numérique sur tableur. Par définition, un processeur ne manipule que des états discrets et finis. L’intervalle séparant deux points consécutifs, si infime soit-il, constitue une zone d’ignorance calculatoire au sein de laquelle des variations locales d’amplitude arbitrairement élevée peuvent être entièrement oblitérées. L’analyste doit ainsi constamment garder à l’esprit que la courbe restituée par Excel n’est qu’un modèle interpolé de la réalité mathématique, assujetti aux règles d’échantillonnage et aux contraintes spatiales du canevas d’affichage.
1.2 Typologie des fonctions mathématiques exploitées en modélisation
L’éventail des fonctions mathématiques mobilisées dans les démarches d’ingénierie et de recherche fondamentale est d’une remarquable diversité, chacune véhiculant des implications structurales singulières pour l’échantillonnage sous tableur. Les relations linéaires, exprimées sous la forme $f(x) = ax + b$, représentent le socle fondamental traduisant la proportionnalité directe entre deux grandeurs physiques ou économiques. Bien que leur comportement global soit trivial, leur restitution précise nécessite la maîtrise de la pente et de l’interception, servant d’étalon de comparaison pour les phénomènes plus complexes.
Les fonctions polynomiales de degré $n ge 2$ introduisent la non-linéarité et permettent de modéliser des paysages d’optimisation comportant des extrema locaux, des points de rebroussement et des points d’inflexion. L’identification géométrique de ces singularités exige une résolution analytique locale accrue afin d’éviter que le lissage graphique ne vienne arrondir de manière factice des transitions anguleuses ou déplacer visuellement un point critique à dérivée nulle.
Les courbes transcendantes — englobant les fonctions exponentielles, logarithmiques et les sigmoïdes logistiques — caractérisent les processus dynamiques évolutifs tels que la croissance bactérienne, la décroissance radioactive ou la saturation de marchés. Ces modèles présentent fréquemment des asymptotes horizontales ou verticales nécessitant une attention métrologique spécifique lors du choix des bornes d’évaluation. Enfin, les modèles oscillatoires et périodiques issus des fonctions trigonométriques décrivent les phénomènes cycliques ondulatoires, acoustiques ou climatiques, dont l’implémentation sous tableur impose une vigilance extrême vis-à-vis des fréquences de coupure spatiale.
1.3 Architecture computationnelle du tableur Excel appliquée aux équations
Pour exploiter pleinement les capacités de calcul d’Excel, il est impératif de disséquer son architecture computationnelle interne. Le tableur fonctionne selon le principe d’un graphe orienté acyclique d’évaluation séquentielle dépendante. Chaque cellule contenant une formule constitue un nœud réactif qui évalue l’antécédent pour produire une image numérique instantanée. Lorsqu’une variable indépendante est modifiée en amont, le moteur de recalcul déclenche une cascade déterministe qui réactualise l’intégralité du vecteur de sortie avant de notifier le sous-système de rendu visuel.
La précision de ce moteur repose sur la spécification matérielle de la norme IEEE 754 pour l’arithmétique en virgule flottante à double précision. Cela confère aux calculs d’Excel une résolution d’environ 15 à 17 chiffres décimaux significatifs avec un exposant binaire s’étendant de $10^{-308}$ à $10^{+308}$. Malgré cette grande latitude opérationnelle, des erreurs d’annulation catastrophique peuvent survenir lors de la soustraction de nombres quasi identiques ou de l’accumulation itérative de fractions décimales inexactes en base 2 (comme 0,1), altérant subtilement l’évaluation des équations aux limites.
Enfin, une distinction fonctionnelle stricte doit être établie entre le moteur de calcul matriciel du tableur et son moteur de rendu graphique (GDI+ ou Direct2D selon les versions). Le moteur de calcul opère une manipulation purement arithmétique de tableaux de flottants, tandis que le moteur graphique traduit ces données abstraites en coordonnées d’écran pixellisées par le biais de transformations affines projectives. Les imprécisions visuelles observables résultent souvent non pas d’une erreur arithmétique sous-jacente, mais de la rastérisation géométrique opérée lors de la génération du tracé vectoriel.
2. Préparation rigoureuse de la table de données et définition des variables
2.1 Détermination du domaine de définition et de l’intervalle d’étude
La première phase opérationnelle du tracé consiste à borner rigoureusement l’espace d’évaluation mathématique. L’identification des limites formelles inférieure ($x_{\min}$) et supérieure ($x_{\max}$) de la variable indépendante dépend de la nature physique du phénomène ou du domaine de validité analytique de la fonction considérée. Par exemple, une fonction racine carrée imposera une borne inférieure positive ou nulle, tandis qu’une loi cinétique de réaction bornera le temps sur un intervalle strictement orienté vers le futur.
Une attention méticuleuse doit être accordée aux discontinuités formelles, aux pôles et aux singularités mathématiques essentielles. Une fonction rationnelle présentant une division par zéro pour une valeur singulière $x = c$ exige que l’intervalle d’étude soit segmenté en sous-domaines disjoints $]-\infty, c[$ et $]c, +\infty[$. Toute tentative d’évaluer naïvement la fonction en ce point précis provoquera une interruption computationnelle invalidant le vecteur de données. Il convient donc d’exclure délibérément le point de singularité ou de l’encadrer par des bornes asymétriques très resserrées.
La segmentation de l’intervalle doit également s’adapter au comportement asymptotique attendu. Pour une fonction manifestant des variations lentes sur de larges plages mais des gradients extrêmement prononcés au sein d’une fenêtre étroite, subdiviser l’axe en plusieurs segments d’évaluation hétérogènes constitue la stratégie optimale. Cette sectorisation préliminaire évite la dispersion inutile de la puissance de calcul sur des zones de platitude informationnelle tout en concentrant la résolution sur les topologies critiques de l’équation.
2.2 Incrémentation optimale et échantillonnage de la variable indépendante
L’échantillonnage de la variable indépendante conditionne directement la fidélité géométrique de la courbe restituée. Le choix du pas d’incrémentation, communément désigné par $\Delta x$, découle d’un compromis entre la résolution topologique et la charge computationnelle du classeur. Un pas trop large ($\Delta x gg 1$) engendre un sous-échantillonnage sévère, provoquant des distorsions polygonales aiguës là où le modèle théorique préconise une courbure continue et différentiable.
Pour fixer ce pas de manière rigoureuse, la formule empirique élémentaire repose sur le ratio :
$$\Delta x = \frac{x_{\max} – x_{\min}}{N}$$
où $N$ représente le nombre total d’intervalles de discrétisation. Dans les usages scientifiques courants sous Excel, une valeur de $N$ comprise entre 100 et 500 points offre une résolution graphique visuellement continue sur les écrans haute définition modernes sans dégrader la réactivité des recalculs. La génération de ces antécédents s’effectue généralement par incrémentation arithmétique linéaire via les outils de séries d’Excel ou par propagation de formules récursives de type =A2+$D$1.
Néanmoins, pour les équations caractérisées par de forts gradients localisés — comme dans le cas de l’effet de peau en électromagnétisme ou des ondes de choc —, l’adoption d’un pas d’échantillonnage adaptatif s’avère hautement souhaitable. Cette approche consiste à condenser les antécédents au voisinage des extrema et des fortes dérivées premières, tout en espaçant les points dans les régimes asymptotiques quasi linéaires. Une distribution basée sur une progression géométrique ou sur la transformée cosinusoïdale de Chebyshev permet de densifier naturellement les extrémités de l’intervalle d’étude.
2.3 Structuration syntaxique des colonnes et règles de référencement
La clarté structurelle de la feuille de calcul constitue le garant de la pérennité et de l’auditabilité du modèle. Les données doivent être organisées selon une géométrie orthogonale stricte, où chaque variable fonctionnelle occupe une colonne dédiée et exclusive. Par convention académique, la colonne de gauche héberge les antécédents de la variable indépendante $x$, tandis que la colonne contiguë à droite recueille les valeurs calculées de l’image $f(x)$. Cette disposition facilite l’assignation automatique des séries par le générateur graphique d’Excel.
La manipulation rigoureuse des types d’adressage de cellules s’avère ici fondamentale. Les coefficients et paramètres constants de l’équation (tels qu’une constante de gravitation $g$, un taux d’amortissement $\gamma$ ou une amplitude initiale $A$) doivent impérativement être isolés dans une zone de métadonnées dédiée, distincte du tableau d’évaluation dynamique. Dans les expressions calculées, ces constantes doivent être appelées au moyen de références absolues (verrouillées par le symbole dollar, par exemple $C$2) ou via des noms de cellules définis dans le Gestionnaire de noms, tandis que la variable indépendante $x$ doit être appelée via une référence relative (par exemple A5).
Cette ségrégation stricte des rôles computationnels évite les erreurs de décalage lors de la recopie incrémentale de la formule sur des centaines de lignes. Elle assure également la traçabilité complète de l’équation : toute modification ultérieure d’un coefficient au sein de sa cellule mère se propage instantanément à travers l’ensemble du réseau de cellules dépendantes, réactualisant la courbe sans qu’il soit nécessaire de reconstruire le tableau de distribution numérique.
3. Méthodologie fondamentale : Tracé d’une équation linéaire
3.1 Traduction syntaxique de l’équation affine dans le moteur de calcul
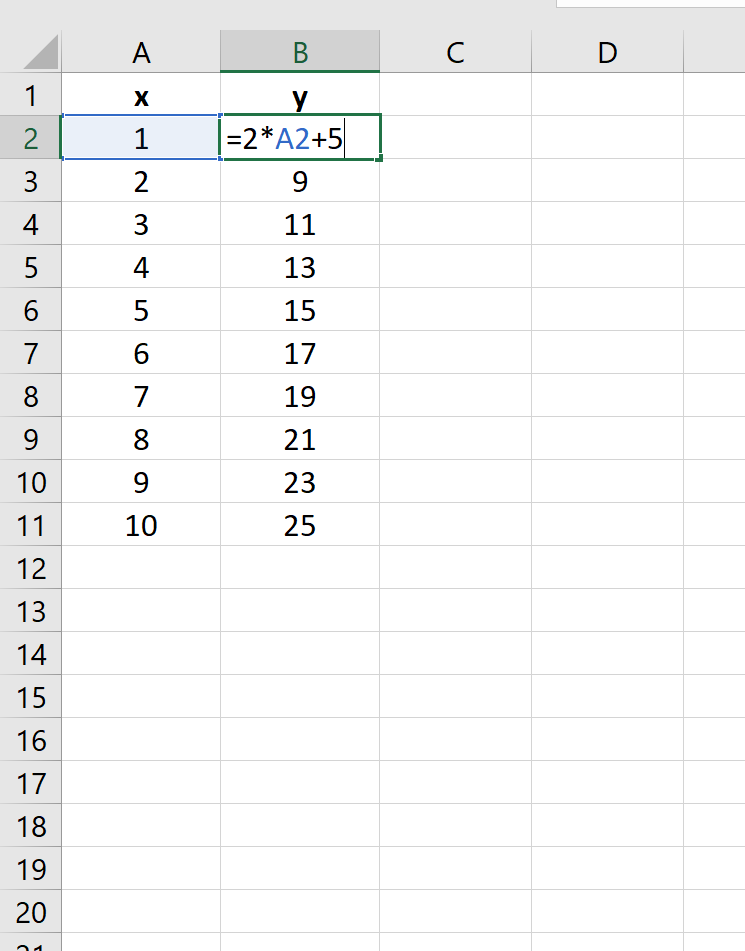
L’équation affine, formulée canoniquement sous la relation $y = ax + b$, sert de paradigme d’initiation pour maîtriser l’écriture syntaxique dans le tableur. Pour transposer cette loi dans Excel, la cellule cible destinée à accueillir la première valeur calculée doit débuter par le signe égal (=), déclencheur de l’analyseur lexical du logiciel. L’écriture respecte l’opérateur de multiplication explicite *, souvent omis en notation mathématique littérale : =$E$2*A5+$E$3, où $E$2 loge la pente $a$ et $E$3 l’ordonnée à l’origine $b$.
Le moteur d’évaluation applique scrupuleusement la hiérarchie conventionnelle des opérations arithmétiques : les termes multiplicatifs et divisifs prévalent sur les additions et soustractions. Bien que l’équation affine ne comporte pas d’ambiguïté syntaxique majeure, l’usage délibéré de parenthèses peut sécuriser la lecture de modèles combinés plus complexes. Une fois l’expression validée dans la cellule initiale, sa propagation s’effectue par double-clic sur la poignée de recopie incrémentale ou par la combinaison de raccourcis Ctrl+C et Ctrl+V sur la plage sélectionnée.
Il est impératif de vérifier visuellement la conformité du calcul sur les premiers rangs de la table. Si la cellule d’antécédent $x$ est nulle, la formule doit renvoyer avec une exactitude absolue la valeur du paramètre d’ordonnée $b$. Cette étape de contrôle élémentaire prévient les erreurs triviales de référencement relatif qui conduiraient la formule à pointer vers des cellules vides ou textuelles lors de son étirement vers le bas.
3.2 Génération et insertion du nuage de points connecté
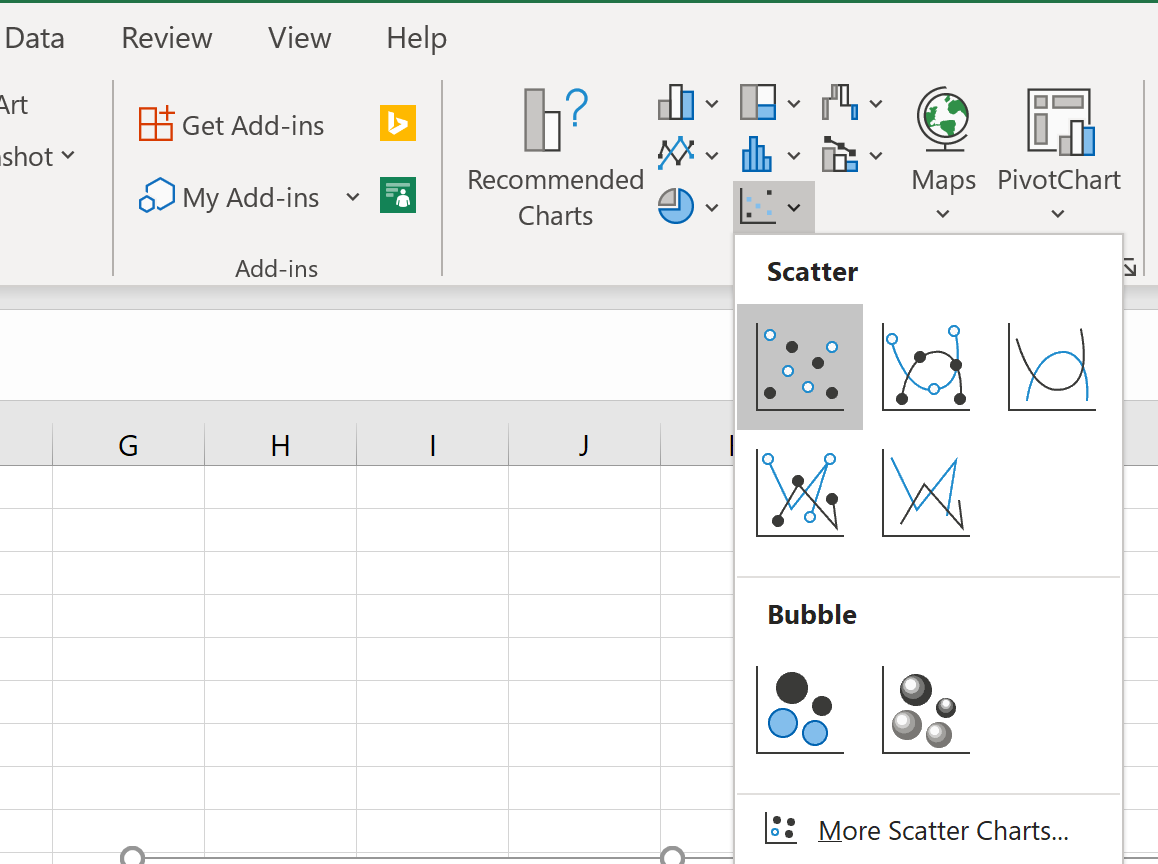
Une fois le tableau bivarié constitué, la création du support visuel requiert une sélection rigoureuse de la plage de données. L’utilisateur doit englober l’ensemble des valeurs des colonnes $x$ et $f(x)$, en incluant de préférence la ligne d’en-tête pour permettre à Excel de labelliser spontanément la série de données. L’accès aux outils de rendu s’effectue par le ruban supérieur en naviguant vers l’onglet Insertion, puis en localisant le groupe fonctionnel Graphiques.
À ce stade, une directive méthodologique catégorique s’impose : le choix doit se porter exclusivement sur le type Nuage de points (XY), accessible via l’icône figurant un semis de coordonnées spatiales. Au sein du sous-menu déroulant, l’analyste sélectionnera la variante Nuage de points avec lignes droites ou Nuage de points avec lignes lissées, selon le caractère discret ou continu du modèle théorique sous-jacent. L’insertion instancie un conteneur graphique flottant sur la feuille de calcul active.
L’erreur la plus fréquente consiste à sélectionner l’icône trompeuse Courbe (Line chart). Cette méprise altère fondamentalement la nature mathématique du tracé, car le type Courbe traite l’axe horizontal comme une simple succession d’étiquettes textuelles discrètes équidistantes, annihilant la notion de distance métrique continue. Seul le nuage de points XY garantit une véritable projection cartésienne respectant fidèlement l’échelle métrologique des abscisses.
3.3 Interprétation géométrique et vérification de la rectitude
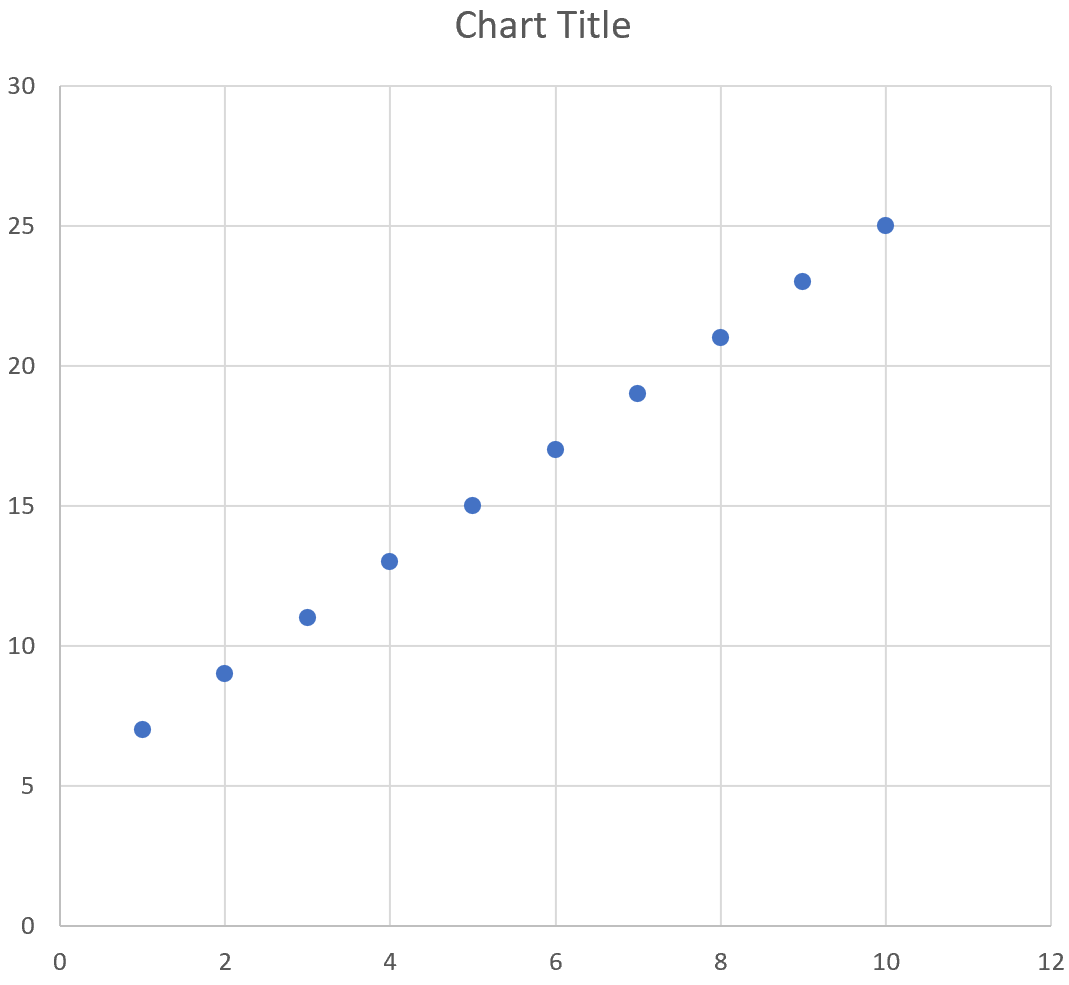
L’affichage de la droite sur le plan cartésien permet d’opérer un contrôle de qualité immédiat. La rectitude absolue du segment tracé constitue la première validation visuelle de la linéarité du modèle. Tout décrochage angulaire, repli ou discontinuité spatiale trahirait une corruption dans la séquence d’incrémentation de la variable $x$ ou une incohérence dans les formules de recopie de la colonne $f(x)$.
La validation métrologique se poursuit par l’inspection de l’intersection de la droite avec l’axe vertical des ordonnées ($x = 0$). La valeur lue doit coïncider rigoureusement avec le paramètre $b$. De même, l’inclinaison spatiale du vecteur graphique renseigne sur le signe de la pente : un vecteur ascendant de gauche à droite valide une valeur $a > 0$, tandis qu’une orientation descendante confirme un coefficient directeur négatif. Le gradient visuel observé peut également être confronté au calcul du taux d’accroissement $\frac{\Delta y}{\Delta x}$ mesuré entre deux points distants de la grille.
Dans le contexte des modèles théoriques purs, aucun résidu ou écart par rapport à la rectitude n’est tolérable. La présence de la moindre courbure perceptible est le symptôme indubitable d’une non-linéarité involontaire introduite dans la formulation arithmétique ou d’une déformation induite par l’activation accidentelle d’une échelle logarithmique sur l’un des axes de référence.
4. Modélisation et tracé des équations quadratiques et polynomiales
4.1 Formulation de l’équation du second degré dans Excel
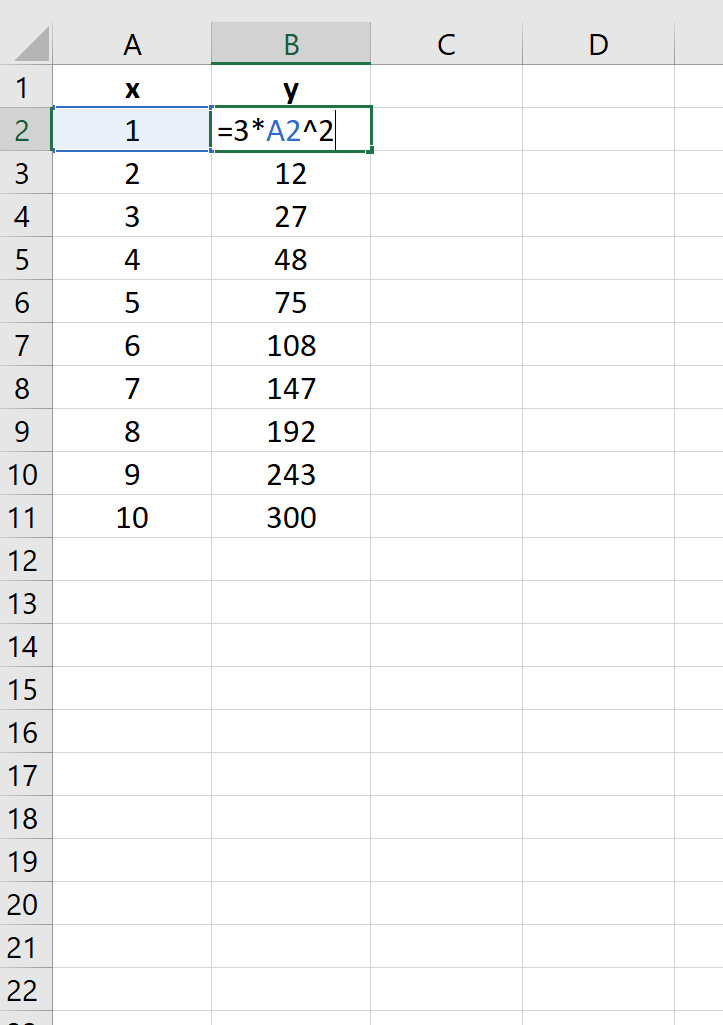
L’équation polynomiale du second degré, formalisée par la structure canonique $y = ax^2 + bx + c$, introduit la courbure parabolique dans la démarche de modélisation. La transcription algorithmique de cette expression sous Excel nécessite l’emploi de l’opérateur d’élévation à la puissance circonflexe ^. Pour une variable indépendante située en cellule A5 et des coefficients paramétriques stockés respectivement dans les cellules $D$2, $D$3 et $D$4, la formule s’énonce : =$D$2*(A5^2)+$D$3*A5+$D$4.
L’isolation systématique des trois coefficients dans des cellules de contrôle indépendantes est indispensable pour permettre l’exploration dynamique du comportement structural de la parabole. Le coefficient directeur quadratique $a$ détermine à lui seul l’orientation de la concavité de la courbe : une valeur positive ($a > 0$) confère à la parabole une concavité dirigée vers le haut (convexe), garantissant l’existence d’un minimum global absolu, alors qu’une valeur négative ($a < 0$) produit une courbure inversée orientée vers le bas, définissant un maximum global.
L’analyste doit veiller à la gestion des parenthèses autour du terme exponentiel afin de lever toute ambiguïté sur l’ordre de priorité opératoire, bien que les standards de calcul accordent la préséance à l’exponentiation sur la multiplication. Cette rigueur syntaxique garantit la cohérence du calcul vectoriel sur l’ensemble de la série de données générée.
4.2 Localisation du sommet et centrage de l’intervalle d’étude
Pour obtenir une représentation graphique harmonieuse et signifiante d’une parabole, il est nécessaire de centrer symétriquement l’intervalle d’étude autour de son extremum analytique. L’abscisse du sommet de la parabole, notée $x_s$, est déterminée formellement par l’annulation de sa dérivée première :
$$x_s = -\frac{b}{2a}$$
Tout tracé qui ignorerait ce point singulier risquerait de ne représenter qu’une branche asymétrique tronquée, privant l’observateur de la vision d’ensemble du comportement fonctionnel.
Il est donc judicieux de calculer cette abscisse critique dans une cellule dédiée de la feuille de travail, à l’aide d’une formule telle que =-$D$3/(2*$D$2). Ensuite, le domaine d’échantillonnage de la colonne $x$ est configuré de façon à s’étendre symétriquement de $x_s – L$ à $x_s + L$, où $L$ représente une demi-largeur d’observation choisie en fonction de l’étalement recherché. Cette précaution garantit que le sommet occupera exactement le centre géométrique de l’espace graphique visualisé.
Cette disposition met en exergue l’axe de symétrie vertical d’équation $x = x_s$. La confirmation de cette symétrie par l’observation de valeurs d’ordonnées rigoureusement identiques pour des antécédents équidistants du centre ($x_s – \delta$ et $x_s + \delta$) sert de validation numérique immédiate de la structure du modèle et de l’intégrité de l’échantillonnage.
4.3 Extension aux polynômes d’ordre supérieur
La modélisation de polynômes de degrés supérieurs (cubiques $y = ax^3 + bx^2 + cx + d$ ou quartiques) complexifie la géométrie des courbes en y intégrant de multiples points d’inflexion et des extrema locaux successifs. Pour capturer fidèlement la richesse morphologique de ces équations, la densité de l’échantillonnage doit être substantiellement augmentée. Un pas d’incrémentation calibré pour une fonction affine devient totalement inopérant s’il saute par-dessus les oscillations locales d’une fonction de degré élevé.
La détection précise des racines réelles — intersections de la courbe avec l’axe horizontal $y = 0$ — nécessite un resserrement drastique du maillage spatial au voisinage immédiat des changements de signe de $f(x)$. Si l’intervalle d’étude est mal échantillonné, l’interpolation linéaire entre deux points consécutifs peut court-circuiter une oscillation de faible amplitude, occultant ainsi des racines pourtant formellement démontrées par le théorème fondamental de l’algèbre.
De surcroît, le calcul de puissances élevées ($x^4, x^5, dots$) expose le moteur de calcul à des phénomènes d’instabilité numérique lorsque $x$ prend des valeurs distantes de l’origine. L’accroissement exponentiel des magnitudes engendre une disparité d’échelle colossale entre les différents termes du polynôme. Dans les cas extrêmes, les termes de bas degré peuvent se trouver numériquement noyés dans le bruit d’arrondi des termes dominants, altérant la précision du tracé au voisinage immédiat de l’origine.
5. Représentation des fonctions non linéaires : exponentielles et logarithmiques
5.1 Implémentation des modèles de croissance et décroissance exponentielles
Les dynamiques exponentielles, modélisées sous la forme générale $y = y_0 e^{kx}$ ou $y = A exp(-t/tau)$, interviennent dans l’étude des processus où le taux de variation d’une grandeur est directement proportionnel à son niveau instantané. Dans l’environnement d’Excel, l’évaluation de la constante de Néper ($e \approx 2{,}71828$) ne doit jamais être introduite sous forme d’une constante tronquée écrite manuellement. Il est impératif d’utiliser la fonction native dédiée EXP(), qui encapsule l’algorithme d’approximation polynomiale optimale de la machine.
La syntaxe standard pour une décroissance s’articule ainsi : =$F$2*EXP(-A5/$F$3), où $F$2 définit l’amplitude initiale $y_0$ et $F$3 la constante de temps caractéristique $tau$. Le paramètre $k$ gouverne la cinétique du processus : une valeur strictement positive modélise une divergence explosive, tandis qu’un coefficient négatif décrit un amortissement asymptotique tendant vers l’équilibre zéro.
L’analyste doit exercer une surveillance étroite sur la saturation computationnelle. En raison de la rapidité de la divergence exponentielle, des valeurs d’arguments modérément élevées conduisent rapidement au dépassement de la capacité de représentation en virgule flottante d’Excel. Dès que l’argument de la fonction dépasse approximativement 709,78, le logiciel cesse d’évaluer l’expression et renvoie le code d’erreur critique #NOMBRE!, interrompant net la chaîne de calcul et le tracé graphique subséquent.
5.2 Tracé rigoureux des équations logarithmiques
Les équations logarithmiques constituent les réciproques fonctionnelles des modèles exponentiels et décrivent des processus de réponse à saturation progressive ou d’atténuation de signaux (comme les échelles de pH ou de décibels). Excel fournit deux primitives fondamentales distinctes : la fonction LN(), correspondant au logarithme népérien en base naturelle $e$, et la fonction LOG10(), calculant le logarithme en base décimale. Il est essentiel de ne pas les confondre avec la fonction générique LOG(valeur; [base]).
La contrainte majeure réside dans le respect absolu du domaine de définition analytique : le logarithme n’est défini que sur l’intervalle ouvert strict $]0, +\infty[$. Toute inclusion d’une valeur nulle ($x = 0$) ou strictement négative dans la colonne des antécédents déclenche immédiatement l’erreur #NOMBRE!. L’échantillonnage de la variable $x$ doit donc obligatoirement débuter à une valeur résiduelle strictement positive mais proche de l’origine (par exemple $x_{\min} = 10^{-4}$) pour révéler le comportement asymptotique vertical.
Ce voisinage immédiat de zéro pose un défi graphique singulier : la pente tendant vers l’infini négatif impose une courbure vertigineuse. Pour éviter un tracé grossier formé d’un segment vertical artificiel, il est recommandé d’adopter un échantillonnage à progression logarithmique pour la variable $x$ elle-même, en calculant les abscisses via la formule $x_i = 10^{\alpha_i}$, où $\alpha_i$ croît de manière uniforme. Cette technique permet de concentrer une grande densité de points au plus près de l’axe vertical.
5.3 Modélisation des équations sigmoïdes et logistiques
La modélisation des cinétiques de saturation et des équilibres compétitifs trouve son expression privilégiée dans la courbe logistique sigmoïde, régie par l’équation canonique :
$$y = \frac{L}{1 + e^{-k(x – x_0)}}$$
où $L$ représente la capacité de charge maximale (asymptote supérieure), $k$ le taux de croissance intrinsèque et $x_0$ l’abscisse du point d’inflexion central caractérisant le franchissement du demi-plafond structurel.
La formulation dans Excel s’écrit de la manière suivante : =$E$2/(1+EXP(-$E$3*(A5-$E$4))). Cette courbe en forme de S étiré nécessite un intervalle d’étude suffisamment vaste pour englober la totalité de la transition d’état, depuis le plateau inférieur asymptotique ($y to 0$) jusqu’au plateau supérieur de saturation ($y to L$). Un intervalle tronqué ne montrerait qu’une phase exponentielle ou logarithmique trompeuse, masquant la nature sigmoïdale complète du processus.
Le point d’inflexion localisé en $x = x_0$ présente une signification géométrique cruciale : c’est en cette coordonnée exacte que la dérivée première de la fonction atteint son maximum absolu (vitesse d’évolution maximale) et que la courbure bascule d’un régime convexe à un régime concave. La vérification visuelle de la symétrie centrale de la sigmoïde autour de ce point $(x_0, L/2)$ confirme la justesse paramétrique de la modélisation sous le tableur.
6. Tracé des équations trigonométriques et oscillatoires
6.1 Gestion de la conversion angulaire en radians
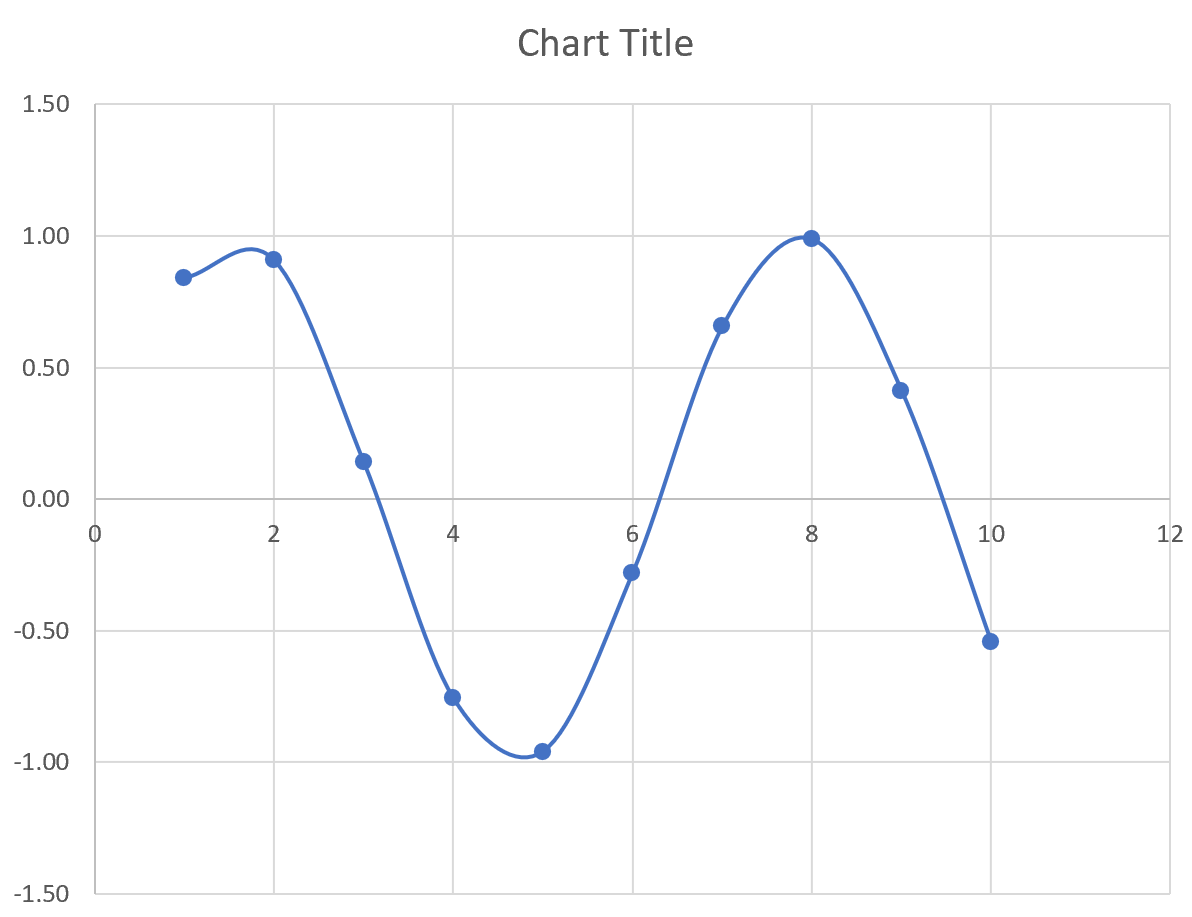
L’implémentation de la trigonométrie dans les tableurs recèle un piège classique : le moteur computationnel d’Excel évalue l’ensemble de ses fonctions trigonométriques natives (SIN, COS, TAN, ACOS, etc.) exclusivement en radians, et non en degrés d’arc conventionnels. L’injection directe d’un angle exprimé en degrés dans la fonction SIN() produit une distorsion complète de la fonction périodique.
Pour convertir une colonne d’abscisses configurée en degrés géométriques ($0^{circ}$ à $360^{circ}$) dans l’unité physique requise par le moteur de calcul, il est impératif d’encapsuler la variable à l’aide de la fonction native RADIANS() : =SIN(RADIANS(A5)). Alternativement, la conversion peut s’effectuer de manière formelle par la multiplication analytique par le facteur de normalisation $pi/180$. Excel intègre pour cela la constante de référence via l’appel de fonction sans argument PI(), ce qui s’écrit : =SIN(A5*PI()/180).
Dans les démarches de recherche avancées, la méthode la plus élégante consiste à générer directement la variable indépendante $x$ sous forme de fractions rationnelles de $\pi$. Ainsi, la suite des antécédents s’exprime sous la forme $x_i = i \cdot \frac{\pi}{n}$, assurant que les singularités et les passages par zéro coïncident avec les nœuds précis de discrétisation de la grille, limitant ainsi la dispersion des résidus de troncature numérique.
6.2 Implémentation des fonctions périodiques sinusoïdales
L’équation d’onde harmonique fondamentale se structure selon la formulation temporelle ou spatiale standard :
$$y(t) = A \sin(\omega t + \phi)$$
où $A$ représente l’amplitude crête du signal, $\omega$ la pulsation temporelle (reliée à la fréquence $f$ par la relation $\omega = 2\pi f$) et $phi$ la phase à l’origine exprimée en radians. Sa transcription dans la cellule de traitement nécessite un adressage scrupuleux des cellules de paramètres : =$E$2*SIN($E$3*A5+$E$4).
La période fondamentale $T$ de cette onde oscillatoire s’exprime mathématiquement par la relation :
$$T = \frac{2\pi}{\omega}$$
Il est essentiel que la fenêtre d’observation temporelle matérialisée par l’intervalle d’étude de la colonne $t$ couvre au minimum deux à trois périodes fondamentales complètes pour que la répétitivité du phénomène ondulatoire soit saisie dans sa plénitude visuelle. Un intervalle inférieur à une période tronque la nature périodique, tandis qu’une fenêtre englobant des centaines d’oscillations compressera graphiquement les crêtes en une masse illisible.
L’approche prend une dimension supérieure lors de la modélisation de signaux polyharmoniques par superposition linéaire de séries de Fourier :
$$y(t) = \sum_{k=1}^m A_k \sin(k\omega t + \phi_k)$$
L’implémentation de telles sommes finies dans Excel permet de visualiser de manière pédagogique la convergence progressive d’oscillations lisses vers des formes d’ondes complexes (créneaux, signaux en dents de scie ou impulsions triangulaires).
6.3 Prévention des distorsions numériques et phénomène d’aliasing
Le tracé d’équations oscillatoires sur un tableur est tributaire des contraintes fondamentales de la théorie du traitement du signal, et plus spécifiquement du théorème d’échantillonnage de Nyquist-Shannon. Ce principe postule que pour restituer sans ambiguïté un signal de fréquence maximale $f_{\max}$, la fréquence d’échantillonnage numérique $f_e = \frac{1}{\Delta t}$ doit impérativement respecter la condition d’inégalité stricte :
$$f_e > 2 f_{\max}$$
Si l’analyste sous-échantillonne une fonction trigonométrique en choisissant un pas $\Delta t$ trop grand par rapport à la pulsation $\omega$, un phénomène d’aliasing (repliement spectral) se produit. Le graphique présente alors une oscillation factice d’une fréquence considérablement plus basse que la fréquence réelle du modèle, voire une fausse immobilité rectiligne. Pour garantir la pureté esthétique et la fidélité scientifique de la courbe, il est recommandé en pratique d’adopter au minimum 20 à 50 points d’échantillonnage par période oscillatoire fondamentale.
Un problème distinct mais tout aussi critique survient lors du tracé de la fonction tangente ($y = tan(x)$). Cette fonction présente des asymptotes verticales infinies discontinues à chaque coordonnée $x = \frac{\pi}{2} + k\pi$. Si l’on applique l’outil de liaison graphique continu d’Excel à travers ces discontinuités, le logiciel joindra de manière fallacieuse l’asymptote tendant vers $+\infty$ avec celle émergeant de $-\infty$ par une barre quasi verticale. La neutralisation de cette hérésie topologique sera examinée en section 12.
7. Sélection critique du type de graphique : Nuage de points versus Courbe
7.1 Différenciation mathématique fondamentale entre les deux paradigmes
La confusion entre le graphique en Nuage de points (XY) et le graphique en Courbe (Ligne) représente la bévue conceptuelle la plus répandue lors de la représentation d’équations mathématiques dans Excel. Bien que leurs aspects visuels puissent sembler analogues à un observateur profane, les fondements mathématiques de leurs moteurs de projection sont radicalement distincts et incompatibles pour l’analyse continue.
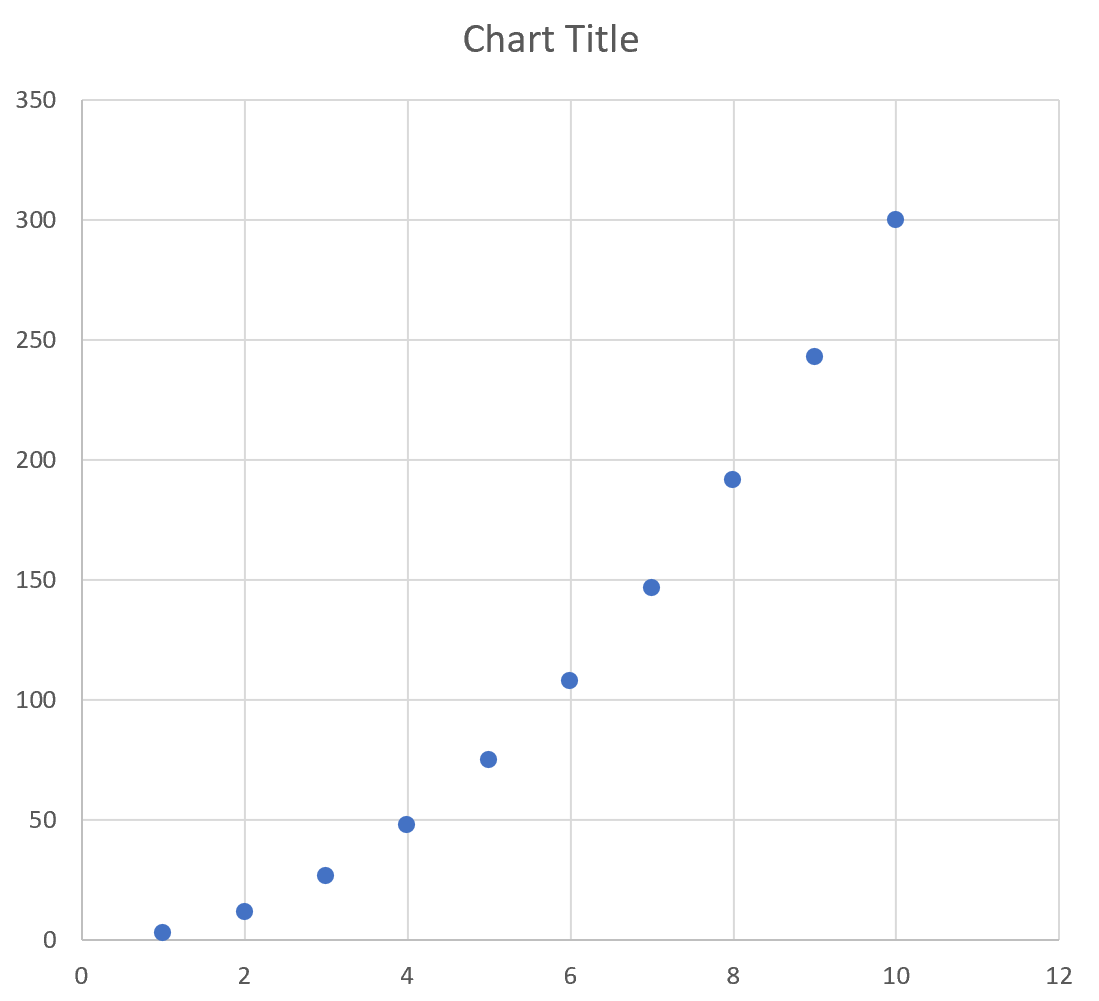
Le graphique en nuage de points XY opère sur un plan cartésien métrique authentique où l’axe horizontal $X$ et l’axe vertical $Y$ sont tous deux des variables quantitatives continues. Chaque point $(x_i, y_i)$ est positionné à des coordonnées d’écran proportionnelles à sa valeur numérique réelle relative à l’origine. Si la distance mathématique séparant deux antécédents consécutifs double, l’espacement spatial sur le graphique double instantanément et de façon proportionnelle.
À l’opposé, le graphique en Courbe traite l’axe horizontal comme une suite ordinale d’étiquettes catégorielles discrètes, exactement comme s’il s’agissait de noms de pays ou de libellés de produits commerciaux. Les valeurs de $x$ ne sont pas traitées comme des grandeurs métriques, mais comme de simples chaînes de caractères disposées à équidistance constante les unes des autres. Les conséquences d’un tel mécanisme sur un échantillonnage mathématique non uniforme sont méthodologiquement catastrophiques.
7.2 Avantages opérationnels du nuage de points pour les équations
L’exploitation exclusive du nuage de points s’avère indispensable dès lors que l’échantillonnage de la fonction n’est pas rigoureusement linéaire ou lorsque les antécédents ne sont pas ordonnés de façon unitaire. Si l’on applique un pas d’échantillonnage adaptatif resserré dans les zones de fort gradient et dilaté dans les plages stables, seul le nuage de points XY préserve la proportionnalité métrique le long de l’axe des abscisses, maintenant l’intégrité de la géométrie de la courbe.
En outre, le nuage de points XY offre la capacité structurelle de tracer des équations paramétriques du type $x = f(t)$ et $y = g(t)$, ainsi que des courbes fermées ou auto-intersectantes telles que les ellipses, les spirales d’Archimède ou les figures de Lissajous. Un graphique en Courbe ordinaire s’avère totalement incapable de tracer une courbe revenant en arrière sur l’axe des abscisses, car il contraint chaque point à avancer d’un pas d’incrément catégoriel vers la droite.
Enfin, le nuage de points garantit une interpolation vectorielle rigoureuse entre les coordonnées spatiales réelles, indépendamment de l’ordre séquentiel d’apparition des lignes dans la grille de données, pourvu que l’algorithme de connexion soit correctement configuré. Il permet d’intercaler dynamiquement des points de calcul additionnels sans déformer l’axe d’échelle horizontal.
7.3 Options de connectivité : segments linéaires versus lissage spline
Au sein du menu du nuage de points, Excel propose deux variantes principales de connectivité vectorielle : les segments linéaires droits et le tracé avec lissage automatique. Le mode à segments linéaires joint chaque couple de points consécutifs par une ligne droite euclidienne d’ordre zéro. Si l’échantillonnage est suffisant ($N > 200$), la densité des segments est telle que l’œil humain perçoit une fluidité absolue sans aucune facette perceptible.
L’activation de l’option Lignes lissées engage un algorithme d’interpolation sous-jacent fondé sur des splines cubiques naturelles ou des courbes de Bézier composites. Le moteur calcule les tangentes locales pour forcer la courbe à traverser tous les points nodaux avec une continuité de classe $\mathcal{C}^1$ ou $\mathcal{C}^2$. Si cette méthode offre une séduisante fluidité visuelle sur des jeux de données clairsemés, elle introduit des artefacts computationnels préjudiciables à l’exactitude scientifique.
En effet, le lissage par spline tend à générer des dépassements non physiques (« overshoots ») au voisinage des transitions de pente brusques. La courbe peut ainsi plonger artificiellement en dessous d’une asymptote horizontale stricte ou produire des oscillations parasites totalement absentes de l’équation originale (phénomène analogue à l’effet de Runge). La règle méthodologique en modélisation rigoureuse est donc formelle : il est préférable d’augmenter la densité d’échantillonnage avec une connexion par segments rectilignes plutôt que de déléguer la courbure à l’algorithme d’interpolation spline d’Excel.
8. Normalisation métrologique et étalonnage précis des axes
8.1 Configuration des bornes et graduations d’échelle
L’étalonnage par défaut fourni par les algorithmes automatiques d’Excel répond à des considérations de visibilité immédiate qui s’écartent souvent des standards de communication scientifique. Le redimensionnement automatique ajuste dynamiquement les limites des axes aux valeurs extrêmes rencontrées dans les données, ce qui peut tronquer visuellement l’allure d’une courbe lors de la modification dynamique de ses paramètres. Il est donc fondamental de désactiver ce mode automatique pour imposer un contrôle déterministe sur les bornes métrologiques.
Cette opération s’effectue par un clic droit sur l’axe visé, suivi de la sélection de Mise en forme de l’axe. Dans le volet latéral d’options d’axe, les champs Minimum et Maximum doivent être fixés manuellement avec des valeurs numériques fermes. De même, les intervalles des Unités principales et secondaires doivent être réglés de manière à afficher des pas décimaux harmonieux (par exemple des multiples de 1, 2, 5 ou 10), garantissant une lecture intuitive sans encombrement visuel des étiquettes.
Un paramètre géométrique fondamental réside dans le positionnement du point d’intersection des axes. Par défaut, Excel fait souvent croiser l’axe vertical à la borne inférieure absolue de l’axe des abscisses. Pour restaurer la lisibilité cartésienne classique d’une étude de fonction, il convient de forcer l’option L’axe horizontal/vertical coupe à la valeur personnalisée 0,0. Dès lors, l’origine cartésienne $(0,0)$ est ancrée au centre de gravité du tracé, permettant une appréciation immédiate des signes et des quadrants mathématiques.
8.2 Emploi raisonné des échelles semi-logarithmiques et log-log
La restitution visuelle d’équations dont la dynamique s’étale sur plusieurs ordres de grandeur est rendue inopérante par l’emploi d’une échelle cartésienne linéaire standard : les faibles valeurs sont écrasées sur l’axe tandis que les grandes valeurs s’envolent hors cadre. L’activation d’une échelle logarithmique permet de comprimer spatialement les étendues géométriques extrêmes tout en révélant les comportements structurels profonds de l’équation.
Dans le volet Mise en forme de l’axe, cocher la case Échelle logarithmique (en base 10 par défaut) applique une anamorphose spatiale immédiate. L’emploi d’une échelle semi-logarithmique — où seul l’axe vertical $Y$ est converti en coordonnées logarithmiques — constitue l’outil par excellence pour l’analyse des équations exponentielles. En vertu de la transformation formelle :
$$\ln(y) = \ln(y_0 e^{kx}) = \ln(y_0) + kx$$
la trajectoire exponentielle se redresse visuellement en une droite d’une parfaite rectitude, dont la pente géométrique reflète directement le taux de croissance $k$.
À l’avenant, l’échelle log-log (doublement logarithmique), appliquant la transformation sur les deux axes orthogonaux simultanément, est l’instrument de prédilection pour l’analyse des lois de puissance du type $y = a x^b$. En appliquant le logarithme aux deux membres, la relation devient $log(y) = log(a) + b log(x)$, transformant la courbe de puissance en une droite affine dont la pente n’est autre que l’exposant scalaire $b$. Une mise en garde méthodologique s’impose impérativement : l’échelle logarithmique étant mathématiquement indéfinie pour les valeurs nulles ou négatives, toute tentative de représentation de données comprenant des points $x le 0$ ou $y le 0$ se soldera par l’éviction arbitraire de ces points de la surface d’affichage.
8.3 Habillage académique : titres, notations et grille de lecture
Un tracé de fonction mathématique ne saurait prétendre au statut de document scientifique sans un appareillage documentaire et typographique complet. Le graphe doit s’accompagner d’un titre formellement informatif, spécifiant la nature du modèle tracé et les hypothèses opérationnelles associées. L’intégration des titres d’axes s’effectue via le menu contextuel Éléments de graphique (icône en forme de croix verte +).
Chaque libellé d’axe doit mentionner explicitement le symbole formel de la variable représentée ainsi que son unité métrologique normalisée entre crochets ou parenthèses conformes aux standards du Système International (ex. : Temps d’évolution $t$ [s] ou Potentiel électrochimique $V(x)$ [V]). L’omission des dimensions physiques vide le graphique de sa valeur analytique et constitue une infraction aux règles élémentaires de publication de la recherche.
Enfin, la configuration de la grille de lecture participe à la précision de l’interpolation visuelle. Il convient d’activer le Quadrillage principal et secondaire sur les deux dimensions, en calibrant les traits secondaires sous une forme fine, ponctuée et d’un gris atténué par rapport aux axes structurels majeurs. Cette matrice orthogonale quadrillée offre à l’analyste un repère spatial précis permettant d’extraire visuellement des coordonnées numériques intermédiaires sans avoir à consulter systématiquement la table de valeurs textuelle.
9. Superposition de séries multiples et analyse comparative
9.1 Architecture du tableau pour la gestion simultanée de fonctions
L’investigation scientifique nécessite fréquemment la comparaison spatiale de plusieurs modèles concurrents ou l’analyse de sensibilité d’une équation soumise à une variation paramétrique incrémentale. Pour réaliser cette superposition au sein d’un tracé unique, la structure du tableau de calcul doit être minutieusement planifiée. L’architecture optimale repose sur le partage d’une colonne directrice unifiée pour la variable indépendante $x$, flanquée d’une suite de colonnes parallèles recevant l’évaluation respective de chaque fonction $f_1(x), f_2(x), dots, f_k(x)$.
Cette disposition tabulaire garantit que chaque fonction est soumise à la même trame de discrétisation temporelle ou spatiale, ce qui facilite la synchronisation comparative des extrema et des phases d’inflexion. Les en-têtes de colonnes doivent renseigner de manière non ambiguë les conditions expérimentales ou les valeurs des constantes assignées à chaque modèle (par exemple, $f(x)$ avec $\tau = 1{,}5\text{ ms}$ versus $f(x)$ avec $\tau = 3{,}0\text{ ms}$).
Dans l’éventualité où les fonctions en compétition posséderaient des domaines de définition disjoints ou asymétriques, une approche avancée consiste à neutraliser les cellules hors domaine à l’aide de la constante d’erreur formelle #N/A (générée par la formule =NA()). Le moteur graphique d’Excel possède la propriété de ne pas tracer de points pour les cellules contenant #N/A, évitant ainsi l’effondrement artificiel de la courbe vers l’axe zéro pour les plages non évaluables d’une série spécifique.
9.2 Intégration technique de séries indépendantes dans le graphique
L’adjonction de séries au sein d’un graphique existant ne doit pas reposer sur des manipulations automatiques par copier-coller, sources fréquentes d’erreurs d’assignation d’axes. Le protocole rigoureux exige l’ouverture de la boîte de dialogue Sélectionner la source de données par clic droit au centre de la zone de traçage. Cet environnement permet d’administrer individuellement chaque série constitutive de l’espace graphique.
En cliquant sur le bouton Ajouter, l’analyste accède à une interface d’assignation précise comportant trois champs obligatoires :
- Nom de la série : pointe vers la cellule d’en-tête décrivant la fonction ;
- Valeurs de la série X : sélectionne la plage absolue des antécédents vectoriels ;
- Valeurs de la série Y : sélectionne la plage des images correspondantes.
Cette désignation manuelle offre la possibilité d’assigner des vecteurs $X$ entièrement différents d’une série à l’autre si les fonctions exigent des résolutions d’échantillonnage dissemblables.
L’ordre séquentiel d’apparition des séries dans cette boîte de dialogue détermine l’ordre d’empilement visuel (« z-order ») sur le canevas d’affichage. La série placée en bas de la liste est dessinée par-dessus les séries précédentes. L’analyste placera donc judicieusement la courbe la plus fine ou la plus critique au sommet de la pile pour éviter qu’elle ne se trouve masquée par le tracé d’une fonction de plus forte épaisseur.
9.3 Ségrégation graphique et identification des points d’intersection
Lorsque de multiples courbes s’entrecroisent au sein d’un même espace de coordonnées, la lisibilité dépend du contraste et de la différenciation visuelle. L’utilisation exclusive de la couleur est proscrite par les normes d’accessibilité et de publication académique, car elle empêche la distinction lors d’une impression monochrome ou pour les personnes atteintes de déficiences chromatiques. Il convient d’associer systématiquement un codage par le style de trait.
Dans les options de mise en forme des séries, il est recommandé d’attribuer une ligne continue à la fonction de référence théorique fondamentale, une ligne en tiretés longs à la première variante paramétrique, et une ligne en pointillés fins à une troisième modulation. Les marqueurs de points (cercles, carrés, losanges évidés) ne doivent être activés qu’avec parcimonie, par exemple à intervalles réguliers espacés, afin de ne pas surcharger la représentation géométrique.
L’identification géométrique des points d’intersection entre deux courbes théoriques $f(x)$ et $g(x)$ constitue souvent l’objectif cardinal de l’analyse bivariée. Ce point d’équilibre correspond formellement à la racine de l’équation différentielle $h(x) = f(x) – g(x) = 0$. Le tableur permet de repérer ces coordonnées d’intersection par l’interpolation visuelle directe sur la grille quadrillée ou, pour une précision analytique absolue, par l’activation de l’utilitaire d’optimisation Valeur cible ou du Solveur d’Excel appliqué à la cellule de différence résiduelle.
10. Régression empirique et ajout de courbes de tendance
10.1 Frontière méthodologique entre tracé d’équation théorique et ajustement
Il est scientifiquement capital de tracer une ligne de démarcation épistémologique nette entre la démarche purement déductive consistant à tracer une équation mathématique formulée a priori et la démarche inductive consistant à ajuster une courbe de tendance sur des données empiriques observées a posteriori. Le tracé d’équation modélise une vérité logique idéale sans incertitude statistique, tandis que la régression cherche à extraire un ordre géométrique sous-jacent au sein d’un semis de mesures altérées par du bruit expérimental.
Néanmoins, ces deux paradigmes convergent fréquemment au sein d’Excel dans le cadre de la vérification de lois physiques. L’expérimentateur trace simultanément sous forme de points discrets non connectés les résultats de ses mesures de laboratoire, puis superpose une courbe théorique dérivée des équations aux dérivées partielles fondamentales pour attester de la pertinence de son modèle conceptuel.
L’outil intégré de Courbe de tendance d’Excel constitue une passerelle algorithmique immédiate entre ces deux mondes. Lorsqu’il est appliqué à un nuage de points expérimental, il exécute une régression mathématique basée sur le principe de minimisation des moindres carrés pour ajuster au plus près la fonction analytique de la classe morphologique sélectionnée.
10.2 Paramétrage des algorithmes d’ajustement intégrés
L’insertion d’une courbe de tendance s’active par clic droit sur une série de points du graphique, en optant pour Ajouter une courbe de tendance. Le volet latéral propose six familles analytiques d’ajustement : linéaire, logarithmique, polynomiale (jusqu’au degré 6), puissance, exponentielle et moyenne mobile. Le choix du modèle ne doit jamais résulter d’un tâtonnement empirique visant à maximiser artificiellement la courbure, mais doit impérativement s’ancrer dans la justification théorique du phénomène physique sous-jacent.
Les paramètres avancés offrent des options de contrôle métrologique de premier plan. L’option Définir l’interception permet de forcer délibérément l’ordonnée à l’origine à une valeur physique incontournable (typiquement imposer $b = 0$ pour une loi de proportionnalité stricte telle que la loi d’Ohm $U = RI$ ou la loi de Beer-Lambert). Cette contrainte réduit le nombre de degrés de liberté de la régression et améliore la robustesse de l’ajustement aux limites du domaine.
Par ailleurs, les champs Prévisions vers l’avant et Prévisions vers l’arrière permettent d’extrapoler mathématiquement le modèle au-delà de la fenêtre d’échantillonnage temporelle ou spatiale des données observées. Cette projection visuelle met en lumière les trajectoires prospectives asymptotiques et permet d’anticiper les seuils de rupture ou les points d’inflexion futurs du système analysé.
10.3 Évaluation de la qualité d’ajustement et extraction de la formule
Pour statuer scientifiquement sur la pertinence d’un ajustement, le volet des courbes de tendance propose de cocher deux cases fondamentales : Afficher l’équation sur le graphique et Afficher le coefficient de détermination (R²) sur le graphique. L’équation affichée livre les paramètres calculés par les algorithmes de moindres carrés au format décimal standard.
Le coefficient de détermination $R^2$ quantifie la proportion de la variance totale des données expliquée par le modèle d’ajustement choisi :
$$R^2 = 1 – \frac{\sum (y_i – \hat{y}_i)^2}{\sum (y_i – \bar{y})^2}$$
Une valeur approchant l’unité ($R^2 \approx 1$) confirme une adhérence rigoureuse de la courbe théorique aux observations empiriques, alors qu’une valeur dégradée alerte sur l’inadéquation du modèle fonctionnel sélectionné ou sur un niveau de bruit statistique inacceptable.
Toutefois, la formule affichée graphiquement sur le canevas est une simple chaîne de caractères figée, impropre à être réutilisée directement dans la chaîne de calcul de la feuille. Pour extraire dynamiquement les coefficients de l’équation dans des cellules indépendantes aux fins de calcul automatisé, l’analyste chevronné déploiera les formules matricielles natives d’Excel telles que DROITEREG() pour les modèles linéaires et polynomiaux, ou exploitera une combinaison des fonctions PENTE(), ORDONNEE.ORIGINE() et INDEX().
11. Automatisation dynamique et conception de modèles paramétriques
11.1 Exploitation des formules matricielles dynamiques modernes
L’introduction récente du moteur de formules matricielles dynamiques dans les versions contemporaines de Microsoft Excel (Microsoft 365 et Excel 2021+) a totalement révolutionné l’infrastructure du calcul d’équations mathématiques. Auparavant, la génération d’un vecteur d’antécédents exigeait l’étirement mécanique de formules sur des centaines de cellules. Aujourd’hui, une expression matricielle unitaire génère instantanément l’intégralité du continuum de discrétisation par débordement dynamique (« spill »).
La génération d’une séquence de $N$ points réguliers bornés entre $x_{\min}$ et $x_{\max}$ s’exécute désormais à l’aide d’une formule unique mobilisant la primitive SEQUENCE() :
=SEQUENCE(N; 1; x_min; (x_max - x_min)/(N - 1))
Saisie dans une seule cellule maîtresse (par exemple A5), cette commande engendre instantanément une colonne de valeurs scalaires s’étendant exactement sur la hauteur prescrite.
L’évaluation fonctionnelle de l’image $f(x)$ bénéficie de la même fluidité matricielle. Il suffit d’écrire la relation en référençant la cellule tête flanquée de l’opérateur de débordement dièse : =2*A5# + 5 ou =SIN(A5#). Le calcul se propage immédiatement sur l’ensemble du vecteur dépendant sans la moindre recopie manuelle. Pour encapsuler formellement des équations élaborées, l’analyste peut recourir à la fonction LAMBDA(), créant ainsi des fonctions personnalisées pures et réutilisables à travers tout le classeur sans recourir au code VBA.
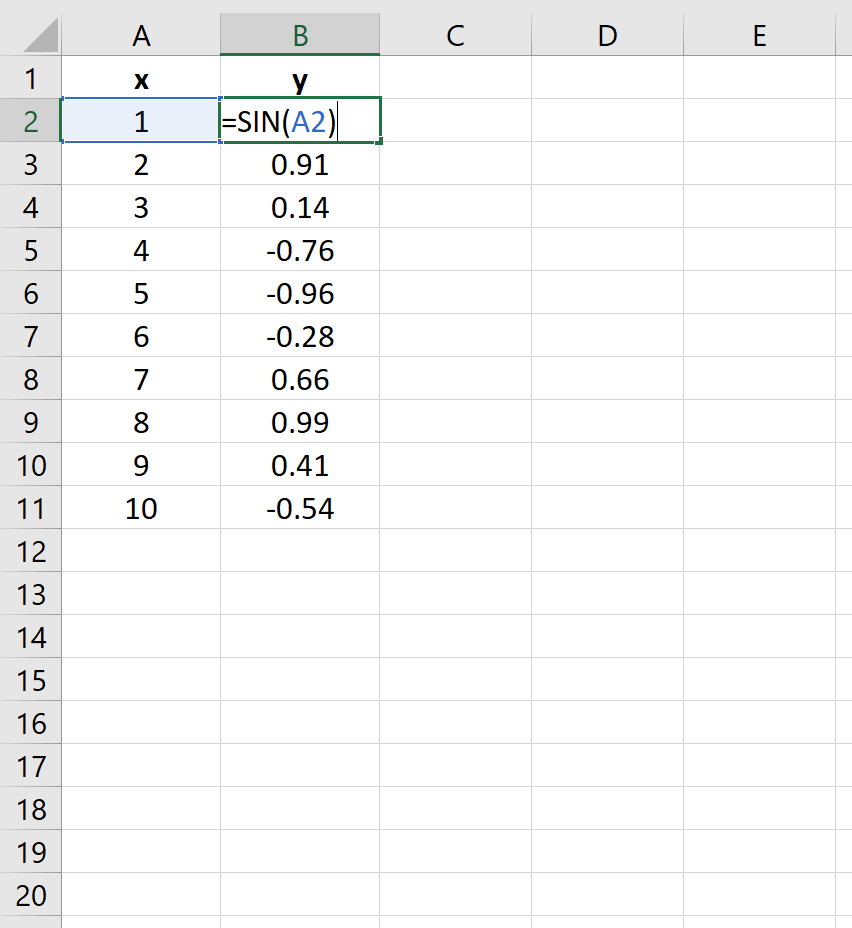
11.2 Création d’interfaces interactives à l’aide de contrôles de formulaire
La transformation d’une feuille de travail statique en une plateforme interactive d’expérimentation paramétrique repose sur l’intégration des contrôles de formulaire graphiques. Accessibles via l’onglet Développeur du ruban (pouvant être activé dans les options de personnalisation d’Excel), le groupe Insérer offre des composants d’interface ergonomiques tels que la Barre de défilement (Slider) et la Toupie (Spin Button).
Une fois le composant dessiné sur la feuille, un clic droit permet d’accéder au menu Format de contrôle. L’analyste assigne une cellule de liaison destinée à recueillir l’état numérique du contrôle, puis paramètre la valeur minimale, la valeur maximale et le pas d’incrément. Les contrôles de formulaire manipulant exclusivement des entiers naturels positifs, une astuce de normalisation consiste à lier le contrôle à une cellule intermédiaire (ex. Z1), puis à diviser cette valeur dans la cellule paramétrique réelle par un facteur d’échelle constant : =$Z$1/100 pour obtenir un incrément fin de $0{,}01$.
La liaison directe de ces contrôles aux cellules logeant les coefficients directeurs, pulsations ou déphasages d’une équation engendre une interaction en temps réel : toute manipulation physique du curseur modifie instantanément les constantes du modèle, déclenche le recalcul du vecteur matriciel dépendant et réactualise de manière synchrone la forme géométrique de la courbe tracée sur le canevas.
11.3 Analyse de sensibilité graphique et exploration de scénarios
L’hybridation des formules matricielles dynamiques et des contrôles interactifs constitue un outil d’investigation heuristique hors pair pour l’analyse de sensibilité. L’observateur peut inspecter en direct la robustesse structurelle d’une solution analytique face aux perturbations paramétriques, observant la déformation progressive de la courbe, l’apparition de modes chaotiques ou le glissement des fréquences de résonance.
Dans l’étude des systèmes physiques complexes — tels que l’oscillateur harmonique amorti soumis à une force d’excitation périodique —, le réglage continu du coefficient d’amortissement via un curseur interactif permet de visualiser la transition topologique exacte entre le régime apériodique suramorti, le régime critique optimal et le régime sous-amorti oscillatoire. La vitesse d’assimilation conceptuelle offerte par cette dynamique visuelle surpasse très nettement l’analyse de tables de données passives.
Pour assurer la pérennité de ce laboratoire virtuel, les graphiques doivent être calibrés avec des échelles fixes et immuables comme établi en section 8. L’auto-calibrage doit être banni dans ce mode d’exploration, sous peine de voir les axes se redimensionner à chaque translation du curseur, annulant l’illusion de mouvement fluide et masquant la perception sensorielle de l’amplitude réelle de la transformation mathématique.
12. Diagnostic des erreurs courantes et protocole de validation
12.1 Résolution des codes d’erreur computationnels classiques
L’évaluation numérique d’équations analytiques sous Excel confronte inéluctablement l’analyste à des ruptures de calcul matérialisées par des codes d’erreur explicites. L’anomalie la plus récurrente est le code #NOMBRE!, qui survient lorsque le moteur de calcul tente d’évaluer une opération mathématiquement impossible sur le corps des réels, telle que l’extraction de la racine carrée d’un antécédent strictement négatif ($\sqrt{x}$ avec $x < 0$) ou l'évaluation du logarithme d'une grandeur nulle.
Ce même code #NOMBRE! sanctionne les dépassements de capacité supérieure ou inférieure (« overflow » et « underflow ») face à des croissances exponentielles divergentes dont le résultat excède le plafond admissible de $1{,}7976931348623157 \times 10^{308}$. Le traitement préventif de ces erreurs réside dans l’encadrement strict du domaine d’échantillonnage de la variable $x$ ou dans l’encapsulation de la formule au moyen de structures de test logique de type =SI(A5>0; LN(A5); NA()).
Le code d’erreur #DIV/0! apparaît instantanément lorsque l’échantillonnage frappe de plein fouet un pôle de la fonction rationnelle étudiée, tentant d’opérer une division arithmétique par zéro. Enfin, l’anomalie #VALEUR! trahit une disparité de type de données, survenant le plus souvent lorsqu’un séparateur décimal n’est pas reconnu par le système d’exploitation de la machine — par exemple l’usage du point décimal anglophone au lieu de la virgule décimale francophone dans une constante textuelle non convertie.
12.2 Élimination des artefacts graphiques et distorsions visuelles
Même lorsque la chaîne computationnelle est exempte de bugs de calcul formels, le rendu visuel peut héberger des artefacts trompeurs dégradant l’intégrité de la représentation. L’effet de facettage anguleux, caractérisé par une suite de segments polygonaux cassés là où la théorie stipule une courbure douce et différentiable, résulte systématiquement d’un sous-échantillonnage spatial. La remédiation consiste simplement à doubler ou quadrupler la valeur de $N$ dans l’intervalle d’étude.
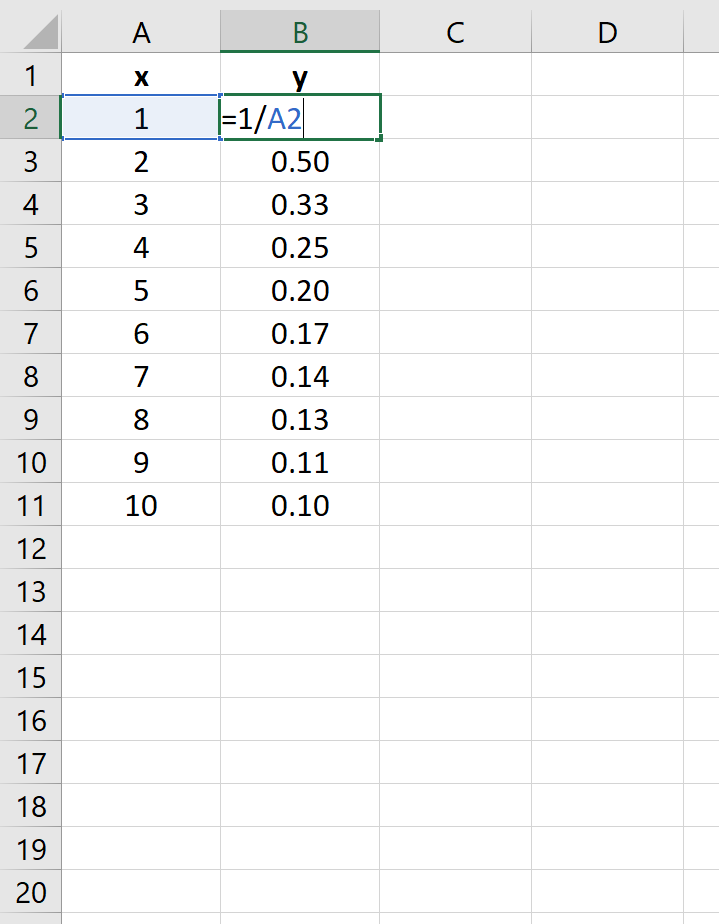
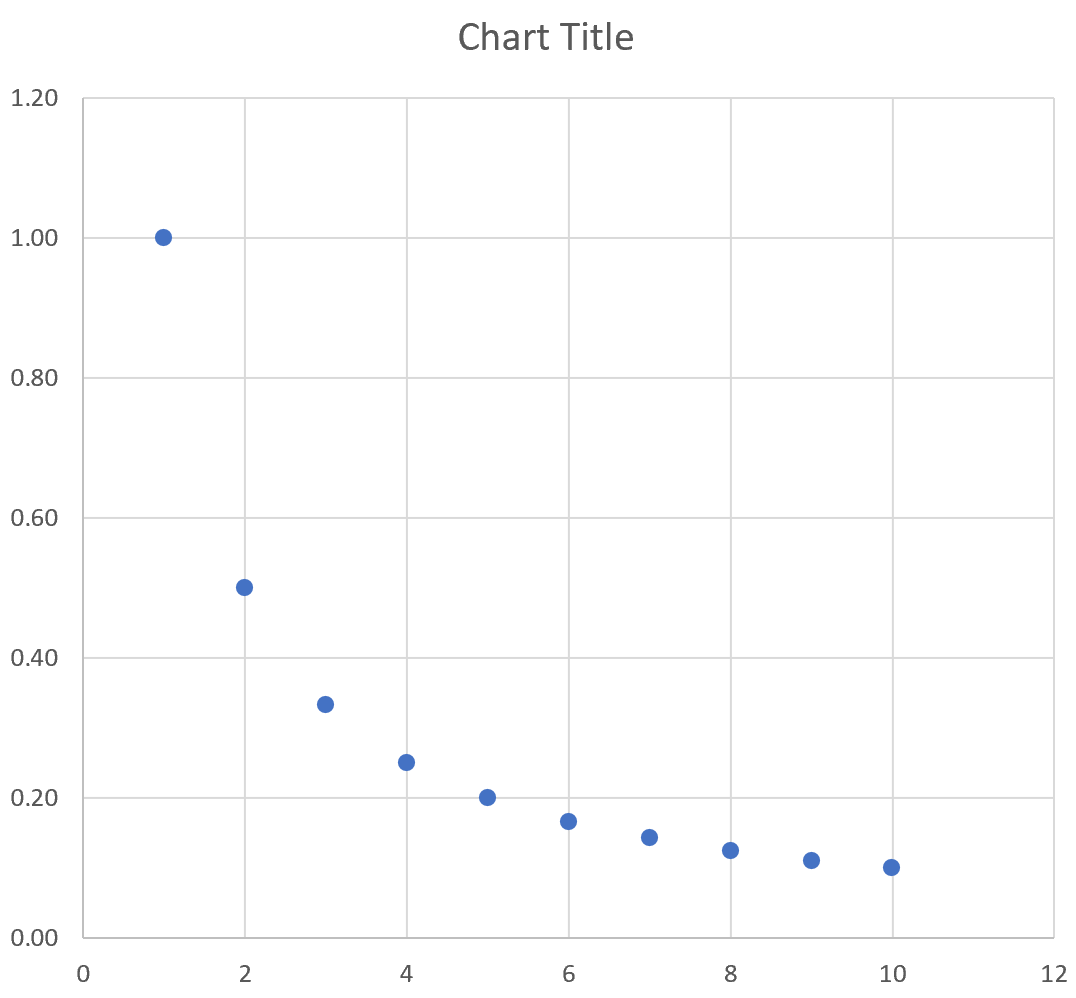
Un artefact beaucoup plus pernicieux concerne la liaison géométrique fallacieuse de branches asymptotiques disjointes. Dans le cas d’une hyperbole $f(x) = 1/x$, la fonction diverge vers $+\infty$ lorsque $x$ approche zéro par valeurs positives et vers $-\infty$ par valeurs négatives. Si les deux points de part et d’autre de l’origine sont consécutifs dans la table, le traceur vectoriel d’Excel reliera les deux extrémités par une droite diagonale traversant toute la hauteur du graphique, matérialisant une liaison inexistante dans la fonction réelle.
L’élimination définitive de ces liaisons parasites exige l’insertion volontaire d’une ligne d’interruption au point singulier exact, dans laquelle l’image est forcée à la valeur formelle =NA(). Excel réagit en suspendant instantanément le tracé du trait vectoriel, créant un décrochage graphique net et restituant la séparation topologique rigoureuse entre les deux branches asymptotiques indépendantes de la courbe.
12.3 Protocole de contrôle de cohérence scientifique de la représentation
Avant d’intégrer un graphique d’équation au sein d’une publication académique, d’un brevet d’invention ou d’un rapport de synthèse industrielle, il est impératif de soumettre la construction à un protocole de validation multidimensionnel structuré. Ce contrôle d’assurance qualité s’articule autour de trois épreuves de vérification analytique :
- Vérification par recoupement des points critiques : Les extrema locaux calculés par l’annulation de la dérivée formelle ($f'(x) = 0$) ainsi que les racines réelles issues de l’équation algébrique ($f(x) = 0$) doivent correspondre rigoureusement aux coordonnées spatiales observées sur les axes du graphique ;
- Contrôle de l’invariance d’échelle et des asymptotes : La dilatation arbitraire de l’intervalle d’étude ne doit pas déformer les régimes asymptotiques horizontaux ou obliques prévus par l’étude analytique aux limites quand $x to \pm\infty$ ;
- Audit métrologique des dimensions et unités : L’ensemble des axes, légendes et quadrillages doit respecter sans ambiguïté les conventions de la métrologie internationale, bannissant les échelles anonymes et les étiquettes catégorielles trompeuses.
L’application scrupuleuse de cette grille d’audit finale garantit que la feuille de calcul s’émancipe de son statut d’outil de bureautique élémentaire pour devenir un instrument de modélisation mathématique rigoureux, reproductible et conforme aux exigences méthodologiques de la science moderne.
Références
Affholder, F., & Guyon, C. (2018). Modélisation mathématique et traitement des données sous tableur : Approche scientifique et pratique. Dunod. https://www.dunod.com
IEEE Computer Society. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://ieeexplore.ieee.org/document/8766229
Microsoft Corporation. (2024). Présenter des données dans un graphique en nuages de points ou un graphique en courbes. Support Microsoft Office. https://support.microsoft.com/fr-fr/office/
Shannon, C. E. (1949). Communication in the presence of noise. Proceedings of the IRE, 37(1), 10–21. https://doi.org/10.1109/JRPROC.1949.232969
Tufte, E. R. (2001). The Visual Display of Quantitative Information (2e éd.). Graphics Press.
Wasserman, L. (2004). All of Statistics: A Concise Course in Statistical Inference. Springer Science+Business Media. https://doi.org/10.1007/978-0-387-21736-9