
Dans le paradigme contemporain de la science des données et de l’analyse computationnelle, la représentation visuelle simultanée de plusieurs trajectoires quantitatives constitue un jalon méthodologique déterminant. Qu’il s’agisse d’évaluer la dynamique comparative d’indicateurs macroéconomiques, de scruter l’évolution de métriques biomédicales au cours d’un essai clinique ou d’analyser la télémétrie de capteurs industriels distribués, la capacité à projeter conjointement plusieurs séries temporelles ou transversales conditionne directement la finesse des inférences exploratoires. L’écosystème Python, articulé autour de la puissance d’abstraction tabulaire conférée par Pandas et de l’infrastructure de rendu vectoriel offerte par Matplotlib, fournit un ensemble d’outils hautement optimisés pour répondre à ces exigences analytiques rigoureuses.
Cependant, le passage d’une visualisation univariée élémentaire à une restitution multivariée intelligible soulève des défis structurels majeurs. La juxtaposition désordonnée de courbes sur un même repère cartésien engendre fréquemment une surcharge sémiotique, où les interférences graphiques occultent les relations de covariance, les découplages d’échelles et les ruptures structurelles sous-jacentes. La maîtrise du traçage multi-séries exige donc non seulement une compréhension technique approfondie des interfaces de programmation — allant de l’encapsulation de haut niveau proposée par les méthodes natives de Pandas jusqu’à la manipulation granulaire de l’arborescence des objets Matplotlib —, mais également une adhésion stricte aux principes cardinaux de la sémiologie graphique et de la psychophysique de la perception.
Le présent traité propose une déconstruction exhaustive des mécanismes théoriques, méthodologiques et programmatiques nécessaires à la mise en œuvre de tracés multivariés de haute précision à partir de structures de données de type DataFrame. À travers l’exploration systématique de la transformation des formats de données, de la gestion des index complexes, de l’harmonisation d’échelles hétérogènes par axes dupliqués et de la partition matricielle en sous-graphiques, ce guide fournit aux chercheurs, ingénieurs et analystes les fondements conceptuels et les recettes algorithmiques indispensables pour convertir des jeux de données multidimensionnels en figures publiables conformes aux normes académiques et industrielles les plus exigeantes.
1. 1. Fondements théoriques et environnement technique du tracé multivarié
1.1 1.1 Architecture logicielle : l’interaction entre Pandas et Matplotlib
L’écosystème scientifique du langage Python repose sur une stratification modulaire hautement spécialisée, au sein de laquelle chaque composant délègue à un niveau d’abstraction inférieur les calculs intensifs ou le rendu matériel. Au cœur de cette architecture, la bibliothèque Pandas assure le rôle fondamental d’orchestrateur de données tabulaires indexées. Structurée autour du concept central de DataFrame, elle confère aux matrices numériques une sémantique riche grâce à la gestion d’étiquettes d’axes explicites, d’alignements relationnels automatiques et d’une prise en charge native des types hétérogènes. Toutefois, Pandas n’intègre pas de moteur d’affichage graphique autonome ; il délègue l’intégralité de la transcription visuelle à la bibliothèque fondatrice Matplotlib, qui opère comme un moteur de rendu vectoriel bidimensionnel polyvalent.
Cette interaction repose sur un modèle d’encapsulation sophistiqué. Lorsque la méthode de tracé intégrée d’un DataFrame est invoquée, Pandas inspecte la topologie des colonnes et la nature de l’index pour formuler une suite ordonnée d’instructions destinées à l’interface de programmation applicative de Matplotlib. Les données sous-jacentes, encapsulées au sein de blocs contigus sous forme de tableaux multidimensionnels gérés par la bibliothèque NumPy, sont extraites sans duplication superflue de mémoire afin d’alimenter les structures géométriques primitives de Matplotlib. Ce couplage garantit une efficience computationnelle maximale, réduisant l’empreinte mémoire lors du traitement de volumes de données massifs tout en préservant les métadonnées contextuelles indispensables à la lisibilité du graphique, telles que les intitulés de variables et les horodatages temporels.
Comprendre cette mécanique d’interfaçage transparent s’avère indispensable dès lors que l’on souhaite dépasser les représentations standardisées. La méthode de haut niveau agit essentiellement comme un translateur qui instancie en coulisses des objets de l’API orientée objet de Matplotlib, principalement l’environnement graphique global et son système de coordonnées cartésiennes. Dès lors, toute modification structurelle poussée nécessite de pouvoir naviguer entre ces deux niveaux d’abstraction : interroger et filtrer les données via l’algèbre relationnelle de Pandas, puis récupérer les références des objets graphiques instanciés pour en moduler la géométrie, l’échantillonnage des axes ou le comportement vectoriel directement au sein de Matplotlib.
1.2 1.2 Typologie des séries multivariées dans la recherche empirique
Dans le cadre de l’investigation empirique, la décision de tracer conjointement plusieurs séries au sein d’un même repère cartésien doit résulter d’une adéquation rigoureuse entre la nature ontologique des données et les objectifs de communication scientifique. Il convient en premier lieu d’opérer une différenciation conceptuelle nette entre les séries temporelles longitudinales et les observations transversales répétées. Une série temporelle modélise l’évolution continue ou discrète d’une variable au fil d’un axe chronologique ordonné, traduisant une dynamique séquentielle sous-tendue par des phénomènes d’autocorrélation, de saisonnalité et de dérive structurelle. À l’inverse, des mesures transversales synchrones reflètent l’état instantané d’une multiplicité d’entités soumises à un même environnement d’observation, comme l’évaluation comparative de rendements financiers ou de métriques de performance sur des sous-populations distinctes.
La mise en relation graphique de ces multiples dimensions quantitatives répond généralement à un impératif cognitif : apprécier de façon intuitive la covariance, les synchronicités de phase ou, à l’opposé, les divergences morphologiques entre des phénomènes théoriquement liés. Par la juxtaposition visuelle, l’analyste cherche à identifier des co-mouvements, des décalages temporels caractéristiques de mécanismes de causalité différée, ou encore des comportements asymétriques face à des chocs exogènes. La trajectoire visuelle partagée permet d’établir une heuristique exploratoire immédiate que les seuls coefficients statistiques agrégés, tels que la corrélation de Pearson ou le tau de Kendall, échouent parfois à capturer pleinement en raison d’effets non linéaires ou de présences aberrantes.
Toutefois, la pertinence méthodologique d’un tracé linéaire multiple n’est avérée que si les séries partagent une unité sémantique cohérente et une continuité logique le long de l’axe des abscisses. Relier arbitrairement des points par des segments continus suppose implicitement l’existence d’une fonction sous-jacente différentiable ou d’un processus continu entre les observations. Lorsque les variables obéissent à des natures d’échelle trop dissemblables ou qu’elles ne s’inscrivent pas dans un ordre naturel, le recours à un graphique multi-lignes linéaire devient fallacieux et doit céder la place à d’autres formalismes de visualisation, tels que les diagrammes de dispersion croisés ou les matrices de corrélation thermographiques.
1.3 1.3 Configuration de l’environnement d’exécution et importations
L’élaboration d’un pipeline de visualisation robuste et reproductible requiert une initialisation méthodique de l’environnement de calcul Python. L’usage académique et professionnel a consacré des conventions d’importation canoniques qui garantissent l’interopérabilité et la clarté lexicale des scripts. L’environnement doit être configuré dès les premières lignes d’instruction en Important explicitement le module Pandas sous l’alias conventionnel conventionnel et le sous-module de rendu procédural de Matplotlib sous sa désignation standardisée. En complément régulier, l’incorporation de la bibliothèque de calcul vectoriel NumPy consolide les capacités de génération de masques booléens et de manipulations matricielles avancées.
Au-delà de ces déclarations d’usage, il est capital de calibrer les paramètres globaux de configuration du moteur graphique, régis par le dictionnaire des paramètres de Matplotlib. L’application précoce de styles prédéfinis permet d’harmoniser la typographie, l’épaisseur relative des tracés, la disposition des grilles et la gestion chromatique d’arrière-plan sans alourdir le code spécifique à chaque figure. L’appel à des fonctions de style dédiées offre la possibilité d’adopter des palettes graphiques standardisées adaptées aux publications scientifiques, qui privilégient un niveau de contraste élevé et des fonds neutres dénués de fioritures susceptibles de parasiter la perception des données brutes.
Enfin, dans le contexte des carnets de recherche interactifs comme l’environnement Jupyter, la gestion du backend de rendu conditionne directement l’expérience utilisateur et la fidélité des sorties. Il est primordial de définir si l’affichage doit s’effectuer de manière vectorielle via des moteurs interactifs autorisant le zoom et l’inspection de points à la volée, ou s’il convient d’activer un moteur statique haute résolution garantissant une restitution conforme au pixel près. Ce choix initial influence non seulement la latence de calcul lors de la manipulation de volumétries imposantes, mais prévient également les dégradations de résolution spatiale lors des exportations finales destinées aux manuscrits académiques.
2. 2. Préparation et structuration rigoureuse des données dans un DataFrame
2.1 2.1 Format large versus format long : implications pour la visualisation
Dans la théorie de la gestion des données relationnelles, la structure géométrique d’un jeu de données s’articule principalement autour de deux topologies distinctes : le format large et le format long, fréquemment désigné sous le vocable d’architecture normalisée ou ordonnée. Au sein d’un schéma large, chaque variable ou série indépendante fait l’objet d’une colonne dédiée, tandis que l’index de ligne représente l’axe de progression continue, qu’il soit chronologique, spatial ou expérimental. Cette morphologie correspond précisément à la modélisation matricielle canonique attendue par les fonctions de tracé de base de Matplotlib et de Pandas, au sein de laquelle chaque vecteur de colonne est directement extrait et projeté sur le plan euclidien en tant que série géométrique autonome.
À l’inverse, le format long consolide l’ensemble des mesures au sein d’une unique colonne de valeurs quantitatives, secondée par une ou plusieurs colonnes de métadonnées qualitatives faisant office de descripteurs ou de clés discriminantes. Bien que ce modèle présente des atouts considérables pour le stockage relationnel et pour l’analyse déclarative via des bibliothèques de grammaire graphique comme Seaborn, il induit une surcharge algorithmique substantielle lorsqu’il s’agit de générer des tracés directs sous Matplotlib. L’opération nécessite alors des filtres itératifs ou une reformulation matricielle préalable par dé-pivotement, sans quoi le moteur graphique est incapable de séparer visuellement les séries sans instruction explicite.
La conversion fluide entre ces deux représentations constitue un savoir-faire incontournable pour l’analyste. L’emploi de la méthode de pivotement permet de transmuter un ensemble de données agrégées au format long vers une structure large parfaitement exploitable pour le tracé simultané de colonnes. Réciproquement, la méthode de fusion permet d’aplatir un schéma large pour préparer des opérations statistiques multidimensionnelles. Maîtriser ces mutations topologiques permet de sélectionner à chaque étape de l’analyse le format structurellement le plus économe en temps de calcul et le plus naturel pour l’API graphique ciblée.
2.2 2.2 Initialisation et inspection d’un échantillon expérimental
Afin d’asseoir les démonstrations conceptuelles sur une base reproductible et exempte de biais d’acquisition, il s’avère opportun de construire par voie programmatique un échantillon de données contrôlé. Cette instanciation synthétique doit incorporer plusieurs variables continues présentant des dynamiques distinctes, telles qu’une dérive stochastique brownienne, une trajectoire oscillatoire périodique et une tendance déterministe linéaire perturbée par un bruit gaussien blanc. Une telle variété permet de reproduire fidèlement les configurations complexes rencontrées lors de l’étude de signaux physiques ou financiers dans des conditions réelles de laboratoire.
Une fois le DataFrame instancié, une inspection diagnostique scrupuleuse de sa structure interne s’impose. Cette phase de validation s’appuie sur la consultation de la typologie des colonnes via l’attribut d’identification des types et l’invocation de la méthode d’information structurelle. Il est impératif de vérifier que les colonnes destinées à être projetées sur l’axe des ordonnées sont strictement reconnues en tant que types numériques à virgule flottante ou entiers signés de 64 bits. L’existence inopinée d’un type textuel générique, causée par la présence de caractères parasites, d’espaces insécables ou de symboles d’absence mal configurés, entraînerait l’échec de la transcription vectorielle ou la transformation catastrophique de l’axe numérique en échelle catégorielle discontinue.
Si des anomalies sont détectées lors de cette phase de contrôle, l’application immédiate de routines de nettoyage vectorielles est requise. L’utilisation de fonctions de conversion numérique forcée garantit la transformation sécurisée des chaînes textuelles en valeurs numériques, en substituant systématiquement des marqueurs standardisés d’absence aux données non convertibles. Cette rigueur de prétraitement assure l’intégrité numérique du pipeline avant toute transmission de données au sous-système graphique, éliminant ainsi les dysfonctionnements silencieux qui faussent l’échelle des représentations.
2.3 2.3 Structuration de l’index comme variable explicative indépendante
Au sein du modèle conceptuel de Pandas, l’index ne se réduit pas à une simple numérotation d’accès aux lignes d’une table ; il matérialise l’armature sémantique fondamentale définissant la variable explicative indépendante par rapport à laquelle s’expriment toutes les séries quantitatives du tableau. Lorsqu’une commande de tracé est sollicitée sans spécification explicite de l’axe des abscisses, c’est invariablement l’index du DataFrame qui est sélectionné comme système de coordonnées horizontales par défaut. La nature, la complétude et la rigueur de son agencement conditionnent de manière déterminante la fidélité géométrique de la figure finale.
Pour les séries temporelles, l’index doit être rigoureusement défini comme une séquence chronologique formalisée, instanciée au moyen de générateurs de plages temporelles régulières. Ce type d’index spécialisé porte en lui des propriétés intrinsèques d’inférence de fréquence qui renseignent automatiquement Matplotlib sur la périodicité sous-jacente des observations, facilitant grandement le placement des graduations majeures et mineures. Lorsque l’index est mal qualifié, par exemple lorsqu’il est constitué de simples chaînes de caractères brutes dépourvues de lien topologique temporel, le moteur graphique traite les entrées comme des catégories discrètes équidistantes, annihilant ainsi la perception correcte des variations d’intervalle entre des mesures irrégulièrement espacées.
La réorganisation dynamique de l’axe indépendant s’opère couramment à l’aide des méthodes de réassignation d’index. L’analyste peut ainsi promouvoir une colonne descriptive de temps ou d’espace au rang d’index structurel, ou au contraire rétablir un index séquentiel par défaut lorsque la logique d’analyse requiert une projection fondée sur le rang d’occurrence plutôt que sur une mesure continue. La manipulation délibérée de cet index s’affirme ainsi comme le levier le plus puissant pour contrôler nativement l’alignement cartésien de l’ensemble des séries hébergées dans la structure tabulaire.
3. 3. Tracé séquentiel standard via l’API Matplotlib pyplot
3.1 3.1 Mécanisme des appels consécutifs à plt.plot()
L’approche procédurale historique de Matplotlib, véhiculée par son module standard, repose sur la métaphore conceptuelle d’une machine à états finis régissant une surface de dessin active en mémoire vive. Lorsque l’on entreprend de tracer plusieurs séries issues d’un même DataFrame par cette méthode, le principe opérationnel réside dans l’accumulation séquentielle d’éléments graphiques sur le canevas en cours. Chaque appel consécutif à la fonction de base ajoute une nouvelle couche géométrique sous forme de ligne brisée vectorielle sans écraser les primitives précédemment déposées, tant que la figure courante n’est pas réinitialisée ou formellement libérée de la mémoire.
Sur le plan de la syntaxe, cette stratégie se traduit par la succession directe d’instructions ciblant individuellement chaque vecteur de colonne du DataFrame. Par exemple, le passage consécutif de deux séries désignées par leurs étiquettes respectives génère la superposition immédiate de deux trajectoires linéaires sur le même repère orthonormé. Cette approche offre une simplicité de lecture pour les scripts d’exploration rapide, car chaque appel peut recevoir des arguments graphiques distincts, modifiant de façon granulaire la couleur, la transparence ou la légende attachée à la série ciblée.
Cette logique d’accumulation progressive trouve son achèvement impératif dans l’exécution de la commande de rendu final. Dans un environnement de production de scripts autonomes hors notebook, cette instruction déclenche la boucle événementielle du gestionnaire de fenêtres de l’interface graphique sous-jacente, figeant la composition géométrique et rendant la figure visible à l’écran. En l’absence de cette étape de clôture procédurale ou en cas d’omission de purge de la figure, les appels de traçage ultérieurs continueraient de s’agréger indéfiniment sur le même état graphique, produisant des superpositions involontaires lors de traitements itératifs en chaîne.
3.2 3.2 Assignation explicite des axes d’abscisses et d’ordonnées
Bien que Matplotlib autorise l’omission du vecteur d’abscisses — adoptant alors implicitement une échelle entière basée sur le rang d’indice des éléments de 0 à N-1 —, la méthodologie scientifique impose l’assignation explicite de l’axe indépendant pour chaque série projetée. Cette déclaration univoque est indispensable pour garantir que chaque point calculé en ordonnée corresponde scrupuleusement à sa coordonnée d’observation réelle sur l’axe des abscisses, prévenant toute distorsion d’échelle en cas de séries incomplètes ou asynchrones.
La syntaxe canonique requiert alors le passage de deux arguments vectoriels conjoints lors de l’appel graphique : la variable explicative commune, généralement issue d’une colonne dédiée ou de l’index du DataFrame, suivie de la variable quantitative à représenter. Ce formalisme garantit une cohérence dimensionnelle rigoureuse. Matplotlib effectue une assertion stricte sur la cardinalité des vecteurs transmis ; toute inadéquation entre la longueur du vecteur horizontal et celle du vecteur vertical déclenche une exception bloquante d’incompatibilité de forme, préservant ainsi le chercheur d’erreurs de projection géométrique.
Au-delà de la conformité dimensionnelle, cette assignation explicite résout les problématiques d’alignement lorsque plusieurs séries proviennent de jeux de données dont les fréquences d’échantillonnage ne coïncident pas parfaitement. En liant formellement chaque valeur d’ordonnée à sa coordonnée d’abscisse propre, Matplotlib assure une interpénétration cartésienne exacte des courbes au sein d’un référentiel commun continu, comblant visuellement les disparités d’intervalles sans nécessiter un rééchantillonnage forcé des structures tabulaires d’origine.
3.3 3.3 Automatisation du tracé séquentiel par itération de colonnes
Lorsque le volume de séries à superposer croît au-delà de trois ou quatre variables, la duplication manuelle des instructions de traçage devient une pratique anti-patron proscrite, génératrice d’erreurs de maintenance et en infraction avec le principe fondamental de non-redondance du code source. L’élégance algorithmique réside dans la factorisation du processus de tracé au moyen de structures de contrôle itératives. L’analyste parcourt dynamiquement un sous-ensemble prédéfini d’étiquettes de colonnes, automatisant l’injection séquentielle de chaque vecteur dans le moteur de rendu.
Cette mécanisation s’articule idéalement autour de la définition préalable d’une liste blanche de variables cibles, ou par l’application de filtres logiques s’appuyant sur les métadonnées du DataFrame. Il est par exemple possible de sélectionner de manière programmatique l’intégralité des colonnes dont le type satisfait une condition numérique stricte, en excluant les identifiants textuels ou les variables auxiliaires. La boucle itère ensuite sur cette collection d’identifiants, procédant à l’appel graphique tout en assignant dynamiquement le paramètre d’étiquetage textuel à partir du nom même de la colonne parcourue.
L’implémentation de cette logique itérative procure une évolutivité immédiate au pipeline de visualisation. Quelle que soit la dimensionnalité du tableau source — qu’il contienne cinq ou cinquante séries —, le code de tracé demeure invariable, compact et exempt d’ambiguïté. De surcroît, cette approche facilite l’application de palettes chromatiques continues ou de règles conditionnelles, modifiant par exemple l’épaisseur de trait selon l’appartenance d’une série à une classe catégorielle spécifique déduite de sa nomenclature.
4. 4. Méthodes de tracé intégrées à Pandas (DataFrame.plot)
4.1 4.1 Tracé direct de l’intégralité d’un DataFrame
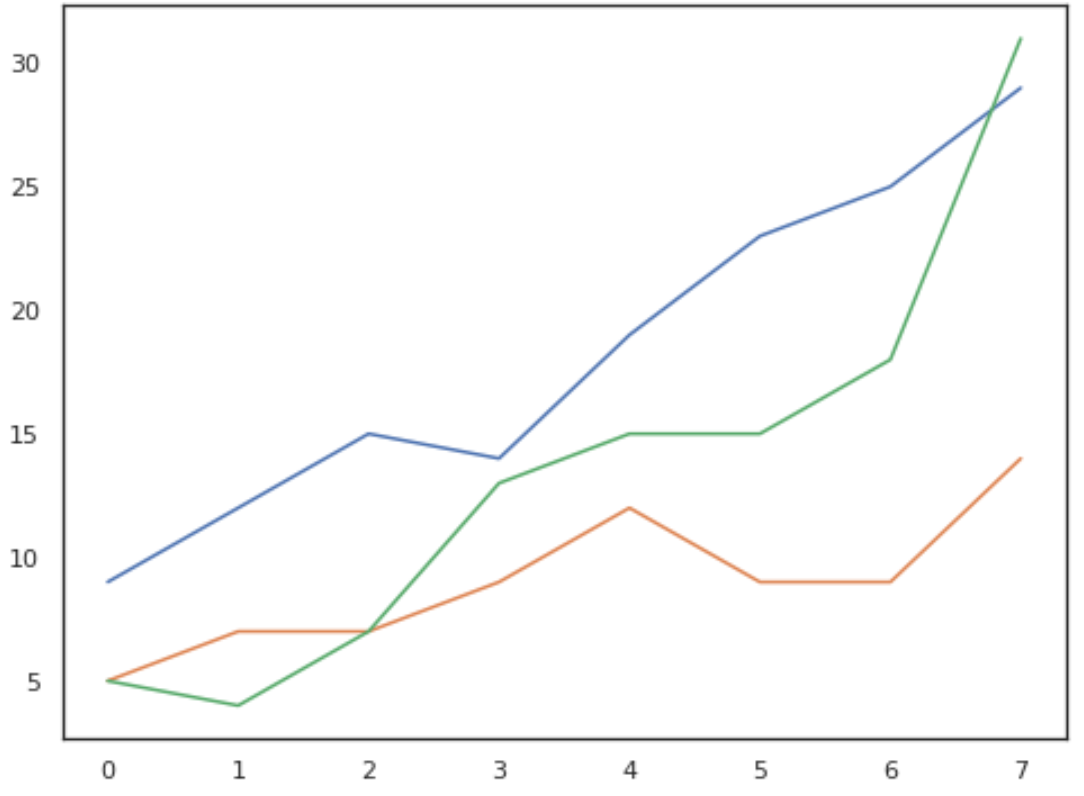
Pour l’analyse exploratoire des données, Pandas met à disposition une interface de tracé d’un niveau d’abstraction supérieur, encapsulée sous l’accesseur dédié aux méthodes graphiques. Accessible directement via la syntaxe compacte appliquée à l’objet tabulaire complet, cette fonction analyse la totalité du DataFrame en une seule opération et génère de manière autonome un tracé multivarié exhaustif. Cette commande unique se charge de vérifier les types des composantes tabulaires pour identifier les grandeurs directement convertibles en représentations graphiques continues.
La puissance de cette intégration repose sur son comportement inférentiel intelligent. La méthode examine l’ensemble des colonnes, procède à l’exclusion silencieuse et rigoureuse des variables non numériques — telles que les chaînes textuelles ou les objets binaires —, et attribue automatiquement l’axe de l’index comme variable d’abscisse universelle. Simultanément, elle active un cycle de couleurs prédéfini distribuant des teintes distinctes à chaque série, tout en construisant une légende explicite qui reprend les étiquettes textuelles exactes des colonnes sans qu’aucune déclaration manuelle ne soit exigée de l’utilisateur.
Ce niveau de synthèse fonctionnelle réduit drastiquement le coût cognitif et la verbosité syntaxique lors de l’évaluation initiale d’un jeu de données. En une ligne de code, l’analyste obtient un panorama structurel complet de ses variables, permettant d’identifier immédiatement d’éventuelles anomalies d’acquisition, des décalages d’amplitudes ou des corrélations macroscopiques, tout en bénéficiant de l’optimisation sous-jacente des calculs vectoriels opérés par les couches C de NumPy.
4.2 4.2 Sélection et projection de sous-ensembles spécifiques
Dans la majorité des scénarios appliqués, le tracé de l’intégralité d’un DataFrame s’avère contre-productif en raison du nombre excessif de colonnes hétérogènes qu’il peut héberger. Il devient alors indispensable d’isoler un sous-ensemble de séries d’intérêt particulier pour circonscrire l’analyse visuelle. L’interface de Pandas offre deux paradigmes complémentaires pour opérer cette restriction sélective : l’indexation préalable du DataFrame par crochetage d’une liste de colonnes, ou la paramétrisation explicite des axes au sein même de la fonction de tracé.
La première technique privilégie la composition fonctionnelle en réduisant la dimensionalité du DataFrame en amont de l’appel graphique. En sélectionnant une collection restreinte d’identifiants de séries, l’analyste crée une vue éphémère ou une copie projetée dont le tracé direct isole uniquement les dynamiques ciblées. Cette approche présente l’avantage de la lisibilité et s’insère naturellement dans les pipelines d’instructions chaînées où les données sont filtrées, normalisées puis immédiatement visualisées sans assignation intermédiaire de variables superflues.
La seconde approche exploite directement les paramètres d’affectation de variables de la méthode de haut niveau. En précisant explicitement les arguments désignant la variable horizontale et la liste des variables verticales, cette méthode offre une flexibilité appréciable lorsqu’il s’agit de choisir une colonne quelconque comme référentiel d’abscisses sans avoir à modifier formellement l’index de la structure de données. Sur le plan des performances algorithmiques brutes, les deux méthodes affichent des métriques d’exécution quasiment indiscernables, le goulot d’étranglement résidant invariablement dans la rastérisation géométrique des pixels par Matplotlib plutôt que dans l’indexation de la mémoire Pandas.
4.3 4.3 Récupération et manipulation de l’objet Axes retourné
L’un des atouts architecturaux les plus notables de la méthode graphique de Pandas réside dans le fait qu’elle ne constitue nullement une impasse procédurale isolée du reste de l’écosystème. À l’issue de son exécution, elle retourne systématiquement une référence vivante vers l’instance de l’objet de système de coordonnées Matplotlib sur laquelle elle a opéré son rendu. Cette restitution crée une passerelle technique transparente entre la concision de Pandas et la granularité quasi infinie de l’interface orientée objet de Matplotlib.
La capture de cet objet dans une variable dédiée confère à l’analyste une maîtrise absolue sur le raffinement post-graphique. Il devient alors trivial d’invoquer l’ensemble des méthodes membres de cette classe pour modifier l’aspect visuel du tracé : redéfinir dynamiquement les bornes cartésiennes, imposer une grille d’arrière-plan paramétrée, restructurer les libellés des axes ou injecter des éléments géométriques additionnels. Cette séparation des responsabilités permet de déléguer à Pandas l’extraction et le tracé lourd des séries, tout en confiant à l’API Matplotlib la finition typographique et la mise en conformité éditoriale.
Ce patron de conception autorise également l’intégration de multiples blocs d’instructions au sein d’un même repère en exploitant le paramètre de réassignation d’axes. En passant l’objet de coordonnées retourné par un premier appel graphique en argument d’un appel ultérieur, on peut combiner harmonieusement des séries issues de DataFrames dissemblables, enrichir un tracé de lignes d’un semis de points d’un autre jeu de données, ou cumuler des sorties statistiques complexes au sein d’une composition visuelle parfaitement cohérente.
5. 5. Séparation visuelle : palettes chromatiques, styles et marqueurs
5.1 5.1 Sélection méthodique des palettes de couleurs
La restitution simultanée de multiples courbes impose une réflexion approfondie quant au choix des vecteurs chromatiques mis en œuvre. La simple acceptation du cycle de couleurs par défaut, bien qu’adaptée aux explorations informelles, s’avère souvent déficiente face aux exigences de publication scientifique ou aux impératifs d’accessibilité universelle. Une palette défaillante, caractérisée par des contrastes de luminance insuffisants ou une mauvaise répartition spectrale, rend la discrimination entre séries adjacentes laborieuse, particulièrement sous un éclairage dégradé ou pour les personnes atteintes de déficiences de la vision des couleurs comme le daltonisme.
Il est donc fortement recommandé d’adopter des palettes séquentiellement uniformes du point de vue perceptif, telles que les célèbres gammes Viridis, Plasma, ou les nuanciers qualitatifs développés par Cynthia Brewer sous le standard ColorBrewer. Ces schémas garantissent que des incréments mathématiques équivalents correspondent à des variations perceptives régulières pour l’œil humain, tout en éliminant les artefacts de fausse saillance générés par des teintes trop saturées. Au sein de Pandas comme de Matplotlib, ces palettes peuvent être instanciées directement via des descripteurs textuels passés au paramètre de carte de couleurs ou définies sous forme de listes de codes hexadécimaux validés.
Sur le plan psychophysique, l’analyste doit respecter le principe de contraste perceptif en réservant les couleurs saturées et à fort contraste aux séries portant le signal expérimental critique, tout en reléguant les trajectoires de référence, les moyennes de population ou les séries de contrôle à des teintes atténuées ou à des nuances de gris neutres. Cette hiérarchisation chromatique prévient la saturation cognitive et guide immédiatement l’attention du lecteur vers les éléments porteurs de l’information théorique majeure de la recherche.
5.2 5.2 Diversification des styles de lignes (Linestyles)
La couleur ne saurait constituer le seul canal sémiotique de distinction visuelle, notamment en prévision d’une reproduction sur support imprimé monochrome ou pour préserver l’accessibilité aux lecteurs daltoniens. L’incorporation concertée de variations géométriques dans le tracé même des segments constitue un principe de redondance perceptuelle essentiel. Les bibliothèques graphiques Python prennent nativement en charge une diversité de motifs linéaires formalisés, allant du trait continu conventionnel aux variations discontinues : tirets larges, pointillés fins, ou alternances mixtes de tirets et de points.
L’utilisation de ces motifs doit répondre à une logique taxinomique cohérente plutôt qu’à une distribution aléatoire. Dans une configuration comparant des valeurs empiriques réelles à des estimations théoriques, l’usage académique commande d’attribuer une ligne continue pleine à la série d’observations concrètes, tandis que la trajectoire dérivée d’un modèle économétrique ou physique sera matérialisée par un motif tireté. Les projections contrefactuelles ou les bornes de variabilité trouveront quant à elles une traduction logique sous la forme de tracés pointillés de moindre densité visuelle.
Conjointement au motif, le calibrage de l’épaisseur du trait représente un puissant modificateur d’impact cognitif. L’ajustement du paramètre d’épaisseur permet d’établir une hiérarchisation visuelle sans équivoque. En augmentant l’épaisseur de la série centrale d’étude tout en réduisant d’un tiers ou de moitié celle des séries contextuelles secondaires, l’analyste empêche l’apparition de l’effet d’enchevêtrement visuel chaotique qui survient inévitablement lorsque plus de quatre séries partagent un tracé d’épaisseur rigoureusement identique.
5.3 5.3 Intégration et paramétrage des marqueurs ponctuels
Lorsque les séries continues se caractérisent par un échantillonnage relativement espacé ou lorsque la mise en évidence des coordonnées de mesure exactes présente une valeur scientifique déterminante, l’adjonction de marqueurs discrets sur les sommets de la ligne brisée s’avère particulièrement instructive. Ces glyphes géométriques — cercles pleins, carrés, triangles orientés, losanges ou croix — viennent ponctuer la courbe et réaffirment l’emplacement des données réelles face à l’interpolation linéaire sous-jacente.
Cependant, l’introduction de marqueurs sur des séries à haute densité temporelle présente un risque majeur de saturation graphique. Si une série comporte des milliers de points, l’affichage indistinct de symboles crée une bande opaque d’encre qui oblitère la lecture de la trajectoire. Pour pallier cet écueil, les interfaces de tracé offrent des paramètres d’échantillonnage de fréquence de marquage permettant de n’afficher un glyphe que tous les N intervalles réguliers le long de l’axe, préservant ainsi la pureté de la courbe tout en matérialisant la présence des points de mesure.
Le paramétrage des dimensions physiques du marqueur et de sa frontière chromatique constitue un raffinement supplémentaire d’une grande valeur plastique. L’assignation d’une teinte de remplissage différenciée de celle du contour extérieur, combinée à une réduction mesurée de la taille globale du glyphe, confère à la figure un niveau de finition et de précision visuelle conforme aux attentes des revues internationales de premier rang, éliminant l’impression de lourdeur propre aux réglages graphiques non calibrés.
6. 6. Normalisation typographique, légendes et annotations sémantiques
6.1 6.1 Paramétrage exhaustif de la légende scientifique
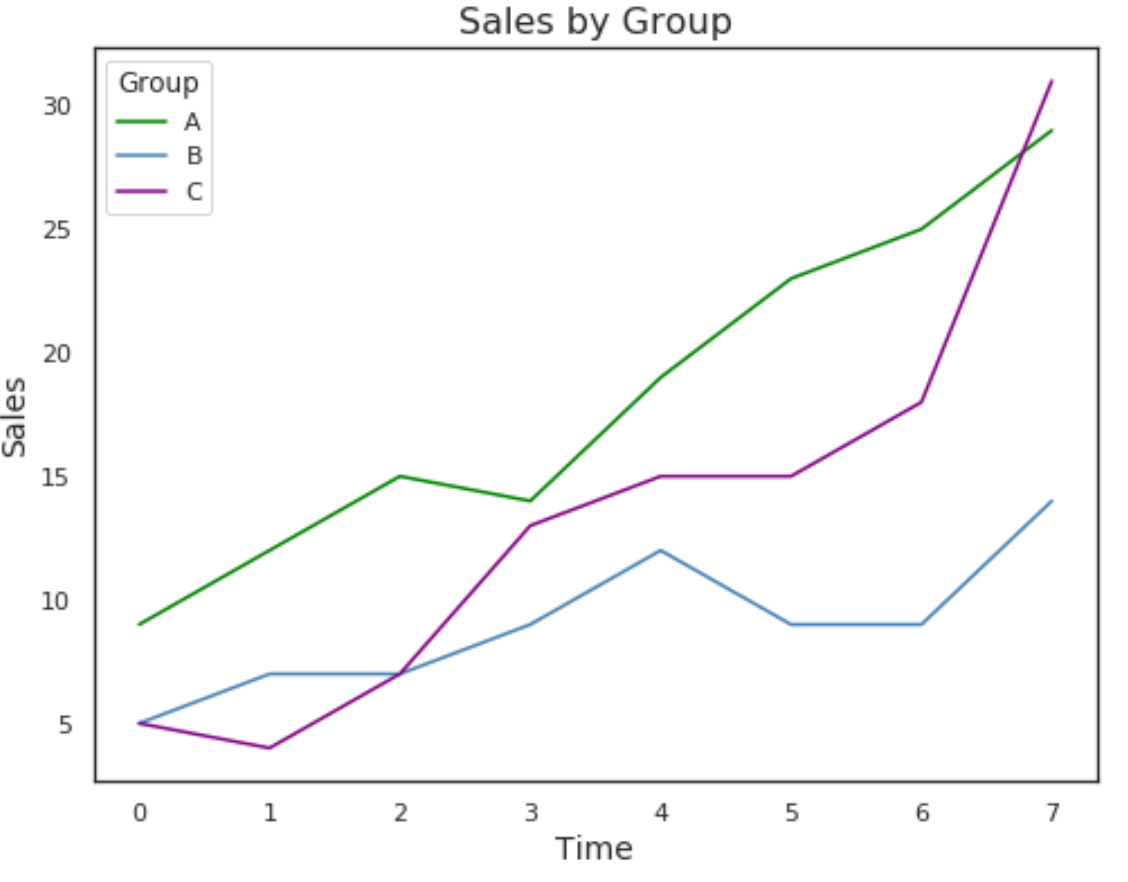
La légende constitue la clef de voûte déictique d’un graphique multivarié : c’est elle qui permet la traduction immédiate entre les attributs géométriques perçus — couleurs, textures, symboles — et les concepts nominatifs du domaine d’étude. Une légende négligée ou positionnée de façon inappropriée compromet gravement l’utilisabilité d’une figure par ailleurs irréprochable. L’analyste doit dès lors contrôler avec la plus grande rigueur son contenu textuel, son formatage typographique et son ancrage spatial au sein de l’espace de la composition.
Le positionnement optimal de la boîte de légende dépend de la distribution des données dans l’espace cartésien. Si l’heuristique de localisation automatique de Matplotlib tente d’insérer la légende dans la zone libre de données la plus vaste, elle engendre parfois des masquages involontaires lors d’analyses automatisées. Il est fréquemment plus rigoureux d’ancrer formellement la légende dans un quadrant dégagé choisi par l’analyste, ou d’exploiter la technique du déport extérieur à l’aide d’une boîte d’ancrage aux limites relatives. Cette dernière méthode repousse la légende en marge de la zone de tracé principale, éliminant tout risque d’interférence avec les trajectoires des courbes.
Au-delà de son emplacement, la structure interne de la légende peut être ajustée pour minimiser son empreinte spatiale. La division des entrées en plusieurs colonnes parallèles fluidifie la lecture lorsque de nombreuses séries sont présentées de front, réduisant la dimension verticale du bloc d’information. La personnalisation de la police typographique, de l’opacité du cadre d’arrière-plan et de la suppression éventuelle de l’ombre portée parachève l’intégration esthétique de la légende, la rendant discrète mais parfaitement intelligible.
6.2 6.2 Labellisation rigoureuse des axes dimensionnels
L’absence ou l’ambiguïté des dénominations d’axes constitue l’un des manquements méthodologiques les plus sévères de la visualisation scientifique. Toute variable projetée sur une échelle euclidienne doit impérativement faire l’objet d’une labellisation explicite précisant non seulement la grandeur physique ou conceptuelle observée, mais également son unité de mesure normalisée entre crochets ou parenthèses. Une courbe représentant un flux financier ou une réponse biophysique perd toute substance si le lecteur ne peut discerner s’il s’agit de millions d’euros constants, de pourcentages relatifs ou de micromoles par litre.
Le calibrage des bornes extrêmes des axes dimensionnels relève également d’un choix analytique conscient. Alors que le comportement par défaut des bibliothèques tend à ajuster dynamiquement les limites au plus près de l’étendue des valeurs observées, il est souvent impératif, pour des raisons de comparabilité ou d’honnêteté intellectuelle, d’ancrer l’axe des ordonnées sur le zéro absolu afin d’éviter d’amplifier de manière trompeuse des variations marginales de faible magnitude. À l’inverse, dans le cadre de phénomènes régis par des lois exponentielles ou de dynamiques de diffusion de chocs, l’imposition de limites manuelles permet de focaliser l’attention sur l’intervalle opérationnel pertinent.
Enfin, la morphologie des étiquettes numériques de graduation gagne à être systématiquement contrôlée via l’usage de formatteurs dédiés. Qu’il s’agisse d’appliquer des séparateurs de milliers pour les grands nombres entiers, d’exprimer des ratios sous forme de pourcentages stricts ou de borner l’affichage à un nombre constant de décimales significatives, cette normalisation typographique affine l’élégance de la restitution et évite la surcharge inutile de chiffres non informatifs sur le pourtour du cadre.
6.3 6.3 Ancrage d’annotations textuelles et fléchées
Si la superposition de multiples séries permet d’appréhender les dynamiques d’ensemble, elle tend parfois à noyer les événements singuliers porteurs de ruptures scientifiques décisives : changement de régime économique, défaillance matérielle d’un système physique ou transition de phase expérimentale. Pour valoriser ces singularités sans exiger une inspection fastidieuse de la part du lecteur, l’implantation d’annotations textuelles contextualisées s’avère indispensable.
Matplotlib fournit à cet égard un mécanisme d’annotation d’une grande sophistication, permettant de relier un bloc de texte descriptif à un point cartésien précis au moyen d’un vecteur fléché paramétrable. L’intérêt méthodologique de cette fonction repose sur sa capacité à découpler l’espace de coordonnées de la cible — défini rigoureusement selon les unités réelles des données du DataFrame — de l’espace d’affichage du texte explicatif, exprimé en points typographiques ou en décalage relatif. Cette séparation prévient tout chevauchement accidentel entre le texte et les points d’inflexion critiques de la courbe.
Sur le plan algorithmique, l’analyste peut automatiser la détection de ces points singuliers en interrogeant programmatiquement le DataFrame sous-jacent. L’extraction conditionnelle d’un maximum local, d’un point d’intersection critique entre deux séries divergentes ou du franchissement d’un seuil critique permet d’alimenter directement la routine d’annotation avec les coordonnées calculées. Cette synergie entre le calcul relationnel de Pandas et la mécanique de pointage vectoriel transforme un simple graphique descriptif en un document scientifique autonome à haute valeur pédagogique.
7. 7. Gestion des échelles temporelles et des index non linéaires
7.1 7.1 Traitement des DatetimeIndex au sein de Pandas
Le traitement des variables chronologiques constitue l’un des domaines d’excellence de la bibliothèque Pandas, qui intègre nativement une gestion sophistiquée des structures de type DatetimeIndex. Dans de nombreux cas pratiques issus de collectes brutes, les variables de temps se présentent initialement sous la forme de chaînes de caractères arbitraires ou de valeurs entières représentant des secondes écoulées depuis une époque conventionnelle. La première étape méthodologique consiste à transmuter impérativement ces données en objets temporels authentiques via les fonctions de conversion spécialisées de Pandas.
Cette conversion opère une rupture qualitative fondamentale dans l’agencement du DataFrame. Dès lors que l’axe chronologique est formalisé sous forme temporelle native, il hérite d’une conscience temporelle aiguë capable de gérer les irrégularités calendaires, les années bissextiles et, si nécessaire, la localisation géopolitique précise relative aux fuseaux horaires. Lorsqu’un DataFrame ainsi structuré est transmis au moteur de rendu de Matplotlib, ce dernier ne traite plus l’abscisse comme une suite de nombres flottants désincarnés, mais fait appel à des modules de conversion d’époques qui adaptent la position spatiale des points selon la durée réelle écoulée entre eux.
Ce formalisme élimine définitivement les erreurs grossières d’interprétation induites par des index textuels, au sein desquels des intervalles temporels asymétriques — par exemple des mesures séparées consécutivement par deux heures, puis par trois semaines — se voyaient attribués un espacement géométrique identique sur le dessin. Avec un DatetimeIndex valide, la distance spatiale cartésienne entre deux sommets successifs devient rigoureusement proportionnelle au temps universel écoulé, restituant avec fidélité la cinétique propre des phénomènes observés.
7.2 7.2 Formatage avancé des graduations temporelles (DateTickLocator)
L’affichage lisible des graduations sur un axe temporel partagé par plusieurs séries constitue une opération délicate. La tendance naturelle des systèmes de tracé élémentaires est de multiplier les étiquettes de date dès lors que la densité d’échantillonnage s’élève, produisant un chevauchement illisible de caractères textuels au bas de la figure. Pour orchestrer harmonieusement cette disposition, il est nécessaire de mobiliser les classes spécialisées du sous-module de gestion des dates de Matplotlib, articulées autour du couple localisateurs et formateurs de dates.
Les localisateurs déterminent de manière programmatique l’emplacement exact des repères majeurs et mineurs le long de l’axe des temps. L’analyste peut ainsi déclarer formellement que les graduations principales doivent correspondre au premier jour de chaque année civile, tandis que les graduations secondaires matérialiseront le passage de chaque trimestre ou de chaque mois d’observation. Cette modularité assure une clarté absolue de l’échelle, quelle que soit l’étendue temporelle couverte par le jeu de données, qu’elle s’étende sur un siècle de mesures macroéconomiques ou sur quelques microsecondes d’enregistrement physique.
En parallèle, les formateurs régissent la syntaxe textuelle exacte projetée sous chaque graduation majeure. À l’aide de masques de formatage de chaînes standardisés, l’analyste contraint l’affichage à ne restituer que les composantes calendaires indispensables à l’interprétation contextuelle : par exemple, le seul millésime à quatre chiffres pour une série pluriannuelle, ou le couple heure-minute pour un suivi intrajournalier. L’adjonction d’une rotation ergonomique des étiquettes d’abscisse, paramétrée généralement entre 30 et 45 degrés d’inclinaison, achève de dégager l’espace visuel et d’éradiquer tout risque de collision textuelle.
7.3 7.3 Rééchantillonnage et lissage de séries temporelles multiples
Dans l’exploration de données empiriques issues du monde réel, les signaux temporels multiples souffrent fréquemment d’une haute fréquence d’acquisition polluée par un bruit stochastique ou des fluctuations saisonnières de court terme. Le tracé direct de plusieurs séries hautement volatiles sur un repère cartésien unique engendre une saturation immédiate, créant un enchevêtrement illisible d’oscillations où les tendances structurelles lourdes deviennent indiscernables. Il est alors scientifiquement requis d’appliquer des opérations de rééchantillonnage ou de lissage conjointe avant la phase de projection graphique.
Pandas propose pour ce faire la méthode de rééchantillonnage temporel, qui s’apparente à une opération de regroupement analytique contrainte par une périodicité chronologique explicite. L’analyste peut ainsi agréger des séries de cotations financières ou de télémesures météorologiques journalières vers une maille hebdomadaire ou mensuelle en calculant simultanément la moyenne, la médiane ou les bornes de variance sur chaque fenêtre. Cette réduction de dimensionalité allège considérablement la charge géométrique sur le canevas et clarifie la lecture des macro-tendances sans dénaturer la représentativité du signal.
Une alternative tout aussi féconde réside dans l’application synchronisée de fenêtres glissantes au moyen de la méthode dédiée. Le calcul d’une moyenne mobile sur une période calibrée génère une trajectoire continue épurée des aléas transitoires. Une pratique visuelle vertueuse consiste d’ailleurs à superposer sur le même graphique la série brute en arrière-plan — rendue très discrète par l’application d’un canal de transparence élevé et d’une épaisseur de ligne réduite — et la courbe de moyenne mobile au premier plan, tracée de manière contrastée et continue. Ce procédé permet de révéler la dynamique fondamentale tout en préservant l’honnêteté descriptive de la dispersion originale.
8. 8. Tracé sur axes doubles ou multiples pour séries hétérogènes
8.1 8.1 Problématique de l’asymétrie d’échelles de grandeur
L’un des défis les plus redoutables de la visualisation multivariée réside dans la cohabitation de séries exprimées dans des unités de mesure distinctes ou présentant des ordres de grandeur radicalement divergents. Si l’analyste tente de superposer naïvement au sein d’un repère orthonormé standard une variable économique oscillant autour de quelques millions d’unités avec un taux d’intérêt exprimé en faibles pourcentages, la seconde série se trouvera mécaniquement écrasée au voisinage immédiat de la ligne du zéro horizontal.
Cette asymétrie dimensionnelle neutralise complètement l’utilité exploratoire du graphique. La série d’amplitude marginale apparaît sous la forme d’un segment rigoureusement plat, privant le chercheur de toute perception de sa variance propre, de ses retournements de tendance ou de ses cycles de récurrence. Même lorsque deux variables partagent la même unité monétaire ou physique, une disproportion massive dans leurs valeurs absolues respectives justifie l’abandon du repère cartésien à ordonnée unique sous peine de biaiser l’appréciation des dynamiques relatives.
D’un point de vue méthodologique, deux options fondamentales s’offrent alors à l’analyste : la normalisation mathématique préalable des séries — par centrage-réduction ou transformation indicielle en base 100 —, ou la duplication matérielle de l’axe des ordonnées au moyen d’un système à double graduation verticale. C’est cette seconde voie d’ingénierie graphique qui permet de conserver l’expression des données dans leurs unités physiques d’origine sans distorsion de variance perceptive.
8.2 8.2 Implémentation technique de l’axe secondaire avec twinx()
La mise en œuvre formelle d’un axe d’ordonnées jumeau dans l’environnement Python repose sur la méthode orientée objet dédiée, accessible depuis toute instance d’axe cartésien Matplotlib. Cette commande instancie en mémoire un second objet de système de coordonnées qui superpose sa géométrie exactement sur l’aire du tracé primaire, verrouillant son axe des abscisses pour qu’il demeure rigoureusement solidaire et aligné avec l’axe horizontal initial, tout en générant un axe vertical indépendant positionné par convention sur le bord droit de la figure.
L’assignation des séries s’opère alors de manière explicite et découplée. L’analyste dirige la projection de la première série sur le repère de coordonnées primaire situé à gauche, puis projette la série dissymétrique sur l’instance de l’axe jumeau situé à droite. Chaque échelle d’ordonnées calibre alors automatiquement ses graduations, ses limites extrêmes et ses formats numériques en fonction de l’intervalle de variation propre à la variable qui lui est échue, rendant à chaque trajectoire sa pleine amplitude visuelle sans écrasement mutuel.
Pour assurer la rigueur sémiotique d’une telle composition, il est impératif d’instaurer une stricte concordance chromatique entre la ligne de la courbe et son échelle verticale de référence. Les graduations de l’axe de gauche, ses étiquettes numériques et son titre descriptif doivent adopter exactement la même nuance colorimétrique que le tracé de la série primaire. Symétriquement, l’ensemble des composantes graphiques de l’axe secondaire droit doivent reprendre la teinte de la seconde série. Cette association visuelle sans équivoque prévient l’erreur cognitive récurrente consistant à lire la valeur d’une courbe sur l’échelle opposée.
8.3 8.3 Fusion et consolidation des légendes issues d’axes multiples
L’emploi d’architectures à axes multiples engendre une complication technique insidieuse au niveau de la génération automatique des légendes. Comme les séries sont portées par des instances d’axes cartésiens distinctes et indépendantes en mémoire, l’invocation standard de la commande de création de légende sur l’axe primaire ou secondaire n’agrège que les seules données hébergées par l’objet sollicité. Le résultat produit par défaut est une légende partielle et trompeuse, ou la présence de deux légendes superposées de manière désordonnée dans l’espace de la figure.
La résolution rigoureuse de cette anomalie requiert l’extraction programmatique des descripteurs graphiques et de leurs étiquettes lexicales associées depuis l’ensemble des axes concernés, afin de procéder à leur fusion préalable. L’analyste interroge successivement chaque système de coordonnées pour récupérer la liste des éléments de tracé vectoriels et la collection des chaînes textuelles d’identification déclarées lors des phases de projection initiales.
Une fois ces deux listes consolidées par une simple concaténation vectorielle au sein du script, l’analyste transmet la totalité des références unifiées à une unique instruction de légende, exécutée sur le système de coordonnées de son choix. Cette manœuvre permet d’obtenir un encadré explicatif centralisé, parfaitement ordonné, restituant la nomenclature exhaustive de l’ensemble des séries projetées. Toutefois, sur le plan épistémologique, l’auteur d’une visualisation à axes doubles doit toujours inviter son lectorat à la prudence : la juxtaposition forcée de deux échelles d’ordonnées distinctes peut créer l’illusion trompeuse d’intersections ou de corrélations de causalité fortes qui ne constituent parfois que de simples artefacts contingents liés au calibrage arbitraire des bornes verticales respectives.
9. 9. Partitionnement en sous-graphiques juxtaposés (Subplots)
9.1 9.1 Génération matricielle via la méthode subplots() de Matplotlib
Lorsque le nombre de séries dépasse une limite critique — généralement estimée à quatre ou cinq trajectoires hautement entrelacées —, la superposition sur un repère cartésien unique, même assistée d’axes jumeaux, engendre inévitablement un enchevêtrement graphique inextricable. La solution méthodologique réside alors dans la fragmentation spatiale ordonnée, principe conceptualisé par Edward Tufte sous la désignation de multiples de petite taille. Il s’agit de distribuer les différentes séries au sein d’une matrice géométrique de sous-graphiques juxtaposés partageant une logique de coordonnées homogène.
L’instanciation de cette architecture matricielle s’accomplit avec une efficacité optimale via l’instruction de partitionnement de Matplotlib. En spécifiant les dimensions de la grille sous forme d’un nombre de lignes et d’un nombre de colonnes, cette méthode génère de concert le conteneur global de la figure et un tableau multidimensionnel NumPy encapsulant l’ensemble des instances de systèmes de coordonnées individuels. Cette modélisation matricielle permet un adressage algorithmique élégant : l’analyste accède à chaque cadran du graphique au moyen de ses indices matriciels de ligne et de colonne.
Pour fluidifier le traitement des grilles étendues, une technique d’ingénierie courante consiste à aplatir le tableau multidimensionnel d’axes en un vecteur unidimensionnel par l’application de la méthode de transformation vectorielle de NumPy. Ce découplage géométrique autorise ensuite un parcours linéaire immédiat au sein d’une simple boucle itérative, associant directement le n-ième élément de la collection de séries du DataFrame au n-ième sous-système de coordonnées du graphique, réduisant considérablement la complexité syntaxique du code d’assemblage.
9.2 9.2 Décomposition automatisée avec le paramètre subplots=True de Pandas
Fidèle à sa vocation de simplificateur d’opérations d’analyse, l’interface graphique de Pandas propose un mécanisme d’encapsulation directe de ce processus de partitionnement matriciel. L’adjonction d’un simple argument d’activation de sous-tracés au sein de la méthode graphique d’un DataFrame déclenche la décomposition automatique de l’ensemble des colonnes numériques en une séquence verticale ou matricielle de graphiques individuels dédiés.
Cette commodité syntaxique s’accompagne d’un contrôle géométrique poussé via des paramètres d’agencement structurel. L’analyste peut contraindre la morphologie globale de la grille en déclarant explicitement le gabarit sous forme d’un couple d’entiers fixant le nombre de rangées et de colonnes cibles, tout en adaptant les proportions physiques globales du dessin par le biais du dimensionnement en pouces. Pandas alloue alors proportionnellement l’espace disponible à chaque sous-système sans nécessiter la gestion manuelle des boucles d’itération par le programmeur.
L’un des leviers méthodologiques les plus critiques de cette décomposition automatisée réside dans la gestion du partage des échelles dimensionnelles. Par le biais d’instructions explicites de solidarisation des axes, l’analyste peut imposer que l’ensemble des sous-graphiques partagent strictement la même échelle d’abscisse temporelle et, surtout, le même domaine d’ordonnée vertical. Cette harmonisation d’échelle garantit que les pentes, les amplitudes et les variances relatives des différentes séries puissent être visuellement comparées d’un cadran à l’autre sans induire en erreur l’observateur par des recentrages ou des renormalisations automatiques locales.
9.3 9.3 Rationalisation des espacements et prévention des chevauchements
L’assemblage matriciel d’une multiplicité de sous-graphiques soulève inéluctablement des problématiques de collision spatiale entre les composants périphériques des cadrans adjacents. Les titres de graphiques, les étiquettes de graduation et les légendes textuelles ont une fâcheuse tendance à déborder sur les bordures des systèmes voisins, engendrant une sensation visuelle d’encombrement et compromettant la lisibilité globale du panneau d’affichage.
Pour prévenir cette dégradation esthétique, Matplotlib propose un moteur d’optimisation géométrique automatique invoqué via la commande de calibrage ergonomique des marges. Cette routine analyse exhaustivement les boîtes englobantes occupées par l’ensemble des éléments textuels et vectoriels de chaque cadran et recalcule dynamiquement les espacements relatifs horizontaux et verticaux entre les sous-graphiques de manière à éradiquer tout chevauchement d’encre sans altérer le ratio d’aspect imposé pour la figure globale.
Lorsque des exigences éditoriales spécifiques imposent un calibrage plus strict que celui offert par les algorithmes heuristiques, l’analyste peut mobiliser la fonction de réglage manuel des espacements inter-graphiques. Cette dernière autorise la spécification fine des marges périphériques et des coefficients d’espacement fractionnaires entre les axes. La composition globale peut ensuite être coiffée par l’apposition d’un titre supérieur unificateur centré au sommet de la figure, qui donne son sens sémantique à l’ensemble du panneau matriciel sans entrer en collision avec les titres individuels de chaque sous-axe.
10. 10. Gestion des données incomplètes et traitement statistique visuel
10.1 10.1 Comportement de Matplotlib face aux valeurs manquantes (NaN)
Dans l’analyse de séries empiriques, l’occurrence de lacunes dans l’échantillonnage de données constitue une réalité universelle induite par des interruptions de capteurs, des abandons d’essais ou des suspensions de cotations boursières. Au sein de l’environnement Python, ces lacunes sont représentées de manière standardisée par des sentinelles numériques de type non-valeur définies par la norme IEEE 754. La manière dont le sous-système de tracé appréhende ces discontinuités structurelles conditionne directement l’exactitude de l’information restituée.
Le comportement algorithmique par défaut de Matplotlib lors de la rencontre d’un marqueur d’absence au sein d’une séquence linéaire consiste en une rupture géométrique immédiate du tracé vectoriel. La courbe continue s’interrompt net au dernier point valide précédant la valeur nulle et ne reprend qu’au premier point valide ultérieur, laissant un intervalle vide matérialisant visuellement l’absence d’information. Si cette béance présente l’avantage fondamental de l’honnêteté descriptive en ne fabriquant pas de données artificielles, elle peut désorganiser la continuité de lecture si les lacunes sont dispersées de manière récurrente le long du signal.
L’analyste dispose dès lors de stratégies méthodologiques différenciées selon la problématique théorique sous-jacente. Si le phénomène étudié relève d’une dynamique continue dont l’absence de capture n’est qu’un artefact technique marginal, l’application préalable de routines d’interpolation polynomiale ou linéaire au sein de Pandas permet de reconstruire une trajectoire mathématique cohérente comblant le fossé. Si au contraire l’absence de donnée porte une charge sémantique majeure — comme l’interruption délibérée d’une politique publique —, la discontinuité graphique originelle doit impérativement être préservée et valorisée, voire accentuée par des trames de fond texturées délimitant formellement les plages d’indisponibilité de la mesure.
10.2 10.2 Tracé de bandes d’incertitude et intervalles de confiance
L’expression graphique de séries quantitatives ne saurait se limiter à la simple transcription déterministe de trajectoires moyennes ou médianes ponctuelles. Tout protocole expérimental rigoureux exige d’associer à l’estimation centrale une mesure tangible de l’incertitude sous-jacente, qu’elle prenne la forme d’un écart-type empirique, d’une erreur standard de la moyenne ou d’un intervalle de confiance bayésien dérivé d’un processus de rééchantillonnage bootstrap.
La transcription cartésienne de cette variabilité s’accomplit de manière optimale au moyen de la méthode de remplissage d’aires bidimensionnelles de Matplotlib. En renseignant conjointement la série des coordonnées d’abscisses, le vecteur des bornes inférieures calculées et le vecteur des bornes supérieures, cette instruction projette un polygone continu d’incertitude entourant fidèlement la courbe représentative de l’espérance mathématique de chaque phénomène.
L’utilisation de cette technique dans un contexte multivarié exige cependant un contrôle méticuleux du paramètre de transparence du canal alpha. Si des enveloppes d’incertitude associées à des séries distinctes viennent à se croiser sans que l’indice de transparence ne soit convenablement abaissé — typiquement entre 0.15 et 0.30 —, l’occlusion mutuelle des aplats de couleur crée des zones opaques confuses qui annihilent la lisibilité des courbes centrales. Un calibrage chromatique adapté permet au contraire de visualiser harmonieusement la superposition des zones de confiance, révélant les plages de divergence statistique avérée et les zones de recouvrement probabiliste entre les séries observées.
10.3 10.3 Détection et marquage distinctif des points aberrants (Outliers)
La présence de valeurs extrêmes ou d’aberrations de mesure au sein de séries multiples pose un dilemme récurrent d’ingénierie visuelle. D’une part, leur inclusion brute au sein de la ligne continue a tendance à déformer l’amplitude générale de l’axe vertical, comprimant artificiellement le reste de la dynamique régulière ; d’autre part, leur éradication aveugle ou leur dissimulation contrevient aux principes de transparence empirique. Une démarche vertueuse consiste à dissocier visuellement la dynamique structurelle continue et la matérialisation discrète des anomalies identifiées.
La mise en œuvre de cette stratégie repose sur un protocole algorithmique en deux temps. Dans un premier temps, l’analyste applique des filtres statistiques vectoriels au sein de Pandas — fondés par exemple sur l’écart interquartile ou le score Z d’écart à la moyenne mobile — pour générer des masques booléens ségréguant formellement les points d’observation conformes des déviations extrêmes. Le tracé linéaire standard est alors calculé sur la série exempte de ces ruptures pour restituer la trajectoire de fond.
Dans un second temps, les points aberrants isolés sont surimposés sur le canevas au moyen d’un appel à la fonction de dispersion de nuages de points de coordonnées. En attribuant à ces observations atypiques des marqueurs spécifiques aux contours accentués et des teintes contrastées, l’analyste attire délibérément le regard du spécialiste sur les zones d’instabilité du protocole sans dégrader la lecture de la tendance séculaire. Cette dissociation sémiotique permet d’engager une discussion critique sur la cause physique ou statistique de chaque aberration au sein du compte-rendu d’analyse.
11. 11. Principes de perception graphique appliqués aux séries multiples
11.1 11.1 Théorie de la charge cognitive et minimisation du ratio d’encre inutile
La création de visualisations scientifiques ne répond pas exclusivement à des contraintes de faisabilité technique ou de programmation ; elle est intimement subordonnée aux limites de la cognition humaine et du traitement visuel de l’information. Dans ses traités fondateurs sur la conception de l’information visuelle, le théoricien Edward Tufte a formalisé le concept fondamental de ratio de données par rapport à l’encre, postulant que l’excellence d’un graphique est directement proportionnelle à la part d’éléments graphiques dédiée exclusivement à la transmission du signal quantitatif, au détriment de l’encre superflue dénuée de fonction informative.
Appliqué au tracé conjoint de plusieurs séries sur un même DataFrame, ce précepte commande une politique rigoureuse de dépouillement graphique. Il implique la suppression méthodique des bordures de cadre superflues qui ceinturent inutilement la zone de tracé sans apporter de valeur de repérage. L’élimination des arrêtes supérieures et droites, couplée à un allègement radical des grilles d’arrière-plan — réduites à des traits gris extrêmement fins et discontinus —, permet de désencombrer le champ visuel et de libérer la bande passante cognitive du lecteur.
Cette économie sémiotique s’étend au traitement des axes et des arrière-plans. L’usage de dégradés chromatiques décoratifs, de cadres proéminents ou de marqueurs redondants doit être banni. Chaque pixel projeté sur la figure finale doit se justifier par sa contribution directe à la distinction des trajectoires, à la lecture des échelles ou à la contextualisation d’un seuil critique. En maximisant ce ratio de densité informationnelle, l’analyste transforme un graphique surchargé en un instrument optique de haute précision où la complexité intrinsèque des données peut se déployer sans friction perceptive.
11.2 11.2 Remplacement de la légende par l’étiquetage direct en fin de courbe
L’une des sources majeures de charge cognitive lors de la consultation de graphiques multivariés réside dans le mécanisme d’attention partagée imposé par les boîtes de légende conventionnelles. Les recherches en ergonomie cognitive et l’analyse des mouvements oculaires démontrent que l’observateur est contraint de réaliser d’incessants allers-retours visuels entre les courbes entrelacées au cœur du tracé et le bloc de légende situé en marge afin d’associer mentalement chaque couleur à son référent conceptuel. Ce découplage spatial induit une fatigue perceptive et ralentit considérablement la vitesse d’assimilation des dynamiques.
Le paradigme de conception le plus efficient consiste à éliminer totalement la boîte de légende séparée au profit de l’étiquetage textuel direct apposé à l’extrémité terminale de chaque courbe. Cette approche dépose le nom de la série dans le prolongement géométrique immédiat du dernier point valide de la trajectoire, guidant le regard vers l’identité de la variable dès que son parcours s’achève sur la bordure droite de l’axe cartésien.
L’automatisation programmatique de cette technique sous Python requiert la mise en place d’une routine algorithmique légère. Pour chaque colonne du DataFrame, le script extrait dynamiquement la coordonnée du point final et injecte une instruction de texte direct calée sur cette abscisse avec un décalage horizontal contrôlé. Pour prévenir les chevauchements textuels lorsque deux séries convergent vers un niveau d’ordonnée final similaire, l’analyste peut intégrer une logique mathématique de répulsion verticale qui réajuste les positions respectives des étiquettes, garantissant une disposition typographique aérée et une identification instantanée de chaque variable.
11.3 11.3 Conception adaptée aux supports de diffusion scientifique
La phase terminale de conception d’une visualisation graphique concerne son intégration physique au sein de supports de diffusion académiques ou professionnels, dont les contraintes techniques diffèrent radicalement de l’affichage dynamique sur un moniteur informatique standard. Une figure conçue sans anticiper la morphologie finale du média d’impression risque de souffrir de dégradations rédhibitoires, telles que des polices de caractères devenues illisibles à la réduction ou des effets de pixelisation disgracieux consécutifs à un échantillonnage spatial inadapté.
La règle cardinale réside dans la sélection de formats d’exportation vectoriels non destructifs, tels que le PDF ou le SVG, lors de la soumission de manuscrits à des comités d’évaluation ou à des éditeurs scientifiques. Contrairement aux formats matriciels qui figent l’image sous la forme d’une grille de pixels immuable, les formats vectoriels codent les séries sous forme d’équations géométriques primitives, autorisant des agrandissements infinis à l’impression sans la moindre perte de netteté typographique ou d’intégrité de trait.
Lorsque des contraintes techniques imposent malgré tout le recours à des images matricielles, l’analyste doit impérativement calibrer le facteur de densité de points par pouce à une valeur au moins égale à 300 ou 600 DPI, garantissant un piqué optimal lors de l’impression sur papier couché. De surcroît, les dimensions physiques initiales de la figure doivent être scrupuleusement paramétrées pour correspondre exactement à la largeur d’une colonne de texte standard d’une revue académique, évitant ainsi les distorsions d’échelle destructrices appliquées lors de la mise en page éditoriale.
12. 12. Cas pratique complet, automatisation et reproductibilité du code
12.1 12.1 Élaboration d’une fonction d’automatisation robuste et paramétrable
Afin de pérenniser les acquis méthodologiques abordés au long de cette étude, il convient de concevoir une fonction logicielle réutilisable et modulaire capable d’orchestrer le tracé multi-séries de manière entièrement automatisée tout en acceptant des paramètres de personnalisation avancés. Ce type d’outil programmatique doit incarner les préceptes de la programmation défensive en procédant à une validation systématique de ses arguments d’entrée avant d’engager toute dépense computationnelle liée au rendu graphique.
L’architecture d’une telle routine implique de vérifier que l’objet fourni appartient rigoureusement à la classe des DataFrames Pandas, que la liste des colonnes requises réside effectivement au sein du registre tabulaire, et que les séries désignées possèdent des attributs numériques exploitables pour un tracé continu. La fonction gère avec flexibilité l’assignation optionnelle d’un système de coordonnées préexistant — autorisant son insertion transparente dans une grille de sous-graphiques plus large — ou instancie de manière autonome une nouvelle figure calibrée selon les dimensions géométriques souhaitées.
Le point d’achèvement fondamental de cette implémentation réside dans son contrat d’interface : la fonction ne doit jamais figer prématurément le rendu par un appel bloquant, mais doit retourner systématiquement le couple constitué de l’instance de la figure globale et de l’objet de système de coordonnées configuré. Cette convention de conception orientée objet garantit que l’utilisateur final conserve la liberté absolue de prolonger, d’amender ou d’annoter le graphique en aval de la fonction, garantissant une composabilité logicielle totale au sein de pipelines de calcul plus complexes.
12.2 12.2 Implémentation pas à pas sur un jeu de données empirique réel
Pour mettre à l’épreuve l’ensemble des bonnes pratiques énoncées, nous appliquons notre protocole à l’exploration d’un jeu de données empirique représentatif des problématiques de surveillance macro-environnementale : le suivi synchronisé d’indicateurs de pollution atmosphérique urbaine collectés sur une période d’observation continue. Ce jeu de données héberge des mesures de concentrations de particules fines, d’oxydes d’azote et de monoxyde de carbone, accompagnées de relevés météorologiques de température et d’hygrométrie relative.
Le pipeline débute par l’ingestion du fichier source, suivi immédiatement par l’assainissement de son architecture temporelle. La variable horodatée est transmise à l’analyseur chronologique de Pandas puis promue au rang d’index structurel, avec une vérification formelle de la monotonicité et de l’absence de duplications temporelles. Les séries quantitatives font ensuite l’objet d’une phase d’harmonisation où les éventuelles non-valeurs isolées sont comblées par une interpolation temporelle rigoureusement documentée, tandis que les anomalies sévères sont cataloguées dans un masque booléen dédié.
L’exécution de la fonction de tracé dédiée déploie alors simultanément les séries sur un repère configuré selon une palette perceptuellement uniforme et accessible. La tendance séculaire mensuelle, extraite par un rééchantillonnage préalable, s’affiche en traits continus francs coiffant les données journalières rendues discrètes par transparence. Les unités dimensionnelles sont formellement précisées sur chaque axe, la légende fusionnée est ancrée à l’extérieur de la surface de tracé, et les épisodes historiques de pic de pollution font l’objet d’annotations fléchées vectorielles directes calculées sur les maxima locaux, produisant une figure exempte d’encre inutile et directement exploitable pour un rapport d’expertise institutionnel.
12.3 12.3 Protocoles de reproductibilité et gestion de versions de l’environnement
L’exigence de reproductibilité computationnelle s’affirme aujourd’hui comme une composante indissociable de toute démarche scientifique digne de ce nom. Une figure analytique ne saurait être considérée comme valide si les résultats visuels et les inférences associées ne peuvent être reproduits à l’identique par un tiers indépendant disposant du même code source et des données brutes initiales. Dans le contexte de visualisations multivariées pouvant comporter des simulations stochastiques d’intervalles ou des lissages probabilistes, la fixation explicite de la graine du générateur de nombres pseudo-aléatoires constitue la première obligation méthodologique.
Au-delà de la stabilité stochastique, la fidélité de restitution graphique est étroitement dépendante des versions exactes des bibliothèques logicielles mobilisées au cours du cycle d’analyse. Des modifications dans l’implémentation interne des algorithmes de calcul de graduations de Matplotlib ou des mécanismes d’inférence d’index de Pandas entre deux itérations majeures peuvent altérer subtilement la géométrie ou l’esthétique d’un graphique complexe. Il est donc indispensable d’accompagner tout script de production d’un relevé formel de l’environnement d’exécution, documentant rigoureusement les numéros de version de l’interpréteur Python, de Pandas, de Matplotlib et de NumPy.
Enfin, la formalisation du code selon les canons stylistiques internationaux — notamment les directives de lisibilité et de typage expressif dictées par la convention standardisée PEP 8 — assure la durabilité logicielle de l’outil. L’intégration de commentaires sémantiques ciblés, l’abandon définitif des variables magiques non déclarées au profit de constantes paramétriques globales et la modularisation du script sous la forme d’un ensemble de fonctions spécialisées transforment l’effort de visualisation en un composant logiciel pérenne, transférable et conforme aux exigences d’ouverture et d’intégrité de la science ouverte contemporaine.
Références
- Brewer, C. A. (2005). Designing better maps: A guide for GIS users. ESRI Press.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56-61). https://doi.org/10.25080/Majora-92bf1924-00a
- McKinney, W. (2022). Python for data analysis: Data wrangling with pandas, NumPy, and Jupyter (3rd ed.). O’Reilly Media.
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Van der Walt, S., Colbert, S. C., & Varoquaux, G. (2011). The NumPy array: A structure for efficient numerical computation. Computing in Science & Engineering, 13(2), 22-30. https://doi.org/10.1109/MCSE.2011.37
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wilke, C. O. (2019). Fundamentals of data visualization: A primer on making informative and compelling figures. O’Reilly Media.