
Dans le champ de la recherche empirique contemporaine, la communication visuelle de l’incertitude statistique constitue l’un des piliers méthodologiques les plus déterminants pour assurer la reproductibilité et la transparence des résultats scientifiques. Longtemps cantonnée à la simple juxtaposition d’une moyenne arithmétique et d’une valeur p issue d’un test d’hypothèse nulle, l’analyse des données quantitatives opère depuis plusieurs décennies une transition paradigmatique majeure vers les statistiques de l’estimation. L’intervalle de confiance s’impose ainsi comme l’outil privilégié permettant de quantifier avec rigueur la précision d’un paramètre populationnel inconnu, tout en offrant une lecture intuitive de l’amplitude de l’effet mesuré. Que ce soit en psychologie cognitive, en neurosciences computationnelles ou dans les sciences du comportement, la capacité à représenter fidèlement cette marge d’erreur graphique conditionne directement la validité des inférences tirées par les pairs.
L’écosystème open-source proposé par le langage de programmation Python s’est hissé au premier rang des environnements scientifiques mondiaux, rivalisant avantageusement avec des solutions propriétaires historiques telles que SPSS ou SAS, ainsi qu’avec l’environnement R. Grâce à la synergie remarquable unissant des bibliothèques fondamentales telles que NumPy pour l’algèbre linéaire, SciPy pour les distributions de probabilités continues et discrètes, Pandas pour la manipulation multidimensionnelle des données, et le binôme graphique formé par Matplotlib et Seaborn, les chercheurs disposent d’un contrôle programmatique absolu sur l’esthétique et la précision mathématique de leurs représentations visuelles. Maîtriser le traçage des intervalles de confiance au sein de cet environnement permet d’automatiser des pipelines analytiques sophistiqués tout en respectant scrupuleusement les exigences des revues internationales les plus rigoureuses.
Ce guide exhaustif a pour vocation d’explorer l’ensemble des dimensions théoriques, mathématiques et informatiques requises pour concevoir, tracer et interpréter des intervalles de confiance en Python. Du traitement des plans transversaux et longitudinaux jusqu’aux corrections spécifiques imposées par les mesures répétées intra-sujets, en passant par les approches non paramétriques par rééchantillonnage bootstrap et la modélisation linéaire généralisée, chaque étape fait l’objet d’une analyse approfondie. En articulant rigueur épistémologique et mise en œuvre technique avancée, ce document constitue une référence complète pour tout chercheur ou praticien désireux d’élever la qualité graphique et inférentielle de ses manuscrits académiques selon les normes de l’American Psychological Association.
1. Fondements théoriques de l’intervalle de confiance en recherche expérimentale et psychologique
1.1 Définition probabiliste et interprétation fréquentiste
L’intervalle de confiance, conceptualisé originellement par le mathématicien et statisticien Jerzy Neyman en 1937, repose sur une modélisation fréquentiste rigoureuse de l’échantillonnage répété. Dans cette perspective, la valeur du paramètre de la population parente, traditionnellement notée sous la forme de la lettre grecque μ pour une moyenne ou β pour un coefficient de régression, est considérée comme une constante fixe mais fondamentalement inconnue de l’expérimentateur. L’échantillon recueilli n’étant qu’une réalisation stochastique parmi une infinité d’échantillons observables possibles tirés de la même population, les bornes inférieure et supérieure de l’intervalle constituent elles-mêmes des variables aléatoires. Affirmer qu’un intervalle de confiance est calculé à un niveau nominal de 95 % signifie qu’en réitérant indéfiniment l’expérience dans des conditions d’échantillonnage parfaitement identiques et indépendantes, exactement 95 % des intervalles ainsi construits recouvriraient la valeur exacte et immuable du paramètre populationnel, tandis que 5 % échoueraient à l’englober.
Il existe une erreur épistémologique ubiquitaire dans la littérature scientifique consistant à attribuer une probabilité a posteriori à l’intervalle calculé sur un échantillon empirique unique. Dès lors que les bornes numériques ont été calculées à partir des données recueillies, l’intervalle réalisé ne possède plus aucune nature aléatoire. En conséquence, la probabilité que le paramètre vrai réside à l’intérieur de cet intervalle fixe particulier est soit de zéro s’il est exclu, soit de un s’il y est présent, mais en aucun cas de 95 %. Confondre cette couverture fréquentiste à long terme avec une distribution de probabilité subjective relève de la logique bayésienne, au sein de laquelle on définit plutôt des intervalles de crédibilité fondés sur une distribution a posteriori conditionnelle aux données observées. En recherche fréquentiste, l’accent est exclusivement placé sur la fiabilité de la procédure d’estimation mathématique au fil des réplications potentielles.
Sur le plan analytique, la largeur de cet intervalle est directement régie par une relation mathématique stricte reliant l’erreur type de la statistique d’intérêt, l’écart-type de la population ou son estimateur non biaisé s, ainsi que la taille effective de l’échantillon N. Pour une moyenne d’échantillon, l’erreur type est définie par le quotient de la dispersion empirique par la racine carrée du nombre d’observations indépendantes. L’amplitude globale de l’intervalle est proportionnelle au produit de cette erreur type par un quantile critique théorique dérivé de la distribution d’échantillonnage appropriée. Ainsi, toute augmentation de la variabilité intra-groupe élargit l’intervalle, traduisant une perte de précision métrologique, alors que l’accroissement de la taille de l’échantillon réduit cet intervalle de manière inversement proportionnelle à la racine de N, garantissant une convergence asymptotique vers la valeur exacte recherchée.
1.2 Rôle des intervalles de confiance dans l’inférence psychologique
Le recours systématique aux tests de signification de l’hypothèse nulle a historiquement favorisé une dichotomisation délétère de l’interprétation scientifique, souvent qualifiée de tyrannie du seuil arbitraire de significativité fixé à cinq centièmes. Cette pratique a fréquemment conduit à rejeter des hypothèses prometteuses sous prétexte d’une valeur p marginalement supérieure au seuil fatidique, ou inversement à célébrer des effets infinitésimaux et cliniquement insignifiants rendus artificiellement significatifs par l’emploi de cohortes massives. L’intervalle de confiance émancipe l’investigateur de ce carcan décisionnel en affichant simultanément l’estimation ponctuelle de la taille de l’effet et le degré de précision métrologique associé. L’observateur est ainsi en mesure d’évaluer non seulement si l’absence d’effet peut être rejetée avec plausibilité, mais surtout d’apprécier la pertinence théorique ou clinique de l’amplitude observée au regard des incertitudes de mesure.
En psychométrie et en psychologie clinique, l’estimation des scores latents et l’évaluation de la fidélité des instruments standardisés dépendent intrinsèquement de la calibration de ces marges d’erreur. Les constructs psychologiques tels que l’anxiété état, la mémoire de travail ou l’intelligence fluide ne sont jamais mesurés directement, mais inférés à travers des indicateurs comportementaux bruités soumis aux fluctuations attentionnelles, à la fatigue et aux erreurs d’échantillonnage d’items. Un intervalle de confiance étendu entourant un score factoriel ou une différence moyenne met immédiatement en garde le praticien contre les risques de surinterprétation diagnostique. L’évaluation visuelle de ces marges permet ainsi de situer les limites inférieures et supérieures de la performance plausible d’un individu ou d’un groupe, conférant aux décisions psychométriques une robustesse indispensable à l’éthique de la recherche.
Cette impérieuse nécessité méthodologique a conduit l’American Psychological Association à formaliser des recommandations d’une grande rigueur au sein de son manuel de publication. L’APA préconise sans ambiguïté l’incorporation systématique des intervalles de confiance pour l’ensemble des tailles d’effet primaires, soulignant qu’ils représentent la méthode la plus complète et la plus informative pour rapporter les résultats quantitatifs. Cette directive s’étend avec une insistance particulière aux représentations graphiques : toute figure illustrant des moyennes de traitement, des corrélations ou des trajectoires longitudinales se doit d’exposer clairement l’incertitude sous-jacente. Les normes actuelles exigent que la légende d’une figure spécifie explicitement la nature des barres d’erreur représentées, leur niveau de couverture nominal, ainsi que le caractère paramétrique ou rééchantillonné des algorithmes de calcul sous-jacents.
1.3 Différence fondamentale entre intervalle de confiance et intervalle de prédiction
Une confusion conceptuelle récurrente en analyse de données consiste à assimiler l’intervalle de confiance à l’intervalle de prédiction, alors que ces deux entités répondent à des questions inférentielles radicalement distinctes et reposent sur des formulations mathématiques divergentes. L’intervalle de confiance vise exclusivement à encadrer un paramètre agrégé de la population, typiquement la moyenne conditionnelle d’une variable de réponse. Sa largeur reflète uniquement l’incertitude d’échantillonnage inhérente à l’estimation de ce centre de gravité théorique. En vertu du théorème central limite et des propriétés de convergence des grands nombres, lorsque la taille de l’échantillon tend vers l’infini, l’erreur type de l’estimateur converge asymptotiquement vers zéro, entraînant une contraction continue de l’intervalle de confiance jusqu’à ce qu’il se réduise à une ligne infiniment fine superposée à la véritable moyenne.
À l’inverse, l’intervalle de prédiction a pour objet d’anticiper la valeur que prendra une observation individuelle future issue de la même population, pour une valeur donnée des covariables. Cet intervalle doit par conséquent modéliser deux sources d’incertitude cumulatives et indépendantes : d’une part, l’incertitude liée à l’estimation de la moyenne populationnelle elle-même, et d’autre part, la variabilité stochastique intrinsèque des individus gravitant autour de cette moyenne, caractérisée par la variance résiduelle de la distribution. Sur le plan mathématique, l’erreur type de prédiction incorpore un terme unitaire supplémentaire sous le radical, combinant la variance de l’estimateur de la moyenne et la variance pure de l’aléa résiduel individuel. Il en résulte qu’un intervalle de prédiction ne converge jamais vers une largeur nulle, même face à un échantillon de taille infinie, puisqu’il demeure borné inférieurement par la dispersion irréductible des données brutes au sein de la population.
Le choix graphique entre ces deux types de modélisation visuelle dicte l’interprétation fonctionnelle du graphique produit. Déployer un intervalle de prédiction sous forme de ruban ombré fournit une cartographie exhaustive de la zone au sein de laquelle 95 % des trajectoires individuelles sont censées se déployer, ce qui s’avère capital dans des contextes d’évaluation normative ou de détection de signaux cliniquement anormaux. En revanche, superposer un ruban d’intervalle de confiance met l’accent sur la précision de l’effet moyen du traitement expérimental au regard des hypothèses de recherche. Utiliser par mégarde un intervalle de confiance là où le lecteur cherche à évaluer la dispersion individuelle induit un sentiment trompeur de déterminisme, en masquant la réalité de l’hétérogénéité biologique et psychologique des sujets observés.
2. Préparation de l’environnement Python et configuration des bibliothèques scientifiques
2.1 Installation et importation de NumPy, SciPy, Matplotlib et Seaborn
La construction d’un pipeline d’analyse statistique et de visualisation graphique pérenne nécessite la mise en place d’un environnement Python standardisé et exempt de conflits de dépendances. Dans le cadre de recherches reproductibles, il est formellement recommandé d’exploiter des gestionnaires d’environnements virtuels isolés, tels que Conda ou les environnements standard créés via le module interne de Python. La compatibilité ascendante entre les versions récentes des bibliothèques scientifiques requiert une vigilance particulière, notamment en ce qui concerne l’articulation entre Matplotlib et Seaborn, cette dernière ayant opéré une refonte structurelle majeure de ses interfaces d’appel à partir de sa version 0.12. Les calculs d’algèbre matricielle et la génération d’échantillons aléatoires reposent sur le moteur optimisé de NumPy, tandis que l’extraction des distributions continues indispensables aux calculs analytiques d’inférence est déléguée au sous-module statistique de SciPy.
L’importation conventionnelle respecte des règles de nommage universellement établies au sein de la communauté scientifique internationale. NumPy est usuellement assigné au pseudonyme canonique standardisé, Pandas est condensé sous son acronyme habituel, tandis que l’interface impérative de traçage de Matplotlib est importée sous la désignation standard. La bibliothèque Seaborn, conçue comme une surcouche de haut niveau enrichissant les capacités graphiques de base de Matplotlib par une intégration étroite des structures de données tabulaires, s’importe traditionnellement sous l’abréviation dédiée. Enfin, l’accès direct aux fonctions de densité, aux fonctions de répartition cumulée et aux fonctions de survie ou de quantiles inverses est assuré par l’importation explicite du module spécialisé de SciPy dédié à la statistique inférentielle.
Pour s’assurer de la stabilité déterministe des procédures de calcul impliquant des processus stochastiques, tels que la génération de données synthétiques pour des simulations de Monte-Carlo ou le rééchantillonnage itératif par bootstrap, l’initialisation explicite d’un générateur de nombres pseudo-aléatoires moderne s’avère impérative. Les versions modernes de NumPy privilégient l’instanciation directe d’un générateur probabiliste indépendant par le biais de son algorithme moderne par défaut, en lieu et place de l’ancienne fonction globale d’initialisation de graine. Cette rigueur algorithmique garantit que chaque transformation, chaque permutation et chaque tirage avec remise demeure rigoureusement reproductible à l’identique sur n’importe quel système d’exploitation ou architecture matérielle.
2.2 Configuration des paramètres esthétiques et académiques avec Matplotlib
Par défaut, les visualisations générées par les bibliothèques logicielles privilégient une esthétique orientée vers l’affichage interactif sur écran ou l’exploration préliminaire, s’éloignant sensiblement des conventions rigoureuses requises par les revues académiques à comité de lecture. Matplotlib pilote l’ensemble de ses attributs typographiques, dimensionnels et chromatiques par le biais d’un dictionnaire centralisé de paramètres de configuration désigné sous l’appellation de paramètres d’exécution. Modifier ces paramètres en amont de toute instruction de tracé permet d’harmoniser l’ensemble des figures d’un manuscrit en garantissant le respect strict des chartes éditoriales, évitant ainsi des interventions manuelles répétitives et sources d’incohérences visuelles au fil de l’analyse.
La sélection typographique constitue le premier jalon de cette normalisation éditoriale. Les directives internationales en sciences comportementales préconisent l’emploi de polices sans empattement d’une lisibilité irréprochable à différentes échelles de réduction, à l’instar d’Helvetica ou d’Arial, ou de typographies avec empattement classiques telles que Times New Roman lorsque le manuscrit s’aligne sur un format composite traditionnel. Il convient d’ajuster simultanément les tailles de police associées aux étiquettes d’axes, aux valeurs numériques des graduations principales et secondaires, ainsi qu’aux annotations textuelles. Les axes graphiques doivent être configurés pour éliminer les bordures superflues, typiquement les segments supérieur et droit de la boîte de délimitation, tout en calibrant la direction, l’épaisseur et la longueur des tirets de graduation pour assurer une lecture optique optimale.
La gestion de la résolution spatiale et du format d’encodage détermine la netteté finale des figures lors de leur intégration dans des épreuves d’imprimerie. Une résolution minimale de 300 points par pouce est exigée pour les images matricielles destinées à la publication, le seuil de 600 points par pouce étant fréquemment requis pour les dessins au trait comportant des barres d’erreur fines ou des nuages de points denses. Cependant, la meilleure pratique éditoriale consiste à privilégier l’exportation vers des formats vectoriels indépendants de la résolution, tels que le format de document portable ou le format vectoriel évolutif. Dans cette optique, configurer Matplotlib pour préserver le texte sous forme d’éléments typographiques éditables plutôt que de les convertir prématurément en tracés vectoriels figés garantit une adaptabilité absolue lors de l’assemblage final du manuscrit par les typographes des éditeurs scientifiques.
2.3 Gestion des structures de données avec Pandas pour l’analyse comportementale
L’efficacité opérationnelle des bibliothèques de haut niveau telles que Seaborn repose fondamentalement sur la structure mathématique et logique des jeux de données sous-jacents. La science des données contemporaine distingue formellement les représentations au format large des représentations au format long, ces dernières étant souvent désignées sous le concept paradigmatique de données ordonnées formalisé par Hadley Wickham. Dans une structure ordonnée, chaque ligne correspond rigoureusement à une observation unique ou à une mesure expérimentale isolée, chaque colonne matérialise une variable théorique distincte, qu’il s’agisse d’un facteur inter-sujets, d’une condition temporelle ou d’un prédicteur continu, et chaque type d’unité d’échantillonnage forme une table cohérente.
Les plans expérimentaux en psychologie recueillent très souvent des mesures répétées à travers de multiples conditions au sein d’une même feuille de calcul, stockant par exemple le score obtenu à un test d’attention sous trois colonnes distinctes correspondant aux sessions pré-test, post-test et suivi à long terme. Cette disposition au format large, bien qu’intuitive lors de la saisie manuelle, paralyse les moteurs d’agrégation graphique automatisés. Il est donc fondamental de maîtriser la transformation de ces matrices par des opérations de restructuration bidimensionnelle, telles que l’opération de fusion et d’empilement fournie par Pandas, afin de rabattre ces colonnes conditionnelles au sein d’une unique variable indicatrice catégorielle couplée à une colonne de scores continus.
La gestion rigoureuse des valeurs manquantes constitue un second défi analytique déterminant pour la validité du traçage des intervalles de confiance. Selon que les données manquantes résultent d’un mécanisme aléatoire ou systématique, l’exclusion par observation complète ou l’imputation conditionnelle doivent être documentées avec précision. Dans un tableau de données Pandas, il est nécessaire de typer explicitement les variables qualitatives à l’aide du type catégoriel plutôt que de simples chaînes de caractères, ce qui permet de figer l’ordre séquentiel des niveaux de facteurs sur les axes graphiques indépendamment de leur tri alphabétique intrinsèque. De plus, la préservation des identifiants uniques des sujets expérimentaux au sein d’une colonne dédiée s’avère indispensable pour permettre aux algorithmes de regroupement de dissocier ultérieurement la variabilité intra-individuelle des contrastes de groupes.
3. Visualisation de l’intervalle de confiance avec seaborn.lineplot()
3.1 Mécanismes d’agrégation et calcul automatique des bandes d’incertitude
La fonction seaborn.lineplot() constitue l’un des outils les plus puissants et les plus élégants pour appréhender l’évolution de variables continues conditionnées par une variable explicative ordonnée, typiquement une dimension temporelle ou des intensités progressives de stimulation sensorielle. Lorsqu’un jeu de données organisé au format long présente de multiples observations indépendantes pour chaque coordonnée d’abscisse, le moteur d’exécution de Seaborn procède automatiquement à une double opération statistique : d’une part, il calcule la tendance centrale conditionnelle sous la forme d’une trajectoire moyenne continue, et d’autre part, il génère une zone d’ombrage polygonale translucide encapsulant les fluctuations d’échantillonnage de cette moyenne.
Ce mécanisme d’agrégation opère de façon transparente pour l’utilisateur sans nécessiter de boucle itérative préalable. Pour chaque valeur distincte de l’axe horizontal, l’algorithme extrait le sous-ensemble vectoriel des réponses associées et applique une procédure d’estimation inférentielle. Par défaut, Seaborn recourt à une méthode de rééchantillonnage bootstrap non paramétrique pour calculer l’intervalle de confiance encadrant l’estimation de la moyenne. Ce calcul itératif génère un grand nombre de pseudo-échantillons tirés avec remise de la distribution empirique locale, en déduit la distribution d’échantillonnage de la moyenne pour chaque pas d’abscisse, et détermine les percentiles inférieur et supérieur délimitant la bande de confiance.
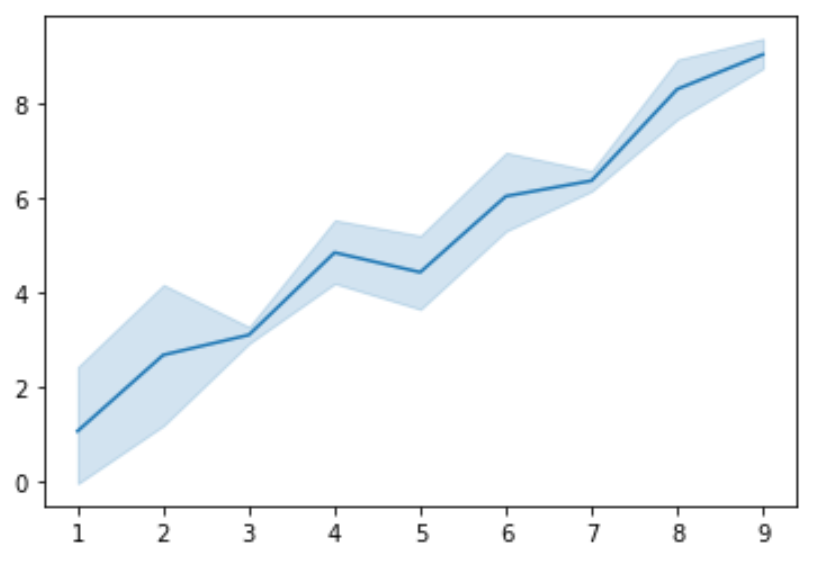
L’avantage épistémique de cette représentation sous forme de ruban d’incertitude continu réside dans sa capacité à traduire visuellement la convergence ou la divergence asymptotique des trajectoires comportementales. Dans les phases d’un protocole d’apprentissage où la variabilité entre les sujets se réduit en raison de l’automatisation d’une tâche cognitive, le ruban se resserre nettement autour de la droite moyenne, signalant une stabilité accrue de l’estimation populationnelle. Inversement, une dilatation substantielle du ruban sur des points temporels distaux révèle immédiatement une perte de puissance statistique, souvent consécutive à l’attrition expérimentale ou à l’hétérogénéité croissante des stratégies individuelles d’adaptation.
3.2 Personnalisation du niveau de confiance via les paramètres ci et errorbar
L’évolution de l’architecture logicielle de Seaborn au cours des dernières versions a profondément restructuré la syntaxe dédiée au paramétrage des bandes d’incertitude. Historiquement, le niveau de confiance était dicté par l’argument numérique direct ci, acceptant une valeur flottante comprise entre 0 et 100 pour fixer le pourcentage de couverture souhaité, ou la valeur booléenne fausse pour supprimer totalement l’affichage du ruban. Bien que cette terminologie demeure largement répandue dans les scripts existants, la documentation contemporaine promeut désormais l’utilisation unifiée du paramètre structuré errorbar. Cette interface novatrice permet de spécifier de manière hautement déclarative non seulement le seuil de couverture probabiliste, mais également la famille méthodologique de l’indicateur d’erreur déployé.
Grâce à ce paramètre moderne, il devient possible d’instancier en une commande concise un intervalle de confiance classique fondé sur un bootstrap à 95 %, mais également d’explorer des seuils plus stricts ou plus conservateurs, tels que des intervalles à 80 %, 90 % ou 99 %, selon les pénalisations appliquées pour parer aux problématiques de comparaisons multiples. Au-delà du modèle non paramétrique par défaut, l’argument permet d’adopter des modélisations purement paramétriques fondées sur l’erreur type classique ou sur l’écart-type brut de la distribution, offrant ainsi aux chercheurs une souplesse d’ajustement sans précédent pour adapter la sémantique de l’incertitude aux objectifs de leur communication scientifique.
L’aspect visuel de ces rubans d’incertitude se module finement au moyen des paramètres graphiques hérités de Matplotlib et exposés par l’interface de Seaborn. Le degré d’opacité du polygone ombré se contrôle à l’aide du paramètre de transparence alpha, dont l’ajustement prévient l’occultation des trajectoires sous-jacentes ou la saturation visuelle en cas de superposition de plusieurs groupes expérimentaux. De surcroît, il est tout à fait envisageable de paramétrer l’affichage de lignes de contour le long des bordures extrêmes du ruban de confiance, ou d’appliquer des styles de pointillés distinctifs afin que l’information structurelle demeure parfaitement intelligible lors d’une impression monochrome sur support papier.
3.3 Représentation temporelle des scores cognitifs avec bandes de dispersion
L’exploration des dynamiques neurocognitives et des processus d’apprentissage longitudinaux constitue un cadre d’application privilégié pour l’emploi de seaborn.lineplot(). Considérons l’évaluation chronométrique de temps de réaction répétés au fil d’une tâche d’inhibition comportementale de type Go/No-Go comprenant plusieurs blocs successifs d’essais. Dans une telle configuration expérimentale, l’investigateur cherche simultanément à illustrer la décroissance globale des temps de latence au fur et à mesure de l’exposition au paradigme, et à certifier que la supériorité d’un groupe expérimental bénéficiant d’un entraînement cognitif informatisé ne relève pas d’une simple fluctuation stochastique.
La puissance expressive de la visualisation réside ici dans la faculté de cartographier distinctement l’effet moyen conditionnel et la variabilité inter-sujets par le croisement des paramètres esthétiques. En cartographiant la variable catégorielle d’appartenance de groupe sur l’argument de teinte de la fonction, Seaborn calcule et superpose instantanément deux profils temporels autonomes, accompagnés chacun de leur propre ruban d’intervalle de confiance calculé point par point. Il devient alors aisé d’observer si les rubans d’incertitude des deux cohortes se chevauchent largement au bloc initial d’habituation, puis se dissocient progressivement au cours de la phase d’acquisition pour aboutir à une divergence statistiquement robuste dans les blocs terminaux.
Pour maximiser la densité informative de la figure sans dégrader sa lisibilité, il est d’usage d’agrémenter le profil continu d’évolution temporelle de marqueurs discrets positionnés à chaque pas temporel réel d’échantillonnage. En assignant des formes géométriques contrastées aux différents groupes expérimentaux, telles que des disques pleins pour le groupe contrôle et des carrés pour le groupe sous intervention, on offre un repère visuel précis qui facilite la lecture des valeurs moyennes ponctuelles. Cette double codification géométrique et chromatique garantit que le lecteur identifie sans la moindre ambiguïté le rythme d’acquisition des données temporelles tout en appréciant la rigueur de l’encadrement probabiliste fourni par les rubans de confiance sous-jacents.
4. Régression linéaire et bandes de confiance avec seaborn.regplot()
4.1 Estimation des moindres carrés ordinaires et ruban de confiance
L’investigation des dépendances fonctionnelles entre variables continues constitue une démarche classique en modélisation psychométrique. La fonction seaborn.regplot() combine harmonieusement la projection spatiale d’un nuage de points bivarié et l’ajustement paramétrique d’un modèle de régression par la méthode des moindres carrés ordinaires. L’élément visuel le plus caractéristique de cette modélisation réside dans l’apparition automatique d’une bande ombrée entourant la droite d’ajustement optimale sur l’ensemble de son étendue, matérialisant l’intervalle de confiance à 95 % assigné à la prédiction de la moyenne conditionnelle de la variable dépendante.
Cette bande de confiance n’adopte pas une géométrie rectiligne d’épaisseur uniforme le long de l’axe des abscisses, mais déploie une forme hyperbolique caractéristique, se resserrant de façon optimale au centre de gravité du nuage de points avant de s’évaser progressivement vers les extrémités du domaine d’observation. Cette morphologie incurvée est la conséquence directe de l’incertitude conjointe pesant sur l’estimation des paramètres de la droite : l’ordonnée à l’origine et le coefficient de pente. L’erreur type de la prédiction de la moyenne dépend du carré de l’écart entre la valeur locale du prédicteur et la moyenne arithmétique globale de ce même prédicteur. Plus l’on s’éloigne du barycentre de la distribution des prédicteurs, plus le levier géométrique amplifie l’imprécision sur l’orientation de la pente, provoquant un élargissement inévitable des bornes d’estimation.
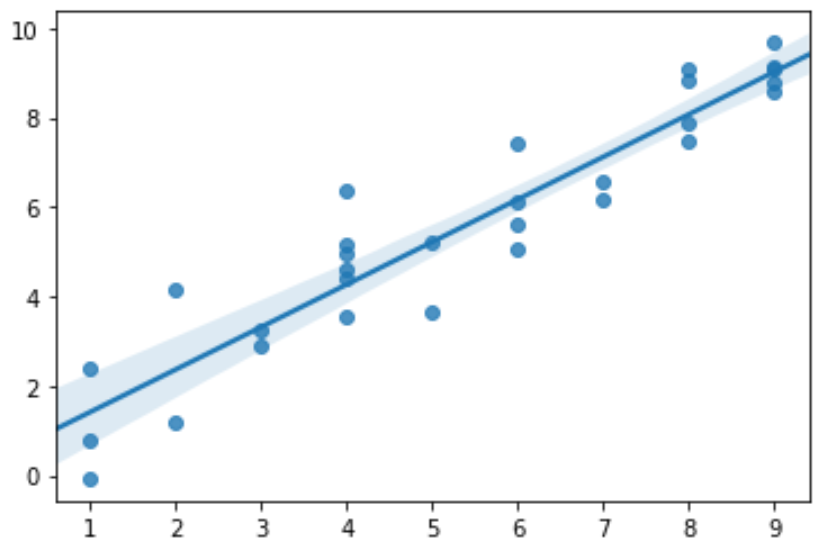
L’observation attentive du comportement asymptotique de ce ruban aux frontières du domaine de prédiction revêt une portée épistémologique majeure pour le chercheur. Elle rappelle visuellement le danger inhérent à l’extrapolation inconsidérée d’un modèle statistique au-delà des limites empiriquement observées dans l’échantillon. Seaborn trace cette bande hyperbolique en interpolant l’incertitude sur une grille discrète de points d’évaluation dense couvrant l’amplitude de l’axe horizontal, offrant ainsi un avertissement graphique explicite : même lorsque la droite centrale suggère une relation linéaire continue et stable, l’incertitude réelle quant à la localisation exacte de la trajectoire moyenne croît de façon accélérée dès que l’on quitte les zones de forte densité d’observation.
4.2 Ajustement du paramètre ci et sensibilité aux valeurs extrêmes
Tout comme pour les fonctions d’agrégation chronologique, le paramètre ci au sein de seaborn.regplot() gouverne l’amplitude probabiliste du ruban d’ajustement linéaire. En fixant cette valeur à des niveaux nominaux alternatifs, le chercheur module l’enveloppe de plausibilité entourant sa droite de régression. Dans les phases d’exploration préliminaire de données massives, il s’avère parfois pertinent d’assigner la valeur None à cet argument afin de désactiver temporairement le calcul matriciel des intervalles. Cette neutralisation accélère le rendu graphique tout en permettant de focaliser l’attention visuelle sur l’inspection de la dispersion brute des observations individuelles et la détection d’éventuelles ruptures structurelles ou non-linéarités patentes.
L’estimation standard des moindres carrés ordinaires s’avère particulièrement vulnérable à la présence d’observations aberrantes ou de points atypiques dotés d’un effet de levier considérable sur le plan bivarié. L’introduction d’un unique point situé aux confins de la distribution conjointe peut dévier artificiellement la pente de la droite et provoquer une distorsion massive du ruban de confiance, qui subit alors un renflement asymétrique révélateur de l’instabilité du modèle. Pour pallier cette fragilité inhérente au paradigme gaussien classique, seaborn.regplot() intègre un paramètre dédié à la régression robuste, fondé sur l’estimateur de Huber ou sur des algorithmes itératifs de moindres carrés pondérés. L’activation de cette modélisation robuste recalcule la droite et ses marges de confiance en atténuant drastiquement l’influence des résidus extrêmes.
La confrontation graphique entre une régression conventionnelle et un ajustement robuste constitue une méthode d’inspection diagnostique d’une remarquable efficacité. Lorsque les deux rubans de confiance se superposent étroitement, l’investigateur acquiert la certitude que ses inférences linéaires ne sont pas contaminées par des artefacts échantillonnaux isolés. Si, au contraire, le ruban robuste opère une translation ou une rotation substantielle par rapport à la bande standard, cela signale impérieusement la présence d’hétérogénéités sous-jacentes ou de sous-populations masquées qu’il conviendra d’examiner par des modélisations stratifiées ou des procédures d’élagage théoriquement motivées.
4.3 Modélisation de la relation anxiété-performance avec intervalles de régression
Afin d’illustrer la pertinence de cet outil dans le champ de la psychologie différentielle et clinique, considérons la modélisation empirique de la célèbre loi de Yerkes-Dodson, reliant les niveaux d’anxiété pré-compétitive aux performances mnésiques ou attentionnelles chez des étudiants universitaires. Dans ce type de protocole, les participants sont soumis à un inventaire d’anxiété validé produisant un continuum de scores de stress, parallèlement à la passation d’une batterie informatisée d’évaluation des capacités de contrôle exécutif.
L’utilisation judicieuse de seaborn.regplot() permet de confronter directement différentes hypothèses théoriques en autorisant des spécifications polynomiales via le paramètre d’ordre. Si le chercheur postule qu’un niveau modéré d’anxiété favorise l’éveil attentionnel tandis qu’une anxiété excessive détériore l’efficience exécutive, il peut ajuster un modèle quadratique d’ordre deux. La fonction générera alors une parabole concave entourée de son ruban de confiance curviligne spécifique. Ce tracé permet d’identifier avec une netteté visuelle parfaite la zone d’anxiété optimale, c’est-à-dire le sommet de la parabole, tout en quantifiant la précision statistique entourant la localisation de cette valeur seuil par la largeur du ruban au niveau du point d’inflexion.
De surcroît, la projection simultanée de sous-groupes cliniques au sein du même espace de coordonnées peut être orchestrée à l’aide de la fonction de plus haut niveau seaborn.lmplot(), qui délègue le tracé à une grille multi-facettes tout en réutilisant l’ensemble des mécanismes inférentiels de régression. L’attribution d’une palette chromatique distincte aux individus présentant des antécédents de troubles paniques par rapport aux sujets sains génère deux droites de régression concurrentes et leurs rubans respectifs. Cette visualisation permet d’évaluer visuellement l’homoscédasticité des résidus : une épaisseur de ruban disproportionnellement variable le long du prédicteur dans un sous-groupe avertit le chercheur d’une violation potentielle de l’hypothèse de variance constante, suggérant l’opportunité d’une modélisation hétéroscédastique formalisée.
5. Représentation par diagrammes à barres et barres d’erreur (barplot et pointplot)
5.1 Visualisation catégorielle des moyennes psychométriques avec sns.barplot()
Le diagramme à barres conventionnel a longtemps constitué la norme visuelle prédominante dans les publications des sciences sociales et comportementales pour juxtaposer les performances moyennes de groupes expérimentaux disjoints. Au sein de la bibliothèque Seaborn, la fonction seaborn.barplot() opérationnalise cette approche en dressant des rectangles dont la hauteur sur l’axe des ordonnées coïncide rigoureusement avec la moyenne arithmétique de la variable dépendante pour chaque modalité factorielle. L’estimation de l’incertitude est matérialisée sous la forme d’un segment vertical émergeant du sommet de chaque barre, traditionnellement étalonné sur l’intervalle de confiance à 95 % obtenu par rééchantillonnage bootstrap.
Cependant, la communauté méthodologique contemporaine formule des critiques sévères à l’encontre de ce format graphique, qualifié péjorativement de graphique d’occultation des données. Le volume géométrique opaque d’une barre suggère implicitement que l’espace sous-jacent est uniformément peuplé d’observations, ce qui induit une asymétrie cognitive majeure : le lecteur perçoit la zone située sous le sommet de la barre comme plus probable que la zone extérieure, quand bien même la distribution réelle des données adopterait une morphologie bimodale ou présenterait un étalement considérable au-delà de la moyenne. Les barres tronquent visuellement l’espace perceptif et concentrent l’attention sur la distance entre la base de l’axe et le sommet plutôt que sur l’intervalle de confiance lui-même.
Pour restaurer l’intégrité informative de ces représentations sans renoncer à la lisibilité synthétique du diagramme à barres, la meilleure pratique consiste à superposer systématiquement la distribution des données brutes au-dessus des rectangles d’agrégation. En combinant l’appel à sns.barplot() avec l’adjonction conjointe d’un nuage de points dispersés par secousse via la fonction seaborn.stripplot() ou seaborn.swarmplot(), l’observateur accède à deux niveaux de granularité complémentaires : les données individuelles révèlent d’éventuels agrégats, asymétries ou valeurs aberrantes, tandis que la barre et son intervalle de confiance fournissent la synthèse inférentielle nécessaire à l’évaluation des hypothèses populationnelles.
5.2 Utilisation de sns.pointplot() pour comparer des groupes expérimentaux
Face aux limitations intrinsèques des diagrammes à barres, la fonction seaborn.pointplot() se révèle être une alternative conceptuellement et visuellement supérieure pour comparer des moyennes entre facteurs expérimentaux. Plutôt que de matérialiser un volume opaque depuis l’origine de l’axe vertical, cette fonction encode l’estimation ponctuelle de chaque condition sous la forme d’un point géométrique isolé dans l’espace bivarié, transpercé verticalement par son segment d’intervalle de confiance. Cette disposition épurée allège drastiquement la charge d’encre superflue et focalise immédiatement l’attention du lecteur sur les contrastes d’estimation et l’amplitude des marges d’erreur.
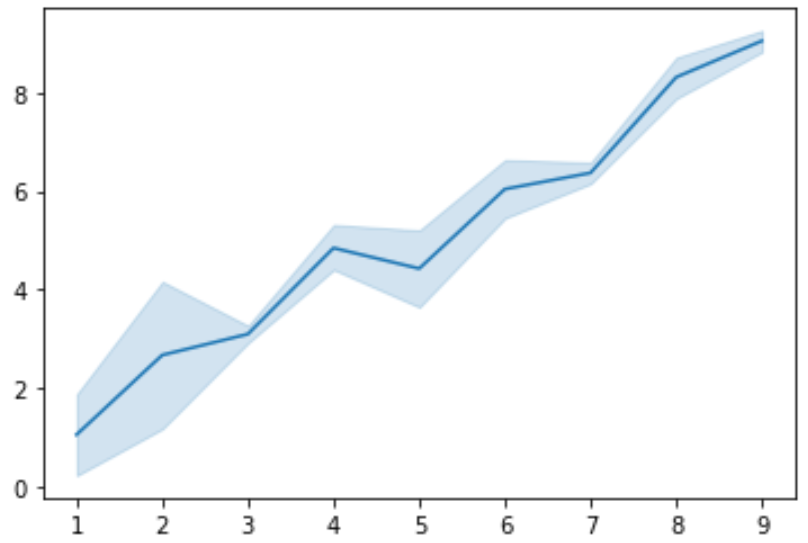
L’apport le plus décisif de seaborn.pointplot() réside dans son aptitude à tracer automatiquement des lignes de liaison continues entre les estimations ponctuelles consécutives appartenant à un même sous-groupe ou à une même condition secondaire. Ces segments de connexion ne doivent pas être interprétés comme une interpolation temporelle continue, mais comme un puissant vecteur cognitif destiné à rendre instantanément perceptibles les effets d’interaction au sein des plans factoriels de type factoriel deux par deux ou plans à mesures mixtes. L’émergence visuelle de trajectoires parallèles dénote une additivité parfaite des effets principaux, tandis que le croisement ou la divergence angulaire marquée des lignes signale avec une remarquable clarté une interaction modératrice significative entre les variables explicatives.
Dans un protocole étudiant l’impact combiné d’une privation de sommeil et de l’ingestion d’une substance psychostimulante sur les capacités de vigilance soutenue, un tracé par points permet d’apprécier en un coup d’œil l’ensemble des conclusions statistiques. L’absence de redondance physique au sol de l’axe ordonné libère un espace visuel précieux, permettant aux intervalles de confiance verticaux de se déployer sans encombre. L’évaluateur peut alors juger directement si l’intervalle d’un groupe sous placebo en état d’éveil normal se dissocie nettement ou non de l’intervalle correspondant au groupe privé de sommeil sous traitement actif, conférant à la démonstration une force probante bien supérieure à celle d’une série de rectangles juxtaposés.
5.3 Gestion des coiffes d’erreur (capsize) et clarté typographique
L’apparence structurelle des barres d’erreur au sein des diagrammes à barres ou des tracés par points soulève des interrogations esthétiques et ergonomiques substantielles au sein de la communauté des concepteurs graphiques. Par défaut, Seaborn trace des segments verticaux purs dépourvus d’extrémités horizontales, une approche minimaliste souvent saluée pour sa sobriété formelle. Néanmoins, l’introduction de petites barres transversales orthogonales délimitant les confins supérieur et inférieur, couramment appelées coiffes d’erreur, s’avère fréquemment réclamée par les évaluateurs et les comités de rédaction de nombreuses revues psychologiques internationales.
Le contrôle de ces terminaisons géométriques s’opère de manière directe via le paramètre capsize au sein des appels d’instructions graphiques. En assignant à cet argument une valeur flottante relative modérée, le développeur instancie des segments horizontaux calibrés avec précision par rapport à la largeur relative des marqueurs ou des barres. La présence de ces coiffes améliore la lisibilité optique des bornes critiques en créant une terminaison visuelle franche, facilitant la projection mentale des coordonnées vers l’axe numérique des ordonnées, en particulier lorsque le graphique est imprimé à échelle réduite sur une colonne étroite de manuscrit.
La calibrage typographique de l’incertitude implique également une maîtrise rigoureuse de l’épaisseur du trait via le paramètre dédié à la largeur des barres d’erreur. Un trait trop épais tend à noyer visuellement le marqueur ponctuel central ou à surcharger la figure, tandis qu’un segment excessivement ténu risque de disparaître lors des processus de compression numérique ou de reproduction photographique. De surcroît, lorsque les libellés de catégories sur l’axe horizontal présentent une longueur syntaxique substantielle, la bonne pratique recommande de basculer l’orientation du graphique en inversant les variables assignées aux abscisses et aux ordonnées. L’affichage horizontal des barres d’erreur libère un espace textuel optimal pour les étiquettes de traitement tout en maintenant les intervalles de confiance rigoureusement horizontaux et parfaitement déchiffrables.
6. Calcul manuel et tracé paramétrique des intervalles de confiance avec Matplotlib
6.1 Formule analytique standard fondée sur la loi normale et la loi t de Student
Bien que les fonctionnalités automatisées des bibliothèques de haut niveau offrent un confort appréciable, la maîtrise complète du traçage paramétrique d’intervalles de confiance impose une compréhension intime des équations sous-jacentes et la capacité d’implémenter leur calcul analytique à bas niveau. L’estimation paramétrique classique de la moyenne s’enracine dans la théorie de l’échantillonnage gaussien. Lorsque l’écart-type de la population parente σ est connu avec certitude, le théorème central limite garantit que la distribution d’échantillonnage de la moyenne suit une loi normale centrée sur la moyenne vraie, dont la dispersion est égale à l’écart-type divisé par la racine de N. L’intervalle à 95 % est alors borné par les quantiles critiques de la loi normale centrée réduite, correspondant au facteur multiplicatif conventionnel d’environ 1,96.
Dans la pratique quasi universelle de la recherche comportementale, l’écart-type populationnel demeure rigoureusement inconnu et doit être estimé à partir de la dispersion non biaisée de l’échantillon observé, calculée en appliquant la correction de Bessel au dénominateur avec N – 1 degrés de liberté. Dès lors que cette variance empirique est substituée au paramètre vrai, la statistique centrée et réduite ne suit plus une distribution normale standard, mais converge vers la loi t de Student à N – 1 degrés de liberté. Cette distribution leptokurtique présente des queues plus épaisses que la loi normale, reflétant l’incertitude stochastique additionnelle introduite par l’estimation de l’écart-type à partir d’un échantillon fini.
Le recours à la loi t de Student devient impérieux dès lors que l’on traite de petits ou moyens échantillons. L’extraction du quantile critique approprié s’opère via la fonction de point de pourcentage ou quantile inverse de SciPy, à laquelle on fournit le quantile d’intérêt calculé à partir du niveau d’erreur α, soit 0,975 pour un intervalle bilatéral à 95 %, couplé aux degrés de liberté effectifs. L’ampleur de l’intervalle est alors obtenue en multipliant ce quantile par l’erreur type empirique. La vectorisation de ce calcul à travers des tableaux NumPy permet de traiter instantanément des séries chronologiques complexes ou des matrices multidimensionnelles, générant des vecteurs de bornes inférieures et supérieures d’une exactitude mathématique absolue.
6.2 Utilisation de plt.fill_between() pour dessiner des zones d’ombre d’incertitude
Une fois les vecteurs des bornes supérieure et inférieure calculés analytiquement, la construction d’un ruban d’incertitude continu dans l’environnement natif de Matplotlib repose sur l’exploitation de la commande matplotlib.pyplot.fill_between(). Cette méthode vectorielle génère un polygone bidimensionnel continu délimité horizontalement par le vecteur des coordonnées d’abscisse et verticalement par les deux courbes correspondant aux trajectoires des bornes inférieure et supérieure de l’intervalle. Contrairement aux solutions automatisées, cette approche à bas niveau octroie à l’expérimentateur un contrôle exhaustif sur chaque attribut du tracé.
L’harmonisation visuelle de cette nappe d’incertitude requiert un réglage méticuleux de l’ordre d’empilement des couches graphiques via le paramètre zorder. Dans un graphique multipanné complexe, il est primordial que la bande d’incertitude soit positionnée au-dessus des lignes de repère secondaires mais rigoureusement en dessous de la courbe directrice matérialisant la trajectoire moyenne centrale, ainsi qu’en dessous des marqueurs de données discrètes. Cet empilement ordonné prévient l’atténuation perceptive de la tendance moyenne par la translucidité du polygone ombré, tout en garantissant que les graduations d’axes et les points expérimentaux demeurent d’une netteté absolue au premier plan.
Un autre avantage déterminant de l’implémentation manuelle via fill_between() réside dans la gestion des discontinuités expérimentales ou des sous-domaines d’interpolation spécifique. Grâce à l’argument conditionnel where exposé par la fonction, il devient possible de suspendre dynamiquement le tracé du ruban sur des plages temporelles où les données seraient absentes ou compromises par des artefacts d’enregistrement. De surcroît, le chercheur peut dégrader le modèle de lissage en employant des méthodes d’interpolation linéaire par morceaux ou des splines cubiques régularisées, adaptant ainsi l’enveloppe géométrique aux propriétés biophysiques ou cognitives du signal modélisé.
6.3 Intégration de plt.errorbar() pour les estimations ponctuelles discrètes
Pour la cartographie d’estimations ponctuelles discrètes n’impliquant aucune continuité temporelle ou fonctionnelle sous-jacente, la fonction matricielle matplotlib.pyplot.errorbar() s’impose comme l’outil de référence fondamental. Cette routine offre une liberté de paramétrage totale en acceptant directement des vecteurs de coordonnées cartésiennes accompagnés de tenseurs d’incertitude symétriques ou asymétriques le long de l’axe vertical via l’argument yerr, ainsi que le long de l’axe horizontal via l’argument xerr si l’incertitude affecte également la variable prédictive.
La morphologie des marqueurs centraux et des segments d’erreur peut être minutieusement personnalisée. L’interface autorise le découplage fonctionnel entre la couleur de remplissage du marqueur géométrique, sa couleur de bordure et la teinte appliquée aux hampes de dispersion. En configurant les paramètres de style de ligne pour supprimer le trait de liaison continu, l’investigateur préserve le caractère strictement disjoint des conditions tout en bénéficiant de l’adjonction de coiffes d’erreur rigoureusement calibrées. Cette flexibilité s’avère particulièrement précieuse lors de l’élaboration de figures destinées à des revues médicales ou neuropsychologiques exigeant une distinction immédiate entre plusieurs instruments diagnostiques juxtaposés.
Dans les configurations expérimentales factorielles comparant simultanément plusieurs cohortes sur les mêmes niveaux discrets d’abscisse, la superposition exacte des barres d’erreur verticales génère fréquemment des occlusions visuelles inextricables rendant la lecture impossible. La parade graphique consiste à appliquer un décalage horizontal artificiel ou jittering systématique aux coordonnées d’abscisse des différents groupes. En décalant imperceptiblement vers la gauche les points de la cohorte témoin et vers la droite ceux du groupe clinique, les intervalles de confiance se déploient parallèlement sans se chevaucher, offrant une visibilité intégrale sur les amplitudes respectives de chaque marge d’incertitude.
7. Méthodes non paramétriques et Bootstrap pour les données psychologiques asymétriques
7.1 Principe du rééchantillonnage par bootstrap empirique
L’inférence paramétrique fondée sur la loi t de Student repose sur l’hypothèse canonique que les distributions d’échantillonnage sous-jacentes respectent une morphologie gaussienne symétrique. Or, en psychologie expérimentale et en neurosciences, de nombreuses métriques fondamentales violent délibérément ce postulat d’idéalité. L’exemple le plus paradigmatique est constitué par les temps de réaction chronométriques, dont les profils empiriques sont caractérisés par une asymétrie positive prononcée, décrits par des lois de type ex-gaussiennes ou log-normales, jalonnées d’une traîne de latences élevées. L’application mécanique des formules paramétriques standard à de telles distributions aboutit à des intervalles de confiance distordus, dont le pouvoir de couverture réel s’écarte substantiellement du seuil nominal escompté.
Le bootstrap empirique, conçu et formalisé par Bradley Efron en 1979, apporte une solution élégante et universelle à cette impasse inférentielle. Cette méthodologie non paramétrique se dispense de toute hypothèse a priori quant à la forme analytique de la distribution parente. Le principe fondamental stipule que l’échantillon empirique recueilli représente la meilleure approximation concrète disponible de la population inconnue dont il est issu. En conséquence, simuler le processus d’échantillonnage théorique de cette population revient mathématiquement à rééchantillonner avec remise au sein même de l’échantillon observé, chaque individu tiré conservant une probabilité uniforme d’être sélectionné à nouveau lors du même tirage.
Pour construire une distribution d’échantillonnage bootstrappée de la statistique d’intérêt, l’ordinateur procède à un nombre considérable d’itérations indépendantes, traditionnellement fixé entre deux mille et dix mille réplications pour assurer une stabilité stochastique optimale des queues de distribution. Pour chaque pseudo-échantillon généré de taille identique à l’échantillon princeps, la métrique cible est recalculée et consignée dans un vecteur de tirages. Ce déploiement algorithmique capture fidèlement l’asymétrie intrinsèque des données d’origine, permettant de forger des intervalles de confiance d’une robustesse exceptionnelle, totalement affranchis des distorsions induites par la non-normalité.
7.2 Implémentation du bootstrap avec scipy.stats.bootstrap
Pendant de nombreuses années, la mise en œuvre du bootstrap en Python nécessitait la programmation manuelle de boucles itératives ou la manipulation directe d’opérations d’indexation vectorielle aléatoire avec NumPy. L’introduction de la fonction unifiée scipy.stats.bootstrap() au sein de la bibliothèque SciPy a considérablement modernisé et standardisé cette pratique. Cette interface déclarative encapsule les meilleures pratiques méthodologiques tout en offrant des performances de calcul optimisées, notamment grâce à la vectorisation native des opérations et à la prise en charge transparente de l’exécution parallélisée sur architectures multi-cœurs.
La signature de cette fonction requiert la transmission des données sous forme de tuple de tableaux, couplée à une référence vers la fonction statistique personnalisée dont on cherche à encadrer l’estimation. Loin de se limiter à la moyenne arithmétique élémentaire, cette architecture modulaire permet d’estimer les intervalles de confiance de métriques non paramétriques complexes pour lesquelles il n’existe aucune solution analytique simple en théorie des grands échantillons, à l’instar de la médiane, de la moyenne tronquée à 20 %, du coefficient de corrélation de rang de Spearman ou de la différence entre percentiles extrêmes.
L’utilisateur configure avec une grande souplesse le nombre d’itérations stochastiques à déployer, le niveau de confiance désiré, ainsi que le générateur de nombres aléatoires pour assurer la réplicabilité des calculs. L’objet résultant renvoyé par la procédure encapsule directement les bornes inférieure et supérieure sous forme d’attributs dédiés, tout en fournissant une estimation numérique de l’erreur type empirique de la distribution bootstrappée. Ce pipeline rationalisé élimine les erreurs courantes de programmation et fluidifie l’intégration des marges non paramétriques au sein des scripts de préparation graphique.
7.3 Graphier les intervalles de confiance bootstrappés (méthode des percentiles et BCa)
L’extraction des bornes d’un intervalle de confiance à partir d’une distribution d’échantillonnage rééchantillonnée peut emprunter plusieurs formalismes algorithmiques distincts. L’approche la plus intuitive est la méthode des percentiles, qui consiste simplement à trier les estimations simulées par ordre croissant et à retenir les valeurs correspondant aux quantiles empiriques directes, par exemple les percentiles à 2,5 % et à 97,5 % pour un seuil à 95 %. Bien que satisfaisante lorsque l’échantillon est volumineux et la distribution exempte de biais systématique, la méthode des percentiles tend à sous-estimer la largeur de l’intervalle face à de petits effectifs asymétriques.
Pour surmonter cette imperfection, Bradley Efron a conçu l’intervalle de confiance corrigé du biais et accéléré, universellement désigné par l’acronyme BCa. Cet algorithme sophistiqué calcule deux paramètres de redressement : un coefficient d’ajustement du biais qui compense l’écart médian entre les estimations rééchantillonnées et l’estimation ponctuelle initiale, et un paramètre d’accélération qui capture l’asymétrie de la variance d’échantillonnage par une procédure d’évaluation par jackknife. L’intervalle BCa résultant présente des propriétés de couverture théorique de second ordre remarquablement précises et s’impose comme le standard méthodologique par excellence dans les revues académiques de pointe.
Sur le plan visuel, la restitution graphique d’un intervalle bootstrappé met immédiatement en lumière son asymétrie caractéristique par rapport à l’estimation ponctuelle centrale. Contrairement aux barres d’erreur paramétriques dont la hampe supérieure est le miroir rigoureusement symétrique de la hampe inférieure, l’intervalle BCa affiche fréquemment un segment asymétrique, la distance séparant le marqueur de la borne supérieure pouvant excéder substantiellement celle le reliant à la borne inférieure. L’intégration de ces résultats non linéaires dans Matplotlib s’effectue aisément en alimentant l’argument matriciel yerr de plt.errorbar() avec un tenseur bidimensionnel à deux lignes distinctes, explicitant l’écart négatif d’une part et l’écart positif d’autre part.
8. Intervalles de confiance pour mesures répétées et plans intra-sujets
8.1 Le problème de la variance inter-sujets dans les visualisations classiques
L’un des pièges méthodologiques les plus insidieux et les plus largement répandus dans la littérature expérimentale concerne la représentation graphique naïve des intervalles de confiance au sein de plans factoriels à mesures répétées ou dispositifs intra-sujets. Dans ce type de protocole expérimental, chaque participant est exposé successivement à l’ensemble des niveaux d’un facteur manipulationnel, agissant ainsi comme son propre contrôle statistique. Ce paradigme expérimental tire sa puissance de sa capacité à neutraliser la variabilité inter-individuelle globale : les variations stables de base entre individus sont isolées de l’erreur expérimentale, ce qui permet de détecter des contrastes fins entre conditions avec une sensibilité statistique considérablement accrue.
Cependant, lorsqu’un chercheur génère des barres d’erreur ou des intervalles de confiance standards en traitant chaque condition séparément au moyen des formules d’échantillonnage conventionnelles, le calcul incorpore inévitablement la variance totale entre les sujets au sein de chaque condition. Il en résulte un gonflement artificiel majeur de la largeur des barres d’erreur graphiques. Ces larges barres d’erreur reflètent simplement le fait que certains sujets présentent structurellement des scores élevés sur toutes les conditions tandis que d’autres affichent des scores bas, masquant totalement l’homogénéité remarquable des différences intra-individuelles d’une condition à l’autre.
Cette dissonance visuelle génère un paradoxe cognitif profond pour le lecteur du manuscrit : l’analyse de variance à mesures répétées ou le test t apparié rapporte un effet hautement significatif avec une valeur p infinitésimale, tandis que la figure associée expose de monumentaux intervalles de confiance se chevauchant presque intégralement. Cette contradiction apparente mine la confiance du lecteur dans les conclusions présentées et trahit une méconnaissance des impératifs métrologiques de la visualisation des designs dépendants. Des intervalles conventionnels conçus pour des comparaisons de groupes indépendants s’avèrent fondamentalement inadaptés pour apprécier l’inférence différentielle de mesures appariées.
8.2 Méthode de normalisation de Cousineau-Morey pour représentations graphiques
Afin de restaurer la cohérence entre la modélisation statistique formelle et sa matérialisation graphique, le psychologue canadien Denis Cousineau a proposé en 2005 une technique de normalisation des données intra-sujets, ultérieurement perfectionnée et mathématiquement corrigée par Richard Morey en 2008. Cette procédure méthodologique a pour finalité d’expurger les données individuelles de la composante de variance inter-sujets avant de procéder au calcul des intervalles de confiance d’échantillonnage, restituant ainsi aux barres d’erreur une amplitude directement proportionnelle à l’erreur résiduelle du modèle apparié.
La première phase de la normalisation de Cousineau consiste à transformer chaque score brut d’un participant dans une condition donnée en lui soustrayant la moyenne propre de ce participant calculée sur l’ensemble des conditions expérimentales qu’il a subies, puis en lui additionnant la grande moyenne générale de l’ensemble de l’échantillon. Cette manipulation algébrique simple opère une translation rigoureuse des profils individuels : elle annule les disparités de niveaux moyens d’un sujet à l’autre sans altérer d’un iota l’amplitude relative des contrastes observés entre les conditions expérimentales au sein de chaque individu.
Toutefois, comme l’a démontré avec rigueur Richard Morey, cette élimination déterministe de la variance inter-sujets induit une contrainte linéaire sur les données transformées, réduisant mécaniquement les degrés de liberté réels du système. Si l’on appliquait directement le calcul d’erreur type sur ces données normalisées, les intervalles résultants seraient artificiellement trop étroits. Morey a par conséquent introduit un facteur de correction analytique multiplicatif égal à la racine carrée du rapport entre le nombre de conditions expérimentales K et ce même nombre diminué d’une unité, soit la racine de K / (K – 1). L’application systématique de ce multiplicateur de Morey rétablit une couverture fréquentiste exacte à 95 % pour les contrastes intra-individuels.
8.3 Tracé Python des intervalles corrigés pour mesures répétées
L’implémentation algorithmique de la méthode de Cousineau-Morey en Python s’articule aisément grâce à l’expressivité des méthodes de transformation groupée offertes par la bibliothèque Pandas. Le pipeline débute par la restructuration des données sous une forme ordonnée identifiant formellement chaque sujet expérimental. On calcule ensuite la moyenne individuelle de chaque sujet à l’aide d’une fonction de regroupement vectorisée, que l’on soustrait colonne par colonne aux scores bruts avant de recentrer la distribution sur la moyenne globale de l’expérience.
Une fois les scores normalisés obtenus au sein d’une nouvelle série dédiée du tableau de données, l’application du facteur d’expansion géométrique de Morey permet de recalculer les variances conditionnelles corrigées. Les barres d’erreur ou les rubans de confiance paramétriques sont alors calculés à partir de cette dispersion résiduelle purifiée, en employant la distribution t de Student calibrée sur les degrés de liberté appropriés. Ce traitement transforme radicalement l’aspect visuel de la figure : les marges d’incertitude se resserrent pour refléter avec une authenticité absolue la précision chirurgicale avec laquelle le plan intra-sujet capture les variations relatives entre conditions.
Pour parachever la rigueur éditoriale de la démarche, il est hautement recommandé de présenter au sein du manuscrit une visualisation comparative côte à côte. La figure de gauche affichera l’intervalle classique non corrigé, illustrant la dispersion globale brute incluant la variabilité inter-individuelle, tandis que la figure de droite présentera l’intervalle ajusté selon la méthode de Cousineau-Morey. Cette contextualisation transparente, explicitement documentée dans la légende du graphique, permet aux lecteurs et aux réviseurs de dissocier immédiatement l’hétérogénéité basale des participants de la robustesse inférentielle du protocole expérimental testé.
9. Modèles linéaires généralisés et courbes logistiques avec intervalles de confiance
9.1 Visualisation de probabilités avec sns.regplot(logistic=True)
L’investigation des processus cognitifs impose très fréquemment l’analyse de variables de réponse dichotomiques, telles que la réussite ou l’échec à une tâche d’attention sélective, l’acceptation ou le refus d’un choix économique risqué, ou encore la détection positive ou négative d’un stimulus auditif subliminal. Dans ces circonstances expérimentales, l’application d’un modèle de régression linéaire gaussien classique s’avère méthodologiquement prohibée : une telle approximation peut générer des probabilités prédites absurdes inférieures à zéro ou supérieures à un, tout en violant de manière flagrante l’hypothèse d’homoscédasticité en raison de la nature binomiale intrinsèque de la variance d’un essai de Bernoulli.
Le recours à la régression logistique s’impose alors comme la modélisation canonique appropriée, reliant la probabilité conditionnelle de survenue de l’événement à un prédicteur continu par l’intermédiaire de la fonction de liaison logit. La bibliothèque Seaborn facilite considérablement l’exploration visuelle de ce paradigme grâce au paramètre booléen logistic=True au sein de sa fonction seaborn.regplot(). L’activation de cet argument ordonne au moteur sous-jacent d’ajuster une courbe sigmoïde sur les données binaires éparpillées entre les ordonnées zéro et un, et de projeter le ruban d’intervalle de confiance correspondant directement projeté sur l’échelle des probabilités réelles.
Cette visualisation permet d’appréhender intuitivement deux paramètres biophysiques et psychométriques cardinaux. D’une part, le point d’inflexion central de la sigmoïde, correspondant à une probabilité de transition de 0,5, identifie avec précision le seuil perceptif décisionnel où le participant répond avec une incertitude maximale. D’autre part, la déclivité de la pente au niveau de ce point d’inflexion traduit la sensibilité discriminative du système cognitif : une pente abrupte signale une acuité sensorielle aiguisée, tandis qu’une transition douce dénote une discrimination hésitante. Le ruban de confiance encadrant cette sigmoïde quantifie visuellement la certitude d’échantillonnage attachée à la détermination de ce seuil et de cette sensibilité.
9.2 Calcul des intervalles de confiance autour de la cote logistique (Log-Odds)
Bien que l’affichage automatisé sur l’échelle des probabilités offre un attrait visuel indéniable, la compréhension technique des marges d’incertitude logistiques impose une incursion dans l’algèbre de l’espace des cotes logarithmiques ou log-odds. Au sein du cadre des modèles linéaires généralisés, l’estimation des coefficients de régression et de leurs matrices de variance-covariance s’effectue par la méthode du maximum de vraisemblance asymptotique sur l’échelle linéaire du logit. C’est exclusivement sur cette échelle non bornée s’étendant de l’infini négatif à l’infini positif que l’estimateur des moindres carrés généralisés présente une distribution asymptotiquement gaussienne autorisant le calcul d’intervalles de Wald symétriques.
Pour construire un tracé paramétrique manuel irréprochable avec Matplotlib, il est nécessaire d’extraire la matrice de covariance des paramètres ajustés via la bibliothèque Statsmodels. Pour chaque point d’évaluation du prédicteur, on calcule la prédiction ponctuelle de la cote logarithmique ainsi que son erreur type associée par projection quadratique vectorielle. Les bornes d’un intervalle de confiance à 95 % sont alors établies de façon rigoureusement symétrique dans cet espace logit en ajoutant et en retranchant le produit de l’erreur type locale par le quantile normal standard 1,96.
L’étape finale de projection cartographique repose sur l’application de la transformation inverse par la fonction logistique standard aux bornes préalablement calculées. Cette opération de transformation non linéaire rétablit les valeurs sur l’échelle de probabilité comprise entre zéro et un. Conséquence remarquable de cette géométrie transformée : l’intervalle de confiance projeté sur l’échelle de probabilité devient asymétrique. Les bornes se compriment naturellement à l’approche des asymptotes horizontales zéro et un, garantissant mathématiquement qu’aucune marge d’incertitude ne franchira jamais les frontières probabilistes théoriques, un avantage conceptuel majeur par rapport à toute modélisation linéaire naïve.
9.3 Applications aux décisions perceptuelles et diagnostics psychologiques
L’application de ces représentations s’avère particulièrement féconde dans le champ de la psychophysique expérimentale et du diagnostic psychologique assisté par ordinateur. Dans une tâche de psychophysique classique évaluant la détection d’un réseau sinusoïdal de contraste variable noyé dans un bruit visuel gaussien, le tracé de la fonction psychométrique empirique bordée de ses intervalles de confiance logistiques permet d’objectiver la précision métrologique de l’appareillage expérimental et la cohérence des jugements perceptifs émis par l’observateur.
L’observation morphologique de la bande d’incertitude révèle immédiatement la structure informative du protocole expérimental mis en œuvre. Typiquement, le ruban de confiance se resserre considérablement autour du seuil d’indécision à 50 % si l’expérimentateur a eu recours à des procédures d’escalier adaptatif ou des méthodes bayésiennes d’échantillonnage dynamique concentrant les essais dans les zones d’ambiguïté perceptive maximale. À l’inverse, si l’intervalle s’évase excessivement dans les zones de bas contraste, cela signale un sous-échantillonnage expérimental des présentations subliminales, guidant l’optimisation des futures sessions d’acquisition.
Dans un contexte de psychologie clinique prédictive, cette démarche graphique permet de projeter la probabilité conditionnelle qu’un patient reçoive un diagnostic de dépression majeure en fonction de ses scores cumulés sur une échelle de marqueurs neurobiologiques ou de dérégulation circadienne. L’adjonction visuelle de seuils décisionnels institutionnels permet d’identifier graphiquement la zone grise d’incertitude clinique : l’intervalle de valeurs du marqueur biologique pour lesquelles l’intervalle de confiance à 95 % de la probabilité englobe simultanément des valeurs jugées sous-cliniques et des seuils nécessitant une intervention thérapeutique immédiate, matérialisant ainsi avec une grande probité les limites inhérentes à l’évaluation diagnostique.
10. Personnalisation graphique avancée pour publications scientifiques (Normes APA)
10.1 Respect des directives de visualisation de l’American Psychological Association (APA 7)
L’American Psychological Association définit, au sein de la septième édition de son manuel de publication, un ensemble de directives éditoriales particulièrement rigoureuses destinées à garantir l’épuration, la probité et l’universalité des supports graphiques. L’un des préceptes fondateurs de la charte APA réside dans l’élimination sans concession de tout encombrement visuel superflu, un concept théorisé initialement par Edward Tufte sous le vocable d’encre inutile. Dans cette optique, une figure scientifique d’excellence doit maximiser le ratio d’encre alloué à la transmission directe de la donnée et de son incertitude statistique au détriment des ornements purement décoratifs.
La mise en œuvre de ces normes sous Python impose de désactiver l’intégralité des quadrillages internes à l’espace de tracé, sauf dans les très rares configurations où la lecture précise de coordonnées absolues conditionne la démonstration empirique. De même, le cadre rectangulaire enveloppant le graphique doit être démantelé : seules les lignes d’axes inférieure et gauche matérialisant respectivement l’abscisse et l’ordonnée doivent subsister, tandis que les bordures supérieure et droite doivent être supprimées sans compromis. L’orientation des tirets de graduation doit être réglée de façon cohérente, généralement pointés vers l’extérieur du tracé pour ne pas interférer optiquement avec les nuages de points ou les bases de rubans d’incertitude.
La typographie des axes requiert une discipline formelle stricte. Tout axe doit comporter un libellé clair rédigé dans une casse de phrase standard, suivi impérativement de l’unité métrique de mesure placée entre parenthèses. Les abréviations conventionnelles de la statistique descriptive et inférentielle doivent être composées en italique selon les conventions éditoriales internationales : ainsi la lettre M majuscule pour la moyenne, SD pour l’écart-type, ou SE pour l’erreur type s’écrivent systématiquement en caractères italiques. Les titres généraux de figures ne sont jamais intégrés directement à l’intérieur de l’image graphique elle-même, mais positionnés au-dessus du tracé dans le corps textuel du manuscrit typographié, accompagnés de leur numéro d’identification officiel.
10.2 Sélection des palettes de couleurs adaptées aux daltoniens et aux nuances de gris
L’inclusivité et la robustesse de la transmission de l’information graphique constituent une préoccupation éthique et technique de premier ordre dans l’édition savante moderne. Environ 8 % de la population masculine et 0,5 % de la population féminine présentent une forme de déficience de la vision des couleurs, le plus souvent une deutéranomalie ou une protanopie affectant la différenciation des teintes rouge et verte. L’usage de palettes chromatiques naïves juxtaposant des tracés ou des rubans d’incertitude rouges et verts est donc formellement proscrit dans les manuels de style contemporains.
L’écosystème Seaborn et Matplotlib intègre nativement des palettes de couleurs perceptuellement uniformes et universellement adaptées à l’ensemble des déficiences visuelles. Les cartes de couleurs développées sous l’égide de Matplotlib, à l’instar de viridis, plasma ou cividis, garantissent une progression monotone rigoureuse de la luminance optique. Cela assure que même lorsque l’image est visualisée par un observateur atteint d’achromatopsie ou reproduite sur une photocopieuse monochrome noir et blanc, l’ordre hiérarchique et la gradation des conditions expérimentales demeurent intégralement préservés sans la moindre ambiguïté perceptive.
Pour les variables indépendantes catégorielles discrètes, la palette spécialisée colorblind accessible dans Seaborn offre un jeu de teintes hautement discriminables pour l’ensemble des formes de dyschromatopsie. Toutefois, la prudence méthodologique commande de ne jamais confier la transmission de l’information expérimentale à la seule dimension chromatique. Il convient de combiner systématiquement le codage des couleurs avec un codage morphologique redondant : affecter des styles de lignes différenciés (traits continus, tirets larges, pointillés fins) aux différentes conditions longitudinales, et assigner des formes géométriques contrastées (cercles pleins, triangles évidés, losanges fermés) aux marqueurs d’estimation ponctuelle.
10.3 Exportation vectorielle haute résolution (PDF, SVG, TIFF à 300 DPI)
L’ultime maillon de la chaîne de production d’une figure académique consiste en sa compilation et son enregistrement sur support de stockage pérenne. L’utilisation de l’interface graphique interactive ou la réalisation de captures d’écran constitue une hérésie technique dégradant irrémédiablement la qualité géométrique du document. La sauvegarde doit être pilotée par l’instruction programmatique matplotlib.pyplot.savefig(), configurée avec des arguments garantissant le respect scrupuleux des exigences techniques des éditeurs de revues internationales.
Le premier paramètre critique réside dans l’ajustement de la boîte englobante à l’aide de l’argument bbox_inches='tight'. Par défaut, Matplotlib peut allouer des marges fixes disproportionnées autour du système d’axes ou, au contraire, tronquer l’extrémité d’une étiquette d’abscisse particulièrement longue ou une note de légende déportée. L’activation de cet ajustement contraint calcule dynamiquement le rectangle minimal circonscrivant l’ensemble réel des éléments textuels et géométriques, assurant un cadrage parfait sans déperdition d’espace. Pour les formats matriciels haute résolution tels que le TIFF ou le PNG destiné aux soumissions initiales, la résolution spatiale doit être explicitement verrouillée à une densité minimale de 300 voire 600 points par pouce via l’argument dpi.
Cependant, la soumission de versions définitives auprès des presses universitaires privilégie de façon quasi unanime les formats de description vectorielle tels que le PDF ou le SVG. L’enregistrement vectoriel consigne chaque droite d’ajustement, chaque ruban ombré et chaque symbole ponctuel sous forme d’instructions mathématiques géométriques fondamentales (courbes de Bézier, coordonnées polygonales). En conséquence, le graphique peut être agrandi ou réduit à l’infini par les typographes sans encourir la moindre pixellisation. De surcroît, en configurant le moteur de rendu pour qu’il n’aplatisse pas les fontes typographiques en chemins vectoriels bruts, les libellés demeurent directement éditables et vectorisés dans les logiciels de mise en page professionnels de publication assistée par ordinateur.
11. Erreurs courantes d’interprétation et pièges visuels des intervalles de confiance
11.1 Confusion fréquente entre chevauchement visuel et significativité statistique
L’inférence visuelle directe à partir de graphiques comportant des barres d’erreur est le théâtre d’un sophisme cognitif universellement documenté par les statisticiens de l’éducation : l’assimilation hâtive du chevauchement géométrique des intervalles de confiance à l’absence de différence statistiquement significative entre deux moyennes d’échantillons indépendants. De nombreux expérimentateurs et évaluateurs présument intuitivement que dès lors que les rubans ou barres d’erreur de deux conditions à 95 % se superposent, ne serait-ce que sur une fraction minime de leur hauteur, le test de comparaison de moyennes échouerait inéluctablement à atteindre le seuil de signification conventionnel de 5 %.
Cette déduction optique est mathématiquement erronée. Comme l’a abondamment formalisé Geoff Cumming dans ses travaux fondateurs sur la nouvelle statistique, la variance de la différence entre deux variables aléatoires indépendantes est égale à la somme des variances d’échantillonnage de chacune de ces variables. En conséquence, l’erreur type de la différence n’est pas la simple somme arithmétique des erreurs types individuelles, mais leur composition géométrique euclidienne sous une racine carrée. Il en résulte qu’une différence entre deux moyennes indépendantes de dispersions identiques devient statistiquement significative au seuil de 5 % dès lors que les deux intervalles de confiance à 95 % se chevauchent de moins d’environ la moitié de la longueur d’un demi-intervalle, ce qui équivaut à un taux de superposition vertical voisin de 58 %.
Le cas limite où les extrémités supérieures et inférieures de deux barres de confiance indépendantes à 95 % se touchent exactement sans aucun chevauchement, correspondant à une tangence géométrique parfaite, équivaut en réalité à une valeur p d’environ 0,005 à 0,01 pour le test t bilatéral de Student, soit un niveau de significativité considérablement plus conservateur que le seuil usuel de 0,05. L’analyste se doit donc de faire preuve d’une grande prudence : déduire une absence d’effet d’un modeste chevauchement visuel constitue une faute d’interprétation grave qui favorise indûment les erreurs de type II dans l’évaluation des manuscrits scientifiques.
11.2 Impact de la taille d’échantillon sur la largeur apparente des bandes
Un deuxième piège perceptif majeur découle de la tentation de confondre la largeur physique d’une bande d’incertitude avec l’amplitude réelle de la variabilité biologique ou psychologique au sein de la population parente. L’intervalle de confiance encadre l’incertitude pesant sur l’estimation d’un paramètre agrégé, et non la dispersion brute des observations individuelles. Par construction mathématique, cette amplitude se contracte inéluctablement sous l’effet de l’accroissement de la taille de l’échantillon N, divisant l’écart-type par la racine carrée de l’effectif.
Ce mécanisme engendre des distorsions d’interprétation diamétralement opposées selon la dimension des cohortes mobilisées. Face à un échantillon de taille colossale comprenant plusieurs dizaines de milliers d’individus, la bande d’intervalle de confiance devient extraordinairement étroite, se superposant presque à l’épaisseur du trait de la moyenne. Cette finesse chirurgicale atteste d’une grande stabilité métrologique de l’estimation, mais elle peut induire chez le lecteur l’illusion trompeuse d’un phénomène expérimental homogène et déterministe, masquant totalement le fait que les comportements individuels sous-jacents demeurent sauvagement dispersés sur l’ensemble de l’échelle psychométrique.
Inversement, dans des études pilotes ou des protocoles cliniques portant sur des populations rares caractérisées par de micro-échantillons, l’intervalle de confiance subit une dilatation majeure. Cette grande largeur géométrique découle à la fois de l’imprécision inhérente à l’erreur type et de l’inflation substantielle du quantile critique de Student consécutive au faible nombre de degrés de liberté. Afin de prémunir le lecteur contre toute confusion entre l’imprécision méthodologique et l’amplitude réelle des phénomènes, la bonne pratique éditoriale impose d’annoter systématiquement l’effectif effectif N à proximité immédiate de chaque condition ou au sein de la légende explicative de la figure.
11.3 Erreurs de troncation de l’axe des ordonnées et distorsions cognitives
La manipulation de l’échelle graphique de l’axe vertical des ordonnées représente le vecteur d’amplification visuelle le plus commun et le plus pernicieux de la communication statistique. La troncation délibérée de l’axe des ordonnées, consistant à supprimer l’origine du zéro absolu pour ne cartographier qu’une fenêtre restreinte gravitant autour des moyennes observées, opère un zoom optique disproportionné qui magnifie artificiellement les moindres contrastes expérimentaux, transformant visuellement des différences résiduelles dérisoires en gouffres monumentaux.
Dans le contexte spécifique des diagrammes comportant des intervalles de confiance, cette pratique déforme considérablement le jugement probabiliste. En restreignant artificiellement l’amplitude de l’axe vertical, l’expérimentateur dilate visuellement la longueur relative des barres d’erreur par rapport à la taille globale de l’image, conférant à l’incertitude une présence plastique oppressante ou, à l’inverse, exagérant la visibilité d’une absence de chevauchement entre deux conditions. Cette dérive est particulièrement pernicieuse lorsque l’instrument de mesure psychométrique sous-jacent repose sur une échelle bornée standardisée, comme une échelle de Likert allant de 1 à 7 points : tronquer le graphique entre 4,2 et 4,8 points dénature l’écologie de l’évaluation psychologique en privant l’observateur de la grille de lecture globale de l’instrument.
S’il est vrai que dans certaines configurations d’enregistrements physiologiques ou d’analyse spectrale fine, le maintien du zéro absolu noierait l’intégralité du signal d’intérêt, toute suspension de l’ancrage à l’origine doit faire l’objet d’une déclaration explicite. La présence d’une rupture d’axe clairement signalée par des symboles graphiques conventionnels (double barre oblique sur le segment d’axe vertical) avertit visuellement l’évaluateur que l’espace métrique a subi une focalisation locale, prévenant ainsi les inférences sensationnalistes et rétablissant l’éthique de la démonstration expérimentale.
12. Étude de cas empirique complète : Analyse d’un essai psychologique contrôlé
12.1 Description du jeu de données expérimental et prétraitement
Afin de synthétiser l’ensemble des concepts théoriques et des compétences techniques développés au fil de ce guide, déployons une étude de cas empirique complète fondée sur un essai clinique randomisé contrôlé en psychologie de la santé. L’objectif de cette investigation scientifique fictive mais réaliste consiste à évaluer l’efficacité différentielle d’un protocole novateur de thérapie cognitive basée sur la pleine conscience par rapport à un groupe contrôle actif placé sous programme d’entraînement cognitif passif, chez une cohorte d’individus souffrant de trouble anxiogène généralisé.
Le plan expérimental combine un facteur inter-sujets à deux modalités (le type d’intervention thérapeutique) et un facteur intra-sujets longitudinal à mesures répétées évaluant l’intensité des symptômes d’anxiété mesurés à l’aide de l’inventaire d’anxiété de Beck à trois périodes charnières : la session pré-interventionnelle (baseline), la session post-interventionnelle clôturant les huit semaines d’entraînement thérapeutique, et une session de suivi à distance menée six mois après l’achèvement du protocole. De surcroît, une covariable continue est colligée pour chaque individu : le score global d’adhésion pratique au protocole, quantifiant le volume horaire d’exercices d’autorégulation exécutés en autonomie au domicile durant la phase active.
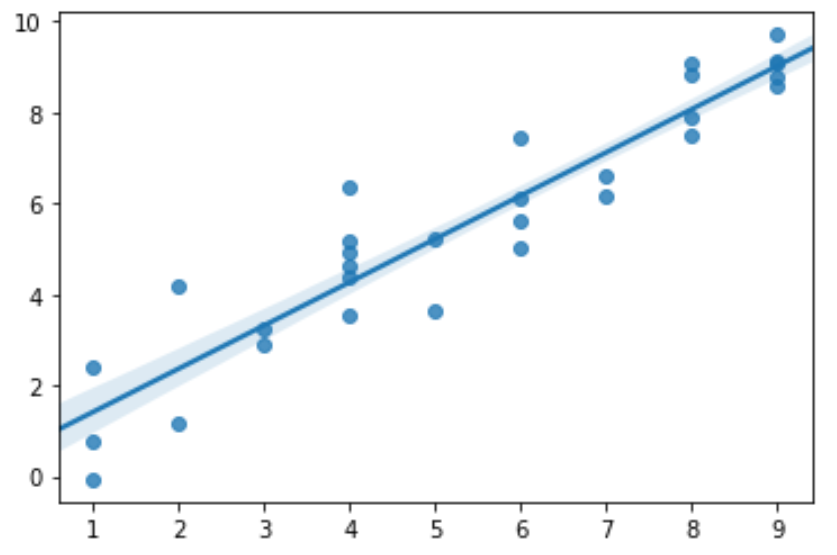
Le pipeline de prétraitement automatisé sous Pandas débute par le contrôle de l’intégrité matricielle, la vérification des types de variables et l’élimination des éventuels doublons techniques. Les données initialement consolidées au format tabulaire large font l’objet d’une restructuration structurelle par l’application d’une méthode de fusion vectorielle pour projeter les scores temporels au format ordonné, optimisé pour l’ingestion par les algorithmes de Seaborn. L’attribution stricte du type catégoriel ordonné à la variable temporelle garantit que l’ordonnancement séquentiel des sessions expérimentales respectera immuablement la chronologie causale lors de la compilation des sous-graphiques.
12.2 Pipeline complet de scriptage pour l’extraction et le tracé multi-panneaux
La construction d’une visualisation académique exhaustive pour cet essai clinique repose sur l’élaboration d’une figure composite multi-panneaux intégrant harmonieusement les dimensions longitudinale, factorielle et corrélationnelle. À l’aide de l’environnement orienté objet de Matplotlib, nous instancions une grille bicaractéristique structurée en deux sous-axes juxtaposés horizontalement au sein d’une figure de proportions dimensionnelles généreuses, respectant scrupuleusement la boîte d’encombrement délimitée pour une publication sur pleine page.
Sur le panneau latéral gauche, nous déployons une modélisation factorielle avancée via seaborn.pointplot() afin de cartographier la trajectoire temporelle de l’anxiété moyenne pour chacun des deux groupes thérapeutiques. Afin d’éviter tout chevauchement fortuit susceptible de dégrader la lecture des marges d’erreur, nous injectons un micro-décalage horizontal contrôlé entre les estimations des deux groupes. Les barres d’erreur associées sont configurées pour matérialiser un intervalle de confiance à 95 % calculé par bootstrap BCa non paramétrique, doté de coiffes d’extrémités nettement découpées. Cette figure met immédiatement en évidence l’interaction thérapeutique : une équivalence parfaite des niveaux d’anxiété lors de l’évaluation initiale, suivie d’une réduction drastique et durable des symptômes chez les bénéficiaires de la thérapie par pleine conscience, contrastant avec la stagnation symptomatique observée dans le groupe témoin.
Sur le panneau latéral droit, nous explorons la dynamique dose-réponse chez les patients du groupe interventionnel en projetant la relation bivariée unissant le temps d’entraînement pratique à l’amplitude de l’amélioration clinique post-interventionnelle. À l’aide de la fonction seaborn.regplot() couplée à un estimateur linéaire robuste, nous traçons le nuage de points individuels translucides transpercé par la droite de régression et son ruban d’incertitude hyperbolique à 95 %. Cette double modélisation conjugue avec élégance l’inférence causale issue de l’expérimentation randomisée et l’analyse mécanistique continue propre à l’évaluation des processus thérapeutiques sous-jacents, condensant l’intégralité du narratif scientifique en un objet graphique unifié et percutant.
12.3 Rédaction des légendes académiques et contextualisation des résultats
Conformément aux normes éditoriales les plus rigoureuses édictées par l’APA, une figure scientifique ne saurait être pleinement opérationnelle sans la présence d’une légende textuelle exhaustive et autosuffisante positionnée immédiatement sous le cadre d’affichage. Cette note de figure remplit une fonction épistémologique déterminante : elle doit permettre à n’importe quel lecteur étranger à l’équipe de recherche de décoder l’ensemble des éléments graphiques, d’appréhender sans ambiguïté les variables représentées et de reconstituer les procédures algorithmiques d’estimation de l’incertitude sans avoir à fouiller le texte principal du manuscrit.
La légende standardisée débute par une description concise du message central de la figure, identifiant la structure du plan factoriel mixte et la nature des cohortes incluses dans l’essai clinique. Immédiatement après cette contextualisation, la note décline avec précision les conventions géométriques et typographiques : la signification exacte des formes géométriques de marqueurs (par exemple, disques pleins pour le groupe expérimental sous pleine conscience et carrés ouverts pour le groupe sous contrôle actif) ainsi que le codage des styles de segments.
L’obligation méthodologique cardinale de cette légende réside dans la déclaration transparente du formalisme d’incertitude utilisé. La mention explicite doit stipuler textuellement que les segments verticaux et les rubans ombrés matérialisent des intervalles de confiance à 95 % dérivés soit d’un algorithme de rééchantillonnage bootstrap non paramétrique à dix mille itérations, soit de la méthode de normalisation de Cousineau-Morey pour la composante répétée, soit d’une projection hyperbolique issue de la théorie des moindres carrés ordinaires. En déclarant rigoureusement ces métriques et en rapportant les effectifs totaux de chaque sous-groupe, le chercheur fait preuve d’une probité scientifique exemplaire, érigeant sa visualisation graphique au rang d’instrument d’inférence universellement reproductible et vérifiable.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cousineau, D. (2005). Confidence intervals in within-subject designs: A simple solution to Loftus and Masson’s method. Tutorials in Quantitative Methods for Psychology, 1(1), 42–45. https://doi.org/10.20982/tqmp.01.1.p042
- Cumming, G. (2012). Understanding the new statistics: Effect sizes, confidence intervals, and meta-analysis. Routledge. https://doi.org/10.4324/9780203807002
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Morey, R. D. (2008). Confidence intervals from normalized data: A correction to Cousineau (2005). Tutorials in Quantitative Methods for Psychology, 4(2), 61–64. https://doi.org/10.20982/tqmp.04.2.p061
- Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 236(767), 333–380. https://doi.org/10.1098/rsta.1937.0005
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10