
Dans le domaine de l’analyse quantitative moderne et de la recherche empirique, la représentation visuelle précise des phénomènes stochastiques constitue un pilier fondamental de l’exploration et de la communication scientifique. Parmi l’ensemble des fonctions théoriques qui structurent les mathématiques appliquées, la loi normale, souvent désignée sous le nom de distribution gaussienne ou courbe en cloche, occupe une position paradigmatique inégalée. Que ce soit pour évaluer des résidus d’estimation dans le cadre de modélisations linéaires complexes ou pour standardiser des métriques psychométriques issues de cohortes massives, la capacité d’élaborer des tracés graphiques rigoureux et élégants de cette distribution représente une compétence méthodologique indispensable pour tout chercheur ou praticien de la donnée.
Le langage de programmation Python s’est imposé comme l’écosystème de référence pour le calcul scientifique et la modélisation statistique computationnelle. Grâce à la symbiose remarquable de ses bibliothèques spécialisées — principalement NumPy pour le calcul matriciel vectorisé, SciPy pour les opérations probabilistes formelles, et Matplotlib ou Seaborn pour l’ingénierie graphique vectorielle —, les analystes disposent d’un environnement flexible permettant de transposer une équation différentielle ou une densité analytique en un artefact visuel répondant aux critères éditoriaux les plus stricts des revues académiques à comité de lecture.
Le présent traité propose une exploration exhaustive, didactique et technique de la visualisation de la distribution normale en environnement Python. En articulant les fondements mathématiques purs de la densité de probabilité, les exigences algorithmiques de la discrétisation numérique et les finesses de la sémiologie graphique contemporaine, ce guide détaille l’ensemble des approches méthodologiques permettant de construire, d’ajuster, de comparer et d’exporter des représentations de distributions gaussiennes prêtes pour publication académique.
1. Introduction théorique à la distribution normale et son utilité en modélisation quantitative
1.1 Définition mathématique et propriétés fondamentales de la loi de Gauss
La distribution normale est une loi de probabilité absolument continue régie par deux paramètres déterminants : son espérance mathématique, traditionnellement notée par la lettre grecque μ (mu), qui caractérise l’emplacement de son centre de gravité et de son axe de symétrie, et sa variance, notée σ² (sigma carré), qui quantifie l’étendue ou la dispersion de la masse probabiliste autour de cette tendance centrale. L’écart-type σ constitue la racine carrée positive de la variance et sert d’étalon métrique intrinsèque à la loi. Analytiquement, la fonction de densité de probabilité, couramment abrégée sous l’acronyme anglo-saxon PDF (pour Probability Density Function), d’une variable aléatoire continue X suivant une loi normale générale s’exprime par la relation mathématique suivante :
f(x) = (1 / (σ √(2π))) * exp( – (x – μ)² / (2σ²) )
Cette expression analytique met en exergue des constantes transcendantes fondamentales, à savoir la constante d’Archimède π et la constante d’Euler e, intégrées dans une structure exponentielle quadratique négative. Cette géométrie garantit une décroissance extrêmement rapide de la densité à mesure que l’on s’éloigne du centre de gravité, assurant que l’intégrale définie de la fonction sur la totalité de l’ensemble des réels — allant de l’infini négatif à l’infini positif — converge strictement vers l’unité, condition sine qua non de toute loi de probabilité formelle.
La symétrie axiale autour de l’espérance μ impose que la moyenne arithmétique, la médiane (le cinquantième percentile) et le mode (la valeur présentant la densité maximale) soient strictement confondues au point central x = μ. Cette symétrie parfaite implique également que le coefficient d’asymétrie statistique, ou skewness de Fisher, soit strictement égal à zéro. Parallèlement, l’aplatissement de la courbe, caractérisé par le coefficient de voussure ou kurtosis, est égal à trois selon la formulation classique de Pearson, ou exactement zéro lorsque l’on emploie le coefficient d’excès de kurtosis, définissant ainsi la référence mésocurtique absolue vis-à-vis de laquelle les distributions leptocurtiques (aux queues plus épaisses) et platycurtiques (aux queues plus légères) sont universellement comparées.
Sur le plan distributionnel, il est primordial de distinguer la distribution normale générale, régie par des valeurs arbitraires de μ et σ, de la distribution normale standard — également appelée loi normale centrée réduite —. Cette dernière constitue une forme canonique particulière où l’espérance mathématique est fixée à zéro (μ = 0) et la variance à l’unité (σ² = 1, donc σ = 1). Toute distribution gaussienne générale peut être convertie en une forme unitaire par le biais d’un changement de variable linéaire nommé standardisation ou calcul du score Z, formalisé par l’opération : z = (x – μ) / σ.
Le statut hégémonique de la loi de Gauss dans les sciences appliquées ne relève pas d’un choix heuristique arbitraire mais trouve son assise théorique dans le théorème central limite. Ce théorème postule que la somme — ou la moyenne normalisée — d’un nombre élevé de variables aléatoires indépendantes et identiquement distribuées, pourvu qu’elles possèdent une espérance et une variance finies, converge asymptotiquement en loi vers une distribution normale, quelle que soit la nature probabiliste sous-jacente des variables individuelles primitives. Ce phénomène d’émergence structurelle explique pourquoi tant de processus naturels et expérimentaux, résultant de l’agrégation additive d’une multitude de perturbations infinitésimales et indépendantes, manifestent spontanément un profil morphologique en cloche.
1.2 Importance de la distribution normale dans les sciences comportementales et cognitives
Dans le champ des sciences comportementales, de la psychologie différentielle et des neurosciences cognitives, l’hypothèse distributionnelle gaussienne constitue l’ossature conceptuelle sur laquelle reposent la plupart des outils de mesure et des modèles psychométriques. Historiquement formalisée par les travaux pionniers de Sir Francis Galton et développée par Charles Spearman, la modélisation des traits latents postule que les aptitudes intellectuelles, les dispositions tempéramentales de la personnalité et les performances cognitives complexes se distribuent de façon continue et normale au sein de la population générale.
Cette perspective s’illustre de manière emblématique à travers la standardisation des scores d’efficience intellectuelle, à l’instar des échelles développées par David Wechsler (notamment la WAIS et la WISC). Afin de conférer une intelligibilité clinique immédiate aux performances individuelles, les scores bruts issus des sous-tests neuropsychologiques sont transformés par étalonnage linéaire de façon à contraindre la distribution empirique à se conformer rigoureusement à une loi normale d’espérance fixée à 100 et d’écart-type calibré à 15. De même, les réponses collectées au travers d’échelles de Likert au sein d’inventaires de personnalité sont couramment agrégées pour générer des scores composites continus qui sont ensuite normalisés pour refléter le positionnement relatif d’un sujet vis-à-vis d’une population de référence normative.
Au-delà de la métrologie des aptitudes, la distribution de Gauss joue un rôle architectural au sein des modèles d’analyse multivariée, et plus particulièrement dans le cadre de la théorie des modèles linéaires généraux (GLM), de la régression multiple et de l’analyse de variance (ANOVA). L’un des postulats fondamentaux garantissant la validité des estimateurs des moindres carrés ordinaires et l’exactitude des tests de significativité associés repose sur la normalité des résidus d’estimation. Les termes d’erreur stochastique doivent impérativement suivre une loi normale homoscédastique d’espérance nulle afin que les statistiques de Student (t) et de Fisher-Snedecor (F) conservent leurs lois d’échantillonnage théoriques.
Lorsque ces postulats sont violés de manière substantielle — par la présence d’asymétries prononcées, d’effets de plancher ou de plafond dans les instruments de recueil de données, ou d’une leptocurticité induite par des valeurs aberrantes —, l’inférence statistique perd de sa robustesse. Le taux d’erreur de première espèce (le risque d’erreur alpha de rejeter à tort l’hypothèse nulle d’absence d’effet) peut être drastiquement gonflé, tandis que la puissance statistique globale du test se trouve dégradée. D’où la nécessité critique pour le chercheur de visualiser, d’explorer et de diagnostiquer la morphologie distributionnelle de ses variables avant toute extrapolation inférentielle.
1.3 Objectifs pédagogiques et méthodologie d’implémentation algorithmique
L’objectif fondamental de cet article est de doter les analystes et chercheurs des compétences méthodologiques nécessaires pour implémenter, adapter et automatiser des représentations graphiques de distributions normales en Python, répondant aux standards les plus pointus de la communication scientifique. Pour y parvenir, il convient d’opérer une translation méthodique entre la modélisation mathématique analytique — continue et indéfinie — et son incarnation informatique concrète, intrinsèquement numérique, discrète et bornée.
Sur le plan algorithmique, représenter une fonction mathématique continue sur un moniteur informatique nécessite une chaîne de transformations séquentielles rigoureuses. La première phase consiste à échantillonner le domaine de définition de la variable en concevant un vecteur numérique ordonné d’abscisses à haute résolution spatiale. Ce maillage régulier — souvent désigné sous le terme de grille d’échantillonnage — doit couvrir une étendue suffisante pour capturer la quasi-totalité de l’intégrale de probabilité sans provoquer de distorsion d’échelle.
La seconde phase repose sur la vectorisation du calcul de densité : chaque élément discret de ce vecteur d’abscisses est soumis à l’évaluation fonctionnelle de la PDF gaussienne afin de produire un vecteur d’ordonnées correspondant. Enfin, la troisième phase implique l’orchestration graphique, qui associe par interpolation linéaire ces paires de coordonnées cartésiennes pour restituer l’illusion d’une continuité curviligne fluide et sans aspérité polygonale.
Pour assurer la pérennité et l’intégrité de ces flux de traitement, une attention particulière doit être allouée aux principes directeurs de la reproductibilité computationnelle. Cela implique l’instanciation délibérée et contrôlée des générateurs de nombres pseudo-aléatoires à travers des graines de réplication fixes (random seeds), le bannissement formel des boucles itératives inefficaces au profit des calculs vectorisés optimisés en langage C compilé sous le moteur de NumPy, et l’encapsulation modulaire du code sous forme de fonctions paramétrables réutilisables et abondamment documentées.
2. Configuration de l’environnement Python et bibliothèques scientifiques nécessaires
2.1 Rôle et intégration de la bibliothèque NumPy pour le calcul vectoriel
Dans l’architecture de calcul scientifique de Python, la bibliothèque NumPy (Numeric Python) forme le socle infrastructurel indispensable sur lequel reposent la quasi-totalité des paquets analytiques de haut niveau. Son apport réside dans l’implémentation de tableaux multidimensionnels homogènes — les objets de type ndarray — associés à une collection d’opérateurs vectorisés codés en langage C. Cette conception offre des gains de performance temporelle substantiels en éliminant la surcharge d’interprétation inhérente aux listes hétérogènes natives de Python.
Pour le traçage d’une courbe continue, NumPy fournit des fonctions d’échantillonnage de premier ordre, dont la fonction np.arange et sa contrepartie np.linspace. Tandis que np.arange génère des valeurs échelonnées selon un pas d’incrémentation prédéfini, np.linspace permet de subdiviser un intervalle clos spécifié par ses bornes inférieure et supérieure en un nombre entier exact de segments équidistants. En matière de tracé gaussien, le choix du pas de discrétisation conditionne directement la fidélité géométrique de la courbe : un maillage trop lâche se traduira par des segments brisés visibles au niveau de l’apex, tandis qu’un échantillonnage démesuré consommera inutilement des cycles d’horloge processeur et de la mémoire vive sans gain perceptif tangible.
La gestion de la précision numérique flottante constitue un aspect technique non négligeable. Par défaut, NumPy alloue des flottants double précision codés sur 64 bits (de type float64), conformément à la norme internationale IEEE 754. Cette précision prévient tout risque d’instabilité ou d’annulation catastrophique lors des calculs d’exponentielles quadratiques appliquées à des valeurs extrêmes situées dans les queues lointaines de la distribution.
2.2 Exploitation du module scipy.stats pour les fonctions probabilistes
Bien qu’il soit tout à fait concevable d’implémenter manuellement l’équation analytique de Gauss au moyen des opérateurs arithmétiques de NumPy, le recours aux structures dédiées de la bibliothèque SciPy, et plus particulièrement à son sous-module scipy.stats, représente la norme de référence en matière de rigueur scientifique et de lisibilité algorithmique. Cette bibliothèque fédère un ensemble exhaustif de distributions statistiques paramétriques univariées et multivariées unifiées sous une même architecture orientée objet.
Au sein de ce module, la classe scipy.stats.norm encapsule la totalité des propriétés fonctionnelles relatives à la loi de Gauss continue. Cette entité propose une panoplie de méthodes intégrées : la méthode pdf(x, loc, scale) pour l’évaluation ponctuelle de la fonction de densité de probabilité, la méthode cdf(x, loc, scale) pour la fonction de répartition cumulative, la méthode ppf(q, loc, scale) pour la fonction des quantiles (inverse de la fonction de répartition), et rvs(loc, scale, size) pour le tirage pseudo-aléatoire de variables déviates selon les paramètres spécifiés.
L’utilisation de la méthode norm.pdf présente des avantages numériques considérables face à une implémentation algébrique manuelle. Les algorithmes internes de SciPy intègrent des routines de traitement d’erreurs et des approximations asymptotiques calibrées pour préserver l’exactitude des calculs même lorsque les coordonnées x se situent à de très multiples écarts-types de la moyenne, évitant ainsi les écueils de sous-dépassement arithmétique (underflow). De surcroît, la standardisation des arguments loc (qui paramètre l’espérance μ) et scale (qui détermine l’écart-type σ) rend le code lisible, homogène et immédiatement intelligible pour tout relecteur externe.
2.3 Paramétrage de l’écosystème graphique Matplotlib pour publications académiques
L’orchestration visuelle en Python est historiquement pilotée par la bibliothèque Matplotlib, et plus particulièrement par son interface procédurale matplotlib.pyplot. Pour élaborer des figures destinées aux revues internationales, il est impératif de s’affranchir de l’approche implicite héritée de l’environnement MATLAB pour adopter résolument l’approche orientée objet de Matplotlib. Cette dernière s’articule autour de deux entités conceptuelles cardinales : la Figure, qui représente la surface globale du canevas graphique, et les Axes, qui correspondent aux sous-régions spatiales sur lesquelles sont projetées les données, dotées de leurs propres axes cartésiens, échelles, graduations et étiquettes.
L’adaptation de Matplotlib aux exigences typographiques et chromatiques académiques passe par la configuration approfondie de son dictionnaire global de paramètres d’exécution, dénommé rcParams. Cet ensemble de clefs permet de modifier uniformément, dès le préambule du script, les polices de caractères vectorielles (en préconisant des familles typographiques avec ou sans empattement standardisées telles que Latin Modern Roman, Helvetica ou DejaVu Sans), l’alignement des textes, l’épaisseur des traits d’axe et le format de restitution des équations mathématiques via le moteur de composition TeX natif ou intégré.
La question des formats d’exportation et de la résolution d’image revêt une portée cruciale. Pour une intégration sans perte d’information au sein d’un manuscrit scientifique compilé sous LaTeX ou Word, la production de formats vectoriels échelonnables tels que le PDF (Portable Document Format) ou le SVG (Scalable Vector Graphics) s’avère hautement préférable, dans la mesure où les vecteurs de primitives géométriques conservent leur netteté indépendamment du facteur de zoom. Lorsque des contraintes éditoriales imposent des fichiers d’images matricielles ou en trame, un paramétrage scrupuleux de la résolution spatiale — exprimée en points par pouce ou DPI (Dots Per Inch) — à une valeur minimale de 300, voire 600 DPI, doit être systématiquement programmé afin d’éradiquer toute pixelisation inesthétique.
3. Fondements mathématiques : Fonction de densité de probabilité (PDF) et discrétisation
3.1 L’évaluation numérique de la fonction de densité de probabilité
Un contresens conceptuel récurrent dans l’interprétation des représentations graphiques de distributions continues réside dans l’assimilation hâtive de l’ordonnée f(x) à une probabilité brute d’occurrence d’un événement discret. Pour une variable aléatoire absolument continue, la probabilité rigoureuse d’observer exactement une valeur scalaire x infiniment précise est formellement nulle (P(X = x) = 0). L’ordonnée d’une PDF représente en réalité une densité différentielle, traduisant le taux instantané avec lequel la masse de probabilité se concentre dans un voisinage infinitésimal dx autour de l’abscisse x considérée.
Cette distinction théorique a des implications géométriques majeures pour la hauteur du tracé. Le paramètre d’échelle σ gouverne l’amplitude verticale maximale du graphique à travers le dénominateur de la fraction préliminaire de la formule gaussienne. Plus l’écart-type σ est restreint, plus la dispersion horizontale est resserrée, et par conséquent, plus l’apex central doit s’élever pour maintenir l’aire sous la courbe strictement égale à un. Analytiquement, en évaluant f(x) à l’espérance x = μ, le terme exponentiel quadratique exp(0) s’annule pour devenir égal à l’unité, ce qui conduit à une hauteur d’apex maximale exacte donnée par :
f(μ) = 1 / (σ √(2π)) ≈ 0,398942 / σ
Ainsi, pour une loi normale standard (σ = 1), l’ordonnée sommitale culminera très précisément aux alentours de 0,3989. En revanche, pour une distribution très resserrée présentant par exemple un écart-type σ = 0,2, la hauteur du pic au point central atteindra approximativement 1,9947, transcendant largement la valeur scalaire de 1,0 sans que cela ne viole d’aucune manière les axiomes de Kolmogorov relatifs aux probabilités, dans la mesure où seule l’intégrale de surface spatiale demeure contrainte par le plafond unitaire.
3.2 Détermination optimale des bornes et du pas d’échantillonnage
Pour matérialiser graphiquement la densité de Gauss sur une fenêtre cartésienne finie, il est nécessaire de borner artificiellement le domaine de discrétisation [a, b] du vecteur x. Le choix empirique le plus rationnel s’appuie directement sur les propriétés de décroissance exponentielle de la loi, formalisées par la règle des écarts-types. Pour une loi normale d’espérance μ et d’écart-type σ, l’intervalle canonique défini par [μ – 3σ, μ + 3σ] concentre déjà approximativement 99,73 % de la masse de probabilité totale, laissant seulement 0,27 % réparti sur les deux queues extrêmes combinées.
Dans un contexte d’édition scientifique haut de gamme, borner le vecteur strictement à trois écarts-types peut provoquer un effet d’interruption abrupte de la courbe au niveau des bordures latérales du cadre graphique, ce qui nuit à la restitution du comportement asymptotique naturel de la fonction. L’usage méthodologique préconise d’étendre la plage d’évaluation à un intervalle compris entre [μ – 4σ, μ + 4σ], voire [μ – 4,5σ, μ + 4,5σ]. Cet élargissement assure que la courbe rejoint visuellement la ligne de base d’ordonnée zéro de façon infinitésimale et sans césure tranchée.
La détermination du pas d’échantillonnage ou de la quantité de nœuds numériques au sein de la grille constitue la deuxième exigence fondamentale. Lorsque l’on emploie np.linspace(start, stop, num), paramétrer num = 500 ou num = 1000 garantit une discrétisation fine offrant un rendu visuel parfait. Un sous-échantillonnage critique — par exemple l’usage d’une trentaine de points scalaires seulement — induit des distorsions polygonales perceptibles, caractérisées par un apex anguleux et des variations de courbure heurtées, détériorant la perception visuelle de la continuité différentiable propre à la distribution de Gauss.
4. Méthode standard : Tracer une distribution normale unitaire avec Matplotlib
4.1 Décomposition ligne par ligne du script minimal de tracé
La conception d’une représentation graphique minimale mais techniquement rigoureuse d’une loi normale unitaire requiert l’articulation de séquences logiques précises au sein de l’interpréteur Python. La démarche débute par l’importation sans ambiguïté des modules fondamentaux, en associant à chaque bibliothèque son alias consensuel reconnu par la communauté scientifique : import numpy as np, import matplotlib.pyplot as plt, et l’accès direct aux fonctions probabilistes par l’instruction from scipy.stats import norm.
L’étape subséquente implique la génération du support de calcul matriciel. En définissant une variable x = np.linspace(-4, 4, 1000), on matérialise un tableau unidimensionnel contenant 1 000 flottants uniformément espacés le long de l’axe réel entre −4 et +4. Ce vecteur correspond à un balayage s’étalant sur quatre écarts-types de part et d’autre de l’espérance d’une loi normale centrée réduite (μ = 0, σ = 1). Le vecteur d’ordonnées correspondant est ensuite instantanément calculé par vectorisation à l’aide de l’instruction y = norm.pdf(x, loc=0, scale=1), qui soumet chaque valeur scalaire de x à l’algorithme d’évaluation de la densité gaussienne.
L’initialisation de l’environnement géométrique s’effectue via l’appel paradigmatique fig, ax = plt.subplots(figsize=(8, 5)), allouant un conteneur global de dimensions contrôlées (huit pouces de largeur par cinq pouces de hauteur). La transmission des coordonnées cartésiennes se fait ensuite au travers de la méthode ax.plot(x, y), qui opère l’interpolation linéaire continue entre les points discrets. Enfin, la séquence se conclut par l’invocation de plt.show() pour afficher la scène dans une interface interactive ou pour purger le buffer graphique mémoire du serveur d’exécution.
4.2 Analyse structurelle du graphique produit
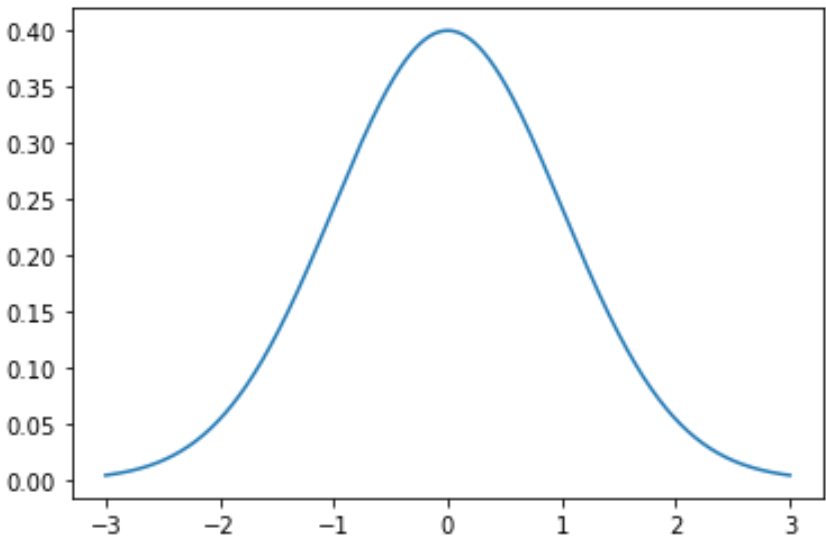
L’examen minutieux de l’artéfact graphique élémentaire ainsi généré permet de vérifier immédiatement la concordance empirique entre la géométrie de la courbe rendue et les théorèmes analytiques de la loi normale unitaire. L’observateur constate en premier lieu la parfaite symétrie bilatérale du tracé par rapport à l’axe des ordonnées passant par x = 0 : la pente de croissance observée pour les valeurs négatives du domaine reflète fidèlement, par réflexion orthogonale, la déclivité de décroissance des abscisses positives symétriques.
En second lieu, l’apogée curviligne se positionne de façon irréprochable au sommet théorique calculé, affichant une hauteur très légèrement inférieure à la barre des 0,4 unités d’ordonnée. Les points d’inflexion — c’est-à-dire les coordonnées géométriques singulières où la dérivée seconde de la fonction s’annule, faisant transiter la courbure d’un état concave à un état convexe — se situent rigoureusement aux abscisses x = −1 et x = +1, correspondant précisément à la distance d’un écart-type scalaire de part et d’autre de l’espérance mathématique centrale.
Enfin, l’observation des ailes latérales du tracé, communément désignées sous l’appellation de queues de distribution (distribution tails), témoigne du comportement asymptotique régulier de l’exponentielle négative. Bien que la courbe s’approche continuellement de l’axe d’ordonnée zéro au fur et à mesure que les abscisses progressent vers −4 et +4, elle ne touche jamais théoriquement la ligne de zéro absolu, restituant visuellement la nature asymptotique intrinsèque de l’expression mathématique gaussienne.
5. Personnalisation graphique avancée : Couleurs, styles et esthétique du tracé
5.1 Contrôle des attributs de ligne pour une lisibilité accrue
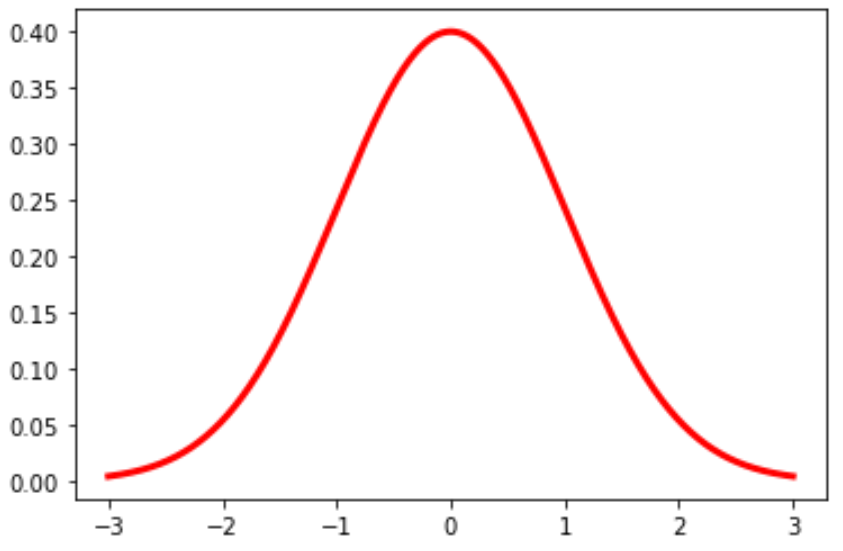
La lisibilité d’une courbe au sein d’une figure complexe publiée dépend de la maîtrise des attributs typographiques et géométriques de son tracé linéaire. Par défaut, Matplotlib applique une épaisseur de ligne unitaire (linewidth=1.5) qui peut paraître ténue lors d’une réduction d’échelle imposée par la mise en page en double colonne d’un article de revue. L’ajustement systématique de l’argument linewidth à des valeurs comprises entre 2,0 et 3,0 points confère à la courbe principale une assise visuelle optimale et une lisibilité accrue.
Le choix chromatique doit faire l’objet d’une réflexion ergonomique approfondie, guidée par les impératifs contemporains d’accessibilité universelle. Les couleurs par défaut saturées peuvent s’avérer indiscernables pour les lecteurs atteints de dyschromatopsies variées (telles que la deutéranopie ou la protanopie). Il est par conséquent hautement recommandé d’adopter des palettes chromatiques perceptuellement uniformes et testées pour le daltonisme, telles que les cartographies Viridis, Cividis, ou les teintes sobres issues de nuanciers professionnels reconnus comme ceux de Cynthia Brewer (ColorBrewer).
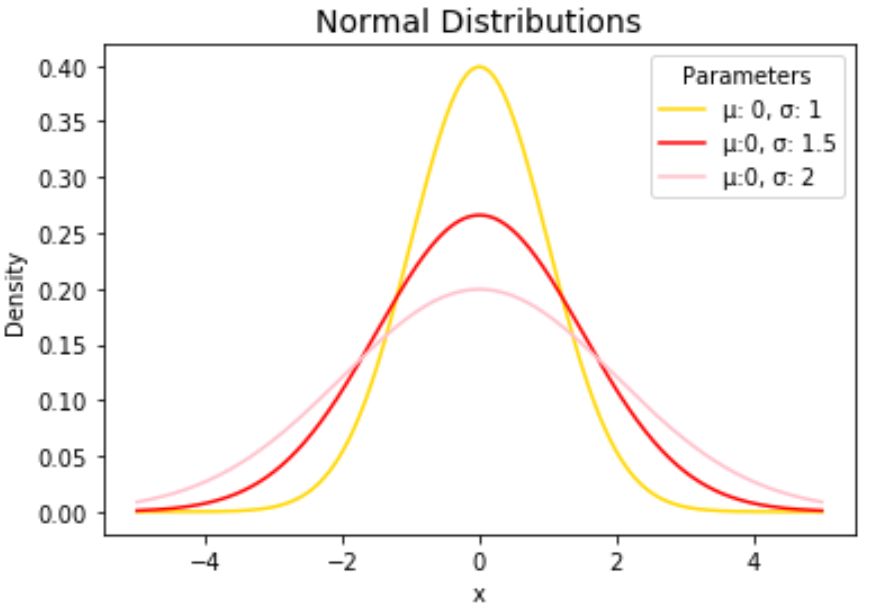
En complément de la modulation chromatique, la différenciation par les textures de trait — contrôlées par le paramètre linestyle — s’avère déterminante lorsque le chercheur doit juxtaposer plusieurs courbes gaussiennes au sein d’un même référentiel cartésien. L’alternance concertée entre traits pleins ('-'), tiretés longs ('--'), pointillés resserrés (':') ou combinaisons alternées tiret-point ('-.') garantit que les différentes conditions expérimentales demeurent parfaitement discriminables, même en cas de photocopie ou d’impression finale de l’article en niveaux de gris monochromes.
5.2 Enrichissement sémantique avec titres, légendes et étiquettes d’axes
Une figure scientifique ne peut prétendre à l’autonomie informative sans un étiquetage textuel contextualisé et mathématiquement rigoureux. Matplotlib intègre un parseur mathématique natif capable d’interpréter un sous-ensemble étendu des commandes syntaxiques de composition typographique LaTeX. En préfixant les chaînes de caractères par la lettre r (désignant une chaîne brute ou raw string), il devient aisé d’insérer des symboles grecs et des constructions algébriques sophistiquées directement au sein des libellés d’axes : ax.set_xlabel(r'Variable aléatoire $X$ (unités standard)') et ax.set_ylabel(r'Densité de probabilité $f(x)$').
Le titrage de la figure, instancié via ax.set_title(), gagne à être scindé sémantiquement : un titre descriptif synthétique mis en exergue par une graisse typographique semi-forte (semi-bold), potentiellement complété d’un sous-titre contextualisant les paramètres statistiques sous-jacents, à l’instar de : r'Distribution Normale Théorique ($mu=0, sigma=1$)'. Cette standardisation élimine toute ambiguïté quant à l’interprétation des échelles métriques retenues.
La légende explicative, générée par la méthode ax.legend(), doit être positionnée avec discernement afin d’éviter tout chevauchement avec les courbures géométriques du signal. Bien que l’argument loc='best' délègue à un algorithme interne la détection d’une zone d’ancrage évitant les collisions d’éléments graphiques, contraindre explicitement son ancrage — par exemple loc='upper right' pour une courbe normale unitaire — assure une prévisibilité absolue du cadrage lors de la génération automatisée de graphiques en lot.
5.3 Application d’un quadrillage scientifique et suppression du bruit visuel
La doctrine moderne de la sémiologie graphique, théorisée notamment par Edward Tufte, prescrit d’optimiser le ratio « encre-données » (data-ink ratio) en éliminant impitoyablement tout artifice ornemental superflu qui ne contribue pas directement à la compréhension du message statistique. Dans le cadre de Matplotlib, cela implique un travail de raffinement subtil sur les bordures du tracé (les spines) et la grille d’arrière-plan cartésien.
Par défaut, les fenêtres graphiques de Matplotlib sont encadrées par quatre bordures rectangulaires opaques. Dans la plupart des revues à comité de lecture, il est de bon ton de masquer les bordures supérieure et droite en exécutant ax.spines['top'].set_visible(False) et ax.spines['right'].set_visible(False), allégeant instantanément la structure visuelle globale. Les bordures inférieure et gauche subsistantes peuvent quant à elles être légèrement amincies et fixées dans une teinte de gris neutre pour souligner discrètement les axes de graduation sans monopoliser l’attention focale.
L’introduction d’un quadrillage scientifique au moyen de la commande ax.grid() améliore considérablement la capacité du lecteur à extrapoler mentalement les valeurs quantitatives d’abscisse et d’ordonnée le long du tracé. Ce quadrillage ne doit jamais entrer en compétition visuelle avec la courbe de densité : il convient de lui attribuer un tracé discontinu léger (linestyle='--'), une épaisseur minimale (linewidth=0.5) et un canal de transparence élevé (alpha=0.4 ou alpha=0.6). L’harmonisation finale des tailles de police — via les arguments labelsize et fontsize — parachève l’intégration esthétique de l’ensemble.
6. Tracer plusieurs distributions normales superposées pour des comparaisons de groupes
6.1 Comparaison de distributions à moyennes divergentes et variances homogènes
La juxtaposition comparative de multiples distributions sur une même échelle orthonormée représente un outil diagnostique fondamental en recherche expérimentale, notamment lors de l’évaluation des effets différentiels de traitements pharmacologiques, d’interventions pédagogiques ou de contrastes sociodémographiques. Le premier cas de figure classique réside dans l’analyse de groupes présentant une homogénéité des variances — condition d’homoscédasticité — mais des espérances mathématiques significativement divergentes.
Sur le plan géométrique, le fait de faire varier le paramètre μ tout en maintenant σ invariant opère une pure translation horizontale rigide de la courbe le long de l’axe des abscisses, sans altérer d’aucune manière sa morphologie, sa courbure intrinsèque ni la hauteur de son apex. En programmant par exemple trois profils distincts partagés sur le domaine continu — tels qu’une condition de contrôle (μ = 0, σ = 1), une condition d’effet modéré (μ = 1.5, σ = 1) et une condition d’effet substantiel (μ = 3, σ = 1) —, l’analyste visualise instantanément la translation de la masse de probabilité.
Cette visualisation graphique met immédiatement en relief le concept d’amplitude de l’effet — conceptuellement analogue au d de Cohen largement usité en méta-analyse et psychométrie. Le décalage horizontal des cloches matérialise sans ambiguïté le recouvrement partiel des distributions de scores et permet d’illustrer concrètement la proportion de participants du groupe expérimental surpassant la tendance centrale du groupe témoin, offrant une perspective complémentaire et souvent plus parlante qu’une simple table de p-valeurs issue d’un test t de Student.
6.2 Comparaison de distributions à variances hétérogènes et moyennes identiques
Le second cas de figure comparatif d’importance majeure met en jeu des sous-groupes partageant une tendance centrale identique (μ constant), mais se distinguant par des dispersions considérablement hétérogènes — condition caractérisée sous le vocable d’hétéroscédasticité. Ce profil se rencontre fréquemment dans les études longitudinales du vieillissement cognitif, où l’espérance générale de performance peut demeurer stable au sein d’une cohorte alors que la variabilité interindividuelle s’accroît sous l’effet de trajectoires neurobiologiques différentielles.
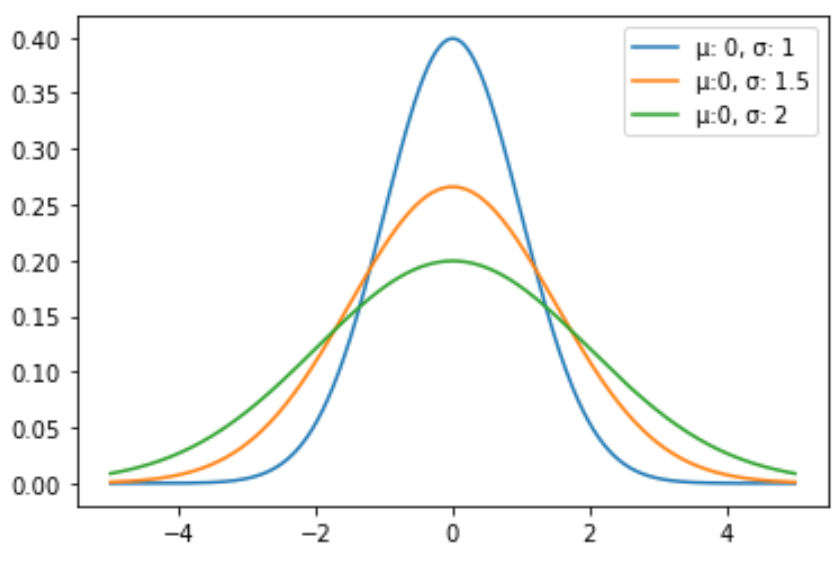
L’impact d’une augmentation de la variance σ² se traduit visuellement par un écrasement bilatéral et un étalement de la courbe le long de l’axe horizontal. Une distribution dotée d’un écart-type restreint (μ = 0, σ = 0.5) exhibera une allure fuselée, hautement leptocurtique en apparence, avec un apex très proéminent dépassant la valeur de 0,7 unités de densité. À l’inverse, une distribution d’écart-type élargi (μ = 0, σ = 2) affichera un profil très aplati, avec un pic central inférieur à 0,2 et une redistribution volumétrique de la probabilité vers les queues de distribution distantes.
Ce type de représentation croisée illustre avec acuité la redistribution constante de la surface intégrale sous la courbe. Bien que le sommet s’affaisse de façon drastique au fur et à mesure que la variance augmente, l’aire totale demeure strictement unitaire. Ce type de graphique permet d’expliquer pourquoi, au sein d’une population caractérisée par une variance élargie, les probabilités d’observer des valeurs extrêmes — qu’elles soient exceptionnellement élevées ou sévèrement déficitaires — sont substantiellement démultipliées par rapport à un échantillon homogène resserré.
6.3 Construction d’une fonction Python réutilisable pour tracés multicourbes
Pour rationaliser les protocoles d’analyse exploratoire et éviter la duplication de blocs de code redondants au fil d’un calepin interactif (Jupyter Notebook), il est judicieux d’encapsuler la logique de tracé comparatif au sein d’une fonction Python paramétrique robuste, réutilisable et documentée. Cette approche de programmation modulaire renforce la maintenabilité du code et garantit la conformité esthétique de l’ensemble des figures d’une étude.
Une fonction bien architecturée — que l’on peut désigner sous le nom de tracer_distributions_gaussiennes(parametres, x_range=None, titre="Comparaison de lois normales", palette='viridis') — prendra comme argument primaire une structure de données structurée, telle qu’une liste de dictionnaires ou de tuples spécifiant pour chaque condition son libellé descriptif, son espérance mathématique, son écart-type, et éventuellement un style de trait personnalisé. Si l’étendue de l’axe des abscisses (x_range) n’est pas fournie explicitement par l’utilisateur, la fonction calcule automatiquement le minimum global [μ_min − 4σ_max] et le maximum global [μ_max + 4σ_max] sur l’ensemble des configurations déclarées.
À travers une simple boucle itérative vectorisée, la fonction instancie les tracés successifs, échantillonne la palette de couleurs sélectionnée via les fonctionnalités d’interpolation chromatique de Matplotlib (plt.get_cmap), applique les styles différentiels, et enrichit méthodiquement la légende cartésienne. L’objet Axes résultant est ensuite retourné à l’utilisateur, lui laissant la pleine liberté d’ajouter a posteriori des annotations contextuelles, des flèches directionnelles ou des marqueurs empiriques avant l’opération terminale de sauvegarde sur disque.
7. Visualisation des propriétés statistiques clés : Moyenne, écart-type et intervalles de confiance
7.1 Tracé des repères verticaux pour la tendance centrale et la dispersion
Si la morphologie générale d’une courbe normale renseigne qualitativement sur la distribution d’un phénomène, l’adjonction de repères géométriques ponctuels permet de transformer un simple dessin en un instrument d’analyse quantitative précis. La matérialisation de l’espérance centrale μ s’effectue idéalement à travers la projection d’une ligne directrice verticale reliant la base de l’axe cartésien au sommet de la cloche. Sous Matplotlib, cette projection est réalisée à l’aide de la méthode ax.axvline(x=mu, color='red', linestyle='--', linewidth=1.5, label='Moyenne').
De même, l’identification de la dispersion requiert le marquage visuel des frontières situées à exactement un écart-type de l’espérance, c’est-à-dire aux abscisses μ − σ et μ + σ. Ces frontières possèdent une signification mathématique singulière : elles correspondent géométriquement aux deux points d’inflexion stricts de la fonction f(x), marquant l’inversion géométrique de la concavité de la courbe de densité. Tracer deux lignes verticales discrètes en pointillés fins à ces emplacements stratégiques confère au lecteur un repère spatial immédiat de l’unité de mesure σ propre au phénomène exploré.
Pour parfaire l’expressivité de la figure, des flèches d’annotation bidirectionnelles enrichies de blocs textuels explicatifs peuvent être incrustées au sein du tracé en employant la commande ax.annotate(). Cette méthode prend en charge des options de ciblage spatial sophistiquées, permettant de positionner une pointe de flèche pointant vers l’apex avec des coordonnées de décalage textuel (xytext) et des configurations de style typographique rigoureuses, matérialisant didactiquement les métriques de dispersion auprès du lectorat non statisticien.
7.2 Matérialisation graphique de la règle empirique 68-95-99.7
La règle empirique 68-95-99.7 — historiquement connue sous le nom de règle des trois sigmas — constitue l’un des axiomes fondamentaux les plus vulgarisés de la statistique descriptive gaussienne. Elle stipule qu’au sein de toute distribution parfaitement normale, indépendamment des valeurs prises par son espérance et son écart-type, approximativement 68,27 % de la totalité des observations se regroupent à l’intérieur de l’intervalle d’un écart-type autour de la moyenne [μ − σ, μ + σ], approximativement 95,45 % se condensent dans l’intervalle de deux écarts-types [μ − 2σ, μ + 2σ], et pas moins de 99,73 % sont confinées dans l’intervalle de trois écarts-types [μ − 3σ, μ + 3σ].
La traduction graphique de cette partition théorique transforme une simple représentation filaire en un schéma d’étalonnage à haute valeur pédagogique. En segmentant l’axe des abscisses selon ces tranches canoniques, le chercheur met en évidence l’extrême rareté probabiliste des scores situés au-delà du seuil de trois écarts-types (seulement 0,135 % de probabilité d’occurrence pour chacune des deux queues résiduelles), expliquant pourquoi ces frontières servent universellement de critères diagnostiques de détection des valeurs atypiques ou aberrantes (outliers).
Pour implémenter cette segmentation par programmation, on recourt à des divisions verticales successives superposées à des indicateurs de pourcentages relatifs inscrits directement entre les bornes. En combinant un calcul d’espacement proportionnel et des annotations centrées horizontalement au milieu de chaque tranche, l’analyste obtient un panneau de référence visuelle conforme aux illustrations les plus prestigieuses des manuels de référence en psychométrie et en statistique inférentielle.
8. Ombrage des aires sous la courbe et calculs de probabilités cumulées
8.1 Coloration des régions critiques à l’aide de la fonction fill_between
La puissance expressive d’un tracé gaussien atteint son paroxysme lorsque l’on matérialise visuellement les probabilités d’occurrence par l’ombrage surfacique des aires sous la courbe. En vertu des principes de l’intégration de Riemann, la probabilité qu’une variable continue X s’inscrive au sein d’un intervalle défini [a, b] équivaut rigoureusement à l’intégrale définie de la fonction f(x) sur ce même intervalle :
P(a ≤ X ≤ b) = ∫ab f(x) dx
Sous l’écosystème Matplotlib, le remplissage surfacique continu s’exécute avec une remarquable fluidité algorithmique grâce à la méthode ax.fill_between(x, y, where=condition, interpolate=True). Le vecteur x et le vecteur de densité y étant préalablement calculés sur une grille à fine granularité, le paramètre where reçoit un masque booléen d’évaluation logique — par exemple (x >= a) & (x <= b) — qui restreint l’application de la couche de remplissage chromatique aux seules abscisses remplissant strictement le critère relationnel stipulé.
La gestion de la transparence du remplissage constitue un paramètre technique critique : il est indispensable de moduler l’argument alpha (idéalement entre 0,25 et 0,50) pour conférer une teinte semi-translucide à la zone ombrée. Cette précaution esthétique évite d’occulter la ligne de profil principale supérieure ou d’effacer les repères verticaux et le quadrillage scientifique sous-jacents, préservant ainsi l’intégrité sémiologique globale du graphique.
8.2 Liaison directe entre visualisation graphique et calcul de p-valeur
L’ombrage surfacique prend toute sa dimension méthodologique lorsqu’il est mis au service de la scénarisation visuelle des tests d’hypothèses statistiques et de l’illustration des p-valeurs (p-values). Que l’on formule un test de conformité unilatéral à droite, unilatéral à gauche ou un test bilatéral symétrique d’égalité des moyennes, la p-valeur correspond exactement à la surface cumulée sous la courbe de la statistique de test au-delà de la valeur empiriquement observée.
Pour automatiser rigoureusement la synchronisation entre la valeur numérique théorique et le tracé géométrique, il convient de conjuguer la fonction graphique ax.fill_between avec la fonction de répartition cumulative analytique scipy.stats.norm.cdf(). Par exemple, pour un test bilatéral évaluant une statistique standardisée z_obs = 1,96 au seuil de significativité nominal de 5 % (α = 0,05), la probabilité unilatérale de dépassement supérieure se quantifie formellement par p_sup = 1 - norm.cdf(1.96), tandis que la région critique totale équivaut à 2 * p_sup, soit rigoureusement 0,05.
Grâce aux capacités de formatage dynamique de Python (telles que les chaînes littérales formatées ou f-strings), il devient trivial d’intégrer le résultat calculé de cette intégrale directement au sein du texte descriptif de la légende ou sous forme d’une annotation textuelle incrustée dans l’aire ombrée : r'Région critique : $p = 2 \times P(Z ge 1.96) = 0.05$'. Cette mise en regard explicite entre calcul analytique et surface projetée transforme une notion abstraite en une démonstration visuelle limpide du mécanisme de rejet de l’hypothèse nulle.
9. Confrontation de données empiriques et théoriques : Histogrammes et courbe de densité normale
9.1 Échantillonnage aléatoire et construction de l’histogramme normalisé
En pratique empirique, le statisticien est rarement confronté à des fonctions analytiques pures ; il manipule des collections d’échantillons bruités recueillis sur le terrain. La première étape diagnostique consiste à apprécier l’adéquation d’une distribution d’échantillonnage à la loi normale au moyen d’un histogramme de distribution de fréquences. Pour simuler une telle cohorte d’observations sous Python, on emploie le générateur pseudo-aléatoire moderne de NumPy : rng = np.random.default_rng(seed=42), suivi du tirage donnees = rng.normal(loc=100, scale=15, size=1000).
Pour autoriser la superposition géométrique ultérieure d’une courbe théorique continue sur l’histogramme de données discrètes, une condition méthodologique absolue doit être respectée : l’histogramme ne doit pas restituer les décomptes bruts de fréquences absolues par classe (le nombre d’observations N), mais doit obligatoirement être converti en une échelle d’évaluation de densité de probabilité surfacique. Cette standardisation est commandée au sein de Matplotlib par l’activation explicite de l’argument booléen density=True dans la fonction ax.hist().
Le choix de l’hyperparamètre régissant le nombre de classes — contrôlé par l’argument bins — revêt une importance capitale sur la lisibilité de la distribution empirique. Un découpage trop grossier masque les asymétries et la structure fine des données, tandis qu’un découpage trop fragmenté produit des variations stochastiques chaotiques avec de multiples colonnes vides. L’analyste averti évitera les sélections arbitraires en recourant aux règles d’optimisation statistique automatisées supportées nativement par Matplotlib, telles que la règle de Freedman-Diaconis (bins='fd'), qui optimise la largeur des classes en fonction de l’intervalle semi-interquartile et de la taille de l’échantillon, ou la règle de Sturges (bins='sturges').
9.2 Superposition rigoureuse de la densité théorique sur les données brutes
Une fois l’histogramme de densité convenablement tracé sur le canevas des axes avec des barres aux contours nets et une teinte adoucie par un canal alpha modéré (alpha=0.6, edgecolor='white'), l’étape suivante consiste à ajuster et à superposer la fonction de densité gaussienne théorique calibrée sur les paramètres de l’échantillon observé.
Cette démarche suppose l’estimation paramétrique ponctuelle sans biais des paramètres de localisation et d’échelle au départ des données recueillies. L’espérance empirique est estimée par la moyenne d’échantillon mu_emp = np.mean(donnees), tandis que l’écart-type est dérivé via sigma_emp = np.std(donnees, ddof=1) — la spécification de l’argument ddof=1 garantissant la correction de Bessel au dénominateur (division par N − 1) pour fournir un estimateur non biaisé de la variance de la population parente.
On génère subséquemment une grille d’abscisses continue s’étendant harmonieusement entre le minimum et le maximum des données observées (x_theo = np.linspace(donnees.min(), donnees.max(), 500)), sur laquelle on évalue la densité y_theo = norm.pdf(x_theo, loc=mu_emp, scale=sigma_emp). L’appel concomitant de ax.plot(x_theo, y_theo, color='crimson', linewidth=2.5) vient plaquer la courbe théorique lissée au premier plan. La confrontation visuelle immédiate des deux représentations permet d’apprécier la concordance morphologique globale ou, à l’inverse, de détecter des discordances flagrantes telles que des asymétries latérales prononcées, une bimodalité latente ou une épaisseur disproportionnée des queues empiriques.
9.3 Outils complémentaires d’évaluation de la normalité : Le diagramme Quantile-Quantile
Bien que l’histogramme enrichi d’une courbe ajustée constitue un outil d’inspection préliminaire intuitif, la perception humaine s’avère notoirement limitée pour juger de la normalité rigoureuse dans les régions périphériques d’une distribution en cloche, où les barres de fréquence deviennent infimes. Pour remédier à cette lacune heuristique, le diagramme Quantile-Quantile — universellement désigné sous le terme de diagramme Q-Q (Q-Q Plot) — s’impose comme le standard méthodologique de diagnostic fin.
Le principe du diagramme Q-Q repose sur la mise en correspondance graphique des quantiles empiriques ordonnés calculés à partir de la série de données observées contre les quantiles théoriques exacts prédits par la distribution de Gauss de référence. Sous SciPy, ce tracé diagnostique hautement spécialisé est généré de manière entièrement automatisée grâce à la fonction scipy.stats.probplot(donnees, dist="norm", plot=ax). Cette commande projette les couples de quantiles sous la forme d’un nuage de points et trace la droite d’adéquation théorique optimale par régression des moindres carrés.
L’interprétation analytique de ce diagramme obéit à une règle géométrique formelle : si l’échantillon provient fidèlement d’une population gaussienne, les points doivent s’aligner de manière quasi parfaite le long de la ligne diagonale de référence. Tout décrochage systématique au centre dénonce une anomalie de tendance centrale ou de symétrie, tandis qu’une déviation incurvée en forme de « S » au niveau des extrémités caractérise des queues de distribution trop épaisses (leptocurticité) ou anormalement tronquées (platycurticité), fournissant un diagnostic plus sensible que les seuls histogrammes ou les tests d’adéquation omnibus comme le test de Shapiro-Wilk lorsque les effectifs d’échantillonnage deviennent substantiels.
10. Approches modernes de visualisation avec Seaborn : kdeplot, histplot et displot
10.1 Avantages de la surcouche Seaborn pour l’analyse exploratoire de données
Au sein de l’écosystème Python, la bibliothèque Seaborn se positionne comme une interface d’abstraction de haut niveau construite directement au-dessus des primitives graphiques de Matplotlib, en interaction intime avec les structures de données tabulaires de la bibliothèque Pandas. Conçue spécifiquement pour fluidifier l’analyse exploratoire et statistique, Seaborn affranchit l’utilisateur du codage verbeux des boucles de discrétisation et de configuration manuelle des éléments de scène.
L’intérêt de Seaborn réside dans son élégance esthétique par défaut — proposant des thèmes typographiques épurés tels que sns.set_theme(style="whitegrid") — conjuguée à une gestion sémantique avancée des jeux de données complexes. Les fonctions statistiques de Seaborn acceptent directement des DataFrame en entrée et prennent en charge automatiquement le calcul des fréquences, l’évaluation des densités et le partitionnement des figures en sous-groupes catégoriels, réduisant substantiellement la longueur du code source requis pour obtenir un résultat de qualité éditoriale.
Un atout distinctif majeur concerne l’estimation non paramétrique de densité par noyau, formalisée sous l’acronyme KDE (pour Kernel Density Estimation). Au lieu de postuler a priori un modèle gaussien rigide défini par deux paramètres, la méthode KDE lisse les données empiriques réelles en positionnant une fonction noyau continue (généralement gaussienne) sur chaque observation individuelle, sommant l’ensemble pour révéler la morphologie sous-jacente sans hypothèse paramétrique préalable.
10.2 Tracer des distributions avec sns.histplot et l’argument kde
L’instruction moderne emblématique de Seaborn pour sonder une variable quantitative continue univariée est la fonction sns.histplot(). Cette routine unifiée dépasse les limitations de l’ancienne fonction sns.distplot() — désormais dépréciée — en offrant un contrôle complet et simultané sur la discrétisation en classes et sur l’ajustement continu non paramétrique.
En formulant simplement l’appel sns.histplot(data=df, x="score", kde=True, stat="density", ax=ax), la fonction effectue un double traitement computationnel synchronisé. D’une part, elle calcule l’histogramme des fréquences normalisé selon l’échelle de densité surfacique (stat="density"). D’autre part, par l’entremise de l’activation de l’argument kde=True, elle superpose une courbe continue résultant de l’estimation de densité par noyau gaussien ajustée par validation croisée.
L’analyste dispose en outre d’un contrôle direct sur la bande passante de lissage (bandwidth) du noyau au moyen du paramètre kde_kws={'bw_adjust': 0.8}. Une valeur inférieure à l’unité accentuera la sensibilité aux micro-variations locales pour démasquer une potentielle multimodalité, tandis qu’une valeur supérieure amplifiera le lissage global, offrant un outil visuel immédiat pour comparer la trajectoire du noyau empirique lissé avec l’arc géométrique régulier d’une loi normale théorique superposée.
10.3 Modularité avancée avec sns.displot pour distributions conditionnelles
Lorsque la question de recherche impose de comparer la distribution d’une même métrique continue conditionnellement à l’appartenance à différentes sous-populations — par exemple des groupes expérimentaux, des tranches d’âge ou des diagnostics cliniques —, la fonction de niveau figure sns.displot() déploie toute son efficacité architecturale. Fonctionnant au-dessus des classes FacetGrid, elle permet de générer des architectures multi-panneaux sophistiquées en une seule déclaration déclarative.
L’introduction du paramètre sémantique hue="groupe" instancie une séparation chromatique immédiate des courbes de distribution au sein du même axe, complétée d’une légende automatique parfaitement ordonnée. Pour éviter l’occultation visuelle générée par l’enchevêtrement des barres d’histogrammes lors de comparaisons de groupes multiples, il est possible de commuter le tracé vers un pur profil d’estimation de densité continue en fixant kind="kde", enrichi de l’option fill=True pour ajouter une trame translucide élégante sous chaque cloche spécifique.
De surcroît, la modularité dimensionnelle peut être étendue spatialement en exploitant les arguments col="modalite_A" ou row="modalite_B". Cette syntaxe segmente automatiquement le canevas en une matrice rectangulaire de sous-graphiques disjoints mais synchronisés en termes d’échelles d’abscisses et d’ordonnées, assurant une neutralité comparative absolue et éliminant tout biais d’interprétation visuelle lié à des variations d’axes clandestines.
11. Application concrète en sciences psychologiques : Normalisation et étalonnage de scores
11.1 Modélisation de la distribution des quotients intellectuels de Wechsler
Pour ancrer ces concepts algorithmiques dans la pratique des sciences psychologiques, considérons l’étalonnage clinique des scores d’efficience globale issus des échelles de l’intelligence de Wechsler. Dans la normalisation internationale contemporaine de ces instruments neuropsychologiques, le score global d’échelle totale est contraint par construction à épouser une distribution normale d’espérance fixée à 100 et d’écart-type égal à 15 (μ = 100, σ = 15).
Le traçage d’une telle distribution en Python dépasse la simple mise en forme géométrique d’une courbe en cloche : il requiert la délimitation graphique des zones diagnostiques conventionnelles de classification nosographique. En matérialisant des bandes verticales ombrées différenciées au moyen de ax.fill_between(), l’analyste colore des intervalles cliniques précis :
- La zone d’efficience moyenne standard, délimitée dans l’intervalle [85, 115] (soit [μ − 1σ, μ + 1σ]), rassemblant approximativement 68,27 % de la population générale.
- Les tranches d’efficience modérément basse [70, 85] et haute [115, 130], correspondant respectivement aux plages d’un à deux écarts-types de part et d’autre de la moyenne.
- La zone du très haut potentiel intellectuel (THPI), définie conventionnellement au-delà du seuil de 130 (μ + 2σ), regroupant une proportion théorique de 2,27 % des sujets.
- La zone de la déficience intellectuelle au sens psychométrique, calibrée en deçà du seuil critique de 70 (μ − 2σ), représentant également 2,27 % de l’effectif normatif.
L’insertion d’annotations textuelles orientées, positionnées avec précision au-dessus de chaque tranche d’étalonnage, confère à ce graphique un intérêt didactique majeur, fréquemment exploité au sein des comptes rendus d’examens neuropsychologiques et des restitutions de bilans cognitifs auprès des équipes pluridisciplinaires.
11.2 Transformation des scores bruts en notes standardisées T et Z
Dans la pratique de l’évaluation de la personnalité — à l’instar des inventaires standardisés tels que le MMPI (Minnesota Multiphasic Personality Inventory) ou le NEO-PI-R —, les praticiens sont confrontés à des distributions brutes de scores d’items dont les métriques de base s’avèrent arbitraires et incommensurables entre sous-échelles. Pour autoriser des comparaisons inter-profils rigoureuses, ces mesures doivent être soumises à une double opération de centrage et de réduction conduisant aux scores standardisés.
Le calcul du score centré réduit — ou score Z — s’effectue vectoriellement sous Python à l’aide de l’équation matricielle z_scores = (scores_bruts - np.mean(scores_bruts)) / np.std(scores_bruts, ddof=1). Ce score Z projette la mesure brute directement sur la loi normale centrée réduite théorique (μ = 0, σ = 1). Afin d’éradiquer la manipulation de valeurs négatives et de décimales — qui peuvent susciter l’incompréhension des personnes testées en pratique clinique —, les scores Z sont classiquement transposés sous forme de notes T linéaires par la transformation métrique : t_scores = (z_scores * 10) + 50, générant une distribution théorique d’espérance fixée à 50 et d’écart-type égal à 10.
La visualisation sous Matplotlib d’une figure bi-axiale juxtaposant la distribution des scores bruts asymétriques initiaux et la distribution transformée standardisée normalisée illustre avec acuité la puissance de ce redressement d’échelle. Le recours à un axe secondaire d’abscisses (ax.twiny()) permet d’afficher en vis-à-vis direct les graduations brutes originales et leurs équivalences exactes en scores Z et notes T standardisées, offrant une synthèse visuelle de la chaîne de normalisation psychométrique.
12. Dépannage, bonnes pratiques d’optimisation et automatisation des graphiques publiables
12.1 Erreurs courantes lors du tracé de distributions en Python et leurs résolutions
La conception de graphiques de distributions statistiques s’accompagne régulièrement d’erreurs d’implémentation récurrentes qui altèrent l’exactitude des représentations. La confusion conceptuelle la plus fréquente réside dans l’attribution des arguments paramétriques entre les fonctions de SciPy et les modules statistiques d’autres écosystèmes. Dans scipy.stats.norm(loc, scale), le paramètre scale attend rigoureusement l’écart-type σ, et non la variance σ². Renseigner par inadvertance la variance produit une courbe dont l’amplitude et la dispersion s’avèrent dramatiquement erronées dès lors que σ s’écarte de la valeur unitaire.
Une seconde erreur rédhibitoire concerne l’omission de l’argument de normalisation density=True lors de la superposition d’une courbe théorique continue sur un histogramme tracé avec plt.hist(). Par défaut, Matplotlib trace des fréquences de comptage brutes (exprimées en dizaines ou centaines d’individus). La tentative de plaquer sur cette échelle une fonction PDF unitaire — dont l’ordonnée culmine aux alentours de 0,4 — génère un graphique illisible où la courbe théorique apparaît sous la forme d’un trait infinitésimal écrasé sur l’axe horizontal à la base de barres d’histogramme gigantesques.
Enfin, une troisième anomalie provient d’erreurs d’interpolation causées par une définition déficiente du domaine d’échantillonnage de l’abscisse x. L’emploi inapproprié de pas de discrétisation trop larges ou l’oubli du tri croissant préalable d’un vecteur x non ordonné provoque des artéfacts graphiques sévères, matérialisés par des lignes obliques se croisant de manière anarchique à travers le canevas au lieu de dessiner un profil lissé. L’utilisation systématique de np.linspace() assortie d’un nombre élevé de nœuds réguliers immunise entièrement le code contre ce risque de distorsion.
12.2 Optimisation des performances pour les jeux de données volumineux
À l’ère des mégadonnées et des cohortes d’imagerie cérébrale ou de génomique comportementale regroupant des centaines de milliers d’individus, l’efficience algorithmique du rendu graphique devient un enjeu de productivité technique. L’impératif premier réside dans la vectorisation intégrale des calculs : tout recours à des boucles explicites Python (de type for ou while) pour évaluer la densité ou filtrer des sous-intervalles d’échantillons doit être banni au profit des masques booléens et des fonctions optimisées en C sous-jacentes de NumPy et SciPy.
Lorsqu’un histogramme ou un nuage de points issu d’un très grand échantillon est projeté au sein d’une figure, le fichier vectoriel final (tel qu’un PDF ou un SVG) peut devenir démesurément lourd en intégrant des dizaines de milliers d’objets géométriques individuels microscopiques, ralentissant considérablement le rendu lors de l’ouverture du manuscrit numérique. Une solution élégante consiste à activer la rasterisation sélective en adjoignant l’argument rasterized=True aux seules commandes de tracé de données denses (comme ax.hist() ou ax.scatter()), tout en conservant le rendu vectoriel pur pour les axes, graduations, textes et courbes théoriques lissées.
Par ailleurs, dans le cadre de serveurs de calcul distants dépourvus de gestionnaire d’affichage graphique (environnement sans tête ou headless), l’initialisation de Matplotlib avec le moteur d’arrière-plan interactif par défaut déclenche des erreurs d’environnement. Il est impératif d’intervenir en tout début d’exécution en configurant explicitement un moteur de rendu non interactif hors écran :
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
Cette directive fondamentale évite les allocations de contextes graphiques fenêtrés impossibles et assure une exécution silencieuse, rapide et sans plantage des scripts de génération automatisée.
12.3 Exportation haute définition aux formats conformes aux standards académiques
L’aboutissement de la chaîne de production graphique réside dans l’exportation physique de l’image vers un support de stockage persistant, régie par la méthode fig.savefig(nom_fichier, ...). Les politiques éditoriales des revues académiques internationales imposent des spécifications techniques exigeantes quant aux formats de fichiers et à leur résolution intrinsèque, distinguant rigoureusement les formats vectoriels échelonnables des formats matriciels en trame.
Pour les schémas théoriques, les diagrammes de flux et les tracés de distributions continues pures, les formats vectoriels PDF ou SVG constituent la référence souveraine. Ils garantissent que les segments curvilignes, les repères typographiques et les formules mathématiques intégrées conservent une netteté absolue, quel que soit le facteur d’agrandissement opéré lors de la mise en page de la revue. Pour exporter un tracé dans ce format, la commande s’articule simplement sous la forme :
fig.savefig('figure_distribution.pdf', format='pdf', bbox_inches='tight')
L’argument bbox_inches='tight' opère un rognage algorithmique intelligent de la surface cartésienne, éliminant automatiquement les marges périphériques superflues et prévenant le tronquage inopiné des libellés d’axes ou des titres longs positionnés en marge du canevas.
Lorsque les directives éditoriales imposent formellement la fourniture de fichiers d’images matricielles ou que la figure intègre des représentations empiriques très denses nécessitant une rastérisation globale, les formats TIFF ou PNG non compressés doivent être privilégiés. Dans cette situation, la désignation d’une résolution spatiale minimale de 300 à 600 points par pouce s’avère obligatoire pour satisfaire les critères de qualité d’impression typographique professionnelle :
fig.savefig('figure_distribution.tiff', format='tiff', dpi=600, bbox_inches='tight')
L’automatisation complète de cette chaîne — depuis l’acquisition des données brutes, l’application des calculs probabilistes formalisés, l’habillage graphique rigoureux jusqu’à l’exportation multiformat horodatée — assure une reproductibilité totale du protocole d’analyse visuelle, conforme aux exigences de rigueur méthodologique les plus strictes de la science ouverte contemporaine.
Références
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., Wieser, E., Taylor, J., Berg, S., Smith, N. J., Kern, R., Picus, M., Hoyer, S., van Kerkwijk, M. H., Brett, M., Haldane, A., del Río, F. A., Wiebe, M., Peterson, P., … Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2e éd.). Lawrence Erlbaum Associates.