
L’analyse statistique moderne et la modélisation probabiliste reposent fondamentalement sur la capacité des chercheurs à traduire des abstractions mathématiques complexes en représentations graphiques tangibles, rigoureuses et interprétables. Au cœur de l’inférence paramétrique et non paramétrique, la distribution du khi-deux (notée couramment avec la lettre grecque χ²) occupe une place prépondérante, servant de pivot théorique tant pour les tests d’indépendance catégorielle que pour l’évaluation de la conformité des variances et l’ajustement global de modèles factoriels ou structurels. La maîtrise de sa représentation visuelle ne relève pas d’une simple considération esthétique : elle constitue un impératif épistémologique permettant d’appréhender intuitivement le comportement asymptotique des statistiques de test, l’influence déterminante des degrés de liberté et la topologie des zones critiques associées au rejet de l’hypothèse nulle.
L’écosystème open source de Python s’est imposé au fil des deux dernières décennies comme la référence contemporaine pour le calcul scientifique et la science des données. Grâce à la symbiose algorithmique établie entre NumPy pour l’algèbre matricielle et le traitement vectoriel, SciPy pour l’évaluation des densités analytiques continues, et Matplotlib pour la restitution cartésienne de haute précision, les analystes disposent d’un environnement programmable d’une flexibilité sans égale. Cet outillage technique permet de dépasser les représentations statiques et sommaires fournies par les logiciels statistiques propriétaires standardisés pour concevoir des visualisations personnalisées, reproductibles et conformes aux exigences éditoriales académiques les plus strictes.
Le présent traité méthodologique a pour vocation de guider le chercheur, l’ingénieur et l’étudiant avancé à travers l’ensemble des étapes conceptuelles, analytiques et algorithmiques requises pour modéliser et tracer la loi du khi-deux sous Python. En abordant les fondements mathématiques stochastiques sous-jacents, l’architecture du calcul numérique vectorisé, la sémiotique visuelle avancée, l’exploration interactive et les applications psychométriques concrètes, ce document propose un protocole complet destiné à convertir des concepts distributionnels abstraits en représentations graphiques publiables d’une rigueur absolue.
1. Fondements théoriques de la distribution du khi-deux dans l’analyse quantitative
1.1 Définition mathématique et propriétés fondamentales
D’un point de vue stochastique formel, la distribution du khi-deux à k degrés de liberté est définie comme la distribution de la somme des carrés de k variables aléatoires indépendantes et identiquement distribuées selon une loi normale standard, c’est-à-dire centrée et réduite, de moyenne nulle et de variance unitaire. Si l’on pose Z1, Z2, …, Zk comme des variables aléatoires indépendantes suivant la loi N(0, 1), alors la variable aléatoire X définie par la sommation de leurs carrés respectifs suit de manière exacte une loi du khi-deux à k degrés de liberté. Cette genèse quadratique explique immédiatement pourquoi le domaine de définition de la variable est strictement restreint à l’ensemble des réels positifs ou nuls. Toute réalisation numérique d’une telle variable ne saurait en aucun cas adopter une valeur négative, conférant à son support spatial une asymétrie intrinsèque orientée vers la droite de l’axe réel.
Sur le plan analytique, la fonction de densité de probabilité (PDF, pour Probability Density Function) associée à une variable aléatoire continue x suivant une loi du khi-deux à k degrés de liberté est formulée au moyen de la célèbre fonction gamma d’Euler. L’expression générale de cette densité s’énonce comme le rapport entre x élevé à la puissance ((k/2) – 1) multiplié par l’exponentielle décroissante de (-x/2), et le produit du scalaire 2 élevé à la puissance (k/2) par la valeur de la fonction gamma évaluée en k/2, pour tout x strictement supérieur à zéro. La fonction gamma agit ici comme une constante de normalisation indispensable, assurant que l’intégrale impropre de la densité sur l’intervalle ouvert allant de zéro à l’infini positif soit rigoureusement égale à l’unité, condition sine qua non de toute distribution de probabilités continue.
Les propriétés structurelles de cette loi découlent directement de cette formulation. Pour les valeurs modérées de k, la distribution présente une asymétrie positive marquée, caractérisée par une longue traîne s’étendant indéfiniment vers les valeurs élevées de l’abscisse. Cependant, en vertu du théorème central limite appliqué à une somme de variables aléatoires indépendantes de carré intégrable, la distribution du khi-deux converge asymptotiquement vers une loi normale lorsque le nombre de degrés de liberté tend vers l’infini. Cette propriété remarquable de régularisation gaussienne constitue l’un des piliers de l’inférence asymptotique en statistique mathématique, reliant intimement les statistiques quadratiques aux théorèmes limites classiques.
1.2 Rôle central des degrés de liberté
Le paramètre unique gouvernant l’intégralité de la distribution du khi-deux est le nombre de degrés de liberté, communément désigné par le symbole k ou l’abréviation df (pour degrees of freedom). Ce paramètre dimensionnel exerce un contrôle déterministe immédiat sur les moments d’ordre un et deux de la variable aléatoire. De manière remarquable par son élégance analytique, l’espérance mathématique d’une loi du khi-deux est exactement égale à son nombre de degrés de liberté, signifiant que le centre de gravité probabiliste de la distribution se translate de manière linéaire et unitaire à mesure que k croît. Parallèlement, la variance théorique équivaut strictement au double des degrés de liberté, impliquant une dispersion d’autant plus importante que la dimensionnalité du modèle sous-jacent s’accroît.
L’évolution morphologique de la courbe de densité en fonction de k constitue un phénomène visuel et mathématique saisissant. Lorsque k est égal à 1, la fonction de densité présente une singularité asymptotique à l’origine : la courbe tend vers l’infini positif lorsque x approche zéro par valeurs positives, décroissant ensuite de façon strictement monotone. Pour k égal à 2, la densité coïncide exactement avec une loi exponentielle de paramètre λ = 0.5, débutant sur l’axe des ordonnées à la valeur 0.5 pour amorcer une décroissance exponentielle continue. Ce n’est qu’à partir de k strictement supérieur à 2 qu’un mode unique et distinct émerge à l’intérieur du domaine positif, situé précisément en x = k – 2. À mesure que k augmente, ce sommet s’aplatit progressivement tout en dérivant vers la droite, illustrant graphiquement l’étalement de la variance conjointe à l’augmentation de l’espérance.
Dans le domaine des sciences humaines et sociales, et plus particulièrement en psychométrie, l’interprétation des degrés de liberté revêt une signification méthodologique fondamentale. Dans un tableau de contingence croisant des variables de comportement ou d’évaluation clinique, les degrés de liberté quantifient le nombre d’éléments d’information indépendants qui demeurent libres de varier après que les contraintes marginales (les totaux des lignes et des colonnes) ont été fixées. De même, au sein des analyses d’adéquation factorielle confirmatoire, les degrés de liberté reflètent le degré de sur-identification du modèle statistique théorique face à la matrice de covariance empirique, conditionnant directement la puissance statistique des tests de rejet des modèles inadéquats.
1.3 Applications méthodologiques en sciences du comportement
L’utilisation de la distribution du khi-deux dans les protocoles quantitatifs des sciences du comportement s’articule prioritairement autour des tests d’indépendance de Pearson. Lorsqu’un psychologue ou un sociologue cherche à déterminer si l’appartenance à un sous-groupe diagnostic est statistiquement indépendante d’une modalité comportementale ou d’une réponse à une échelle d’évaluation ordinale, la statistique calculée mesure l’écart quadratique normalisé entre les fréquences observées sur le terrain et les fréquences théoriquement attendues sous l’hypothèse nulle d’indépendance stochastique. La distribution du khi-deux sert alors de loi de référence sous l’hypothèse nulle, permettant de délimiter avec une précision mathématique la probabilité d’observer un tel écart par simple fluctuation d’échantillonnage.
Au-delà des simples tableaux croisés, la distribution intervient de façon cruciale dans la modélisation par équations structurelles (connu sous l’acronyme SEM, pour Structural Equation Modeling). Dans ce cadre analytique avancé, l’adéquation d’un modèle théorique reliant des variables latentes (telles que l’anxiété, la résilience ou l’intelligence émotionnelle) aux indicateurs psychométriques observés est évaluée par une statistique du khi-deux minimisant une fonction de divergence matricielle. Bien que cette statistique soit particulièrement sensible à la taille des cohortes expérimentales, elle demeure le point d’ancrage fondamental à partir duquel sont dérivés les principaux indices d’adéquation globale, tels que le CFI (Comparative Fit Index) ou le RMSEA (Root Mean Square Error of Approximation).
Enfin, les plans expérimentaux randomisés et les analyses de régression multiple exploitent également cette loi pour la modélisation de l’erreur résiduelle et le contrôle rigoureux des hypothèses d’homoscédasticité. Les tests de rapport de vraisemblance (Likelihood Ratio Tests), couramment mis en œuvre lors de la comparaison de modèles imbriqués dans l’analyse de réponses multiniveaux ou longitudinales, reposent sur le théorème de Wilks : la différence de log-vraisemblance multipliée par deux suit asymptotiquement une distribution du khi-deux dont les degrés de liberté correspondent exactement au différentiel de paramètres libres entre les deux architectures théoriques confrontées.
2. Configuration de l’environnement informatique scientifique sous Python
2.1 Sélection et rôle des bibliothèques fondamentales
L’édification d’un pipeline d’analyse et de visualisation statistique performant requiert la coordination ordonnée de trois bibliothèques logicielles centrales de l’écosystème Python. En premier lieu, la bibliothèque NumPy constitue le socle calculatoire sur lequel reposent la discrétisation spatiale continue des axes cartésiens et les opérations vectorisées. En substituant aux listes hétérogènes de Python des tableaux multidimensionnels contigus en mémoire (les objets ndarray), NumPy permet d’exécuter des transformations arithmétiques complexes à une vitesse proche de celle du langage C compilé, éliminant tout goulet d’étranglement informatique lors de l’échantillonnage de plusieurs milliers de coordonnées.
En second lieu, la bibliothèque SciPy, et tout particulièrement son sous-module spécialisé scipy.stats, fournit les abstractions probabilistes indispensables. L’objet scipy.stats.chi2 encapsule l’ensemble des formulations fonctionnelles de la loi du khi-deux, de sa densité à sa fonction cumulative, en passant par ses fonctions quantiles et ses générateurs de nombres pseudo-aléatoires. L’intérêt majeur de recourir à SciPy réside dans son implémentation algorithmique de haute précision, optimisée pour éviter les instabilités numériques, les phénomènes de sous-dépassement (underflow) ou de dépassement de capacité (overflow) lors du calcul des valeurs de la fonction gamma pour des degrés de liberté particulièrement élevés ou des valeurs extrêmes d’abscisse.
Enfin, la bibliothèque Matplotlib, via son interface procédurale matplotlib.pyplot et son interface orientée objet, matérialise l’architecture de rendu graphique vectoriel. Conçue initialement pour émuler la syntaxe graphique de MATLAB, Matplotlib a évolué pour devenir un moteur graphique polyvalent, capable de générer des sorties vectorielles en formats PDF, SVG ou EPS destinées aux publications scientifiques internationales. Sa structure modulaire permet un contrôle total sur l’intégralité des éléments constitutifs d’une figure : gestion des axes, typographie, courbes de Bézier, hachures et compositions mathématiques complexes.
2.2 Mise en place d’un environnement virtuel reproductible
La reproductibilité computationnelle constitue l’un des critères les plus exigeants de la démarche scientifique moderne. Pour garantir qu’un script de tracé distributionnel génère des résultats rigoureusement identiques à travers différents systèmes d’exploitation et au fil des mises à jour logicielles, l’isolation des dépendances au sein d’un environnement virtuel dédié est impérative. L’utilisation d’outils tels que venv ou le gestionnaire de paquets Conda permet de figer les versions exactes de l’interpréteur Python, de NumPy, de SciPy et de Matplotlib, empêchant les ruptures de compatibilité ascendante qui altèrent fréquemment les paramètres de rendu graphique ou le comportement des fonctions statistiques.
La gestion des moteurs de rendu graphique (backends) requiert une attention méthodologique spécifique. Selon le contexte d’exécution, l’utilisateur peut opter pour un affichage interactif au sein d’un carnet de recherche (utilisant par exemple le backend interactif d’un environnement Jupyter) ou pour un mode d’exécution purement non interactif (headless), typique des serveurs de calcul distants ou des chaînes d’intégration continue. Dans ce dernier cas, l’assignation explicite du backend Agg (Anti-Grain Geometry) garantit la génération sans plantage de fichiers d’images matricielles ou vectorielles sans nécessiter la présence d’un serveur d’affichage X11 sous Linux.
De surcroît, la standardisation esthétique des figures académiques est grandement facilitée par la configuration globale des paramètres de style au moyen du dictionnaire matplotlib.rcParams. Cette interface permet d’instaurer, dès l’initialisation du script, des conventions typographiques immuables : choix de polices avec ou sans empattement conformes aux recommandations des revues internationales (telles que Times New Roman ou Helvetica), définition d’épaisseurs de ligne cohérentes, dimensions fixes des figures en pouces ou centimètres, et résolution matricielle minimale de 300 à 600 points par pouce (DPI) pour l’exportation finale.
2.3 Gestion des versions et stabilité numérique
L’évaluation des fonctions statistiques continues sur un ordinateur repose inéluctablement sur la norme IEEE 754 régissant l’arithmétique en virgule flottante à double précision (64 bits). Cette contrainte matérielle implique une vigilance continue lors de l’intégration numérique ou de l’évaluation de densités aux frontières du domaine analytique. Dans le cas spécifique de la distribution du khi-deux, le calcul de la densité au voisinage immédiat de zéro pour des degrés de liberté inférieurs à 2 engendre des valeurs théoriques qui tendent vers l’infini, exposant les calculs à des erreurs d’arrondi ou à la génération indésirable de valeurs non définies (NaN ou Inf).
Lorsqu’un protocole expérimental requiert la génération en série de centaines de figures pour cartographier les distributions d’une vaste cohorte de participants ou d’itérations de Monte-Carlo, la gestion de la mémoire vive devient un facteur critique. Matplotlib conserve par défaut en mémoire chaque figure instanciée jusqu’à sa fermeture explicite, ce qui peut saturer rapidement les ressources système. Il convient par conséquent de structurer le flux d’exécution autour d’une invocation systématique des méthodes de libération de mémoire (comme plt.close(fig)) ou de contextes de gestion automatisée, permettant au ramasse-miettes (garbage collector) de Python de recycler immédiatement les structures de données graphiques allouées.
Enfin, tout protocole scientifique sérieux doit s’accompagner d’une procédure formelle de validation de l’environnement d’exécution. L’enregistrement systématique dans les métadonnées de l’analyse des versions exactes de Python et des bibliothèques mobilisées garantit que de futures réplications pourront identifier immédiatement d’éventuelles discordances graphiques ou analytiques, pérennisant ainsi les découvertes et les supports visuels qui les accompagnent dans les archives scientifiques ouvertes.
3. Génération de l’espace vectoriel d’échantillonnage avec NumPy
3.1 Discrétisation de l’axe des abscisses
Pour matérialiser graphiquement une fonction mathématique continue sous un environnement numérique discret, il est impératif de construire un échantillonnage régulier de points le long de l’axe des abscisses. Deux approches fondamentales coexistent au sein de la bibliothèque NumPy pour accomplir cette tâche : l’emploi de la fonction np.arange et celui de la fonction np.linspace. La première méthode repose sur la définition d’un intervalle semi-ouvert spécifié par sa borne inférieure, sa borne supérieure et un pas d’incrémentation constant. Bien qu’elle offre un contrôle absolu sur la distance exacte séparant deux évaluations consécutives, elle souffre parfois d’imprécisions cumulatives dues aux arrondis en virgule flottante, rendant incertaine l’inclusion exacte de la borne supérieure.
À l’inverse, la fonction np.linspace est généralement privilégiée pour la cartographie des densités théoriques, car elle garantit l’inclusion stricte des bornes d’intervalle tout en recevant comme paramètre explicite le nombre total de points d’échantillonnage souhaité. La définition de l’intervalle spatial d’évaluation ne peut être arbitraire : elle doit s’adapter dynamiquement au profil morphologique de la distribution gouverné par le paramètre df. Pour une loi du khi-deux, la borne inférieure doit être positionnée soit à zéro, soit à un infiniment petit positif (ε > 0) pour pallier les singularités analytiques, tandis que la borne supérieure doit être sélectionnée de manière à englober la quasi-totalité de la masse probabiliste.
Une heuristique rigoureuse pour fixer cette borne supérieure consiste à exploiter les fonctions de quantiles théoriques. Plutôt que de choisir empiriquement une valeur fixe comme 20 ou 50, il est méthodologiquement supérieur de définir la limite d’affichage comme le quantile correspondant à une probabilité cumulée de 0.999 ou 0.9999. Cette approche adaptative assure que la courbe s’étendra toujours suffisamment loin pour illustrer l’amincissement de la queue de distribution, quelle que soit la valeur attribuée aux degrés de liberté, évitant ainsi les troncatures disgracieuses ou, inversement, un tassement illisible de la zone de densité utile à l’extrême gauche de la figure.
3.2 Résolution numérique et préservation de la courbure
L’arbitrage entre la densité de points d’échantillonnage et l’efficacité computationnelle constitue une décision de modélisation essentielle. Si un maillage spatial comprenant une centaine de coordonnées s’avère souvent suffisant pour des fonctions présentant une courbure modérée et régulière, il devient manifestement déficient pour capturer les forts gradients de la loi du khi-deux au voisinage de l’origine lorsque les degrés de liberté sont faibles. Un échantillonnage trop lâche conduit inévitablement à des artefacts d’interpolation linéaire, où des segments de droite visibles se substituent à la courbure continue théorique, dégradant la fidélité géométrique de la représentation.
Pour atténuer ces artefacts visuels près de l’origine sans surcharger inutilement la mémoire par une débauche uniforme de millions de points, des stratégies d’échantillonnage non linéaire peuvent être mobilisées. Le recours à un espacement logarithmique au moyen de np.geomspace ou la combinaison de grilles d’échantillonnage multi-résolutions permet d’accroître considérablement la densité des nœuds de calcul là où la dérivée seconde de la fonction de densité atteint des sommets vertigineux, tout en espaçant les points dans la queue de distribution où l’évolution de la fonction devient quasi linéaire et asymptotique.
Néanmoins, dans la majorité des configurations standards de publication, un vecteur linéaire homogène constitué de 1 000 à 2 000 éléments généré par np.linspace représente un compromis idéal. Cette résolution permet d’éliminer toute sensation de discrétisation à l’œil nu, y compris lors de zooms vectoriels importants sur les sorties graphiques au format PDF, tout en limitant le temps de calcul analytique à quelques fractions de milliseconde sur n’importe quel processeur contemporain.
3.3 Structuration modulaire des structures de données
L’intégrité du pipeline de visualisation dépend d’une synchronisation dimensionnelle parfaite entre le vecteur des abscisses et le vecteur résultant des ordonnées. Toute divergence de forme (shape) entre ces deux structures de données entraîne immédiatement des exceptions lors du passage des paramètres aux fonctions de traçage de Matplotlib. En encapsulant les données au sein de tableaux typés ndarray de type float64, le chercheur s’assure d’une cohérence absolue de l’espace vectoriel d’entrée et de sortie, tout en bénéficiant des optimisations vectorielles SIMD (Single Instruction, Multiple Data) prises en charge par les architectures matérielles récentes.
Dans le cas d’applications analytiques intensives, telles que la génération répétée de tracés au sein d’interfaces graphiques interactives ou de simulations de rééchantillonnage bootstrap, il devient judicieux de mettre en cache les vecteurs de coordonnées récurrents. La réallocation perpétuelle de tableaux NumPy au sein de boucles itératives engendre une charge inutile pour le gestionnaire de mémoire. L’instanciation préalable de matrices d’abscisses préallouées permet d’accélérer significativement la fréquence de rafraîchissement graphique, assurant une fluidité exemplaire lors de l’exploration visuelle de vastes espaces de paramètres.
De plus, cette modularité structurelle facilite grandement l’application d’opérations de masquage booléen. En Python, les tableaux NumPy permettent d’extraire instantanément des sous-ensembles géométriques au moyen de conditions logiques appliquées directement aux vecteurs d’abscisses. Cette fonctionnalité se révélera particulièrement déterminante lorsqu’il s’agira d’isoler des intervalles d’intégration spécifiques ou d’appliquer des colorations différentielles sous la courbe pour matérialiser les régions critiques d’un test d’hypothèse.
4. Implémentation du tracé d’une courbe de densité unique
4.1 Évaluation de la densité théorique avec scipy.stats.chi2.pdf
La transcription opérationnelle de la densité analytique du khi-deux sous Python s’effectue avec une remarquable concision grâce à la méthode pdf de l’objet scipy.stats.chi2. Cette méthode prend comme premier argument obligatoire le tableau vectoriel des points d’abscisse où la densité doit être quantifiée, et comme second paramètre scalaire le nombre de degrés de liberté df. L’évaluation s’exécute de façon entièrement vectorisée : la bibliothèque SciPy délègue les calculs à des routines compilées de bas niveau qui parcourent l’ensemble du tableau sans qu’aucune boucle itérative explicite en langage Python ne soit nécessaire, conférant une rapidité d’exécution optimale.
Une vigilance particulière doit être observée quant au comportement asymptotique de la fonction lorsque la valeur x = 0 est incluse dans le domaine d’évaluation. Pour df = 1, la densité théorique tend vers l’infini positif lorsque x s’annule, ce qui conduit SciPy à renvoyer la constante inf ou une valeur anormalement élevée susceptible de perturber le calcul d’échelle automatique de l’axe vertical lors du rendu graphique. Pour df = 2, la valeur exacte en zéro est 0.5. Pour contourner les artefacts d’affichage liés à l’infiniment grand sans biaiser l’analyse, il est recommandé de démarrer le vecteur spatial à un seuil infinitésimal, par exemple 1e-4, ou de tronquer manuellement les valeurs d’ordonnées excessives au moyen de la fonction np.clip.
Le sous-module scipy.stats offre également la possibilité d’ajuster des paramètres optionnels d’échelle (scale) et de position (loc). Cependant, dans le cadre de la définition formelle de la distribution standard du khi-deux issue de la sommation de normales réduites, ces paramètres doivent impérativement être maintenus à leurs valeurs par défaut, à savoir loc=0 et scale=1. L’introduction de paramètres non nuls transformerait en effet la variable en une forme mise à l’échelle ou translatée, perdant son adéquation directe avec les distributions d’échantillonnage théoriques des statistiques de Pearson.
4.2 Syntaxe minimale de rendu avec pyplot.plot
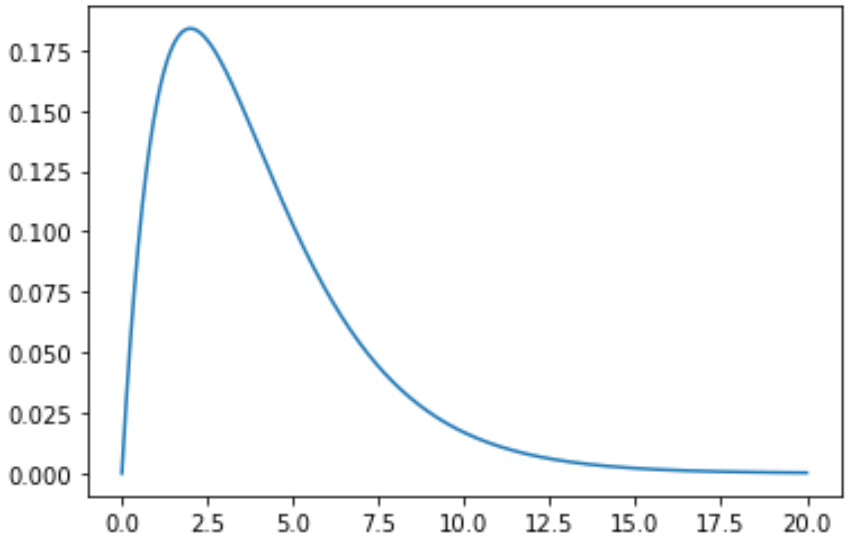
L’initialisation et la génération du rendu graphique linéaire minimaliste s’orchestrent au moyen de l’interface procédurale de matplotlib.pyplot. En transmettant conjointement le vecteur des abscisses généré par NumPy et le vecteur des ordonnées calculé par SciPy à la fonction plt.plot(), Matplotlib procède à la création des primitives géométriques constitutives du tracé. La fonction relie séquentiellement chaque coordonnée cartésienne (x, y) par un segment infinitésimal, générant une illusion parfaite de courbure continue lorsque la résolution spatiale a été adéquatement paramétrée lors des étapes précédentes.
L’architecture de Matplotlib repose sur une hiérarchie d’objets clairement définie : l’objet Figure incarne la fenêtre ou la surface totale du document graphique, tandis que l’objet Axes matérialise l’espace cartésien proprement dit, délimité par les échelles, les graduations et les bordures. Dans une approche orientée objet, hautement recommandée pour les publications académiques, on instancie formellement ces entités via l’instruction fig, ax = plt.subplots(), permettant d’interagir directement avec les méthodes de l’objet ax plutôt que de s’en remettre aveuglément à l’état global et implicite géré par l’interface pyplot.
Une fois les coordonnées tracées sur l’espace cartésien, l’instruction plt.show() déclenche l’affichage interactif à l’écran, bloquant l’exécution du script jusqu’à ce que la fenêtre graphique soit manuellement refermée par l’opérateur. Dans un contexte de production de documents éditoriaux ou d’automatisation scientifique, cette instruction finale est avantageusement remplacée par plt.savefig(), qui écrit directement le flux d’instructions graphiques dans un fichier vectoriel ou matriciel pérenne, assurant la conservation des figures produites sans intervention humaine directe.
4.3 Vérification formelle de la cohérence de l’aire sous la courbe
Un principe fondamental de l’analyse distributionnelle stipule que la surface totale délimitée par la courbe d’une fonction de densité de probabilité et l’axe des abscisses, sur l’intégralité de son support spatial, doit être rigoureusement égale à l’unité. Avant de valider définitivement une configuration de tracé ou de s’en servir dans une démonstration pédagogique, il est scientifiquement sain de procéder à une vérification formelle de cette propriété par le biais d’une intégration numérique discrète.
La bibliothèque NumPy intègre des outils d’approximation géométrique d’une grande efficacité, au premier rang desquels figure la fonction np.trapz (ou scipy.integrate.trapezoid dans les versions les plus récentes de l’écosystème). En appliquant la règle d’intégration trapézoïdale composite sur le couple vectoriel des abscisses et des ordonnées, le chercheur calcule l’approximation de l’intégrale de Riemann sous-jacente. Si le domaine spatial d’échantillonnage s’est étendu sur une plage d’abscisses suffisamment vaste pour englober la queue de distribution, la valeur numérique obtenue doit converger de manière extrêmement étroite vers 1.0, avec une marge d’erreur typiquement inférieure à 1e-3 ou 1e-4.
L’observation d’une intégrale numérique significativement inférieure à l’unité (par exemple 0.95 ou 0.90) constitue un diagnostic visuel et computationnel infaillible révélant une troncature prématurée de la borne supérieure d’évaluation. Ce phénomène d’écrêtage altère la véracité géométrique du graphique en suggérant à tort que les probabilités d’événements extrêmes sont nulles. La vérification de l’aire totale sert ainsi de garde-fou quantitatif, garantissant que la courbe dessinée illustre fidèlement l’intégralité du phénomène probabiliste théorique.
5. Paramétrisation visuelle avancée et sémiotique graphique
5.1 Contrôle chromatique et dimensionnel de la ligne
La sémiotique graphique d’une figure scientifique transcende la simple élégance visuelle : elle conditionne la vitesse et la précision avec lesquelles les lecteurs décodent les informations quantitatives présentées. Dans cette perspective, la personnalisation chromatique de la courbe de densité doit obéir à des impératifs d’accessibilité visuelle universelle. Le choix de teintes contrastées et perceptuellement uniformes évite les écueils des palettes par défaut qui peuvent s’avérer indiscernables pour les individus atteints de déficits de la vision des couleurs (tels que la deutéranopie ou la protanopie). L’usage de codes hexadécimaux stricts ou de palettes issues de directives reconnues, telles que les nuanciers de Paul Tol ou de ColorBrewer, garantit une discrimination optimale des signaux graphiques.
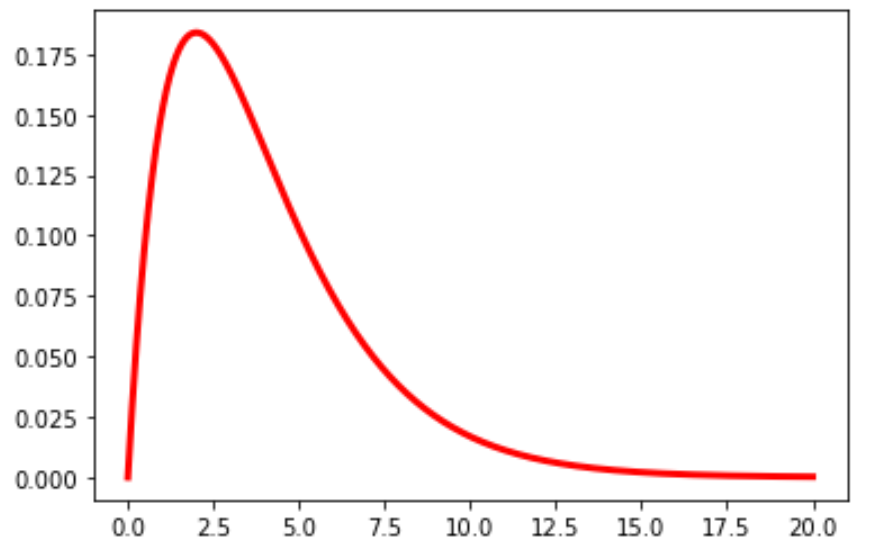
La modulation de l’épaisseur du trait, contrôlée via le paramètre linewidth au sein de la fonction de tracé, participe directement à la hiérarchisation visuelle de l’information. Un trait trop fin (inférieur à 1 point typographique) a tendance à s’estomper lors de la réduction d’échelle imposée par les mises en page sur deux colonnes des revues scientifiques, tandis qu’un trait excessivement gras (supérieur à 3 points) masque la courbure précise et donne une impression d’imprécision géométrique. Une épaisseur calibrée entre 1.5 et 2.2 points représente le standard typographique optimal pour une transmission claire de la trajectoire de densité.
L’application judicieuse de motifs de traits (paramètre linestyle) apporte une dimension sémantique complémentaire, particulièrement lorsque plusieurs modèles analytiques sont mis en concurrence. L’alternance entre des lignes continues (solid), tiretées (dashed), pointillées (dotted) ou mixtes (dashdot) permet de différencier formellement des conditions expérimentales ou des variantes paramétriques sans dépendre exclusivement du canal chromatique, assurant ainsi une lisibilité intégrale lors d’impressions documentaires monochromes en niveaux de gris.
5.2 Typographie et contextualisation textuelle des axes
L’ambiguïté sémantique est l’ennemie de la rigueur scientifique. L’attribution d’étiquettes textuelles précises, exhaustives et mathématiquement rigoureuses sur chacun des axes cartésiens constitue une obligation déontologique dans l’élaboration de figures statistiques. Matplotlib intègre un puissant moteur de rendu mathématique dérivé de la typographie LaTeX, activable en entourant les expressions symboliques de balises dollar. Cette fonctionnalité permet d’inscrire directement sur l’axe des abscisses des notations académiques impeccables telles que l’expression de la variable x ou de la statistique calculée χ², accompagnées de la précision d’éventuelles unités de mesure ou de normalisation.
L’axe vertical requiert une contextualisation tout aussi rigoureuse : il ne mesure pas une probabilité discrète brute, mais bien une densité de probabilité, ce qui implique que l’étiquette correspondante doit afficher explicitement la fonction f(x; df) ou le terme francisé « Densité de probabilité ». La configuration des échelles typographiques impose une harmonisation d’échelle entre la taille de police des graduations numériques (tick_params) et celle des titres d’axes principaux. Un ratio d’environ 0.8 entre la dimension des graduations et celle des étiquettes d’axes garantit un équilibre esthétique éprouvé.
Le titre principal de la figure, lorsqu’il est requis dans un contexte pédagogique ou lors d’une présentation orale, doit expliciter sans équivoque le modèle théorique illustré. L’intégration dynamique de la valeur paramétrique des degrés de liberté au sein du titre, par le biais des chaînes de caractères formatées de Python (f-strings), garantit que toute modification ultérieure du paramètre algorithmique se reflétera instantanément dans le cartouche textuel supérieur, éliminant tout risque de discordance entre le code source et la légende affichée.
5.3 Structuration cartésienne et grille de lecture
L’environnement cartésien dans lequel s’inscrit la courbe de distribution doit structurer le regard du lecteur sans entrer en concurrence visuelle avec la trajectoire analytique principale. L’activation d’un quadrillage discret au moyen de la méthode grid() facilite l’interpolation visuelle et permet à l’analyste d’estimer rapidement les coordonnées des maxima locaux ou des quantiles clés. Pour éviter que cette trame de fond ne sature le dessin, il est recommandé de paramétrer une faible opacité relative (paramètre alpha fixé entre 0.2 et 0.4), une épaisseur de ligne réduite et un motif discontinu tel que des tirets courts.
Le calibrage des bornes visibles d’affichage au moyen des méthodes set_xlim() et set_ylim() permet de juguler les espaces vides superflus et d’ancrer fermement la distribution sur son origine naturelle. L’abscisse minimale gagne à être verrouillée rigoureusement à zéro, rappelant au lecteur la stricte positivité du support stochastique, tandis que la limite d’ordonnée minimale doit épouser la ligne zéro pour que la base de la distribution s’aligne harmonieusement avec l’axe horizontal, interdisant tout flottement visuel de la courbe.
Enfin, la personnalisation des bordures du cadre graphique, désignées sous le terme technique de spines dans l’architecture logicielle de Matplotlib, offre l’opportunité d’épurer le rendu final selon les canons esthétiques les plus contemporains. L’inactivation pure et simple des bordures supérieure et droite (spines ‘top’ et ‘right’) réduit substantiellement le ratio d’encre superflue selon les principes fondateurs théorisés par Edward Tufte, ne laissant subsister que les axes directeurs gauche et inférieur nécessaires et suffisants au décodage géométrique des données quantitatives.
6. Superposition comparative de distributions à degrés de liberté multiples
6.1 Stratégie itérative pour le tracé simultané
La compréhension intuitive de l’impact des degrés de liberté sur la morphologie de la distribution du khi-deux s’enrichit considérablement lorsque plusieurs courbes théoriques sont visualisées conjointement sur un canevas géométrique unique. Cette démarche comparative permet d’observer en un coup d’œil la transition spectaculaire opérée entre la décroissance monotone des lois à faibles degrés de liberté et la symétrisation progressive caractéristique des grands échantillons. Sur le plan algorithmique, une telle restitution s’opère par l’implémentation d’une boucle automatisée parcourant une liste ou un tableau ordonné de paramètres k sélectionnés stratégiquement, tels que les valeurs 1, 2, 3, 5, 10 et 15.
Au cours de chaque itération de la boucle séquentielle, l’algorithme calcule le vecteur de densité correspondant au degré de liberté courant et envoie l’instruction de tracé linéaire à l’objet Axes partagé. Ce mode opératoire garantit que toutes les fonctions sont projetées sur le même système de coordonnées spatiales, partageant une mise à l’échelle rigoureusement identique des abscisses et des ordonnées. Cette constance d’échelle est indispensable pour que le regard puisse apprécier le nivellement corrélatif des pics de densité à mesure que l’espérance mathématique se déplace vers la droite de l’espace cartésien.
La génération programmatique des étiquettes textuelles au sein de la boucle assure l’automatisation complète de la nomenclature. À l’aide de gabarits de chaînes intégrant la syntaxe mathématique LaTeX, chaque itération assigne dynamiquement à la courbe tracée une légende descriptive codifiée, par exemple « $k = 1$ », « $k = 2$ » ou « $\nu = 5$ », préparant ainsi le terrain pour la compilation ultérieure d’un module de légende globale sans intervention manuelle répétitive.
6.2 Gestion des contrastes et hiérarchie visuelle
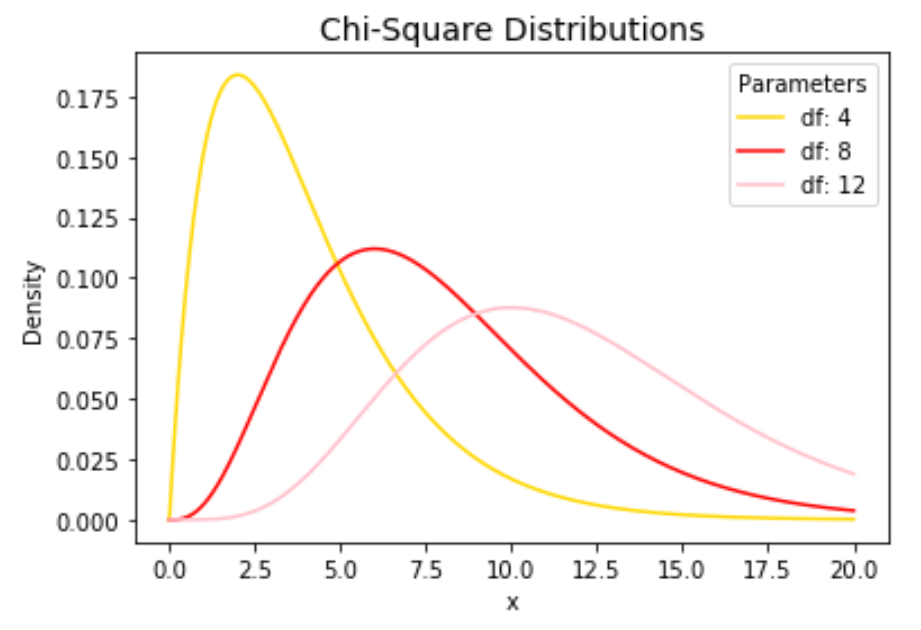
La superposition d’une pluralité de profils de densité sur une figure unique introduit un risque substantiel de confusion visuelle et de chevauchement illisible, particulièrement au voisinage immédiat de l’origine où les trajectoires se croisent de manière dense. Pour maîtriser cette complexité graphique, l’analyste doit instaurer une hiérarchie visuelle irréprochable fondée sur l’utilisation raisonnée de nuanciers séquentiels ou divergents fournis par les modules de colormaps de Matplotlib, tels que viridis, plasma ou cividis.
L’affectation des gradients de couleur doit refléter la gradation numérique des degrés de liberté : attribuer des teintes sombres et saturées aux faibles valeurs de k et faire évoluer progressivement la palette vers des tonalités plus lumineuses ou plus vives pour les valeurs élevées de k permet au cerveau d’établir une association cognitive spontanée entre l’ordre spectral et l’amplitude de la dimensionnalité statistique sous-jacente. Cette progressivité chromatique remplace avec avantage l’attribution aléatoire de couleurs disparates qui entrave l’assimilation globale de la tendance évolutive.
Le contrôle de la transparence relative (paramètre alpha) s’avère tout aussi déterminant pour résoudre les ambiguïtés spatiales aux points d’intersection. En assignant un coefficient d’opacité compris entre 0.75 et 0.90 à chaque courbe, le tracé permet aux trajectoires sous-jacentes de demeurer parfaitement discernables lors des croisements de lignes. Si une condition expérimentale particulière doit être mise en exergue parmi l’ensemble comparatif, il devient opportun d’accroître sélectivement son épaisseur de trait tout en maintenant les autres distributions dans un rôle secondaire d’arrière-plan contextuel plus estompé.
6.3 Conception d’une légende scientifique rigoureuse
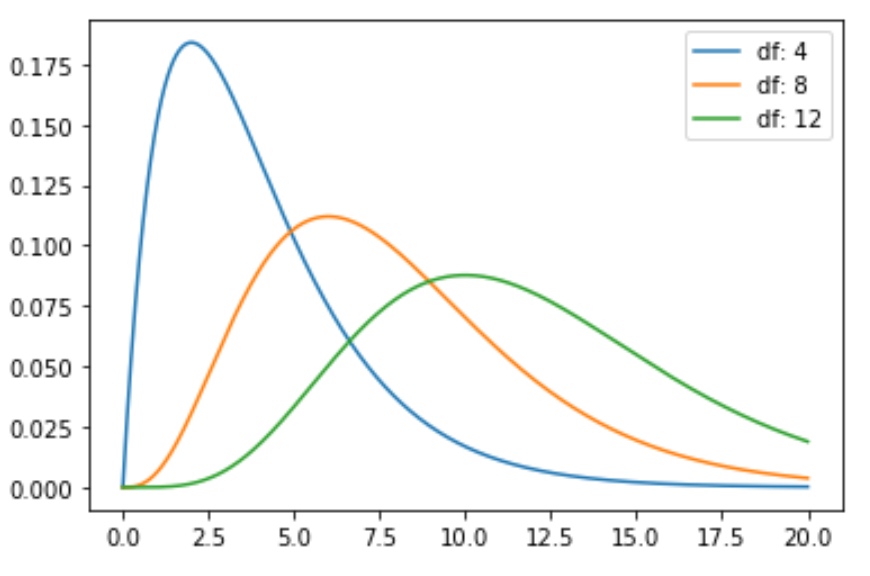
L’insertion d’une légende explicative au sein d’un graphique multi-courbes obéit à des contraintes spatiales exigeantes. L’écueil le plus fréquent réside dans l’obstruction par le cartouche de légende des sommets de densité ou des portions de queue critiques. Le positionnement de la légende doit donc être géré de manière méthodique, soit en spécifiant des localisations cardinales stratégiques (telles que loc='upper right' pour les distributions fortement asymétriques dont la masse principale réside à gauche), soit en contraignant la boîte englobante de légende via l’argument bbox_to_anchor afin de la déporter harmonieusement en marge de la zone cartésienne active.
Lorsque le comparatif implique un nombre substantiel de degrés de liberté (par exemple cinq à huit courbes simultanées), l’alignement vertical conventionnel de la légende peut induire un allongement démesuré de l’encadré, empiétant inévitablement sur le champ des données. L’introduction du paramètre ncol au sein de la méthode legend() permet de scinder les entrées explicatives en deux ou trois colonnes parallèles, optimisant l’occupation horizontale de l’espace disponible au-dessus des queues de distribution aplaties.
Enfin, l’esthétique du cadre de la légende mérite un traitement attentif : la neutralisation de l’ombre portée (shadow=False), le choix d’un fond transparent ou semi-opaque (framealpha=0.85) et la suppression d’une bordure noire agressive au profit d’un contour grisâtre épuré confèrent à la figure finale une finition éditoriale impeccable, conforme aux maquettes des revues scientifiques internationales les plus exigeantes.
7. Visualisation des régions critiques, seuils de rejet et valeurs p
7.1 Calcul analytique des quantiles critiques
Dans la démarche hypothético-déductive de l’inférence statistique unilatérale à droite, propre à la majorité des tests basés sur le khi-deux, la prise de décision quant au rejet de l’hypothèse nulle H0 s’articule autour de la confrontation de la statistique empirique observée avec une valeur seuil théorique, désignée sous le nom de valeur critique. Ce seuil critique dépend exclusivement du risque d’erreur de première espèce (α) préalablement toléré par l’investigateur — couramment fixé par convention académique aux niveaux 0.05, 0.01 ou 0.001 — et du nombre de degrés de liberté df régissant le modèle statistique.
Sur le plan algorithmique sous Python, la détermination de ce seuil critique ne requiert aucune consultation approximative de tables statistiques imprimées archaïques. Elle s’opère de façon exacte et instantanée au moyen de la fonction de point de pourcentage (PPF, pour Percent Point Function), incarnée par la méthode scipy.stats.chi2.ppf. Cette fonction, mathématiquement définie comme la réciproque exacte de la fonction de répartition cumulative, prend en paramètre d’entrée la probabilité cumulée unilatérale (1 – α) et les degrés de liberté, renvoyant l’abscisse théorique précise au-delà de laquelle réside exactement une fraction α de l’aire distributionnelle totale.
La transcription computationnelle de cette notion de risque statistique permet de contextualiser avec une précision mathématique la frontière séparent la zone d’acceptation (ou plus rigoureusement de non-rejet) de l’hypothèse nulle et la zone de rejet critique. Toute statistique de test dont la magnitude géométrique dépasse cette valeur charnière sur l’axe des abscisses induit mécaniquement le rejet de l’hypothèse nulle d’indépendance ou de conformité, au seuil de signification α prédéterminé.
7.2 Remplissage géométrique sous la courbe avec fill_between
La matérialisation graphique de la zone de rejet critique constitue l’un des moyens pédagogiques les plus saisissants pour faire comprendre la notion abstraite de probabilité d’erreur de première espèce. Pour convertir une portion de la courbe continue en un polygone de remplissage géométrique teinté, Matplotlib met à disposition la fonction vectorisée plt.fill_between() (ou ax.fill_between() dans l’approche orientée objet). Cette méthode interpole une surface colorée continue entre une borne d’ordonnée inférieure (habituellement fixée à zéro) et le profil supérieur de la densité de probabilité.
Pour restreindre rigoureusement ce remplissage à la seule queue critique unilatérale, il convient d’exploiter les capacités de masquage booléen de NumPy via l’argument formel where de la fonction. En définissant une condition vectorielle telle que x_vecteur >= seuil_critique, l’interpréteur applique sélectivement l’ombrage coloré uniquement sur les coordonnées cartésiennes vérifiant cette assertion spatiale. Les segments de courbe situés en deçà de la valeur critique conservent leur fond transparent d’origine, matérialisant instantanément la dichotomie fondamentale entre la région d’acceptation et la région critique de rejet.
La sémiotique de cette zone remplie exige une sélection réfléchie des paramètres visuels. L’application d’une saturation modérée combinée à un degré de transparence (paramètre alpha compris entre 0.3 et 0.5) évite que la couleur d’ombrage ne masque les graduations du quadrillage sous-jacent ou l’éventuelle présence d’autres repères verticaux. L’adjonction de hachures diagonales au moyen de l’argument hatch='//' enrichit l’expressivité de la figure en garantissant la préservation du contraste sémantique lors de la reproduction du graphique en noir et blanc.
7.3 Annotation dynamique et repères orthogonaux
L’implantation d’une statistique empirique issue de données réelles sur le canevas théorique de la loi du khi-deux s’effectue au moyen de repères orthogonaux verticaux. La méthode ax.axvline() permet de tracer une ligne perpendiculaire s’élevant de l’axe des abscisses jusqu’au sommet du tracé cartésien. En conférant à cette ligne une couleur d’avertissement hautement contrastée (telle qu’un rouge cramoisi ou un pourpre sombre) et un motif discontinu affirmé, le chercheur localise sans la moindre équivoque la position de la découverte empirique par rapport aux frontières théoriques d’acceptation et de rejet.
Pour parachever l’articulation entre l’abstraction distributionnelle et la décision d’inférence, l’insertion d’annotations textuelles explicatives reliées par des flèches directionnelles est hautement recommandée. La méthode ax.annotate() fournit l’outillage géométrique idoine pour positionner un texte explicatif à des coordonnées spécifiques tout en pointant avec précision vers la statistique empirique ou vers la région critique au moyen d’un vecteur fléché paramétrable (via le dictionnaire arrowprops).
Cette méthodologie d’annotation dynamique permet d’inclure au sein même du graphique des données quantitatives calculées en temps réel par le code Python, telles que la valeur exacte de la statistique obtenue (χ²obs) et la probabilité empirique associée (la célèbre p-valeur). Le lecteur bénéficie d’une synthèse visuelle immédiate : si la balise verticale de la statistique empirique s’enfonce profondément à l’intérieur de la zone ombrée de rejet critique, l’extrême faiblesse de la p-valeur apparaît comme une évidence géométrique incontestable.
8. Tracé de la fonction de distribution cumulative et de la fonction de survie
8.1 Implémentation de la fonction de répartition (CDF)
Si la fonction de densité de probabilité (PDF) offre une vision immédiate de la concentration locale des masses de probabilité et de la position des modes, la fonction de répartition cumulative (CDF, pour Cumulative Distribution Function) traduit l’accumulation progressive de cette probabilité depuis l’origine jusqu’à l’infini positif. Mathématiquement formalisée par l’intégrale de la PDF de zéro à x, la CDF associe à toute valeur de l’abscisse la probabilité exacte d’observer une réalisation aléatoire inférieure ou égale à cette valeur spécifique. Sous Python, cette fonction est évaluée avec une rigueur absolue au moyen de la méthode scipy.stats.chi2.cdf.
La représentation graphique de la CDF d’une loi du khi-deux présente l’allure d’une sigmoïde asymétrique qui s’élance de zéro pour converger de façon strictement monotone vers une asymptote horizontale plafonnée à l’unité. L’analyse visuelle de cette courbe offre des insights méthodologiques complémentaires de premier ordre : le tracé direct de lignes horizontales coupant la courbe cumulative à des hauteurs ordonnées de 0.25, 0.50 et 0.75 permet d’identifier visuellement par projection orthogonale sur l’axe des abscisses les trois quartiles théoriques de la distribution, au premier rang desquels figure la médiane distributionnelle.
L’observation comparée de la médiane (point où la CDF vaut 0.5) et de l’espérance mathématique théorique (située exactement en x = k) met en lumière de manière éclatante l’asymétrie positive fondamentale de la loi du khi-deux. Pour les degrés de liberté modérés, la médiane se situe systématiquement en deçà de la moyenne mathématique, attestant graphiquement que plus de la moitié des réalisations stochastiques d’un échantillon s’accumulent dans des valeurs inférieures à l’espérance de la loi, tirée vers le haut par l’étirement asymptotique de la queue distributionnelle droite.
8.2 Représentation de la fonction de survie (SF)
La fonction de survie (SF, pour Survival Function), également désignée sous le terme de fonction de distribution cumulative complémentaire, est définie mathématiquement comme le complémentaire à l’unité de la CDF, soit 1 – CDF(x). Elle quantifie la probabilité exacte qu’une variable aléatoire prenne une valeur strictement supérieure à une coordonnée d’abscisse donnée. Bien qu’il puisse sembler conceptuellement équivalent d’écrire en syntaxe Python 1.0 - scipy.stats.chi2.cdf(x, df), cette pratique naïve engendre de sévères désagréments computationnels lors de l’exploration des queues de distribution extrêmes en raison des limitations de l’arithmétique en virgule flottante.
Lorsque la valeur de l’abscisse x devient considérablement élevée, la valeur de la CDF s’approche si étroitement de 1.0 que la soustraction arithmétique subit un phénomène pernicieux d’annulation catastrophique, tronquant les décimales critiques et renvoyant prématurément un zéro numérique absolu. Pour obvier à cette instabilité majeure, la bibliothèque SciPy met à la disposition des modélisateurs la méthode dédiée scipy.stats.chi2.sf, qui implémente des développements asymptotiques directs de la fonction gamma incomplète permettant de calculer avec une précision analytique intacte des probabilités d’ordre infinitésimal (par exemple 1e-15 ou 1e-30).
L’exploitation graphique de la fonction de survie, particulièrement lorsqu’elle est projetée sur une échelle verticale semi-logarithmique au moyen de ax.set_yscale('log'), se révèle indispensable lors de l’investigation des valeurs p extrêmes rencontrées dans les études d’association pangénomique (GWAS) ou les méga-analyses psychométriques. Cette échelle transformée dévoile avec une netteté chirurgicale le taux de décroissance exponentiel de la probabilité d’erreur résiduelle dans les régions les plus reculées de la queue de distribution.
8.3 Architecture graphique multi-panneaux (Subplots)
Afin de proposer une synthèse distributionnelle exhaustive prête à être intégrée dans une monographie de recherche ou un rapport technique d’envergure, il est d’usage d’ordonnancer la fonction de densité, la fonction de répartition et la fonction de survie au sein d’une composition graphique multi-panneaux unifiée. Cette disposition géométrique s’échafaude avec élégance grâce aux méthodes plt.subplots() ou à la classe plus modulaire matplotlib.gridspec.GridSpec, qui autorise la subdivision de la figure en matrices de sous-graphiques interconnectés.
Une configuration didactique de référence repose sur la création de deux panneaux juxtaposés horizontalement (1 ligne, 2 colonnes) ou superposés verticalement (2 lignes, 1 colonne). La synchronisation spatiale des axes d’abscisse, activable nativement via l’argument sharex=True, constitue une exigence fonctionnelle essentielle : elle assure que tout ajustement dimensionnel ou zoom interactif opéré sur l’un des graphiques se répercute instantanément sur l’autre, permettant au lecteur d’établir une correspondance visuelle immédiate entre l’inflexion locale de la densité supérieure et le point de pente maximale de la sigmoïde cumulative inférieure.
L’harmonisation stylistique inter-panneaux impose une application scrupuleuse des mêmes codes de couleurs, épaisseurs de traits et standards typographiques sur l’ensemble des sous-fenêtres d’affichage. L’adjonction de lettres indicatrices d’étiquetage académique (comme les mentions « A » et « B » positionnées dans les angles supérieurs gauches selon les préconisations des manuels de publication) parachève la structuration du document, conférant à la double figure une cohérence globale d’un niveau éditorial professionnel.
9. Approches graphiques avancées avec Seaborn et visualisations interactives
9.1 Optimisation esthétique rapide avec la bibliothèque Seaborn
Édifiée au-dessus de la bibliothèque Matplotlib, la bibliothèque logicielle Seaborn s’est hissée au rang de référence visuelle incontournable pour la modélisation statistique appliquée grâce à sa capacité à embellir instantanément l’environnement cartésien tout en allégeant considérablement le code de mise en page. En invoquant simplement la commande sns.set_theme(), l’analyste substitue aux paramètres rudimentaires d’origine des palettes chromatiques sophistiquées, des typographies adoucies et des arrière-plans grisés discrètement striés de lignes blanches (style darkgrid) ou des toiles de fond épurées idéales pour l’impression papier (style whitegrid ou ticks).
L’intérêt de Seaborn dans le cadre du tracé de la distribution du khi-deux réside également dans ses fonctionnalités intégrées de gestion de contextes visuels (sns.set_context()). Cette fonction ajuste proportionnellement la taille de l’ensemble des éléments graphiques — de l’épaisseur du trait à l’échelle des graduations en passant par les étiquettes de légende — selon le vecteur de communication final sélectionné, qu’il s’agisse d’un article de recherche imprimé (contexte paper), d’un carnet de notes numérique (notebook), d’un support de cours projeté (talk) ou d’un poster de congrès scientifique grand format (poster).
De plus, Seaborn facilite l’estimation non paramétrique de densités empiriques issues de jeux de données réels au moyen de sa fonction sns.kdeplot(). Cette méthode procède à un lissage par noyau gaussien (Kernel Density Estimation) sur des variables d’échantillonnage continu, permettant de superposer sans effort de programmation complexe une estimation empirique fluide directement au-dessus de la courbe analytique théorique fournie par SciPy, offrant un puissant outil de diagnostic graphique préliminaire.
9.2 Introduction à l’exploration dynamique avec Plotly
Bien que les figures vectorielles statiques demeurent indispensables pour les publications imprimées sur papier ou au format PDF traditionnel, l’avènement des rapports reproductibles sous forme de pages HTML interactives invite à mobiliser des technologies de rendu graphique dynamiques. La bibliothèque Plotly s’illustre particulièrement dans ce registre en s’appuyant sur le moteur de rendu JavaScript Plotly.js pour métamorphoser des graphiques statistiques en véritables tableaux de bord exploratoires manipulables à la souris.
L’apport d’un tracé interactif de la distribution du khi-deux réside prioritairement dans l’exploitation des cartouches d’inspection au survol (tooltips ou hover templates). Lorsqu’un chercheur ou un étudiant déplace son curseur le long de la trajectoire analytique, Plotly affiche en temps réel les coordonnées cartésiennes de haute précision associées au point désigné, explicitant simultanément la valeur de la statistique d’abscisse, la densité de probabilité exacte et la fraction de probabilité cumulée accumulée jusqu’à cette coordonnée, rendant l’apprentissage intuitif et immédiat.
Par ailleurs, Plotly permet d’intégrer nativement des composants d’interface utilisateur directement au sein du fichier graphique autonome sans nécessiter l’exécution en arrière-plan d’un serveur applicatif lourd. L’inclusion d’un curseur de défilement horizontal (slider) ou de boutons d’incrémentation permet à l’utilisateur de modifier interactivement le paramètre des degrés de liberté. La courbe s’anime et se déforme alors dynamiquement sous ses yeux, offrant une démonstration visuelle d’une force pédagogique inégalée quant à l’impact structurel de k sur l’asymétrie et la dérive de la distribution.
9.3 Représentation tridimensionnelle de l’évolution paramétrique
Pour appréhender dans toute sa continuité spatiale la métamorphose topologique de la fonction de densité du khi-deux sous l’effet conjoint de la variable stochastique x et du paramètre des degrés de liberté df, il est possible de dépasser le cadre conventionnel du plan cartésien bidimensionnel pour concevoir une surface de densité tridimensionnelle. Cette projection 3D requiert l’utilisation conjointe de la fonction np.meshgrid de NumPy et de la boîte à outils mpl_toolkits.mplot3d de Matplotlib.
La mise en œuvre algorithmique débute par la discrétisation conjointe d’un intervalle continu d’abscisses spatiales x et d’un continuum théorique de degrés de liberté k. L’évaluation de la fonction de densité analytique sur ce maillage matriciel bidimensionnel engendre une grille de hauteurs Z représentant la surface de probabilité f(x, k). La fonction de rendu de surface ax.plot_surface() matérialise ensuite cette nappe probabiliste dans l’espace 3D, enrichie d’un dégradé chromatique texturé reflétant l’altitude locale de la densité.
L’exploration visuelle de cette surface volumique, visualisable sous différentes perspectives grâce aux commandes d’élévation et d’azimut de la caméra virtuelle (méthode view_init), révèle de façon saisissante la résorption progressive de la singularité à l’origine et l’aplanissement asymptotique de la crête de densité. Cette perspective globale offre une conceptualisation géométrique unifiée de la distribution, reliant harmonieusement toutes les courbes uni-dimensionnelles individuelles au sein d’un même continuum mathématique.
10. Confrontation de données empiriques d’échantillonnage à la courbe théorique
10.1 Génération de variables aléatoires distribuées selon le khi-deux
L’assimilation pratique de l’inférence statistique requiert une compréhension aiguë de la dialectique reliant les données d’échantillonnage empiriques finies à la loi probabiliste théorique idéale dont elles sont présumées découler. Pour simuler ce processus d’échantillonnage stochastique sous Python, on utilise la méthode rvs (pour Random Variates Simulation) fournie par l’objet scipy.stats.chi2. Cette routine permet de tirer un nombre arbitraire N de réalisations pseudo-aléatoires distribuées scrupuleusement selon une loi du khi-deux de paramètre df déterminé.
La reproductibilité calculatoire de toute simulation de Monte-Carlo exige impérativement la fixation rigoureuse d’une graine d’aléa (random seed) au moyen de l’objet générateur contemporain de NumPy (np.random.default_rng) ou du paramètre random_state de SciPy. L’omission de cette fixation initiale engendre des tirages divergents à chaque réévaluation du script, interdisant toute réplication fidèle des histogrammes et des statistiques descriptives obtenues au sein de la publication scientifique.
Une fois le vecteur d’échantillonnage généré, il est hautement instructif de quantifier les moments d’ordre un et deux de l’échantillon empirique (moyenne arithmétique et variance empirique non biaisée) afin de les confronter immédiatement aux prédictions analytiques théoriques, à savoir respectivement df et 2×df. Pour de grands effectifs d’échantillonnage (N ≥ 10 000), les statistiques empiriques convergent avec une exactitude frappante vers ces constantes mathématiques, illustrant l’action concrète de la loi forte des grands nombres.
10.2 Superposition d’un histogramme normalisé et de la densité théorique
La technique graphique la plus répandue pour apprécier la conformité d’un jeu de données quantitatif à un modèle distributionnel continu réside dans la superposition d’un histogramme d’échantillonnage et de la courbe analytique de densité. Une exigence méthodologique primordiale s’impose toutefois lors de cette opération : l’histogramme empirique doit impérativement être converti sur une échelle de densité de probabilité, et non conservé sous forme d’effectifs bruts (fréquences absolues). Cette normalisation s’active en fixant l’argument density=True au sein de la fonction ax.hist() de Matplotlib.
Cette mise à l’échelle garantit que la somme des aires de l’ensemble des rectangles verticaux de l’histogramme soit exactement égale à l’unité, rendant la surface empirique directement commensurable avec l’aire unitaire sous la courbe théorique de densité. L’analyste peut alors tracer, sur le même système cartésien d’axes, la courbe théorique scipy.stats.chi2.pdf calculée sur la même plage d’abscisses, permettant d’évaluer d’un simple regard l’ajustement géométrique des données observées au modèle théorique.
Le paramétrage du partitionnement spatial de l’histogramme, c’est-à-dire le choix de la largeur et du nombre de classes (paramètre bins), exerce une influence déterminante sur la pertinence du diagnostic visuel. Un nombre de classes trop faible conduit à un lissage grossier gommant l’asymétrie de la distribution, tandis qu’un partitionnement excessif fragmente l’histogramme en une multitude de barres erratiques dominées par le bruit d’échantillonnage. L’utilisation d’algorithmes de sélection automatisés optimaux, tels que la règle de Freedman-Diaconis (activable via bins='fd'), offre le meilleur compromis robuste face aux distributions asymétriques en fondant le découpage sur l’intervalle interquartile de l’échantillon.
10.3 Construction d’un tracé Quantile-Quantile (Q-Q Plot)
Si la superposition d’un histogramme normalisé et d’une courbe de densité fournit une intuition graphique globale, elle demeure un instrument d’évaluation visuelle imparfait pour scruter le comportement des données dans les queues de distribution, là où les effectifs se raréfient. L’outil diagnostique de référence universellement plébiscité par les statisticiens pour sonder l’adéquation distributionnelle fine est le tracé Quantile-Quantile (couramment abrégé sous l’appellation de Q-Q Plot).
La mécanique conceptuelle du Q-Q Plot repose sur la projection cartésienne croisée des quantiles observés empiriquement au sein de l’échantillon trié en regard des quantiles théoriques attendus sous la loi de référence postulée. Sous Python, la génération de ce tracé diagnostique avancé s’exécute de façon magistrale au moyen de la fonction scipy.stats.probplot. En lui spécifiant explicitement la distribution de référence (dist='chi2') et les paramètres de forme appropriés (sparams=(df,)), la fonction ordonne automatiquement l’espace d’échantillonnage et calcule la position géométrique de chaque point d’observation.
La validation formelle de l’adéquation au modèle repose ensuite sur l’examen de l’alignement des coordonnées le long d’une droite de référence identitaire à 45 degrés superposée au tracé (argument plot=ax). Tout écart systématique par rapport à cette diagonale fournit un diagnostic précis quant aux pathologies distributionnelles des données : un infléchissement des points vers le bas ou vers le haut aux extrémités de la ligne de référence signale sans ambiguïté des phénomènes de queues lourdes, de queues légères ou d’asymétries résiduelles non capturées par le modèle théorique, alertant le chercheur sur les violations potentielles des postulats d’inférence.
11. Cas d’application concrète : Tracé du khi-deux dans un test d’indépendance psychométrique
11.1 Établissement du problème d’analyse de contingence
Pour illustrer la valeur opérationnelle de ces protocoles graphiques au sein de la pratique scientifique concrète, considérons une investigation psychométrique standard portant sur l’indépendance présumée entre deux dimensions qualitatives chez une cohorte clinique : le profil d’attachement interpersonnel (décliné en quatre modalités : sécure, anxieux, évitant, désorganisé) et la typologie de réponse à un protocole de gestion du stress aigu (trois modalités : adaptive, inhibitrice, externalisée). L’objectif du chercheur consiste à éprouver l’hypothèse nulle H0 postulant une indépendance stochastique parfaite entre le style d’attachement relationnel et la modalité d’expression comportementale face à l’adversité.
Les observations colligées sur le terrain expérimental sont consolidées sous la forme d’un tableau de contingence croisé de dimension 4 lignes par 3 colonnes. À partir de cette matrice d’effectifs empiriques observés, l’analyste calcule la matrice des effectifs théoriques attendus sous la condition stricte d’indépendance marginale, selon la règle probabiliste classique du produit des probabilités marginales de lignes et de colonnes rapporté à la taille de l’effectif total N. La sommation des divergences quadratiques normalisées entre effectifs observés et théoriques fournit la statistique empirique globale du khi-deux de Pearson, notée χ²calc.
Le nombre de degrés de liberté associé à cette matrice s’obtient par la formule canonique df = (nombre de lignes – 1) × (nombre de colonnes – 1), aboutissant dans ce contexte précis à (4 – 1) × (3 – 1) = 3 × 2 = 6 degrés de liberté. Ce paramètre scalaire df = 6 gouverne de manière exclusive l’ensemble de la distribution théorique du khi-deux sous l’hypothèse nulle qui servira d’étalon décisionnel pour statuer sur la significativité de l’association psychologique observée.
11.2 Visualisation de l’emplacement du test empirique sur la courbe théorique
L’étape de visualisation scientifique prend immédiatement le relais du calcul algébrique. À l’aide de l’infrastructure logicielle précédemment détaillée, le chercheur génère la courbe théorique de la fonction de densité du khi-deux paramétrée avec df = 6 sur une étendue d’abscisses s’étirant de zéro à 25. Cette perspective permet de matérialiser le profil morphologique unimodal typique de cette dimensionnalité, dont le mode théorique culmine en x = 6 – 2 = 4, et dont l’espérance mathématique se positionne rigoureusement en x = 6.
Supposons que le calcul d’analyse de contingence mené sur les données expérimentales de la cohorte aboutisse à une statistique empirique de Pearson de magnitude χ²calc = 14.85. Pour traduire visuellement cette métrique, le script implante une balise orthogonale contrastée au point d’abscisse x = 14.85. Conjointement, le seuil critique théorique correspondant au risque alpha canonique de 5% (α = 0.05 pour df = 6, qui s’établit analytiquement à chi2.ppf(0.95, 6) ≈ 12.59) est projeté sous la forme d’une ligne discontinue distinctive délimitant le début de la région d’ombrage critique.
La coloration de l’aire géométrique sous la courbe située au-delà de la valeur observée χ²calc = 14.85 matérialise directement la notion de p-valeur empirique (calculable analytiquement via chi2.sf(14.85, 6) ≈ 0.0214). Le lecteur visualise instantanément que la statistique observée franchit le seuil critique d’acceptation de 12.59 pour s’ancrer dans la queue de rejet, attestant graphiquement que la surface de probabilité résiduelle n’occupe plus qu’environ 2.14% de la masse probabiliste totale du modèle théorique.
11.3 Interprétation décisionnelle et communication des résultats
L’intégration de la conclusion décisionnelle au sein même du document graphique assure une communication scientifique sans faille, excluant toute interprétation équivoque des données lors de la revue par les pairs. En incorporant un bloc d’annotation textuelle typographiquement soigné dans une zone dégagée du graphique, le chercheur fait figurer la formalisation standardisée complète de l’inférence : χ²(6, N = 240) = 14.85, p = 0.021, accompagnée de la mention décisionnelle explicite rejetant l’hypothèse nulle d’indépendance au seuil de significativité α = 0.05.
La préparation du fichier d’exportation doit se conformer rigoureusement aux normes édictées par les organismes savants internationaux, au premier rang desquels figure l’American Psychological Association (dont le style APA en est à sa 7e édition). Ces directives préconisent des figures exemptes de titrages superfétatoires encombrants à l’intérieur du cadre, recommandant plutôt de reléguer les explications méthodologiques détaillées dans la légende textuelle accompagnant la figure dans le manuscrit éditorial final.
Enfin, l’exportation du graphique doit s’effectuer impérativement dans des formats de compression vectoriels préservant l’intégrité de la résolution typographique et géométrique, tels que le format PDF ou le format SVG (via plt.savefig('contingence_khi2.pdf', format='pdf', bbox_inches='tight')). L’utilisation de l’option bbox_inches='tight' garantit l’élimination des marges blanches périphériques excessives, permettant à la figure de s’intégrer harmonieusement dans les gabarits de publication des presses universitaires les plus exigeantes.
12. Bonnes pratiques, modularité algorithmique et résolution d’anomalies
12.1 Création d’une fonction réutilisable hautement configurable
L’élévation de la qualité du code scientifique commande de dépasser l’écriture de scripts linéaires et séquentiels au profit d’une architecture logicielle modulaire articulée autour de fonctions réutilisables, paramétrables et robustes. Concevoir une fonction Python dédiée au tracé de la distribution du khi-deux constitue la démarche d’ingénierie logicielle idéale pour mutualiser les efforts d’implémentation et standardiser la production graphique à travers l’ensemble des projets de recherche d’une équipe scientifique.
Une fonction de niveau professionnel doit recevoir en arguments obligatoires les degrés de liberté, tout en offrant une panoplie d’arguments optionnels richement typés via les annotations de type (type hints) introduites dans les versions modernes de Python. Ces paramètres facultatifs permettent de définir la plage d’abscisses, les niveaux des seuils critiques α à ombrer, la présence éventuelle d’une statistique empirique à annoter, le style chromatique global ou encore l’assignation optionnelle d’un objet Axes préexistant pour intégrer harmonieusement la courbe au sein d’une figure multi-panneaux complexe.
La fonction doit retourner formellement un tuple structuré contenant les références vers les objets Figure et Axes de Matplotlib (tuple[plt.Figure, plt.Axes]). Cette conception découplée offre à l’utilisateur final la liberté de prolonger la personnalisation graphique a posteriori (par l’ajout de titres spécifiques, de filigranes ou d’ajustements de graduations) avant de déclencher l’écriture finale du fichier. De surcroît, le corps de la fonction doit inclure une documentation formelle exhaustive conforme aux standards de documentation scientifique (tels que le format NumPy Docstring), explicitant la nature de chaque paramètre et décrivant précisément le comportement algorithmique attendu.
12.2 Diagnostic et correction des erreurs numériques et graphiques fréquentes
La manipulation logicielle des distributions de probabilités asymétriques expose fréquemment les analystes à des déconvenues techniques bien répertoriées. La première d’entre elles concerne le traitement inadéquat de la singularité à l’abscisse zéro lorsque df ≤ 2. L’évaluation naïve d’un maillage débutant strictement en zéro engendre des exceptions de division par zéro ou l’apparition de valeurs infinies qui contraignent Matplotlib à étendre démesurément l’échelle verticale, écrasant la quasi-totalité de la dynamique utile de la courbe sur l’axe horizontal. L’instauration d’un filtre conditionnel décalant la borne d’évaluation initiale à un seuil infinitésimal pour df = 1 et tronquant le plafond d’affichage vertical résout définitivement cette anomalie structurelle.
Une seconde pathologie graphique récurrente réside dans le débordement d’échelle verticale induit par des extrema locaux non maîtrisés. Lorsque plusieurs distributions aux morphologies disparates sont superposées, le pic extrêmement élevé d’une courbe à faible degré de liberté peut rendre imperceptibles les oscillations des courbes à degrés de liberté plus élevés. Il convient alors de fixer explicitement la borne supérieure de l’axe vertical au moyen de ax.set_ylim(), calibrée non pas sur la valeur singulière maximale théorique, mais sur une hauteur représentative (par exemple 1.15 fois la densité maximale observée sur le sous-ensemble des courbes présentant un mode réel).
Enfin, le phénomène de collision textuelle, où des annotations de légende ou des étiquettes d’axes se chevauchent lors du redimensionnement de la fenêtre graphique, trouve sa résolution élégante dans l’activation systématique de l’algorithme d’agencement automatique de Matplotlib. L’invocation préalable de la méthode fig.tight_layout() ou l’utilisation du gestionnaire contemporain layout='constrained' lors de l’instanciation de la figure force l’environnement graphique à recalculer dynamiquement les espacements interstitiels, prévenant toute troncature malheureuse des métadonnées textuelles lors de l’exportation sur disque.
12.3 Synthèse architecturale et checklist avant publication
L’ultime étape avant l’incorporation définitive d’une figure statistique au sein d’un manuscrit soumis pour publication académique réside dans l’application rigoureuse d’une grille de contrôle méthodologique et sémiotique. Cette checklist scientifique résume les exigences de conformité technique indispensables pour garantir la validité et la lisibilité universelle de la représentation graphique :
- Vérification dimensionnelle et théorique : Le nombre de degrés de liberté k matérialisé sur la figure correspond-il rigoureusement au modèle théorique déployé ou aux contraintes marginales exactes du protocole empirique analysé ?
- Équilibre de l’espace vectoriel : La borne supérieure des abscisses englobe-t-elle la totalité de la traîne de probabilité significative sans troncature artificielle (validation par la convergence de l’intégrale numérique vers 1.0) ?
- Lisibilité et accessibilité chromatique : Les contrastes colorimétriques demeurent-ils parfaitement discriminables après conversion du fichier en niveaux de gris purs, ou pour un évaluateur atteint de dyschromatopsie ?
- Exactitude sémantique des étiquettes : L’axe des ordonnées porte-t-il explicitement la mention d’une densité de probabilité continue, évitant la confusion conceptuelle dommageable avec une probabilité discrète brute ?
- Rigueur de l’ancrage spatial : L’axe vertical et l’axe horizontal sont-ils adéquatement verrouillés à zéro, rappelant géométriquement la positivité stricte du domaine de définition du khi-deux ?
- Fidélité vectorielle et résolution éditoriale : Le fichier généré est-il encodé dans un format vectoriel (PDF/SVG) ou, à défaut, dans un format matriciel matricé à une résolution d’au moins 300 à 600 DPI exempt de toute compression destructive avec pertes ?
- Reproductibilité algorithmique absolue : Le code source Python complet ayant produit la figure est-il documenté, encapsulé au sein d’un environnement virtuel maîtrisé et assorti de la fixation immuable de ses graines d’aléa stochastique ?
En respectant scrupuleusement l’ensemble de ces préceptes algorithmiques, méthodologiques et sémiotiques, l’analyste statistique s’assure que ses représentations de la distribution du khi-deux sous Python ne constitueront pas seulement des illustrations esthétiquement abouties, mais s’érigeront en véritables instruments de rigueur scientifique et de démonstration épistémologique au service de la recherche quantitative contemporaine.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Lancaster, H. O. (1969). The Chi-squared Distribution. John Wiley & Sons.
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine Series 5, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental Algorithms for Scientific Computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021