
Dans le paysage contemporain de la modélisation statistique, de l’apprentissage automatique et des neurosciences computationnelles, la représentation graphique rigoureuse des distributions de probabilité continues constitue une compétence méthodologique fondamentale. Parmi la riche taxonomie des lois statistiques asymétriques, la distribution Gamma occupe une place prépondérante en raison de sa flexibilité analytique remarquable et de sa capacité intrinsèque à modéliser des variables continues strictement positives. Qu’il s’agisse d’analyser la durée de survie de composants d’ingénierie, d’évaluer le temps d’attente précédant l’occurrence d’événements stochastiques via des processus de Poisson, ou de disséquer la latence des réponses motrices dans des protocoles de psychologie cognitive, la loi Gamma fournit un cadre paramétrique robuste et mathématiquement élégant.
Le langage de programmation Python, renforcé par son écosystème scientifique comprenant NumPy, SciPy et Matplotlib, s’est imposé comme le standard de facto pour l’exploration, l’ajustement et la visualisation de ces dynamiques stochastiques. Cependant, le passage de la formulation mathématique théorique à son implémentation programmatique concrète se heurte fréquemment à des ambiguïtés syntaxiques et conceptuelles. La dualité des paramétrisations (forme/échelle versus forme/taux), la manipulation des paramètres de localisation et la gestion précise de la densité numérique exigent une compréhension approfondie des mécanismes sous-jacents aux bibliothèques scientifiques pour éviter des erreurs d’interprétation préjudiciables à la validité des conclusions expérimentales.
Ce guide exhaustif a pour vocation d’offrir une exploration intégrale et rigoureuse de la distribution Gamma, en conjuguant théorie probabiliste avancée, méthodologie de programmation vectorisée et principes de visualisation conformes aux exigences des publications scientifiques internationales. À travers une progression didactique détaillée, nous aborderons les fondements analytiques de la loi, l’anatomie fonctionnelle du module scipy.stats, la construction d’affichages comparatifs sophistiqués, l’estimation des paramètres empiriques par le maximum de vraisemblance, ainsi que les diagnostics d’adéquation graphique et les fonctions de survie. Chaque étape est minutieusement documentée pour fournir aux chercheurs, ingénieurs et analystes de données les outils nécessaires à une maîtrise complète de cet instrument statistique.
1. 1. Fondements théoriques de la distribution Gamma et pertinence en modélisation comportementale
1.1 Définition mathématique et paramétrisation de la loi Gamma
La distribution Gamma est une loi de probabilité continue définie sur le support réel positif non nul, appartenant à la famille exponentielle naturelle. Sa fonction de densité de probabilité (PDF, pour Probability Density Function) s’articule autour de deux paramètres fondamentaux qui régissent respectivement sa géométrie globale et son étalement spatial. Dans sa forme canonique la plus répandue en ingénierie et en sciences physiques, elle s’exprime à travers les paramètres de forme (souvent noté k) et d’échelle (noté θ). L’équation différentielle régissant cette densité analytique prend la forme suivante pour toute variable aléatoire réelle x strictement supérieure à zéro :
Le terme central de cette équation intègre la célèbre fonction Gamma d’Euler, notée Γ(k), qui agit comme une constante de normalisation indispensable garantissant que l’intégrale de la densité sur l’ensemble du support positif soit rigoureusement égale à l’unité. Historiquement introduite par Leonhard Euler comme une extension de la fonction factorielle aux nombres réels et complexes, la fonction Gamma d’Euler est définie formellement par l’intégrale impropre convergente pour tout paramètre complexe dont la partie réelle est strictement positive :
Il existe dans la littérature scientifique une dualité persistante relative à la paramétrisation de cette loi, source fréquente d’erreurs d’implémentation numérique. Tandis que la formulation forme-échelle utilise le couple (k, θ), l’école statistique bayésienne et l’économétrie privilégient traditionnellement la formulation forme-taux, faisant intervenir les paramètres (α, β). Dans cette seconde approche, le paramètre de forme α est strictement équivalent à k, tandis que le paramètre de taux β (parfois désigné sous le terme d’intensité stochastique) constitue l’inverse mathématique strict du paramètre d’échelle : β = 1 / θ. Cette divergence notationnelle implique que, sous la paramétrisation forme-taux, la densité intègre le terme multiplicatif d’échelle directement dans l’argument exponentiel négatif sous la forme exp(-βx).
L’étude formelle des moments statistiques permet de caractériser sans ambiguïté les propriétés centrales de la distribution Gamma. Le premier moment centré sur l’origine, correspondant à l’espérance mathématique E[X], s’obtient par l’intégration du produit de la variable par sa densité, aboutissant à la relation remarquable E[X] = k × θ (ou, sous l’autre paramétrisation, E[X] = α / β). Le second moment centré, représentant la variance Var(X), découle de l’intégration de (x – E[X])² et se simplifie sous la formulation élégante Var(X) = k × θ² (soit α / β²). L’asymétrie (skewness) de la distribution est exclusivement déterminée par le paramètre de forme, valant rigoureusement 2 / √k, ce qui démontre mathématiquement que la distribution présente une queue positive étirée vers la droite pour les petites valeurs de k et converge vers une symétrie parfaite lorsque k tend vers l’infini.
1.2 Applications psychologiques et modélisation des temps de latence
Dans le domaine de la psychologie expérimentale et de la chronométrie mentale, l’analyse des temps de réaction (TR) lors de tâches cognitives standardisées constitue une fenêtre privilégiée sur l’architecture cognitive humaine. Depuis les travaux pionniers de Franciscus Donders, il est établi que les distributions empiriques des latences motrices et décisionnelles ne suivent jamais une loi normale gaussienne, car elles exhibent systématiquement une asymétrie positive marquée, caractérisée par une frontière infranchissable à gauche (imposée par les limites physiologiques de la conduction nerveuse) et une longue traîne vers les valeurs temporelles élevées.
La distribution Gamma fournit un modèle mécanistique particulièrement convaincant pour rendre compte de ces dynamiques temporelles. Sur le plan théorique, une loi Gamma de paramètre de forme entier k (alors appelée loi d’Erlang) représente la distribution de la somme de k variables aléatoires indépendantes et identiquement distribuées suivant chacune une loi exponentielle de paramètre β. Dans le contexte de la psychologie cognitive, cette propriété s’interprète élégamment comme un processus séquentiel d’accumulation d’information neuronale : pour qu’une décision comportementale soit exécutée, le système cognitif doit franchir successivement k étapes discrètes de traitement de l’information (détection sensorielle, identification du stimulus, sélection de la réponse et programmation motrice), chaque étape présentant un taux d’achèvement stochastique constant.
Il importe toutefois de distinguer la loi Gamma d’autres distributions concurrentes fréquemment mobilisées dans l’analyse des latences de réponse, telles que la distribution Ex-Gaussienne et la loi de Weibull. La distribution Ex-Gaussienne résulte de la convolution d’une composante normale (reflétant le bruit moteur périphérique) et d’une composante exponentielle (capturant la délibération centrale) ; bien que très populaire pour sa flexibilité descriptive, elle manque de fondement computationnel direct concernant la structure séquentielle interne du traitement. À l’inverse, la loi de Weibull dérive de la théorie des valeurs extrêmes et s’applique principalement aux mécanismes où la réponse survient dès qu’un seuil critique est atteint par le plus rapide d’une série de processus concurrents. La loi Gamma se distingue de ces alternatives par sa justification naturelle dans le cadre des modèles d’accumulation par étapes, fournissant des estimateurs physiologiquement interprétables de la complexité de la tâche et de la cadence du traitement synaptique.
2. 2. Configuration de l’environnement scientifique Python
2.1 Sélection et installation de l’écosystème d’analyse de données
La mise en place d’un environnement de calcul scientifique moderne exige une sélection minutieuse de bibliothèques logicielles garantissant à la fois l’exactitude numérique, la performance computationnelle et la reproductibilité des visualisations. Au cœur de cet écosystème se trouve la bibliothèque NumPy, qui constitue l’épine dorsale du calcul matriciel en Python. Grâce à son objet fondamental ndarray, NumPy permet d’exécuter des opérations vectorisées précompilées en langage C, éliminant ainsi les goulots d’étranglement inhérents aux boucles interprétées de Python et facilitant la génération de maillages d’échantillonnage denses sur l’axe des réels.
Le sous-module scipy.stats, intégré à l’infrastructure SciPy, constitue le référentiel algorithmique incontournable pour la manipulation rigoureuse des distributions de probabilité. Ce module encapsule des routines d’intégration numérique de haute précision, des approximations polynomiales de pointe issues des bibliothèques Cephes et Fortran, ainsi que des optimiseurs sophistiqués dédiés à l’ajustement paramétrique. Pour la composante de restitution visuelle, le couplage de Matplotlib et de Seaborn offre un contrôle total sur l’ensemble de la hiérarchie graphique, permettant de produire des tracés vectoriels répondant aux standards esthétiques et techniques des revues scientifiques les plus exigeantes.
Afin de préserver l’intégrité de l’environnement de développement et de prévenir les conflits de dépendances binaires, il est impératif d’isoler ces composants au sein d’un environnement virtuel dédié. Les commandes d’installation sous l’utilitaire en ligne de commande pip s’articulent autour de l’instruction standardisée d’installation groupée des dépendances fondamentales. Les utilisateurs préférant la distribution de paquets Anaconda ou Miniconda recourront quant à eux à la commande de création d’environnement conda create, en ciblant spécifiquement le canal de distribution conda-forge, reconnu pour la cohérence des compilations croisées de ses binaires scientifiques mathématiques.
2.2 Standardisation de l’environnement d’exécution
L’obtention de tracés de qualité publication nécessite une configuration explicite et centralisée des paramètres globaux de l’interface graphique de Matplotlib, régis par le dictionnaire rcParams. Ce dictionnaire permet de standardiser, en amont de toute exécution de script, les dimensions de la figure, la résolution spatiale en points par pouce (DPI), les polices typographiques, les épaisseurs de ligne, ainsi que la gestion des marges et des espacements. En fixant une résolution de 300 DPI par défaut et en sélectionnant des polices à empattement conformes aux directives de l’American Psychological Association (APA), l’analyste assure une homogénéité graphique absolue à travers l’intégralité de son corpus d’expérimentations.
La reproductibilité scientifique impose une gestion rigoureuse des processus stochastiques sous-jacents. Dans les versions modernes de NumPy et de SciPy, l’utilisation obsolète de l’état global du générateur pseudo-aléatoire est avantageusement remplacée par l’instanciation explicite d’un générateur stochastique via la méthode default_rng. Cette approche permet de fixer de manière univoque une graine aléatoire (seed), assurant ainsi que chaque échantillon simulé de variables aléatoires Gamma présentera une trajectoire numérique strictement identique d’une exécution à l’autre, condition sine qua non de la validation croisée des analyses par les comités de lecture académiques.
Enfin, la configuration du moteur de rendu graphique doit privilégier les formats de sérialisation vectorielle, tels que le format de document portable (PDF) ou le graphisme vectoriel évolutif (SVG). Contrairement aux représentations matricielles constituées de pixels rigides, ces formats préservent la netteté mathématique des courbes de densité, des marqueurs et des étiquettes typographiques quelle que soit l’échelle d’agrandissement appliquée lors de la mise en page finale d’un manuscrit de recherche ou d’un rapport technique d’ingénierie.
3. 3. Anatomie de la fonction scipy.stats.gamma
3.1 Correspondance des paramètres mathématiques et syntaxiques
La classe scipy.stats.gamma constitue l’implémentation logicielle de référence de la loi Gamma au sein de l’écosystème Python. Cependant, la structure de ses arguments d’appel reflète une généralisation paramétrique qui nécessite une traduction minutieuse vers les notations théoriques habituelles. L’argument de forme fondamental est représenté par le paramètre syntaxique a. Ce paramètre correspond directement au symbole k dans la paramétrisation (k, θ) ou à α dans la convention (α, β). Il doit impérativement recevoir une valeur réelle strictement positive, déterminant le profil d’asymétrie et de concavité de la courbe de densité.
L’étalement de la distribution est régulé par le paramètre nommé scale, qui coïncide conceptuellement avec le paramètre d’échelle θ. Si l’expérimentateur formule initialement son modèle théorique sous la forme d’un taux β, il est primordial d’appliquer la transformation réciproque et d’assigner l’argument sous la forme syntaxique scale = 1.0 / beta. L’omission de cette inversion constitue l’une des erreurs d’implémentation les plus communes en analyse de données, conduisant à des déformations d’échelle d’un ordre de grandeur inversement proportionnel à la variance recherchée.
De surcroît, l’architecture logicielle de SciPy adjoint systématiquement à toutes ses distributions continues un paramètre de décalage spatial dénommé loc. Ce paramètre de translation modifie le support mathématique fondamental de la distribution : alors que la loi Gamma standard est définie sur l’intervalle semi-infini [0, ∞), la loi translatée opère sur l’intervalle [loc, ∞). En modélisation comportementale des temps de réponse, ce paramètre loc revêt une signification physiologique cruciale : il quantifie le temps non-décisionnel résiduel, englobant la latence incompressible de transduction visuelle rétinienne et le délai de commande neuromusculaire périphérique précédant l’exécution de la réponse digitale sur l’appareil de mesure.
3.2 Méthodes principales associées à l’objet gamma
L’objet de distribution scipy.stats.gamma se structure selon deux modes opératoires distincts : l’approche fonctionnelle continue, recevant les paramètres à chaque invocation, et l’approche orientée objet par instanciation gelée (frozen distribution). Lorsque les paramètres structurels (a, loc, scale) sont passés lors de l’instanciation de l’objet, ce dernier capture l’état probabiliste spécifique et expose un ensemble de méthodes vectorisées dédiées à l’extraction de métriques statistiques sans qu’il soit nécessaire de respécifier la géométrie de la distribution lors des calculs subséquents.
La méthode pdf() (fonction de densité de probabilité) accepte en entrée un tableau scalaire ou multidimensionnel de valeurs réelles et retourne la densité de probabilité locale associée à chaque coordonnée spatiale. Pour l’évaluation de la probabilité cumulée sous un seuil donné, la méthode cdf() (fonction de répartition cumulative) calcule l’intégrale numérique de la distribution depuis l’origine jusqu’au point d’évaluation. L’opération inverse, absolument fondamentale pour la détermination des percentiles et la construction des intervalles de confiance théoriques, est assurée par la méthode ppf() (fonction de point de pourcentage, ou fonction quantile), qui résout l’inversion analytique de la fonction de répartition cumulative.
Enfin, la méthode rvs() (échantillonnage de variables aléatoires) permet de générer des jeux de données synthétiques stochastiques en mettant en œuvre des générateurs de pointe basés sur des méthodes de rejet géométrique adaptatif et d’inversion numérique. Complétant cette panoplie, la méthode sf() évalue directement la fonction de survie (1 – CDF), offrant une stabilité numérique substantiellement supérieure à la soustraction arithmétique manuelle dans les queues de distribution extrêmes où l’arithmétique flottante standard à double précision est exposée à des risques d’annulation catastrophique.
4. 4. Exemple 1 : Tracer une fonction de densité de probabilité (PDF) unique
4.1 Construction du maillage d’abscisse et calcul vectorisé
La construction graphique d’une fonction de densité de probabilité continue exige la génération préalable d’une discrétisation fine et régulière du continuum spatial sur lequel la courbe sera projetée. Cette tâche repose sur l’utilisation de la fonction numpy.linspace, qui produit une séquence linéaire de coordonnées équidistantes au sein d’un intervalle délimité par des bornes inférieure et supérieure judicieusement choisies en fonction des propriétés théoriques des paramètres sélectionnés.
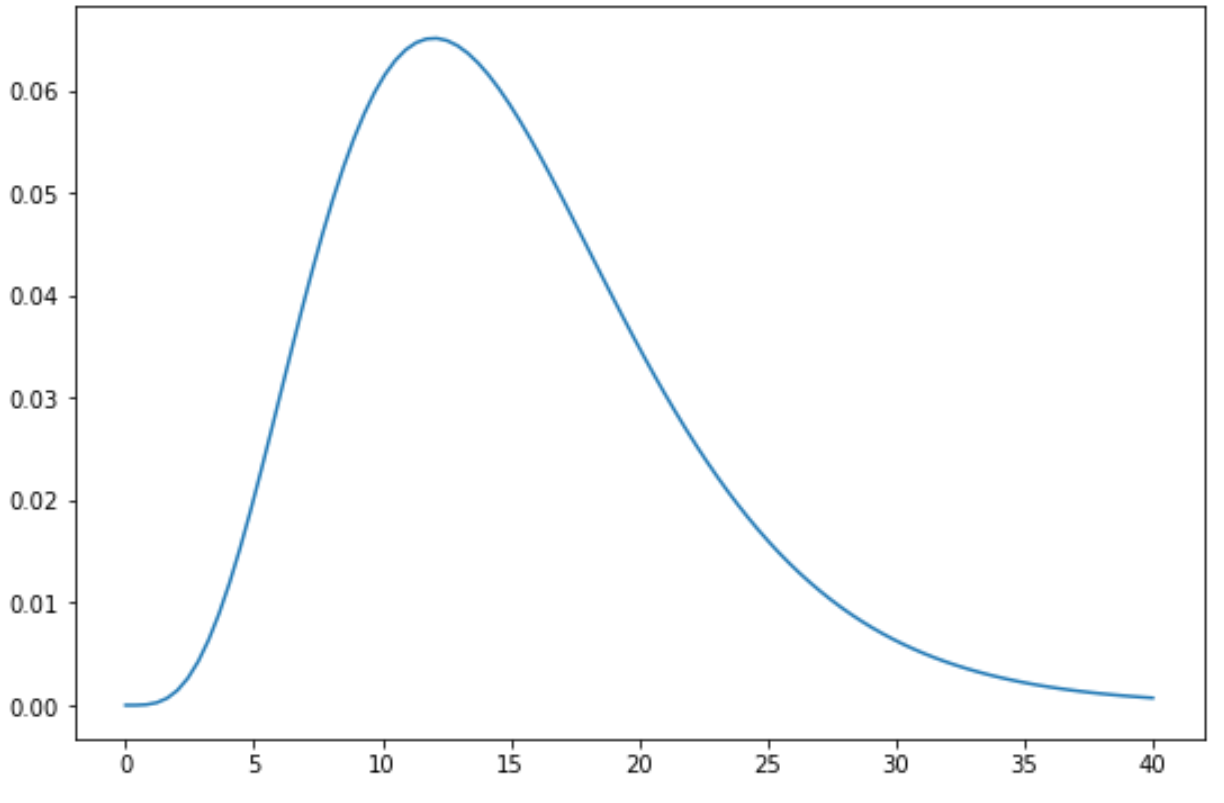
Pour illustrer ce processus fondamental, considérons une distribution Gamma caractérisée par une forme a = 5 et une échelle scale = 3. Le support théorique de cette distribution est formellement borné inférieurement par zéro. Afin de déterminer une borne supérieure garantissant la capture de la quasi-totalité de la masse de probabilité sans tronquer arbitrairement la queue droite, il est méthodologiquement recommandé de solliciter la fonction quantile ppf pour identifier la coordonnée correspondant au quantile 99.9% (α = 0.999). Un maillage composé de cinq cents à mille points interpolés entre zéro et cette valeur critique assure une régularité graphique parfaite exempte d’artefacts polygonaux.
Une fois le vecteur d’abscisse généré, l’évaluation de la fonction de densité s’effectue de manière entièrement vectorisée en passant ce tableau directement à la méthode stats.gamma.pdf(x, a=5, scale=3). Pour valider l’intégrité numérique du calcul vectoriel avant tout rendu visuel, il est pertinent d’exécuter une intégration numérique trapézoïdale de ce profil en exploitant la fonction scipy.integrate.trapezoid. La confirmation que la surface totale sous la courbe converge rigoureusement vers 1.0 (à l’ordre de précision machine près) certifie que le domaine spatial choisi englobe fidèlement l’intégralité du phénomène probabiliste modélisé.
4.2 Génération et formatage du tracé basique avec Matplotlib
L’orchestration du tracé fait appel à l’interface orientée objet de Matplotlib, considérée par la communauté scientifique comme supérieure à l’interface procédurale state-machine (pyplot) pour la reproductibilité et la modularité logicielle. Cette approche s’amorce par l’instanciation conjointe des objets Figure et Axes via l’appel à la fonction standardisée plt.subplots, en paramétrant des proportions de cadre harmonieuses adaptées aux gabarits des articles de recherche.
La projection de la densité s’opère par l’invocation de la méthode ax.plot(), appliquée aux coordonnées d’abscisse et d’ordonnée préalablement vectorisées. Afin de conférer au tracé une lisibilité optimale, l’épaisseur de trait (linewidth) doit être calibrée entre 2.0 et 2.5 points, et la teinte chromatique sélectionnée au sein d’un espace colorimétrique contrasté. L’embellissement informatif du tracé requiert l’étiquetage formel des axes au moyen des méthodes set_xlabel() et set_ylabel(), en prenant soin d’expliciter clairement la nature de la grandeur physique ou comportementale représentée (par exemple, Temps de réponse en millisecondes) ainsi que l’unité de densité scalaire correspondante.
L’ajout d’une grille de fond discrète et semi-transparente, configurée par ax.grid(True, linestyle=’–‘, alpha=0.5), facilite la projection mentale des coordonnées par le lecteur sans surcharger la clarté visuelle de l’espace de données. L’enregistrement définitif du graphique est accompli par l’instruction fig.savefig(), en stipulant les paramètres d’ajustement géométrique strict bbox_inches=’tight’ pour éliminer tout rognage accidentel des libellés typographiques périphériques.
5. 5. Exemple 2 : Tracé comparatif de multiples distributions Gamma
5.1 Modulation du paramètre de forme (Shape)
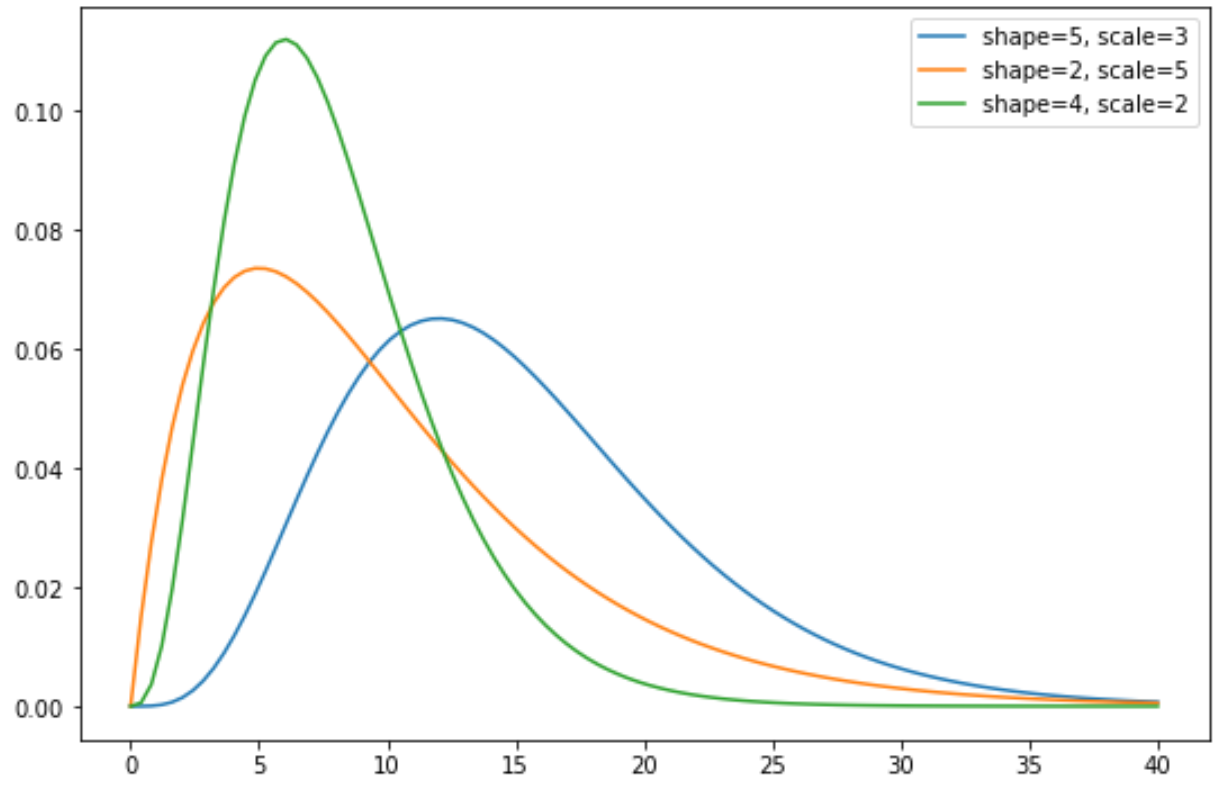
L’exploration visuelle de l’impact exercé par les variations structurelles du paramètre de forme constitue un exercice pédagogique fondamental pour appréhender la souplesse morphologique de la loi Gamma. Lorsque l’analyste fait varier le paramètre a tout en maintenant le paramètre d’échelle rigoureusement invariant (par exemple, scale = 2.0), la distribution traverse des métamorphoses qualitatives spectaculaires qui redéfinissent sa nature probabiliste.
Pour les valeurs de forme strictement inférieures à l’unité (a < 1), la fonction de densité exhibe un comportement asymptotique divergent lorsque la variable x tend vers zéro, générant une singularité infinie à l’origine suivie d’une décroissance monotone hyperbolique prononcée. Lorsque le paramètre franchit la valeur frontière unitaire (a = 1), la distribution se métamorphose exactement en une loi exponentielle standard, caractérisée par une ordonnée à l’origine finie valant 1/scale et une décroissance exponentielle constante de paramètre d’intensité identique. Dès que la forme dépasse cette valeur charnière (a > 1), la distribution adopte un profil unimodal strict, son mode se déplaçant progressivement vers la droite selon la relation analytique exacte Mode = (a – 1) × scale.
En superposant graphiquement sur une même fenêtre de coordonnées cartésiennes une série de courbes correspondant à des formes incrémentales (par exemple, a prenant les valeurs successives 0.5, 1.0, 2.5, 5.0 et 9.0), l’observateur perçoit de manière frappante le phénomène d’atténuation de l’asymétrie positive. Au fur et à mesure que a progresse vers des valeurs élevées, le théorème central limite commence à opérer son emprise asymptotique : la traîne droite se résorbe, le mode s’arrondit symétriquement et la distribution Gamma converge structurellement vers un profil gaussien standardisé.
5.2 Modulation du paramètre d’échelle (Scale)
L’analyse comparative de la distribution sous modulation exclusive du paramètre d’échelle (scale = θ), tout en conservant une forme invariante (par exemple, a = 4.0), dévoile un comportement fondamental de dilatation géométrique et de redistribution de la masse de probabilité. Sur le plan mathématique, multiplier l’échelle par un facteur constant équivaut à étirer horizontalement la trajectoire de la variable aléatoire le long de l’axe des abscisses.
Puisque l’intégrale totale de la fonction de densité doit obligatoirement demeurer invariante et égale à 1.0 afin de préserver l’axiome de normalisation de Kolmogorov, tout étirement le long de l’axe horizontal induit mécaniquement un aplatissement vertical proportionnel du sommet de la courbe de densité. Ainsi, à mesure que l’échelle s’accroît, la variance explose de manière quadratique proportionnellement à scale², provoquant une dispersion étendue des réalisations stochastiques potentielles et une diminution substantielle de la hauteur du mode.
Pour traduire visuellement ce phénomène avec une clarté irréprochable, l’application d’une palette séquentielle continue (telle que viridis ou plasma) s’avère hautement supérieure à l’utilisation de couleurs catégorielles arbitraires. L’assignation de teintes dont la luminance progresse de façon monotone avec la magnitude de l’échelle permet au cortex visuel humain d’associer intuitivement la profondeur colorimétrique à l’intensité de l’étalement probabiliste. Une légende mathématique rigoureusement formatée à l’aide de syntaxes LaTeX intégrées vient parachever la figure en explicitant les paramètres exacts de chaque trace fonctionnelle.
6. 6. Représentation graphique de la fonction de répartition cumulative (CDF)
6.1 Calcul et visualisation de la probabilité cumulée
Tandis que la fonction de densité de probabilité permet de visualiser les concentrations relatives de probabilité locale, la fonction de répartition cumulative (CDF, pour Cumulative Distribution Function) modélise la probabilité intégrée qu’une observation empirique issue du processus stochastique soit inférieure ou égale à une valeur temporelle spécifique. Elle s’évalue analytiquement au moyen du rapport de la fonction Gamma incomplète regularisée sur la fonction Gamma d’Euler standard.
Sur le plan géométrique, la fonction de répartition de la loi Gamma trace une courbe sigmoïde monotone strictement croissante, dont les asymptotes horizontales sont rigoureusement fixées à 0.0 lorsque x tend vers l’origine (ou vers loc) et à 1.0 lorsque x tend vers l’infini positif. L’évaluation de cette trajectoire s’exécute de manière limpide sous Python en invoquant la méthode stats.gamma.cdf(x, a, loc, scale) sur le maillage d’abscisse vectorisé.
D’un point de vue didactique et diagnostique, la présentation simultanée de la PDF et de la CDF au sein d’une figure composite à double volet (exploitant plt.subplots(1, 2)) constitue une approche analytique de premier ordre. Le panneau de gauche expose la topographie des densités et la localisation du mode, tandis que le panneau de droite permet d’évaluer directement les seuils opérationnels d’achèvement de tâche, révélant avec précision la latence nécessaire pour qu’une proportion donnée d’essais expérimentaux ait franchi le seuil de décision comportementale.
6.2 Identification graphique des percentiles et des quantiles
L’exploitation de la fonction de répartition cumulative prend toute sa dimension pratique lors de la projection graphique des percentiles clés de la distribution. Les quartiles statistiques fondamentaux — le premier quartile (Q1 ou percentile 25%), la médiane (Q2 ou percentile 50%) et le troisième quartile (Q3 ou percentile 75%) — s’extraient avec une précision arithmétique absolue grâce à la fonction quantile stats.gamma.ppf().
L’intégration de ces repères structuraux sur le tracé de la fonction de répartition enrichit substantiellement la portée analytique de la figure. En programmant des tracés orthogonaux discontinus reliant l’axe des ordonnées (où sont repérées les probabilités cumulées 0.25, 0.50 et 0.75) à la courbe sigmoïde, puis en projetant ces intersections perpendiculairement vers l’axe temporel des abscisses au moyen des méthodes ax.hlines() et ax.vlines(), l’analyste matérialise instantanément l’asymétrie de distribution : l’écart spatial séparant la médiane de Q1 est invariablement plus resserré que la distance séparant cette même médiane de Q3, témoignant de l’étirement structurel de la queue droite.
Il est en outre possible de hachurer élégamment l’aire interquartile sur la courbe de densité conjointe en utilisant l’instruction ax.fill_between(). En psychométrie expérimentale, cette zone hachurée représente la fenêtre temporelle centrale dans laquelle se concentre la moitié exacte des réponses comportementales du sujet, fournissant un indicateur visuel de dispersion non-paramétrique remarquablement robuste face aux éventuelles réponses aberrantes causées par des lapsus attentionnels.
7. 7. Ajustement d’une distribution Gamma à des données expérimentales empiriques
7.1 Estimation des paramètres par maximum de vraisemblance (MLE)
Dans la pratique de la recherche empirique, la démarche statistique est fréquemment inverse à celle de la simulation pure : le chercheur dispose d’une série d’observations brutes et cherche à identifier la paramétrisation théorique optimale susceptible d’avoir engendré ces données. La méthode d’estimation par le maximum de vraisemblance (MLE, pour Maximum Likelihood Estimation) s’impose comme l’étalon-or mathématique pour dériver ces estimateurs ponctuels optimaux.
SciPy encapsule cette procédure complexe d’optimisation non linéaire sous la méthode dédiée stats.gamma.fit(). En lui transmettant un tableau de données empiriques représentant, par exemple, les temps de réaction de participants confrontés à une tâche de discrimination visuelle sélective, l’algorithme maximise numériquement le logarithme de la fonction de vraisemblance jointe des observations sous contrainte de positivité des paramètres. Cette routine retourne un triplet scalaire contenant les estimateurs de forme (a_hat), de décalage spatial (loc_hat) et d’échelle (scale_hat).
Une vigilance méthodologique impérative s’impose concernant le traitement du paramètre loc. Par défaut, la méthode tente d’optimiser conjointement ce décalage avec la forme et l’échelle. Or, si le protocole expérimental garantit intrinsèquement que la variable aléatoire débute à l’origine stricte du repère temporel, laisser l’optimiseur libre peut engendrer des estimations aberrantes de décalages légèrement négatifs ou instables. Pour parer à cette dérive, il convient de verrouiller explicitement ce paramètre en renseignant l’argument floc=0 au sein de l’instruction d’ajustement, forçant l’algorithme à focaliser la puissance de calcul sur le couple canonique forme-échelle.
7.2 Superposition de la PDF ajustée sur l’histogramme normalisé
Une fois les estimateurs ponctuels dérivés par le maximum de vraisemblance, la validation visuelle de la convergence entre le modèle théorique et la distribution empirique constitue une étape incontournable du diagnostic statistique. Cette opération nécessite le tracé préalable d’un histogramme de fréquences rigoureusement normalisé, converti en densité continue au moyen de l’argument density=True au sein de la méthode ax.hist() de Matplotlib ou de l’instruction sns.histplot() de Seaborn.
Le paramétrage du nombre de classes (bins) de l’histogramme empirique ne doit en aucun cas être laissé à des heuristiques par défaut sous-dimensionnées. L’application de la règle robuste de Freedman-Diaconis, qui calibre la largeur des intervalles en fonction de l’intervalle interquartile empirique normalisé par la racine cubique de l’effectif d’échantillonnage, offre une résistance optimale aux biais de discrétisation tout en révélant la véritable concavité de la distribution.
Sur cet histogramme ainsi calibré, l’analyste superpose la courbe continue de la densité théorique calculée en appliquant les paramètres estimés (a_hat, scale_hat) sur un maillage d’interpolation dense. Si l’ajustement est satisfaisant, la courbe théorique doit épouser fidèlement le sommet des barres de l’histogramme le long de la phase ascendante rapide, culminer harmonieusement au niveau du pic modal empirique et descendre avec une courbure identique le long de la traîne des valeurs lentes. L’adjonction optionnelle d’une estimation de densité par noyau (KDE, pour Kernel Density Estimation) permet de croiser deux approches non-paramétriques et paramétriques pour vérifier l’absence d’ondulations multimodales masquées.
8. 8. Génération d’échantillons aléatoires et comparaison empirique versus théorique
8.1 Simulation stochastique par inversion ou rejet
La validation empirique des modèles de traitement statistique repose fréquemment sur la génération de cohortes synthétiques de données stochastiques. La méthode stats.gamma.rvs() exploite des algorithmes de pointe pour matérialiser ces échantillons aléatoires. Lorsque le paramètre de forme est supérieur ou égal à l’unité, l’algorithme mis en œuvre repose sur la méthode de transformation par rejet rapide développée par Marsaglia et Tsang, garantissant une efficacité computationnelle maximale et une quasi-indépendance vis-à-vis de l’amplitude du paramètre de forme.
L’observation de l’influence exercée par la taille de l’échantillon (N) sur la fidélité de l’approximation statistique permet d’illustrer de manière pragmatique les prédictions de la loi forte des grands nombres. Lorsqu’un chercheur simule un échantillon modeste de trente observations (N = 30), les fluctuations d’échantillonnage induisent des déformations morphologiques considérables : le mode empirique peut sembler décalé, des lacunes peuvent apparaître le long de la distribution et la moyenne observée peut diverger substantiellement de l’espérance théorique calculée.
À l’inverse, l’expansion de la taille d’échantillon vers des régimes massifs (N = 10 000 ou 100 000 réalisations) conduit à une convergence asymptotique remarquable. Les moments empiriques (moyenne arithmétique, variance d’échantillon et coefficient d’asymétrie calculés via NumPy) s’alignent avec une précision décimale absolue sur les valeurs paramétriques théoriques déduites des équations d’Euler, tandis que l’erreur quadratique moyenne (MSE) entre l’histogramme discrétisé et la densité continue sous-jacente tend inexorablement vers zéro.
8.2 Visualisation de la variabilité d’échantillonnage
Afin de quantifier visuellement l’incertitude inhérente aux petits effectifs d’échantillonnage, la technique du tracé de répliques stochastiques multiples (spaghetti plot) s’avère particulièrement éclairante. En générant, par exemple, cinquante échantillons synthétiques distincts de taille modeste (N = 50) issus d’une même distribution Gamma mère, l’analyste peut estimer la densité par noyau de chaque tirage et projeter ces cinquante trajectoires sur le même graphique avec une opacité réduite (alpha = 0.15).
Le nuage de courbes résultant trace une enveloppe visuelle de variabilité qui matérialise immédiatement la volatilité des estimations ponctuelles dans des conditions d’échantillonnage restreintes. Il apparaît clairement que la queue droite de la distribution est le siège de la dispersion relative la plus prononcée, soulignant le risque élevé de sous-estimation ou de surestimation de l’asymétrie lorsque des études comportementales s’appuient sur un nombre insuffisant d’essais par condition expérimentale.
Cette approche peut être formalisée avec une grande rigueur statistique par la construction de bandes de confiance empiriques dérivées du rééchantillonnage bootstrap non-paramétrique. En calculant les quantiles 2.5% et 97.5% de la densité à chaque point d’abscisse à travers les milliers d’itérations bootstrap, on obtient un ruban continu semi-transparent encadrant la courbe théorique. Cette méthodologie graphique de pointe fournit aux évaluateurs d’un manuscrit scientifique une appréciation visuelle immédiate de la précision statistique sans recourir à des tableaux de données numériques arides.
9. 9. Personnalisation esthétique avancée aux normes des publications académiques
9.1 Typographie, annotations LaTeX et repères statistiques
L’accession aux standards graphiques requis par les revues scientifiques de premier plan impose une personnalisation typographique intégrale capable d’interpréter nativement les équations mathématiques complexes. En activant l’analyseur textuel mathématique de Matplotlib (mathtext) ou en déléguant le rendu directement à une distribution TeX locale via rcParams[‘text.usetex’] = True, l’utilisateur a la faculté d’insérer des formules analytiques complètes au sein des titres, légendes et annotations de ses figures.
Un tracé académique de haut niveau se distingue par l’adjonction de repères visuels explicites signalant la position exacte des métriques de tendance centrale fondamentales. La moyenne (k × θ), la médiane (évaluée par ppf(0.5)) et le mode ((k – 1) × θ) ne coïncident aucunement au sein d’une distribution asymétrique. En traçant des lignes verticales différenciées (en traits pleins, tiretés et pointillés de nuances chromatiques distinctes) accompagnées de zones de texte d’annotation ancrées avec précision par la méthode ax.annotate(), l’analyste guide le regard du lecteur et désamorce immédiatement toute confusion conceptuelle entre le centre de gravité probabiliste et le point de densité maximale.
L’épuration géométrique du cadre d’affichage répond aux principes cardinaux de minimalisme graphique théorisés par Edward Tufte. Cela se traduit par la suppression méthodique des bordures supérieures et droites de l’axe (spines) au moyen des instructions ax.spines[‘top’].set_visible(False) et ax.spines[‘right’].set_visible(False). Ce délestage structurel concentre l’attention visuelle sur l’espace d’interaction des données tout en conférant à la figure une esthétique moderne et aérée parfaitement adaptée aux exigences de publication contemporaines.
9.2 Optimisation pour les revues scientifiques et conformité APA
Le respect scrupuleux des normes de l’American Psychological Association (APA, 7e édition) impose des contraintes sévères sur la typographie, l’agencement des légendes et la reproductibilité chromatique des illustrations. Les directives préconisent l’utilisation exclusive de polices standardisées universellement lisibles (telles que Times New Roman, Arial ou Helvetica), calibrées selon une échelle hiérarchique stricte : les étiquettes des axes doivent présenter une taille minimale de 10 à 12 points, tandis que les valeurs des graduations ne doivent pas descendre en deçà de 8 à 9 points.
La question de l’accessibilité chromatique constitue un impératif éthique et scientifique incontournable. Les graphiques doivent être conçus de manière à demeurer parfaitement intelligibles pour les relecteurs présentant des déficits de la vision des couleurs (daltonisme, deutéranopie, protanopie). Il est donc formellement proscrit de fonder la différenciation de courbes critiques sur des contrastes vert-rouge. L’adoption de palettes universellement reconnues, comme les palettes viridis ou l’échelle d’Okabe-Ito, garantit une discrimination visuelle parfaite, y compris lorsque le manuscrit final est imprimé en niveaux de gris purs.
Sur le plan de la sérialisation technique des fichiers, la préparation des figures destinées aux presses universitaires exige la génération de fichiers matriciels TIFF ou vectoriels EPS et PDF configurés à une résolution minimale absolue de 300 points par pouce (DPI), voire 600 DPI pour les illustrations combinant des tracés de courbes fins et des textes denses. L’encapsulation de ces directives au sein d’un script de mise en page réutilisable permet d’automatiser la génération de figures impeccablement calibrées pour la soumission immédiate aux revues internationales.
10. 10. Visualisation de la fonction de survie et du taux de défaillance (Hazard Rate)
10.1 Tracé de la fonction de survie (Survival Function)
Dans de nombreuses applications relatives à la fiabilité technique, à l’analyse de survie biomédicale ou à la persistance attentionnelle en psychologie expérimentale, l’objet statistique d’intérêt primaire n’est pas la probabilité qu’un événement survienne avant un temps donné, mais au contraire la probabilité que le processus survive ou persiste au-delà de cette échéance temporelle. Cette dynamique est quantifiée par la fonction de survie, traditionnellement formalisée par S(t) = 1 – F(t), où F(t) désigne la fonction de répartition cumulative standard.
Bien que l’évaluation arithmétique 1.0 – stats.gamma.cdf() soit théoriquement exacte, elle s’avère numériquement instable dans les environnements de calcul en virgule flottante lorsque t s’aventure loin dans la queue droite de la distribution, conduisant à des pertes de précision dramatiques dès que la CDF s’approche de 1.0 à moins de 10-16. Pour contourner ce compromis numérique, l’infrastructure SciPy met à disposition la méthode native stats.gamma.sf(). Cette dernière évalue directement la fonction Gamma incomplète supérieure complémentaire avec une précision analytique intégrale, sans transiter par la soustraction unitaire.
Le tracé comparatif de la fonction de survie sous différentes conditions expérimentales — illustrant, par exemple, la décroissance temporelle de la rétention d’une consigne en mémoire de travail à travers diverses conditions de charge cognitive — dévoile la trajectoire de l’oubli ou du désengagement comportemental. La projection de ces courbes sur un axe des ordonnées logarithmique permet fréquemment de mettre en lumière des ruptures de pente ou des régimes de transition exponentiels invisibles sur les représentations cartésiennes linéaires conventionnelles.
10.2 Calcul et modélisation graphique du taux de hasard
Le taux de hasard instantané (souvent désigné sous les appellations de hazard rate, taux de défaillance ou force de mortalité), noté h(t), représente la probabilité conditionnelle qu’un événement transitoire s’exécute dans un intervalle de temps infinitésimal consécutif à l’instant t, sachant que le système a persisté jusqu’à ce même instant t. Sa formulation analytique continue s’exprime comme le rapport strict entre la fonction de densité de probabilité et la fonction de survie : h(t) = f(t) / S(t).
L’implémentation numérique vectorisée de cette fonction de risque sous Python s’exécute de manière élégante par la division terme à terme des tableaux de calcul : hazard = stats.gamma.pdf(t, a, scale=scale) / stats.gamma.sf(t, a, scale=scale). L’examen graphique du taux de hasard d’une distribution Gamma révèle des propriétés structurales d’une profondeur théorique exceptionnelle qui dépendent de façon exclusive de la valeur du paramètre de forme a :
- Lorsque le paramètre de forme est inférieur à l’unité (a < 1), le taux de hasard est strictement décroissant à partir d’une singularité infinie initiale, traduisant un phénomène de mortalité infantile ou d’apprentissage adaptatif rapide où le risque de rupture diminue à mesure que le temps s’écoule.
- Lorsque la forme est rigoureusement égale à un (a = 1), le taux de hasard demeure parfaitement plat et constant au cours du temps, égal à 1/scale, illustrant la propriété mathématique de perte de mémoire caractéristique exclusive du processus de Poisson et de la loi exponentielle.
- Lorsque la forme dépasse l’unité (a > 1), le taux de hasard est une fonction monotone croissante débutant à zéro et convergeant asymptotiquement vers une valeur limite plateau égale à 1/scale (soit le paramètre de taux β).
Dans l’analyse des temps de réaction en neurosciences décisionnelles, cette convergence asymptotique vers une constante finie modélise avec une fidélité remarquable l’accroissement de la pression temporelle ressentie par le sujet : plus le temps passe sans qu’une réponse n’ait été émise, plus la probabilité conditionnelle d’un déclenchement moteur immédiat augmente, pour finalement se stabiliser à une intensité stochastique maximale bornée par les capacités physiologiques de transmission de l’information dans les voies corticospinales.
11. 11. Diagnostic graphique de l’adéquation du modèle : Graphiques Q-Q et P-P
11.1 Construction et interprétation du tracé Quantile-Quantile (Q-Q Plot)
L’évaluation rigoureuse de la qualité de calibration d’une loi Gamma appliquée à un corpus d’observations expérimentales ne peut se satisfaire d’une simple inspection subjective d’histogrammes superposés. Le diagramme Quantile-Quantile (Q-Q plot) représente l’instrument diagnostique de référence pour disséquer avec une sensibilité microscopique l’alignement entre les quantiles théoriques du modèle probabiliste supposé et les quantiles empiriques extraits du jeu de données réel.
Sous Python, la construction de ce graphique diagnostique s’appuie sur la fonction scipy.stats.probplot. Contrairement aux visualisations par défaut calibrées sur l’hypothèse d’une distribution normale sous-jacente, il est impératif de configurer explicitement l’argument dist=stats.gamma tout en renseignant le tuple des paramètres structurels estimés (notamment la forme sparams=(a_hat,)) afin de projeter les données contre le modèle statistique approprié.
L’interprétation visuelle d’un tracé Q-Q s’articule autour de l’adhérence des points de données individuels le long de la bissectrice à 45 degrés marquant l’identité théorique parfaite. Toute déviation morphologique systématique par rapport à cette trajectoire linéaire fournit un diagnostic immédiat sur les défauts d’ajustement du modèle :
- Une courbure ascendante prononcée dans les percentiles extrêmes signale que la distribution empirique possède une traîne droite substantiellement plus lourde (heavy-tailed) que ne le prévoit le modèle Gamma calibré.
- Une courbure descendante traduit à l’inverse un écourtement abrupt des observations maximales, suggérant un mécanisme de troncature artificielle ou un effet plafond imposé par le protocole de mesure.
- La présence de points isolés décrochant brutalement de l’alignement permet d’isoler sans ambiguïté des valeurs aberrantes (outliers), qui doivent faire l’objet d’une analyse clinique ciblée avant toute modélisation définitive.
11.2 Tracé Probabilité-Probabilité (P-P Plot) et tests de concordance
Complémentaire du tracé Q-Q, le graphique Probabilité-Probabilité (P-P plot) compare la fonction de répartition empirique observée (obtenue en associant à chaque observation ordonnée son rang normalisé i / (N + 1)) à la probabilité cumulée théorique calculée par stats.gamma.cdf(x_i, a_hat, loc_hat, scale_hat). Alors que le tracé Q-Q excelle dans l’exploration des anomalies situées aux confins des queues de distribution, le tracé P-P présente une sensibilité accrue aux déformations et distorsions survenant au cœur de la masse probabiliste, au voisinage du mode et de la médiane.
L’exploitation de ces outils de diagnostic visuel doit être systématiquement corroborée par des tests d’hypothèse formels de conformité distributionnelle. Le test non-paramétrique de Kolmogorov-Smirnov, exécutable via scipy.stats.kstest, évalue la distance supremum (la plus grande divergence verticale absolue) séparant la CDF empirique de la CDF théorique paramétrée. De manière plus puissante encore, le test de Cramér-von Mises (disponible via scipy.stats.cramervonmises) intègre l’ensemble des écarts quadratiques pondérés sur tout le support, offrant une robustesse supérieure pour statuer sur la validité de l’hypothèse nulle d’adéquation à la loi Gamma.
Enfin, lorsque le chercheur est confronté à la nécessité d’arbitrer entre plusieurs modèles candidats concurrents (comme départager formellement une loi Gamma, une loi Lognormale et une loi de Weibull), les critères d’information pénalisés fondés sur la vraisemblance, tels que le critère d’Akaike (AIC) et le critère bayésien de Schwarz (BIC), fournissent une boussole décisionnelle quantitative rigoureuse. Le modèle minimisant ces critères d’information, conjugué à un tracé P-P exempt d’ondulations résiduelles et à une absence de rejet aux tests de concordance, offre la garantie d’une modélisation à la fois parcimonieuse, exacte et reproductible.
12. 12. Pièges d’implémentation courants, erreurs numériques et bonnes pratiques
12.1 Erreurs classiques lors du paramétrage sous SciPy
L’exploitation pratique de la loi Gamma sous SciPy est parsemée de subtilités numériques et conceptuelles susceptibles de fausser les conclusions analytiques si elles ne sont pas maîtrisées. Le piège le plus omniprésent réside incontestablement dans l’ambiguïté entourant l’argument scale. Les chercheurs familiers des traités mathématiques formalisés en termes de taux d’intensité β commettent fréquemment l’erreur de passer directement la valeur de ce taux à l’argument scale de SciPy. Cette confusion conceptuelle inverse l’échelle de dispersion : un taux élevé, censé comprimer la variance temporelle, se traduit alors par une explosion de la variance dans le graphique tracé.
Un deuxième écueil majeur concerne la gestion non contrôlée du paramètre loc lors de l’exécution d’ajustements automatisés par la méthode fit. Lorsqu’on omet de spécifier floc=0 sur des chronométries de latence motrice, l’optimiseur numérique peut identifier une amélioration infinitésimale de la vraisemblance en assignant une valeur négative au paramètre loc. Cela crée une anomalie mathématique rédhibitoire : le support de la distribution s’étend alors artificiellement sur des valeurs temporelles négatives, violant le principe causal physique le plus élémentaire qui interdit l’exécution d’une réponse motrice avant l’apparition du stimulus inducteur.
Sur le plan computationnel pur, des phénomènes de sous-échantillonnage de l’axe des abscisses peuvent gravement dénaturer l’affichage graphique lorsque le paramètre de forme est grand (a >> 1). Dans ces conditions, la distribution se resserre en un pic modal extrêmement étroit et haut perché. Si le vecteur linéaire généré par linspace ne dispose pas d’une densité de points suffisante dans l’intervalle critique encadrant le mode, le tracé interpolé tronquera artificiellement le sommet de la courbe, conduisant l’observateur à une sous-estimation visuelle grossière de la densité maximale réelle.
12.2 Bonnes pratiques de programmation et modularité du code
Pour assurer la pérennité, la lisibilité et la réplicabilité des chaînes d’analyse et de visualisation, le développement de scripts monolithiques informels doit être banni au profit d’une architecture modulaire et fonctionnelle. L’ensemble des routines de tracé doit être encapsulé au sein de fonctions Python spécialisées, acceptant en arguments des objets d’axes Matplotlib explicites, des tableaux de données typés et des dictionnaires de paramètres esthétiques configurables.
L’introduction du typage statique (type hints), rendu possible par les modules typing et numpy.typing, permet de sécuriser le transit des données au sein des fonctions de modélisation. En stipulant expressément que les arguments attendus doivent être des tableaux NumPy unidimensionnels de nombres flottants à double précision (NDArray[np.float64]), l’analyste prévient les erreurs d’exécution silencieuses induites par le passage accidentel de listes hétérogènes, de séries Pandas contenant des valeurs manquantes ou de structures dimensionnelles inadaptées.
Enfin, la robustesse de l’environnement de visualisation gagne à être systématiquement validée par une suite de tests unitaires automatisés élaborés sous le cadriciel pytest. Ces tests vérifient que l’intégrale des courbes générées converge rigoureusement vers un, que les quantiles théoriques retournés par les fonctions de tracé correspondent aux attentes théoriques et que les figures sérialisées ne comportent aucun objet graphique dégradé. Cette discipline de programmation garantit que les artefacts visuels et les erreurs numériques soient éradiqués bien avant la phase finale d’interprétation scientifique et de dissémination des résultats.
Références
- Donders, F. C. (1969). On the speed of mental processes. Acta Psychologica, 30, 412-431. https://doi.org/10.1016/0001-6918(69)90065-1
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- Johnson, N. L., Kemp, A. W., & Kotz, S. (2005). Univariate Discrete Distributions (3rd ed.). John Wiley & Sons.
- Luce, R. D. (1986). Response Times: Their Role in Inferring Elementary Mental Organization. Oxford University Press.
- Marsaglia, G., & Tsang, W. W. (2000). A simple method for generating gamma variables. ACM Transactions on Mathematical Software, 26(3), 363-372. https://doi.org/10.1145/358407.358414
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Van Zandt, T. (2000). How to fit a response time distribution. Psychonomic Bulletin & Review, 7(3), 424-465. https://doi.org/10.3758/BF03214357
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021